Tablas y clusters de tablas
En este capítulo se ofrece una introducción a los objetos de esquema y se tratan las tablas, que son los tipos más comunes de objetos de esquema.
-
Introducción a los Objetos de Esquema Un esquema de base de datos es un contenedor lógico para estructuras de datos, denominado objetos de esquema. Algunos ejemplos de objetos de esquema son tablas e índices. Puede crear y manipular objetos de esquema con SQL.
-
Visión General de Tablas Una tabla es la unidad básica de organización de datos en una base de datos Oracle.
-
Visión General de Clusters de Tabla Un cluster de tabla es un grupo de tablas que comparten columnas comunes y almacenan datos relacionados en los mismos bloques.
-
Visión general de las tablas agrupadas en clusters de atributos Una tabla agrupada en clusters de atributos es una tabla organizada por pilas que almacena datos muy cerca del disco en función de las directivas de agrupación en clusters especificadas por el usuario. Las directivas especifican columnas en una o varias tablas.
-
Visión General de Tablas Temporales Una tabla temporal contiene datos que sólo existen durante una transacción o sesión.
-
Visión General de Tablas Externas Una tabla externa accede a los datos de orígenes externos como si estos datos estuvieran en una tabla de la base de datos.
-
Visión general de tablas de cadena de bloques Una tabla de cadena de bloques es una tabla de solo adición diseñada para aplicaciones de cadena de bloques centralizadas.
-
Visión general de tablas inmutables Las Tablas inmutables son tablas de solo lectura que se realizan agregadas que impiden que parte de usuarios internos modifique datos no autorizados, así como modificaciones accidentales de datos resultantes de errores humanos.
-
Visión General de Tablas de Objetos Una tabla de objetos es un tipo especial de tabla en la que cada fila representa un objeto.
Introducción a los Objetos de esquema
Un esquema de base de datos es un contenedor lógico para estructuras de datos, denominado objetos de esquema. Algunos ejemplos de objetos de esquema son tablas e índices. Puede crear y manipular objetos de esquema con SQL.
Esta sección incluye los siguientes temas:
-
Acerca de las Cuentas de Usuario Comunes y Locales Una cuenta de usuario de base de datos tiene una contraseña y privilegios de base de datos específicos.
-
Objetos comunes y locales Un objeto común se define en la raíz de CDB o en una raíz de aplicación, y se puede hacer referencia a él mediante enlaces de metadatos o enlaces de objetos. Un objeto local es todo objeto que no es un objeto común.
-
Tipos de Objetos de Esquema Oracle SQL permite crear y manipular muchos otros tipos de objetos de esquema.
-
Almacenamiento de objetos de esquema Algunos objetos de esquema almacenan datos en un tipo de estructura de almacenamiento lógica denominada segmento. Por ejemplo, una tabla organizada en pilas no particionada o un índice crea un segmento.
-
Dependencias de objetos de esquema Algunos objetos de esquema hacen referencia a otros objetos y crean una dependencia de objetos de esquema.
-
Esquemas de ejemplo Una base de datos Oracle puede incluir esquemas de ejemplo, que son un juego de esquemas entrelazados que permiten que la documentación de Oracle y los materiales de instrucciones de Oracle ilustren las tareas comunes de la base de datos. Consulte también: Guía de seguridad de Oracle AI Database para obtener más información sobre usuarios y privilegios
Acerca de las cuentas de usuario comunes y locales
Una cuenta de usuario de base de datos tiene una contraseña y privilegios de base de datos específicos.
Esquemas y Cuentas de Usuario
Cada cuenta de usuario posee un único esquema, que tiene el mismo nombre que el usuario. El esquema contiene los datos del usuario propietario del esquema. Por ejemplo, la cuenta de usuario hr es propietaria del esquema hr, que contiene objetos de esquema como la tabla employees. En una base de datos de producción, el propietario del esquema suele representar una aplicación de base de datos en lugar de una persona.
Dentro de un esquema, cada objeto de esquema de un tipo concreto tiene un nombre único. Por ejemplo, hr.employees hace referencia a la tabla employees del esquema hr. En la siguiente figura se muestra un propietario de esquema denominado hr y objetos de esquema en el esquema hr.
Figura 1: Esquema HR
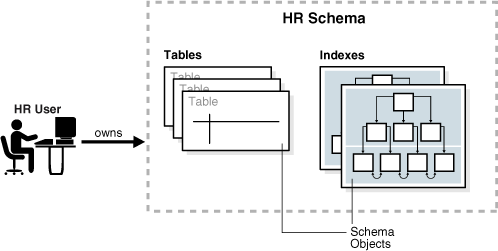
Descripción de la ilustración cncpt230.gif
Cuentas de usuario comunes y locales
Si una cuenta de usuario posee objetos que definen la base de datos, esta cuenta de usuario es común. Las cuentas de usuario que no están proporcionadas por Oracle son locales o comunes. Un usuario común de CDB es un usuario común que se crea en la raíz de CDB. Un usuario común de aplicación es un usuario que se crea en una raíz de aplicación y solo es común dentro de este contenedor de aplicaciones.
En el siguiente gráfico se muestran los posibles tipos de cuenta de usuario en una CDB.
Figura 2: Cuentas de usuario en una CDB
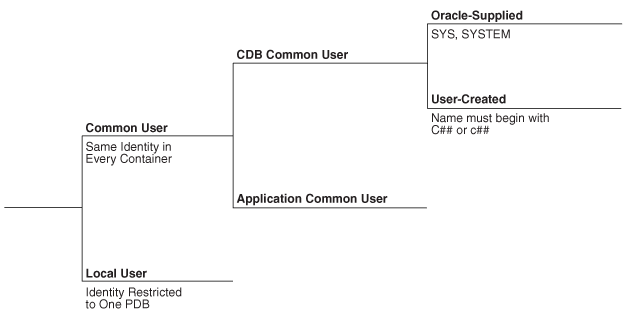
Descripción de la ilustración cncpt370.png
Un usuario común de la CDB puede conectarse a cualquier contenedor de la CDB al que tenga privilegios suficientes. Por el contrario, un usuario común de la aplicación solo puede conectarse a la raíz de la aplicación en la que se ha creado o a una PDB que esté conectada a esta raíz de la aplicación, según sus privilegios.
-
Cuentas de Usuario Comunes En el contexto del contenedor del sistema (CDB) o de un contenedor de aplicaciones, un usuario común es un usuario de base de datos que tiene la misma identidad en la raíz y en todas las PDB existentes y futuras de este contenedor.
-
Cuentas de usuario locales Un usuario local es un usuario de base de datos que no es común y que solo puede funcionar dentro de una única PDB.
Cuentas de usuario comunes
En el contexto del contenedor del sistema (CDB) o de un contenedor de aplicación, un usuario común es un usuario de base de datos que tiene la misma identidad en la raíz y en todas las PDB existentes y futuras de este contenedor.
Cada usuario común puede conectarse y realizar operaciones en la raíz de su contenedor y en cualquier PDB en la que tenga privilegios suficientes. Un usuario común debe realizar algunas tareas administrativas. Algunos ejemplos son la creación de una PDB y la desconexión de una PDB.
Por ejemplo, SYSTEM es un usuario común de CDB con privilegios de DBA. Por lo tanto, SYSTEM se puede conectar a la raíz de CDB y a cualquier PDB de la base de datos. Puede crear un usuario común saas_sales_admin en el contenedor de aplicaciones saas_sales. En este caso, el usuario saas_sales_admin solo pudo conectarse a la raíz de aplicación saas_sales o a una PDB de aplicación en el contenedor de aplicación saas_sales.
Cada usuario común es proporcionado por Oracle o creado por el usuario. Ejemplos de usuarios comunes proporcionados por Oracle son SYS y SYSTEM. Cada usuario común creado por el usuario es un usuario común de CDB o un usuario común de aplicación.
En la siguiente figura se muestran los usuarios y esquemas de ejemplo en dos PDB: hrpdb y salespdb. SYS y c##dba son usuarios comunes de CDB que tienen esquemas en CDB$ROOT, hrpdb y salespdb. Los usuarios locales hr y rep existen en hrpdb. Los usuarios locales hr y rep también existen en salespdb.
Figura 3: Usuarios y Esquemas en una CDB
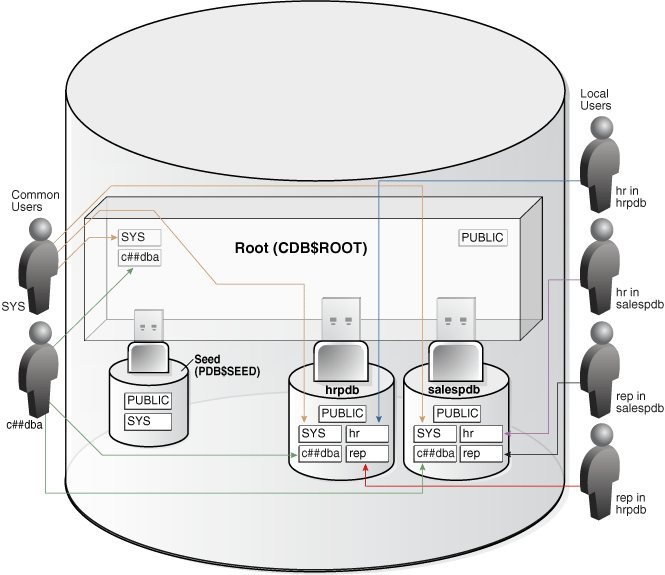
Descripción de la ilustración cncpt340.png
Los usuarios comunes tienen las siguientes características:
-
Un usuario común puede conectarse a cualquier contenedor (incluido
CDB$ROOT) en el que tenga el privilegioCREATE SESSION.Un usuario común no necesita tener los mismos privilegios en cada contenedor. Por ejemplo, el usuario
c##dbapuede tener el privilegio para crear una sesión enhrpdby en la raíz, pero no para crear una sesión ensalespdb. Puesto que un usuario común con los privilegios adecuados puede cambiar entre contenedores, un usuario común en la raíz puede administrar PDB -
Un usuario común de aplicación no tiene el privilegio
CREATE SESSIONen ningún contenedor fuera de su propio contenedor de aplicación.Por lo tanto, un usuario común de aplicación está restringido a su propio contenedor de aplicaciones. Por ejemplo, el usuario común de la aplicación creado en la aplicación
saas_salessolo se puede conectar a la raíz de la aplicación y a las PDB en el contenedor de aplicacionessaas_sales. -
Los nombres de los usuarios comunes de CDB creados por el usuario deben seguir las reglas de nomenclatura para otros usuarios de la base de datos. Además, los nombres deben empezar por los caracteres especificados por el parámetro de inicialización
COMMON_USER_PREFIX, que sonc##oC##por defecto. Los nombres de usuario comunes proporcionados por Oracle y los nombres de usuario comunes de aplicaciones creadas por el usuario no tienen esta restricción.Ningún nombre de usuario local puede empezar por los caracteres
c##oC##. -
A cada usuario común se le asigna un nombre único en todas las PDB del contenedor (ya sea el contenedor del sistema o un contenedor de aplicaciones específico) en el que se creó.
Un usuario común de CDB se define en la raíz de CDB, pero debe poder conectarse a cada PDB con la misma identidad. Un usuario común de la aplicación reside en la raíz de la aplicación y se puede conectar a cada PDB de la aplicación en su contenedor con la misma identidad.
-
Características de los usuarios comunes Cada usuario común es proporcionado por Oracle o creado por el usuario.
-
Cuentas SYS y SYSTEM Todas las bases de datos Oracle incluyen cuentas de usuario comunes por defecto con privilegios administrativos.
Características de los usuarios comunes
Cada usuario común es proporcionado por Oracle o creado por el usuario.
Las cuentas de usuario comunes tienen las siguientes características:
-
Un usuario común puede conectarse a cualquier contenedor (incluido
CDB$ROOT) en el que tenga el privilegioCREATE SESSION.Un usuario común no necesita tener los mismos privilegios en cada contenedor. Por ejemplo, el usuario
c##dbapuede tener el privilegio para crear una sesión enhrpdby en la raíz, pero no para crear una sesión ensalespdb. Debido a que un usuario común con los privilegios adecuados puede cambiar entre contenedores, un usuario común en la raíz puede administrar PDB. -
Un usuario común de aplicación no tiene el privilegio
CREATE SESSIONen ningún contenedor fuera de su propio contenedor de aplicación.Por lo tanto, un usuario común de aplicación está restringido a su propio contenedor de aplicaciones. Por ejemplo, el usuario común de la aplicación creado en la aplicación
saas_salessolo se puede conectar a la raíz de la aplicación y a las PDB en el contenedor de aplicacionessaas_sales. -
Los nombres de los usuarios comunes de CDB creados por el usuario deben seguir las reglas de nomenclatura para otros usuarios de la base de datos. Además, los nombres deben empezar por los caracteres especificados por el parámetro de inicialización
COMMON_USER_PREFIX, que sonc##oC##por defecto. Los nombres de usuario comunes proporcionados por Oracle y los nombres de usuario comunes de aplicaciones creadas por el usuario no tienen esta restricción.Ningún nombre de usuario local puede empezar por los caracteres
c##oC##. -
A cada usuario común se le asigna un nombre único en todas las PDB del contenedor (ya sea el contenedor del sistema o un contenedor de aplicaciones específico) en el que se creó.
Un usuario común de CDB se define en la raíz de CDB, pero debe poder conectarse a cada PDB con la misma identidad. Un usuario común de la aplicación reside en la raíz de la aplicación y se puede conectar a cada PDB de la aplicación en su contenedor con la misma identidad.
En la siguiente figura se muestran los usuarios y esquemas de ejemplo en dos PDB: hrpdb y salespdb. SYS y c##dba son usuarios comunes de CDB que tienen esquemas en CDB$ROOT, hrpdb y salespdb. Los usuarios locales hr y rep existen en hrpdb. Los usuarios locales hr y rep también existen en salespdb.
Figura 4: Usuarios y Esquemas en una CDB
Descripción de la ilustración cncpt340.png
Consulte además:
-
Oracle AI Database Security Guide para obtener más información sobre las cuentas de usuario comunes
-
Referencia de Oracle AI Database para obtener más información sobre
COMMON_USER_PREFIX
Cuentas SYS y SYSTEM
Todas las bases de datos Oracle incluyen cuentas de usuario comunes por defecto con privilegios administrativos.
Las cuentas administrativas tienen numerosos privilegios y únicamente las necesitan los DBA autorizados para realizar tareas como iniciar y parar la base de Datos, gestionar la memoria y almacenamiento, crear y gestionar usuarios de base de Datos, etc.
La cuenta de usuario común SYS se crea automáticamente cuando se crea una base de datos. Esta cuenta puede realizar todas las funciones administrativas de la base de datos. El esquema SYS almacena las tablas y vistas base para el diccionario de datos. Estas vistas y tablas base son críticas para la operación de Oracle AI Database. Las tablas del esquema SYS sólo las manipula la base de datos y nunca las debe modificar ningún usuario.
La cuenta administrativa SYSTEM también se crea automáticamente cuando se crea una base de datos. El esquema SYSTEM almacena tablas y vistas adicionales que muestran información administrativa y tablas y vistas internas utilizadas por varias opciones y herramientas de Oracle AI Database. Nunca utilice el esquema SYSTEM para almacenar tablas de interés para usuarios no administrativos.
Consulte además:
-
Oracle AI Database Security Guide para obtener más información sobre las cuentas de usuario
-
Oracle AI Database Administrator's Guide para obtener más información sobre
SYS,SYSTEMy otras cuentas administrativas
Cuentas de usuario locales
Un usuario local es un usuario de base de datos que no es común y que solo puede funcionar dentro de una única PDB.
Los usuarios locales tienen las siguientes características:
-
Un usuario local es específico de una PDB y puede ser propietario de un esquema en esta PDB.
En el ejemplo que se muestra en "Characteristics of Common Users", el usuario local
hrdehrpdbes propietario del esquemahr. Ensalespdb, el usuario localrepes propietario del esquemarepy el usuario localhres propietario del esquemahr. -
Un usuario local puede administrar una PDB, lo que incluye abrirla y cerrarla.
Un usuario común con privilegios
SYSDBApuede otorgar privilegiosSYSDBAa un usuario local. En este caso, el usuario con privilegios sigue siendo local. -
Un usuario local de una PDB no puede conectarse a otra PDB ni a la raíz de la CDB.
Por ejemplo, cuando el usuario local
hrse conecta ahrpdb,hrno puede acceder a los objetos del esquemashque residen en la base de datossalespdbsin utilizar un enlace de base de datos. Del mismo modo, cuando el usuario localshse conecta a la PDBsalespdb,shno puede acceder a los objetos del esquemahrque reside enhrpdbsin utilizar un enlace de base de datos. -
El nombre de un usuario local no debe empezar por los caracteres
c##oC##. -
El nombre de un usuario local solo debe ser único en su PDB.
El nombre de usuario y la PDB en la que está contenido ese esquema de usuario determinan un usuario local único. "Características de Usuarios Comunes" muestra que existe un usuario local y un esquema denominado
repenhrpdb. Hay un usuario local y un esquema completamente independientes denominadosrepen la PDBsalespdb.
En la siguiente tabla, se describe un escenario relacionado con la CDB en "Characteristics of Common Users". Cada fila describe una acción que se produce después de la acción en la fila anterior. El usuario común SYSTEM crea usuarios locales en dos PDB.
Tabla 1 Usuarios locales en una CDB
| Operación | Descripción |
|---|---|
|
SYSTEM se conecta al contenedor hrpdb mediante el nombre de servicio hrpdb. |
|
SYSTEM ahora crea un usuario local rep y otorga el privilegio CREATE SESSION en esta PDB a este usuario. El usuario es local porque los usuarios comunes solo pueden ser creados por un usuario común conectado a la raíz. |
|
El usuario rep, que es local de hrpdb, intenta conectarse a salespdb. El intento falla porque rep no existe en la PDB salespdb. |
|
SYSTEM se conecta al contenedor salespdb mediante el nombre de servicio salespdb. |
|
SYSTEM crea un usuario local rep en salespdb y otorga el privilegio CREATE SESSION en esta PDB a este usuario. Debido a que el nombre de un usuario local solo debe ser único en su PDB, un usuario denominado rep puede existir tanto en salespdb como en hrpdb. |
|
El usuario rep se conecta correctamente a salespdb. |
Consulte también: Guía de seguridad de Oracle AI Database para obtener información sobre las cuentas de usuario locales
Objetos comunes y locales
Un objeto común se define en la raíz de CDB o en una raíz de aplicación, y se puede hacer referencia a él mediante enlaces de metadatos o enlaces de objetos. Un objeto local es todo objeto que no es un objeto común.
Los objetos comunes proporcionados por la base de datos se definen en CDB$ROOT y no se pueden cambiar. Oracle Database no soporta la creación de objetos comunes en CDB$ROOT.
Puede crear la mayoría de los objetos de esquema, como tablas, vistas, unidades de programa PL/SQL y Java, secuencias, etc., como objetos comunes en una raíz de aplicación. Si el objeto existe en una raíz de aplicación, se denomina objeto común de aplicación.
Un usuario local puede ser propietario de un objeto común. Además, un usuario común puede ser propietario de un objeto local, pero solo cuando el objeto no está enlazado a datos ni a metadatos, y tampoco es un enlace de metadatos ni un enlace de datos.
Consulte también: Oracle AI Database Security Guide para obtener más información sobre la gestión de privilegios para objetos comunes
Tipos De Objetos de Esquema
Oracle SQL permite crear y manipular muchos otros tipos de objetos de esquema.
Los tipos principales de objetos de esquema se muestran en la siguiente tabla.
Tabla 2 Objetos de esquema
| Objeto | Descripción | Para saber más |
|---|---|---|
| Tabla | Una tabla almacena datos en filas. Las tablas son los objetos de esquema más importantes de una base de datos relacional. | "Visión General de Tablas" |
| Índices | Los índices son objetos de esquema que contienen una entrada para cada fila indexada de la tabla o cluster de tabla y proporcionan acceso directo y rápido a las filas. Oracle AI Database soporta varios tipos de índices. Una tabla organizada por índices es una tabla en la que los datos se almacenan en una estructura de índice. | "Índices y Tablas Organizadas por Índices" |
| Particiones | Las particiones son partes de tablas e índices grandes. Cada partición tiene su propio nombre y, opcionalmente, puede tener sus propias características de almacenamiento. | "Visión General de Particiones" |
| Vistas | Las vistas son presentaciones personalizadas de datos en una o varias tablas u otras vistas. En cierto modo, se asemejan a consultas almacenadas. Las vistas no contienen realmente datos. | "Visión General de las Vistas" |
| Secuencias | Una secuencia es un objeto creado por el usuario que pueden compartir varios usuarios para generar enteros. Normalmente, las secuencias se utilizan para generar valores de clave primaria. | "Visión general de secuencias" |
| Dimensiones | Una dimensión define una relación principal-secundario entre pares de juegos de columnas, donde todas las columnas de un juego de columnas deben proceder de la misma tabla. Las dimensiones se suelen utilizar para clasificar datos como clientes, productos y tiempo. | "Descripción general de Dimensiones" |
| Sinónimos | Un sinónimo es un alias para otro objeto del esquema. Un sinónimo es simplemente un alias, por lo que no requiere almacenamiento aparte de su definición en el diccionario de datos. | "Visión General de Sinónimas" |
| Subprogramas y paquetes PL/SQL | PL/SQL es la extensión de procedimiento de Oracle de SQL. Un subprograma PL/SQL es un bloque PL/SQL con nombre que se puede llamar con un juego de parámetros. Un paquete PL/SQL agrupa tipos, variables y subprogramas PL/SQL relacionados lógicamente. | "Subprogramas PL/SQL" |
Otros tipos de objetos también se almacenan en la base de datos y se pueden crear y manipular con sentencias SQL, pero no se incluyen en un esquema. Estos objetos incluyen la cuenta de usuario de la base de datos, roles, contextos y objetos de diccionario.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a gestionar objetos de esquema
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre objetos de esquema y objetos de base de datos
Almacenamiento de objetos de esquema
Algunos objetos de esquema almacenan datos en un tipo de estructura de almacenamiento lógica denominada segmento. Por ejemplo, una tabla organizada en pilas no particionada o un índice crea un segmento.
Otros objetos de esquema, como vistas y secuencias, constan solo de metadatos. En este tema se describen solo los objetos de esquema que tienen segmentos.
Oracle AI Database almacena un objeto de esquema de forma lógica en un espacio de tabla. No hay ninguna relación entre los esquemas y los tablespaces: un tablespace puede contener objetos de diferentes esquemas y los objetos de un esquema pueden estar contenidos en diferentes tablespaces. Los datos de cada objeto están contenidos físicamente en uno o más archivos de datos.
En la siguiente figura se muestra una posible configuración de segmentos de tabla e índice, tablespaces y archivos de datos. El segmento de datos de una tabla abarca dos archivos de datos, que forman parte del mismo tablespace. Un segmento no puede abarcar varios tablespaces.
Figura 5: Segmentos, Tablespaces y Archivos de Datos
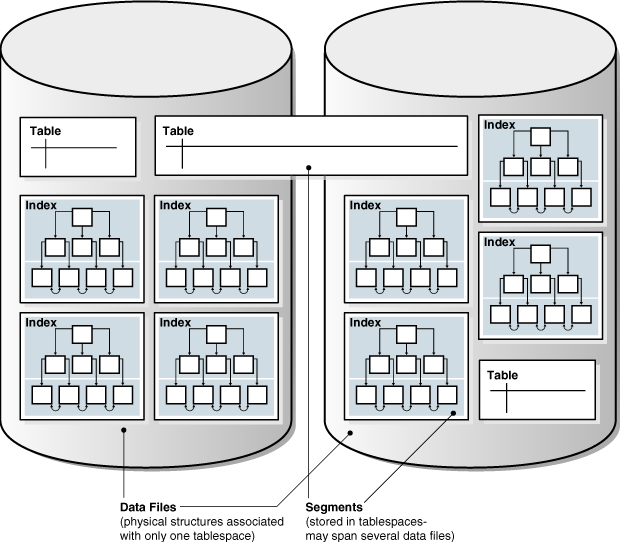
Descripción de la ilustración cncpt284.gif
Consulte además:
-
"Estructuras de Almacenamiento Lógicas" para obtener más información sobre tablespaces y segmentos
-
Oracle AI Database Administrator's Guide para aprender a gestionar el almacenamiento de objetos de esquema
Dependencias de objetos de esquema
Algunos objetos de esquema hacen referencia a otros objetos y crean una dependencia de objeto de esquema.
Por ejemplo, una vista contiene una consulta que hace referencia a tablas o vistas, mientras que un subprograma PL/SQL llama a otros subprogramas. Si la definición del objeto A hace referencia a B, entonces A es un objeto dependiente en B, y B es un objeto al que se hace referencia para A.
Oracle AI Database proporciona un mecanismo automático para garantizar que un objeto dependiente esté siempre actualizado con respecto a los objetos a los que se hace referencia. Al crear un objeto dependiente, la base de datos realiza un seguimiento de las dependencias entre el objeto dependiente y sus objetos a los que se hace referencia. Cuando un objeto al que se hace referencia cambia de una manera que puede afectar a un objeto dependiente, la base de datos marca el objeto dependiente como no válido. Por ejemplo, si un usuario borra una tabla, no se puede utilizar ninguna vista basada en la tabla borrada.
Se debe recompilar un objeto dependiente no válido para la nueva definición de un objeto al que se hace referencia antes de que se pueda utilizar el objeto dependiente. La recompilación se produce automáticamente cuando se hace referencia al objeto dependiente no válido.
Como ilustración de cómo los objetos de esquema pueden crear dependencias, el siguiente script de ejemplo crea una tabla test_table y, a continuación, un procedimiento que consulta esta tabla:
CREATE TABLE test_table ( col1 INTEGER, col2 INTEGER );

CREATE OR REPLACE PROCEDURE test_proc
AS
BEGIN
 FOR x IN ( SELECT col1, col2 FROM test_table )
 LOOP
   -- process data
   NULL;
 END LOOP;
END;
/
La siguiente consulta del estado del procedimiento test_proc muestra que es válido:
SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Después de agregar la columna col3 a test_table, el procedimiento sigue siendo válido porque el procedimiento no tiene dependencias en esta columna:
SQL> ALTER TABLE test_table ADD col3 NUMBER;

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Sin embargo, al cambiar el tipo de dato de la columna col1, de la que depende el procedimiento test_proc, se invalida el procedimiento:
SQL> ALTER TABLE test_table MODIFY col1 VARCHAR2(20);

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   INVALID
La ejecución o recompilación del procedimiento vuelve a ser válido, como se muestra en el siguiente ejemplo:
SQL> EXECUTE test_proc

PL/SQL procedure successfully completed.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Consulte también: Guía del administrador de Oracle AI Database y Guía de desarrollo de Oracle AI Database para aprender a gestionar dependencias de objetos de esquema
Esquemas de ejemplo
Una base de datos Oracle puede incluir esquemas de ejemplo, que son un juego de esquemas entrelazados que permiten a la documentación de Oracle y a los materiales de instrucciones de Oracle ilustrar tareas comunes de la base de datos.
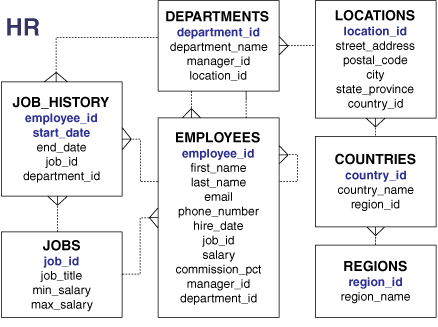
El esquema de ejemplo hr contiene información sobre empleados, departamentos y ubicaciones, historiales de trabajo, etc. En la siguiente ilustración se muestra un diagrama de relación de entidad de las tablas de hr. La mayoría de los ejemplos de este manual utilizan objetos de este esquema.
Figura 6: Esquema HR
Descripción de la ilustración cncpt292.gif
Consulte también: Esquemas de ejemplo de Oracle AI Database para aprender a instalar los esquemas de ejemplo
Visión general de tablas
Una tabla es la unidad básica de organización de datos en una base de datos Oracle.
En una tabla, se describe una entidad, que es importante sobre qué información se debe registrar. Por ejemplo, un empleado podría ser una entidad.
Las tablas de Oracle AI Database se dividen en las siguientes categorías básicas:
-
Tablas relacionales
Las tablas relacionales tienen columnas simples y son el tipo de tabla más común. El ejemplo 4-1 muestra una sentencia
CREATE TABLEpara una tabla relacional. -
Tablas de objetos
Las columnas corresponden a los atributos de nivel superior de un tipo de objeto. Consulte "Visión General de Tablas de Objetos".
Puede crear una tabla relacional con las siguientes características organizativas:
-
Una tabla organizada en pilas no almacena filas en ningún orden concreto. La sentencia
CREATE TABLEcrea una tabla organizada en pilas por defecto. -
Una tabla organizada por índices ordena las filas según los valores de clave primaria. Para algunas aplicaciones, las tablas organizadas por índices mejoran el rendimiento y utilizan el espacio en disco de forma más eficaz. Consulte "Visión General de Tablas Organizadas por Índices".
-
Una tabla externa es una tabla de sólo lectura cuyos metadatos se almacenan en la base de datos pero cuyos datos se almacenan fuera de la base de datos. Consulte "Visión General de Tablas Externas".
Una tabla es permanente o temporal. Una definición de tabla permanente y los datos persisten en las sesiones. Una definición de tabla temporal se mantiene de la misma forma que una definición de tabla permanente, pero los datos solo existen durante la duración de una transacción o sesión. Las tablas temporales son útiles en aplicaciones en las que se debe retener temporalmente un juego de resultados, tal vez porque el resultado se crea ejecutando varias operaciones.
-
Columnas Una definición de tabla incluye un nombre de tabla y un juego de columnas.
-
Filas Una fila es una recopilación de información de columna que corresponde a un registro de una tabla.
-
Ejemplo: CREATE TABLE y ALTER TABLE Statements La sentencia SQL de Oracle para crear una tabla es
CREATE TABLE. -
Tipos de dato de Oracle Cada columna tiene un tipo de dato, que está asociado a un formato de almacenamiento específico, restricciones y un rango de valores válido. El tipo de dato de un valor asocia un juego fijo de propiedades con el valor.
-
Restricciones de integridad Una restricción de integridad es una regla con nombre que restringe los valores de una o más columnas de una tabla.
-
Almacenamiento de tablas Oracle AI Database utiliza un segmento de datos en un tablespace para contener los datos de la tabla.
-
Compresión de Tabla: La base de datos puede utilizar la compresión de tabla para reducir la cantidad de almacenamiento necesaria para la tabla. Consulte también: Guía del administrador de Oracle AI Database para aprender a gestionar tablas
Columnas
Una definición de tabla incluye un nombre de tabla y un juego de columnas.
Una columna identifica un atributo de la entidad descrita en la tabla. Por ejemplo, la columna employee_id de la tabla employees hace referencia al atributo de ID de empleado de una entidad de empleado.
En general, se asigna a cada columna un nombre de columna, un tipo de dato y un ancho al crear una tabla. Por ejemplo, el tipo de dato para employee_id es NUMBER(6), lo que indica que esta columna solo puede contener datos numéricos de hasta 6 dígitos de ancho. El ancho puede ser predeterminado por el tipo de datos, como con DATE.
-
Columnas virtuales Una tabla puede contener una columna virtual, también denominada columna de expresión. Las columnas de expresión pueden ser virtuales, lo que significa que no se almacenan en el disco o materializadas, lo que significa que se almacenan en el disco.
-
Columnas invisibles Una columna invisible es una columna especificada por el usuario cuyos valores sólo son visibles cuando la columna se especifica explícitamente por nombre. Puede agregar una columna invisible a una tabla sin afectar a las aplicaciones existentes y hacer que la columna esté visible si es necesario.
-
Reserva sin bloqueo Una reserva sin bloqueo permite que varias actualizaciones simultáneas en un valor de columna numérica continúen sin que las actualizaciones sin confirmar las bloqueen al agregar o restar el valor de columna.
Columnas Virtuales
Una tabla puede contener una columna virtual, también denominada columna de expresión. Las columnas de expresión pueden ser virtuales, lo que significa que no se almacenan en el disco o materializadas, lo que significa que se almacenan en el disco.
Las columnas virtuales, también conocidas como columnas de expresión, derivan los valores calculando un juego de funciones o expresiones especificadas por el usuario. Una tabla puede contener una de estas varias columnas, pero siempre debe tener una columna normal. Por ejemplo, la siguiente definición de tabla EMP contiene la tarifa por hora calculada basada en el salario del empleado dividido entre 2080 horas al año.
CREATE TABLE emp
(
   emp_id           NUMBER(9)     CONSTRAINT emp_pk PRIMARY KEY,
   emp_last_name    VARCHAR2(30)  CONSTRAINT emp_last_name_nn NOT NULL,
   emp_first_name   VARCHAR2(30)  CONSTRAINT emp_first_name_nn NOT NULL,
   emp_salary       NUMBER(9,2),
   emp_hourly_rate  NUMBER(7,2)   GENERATED ALWAYS AS (emp_salary/2080) VIRTUAL,
   emp_phone_no     VARCHAR2(10)
);
A continuación, inserte valores en las columnas no virtuales.
INSERT INTO emp (emp_id, emp_last_name, emp_first_name, emp_salary, emp_phone_no)
VALUES (8291, 'Patel', 'Siddharth', 60000, '6505551234');
Al consultar la tabla, ahora verá el valor calculado devuelto como una columna de expresión.
SELECT * FROM emp;

 EMP_ID EMP_LAST_NAME  EMP_FIRST_NAME     EMP_SALARY  EMP_HOURLY_RATE EMP_PHONE_NO
_______ ______________ _______________ _____________ ________________ _____________
   8291 Patel          Siddharth               60000            28.85 6505551234
Estas columnas de expresión pueden ser virtuales o materializadas en disco. En el caso de columnas virtuales (expresión) puras, los valores de columna no consumen espacio en disco y se calculan a demanda en el momento del acceso. En el caso de columnas de expresión materializadas, los valores se calcularán en el momento de DML y se almacenarán en el disco.
Consulte también: Guía del administrador de Oracle AI Database para aprender a gestionar columnas virtuales
Columnas invisibles
Una columna invisible es una columna especificada por el usuario cuyos valores solo son visibles cuando la columna se especifica explícitamente por nombre. Puede agregar una columna invisible a una tabla sin afectar a las aplicaciones existentes y hacer que la columna esté visible si es necesario.
En general, las columnas invisibles ayudan a migrar y evolucionar las aplicaciones en línea. Un caso de uso puede ser una aplicación que consulta una tabla de tres columnas con una sentencia SELECT *. Si se agrega una cuarta columna a la tabla, se rompería la aplicación, que espera tres columnas de datos. La adición de una cuarta columna invisible hace que la aplicación funcione normalmente. A continuación, un desarrollador puede modificar la aplicación para manejar una cuarta columna y hacer que la columna esté visible cuando la aplicación se active.
En el siguiente ejemplo se crea una tabla products con una columna invisible count y, a continuación, se hace visible la columna invisible:
CREATE TABLE products ( prod_id INT, count INT INVISIBLE );
ALTER TABLE products MODIFY ( count VISIBLE );
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a gestionar columnas invisibles
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre columnas invisibles
Reserva sin bloqueo
Una reserva sin bloqueo permite que varias actualizaciones simultáneas en un valor de columna numérico continúen sin que las actualizaciones sin confirmar las bloqueen al agregar o restar el valor de columna.
Al evitar el mecanismo de bloqueo tradicional durante las actualizaciones, esta función le permite mejorar en gran medida la experiencia del usuario con un bloqueo reducido en presencia de actualizaciones simultáneas frecuentes en columnas reservables. En versiones anteriores, cuando un valor de columna de una fila se actualiza sumando o restando de ella, todas las demás actualizaciones de esa fila se bloquean hasta que se confirma la transacción. Con la introducción de la función de reserva sin bloqueo en Oracle AI Database 26ai, puede permitir que las transacciones se sumen o resten simultáneamente de la columna reservable de la misma fila sin bloquearse entre sí especificando las condiciones para las que pueden continuar las actualizaciones. Para ello, se especifica que la columna numérica es una columna RESERVABLE y se crea una restricción CHECK para la columna. También se puede lograr una mejora adicional del rendimiento debido a que las actualizaciones de columnas reservables no bloquean las filas y, por lo tanto, no bloquean que otra transacción actualice columnas no reservables de la misma fila simultáneamente.
Por ejemplo, puede permitir que las operaciones de suma y resta de una cantidad de inventario se realicen correctamente si la cantidad física es suficiente para la solicitud y no supera nuestro espacio en estante para 100 artículos. Cualquier actualización de este tipo en el valor de cantidad puede continuar sin ser bloqueada por actualizaciones sin confirmar siempre que el valor de cantidad sea mayor que cero y menor o igual que 100. El importe que se suma o resta se reserva y se garantiza mediante un mecanismo interno de reserva, de modo que la transacción pueda continuar sin esperar a que se confirmen otras transacciones que hayan realizado reservas anteriores en la columna reservable de la misma fila.
Las restricciones CHECK de nivel de tabla pueden incluir columnas reservables y no reservables. Una reserva pendiente sin bloqueo que se aprobó en el momento en que se emite una actualización puede violar posteriormente dicha restricción en el momento de la confirmación de la transacción. Esto puede ocurrir si las columnas no reservables de la restricción se han actualizado en el momento posterior a la reserva, de modo que sus valores actuales puedan violar la restricción CHECK. La transacción tendrá que terminar si se viola la restricción. Sin embargo, las columnas no reservables de una restricción de nivel de tabla suelen ser umbrales que se modifican con poca frecuencia. El espacio de estante, el saldo requerido en una cuenta y los límites de gasto son ejemplos de dichos umbrales.
En el siguiente ejemplo se crea una tabla inventory con una columna reservable qty_on_hand. La restricción CHECK en qty_on_hand especifica que debe haber cero o más artículos en stock y no más que la capacidad de estante para este artículo para una actualización en qty_on_hand para continuar sin bloquear otras actualizaciones. En el ejemplo siguiente, la tabla inventory se crea con las restricciones adecuadas, se insertan varias filas de datos y se consulta el diccionario de datos para la tabla inventory.
CREATE TABLE inventory
( item_id            NUMBER          CONSTRAINT inv_pk PRIMARY KEY,
  item_display_name  VARCHAR2(100)   NOT NULL,
  item_desc          VARCHAR2(2000),
  qty_on_hand        NUMBER          RESERVABLE CONSTRAINT qty_ck CHECK
                                        (qty_on_hand >= 0) NOT NULL,
  shelf_capacity     NUMBER          NOT NULL,
    CONSTRAINT shelf_ck CHECK (qty_on_hand <= shelf_capacity)
);

-- Insert a few rows in the inventory table
INSERT INTO inventory VALUES (123, 'Milk', 'Lowfat 2%', 100, 120);
INSERT INTO inventory VALUES (456, 'Bread', 'Multigrain', 50, 100);
INSERT INTO inventory VALUES (789, 'Eggs', 'Organic', 50, 75);

COMMIT;

SELECT * FROM inventory;

-- Check views user_tab_cols and user_tables to check
-- if the table is a reservable table and the names of the reservable columns

SELECT table_name, has_reservable_column
FROM   user_tables
WHERE  table_name = 'INVENTORY';

SELECT column_name, reservable_column
FROM   user_tab_cols
WHERE  table_name = 'INVENTORY'
  AND  reservable_column = 'YES';
Un ejemplo de varias actualizaciones simultáneas en la columna reservable:
-
Transacción 1:
UPDATE inventory SET qty_on_hand = qty_on_hand - 10 WHERE item_id = 123; -
Transacción 2:
UPDATE inventory SET qty_on_hand = qty_on_hand + 20 WHERE item_id = 123; -
Transacción 3:
UPDATE inventory SET qty_on_hand = qty_on_hand - 30 WHERE item_id = 123; -
Transacción 2:
commit; -
Transacción 3:
commit; -
Transacción 1:
commit;
Se puede agregar una columna reservable a una tabla mediante el comando ALTER TABLE que especifica una restricción CHECK opcional. Por ejemplo:
ALTER TABLE inventory ADD
(qty_on_hold NUMBER RESERVABLE DEFAULT 0
 CONSTRAINT qty_hold CHECK (qty_on_hold >= 0 and qty_on_hold <= 25));
Una columna reservable se puede convertir en una columna no reservable mediante el siguiente comando ALTER TABLE. Las aplicaciones pueden optar por aplicar las restricciones aunque las reservas reservables estén desactivadas, por lo que la restricción no se borra automáticamente cuando una columna se convierte en una columna no reservable. El borrado de la restricción es opcional, según sus requisitos. Por ejemplo:
ALTER TABLE inventory MODIFY (qty_on_hand NOT RESERVABLE);
ALTER TABLE inventory DROP CONSTRAINT qty_ck;
Una columna no reservable se puede convertir en una columna reservable mediante el comando ALTER TABLE. Por ejemplo:
ALTER TABLE inventory MODIFY
(qty_on_hand RESERVABLE
 CONSTRAINT qty_ck CHECK (qty_on_hand >= 0 and qty_on_hand <= 100));
Filas
Una fila es una recopilación de información de columna que corresponde a un registro de una tabla.
Por ejemplo, una fila de la tabla employees describe los atributos de un empleado específico: ID de empleado, apellido, nombre, etc. Después de crear una tabla, puede insertar, consultar, suprimir y actualizar filas mediante SQL.
Ejemplo: sentencias CREATE TABLE y ALTER TABLE
La sentencia SQL de Oracle para crear una tabla es CREATE TABLE.
Ejemplo 4-1 Empleados de CREATE TABLE
En el siguiente ejemplo se muestra la sentencia CREATE TABLE para la tabla employees en el esquema de ejemplo hr. La sentencia especifica columnas como employee_id, first_name, etc., especificando un tipo de dato como NUMBER o DATE para cada columna.
CREATE TABLE employees
    ( employee_id    NUMBER(6),
      first_name     VARCHAR2(20),
      last_name      VARCHAR2(25)   CONSTRAINT emp_last_name_nn  NOT NULL,
      email          VARCHAR2(25)   CONSTRAINT emp_email_nn      NOT NULL,
      phone_number   VARCHAR2(20),
      hire_date      DATE           CONSTRAINT emp_hire_date_nn  NOT NULL,
      job_id         VARCHAR2(10)   CONSTRAINT emp_job_nn        NOT NULL,
      salary         NUMBER(8,2),
      commission_pct NUMBER(2,2),
      manager_id     NUMBER(6),
      department_id  NUMBER(4),
      CONSTRAINT     emp_salary_min CHECK (salary > 0),
      CONSTRAINT     emp_email_uk   UNIQUE (email)
    ) ;
Ejemplo 4-2 Empleados de ALTER TABLE
En el siguiente ejemplo se muestra una sentencia ALTER TABLE que agrega restricciones de integridad a la tabla employees. Las restricciones de integridad aplican las reglas de negocio e impiden la introducción de información no válida en las tablas.
ALTER TABLE employees
ADD ( CONSTRAINT emp_emp_id_pk   PRIMARY KEY (employee_id),
      CONSTRAINT emp_dept_fk     FOREIGN KEY (department_id)
                                   REFERENCES departments,
      CONSTRAINT emp_job_fk      FOREIGN KEY (job_id)
                                   REFERENCES jobs (job_id),
      CONSTRAINT emp_manager_fk  FOREIGN KEY (manager_id)
                                   REFERENCES employees
    ) ;
Ejemplo 4-3 Filas en la Tabla employees
En la siguiente salida de ejemplo se muestran 8 filas y 6 columnas de la tabla hr.employees.
EMPLOYEE_ID FIRST_NAME  LAST_NAME      SALARY COMMISSION_PCT DEPARTMENT_ID
----------- ----------- ------------- ------- -------------- -------------
        100 Steven      King            24000                           90
        101 Neena       Kochhar         17000                           90
        102 Lex         De Haan         17000                           90
        103 Alexander   Hunold           9000                           60
        107 Diana       Lorentz          4200                           60
        149 Eleni       Zlotkey         10500             .2            80
        174 Ellen       Abel            11000             .3            80
        178 Kimberely   Grant            7000            .15
La salida anterior ilustra algunas de las siguientes características importantes de tablas, columnas y filas:
-
Una fila de la tabla describe los atributos de un empleado: nombre, salario, departamento, etc. Por ejemplo, la primera fila de la salida muestra el registro del empleado llamado Steven King.
-
Una columna describe un atributo del empleado. En el ejemplo, la columna
employee_ides la clave primaria, lo que significa que cada empleado se identifica de forma única por ID de empleado. Se garantiza que dos empleados no tengan el mismo ID de empleado. -
Una columna no de clave puede contener filas con valores idénticos. En el ejemplo, el valor de salario de los empleados 101 y 102 es el mismo:
17000. -
Una columna Clave Extranjera hace referencia a una clave primaria o única en la misma tabla o en una tabla diferente. En este ejemplo, el valor de
90endepartment_idcorresponde a la columnadepartment_idde la tabladepartments. -
Un campo es la intersección de una fila y columna. Solo puede contener un valor. Por ejemplo, el campo del ID de departamento del empleado 103 contiene el valor
60. -
Un campo puede carecer de un valor. En este caso, se dice que el campo contiene un valor null. El valor de la columna
commission_pctpara el empleado 100 es nulo, mientras que el valor del campo para el empleado 149 es.2. Una columna permite valores nulos a menos que se haya definido una restricción de integridad de clave primaria oNOTNULLen esta columna, en cuyo caso no se puede insertar ninguna fila sin un valor para esta columna.
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica de CREATE TABLE
Tipos de Dato de Oracle
Cada columna tiene un tipo de dato, que está asociado a un formato de almacenamiento específico, restricciones y un rango de valores válido. El tipo de dato de un valor asocia un juego fijo de propiedades con el valor.
Estas propiedades hacen que Oracle AI Database trate los valores de un tipo de datos de forma diferente a los valores de otro. Por ejemplo, puede multiplicar valores del tipo de dato NUMBER, pero no valores del tipo de dato RAW.
Al crear una tabla, debe especificar un tipo a cada uno de sus columnas. Cada uno de los valores insertados con posterioridad en una columna debe ceñirse al tipo de dato de la columna en cuestión.
Oracle AI Database proporciona varios tipos de datos integrados. Los tipos de dato más utilizados se incluyen en las categorías detalladas en esta sección.
Otras categorías importantes de tipos incorporados incluyen objetos raw, grandes (LOB) y recopilaciones. PL/SQL tiene tipos de dato para constantes y variables, que incluyen BOOLEAN, tipos de referencia, tipos compuestos (registros) y tipos definidos por el usuario.
-
Los tipos de dato de caracteres de los tipos de datos de caracteres almacenan datos alfanuméricos en cadenas. El tipo de dato de caracteres más común es
VARCHAR2, que es la opción más eficaz para almacenar datos de caracteres. -
Tipos de datos numéricos Los tipos de datos numéricos de Oracle AI Database almacenan números fijos y de punto flotante, cero e infinito. Algunos tipos numéricos también almacenan valores que son el resultado no definido de una operación, que se conoce como "no es un número" o
NaN. -
Tipos de dato Datetime Los tipos de dato datetime son
DATEyTIMESTAMP. Oracle AI Database proporciona soporte de zona horaria completo para registros de hora. -
Tipos de datos de fila Cada fila almacenada en la base de datos tiene una dirección, una representación interna para localizar esa fila dentro de la base de datos. Oracle AI Database utiliza un tipo de dato
ROWIDpara almacenar la dirección (rowid) de cada fila de la base de datos. -
Tipo de dato booleano El tipo de dato BOOLEAN consta de los distintos valores de verdad
TrueyFalse. -
Formato de modelos y tipos de datos Un modelo de formato es un literal que describe el formato de datos numéricos o de fecha y hora almacenados en una cadena de caracteres. Un modelo de formato no cambia la representación interna del valor en la base de datos.
Consulte además:
-
Guía del desarrollador de Oracle AI Database SecureFiles y objetos grandes
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre los tipos de dato SQL incorporados
-
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para obtener más información sobre los tipos de dato PL/SQL
-
Guía de desarrollo de Oracle AI Database para aprender a utilizar los tipos de datos integrados
Tipos de datos de caracteres
Los tipos de dato de caracteres almacenan datos alfanuméricos en cadenas. El tipo de dato de caracteres más común es VARCHAR2, que es la opción más eficaz para almacenar datos de caracteres.
Los valores de bytes corresponden al esquema de codificación de caracteres, generalmente denominado conjunto de caracteres. El juego de caracteres de la base de datos se establece al crear la base de datos. Algunos ejemplos de juegos de caracteres son ASCII de 7 bits, EBCDIC y Unicode UTF-8.
La semántica de longitud de los tipos de dato de caracteres se puede medir en bytes o caracteres. El tratamiento de las cadenas como una secuencia de bytes se denomina semántica de bytes. Este es el valor por defecto para los tipos de dato de caracteres. El tratamiento de las cadenas como una secuencia de caracteres se denomina semántica de caracteres. Un carácter es un punto de código del juego de caracteres de la base de datos.
-
Tipos de dato VARCHAR2 y CHAR El tipo de dato
VARCHAR2almacena literales de caracteres de longitud variable. Un valor literal es un valor de datos fijo. -
Tipos de dato NCHAR y NVARCHAR2 Los tipos de dato
NCHARyNVARCHAR2almacenan datos de caracteres Unicode.
Consulte además:
-
Oracle AI Database Globalization Support Guide para obtener más información sobre los juegos de caracteres
-
Oracle AI Database: introducción al desarrollo de Oracle AI Database para obtener una breve introducción a los tipos de datos
-
Oracle AI Database Development Guide para aprender a seleccionar un tipo de dato de carácter
Tipos de Dato VARCHAR2 y CHAR
El tipo de dato VARCHAR2 almacena literales de caracteres de longitud variable. Un valor literal es un valor de datos fijo.
Por ejemplo, 'LILA', 'St. George Island' y '101' son todos literales de caracteres; 5001 es un literal numérico. Los literales de caracteres se incluyen entre comillas simples para que la base de datos pueda distinguirlos de los nombres de objetos de esquema. Nota: Este manual utiliza los términos literal de texto, literal de caracteres y cadena indistintamente.
Al crear una tabla con una columna VARCHAR2, se especifica una longitud máxima de cadena. En el ejemplo 4-1, la columna last_name tiene un tipo de dato VARCHAR2(25), lo que significa que cualquier nombre almacenado en la columna tiene un máximo de 25 bytes.
Para cada fila, Oracle AI Database almacena cada valor de la columna como un campo de longitud variable a menos que un valor supere la longitud máxima, en cuyo caso la base de datos devuelve un error. Por ejemplo, en un juego de caracteres de un solo byte, si introduce 10 caracteres para el valor de columna last_name en una fila, la columna de la parte de fila almacena solo 10 caracteres (10 bytes), no 25. El uso de VARCHAR2 reduce el consumo de espacio.
A diferencia de VARCHAR2, CHAR almacena cadenas de caracteres de longitud fija. Al crear una tabla con una columna CHAR, la columna necesita una longitud de cadena. El valor por defecto es 1 byte. La base de datos utiliza espacios en blanco para rellenar el valor con la longitud especificada.
Oracle AI Database compara los valores VARCHAR2 mediante la semántica de comparación sin relleno y compara los valores CHAR mediante la semántica de comparación con relleno en blanco.
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para obtener detalles sobre la semántica de comparación con relleno en blanco y sin relleno.
Tipos de Dato NCHAR y NVARCHAR2
Los tipos de dato NCHAR y NVARCHAR2 almacenan datos de caracteres Unicode.
Unicode es un juego de caracteres codificado universal que puede almacenar información en cualquier idioma mediante un único juego de caracteres. NCHAR almacena cadenas de caracteres de longitud fija que corresponden al juego de caracteres nacional, mientras que NVARCHAR2 almacena cadenas de caracteres de longitud variable.
Debe especificar un juego de caracteres nacional al crear una base de datos. El juego de caracteres de los tipos de dato NCHAR y NVARCHAR2 debe ser AL16UTF16 o UTF8. Ambos juegos de caracteres utilizan la codificación Unicode.
Al crear una tabla con una columna NCHAR o NVARCHAR2, el tamaño máximo siempre está en la semántica de longitud de caracteres. La semántica de longitud de caracteres es la semántica por defecto y solo de longitud para NCHAR o NVARCHAR2.
Consulte también: Guía de soporte de globalización de Oracle AI Database para obtener información sobre la función de soporte de globalización de Oracle
Tipos de datos numéricos
Los tipos de dato numéricos de Oracle AI Database almacenan números fijos y de punto flotante, cero e infinito. Algunos tipos numéricos también almacenan valores que son el resultado no definido de una operación, que se conoce como "no es un número" o NaN.
Oracle AI Database almacena datos numéricos en formato de longitud variable. Cada valor se almacena en notación científica, con 1 byte utilizado para almacenar el exponente. La base de datos utiliza hasta 20 bytes para almacenar el comando mantissa, que es la parte de un número de punto flotante que contiene sus dígitos significativos. Oracle AI Database no almacena ceros iniciales y finales.
-
NUMBER Data Type El tipo de dato
NUMBERalmacena números fijos y de punto flotante. La base de datos puede almacenar números de prácticamente cualquier magnitud. Se garantiza que estos datos se pueden transportar entre diferentes sistemas operativos que ejecutan Oracle AI Database. Se recomienda el tipo de datoNUMBERpara la mayoría de los casos en los que debe almacenar datos numéricos. -
Números de punto flotante Oracle AI Database proporciona dos tipos de datos numéricos exclusivamente para números de punto flotante:
BINARY_FLOATyBINARY_DOUBLE.
Tipo de datos NUMBER
El tipo de dato NUMBER almacena números fijos y de punto flotante. La base de datos puede almacenar números de prácticamente cualquier magnitud. Se garantiza que estos datos se pueden transportar entre diferentes sistemas operativos que ejecutan Oracle AI Database. Se recomienda el tipo de dato NUMBER para la mayoría de los casos en los que debe almacenar datos numéricos.
Puede especificar un número de punto fijo con el formato NUMBER(p,s), donde p y s hacen referencia a las siguientes características:
-
Precisión
La precisión especifica el número total de dígitos. Si no se especifica una precisión, la columna almacena los valores exactamente como lo proporciona la aplicación sin redondeo alguno.
-
Escala
scale especifica el número de dígitos desde la coma decimal hasta el dígito menos significativo. La escala positiva cuenta dígitos a la derecha de la coma decimal hasta el dígito menos significativo incluido. La escala negativa cuenta dígitos a la izquierda de la coma decimal, pero no incluye el dígito menos significativo. Si especifica una precisión sin escala, como en
NUMBER(6), la escala es 0.
En el ejemplo 4-1, la columna salary es de tipo NUMBER(8,2), por lo que la precisión es 8 y la escala es 2. Por lo tanto, la base de datos almacena un salario de 100 000 como 100000.00.
Números de coma flotante
Oracle AI Database proporciona dos tipos de datos numéricos exclusivamente para números de punto flotante: BINARY_FLOAT y BINARY_DOUBLE.
Estos tipos soportan todas las funciones básicas proporcionadas por el tipo de dato NUMBER. Sin embargo, mientras que NUMBER utiliza precisión decimal, BINARY_FLOAT y BINARY_DOUBLE utilizan precisión binaria, lo que permite cálculos aritméticos más rápidos y, por lo general, reduce los requisitos de almacenamiento.
BINARY_FLOAT y BINARY_DOUBLE son tipos de dato numéricos aproximados. Almacenan representaciones aproximadas de valores decimales, en lugar de representaciones exactas. Por ejemplo, el valor 0.1 no puede estar representado exactamente por BINARY_DOUBLE o BINARY_FLOAT. Se utilizan con frecuencia para cálculos científicos. Su comportamiento es similar a los tipos de dato FLOAT y DOUBLE en Java y XMLSchema.
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para obtener información sobre la precisión, la escala y otras características de los tipos numéricos
Tipos de dato de fecha y hora
Los tipos de dato datetime son DATE y TIMESTAMP. Oracle AI Database proporciona soporte de zona horaria completo para registros de hora.
-
DATE Data Type El tipo de dato
DATEalmacena la fecha y la hora. Aunque las fechas y horas se pueden representar en tipos de dato de caracteres o números,DATEtiene propiedades asociadas especiales. -
TIMESTAMP Data Type El tipo
TIMESTAMPes una extensión del tipoDATE.
Tipo de datos de fecha
El tipo de dato DATE almacena la fecha y la hora. Aunque las fechas y horas se pueden representar en tipos de dato de caracteres o números, DATE tiene propiedades asociadas especiales.
La base de datos almacena las fechas internamente como números. Las fechas se almacenan en campos de longitud fija de 7 bytes cada uno, correspondientes a siglo, año, mes, día, hora, minuto y segundo. Nota: Las fechas soportan por completo las operaciones aritméticas, por lo que puede sumar y restar fechas de la misma manera que puede con números.
La base de datos muestra las fechas según el modelo de formato especificado. Un modelo de formato es un literal de carácter que describe el formato de una fecha y hora en una cadena de caracteres. El formato de fecha estándar es DD-MON-RR, que muestra las fechas con el formato 01-JAN-11.
RR es similar a YY (los dos últimos dígitos del año), pero el siglo del valor de retorno varía según el año de dos dígitos especificado y los dos últimos dígitos del año actual. Supongamos que en 1999 la base de datos muestra 01-JAN-11. Si el formato de fecha utiliza RR, 11 especifica 2011, mientras que si el formato utiliza YY, 11 especifica 1911. Puede cambiar el formato de fecha por defecto tanto a nivel de instancia de base de datos como de sesión.
Oracle AI Database almacena el tiempo en formato de 24 horas: HH:MI:SS. Si no se introduce ninguna parte de tiempo, la hora de un campo de fecha por defecto es 00:00:00 A.M. En una entrada de sólo horas, la parte de fecha toma por defecto el primer día del mes actual.
Consulte además:
-
Oracle AI Database Development Guide para obtener más información sobre las máscaras de formato de fecha y siglos
-
Referencia de lenguaje SQL de Oracle AI Database para obtener información sobre los códigos de formato de fecha y hora
-
Guía de desarrollo de Oracle AI Database para aprender a realizar operaciones aritméticas con tipos de dato datetime
Tipo de datos de TIMESTAMP
El tipo de dato TIMESTAMP es una extensión del tipo de dato DATE.
TIMESTAMP almacena segundos fraccionarios además de la información almacenada en el tipo de dato DATE. El tipo de dato TIMESTAMP es útil para almacenar valores de tiempo precisos, como en aplicaciones que deben realizar un seguimiento del orden de los eventos.
Los tipos de dato DATETIME TIMESTAMP WITH TIME ZONE y TIMESTAMP WITH LOCAL TIME ZONE son conscientes de la zona horaria. Cuando un usuario selecciona los datos, el valor se ajusta a la zona horaria de la sesión de usuario. Este tipo de datos es útil para recopilar y evaluar información de fecha entre regiones geográficas.
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para obtener detalles sobre la sintaxis de creación e introducción de datos en columnas de registro de hora
Tipos de datos de ID de fila
Cada fila almacenada en la base de datos tiene una dirección, una representación interna para localizar esa fila dentro de la base de datos. Oracle AI Database utiliza un tipo de dato ROWID para almacenar la dirección (rowid) de cada fila de la base de datos.
Los Rowids se clasifican en las siguientes categorías:
-
Los rowid físicos almacenan las direcciones de las filas en las tablas organizadas por pilas, los clusters de tablas y las particiones de tabla e índice.
-
Los rowid lógicos almacenan las direcciones de las filas en tablas organizadas por índices.
-
Los rowid ajenos son identificadores en tablas ajenas, como las tablas DB2 a las que se accede a través de un gateway. No son rowid estándar de Oracle AI Database.
Un tipo de dato denominado universal rowid, o urowid, admite todos los tipos de rowid.
-
Uso de Rowids Oracle AI Database utiliza rowids internamente para la construcción de índices.
-
Pseudocolumna ROWID Cada tabla de una base de datos Oracle tiene una pseudocolumna denominada
ROWID.
Uso de Rowids
Oracle AI Database utiliza los rowid internamente para la construcción de índices.
Un índice de árbol B, que es el tipo más común, contiene una lista ordenada de claves dividida en rangos. Cada clave está asociada a un ID de fila que apunta a la dirección de la fila asociada para un acceso rápido.
Los usuarios finales y los desarrolladores de aplicaciones también pueden utilizar rowid para varias funciones importantes:
-
Los Rowids son un medio rápido de volver a acceder a una fila si su
rowidse ha recuperado previamente con una sentencia SELECT. -
Los Rowids proporcionan la capacidad de ver cómo se organiza una tabla.
Aunque puede crear tablas con columnas definidas mediante el tipo de dato ROWID, no debe almacenar los rowid con la intención de utilizarlos para acceder a los datos en una etapa posterior. El uso de rowid de esta manera puede producir resultados impredecibles o incorrectos. El valor rowid de una fila puede cambiar por una serie de motivos que pueden ser iniciados por el usuario o internamente por el motor de base de datos. No puede depender de que rowid apunte a la misma fila o a una fila válida después de que se haya producido cualquiera de estas operaciones.
Pseudocolumna ROWID
Cada tabla de una base de datos Oracle tiene una pseudocolumna denominada ROWID.
Una pseudocolumna se comporta como una columna de tabla, pero realmente no está almacenada en la tabla. Puede realizar una selección desde las pseudocolumnas, pero no puede insertar, actualizar ni suprimir sus valores. Una pseudocolumna también es similar a una función de SQL sin argumentos. Las funciones sin argumentos normalmente devuelven el mismo valor para cada fila del juego de resultado, mientras que en las pseudocolumnas normalmente se devuelve un valor diferente para cada fila.
Los valores de la pseudocolumna ROWID son cadenas que representan la dirección de cada fila. Estas cadenas tienen el tipo de dato ROWID. Esta pseudocolumna no es evidente al mostrar la estructura de una tabla mediante la ejecución de SELECT o DESCRIBE, ni la pseudocolumna consume espacio. Sin embargo, el ID de fila de cada fila se puede recuperar con una consulta SQL que utilice la palabra reservada ROWID como nombre de columna.
En el siguiente ejemplo se consulta la pseudocolumna ROWID para mostrar el ID de fila de la fila en la tabla employees para el empleado 100:
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
Consulte además:
-
"Rowid Format" (Formato de fila)
-
Oracle AI Database Development Guide para aprender a identificar filas por dirección
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre los tipos de ID de fila
Tipo de dato booleano
El tipo de dato BOOLEAN comprende los distintos valores de verdad True y False.
A menos que una restricción NOT NULL lo prohíba, el tipo de dato booleano también soporta el valor verdadero UNKNOWN como valor nulo. Puede utilizar el tipo de dato booleano siempre que el tipo de dato aparezca en la sintaxis SQL de Oracle.
Consulte además:
- Referencia rápida de lenguaje SQL de Oracle AI Database para obtener información sobre el tipo de dato booleano.
Modelos de Formato y Tipos de Dato
Un modelo de formato es un literal de carácter que describe el formato de fecha y hora o los datos numéricos almacenados en una cadena de caracteres. Un modelo de formato no cambia la representación interna del valor en la base de datos.
Al convertir una cadena de caracteres en una fecha o número, un modelo de formato determina cómo interpreta la cadena la base de datos. En SQL, puede utilizar un modelo de formato como argumento de las funciones TO_CHAR y TO_DATE para dar formato a un valor que se va a devolver de la base de datos o para dar formato a un valor que se va a almacenar en la base de datos.
La siguiente sentencia selecciona los salarios de los empleados del departamento 80 y utiliza la función TO_CHAR para convertir estos salarios en valores de caracteres con el formato especificado por el modelo de formato numérico '$99,990.99':
SQL> SELECT last_name employee, TO_CHAR(salary, '$99,990.99') AS "SALARY"
  2  FROM   employees
  3  WHERE  department_id = 80 AND last_name = 'Russell';

EMPLOYEE                  SALARY
------------------------- -----------
Russell                    $14,000.00
En el siguiente ejemplo, se actualiza una fecha de contratación mediante la función TO_DATE con la máscara de formato 'YYYY MM DD' para convertir la cadena '1998 05 20' en un valor DATE:
SQL> UPDATE employees
  2  SET hire_date = TO_DATE('1998 05 20','YYYY MM DD')
  3  WHERE last_name = 'Hunold';
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre los modelos de formato
Restricciones de integridad
Una restricción de integridad es una regla con nombre que restringe los valores de una o más columnas de una tabla.
Las reglas de integridad de datos evitan la entrada de datos no válidos en las tablas. Además, las restricciones pueden evitar la supresión de una tabla cuando existen determinadas dependencias.
Si una restricción está activada, la base de datos comprueba los datos a medida que se introducen o actualizan. Oracle AI Database evita que se introduzcan datos que no se ajustan a la restricción. Si se desactiva una restricción, Oracle AI Database permite que los datos que no se ajustan a la restricción entren en la base de datos.
En el ejemplo 4-1, la sentencia CREATE TABLE especifica restricciones NOT NULL para las columnas last_name, email, hire_date y job_id. Las cláusulas de restricción identifican las columnas y las condiciones de la restricción. Estas restricciones garantizan que las columnas especificadas no contengan valores nulos. Por ejemplo, si se intenta insertar un nuevo empleado sin un ID de puesto, se genera un error.
Puede crear una restricción cuando cree una tabla o después de hacerlo. Puede desactivar temporalmente las restricciones si es necesario. La base de datos almacena restricciones en el diccionario de datos.
Consulte además:
-
"Integridad de datos" para obtener información sobre las restricciones de integridad
-
"Visión General del Diccionario de Datos" para obtener más información sobre el diccionario de datos
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre las cláusulas de restricción SQL
Almacenamiento de tablas
Oracle AI Database utiliza un segmento de datos en un tablespace para contener los datos de la tabla.
Un segmento contiene extensiones formadas por bloques de datos. El segmento de datos de una tabla (o segmento de datos de cluster, para un cluster de tabla) se encuentra en el tablespace por defecto del propietario de la tabla o en un tablespace denominado en la sentencia CREATE TABLE.
-
Organización de la Tabla Por defecto, una tabla se organiza como una pila, lo que significa que la base de datos coloca las filas donde mejor se ajustan en lugar de en un orden especificado por el usuario. Por lo tanto, una tabla organizada en pilas es una recopilación desordenada de filas.
-
Almacenamiento de filas: la base de datos almacena filas en bloques de datos. Cada fila de una tabla que contiene datos de menos de 256 columnas está contenida en una o más partes de fila.
-
Rowids of Row Pieces Un rowid es efectivamente una dirección física de 10 bytes de una fila.
-
Almacenamiento de valores nulos Un nulo es la ausencia de un valor en una columna. Los valores nulos indican que faltan datos, son desconocidos o no son aplicables. Consulte también: "Segmentos de usuarios" para obtener información sobre los tipos de segmentos y cómo se crean.
Organización de Tabla
Por defecto, una tabla se organiza como una pila, lo que significa que la base de datos coloca las filas donde mejor se ajustan en lugar de en un orden especificado por el usuario. Por lo tanto, una tabla organizada en pilas es una recopilación desordenada de filas. Nota: Las tablas organizadas por índices utilizan un principio de organización diferente.
A medida que los usuarios agregan filas, la base de datos coloca las filas en el primer espacio libre disponible en el segmento de datos. No se garantiza que las filas se recuperen en el orden en que se insertaron.
La tabla hr.departments es una tabla organizada en pilas. Tiene columnas para el ID de departamento, el nombre, el ID de gerente y el ID de ubicación. A medida que se insertan filas, la base de datos las almacena donde se ajusten. Un bloque de datos en el segmento de tabla puede contener las filas no ordenadas que se muestran en el siguiente ejemplo:
50,Shipping,121,1500
120,Treasury,,1700
70,Public Relations,204,2700
30,Purchasing,114,1700
130,Corporate Tax,,1700
10,Administration,200,1700
110,Accounting,205,1700
El orden de las columnas es el mismo para todas las filas de una tabla. La base de datos suele almacenar columnas en el orden en el que se muestran en la sentencia CREATE TABLE, pero este orden no está garantizado. Por ejemplo, si una tabla tiene una columna de tipo LONG, Oracle AI Database siempre almacena esta columna en último lugar en la fila. Además, si agrega una nueva columna a una tabla, la nueva columna se convierte en la última columna almacenada.
Una tabla puede contener una columna virtual, que, a diferencia de las columnas normales, no consume espacio en el disco. La base de datos deriva los valores de una columna virtual bajo demanda calculando un juego de funciones o expresiones especificadas por el usuario. Puede indexar columnas virtuales, recopilar estadísticas sobre ellas y crear restricciones de integridad. Por lo tanto, las columnas virtuales son muy similares a las columnas no virtuales.
Consulte además:
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre las columnas virtuales
Almacenamiento de filas
La base de datos almacena filas en bloques de datos. Cada fila de una tabla que contiene datos de menos de 256 columnas está contenida en una o más partes de fila.
Si es posible, Oracle AI Database almacena cada fila como una parte de fila. Sin embargo, si no se pueden insertar todos los datos de fila en un único bloque de datos o si una actualización de una fila existente hace que la fila supere su bloque de datos, la base de datos almacena la fila utilizando varias partes de fila.
Las filas de un cluster de tabla contienen la misma información que las filas de las tablas que no están en cluster. Además, las filas de un cluster de tabla contienen información que hace referencia a la clave de cluster a la que pertenecen.
Consulte también: "Formato de Bloque de Datos" para obtener más información sobre los componentes de un bloque de datos.
Rowids de piezas de fila
Un rowid es efectivamente una dirección física de 10 bytes de una fila.
Cada fila de una tabla organizada en pilas tiene un ID de fila único para esta tabla que corresponde a la dirección física de una parte de fila. Para los clusters de tabla, las filas de diferentes tablas que están en el mismo bloque de datos pueden tener el mismo ID de fila.
Oracle AI Database utiliza los rowid internamente para la construcción de índices. Por ejemplo, cada clave de un índice de árbol B está asociada a un ID de fila que apunta a la dirección de la fila asociada para un acceso rápido. Los rowid físicos proporcionan el acceso más rápido posible a una fila de tabla, lo que permite a la base de datos recuperar una fila en tan solo una E/S.
Consulte además:
-
"Formato Rowid" para obtener más información sobre la estructura de un rowid
-
"Visión General de Índices de Árbol B" para obtener más información sobre los tipos y la estructura de los índices de árbol B
Almacenamiento de valores nulos
Un valor nulo es la ausencia de un valor en una columna. Los valores nulos indican que faltan datos, son desconocidos o no son aplicables.
Los valores nulos se almacenan en la base de datos si se encuentran entre columnas con valores de datos. En estos casos, necesitan 1 byte para almacenar la longitud de la columna (cero). Los valores nulos finales de una fila no necesitan almacenamiento porque una nueva cabecera de fila indica que las columnas restantes de la fila anterior son nulas. Por ejemplo, si las últimas tres columnas de una tabla son nulas, no se almacena ningún dato para estas columnas.
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre los valores nulos
Compresión de Tabla
La base de datos puede utilizar la compresión de tabla para reducir la cantidad de almacenamiento necesaria para la tabla.
La compresión ahorra espacio en disco, reduce el uso de memoria en la caché de buffers de la base de datos y, en algunos casos, acelera la ejecución de consultas. La compresión de tablas es transparente para las aplicaciones de base de datos.
-
Compresión de Tabla Básica y Compresión Avanzada de Filas La compresión de tablas basada en diccionario proporciona buenos ratios de compresión para tablas organizadas por pilas.
-
Compresión de columnas híbridas Con la compresión de columnas híbridas, la base de datos almacena la misma columna para un grupo de filas juntas. El bloque de datos no almacena datos en formato de fila mayor, sino que utiliza una combinación de métodos de fila y columna.
-
Compresión de columnas híbridas de velocidad de memoria La compresión de columnas híbridas de velocidad de memoria introduce formatos de unidades de compresión en disco que se pueden procesar a la velocidad de la memoria.
Compresión Básica de Tablas y Compresión Avanzada de Filas
La compresión de tablas basada en diccionario proporciona buenos ratios de compresión para tablas organizadas en pilas.
Oracle AI Database soporta los siguientes tipos de compresión de tablas basada en diccionario:
-
Compresión básica de tablas
Este tipo de compresión está destinado a operaciones de carga masiva. La base de datos no comprime los datos modificados mediante DML convencional. Debe utilizar las operaciones direct path INSERT, las operaciones
ALTER TABLE . . . MOVEo la redefinición de tablas en línea para lograr la compresión básica de tablas. -
Compresión avanzada de filas
Este tipo de compresión está destinado a aplicaciones OLTP y comprime los datos manipulados por cualquier operación SQL. La base de datos logra un ratio de compresión competitivo al tiempo que permite a la aplicación realizar DML en aproximadamente la misma cantidad de tiempo que DML en una tabla sin comprimir.
Para los tipos anteriores de compresión, la base de datos almacena las filas comprimidas en formato principal de fila. Todas las columnas de una fila se almacenan juntas, seguidas de todas las columnas de la siguiente fila, etc. La base de datos sustituye los valores duplicados por una breve referencia a una tabla de símbolos almacenada al principio del bloque. Por lo tanto, la información que la base de datos necesita para volver a crear los datos sin comprimir se almacena en el propio bloque de datos.
Los bloques de datos comprimidos se parecen mucho a los bloques de datos normales. La mayoría de las funciones y funciones de la base de datos que funcionan en bloques de datos normales también funcionan en bloques comprimidos.
Puede declarar la compresión en el nivel de tablespace, tabla, partición o subpartición. Si se especifica en el nivel de tablespace, todas las tablas creadas en el tablespace se comprimen por defecto.
Ejemplo 4-4 Compresión a nivel de tabla
La siguiente sentencia aplica la compresión avanzada de filas a la tabla orders:
ALTER TABLE oe.orders ROW STORE COMPRESS ADVANCED;Ejemplo 4-5 Compresión a Nivel de Partición
El siguiente ejemplo de una sentencia CREATE TABLE parcial especifica la compresión avanzada de filas para una partición y la compresión básica de tablas para la otra partición:
CREATE TABLE sales (
    prod_id     NUMBER     NOT NULL,
    cust_id     NUMBER     NOT NULL, ... )
 PCTFREE 5 NOLOGGING NOCOMPRESS
 PARTITION BY RANGE (time_id)
 ( partition sales_2013 VALUES LESS THAN(TO_DATE(...)) ROW STORE COMPRESS BASIC,
   partition sales_2014 VALUES LESS THAN (MAXVALUE) ROW STORE COMPRESS ADVANCED );
Consulte además:
-
"Formato de Fila" para aprender cómo se almacenan los valores en una fila
-
"Compresión de Bloques de Datos" para obtener más información sobre el formato de los bloques de datos comprimidos
-
Utilidades de Oracle AI Database para obtener más información sobre el uso de SQL*Loader para cargas de rutas de acceso directas
-
Oracle AI Database Administrator's Guide y Oracle AI Database Performance Tuning Guide para obtener más información sobre la compresión de tablas
Compresión de Columnas Híbridas
Con la compresión de columnas híbridas, la base de datos almacena la misma columna para un grupo de filas juntas. El bloque de datos no almacena datos en formato de fila mayor, sino que utiliza una combinación de métodos de fila y columna.
El almacenamiento de datos de columna junto con el mismo tipo de datos y características similares aumenta drásticamente los ahorros de almacenamiento logrados por la compresión. La base de datos comprime los datos manipulados por cualquier operación SQL, aunque los niveles de compresión son mayores para las cargas de ruta de acceso directa. Las operaciones de base de datos funcionan de forma transparente con objetos comprimidos, por lo que no es necesario realizar cambios en la aplicación.
Nota: La compresión de columnas híbridas y el almacén de columnas en memoria (almacén de columnas IM) están estrechamente relacionados. La principal diferencia es que la compresión de columnas híbridas optimiza el almacenamiento en disco, mientras que el almacén de columnas de IM optimiza el almacenamiento en memoria.
-
Tipos de compresión de columnas híbridas Si el almacenamiento subyacente soporta la compresión de columnas híbridas, puede especificar diferentes tipos de compresión, según sus requisitos.
-
La compresión de columnas híbridas de unidades de compresión utiliza una construcción lógica denominada unidad de compresión para almacenar un juego de filas.
-
La compresión de columnas híbridas DML y la compresión de columnas híbridas tiene implicaciones para el bloqueo de filas en diferentes tipos de operaciones DML. Consulte también: "Área en Memoria" para obtener más información sobre el almacén de columnas de IM
Tipos de compresión de columnas híbridas
Si el almacenamiento subyacente soporta la compresión de columnas híbridas, puede especificar diferentes tipos de compresión, según sus requisitos.
Las opciones de compresión son:
-
Compresión del almacén
Este tipo de compresión está optimizado para ahorrar espacio de almacenamiento y está destinado a aplicaciones de almacén de datos.
-
Compresión de archivo
Este tipo de compresión está optimizado para niveles de compresión máximos y está destinado a datos históricos y datos que no cambian.
La compresión de columnas híbridas está optimizada para aplicaciones de almacenamiento de datos y toma de decisiones en el almacenamiento de Oracle Exadata. Oracle Exadata maximiza el rendimiento de las consultas en tablas comprimidas mediante la compresión de columnas híbridas, aprovechando la potencia de procesamiento, la memoria y el ancho de banda de red Infiniband que son parte integral del servidor de almacenamiento de Oracle Exadata.
Otros sistemas de almacenamiento de Oracle soportan la compresión de columnas híbridas y ofrecen el mismo ahorro de espacio que en el almacenamiento de Oracle Exadata, pero no ofrecen el mismo nivel de rendimiento de consulta. Para estos sistemas de almacenamiento, la compresión de columnas híbridas es ideal para el archivado en la base de datos de datos antiguos a los que no se suele acceder con frecuencia.
Unidades de compresión
La compresión de columnas híbridas utiliza una construcción lógica denominada unidad de compresión para almacenar un juego de filas.
Al cargar datos en una tabla, la base de datos almacena grupos de filas en formato de columna, con los valores de cada columna almacenados y comprimidos juntos. Una vez que la base de datos ha comprimido los datos de columna para un juego de filas, la base de datos ajusta los datos a la unidad de compresión.
Por ejemplo, puede aplicar la compresión de columnas híbridas a una tabla daily_sales. Al final de cada día, se rellena la tabla con los artículos y el número vendido, con el ID de artículo y la fecha formando una clave primaria compuesta. En la siguiente tabla se muestra un subjuego de las filas en daily_sales.
Cuadro 3 Cuadro de ejemplo daily_sales
| Item_ID | Fecha | Num_Sold | Shipped_From | Reponer stock |
|---|---|---|---|---|
| 1.000 | 01-JUN-18 | 2 | WAREHOUSE1 | S |
| 1.001 | 01-JUN-18 | 0 | WAREHOUSE3 | N |
| 1.002 | 01-JUN-18 | 1 | WAREHOUSE3 | N |
| 1.003 | 01-JUN-14 | 0 | WAREHOUSE2 | N |
| 1.004 | 01-JUN-18 | 2 | WAREHOUSE1 | N |
| 1.005 | 01-JUN-18 | 1 | WAREHOUSE2 | N |
Supongamos que este subjuego de filas se almacena en una unidad de compresión. La compresión de columnas híbridas almacena los valores de cada columna juntos y, a continuación, utiliza varios algoritmos para comprimir cada columna. La base de datos selecciona los algoritmos en función de una variedad de factores, incluidos el tipo de dato de la columna, la cardinalidad de los valores reales de la columna y el nivel de compresión elegido por el usuario.
Como se muestra en el siguiente gráfico, cada unidad de compresión puede abarcar varios bloques de datos. Los valores de una columna concreta pueden abarcar varios bloques o no.
Figura 7: Unidad de compresión
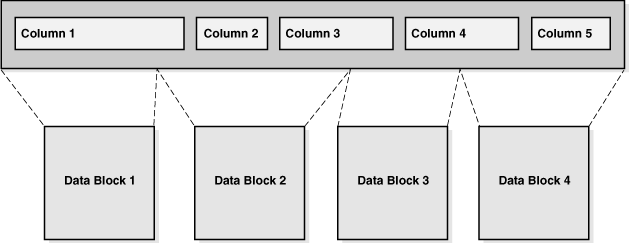
Descripción de la ilustración sagug004.gif
Si la compresión de columnas híbridas no permite ahorrar espacio, la base de datos almacena los datos en formato DBMS_COMPRESSION.COMP_BLOCK. En este caso, la base de datos aplica la compresión OLTP a los bloques, que residen en un segmento de compresión de columnas híbridas.
Consulte además:
-
Manual de usuario de información de licencias de Oracle AI Database para obtener más información sobre los requisitos de licencia para la compresión de columnas híbridas
-
Oracle AI Database Administrator's Guide para aprender a utilizar la compresión de columnas híbridas
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
CREATE TABLE -
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para obtener más información sobre el paquete
DBMS_COMPRESSION
DML y Compresión de Columnas Híbridas
La compresión de columnas híbridas tiene implicaciones para el bloqueo de filas en diferentes tipos de operaciones DML.
Cargas de ruta de acceso directa e inserciones convencionales
Al cargar datos en una tabla que utiliza la compresión de columnas híbridas, puede utilizar inserciones convencionales o cargas de ruta de acceso directa. Las cargas de ruta de acceso directa bloquean toda la tabla, lo que reduce la simultaneidad.
A partir de la versión 2 de Oracle Database 12c (12.2), se agrega soporte para inserciones de matriz convencionales en el formato de compresión de columnas híbridas. Las ventajas de los insertos de matriz convencionales son:
-
Las filas insertadas utilizan bloqueos de nivel de fila, lo que aumenta la simultaneidad.
-
La optimización automática de datos (ADO) y el mapa de calor soportan la compresión de columnas híbridas para políticas de nivel de fila. Por lo tanto, la base de datos puede utilizar la compresión de columnas híbridas para los bloques elegibles, incluso cuando se produce actividad DML en otras partes del segmento.
Cuando la aplicación utiliza inserciones de matriz convencionales, Oracle AI Database almacena las filas en unidades de compresión cuando se cumplen las siguientes condiciones:
-
La tabla se almacena en un tablespace de ASSM.
-
El nivel de compatibilidad es 12.2.0.1 o posterior.
-
La definición de tabla cumple las restricciones de tabla de compresión de columnas híbridas existentes, sin columnas de tipo
LONGni dependencias de filas.
Las inserciones convencionales generan redo y deshacer. Por lo tanto, se realiza un rollback o confirmación de las unidades de compresión creadas por la sentencia DML convencional junto con DML. La base de datos realiza automáticamente el mantenimiento del índice, al igual que para las filas que se almacenan en bloques de datos convencionales.
A partir de Oracle AI Database 26ai, la compresión automática de almacenamiento permite a Oracle AI Database dirigir la carga de datos en un formato sin comprimir inicialmente y, a continuación, mover gradualmente las filas al formato de compresión de columnas híbridas en segundo plano. Esto es transparente para los usuarios, al tiempo que mejora el rendimiento de ETL y mantiene un rendimiento de consulta rápido.
Actualizaciones y supresiones
Por defecto, la base de datos bloquea todas las filas de la unidad de compresión si se aplica una actualización o supresión a cualquier fila de la unidad. Para evitar este problema, puede activar el bloqueo de nivel de fila para una tabla. En este caso, la base de datos sólo bloquea las filas que se ven afectadas por la operación de actualización o supresión.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a realizar inserciones convencionales
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre la sentencia
INSERT -
Referencia de lenguaje SQL de Oracle AI Database para obtener información sobre el uso de la indicación
COMPRESS_IMMEDIATE -
Oracle AI Database VLDB and Partitioning Guide para obtener información sobre el uso de la compresión automática del almacenamiento
Compresión de columnas híbridas de velocidad de memoria
Memory Speed Hybrid Columnar Compression presenta formatos de unidad de compresión en disco que se pueden procesar a la velocidad de la memoria.
Al igual que la compresión de columnas híbridas, la compresión de columnas híbridas de velocidad de memoria es adecuada para entornos de almacenamiento de datos. Transforma los datos en un formato orientado a columnas y los comprime durante la carga de datos. La diferencia clave es que la compresión de columnas híbridas de velocidad de memoria utiliza el mismo formato columnar especial que el almacén de columnas en memoria y CELLMEMORY en la caché flash de Exadata, lo que permite realizar exploraciones de columnas de alta velocidad y un almacenamiento en caché columnar eficiente en todos los niveles de almacenamiento. Además, las unidades de compresión columnar híbridas de velocidad de memoria son significativamente más grandes que las unidades de compresión columnar híbridas, lo que permite el uso efectivo del formato columnar en memoria en el disco.
La compresión de columnas híbridas de velocidad de memoria se activa como una extensión de la compresión de columnas híbridas mediante el comando CREATE TABLE agregando la palabra clave MEMSPEED.
Ejemplo 4-6 Compresión de columnas híbridas de velocidad de memoria
En el siguiente ejemplo se crea la tabla orders con la compresión columnar híbrida de velocidad de memoria activada:
CREATE TABLE orders COLUMN STORE COMPRESS FOR MEMSPEED QUERY;Nota: Consulte Referencia de lenguaje SQL de Oracle AI Database para obtener más información.
Visión General de Clusters de Tabla
Un cluster de tablas es un grupo de tablas que comparten columnas comunes y almacenan datos relacionados en los mismos bloques.
Cuando las tablas se agrupan en clusters, un único bloque de datos puede contener filas de varias tablas. Por ejemplo, un bloque puede almacenar filas de las tablas employees y departments en lugar de solo de una tabla.
La clave de cluster es la columna o columnas que tienen en común las tablas en cluster. Por ejemplo, las tablas employees y departments comparten la columna department_id. Puede especificar la clave de cluster al crear el cluster de tabla y al crear todas las tablas agregadas al cluster de tabla.
El valor de clave de cluster es el valor de las columnas de clave de cluster para un juego concreto de filas. Todos los datos que contienen el mismo valor de clave de cluster, como department_id=20, se almacenan físicamente juntos. Cada valor de clave de cluster se almacena una sola vez en el cluster y el índice de cluster, independientemente de cuántas filas de diferentes tablas contengan el valor.
Para una analogía, supongamos que un gerente de RR. HH. tiene dos casos de libro: uno con cuadros de carpetas de empleados y el otro con cuadros de carpetas de departamento. Los usuarios suelen solicitar las carpetas de todos los empleados de un departamento concreto. Para facilitar la recuperación, el gerente reorganiza todas las cajas en una sola caja de libro. Divide los cuadros por ID de departamento. Por lo tanto, todas las carpetas de los empleados del departamento 20 y la carpeta del propio departamento 20 están en un cuadro; las carpetas de los empleados del departamento 100 y la carpeta del departamento 100 están en otro cuadro, y así sucesivamente.
Considere la posibilidad de agrupar tablas cuando se consultan principalmente (pero no se modifican) y los registros de las tablas se consultan o unen con frecuencia. Puesto que los clusters de tabla almacenan filas relacionadas de diferentes tablas en los mismos bloques de datos, los clusters de tabla utilizados correctamente ofrecen las siguientes ventajas sobre las tablas no de cluster:
-
La E/S de disco se reduce para las uniones de tablas en cluster.
-
El tiempo de acceso mejora para las uniones de tablas agrupadas.
-
Se necesita menos almacenamiento para almacenar datos de índice y tabla relacionados porque el valor de clave de cluster no se almacena repetidamente para cada fila.
Normalmente, las tablas de agrupación en clusters no son adecuadas en las siguientes situaciones:
-
Las tablas se actualizan con frecuencia.
-
Las tablas con frecuencia requieren una exploración completa de la tabla.
-
Las tablas requieren truncamiento.
-
Visión General de Clusters Indexados Un cluster de índice es un cluster de tabla que utiliza un índice para localizar datos. El índice de cluster es un índice de árbol B en la clave de cluster. Se debe crear un índice de cluster antes de insertar cualquier fila en las tablas de cluster.
-
Visión general de clusters hash Un cluster hash es como un cluster indexado, excepto que la clave de índice se sustituye por una función hash. No existe ningún índice de cluster independiente. En un cluster hash, los datos son el índice.
Visión General de Clusters Indexados
Un cluster de índice es un cluster de tabla que utiliza un índice para localizar datos. El índice de cluster es un índice de árbol B en la clave de cluster. Se debe crear un índice de cluster antes de insertar cualquier fila en las tablas de cluster.
Ejemplo 4-7 Creación de un Cluster de Tabla e Índice Asociado
Supongamos que crea el cluster employees_departments_cluster con la clave de cluster department_id, como se muestra en el siguiente ejemplo:
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 512;

CREATE INDEX idx_emp_dept_cluster
   ON CLUSTER employees_departments_cluster;
Debido a que no se especifica la cláusula HASHKEYS, employees_departments_cluster es un cluster indexado. En el ejemplo anterior se crea un índice denominado idx_emp_dept_cluster en la clave de cluster department_id.
Ejemplo 4-8 Creación de tablas en un cluster indexado
Las tablas employees y departments se crean en el cluster, especificando la columna department_id como clave de cluster, de la siguiente forma (los puntos suspensivos marcan el lugar al que va la especificación de columna):
CREATE TABLE employees ( ... )
   CLUSTER employees_departments_cluster (department_id);

CREATE TABLE departments ( ... )
   CLUSTER employees_departments_cluster (department_id);
Supongamos que agrega filas a las tablas employees y departments. La base de datos almacena físicamente todas las filas de cada departamento de las tablas employees y departments en los mismos bloques de datos. La base de datos almacena las filas en una pila y las ubica con el índice. La Figura 4-8 muestra el cluster de tabla employees_departments_cluster, que contiene employees y departments. La base de datos almacena filas para los empleados del departamento 20 juntos, del departamento 110 juntos, etc. Si las tablas no están agrupadas en clusters, la base de datos no garantiza que las filas relacionadas se almacenen juntas.
Figura 8: Datos de tablas agrupadas
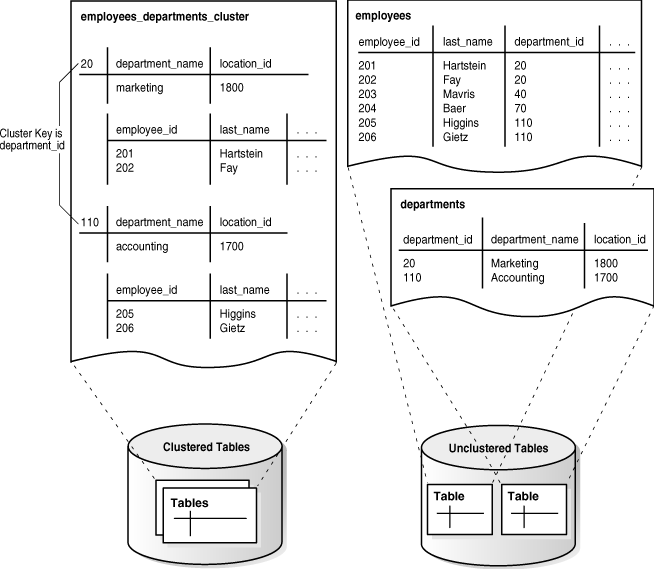
Descripción de la ilustración cncpt023.gif
El índice de cluster de árbol B asocia el valor de clave de cluster a la dirección de bloque de base de datos (DBA) del bloque que contiene los datos. Por ejemplo, la entrada de índice para la clave 20 muestra la dirección del bloque que contiene datos para los empleados del departamento 20:
20,AADAAAA9dEl índice de cluster se gestiona por separado, al igual que un índice de una tabla no de cluster, y puede existir en un tablespace independiente del cluster de tabla.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a crear y gestionar clusters indexados
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
CREATE CLUSTER
Visión General de Clusters Hash
Un cluster hash es como un cluster indexado, excepto que la clave de índice se sustituye por una función hash. No existe ningún índice de cluster independiente. En un cluster hash, los datos son el índice.
Con una tabla indexada o un cluster indexado, Oracle AI Database localiza las filas de la tabla mediante valores clave almacenados en un índice independiente. Para buscar o almacenar una fila en una tabla indexada o un cluster de tabla, la base de datos debe realizar al menos dos E/S:
-
Una o más E/S para buscar o almacenar el valor de clave en el índice
-
Otra E/S para leer o escribir la fila en la tabla o el cluster de tabla
Para buscar o almacenar una fila en un cluster hash, Oracle AI Database aplica la función hash al valor de clave de cluster de la fila. El valor hash resultante corresponde a un bloque de datos del cluster, que la base de datos lee o escribe en nombre de la sentencia emitida.
El hash es una forma opcional de almacenar datos de tabla para mejorar el rendimiento de la recuperación de datos. Los clusters hash pueden ser beneficiosos cuando se cumplen las siguientes condiciones:
-
Una tabla se consulta mucho más a menudo que se modifica.
-
La columna de clave hash se consulta frecuentemente con condiciones de igualdad, por ejemplo,
WHERE department_id=20. Para dichas consultas, el valor de clave de cluster se aplica hash. El valor de clave hash apunta directamente al área de disco que almacena las filas. -
Puede adivinar razonablemente el número de claves hash y el tamaño de los datos almacenados con cada valor de clave.
-
Creación de cluster hash Para crear un cluster hash, utilice la misma sentencia
CREATE CLUSTERque para un cluster indexado, con la adición de una clave hash. El número de valores hash para el cluster depende de la clave hash. -
Consultas de cluster hash En las consultas de un cluster hash, la base de datos determina cómo aplicar hash a los valores clave introducidos por el usuario.
-
Variaciones de cluster hash Un cluster hash de tabla única es una versión optimizada de un cluster hash que solo soporta una tabla a la vez. Existe una asignación uno a uno entre las claves hash y las filas.
-
Almacenamiento de cluster hash Oracle AI Database asigna espacio para un cluster hash de forma diferente a un cluster indexado.
Creación de cluster hash
Para crear un cluster hash, utilice la misma sentencia CREATE CLUSTER que para un cluster indexado, con la adición de una clave hash. El número de valores hash para el cluster depende de la clave hash.
La clave de cluster, como la clave de un cluster indexado, es una única columna o clave compuesta compartida por las tablas del cluster. Un valor de clave hash es un valor real o posible insertado en la columna de clave de cluster. Por ejemplo, si la clave de cluster es department_id, los valores de clave hash podrían ser 10, 20, 30, etc.
Oracle AI Database utiliza una función hash que acepta un número infinito de valores de clave hash como entrada y los ordena en un número finito de cubos. Cada cubo tiene un ID numérico único conocido como valor hash. Cada valor hash se asigna a la dirección del bloque de base de datos para el bloque que almacena las filas correspondientes al valor de clave hash (departamento 10, 20, 30, etc.).
En el siguiente ejemplo, el número de departamentos que es probable que existan es 100, por lo que HASHKEYS se define en 100:
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 8192 HASHKEYS 100;
Después de crear employees_departments_cluster, puede crear las tablas employees y departments en el cluster. A continuación, puede cargar datos en el cluster hash al igual que en el cluster indexado.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a crear y gestionar clusters hash
Consultas de cluster hash
En las consultas de un cluster hash, la base de datos determina cómo aplicar hash a los valores clave introducidos por el usuario.
Por ejemplo, los usuarios ejecutan con frecuencia consultas como las siguientes, introduciendo diferentes números de ID de departamento para p_id:
SELECT *
FROM   employees
WHERE  department_id = :p_id;

SELECT *
FROM   departments
WHERE  department_id = :p_id;

SELECT *
FROM   employees e, departments d
WHERE  e.department_id = d.department_id
AND    d.department_id = :p_id;
Si un usuario consulta a los empleados en department_id=20, la base de datos puede aplicar hash a este valor en el cubo 77. Si un usuario consulta a los empleados en department_id=10, la base de datos puede aplicar hash a este valor en el cubo 15. La base de datos utiliza el valor hash generado internamente para localizar el bloque que contiene las filas del empleado para el departamento solicitado.
En la siguiente ilustración, se muestra un segmento de cluster hash como una fila horizontal de bloques. Como se muestra en el gráfico, una consulta puede recuperar datos en una única E/S.
Figura 9: Recuperación de datos de un cluster hash
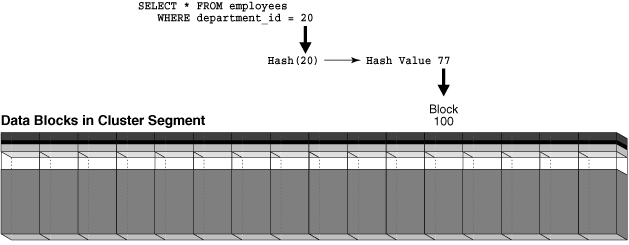
Descripción de la ilustración cncpt329.gif
Una limitación de los clusters hash es la falta de disponibilidad de exploraciones de rango en claves de cluster no indexadas. Supongamos que no existe ningún índice independiente para el cluster hash creado en Creación de cluster hash. Una consulta para departamentos con ID entre 20 y 100 no puede utilizar el algoritmo hash porque no puede aplicar hash a todos los valores posibles entre 20 y 100. Puesto que no existe ningún índice, la base de datos debe realizar una exploración completa.
Consulte también: "Exploración de Rango de Índices"
Variaciones de cluster hash
Un cluster hash de tabla única es una versión optimizada de un cluster hash que solo soporta una tabla a la vez. Existe una asignación uno a uno entre las claves hash y las filas.
Un cluster hash de tabla única puede ser útil cuando los usuarios necesitan un acceso rápido a una tabla por clave primaria. Por ejemplo, los usuarios suelen buscar un registro de empleado en la tabla employees por employee_id.
Un cluster hash ordenado almacena las filas correspondientes a cada valor de la función hash de forma que la base de datos pueda devolverlas de forma eficaz en orden ordenado. La base de datos realiza la ordenación optimizada internamente. Para las aplicaciones que siempre consumen datos en orden ordenado, esta técnica puede significar una recuperación de datos más rápida. Por ejemplo, una aplicación siempre puede ordenar en la columna order_date de la tabla orders.
Consulte también: Guía del administrador de Oracle AI Database para aprender a crear clusters hash ordenados y de tabla única
Almacenamiento de cluster hash
Oracle AI Database asigna espacio para un cluster hash de forma diferente a un cluster indexado.
En el ejemplo de Creación de cluster hash, HASHKEYS especifica el número de departamentos que es probable que existan, mientras que SIZE especifica el tamaño de los datos asociados a cada departamento. La base de datos calcula un valor de espacio de almacenamiento en función de la siguiente fórmula:
HASHKEYS * SIZE / database_block_sizePor lo tanto, si el tamaño del bloque es de 4096 bytes en el ejemplo que se muestra en Creación de cluster hash, la base de datos asigna al menos 200 bloques al cluster hash.
Oracle AI Database no limita el número de valores de clave hash que puede insertar en el cluster. Por ejemplo, aunque HASHKEYS es 100, nada impide insertar 200 departamentos únicos en la tabla departments. Sin embargo, la eficacia de la recuperación del cluster hash disminuye cuando el número de valores hash excede el número de claves hash.
Para ilustrar los problemas de recuperación, suponga que el bloque 100 de la Figura 4-9 está completamente lleno de filas para el departamento 20. Un usuario inserta un nuevo departamento con department_id 43 en la tabla departments. El número de departamentos supera el valor HASHKEYS, por lo que la base de datos tiene un hash de department_id 43 para el valor hash 77, que es el mismo valor hash utilizado para department_id 20. El hash de varios valores de entrada para el mismo valor de salida se denomina colisión hash.
Cuando los usuarios insertan filas en el cluster para el departamento 43, la base de datos no puede almacenar estas filas en el bloque 100, que está lleno. La base de datos enlaza el bloque 100 a un nuevo bloque de desbordamiento, por ejemplo, el bloque 200, y almacena las filas insertadas en el nuevo bloque. Tanto el bloque 100 como el 200 ahora son elegibles para almacenar datos para cualquiera de los departamentos. Como se muestra en la Figura 4-10, una consulta de los departamentos 20 o 43 ahora requiere dos E/S para recuperar los datos: el bloque 100 y su bloque asociado 200. Puede resolver este problema volviendo a crear el cluster con un valor HASHKEYS diferente.
Figura 10: Recuperación de datos de un cluster hash cuando se produce una colisión hash
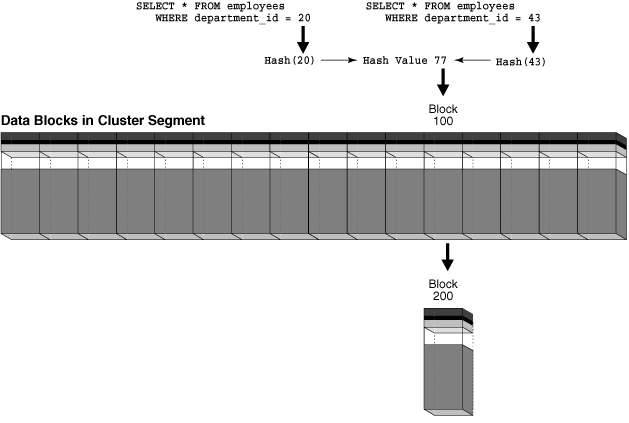
Descripción de la ilustración cncpt331.gif
Consulte también: Guía del administrador de Oracle AI Database para aprender a gestionar el espacio en clusters hash.
Visión General de Tablas en Cluster de Atributos
Una tabla de cluster de atributos es una tabla organizada por pilas que almacena datos muy cerca del disco en función de las directivas de agrupación en clusters especificadas por el usuario. Las directivas especifican columnas en una o varias tablas.
Las directivas son las siguientes:
-
La directiva
CLUSTERING ... BY LINEAR ORDERordena los datos de una tabla según las columnas especificadas.Considere el uso de la agrupación en clusters
BY LINEAR ORDER, que es el valor por defecto, cuando las consultas cualifiquen el prefijo de las columnas especificadas en la cláusula de agrupación en clusters. Por ejemplo, si las consultas desh.salessuelen especificar un ID de cliente o tanto un ID de cliente como un ID de producto, puede agrupar datos en la tabla mediante el orden de columna linealcust_id,prod_id. -
La directiva
CLUSTERING ... BY INTERLEAVED ORDERordena los datos en una o más tablas mediante un algoritmo especial, similar a una función de orden Z, que permite la reducción de E/S de varias columnas.Considere el uso de clusters
BY INTERLEAVED ORDERcuando las consultas especifiquen una variedad de combinaciones de columnas. Por ejemplo, si las consultas desh.salesespecifican diferentes dimensiones en diferentes órdenes, puede agrupar datos en la tablasalessegún las columnas de estas dimensiones.
La agrupación en clusters de atributos solo está disponible para las operaciones direct path INSERT. Se ignora para el DML convencional.
Esta sección incluye los siguientes temas:
-
Ventajas de las tablas agrupadas en clusters de atributos La principal ventaja de las tablas agrupadas en clusters de atributos es la reducción de E/S, que puede reducir significativamente el costo de E/S y el costo de CPU de las exploraciones de tablas. La reducción de E/S se produce con zonas o mediante la reducción de E/S físicas mediante una proximidad física más cercana en el disco para los valores en cluster.
-
La agrupación en clusters de atributos Unirse a tablas en cluster de atributos que se basa en columnas unidas se denomina unión de clusters de atributos. A diferencia de los clusters de tabla, las tablas agrupadas de atributos de unión no almacenan datos de un grupo de tablas en los mismos bloques de base de datos.
-
Reducción de E/S mediante zonas Una zona es un juego de bloques de datos contiguos que almacena los valores mínimo y máximo de las columnas relevantes.
-
Tablas agrupadas en atributos con ordenación lineal Un esquema de ordenación lineal para una tabla divide las filas en rangos basados en atributos especificados por el usuario en un orden específico. Oracle AI Database admite el orden lineal en una o varias tablas que están conectadas a través de una relación de clave primaria y ajena.
-
Tablas agrupadas en atributos con ordenación intercalada El orden intercalado utiliza una técnica similar a una orden Z.
Ventajas de las Tablas en Cluster de Atributos
La principal ventaja de las tablas de cluster de atributos es la reducción de E/S, que puede reducir significativamente el costo de E/S y el costo de CPU de las exploraciones de tablas. La reducción de E/S se produce con zonas o mediante la reducción de E/S físicas mediante una proximidad física más cercana en el disco para los valores en cluster.
Una tabla de cluster de atributos tiene las siguientes ventajas:
-
Puede agrupar tablas de hechos basadas en columnas de dimensión en esquemas de estrella.
En los esquemas de estrella, la mayoría de las consultas cualifican las tablas de dimensiones y no las tablas de hechos, por lo que la agrupación en clusters por columnas de tablas de hechos no es efectiva. Oracle AI Database soporta la agrupación en clusters en columnas de tablas de dimensiones.
-
La reducción de E/S se puede producir en varios escenarios diferentes:
-
Cuando se utiliza con índices de almacenamiento de Oracle Exadata, depuración mínima/máxima de Oracle In-Memory o asignaciones de zona
-
En aplicaciones OLTP para consultas que cualifican un prefijo y utilizan clusters de atributos en orden lineal
-
En un subjuego de columnas de agrupación en clusters para la agrupación en clusters
BY INTERLEAVED ORDER
-
-
Los clusters de atributos pueden mejorar la compresión de datos y, de esta forma, mejorar indirectamente los costos de exploración de tablas.
Cuando los mismos valores se acercan entre sí en el disco, la base de datos puede comprimirlos más fácilmente.
-
Oracle AI Database no incurre en el costo de almacenamiento y mantenimiento de un índice.
Consulte también: Guía de almacenamiento de datos de Oracle AI Database para obtener más ventajas de las tablas de cluster de atributos
Tablas en Cluster de Atributos de Unión
La agrupación en clusters de atributos basada en columnas unidas se denomina agrupación en clusters de atributos de unión. A diferencia de los clusters de tabla, las tablas agrupadas de atributos de unión no almacenan datos de un grupo de tablas en los mismos bloques de base de datos.
Por ejemplo, considere una tabla de cluster de atributos, sales, unida con una tabla de dimensiones, products. La tabla sales solo contiene filas de la tabla sales, pero el orden de las filas se basa en los valores de las columnas unidas de la tabla products. La unión adecuada se ejecuta durante el movimiento de datos, la inserción de ruta de acceso directa y las operaciones CREATE TABLE AS SELECT. Por el contrario, si sales y products estuvieran en un cluster de tabla estándar, los bloques de datos contenerían filas de ambas tablas.
Consulte también: Guía de almacenamiento de datos de Oracle AI Database para obtener más información sobre la agrupación en clusters de atributos de unión
Reducción de E/S mediante zonas
Una zona es un juego de bloques de datos contiguos que almacena los valores mínimo y máximo de las columnas relevantes.
Cuando una sentencia SQL contiene predicados en columnas almacenadas en una zona, la base de datos compara los valores de predicado con el mínimo y el máximo almacenados en la zona. De esta forma, la base de datos determina qué zonas leer durante la ejecución de SQL.
La reducción de E/S es la capacidad de omitir bloques de tabla o índice que no contienen datos que la base de datos necesita para satisfacer una consulta. Esta reducción puede reducir significativamente el costo de E/S y CPU de las exploraciones de tablas.
-
Propósito de las zonas Para una analogía suelta de las zonas, considere un mánager de ventas que utilice una librería de palomas, que son análogas a los bloques de datos.
-
Asignaciones de zonas Un mapa de zonas es una estructura de acceso independiente que divide los bloques de datos en zonas. Oracle AI Database implementa cada asignación de zona como un tipo de vista materializada.
-
Creación de mapas de zonas Los mapas de zonas básicos se crean de forma manual o automática.
-
Cómo funciona un mapa de zona: ejemplo Este ejemplo ilustra cómo un mapa de zona puede depurar datos en una consulta cuyo predicado contiene una constante.
Objetivo de las zonas
Para una analogía suelta de las zonas, considere un gerente de ventas que utiliza una librería de agujeros de paloma, que son análogos a los bloques de datos.
Cada paloma tiene recibos (filas) que describen camisas vendidas a un cliente, ordenadas por fecha de envío. En esta analogía, un mapa de zona es como una pila de tarjetas de índice. Cada tarjeta corresponde a una "zona" (rango contiguo) de agujeros de paloma, como los agujeros de paloma 1-10. Para cada zona, la tarjeta muestra las fechas de envío mínimo y máximo de los recibos almacenados en la zona.
Cuando alguien quiere saber qué camisas se envían en una fecha determinada, el gerente invierte las tarjetas hasta que llega al rango de fechas que contiene la fecha solicitada, toma nota de la zona de enigmas y luego busca solo en las palomas de esta zona los recibos solicitados. De esta manera, el gerente evita buscar los recibos en todas las palomas de la librería.
Mapas de zonas
Un mapa de zonas es una estructura de acceso independiente que divide los bloques de datos en zonas. Oracle AI Database implementa cada asignación de zona como un tipo de vista materializada.
Al igual que los índices, las asignaciones de zona pueden reducir los costos de E/S y CPU de las exploraciones de tablas. Cuando una sentencia SQL contiene predicados en columnas de una asignación de zona, la base de datos compara los valores de predicado con los valores de columna de tabla mínimo y máximo almacenados en cada zona para determinar qué zonas leer durante la ejecución de SQL.
Un mapa de zona básica se define en una sola tabla y mantiene los valores mínimo y máximo de algunas columnas de esta tabla. Una mapa de zona de unión se define en una tabla que tiene una unión externa a una o más tablas y mantiene los valores mínimo y máximo de algunas columnas de las otras tablas. Oracle AI Database mantiene ambos tipos de asignación de zona automáticamente.
Como máximo, puede existir un mapa de zona en una tabla. En el caso de una tabla particionada, existe una asignación de zona para todas las particiones y subparticiones. Una asignación de zona de una tabla particionada también realiza un seguimiento de los valores mínimo y máximo por zona, por partición y por subpartición. Las definiciones de asignación de zona pueden incluir valores mínimos y máximos de columnas de dimensión siempre que la tabla tenga una unión externa con las tablas de dimensión. Nota: Puede crear un mapa de zona que contenga sólo la zona de nivel de partición o subpartición. La creación de un mapa de zona de este tipo amplía las capacidades de depuración de particiones más allá de los metadatos de partición.
Consulte también: Guía de almacenamiento de datos de Oracle AI Database para obtener una visión general de los mapas de zona
Creación de mapa de zona
Los mapas de zona básicos se crean de forma manual o automática.
-
Asignaciones de zona manuales Puede crear, borrar y mantener asignaciones de zona mediante sentencias DDL.
-
Asignaciones automáticas de zonas Oracle AI Database puede crear asignaciones de zonas básicas automáticamente. Estos se conocen como mapas de zona automáticos.
Mapas de zonas manuales
Puede crear, borrar y mantener asignaciones de zona mediante sentencias DDL.
Cada vez que se especifica la cláusula CLUSTERING en una sentencia CREATE TABLE o ALTER TABLE, la base de datos crea automáticamente una asignación de zona en las columnas de cluster especificadas. La asignación de zona correlaciona los valores mínimo y máximo de las columnas con bloques de datos consecutivos en la tabla de cluster de atributos. Las tablas de cluster de atributos utilizan mapas de zona para realizar la reducción de E/S.
También puede crear asignaciones de zona explícitamente mediante la sentencia CREATE MATERIALIZED ZONEMAP. En este caso, puede crear asignaciones de zona para utilizarlas con o sin agrupación en clusters de atributos. Por ejemplo, puede crear una asignación de zona en una tabla cuyas filas se ordenan de forma natural en un juego de columnas, como una tabla de operaciones bursátiles cuyas operaciones se ordenan por tiempo.
Consulte además:
-
Guía de almacenamiento de datos de Oracle AI Database para obtener más información sobre cómo crear asignaciones de zona
Asignaciones de zonas automáticas
Oracle AI Database puede crear asignaciones de zona básicas automáticamente. Estos se conocen como mapas de zona automáticos.
Oracle AI Database puede crear automáticamente asignaciones de zona básicas para tablas particionadas y no particionadas. Un proceso en segundo plano mantiene automáticamente los mapas de zona creados de esta manera.
Utilice el procedimiento DBMS_AUTO_ZONEMAP para activar las asignaciones automáticas de zonas:
EXEC DBMS_AUTO_ZONEMAP.CONFIGURE('AUTO_ZONEMAP_MODE','ON')Consulte además:
-
Oracle AI Database Data Warehousing Guide para obtener más información sobre la gestión automática de asignaciones de zona mediante el paquete
DBMS_AUTO_ZONEMAP -
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para obtener más información sobre el paquete
DBMS_AUTO_ZONEMAP -
Manual de usuario de información de licencias de Oracle AI Database para obtener detalles sobre qué funciones están soportadas para diferentes ediciones y servicios
Cómo funciona un mapa de zona: ejemplo
Este ejemplo ilustra cómo un mapa de zona puede depurar datos en una consulta cuyo predicado contiene una constante.
Supongamos que crea la siguiente tabla lineitem:
CREATE TABLE lineitem
  ( orderkey      NUMBER        ,
    shipdate      DATE          ,
    receiptdate   DATE          ,
    destination   VARCHAR2(50)  ,
    quantity      NUMBER        );
La tabla lineitem contiene 4 bloques de datos con 2 filas por bloque. La Tabla 4-4 muestra las 8 filas de la tabla.
Tabla 4 Bloques de datos para la tabla lineitem
| Bloque | clave de orden | fecha de envío | fecha de recepción | destino | cantidad |
|---|---|---|---|---|---|
| 1 | 1 | 1-1-2014 | 1-10-2014 | San_Fran | 100 |
| 1 | 2 | 1-2-2014 | 1-10-2014 | San_Fran | 200 |
| 2 | 3 | 1-3-2014 | 1-9-2014 | San_Fran | 100 |
| 2 | 4 | 1-5-2014 | 1-10-2014 | San_Diego | 100 |
| 3 | 5 | 1-10-2014 | 1-15-2014 | San_Fran | 100 |
| 3 | 6 | 1-12-2014 | 1-16-2014 | San_Fran | 200 |
| 4 | 7 | 1-13-2014 | 1-20-2014 | San_Fran | 100 |
| 4 | 8 | 1-15-2014 | 1-30-2014 | San_Jose | 100 |
Puede utilizar la sentencia CREATE MATERIALIZED ZONEMAP para crear una asignación de zona en la tabla lineitem. Cada zona contiene 2 bloques y almacena el mínimo y el máximo de las columnas orderkey, shipdate y receiptdate. En la Tabla 4-5 se muestra el mapa de zonas.
Tabla 5 Mapa de zonas para la tabla lineitem
| Rango de bloques | min clave de orden | clave de orden máxima | fecha de envío mínima | fecha de envío máxima | fecha de recepción mínima | fecha de recepción máxima |
|---|---|---|---|---|---|---|
| 1-2 | 1 | 4 | 1-1-2014 | 1-5-2014 | 1-9-2014 | 1-10-2014 |
| 3-4 | 5 | 8 | 1-10-2014 | 1-15-2014 | 1-15-2014 | 1-30-2014 |
Al ejecutar la siguiente consulta, la base de datos puede leer el mapa de zona y, a continuación, explorar solo los bloques 1 y 2 y, por lo tanto, omitir los bloques 3 y 4, porque la fecha 1-3-2014 está entre las fechas mínima y máxima:
SELECT * FROM lineitem WHERE shipdate = '1-3-2014';Consulte además:
-
Oracle AI Database Data Warehousing Guide para aprender a utilizar mapas de zona
-
Referencia de lenguaje SQL de Oracle AI Database para obtener la sintaxis y la semántica de la sentencia
CREATE MATERIALIZED ZONEMAP
Tablas en clusters de atributos con ordenación lineal
Un esquema de ordenación lineal para una tabla divide las filas en rangos basados en atributos especificados por el usuario en un orden específico. Oracle AI Database admite el orden lineal en una o varias tablas que están conectadas a través de una relación de clave primaria y ajena.
Por ejemplo, la tabla sales divide las columnas cust_id y prod_id en rangos y, a continuación, agrupa estos rangos en el disco. Al especificar la directiva BY LINEAR ORDER para una tabla, se puede producir una reducción significativa de E/S cuando un predicado especifica la columna de prefijo o todas las columnas de la directiva.
Supongamos que las consultas de sales suelen especificar un ID de cliente o una combinación de un ID de cliente y un ID de producto. Puede crear una tabla de cluster de atributos para que dichas consultas se beneficien de la reducción de E/S:
CREATE TABLE sales
(
   prod_id     NOT NULL NUMBER
,  cust_id     NOT NULL NUMBER
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING
  BY LINEAR ORDER (cust_id, prod_id)
  YES ON LOAD YES ON DATA MOVEMENT
  WITH MATERIALIZED ZONEMAP;
Consultas que cualifican ambas columnas cust_id y prod_id, o la reducción de E/S de experiencia del prefijo cust_id. Las consultas que solo califican prod_id no experimentan una reducción significativa de E/S porque prod_id es el sufijo de la cláusula BY LINEAR ORDER. Los siguientes ejemplos muestran cómo la base de datos puede reducir la E/S durante las exploraciones de tablas.
Ejemplo 4-9 Especificación Sólo de cust_id
Una aplicación emite la siguiente consulta:
SELECT * FROM sales WHERE cust_id = 100;Puesto que la tabla sales es un cluster BY LINEAR ORDER, la base de datos solo debe leer las zonas que incluyen el valor cust_id de 100.
Ejemplo 4-10 Especificación de prod_id y cust_id
Una aplicación emite la siguiente consulta:
SELECT * FROM sales WHERE cust_id = 100 AND prod_id = 2300;Puesto que la tabla sales es un cluster BY LINEAR ORDER, la base de datos solo debe leer las zonas que incluyen el valor cust_id de 100 y el valor prod_id de 2300.
Consulte además:
-
Oracle AI Database Data Warehousing Guide para aprender a agrupar tablas mediante el orden lineal
-
Referencia de lenguaje SQL de Oracle AI Database para obtener la sintaxis y la semántica de la cláusula
BY LINEAR ORDER
Tablas agrupadas por atributos con ordenación intercalada
El orden entrelazado utiliza una técnica similar a una Z-order.
El orden entrelazado permite a la base de datos eliminar la E/S en función de cualquier subjuego de predicados en las columnas de agrupación en clusters. El orden entre hojas es útil para jerarquías dimensionales en un almacén de datos.
Al igual que con las tablas de cluster de atributos con ordenación lineal, Oracle AI Database soporta el orden entre hojas en una o varias tablas conectadas mediante una relación de clave primaria y ajena. Las columnas de tablas distintas de la tabla de cluster de atributos deben estar enlazadas por clave ajena y unidas a la tabla de cluster de atributos.
Los grandes almacenes de datos suelen organizar los datos en un esquema estrella. Una tabla de dimensiones utiliza una jerarquía principal-secundario y está conectada a una tabla de hechos mediante una clave ajena. La agrupación en clusters de una tabla de hechos por orden intercalado permite a la base de datos utilizar una función especial para omitir valores en columnas de dimensión durante exploraciones de tablas.
Ejemplo 4-11 Ejemplo de ordenación intercalada
Supongamos que el almacén de datos contiene una tabla de hechos sales y sus dos tablas de dimensiones: customers y products. La mayoría de las consultas tienen predicados en la jerarquía de tabla customers (cust_state_province, cust_city) y en la jerarquía de productos (prod_category, prod_subcategory). Puede utilizar el orden entre hojas para la tabla sales como se muestra en la sentencia parcial del siguiente ejemplo:
CREATE TABLE sales
(
   prod_id NUMBER NOT NULL
,  cust_id NUMBER NOT NULL
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING sales
   JOIN products ON (sales.prod_id = products.prod_id)
   JOIN customers ON (sales.cust_id = customers.cust_id)
   BY INTERLEAVED ORDER
   (
     (  products.prod_category
     ,  products.prod_subcategory
     ),
     (  customers.cust_state_province
     ,  customers.cust_city
     )
   )
WITH MATERIALIZED ZONEMAP;
Nota: Las columnas especificadas en la cláusula BY INTERLEAVED ORDER no tienen que estar en tablas de dimensiones reales, pero deben estar conectadas mediante una relación de clave primaria-ajena.
Supongamos que una aplicación consulta las tablas sales, products y customers en una unión. La consulta especifica las columnas customers.prod_category y customers_cust_state_province en el predicado de la siguiente forma:
SELECT cust_city, prod_sub_category, SUM(amount_sold)
FROM   sales, products, customers
WHERE  sales.prod_id = products.prod_id
AND    sales.cust_id = customers.cust_id
AND    customers.prod_category = 'Boys'
AND    customers.cust_state_province = 'England - Norfolk'
GROUP BY cust_city, prod_sub_category;
En la consulta anterior, las columnas prod_category y cust_state_province forman parte de la definición de agrupación en clusters que se muestra en el ejemplo CREATE TABLE. Durante la exploración de la tabla sales, la base de datos puede consultar el mapa de zona y acceder solo a los rowid de esta zona.
Consulte además:
-
Oracle AI Database Data Warehousing Guide para aprender a agrupar tablas mediante el orden entre hojas
-
Referencia de lenguaje SQL de Oracle AI Database para obtener la sintaxis y la semántica de la cláusula
BY INTERLEAVED ORDER
Visión General de Tablas Temporales
Una tabla temporal contiene datos que sólo existen durante una transacción o sesión.
Los datos de una tabla temporal son privados para la sesión. Cada sesión solo puede ver y modificar sus propios datos.
Puede crear una tabla temporal global o una tabla temporal privada. En la siguiente tabla se muestran las diferencias esenciales entre ellos.
Tabla 6 Características de la tabla temporal
| Característica | Global | Privado |
|---|---|---|
| Reglas de nomenclatura | Igual que para tablas permanentes | Debe tener el prefijo ORA$PTT_ |
| Visibilidad de la definición de tabla | Todas las Sesiones | Solo la sesión que ha creado la tabla |
| Almacenamiento de la definición de tabla | Disco | Solo memoria |
| Tipos | Específicos de la transacción (ON COMMIT DELETE ROWS) o específicos de la sesión (ON COMMIT PRESERVE ROWS) |
Específicos de la transacción (ON COMMIT DROP DEFINITION) o específicos de la sesión (ON COMMIT PRESERVE DEFINITION) |
La base de datos crea automáticamente un tercer tipo de tabla temporal, conocida como tabla temporal de duración de cursores, para determinados tipos de consultas.
-
Propósito de Tablas Temporales Las tablas temporales son útiles en aplicaciones en las que se debe almacenar en buffer un juego de resultados.
-
Asignación de Segmentos en Tablas Temporales Al igual que las tablas permanentes, las tablas temporales globales son objetos persistentes que se definen estáticamente en el diccionario de datos. En el caso de las tablas temporales privadas, los metadatos sólo existen en la memoria, pero pueden residir en el tablespace temporal del disco.
-
Creación de tablas temporales La sentencia
CREATE ... TEMPORARY TABLEcrea una tabla temporal. Consulte también: Guía de ajustes SQL de Oracle AI Database para obtener más información sobre las tablas temporales de duración de cursor
Objetivo de las Tablas Temporales
Las tablas temporales son útiles en aplicaciones en las que se debe almacenar en buffer un juego de resultados.
Por ejemplo, una aplicación de programación permite a los estudiantes universitarios crear programas de cursos semestrales opcionales. Una fila de una tabla temporal global representa cada programa. Durante la sesión, los datos del programa son privados. Cuando el alumno elige un horario, la aplicación mueve la fila del horario elegido a una tabla permanente. Al final de la sesión, la base de datos borra automáticamente los datos del programa que estaban en la tabla temporal global.
Las tablas temporales privadas son útiles para las aplicaciones de informes dinámicos. Por ejemplo, una aplicación de gestión de recursos del cliente (CRM) puede conectarse como el mismo usuario indefinidamente, con varias sesiones activas al mismo tiempo. Cada sesión crea una tabla temporal privada denominada ORA$PTT_crm para cada nueva transacción. La aplicación puede utilizar el mismo nombre de tabla para cada sesión, pero puede cambiar la definición. Los datos y la definición solo son visibles para la sesión. La definición de tabla se mantiene hasta que finaliza la transacción o la tabla se borra manualmente.
Asignación de segmentos en tablas temporales
Al igual que las tablas permanentes, las tablas temporales globales son objetos persistentes que se definen estáticamente en el diccionario de datos. En el caso de las tablas temporales privadas, los metadatos sólo existen en la memoria, pero pueden residir en el tablespace temporal del disco.
Para las tablas temporales globales y privadas, la base de datos asigna segmentos temporales cuando una sesión inserta datos por primera vez. Hasta que los datos se carguen en una sesión, la tabla aparecerá vacía. En el caso de las tablas temporales específicas de transacciones, la base de datos anula la asignación de segmentos temporales al final de la transacción. Para las tablas temporales específicas de la sesión, la base de datos anula la asignación de segmentos temporales al final de la sesión.
Consulte también: "Segmentos temporales"
Creación de tablas temporales
La sentencia CREATE ... TEMPORARY TABLE crea una tabla temporal.
Especifique GLOBAL TEMPORARY TABLE o PRIVATE TEMPORARY TABLE. En ambos casos, la cláusula ON COMMIT especifica si los datos de la tabla son específicos de la transacción (por defecto) o específicos de la sesión. Puede crear una tabla temporal para la propia base de datos, no para cada procedimiento PL/SQL almacenado.
Puede crear índices para tablas temporales globales (no privadas) con la sentencia CREATE INDEX. Estos índices también son temporales. Los datos del índice tienen el mismo ámbito de sesión o transacción que los datos de la tabla temporal. También puede crear una vista o un disparador en una tabla temporal global.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a crear y gestionar tablas temporales
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
CREATE ... TEMPORARY TABLE
Visión general de tablas externas
Una tabla externa accede a los datos de orígenes externos como si estos datos estuvieran en una tabla de la base de datos.
Los datos pueden estar en cualquier formato para el que se proporcione un controlador de acceso. Puede utilizar SQL (serial o paralelo), PL/SQL y Java para consultar tablas externas.
-
Las tablas externas Propósito de tablas externas son útiles cuando una aplicación de base de datos Oracle debe acceder a datos no relacionales.
-
Las tablas externas de datos en almacenes de objetos se pueden utilizar para acceder a los datos en almacenes de objetos.
-
Controladores externos de acceso a tablas Un controlador de acceso es una API que interpreta los datos externos de la base de datos. El controlador de acceso se ejecuta dentro de la base de datos, que utiliza el controlador para leer los datos de la tabla externa. El controlador de acceso y la capa de tabla externa son responsables de realizar las transformaciones necesarias en los datos del archivo de datos para que coincidan con la definición de tabla externa.
-
Creación de Tablas Externas Internamente, la creación de una tabla externa significa crear metadatos en el diccionario de datos. A diferencia de una tabla normal, una tabla externa no describe los datos almacenados en la base de datos, ni describe cómo se almacenan los datos externamente. En su lugar, los metadatos de la tabla externa describen cómo la capa de tabla externa debe presentar datos a la base de datos.
-
Almacenamiento Automático en Caché de Datos de Tabla Externa Los datos de tablas externas se almacenan en caché de forma transparente para mejorar el rendimiento de las consultas.
Finalidad de las tablas externas
Las tablas externas son útiles cuando una aplicación de base de datos Oracle debe acceder a datos no relacionales.
Por ejemplo, una aplicación basada en SQL puede necesitar acceder a un archivo de texto cuyos registros tienen el siguiente formato:
100,Steven,King,SKING,515.123.4567,17-JUN-03,AD_PRES,31944,150,90
101,Neena,Kochhar,NKOCHHAR,515.123.4568,21-SEP-05,AD_VP,17000,100,90
102,Lex,De Haan,LDEHAAN,515.123.4569,13-JAN-01,AD_VP,17000,100,90
Puede crear una tabla externa, copiar el archivo de texto en la ubicación especificada en la definición de tabla externa y, a continuación, utilizar SQL para consultar los registros del archivo de texto. Del mismo modo, puede utilizar tablas externas para proporcionar acceso de solo lectura a documentos JSON o LOB.
En los entornos de almacén de datos, las tablas externas son valiosas para realizar tareas de extracción, transformación y carga (ETL). Por ejemplo, las tablas externas permiten canalizar la fase de carga de datos con la fase de transformación. Esta técnica elimina la necesidad de almacenar temporalmente los datos dentro de la base de datos como preparación para el procesamiento posterior dentro de la base de datos.
Puede particionar tablas externas en columnas virtuales o no virtuales. Además, puede crear una tabla particionada híbrida, donde algunas particiones son internas y otras externas. Al igual que las particiones internas, las particiones externas se benefician de mejoras en el rendimiento, como la depuración de particiones y las uniones de particiones. Por ejemplo, puede utilizar tablas externas particionadas para analizar grandes volúmenes de datos no relacionales almacenados en Hadoop Distributed File System (HDFS) o en una base de datos NoSQL.
Consulte también: "Tablas Particionadas"
Datos en almacenes de objetos
Las tablas externas se pueden utilizar para acceder a los datos de los almacenes de objetos.
Además de soportar el acceso a datos externos que residen en archivos del sistema operativo y orígenes de Big Data, Oracle soporta el acceso a datos externos en almacenes de objetos. El almacenamiento de objetos es común en la nube y proporciona una arquitectura plana para gestionar objetos individuales, cualquier tipo de datos no estructurados con metadatos, agrupándolos en contenedores simples. Aunque el almacenamiento de objetos es principalmente una arquitectura de almacenamiento de datos en la nube, también está disponible como hardware de almacenamiento local.
Puede acceder a los datos de los almacenes de objetos mediante el paquete DBMS_CLOUD o definiendo manualmente tablas externas. Oracle recomienda utilizar el paquete DBMS_CLOUD porque proporciona funcionalidad adicional y es totalmente compatible con Oracle Autonomous Database.
Controladores de acceso a tablas externas
Un controlador de acceso es una API que interpreta los datos externos de la base de datos. El controlador de acceso se ejecuta dentro de la base de datos, que utiliza el controlador para leer los datos de la tabla externa. El controlador de acceso y la capa de tabla externa son responsables de realizar las transformaciones necesarias en los datos del archivo de datos para que coincidan con la definición de tabla externa.
La siguiente figura representa el acceso SQL de los datos externos.
Figura 11: Tablas Externas
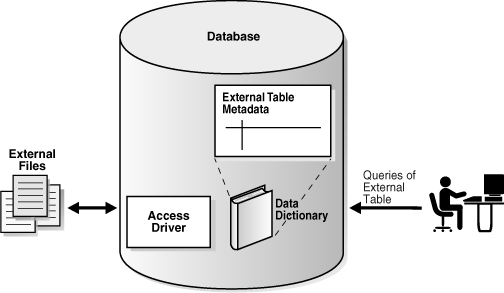
Descripción de la ilustración cncpt231.gif
Oracle proporciona los siguientes controladores de acceso para tablas externas:
-
ORACLE_LOADER(por defecto)Permite el acceso a archivos externos mediante la mayoría de los formatos soportados por SQL*Loader. No puede crear, actualizar ni agregar a un archivo externo mediante el controlador
ORACLE_LOADER. -
ORACLE_DATAPUMPPermite descargar o cargar datos externos. Una operación de descarga lee datos de la base de datos e inserta los datos en una tabla externa, representada por uno o más archivos externos. Una vez creados los archivos externos, la base de datos no puede actualizarlos ni agregarles datos. Una operación de carga lee una tabla externa y carga sus datos en una base de datos.
-
ORACLE_HDFSPermite la extracción de datos almacenados en un sistema de archivos distribuido (HDFS) de Hadoop.
-
ORACLE_HIVEPermite el acceso a los datos almacenados en una base de datos de Apache Hive. Los datos de origen se pueden almacenar en HDFS, HBase, Cassandra u otros sistemas. A diferencia de los otros controladores de acceso, no puede especificar una ubicación porque
ORACLE_HIVEobtiene información de ubicación de un almacén de metadatos externo. -
ORACLE_BIGDATAPermite el acceso de solo lectura a los datos almacenados en formatos estructurados y no estructurados, incluidos Apache Parquet, Apache Avro, Apache ORC, Apache Iceberg, el protocolo Linux Open Project Delta Sharing y los formatos de texto. También puede utilizar este controlador para consultar datos locales, lo que resulta útil para pruebas y juegos de datos más pequeños.
Creación de tabla externa
Internamente, crear una tabla externa significa crear metadatos en el diccionario de datos. A diferencia de una tabla normal, una tabla externa no describe los datos almacenados en la base de datos, ni describe cómo se almacenan los datos externamente. En su lugar, los metadatos de la tabla externa describen cómo la capa de tabla externa debe presentar datos a la base de datos.
Una sentencia CREATE TABLE ... ORGANIZATION EXTERNAL tiene dos partes. La definición de tabla externa describe los tipos de columna. Esta definición es como una vista que permite a SQL consultar datos externos sin cargarlos en la base de datos. La segunda parte de la sentencia asigna los datos externos a las columnas.
Las tablas externas son de solo lectura a menos que se creen con CREATE TABLE AS SELECT con el controlador de acceso ORACLE_DATAPUMP. Las restricciones para las tablas externas no incluyen soporte para columnas indexadas y objetos de columna.
Consulte además:
-
Oracle AI Database Utilities para obtener más información sobre las tablas externas
-
Oracle AI Database Administrator's Guide para obtener más información sobre la gestión de tablas externas, conexiones externas y objetos de directorio
-
Referencia de lenguaje SQL de Oracle AI Database para obtener información sobre la creación y consulta de tablas externas
Almacenamiento automático en caché de datos de tablas externas
Los datos de tablas externas se almacenan en caché de forma transparente para mejorar el rendimiento de las consultas.
Los datos a los que se accede con frecuencia desde tablas externas que residen total o parcialmente en el almacenamiento de objetos se almacenan en caché automáticamente para mejorar el rendimiento. El almacenamiento en caché de los datos de tablas externas no requiere cambios de aplicación porque la base de datos Oracle los maneja automáticamente.
Visión General de Tablas de Blockchain
Una tabla de blockchain es una tabla de solo adición diseñada para aplicaciones de blockchain centralizadas.
En la tabla de Oracle Blockchain, los peers son usuarios de bases de datos que confían en la base de datos para mantener un libro mayor a prueba de alteraciones. El libro mayor se implementa como una tabla de cadenas de bloques, que la aplicación define y gestiona. Las aplicaciones existentes pueden protegerse contra el fraude sin necesidad de una nueva infraestructura o modelo de programación. Aunque el rendimiento de las transacciones es inferior al de una tabla estándar, el rendimiento de una tabla de blockchain es mejor que el de una cadena de bloques descentralizada.
Una tabla de blockchain solo se agrega porque los únicos DML permitidos son los comandos INSERT. La tabla no permite cargas UPDATE, DELETE, MERGE, TRUNCATE y de ruta de acceso directa. Las transacciones de base de datos pueden abarcar tablas de blockchain y tablas estándar. Por ejemplo, una sola transacción puede insertar filas en una tabla estándar y dos tablas de blockchain diferentes.
Las tablas de blockchain se pueden utilizar para proteger el contenido de flashback de archivo de datos. Esto le permite determinar si alguien ha alterado el contenido de una tabla. Una tabla de historial de logs de blockchain se puede considerar como el mantenimiento de un redo log lógico criptográficamente seguro para los cambios en una tabla de usuario con seguimiento.
Puede agregar o borrar columnas de usuario de tablas de blockchain a partir de la versión 2 de las tablas de blockchain. No se permite agregar o borrar columnas de usuario de las tablas de blockchain de la versión 1. Las columnas físicas y los datos no se borran realmente, sino que se marcan como invisibles.
-
Cadenas de filas En una tabla de blockchain, una cadena de filas es una serie de filas enlazadas junto con un esquema de hashing.
-
Contenido de fila: el contenido de fila es una secuencia contigua de bytes que contiene los datos de columna de la fila y el valor hash de la fila anterior de la cadena.
-
Interfaz de usuario para tablas de blockchain Al igual que una tabla estándar, SQL crea una tabla de blockchain y soporta tipos de datos escalares, LOB, JSON y particiones. También puede crear índices y disparadores para tablas de blockchain.
Cadenas de filas
En una tabla de blockchain, una cadena de filas es una serie de filas enlazadas junto con un esquema de hashing.
Una cadena de filas del sistema se identifica mediante una combinación única de ID de instancia de base de datos e ID de cadena en una tabla de cadenas de bloques de la versión 1. A partir de las tablas de blockchain de la versión 2, se necesita el identificador único global de la base de datos que insertó la fila, además de estos dos identificadores. Una cadena de filas del sistema se identifica mediante una combinación única de ID único global de base de datos conectable, ID de instancia de base de datos e ID de cadena en una tabla de cadenas de bloques de la versión 2. Una fila de una tabla de cadenas de bloques pertenece exactamente a una cadena de filas del sistema. Una sola tabla soporta varias cadenas de filas del sistema. Nota: Una fila encadenada en una tabla estándar es ortogonal a una cadena de filas en una tabla de blockchain. Solo la palabra "cadena" es la misma.
Cada fila de una cadena tiene un número de secuencia único. La base de datos secuencia las filas mediante un cálculo hash SHA2-512 en las filas de cada cadena. El hash de cada fila insertada se deriva del contenido de la fila insertada, que incluye el valor hash de la fila insertada anteriormente en la cadena.
Si bien cada fila de una tabla de blockchain pertenece exactamente a una cadena de sistema, también puede pertenecer a una cadena de usuario basada en valores de un juego de columnas de usuario especificadas cuando se crea la tabla de blockchain.
Contenido de fila
El contenido de fila es una secuencia contigua de bytes que contiene los datos de columna de la fila y el valor hash de la fila anterior de la cadena.
Al crear una tabla de blockchain, la base de datos crea varias columnas ocultas. Por ejemplo, puede crear la tabla blockchain bank_ledger con las columnas bank y deposit:
CREATE BLOCKCHAIN TABLE bank_ledger (bank VARCHAR2 (128), deposit NUMBER)
  NO DROP UNTIL 31 DAYS IDLE
  NO DELETE UNTIL 31 DAYS AFTER INSERT
  HASHING USING "SHA2_512" VERSION "v1";
La base de datos crea automáticamente columnas ocultas con el prefijo ORABCTAB: ORABCTAB_INST_ID$, ORABCTAB_CHAIN_ID$, ORABCTAB_SEQ_NUM$ y otros. Estas columnas ocultas, la mayoría de las cuales no se pueden modificar ni gestionar, implementan el algoritmo antimanipulación. Este algoritmo evita interbloqueos mediante la adquisición de bloqueos de cadena únicos a nivel de tabla en un orden específico en el momento de la confirmación.
Nota: El contenido de fila de las tablas de blockchain se almacena en bloques de datos estándar. En esta versión de Oracle AI Database, las tablas de blockchain no soportan clusters de tabla.
El ID de instancia, el ID de cadena y el número de secuencia identifican de forma única una fila. A partir de las tablas de blockchain de la versión 2, se necesita el identificador único global de la base de datos que insertó la fila además de estos tres valores. Cada fila tiene un hash SHA2-512 independiente de la plataforma que se almacena en la columna oculta ORABCTAB_HASH$. El hash se basa en el contenido de la fila insertada y el hash de la fila anterior de la cadena.
El formato de datos para el valor de columna de una fila consta de bytes de los metadatos y el contenido de la columna. Los metadatos de columna son una estructura de 20 bytes que describe características como la posición en la tabla, el tipo de dato, el estado nulo y la longitud de byte. El contenido de la columna es el juego de bytes que representa el valor de una fila. Por ejemplo, la representación ASCII del valor Chase es 43 68 61 73 65. Puede utilizar la función DUMP en SQL para obtener contenido y metadatos de columna.
El contenido de fila de un cálculo hash incluye los formatos de datos de columna de varias columnas: el valor hash de la fila anterior de la cadena, las columnas definidas por el usuario y un número fijo de columnas ocultas.
El sistema puede realizar un seguimiento del orden en que se insertan las filas relacionadas, denominadas versiones de fila, y registrarlas especificando un conjunto de columnas sobre las que se definen las versiones de fila. Además, si se especifican versiones de fila, se crea y mantiene automáticamente una vista que muestra la última fila insertada para cada combinación de valores en el juego de columnas especificado por el usuario. El nombre de vista utiliza la convención de nomenclatura Blockchain_Table_Name_LAST$.
Hay muchos casos en los que las filas deben ser firmadas adicionalmente o alternativamente por un delegado del usuario final. Un ejemplo es un gestor bancario que firma una fila insertada por un usuario final. Un firmante delegado es otro usuario de la base de datos que puede agregar su firma en una fila que se calcula a través del hash criptográfico del sistema de la fila. Un usuario final, un delegado o ambos pueden firmar una fila. La firma de un delegado solo se acepta si la firma se puede verificar mediante el certificado del delegado y el certificado del delegado se registra en una tabla del diccionario de la base de datos.
Cuando un usuario final o un delegado firman una fila, es posible que el usuario desee obtener una contrafirma para la fila. Una contrafirma puede considerarse un resumen de tabla de blockchain específicamente para la fila que ya ha sido firmada por un usuario final o delegado. Cuando se firma una fila, la firma se devuelve al firmante de fila y también se guarda en esa fila. El usuario que solicita la contrafirma en la fila puede guardar esta información para fines no de rechazo en un almacén de datos independiente.
Interfaz de usuario para tablas de blockchain
Al igual que una tabla estándar, SQL crea una tabla de blockchain y soporta tipos de dato escalares, LOB, JSON y particiones. También puede crear índices y disparadores para tablas de blockchain.
Para crear una tabla de cadenas de bloques, utilice una sentencia CREATE BLOCKCHAIN TABLE. Una tabla de blockchain tiene un período de retención especificado por la cláusula NO DROP UNTIL n DAYS IDLE. Puede eliminar la tabla mediante DROP TABLE.
Oracle Blockchain Table soporta las siguientes interfaces:
-
El paquete
DBMS_BLOCKCHAIN_TABLEpermite realizar varias operaciones en las filas de la tabla. Por ejemplo, para aplicar una firma al contenido de una fila insertada anteriormente, utilice el procedimientoSIGN_ROW. Para verificar que las filas no se han alterado, utiliceVERIFY_ROWS. Para eliminar filas después de que haya pasado el período de retención (especificado por la cláusulaNO DELETE), utiliceDELETE_EXPIRED_ROWS. -
La vista
DBA_BLOCKCHAIN_TABLESmuestra metadatos de tabla como el período de retención de filas, el período de inactividad antes de permitir el borrado de una tabla y el algoritmo hash.
Nota:
-
Guía del administrador de Oracle AI Database para aprender a gestionar tablas de blockchain
-
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para obtener más información sobre el paquete
DBMS_BLOCKCHAIN_TABLE -
Oracle AI Database Reference para obtener más información sobre la vista
DBA_BLOCKCHAIN_TABLES
Visión General de Tablas Inmutables
Las Tablas inmutables son tablas de solo lectura que impiden que parte de usuarios internos modifique los datos no autorizados, así como modificaciones accidentales de datos resultantes de errores humanos.
Las modificaciones no autorizadas pueden ser intentadas por empleados comprometidos o deshonestos que tienen acceso a credenciales de información privilegiada.
Se pueden agregar nuevas filas a una tabla inmutable, pero las filas existentes no se pueden modificar. Debe especificar un período de retención tanto para la tabla inmutable como para las filas de la tabla inmutable. Las filas quedan obsoletas después del período de retención de filas especificado. Solo se pueden suprimir filas obsoletas de la tabla inmutable.
Las tablas inmutables contienen columnas ocultas generadas por el sistema. Las columnas son las mismas que las de las tablas de blockchain. Cuando se inserta una fila, se define un valor no nulo para las columnas ORABCTAB_CREATION_TIME$ y ORABCTAB_USER_NUMBER$. A excepción de las tablas inmutables V1, se define un valor no NULL para la columna ORABCTAB_PDB_GUID$. Si la tabla inmutable se ha creado con versiones de fila, se define un valor no NULL para las columnas ORABCTAB_ROW_VERSION$ y ORABCTAB_LAST_ROW_VERSION_NUMBER$. El valor de las columnas ocultas restantes generadas por el sistema se define en NULL.
El uso de tablas inmutables no requiere cambios en las aplicaciones existentes.
Visión General de Tablas de Objetos
Una tabla de objetos es un tipo especial de tabla en la que cada fila representa un objeto.
Un tipo de objeto de Oracle es un tipo definido por el usuario con un nombre, atributos y métodos. Los tipos de objetos permiten modelar entidades reales como clientes y órdenes de compra como objetos en la base de datos.
Un tipo de objeto define una estructura lógica, pero no crea almacenamiento. En el siguiente ejemplo se crea un tipo de objeto denominado department_typ:
CREATE TYPE department_typ AS OBJECT
   ( d_name     VARCHAR2(100),
     d_address  VARCHAR2(200) );
/
En el ejemplo siguiente se crea una tabla de objetos denominada departments_obj_t del tipo de objeto department_typ y, a continuación, se inserta una fila en la tabla. Los atributos (columnas) de la tabla departments_obj_t se derivan de la definición del tipo de objeto.
CREATE TABLE departments_obj_t OF department_typ;
INSERT INTO departments_obj_t VALUES ('hr', '10 Main St, Sometown, CA');
Al igual que una columna relacional, una tabla de objetos puede contener filas de un solo tipo, es decir, instancias de objetos del mismo tipo declarado que la tabla. Por defecto, cada objeto de fila de una tabla de objetos tiene un identificador de objeto lógico (OID) asociado que lo identifica de forma única en una tabla de objetos. La columna OID de una tabla de objetos es una columna oculta.
Consulte además:
-
Oracle AI Database Object-Relational Developer's Guide para obtener más información sobre las funciones objeto-relacionales en Oracle AI Database
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
CREATE TYPE