Particiones, Vistas y Otros Objetos de Esquema
Aunque las tablas y los índices son los objetos de esquema más importantes y de uso común, la base de datos soporta muchos otros tipos de objetos de esquema, los más comunes de los cuales se tratan en este capítulo.
-
Visión General de Particiones En una base de datos Oracle, la partición permite descomponer tablas e índices muy grandes en partes más pequeñas y manejables denominadas particiones. Cada partición es un objeto independiente con su propio nombre y, opcionalmente, sus propias características de almacenamiento.
-
Visión General de Tablas con Partición En una base de datos Oracle, la función Globally Distributed Database permite dividir cualquier tabla en partes denominadas particiones horizontales que se pueden almacenar en varias bases de datos.
-
Visión General de Vistas Una vista es una representación lógica de una o más tablas. Básicamente, una vista es una consulta almacenada.
-
Visión General de Vistas Materializadas Una vista materializada es un resultado de consulta que se ha almacenado o "materializado" por adelantado como objeto de esquema. La cláusula
FROMde la consulta puede asignar un nombre a tablas, vistas o vistas materializadas. -
Visión General de Secuencias Una secuencia es un objeto de esquema desde el que varios usuarios pueden generar enteros únicos. Un generador de secuencias proporciona un método altamente escalable y de buen rendimiento para generar claves de sustitución para un tipo de dato numérico.
-
Visión general de dimensiones Un almacén de datos típico tiene dos componentes importantes: dimensiones y hechos.
-
Visión general de sinónimos Un sinónimo es un alias para un objeto de esquema. Por ejemplo, puede crear un sinónimo para una tabla o vista, secuencia, unidad de programa PL/SQL, tipo de objeto definido por el usuario u otro sinónimo. Un sinónimo es simplemente un alias, por lo que no requiere almacenamiento alguno aparte de su definición en el diccionario de datos.
Visión General de Particiones
En una base de datos Oracle, la partición permite descomponer tablas e índices muy grandes en partes más pequeñas y manejables denominadas particiones. Cada partición es un objeto independiente con su propio nombre y, opcionalmente, sus propias características de almacenamiento.
Para una analogía que ilustra la partición, supongamos que un gerente de RR. HH. tiene un cuadro grande que contiene carpetas de empleados. Cada carpeta muestra la fecha de contratación del empleado. Las consultas a menudo se realizan para empleados contratados en un mes determinado. Un enfoque para satisfacer tales solicitudes es crear un índice en la fecha de contratación del empleado que especifique las ubicaciones de las carpetas dispersas en todo el cuadro. Por el contrario, una estrategia de partición utiliza muchos cuadros más pequeños, con cada cuadro que contiene carpetas para los empleados contratados en un mes determinado.
El uso de cajas pequeñas tiene varias ventajas. Cuando se le pide que recupere las carpetas de los empleados contratados en junio, el gerente de RR. HH. puede recuperar el cuadro de junio. Además, si alguna caja pequeña está temporalmente dañada, las otras cajas pequeñas permanecen disponibles. Mover oficinas también se vuelve más fácil porque en lugar de mover una sola caja pesada, el gerente puede mover varias cajas pequeñas.
Desde la perspectiva de una aplicación, solo existe un objeto de esquema. Las sentencias SQL no necesitan ninguna modificación para acceder a las tablas particionadas. La partición es útil para muchos tipos diferentes de aplicaciones de base de datos, especialmente aquellas que gestionan grandes volúmenes de datos. Estas son algunas de las ventajas:
-
Mayor disponibilidad
La falta de disponibilidad de una partición no implica la falta de disponibilidad del objeto. La consulta optimizer elimina automáticamente las particiones a las que no se hace referencia del plan de consulta para que las consultas no se vean afectadas cuando las particiones no estén disponibles.
-
Administración más sencilla de objetos de esquema
Un objeto particionado tiene partes que se pueden gestionar de forma colectiva o individual. Las sentencias DDL pueden manipular particiones en lugar de tablas o índices completos. Por lo tanto, puede dividir las tareas que utilizan muchos recursos, como la reconstrucción de un índice o una tabla. Por ejemplo, puede mover una partición de tabla a la vez. Si se produce un problema, solo se debe rehacer el movimiento de partición, no el movimiento de tabla. Además, al borrar una partición, se evita la ejecución de numerosas sentencias
DELETE. -
Disminución de contención para recursos compartidos en sistemas OLTP
En algunos sistemas OLTP, las particiones pueden reducir la contención de un recurso compartido. Por ejemplo, DML se distribuye en muchos segmentos en lugar de en un segmento.
-
Rendimiento de consultas mejorado en almacenes de datos
En un almacén de datos, la partición puede acelerar el procesamiento de consultas ad hoc. Por ejemplo, una tabla de ventas que contiene un millón de filas se puede particionar por trimestre.
-
Características de la partición Cada partición de una tabla o índice debe tener los mismos atributos lógicos, como nombres de columna, tipos de dato y restricciones.
-
Tablas Particionadas Una tabla particionada consta de una o más particiones, que se gestionan individualmente y pueden funcionar independientemente de las otras particiones.
-
Índices Particionados Un índice particionado es un índice que, al igual que una tabla particionada, se ha dividido en partes más pequeñas y manejables.
-
Índices Parciales para Tablas Particionadas Un índice parcial es un índice que se correlaciona con las propiedades de indexación de una tabla particionada asociada.
-
Uso del almacén de objetos para particiones anteriores Para particiones de solo lectura, puede utilizar almacenamiento de bajo costo, como el almacenamiento de objetos en la nube. Consulte también: Guía de partición y VLDB de Oracle AI Database para obtener una introducción a la partición
Características de partición
Cada partición de una tabla o índice debe tener los mismos atributos lógicos, como nombres de columna, tipos de dato y restricciones.
Por ejemplo, todas las particiones de una tabla comparten las mismas definiciones de columna y restricción. Sin embargo, cada partición puede tener atributos físicos independientes, como el tablespace al que pertenece.
-
Partition Key (Clave de partición) La partition key (Clave de partición) es un juego de una o varias columnas que determina la partición a la que debe ir cada fila de una tabla particionada. Cada fila se asigna de forma inequívoca a una sola partición.
-
Estrategias de Partición Oracle Partitioning ofrece varias estrategias de partición que controlan cómo la base de datos coloca los datos en particiones. Las estrategias básicas son la partición de rango, lista y hash.
Clave de Partición
La clave de partición es un juego de una o varias columnas que determina la partición a la que debe ir cada fila de una tabla particionada. Cada fila se asigna de forma inequívoca a una sola partición.
En la tabla sales, puede especificar la columna time_id como la clave de una partición de rango. La base de datos asigna filas a las particiones en función de si la fecha de esta columna se encuentra en un rango especificado. Oracle AI Database dirige automáticamente las operaciones de inserción, actualización y supresión a la partición adecuada mediante la clave de partición.
Estrategias de Partición
Oracle Partitioning ofrece varias estrategias de partición que controlan cómo la base de datos coloca los datos en particiones. Las estrategias básicas son la partición de rango, lista y hash.
Una partición de un solo nivel utiliza sólo un método de distribución de datos, por ejemplo, sólo la partición de lista o sólo la partición de rango. En la partición compuesta, una tabla se particiona mediante un método de distribución de datos y, a continuación, cada partición se divide en subparticiones mediante un segundo método de distribución de datos. Por ejemplo, puede utilizar una partición de lista para channel_id y una subpartición de rango para time_id.
Ejemplo 6-1 Juego de Filas de Ejemplo para Tabla Particionada
En este ejemplo de partición se asume que desea rellenar una tabla particionada sales con las siguientes filas:
  PROD_ID    CUST_ID TIME_ID   CHANNEL_ID   PROMO_ID QUANTITY_SOLD AMOUNT_SOLD
---------- ---------- --------- ---------- ---------- ------------- -----------
      116      11393 05-JUN-99          2        999             1
12.18
       40     100530 30-NOV-98          9         33             1       44.99
      118        133 06-JUN-01          2        999             1       17.12
      133       9450 01-DEC-00          2        999             1       31.28
       36       4523 27-JAN-99          3        999             1       53.89
      125       9417 04-FEB-98          3        999             1       16.86
       30        170 23-FEB-01          2        999             1         8.8
       24      11899 26-JUN-99          4        999             1       43.04
       35       2606 17-FEB-00          3        999             1       54.94
45 9491 28-AUG-98 4 350 1 47.45-
Rango de Particiones En rango de Particiones, la base de datos asigna filas a particiones en función de rangos de valores de la clave de partición. La partición de rango es el tipo más común de partición y a menudo se utiliza con fechas.
-
La partición de intervalo es una extensión de la partición de rango.
-
Partición de lista En la partición de lista, la base de datos utiliza una lista de valores discretos como clave de partición para cada partición. La clave de partición consta de una o más columnas.
-
Partición hash En la partición hash, la base de datos asigna filas a particiones según un algoritmo hash que la base de datos aplica a la clave de partición especificada por el usuario.
-
Partición de Referencia En la partición de Referencia, la estrategia de partición de una tabla secundaria se define únicamente mediante la relación de clave ajena con una tabla principal. Para cada partición de la tabla principal, existe exactamente una partición correspondiente en la tabla secundaria. La tabla principal almacena los registros principales en una partición específica y la tabla secundaria almacena los registros secundarios en la partición correspondiente.
-
Partición compuesta En la partición compuesta, una tabla se particiona mediante un método de distribución de datos y, a continuación, cada partición se subdivide en subparticiones mediante un segundo método de distribución de datos. Por lo tanto, la partición compuesta combina los métodos de distribución de datos básicos. Todas las subparticiones de una partición determinada representan un subjuego lógico de los datos.
Partición de Rango
En partición de rango, la base de datos asigna filas a particiones en función de rangos de valores de la clave de partición. La partición de rango es el tipo más común de partición y a menudo se utiliza con fechas.
Supongamos que crea time_range_sales como tabla particionada mediante la siguiente sentencia SQL, con la columna time_id como clave de partición:
CREATE TABLE time_range_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY RANGE (time_id)
 (PARTITION SALES_1998 VALUES LESS THAN (TO_DATE('01-JAN-1999','DD-MON-YYYY')),
  PARTITION SALES_1999 VALUES LESS THAN (TO_DATE('01-JAN-2000','DD-MON-YYYY')),
  PARTITION SALES_2000 VALUES LESS THAN (TO_DATE('01-JAN-2001','DD-MON-YYYY')),
  PARTITION SALES_2001 VALUES LESS THAN (MAXVALUE)
 );
Posteriormente, cargará time_range_sales con las filas del Ejemplo 6-1. El código muestra las distribuciones de fila en las cuatro particiones. La base de datos selecciona la partición para cada fila según el valor time_id según las reglas especificadas en la cláusula PARTITION BY RANGE. El valor de clave de partición de rango determina el límite superior no incluido para una partición especificada.
Partición a Intervalos
La partición de intervalo es una extensión de la partición de rango.
Si inserta datos que superan las particiones de rango existentes, Oracle AI Database crea automáticamente particiones de un intervalo especificado. Por ejemplo, puede crear una tabla de historial de ventas que almacene los datos de cada mes en una partición independiente.
Las particiones de intervalo permiten evitar la creación explícita de particiones de rango. Puede utilizar la partición de intervalos para casi todas las tablas que están particionadas por rango y que utilizan intervalos fijos para nuevas particiones. A menos que cree particiones de rango con intervalos diferentes, o a menos que siempre defina atributos de partición específicos, considere el uso de particiones de intervalo.
Al particionar por intervalo, debe especificar al menos una partición de rango. El valor de la clave de partición de rango determina el valor alto de las particiones de rango, que se denomina punto de transición. La base de datos crea automáticamente particiones de intervalo para los datos con valores que superan el punto de transición. El límite inferior de cada partición de intervalo es el límite superior inclusivo del rango o partición de intervalo anterior. Por lo tanto, en el Ejemplo 6-2, el valor 01-JAN-2011 está en la partición p2.
La base de datos crea particiones de intervalo para los datos más allá del punto de transición. Una partición de intervalo amplía la partición de rango indicando a la base de datos que cree particiones del intervalo o rango especificado. La base de datos crea automáticamente las particiones cuando los datos insertados en la tabla superan todas las particiones de rango existentes. En el ejemplo 6-2, la partición p3 contiene filas con valores de clave de partición time_id mayores o iguales que 01-JAN-2013.
Ejemplo 6-2 Partición a Intervalos
Supongamos que crea una tabla de ventas con cuatro particiones de anchos variables. Especifique que, por encima del punto de transición del 1 de enero de 2013, la base de datos debe crear particiones en intervalos de un mes. El límite superior de la partición p3 representa el punto de transición. La partición p3 y todas las particiones debajo de ella se encuentran en la sección de rango, mientras que todas las particiones por encima de ella se encuentran en la sección de intervalo.
CREATE TABLE interval_sales
    ( prod_id        NUMBER(6)
    , cust_id        NUMBER
    , time_id        DATE
    , channel_id     CHAR(1)
    , promo_id       NUMBER(6)
    , quantity_sold  NUMBER(3)
    , amount_sold    NUMBER(10,2)
    )
  PARTITION BY RANGE (time_id)
  INTERVAL(NUMTOYMINTERVAL(1, 'MONTH'))
    ( PARTITION p0 VALUES LESS THAN (TO_DATE('1-1-2010', 'DD-MM-YYYY'))
    , PARTITION p1 VALUES LESS THAN (TO_DATE('1-1-2011', 'DD-MM-YYYY'))
    , PARTITION p2 VALUES LESS THAN (TO_DATE('1-7-2012', 'DD-MM-YYYY'))
    , PARTITION p3 VALUES LESS THAN (TO_DATE('1-1-2013', 'DD-MM-YYYY')) );
Usted inserta una venta hecha en la fecha 10 de octubre de 2014:
SQL> INSERT INTO interval_sales VALUES (39,7602,'10-OCT-14',9,null,1,11.79);

1 row created.
Una consulta de USER_TAB_PARTITIONS muestra que la base de datos ha creado una nueva partición para la venta del 10 de octubre porque la fecha de venta era posterior al punto de transición:
SQL> COL PNAME FORMAT a9
SQL> COL HIGH_VALUE FORMAT a40
SQL> SELECT PARTITION_NAME AS PNAME, HIGH_VALUE
  2  FROM USER_TAB_PARTITIONS WHERE TABLE_NAME = 'INTERVAL_SALES';

PNAME     HIGH_VALUE
--------- ----------------------------------------
P0        TO_DATE(' 2007-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P1        TO_DATE(' 2008-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P2        TO_DATE(' 2009-07-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P3        TO_DATE(' 2010-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
SYS_P1598 TO_DATE(' 2014-11-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
Consulte también: Guía de Oracle AI Database VLDB y particiones para obtener más información sobre las particiones a intervalos
Partición de Lista
En list partitioning, la base de datos utiliza una lista de valores discretos como clave de partición para cada partición. La clave de partición consta de una o más columnas.
Puede utilizar la partición de lista para controlar cómo se asignan las filas individuales a particiones específicas. Mediante el uso de listas, puede agrupar y organizar conjuntos de datos relacionados cuando la clave utilizada para identificarlos no está ordenada convenientemente.
Ejemplo 6-3 Partición de lista
Supongamos que crea list_sales como una tabla particionada por lista mediante la siguiente sentencia, donde la columna channel_id es la clave de partición:
CREATE TABLE list_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY LIST (channel_id)
 ( PARTITION even_channels VALUES ('2','4'),
   PARTITION odd_channels VALUES ('3','9')
 );
Posteriormente, cargará la tabla con las filas del Ejemplo 6-1. El código muestra la distribución de filas en las dos particiones. La base de datos selecciona la partición para cada fila según el valor channel_id según las reglas especificadas en la cláusula PARTITION BY LIST. Las filas con un valor channel_id de 2 o 4 se almacenan en las particiones EVEN_CHANNELS, mientras que las filas con un valor channel_id de 3 o 9 se almacenan en la partición ODD_CHANNELS.
Partición Hash
En partición hash, la base de datos asigna filas a particiones basadas en un algoritmo de hash que la base de datos aplica a la clave de partición especificada por el usuario.
El destino de una fila viene determinado por la función hash interna aplicada a la fila por la base de datos. Cuando el número de particiones es una potencia de 2, el algoritmo hash crea una distribución aproximadamente uniforme de las filas en todas las particiones.
La partición hash es útil para dividir tablas grandes a fin de aumentar la capacidad de gestión. En lugar de una mesa grande para administrar, tiene varias piezas más pequeñas. La pérdida de una sola partición hash no afecta a las particiones restantes y se puede recuperar de forma independiente. La partición hash también es útil en sistemas OLTP con contención de actualización alta. Por ejemplo, un segmento se divide en varias partes, cada una de las cuales se actualiza, en lugar de un único segmento que experimenta contención.
Supongamos que crea la tabla hash_sales particionada mediante la siguiente sentencia, con la columna prod_id como clave de partición:
CREATE TABLE hash_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY HASH (prod_id)
PARTITIONS 2;
Posteriormente, cargará la tabla con las filas del Ejemplo 6-1. El código muestra una posible distribución de filas en las dos particiones. Los nombres de estas particiones se generan por el sistema.
Al insertar filas, la base de datos intenta distribuirlas de forma aleatoria y uniforme entre las particiones. No puede especificar la partición en la que se coloca una fila. La base de datos aplica la función hash, cuyo resultado determina qué partición contiene la fila.
Consulte además:
-
Oracle AI Database VLDB and Partitioning Guide para aprender a crear particiones
-
Referencia de lenguaje SQL de Oracle AI Database para ejemplos de
CREATE TABLE ... PARTITION BY
Partición de referencia
En la partición de referencia, la estrategia de partición de una tabla secundaria se define únicamente mediante la relación de clave ajena con una tabla principal. Para cada partición de la tabla principal, existe exactamente una partición correspondiente en la tabla secundaria. La tabla principal almacena los registros principales en una partición específica y la tabla secundaria almacena los registros secundarios en la partición correspondiente.
Por ejemplo, una tabla orders es el principal de la tabla line_items, con una clave primaria y una clave ajena definidas en order_id. Las tablas se particionan por referencia. Por ejemplo, si la base de datos almacena la orden 233 en la partición Q3_2015 de orders, la base de datos almacena todas las líneas de ítem de la orden 233 en la partición Q3_2015 de line_items. Si la partición Q4_2015 se agrega a orders, la base de datos agrega automáticamente Q4_2015 a line_items.
Las ventajas de la partición de referencia son:
-
Al utilizar la misma estrategia de partición para las tablas principal y secundaria, se evita duplicar todas las columnas de clave de partición. Esta estrategia reduce la sobrecarga manual de la desnormalización y ahorra espacio.
-
Las operaciones de mantenimiento de una tabla principal se producen automáticamente en la tabla secundaria. Por ejemplo, al agregar una partición a la tabla primaria, la base de datos propaga automáticamente esta adición a sus descendientes.
-
La base de datos utiliza automáticamente uniones de partición de las particiones de la tabla principal y secundaria, lo que mejora el rendimiento.
Puede utilizar la partición de referencia con todas las estrategias de partición básicas, incluida la partición a intervalos. También puede crear tablas particionadas de referencia como tablas particionadas compuestas.
Ejemplo 6-4 Creación de Tablas Particionadas de Referencia
Este ejemplo crea un orden de tabla principal particionado por rango en order_date. La tabla secundaria particionada por referencia order_items se crea con cuatro particiones, Q1_2015, Q2_2015, Q3_2015 y Q4_2015, donde cada partición contiene las filas order_items correspondientes a los pedidos de la partición principal respectiva.
CREATE TABLE orders
    ( order_id           NUMBER(12),
      order_date         DATE,
      order_mode         VARCHAR2(8),
      customer_id        NUMBER(6),
      order_status       NUMBER(2),
      order_total        NUMBER(8,2),
      sales_rep_id       NUMBER(6),
      promotion_id       NUMBER(6),
      CONSTRAINT orders_pk PRIMARY KEY(order_id)
    )
  PARTITION BY RANGE(order_date)
    ( PARTITION Q1_2015 VALUES LESS THAN (TO_DATE('01-APR-2015','DD-MON-YYYY')),
      PARTITION Q2_2015 VALUES LESS THAN (TO_DATE('01-JUL-2015','DD-MON-YYYY')),
      PARTITION Q3_2015 VALUES LESS THAN (TO_DATE('01-OCT-2015','DD-MON-YYYY')),
      PARTITION Q4_2015 VALUES LESS THAN (TO_DATE('01-JAN-2006','DD-MON-YYYY'))
    );

CREATE TABLE order_items
    ( order_id           NUMBER(12) NOT NULL,
      line_item_id       NUMBER(3)  NOT NULL,
      product_id         NUMBER(6)  NOT NULL,
      unit_price         NUMBER(8,2),
      quantity           NUMBER(8),
      CONSTRAINT order_items_fk
      FOREIGN KEY(order_id) REFERENCES orders(order_id)
    )
    PARTITION BY REFERENCE(order_items_fk);
Consulte también: Guía de partición y VLDB de Oracle AI Database para obtener una visión general de la partición de referencia
Partición Compuesta
En la partición compuesta, una tabla se particiona mediante un método de distribución de datos y, a continuación, cada partición se subdivide en subparticiones mediante un segundo método de distribución de datos. Por lo tanto, la partición compuesta combina los métodos de distribución de datos básicos. Todas las subparticiones de una partición determinada representan un subjuego lógico de los datos.
La partición compuesta proporciona varias ventajas:
-
Según la sentencia SQL, la depuración de particiones en una o dos dimensiones puede mejorar el rendimiento.
-
Las consultas pueden utilizar uniones de partición completas o parciales en cualquiera de las dimensiones.
-
Puede realizar una copia de seguridad y recuperación en paralelo de una sola tabla.
-
El número de particiones es mayor que en la partición de un solo nivel, lo que puede ser beneficioso para la ejecución en paralelo.
-
Puede implantar una ventana de acumulación para soportar datos históricos y seguir particionando en otra dimensión si muchas sentencias se pueden beneficiar de la depuración de particiones o de uniones por partición.
-
Puede almacenar datos de forma diferente según la identificación mediante una clave de partición. Por ejemplo, puede decidir almacenar datos para un tipo de producto específico en un formato comprimido de solo lectura y mantener sin comprimir otros datos de tipo de producto.
Las particiones de rango, lista y hash son elegibles como estrategias de subpartición para tablas particionadas compuestas. La siguiente figura ofrece una vista gráfica de la partición compuesta rango-hash y rango-lista.
Figura 1: Partición de Lista de Rango Compuesto
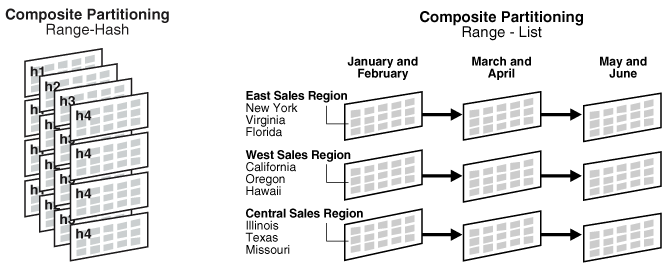
Descripción de la ilustración vldbg009.gif
La base de datos almacena cada subpartición en una tabla particionada compuesta como un segmento independiente. Por lo tanto, las propiedades de subpartición pueden diferir de las propiedades de la tabla o de la partición a la que pertenecen las subparticiones.
Consulte también: Oracle AI Database VLDB and Partitioning Guide para obtener más información sobre la partición de compuestos
Tablas Particionadas
Una tabla particionada consta de una o más particiones, que se gestionan individualmente y pueden funcionar independientemente del resto de particiones.
Una tabla está particionada o no. Incluso si una tabla particionada consta de una sola partición, esta tabla es diferente de una tabla no particionada, que no puede tener particiones agregadas.
-
Segmentos para Tablas Particionadas Una tabla particionada está formada por uno o más segmentos de partición de tabla.
-
Compresión para Tablas Particionadas Algunas o todas las particiones de una tabla organizada en pilas se pueden almacenar en un formato comprimido.
Consulte además:
"Partition Characteristics" para ejemplos de tablas particionadas
"Visión General de Tablas Organizadas por Índices" para obtener más información sobre la finalidad y las características de las tablas organizadas por índices, que también pueden beneficiarse de la partición que proporciona una capacidad de gestión, disponibilidad y rendimiento mejorados.
Segmentos para Tablas Particionadas
Una tabla particionada está formada por uno o más segmentos de partición de tabla.
Si crea una tabla particionada denominada hash_products, no se asigna ninguna tabla segmento para esta tabla. En su lugar, la base de datos almacena datos para cada partición de tabla en su propio segmento de partición. Cada segmento de partición de tabla contiene una parte de los datos de la tabla.
Cuando se particiona una tabla externa, todas las particiones residen fuera de la base de datos. En una tabla particionada híbrida, algunas particiones se almacenan en segmentos, mientras que otras se almacenan externamente. Por ejemplo, algunas particiones de la tabla sales se pueden almacenar en archivos de datos y otras en hojas de cálculo.
Consulte además:
para conocer la relación entre objetos y segmentos
Compresión para Tablas Particionadas
Algunas o todas las particiones de una tabla organizada en pilas se pueden almacenar en un formato comprimido.
La compresión ahorra espacio y puede acelerar la ejecución de consultas. Por este motivo, la compresión puede ser útil en entornos tales como almacenes, donde la cantidad de operaciones de inserción y actualización es pequeña y en entornos OLTP.
Puede declarar los atributos de la compresión de tabla para un tablespace, tabla o partición de tabla. Si se declara en el nivel de tablespace, todas las tablas creadas en el tablespace se comprimen por defecto. Puede modificar el atributo de compresión para una tabla, en cuyo caso el cambio sólo se aplicará a los nuevos datos que vayan a esa tabla. En consecuencia, una sola tabla o partición puede contener bloques comprimidos y sin comprimir, lo que garantiza que el tamaño de los datos no aumentará debido a la compresión. Si la compresión puede aumentar el tamaño de un bloque, la base de datos no lo aplica al bloque.
Consulte además:
-
"Compresión de Tabla" para obtener más información sobre los tipos de compresión de tabla, incluida la compresión básica, avanzada de filas y de columnas híbridas
-
Guía de almacenamiento de datos de Oracle AI Database para obtener más información sobre la compresión de tablas en un almacén de datos
Índices Particionados
Un índice particionado es un índice que, al igual que una tabla particionada, se ha dividido en partes más pequeñas y manejables.
Los índices globales se particionan independientemente de la tabla en la que se crean, mientras que los índices locales se enlazan automáticamente al método de partición de una tabla. Al igual que las tablas particionadas, los índices particionadas mejoran la capacidad de gestión, la disponibilidad, el rendimiento y la escalabilidad.
En el siguiente gráfico se muestran las opciones de partición de índice.
Figura 2: Opciones de Partición de Índice
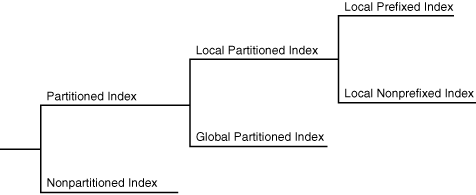
Descripción de la ilustración cncpt301.gif
-
Índices Particionados Locales En un índice particionado local, el índice se particiona en las mismas columnas, con el mismo número de particiones y los mismos límites de partición que su tabla.
-
Índices Particionados Globales Un índice particionado global es un índice de árbol B que se particiona independientemente de la tabla subyacente en la que se crea. Una única partición de índice puede apuntar a cualquiera o a todas las particiones de tabla, mientras que en un índice particionado localmente, existe una paridad uno a uno entre las particiones de índice y las particiones de tabla.
Consulte además:
-
"Introducción a Índices" para obtener más información sobre la diferencia entre índices únicos y no únicos y los diferentes tipos de índice
-
Oracle AI Database VLDB and Partitioning Guide para obtener más información sobre los índices particionados y cómo decidir qué tipo utilizar
Índices Particionados Locales
En un índice particionado local, el índice se particiona en las mismas columnas, con el mismo número de particiones y los mismos límites de partición que su tabla.
Cada partición de índice está asociada a exactamente una partición de la tabla subyacente, por lo que todas las claves de una partición de índice hacen referencia solo a las filas almacenadas en una sola partición de tabla. De esta forma, la base de datos sincroniza automáticamente las particiones de índice con sus particiones de tabla asociadas, lo que hace que cada par de índice de tabla sea independiente.
Los índices particionados locales son comunes en los entornos de almacenamiento de datos. Los índices locales ofrecen las siguientes ventajas:
-
La disponibilidad aumenta porque las acciones que hacen que los datos no sean válidos o no estén disponibles en una partición solo afectan a esta partición.
-
El mantenimiento de particiones se simplifica. Al mover una partición de tabla o cuando los datos se quedan fuera de una partición, solo se debe volver a crear o mantener la partición de índice local asociada. En un índice global, todas las particiones de índice se deben volver a crear o mantener.
-
Si se produce una recuperación puntual de una partición, los índices se pueden recuperar hasta el tiempo de recuperación (consulte la Guía del usuario de copia de seguridad y recuperación de Oracle AI Database). No es necesario volver a crear todo el índice.
En el ejemplo de Partición hash se muestra la sentencia de creación de la tabla hash_sales particionada, utilizando la columna prod_id como clave de partición. En el siguiente ejemplo se crea un índice particionado local en la columna time_id de la tabla hash_sales:
CREATE INDEX hash_sales_idx ON hash_sales(time_id) LOCAL;En la Figura 6-3, la tabla hash_products tiene dos particiones, por lo que hash_sales_idx tiene dos particiones. Cada partición de índice está asociada a una partición de tabla diferente. La partición de índice SYS_P38 indexa filas en la partición de tabla SYS_P33, mientras que la partición de índice SYS_P39 indexa filas en la partición de tabla SYS_P34.
Figura 3: Particiones de Índice Local
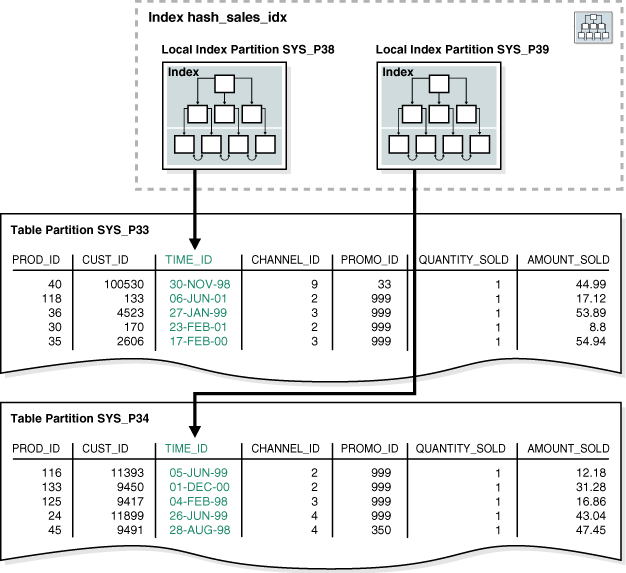
Descripción de la ilustración cncpt302.gif
No puede agregar explícitamente una partición a un índice local. En su lugar, las nuevas particiones se agregan a los índices locales solo cuando se agrega una partición a la tabla subyacente. Del mismo modo, no puede borrar explícitamente una partición de un índice local. En su lugar, las particiones de índice local sólo se borran al borrar una partición de la tabla subyacente.
Al igual que otros índices, puede crear un índice de mapa de bits en tablas particionadas. La única restricción es que los índices de bitmap deben ser locales para la tabla particionada; no pueden ser índices globales. Los índices de bitmap globales solo están soportados en tablas no particionadas.
-
Índices locales con y sin prefijo Los índices particionados locales tienen prefijo o no tienen prefijo.
-
Almacenamiento de Índice Particionado Local Al igual que una partición de tabla, una partición de índice local se almacena en su propio segmento. Cada segmento contiene una parte del total de los datos de índice. Por lo tanto, un índice local formado por cuatro particiones no se almacena en un único segmento de índice, sino en cuatro segmentos independientes.
Índices locales con y sin prefijo
Los índices particionados locales tienen o no un prefijo.
Los subtipos de índice se definen de la siguiente manera:
-
Índices locales con prefijo
En este caso, las claves de partición están al principio de la definición de índice. En el ejemplo
time_range_salesde Range Partitioning, la tabla se particiona por rango entime_id. Un índice local con prefijo en esta tabla tendríatime_idcomo la primera columna de su lista. -
Índices locales sin prefijo
En este caso, las claves de partición no están al principio de la lista de columnas indexadas y no es necesario que estén en la lista. En el ejemplo
hash_sales_idxde Local Particionado Indexes, el índice es local sin prefijo porque la clave de particiónproduct_idno está en el borde principal.
Ambos tipos de índices pueden aprovechar la eliminación de particiones (también denominada depuración de particiones), que se produce cuando el optimizador acelera el acceso a los datos al excluir las particiones de la consideración. Si una consulta puede eliminar particiones depende de la consulta predicado. Una consulta que utiliza un índice local con prefijo siempre permite la eliminación de particiones de índice, mientras que una consulta que utiliza un índice local sin prefijo podría no hacerlo.
Consulte también: Oracle AI Database VLDB and Partitioning Guide para aprender a utilizar índices con y sin prefijo
Almacenamiento de Índices Particionados Local
Al igual que una partición de tabla, una partición de índice local se almacena en su propio segmento. Cada segmento contiene una parte del total de los datos de índice. Por lo tanto, un índice local formado por cuatro particiones no se almacena en un único segmento de índice, sino en cuatro segmentos independientes.
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para ver ejemplos de CREATE INDEX ... LOCAL
Índices Particionados Globales
Un índice particionado global es un índice de árbol B que se particiona independientemente de la tabla subyacente en la que se crea. Una única partición de índice puede apuntar a cualquiera o a todas las particiones de tabla, mientras que en un índice particionado localmente, existe una paridad uno a uno entre las particiones de índice y las particiones de tabla.
En general, los índices globales son útiles para las aplicaciones OLTP, donde el acceso rápido, la integridad de los datos y la disponibilidad son importantes. En un sistema OLTP, una tabla se puede particionar por una clave, por ejemplo, la columna employees.department_id, pero una aplicación puede necesitar acceder a los datos con muchas claves diferentes, por ejemplo, por employee_id o job_id. Los índices globales pueden ser útiles en este escenario.
Como ilustración, supongamos que crea un índice particionado global en la tabla time_range_sales desde "Range Partitioning". En esta tabla, las filas de ventas de 1998 se almacenan en una partición, las filas de ventas de 1999 se almacenan en otra, etc. En el siguiente ejemplo se crea un índice global particionado por rango en la columna channel_id:
CREATE INDEX time_channel_sales_idx ON time_range_sales (channel_id)
   GLOBAL PARTITION BY RANGE (channel_id)
      (PARTITION p1 VALUES LESS THAN (3),
       PARTITION p2 VALUES LESS THAN (4),
       PARTITION p3 VALUES LESS THAN (MAXVALUE));
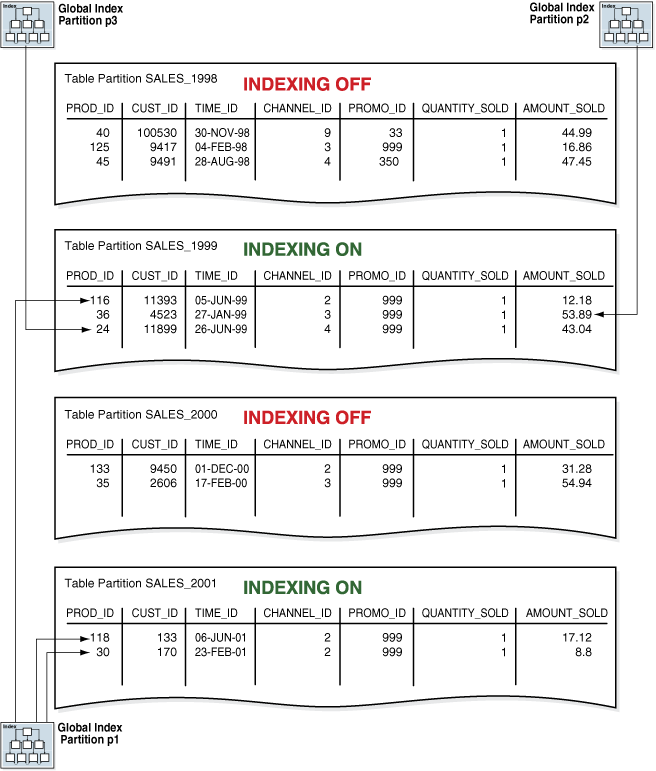
Como se muestra en la Figura 6-4, una partición de índice global puede contener entradas que apuntan a varias particiones de tabla. La partición de índice p1 apunta a las filas con un valor channel_id de 2, la partición de índice p2 apunta a las filas con un valor channel_id de 3 y la partición de índice p3 apunta a las filas con un valor channel_id de 4 o 9.
Figura 4: Índice Particionado Global
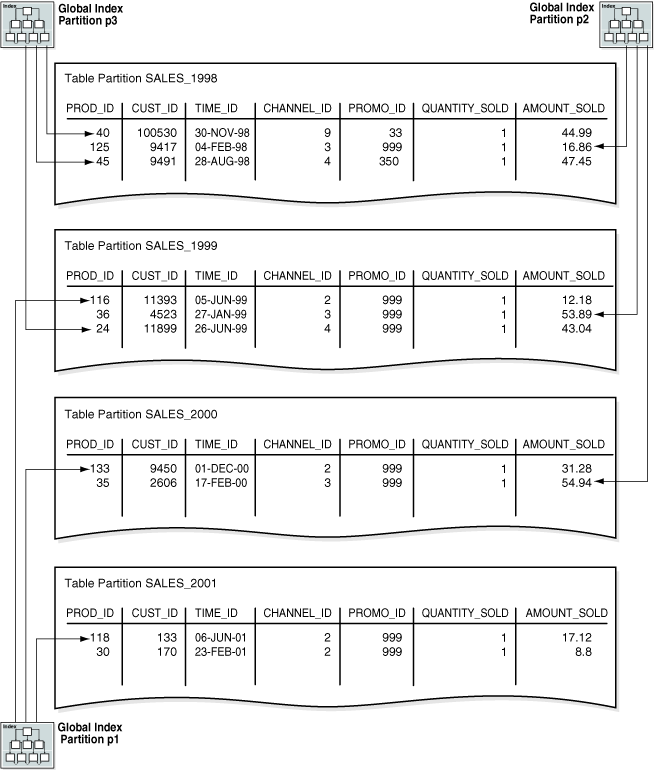
Descripción de la ilustración cncpt300.gif
Consulte además:
-
Oracle AI Database VLDB and Partitioning Guide para aprender a gestionar índices particionados globales
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre la cláusula
GLOBAL PARTITIONdeCREATE INDEX
Índices Parciales para Tablas Particionadas
Un índice parcial es un índice que se correlaciona con las propiedades de indexación de una tabla particionada asociada.
La correlación permite especificar qué particiones de tabla se indexan. Los índices parciales proporcionan las siguientes ventajas:
-
Las particiones de tabla que no están indexadas evitan consumir espacio de almacenamiento de índice innecesario.
-
El rendimiento de las cargas y consultas puede mejorar.
Antes de Oracle Database 12c, una operación de partición de intercambio necesitaba una actualización física de un índice global asociado para conservarlo como utilizable. A partir de Oracle Database 12c, si las particiones implicadas en una operación de mantenimiento de particiones no forman parte de un índice global parcial, el índice permanece utilizable sin necesidad de ningún mantenimiento de índice global.
-
Si indexa sólo algunas particiones de tabla durante la creación del índice y, posteriormente, indexa otras particiones, puede reducir el espacio de ordenación necesario para la creación del índice.
Puede activar o desactivar la indexación para las particiones individuales de una tabla. Un índice local parcial no tiene particiones de índice utilizables para todas las particiones de tabla que tienen desactivada la indexación. Un índice global, particionado o no, excluye los datos de todas las particiones que tienen desactivada la indexación. La base de datos no soporta índices parciales para índices que aplican restricciones únicas. La Figura 6-5 muestra el mismo índice global que en la Figura 6-4, excepto que el índice global es parcial. Las particiones de tabla SALES_1998 y SALES_2000 tienen la propiedad de indexación definida en OFF, por lo que el índice global parcial no las indexa.
Figura 5: Índice Particionado Global Parcial
Descripción de la ilustración cncpt342.png
Uso del almacén de objetos para particiones anteriores
Para las particiones de solo lectura, puede utilizar el almacenamiento de bajo costo, como el almacenamiento de objetos en la nube.
Los volúmenes de datos han crecido enormemente en la última década. Además, las regulaciones y políticas gubernamentales han ordenado la retención de datos durante largos períodos de tiempo en muchos casos. Los clientes de bases de datos Oracle utilizan varias estrategias de gestión de datos para bases de datos muy grandes. Los clientes tienen los siguientes objetivos principales que están tratando de satisfacer.
Para almacenar grandes cantidades de datos al menor costo posible Para cumplir con los nuevos requisitos normativos para la retención y protección de datos Para mejorar las oportunidades de negocio mediante un mejor análisis basado en una mayor cantidad de datos.
Los clientes locales tienen varias soluciones para lograr los objetivos anteriores. Oracle AI Database ahora le proporciona esta función que le permite desarrollar estrategias de gestión de datos similares para sus bases de datos en la nube al aprovechar niveles de almacenamiento de bajo costo como el almacenamiento de objetos en la nube.
Los clientes de bases de datos de Oracle han ideado varias estrategias de gestión de datos a medida que sus conjuntos de datos han evolucionado y crecido. Todas estas estrategias están incluidas en la gestión del ciclo de vida de la información (ILM). Algunas de las funciones de la base de datos que ayudan a implementar una solución ILM incluyen la partición de datos, la compresión avanzada de filas, la compresión de columnas híbridas, la optimización automática de datos y otras.
Uno de los aspectos de una solución de ILM es definir un nivel de almacenamiento de bajo costo. Esto le permite retener grandes cantidades de datos por el menor costo posible. La estrategia de ILM de Oracle permite la compresión y el movimiento automáticos de datos a un nivel de almacenamiento de menor costo. Los clientes de bases de datos locales de Oracle utilizan soluciones de almacenamiento de Oracle como Oracle ZFS Storage Appliance u Oracle Exadata Extended (XT) Storage Server como opción de almacenamiento de bajo costo para datos a los que no se accede con frecuencia, antiguos o normativos. También puede elegir opciones de almacenamiento de bajo costo similares de proveedores externos.
El uso del almacén de objetos permite:
-
Almacene particiones antiguas y tablespaces de solo lectura en Object Storage.
-
Consultar los datos de los archivos de almacenamiento de objetos de forma online.
-
Evite el acceso no autorizado a los archivos de almacenamiento de objetos propiedad de una PDB desde otra PDB.
-
Vuelva a mover los datos del almacén de objetos al almacenamiento normal en el raro caso de que desee realizar cambios en los datos de solo lectura.
-
Suprimir tablespaces con archivos de datos en el almacén de objetos.
-
Movimiento de Particiones Antiguas y Tablespaces de Sólo Lectura al Almacén de Objetos Puede crear una estrategia de partición basada en tiempo y mover los archivos de datos de un tablespace de solo lectura a un nivel de almacenamiento de menor costo, como el almacenamiento de objetos.
-
Acceso a objetos en Object Storage El acceso a datos de tablas y particiones en Object Storage será completamente transparente para los usuarios y clientes SQL.
-
Gestión de credenciales para archivos del almacén de objetos Para acceder a los archivos del almacenamiento de objetos se necesita una credencial.
-
Movimiento de los archivos de datos del almacenamiento de objetos al almacenamiento tradicional Si se deben actualizar los datos del almacén de objetos, los datos primero se deben mover al almacenamiento tradicional.
-
Supresión de Archivos de Datos del Almacén de Objetos Puede suprimir tablespaces con archivos de datos mediante el comando
DROP TABLESPACEestándar.
Movimiento de Particiones Antiguas y Tablespaces de Sólo Lectura al Almacén de Objetos
Puede crear una estrategia de partición basada en tiempo y mover los archivos de datos de un tablespace de solo lectura a un nivel de almacenamiento de menor costo, como el almacenamiento de objetos.
Supongamos que tiene una tabla denominada 'orders' particionada por rango en la columna DATE. Cada partición contiene filas para un año concreto y hay particiones existentes para 2022 y 2023. A medida que se acerca un año nuevo, el administrador de la base de datos decide agregar una nueva partición para el año 2024. Al mismo tiempo, el administrador de la base de datos decide que desea mover la partición más antigua a un nivel de almacenamiento de bajo costo.
El siguiente ejemplo de flujo de trabajo representa un escenario en el que el espacio de tabla tiene una sola partición para una sola tabla. Esto no es una restricción. El tablespace de sólo lectura puede tener particiones para una o más tablas. También tiene la opción de hacer que la partición sea de solo lectura, además de hacer que el tablespace sea de solo lectura. Como mejor práctica, puede hacer que el tablespace sea de solo lectura y esperar un período de tiempo bien definido antes de mover los archivos al almacén de objetos. Esto garantizará que se detecten todos los intentos de actualización de los datos de solo lectura y se devuelva un error. Es mucho más rápido mover datos mutantes a otro tablespace mientras los datos siguen estando en Exadata u otro almacenamiento tradicional. Será mucho más lento si estos datos se deben copiar del almacenamiento de objetos.
create tablespace orders_2022 DATAFILE '+DATA_DG/orders_2022.dbf' size 100g;
create tablespace orders_2023 DATAFILE '+DATA_DG/orders_2023.dbf' size 100g;

create table orders
( prod_id         NUMBER NOT NULL,
  time_id         DATE NOT NULL,
  quantity_sold   NUMBER(10,2) NOT NULL,
  amount_sold     NUMBER(10,2) NOT NULL)
    partition by range (time_id)
    ( partition orders_2022 VALUES LESS THAN (TO_DATE('2023-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2022,
      partition orders_2023 VALUES LESS THAN (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2023)
  ENABLE ROW MOVEMENT;

create tablespace orders_2024 DATAFILE '+DATA_DG/orders_2024.dbf' size 100g;

alter table orders
  ADD partition orders_2024
  values less than (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
  TABLESPACE orders_2024;

alter tablespace orders_2022 read only;

alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database
  move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
Acceso a objetos en Object Storage
El acceso a datos de tablas y particiones en Object Storage será completamente transparente para los usuarios y clientes SQL.
El subsistema de entrada/salida de la base de datos consultará y servirá internamente bloques de archivos almacenados en el almacenamiento de objetos. El siguiente SQL consultará las filas de la partición de solo lectura orders_2022 que se ha movido al almacenamiento de objetos en el ejemplo anterior.
select prod_id
from   orders
where  time_id < TO_DATE('2020-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN');
Los índices existentes, tanto globales como locales, funcionan de forma transparente. La consulta de datos híbridos de compresión de columnas y datos cifrados de TDE también funciona de forma transparente desde la perspectiva del cliente.
Gestión de Credenciales para Archivos del Almacén de Objetos
Para acceder a los archivos en Object Storage se necesita una credencial.
Una credencial es un objeto de base de datos que almacena un nombre de usuario y una contraseña. Los datos de credenciales se cifran y almacenan de forma segura en el esquema de PDB en el que se crean.
Cuando tiene previsto mover archivos de datos a Object Storage, debe definir una credencial por defecto. Esta credencial por defecto se utiliza para acceder a los archivos de datos en Object Storage.
Seleccione la credencial por defecto con los privilegios mínimos necesarios. Una vez que la credencial por defecto permite el acceso al almacén de objetos, la autenticación y autorización estándar de la base de datos determinan qué usuarios de la base de datos pueden consultar u operar en esos archivos de datos.
alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
Traslado de archivos de datos del almacenamiento de objetos al almacenamiento tradicional
Si los datos del almacén de objetos se deben actualizar, los datos se deben mover primero de nuevo al almacenamiento tradicional.
En el raro caso de que necesite modificar los datos de solo lectura que ya están en el almacenamiento de objetos, la única opción es volver a mover los datos del almacenamiento de objetos al almacenamiento tradicional. El siguiente flujo de trabajo muestra cómo se puede mover el archivo de datos del almacén de objetos de nuevo al sistema de archivos de ASM. La copia de un archivo del almacenamiento de objetos tendrá implicaciones en el rendimiento.
alter database move datafile
  'https://objectstorage.example.com/oracle/orders_2022.dbf' to
  '+DATA_DG/orders_2022.dbf';

alter tablespace orders_2022 read write;
Supresión de archivos de datos del almacén de objetos
Puede suprimir tablespaces con archivos de datos mediante el comando DROP TABLESPACE estándar.
La cláusula AND DATAFILES se utiliza para suprimir los archivos de datos del almacenamiento de backend. Esto suprimirá los archivos del almacén de objetos. Si el archivo del almacén de objetos tiene varios fragmentos en el almacén de objetos, todos los fragmentos se suprimirán, así como el manifiesto.
drop tablespace orders_2022 including contents and datafiles;Visión General de Tablas Particionadas
En una base de datos Oracle, la función Globally Distributed Database permite dividir cualquier tabla en partes denominadas particiones horizontales que se pueden almacenar en varias bases de datos.
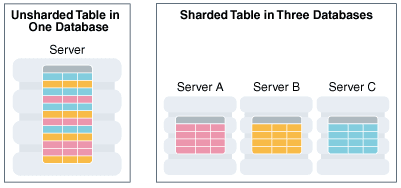
La partición horizontal implica dividir una tabla de base de datos entre particiones horizontales para que cada partición contenga la tabla con las mismas columnas pero un subjuego diferente de filas. Una división de tabla de esta forma también se conoce como tabla con particiones horizontales.
En la siguiente figura, se muestra una tabla particionada horizontalmente en tres particiones horizontales.
Figura 6: Partición horizontal de una tabla entre particiones horizontales
Descripción de la ilustración admin_3v_134a.png
- Tablas con particiones horizontales Una tabla de base de datos se divide entre las particiones horizontales, de modo que cada partición horizontal contiene la tabla con las mismas columnas, pero un subjuego diferente de filas. Una tabla dividida de esta forma se denomina tabla con particiones horizontales. Consulte también: Base de datos de IA distribuida globalmente de Oracle
Tablas con Particiones Horizontales
Una tabla de base de datos se divide entre las particiones horizontales, de modo que cada partición contiene la tabla con las mismas columnas, pero un subjuego diferente de filas. Una tabla dividida de esta forma se denomina tabla con particiones horizontales.
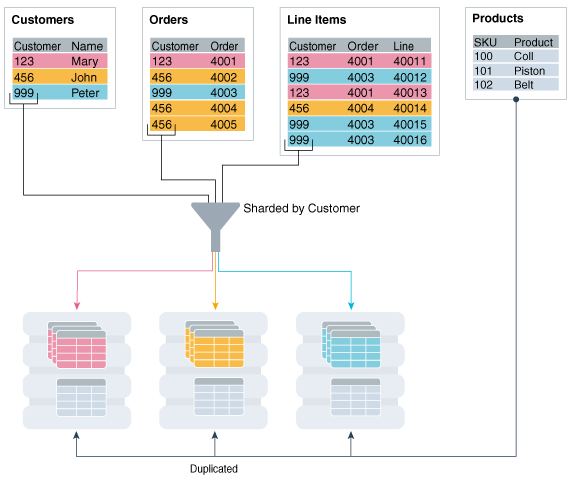
En la siguiente figura se muestra cómo se puede particionar horizontalmente un juego de tablas (denominado familia de tablas) en un juego de PDB de partición horizontal, de modo que cada partición horizontal contenga un subjuego de los datos, indicado con filas rojas, amarillas y azules.
Figura 7: Partición horizontal de una tabla entre particiones horizontales
Descripción de la ilustración admin_3v_138e.png
Las particiones se distribuyen entre particiones horizontales a nivel de tablespace, en función de una clave de partición horizontal. Algunos ejemplos de claves son el ID de cliente, el número de cuenta y el ID de país.
Cada partición de una tabla con particiones horizontales reside en un tablespace independiente y cada tablespace está asociado a una partición horizontal específica. Según el método de fragmentación, el administrador puede establecer la asociación automáticamente o definirla.
Aunque las particiones de una tabla con particiones horizontales residen en varias particiones horizontales, para la aplicación, la tabla busca y se comporta exactamente igual que una tabla particionada en una sola base de datos. Las sentencias SQL emitidas por una aplicación nunca tienen que hacer referencia a particiones horizontales ni depender del número de particiones horizontales y su configuración.
La sintaxis SQL familiar para la partición de tablas especifica cómo se deben particionar las filas entre particiones horizontales. Por ejemplo, la siguiente sentencia SQL crea una tabla con particiones horizontales, particionando horizontalmente la tabla entre particiones horizontales según la clave de partición horizontal cust_id.
CREATE SHARDED TABLE customers
( cust_id     NUMBER NOT NULL,
  name        VARCHAR2(50),
  address     VARCHAR2(250),
  region      VARCHAR2(20),
  class       VARCHAR2(3),
  signup      DATE,
  CONSTRAINT cust_pk PRIMARY KEY(cust_id)
)
PARTITION BY CONSISTENT HASH (cust_id)
PARTITIONS AUTO
TABLESPACE SET ts1;
La tabla con particiones horizontales en el ejemplo anterior se particiona mediante hash consistente, un tipo especial de partición hash que se utiliza comúnmente en sistemas distribuidos escalables. Esta técnica distribuye automáticamente los tablespaces entre las particiones horizontales para proporcionar una distribución uniforme de los datos y la carga de trabajo. Nota: Los índices globales de las tablas con particiones horizontales no están soportados, pero sí los índices locales.
Descripción general de las vistas
Una vista es una representación lógica de una o más tablas. Básicamente, una vista es una consulta almacenada.
Una vista deriva sus datos de las tablas en las que se basa, denominadas tablas base. Las tablas base pueden ser tablas u otras vistas. En realidad, todas las operaciones realizadas en una vista afectan a las tablas base. Puede utilizar vistas en la mayoría de los lugares donde se utilizan tablas.
Nota: Las vistas materializadas utilizan una estructura de datos diferente de las vistas estándar.
Las vistas permiten personalizar la presentación de los datos en diferentes tipos de usuarios. Las vistas a menudo se utilizan para:
-
Proporcionar un nivel adicional de Seguridad de Tablas restringiendo el acceso a un Juego Predeterminado de Filas o Columnas de una Tabla
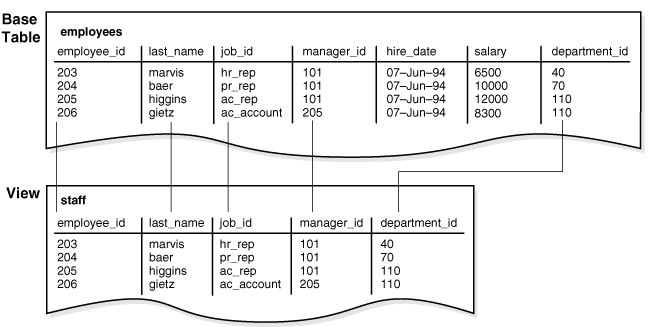
Por ejemplo, la Figura 6-8 muestra cómo la vista
staffno muestra las columnassalaryocommission_pctde la tabla baseemployees. -
Ocultar la complejidad del dato
Por ejemplo, se puede definir una única vista con una unión, que es una recopilación de columnas o filas relacionadas en varias tablas. Sin embargo, la vista oculta el hecho de que esta información realmente se origina en varias tablas. Una consulta también puede realizar cálculos exhaustivos con información de tabla. Por lo tanto, los usuarios pueden consultar una vista sin saber cómo realizar una unión o cálculos.
-
Presentar los datos en una perspectiva diferente a la de la tabla base
Por ejemplo, se puede cambiar el nombre de las columnas de una vista sin afectar a las tablas en las que se basa la vista.
-
Aislar las aplicaciones de los cambios en la definición de las tablas base
Por ejemplo, si la consulta de definición de una vista hace referencia a tres columnas de una tabla de cuatro columnas y se agrega una quinta columna a la tabla, la definición de la vista no se verá afectada y todas las aplicaciones que utilicen la vista no se verán afectadas.
Para ver un ejemplo del uso de vistas, considere la tabla hr.employees, que tiene varias columnas y numerosas filas. Para permitir a los usuarios ver solo cinco de estas columnas o solo filas específicas, puede crear una vista de la siguiente manera:
CREATE VIEW staff AS
  SELECT employee_id, last_name, job_id, manager_id, department_id
  FROM   employees;
Al igual que con todas las subconsultas, la consulta que define una vista no puede contener la cláusula FOR UPDATE. El siguiente gráfico ilustra la vista denominada staff. Observe que la vista muestra solo cinco de las columnas de la tabla base.
Figura 8: Ver
Descripción de la ilustración cncpt045.gif
-
Características de las Vistas A diferencia de una tabla, a una vista no se le asigna espacio de almacenamiento ni tampoco contiene datos. En su lugar, una vista se define mediante una consulta que extrae o deriva datos de las tablas base a las que hace referencia la vista. Puesto que una vista se basa en otros objetos, no necesita ningún almacenamiento que no sea el almacenamiento para la consulta que define la vista en el diccionario de datos.
-
Vistas de Unión Actualizables Una vista de unión tiene varias tablas o vistas en su cláusula
FROM. -
Vistas de objetos Al igual que una vista es una tabla virtual, una vista de objetos es una tabla de objetos virtuales. Cada fila de la vista es un objeto, que es una instancia de un tipo de objeto. Un tipo de objeto es un tipo de dato definido por el usuario.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a gestionar vistas
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
CREATE VIEW
Características de las vistas
A diferencia de una tabla, una vista no tiene espacio de almacenamiento asignado ni contiene datos. En su lugar, una vista se define mediante una consulta que extrae o deriva datos de las tablas base a las que hace referencia la vista. Puesto que una vista se basa en otros objetos, no necesita ningún almacenamiento que no sea el almacenamiento para la consulta que define la vista en el diccionario de datos.
Una vista tiene dependencias en sus objetos a los que se hace referencia, que son manejados automáticamente por la base de datos. Por ejemplo, si borra y vuelve a crear una tabla base de una vista, la base de datos determina si la nueva tabla base es aceptable para la definición de vista.
-
Manipulación de datos en vistas Debido a que las vistas se derivan de tablas, tienen muchas similitudes. Los usuarios pueden consultar vistas y, con algunas restricciones, pueden realizar DML en las vistas. Las operaciones realizadas en una vista afectan a los datos de alguna tabla base de la vista y están sujetas a las restricciones de integridad y los disparadores de las tablas base.
-
Cómo se accede a los datos en las vistas Oracle AI Database almacena una definición de vista en el diccionario de datos como el texto de la consulta que define la vista.
Manipulación de datos en vistas
Debido a que las vistas se derivan de tablas, tienen muchas similitudes. Los usuarios pueden consultar vistas y, con algunas restricciones, pueden realizar DML en las vistas. Las operaciones realizadas en una vista afectan a los datos de alguna tabla base de la vista y están sujetas a las restricciones de integridad y los disparadores de las tablas base.
En el siguiente ejemplo se crea una vista de la tabla hr.employees:
CREATE VIEW staff_dept_10 AS
SELECT employee_id, last_name, job_id,
       manager_id, department_id
FROM   employees
WHERE  department_id = 10
WITH CHECK OPTION CONSTRAINT staff_dept_10_cnst;
La consulta de definición sólo hace referencia a filas para el departamento 10. CHECK OPTION crea la vista con una restricción para que las sentencias INSERT y UPDATE emitidas en la vista no puedan generar filas que la vista no pueda seleccionar. Por lo tanto, se pueden insertar filas para los empleados del departamento 10, pero no filas para el departamento 30.
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre las restricciones de subconsulta en sentencias CREATE VIEW
Acceso a los datos en las vistas
Oracle AI Database almacena una definición de vista en el diccionario de datos como el texto de la consulta que define la vista.
Al hacer referencia a una vista en una sentencia SQL, Oracle AI Database realiza las siguientes tareas:
-
Fusiona una consulta (siempre que sea posible) con una vista con las consultas que definen la vista y cualquier vista subyacente
Oracle AI Database optimiza la consulta fusionada como si hubiera emitido la consulta sin hacer referencia a las vistas. Por lo tanto, Oracle AI Database puede utilizar índices en cualquier columna de tabla base a la que se haga referencia, tanto si se hace referencia a las columnas en la definición de vista como en la consulta de usuario en la vista.
A veces, Oracle AI Database no puede fusionar la definición de vista con la consulta de usuario. En estos casos, es posible que Oracle AI Database no utilice todos los índices de las columnas a las que se hace referencia.
-
Analiza la sentencia fusionada en un área SQL compartida
Oracle AI Database analiza una sentencia que hace referencia a una vista en un nuevo área SQL compartida solo si ningún área SQL compartida existente contiene una sentencia similar. Por lo tanto, las vistas proporcionan la ventaja de un uso reducido de memoria asociado a SQL compartido.
-
Ejecuta la sentencia SQL
El siguiente ejemplo ilustra el acceso a los datos cuando se consulta una vista. Supongamos que crea employees_view basado en las tablas employees y departments:
CREATE VIEW employees_view AS
  SELECT employee_id, last_name, salary, location_id
  FROM   employees JOIN departments USING (department_id)
  WHERE  department_id = 10;
Un usuario ejecuta la siguiente consulta de employees_view:
SELECT last_name
FROM   employees_view
WHERE  employee_id = 200;
Oracle AI Database fusiona la vista y la consulta de usuario para crear la siguiente consulta que, a continuación, se ejecuta para recuperar los datos:
SELECT last_name
FROM   employees, departments
WHERE  employees.department_id = departments.department_id
AND    departments.department_id = 10
AND    employees.employee_id = 200;
Consulte además:
-
Oracle AI Database SQL Tuning Guide para obtener más información sobre la optimización de consultas
Vistas de Unión Actualizables
Una vista de unión tiene varias tablas o vistas en su cláusula FROM.
En el siguiente ejemplo, la vista staff_dept_10_30 une las tablas employees y departments, incluidos solo los empleados de los departamentos 10 o 30:
CREATE VIEW staff_dept_10_30 AS
SELECT employee_id, last_name, job_id, e.department_id
FROM   employees e, departments d
WHERE  e.department_id IN (10, 30)
AND    e.department_id = d.department_id;
Una vista de unión actualizable, también denominada vista de unión modificable, implica dos o más tablas o vistas base y permite operaciones DML. Una vista actualizable contiene varias tablas en la cláusula FROM de nivel superior de la sentencia SELECT y no está restringida por la cláusula WITH READ ONLY.
Para poder actualizarse de forma inherente, una vista debe cumplir varios criterios. Por ejemplo, una regla general es que una operación INSERT, UPDATE o DELETE en una vista de unión sólo puede modificar una tabla base a la vez. La siguiente consulta de la vista del diccionario de datos USER_UPDATABLE_COLUMNS muestra que la vista staff_dept_10_30 es actualizable:
SQL> SELECT TABLE_NAME, COLUMN_NAME, UPDATABLE
  2  FROM   USER_UPDATABLE_COLUMNS
  3  WHERE  TABLE_NAME = 'STAFF_DEPT_10_30';

TABLE_NAME                     COLUMN_NAME                    UPD
------------------------------ ------------------------------ ---
STAFF_DEPT_10_30               EMPLOYEE_ID                    YES
STAFF_DEPT_10_30               LAST_NAME                      YES
STAFF_DEPT_10_30               JOB_ID                         YES
STAFF_DEPT_10_30               DEPARTMENT_ID                  YES
A partir de la versión 21c de Oracle Database, no es obligatorio que todas las columnas actualizables de una vista de unión se asignen a columnas de una tabla conservada por claves. La tabla conservada por claves es una tabla en la que cada fila de la tabla subyacente aparece como máximo una vez en la salida de la consulta. En la vista staff_dept_10_30, department_id es la clave primaria de la tabla departments, por lo que cada fila de la tabla employees aparece como máximo una vez en el juego de resultados, lo que mantiene la clave de la tabla employees. La tabla departments no se conserva mediante claves porque cada una de sus filas puede aparecer muchas veces en el juego de resultados. Las columnas de una tabla no conservada por claves se pueden actualizar si la operación UPDATE solo actualiza columnas de una sola tabla y la actualización es determinista, es decir, actualiza cada fila solo una vez.
Consulte también: Guía del administrador de Oracle AI Database para obtener información sobre cómo actualizar vistas de unión
Vistas de Objetos
Al igual que una vista es una tabla virtual, una vista de objeto es una tabla de objetos virtuales. Cada fila de la vista es un objeto, que es una instancia de un tipo de objeto. Un tipo de objeto es un tipo de dato definido por el usuario.
Puede recuperar, actualizar, insertar y suprimir datos relacionales como si se hubieran almacenado como un tipo de objeto. También puede definir las vistas con columnas que son tipos de datos de objeto, como objetos, REF y recopilaciones (tablas anidadas y VARRAY).
Al igual que las vistas relacionales, las vistas de objetos solo pueden presentar los datos que los administradores de la base de datos desean que vean los usuarios. Por ejemplo, una vista de objeto podría presentar datos sobre programadores de TI, pero omitir datos confidenciales sobre salarios. En el siguiente ejemplo se crea un objeto employee_type y, a continuación, la vista it_prog_view basada en este objeto:
CREATE TYPE employee_type AS OBJECT
(
  employee_id  NUMBER (6),
  last_name    VARCHAR2 (25),
  job_id       VARCHAR2 (10)
);
/

CREATE VIEW it_prog_view OF employee_type
  WITH OBJECT IDENTIFIER (employee_id) AS
SELECT  e.employee_id, e.last_name, e.job_id
FROM    employees e
WHERE   job_id = 'IT_PROG';
Las vistas de objetos son útiles para crear prototipos o realizar la transición a aplicaciones orientadas a objetos porque los datos de la vista se pueden tomar de tablas relacionales y acceder a ellos como si la tabla se definiera como una tabla de objetos. Puede ejecutar aplicaciones orientadas a objetos sin convertir las tablas existentes en una estructura física diferente.
Consulte además:
-
Oracle AI Database Object-Relational Developer's Guide para obtener más información sobre los tipos de objetos y las vistas de objetos
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre la sentencia
CREATE TYPE
Visión General de las Vistas Materializadas
Una vista materializada es un resultado de consulta que se ha almacenado o "materializado" por adelantado como objeto de esquema. La cláusula FROM de la consulta puede asignar un nombre a tablas, vistas o vistas materializadas.
Una vista materializada suele servir como tabla maestra en la replicación y como tabla de hechos en el almacenamiento de datos. Las vistas materializadas resumen, calculan, replican y distribuyen datos. Son adecuados en varios entornos informáticos, como los siguientes:
-
En los almacenes de datos, las vistas materializadas pueden calcular y almacenar datos generados a partir de funciones de agregación, como sumas y medias.
Un resumen es una vista de agregación que reduce el tiempo de consulta mediante el cálculo previo de uniones y operaciones de agregación y el almacenamiento de los resultados en una tabla. Las vistas materializadas son equivalentes a los resúmenes. También puede utilizar vistas materializadas para calcular uniones con o sin agregaciones.
-
En la replicación de vista materializada, que se logra mediante XStream y Oracle GoldenGate, la vista contiene una copia completa o parcial de una tabla desde un único punto en el tiempo. Las vistas materializadas replican datos en ubicaciones distribuidas y sincronizan las actualizaciones realizadas en varias ubicaciones. Esta forma de replicación es adecuada para entornos como las ventas de campo cuando las bases de datos no siempre están conectadas a la red.
-
En entornos de computación móvil, las vistas materializadas pueden descargar un subjuego de datos de servidores centrales a clientes móviles, con refrescamientos periódicos de los servidores centrales y propagación de actualizaciones por parte de los clientes a los servidores centrales.
En un entorno de replicación, una vista materializada comparte los datos con una tabla de una base de datos diferente denominada base de datos maestra. La tabla asociada a la vista materializada en la ubicación maestra es la tabla maestra. La Figura 6-9 ilustra una vista materializada en una base de datos basada en una tabla maestra de otra base de datos. Actualizaciones de la tabla maestra replicada en la base de datos de vista materializada.
Figura 9: Vista Materializada
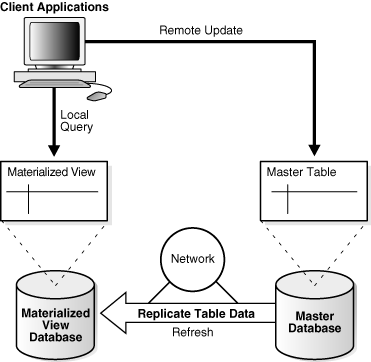
Descripción de la ilustración cncpt260.gif
-
Características de las Vistas Materializadas Las vistas materializadas comparten algunas características de los índices y las vistas no materializadas.
-
Métodos de Refrescamiento para Vistas Materializadas La base de datos mantiene los datos en las vistas materializadas refrescándolos después de los cambios en las tablas base. El método de refrescamiento puede ser incremental o un refrescamiento completo.
-
Vistas Materializadas Automáticas A partir de la versión 21c de Oracle Database, las vistas materializadas se pueden crear y mantener automáticamente.
-
La reescritura de consulta transforma una solicitud del usuario escrita en términos de tablas maestras, en una solicitud semánticamente equivalente que incluye vistas materializadas.
Consulte además:
-
Guía de almacenamiento de datos de Oracle AI Database para obtener más información sobre los resúmenes
-
Guía de Oracle AI Database XStream para obtener una introducción a XStream
-
http://www.oracle.com/technetwork/middleware/goldengate/documentation/index.html para obtener más información sobre Oracle GoldenGate
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre la sentencia
CREATE MATERIALIZED VIEW
Características de las Vistas Materializadas
Las vistas materializadas comparten algunas características de los índices y las vistas no materializadas.
Las vistas materializadas son similares a los índices de las siguientes formas:
-
Contienen datos reales y consumen espacio de almacenamiento.
-
Se pueden refrescar cuando cambian los datos de sus tablas maestras.
-
Pueden mejorar el rendimiento de la ejecución de SQL cuando se utilizan para operaciones de reescritura de consultas.
-
Su existencia es transparente para las aplicaciones y los usuarios SQL.
Una vista materializada es similar a una vista no materializada porque representa datos en otras tablas y vistas. A diferencia de los índices, los usuarios pueden consultar vistas materializadas directamente mediante sentencias SELECT. Según los tipos de refrescamiento que sean necesarios, las vistas también se pueden actualizar con sentencias DML.
En el siguiente ejemplo se crea y rellena una vista de agregación materializada basada en tres tablas maestras en el esquema de ejemplo sh:
CREATE MATERIALIZED VIEW sales_mv AS
  SELECT t.calendar_year, p.prod_id, SUM(s.amount_sold) AS sum_sales
  FROM   times t, products p, sales s
  WHERE  t.time_id = s.time_id
  AND    p.prod_id = s.prod_id
  GROUP BY t.calendar_year, p.prod_id;
En el siguiente ejemplo se borra la tabla sales, que es una tabla maestra para sales_mv y, a continuación, consulta sales_mv. La consulta selecciona los datos porque las filas se almacenan (materializan) independientemente de los datos de las tablas maestras.
SQL> DROP TABLE sales;

Table dropped.

SQL> SELECT * FROM sales_mv WHERE ROWNUM < 4;

CALENDAR_YEAR    PROD_ID  SUM_SALES
------------- ---------- ----------
         1998         13  936197.53
         1998         26  567533.83
         1998         27  107968.24
Las vistas materializadas se pueden particionar. Puede definir una vista materializada sobre una tabla particionada y uno o más índices sobre la vista materializada.
Consulte también: Guía de almacenamiento de datos de Oracle AI Database para aprender a utilizar vistas materializadas en un almacén de datos
Métodos de Refrescamiento para Vistas Materializadas
La base de datos mantiene los datos en las vistas materializadas refrescándolos después de los cambios realizados en las tablas base. El método de refrescamiento puede ser incremental o un refrescamiento completo.
-
Completar Refrescamiento Un refrescamiento completo ejecuta la consulta que define la vista materializada. Se produce un refrescamiento completo al crear inicialmente la vista materializada, a menos que la vista materializada haga referencia a una tabla predefinida o defina la tabla como
BUILD DEFERRED. -
Refrescamiento incremental Un refrescamiento incremental, también denominado refrescamiento rápido, solo procesa los cambios en los datos existentes. Este método elimina la necesidad de volver a crear vistas materializadas desde el principio. El procesamiento solo de los cambios puede generar un tiempo de refrescamiento muy rápido.
-
Refrescamiento In Situ y Fuera de Lugar Para los métodos completos e incrementales, la base de datos puede refrescar la vista materializada en su lugar, que refresca las sentencias directamente en la vista o fuera de lugar.
Refrescamiento Completo
Un refrescamiento completo ejecuta la consulta que define la vista materializada. Se produce un refrescamiento completo al crear inicialmente la vista materializada, a menos que la vista materializada haga referencia a una tabla predefinida o defina la tabla como BUILD DEFERRED.
Una actualización completa puede ser lenta, especialmente si la base de datos debe leer y procesar grandes cantidades de datos. Puede realizar un refrescamiento completo en cualquier momento después de la creación de la vista materializada.
Refrescamiento incremental
Un refrescamiento incremental, también denominado refrescamiento rápido, procesa solo los cambios en los datos existentes. Este método elimina la necesidad de volver a crear vistas materializadas desde el principio. El procesamiento solo de los cambios puede generar un tiempo de refrescamiento muy rápido.
Puede refrescar vistas materializadas a petición o en intervalos de tiempo regulares. También puede configurar vistas materializadas en la misma base de datos que sus tablas base para refrescar cada vez que una transacción confirme los cambios en las tablas base.
La actualización rápida viene en cualquiera de las siguientes formas:
-
Refrescamiento basado en log
En este tipo de refrescamiento, un log de vista materializada o un log de cargador directo mantienen un registro de los cambios en las tablas base. Un log de vista materializada es un objeto de esquema que registra los cambios en una tabla base para que una vista materializada definida en la tabla base se pueda refrescar de forma incremental. Cada log de vista materializada está asociado a una única tabla base.
-
Refrescamiento de seguimiento de cambios de partición (PCT)
El refrescamiento de PCT solo es válido cuando las tablas base están particionadas. El refrescamiento de PCT elimina todos los datos de las particiones de vista materializada afectadas o de las partes de datos afectadas y, a continuación, los recompra. La base de datos utiliza las particiones de tabla base modificadas para identificar las particiones o partes de datos afectadas en la vista. Cuando se han producido operaciones de mantenimiento de particiones en las tablas base, el refrescamiento de PCT es el único método de refrescamiento incremental utilizable.
Refrescamiento in situ y fuera de lugar
Para los métodos completos e incrementales, la base de datos puede refrescar la vista materializada en su lugar, que refresca las sentencias directamente en la vista o fuera de lugar.
Un refrescamiento externo crea una o más tablas externas, ejecuta las sentencias de refrescamiento en ellas y, a continuación, cambia la vista materializada o las particiones afectadas por las tablas externas. Esta técnica logra una alta disponibilidad durante el refrescamiento, especialmente cuando las sentencias de refrescamiento tardan mucho tiempo en terminar.
El refrescamiento síncrono es un tipo de refrescamiento externo. Un refrescamiento síncrono no modifica el contenido de las tablas base, sino que utiliza las API del paquete de refrescamiento síncrono, lo que garantiza la consistencia aplicando estos cambios a las tablas base y las vistas materializadas al mismo tiempo. Este enfoque permite sincronizar siempre un juego de tablas y las vistas materializadas definidas en ellas. En un almacén de datos, el método de refrescamiento síncrono es adecuado por los siguientes motivos:
-
La carga de datos incrementales está estrechamente controlada y se produce a intervalos periódicos.
-
Las tablas y sus vistas materializadas suelen estar particionadas de la misma forma, o sus particiones están relacionadas por una dependencia funcional.
Consulte también: Guía de almacenamiento de datos de Oracle AI Database para aprender a refrescar vistas materializadas
Vistas Materializadas Automáticas
A partir de la versión 21c de Oracle Database, las vistas materializadas se pueden crear y mantener automáticamente.
Oracle AI Database puede crear y gestionar automáticamente vistas materializadas para optimizar el rendimiento de las consultas. Con muy poca o ninguna interacción con el DBA, las tareas en segundo plano supervisan y analizan las características de la carga de trabajo e identifican dónde las vistas materializadas mejorarán el rendimiento SQL. La ventaja de rendimiento de las vistas materializadas candidatas se mide en segundo plano (mediante consultas de carga de trabajo) antes de que sean visibles para la carga de trabajo.
Consulte además:
-
Guía de almacenamiento de datos de Oracle AI Database para obtener información adicional
-
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para aprender a utilizar el paquete
DBMS_AUTO_MVpara implantar vistas materializadas automáticas
Reescritura de consultas
La reescritura de consulta transforma una solicitud del usuario escrita en términos de tablas maestras, en una solicitud semánticamente equivalente que incluye vistas materializadas.
Cuando las tablas base contienen grandes cantidades de datos, calcular un agregado o unión es costoso y requiere mucho tiempo. Puesto que las vistas materializadas contienen agregaciones y uniones calculadas previamente, la reescritura de consultas puede responder rápidamente a las consultas mediante vistas materializadas.
El transformador de consulta reescribe de forma transparente la solicitud para utilizar la vista materializada, sin necesidad de intervención del usuario y sin referencia a la vista materializada en la sentencia SQL. Puesto que la reescritud de consultas es transparente, las vistas materializadas se pueden agregar o borrar sin invalidar el SQL en el código de la aplicación.
En general, la reescritura de consultas para utilizar vistas materializadas en lugar de tablas de detalles mejora el tiempo de respuesta. En la siguiente figura, se muestra la base de datos que genera un plan de ejecución para la consulta original y reescrita, y que selecciona el plan de menor costo.
Figura 10: Reescritura de consultas
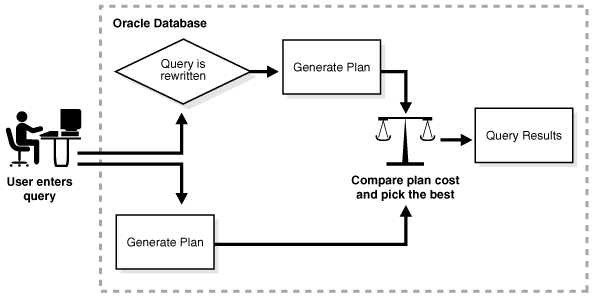
Descripción de la ilustración cncpt334.gif
Consulte además:
-
"Visión General del Optimizador" para obtener más información sobre la transformación de consultas
-
Guía de almacenamiento de datos de Oracle AI Database para aprender a utilizar la reescritura de consultas
Visión general de secuencias
Una secuencia es un objeto de esquema a partir del cual varios usuarios pueden generar enteros únicos. Un generador de secuencias proporciona un método altamente escalable y de buen rendimiento para generar claves de sustitución para un tipo de dato numérico.
-
Características de secuencia: una definición de secuencia indica información general sobre la secuencia, incluido su nombre y si la secuencia asciende o desciende.
-
Acceso simultáneo a secuencias El mismo generador de secuencias puede generar números para varias tablas.
Características de secuencia
Una definición de secuencia indica información general sobre la secuencia, incluido su nombre y si la secuencia asciende o desciende.
Una definición de secuencia también indica:
-
El intervalo entre números
-
Si la base de datos debe almacenar en caché juegos de números de secuencia generados en la memoria
-
Si la secuencia se debe sincronizar cuando se alcanza un límite
En el siguiente ejemplo se crea la secuencia customers_seq en el esquema de ejemplo oe. Una aplicación podría utilizar esta secuencia para proporcionar números de ID de cliente cuando se agregan filas a la tabla customers.
CREATE SEQUENCE customers_seq
START WITH      1000
INCREMENT BY    1
NOCACHE
NOCYCLE;
La primera referencia a customers_seq.nextval devuelve 1000. El segundo devuelve 1001. Cada referencia posterior devuelve un valor 1 mayor que la referencia anterior.
Consulte además:
-
Introducción a Oracle AI Database en Oracle AI Database Development para un tutorial que muestra cómo crear una secuencia
-
Oracle AI Database Administrator's Guide para aprender a hacer referencia a una secuencia en una sentencia SQL
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
CREATE SEQUENCE
Acceso simultáneo a secuencias
El mismo generador de secuencias puede generar números para varias tablas.
El generador puede crear claves primarias automáticamente y coordinar claves entre varias filas o tablas. Por ejemplo, una secuencia puede generar claves primarias para una tabla orders y una tabla customers.
El generador de secuencias es útil en entornos de varios usuarios para generar números únicos sin la sobrecarga de E/S de disco o bloqueo de transacciones. Por ejemplo, dos usuarios insertan simultáneamente nuevas filas en la tabla orders. Al utilizar una secuencia para generar números únicos para la columna order_id, ninguno de los usuarios tiene que esperar a que el otro introduzca el siguiente número de orden disponible. La secuencia genera automáticamente los valores correctos para cada usuario.
Cada usuario que hace referencia a una secuencia tiene acceso a su número de secuencia actual, que es la última secuencia generada en la sesión. Un usuario puede emitir una sentencia para generar un nuevo número de secuencia o utilizar el número actual generado por última vez por la sesión. Una vez que una sentencia de una sesión genera un número de secuencia, solo está disponible para esta sesión. Los números de secuencia individuales se pueden omitir si se han generado y utilizado en una transacción a la que finalmente se ha realizado un rollback.
Advertencia: si la aplicación necesita un conjunto de números sin espacios, no podrá utilizar las secuencias de Oracle. Debe serializar las actividades de la base de datos con su propio código desarrollado.
Consulte también: "Concurrencia y coherencia de datos" para obtener información sobre cómo las sesiones acceden a los datos al mismo tiempo
Visión General de Dimensiones
Un almacén de datos típico tiene dos componentes importantes: dimensiones y hechos.
Una dimensión es cualquier categoría que se utiliza para especificar preguntas de negocio, por ejemplo, tiempo, geografía, producto, departamento y canal de distribución. Un hecho es un evento o entidad asociado a un juego concreto de valores de dimensión, por ejemplo, unidades vendidas o beneficios.
Entre los ejemplos de solicitudes multidimensionales se incluyen los siguientes:
-
Muestra las ventas totales en todos los productos en niveles de agregación crecientes para una dimensión geográfica, de estado a país y región, para 2013 y 2014.
-
Cree un análisis transversal de nuestras operaciones que muestre los gastos por territorio en América del Sur para 2013 y 2014. Incluya todos los subtotales posibles.
-
Enumere los 10 principales representantes de ventas en Asia según los ingresos por ventas de productos de automoción en 2014 y clasifique sus comisiones.
Muchas preguntas multidimensionales requieren datos agregados y comparaciones de conjuntos de datos, a menudo en el tiempo, la geografía o los presupuestos.
La creación de una dimensión permite el uso más amplio de la función de reescritura de consultas. Al volver a escribir consultas de forma transparente para utilizar vistas materializadas, la base de datos puede mejorar el rendimiento de las consultas.
-
Estructura jerárquica de una dimensión Una tabla de dimensiones es una estructura lógica que define relaciones jerárquicas (principal/secundario) entre pares de columnas o juegos de columnas.
-
Creación de dimensiones Puede crear dimensiones con la sentencia SQL
CREATE DIMENSION. Consulte también: Guía de almacenamiento de datos de Oracle AI Database para obtener más información sobre las dimensiones
Estructura Jerárquica de una Dimensión
Una tabla de dimensiones es una estructura lógica que define las relaciones jerárquicas (principal/secundario) entre pares de columnas o juegos de columna.
Por ejemplo, una dimensión puede indicar que en una fila la columna city implica el valor de la columna state y la columna state implica el valor de la columna country.
Dentro de una dimensión de cliente, los clientes podrían acumularse en ciudad, estado, país, subregión y región. El análisis de datos normalmente comienza en niveles más altos en la jerarquía dimensional y gradualmente se profundiza si la situación justifica dicho análisis.
Cada valor a nivel secundario tiene asociado un valor sólo en el nivel principal. Una relación jerárquica es una dependencia funcional desde un nivel de una jerarquía hasta el siguiente nivel de la jerarquía.
Una dimensión no tiene ningún almacenamiento de datos asignado. La información dimensional se almacena en tablas de dimensiones, mientras que la información de hechos se almacena en una tabla de hechos.
Consulte además:
- Guía de almacenamiento de datos de Oracle AI Database para obtener más información sobre las dimensiones
Creación de dimensiones
Cree dimensiones con la sentencia SQL CREATE DIMENSION.
Esta sentencia especifica:
-
Varias cláusulas
LEVEL, cada una de las cuales identifica una columna o juego de columnas de la dimensión. -
Una o más cláusulas
HIERARCHYque especifican la relación principal/secundario entre niveles adyacentes -
Cláusulas
ATTRIBUTEopcionales, cada una de las cuales identifica una columna o juego de columna adicional asociado a un nivel concreto
La siguiente sentencia se ha utilizado para crear la dimensión customers_dim en el esquema de ejemplo sh:
CREATE DIMENSION customers_dim
   LEVEL customer   IS (customers.cust_id)
   LEVEL city       IS (customers.cust_city)
   LEVEL state      IS (customers.cust_state_province)
   LEVEL country    IS (countries.country_id)
   LEVEL subregion  IS (countries.country_subregion)
   LEVEL region     IS (countries.country_region)
   HIERARCHY geog_rollup (
      customer      CHILD OF
      city          CHILD OF
      state         CHILD OF
      country       CHILD OF
      subregion     CHILD OF
      region
   JOIN KEY (customers.country_id) REFERENCES country )
   ATTRIBUTE customer DETERMINES
   (cust_first_name, cust_last_name, cust_gender,
    cust_marital_status, cust_year_of_birth,
    cust_income_level, cust_credit_limit)
   ATTRIBUTE country DETERMINES (countries.country_name);
Las columnas de una dimensión pueden venir de la misma tabla (desnormalizada) o de varias tablas (normalizada parcial o completamente). Por ejemplo, una dimensión de tiempo normalizada puede incluir una tabla de fecha, una tabla de mes y una tabla de año, con condiciones de unión que conectan cada fila de fecha a una fila de mes y cada fila de mes a una fila de año. En una dimensión de tiempo totalmente desnormalizada, las columnas de fecha, mes y año están en la misma tabla. Tanto si se normalizan como si se desnormalizan, las relaciones jerárquicas entre las columnas se deben especificar en la sentencia CREATE DIMENSION.
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica de CREATE DIMENSION
Descripción general de sinónimos
Un sinónimo es un alias para un objeto del esquema. Por ejemplo, puede crear un sinónimo para una tabla o vista, secuencia, unidad de programa PL/SQL, tipo de objeto definido por el usuario u otro sinónimo. Un sinónimo es simplemente un alias, por lo que no requiere almacenamiento alguno aparte de su definición en el diccionario de datos.
Los sinónimos pueden simplificar las sentencias SQL para los usuarios de base de datos. Los sinónimos también son útiles para ocultar la identidad y la ubicación de un objeto de esquema subyacente. Si se debe cambiar el nombre o mover el objeto subyacente, solo se debe volver a definir el sinónimo. Las aplicaciones basadas en el sinónimo siguen funcionando sin modificaciones.
Puede crear sinónimos privados y públicos. Un sinónimo privado está en el esquema de un usuario específico que tiene control sobre su disponibilidad para otros usuarios. Un sinónimo público es propiedad del grupo de usuarios denominado PUBLIC y todos los usuarios de la base de datos pueden acceder a él.
Ejemplo 6-5 Sinónimo Público
Supongamos que un administrador de base de datos crea un sinónimo público denominado people para la tabla hr.employees. A continuación, el usuario se conecta al esquema oe y cuenta el número de filas de la tabla a la que hace referencia el sinónimo.
SQL> CREATE PUBLIC SYNONYM people FOR hr.employees;

Synonym created.

SQL> CONNECT oe
Enter password: password
Connected.

SQL> SELECT COUNT(*) FROM people;

  COUNT(*)
----------
       107
Utilice sinónimos públicos con moderación porque dificultan la consolidación de la base de datos. Como se muestra en el siguiente ejemplo, si otro administrador intenta crear el sinónimo público people, la creación falla porque solo puede existir un sinónimo público people en la base de datos. El uso excesivo de sinónimos públicos provoca conflictos de espacio de nombres entre aplicaciones.
SQL> CREATE PUBLIC SYNONYM people FOR oe.customers;
CREATE PUBLIC SYNONYM people FOR oe.customers
                      *
ERROR at line 1:
ORA-00955: name is already used by an existing object

SQL> SELECT OWNER, SYNONYM_NAME, TABLE_OWNER, TABLE_NAME
  2  FROM DBA_SYNONYMS
  3  WHERE SYNONYM_NAME = 'PEOPLE';

OWNER      SYNONYM_NAME TABLE_OWNER TABLE_NAME
---------- ------------ ----------- ----------
PUBLIC     PEOPLE       HR          EMPLOYEES
Los sinónimos en sí no son seguros. Cuando otorga privilegios de objeto en un sinónimo, realmente otorga privilegios en el objeto subyacente. El sinónimo sólo actúa como alias para el objeto en la sentencia GRANT.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a gestionar sinónimos
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
CREATE SYNONYM