Estructuras de almacenamiento lógico
En este capítulo, se describe la naturaleza y las relaciones entre las estructuras de almacenamiento lógicas. Oracle AI Database crea y reconoce estas estructuras y no las conoce el sistema operativo.
-
Introducción a las estructuras de almacenamiento lógico Oracle AI Database asigna espacio lógico para todos los datos de la base de datos.
-
Visión general de los bloques de datos Oracle AI Database gestiona el espacio de almacenamiento lógico en los archivos de datos de una base de datos en una unidad denominada bloque de datos, también denominado bloque de Oracle o página. Un bloque de datos es la unidad mínima de E/S de base de datos.
-
Visión general de extensiones: una extensión es una unidad de almacenamiento de base de datos formada por bloques de datos lógicamente contiguos. Los bloques de datos se pueden distribuir físicamente en el disco debido a las implementaciones del sistema de archivos y la segmentación RAID.
-
Visión General de Segmentos Un segmento es un juego de extensiones que contiene todos los datos de una estructura de almacenamiento lógico dentro de un tablespace.
-
Visión General de Tablespaces Un tablespace es un contenedor de almacenamiento lógico para segmentos.
Introducción a estructuras de almacenamiento lógicas
Oracle AI Database asigna espacio lógico para todos los datos de la base de datos.
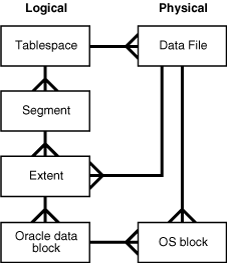
Las unidades lógicas de la asignación de espacio de base de datos son bloques de datos, extensiones, segmentos y tablespaces. En el nivel físico, los datos se almacenan en los archivos de datos del disco. Los datos de los archivos de datos se almacenan en bloques del sistema operativo.
La siguiente figura es un diagrama entidad-relación para el almacenamiento físico y lógico. La notación de pata de gallo representa una relación de uno a varios.
Figura 1: Almacenamiento lógico y físico
Descripción de la ilustración cncpt227.gif
-
Jerarquía de almacenamiento lógico Un segmento contiene una o más extensiones, cada una de las cuales contiene varios bloques de datos.
-
Gestión de Espacio Lógico Oracle AI Database debe utilizar la gestión de espacio lógico para realizar un seguimiento de las extensiones de un tablespace y asignarlas. Consulte también: "Estructuras de almacenamiento físico"
Jerarquía de almacenamiento lógico
Un segmento contiene una o más extensiones, cada una de las cuales contiene varios bloques de datos.
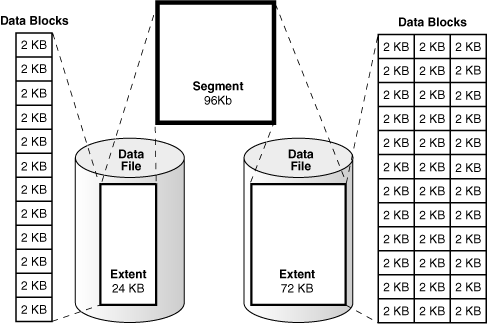
En la siguiente figura se muestran las relaciones entre los bloques de datos, las extensiones y los segmentos de un tablespace. En este ejemplo, un segmento tiene dos extensiones almacenadas en diferentes archivos de datos.
Figura 2: Segmentos, Extensiones y Bloques de Datos en un Tablespace
Descripción de la ilustración cncpt027.gif
Desde el nivel más bajo de granularidad hasta el más alto, Oracle AI Database almacena los datos de la siguiente manera:
-
Un bloque de datos es la unidad lógica más pequeña de almacenamiento de datos en Oracle AI Database.
Un bloque de datos lógico corresponde a un número específico de bytes de almacenamiento persistente, por ejemplo, 2 KB. Los bloques de datos son las unidades de almacenamiento más pequeñas que Oracle AI Database puede utilizar o asignar.
Tradicionalmente, los archivos de datos se han almacenado en disco magnético o disco de estado sólido (SSD). Oracle AI Database también soporta la memoria persistente (PMEM) para el almacenamiento de archivos de base de datos. Independientemente de cómo se almacenen físicamente los datos subyacentes, los procesos de Oracle siempre leen y escriben bloques de datos lógicos.
-
Un extent es un juego de bloques de datos lógicamente contiguos asignados para almacenar un tipo específico de información.
En el gráfico anterior, la extensión de 24 KB tiene 12 bloques de datos, mientras que la extensión de 72 KB tiene 36 bloques de datos.
-
Un segmento es un juego de extensiones asignadas para un objeto de base de datos específico, como una tabla.
Por ejemplo, los datos de la tabla
employeesse almacenan en su propio segmento de datos, mientras que cada índice paraemployeesse almacena en su propio segmento de índice. Cada objeto de base de datos que consume almacenamiento consta de un único segmento. -
Un tablespace es una unidad de almacenamiento de base de datos que contiene uno o más segmentos.
Cada segmento pertenece a un único tablespace. Por lo tanto, todas las extensiones de un segmento se almacenan en el mismo tablespace. En un tablespace, un segmento puede incluir extensiones de varios archivos de datos, como se muestra en el gráfico anterior. Por ejemplo, una extensión de un segmento se puede almacenar en
users01.dbf, mientras que otra se almacena enusers02.dbf. Una sola extensión nunca puede abarcar archivos de datos.
Consulte también: "Introducción a Estructuras de Almacenamiento Físico"
Gestión de Espacio Lógico
Oracle AI Database debe utilizar la gestión lógica de espacio para realizar un seguimiento y asignar las extensiones en un tablespace.
Cuando un objeto de base de datos necesita una extensión, la base de datos debe tener un método de búsqueda y suministro. Del mismo modo, cuando un objeto ya no requiere una extensión, la base de datos debe tener un método para hacer que la extensión libre esté disponible.
Oracle AI Database gestiona el espacio en un tablespace en función del tipo que cree. Puede crear uno de los siguientes tipos de tablespaces:
-
Tablespaces gestionados Localmente (valor por defecto)
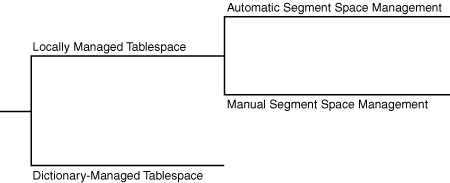
La base de datos utiliza bitmaps en los propios tablespaces para gestionar extensiones. Por lo tanto, los tablespaces gestionados de forma local tienen una parte del tablespace reservada para un bitmap. En un tablespace, la base de datos puede gestionar segmentos con la gestión automática de espacio de segmento (ASSM) o la gestión manual de espacio de segmento (MSSM).
-
Tablespaces gestionados por diccionario
La base de datos utiliza el diccionario de datos para gestionar extensiones.
La Figura 15-3 muestra las alternativas para la gestión lógica de espacio en un tablespace.
Figura 3: Gestión Lógica del Espacio
Descripción de la ilustración cncpt268.gif
-
Tablespaces Gestionados Localmente Un tablespace gestionado localmente mantiene un bitmap en la cabecera del archivo de datos para realizar un seguimiento del espacio libre y utilizado en el cuerpo del archivo de datos.
-
Tablespaces Gestionados por Diccionario Un tablespace gestionado por diccionario utiliza el diccionario de datos para gestionar sus extensiones. Consulte también: "Visión General del Diccionario de Datos"
Tablespaces Gestionados Localmente
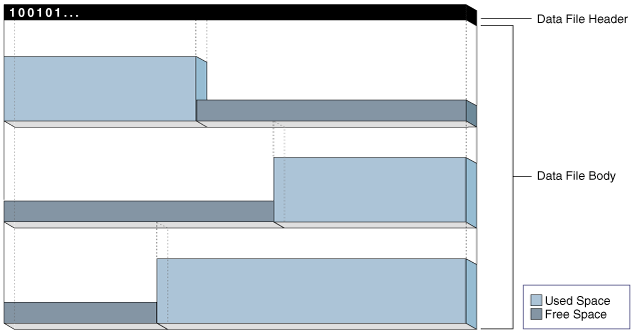
Un tablespace gestionado localmente mantiene un bitmap en la cabecera del archivo de datos para realizar un seguimiento del espacio libre y utilizado en el cuerpo del archivo de datos.
Cada bit corresponde a un grupo de bloques. Cuando se asigna o libera espacio, Oracle AI Database cambia los valores de bitmap para reflejar el nuevo estado de los bloques.
El siguiente gráfico es una representación conceptual del almacenamiento gestionado por bitmap. Un valor 1 en la cabecera hace referencia al espacio utilizado, mientras que un valor 0 hace referencia al espacio libre.
Figura 4: Almacenamiento gestionado por bitmap
Descripción de la ilustración cncpt332.gif
Un tablespace gestionado localmente tiene las siguientes ventajas:
-
Evita el uso del diccionario de datos para gestionar extensiones
Las operaciones recursivas se pueden producir en tablespaces gestionados por el diccionario si el consumo o la liberación de espacio en una extensión provoca otra operación que consuma o libere espacio en una tabla de diccionario o en un segmento de deshacer.
-
Rastrea el espacio libre adyacente automáticamente
De esta forma, la base de datos elimina la necesidad de fusionar extensiones libres.
-
Determina el tamaño de las extensiones gestionadas localmente automáticamente
Además, todas las extensiones pueden tener el mismo tamaño en un tablespace gestionado localmente y sustituir las opciones de almacenamiento de objetos. Nota: Oracle recomienda encarecidamente el uso de tablespaces gestionados localmente con la gestión automática de espacio de segmento.
La gestión de espacio de segmento es un atributo heredado del tablespace que contiene el segmento. En un tablespace gestionado localmente, la base de datos puede gestionar segmentos de forma automática o manual. Por ejemplo, los segmentos del tablespace users se pueden gestionar automáticamente mientras que los segmentos del tablespace tools se gestionan manualmente.
-
Gestión Automática de Espacio de Segmento El método Gestión Automática de Espacio de Segmento (ASSM) utiliza mapas de bits para gestionar el espacio en un tablespace.
-
Gestión manual del espacio de segmento El método antiguo de gestión manual del espacio de segmento (MSSM) utiliza una lista enlazada denominada lista libre para gestionar el espacio libre en el segmento.
Gestión Automática de Espacio de Segmento
El método de gestión automática de espacio de segmento (ASSM) utiliza mapas de bits para gestionar el espacio en un tablespace.
Los bitmaps ofrecen las siguientes ventajas:
-
Administración simplificada
ASSM evita la necesidad de determinar manualmente la configuración correcta para muchos parámetros de almacenamiento. Solo un parámetro SQL crucial controla la asignación de espacio:
PCTFREE. Este parámetro especifica el porcentaje de espacio que se va a reservar en un bloque para futuras actualizaciones (consulte "Porcentaje de Espacio Libre en Bloques de Datos"). -
Mayor simultaneidad
Varias transacciones pueden buscar listas separadas de bloques de datos libres, lo que reduce la contención y las esperas. Para muchas cargas de trabajo estándar, el rendimiento de las aplicaciones con ASSM es mejor que el rendimiento de una aplicación bien ajustada que utiliza MSSM.
-
Afinidad dinámica de espacio a instancias en un entorno de Oracle Real Application Clusters (Oracle RAC)
ASSM es más eficaz y es el valor por defecto para los tablespaces permanentes gestionados localmente.
Nota: en este capítulo se asume el uso de ASSM en todas las discusiones sobre el espacio de almacenamiento lógico.
Gestión Manual de Espacio de Segmento
El método antiguo de gestión manual de espacio de segmento (MSSM) utiliza una lista enlazada denominada lista libre para gestionar el espacio libre en el segmento.
Para un objeto de base de datos que tiene espacio libre, una lista de bloques libres realiza un seguimiento de los bloques bajo el límite superior (HWM) (HWM), que es la línea divisoria entre el espacio de segmento que se utiliza y que aún no se utiliza. A medida que se utilizan bloques, la base de datos coloca bloques en la lista libre o los elimina según sea necesario.
Además de PCTFREE, MSSM requiere que controle la asignación de espacio con parámetros SQL como PCTUSED, FREELISTS y FREELIST GROUPS. PCTUSED define el porcentaje de espacio libre que debe existir en un bloque utilizado actualmente para que la base de datos lo incluya en la lista de bloques libres. Por ejemplo, si define PCTUSED en 40 en una sentencia CREATE TABLE, no podrá insertar filas en un bloque del segmento hasta que se utilice menos del 40% del espacio en bloque.
Por ejemplo, supongamos que inserta una fila en una tabla. La base de datos comprueba en una lista libre de la tabla el primer bloque disponible. Si la fila no cabe en el bloque y el espacio utilizado en el bloque es mayor o igual que PCTUSED, la base de datos elimina el bloque de la lista y busca otro bloque. Si suprime filas del bloque, la base de datos comprueba si el espacio utilizado en el bloque es ahora menor que PCTUSED. Si es así, la base de datos coloca el bloque al principio de la lista libre.
Un objeto puede tener varias listas libres. De esta forma, varias sesiones que realizan DML en una tabla pueden utilizar diferentes listas, lo que puede reducir la contención. Cada sesión de base de datos utiliza sólo una lista libre durante la sesión.
Como se muestra en la Figura 15-5, también puede crear un objeto con uno o más grupos de listas libres, que son recopilaciones de listas libres. Cada grupo tiene una lista libre maestra que gestiona la lista libre de procesos individual del grupo. La sobrecarga de espacio para listas libres, especialmente para grupos de listas libres, puede ser significativa.
Figura 5: Grupos de listas libres
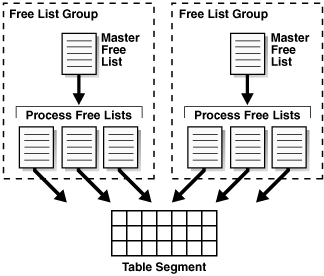
Descripción de la ilustración cncpt320.gif
La gestión manual del espacio de segmento puede ser compleja. Debe ajustar PCTFREE y PCTUSED para reducir la migración de filas y evitar el desperdicio de espacio. Por ejemplo, si cada bloque utilizado de un segmento está medio lleno y si PCTUSED es 40, la base de datos no permite inserciones en ninguno de estos bloques. Debido a la dificultad de ajustar los parámetros de asignación de espacio, Oracle recomienda encarecidamente ASSM. En ASSM, PCTFREE determina si se puede insertar una nueva fila en un bloque, pero no utiliza listas libres e ignora PCTUSED.
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener más información sobre los tablespaces gestionados localmente
-
Oracle AI Database Administrator's Guide para obtener más información sobre la gestión automática de espacio de segmento
-
Referencia de lenguaje SQL de Oracle AI Database para obtener información sobre parámetros de almacenamiento como
PCTFREEyPCTUSED
Tablespaces Gestionados por Diccionario
Un tablespace gestionado por diccionario utiliza el diccionario de datos para gestionar sus extensiones.
Oracle AI Database actualiza las tablas en el diccionario de datos cada vez que una extensión se asigna o se libera para volver a utilizarla. Por ejemplo, cuando una tabla necesita una extensión, la base de datos consulta las tablas del diccionario de datos y busca extensiones libres. Si la base de datos encuentra espacio, modifica una tabla del diccionario de datos e inserta una fila en otra. De esta forma, la base de datos gestiona el espacio modificando y moviendo datos.
El SQL que la base de datos ejecuta en segundo plano para obtener espacio para los objetos de base de datos es SQL recursivo. El uso frecuente de SQL recursivo puede tener un impacto negativo en el rendimiento, ya que las actualizaciones del diccionario de datos se deben serializar. Los tablespaces gestionados localmente, que son los predeterminados, evitan este problema de rendimiento.
Consulte también: Guía del administrador de Oracle AI Database para aprender a migrar tablespaces de gestionados por diccionario a gestionados localmente
Visión General de Bloques de Datos
Oracle AI Database gestiona el espacio de almacenamiento lógico en los archivos de datos de una base de datos en una unidad denominada bloque de datos, también denominado bloque de Oracle o página. Un bloque de datos es la unidad mínima de E/S de base de datos.
-
Bloques de datos y bloques del sistema operativo En el nivel físico, los datos de la base de datos se almacenan en archivos de disco formados por bloques del sistema operativo.
-
Formato de Bloque de Datos Cada bloque de datos tiene un formato o una estructura interna que permite a la base de datos realizar un seguimiento de los datos y el espacio libre en el bloque. Este formato es similar tanto si el bloque de datos contiene datos de tabla, índice o cluster de tabla.
-
Compresión de bloques de datos: la base de datos puede utilizar la compresión de tablas para eliminar valores duplicados en un bloque de datos. En esta sección, se describe el formato de los bloques de datos que utilizan compresión.
-
Gestión de espacio en bloques de datos A medida que la base de datos rellena un bloque de datos de abajo hacia arriba, la cantidad de espacio libre entre los datos de fila y la cabecera de bloque disminuye.
-
Visión General de Bloques de Índice Un bloque de índice es un tipo especial de bloque de datos que gestiona el espacio de forma diferente a los bloques de tabla. Oracle AI Database utiliza bloques de índice para gestionar el espacio de almacenamiento lógico en un índice.
Bloques de datos y bloques del sistema operativo
En el nivel físico, los datos de la base de datos se almacenan en archivos de disco formados por bloques del sistema operativo.
Un bloque del sistema operativo es la unidad mínima de datos que el sistema operativo puede leer o escribir. Por el contrario, un bloque de Oracle es una estructura de almacenamiento lógica cuyo tamaño y estructura no conoce el sistema operativo.
En la siguiente figura, se muestra que los bloques del sistema operativo pueden diferir en tamaño de los bloques de datos. La base de datos solicita datos en múltiplos de bloques de datos, no en bloques del sistema operativo.
Figura 6: Bloques de datos y bloques del sistema operativo
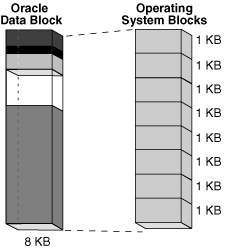
Descripción de la ilustración cncpt293.gif
Cuando la base de datos solicita un bloque de datos, el sistema operativo convierte esta operación en una solicitud de datos en almacenamiento permanente. La separación lógica de los bloques de datos de los bloques del sistema operativo tiene las siguientes implicaciones:
-
Las aplicaciones no necesitan determinar las direcciones físicas de los datos en el disco.
-
Los datos de la base de datos se pueden segmentar o duplicar en varios discos físicos.
-
Tamaño del Bloque de Base de Datos Cada base de datos tiene un tamaño de bloque de base de datos.
-
Tamaño de Bloque de Tablespace Puede crear tablespaces individuales cuyo tamaño de bloque difiera del valor
DB_BLOCK_SIZE.
Tamaño del Bloque de Base de Datos
Cada base de datos tiene un tamaño de bloque de base de datos.
El parámetro de inicialización DB_BLOCK_SIZE define el tamaño del bloque de datos para una base de datos cuando se crea. El tamaño se define para los tablespaces SYSTEM y SYSAUX y es el valor por defecto para todos los demás tablespaces. El tamaño del bloque de base de datos no se puede cambiar, excepto volviendo a crear la base de datos.
Si no se define DB_BLOCK_SIZE, el tamaño de bloque de datos predeterminado es específico del sistema operativo. El tamaño de bloque de datos estándar para una base de datos es de 4 KB u 8 KB. Si el tamaño es diferente para los bloques de datos y los bloques del sistema operativo, el tamaño del bloque de datos debe ser un múltiplo del tamaño del bloque del sistema operativo.
Consulte además:
-
Oracle AI Database Reference para obtener más información sobre el parámetro de inicialización
DB_BLOCK_SIZE -
Oracle AI Database Administrator's Guide y Oracle AI Database Performance Tuning Guide para aprender a elegir tamaños de bloques
Tamaño de Bloque de Tablespace
Puede crear tablespaces individuales cuyo tamaño de bloque difiera del valor DB_BLOCK_SIZE.
Un tamaño de bloque no estándar puede ser útil al mover un tablespace transportable a una plataforma diferente.
Consulte también: Oracle AI Database Administrator's Guide para aprender a especificar un tamaño de bloque no estándar para un tablespace
Formato de bloque de datos
Cada bloque de datos tiene un formato o una estructura interna que permite a la base de datos realizar un seguimiento de los datos y el espacio libre en el bloque. Este formato es similar tanto si el bloque de datos contiene datos de tabla, índice o cluster de tabla.
En la siguiente figura, se muestra el formato de un bloque de datos sin comprimir.
Figura 7: Formato de Bloque de Datos
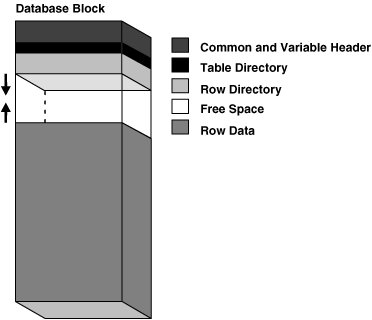
Descripción de la ilustración cncpt028.gif
-
Sobrecarga de bloques de datos Oracle AI Database utiliza la sobrecarga de bloques para gestionar el bloque en sí. La sobrecarga de bloque no está disponible para almacenar datos de usuario.
-
Formato de fila La parte de datos de fila del bloque contiene los datos reales, como filas de tabla o entradas de clave de índice. Al igual que cada bloque de datos tiene un formato interno, cada fila tiene un formato de fila que permite a la base de datos realizar un seguimiento de los datos de la fila. Consulte también: "Compresión de Bloques de Datos" para obtener información sobre los bloques comprimidos.
Gastos generales de bloque de datos
Oracle AI Database utiliza la sobrecarga de bloques para gestionar el bloque en sí. La sobrecarga de bloque no está disponible para almacenar datos de usuario.
Como se muestra en "Formato de bloque de datos", la sobrecarga de bloque incluye las siguientes partes:
-
Cabecera de bloque
Esta parte contiene información general sobre el bloque, incluida la dirección del disco y el tipo de segmento. Para los bloques gestionados por transacciones, la cabecera de bloque contiene información de transacciones activas e históricas.
Se requiere una entrada de transacción para cada transacción que actualiza el bloque. Inicialmente, Oracle AI Database reserva espacio en la cabecera de bloque para las entradas de transacción. En los bloques de datos asignados a segmentos que admiten cambios transaccionales, el espacio libre también puede contener entradas de transacción cuando se agota el espacio de cabecera. El espacio necesario para las entradas de transacción depende del sistema operativo. Sin embargo, las entradas de transacción en la mayoría de los sistemas operativos requieren aproximadamente 23 bytes.
-
Directorio de tabla
Para una tabla organizada en pilas, este directorio contiene metadatos sobre las tablas cuyas filas se almacenan en este bloque. En un cluster de tablas, varias tablas pueden almacenar filas en el mismo bloque.
-
Directorio de fila
En el caso de una tabla organizada en pilas, este directorio describe la ubicación de las filas en la parte de datos del bloque. La base de datos puede colocar una fila en cualquier parte de la parte inferior del bloque. La dirección de fila se registra en una de las ranuras del vector de directorio de fila.
Un rowid apunta a un archivo, bloque y número de fila específicos. Por ejemplo, en el ID de fila
AAAPecAAFAAAABSAAA, elAAAfinal representa el número de fila. El número de fila es un índice de una entrada en el directorio de filas. La entrada del directorio de filas contiene un puntero a la ubicación de la fila en el bloque de datos. Si la base de datos mueve una fila dentro de un bloque, la base de datos actualiza la entrada del directorio de filas para modificar el puntero. El rowid permanece constante.Una vez que la base de datos asigna espacio en el directorio de filas, la base de datos no recupera este espacio después de suprimir filas. Por lo tanto, un bloque que está actualmente vacío pero que anteriormente tenía hasta 50 filas sigue teniendo 100 bytes asignados para el directorio de filas. La base de datos reutiliza este espacio solo cuando una sesión inserta nuevas filas en el bloque.
Algunas partes de la sobrecarga del bloque son de tamaño fijo, pero el tamaño total es variable. En promedio, la sobrecarga del bloque asciende a 84 a 107 bytes.
Formato de Fila
La parte de datos de fila del bloque contiene los datos reales, como filas de tabla o entradas de clave de índice. Al igual que cada bloque de datos tiene un formato interno, cada fila tiene un formato de fila que permite a la base de datos realizar un seguimiento de los datos de la fila.
Oracle AI Database almacena filas como registros de longitud variable. Una fila está contenida en una o más secciones. Cada sección se denomina parte de fila. Cada parte de fila tiene una cabecera de fila y datos de columna.
En la siguiente figura, se muestra el formato de una fila.
Figura 8: El formato de una pieza de fila
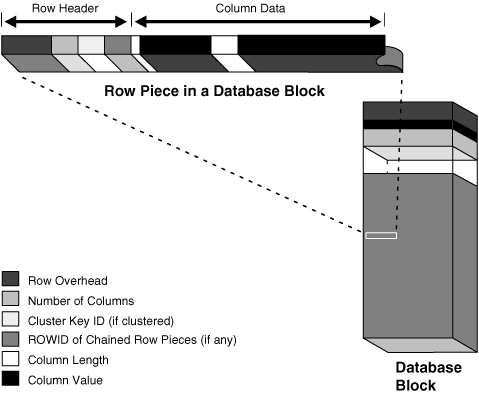
Descripción de la ilustración cncpt043.gif
-
Cabecera de fila Oracle AI Database utiliza la cabecera de fila para gestionar la parte de fila almacenada en el bloque.
-
Datos de columna Después de la cabecera de fila, la sección de datos de columna almacena los datos reales en la fila. La parte de fila suele almacenar columnas en el orden que se muestra en la sentencia
CREATE TABLE, pero este orden no está garantizado. Por ejemplo, las columnas de tipoLONGse crean en último lugar. -
Rowid Format Oracle AI Database utiliza un rowid para identificar de forma única una fila. Internamente, el rowid es una estructura que contiene información que la base de datos necesita para acceder a una fila. Un rowid no se almacena físicamente en la base de datos, sino que se infiere del archivo y bloque en los que se almacenan los datos.
Cabecera de Fila
Oracle AI Database utiliza la cabecera de fila para gestionar la parte de fila almacenada en el bloque.
La cabecera de fila contiene información como la siguiente:
-
Columnas en la parte de la fila
-
Piezas de la fila ubicadas en otros bloques de datos
Si se puede insertar una fila completa en un único bloque de datos, Oracle AI Database almacena la fila como una parte de la fila. Sin embargo, si todos los datos de fila no se pueden insertar en un solo bloque o si una actualización hace que una fila existente supere a su bloque, la base de datos almacena la fila en varias partes de fila. Un bloque de datos suele contener solo una parte de fila por fila.
-
Claves de cluster para clusters de tabla
Una fila totalmente contenida en un bloque tiene al menos 3 bytes de cabecera de fila.
Consulte además:
Datos de Columna
Después de la cabecera de fila, la sección de datos de columna almacena los datos reales en la fila. La parte de fila suele almacenar columnas en el orden que se muestra en la sentencia CREATE TABLE, pero este orden no está garantizado. Por ejemplo, las columnas de tipo LONG se crean en último lugar.
Como se muestra en la figura de "Formato de fila", para cada columna de una parte de fila, Oracle AI Database almacena la longitud de la columna y los datos por separado. El espacio necesario depende del tipo de dato. Si el tipo de dato de una columna tiene una longitud variable, el espacio necesario para contener un valor puede crecer y reducirse con actualizaciones de los datos.
Cada fila tiene un espacio en el directorio de filas de la cabecera del bloque de datos. El espacio apunta al principio de la fila.
Consulte también: "Almacenamiento de tablas" y "Almacenamiento de índices"
Formato de ID de fila
Oracle AI Database utiliza un rowid para identificar de forma única una fila. Internamente, el rowid es una estructura que contiene información que la base de datos necesita para acceder a una fila. Un rowid no se almacena físicamente en la base de datos, sino que se infiere del archivo y bloque en los que se almacenan los datos.
Un ID de fila ampliado incluye un número de objeto de datos. Este tipo de ID de fila utiliza una codificación base de 64 de la dirección física para cada fila. Los caracteres de codificación son A-Z, a-z, 0-9, + y /.
Ejemplo 15-1 Pseudocolumna ROWID
En el siguiente ejemplo se consulta la pseudocolumna ROWID para mostrar el ID de fila ampliado de la fila en la tabla employees para el empleado 100:
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
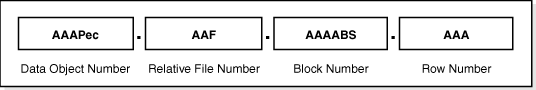
En la siguiente figura, se muestra el formato de un ID de fila ampliado.
Figura 9: Formato ROWID
Descripción de la ilustración cncpt249.gif
Se muestra un rowid extendido en un formato de cuatro piezas, OOOOOOFFFBBBBBBRRR, con el formato dividido en los siguientes componentes:
-
OOOOOOEl número de objeto de datos identifica el segmento (objeto de datos
AAAPecen la consulta de ejemplo). Se asigna un número de objeto de datos a cada segmento de base de datos. Los objetos de esquema del mismo segmento, como un cluster de tablas, tienen el mismo número de objeto de datos. -
FFFEl número de archivo de datos relativo al tablespace identifica el archivo de datos que contiene la fila (archivo
AAFen la consulta de ejemplo). -
BBBBBBEl número de bloque de datos identifica el bloque que contiene la fila (bloque
AAAABSen la consulta de ejemplo). Los números de bloque son relativos a su archivo de datos, no a su tablespace. Por lo tanto, dos filas con números de bloque idénticos podrían residir en archivos de datos diferentes del mismo tablespace. -
RRREl número de fila identifica la fila del bloque (fila
AAAen la consulta de ejemplo).
Después de asignar un ID de fila a una parte de fila, el ID de fila puede cambiar en circunstancias especiales. Por ejemplo, si el movimiento de filas está activado, el ID de fila puede cambiar debido a las actualizaciones de clave de partición, las operaciones de flashback de tabla, las operaciones de reducción de tabla, etc. Si el movimiento de filas está desactivado, un ID de fila puede cambiar si la fila se exporta e importa mediante las utilidades de Oracle AI Database. Nota: Internamente, la base de datos realiza el movimiento de filas como si la fila se hubiera suprimido y vuelto a insertar físicamente. Sin embargo, el movimiento de filas se considera una actualización, lo que tiene implicaciones para los activadores.
Consulte además:
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre los rowid
Compresión de bloques de datos
La base de datos puede utilizar la compresión de tablas para eliminar valores duplicados en un bloque de datos. En esta sección, se describe el formato de los bloques de datos que utilizan compresión.
El formato de un bloque de datos que utiliza la compresión básica de tablas y filas avanzadas es esencialmente el mismo que el de un bloque sin comprimir. La diferencia es que una tabla de símbolos al principio del bloque almacena valores duplicados para las filas y columnas. La base de datos sustituye las incidencias de estos valores por una breve referencia a la tabla de símbolos.
Ejemplo 15-2 Formato de bloques de datos comprimidos
Supongamos que las siguientes filas se almacenan en un bloque de datos para la tabla sales de siete columnas:
2190,13770,25-NOV-00,S,9999,23,161
2225,15720,28-NOV-00,S,9999,25,1450
34005,120760,29-NOV-00,P,9999,44,2376
9425,4750,29-NOV-00,I,9999,11,979
1675,46750,29-NOV-00,S,9999,19,1121
Cuando se aplica compresión básica de tablas o filas avanzadas a esta tabla, la base de datos sustituye los valores duplicados por una referencia de símbolo. La siguiente representación conceptual de la compresión muestra el símbolo * que sustituye a 29-NOV-00 y % que sustituye a 9999:
2190,13770,25-NOV-00,S,%,23,161
2225,15720,28-NOV-00,S,%,25,1450
34005,120760,*,P,%,44,2376
9425,4750,*,I,%,11,979
1675,46750,*,S,%,19,1121
La Tabla 15-1 representa conceptualmente la tabla de símbolos que asigna símbolos a valores.
Tabla 1 Tabla de símbolos
| Símbolo | Valor | Columna | Filas |
|---|---|---|---|
| * | 29-NOV-00 | 3 | 958-960 |
| % | 9.999 | 5 | 956-960 |
Consulte también: "Compresión de Tabla"
Gestión de Espacio en Bloques de Datos
A medida que la base de datos llena un bloque de datos de abajo hacia arriba, la cantidad de espacio libre entre los datos de fila y la cabecera del bloque disminuye.
El espacio libre en un bloque de datos también se puede reducir durante las actualizaciones, como al cambiar un valor nulo final a un valor no nulo. La base de datos gestiona el espacio libre en el bloque de datos para optimizar el rendimiento y evitar el desperdicio de espacio.
Nota: En esta sección se asume el uso de la gestión automática de espacio de segmento.
-
Porcentaje de Espacio Libre en Bloques de Datos El parámetro SQL
PCTFREEdefine el porcentaje mínimo de un bloque de datos reservado como espacio libre para las actualizaciones de filas existentes.PCTFREEes importante para evitar la migración de filas y el desperdicio de espacio. -
Optimización del espacio libre en bloques de datos Si bien el porcentaje de espacio libre no puede ser menor que
PCTFREE, la cantidad de espacio libre puede ser mayor. Por ejemplo, si se definePCTFREEen el 20%, se evita que la cantidad total de espacio libre se caiga al 5% del bloque, pero se permite que el 50% del bloque esté libre. -
Filas encadenadas y migradas Oracle AI Database utiliza el encadenamiento y la migración para gestionar filas que son demasiado grandes para caber en un solo bloque.
Porcentaje de espacio libre en bloques de datos
El parámetro SQL PCTFREE define el porcentaje mínimo de un bloque de datos reservado como espacio libre para las actualizaciones de filas existentes. PCTFREE es importante para evitar la migración de filas y el desperdicio de espacio.
Por ejemplo, supongamos que crea una tabla que sólo necesitará actualizaciones ocasionales, la mayoría de las cuales no aumentará el tamaño de los datos existentes. Especifique el parámetro PCTFREE en una sentencia CREATE TABLE de la siguiente manera:
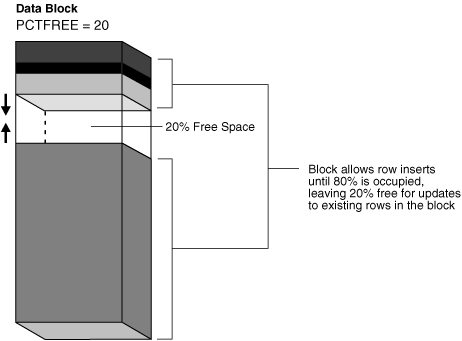
CREATE TABLE test_table (n NUMBER) PCTFREE 20;La Figura 15-10 muestra cómo un valor PCTFREE de 20 afecta a la gestión de espacio. La base de datos agrega filas al bloque a lo largo del tiempo, lo que hace que los datos de fila crezcan hacia arriba hacia la cabecera del bloque, que a su vez se expande hacia abajo hacia los datos de fila. La configuración PCTFREE garantiza que al menos el 20 % del bloque de datos esté libre. Por ejemplo, la base de datos impide que una sentencia INSERT llene el bloque de modo que los datos de fila y la cabecera ocupen un 90% combinado del espacio total del bloque, dejando solo un 10% libre.
Figura 10: PCTFREE
Descripción de la ilustración cncpt029.gif
Nota: Esta explicación no se aplica a los tipos de dato LOB, que no utilizan el parámetro de almacenamiento PCTFREE ni las listas libres.
Consulte además:
-
Guía del desarrollador de Oracle AI Database SecureFiles y objetos grandes
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica del parámetro
PCTFREE
Optimización del Espacio Libre en Bloques de Datos
Si bien el porcentaje de espacio libre no puede ser menor que PCTFREE, la cantidad de espacio libre puede ser mayor. Por ejemplo, si se define PCTFREE en el 20%, se evita que la cantidad total de espacio libre se caiga al 5% del bloque, pero se permite que el 50% del bloque esté libre.
-
Optimización mediante el aumento del espacio libre Algunas sentencias DML pueden aumentar el espacio libre en bloques de datos.
-
Optimización mediante Fragmentación de Espacio El espacio liberado puede o no ser contiguo al área principal de espacio libre en un bloque de datos. El espacio libre no contiguo se denomina espacio fragmentado.
Optimización mediante el aumento del espacio libre
Algunas sentencias DML pueden aumentar el espacio libre en los bloques de datos.
Las siguientes sentencias pueden aumentar el espacio:
-
Sentencias
DELETE -
Sentencias
UPDATEque actualizan los valores existentes a valores más pequeños o aumentan los valores existentes y fuerzan la migración de una fila -
Sentencias
INSERTen una tabla que utiliza la compresión avanzada de filasSi las sentencias
INSERTrellenan un bloque con datos, la base de datos llama a la compresión de bloques, lo que puede provocar que el bloque tenga más espacio libre.
El espacio liberado está disponible para las sentencias INSERT en las siguientes condiciones:
-
Si la sentencia
INSERTestá en la misma transacción y después de la sentencia que libera espacio, la sentencia puede utilizar el espacio. -
Si la sentencia
INSERTestá en una transacción independiente de la sentencia que libera espacio (quizás ejecutado por otro usuario) y si se necesita espacio, la sentencia puede utilizar el espacio disponible, pero solo después de que la otra transacción se confirme.
Consulte también: Guía del administrador de Oracle AI Database para obtener información sobre la compresión avanzada de filas
Optimización mediante la fusión del espacio fragmentado
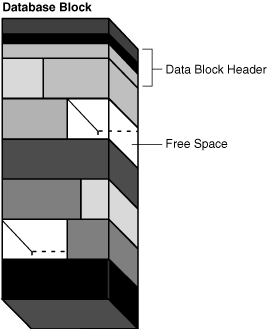
El espacio liberado puede ser o no contiguo al área principal de espacio libre en un bloque de datos. El espacio libre no contiguo se denomina espacio fragmentado.
En la siguiente figura, se muestra un bloque de datos con espacio libre no contiguo.
Figura 11: Bloque de datos con espacio fragmentado
Descripción de la ilustración cncpt210.gif
Oracle AI Database fusiona de forma automática y transparente el espacio libre de un bloque de datos solo cuando se cumplen las siguientes condiciones:
-
Una sentencia
INSERToUPDATEintenta utilizar un bloque que contiene suficiente espacio libre para contener una nueva parte de fila. -
El espacio libre está fragmentado para que la parte de la fila no se pueda insertar en una sección contigua del bloque.
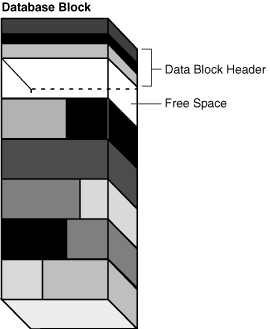
Después de la fusión, la cantidad de espacio libre es idéntica a la cantidad anterior a la operación, pero el espacio ahora es contiguo. La Figura 15-12 muestra un bloque de datos después de la fusión del espacio.
Figura 12: Bloque de datos después de fusionar el espacio libre
Descripción de la ilustración cncpt211.gif
Oracle AI Database realiza la fusión solo en las situaciones anteriores porque, de lo contrario, el rendimiento disminuiría debido a la fusión continua del espacio libre en los bloques de datos.
Filas Encadenadas y Migradas
Oracle AI Database utiliza el encadenamiento y la migración para gestionar las filas que son demasiado grandes para caber en un solo bloque. Nota: Una fila encadenada de una tabla estándar es diferente de una cadena de filas de una tabla de cadenas de bloques. Oracle AI Database utiliza diferentes tecnologías para gestionar filas en una tabla de blockchain.
Las situaciones posibles son las siguientes:
-
La fila es demasiado grande para un bloque de datos la primera vez que se inserta.
En el encadenamiento de filas, Oracle AI Database almacena los datos de la fila en una cadena de uno o más bloques de datos reservados para el segmento. El encadenamiento de filas se produce con mayor frecuencia con filas grandes. Entre los ejemplos se incluyen filas que contienen una columna del tipo de dato
LONGoLONG RAW, o una fila con un gran número de columnas. En estos casos no se puede evitar la encadenación de filas. -
Se actualiza una fila que originalmente cabía en un bloque de datos para que la longitud total de la fila aumente, pero no hay suficiente espacio libre para contener la fila actualizada.
En migración de filas, Oracle AI Database mueve toda la fila a un nuevo bloque de datos, suponiendo que la fila pueda caber en un nuevo bloque. La parte de fila original de una fila migrada contiene un puntero o una "dirección de reenvío" al nuevo bloque que contiene la fila migrada. El ID de fila de una fila migrada no cambia.
-
Una fila tiene más de 255 columnas.
Oracle AI Database solo puede almacenar 255 columnas en una fila. Por lo tanto, si inserta una fila en una tabla que tiene 1000 columnas, la base de datos crea 4 partes de fila, normalmente encadenadas en varios bloques.
La Figura 15-13 muestra la inserción de una fila grande en un bloque de datos. La fila es demasiado grande para el bloque izquierdo, por lo que la base de datos encadena la fila colocando la primera parte de la fila en el bloque izquierdo y la segunda parte de la fila en el bloque derecho.
Figura 13: Encadenamiento de filas
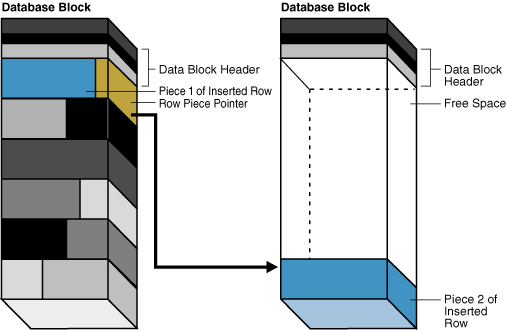
Descripción de la ilustración cncpt316.gif
Figura 15-14, el bloque izquierdo contiene una fila que se actualiza para que la fila sea ahora demasiado grande para el bloque. La base de datos mueve toda la fila al bloque derecho y deja un puntero a la fila migrada en el bloque izquierdo.
Figura 14: Migración de Filas
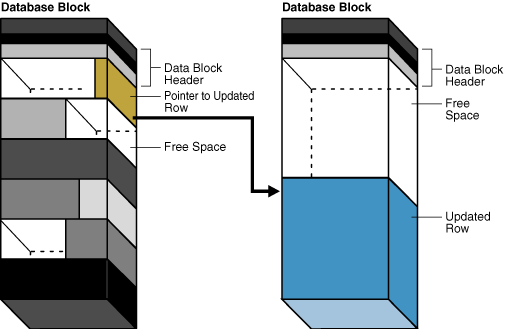
Descripción de la ilustración cncpt306.gif
Cuando una fila se encadena o se migra, la E/S necesaria para recuperar los datos aumenta. Esta situación se debe a que Oracle AI Database debe explorar varios bloques para recuperar la información de la fila. Por ejemplo, si la base de datos realiza una E/S para leer un índice y una E/S para leer una fila de tabla no migrada, se necesita una E/S adicional para obtener los datos de una fila migrada.
El Asesor de Segmentos, que se puede ejecutar de forma manual y automática, es un componente de Oracle AI Database que identifica los segmentos que tienen espacio disponible para la reclamación. El asesor puede ofrecer consejos sobre objetos que tienen mucho espacio libre o demasiadas filas encadenadas.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a reclamar espacio desperdiciado
-
Oracle AI Database Performance Tuning Guide para obtener más información sobre la reducción de filas encadenadas y migradas
Visión General de los Bloques de Índice
Un bloque de índice es un tipo especial de bloque de datos que gestiona el espacio de forma diferente a los bloques de tabla. Oracle AI Database utiliza bloques de índice para gestionar el espacio de almacenamiento lógico en un índice.
-
Tipos de bloques de índice: un índice contiene un bloque raíz, bloques de rama y bloques de hoja.
-
Las entradas de índice Almacenamiento de Entradas de Índice se almacenan en bloques de índice de la misma forma que las filas de tabla de un bloque de datos. Las entradas de índice de la parte de bloque no se almacenan en orden binario, sino en una pila.
-
Reutilización de ranuras en un bloque de índice La base de datos puede reutilizar el espacio dentro de un bloque de índice.
-
La fusión de índices de coalescing an Index Block compacta los datos de índice existentes en su lugar y, si la reorganización libera bloques, deja los bloques libres en la estructura de índice. Por lo tanto, la fusión no libera bloques de índice para otros usos ni hace que el índice reasigne bloques.
Tipos de Bloques de Índice
Un índice contiene un bloque raíz, bloques de rama y bloques de hoja.
Los tipos de bloques se definen de la siguiente manera:
-
Bloque raíz
Este bloque identifica el punto de entrada en el índice.
-
Bloques de rama
Las bases de datos navegan por los bloques de rama al buscar una clave de índice.
-
Bloques de Hoja
Estos bloques contienen los ID de fila de valores clave indexados que apuntan a las filas asociadas. Los bloques de hoja almacenan los valores clave en orden ordenado para que la base de datos pueda buscar de forma eficaz todas las filas de un rango de valores clave.
Almacenamiento de Entradas de Índice
Las entradas de índice se almacenan en bloques de índice de la misma forma que las filas de tabla en un bloque de datos. Las entradas de índice en la parte de bloque no se almacenan en orden binario, sino en una pila.
La base de datos gestiona el directorio de filas en un bloque de índice de forma diferente al directorio en un bloque de datos. Las entradas del directorio de filas (no las entradas del cuerpo del bloque de índice) se ordenan por valor clave. Por ejemplo, en el directorio de filas, la entrada de directorio para la clave de índice 000000 precede a la entrada de directorio para la clave de índice 111111, etc.
El orden de las entradas en el directorio de filas mejora la eficacia de las exploraciones de índices. En una exploración de rango, la base de datos debe leer todas las claves de índice especificadas en el rango. La base de datos recorre los bloques de rama para identificar el bloque de hoja que contiene la primera clave. Puesto que las entradas del directorio de filas están ordenadas, la base de datos puede utilizar una búsqueda binaria para buscar la primera clave de índice del rango y, a continuación, avanzar secuencialmente por las entradas del directorio de filas hasta que encuentre la última clave. De esta forma, la base de datos evita leer todas las claves del cuerpo del bloque de hoja.
Consulte también: "Sobrecarga de Bloques de Datos"
Reutilización de espacios en un bloque de índices
La base de datos puede reutilizar el espacio dentro de un bloque de índice.
Por ejemplo, una aplicación puede insertar un valor en una columna y, a continuación, suprimir el valor. Cuando una fila necesita espacio, la base de datos puede reutilizar la ranura de índice que anteriormente ocupaba el valor suprimido.
Un bloque de índice suele tener muchas más filas que un bloque de tabla organizado por pilas. La capacidad de almacenar muchas filas en un único bloque de índice facilita a la base de datos el mantenimiento de un índice, ya que evita frecuentes divisiones del bloque para almacenar nuevos datos.
Un índice no se puede fusionar a sí mismo, aunque puede hacerlo manualmente con una sentencia ALTER INDEX con las opciones REBUILD o COALESCE. Por ejemplo, si rellena una columna con los valores 1 a 500000 y, a continuación, suprime las filas que contienen números pares, el índice contendrá 250 000 espacios vacíos. La base de datos reutiliza un espacio solo si puede insertar datos que encajen en un bloque de índice que contenga un espacio vacío.
Fusión de un Bloque de Índice
La fusión de índices compacta los datos de índice existentes y, si la reorganización libera bloques, deja los bloques libres en la estructura de índice. Por lo tanto, la fusión no libera bloques de índice para otros usos ni hace que el índice reasigne bloques.
Oracle AI Database no compacta automáticamente el índice: debe ejecutar una sentencia ALTER INDEX con las opciones REBUILD o COALESCE. La Figura 15-15 muestra un índice de la columna employees.department_id antes de que se fusione el índice. Los primeros tres bloques de hojas solo están parcialmente llenos, como lo indican las líneas de relleno grises.
Figura 15: Índice antes de la fusión
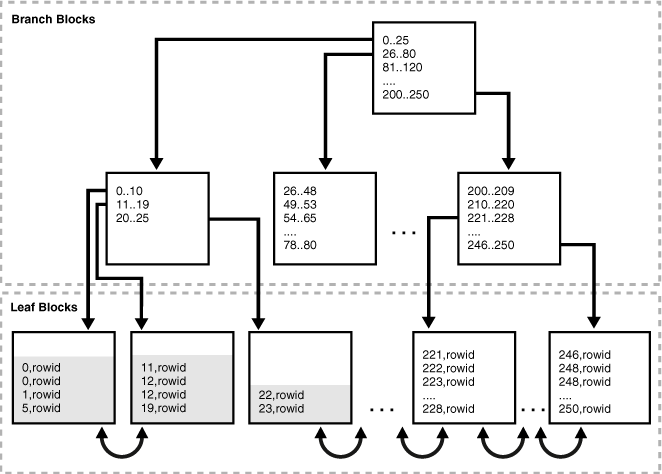
Descripción de la ilustración cncpt294.gif
La Figura 15-16 muestra el índice en la Figura 15-15 después de que se haya fusionado el índice. Los dos primeros bloques de hojas ahora están llenos, como lo indican las líneas de relleno grises, y el tercer bloque de hojas se ha liberado.
Figura 16: Índice después de la fusión
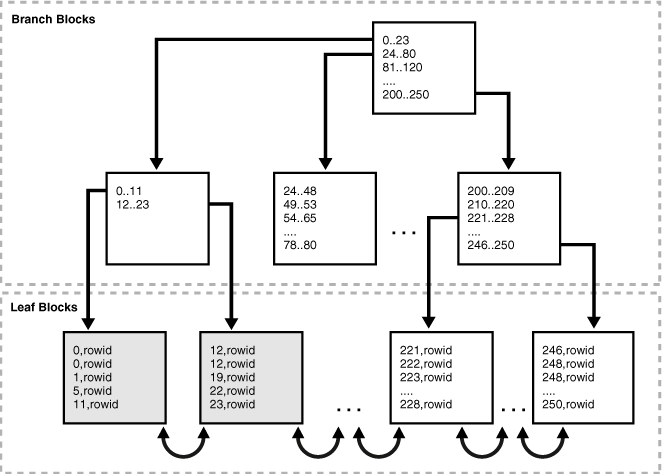
Descripción de la ilustración cncpt295.gif
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a fusionar y reconstruir índices
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre la sentencia
COALESCE
Visión General de Extensiones
Una extensión es una unidad de almacenamiento de base de datos formada por bloques de datos lógicamente contiguos. Los bloques de datos se pueden distribuir físicamente en el disco debido a la segmentación RAID y las implementaciones del sistema de archivos.
-
Asignación de extensiones Por defecto, la base de datos asigna una extensión inicial para un segmento de datos cuando se crea el segmento. Una extensión siempre está contenida en un archivo de datos.
-
Desasignación de Extensiones En general, las extensiones de un segmento de usuario no vuelven al tablespace a menos que borre el objeto mediante una sentencia
DROP. -
Parámetros de almacenamiento para extensiones Cada segmento se define mediante parámetros de almacenamiento expresados en términos de extensiones. Estos parámetros controlan cómo Oracle AI Database asigna espacio libre para un segmento.
Asignación de extensiones
Por defecto, la base de datos asigna una extensión inicial para un segmento de datos cuando se crea el segmento. Una extensión siempre está contenida en un archivo de datos.
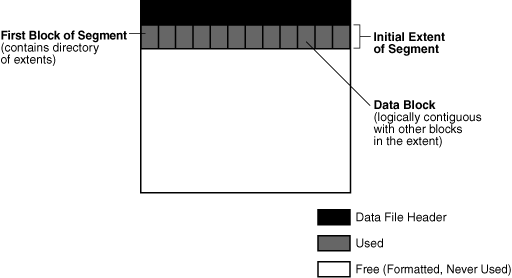
Aunque no se han agregado datos al segmento, los bloques de datos de la extensión inicial se reservan exclusivamente para este segmento. El primer bloque de datos de cada segmento contiene un directorio de las extensiones del segmento. La Figura 15-17 muestra la extensión inicial en un segmento de un archivo de datos que anteriormente no contenía datos.
Figura 17: Extensión inicial de un segmento
Descripción de la ilustración cncpt274.gif
Si la extensión inicial se llena y se necesita más espacio, la base de datos asigna automáticamente una extensión incremental para este segmento. Una extensión incremental es una extensión posterior creada para el segmento.
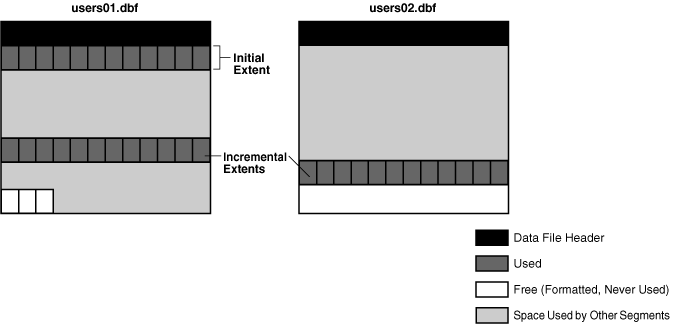
El algoritmo de asignación depende de si el tablespace está gestionado localmente o gestionado por diccionario. En el caso gestionado localmente, la base de datos busca en el mapa de bits de un archivo de datos bloques libres adyacentes. Si el archivo de datos no tiene suficiente espacio, la base de datos busca en otro archivo de datos. Las extensiones de un segmento siempre están en el mismo tablespace, pero pueden estar en archivos de datos diferentes. La Figura 15-18 muestra que la base de datos puede asignar extensiones para un segmento en cualquier archivo de datos del tablespace. Por ejemplo, el segmento puede asignar la extensión inicial en users01.dbf, asignar la primera extensión incremental en users02.dbf y, a continuación, asignar la siguiente extensión en users01.dbf.
Figura 18: Extensión incremental de un segmento
Descripción de la ilustración cncpt278.gif
Los bloques de una extensión recién asignada, aunque eran libres, pueden no estar vacíos de datos antiguos. En ASSM, Oracle AI Database formatea los bloques de una extensión recién asignada cuando comienza a utilizar la extensión, pero solo según sea necesario. Nota: Esta sección se aplica a las operaciones en serie, en las que un proceso de servidor analiza y ejecuta una sentencia. La base de datos asigna extensiones de forma diferente en sentencias SQL paralelas, que implican varios procesos de servidor.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a asignar extensiones manualmente
Desasignación de extensiones
En general, las extensiones de un segmento de usuario no vuelven al tablespace a menos que borre el objeto mediante una sentencia DROP.
Por ejemplo, si suprime todas las filas de una tabla, la base de datos no reclamará los bloques de datos para que los utilicen otros objetos del tablespace. También puede borrar el segmento mediante el paquete DBMS_SPACE_ADMIN.
Nota: En un segmento de deshacer, Oracle AI Database anula periódicamente la asignación de una o más extensiones si tiene el tamaño OPTIMAL especificado o si la base de datos está en el modo de gestión automática de deshacer.
En algunas circunstancias, puede desasignar manualmente el espacio. El Asesor de Segmentos de Oracle ayuda a determinar si un objeto tiene espacio disponible para la reclamación en función del nivel de fragmentación en el objeto. Las siguientes técnicas pueden liberar extensiones:
-
Utilice una reducción de segmento en línea para reclamar espacio fragmentado en un segmento. La reducción de segmentos es una operación en línea y en el lugar. En general, la compactación de datos conduce a una mejor utilización de la caché y requiere que se lean menos bloques en una exploración completa de tablas.
-
Mueva los datos de una tabla o partición de tabla no particionada a un nuevo segmento y, opcionalmente, a un tablespace diferente para el que tenga cuota.
-
Volver a crear o fusionar el índice.
-
Truncar una tabla o un cluster de tabla, lo que elimina todas las filas. Por defecto, Oracle AI Database desasigna todo el espacio utilizado por las filas eliminadas, excepto el especificado por el parámetro de almacenamiento
MINEXTENTS. A partir de Oracle Database 11g Versión 2 (11.2.0.2), también puede utilizarTRUNCATEcon la opciónDROP ALL STORAGEpara borrar segmentos completos. -
Desasigne el espacio no utilizado, lo que libera el espacio no utilizado en el extremo superior del límite superior del segmento de base de datos y hace que el espacio esté disponible para otros segmentos del tablespace.
Cuando se liberan extensiones, Oracle AI Database modifica el bitmap del archivo de datos para que los tablespaces gestionados localmente reflejen las extensiones recuperadas como espacio disponible. Los datos de los bloques de extensiones liberadas se vuelven inaccesibles.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a reclamar espacio de segmento
Parámetros de almacenamiento para extensiones
Cada segmento se define mediante parámetros de almacenamiento expresados en términos de extensiones. Estos parámetros controlan cómo Oracle AI Database asigna espacio libre para un segmento.
La configuración de almacenamiento se determina en el siguiente orden de prioridad, con la configuración superior en la lista que sustituye la configuración inferior en la lista:
-
Cláusula de almacenamiento de segmentos
-
Cláusula de almacenamiento de tablespace
-
Valor por defecto de Oracle AI Database
Un tablespace gestionado localmente puede tener tamaños de extensión uniformes o tamaños de extensión variables determinados automáticamente por el sistema:
-
Si se trata de extensiones uniformes, puede especificar un tamaño de extensión o utilizar el tamaño por defecto de 1 MB. Todas las extensiones del tablespace son de este tamaño. Los tablespaces temporales gestionados localmente solo pueden utilizar este tipo de asignación.
-
Para las extensiones asignadas automáticamente, Oracle AI Database determina el tamaño óptimo de las extensiones adicionales.
Para los tablespaces gestionados localmente, algunos parámetros de almacenamiento no se pueden especificar en el nivel de tablespace. Sin embargo, puede especificar estos parámetros en el nivel de segmento. En este caso, la base de datos utiliza todos los parámetros juntos para calcular el tamaño inicial del segmento. Los algoritmos internos determinan el tamaño posterior de cada extensión.
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener más información sobre las consideraciones de gestión de extensiones al crear un tablespace gestionado localmente
-
Referencia de lenguaje SQL de Oracle AI Database para obtener información sobre las opciones de la cláusula de almacenamiento
Visión General de Segmentos
Un segmento es un juego de extensiones que contiene todos los datos de una estructura de almacenamiento lógico dentro de un tablespace.
Por ejemplo, Oracle AI Database asigna una o más extensiones para formar el segmento de datos de una tabla. La base de datos también asigna una o más extensiones para formar el segmento de índice para un índice en una tabla.
Oracle AI Database gestiona el espacio de segmento de forma automática o manual. En esta sección se asume el uso de ASSM.
-
Segmentos de usuario Un único segmento de datos de una base de datos almacena los datos de un objeto de usuario.
-
Segmentos temporales Al procesar una consulta, Oracle AI Database suele requerir un espacio de trabajo temporal para etapas intermedias de ejecución de sentencias SQL.
-
Deshacer segmentos Oracle AI Database mantiene registros de las acciones de las transacciones, conocidas colectivamente como datos de deshacer.
-
Espacio de segmento y marca de agua alta Para gestionar el espacio, Oracle AI Database realiza un seguimiento del estado de los bloques en el segmento. El límite superior (HWM) es el punto de un segmento más allá del cual los bloques de datos no tienen formato y nunca se han utilizado. Consulte también: "Gestión de Espacio Lógico" para obtener más información sobre ASSM
Segmentos de Usuario
Un único segmento de datos de una base de datos almacena los datos de un objeto de usuario.
Hay diferentes tipos de segmentos. Entre los ejemplos de segmentos de usuarios se incluyen:
-
Tabla, partición de tabla o cluster de tabla
-
LOB o partición LOB
-
Partición de índice o índice
Cada partición de objeto y objeto no particionada se almacena en su propio segmento. Por ejemplo, si un índice tiene cinco particiones, cinco segmentos contienen los datos del índice.
- Creación de Segmentos de Usuario Por defecto, la base de datos utiliza la creación de segmentos diferidos para actualizar solo los metadatos de la base de datos al crear tablas, índices y particiones.
Creación de segmentos de usuarios
Por defecto, la base de datos utiliza la creación de segmentos diferidos para actualizar solo los metadatos de la base de datos al crear tablas, índices y particiones.
Cuando un usuario inserta la primera fila en una tabla o partición, la base de datos crea segmentos para la tabla o partición, sus columnas LOB y sus índices. La creación diferida de segmentos evita el uso innecesario de recursos de base de datos. Por ejemplo, la instalación de una aplicación puede crear miles de objetos, lo que consume mucho espacio en disco. Muchos de estos objetos nunca se pueden utilizar.
El paquete DBMS_SPACE_ADMIN gestiona segmentos para objetos vacíos. Puede utilizar este paquete PL/SQL para realizar lo siguiente:
-
Materializar manualmente segmentos para tablas o particiones vacías que no tienen segmentos creados
-
Eliminar segmentos de tablas o particiones vacías que actualmente tienen un segmento vacío asignado
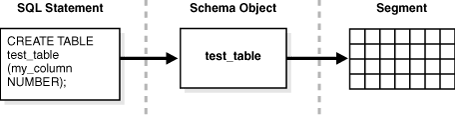
Para ilustrar mejor la relación entre la creación de objetos y la creación de segmentos, asuma que la creación de segmentos diferidos está desactivada. Puede crear una tabla de la siguiente manera:
CREATE TABLE test_table (my_column NUMBER);Como se muestra en la Figura 15-19, la base de datos crea un segmento para la tabla.
Figura 19: Creación de un segmento de usuario
Descripción de la ilustración cncpt246.gif
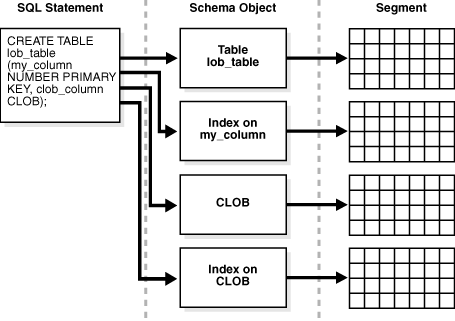
Al crear una tabla con una clave primaria o clave única, Oracle AI Database crea automáticamente un índice para esta clave. De nuevo, suponga que la creación de segmentos diferidos está desactivada. Puede crear una tabla de la siguiente manera:
CREATE TABLE lob_table (my_column NUMBER PRIMARY KEY, clob_column CLOB);La Figura 15-20 muestra que los datos de lob_table se almacenan en un segmento, mientras que el índice creado implícitamente está en un segmento diferente. Además, los datos CLOB se almacenan en su propio segmento, al igual que su índice CLOB asociado. Por lo tanto, la sentencia CREATE TABLE da como resultado la creación de cuatro segmentos diferentes.
Figura 20: Varios segmentos
Descripción de la ilustración cncpt245.gif
Nota: Los segmentos de una tabla y el índice de esta tabla no tienen que ocupar el mismo tablespace.
La base de datos asigna una o más extensiones cuando se crea un segmento. Los parámetros de almacenamiento para el objeto determinan cómo se asignan las extensiones de cada segmento. Los parámetros afectan a la eficacia de la recuperación y el almacenamiento de datos para el segmento de datos asociado al objeto.
Consulte además:
-
Oracle AI Database SecureFiles y Large Objects Developer's Guide para obtener más información sobre las líneas de negocio internas
-
Oracle AI Database Administrator's Guide para aprender a gestionar la creación diferida de segmentos
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis
CREATE TABLE
Segmentos Temporales
Al procesar una consulta, Oracle AI Database a menudo requiere un espacio de trabajo temporal para etapas intermedias de la ejecución de sentencias SQL.
Las operaciones habituales que pueden requerir un segmento temporal incluyen la ordenación, el hashing y la fusión de bitmaps. Al crear un índice, Oracle AI Database también coloca segmentos de índice en segmentos temporales y, a continuación, los convierte en segmentos permanentes cuando se completa el índice.
Oracle AI Database no crea un segmento temporal si se puede realizar una operación en la memoria. Sin embargo, si no es posible el uso de memoria, la base de datos asigna automáticamente un segmento temporal en el disco.
-
Asignación de segmentos temporales para consultas Oracle AI Database asigna segmentos temporales para consultas según sea necesario durante una sesión de usuario y los borra cuando finaliza la consulta. Los cambios en los segmentos temporales no se registran en el redo log en línea, excepto para las operaciones de gestión de espacio en el segmento temporal.
-
Asignación de segmentos para tablas e índices temporales Oracle AI Database puede asignar segmentos temporales para tablas temporales y sus índices.
Asignación de segmentos temporales para consultas
Oracle AI Database asigna segmentos temporales para consultas según sea necesario durante una sesión de usuario y los borra cuando finaliza la consulta. Los cambios en los segmentos temporales no se registran en el redo log en línea, excepto para las operaciones de gestión de espacio en el segmento temporal.
La base de datos crea segmentos temporales en el tablespace temporal asignado al usuario. Las características de almacenamiento por defecto del tablespace determinan las características de las extensiones del segmento temporal. Debido a que la asignación y la desasignación de segmentos temporales se producen con frecuencia, la mejor práctica es crear al menos un tablespace especial para los segmentos temporales. La base de datos distribuye la E/S entre los discos y evita la fragmentación de SYSTEM y otros tablespaces con segmentos temporales.
Nota: Cuando SYSTEM se gestiona localmente, debe definir un tablespace temporal por defecto al crear la base de datos. No se puede utilizar un tablespace SYSTEM gestionado localmente para el almacenamiento temporal por defecto.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a crear tablespaces temporales
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
CREATE TEMPORARY TABLESPACE
Asignación de Segmentos para Tablas e Índices Temporales
Oracle AI Database puede asignar segmentos temporales para tablas temporales y sus índices.
Las tablas temporales mantienen datos que sólo existen mientras dure una transacción o sesión. Cada sesión solo accede a las extensiones asignadas para sí misma y no puede acceder a las extensiones asignadas para otras sesiones.
Oracle AI Database asigna segmentos para una tabla temporal global cuando se produce la primera INSERT en la tabla y para una tabla temporal privada solo cuando es necesario. La inserción se puede producir de forma explícita o debido a CREATE TABLE AS SELECT. La base de datos asigna los segmentos para la tabla y sus índices, crea la página raíz para los índices y asigna los segmentos LOB.
Un tablespace temporal del usuario actual asigna segmentos para una tabla temporal. Por ejemplo, el tablespace temporal asignado a user1 es temp1 y el tablespace temporal asignado a user2 es temp2. En este caso, user1 almacena datos temporales en los segmentos temp1, mientras que user2 almacena datos temporales en los segmentos temp2.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a crear tablas temporales
Segmentos de deshacer
Oracle AI Database mantiene registros de las acciones de las transacciones, conocidas colectivamente como datos de deshacer.
Oracle AI Database utiliza datos de deshacer para realizar lo siguiente:
-
Realizar rollback de una transacción activa
-
Recuperar una transacción terminada
-
Proporcionar consistencia de lectura
-
Realizar algunas operaciones de flashback lógicas
Oracle AI Database almacena datos de deshacer dentro de la base de datos en lugar de en logs externos. Los datos de deshacer se almacenan en bloques que se actualizan al igual que los bloques de datos, con cambios en estos bloques que generan registros de redo. De esta forma, Oracle AI Database puede acceder eficazmente a los datos de deshacer sin necesidad de leer logs externos.
Los datos de deshacer de los objetos permanentes se almacenan en un tabla de deshacer. Oracle AI Database proporciona un mecanismo totalmente automatizado, conocido como modo de gestión automática de deshacer, para gestionar segmentos de deshacer y espacio en un tablespace de deshacer.
La base de datos separa los datos de deshacer en dos flujos. Un flujo de deshacer temporal encapsula sólo los registros de deshacer generados por los cambios realizados en los objetos temporales, mientras que un flujo de deshacer permanente encapsula sólo los registros de deshacer de los objetos permanentes. La base de datos gestiona los procesos de deshacer temporales y permanentes de forma independiente. La separación de deshacer reduce el almacenamiento y mejora el rendimiento al hacer lo siguiente:
-
Permite configurar tamaños de tablespace permanentes y de deshacer que se ajusten mejor a las cargas de trabajo de las tablas permanentes y temporales
-
Reducción del tamaño de redo escrito en el redo log en línea
-
Evitar la necesidad de realizar copias de seguridad de datos de deshacer temporales
En una instancia de Active Data Guard, DML en tablas temporales globales necesita que el proceso de deshacer se genere en segmentos de deshacer temporales.
-
Deshacer Segmentos y Transacciones Cuando se inicia una transacción, la base de datos enlaza (asigna) la transacción a un segmento de deshacer y, por lo tanto, a una tabla de transacciones, en el tablespace de deshacer actual. En raras circunstancias, si la instancia de base de datos no tiene un tablespace de deshacer designado, la transacción se enlaza al segmento de deshacer del sistema.
-
Restitución de transacciones Cuando se ejecuta una sentencia
ROLLBACK, la base de datos utiliza registros de deshacer para realizar un rollback de los cambios realizados en la base de datos por la transacción sin confirmar. -
Segmentos de Deshacer Temporales Un segmento de deshacer temporal es un contenedor de gestión de espacio opcional solo para datos de deshacer temporales.
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener más información sobre los segmentos de deshacer temporales
-
Oracle AI Database Reference para obtener más información sobre el parámetro de inicialización
TEMP_UNDO_ENABLED
Deshacer segmentos y transacciones
Cuando se inicia una transacción, la base de datos enlaza (asigna) la transacción a un segmento de deshacer y, por lo tanto, a una tabla de transacciones, en el tablespace de deshacer actual. En raras circunstancias, si la instancia de base de datos no tiene un tablespace de deshacer designado, la transacción se enlaza al segmento de deshacer del sistema.
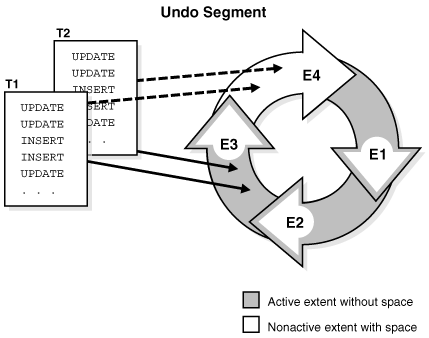
Varias transacciones activas pueden escribir simultáneamente en el mismo segmento de deshacer o en segmentos diferentes. Por ejemplo, las transacciones T1 y T2 pueden escribir en el segmento de deshacer U1 o T1 puede escribir en U1 mientras que T2 escribe en el segmento de deshacer U 2.
Conceptualmente, las extensiones de un segmento de deshacer forman un anillo. Las transacciones se escriben en una extensión de deshacer y, a continuación, en la siguiente extensión del anillo, y así sucesivamente de forma cíclica. En la Figura 15-21 se muestran dos transacciones, T1 y T2, que comienzan a escribir en la tercera extensión (E3) de un segmento de deshacer y continúan escribiendo en la cuarta extensión (E4).
Figura 21: Anillo de extensiones asignadas en un segmento de deshacer
Descripción de la ilustración cncpt328.gif
En un momento dado, una transacción escribe secuencialmente solo en una extensión de un segmento de deshacer, conocida como la extensión actual de la transacción. Varias transacciones activas pueden escribir simultáneamente en la misma extensión actual o en diferentes extensiones actuales. La Figura 15-21 muestra las transacciones T1 y T2 escribiendo simultáneamente en la extensión E3. En una extensión de deshacer, un bloque de datos contiene datos para una sola transacción.
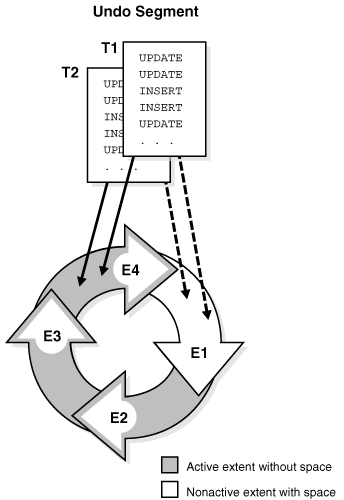
A medida que se completa la extensión de deshacer actual, la primera transacción que necesita espacio comprueba la disponibilidad de la siguiente extensión asignada en el anillo. Si la siguiente extensión no contiene datos de una transacción activa, esta extensión se convierte en la extensión actual. Ahora todas las transacciones que necesitan espacio pueden escribir en la nueva extensión actual. En la Figura 15-22, cuando E4 está lleno, T1 y T2 siguen escribiendo en E1, sobrescribiendo los datos de deshacer no activos en E1.
Figura 22: Uso cíclico de extensiones asignadas en un segmento de deshacer
Descripción de la ilustración cncpt327.gif
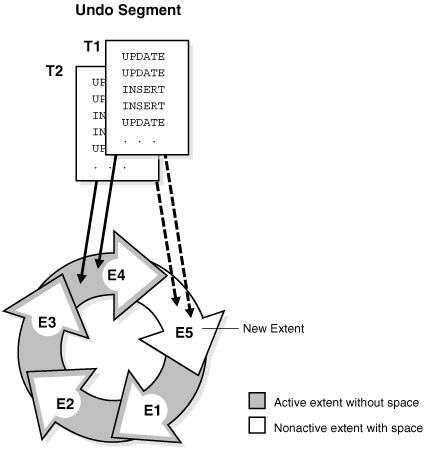
Si la siguiente extensión contiene datos de una transacción activa, la base de datos debe asignar una nueva extensión. La Figura 15-23 muestra un escenario en el que T1 y T2 escriben en E4. Cuando E4 se llena, las transacciones no pueden continuar escribiendo en E1 porque E1 contiene entradas de deshacer activas. Por lo tanto, la base de datos asigna una nueva extensión (E5) para este segmento de deshacer. Las transacciones continúan escribiendo a E5.
Figura 23: Asignación de una nueva extensión para un segmento de deshacer
Descripción de la ilustración cncpt326.gif
Consulte también: Guía del administrador de Oracle AI Database para aprender a gestionar segmentos de deshacer
Rollback de transacción
Cuando se emite una sentencia ROLLBACK, la base de datos utiliza registros de deshacer para realizar un rollback de los cambios realizados en la base de datos por la transacción sin confirmar.
Durante la recuperación, la base de datos realiza un rollback de los cambios sin confirmar aplicados desde el redo log en línea a los archivos de datos. Los registros de deshacer proporcionan consistencia de lectura al mantener la imagen anterior de los datos para los usuarios que acceden a los datos al mismo tiempo que otro usuario los cambia.
Segmentos de Deshacer Temporales
Un segmento de deshacer temporal es un contenedor de gestión de espacio opcional solo para datos de deshacer temporales.
Los registros de deshacer de los cambios en las tablas temporales son tanto específicos de la sesión como útiles solo para la consistencia de lectura y el rollback de transacciones. Antes de Oracle Database 12c, la base de datos siempre almacenaba estos registros en el redo log en línea. Puesto que los cambios en objetos temporales no se registran en el redo log en línea, la escritura de deshacer para objetos temporales en segmentos de deshacer temporales ahorra espacio en los archivos redo log en línea y archivados. La base de datos no registra cambios en el proceso de deshacer ni cambios en la tabla temporal, lo que mejora el rendimiento.
Puede definir el parámetro de inicialización TEMP_UNDO_ENABLED para que las tablas temporales almacenen datos de deshacer en un segmento de deshacer temporal. Cuando este parámetro es TRUE, la base de datos asigna segmentos de deshacer temporales de tablespaces temporales.
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener más información sobre los segmentos de deshacer temporales
-
Oracle AI Database Reference para obtener más información sobre el parámetro de inicialización
TEMP_UNDO_ENABLED
Espacio de segmento y marca de agua alta
Para gestionar el espacio, Oracle AI Database realiza un seguimiento del estado de los bloques en el segmento. El límite superior (HWM) es el punto de un segmento más allá del cual los bloques de datos no tienen formato y nunca se han utilizado.
MSSM utiliza listas de bloques libres para gestionar el espacio de segmento. Al crear la tabla, no se formatea ningún bloque del segmento. Cuando una sesión inserta por primera vez filas en la tabla, la base de datos busca en la lista de bloques libres bloques utilizables. Si la base de datos no encuentra ningún bloque utilizable, preformatea un grupo de bloques, los coloca en la lista de bloques libres y comienza a insertar datos en los bloques. En MSSM, una exploración de tabla completa lee todos los bloques debajo del HWM.
ASSM no utiliza listas de bloques libres, por lo que debe gestionar el espacio de forma diferente. Cuando una sesión inserta por primera vez datos en una tabla, la base de datos formatea un único bloque de bitmap en lugar de formatear previamente un grupo de bloques como en MSSM. El bitmap realiza un seguimiento del estado de los bloques en el segmento, ocupando el lugar de la lista libre. La base de datos utiliza el mapa de bits para buscar bloques libres y, a continuación, formatea cada bloque antes de llenarlo con datos. ASSM distribuye las inserciones entre bloques para evitar problemas de simultaneidad.
Cada bloque de datos de un segmento de ASSM se encuentra en uno de los siguientes estados:
-
Por encima del HWM
Estos bloques no tienen formato y nunca se han utilizado.
-
Por debajo del HWM
Estos bloques se encuentran en uno de los siguientes estados:
-
Asignado, pero actualmente sin formato y sin utilizar
-
Formateado y contiene datos
-
Formato y vacío porque se han suprimido los datos
-
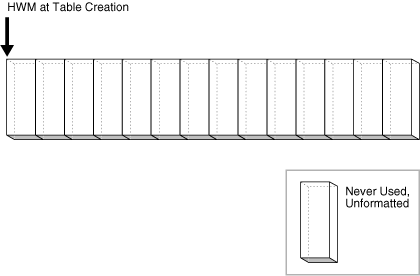
La Figura 15-24 muestra un segmento de ASSM como una serie horizontal de bloques. Al crear la tabla, el HWM está al principio del segmento de la izquierda. Puesto que aún no se ha insertado ningún dato, todos los bloques del segmento no tienen formato y no se utilizan nunca.
Figura 24: HWM en la creación de la mesa
Descripción de la ilustración cncpt275.gif
Supongamos que una transacción inserta filas en el segmento. La base de datos debe asignar un grupo de bloques para contener las filas. Los bloques asignados están por debajo del HWM. La base de datos formatea un bloque de bitmap en este grupo para que contenga los metadatos, pero no formatea los bloques restantes del grupo.
En la Figura 15-25, los bloques por debajo del HWM se asignan, mientras que los bloques por encima del HWM no se asignan ni se formatean. A medida que se producen inserciones, la base de datos puede escribir en cualquier bloque con espacio disponible. La marca de agua baja alta (baja HWM) marca el punto por debajo del cual se sabe que todos los bloques están formateados porque contienen datos o contienen datos anteriormente.
Figura 25: HWM y HWM bajo
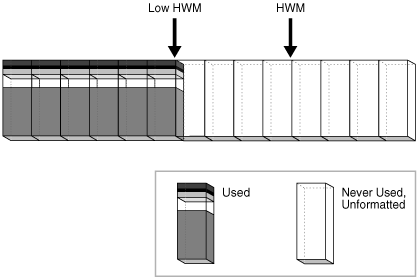
Descripción de la ilustración cncpt276.gif
En la Figura 15-26, la base de datos selecciona un bloque entre el HWM y el HWM bajo y escribe en él. La base de datos podría haber elegido fácilmente cualquier otro bloque entre el HWM y el HWM bajo, o cualquier bloque por debajo del HWM bajo que tuviera espacio disponible. En la Figura 15-26, los bloques a cada lado del bloque recién rellenado no tienen formato.
Figura 26: HWM y HWM bajo
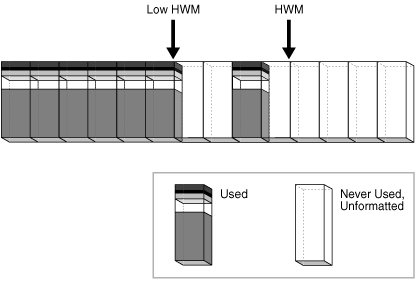
Descripción de la ilustración cncpt333.gif
El bajo HWM es importante en una exploración completa de la tabla. Debido a que los bloques debajo del HWM solo se formatean cuando se utilizan, es posible que algunos bloques no tengan formato, como en la Figura 15-26. Por este motivo, la base de datos lee el bloque de bitmap para obtener la ubicación del HWM bajo. La base de datos lee todos los bloques hasta el bajo HWM porque se sabe que están formateados y, a continuación, lee cuidadosamente solo los bloques formateados entre el bajo HWM y el HWM.
Supongamos que una nueva transacción inserta filas en la tabla, pero el mapa de bits indica que no hay suficiente espacio libre en el HWM. En la Figura 15-27, la base de datos avanza el HWM a la derecha, asignando un nuevo grupo de bloques sin formato.
Figura 27: Avanzando HWM y HWM bajo
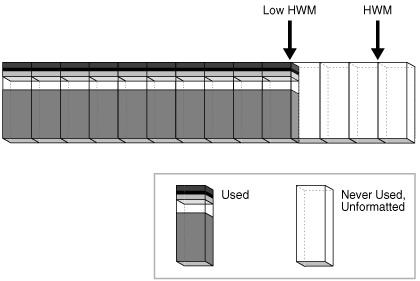
Descripción de la ilustración cncpt277.gif
Cuando los bloques entre el HWM y el HWM bajo están llenos, el HWM avanza a la derecha y el HWM bajo avanza a la ubicación del HWM antiguo. A medida que la base de datos inserta datos a lo largo del tiempo, el HWM sigue avanzando hacia la derecha, con el HWM bajo siempre detrás. A menos que reconstruya, trunque o reduzca manualmente el objeto, el HWM nunca se retira.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a reducir segmentos en línea
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
TRUNCATE TABLE
Visión General de Tablespaces
Un tablespace es un contenedor de almacenamiento lógico para segmentos.
Los segmentos son objetos de base de datos, como tablas e índices, que consumen espacio de almacenamiento. En el nivel físico, un tablespace almacena datos en uno o más archivos de datos o archivos temporales.
-
Tablespaces en un entorno multiinquilino En una CDB, cada PDB y raíz de aplicación tienen su propio juego de tablespaces.
-
Tablespaces Permanentes Un tabla permanente agrupa objetos de esquema persistentes. Los segmentos de los objetos del tablespace se almacenan físicamente en los archivos de datos.
-
Tablespaces Temporales Un tabla temporal contiene datos transitorios que persisten solo durante la duración de una sesión. Ningún objeto de esquema permanente puede residir en un tablespace temporal. Un archivo de plantilla almacena datos de tablespace temporal.
-
Modos de Tablespace El modo de tablespace determina la accesibilidad del tablespace.
-
Tamaño de Archivo de Tablespace Un tablespace es un tabla de archivo grande o un tabla de archivo pequeño. Estos tablespaces no se pueden distinguir en términos de ejecución de sentencias SQL que no hacen referencia explícita a archivos de datos o archivos temporales.
Tablespaces en un Entorno Multi-Inquilino
En una CDB, cada PDB y raíz de aplicación tiene su propio juego de tablespaces.
Cada raíz de CDB, PDB y raíz de aplicación debe tener los tablespaces SYSTEM y SYSAUX. En la siguiente figura se muestran los tablespaces en un contenedor típico.
Figura 28: Tablespaces
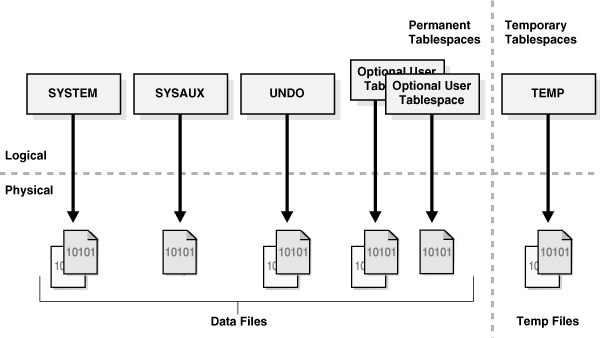
Descripción de la ilustración cncpt319.gif
Una CDB contiene lo siguiente:
-
Un archivo de control
-
Un redo log en línea
-
Uno o más tablespaces de deshacer
Solo un usuario común que tenga los privilegios adecuados y cuyo contenedor actual sea la raíz de CDB puede crear un tablespace de deshacer. En un momento dado, una CDB se encuentra en cualquiera de los siguientes modos de deshacer:
-
Modo de deshacer local
En este caso, cada PDB tiene su propio tablespace de deshacer. Si una CDB utiliza el modo de deshacer local, la base de datos crea automáticamente un tablespace de deshacer en cada PDB. El proceso de deshacer local proporciona ventajas como la capacidad de realizar una clonación en caliente de una PDB y reubicar las PDB rápidamente. Además, el proceso de deshacer local proporciona un nivel de aislamiento y permite operaciones de desconexión y recuperación puntuales más rápidas.
Se necesita un tablespace de deshacer local para cada nodo de un cluster de Oracle Real Application Clusters (RAC) en el que la PDB está abierta. Por ejemplo, si mueve una PDB de un cluster de dos nodos a un cluster de cuatro nodos y si la PDB está abierta en todos los nodos, la base de datos crea automáticamente los tablespaces de deshacer adicionales necesarios. Si vuelve a mover la PDB, puede borrar los tablespaces de deshacer redundantes.
Nota: Por defecto, el Asistente de Configuración de Bases de Datos (DBCA) crea nuevas CDB con deshacer local activado.
-
Modo deshacer compartido
En una CDB de instancia única, solo existe un tablespace de deshacer activo. Para una CDB de Oracle RAC, existe un tablespace de deshacer activo para cada instancia. Todos los tablespaces de deshacer están visibles en los diccionarios de datos y en las vistas relacionadas de todos los contenedores.
El modo de deshacer se aplica a toda la CDB, lo que significa que cada contenedor utiliza deshacer compartido o cada contenedor utiliza deshacer local. Puede cambiar entre modos de deshacer en una CDB, lo que requiere reiniciar la base de datos.
-
-
Tablespaces
SYSTEMySYSAUXpara cada contenedorLa raíz de CDB, cada raíz de aplicación y cada PDB tienen sus propios tablespaces
SYSTEMySYSAUX. Cada contenedor también tiene su propio juego de tablas del diccionario de datos que describen los objetos que residen en el contenedor. -
Cero o más tablespaces creados por el usuario
En un caso de uso típico, cada PDB tiene su propio juego de tablespaces que no son del sistema. Estos tablespaces contienen los datos de los esquemas y objetos definidos por el usuario en la PDB. Puede limitar la cantidad de almacenamiento que utilizan los archivos de datos para una PDB mediante la cláusula
STORAGEen una sentenciaCREATE PLUGGABLE DATABASEoALTER PLUGGABLE DATABASE.El almacenamiento del diccionario de datos en la PDB permite que sea portátil. Puede desconectar una PDB de una CDB y conectarla a una CDB diferente.
-
Un juego de archivos temporales para cada contenedor
Existe un tablespace temporal por defecto para la raíz de CDB y uno para cada raíz de aplicación, PDB de aplicación y PDB.
Ejemplo 15-3 CDB en modo de deshacer local
En este ejemplo se muestran aspectos de la arquitectura de almacenamiento físico de una CDB con dos PDB: hrpdb y salespdb. En este ejemplo, la base de datos utiliza el modo de deshacer local y, por lo tanto, tiene archivos de datos de deshacer en la raíz de CDB, hrpdb y salespdb.
Figura 29: Arquitectura Física de una CDB en Modo de Deshacer Local
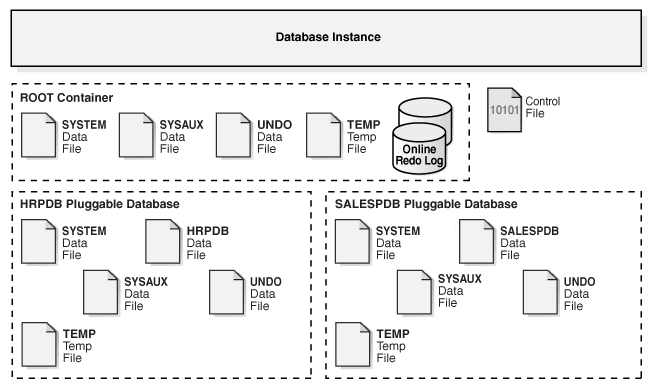
Descripción de la ilustración cncpt386.png
Consulte también: "Separación del Diccionario de Datos en una CDB"
Tablespaces Permanentes
Un tabla permanente agrupa objetos de esquema persistentes. Los segmentos de los objetos del tablespace se almacenan físicamente en los archivos de datos.
A cada usuario de base de datos se le asigna un tablespace permanente por defecto. Una base de datos muy pequeña solo puede necesitar los tablespaces SYSTEM y SYSAUX por defecto. Sin embargo, Oracle recomienda crear al menos un tablespace para almacenar datos de usuario y de aplicación. Puede utilizar tablespaces para alcanzar los siguientes objetivos:
-
Controlar la asignación de espacio en disco para datos de base de datos
-
Asignar una cuota (permiso de espacio o límite) a un usuario de base de datos
-
Poner los tablespaces individuales en línea o fuera de línea sin afectar a la disponibilidad de toda la base de datos
-
Realizar copias de seguridad y recuperación de tablespaces individuales
-
Importar o exportar datos de aplicación mediante la utilidad Oracle Data Pump
-
Crear un tablespace transportable que pueda copiar o mover de una base de datos a otra, incluso entre plataformas
El movimiento de datos mediante el transporte de tablespaces puede ser de orden de magnitud más rápido que la exportación/importación o la descarga/carga de los mismos datos, ya que el transporte de un tablespace solo implica copiar archivos de datos e integrar los metadatos del tablespace. Al transportar tablespaces, también puede mover datos de índice.
-
Tablespace SYSTEM: el tablespace
SYSTEMes un tablespace administrativo necesario que se incluye con la base de datos cuando se crea. Oracle AI Database utilizaSYSTEMpara gestionar la base de datos. -
El tablespace SYSAUX El tablespace
SYSAUXsirve como tablespace auxiliar para el tablespaceSYSTEM. -
Tablespaces de Deshacer Un tablespace de deshacer es un tablespace gestionado localmente reservado para los datos de deshacer gestionados por el sistema.
-
Tablespaces shadow Un tabla shadow es un tablespace de archivo grande destinado a la protección de escritura perdida shadow.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a transportar tablespaces
-
Utilidades de Oracle AI Database para obtener más información sobre Oracle Data Pump
Tablespace SYSTEM
El tablespace SYSTEM es un tablespace administrativo necesario que se incluye con la base de datos cuando se crea. Oracle AI Database utiliza SYSTEM para gestionar la base de datos.
El tablespace SYSTEM incluye la siguiente información, que es propiedad del usuario SYS:
-
El diccionario de datos
-
Tablas y vistas que incluyen información administrativa de la base de datos
-
Objetos almacenados compilados, como disparadores, procedimientos y paquetes
El tablespace SYSTEM se gestiona como cualquier otro tablespace, pero necesita un nivel superior de privilegios y está restringido de alguna forma. Por ejemplo, no puede cambiar el nombre ni borrar el tablespace SYSTEM.
Por defecto, Oracle AI Database define todos los tablespaces de usuario recién creados para que se gestionen localmente. En una base de datos con un tablespace SYSTEM gestionado localmente, no puede crear tablespaces gestionados por diccionario (que están en desuso). Sin embargo, si ejecuta la sentencia CREATE DATABASE manualmente y acepta los valores por defecto, el tablespace SYSTEM está gestionado por diccionario. Puede migrar un tablespace SYSTEM gestionado por diccionario existente a un formato gestionado localmente. Nota: Oracle recomienda utilizar el Asistente de Configuración de Bases de Datos (DBCA) para crear nuevas bases de datos para que todos los tablespaces, incluido SYSTEM, se gestionen localmente por defecto.
Consulte además:
-
"Tablespaces en Línea y Fuera de Línea" para obtener información sobre la condición en línea permanente del tablespace
SYSTEM -
Oracle AI Database Administrator's Guide para aprender a crear o migrar a un tablespace
SYSTEMgestionado localmente -
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
CREATE DATABASE
Tablespace SYSAUX
El tablespace SYSAUX sirve como tablespace auxiliar para el tablespace SYSTEM.
Como SYSAUX es el tablespace por defecto para muchas funciones y productos de Oracle AI Database que anteriormente necesitaban sus propios tablespaces, reduce el número de tablespaces necesarios para la base de datos. También reduce la carga en el tablespace SYSTEM.
La creación o actualización de la base de datos crea automáticamente el tablespace SYSAUX. Durante el funcionamiento normal de la base de datos, la base de datos no permite borrar ni cambiar el nombre del tablespace SYSAUX. Si el tablespace SYSAUX deja de estar disponible, la funcionalidad principal de la base de datos permanece operativa. Las funciones de la base de datos que utilizan el tablespace SYSAUX pueden fallar o funcionar con capacidad limitada.
Consulte también: Guía del administrador de Oracle AI Database para obtener más información sobre el tablespace SYSAUX
Tablespaces de Deshacer
Un tabla de deshacer es un tablespace gestionado localmente reservado para los datos de deshacer gestionados por el sistema.
Al igual que otros tablespaces permanentes, los tablespaces de deshacer contienen archivos de datos. Los bloques de deshacer de estos archivos se agrupan en extensiones.
-
Modo de Gestión de Deshacer Automático Los tablespaces de deshacer necesitan que la base de datos esté en el modo de deshacer automático por defecto.
-
Retención automática de deshacer El período de retención de deshacer es la cantidad mínima de tiempo que Oracle AI Database intenta retener los datos de deshacer antiguos antes de sobrescribirlos. Consulte también: "Deshacer Segmentos"
Modo de gestión automática de deshacer
Los tablespaces de deshacer necesitan que la base de datos esté en el modo de deshacer automático por defecto.
El modo automático elimina las complejidades de administrar manualmente segmentos de deshacer. La base de datos se ajusta automáticamente para proporcionar la mejor retención posible de datos de deshacer para satisfacer las consultas de larga ejecución que puedan necesitar estos datos.
Una nueva instalación de Oracle AI Database crea automáticamente un tablespace de deshacer. Es posible que las versiones anteriores de Oracle AI Database no incluyan un tablespace de deshacer y utilicen segmentos de rollback heredados en su lugar, conocidos como modo de gestión manual de deshacer. Oracle AI Database contiene un asesor de deshacer que proporciona asesoramiento y ayuda a automatizar el entorno de deshacer.
Una base de datos puede contener varios tablespaces de deshacer, pero solo uno puede estar en uso a la vez. Cuando una instancia intenta abrir una base de datos, Oracle AI Database selecciona automáticamente el primer tablespace de deshacer disponible. Si no hay ningún tablespace de deshacer disponible, la instancia se inicia sin un tablespace de deshacer y almacena los datos de deshacer en el tablespace SYSTEM. No se recomienda almacenar datos de deshacer en SYSTEM.
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener más información sobre la gestión automática de deshacer
-
Oracle AI Database Upgrade Guide para aprender a migrar al modo de gestión automática de deshacer
Retención Automática de Deshacer
El período de retención de deshacer es la cantidad mínima de tiempo que Oracle AI Database intenta retener los datos de deshacer antiguos antes de sobrescribirlos.
La retención de deshacer es importante porque las consultas de larga ejecución pueden requerir imágenes de bloque más antiguas para proporcionar consistencia de lectura. Además, algunas funciones de Oracle Flashback pueden depender de la disponibilidad de deshacer.
En general, se recomienda conservar los datos de deshacer antiguos el mayor tiempo posible. Después de confirmar una transacción, los datos de deshacer ya no son necesarios para el rollback o la recuperación de la transacción. La base de datos puede retener los datos de deshacer antiguos si el tablespace de deshacer tiene espacio para nuevas transacciones. Cuando el espacio disponible es bajo, la base de datos comienza a sobrescribir los datos de deshacer antiguos para las transacciones confirmadas.
Oracle AI Database proporciona automáticamente la mejor retención de deshacer posible para el tablespace de deshacer actual. La base de datos recopila estadísticas de uso y ajusta el período de retención según estas estadísticas y el tamaño del tablespace de deshacer. Si el tablespace de deshacer está configurado con la opción AUTOEXTEND y no se especifica el tamaño máximo, el ajuste de retención de deshacer es diferente. En este caso, la base de datos ajusta el período de retención de deshacer para que sea ligeramente más largo que la consulta de ejecución más larga, si el espacio lo permite.
Consulte también: Oracle AI Database Administrator's Guide para obtener más información sobre el ajuste automático de la retención de deshacer
Tablespaces de Sombra
Un tabla shadow es un tablespace de archivo grande destinado a la protección contra escritura perdida shadow.
Nota: La protección contra escritura perdida shadow no está relacionada con la protección contra escritura perdida configurada con el parámetro de inicialización DB_LOST_WRITE_PROTECT y una base de datos en espera.
-
Propósito de los tablespaces shadow La protección de escritura perdida shadow proporciona una detección rápida y una respuesta inmediata a una escritura perdida.
-
Cómo funcionan los tablespaces shadow La protección de escritura perdida requiere dos tablespaces: un tablespace shadow y un tablespace no shadow cuyos bloques son objeto de seguimiento por parte del tablespace shadow.
-
Interfaz de usuario para tablespaces shadow Puede activar y desactivar la protección de escritura perdida mediante el comando
ALTER PLUGGABLE DATABASE. -
Ejemplo: Configuración de Protección de Escritura Perdida Este ejemplo activa el seguimiento de escritura perdida de sombra para un juego de tablespaces.
Objetivo de los Tablespaces shadow
La protección contra escritura perdida shadow proporciona una detección rápida y una respuesta inmediata a una escritura perdida.
Una escritura perdida de bloque de datos se produce cuando un subsistema de E/S reconoce la finalización de la escritura de bloque aunque no se haya producido la escritura o cuando una imagen anterior del bloque sobrescribe la imagen actual.
Una escritura perdida no detectada puede provocar daños en los datos porque los datos incorrectos se pueden utilizar para otras transacciones DML. Por ejemplo, una transacción puede leer datos antiguos e incorrectos de una tabla y, a continuación, actualizar cientos de otras tablas basadas en estos datos. De esta forma, la corrupción de datos se puede difundir en toda la base de datos.
La protección contra escritura perdida shadow proporciona las siguientes ventajas:
-
Detecta una escritura perdida antes de que se utilice para DML estándar, carga de ruta de acceso convencional de SQL*Loader, carga de ruta de acceso directa y copias de seguridad de RMAN.
-
Puede activar la protección de escritura perdida shadow para tablespaces y archivos de datos específicos. No es necesario realizar un seguimiento de todos los datos.
-
Puede sustituir un tablespace shadow por otro para cambiar su configuración o ubicación.
-
Puede suspender y reanudar la protección contra escritura perdida shadow para un tablespace o archivo de datos.
-
Puede activarla o desactivarla para una PDB con una única sentencia
ALTER DATABASE ... LOST WRITE PROTECTION. La tablaPROP$indica si el seguimiento está activado para una PDB.
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre la cláusula LOST WRITE PROTECTION
Funcionamiento de los Tablespaces en Sombra
La protección contra escritura perdida necesita dos tablespaces: un tablespace shadow y un tablespace no shadow cuyos bloques son objeto de seguimiento por parte del tablespace shadow.
En la siguiente figura se proporciona un escenario de ejemplo. Los archivos de datos de los tablespaces TBS1 y TBS2 se rastrean mediante un tablespace shadow. Sólo el tablespace shadow realiza un seguimiento del archivo de datos DBF6 en el tablespace TBS3.
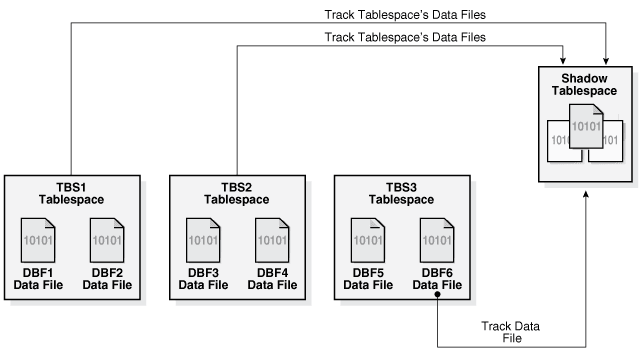
Descripción de la ilustración cncpt390.png
Un archivo de datos con seguimiento se asigna a una extensión shadow en un tablespace shadow. Cada bloque de datos de un archivo de datos con seguimiento tiene una entrada correspondiente en un bloque shadow. Esta entrada contiene el SCN del bloque de datos con seguimiento. Cuando se lee un bloque de datos con seguimiento desde el disco, la protección contra escritura perdida de sombra compara el SCN del bloque en el tablespace de sombra con el SCN de la escritura más reciente en el bloque de datos con seguimiento. Si la entrada shadow tiene un SCN mayor que el bloque de datos que se está leyendo, se ha producido una escritura perdida, lo que indica un error.
El tamaño de la extensión de sombra tiene un espacio adicional significativo para evitar que el cambio de tamaño automático de los archivos de datos provoque que la extensión de sombra crezca demasiado. Si se cambia el tamaño de un archivo de datos con seguimiento de forma manual o automática, y si la extensión shadow necesita aumentar, la base de datos intenta cambiar el tamaño de los datos de seguimiento. Si no hay suficiente espacio en los tablespaces shadow, la base de datos escribe una advertencia en el log de alertas y realiza un seguimiento del mayor número posible de bloques de datos.
Consulte también: Guía del administrador de Oracle AI Database para obtener información sobre cómo gestionar la protección contra escritura perdida shadow
Interfaz de Usuario para Tablespaces shadow
Puede activar y desactivar la protección contra escritura perdida de sombra mediante el comando ALTER PLUGGABLE DATABASE.
Para la protección contra escritura perdida shadow para proteger un tablespace o archivo de datos específicos, se deben cumplir las siguientes condiciones:
-
Debe haber activado la protección de escritura perdida shadow para toda la PDB mediante la sentencia
ALTER PLUGGABLE DATABASE ENABLE LOST WRITE PROTECTION.Nota: En una CDB, si activa la protección de escritura perdida de sombra en la raíz, las PDB no la heredan. Debe activar la protección contra escritura perdida shadow para cada PDB que desee proteger.
-
Debe haber activado la protección de escritura perdida de sombra para que el tablespace o el archivo de datos se protejan mediante la cláusula
ENABLE LOST WRITE PROTECTION.Al activar la protección de escritura perdida shadow para un tablespace, se protegen todos los archivos de datos del tablespace y los archivos de datos agregados al tablespace también se protegen. Tenga en cuenta que no puede activar la protección contra escritura perdida en tablespaces temporales ni en otro tablespace de escritura perdida.
-
Debe haber creado uno o más tablespaces shadow mediante la sentencia
CREATE BIGFILE TABLESPACEcon la cláusulaLOST WRITE PROTECTION.
Oracle AI Database asigna automáticamente un archivo de datos con seguimiento a un tablespace shadow específico. No puede especificar qué tablespace shadow se utiliza para un archivo de datos concreto.
Las siguientes vistas del diccionario de datos supervisan los tablespaces shadow:
-
DBA_TABLESPACESMuestra qué tablespaces son tablespaces shadow mediante consultas.
-
DBA_DATA_FILES.LOST_WRITE_PROTECTMuestra si las protecciones de escritura perdida están activadas para un archivo de datos
-
USER_TABLESPACES.LOST_WRITE_PROTECTMuestra si la protección contra escritura perdida está activada para un tablespace específico.
DBA_DATA_FILESno indica si la escritura perdida está activada para un tablespace: en su lugar, debe consultarUSER_TABLESPACES.
Consulte además:
-
Oracle AI Database Administrator's Guide (Guía del administrador de Oracle AI Database) para aprender a gestionar la protección contra escritura perdida con tablespaces shadow
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre la sentencia
CREATE TABLESPACE -
Referencia de Oracle AI Database para obtener más información sobre
DBA_TABLESPACES
Ejemplo: configuración de protección contra escritura perdida
Este ejemplo activa el seguimiento de escritura perdida de sombra para un juego de tablespaces.
En este ejemplo, su objetivo es proteger los tablespaces salestbs y hrtbs dentro de una PDB. También desea proteger el archivo de datos oetbs01.dbf, y solo este archivo de datos, en el tablespace oetbs. Debe realizar las siguientes acciones:
-
Conéctese a la PDB como administrador.
-
Cree un único tablespace shadow de la siguiente manera:
CREATE BIGFILE TABLESPACE shadow_lwp1 DATAFILE 'shadow_lwp1_df' SIZE 10M LOST WRITE PROTECTION; -
Active la protección contra escritura perdida para la PDB de la siguiente manera:
ALTER DATABASE ENABLE LOST WRITE PROTECTION; -
Active la protección de escritura perdida shadow para los tablespaces
salestbsyhrtbsde la siguiente manera:ALTER TABLESPACE salestbs ENABLE LOST WRITE PROTECTION; ALTER TABLESPACE hrtbs ENABLE LOST WRITE PROTECTION; -
Active la protección contra escritura perdida shadow para el archivo de datos
oetbs01.dbfde la siguiente manera:ALTER DATABASE DATAFILE 'oetbs01.dbf' ENABLE LOST WRITE PROTECTION;
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a gestionar tablespaces shadow
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre la sentencia
CREATE TABLESPACE
Tablespaces Temporales
Un tabla temporal contiene datos transitorios que persisten solo durante una sesión. Ningún objeto de esquema permanente puede residir en un tablespace temporal. Un archivo temporal almacena los datos del tablespace temporal.
Los tablespaces temporales pueden mejorar la simultaneidad de varias operaciones de ordenación que no caben en la memoria. Estos tablespaces también mejoran la eficacia de las operaciones de gestión de espacio durante las ordenaciones.
-
Tablespaces Temporales Compartidos y Locales Los tablespaces temporales son compartidos o locales.
-
Tablespaces Temporales por Defecto A cada cuenta de usuario de base de datos se le asigna un tablespace temporal compartido por defecto. Si la base de datos contiene tablespaces temporales locales, a cada cuenta de usuario también se le asigna un almacenamiento temporal local por defecto.
Tablespaces Temporales Compartidos y Locales
Los tablespaces temporales son compartidos o locales.
Un tabla temporal compartida almacena archivos temporales en un disco compartido, de modo que todas las instancias de base de datos puedan acceder al espacio temporal. En cambio, un tabla temporal local almacena archivos temporales independientes no compartidos para cada instancia de base de datos. Los tablespaces temporales locales son útiles para Oracle Real Application Clusters u Oracle Flex Clusters.
Puede crear tablespaces temporales locales para instancias de base de datos de solo lectura y de lectura/escritura. Cuando muchas instancias de solo lectura acceden a una única base de datos, los tablespaces temporales locales pueden mejorar el rendimiento de las consultas que implican ordenaciones, agregaciones hash y uniones. Las ventajas son:
-
Mejora del rendimiento de E/S mediante el uso de almacenamiento en disco local en lugar de compartido
-
Evitar la costosa gestión de espacio temporal entre instancias
-
Mejora del rendimiento de inicio de la instancia al eliminar la gestión de metadatos de espacio en disco
En la siguiente tabla se comparan las características de los tablespaces temporales locales y compartidos.
Tabla 2 Tablespaces Temporales Locales y Compartidos
| Tablespace Temporal Compartido | Tablespace temporal local |
|---|---|
Se crea con la sentencia CREATE TEMPORARY TABLESPACE. |
Se crea con la sentencia Nota: Los tablespaces temporales locales siempre son un tabla de archivo grande, pero la palabra clave |
| Crea un único tablespace temporal para la base de datos. | Crea tablespaces temporales independientes para cada instancia de base de datos. La opción FOR LEAF crea tablespaces solo para instancias de solo lectura. La opción FOR ALL crea tablespaces para todas las instancias, tanto de solo lectura como de lectura/escritura. |
| Soporta grupos de tablespaces. | No soporta grupos de tablespaces. |
| Almacena metadatos de archivos temporales en el archivo de control. | Almacena metadatos de archivos temporales comunes a todas las instancias del archivo de control y metadatos específicos de la instancia (por ejemplo, los bitmaps para la asignación, los tamaños de archivos temporales actuales y el estado de los archivos) en SGA. |
Consulte también: "Introducción a la instancia de Oracle AI Database"
Tablespaces Temporales por Defecto
Cada cuenta de usuario de base de datos tiene asignado un tablespace temporal compartido por defecto. Si la base de datos contiene tablespaces temporales locales, a cada cuenta de usuario también se le asigna un almacenamiento temporal local por defecto.
Puede especificar un tablespace temporal diferente para una cuenta de usuario con las sentencias CREATE USER o ALTER USER. Oracle AI Database utiliza el tablespace temporal por defecto a nivel de sistema para los usuarios para los que no especifique un tablespace temporal diferente.
-
Creación de Tablespaces Temporales por Defecto Al crear una base de datos, el almacenamiento temporal por defecto depende de si el tablespace
SYSTEMestá gestionado localmente. -
Acceso al almacenamiento temporal Si un usuario tiene asignado un tablespace temporal, la base de datos accede a él primero; de lo contrario, la base de datos accede al tablespace temporal por defecto. Una vez que la base de datos accede a un tablespace temporal para una consulta, no cambia a otro diferente. Consulte también: Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre la sentencia
CREATE USER
Creación de Tablespaces Temporales por Defecto
Al crear una base de datos, el almacenamiento temporal por defecto depende de si el tablespace SYSTEM está gestionado localmente.
En la siguiente tabla se muestra cómo Oracle AI Database selecciona los tablespaces temporales por defecto al crear la base de datos.
Tabla 3 Creación de tablespaces temporales por defecto
| ¿Está gestionado localmente el tablespace SYSTEM? | ¿Especifica la sentencia CREATE DATABASE un tablespace temporal por defecto? | A continuación, la base de datos... |
|---|---|---|
| Sí | Sí | Utiliza el tablespace especificado como valor por defecto. |
| Sí | No | Crea un tablespace temporal. |
| No | Sí | Utiliza el tablespace especificado como valor por defecto. |
| No | No | Utiliza SYSTEM para el almacenamiento temporal por defecto. La base de datos escribe una advertencia en el log de alertas que indica que se recomienda un tablespace temporal por defecto. |
Después de crear la base de datos, puede cambiar el tablespace temporal por defecto para la base de datos con la sentencia ALTER DATABASE DEFAULT TEMPORARY TABLESPACE. Nota: No puede hacer que un tablespace temporal por defecto sea permanente.
Consulte además:
-
"Permanent and Temporal Data Files" (Archivos de datos permanentes y temporales)
-
Oracle AI Database Administrator's Guide para aprender a crear un tablespace temporal por defecto
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis de la cláusula
DEFAULT TEMPORARY TABLESPACEdeCREATE DATABASEyALTER DATABASE
Acceso al almacenamiento temporal
Si un usuario tiene asignado un tablespace temporal, la base de datos accede a él primero; de lo contrario, la base de datos accede al tablespace temporal por defecto. Una vez que la base de datos accede a un tablespace temporal para una consulta, no cambia a otro diferente.
Una consulta de usuario puede acceder al almacenamiento temporal local o compartido. Además, un usuario puede tener un tablespace temporal local por defecto asignado para instancias de sólo lectura y un tablespace temporal local por defecto diferente asignado para instancias de lectura/escritura.
Para las instancias de lectura/escritura, la base de datos otorga mayor prioridad a los tablespaces temporales compartidos. Para las instancias de solo lectura, la base de datos otorga mayor prioridad a los tablespaces temporales locales. Si la instancia de base de datos es de lectura/escritura, la base de datos busca espacio en el siguiente orden:
-
¿Se asigna un tablespace temporal compartido al usuario?
-
¿Se asigna un tablespace temporal local al usuario?
-
¿Tiene espacio el tablespace temporal por defecto de la base de datos?
Si la respuesta a cualquier pregunta anterior es sí, la base de datos para la búsqueda y asigna espacio del tablespace especificado; de lo contrario, el espacio se asigna desde el tablespace temporal local por defecto de la base de datos.
Si la instancia de base de datos es de solo lectura, la base de datos busca espacio en el siguiente orden:
-
¿Se asigna un tablespace temporal local al usuario?
-
¿Tiene espacio el tablespace temporal local por defecto de la base de datos asignado?
-
¿Se asigna un tablespace temporal compartido al usuario?
Si la respuesta a cualquier pregunta anterior es sí, la base de datos para la búsqueda y asigna espacio del tablespace especificado; de lo contrario, se asigna espacio del tablespace temporal compartido por defecto de la base de datos.
Modos de Tablespace
El modo de tablespace determina la accesibilidad del tablespace.
-
Tablespaces de Lectura/Escritura y de Sólo Lectura Cada tablespace se encuentra en modo de escritura que especifica si se puede escribir en él.
-
Tablespaces en Línea y Fuera de Línea Un tablespace puede estar en línea (accesible) o fuera de línea (no accesible) siempre que la base de datos esté abierta.
Tablespaces de Lectura/Escritura y de Sólo Lectura
Cada tablespace se encuentra en modo de escritura que especifica si se puede escribir en él.
Los modos mutuamente excluyentes son los siguientes:
-
Modo de lectura/escritura
Los usuarios pueden leer y escribir en el tablespace. Todos los tablespaces se crean inicialmente como de lectura/escritura. Los tablespaces
SYSTEMySYSAUXy los tablespaces temporales son de lectura/escritura permanente, lo que significa que no se pueden convertir en de solo lectura. -
Modo de sólo lectura
Se evitan las operaciones de escritura en los archivos de datos del tablespace. Un tablespace de solo lectura puede residir en medios de solo lectura, como DVD o unidades WORM.
Los tablespaces de solo lectura eliminan la necesidad de realizar copias de seguridad y recuperación de grandes partes estáticas de una base de datos. Los tablespaces de solo lectura no cambian y, por lo tanto, no necesitan una copia de seguridad repetida. Si recupera una base de datos después de un fallo del medio físico, no necesita recuperar tablespaces de solo lectura.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a cambiar un tablespace a modo de solo lectura o de lectura/escritura
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
ALTER TABLESPACE -
Oracle AI Database Backup and Recovery User's Guide para obtener más información sobre la recuperación
Tablespaces en Línea y Fuera de Línea
Un tablespace puede estar en línea (accesible) o fuera de línea (no accesible) siempre que la base de datos esté abierta.
Un tablespace suele estar en línea para que sus datos estén disponibles para los usuarios. El tablespace SYSTEM y los tablespaces temporales no se pueden poner fuera de línea.
Un tablespace se puede poner fuera de línea de forma automática o manual. Por ejemplo, puede poner un tablespace fuera de línea para mantenimiento o copia de seguridad y recuperación. La base de datos pone automáticamente un tablespace fuera de línea cuando se encuentran ciertos errores, como cuando el proceso de escritor de base de datos (DBW) falla en varios intentos de escritura en un archivo de datos. Los usuarios que intentan acceder a tablas de un tablespace fuera de línea reciben un error.
Cuando un tablespace se pone fuera de línea, la base de datos realiza lo siguiente:
-
La base de datos no permite que las sentencias DML posteriores hagan referencia a objetos en el tablespace fuera de línea. Cualquier utilidad que no sea Oracle AI Database no puede leer ni editar un tablespace fuera de línea.
-
Las transacciones activas con sentencias terminadas que hacen referencia a datos en ese tablespace no se ven afectadas en el nivel de transacción.
-
La base de datos guarda los datos de deshacer correspondientes a las sentencias terminadas en un segmento de deshacer diferido en el tablespace
SYSTEM. Cuando el tablespace se pone en línea, la base de datos aplica los datos de deshacer al tablespace, si es necesario.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a modificar la disponibilidad de los tablespaces
Tamaño de Archivo de Tablespace
Un tablespace es un tabla de archivos grandes o un tabla de archivos pequeños. Estos tablespaces no se pueden distinguir en términos de ejecución de sentencias SQL que no hacen referencia explícita a archivos de datos o archivos temporales.
La diferencia es la siguiente:
-
Un tablespace de archivo pequeño puede contener varios archivos de datos o archivos temporales, pero los archivos no pueden ser tan grandes como en un tablespace de archivo grande. Este es el tipo de tablespace por defecto.
-
Un tablespace de archivo grande contiene un archivo de datos muy grande o un archivo temporal. Este tipo de tablespace puede hacer lo siguiente:
-
Aumentar la capacidad de almacenamiento de una base de datos
El número máximo de archivos de datos de una base de datos es limitado, por lo que el aumento del tamaño de cada archivo de datos aumenta el almacenamiento general.
-
Reduzca la carga de gestionar muchos archivos de datos y archivos temporales
Los tablespaces de archivo grande simplifican la gestión de archivos con Oracle Managed Files y Automatic Storage Management (Oracle ASM) al eliminar la necesidad de agregar nuevos archivos y tratar varios archivos.
-
Realizar operaciones en tablespaces en lugar de en archivos individuales
Los tablespaces de archivo grande convierten al tablespace en la unidad principal de la administración, copia de seguridad y recuperación de espacio en disco, etc.
Los tablespaces de archivo grande solo están soportados para tablespaces gestionados localmente con ASSM. Sin embargo, los tablespaces temporales y de deshacer gestionados localmente pueden ser tablespaces de archivo grande incluso cuando los segmentos se gestionan manualmente.
A partir de Oracle AI Database 26ai, los tablespaces SYSTEM, SYSAUX y USER se crean como tablespaces de archivo grande por defecto. Una base de datos actualizada a partir de una versión anterior conserva su tipo de tablespace.
-
Consulte además:
-
Guía del usuario de copia de seguridad y recuperación de Oracle AI Database para obtener más información sobre copia de seguridad y recuperación
-
Oracle AI Database Administrator's Guide para aprender a gestionar tablespaces de archivo grande