Índices y Tablas Organizadas por Índices
Los índices son objetos de esquema que pueden acelerar el acceso a las filas de tabla. Las tablas organizadas por índices son tablas almacenadas en una estructura de índices.
-
Introducción a Índices Un índice es una estructura opcional, asociada a una tabla o un cluster de tabla, que a veces puede acelerar el acceso a los datos.
-
Los árboles B de visión general de los índices de árbol B, abreviatura de árboles equilibrados, son el tipo más común de índice de base de datos. Un índice de árbol B es una lista ordenada de valores dividida en rangos. Al asociar una clave a una fila o rango de filas, los árboles B proporcionan un excelente rendimiento de recuperación para una amplia gama de consultas, incluidas las búsquedas de coincidencia exacta y rango.
-
Visión General de Índices de Bitmap En un índice de bitmap, la base de datos almacena un bitmap para cada clave de índice. En un índice de árbol B convencional, una entrada de índice apunta a una sola fila. En un índice de bitmap, cada clave de índice almacena punteros en varias filas.
-
Visión General de Índices Basados en Funciones Un índice basado en funciones calcula el valor de una función o expresión que implica una o más columnas y lo almacena en un índice. Un índice basado en funciones puede ser un índice de árbol B o un índice de bitmap.
-
Visión general de índices de dominio de aplicación Un índice de dominio de aplicación es un índice personalizado específico de una aplicación.
-
Visión general de índices HNSW cuantificados escalares Los índices Hierarchical Navigable Small World (HNSW) cuantificados escalares se pueden utilizar para reducir los requisitos de memoria y acelerar la búsqueda de similitud.
-
Visión General de Tablas Organizadas por Índices Una tabla organizada por índices es una tabla almacenada en una variación de una estructura de índice de árbol B. Por el contrario, una tabla organizada en pilas inserta filas donde se ajusten.
Introducción a Índices
Un índice es una estructura opcional, asociada a una tabla o cluster de tabla, que a veces puede acelerar el acceso a los datos.
Los índices son objetos de esquema que son lógica y físicamente independientes de los datos de los objetos con los que están asociados. Por lo tanto, puede borrar o crear un índice sin que afecte físicamente a la tabla indexada.
Nota: Si borra un índice, las aplicaciones seguirán funcionando. Sin embargo, el acceso a los datos indexados anteriormente puede ser más lento.
Para una analogía, supongamos que un gerente de RR. HH. tiene un estante de cajas de cartón. Las carpetas que contienen información de empleado se insertan aleatoriamente en los cuadros. La carpeta para el empleado Whalen (ID 200) es de 10 carpetas arriba de la parte inferior de la casilla 1, mientras que la carpeta para King (ID 100) está en la parte inferior de la casilla 3. Para localizar una carpeta, el gestor consulta todas las carpetas del cuadro 1 de abajo a arriba y, a continuación, pasa de un cuadro a otro hasta que se encuentra la carpeta. Para acelerar el acceso, el gerente puede crear un índice que muestre secuencialmente cada ID de empleado con su ubicación de carpeta:
ID 100: Box 3, position 1 (bottom)
ID 101: Box 7, position 8
ID 200: Box 1, position 10
.
.
.
Del mismo modo, el gerente podría crear índices independientes para los apellidos de los empleados, los ID de departamento, etc.
Esta sección incluye los siguientes temas:
-
Ventajas y Desventajas de los Índices La ausencia o presencia de un índice no requiere un cambio en la redacción de ninguna sentencia SQL.
-
Los índices de utilización y visibilidad del índice son utilizables (por defecto) o no utilizables, visibles (por defecto) o invisibles.
-
Claves y columnas Una clave es un juego de columnas o expresiones en las que puede crear un índice.
-
Índices compuestos Un índice compuesto, también denominado índice concatenado, es un índice de varias columnas de una tabla.
-
Los índices únicos y no únicos pueden ser únicos o no únicos. Los índices únicos garantizan que no haya dos filas de una tabla que tengan valores duplicados en la columna o columnas clave.
-
Tipos de índices Oracle AI Database proporciona varios esquemas de indexación, que proporcionan funcionalidad de rendimiento complementaria.
-
Cómo mantiene la base de datos los índices La base de datos mantiene y utiliza automáticamente los índices después de crearlos.
-
Almacenamiento de índice Oracle AI Database almacena datos de índice en un segmento de índice.
Ventajas y desventajas de los índices
La ausencia o presencia de un índice no requiere un cambio en la redacción de ninguna sentencia SQL.
Un índice es una ruta de acceso rápida a una única fila de datos. Sólo afecta a la velocidad de ejecución. Dado un valor de datos que se ha indexado, el índice apunta directamente a la ubicación de las filas que contienen ese valor.
Cuando existe un índice en una o más columnas de una tabla, la base de datos puede, en algunos casos, recuperar un pequeño juego de filas distribuidas aleatoriamente de la tabla. Los índices son uno de los muchos medios para reducir la E/S de disco. Si una tabla organizada por pilas no tiene índices, la base de datos debe realizar una exploración completa de la tabla para buscar un valor. Por ejemplo, una consulta de la ubicación 2700 en la tabla hr.departments no indexada requiere que la base de datos busque cada fila de cada bloque. Este enfoque no se escala bien, ya que los volúmenes de datos aumentan.
Las desventajas de los índices incluyen lo siguiente:
-
La Creación manual de índices requiere a menudo un profundo conocimiento del modelo y de la aplicación y de la distribución de datos.
-
A medida que los datos cambian, debe volver a consultar las decisiones anteriores sobre los índices. Es posible que un índice deje de ser útil o que se necesiten nuevos índices.
-
Los índices ocupan espacio en disco.
-
La base de datos debe actualizar el índice cuando se produce DML en los datos indexados, lo que crea una sobrecarga de rendimiento. Nota: A partir de Oracle Database 19c, la base de datos Oracle puede supervisar constantemente la carga de trabajo de la aplicación, creando y gestionando índices automáticamente. La indexación automatizada se implanta como una tarea de base de datos que se ejecuta en un intervalo fijo.
Considere la creación de un índice en las siguientes situaciones:
-
Las columnas indexadas se consultan con frecuencia y devuelven un pequeño porcentaje del número total de filas de la tabla.
-
Existe una restricción de integridad referencial en la columna o columnas indexadas. El índice es un medio para evitar un bloqueo de tabla completa que, de lo contrario, sería necesario si actualiza la clave primaria de la tabla principal, se fusiona en la tabla principal o se suprime de la tabla principal.
-
Se colocará una restricción de clave única en la tabla y desea especificar manualmente el índice y todas las opciones de índice.
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener más información sobre la indexación automatizada
-
Manual de usuario de información de licencias de Oracle AI Database para obtener detalles sobre qué funciones están soportadas para diferentes ediciones y servicios
Usabilidad y visibilidad del índice
Los índices se pueden utilizar (por defecto) o no se pueden utilizar, son visibles (por defecto) o son invisibles.
Estas propiedades se definen de la siguiente manera:
-
Usabilidad
Un índice no utilizable, que el optimizador ignora, no se mantiene mediante operaciones DML. Un índice no utilizable puede mejorar el rendimiento de las cargas en bloque. En lugar de borrar un índice y volver a crearlo posteriormente, puede hacer que el índice no se pueda utilizar y, a continuación, volver a crearlo. Los índices y las particiones de índice no utilizables no consumen espacio. Cuando hace que un índice utilizable no se pueda utilizar, la base de datos borra su índice segmento.
-
Visibilidad
Las operaciones DML mantienen un índice invisible, pero el optimizador no lo utiliza por defecto. Hacer que un índice sea invisible es una alternativa a hacerlo inutilizable o borrarlo. Los índices invisibles son especialmente útiles para probar la eliminación de un índice antes de borrarlo o utilizar índices temporalmente sin afectar a la aplicación general.
Consulte también: "Visión General del Optimizador" para obtener más información sobre cómo el optimizador selecciona planes de ejecución
Claves y columnas
Una clave es un juego de columnas o expresiones en las que puede crear un índice.
Aunque los términos se utilizan a menudo indistintamente, los índices y las claves son diferentes. Los índices son estructuras almacenadas en la base de datos que los usuarios gestionan mediante sentencias SQL. Las claves son estrictamente un concepto lógico.
La siguiente sentencia crea un índice en la columna customer_id de la tabla de ejemplo oe.orders:
CREATE INDEX ord_customer_ix ON orders (customer_id);En la sentencia anterior, la columna customer_id es la clave de índice. El índice en sí se denomina ord_customer_ix.
Nota: Las claves primarias y únicas tienen índices automáticamente, pero puede que desee crear un índice en una clave ajena.
Consulte además:
-
Referencia de lenguaje SQL de Oracle AI Database Sintaxis y semántica de
CREATE INDEX
Índices compuestos
Un índice compuesto, también denominado índice concatenado, es un índice de varias columnas de una tabla.
Coloque las columnas en un índice compuesto en el orden que más tenga sentido para las consultas que recuperarán los datos. No es necesario que las columnas sean adyacentes en la tabla.
Los índices compuestos pueden acelerar la recuperación de datos para las sentencias SELECT en las que la cláusula WHERE hace referencia a todas las columnas o a la parte inicial del índice compuesto. Por lo tanto, el orden de las columnas utilizadas en la definición es importante. En general, las columnas a las que se accede con más frecuencia son las primeras.
Por ejemplo, supongamos que una aplicación consulta con frecuencia las columnas last_name, job_id y salary en la tabla employees. Supongamos también que last_name tiene una cardinalidad alta, lo que significa que el número de valores distintos es grande en comparación con el número de filas de la tabla. Puede crear un índice con el siguiente orden de columnas:
CREATE INDEX employees_ix
   ON employees (last_name, job_id, salary);
Las consultas que acceden a las tres columnas, solo a la columna last_name o solo a las columnas last_name y job_id utilizan este índice. En este ejemplo, las consultas que no acceden a la columna last_name no utilizan el índice.
Nota: En algunos casos, como cuando la columna inicial tiene una cardinalidad muy baja, la base de datos puede utilizar una exploración de omisión de este índice (consulte "Escaneo de Omisión de Índice").
Pueden existir varios índices en la misma tabla con el mismo orden de columnas cuando cumplen cualquiera de las siguientes condiciones:
-
Los índices son de diferentes tipos.
Por ejemplo, puede crear índices de bitmap y de árbol B en las mismas columnas.
-
Los índices utilizan diferentes esquemas de partición.
Por ejemplo, puede crear índices que estén particionados localmente y índices que estén particionados globalmente.
-
Los índices tienen diferentes propiedades de unicidad.
Por ejemplo, puede crear un índice único y un índice no único en el mismo juego de columnas.
Por ejemplo, puede existir un índice no particionado, un índice particionado global y un índice particionado localmente para las mismas columnas de tabla en el mismo orden. Solo un índice con el mismo número de columnas en el mismo orden puede ser visible a la vez.
Esta capacidad permite migrar aplicaciones sin la necesidad de borrar un índice existente y volver a crearlo con diferentes atributos. Además, esta capacidad resulta útil en una base de datos OLTP cuando una clave de índice sigue aumentando, lo que provoca que la base de datos inserte nuevas entradas en el mismo juego de bloques de índice. Para aliviar estos "puntos calientes", podría evolucionar el índice de un índice no particionado a un índice particionado global.
Si los índices del mismo juego de columnas no difieren en el tipo o el esquema de partición, estos índices deben utilizar permutaciones de columnas diferentes. Por ejemplo, las siguientes sentencias SQL especifican permutaciones de columnas válidas:
CREATE INDEX employee_idx1 ON employees (last_name, job_id);
CREATE INDEX employee_idx2 ON employees (job_id, last_name);
Consulte también: Guía de ajustes SQL de Oracle AI Database para obtener más información sobre la creación de varios índices en el mismo juego de columnas
Índices Únicos y No Únicos
Los índices pueden ser únicos o no únicos. Los índices únicos garantizan que no haya dos filas de una tabla que tengan valores duplicados en la columna o columnas clave.
Por ejemplo, la aplicación puede requerir que dos empleados no tengan el mismo ID de empleado. En un índice único, existe un ID de fila para cada valor de datos. Los datos de los bloques de hoja solo se ordenan por clave.
Los índices no únicos permiten valores duplicados en la columna o columnas indexadas. Por ejemplo, la columna first_name de la tabla employees puede contener varios valores Mike. Para un índice no único, el rowid se incluye en la clave en orden ordenado, por lo que los índices no únicos se ordenan por la clave de índice y el rowid (ascendente).
Oracle AI Database no indexa filas de tabla en las que todas las columnas de clave sean nulas, excepto los índices de bitmap o cuando el valor de columna de clave de cluster es nulo.
Tipos de índices
Oracle AI Database proporciona varios esquemas de indexación, que proporcionan una funcionalidad de rendimiento complementaria.
Los índices de árbol B son el tipo de índice estándar. Son excelentes para índices altamente selectivos (pocas filas corresponden a cada entrada de índice) e índices de clave primaria. Utilizado como índices concatenados, un índice de árbol B puede recuperar los datos ordenados por las columnas indexadas. Los índices de árbol B tienen los subtipos que se muestran en la siguiente tabla.
Tabla 1 Subtipos de Índice de Árbol B
| Subtipo de índice de árbol B | Descripción | Para saber más |
|---|---|---|
| Tablas organizadas por índice | Una tabla organizada por índices difiere de una organizada por pilas porque los datos son en sí mismos el índice. | "Visión General de Tablas Organizadas por Índices" |
| Índices de clave inversos | En este tipo de índice, los bytes de la clave de índice se invierten, por ejemplo, 103 se almacena como 301. La reversión de bytes extiende las inserciones en el índice sobre muchos bloques. | "Índices de clave hacia atrás" |
| Índices descendente | Este tipo de índice almacena datos en una columna o columnas concretas en orden descendente. | "Ascending and Descending Indexes (Índices Ascendente y Descendente)" |
| Índices de cluster de árbol B | Este tipo de índice almacena datos en una columna o columnas concretas en orden descendente. | "Ascending and Descending Indexes (Índices Ascendente y Descendente)" |
En la siguiente tabla se muestran los tipos de índices que no utilizan una estructura de árbol B.
Tabla 2 Índices que no utilizan una estructura de árbol B
| Tipo | Descripción | Para saber más |
|---|---|---|
| Índices de unión de bitmap y bitmap | En un índice de bitmap, una entrada de índice utiliza un bitmap para apuntar a varias filas. Por el contrario, una entrada de índice de árbol B apunta a una sola fila. Un índice de unión de bitmap es un índice de bitmap para la unión de dos o más tablas. | "Visión General de Índices de Bitmap" |
| Índices basados en funciones | Este tipo de índice incluye columnas que una función transforma, como la función UPPER, o que se incluyen en una expresión. Los índices de árbol B o de bitmap pueden estar basados en funciones. |
"Visión General de los Índices Basados en Funciones" |
| Índices de dominio de aplicación | Un usuario crea este tipo de índice para los datos en un dominio específico de la aplicación. El índice físico no necesita utilizar una estructura de índice tradicional y se puede almacenar en la base de datos Oracle como tablas o externamente como un archivo. | "Visión General de Índices de Dominio de Aplicación" |
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a gestionar índices
-
Oracle AI Database SQL Tuning Guide para obtener más información sobre las diferentes rutas de acceso a índices
Cómo mantiene la base de datos los índices
La base de datos mantiene y utiliza índices automáticamente después de crearlos.
Los índices reflejan automáticamente los cambios de datos en sus tablas subyacentes. Entre los ejemplos de cambios se incluyen la adición, actualización y supresión de filas. No se necesitan acciones de usuario.
El rendimiento de recuperación de los datos indexados permanece casi constante, incluso cuando se insertan filas. Sin embargo, la presencia de muchos índices en una tabla degrada el rendimiento de DML porque la base de datos también debe actualizar los índices.
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener más información sobre la indexación automatizada
-
Manual de usuario de información de licencias de Oracle AI Database para obtener detalles sobre qué funciones están soportadas para diferentes ediciones y servicios
Almacenamiento de Índices
Oracle AI Database almacena datos de índice en un segmento de índice.
El espacio disponible para los datos de índice en un bloque de datos es el tamaño del bloque de datos menos la sobrecarga del bloque, la sobrecarga de entrada, el ID de fila y un byte de longitud para cada valor indexado.
El espacio de tabla de un segmento de índice es el tablespace por defecto del propietario o un tablespace denominado específicamente en la sentencia CREATE INDEX. Para facilitar la administración, puede almacenar un índice en un tablespace independiente de su tabla. Por ejemplo, puede optar por no realizar copias de seguridad de los tablespaces que solo contienen índices, que se pueden volver a crear y, por lo tanto, reducir el tiempo y el almacenamiento necesarios para las copias de seguridad.
Consulte también: "Visión General de Bloques de Índice" para obtener más información sobre los tipos de bloques de índice (raíz, rama y hoja) y cómo se almacenan las entradas de índice en un bloque
Visión General de Índices de Árbol B
Los árboles B, abreviatura de árboles equilibrados, son el tipo más común de índice de base de datos. Un índice de árbol B es una lista ordenada de valores dividida en rangos. Al asociar una clave a una fila o rango de filas, los árboles B proporcionan un excelente rendimiento de recuperación para una amplia gama de consultas, incluidas las búsquedas de coincidencia exacta y rango.
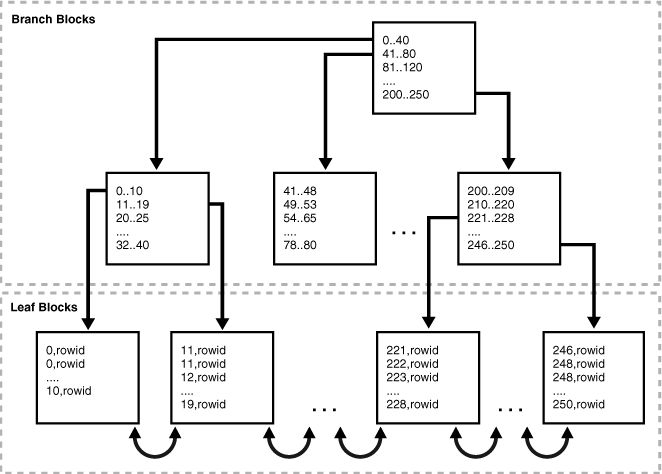
La siguiente figura ilustra la estructura de un índice de árbol B. En el ejemplo se muestra un índice en la columna department_id, que es una columna de clave ajena en la tabla employees.
Figura 1: Estructura interna de un índice de árbol B
Descripción de la ilustración cncpt244.gif
Esta sección incluye los siguientes temas:
-
Bloques de rama y bloques de hoja Un índice de árbol B tiene dos tipos de bloques: el bloque de rama para la búsqueda y el bloque de hoja para almacenar valores clave. Los bloques de rama de nivel superior de un índice de árbol B contienen datos de índice que apuntan a bloques de índice de nivel inferior.
-
Exploraciones de Índice En una exploración de Índice, la base de datos recupera una fila recorriendo el índice, utilizando los valores de columna indexados especificados por la sentencia. Si la base de datos examina el índice en busca de un valor, encontrará este valor en n E/S, donde n es la altura del índice de árbol B. Este es el principio básico detrás de los índices de Oracle AI Database.
-
Índices de clave inversa Un índice de clave inversa es un tipo de índice de árbol B que invierte físicamente los bytes de cada clave de índice mientras mantiene el orden de las columnas.
-
Índices Ascendente y Descendente En un índice ascendente, Oracle AI Database almacena los datos en orden ascendente. Por defecto, los datos de caracteres se ordenan por los valores binarios contenidos en cada byte del valor, los datos numéricos del número más pequeño al más grande y la fecha del valor más antiguo al más reciente.
-
Compresión de índice Para reducir el espacio en los índices, Oracle AI Database puede emplear diferentes algoritmos de compresión.
Bloques de rama y bloques de hoja
Un índice de árbol B tiene dos tipos de bloques: el bloque de rama para la búsqueda y el bloque de hoja para almacenar valores clave. Los bloques de rama de nivel superior de un índice de árbol B contienen datos de índice que apuntan a bloques de índice de nivel inferior.
En la Figura 5-1, el bloque de rama raíz tiene una entrada 0-40, que apunta al bloque del extremo izquierdo en el siguiente nivel de rama. Este bloque de rama contiene entradas como 0-10 y 11-19. Cada una de estas entradas apunta a un bloque de hoja que contiene valores clave que están dentro del rango.
Un índice de árbol B está equilibrado porque todos los bloques de hoja permanecen automáticamente en la misma profundidad. Por lo tanto, la recuperación de cualquier registro desde cualquier lugar del índice toma aproximadamente la misma cantidad de tiempo. La altura del índice es el número de bloques necesarios para pasar del bloque raíz a un bloque de hoja. El nivel de rama es la altura menos 1. En la Figura 5-1, el índice tiene una altura de 3 y un nivel de rama de 2.
Los bloques de rama almacenan el prefijo de clave mínimo necesario para tomar una decisión de bifurcación entre dos claves. Esta técnica permite a la base de datos ajustar tantos datos como sea posible en cada bloque de rama. Los bloques de rama contienen un puntero al bloque secundario que contiene la clave. El número de teclas y punteros está limitado por el tamaño del bloque.
Los bloques de hoja contienen todos los valores de datos indexados y un ID de fila correspondiente utilizado para localizar la fila real. Cada entrada se ordena por (clave, ID de fila). Dentro de un bloque de hoja, una clave y un rowid están vinculados a sus entradas hermanas izquierda y derecha. Los bloques de hojas también están doblemente vinculados. En la Figura 5-1, el bloque de hoja del extremo izquierdo (0-10) está enlazado al segundo bloque de hoja (11-19). Nota: Los índices de columnas con datos de caracteres se basan en los valores binarios de los caracteres del juego de caracteres de la base de datos.
Exploraciones de Índice
En una exploración de índice, la base de datos recupera una fila recorriendo el índice, utilizando los valores de columna indexados especificados por la sentencia. Si la base de datos examina el índice en busca de un valor, encontrará este valor en n E/S, donde n es la altura del índice de árbol B. Este es el principio básico detrás de los índices de Oracle AI Database.
Si una sentencia SQL accede solo a columnas indexadas, la base de datos lee los valores directamente desde el índice en lugar de desde la tabla. Si la sentencia accede a columnas no indexadas además de las columnas indexadas, la base de datos utiliza rowid para buscar las filas de la tabla. Normalmente, la base de datos recupera datos de tabla leyendo alternativamente un bloque de índice y, a continuación, un bloque de tabla.
-
Exploración de Índice Completo En una Exploración de Índice Completo, la base de datos lee todo el índice en orden. Una exploración de índice completa está disponible si un predicado (cláusula
WHERE) de la sentencia SQL hace referencia a una columna del índice y, en algunas circunstancias, cuando no se especifica ningún predicado. Una exploración completa puede eliminar la ordenación porque los datos se ordenan por clave de índice. -
Exploración Rápida de Índice Completo Una Exploración Rápida de Índice Completo es una exploración de índice completa en la que la base de datos accede a los datos del índice en sí sin acceder a la tabla, y la base de datos lee los bloques de índice en ningún orden concreto.
-
Exploración de Rango de Índices Una Exploración de Rango de Índices es una exploración ordenada de un índice en la que se especifican una o más columnas iniciales de un índice en condiciones, y se pueden utilizar 0, 1 o más valores para una clave de índice.
-
Exploración Única de Índice A diferencia de una exploración de rango de índices, una exploración única de índice debe tener 0 o 1 ID de fila asociado a una clave de índice.
-
Índice Omitir Exploración Una exploración de omisión de índice utiliza subíndices lógicos de un índice compuesto. La base de datos "omita" a través de un único índice como si estuviera buscando índices separados.
-
Factor de agrupación en clusters de índice El factor de agrupación en clusters de índice mide el orden de las filas en relación con un valor indexado, como el apellido del empleado. A medida que aumenta el grado de orden, disminuye el factor de agrupación en clusters. Consulte también: Guía de ajustes SQL de Oracle AI Database para obtener información detallada sobre las exploraciones de índices
Exploración de índice completo
En una exploración completa de índice, la base de datos lee todo el índice en orden. Una exploración de índice completa está disponible si un predicado (cláusula WHERE) de la sentencia SQL hace referencia a una columna del índice y, en algunas circunstancias, cuando no se especifica ningún predicado. Una exploración completa puede eliminar la ordenación porque los datos se ordenan por clave de índice.
Ejemplo 5-1 Exploración de índice completa
Supongamos que una aplicación ejecuta la siguiente consulta:
SELECT department_id, last_name, salary
FROM   employees
WHERE  salary > 5000
ORDER BY department_id, last_name;
En este ejemplo, department_id, last_name y salary son una clave compuesta en un índice. Oracle AI Database realiza una exploración completa del índice, la lee en orden ordenado (ordenado por ID de departamento y apellidos) y filtra el atributo de salario. De esta forma, la base de datos explora un juego de datos menor que la tabla employees, que contiene más columnas de las que se incluyen en la consulta y evita la ordenación de los datos.
La exploración completa podría leer las entradas de índice de la siguiente manera:
50,Atkinson,2800,rowid
60,Austin,4800,rowid
70,Baer,10000,rowid
80,Abel,11000,rowid
80,Ande,6400,rowid
110,Austin,7200,rowid
.
.
.
Exploración de Índice Rápido Completo
Una exploración de índice completa rápida es una exploración de índice completa en la que la base de datos accede a los datos del índice en sí sin acceder a la tabla, y la base de datos lee los bloques de índice en ningún orden concreto.
Las exploraciones de índice completas rápidas son una alternativa a una exploración de tabla completa cuando se cumplen las dos condiciones siguientes:
-
El índice debe contener todas las columnas necesarias para la consulta.
-
Una fila que contenga todos los valores nulos no debe aparecer en el juego de resultados de la consulta. Para que se garantice este resultado, al menos una columna del índice debe tener:
-
Una restricción
NOT NULL -
Predicado aplicado a la columna que impide que se tengan en cuenta los valores nulos en el juego de resultados de consulta
-
Ejemplo 5-2 Exploración rápida de índice completo
Supongamos que una aplicación emite la siguiente consulta, que no incluye una cláusula ORDER BY:
SELECT last_name, salary
FROM   employees;
La columna last_name tiene una restricción no nula. Si el apellido y el salario son una clave compuesta en un índice, una exploración de índice completa rápida puede leer las entradas de índice para obtener la información solicitada:
Baida,2900,rowid
Atkinson,2800,rowid
Zlotkey,10500,rowid
Austin,7200,rowid
Baer,10000,rowid
Austin,4800,rowid
.
.
.
Exploración de rango de índices
Una exploración de rango de índices es una exploración ordenada de un índice en la que se especifican una o más columnas iniciales de un índice en condiciones, y se pueden utilizar 0, 1 o más valores para una clave de índice.
Una condición especifica una combinación de una o más expresiones y operadores lógicos (booleanos). Devuelve un valor de TRUE, FALSE o UNKNOWN.
La base de datos suele utilizar una exploración de rango de índices para acceder a datos selectivos. La selectividad es el porcentaje de filas de la tabla que selecciona la consulta, con 0 que significa que no hay filas y 1 que significa todas las filas. La selectividad está vinculada a un predicado de consulta, como WHERE last_name LIKE 'A%', o a una combinación de predicados. Un predicado se vuelve más selectivo a medida que el valor se acerca a 0 y menos selectivo (o más no selectivo) a medida que el valor se acerca a 1.
Por ejemplo, un usuario consulta a los empleados cuyos apellidos empiezan por A. Supongamos que la columna last_name está indexada, con entradas de la siguiente forma:
Abel,rowid
Ande,rowid
Atkinson,rowid
Austin,rowid
Austin,rowid
Baer,rowid
.
.
.
La base de datos podría utilizar una exploración de rango porque la columna last_name se especifica en el predicado y se pueden utilizar varios rowid para cada clave de índice. Por ejemplo, dos empleados se denominan Austin, por lo que dos rowid se asocian a la clave Austin.
Una exploración de rango de índices se puede enlazar en ambos lados, como en una consulta para departamentos con ID entre 10 y 40, o enlazada en un solo lado, como en una consulta para ID de más de 40. Para explorar el índice, la base de datos avanza o retrocede por los bloques de hoja. Por ejemplo, una exploración de ID entre 10 y 40 localiza el primer bloque de hoja de índice que contiene el valor de clave más bajo que es 10 o superior. A continuación, la exploración continúa horizontalmente a través de la lista enlazada de nodos de hoja hasta que localiza un valor mayor que 40.
Exploración única de índice
A diferencia de una exploración de rango de índices, una exploración única de índice debe tener 0 o 1 ID de fila asociado a una clave de índice.
La base de datos realiza una exploración única cuando un predicado hace referencia a todas las columnas de la clave de un índice UNIQUE mediante un operador de igualdad. Una exploración única de índice deja de procesarse tan pronto como encuentra el primer registro porque no es posible ningún segundo registro.
Como ilustración, supongamos que un usuario ejecuta la siguiente consulta:
SELECT *
FROM   employees
WHERE  employee_id = 5;
Supongamos que la columna employee_id es la clave primaria y se indexa con entradas de la siguiente manera:
1,rowid
2,rowid
4,rowid
5,rowid
6,rowid
.
.
.
En este caso, la base de datos puede utilizar una exploración única de índice para localizar el ID de fila del empleado cuyo ID es 5.
Exploración de omisión de índice
Una exploración de omisión de índice utiliza subíndices lógicos de un índice compuesto. La base de datos "omita" a través de un único índice como si estuviera buscando índices separados.
La exploración de omisión es beneficiosa si hay pocos valores distintos en la columna inicial de un índice compuesto y muchos valores distintos en la clave no inicial del índice. La base de datos puede seleccionar una exploración de omisión de índice cuando la columna inicial del índice compuesto no se especifica en un predicado de consulta.
Ejemplo 5-3 Omisión de Exploración de un Índice Compuesto
Supongamos que ejecuta la siguiente consulta para un cliente en la tabla sh.customers:
SELECT * FROM sh.customers WHERE cust_email = 'Abbey@company.example.com';La tabla customers tiene una columna cust_gender cuyos valores son M o F. Supongamos que existe un índice compuesto en las columnas (cust_gender, cust_email). En el siguiente ejemplo, se muestra una parte de las entradas de índice:
F,Wolf@company.example.com,rowid
F,Wolsey@company.example.com,rowid
F,Wood@company.example.com,rowid
F,Woodman@company.example.com,rowid
F,Yang@company.example.com,rowid
F,Zimmerman@company.example.com,rowid
M,Abbassi@company.example.com,rowid
M,Abbey@company.example.com,rowid
La base de datos puede utilizar una exploración de omisión de este índice aunque cust_gender no esté especificado en la cláusula WHERE.
En una exploración de omisión, el número de subíndices lógicos viene determinado por el número de valores distintos en la columna inicial. En el ejemplo anterior, la columna inicial tiene dos valores posibles. La base de datos divide lógicamente el índice en un subíndice con la clave F y un segundo subíndice con la clave M.
Al buscar el registro del cliente cuyo correo electrónico es Abbey@company.example.com, la base de datos busca el subíndice con el valor F en primer lugar y, a continuación, busca el subíndice con el valor M. Conceptualmente, la base de datos procesa la consulta de la siguiente forma:
SELECT * FROM sh.customers WHERE cust_gender = 'F'
  AND cust_email = 'Abbey@company.example.com'
UNION ALL
SELECT * FROM sh.customers WHERE cust_gender = 'M'
  AND cust_email = 'Abbey@company.example.com';
Consulte también: Guía de ajustes SQL de Oracle AI Database para obtener más información sobre los análisis de omisión
Factor de agrupación en clusters de índice
El factor de agrupación en clusters de índice mide el orden de las filas en relación con un valor indexado, como el apellido del empleado. A medida que aumenta el grado de orden, disminuye el factor de agrupación en clusters.
El factor de agrupación en clusters es útil como una medida aproximada del número de E/S necesarias para leer una tabla completa mediante un índice:
-
Si el factor de agrupación en clusters es alto, Oracle AI Database realiza un número relativamente alto de E/S durante una exploración de rango de índices grande. Las entradas de índice apuntan a bloques de tabla aleatorios, por lo que es posible que la base de datos tenga que leer y volver a leer los mismos bloques una y otra vez para recuperar los datos a los que apunta el índice.
-
Si el factor de agrupación en clusters es bajo, Oracle AI Database realiza un número relativamente bajo de E/S durante una exploración de rango de índices grande. Las claves de índice de un rango tienden a apuntar al mismo bloque de datos, por lo que la base de datos no tiene que leer ni volver a leer los mismos bloques una y otra vez.
El factor de agrupación en clusters es relevante para las exploraciones de índice porque puede mostrar:
-
Si la base de datos utilizará un índice para exploraciones de rango grande
-
Grado de organización de tabla en relación con la clave de índice
-
Si debe considerar el uso de una tabla organizada por índices, una partición o un cluster de tabla si las filas se deben ordenar por la clave de índice
Ejemplo 5-4 Factor de agrupación en clusters
Supongamos que la tabla employees encaja en dos bloques de datos. La Tabla 5-3 representa las filas de los dos bloques de datos (los puntos suspensivos indican datos que no se muestran).
Tabla 3 Contenido de dos bloques de datos en la tabla Empleados
| Bloque de Datos 1 | Bloque de Datos 2 |
|---|---|
|
|
Las filas se almacenan en los bloques en orden de apellidos (que se muestran en negrita). Por ejemplo, la fila inferior del bloque de datos 1 describe a Abel, la siguiente fila hacia arriba describe a Ande, y así sucesivamente alfabéticamente hasta la fila superior del bloque 1 para Steven King. La fila inferior del bloque 2 describe Kochar, la siguiente fila hacia arriba describe Kumar, y así sucesivamente alfabéticamente hasta la última fila del bloque para Zlotkey.
Supongamos que existe un índice en la columna de apellidos. Cada entrada de nombre corresponde a un ID de fila. Conceptualmente, las entradas de índice serían las siguientes:
Abel,block1row1
Ande,block1row2
Atkinson,block1row3
Austin,block1row4
Baer,block1row5
.
.
.
Supongamos que existe un índice independiente en la columna ID de empleado. Conceptualmente, las entradas de índice pueden tener el siguiente aspecto, con ID de empleado distribuidos en ubicaciones casi aleatorias en los dos bloques:
100,block1row50
101,block2row1
102,block1row9
103,block2row19
104,block2row39
105,block1row4
.
.
.
La siguiente sentencia consulta la vista ALL_INDEXES para el factor de agrupación en clusters de estos dos índices:
SQL> SELECT INDEX_NAME, CLUSTERING_FACTOR
  2  FROM ALL_INDEXES
  3  WHERE INDEX_NAME IN ('EMP_NAME_IX','EMP_EMP_ID_PK');

INDEX_NAME           CLUSTERING_FACTOR
-------------------- -----------------
EMP_EMP_ID_PK                       19
EMP_NAME_IX                          2
El factor de agrupación en clusters para EMP_NAME_IX es bajo, lo que significa que las entradas de índice adyacentes en un único bloque de hoja tienden a apuntar a filas en los mismos bloques de datos. El factor de agrupación en clusters para EMP_EMP_ID_PK es alto, lo que significa que las entradas de índice adyacentes en el mismo bloque de hoja tienen muchas menos probabilidades de apuntar a filas en los mismos bloques de datos.
Consulte también: Referencia de Oracle AI Database para obtener más información sobre ALL_INDEXES
Índices de clave hacia atrás
Un índice de clave inversa es un tipo de índice de árbol B que invierte físicamente los bytes de cada clave de índice mientras mantiene el orden de las columnas.
Por ejemplo, si la clave de índice es 20 y los dos bytes almacenados para esta clave en hexadecimal son C1,15 en un índice de árbol B estándar, un índice de clave inversa almacena los bytes como 15,C1.
La reversión de la clave resuelve el problema de la contención de bloques de hoja en el lado derecho de un índice de árbol B. Este problema puede ser especialmente grave en una base de datos Oracle Real Application Clusters (Oracle RAC) en la que varias instancias modifican repetidamente el mismo bloque. Por ejemplo, en una tabla orders, las claves primarias para los pedidos son secuenciales. Una instancia del cluster agrega el orden 20, mientras que otra agrega 21, con cada instancia escribiendo su clave en el mismo bloque de hoja en la parte derecha del índice.
En un índice de clave inversa, la reversión del orden de bytes distribuye las inserciones entre todas las claves de hoja del índice. Por ejemplo, las claves como 20 y 21 que habrían sido adyacentes en un índice de claves estándar ahora se almacenan separadas en bloques separados. Por lo tanto, la E/S para inserciones de claves secuenciales se distribuye de manera más uniforme.
Puesto que los datos del índice no se ordenan por clave de columna cuando se almacenan, la disposición de clave inversa elimina la capacidad de ejecutar una consulta de exploración de rango de índices en algunos casos. Por ejemplo, si un usuario emite una consulta para los ID de indicación mayores que 20, la base de datos no puede empezar por el bloque que contiene este ID y continuar horizontalmente por los bloques de hoja.
Índices Ascendente y Descendente
En un índice ascendente, Oracle AI Database almacena los datos en orden ascendente. Por defecto, los datos de caracteres se ordenan por los valores binarios contenidos en cada byte del valor, los datos numéricos del número más pequeño al más grande y la fecha del valor más antiguo al más reciente.
Para ver un ejemplo de un índice ascendente, considere la siguiente sentencia SQL:
CREATE INDEX emp_deptid_ix ON hr.employees(department_id);Oracle AI Database ordena la tabla hr.employees en la columna department_id. Carga el índice ascendente con department_id y los valores de rowid correspondientes en orden ascendente, empezando por 0. Cuando utiliza el índice, Oracle AI Database busca los valores department_id ordenados y utiliza los rowid asociados para localizar las filas que tienen el valor department_id solicitado.
Al especificar la palabra clave DESC en la sentencia CREATE INDEX, puede crear un índice descendente. En este caso, el índice almacena datos en una o varias columnas especificadas en orden descendente. Si el índice de la Tabla 5-3 de la columna employees.department_id estuviera descendente, el bloqueo de hoja que contiene 250 estaría en el lado izquierdo del árbol y el bloque con 0 a la derecha. La búsqueda por defecto a través de un índice descendente es del valor más alto al más bajo.
Los índices descendentes son útiles cuando una consulta ordena algunas columnas en sentido ascendente y otras en sentido descendente. Para un ejemplo, supongamos que crea un índice compuesto en las columnas last_name y department_id de la siguiente forma:
CREATE INDEX emp_name_dpt_ix ON hr.employees(last_name ASC, department_id DESC);Si un usuario consulta a hr.employees los apellidos en orden ascendente (A a Z) y los ID de departamento en orden descendente (de mayor a menor), la base de datos puede utilizar este índice para recuperar los datos y evitar el paso adicional de ordenación.
Consulte además:
-
Oracle AI Database SQL Tuning Guide para obtener más información sobre las búsquedas de índice ascendente y descendente
-
Referencia de lenguaje SQL de Oracle AI Database para obtener descripciones de las opciones
ASCyDESCdeCREATE INDEX
Compresión de índice
Para reducir el espacio en los índices, Oracle AI Database puede emplear diferentes algoritmos de compresión.
-
Compresión de prefijo Oracle AI Database puede utilizar la compresión de prefijo, también conocida como compresión de clave, para comprimir partes de los valores de columna de clave primaria en un índice de árbol B o una tabla organizada por índices. La compresión de prefijos puede reducir considerablemente el espacio consumido por el índice.
-
Compresión avanzada de índices A partir de Oracle Database 12c versión 1 (12.1.0.2), la compresión avanzada de índices mejora la compresión tradicional de prefijos para los índices soportados en tablas organizadas por pilas.
Compresión de prefijo
Oracle AI Database puede utilizar la compresión de prefijo, también conocida como compresión de clave, para comprimir partes de los valores de columna de clave primaria en un índice de árbol B o una tabla organizada por índices. La compresión de prefijos puede reducir considerablemente el espacio consumido por el índice.
Una entrada de índice sin comprimir tiene una parte. Una entrada de índice que utiliza compresión de prefijo tiene dos partes: una entrada de prefijo, que es la parte de agrupación, y una entrada de sufijo, que es la parte única o casi única. La base de datos logra la compresión al compartir las entradas de prefijo entre las entradas de sufijo en un bloque de índice. Nota: Si no se define una clave para que tenga una parte única, la base de datos proporciona una agregando un ID de fila a la parte de agrupación.
Por defecto, el prefijo de un índice único consta de todas las columnas de clave, excepto la última, mientras que el prefijo de un índice no único consta de todas las columnas de clave. Supongamos que crea un índice compuesto único en dos columnas de la tabla oe.orders de la siguiente forma:
CREATE UNIQUE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );En el ejemplo anterior, una clave de índice puede ser online,0. El ID de fila se almacena en la parte de datos clave de la entrada y no forma parte de la clave en sí.
Nota: Si crea un índice único en una sola columna, Oracle AI Database no puede utilizar la compresión de clave de prefijo porque no existen prefijos comunes.
Como alternativa, suponga que crea un índice no único en las mismas columnas:
CREATE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );Suponga también que los valores repetidos se producen en las columnas order_mode y order_status. Un bloque de índice podría tener entradas como se muestra en el siguiente ejemplo:
online,0,AAAPvCAAFAAAAFaAAa
online,0,AAAPvCAAFAAAAFaAAg
online,0,AAAPvCAAFAAAAFaAAl
online,2,AAAPvCAAFAAAAFaAAm
online,3,AAAPvCAAFAAAAFaAAq
online,3,AAAPvCAAFAAAAFaAAt
En el ejemplo anterior, el prefijo de clave constaría de una concatenación de los valores order_mode y order_status, como en online,0. El sufijo consiste en el ID de fila, como en AAAPvCAAFAAAAFaAAa. El ID de fila hace que toda la entrada de índice sea única porque un ID de fila es en sí único en la base de datos.
Si el índice del ejemplo anterior se ha creado con compresión de prefijo por defecto (especificado por la palabra clave COMPRESS), se comprimirán prefijos de clave duplicados, como online,0 y online,3. Conceptualmente, la base de datos logra la compresión de la siguiente manera:
online,0
AAAPvCAAFAAAAFaAAa
AAAPvCAAFAAAAFaAAg
AAAPvCAAFAAAAFaAAl
online,2
AAAPvCAAFAAAAFaAAm
online,3
AAAPvCAAFAAAAFaAAq
AAAPvCAAFAAAAFaAAt
Las entradas de sufijo (los rowid) forman la versión comprimida de las filas de índice. Cada entrada de sufijo hace referencia a una entrada de prefijo, que se almacena en el mismo bloque de índice que el sufijo.
También puede especificar una longitud de prefijo al crear un índice que utilice la compresión de prefijo. Por ejemplo, si ha especificado COMPRESS 1, el prefijo sería order_mode y el sufijo sería order_status,rowid. Para los valores del ejemplo de bloque de índice, el índice factorizaría las incidencias duplicadas del prefijo online, que se puede representar conceptualmente de la siguiente manera:
online
0,AAAPvCAAFAAAAFaAAa
0,AAAPvCAAFAAAAFaAAg
0,AAAPvCAAFAAAAFaAAl
2,AAAPvCAAFAAAAFaAAm
3,AAAPvCAAFAAAAFaAAq
3,AAAPvCAAFAAAAFaAAt
El índice almacena un prefijo específico una vez por bloque de hoja como máximo. Sólo se comprimen las claves de los bloques de hoja de un índice de árbol B. En los bloques de rama, el sufijo de clave se puede truncar, pero la clave no se comprime.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a utilizar índices comprimidos
-
Oracle AI Database VLDB and Partitioning Guide para aprender a utilizar la compresión de prefijos para los índices particionados
-
Referencia de lenguaje SQL de Oracle AI Database para obtener descripciones de la cláusula key_compression de
CREATE INDEX
Compresión de Índice Avanzada
A partir de Oracle Database 12c versión 1 (12.1.0.2), la compresión avanzada de índices mejora la compresión tradicional de prefijos para los índices soportados en tablas organizadas por pilas.
Ventajas de la Compresión Avanzada de Índices
La compresión de prefijos tiene limitaciones para los tipos de índices soportados, la relación de compresión y la facilidad de uso. A diferencia de la compresión de prefijos, que utiliza la eliminación fija de claves duplicadas para cada bloque, la compresión avanzada de índices utiliza la eliminación adaptativa de claves duplicadas por bloque. Las principales ventajas de la compresión avanzada de índices son:
-
La base de datos elige automáticamente la mejor compresión para cada bloque, utilizando una serie de algoritmos internos, como prefijos de nivel dentro de la columna, eliminación de claves duplicadas y compresión rowid. A diferencia de la compresión de prefijos, la compresión avanzada de índices no requiere que el usuario conozca las características de los datos.
-
La compresión avanzada funciona en índices y únicos no únicos. La compresión de prefijos funciona bien en algunos índices no únicos, pero los ratios son más bajos en los índices cuyas columnas iniciales no tienen muchas repeticiones.
-
El índice comprimido se puede utilizar de la misma forma que un índice sin comprimir. El índice soporta las mismas rutas de acceso: consultas de claves únicas, exploraciones de rango y exploraciones completas rápidas.
-
Los índices pueden heredar la compresión avanzada de una tabla principal o que contenga un tablespace.
-
Las tablas organizadas por índices y los índices basados en funciones soportan la compresión avanzada de índices. Las tablas organizadas por índices soportan una compresión baja. Los índices basados en funciones soportan la compresión baja y alta.
Funcionamiento de la Compresión de Índices Avanzados
La compresión avanzada de índices funciona a nivel de bloque para proporcionar la mejor compresión para cada bloque. La base de datos utiliza la siguiente técnica:
-
Durante la creación del índice, a medida que un bloque de hoja se llena, la base de datos comprime automáticamente el bloque al nivel óptimo.
-
Al reorganizar un bloque de índice como resultado de DML, si la base de datos puede crear suficiente espacio para la entrada de índice entrante, no se produce una división de bloque. Sin embargo, durante DML sin compresión de índice avanzada, siempre se produce una división de bloque de índice cuando el bloque se llena.
Compresión de índice avanzada ALTA
En las versiones anteriores a Oracle Database 12c versión 2 (12.2), la única forma de compresión avanzada de índice era la compresión baja (COMPRESS ADVANCED LOW). Ahora también puede especificar una compresión alta (COMPRESS ADVANCED HIGH), que es el valor por defecto. La compresión avanzada de índices con la opción HIGH ofrece las siguientes ventajas:
-
Proporciona ratios de compresión más altos en la mayoría de los casos, al tiempo que mejora el rendimiento de las consultas que acceden al índice
-
Emplea algoritmos de compresión más complejos que los avanzados de bajo
-
Almacena datos en una unidad de compresión, que es un formato especial en disco Nota: Al aplicar la compresión
HIGH, todos los bloques tienen compresión. Al aplicar la compresiónLOW, la base de datos puede dejar algunos bloques sin comprimir. Puede utilizar estadísticas para determinar cuántos bloques quedaron sin comprimir.
Ejemplo 5-5 Creación de un índice con compresión alta avanzada
Este ejemplo permite la compresión avanzada de índices para un índice en la tabla hr.employees:
CREATE INDEX hr.emp_mndp_ix
  ON hr.employees(manager_id, department_id)
  COMPRESS ADVANCED;
La siguiente consulta muestra el tipo de compresión:
SELECT COMPRESSION FROM DBA_INDEXES WHERE INDEX_NAME ='EMP_MNDP_IX';

COMPRESSION
-------------
ADVANCED HIGH
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a activar la compresión avanzada de índices
-
Referencia de lenguaje SQL de Oracle AI Database para obtener descripciones de la cláusula key_compression de
CREATE INDEX -
Referencia de Oracle AI Database para obtener más información sobre
ALL_INDEXES
Visión General de Índices de Bitmap
En un índice de mapa de bits, la base de datos almacena un mapa de bits para cada clave de índice. En un índice de árbol B convencional, una entrada de índice apunta a una sola fila. En un índice de bitmap, cada clave de índice almacena punteros en varias filas.
Los índices de bitmap están diseñados principalmente para el almacenamiento de datos o entornos en los que las consultas hacen referencia a muchas columnas de forma ad hoc. Las situaciones que pueden requerir un índice de bitmap incluyen:
-
Las columnas indexadas tienen una cardinalidad baja, es decir, el número de valores distintos es pequeño en comparación con el número de filas de tabla.
-
La tabla indexada es de solo lectura o no está sujeta a modificaciones significativas por las sentencias DML.
Para un ejemplo de almacén de datos, la tabla sh.customers tiene una columna cust_gender con solo dos valores posibles: M y F. Supongamos que las consultas para el número de clientes de un género concreto son comunes. En este caso, la columna customers.cust_gender sería un candidato para un índice de bitmap.
Cada bit del bitmap corresponde a un posible rowid. Si se define el bit, la fila con el ID de fila correspondiente contiene el valor clave. Una función de asignación convierte la posición de bit en un rowid real, por lo que el índice de bitmap proporciona la misma funcionalidad que un índice de árbol B, aunque utiliza una representación interna diferente.
Si se actualiza la columna indexada en una sola fila, la base de datos bloquea la entrada de clave de índice (por ejemplo, M o F) y no el bit individual asignado a la fila actualizada. Debido a que una clave apunta a muchas filas, el DML en los datos indexados normalmente bloquea todas estas filas. Por este motivo, los índices de bitmap no son adecuados para muchas aplicaciones OLTP.
-
Ejemplo: Índices de Bitmap en una Tabla Única En este ejemplo, algunas columnas de la tabla
sh.customersson candidatas para un índice de bitmap. -
Índices de unión de mapa de bits Un índice de unión de mapa de bits es un índice de mapa de bits para la unión de dos o más tablas.
-
Estructura de almacenamiento de mapa de bits Oracle AI Database utiliza una estructura de índice de árbol B para almacenar mapas de bits para cada clave indexada.
Consulte además:
-
Oracle AI Database SQL Tuning Guide para obtener más información sobre los índices de bitmap
-
Guía de almacenamiento de datos de Oracle AI Database para aprender a utilizar índices de bitmap en un almacén de datos
Ejemplo: Índices de Bitmap en una única tabla
En este ejemplo, algunas columnas de la tabla sh.customers son candidatas para un índice de bitmap.
Observe la siguiente consulta:
SQL> SELECT cust_id, cust_last_name, cust_marital_status, cust_gender
  2  FROM   sh.customers
  3  WHERE  ROWNUM < 8 ORDER BY cust_id;

   CUST_ID CUST_LAST_ CUST_MAR C
---------- ---------- -------- -
         1 Kessel              M
         2 Koch                F
         3 Emmerson            M
         4 Hardy               M
         5 Gowen               M
         6 Charles    single   F
         7 Ingram     single   F

7 rows selected.
Las columnas cust_marital_status y cust_gender tienen baja cardinalidad, mientras que las columnas cust_id y cust_last_name no. Por lo tanto, los índices de bitmap pueden ser adecuados en cust_marital_status y cust_gender. Un índice de bitmap probablemente no sea útil para las otras columnas. En su lugar, un índice de árbol B único en estas columnas probablemente proporcionaría la representación y recuperación más eficaz. La Tabla 5-4 ilustra el índice de bitmap para la salida de la columna cust_gender que se muestra en el ejemplo anterior. Consta de dos bitmaps separados, uno para cada género.
Tabla 4 Mapa de bits de ejemplo para una columna
| Valor | Fila 1 | Fila 2 | Fila 3 | Fila 4 | Fila 5 | Fila 6 | Fila 7 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
Una función de asignación convierte cada bit del mapa de bits en un ID de fila de la tabla customers. Cada valor de bit depende de los valores de la fila correspondiente de la tabla. Por ejemplo, el bitmap para el valor M contiene un 1 como primer bit porque el género es M en la primera fila de la tabla customers. El mapa de bits cust_gender='M' tiene un valor 0 para los bits en las filas 2, 6 y 7 porque estas filas no contienen M como valor.
Nota: Los índices de bitmap pueden incluir claves que constan completamente de valores nulos, a diferencia de los índices de árbol B. La indexación de valores nulos puede ser útil para algunas sentencias SQL, como consultas con la función de agregación COUNT.
Un analista que investiga las tendencias demográficas de los clientes puede preguntar: "¿Cuántas de nuestras clientas son solteras o divorciadas?" Esta pregunta corresponde a la siguiente consulta SQL:
SELECT COUNT(*)
FROM   customers
WHERE  cust_gender = 'F'
AND    cust_marital_status IN ('single', 'divorced');
Los índices de bitmap pueden procesar esta consulta de forma eficaz contando el número de valores 1 en el bitmap resultante, como se ilustra en la Tabla 5-5. Para identificar a los clientes que cumplen los criterios, Oracle AI Database puede utilizar el mapa de bits resultante para acceder a la tabla.
Tabla 5 Mapa de bits de ejemplo para dos columnas
| Valor | Fila 1 | Fila 2 | Fila 3 | Fila 4 | Fila 5 | Fila 6 | Fila 7 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
single |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
divorced |
0 | 0 | 0 | 0 | 0 | 0 | 0 |
single o divorced, y F |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
La indexación de bitmap fusiona de forma eficaz índices que corresponden a varias condiciones en una cláusula WHERE. Las filas que cumplen algunas condiciones, pero no todas, se filtran antes de que se acceda a la tabla. Esta técnica mejora el tiempo de respuesta, a menudo dramáticamente.
Índices de Unión de Bitmap
Un índice de unión de mapa de bits es un índice de mapa de bits para la unión de dos o más tablas.
Para cada valor de una columna de tabla, el índice almacena el ID de fila de la fila correspondiente en la tabla indexada. Por el contrario, se crea un índice de bitmap estándar en una sola tabla.
Un índice de unión de bitmap es un medio eficaz para reducir el volumen de datos que se deben unir mediante restricciones por adelantado. Para ver un ejemplo de cuándo sería útil un índice de unión de bitmap, suponga que los usuarios suelen consultar el número de empleados con un tipo de trabajo concreto. Una consulta típica puede tener el siguiente aspecto:
SELECT COUNT(*)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
AND    jobs.job_title = 'Accountant';
La consulta anterior suele utilizar un índice en jobs.job_title para recuperar las filas de Accountant y, a continuación, el identificador de trabajo y un índice en employees.job_id para buscar las filas coincidentes. Para recuperar los datos del índice en sí en lugar de una exploración de las tablas, puede crear un índice de unión de bitmap de la siguiente forma:
CREATE BITMAP INDEX employees_bm_idx
ON     employees (jobs.job_title)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id;
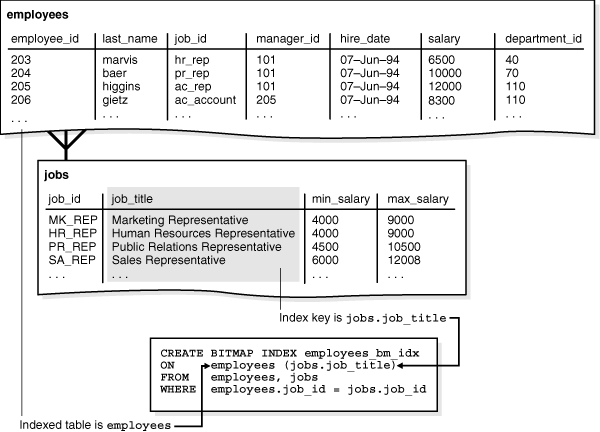
Como se muestra en la siguiente figura, la clave de índice es jobs.job_title y la tabla indexada es employees.
Figura 2: Índice de Unión de Bitmap
Descripción de la ilustración cncpt239.gif
Conceptualmente, employees_bm_idx es un índice de la columna jobs.title en la consulta SQL que se muestra en la siguiente consulta (salida de ejemplo incluida). La clave job_title del índice apunta a las filas de la tabla employees. Una consulta del número de contadores puede utilizar el índice para evitar el acceso a las tablas employees y jobs porque el propio índice contiene la información solicitada.
SELECT jobs.job_title AS "jobs.job_title", employees.rowid AS "employees.rowid"
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
ORDER BY job_title;

jobs.job_title                      employees.rowid
----------------------------------- ------------------
Accountant                          AAAQNKAAFAAAABSAAL
Accountant                          AAAQNKAAFAAAABSAAN
Accountant                          AAAQNKAAFAAAABSAAM
Accountant                          AAAQNKAAFAAAABSAAJ
Accountant                          AAAQNKAAFAAAABSAAK
Accounting Manager                  AAAQNKAAFAAAABTAAH
Administration Assistant            AAAQNKAAFAAAABTAAC
Administration Vice President       AAAQNKAAFAAAABSAAC
Administration Vice President       AAAQNKAAFAAAABSAAB
.
.
.
En un almacén de datos, la condición de unión es una unión igualitaria (utiliza el operador de igualdad) entre las columnas de clave primaria de las tablas de dimensiones y las columnas de clave ajena de la tabla de hechos. Los índices de unión de bitmap a veces son mucho más eficaces en el almacenamiento que las vistas de unión materializadas, una alternativa para materializar uniones por adelantado.
Consulte también: Guía de almacenamiento de datos de Oracle AI Database para obtener más información sobre los índices de unión de bitmap
Estructura de almacenamiento de mapa de bits
Oracle AI Database utiliza una estructura de índice de árbol B para almacenar mapas de bits para cada clave indexada.
Por ejemplo, si jobs.job_title es la columna clave de un índice de bitmap, un árbol B almacena los datos del índice. Los bloques de hoja almacenan los bitmaps individuales.
Ejemplo 5-6 Ejemplo de almacenamiento de mapa de bits
Supongamos que la columna jobs.job_title tiene valores únicos Shipping Clerk, Stock Clerk y varios más. Una entrada de índice de bitmap para este índice tiene los siguientes componentes:
-
El cargo como clave de índice
-
ID de fila bajo y alto para un rango de ID de fila
-
Un bitmap para rowid específicos en el rango
Conceptualmente, un bloque de hoja de índice de este índice podría contener entradas de la siguiente forma:
Shipping Clerk,AAAPzRAAFAAAABSABQ,AAAPzRAAFAAAABSABZ,0010000100
Shipping Clerk,AAAPzRAAFAAAABSABa,AAAPzRAAFAAAABSABh,010010
Stock Clerk,AAAPzRAAFAAAABSAAa,AAAPzRAAFAAAABSAAc,1001001100
Stock Clerk,AAAPzRAAFAAAABSAAd,AAAPzRAAFAAAABSAAt,0101001001
Stock Clerk,AAAPzRAAFAAAABSAAu,AAAPzRAAFAAAABSABz,100001
.
.
.
El mismo cargo aparece en varias entradas porque el rango de ID de fila es diferente.
Una sesión actualiza el ID de trabajo de un empleado de Shipping Clerk a Stock Clerk. En este caso, la sesión necesita acceso exclusivo a la entrada de clave de índice para el valor antiguo (Shipping Clerk) y el nuevo valor (Stock Clerk). Oracle AI Database bloquea las filas a las que apuntan estas dos entradas, pero no las filas a las que apunta Accountant o cualquier otra clave, hasta que UPDATE se confirma.
Los datos de un índice de bitmap se almacenan en un segmento. Oracle AI Database almacena cada bitmap en una o más partes. Cada pieza ocupa parte de un único bloque de datos.
Consulte también: "Segmentos de usuarios" explica los diferentes tipos de segmentos y cómo se crean.
Visión general de los índices basados en función
Un índice basado en función calcula el valor de una función o expresión que implica una o más columnas y lo almacena en un índice. Un índice basado en funciones puede ser un índice de árbol B o un índice de bitmap.
La función indexada puede ser una expresión aritmética o una expresión que contenga una función SQL, una función PL/SQL definida por el usuario, una función de paquete o una llamada C. Por ejemplo, una función podría agregar los valores en dos columnas.
-
Los uso de los índices basados en funciones son eficaces para evaluar sentencias que contienen funciones en sus cláusulas
WHERE. La base de datos solo utiliza el índice basado en funciones cuando la función se incluye en una consulta. Sin embargo, cuando la base de datos procesa las sentenciasINSERTyUPDATE, debe seguir evaluando la función para procesar la sentencia. -
Optimización con Índices Basados en Funciones Para consultas con expresiones en una cláusula
WHERE, el optimizador puede utilizar una exploración de rango de índices en un índice basado en funciones.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a crear índices basados en funciones
-
Oracle AI Database Development Guide para obtener más información sobre el uso de índices basados en funciones
-
Referencia de lenguaje SQL de Oracle AI Database para restricciones y notas de uso para índices basados en funciones
Usos de los índices basados en función
Los índices basados en funciones son eficaces para evaluar sentencias que contienen funciones en sus cláusulas WHERE. La base de datos solo utiliza el índice basado en funciones cuando la función se incluye en una consulta. Sin embargo, cuando la base de datos procesa las sentencias INSERT y UPDATE, debe seguir evaluando la función para procesar la sentencia.
Ejemplo 5-7 Índice Basado en Expresión Aritmética
Por ejemplo, supongamos que crea el siguiente índice basado en funciones:
CREATE INDEX emp_total_sal_idx
  ON employees (12 * salary * commission_pct, salary, commission_pct);
La base de datos puede utilizar el índice anterior al procesar consultas como las siguientes (salida de ejemplo parcial incluida):
SELECT   employee_id, last_name, first_name,
         12*salary*commission_pct AS "ANNUAL SAL"
FROM     employees
WHERE    (12 * salary * commission_pct) < 30000
ORDER BY "ANNUAL SAL" DESC;

EMPLOYEE_ID LAST_NAME                 FIRST_NAME           ANNUAL SAL
----------- ------------------------- -------------------- ----------
        159 Smith                     Lindsey                   28800
        151 Bernstein                 David                     28500
        152 Hall                      Peter                     27000
        160 Doran                     Louise                    27000
        175 Hutton                    Alyssa                    26400
        149 Zlotkey                   Eleni                     25200
        169 Bloom                     Harrison                  24000
Ejemplo 5-8 Índice Basado en una Función UPPER
Los índices basados en funciones definidos en las funciones SQL UPPER(column_name) o LOWER(column_name) facilitan las búsquedas no sensibles a mayúsculas/minúsculas. Por ejemplo, supongamos que la columna first_name de employees contiene caracteres en mayúsculas y minúsculas. Puede crear el siguiente índice basado en funciones en la tabla hr.employees:
CREATE INDEX emp_fname_uppercase_idx
ON employees ( UPPER(first_name) );
El índice emp_fname_uppercase_idx puede facilitar consultas como las siguientes:
SELECT *
FROM   employees
WHERE  UPPER(first_name) = 'AUDREY';
Ejemplo 5-9 Indexación de filas específicas en una tabla
Un índice basado en funciones también es útil para indexar solo filas específicas de una tabla. Por ejemplo, la columna cust_valid de la tabla sh.customers tiene I o A como valor. Para indexar solo las filas A, puede escribir una función que devuelva un valor nulo para cualquier fila que no sea las filas A. Puede crear el índice de la siguiente forma:
CREATE INDEX cust_valid_idx
ON customers ( CASE cust_valid WHEN 'A' THEN 'A' END );
Consulte además:
-
Guía de soporte de globalización de Oracle AI Database para obtener información sobre los índices lingüísticos
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre las funciones SQL
Optimización con índices basados en función
Para consultas con expresiones en una cláusula WHERE, el optimizador puede utilizar una exploración de rango de índices en un índice basado en funciones.
La ruta de acceso de exploración de rango es especialmente beneficiosa cuando el predicado es altamente selectivo, es decir, cuando selecciona relativamente pocas filas. En el Ejemplo 5-7, si se crea un índice a partir de la expresión 12*salary*commission_pct, el optimizador puede utilizar una exploración de rango de índices.
Una columna virtual también es útil para acelerar el acceso a los datos derivados de expresiones. Por ejemplo, puede definir la columna virtual annual_sal como 12*salary*commission_pct y crear un índice basado en funciones en annual_sal.
El optimizador realiza la coincidencia de expresiones analizando la expresión en una sentencia SQL y, a continuación, comparando los árboles de expresiones de la sentencia y el índice basado en funciones. Esta comparación no distingue entre mayúsculas y minúsculas e ignora los espacios en blanco.
Las distintas consultas pueden utilizar diferentes tipos de exploraciones de índice.
Consulte además:
-
Oracle AI Database SQL Tuning Guide para obtener más información sobre la recopilación de estadísticas
-
Oracle AI Database Administrator's Guide para aprender a agregar columnas virtuales a una tabla
Visión General de Índices de Dominio de Aplicación
Un índice de dominio de aplicación es un índice personalizado específico de una aplicación.
La indexación extensa puede:
-
Incorpore índices en tipos de datos complejos y personalizados, como documentos, datos espaciales, imágenes y clips de vídeo (consulte )
-
Utilizar técnicas de indexación especializadas
Puede encapsular rutinas de gestión de índices específicas de la aplicación como un objeto de esquema de tipo de índice y, a continuación, definir un índice de dominio en columnas de tabla o atributos de un tipo de objeto. La indexación ampliable puede procesar de forma eficaz operadores específicos de la aplicación.
El software de la aplicación, denominado cartucho, controla la estructura y el contenido de un índice de dominio. La base de datos interactúa con la aplicación para crear, mantener y buscar el índice de dominio. La propia estructura de índice se puede almacenar en la base de datos como una tabla organizada por índices o externamente como un archivo.
Consulte además:
-
Guía de desarrollo de Oracle AI Database para obtener más información sobre tipos de datos complejos
-
Oracle AI Database Data Cartridge Developer's Guide para obtener información sobre el uso de cartuchos de datos dentro de la arquitectura de extensibilidad de Oracle AI Database
Visión general de índices HNSW cuantificados escalares
Los índices escalares cuantificados Hierarchical Navigable Small World (HNSW) se pueden utilizar para reducir los requisitos de memoria y acelerar la búsqueda de similitud.
En el contexto de las bases de datos vectoriales, la cuantificación escalar es un método para comprimir o aproximar vectores de datos de alta dimensión mediante la cuantificación independiente de cada dimensión (o componente escalar) del vector. Este enfoque se utiliza para reducir los requisitos de almacenamiento de una base de datos vectorial y, al mismo tiempo, preservar la estructura esencial de los datos para tareas como la búsqueda de similitud. La cuantificación escalar puede ser particularmente beneficiosa cuando la simplicidad y los bajos requisitos de almacenamiento son prioridades altas.
Los vectores de alta dimensión almacenados como números de punto flotante requieren un espacio de almacenamiento significativo. La cuantificación escalar ahorra memoria al comprimir los vectores. Por ejemplo, un vector de 128 dimensiones almacenado en 8 bits (INT8) por dimensión solo requiere 128 bytes de memoria, mientras que el almacenamiento de punto flotante de 32 bits (Float32) requeriría 512 bytes y el almacenamiento doble de 64 bits (Float64) requeriría 1024 bytes. Debido a este requisito de almacenamiento reducido, la cuantificación escalar puede permitir que las bases de datos vectoriales manejen conjuntos de datos muy grandes, compuestos incluso por miles de millones de vectores, que de otro modo no serían prácticos debido a las restricciones de almacenamiento.
Otro beneficio de la cuantificación escalar es la mejora de la velocidad de búsqueda. Los métodos de búsqueda aproximados de vecino más cercano (ANN) pueden aprovechar los datos cuantificados para comparaciones más rápidas, ya que las operaciones en números enteros o códigos binarios son más rápidas que los cálculos de coma flotante.
Con Oracle AI Database, la cuantificación escalar uniforme es el método de compresión implementado, lo que significa que el rango de entrada se divide en intervalos de igual tamaño. Cada intervalo está representado por un único nivel de cuantificación, generalmente su punto medio. El rango de cada dimensión se divide en intervalos iguales 2b, donde b es el número de bits (por ejemplo, 8 bits para int8). Cada valor flotante se asigna al nivel de cuantificación más cercano.
Consulte además:
-
Guía del usuario de Oracle AI Database AI Vector Search para la sintaxis y los parámetros del índice HNSW
-
Referencia de lenguaje SQL de Oracle AI Database para la sentencia
CREATE VECTOR INDEX
Visión general de tablas organizadas por índices
Una tabla organizada por índices es una tabla almacenada en una variación de una estructura de índice de árbol B. Por el contrario, una tabla organizada en pilas inserta filas donde se ajusten.
En una tabla organizada por índices, las filas se almacenan en un índice definido en la clave primaria de la tabla. Cada entrada de índice del árbol B también almacena los valores de columna no de clave. Por lo tanto, el índice son los datos y los datos son el índice. Las aplicaciones manipulan tablas organizadas por índices de la misma forma que las tablas organizadas por pilas mediante sentencias SQL.
Para una analogía de una tabla organizada por índices, supongamos que un gestor de recursos humanos tiene un caso de libro de cajas de cartón. Cada caja está etiquetada con un número 1, 2, 3, 4, etc., pero las cajas no se encuentran en los estantes en orden secuencial. En su lugar, cada cuadro contiene un puntero a la ubicación de la estantería del siguiente cuadro de la secuencia.
Las carpetas que contienen registros de empleados se almacenan en cada cuadro. Las carpetas se ordenan por ID de empleado. Employee King tiene el ID 100, que es el ID más bajo, por lo que su carpeta está en la parte inferior de la casilla 1. La carpeta para el empleado 101 está encima de 100, 102 está encima de 101, y así sucesivamente hasta que la casilla 1 esté llena. La siguiente carpeta de la secuencia se encuentra en la parte inferior del cuadro 2.
En esta analogía, ordenar carpetas por ID de empleado permite buscar carpetas de manera eficiente sin tener que mantener un índice independiente. Supongamos que un usuario solicita los registros de los empleados 107, 120 y 122. En lugar de buscar un índice en un paso y recuperar las carpetas en otro, el gestor puede buscar las carpetas en orden secuencial y recuperar cada carpeta según se encuentre.
Las tablas organizadas por índices proporcionan un acceso más rápido a la fila de las tablas por clave principal o por un prefijo válido de la clave. La presencia de columnas no clave de una fila en el bloque de hoja evita una E/S de bloque de datos adicional. Por ejemplo, el salario del empleado 100 se almacena en la propia fila de índice. Además, dado que las filas se almacenan en orden de clave primaria, el acceso de rango por clave primaria o prefijo implica E/S de bloque mínimas. Otra ventaja es evitar la sobrecarga de espacio de un índice de clave primaria independiente.
Las tablas organizadas por índices son útiles cuando los datos relacionados se deben almacenar juntos o los datos se deben almacenar físicamente en un orden específico. Un uso típico de este tipo de tabla es para recuperación de información, datos espaciales y aplicaciones OLAP.
-
Características de Tabla Organizada por Índices: el sistema de base de datos realiza todas las operaciones en tablas organizadas por índices mediante la manipulación de la estructura de índice de árbol B.
-
Tablas Organizadas por Índices con Área de Desbordamiento de Filas Al crear una tabla organizada por índices, puede especificar un segmento independiente como área de desbordamiento de filas.
-
Índices Secundarios en Tablas Organizadas por Índices Un índice secundario es un índice en una tabla organizada por índice.
Consulte además:
-
Guía del desarrollador de Oracle Spatial para obtener una visión general de Oracle Spatial and Graph
-
Oracle AI Database Administrator's Guide para aprender a gestionar tablas organizadas por índices
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
CREATE TABLE ... ORGANIZATION INDEX
Características de Tabla Organizada por Índices
El sistema de base de datos realiza todas las operaciones en tablas organizadas por índices mediante la manipulación de la estructura de índice de árbol B.
En la siguiente tabla se resumen las diferencias entre las tablas organizadas por índices y las organizadas por pilas.
Tabla 6 Comparación de Tablas Organizadas por Pila con Tablas Organizadas por Índice
| Tabla Organizada por Pila | Tabla organizada por índices |
|---|---|
| El ID de fila identifica de forma única una fila. Opcionalmente, se puede definir la restricción de clave primaria. | La clave primaria identifica de forma única una fila. Se debe definir la restricción de clave primaria. |
El ID de fila físico en ROWID pseudocolumna permite crear índices secundarios. |
El ID de fila lógico en la pseudocolumna ROWID permite crear índices secundarios. |
| Se puede acceder a las filas individuales directamente mediante rowid. | El acceso a filas individuales se puede lograr indirectamente por clave primaria. |
| La exploración de tabla completa secuencial devuelve todas las filas en algún orden. | Una exploración de índice completa o una exploración de índice completa rápida devuelve todas las filas en algún orden. |
| Se puede almacenar en un cluster de tablas con otras tablas. | No se puede almacenar en un cluster de tabla. |
Puede contener una columna del tipo de dato LONG y columnas de tipos de dato LOB. |
Puede contener columnas LOB pero no columnas LONG. |
| Puede contener columnas virtuales (solo están soportadas las tablas de pila relacionales). | No puede contener columnas virtuales. |
Las tablas organizadas por índices se pueden comprimir mediante la compresión avanzada baja agregando la cláusula COMPRESS ADVANCED LOW a la sentencia CREATE TABLE. La compresión avanzada baja es una forma adaptativa de compresión de prefijos que calcula de forma autónoma el número óptimo de columnas de prefijo para cada bloque de hoja, lo que lleva a una compresión óptima a nivel de bloque sin intervención del usuario. Esto incluye la posibilidad de no comprimir en absoluto, si procede. Esto garantiza que no es posible la compresión negativa. Se observan mayores relaciones de compresión con una sobrecarga general insignificante.
Las exploraciones de tablas organizadas por índices se pueden descargar en Exadata Smart Scan, donde el optimizador ha considerado que la consulta se puede ejecutar como una exploración completa rápida. Esto no requiere ninguna intervención del usuario. El procesamiento de celda completa estará soportado en bloques de hoja de tabla organizados por índices en los que todas las columnas de interés residan en el bloque de hoja. En los casos en que algunas columnas residen en el segmento de desbordamiento, la exploración inteligente no procesará dichas columnas y la base de datos completará la exploración. La Figura 5-3 ilustra la estructura de una tabla departments organizada por índices. Los bloques de hoja contienen las filas de la tabla, ordenadas secuencialmente por clave primaria. Por ejemplo, el primer valor del primer bloque de hoja muestra un ID de departamento de 20, un nombre de departamento de Marketing, un ID de gestor de 201 y un ID de ubicación de 1800.
Figura 3: Tabla organizada por índices
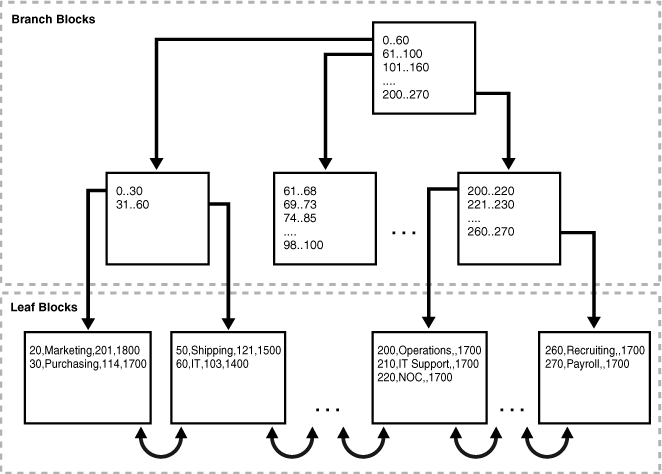
Descripción de la ilustración cncpt272.gif
Ejemplo 5-10 Exploración de Tabla Organizada por Índices
Una tabla organizada por índices almacena todos los datos en la misma estructura y no necesita almacenar el ID de fila. Como se muestra en la Figura 5-3, el bloque de hoja 1 de una tabla organizada por índices puede contener entradas de la siguiente manera, ordenadas por clave primaria:
20,Marketing,201,1800
30,Purchasing,114,1700
El bloque de hoja 2 de una tabla organizada por índices puede contener entradas de la siguiente forma:
50,Shipping,121,1500
60,IT,103,1400
Una exploración de las filas de tabla organizadas por índices en orden de clave primaria lee los bloques en la siguiente secuencia:
-
Bloque 1
-
Bloque 2
Ejemplo 5-11 Exploración de Tabla Organizada por Pila
Para contrastar el acceso a los datos de una tabla organizada en pilas con una tabla organizada en índices, suponga que el bloque 1 de un segmento de tabla departments organizado en pilas contiene filas de la siguiente manera:
50,Shipping,121,1500
20,Marketing,201,1800
El bloque 2 contiene filas para la misma tabla como se indica a continuación:
30,Purchasing,114,1700
60,IT,103,1400
Un bloque de hoja de índice de árbol B para esta tabla organizada en pilas contiene las siguientes entradas, donde el primer valor es la clave primaria y el segundo es el rowid:
20,AAAPeXAAFAAAAAyAAD
30,AAAPeXAAFAAAAAyAAA
50,AAAPeXAAFAAAAAyAAC
60,AAAPeXAAFAAAAAyAAB
Una exploración de las filas de la tabla en orden de clave primaria lee los bloques de segmentos de la tabla en la siguiente secuencia:
-
Bloque 1
-
Bloque 2
-
Bloque 1
-
Bloque 2
Por lo tanto, el número de E/S de bloque en este ejemplo es el doble del número en el ejemplo organizado por índices.
Consulte además:
para obtener más información sobre las tablas organizadas en pilas
para obtener más información sobre la relación entre segmentos y bloques de datos
Tablas Organizadas por Índices con Área de Desbordamiento de Filas
Al crear una tabla organizada por índices, puede especificar un segmento independiente como un área de desbordamiento de filas.
En las tablas organizadas por índices, las entradas de índice de árbol B pueden ser grandes porque contienen una fila completa, por lo que resulta útil un segmento independiente que contenga las entradas. Por el contrario, las entradas de árbol B suelen ser pequeñas porque consisten en la clave y el rowid.
Si se especifica un área de desbordamiento de filas, la base de datos puede dividir una fila en una tabla organizada por índices en las siguientes partes:
-
La entrada de índice
Esta parte contiene valores de columna para todas las columnas de clave primaria, un ID de fila físico que apunta a la parte de desbordamiento de la fila y, opcionalmente, algunas de las columnas no clave. Esta parte se almacena en el segmento de índice.
-
La parte de desbordamiento
Esta parte contiene valores de columna para las columnas no clave restantes. Esta parte se almacena en el segmento de área de almacenamiento de desbordamiento.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a utilizar la cláusula
OVERFLOWdeCREATE TABLEpara definir un área de desbordamiento de filas -
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
CREATE TABLE ... OVERFLOW
Índices Secundarios en Tablas Organizadas por Índices
Un índice secundario es un índice de una tabla organizada por índice.
En cierto sentido, un índice secundario es un índice de un índice. Se trata de un objeto de esquema independiente y se almacena independientemente de la tabla organizada por índices.
Oracle AI Database utiliza identificadores de fila denominados rowid lógicos para las tablas organizadas por índices. Un ID de fila lógico es una representación codificada por base64 de la clave primaria de la tabla. La longitud del ID de fila lógico depende de la longitud de la clave primaria.
Las filas de los bloques de hoja de índice se pueden mover dentro o entre bloques debido a las inserciones. Las filas de las tablas organizadas por índices no se migran como hacen las filas organizadas por pilas. Puesto que las filas de las tablas organizadas por índices no tienen direcciones físicas permanentes, la base de datos utiliza rowid lógicos basados en la clave primaria.
Por ejemplo, supongamos que la tabla departments está organizada por índices. La columna location_id almacena el ID de cada departamento. La tabla almacena las filas de la siguiente manera, con el último valor como ID de ubicación:
10,Administration,200,1700
20,Marketing,201,1800
30,Purchasing,114,1700
40,Human Resources,203,2400
Un índice secundario en la columna location_id puede tener entradas de índice como se indica a continuación, donde el valor que sigue a la coma es el ID de fila lógico:
1700,*BAFAJqoCwR/+
1700,*BAFAJqoCwQv+
1800,*BAFAJqoCwRX+
2400,*BAFAJqoCwSn+
Los índices secundarios proporcionan un acceso rápido y eficaz a las tablas organizadas por índices mediante columnas que no son la clave primaria ni un prefijo de la clave primaria. Por ejemplo, una consulta de los nombres de los departamentos cuyo ID es mayor que 1700 podría utilizar el índice secundario para acelerar el acceso a los datos.
-
Los índices secundarios Logical Rowids and Physical Guesses utilizan rowid lógicos para localizar filas de tabla.
-
Índices de bitmap en tablas organizadas por índices Un índice secundario en una tabla organizada por índices puede ser un índice de bitmap. Un índice de bitmap almacena un bitmap para cada clave de índice.
Consulte además:
-
"Tipos de Dato de Rowid" para obtener más información sobre el uso de rowid y la pseudocolumna
ROWID -
"Filas Cadenas y Migradas" para saber por qué se migran las filas y por qué la migración aumenta el número de E/S
-
Oracle AI Database Administrator's Guide para aprender a crear índices secundarios en una tabla organizada por índices
-
Oracle AI Database VLDB and Partitioning Guide para obtener más información sobre la creación de índices secundarios en particiones de tablas organizadas por índices.
Rowids lógicos y adivinanzas físicas
Los índices secundarios utilizan rowid lógicos para localizar filas de tabla.
Un rowid lógico incluye una suposición física, que es el rowid físico de la entrada de índice cuando se realizó por primera vez. Oracle AI Database puede utilizar adivinaciones físicas para sondear directamente en el bloque de hoja de la tabla organizada por índices, omitiendo la búsqueda de clave primaria. Cuando cambia la ubicación física de una fila, el ID de fila lógico sigue siendo válido incluso si contiene una estimación física que está obsoleta.
Para una tabla organizada en pilas, el acceso por un índice secundario implica una exploración del índice secundario y una E/S adicional para recuperar el bloque de datos que contiene la fila. Para las tablas organizadas por índices, el acceso por un índice secundario varía según el uso y la precisión de las conjeturas físicas:
-
Sin conjeturas físicas, el acceso implica dos exploraciones de índice: una exploración del índice secundario seguida de una exploración del índice de clave primaria.
-
Con conjeturas físicas, el acceso depende de su precisión:
-
Con conjeturas físicas precisas, el acceso implica una exploración de índice secundaria y una E/S adicional para recuperar el bloque de datos que contiene la fila.
-
Con estimaciones físicas inexactas, el acceso implica una exploración de índice secundaria y una E/S para recuperar el bloque de datos incorrecto (como indica la estimación), seguida de una exploración única de índice de la tabla organizada por índices por valor de clave primaria.
-
Índices de Bitmap en Tablas Organizadas por Índices
Un índice secundario en una tabla organizada por índices puede ser un índice de bitmap. Un índice de bitmap almacena un bitmap para cada clave de índice.
Cuando existen índices de bitmap en una tabla organizada por índices, todos los índices de bitmap utilizan una tabla de asignación organizada por pilas. La tabla de asignación almacena los rowid lógicos de la tabla organizada por índices. Cada fila de tabla de asignación almacena un ID de fila lógico para la fila de tabla organizada por índices correspondiente.
La base de datos accede a un índice de bitmap mediante una clave de búsqueda. Si la base de datos encuentra la clave, la entrada de mapa de bits se convierte en un ID de fila físico. Con las tablas organizadas por pilas, la base de datos utiliza el ID de fila físico para acceder a la tabla base. Con las tablas organizadas por índices, la base de datos utiliza el ID de fila físico para acceder a la tabla de asignación, que a su vez genera un ID de fila lógico que la base de datos utiliza para acceder a la tabla organizada por índices. En la siguiente figura, se muestra el acceso al índice para una consulta de la tabla departments_iot.
Figura 4: Índice de Bitmap en Tabla Organizada por Índices
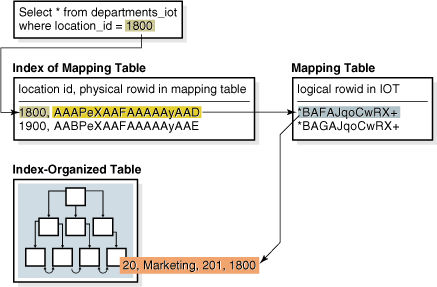
Descripción de la ilustración cncpt330.gif
Nota: el movimiento de filas en una tabla organizada por índices no deja inutilizables los índices de bitmap creados en esa tabla organizada por índices.
Consulte también: "Rowids of Row Pieces" para obtener información sobre las diferencias entre los rowid físicos y lógicos