SQL
En este capítulo se proporciona una visión general del lenguaje de consulta estructurado (SQL) y cómo Oracle AI Database procesa las sentencias SQL.
-
Introduction to SQL SQL (que se pronuncia sequel) es el lenguaje informático de alto nivel basado en juegos con los que todos los programas y usuarios acuerdan datos de una base de datos Oracle.
-
Visión General de Sentencias SQL Todas las operaciones realizadas en la información de una base de datos Oracle se ejecutan mediante sentencias SQL. Una sentencia SQL es un programa informático o instrucción que consta de identificadores, parámetros, variables, nombres, tipos de dato y palabras reservadas SQL.
-
Visión general del optimizador Para comprender cómo Oracle AI Database procesa las sentencias SQL, es necesario comprender la parte de la base de datos denominada optimizador (también conocido como optimizador de consultas o optimizador basado en costos). Todas las sentencias SQL utilizan el optimizador para determinar el medio más eficaz para acceder a los datos especificados.
-
Visión general del procesamiento SQL En esta sección se explica cómo Oracle AI Database procesa las sentencias SQL. En concreto, la sección explica la forma en que la base de datos procesa las sentencias DDL para crear objetos, DML para modificar datos y consultas para recuperar datos.
Introducción a SQL
SQL (que se pronuncia sequel) es el lenguaje informático de alto nivel basado en juegos con los que todos los programas y usuarios acuerdan a datos de una base de datos Oracle.
Aunque algunas herramientas y aplicaciones de Oracle enmascaran el uso de SQL, todas las tareas de la base de datos se realizan con SQL. Cualquier otro método de acceso a datos elude la seguridad integrada en Oracle AI Database y potencialmente compromete la seguridad y la integridad de los datos.
SQL proporciona una interfaz a una base de datos relacional como Oracle AI Database. SQL unifica tareas como las siguientes en un lenguaje consistente:
-
Creación, sustitución, modificación y borrado de objetos
-
Inserción, actualización y supresión de filas de tabla
-
Consulta de datos
-
Control de acceso a la base y sus objetos
-
Garantía de integridad y consistencia de la base de datos
SQL se puede utilizar de forma interactiva, lo que significa que las sentencias se introducen manualmente en un programa. Las sentencias SQL también se pueden embeber en un programa escrito en un lenguaje diferente, como C o Java.
-
Acceso a datos SQL Hay dos familias amplias de lenguajes informáticos: lenguajes declarativos que no son de procedimiento y describen qué se debe hacer y lenguajes de procedimiento, como C++ y Java, que describen cómo se deben hacer las cosas.
-
SQL Standards Oracle se esfuerza por seguir los estándares aceptados por el sector y participa activamente en los comités de estándares SQL.
Consulte además:
-
Oracle AI Database Development Guide para aprender a elegir un entorno de programación
-
Referencia de lenguaje SQL de Oracle AI Database para una introducción a SQL
Acceso a datos SQL
Hay dos familias amplias de lenguajes informáticos: lenguajes declarativos que no son de procedimiento y describen qué se debe hacer, y lenguajes de procedimiento como C++ y Java que describen cómo se deben hacer las cosas.
SQL es declarativo en el sentido de que los usuarios especifican el resultado que desean, no cómo derivarlo. Por ejemplo, la siguiente sentencia consulta los registros de los empleados cuyo apellido empiece por K:
La base de datos realiza el trabajo de generar un procedimiento para navegar por los datos y recuperar los resultados solicitados. La naturaleza declarativa de SQL permite trabajar con datos en el nivel lógico. Solo tiene que preocuparse de los detalles de implantación cuando manipule los datos.
SELECT   last_name, first_name
FROM     hr.employees
WHERE    last_name LIKE 'K%'
ORDER BY last_name, first_name;
La base de datos recupera todas las filas que cumplen la condición WHERE, también denominada predicado, en un solo paso. La base de datos puede transferir estas filas como una unidad al usuario, a otra sentencia SQL o a una aplicación. La aplicación no necesita procesar las filas una por una, ni el desarrollador necesita saber cómo se almacenan o recuperan físicamente las filas.
Todas las sentencias SQL utilizan el optimizador, un componente de la base de datos que determina el medio más eficaz para acceder a los datos solicitados. Oracle Database también soporta técnicas que puede utilizar para que el optimizador realice mejor su trabajo.
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para obtener información detallada sobre sentencias SQL y otras partes de SQL (como operadores, funciones y modelos de formato)
Estándares SQL
Oracle se esfuerza por seguir los estándares aceptados por el sector y participa activamente en los comités de estándares SQL.
Los comités aceptados por la industria son el American National Standards Institute (ANSI) y la Organización Internacional de Normalización (ISO). Tanto ANSI como ISO/IEC han aceptado SQL como lenguaje estándar para bases de datos relacionales.
El estándar SQL consta de diez partes. Una parte (SQL/RPR:2012) es nueva en 2012. Otras cinco partes fueron revisadas en 2011. Para las otras cuatro partes, la versión de 2008 sigue en su lugar. Oracle SQL incluye muchas extensiones del lenguaje SQL estándar ANSI/ISO, y las herramientas y aplicaciones de Oracle AI Database proporcionan sentencias adicionales. Las herramientas SQL*Plus, SQL Developer y Oracle Enterprise Manager permiten ejecutar cualquier sentencia SQL estándar ANSI/ISO en una base de datos Oracle y cualquier sentencia o función adicional disponible para dichas herramientas.
Consulte además:
-
Oracle AI Database: Introducción al desarrollo de Oracle AI Database
-
Referencia de lenguaje SQL de Oracle AI Database para obtener una explicación de las diferencias entre Oracle SQL y SQL estándar
-
Referencia y guía del usuario de SQL*Plus para comandos SQL*Plus, incluida su distinción de sentencias SQL
Visión General de Sentencias SQL
Todas las operaciones realizadas en la información de una base de datos Oracle se ejecutan mediante sentencias SQL. Una sentencia SQL es un programa informático o instrucción que consta de identificadores, parámetros, variables, nombres, tipos de dato y palabras reservadas SQL. Nota: Las palabras reservadas SQL tienen un significado especial en SQL y no se deben utilizar para ningún otro fin. Por ejemplo, SELECT y UPDATE son palabras reservadas y no se deben utilizar como nombres de tabla.
Una sentencia SQL debe ser el equivalente a una sentencia SQL completa, como:
SELECT last_name, department_id FROM employeesOracle AI Database solo ejecuta sentencias SQL completas. Un fragmento como el siguiente genera un error que indica que se necesita más texto:
SELECT last_name;Las sentencias SQL de Oracle se dividen en las siguientes categorías:
-
Sentencias de lenguaje de definición de datos (DDL) Las sentencias de lenguaje de definición de datos (DLL) definen, cambian estructuralmente y borran objetos de esquema.
-
Las sentencias del lenguaje de manipulación de datos (DML) de lenguaje de manipulación de datos (DML) consultan o manipulan datos en objetos de esquema existentes.
-
Las sentencias de control de transacciones Sentencias de control de transacciones gestionan los cambios realizados por las sentencias DML y agrupan las sentencias DML en transacciones.
-
Las sentencias de control de sesión Session Control Statements gestionan dinámicamente las propiedades de una session de usuario.
-
Sentencia de control del sistema: una sentencia de control del sistema cambia las propiedades de la instancia de base de datos.
-
Las sentencias SQL embebidas de sentencias SQL embebidas incorporan sentencias de control de transacciones, DML y DDL dentro de un programa de lenguaje de procedimiento.
sentencias de Lenguaje de Definición de Datos (DDL)
Las sentencias de lenguaje de definición de datos (DLL) definen, cambian estructuralmente y borran objetos de esquema.
DDL permite modificar los atributos de un objeto sin modificar las aplicaciones que acceden al objeto. Por ejemplo, puede agregar una columna a una tabla a la que acceda una aplicación de recursos humanos sin volver a escribir la aplicación. También puede utilizar DDL para modificar la estructura de objetos mientras los usuarios de la base de datos realizan trabajos en la base de datos.
Más concretamente, las sentencias DDL permiten:
-
Crear, modificar y borrar objetos de esquema y otras estructuras de base de datos, incluida la propia base de datos y los usuarios de la base de datos. La mayoría de las sentencias DDL comienzan con las palabras clave
CREATE,ALTERoDROP. -
Suprima todos los datos de los objetos de esquema sin eliminar la estructura de estos objetos (
TRUNCATE).Nota: A diferencia de
DELETE,TRUNCATEno genera datos de deshacer, lo que hace que sea más rápido queDELETE. Además,TRUNCATEno llama a los disparadores de supresión -
Otorgue y revoque privilegios y roles (
GRANT,REVOKE). -
Active y desactive las opciones de auditoría (
AUDIT,NOAUDIT). -
Agregue un comentario al diccionario de datos (
COMMENT).
Ejemplo 10-1 Sentencias DDL
En el siguiente ejemplo se utilizan sentencias DDL para crear la tabla plants y, a continuación, se utiliza DML para insertar dos filas en la tabla. A continuación, el ejemplo utiliza DDL para modificar la estructura de la tabla, otorgar y revocar privilegios de lectura en esta tabla a un usuario y, a continuación, borrar la tabla.
CREATE TABLE plants
    ( plant_id    NUMBER PRIMARY KEY,
      common_name VARCHAR2(15) );

INSERT INTO plants VALUES (1, 'African Violet'); # DML statement

INSERT INTO plants VALUES (2, 'Amaryllis'); # DML statement

ALTER TABLE plants ADD
    ( latin_name VARCHAR2(40) );

GRANT READ ON plants TO scott;

REVOKE READ ON plants FROM scott;

DROP TABLE plants;
Una COMMIT implícita se produce inmediatamente antes de que la base de datos ejecute una sentencia DDL y una COMMIT o ROLLBACK se produce inmediatamente después. En el ejemplo anterior, dos sentencias INSERT van seguidas de una sentencia ALTER TABLE, por lo que la base de datos confirma las dos sentencias INSERT. Si la sentencia ALTER TABLE se realiza correctamente, la base de datos confirma esta sentencia; de lo contrario, la base de datos realiza un rollback de esta sentencia. En cualquier caso, las dos sentencias INSERT ya se han confirmado.
Consulte además:
-
Guía de seguridad de Oracle AI Database para obtener información sobre privilegios y roles
-
Oracle AI Database Get Started with Oracle AI Database Development y Oracle AI Database Administrator's Guide para aprender a crear objetos de esquema
-
Oracle AI Database Development Guide para obtener más información sobre la diferencia entre el DDL de bloqueo y el DDL de no bloqueo
-
Referencia de lenguaje SQL de Oracle AI Database para una lista de sentencias DDL
sentencias de Lenguaje de Manipulación de Datos (DML)
Las sentencias de lenguaje de manipulación de datos (DML) consultan o manipulan datos en objetos de esquema existentes.
Mientras que las sentencias DDL cambian la estructura de la base de datos, las sentencias DML consultan o cambian el contenido. Por ejemplo, ALTER TABLE cambia la estructura de una tabla, mientras que INSERT agrega una o más filas a la tabla.
Las sentencias DML son las sentencias SQL utilizadas con más frecuencia y le permiten:
-
Recuperar o recuperar datos de una o más tablas o vistas (
SELECT). -
Agregue nuevas filas de datos a una tabla o vista (
INSERT) especificando una lista de valores de columna o utilizando una subconsulta para seleccionar y manipular los datos existentes. -
Cambiar los valores de columna en las filas existentes de una tabla o vista (
UPDATE). -
Actualizar o insertar filas condicionalmente en una tabla o ver (
MERGE). -
Eliminar filas de tablas o vistas (
DELETE). -
Visualice el plan de ejecución de una sentencia SQL (
EXPLAINPLAN). -
Bloquee una tabla o vista, limitando temporalmente el acceso de otros usuarios (
LOCKTABLE).
En el siguiente ejemplo se utiliza DML para consultar la tabla employees. En el ejemplo se utiliza DML para insertar una fila en employees, actualizar esta fila y, a continuación, suprimirla:
SELECT * FROM employees;

INSERT INTO employees (employee_id, last_name, email, job_id, hire_date, salary)
  VALUES (1234, 'Mascis', 'JMASCIS', 'IT_PROG', '14-FEB-2008', 9000);

UPDATE employees SET salary=9100 WHERE employee_id=1234;

DELETE FROM employees WHERE employee_id=1234;
Una recopilación de sentencias DML que forma una unidad lógica de trabajo se denomina transacción. Por ejemplo, una transacción para transferir dinero podría implicar tres operaciones discretas: disminuir el saldo de la cuenta de ahorros, aumentar el saldo de la cuenta corriente y registrar la transferencia en una tabla de historial de cuentas. A diferencia de las sentencias DDL, las sentencias DML no confirman implícitamente la transacción actual.
-
Sentencias SELECT Una consulta es una operación que recupera datos de una tabla o vista.
-
Uniones Una unión es una consulta que combina filas de dos o más tablas, vistas o vistas materializadas.
-
Subconsultas Una subconsulta es una sentencia
SELECTanidada en otra sentencia SQL. Las subconsultas son útiles cuando se deben ejecutar varias consultas para resolver un único problema.
Consulte además:
-
Oracle AI Database: introducción al desarrollo de Oracle AI Database para aprender a consultar y manipular datos
-
Referencia de lenguaje SQL de Oracle AI Database para obtener una lista de sentencias DML
Sentencias SELECT
Una consulta es una operación que recupera datos de una tabla o vista.
SELECT es la única sentencia SQL que puede utilizar para consultar datos. El juego de datos recuperado de la ejecución de una sentencia SELECT se conoce como juego de resultados.
La siguiente tabla muestra una palabra clave necesaria y tres palabras clave que se encuentran normalmente en una sentencia SELECT. La tabla también asocia las capacidades de una sentencia SELECT con las palabras clave.
Tabla 1 Palabras clave en una sentencia SQL
| Palabra clave | Necesario | Descripción | Capacidad |
|---|---|---|---|
SELECT |
Sí | Especifica qué columnas se deben mostrar en el resultado. La proyección produce un subjuego de las columnas de la tabla. Una expresión es una combinación de uno o más valores, operadores y funciones SQL que se resuelven en un valor. La lista de expresiones que aparece después de la palabra clave |
Proyecto |
FROM |
No | Especifica las tablas o vistas desde las que se deben recuperar los datos. | Unión |
WHERE |
No | Especifica una condición para filtrar filas, produciendo un subjuego de las filas de la tabla. Una condición especifica una combinación de una o más expresiones y operadores lógicos (booleanos) y devuelve un valor de TRUE, FALSE o UNKNOWN. |
Selección |
ORDER BY |
No | Especifica el orden en el que se deben mostrar las filas. |
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica de SELECT
Uniones
Una unión es una consulta que combina filas de dos o más tablas, vistas o vistas materializadas.
El siguiente ejemplo une las tablas employees y departments (cláusula FROM), selecciona solo las filas que cumplen los criterios especificados (cláusula WHERE) y utiliza la proyección para recuperar datos de dos columnas (SELECT). La salida de ejemplo sigue la sentencia SQL.
SELECT email, department_name
FROM   employees
JOIN   departments
ON     employees.department_id = departments.department_id
WHERE  employee_id IN (100,103)
ORDER BY email;

EMAIL                     DEPARTMENT_NAME
------------------------- ------------------------------
AHUNOLD                   IT
SKING                     Executive
El siguiente gráfico representa las operaciones de proyección y selección en la unión que se muestra en la consulta anterior.
Figura 1: Proyección y selección
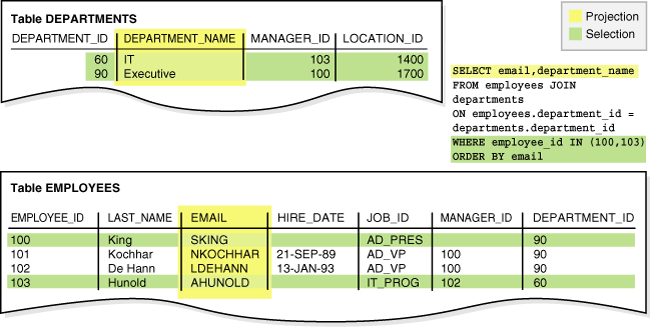
Descripción de la ilustración cncpt290.gif
La mayoría de las uniones tienen al menos una condición de unión, ya sea en la cláusula FROM o en la cláusula WHERE, que compara dos columnas, cada una de una tabla diferente. La base de datos combina pares de filas, cada una con una fila de cada tabla, para las que la condición de unión se evalúa como TRUE. El optimizador determina el orden en el que la base de datos une tablas en función de las condiciones de unión, los índices y las estadísticas disponibles para las tablas.
Los tipos de unión incluyen los siguientes:
-
Uniones internas
Una unión interna es una unión de dos o más tablas que devuelve solo las filas que cumplen la condición de unión. Por ejemplo, si la condición de unión es
employees.department_id=departments.department_id, no se devuelven las filas que no cumplan esta condición. -
Uniones externas
Una unión externa devuelve todas las filas que cumplen la condición del enlace, y también devuelve las filas de una tabla para la que ninguna de la otra tabla cumple la condición.
El resultado de una unión externa izquierda para las tablas A y B siempre contiene todos los registros de la tabla izquierda A, incluso si la condición de unión no coincide con un registro de la tabla derecha B. Si no existe ninguna fila coincidente de B, las columnas B contienen valores nulos para las filas que no tienen ninguna coincidencia en B. Por ejemplo, si no todos los empleados están en departamentos, una unión externa izquierda de
employees(tabla izquierda) ydepartments(tabla derecha) recupera todas las filas deemployeesincluso si ninguna fila dedepartmentscumple la condición de unión (employees.department_ides nula).El resultado de una unión externa derecha para la tabla A y B contiene todos los registros de la tabla derecha B, incluso si la condición de unión no coincide con una fila de la tabla izquierda A. Si no existe ninguna fila coincidente de A, las columnas A contienen valores nulos para las filas que no tienen ninguna coincidencia en A. Por ejemplo, si no todos los departamentos tienen empleados, una unión externa derecha de
employees(tabla izquierda) ydepartments(tabla derecha) recupera todas las filas dedepartmentsincluso si ninguna fila deemployeescumple la condición de unión.Una unión externa completa es la combinación de una unión externa izquierda y una unión externa derecha.
-
Productos cartesianos
Si dos tablas de una consulta de unión no tienen ninguna condición de unión, la base de datos realiza una unión cartesiana. Cada fila de una tabla se combina con cada fila de la otra. Por ejemplo, si
employeestiene 107 filas ydepartmentstiene 27, el producto cartesiano contiene 107*27 filas. Un producto cartesiano rara vez es útil.
Consulte además:
-
Oracle AI Database SQL Tuning Guide para obtener más información sobre las uniones
-
Referencia de lenguaje SQL de Oracle AI Database para obtener descripciones detalladas y ejemplos de uniones
Subconsultas
Una subconsulta es una sentencia SELECT anidada en otra sentencia SQL. Las subconsultas son útiles cuando se deben ejecutar varias consultas para resolver un único problema.
Cada parte de la consulta de una sentencia se denomina bloque de consulta. En la siguiente consulta, la subconsulta entre paréntesis es el bloque de consulta interno:
SELECT first_name, last_name
FROM   employees
WHERE  department_id
IN     ( SELECT department_id
         FROM departments
         WHERE location_id = 1800 );
La sentencia SELECT interna recupera los ID de los departamentos con el ID de ubicación 1800. Estos ID de departamento son necesarios para el bloque de consulta externo, que recupera los nombres de los empleados de los departamentos cuyos ID fueron proporcionados por la subconsulta.
La estructura de la sentencia SQL no obliga a la base de datos a ejecutar primero la consulta interna. Por ejemplo, la base de datos podría reescribir toda la consulta como una unión de employees y departments, para que la subconsulta nunca se ejecute por sí misma. Como otro ejemplo, la función de base de datos privada virtual (VPD) podría restringir la consulta de los empleados mediante una cláusula WHERE, de modo que la base de datos consulte primero a los empleados y, a continuación, obtenga los ID de departamento. El optimizador determina la mejor secuencia de pasos para recuperar las filas solicitadas.
Consulte también: Guía de seguridad de Oracle AI Database para obtener más información sobre la VPD
Sentencias de Control de Transacciones
Las sentencias de control de transacciones gestionan los cambios realizados por las sentencias DML y agrupan las sentencias DML en transacciones.
Estas sentencias permiten:
-
Haga que los cambios en una transacción sean permanentes (
COMMIT). -
Deshacer los cambios en una transacción, desde que se inició la transacción (
ROLLBACK) o desde un punto de grabación (ROLLBACK TO SAVEPOINT). Un punto de guardado es un marcador intermedio declarado por el usuario en el contexto de una transacción.Nota: La sentencia
ROLLBACKfinaliza una transacción, peroROLLBACK TO SAVEPOINTno. -
Defina un punto en el que pueda realizar un rollback (
SAVEPOINT). -
Establecer propiedades para una transacción (
SETTRANSACTION). -
Especifique si se comprueba una restricción de integridad diferible después de cada sentencia DML o cuando se confirma la transacción (
SET CONSTRAINT).
En el siguiente ejemplo se inicia una transacción denominada Update salaries. En el ejemplo se crea un punto de grabación, se actualiza un salario de empleado y, a continuación, se realiza un rollback de la transacción al punto de grabación. En el ejemplo, se actualiza el salario a un valor diferente y se confirman.
SET TRANSACTION NAME 'Update salaries';

SAVEPOINT before_salary_update;

UPDATE employees SET salary=9100 WHERE employee_id=1234 # DML

ROLLBACK TO SAVEPOINT before_salary_update;

UPDATE employees SET salary=9200 WHERE employee_id=1234 # DML

COMMIT COMMENT 'Updated salaries';
Consulte además:
-
Cuando la Base de Datos Comprueba la Validez de las Restricciones y Afirmaciones
-
Referencia de lenguaje SQL de Oracle AI Database para obtener más información sobre las sentencias de control de transacciones
Sentencias de Control de Sesión
Las sentencias de control de sesión gestionan dinámicamente las propiedades de una sesión de usuario.
Una sesión es una entidad lógica en la memoria de la instancia de base de datos que representa el estado de una conexión de usuario actual a una base de datos. Una sesión dura desde el momento en que la base de datos autentica al usuario hasta que el usuario se desconecta o sale de la aplicación de base de datos.
Las sentencias de control de sesión permiten:
-
Modifique la sesión actual mediante una función especializada, como la definición del formato de fecha por defecto (
ALTER SESSION). -
Active y desactive los roles, que son grupos de privilegios, para la sesión actual (
SET ROLE).
La siguiente sentencia cambia dinámicamente el formato de fecha por defecto para la sesión a 'YYYY MM DD-HH24:MI:SS':
ALTER SESSION
   SET NLS_DATE_FORMAT = 'YYYY MM DD HH24:MI:SS';
Las sentencias de control de sesión no confirman implícitamente la transacción actual.
Consulte además:
-
Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica
ALTER SESSION
Sentencia de control del sistema
Una sentencia de control del sistema cambia las propiedades de la instancia de base de datos.
La única sentencia de control del sistema es ALTER SYSTEM. Permite cambiar la configuración, como el número mínimo de servidores compartidos, terminar una sesión y realizar otras tareas de nivel de sistema.
Entre los ejemplos de la sentencia de control del sistema se incluyen:
ALTER SYSTEM SWITCH LOGFILE;

ALTER SYSTEM KILL SESSION '39, 23';
La sentencia ALTER SYSTEM no confirma implícitamente la transacción actual.
Consulte también: Referencia de lenguaje SQL de Oracle AI Database para la sintaxis y la semántica de ALTER SYSTEM
Sentencias SQL Embebidas
Las sentencias SQL embebidas incorporan sentencias de control de transacciones, DML y DDL dentro de un programa de lenguaje de procedimiento.
Las sentencias embebidas se utilizan con los precompiladores de Oracle. Embedded SQL es un enfoque para incorporar SQL en las aplicaciones de lenguaje de procedimiento. Otro enfoque es utilizar una API de procedimiento como Open Database Connectivity (ODBC) o Java Database Connectivity (JDBC).
Las sentencias SQL embebidas permiten:
-
Defina, asigne y libere un cursor (
DECLARE CURSOR,OPEN,CLOSE). -
Especifique una base de datos y conéctese a ella (
DECLARE DATABASE,CONNECT). -
Asigne nombres de variables (
DECLARE STATEMENT). -
Inicialice los descriptores (
DESCRIBE). -
Especifique cómo se manejan las condiciones de error y advertencia (
WHENEVER). -
Analizar y ejecutar sentencias SQL (
PREPARE,EXECUTE,EXECUTE IMMEDIATE). -
Recupere datos de la base de datos (
FETCH).
Consulte además:
Visión General del Optimizador
Para comprender cómo Oracle AI Database procesa las sentencias SQL, es necesario comprender la parte de la base de datos denominada optimizador (también conocido como optimizador de consultas o optimizador basado en costos). Todas las sentencias SQL utilizan el optimizador para determinar el medio más eficaz para acceder a los datos especificados.
-
Uso del Optimizador: el optimizador genera planes de ejecución que describen los posibles métodos de ejecución.
-
Componentes del Optimizador El optimizador contiene tres componentes principales: el transformador, el estimador y el generador de planes.
-
Rutas de acceso Una ruta de acceso es la técnica que utiliza una consulta para recuperar filas.
-
Estadísticas del optimizador Las estadísticas del optimizador son una recopilación de datos que describen los detalles sobre la base de datos y sus objetos. Las estadísticas proporcionan una imagen estadísticamente correcta del almacenamiento y la distribución de datos que puede utilizar el optimizador al evaluar las rutas de acceso.
-
Indicaciones del Optimizador Una indicación es un comentario de una sentencia SQL que actúa como instrucción para el optimizador.
Uso del Optimizador
El optimizador genera planes de ejecución que describen los posibles métodos de ejecución.
El optimizador determina qué plan de ejecución es más eficaz teniendo en cuenta varios orígenes de información. Por ejemplo, el optimizador tiene en cuenta las condiciones de consulta, las rutas de acceso disponibles, las estadísticas recopiladas para el sistema y las indicaciones.
Para ejecutar una sentencia DML, puede que Oracle AI Database tenga que realizar muchos pasos. Cada paso recupera filas de datos físicamente de la base datos o los prepara para el usuario que emite la sentencia. Los pasos que utiliza la base de datos para ejecutar una sentencia afectan en gran medida a la rapidez con la que se ejecuta la sentencia. Muchas formas diferentes de procesar una sentencia DML suelen ser posibles. Por ejemplo, el orden en el que se accede a las tablas o índices puede variar.
Al determinar el mejor plan de ejecución para una sentencia SQL, el optimizador realiza las siguientes operaciones:
-
Evaluación de expresiones y condiciones
-
Inspección de restricciones de integridad para obtener más información sobre los datos y optimizar en función de estos metadatos
-
Transformación de sentencias
-
Elección de objetivos del optimizador
-
Elección de rutas de acceso
-
Elección de órdenes de unión
El optimizador genera la mayoría de las formas posibles de procesar una consulta y asigna un costo a cada paso del plan de ejecución generado. El plan con el costo más bajo se selecciona como el plan de consulta que se va a ejecutar.
Nota: Puede obtener un plan de ejecución para una sentencia SQL sin ejecutar el plan. Sólo un plan de ejecución que la base de datos realmente utiliza para ejecutar una consulta se denomina correctamente un plan de consulta.
Puede influir en las opciones del optimizador definiendo el objetivo del optimizador y recopilando estadísticas representativas para el optimizador. Por ejemplo, puede definir el objetivo del optimizador en una de las siguientes opciones:
-
Rendimiento total
La indicación
ALL_ROWSindica al optimizador que obtenga la última fila del resultado en la aplicación cliente lo más rápido posible. -
Tiempo de Respuesta Inicial
La indicación
FIRST_ROWSindica al optimizador que obtenga la primera fila para el cliente lo más rápido posible.
Una aplicación interactiva típica para el usuario final se beneficiaría de la optimización del tiempo de respuesta inicial, mientras que una aplicación no interactiva en modo por lotes se beneficiaría de la optimización del rendimiento total.
Consulte además:
-
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para obtener información sobre el uso de
DBMS_STATS -
Oracle AI Database SQL Tuning Guide para obtener más información sobre el optimizador y el uso de indicaciones
Componentes del Optimizador
El optimizador contiene tres componentes principales: el transformador, el estimador y el generador de planes.
En el siguiente diagrama se muestran los componentes:
Figura 2: Componentes del Optimizador
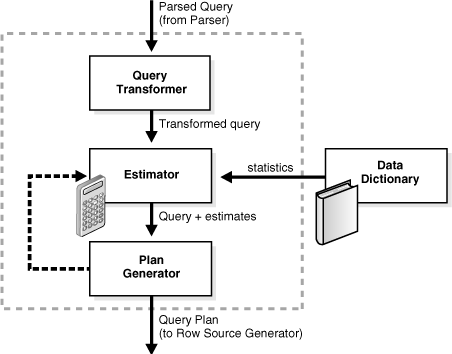
Descripción de la ilustración cncpt287.gif
La entrada al optimizador es una consulta analizada. El optimizador realiza las siguientes operaciones:
-
El optimizador recibe la consulta analizada y genera un juego de posibles planes para la sentencia SQL en función de las rutas de acceso e indicaciones disponibles.
-
El optimizador estima el costo de cada plan en función de las estadísticas del diccionario de datos. El costo es un valor estimado proporcional al uso del recurso esperado necesario para ejecutar la sentencia con un plan concreto.
-
El optimizador compara los costos de los planes y selecciona el plan de menor costo, conocido como el plan de consulta, para transferirlo al generador de origen de fila.
-
Transformador de consultas El transformador de consultas determina si es útil cambiar la forma de la consulta para que el optimizador pueda generar un mejor plan de ejecución. La entrada al transformador de consulta es una consulta analizada, que el optimizador representa como un juego de bloques de consulta.
-
Estimador: el estimador determina el costo general de un plan de ejecución determinado.
-
Generador de planes: el generador de planes prueba diferentes planes para una consulta enviada. El optimizador selecciona el plan con el costo más bajo.
Consulte además:
Transformador de consulta
El transformador de consulta determina si es útil cambiar la forma de la consulta para que el optimizador pueda generar un mejor plan de ejecución. La entrada al transformador de consulta es una consulta analizada, que el optimizador representa como un juego de bloques de consulta.
Consulte también: Reescritura de consultas
Estimador
El estimador determina el costo general de un plan de ejecución determinado.
El estimador genera tres tipos diferentes de medidas para lograr este objetivo:
-
Selectividad
Esta medida representa una fracción de las filas de un juego de filas. La selectividad está ligada a un predicado de consulta, como
last_name='Smith', o a una combinación de predicados. -
Cardinalidad
Esta medida representa el número de filas de un juego de filas.
-
Costo
Esta medida representa las unidades de trabajo o el recurso utilizado. El optimizador de consulta utiliza la E/S de disco, el uso de CPU y el uso de memoria como unidades de trabajo.
Si hay estadísticas disponibles, el estimador las utiliza para calcular las medidas. Las estadísticas mejoran el grado de precisión de las medidas.
Generador de planes
El generador de planes prueba diferentes planes para una consulta enviada. El optimizador selecciona el plan con el costo más bajo.
Para cada subconsulta anidada y vista sin fusionar, el optimizador genera un subplan. El optimizador representa cada subplan como un bloque de consulta independiente. El generador de planes explora varios planes para un bloque de consultas probando diferentes rutas de acceso, métodos de unión y órdenes de unión.
La capacidad de optimización de consultas adaptativa cambia los planes en función de las estadísticas recopiladas durante la ejecución de sentencias. Todos los mecanismos adaptativos pueden ejecutar un plan final para una sentencia que difiera del plan por defecto. La optimización adaptativa utiliza planes dinámicos, que eligen entre los subplanes durante la ejecución de sentencias, o la reoptimización, que cambia un plan de ejecuciones después de la ejecución actual.
Consulte además:
-
Oracle AI Database: introducción al ajuste de rendimiento para obtener una introducción al ajuste SQL
-
Oracle AI Database SQL Tuning Guide para obtener más información sobre los componentes del optimizador y la optimización adaptativa
Rutas de Acceso
Una ruta de acceso es la técnica que una consulta utiliza para recuperar filas.
Por ejemplo, una consulta que utiliza un índice tiene una ruta de acceso diferente a la de una consulta que no lo hace. En general, las rutas de acceso de índice son las mejores para las sentencias que recuperan un pequeño subjuego de filas de tabla. Las exploraciones completas son más eficaces para acceder a una gran parte de una tabla.
La base de datos puede utilizar varias rutas de acceso diferentes para recuperar datos de una tabla. A continuación se muestra una lista representativa:
-
Exploraciones de tablas completas
Este tipo de exploración lee todas las filas de una tabla y filtra aquellas que no cumplen los criterios de selección. La base de datos analiza secuencialmente todos los bloques de datos del segmento, incluidos los que se encuentran bajo el marco de agua superior (HWM) que separa el espacio utilizado del espacio no utilizado (consulte "Espacio de segmento y el marca de agua superior").
-
Exploraciones de ID de fila
El rowid de una fila especifica el archivo de datos y bloque que contiene la fila y la ubicación de la fila en ese bloque. La base de datos obtiene primero los rowid de las filas seleccionadas, ya sea de la cláusula
WHEREde la sentencia o mediante una exploración de índice y, a continuación, localiza cada fila seleccionada en función de su rowid. -
Exploraciones del índice
Esta exploración busca un índice para los valores de columna indexados a los que accede la sentencia SQL (consulte "Exploraciones de Índice"). Si la sentencia sólo accede a las columnas del índice, Oracle AI Database lee los valores del índice directamente desde el índice.
-
Exploraciones de cluster
Una exploración de cluster recupera datos de una tabla almacenada en un cluster de tabla indexado, donde todas las filas con el mismo valor clave de cluster se almacenan en el mismo bloque de datos (consulte "Visión General de los Clusters Indexados"). La base de datos obtiene primero el ID de fila de una fila seleccionada mediante la exploración del índice de cluster. Oracle AI Database localiza las filas según este ID de fila.
-
Exploraciones hash
Una exploración hash localiza filas en un cluster hash, donde todas las filas con el mismo valor hash se almacenan en el mismo bloque de datos (consulte "Visión General de Clusters Hash"). Para obtener primero el valor hash, la base de datos aplica una función hash a un valor clave del cluster especificado por la sentencia. A continuación, Oracle AI Database explora los bloques de datos que contienen filas con este valor de comprobación aleatoria.
El optimizador selecciona una ruta de acceso basada en las rutas de acceso disponibles para la sentencia y el costo estimado de utilizar cada ruta de acceso o combinación de rutas.
Consulte también: Oracle AI Database Get Started with Performance Tuning y Oracle AI Database SQL Tuning Guide para obtener más información sobre las rutas de acceso
Estadísticas del optimizador
Las estadísticas del optimizador son una recopilación de datos que describen los detalles sobre la base de datos y los objetos de la base de datos. Las estadísticas proporcionan una imagen estadísticamente correcta del almacenamiento y la distribución de datos que puede utilizar el optimizador al evaluar las rutas de acceso.
Las estadísticas del optimizador incluyen lo siguiente:
-
Estadísticas de tablas
Estos incluyen el número de filas, el número de bloques y el promedio de longitud de fila.
-
Estadísticas de columna
Estos incluyen el número de valores distintos y nulos en una columna y la distribución de los datos.
-
Estadísticas de índice
Estos incluyen el número de bloques de hoja y los niveles de índice.
-
Estadísticas del sistema
Estos incluyen el rendimiento y el uso de CPU y E/S.
Oracle AI Database recopila estadísticas del optimizador en todos los objetos de base de datos automáticamente y mantiene estas estadísticas como una tarea de mantenimiento automatizada. También puede recopilar estadísticas manualmente mediante el paquete DBMS_STATS. Este paquete PL/SQL puede modificar, ver, exportar, importar y suprimir estadísticas. Nota: Las estadísticas del optimizador se crean para la optimización de consultas y se almacenan en el diccionario de datos. No confunda estas estadísticas con estadísticas de rendimiento visibles mediante vistas de rendimiento dinámico.
El asesor de estadísticas del optimizador es un software de diagnóstico incorporado que analiza cómo está recopilando estadísticas actualmente, la eficacia de los trabajos de recopilación de estadísticas existentes y la calidad de las estadísticas recopiladas. El asesor de estadísticas del optimizador mantiene reglas que incorporan las mejores prácticas de Oracle basadas en el juego de funciones actual. De esta forma, el asesor siempre proporciona las recomendaciones más actualizadas para la recopilación de estadísticas.
Consulte además:
-
Oracle AI Database Get Started with Performance Tuning y Oracle AI Database SQL Tuning Guide para aprender a recopilar y gestionar estadísticas
-
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para obtener más información sobre
DBMS_STATS
Indicaciones de Optimizador
Una indicación es un comentario de una sentencia SQL que actúa como instrucción para el optimizador.
A veces, el diseñador de aplicaciones, que tiene más información sobre los datos de una aplicación concreta de la que está disponible para el optimizador, puede elegir una forma más eficaz de ejecutar una sentencia SQL. El diseñador de aplicaciones puede utilizar indicaciones en sentencias SQL para especificar cómo se debe ejecutar la sentencia. Los ejemplos siguientes ilustran el uso de indicaciones.
Ejemplo 10-2 Plan de Ejecución para SELECT con Indicación FIRST_ROWS
Supongamos que la aplicación interactiva ejecuta una consulta que devuelve 50 filas. Esta aplicación recupera inicialmente solo las primeras 25 filas de la consulta que se van a presentar al usuario final. Desea que el optimizador genere un plan que obtenga los primeros 25 registros lo antes posible para que el usuario no se vea obligado a esperar. Puede utilizar una indicación para transferir esta instrucción al optimizador como se muestra en la sentencia SELECT y la salida AUTOTRACE en el siguiente ejemplo:
SELECT /*+ FIRST_ROWS(25) */ employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation                    | Name              | Rows | Bytes
------------------------------------------------------------------------
|  0 | SELECT STATEMENT             |                   | 26   | 182
|  1 |  TABLE ACCESS BY INDEX ROWID | EMPLOYEES         | 26   | 182
|* 2 |   INDEX RANGE SCAN           | EMP_DEPARTMENT_IX |      |
------------------------------------------------------------------------
En este ejemplo, el plan de ejecución muestra que el optimizador selecciona un índice en la columna employees.department_id para buscar las primeras 25 filas de employees cuyo ID de departamento es superior a 50. El optimizador utiliza el ID de fila recuperado del índice para recuperar el registro de la tabla employees y devolverlo al cliente. La recuperación del primer registro suele ser casi instantánea.
Ejemplo 10-3 Plan de ejecución para SELECT sin indicación
Supongamos que ejecuta la misma sentencia, pero sin la indicación del optimizador:
SELECT employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation              | Name              | Rows | Bytes | Cos
------------------------------------------------------------------------
|  0 | SELECT STATEMENT       |                   | 50   | 350   |
|* 1 |  VIEW                  | index$_join$_001  | 50   | 350   |
|* 2 |   HASH JOIN            |                   |      |       |
|* 3 |    INDEX RANGE SCAN    | EMP_DEPARTMENT_IX | 50   | 350   |
|  4 |    INDEX FAST FULL SCAN| EMP_EMP_ID_PK     | 50   | 350   |
En este caso, el plan de ejecución une dos índices para devolver los registros solicitados lo más rápido posible. En lugar de pasar repetidamente de un índice a otra tabla como en el Ejemplo 10-2, el optimizador selecciona una exploración de rango de EMP_DEPARTMENT_IX para buscar todas las filas en las que el ID de departamento sea superior a 50 y colocar estas filas en una tabla hash. A continuación, el optimizador selecciona leer el índice EMP_EMP_ID_PK. Para cada fila de este índice, sondea la tabla hash para buscar el ID de departamento.
En este caso, la base de datos no puede devolver la primera fila al cliente hasta que se complete la exploración de rango de índices de EMP_DEPARTMENT_IX. Por lo tanto, este plan generado tardaría más en devolver el primer registro. A diferencia del plan del Ejemplo 10-2, que accede a la tabla por ID de fila de índice, el plan utiliza E/S multibloque, lo que da como resultado lecturas grandes. Las lecturas permiten que la última fila de todo el juego de resultados se devuelva más rápidamente.
Consulte también: Guía de ajustes SQL de Oracle AI Database para aprender a utilizar indicaciones del optimizador
Visión General del Procesamiento SQL
En esta sección se explica cómo Oracle AI Database procesa las sentencias SQL. En concreto, la sección explica la forma en que la base de datos procesa las sentencias DDL para crear objetos, DML para modificar datos y consultas para recuperar datos.
-
Etapas de procesamiento SQL: las etapas generales del procesamiento SQL son el análisis, la optimización, la generación de origen de fila y la ejecución. En función de la sentencia, la base de datos puede omitir algunos de estos pasos.
-
Diferencias entre el procesamiento DML y DDL Oracle AI Database procesa DDL de forma diferente a DML.
Etapas del Procesamiento SQL
Las etapas generales de procesamiento SQL son el análisis, la optimización, la generación de origen de fila y la ejecución. En función de la sentencia, la base de datos puede omitir algunos de estos pasos.
En la siguiente figura, se muestran las etapas generales:
Figura 3: Etapas del Procesamiento SQL
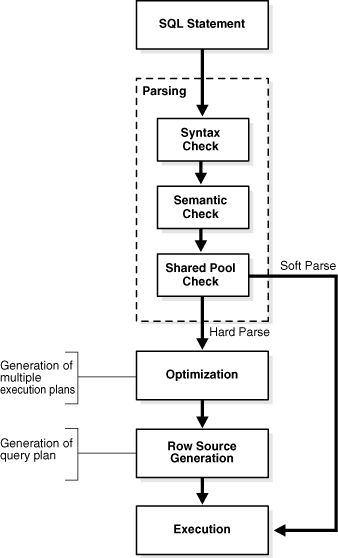
Descripción de la ilustración cncpt250.gif
-
Análisis SQL La primera etapa del procesamiento SQL es el análisis SQL. Esta etapa implica la separación de parte de una sentencia SQL en una estructura de datos que puedan procesar otras rutinas.
-
La optimización de consultas es el proceso de selección de los medios más eficaces para ejecutar una sentencia SQL.
-
Generación de origen de fila SQL El generador de origen de fila es un software que recibe el Plan de ejecución óptimo desde el optimizador y produce un plan iterativo, denominado plan de consulta, que puede usar el resto de la base de datos.
-
Ejecución de SQL Durante la ejecución, el motor SQL ejecuta cada origen de fila del árbol producido por el generador de orígenes de fila. Este es el único paso obligatorio en el procesamiento DML.
Análisis SQL
La primera etapa del procesamiento SQL es el análisis de SQL. Esta etapa implica la separación de parte de una sentencia SQL en una estructura de datos que puedan procesar otras rutinas.
Cuando una aplicación emite una sentencia SQL, la aplicación realiza una llamada de análisis a la base de datos para preparar la sentencia para su ejecución. La llamada de análisis abre o crea un cursor, que es un manejador para el área SQL privada específica de la sesión que contiene una sentencia SQL analizada y otra información de procesamiento. El cursor y el área SQL privada están en PGA.
Durante la llamada de análisis, la base de datos realiza las siguientes comprobaciones:
-
Comprobación de sintaxis
-
Comprobación semántica
-
Comprobación de pool compartido
Las comprobaciones anteriores identifican los errores que se pueden encontrar antes de la ejecución de la sentencia. Algunos errores no se pueden detectar mediante el análisis. Por ejemplo, la base de datos puede encontrar un desbloqueo o errores en la conversión de datos solo durante la ejecución de la sentencia.
La base de datos intenta la mitigación automática de errores para las sentencias SQL que fallan con un error ORA-00600 durante la fase de análisis. Un ORA-00600 es un error grave. Indica que un proceso ha encontrado una condición inesperada de bajo nivel. Cuando una sentencia SQL falla con este error durante la fase de análisis, la mitigación automática de errores lo detecta e intenta resolver la condición. Si se encuentra una resolución, la base de datos genera un parche SQL para ajustar el plan de ejecución SQL. Si este parche permite que el análisis se complete correctamente, no se emite el error ORA-00600. La aplicación no ve ninguna excepción.
Consulte también: Bloques y interbloqueos Acerca de la mitigación automática de errores de SQL
Optimización de SQL
La optimización de consultas es el proceso de selección de los medios más eficaces para ejecutar una sentencia SQL.
La base de datos optimiza las consultas basándose en las estadísticas recopiladas sobre los datos reales a los que se está accediendo. El optimizador utiliza el número de filas, el tamaño del juego de datos y otros factores para generar posibles planes de ejecución, asignando un costo numérico a cada plan. La base de datos utiliza el plan con el costo más reducido.
La base de datos debe realizar un análisis pesado al menos una vez para cada sentencia DML única y realizar la optimización durante este análisis. DDL nunca se optimiza a menos que incluya un componente DML como una subconsulta que requiera optimización.
Consulte además:
-
Oracle AI Database SQL Tuning Guide para obtener información detallada sobre el optimizador de consultas
Generación de origen de fila SQL
El generador de origen de fila es un software que recibe el plan a ejecutar óptimo desde el optimizador y produce un plan iterativo, denominado plan de consulta, que puede usar el resto de la base de datos.
El plan de consulta adopta la forma de una combinación de pasos. Cada paso devuelve un juego de filas. Las filas de este juego se utilizan en el siguiente paso o, en el último paso, se devuelven a la aplicación mediante la emisión de una sentencia SQL.
Un origen de fila es un juego de filas devuelto por un paso del plan de ejecución junto con una estructura de control que puede procesar iterativamente las filas. El origen de fila puede ser una tabla, vista o resultado de una operación de unión o agrupación.
Ejecución SQL
Durante la ejecución, el motor SQL ejecuta cada origen de fila del árbol producido por el generador del origen de fila. Este es el único paso obligatorio en el procesamiento DML.
Durante la ejecución, si los datos no están en memoria, la base de datos lee los datos del disco en memoria. La base de datos también elimina los bloqueos y bloqueos internos necesarios para garantizar la integridad de los datos y registra los cambios realizados durante la ejecución de SQL. La última etapa del procesamiento de una sentencia SQL es cerrar el cursor.
Si la base de datos está configurada para utilizar el almacén de columnas en memoria (almacén de columnas de IM), la base de datos enruta las consultas de forma transparente al almacén de columnas de IM cuando sea posible, y al disco y a la caché de buffers de la base de datos de lo contrario. Una sola consulta también puede utilizar el almacén de columnas de IM, el disco y la caché de buffers. Por ejemplo, una consulta puede unir dos tablas, una de las cuales solo se almacena en caché en el almacén de columnas de IM.
Consulte además:
-
Guía de ajustes SQL de Oracle AI Database para obtener información detallada sobre los planes de ejecución y la sentencia
EXPLAIN PLAN
Diferencias entre el procesamiento DML y DDL
Oracle AI Database procesa DDL de forma diferente a DML.
Por ejemplo, al crear una tabla, la base de datos no optimiza la sentencia CREATE TABLE. En su lugar, Oracle AI Database analiza la sentencia DDL y ejecuta el comando.
A diferencia del DDL, la mayoría de las sentencias DML tienen un componente de consulta. En una consulta, la ejecución de un cursor coloca la fila generada por la consulta en el juego de resultados.
La base de datos puede recuperar filas de juegos de resultados de una fila a la vez o en grupos. En la recuperación, la base de datos selecciona filas y, si la consulta lo solicita, ordena las filas. Cada recuperación sucesiva recupera otra fila del resultado hasta que se haya recuperado la última fila.
Consulte también: Oracle AI Database Development Guide para obtener más información sobre el procesamiento de DDL, el control de transacciones y otros tipos de sentencias