Arquitectura de Procesos
En este capítulo se describen los procesos de una base de datos Oracle.
-
Introducción a los procesos Un proceso es un mecanismo de un sistema operativo que puede ejecutar una serie de pasos.
-
Visión General de Procesos de Cliente Cuando un usuario ejecuta una aplicación como un programa Pro*C o SQL*Plus, el sistema operativo crea un proceso de cliente (a veces denominado proceso de usuario) para ejecutar la aplicación de usuario. La aplicación cliente tiene bibliotecas de Oracle AI Database enlazadas que proporcionan las API necesarias para comunicarse con la base de datos.
-
Visión general de los procesos del servidor Oracle AI Database crea procesos del servidor para manejar las solicitudes de los procesos del cliente conectados a la instancia. Un proceso de cliente siempre se comunica con una base de datos a través de un proceso de servidor independiente.
-
Visión General de Procesos en Segundo Plano Los procesos en segundo plano son procesos adicionales que utiliza una base de datos Oracle de varios procesos. Los procesos en segundo plano realizan las tareas de mantenimiento necesarias para operar la base de datos y maximizar el rendimiento de varios usuarios.
Introducción a los procesos
Un proceso es un mecanismo de un sistema operativo que puede ejecutar una serie de pasos.
La arquitectura de ejecución del proceso depende del sistema operativo. Por ejemplo, en Windows, un proceso en segundo plano de Oracle es un thread de ejecución dentro de un proceso. En Linux y UNIX, un proceso de Oracle es un proceso del sistema operativo o un thread dentro de un proceso del sistema operativo.
Permite procesar módulos de código de ejecución. Todos los usuarios de Oracle AI Database conectados deben ejecutar los siguientes módulos para acceder a una instancia de base de datos:
-
Utilidad de aplicación u Oracle AI Database
Un usuario de base de datos ejecuta una aplicación de base de datos, como un programa precompilador o una herramienta de base de datos como SQL*Plus, que emite sentencias SQL a una base de datos.
-
Código de base de datos Oracle
Cada usuario tiene código de base de datos Oracle ejecutándose en su nombre que interpreta y procesa las sentencias SQL de la aplicación.
Normalmente, un proceso se ejecuta en su propia área de memoria privada. La mayoría de los procesos pueden escribir periódicamente en un archivo de rastreo asociado.
-
Tipos de procesos: una instancia de base de datos contiene varios procesos o interactúa con ellos.
-
Multiprocess and Multithread Oracle AI Database Systems Multiprocess Oracle AI Database (también llamado multiusuario Oracle AI Database) utiliza varios procesos para ejecutar diferentes partes del código de Oracle AI Database y procesos adicionales de Oracle para los usuarios, ya sea un proceso para cada usuario conectado o uno o más procesos compartidos por varios usuarios.
Consulte además:
Tipos de Procesos
Una instancia de base de datos contiene varios procesos o interactúa con ellos.
Los procesos se dividen en los siguientes tipos:
-
Un proceso de cliente ejecuta la aplicación o el código de herramienta de Oracle.
-
Un proceso de Oracle es una unidad de ejecución que ejecuta el código de la base de datos Oracle. En la arquitectura multithread, un proceso de Oracle puede ser un proceso del sistema operativo o un thread dentro de un proceso del sistema operativo. Los procesos de Oracle incluyen los siguientes subtipos:
-
Un proceso en segundo plano se inicia con la instancia de base de datos y realiza tareas de mantenimiento como la realización de recuperación de instancias, la limpieza de procesos, la escritura de buffers de redo en el disco, etc.
-
Un proceso de servidor realiza el trabajo según una solicitud de cliente.
Por ejemplo, estos procesos analizan consultas SQL, las colocan en el pool compartido, crean y ejecutan un plan de consulta para cada consulta y leen buffers desde la caché de buffers de base de datos o desde el disco.
Nota: Los procesos de servidor y la memoria de proceso asignada en estos procesos se ejecutan en la instancia de base de datos. La instancia sigue funcionando cuando terminan los procesos del servidor.
-
Un proceso secundario realiza tareas adicionales para un proceso de servidor o en segundo plano.
-
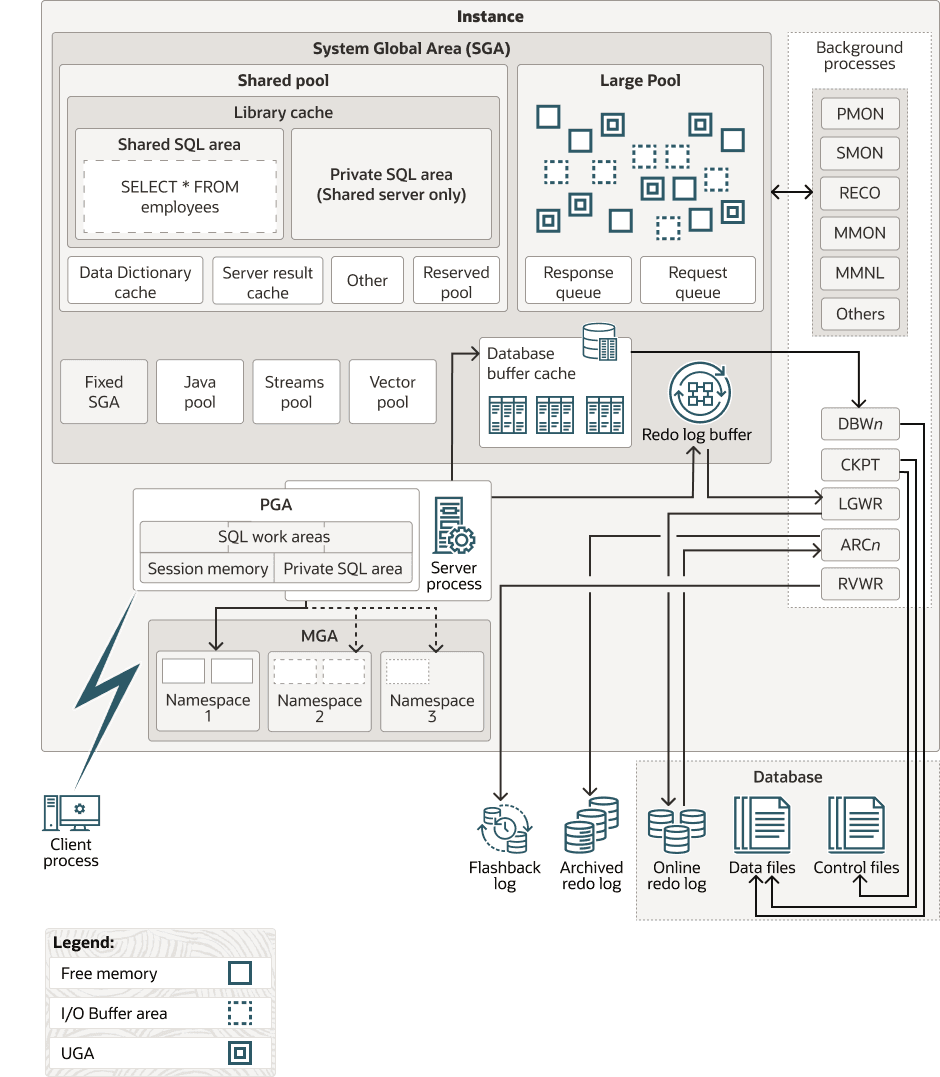
La estructura del proceso varía según el sistema operativo y la elección de las opciones de Oracle AI Database. Por ejemplo, puede configurar el código para los usuarios conectados para las conexiones de servidor dedicado o servidor compartido. En una arquitectura de servidor compartido, cada proceso de servidor que ejecuta código de base de datos puede servir a varios procesos de cliente. La Figura 18-1 muestra un área global del sistema (SGA) y procesos en segundo plano que utilizan conexiones de servidor dedicado. Para cada conexión de usuario, un proceso cliente ejecuta la aplicación. Este proceso de cliente es diferente del proceso de servidor dedicado que ejecuta el código de base de datos. Cada proceso de cliente está asociado a su propio proceso de servidor, que tiene su propio área global de programa (PGA).
Figura 1: Procesos de Oracle y SGA
Descripción de la ilustración cncpt283.png
Consulte además:
-
"Arquitectura de servidor dedicado" y "Arquitectura de servidor compartido"
-
La documentación específica del sistema operativo Oracle AI Database para obtener más información sobre las opciones de configuración
-
Oracle AI Database Reference para obtener más información sobre la vista
V$PROCESS
Sistemas Oracle AI Database multiprocesos y multiprocesos
Oracle AI Database multiproceso (también denominado Oracle AI Database multiusuario) utiliza varios procesos para ejecutar diferentes partes del código de Oracle AI Database y procesos adicionales de Oracle para los usuarios, ya sea un proceso para cada usuario conectado o uno o más procesos compartidos por varios usuarios.
La mayoría de las bases de datos son multiusuario porque una ventaja principal de una base de datos es gestionar los datos que necesitan varios usuarios simultáneamente. Cada proceso de una instancia de base de datos realiza un trabajo específico. Al dividir el trabajo de la base de datos y las aplicaciones en varios procesos, varios usuarios y aplicaciones pueden conectarse a una instancia simultáneamente, mientras que el sistema proporciona un buen rendimiento.
En versiones anteriores a Oracle Database 12c, los procesos de Oracle no se ejecutaban como threads en sistemas UNIX y Linux. A partir de Oracle Database 12c, el modelo de Oracle AI Database multithread permite que los procesos de Oracle se ejecuten como threads del sistema operativo en espacios de direcciones independientes. Cuando se instala Oracle AI Database, la base de datos se ejecuta en modo de proceso. Debe definir el parámetro de inicialización THREADED_EXECUTION en TRUE para ejecutar la base de datos en modo de thread. En el modo de thread, algunos procesos en segundo plano en UNIX y Linux se ejecutan como procesos (con cada proceso que contiene un thread), mientras que los procesos de Oracle restantes se ejecutan como threads dentro de los procesos.
En una base de datos que se ejecuta en modo de thread, PMON y DBW pueden ejecutarse como procesos del sistema operativo, mientras que LGWR y CMON pueden ejecutarse como threads dentro de un único proceso. Dos procesos en primer plano y un proceso de servidor de ejecución en paralelo (PX) pueden ejecutarse como threads en un segundo proceso del sistema operativo. Un tercer proceso del sistema operativo puede contener varios threads de primer plano. Por lo tanto, "proceso de Oracle" no siempre significa "proceso del sistema operativo". Nota: Cuando el parámetro de inicialización THREADED_EXECUTION se define en TRUE, la autenticación del sistema operativo no está soportada.
Ejemplo 18-1 Visualización de Metadatos de Oracle Process
La vista V$PROCESS contiene una fila para cada proceso de Oracle conectado a una instancia de base de datos. Por ejemplo, puede ejecutar la siguiente consulta en SQL*Plus para obtener el ID de proceso del sistema operativo y el ID de thread del sistema operativo para cada proceso:
COL SPID FORMAT a8
COL STID FORMAT a8
SELECT SPID, STID, PROGRAM FROM V$PROCESS ORDER BY SPID;
La consulta genera la siguiente salida de ejemplo parcial:
SPID   STID   PROGRAM
-----  -----  ---------------------------
7190   7190   oracle@samplehost (PMON)
7192   7192   oracle@samplehost (PSP0)
7194   7194   oracle@samplehost (VKTM)
7198   7198   oracle@samplehost (SCMN)
7198   7200   oracle@samplehost (GEN0)
7202   7202   oracle@samplehost (SCMN)
7202   7204   oracle@samplehost (DIAG)
7198   7205   oracle@samplehost (DBRM)
7202   7206   oracle@samplehost (DIA0)
.
.
.
Consulte además:
-
Oracle AI Database Performance Tuning Guide para aprender a utilizar la vista
V$PROCESS -
Oracle AI Database Reference para obtener más información sobre el parámetro de inicialización
THREADED_EXECUTION
Visión General de los Procesos de Cliente
Cuando un usuario ejecuta una aplicación como un programa Pro*C o SQL*Plus, el sistema operativo crea un proceso de cliente (a veces denominado proceso de usuario) para ejecutar la aplicación de usuario. La aplicación cliente tiene bibliotecas de Oracle AI Database enlazadas que proporcionan las API necesarias para comunicarse con la base de datos.
-
Procesos de Cliente y Servidor Los procesos de cliente difieren de manera importante de los procesos de Oracle que interactúan directamente con la instancia.
-
Conexiones y sesiones Una conexión de base de datos es una ruta de comunicación física entre un proceso de cliente y una instancia de base de datos.
-
Contenedor actual Una sesión de base de datos es una entidad lógica en la memoria de la instancia de base de datos que representa el estado de una conexión de usuario actual a una base de datos.
-
Operaciones de base de datos En el contexto de la supervisión de la base de datos, una operación de base de datos es la actividad de sesión entre dos puntos en el tiempo, según lo definido por los usuarios finales o el código de aplicación.
Procesos de cliente y servidor
Los procesos cliente difieren de forma importante de los procesos de Oracle que interactúan directamente con la instancia.
Los procesos de Oracle que sirven al proceso de cliente pueden leer y escribir en SGA, mientras que el proceso de cliente no puede. Un proceso de cliente se puede ejecutar en un host que no sea el host de base de datos, mientras que los procesos de Oracle no pueden.
Por ejemplo, supongamos que un usuario en un host de cliente inicia SQL*Plus y, a continuación, se conecta a través de la red a la base de datos sample en un host diferente cuando no se inicia la instancia de base de datos:
SQL> CONNECT SYS@inst1 AS SYSDBA
Enter password: *********
Connected to an idle instance.
En el host de cliente, una búsqueda de los procesos para sqlplus o sample muestra solo el proceso de cliente sqlplus:
% ps -ef | grep -e sample -e sqlplus | grep -v grep
clientuser 29437 29436  0 15:40 pts/1    00:00:00 sqlplus           as sysdba
En el host de la base de datos, una búsqueda de los procesos para sqlplus o sample muestra un proceso de servidor con una conexión no local, pero ningún proceso de cliente:
% ps -ef | grep -e sample -e sqlplus | grep -v grep
serveruser 29441     1  0 15:40 ?        00:00:00 oraclesample (LOCAL=NO)
Consulte también: "Cómo se inicia una instancia" para obtener información sobre cómo un cliente puede conectarse a una base de datos cuando no se inicia la instancia.
Conexiones y sesiones
Una conexión de base de datos es una ruta de comunicación física entre un proceso de cliente y una instancia de base de datos.
Durante una conexión, se establece una vía de comunicación mediante los mecanismos de comunicación entre procesos disponibles o el software de red. Normalmente, se produce una conexión entre un proceso de cliente y un proceso de servidor o distribuidor, pero también puede ocurrir entre un proceso de cliente y Oracle Connection Manager (CMAN).
Contenedor Actual
Una sesión de base de datos es una entidad lógica en la memoria de la instancia de base de datos que representa el estado de una conexión de usuario actual a una base de datos.
Por ejemplo, cuando la base de datos autentica un usuario con una contraseña, se establece una sesión para este usuario. Una sesión dura desde el momento en que la base de datos autentica al usuario hasta que el usuario se desconecta o sale de la aplicación de la base de datos.
Sesiones y contenedores
Para una sesión determinada, el contenedor actual en la CDB es el que se está ejecutando una sesión. El contenedor actual puede ser la raíz de CDB, una raíz de aplicación o una PDB.
Cada sesión tiene exactamente un contenedor actual en cualquier momento. Puesto que el diccionario de datos de cada contenedor es independiente, Oracle AI Database utiliza el diccionario de datos del contenedor actual para la resolución de nombres y la autorización de privilegios.
Relación entre Conexiones y Sesiones
Una sola conexión puede tener 0, 1 o más sesiones establecidas en ella. Las sesiones son independientes: una confirmación en una sesión no afecta a las transacciones de otras sesiones.
Nota: Si se configura el pooling de conexiones de Red de Oracle, es posible que una conexión se borre pero deje las sesiones intactas.
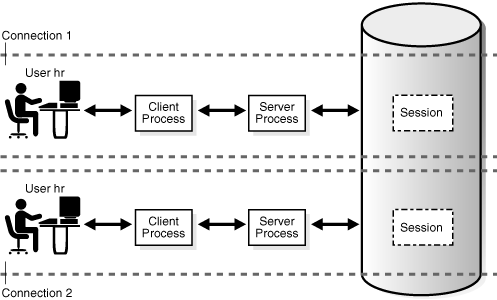
Pueden existir varias sesiones simultáneamente para un único usuario de base de datos. Como se muestra en la siguiente figura, el usuario hr puede tener varias conexiones a una base de datos. En las conexiones de servidor dedicado, la base de datos crea un proceso de servidor en nombre de cada conexión. Sólo lo utiliza el proceso de cliente que hace que se cree el servidor dedicado. En una conexión de servidor compartido, muchos procesos de cliente acceden a un único proceso de servidor compartido.
Figura 2: Una sesión para cada conexión
Descripción de la ilustración cncpt237.gif
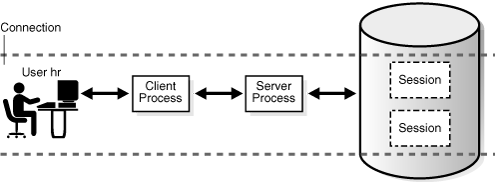
La Figura 18-3 ilustra un caso en el que el usuario hr tiene una única conexión a una base de datos, pero esta conexión tiene dos sesiones.
Figura 3: Dos sesiones en una conexión
Descripción de la ilustración cncpt238.gif
Al generar un informe de rastreo automático de estadísticas de ejecución de sentencias SQL, se vuelve a crear el escenario en la Figura 18-3.
El comando DISCONNECT del Example 18-2 finaliza realmente las sesiones, no la conexión.
Ejemplo 18-2 Conexiones y sesiones
En el siguiente ejemplo se conecta SQL*Plus a la base de datos como usuario SYSTEM y se activa el rastreo, creando así una nueva sesión (salida de ejemplo incluida):
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 90      91 3BE2E41C

SQL> SET AUTOTRACE ON STATISTICS;
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 88      93 3BE2E41C
 90      91 3BE2E41C
...
SQL> DISCONNECT
El comando DISCONNECT finaliza realmente las sesiones, no la conexión. Al abrir un nuevo terminal y conectarse a la instancia como un usuario diferente, la siguiente consulta muestra que la conexión con la dirección 3BE2E41C sigue activa.
SQL> CONNECT dba1@inst1
Password: ********
Connected.
SQL> SELECT PROGRAM FROM V$PROCESS WHERE ADDR = HEXTORAW('3BE2E41C');

PROGRAM
------------------------------------------------
oracle@stbcs09-1 (TNS V1-V3)
Consulte también: "Arquitectura de Servidor Compartido"
Operaciones de Base de Datos
En el contexto de la supervisión de la base de datos, una operación de base de datos es la actividad de sesión entre dos puntos en el tiempo, según lo definido por los usuarios finales o el código de aplicación.
Una operación de base de datos simple es una única sentencia SQL o un único procedimiento o función PL/SQL. Una operación de base de datos compuesta es un juego de operaciones únicas o compuestas.
Para supervisar, comparar y ajustar tareas, puede dividir un gran juego de tareas en operaciones de base de datos y subdividir las operaciones en fases. Un caso de uso es un trabajo por lotes PL/SQL que se ejecuta más lento de lo normal. Al configurar el trabajo como una operación de base de datos, puede identificar y ajustar los costosos pasos del trabajo.
Cada ejecución de una operación de base de datos se identifica de forma única mediante un par de atributos: nombre de operación e ID de ejecución. Una sesión puede iniciar o parar una operación de base de datos en una sesión diferente especificando su ID de sesión y su número de serie.
Dos incidencias de la misma operación de base de datos se pueden ejecutar al mismo tiempo con el mismo nombre pero con distintos ID de ejecución. Cada ejecución de una operación de base de datos con el mismo nombre puede contener sentencias diferentes.
Puede crear y gestionar operaciones de base de datos con el paquete PL/SQL DBMS_SQL_MONITOR. Puede supervisar las operaciones mediante V$SQL_MONITOR, V$SQL_PLAN_MONITOR y V$SQL_MONITOR_SESSTAT.
Consulte además:
-
Oracle AI Database SQL Tuning Guide para aprender a supervisar las operaciones de la base de datos
-
Guía de almacenamiento de datos de Oracle AI Database para aprender a supervisar cargas de larga ejecución
-
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para obtener más información sobre
DBMS_SQL_MONITOR -
Referencia de Oracle AI Database para obtener más información sobre
V$SQL_MONITOR
Visión General de los Procesos del Servidor
Oracle AI Database crea procesos de servidor para manejar las solicitudes de los procesos de cliente conectados a la instancia. Un proceso de cliente siempre se comunica con una base de datos a través de un proceso de servidor independiente.
Los procesos de servidor creados en nombre de una aplicación de base de datos pueden realizar una o más de las siguientes tareas:
-
Analizar y ejecutar sentencias SQL emitidas a través de la aplicación, incluida la creación y ejecución del plan de consulta
-
Ejecutar código PL/SQL
-
Leer bloques de datos de archivos de datos en la caché de buffers de la base de datos (el proceso en segundo plano de DBW tiene la tarea de volver a escribir bloques modificados en el disco)
-
Devolver los resultados de forma que la aplicación pueda procesar la información
-
Procesos de Servidor Dedicado En las conexiones de servidor dedicado, la conexión de cliente está asociada a un único proceso de servidor.
-
Procesos de Servidor Compartido En las conexiones de servidor compartido, las aplicaciones cliente se conectan a través de una red a un proceso de distribuidor, no a un proceso de servidor. Por ejemplo, 20 procesos de cliente se pueden conectar a un único proceso de distribuidor.
-
Cómo Oracle AI Database Crea Procesos de Servidor La base de datos crea procesos de servidor de varias formas, según los métodos de conexión. Consulte también: "Etapas del Procesamiento SQL"
Procesos de servidor dedicados
En las conexiones de servidor dedicado, la conexión de cliente está asociada a un único proceso de servidor.
En Linux, 20 procesos de cliente conectados a una instancia de base de datos son atendidos por 20 procesos de servidor. Cada proceso de cliente se comunica directamente con su proceso de servidor. Este proceso de servidor está dedicado a su proceso de cliente durante la sesión. El proceso de servidor almacena información específica del proceso y el UGA en su PGA.
Consulte además:
Procesos de Servidor Compartido
En las conexiones de servidor compartido, las aplicaciones cliente se conectan a través de una red a un proceso de distribuidor, no a un proceso de servidor. Por ejemplo, 20 procesos de cliente se pueden conectar a un único proceso de distribuidor.
El proceso de distribuidor recibe solicitudes de clientes conectados y las coloca en una cola de solicitudes en el pool grande. El primer proceso de servidor compartido disponible toma la solicitud de la cola y la procesa. Posteriormente, el servidor compartido coloca el resultado en la cola de respuesta del distribuidor. El proceso de distribuidor supervisa esta cola y transmite el resultado al cliente.
Al igual que un proceso de servidor dedicado, un proceso de servidor compartido tiene su propio PGA. Sin embargo, el UGA para una sesión está en el MGA para que cualquier servidor compartido pueda acceder a los datos de la sesión.
Consulte además:
-
"Large Pool" (Pool grande)
Cómo Oracle AI Database Crea Procesos del Servidor
La base de datos crea procesos de servidor de varias formas, según los métodos de conexión.
Los métodos de conexión son los siguientes:
-
Bequeath
SQL*Plus, un cliente OCI u otra aplicación cliente inician directamente el proceso del servidor.
-
Listener de Red de Oracle
La aplicación cliente se conecta a la base de datos a través de un listener.
-
Broker dedicado
Se trata de un proceso de base de datos que crea procesos en primer plano. A diferencia del listener, el broker reside en la instancia de la base de datos. Al utilizar un broker dedicado, el cliente se conecta al listener y, a continuación, transfiere la conexión al broker dedicado.
Cuando una conexión no utiliza legado, la base de datos crea el proceso de servidor de la siguiente manera:
-
La aplicación cliente solicita una nueva conexión desde el listener o broker.
-
El agente de escucha o broker inicia la creación de un nuevo proceso o thread.
-
El sistema operativo crea el nuevo proceso o thread.
-
Oracle AI Database inicializa varios componentes y notificaciones.
-
La base de datos entrega la conexión y el código específico de la conexión.
Opcionalmente, si utiliza el método de conexión de broker dedicado, puede crear previamente un pool de procesos de servidor con el paquete DBMS_PROCESS. En este caso, el proceso en segundo plano del gestor de procesos (PMAN) supervisa el pool de procesos creados previamente, que esperan a asociarse con una solicitud de cliente. Cuando una conexión requiere un proceso de servidor, la base de datos omite los pasos 2 a 4 de creación de procesos y solo realiza el paso 5. Esta optimización mejora el rendimiento.
Nota:
-
Referencia de tipos y paquetes PL/SQL de Oracle AI Database para obtener más información sobre el paquete PL/SQL
DBMS_PROCESS -
Oracle AI Database Reference para obtener más información sobre el proceso en segundo plano de PMAN
Visión General de Procesos en Segundo Plano
Los procesos en segundo plano son procesos adicionales que utiliza una base de datos Oracle de varios procesos. Los procesos en segundo plano realizan las tareas de mantenimiento necesarias para operar la base de datos y maximizar el rendimiento de varios usuarios.
Cada proceso en segundo plano tiene una tarea independiente, pero funciona con los demás procesos. Por ejemplo, el proceso LGWR escribe datos del buffer de redo log en el redo log en línea. Cuando un archivo redo log rellenado está listo para ser archivado, LGWR señala otro proceso para archivar el archivo redo log.
Oracle AI Database crea procesos en segundo plano automáticamente cuando se inicia una instancia de base de datos. Una instancia puede tener muchos procesos en segundo plano, no todos los cuales siempre existen en cada configuración de base de datos. La siguiente consulta muestra los procesos en segundo plano que se ejecutan en la base de datos:
SELECT PNAME
FROM   V$PROCESS
WHERE  PNAME IS NOT NULL
ORDER BY PNAME;
En esta sección se incluyen los temas siguientes:
-
Procesos en segundo plano obligatorios Los procesos en segundo plano obligatorios están presentes en todas las configuraciones de base de datos típicas.
-
Procesos en segundo plano opcionales Un proceso en segundo plano opcional es cualquier proceso en segundo plano no definido como obligatorio.
-
Procesos secundarios Los procesos secundarios son procesos en segundo plano que realizan trabajo en nombre de otros procesos. Consulte también: Referencia de Oracle AI Database para obtener descripciones de todos los procesos en segundo plano
Procesos en segundo plano obligatorios
Los procesos en segundo plano obligatorios están presentes en todas las configuraciones de base de datos típicas.
Estos procesos se ejecutan por defecto en una instancia de base de datos de lectura/escritura iniciada con un archivo de parámetros de inicialización configurado mínimamente. Una instancia de base de datos de solo lectura desactiva algunos de estos procesos.
En esta sección, se describen los siguientes procesos en segundo plano obligatorios:
-
Grupo Process Monitor Process (PMON) El grupo PMON incluye PMON, proceso principal de limpieza (CLMN) y procesos auxiliares de limpieza (CLnn). Estos procesos son responsables de la supervisión y limpieza de otros procesos.
-
Process Manager (PMAN) Process Manager (PMAN) supervisa varios procesos en segundo plano, incluidos los servidores compartidos, los servidores agrupados y los procesos de cola de trabajos.
-
Proceso de Registro de Listener (LREG) El proceso de registro de listener (LREG) registra información sobre la instancia de base de datos y los procesos de distribuidor con Oracle Net Listener.
-
Proceso de supervisión del sistema (SMON) El proceso de supervisión del sistema (SMON) se encarga de una variedad de tareas de limpieza en el nivel del sistema.
-
Proceso de escritor de base de datos (DBW) El proceso de escritor de base de datos (DBW) escribe el contenido de los buffers de base de datos en los archivos de datos. Los procesos de DBW escriben buffers modificados en la caché de buffers de la base de datos en el disco.
-
Proceso de escritor de log (LGWR) El proceso de escritor de log (LGWR) gestiona el buffer de redo log en línea.
-
Proceso de punto de control (CKPT) El proceso de punto de control (CKPT) actualiza las cabeceras del archivo de control y del archivo de datos con información de punto de control y señala a DBW que escriba bloques en el disco. La información de punto de control incluye la posición, el SCN y la ubicación del punto de control en el redo log en línea para iniciar la recuperación.
-
Procesos de supervisión de gestión (MMON y MMNL) El proceso de supervisión de gestión (MMON) realiza muchas tareas relacionadas con el repositorio de carga de trabajo automática (AWR).
-
Proceso de recuperador (RECO) En una base de datos distribuida, el proceso de recuperador (RECO) resuelve automáticamente los fallos en las transacciones distribuidas.
-
Proceso en segundo plano (BGnn) Los procesos en segundo plano (BGnn) son un proceso en segundo plano estándar en entornos de Oracle RAC que realiza varias tareas de mantenimiento y supervisión.
-
Proceso de daemon del sistema operativo virtual (VOSD) El proceso de daemon del sistema operativo virtual (VOSD) ejecuta acciones de servicio de base de datos Oracle de límite temporal.
-
Proceso de supervisión de red (NMON) El proceso de supervisión de red (NMON) es un servicio de supervisión de red ligero.
Consulte además:
-
Oracle AI Database Reference para obtener descripciones de otros procesos obligatorios, incluidos MMAN, DIAG, VKTM, DBRM y PSP0
-
Oracle Real Application Clusters Administration and Deployment Guide y Oracle Clusterware Administration and Deployment Guide para obtener más información sobre los procesos en segundo plano específicos de Oracle RAC y Oracle Clusterware
Grupo de procesos de supervisión de procesos (PMON)
El grupo PMON incluye PMON, proceso principal de limpieza (CLMN) y procesos de ayuda de limpieza (CLnn). Estos procesos son responsables de la supervisión y limpieza de otros procesos.
El grupo PMON supervisa la limpieza de la caché de buffers y la liberación de los recursos utilizados por un proceso de cliente. Por ejemplo, el grupo PMON es responsable de restablecer el estado de la tabla de transacciones activas, liberar bloqueos que ya no son necesarios y eliminar el ID de proceso de los procesos terminados de la lista de procesos activos.
La base de datos debe garantizar que los recursos retenidos por los procesos terminados se liberen para que otros procesos los puedan utilizar. De lo contrario, el proceso puede terminar bloqueado o bloqueado en contención.
-
Proceso de supervisión de procesos (PMON) El supervisor de procesos (PMON) detecta la terminación de otros procesos en segundo plano. Si un proceso de servidor o distribuidor termina de forma anormal, el grupo PMON es responsable de realizar la recuperación del proceso. La terminación de procesos puede tener varias causas, incluidos los comandos de terminación del sistema operativo o las sentencias
ALTER SYSTEM KILL SESSION. -
Proceso principal de limpieza (CLMN) PMON delega el trabajo de limpieza en el proceso principal de limpieza (CLMN). La tarea de detectar la terminación anormal permanece con PMON.
-
Procesos de ayuda de limpieza (CLnn) CLMN delega el trabajo de limpieza en los procesos de ayuda de CLnn.
-
Cuarentena de recursos de base de datos Si termina un proceso o una sesión, el grupo PMON libera los recursos retenidos a la base de datos. En algunos casos, el grupo PMON puede poner en cuarentena automáticamente los recursos dañados e irrecuperables para que la instancia de base de datos no se vea obligada a terminar de inmediato.
Proceso de supervisión de procesos (PMON)
El supervisor de procesos (PMON) detecta la terminación de otros procesos en segundo plano. Si un proceso de servidor o distribuidor termina de forma anormal, el grupo PMON es responsable de realizar la recuperación del proceso. La terminación de procesos puede tener varias causas, incluidos los comandos de terminación del sistema operativo o las sentencias ALTER SYSTEM KILL SESSION.
Proceso principal de limpieza (CLMN)
PMON delega el trabajo de limpieza en el proceso principal de limpieza (CLMN). La tarea de detectar la terminación anormal permanece con PMON.
CLMN realiza periódicamente una limpieza de los procesos terminados, las sesiones terminadas, las transacciones, las conexiones de red, las sesiones inactivas, las transacciones desasociadas y las conexiones de red desasociadas que han excedido el timeout de inactividad.
Procesos de ayuda de limpieza (CLnn)
CLMN delega el trabajo de limpieza en los procesos auxiliares de CLnn.
Los procesos CLnn ayudan en la limpieza de los procesos y sesiones terminados. El número de procesos auxiliares es proporcional a la cantidad de trabajo de limpieza que se va a realizar y a la eficiencia actual de la limpieza.
Un proceso de limpieza puede bloquearse, lo que impide que continúe limpiando otros procesos. Además, si varios procesos requieren limpieza, el tiempo de limpieza puede ser significativo. Por estas razones, Oracle AI Database puede utilizar varios procesos auxiliares en paralelo para realizar la limpieza, lo que reduce el rendimiento lento.
Las vistas V$CLEANUP_PROCESS y V$DEAD_CLEANUP contienen metadatos sobre la limpieza de CLMN. La vista V$CLEANUP_PROCESS contiene una fila por cada proceso de limpieza. Por ejemplo, si V$CLEANUP_PROCESS.STATE es BUSY, el proceso está actualmente en proceso de limpieza.
Consulte también: Referencia de Oracle AI Database para obtener más información sobre V$CLEANUP_PROCESS
Cuarentena de recursos de base de datos
Si un proceso o sesión termina, el grupo PMON libera los recursos retenidos a la base de datos. En algunos casos, el grupo PMON puede poner en cuarentena automáticamente los recursos dañados e irrecuperables para que la instancia de base de datos no se vea obligada a terminar de inmediato.
El grupo PMON continúa realizando la mayor limpieza posible en el proceso o sesión que estaba reteniendo el recurso en cuarentena. La vista V$QUARANTINE contiene metadatos como el tipo de recurso, la cantidad de memoria consumida, el error de Oracle que provoca la cuarentena, etc.
Consulte también: Referencia de Oracle AI Database para obtener más información sobre V$QUARANTINE
Gestor de procesos (PMAN)
Process Manager (PMAN) supervisa varios procesos en segundo plano, incluidos los servidores compartidos, los servidores agrupados y los procesos de cola de trabajos.
PMAN supervisa, inicia y detiene los siguientes tipos de procesos:
-
Procesos del distribuidor y del servidor compartido
-
Broker de conexiones y procesos de servidor de pool para pools de conexiones residentes de la base de datos
-
Procesos de cola de trabajos
-
Procesos en segundo plano reiniciables
Proceso de Registro de Listener (LREG)
El proceso de registro de listener (LREG) registra información sobre la instancia de base de datos y los procesos de distribuidor con Oracle Net Listener.
Cuando se inicia una instancia, LREG sondea el listener para determinar si se está ejecutando. Si el listener se está ejecutando, LREG lo transfiere a los parámetros relevantes. Si no se está ejecutando, LREG intenta contactarlo periódicamente.
Nota: en las versiones anteriores a Oracle Database 12c, PMON realizó el registro del listener.
Consulte también: "Oracle Net Listener"
Proceso de supervisión del sistema (SMON)
El proceso de supervisión del sistema (SMON) está a cargo de una variedad de tareas de limpieza en el nivel del sistema.
Las tareas asignadas a SMON incluyen:
-
Realización de la recuperación de instancias, si es necesario, al iniciar la instancia. En una base de datos Oracle RAC, el proceso SMON de una instancia de base de datos puede realizar una recuperación de instancia para una instancia fallida.
-
Recuperando transacciones terminadas que se han omitido durante el proceso de recuperación de instancias debido al error de fuera de línea del tablespace o la lectura del archivo. SMON recupera las transacciones cuando el tablespace o el archivo se vuelve a poner en línea.
-
Limpieza de segmentos temporales no utilizados en tablespaces permanentes. Por ejemplo, Oracle AI Database asigna extensiones al crear un índice. Si la operación falla, SMON limpia el espacio temporal.
-
Fusión de extensiones libres contiguas en tablespaces gestionados por diccionario.
SMON comprueba regularmente si es necesario. Otros procesos pueden llamar a SMON si detectan que es necesario.
Proceso de escritor de base de datos (DBW)
El proceso de escritor de base de datos (DBW) escribe el contenido de los buffers de base de datos en los archivos de datos. Los procesos de DBW escriben buffers modificados en la caché de buffers de la base de datos en el disco.
Aunque un proceso de escritor de base de datos (DBW0) es adecuado para la mayoría de los sistemas, puede configurar procesos adicionales de DBW1 a DBW9, de DBWa a DBWz y de BW36 a BW99 para mejorar el rendimiento de escritura si el sistema modifica los datos en gran medida. Estos procesos de DBW adicionales no son útiles en los sistemas de uniprocesador.
El proceso DBW escribe buffers sucios en el disco en las siguientes condiciones:
-
Cuando un proceso de servidor no puede encontrar un buffer reutilizable limpio después de explorar un número umbral de buffers, indica a DBW que escriba. DBW escribe buffers sucios en el disco de forma asíncrona si es posible mientras se realiza otro procesamiento.
-
DBW escribe periódicamente buffers para avanzar en el punto de control, que es la posición en el subproceso de redo desde el que comienza la recuperación de la instancia. La posición del log del punto de control viene determinada por el buffer sucio más antiguo de la caché de buffers.
En muchos casos, los bloques que escribe DBW se dispersan por todo el disco. Por lo tanto, las escrituras tienden a ser más lentas que las escrituras secuenciales realizadas por LGWR. DBW realiza escrituras multibloque cuando es posible para mejorar la eficiencia. El número de bloques escritos en una escritura de varios bloques varía según el sistema operativo.
Consulte además:
-
Oracle AI Database Performance Tuning Guide para obtener consejos sobre la configuración, la supervisión y el ajuste de DBW.
Proceso de Escritor de Log (LGWR)
El proceso de escritor de logs (LGWR) gestiona el buffer de redo log en línea.
LGWR escribe una parte del buffer en el redo log en línea. Al separar las tareas de modificación de los buffers de la base de datos, realizar escrituras dispersas de buffers sucios en el disco y realizar escrituras secuenciales rápidas de redo en el disco, la base de datos mejora el rendimiento.
En las siguientes circunstancias, LGWR escribe todas las entradas de redo que se han copiado en el buffer desde la última vez que escribió:
-
Un usuario confirma una transacción.
-
Se produce un conmutador de log de redo en línea.
-
Han pasado tres segundos desde que LGWR escribió por última vez.
-
El buffer de redo log está lleno en un tercio o contiene 1 MB de datos en buffer.
-
DBW debe escribir buffers modificados en el disco.
Antes de que DBW pueda escribir un buffer sucio, la base de datos debe escribir en el disco los registros de redo asociados a los cambios en el buffer (el protocolo de escritura anticipada). Si DBW descubre que algunos registros de redo no se han escrito, indica a LGWR que escriba los registros en el disco y espera a que se complete LGWR antes de escribir los buffers de datos en el disco.
-
LGWR y Commits Oracle AI Database utiliza un mecanismo de confirmación rápida para mejorar el rendimiento de las transacciones confirmadas.
-
LGWR y archivos inaccesibles LGWR escribe de forma síncrona en el grupo reflejado activo de archivos redo log en línea. Consulte también: "Confirmaciones de Transacciones"
LGWR y confirmaciones
Oracle AI Database utiliza un mecanismo de confirmación rápida para mejorar el rendimiento de las transacciones confirmadas.
Cuando un usuario emite una sentencia COMMIT, a la transacción se le asigna un número de cambio del sistema (SCN). LGWR coloca un registro de confirmación en el buffer de redo log y lo escribe en el disco inmediatamente, junto con el SCN de confirmación y las entradas de redo de la transacción.
El buffer de redo log es circular. Cuando LGWR escribe entradas de redo del buffer de redo log en un archivo redo log en línea, los procesos del servidor pueden copiar nuevas entradas en las entradas del buffer de redo log que se han escrito en el disco. LGWR normalmente escribe lo suficientemente rápido como para asegurarse de que el espacio siempre está disponible en el buffer para nuevas entradas, incluso cuando el acceso al redo log en línea es pesado.
La escritura atómica de la entrada de redo que contiene el registro de confirmación de la transacción es el único evento que determina que la transacción se ha confirmado. Oracle AI Database devuelve un código de éxito a la transacción de confirmación, aunque los buffers de datos aún no se han escrito en el disco. Los cambios correspondientes en los bloques de datos se aplazan hasta que DBW pueda escribirlos en los archivos de datos.
Nota: LGWR puede escribir entradas de redo log en el disco antes de que se confirme una transacción. Los cambios protegidos por las entradas de redo se convierten en permanentes sólo si la transacción se confirma posteriormente.
Cuando la actividad es alta, LGWR puede utilizar confirmaciones de grupo. Por ejemplo, un usuario confirma, lo que hace que LGWR escriba las entradas de redo de la transacción en el disco. Durante esta escritura, se confirman otros usuarios. LGWR no puede escribir en el disco para confirmar estas transacciones hasta que se complete la escritura anterior. Al finalizar, LGWR puede escribir la lista de entradas de redo de transacciones en espera (todavía no confirmadas) en una operación. De esta manera, la base de datos minimiza la E/S del disco y maximiza el rendimiento. Si las solicitudes de confirmación continúan a un ritmo alto, cada escritura de LGWR puede contener varios registros de confirmación.
LGWR y archivos inaccesibles
LGWR escribe de forma síncrona en el grupo reflejado activo de archivos redo log en línea.
Si no se puede acceder a un archivo log, LGWR continúa escribiendo en otros archivos del grupo y escribe un error en el archivo de rastreo de LGWR y en el registro de alertas. Si todos los archivos de un grupo están dañados o si el grupo no está disponible porque no se ha archivado, LGWR no puede continuar funcionando.
Consulte además:
-
"Cómo escribe Oracle AI Database en el redo log en línea" y "Buffer de Redo Log"
-
Guía de ajuste de rendimiento de Oracle AI Database para obtener información sobre cómo supervisar y ajustar el rendimiento de LGWR
Proceso de punto de control (CKPT)
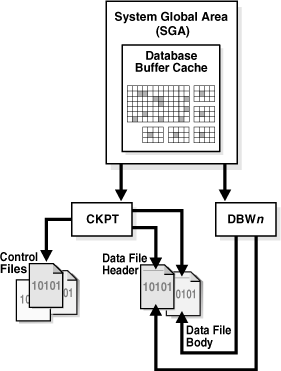
El proceso de punto de control (CKPT) actualiza las cabeceras del archivo de control y del archivo de datos con información de punto de control y señala a DBW que escriba bloques en el disco. La información de punto de control incluye la posición, el SCN y la ubicación del punto de control en el redo log en línea para iniciar la recuperación.
Como se muestra en la Figura 18-4, CKPT no escribe bloques de datos en archivos de datos ni bloques de redo en archivos redo log en línea.
Figura 4: Proceso de punto de control
Descripción de la ilustración cncpt228.gif
Consulte también: "Visión General de los Puntos de Control"
Procesos de supervisión de gestión (MMON y MMNL)
El proceso de supervisión de gestión (MMON) realiza muchas tareas relacionadas con el repositorio de carga de trabajo automática (AWR).
Por ejemplo, MMON escribe cuando una métrica viola su valor de umbral, toma instantáneas y captura del valor de estadísticas para los objetos SQL modificados recientemente.
El proceso ligero de supervisión de gestión (MMNL) escribe estadísticas del buffer de historial de sesiones activas (ASH) en el SGA en el disco. MMNL escribe en el disco cuando el buffer ASH está lleno.
Consulte también: "Introducción a Oracle AI Database al Ajuste del Rendimiento" y "Visión General del Historial de Sesiones Activas"
Proceso Recuperador (RECO)
En una base de datos distribuida, el proceso de recuperador (RECO) resuelve automáticamente los fallos en las transacciones distribuidas.
El proceso RECO de un nodo se conecta automáticamente a otras bases de datos implicadas en una transacción distribuida dudosa. Cuando RECO restablece una conexión entre las bases de datos, resuelve automáticamente todas las transacciones dudosas, eliminando de la tabla de transacciones pendientes de cada base de datos las filas que corresponden a las transacciones resueltas.
Consulte también: Guía del administrador de Oracle AI Database para obtener más información sobre la recuperación de transacciones en sistemas distribuidos
Proceso en segundo plano (BG nn)
Los procesos en segundo plano (BGnn) son un proceso estándar en segundo plano en entornos de Oracle RAC que realiza varias tareas de mantenimiento y supervisión.
El proceso en segundo plano es responsable de la gestión de la caché de buffers, el soporte de procesos de escritor de logs (LGWR), la coordinación de puntos de control, la supervisión de procesos en segundo plano y la recopilación de estadísticas.
Proceso de daemon del sistema operativo virtual (VOSD)
El proceso de daemon del sistema operativo virtual (VOSD) ejecuta acciones de servicio de base de datos Oracle de límite temporal.
Este proceso se inicia al iniciar la instancia y es responsable de ejecutar las acciones de servicio del sistema críticas para la base de datos. Este proceso lo utilizan instancias de base de datos, instancias de Oracle ASM y Oracle RAC.
Proceso de supervisión de red (NMON)
El proceso de supervisión de red (NMON) es un servicio de supervisión de red ligero.
Network Monitor (NMON) es un servicio de supervisión de red de baja sobrecarga que aprovecha las funciones avanzadas del núcleo para ofrecer una supervisión completa y siempre activa. Captura continuamente estadísticas y eventos de red en varios niveles, incluidos los de todo el sistema, por interfaz, por IP y por flujo, proporcionando métricas detalladas para servicios de nivel superior. Basado en NMON, el servicio Health Score simplifica la evaluación del estado de la red con una puntuación estandarizada de 0 a 100 y aborda los problemas de forma proactiva mediante la recopilación de diagnósticos según sea necesario. NMON proporciona estadísticas de red eficientes y útiles, lo que permite la detección oportuna de anomalías y la correlación efectiva con las actividades de la base de datos.
Procesos en segundo plano opcionales
Un proceso opcional en segundo plano es cualquier proceso en segundo plano no definido como obligatorio.
La mayoría de los procesos opcionales en segundo plano son específicos de tareas o funciones. Por ejemplo, los procesos en segundo plano que soportan Oracle ASM solo están disponibles cuando esta función está activada.
En este apartado se describen algunos procesos opcionales comunes:
-
Procesos de archivador (ARCn) Un proceso de archivador (ARCn) copia los archivos redo log en línea en el almacenamiento fuera de línea después de que se produzca un cambio de redo log.
-
Procesos de cola de trabajos (CJQ0 y Jnnn) Un proceso de cola ejecuta trabajos de usuario, a menudo en modo por lotes. Un trabajo es una tarea definida por el usuario que se planifica para que se ejecute una o más veces.
-
Proceso de flashback de archivo de datos (FBDA) El proceso de flashback de archivo de datos (FBDA) archiva filas históricas de tablas con seguimiento en archivos de datos de flashback.
-
Proceso de Coordinador de Gestión Espacial (SMCO) El proceso de coordinador de gestión espacial (SMCO) es iniciado por SMON y coordina la ejecución de varias tareas relacionadas con la gestión espacial.
Consulte además:
-
Guía del usuario de Advanced Queuing y Oracle AI Database Transactional Event Queues para obtener una introducción a Advanced Queuing (AQ)
-
Oracle AI Database Reference para obtener descripciones de los procesos en segundo plano específicos de AQ y Oracle ASM
Procesos de archivador (ARC n)
Un proceso de archivador (ARCn) copia los archivos redo log en línea en el almacenamiento fuera de línea después de que se produzca un cambio de redo log.
Estos procesos también pueden recopilar datos de redo de transacción y transmitirlos a destinos de base de datos en espera. Los procesos ARCn existen únicamente cuando la base de datos está en modo ARCIVELOG y el archivado automático está activado.
Consulte además:
-
Oracle AI Database Administrator's Guide para aprender a ajustar el número de procesos de archivador
-
Guía de ajuste de rendimiento de Oracle AI Database para aprender a ajustar el rendimiento del archivador
Procesos de Cola de Trabajos (CJQ0 y Jnnn)
Un proceso de cola ejecuta trabajos de usuario, a menudo en modo por lotes. Un trabajo es una tarea definida por el usuario que se planifica para que se ejecute una o más veces.
Por ejemplo, puede utilizar una cola de trabajos para programar una actualización de larga ejecución en segundo plano. Teniendo en cuenta una fecha de inicio y un intervalo de tiempo, los procesos de cola de trabajos intentan ejecutar el trabajo en la siguiente incidencia del intervalo.
Oracle AI Database gestiona los procesos de cola de trabajos de forma dinámica, lo que permite a los clientes de cola de trabajos utilizar más procesos de cola de trabajos cuando es necesario. La base de datos libera los recursos utilizados por los nuevos procesos cuando están inactivos.
Los procesos de cola de trabajos dinámicos pueden ejecutar varios trabajos simultáneamente en un intervalo determinado. La secuencia de eventos es la siguiente:
-
El proceso de coordinador de trabajos (CJQ0) se inicia y para automáticamente según lo necesite Oracle Scheduler. El proceso de coordinador selecciona periódicamente los trabajos que se deben ejecutar desde la tabla
JOB$del sistema. Los nuevos trabajos seleccionados se ordenan por hora. -
El proceso de coordinador inicia dinámicamente procesos secundarios de cola de trabajos (Jnnn) para ejecutar los trabajos.
-
El proceso de cola de trabajos ejecuta uno de los trabajos seleccionados por el proceso CJQ0 para su ejecución. Cada proceso de cola de trabajos ejecuta un trabajo a la vez hasta su finalización.
-
Una vez que el proceso finaliza la ejecución de un solo trabajo, sondea más trabajos. Si no hay trabajos programados para su ejecución, entonces entra en un estado de suspensión, desde el cual se despierta a intervalos periódicos y sondea para obtener más trabajos. Si el proceso no encuentra ningún trabajo nuevo, termina después de un intervalo predefinido.
El parámetro de inicialización JOB_QUEUE_PROCESSES representa el número máximo de procesos de cola de trabajos que se pueden ejecutar simultáneamente en una instancia. Sin embargo, los clientes no deben asumir que todos los procesos de cola de trabajos están disponibles para la ejecución de trabajos. Nota: El proceso de coordinador no se inicia si el parámetro de inicialización JOB_QUEUE_PROCESSES está definido en 0.
Consulte además:
-
Oracle AI Database Administrator's Guide para obtener más información sobre Oracle Scheduler
-
Guía del usuario de Oracle AI Database Transactional Event Queues and Advanced Queuing para obtener más información sobre los procesos en segundo plano de AQ
Proceso de flashback de archivo de datos (FBDA)
El proceso de flashback de archivo de datos (FBDA) archiva filas históricas de tablas con seguimiento en archivos de datos de flashback.
Cuando una transacción que contiene DML en una tabla con seguimiento se confirma, este proceso almacena la imagen previa de las filas cambiadas en el archivo de datos de flashback. También mantiene los metadatos en las filas actuales.
FBDA gestiona automáticamente el flashback de archivo de datos para espacio, organización y retención. Además, el proceso realiza un seguimiento del tiempo durante el que se han archivado las transacciones con seguimiento.
Proceso de Coordinador de Gestión Espacial (SMCO)
El proceso de coordinación de la gestión espacial (SMCO) es iniciado por SMON y coordina la ejecución de varias tareas relacionadas con la gestión espacial.
El proceso SMCO coordina la ejecución de varias tareas relacionadas con la gestión del espacio.
Las tareas habituales incluyen la asignación y recuperación proactivas de espacio y el mantenimiento de tablespaces temporales. SMCO inicia dinámicamente procesos secundarios (Wnnn) para implementar la tarea.
Consulte también: Guía de desarrollo de Oracle AI Database para obtener información sobre el flashback de archivo de datos y la función Temporal History
Procesos secundarios
Los procesos secundarios son procesos en segundo plano que realizan trabajo en nombre de otros procesos.
En esta sección se describen algunos procesos secundarios que utiliza Oracle AI Database.
-
Procesos secundarios de E/S Los procesos secundarios de E/S (Innn) simulan E/S asíncrona para sistemas y dispositivos que no la admiten.
-
Procesos del servidor de ejecución en paralelo (PX) En ejecución en paralelo, varios procesos trabajan juntos simultáneamente para ejecutar una única sentencia SQL. Consulte también: Oracle AI Database Reference para obtener descripciones de los procesos secundarios de Oracle AI Database.
Procesos secundarios de E/S
Los procesos secundarios de E/S (Innn) simulan E/S asíncrona para sistemas y dispositivos que no la admiten.
En la E/S asíncrona, no hay ningún requisito de temporización para la transmisión, lo que permite que otros procesos se inicien antes de que finalice la transmisión.
Por ejemplo, supongamos que una aplicación escribe 1000 bloques en un disco en un sistema operativo que no admite E/S asíncrona. Cada escritura se produce de forma secuencial y espera la confirmación de que la escritura se ha realizado correctamente. Con el disco asíncrono, la aplicación puede escribir los bloques en bloque y realizar otro trabajo mientras espera una respuesta del sistema operativo que indique que todos los bloques se han escrito.
Para simular E/S asíncrona, un proceso supervisa varios procesos secundarios. El proceso de invocador asigna trabajo a cada uno de los procesos secundarios, que esperan a que se complete cada escritura y devuelven el informe al invocador cuando haya terminado. En la E/S asíncrona verdadera, el sistema operativo espera a que la E/S se complete y devuelve los informes al proceso, mientras que en la E/S asíncrona simulada, los procesos secundarios esperan y devuelven el informe al invocador.
La base de datos soporta diferentes tipos de procesos secundarios de E/S, incluidos los siguientes:
-
Procesos secundarios de E/S para Recovery Manager (RMAN)
Al utilizar RMAN para realizar copias de seguridad o restaurar datos, puede utilizar procesos secundarios de E/S para dispositivos de disco y cinta.
-
Procesos secundarios de escritor de base de datos
Si no resulta práctico utilizar varios procesos de escritor de base de datos, como cuando el equipo tiene una CPU, la base de datos puede distribuir la E/S en varios procesos secundarios. DBW es el único proceso que explora la lista LRU de caché de buffers en busca de bloques que se escribirán en el disco. Sin embargo, los procesos secundarios de E/S realizan la E/S para estos bloques.
Consulte además:
-
Guía del usuario de copia de seguridad y recuperación de Oracle AI Database para obtener más información sobre los procesos secundarios de E/S para operaciones de copia de seguridad y restauración
-
Oracle AI Database Performance Tuning Guide para obtener más información sobre los procesos secundarios del escritor de base de datos
Procesos del Servidor de Ejecución Paralela (PX)
En la ejecución paralela, varios procesos trabajan juntos simultáneamente para ejecutar una única sentencia SQL.
Al dividir el trabajo entre varios procesos, Oracle AI Database puede ejecutar la sentencia más rápidamente. Por ejemplo, cuatro procesos gestionan cuatro trimestres diferentes de un año, en lugar de que un único proceso que gestiona los cuatro trimestres por sí solo.
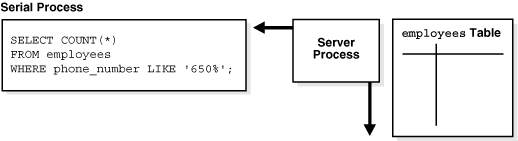
La ejecución en paralelo contrasta con la ejecución en serie, en la que un único proceso de servidor realiza todo el procesamiento necesario para la ejecución secuencial de una sentencia SQL. Por ejemplo, para realizar una exploración completa de tablas, como SELECT * FROM employees, un proceso de servidor realiza todo el trabajo, como se muestra en la Figura 18-5.
Figura 5: Exploración de tabla completa en serie
Descripción de la ilustración cncpt016.gif
La ejecución en paralelo reduce el tiempo de respuesta de las operaciones que hacen un uso intensivo de los datos en bases de datos de gran tamaño, como almacenes de datos. El multiprocesamiento simétrico (SMP) y el sistema en cluster obtienen los mayores beneficios de rendimiento de la ejecución en paralelo porque el procesamiento de sentencias se puede dividir entre varias CPU. La ejecución en paralelo también puede beneficiar ciertos tipos de sistemas OLTP e híbridos.
En los sistemas Oracle RAC, la colocación de un servicio específico controla la ejecución en paralelo. Específicamente, los procesos paralelos se ejecutan en los nodos en los que se configura el servicio. Por defecto, Oracle AI Database ejecuta procesos paralelos solo en una instancia que ofrece el servicio utilizado para conectarse a la base de datos. Esto no afecta a otras operaciones paralelas, como la recuperación en paralelo o el procesamiento de consultas GV$.
-
Coordinador de consultas En la ejecución en paralelo, el proceso de servidor actúa como coordinador de consultas (también denominado coordinador de ejecución en paralelo).
-
Los servidores de ejecución en paralelo de productores y consumidores se dividen en productores y consumidores. Los productores son responsables de procesar sus datos y luego distribuirlos a los consumidores que lo necesitan.
-
Gránulos En la ejecución en paralelo, una tabla se divide dinámicamente en unidades de carga. Cada unidad, denominada gránulo, es la unidad de trabajo más pequeña al acceder a los datos.
Consulte además:
-
Guía de Oracle AI Database VLDB y partición para obtener más información sobre la ejecución en paralelo
-
Oracle Real Application Clusters Administration and Deployment Guide para obtener consideraciones sobre la ejecución en paralelo en entornos Oracle RAC
Coordinador de Consulta
En la ejecución en paralelo, el proceso de servidor actúa como el coordinador de consulta (también denominado coordinador de ejecución en paralelo).
El coordinador de consultas es responsable de lo siguiente:
-
Análisis de la consulta
-
Asignación y control de los procesos del servidor de ejecución en paralelo
-
Enviando salida al usuario
Teniendo en cuenta un plan de consulta para una consulta, el coordinador desglosa cada operador de una consulta SQL en partes paralelas, las ejecuta en el orden especificado en la consulta y después integra los resultados parciales producidos por las instancias de ejecución paralelas que ejecutan los operadores.
El número de servidores para ejecución paralela asignados a una única operación es el grado de paralelismo para una operación. Varias operaciones dentro de la misma sentencia SQL tienen todas el mismo grado de paralelismo.
Consumidores y productores
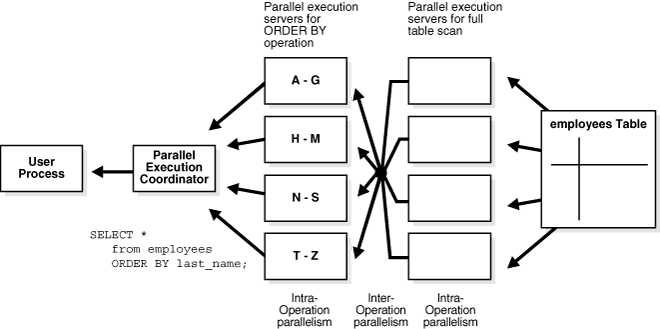
Los servidores de ejecución en paralelo se dividen en productores y consumidores. Los productores son responsables de procesar sus datos y luego distribuirlos a los consumidores que lo necesitan.
La base de datos puede realizar la distribución mediante diversas técnicas. Dos técnicas comunes son una emisión y un hash. En una emisión, cada productor envía las filas a todos los consumidores. En un hash, la base de datos calcula una función hash en un juego de claves y hace que cada consumidor sea responsable de un subjuego de valores hash. La Figura 18-6 representa la interacción entre productores y consumidores en la ejecución paralela de la siguiente sentencia:
SELECT * FROM employees ORDER BY last_name;El plan de ejecución implanta una exploración completa de la tabla employees. La exploración va seguida de una ordenación de las filas recuperadas. Todos los procesos de productor implicados en la operación de exploración envían filas al proceso de consumidor adecuado que realiza la ordenación.
Figura 6: Productores y consumidores
Descripción de la ilustración vldbg013.gif
Gránulos
En la ejecución en paralelo, una tabla se divide dinámicamente en unidades de carga. Cada unidad, denominada gránulo, es la unidad de trabajo más pequeña al acceder a los datos.
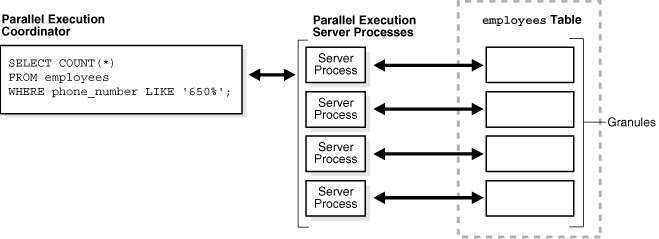
Un gránulo basado en bloques es un rango de bloques de datos de la tabla leídos por un único servidor de ejecución en paralelo (también denominado servidor PX), que utiliza Pnnn como formato de nombre. Para obtener una distribución uniforme del trabajo entre los procesos de servidor paralelo, el número de gránulos siempre es mucho mayor que el DOP solicitado. La Figura 18-7 muestra una exploración paralela de la tabla employees.
Figura 7: Exploración de Tabla Completa Paralela
Descripción de la ilustración cncpt017.gif
La base de datos asigna gránulos a servidores de ejecución en paralelo en tiempo de ejecución. Cuando un servidor de ejecución en paralelo termina de leer las filas correspondientes a un gránulo y cuando quedan gránulos, obtiene otro gránulo del coordinador de consultas. Esta operación continúa hasta que se haya leído la tabla. Los servidores de ejecución devuelven los resultados al coordinador, que ensambla las partes en la exploración completa de la tabla deseada.
Consulte además:
-
Oracle AI Database VLDB and Partitioning Guide para aprender a utilizar la ejecución en paralelo
-
Guía de almacenamiento de datos de Oracle AI Database para obtener información sobre los parámetros de inicialización recomendados para el paralelismo