Présentation d'Oracle AI Database
Ce chapitre présente Oracle AI Database.
Ce chapitre contient les rubriques suivantes :
-
A propos des systèmes d'information Chaque organisation dispose d'informations qu'elle doit stocker et gérer pour répondre à ses besoins. Par exemple, une société doit collecter et tenir à jour les dossiers des ressources humaines de ses employés. Ces informations doivent être accessibles à ceux qui en ont besoin.
-
Objets de schéma L'une des caractéristiques d'un SGBDR est l'indépendance du stockage de données physique par rapport aux structures de données logiques.
-
Accès aux données Une exigence générale pour un SGBD est de respecter les normes du secteur acceptées pour un langage d'accès aux données.
-
Gestion des transactions Oracle AI Database est conçu comme une base de données multiutilisateur. La base de données doit s'assurer que plusieurs utilisateurs peuvent travailler simultanément sans endommager les données les uns des autres.
-
Architecture d'Oracle AI Database Un serveur de base de données est la clé de la gestion des informations.
A propos des systèmes d'information
Chaque organisation dispose d'informations qu'elle doit stocker et gérer pour répondre à ses besoins. Par exemple, une société doit collecter et tenir à jour les dossiers des ressources humaines de ses employés. Ces informations doivent être accessibles à ceux qui en ont besoin.
Un système d'information est un système formel de stockage et de traitement des informations. Une base de données est un ensemble organisé d'informations traitées comme une unité. La finalité des bases de données est de recueillir, de stocker et d'extraire des informations associées afin de les utiliser par des applications de base de données.
Lorsque les systèmes de base de données ont été inventés pour la première fois, ils étaient conçus pour une charge de travail spécifique. Au fil des ans, il est devenu évident que les bases de données à usage unique ne répondent plus à toutes les exigences : en plus des charges de travail relationnelles, les développeurs devaient stocker des données dans d'autres formats tels que XML, spatial, graphique, JSON et, plus récemment, des données vectorielles pour l'ère de l'IA.
Oracle AI Database est passé d'un moteur de base de données relationnelle à un moteur convergé, ce qui permet aux développeurs de stocker presque tous les types de données dans le format dont leur application a besoin de manière native et entièrement intégré à son architecture de niveau entreprise.
-
Système de gestion de base de données (SGBD) Un système de gestion de base de données (SGBD) est un logiciel qui contrôle le stockage, l'organisation et l'extraction des données.
-
Relational Model Dans son article fondateur de 1970 intitulé "A Relational Model of Data for Large Shared Data Banks", E. F. Codd a défini un modèle relationnel basé sur la théorie des ensembles mathématiques. Aujourd'hui, le modèle de base de données le plus largement accepté est le modèle relationnel.
-
Système de gestion de base de données relationnelle (SGBDR) Le modèle relationnel est la base d'un système de gestion de base de données relationnelle (SGBDR). Un SGBDR déplace les données dans une base, les stocke et les extrait pour que les applications puissent les manipuler.
Système de gestion des bases de données (SGBD)
Un système de gestion de base de données (SGBD) est un logiciel qui contrôle le stockage, l'organisation et l'extraction des données.
En général, un SGBD contient les éléments suivants :
-
Code du noyau
Ce code gère l'espace de mémoire et de stockage pour le SGBD.
-
Référentiel de métadonnées
Ce référentiel est généralement appelé dictionnaire de données ou catalogue de métadonnées.
-
Langues de requête
Les langages de requête facilitent l'accès aux données. Les bases de données convergées telles qu'Oracle AI Database prennent en charge plusieurs langages de requête.
Une application de base de données est un programme logiciel qui interagit avec une base de données pour accéder aux données et les manipuler. Oracle AI Database a été l'un des premiers moteurs de base de données à prendre en charge le modèle relationnel. Depuis sa création, il est devenu un moteur de base de données convergé, prenant en charge presque tous les types de données et de nombreuses charges de travail diverses.
Modèle relationnel
Dans son article fondateur de 1970 "Un modèle relationnel de données pour les grandes banques de données partagées", E. F. Codd a défini un modèle relationnel basé sur la théorie des ensembles mathématiques. Aujourd'hui, le modèle de base de données le plus largement accepté est le modèle relationnel.
Une base de données relationnelle est une base de données conforme au modèle relationnel. Le modèle relationnel présente les principaux aspects suivants :
-
Structures
Les objets bien définis stockent les données d'une base de données ou y accèdent.
-
Opérations
Les actions clairement définies permettent aux applications de manipuler les données et les structures d'une base de données.
-
Règles d'intégrité
Les règles d'intégrité régissent les opérations sur les données et les structures d'une base de données.
Une base de données relationnelle stocke les données dans un ensemble de relations simples. Une relation est un ensemble de tuples. Un uplet est un ensemble non trié de valeurs d'attribut.
Une table est une représentation bidimensionnelle d'une relation sous la forme de lignes (uplets) et de colonnes (attributs). Chaque ligne d'une table comporte le même ensemble de colonnes. Une base de données relationnelle est une base de données qui stocke des données dans des relations (tables). Par exemple, une base de données relationnelle peut stocker des informations sur les employés de la société dans une table des employés, une table des services et une table des salaires.
Rubriques connexes
Système de gestion de base de données relationnelle (SGBDR)
Le modèle relationnel est la base d'un système de gestion de base de données relationnelle (SGBDR). Un SGBDR déplace les données dans une base, les stocke et les extrait pour que les applications puissent les manipuler.
Un SGBDR distingue les types d'opération suivants :
-
Opérations logiques
Dans ce cas, une application spécifie le contenu requis. Par exemple, une application demande un nom d'employé ou ajoute un enregistrement d'employé à une table.
-
Opérations physiques
Dans ce cas, le SGBDR détermine la façon de procéder et d'effectuer l'opération. Par exemple, après qu'une application interroge une table, la base de données peut utiliser un index pour rechercher les lignes demandées, lire les données en mémoire et effectuer de nombreuses autres étapes avant de renvoyer un résultat à l'utilisateur. Le SGBDR stocke et extrait les données afin que les opérations physiques soient transparentes pour les applications de base de données.
Oracle AI Database est un SGBDR central. Un SGBDR qui implémente des fonctionnalités orientées objet telles que les types définis par l'utilisateur, l'héritage et le polymorphisme est appelé système de gestion de base de données relationnelle objet (ORDBMS). Oracle AI Database étend le modèle relationnel à un modèle objet-relationnel, ce qui permet de stocker des modèles de gestion complexes dans une base de données relationnelle. Au fil du temps, le moteur de données principal d'Oracle a évolué pour devenir un modèle beaucoup plus puissant désormais appelé base de données convergée.
Architecture d'une base de données convergée
Oracle AI Database est une base de données convergée qui prend en charge plusieurs modèles de données et charges de travail dans un seul moteur de base de données. Outre les données relationnelles, il peut gérer des documents JSON, des données graphiques, des données spatiales, du texte, des vecteurs et d'autres types de données spécialisés.
Ces fonctionnalités partagent des services de base de données communs, notamment les transactions, la sécurité, la sauvegarde et la récupération, la haute disponibilité, l'audit et l'optimisation des requêtes. Les applications peuvent donc utiliser différents modèles de données sans nécessiter de base de données distincte pour chacune d'elles.
Par exemple, une application peut stocker des données de client et de transaction dans des tables relationnelles, des attributs flexibles dans des documents JSON, des informations géographiques en tant que données spatiales et des incorporations vectorielles pour la recherche sémantique. Le langage SQL peut être utilisé pour interroger et combiner ces formes de données en une seule opération. Une API de type document est disponible pour les développeurs qui préfèrent ce style NoSQL.
Une base de données convergée offre les avantages suivants :
- Réduction des mouvements de données entre les systèmes spécialisés
- Une sécurité et une gouvernance cohérentes
- Transactions intégrées entre les données associées
- Architecture simplifiée des applications et des opérations
- Analyse unifiée de plusieurs types de données
- Audit unifié des opérations de base de données
La convergence n'exige pas que chaque charge globale utilise toutes les fonctionnalités ou réside dans une base de données physique. Les applications ne peuvent utiliser que les fonctionnalités dont elles ont besoin. L'architecture flexible d'Oracle permet aux développeurs de répartir les applications sur plusieurs bases de données pluggables.
Oracle Database reste une base relationnelle. Son architecture convergée étend cette base afin que les applications puissent travailler avec plusieurs modèles de données tout en utilisant un ensemble commun de services de base de données pour presque toutes les charges de travail.
Objets de schéma
Une caractéristique d'un SGBDR est l'indépendance du stockage physique des données par rapport aux structures de données logiques.
Dans Oracle AI Database, un schéma de base de données est un ensemble de structures de données logiques ou d'objets de schéma. Un utilisateur de base de données possède un schéma de base de données, qui porte le même nom que le nom utilisateur.
Les objets de schéma sont des structures créées par l'utilisateur qui font directement référence aux données de la base. La base de données prend en charge de nombreux types d'objet de schéma, les plus importants étant les tables et les index. Les utilisateurs qui préfèrent une API de type document pour accéder à leurs données peuvent créer des collections (JSON) ou des vues de dualité relationnelle JSON.
Un objet de schéma est un type d'objet de base de données. Certains objets de base de données, tels que les profils et les rôles, ne résident pas dans les schémas.
-
Tables Un tableau décrit une entité telle que des employés.
-
Index Un index est une structure de données facultative que vous pouvez créer sur une ou plusieurs colonnes d'une table. Les index peuvent améliorer les performances de l'extraction des données.
Rubriques connexes
Tables
Un tableau décrit une entité telle que employees.
Vous définissez une table avec un nom, tel que employees, et un ensemble de colonnes. En général, vous donnez à chaque colonne un nom, un type de données et une largeur lorsque vous créez la table.
Une table est un ensemble de lignes. Une colonne identifie un attribut de l'entité décrite par la table, tandis qu'une ligne identifie une instance de l'entité. Par exemple, les attributs de l'entité employees correspondent aux colonnes de matricule et de nom de famille de l'employé. Une ligne identifie un employé spécifique.
Vous pouvez éventuellement spécifier une règle, appelée contrainte d'intégrité, pour une colonne. Par exemple, une contrainte d'intégrité NOT NULL. Cette contrainte force la colonne à contenir une valeur dans chaque ligne. Les contraintes couvrant plusieurs tables peuvent être définies en tant qu'assertions SQL. Avant Oracle AI Database 26ai, vous pouviez utiliser des déclencheurs de base de données pour appliquer la logique métier dans le cadre d'une transaction.
Rubriques connexes
Index
Un index est une structure de données facultative que vous pouvez créer sur une ou plusieurs colonnes d'une table. Les index peuvent améliorer les performances de l'extraction des données.
Lors du traitement d'une demande, la base de données peut utiliser les index disponibles pour localiser efficacement les lignes demandées. Les index sont utiles lorsque les applications interrogent souvent une ligne ou une plage de lignes spécifique.
Les index sont logiquement et physiquement indépendants des données. Par conséquent, vous pouvez supprimer et créer des index sans effet sur les tables ou autres index. Toutes les applications continuent de fonctionner après la suppression d'un index.
Rubriques connexes
Accès aux données
Une exigence générale pour un SGBD est de respecter les normes reconnues du secteur pour un langage d'accès aux données. Remarque : JavaScript requiert l'exécution d'Oracle 26ai sur Linux x86-64 ou Linux aarch64.
-
Le langage SQL (Structured Query Language) est un langage déclaratif basé sur un ensemble qui fournit une interface vers un SGBDR tel qu'Oracle AI Database.
-
PL/SQL est une extension procédurale d'Oracle SQL. Java et JavaScript sont des options supplémentaires que vous pouvez utiliser pour stocker la logique métier dans la base de données.
SQL (Structured Query Language)
Le langage SQL est un langage déclaratif basé sur un ensemble qui fournit une interface à un SGBDR tel qu'Oracle AI Database.
Les langages procéduraux tels que C décrivent la façon dont les choses doivent être faites. Le langage SQL n'est pas procédural et décrit ce qui doit être fait.
SQL est le langage standard ANSI pour les bases de données relationnelles. Toutes les opérations sur les données d'une base de données Oracle sont effectuées à l'aide d'instructions SQL. Par exemple, vous utilisez SQL pour créer des tables, interroger et modifier des données dans des tables.
Une instruction SQL peut être considérée comme un programme ou une instruction informatique très simple, mais puissant. Les utilisateurs indiquent le résultat qu'ils veulent (par exemple, les noms des employés) et non comment le dériver. Une instruction SQL est une chaîne de texte SQL, par exemple :
SELECT first_name, last_name FROM employees;Les instructions SQL vous permettent d'effectuer les tâches suivantes :
-
Interroger des données
-
Insérer, mettre à jour et supprimer des lignes dans une table
-
Créer, remplacer, modifier et supprimer des objets
-
contrôler l'accès à la base de données et à ses objets ;
-
garantir la cohérence et l'intégrité de la base de données.
Le langage SQL unifie les tâches précédentes dans un langage cohérent. Oracle SQL est une implémentation de la norme ANSI. Oracle SQL prend en charge de nombreuses fonctionnalités qui vont au-delà du langage SQL standard.
Rubriques connexes
PL/SQL, Java et JavaScript
PL/SQL est une extension procédurale d'Oracle SQL. Java et JavaScript sont des options supplémentaires que vous pouvez utiliser pour stocker la logique métier dans la base de données.
Le langage PL/SQL est intégré à Oracle AI Database, ce qui vous permet d'utiliser l'ensemble des instructions, fonctions et types de données SQL d'Oracle AI Database. Vous pouvez utiliser du code PL/SQL pour contrôler le flux d'un programme SQL, utiliser des variables et écrire des procédures de gestion des erreurs.
L'un des principaux avantages du langage PL/SQL est la possibilité de stocker la logique applicative dans la base de données elle-même. Une procédure PL/SQL ou une fonction est un objet de schéma constitué d'un ensemble d'instructions SQL et d'autres structures PL/SQL, regroupés, stockés dans la base de données et exécutés en tant qu'unité pour résoudre un problème spécifique ou réaliser un ensemble de tâches connexes. Le principal avantage de la programmation côté serveur est que les fonctionnalités intégrées peuvent être déployées n'importe où.
Oracle AI Database peut également stocker des unités de programme écrites en Java et JavaScript. Une procédure stockée Java est une méthode Java publiée dans SQL et stockée dans la base de données à des fins d'utilisation générale. Vous pouvez appeler des programmes PL/SQL existants à partir de programmes Java et JavaScript, et des programmes Java et JavaScript à partir de programmes PL/SQL.
Multilingual Engine (MLE) vous permet d'écrire la logique métier dans JavaScript et de stocker le code dans la base de données en tant que modules MLE. Les fonctions exportées par les modules MLE peuvent être exposées au langage SQL et PL/SQL au moyen de spécifications d'appel. Ces spécifications d'appel sont des unités PL/SQL (fonctions, procédures et packages) et peuvent être appelées partout où le langage PL/SQL est appelé.
Rubriques connexes
API NoSQL pour l'accès aux documents
Simple Oracle Document Access (SODA) est un ensemble d'API de type NoSQL permettant de gérer les collections de documents, en particulier les documents JSON, dans Oracle AI Database. Les applications peuvent créer des ensembles et insérer, extraire, mettre à jour, supprimer et interroger des documents sans avoir besoin de connaître SQL ou le schéma de base de données sous-jacent.
SODA fournit un modèle de programmation centré sur les documents basé sur des collections, des documents et des filtres interrogation par exemple. Il s'agit de l'inverse de SQL, qui fournit une interface déclarative orientée ensemble pour l'interrogation et la modification des données relationnelles et peut exprimer des jointures, des agrégations et des opérations sur plusieurs types de données.
SODA est utile lorsqu'une application fonctionne principalement avec des documents JSON et nécessite une API de document simple, et peut être une alternative pour les développeurs qui souhaitent utiliser une API NoSQL.
Les développeurs qui transfèrent des charges de travail de documents vers une base de données Oracle AI à partir d'une banque de données tierce à usage unique ont la possibilité d'utiliser l'API Mongo DB pour Oracle AI Database, qui est similaire à SODA mais vise à faciliter les migrations. Dans le cas le plus simple, la modification de la chaîne de connexion de l'application de la banque de données à usage unique à Oracle AI Database est tout ce qui doit être fait.
Gestion des transactions
Oracle AI Database est conçu comme une base de données multiutilisateur. La base de données doit s'assurer que plusieurs utilisateurs peuvent travailler simultanément sans endommager les données les uns des autres.
-
Transactions Une transaction est une unité de travail atomique logique qui contient une ou plusieurs instructions SQL.
-
Concomitance des données Un SGBDR multiutilisateur doit contrôler la concomitance des données, c'est-à-dire l'accès simultané des mêmes données par plusieurs utilisateurs.
-
Cohérence des données Dans Oracle AI Database, chaque utilisateur doit voir une vue cohérente des données, y compris les modifications visibles apportées par ses propres transactions et les transactions validées d'autres utilisateurs.
Transactions
Une transaction est une unité de travail atomique logique qui contient une ou plusieurs instructions SQL.
Un SGBDR doit pouvoir regrouper les instructions SQL de sorte qu'elles soient toutes validées (commit), ce qui signifie qu'elles sont appliquées à la base de données, ou toutes annulées (rollback), ce qui signifie qu'elles sont annulées.
Un transfert de fonds d'un compte épargne vers un compte chèques illustre le besoin de transactions. Le transfert comprend les opérations distinctes suivantes :
-
Réduire le compte épargne.
-
Augmentez le compte chèque.
-
Enregistrer la transaction dans l'écriture comptable de la transaction.
Oracle AI Database garantit que les trois opérations réussissent ou échouent en tant qu'unité. Par exemple, si une panne matérielle empêche l'exécution d'une instruction de la transaction, les autres instructions doivent être annulées.
Les transactions sont une fonctionnalité qui distingue Oracle AI Database d'un système de fichiers. Si vous effectuez une opération atomique qui met à jour plusieurs fichiers, et si le système échoue à mi-chemin, les fichiers ne seront pas cohérents. En revanche, une transaction fait passer une base de données Oracle d'un état cohérent à un autre. Le principe de base d'une transaction est "tout ou rien" : une opération atomique réussit ou échoue dans son ensemble.
Rubriques connexes
Accès simultanés aux données
Le contrôle de la concomitance de données, qui est l'accès simultané des mêmes données par plusieurs utilisateurs, est une condition d'un SGBDR multiutilisateur.
Sans contrôle de simultanéité, les utilisateurs pourraient modifier les données de manière incorrecte, compromettant ainsi l'intégrité des données. Par exemple, un utilisateur peut mettre à jour une ligne alors qu'un autre utilisateur la met à jour simultanément.
Si plusieurs utilisateurs accèdent aux mêmes données, l'une des méthodes de gestion de la simultanéité consiste à faire attendre les utilisateurs. Cependant, l'objectif d'un SGBD est de réduire le temps d'attente afin qu'il soit inexistant ou négligeable. Toutes les instructions SQL qui modifient les données doivent procéder avec le moins d'interférences possible. Les interactions destructives, qui sont des interactions qui mettent à jour les données de manière incorrecte ou modifient les structures de données sous-jacentes, doivent être évitées.
Oracle AI Database utilise des verrous pour contrôler l'accès simultané aux données. Un verrou est un mécanisme qui empêche toute interaction destructive entre les transactions accédant à une ressource partagée. Les verrous permettent d'assurer l'intégrité des données tout en autorisant un accès simultané maximal aux données.
Rubriques connexes
Cohérence de données
Dans Oracle AI Database, chaque utilisateur doit voir une vue cohérente des données, y compris les modifications visibles apportées par ses propres transactions et les transactions validées d'autres utilisateurs.
Par exemple, la base de données doit éviter le problème de lecture incorrecte, qui se produit lorsqu'une transaction voit des modifications non validées effectuées par une autre transaction simultanée.
Oracle AI Database applique toujours la cohérence de lecture au niveau des instructions, ce qui garantit que les données renvoyées par une seule requête sont validées et cohérentes pour un seul point dans le temps. Selon le niveau d'isolement de la transaction, il s'agit de l'heure à laquelle l'instruction a été ouverte ou de l'heure à laquelle la transaction a commencé. La fonctionnalité Oracle Flashback Query vous permet d'indiquer explicitement ce point dans le temps.
La base de données peut également assurer la cohérence en lecture de toutes les interrogations d'une transaction, appelée cohérence en lecture au niveau transaction. Dans ce cas, chaque instruction d'une transaction voit les données du même point dans le temps, qui est l'heure à laquelle la transaction a commencé.
Rubriques connexes
Architecture d'Oracle AI Database
Un serveur de base de données est la clé de la gestion des informations.
En général, un serveur gère de manière fiable une grande quantité de données dans un environnement multiutilisateur afin que les utilisateurs puissent accéder simultanément aux mêmes données. Un serveur de base de données empêche également tout accès non autorisé et fournit des solutions efficaces pour la récupération après défaillance.
-
Base de données et instance Un serveur de base de données Oracle se compose d'une base de données et d'au moins une instance de base de données, généralement appelée simplement instance.
-
Structures de stockage de base de données Une base de données peut être considérée à la fois du point de vue physique et logique.
-
Structures d'instance de base de données Une base de données Oracle utilise des structures mémoire et des processus pour gérer la base de données Conteneur et y accéder. Toutes les structures mémoire existent dans la mémoire principale des ordinateurs qui constituent le SGBDR.
-
Architecture d'application et de mise en réseau Pour tirer pleinement parti d'un système informatique ou d'un réseau donné, Oracle AI Database permet de répartir le traitement entre le serveur de base de données et les programmes client. L'ordinateur exécutant le SGBDR gère les responsabilités du serveur de base de données tandis que les ordinateurs exécutant les applications gèrent l'interprétation et l'affichage des données.
Base de données et instance
Un serveur de base de données Oracle se compose d'une base de données et d'au moins une instance de base de données, généralement appelée simplement instance.
Etant donné qu'une instance et une base de données sont si étroitement connectées, le terme base de données Oracle fait parfois référence à la fois à une instance et à une base de données. Au sens strict, les termes ont les significations suivantes :
-
Base de données
Une base de données est un ensemble de fichiers, situés sur le disque, qui stockent les données utilisateur. Ces fichiers de données peuvent exister indépendamment d'une instance de base de données. A partir d'Oracle Database 21c, la "base de données" fait spécifiquement référence aux fichiers de données d'une base de données Conteneur colocative, d'une base de données pluggable ou d'un conteneur d'applications.
-
Instance de base de données
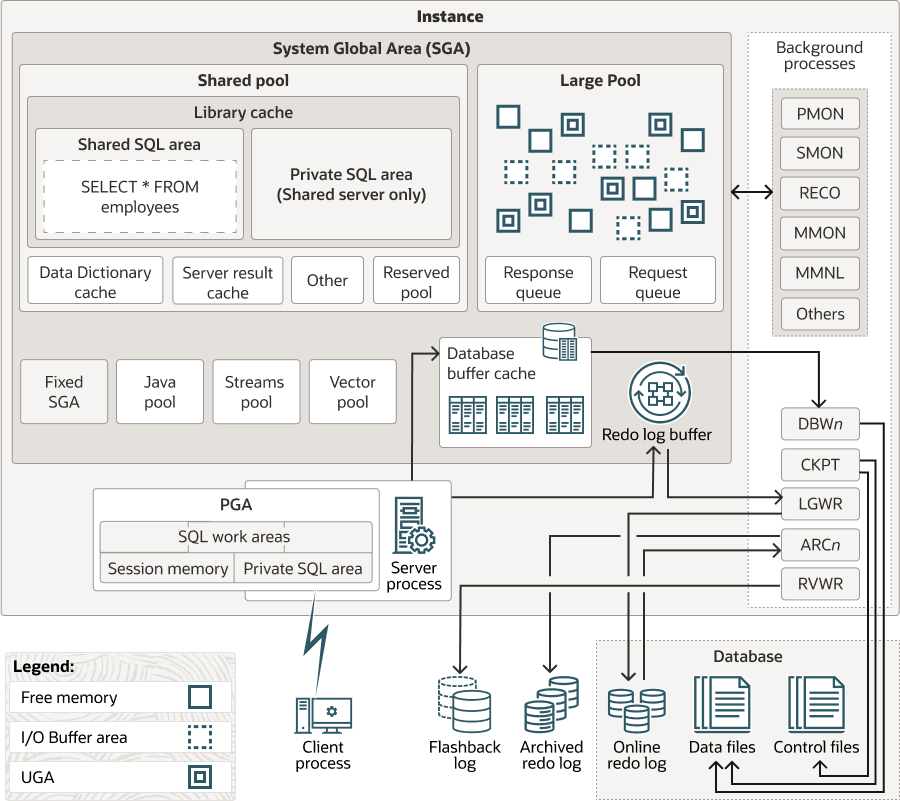
Une instance est un ensemble nommé de structures mémoire qui gèrent les fichiers de base de données. Une instance de base de données se compose d'une zone de mémoire partagée, appelée zone globale du système (SGA), et d'un ensemble de processus en arrière-plan. Une instance peut exister indépendamment des fichiers de base de données.
-
Architecture colocative L'architecture colocative permet à une base de données Conteneur d'Oracle AI Database.
-
Architecture de base de données distribuée à l'échelle mondiale Oracle Globally Distributed Database (anciennement appelé sharding Oracle) est une technique de mise à l'échelle de base de données basée sur le partitionnement horizontal des données entre plusieurs bases pluggables. Les applications perçoivent le pool de bases pluggables comme une base de données logique unique. Chaque partition est appelée shard.
Architecture colocative
L'architecture colocative permet à une base de données Conteneur d'Oracle AI Database.
Chaque base de données Oracle AI Database doit contenir ou être contenue par une autre base de données. Par exemple, une base Conteneur contient des bases pluggables et un conteneur d'application contient des bases pluggables d'application. Une base de données pluggable est contenue par une base de données Conteneur ou un conteneur d'application, et un conteneur d'application est contenu par une base de données Conteneur.
A partir d'Oracle Database 21c, une base de données Conteneur colocative est la seule architecture prise en charge. Dans les versions précédentes, Oracle prenait en charge les bases de données non Conteneur.
-
Bases de données Conteneur Une base de données Conteneur contient des bases de données pluggables et des conteneurs d'application créés par l'utilisateur.
-
Bases de données pluggables Une base de données pluggable est un ensemble portable de schémas, d'objets de schéma et d'objets non schéma qui apparaît à une application en tant que base de données distincte.
-
Conteneurs d'application Un conteneur d'application est un conteneur facultatif créé par l'utilisateur dans une base de données Conteneur qui stocke les données et les métadonnées d'une ou de plusieurs applications.
Bases de données Conteneur
Une base Conteneur contient des bases pluggables et des conteneurs d'application créés par l'utilisateur.
Au niveau physique, une base de données Conteneur est un ensemble de fichiers : fichier de contrôle, fichiers de journalisation en ligne et fichiers de données. L'instance de base de données gère les fichiers qui constituent la base de données Conteneur.
La figure suivante illustre une base de données Conteneur et une instance de base de données associée.
Figure 1 : Instance de base de données et base de données Conteneur
Description de l'image cncpt233.png
Bases de données pluggables
Une base de données pluggable est un ensemble portable de schémas, d'objets de schéma et d'objets non schéma qui apparaît à une application en tant que base de données distincte.
Au niveau physique, chaque base de données pluggable dispose de son propre ensemble de fichiers de données qui stockent les données de la base. La base de données Conteneur inclut tous les fichiers de données des bases de données pluggables qu'elle contient, ainsi qu'un ensemble de fichiers de données système qui stockent les métadonnées de la base de données Conteneur elle-même.
Pour déplacer ou archiver une base de données pluggable, vous pouvez la déconnecter. Une base pluggable déconnectée se compose des fichiers de données et d'un fichier de métadonnées de la base pluggable. Une base de données pluggable déconnectée n'est pas utilisable tant qu'elle n'est pas connectée à une base de données Conteneur.
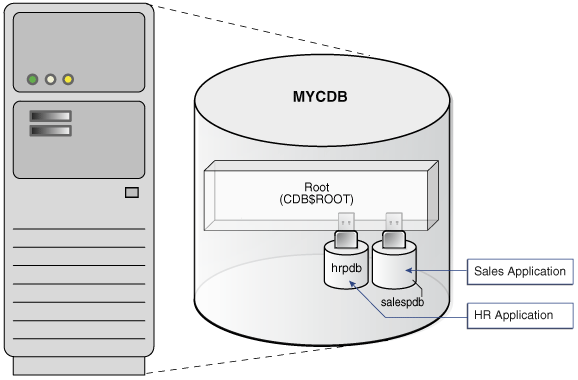
La figure suivante présente une base de données Conteneur nommée MYCDB.
Figure 2 : Base de données pluggable dans une base de données Conteneur
Description de l'image cncpt352.png
Physiquement, MYCDB est une base de données Oracle AI Database, au sens d'un ensemble de fichiers de données associés à une instance. MYCDB comporte une instance de base de données, bien que plusieurs instances soient possibles dans Oracle Real Application Clusters, et un ensemble de fichiers de base de données.
MYCDB contient deux bases de données pluggables : hrpdb et salespdb. Comme le montre la figure 1-2, ces bases de données pluggables apparaissent dans leurs applications respectives en tant que bases de données distinctes et indépendantes. Une application ne sait pas si elle se connecte à une base de données Conteneur ou pluggable.
Pour administrer la base de données Conteneur elle-même ou toute base de données pluggable qu'elle contient, vous pouvez vous connecter à la racine de la base de données Conteneur. La racine est un ensemble de schémas, d'objets de schéma et d'objets non schéma auxquels appartiennent toutes les bases pluggables et conteneurs d'application.
Conteneurs d'application
Un conteneur d'application est un conteneur facultatif créé par l'utilisateur dans une base de données Conteneur qui stocke les données et les métadonnées d'une ou de plusieurs applications.
Dans ce contexte, une application (également appelée définition d'application maître) est un ensemble nommé avec numéro de version de données et de métadonnées communes stockées dans la racine d'application. Par exemple, l'application peut inclure des définitions de tables, de vues, de comptes utilisateur et de packages PL/SQL communs à un ensemble de bases de données pluggables.
D'une certaine manière, un conteneur d'application fonctionne comme une base de données Conteneur propre à l'application dans une base de données Conteneur. Un conteneur d'application, comme la base de données Conteneur elle-même, peut inclure plusieurs bases de données pluggables d'application et permet à ces bases de données pluggables de partager des métadonnées et des données. Au niveau physique, un conteneur d'application possède son propre ensemble de fichiers de données, tout comme une base de données pluggable.
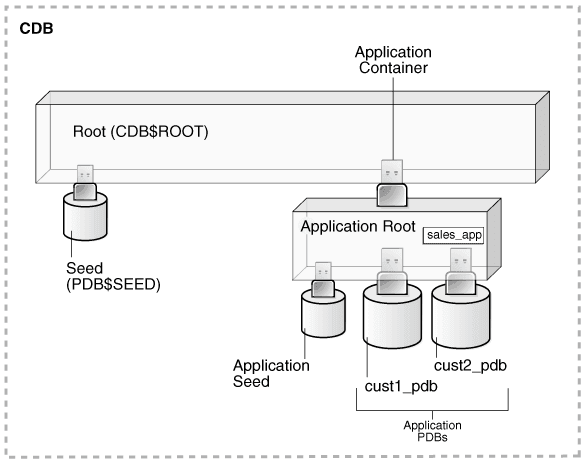
Par exemple, un déploiement SaaS peut utiliser plusieurs bases de données pluggables d'application, chacune pour un client distinct, qui partagent les métadonnées et les données d'application. Par exemple, dans la figure suivante, sales_app est le modèle d'application dans la racine d'application. La base de données pluggable d'application nommée cust1_pdb contient les données de vente uniquement pour le client 1, tandis que la base de données pluggable d'application nommée cust2_pdb contient les données de vente uniquement pour le client 2. Les opérations de connexion, de déconnexion, de clonage et autres opérations au niveau des bases de données pluggables sont disponibles pour les bases de données pluggables client individuelles.
Figure 3 : Cas d'utilisation de SaaS
Description de l'image cncpt389.png
Architecture de base de données distribuée globalement
Oracle Globally Distributed Database (anciennement appelé Oracle Sharding) est une technique de redimensionnement de base de données basée sur le partitionnement horizontal des données entre plusieurs bases pluggables. Les applications perçoivent le pool de bases pluggables comme une base de données logique unique. Chaque partition est appelée shard.
Les principaux avantages du sharding pour les applications incluent l'évolutivité linéaire, le confinement des pannes et la distribution des données géographiques. Globally Distributed Database est adapté au déploiement dans Oracle Cloud. Contrairement aux banques de données NoSQL qui implémentent le sharding, Globally Distributed Database offre les avantages du sharding sans sacrifier les fonctionnalités d'un SGBDR d'entreprise.
Dans une architecture de sharding, chaque base de données Conteneur est hébergée sur un serveur dédié avec ses propres ressources locales : CPU, mémoire, mémoire flash ou disque. Vous pouvez désigner une base de données pluggable comme shard. Les shards de base de données pluggable issus de différentes bases de données Conteneur constituent une base de données logique unique, appelée base de données distribuée. Deux shards dans la même base de données Conteneur ne peuvent pas être membres de la même base de données distribuée. Toutefois, dans la même base de données Conteneur, une base de données pluggable peut se trouver dans une base de données distribuée et une autre dans une base de données distribuée distincte.
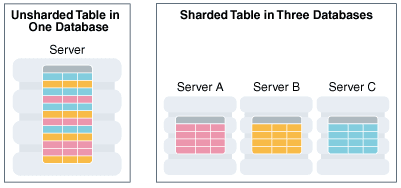
Le partitionnement horizontal implique de diviser une table de base de données entre les shards de sorte que chaque shard contienne la table avec les mêmes colonnes mais un sous-ensemble de lignes différent. Une table ainsi fractionnée est également appelée table distribuée. La figure suivante présente une table distribuée partitionnée horizontalement sur trois shards, chacun d'eux étant une base de données pluggable dans une base de données Conteneur distincte.
Figure 4 : Partitionnement horizontal d'une table sur plusieurs shards
Description de l'illustration admin_3v_134a.png
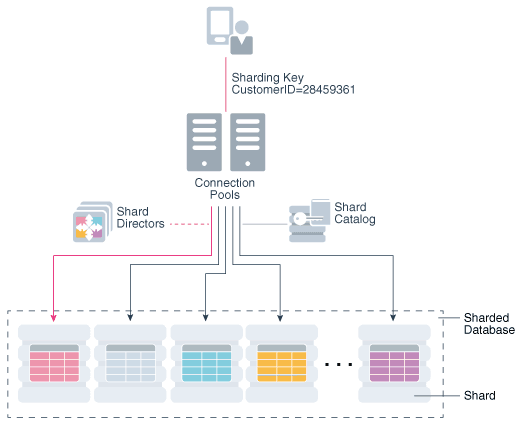
Un cas d'utilisation consiste à répartir les données de compte client entre plusieurs bases de données Conteneur. Par exemple, un client portant l'ID 28459361 peut rechercher ses enregistrements. La figure suivante présente une architecture possible. La demande client est acheminée via un pool de connexions, où les directeurs de sharding (processus d'écoute réseau) dirigent la demande vers le shard de base de données pluggable approprié, qui contient toutes les lignes client.
Figure 5 : Architecture d'Oracle Globally Distributed Database
Description de l'illustration admin_3v_143d.png
Rubriques connexes
Structures de stockage de base de données
Une base de données peut être considérée à la fois d'un point de vue physique et logique.
Les données physiques sont consultables au niveau du système d'exploitation. Par exemple, les utilitaires du système d'exploitation tels que Linux ls et ps peuvent répertorier les fichiers et les processus de base de données. Les données logiques telles qu'une table ne sont significatives que pour la base de données. Une instruction SQL peut répertorier les tables d'une base de données Oracle, mais pas un utilitaire du système d'exploitation.
La base de données possède des structures physiques et logiques. Les structures physiques et logiques étant distinctes, vous pouvez gérer le stockage physique des données sans affecter l'accès aux structures de stockage logiques. Par exemple, le changement de nom d'un fichier de base de données physique ne renomme pas les tables dont les données sont stockées dans ce fichier.
-
Structures de stockage physique Les structures de base de données physiques sont les fichiers qui stockent les données.
-
Structures de stockage logiques Les structures de stockage logiques permettent à Oracle AI Database d'avoir un contrôle précis de l'utilisation de l'espace disque.
Structures de stockage physique
Les structures de base de données physiques sont les fichiers qui stockent les données.
Lorsque vous exécutez une commande CREATE DATABASE, vous créez une base de données Conteneur. Les fichiers suivants sont créés :
-
fichiers de données
Chaque base de données Conteneur contient un ou plusieurs fichiers de données physiques, qui contiennent toutes les données de la base. Les données des structures de base de données logiques, telles que les tables et les index, sont stockées physiquement dans les fichiers de données.
-
Fichiers de contrôle
Chaque base de données Conteneur possède un fichier de contrôle. Un fichier de contrôle contient des métadonnées indiquant la structure physique de la base de données, y compris le nom et l'emplacement des fichiers de base de données.
-
Fichiers de fichiers de journalisation en ligne
Chaque base de données Conteneur dispose d'un fichier de journalisation en ligne, qui est un ensemble de plusieurs fichiers en ligne. Un journal de journalisation en ligne est constitué d'entrées de journalisation (également appelées enregistrements de journalisation), qui enregistrent toutes les modifications apportées aux données.
Lorsque vous exécutez une commande CREATE PLUGGABLE DATABASE dans une base de données Conteneur, vous créez une base de données pluggable. La base de données pluggable contient un ensemble dédié de fichiers de données dans la base Conteneur. Une base de données pluggable ne dispose pas d'un fichier de contrôle dédié et d'un fichier de journalisation en ligne distinct : ces fichiers sont partagés par les bases de données pluggables.
De nombreux autres fichiers sont importants pour le fonctionnement d'une base de données Conteneur. Il s'agit notamment des fichiers de paramètres et des fichiers réseau. Les fichiers de sauvegarde et les fichiers de journalisation archivés sont des fichiers hors ligne importants pour la sauvegarde et la récupération.
Rubriques connexes
Voir aussi : "Structures de stockage physique"
Structures de stockage logique
Les structures de stockage logiques permettent à Oracle AI Database d'avoir un contrôle précis de l'utilisation de l'espace disque.
Cette rubrique présente les structures de stockage logique :
-
Blocs de données
Au niveau de granularité le plus élevé, les données Oracle AI Database sont stockées dans des blocs de données. Un bloc de données correspond à un nombre spécifique d'octets sur le disque.
-
Extents
Un extent correspond à un certain nombre de blocs d'informations contigus, alloués en une seule nouvelle fois et utilisés pour stocker des informations spécifiques.
-
Segments
Un segment est un ensemble d'extents alloués pour un objet utilisateur (par exemple, une table ou un index), des données d'annulation ou des données temporaires.
-
Tablespaces
Une base de données est divisée en unités de stockage logiques appelées tablespaces. Un tablespace est le conteneur logique pour les segments. Chaque tablespace comprend au moins un fichier de données.
Rubriques connexes
Structures d'instance de base de données
Une base de données Oracle utilise des structures mémoire et des processus pour gérer la base de données Conteneur et y accéder. Toutes les structures mémoire existent dans la mémoire principale des ordinateurs qui constituent le SGBDR.
Lorsque les applications se connectent à une base de données Conteneur ou pluggable, elles se connectent à une instance de base de données. L'instance sert les applications en allouant d'autres zones de mémoire en plus de la mémoire SGA, et en démarrant d'autres processus en plus des processus en arrière-plan.
-
Processus Oracle AI Database Un processus est un mécanisme d'un système d'exploitation qui peut exécuter une série d'étapes. Certains systèmes d'exploitation utilisent les termes job, task ou thread.
-
Structures de mémoire d'instance Oracle AI Database crée et utilise des structures de mémoire pour le code de programme, les données partagées entre les utilisateurs et les zones de données privées pour chaque utilisateur connecté.
Processus Oracle AI Database
Un processus est un mécanisme dans un système d'exploitation qui peut exécuter une série d'étapes. Certains systèmes d'exploitation utilisent les termes job, task ou thread.
Pour les besoins de cette rubrique, un thread est équivalent à un processus. Une instance de base de données Oracle présente les types de processus suivants :
-
Processus client
Ces processus sont créés et gérés pour exécuter le code logiciel d'un programme d'application ou d'un outil Oracle. La plupart des environnements disposent d'ordinateurs distincts pour les processus client.
-
Processus en arrière-plan
Ces processus consolident les fonctions qui seraient autrement gérées par plusieurs programmes Oracle AI Database exécutés pour chaque processus client. Les processus en arrière-plan effectuent des E/S de manière asynchrone et surveillent d'autres processus Oracle AI Database afin de fournir un parallélisme accru pour de meilleures performances et fiabilité.
-
Processus serveur
Ces processus communiquent avec les processus client et interagissent avec Oracle AI Database pour répondre aux demandes.
Les processus Oracle incluent les processus serveur et les processus en arrière-plan. Dans la plupart des environnements, les processus Oracle et les processus client s'exécutent sur des ordinateurs distincts.
Rubriques connexes
Structures de mémoire d'instance
Oracle AI Database crée et utilise des structures mémoire pour le code de programme, les données partagées entre les utilisateurs et les zones de données privées pour chaque utilisateur connecté.
Les structures mémoire suivantes sont associées à une instance de base de données :
-
Zone système globale (SGA)
La SGA est un groupe de structures mémoire partagées contenant les données et les informations d'un contrôle d'une instance de base de données. Par exemple, le cache de tampons (buffer cache) de la base de données et les zones SQL partagées. La mémoire SGA peut contenir un stockage en colonnes en mémoire facultatif (stockage de colonnes IM), qui permet de renseigner les données en mémoire dans un format de colonne.
-
Program Global Areas (PGA)
Une mémoire PGA est une zone de mémoire qui contient des données et des informations de contrôle pour un processus serveur ou en arrière-plan. L'accès à la mémoire PGA est exclusif au processus. Chaque processus serveur et processus en arrière-plan possède sa propre mémoire PGA.
Rubriques connexes
Architecture d'application et de mise en réseau
Pour tirer pleinement parti d'un système informatique ou d'un réseau donné, Oracle AI Database permet de répartir le traitement entre le serveur de base de données et les programmes client. L'ordinateur exécutant le SGBDR gère les responsabilités du serveur de base de données tandis que les ordinateurs exécutant les applications gèrent l'interprétation et l'affichage des données.
-
Architecture d'application L'architecture d'application est l'environnement informatique dans lequel une application de base de données se connecte à une base de données Oracle. Les deux architectures de base de données les plus courantes sont client/serveur et multiniveau.
-
Architecture Oracle Net Services
Oracle Net Services est l'interface entre la base de données et les protocoles de communication réseau qui facilitent le traitement distribué et les bases de données distribuées.
Architecture d'application
L'architecture d'application est l'environnement informatique dans lequel une application de base de données se connecte à une base de données Oracle. Les deux architectures de base de données les plus courantes sont client/serveur et multiniveau.
Architecture client/serveur
Dans une architecture client/serveur, l'application client lance une demande d'opération à effectuer sur le serveur de base de données. Le serveur exécute le logiciel Oracle AI Database et gère les fonctions requises pour l'accès simultané et partagé aux données. Le serveur reçoit et traite les demandes provenant des clients.
Architecture à plusieurs niveaux
Dans une architecture multiniveau, un ou plusieurs serveurs d'applications effectuent une partie de l'opération. Un serveur d'applications contient une grande partie de la logique de l'application, fournit l'accès aux données pour le client et effectue un certain traitement des requêtes. Ainsi, la charge sur la base de données diminue. Le serveur d'applications peut servir d'interface entre les clients et plusieurs bases de données et fournir un niveau de sécurité supplémentaire.
Une architecture orientée service (SOA) est une architecture à plusieurs niveaux dans laquelle les fonctionnalités des applications sont encapsulées dans les services. Les services SOA sont généralement implémentés en tant que services Web. Les services Web sont accessibles via HTTP et sont basés sur des normes XML telles que WSDL (Web Services Description Language) et SOAP. Oracle AI Database peut agir en tant que fournisseur de services Web dans un environnement SOA ou à plusieurs niveaux traditionnel.
Une architecture de microservices divise une application en petits services développés et déployés de manière indépendante. Chaque service possède sa logique métier et, idéalement, ses données, ce qui réduit les couplages et permet aux équipes d'évoluer, de mettre à jour et d'exploiter les services de manière indépendante.
L'architecture colocative d'Oracle correspond naturellement au modèle de base de données par service. Chaque microservice peut utiliser sa propre base de données pluggable, fournissant une limite de données, de sécurité et d'administration distincte, tandis que plusieurs bases de données pluggables partagent les ressources d'une base de données Conteneur commune.
Cette approche associe l'isolement des services à une consolidation efficace. Les bases pluggables peuvent être provisionnées, clonées, corrigées, sauvegardées, déplacées et redimensionnées indépendamment, tandis que les administrateurs conservent un contrôle centralisé de l'infrastructure de base de données sous-jacente.
Rubriques connexes
Architecture Oracle Net Services
Oracle Net Services est l'interface entre la base de données et les protocoles de communication réseau qui facilitent le traitement distribué et les bases de données distribuées.
Les protocoles de communication définissent la façon dont les données sont transmises et reçues sur un réseau. Oracle Net Services prend en charge les communications sur tous les principaux protocoles réseau, notamment TCP/IP, HTTP, FTP et WebDAV. Oracle Net, composant d'Oracle Net Services, établit et gère une session réseau entre une application client et un serveur de base de données. Une fois qu'une session réseau est établie, Oracle Net sert de coursier de données pour l'application client et le serveur de base de données, en échangeant des messages entre eux. Oracle Net peut effectuer ces tâches, car il réside sur chaque ordinateur du réseau.
Oracle Net Listener (appelé processus d'écoute) est un composant important de Net Services. Il s'agit d'un processus qui s'exécute sur la base de données ou ailleurs dans le réseau. Les applications client envoient des demandes de connexion au processus d'écoute, qui gère le trafic de ces demandes vers la base de données. Lorsqu'une connexion est établie, le client et la base de données communiquent directement.
Oracle REST Data Services
Oracle REST Data Services (ORDS) fournit une passerelle HTTPS vers Oracle AI Database. Elle permet aux applications de présenter des tables, des vues, des procédures stockées écrites en PL/SQL, JavaScript et Java, ainsi que des opérations de base de données personnalisées en tant qu'API REST sécurisées, souvent sans nécessiter de serveur d'applications distinct ni de code middleware étendu.
ORDS prend également en charge l'API Oracle Database API for MongoDB, permettant aux applications d'utiliser des pilotes, des outils et des commandes MongoDB compatibles pour accéder aux collections de documents JSON stockées dans Oracle Database. Le protocole de connexion MongoDB est converti en opérations de base de données via ORDS, ce qui permet aux applications REST, MongoDB et SQL d'utiliser des données gérées par la même base de données convergée.
Rubriques connexes