Structures de stockage physique
Les structures physiques d'une base de données Oracle sont visibles au niveau du système d'exploitation.
-
Introduction aux structures de stockage physique L'une des caractéristiques d'un SGBDR est l'indépendance des structures de données logiques telles que les tables, les vues et les index par rapport aux structures de stockage physiques telles que les fichiers.
-
Présentation des fichiers de données Au niveau du système d'exploitation, Oracle AI Database stocke les données dans des structures appelées fichiers de données. Chaque base de données Oracle, qu'il s'agisse d'une base Conteneur ou d'une base pluggable, doit comporter au moins un fichier de données.
-
Présentation des fichiers de contrôle Le fichier de contrôle de base de données est un petit fichier binaire associé à une seule base de données Conteneur.
-
Présentation du fichier de journalisation en ligne La structure la plus cruciale pour la récupération est le fichier de journalisation en ligne, qui se compose de deux fichiers préalloués ou plus qui stockent les modifications apportées à la base de données lorsqu'elles se produisent. Le fichier de journalisation en ligne enregistre les modifications apportées aux fichiers de données.
Présentation des structures de stockage physique
Une caractéristique d'un SGBDR est l'indépendance des structures de données logiques telles que les tables, les vues et les index par rapport aux structures de stockage physiques telles que les fichiers.
Les structures physiques et logiques étant distinctes, vous pouvez gérer le stockage physique des données sans affecter l'accès aux structures logiques. Par exemple, le changement de nom d'un fichier de base de données ne renomme pas les tables qui y sont stockées.
Une base de données Oracle est un ensemble de fichiers qui stockent les données Oracle dans le stockage persistant. A partir d'Oracle Database 21c, une base de données Conteneur colocative est la seule architecture prise en charge. Une base de données Conteneur contient des bases de données pluggables.
Cette section présente les fichiers de base de données générés lorsque vous exécutez une instruction CREATE DATABASE pour créer une base de données Conteneur :
-
Fichiers de données et fichiers temporaires
Un fichier de données est un fichier physique dans le stockage persistant qui a été créé par Oracle AI Database et contient des structures de données telles que des tables et des index. Un fichier temporaire est un fichier de données appartenant à un tablespace temporaire. La base de données écrit des données dans ces fichiers dans un format propriétaire Oracle qui ne peut pas être lu par d'autres programmes.
Lorsque vous créez une base de données pluggable dans une base de données pluggable, elle dispose de son propre ensemble de fichiers de données dans l'ensemble global de fichiers de données qui la compose. Par exemple, vous pouvez créer une base de données Conteneur nommée
mycdb, puis y créer deux bases de données pluggables :hrpdbetsalespdb. Dans ce cas,mycdbaurait son propre ensemble de fichiers de données et de fichiers temporaires, commehrpdbetsalespdb. -
Fichiers de contrôle
Un fichier de contrôle est un fichier root qui suit les composants physiques de la base de données Conteneur. Les bases pluggables ne disposent pas de leurs propres fichiers de contrôle.
-
Fichiers de fichiers de journalisation en ligne
Le fichier de journalisation en ligne est un ensemble de fichiers contenant les enregistrements des modifications apportées aux données de la base Conteneur. Les bases pluggables ne disposent pas de leurs propres fichiers de journalisation en ligne.
Une instance de base de données est un ensemble de structures mémoire qui gèrent les fichiers de base de données dans une base de données Conteneur. Le graphique suivant illustre la relation entre l'instance et les fichiers qu'elle gère.
Figure 1 : Instance de base de données et fichiers de base de données
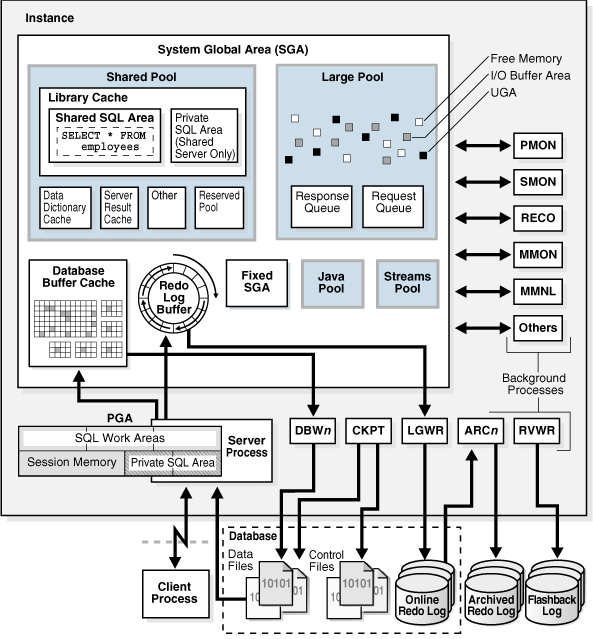
Description de l'image cncpt223.gif
-
Mécanismes de stockage des fichiers de base de données Plusieurs mécanismes sont disponibles pour l'allocation et la gestion du stockage de ces fichiers.
-
Oracle Managed Files and User-Managed Files Oracle Managed Files est une stratégie de résolution de noms de fichier qui vous permet de spécifier des opérations en termes d'objets de base de données plutôt que de noms de fichier. Par exemple, vous pouvez créer un tablespace sans indiquer le nom de ses fichiers de données.
-
Oracle Automatic Storage Management (Oracle ASM) Oracle ASM est une solution de stockage hautes performances et facile à gérer pour les fichiers Oracle AI Database. Oracle ASM est un gestionnaire de volumes qui fournit un système de fichiers conçu exclusivement pour être utilisé par la base de données.
-
La PMEM d'Oracle Persistent Memory Filestore (PMEM Filestore) est une mémoire persistante adressable par octets. Oracle Persistent Memory Filestore (PMEM Filestore) peut stocker des fichiers de données, des fichiers de journalisation en ligne et des fichiers de contrôle.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment créer une base de données
-
Référence du langage SQL d'Oracle AI Database pour la sémantique et la syntaxe
CREATE DATABASE
Mécanismes de stockage des fichiers de base de données
Plusieurs mécanismes sont disponibles pour l'allocation et la gestion du stockage de ces fichiers.
Les mécanismes comprennent :
-
Système de fichiers du système d'exploitation
La plupart des bases de données Oracle stockent des fichiers dans un système de fichiers, qui est une structure permettant de stocker et d'extraire des données.
Un système de fichiers permet d'utiliser l'espace de stockage pour les données d'application de manière standard et cohérente. Chaque fichier a un nom et apparaît comme un espace d'adressage contigu pour des applications telles qu'Oracle AI Database. La base de données peut créer, lire, écrire, redimensionner et supprimer des fichiers.
Un système de fichiers est généralement construit sur un volume logique construit par un package logiciel appelé gestionnaire de volumes logiques (LVM). Le LVM permet à plusieurs disques physiques de se combiner en un seul espace d'adressage contigu.
-
Système de fichiers du cluster
Un système de fichiers de cluster est un système de fichiers distribué qui est un cluster de serveurs qui collaborent pour fournir une cohérence et des performances élevées à leurs clients. Dans un environnement Oracle RAC, un système de fichiers de cluster fait apparaître le stockage partagé comme un système de fichiers partagé par de nombreux ordinateurs d'un environnement en cluster. Avec un système de fichiers de cluster, la panne d'un ordinateur dans le cluster ne rend pas le système de fichiers indisponible. Toutefois, dans un système de fichiers du système d'exploitation, si un ordinateur partageant des fichiers via NFS ou d'autres moyens échoue, le système de fichiers n'est pas disponible.
-
Fichier de journalisation de la mémoire persistante Oracle (fichier PMEM)
Le fichier PMEM est conçu pour stocker les fichiers de base de données dans la mémoire persistante (PMEM), qui est une mémoire persistante adressable par octet. Vous créez un fichier de journalisation à l'aide de la commande
CREATE PMEM FILESTORE. Au niveau du système d'exploitation Linux, le fichier de journalisation stocke les données dans un système de fichiers ext4 volumineux monté en modefsdax. PMEM Filestore apparaît à Oracle AI Database comme un système de fichiers natif sous Linux.Remarque : contrairement à un système de fichiers compatible POSIX, PMEM Filestore ne peut pas être partagé par plusieurs bases de données Oracle.
-
Oracle Automatic Storage Management (Oracle ASM)
Oracle ASM inclut un système de fichiers conçu exclusivement pour être utilisé par Oracle AI Database.
Une base de données peut utiliser une combinaison des mécanismes de stockage précédents. Par exemple, une base de données peut stocker le fichier de paramètres serveur dans un système de fichiers traditionnel, stocker les fichiers de base de données dans le fichier de journalisation PMEM, puis archiver les fichiers de journalisation dans un système de fichiers de cluster.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour visualiser les structures de stockage de base de données en interrogeant les vues de base de données
Fichiers gérés par Oracle et fichiers gérés par l'utilisateur
Oracle Managed Files est une stratégie de dénomination de fichiers qui vous permet de spécifier des opérations en termes d'objets de base de données plutôt que de noms de fichier. Par exemple, vous pouvez créer un tablespace sans indiquer le nom de ses fichiers de données.
Oracle Managed Files élimine la nécessité pour les administrateurs de gérer directement les fichiers du système d'exploitation dans une base de données. Oracle ASM requiert Oracle Managed Files.
Remarque : cette fonctionnalité n'a aucune incidence sur la création ou l'attribution de noms de fichiers d'administration tels que les fichiers trace, les fichiers d'audit et les journaux d'alertes.
Avec les fichiers gérés par l'utilisateur, vous gérez directement les fichiers du système d'exploitation dans la base de données. Vous prenez les décisions concernant la structure et la dénomination des fichiers. Par exemple, lorsque vous créez un tablespace, vous définissez le nom et le chemin des fichiers de données du tablespace.
Par le biais des paramètres d'initialisation, vous indiquez le répertoire du système de fichiers pour un type de fichier spécifique. La fonctionnalité Oracle Managed Files garantit que la base de données crée un fichier unique et le supprime lorsqu'il n'est plus nécessaire. La base de données utilise en interne des interfaces de système de fichiers standard pour créer et supprimer des fichiers pour les fichiers de données et temporaires, les fichiers de contrôle et les fichiers liés à la récupération stockés dans la zone de récupération rapide.
Oracle Managed Files n'élimine pas les fonctionnalités existantes. Vous pouvez créer de nouveaux fichiers tout en administrant manuellement les anciens fichiers. Par conséquent, une base de données peut comporter une combinaison de fichiers gérés par Oracle et de fichiers gérés par l'utilisateur.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment utiliser Oracle Managed Files
Oracle Automatic Storage Management (Oracle ASM)
Oracle ASM est une solution de stockage hautes performances et facile à gérer pour les fichiers Oracle AI Database. Oracle ASM est un gestionnaire de volumes qui fournit un système de fichiers conçu exclusivement pour être utilisé par la base de données.
Oracle ASM offre plusieurs avantages par rapport aux systèmes de fichiers et aux gestionnaires de stockage conventionnels, notamment :
-
Simplifie les tâches liées au stockage telles que la création et la disposition de bases de données et la gestion de l'espace disque
-
Répartit les données entre les disques physiques pour éliminer les points chauds et assurer des performances uniformes entre les disques.
-
Rééquilibre automatiquement les données après modification de la configuration du stockage
Pour utiliser Oracle ASM, vous allouez des disques partitionnés pour Oracle AI Database avec des préférences de striping et de mise en miroir. Oracle ASM gère l'espace disque, répartissant la charge d'E/S entre toutes les ressources disponibles afin d'optimiser les performances tout en éliminant le besoin de réglage manuel des E/S. Par exemple, vous pouvez augmenter la taille du disque de la base de données ou déplacer des parties de la base vers de nouveaux périphériques sans avoir à arrêter la base de données.
-
Composants de stockage Oracle ASM Oracle AI Database peut stocker un fichier de données en tant que fichier Oracle ASM dans un groupe de disques Oracle ASM. Dans un groupe de disques, Oracle ASM présente une interface de système de fichiers pour les fichiers de base de données.
-
Instances Oracle ASM Une instance Oracle ASM est une instance Oracle spéciale qui gère les disques Oracle ASM.
Composants de stockage Oracle ASM
Oracle AI Database peut stocker un fichier de données en tant que fichier Oracle ASM dans un groupe de disques Oracle ASM. Dans un groupe de disques, Oracle ASM présente une interface de système de fichiers pour les fichiers de base de données.
La figure suivante illustre les relations entre les composants de stockage d'une base de données qui utilise Oracle ASM. Le diagramme décrit la relation entre un fichier Oracle ASM et un fichier de données, bien qu'Oracle ASM puisse stocker d'autres types de fichier. La notation en patte d'oie représente une relation de un à plusieurs.
Figure 2 : Composants d'Oracle ASM
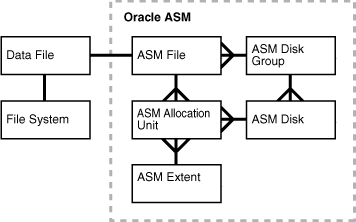
Description de l'image cncpt267.gif
La Figure 14-2 illustre les concepts Oracle ASM suivants :
-
Disques Oracle ASM
Un disque Oracle ASM est un périphérique de stockage provisionné sur un groupe de disques Oracle ASM. Un disque Oracle ASM peut être un disque physique ou une partition, un LUN (Logical Unit Number) d'une baie de stockage, un volume logique ou un fichier connecté au réseau.
Il est possible d'ajouter ou de supprimer des disques Oracle ASM sans, pour autant, avoir à arrêter la base de données. Lorsque vous ajoutez un disque à un groupe de disques, vous affectez un nom de disque ou le disque reçoit automatiquement un nom de disque Oracle ASM.
-
Groupes de disques Oracle ASM
Un groupe de disques Oracle ASM est un ensemble de disques Oracle ASM gérés en tant qu'unité logique. Les structures de données d'un groupe sont autonomes et consomment de l'espace disque dans un groupe.
Dans un groupe de disques, Oracle ASM présente une interface de système de fichiers pour les fichiers de base de données Oracle. Le contenu des fichiers stockés dans un groupe de disques est réparti ou réparti de façon uniforme, afin d'éliminer les points chauds et d'assurer des performances uniformes sur les disques.
-
Fichiers Oracle ASM
Un fichier Oracle ASM est un fichier stocké dans un groupe de disques Oracle ASM. Oracle AI Database communique avec Oracle ASM en termes de fichiers. La base de données peut stocker des fichiers de données, des fichiers de contrôle, des fichiers de journalisation en ligne et d'autres types de fichier en tant que fichiers Oracle ASM. Sur demande de la base de données, Oracle ASM crée un fichier Oracle ASM et lui affecte un nom commençant par le signe plus (
+), suivi d'un nom de groupe de disques, comme dans+DISK1.Remarque : les fichiers Oracle ASM peuvent coexister avec d'autres options de gestion du stockage, telles que des systèmes de fichiers tiers. Cette fonctionnalité simplifie l'intégration d'Oracle ASM dans des environnements préexistants.
-
Extents Oracle ASM
Une étendue Oracle ASM est une section d'un fichier Oracle ASM. Un fichier Oracle ASM est composé d'au moins un extent de fichiers. Chaque étendue Oracle ASM se compose d'une ou de plusieurs unités d'allocation sur un disque spécifique.
Remarque : une étendue Oracle ASM est différente de l'étendue utilisée pour stocker des données dans un segment.
-
Unités d'allocation Oracle ASM
Une unité d'allocation Oracle ASM est l'unité fondamentale d'allocation au sein d'un groupe de disques. Une unité d'allocation représente le plus petit espace disque contigu alloué par Oracle ASM. Une ou plusieurs unités d'allocation forment un extent Oracle ASM.
Voir aussi : Guide de l'administrateur Oracle Automatic Storage Management pour en savoir plus sur Oracle ASM
Instances Oracle ASM
Une instance Oracle ASM est une instance Oracle spéciale qui gère les disques Oracle ASM.
Les instances Oracle ASM et de base de données nécessitent un accès partagé aux disques d'un groupe de disques Oracle ASM. Les instances Oracle ASM gèrent les métadonnées du groupe de disques et fournissent des informations sur la présentation des fichiers aux instances de base de données. Les instances de base de données dirigent les E/S vers les disques Oracle ASM sans passer par une instance Oracle ASM.
Une instance Oracle ASM repose sur la même technologie qu'une instance de base de données. Par exemple, une instance Oracle ASM dispose d'une zone SGA (System Global Area) et de processus en arrière-plan similaires à ceux d'une instance de base de données. Toutefois, une instance Oracle ASM ne peut pas monter une base de données et effectue moins de tâches qu'une instance de base de données. La figure 14-3 présente une configuration à noeud unique avec une instance Oracle ASM et deux instances de base de données, chacune associée à une base de données à instance unique différente. L'instance Oracle ASM gère les métadonnées et fournit une allocation d'espace pour les fichiers Oracle ASM stockant les données des deux bases de données. Un groupe de disques Oracle ASM comporte quatre disques Oracle ASM et l'autre deux disques. Les deux instances de base de données peuvent accéder aux groupes de disques.
Figure 3 : Instances Oracle ASM et instances de base de données
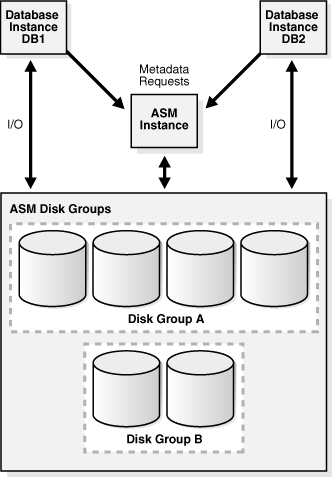
Description de l'image cncpt266.gif
Voir aussi : Guide de l'administrateur Oracle Automatic Storage Management pour en savoir plus sur Oracle ASM
Fichier de journalisation de la mémoire persistante Oracle (fichier PMEM)
PMEM est une mémoire persistante adressable par octet. Oracle Persistent Memory Filestore (PMEM Filestore) peut stocker des fichiers de données, des fichiers de journalisation en ligne et des fichiers de contrôle.
Les requêtes peuvent lire les octets directement à partir de PMEM sans d'abord migrer les blocs vers le cache de tampons de la base de données. Ce mécanisme hautes performances évite la redondance des données et les E/S inutiles. Remarque : Un fichier PMEM ne peut pas stocker de fichiers trace, d'audit ou de paramètres serveur. Les types de fichier pris en charge pour PMEM sont similaires à ceux d'Oracle ASM.
-
Cache de tampon mappé directement Dans la pyramide de stockage traditionnelle, la PMEM se trouve entre la DRAM, qui n'est pas persistante, et la Flash, qui est persistante (non volatile).
-
L'interface de système de fichiers pour PMEM Filestore PMEM Filestore implémente un protocole appelé Système de fichiers dans l'espace utilisateur.
-
Interface utilisateur pour le magasin de fichiers PMEM Pour créer un magasin de fichiers PMEM, utilisez la commande
CREATE PMEM FILESTORE.
Cache de tampons directement mappé
Dans la pyramide de stockage traditionnelle, la PMEM se situe entre la DRAM, qui n'est pas persistante, et la Flash, qui est persistante (non volatile).
Figure 4 : Pyramide de stockage
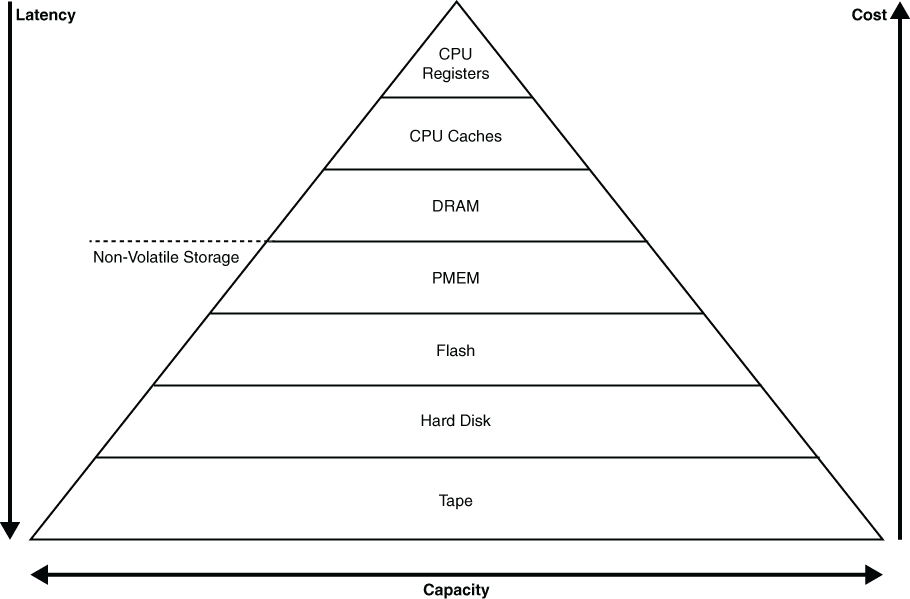
description de l'illustration pmem.png,
Le cache de tampons de la base de données réside dans la mémoire DRAM. Les processus Oracle disposent d'un accès direct adressable aux octets aux blocs d'un fichier de journalisation PMEM, qui sont mis en correspondance avec le cache de tampons de la base de données. Le mécanisme de mappage est automatiquement appelé lorsque vous placez un fichier de données dans un fichier de fichiers PMEM.
Oracle AI Database utilise un algorithme interne pour décider de migrer les blocs de données du magasin de fichiers PMEM vers la DRAM. Les raisons typiques de la migration sont les modifications LMD, la cohérence en lecture et l'accès plus rapide aux blocs de données à chaud.
Voir aussi : "Tampons DRAM et PMEM"
Interface de système de fichiers pour PMEM Filestore
Le fichier PMEM implémente un protocole appelé Système de fichiers dans l'espace utilisateur (FUSE).
FUSE permet aux utilisateurs de systèmes d'exploitation non privilégiés, tels que le propriétaire du logiciel Oracle AI Database, de créer et de gérer des systèmes de fichiers et les répertoires et fichiers qu'ils contiennent. Par exemple, vous pouvez utiliser les commandes cp, rm et ls.
Un système de fichiers standard utilise le stockage brut comme magasin de sauvegarde, tandis que PMEM Filestore obtient le stockage à partir d'un fichier de système d'exploitation natif dans un système de fichiers DAX PMEM. Ce fichier est appelé fichier de sauvegarde et est visible en tant que fichier dans le système d'exploitation. PMEM Filestore subdivise le stockage dans le fichier de sauvegarde et le présente en tant que système de fichiers local.
Voir aussi :
- Guide de l'administrateur Oracle AI Database pour en savoir plus sur PMEM Filestore
Interface utilisateur pour le magasin de fichiers PMEM
Pour créer un fichier de journalisation PMEM, utilisez la commande CREATE PMEM FILESTORE.
Le fichier de journalisation PMEM est automatiquement monté après sa création. Le fichier PMEM apparaît sous le point de montage spécifié comme s'il s'agissait d'un système de fichiers natif.
Le paramètre d'initialisation PMEM_FILESTORE indique un fichier de journalisation PMEM monté automatiquement par l'instance de base de données au démarrage. Le paramètre est défini sur une paire ordonnée de chaînes. La première chaîne de la liste de valeurs de paramètre est le répertoire dans lequel le fichier PMEM est monté. La deuxième chaîne est le fichier de sauvegarde.
V$PMEM_FILESTORE affiche les métadonnées relatives à un fichier de journalisation PMEM. Par exemple, vous pouvez afficher le chemin du répertoire du point de montage, le chemin du fichier de sauvegarde et la taille du fichier de stockage de fichiers.
Voir aussi : Guide de l'administrateur Oracle AI Database pour découvrir comment créer et gérer un fichier de stockage PMEM
Présentation des fichiers de données
Au niveau du système d'exploitation, Oracle AI Database stocke les données dans des structures appelées fichiers de données. Chaque base de données Oracle, qu'il s'agisse d'une base Conteneur ou d'une base pluggable, doit comporter au moins un fichier de données.
-
Utilisation de fichiers de données Oracle AI Database stocke physiquement les données de tablespace dans des fichiers de données.
-
Fichiers de données permanents et temporaires Un tablespace permanent contient des objets de schéma persistants. Les objets des tablespaces permanents sont stockés dans des fichiers de données.
-
Fichiers de données en ligne et hors ligne Chaque fichier de données est en ligne (disponible) ou hors ligne (indisponible).
-
Structure de fichiers de données Oracle AI Database crée un fichier de données pour un tablespace en allouant la quantité d'espace disque indiquée plus la surcharge pour l'en-tête de fichier de données. Le système d'exploitation sous lequel Oracle AI Database s'exécute est responsable de la suppression des anciennes informations et autorisations d'un fichier avant de l'allouer à la base de données.
Utilisation des fichiers de données
Oracle AI Database stocke physiquement les données de tablespace dans des fichiers de données.
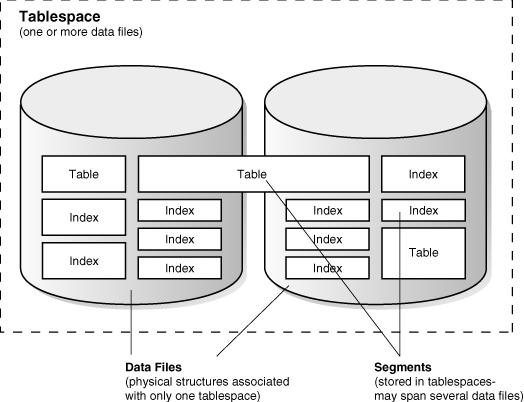
Chaque objet de schéma non partitionné et chaque partition d'un objet sont stockés dans son propre segment, qui appartient à un seul tablespace. Par exemple, les données d'une table non partitionnée sont stockées dans un seul segment, qui à son tour est stocké dans un tablespace. Les tablespaces et les fichiers de données sont étroitement liés, mais présentent des différences importantes :
-
Chaque tablespace se compose d'un ou de plusieurs fichiers de données, qui sont conformes au système d'exploitation dans lequel Oracle AI Database est exécuté.
-
Les données d'une base de données sont stockées collectivement dans les fichiers de données situés dans chaque tablespace de la base.
-
Un segment peut s'étendre sur un ou plusieurs fichiers de données, mais pas sur plusieurs tablespaces.
-
Une base de données Conteneur doit avoir les tablespaces
SYSTEMetSYSAUX. Chaque base de données pluggable d'une base de données Conteneur possède ses propres tablespacesSYSTEMetSYSAUX. Oracle AI Database alloue automatiquement les premiers fichiers de données d'une base de données pour le tablespaceSYSTEMlors de la création de la base de données.Le tablespace
SYSTEMcontient le dictionnaire de données, un ensemble de tables contenant des métadonnées de base de données. En général, une base de données comporte également un tablespace d'annulation et un tablespace temporaire (généralement nomméTEMP).
La figure suivante illustre la relation entre les tablespaces, les fichiers de données et les segments.
Figure 5 : Fichiers de données et tablespaces
Description de l'image cncpt037.gif
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer les fichiers de données
Fichiers de données permanents et temporaires
Un tablespace permanent contient des objets de schéma persistants. Les objets des tablespaces permanents sont stockés dans des fichiers de données.
Un tablespace temporaire contient des objets de schéma uniquement pendant la durée d'une session. Les tablespaces temporaires gérés localement contiennent des fichiers temporaires (fichiers temporaires), qui sont des fichiers spéciaux conçus pour stocker des données dans des opérations de hachage, de tri et autres. Les fichiers temporaires stockent également les données de l'ensemble de résultats lorsqu'il n'y a pas suffisamment d'espace en mémoire.
Les fichiers temporaires sont similaires aux fichiers de données permanents, avec les exceptions suivantes :
-
Les objets de base de données permanents tels que les tables ne sont jamais stockés dans des fichiers temporaires.
-
Les fichiers temporaires sont toujours définis sur le mode
NOLOGGING, ce qui signifie qu'ils n'ont jamais généré de données de journalisation pour eux. La restauration physique ne reconnaît pas les fichiers temporaires. -
Vous ne pouvez pas définir un fichier temporaire en lecture seule.
-
Vous ne pouvez pas créer de fichier temporaire avec l'instruction
ALTERDATABASE. -
Lorsque vous créez ou redimensionnez des fichiers temporaires, l'allocation d'espace disque pour la taille de fichier indiquée n'est pas toujours garantie. Sur les systèmes de fichiers tels que Linux et UNIX, les fichiers temporaires sont créés en tant que fichiers dispersés. Dans ce cas, les blocs de disque ne sont pas alloués lors de la création ou du redimensionnement du fichier, mais lors du premier accès aux blocs.
Remarque : les fichiers dispersés permettent de créer et de redimensionner rapidement des fichiers temporaires. Toutefois, le disque risque de manquer d'espace ultérieurement lors de l'accès aux fichiers temporaires.
-
Les informations de fichier temporaire sont affichées dans la vue de dictionnaire de données
DBA_TEMP_FILESet la vue de performances dynamiquesV$TEMPFILE, mais pas dans la vueDBA_DATA_FILESouV$DATAFILE.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer les fichiers temporaires
Fichiers de données en ligne et hors ligne
Chaque fichier de données est en ligne (disponible) ou hors ligne (indisponible).
Vous pouvez modifier la disponibilité de fichiers de données ou de fichiers temporaires individuels en les mettant hors ligne ou en les mettant en ligne. La base de données ne peut pas accéder aux fichiers de données hors ligne tant qu'ils ne sont pas mis en ligne.
Vous pouvez mettre les fichiers de données hors ligne pour de nombreuses raisons, y compris l'exécution de sauvegardes hors ligne ou la corruption de blocs. La base de données met automatiquement un fichier de données hors ligne si elle ne peut pas y écrire.
A l'instar d'un fichier de données, un tablespace lui-même est hors ligne ou en ligne. Lorsque vous mettez un fichier de données hors ligne dans un tablespace en ligne, le tablespace lui-même reste en ligne. Vous pouvez rendre temporairement indisponibles tous les fichiers de données d'un tablespace en le mettant hors ligne.
A partir d'Oracle Database 12c, vous pouvez utiliser l'instruction ALTER DATABASE MOVE DATAFILE pour déplacer un fichier de données en ligne d'un fichier physique vers un autre pendant que la base de données est ouverte et accède au fichier. Vous pouvez utiliser cette technique pour atteindre les objectifs suivants :
-
Déplacer un tablespace d'un type de stockage vers un autre
-
Déplacer les fichiers de données rarement consultés pour réduire les coûts de stockage
-
Définir un tablespace en lecture seule et déplacer ses fichiers de données vers un stockage en écriture unique, tel qu'un lecteur WORM (Write Once Read Many)
-
Déplacement d'une base de données vers Oracle ASM
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment modifier la disponibilité des fichiers de données
-
Guide de l'administrateur Oracle AI Database pour savoir comment déplacer des fichiers de données en ligne
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur
ALTER DATABASE . . . MOVE DATAFILE
Structure de fichier de données
Oracle AI Database crée un fichier de données pour un tablespace en allouant la quantité d'espace disque spécifiée plus la surcharge pour l'en-tête de fichier de données. Le système d'exploitation sous lequel Oracle AI Database s'exécute est responsable de la suppression des anciennes informations et autorisations d'un fichier avant de l'allouer à la base de données.
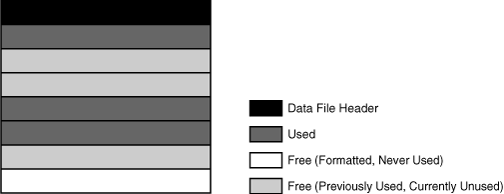
L'en-tête du fichier de données contient des métadonnées sur le fichier de données, telles que sa taille et le SCN point de reprise. Chaque en-tête contient un numéro de fichier absolu, qui identifie de manière unique le fichier de données dans la base, et un numéro de fichier relatif, qui identifie de manière unique un fichier de données dans un tablespace.
Lorsqu'Oracle AI Database crée un fichier de données pour la première fois, l'espace disque alloué est formaté mais ne contient aucune donnée utilisateur. Toutefois, la base de données réserve l'espace nécessaire pour stocker les données pour les segments futurs du tablespace associé. Au fur et à mesure que les données se développent dans un tablespace, Oracle AI Database utilise l'espace libre dans les fichiers de données pour allouer des extents au segment.
La figure suivante illustre les différents types d'espace dans un fichier de données. Les extents sont soit utilisés, ce qui signifie qu'ils contiennent des données de segment, soit libres, ce qui signifie qu'ils peuvent être réutilisés. Au fil du temps, les mises à jour et les suppositions d'objets dans un tablespace peuvent créer des espaces vides qui, individuellement, ne sont pas suffisamment grands pour pouvoir être réutilisés pour de nouvelles données. Ce type d'espace vide est appelé espace libre fragmenté.
Figure 6 : Espace dans un fichier de données
Description de l'image cncpt273.gif
Voir aussi : Guide de l'administrateur Oracle AI Database pour savoir comment afficher les informations sur les fichiers de données
Généralités sur les fichiers de contrôle
Le fichier de contrôle de base de données est un petit fichier binaire associé à une seule base de données Conteneur.
Chaque base de données Conteneur possède un fichier de contrôle unique, bien que plusieurs copies identiques soient autorisées. Les bases pluggables n'ont pas de fichiers de contrôle distincts.
-
Utilisation des fichiers de contrôle Oracle AI Database utilise le fichier de contrôle pour localiser les fichiers de base de données et gérer l'état de la base de données en général.
-
Plusieurs fichiers de contrôle Oracle AI Database permet à plusieurs fichiers de contrôle identiques d'être ouverts simultanément et écrits dans la même base de données. En multiplexant un fichier de contrôle sur différents disques, la base de données peut obtenir une redondance et ainsi éviter un point d'échec unique.
-
Structure de fichier de contrôle Les informations relatives à la base de données sont stockées dans différentes sections du fichier de contrôle. Chaque section est un ensemble d'enregistrements sur un aspect de la base de données.
Utilisation des fichiers de contrôle
Oracle AI Database utilise le fichier de contrôle pour localiser les fichiers de base de données et pour gérer l'état de la base de données en général.
Un fichier de contrôle contient des informations telles que :
-
Nom de base de données et identificateur unique de base de données (DBID)
-
Horodatage de la création de la base de données
-
Informations sur les fichiers de données, les fichiers de journalisation en ligne et les fichiers de journalisation archivés
-
Informations sur le tablespace
-
Sauvegardes RMAN
Le fichier de contrôle remplit les fonctions suivantes :
-
Il contient des informations sur les fichiers de données, les fichiers de journalisation en ligne, etc., nécessaires à l'ouverture de la base.
Le fichier de contrôle suit les modifications structurelles apportées à la base de données. Par exemple, lorsqu'un administrateur ajoute, renomme ou supprime un fichier de données ou un fichier de journalisation en ligne, la base de données met à jour le fichier de contrôle pour refléter cette modification.
-
Il contient des métadonnées qui doivent être accessibles lorsque la base de données n'est pas ouverte.
Par exemple, le fichier de contrôle contient les informations requises pour récupérer la base de données, y compris les points de reprise. Un point de reprise indique le SCN dans le flux de données de journalisation où la récupération d'instance doit commencer. Chaque modification validée avant un SCN de point de reprise est garantie d'être enregistrée sur disque dans les fichiers de données. Au moins toutes les trois secondes, le processus de point de reprise enregistre dans le fichier de contrôle les informations relatives à la position du point de reprise dans le fichier de journalisation en ligne.
Oracle AI Database lit et écrit le fichier de contrôle en continu pendant l'utilisation de la base de données et doit être disponible pour écriture chaque fois que la base de données est ouverte. Par exemple, la récupération d'une base de données consiste à lire dans le fichier de contrôle les noms de tous les fichiers de données qu'elle contient. D'autres opérations, telles que l'ajout d'un fichier de données, mettent à jour les informations stockées dans le fichier de contrôle.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer le fichier de contrôle
Plusieurs fichiers de contrôle
Oracle AI Database permet à plusieurs fichiers de contrôle identiques d'être ouverts simultanément et écrits dans la même base de données. En multiplexant un fichier de contrôle sur différents disques, la base de données peut obtenir une redondance et ainsi éviter un point d'échec unique. Remarque : Oracle recommande de gérer plusieurs copies de fichier de contrôle, chacune sur un disque différent.
Si un fichier de contrôle devient inutilisable, l'instance de base de données échoue lorsqu'elle tente d'accéder au fichier de contrôle endommagé. Lorsque d'autres copies actuelles du fichier de contrôle existent, vous pouvez remonter la base de données et l'ouvrir sans récupération de média. Toutefois, si tous les fichiers de contrôle d'une base de données sont perdus, l'instance de base de données échoue et une restauration physique est requise. La restauration physique n'est pas simple si une ancienne sauvegarde d'un fichier de contrôle doit être utilisée car aucune copie en cours n'est disponible.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment gérer plusieurs fichiers de contrôle
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour savoir comment sauvegarder et restaurer les fichiers de contrôle
Structure du fichier de contrôle
Les informations relatives à la base de données sont stockées dans différentes sections du fichier de contrôle. Chaque section est un ensemble d'enregistrements sur un aspect de la base de données.
Par exemple, une section du fichier de contrôle suit les fichiers de données et contient un ensemble d'enregistrements, un pour chaque fichier de données. Chaque section est stockée dans plusieurs blocs de fichier de contrôle logique. Les enregistrements peuvent s'étendre sur des blocs d'une section.
Le fichier de contrôle contient les types d'enregistrement suivants :
-
Enregistrements de réutilisation circulaire
Un enregistrement de réutilisation circulaire contient des informations non critiques qui peuvent être écrasées si nécessaire. Lorsque tous les emplacements d'enregistrement disponibles sont pleins, la base de données développe le fichier de contrôle pour laisser de la place à un nouvel enregistrement ou remplace le plus ancien enregistrement. Par exemple, les enregistrements concernant les fichiers de journalisation archivés (archived redo logs) et les sauvegardes RMAN.
-
Enregistrements de réutilisation non circulaires
Un enregistrement de réutilisation non circulaire contient des informations critiques qui ne changent pas souvent et ne peuvent pas être écrasées. Par exemple, les tablespaces, les fichiers de données, les fichiers de journalisation en ligne (online redo logs) et les threads de journalisation. Oracle AI Database ne réutilise jamais ces enregistrements, sauf si l'objet correspondant est supprimé du tablespace.
Vous pouvez interroger les vues dynamiques des performances, également appelées vues V$, pour visualiser les informations stockées dans le fichier de contrôle. Par exemple, vous pouvez interroger V$DATABASE pour obtenir le nom de base de données et le DBID. Toutefois, seule la base de données peut modifier les informations contenues dans le fichier de contrôle.
La lecture et l'écriture des blocs de fichier de contrôle sont différentes de celles des blocs de données. Pour le fichier de contrôle, Oracle AI Database lit et écrit directement à partir du disque vers la mémoire PGA (Program Global Area). Chaque processus alloue une certaine quantité de mémoire PGA pour les blocs de fichier de contrôle.
Voir aussi :
-
Référence Oracle AI Database pour en savoir plus sur la vue
V$CONTROLFILE_RECORD_SECTION -
Référence Oracle AI Database pour en savoir plus sur le paramètre d'initialisation
CONTROL_FILE_RECORD_KEEP_TIME
Présentation du fichier de journalisation en ligne
La structure la plus cruciale pour la récupération est le fichier de journalisation en ligne, qui se compose de deux fichiers préalloués ou plus qui stockent les modifications apportées à la base de données au fur et à mesure qu'elles se produisent. Le fichier de journalisation en ligne enregistre les modifications apportées aux fichiers de données.
-
Utilisation du fichier de journalisation en ligne La base de données gère les fichiers de journalisation en ligne afin d'éviter toute perte de données. Plus précisément, après une défaillance d'instance, les fichiers de journalisation en ligne permettent à Oracle AI Database de récupérer les données validées qu'il n'a pas encore écrites dans les fichiers de données.
-
Comment Oracle AI Database écrit dans le fichier de journalisation en ligne Le fichier de journalisation en ligne d'une instance de base de données est appelé thread de journalisation.
-
Les fichiers de journalisation en ligne Structure du fichier de journalisation en ligne contiennent des enregistrements de journalisation.
Utiliser le fichier de journalisation en ligne
La base de données gère les fichiers de journalisation en ligne afin d'éviter toute perte de données. Plus précisément, après une défaillance d'instance, les fichiers de journalisation en ligne permettent à Oracle AI Database de récupérer les données validées qu'il n'a pas encore écrites dans les fichiers de données.
Les processus serveur écrivent chaque transaction de manière synchrone dans le tampon de journalisation, que le processus LGWR écrit ensuite dans le fichier de journalisation en ligne. Le contenu du fichier de journalisation en ligne inclut les transactions non validées, ainsi que les instructions de gestion des schémas et des objets.
Lorsque la base de données apporte des modifications aux segments d'annulation, elle les écrit également dans les fichiers de journalisation en ligne. Par conséquent, le fichier de journalisation en ligne contient toujours les données d'annulation pour les objets permanents. Vous pouvez configurer la base de données pour qu'elle stocke toutes les données d'annulation des objets temporaires dans un segment d'annulation temporaire, ce qui permet d'économiser de l'espace et d'améliorer les performances, ou de permettre à la base de données de stocker les données d'annulation permanentes et temporaires dans le fichier de journalisation en ligne.
Oracle AI Database utilise le fichier de journalisation en ligne uniquement pour la récupération. Toutefois, les administrateurs peuvent interroger les fichiers de journalisation en ligne via une interface SQL dans l'utilitaire Oracle LogMiner. Les fichiers de journalisation constituent une source utile d'informations historiques sur l'activité de la base de données.
Voir aussi :
-
"Architecture de processus" pour en savoir plus sur les processus Oracle
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur les segments d'annulation temporaires
-
Référence Oracle AI Database pour en savoir plus sur le paramètre d'initialisation
TEMP_UNDO_ENABLED
Comment Oracle AI Database écrit dans le fichier de journalisation en ligne
Le fichier de journalisation en ligne d'une instance de base de données est appelé thread de journalisation.
Dans les configurations à instance unique, une seule instance accède à une base de données, de sorte qu'un seul thread de journalisation est présent. Toutefois, dans une configuration Oracle Real Application Clusters (Oracle RAC), plusieurs instances accèdent simultanément à une base de données, chaque instance ayant son propre thread de journalisation. Un thread de journalisation distinct pour chaque instance évite les conflits pour un seul ensemble de fichiers de journalisation en ligne.
Un fichier de journalisation en ligne se compose d'au moins deux fichiers de journalisation en ligne. Oracle AI Database requiert un minimum de deux fichiers pour garantir qu'un fichier est toujours disponible pour écriture au cas où l'autre serait en cours d'effacement ou d'archivage.
-
Commutateurs de fichier de journalisation en ligne Oracle AI Database n'utilise qu'un seul fichier de journalisation en ligne à la fois pour stocker les enregistrements écrits à partir du tampon de journalisation.
-
Plusieurs copies des fichiers de journalisation en ligne Oracle AI Database peut gérer automatiquement deux copies identiques ou plus du fichier de journalisation en ligne à des emplacements distincts.
-
Fichiers de journalisation archivés Un fichier de journalisation archivé est une copie d'un membre rempli d'un groupe de fichiers de journalisation en ligne.
Voir aussi : Guide d'administration et de déploiement Oracle Real Application Clusters pour en savoir plus sur les groupes de fichiers de journalisation en ligne dans Oracle RAC
Commutateurs de journalisation en ligne
Oracle AI Database utilise un seul fichier de journalisation en ligne à la fois pour stocker les enregistrements écrits à partir du tampon de journalisation.
Le fichier de journalisation en ligne dans lequel le processus LGWR (log Writer) écrit activement est appelé fichier de journalisation en ligne en cours.
Un commutateur de journal se produit lorsque la base de données arrête d'écrire dans un fichier de journalisation en ligne et commence à écrire dans un autre fichier. Normalement, un changement se produit lorsque le fichier de journalisation en ligne en cours est plein et que l'écriture doit continuer. Toutefois, vous pouvez configurer des changements de fichier de journalisation à intervalles réguliers, que le fichier de journalisation en ligne actuel soit rempli ou non, et forcer les changements de fichier de journalisation manuellement.
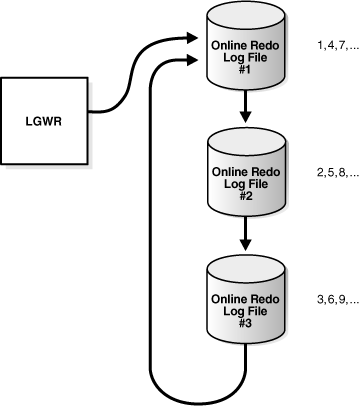
Log Writer écrit de manière circulaire dans les fichiers de journalisation en ligne. Lorsque le processus Log Writer remplit le dernier fichier de journalisation en ligne disponible, le processus écrit dans le premier fichier de journalisation, en relançant le cycle. La figure 14-7 illustre l'écriture circulaire du fichier de journalisation.
Figure 7 : Réutilisation des fichiers de journalisation en ligne
Description de l'image admin054.gif
Les numéros de la Figure 14-7 indiquent la séquence dans laquelle le processus LGWR écrit dans chaque fichier de journalisation en ligne. La base de données affecte à chaque fichier un nouveau numéro de séquence de journal lorsqu'un journal bascule et qu'un processus d'écriture de journal commence à y écrire. Lorsque la base de données réutilise un fichier de journalisation en ligne, ce fichier reçoit le numéro de séquence de journal disponible suivant.
Les fichiers de journalisation en ligne remplis peuvent être réutilisés en fonction du mode d'archivage :
-
Si l'archivage est désactivé, ce qui signifie que la base de données est en mode
NOARCHIVELOG, un fichier de journalisation en ligne rempli est disponible une fois que les modifications enregistrées ont été pointées (écrites) sur le disque par database Writer (DBW). -
Si l'archivage est activé, ce qui signifie que la base de données est en mode ARCHIVELOG, un fichier de journalisation en ligne rempli est disponible pour Log Writer une fois que les modifications ont été écrites dans les fichiers de données et que le fichier a été archivé.
Dans certains cas, le processus Log Writer peut être empêché de réutiliser un fichier de journalisation en ligne existant. Un fichier de journalisation en ligne actif est requis pour la récupération d'instance, où un fichier de journalisation en ligne inactif n'est pas requis pour la récupération d'instance. En outre, un fichier de journalisation en ligne peut être en cours d'effacement.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer le fichier de journalisation en ligne
Plusieurs copies des fichiers de journalisation en ligne
Oracle AI Database peut gérer automatiquement deux ou plusieurs copies identiques du fichier de journalisation en ligne dans des emplacements distincts.
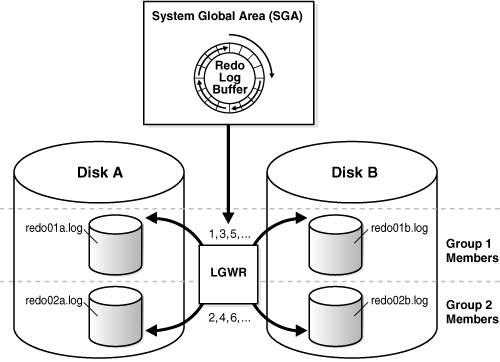
Un groupe de fichiers de journalisation en ligne se compose d'un fichier de journalisation en ligne et de ses copies redondantes. Chaque copie identique est membre du groupe de fichiers de journalisation en ligne. Chaque groupe est défini par un nombre, par exemple Groupe 1, Groupe 2, etc.
La gestion de plusieurs membres d'un groupe de fichiers de journalisation en ligne protège contre la perte du fichier de journalisation. Dans l'idéal, les emplacements des membres doivent se trouver sur des disques distincts de sorte que la défaillance d'un disque n'entraîne pas la perte de l'ensemble du fichier de journalisation en ligne.
Dans la Figure 14-8, A_LOG1 et B_LOG1 sont des membres identiques du groupe 1, tandis que A_LOG2 et B_LOG2 sont des membres identiques du groupe 2. Chaque membre d'un groupe doit avoir la même taille. Le processus LGWR écrit simultanément dans le groupe 1 (membres A_LOG1 et B_LOG1), puis écrit simultanément dans le groupe 2 (membres A_LOG2 et B_LOG2), puis écrit dans le groupe 1, etc. Le processus LGWR n'écrit jamais simultanément sur les membres de différents groupes.
Figure 8 : Plusieurs copies des fichiers de journalisation en ligne
Description de l'image cncpt270.gif
Remarque : Oracle recommande de multiplexer le fichier de journalisation en ligne. La perte de fichiers journaux peut être catastrophique si une récupération est nécessaire. Lorsque vous multipliez le fichier de journalisation en ligne, la base de données doit augmenter la quantité d'E/S qu'elle exécute. Selon votre système, ces E/S supplémentaires peuvent avoir une incidence sur les performances globales de la base de données.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer plusieurs copies des fichiers de journalisation en ligne
-
Oracle Data Guard Concepts and Administration, pour en savoir plus sur le transfert automatisé des données de journalisation entre les membres d'une configuration Data Guard
Fichiers de journalisation archivés
Un fichier de journalisation archivé est une copie d'un membre rempli d'un groupe de fichiers de journalisation en ligne.
Un fichier de journalisation archivé n'est pas considéré comme faisant partie de la base de données. Il s'agit plutôt d'une copie hors ligne d'un fichier de journalisation en ligne créé par la base de données et écrit dans un emplacement défini par l'utilisateur.
Les fichiers de journalisation archivés (archived redo logs) sont un élément essentiel d'une stratégie de sauvegarde et de récupération. Vous pouvez utiliser des fichiers de journalisation archivés pour :
-
Récupérer une sauvegarde de la base de données
-
Mise à jour d'une base de données de réserve
-
Obtenir des informations sur l'historique d'une base de données à l'aide de l'utilitaire Oracle LogMiner
L'opération de génération d'un fichier de journalisation archivé est appelée archivage. Cette opération est automatique ou manuelle. Elle n'est possible que lorsque la base de données est en mode ARCHIVELOG.
Un fichier de journalisation archivé inclut les entrées de journalisation et le numéro de séquence du fichier de journalisation identique au membre du groupe de fichiers de journalisation en ligne. Dans "Multiple Copies of Online Redo Log Files", les fichiers A_LOG1 et B_LOG1 sont des membres identiques du groupe 1. Si la base de données est en mode ARCHIVELOG et que l'archivage automatique est activé, le processus d'archiveur (ARCn) archivera l'un de ces fichiers. Si A_LOG1 est endommagé, le processus peut archiver B_LOG1. Le fichier de journalisation archivé contient une copie de chaque groupe de fichiers de journalisation existant à partir de l'heure à laquelle vous avez activé l'archivage.
Voir aussi :
-
Utilitaires Oracle AI Database pour en savoir plus sur Oracle LogMiner
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer le fichier de journalisation archivé
-
Oracle Data Guard Concepts and Administration, pour apprendre à configurer l'archivage des fichiers de journalisation de secours
Structure de fichier de journalisation en ligne
Les fichiers de journalisation en ligne contiennent des enregistrements de journalisation.
Un enregistrement de journalisation est constitué d'un groupe de vecteurs de modification, chacun décrivant une modification apportée à un bloc de données. Par exemple, une mise à jour d'un salaire dans la table employees génère un enregistrement de journalisation qui décrit les modifications apportées au bloc de segment de données pour la table, au bloc de données de segment d'annulation et à la table de transaction des segments d'annulation.
Les enregistrements de journalisation contiennent toutes les métadonnées pertinentes pour la modification, notamment les suivantes :
-
SCN et horodatage de la modification
-
ID transaction de la transaction ayant généré la modification
-
SCN et horodatage lors de la validation de la transaction (si elle a été validée)
-
Type d'opération ayant effectué la modification
-
Nom et type du segment de données modifié
Voir aussi : "Présentation des blocs de données"