Architecture des processus
Ce chapitre présente les traitements d'une base de données Oracle.
-
Introduction aux processus Un processus est un mécanisme d'un système d'exploitation qui peut exécuter une série d'étapes.
-
Présentation des processus client Lorsqu'un utilisateur exécute une application telle que Pro*C ou SQL*Plus, le système d'exploitation crée un processus client (parfois appelé processus utilisateur) pour exécuter l'application utilisateur. L'application client est associée à des bibliothèques Oracle AI Database qui fournissent les API requises pour communiquer avec la base de données.
-
Présentation des processus serveur Oracle AI Database crée des processus serveur pour gérer les demandes des processus client connectés à l'instance. Un processus client communique toujours avec une base de données via un processus serveur distinct.
-
Présentation des processus en arrière-plan Les processus en arrière-plan sont des processus supplémentaires utilisés par une base de données Oracle multiprocessus. Les processus en arrière-plan effectuent les tâches de maintenance nécessaires au fonctionnement de la base de données et à l'optimisation des performances pour plusieurs utilisateurs.
Présentation des processus
Un processus est un mécanisme dans un système d'exploitation qui peut exécuter une série d'étapes.
L'architecture d'exécution du processus dépend du système d'exploitation. Par exemple, sous Windows, un processus en arrière-plan Oracle est un thread d'exécution au sein d'un processus. Sous Linux et UNIX, un processus Oracle est un processus de système d'exploitation ou un thread au sein d'un processus de système d'exploitation.
Traite les modules de code d'exécution. Tous les utilisateurs Oracle AI Database connectés doivent exécuter les modules suivants pour accéder à une instance de base de données :
-
Application ou utilitaire Oracle AI Database
Un utilisateur de base de données exécute une application de base de données, telle qu'un programme precompiler ou un outil de base de données tel que SQL*Plus, qui émet des instructions SQL vers une base de données.
-
Code de base de données Oracle
Chaque utilisateur dispose d'un code de base de données Oracle exécuté en son nom qui interprète et traite les instructions SQL de l'application.
Un processus s'exécute normalement dans sa propre zone de mémoire privée. La plupart des processus peuvent écrire régulièrement dans un fichier trace associé.
-
Types de processus Une instance de base de données contient plusieurs processus ou interagit avec eux.
-
Systèmes Oracle AI Database multiprocessus et multithread Oracle AI Database multiprocessus (également appelé Oracle AI Database multiutilisateur) utilise plusieurs processus pour exécuter différentes parties du code Oracle AI Database et des processus Oracle supplémentaires pour les utilisateurs, soit un processus pour chaque utilisateur connecté, soit un ou plusieurs processus partagés par plusieurs utilisateurs.
Voir aussi :
Types de processus
Une instance de base de données contient plusieurs processus ou interagit avec eux.
Les processus sont divisés en types suivants :
-
Un processus client exécute l'application ou le code d'outil Oracle.
-
Un processus Oracle est une unité d'exécution qui exécute le code de base de données Oracle. Dans l'architecture multithread, un processus Oracle peut être un processus de système d'exploitation ou un thread au sein d'un processus de système d'exploitation. Les processus Oracle incluent les sous-types suivants :
-
Un processus en arrière-plan démarre avec l'instance de base de données et effectue des tâches de maintenance telles que la récupération d'instance, le nettoyage des processus, l'écriture des tampons de journalisation sur le disque, etc.
-
Un processus serveur effectue un travail en fonction d'une demande client.
Par exemple, ces processus analysent les requêtes SQL, les placent dans le pool partagé, créent et exécutent un plan d'interrogation pour chaque interrogation, et lisent les tampons à partir du cache de tampons de base de données ou du disque.
Remarque : les processus serveur et la mémoire allouée à ces processus sont exécutés dans l'instance de base de données. L'instance continue de fonctionner lorsque les processus serveur se terminent.
-
Un processus enfant effectue des tâches supplémentaires pour un processus en arrière-plan ou un processus serveur.
-
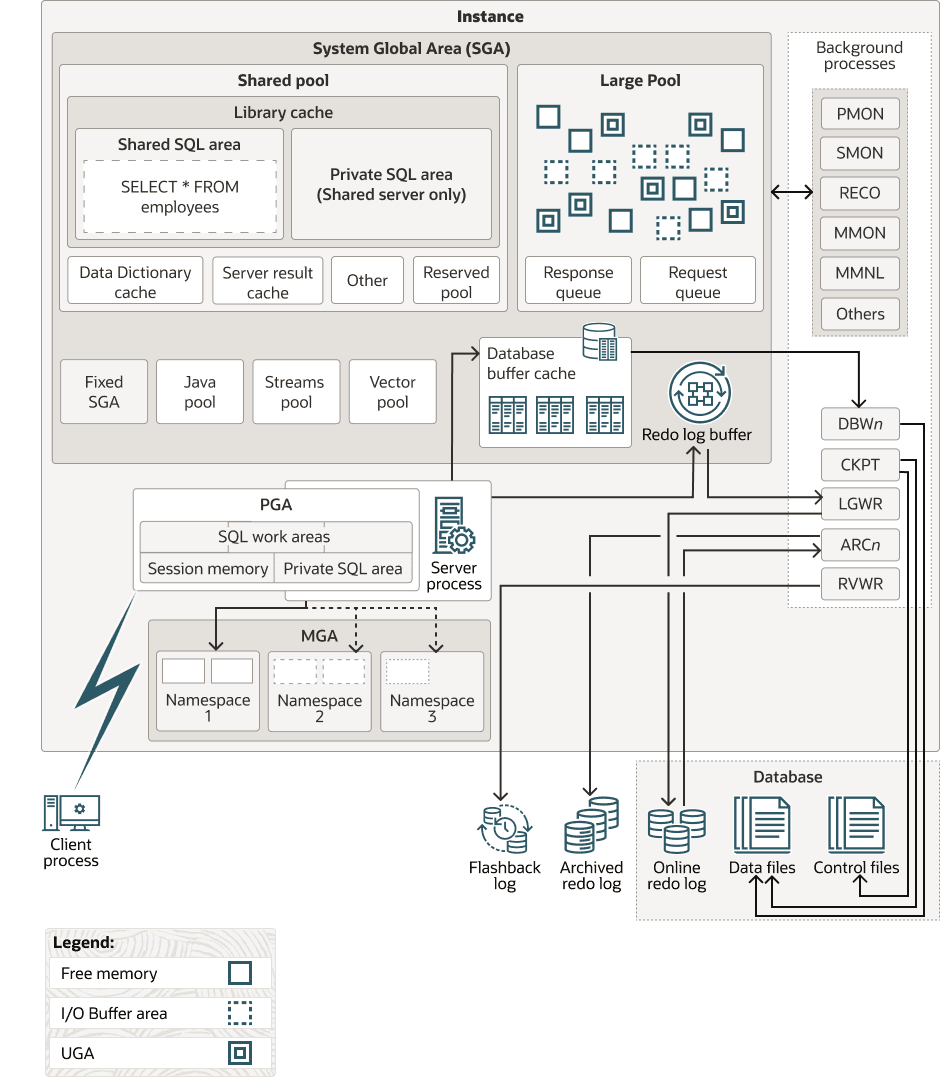
La structure du processus varie en fonction du système d'exploitation et du choix des options d'Oracle AI Database. Par exemple, vous pouvez configurer le code pour les utilisateurs connectés pour les connexions de serveur dédié ou de serveur partagé. Dans une architecture de serveur partagé, chaque processus serveur qui exécute le code de base de données peut servir plusieurs processus client. La Figure 18-1 illustre une zone globale du système (SGA) et des processus en arrière-plan utilisant des connexions de serveur dédiées. Pour chaque connexion utilisateur, un processus client exécute l'application. Processus client différent du processus serveur dédié qui exécute le code de base de données. Chaque processus client est associé à son propre processus serveur, qui dispose de sa propre mémoire PGA (Program Global Area).
Figure 1 : Processus Oracle et mémoire SGA
Description de l'image cncpt283.png
Voir aussi :
-
"Architecture de serveur dédié" et "Architecture de serveur partagé"
-
Votre documentation propre au système d'exploitation Oracle AI Database pour plus de détails sur les choix de configuration
-
Référence Oracle AI Database pour en savoir plus sur la vue
V$PROCESS
Systèmes Oracle AI Database multiprocessus et multithread
Oracle AI Database multiprocessus (également appelé Oracle AI Database multiutilisateur) utilise plusieurs processus pour exécuter différentes parties du code Oracle AI Database et des processus Oracle supplémentaires pour les utilisateurs, soit un processus pour chaque utilisateur connecté, soit un ou plusieurs processus partagés par plusieurs utilisateurs.
La plupart des bases de données sont multi-utilisateurs car l'un des principaux avantages d'une base de données est la gestion simultanée des données dont plusieurs utilisateurs ont besoin. Chaque processus d'une instance de base de données exécute un travail spécifique. En divisant le travail de la base de données et des applications en plusieurs processus, plusieurs utilisateurs et applications peuvent se connecter à une instance simultanément, tandis que le système offre de bonnes performances.
Dans les versions antérieures à Oracle Database 12c, les processus Oracle ne s'exécutaient pas en tant que threads sur les systèmes UNIX et Linux. A partir d'Oracle Database 12c, le modèle Oracle AI Database multithread permet aux processus Oracle de s'exécuter en tant que threads de système d'exploitation dans des espaces d'adressage distincts. Une fois qu'Oracle AI Database est installé, la base de données s'exécute en mode processus. Vous devez définir le paramètre d'initialisation THREADED_EXECUTION sur TRUE pour exécuter la base de données en mode thread. En mode thread, certains processus en arrière-plan sous UNIX et Linux s'exécutent en tant que processus (chaque processus contenant un thread), tandis que les autres processus Oracle s'exécutent en tant que threads au sein des processus.
Dans une base de données exécutée en mode thread, PMON et DBW peuvent s'exécuter en tant que processus du système d'exploitation, tandis que LGWR et CMON peuvent s'exécuter en tant que threads dans un seul processus. Deux processus de premier plan et un processus serveur d'exécution parallèle (PX) peuvent s'exécuter en tant que threads dans un second processus du système d'exploitation. Un troisième processus du système d'exploitation peut contenir plusieurs threads de premier plan. Par conséquent, "processus Oracle" ne signifie pas toujours "processus de système d'exploitation". Remarque : lorsque le paramètre d'initialisation THREADED_EXECUTION est défini sur TRUE, l'authentification par le système d'exploitation n'est pas prise en charge.
Exemple 18-1 Visualisation des métadonnées Oracle Process
La vue V$PROCESS contient une ligne pour chaque processus Oracle connecté à une instance de base de données. Par exemple, vous pouvez exécuter l'interrogation suivante dans SQL*Plus pour obtenir l'ID de processus du système d'exploitation et l'ID de thread du système d'exploitation pour chaque processus :
COL SPID FORMAT a8
COL STID FORMAT a8
SELECT SPID, STID, PROGRAM FROM V$PROCESS ORDER BY SPID;
L'interrogation génère l'exemple de sortie partiel suivant :
SPID   STID   PROGRAM
-----  -----  ---------------------------
7190   7190   oracle@samplehost (PMON)
7192   7192   oracle@samplehost (PSP0)
7194   7194   oracle@samplehost (VKTM)
7198   7198   oracle@samplehost (SCMN)
7198   7200   oracle@samplehost (GEN0)
7202   7202   oracle@samplehost (SCMN)
7202   7204   oracle@samplehost (DIAG)
7198   7205   oracle@samplehost (DBRM)
7202   7206   oracle@samplehost (DIA0)
.
.
.
Voir aussi :
-
Guide de réglage des performances d'Oracle AI Database pour découvrir comment utiliser la vue
V$PROCESS -
Référence Oracle AI Database pour en savoir plus sur le paramètre d'initialisation
THREADED_EXECUTION
Présentation des processus client
Lorsqu'un utilisateur exécute une application telle qu'un programme Pro*C ou SQL*Plus, le système d'exploitation crée un processus client (parfois appelé processus utilisateur) pour exécuter l'application utilisateur. L'application client est associée à des bibliothèques Oracle AI Database qui fournissent les API requises pour communiquer avec la base de données.
-
Les processus client Processus client et processus serveur diffèrent considérablement des processus Oracle qui interagissent directement avec l'instance.
-
Connexions et sessions Une connexion de base de données est un chemin de communication physique entre un processus client et une instance de base de données.
-
Conteneur en cours Une session de base de données est une entité logique dans la mémoire de l'instance de base de données qui représente l'état d'une connexion utilisateur en cours à une base de données.
-
Opérations de base de données Dans le contexte de la surveillance de la base de données, une opération de base de données est une activité de session entre deux points dans le temps, telle que définie par les utilisateurs finaux ou le code d'application.
Processus client et serveur
Les processus client diffèrent considérablement des processus Oracle qui interagissent directement avec l'instance.
Les processus Oracle qui traitent le processus client peuvent lire et écrire dans la mémoire SGA, contrairement au processus client. Un processus client peut s'exécuter sur un hôte autre que l'hôte de base de données, alors que les processus Oracle ne le peuvent pas.
Par exemple, supposons qu'un utilisateur sur un hôte client démarre SQL*Plus, puis se connecte via le réseau à la base de données sample sur un autre hôte lorsque l'instance de base de données n'est pas démarrée :
SQL> CONNECT SYS@inst1 AS SYSDBA
Enter password: *********
Connected to an idle instance.
Sur l'hôte client, une recherche des processus pour sqlplus ou sample affiche uniquement le processus client sqlplus :
% ps -ef | grep -e sample -e sqlplus | grep -v grep
clientuser 29437 29436  0 15:40 pts/1    00:00:00 sqlplus           as sysdba
Sur l'hôte de base de données, une recherche des processus pour sqlplus ou sample affiche un processus serveur avec une connexion non locale, mais aucun processus client :
% ps -ef | grep -e sample -e sqlplus | grep -v grep
serveruser 29441     1  0 15:40 ?        00:00:00 oraclesample (LOCAL=NO)
Voir aussi : "Démarrage d'une instance" pour découvrir comment un client peut se connecter à une base de données lorsque l'instance n'est pas démarrée
Connexions et sessions
Une connexion de base de données est un chemin de communication physique entre un processus client et une instance de base de données.
Au cours d'une connexion, une voie de communication est établie à l'aide des mécanismes de communication interprocessus ou des logiciels réseau disponibles. En général, une connexion se produit entre un processus client et un processus serveur ou un répartiteur, mais elle peut également se produire entre un processus client et Oracle Connection Manager (CMAN).
Conteneur actuel
Une session de base de données est une entité logique dans la mémoire de l'instance de base de données qui représente l'état d'une connexion utilisateur en cours à une base de données.
Par exemple, lorsqu'un utilisateur est authentifié par la base de données avec un mot de passe, une session est établie pour cet utilisateur. La session dure de l'instant où l'utilisateur est authentifié par la base de données jusqu'à la déconnexion ou la fermeture de l'application de base de données.
Sessions et conteneurs
Pour une session donnée, le conteneur en cours dans la base de données Conteneur est celui dans lequel une session est exécutée. Le conteneur en cours peut être la racine de base de données Conteneur, une racine d'application ou une base de données pluggable.
Chaque session comporte exactement un conteneur en cours à un moment donné. Etant donné que le dictionnaire de données de chaque conteneur est distinct, Oracle AI Database utilise le dictionnaire de données du conteneur en cours pour la résolution de noms et l'autorisation de privilèges.
Relation entre les connexions et les sessions
Une connexion unique peut comporter 0, 1 session ou plus. Les sessions sont indépendantes : une validation dans une session n'affecte pas les transactions dans d'autres sessions.
Remarque : si le pooling de connexions Oracle Net est configuré, il est possible qu'une connexion soit supprimée mais que les sessions restent intactes.
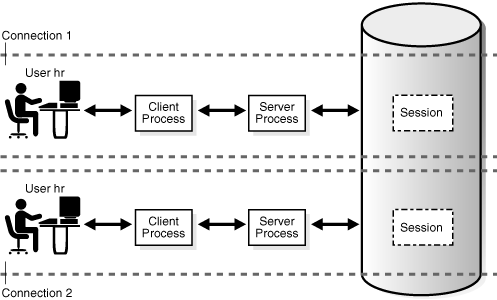
Plusieurs sessions peuvent exister simultanément pour un seul utilisateur de base de données. Comme indiqué dans la figure suivante, l'utilisateur hr peut avoir plusieurs connexions à une base de données. Dans les connexions de serveur dédié, la base de données crée un processus serveur pour le compte de chaque connexion. Seul le processus client qui provoque la création du serveur dédié l'utilise. Dans une connexion de serveur partagé, de nombreux processus client accèdent à un seul processus de serveur partagé.
Figure 2 : Une session pour chaque connexion
Description de l'image cncpt237.gif
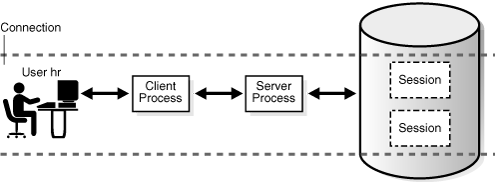
La figure 18-3 illustre un cas où l'utilisateur hr dispose d'une connexion unique à une base de données, mais que cette connexion comporte deux sessions.
Figure 3 : Deux sessions en une seule connexion
Description de l'image cncpt238.gif
La génération d'un rapport de trace automatique des statistiques d'exécution des instructions SQL recrée le scénario de la figure 18-3.
La commande DISCONNECT de l'Example 18-2 met fin aux sessions, et non à la connexion.
Exemple 18-2 Connexions et sessions
L'exemple suivant connecte SQL*Plus à la base de données en tant qu'utilisateur SYSTEM et active la trace, créant ainsi une session (exemple de sortie inclus) :
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 90      91 3BE2E41C

SQL> SET AUTOTRACE ON STATISTICS;
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 88      93 3BE2E41C
 90      91 3BE2E41C
...
SQL> DISCONNECT
La commande DISCONNECT termine réellement les sessions, et non la connexion. Ouverture d'un nouveau terminal et connexion à l'instance en tant qu'utilisateur différent, la requête suivante indique que la connexion avec l'adresse 3BE2E41C est toujours active.
SQL> CONNECT dba1@inst1
Password: ********
Connected.
SQL> SELECT PROGRAM FROM V$PROCESS WHERE ADDR = HEXTORAW('3BE2E41C');

PROGRAM
------------------------------------------------
oracle@stbcs09-1 (TNS V1-V3)
Voir aussi : "Architecture de serveur partagé"
Opérations sur la base de données
Dans le contexte de la surveillance de la base de données, une opération de base de données est une activité de session entre deux points dans le temps, telle que définie par les utilisateurs finaux ou le code d'application.
Une opération de base de données simple est une instruction SQL unique, ou une procédure ou une fonction PL/SQL unique. Une opération de base de données composite est un ensemble d'opérations uniques ou composites.
Pour surveiller, comparer et régler des tâches, vous pouvez diviser un ensemble important de tâches en opérations de base de données et subdiviser les opérations en phases. Un cas d'utilisation est un traitement batch PL/SQL qui s'exécute plus lentement que d'habitude. En configurant le travail en tant qu'opération de base de données, vous pouvez identifier et régler les étapes coûteuses du travail.
Chaque exécution d'une opération de base de données est identifiée de manière unique par une paire d'attributs : nom d'opération et ID d'exécution. Une session peut démarrer ou arrêter une opération de base de données dans une autre session en indiquant son ID de session et son numéro de série.
Deux occurrences d'une même opération de base de données peuvent être exécutées en même temps avec le même nom mais des ID d'exécution différents. Chaque exécution d'une opération de base de données portant le même nom peut contenir différentes instructions.
Vous créez et gérez les opérations de base de données à l'aide du package PL/SQL DBMS_SQL_MONITOR. Vous pouvez surveiller les opérations à l'aide de V$SQL_MONITOR, V$SQL_PLAN_MONITOR et V$SQL_MONITOR_SESSTAT.
Voir aussi :
-
Guide de réglage SQL Oracle AI Database pour apprendre à surveiller les opérations de base de données
-
Guide de l'entreposage de données Oracle AI Database pour apprendre à surveiller les chargements à longue durée d'exécution
-
Référence des types et packages PL/SQL d'Oracle AI Database pour en savoir plus sur
DBMS_SQL_MONITOR -
Référence Oracle AI Database pour en savoir plus sur
V$SQL_MONITOR
Présentation des processus serveur
Oracle AI Database crée des processus serveur pour gérer les demandes des processus client connectés à l'instance. Un processus client communique toujours avec une base de données via un processus serveur distinct.
Les processus serveur créés pour le compte d'une application de base de données peuvent effectuer une ou plusieurs des tâches suivantes :
-
Analyser et exécuter les instructions SQL émises via l'application, y compris la création et l'exécution du plan d'interrogation
-
Exécuter du code PL/SQL
-
Lire les blocs de données des fichiers de données dans le cache de tampons de la base de données (le processus en arrière-plan DBW a pour tâche de réécrire les blocs modifiés sur le disque)
-
Renvoyer les résultats de manière à ce que l'application puisse traiter les informations
-
Processus de serveur dédié Dans les connexions de serveur dédié, la connexion client est associée à un seul et unique processus serveur.
-
Processus de serveur partagé Dans les connexions de serveur partagé, les applications client se connectent sur un réseau à un processus de répartiteur, et non à un processus serveur. Par exemple, 20 processus client peuvent se connecter à un seul processus répartiteur.
-
Comment Oracle AI Database crée des processus serveur La base de données crée des processus serveur de différentes manières, en fonction des méthodes de connexion. Voir aussi : "Etapes de traitement SQL"
Processus serveur dédiés
Dans les connexions de serveur dédié, la connexion client est associée à un seul et unique processus serveur.
Sous Linux, 20 processus client connectés à une instance de base de données sont gérés par 20 processus serveur. Chaque processus client communique directement avec son processus serveur. Ce processus serveur est dédié à son processus client pendant la durée de la session. Le processus serveur stocke les informations propres au processus et la mémoire UGA dans sa mémoire PGA.
Voir aussi :
Processus serveur partagé
Dans les connexions de serveur partagé, les applications client se connectent via un réseau à un processus de répartiteur, et non à un processus serveur. Par exemple, 20 processus client peuvent se connecter à un seul processus répartiteur.
Le processus répartiteur reçoit les demandes des clients connectés et les place dans une file d'attente de demandes dans le grand pool. Le premier processus de serveur partagé disponible prend la demande de la file d'attente et la traite. Ensuite, le serveur partagé place le résultat dans la file d'attente des réponses du répartiteur. Le processus répartiteur surveille cette file d'attente et transmet le résultat au client.
Comme un processus serveur dédié, un processus serveur partagé possède sa propre mémoire PGA. Toutefois, la mémoire UGA d'une session se trouve dans la mémoire MGA afin que tout serveur partagé puisse accéder aux données de session.
Voir aussi :
Comment Oracle AI Database crée des processus serveur
La base de données crée des processus serveur de différentes manières, en fonction des méthodes de connexion.
Les méthodes de connexion sont les suivantes :
-
Bequeath
SQL*Plus, un client OCI ou une autre application client génèrent directement le processus serveur.
-
Processus d'écoute Oracle Net
L'application client se connecte à la base de données via un processus d'écoute.
-
Courtier dédié
Il s'agit d'un processus de base de données qui crée des processus de premier plan. Contrairement au processus d'écoute (listener), le broker réside dans l'instance de base de données. Lors de l'utilisation d'un courtier dédié, le client se connecte au processus d'écoute, qui met ensuite fin à la connexion au courtier dédié.
Lorsqu'une connexion n'utilise pas bequeath, la base de données crée le processus serveur comme suit :
-
L'application client demande une nouvelle connexion à partir du processus d'écoute ou du broker.
-
Le processus d'écoute ou le broker lance la création d'un nouveau processus ou thread.
-
Le système d'exploitation crée le nouveau processus ou thread.
-
Oracle AI Database initialise divers composants et notifications.
-
La base de données transmet la connexion et le code propre à la connexion.
Si vous utilisez la méthode de connexion du broker dédié, vous pouvez éventuellement créer à l'avance un pool de processus serveur avec le package DBMS_PROCESS. Dans ce cas, le processus en arrière-plan du gestionnaire de processus (PMAN) surveille le pool de processus pré-créés, qui attendent d'être associés à une demande client. Lorsqu'une connexion nécessite un processus serveur, la base de données ignore les étapes 2 à 4 de la création du processus et effectue uniquement l'étape 5. Cette optimisation améliore les performances.
Remarque :
-
Référence Oracle AI Database PL/SQL Packages and Types pour en savoir plus sur le package PL/SQL
DBMS_PROCESS -
Référence Oracle AI Database pour en savoir plus sur le processus en arrière-plan PMAN
Présentation des processus en arrière-plan
Les processus en arrière-plan sont des processus supplémentaires utilisés par une base de données Oracle multiprocessus. Les processus en arrière-plan effectuent les tâches de maintenance nécessaires au fonctionnement de la base de données et à l'optimisation des performances pour plusieurs utilisateurs.
Chaque processus en arrière-plan a une tâche distincte, mais fonctionne avec les autres processus. Par exemple, le processus LGWR écrit les données du tampon de journalisation dans le fichier de journalisation en ligne. Lorsqu'un fichier de journalisation rempli est prêt à être archivé, le processus LGWR signale à un autre processus d'archivage du fichier de journalisation.
Oracle AI Database crée automatiquement des processus en arrière-plan lorsqu'une instance de base de données démarre. Une instance peut comporter de nombreux processus en arrière-plan, qui n'existent pas toujours dans chaque configuration de base de données. La requête suivante répertorie les processus en arrière-plan en cours d'exécution sur votre base de données :
SELECT PNAME
FROM   V$PROCESS
WHERE  PNAME IS NOT NULL
ORDER BY PNAME;
Cette section traite des sujets suivants :
-
Processus en arrière-plan obligatoires Des processus en arrière-plan obligatoires sont présents dans toutes les configurations de base de données standard.
-
Processus en arrière-plan facultatifs Un processus en arrière-plan facultatif est tout processus en arrière-plan non défini comme obligatoire.
-
Les processus secondaires Processus secondaires sont des processus en arrière-plan qui effectuent des tâches pour le compte d'autres processus. Voir aussi : Référence Oracle AI Database pour une description de tous les processus en arrière-plan
Processus en arrière-plan obligatoires
Des processus en arrière-plan obligatoires sont présents dans toutes les configurations de base de données standard.
Ces processus s'exécutent par défaut dans une instance de base de données en lecture/écriture démarrée avec un fichier de paramètres d'initialisation configuré de manière minimale. Une instance de base de données en lecture seule désactive certains de ces processus.
Cette section décrit les processus en arrière-plan obligatoires suivants :
-
Groupe Processus du moniteur de processus (PMON) Le groupe PMON inclut PMON, Processus principal de nettoyage (CLMN) et Processus auxiliaires de nettoyage (CLnn). Ces processus sont responsables de la surveillance et du nettoyage d'autres processus.
-
Le Gestionnaire de processus (PMAN) Gestionnaire de processus (PMAN) supervise plusieurs processus en arrière-plan, notamment les serveurs partagés, les serveurs en pool et les processus de file d'attente des travaux.
-
Processus d'inscription du processus d'écoute (LREG) Le processus d'inscription du processus d'écoute (LREG) enregistre des informations sur l'instance de base de données et les processus du répartiteur avec Oracle Net Listener.
-
Processus SMON (System Monitor Process) Le processus SMON (System Monitor Process) est chargé de diverses tâches de nettoyage au niveau système.
-
Processus Database Writer (DBW) Le processus Database Writer (DBW) écrit le contenu des tampons de base de données dans des fichiers de données. Les processus DBW écrivent sur le disque les tampons modifiés du cache de tampons de la base de données.
-
Processus d'écriture de journal (LGWR) Le processus d'écriture de journal (LGWR) gère le tampon de journalisation en ligne.
-
Processus de point de reprise (CKPT) Le processus de point de reprise (CKPT) met à jour le fichier de contrôle et les en-têtes de fichier de données avec des informations de point de reprise et indique à DBW d'écrire des blocs sur le disque. Les informations de point de reprise incluent la position, le numéro SCN et l'emplacement du point de reprise dans le fichier de journalisation en ligne pour commencer la récupération.
-
Processus de contrôle de la gestion (MMON et MMNL) Le processus de contrôle de la gestion (MMON) effectue de nombreuses tâches liées au référentiel de charge globale automatique (AWR).
-
Processus de récupération (RECO) Dans une base de données distribuée, le processus de récupération (RECO) résout automatiquement les échecs dans les transactions distribuées.
-
Processus en arrière-plan (BGnn) Les processus en arrière-plan (BGnn) sont des processus en arrière-plan standard dans les environnements Oracle RAC qui effectuent diverses tâches de maintenance et de surveillance.
-
Processus du démon du système d'exploitation virtuel (VOSD) Le processus du démon du système d'exploitation virtuel (VOSD) exécute des actions de service de base de données Oracle liées au temps.
-
NMON (Network Monitor Process) Le NMON (Network Monitor Process) est un service léger de surveillance réseau.
Voir aussi :
-
Référence Oracle AI Database pour les descriptions des autres processus obligatoires, notamment MMAN, DIAG, VKTM, DBRM et PSP0
-
Guide d'administration et de déploiement Oracle Real Application Clusters et Guide d'administration et de déploiement Oracle Clusterware pour plus d'informations sur les processus en arrière-plan propres à Oracle RAC et Oracle Clusterware
Groupe traitements moniteur de traitements (PMON)
Le groupe PMON inclut le processus PMON, le processus principal de nettoyage (CLMN) et les processus auxiliaires de nettoyage (CLnn). Ces processus sont responsables de la surveillance et du nettoyage d'autres processus.
Le groupe PMON supervise le nettoyage du cache de tampons et la libération des ressources utilisées par un processus client. Par exemple, le groupe PMON est chargé de réinitialiser le statut de la table de transactions active, de libérer les verrous qui ne sont plus requis et de supprimer l'ID de processus des processus terminés de la liste des processus actifs.
La base de données doit s'assurer que les ressources détenues par les processus terminés sont libérées afin qu'elles puissent être utilisées par d'autres processus. Sinon, le processus risque d'être bloqué ou bloqué en conflit.
-
Process Monitor Process (PMON) Le process Monitor (PMON) détecte la fin d'autres processus en arrière-plan. Si un processus serveur ou répartiteur s'interrompt anormalement, le groupe PMON est responsable de la récupération du processus. L'interruption de processus peut avoir plusieurs causes, notamment les commandes d'interruption du système d'exploitation ou les instructions
ALTER SYSTEM KILL SESSION. -
Processus principal de nettoyage (CLMN) Le processus PMON délègue le travail de nettoyage au processus principal de nettoyage (CLMN). La tâche de détection de terminaison anormale reste avec PMON.
-
Le CLMN Nettoyer les processus d'aide (CLnn) délègue le travail de nettoyage aux processus d'aide CLnn.
-
Mise en quarantaine des ressources de base de données Si un processus ou une session se termine, le groupe PMON libère les ressources bloquées dans la base de données. Dans certains cas, le groupe PMON peut mettre automatiquement en quarantaine les ressources corrompues et irrécupérables afin que l'instance de base de données ne soit pas immédiatement forcée à s'arrêter.
Processus PMON (Process Monitor)
Le process monitor (PMON) détecte l'interruption d'autres processus en arrière-plan. Si un processus serveur ou répartiteur s'interrompt anormalement, le groupe PMON est responsable de la récupération du processus. L'interruption de processus peut avoir plusieurs causes, notamment les commandes d'interruption du système d'exploitation ou les instructions ALTER SYSTEM KILL SESSION.
Nettoyer le processus principal (CLMN)
Le processus PMON délègue les travaux de nettoyage au processus principal de nettoyage (CLMN). La tâche de détection de terminaison anormale reste avec PMON.
CLMN effectue régulièrement le nettoyage des processus interrompus, des sessions interrompues, des transactions, des connexions réseau, des sessions inactives, des transactions détachées et des connexions réseau détachées qui ont dépassé leur délai d'inactivité.
Processus d'aide au nettoyage (CLnn)
Le CLMN délègue le travail de nettoyage aux processus d'aide CLnn.
Les processus CLnn aident à nettoyer les processus et les sessions interrompus. Le nombre de processus d'aide est proportionnel à la quantité de travaux de nettoyage à effectuer et à l'efficacité actuelle du nettoyage.
Un processus de nettoyage peut être bloqué, ce qui l'empêche de procéder au nettoyage d'autres processus. En outre, si plusieurs processus nécessitent un nettoyage, le temps de nettoyage peut être important. Pour ces raisons, Oracle AI Database peut utiliser plusieurs processus d'aide en parallèle pour effectuer un nettoyage, ce qui réduit les performances.
Les vues V$CLEANUP_PROCESS et V$DEAD_CLEANUP contiennent des métadonnées sur le nettoyage CLMN. La vue V$CLEANUP_PROCESS contient une ligne pour chaque processus de nettoyage. Par exemple, si V$CLEANUP_PROCESS.STATE est BUSY, le processus est en cours de nettoyage.
Voir aussi : Référence Oracle AI Database pour en savoir plus sur V$CLEANUP_PROCESS
Quarantaine des ressources de base de données
Si un processus ou une session se termine, le groupe PMON libère les ressources bloquées dans la base de données. Dans certains cas, le groupe PMON peut mettre automatiquement en quarantaine les ressources endommagées et irrécupérables afin que l'instance de base de données ne soit pas immédiatement forcée à s'arrêter.
Le groupe PMON continue d'effectuer autant de nettoyage que possible sur le processus ou la session qui contenait la ressource mise en quarantaine. La vue V$QUARANTINE contient des métadonnées telles que le type de ressource, la quantité de mémoire consommée, l'erreur Oracle à l'origine de la mise en quarantaine, etc.
Voir aussi : Référence Oracle AI Database pour en savoir plus sur V$QUARANTINE
Gestionnaire de processus (PMAN)
Le gestionnaire de processus (PMAN) supervise plusieurs processus en arrière-plan, notamment les serveurs partagés, les serveurs en pool et les processus de file d'attente des travaux.
PMAN surveille, génère dynamiquement et arrête les types de processus suivants :
-
Processus de serveur partagé et de répartiteur
-
Processus Connection Broker et pool de serveurs pour les pools de connexions résidant dans la base de données
-
traitements de la file d'attente des travaux
-
Processus en arrière-plan redémarrables
Processus d'enregistrement du processus d'écoute (LREG)
Le processus d'inscription du processus d'écoute (LREG) enregistre des informations sur l'instance de base de données et les processus du répartiteur avec Oracle Net Listener.
Lorsqu'une instance démarre, LREG interroge le processus d'écoute pour déterminer s'il est en cours d'exécution. Si le processus d'écoute est en cours d'exécution, LREG lui transmet les paramètres pertinents. S'il n'est pas en cours d'exécution, LREG tente régulièrement de le contacter.
Remarque : dans les versions antérieures à Oracle Database 12c, PMON a effectué l'inscription du processus d'écoute.
Voir aussi : "Oracle Net Listener"
Processus SMON (System Monitor)
Le processus de surveillance du système (SMON) est chargé de diverses tâches de nettoyage au niveau du système.
Les responsabilités affectées au processus SMON sont les suivantes :
-
Effectuer une récupération d'instance, si nécessaire, au démarrage de l'instance. Dans une base de données Oracle RAC, le processus SMON d'une instance de base de données peut effectuer une récupération d'instance pour une instance en échec.
-
Récupération des transactions terminées qui ont été ignorées lors de la récupération d'instance en raison d'erreurs de lecture de fichier ou de mise hors ligne de tablespace. Le processus SMON récupère les transactions lorsque le tablespace ou le fichier est remis en ligne.
-
Nettoyage des segments temporaires inutilisés dans les tablespaces permanents. Par exemple, Oracle AI Database alloue des extents lors de la création d'un index. Si l'opération échoue, le processus SMON nettoie l'espace temporaire.
-
Fusion d'extents libres contigus dans des tablespaces gérés par le dictionnaire.
Le processus SMON vérifie régulièrement si cela est nécessaire. D'autres processus peuvent appeler le processus SMON s'ils en détectent le besoin.
Processus Database Writer (DBW)
Le processus DBW (Database Writer) écrit le contenu des tampons de base de données dans des fichiers de données. Les processus DBW écrivent sur le disque les tampons modifiés du cache de tampons de la base de données.
Bien qu'un processus Database Writer (DBW0) soit approprié pour la plupart des systèmes, vous pouvez configurer des processus supplémentaires (DBW1 à DBW9, DBWa à DBWz et BW36 à BW99) pour améliorer les performances d'écriture si votre système modifie fortement les données. Ces processus DBW supplémentaires ne sont pas utiles sur les systèmes uniprocessor.
Le processus DBW écrit les tampons "dirty" sur le disque dans les conditions suivantes :
-
Lorsqu'un processus serveur ne peut pas trouver de tampon réutilisable nettoyé après un balayage d'un seuil de tampons, il envoie un signal d'écriture à DBW. DBW écrit les tampons "dirty" sur le disque de manière asynchrone si possible lors d'autres traitements.
-
DBW écrit régulièrement des tampons pour faire avancer le point de reprise, qui est la position dans le thread de journalisation à partir duquel la récupération d'instance commence. La position du journal du point de reprise est déterminée par le tampon modifié le plus ancien du cache de tampons.
Dans de nombreux cas, les blocs écrits par DBW sont dispersés sur l'ensemble du disque. Ainsi, les écritures ont tendance à être plus lentes que les écritures séquentielles effectuées par LGWR. DBW effectue des écritures multiblocs lorsque cela est possible pour améliorer l'efficacité. Le nombre de blocs écrits dans une écriture multibloc varie selon le système d'exploitation.
Voir aussi :
-
Guide de réglage des performances Oracle AI Database pour obtenir des conseils sur la configuration, la surveillance et le réglage de DBW.
Processus LGWR (Log Writer)
Le processus d'écriture de journal (LGWR) gère le tampon de journalisation en ligne.
Le processus LGWR écrit une partie du tampon dans le fichier de journalisation en ligne. En séparant les tâches de modification des tampons de base de données, d'écriture dispersée des tampons modifiés sur le disque et d'écriture séquentielle rapide des informations de journalisation sur le disque, la base de données améliore les performances.
Dans les cas suivants, le processus LGWR écrit toutes les entrées de journalisation qui ont été copiées dans le tampon depuis la dernière écriture :
-
Un utilisateur valide une transaction.
-
Une opération log switch de journalisation en ligne se produit.
-
Trois secondes se sont écoulées depuis la dernière écriture du LGWR.
-
Le tampon de journalisation est plein d'un tiers ou contient 1 Mo de données mises en mémoire tampon.
-
DBW doit écrire sur le disque les tampons modifiés.
Pour que DBW puisse écrire un tampon "dirty", la base de données doit écrire sur disque les enregistrements de journalisation associés aux modifications du tampon (protocole d'écriture anticipée). Si DBW découvre que certains enregistrements de journalisation n'ont pas été écrits, il indique au processus LGWR d'écrire les enregistrements sur le disque et attend que le processus LGWR se termine avant d'écrire les tampons de données sur le disque.
-
LGWR et validations Oracle AI Database utilise un mécanisme de validation rapide pour améliorer les performances des transactions validées.
-
LGWR et fichiers inaccessibles Le processus LGWR écrit de manière synchrone dans le groupe actif de fichiers de journalisation en ligne mis en miroir. Voir aussi : "Validations de mouvements"
LGWR et validations
Oracle AI Database utilise un mécanisme de validation rapide pour améliorer les performances des transactions validées.
Lorsqu'un utilisateur émet une instruction COMMIT, la transaction reçoit un numéro SCN (System Change Number). Le processus LGWR place un enregistrement de validation dans le tampon de journalisation (redo log buffer) et l'écrit immédiatement sur le disque, avec le numéro SCN de validation (commit) et les entrées de journalisation de la transaction.
Le tampon de journalisation est circulaire. Lorsque LGWR écrit des entrées du tampon de journalisation dans le fichier de journalisation en ligne, les processus serveur peuvent copier les nouvelles entrées sur celles du tampon de journalisation qui ont été écrites dans le disque. En règle générale, LGWR écrit suffisamment rapidement pour s'assurer que l'espace disponible pour les nouvelles entrées est toujours disponible dans le tampon, même lorsque l'accès au fichier de journalisation en ligne est dense.
L'écriture atomique de l'entrée de journalisation contenant l'enregistrement de validation de la transaction est l'événement unique qui détermine que la transaction a été validée. Oracle AI Database renvoie un code de réussite à la transaction de validation, bien que les tampons de données n'aient pas encore été écrits sur le disque. Les modifications correspondantes apportées aux blocs de données sont différées jusqu'à ce que DBW puisse les écrire dans les fichiers de données.
Remarque : le processus LGWR peut écrire des entrées de fichier de journalisation sur le disque avant la validation d'une transaction. Les modifications qui sont protégées par les entrées de journalisation ne deviennent permanentes que si la transaction est validée ultérieurement.
Lorsque l'activité est élevée, le processus LGWR peut utiliser des validations de groupe. Par exemple, un utilisateur effectue une validation (commit) et le processus LGWR écrit les entrées de journalisation de la transaction sur le disque. Au cours de cette opération, les autres utilisateurs s'engagent. Le processus LGWR ne peut pas écrire sur le disque pour valider ces transactions tant que l'écriture précédente n'est pas terminée. Une fois le processus LGWR terminé, il peut écrire la liste des entrées de journalisation des transactions en attente (non encore validées) en une seule opération. Ainsi, la base de données minimise les E/S disque et optimise les performances. Si le taux de demandes de validation est élevé, chaque écriture par LGWR peut contenir plusieurs enregistrements de validation.
LGWR et fichiers inaccessibles
Le processus LGWR écrit de manière synchrone dans le groupe actif de fichiers de journalisation en ligne mis en miroir.
Si un fichier journal est inaccessible, le processus LGWR continue d'écrire dans d'autres fichiers du groupe et écrit une erreur dans le fichier trace du processus LGWR et dans le journal d'alertes. Si tous les fichiers d'un groupe sont endommagés ou si le groupe n'est pas disponible car il n'a pas été archivé, LGWR ne peut pas continuer à fonctionner.
Voir aussi :
-
"Comment Oracle AI Database écrit dans le fichier de journalisation en ligne" et "Tampon de journalisation"
-
Guide de réglage des performances d'Oracle AI Database pour plus d'informations sur la surveillance et le réglage des performances du processus LGWR
Processus de point de reprise (CKPT)
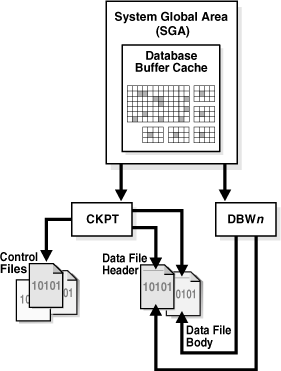
Le processus de point de reprise (CKPT) met à jour le fichier de contrôle et les en-têtes de fichier de données avec des informations de point de reprise et indique au processus DBW d'écrire des blocs sur le disque. Les informations de point de reprise incluent la position, le numéro SCN et l'emplacement du point de reprise dans le fichier de journalisation en ligne pour commencer la récupération.
Comme illustré dans la Figure 18-4, CKPT n'écrit pas de blocs de données dans des fichiers de données ou des blocs de journalisation dans des fichiers de journalisation en ligne.
Figure 4 : Processus de point de reprise
Description de l'image cncpt228.gif
Voir aussi : "Présentation des points de reprise"
Processus du contrôleur de gestion (MMON et MMNL)
Le processus de surveillance de la gestion (MMON) effectue de nombreuses tâches liées au référentiel AWR (Automatic Workload Repository).
Par exemple, MMON écrit lorsqu'une mesure viole sa valeur de seuil, prend des clichés et capture des statistiques pour les objets SQL récemment modifiés.
Le processus Lite du contrôleur de gestion (MMNL) écrit sur le disque les statistiques du tampon ASH (Active Session History) de la mémoire SGA. MMNL écrit sur le disque lorsque le tampon ASH est plein.
Voir aussi : "Oracle AI Database - Introduction au réglage des performances" et "Présentation de l'historique des sessions actives"
Processus de récupération (RECO)
Dans une base de données distribuée, le processus de récupération (RECO) résout automatiquement les échecs dans les transactions distribuées.
Le processus RECO d'un noeud se connecte automatiquement aux autres bases de données impliquées dans une transaction distribuée douteuse. Lorsque RECO rétablit une connexion entre les bases de données, il résout automatiquement toutes les transactions douteuses, en supprimant de la table des transactions en attente de chaque base de données toutes les lignes qui correspondent aux transactions résolues.
Voir aussi : Guide de l'administrateur Oracle AI Database pour plus d'informations sur la récupération des transactions dans les systèmes distribués
Processus en arrière-plan (BG nn)
Les processus en arrière-plan (BGnn) sont des processus en arrière-plan standard dans les environnements Oracle RAC qui effectuent diverses tâches de maintenance et de surveillance.
Le processus en arrière-plan est responsable de la gestion du cache de tampons (buffer cache), de la prise en charge du processus Log Writer (LGWR), de la coordination des points de reprise (checkpoints), de la surveillance des processus en arrière-plan et de la collecte de statistiques.
Processus du démon du système d'exploitation virtuel (VOSD)
Le processus du démon du système d'exploitation virtuel (VOSD) exécute des actions de service de base de données Oracle liées au temps.
Ce processus est généré dynamiquement au démarrage de l'instance et est chargé d'exécuter les actions de service système essentielles pour la base de données. Ce processus est utilisé par les instances de base de données, les instances Oracle ASM et Oracle RAC.
Processus de surveillance réseau (NMON)
Le network monitor process (NMON) est un service léger de surveillance réseau.
Network Monitor (NMON) est un service de surveillance réseau à faible coût d'exploitation qui tire parti des fonctionnalités avancées du noyau pour fournir une surveillance complète et permanente. Il capture en permanence les statistiques et les événements réseau à plusieurs niveaux, notamment à l'échelle du système, par interface, par adresse IP et par flux, et fournit des mesures détaillées pour les services de niveau supérieur. Basé sur NMON, le service Health Score simplifie l'évaluation de l'état du réseau avec un score standardisé de 0 à 100 et résout les problèmes de manière proactive en collectant des diagnostics selon les besoins. NMON fournit des statistiques réseau efficaces et exploitables, permettant une détection rapide des anomalies et une corrélation efficace avec les activités de la base de données.
Processus en arrière-plan facultatifs
Un processus en arrière-plan facultatif est un processus en arrière-plan non défini comme obligatoire.
La plupart des processus en arrière-plan facultatifs sont spécifiques aux tâches ou aux fonctionnalités. Par exemple, les processus en arrière-plan qui prennent en charge Oracle ASM ne sont disponibles que lorsque cette fonctionnalité est activée.
Cette section décrit certains processus facultatifs courants :
-
Processus d'archiveur (ARCn) Un processus d'archiveur (ARCn) copie les fichiers de journalisation en ligne vers le stockage hors ligne après un changement de fichier de journalisation.
-
Processus de la file d'attente des travaux (CJQ0 et Jnnn) Un processus de mise en file d'attente exécute des travaux utilisateur, souvent en mode batch. Un travail est une tâche définie par l'utilisateur, qui peut être programmée pour s'exécuter une ou plusieurs fois.
-
Processus d'archivage des données Flashback (FBDA) Le processus d'archivage des données Flashback (FBDA) archive les lignes historiques des tables suivies dans Flashback Data Archives.
-
Processus SMCO (Space Management Coordinator Process) Le processus SMCO (Space Management Coordinator Process) est lancé par le processus SMON et coordonne l'exécution de diverses tâches liées à la gestion de l'espace.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Transactional Event Queues et Advanced Queuing pour une introduction à Advanced Queuing (AQ)
-
Référence Oracle AI Database pour les descriptions des processus en arrière-plan propres à AQ et à Oracle ASM
Processus d'archiveur (ARC n)
Un processus d'archiveur (ARCn) copie les fichiers de journalisation en ligne vers le stockage hors ligne après un changement de fichier de journalisation.
Ces processus peuvent également collecter des données de journalisation de transaction et les transmettre à des destinations de base de données de secours. Les processus ARCn existent uniquement lorsque la base de données est en mode ARCHIVELOG et que l'archivage automatique est activé.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment ajuster le nombre de processus d'archiveur
-
Guide de réglage des performances d'Oracle AI Database pour savoir comment régler les performances de l'archiveur
Processus de mise en file d'attente des travaux (CJQ0 et Jnnn)
Un processus de mise en file d'attente exécute des travaux utilisateur, souvent en mode batch. Un travail est une tâche définie par l'utilisateur, qui peut être programmée pour s'exécuter une ou plusieurs fois.
Par exemple, vous pouvez utiliser une file d'attente de travaux pour planifier une mise à jour longue en arrière-plan. Compte tenu d'une date de début et d'un intervalle de temps, les processus de la file d'attente des travaux tentent d'exécuter le travail à la prochaine occurrence de l'intervalle.
Oracle AI Database gère les processus de file d'attente de travaux de manière dynamique, ce qui permet aux clients de file d'attente de travaux d'utiliser davantage de processus de file d'attente de travaux si nécessaire. La base de données libère les ressources utilisées par les nouveaux processus lorsqu'elles sont inactives.
Les processus de file d'attente de travaux dynamiques peuvent exécuter plusieurs travaux simultanément à un intervalle donné. La séquence d'événements est la suivante :
-
Le processus de coordinateur de travaux (CJQ0) est automatiquement démarré et arrêté selon les besoins par Oracle Scheduler. Le processus coordinateur sélectionne périodiquement les travaux qui doivent être exécutés à partir de la table
JOB$du système. Les nouveaux travaux sélectionnés sont triés par heure. -
Le processus coordinateur génère dynamiquement les processus enfant de file d'attente de travaux (Jnnn) pour exécuter les travaux.
-
Le processus de file d'attente des travaux exécute l'un des travaux sélectionnés par le processus CJQ0 pour exécution. Chaque traitement de la file d'attente des travaux exécute un travail à la fois.
-
Une fois que le processus a terminé l'exécution d'un seul travail, il recherche d'autres travaux. Si aucune tâche n'est planifiée pour exécution, elle passe à l'état de veille, à partir duquel elle se réveille à intervalles réguliers et recherche d'autres tâches. Si le processus ne trouve aucun nouveau travail, il se termine après un intervalle prédéfini.
Le paramètre d'initialisation JOB_QUEUE_PROCESSES représente le nombre maximal de processus de file d'attente de travaux pouvant être exécutés simultanément sur une instance. Toutefois, les clients ne doivent pas supposer que tous les processus de file d'attente des travaux sont disponibles pour l'exécution des travaux. Remarque : le processus de coordinateur n'est pas démarré si le paramètre d'initialisation JOB_QUEUE_PROCESSES est défini sur 0.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur Oracle Scheduler
-
Guide de l'utilisateur Oracle AI Database Transactional Event Queues et Advanced Queuing pour en savoir plus sur les processus en arrière-plan AQ
Processus Flashback Data Archive (FBDA)
Le processus d'archivage des données Flashback (FBDA) archive les lignes historiques des tables suivies dans Flashback Data Archives.
Lorsqu'une transaction contenant des instructions LMD sur une table faisant l'objet d'un suivi est validée, ce processus stocke la pré-image des lignes modifiées dans la Flashback Data Archive. Il conserve également les métadonnées sur les lignes en cours.
FBDA gère automatiquement l'archive Flashback Data Archive pour l'espace, l'organisation et la conservation. En outre, le traitement effectue le suivi de la durée de l'archivage des transactions suivies.
Processus du coordonnateur de la gestion de l'espace (SMCO)
Le processus de coordination de la gestion de l'espace (SMCO) est lancé par le processus SMON et coordonne l'exécution de diverses tâches liées à la gestion de l'espace.
Le processus SMCO coordonne l'exécution de diverses tâches liées à la gestion de l'espace.
Les tâches standard incluent l'allocation proactive de l'espace et la récupération, ainsi que la maintenance des tablespaces temporaires. SMCO génère dynamiquement des processus enfant (Wnnn) pour implémenter la tâche.
Voir aussi : Guide de développement Oracle AI Database pour en savoir plus sur la fonctionnalité Flashback Data Archive et l'historique temporel
Processus secondaires
Les traitements secondaires sont des traitements en arrière-plan qui effectuent des tâches pour le compte d'autres traitements.
Cette section décrit certains processus secondaires utilisés par Oracle AI Database.
-
Processus secondaires d'E/S Les processus secondaires d'E/S (Innn) simulent des E/S asynchrones pour les systèmes et les périphériques qui ne les prennent pas en charge.
-
Processus serveur d'exécution parallèle (PX) Dans l'exécution parallèle, plusieurs processus travaillent ensemble simultanément pour exécuter une seule instruction SQL. Voir aussi : Référence Oracle AI Database pour une description des processus secondaires Oracle AI Database.
Processus secondaires d'E/S
Les processus secondaires d'E/S (Innn) simulent des E/S asynchrones pour les systèmes et les périphériques qui ne les prennent pas en charge.
Dans les E/S asynchrones, il n'y a pas besoin de temps pour la transmission, ce qui permet à d'autres processus de démarrer avant la fin de la transmission.
Par exemple, supposons qu'une application écrit 1000 blocs sur un disque d'un système d'exploitation qui ne prend pas en charge les E/S asynchrones. Chaque écriture se produit de manière séquentielle et attend une confirmation de la réussite de l'écriture. Avec un disque asynchrone, l'application peut écrire les blocs en masse et effectuer d'autres tâches en attendant une réponse du système d'exploitation indiquant que tous les blocs ont été écrits.
Pour simuler des E/S asynchrones, un processus supervise plusieurs processus secondaires. Le processus appelant affecte du travail à chacun des processus secondaires, qui attendent la fin de chaque écriture et rapportent à l'appelant une fois terminé. En cas d'E/S asynchrones réelles, le système d'exploitation attend que les E/S se terminent et renvoie un rapport au processus, tandis qu'en cas d'E/S asynchrones simulées, les processus secondaires attendent et renvoient un rapport à l'appelant.
La base de données prend en charge différents types de processus secondaires d'E/S, notamment :
-
Processus secondaires d'E/S pour Recovery Manager (RMAN)
Lorsque vous utilisez RMAN pour sauvegarder ou restaurer des données, vous pouvez utiliser des processus secondaires d'E/S pour les périphériques de disque et de bande.
-
Processus secondaires Database Writer
S'il n'est pas pratique d'utiliser plusieurs processus Database Writer, par exemple lorsque l'ordinateur dispose d'une CPU, la base de données peut répartir les E/S sur plusieurs processus secondaires. DBW est le seul processus qui analyse la liste LRU du cache de tampons pour rechercher les blocs à écrire sur le disque. Toutefois, les processus secondaires d'E/S effectuent les E/S pour ces blocs.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour en savoir plus sur les processus secondaires d'E/S pour les opérations de sauvegarde et de restauration
-
Guide de réglage des performances d'Oracle AI Database pour en savoir plus sur les processus secondaires Database Writer
Processus serveur d'exécution parallèle (PX)
Dans une exécution en parallèle, plusieurs processus fonctionnent simultanément pour exécuter une seule instruction SQL.
En divisant le travail entre plusieurs processus, Oracle AI Database peut exécuter l'instruction plus rapidement. Par exemple, quatre processus gèrent quatre trimestres différents de l'année au lieu d'un seul processus gérant ces quatre trimestres.
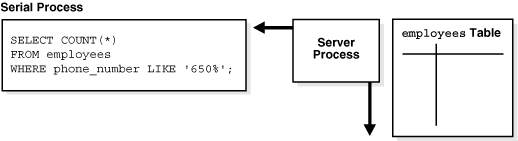
L'exécution parallèle contraste avec l'exécution série, dans laquelle un processus serveur unique exécute tous les traitements nécessaires à l'exécution séquentielle d'une instruction SQL. Par exemple, pour effectuer un balayage complet de table tel que SELECT * FROM employees, un processus serveur effectue tout le travail, comme illustré dans la Figure 18-5.
Figure 5 : Balayage complet de table en série
Description de l'image cncpt016.gif
L'exécution parallèle réduit le temps de réponse pour les opérations gourmandes en données sur les bases de données volumineuses telles que les entrepôts de données. Le multitraitement symétrique (SMP) et le système en cluster bénéficient des avantages les plus importants en termes de performances grâce à l'exécution parallèle, car le traitement des instructions peut être réparti entre plusieurs CPU. L'exécution parallèle peut également bénéficier à certains types de systèmes OLTP et hybrides.
Dans les systèmes Oracle RAC, le placement d'un service spécifique contrôle l'exécution en parallèle. Plus précisément, les processus parallèles s'exécutent sur les noeuds sur lesquels le service est configuré. Par défaut, Oracle AI Database exécute des processus parallèles uniquement sur une instance qui offre le service utilisé pour se connecter à la base de données. Cela n'affecte pas les autres opérations parallèles telles que la récupération en parallèle ou le traitement des requêtes GV$.
-
Coordinateur de requête Lors d'une exécution en parallèle, le processus serveur agit en tant que coordinateur de requête (également appelé coordinateur d'exécution en parallèle).
-
Producteurs et consommateurs Les serveurs d'exécution parallèles sont divisés en émetteurs et consommateurs. Les producteurs sont responsables du traitement de leurs données, puis de leur distribution aux consommateurs qui en ont besoin.
-
Granules Lors d'une exécution en parallèle, une table est divisée dynamiquement en unités de charge. Chaque unité, appelée granule, est la plus petite unité de travail lors de l'accès aux données.
Voir aussi :
-
Oracle AI Database VLDB and Partitioning Guide pour en savoir plus sur l'exécution parallèle
-
Guide d'administration et de déploiement Oracle Real Application Clusters, pour connaître les considérations relatives à l'exécution parallèle dans les environnements Oracle RAC
Coordinateur de requête
En parallèle, le processus serveur agit en tant que coordinateur d'exécution en parallèle (également appelé coordinateur d'exécution en parallèle).
Le coordinateur de requêtes est responsable des éléments suivants :
-
Analyse de la requête
-
Allouer et contrôler les processus du serveur d'exécution parallèle
-
Envoi de la sortie à l'utilisateur
En fonction d'un plan d'exécution pour une requête, le coordinateur décompose chaque opérateur d'une requête SQL en éléments parallèles, les exécute dans l'ordre indiqué dans la requête et intègre les résultats partiels produits par les serveurs d'exécution parallèle qui exécutaient les opérateurs.
Le nombre de serveurs d'exécution parallèle affectés à une opération unique est le degré de parallélisme d'une opération. Plusieurs opérations d'une même instruction SQL ont toutes le même degré de parallélisme.
Producteurs et destinataires
Les serveurs d'exécution parallèles sont divisés en émetteurs et consommateurs. Les producteurs sont responsables du traitement de leurs données, puis de leur distribution aux consommateurs qui en ont besoin.
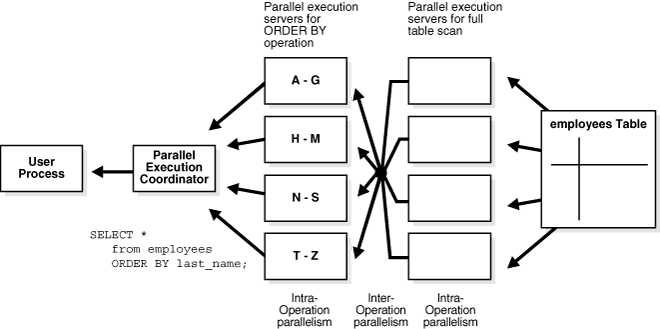
La base de données peut effectuer la distribution à l'aide de diverses techniques. Deux techniques courantes sont la diffusion et le hachage. Dans une diffusion, chaque producteur envoie les lignes à tous les consommateurs. Dans un hachage, la base de données calcule une fonction de hachage sur un ensemble de clés et rend chaque consommateur responsable d'un sous-ensemble de valeurs de hachage. La Figure 18-6 représente l'interaction entre les émetteurs et les destinataires dans l'exécution parallèle de l'instruction suivante :
SELECT * FROM employees ORDER BY last_name;Le plan d'exécution implémente un balayage complet de la table employees. L'analyse est suivie d'une sorte de lignes extraites. Tous les processus d'émetteur impliqués dans l'opération d'analyse envoient des lignes au processus destinataire approprié qui effectue le tri.
Figure 6 : Fournisseurs et consommateurs
Description de l'image vldbg013.gif
Granulés
En exécution parallèle, une table est divisée dynamiquement en unités de charge. Chaque unité, appelée granule, est la plus petite unité de travail lors de l'accès aux données.
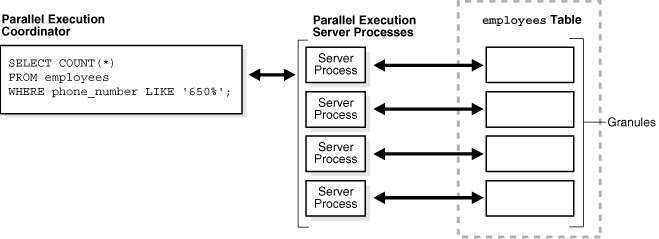
Un granule basé sur des blocs est une plage de blocs de données de la table lus par un serveur d'exécution parallèle unique (également appelé serveur PX), qui utilise Pnnn comme format de nom. Pour obtenir une répartition uniforme du travail entre les processus serveur parallèles, le nombre de granules est toujours beaucoup plus élevé que le DOP demandé. La figure 18-7 présente un balayage parallèle de la table employees.
Figure 7 : Analyse de table complète en parallèle
Description de l'image cncpt017.gif
La base de données met en correspondance des granules avec des serveurs d'exécution parallèles au moment de l'exécution. Lorsqu'un serveur d'exécution parallèle termine la lecture des lignes correspondant à un granule et qu'il reste des granules, il obtient un autre granule auprès du coordinateur d'interrogation. Cette opération se poursuit jusqu'à ce que la table soit lue. Les serveurs d'exécution renvoient les résultats au coordinateur, qui assemble les éléments dans le balayage complet de table souhaité.
Voir aussi :
-
Oracle AI Database VLDB and Partitioning Guide pour apprendre à utiliser l'exécution parallèle
-
Guide d'entreposage de données Oracle AI Database, pour en savoir plus sur les paramètres d'initialisation recommandés pour le parallélisme