Architecture des applications et d'Oracle Net Services
Ce chapitre définit l'architecture des applications et décrit le fonctionnement d'une base de données et d'applications de base de données Oracle dans un environnement de traitement distribué. Ce matériel s'applique à presque tous les types d'environnement Oracle AI Database.
-
Présentation de l'architecture des applications Oracle Dans le contexte de ce chapitre, l'architecture des applications fait référence à l'environnement informatique dans lequel une application de base de données se connecte à une base de données Oracle.
-
Présentation de l'architecture d'Oracle Net Services
Oracle Net Services est une suite de composants réseau qui fournit des solutions de connectivité à l'échelle de l'entreprise dans des environnements informatiques distribués et hétérogènes.
-
Présentation de l'interface de programme L'interface de programme est la couche logicielle entre une application de base de données et Oracle AI Database.
-
Présentation d'Oracle True Cache True Cache est un cache en mémoire en lecture seule devant une base de données Oracle AI Database.
Présentation de l'architecture d'Oracle Application
Dans le contexte de ce chapitre, l'architecture d'application fait référence à l'environnement informatique dans lequel une application de base de données se connecte à une base de données Oracle.
-
Présentation de l'architecture client/serveur Dans l'environnement Oracle AI Database, l'application de base de données et la base de données sont séparées en une architecture client/serveur.
-
Présentation de l'architecture à plusieurs niveaux Dans une architecture à plusieurs niveaux classique, un serveur d'applications fournit des données aux clients et sert d'interface entre les clients et les serveurs de base de données.
-
Présentation de l'architecture de grille Dans un environnement Oracle AI Database, le grid computing est une architecture informatique qui regroupe efficacement un grand nombre de serveurs et de stockage en une ressource informatique flexible à la demande.
Présentation de l'architecture client/serveur
Dans l'environnement Oracle AI Database, l'application de base de données et la base de données sont séparées en une architecture client/serveur.
Les composants sont les suivants :
-
Le client exécute l'application de base de données, par exemple SQL*Plus ou un programme de saisie de données Visual Basic, qui accède aux informations de la base de données et interagit avec un utilisateur.
-
Le serveur exécute le logiciel Oracle AI Database et gère les fonctions requises pour un accès simultané et partagé aux données d'une base de données Oracle.
Bien que l'application client et la base de données puissent s'exécuter sur le même ordinateur, une plus grande efficacité est souvent obtenue lorsque les parties client et serveur sont exécutées par différents ordinateurs connectés via un réseau. Les sections suivantes traitent des variations de l'architecture client/serveur d'Oracle AI Database.
-
Traitement distribué L'utilisation de plusieurs hôtes pour traiter une tâche individuelle est appelée traitement distribué.
-
Avantages d'une architecture client/serveur L'architecture client/serveur d'Oracle AI Database dans un environnement de traitement distribué offre de nombreux avantages.
Traitement distribué
L'utilisation de plusieurs hôtes pour traiter une tâche individuelle est appelée traitement distribué.
Le traitement front-end et back-end se produit sur différents ordinateurs. Dans la Figure 19-1, le client et le serveur se trouvent sur différents hôtes connectés via Oracle Net Services.
Figure 1 : Architecture client/serveur et traitement distribué
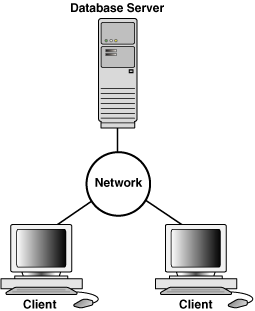
Description de l'image cncpt083.gif
La figure 19-2 est une variante représentant une base de données distribuée. Dans cet exemple, une base de données sur un hôte accède aux données d'une base de données distincte située sur un autre hôte.
Figure 2 : Architecture client/serveur et base de données distribuée
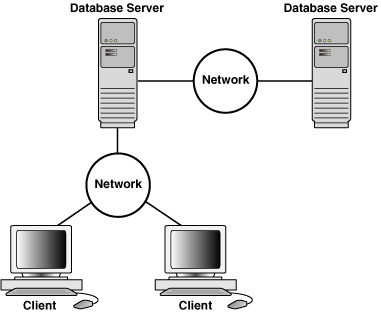
Description de l'image cncpt240.gif
Remarque : le reste de ce chapitre s'applique aux environnements comportant une base de données sur un serveur.
Avantages d'une architecture client/serveur
L'architecture client/serveur d'Oracle AI Database dans un environnement de traitement distribué offre de nombreux avantages.
Les avantages sont les suivants :
-
Les applications client ne sont pas responsables de l'exécution du traitement des données. Au contraire, ils demandent l'entrée des utilisateurs, demandent des données au serveur, puis analysent et présentent ces données à l'aide des capacités d'affichage du poste de travail client ou du terminal (par exemple, à l'aide de graphiques ou de feuilles de calcul).
-
Les applications client ne dépendent pas de l'emplacement physique des données. Même si les données sont déplacées ou distribuées vers d'autres serveurs de base de données, l'application continue de fonctionner avec peu ou pas de modifications.
-
Oracle AI Database exploite les installations à plusieurs tâches et à mémoire partagée de son système d'exploitation sous-jacent. Par conséquent, il offre le plus haut degré possible de simultanéité, d'intégrité des données et de performances à ses applications client.
-
Les postes de travail ou terminaux clients peuvent être optimisés pour la présentation de données (par exemple, en fournissant un support graphique et souris), tandis que le serveur peut être optimisé pour le traitement et le stockage de données (par exemple, en ayant de grandes quantités de mémoire et d'espace disque).
-
Dans les environnements en réseau, vous pouvez utiliser des postes de travail client peu coûteux pour accéder efficacement aux données distantes du serveur.
-
La base de données peut évoluer au fur et à mesure de la croissance de votre système. Vous pouvez ajouter plusieurs serveurs pour répartir la charge de traitement de la base de données sur l'ensemble du réseau (mise à l'échelle horizontale), ou vous pouvez déplacer la base de données vers un miniordinateur ou un mainframe pour tirer parti des performances d'un système plus important (mise à l'échelle verticale). Dans les deux cas, les données et les applications sont gérées avec peu ou pas de modification car Oracle AI Database est portable entre les systèmes.
-
Dans les environnements en réseau, les données partagées sont stockées sur les serveurs plutôt que sur tous les ordinateurs, ce qui facilite et rend plus efficace la gestion des accès simultanés.
-
Dans les environnements en réseau, les applications client soumettent des demandes de base de données au serveur à l'aide d'instructions SQL. Une fois reçue, chaque instruction SQL est traitée par le serveur, ce qui renvoie les résultats au client. Le trafic réseau est réduit car seules les demandes et les résultats sont expédiés sur le réseau.
Voir aussi : Guide de l'administrateur Oracle AI Database pour en savoir plus sur les bases de données distribuées
Présentation de l'architecture à plusieurs niveaux
Dans une architecture à plusieurs niveaux classique, un serveur d'applications fournit des données aux clients et sert d'interface entre les clients et les serveurs de base de données.
Cette architecture permet d'utiliser un serveur d'applications pour :
-
Valider les informations d'identification d'un client, tel qu'un navigateur Web
-
Se connecter à un serveur.
-
Exécuter l'opération demandée
Un exemple d'architecture à plusieurs niveaux apparaît dans la Figure 19-3.
Figure 3 : Environnement d'architecture multiniveau
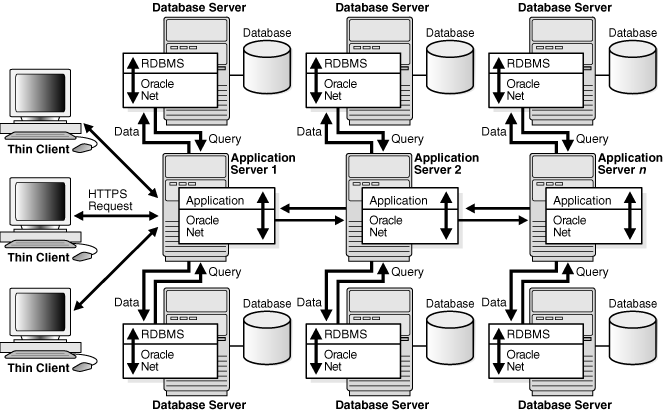
Description de l'image cncpt121.gif
-
Clients Un client lance une demande d'opération à effectuer sur le serveur de base de données.
-
Serveurs d'applications Un serveur d'applications permet d'accéder aux données du client. Il sert d'interface entre le client et un ou plusieurs serveurs de base de données et héberge les applications.
-
Serveurs de base de données Un serveur de base de données fournit les données demandées par un serveur d'applications pour le compte d'un client. La base de données effectue le traitement des requêtes.
-
Architecture orientée service (SOA) La base de données peut servir de fournisseur de services Web dans des environnements à plusieurs niveaux traditionnels ou architecture orientée service (SOA).
Clients
Un client lance une demande d'opération à effectuer sur le serveur de base de données.
Le client peut être un navigateur Web ou un autre programme utilisateur final. Dans une architecture à plusieurs niveaux, le client se connecte au serveur de base de données via un ou plusieurs serveurs d'applications.
Serveurs d'applications
Un serveur d'applications permet d'accéder aux données du client. Il sert d'interface entre le client et un ou plusieurs serveurs de base de données et héberge les applications.
Un serveur d'applications permet aux clients légers, qui sont des clients équipés de configurations logicielles minimales, d'accéder aux applications sans nécessiter de maintenance continue des ordinateurs clients. Le serveur d'applications peut également effectuer un reformatage des données pour le client, ce qui réduit la charge sur le poste de travail client.
Le serveur d'applications prend l'identité du client lorsqu'il effectue des opérations sur le serveur de base de données pour ce client. La meilleure pratique consiste à restreindre les privilèges du serveur d'applications pour l'empêcher d'effectuer des opérations inutiles et indésirables pendant une opération client.
Serveurs de base de données
Un serveur de base de données fournit les données demandées par un serveur d'applications pour le compte d'un client. La base de données effectue le traitement des requêtes.
Le serveur de base de données peut auditer les opérations effectuées par le serveur d'applications pour le compte des clients et pour son propre compte. Par exemple, une opération client peut demander des informations à afficher sur le client, tandis qu'une opération de serveur d'applications peut demander une connexion au serveur de base de données.
Dans l'audit unifié, la base de données peut ajouter des contextes d'application, qui sont des paires nom-valeur propres à l'application, aux enregistrements de la trace d'audit unifié. Vous pouvez configurer les contextes applicatifs dans lesquels la base de données écrit dans les enregistrements d'audit de base de données.
Voir aussi : Guide de sécurité Oracle AI Database pour une introduction à l'audit
SOA (architecture orientée service)
La base de données peut servir de fournisseur de services Web dans des environnements à plusieurs niveaux traditionnels ou architecture orientée service (SOA).
SOA est une architecture à plusieurs niveaux qui s'appuie sur des services qui prennent en charge l'interaction ordinateur-ordinateur sur un réseau. Dans le contexte de l'architecture SOA, un service est une adresse fonctionnelle autonome qui dispose d'un contrat de niveau de service et de fonctionnalités bien défini, qui peut être surveillée et gérée, et qui peut aider à appliquer la conformité aux stratégies.
Les services SOA sont généralement implémentés en tant que services Web accessibles via le protocole HTTP. Ils sont basés sur des normes XML telles que WSDL et SOAP.
La fonctionnalité de service Web d'Oracle AI Database, qui est implémentée dans le cadre d'Oracle XML DB, doit être activée spécifiquement par l'administrateur de base de données. Les applications peuvent ensuite effectuer les opérations suivantes via les services Web de base de données :
-
Soumettre des requêtes SQL ou XQuery et recevoir des résultats au format XML
-
Appeler des fonctions PL/SQL autonomes et obtenir des résultats
-
Appeler des fonctions de package PL/SQL et recevoir des résultats
Les services Web de base de données permettent d'ajouter des services Web à un environnement d'application sans avoir besoin d'un serveur d'applications. Toutefois, l'appel de services Web via des serveurs d'applications tels qu'Oracle Fusion Middleware offre la sécurité, l'évolutivité, l'enregistrement UDDI et une messagerie fiable dans un environnement SOA. Toutefois, étant donné que les services Web de base de données s'intègrent facilement à Oracle Fusion Middleware, ils peuvent être appropriés pour optimiser les solutions SOA.
Voir aussi :
-
Guide du programmeur Oracle XML Developer's Kit pour plus d'informations sur l'activation et l'utilisation des services Web de base de données
-
Documentation Oracle Fusion Middleware pour plus d'informations sur SOA et les services Web
Présentation de l'architecture de Grid
Dans un environnement Oracle AI Database, le grid computing est une architecture informatique qui regroupe efficacement un grand nombre de serveurs et de stockage en une ressource de calcul flexible à la demande.
Les composants matériels et logiciels modulaires peuvent être connectés et rejoints à la demande pour répondre aux besoins changeants des entreprises.
Voir aussi : Guide d'administration et de déploiement Oracle Clusterware pour plus d'informations sur les grilles de serveur et de stockage
Présentation de l'architecture d'Oracle Net Services
Oracle Net Services est une suite de composants réseau qui fournit des solutions de connectivité à l'échelle de l'entreprise dans des environnements informatiques distribués et hétérogènes.
Oracle Net Services active une session réseau entre une application et une instance de base de données, et une instance de base de données vers une autre instance de base de données.
Oracle Net Services assure la transparence du lieu, une configuration et une gestion centralisées, ainsi qu'une installation et une configuration rapides. Il vous permet également d'optimiser les ressources système et d'améliorer les performances. L'architecture de serveur partagé augmente l'évolutivité des applications et le nombre de clients connectés simultanément à la base de données. Le protocole d'interface virtuelle (VI) impose la majeure partie de la charge de messagerie sur le matériel réseau haut débit, libérant ainsi la CPU.
Oracle Net Services utilise les protocoles de communication ou les interfaces de programmation d'application (API) prises en charge par un large éventail de réseaux pour fournir une base de données distribuée et un traitement distribué. Une fois qu'une session réseau est établie, Oracle Net Services agit en tant que messagerie de données pour l'application client et le serveur de base de données, en établissant et en maintenant une connexion et en échangeant des messages. Oracle Net Services peut effectuer ces tâches car elles existent sur chaque ordinateur du réseau.
-
Fonctionnement d'Oracle Net Services Les protocoles Oracle AI Database acceptent les instructions SQL de l'interface des applications Oracle, puis les package pour transmission à Oracle AI Database.
-
Oracle Net Listener Le processus d'écoute (listener) Oracle Net Listener est un processus côté serveur qui écoute les demandes de connexion client entrantes et gère le trafic vers la base de données. Lorsqu'une instance de base de données démarre et à différents moments de sa vie, elle contacte un processus d'écoute et établit un protocole de communication vers cette instance.
-
Architecture de serveur dédié Dans une architecture de serveur dédié, le processus serveur créé pour le compte de chaque processus client est appelé processus serveur dédié (ou processus shadow).
-
Architecture de serveur partagé Dans une architecture de serveur partagé, un répartiteur dirige plusieurs demandes de session réseau entrantes vers un pool de processus de serveur partagé.
-
Le pool de connexions résidentes de base de données (DRCP) fournit un pool de connexions de serveurs dédiés pour les scénarios d'application Web classiques. Voir aussi : Guide de l'administrateur Oracle AI Database Net Services pour une présentation de l'architecture Oracle Net
Fonctionnement d'Oracle Net Services
Les protocoles Oracle AI Database acceptent les instructions SQL de l'interface des applications Oracle, puis les packagent pour transmission à Oracle AI Database.
La transmission se fait via un protocole ou une API de niveau supérieur standard pris en charge. Les réponses d'Oracle AI Database sont packagées via le même mécanisme de communication de niveau supérieur. Ce travail est effectué indépendamment du système d'exploitation du réseau.
Selon le système d'exploitation qui exécute Oracle AI Database, le logiciel Oracle Net Services du serveur de base de données peut inclure le logiciel pilote et démarrer un processus en arrière-plan supplémentaire.
Voir aussi : Guide de l'administrateur Oracle AI Database Net Services pour plus d'informations sur le fonctionnement d'Oracle Net Services
Processus d'écoute d'Oracle Net Listener
Le processus d'écoute (Oracle Net Listener) est un processus côté serveur qui écoute les demandes de connexion client entrantes et gère le trafic vers la base de données. Lorsqu'une instance de base de données démarre et à différents moments de sa vie, elle contacte un processus d'écoute et établit un protocole de communication vers cette instance.
L'enregistrement de service permet au processus d'écoute de déterminer si un service de base de données et ses gestionnaires de service sont disponibles. Un gestionnaire de service est un processus serveur ou un répartiteur dédié qui agit comme un point de connexion à une base de données. Lors de l'inscription, le processus LREG fournit au processus d'écoute le nom de l'instance, les noms de service de base de données, ainsi que le type et les adresses des gestionnaires de service. Ces informations permettent au processus d'écoute de démarrer un gestionnaire de services lorsqu'une demande client arrive.
Le graphique suivant présente deux bases de données, chacune sur un hôte distinct. L'environnement de base de données est géré par deux processus d'écoute, chacun sur un hôte distinct. Le processus LREG exécuté dans chaque instance de base de données communique avec les deux processus d'écoute pour enregistrer la base de données.
Figure 4 : Deux processus d'écoute
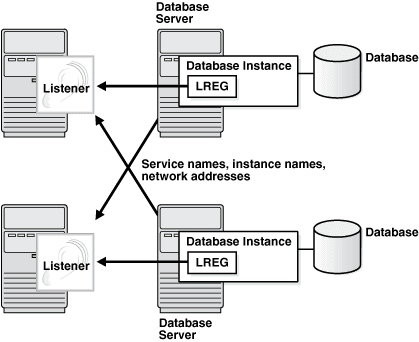
Description de l'image cncpt315.png
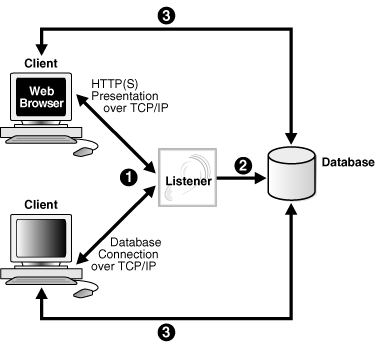
La figure 19-5 présente un navigateur qui établit une connexion HTTP et un client qui établit une connexion de base de données via un processus d'écoute. Le processus d'écoute n'a pas besoin de résider sur l'hôte de base de données.
Figure 5 : Architecture du processus d'écoute
Description de l'image cncpt311.gif
Les étapes de base par lesquelles un client établit une connexion via un processus d'écoute sont les suivantes :
-
Un processus client ou une autre base de données demande une connexion.
-
Le processus d'écoute sélectionne un gestionnaire de services approprié pour traiter la demande client et la transmet au gestionnaire.
-
Le processus client se connecte directement au gestionnaire de service. L'auditeur n'est plus impliqué dans la communication.
-
Noms de service Un nom de service est une représentation logique d'un service utilisé pour les connexions client.
-
Les clients Services dans un environnement colocatif doivent se connecter aux bases de données pluggables ou aux racines des applications à l'aide de services.
-
Inscription de service Dans Oracle Net, l'inscription de service est une fonctionnalité par laquelle le processus LREG enregistre dynamiquement les informations d'instance avec un processus d'écoute. Voir aussi : "Présentation des processus client" et "Présentation des processus serveur"
Noms de service
Un nom de service est une représentation logique d'un service utilisé pour les connexions client.
Lorsqu'un client se connecte à un processus d'écoute, il demande une connexion à un service. Lorsqu'une instance de base de données démarre, elle s'enregistre auprès d'un processus d'écoute comme fournissant un ou plusieurs services par nom. Ainsi, le processus d'écoute agit en tant que médiateur entre le client et les instances et achemine la demande de connexion au bon endroit.
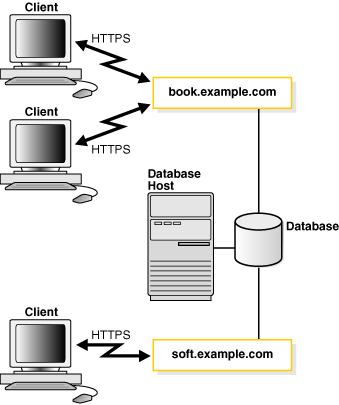
Un service unique, tel qu'il est connu par un processus d'écoute, peut identifier des instances de base de données. En outre, une seule instance de base de données peut inscrire des services auprès d'un processus d'écoute. Les clients se connectant à un service n'ont pas besoin d'indiquer l'instance dont ils ont besoin. La figure 19-6 présente une base de données à instance unique associée à deux services, book.example.com et soft.example.com. Les services permettent à la même base de données d'être identifiée différemment par différents clients. Un administrateur de base de données peut limiter ou réserver des ressources système, ce qui permet une meilleure allocation des ressources aux clients qui demandent l'un de ces services.
Figure 6 : Services multiples associés à une base de données
Description de l'image cncpt314.gif
Voir aussi : Guide de l'administrateur Oracle AI Database Net Services pour en savoir plus sur les méthodes de résolution de noms
Services dans un environnement colocatif
Les clients doivent se connecter à des bases pluggables ou à des racines d'application à l'aide de services.
Une connexion utilisant un nom de service démarre une nouvelle session dans une base de données pluggable ou une racine d'application. Un processus de premier plan, et donc une session, à chaque moment de sa vie, a un conteneur courant défini de manière unique.
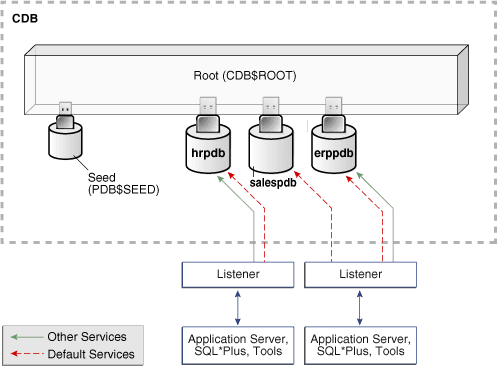
L'illustration suivante présente deux clients qui se connectent à des bases pluggables à l'aide de deux processus d'écoute différents.
Figure 7 : Services dans une base Conteneur
Description de l'image cncpt368.png
-
Création de service Lorsque vous exécutez l'instruction
CREATE PLUGGABLE DATABASEpour créer une base de données pluggable, la base de données crée et démarre automatiquement un service dans la base de données Conteneur. -
Connexions à des conteneurs dans une base de données Conteneur En général, un administrateur de base de données Conteneur doit disposer des privilèges appropriés pour provisionner des bases de données pluggables et se connecter à divers conteneurs. Les administrateurs de base de données Conteneur sont des utilisateurs communs.
Création du service
Lorsque vous exécutez l'instruction CREATE PLUGGABLE DATABASE pour créer une base de données pluggable, la base de données crée et démarre automatiquement un service dans la base de données Conteneur.
Le service par défaut possède une propriété qui identifie la base de données pluggable comme conteneur en cours initial pour le service. La propriété est affichée dans la colonne DBA_SERVICES.PDB.
-
Services par défaut Le service par défaut porte le même nom que la base de données pluggable. Le nom de la base de données pluggable doit être un nom de service valide, qui doit être unique au sein de la base de données Conteneur.
-
Services autres que par défaut Vous pouvez créer des services supplémentaires pour chaque base de données pluggable, jusqu'à un maximum de 10 000 par base de données Conteneur. Chaque service supplémentaire désigne sa base de données pluggable comme conteneur en cours initial.
Services par défaut
Le service par défaut porte le même nom que la base de données pluggable. Le nom de la base de données pluggable doit être un nom de service valide, qui doit être unique au sein de la base de données Conteneur.
Lorsque vous créez un conteneur d'application, ce qui nécessite la spécification de la clause AS APPLICATION CONTAINER, Oracle AI Database crée automatiquement un service par défaut pour la racine d'application. Le service porte le même nom que le conteneur d'application. Oracle Net Services doit être configuré correctement pour que les clients puissent accéder à ce service. De même, chaque base de données pluggable d'application a son propre nom de service par défaut et une base de données pluggable prédéfinie d'application a son propre nom de service par défaut.
Exemple 19-1 Passage à une base de données pluggable à l'aide d'un service par défaut
Cet exemple bascule vers les noms de base de données pluggable salespdb à l'aide du service par défaut, qui porte le même nom que la base de données pluggable :
ALTER SESSION SET CONTAINER = salespdb;Services autres que par défaut
Vous pouvez créer des services supplémentaires pour chaque base de données pluggable, jusqu'à un maximum de 10 000 par base de données Conteneur. Chaque service supplémentaire désigne sa base de données pluggable comme conteneur en cours initial.
Dans la Figure 19-7, des services autres que ceux par défaut existent pour erppdb et hrpdb. Par exemple, dans la Figure 19-7, la base de données pluggable nommée hrpdb a un service par défaut nommé hrpdb. Le service par défaut ne peut pas être supprimé.
Lorsque vous basculez vers un conteneur à l'aide de ALTER SESSION SET CONTAINER, la session utilise le service par défaut du conteneur. Vous pouvez éventuellement utiliser un autre service pour le conteneur en indiquant SERVICE = service_name, où service_name est le nom du service. Vous pouvez utiliser un service particulier pour que la session puisse tirer parti de ses attributs et fonctionnalités de service, tels que les mesures de service, l'équilibrage de charge, les paramètres Resource Manager, etc.
Exemple 19-2 Basculement vers une base de données pluggable à l'aide d'un service non par défaut
Dans cet exemple, le service par défaut pour hrpdb ne prend pas en charge tous les attributs et fonctionnalités de service, tels que les mesures de service, la fonction FAN, l'équilibrage de charge, Oracle AI Database Resource Manager, Transaction Guard, la continuité des applications, etc. Vous passez à un service autre que par défaut comme suit :
ALTER SESSION SET CONTAINER = hrpdb SERVICE = hrpdb_full;Connexions à des conteneurs d'une base Conteneur
En général, un administrateur de base de données Conteneur doit disposer des privilèges appropriés pour provisionner des bases de données pluggables et se connecter à divers conteneurs. Les administrateurs de base de données Conteneur sont des utilisateurs communs.
L'administrateur de base de données Conteneur peut utiliser l'une des techniques suivantes :
-
Se connecter directement à une base de données pluggable ou à la racine d'application.
L'utilisateur requiert le privilège
CREATE SESSIONdans le conteneur. -
Utilisez l'instruction
ALTER SESSION SET CONTAINER, qui est utile pour le regroupement de connexions et l'administration avancée de bases de données Conteneur, pour basculer d'un conteneur à l'autre. La syntaxe estALTER SESSION SET CONTAINER = container_name [SERVICE = service_name].Par exemple, un administrateur de base de données Conteneur peut se connecter à la racine dans une session, puis, dans la même session, basculer vers une base de données pluggable. Dans ce cas, l'utilisateur requiert le privilège système
SET CONTAINERdans le conteneur.
Le tableau suivant décrit un scénario impliquant la base de données Conteneur dans la Figure 19-7. Chaque ligne décrit une action qui se produit après l'action de la ligne précédente. L'utilisateur commun SYSTEM interroge le nom du conteneur en cours et les noms des bases de données pluggables dans la base de données Conteneur.
Table des services dans une base de données Conteneur
| Opération | Description |
|---|---|
|
L'utilisateur SYSTEM, qui est commun à tous les conteneurs de la base de données Conteneur, se connecte à la racine à l'aide du service nommé prod. |
|
SYSTEM utilise la commande SQL*Plus SHOW CON_NAME pour répertorier le nom du conteneur auquel l'utilisateur est actuellement connecté. CDB$ROOT est le nom du conteneur racine. |
|
Une requête V$SERVICES indique que trois bases de données pluggables existent avec des noms de service qui correspondent au nom de la base de données pluggable. hrpdb et erppdb ont tous deux un service supplémentaire. |
|
SYSTEM utilise ALTER SESSION pour se connecter à hrpdb. |
|
Une requête confirme que le conteneur en cours est désormais hrpdb. |
Voir aussi : Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique de ALTER SESSION SET CONTAINER
Inscription de service
Dans Oracle Net, l'inscription de service est une fonctionnalité par laquelle le processus LREG enregistre dynamiquement les informations d'instance avec un processus d'écoute.
Ces informations permettent au processus d'écoute de transmettre les demandes de connexion client au gestionnaire de services approprié. LREG fournit au processus d'écoute les informations suivantes :
-
Noms des services de base de données fournis par la base
-
Nom de l'instance de base de données associée aux services et charge actuelle et maximale associée
-
Gestionnaires de service (répartiteurs et serveurs dédiés) disponibles pour l'instance, y compris leur type, leurs adresses de protocole et leur charge actuelle et maximale
L'enregistrement de service est dynamique et ne nécessite pas de configuration dans le fichier listener.ora. L'enregistrement dynamique réduit la surcharge administrative pour plusieurs bases de données ou instances.
Le paramètre d'initialisation SERVICE_NAMES répertorie les services auxquels une instance appartient. Au démarrage, chaque instance s'enregistre auprès des processus d'écoute d'autres instances appartenant aux mêmes services. Au cours des opérations de base de données, les instances de chaque service transmettent des informations sur l'utilisation de la CPU et le nombre de connexions en cours à tous les processus d'écoute des mêmes services. Cette communication permet l'équilibrage dynamique de la charge et le basculement des connexions.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database Net Services pour en savoir plus sur l'inscription de service
-
Guide d'administration et de déploiement Oracle Real Application Clusters, pour en savoir plus sur l'inscription d'instance et les connexions client/service dans Oracle RAC
Architecture de serveur dédié
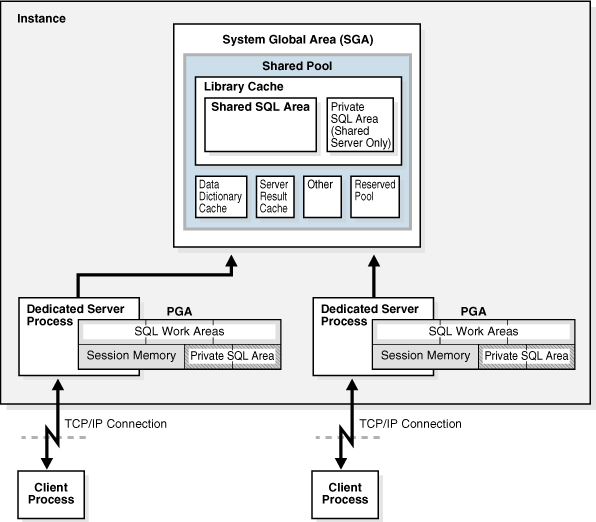
Dans une architecture de serveur dédié, le processus serveur créé pour le compte de chaque processus client est appelé processus serveur dédié (ou processus shadow).
Un processus serveur dédié est distinct du processus client et agit uniquement en son nom, comme illustré dans la Figure 19-8.
Figure 8 : Oracle AI Database utilisant des processus serveur dédiés
Description de l'image cncpt303.gif
Il existe un rapport un à un entre les processus client et les processus serveur. Même lorsque l'utilisateur ne fait pas activement de demande de base de données, le processus serveur dédié reste inactif et peut être transféré sur certains systèmes d'exploitation. La Figure 19-8 illustre les processus utilisateur et serveur exécutés sur des ordinateurs en réseau. Toutefois, l'architecture de serveur dédié est également utilisée si le même ordinateur exécute à la fois l'application client et le code de base de données, mais que le système d'exploitation hôte n'a pas pu maintenir la séparation des deux programmes s'ils étaient exécutés dans un seul processus. Linux est un exemple de ce système d'exploitation.
Dans l'architecture serveur dédiée, les processus utilisateur et serveur communiquent à l'aide de différents mécanismes :
-
Si le processus client et le processus serveur dédié s'exécutent sur le même ordinateur, l'interface de programme utilise le mécanisme de communication interprocessus du système d'exploitation hôte pour effectuer sa tâche.
-
Si le processus client et le processus serveur dédié s'exécutent sur différents ordinateurs, l'interface du programme fournit les mécanismes de communication (tels que le logiciel réseau et Oracle Net Services) entre les programmes.
Les serveurs dédiés sous-utilisés entraînent parfois une utilisation inefficace des ressources du système d'exploitation. Envisagez un système de saisie de prescriptions avec des processus serveur dédiés. Un client passe une commande en tant que commis entre la commande dans la base de données. Pour la plupart de la transaction, le greffier parle au client pendant que le processus serveur dédié au processus client du greffier est inactif. Le processus serveur n'est pas nécessaire pendant la majeure partie de la transaction et le système peut être plus lent pour les autres préposés à la saisie des prescriptions si le système gère trop de processus. Pour les applications de ce type, l'architecture de serveur partagé peut être préférable.
Voir aussi : Guide de l'administrateur Oracle AI Database Net Services pour en savoir plus sur les processus serveur dédiés
Architecture de serveur partagé
Dans une architecture de serveur partagé, un répartiteur dirige plusieurs demandes de session réseau entrantes vers un pool de processus serveur partagés.
Avec la zone de mémoire partagée, il est inutile d'avoir un processus serveur dédié pour chaque connexion. A partir d'un pool de serveurs partagés inactif extrait une demande dans une file d'attente commune.
Les avantages potentiels du serveur partagé sont les suivants :
-
Réduit le nombre de processus sur le système d'exploitation
Un petit nombre de serveurs partagés peut effectuer la même quantité de traitement que de nombreux serveurs dédiés.
-
Réduit la mémoire PGA de l'instance
Chaque serveur dédié ou partagé dispose d'une mémoire PGA. Moins de processus serveur signifie moins de PGA et moins de gestion des processus.
-
Augmente l'évolutivité des applications et le nombre de clients pouvant se connecter simultanément à la base de données
-
Peut être plus rapide que le serveur dédié lorsque le taux de connexions et de déconnexions client est élevé
Le serveur partagé présente plusieurs inconvénients, notamment un temps de réponse plus lent dans certains cas, une prise en charge incomplète des fonctionnalités et une complexité accrue pour la configuration et le réglage. En règle générale, utilisez un serveur partagé uniquement lorsque vous avez plus de connexions simultanées à la base de données que le système d'exploitation ne peut gérer.
Les processus suivants sont nécessaires dans une architecture de serveur partagé :
-
Processus d'écoute réseau qui connecte les processus client aux répartiteurs ou aux serveurs dédiés (le processus d'écoute fait partie d'Oracle Net Services et non d'Oracle AI Database).
Remarque : pour utiliser des serveurs partagés, un processus client doit se connecter via Oracle Net Services, même si le processus s'exécute sur le même ordinateur que l'instance Oracle AI Database.
-
Un ou plusieurs processus de répartiteur (Dnnn)
-
Un ou plusieurs processus serveur partagés
Une base de données peut prendre en charge simultanément les connexions de serveur partagé et de serveur dédié. Par exemple, un client peut se connecter à l'aide d'un serveur dédié tandis qu'un autre client se connecte à la même base de données à l'aide d'un serveur partagé.
-
File d'attente de demandes et de réponses du répartiteur Une demande d'un utilisateur est un appel d'API unique qui fait partie de l'instruction SQL de l'utilisateur.
-
Opérations restreintes du serveur partagé Des activités d'administration spécifiques ne peuvent pas être exécutées lors de la connexion à un processus de répartiteur, y compris l'arrêt ou le démarrage d'une instance et la restauration physique.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database Net Services pour plus d'informations sur l'architecture de serveur partagé
-
Guide de l'administrateur Oracle AI Database pour savoir comment configurer une base de données pour un serveur partagé
Files d'attente de demandes et de réponses du répartiteur
Une demande d'un utilisateur est un appel d'API unique qui fait partie de l'instruction SQL de l'utilisateur.
Lorsqu'un utilisateur effectue un appel, les actions suivantes se produisent :
-
Le répartiteur place la demande dans la file d'attente des demandes, où elle est récupérée par le prochain processus de serveur partagé disponible.
La file d'attente des demandes se trouve dans la mémoire SGA et est commune à tous les processus de répartition d'une instance.
-
Les processus serveur partagés vérifient la présence de nouvelles demandes dans la file d'attente des demandes communes, en récupérant les nouvelles demandes selon le principe du premier entré, premier sorti.
-
Un processus serveur partagé sélectionne une demande dans la file d'attente et effectue tous les appels nécessaires à la base de données pour terminer cette demande.
Un processus serveur différent peut gérer chaque appel de base de données. Par conséquent, les demandes d'analyse d'une requête, d'extraction de la première ligne, d'extraction de la ligne suivante et de fermeture de l'ensemble de résultats peuvent toutes être traitées par un serveur partagé différent.
-
Lorsque le processus serveur termine la demande, il place la réponse dans la file d'attente des réponses du répartiteur appelant. Chaque répartiteur dispose de sa propre file d'attente de réponses.
-
Le répartiteur renvoie la demande terminée au processus client approprié.
Par exemple, dans un système de saisie de commandes, le processus client de chaque commis se connecte à un répartiteur. Chaque demande faite par le greffier est envoyée à ce répartiteur, qui place la demande dans la file d'attente. Le prochain serveur partagé disponible récupère la demande, la traite et place la réponse dans la file d'attente des réponses. Lorsqu'une demande est terminée, le commis reste connecté au répartiteur, mais le serveur partagé qui a traité la demande est libéré et disponible pour d'autres demandes. Alors qu'un employé parle à un client, un autre employé peut utiliser le même processus de serveur partagé. La figure 19-9 montre comment les processus client communiquent avec le répartiteur dans l'API et comment le répartiteur communique les demandes utilisateur aux processus serveur partagés.
Figure 9 : Configuration et processus du serveur partagé
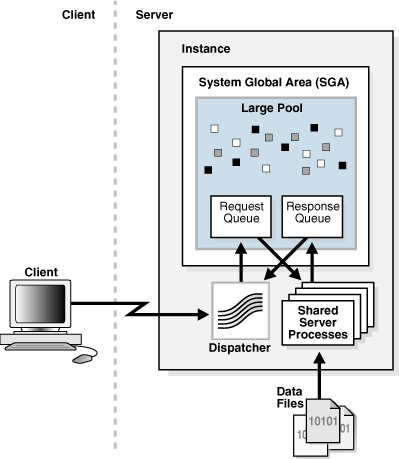
Description de l'image cncpt067.gif
-
Processus de répartiteur (Dnnn) Les processus de répartiteur permettent aux processus client de partager un nombre limité de processus serveur.
-
Processus serveur partagé (Snnn) Chaque processus serveur partagé répond à plusieurs demandes client dans la configuration du serveur partagé. Voir aussi : "Large Pool"
Processus de répartiteur (D nnn)
Les processus de répartiteur permettent aux processus client de partager un nombre limité de processus serveur.
Vous pouvez créer plusieurs processus répartiteur pour une seule instance de base de données. Nombre optimal de processus répartiteur en fonction de la limitation du système d'exploitation et du nombre de connexions pour chaque processus.
Remarque : chaque processus client qui se connecte à un répartiteur doit utiliser Oracle Net Services, même si les deux processus s'exécutent sur le même hôte.
Les processus du répartiteur établissent la communication comme suit :
-
Lorsqu'une instance démarre, le processus d'écoute réseau s'ouvre et établit un chemin de communication par lequel les utilisateurs se connectent à Oracle AI Database.
-
Chaque processus répartiteur donne au processus d'écoute une adresse à laquelle il écoute les demandes de connexion.
Au moins un processus de répartiteur doit être configuré et démarré pour chaque protocole réseau que les clients de base de données utiliseront.
-
Lorsqu'un processus client effectue une demande de connexion, le processus d'écoute détermine si le processus client doit utiliser un processus serveur partagé :
-
Si le processus d'écoute détermine qu'un processus serveur partagé est requis, il renvoie l'adresse du processus répartiteur qui a la charge la plus faible et le processus client se connecte directement au répartiteur.
-
Si le processus ne peut pas communiquer avec le répartiteur ou si le processus client demande un serveur dédié, le processus d'écoute crée un processus serveur dédié et établit une connexion appropriée.
-
Voir aussi : Guide de l'administrateur Oracle AI Database Net Services pour savoir comment configurer les répartiteurs
Processus serveur partagés (S nnn)
Chaque processus serveur partagé traite plusieurs demandes client dans la configuration du serveur partagé.
Les processeurs serveur partagé et serveur dédié offrent les mêmes fonctionnalités, sauf si les processeurs serveur partagé ne sont pas associés à un process client spécifique. Au lieu de cela, un processus de serveur partagé prend en compte toute demande client dans la configuration du serveur partagé.
La mémoire PGA d'un processus serveur partagé ne contient pas de données UGA, qui doivent être accessibles à tous les processus serveur partagé. La mémoire PGA du serveur partagé contient uniquement des données propres au processus.
Toutes les informations de session sont contenues dans la mémoire SGA. Chaque processus serveur partagé doit pouvoir accéder aux espaces d'informations de toutes les sessions afin que tout serveur puisse traiter toutes les demandes de n'importe quelle session. L'espace de données de chaque session fait l'objet d'une allocation d'espace dans la mémoire SGA.
Voir aussi : "Présentation de la mémoire PGA (Program Global Area)"
Opérations restreintes du serveur partagé
Des activités d'administration spécifiques ne peuvent pas être exécutées lors de la connexion à un processus de répartiteur, notamment l'arrêt ou le démarrage d'une instance et la restauration physique.
Ces activités sont généralement exécutées lorsque vous êtes connecté avec des privilèges d'administrateur. Pour vous connecter avec des privilèges d'administrateur dans un système configuré avec des serveurs partagés, vous devez indiquer que vous utilisez un processus serveur dédié.
Voir aussi : Guide de l'administrateur Oracle AI Database Net Services pour connaître la syntaxe de chaîne de connexion appropriée
Pool de connexions résidant en base de données
Le pool de connexions résident de base de données (DRCP) fournit un pool de connexions de serveurs dédiés pour les scénarios d'application Web classiques.
En général, une application Web établit une connexion de base de données, l'utilise brièvement, puis la libère. Grâce à DRCP, la base de données peut évoluer pour atteindre des dizaines de milliers de connexions simultanées.
DRCP offre les avantages suivants :
-
Complète les pools de connexions de niveau intermédiaire qui partagent les connexions entre les threads d'un processus de niveau intermédiaire.
-
Permet de partager les connexions de base de données entre plusieurs processus de niveau intermédiaire. Ces processus de niveau intermédiaire peuvent appartenir au même hôte de niveau intermédiaire ou à un hôte différent.
-
Permet une réduction significative des ressources de base de données clés requises pour prendre en charge de nombreuses connexions client. Par exemple, DRCP réduit la mémoire requise pour la base de données et augmente l'évolutivité de la base de données et du niveau intermédiaire. Le pool de serveurs disponibles réduit également le coût de la recréation des connexions client.
-
Fournit la mise en pool pour les architectures avec des serveurs d'applications multiprocessus et à thread unique, tels que PHP et Apache, qui ne peuvent pas effectuer de mise en pool de connexions de niveau intermédiaire.
DRCP utilise un serveur en pool, qui est l'équivalent d'un processus serveur dédié (et non d'un processus serveur partagé) et d'une session de base de données combinée. Le modèle de serveur groupé évite la surcharge de dédier un serveur à chaque connexion nécessitant le serveur pendant une courte période.
Les clients qui obtiennent des connexions à partir du pool de connexions résident de base de données se connectent à un processus en arrière-plan Oracle appelé courtier de connexions. Le courtier de connexions implémente la fonctionnalité de pool et multiplie les serveurs regroupés parmi les connexions entrantes des processus client.
Comme le montre la Figure 19-10, lorsqu'un client a besoin d'un accès à la base de données, le broker de connexions récupère un processus serveur du pool et le transfère au client. Le client est directement connecté au processus serveur jusqu'à ce que la demande soit traitée. Une fois le serveur terminé, le processus serveur est libéré dans le pool. La connexion du client est restaurée vers le broker.
Figure 10 : DRCP
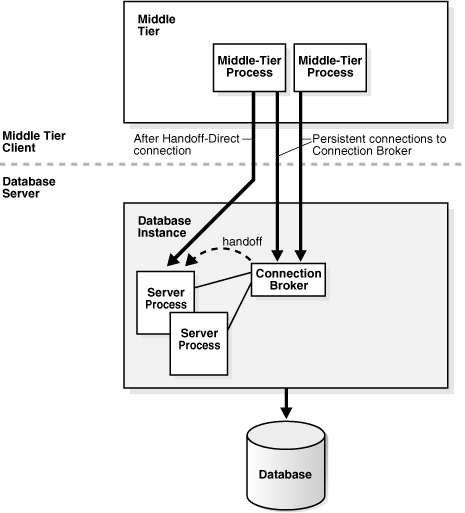
Description de l'image cncpt312.gif
Dans DRCP, la libération de ressources laisse la session intacte, mais n'est plus associée à une connexion (processus serveur). Contrairement au serveur partagé, cette session stocke sa mémoire UGA dans la mémoire PGA, et non dans la mémoire SGA. Un client peut rétablir une connexion de manière transparente lors de la détection de l'activité.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database et Guide du développeur Oracle Call Interface pour en savoir plus sur DRCP
Présentation de l'interface de programme
L'interface de programme est la couche logicielle entre une application de base de données et Oracle AI Database.
L'interface de programme exécute les fonctions suivantes :
-
Elle constitue une barrière de sécurité qui empêche les processus client d'accéder de manière destructive à la mémoire SGA.
-
agit en tant que mécanisme de communication, formate les demandes d'informations, transmet les données, intercepte et renvoie les erreurs
-
Convertit et traduit des données, en particulier entre différents types d'ordinateur ou vers des types de données de programme utilisateur externe
Le code Oracle agit comme un serveur, effectuant des tâches de base de données pour le compte d'une application (un client), telles que l'extraction de lignes à partir de blocs de données. L'interface de programme se compose de plusieurs parties, fournies à la fois par le logiciel Oracle AI Database et le logiciel propre au système d'exploitation.
-
Structure de l'interface de programme L'interface de programme comprend plusieurs composants différents.
-
Pilotes d'interface de programme Un pilote est un logiciel qui transporte des données, généralement sur un réseau.
-
Logiciel de communication pour le système d'exploitation Le logiciel de niveau le plus bas qui connecte le côté utilisateur au côté Oracle AI Database de l'interface de programme est le logiciel de communication, fourni par le système d'exploitation hôte.
Structure de l'interface de programme
L'interface de programme se compose de plusieurs composants différents.
Ces composants sont les suivants :
-
Interface d'appel Oracle (OCI) ou bibliothèque d'exécution Oracle (SQLLIB)
-
Côté client ou utilisateur de l'interface de programme
-
Divers pilotes Oracle Net Services (logiciel de communication propre à un protocole)
-
Logiciel de communication du système d'exploitation
-
Côté serveur ou Oracle AI Database de l'interface de programme (également appelé OPI)
Les côtés utilisateur et Oracle AI Database de l'interface de programme exécutent les logiciels Oracle, tout comme les pilotes.
Pilotes de l'interface de programme
Un pilote est un logiciel qui transporte des données, généralement sur un réseau.
Les pilotes effectuent des opérations telles que la connexion, la déconnexion, les erreurs de signal et le test des erreurs. Les pilotes sont spécifiques à un protocole de communication.
Un pilote par défaut existe toujours. Vous pouvez installer plusieurs pilotes, tels que les pilotes asynchrones ou DECnet, et en sélectionner un comme pilote par défaut, mais autoriser un utilisateur à utiliser d'autres pilotes en spécifiant un pilote lors de la connexion.
Différents processus peuvent utiliser différents pilotes. Un processus peut avoir des connexions simultanées à une seule base de données ou à plusieurs bases de données à l'aide de pilotes Oracle Net Services différents.
Voir aussi :
-
Guide d'installation et de configuration de votre système pour plus d'informations sur le choix, l'installation et l'ajout de pilotes
-
Guide de l'administrateur Oracle AI Database Net Services pour en savoir plus sur les pilotes JDBC
Logiciel de communication pour le système d'exploitation
Le logiciel de plus bas niveau qui connecte le côté utilisateur au côté Oracle AI Database de l'interface de programme est le logiciel de communication, fourni par le système d'exploitation hôte.
DECnet, TCP/IP, LU6.2 et ASYNC sont des exemples. Le logiciel de communication peut être fourni par Oracle, mais il est généralement acheté séparément du fournisseur de matériel ou d'un fournisseur de logiciel tiers.
Présentation d'Oracle True Cache
True Cache est un cache en mémoire en lecture seule devant une base de données Oracle AI Database.
A l'instar d'Oracle Active Data Guard, True Cache est une réplique entièrement fonctionnelle en lecture seule de la base de données principale, sauf qu'elle est principalement sans disque.
Les applications modernes nécessitent souvent un grand nombre de connexions et un accès rapide et à faible latence aux données. Une approche courante consiste à placer des caches devant la base de données, car les applications effectuent généralement beaucoup plus de lectures que de mises à jour, et elles peuvent lire à partir du cache sans affecter les performances de la base de données. Par exemple, un système de réservation de compagnie aérienne lit les données fréquemment lorsque les gens achètent des vols, et il est acceptable que les données ne soient pas les plus récentes par rapport à ce qui se trouve dans la base de données. L'application n'a besoin d'accéder aux données les plus récentes que lorsqu'une personne réserve un vol.
Contrairement aux caches classiques, True Cache conserve automatiquement les données les plus fréquemment consultées dans le cache, et le cache reste cohérent avec la base de données principale, les autres objets du même cache et les autres caches. Il met en cache tous les objets et types de données Oracle AI Database, y compris JSON.
Comme True Cache implémente les stratégies de sécurité d'Oracle AI Database, vous pouvez contrôler l'accès au cache. Cela vous permet de mettre en cache des données sensibles, telles que des informations personnelles privées, que vous risquez de ne pas normalement mettre en cache.
Rubriques connexes