Architecture de la mémoire
Ce chapitre traite de l'architecture mémoire d'une instance de base de données.
-
Introduction aux structures de mémoire d'Oracle AI Database Lorsqu'une instance est démarrée, Oracle AI Database alloue une zone de mémoire et démarre les processus en arrière-plan.
-
Présentation de la mémoire SGA (System Global Area) La SGA est une zone de mémoire en lecture/écriture qui, avec les processus en arrière-plan Oracle, forment une instance de base de données.
-
Présentation de la mémoire PGA (Program Global Area) La mémoire PGA est une mémoire propre à un processus d'exploitation ou à un thread qui n'est pas partagé par d'autres processus ou threads du système. Etant donné que la mémoire PGA est propre à un processus, elle n'est jamais allouée dans la mémoire SGA.
-
Présentation de la zone globale utilisateur La mémoire UGA est la mémoire de session, c'est-à-dire la mémoire allouée aux variables de session, telles que les informations de connexion, et d'autres informations requises par une session de base de données. La mémoire UGA stocke essentiellement l'état de la session.
-
Présentation de la mémoire MGA (Managed Global Area) La mémoire MGA (Managed Global Area) est une structure de mémoire unique qui permet de partager et de coordonner la mémoire sur un ensemble de processus Oracle de confiance.
-
Présentation des zones de code logiciel Une zone de code logiciel est une partie de la mémoire qui stocke le code en cours d'exécution ou qui peut être exécuté. Le code Oracle AI Database est stocké dans une zone logicielle généralement plus exclusive et protégée que l'emplacement des programmes utilisateur. Voir aussi : Guide de l'administrateur Oracle AI Database pour obtenir des instructions sur la configuration et la gestion de la mémoire.
Présentation des structures de mémoire d'Oracle AI Database
Lorsqu'une instance est démarrée, Oracle AI Database alloue une zone mémoire et démarre les processus en arrière-plan.
La zone mémoire stocke des informations telles que :
-
Code programme
-
Informations sur chaque session connectée, même si elle n'est pas active actuellement
-
Informations nécessaires lors de l'exécution du programme, par exemple l'état actuel d'une interrogation à partir de laquelle les lignes sont extraites
-
Informations telles que les données de verrouillage qui sont partagées et communiquées entre les processus
-
Données en cache, telles que les blocs de données et les enregistrements de journalisation, qui existent également sur le disque
-
Structures de mémoire de base Oracle AI Database inclut plusieurs zones de mémoire, chacune contenant plusieurs sous-composants.
-
Gestion de la mémoire d'Oracle AI Database La gestion de la mémoire implique le maintien d'une taille optimale pour les structures mémoire d'instance Oracle en fonction de la modification de la base de données. Oracle AI Database gère la mémoire en fonction des paramètres d'initialisation liés à la mémoire. Voir aussi : "Architecture de processus"
Structures de mémoire de base
Oracle AI Database inclut plusieurs zones de mémoire, chacune contenant plusieurs sous-composants.
Les structures mémoire de base associées à Oracle AI Database sont les suivantes :
-
Mémoire SGA (System Global Area)
La mémoire SGA est un groupe de structures mémoire partagées, appelées composants de mémoire SGA, qui contiennent les données et les informations d'un contrôle pour une instance Oracle AI Database. Tous les processus serveur et en arrière-plan partagent la mémoire SGA. Les blocs de données mis en cache et les zones SQL partagées sont des exemples de données stockées dans la mémoire SGA.
-
Program global area (PGA, zone globale de programme)
Une mémoire PGA est une région de mémoire non partagée qui contient des données et des informations de contrôle destinées exclusivement à un processus Oracle. Oracle AI Database crée la mémoire PGA au démarrage d'un processus Oracle.
Une mémoire PGA existe pour chaque processus serveur et processus en arrière-plan. L'ensemble des PGA est la mémoire PGA totale de l'instance, ou la mémoire PGA de l'instance. Les paramètres d'initialisation de la base de données définissent la taille de la mémoire PGA de l'instance, et non des autorisations PGA individuelles.
-
Zone globale utilisateur (UGA)
La mémoire UGA est la mémoire associée à une session utilisateur.
-
Zone globale gérée (MGA)
La mémoire MGA est un composant de mémoire semi-partagée utilisé par une instance Oracle AI Database. Il peut partager et coordonner la mémoire sur un petit ensemble de processus Oracle de confiance. Il peut être configurable, élastique, modulaire, à la demande et réutilisé. Contrairement à la mémoire SGA, les modules Oracle AI Database peuvent choisir les processus qui s'attachent à cette zone et ce comportement est dynamique.
-
Zones de code logiciel
Les zones de code logicielles sont des portions de mémoire utilisées pour stocker le code en cours d'exécution ou pouvant être exécuté. Le code Oracle AI Database est stocké dans une zone logicielle qui se trouve généralement à un emplacement différent des programmes utilisateur, un emplacement plus exclusif ou protégé.
La figure ci-dessous illustre les relations entre ces structures mémoire.
Figure 1 : Structures de mémoire d'Oracle AI Database
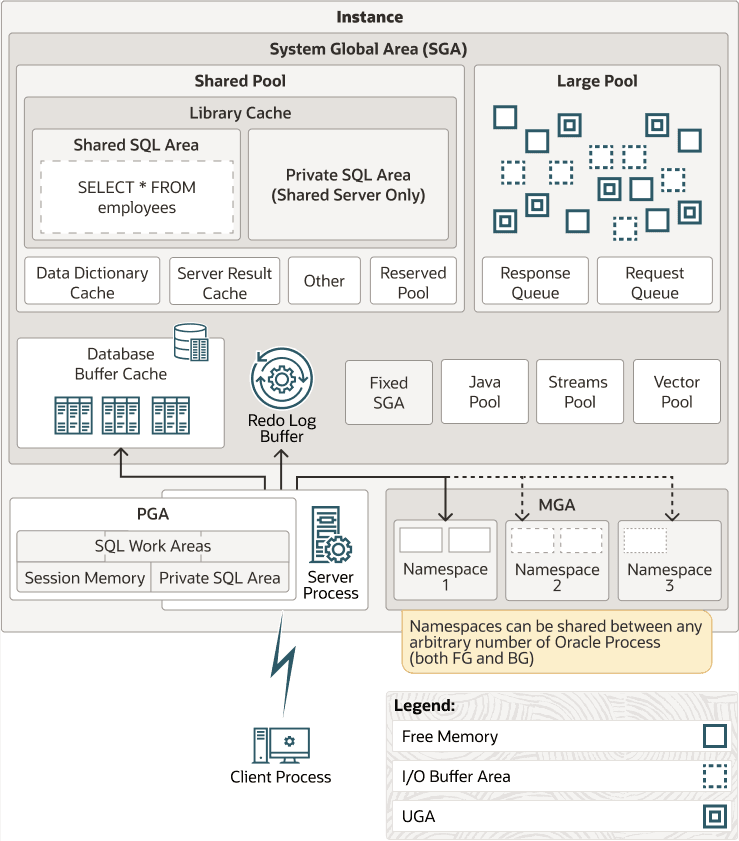
Description de l'image cncpt217.png
Gestion de la mémoire d'Oracle AI Database
La gestion de la mémoire implique de conserver une taille optimale pour les structures mémoire d'instance Oracle au fil des modifications de la base de données. Oracle AI Database gère la mémoire en fonction des paramètres d'initialisation liés à la mémoire.
Les options de base pour la gestion de la mémoire sont les suivantes :
-
Gestion unifiée de la mémoire
La mémoire unifiée configure la mémoire de l'instance de base de données avec un seul paramètre,
MEMORY_SIZE. La base de données peut utiliser cette mémoire de manière dynamique pour tous les segments de mémoire SGA, PGA, MGA, UGA et autres segments de mémoire en fonction de la charge globale en cours. La répartition entre les différents segments de mémoire est basée sur le dimensionnement de la mémoire des bases pluggables actuellement ouvertes dans la base de données Conteneur. Si des pages volumineuses sont configurées, elles peuvent être utilisées à la fois pour la mémoire SGA et la mémoire PGA. La mémoire unifiée offre une configuration de mémoire extrêmement flexible. -
Gestion automatique de la mémoire
Vous indiquez la taille cible de la mémoire de l'instance de base de données. L'instance est réglée automatiquement sur la taille de mémoire cible, en redistribuant la mémoire nécessaire entre la mémoire SGA et la mémoire PGA de l'instance.
-
Gestion automatique de la mémoire partagé
Ce mode de gestion est partiellement automatisé. Vous définissez une taille cible pour la mémoire SGA, puis vous pouvez définir une taille cible agrégée pour la mémoire PGA ou gérer individuellement les zones de travail de la mémoire PGA.
-
Gestion de la mémoire manuelle
Au lieu de définir la taille totale de la mémoire, vous devez définir de nombreux paramètres d'initialisation pour gérer individuellement les composants de la mémoire SGA et de la mémoire PGA de l'instance.
Si vous créez une base de données avec DBCA (Database Configuration Assistant) et que vous choisissez l'option d'installation de base, la gestion automatique de la mémoire est la valeur par défaut.
Voir aussi :
-
Guide de réglage des performances Oracle AI Database, pour plus d'informations sur les options de gestion de la mémoire des DBA.
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur les options de gestion de la mémoire.
-
Référence Oracle AI Database pour en savoir plus sur les paramètres d'initialisation.
Présentation de la mémoire SGA (System Global Area)
La SGA est une zone de mémoire en lecture/écriture qui, avec les processus en arrière-plan Oracle, forment une instance de base de données. Remarque : les processus serveur et en arrière-plan ne résident pas dans la mémoire SGA, mais existent dans un espace mémoire distinct.
Tous les processus serveur qui s'exécutent pour le compte des utilisateurs peuvent lire des informations dans la mémoire SGA de l'instance. Plusieurs processus écrivent dans la mémoire SGA pendant le fonctionnement de la base de données.
Chaque instance de base de données dispose de sa propre mémoire SGA. Oracle AI Database alloue automatiquement de la mémoire pour une mémoire SGA au démarrage de l'instance et la récupère à l'arrêt de l'instance. Lorsque vous démarrez une instance avec SQL*Plus ou Oracle Enterprise Manager, la taille de la mémoire SGA est indiquée dans l'exemple suivant :
SQL> STARTUP
ORACLE instance started.

Total System Global Area  368283648 bytes
Fixed Size                  1300440 bytes
Variable Size             343935016 bytes
Database Buffers           16777216 bytes
Redo Buffers                6270976 bytes
Database mounted.
Database opened.
Comme illustré dans la Figure 17-1, la mémoire SGA se compose de plusieurs composants de mémoire, qui sont des pools de mémoire utilisés pour satisfaire une classe particulière de demandes d'allocation de mémoire. Tous les composants de la mémoire SGA, à l'exception du tampon de journalisation, allouent et libèrent de l'espace en unités de mémoire contiguë appelées granules. La taille du granule est propre à la plate-forme et est déterminée par la taille totale de la mémoire SGA.
Vous pouvez interroger la vue V$SGASTAT pour obtenir des informations sur les composants de la mémoire SGA.
Les composants SGA les plus importants sont les suivants :
-
Cache de tampons de la base de données Le cache de tampons de la base de données, également appelé cache de tampons, est la zone mémoire qui stocke les copies des blocs de données lus à partir de fichiers de données.
-
Tampon de journalisation Le tampon de journalisation est un tampon circulaire de la mémoire SGA qui stocke les entrées de journalisation décrivant les modifications apportées à la base de données.
-
Pool partagé Le pool partagé met en cache différents types de données de programme.
-
Large Pool La large pool est une zone de mémoire facultative destinée aux allocations de mémoire qui sont plus importantes que ce qui est approprié pour la zone de mémoire partagée.
-
Pool Java La pool Java est une zone de mémoire qui stocke l'ensemble du code et des données Java propres à une session dans la JVM (Java Virtual Machine). Cette mémoire inclut les objets Java qui sont migrés vers l'espace de session Java en fin d'appel.
-
SGA fixe La SGA fixe est une zone interne de gestion.
-
Sous-zones de mémoire SGA facultatives liées aux performances Certaines sous-zones de mémoire SGA sont uniquement activées pour des fonctionnalités de performances spécifiques.
Voir aussi :
-
Guide de réglage des performances d'Oracle AI Database pour en savoir plus sur le dimensionnement des granules
Cache de tampons de base de données
Le cache de tampons de base de données, également appelé cache de tampons, est la zone de mémoire qui stocke les copies des blocs de données lus à partir de fichiers de données.
Un tampon est une adresse de mémoire principale dans laquelle le gestionnaire de tampons met temporairement en cache un bloc de données utilisé actuellement ou récemment. Tous les utilisateurs connectés simultanément à une instance de base de données partagent l'accès au cache de tampons.
-
Objectif du cache de tampons de base de données Oracle AI Database utilise le cache de tampons pour atteindre plusieurs objectifs.
-
Etats des tampons La base de données utilise des algorithmes internes pour gérer les tampons dans le cache.
-
Modes de tampon Lorsqu'un client demande des données, Oracle AI Database extrait les tampons du cache de tampons de la base de données en mode en cours ou en mode cohérent.
-
E/S du tampon Une E/S logique, également appelée E/S du tampon, fait référence aux lectures et écritures de tampons dans le cache.
-
Pools de tampons Un pool de tampons est un ensemble de tampons.
-
Tampons et balayages complets de table La base de données utilise un algorithme complexe pour gérer les balayages de table. Par défaut, lorsque les tampons doivent être lus à partir du disque, la base de données les insère au milieu de la liste LRU. De cette façon, les blocs à chaud peuvent rester dans le cache afin qu'ils n'aient pas besoin d'être lus à nouveau à partir du disque.
-
Les tampons de base de données DRAM et PMEM standard (DRAM) diffèrent des tampons PMEM, mais ils partagent des caractéristiques.
Rôle du cache de tampon de base de donnée
Oracle AI Database utilise le cache de tampons pour atteindre plusieurs objectifs.
Les objectifs sont les suivants :
-
Optimiser les E/S physique
La base de données met à jour les blocs de données dans le cache et stocke les métadonnées relatives aux modifications dans le tampon de journalisation. Après
COMMIT, la base de données écrit les tampons de journalisation dans le fichier de journalisation en ligne, mais n'écrit pas immédiatement les blocs de données dans les fichiers de données. Au lieu de cela, le processus d'écriture de base de données (DBW) effectue des écritures lazy en arrière-plan. -
Conserver les blocs fréquemment consultés dans le cache de tampons et écrire sur le disque les blocs rarement consultés
Lorsque Database Smart Flash Cache (cache Flash) est activé, une partie du cache de tampons peut résider dans le cache Flash. Cette extension de cache de tampons est stockée sur un ou plusieurs périphériques Flash. La base de données peut améliorer les performances en mettant en cache des tampons dans la mémoire flash au lieu de lire à partir d'un disque magnétique.
Utilisez les paramètres d'initialisation
DB_FLASH_CACHE_FILEetDB_FLASH_CACHE_SIZEpour configurer plusieurs périphériques Flash. Le cache de tampons suit chaque périphérique et distribue uniformément les tampons aux périphériques.Remarque : Database Smart Flash Cache est disponible uniquement sous Solaris et Oracle Linux.
-
Gérer les en-têtes de tampon qui pointent vers les fichiers de données dans Oracle Persistent Memory Filestore (PMEM Filestore)
Si vous activez le fichier PMEM Filestore, les fichiers de base de données sont mis en correspondance pour un accès direct en lecture seule. Les requêtes peuvent contourner le mécanisme traditionnel du cache de tampons, ce qui évite les E/S inutiles. Dans ce cas, les en-têtes de tampon doivent stocker les métadonnées correspondant aux blocs PMEM. La base de données peut toujours utiliser le cache de tampons (buffer cache) traditionnel (DRAM) pour les modifications, la cohérence en lecture et un accès plus rapide aux blocs de données "à chaud".
Voir aussi :
-
Référence Oracle AI Database pour en savoir plus sur le paramètre d'initialisation
DB_FLASH_CACHE_FILE
Etats du tampon
La base de données utilise des algorithmes internes pour gérer les tampons dans le cache.
Un tampon peut avoir l'un des états suivants qui s'excluent mutuellement :
-
Inutilisé
Le tampon est disponible pour utilisation car il n'a jamais été utilisé ou est actuellement inutilisé. Ce type de tampon est le plus facile à utiliser pour la base de données.
-
Nettoyer
Ce tampon a été utilisé précédemment et contient désormais une version cohérente en lecture d'un bloc à un moment donné. Le bloc contient des données mais est "propre" de sorte qu'il n'a pas besoin d'être pointé. La base de données peut épingler et réutiliser le bloc.
-
Sale
Le tampon contient des données modifiées qui n'ont pas encore été écrites sur le disque. La base de données doit effectuer un point de reprise sur le bloc avant de le réutiliser.
Chaque tampon a un mode d'accès : épinglé ou libre (non épinglé). Un tampon est "épinglé" dans le cache, de sorte qu'il ne manque pas de mémoire lorsqu'une session utilisateur y accède. Plusieurs sessions ne peuvent pas modifier un tampon localisé en même temps.
Modes de tampon
Lorsqu'un client demande des données, Oracle AI Database extrait les tampons du cache de tampons de la base de données en mode en cours ou en mode cohérent.
Les modes diffèrent comme suit :
-
Mode actuel
Une obtention en mode courant, également appelée obtention de bloc de base de données, est une extraction d'un bloc tel qu'il apparaît actuellement dans le cache de tampons. Par exemple, si une transaction non validée a mis à jour deux lignes dans un bloc, un mode en cours extrait le bloc avec ces lignes non validées. La base de données utilise le bloc de base de données le plus souvent lors des instructions de modification, qui doivent mettre à jour uniquement la version actuelle du bloc.
-
Mode cohérent
Une obtention de lecture cohérente est une extraction d'une version cohérente en lecture d'un bloc. Cette extraction peut utiliser des données d'annulation. Par exemple, si une transaction non validée a mis à jour deux lignes dans un bloc, et si une requête dans une session distincte demande le bloc, la base de données utilise les données d'annulation pour créer une version cohérente en lecture de ce bloc (appelée clone de lecture cohérente) qui n'inclut pas les mises à jour non validées. En général, une interrogation extrait des blocs en mode cohérent.
Voir aussi :
-
Référence Oracle AI Database pour une description des statistiques de base de données telles que l'obtention de bloc de base de données et l'obtention de lecture cohérente
E/S de tampon
Une E/S logique, également désignée comme E/S tampon, fait référence aux lectures et écritures de tampons dans le cache.
Lorsqu'un tampon demandé est introuvable dans la mémoire, la base de données effectue une E/S physique pour copier le tampon du cache Flash ou du disque dans la mémoire. La base de données effectue ensuite une E/S logique pour lire le tampon mis en cache.
-
Algorithmes de remplacement de tampon Pour rendre l'accès aux tampons efficace, la base de données doit décider quels tampons mettre en mémoire cache et lesquels accéder à partir du disque.
-
Écritures de tampon Le processus database Writer (DBW) écrit périodiquement sur le disque les tampons "cold" et "dirty".
-
Lectures de tampon Lorsque le nombre de tampons inutilisés est faible, la base de données doit supprimer les tampons du cache de tampons.
-
Nombre de tampons tactiles La base de données mesure la fréquence d'accès des tampons de la liste LRU à l'aide d'un nombre de touches. Ce mécanisme permet à la base de données d'incrémenter un compteur lorsqu'un tampon est épinglé au lieu de réorganiser constamment les tampons de la liste LRU.
Algorithmes de remplacement de tampon
Pour que l'accès aux tampons soit efficace, la base de données doit décider des tampons à mettre en mémoire cache et des tampons auxquels accéder à partir du disque.
La base de données utilise les algorithmes suivants :
-
Algorithme de remplacement au niveau bloc basé sur LRU
Cet algorithme sophistiqué, qui est la valeur par défaut, utilise une liste LRU (Least Recently Used) qui contient des pointeurs vers des tampons modifiés et non modifiés. La liste LRU a une extrémité chaude et une extrémité froide. Un tampon à froid est un tampon qui n'a pas été utilisé récemment. Un tampon de secours est fréquemment utilisé et a été récemment utilisé. Sur le plan conceptuel, il n'existe qu'une seule LRU, mais pour la concomitance de données, la base de données utilise en fait plusieurs LRU.
-
Algorithme de remplacement de niveau objet basé sur la température
A partir d'Oracle Database 12c version 1 (12.1.0.2), la fonction de mise en cache automatique des grandes tables permet aux balayages de table d'utiliser un algorithme différent dans les scénarios suivants :
-
Requêtes parallèles
Dans les bases de données mono-instance et Oracle Real Applications Cluster (Oracle RAC), les interrogations parallèles peuvent utiliser le cache Big Table lorsque le paramètre d'initialisation
DB_BIG_TABLE_CACHE_PERCENT_TARGETest défini sur une valeur différente de zéro et quePARALLEL_DEGREE_POLICYest défini surautoouadaptive. -
Requêtes série
Dans une configuration à instance unique uniquement, les requêtes série peuvent utiliser le cache Big Table lorsque le paramètre d'initialisation
DB_BIG_TABLE_CACHE_PERCENT_TARGETest défini sur une valeur différente de zéro.
Lorsqu'une table ne tient pas dans la mémoire, la base de données détermine les tampons à mettre en cache en fonction des modèles d'accès. Par exemple, si seulement 95 % d'une table populaire tient dans la mémoire, la base de données peut choisir de laisser 5 % des blocs sur le disque plutôt que de lire des blocs de façon cyclique en mémoire et d'écrire des blocs sur le disque, phénomène connu sous le nom de thrashing. Lors de la mise en cache de plusieurs objets LOB, la base de données prend en compte les tables les plus populaires et les tables les moins populaires, ce qui influence les blocs mis en cache. Le paramètre d'initialisation
DB_BIG_TABLE_CACHE_PERCENT_TARGETdéfinit le pourcentage du cache de tampons qui utilise cet algorithme.Remarque : Ce document décrit l'algorithme de remplacement au niveau bloc basé sur LRU.
-
Voir aussi : Oracle AI Database VLDB and Partitioning Guide pour en savoir plus sur l'algorithme basé sur la température
Ecritures de tampon
Le processus database Writer (DBW) écrit régulièrement sur le disque les tampons "cold" et "dirty".
DBW écrit des tampons dans les cas suivants :
-
Un processus serveur ne peut pas trouver de tampons propres pour la lecture de nouveaux blocs dans le cache de tampons de la base de données.
Lorsque les tampons sont modifiés, le nombre de tampons libres diminue Si le nombre tombe en dessous d'un seuil interne et que des tampons nettoyés sont requis, les processus serveur signalent que DBW doit écrire.
La base de données utilise le LRU pour déterminer les tampons "dirty" à écrire. Lorsque les tampons modifiés atteignent l'extrémité froide du LRU, la base de données les déplace hors du LRU vers une file d'attente d'écriture. DBW écrit les tampons de la file d'attente sur le disque, en utilisant des écritures multiblocs si possible. Ce mécanisme empêche l'extrémité du LRU de se boucher avec des tampons sales et permet de trouver des tampons propres pour la réutilisation.
-
La base de données doit faire progresser le point de reprise, qui est la position dans le thread de journalisation à partir duquel la récupération d'instance doit commencer.
-
Les tablespaces passent au statut en lecture seule ou sont mis hors ligne.
Voir aussi :
-
Guide de réglage des performances d'Oracle AI Database pour découvrir comment diagnostiquer et régler les problèmes d'écriture de tampon
Lectures de tampon
Lorsque le nombre de tampons inutilisés est faible, la base de données doit supprimer les tampons du cache de tampons.
L'algorithme dépend de l'activation ou non du cache Flash :
-
Cache Flash désactivé
La base de données réutilise chaque tampon propre si nécessaire, en le remplaçant. Si le tampon remplacé est nécessaire ultérieurement, la base de données doit le lire à partir du disque magnétique.
-
Cache Flash activé
DBW peut écrire le corps d'un tampon propre dans le cache Flash, ce qui permet de réutiliser son tampon en mémoire. La base de données conserve l'en-tête du tampon dans une liste LRU en mémoire principale pour suivre l'état et l'emplacement du corps du tampon dans le cache Flash. Si ce tampon est nécessaire ultérieurement, la base de données peut le lire à partir du cache Flash au lieu du disque magnétique.
Lorsqu'un processus client demande un tampon, le processus serveur recherche le tampon dans le cache de tampons. Un succès en mémoire cache se produit si la base de données trouve le tampon en mémoire. L'ordre de recherche est le suivant :
-
Le processus serveur recherche l'ensemble du tampon dans le cache de tampons.
Si le processus trouve l'ensemble du tampon, la base de données effectue une lecture logique de ce tampon.
-
Le processus serveur recherche l'en-tête de tampon dans la liste LRU du cache Flash.
Si le processus trouve l'en-tête de tampon, la base de données effectue une lecture physique optimisée du corps du tampon à partir du cache Flash vers le cache en mémoire.
-
Si le processus ne trouve pas le tampon en mémoire (échec du cache), le processus serveur effectue les opérations suivantes :
-
Copie le bloc d'un fichier de données sur disque dans la mémoire (lecture physique)
-
Effectue une lecture logique du tampon qui a été lu en mémoire
-
La figure 17-2 illustre l'ordre de recherche du tampon. Le cache de tampons étendu inclut à la fois le cache de tampons en mémoire, qui contient des tampons entiers, et le cache Flash, qui contient des corps de tampons. Dans la figure, la base de données recherche un tampon dans le cache de tampons et, sans le trouver, le lit en mémoire à partir du disque magnétique.
Figure 2 : Recherche de tampon
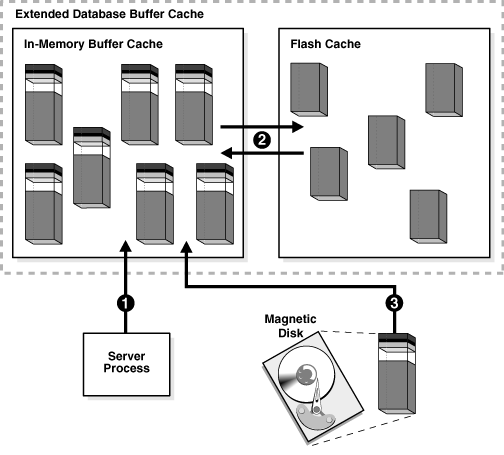
Description de l'image cncpt304.gif
En général, l'accès aux données via un succès au cache est plus rapide que l'accès via un échec au cache. Le taux de succès du cache de tampons mesure la fréquence à laquelle la base de données a trouvé un bloc demandé dans le cache de tampons sans avoir à le lire à partir du disque.
La base de données peut effectuer des lectures physiques à partir d'un fichier de données ou d'un fichier temporaire. Les lectures à partir d'un fichier de données sont suivies d'E/S logiques. Les lectures à partir d'un fichier temporaire se produisent lorsque la mémoire insuffisante force la base de données à écrire des données dans une table temporaire et à les lire ultérieurement. Ces lectures physiques contournent le cache de tampons et n'engagent pas d'E/S logiques.
Voir aussi : Guide de réglage des performances d'Oracle AI Database pour savoir comment calculer le taux de succès du cache de tampons
Nombre de touches du tampon
La base de données mesure la fréquence d'accès des tampons de la liste LRU à l'aide d'un nombre de touches. Ce mécanisme permet à la base de données d'incrémenter un compteur lorsqu'un tampon est épinglé au lieu de réorganiser constamment les tampons de la liste LRU.
Remarque : la base de données ne déplace pas physiquement les blocs en mémoire. Le mouvement correspond au changement d'emplacement d'un pointeur sur une liste.
Lorsqu'un tampon est épinglé, la base de données détermine le dernier incrément de son nombre de touches. Si le nombre a été incrémenté il y a plus de trois secondes, il est incrémenté ; sinon, le nombre reste le même. La règle des trois secondes empêche une rafale de broches sur un tampon comptant autant de touches. Par exemple, une session peut insérer plusieurs lignes dans un bloc de données, mais la base de données considère ces insertions comme une seule touche.
Si un tampon se trouve à l'extrémité froide du LRU, mais que son nombre de touches est élevé, le tampon se déplace vers l'extrémité chaude. Si le nombre de touches est faible, le tampon est retiré du cache.
Pools de tampons
Un pool de tampons est un ensemble de tampons.
Le cache de tampons de la base de données est divisé en un ou plusieurs pools de tampons, qui gèrent les blocs de la même manière. Les pools n'ont pas d'algorithmes radicalement différents pour l'ancienneté ou la mise en cache des blocs.
Vous pouvez configurer manuellement des pools de tampons distincts qui conservent les données dans le cache de tampons ou qui rendent les tampons disponibles pour les nouvelles données immédiatement après avoir utilisé les blocs de données. Vous pouvez ensuite affecter des objets de schéma spécifiques au pool de tampons approprié pour contrôler la façon dont les blocs sortent du cache. Par exemple, vous pouvez séparer les segments en pools de tampons chauds, chauds et froids.
Les pools de tampons possibles sont les suivants :
-
Pool par défaut
Ce pool est l'emplacement où les blocs sont normalement mis en cache. Sauf si vous configurez manuellement des pools distincts, le pool par défaut est le seul pool de tampons. La configuration facultative des autres pools n'a aucun effet sur le pool par défaut.
Le cache de grande table est une section facultative du pool par défaut qui utilise un algorithme de remplacement de niveau objet basé sur la température. Dans les bases de données mono-instance et Oracle RAC, les interrogations parallèles peuvent utiliser le cache Big Table lorsque le paramètre d'initialisation
DB_BIG_TABLE_CACHE_PERCENT_TARGETest défini sur une valeur différente de zéro et quePARALLEL_DEGREE_POLICYest défini surautoouadaptive. Dans les configurations à instance unique uniquement, les requêtes série peuvent utiliser le cache Big Table lorsqueDB_BIG_TABLE_CACHE_PERCENT_TARGETest défini. -
Conserver le pool
Ce pool est destiné aux blocs qui ont été fréquemment consultés, mais qui ont été retirés du pool par défaut en raison d'un manque d'espace. Le pool du tampon de conservation permet de conserver les objets en mémoire, et donc d'éviter les opérations d'entrées/sorties.
Remarque : le pool de conservation gère les tampons de la même manière que les autres pools : il n'utilise pas d'algorithme spécial pour épingler les tampons. Le mot "keep" est une convention de nommage. Vous pouvez placer les tables que vous souhaitez conserver dans le plus grand pool de conservation et les placer dans le plus petit pool de recyclage.
-
Pool de recyclage
Ce pool est destiné aux blocs qui sont rarement utilisés. Un pool de recyclage empêche les objets de consommer de l'espace inutile dans le cache.
Une base de données a une taille de bloc standard. Vous pouvez créer un tablespace dont la taille de bloc diffère de la taille standard. Chaque taille de bloc autre que celle par défaut possède son propre pool. Oracle AI Database gère les blocs de ces pools de la même manière que dans le pool par défaut.
La figure suivante illustre la structure du cache de tampons lorsque plusieurs pools sont utilisés. Le cache contient les pools par défaut, de conservation et de recyclage. La taille d'un bloc par défaut est de8 Ko. Le cache contient des pools distincts pour les tablespaces qui utilisent des tailles de bloc non standard de 2 ko, 4 ko et 16 ko.
Figure 3 : Cache de tampon de base de donnée
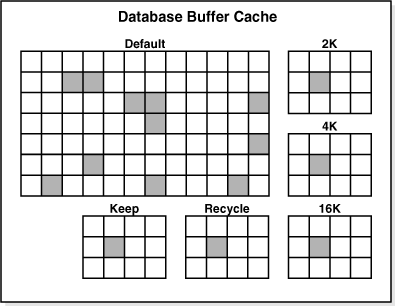
Description de l'image cncpt220.gif
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur les pools de tampons
-
Guide de réglage des performances d'Oracle AI Database pour apprendre à utiliser plusieurs pools de tampons
-
Référence Oracle AI Database pour en savoir plus sur le paramètre d'initialisation
DB_BIG_TABLE_CACHE_PERCENT_TARGET
Tampons et balayages complets de table
La base de données utilise un algorithme complexe pour gérer les balayages de table. Par défaut, lorsque les tampons doivent être lus à partir du disque, la base de données les insère au milieu de la liste LRU. De cette façon, les blocs à chaud peuvent rester dans le cache afin qu'ils n'aient pas besoin d'être lus à nouveau à partir du disque.
Un problème est posé par un balayage complet de la table, qui lit séquentiellement toutes les lignes sous la table limite supérieure du contrôle du débit (HWM). Supposons que la taille totale des blocs d'un segment de table soit supérieure à la taille du cache de tampons. Un balayage complet de cette table peut éliminer le cache de tampons, ce qui empêche la base de données de conserver un cache contenant les blocs fréquemment consultés.
-
Mode par défaut pour les balayages complets de table (full table scans) Par défaut, la base de données adopte une approche prudente pour les balayages complets de table (full table scans), en chargeant une petite table en mémoire uniquement lorsque la taille de la table est un petit pourcentage du cache de tampons (buffer cache).
-
Exécution de requête en parallèle Lors d'un balayage complet de table, la base de données peut parfois améliorer le temps de réponse en utilisant plusieurs serveurs d'exécution en parallèle.
-
Attribut CACHE Dans les rares cas où le comportement de mise en CACHE par défaut n'est pas souhaité, vous pouvez utiliser
ALTER TABLE ... CACHEpour modifier le mode de lecture des blocs de tables volumineuses dans le CACHE de tampons de la base de données. -
AttributKEEP Pour les tables volumineuses, vous pouvez utiliser
ALTER TABLE ... STORAGE BUFFER_POOL KEEPpour que les analyses chargent les blocs de ces tables dans le pool de conservation. -
Forcer le mode de mise en cache complète de la base de données Pour améliorer les performances dans certains cas, vous pouvez exécuter explicitement l'instruction
ALTER DATABASE ... FORCE FULL DATABASE CACHINGafin d'activer le mode de mise en cache complète de la base de données. Voir aussi : "Espace de segment et marque High Water Mark"
Mode par défaut pour les balayages complets de table
Par défaut, la base de données adopte une approche prudente pour les balayages complets de table (full table scans), en chargeant une petite table dans la mémoire uniquement lorsque la taille de la table représente un faible pourcentage du cache de tampons (buffer cache).
Pour déterminer si les tables de taille moyenne doivent être mises en cache, la base de données utilise un algorithme qui intègre l'intervalle entre le dernier balayage de table, l'horodatage de vieillissement du cache de tampons et l'espace restant dans le cache de tampons.
Pour les tables très volumineuses, la base de données utilise généralement une lecture par chemin direct, qui charge les blocs directement dans la mémoire PGA et ignore complètement la mémoire SGA, afin d'éviter de remplir le cache de tampons. Pour les tables de taille moyenne, la base de données peut utiliser une lecture directe ou une lecture en cache. Si elle décide d'utiliser une lecture de cache, la base de données place les blocs à la fin de la liste LRU pour empêcher l'analyse de nettoyer efficacement le cache de tampons.
A partir d'Oracle Database 12c Release 1 (12.1.0.2), le cache de tampons d'une instance de base de données effectue automatiquement un calcul interne pour déterminer si la mémoire est suffisante pour que la base de données soit entièrement mise en mémoire cache dans la mémoire SGA de l'instance, et si la mise en mémoire cache des tables lors de l'accès est bénéfique pour les performances. Si l'ensemble de la base de données peut tenir entièrement en mémoire et que d'autres critères internes sont remplis, Oracle AI Database traite toutes les tables de la base de données comme de petites tables et les considère comme éligibles à la mise en cache. Toutefois, la base de données ne met pas en cache les objets LOB marqués avec l'attribut NOCACHE.
Exécution de requêtes parallèles
Lorsque vous effectuez un balayage complet de table (full table scan), la base de données peut parfois améliorer le temps de réponse en utilisant plusieurs serveurs d'exécution en parallèle.
Dans certains cas, comme lorsque la base de données dispose d'une grande quantité de mémoire, elle peut mettre en cache des données d'interrogation parallèles dans la mémoire SGA (System Global Area) au lieu d'utiliser des lectures par chemin direct dans la mémoire PGA (Program Global Area). En général, les requêtes parallèles sont exécutées dans des data warehouses peu simultanés en raison de l'utilisation potentielle des ressources.
Voir aussi :
-
Guide d'entreposage de données Oracle AI Database pour une introduction aux entrepôts de données
-
Oracle AI Database VLDB and Partitioning Guide pour en savoir plus sur l'exécution parallèle
Attribut CACHE
Dans les rares cas où le comportement de mise en cache par défaut n'est pas souhaité, vous pouvez utiliser ALTER TABLE ... CACHE pour modifier la façon dont les blocs des tables volumineuses sont lus dans le cache de tampons de la base de données.
Pour les tables dont l'attribut CACHE est défini, la base de données ne force ni n'épingle les blocs dans le cache de tampons. Au lieu de cela, la base de données retire les blocs du cache de la même manière que tout autre bloc de table. Faites attention lorsque vous utilisez cette option, car un balayage complet d'une table volumineuse peut nettoyer la plupart des autres blocs du cache. Remarque : l'exécution de ALTER TABLE ... CACHE n'entraîne pas la mise en cache d'une table.
Attribut KEEP
Pour les tables volumineuses, vous pouvez utiliser ALTER TABLE ... STORAGE BUFFER_POOL KEEP pour que les analyses chargent les blocs de ces tables dans le pool de conservation.
Le fait de placer une table dans le pool de conservation modifie la partie du cache de tampons où les blocs sont stockés. Au lieu de mettre en cache des blocs dans le pool de tampons par défaut, la base de données les met en cache dans le pool de tampons de conservation. Aucun contrôle d'algorithme distinct ne conserve la mise en cache du pool.
Voir aussi :
-
Référence de langage SQL Oracle AI Database pour plus d'informations sur la clause
CACHEet l'attributKEEP -
Guide de réglage des performances d'Oracle AI Database pour apprendre à interpréter les statistiques de conseil relatives au cache de tampons
Forcer le mode de mise en cache complète de la base de données
Pour améliorer les performances dans certains cas, vous pouvez exécuter explicitement l'instruction ALTER DATABASE ... FORCE FULL DATABASE CACHING afin d'activer le mode de mise en cache complète de la base de données.
Contrairement au mode par défaut, qui est automatique, le mode Forcer la mise en cache complète de la base de données considère l'ensemble de la base de données, y compris les LOB NOCACHE, comme pouvant être mis en cache dans le cache de tampons de la base de données. Ce mode est disponible à partir d'Oracle Database 12c version 1 (12.1.0.2). Remarque : l'activation du mode Forcer la mise en cache complète de la base de données n'oblige pas la base à entrer en mémoire. Au lieu de cela, la base de données entière est admissible à la mise en cache dans le cache de tampons. Oracle AI Database met en cache les tables uniquement lorsqu'elles sont accessibles.
Oracle recommande d'activer le mode Forcer la mise en cache complète de la base de données uniquement lorsque la taille du cache de tampons de chaque instance est supérieure à la taille de la base de données. Cette directive s'applique aux bases de données mono-instance et Oracle RAC. Toutefois, lorsque les applications Oracle RAC sont bien partitionnées, vous pouvez activer le mode Forcer la mise en cache complète de la base de données lorsque le cache de tampons combiné de toutes les instances, avec un espace supplémentaire pour gérer les blocs mis en cache en double entre les instances, est supérieur à la taille de la base de données.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à activer le mode de mise en cache de base de données complète forcée
-
Référence du langage SQL d'Oracle AI Database pour plus d'informations sur l'instruction
ALTER DATABASE ... FORCE FULL DATABASE CACHING
Tampons DRAM et PMEM
Les tampons de base de données standard (DRAM) diffèrent des tampons PMEM, mais ils partagent des caractéristiques.
Lorsque le fichier Oracle Persistent Memory Filestore (PMEM Filestore) est configuré, chaque bloc de données est directement mis en correspondance avec le cache de tampons dans DRAM. Contrairement aux tampons DRAM, les tampons PMEM ne copient pas le contenu des blocs de données. Les en-têtes de tampon PMEM pointent plutôt vers les blocs de données stockés dans le fichier PMEM Filestore. Pour la plupart des lectures, la base de données ne met en cache que les métadonnées de bloc, et non le contenu. Les tampons PMEM utilisent un type spécial de granule dont la structure est différente des granules de cache de tampons standard.
Remarque : le paramètre d'initialisation DB_CACHE_SIZE indique la taille minimale du cache DRAM. La surcharge de métadonnées PMEM n'est pas incluse dans cette allocation.
Les tampons PMEM peuvent avoir l'un des états suivants :
-
Actuel
Il s'agit de la version actuelle d'un tampon PMEM. Vous pouvez y accéder directement à partir du magasin de fichiers.
Oracle AI Database conserve la version actuelle de la PMEM distincte de la version actuelle du tampon DRAM standard. Cette séparation permet de réduire la complexité du code lors de l'épinglage, du nettoyage et de la migration des blocs PMEM vers la DRAM.
-
Cohérent
Il s'agit de la version de lecture cohérente d'un tampon PMEM. Elle est créée une fois que la base de données a créé un clone dans DRAM. Le tampon PMEM est accessible directement depuis le magasin de fichiers.
-
Gratuit
Il s'agit d'un tampon PMEM libre. Il peut être réutilisé par un bloc PMEM. Après le démarrage de l'instance, tous les tampons PMEM sont à l'état libre.
La PMEM présente une latence plus élevée que la DRAM. Oracle AI Database utilise un algorithme interne basé sur la charge de travail pour décider quels blocs migrer de la PMEM vers la DRAM.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment configurer PMEM Filestore
Tampon du fichier de journalisation
Le tampon de journalisation est un tampon circulaire de la mémoire SGA qui stocke les entrées de journalisation décrivant les modifications apportées à la base de données.
Un enregistrement de journalisation est une structure de données qui contient les informations nécessaires à la reconstruction ou au rétablissement des modifications apportées à la base de données par des opérations LMD ou LDD. La récupération de base de données applique des entrées de journalisation aux fichiers de données pour reconstruire les modifications perdues.
Les processus de base de données copient les entrées de journalisation de l'espace mémoire utilisateur dans le tampon de journalisation de la mémoire SGA. Les entrées de journalisation occupent un espace continu et séquentiel dans le tampon. Le processus en arrière-plan LGWR écrit le tampon de journalisation dans le groupe de fichiers de journalisation en ligne actif sur le disque. La figure 17-4 illustre cette activité de tampon de journalisation.
Figure 4 : Tampon de journalisation
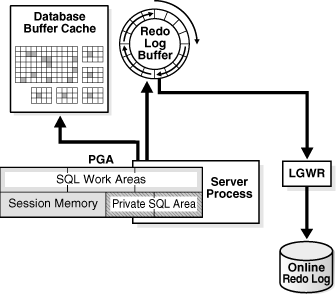
Description de l'image cncpt226.gif
Le processus LGWR écrit les informations de journalisation de manière séquentielle sur le disque, tandis que le processus DBW effectue des écritures dispersées de blocs de données sur le disque. Les écritures dispersées ont tendance à être beaucoup plus lentes que les écritures séquentielles. Etant donné que le processus LGWR permet aux utilisateurs d'éviter d'attendre que le processus DBW termine ses écritures lentes, la base de données offre de meilleures performances.
Le paramètre d'initialisation LOG_BUFFER indique la quantité de mémoire utilisée par Oracle AI Database lors de la mise en mémoire tampon des entrées de journalisation. Contrairement aux autres composants de la mémoire SGA, le tampon de journalisation et le tampon SGA fixe ne divisent pas la mémoire en granules.
Voir aussi :
-
"Processus d'écriture de journal (LGWR)" et "Importance des points de reprise pour la récupération d'instance"
-
Guide de l'administrateur Oracle AI Database, pour plus d'informations sur le fichier de journalisation en ligne
Pool partagé
Le pool partagé met en cache différents types de données de programme.
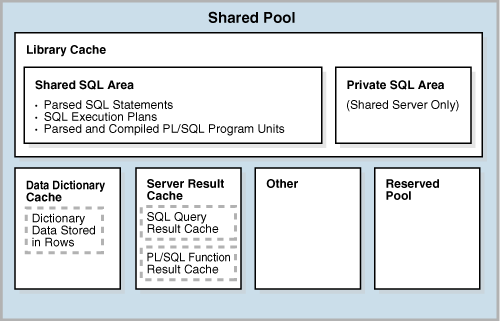
Par exemple, la zone de mémoire partagée stocke le code SQL analysé, le code PL/SQL, les paramètres système et les informations du dictionnaire de données. La zone de mémoire partagée est impliquée dans presque toutes les opérations effectuées dans la base de données. Par exemple, si un utilisateur exécute une instruction SQL, Oracle AI Database accède à la zone de mémoire partagée.
La zone de mémoire partagée est divisée en plusieurs sous-composants, dont le plus important est illustré dans la Figure 17-5.
Figure 5 : Pool partagé
Description de l'image cncpt225.gif
Cette section traite des sujets suivants :
-
Cache de bibliothèque Le cache de bibliothèque est une structure de mémoire de zone de mémoire partagée qui stocke le code SQL et PL/SQL exécutables.
-
Dictionnaire de données cache : le dictionnaire de données est un ensemble de tables de base de données et de vues contenant des informations de référence sur les bases de données, leurs structures et ses utilisateurs.
-
Cache de résultats du serveur Le cache de résultats du serveur est un pool de mémoire au sein de la zone de mémoire partagée. Contrairement aux pools de tampons, le cache de résultats du serveur contient des ensembles de résultats et non des blocs de données.
-
Pool réservé Le pool réservé est une zone de mémoire de la zone de mémoire partagée qu'Oracle AI Database peut utiliser pour allouer de gros blocs contigus de mémoire.
Cache de bibliothèque
Le cache de bibliothèque est une structure de mémoire de zone de mémoire partagée qui stocke le code SQL et PL/SQL exécutables.
Ce cache contient les zones et les structures de contrôle SQL et PL/SQL partagées, telles que les verrous et les poignées du cache "library". Dans une architecture de serveur partagé, le cache "library" contient également des zones SQL privées.
Lorsqu'une instruction SQL est exécutée, la base de données tente de réutiliser le code exécuté précédemment. Si une représentation analysée d'une instruction SQL existe dans le cache "library" et peut être partagée, la base de données réutilise le code, appelé analyse partielle ou accès réussi au cache "library". Sinon, la base de données doit créer une nouvelle version exécutable du code de l'application, appelée analyse complète ou échec du cache de la bibliothèque.
-
Zones SQL partagées La base de données représente chaque instruction SQL qu'elle exécute dans la zone SQL partagée et la zone SQL privée.
-
Unités de programme et cache "library" Le cache "library" contient des formes exécutables de programmes PL/SQL et de classes Java. Ces éléments sont collectivement appelés unités de programme.
-
Allocation et réutilisation de la mémoire dans la zone de mémoire partagée La base de données alloue la mémoire de la zone de mémoire partagée lorsqu'une nouvelle instruction SQL est analysée, sauf si l'instruction est LDD, ce qui n'est pas considéré comme partageable. La taille de la mémoire allouée dépend de la complexité de l'instruction.
Zones SQL partagées
La base de données représente chaque instruction SQL qu'elle exécute dans la zone SQL partagée et la zone SQL privée.
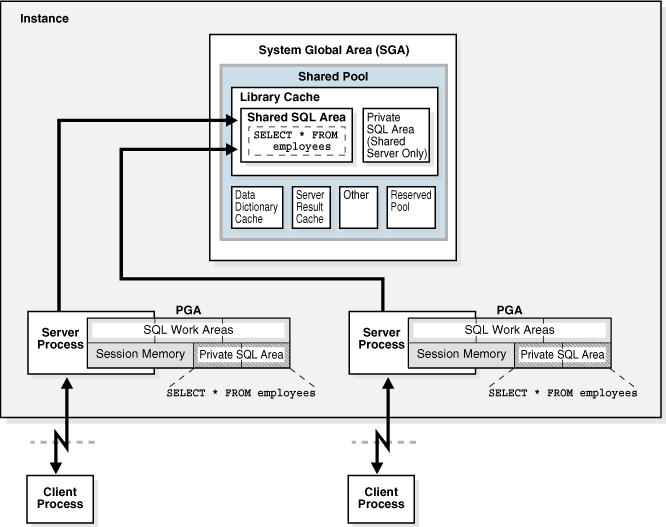
La base de données utilise la zone SQL partagée pour traiter la première occurrence d'une instruction SQL. Cette zone est accessible à tous les utilisateurs et contient l'arborescence d'analyse des instructions et le plan d'exécution. Une seule zone SQL partagée existe pour une instruction unique. Chaque session qui émet une instruction SQL comporte une zone SQL privée dans sa mémoire PGA. Chaque utilisateur qui soumet la même instruction dispose d'une zone SQL privée pointant vers la même zone SQL partagée. Par conséquent, de nombreuses zones SQL privées dans des autorisations préalables distinctes peuvent être associées à la même zone SQL partagée.
La base de données détermine automatiquement quand les applications soumettent des instructions SQL similaires. La base de données prend en compte les instructions SQL émises directement par les utilisateurs et les applications, ainsi que les instructions SQL récursives émises en interne par d'autres instructions.
La base de données effectue les opérations suivantes :
-
Vérifie si une zone SQL partagée existe pour une instruction identique d'un point de vue syntaxique et sémantique :
-
Si une instruction identique existe, la base de données utilise la zone SQL partagée pour exécuter les nouvelles instances suivantes de l'instruction, ce qui réduit la consommation de mémoire.
-
Si aucune instruction identique n'existe, la base de données alloue une nouvelle zone SQL partagée dans la zone de mémoire partagée. Une instruction avec la même syntaxe mais une sémantique différente utilise un curseur enfant.
Dans les deux cas, la zone SQL privée de l'utilisateur pointe vers la zone SQL partagée qui contient l'instruction et le plan d'exécution.
-
-
Alloue une zone SQL privée pour le compte de la session
L'emplacement de la zone SQL privée dépend de la connexion établie pour la session. Si une session est connectée via un serveur partagé, une partie de la zone SQL privée est conservée dans la mémoire SGA.
La Figure 17-6 illustre une architecture de serveur dédiée dans laquelle deux sessions conservent une copie de la même instruction SQL dans leurs propres autorisations de groupe de propriétés. Dans un serveur partagé, cette copie se trouve dans la mémoire UGA, qui se trouve dans la mémoire MGA.
Figure 6 : Zones SQL privées et zone SQL partagée
Description de l'image cncpt252.gif
Voir aussi :
-
Guide de réglage des performances d'Oracle AI Database pour en savoir plus sur la gestion du cache de bibliothèque
-
Guide de développement Oracle AI Database pour plus d'informations sur le langage SQL partagé
Unités de programme et cache "library"
Le cache "library" contient des formes exécutables de programmes PL/SQL et de classes Java. Ces éléments sont collectivement appelés unités de programme.
La base de données traite les unités de programme de la même manière que les instructions SQL. Par exemple, la base de données alloue une zone partagée pour contenir la forme analysée et compilée d'un programme PL/SQL. La base de données alloue une zone privée pour contenir les valeurs propres à la session qui exécute le programme, y compris les variables locales, globales et de package, et les tampons pour l'exécution du code SQL. Si plusieurs utilisateurs exécutent le même programme, chaque utilisateur conserve une copie distincte de sa zone SQL privée, qui contient les valeurs propres à la session et accède à une seule zone SQL partagée.
La base de données traite des instructions SQL individuelles au sein d'un programme PL/SQL, comme décrit précédemment. Malgré leur origine dans une unité de programme PL/SQL, ces instructions SQL utilisent une zone partagée pour contenir leurs représentations analysées et une zone privée pour chaque session qui exécute l'instruction.
Allocation et réutilisation de mémoire dans la zone de mémoire partagée
La base de données alloue la mémoire de la zone de mémoire partagée lorsqu'une nouvelle instruction SQL est analysée, sauf si l'instruction est LDD, ce qui n'est pas considéré comme partageable. La taille de la mémoire allouée dépend de la complexité de l'instruction.
En général, un élément de la zone de mémoire partagée reste jusqu'à ce que la base de données le supprime en fonction d'un algorithme LRU (Least Recently Used). La base de données permet aux éléments de la zone de mémoire partagée utilisés par de nombreuses sessions de rester en mémoire tant qu'ils sont utiles, même si le processus de base de données qui a créé l'élément prend fin. Ce mécanisme réduit la surcharge et le traitement des instructions SQL. Si de l'espace est nécessaire pour les nouveaux éléments, la base de données libère de la mémoire consommée par les éléments rarement utilisés.
L'instruction ALTER SYSTEM FLUSH SHARED_POOL supprime toutes les informations de la zone de mémoire partagée, tout comme la modification du nom global de la base de données.
Voir aussi :
-
Guide de réglage SQL Oracle AI Database, pour une présentation du cycle de vie d'une zone SQL partagée
-
Référence de langage SQL Oracle AI Database pour plus d'informations sur l'utilisation de
ALTER SYSTEM FLUSH SHARED_POOL -
Référence Oracle AI Database pour plus d'informations sur les vues dynamiques
V$SQLetV$SQLAREA
Cache du dictionnaire de données
Le dictionnaire de données est un ensemble de tables de base de données et de vues contenant des informations de référence sur cette base de données, ses structures et ses utilisateurs.
Oracle AI Database accède fréquemment au dictionnaire de données lors de l'analyse des instructions SQL. Oracle AI Database accède si souvent au dictionnaire de données que les emplacements de mémoire spéciaux suivants sont désignés pour contenir les données du dictionnaire :
-
Le cache du dictionnaire de données
Ce cache contient des informations sur les objets de base de données. Le cache est également appelé cache de ligne car il contient les données sous forme de lignes au lieu de tampons.
-
cache de bibliothèque
Tous les processus serveur partagent ces caches pour accéder aux informations du dictionnaire de données.
Voir aussi :
-
"Dictionnaire de données et vues dynamiques des performances"
-
Guide de réglage des performances d'Oracle AI Database pour apprendre à allouer de la mémoire supplémentaire au cache du dictionnaire de données
Cache des résultats du serveur
Le cache de résultats du serveur est un pool de mémoire au sein de la zone de mémoire partagée. Contrairement aux pools de tampons, le cache de résultats du serveur contient des ensembles de résultats et non des blocs de données. Remarque : Un cache de résultats client diffère du cache de résultats du serveur. Un cache client est configuré au niveau de l'application et se trouve dans la mémoire client, et non dans la mémoire de la base de données.
-
Cache des résultats de requête SQL Le cache des résultats de requête SQL est un sous-ensemble du cache des résultats du serveur qui stocke les résultats des requêtes et des fragments de requête. Vous pouvez activer ou désactiver la mise en cache des résultats au niveau de la base de données ou de l'instruction.
-
Cache de résultats de fonction PL/SQL Le cache de résultats de fonction PL/SQL est un sous-ensemble du cache de résultats de serveur qui stocke les ensembles de résultats de fonction.
-
Infrastructure de cache des résultats de serveur Le cache des résultats de requête et le cache des résultats de fonction PL/SQL partagent la même infrastructure.
-
Interface utilisateur du cache des résultats du serveur Le paramètre d'initialisation
RESULT_CACHE_MODEdétermine si le cache des résultats de requête SQL est utilisé pour toutes les requêtes possibles ou uniquement pour les requêtes suggérées.
Cache des résultats de requête SQL
Le cache de résultats de requête SQL est un sous-ensemble du cache de résultats du serveur qui stocke les résultats des requêtes et des fragments de requête. Vous pouvez activer ou désactiver la mise en cache des résultats au niveau de la base de données ou de l'instruction.
Lorsqu'une requête est exécutée, la base de données détermine si le résultat existe dans le cache des résultats de requête. Si le résultat n'est pas mis en cache et que la mise en cache est activée pour l'interrogation, la base de données exécute l'interrogation, renvoie le résultat, puis le met en cache. Toutefois, si le résultat existe, la base de données l'extrait du cache au lieu d'exécuter l'interrogation.
La base de données invalide automatiquement un résultat mis en cache chaque fois qu'une transaction modifie les données ou les métadonnées des objets de base de données utilisés pour construire le résultat. L'interrogation suivante ne peut pas utiliser le résultat mis en cache. Par conséquent, la base de données calcule automatiquement un nouveau résultat, puis le met en cache pour être utilisé par les interrogations suivantes. Le processus d'actualisation du cache est transparent pour l'application.
En effet, le cache des résultats d'interrogation fonctionne comme une vue matérialisée "juste à temps" que la base de données crée et gère selon les besoins. Le cache permet à la base de données d'éviter les opérations coûteuses de relecture de blocs de données et de recalcul des résultats. La plupart des applications bénéficient de cette amélioration des performances.
Voir aussi : Guide de l'administrateur Oracle AI Database pour apprendre à optimiser le temps de réponse à l'aide du cache de résultats de requête
Cache de résultats des fonctions PL/SQL
Le cache de résultats de fonction PL/SQL est un sous-ensemble du cache de résultats du serveur qui stocke les ensembles de résultats de fonction.
Sans la mise en cache, 1000 appels d'une fonction PL/SQL à 1 seconde par appel prendraient 1000 secondes. Avec la mise en cache, 1000 appels de fonction avec les mêmes entrées peuvent prendre 1 seconde total. Les bons candidats pour la mise en cache des résultats sont des fonctions fréquemment appelées qui dépendent de données relativement statiques.
Le code de fonction PL/SQL peut inclure une demande de mise en cache de ses résultats. Lors de l'appel de cette fonction, le système vérifie le cache. Si le cache contient le résultat d'un appel de fonction précédent avec les mêmes valeurs de paramètre, le système renvoie le résultat à l'appelant et ne réexécute pas le corps de la fonction. Si le cache ne contient pas le résultat, le système exécute le corps de la fonction et ajoute le résultat (pour ces valeurs de paramètre) au cache avant de renvoyer le contrôle à l'appelant.
Remarque : vous pouvez indiquer les objets de base de données utilisés pour calculer un résultat mis en cache. Ainsi, si l'un d'entre eux est mis à jour, le résultat mis en cache devient non valide et doit être recalculé.
Une fonction qui est appelée fréquemment avec des arguments différents peut générer des résultats rarement réutilisés, ce qui entraîne une dégradation des performances. Oracle AI Database effectue le suivi des fonctions PL/SQL récemment utilisées qui ont le conseil RESULT_CACHE. A l'aide de cet historique, la base de données ne met en cache une paire fonction/argument PL/SQL que si elle l'a vue x fois dans l'historique récent, où x est défini par un seuil interne. Si la base de données a besoin de plus de mémoire car trop de résultats sont mis en mémoire cache, un ou plusieurs résultats mis en mémoire cache sont supprimés.
RESULT_CACHE_EXECUTION_THRESHOLD indique le nombre de fois où une fonction et un ensemble particulier d'arguments doivent être vus jusqu'à ce qu'ils soient mis en cache. Les fonctions sont considérées comme uniques si elles ont des arguments différents, par exemple, MYFUNC(1,2) et MYFUNC(1,3). Vous pouvez uniquement définir ce paramètre au niveau du système, et non au niveau de la session.
Voir aussi :
-
Guide de développement Oracle AI Database pour en savoir plus sur le cache de résultats des fonctions PL/SQL
-
Référence du langage PL/SQL d'Oracle AI Database pour en savoir plus sur le cache de résultats des fonctions PL/SQL
Infrastructure de cache des résultats du serveur
Le cache de résultats d'interrogation et le cache de résultats de fonction PL/SQL partagent la même infrastructure.
Types d'objet : résultat, dépendance et temp
Dans le cache des résultats du serveur, un objet de résultat est une structure de données qui stocke les lignes renvoyées par une requête ou une fonction PL/SQL. Un objet de dépendance stocke les métadonnées des objets référencés par des requêtes stockées en tant qu'objets de résultat.
Un résultat d'interrogation typique est petit, coûteux à calculer, réutilisé souvent et basé sur des tables non volatiles. Cependant, les résultats peuvent parfois être importants. Si un résultat de requête dépasse la limite de taille, la base de données stocke une partie du résultat en tant qu'objet de requête et une partie en tant qu'objet de résultat standard. Un objet temporaire est un ensemble de métadonnées du cache de résultats qui pointe vers un segment de tablespace temporaire contenant le résultat réel de l'interrogation.
Sous-caches de résultats
En fonction de la charge globale, la base de données peut créer des sous-caches de résultats pour prendre en charge une simultanéité d'accès accrue lors de l'accès en lecture/écriture. Oracle AI Database utilise un algorithme interne pour décider s'il faut créer des sous-caches et, le cas échéant, combien créer.
Interface utilisateur du cache des résultats du serveur
Le paramètre d'initialisation RESULT_CACHE_MODE détermine si le cache des résultats de requête SQL est utilisé pour toutes les requêtes possibles ou uniquement pour les requêtes suggérées.
Le paramètre d'initialisation RESULT_CACHE_MAX_TEMP_SIZE contrôle la quantité maximale de mémoire de tablespace temporaire que le cache de résultats peut utiliser dans la base de données pluggable. RESULT_CACHE_MAX_TEMP_RESULT contrôle la quantité maximale de mémoire de tablespace temporaire qu'une interrogation mise en cache peut utiliser.
Pour remplacer la valeur du paramètre RESULT_CACHE_MODE, vous pouvez annoter une requête ou un fragment de requête avec un conseil RESULT_CACHE. A partir de la version 21c d'Oracle Database, le conseil accepte l'option TEMP={TRUE|FALSE}, qui contrôle si les résultats peuvent être stockés dans un tablespace temporaire.
Le package DBMS_RESULT_CACHE vous permet d'administrer la partie de la zone de mémoire partagée utilisée par le cache de résultats SQL et le cache de résultats de fonction PL/SQL. Vous pouvez invalider des objets, des requêtes de liste de blocage et des objets, et effectuer des opérations associées.
La colonne V$RESULT_CACHE_OBJECTS.TYPE indique le type d'objet dans le cache. Si les résultats d'interrogation sont stockés dans un tablespace temporaire, TYPE affiche deux objets : Result et Temp. Les métadonnées de sous-cache sont accessibles à l'aide de V$RESULT_SUBCACHE_STATISTICS et des vues associées.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database, pour en savoir plus sur le dimensionnement et le contrôle du comportement du cache de résultats
-
Référence des types et packages PL/SQL Oracle AI Database pour plus d'informations sur le package
DBMS_RESULT_CACHE -
Guide de réglage des performances d'Oracle AI Database, pour plus d'informations sur le cache de résultats client
-
Référence Oracle AI Database pour en savoir plus sur le paramètre d'initialisation
RESULT_CACHE_MODE -
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur le conseil
RESULT_CACHE
Pool réservé
Le pool réservé est une zone de mémoire de la zone de mémoire partagée qu'Oracle AI Database peut utiliser pour allouer de gros blocs contigus de mémoire.
La base de données alloue de la mémoire à partir de la zone de mémoire partagée en blocs. Le découpage permet de charger des objets volumineux (plus de 5 ko) dans le cache sans nécessiter une seule zone contiguë. Ainsi, la base de données réduit la possibilité de manquer de mémoire contiguë en raison de la fragmentation.
Il arrive rarement que des curseurs Java, PL/SQL ou SQL effectuent des allocations dans la zone de mémoire partagée supérieures à 5 ko. Pour permettre à ces allocations de se produire plus efficacement, la base de données sépare une petite quantité de la zone de mémoire partagée pour la zone de mémoire réservée.
Voir aussi : Guide de réglage des performances d'Oracle AI Database pour savoir comment configurer le pool réservé
Pool LARGE POOL
La large pool est une zone de mémoire facultative destinée aux allocations de mémoire plus importantes que ce qui est approprié pour la zone de mémoire partagée.
La zone de mémoire LARGE POOL peut fournir des allocations de mémoire importantes pour les éléments suivants :
-
Mémoires tampons utilisées dans l'exécution en parallèle
-
Tampons pour les processus enfants d'E/S Recovery Manager (RMAN)
-
Tampons pour les insertions différées (insertions avec le conseil
MEMOPTIMIZE_WRITE)
La figure suivante représente la zone de mémoire LARGE POOL.
Figure 7 : Grande piscine
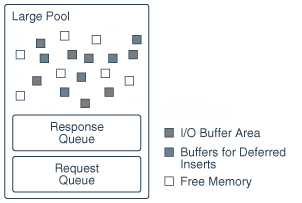
Description de l'image cncpt221.png
-
Gestion de la mémoire de pool étendu La zone de mémoire LARGE POOL gère la mémoire différemment de la zone de mémoire partagée, qui utilise une liste LRU afin que des portions de mémoire puissent être supprimées.
-
Tampons de pool important pour les insertions différées Pour un type spécial d'insertion appelé insertion différée, la base de données alloue des tampons à partir de la zone de mémoire LARGE POOL.
Voir aussi :
-
"Coordinateur de requête" pour plus d'informations sur l'allocation de mémoire pour l'exécution en parallèle
-
"Dispatcher Request and Response Queues" pour en savoir plus sur l'allocation de mémoire de session pour le serveur partagé
-
Guide de développement Oracle AI Database pour en savoir plus sur Oracle XA
-
Guide de réglage des performances d'Oracle AI Database pour plus d'informations sur la zone de mémoire LARGE POOL
Gestion de la mémoire des grands pools
La zone de mémoire LARGE POOL gère la mémoire différemment de la zone de mémoire partagée, qui utilise une liste LRU afin que des portions de mémoire puissent être supprimées.
La zone de mémoire LARGE POOL n'a pas de liste LRU. Lorsque la base de données alloue de la mémoire de grande capacité à une session de base de données, cette mémoire ne peut pas être libérée, sauf si la session la libère. Dès qu'une partie de la mémoire est libérée, d'autres processus peuvent l'utiliser. En allouant de la mémoire de session à partir de la zone de mémoire LARGE POOL, la base de données évite la fragmentation qui peut se produire dans la zone de mémoire partagée.
Tampons de pool volumineux pour insertion différée
Pour un type spécial d'insertion appelé insertion différée, la base de données alloue des tampons à partir de la zone de mémoire LARGE POOL.
Pour les insertions rapides "fire and oubli" à partir des applications Internet of Things (IoT), l'infrastructure de base de données crée des surcharges de performances. Par exemple, le chemin de code inclut la navigation dans le cache de tampons, les broches de tampons et les protections de simultanéité. Les insertions de tableau réduisent ces coûts, mais la baie doit être construite côté client, ce qui n'est pas typique pour les applications Internet of Things. Pour résoudre ce problème, une application Oracle peut utiliser un conseil pour insérer des lignes dans une table indiquée en tant que MEMOPTIMIZE FOR WRITE.
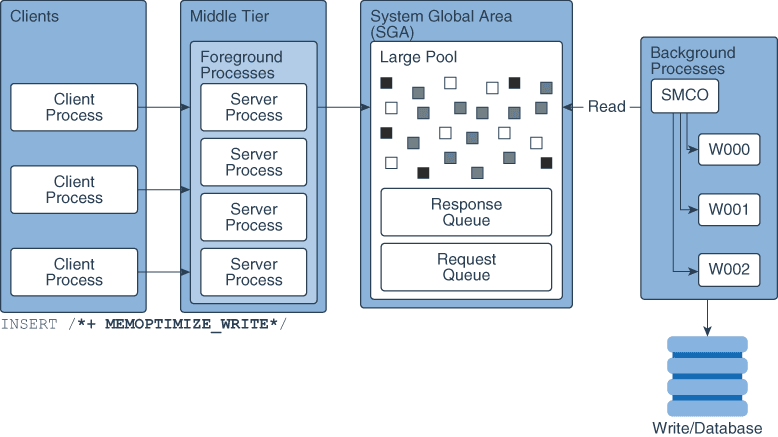
Les insertions sont différées car elles sont mises en mémoire tampon dans la zone de mémoire LARGE POOL, puis écrites sur le disque de manière asynchrone par les processus en arrière-plan. La base de données traite les insertions différées comme suit :
-
L'application envoie des insertions
MEMOPTIMIZE_WRITEà un niveau intermédiaire, qui peut agréger les données. Bien qu'une application IoT envoie presque toujours des insertions au niveau intermédiaire, il est également possible d'envoyer des insertions directement à la base de données. Par exemple, SQL*Plus envoie les insertions directement à la base de données. -
Le niveau intermédiaire écrit l'agrégation des insertions sur le serveur de base de données.
-
Le client de niveau intermédiaire conserve éventuellement une copie locale des données qu'il a écrites à l'étape précédente.
-
Un processus serveur écrit les données dans un ou plusieurs tampons de la zone de mémoire LARGE POOL.
Pour éviter toute contention, chaque tampon dispose de son propre mécanisme de verrouillage interne. Ce mécanisme de verrouillage est distinct du mécanisme de verrouillage utilisé par le cache de tampons de la base de données pour ses tampons. Le processus d'écriture de base est le suivant :
-
Après le démarrage de l'instance, la première insertion
MEMOPTIMIZE_WRITEalloue les tampons du pool de grande taille. -
Le processus d'écriture choisit un tampon dans la liste des tampons disponibles.
-
Si le tampon choisi n'est pas verrouillé et que ce tampon a de l'espace libre, le client écrit dans le tampon, horodatant chaque tampon d'un numéro de séquence spécifique à la session. Sinon, le processus d'écriture revient à l'étape précédente et continue ainsi jusqu'à ce qu'un tampon soit trouvé ou qu'un espace suffisant soit libéré dans la zone de mémoire LARGE POOL.
-
-
La base de données crée un groupe côté serveur à partir des données mises en mémoire tampon.
-
Le coordinateur de la gestion de l'espace (SMCO) et ses processus d'aide (Wnnn) écrivent la baie sur le disque de manière asynchrone en utilisant le format de bloc de données standard.
Contrairement aux insertions standard, les insertions différées sont validées automatiquement et ne peuvent pas être annulées. La base de données valide les insertions sur un objet donné dans l'ordre dans lequel elles apparaissent dans une session. Il n'y a aucune garantie de classement entre les objets ou les sessions.
La base de données prend en charge les contraintes et la maintenance des index, tout comme les insertions régulières. Toutefois, la base de données effectue des évaluations pendant l'écriture sur disque, et non l'écriture dans la zone de mémoire LARGE POOL.
Remarque : pour des performances optimales, Oracle recommande de désactiver les contraintes.
La figure suivante illustre le workflow pour les insertions différées.
Figure 8 : Différé InsertMechanism
Description de l'illustration cncpt_pb_002a.png
Voir aussi :
-
Guide de réglage des performances Oracle AI Database pour apprendre à spécifier des tables en tant que
MEMOPTIMIZE FOR WRITE -
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
INSERT -
Référence Oracle AI Database pour en savoir plus sur
MEMOPTIMIZE_POOL_SIZE
Pool Java
La pool Java est une zone de mémoire qui stocke tous les données et le code Java propres à une session dans la JVM (Java Virtual Machine). Cette mémoire inclut les objets Java qui sont migrés vers l'espace de session Java en fin d'appel.
Pour les connexions de serveur dédié, la zone de mémoire Java inclut la partie partagée de chaque classe Java, y compris les méthodes et la mémoire en lecture seule telles que les vecteurs de code, mais pas l'état Java par session de chaque session. Pour le serveur partagé, le pool inclut la partie partagée de chaque classe et une mémoire UGA utilisée pour l'état de chaque session. Chaque mémoire UGA augmente et diminue si nécessaire, mais la taille totale de la mémoire UGA doit tenir dans l'espace de la zone de mémoire Java.
Les statistiques de la fonction de conseil Java Pool Advisor fournissent des informations sur la mémoire cache "library" utilisée pour Java et prédisent comment les modifications de la taille de la zone de mémoire Java peuvent affecter le taux d'analyse. La fonction de conseil Java Pool Advisor est activée en interne lorsque statistics_level est défini sur TYPICAL ou une valeur supérieure. Ces statistiques sont réinitialisées lorsque la fonction de conseil est désactivée.
Voir aussi :
-
Guide de réglage des performances d'Oracle AI Database, pour en savoir plus sur les vues contenant des statistiques de conseil sur la zone de mémoire Java
Mémoire SGA fixe
La SGA fixe est une zone interne de gestion.
Par exemple, la mémoire SGA fixe contient :
-
Informations générales sur l'état de la base de données et de l'instance auxquelles les processus en arrière-plan doivent accéder
-
Informations communiquées entre les processus, telles que des informations sur les verrous
La taille de la mémoire SGA fixe est définie par Oracle AI Database et ne peut pas être modifiée manuellement. La taille fixe de la mémoire SGA peut changer d'une version à l'autre.
Voir aussi : "Présentation des verrous automatiques"
Sous-zones SGA facultatives liées aux performances
Certaines sous-zones de la mémoire SGA ne sont activées que pour des fonctions de performances spécifiques.
Cette section comprend les rubriques suivantes :
-
Zone en mémoire La zone en mémoire est un composant facultatif de la mémoire SGA qui contient le stockage en colonnes en mémoire (stockage en colonnes IM).
-
Memoptimize Pool Le pool memoptimize stocke les tampons et les structures associées pour les tables organisées en portions de mémoire indiquées en tant que
MEMOPTIMIZE FOR READ.
Zone en mémoire
La zone en mémoire est un composant SGA facultatif qui contient le stockage en colonnes en mémoire (stockage en colonnes IM).
Le magasin de colonnes IM contient des copies de tables, de partitions et de vues matérialisées dans un format de colonne optimisé pour des analyses rapides. La banque de colonnes IM complète le cache de tampons de la base de données, qui stocke les données au format de ligne traditionnel.
Remarque : pour activer une banque de colonnes IM, vous devez disposer de l'option Oracle AI Database In-Memory.
Voir aussi : Guide Oracle AI Database en mémoire pour en savoir plus sur la zone en mémoire et la banque de colonnes IM
Pool Memoptimize
Le pool memoptimize stocke les tampons et les structures associées pour les tables organisées en portions de mémoire indiquées en tant que MEMOPTIMIZE FOR READ.
Cette structure offre des performances et une évolutivité élevées pour les requêtes basées sur des clés telles que SELECT * FROM cust WHERE cid = 10. Pour réduire le temps de réponse de bout en bout, les clients extraient les tampons demandés directement de la mémoire SGA sur le réseau, ce qui évite la surcharge de la CPU et du système d'exploitation. Les applications peuvent bénéficier du pool memoptimize sans nécessiter de modification du code.
Le pool memoptimize contient deux parties :
-
Zone tampon Memoptimize
Pour éviter les E/S disque, la base de données verrouille définitivement les tampons pour les tables
MEMOPTIMIZE FOR READdans le pool memoptimize, jusqu'à ce que la table soit marquéeNO MEMOPTIMIZE FOR READ. Les tampons memoptimize utilisent la même structure que les tampons du cache de tampons de la base de données. Toutefois, les tampons du pool memoptimize sont complètement séparés du cache de tampons de la base de données et ne sont pas pris en compte dans leur taille. La zone tampon memoptimize occupe 75% du pool memoptimize. -
Index de hachage
Un index de hachage est une structure de données de segment non persistante. La base de données alloue l'index de hachage en plusieurs unités de mémoire non contiguës. Chaque unité contient un certain nombre de compartiments de hachage. Une structure de carte distincte met en corrélation une unité de mémoire avec une clé primaire. L'indice de hachage occupe 25% du pool memoptimize. Figure 9 : Pool Memoptimize
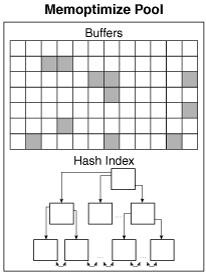
Description de l'illustration cncpt_pb_001a.png
Pour activer le pool memoptimize, définissez le paramètre d'initialisation MEMOPTIMIZE_POOL_SIZE sur une valeur entière (le pool est désactivé par défaut). La valeur indique la quantité de mémoire SGA à allouer au pool. La valeur MEMOPTIMIZE_POOL_SIZE compte vers SGA_TARGET, mais la base de données n'augmente pas et ne réduit pas automatiquement le pool memoptimize. Par exemple, si SGA_TARGET est de 10 Go et si MEMOPTIMIZE_POOL_SIZE est de 1 Go, un total de 9 Go est disponible pour la mémoire SGA autre que le pool memoptimize.
Pour modifier la taille du pool memoptimize, vous devez définir MEMOPTIMIZE_POOL_SIZE manuellement et redémarrer l'instance de base de données. Vous ne pouvez pas modifier la taille du pool de manière dynamique à l'aide de ALTER SYSTEM.
Le package DBMS_MEMOPTIMIZE vous permet de remplir explicitement une table dans le pool memoptimize.
Voir aussi :
-
Guide de réglage des performances d'Oracle AI Database pour apprendre à améliorer les performances des requêtes en activant le pool memoptimize
-
Référence des types et packages PL/SQL Oracle AI Database pour en savoir plus sur le package
DBMS_MEMOPTIMIZE -
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur
CREATE TABLE ... MEMOPTIMIZE FOR READ -
Référence Oracle AI Database pour en savoir plus sur
MEMOPTIMIZE_POOL_SIZE
Présentation de la mémoire PGA (Program Global Area)
La mémoire PGA est une mémoire propre à un processus d'exploitation ou un thread qui n'est pas partagé par d'autres processus ou threads du système. Etant donné que la mémoire PGA est propre à un processus, elle n'est jamais allouée dans la mémoire SGA.
La mémoire PGA est une portion de mémoire qui contient les variables dépendantes de la session requises par un processus serveur dédié ou partagé. Le processus serveur alloue les structures mémoire dont il a besoin dans la mémoire PGA.
Une analogie pour une mémoire PGA est un espace de travail de comptoir temporaire utilisé par un commis aux fichiers. Dans cette analogie, le greffier de fichiers est le processus serveur qui travaille pour le compte du client (processus client). Le commis efface une section du comptoir, utilise l'espace de travail pour stocker les détails sur la demande du client et trier les dossiers demandés par le client, puis abandonne l'espace lorsque le travail est terminé.
La figure suivante présente une mémoire PGA d'instance (collecte de tous les PGA) pour une instance qui n'est pas configurée pour les serveurs partagés. Vous pouvez utiliser un paramètre d'initialisation pour définir la taille maximale cible de la mémoire PGA de l'instance. Les PGA individuels peuvent augmenter selon les besoins jusqu'à cette taille cible.
Figure 10 : Mémoire PGA d'instance
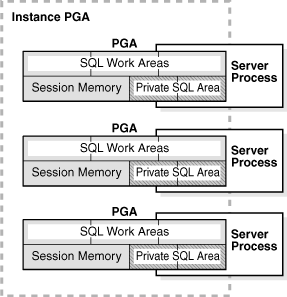
Description de l'image cncpt218.gif
Remarque : les processus en arrière-plan allouent également leurs propres autorisations préalables de garantie. Cette discussion porte uniquement sur les PGA de processus serveur.
-
Contenu de la mémoire PGA La mémoire PGA est subdivisée en différentes zones, chacune ayant un objectif différent.
-
Utilisation de la mémoire PGA dans les modes serveur dédié et serveur partagé L'allocation de mémoire PGA dépend du fait que la base de données utilise des connexions serveur dédiées ou partagées. Voir aussi : Guide de réglage des performances d'Oracle AI Database pour une présentation de la gestion de la mémoire PGA
Contenu de la mémoire PGA
La mémoire PGA est subdivisée en différentes zones, chacune ayant un objectif différent.
La figure suivante présente le contenu possible de la mémoire PGA pour une session de serveur dédiée. Toutes les zones de mémoire PGA n'existent pas.
Figure 11 : Contenu de la mémoire PGA
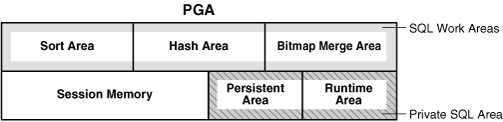
Description de l'image cncpt219.gif
-
Zone SQL privée Une zone SQL privée contient des informations sur une instruction SQL analysée et d'autres informations propres à la session à traiter.
-
Zones de travail SQL Une zone de travail est une allocation privée de mémoire PGA utilisée pour les opérations consommant beaucoup de mémoire.
Zone SQL privée
Une zone SQL privée contient des informations sur une instruction SQL analysée et d'autres informations propres à la session à traiter.
Lorsqu'un processus serveur exécute du code SQL ou PL/SQL, il utilise la zone SQL privée pour stocker les valeurs de variable de liaison, les informations d'état d'exécution des requêtes et les zones de travail d'exécution des requêtes.
Ne confondez pas une zone SQL privée, située dans la mémoire PGA, avec la zone SQL partagée, qui stocke les plans d'exécution dans la mémoire SGA. Plusieurs zones SQL privées d'une même session ou de sessions différentes peuvent pointer vers un seul plan d'exécution de la mémoire SGA. Par exemple, 20 exécutions de SELECT * FROM sales dans une session et 10 exécutions de la même requête dans une autre session peuvent partager le même plan. Les zones SQL privées de chaque exécution ne sont pas partagées et peuvent contenir des valeurs et des données différentes.
Un curseur est un nom ou un descripteur d'une zone SQL privée spécifique. Comme indiqué dans le graphique suivant, vous pouvez considérer un curseur comme un pointeur côté client et comme un état côté serveur. Etant donné que les curseurs sont étroitement associés aux zones SQL privées, les termes sont parfois utilisés de manière interchangeable.
Figure 12 : Curseur
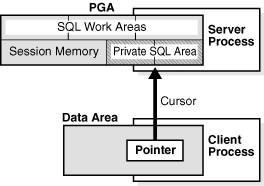
Description de l'image cncpt324.gif
Une zone SQL privée est divisée en zones suivantes :
-
Zone d'exécution
Cette zone contient des informations sur l'état d'exécution des requêtes. Par exemple, la zone d'exécution suit le nombre de lignes extraites jusqu'à présent dans un balayage complet de table.
Oracle AI Database crée la zone d'exécution comme première étape d'une demande d'exécution. Pour les instructions DML, la zone d'exécution est libérée lorsque l'instruction SQL est fermée.
-
La zone persistante
Cette zone contient des valeurs de variable de liaison. Une valeur de variable attachée est fournie à une instruction SQL lors de l'exécution de l'instruction. La zone persistante n'est libérée que lorsque le curseur est fermé.
Le processus client est responsable de la gestion des zones SQL privées. L'allocation et la désallocation des zones SQL privées dépendent en grande partie de l'application, bien que le nombre de zones SQL privées qu'un processus client peut allouer soit limité par le paramètre d'initialisation OPEN_CURSORS.
Bien que la plupart des utilisateurs s'appuient sur la gestion automatique des curseurs des utilitaires de base de données, les interfaces de programmation d'Oracle AI Database permettent aux développeurs de mieux contrôler les curseurs. En général, les applications doivent fermer tous les curseurs ouverts qui ne seront pas utilisés à nouveau pour libérer la zone persistante et réduire la mémoire requise pour les utilisateurs de l'application.
Voir aussi :
-
Guide de développement Oracle AI Database et Référence du langage PL/SQL d'Oracle AI Database pour apprendre à utiliser des curseurs
Zones de travail SQL
Une zone de travail est une allocation privée de mémoire PGA utilisée pour les opérations consommant beaucoup de mémoire.
Par exemple, un opérateur de tri utilise la zone de tri pour trier un ensemble de lignes. De même, un opérateur de jointure de hachage utilise une zone de hachage pour créer une table de hachage à partir de son entrée gauche, tandis qu'un opérateur de fusion de bitmap utilise la zone de fusion de bitmap pour fusionner les données extraites des analyses de plusieurs index bitmap.
L'exemple suivant présente une jointure de employees et departments avec son plan d'interrogation :
SQL> SELECT *
  2  FROM   employees e JOIN departments d
  3  ON     e.department_id=d.department_id
  4  ORDER BY last_name;
.
.
.
--------------------------------------------------------------------------------
| Id| Operation           | Name        | Rows  | Bytes | Cost (%CPU)| Time    |
--------------------------------------------------------------------------------
| 0 | SELECT STATEMENT    |             |   106 |  9328 |    7  (29)| 00:00:01 |
| 1 |  SORT ORDER BY      |             |   106 |  9328 |    7  (29)| 00:00:01 |
|*2 |   HASH JOIN         |             |   106 |  9328 |    6  (17)| 00:00:01 |
| 3 |    TABLE ACCESS FULL| DEPARTMENTS |    27 |   540 |    2   (0)| 00:00:01 |
| 4 |    TABLE ACCESS FULL| EMPLOYEES   |   107 |  7276 |    3   (0)| 00:00:01 |
--------------------------------------------------------------------------------
Dans l'exemple précédent, la zone d'exécution suit la progression des balayages complets de table (full table scans). La session effectue une jointure de hachage dans la zone de hachage pour faire correspondre les lignes des deux tables. Le tri ORDER BY se produit dans la zone de tri.
Si la quantité de données à traiter par les opérateurs ne rentre pas dans une zone de travail, Oracle AI Database divise les données d'entrée en éléments plus petits. De cette façon, la base de données traite certains éléments de données en mémoire tout en écrivant le reste dans le stockage sur disque temporaire pour traitement ultérieur.
La base de données règle automatiquement la taille des zones de travail lorsque la gestion automatique de la mémoire PGA est activée. Vous pouvez également contrôler et régler manuellement la taille d'une zone de travail.
En général, de plus grandes zones de travail peuvent améliorer considérablement les performances d'un opérateur au prix d'une consommation de mémoire plus élevée. De manière optimale, la taille d'une zone de travail est suffisante pour prendre en charge les données d'entrée et les structures mémoire auxiliaires allouées par l'opérateur SQL associé. Sinon, le temps de réponse augmente car une partie des données d'entrée doit être mise en cache sur le disque. Dans le cas extrême, si la taille d'une zone de travail est trop petite par rapport à la taille des données d'entrée, la base de données doit effectuer plusieurs passes sur les éléments de données, ce qui augmente considérablement le temps de réponse.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à utiliser la gestion automatique de la mémoire PGA
-
Guide de réglage des performances d'Oracle AI Database pour découvrir comment régler la mémoire PGA
Utilisation de la mémoire PGA dans les modes serveur dédié et serveur partagé
L'allocation de mémoire PGA dépend du fait que la base de données utilise des connexions de serveur dédiées ou partagées.
Le tableau suivant présente les différences.
Tableau 1 : Différences d'allocation de mémoire entre serveurs dédiés et partagés
| Zone mémoire | Serveur dédié | Serveur partagé |
|---|---|---|
| Nature de la mémoire de session | Privé | Partagé |
| Emplacement de la zone persistante | Mémoire PGA | Mémoire SGA |
| Emplacement de la zone d'exécution pour les instructions LMD et LDD | Mémoire PGA | Mémoire PGA |
Voir aussi : Guide de l'administrateur Oracle AI Database pour savoir comment configurer une base de données pour un serveur partagé
Présentation de la zone globale Utilisateur
La mémoire UGA est la mémoire de session, qui est allouée aux variables de session, telles que les informations de connexion, et d'autres informations requises par une session de base de données. La mémoire UGA stocke essentiellement l'état de la session.
La figure suivante représente la mémoire UGA.
Figure 13 : UGA (User Global Area)
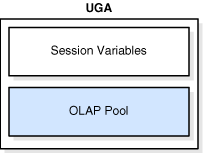
Description de l'image cncpt222.gif
Si une session charge un package PL/SQL en mémoire, la mémoire UGA contient l'état du package, qui est l'ensemble de valeurs stockées dans toutes les variables du package à un moment donné. L'état du package change lorsqu'un sous-programme de package modifie les variables. Par défaut, les variables de package sont uniques et persistent pendant toute la durée de la session.
Le pool de pages OLAP est également stocké dans la mémoire UGA. Ce pool gère les pages de données OLAP, qui sont équivalentes aux blocs de données. Le pool de pages est alloué au début d'une session OLAP et libéré à la fin de la session. Une session OLAP s'ouvre automatiquement chaque fois qu'un utilisateur interroge un objet dimensionnel tel qu'un cube.
La mémoire UGA doit être disponible pour une session de base de données pendant toute la durée de la session. Pour cette raison, la mémoire UGA ne peut pas être stockée dans la mémoire PGA lors de l'utilisation d'une connexion de serveur partagé, car la mémoire PGA est spécifique à un seul processus. Par conséquent, la mémoire UGA est stockée dans la mémoire MGA lors de l'utilisation de connexions au serveur partagé, ce qui permet à tout processus serveur partagé d'y accéder. Lors de l'utilisation d'une connexion de serveur dédié, la mémoire UGA est stockée dans la mémoire PGA.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database Net Services pour en savoir plus sur les connexions de serveur partagé
Présentation de la mémoire MGA (Managed Global Area)
La mémoire MGA (Managed Global Area) est une structure de mémoire unique qui permet de partager et de coordonner la mémoire sur un ensemble de processus Oracle de confiance.
Il peut s'agir d'une zone de mémoire partagée configurable, élastique, modulaire, à la demande et récupérable. La mémoire MGA permet d'utiliser différents types de zone de mémoire partagée dans la base de données. Elle est exposée en tant qu'espaces de noms pour les couches de base de données internes, chacune appartenant à une seule d'entre elles. Un espace de noms se compose principalement d'un ensemble de segments de mémoire partagée et de métadonnées qui l'accompagnent.
Les couches de la base de données peuvent définir les caractéristiques, la portée, la durée de vie et la taille de segment interne de l'espace de noms. Toute la mémoire MGA est comptabilisée sous la limite d'agrégation de la mémoire PGA.
Sous Linux, la mémoire MGA requiert tempfs montée sur /dev/shm et est configurée pour au moins la taille de la limite d'agrégation de la mémoire PGA. Lorsque plusieurs instances sont exécutées sur le même ordinateur, la taille de /dev/shm doit être d'au moins sum(PGA_AGGREGATE_LIMIT) sur toutes les instances.
Voir aussi :
-
Guide de réglage des performances d'Oracle AI Database pour en savoir plus sur le dimensionnement des granules
Présentation des zones de code logiciel
Une zone de code logicielle est une partie de la mémoire qui stocke le code en cours d'exécution ou qui peut être exécuté. Le code Oracle AI Database est stocké dans une zone logicielle généralement plus exclusive et protégée que l'emplacement des programmes utilisateur.
Les zones logicielles sont généralement de taille statique, ne changeant que lorsque le logiciel est mis à jour ou réinstallé. La taille requise de ces zones varie selon le système d'exploitation.
Les zones logicielles sont en lecture seule et peuvent être installées partagées ou non partagées. Certains outils et utilitaires de base de données, tels qu'Oracle Forms et SQL*Plus, peuvent être installés en mode partagé, mais certains ne le peuvent pas. Lorsque cela est possible, le code de la base de données est partagé afin que tous les utilisateurs puissent y accéder sans avoir plusieurs copies en mémoire, ce qui entraîne une réduction de la mémoire principale et une amélioration globale des performances. Plusieurs instances d'une base de données peuvent utiliser la même zone de code de base de données avec différentes bases de données si elles sont exécutées sur le même ordinateur. Remarque : l'option d'installation de logiciels partagés n'est pas disponible pour tous les systèmes d'exploitation, par exemple sur les ordinateurs fonctionnant sous Microsoft Windows. Pour plus d'informations, reportez-vous à la documentation propre à votre système d'exploitation.