Instance Oracle AI Database
Ce chapitre décrit la nature d'une instance de base de données Oracle, les fichiers de paramètres et de diagnostic associés à une instance, ainsi que ce qui se produit lors de la création et de l'ouverture et de la fermeture d'une base de données.
Remarque : Aux fins du présent chapitre, le terme "base de données" fait référence à une base de données Conteneur colocative, sauf indication contraire.
-
Introduction à l'instance Oracle AI Database Une instance de base de données est un ensemble de structures mémoire qui gèrent les fichiers de base de données.
-
Présentation du démarrage et de l'arrêt d'une instance de base de données Une instance de base de données permet à l'utilisateur d'accéder à une base de données. L'instance et la base de données peuvent présenter différents états.
-
Présentation des points de reprise Un point de reprise est un mécanisme crucial pour des arrêts cohérents de la base de données, la récupération d'instance et le fonctionnement d'Oracle AI Database en général.
-
Présentation de la récupération d'instance
La récupération d'instance est le processus qui consiste à appliquer les enregistrements du fichier de journalisation en ligne aux fichiers de données afin de reconstruire les modifications apportées après le point de reprise le plus récent.
-
Présentation des fichiers de paramètres Pour démarrer une instance de base de données, Oracle AI Database doit lire soit un fichier de paramètres serveur, qui est recommandé, soit un fichier de paramètres d'initialisation de texte, qui est une implémentation héritée. Ces fichiers contiennent une liste de paramètres de configuration.
-
Présentation des fichiers de diagnostic Oracle AI Database inclut une infrastructure d'établissement de diagnostic des pannes permettant de prévenir, de détecter, de diagnostiquer et de résoudre les problèmes de base de données. Les problèmes incluent les erreurs critiques telles que les bogues de code, l'altération des métadonnées et l'altération des données client.
Introduction à l'instance Oracle AI Database
Une instance de base de données est un ensemble de structures mémoire qui gèrent les fichiers de base de données.
Au niveau physique, une base de données Conteneur est un ensemble de fichiers sur disque créé par l'instruction CREATE DATABASE. Une base de données Conteneur contient des bases de données pluggables créées par l'utilisateur. Une base pluggable contient son propre ensemble de fichiers de données dans l'ensemble global de fichiers de données appartenant à la base Conteneur. L'instance de base de données gère les données associées à la base de données Conteneur et à ses bases de données pluggables et sert ses utilisateurs.
Chaque base Conteneur en cours d'exécution est associée à au moins une instance de base de données Oracle. Etant donné qu'une instance existe en mémoire et qu'une base de données (au sens strict du terme) est un ensemble de fichiers sur disque, une instance peut exister sans base de données et une base de données peut exister sans instance.
-
Structure d'instance de base de données Lorsqu'une instance est démarrée, Oracle AI Database alloue une zone de mémoire appelée zone globale du système (SGA) et démarre des processus en arrière-plan.
-
Configurations d'instance de base de données Oracle AI Database s'exécute dans une configuration à instance unique ou dans une configuration Oracle Real Application Clusters (Oracle RAC). Ces configurations s'excluent mutuellement.
-
Instances en lecture/écriture et en lecture seule Chaque instance de base de données est en lecture/écriture ou en lecture seule.
-
Durée d'une instance de base de données Une instance de base de données commence lorsqu'elle est créée à l'aide de la commande
STARTUPet se termine lorsqu'elle prend fin. -
Identification d'une instance de base de données Plusieurs instances de base de données peuvent résider sur un seul hôte. Par conséquent, vous devez avoir un moyen de spécifier l'instance à laquelle vous souhaitez accéder.
Structure d'instance de base de données
Lorsqu'une instance est démarrée, Oracle AI Database alloue une zone de mémoire appelée zone globale du système (SGA) et démarre un ou plusieurs processus en arrière-plan.
La mémoire SGA sert à diverses fins, notamment :
-
Gérer les structures de données internes auxquelles de nombreux processus et threads accèdent simultanément
-
Mettre en cache les blocs de données lus à partir du disque
-
mettre en mémoire tampon les données de journalisation avant de les écrire dans les fichiers de journalisation en ligne.
-
Stockage des plans d'exécution SQL
Les processus Oracle exécutés sur un seul ordinateur partagent la mémoire SGA. La façon dont les processus Oracle s'associent à la mémoire SGA varie en fonction du système d'exploitation.
Une instance de base de données inclut également des processus en arrière-plan et des processus serveur. Chaque processus dispose de sa propre mémoire dédiée considérée comme faisant partie de l'instance. L'instance continue de fonctionner lorsque les processus serveur se terminent.
L'illustration suivante présente les principaux composants d'une instance de base de données Oracle.
Figure 1 : Instance de base de données
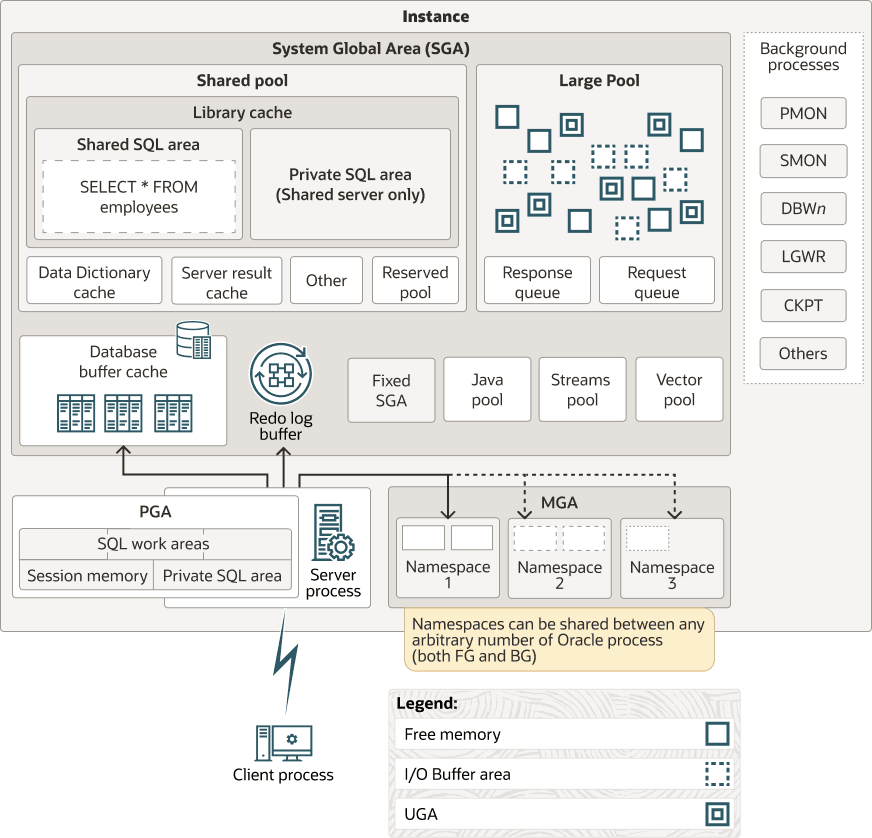
Description de l'image cncpt325.png
Voir aussi :
Configurations de l'instance de base de donnée
Oracle AI Database s'exécute dans une configuration à instance unique ou dans une configuration Oracle Real Application Clusters (Oracle RAC). Ces configurations s'excluent mutuellement.
Dans une configuration à instance unique, il existe une relation un-à-un entre la base de données et une instance de base de données. Dans Oracle RAC, il existe une relation de un à plusieurs entre la base de données et les instances de base de données.
La figure suivante présente les configurations d'instance de base de données possibles.
Figure 2 : Configurations d'instance de base de données
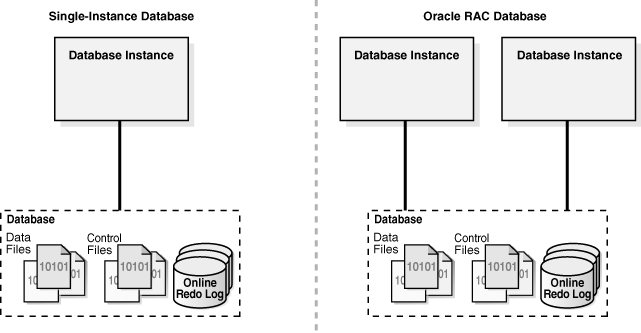
Description de l'image cncpt296.gif
Que ce soit dans une configuration monoinstance ou Oracle RAC, une instance de base de données est associée à une seule base de données à la fois. Vous pouvez démarrer une instance de base de données et monter (associer l'instance à) une base de données, mais pas monter deux bases de données simultanément avec la même instance. Remarque : ce chapitre traite de la configuration d'une base de données à instance unique, sauf indication contraire.
Plusieurs instances peuvent être exécutées simultanément sur le même ordinateur, chacune accédant à sa propre base de données. Par exemple, un ordinateur peut héberger deux bases de données distinctes : prod1 et prod2. Une instance de base de données gère prod1, tandis qu'une instance distincte gère prod2.
Voir aussi : Guide d'administration et de déploiement Oracle Real Application Clusters pour plus d'informations sur Oracle RAC
Instances en lecture/écriture et en lecture seule
Chaque instance de base de données est en lecture/écriture ou en lecture seule.
Une instance de base de données en lecture/écriture, qui est la valeur par défaut, peut traiter les instructions LMD et prendre en charge les connexions directes à partir des applications client. En revanche, une instance de base de données en lecture seule peut traiter des requêtes, mais ne prend pas en charge les connexions client directes ou LMD de modification (UPDATE, DELETE, INSERT et MERGE).
Remarque : sauf indication contraire dans ce manuel, toutes les références aux instances de base de données sont des instances en lecture/écriture.
Dans les versions précédentes, toutes les instances de base de données, à moins qu'elles n'aient accédé à une base de données de secours, étaient en lecture/écriture. A partir d'Oracle Database 12c version 2 (12.2), les instances en lecture seule et en lecture/écriture peuvent coexister dans une seule base de données. Cette configuration est utile pour les instructions SQL parallèles qui interrogent et modifient les données, car les instances en lecture/écriture et en lecture seule peuvent interroger, tandis que les instances en lecture/écriture modifient.
Contrairement aux instances en lecture/écriture, les instances en lecture seule présentent les caractéristiques suivantes :
-
Peut uniquement ouvrir une base de données qui a déjà été ouverte par une instance en lecture/écriture
-
Désactiver de nombreux processus en arrière-plan, y compris les processus de point de reprise et d'archiveur, qui ne sont pas nécessaires
-
Peut monter un thread de journalisation désactivé ou un thread sans journal de journalisation en ligne
Pour désigner une instance en lecture seule, définissez le paramètre d'initialisation INSTANCE_MODE sur READ_ONLY. La valeur par défaut du paramètre est READ_WRITE.
Voir aussi :
-
"Présentation des processus en arrière-plan" pour en savoir plus sur les processus en arrière-plan de point de reprise et d'archiveur
-
Référence Oracle AI Database pour en savoir plus sur le paramètre d'initialisation
INSTANCE_MODE
Durée d'une instance de base de données
Une instance de base de données commence lorsqu'elle est créée avec la commande STARTUP et se termine lorsqu'elle prend fin.
Au cours de cette période, une instance de base de données peut s'associer à une seule base de données. En outre, l'instance ne peut monter une base de données qu'une seule fois, la fermer une seule fois et l'ouvrir une seule fois. Une fois qu'une base de données a été fermée ou arrêtée, vous devez démarrer une instance différente pour la monter et l'ouvrir.
Le tableau suivant illustre une instance de base de données qui tente de rouvrir une base de données précédemment fermée.
Tableau 1 Durée d'une instance
| Instruction | Explication |
|---|---|
|
La commande STARTUP crée une instance, qui monte et ouvre la base de données. |
|
Cette requête indique l'heure à laquelle l'instance en cours a été démarrée. |
|
L'instance ferme la base de données et s'arrête, ce qui met fin à sa durée de vie. |
|
La commande STARTUP crée une instance, monte et ouvre la base de données. |
|
Cette requête indique l'heure à laquelle l'instance en cours a été démarrée. L'heure de début différente indique que cette instance est différente de celle qui a arrêté la base de données. |
Identification d'une instance de base de données
Plusieurs instances de base de données peuvent résider sur un seul hôte. Par conséquent, vous devez avoir un moyen de spécifier l'instance à laquelle vous souhaitez accéder. Les règles Oracle Optimal Flexible Architecture (OFA) sont un ensemble de directives de configuration créées pour garantir des installations Oracle bien organisées. Les exemples de cette section supposent une architecture OFA.
Cette section comprend les rubriques suivantes :
-
Répertoire Oracle Base Le répertoire Oracle Base stocke les fichiers binaires des produits Oracle.
-
Répertoire de base Oracle Le répertoire de base Oracle est l'emplacement logiciel d'une base de données Oracle.
-
Oracle System Identifier (SID) L'identificateur système (SID) est un nom unique pour une instance de base de données Oracle sur un hôte spécifique. Voir aussi : Guide d'installation d'Oracle AI Database pour Linux pour une présentation de l'architecture OFA
Répertoire Oracle Base
Le répertoire Oracle Base stocke les fichiers binaires des produits Oracle.
Le répertoire Oracle Base est le répertoire de base de la base de données pour les propriétaires d'installation d'Oracle AI Database. Il peut y avoir de nombreuses installations Oracle AI Database sur un hôte et de nombreux propriétaires d'installation du logiciel Oracle AI Database.
L'exemple suivant illustre le répertoire Oracle Base du compte utilisateur du système d'exploitation oracle :
/u01/app/oracleDans le chemin précédent, /u01/ est le point de montage et /u01/app/ est la sous-arborescence du logiciel d'application.
Voir aussi : Guide d'installation d'Oracle AI Database pour Linux pour une présentation de la base Oracle
Répertoire de base Oracle
Le répertoire de base Oracle est l'emplacement logiciel d'une base de données Oracle.
Vous devez indiquer un nouveau répertoire Oracle Home pour chaque nouvelle installation du logiciel Oracle AI Database. A partir de la version 21c d'Oracle Database, le répertoire de base Oracle est en lecture seule. Le répertoire de base Oracle stocke les fichiers statiques tels que les fichiers binaires.
Par défaut, le répertoire de base Oracle est un descendant dans l'arborescence de répertoires Oracle Base (ORACLE_BASE). Vous pouvez installer cette version, ou des versions antérieures du logiciel de base de données, plusieurs fois sur le même hôte, dans différents répertoires d'accueil Oracle au sein d'un seul Oracle Base. Plusieurs bases de données, de différentes versions et appartenant à différents comptes utilisateur, peuvent coexister simultanément.
L'exemple suivant présente les chemins d'accès complets de trois répertoires de base Oracle différents, tous dans le même répertoire de base Oracle de /u01/app/oracle/ :
/u01/app/oracle/product/19.3.0/dbhome_1
/u01/app/oracle/product/19.3.0/dbhome_2
/u01/app/oracle/product/20.1.0/dbhome_1
La partie du nom du chemin après le répertoire de base Oracle (/u01/app/oracle/) inclut le numéro de version du produit (par exemple, 19.3.0) et le répertoire relatif du répertoire de base Oracle (par exemple, dbhome_1). Le répertoire /u01/app/oracle/product/19.3.0/ contient deux répertoires de base Oracle distincts : dbhome_1 et dbhome_2.
Le répertoire de base Oracle Base Home (ORACLE_BASE_HOME), situé dans ORACLE_BASE/homes/home_name, stocke les fichiers dynamiques propres à un répertoire de base Oracle. Le répertoire de configuration Oracle Base (ORACLE_BASE_CONFIG), qui est partagé par tous les répertoires de base Oracle d'un répertoire de base Oracle Base, stocke les fichiers dynamiques propres à l'instance.
Dans l'exemple suivant, le premier chemin est un répertoire de base Oracle et le deuxième chemin est le répertoire de base Oracle pour ce répertoire de base Oracle :
/u01/app/oracle/product/20.1.0/dbhome_1
/u01/app/oracle/homes/dbhome_1
Voir aussi : Guide d'installation d'Oracle AI Database pour Linux pour une présentation du répertoire de base Oracle
SID Oracle
L'identificateur système (SID) est le nom unique d'une instance de base de données Oracle sur un hôte spécifique.
Sous UNIX et Linux, Oracle AI Database utilise les valeurs de SID et de répertoire de base Oracle pour créer une clé de mémoire partagée. Par ailleurs, Oracle AI Database utilise le SID par défaut pour localiser le fichier de paramètres d'initialisation, qui localise les fichiers pertinents tels que les fichiers de contrôle de base de données.
Sur la plupart des plates-formes, la variable d'environnement ORACLE_SID définit le SID et la variable ORACLE_HOME définit le répertoire de base Oracle. Lors de la connexion à une instance de base de données, les clients peuvent indiquer le SID dans une connexion Oracle Net ou utiliser un nom de service réseau. Oracle AI Database convertit un nom de service réseau en ORACLE_HOME et ORACLE_SID.
Les fichiers propres à l'instance sont stockés séparément dans le répertoire Oracle Base. Les fichiers dont le nom inclut le SID résident dans le sous-répertoire dbs du répertoire de configuration Oracle Base (ORACLE_BASE_CONFIG). En raison de cette séparation, vous pouvez créer une base de données à l'aide d'un logiciel dans un répertoire de base Oracle existant, puis démarrer une instance pour cette base de données à l'aide d'un logiciel qui réside dans un nouveau répertoire de base Oracle.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment spécifier un SID Oracle
Présentation des opérations de démarrage et d'arrêt d'une instance de base de données
Une instance de base de données permet aux utilisateurs d'accéder à une base de données. L'instance et la base de données peuvent présenter différents états.
-
Présentation du démarrage d'instance et de base de données En général, vous démarrez manuellement une instance, puis vous montez et ouvrez la base de données, ce qui la rend disponible pour les utilisateurs. Pour effectuer ces étapes, vous pouvez utiliser la commande SQL*Plus
STARTUP, Oracle Enterprise Manager (Enterprise Manager) ou l'utilitaire SRVCTL. -
Présentation de l'arrêt de la base de données et de l'instance Dans un cas d'emploi classique, vous arrêtez manuellement la base de données, ce qui la rend indisponible pour les utilisateurs pendant que vous effectuez des tâches de maintenance ou d'administration. Vous pouvez utiliser la commande SQL*Plus
SHUTDOWNou Enterprise Manager pour effectuer ces étapes.
Présentation du démarrage d'instance et de base de données
En général, vous démarrez manuellement une instance, puis vous montez et ouvrez la base de données, ce qui la rend disponible pour les utilisateurs. Pour effectuer ces étapes, vous pouvez utiliser la commande SQL*Plus STARTUP, Oracle Enterprise Manager (Enterprise Manager) ou l'utilitaire SRVCTL.
Pour démarrer une instance de base de données à l'aide d'Oracle Net, les conditions suivantes doivent être remplies :
-
La base de données est inscrite de manière statique auprès d'un processus d'écoute Oracle Net.
-
Votre client est connecté à la base de données avec le privilège
SYSDBA.
Le processus d'écoute crée un serveur dédié, qui peut démarrer l'instance de base de données.
Le graphique suivant illustre la progression de la base de données d'un état d'arrêt à un état ouvert.
Figure 3 : Séquence de démarrage d'instance et de base de données
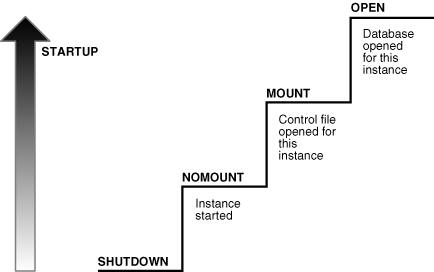
Description de l'image cncpt212.gif
Une base de données passe par les phases suivantes lorsqu'elle passe de l'état d'arrêt à l'état ouvert.
Tableau 2 Etapes du démarrage d'instance
| Phase | Etat du montage | Description | Pour en savoir plus |
|---|---|---|---|
| 1 | Instance démarrée sans montage de base de données | L'instance est démarrée mais n'est pas encore associée à une base de données. | Démarrage d'une instance |
| 2 | Base de données montée | L'instance est démarrée et associée à une base de données en lisant son fichier de contrôle. La base de données est fermée aux utilisateurs. | "Montage d'une base de données" |
| 3 | Ouverture de la base de données | L'instance est démarrée et associée à une base de données ouverte. Les données contenues dans les fichiers de données sont accessibles aux utilisateurs autorisés. | "Ouverture d'une base de données" |
-
Le démarrage et l'arrêt de la base de données Connection with Administrator Privileges sont de puissantes options d'administration qui sont limitées aux utilisateurs qui se connectent à Oracle AI Database avec des privilèges d'administrateur.
-
Démarrage d'une instance Lorsqu'Oracle AI Database démarre une instance, elle passe par des étapes.
-
Montage d'une base de données L'instance monte une base de données pour l'associer à cette instance.
-
Ouverture d'une base de données L'ouverture d'une base de données montée la rend disponible pour un fonctionnement normal.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment démarrer une instance
-
Guide de l'administrateur Oracle AI Database pour apprendre à utiliser SRVCTL
Connexion avec les privilèges d'administrateur
Le démarrage et l'arrêt de la base de données sont des options d'administration puissantes qui sont limitées aux utilisateurs qui se connectent à Oracle AI Database avec des privilèges d'administrateur.
Les utilisateurs normaux ne contrôlent pas le statut actuel d'une base de données Oracle. Selon le système d'exploitation, l'une des conditions suivantes établit les privilèges d'administrateur pour un utilisateur :
-
Les privilèges du système d'exploitation de l'utilisateur permettent à l'utilisateur de se connecter à l'aide des privilèges d'administrateur.
-
L'utilisateur bénéficie de privilèges système spéciaux et la base de données utilise des fichiers de mots de passe pour authentifier les administrateurs de base de données sur le réseau.
Les privilèges système spéciaux suivants permettent d'accéder à une instance de base de données même si celle-ci n'est pas ouverte :
-
SYSDBA -
SYSOPER -
SYSBACKUP -
SYSDG -
SYSKM
Le contrôle des privilèges précédents se fait hors de la base de données elle-même. Lorsque vous vous connectez à une base de données avec le privilège système SYSDBA, vous êtes dans le schéma appartenant à SYS. Lorsque vous connectez-vous en tant que SYSOPER, vous êtes dans le schéma public. Les privilèges SYSOPER sont un sous-ensemble de privilèges SYSDBA.
Voir aussi :
-
Guide de sécurité Oracle AI Database pour en savoir plus sur les comptes d'administration prédéfinis
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur les privilèges système
-
Guide d'installation d'Oracle AI Database pour en savoir plus sur les groupes de privilèges du système d'exploitation
Démarrage d'une instance
Lorsqu'Oracle AI Database démarre une instance, elle passe par des étapes.
Les étapes sont les suivantes :
-
Recherche un fichier de paramètres serveur dans un emplacement par défaut propre à la plate-forme et, s'il est introuvable, un fichier de paramètres d'initialisation texte (la spécification de
STARTUPavec les paramètresSPFILEouPFILEremplace le comportement par défaut) -
Lit le fichier de paramètres pour déterminer les valeurs des paramètres d'initialisation.
-
alloue la mémoire SGA en fonction des paramètres d'initialisation
-
Démarre les processus en arrière-plan Oracle
-
Ouvre le journal d'alertes et les fichiers trace et écrit tous les paramètres explicites dans le journal d'alertes dans une syntaxe de paramètre valide.
A ce stade, aucune base de données n'est associée à l'instance. Les scénarios qui nécessitent un état NOMOUNT incluent la création de la base de données et certaines opérations de sauvegarde et de récupération.
Voir aussi : Guide de l'administrateur Oracle AI Database pour apprendre à gérer les paramètres d'initialisation à l'aide d'un fichier de paramètres serveur
Montage d'une base de données
L'instance monte une base de données pour l'associer à cette instance.
Pour monter la base de données, l'instance obtient les noms des fichiers de contrôle de base de données indiqués dans le paramètre d'initialisation CONTROL_FILES et ouvre les fichiers. Oracle AI Database lit les fichiers de contrôle pour rechercher les noms des fichiers de données et des fichiers de journalisation en ligne auxquels il tentera d'accéder lors de l'ouverture de la base.
Dans une base de données montée, la base est fermée et accessible uniquement aux administrateurs de base de données. Les administrateurs peuvent maintenir la base de données fermée tout en effectuant des opérations de maintenance spécifiques. Toutefois, la base de données n'est pas disponible pour les opérations normales.
Si Oracle AI Database autorise plusieurs instances à monter simultanément la même base de données, le paramètre d'initialisation CLUSTER_DATABASE peut rendre la base de données disponible pour plusieurs instances. Le comportement de la base de données dépend du paramètre :
-
Si
CLUSTER_DATABASEestfalse(valeur par défaut) pour la première instance qui monte une base de données, seule cette instance peut monter la base de données. -
Si
CLUSTER_DATABASEesttruepour la première instance, d'autres instances peuvent monter la base de données si leurs paramètresCLUSTER_DATABASEsont définis surtrue. Le nombre d'instances pouvant monter la base de données est soumis à un nombre maximal prédéterminé spécifié lors de la création de la base de données.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment monter une base de données
-
Guide d'administration et de déploiement Oracle Real Application Clusters, pour plus d'informations sur l'utilisation de plusieurs instances avec une seule base de données
Ouverture d'une base de données
L'ouverture d'une base de données montée la rend disponible pour un fonctionnement normal.
Tout utilisateur valide peut se connecter à une base de données ouverte et accéder à ses informations. En général, un administrateur de base de données ouvre la base de données pour la rendre disponible pour une utilisation générale.
Lorsque vous ouvrez la base de données, Oracle AI Database effectue les actions suivantes :
-
Ouvre les fichiers de données en ligne dans les tablespaces autres que les tablespaces d'annulation
Si un tablespace était hors ligne lorsque la base de données a été précédemment arrêtée, le tablespace et les fichiers de données correspondants seront hors ligne lors de la réouverture de la base de données.
-
acquiert un tablespace d'annulation
S'il existe plusieurs tablespaces d'annulation, le paramètre d'initialisation
UNDO_TABLESPACEdésigne le tablespace d'annulation à utiliser. Si ce paramètre n'est pas défini, le premier tablespace d'annulation disponible est choisi. -
Ouvre les fichiers de journalisation en ligne.
-
Mode lecture seule Par défaut, la base de données s'ouvre en mode lecture/écriture. Dans ce mode, les utilisateurs peuvent apporter des modifications aux données et générer des informations de journalisation dans le fichier de journalisation en ligne. Vous pouvez également ouvrir en mode lecture seule pour empêcher la modification des données par les transactions utilisateur.
-
Vérifications des fichiers de base de données Si l'un des fichiers de données ou des fichiers de journalisation n'est pas présent lorsque l'instance tente d'ouvrir la base de données, ou si les fichiers sont présents mais échouent aux tests de cohérence, la base de données renvoie une erreur. Une restauration physique peut être nécessaire.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour en savoir plus sur la réparation des données
Mode Lecture seule
Par défaut, la base de données s'ouvre en mode lecture/écriture. Dans ce mode, les utilisateurs peuvent apporter des modifications aux données et générer des informations de journalisation dans le fichier de journalisation en ligne. Vous pouvez également ouvrir en mode lecture seule pour empêcher la modification des données par les transactions utilisateur. Remarque : Par défaut, une base de données de secours physique s'ouvre en mode lecture seule.
Le mode lecture seule restreint l'accès à la base de données aux transactions en lecture seule, qui ne peuvent pas écrire dans des fichiers de données ou dans des fichiers de journalisation en ligne. Toutefois, la base de données peut effectuer des opérations de récupération ou des opérations qui modifient l'état de la base sans générer les informations de journalisation. Par exemple, en mode lecture seule :
-
Les fichiers de données peuvent être mis hors ligne et en ligne. Toutefois, vous ne pouvez pas mettre les tablespaces permanents hors ligne.
-
Les fichiers de données et les tablespaces hors ligne peuvent être récupérés.
-
Le fichier de contrôle reste disponible pour les mises à jour concernant l'état de la base de données.
-
Les tablespaces temporaires créés avec l'instruction
CREATE TEMPORARY TABLESPACEsont en lecture/écriture. -
Les écritures dans les traces d'audit du système d'exploitation, les fichiers trace et les journaux d'alertes peuvent continuer.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment ouvrir une base de données en mode lecture seule
Vérifications de fichier de base de données
Si l'un des fichiers de données ou de journalisation n'est pas présent lorsque l'instance tente d'ouvrir la base de données, ou si les fichiers sont présents mais échouent aux tests de cohérence, la base de données renvoie une erreur. Une restauration physique peut être nécessaire.
Voir aussi : Guide de l'utilisateur Oracle AI Database Backup and Recovery pour une présentation de la sauvegarde et de la récupération
Présentation de l'arrêt de la base de données et de l'instance
Dans un cas d'emploi classique, vous arrêtez manuellement la base de données, ce qui la rend indisponible pour les utilisateurs pendant que vous effectuez des tâches de maintenance ou d'administration. Vous pouvez utiliser la commande SQL*Plus SHUTDOWN ou Enterprise Manager pour effectuer ces étapes.
La figure suivante illustre la progression d'un état ouvert à un arrêt cohérent.
Figure 4 : Séquence d'arrêt d'instance et de base de données
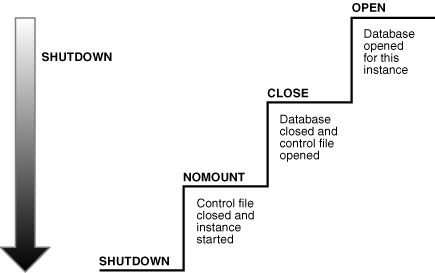
Description de l'image cncpt281.gif
Oracle AI Database effectue automatiquement les étapes suivantes chaque fois qu'une base de données ouverte est arrêtée de manière cohérente.
Tableau 3 Etapes d'un arrêt cohérent
| Phase | Etat du montage | Description | Pour en savoir plus |
|---|---|---|---|
| 1 | Database closed | La base de données est montée, mais les fichiers de données en ligne et les fichiers de journalisation sont fermés. | "Fermeture d'une base de données" |
| 2 | Base de données démontée | L'instance est démarrée mais n'est plus associée au fichier de contrôle de la base de données. | "Démontage d'une base de données" |
| 3 | Arrêt de l'instance de base de données | L'instance de base de données n'est plus démarrée. | Arrêt d'une instance |
Oracle AI Database ne passe pas par toutes les étapes précédentes en cas d'échec d'une instance ou SHUTDOWN ABORT, ce qui met immédiatement fin à l'instance.
-
Modes d'arrêt Un administrateur de base de données disposant des privilèges
SYSDBAouSYSOPERpeut arrêter la base de données à l'aide de la commande SQL*PlusSHUTDOWNou d'Enterprise Manager. La commandeSHUTDOWNcomporte des options qui déterminent le comportement d'arrêt. -
Fermeture d'une base de données L'opération de fermeture de la base de données est implicite lors d'un arrêt de la base de données. La nature de l'opération varie selon que l'arrêt de la base de données est normal ou anormal.
-
Démontage d'une base de données Une fois la base de données fermée, Oracle AI Database démonte la base de données pour la dissocier de l'instance.
-
Arrêt d'une instance La dernière étape de l'arrêt de la base de données consiste à arrêter l'instance. Lorsque l'instance de base de données est arrêtée, la mémoire SGA cesse d'occuper de la mémoire et les processus en arrière-plan prennent fin. Voir aussi : Guide de l'administrateur Oracle AI Database pour savoir comment arrêter une base de données
Modes de fermeture
Un administrateur de base de données disposant des privilèges SYSDBA ou SYSOPER peut arrêter la base de données à l'aide de la commande SQL*Plus SHUTDOWN ou d'Enterprise Manager. La commande SHUTDOWN comporte des options qui déterminent le comportement d'arrêt.
Le tableau suivant récapitule le comportement des différents modes d'arrêt.
Tableau 4 Modes d'arrêt de la base de données
| Comportement de la base de données | ABORT | IMMEDIATE | TRANSACTIONNEL | NORMAL |
|---|---|---|---|---|
| Permet les nouvelles connexions utilisateur | Non | Non | Non | Non |
| Attend la fin des sessions en cours | Non | Non | Non | Oui |
| Attend la fin des transactions en cours | Non | Non | Oui | Oui |
| Effectue un point de reprise et ferme les fichiers ouverts | Non | Oui | Oui | Oui |
Les instructions SHUTDOWN possibles sont les suivantes :
-
SHUTDOWN ABORTCe mode est destiné aux situations d'urgence, par exemple lorsqu'aucune autre forme d'arrêt ne réussit. Ce mode d'arrêt est le plus rapide. Toutefois, une ouverture ultérieure de cette base de données peut prendre beaucoup plus de temps car une récupération d'instance doit être effectuée pour assurer la cohérence des fichiers de données.
Etant donné que
SHUTDOWN ABORTne pointe pas vers les fichiers de données ouverts, la récupération d'instance est nécessaire pour que la base de données puisse rouvrir. Les autres modes d'arrêt ne nécessitent pas de récupération d'instance avant que la base de données puisse rouvrir.Remarque : dans une base de données pluggable, l'émission de
SHUTDOWN ABORTéquivaut à l'émission deSHUTDOWN IMMEDIATEau niveau de la base de données Conteneur. -
SHUTDOWN IMMEDIATECe mode est généralement le plus rapide à côté de
SHUTDOWN ABORT. Oracle AI Database met fin à toute instruction SQL en cours d'exécution et déconnecte les utilisateurs. Les transactions actives sont interrompues et les modifications non validées sont annulées. -
SHUTDOWN TRANSACTIONALCe mode empêche les utilisateurs de démarrer de nouvelles transactions, mais attend que toutes les transactions en cours se terminent avant de s'arrêter. Ce mode peut prendre beaucoup de temps en fonction de la nature des transactions en cours.
-
SHUTDOWN NORMALIl s'agit du mode d'arrêt par défaut. La base de données attend que tous les utilisateurs connectés se déconnectent avant de s'arrêter.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur les différents modes d'arrêt
-
Guide de référence et d'utilisation de SQL*Plus pour en savoir plus sur la commande
SHUTDOWN
Fermeture d'une base de données
L'opération de fermeture de la base de données est implicite dans un arrêt de la base de données. La nature de l'opération varie selon que l'arrêt de la base de données est normal ou anormal.
-
Fermeture d'une base de données lors d'un arrêt normal Lorsqu'une base de données est fermée dans le cadre d'un fichier
SHUTDOWNavec une option autre queABORT, Oracle AI Database écrit les données de la mémoire SGA dans les fichiers de données et les fichiers de journalisation en ligne. -
How a Database Is Closed During Abnormal Shutdown If a
SHUTDOWN ABORTor abnormal termination occurs, then the instance of an open database closes and shuts down the database instantaneously.
Fermeture d'une base de données lors d'un arrêt normal
Lorsqu'une base de données est fermée dans le cadre d'un fichier SHUTDOWN avec une option autre que ABORT, Oracle AI Database écrit les données de la mémoire SGA dans les fichiers de données et les fichiers de journalisation en ligne.
Ensuite, la base ferme les fichiers de données en ligne et les fichiers de journalisation en ligne. Tous les fichiers de données hors ligne des tablespaces hors ligne ont déjà été fermés. Lorsque la base de données est rouverte, tout tablespace qui était hors ligne reste hors ligne.
A ce stade, la base de données est fermée et inaccessible pour les opérations normales. Les fichiers de contrôle restent ouverts une fois la base fermée.
Fermeture d'une base de données lors d'un arrêt anormal
Si une terminaison de type SHUTDOWN ABORT ou anormale se produit, l'instance d'une base de données ouverte est fermée et arrête la base de données de façon instantanée.
En cas d'arrêt anormal, Oracle AI Database n'écrit pas de données dans les tampons de la mémoire SGA dans les fichiers de données et les fichiers de journalisation. La réouverture ultérieure de la base de données nécessite une récupération d'instance, qui est effectuée automatiquement par Oracle AI Database.
Démontage d'une base de données
Une fois la base de données fermée, Oracle AI Database démonte la base de données pour la dissocier de l'instance.
Une fois qu'une base de données est démontée, Oracle AI Database ferme les fichiers de contrôle de la base. A ce stade, l'instance de base de données reste en mémoire.
Arrêt d'une instance
La dernière étape de l'arrêt de la base de données consiste à arrêter l'instance. Lorsque l'instance de base de données est arrêtée, la mémoire SGA cesse d'occuper de la mémoire et les processus en arrière-plan prennent fin.
Dans des circonstances inhabituelles, l'arrêt d'une instance de base de données peut ne pas se produire correctement. Les structures de mémoire ne peuvent pas être supprimées de la mémoire ou l'un des processus en arrière-plan ne peut pas être arrêté. Lorsqu'il existe des restes d'une instance précédente, un démarrage d'instance ultérieur peut échouer. Dans ce cas, vous pouvez forcer la nouvelle instance à démarrer en supprimant les éléments restants de l'instance précédente, puis en démarrant une nouvelle instance, ou en émettant une instruction SHUTDOWN ABORT.
Dans certains cas, le nettoyage du processus lui-même peut rencontrer des erreurs, ce qui peut entraîner la terminaison du processus Monitor (PMON) ou de l'instance. Le paramètre d'initialisation dynamique INSTANCE_ABORT_DELAY_TIME indique le nombre de secondes pendant lesquelles retarder une défaillance d'instance générée en interne. Ce délai vous donne une chance de répondre. La base de données écrit un message dans le journal des alertes lorsque la terminaison retardée est lancée. Dans certains cas, en autorisant la mise en quarantaine de certaines ressources de base de données, l'instance peut éviter l'interruption.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour plus d'informations sur l'arrêt de la base de données
-
Référence Oracle AI Database pour en savoir plus sur le paramètre d'initialisation
INSTANCE_ABORT_DELAY_TIME
Généralités sur les points de reprise
Un point de reprise est un mécanisme crucial pour des arrêts cohérents de la base de données, la récupération d'instance et le fonctionnement d'Oracle AI Database en général.
Le terme a les significations connexes suivantes :
-
Structure de données indiquant la position du point de reprise, qui est le SCN dans le flux de données de journalisation où la récupération d'instance doit commencer
La position du point de reprise est déterminée par le tampon "dirty" le plus ancien du cache de tampons de la base de données. La position du point de reprise sert de pointeur vers le flux de données de journalisation et est stockée dans le fichier de contrôle et dans chaque en-tête de fichier de données.
-
Ecriture de tampons de base de données modifiés dans le cache de tampons de base de données sur disque
-
Objectif des points de reprise Oracle AI Database utilise des points de reprise pour atteindre plusieurs objectifs.
-
Lorsque Oracle AI Database lance des points de reprise Le processus de point de reprise (CKPT) est chargé d'écrire des points de reprise dans les en-têtes de fichier de données et le fichier de contrôle. Voir aussi : "System Change Numbers (SCNs)"
Finalité des points de reprise
Oracle AI Database utilise des points de reprise pour atteindre plusieurs objectifs.
Les objectifs sont les suivants :
-
Réduire le temps nécessaire à la récupération en cas de défaillance d'une instance ou d'un média
-
Assurez-vous que la base de données écrit régulièrement des tampons "dirty" dans le cache de tampons sur le disque.
-
Assurez-vous que la base de données écrit toutes les données validées sur le disque pendant un arrêt cohérent.
Quand Oracle AI Database lance des points de reprise
Le processus de point de reprise (CKPT) est chargé d'écrire les points de reprise dans les en-têtes de fichier de données et le fichier de contrôle.
Les points de contrôle se produisent dans diverses situations. Par exemple, Oracle AI Database utilise les types de point de reprise suivants :
-
Points de reprise de thread
La base de données écrit sur le disque tous les tampons modifiés par les informations de journalisation dans un thread spécifique avant une cible donnée. L'ensemble de points de reprise de thread sur toutes les instances d'une base de données est un point de reprise de base de données. Les points de reprise de thread se produisent dans les situations suivantes :
-
Arrêt cohérent de la base de données
-
Instruction
ALTER SYSTEM CHECKPOINT -
Changement de fichier de journalisation en ligne
-
Instruction
ALTER DATABASE BEGIN BACKUP
-
-
Points de reprise des tablespaces et des fichiers de données
La base de données écrit sur le disque tous les tampons modifiés par les informations de journalisation avant une cible spécifique. Un point de reprise de tablespace est un ensemble de points de reprise de fichier de données, un pour chaque fichier de données du tablespace. Ces points de reprise se produisent dans diverses situations, notamment en rendant un tablespace en lecture seule ou en le mettant hors ligne normalement, en réduisant un fichier de données ou en exécutant
ALTER TABLESPACE BEGIN BACKUP. -
Points de reprise incrémentiels
Un point de reprise incrémentiel est un type de point de reprise de thread, en partie destiné à éviter l'écriture d'un grand nombre de blocs lors de changements de fichier de journalisation en ligne. DBW vérifie au moins toutes les trois secondes s'il a du travail à faire. Lorsque DBW écrit des tampons "dirty", il avance la position du point de reprise, ce qui fait que CKPT écrit la position du point de reprise dans le fichier de contrôle, mais pas dans les en-têtes du fichier de données.
Les autres types de point de reprise incluent les points de reprise et les points de reprise d'instance et de restauration physique lorsque des objets de schéma sont supprimés ou tronqués.
Voir aussi :
-
Guide d'administration et de déploiement Oracle Real Application Clusters, pour plus d'informations sur les points de reprise globaux dans Oracle RAC
Présentation de la récupération d'instance
La récupération d'instance est le processus qui consiste à appliquer les enregistrements du fichier de journalisation en ligne aux fichiers de données afin de reconstruire les modifications apportées après le point de reprise le plus récent.
La récupération d'instance se produit automatiquement lorsqu'un administrateur tente d'ouvrir une base de données précédemment arrêtée de manière incohérente.
-
Objectif de la récupération d'instance La récupération d'instance garantit que la base de données est dans un état cohérent après une défaillance d'instance. Les fichiers d'une base de données peuvent rester dans un état incohérent en raison de la façon dont Oracle AI Database gère les modifications de base de données.
-
Lorsque Oracle AI Database effectue une récupération d'instance, le fait que la récupération d'instance soit requise dépend de l'état des threads de journalisation.
-
Importance des points de reprise pour la récupération d'instance La récupération d'instance utilise des points de reprise pour déterminer les modifications à appliquer aux fichiers de données. La position du point de reprise garantit que chaque modification validée avec un numéro SCN inférieur au numéro SCN du point de reprise est enregistrée dans les fichiers de données.
-
Phases de récupération d'instance La première phase de récupération d'instance est appelée récupération du cache ou réintégration progressive, et applique de nouveau toutes les modifications enregistrées dans le fichier de journalisation en ligne aux fichiers de données.
Finalité de la récupération d'instance
La récupération d'instance garantit que la base de données est dans un état cohérent après une défaillance d'instance. Les fichiers d'une base de données peuvent rester dans un état incohérent en raison de la façon dont Oracle AI Database gère les modifications de base de données.
Un fil de journalisation est un enregistrement de toutes les modifications générées par une instance. Une base de données à instance unique comporte un thread de journalisation, tandis qu'une base de données Oracle RAC comporte plusieurs threads de journalisation, un pour chaque instance.
Lorsqu'une transaction est validée, le processus d'écriture de journal (LGWR) écrit à la fois les entrées de journalisation restantes en mémoire et le numéro SCN de transaction dans le fichier de journalisation en ligne. Toutefois, le processus database Writer (DBW) écrit les blocs de données modifiés dans les fichiers de données chaque fois qu'il est le plus efficace. Pour cette raison, les modifications non validées peuvent exister temporairement dans les fichiers de données alors que les modifications validées n'existent pas encore dans les fichiers de données.
Si une instance d'une base de données ouverte échoue, en raison d'une instruction SHUTDOWN ABORT ou d'une terminaison anormale, les situations suivantes peuvent se produire :
-
Les blocs de données validés par une transaction ne sont pas écrits dans les fichiers de données et apparaissent uniquement dans le fichier de journalisation en ligne. Ces modifications doivent être réappliquées aux fichiers de données.
-
Les fichiers de données contiennent des modifications qui n'ont pas été validées lorsque l'instance a échoué. Ces modifications doivent être annulées pour garantir la cohérence transactionnelle.
La récupération d'instance utilise uniquement des fichiers de journalisation en ligne et des fichiers de données en ligne pour synchroniser les fichiers de données et garantir leur cohérence.
Voir aussi :
Lorsqu'Oracle AI Database effectue une récupération d'instance
La nécessité d'une récupération d'instance dépend de l'état des threads de journalisation.
Un thread de journalisation est marqué comme ouvert dans le fichier de contrôle lorsqu'une instance de base de données s'ouvre en mode lecture/écriture et est marqué comme fermé lorsque l'instance est arrêtée de manière cohérente. Si les threads de journalisation sont marqués comme ouverts dans le fichier de contrôle, mais qu'aucune instance active ne contient les mises en file d'attente de thread correspondant à ces threads, la base de données requiert une récupération d'instance.
Oracle AI Database effectue automatiquement la récupération d'instance dans les situations suivantes :
-
La base de données s'ouvre pour la première fois après l'échec d'une base de données à instance unique ou de toutes les instances d'une base de données Oracle RAC. Cette forme de récupération d'instance est également appelée récupération après panne. Oracle AI Database récupère les threads de journalisation en ligne des instances terminées ensemble.
-
Certaines instances d'une base de données Oracle RAC, mais pas toutes, échouent. La récupération d'instance est effectuée automatiquement par une instance restante de la configuration.
Le processus en arrière-plan SMON effectue une récupération d'instance, en appliquant automatiquement les informations de journalisation en ligne. Aucune intervention de l'utilisateur n'est requise.
Voir aussi :
-
Guide d'administration et de déploiement Oracle Real Application Clusters, pour en savoir plus sur la récupération d'instance dans une base de données Oracle RAC
Importance des points de reprise pour la récupération d'instance
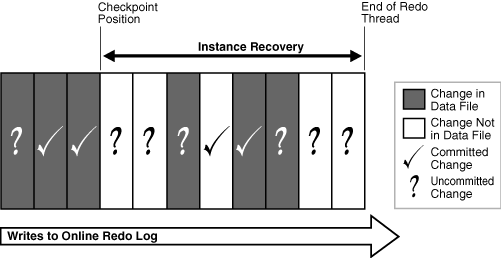
La récupération d'instance utilise des points de reprise pour déterminer les modifications à appliquer aux fichiers de données. La position du point de reprise garantit que chaque modification validée avec un numéro SCN inférieur au numéro SCN du point de reprise est enregistrée dans les fichiers de données.
La figure suivante représente le thread de journalisation dans le fichier de journalisation en ligne.
Figure 5 : Position du point de reprise dans le fichier de journalisation en ligne
Description de l'image cncpt282.gif
Lors de la récupération d'instance, la base de données doit appliquer les modifications qui se produisent entre la position du point de reprise et la fin du thread de journalisation. Comme illustré dans la Figure 16-5, certaines modifications ont peut-être déjà été écrites dans les fichiers de données. Cependant, seules les modifications dont le numéro SCN est inférieur à la position du point de reprise sont garanties sur le disque.
Voir aussi : Guide de réglage des performances d'Oracle AI Database pour apprendre à limiter le temps de récupération d'instance
Phases de récupération d'instance
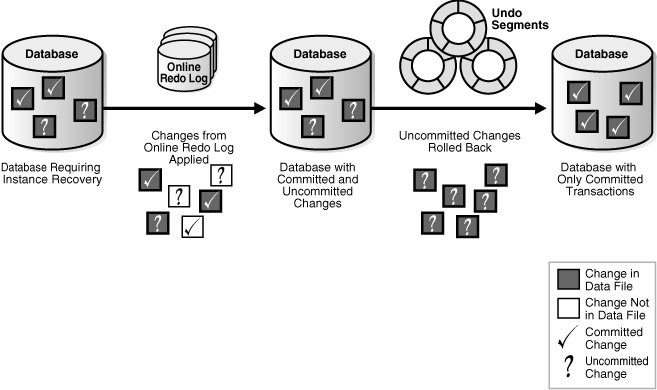
La première phase de récupération d'instance est appelée récupération du cache ou réacheminement amont et réapplique toutes les modifications enregistrées dans le fichier de journalisation en ligne aux fichiers de données.
Etant donné que le fichier de journalisation en ligne contient des données d'annulation, le report à nouveau régénère également les segments d'annulation correspondants. L'exécution non simultanée parcourt autant de fichiers de journalisation en ligne que nécessaire pour faire avancer la base de données dans le temps. Une fois l'opération de réimplémentation des modifications effectuée, les blocs de données contiennent toutes les modifications validées enregistrées dans les fichiers de journalisation en ligne. Ces fichiers peuvent également contenir des modifications non validées qui ont été enregistrées dans les fichiers de données avant l'échec ou qui ont été enregistrées dans le fichier de journalisation en ligne et introduites lors de la récupération du cache.
Après le report, toutes les modifications qui n'ont pas été validées doivent être annulées. Oracle AI Database utilise la position de point de reprise, ce qui garantit que chaque modification validée dont le numéro SCN est inférieur au numéro SCN de point de reprise est enregistrée sur disque. Oracle AI Database applique des blocs d'annulation pour annuler les modifications non validées dans les blocs de données qui ont été écrits avant l'échec ou introduits lors de la récupération du cache. Cette phase est appelée reprise progressive ou récupération des transactions.
La figure suivante illustre l'annulation (rollback) et l'annulation (rollback), les deux étapes nécessaires à la récupération après une défaillance d'instance de base de données.
Figure 6 : Etapes de récupération d'instance de base : Avancement et annulation
Description de l'image cncpt196.gif
Oracle AI Database peut annuler plusieurs transactions simultanément si nécessaire. Toutes les transactions qui étaient actives au moment de l'échec sont marquées comme terminées. Au lieu d'attendre que le processus SMON annule les transactions terminées, les nouvelles transactions peuvent annuler les blocs eux-mêmes pour obtenir les données requises.
Voir aussi :
-
"Segments d'annulation" pour en savoir plus sur les données d'annulation
-
Guide de réglage des performances d'Oracle AI Database pour une discussion sur la mécanique et le réglage de la récupération d'instance
Généralités sur les fichiers de paramètres
Pour démarrer une instance de base de données, Oracle AI Database doit lire un fichier de paramètres serveur, qui est recommandé, ou un fichier de paramètres d'initialisation texte, qui est une implémentation héritée. Ces fichiers contiennent une liste de paramètres de configuration.
Pour créer une base de données manuellement, vous devez démarrer une instance avec un fichier de paramètres, puis émettre une instruction CREATE DATABASE. Par conséquent, l'instance et le fichier de paramètres peuvent exister même lorsque la base de données elle-même n'existe pas.
-
Les paramètres d'initialisation sont des paramètres de configuration qui affectent le fonctionnement de base d'une instance. L'instance lit les paramètres d'initialisation à partir d'un fichier pendant le démarrage.
-
Fichiers de paramètres serveur Un fichier de paramètres serveur est un référentiel pour les paramètres d'initialisation.
-
Fichiers de paramètres d'initialisation de texte Un fichier de paramètres d'initialisation de texte est un fichier texte qui contient la liste des paramètres d'initialisation.
-
Modification des valeurs des paramètres d'initialisation Vous pouvez ajuster les paramètres d'initialisation pour modifier le comportement d'une base de données. La classification des paramètres en tant que paramètres statiques ou dynamiques détermine la manière dont ils peuvent être modifiés.
Paramètres d'initialisation
Les paramètres d'initialisation sont des paramètres de configuration qui affectent le fonctionnement de base d'une instance. L'instance lit les paramètres d'initialisation à partir d'un fichier pendant le démarrage.
Oracle AI Database fournit de nombreux paramètres d'initialisation pour optimiser son fonctionnement dans divers environnements. Seuls quelques-uns de ces paramètres doivent être définis explicitement car les valeurs par défaut sont généralement adéquates.
-
Groupes fonctionnels de paramètres d'initialisation Les paramètres d'initialisation appartiennent à des groupes fonctionnels différents.
-
Paramètres d'initialisation de base et avancés Les paramètres d'initialisation sont divisés en deux groupes : élémentaire et avancé.
Groupes fonctionnels des paramètres d'initialisation
Les paramètres d'initialisation appartiennent à différents groupes fonctionnels.
La plupart des paramètres d'initialisation appartiennent à l'un des groupes suivants :
-
Paramètres qui nomment des entités telles que des fichiers ou des répertoires
-
Paramètres qui définissent des limites pour un processus, une ressource de base de données ou la base de données elle-même
-
Paramètres qui affectent la capacité, tels que la taille de la mémoire SGA (ces paramètres sont appelés paramètres variables).
Les paramètres variables présentent un intérêt particulier pour les administrateurs de base de données car ils peuvent les utiliser pour améliorer les performances de la base.
Paramètres d'initialisation de base et avancés
Les paramètres d'initialisation sont divisés en deux groupes : élémentaire et avancé.
En règle générale, vous devez définir et régler uniquement les 30 paramètres de base environ pour obtenir des performances raisonnables. Les paramètres de base définissent des caractéristiques telles que le nom de la base de données, l'emplacement des fichiers de contrôle, la taille des blocs de la base de données et le tablespace d'annulation.
Dans de rares cas, une modification des paramètres avancés peut être nécessaire pour des performances optimales. Les paramètres avancés permettent aux administrateurs de base de données experts d'adapter le comportement d'Oracle AI Database pour répondre à des exigences uniques.
Oracle AI Database fournit des valeurs dans le fichier de paramètres d'initialisation de départ fourni avec votre logiciel de base de données, ou tel que créé pour vous par l'assistant DBCA (Database Configuration Assistant). Vous pouvez modifier ces paramètres d'initialisation fournis par Oracle et en ajouter d'autres en fonction de votre configuration et de la manière dont vous prévoyez de régler la base de données. Pour les paramètres d'initialisation pertinents non inclus dans le fichier de paramètres, Oracle AI Database fournit des valeurs par défaut.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment spécifier des paramètres d'initialisation
-
Référence Oracle AI Database pour une explication des types de paramètre d'initialisation
-
Référence Oracle AI Database, pour une description de
V$PARAMETERet du Guide de l'utilisateur et référence SQL*Plus pour la syntaxeSHOW PARAMETER
Fichiers de paramètre du serveur
Un fichier de paramètres serveur est un référentiel pour les paramètres d'initialisation.
Un fichier de paramètres serveur présente les caractéristiques clés suivantes :
-
Seul Oracle AI Database lit et écrit dans le fichier de paramètres serveur.
-
Un seul fichier de paramètres serveur existe pour une base de données. Ce fichier doit résider sur l'hôte de la base de données.
-
Le fichier de paramètres serveur est binaire et ne peut pas être modifié par un éditeur de texte.
-
Les paramètres d'initialisation stockés dans le fichier de paramètres serveur sont persistants. Toutes les modifications apportées aux paramètres pendant l'exécution d'une instance de base de données peuvent persister après l'arrêt et le démarrage de l'instance.
Un fichier de paramètres serveur élimine la nécessité de gérer plusieurs fichiers de paramètres d'initialisation au format texte pour les applications client. Un fichier de paramètres serveur est initialement créé à partir d'un fichier de paramètres d'initialisation au format texte à l'aide de l'instruction CREATE SPFILE. Il peut également être créé directement par l'assistant Configuration de base de données.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur les fichiers de paramètres serveur
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur
CREATE SPFILE
Fichiers de paramètres d'initialisation de texte
Un fichier de paramètres d'initialisation de texte est un fichier texte qui contient une liste de paramètres d'initialisation.
Ce type de fichier de paramètres, qui est une implémentation héritée du fichier de paramètres, présente les caractéristiques clés suivantes :
-
Lorsque vous démarrez ou arrêtez une base de données, le fichier de paramètres d'initialisation au format texte doit résider sur le même hôte que l'application client qui se connecte à la base de données.
-
Un fichier de paramètres d'initialisation au format texte n'est pas binaire.
-
Oracle AI Database peut lire mais pas écrire dans le fichier de paramètres d'initialisation au format texte. Pour modifier les valeurs des paramètres, vous devez modifier manuellement le fichier à l'aide d'un éditeur de texte.
-
Les modifications apportées aux valeurs des paramètres d'initialisation par
ALTER SYSTEMne sont effectives que pour l'instance en cours. Vous devez mettre à jour manuellement le fichier de paramètres d'initialisation au format texte et redémarrer l'instance pour que les modifications soient connues.
Le fichier de paramètres d'initialisation texte contient une série de paires key=value, une par ligne. Par exemple, une partie d'un fichier de paramètres d'initialisation peut se présenter comme suit :
db_name=sample
control_files=/disk1/oradata/sample_cf.dbf
db_block_size=8192
open_cursors=52
undo_management=auto
shared_pool_size=280M
pga_aggregate_target=29M
.
.
.
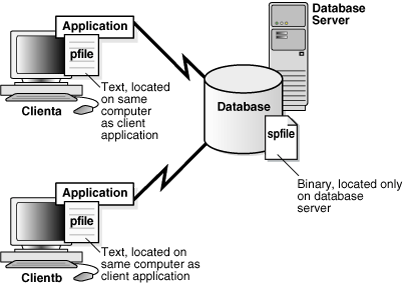
Pour illustrer les problèmes de gestion que les fichiers de paramètres texte peuvent créer, supposons que vous utilisiez les ordinateurs clienta et clientb et que vous puissiez démarrer la base de données avec SQL*Plus sur chaque ordinateur. Dans ce cas, deux fichiers de paramètres d'initialisation au format texte distincts doivent exister, un sur chaque ordinateur, comme illustré dans la Figure 16-7. Un fichier de paramètres serveur résout le problème de la prolifération des fichiers de paramètres.
Figure 7 : Fichiers de paramètres d'initialisation multiples
Description de l'image cncpt247.gif
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur les fichiers de paramètres d'initialisation au format texte
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur
CREATE PFILE
Modification des valeurs des paramètres d'initialisation
Vous pouvez ajuster les paramètres d'initialisation pour modifier le comportement d'une base de données. La classification des paramètres en tant que statique ou dynamique détermine la façon dont ils peuvent être modifiés.
Le tableau suivant récapitule les différences.
Tableau 5 Paramètres d'initialisation statiques et dynamiques
| Caractéristique | Statique | Dynamique |
|---|---|---|
| Nécessite la modification du fichier de paramètres (texte ou serveur) | Oui | Non |
| Requiert le redémarrage de l'instance de base de données avant que la définition ne prenne effet | Oui | Non |
| Décrit comme "Modifiable" dans l'entrée de paramètre d'initialisation Oracle AI Database Reference | Non | Oui |
| Modifiable uniquement pour la base de données ou l'instance | Oui | Non |
Les paramètres statiques incluent DB_BLOCK_SIZE, DB_NAME et COMPATIBLE. Les paramètres dynamiques sont regroupés en paramètres de niveau session, qui affectent uniquement la session utilisateur en cours, et en paramètres de niveau système, qui affectent la base de données et toutes les sessions. Par exemple, MEMORY_TARGET est un paramètre de niveau système, tandis que NLS_DATE_FORMAT est un paramètre de niveau session.
La portée d'une modification de paramètre dépend du moment où la modification prend effet. Lorsqu'une instance a été démarrée avec un fichier de paramètres serveur, vous pouvez utiliser l'instruction ALTER SYSTEM SET pour modifier les valeurs des paramètres de niveau système comme suit :
-
SCOPE=MEMORYLes modifications s'appliquent uniquement à l'instance de base de données. La modification ne persistera pas si la base de données est arrêtée et redémarrée.
-
SCOPE=SPFILELes modifications s'appliquent au fichier de paramètres serveur mais n'affectent pas l'instance en cours. Par conséquent, les modifications ne prennent effet que lorsque l'instance est redémarrée.
Remarque : vous devez indiquer
SPFILElorsque vous modifiez la valeur d'un paramètre décrit comme non modifiable dans Référence Oracle AI Database. -
SCOPE=BOTHOracle AI Database écrit les modifications à la fois dans la mémoire et dans le fichier de paramètres serveur. Il s'agit de la portée par défaut lorsque la base de données utilise un fichier des paramètres du serveur.
La base de données imprime la nouvelle valeur et l'ancienne valeur d'un paramètre d'initialisation dans le fichier d'alertes. Par mesure préventive, la base de données valide les modifications des paramètres de base pour éviter que des valeurs non valides ne soient écrites dans le fichier de paramètres serveur.
Voir aussi :
-
Guide de prise en charge de la globalisation d'Oracle AI Database pour savoir comment choisir un environnement linguistique avec la variable d'environnement
NLS_LANG -
Guide de l'administrateur Oracle AI Database pour savoir comment modifier les paramètres d'initialisation
-
Référence Oracle AI Database pour une description de tous les paramètres d'initialisation
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
ALTER SYSTEM
Présentation des fichiers de diagnostic
Oracle AI Database inclut une infrastructure d'établissement de diagnostic des pannes pour prévenir, détecter, diagnostiquer et résoudre les problèmes de base de données. Les problèmes incluent les erreurs critiques telles que les bogues de code, l'altération des métadonnées et l'altération des données client.
Les objectifs de l'infrastructure avancée de diagnostic des pannes sont les suivants :
-
Détecter les problèmes de manière proactive
-
Limitation des dommages et des interruptions après la détection d'un problème
-
Réduction du temps de diagnostic et de résolution des problèmes
-
Amélioration de la facilité de gestion en permettant le partitionnement des fichiers trace, en permettant à l'utilisateur de définir la taille par pièce et le nombre maximal d'éléments à conserver, et en désactivant la fonction de trace après qu'une limite d'espace disque spécifiée par l'utilisateur a été atteinte
-
Simplification de l'interaction client avec le support technique Oracle
-
Le référentiel ADR (Automatic Diagnostic Repository) est un référentiel basé sur des fichiers qui stocke les données de diagnostic de la base de données telles que les fichiers trace, le journal d'alertes, le journal LDD et les rapports Health Monitor.
-
Journal d'alertes Chaque base de données comporte un journal d'alertes, qui est un fichier contenant un journal chronologique des messages et des erreurs de base de données.
-
Journal d'attention Chaque base de données dispose d'un journal d'attention contenant des événements de base de données critiques et hautement visibles.
-
Journal LDD Le journal LDD a le même format et le même comportement de base que le journal d'alertes, mais contient uniquement des instructions LDD et des détails. La base de données écrit les informations LDD dans son propre fichier afin de réduire l'encombrement du fichier d'alertes.
-
Fichiers trace Un fichier trace est un fichier qui contient les données de diagnostic utilisées pour étudier les problèmes. En outre, les fichiers trace peuvent fournir des conseils pour le réglage d'applications ou d'une instance.
-
Vidages de diagnostic Un fichier de vidage de diagnostic est un type spécial de fichier trace qui contient des informations détaillées sur un état ou une structure. Voir aussi : Guide de l'administrateur Oracle AI Database pour savoir comment gérer les fichiers de diagnostic
Référentiel ADR (Automatic Diagnostic Repository)
Le référentiel ADR (Automatic Diagnostic Repository) est un référentiel basé sur des fichiers qui stocke les données de diagnostic de la base de données telles que les fichiers trace, le journal d'alertes, le journal LDD et les rapports Health Monitor.
Les principales caractéristiques de l'ADR sont les suivantes :
-
Structure de répertoires unifiée
-
Formats de données de diagnostic cohérents
-
Ensemble d'outils unifiés
Les caractéristiques précédentes permettent aux clients et au support technique Oracle de corréler et d'analyser les données de diagnostic entre plusieurs instances, composants et produits Oracle.
Le référentiel ADR est situé en dehors de la base de données, ce qui permet à Oracle AI Database d'accéder au référentiel ADR et de le gérer lorsque la base de données physique n'est pas disponible. Une instance de base de données peut créer un référentiel ADR avant qu'une base de données ne soit créée.
-
Problèmes et incidents Le référentiel ADR effectue le suivi proactif des problèmes, qui sont des erreurs critiques dans la base de données.
-
Structure ADR La base ADR est le répertoire racine ADR.
Problèmes et incidents
ADR suit de manière proactive les problèmes, qui sont des erreurs critiques dans la base de données.
Les erreurs critiques se manifestent sous la forme d'erreur interne, comme ORA-600, ou d'autres erreurs graves. Chaque problème comporte une clé de problèmes , qui est une chaîne qui décrit le problème.
Lorsqu'un problème survient plusieurs fois, le référentiel ADR crée un incident horodaté pour chaque occurrence. Un incident est identifié de manière unique par un ID incident numérique. Lorsqu'un incident se produit, le référentiel ADR envoie une alerte d'incident à Enterprise Manager. Le diagnostic et la résolution d'une erreur critique commencent généralement par une alerte d'incident.
Etant donné qu'un problème peut générer de nombreux incidents en peu de temps, le référentiel ADR applique le contrôle des inondations à la génération d'incidents une fois que certains seuils sont atteints. Un incident contrôlé par l'inondation génère une entrée de journal d'alertes, mais ne génère pas de vidages d'incident. De cette façon, le référentiel ADR vous informe qu'une erreur critique est en cours sans surcharger le système avec des données de diagnostic.
Voir aussi : Guide de l'administrateur Oracle AI Database pour plus d'informations sur l'infrastructure d'établissement de diagnostic des pannes
Structure ADR
La base ADR est le répertoire root ADR.
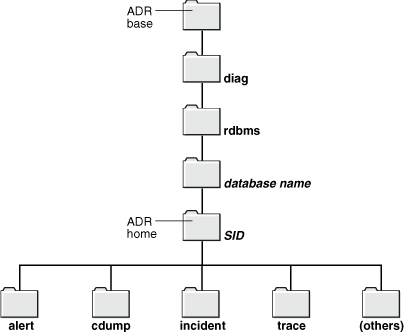
La base ADR peut contenir plusieurs répertoires de base ADR, où chaque répertoire de base ADR est le répertoire racine de toutes les traces de données de diagnostic, des dumps, du fichier d'alertes, etc. pour une instance d'un produit ou d'un composant Oracle. Par exemple, dans un environnement Oracle RAC avec stockage partagé et Oracle ASM, chaque instance de base de données et chaque instance Oracle ASM possède son propre répertoire de base ADR. La figure 16-8 illustre la hiérarchie de répertoires ADR d'une instance de base de données. D'autres répertoires de base ADR pour d'autres produits ou composants Oracle, tels qu'Oracle ASM ou Oracle Net Services, peuvent exister au sein de cette hiérarchie, sous la même base ADR.
Figure 8 : Structure de répertoires ADR pour une instance Oracle AI Database
Description de l'image admin077.gif
Comme le montre l'exemple Linux suivant, lorsque vous démarrez une instance avec un SID et un nom de base de données uniques avant de créer une base de données, Oracle AI Database crée le référentiel ADR par défaut en tant que structure de répertoires dans le système de fichiers hôte. Le SID et le nom de la base de données font partie du chemin d'accès des fichiers du répertoire de base ADR.
Exemple 16-1 Création d'ADR
% setenv ORACLE_SID osi
% echo "DB_NAME=dbn" > init.ora
% sqlplus / as sysdba
.
.
.
Connected to an idle instance.

SQL> STARTUP NOMOUNT PFILE="./init.ora"
ORACLE instance started.

Total System Global Area  146472960 bytes
Fixed Size                  1317424 bytes
Variable Size              92276176 bytes
Database Buffers           50331648 bytes
Redo Buffers                2547712 bytes

SQL> COL NAME FORMAT a21
SQL> COL VALUE FORMAT a60
SQL> SELECT NAME, VALUE FROM V$DIAG_INFO;

NAME                  VALUE
--------------------- --------------------------------------------------------
Diag Enabled          TRUE
ADR Base              /d1/3910926111/oracle/log
ADR Home              /d1/3910926111/oracle/log/diag/rdbms/dbn/osi
Diag Trace            /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/trace
Diag Alert            /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/alert
Diag Incident         /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/incident
Diag Cdump            /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/cdump
Health Monitor        /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/hm
Default Trace File    /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/trace/osi_ora_29229.trc
Active Problem Count  0
Active Incident Count 0
ORACLE_HOME           /d1/3910926111/oracle
Attention Log         /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/trace/attention_osi.log
13 rows selected.
Journal d'alertes
Chaque base de données possède un journal d'alertes, qui est un fichier contenant un journal chronologique des messages et des erreurs de base de données.
Le contenu du fichier d'alertes inclut les éléments suivants :
-
Toutes les erreurs internes (
ORA-600), les erreurs d'altération de bloc (ORA-1578) et les erreurs de déverrouillage (ORA-60) -
Opérations d'administration telles que les commandes SQL*Plus
STARTUP,SHUTDOWN,ARCHIVE LOGetRECOVER -
Plusieurs messages et erreurs relatifs aux fonctions des processus serveur et répartiteur partagés
-
Erreurs lors de l'actualisation automatique d'une vue matérialisée
Si une opération d'administration réussit, Oracle AI Database écrit un message dans le fichier d'alertes comme étant "terminé" avec un horodatage.
Oracle AI Database crée un fichier d'alertes dans le sous-répertoire alert illustré dans la figure 16-8 lorsque vous démarrez une instance de base de données pour la première fois, même si aucune base de données n'a encore été créée. Le fichier est au format XML. Le sous-répertoire trace contient un fichier d'alertes en mode texte uniquement.
Interrogez V$DIAG_INFO pour localiser le fichier d'alertes.
Journal d'éléments nécessitant une attention particulière
Chaque base de données dispose d'un journal d'attention, contenant des événements de base de données critiques et hautement visibles.
Le journal d'attention inclut uniquement les événements de base de données critiques et hautement visibles, ce qui vous permet d'identifier une alerte et d'effectuer l'action appropriée. Chaque message de journal d'attention a différents attributs, notamment le public cible, la cause et une action à effectuer. Le journal d'attention fournit des informations au format suivant :
-
ID du message d'attention
-
Type de message d'attention : erreur, notification, avertissement
-
Message d'attention urgence : DIFFERABLE, IMMÉDIATE, INFO, Bientôt
-
Portée du message d'attention : base de données Conteneur, cluster de bases de données Conteneur, instance de base de données Conteneur, base de données pluggable, session, instance de base de données pluggable, processus, session
-
Texte du message d'attention
-
Utilisateur cible du message d'attention : administrateur de base de données Conteneur, administrateur de Clusterware, administrateur de base de données pluggable
-
Cause
-
Action
Oracle AI Database crée un journal d'attention nommé attention_ORACLE_SID.log dans le sous-répertoire trace illustré dans la figure 16-8. Vous pouvez également interroger V$DIAG_INFO pour localiser le journal d'attention.
Journal LDD
Le journal LDD a le même format et le même comportement de base que le journal d'alertes, mais contient uniquement des instructions LDD et des détails. La base de données écrit les informations LDD dans son propre fichier afin de réduire l'encombrement du fichier d'alertes.
Les enregistrements de journal LDD sont des textes LDD, éventuellement complétés par des informations supplémentaires. Un enregistrement de journal existe pour chaque instruction LDD. Le journal LDD est stocké dans le sous-répertoire log/ddl du répertoire de base ADR.
Fichiers trace
Un fichier trace est un fichier qui contient les données de diagnostic utilisées pour étudier les problèmes. En outre, les fichiers trace peuvent fournir des conseils pour le réglage d'applications ou d'une instance.
-
Types de fichier trace Chaque serveur et processus en arrière-plan peuvent écrire régulièrement dans un fichier trace associé. Les fichiers contiennent des informations sur l'environnement de processus, le statut, les activités et les erreurs.
-
Emplacements des fichiers trace Le référentiel ADR stocke les fichiers trace dans le sous-répertoire
trace. Les noms de fichier trace dépendent de la plate-forme et utilisent l'extension.trc. -
Segmentation des fichiers trace Lorsque la taille du fichier trace est limitée, la base de données peut automatiquement le fractionner en un maximum de cinq segments. Les segments sont des fichiers distincts portant le même nom que le fichier trace actif, mais avec un numéro de segment ajouté, comme dans
ora_1234_2.trc. Voir aussi : Oracle AI Database - Introduction au réglage des performances
Types de fichier trace
Chaque serveur et processus en arrière-plan peuvent écrire régulièrement dans un fichier trace associé. Les fichiers contiennent des informations sur l'environnement de processus, le statut, les activités et les erreurs.
L'utilitaire de trace SQL crée également des fichiers trace qui fournissent des informations sur les performances de chaque instruction SQL. Vous pouvez activer la fonction de trace pour un identificateur client, un service, un module, une action, une session, une instance ou une base de données de différentes manières. Par exemple, vous pouvez exécuter les procédures appropriées dans le package DBMS_MONITOR ou définir des événements.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur les fichiers trace, les dumps et les dumps noyau
-
Guide de réglage SQL Oracle AI Database pour en savoir plus sur la fonction de trace d'application
Emplacements des fichiers trace
Le référentiel ADR stocke les fichiers trace dans le sous-répertoire trace. Les noms des fichiers trace dépendent de la plate-forme et utilisent l'extension .trc.
En général, les noms des fichiers trace de processus en arrière-plan de la base de données contiennent le SID Oracle, le nom du processus en arrière-plan et le numéro du processus du système d'exploitation. mytest_reco_10355.trc est un exemple de fichier trace pour le processus RECO.
Les noms des fichiers trace de processus serveur contiennent le SID Oracle, la chaîne ora et le numéro de processus du système d'exploitation. Un exemple de nom de fichier trace de processus serveur est mytest_ora_10304.trc.
Parfois, les fichiers trace ont des fichiers de métadonnées de trace correspondants, qui se terminent par l'extension .trm. Ces fichiers contiennent des informations structurelles appelées cartes de suivi que la base de données utilise pour la recherche et la navigation.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment rechercher des fichiers trace
Segmentation des fichiers trace
Lorsque la taille du fichier trace est limitée, la base de données peut automatiquement le fractionner en un maximum de cinq segments. Les segments sont des fichiers distincts portant le même nom que le fichier trace actif, mais avec un numéro de segment ajouté, comme dans ora_1234_2.trc.
Chaque segment représente généralement 20 % de la limite définie par MAX_DUMP_FILE_SIZE. Lorsque la taille combinée de tous les segments dépasse la limite, la base de données supprime le segment le plus ancien (bien que jamais le premier segment, qui peut contenir des informations pertinentes sur l'état initial du processus), puis crée un nouveau segment vide.
Voir aussi : Guide de l'administrateur Oracle AI Database pour savoir comment contrôler la taille des fichiers trace
Fichiers dump de diagnostic
Un fichier dump de diagnostic est un type spécial de fichier trace qui contient des informations détaillées sur un état ou une structure.
Une trace a tendance à être une sortie continue de données de diagnostic. En revanche, un dump est généralement une sortie unique de données de diagnostic en réponse à un événement.
- Trace des vidages et des incidents La plupart des vidages surviennent en raison d'incidents.
Trace des vidages et des incidents
La plupart des vidages sont dus à des incidents.
Lorsqu'un incident se produit, la base de données écrit un ou plusieurs dumps dans le répertoire d'incidents créé pour l'incident. Les dumps d'incident contiennent également le numéro d'incident dans le nom du fichier.
Lors de la création d'un incident, une application peut effectuer une portion de mémoire ou un vidage de l'état du système dans le cadre d'une action. Dans ce cas, la base de données ajoute le nom du fichier dump au nom du fichier d'incident au lieu du nom du fichier trace par défaut. Par exemple, en raison d'un incident dans un processus, la base de données crée le fichier prod_ora_90348.trc. Un dump de l'incident génère le fichier prod_ora_90348_incident_id.trc, où incident_id est l'ID numérique de l'incident. Une action de vidage de portion de mémoire créée dans le cadre de l'incident génère le fichier de vidage de portion de mémoire prod_ora_90348_incident_id_dump_id.trc, où dump_id est l'ID numérique du vidage de trace.