Transactions
Le contenu du script de cette page a pour seul objectif la navigation et n'altère en rien le contenu.
Ce chapitre définit une transaction et décrit comment la base de données traite les transactions.
-
Introduction aux transactions Une transaction est une unité de travail atomique logique qui contient une ou plusieurs instructions SQL.
-
Généralités sur le contrôle des transactions Le contrôle des transactions est la gestion des modifications apportées par les instructions LMD et le regroupement des instructions LMD en transactions.
-
Généralités sur les transactions en quarantaine Une transaction en quarant est une transaction isolée et non récupérée lors de la récupération de la base de données. Le DBA doit intervenir pour résoudre le problème avant que les verrous ne puissent être libérés.
-
Présentation de Transaction Guard
Transaction Guard est une API que les applications peuvent utiliser pour fournir une idémpotence de transaction, qui permet à la base de données de conserver un résultat de validation garanti indiquant si une transaction a été validée et terminée. Oracle AI Database fournit l'API pour JDBC thin, OCI, OCCI et ODP.Net.
-
Présentation de la continuité des applications Continuité des applications tente de masquer les interruptions des applications en réexécutant les demandes d'application incomplètes après les interruptions non planifiées et planifiées. Dans ce contexte, une demande est une unité de travail de l'application.
-
Présentation des transactions autonomes Une transaction autonome est une transaction indépendante qui peut être appelée à partir d'une autre transaction, qui est la transaction principale. Vous pouvez suspendre la transaction appelante, effectuer des opérations SQL, les valider ou les annuler dans la transaction autonome, puis reprendre la transaction appelante.
-
Présentation des transactions distribuées Une transaction distribuée est une transaction qui inclut une ou plusieurs instructions qui mettent à jour les données sur deux noeuds distincts ou plus d'une base de données distribuée, à l'aide d'un objet de schéma appelé lien de base de données.
Présentation des transactions
Une transaction est une unité de travail atomique logique qui contient une ou plusieurs instructions SQL.
Une transaction regroupe les instructions SQL de sorte qu'elles soient toutes validées (commit), ce qui signifie qu'elles sont appliquées à la base de données, ou toutes annulées (rollback), ce qui signifie qu'elles sont annulées de la base de données. Oracle AI Database affecte à chaque transaction un identificateur unique appelé ID de transaction.
Toutes les transactions Oracle obéissent aux propriétés de base d'une transaction de base de données, appelées propriétés ACID. ACID est un acronyme pour les éléments suivants :
-
Atomicité
Toutes les tâches d'une transaction sont exécutées ou aucune d'entre elles ne l'est. Il n'y a aucune transaction partielle. Par exemple, si une transaction commence à mettre à jour 100 lignes, mais que le système échoue après 20 mises à jour, la base de données annule les modifications apportées à ces 20 lignes.
-
Cohérence
La transaction fait passer la base de données d'un état cohérent à un autre. Par exemple, dans une transaction bancaire qui débite un compte épargne et crédite un compte courant, une défaillance ne doit pas entraîner le crédit d'un seul compte par la base de données, ce qui entraînerait des données incohérentes.
-
Isolation
L'effet d'une transaction n'est pas visible pour les autres transactions tant que la transaction n'est pas validée. Par exemple, un utilisateur qui met à jour la table
hr.employeesne voit pas les modifications non validées apportées àemployeessimultanément par un autre utilisateur. Ainsi, il apparaît aux utilisateurs comme si les transactions s'exécutaient en série. -
Durabilité
Les modifications apportées par les transactions validées sont permanentes. Une fois la transaction terminée, la base de données s'assure par le biais de ses mécanismes de récupération que les modifications apportées à la transaction ne sont pas perdues.
L'utilisation de transactions est l'un des moyens les plus importants qu'un système de gestion de base de données diffère d'un système de fichiers.
-
Exemple de transaction : Compte - Débit et crédit Pour illustrer le concept d'une transaction, considérez une base de données bancaire.
-
Structure d'une transaction Une transaction de base de données se compose d'une ou plusieurs instructions.
-
Atomicité au niveau de l'instruction Oracle AI Database prend en charge l'atomicité au niveau de l'instruction, ce qui signifie qu'une instruction SQL est une unité de travail atomique et qu'elle réussit complètement ou échoue complètement.
-
Numéros de modification système (SCN) Un numéro de modification système (SCN) est un horodatage interne logique utilisé par Oracle AI Database.
Transaction d'échantillon : débit et crédit du compte
Pour illustrer le concept d'une transaction, envisagez une base de données bancaire.
Lorsqu'un client transfère de l'argent d'un compte épargne vers un compte courant, la transaction doit se composer de trois opérations distinctes :
-
Diminuer le compte épargne
-
Incrémenter le compte chèque
-
Enregistrer la transaction dans l'écriture comptable de transaction
Oracle AI Database doit permettre deux situations. Si les trois instructions SQL conservent le solde correct des comptes, les effets de la transaction peuvent être appliqués à la base de données. Toutefois, si un problème tel que des fonds insuffisants, un numéro de compte non valide ou une défaillance matérielle empêche l'exécution d'un ou deux des relevés de la transaction, la base de données doit annuler l'intégralité de la transaction afin que le solde de tous les comptes soit correct.
Le graphique suivant illustre une transaction bancaire. Le premier relevé soustrait 500 $ du compte d'épargne 3209. Le deuxième relevé ajoute 500 $ au compte courant 3208. La troisième instruction insère un enregistrement du transfert dans la table des écritures. L'instruction finale valide la transaction.
Figure 1 : Une transaction bancaire
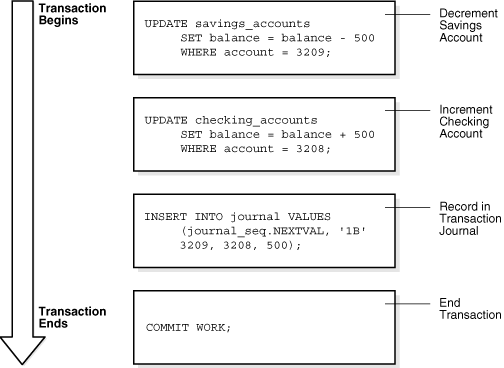
Description de l'image cncpt025.gif
Structure d'une transaction
Une transaction de base de donnée est constituée d'une ou plusieurs instructions.
Plus précisément, une transaction se compose de l'un des éléments suivants :
-
Une ou plusieurs instructions LMD (Langage de manipulation de données) qui constituent ensemble une modification atomique de la base de données.
-
Une instruction LDD (Langage de définition de données)
Une transaction a un début et une fin.
-
Début d'une transaction Une transaction commence lorsque la première instruction SQL exécutable est rencontrée.
-
Fin d'une transaction Une transaction peut se terminer dans différentes circonstances.
Voir aussi :
-
Référence de langage SQL Oracle AI Database pour un compte des types d'instruction SQL
Début d'une transaction
Une transaction commence lorsque la première instruction SQL exécutable est rencontrée.
Une instruction SQL exécutable est une instruction SQL qui génère des appels vers une instance de base de données, y compris les instructions LMD et LDD et l'instruction SET TRANSACTION.
Lorsqu'une transaction commence, Oracle AI Database affecte la transaction à un segment de données d'annulation disponible afin d'enregistrer les entrées d'annulation pour la nouvelle transaction. Un ID de transaction n'est pas alloué tant qu'un segment d'annulation et un emplacement de table de transactions n'ont pas été alloués, ce qui se produit lors de la première instruction LMD. Un ID de transaction est unique à une transaction et représente le numéro de segment d'annulation, le créneau et le numéro de séquence.
L'exemple suivant exécute une instruction UPDATE pour démarrer une transaction et interroge V$TRANSACTION pour obtenir des détails sur la transaction :
SQL> UPDATE hr.employees SET salary=salary;

107 rows updated.

SQL> SELECT XID AS "txn id", XIDUSN AS "undo seg", XIDSLOT AS "slot",
  2  XIDSQN AS "seq", STATUS AS "txn status"
  3  FROM V$TRANSACTION;

txn id             undo seg       slot        seq txn status
---------------- ---------- ---------- ---------- ----------------
0600060037000000          6          6         55 ACTIVE
Voir aussi : "Annuler des segments"
Fin d'une transaction
Une transaction peut se terminer dans différentes circonstances.
Une transaction se termine lorsque l'une des actions suivantes se produit :
-
Un utilisateur émet une instruction
COMMITouROLLBACKsans clauseSAVEPOINT.Dans une commande commit, un utilisateur a explicitement ou implicitement demandé que les modifications apportées à la transaction deviennent permanentes. Les modifications apportées par la transaction sont permanentes et visibles par les autres utilisateurs uniquement après la validation d'une transaction.
-
Un utilisateur exécute une commande LDD telle que
CREATE,DROP,RENAMEouALTER.La base de données émet une instruction
COMMITimplicite avant et après chaque instruction LDD. Si la transaction en cours contient des instructions LMD, Oracle AI Database valide d'abord la transaction, puis exécute et valide l'instruction LDD en tant que nouvelle transaction à instruction unique. -
Un utilisateur quitte normalement la plupart des utilitaires et outils Oracle AI Database, ce qui entraîne la validation implicite de la transaction en cours. Le comportement de validation lorsqu'un utilisateur se déconnecte dépend de l'application et peut être configuré.
Remarque : Les applications doivent toujours valider ou annuler explicitement les transactions avant la fin du programme.
-
Un processus client s'interrompt anormalement, ce qui entraîne une annulation implicite de la transaction à l'aide des métadonnées stockées dans la table de transactions et dans le segment d'annulation.
Après la fin d'une transaction, l'instruction SQL exécutable suivante démarre automatiquement la transaction suivante. L'exemple suivant exécute un élément UPDATE pour démarrer une transaction, termine la transaction par une instruction ROLLBACK, puis exécute un élément UPDATE pour démarrer une nouvelle transaction (notez que les ID de transaction sont différents) :
SQL> UPDATE hr.employees SET salary=salary;
107 rows updated.

SQL> SELECT XID, STATUS FROM V$TRANSACTION;

XID              STATUS
---------------- ----------------
0800090033000000 ACTIVE

SQL> ROLLBACK;

Rollback complete.

SQL> SELECT XID FROM V$TRANSACTION;

no rows selected

SQL> UPDATE hr.employees SET last_name=last_name;

107 rows updated.

SQL> SELECT XID, STATUS FROM V$TRANSACTION;

XID              STATUS
---------------- ----------------
0900050033000000 ACTIVE
Voir aussi :
-
"Exemple de transaction : débit et crédit du compte" pour un exemple de transaction qui se termine par une validation.
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur
COMMIT
Atomicité au niveau instruction
Oracle AI Database prend en charge l'atomicité au niveau de l'instruction, ce qui signifie qu'une instruction SQL est une unité de travail atomique et qu'elle réussit complètement ou échoue complètement.
Une instruction réussie est différente d'une transaction validée. Une seule instruction SQL s'exécute avec succès si la base de données l'analyse et l'exécute sans erreur en tant qu'unité atomique, comme lorsque toutes les lignes sont modifiées dans une mise à jour multiligne.
Si une instruction SQL provoque une erreur lors de l'exécution, elle échoue et tous les effets de l'instruction sont annulés. Cette opération est une annulation au niveau instruction. Cette opération présente les caractéristiques suivantes :
-
Une instruction SQL qui échoue entraîne uniquement la perte du travail qu'elle aurait effectué elle-même.
L'échec de la déclaration n'entraîne pas la perte d'un travail qui l'a précédé dans la transaction en cours. Par exemple, si l'exécution de la deuxième instruction
UPDATEdans "Exemple de transaction : débit et crédit du compte" provoque une erreur et est annulée, le travail effectué par la première instructionUPDATEn'est pas annulé. La première instructionUPDATEpeut être validée ou annulée explicitement par l'utilisateur. -
L'effet de la restauration est comme si l'instruction n'avait jamais été exécutée.
Tous les effets secondaires d'une instruction atomique, par exemple les déclencheurs appelés lors de l'exécution de l'instruction, sont considérés comme faisant partie de l'instruction atomique. Tout le travail généré dans le cadre de l'instruction atomique réussit ou aucun ne le fait.
Un exemple d'erreur entraînant une annulation au niveau instruction est une tentative d'insertion d'une clé primaire en double. Les instructions SQL uniques impliquées dans un verrou mortel, qui est en concurrence pour les mêmes données, peuvent également entraîner une annulation au niveau instruction. Toutefois, les erreurs détectées lors de l'analyse des instructions SQL, telles qu'une erreur de syntaxe, n'ont pas encore été exécutées et n'entraînent donc pas d'annulation (rollback) au niveau instruction.
Voir aussi :
Numéros système de modification (SCN)
Un numéro de modification système (SCN) est un horodatage interne logique utilisé par Oracle AI Database.
Les SCN prescrivent les événements qui se produisent dans la base de données, ce qui est nécessaire pour satisfaire les propriétés ACID d'une transaction. Oracle AI Database utilise des SCN pour marquer le SCN avant lequel toutes les modifications sont connues sur le disque afin que la récupération évite d'appliquer des informations de journalisation inutiles. La base de données utilise également des numéros SCN pour marquer le point auquel aucune information de journalisation n'existe pour un ensemble de données afin que la récupération puisse s'arrêter.
Les SCN se produisent dans une séquence monotone croissante. Oracle AI Database peut utiliser un SCN comme une horloge car un SCN observé indique un point dans le temps logique et les observations répétées renvoient des valeurs égales ou supérieures. Si un événement a un SCN inférieur à celui d'un autre, il s'est produit à un moment antérieur dans la base de données. Plusieurs événements peuvent partager le même numéro SCN, ce qui signifie qu'ils se sont produits en même temps dans la base de données.
Chaque transaction a un numéro SCN. Par exemple, si une transaction met à jour une ligne, la base de données enregistre le numéro SCN auquel cette mise à jour a eu lieu. Les autres modifications de cette transaction ont le même SCN. Lorsqu'une transaction est validée, la base de données enregistre un SCN pour cette validation.
Oracle AI Database incrémente les SCN dans la zone globale du système (SGA). Lorsqu'une transaction modifie des données, la base de données écrit un nouveau numéro SCN dans le segment de données d'annulation affecté à la transaction. Le processus Log Writer écrit ensuite l'enregistrement de validation de la transaction immédiatement dans le fichier de journalisation en ligne. L'enregistrement de validation a le SCN unique de la transaction. Oracle AI Database utilise également des numéros SCN dans le cadre de ses mécanismes de récupération d'instance et de récupération de média.
Voir également : "Présentation de la récupération d'instance"
Présentation de Transaction Control
Le contrôle des transactions est la gestion des modifications apportées par les instructions LMD et le regroupement des instructions LMD en transactions.
En général, les concepteurs d'applications s'occupent du contrôle des transactions afin que le travail soit effectué en unités logiques et que les données restent cohérentes.
Le contrôle de transaction implique l'utilisation des instructions suivantes, comme décrit dans la section "Instructions de contrôle de transaction" :
-
L'instruction
COMMITmet fin à la transaction en cours et rend permanentes toutes les modifications effectuées dans la transaction.COMMITefface également tous les points de sauvegarde de la transaction et libère les verrous de transaction. -
L'instruction
ROLLBACKinverse le travail effectué dans la transaction en cours. Toutes les modifications de données depuis la dernière opérationCOMMITouROLLBACKsont ignorées. L'instructionROLLBACK TO SAVEPOINTannule les modifications depuis le dernier point de sauvegarde, mais ne met pas fin à la transaction entière. -
L'instruction
SAVEPOINTidentifie un point d'une transaction vers lequel vous pourrez ensuite procéder à l'annulation.
La session du Table 13-1 présente les concepts de base du contrôle des transactions.
Tableau 1 Contrôle des transactions
| T | Session | Explication |
|---|---|---|
| t0 | |
Cette instruction met fin à toute transaction existante dans la session. |
| t1 | |
Cette instruction commence une transaction et la nomme sal_update. |
| t2 | |
Cette déclaration met à jour le salaire de Banda à 7000. |
| t3 | |
Cette instruction crée un point de sauvegarde nommé after_banda_sal, ce qui permet d'annuler les modifications apportées à cette transaction jusqu'à ce point. |
| t4 | |
Cette déclaration met à jour le salaire de Greene à 12000. |
| t5 | |
Cette instruction crée un point de sauvegarde nommé after_greene_sal, ce qui permet d'annuler les modifications apportées à cette transaction jusqu'à ce point. |
| t6 | |
Cette instruction annule la transaction vers t3, annulant ainsi la mise à jour du salaire de Greene à l'adresse t4. La transaction sal_update n'est pas terminée. |
| t7 | |
Cette instruction met à jour le salaire de Greene à 11000 dans la transaction sal_update. |
| t8 | |
Cette instruction annule toutes les modifications dans la transaction sal_update, ce qui met fin à la transaction. |
| t9 | |
Cette instruction commence une nouvelle transaction dans la session et la nomme sal_update2. |
| t10 | |
Cette déclaration met à jour le salaire de Banda à 7050. |
| t11 | |
Cette déclaration met à jour le salaire de Greene à 10950. |
| t12 | |
Cette instruction valide toutes les modifications apportées à la transaction sal_update2, ce qui met fin à la transaction. La validation garantit que les modifications sont enregistrées dans les fichiers de journalisation en ligne. |
-
Noms de transaction Un nom de transaction est une balise facultative spécifiée par l'utilisateur qui sert de rappel du travail effectué par la transaction. Vous nommez une transaction avec l'instruction
SET TRANSACTION...NAME, qui, si elle est utilisée, doit être la première instruction de la transaction. -
Transactions actives Une transaction active est une transaction qui a démarré mais n'a pas encore été validée ou annulée.
-
Points de sauvegarde Un point de sauvegarde est un marqueur intermédiaire déclaré par l'utilisateur dans le contexte d'une transaction.
-
Annulation des transactions Une annulation d'une transaction non validée annule toute modification apportée aux données qui ont été effectuées par des instructions SQL au sein de la transaction.
-
Validations de transactions Une validation met fin à la transaction en cours et rend permanentes toutes les modifications effectuées dans la transaction. Voir aussi : Référence du langage SQL d'Oracle AI Database pour en savoir plus sur les instructions de contrôle des transactions
Noms de transaction
Un nom de transaction est une balise facultative spécifiée par l'utilisateur qui sert de rappel du travail effectué par la transaction. Vous nommez une transaction avec l'instruction SET TRANSACTION ... NAME, qui, si elle est utilisée, doit être la première instruction de la transaction.
Dans le Table 13-1, la première transaction a été nommée sal_update et la seconde sal_update2.
Les noms de transaction offrent les avantages suivants :
-
Il est plus facile de surveiller les transactions à longue durée d'exécution et de résoudre les transactions distribuées douteuses.
-
Vous pouvez consulter les noms de transaction ainsi que les ID de transaction dans les applications. Par exemple, un administrateur de base de données peut afficher les noms des transactions dans Oracle Enterprise Manager (Enterprise Manager) lors de la surveillance de l'activité du système.
-
La base de données écrit les noms de transaction dans l'enregistrement de journalisation d'audit des transactions. Vous pouvez donc utiliser LogMiner pour rechercher une transaction spécifique dans le fichier de journalisation.
-
Vous pouvez utiliser des noms de transaction pour rechercher une transaction spécifique dans les vues du dictionnaire de données telles que
V$TRANSACTION.
Voir aussi :
-
Référence Oracle AI Database pour en savoir plus sur
V$TRANSACTION -
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur
SET TRANSACTION
Transactions actives
Une transaction active est une transaction qui a démarré mais qui n'a pas encore été validée ou annulée.
Dans le tableau 13-1, la première instruction permettant de modifier les données de la transaction sal_update est la mise à jour du salaire de Banda. De l'exécution réussie de cette mise à jour jusqu'à la fin de la transaction par l'instruction ROLLBACK, la transaction sal_update est active.
Les modifications apportées aux données par une transaction sont temporaires jusqu'à ce que la transaction soit validée ou annulée. Avant la fin de la transaction, l'état des données est le suivant.
Tableau 2 Etat des données avant la fin de la transaction
| Département | Description | Pour en savoir plus |
|---|---|---|
| Oracle AI Database a généré des informations d'annulation dans la mémoire SGA. | Les données d'annulation contiennent les anciennes valeurs de données modifiées par les instructions SQL de la transaction. | "Consistance en lecture dans le niveau d'isolement validé en lecture" |
| Oracle AI Database a généré des informations de journalisation dans le tampon de journalisation en ligne de la mémoire SGA. | L'enregistrement du fichier de journalisation contient les modifications apportées au bloc de données et au bloc d'annulation. | Tampon de journalisation |
| Des modifications ont été apportées aux tampons de base de données de la mémoire SGA. | Les modifications de données d'une transaction validée, stockées dans les tampons de base de données de la mémoire SGA, ne sont pas nécessairement écrites immédiatement dans les fichiers de données par le processus d'écriture de base de données (DBW). L'écriture sur disque peut avoir lieu avant ou après la validation. | "Cache de tampons de base de données" |
| Les lignes concernées par la modification des données sont verrouillées. | Les autres utilisateurs ne peuvent pas modifier les données des lignes concernées ni voir les modifications non validées. | "Récapitulatif du comportement de verrouillage" |
Points de sauvegarde
Un point de sauvegarde est un marqueur intermédiaire déclaré par l'utilisateur dans le contexte d'une transaction.
En interne, le marqueur de point de sauvegarde est résolu en SCN. Les points de sauvegarde divisent une transaction longue en parties plus petites.
Si vous utilisez des points de sauvegarde dans une transaction longue, vous avez la possibilité ultérieurement d'annuler le travail effectué avant le point actuel de la transaction, mais après un point de sauvegarde déclaré dans la transaction. Par conséquent, si vous faites une erreur, vous n'avez pas besoin de soumettre à nouveau toutes les instructions. Le tableau 13-1 crée le point de sauvegarde after_banda_sal afin que la mise à jour du salaire Greene puisse être annulée vers ce point de sauvegarde.
-
Annuler vers le point de sauvegarde Une annulation vers un point de sauvegarde dans une transaction non validée signifie annuler toutes les modifications apportées après le point de sauvegarde spécifié, mais ne signifie pas une annulation de la transaction elle-même.
-
Transactions mises en file d'attente Selon le scénario, les transactions en attente de ressources précédemment verrouillées peuvent toujours être bloquées après une annulation vers le point de sauvegarde.
Annuler jusqu'au point de sauvegarde
L'annulation (rollback) d'un point de sauvegarde dans une transaction non validée signifie que toutes les modifications apportées après le point de sauvegarde indiqué sont annulées, mais pas la transaction elle-même.
Lorsqu'une transaction est restaurée vers un point de sauvegarde, comme lorsque ROLLBACK TO SAVEPOINT after_banda_sal est exécuté dans le Table 13-1, les événements suivants se produisent :
-
Oracle AI Database annule uniquement les instructions exécutées après le point de sauvegarde.
Dans letableau 13-1,
ROLLBACK TO SAVEPOINTentraîne l'annulation de l'élémentUPDATEpour Greene, mais pas de l'élémentUPDATEpour Banda. -
Oracle AI Database conserve le point de sauvegarde indiqué dans l'instruction
ROLLBACK TO SAVEPOINT, mais tous les points de sauvegarde suivants sont perdus.Dans le Table 13-1,
ROLLBACK TO SAVEPOINTentraîne la perte du point de sauvegardeafter_greene_sal. -
Oracle AI Database libère tous les verrous de table et de ligne acquis après le point de sauvegarde spécifié, mais conserve tous les verrous de données acquis avant le point de sauvegarde.
La transaction reste active et peut être poursuivie.
Voir aussi :
-
Référence du langage SQL Oracle AI Database pour en savoir plus sur les instructions
ROLLBACKetSAVEPOINT -
Référence du langage PL/SQL d'Oracle AI Database pour en savoir plus sur le traitement et le contrôle des transactions
Transactions mises en file d'attente
Selon le scénario, les transactions en attente de ressources précédemment verrouillées peuvent toujours être bloquées après une restauration vers le point de sauvegarde.
Lorsqu'une transaction est bloquée par une autre transaction, elle est mise en file d'attente sur la transaction bloquante elle-même, de sorte que la transaction bloquante entière doit être validée ou annulée pour que la transaction bloquée puisse continuer.
Dans le scénario présenté dans le tableau suivant, la session 1 revient à un point de sauvegarde créé avant d'exécuter une instruction LMD. Cependant, la session 2 est toujours bloquée car elle attend la fin de la transaction de la session 1.
Tableau 3 - Exemple d'annulation jusqu'au point de sauvegarde
| T | Session 1 | Session 2 | Session 3 | Explication |
|---|---|---|---|---|
| t0 | UPDATE employees SET salary=7000 WHERE last_name= 'Banda'; |
La session 1 commence une transaction. La session place un verrou exclusif sur la ligne Banda (TX) et un verrou de table sous-exclusif (SX) sur la table. |
||
| t1 | SAVEPOINT after_banda_sal; |
La session 1 crée un point de sauvegarde nommé after_banda_sal. |
||
| t2 | UPDATE employees SET salary=12000 WHERE last_name= 'Greene'; |
La session 1 verrouille la ligne Greene. |
||
| t3 | UPDATE employees SET salary=14000 WHERE last_name= 'Greene'; |
La session 2 tente de mettre à jour la ligne Greene, mais n'obtient pas de verrou car la session 1 comporte un verrou sur cette ligne. Aucune transaction n'a commencé dans la session 2. |
||
| t4 | ROLLBACK TO SAVEPOINT after_banda_sal; |
La session 1 annule la mise à jour du salaire pour A ce stade, la session 2 est encore bloquée par la session 1 car la session 2 est mise en file d'attente sur la transaction de la session 1, qui n'est pas encore terminée. |
||
| t5 | UPDATE employees SET salary=11000 WHERE last_name= 'Greene'; |
La ligne Greene est actuellement déverrouillée. La session 3 acquiert donc un verrou pour une mise à jour de la ligne Greene. Cette instruction commence une transaction dans la session 3. |
||
| t6 | COMMIT; |
La session 1 se valide et met fin à sa transaction. La session 2 est maintenant mise en file d'attente pour sa mise à jour vers la ligne Greene derrière la transaction dans la session 3. |
Voir aussi : "Durée de verrouillage" pour en savoir plus sur le moment où Oracle AI Database libère des verrous
Annulation de transactions
Une annulation (rollback) d'une transaction non validée annule toutes les modifications apportées aux données qui ont été effectuées par les instructions SQL au sein de la transaction.
Une fois qu'une transaction a été annulée, les effets du travail effectué dans la transaction n'existent plus. En annulant l'intégralité d'une transaction, sans référencer de points de sauvegarde, Oracle AI Database effectue les actions suivantes :
-
annule toutes les modifications apportées par toutes les instructions SQL de la transaction à l'aide des segments d'annulation correspondants.
L'entrée de la table des transactions pour chaque transaction active contient un pointeur vers toutes les données d'annulation (dans l'ordre inverse de l'application) de la transaction. La base de données lit les données du segment d'annulation, inverse l'opération, puis marque l'entrée d'annulation comme appliquée. Par conséquent, si une transaction insère une ligne, une annulation la supprime. Si une transaction met à jour une ligne, une annulation annule la mise à jour. Si une transaction supprime une ligne, une annulation la réinsère. Dans le tableau 13-1,
ROLLBACKannule les mises à jour des salaires de Greene et Banda. -
Libère tous les verrous des données détenus par la transaction
-
Efface tous les points de sauvegarde de la transaction
Dans le tableau 13-1,
ROLLBACKsupprime le point de sauvegardeafter_banda_sal. Le point de sauvegardeafter_greene_sala été enlevé par l'instructionROLLBACK TO SAVEPOINT. -
met fin à la transaction,
Dans le Table 13-1,
ROLLBACKlaisse la base de données dans le même état qu'après l'exécution initiale deCOMMIT.
La durée d'une annulation est fonction de la quantité de données modifiées.
Voir aussi :
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur la commande
ROLLBACK
Validations de transactions
Une validation met fin à la transaction en cours et rend permanentes toutes les modifications effectuées dans la transaction.
Dans le Table 13-1, une deuxième transaction commence par sal_update2 et se termine par une instruction COMMIT explicite. Les modifications résultant des deux instructions UPDATE sont désormais rendues permanentes.
Lorsqu'une transaction est validée, les actions suivantes se produisent :
-
La base de données génère un numéro SCN pour
COMMIT.La table des transactions internes pour les enregistrements undo tablespace associés que la transaction a validés. Le SCN unique correspondant de la transaction est affecté et enregistré dans la table des transactions.
-
Le processus LGWR écrit les entrées de fichier de journalisation restantes dans les tampons de journalisation dans le fichier de journalisation en ligne et écrit le numéro SCN de transaction dans le fichier de journalisation en ligne. Cet événement atomique constitue la validation de la transaction.
-
Oracle AI Database libère des verrous sur les lignes et les tables.
Les utilisateurs qui ont été mis en file d'attente sur des verrous détenus par la transaction non validée sont autorisés à poursuivre leur travail.
-
Oracle AI Database supprime les points de sauvegarde.
Dans le tableau 13-1, aucun point de sauvegarde n'existait dans la transaction
sal_update. Par conséquent, aucun point de sauvegarde n'a été effacé. -
Oracle AI Database effectue un nettoyage de validation.
Si des blocs modifiés contenant des données de la transaction validée se trouvent toujours dans la mémoire SGA, et si aucune autre session ne les modifie, la base de données supprime les informations relatives aux transactions liées aux verrous (l'entrée ITL) des blocs.
Dans l'idéal,
COMMITnettoie les blocs afin qu'un élémentSELECTultérieur n'ait pas à effectuer cette tâche. Si aucune entrée ITL n'existe pour une ligne spécifique, elle n'est pas verrouillée. Si une entrée ITL existe pour une ligne spécifique, elle est peut-être verrouillée. Par conséquent, une session doit vérifier l'en-tête du segment d'annulation pour déterminer si la transaction intéressée a été validée. Si la transaction intéressée a été validée, la session nettoie le bloc, ce qui génère des informations de journalisation. Toutefois, siCOMMITa précédemment nettoyé l'ITL, la vérification et le nettoyage ne sont pas nécessaires.Remarque : Etant donné qu'un nettoyage de bloc génère des informations de journalisation, une interrogation peut générer des informations de journalisation et entraîner l'écriture de blocs au cours du point de reprise suivant.
-
Oracle AI Database marque la transaction comme terminée.
Une fois la transaction validée, les utilisateurs peuvent consulter les modifications.
En général, une validation (commit) est une opération rapide, quelle que soit la taille de la transaction. La vitesse d'une validation n'augmente pas avec la taille des données modifiées dans la transaction. La partie la plus longue de la validation est les E/S de disque physique effectuées par LGWR. Toutefois, le temps passé par le processus LGWR est réduit car il a écrit de manière incrémentielle le contenu du tampon de journalisation en arrière-plan.
Par défaut, le processus LGWR écrit les informations de journalisation dans le fichier de journalisation en ligne de manière synchrone et les transactions attendent que les informations de journalisation mises en mémoire tampon soient sur le disque avant de renvoyer une validation à l'utilisateur. Toutefois, pour réduire la latence de validation des transactions, les développeurs d'applications peuvent indiquer que les informations de journalisation doivent être écrites de manière asynchrone afin que les transactions n'aient pas besoin d'attendre que les informations de journalisation soient sur disque et puissent immédiatement revenir de l'appel COMMIT.
Voir aussi :
-
"Présentation des processus en arrière-plan" pour plus d'informations sur le processus LGWR
-
Référence des types et packages PL/SQL d'Oracle AI Database pour plus d'informations sur la validation asynchrone
Généralités sur les transactions mises en quarantaine
Une transaction en quarantaine est une transaction isolée et non récupérée lors de la récupération de la base de données. Le DBA doit intervenir pour résoudre le problème avant que les verrous ne puissent être libérés.
Oracle AI Database utilise les informations de journalisation et d'annulation pour assurer la cohérence des données. Lorsque la base de données est ouverte suite à une panne, l'application des informations de journalisation annule (redo roll) la base de données pour obtenir toutes les modifications validées, appelées récupération du cache, et annule (rollback) les modifications apportées par les transactions non validées et désormais inactives en raison de la panne. Cette opération est appelée récupération après panne. L'ouverture de la base de données n'attend pas que l'annulation des transactions non validées soit appliquée pour accélérer le démarrage. Au lieu de cela, il marque l'état de la transaction comme "inactif" dans la table des transactions et la base de données est ouverte rapidement. L'application des informations d'annulation pour les transactions inactives est ensuite effectuée de manière asynchrone par le processus en arrière-plan du moniteur système (SMON) et est appelée récupération des transactions.
L'autre moment où les transactions inactives sont récupérées par le processus SMON est pendant la récupération d'instance. Une instance Oracle RAC peut planter avec des transactions en cours d'exécution. Ces transactions inactives contiennent des rowlocks qui bloquent les transactions sur les mêmes lignes sur les autres instances RAC. Le processus en arrière-plan SMON sur l'une des instances restantes effectue une récupération d'instance en deux phases, la récupération du cache suivie de la récupération des transactions.
Le processus en arrière-plan PMON peut également décharger le travail consistant à mettre fin à une transaction volumineuse pendant le nettoyage du processus en échec vers SMON.
Le processus SMON effectue des tâches de niveau système telles que le nettoyage des segments temporaires inutilisés, la fusion des extents contigus et de nombreuses autres tâches. Il s'agit d'un processus irrécupérable, ce qui signifie qu'une panne du processus SMON entraîne une panne d'instance de base Conteneur. Un échec de récupération de transaction SMON peut se produire pour diverses raisons :
-
Altération des blocs de données physiques, d'index ou d'annulation
-
Altération des données logiques
-
Altération de la mémoire
Non seulement une panne arrête la récupération de la transaction qui est activement récupérée par le processus SMON, mais la récupération s'arrête également pour le reste des transactions inactives. En cas d'échec persistant, le support technique Oracle recommande aux clients de désactiver la récupération des transactions SMON et d'ouvrir la base de données pour réduire l'impact. Ainsi, les rowlocks sont bloqués plus longtemps par des transactions inactives. Cela a un impact considérable sur les opérations commerciales critiques.
Toute transaction qui ne peut pas être récupérée est mise en quarantaine et reste non récupérée jusqu'à ce que le DBA puisse résoudre le problème. Le DBA est informé de la transaction mise en quarantaine et doit agir immédiatement afin que les verrous de ligne détenus par la transaction mise en quarantaine puissent être libérés.
Le DBA est averti de la présence de transactions mises en quarantaine dans divers journaux et vues pour aider à identifier les transactions mises en quarantaine et la raison pour laquelle elles sont mises en quarantaine. Le DBA utilise ces informations pour résoudre le problème spécifique afin que la quarantaine puisse être abandonnée.
Lorsque des défaillances surviennent sur plusieurs transactions ou s'étendent sur l'ensemble de la base de données pluggable, telles qu'une corruption de données logiques due à un bogue de code, une corruption physique de plusieurs blocs ou une corruption de la mémoire SGA de la base de données pluggable, la mise en quarantaine de la récupération de transaction inactive défaillante peut ou non aider. Cela dépend du fait que la cause première de ces échecs soit la même ou non, car la récupération d'autres transactions inactives peut entraîner le même problème. Le système continue de fonctionner dans un état incohérent même après la mise en quarantaine de quelques transactions. Il peut être dangereux lorsque la panne est due à une corruption logique des données, car elle se répartit au fil du temps. Pour éviter cela, la limite de quarantaine des transactions est de trois (3), après quoi la quarantaine est remontée au niveau de la base de données et la base de données pluggable prend fin à l'aide de shutdown abort si la journalisation d'archivage est activée pour la base de données pluggable et qu'il est possible d'arrêter la base de données pluggable. La récupération de transaction pour la base de données pluggable est automatiquement désactivée afin que l'administrateur de base de données puisse corriger les problèmes au prochain démarrage. Une fois les problèmes résolus, le DBA doit activer la récupération pour le démarrage suivant.
Remarque : Oracle Data Guard utilisant la réplication logique, les métadonnées de quarantaine ne sont pas répliquées sur le serveur de secours lors de l'utilisation d'Oracle Data Guard. Par conséquent, le contenu des vues de quarantaine des transactions, telles que DBA_QUARANTINED_TRANSACTIONS, sur le serveur de secours peut être différent des entrées sur le serveur principal.
Rubriques connexes
Présentation de Transaction Guard
Transaction Guard est une API que les applications peuvent utiliser pour fournir une idémpotence de transaction, qui est la capacité de la base de données à conserver un résultat de validation garanti indiquant si une transaction a été validée et terminée. Oracle AI Database fournit l'API pour JDBC thin, OCI, OCCI et ODP.Net.
Une erreur récupérable est causée par une défaillance du système tiers, indépendamment de la logique de session d'application en cours d'exécution. Les erreurs récupérables surviennent après des pannes planifiées et non planifiées de processus, de réseaux, de noeuds, de stockage et de bases de données de premier plan. Si une coupure interrompt la connexion entre une application client et la base de données, l'application reçoit un message d'erreur de déconnexion. La transaction qui était en cours d'exécution lorsque la connexion a été interrompue est appelée transaction en cours.
Pour décider de resoumettre la transaction ou de renvoyer le résultat (commit ou non) au client, l'application doit déterminer le résultat de la transaction en cours. Avant Oracle Database 12c, les messages de validation renvoyés au client n'étaient pas persistants. La vérification d'une transaction n'était pas une garantie qu'elle ne serait pas validée après avoir été vérifiée, autorisant les transactions en double et d'autres formes de corruption logique. Par exemple, un utilisateur peut actualiser un navigateur Web lors de l'achat d'un livre en ligne et être facturé deux fois pour le même livre.
-
Avantages de Transaction Guard A partir d'Oracle Database 12c, Transaction Guard fournit aux applications un outil permettant de déterminer le statut d'une transaction en cours de traitement suite à une panne récupérable.
-
Fonctionnement de Transaction Guard Cette section explique le problème des messages de validation perdus et comment Transaction Guard utilise des ID de transaction logiques pour résoudre le problème.
-
Transaction Guard : Exemple : dans ce scénario, le message de validation est perdu en raison d'une erreur récupérable.
Voir aussi :
-
Guide de développement Oracle AI Database pour en savoir plus sur Transaction Guard
-
Guide d'administration et de déploiement Oracle Real Application Clusters pour découvrir comment configurer des services pour Transaction Guard
Avantages de Transaction Guard
A partir d'Oracle Database 12c, Transaction Guard fournit aux applications un outil permettant de déterminer le statut d'une transaction en cours de traitement suite à une panne récupérable.
Grâce à Transaction Guard, une application peut garantir qu'une transaction ne s'exécute pas plus d'une fois. Par exemple, si une application de librairie en ligne détermine que la validation précédemment soumise a échoué, l'application peut resoumettre en toute sécurité.
Transaction Guard fournit un outil pour une exécution au plus une fois afin d'éviter que l'application n'exécute des soumissions en double. Transaction Guard fournit un résultat connu pour chaque transaction.
Transaction Guard est une fonctionnalité principale d'Oracle AI Database. La continuité des applications utilise Transaction Guard lors du masquage des pannes des utilisateurs finals. Sans Transaction Guard, une nouvelle tentative d'application après une erreur peut entraîner la validation des transactions en double.
Voir aussi :
-
"Présentation de la continuité des applications" pour en savoir plus sur la continuité des applications, qui fonctionne avec Transaction Guard pour aider les développeurs à atteindre une haute disponibilité des applications
-
Guide de développement Oracle AI Database pour en savoir plus sur Transaction Guard, y compris les types de transactions prises en charge et incluses
Fonctionnement de Transaction Guard
Cette section explique le problème des messages de validation perdus et comment Transaction Guard utilise des ID de transaction logiques pour résoudre le problème.
-
Messages de validation perdus Lors de la conception pour l'idempotence, les développeurs doivent résoudre le problème des échecs de communication après la soumission des instructions de validation. Les messages de validation ne sont pas persistants dans la base de données et ne peuvent donc pas être extraits après un échec.
-
ID de transaction logique Oracle AI Database résout l'échec de communication à l'aide d'un identificateur unique global appelé ID de transaction logique.
Messages de validation perdus
Lors de la conception pour l'idempotence, les développeurs doivent résoudre le problème des échecs de communication après la soumission des instructions commit. Les messages de validation ne sont pas persistants dans la base de données et ne peuvent donc pas être extraits après un échec.
Le graphique suivant représente de haut niveau une interaction entre une application client et une base de données.
Figure 2 : Message de validation perdu
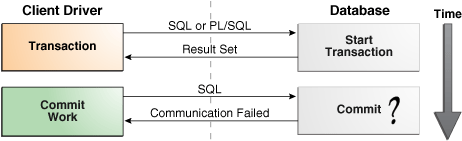
Description de l'image cncpt356.png
Dans le cas d'une validation standard, la base de données valide une transaction et renvoie un message de succès au client. Dans la Figure 13-2, le client soumet une instruction de validation et reçoit un message indiquant que la communication a échoué. Ce type de panne peut se produire pour plusieurs raisons, notamment une panne d'instance de base de données ou une panne réseau. Dans ce scénario, le client ne connaît pas l'état de la transaction.
Après un échec de communication, la base de données peut toujours exécuter la soumission et ne pas être consciente que le client s'est déconnecté. La vérification de l'état de la transaction ne garantit pas qu'une transaction active ne sera pas validée après avoir été vérifiée. Si le client renvoie la validation en raison de ces informations obsolètes, la base de données peut répéter la transaction, ce qui entraîne une corruption logique.
ID transaction logique
Oracle AI Database résout l'échec de communication à l'aide d'un identificateur unique global appelé ID de transaction logique.
Cet ID contient le numéro de session logique alloué lors de la première connexion d'une session, et un numéro de validation en cours d'exécution qui est mis à jour chaque fois que la session valide ou annule back.Foot 1 Du point de vue de l'application, l'ID de transaction logique identifie de manière unique la dernière transaction de base de données soumise sur la session qui a échoué.
Pour chaque aller-retour à partir du client dans lequel une ou plusieurs transactions sont validées, la base de données stocke un ID de transaction logique. Cet ID peut fournir une idémpotence de transaction pour les interactions entre l'application et la base de données pour chaque aller-retour qui valide les données.
Le protocole au plus une fois permet d'accéder au résultat de validation en exigeant que la base de données effectue les opérations suivantes :
-
Tenir à jour l'ID de transaction logique pour la période de conservation convenue pour la nouvelle tentative
-
Conserver l'ID de transaction logique lors de la validation
Lorsqu'une transaction est en cours d'exécution, la base de données et le client contiennent tous deux l'ID de transaction logique. La base de données fournit au client un ID de transaction logique lors de l'authentification, lors de l'emprunt à partir d'un pool de connexions, et à chaque aller-retour à partir du pilote client qui exécute une ou plusieurs opérations de validation.
Pour que l'application puisse déterminer le résultat de la dernière transaction suite à une erreur récupérable, elle obtient l'ID de transaction logique détenu au niveau du client à l'aide des API Java, OCI, OCCI ou ODP.Net. L'application appelle ensuite la procédure PL/SQL DBMS_APP_CONT.GET_LTXID_OUTCOME avec l'ID de transaction logique pour déterminer le résultat de la dernière soumission : validée (true ou false) et l'appel utilisateur terminé (true ou false).
Lorsque vous utilisez Transaction Guard, l'application peut réexécuter des transactions lorsque l'erreur est récupérable et que la dernière transaction de la session n'a pas été validée. L'application peut continuer lorsque la dernière transaction a été validée et que l'appel utilisateur est terminé. L'application peut utiliser Transaction Guard pour renvoyer le résultat connu au client afin que ce dernier puisse décider de l'action suivante à effectuer.
Voir aussi :
-
Guide de développement Oracle AI Database pour en savoir plus sur les ID de transaction logique
-
Référence des types et packages PL/SQL Oracle AI Database pour en savoir plus sur la procédure
DBMS_APP_CONT.GET_LTXID_OUTCOME
Transaction Guard : Exemple
Dans ce scénario, le message de validation est perdu en raison d'une erreur récupérable.
Transaction Guard utilise l'ID de transaction logique pour conserver le résultat de l'instruction COMMIT, en veillant à ce qu'il existe un résultat connu pour la transaction.
Figure 3 : Vérification du statut des transactions logiques
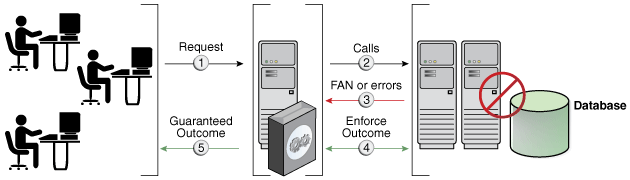
Description de l'image cncpt365.png
Dans la figure 13-3, la base de données indique à l'application si la transaction a été validée et si le dernier appel utilisateur est terminé. L'application peut alors renvoyer le résultat à l'utilisateur final. Les possibilités sont les suivantes :
-
Si la transaction est validée et que l'appel utilisateur est terminé, l'application peut renvoyer le résultat à l'utilisateur final et continuer.
-
Si la transaction a été validée mais que l'appel de l'utilisateur n'a pas abouti, l'application peut renvoyer le résultat à l'utilisateur final avec des avertissements. Il peut s'agir, par exemple, d'une liaison perdue ou d'un nombre perdu de lignes traitées. Certaines applications dépendent des informations supplémentaires, tandis que d'autres ne le font pas.
-
Si l'appel utilisateur n'a pas été validé, l'application peut renvoyer ces informations à l'utilisateur final ou les soumettre à nouveau en toute sécurité. Le protocole est garanti. Lorsque le statut de validation renvoie False, la dernière soumission est bloquée.
Voir aussi : Guide de développement Oracle AI Database pour découvrir comment utiliser Transaction Guard
Présentation de la continuité des applications
La continuité des applications tente de masquer les interruptions des applications en réexécutant les demandes d'application incomplètes après les interruptions non planifiées et planifiées. Dans ce contexte, une demande est une unité de travail de l'application.
En général, une demande correspond aux instructions LMD et aux autres appels de base de données d'une seule demande Web sur une seule connexion de base de données. En général, une demande est délimitée par les appels effectués entre l'extraction et l'archivage d'une connexion de base de données à partir d'un pool de connexions.
Cette section comprend les rubriques suivantes :
-
Avantages de la continuité des applications Un problème de base pour les développeurs est de savoir comment masquer une session de base de données perdue aux utilisateurs finals.
-
Architecture de continuité des applications Les principaux composants de la continuité des applications sont l'exécution, la reconnexion et la réexécution.
Avantages de la continuité des applications
Un problème de base pour les développeurs est de savoir comment masquer une session de base de données perdue des utilisateurs finaux.
La continuité des applications tente de résoudre le problème de session perdue en restaurant la session de base de données lorsqu'un composant interrompt la conversation entre la base de données et le client. La session de base de données restaurée inclut tous les états, curseurs, variables et la transaction la plus récente, le cas échéant.
-
Cas d'utilisation pour la continuité des applications Dans un cas type, un client a soumis une demande à la base de données, qui a créé des états transactionnels et non transactionnels.
-
La continuité des applications Continuité des applications pour maintenance planifiée pour les interruptions planifiées permet aux applications de poursuivre les opérations pour les sessions de base de données qui peuvent être purgées ou migrées de manière fiable.
Cas d'utilisation pour la continuité des applications
Dans un cas typique, un client a soumis une demande à la base de données, qui a créé des états transactionnels et non transactionnels.
L'état du client reste à jour, avec éventuellement des données entrées, des données renvoyées et des données et variables mises en cache. Toutefois, l'état de la session de base de données dans laquelle l'application doit opérer est perdu.
Si la demande du client a initié une ou plusieurs transactions, l'application est confrontée aux possibilités suivantes :
-
Si une validation a été émise, le message de validation renvoyé au client n'est pas durable. Le client ne sait pas si la demande a été validée et où elle a atteint l'état de traitement non transactionnel.
-
Si une validation n'a pas été émise, ou si elle a été émise mais n'a pas été exécutée, la transaction en cours est annulée et doit être resoumise à l'aide d'une session dans le bon état.
Si la réexécution aboutit, le service utilisateur de base de données pour les interruptions planifiées et non planifiées n'est pas interrompu. Si la base de données détecte des modifications dans les données vues et potentiellement traitées par l'application, la réexécution est rejetée. La réexécution n'est pas tentée lorsque le temps autorisé pour le démarrage de la réexécution est dépassé, que l'application utilise un appel restreint ou que l'application a explicitement désactivé la réexécution à l'aide de la méthode disableReplay.
Voir aussi : Guide d'administration et de déploiement Oracle Real Application Clusters pour en savoir plus sur le fonctionnement de la continuité des applications pour les sessions de base de données
Continuité des demandes pour la maintenance planifiée
La continuité des applications pour les coupures planifiées permet aux applications de poursuivre les opérations pour les sessions de base de données qui peuvent être purgées ou migrées de manière fiable.
La maintenance programmée n'a pas besoin d'interrompre le travail de l'application. La continuité d'application donne un temps de travail actif pour la vidange de son emplacement actuel vers un nouvel emplacement actuellement non affecté par la maintenance. A la fin de l'intervalle de purge, les sessions peuvent rester sur l'instance de base de données où la maintenance est planifiée. Au lieu de forcer la déconnexion de ces sessions, la continuité des applications peut basculer ces sessions sur un site restant et soumettre à nouveau toutes les transactions en cours.
Lorsque la continuité des applications est activée, la base de données peut effectuer les opérations suivantes :
-
Aucune erreur n'est signalée pour le travail entrant ou existant pendant la maintenance
-
Rediriger les sessions de base de données actives vers d'autres services fonctionnels
-
Rééquilibrer les sessions de base de données, si nécessaire, pendant et après la maintenance
Contrôlez le comportement de purge lors de la maintenance planifiée à l'aide des attributs de service drain_timeout et stop_option de l'utilitaire SRVCTL, de l'utilitaire Global Data Services Control Utility (GDSCTL) et du broker Oracle Data Guard. Le package DBMS_SERVICE fournit l'infrastructure sous-jacente.
Voir aussi :
-
Guide d'administration et de déploiement Oracle Real Application Clusters pour en savoir plus sur la continuité des applications
-
Référence des types et packages PL/SQL d'Oracle AI Database pour en savoir plus sur
DBMS_SERVICE -
Guide d'administration et de déploiement Oracle Real Application Clusters pour la référence de la commande SRVCTL
-
Guide d'administration et des concepts Oracle AI Database Global Data Services pour la référence de commande GDSCTL
Architecture de continuité des applications
Les composants clés de la continuité des applications sont l'exécution, la reconnexion et la réexécution.
Les phases sont les suivantes :
-
Exécution normale
Dans cette phase, la continuité des applications effectue les tâches suivantes :
-
Identifie les demandes de base de données
-
Détermine si les appels locaux et de base de données peuvent être réexécutés
-
Crée des objets proxy pour activer la réexécution, si nécessaire, et pour gérer les files d'attente
-
Contient les appels initiaux et la validation de ces appels jusqu'à ce que la fin de la demande ou de la réexécution de la base de données soit désactivée
-
-
Reconnexion
Cette phase est déclenchée par une erreur récupérable. La continuité des applications effectue les tâches suivantes :
-
Garantit que la réexécution est activée pour les demandes de base de données
-
Gère les délais d'attente
-
Obtient une nouvelle connexion à la base de données, puis vérifie qu'il s'agit d'une cible de base de données valide
-
Utilise Transaction Guard pour déterminer si la dernière transaction a été validée (les transactions validées ne sont pas resoumises)
-
-
Réexécuter
La continuité des applications effectue les tâches suivantes :
-
Réexécute les appels placés dans la file d'attente
-
Désactive la réexécution si les modifications visibles par l'utilisateur dans les résultats apparaissent pendant la réexécution
-
N'autorise pas de validation, mais autorise le dernier rappel (qui a rencontré l'erreur) à valider
-
Après une réexécution réussie, la demande se poursuit à partir du point d'échec.
Voir aussi :
-
Guide d'administration et de déploiement Oracle Real Application Clusters pour en savoir plus sur la continuité des applications
-
Guide du développeur JDBC Oracle AI Database pour en savoir plus sur JDBC et la continuité des applications
Présentation des transactions autonomes
Une transaction autonome est une transaction indépendante qui peut être appelée à partir d'une autre transaction, qui est la transaction principale. Vous pouvez suspendre la transaction appelante, effectuer des opérations SQL, les valider ou les annuler dans la transaction autonome, puis reprendre la transaction appelante.
Les transactions autonomes sont utiles pour les actions qui doivent être exécutées indépendamment, que la transaction appelante soit validée ou annulée. Par exemple, dans une transaction d'achat de stock, vous souhaitez valider les données client, que l'achat de stock global ait lieu ou non. En outre, vous souhaitez enregistrer les messages d'erreur dans une table de débogage même si la transaction globale est annulée.
Les transactions autonomes présentent les caractéristiques suivantes :
-
La transaction autonome ne voit pas les modifications non validées apportées par la transaction principale et ne partage pas les verrous ou les ressources avec la transaction principale.
-
Les modifications apportées à une transaction autonome sont visibles par les autres transactions lors de la validation des transactions autonomes. Ainsi, les utilisateurs peuvent accéder aux informations mises à jour sans avoir à attendre que la transaction principale soit validée.
-
Les transactions autonomes peuvent démarrer d'autres transactions autonomes. Le nombre de niveaux de transactions autonomes pouvant être appelés n'est pas limité, à l'exception des limites de ressources.
Dans le langage PL/SQL, une transaction autonome s'exécute dans une portée autonome, qui est une routine marquée avec le pragma AUTONOMOUS_TRANSACTION. Dans ce contexte, les sous-programmes incluent des blocs PL/SQL anonymes de niveau supérieur, ainsi que des sous-programmes et des déclencheurs PL/SQL. Un pragma est une directive qui indique au compilateur d'effectuer une option de compilation. Le pragma AUTONOMOUS_TRANSACTION indique à la base de données que cette procédure, lorsqu'elle est exécutée, doit être exécutée en tant que nouvelle transaction autonome indépendante de sa transaction parent.
Le graphique suivant montre comment le contrôle passe de la routine principale (MT) à une routine autonome et inversement. La routine principale est proc1 et la routine autonome est proc2. La routine autonome peut valider plusieurs transactions (AT1 et AT2) avant que le contrôle ne retourne à la routine principale.
Figure 4 : Flux de contrôle des transactions
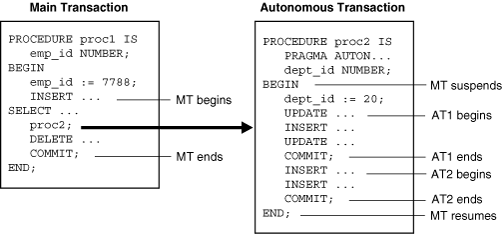
Description de l'image cncpt288.gif
Lorsque vous entrez la section exécutable d'une routine autonome, la routine principale est suspendue. Lorsque vous quittez la routine autonome, la routine principale reprend.
Dans la Figure 13-4, COMMIT à l'intérieur de proc1 rend permanent non seulement son propre travail, mais tout travail en cours effectué dans sa session. Toutefois, une valeur COMMIT dans proc2 rend permanent uniquement le travail effectué dans la transaction proc2. Par conséquent, les instructions COMMIT des transactions AT1 et AT2 n'ont aucun effet sur la transaction MT.
Voir aussi : Guide de développement Oracle AI Database et Référence de langage PL/SQL Oracle AI Database pour apprendre à utiliser les transactions autonomes
Présentation des transactions distribuées
Une transaction distribuée est une transaction qui inclut une ou plusieurs instructions qui mettent à jour les données sur deux noeuds distincts ou plus d'une base de données distribuée, à l'aide d'un objet de schéma appelé lien de base de données.
Une base de données distribuée est un ensemble de bases de données dans un système distribué qui peut apparaître pour les applications en tant que source de données unique. Un lien de base de données décrit comment une instance de base de données peut se connecter à une autre instance de base de données.
Contrairement à une transaction sur une base de données locale, une transaction distribuée modifie les données de plusieurs bases de données. Par conséquent, le traitement des transactions distribuées est plus compliqué car la base de données doit coordonner la validation ou l'annulation des modifications dans une transaction en tant qu'unité atomique. La transaction entière doit être validée ou annulée. Oracle AI Database doit coordonner le contrôle des transactions sur un réseau et maintenir la cohérence des données, même en cas de panne du réseau ou du système.
-
Validation en deux phases Le mécanisme de validation en deux phases garantit que toutes les bases de données participant à une transaction distribuée valident ou annulent toutes les instructions de la transaction. Ce mécanisme protège également les instructions LMD implicites exécutées par des contraintes d'intégrité, des appels de procédure distante et des déclencheurs.
-
Transactions en double Une transaction distribuée en double se produit lorsqu'une validation en deux phases a été interrompue par tout type de défaillance du système ou du réseau. Voir aussi : Guide de l'administrateur Oracle AI Database pour apprendre à gérer les transactions distribuées
Validation en deux phases
Le mécanisme de validation en deux phases garantit que toutes les bases de données participant à une transaction distribuée valident ou annulent toutes les instructions de la transaction. Ce mécanisme protège également les instructions LMD implicites exécutées par des contraintes d'intégrité, des appels de procédure distante et des déclencheurs.
Dans une validation en deux phases entre plusieurs bases de données, une base de données coordonne la transaction distribuée. Le noeud initiateur est appelé coordinateur global. Le coordinateur demande aux autres bases de données si elles sont prêtes à s'engager. Si une base de données répond avec un non, la transaction entière est annulée. Si toutes les bases de données votent oui, le coordinateur diffuse un message pour rendre la validation permanente sur chacune des bases de données.
Le mécanisme de validation en deux phases est transparent pour les utilisateurs qui émettent des transactions distribuées. En fait, les utilisateurs n'ont même pas besoin de savoir que la transaction est distribuée. Une instruction COMMIT indiquant la fin d'une transaction déclenche automatiquement le mécanisme de validation en deux phases. Aucune syntaxe d'instruction complexe ou de codage n'est requise pour inclure des transactions distribuées dans le corps d'une application de base de données.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur le mécanisme de validation en deux phases
Transactions en suspens
Une transaction distribuée équivoque se produit lorsqu'une validation en deux phases a été interrompue par tout type de défaillance du système ou du réseau.
Par exemple, deux bases de données signalent à la base de données de coordination qu'elles étaient prêtes à valider, mais l'instance de base de données de coordination échoue immédiatement après la réception des messages. Les deux bases de données qui sont prêtes à être validées restent bloquées pendant qu'elles attendent la notification du résultat.
Le processus en arrière-plan du récupérateur (RECO) résout automatiquement le résultat des transactions distribuées douteuses. Une fois la panne réparée et la communication rétablie, le processus RECO de chaque base de données Oracle locale valide ou annule automatiquement toutes les transactions distribuées douteuses de manière cohérente sur tous les noeuds impliqués.
En cas d'échec à long terme, Oracle AI Database permet à chaque administrateur local de valider ou d'annuler manuellement toutes les transactions distribuées qui sont en doute en raison de l'échec. Cette option permet à l'administrateur de base de données local de libérer toutes les ressources verrouillées qui sont bloquées indéfiniment en raison de l'échec à long terme.
Si une base de données doit être récupérée dans le passé, les utilitaires de récupération de base de données permettent aux administrateurs de base de données d'autres sites de renvoyer leurs bases de données au point antérieur dans le temps. Cette opération garantit que la base de données globale reste cohérente.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer les transactions équivoques
Note
Note de bas de page 1 :
Pour Oracle Real Application Clusters (Oracle RAC), l'ID de transaction logique inclut le numéro d'instance de base de données en tant que préfixe.