SQL
Ce chapitre présente le SQL (Structured Query Language) et la façon dont Oracle AI Database traite les instructions SQL.
-
Introduction à SQL SQL (prononcé sequel) est le langage informatique déclaratif de haut niveau basé sur un ensemble avec lequel tous les programmes et utilisateurs accèdent aux données d'une base de données Oracle.
-
Présentation des instructions SQL Toutes les opérations effectuées sur les informations d'une base de données Oracle sont exécutées à l'aide d'instructions SQL. Une instruction SQL est un programme ou une instruction informatique composé d'identificateurs, de paramètres, de variables, de noms, de types de données et de mots réservés SQL.
-
Présentation de l'optimiseur Pour comprendre comment Oracle AI Database traite les instructions SQL, il est nécessaire de comprendre la partie de la base de données appelée optimiseur (également appelé optimiseur d'interrogation ou optimiseur basé sur les coûts). Toutes les instructions SQL utilisent l'optimiseur pour déterminer le moyen le plus efficace d'accéder aux données indiquées.
-
Présentation du traitement SQL Cette section explique comment Oracle AI Database traite les instructions SQL. Plus précisément, cette section explique comment la base de données traite les instructions LDD pour créer des objets, les instructions LMD pour modifier des données et les interrogations pour extraire des données.
Introduction à SQL
SQL (prononcé sequel) est le langage informatique déclaratif de haut niveau basé sur un ensemble avec lequel tous les programmes et utilisateurs accèdent aux données d'une base de données Oracle.
Bien que certains outils et applications Oracle masquent l'utilisation du langage SQL, toutes les tâches de base de données sont exécutées à l'aide du langage SQL. Toute autre méthode d'accès aux données contourne la sécurité intégrée à Oracle AI Database et compromet potentiellement la sécurité et l'intégrité des données.
SQL fournit une interface vers une base de données relationnelle telle qu'Oracle AI Database. Le langage SQL unifie des tâches telles que les suivantes dans un langage cohérent :
-
Créer, remplacer, modifier et supprimer des objets
-
Insertion, mise à jour et suppression de lignes de table
-
Interroger des données
-
Contrôler l'accès à la base de données et à ses objets
-
Garantir la cohérence et l'intégrité de la base de donnée
SQL peut être utilisé de manière interactive, ce qui signifie que les instructions sont entrées manuellement dans un programme. Les instructions SQL peuvent également être intégrées à un programme écrit dans un langage différent, tel que C ou Java.
-
Accès aux données SQL Il existe deux grandes familles de langages informatiques : les langages de déclaration qui ne sont pas procéduraux et qui décrivent ce qui doit être fait, et les langages de procédure tels que C++ et Java qui décrivent comment les choses doivent être faites.
-
Normes SQL Oracle s'efforce de suivre les normes acceptées par le secteur et participe activement aux comités des normes SQL.
Voir aussi :
-
Guide de développement Oracle AI Database pour découvrir comment choisir un environnement de programmation
-
Référence du langage SQL d'Oracle AI Database pour une introduction à SQL
Accès aux données SQL
Il existe deux grandes familles de langages informatiques : les langages de déclaration qui ne sont pas de procédure et décrivent ce qui doit être fait, et les langages de procédure tels que C++ et Java qui décrivent comment les choses doivent être faites.
Le langage SQL est déclaratif, c'est-à-dire que les utilisateurs indiquent le résultat qu'ils veulent et non comment le dériver. Par exemple, l'instruction suivante interroge les enregistrements des employés dont le nom commence par K :
La base de données effectue le travail de génération d'une procédure permettant de parcourir les données et d'extraire les résultats demandés. La nature déclarative du langage SQL permet d'utiliser des données au niveau logique. Vous devez vous préoccuper des détails d'implémentation uniquement lorsque vous manipulez les données.
SELECT   last_name, first_name
FROM     hr.employees
WHERE    last_name LIKE 'K%'
ORDER BY last_name, first_name;
La base de données extrait toutes les lignes répondant à la condition WHERE, également appelée prédicat, en une seule étape. La base de données peut transmettre ces lignes en tant qu'unité à l'utilisateur, à une autre instruction SQL ou à une application. L'application n'a pas besoin de traiter les lignes une par une, et le développeur n'a pas non plus besoin de savoir comment les lignes sont stockées ou extraites physiquement.
Toutes les instructions SQL utilisent l'optimiseur, un composant de la base de données qui détermine le moyen le plus efficace d'accéder aux données demandées. Oracle Database prend également en charge les techniques permettant à l'optimiseur d'améliorer ses performances.
Voir aussi : Référence du langage SQL d'Oracle AI Database pour obtenir des informations détaillées sur les instructions SQL et d'autres parties du langage SQL (telles que les opérateurs, les fonctions et les modèles de format).
Normes SQL
Oracle s'efforce de suivre les normes acceptées par le secteur et participe activement aux comités des normes SQL.
Les comités reconnus par l'industrie sont l'Institut national américain de normalisation (ANSI) et l'Organisation internationale de normalisation (ISO). L'ANSI et l'ISO/IEC ont accepté le langage SQL comme langage standard pour les bases de données relationnelles.
La norme SQL est composée de dix parties. Une partie (SQL/RPR:2012) est nouvelle en 2012. Cinq autres parties ont été révisées en 2011. Pour les quatre autres parties, la version 2008 reste en place. Oracle SQL inclut de nombreuses extensions du langage SQL standard ANSI/ISO, et les outils et applications Oracle AI Database fournissent des instructions supplémentaires. Les outils SQL*Plus, SQL Developer et Oracle Enterprise Manager vous permettent d'exécuter n'importe quelle instruction SQL standard ANSI/ISO sur une base de données Oracle, ainsi que toutes les instructions ou fonctions supplémentaires disponibles pour ces outils.
Voir aussi :
-
Oracle AI Database - Démarrer avec le développement d'Oracle AI Database
-
Référence du langage SQL Oracle AI Database pour une explication des différences entre Oracle SQL et le langage SQL standard
-
Guide de l'utilisateur et référence SQL*Plus pour les commandes SQL*Plus, avec distinction entre les instructions SQL et les instructions SQL
Présentation des instructions SQL
Toutes les opérations effectuées sur les informations d'une base de données Oracle sont exécutées à l'aide d'instructions SQL. Une instruction SQL est un programme ou une instruction informatique composé d'identificateurs, de paramètres, de variables, de noms, de types de données et de mots réservés SQL. Remarque : les mots réservés SQL ont une signification particulière dans SQL et ne doivent pas être utilisés à d'autres fins. Par exemple, SELECT et UPDATE sont des mots réservés et ne doivent pas être utilisés comme noms de table.
Une instruction SQL doit être équivalente à une phrase SQL complète, par exemple :
SELECT last_name, department_id FROM employeesOracle AI Database exécute uniquement des instructions SQL complètes. Un fragment tel que le suivant génère une erreur indiquant qu'un texte supplémentaire est requis :
SELECT last_name;Les instructions SQL Oracle sont divisées en plusieurs catégories :
-
Les instructions de langage de définition de données (DDL) (DLL) définissent, modifient et suppriment structurellement des objets de schéma.
-
Instructions DML (Data Manipulation Language) Les instructions DML (DML) interrogent ou manipulent des données dans des objets de schéma existants.
-
Les instructions de contrôle de transaction Instructions de contrôle de transaction gèrent les modifications apportées par les instructions LMD et regroupent les instructions LMD en transactions.
-
Les instructions de contrôle de session Instructions de contrôle de session gèrent dynamiquement les propriétés d'une session utilisateur.
-
Instruction de contrôle système Une instruction de contrôle système modifie les propriétés de l'instance de base de données.
-
Instructions SQL intégrées Les instructions SQL intégrées intègrent des instructions LDD, LMD et de contrôle des transactions dans un programme de langage procédural.
Instructions DDL (Data Definition Language - langage de définition des données)
Les instructions de langage de définition de données (DLL) définissent, modifient et suppriment les objets de schéma.
Le langage DDL permet de modifier les attributs d'un objet sans modifier les applications qui y accèdent. Par exemple, vous pouvez ajouter une colonne à une table à laquelle accède une application de ressources humaines sans réécrire l'application. Vous pouvez également utiliser des instructions LDD pour modifier la structure des objets pendant que les utilisateurs de base de données effectuent des tâches dans la base.
Plus précisément, les instructions LDD permettent d'effectuer les opérations suivantes :
-
Créez, modifiez et supprimez des objets de schéma et d'autres structures de base de données, y compris la base de données elle-même et les utilisateurs de base de données. La plupart des instructions LDD commencent par les mots-clés
CREATE,ALTERouDROP. -
Supprimez toutes les données des objets de schéma sans supprimer la structure de ces objets (
TRUNCATE).Remarque : contrairement à
DELETE,TRUNCATEne génère aucune données d'annulation, ce qui la rend plus rapide queDELETE. En outre,TRUNCATEn'appelle pas de déclencheurs de suppression. -
Accordez et révoquez des privilèges et des rôles (
GRANT,REVOKE). -
Activez et désactivez les options d'audit (
AUDIT,NOAUDIT). -
Ajoutez un commentaire au dictionnaire de données (
COMMENT).
Exemple 10-1 Instructions LDD
L'exemple suivant utilise des instructions LDD pour créer la table plants, puis une instruction LMD pour insérer deux lignes dans la table. L'exemple utilise ensuite le langage DDL pour modifier la structure de la table, accorder et révoquer des privilèges de lecture sur cette table à un utilisateur, puis supprimer la table.
CREATE TABLE plants
    ( plant_id    NUMBER PRIMARY KEY,
      common_name VARCHAR2(15) );

INSERT INTO plants VALUES (1, 'African Violet'); # DML statement

INSERT INTO plants VALUES (2, 'Amaryllis'); # DML statement

ALTER TABLE plants ADD
    ( latin_name VARCHAR2(40) );

GRANT READ ON plants TO scott;

REVOKE READ ON plants FROM scott;

DROP TABLE plants;
Une instruction COMMIT implicite se produit immédiatement avant que la base de données n'exécute une instruction LDD et une instruction COMMIT ou ROLLBACK se produit immédiatement après. Dans l'exemple précédent, deux instructions INSERT sont suivies d'une instruction ALTER TABLE, de sorte que la base de données valide les deux instructions INSERT. Si l'instruction ALTER TABLE réussit, la base de données valide cette instruction. Sinon, la base de données annule cette instruction. Dans les deux cas, les deux instructions INSERT ont déjà été validées.
Voir aussi :
-
Guide de sécurité Oracle AI Database pour en savoir plus sur les privilèges et les rôles
-
Oracle AI Database - Introduction à Oracle AI Database Development et Guide de l'administrateur Oracle AI Database pour apprendre à créer des objets de schéma
-
Guide de développement Oracle AI Database pour en savoir plus sur la différence entre les instructions DDL bloquantes et non bloquantes
-
Référence du langage SQL d'Oracle AI Database pour obtenir la liste des instructions DDL
Instructions DML (Data Manipulation Language - langage de manipulation des données)
Les instructions de langage de manipulation de données (DML) interrogent ou manipulent des données dans des objets de schéma existants.
Alors que les instructions LDD modifient la structure de la base de données, les instructions LMD interrogent ou modifient le contenu. Par exemple, ALTER TABLE modifie la structure d'une table, tandis que INSERT ajoute une ou plusieurs lignes à la table.
Les instructions LMD sont les instructions SQL les plus utilisées et vous permettent d'effectuer les opérations suivantes :
-
Extrayez ou extrayez des données à partir de tables ou de vues (
SELECT). -
Ajoutez de nouvelles lignes de données dans une table ou une vue (
INSERT) en indiquant une liste de valeurs de colonne ou en utilisant une sous-requête pour sélectionner et manipuler des données existantes. -
Modifiez les valeurs de colonne dans les lignes existantes d'une table ou d'une vue (
UPDATE). -
Mettez à jour ou insérez des lignes de manière conditionnelle dans une table ou une vue (
MERGE). -
Enlevez des lignes des tables ou des vues (
DELETE). -
Affichez le plan d'exécution d'une instruction SQL (
EXPLAINPLAN). -
Verrouillez une table ou une vue, ce qui limite temporairement l'accès des autres utilisateurs (
LOCKTABLE).
L'exemple suivant utilise une instruction LMD pour interroger la table employees. L'exemple utilise le langage LMD pour insérer une ligne dans employees, mettre à jour cette ligne, puis la supprimer :
SELECT * FROM employees;

INSERT INTO employees (employee_id, last_name, email, job_id, hire_date, salary)
  VALUES (1234, 'Mascis', 'JMASCIS', 'IT_PROG', '14-FEB-2008', 9000);

UPDATE employees SET salary=9100 WHERE employee_id=1234;

DELETE FROM employees WHERE employee_id=1234;
Un ensemble d'instructions DML qui forme une unité logique de travail est appelé une transaction. Par exemple, une transaction de transfert d'argent peut impliquer trois opérations distinctes : réduire le solde du compte épargne, augmenter le solde du compte courant et enregistrer le transfert dans une table d'historique des comptes. Contrairement aux instructions LDD, les instructions LMD ne valident pas implicitement la transaction en cours.
-
Instructions SELECT Une requête est une opération qui extrait des données d'une table ou d'une vue.
-
Jointures Une jointure est une requête qui combine des lignes de plusieurs tables, vues ou vues matérialisées.
-
Sous-requêtes Une sous-requête est une instruction
SELECTimbriquée dans une autre instruction SQL. Les sous-interrogations sont utiles lorsque vous devez exécuter plusieurs interrogations pour résoudre un seul problème.
Voir aussi :
-
Oracle AI Database - Introduction à Oracle AI Database Development pour apprendre à interroger et manipuler des données
-
Référence de langage SQL Oracle AI Database pour obtenir la liste des instructions LMD
Instructions SELECT
Une requête est une opération qui extrait des données d'une table ou d'une vue.
SELECT est la seule instruction SQL que vous pouvez utiliser pour interroger des données. L'ensemble de données extraites de l'exécution d'une instruction SELECT est appelé ensemble de résultats.
Le tableau suivant présente un mot-clé requis et trois mots-clés couramment trouvés dans une instruction SELECT. La table associe également les fonctionnalités d'une instruction SELECT aux mots-clés.
Tableau 1 Mots-clés dans une instruction SQL
| Mot-clé | Obligatoire ? | Description | Capacité |
|---|---|---|---|
SELECT |
Oui | Indique les colonnes à afficher dans le résultat. La projection produit un sous-ensemble des colonnes de la table. Une expression est une combinaison de valeurs, d'opérateurs et de fonctions SQL qui aboutit à une valeur. La liste des expressions qui apparaît après le mot-clé |
Projection |
FROM |
Non | Indique les tables ou les vues à partir desquelles les données doivent être extraites. | Jointure |
WHERE |
Non | Spécifie une condition pour filtrer les lignes, produisant un sous-ensemble des lignes de la table. Une condition indique une combinaison d'expressions et d'opérateurs (booléens) logiques, et renvoie la valeur TRUE, FALSE ou UNKNOWN. |
Sélection |
ORDER BY |
Non | Indique l'ordre dans lequel les lignes doivent être affichées. |
Voir aussi : Référence du langage SQL d'Oracle AI Database pour la syntaxe et la sémantique SELECT
Jointures
Une jointure est une requête qui combine des lignes de plusieurs tables, vues ou vues matérialisées.
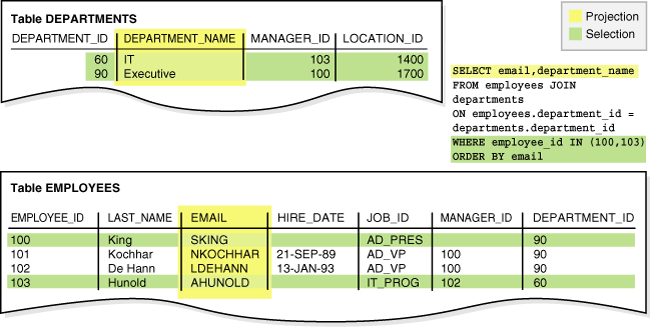
L'exemple suivant joint les tables employees et departments (clause FROM), sélectionne uniquement les lignes qui répondent aux critères indiqués (clause WHERE) et utilise la projection pour extraire les données de deux colonnes (SELECT). L'exemple de sortie suit l'instruction SQL.
SELECT email, department_name
FROM   employees
JOIN   departments
ON     employees.department_id = departments.department_id
WHERE  employee_id IN (100,103)
ORDER BY email;

EMAIL                     DEPARTMENT_NAME
------------------------- ------------------------------
AHUNOLD                   IT
SKING                     Executive
Le graphique suivant représente les opérations de projection et de sélection dans la jointure illustrée dans la requête précédente.
Figure 1 : Projection et sélection
Description de l'image cncpt290.gif
La plupart des jointures ont au moins une condition de jointure, dans la clause FROM ou dans la clause WHERE, qui compare deux colonnes, chacune provenant d'une table différente. La base de données combine des paires de lignes contenant chacune une ligne de chaque table, pour lesquelles la condition de jointure est évaluée à TRUE. L'optimiseur détermine l'ordre dans lequel la base de données joint les tables en fonction des conditions de jointure, des index et des statistiques disponibles pour ces tables.
Les types de jointure sont les suivants :
-
Jointures internes
Une jointure interne est une jointure de plusieurs tables qui renvoie uniquement les lignes qui satisfont à la condition de jointure. Par exemple, si la condition de jointure est
employees.department_id=departments.department_id, les lignes qui ne satisfont pas cette condition ne sont pas renvoyées. -
Jointures externes
Une jointure externe renvoie toutes les lignes qui répondent à la condition d'une jointure, ainsi que toutes les lignes d'une table pour laquelle aucune des lignes de l'autre table n'y répond.
Le résultat d'une jointure externe gauche pour les tables A et B contient toujours tous les enregistrements de la table de gauche A, même si la condition de jointure ne correspond pas à un enregistrement de la table de droite B. S'il n'existe aucune ligne correspondante dans B, les colonnes B contiennent des valeurs NULL pour les lignes qui ne correspondent pas dans B. Par exemple, si tous les employés ne font pas partie des services, une jointure externe gauche de
employees(table de gauche) etdepartments(table de droite) extrait toutes les lignes deemployeesmême si aucune ligne dedepartmentsne satisfait à la condition de jointure (employees.department_ida la valeur NULL).Le résultat d'une jointure externe droite pour les tables A et B contient tous les enregistrements de la table de droite B, même si la condition de jointure ne correspond pas à une ligne de la table de gauche A. S'il n'existe aucune ligne correspondante dans A, les colonnes A contiennent des valeurs NULL pour les lignes qui ne correspondent pas dans A. Par exemple, si tous les services n'ont pas d'employés, une jointure externe droite de type
employees(table de gauche) etdepartments(table de droite) extrait toutes les lignes dansdepartmentsmême si aucune ligne dansemployeesne satisfait à la condition de jointure.Une jointure externe complète est la combinaison d'une jointure externe gauche et d'une jointure externe droite.
-
Produits cartésiens
Si deux tables d'une requête de jointure n'ont pas de condition de jointure, la base de données effectue une jointure cartésienne. Chaque ligne d'une table est associée à chaque ligne de l'autre. Par exemple, si
employeescontient 107 lignes etdepartments27, le produit cartésien contient 107*27 lignes. Un produit cartésien est rarement utile.
Voir aussi :
-
Guide de réglage SQL d'Oracle AI Database pour en savoir plus sur les jointures
-
Référence du langage SQL Oracle AI Database pour obtenir des descriptions détaillées et des exemples de jointures
Sous-requêtes
Une sous-interrogation est une instruction SELECT imbriquée dans une autre instruction SQL. Les sous-interrogations sont utiles lorsque vous devez exécuter plusieurs interrogations pour résoudre un seul problème.
Chaque partie de requête d'une instruction est appelée bloc de requête. Dans l'interrogation suivante, la sous-interrogation entre parenthèses est le bloc d'interrogation interne :
SELECT first_name, last_name
FROM   employees
WHERE  department_id
IN     ( SELECT department_id
         FROM departments
         WHERE location_id = 1800 );
L'instruction interne SELECT extrait les ID des services dont l'ID d'emplacement est 1800. Ces codes service sont requis par le bloc d'interrogation externe, qui extrait les noms des employés des services dont les codes ont été fournis par la sous-interrogation.
La structure de l'instruction SQL n'oblige pas la base de données à exécuter d'abord l'interrogation interne. Par exemple, la base de données peut réécrire l'interrogation entière en tant que jointure de employees et departments, de sorte que la sous-interrogation ne s'exécute jamais seule. Autre exemple, la fonctionnalité Virtual Private Database (VPD) peut restreindre l'interrogation des employés à l'aide d'une clause WHERE, de sorte que la base de données interroge d'abord les employés, puis obtient les ID de service. L'optimiseur détermine la meilleure séquence d'étapes pour extraire les lignes demandées.
Voir aussi : Guide de sécurité Oracle AI Database pour en savoir plus sur VPD
Instructions de contrôle de transaction
Les instructions de contrôle de transaction gèrent les modifications apportées par les instructions LMD et regroupent les instructions LMD en transactions.
Ces instructions permettent d'effectuer les opérations suivantes :
-
Rendre les modifications apportées à une transaction permanentes (
COMMIT). -
Annulez les modifications dans une transaction, depuis le début de la transaction (
ROLLBACK) ou depuis un point de sauvegarde (ROLLBACK TO SAVEPOINT). Un point de sauvegarde est un marqueur intermédiaire déclaré par l'utilisateur dans le contexte d'une transaction.Remarque : l'instruction
ROLLBACKmet fin à une transaction, mais pasROLLBACK TO SAVEPOINT. -
Définissez un point vers lequel vous pouvez revenir en arrière (
SAVEPOINT). -
Définissez les propriétés d'une transaction (
SETTRANSACTION). -
Indiquez si une contrainte d'intégrité pouvant être différée est vérifiée après chaque instruction LMD ou lorsque la transaction est validée (
SET CONSTRAINT).
L'exemple suivant démarre une transaction nommée Update salaries. L'exemple de la diapositive ci-dessus crée un point de sauvegarde, met à jour le salaire d'un employé, puis annule la transaction jusqu'au point de sauvegarde. L'exemple met à jour le salaire avec une valeur différente et valide.
SET TRANSACTION NAME 'Update salaries';

SAVEPOINT before_salary_update;

UPDATE employees SET salary=9100 WHERE employee_id=1234 # DML

ROLLBACK TO SAVEPOINT before_salary_update;

UPDATE employees SET salary=9200 WHERE employee_id=1234 # DML

COMMIT COMMENT 'Updated salaries';
Voir aussi :
-
Vérification de la validité des contraintes et assertions par la base de données
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur les instructions de contrôle des transactions
Instructions de contrôle de session
Les instructions de contrôle de session gèrent dynamiquement les propriétés d'une session utilisateur.
Une session est une entité logique de la mémoire de l'instance de base de données qui représente l'état d'une connexion utilisateur en cours à une base de données. Une session dure à partir du moment où l'utilisateur est authentifié par la base de données jusqu'à ce qu'il se déconnecte ou quitte l'application de base de données.
Les instructions de contrôle de session permettent d'effectuer les opérations suivantes :
-
Modifiez la session en cours en exécutant une fonction spécialisée, telle que la définition du format de date par défaut (
ALTER SESSION). -
Activez et désactivez les rôles, qui sont des groupes de privilèges, pour la session en cours (
SET ROLE).
L'instruction suivante modifie dynamiquement le format de date par défaut de votre session en 'YYYY MM DD-HH24:MI:SS' :
ALTER SESSION
   SET NLS_DATE_FORMAT = 'YYYY MM DD HH24:MI:SS';
Les instructions de contrôle de session ne valident pas implicitement la transaction en cours.
Voir aussi :
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
ALTER SESSION
Instruction de contrôle système
Une instruction de contrôle système modifie les propriétés de l'instance de base de données.
La seule instruction de contrôle système est ALTER SYSTEM. Il vous permet de modifier des paramètres tels que le nombre minimal de serveurs partagés, de mettre fin à une session et d'effectuer d'autres tâches au niveau du système.
Exemples d'instructions de contrôle système :
ALTER SYSTEM SWITCH LOGFILE;

ALTER SYSTEM KILL SESSION '39, 23';
L'instruction ALTER SYSTEM ne valide pas implicitement la transaction en cours.
Voir aussi : Référence du langage SQL d'Oracle AI Database pour la syntaxe et la sémantique ALTER SYSTEM
Instructions SQL intégrées
Les instructions SQL intégrées intègrent des instructions LDD, LMD et de contrôle des transactions dans un programme en langage procédural.
Les instructions intégrées sont utilisées avec les précompilateurs Oracle. Le langage SQL intégré est une approche pour intégrer le langage SQL dans vos applications de langage procédural. Une autre approche consiste à utiliser une API procédurale telle que la connectivité ODBC (Open Database Connectivity) ou JDBC (Java Database Connectivity).
Les instructions SQL intégrées permettent d'effectuer les opérations suivantes :
-
Définissez, allouez et libérez un cursor (
DECLARE CURSOR,OPEN,CLOSE). -
Indiquez une base de données et connectez-vous à celle-ci (
DECLARE DATABASE,CONNECT). -
Affectez des noms de variable (
DECLARE STATEMENT). -
Initialisez les descripteurs (
DESCRIBE). -
Indiquez comment les conditions d'erreur et d'avertissement sont gérées (
WHENEVER). -
Analysez et exécutez des instructions SQL (
PREPARE,EXECUTE,EXECUTE IMMEDIATE). -
Extrayez les données de la base de données (
FETCH).
Voir aussi :
Présentation de l'optimiseur
Pour comprendre comment Oracle AI Database traite les instructions SQL, il est nécessaire de comprendre la partie de la base de données appelée optimiseur (également appelé optimiseur d'interrogation ou optimiseur basé sur les coûts). Toutes les instructions SQL utilisent l'optimiseur pour déterminer le moyen le plus efficace d'accéder aux données indiquées.
-
Utilisation de l'optimiseur L'optimiseur génère des plans d'exécution décrivant les méthodes d'exécution possibles.
-
Composants de l'optimiseur L'optimiseur contient trois composants principaux : le transformateur, l'estimateur et le générateur de plans.
-
Chemins d'accès Un chemin d'accès est la technique utilisée par une requête pour extraire des lignes.
-
Statistiques de l'optimiseur Les statistiques de l'optimiseur sont un ensemble de données qui décrivent les détails de la base de données et des objets qu'elle contient. Les statistiques offrent une image statistiquement correcte du stockage et de la répartition des données, qui est utilisable par l'optimiseur lors de l'évaluation des chemins d'accès.
-
Conseils de l'optimiseur Un conseil est un commentaire d'une instruction SQL qui sert d'instruction à l'optimiseur.
Utilisation de l'optimiseur
L'optimiseur génère des plans d'exécution décrivant les méthodes d'exécution possibles.
L'optimiseur détermine le plan d'exécution le plus efficace en tenant compte de plusieurs sources d'informations. Par exemple, l'optimiseur prend en compte les conditions d'interrogation, les chemins d'accès disponibles, les statistiques collectées pour le système et les conseils.
Pour exécuter une instruction LMD, Oracle AI Database peut être amené à effectuer de nombreuses étapes. Chacune d'elles extrait physiquement des lignes de données de la base ou les prépare de manière à ce que l'utilisateur émettant l'instruction. Les étapes que la base de données utilise pour exécuter une instruction ont une incidence considérable sur la rapidité d'exécution de l'instruction. Plusieurs méthodes de traitement d'une instruction LMD sont souvent possibles. Par exemple, l'ordre d'accès aux tables ou aux index peut varier.
Lorsque l'optimiseur détermine le meilleur plan d'exécution pour une instruction SQL, il effectue les opérations suivantes :
-
Évaluation des expressions et des conditions
-
Inspection des contraintes d'intégrité pour en savoir plus sur les données et les optimiser en fonction de ces métadonnées
-
Transformation d'instruction
-
Choix des objectifs de l'optimiseur
-
Choix des chemins d'accès
-
Choix des ordres de jointure
L'optimiseur génère la plupart des méthodes possibles de traitement d'une interrogation et affecte un coût à chaque étape du plan d'exécution généré. Le plan dont le coût est le plus bas est choisi comme plan de requête à exécuter.
Remarque : vous pouvez obtenir un plan d'exécution pour une instruction SQL sans exécuter le plan. Seul un plan d'exécution que la base de données utilise réellement pour exécuter une interrogation est correctement appelé plan d'interrogation.
Vous pouvez influencer les choix de l'optimiseur en définissant l'objectif de l'optimiseur et en collectant des statistiques représentatives pour l'optimiseur. Par exemple, vous pouvez définir l'objectif de l'optimiseur sur l'un des éléments suivants :
-
Débit total
Le conseil
ALL_ROWSindique à l'optimiseur d'obtenir la dernière ligne du résultat à l'application client aussi rapidement que possible. -
Délai de réponse initial
Le conseil
FIRST_ROWSindique à l'optimiseur d'envoyer la première ligne au client le plus rapidement possible.
Une application interactive utilisateur final classique bénéficierait de l'optimisation du temps de réponse initial, tandis qu'une application non interactive en mode batch bénéficierait de l'optimisation du débit total.
Voir aussi :
-
Référence des types et packages PL/SQL d'Oracle AI Database pour plus d'informations sur l'utilisation de
DBMS_STATS -
Guide de réglage SQL Oracle AI Database pour plus d'informations sur l'optimiseur et l'utilisation de conseils
Composants d'optimiseur
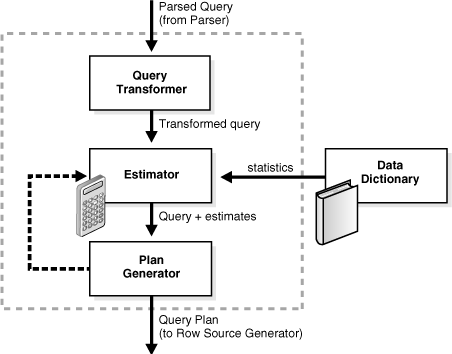
L'optimiseur contient trois composants principaux : le transformateur, l'estimateur et le générateur de plans.
Le diagramme suivant représente les composants :
Figure 2 : Composants de l'optimiseur
Description de l'image cncpt287.gif
L'entrée de l'optimiseur est une interrogation analysée. L'optimiseur effectue les opérations suivantes :
-
L'optimiseur reçoit l'interrogation analysée et génère un ensemble de plans potentiels pour l'instruction SQL en fonction des chemins d'accès et des conseils disponibles.
-
L'optimiseur estime le coût de chaque plan en fonction des statistiques du dictionnaire de données. Le coût est une valeur estimée, proportionnelle à l'utilisation des ressources prévue, nécessaire pour exécuter l'instruction avec un plan particulier.
-
L'optimiseur compare les coûts des plans et choisit le plan le moins coûteux, appelé plan d'interrogation, à transmettre au générateur de row sources.
-
Transformateur de requête Le transformateur de requête détermine s'il est utile de modifier la forme de la requête afin que l'optimiseur puisse générer un meilleur plan d'exécution. L'entrée du transformateur d'interrogation est une interrogation analysée, que l'optimiseur représente sous la forme d'un ensemble de blocs d'interrogation.
-
Estimateur L'estimateur détermine le coût global d'un plan d'exécution donné.
-
Générateur de plans Le générateur de plans teste différents plans pour une requête soumise. L'optimiseur choisit le plan dont le coût est le plus bas.
Voir aussi :
Transformateur de requêtes
Le transformateur d'interrogation détermine s'il est utile de modifier la forme de l'interrogation afin que l'optimiseur puisse générer un meilleur plan d'exécution. L'entrée du transformateur d'interrogations est une interrogation analysée, que l'optimiseur représente sous la forme d'un ensemble de blocs d'interrogation.
Voir aussi : Réécriture de requête
Estimateur
L'estimateur détermine le coût global d'un plan d'exécution donné.
L'estimateur génère trois types de mesures différents pour atteindre cet objectif :
-
Sélectivité
Cette mesure représente une fraction des lignes d'un ensemble de lignes. La sélectivité est liée à un prédicat de requête, tel que
last_name='Smith', ou à une combinaison de prédicats. -
Cardinalité
Cette mesure représente le nombre de lignes d'un ensemble de lignes.
-
Coût
Cette mesure représente les unités de travail ou la ressource utilisée. L'optimiseur d'instructions utilise les E/S disque, l'utilisation de la CPU et l'utilisation de la mémoire en tant qu'unités de travail.
Si des statistiques sont disponibles, l'estimateur les utilise pour calculer les mesures. Les statistiques améliorent le degré de précision des mesures.
Générateur de plan
Le générateur de plans teste différents plans pour une requête soumise. L'optimiseur choisit le plan dont le coût est le plus bas.
Pour chaque sous-interrogation imbriquée et vue non fusionnée, l'optimiseur génère un sous-plan. L'optimiseur représente chaque sous-plan sous la forme d'un bloc de requête distinct. Le générateur de plans explore différents plans pour un bloc d'interrogation en essayant différents chemins d'accès, méthodes de jointure et ordres de jointure.
La fonction d'optimisation adaptative des requêtes modifie les plans en fonction des statistiques collectées lors de l'exécution des instructions. Tous les mécanismes adaptatifs peuvent exécuter un plan final pour une instruction qui diffère du plan par défaut. L'optimisation adaptative utilise des plans dynamiques, qui choisissent parmi les sous-plans lors de l'exécution de l'instruction, ou la réoptimisation, qui modifie un plan lors des exécutions après l'exécution en cours.
Voir aussi :
-
Oracle AI Database - Introduction au réglage des performances pour une introduction au réglage SQL
-
Guide de réglage SQL d'Oracle AI Database pour en savoir plus sur les composants de l'optimiseur et l'optimisation adaptative
Chemins d'accès
Un chemin d'accès est la technique utilisée par une requête pour extraire des lignes.
Par exemple, une requête qui utilise un index a un chemin d'accès différent d'une requête qui ne le fait pas. En général, les chemins d'accès aux index sont les meilleurs pour les instructions qui extraient un petit sous-ensemble de lignes de table. Les balayages complets sont plus efficaces pour accéder à une grande partie d'une table.
La base de données peut utiliser plusieurs chemins d'accès différents pour extraire des données d'une table. Voici une liste représentative :
-
Balayages complets de table
Ce type d'analyse lit toutes les lignes d'une table et filtre celles qui ne répondent pas aux critères de sélection. La base de données analyse séquentiellement tous les blocs de données du segment, y compris ceux situés sous la limite supérieure du contrôle du débit (HWM) qui sépare l'espace utilisé de l'espace inutilisé (reportez-vous à la section "Espace du segment et marque du contrôle du débit").
-
Analyses Rowid
La valeur rowid d'une ligne indique le fichier de données et la zone de données contenant la ligne, ainsi que l'emplacement de la ligne dans ce bloc. La base de données obtient d'abord les rowids des lignes sélectionnées, soit à partir de la clause d'instruction
WHERE, soit via un balayage d'index, puis localise chaque ligne sélectionnée en fonction de son rowid. -
Analyses d'index
Cette analyse recherche dans un index les valeurs de colonne indexées auxquelles accède l'instruction SQL (reportez-vous à Analyses d'index). Si l'instruction accède uniquement aux colonnes de l'index, Oracle AI Database lit les valeurs de colonne indexées directement dans l'index.
-
Analyses de cluster
Une analyse de cluster extrait les données d'une table stockée dans un cluster de tables indexé, où toutes les lignes avec la même valeur de clé de cluster sont stockées dans le même bloc de données (reportez-vous à Présentation des clusters indexés). La base de données obtient d'abord l'ID de ligne d'une ligne sélectionnée en analysant l'index de cluster. Oracle AI Database localise les lignes en fonction de cet ID de ligne.
-
Analyses de hachage
Un balayage par hachage localise les lignes d'un cluster de hachage, où toutes les lignes ayant la même valeur de hachage sont stockées dans le même bloc de données (reportez-vous à Présentation des clusters de hachage). Pour obtenir la valeur du hachage, la base de données obtient d'abord la valeur du hachage en appliquant une fonction de hachage à une valeur d'une clé du cluster spécifiée par l'instruction. Oracle AI Database analyse ensuite les blocs de données contenant les lignes dotées de la valeur de hachage.
L'optimiseur choisit un chemin d'accès en fonction des chemins d'accès disponibles pour l'instruction et du coût estimé de l'utilisation de chaque chemin d'accès ou combinaison de chemins.
Voir aussi : Oracle AI Database - Introduction au réglage des performances et Guide de réglage SQL Oracle AI Database pour en savoir plus sur les chemins d'accès
Statistiques de l'optimiseur
Les statistiques de l'optimiseur sont un ensemble de données qui décrivent les détails de la base de données et des objets qu'elle contient. Les statistiques offrent une image statistiquement correcte du stockage et de la répartition des données, qui est utilisable par l'optimiseur lors de l'évaluation des chemins d'accès.
Elles se composent des éléments suivants :
-
Statistiques de table
Il s'agit notamment du nombre de lignes, du nombre de blocs et de la longueur moyenne des ligne.
-
Statistiques de colonne
Il s'agit du nombre de valeurs distinctes et NULL dans une colonne, ainsi que de la répartition des données.
-
Statistiques d'index
Il s'agit notamment du nombre de blocs de feuilles et des niveaux d'index.
-
Statistiques système
Il s'agit notamment de l'utilisation et des performances d'E/S et d'UC.
Oracle AI Database collecte automatiquement les statistiques destinées à l'optimiseur sur tous les objets de base de données et les tient à jour en tant que tâche de maintenance automatisée. Vous pouvez également collecter des statistiques manuellement à l'aide du package DBMS_STATS. Ce package PL/SQL peut modifier, afficher, exporter, importer et supprimer des statistiques. Remarque : les statistiques destinées à l'optimiseur sont créées à des fins d'optimisation des requêtes et stockées dans le dictionnaire de données. Ne confondez pas ces statistiques avec les statistiques de performances visibles via des vues dynamiques des performances.
Optimizer Statistics Advisor est un logiciel de diagnostic intégré qui analyse la façon dont vous collectez actuellement des statistiques, l'efficacité des travaux de collecte de statistiques existants et la qualité des statistiques collectées. Elle tient à jour des règles qui reflètent les meilleures pratiques Oracle en fonction de l'ensemble actuel de fonctionnalités. De cette façon, la fonction de conseil fournit toujours les recommandations les plus récentes pour la collecte de statistiques.
Voir aussi :
-
Oracle AI Database - Introduction au réglage des performances et Oracle AI Database SQL Tuning Guide pour apprendre à collecter et à gérer des statistiques
-
Référence des types et packages PL/SQL d'Oracle AI Database pour en savoir plus sur
DBMS_STATS
Conseils de l'optimiseur
Un conseil est un commentaire dans une instruction SQL qui sert d'instruction à l'optimiseur.
Parfois, le concepteur d'applications, qui dispose de plus d'informations sur les données d'une application particulière que celles dont dispose l'optimiseur, peut choisir un moyen plus efficace d'exécuter une instruction SQL. Le concepteur d'applications peut utiliser des conseils dans les instructions SQL pour indiquer comment l'instruction doit être exécutée. Les exemples suivants illustrent l'utilisation des conseils.
Exemple 10-2 : plan d'exécution pour SELECT avec conseil FIRST_ROWS
Supposons que votre application interactive exécute une requête qui renvoie 50 lignes. Cette application extrait initialement uniquement les 25 premières lignes de la requête à présenter à l'utilisateur final. Vous souhaitez que l'optimiseur génère un plan qui obtient les 25 premiers enregistrements le plus rapidement possible afin que l'utilisateur ne soit pas obligé d'attendre. Vous pouvez utiliser un conseil pour transmettre cette instruction à l'optimiseur, comme indiqué dans l'instruction SELECT et dans la sortie AUTOTRACE de l'exemple suivant :
SELECT /*+ FIRST_ROWS(25) */ employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation                    | Name              | Rows | Bytes
------------------------------------------------------------------------
|  0 | SELECT STATEMENT             |                   | 26   | 182
|  1 |  TABLE ACCESS BY INDEX ROWID | EMPLOYEES         | 26   | 182
|* 2 |   INDEX RANGE SCAN           | EMP_DEPARTMENT_IX |      |
------------------------------------------------------------------------
Dans cet exemple, le plan d'exécution indique que l'optimiseur choisit un index sur la colonne employees.department_id pour rechercher les 25 premières lignes de employees dont l'ID de département est supérieur à 50. L'optimiseur utilise l'ID de ligne extrait de l'index pour extraire l'enregistrement de la table employees et le renvoyer au client. La récupération du premier enregistrement est généralement quasi instantanée.
Exemple 10-3 : plan d'exécution pour SELECT sans conseil
Supposons que vous exécutez la même instruction, mais sans le conseil de l'optimiseur :
SELECT employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation              | Name              | Rows | Bytes | Cos
------------------------------------------------------------------------
|  0 | SELECT STATEMENT       |                   | 50   | 350   |
|* 1 |  VIEW                  | index$_join$_001  | 50   | 350   |
|* 2 |   HASH JOIN            |                   |      |       |
|* 3 |    INDEX RANGE SCAN    | EMP_DEPARTMENT_IX | 50   | 350   |
|  4 |    INDEX FAST FULL SCAN| EMP_EMP_ID_PK     | 50   | 350   |
Dans ce cas, le plan d'exécution joint deux index pour renvoyer les enregistrements demandés le plus rapidement possible. Plutôt que de passer de manière répétée d'un index à une autre, comme dans l'Example 10-2, l'optimiseur choisit un balayage de plage de EMP_DEPARTMENT_IX pour rechercher toutes les lignes dont l'ID de département est supérieur à 50 et placer ces lignes dans une table de hachage. L'optimiseur choisit ensuite de lire l'index EMP_EMP_ID_PK. Pour chaque ligne de cet index, il sonde la table de hachage pour trouver l'ID de département.
Dans ce cas, la base de données ne peut pas renvoyer la première ligne au client tant que l'analyse de plage d'index de EMP_DEPARTMENT_IX n'est pas terminée. Ainsi, ce plan généré prendrait plus de temps pour renvoyer le premier enregistrement. Contrairement au plan de l'Example 10-2, qui accède à la table par rowid d'index, le plan utilise des E/S multiblocs, ce qui entraîne des lectures volumineuses. Les lectures permettent de renvoyer plus rapidement la dernière ligne de l'ensemble de résultats.
Voir aussi : Guide de réglage SQL Oracle AI Database pour apprendre à utiliser les conseils de l'optimiseur
Présentation du traitement SQL
Cette section explique comment Oracle AI Database traite les instructions SQL. Plus précisément, cette section explique comment la base de données traite les instructions LDD pour créer des objets, les instructions LMD pour modifier des données et les interrogations pour extraire des données.
-
Etapes du traitement SQL : les étapes générales du traitement SQL sont l'analyse, l'optimisation, la génération de sources de ligne et l'exécution. Selon l'instruction, la base de données peut omettre certaines de ces étapes.
-
Différences entre le traitement DML et le traitement DDL Oracle AI Database traite les instructions DDL différemment des instructions DML.
Etapes de traitement SQL
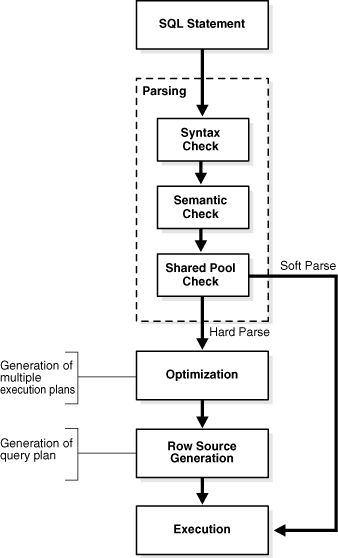
Les étapes générales du traitement SQL sont l'analyse, l'optimisation, la génération de row sources et l'exécution. Selon l'instruction, la base de données peut omettre certaines de ces étapes.
La figure suivante représente les étapes générales :
Figure 3 : Etapes de traitement SQL
Description de l'image cncpt250.gif
-
Analyse SQL La première étape du traitement SQL est l'analyse SQL. Cette étape consiste à séparer les morceaux d'une instruction SQL en une structure des données pouvant être traitée par d'autres routines.
-
L'optimisation des requêtes est le processus qui consiste à choisir le moyen le plus efficace d'exécuter une instruction SQL.
-
Génération de sources de lignes SQL Le générateur de sources de lignes est le logiciel qui reçoit le plan d'exécution optimal de l'optimiseur et produit un plan itératif, appelé plan de requête, utilisable par le reste de la base de données.
-
Exécution SQL Au cours de l'exécution, le moteur SQL exécute chaque source des lignes dans l'arborescence produite par le générateur de sources de lignes. Il s'agit de la seule étape obligatoire du traitement LMD.
Analyse SQL
La première étape du traitement SQL est l'analyse SQL. Cette étape consiste à séparer les morceaux d'une instruction SQL en une structure des données pouvant être traitée par d'autres routines.
Lorsqu'une application émet une instruction SQL, elle envoie un appel d'analyse à la base de données pour préparer l'instruction en vue de son exécution. L'appel d'analyse ouvre ou crée un curseur, qui est un descripteur pour la zone SQL privée propre à la session qui contient une instruction SQL analysée et d'autres informations de traitement. Le curseur et la zone SQL privée se trouvent dans la PGA.
Au cours de l'appel d'analyse, la base de données effectue les vérifications suivantes :
-
Vérification de la syntaxe
-
Contrôle sémantique
-
Vérification de zone de mémoire partagée
Les vérifications précédentes identifient les erreurs détectées avant l'exécution de l'instruction. Certaines erreurs ne peuvent pas être détectées par l'analyse. Par exemple, la base de données peut rencontrer un verrou mortel ou des erreurs de conversion de données uniquement lors de l'exécution de l'instruction.
La base de données tente d'atténuer automatiquement les erreurs pour les instructions SQL qui échouent avec une erreur ORA-00600 pendant la phase d'analyse. Une erreur ORA-00600 est grave. Elle indique qu'un processus a rencontré une condition inattendue de bas niveau. Lorsqu'une instruction SQL échoue avec cette erreur pendant la phase d'analyse, la réduction automatique des erreurs l'interrompt et tente de résoudre la condition. Si une résolution est trouvée, la base de données génère un patch SQL afin d'ajuster le plan d'exécution SQL. Si ce patch permet à l'analyse de se terminer correctement, l'erreur ORA-00600 n'est pas générée. Aucune exception n'est détectée par l'application.
Optimisation SQL
L'optimisation des requêtes est le processus qui consiste à choisir le moyen le plus efficace d'exécuter une instruction SQL.
La base de données optimise les requêtes en fonction des statistiques recueillies sur les données auxquelles les utilisateurs accèdent. L'optimiseur utilise le nombre de lignes, la taille de l'ensemble de données et d'autres facteurs pour générer des plans d'exécution possibles, en attribuant un coût numérique à chaque plan. La base de données a recours au plan présentant le coût le plus bas.
La base de données doit effectuer une analyse complète au moins une fois pour chaque instruction LMD unique et effectue une optimisation au cours de cette analyse. Le langage DDL n'est jamais optimisé, sauf s'il inclut un composant LMD tel qu'une sous-interrogation nécessitant une optimisation.
Voir aussi :
-
Guide de réglage SQL Oracle AI Database pour plus d'informations sur l'optimiseur de requêtes
Génération de sources de ligne SQL
Le générateur de sources de ligne est le logiciel qui reçoit le plan d'exécution optimal de l'optimiseur et produit un plan itératif, appelé plan de requête, utilisable par le reste de la base de données.
Le plan de requête prend la forme d'une combinaison d'étapes. Chaque étape renvoie un ensemble de lignes. Les lignes de cet ensemble sont utilisées à l'étape suivante ou, à la dernière étape, renvoyées à l'application à l'origine de l'instruction SQL.
Un row source est un ensemble de lignes renvoyé par une étape du plan d'exécution, ainsi qu'une structure de contrôle qui peut traiter les lignes de manière itérative. Le row source peut être une table, une vue ou le résultat d'une opération de jointure ou de regroupement.
Exécution SQL
Pendant l'exécution, le moteur SQL exécute chaque source des lignes dans l'arborescence produite par le générateur de sources de lignes. Il s'agit de la seule étape obligatoire du traitement LMD.
Lors de l'exécution, si les données ne sont pas en mémoire, la base lit les données du disque dans la mémoire. La base de données élimine également tous les verrous et verrous internes nécessaires pour garantir l'intégrité des données et consigne toutes les modifications apportées pendant l'exécution SQL. La dernière étape du traitement d'une instruction SQL consiste à fermer le curseur.
Si la base de données est configurée pour utiliser le stockage en colonnes en mémoire (emplacement de stockage des colonnes IM), elle achemine les requêtes de manière transparente vers l'emplacement de stockage des colonnes IM, si possible, vers le disque et le cache de tampons de la base de données. Une requête unique peut également utiliser le stockage de colonnes IM, le disque et le cache de tampons. Par exemple, une requête peut joindre deux tables, dont une seule est mise en cache dans la banque de colonnes IM.
Voir aussi :
-
Guide de réglage SQL Oracle AI Database pour plus d'informations sur les plans d'exécution et l'instruction
EXPLAIN PLAN
Différences entre le traitement LMD et LDD
Oracle AI Database traite les instructions DDL différemment des instructions DML.
Par exemple, lorsque vous créez une table, la base de données n'optimise pas l'instruction CREATE TABLE. A la place, Oracle AI Database analyse l'instruction DDL et exécute la commande.
Contrairement aux instructions LDD, la plupart des instructions LMD comportent un composant d'interrogation. Dans une interrogation, l'exécution d'un curseur place la ligne générée par l'interrogation dans l'ensemble de résultats.
La base de données peut extraire des lignes d'ensemble de résultats une ligne à la fois ou en groupes. Lors de l'extraction, la base de données sélectionne les lignes et, si l'interrogation le demande, trie les lignes. Chaque extraction successive extrait une autre ligne du résultat jusqu'à ce que la dernière ligne ait été extraite.
Voir aussi : Guide de développement Oracle AI Database pour en savoir plus sur le traitement des instructions DDL, le contrôle des transactions et d'autres types d'instruction