Tables et clusters de tables
Ce chapitre présente les objets de schéma et les tables, qui sont les types d'objet de schéma les plus courants.
-
Introduction aux objets de schéma Un schéma de base de données est un conteneur logique pour les structures de données, appelé objets de schéma. Les tables et les index sont des exemples d'objets de schéma. Vous créez et manipulez des objets de schéma à l'aide du langage SQL.
-
Présentation des tables Une table est l'unité de base de l'organisation des données dans une base de données Oracle.
-
Présentation des clusters de tables Un cluster de tables est un groupe de tables qui partagent des colonnes communes et stockent les données associées dans les mêmes blocs.
-
Présentation des tables clusterisées d'attributs Une table clusterisée d'attributs est une table organisée en portions de mémoire qui stocke les données à proximité immédiate du disque en fonction des directives de clustering spécifiées par l'utilisateur. Les directives indiquent des colonnes dans une ou plusieurs tables.
-
Généralités sur les tables temporaires Une table temporaire contient des données qui n'existent que pendant la durée d'une transaction ou d'une session.
-
Présentation des tables externes Une table externe accède aux données des sources externes comme si ces données se trouvaient dans une table de la base de données.
-
Présentation des tables de chaîne de blocs Une table de chaîne de blocs est une table d'ajout uniquement conçue pour les applications de chaîne de blocs centralisées.
-
Généralités sur les tables non mutables Les tables non mutables sont des tables en annexe uniquement qui empêchent la modification de données non autorisées en internes et la modification de données accidentelles résultant d'erreurs humaines.
-
Présentation des tables d'objets Une table d'objets est un type spécial de table dans lequel chaque ligne représente un objet.
Présentation des objets de schéma
Un schéma de base de données est un conteneur logique pour les structures de données, appelé objets de schéma. Les tables et les index sont des exemples d'objets de schéma. Vous créez et manipulez des objets de schéma à l'aide du langage SQL.
Cette section comprend les rubriques suivantes :
-
A propos des comptes utilisateur communs et locaux Un compte utilisateur de base de données dispose d'un mot de passe et de privilèges de base de données spécifiques.
-
Objets communs et locaux Un objet commun est défini dans la racine de la base de données Conteneur ou dans la racine de l'application et peut être référencé à l'aide de liens de métadonnées ou d'objets. Un objet local est tout objet qui n'est pas un objet commun.
-
Oracle SQL permet de créer et de manipuler de nombreux autres types d'objet de schématypes d'objet de schéma.
-
Stockage d'objets de schéma Certains objets de schéma stockent des données dans un type de structure de stockage logique appelé segment. Par exemple, une table non partitionnée organisée en portions de mémoire ou un index crée un segment.
-
Dépendances d'objet de schéma Certains objets de schéma font référence à d'autres objets, créant ainsi une dépendance d'objet de schéma.
-
Exemples de schémas Une base de données Oracle peut inclure des exemples de schémas, qui sont un ensemble de schémas interconnectés qui permettent à la documentation Oracle et aux supports pédagogiques Oracle d'illustrer les tâches de base de données courantes. Voir aussi : Guide de sécurité Oracle AI Database pour en savoir plus sur les utilisateurs et les privilèges
A propos des comptes utilisateur communs et locaux
Un compte utilisateur de base de données possède un mot de passe et des privilèges de base de données spécifiques.
Comptes utilisateur et schémas
Chaque compte utilisateur possède un schéma unique, qui porte le même nom que l'utilisateur. Le schéma contient les données de l'utilisateur propriétaire du schéma. Par exemple, le compte utilisateur hr est propriétaire du schéma hr, qui contient des objets de schéma tels que la table employees. Dans une base de données de production, le propriétaire du schéma représente généralement une application de base de données plutôt qu'une personne.
Dans un schéma, chaque objet de schéma d'un type particulier a un nom unique. Par exemple, hr.employees fait référence à la table employees du schéma hr. La figure suivante représente un propriétaire de schéma nommé hr et des objets de schéma dans le schéma hr.
Figure 1 : Schéma HR
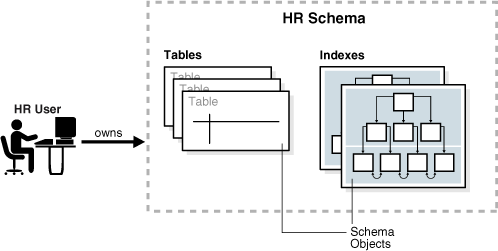
Description de l'image cncpt230.gif
Comptes utilisateur communs et locaux
Si un compte utilisateur possède des objets qui définissent la base de données, ce compte utilisateur est commun. Les comptes utilisateur qui ne sont pas fournis par Oracle sont locaux ou communs. Un utilisateur commun de base de données Conteneur est un utilisateur commun créé dans la racine de base de données Conteneur. Un utilisateur commun à une application est un utilisateur créé dans une racine d'application et n'est commun qu'au sein de ce conteneur d'application.
L'illustration suivante présente les types de compte utilisateur possibles dans une base de données Conteneur.
Figure 2 : Comptes utilisateur dans une base de données Conteneur
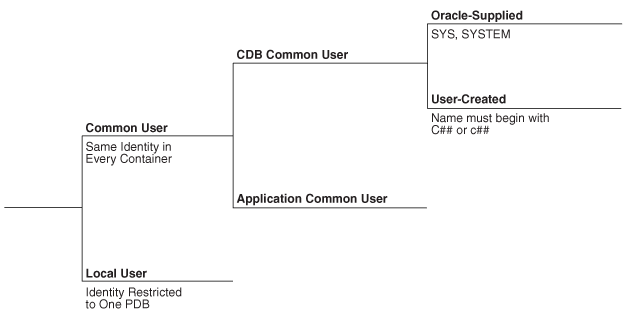
Description de l'image cncpt370.png
Un utilisateur commun de base de données Conteneur peut se connecter à n'importe quel conteneur de la base de données Conteneur auquel il dispose de privilèges suffisants. En revanche, un utilisateur commun d'application ne peut se connecter qu'à la racine d'application dans laquelle il a été créé, ou à une base de données pluggable connectée à cette racine d'application, en fonction de ses privilèges.
-
Comptes utilisateur communs Dans le contexte du conteneur système ou d'un conteneur d'application, un utilisateur commun est un utilisateur de base de données qui a la même identité dans la racine et dans toutes les bases de données pluggables existantes et futures de ce conteneur.
-
Comptes utilisateur locaux Un utilisateur local est un utilisateur de base de données qui n'est pas commun et qui ne peut fonctionner que dans une seule base de données pluggable.
Comptes utilisateur communs
Dans le contexte du conteneur système (CDB) ou d'un conteneur d'application, un utilisateur commun est un utilisateur de base de données qui a la même identité dans la racine et dans toutes les bases de données pluggables existantes et futures de ce conteneur.
Chaque utilisateur commun peut se connecter à la racine de son conteneur et effectuer des opérations dans toute base de données pluggable dans laquelle il dispose de privilèges suffisants. Certaines tâches d'administration doivent être effectuées par un utilisateur commun. Par exemple, la création d'une base pluggable et la déconnexion d'une base pluggable.
Par exemple, SYSTEM est un utilisateur commun de base de données Conteneur avec des privilèges DBA. Par conséquent, SYSTEM peut se connecter à la racine de la base de données Conteneur et à toute base de données pluggable de la base de données. Vous pouvez créer un utilisateur commun saas_sales_admin dans le conteneur d'application saas_sales. Dans ce cas, l'utilisateur saas_sales_admin ne peut se connecter qu'à la racine d'application saas_sales ou à une base de données pluggable d'application dans le conteneur d'application saas_sales.
Chaque utilisateur commun est fourni par Oracle ou créé par l'utilisateur. SYS et SYSTEM sont des exemples d'utilisateurs communs fournis par Oracle. Chaque utilisateur commun créé par l'utilisateur est soit un utilisateur commun de base de données Conteneur, soit un utilisateur commun d'application.
La figure suivante présente des exemples d'utilisateurs et de schémas dans deux bases de données pluggables : hrpdb et salespdb. SYS et c##dba sont des utilisateurs communs de base de données Conteneur qui ont des schémas dans CDB$ROOT, hrpdb et salespdb. Les utilisateurs locaux hr et rep existent dans hrpdb. Les utilisateurs locaux hr et rep existent également dans salespdb.
Figure 3 : Utilisateurs et schémas dans une base Conteneur
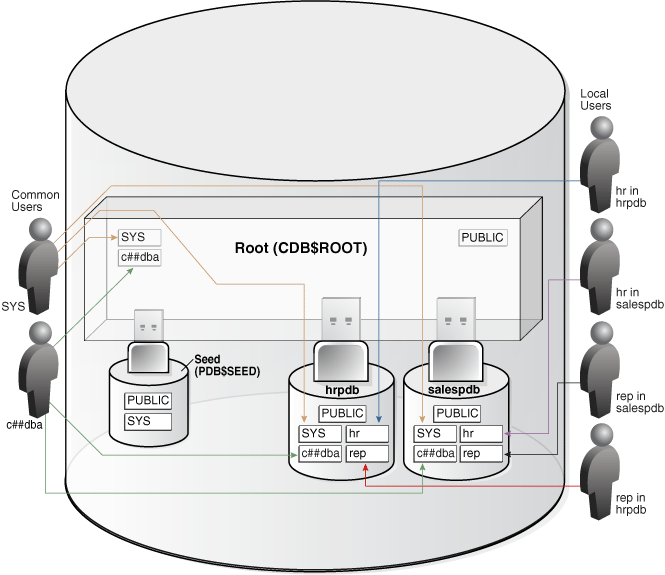
Description de l'image cncpt340.png
Les utilisateurs communs présentent les caractéristiques suivantes :
-
Un utilisateur commun peut se connecter à n'importe quel conteneur (y compris
CDB$ROOT) dans lequel il dispose du privilègeCREATE SESSION.Un utilisateur commun n'a pas besoin des mêmes privilèges dans chaque conteneur. Par exemple, l'utilisateur
c##dbapeut disposer du privilège nécessaire pour créer une session danshrpdbet dans la racine, mais pas pour créer une session danssalespdb. Etant donné qu'un utilisateur commun disposant des privilèges appropriés peut basculer d'un conteneur à l'autre, un utilisateur commun de la racine peut administrer les bases pluggables. -
Un utilisateur commun d'application ne dispose pas du privilège
CREATE SESSIONdans un conteneur situé en dehors de son propre conteneur d'application.Par conséquent, un utilisateur commun d'application est limité à son propre conteneur d'application. Par exemple, l'utilisateur commun d'application créé dans l'application
saas_salespeut se connecter uniquement à la racine de l'application et aux bases de données pluggables dans le conteneur d'applicationsaas_sales. -
Les noms des utilisateurs communs de base de données Conteneur créés par l'utilisateur doivent respecter les règles de dénomination des autres utilisateurs de base de données. En outre, les noms doivent commencer par les caractères indiqués par le paramètre d'initialisation
COMMON_USER_PREFIX, qui sontc##ouC##par défaut. Les noms utilisateur communs fournis par Oracle et les noms utilisateur communs d'application créés par l'utilisateur ne sont pas soumis à cette restriction.Aucun nom d'utilisateur local ne peut commencer par les caractères
c##ouC##. -
Chaque utilisateur commun porte un nom unique dans toutes les bases pluggables du conteneur (conteneur système ou conteneur d'application spécifique) dans lequel il a été créé.
Un utilisateur commun de base de données Conteneur est défini dans la racine de base de données Conteneur, mais doit pouvoir se connecter à chaque base de données pluggable avec la même identité. Un utilisateur commun d'application réside dans la racine de l'application et peut se connecter à chaque base de données pluggable d'application dans son conteneur avec la même identité.
-
Caractéristiques des utilisateurs communs Chaque utilisateur commun est fourni par Oracle ou créé par l'utilisateur.
-
Comptes SYSTEM et SYS Toutes les bases de données Oracle incluent des comptes utilisateur communs par défaut avec des privilèges d'administration.
Caractéristiques des utilisateurs communs
Chaque utilisateur commun est fourni par Oracle ou créé par l'utilisateur.
Les comptes utilisateur communs ont les caractéristiques suivantes :
-
Un utilisateur commun peut se connecter à n'importe quel conteneur (y compris
CDB$ROOT) dans lequel il dispose du privilègeCREATE SESSION.Un utilisateur commun n'a pas besoin des mêmes privilèges dans chaque conteneur. Par exemple, l'utilisateur
c##dbapeut disposer du privilège permettant de créer une session danshrpdbet dans la racine, mais pas de créer une session danssalespdb. Etant donné qu'un utilisateur commun disposant des privilèges appropriés peut basculer d'un conteneur à l'autre, un utilisateur commun de la racine peut administrer les bases de données pluggables. -
Un utilisateur commun d'application ne dispose pas du privilège
CREATE SESSIONdans un conteneur situé en dehors de son propre conteneur d'application.Par conséquent, un utilisateur commun d'application est limité à son propre conteneur d'application. Par exemple, l'utilisateur commun d'application créé dans l'application
saas_salespeut se connecter uniquement à la racine de l'application et aux bases de données pluggables dans le conteneur d'applicationsaas_sales. -
Les noms des utilisateurs communs de base de données Conteneur créés par l'utilisateur doivent respecter les règles de dénomination des autres utilisateurs de base de données. En outre, les noms doivent commencer par les caractères indiqués par le paramètre d'initialisation
COMMON_USER_PREFIX, qui sontc##ouC##par défaut. Les noms utilisateur communs fournis par Oracle et les noms utilisateur communs d'application créés par l'utilisateur ne sont pas soumis à cette restriction.Aucun nom d'utilisateur local ne peut commencer par les caractères
c##ouC##. -
Chaque utilisateur commun porte un nom unique dans toutes les bases pluggables du conteneur (conteneur système ou conteneur d'application spécifique) dans lequel il a été créé.
Un utilisateur commun de base de données Conteneur est défini dans la racine de base de données Conteneur, mais doit pouvoir se connecter à chaque base de données pluggable avec la même identité. Un utilisateur commun d'application réside dans la racine de l'application et peut se connecter à chaque base de données pluggable d'application dans son conteneur avec la même identité.
La figure suivante présente des exemples d'utilisateurs et de schémas dans deux bases de données pluggables : hrpdb et salespdb. SYS et c##dba sont des utilisateurs communs de base de données Conteneur qui ont des schémas dans CDB$ROOT, hrpdb et salespdb. Les utilisateurs locaux hr et rep existent dans hrpdb. Les utilisateurs locaux hr et rep existent également dans salespdb.
Figure 4 : Utilisateurs et schémas dans une base de données Conteneur
Description de l'image cncpt340.png
Voir aussi :
-
Guide de sécurité Oracle AI Database pour en savoir plus sur les comptes utilisateur courants
-
Référence Oracle AI Database pour en savoir plus sur
COMMON_USER_PREFIX
Comptes SYS et SYSTEM
Toutes les bases de données Oracle incluent des comptes utilisateur communs par défaut avec des privilèges d'administration.
Les comptes d'administration disposent de privilèges très élevés et ne sont donc nécessaires qu'aux individus autorisés à réaliser les tâches d'administration, telles que la création et l'arrêt de la base de données, la gestion de l'espace de stockage et de la mémoire, la création et la gestion d'utilisateurs de la base de données, etc.
Le compte utilisateur commun SYS est créé automatiquement lorsqu'une base de données est créée. Ce compte permet d'exécuter toutes les fonctions d'administration de base de données. Le schéma SYS stocke les tables de base et les vues du dictionnaire de données. Ces tables et vues de base sont essentielles au fonctionnement d'Oracle AI Database. Les tables du schéma SYS sont manipulées uniquement par la base de données et ne doivent jamais être modifiées par un utilisateur.
Le compte d'administration SYSTEM est également créé automatiquement lorsqu'une base de données est créée. Le schéma SYSTEM stocke les tables et les vues supplémentaires qui affichent les informations administratives, ainsi que les tables et les vues internes utilisées par divers outils et options Oracle AI Database. N'utilisez jamais le schéma SYSTEM pour stocker les tables qui intéressent les utilisateurs non administratifs.
Voir aussi :
-
Guide de sécurité Oracle AI Database pour en savoir plus sur les comptes utilisateur
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur
SYS,SYSTEMet d'autres comptes d'administration
Comptes utilisateur locaux
Un utilisateur local est un utilisateur de base de données qui n'est pas commun et qui ne peut fonctionner que dans une seule base de données pluggable.
Les utilisateurs locaux présentent les caractéristiques suivantes :
-
Un utilisateur local est propre à une base de données pluggable et peut posséder un schéma dans cette base de données pluggable.
Dans l'exemple présenté dans la section "Caractéristiques des utilisateurs communs", l'utilisateur local
hrsurhrpdbpossède le schémahr. Sursalespdb, l'utilisateur localrepest propriétaire du schémarepet l'utilisateur localhrest propriétaire du schémahr. -
Un utilisateur local peut administrer une base de données pluggable, notamment en l'ouvrant et en la fermant.
Un utilisateur commun disposant de privilèges
SYSDBApeut accorder des privilègesSYSDBAà un utilisateur local. Dans ce cas, l'utilisateur privilégié reste local. -
Un utilisateur local d'une base de données pluggable ne peut pas se connecter à une autre base de données pluggable ou à la racine de la base de données Conteneur.
Par exemple, lorsque l'utilisateur local
hrse connecte àhrpdb,hrne peut pas accéder aux objets du schémashqui résident dans la base de donnéessalespdbsans utiliser de lien de base de données. De la même manière, lorsque l'utilisateur localshse connecte à la base de données pluggablesalespdb,shne peut pas accéder aux objets du schémahrqui réside danshrpdbsans utiliser de lien de base de données. -
Le nom d'un utilisateur local ne doit pas commencer par les caractères
c##ouC##. -
Le nom d'un utilisateur local doit uniquement être unique au sein de sa base de données pluggable.
Le nom utilisateur et la base de données pluggable dans laquelle ce schéma utilisateur est contenu déterminent un utilisateur local unique. "Caractéristiques des utilisateurs communs" indique qu'un utilisateur local et un schéma nommé
repexistent surhrpdb. Un schéma et un utilisateur locaux entièrement indépendants nommésrepexistent sur la base de données pluggablesalespdb.
Le tableau suivant décrit un scénario impliquant la base de données Conteneur dans "Caractéristiques des utilisateurs communs". Chaque ligne décrit une action qui se produit après l'action de la ligne précédente. L'utilisateur commun SYSTEM crée des utilisateurs locaux dans deux bases de données pluggables.
Tableau 1 Utilisateurs locaux dans une base de données Conteneur
| Opération | Description |
|---|---|
|
SYSTEM se connecte au conteneur hrpdb à l'aide du nom de service hrpdb. |
|
SYSTEM crée désormais un utilisateur local rep et accorde le privilège CREATE SESSION dans cette base de données pluggable à cet utilisateur. L'utilisateur est local car les utilisateurs communs ne peuvent être créés que par un utilisateur commun connecté à la racine. |
|
L'utilisateur rep, qui est local à hrpdb, tente de se connecter à salespdb. La tentative échoue car rep n'existe pas dans la base de données pluggable salespdb. |
|
SYSTEM se connecte au conteneur salespdb à l'aide du nom de service salespdb. |
|
SYSTEM crée un utilisateur local rep dans salespdb et accorde le privilège CREATE SESSION dans cette base de données pluggable à cet utilisateur. Etant donné que le nom d'un utilisateur local ne doit être unique que dans sa base de données pluggable, un utilisateur nommé rep peut exister à la fois dans salespdb et hrpdb. |
|
L'utilisateur rep se connecte à salespdb. |
Voir aussi : Guide de sécurité Oracle AI Database pour en savoir plus sur les comptes utilisateur locaux
Objets communs et locaux
Un objet commun est défini dans la racine de la base de données Conteneur ou dans la racine de l'application et peut être référencé à l'aide de liens de métadonnées ou d'objets. Un objet local est tout objet qui n'est pas un objet commun.
Les objets communs fournis par la base de données sont définis dans CDB$ROOT et ne peuvent pas être modifiés. Oracle Database ne prend pas en charge la création d'objets communs dans CDB$ROOT.
Vous pouvez créer la plupart des objets de schéma, tels que des tables, des vues, des unités de programme PL/SQL et Java, des séquences, etc., en tant qu'objets communs dans une racine d'application. Si l'objet existe dans une racine d'application, il est appelé objet commun d'application.
Un utilisateur local peut posséder un objet commun. En outre, un utilisateur commun peut posséder un objet local, mais seulement lorsque l'objet n'est pas lié aux données ou aux métadonnées, et n'est ni un lien de métadonnées ni un lien de données.
Voir aussi : Guide de sécurité Oracle AI Database pour en savoir plus sur la gestion des privilèges pour les objets communs
Types d'objet de schéma
Oracle SQL vous permet de créer et de manipuler de nombreux autres types d'objet de schéma.
Les principaux types d'objet de schéma sont présentés dans le tableau suivant.
Tableau 2 - Objets de schéma
| Objet | Description | Pour en savoir plus |
|---|---|---|
| Table | Une table stocke les données dans des lignes. Les tables sont les objets de schéma les plus importants d'une base de données relationnelle. | "Présentation des tables" |
| Index | Les index sont des objets de schéma qui contiennent une entrée pour chaque ligne indexée de la table ou du cluster de tables et fournissent un accès direct et rapide aux lignes. Oracle AI Database prend en charge plusieurs types d'index. Une table organisée en index est une table dans laquelle les données sont stockées dans une structure d'index. | "Index et tables organisées en index" |
| Partitions | Les partitions sont des morceaux de tables et d'index de grande taille. Chaque partition a son propre nom et peut éventuellement avoir ses propres caractéristiques de stockage. | "Présentation des partitions" |
| Vues | Les vues sont des présentations personnalisées des données dans des tables ou d'autres vues. Les vues peuvent être considérées comme des requêtes stockées. Les vues ne contiennent pas réellement de données. | Généralités sur les vues |
| Numéros | Une séquence est un objet créé par l'utilisateur qui peut être partagé par plusieurs utilisateurs pour générer des entiers. En général, vous utilisez des séquences pour générer des valeurs de clé primaire. | Généralités sur les séquences |
| Dimensions | Une dimension définit une relation parent-enfant entre des paires d'ensembles de colonnes, où toutes les colonnes d'un ensemble de colonnes doivent provenir de la même table. Les dimensions sont généralement utilisées pour classer les données telles que les clients, les produits et le temps. | "Présentation des dimensions" |
| Synonymes | Un synonyme est un alias pour l'autre objet de schéma. Etant donné qu'un synonyme est un simple alias, il suffit de stocker sa définition dans le dictionnaire de données. | Généralités sur les synonymes |
| Sous-programmes et packages PL/SQL | Le langage PL/SQL est l'extension procédurale Oracle de SQL. Un sous-programme PL/SQL est un bloc PL/SQL nommé qui peut être appelé avec un ensemble de paramètres. Un package PL/SQL regroupe les types, variables et sous-programmes PL/SQL liés logiquement. | "Sous-programmes PL/SQL" |
D'autres types d'objet sont également stockés dans la base de données et peuvent être créés et manipulés à l'aide d'instructions SQL, mais ne sont pas contenus dans un schéma. Ces objets incluent les comptes utilisateur de base de données, les rôles, les contextes et les objets de dictionnaire.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer les objets de schéma
-
Référence du langage SQL d'Oracle AI Database pour plus d'informations sur les objets de schéma et de base de données
Stockage d'objet de schéma
Certains objets de schéma stockent des données dans un type de structure de stockage logique appelé segment. Par exemple, une table non partitionnée organisée en portions de mémoire ou un index crée un segment.
Les autres objets de schéma, tels que les vues et les séquences, se composent uniquement de métadonnées. Cette rubrique décrit uniquement les objets de schéma comportant des segments.
Oracle AI Database stocke logiquement un objet de schéma dans un tablespace. Il n'existe aucune relation entre les schémas et les tablespaces : un tablespace peut contenir des objets provenant de différents schémas et les objets d'un schéma peuvent être contenus dans différents tablespaces. Les données de chaque objet sont physiquement contenues dans un ou plusieurs fichiers de données.
La figure suivante présente une configuration possible de segments de table et d'index, de tablespaces et de fichiers de données. Le segment de données d'une table englobe deux fichiers de données, qui font tous deux partie du même tablespace. Un segment ne peut pas couvrir plusieurs tablespaces.
Figure 5 : Segments, tablespaces et fichiers de données
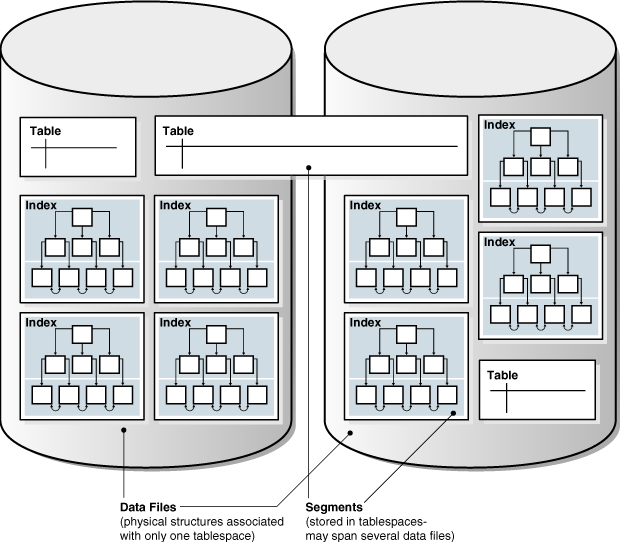
Description de l'image cncpt284.gif
Voir aussi :
-
"Structures de stockage logique" pour en savoir plus sur les tablespaces et les segments
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer le stockage pour les objets de schéma
Dépendances d'objet de schéma
Certains objets de schéma font référence à d'autres objets, créant ainsi une dépendance d'objet de schéma.
Par exemple, une vue contient une requête qui référence des tables ou des vues, tandis qu'un sous-programme PL/SQL appelle d'autres sous-programmes. Si la définition de l'objet A fait référence à l'objet B, A est un objet dépendant de B, et B est un objet référencé de A.
Oracle AI Database fournit un mécanisme automatique qui garantit qu'un objet dépendant est toujours à jour par rapport à ses objets référencés. Lorsque vous créez un objet dépendant, la base de données effectue le suivi des dépendances entre l'objet dépendant et ses objets référencés. Lorsqu'un objet référencé change d'une manière susceptible d'affecter un objet dépendant, la base de données le marque comme non valide. Par exemple, si un utilisateur supprime une table, aucune vue basée sur la table supprimée n'est utilisable.
Un objet dépendant non valide doit être recompilé par rapport à la nouvelle définition d'un objet référencé pour que l'objet dépendant soit utilisable. La recompilation se produit automatiquement lorsque l'objet dépendant non valide est référencé.
Pour illustrer la façon dont les objets de schéma peuvent créer des dépendances, l'exemple de script suivant crée une table test_table, puis une procédure qui interroge cette table :
CREATE TABLE test_table ( col1 INTEGER, col2 INTEGER );

CREATE OR REPLACE PROCEDURE test_proc
AS
BEGIN
 FOR x IN ( SELECT col1, col2 FROM test_table )
 LOOP
   -- process data
   NULL;
 END LOOP;
END;
/
La requête suivante sur le statut de la procédure test_proc indique qu'elle est valide :
SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Après l'ajout de la colonne col3 à test_table, la procédure est toujours valide car elle n'a aucune dépendance sur cette colonne :
SQL> ALTER TABLE test_table ADD col3 NUMBER;

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Toutefois, la modification du type de données de la colonne col1, dont dépend la procédure test_proc, invalide la procédure :
SQL> ALTER TABLE test_table MODIFY col1 VARCHAR2(20);

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   INVALID
L'exécution ou la recompilation de la procédure la rend valide à nouveau, comme indiqué dans l'exemple suivant :
SQL> EXECUTE test_proc

PL/SQL procedure successfully completed.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Voir aussi : Guide de l'administrateur Oracle AI Database et Guide de développement Oracle AI Database pour apprendre à gérer les dépendances d'objet de schéma
Schémas échantillon
Une base de données Oracle peut inclure des exemples de schéma, qui sont un ensemble de schémas interconnectés qui permettent à la documentation Oracle et aux supports pédagogiques Oracle d'illustrer les tâches de base de données courantes.
L'exemple de schéma hr contient des informations sur les employés, les services et les lieux, les historiques de travail, etc. L'illustration suivante représente un diagramme entité-relation des tables dans hr. La plupart des exemples de ce schéma utilisent manuellement des objets.
Figure 6 : Schéma HR
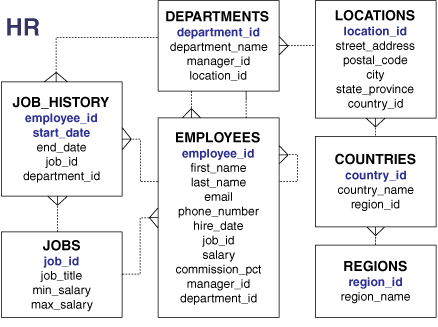
Description de l'image cncpt292.gif
Voir aussi : Exemples de schémas Oracle AI Database pour savoir comment installer les exemples de schémas
Présentation des tables
Une table est l'unité de base de l'organisation des données dans une base de données Oracle.
Un tableau décrit une entité, qui est un élément important sur lequel les informations doivent être enregistrées. Par exemple, un employé peut être une entité.
Les tables Oracle AI Database se classent dans les catégories de base suivantes :
-
Tables relationnelles
Les tables relationnelles ont des colonnes simples et sont les types de table les plus courants. L'exemple 4-1 présente une instruction
CREATE TABLEpour une table relationnelle. -
Tables d'objets
Les colonnes correspondent aux attributs de niveau supérieur du type d'objet . Reportez-vous à Présentation des tables d'objets.
Vous pouvez créer une table relationnelle présentant les caractéristiques organisationnelles suivantes :
-
Une table organisée en portions de mémoire ne stocke pas les lignes dans un ordre particulier. L'instruction
CREATE TABLEcrée une table organisée en portions de mémoire par défaut. -
Une table organisée en index trie les lignes en fonction des valeurs de clé primaire. Pour certaines applications, les tables organisées en index améliorent les performances et utilisent l'espace disque plus efficacement. Reportez-vous à Présentation des tables organisées par index.
-
Une table externe est une table en lecture seule dont les métadonnées sont stockées dans la base de données mais dont les données sont stockées en dehors de celle-ci. Reportez-vous à Présentation des tables externes.
Une table est permanente ou temporaire. Les données et les définitions de table permanentes sont conservées d'une session à l'autre. Une définition de table temporaire persiste de la même manière qu'une définition de table permanente, mais les données existent uniquement pendant la durée d'une transaction ou d'une session. Les tables temporaires sont utiles dans les applications où un ensemble de résultats doit être conservé temporairement, peut-être parce que le résultat est construit en exécutant plusieurs opérations.
-
Colonnes Une définition de table inclut un nom de table et un ensemble de colonnes.
-
Lignes Une ligne est un ensemble d'informations de colonne correspondant à un enregistrement d'une table.
-
Exemple : instructions CREATE TABLE et ALTER TABLE L'instruction SQL Oracle permettant de créer une TABLE est
CREATE TABLE. -
Types de données Oracle Chaque colonne a un type de données, qui est associé à un format de stockage spécifique, à des contraintes et à une plage de valeurs valide. Le type de données d'une valeur associe un ensemble fixe de propriétés à la valeur.
-
Contraintes d'intégrité Une contrainte d'intégrité est une règle nommée qui limite les valeurs d'une ou de plusieurs colonnes d'une table.
-
Stockage de table Oracle AI Database utilise un segment de données dans un tablespace pour stocker les données de table.
-
Compression de table La base de données peut utiliser la compression de table pour réduire la quantité de stockage requise pour la table. Voir aussi : Guide de l'administrateur Oracle AI Database pour apprendre à gérer les tables
Colonnes
Une définition de table inclut un nom de table et un ensemble de colonnes.
Une colonne identifie un attribut de l'entité décrite par la table. Par exemple, la colonne employee_id de la table employees fait référence à l'attribut employee ID d'une entité employee.
En général, vous donnez à chaque colonne un nom de colonne, un type de données et une largeur lorsque vous créez une table. Par exemple, le type de données pour employee_id est NUMBER(6), ce qui indique que cette colonne ne peut contenir que des données numériques jusqu'à 6 chiffres de largeur. La largeur peut être prédéterminée par le type de données, comme avec DATE.
-
Colonnes virtuelles Une table peut contenir une colonne virtuelle, également appelée colonne d'expression. Les colonnes d'expression peuvent être virtuelles, c'est-à-dire non stockées sur le disque, ou matérialisées, c'est-à-dire stockées sur le disque.
-
Colonnes invisibles Une colonne invisible est une colonne spécifiée par l'utilisateur dont les valeurs ne sont visibles que lorsque la colonne est explicitement spécifiée par son nom. Vous pouvez ajouter une colonne invisible à une table sans affecter les applications existantes et la rendre visible si nécessaire.
-
Réservation sans verrouillage Une réservation sans verrouillage permet de procéder à plusieurs mises à jour simultanées sur une valeur de colonne numérique sans être bloquée par des mises à jour non validées lors de l'ajout ou de la soustraction de la valeur de colonne.
Colonnes virtuelles
Une table peut contenir une colonne virtuelle, également appelée colonne d'expression. Les colonnes d'expression peuvent être virtuelles, c'est-à-dire non stockées sur le disque, ou matérialisées, c'est-à-dire stockées sur le disque.
Les colonnes virtuelles, également appelées colonnes d'expression, dérivent les valeurs en calculant un ensemble d'expressions ou de fonctions spécifiées par l'utilisateur. Une table peut contenir l'une de ces colonnes, mais elle doit toujours contenir une colonne standard. Par exemple, la définition de la table EMP ci-dessous contient le taux horaire calculé en fonction du salaire de l'employé divisé par 2080 heures par an.
CREATE TABLE emp
(
   emp_id           NUMBER(9)     CONSTRAINT emp_pk PRIMARY KEY,
   emp_last_name    VARCHAR2(30)  CONSTRAINT emp_last_name_nn NOT NULL,
   emp_first_name   VARCHAR2(30)  CONSTRAINT emp_first_name_nn NOT NULL,
   emp_salary       NUMBER(9,2),
   emp_hourly_rate  NUMBER(7,2)   GENERATED ALWAYS AS (emp_salary/2080) VIRTUAL,
   emp_phone_no     VARCHAR2(10)
);
Insérez ensuite des valeurs dans les colonnes non virtuelles.
INSERT INTO emp (emp_id, emp_last_name, emp_first_name, emp_salary, emp_phone_no)
VALUES (8291, 'Patel', 'Siddharth', 60000, '6505551234');
Lorsque vous interrogez la table, vous voyez désormais la valeur calculée renvoyée en tant que colonne d'expression.
SELECT * FROM emp;

 EMP_ID EMP_LAST_NAME  EMP_FIRST_NAME     EMP_SALARY  EMP_HOURLY_RATE EMP_PHONE_NO
_______ ______________ _______________ _____________ ________________ _____________
   8291 Patel          Siddharth               60000            28.85 6505551234
Ces colonnes d'expression peuvent être virtuelles ou matérialisées sur disque. Dans le cas de colonnes virtuelles pures (expression), les valeurs de colonne ne consomment pas d'espace disque et sont calculées à la demande au moment de l'accès. Dans le cas des colonnes d'expression matérialisées, les valeurs sont calculées au moment de l'opération LMD et stockées sur disque.
Voir aussi : Guide de l'administrateur Oracle AI Database pour apprendre à gérer les colonnes virtuelles
Colonnes invisibles
Une colonne invisible est une colonne spécifiée par l'utilisateur dont les valeurs ne sont visibles que lorsque la colonne est explicitement spécifiée par son nom. Vous pouvez ajouter une colonne invisible à une table sans affecter les applications existantes et la rendre visible si nécessaire.
En général, les colonnes invisibles aident à migrer et à faire évoluer les applications en ligne. Un cas d'emploi peut être une application qui interroge une table à trois colonnes avec une instruction SELECT *. L'ajout d'une quatrième colonne à la table briserait l'application, qui attend trois colonnes de données. Si vous ajoutez une quatrième colonne invisible, l'application fonctionne normalement. Un développeur peut ensuite modifier l'application pour qu'elle gère une quatrième colonne et la rendre visible lors de sa mise en service.
L'exemple suivant crée une table products avec une colonne invisible count, puis rend la colonne invisible visible :
CREATE TABLE products ( prod_id INT, count INT INVISIBLE );
ALTER TABLE products MODIFY ( count VISIBLE );
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer les colonnes invisibles
-
Référence du langage SQL d'Oracle AI Database pour plus d'informations sur les colonnes invisibles
Réservation sans verrouillage
Une réservation sans verrouillage permet à plusieurs mises à jour simultanées sur une valeur de colonne numérique de continuer sans être bloquée par des mises à jour non validées lors de l'ajout ou de la soustraction de la valeur de colonne.
En évitant le mécanisme de verrouillage traditionnel lors des mises à jour, cette fonctionnalité vous permet d'améliorer considérablement l'expérience utilisateur avec un blocage réduit en présence de mises à jour simultanées fréquentes des colonnes réservables. Dans les versions précédentes, lorsqu'une valeur de colonne d'une ligne est mise à jour en l'ajoutant ou en la soustrayant, toutes les autres mises à jour de cette ligne sont bloquées jusqu'à ce que la transaction soit validée. Avec l'introduction de la fonction de réservation sans verrouillage dans Oracle AI Database 26ai, vous pouvez autoriser les transactions à ajouter ou à soustraire simultanément la colonne réservable de la même ligne sans se bloquer en spécifiant les conditions pour lesquelles les mises à jour peuvent être effectuées. Pour ce faire, vous devez indiquer que la colonne numérique est une colonne RESERVABLE et créer une contrainte CHECK pour la colonne. Une amélioration supplémentaire du débit peut également être obtenue car les mises à jour des colonnes réservables ne verrouillent pas les lignes et n'empêchent donc pas une autre transaction de mettre à jour simultanément les colonnes non réservables de la même ligne.
Par exemple, vous pouvez autoriser la réussite des opérations d'addition et de soustraction sur une quantité en stock si la quantité en stock est suffisante pour la demande et ne dépasse pas notre espace de stockage pour 100 articles. Une telle mise à jour de la valeur de quantité peut se poursuivre sans être bloquée par des mises à jour non validées tant que la valeur de quantité est supérieure à zéro et inférieure ou égale à 100. Le montant ajouté ou soustrait est réservé et garanti via un mécanisme de réservation interne afin que la transaction puisse se poursuivre sans attendre d'autres transactions qui ont effectué des réservations antérieures sur la colonne réservable de la même ligne à valider.
Les contraintes CHECK de niveau table peuvent inclure à la fois des colonnes réservables et des colonnes non réservables. Une réservation sans verrouillage en attente qui a été approuvée au moment où une mise à jour est émise peut ultérieurement violer une telle contrainte au moment de la validation de la transaction. Cela peut se produire si les colonnes non réservables de la contrainte ont été mises à jour dans le temps suivant la réservation, de sorte que leurs valeurs actuelles peuvent violer la contrainte CHECK. La transaction devra être interrompue si la contrainte est violée. Toutefois, les colonnes non réservables d'une contrainte de niveau table sont généralement des seuils qui sont très rarement modifiés. L'espace de stockage, le solde requis dans un compte et les limites de dépenses sont des exemples de ces seuils.
L'exemple suivant crée une table inventory avec une colonne réservable qty_on_hand. La contrainte CHECK sur qty_on_hand spécifie qu'il doit y avoir zéro ou plusieurs articles en stock et pas plus que la capacité d'étagère pour cet article pour qu'une mise à jour sur qty_on_hand puisse se poursuivre sans bloquer d'autres mises à jour. Dans l'exemple ci-dessous, la table inventory est créée avec les contraintes appropriées, plusieurs lignes de données sont insérées et le dictionnaire de données de la table inventory est interrogé.
CREATE TABLE inventory
( item_id            NUMBER          CONSTRAINT inv_pk PRIMARY KEY,
  item_display_name  VARCHAR2(100)   NOT NULL,
  item_desc          VARCHAR2(2000),
  qty_on_hand        NUMBER          RESERVABLE CONSTRAINT qty_ck CHECK
                                        (qty_on_hand >= 0) NOT NULL,
  shelf_capacity     NUMBER          NOT NULL,
    CONSTRAINT shelf_ck CHECK (qty_on_hand <= shelf_capacity)
);

-- Insert a few rows in the inventory table
INSERT INTO inventory VALUES (123, 'Milk', 'Lowfat 2%', 100, 120);
INSERT INTO inventory VALUES (456, 'Bread', 'Multigrain', 50, 100);
INSERT INTO inventory VALUES (789, 'Eggs', 'Organic', 50, 75);

COMMIT;

SELECT * FROM inventory;

-- Check views user_tab_cols and user_tables to check
-- if the table is a reservable table and the names of the reservable columns

SELECT table_name, has_reservable_column
FROM   user_tables
WHERE  table_name = 'INVENTORY';

SELECT column_name, reservable_column
FROM   user_tab_cols
WHERE  table_name = 'INVENTORY'
  AND  reservable_column = 'YES';
Exemple de mises à jour simultanées multiples de la colonne réservable :
-
Transaction 1:
UPDATE inventory SET qty_on_hand = qty_on_hand - 10 WHERE item_id = 123; -
Transaction 2:
UPDATE inventory SET qty_on_hand = qty_on_hand + 20 WHERE item_id = 123; -
Transaction 3:
UPDATE inventory SET qty_on_hand = qty_on_hand - 30 WHERE item_id = 123; -
Transaction 2:
commit; -
Transaction 3:
commit; -
Transaction 1:
commit;
Une colonne réservable peut être ajoutée à une table à l'aide de la commande ALTER TABLE en spécifiant une contrainte CHECK facultative. Par exemple :
ALTER TABLE inventory ADD
(qty_on_hold NUMBER RESERVABLE DEFAULT 0
 CONSTRAINT qty_hold CHECK (qty_on_hold >= 0 and qty_on_hold <= 25));
Une colonne réservable peut être convertie en colonne non réservable à l'aide de la commande ALTER TABLE suivante. Les applications peuvent choisir d'appliquer les contraintes bien que les réservations réservables soient désactivées. Par conséquent, la contrainte n'est pas automatiquement supprimée lorsqu'une colonne est convertie en colonne non réservable. La suppression de la contrainte est facultative, en fonction de vos besoins. Exemple :
ALTER TABLE inventory MODIFY (qty_on_hand NOT RESERVABLE);
ALTER TABLE inventory DROP CONSTRAINT qty_ck;
Une colonne non réservable peut être convertie en colonne réservable à l'aide de la commande ALTER TABLE. Par exemple :
ALTER TABLE inventory MODIFY
(qty_on_hand RESERVABLE
 CONSTRAINT qty_ck CHECK (qty_on_hand >= 0 and qty_on_hand <= 100));
Lignes
Une ligne est un ensemble d'informations de colonne correspondant à un enregistrement d'une table.
Par exemple, une ligne de la table employees décrit les attributs d'un employé spécifique : ID d'employé, nom, prénom, etc. Une fois que vous avez créé une table, vous pouvez insérer, interroger, supprimer et mettre à jour des lignes à l'aide de SQL.
Exemple : instructions CREATE TABLE et ALTER TABLE
L'instruction SQL Oracle permettant de créer une table est CREATE TABLE.
Exemple 4-1 CREATE TABLE employees
L'exemple suivant présente l'instruction CREATE TABLE pour la table employees dans l'exemple de schéma hr. L'instruction indique des colonnes telles que employee_id, first_name, etc., en indiquant un type de données tel que NUMBER ou DATE pour chaque colonne.
CREATE TABLE employees
    ( employee_id    NUMBER(6),
      first_name     VARCHAR2(20),
      last_name      VARCHAR2(25)   CONSTRAINT emp_last_name_nn  NOT NULL,
      email          VARCHAR2(25)   CONSTRAINT emp_email_nn      NOT NULL,
      phone_number   VARCHAR2(20),
      hire_date      DATE           CONSTRAINT emp_hire_date_nn  NOT NULL,
      job_id         VARCHAR2(10)   CONSTRAINT emp_job_nn        NOT NULL,
      salary         NUMBER(8,2),
      commission_pct NUMBER(2,2),
      manager_id     NUMBER(6),
      department_id  NUMBER(4),
      CONSTRAINT     emp_salary_min CHECK (salary > 0),
      CONSTRAINT     emp_email_uk   UNIQUE (email)
    ) ;
Exemple 4-2 Employés ALTER TABLE
L'exemple suivant présente une instruction ALTER TABLE qui ajoute des contraintes d'intégrité à la table employees. Les contraintes d'intégrité appliquent les règles métier et empêchent la saisie d'informations non valides dans les tables.
ALTER TABLE employees
ADD ( CONSTRAINT emp_emp_id_pk   PRIMARY KEY (employee_id),
      CONSTRAINT emp_dept_fk     FOREIGN KEY (department_id)
                                   REFERENCES departments,
      CONSTRAINT emp_job_fk      FOREIGN KEY (job_id)
                                   REFERENCES jobs (job_id),
      CONSTRAINT emp_manager_fk  FOREIGN KEY (manager_id)
                                   REFERENCES employees
    ) ;
Exemple 4-3 lignes dans la table employees
L'exemple de sortie suivant présente 8 lignes et 6 colonnes de la table hr.employees.
EMPLOYEE_ID FIRST_NAME  LAST_NAME      SALARY COMMISSION_PCT DEPARTMENT_ID
----------- ----------- ------------- ------- -------------- -------------
        100 Steven      King            24000                           90
        101 Neena       Kochhar         17000                           90
        102 Lex         De Haan         17000                           90
        103 Alexander   Hunold           9000                           60
        107 Diana       Lorentz          4200                           60
        149 Eleni       Zlotkey         10500             .2            80
        174 Ellen       Abel            11000             .3            80
        178 Kimberely   Grant            7000            .15
La sortie précédente illustre certaines des caractéristiques importantes suivantes des tables, des colonnes et des lignes :
-
Une ligne du tableau décrit les attributs d'un employé : nom, salaire, service, etc. Par exemple, la première ligne de la sortie affiche l'enregistrement de l'employé nommé Steven King.
-
Une colonne décrit un attribut de l'employé. Dans l'exemple, la colonne
employee_idest la clé primaire, ce qui signifie que chaque employé est identifié de manière unique par son ID. Il est garanti que deux salariés n'ont pas le même matricule. -
Une colonne non clé peut contenir des lignes avec des valeurs identiques. Dans l'exemple, la valeur de salaire des employés 101 et 102 est la même :
17000. -
Une colonne de clé étrangère fait référence à une clé primaire ou unique dans la même table ou dans une autre table. Dans cet exemple, la valeur de
90dansdepartment_idcorrespond à la colonnedepartment_idde la tabledepartments. -
Un champ est l'intersection d'une ligne et d'une colonne. Il ne peut contenir qu'une seule valeur. Par exemple, le champ de l'ID de service de l'employé 103 contient la valeur
60. -
Un champ peut ne pas avoir de valeur. Dans ce cas, le champ est dit contenir une valeur null. La valeur de la colonne
commission_pctpour l'employé 100 est NULL, tandis que la valeur du champ pour l'employé 149 est.2. Une colonne autorise les valeurs NULL, sauf si une contrainte d'intégrité de clé primaire ouNOTNULLa été définie sur cette colonne, auquel cas aucune ligne ne peut être insérée sans valeur pour cette colonne.
Voir aussi : Référence du langage SQL d'Oracle AI Database pour la syntaxe et la sémantique CREATE TABLE
Types de données Oracle
Chaque colonne a un type de données, qui est associé à un format de stockage, des contraintes et une plage de valeurs valides spécifiques. Le type de données d'une valeur associe un ensemble fixe de propriétés à la valeur.
Ces propriétés font qu'Oracle AI Database traite les valeurs d'un type de données différemment des valeurs d'un autre. Par exemple, vous pouvez multiplier les valeurs du type de données NUMBER, mais pas celles du type de données RAW.
Lorsque vous créez une table, vous devez indiquer un type de données pour chacune de ses colonnes. Chaque valeur insérée dans une colonne doit correspondre au type de données défini pour celle-ci.
Oracle AI Database fournit plusieurs types de données intégrés. Les types de données les plus couramment utilisés relèvent des catégories détaillées dans cette section.
D'autres catégories importantes de types intégrés incluent les objets bruts, les objets LOB (Large Object) et les collections. Le langage PL/SQL contient des types de données pour les constantes et les variables, notamment BOOLEAN, les types de référence, les types de composite (enregistrements) et les types définis par l'utilisateur.
-
Les types de données de caractère stockent les données alphanumériques dans des chaînes. Le type de données alphanumérique le plus courant est
VARCHAR2, qui est l'option la plus efficace pour le stockage des données alphanumériques. -
Types de données numériques Les types de données numériques Oracle AI Database stockent les nombres fixes et à virgule flottante, zéro et infini. Certains types numériques stockent également des valeurs qui sont le résultat non défini d'une opération, appelée "pas un nombre" ou
NaN. -
Types de données Datetime Les types de données datetime sont
DATEetTIMESTAMP. Oracle AI Database fournit une prise en charge complète des fuseaux horaires pour les horodatages. -
Types de données Rowid Chaque ligne stockée dans la base de données possède une adresse, une représentation interne permettant de localiser cette ligne dans la base de données. Oracle AI Database utilise un type de données
ROWIDpour stocker l'adresse (rowid) de chaque ligne de la base de données. -
Type de données booléen Le type de données BOOLEAN comprend les valeurs de vérité distinctes
TrueetFalse. -
Modèles de format et types de données Un modèle de format est un littéral qui décrit le format de données date/heure ou nombre stocké dans une chaîne de caractères. Le modèle de format ne modifie pas la représentation interne de la valeur dans la base de données.
Voir aussi :
-
Guide du développeur d'Oracle AI Database SecureFiles et de LOB
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur les types de données SQL intégrés
-
Référence Oracle AI Database PL/SQL Packages and Types pour en savoir plus sur les types de données PL/SQL
-
Guide de développement Oracle AI Database pour découvrir comment utiliser les types de données intégrés
Types de données de caractère
Les types de données alphanumériques stockent les données dans des chaînes. Le type de données alphanumérique le plus courant est VARCHAR2, qui est l'option la plus efficace pour le stockage des données alphanumériques.
Les valeurs d'octet correspondent au schéma d'encodage de caractères, généralement appelé jeu de caractères. Le jeu de caractères de la base de données est établi lors de sa création. Exemples de jeux de caractères : ASCII 7 bits, EBCDIC et Unicode UTF-8.
La sémantique de longueur des types de données alphanumériques est mesurable en octets ou en caractères. Le traitement des chaînes en tant que séquence d'octets est appelé sémantique des octets. Il s'agit de la valeur par défaut pour les types de données alphanumériques. Le traitement des chaînes en tant que séquence de caractères est appelé sémantique des caractères. Un caractère est un point de code du jeu de caractères de la base de données.
-
Types de données VARCHAR2 et CHAR Le type de données
VARCHAR2stocke les littéraux alphanumériques de longueur variable. Un littéral est une valeur de données fixe. -
Types de données NCHAR et NVARCHAR2 Les types de données
NCHARetNVARCHAR2stockent les données de type caractère Unicode.
Voir aussi :
-
Guide de support pour la globalisation d'Oracle AI Database pour en savoir plus sur les jeux de caractères
-
Oracle AI Database - Introduction au développement d'Oracle AI Database pour une brève introduction aux types de données
-
Guide de développement Oracle AI Database pour savoir comment choisir un type de données de type caractère
VARCHAR2 et types de données CHAR
Le type de données VARCHAR2 stocke des littéraux de type caractère de longueur variable. Un littéral est une valeur de données fixe.
Par exemple, 'LILA', 'St. George Island' et '101' sont tous des littéraux alphanumériques ; 5001 est un littéral numérique. Les littéraux de type caractère sont placés entre apostrophes afin que la base de données puisse les distinguer des noms d'objet de schéma. Remarque : ce manuel utilise les termes littéral de texte, littéral de caractère et chaîne de manière interchangeable.
Lorsque vous créez une table avec une colonne VARCHAR2, vous indiquez une longueur de chaîne maximale. Dans l'exemple 4-1, le type de données de la colonne last_name est VARCHAR2(25), ce qui signifie que tout nom stocké dans la colonne comporte un maximum de 25 octets.
Pour chaque ligne, Oracle AI Database stocke chaque valeur de la colonne en tant que champ de longueur variable, sauf si une valeur dépasse la longueur maximale, auquel cas la base de données renvoie une erreur. Par exemple, dans un jeu de caractères à un octet, si vous entrez 10 caractères pour la valeur de colonne last_name dans une ligne, la colonne du morceau de ligne ne stocke que 10 caractères (10 octets), et non 25. L'utilisation de VARCHAR2 réduit la consommation d'espace.
Contrairement à VARCHAR2, CHAR stocke les chaînes de caractères de longueur fixe. Lorsque vous créez une table avec une colonne CHAR, la colonne requiert une longueur de chaîne. La valeur par défaut est de 1 octet. La base de données utilise des espaces pour remplir la valeur à la longueur indiquée.
Oracle AI Database compare les valeurs VARCHAR2 à l'aide de la sémantique de comparaison non complétée et les valeurs CHAR à l'aide de la sémantique de comparaison complétée par des blancs.
Voir aussi : Référence du langage SQL Oracle AI Database pour plus de détails sur la sémantique de comparaison complétée et non complétée
Types de données NCHAR et NVARCHAR2
Les types de données NCHAR et NVARCHAR2 stockent des données de type caractère Unicode.
Unicode est un jeu de caractères encodé universel qui peut stocker des informations dans n'importe quelle langue à l'aide d'un seul jeu de caractères. NCHAR stocke les chaînes de caractères de longueur fixe qui correspondent au jeu de caractères national, tandis que NVARCHAR2 stocke les chaînes de caractères de longueur variable.
Vous indiquez un jeu de caractères national lors de la création d'une base de données. Le jeu de caractères des types de données NCHAR et NVARCHAR2 doit être AL16UTF16 ou UTF8. Les deux jeux de caractères utilisent l'encodage Unicode.
Lorsque vous créez une table avec une colonne NCHAR ou NVARCHAR2, la taille maximale est toujours en sémantique de longueur de caractère. La sémantique de longueur de caractère est la sémantique de longueur par défaut et uniquement pour NCHAR ou NVARCHAR2.
Voir aussi : Oracle AI Database Globalization Support Guide pour plus d'informations sur la fonctionnalité de prise en charge de la mondialisation d'Oracle
Types de données numériques
Les types de données numériques d'Oracle AI Database stockent les nombres fixes et à virgule flottante, zéro et infini. Certains types numériques stockent également des valeurs qui sont le résultat non défini d'une opération, appelée "pas un nombre" ou NaN.
Oracle AI Database stocke les données numériques au format de longueur variable. Chaque valeur est stockée en notation scientifique, avec 1 octet utilisé pour stocker l'exposant. La base de données utilise jusqu'à 20 octets pour stocker le mantissa, qui est la partie d'un nombre à virgule flottante qui contient ses chiffres significatifs. Oracle AI Database ne stocke pas les zéros de début et de fin.
-
Type de données numéro Le type de données
NUMBERstocke les nombres fixes et à virgule flottante. La base de données peut stocker des nombres de pratiquement n'importe quelle ampleur. Ces données sont assurées d'être portables entre différents systèmes d'exploitation exécutant Oracle AI Database. Le type de donnéesNUMBERest recommandé pour la plupart des cas où vous devez stocker des données numériques. -
Numéros à virgule flottante Oracle AI Database fournit deux types de données numériques exclusivement pour les nombres à virgule flottante :
BINARY_FLOATetBINARY_DOUBLE.
Type de données NUMBER
Le type de données NUMBER stocke les nombres fixes et à virgule flottante. La base de données peut stocker des nombres de pratiquement n'importe quelle ampleur. Ces données sont assurées d'être portables entre différents systèmes d'exploitation exécutant Oracle AI Database. Le type de données NUMBER est recommandé pour la plupart des cas où vous devez stocker des données numériques.
Vous spécifiez un numéro de point fixe sous la forme NUMBER(p,s), où p et s font référence aux caractéristiques suivantes :
-
Précision
La précision spécifie le nombre total de chiffres. Si aucune précision n'est indiquée, la colonne stocke les valeurs exactement telles qu'elles sont fournies par l'application sans aucun arrondi.
-
Redimensionner
L'échelle indique le nombre de chiffres entre le séparateur décimal et le dernier chiffre significatif. L'échelle positive compte les chiffres à droite de la virgule jusqu'au chiffre le moins significatif inclus. L'échelle négative compte les chiffres à gauche de la virgule jusqu'au chiffre le moins significatif, mais ne l'inclut pas. Si vous indiquez une précision sans échelle, comme dans
NUMBER(6), l'échelle est 0.
Dans l'exemple 4-1, la colonne salary est de type NUMBER(8,2), de sorte que la précision est de 8 et l'échelle de 2. Par conséquent, la base de données stocke un salaire de 100 000 sous la forme 100000.00.
Nombres à virgule flottante
Oracle AI Database fournit deux types de données numériques exclusivement pour les nombres à virgule flottante : BINARY_FLOAT et BINARY_DOUBLE.
Ces types prennent en charge toutes les fonctionnalités de base fournies par le type de données NUMBER. Cependant, alors que NUMBER utilise la précision décimale, BINARY_FLOAT et BINARY_DOUBLE utilisent la précision binaire, ce qui permet des calculs arithmétiques plus rapides et réduit généralement les besoins de stockage.
BINARY_FLOAT et BINARY_DOUBLE sont des types de données numériques approximatifs. Ils stockent des représentations approximatives de valeurs décimales plutôt que des représentations exactes. Par exemple, la valeur 0.1 ne peut pas être exactement représentée par BINARY_DOUBLE ou BINARY_FLOAT. Ils sont souvent utilisés pour les calculs scientifiques. Leur comportement est similaire aux types de données FLOAT et DOUBLE dans Java et XMLSchema.
Voir aussi : Référence du langage SQL d'Oracle AI Database pour en savoir plus sur la précision, l'échelle et d'autres caractéristiques des types numériques
Types de données Datetime
Les types de données datetime sont DATE et TIMESTAMP. Oracle AI Database fournit une prise en charge complète des fuseaux horaires pour les horodatages.
-
Type de données de DATE Le type de données
DATEstocke la DATE et l'heure. Bien que les dates/heures puissent être représentées dans des types de données alphanumériques ou numériques,DATEest associé à des propriétés spéciales. -
Type de données TIMESTAMP Le type de données
TIMESTAMPest une extension du type de donnéesDATE.
Type données DATE
Le type de données DATE stocke la date et l'heure. Bien que les dates/heures puissent être représentées dans des types de données alphanumériques ou numériques, DATE est associé à des propriétés spéciales.
La base de données stocke les dates en interne sous forme de nombres. Les dates sont stockées dans des champs de longueur fixe de 7 octets chacun, correspondant au siècle, à l'année, au mois, au jour, à l'heure, à la minute et à la seconde. Remarque : les dates prennent entièrement en charge les opérations arithmétiques. Vous pouvez donc les ajouter aux dates et les soustraire de la même façon que les nombres.
La base de données affiche les dates en fonction du modèle de format spécifié. Un modèle de format est un littéral qui décrit le format d'une date/heure dans une chaîne de caractères. Le format de date standard est DD-MON-RR, qui affiche les dates sous la forme 01-JAN-11.
RR est similaire à YY (les deux derniers chiffres de l'année), mais le siècle de la valeur renvoyée varie en fonction de l'année à deux chiffres spécifiée et des deux derniers chiffres de l'année en cours. Supposons qu'en 1999, la base de données affiche 01-JAN-11. Si le format de date utilise RR, 11 indique 2011, tandis que si le format utilise YY, 11 indique 1911. Vous pouvez modifier le format de date par défaut au niveau de l'instance de base de données et de la session.
Oracle AI Database stocke l'heure au format 24 heures-HH:MI:SS. Si aucune partie de temps n'est saisie, l'heure dans un champ de date est par défaut 00:00:00 A.M. Dans une saisie de temps uniquement, la date est définie par défaut sur le premier jour du mois en cours.
Voir aussi :
-
Guide de développement Oracle AI Database pour plus d'informations sur les masques de format de date et de siècles
-
Référence du langage SQL Oracle AI Database pour plus d'informations sur les codes de format de date/heure
-
Guide de développement Oracle AI Database pour apprendre à effectuer des opérations arithmétiques avec des types de données date-heure
Type de données TIMESTAMP
Le type de données TIMESTAMP est une extension du type de données DATE.
TIMESTAMP stocke des fractions de seconde en plus des informations stockées dans le type de données DATE. Le type de données TIMESTAMP est utile pour stocker des valeurs temporelles précises, par exemple dans les applications qui doivent suivre l'ordre des événements.
Les types de données DATETIME TIMESTAMP WITH TIME ZONE et TIMESTAMP WITH LOCAL TIME ZONE tiennent compte des fuseaux horaires. Lorsqu'un utilisateur sélectionne les données, la valeur est ajustée en fonction du fuseau horaire de la session utilisateur. Ce type de données est utile pour collecter et évaluer les informations de date dans les différentes régions géographiques.
Voir aussi : Référence du langage SQL d'Oracle AI Database pour plus de détails sur la syntaxe de création et de saisie de données dans les colonnes d'horodatage
Types de données Rowid
Chaque ligne stockée dans la base de données dispose d'une adresse - une représentation interne pour localiser cette ligne dans la base de données. Oracle AI Database utilise un type de données ROWID pour stocker l'adresse (rowid) de chaque ligne de la base de données.
Les Rowid appartiennent aux catégories suivantes :
-
Les rowids physiques stockent les adresses des lignes dans des tables organisées en "heaps", des clusters de tables et des partitions de table et d'index.
-
Les rowids logiques stockent les adresses des lignes dans des tables organisées en index.
-
Les rowids étrangers sont des identificateurs dans les tables étrangères, telles que les tables DB2 accessibles via une passerelle. Ils ne sont pas des rowids Oracle AI Database standard.
Un type de données appelé r rowid universel, ou urowid, prend en charge tous les types de rowid.
-
Utilisation des rowids Oracle AI Database utilise les rowids en interne pour la construction des index.
-
PseudocolonneROWID Chaque table d'une base de données Oracle possède une pseudo-colonne nommée
ROWID.
Utilisation de Rowids
Oracle AI Database utilise des rowids en interne pour la construction d'index.
Un index B-tree, qui est le type le plus courant, contient une liste ordonnée de clés divisées en plages. Chaque clé est associée à un rowid qui pointe vers l'adresse de la ligne associée pour un accès rapide.
Les utilisateurs finaux et les développeurs d'applications peuvent également utiliser des rowids pour plusieurs fonctions importantes :
-
Les rowids sont un moyen rapide de réaccéder à une ligne si
rowida déjà été extrait avec une instruction SELECT. -
Les Rowids permettent de voir comment une table est organisée.
Bien que vous puissiez créer des tables avec des colonnes définies à l'aide du type de données ROWID, vous ne devez pas stocker de rowids dans le but de les utiliser pour accéder aux données ultérieurement. L'utilisation de rowids de cette manière peut produire des résultats imprévisibles ou incorrects. La valeur rowid d'une ligne peut changer pour un certain nombre de raisons qui peuvent être lancées par l'utilisateur ou en interne par le moteur de base de données. Vous ne pouvez pas dépendre de rowid pour pointer vers la même ligne ou une ligne valide après l'une de ces opérations.
Pseudo-colonne ROWID
Chaque table d'une base de données Oracle a une pseudo-colonne nommée ROWID.
La pseudo-colonne se comporte comme une colonne de table mais n'est pas en fait stockée dans la table. Vous pouvez sélectionner des éléments dans les pseudo-colonnes, mais vous ne pouvez pas y insérer des valeurs, ni les mettre à jour ou en supprimer le contenu. Une pseudo-colonne est également comparable à une fonction SQL sans argument. En général, les fonctions sans arguments renvoient la même valeur pour chaque ligne dans l'ensemble de résultats, alors que des pseudo-colonnes renvoient une valeur différente pour chaque ligne.
Les valeurs de la pseudo-colonne ROWID sont des chaînes représentant l'adresse de chaque ligne. Ces chaînes ont le type de données ROWID. Cette pseudo-colonne n'est pas évidente lors de l'énumération de la structure d'une table en exécutant SELECT ou DESCRIBE, et la pseudo-colonne ne consomme pas non plus d'espace. Cependant, le rowid de chaque ligne peut être extrait avec une requête SQL en utilisant le mot réservé ROWID comme nom de colonne.
L'exemple suivant interroge la pseudo-colonne ROWID pour afficher le rowid de la ligne dans la table employees pour l'employé 100 :
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
Voir aussi :
-
Guide de développement Oracle AI Database pour apprendre à identifier les lignes par adresse
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur les types de rowid
Type de données booléennes
Le type de données BOOLEAN comprend les valeurs de vérité distinctes True et False.
Sauf si une contrainte NOT NULL l'interdit, le type de données booléen prend également en charge la valeur de vérité UNKNOWN en tant que valeur NULL. Vous pouvez utiliser le type de données booléen partout où il apparaît dans la syntaxe Oracle SQL.
Voir aussi :
- Référence rapide du langage SQL d'Oracle AI Database pour plus d'informations sur le type de données booléen.
Modèles de format et types de données
Un modèle de format est un littéral qui décrit le format de données date/heure ou nombre stocké dans une chaîne de caractères. Le modèle de format ne modifie pas la représentation interne de la valeur dans la base de données.
Quand vous convertissez une chaîne de caractères dans une date ou un nombre, le modèle du format détermine la manière dont la base de données interprète cette chaîne. Dans SQL, vous pouvez utiliser un modèle de format comme argument des fonctions TO_CHAR et TO_DATE pour formater une valeur à renvoyer à partir de la base de données ou pour formater une valeur à stocker dans la base de données.
L'instruction suivante sélectionne les salaires des employés du service 80 et utilise la fonction TO_CHAR pour convertir ces salaires en valeurs alphanumériques au format spécifié par le modèle de format numérique '$99,990.99' :
SQL> SELECT last_name employee, TO_CHAR(salary, '$99,990.99') AS "SALARY"
  2  FROM   employees
  3  WHERE  department_id = 80 AND last_name = 'Russell';

EMPLOYEE                  SALARY
------------------------- -----------
Russell                    $14,000.00
L'exemple suivant met à jour une date d'embauche à l'aide de la fonction TO_DATE avec le masque de format 'YYYY MM DD' pour convertir la chaîne '1998 05 20' en valeur DATE :
SQL> UPDATE employees
  2  SET hire_date = TO_DATE('1998 05 20','YYYY MM DD')
  3  WHERE last_name = 'Hunold';
Voir aussi : Référence du langage SQL d'Oracle AI Database pour en savoir plus sur les modèles de format
Contraintes d'intégrité
Une contrainte d'intégrité est une règle nommée qui limite les valeurs d'une ou de plusieurs colonnes d'une table.
Les règles d'intégrité des données empêchent la saisie de données non valides dans les tables. En outre, les contraintes peuvent empêcher la suppression d'une table lorsque certaines dépendances existent.
Si une contrainte est activée, la base de données vérifie les données au fur et à mesure qu'elles sont entrées ou mises à jour. Oracle AI Database empêche l'entrée de données non conformes à la contrainte. Si une contrainte est désactivée, Oracle AI Database autorise les données non conformes à la contrainte à entrer dans la base de données.
Dans l'exemple 4-1, l'instruction CREATE TABLE spécifie les contraintes NOT NULL pour les colonnes last_name, email, hire_date et job_id. Les clauses de contrainte identifient les colonnes et les conditions de la contrainte. Ces contraintes garantissent que les colonnes indiquées ne contiennent aucune valeur NULL. Par exemple, une tentative d'insertion d'un nouveau salarié sans code emploi génère une erreur.
Vous pouvez créer une contrainte lorsque vous créez une table ou après. Vous pouvez désactiver temporairement les contraintes si nécessaire. La base de données stocke les contraintes dans le dictionnaire de données.
Voir aussi :
-
"Intégrité des données" pour en savoir plus sur les contraintes d'intégrité
-
"Présentation du dictionnaire de données" pour en savoir plus sur le dictionnaire de données
-
Référence de langage SQL Oracle AI Database pour en savoir plus sur les clauses de contrainte SQL
Stockage de table
Oracle AI Database utilise un segment de données dans un tablespace pour stocker les données de table.
Un segment contient des extents composés de blocs de données. Le segment de données d'une table (ou d'un segment de données de cluster pour un cluster de tables) se trouve dans le tablespace par défaut du propriétaire de la table ou dans un tablespace nommé dans l'instruction CREATE TABLE.
-
Organisation de table Par défaut, une table est organisée en portion de mémoire, ce qui signifie que la base de données place les lignes là où elles conviennent le mieux plutôt que dans un ordre défini par l'utilisateur. Par conséquent, une table organisée en portions de mémoire est un ensemble de lignes non triées.
-
Stockage de ligne La base de données stocke les lignes dans des blocs de données. Chaque ligne d'une table contenant des données pour moins de 256 colonnes est contenue dans un ou plusieurs éléments de ligne.
-
Lignes d'une ligne Un rowid est en fait une adresse physique de 10 octets d'une ligne.
-
Stockage de valeurs NULL Une valeur null est l'absence de valeur dans une colonne. Les valeurs NULL indiquent des données manquantes, inconnues ou inapplicables. Voir aussi : "Segments utilisateur" pour en savoir plus sur les types de segment et leur mode de création
Organisation de la table
Par défaut, une table est organisée en portion de mémoire, ce qui signifie que la base de données place les lignes là où elles correspondent le mieux plutôt que dans un ordre défini par l'utilisateur. Par conséquent, une table organisée en portions de mémoire est un ensemble de lignes non triées. Remarque : Les tables organisées en index utilisent un principe d'organisation différent.
Lorsque les utilisateurs ajoutent des lignes, la base de données place les lignes dans le premier espace libre disponible du segment de données. L'extraction des lignes n'est pas garantie dans l'ordre dans lequel elles ont été insérées.
La table hr.departments est une table organisée en portions de mémoire. Il comporte des colonnes pour l'ID de service, le nom, l'ID de responsable et l'ID de lieu. Lorsque des lignes sont insérées, la base de données les stocke où elles se trouvent. Un bloc de données du segment de table peut contenir les lignes non triées indiquées dans l'exemple suivant :
50,Shipping,121,1500
120,Treasury,,1700
70,Public Relations,204,2700
30,Purchasing,114,1700
130,Corporate Tax,,1700
10,Administration,200,1700
110,Accounting,205,1700
L'ordre des colonnes est le même pour toutes les lignes d'une table. La base de données stocke généralement les colonnes dans l'ordre dans lequel elles ont été répertoriées dans l'instruction CREATE TABLE, mais cet ordre n'est pas garanti. Par exemple, si une table a une colonne de type LONG, Oracle AI Database stocke toujours cette colonne en dernier dans la ligne. En outre, si vous ajoutez une nouvelle colonne à une table, la nouvelle colonne devient la dernière colonne stockée.
Une table peut contenir une colonne virtuelle, qui, contrairement aux colonnes normales, ne consomme pas d'espace sur le disque. La base de données dérive les valeurs d'une colonne virtuelle à la demande en calculant un ensemble d'expressions ou de fonctions spécifiées par l'utilisateur. Vous pouvez indexer des colonnes virtuelles, collecter des statistiques sur ces colonnes et créer des contraintes d'intégrité. Par conséquent, les colonnes virtuelles ressemblent beaucoup aux colonnes non virtuelles.
Voir aussi :
-
Référence du langage SQL Oracle AI Database pour en savoir plus sur les colonnes virtuelles
Stockage de lignes
La base de données stocke les lignes dans des blocs de données. Chaque ligne d'une table contenant des données pour moins de 256 colonnes est contenue dans un ou plusieurs éléments de ligne.
Si possible, Oracle AI Database stocke chaque ligne sous la forme d'une ligne. Toutefois, si toutes les données de ligne ne peuvent pas être insérées dans un seul bloc de données, ou si une mise à jour d'une ligne existante entraîne la croissance de la ligne dans son bloc de données, la base de données stocke la ligne à l'aide de plusieurs éléments de ligne.
Les lignes d'un cluster de tables contiennent les mêmes informations que les lignes des tables non clusterisées. En outre, les lignes d'un cluster de tables contiennent des informations qui font référence à la clé de cluster à laquelle elles appartiennent.
Voir aussi : "Format de bloc de données" pour en savoir plus sur les composants d'un bloc de données
Rowids of Row Pieces
Un rowid est en fait une adresse physique de 10 octets d'une ligne.
Chaque ligne d'une table organisée en portions de mémoire possède un rowid unique à cette table qui correspond à l'adresse physique d'un élément de ligne. Pour les clusters de tables, les lignes de différentes tables qui se trouvent dans le même bloc de données peuvent avoir le même rowid.
Oracle AI Database utilise des rowids en interne pour la construction d'index. Par exemple, chaque clé d'un index B-tree est associée à un rowid qui pointe vers l'adresse de la ligne associée pour un accès rapide. Les rowids physiques fournissent l'accès le plus rapide possible à une ligne de table, ce qui permet à la base de données d'extraire une ligne en une seule E/S.
Voir aussi :
-
"Format Rowid" pour en savoir plus sur la structure d'un rowid
-
"Présentation des index B-Tree" pour en savoir plus sur les types et la structure des index B-tree
Stockage des valeurs NULL
Un null est l'absence de valeur dans une colonne. Les valeurs NULL indiquent des données manquantes, inconnues ou inapplicables.
Les valeurs NULL sont stockées dans la base de données si elles se situent entre des colonnes contenant des valeurs de données. Dans ces cas, ils nécessitent 1 octet pour stocker la longueur de la colonne (zéro). Les valeurs NULL de fin d'une ligne ne doivent pas être stockées car un nouvel en-tête de ligne indique que les colonnes restantes de la ligne précédente sont NULL. Par exemple, si les trois dernières colonnes d'une table sont NULL, aucune donnée n'est stockée pour ces colonnes.
Voir aussi : Référence du langage SQL d'Oracle AI Database pour en savoir plus sur les valeurs NULL
Compression de table
La base de données peut utiliser la compression de table pour réduire la quantité de stockage requise pour la table.
La compression permet d'économiser de l'espace disque, de réduire l'utilisation de la mémoire dans le cache de tampons de la base de données et, dans certains cas, d'accélérer l'exécution des requêtes. La compression de table est transparente pour les applications de base de données.
-
La compression de table basée sur le dictionnaire Basic Table Compression and Advanced Row Compression fournit de bons taux de compression pour les tables organisées en portions de mémoire.
-
Compression en colonnes hybride Avec la compression en colonnes hybride, la base de données stocke la même colonne pour un groupe de lignes ensemble. Le bloc de données ne stocke pas les données au format de ligne, mais utilise une combinaison de méthodes en ligne et en colonne.
-
Compression en colonnes hybride de vitesse de mémoire La compression en colonnes hybride de vitesse de mémoire introduit des formats d'unités de compression sur disque qui peuvent être traités à la vitesse de la mémoire.
Compression de table de base et compression de ligne avancée
La compression de table basée sur un dictionnaire fournit de bons taux de compression pour les tables organisées en tas.
Oracle AI Database prend en charge les types de compression de table basés sur un dictionnaire suivants :
-
Compression de table de base
Ce type de compression est destiné aux opérations de chargement en masse. La base de données ne compresse pas les données modifiées à l'aide d'instructions LMD classiques. Vous devez utiliser les opérations de chemin d'accès direct INSERT, les opérations
ALTER TABLE . . . MOVEou la redéfinition de table en ligne pour obtenir une compression de table de base. -
Compression de ligne avancée
Ce type de compression est destiné aux applications OLTP et compresse les données manipulées par n'importe quelle opération SQL. La base de données atteint un taux de compression compétitif tout en permettant à l'application d'effectuer des opérations LMD approximativement pendant la même durée que les opérations LMD sur une table non compressée.
Pour les types de compression précédents, la base de données stocke les lignes compressées au format principal de ligne. Toutes les colonnes d'une ligne sont stockées ensemble, suivies de toutes les colonnes de la ligne suivante, etc. La base de données remplace les valeurs en double par une courte référence à une table de symboles stockée au début du bloc. Ainsi, les informations dont la base de données a besoin pour recréer les données non compressées sont stockées dans le bloc de données lui-même.
Les blocs de données compressés ressemblent à des blocs de données normaux. La plupart des fonctions et fonctionnalités de base de données qui fonctionnent sur des blocs de données standard fonctionnent également sur des blocs compressés.
Vous pouvez déclarer la compression au niveau tablespace, table, partition ou sous-partition. Si cette valeur est indiquée au niveau du tablespace, toutes les tables créées dans le tablespace sont compressées par défaut.
Exemple 4-4 Compression au niveau du tableau
L'instruction suivante applique la compression de ligne avancée à la table orders :
ALTER TABLE oe.orders ROW STORE COMPRESS ADVANCED;Exemple 4-5 Compression au niveau de la partition
L'exemple suivant d'instruction CREATE TABLE partielle spécifie la compression de ligne avancée pour une partition et la compression de table de base pour l'autre partition :
CREATE TABLE sales (
    prod_id     NUMBER     NOT NULL,
    cust_id     NUMBER     NOT NULL, ... )
 PCTFREE 5 NOLOGGING NOCOMPRESS
 PARTITION BY RANGE (time_id)
 ( partition sales_2013 VALUES LESS THAN(TO_DATE(...)) ROW STORE COMPRESS BASIC,
   partition sales_2014 VALUES LESS THAN (MAXVALUE) ROW STORE COMPRESS ADVANCED );
Voir aussi :
-
"Format de ligne" pour savoir comment les valeurs sont stockées dans une ligne
-
"Compression des blocs de données" pour en savoir plus sur le format des blocs de données compressés
-
Utilitaires Oracle AI Database pour en savoir plus sur l'utilisation de SQL*Loader pour les chargements par chemin direct
-
Guide de l'administrateur Oracle AI Database et Guide de réglage des performances Oracle AI Database pour en savoir plus sur la compression de table
Compression en colonnes hybride
Avec la compression en colonnes hybride, la base de données stocke la même colonne pour un groupe de lignes. Le bloc de données ne stocke pas les données au format de ligne, mais utilise une combinaison de méthodes en ligne et en colonne.
Le stockage des données de colonne ensemble, avec le même type de données et des caractéristiques similaires, augmente considérablement les économies de stockage réalisées grâce à la compression. La base de données compresse les données manipulées par n'importe quelle opération SQL, bien que les niveaux de compression soient plus élevés pour les chargements par chemin direct. Les opérations de base de données fonctionnent de manière transparente sur les objets compressés, de sorte qu'aucune modification d'application n'est requise.
Remarque : la compression de colonne hybride et le stockage en colonnes en mémoire (stockage de colonnes IM) sont étroitement liés. La principale différence est que Hybrid Column Compression optimise le stockage sur disque, tandis que le stockage sur colonne IM optimise le stockage sur mémoire.
-
Types de compression en colonnes hybride Si votre stockage sous-jacent prend en charge la compression en colonnes hybride, vous pouvez spécifier différents types de compression, en fonction de vos besoins.
-
La compression en colonnes hybride des unités de compression utilise une construction logique appelée unité de compression pour stocker un ensemble de lignes.
-
La compression en colonnes hybride LMD et compression en colonnes hybride a des implications pour le verrouillage de lignes dans différents types d'opérations LMD. Voir aussi : "Zone en mémoire" pour en savoir plus sur la banque de colonnes IM
Types de compression hybride en colonnes
Si votre stockage sous-jacent prend en charge la compression en colonnes hybride, vous pouvez spécifier différents types de compression, en fonction de vos besoins.
Les options de compression sont les suivantes :
-
Compression d'entrepôt
Ce type de compression est optimisé pour économiser de l'espace de stockage et est destiné aux applications de data warehouse.
-
Compression d'archivage
Ce type de compression est optimisé pour les niveaux de compression maximaux et est destiné aux données historiques et aux données qui ne changent pas.
La compression en colonnes hybride est optimisée pour les applications d'entreposage de données et d'aide à la décision sur le stockage Oracle Exadata. Oracle Exadata optimise les performances des requêtes sur les tables compressées à l'aide de la compression en colonnes hybride, en tirant parti de la puissance de traitement, de la mémoire et de la bande passante réseau Infiniband qui font partie intégrante du serveur de stockage Oracle Exadata.
D'autres systèmes de stockage Oracle prennent en charge la compression en colonnes hybride et offrent les mêmes économies d'espace que sur le stockage Oracle Exadata, mais ne fournissent pas le même niveau de performances de requête. Pour ces systèmes de stockage, la compression en colonnes hybride est idéale pour l'archivage dans la base de données d'anciennes données rarement consultées.
Unités de compression
La compression en colonnes hybride utilise une construction logique appelée unité de compression pour stocker un ensemble de lignes.
Lorsque vous chargez des données dans une table, la base de données stocke les groupes de lignes sous forme de colonnes, les valeurs de chaque colonne étant stockées et compressées ensemble. Une fois que la base de données a compressé les données de colonne pour un ensemble de lignes, elle les place dans l'unité de compression.
Par exemple, vous appliquez la compression en colonnes hybride à une table daily_sales. A la fin de chaque jour, vous renseignez la table avec les articles et le numéro de vente, avec l'ID et la date de l'article formant une clé primaire composite. Le tableau suivant présente un sous-ensemble des lignes dans daily_sales.
Tableau 3 Exemple de tableau daily_sales
| Item_ID | Date | Num_Sold | Shipped_From | Remettre en stock |
|---|---|---|---|---|
| 1 000 | 01-JUN-18 | 2 | WAREHOUSE1 | Y (Oui) |
| 1 001 | 01-JUN-18 | 0 | WAREHOUSE3 | N |
| 1 002 | 01-JUN-18 | 1 | WAREHOUSE3 | N |
| 1 003 | 01-JUN-14 | 0 | WAREHOUSE2 | N |
| 1 004 | 01-JUN-18 | 2 | WAREHOUSE1 | N |
| 1 005 | 01-JUN-18 | 1 | WAREHOUSE2 | N |
Supposons que ce sous-ensemble de lignes soit stocké dans une unité de compression. La compression hybride en colonnes stocke les valeurs de chaque colonne ensemble, puis utilise plusieurs algorithmes pour compresser chaque colonne. La base de données choisit les algorithmes en fonction de divers facteurs, notamment le type de données de la colonne, la cardinalité des valeurs réelles de la colonne et le niveau de compression choisi par l'utilisateur.
Comme indiqué dans le graphique suivant, chaque unité de compression peut s'étendre sur plusieurs blocs de données. Les valeurs d'une colonne particulière peuvent ou non s'étendre sur plusieurs blocs.
Figure 7 : Unité de compression
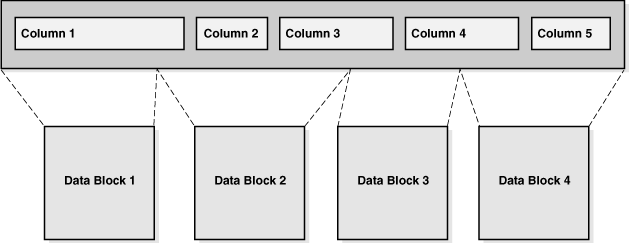
Description de l'image sagug004.gif
Si la compression en colonnes hybride ne permet pas d'économiser de l'espace, la base de données stocke les données au format DBMS_COMPRESSION.COMP_BLOCK. Dans ce cas, la base de données applique la compression OLTP aux blocs, qui résident dans un segment de compression en colonnes hybride.
Voir aussi :
-
Manuel de l'utilisateur Oracle AI Database Licensing Information pour en savoir plus sur les exigences en matière de licence pour la compression en colonnes hybride
-
Guide de l'administrateur Oracle AI Database pour apprendre à utiliser la compression en colonnes hybride
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
CREATE TABLE -
Référence Oracle AI Database PL/SQL Packages and Types pour en savoir plus sur le package
DBMS_COMPRESSION
LMD et compression en colonnes hybride
La compression en colonnes hybride a des implications pour le verrouillage de ligne dans différents types d'opérations LMD.
Chargements par chemin direct et insertions conventionnelles
Lorsque vous chargez des données dans une table qui utilise la compression en colonnes hybride, vous pouvez utiliser des insertions conventionnelles ou des chargements par chemin direct. Les chargements par chemin direct verrouillent la table entière, ce qui réduit la simultanéité.
A partir d'Oracle Database 12c version 2 (12.2), la prise en charge des insertions de tableau conventionnel dans le format de compression en colonnes hybride est ajoutée. Les avantages des inserts conventionnels sont :
-
Les lignes insérées utilisent des verrous de niveau ligne, ce qui augmente la simultanéité d'accès aux données.
-
L'optimisation automatique des données (ADO) et la carte d'activité prennent en charge la compression en colonnes hybride pour les stratégies de niveau ligne. Par conséquent, la base de données peut utiliser la compression en colonnes hybride pour les blocs éligibles même lorsque l'activité LMD se produit sur d'autres parties du segment.
Lorsque l'application utilise des insertions de baies conventionnelles, Oracle AI Database stocke les lignes en unités de compression lorsque les conditions suivantes sont remplies :
-
La table est stockée dans un tablespace ASSM.
-
Le niveau de compatibilité est 12.2.0.1 ou ultérieur.
-
La définition de table satisfait les contraintes de table de compression de colonne hybride existantes, y compris aucune colonne de type
LONGet aucune dépendance de ligne.
Les insertions conventionnelles génèrent des informations de journalisation et des informations d'annulation. Par conséquent, les unités de compression créées par une instruction LMD conventionnelle sont annulées (rollback) ou validées (commit) avec l'instruction LMD. La base de données assure automatiquement la maintenance des index, tout comme pour les lignes stockées dans des blocs de données conventionnels.
A partir d'Oracle AI Database 26ai, la compression automatique du stockage permet à Oracle AI Database de diriger initialement le chargement des données vers un format non compressé, puis de déplacer progressivement les lignes vers le format de compression hybride en colonnes en arrière-plan. Cela est transparent pour les utilisateurs tout en améliorant les performances ETL et en maintenant des performances de requête rapides.
Mises à jour et suppressions
Par défaut, la base de données verrouille toutes les lignes de l'unité de compression si une mise à jour ou une suppression est appliquée à une ligne de l'unité. Pour éviter ce problème, vous pouvez choisir d'activer le verrouillage de niveau ligne pour une table. Dans ce cas, la base de données verrouille uniquement les lignes affectées par l'opération de mise à jour ou de suppression.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment effectuer des insertions conventionnelles
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur l'instruction
INSERT -
Référence de langage SQL Oracle AI Database pour plus d'informations sur l'utilisation du conseil
COMPRESS_IMMEDIATE -
Oracle AI Database VLDB and Partitioning Guide, pour plus d'informations sur l'utilisation de la compression automatique du stockage
Compression en colonnes hybride de vitesse de mémoire
Memory Speed Hybrid Columnar Compression introduit des formats d'unités de compression sur disque qui peuvent être traités à la vitesse de la mémoire.
Semblable à la compression de colonne hybride, la compression de colonne hybride de vitesse de mémoire convient aux environnements d'entreposage de données. Il transforme les données dans un format orienté colonne et les compresse pendant le chargement des données. La principale différence réside dans le fait que la compression en colonnes hybride de la vitesse de la mémoire utilise le même format de colonne spécial que le stockage en colonnes en mémoire et CELLMEMORY dans le cache Flash Exadata, ce qui permet d'effectuer des analyses en colonnes à haut débit et une mise en cache en colonnes efficace dans tous les niveaux de stockage. En outre, les unités de compression en colonnes hybrides de la vitesse de la mémoire sont beaucoup plus grandes que les unités de compression en colonnes hybrides, ce qui permet une utilisation efficace du format en colonnes en mémoire sur le disque.
La compression de colonne hybride de vitesse de mémoire est activée en tant qu'extension de la compression de colonne hybride à l'aide de la commande CREATE TABLE en ajoutant le mot-clé MEMSPEED.
Exemple 4-6 Compression en colonnes hybride de vitesse de mémoire
L'exemple suivant crée la table orders avec la compression en colonnes hybride de vitesse de mémoire activée :
CREATE TABLE orders COLUMN STORE COMPRESS FOR MEMSPEED QUERY;Remarque : pour plus d'informations, reportez-vous à Référence de langage SQL Oracle AI Database.
Présentation des clusters de tables
Un cluster de tables est un groupe de tables qui partagent des colonnes communes et stockent les données associées dans les mêmes blocs.
Lorsque des tables sont clusterisées, un seul bloc de données peut contenir des lignes provenant de plusieurs tables. Par exemple, un bloc peut stocker des lignes provenant à la fois des tables employees et departments plutôt que d'une seule table.
La clé de cluster est la ou les colonnes que les tables clusterisées ont en commun. Par exemple, les tables employees et departments partagent la colonne department_id. Vous indiquez la clé de cluster lors de la création du cluster de tables et lors de la création de chaque table ajoutée au cluster de tables.
La valeur de clé de cluster est la valeur des colonnes de clé de cluster pour un ensemble particulier de lignes. Toutes les données qui contiennent la même valeur de clé de cluster, telle que department_id=20, sont stockées physiquement ensemble. Chaque valeur d'une clé de cluster n'est stockée qu'une seule fois dans le cluster et l'index du cluster, quel que soit la quantité de lignes des différentes tables contenant la valeur.
Pour une analogie, supposons qu'un responsable RH dispose de deux cas de liasse : l'un avec des boîtes de dossiers d'employé et l'autre avec des boîtes de dossiers de service. Les utilisateurs demandent souvent les dossiers de tous les employés d'un service donné. Pour faciliter la récupération, le responsable réorganise toutes les cases dans un seul cas de livre. Elle divise les cases par code service. Ainsi, tous les dossiers pour les employés du service 20 et le dossier pour le service 20 lui-même sont dans une boîte ; les dossiers pour les employés du service 100 et le dossier pour le service 100 sont dans une autre boîte, etc.
Envisagez de regrouper les tables lorsqu'elles sont principalement interrogées (mais pas modifiées) et que les enregistrements des tables sont fréquemment interrogés ensemble ou joints. Etant donné que les clusters de tables stockent des lignes associées de différentes tables dans les mêmes blocs de données, les clusters de tables correctement utilisés offrent les avantages suivants par rapport aux tables non clusterisées :
-
L'E/S disque est réduite pour des jointures de tables clusterisées.
-
Le temps d'accès améliore les jointures des tables clusterisées.
-
Le stockage des données de table et d'index associées est réduit car la valeur de clé de cluster n'est pas stockée de façon répétée pour chaque ligne.
En général, les tables de clustering ne sont pas appropriées dans les situations suivantes :
-
Les tables sont fréquemment mises à jour.
-
Les tables nécessitent souvent un balayage complet des tables.
-
Les tables doivent être tronquées.
-
Présentation des clusters indexés Un cluster d'index est un cluster de tables qui utilise un index pour localiser les données. L'index de cluster est un index B-tree sur la clé de cluster. Un index de cluster doit être créé pour que des lignes puissent être insérées dans des tables clusterisées.
-
Présentation des clusters hash Un cluster hash est comme un cluster indexé, à la différence près que la clé d'index est remplacée par une fonction de hachage. Aucun index de cluster distinct n'existe. Dans un cluster de hachage, les données sont l'index.
Présentation des clusters indexés
Un cluster d'index est un cluster de tables qui utilise un index pour localiser les données. L'index de cluster est un index B-tree sur la clé de cluster. Un index de cluster doit être créé pour que des lignes puissent être insérées dans des tables clusterisées.
Exemple 4-7 Création d'un cluster de tables et d'un index associé
Supposons que vous créez le cluster employees_departments_cluster avec la clé de cluster department_id, comme indiqué dans l'exemple suivant :
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 512;

CREATE INDEX idx_emp_dept_cluster
   ON CLUSTER employees_departments_cluster;
Etant donné que la clause HASHKEYS n'est pas indiquée, employees_departments_cluster est un cluster indexé. L'exemple précédent crée un index nommé idx_emp_dept_cluster sur la clé de cluster department_id.
Exemple 4-8 Création de tables dans un cluster indexé
Vous créez les tables employees et departments dans le cluster en indiquant la colonne department_id comme clé de cluster, comme suit (les points de suspension indiquent l'emplacement où la spécification de colonne va) :
CREATE TABLE employees ( ... )
   CLUSTER employees_departments_cluster (department_id);

CREATE TABLE departments ( ... )
   CLUSTER employees_departments_cluster (department_id);
Supposons que vous ajoutez des lignes aux tables employees et departments. La base de données stocke physiquement toutes les lignes de chaque département des tables employees et departments dans les mêmes blocs de données. La base de données stocke les lignes dans une portion de mémoire et les localise avec l'index. La figure 4-8 présente le cluster de tables employees_departments_cluster, qui contient employees et departments. La base de données stocke les lignes des employés du service 20 ensemble, du service 110 ensemble, etc. Si les tables ne sont pas clusterisées, la base de données ne garantit pas que les lignes associées sont stockées ensemble.
Figure 8 : Données de table clusterisées
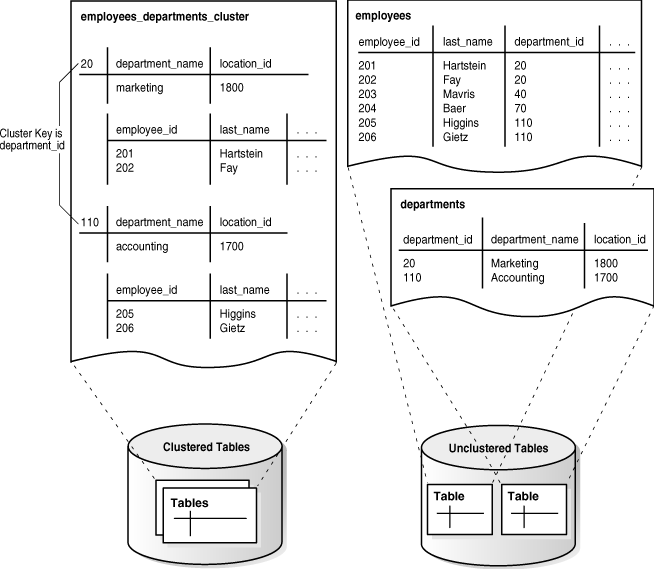
Description de l'image cncpt023.gif
L'index de cluster B-tree associe la valeur de clé de cluster à l'adresse de bloc de base de données (DBA) du bloc contenant les données. Par exemple, l'entrée d'index de la clé 20 indique l'adresse du bloc qui contient les données des employés du service 20 :
20,AADAAAA9dL'index de cluster est géré séparément, tout comme un index sur une table non clusterisée, et peut exister dans un tablespace distinct du cluster de tables.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment créer et gérer des clusters indexés
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
CREATE CLUSTER
Présentation des clusters de hachage
Un cluster de hachage est comme un cluster indexé, sauf que la clé d'index est remplacée par une fonction de hachage. Aucun index de cluster distinct n'existe. Dans un cluster de hachage, les données sont l'index.
Avec une table indexée ou un cluster indexé, Oracle AI Database localise les lignes de table à l'aide de valeurs de clé stockées dans un index distinct. Pour rechercher ou stocker une ligne dans une table indexée ou un cluster de tables, la base de données doit effectuer au moins deux E/S :
-
E/S pour rechercher ou stocker la valeur de clé dans l'index
-
Une autre E/S pour lire ou écrire la ligne dans la table ou le cluster de tables
Pour rechercher ou stocker une ligne dans un cluster de hachage, Oracle AI Database applique la fonction de hachage à la valeur de clé de cluster de la ligne. La valeur de hachage résultante correspond à un bloc de données du cluster, que la base de données lit ou écrit pour le compte de l'instruction émise.
Le hachage est un moyen facultatif de stocker des données de table pour améliorer les performances de l'extraction des données. Les clusters de hachage peuvent être bénéfiques lorsque les conditions suivantes sont remplies :
-
Une table est interrogée beaucoup plus souvent que modifiée.
-
La colonne de clé de hachage est fréquemment interrogée avec des conditions d'égalité, par exemple,
WHERE department_id=20. Pour ces requêtes, la valeur de la clé de cluster est hachée. La valeur de la clé de hachage pointe directement vers la zone de disque qui stocke les lignes. -
Vous pouvez raisonnablement deviner le nombre de clés de hachage et la taille des données stockées avec chaque valeur de clé.
-
Création de cluster de hachage Pour créer un cluster de hachage, vous utilisez la même instruction
CREATE CLUSTERque pour un cluster indexé, avec l'ajout d'une clé de hachage. Le nombre de valeurs de hachage pour le cluster dépend de la clé de hachage. -
Requêtes de cluster de hachage Dans les requêtes d'un cluster de hachage, la base de données détermine le hachage des valeurs de clé entrées par l'utilisateur.
-
Variations de cluster de hachage Un cluster de hachage à table unique est une version optimisée d'un cluster de hachage qui prend en charge une seule table à la fois. Il existe un mapping un à un entre les clés de hachage et les lignes.
-
Stockage de cluster de hachage Oracle AI Database alloue de l'espace à un cluster de hachage différemment d'un cluster indexé.
Création de cluster de hachage
Pour créer un cluster de hachage, vous utilisez la même instruction CREATE CLUSTER que pour un cluster indexé, avec l'ajout d'une clé de hachage. Le nombre de valeurs de hachage pour le cluster dépend de la clé de hachage.
La clé de cluster, comme la clé d'un cluster indexé, est une clé composite ou à colonne unique partagée par les tables du cluster. Une valeur de clé de hachage est une valeur réelle ou possible insérée dans la colonne de clé de cluster. Par exemple, si la clé de cluster est department_id, les valeurs de clé de hachage peuvent être 10, 20, 30, etc.
Oracle AI Database utilise une fonction de hachage qui accepte un nombre infini de valeurs de clé de hachage en entrée et les trie en un nombre fini de buckets. Chaque bucket possède un ID numérique unique appelé valeur de hachage. Chaque valeur de hachage correspond à l'adresse de bloc de la base de données du bloc qui stocke les lignes correspondant à la valeur de clé de hachage (service 10, 20, 30, etc.).
Dans l'exemple suivant, le nombre de services susceptibles d'exister est de 100. Par conséquent, HASHKEYS est défini sur 100 :
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 8192 HASHKEYS 100;
Une fois que vous avez créé employees_departments_cluster, vous pouvez créer les tables employees et departments dans le cluster. Vous pouvez ensuite charger des données dans le cluster de hachage comme dans le cluster indexé.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment créer et gérer des clusters de hachage
Requêtes de cluster hash
Dans les requêtes d'un cluster de hachage, la base de données détermine comment hacher les valeurs de clé entrées par l'utilisateur.
Par exemple, les utilisateurs exécutent fréquemment des requêtes telles que les suivantes, en saisissant différents numéros d'ID de département pour p_id :
SELECT *
FROM   employees
WHERE  department_id = :p_id;

SELECT *
FROM   departments
WHERE  department_id = :p_id;

SELECT *
FROM   employees e, departments d
WHERE  e.department_id = d.department_id
AND    d.department_id = :p_id;
Si un utilisateur interroge des employés dans department_id=20, la base de données peut hacher cette valeur au bucket 77. Si un utilisateur interroge des employés dans department_id=10, la base de données peut hacher cette valeur dans le bucket 15. La base de données utilise la valeur de hachage générée en interne pour localiser le bloc qui contient les lignes d'employé pour le service demandé.
L'illustration suivante représente un segment de cluster de hachage sous la forme d'une ligne horizontale de blocs. Comme indiqué dans le graphique, une requête peut extraire des données en une seule E/S.
Figure 9 : Extraire des données d'un cluster de hachages
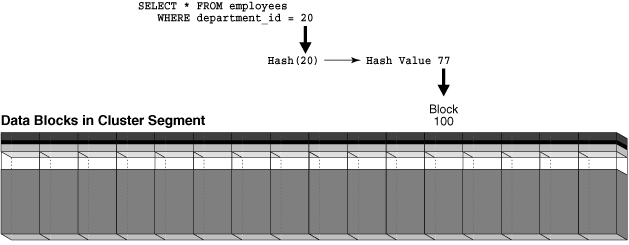
Description de l'image cncpt329.gif
Une limitation des clusters de hachage est l'indisponibilité des balayages de plage sur les clés de cluster non indexées. Supposons qu'aucun index distinct n'existe pour le cluster de hachage créé dans Création de cluster de hachage. Une requête pour les services dont l'ID est compris entre 20 et 100 ne peut pas utiliser l'algorithme de hachage car elle ne peut pas hacher toutes les valeurs possibles entre 20 et 100. Etant donné qu'aucun index n'existe, la base de données doit effectuer un balayage complet.
Voir aussi : "Analyse de plage d'index"
Variations de cluster de hachages
Un cluster de hachage à table unique est une version optimisée d'un cluster de hachage qui prend en charge une seule table à la fois. Il existe un mapping un à un entre les clés de hachage et les lignes.
Un cluster de hachage à table unique peut être avantageux lorsque les utilisateurs ont besoin d'un accès rapide à une table par clé primaire. Par exemple, les utilisateurs recherchent souvent un enregistrement d'employé dans la table employees par employee_id.
Un cluster de hachage trié stocke les lignes correspondant à chaque valeur de la fonction de hachage de manière à ce que la base de données puisse les renvoyer efficacement par ordre trié. La base de données effectue le tri optimisé en interne. Pour les applications qui consomment toujours des données par ordre trié, cette technique peut accélérer l'extraction des données. Par exemple, une application peut toujours trier les données sur la colonne order_date de la table orders.
Voir aussi : Guide de l'administrateur Oracle AI Database pour découvrir comment créer des clusters de hachage triés et à table unique
Stockage de cluster hash
Oracle AI Database alloue l'espace à un cluster de hachage différemment d'un cluster indexé.
Dans l'exemple de la section Création de cluster de hachage, HASHKEYS indique le nombre de services susceptibles d'exister, tandis que SIZE indique la taille des données associées à chaque service. La base de données calcule une valeur d'espace de stockage en fonction de la formule suivante :
HASHKEYS * SIZE / database_block_sizePar conséquent, si la taille de bloc est de 4096 octets dans l'exemple présenté dans la section Création de cluster de hachage, la base de données alloue au moins 200 blocs au cluster de hachage.
Oracle AI Database ne limite pas le nombre de valeurs de clé de hachage que vous pouvez insérer dans le cluster. Par exemple, même si HASHKEYS est 100, rien ne vous empêche d'insérer 200 services uniques dans la table departments. Cependant, l'efficacité de la récupération de cluster de hachage diminue lorsque le nombre de valeurs de hachage dépasse le nombre de clés de hachage.
Pour illustrer les problèmes d'extraction, supposons que le bloc 100 de la figure 4-9 est complètement rempli de lignes pour le département 20. Un utilisateur insère un nouveau département avec department_id 43 dans la table departments. Le nombre de services dépasse la valeur HASHKEYS, de sorte que la base de données hachage department_id 43 à la valeur de hachage 77, qui est la même valeur de hachage que celle utilisée pour department_id 20. Le hachage de plusieurs valeurs d'entrée à la même valeur de sortie est appelé une collision de hachage.
Lorsque les utilisateurs insèrent des lignes dans le cluster pour le département 43, la base de données ne peut pas stocker ces lignes dans le bloc 100, qui est plein. La base de données relie le bloc 100 à un nouveau bloc de débordement, par exemple le bloc 200, et stocke les lignes insérées dans le nouveau bloc. Les blocs 100 et 200 peuvent désormais stocker des données pour chaque service. Comme l'illustre la figure 4-10, une requête de département 20 ou 43 requiert désormais deux E/S pour extraire les données : le bloc 100 et le bloc 200 associé. Vous pouvez résoudre ce problème en recréant le cluster avec une valeur HASHKEYS différente.
Figure 10 : Extraction de données d'un cluster de hachages en cas de collision de hachages
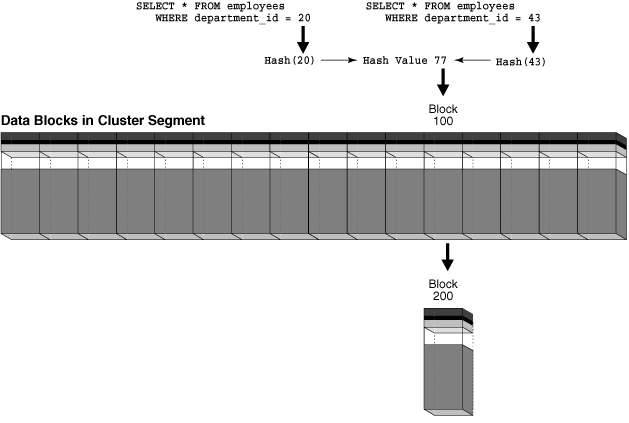
Description de l'image cncpt331.gif
Voir aussi : Guide de l'administrateur Oracle AI Database pour savoir comment gérer l'espace dans les clusters de hachage
Présentation des tables à cluster d'attributs
Une table clusterisée d'attributs est une table organisée en portions de mémoire qui stocke les données à proximité immédiate du disque en fonction des directives de clustering spécifiées par l'utilisateur. Les directives indiquent des colonnes dans une ou plusieurs tables.
Les directives sont les suivantes :
-
La directive
CLUSTERING ... BY LINEAR ORDERordonne les données d'une table en fonction des colonnes indiquées.Envisagez d'utiliser le clustering
BY LINEAR ORDER, qui est la valeur par défaut, lorsque les requêtes qualifient le préfixe des colonnes indiqué dans la clause de clustering. Par exemple, si les requêtes desh.salesspécifient souvent un ID client ou un ID client et un ID produit, vous pouvez regrouper les données de la table à l'aide de l'ordre linéaire des colonnescust_id,prod_id. -
La directive
CLUSTERING ... BY INTERLEAVED ORDERordonne les données dans une ou plusieurs tables à l'aide d'un algorithme spécial, semblable à une fonction d'ordre Z, qui permet de réduire les E/S multicolonnes.Envisagez d'utiliser le clustering
BY INTERLEAVED ORDERlorsque les requêtes indiquent une variété de combinaisons de colonnes. Par exemple, si les requêtes desh.salesindiquent différentes dimensions dans différents ordres, vous pouvez regrouper les données de la tablesalesen fonction des colonnes de ces dimensions.
Le clustering d'attributs n'est disponible que pour les opérations d'insertion de chemin direct. Elle est ignorée pour les instructions LMD classiques.
Cette section comprend les rubriques suivantes :
-
Avantages des tables clusterisées d'attributs Le principal avantage des tables clusterisées d'attributs est la réduction des E/S, qui peut réduire considérablement le coût des E/S et le coût CPU des analyses de table. La réduction des E/S se produit soit avec des zones, soit en réduisant les E/S physiques grâce à une proximité physique plus étroite sur le disque pour les valeurs clusterisées.
-
Le clustering d'attributs Joindre des tables clusterisées d'attributs basé sur des colonnes jointes est appelé clustering d'attributs de jointure. Contrairement aux clusters de tables, les tables clusterisées avec attributs de jointure ne stockent pas les données d'un groupe de tables dans les mêmes blocs de base de données.
-
Réduction d'E/S à l'aide de zones Une zone est un ensemble de blocs de données contigus qui stocke les valeurs minimale et maximale des colonnes pertinentes.
-
Tables à attributs groupés avec tri linéaire Un schéma de tri linéaire pour une table divise les lignes en plages en fonction des attributs spécifiés par l'utilisateur dans un ordre spécifique. Oracle AI Database prend en charge l'ordre linéaire sur une ou plusieurs tables connectées via une relation clé primaire-clé étrangère.
-
Le tri entrelacé des tables clusterisées d'attributs avec commande entrelacée utilise une technique similaire à un ordre Z.
Avantages des tables clusterisées par attributs
Le principal avantage des tables clusterisées d'attributs est la réduction des E/S, qui peut réduire considérablement le coût des E/S et le coût CPU des analyses de table. La réduction des E/S se produit soit avec des zones, soit en réduisant les E/S physiques grâce à une proximité physique plus étroite sur le disque pour les valeurs clusterisées.
Une table clusterisée d'attributs présente les avantages suivants :
-
Vous pouvez clusteriser des tables de faits en fonction de colonnes de dimension dans des schémas en étoile.
Dans les schémas en étoile, la plupart des interrogations qualifient les tables de dimension et non les tables de faits. Par conséquent, le regroupement par colonnes de table de faits n'est pas efficace. Oracle AI Database prend en charge le clustering sur les colonnes des tables de dimensions.
-
La réduction des E/S peut se produire dans plusieurs scénarios différents :
-
Utilisé avec les index de stockage Oracle Exadata, l'élagage min/max Oracle In-Memory ou les cartes de zones
-
Dans les applications OLTP pour les requêtes qui qualifient un préfixe et utilisent un cluster d'attributs avec ordre linéaire
-
Sur un sous-ensemble de colonnes de clustering pour le clustering
BY INTERLEAVED ORDER
-
-
Le clustering d'attributs peut améliorer la compression des données et ainsi indirectement améliorer les coûts de balayage des tables.
Lorsque les mêmes valeurs sont proches les unes des autres sur le disque, la base de données peut plus facilement les compresser.
-
Oracle AI Database n'engage pas le coût de stockage et de maintenance d'un index.
Voir aussi : Guide d'entreposage de données Oracle AI Database pour plus d'avantages des tables clusterisées d'attributs
Joindre des tables clusterisées d'attributs
Le clustering d'attributs basé sur des colonnes jointes est appelé clustering d'attributs de jointure. Contrairement aux clusters de tables, les tables clusterisées avec attributs de jointure ne stockent pas les données d'un groupe de tables dans les mêmes blocs de base de données.
Prenons par exemple une table de cluster d'attributs, sales, jointe à une table de dimension, products. La table sales contient uniquement les lignes de la table sales, mais l'ordre des lignes est basé sur les valeurs des colonnes jointes de la table products. La jointure appropriée est exécutée pendant les opérations de déplacement de données, d'insertion de chemin direct et CREATE TABLE AS SELECT. En revanche, si sales et products se trouvaient dans un cluster de tables standard, les blocs de données contiennent des lignes des deux tables.
Voir aussi : Guide de l'entreposage de données Oracle AI Database pour en savoir plus sur le clustering d'attributs de jointure
Réduction des E/S à l'aide de zones
Une zone est un ensemble de blocs de données contigus qui stocke les valeurs minimale et maximale des colonnes pertinentes.
Lorsqu'une instruction SQL contient des prédicats sur des colonnes stockées dans une zone, la base de données compare les valeurs de prédicat aux valeurs minimale et maximale stockées dans la zone. Ainsi, la base de données détermine les zones à lire lors de l'exécution SQL.
La réduction des E/S est la possibilité d'ignorer les blocs de table ou d'index qui ne contiennent pas de données dont la base de données a besoin pour satisfaire une requête. Cette réduction peut considérablement réduire le coût d'E/S et d'UC des analyses de table.
-
Objectif des zones Pour une analogie lâche des zones, envisagez un responsable des ventes qui utilise une bibliothèque de pigeons, qui sont analogues aux blocs de données.
-
Carte des zones Une carte des zones est une structure d'accès indépendante qui divise les blocs de données en zones. Oracle AI Database implémente chaque carte de zones en tant que type de vue matérialisée.
-
Création de carte de zone Les cartes de zone de base sont créées manuellement ou automatiquement.
-
Fonctionnement d'une carte de zones : Exemple Cet exemple illustre comment une carte de zones peut élaguer des données dans une requête dont le prédicat contient une constante.
Finalité des zones
Pour une analogie lâche des zones, envisagez un directeur des ventes qui utilise une bibliothèque de pigeons, qui sont analogues aux blocs de données.
Chaque trou de pigeon a des reçus (lignes) décrivant les chemises vendues à un client, commandées par date d'expédition. Dans cette analogie, une carte de zone est comme une pile de cartes d'index. Chaque carte correspond à une "zone" (plage contigu) de trous de pigeon, tels que des trous de pigeon 1-10. Pour chaque zone, la carte indique les dates d'expédition minimum et maximum des reçus stockés dans la zone.
Quand quelqu'un veut savoir quelles chemises ont été expédiées à une certaine date, le gestionnaire retourne les cartes jusqu'à ce qu'elle arrive à la plage de dates qui contient la date demandée, note la zone de trou de pigeon, puis recherche uniquement les pigeons dans cette zone pour les reçus demandés. De cette façon, le gestionnaire évite de rechercher les reçus dans chaque trou de pigeon de la bibliothèque.
Cartes de zones
Une carte de zones est une structure d'accès indépendante qui divise les blocs de données en zones. Oracle AI Database implémente chaque carte de zones en tant que type de vue matérialisée.
Comme les index, les cartes de zones peuvent réduire les coûts d'E/S et de CPU des balayages de table. Lorsqu'une instruction SQL contient des prédicats sur les colonnes d'une carte de zones, la base de données compare les valeurs de prédicat aux valeurs de colonne de table minimum et maximum stockées dans chaque zone pour déterminer les zones à lire lors de l'exécution SQL.
Une carte de zone de base est définie sur une seule table et conserve les valeurs minimale et maximale de certaines colonnes de cette table. Une matrice de zones de jointure est définie sur une table qui a une jointure externe avec une ou plusieurs autres tables et conserve les valeurs minimale et maximale de certaines colonnes dans les autres tables. Oracle AI Database gère automatiquement les deux types de carte de zones.
Au plus une carte de zones peut exister sur une table. Dans le cas d'une table partitionnée, une carte de zones existe pour toutes les partitions et sous-partitions. Une carte de zones d'une table partitionnée permet également de suivre les valeurs minimale et maximale par zone, par partition et par sous-partition. Les définitions de carte de zones peuvent inclure les valeurs minimum et maximum des colonnes de dimension, à condition que la table comporte une jointure externe avec les tables de dimension. Remarque : vous pouvez créer une carte de zones contenant uniquement la zone de niveau partition ou sous-partition. La création d'une telle carte de zones étend les fonctions d'élagage de partition au-delà des métadonnées de partition.
Voir aussi : Guide de l'entreposage de données Oracle AI Database pour une présentation des cartes de zones
Création de carte de zones
Les cartes de zone de base sont créées manuellement ou automatiquement.
-
Cartes de zones manuelles Vous pouvez créer, supprimer et tenir à jour des cartes de zones à l'aide d'instructions LDD.
-
Cartes de zones automatiques Oracle AI Database peut créer des cartes de zones de base automatiquement. Ces cartes sont appelées cartes de zones automatiques.
Cartes de zones manuelles
Vous pouvez créer, supprimer et gérer des cartes de zones à l'aide d'instructions LDD.
Chaque fois que vous indiquez la clause CLUSTERING dans une instruction CREATE TABLE ou ALTER TABLE, la base de données crée automatiquement une correspondance de zones sur les colonnes de clustering indiquées. La carte de zones met en corrélation les valeurs minimale et maximale des colonnes avec des blocs de données consécutifs dans la table clusterisée d'attributs. Les tables clusterisées d'attributs utilisent des mappes de zones pour réduire les E/S.
Vous pouvez également créer des cartes de zones explicitement à l'aide de l'instruction CREATE MATERIALIZED ZONEMAP. Dans ce cas, vous pouvez créer des cartes de zones à utiliser avec ou sans clustering d'attributs. Par exemple, vous pouvez créer une carte de zones sur une table dont les lignes sont naturellement triées sur un ensemble de colonnes, comme une table boursière dont les transactions sont triées par heure.
Voir aussi :
-
Guide de l'entreposage de données Oracle AI Database pour en savoir plus sur la création de cartes de zones
Cartes de zones automatiques
Oracle AI Database peut créer automatiquement des cartes de zone de base. Ces cartes sont appelées cartes de zones automatiques.
Oracle AI Database peut créer automatiquement des mappings de zone de base pour les tables partitionnées et non partitionnées. Un processus en arrière-plan gère automatiquement les cartes de zones créées de cette manière.
Utilisez la procédure DBMS_AUTO_ZONEMAP pour activer les cartes de zones automatiques :
EXEC DBMS_AUTO_ZONEMAP.CONFIGURE('AUTO_ZONEMAP_MODE','ON')Voir aussi :
-
Guide de l'entreposage de données Oracle AI Database pour en savoir plus sur la gestion des cartes de zones automatiques à l'aide du package
DBMS_AUTO_ZONEMAP -
Référence des types et packages PL/SQL Oracle AI Database pour en savoir plus sur le package
DBMS_AUTO_ZONEMAP -
Manuel de l'utilisateur Oracle AI Database Licensing Information pour plus de détails sur les fonctionnalités prises en charge pour différentes éditions et différents services
Fonctionnement d'une carte de zones : Exemple
Cet exemple illustre comment une carte de zones peut élaguer des données dans une requête dont le prédicat contient une constante.
Supposons que vous créez la table lineitem suivante :
CREATE TABLE lineitem
  ( orderkey      NUMBER        ,
    shipdate      DATE          ,
    receiptdate   DATE          ,
    destination   VARCHAR2(50)  ,
    quantity      NUMBER        );
La table lineitem contient 4 blocs de données avec 2 lignes par bloc. Le Table 4-4 présente les 8 lignes de la table.
Tableau 4 Blocs de données pour la table de lignes
| Bloc | clé de commande | date d'expédition | date de réception | destination | quantité |
|---|---|---|---|---|---|
| 1 | 1 | 1-1-2014 | 1-10-2014 | San_Fran | 100 |
| 1 | 2 | 1-2-2014 | 1-10-2014 | San_Fran | 200 |
| 2 | 3 | 1-3-2014 | 1-9-2014 | San_Fran | 100 |
| 2 | 4 | 1-5-2014 | 1-10-2014 | San_Diego | 100 |
| 3 | 5 | 1-10-2014 | 1-15-2014 | San_Fran | 100 |
| 3 | 6 | 1-12-2014 | 1-16-2014 | San_Fran | 200 |
| 4 | 7 | 1-13-2014 | 1-20-2014 | San_Fran | 100 |
| 4 | 8 | 1-15-2014 | 1-30-2014 | San_Jose | 100 |
Vous pouvez utiliser l'instruction CREATE MATERIALIZED ZONEMAP pour créer une carte de zones sur la table lineitem. Chaque zone contient 2 blocs et stocke les valeurs minimale et maximale des colonnes orderkey, shipdate et receiptdate. Le Table 4-5 présente la carte des zones.
Tableau 5 Carte des zones pour la table des lignes
| Plage de blocs | clé de commande min. | clé de commande max | date d'expédition minimum | date d'expédition max. | date de réception min. | date de réception maximum |
|---|---|---|---|---|---|---|
| 1-2 | 1 | 4 | 1-1-2014 | 1-5-2014 | 1-9-2014 | 1-10-2014 |
| 3-4 | 5 | 8 | 1-10-2014 | 1-15-2014 | 1-15-2014 | 1-30-2014 |
Lorsque vous exécutez l'interrogation suivante, la base de données peut lire la carte de zones, puis analyser uniquement les blocs 1 et 2, et donc ignorer les blocs 3 et 4, car la date 1-3-2014 est comprise entre les dates minimum et maximum :
SELECT * FROM lineitem WHERE shipdate = '1-3-2014';Voir aussi :
-
Guide de l'entreposage de données Oracle AI Database pour apprendre à utiliser les cartes de zones
-
Référence de langage SQL Oracle AI Database pour la syntaxe et la sémantique de l'instruction
CREATE MATERIALIZED ZONEMAP
Tables groupées d'attributs avec tri linéaire
Un schéma de tri linéaire pour une table divise les lignes en plages en fonction des attributs spécifiés par l'utilisateur dans un ordre spécifique. Oracle AI Database prend en charge l'ordre linéaire sur une ou plusieurs tables connectées via une relation clé primaire-clé étrangère.
Par exemple, la table sales divise les colonnes cust_id et prod_id en plages, puis regroupe ces plages sur le disque. Lorsque vous indiquez la directive BY LINEAR ORDER pour une table, une réduction significative des E/S peut se produire lorsqu'un prédicat spécifie la colonne de préfixe ou toutes les colonnes de la directive.
Supposons que les requêtes de sales spécifient souvent un ID client ou une combinaison d'un ID client et d'un ID produit. Vous pouvez créer une table clusterisée d'attributs pour que ces requêtes bénéficient d'une réduction des E/S :
CREATE TABLE sales
(
   prod_id     NOT NULL NUMBER
,  cust_id     NOT NULL NUMBER
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING
  BY LINEAR ORDER (cust_id, prod_id)
  YES ON LOAD YES ON DATA MOVEMENT
  WITH MATERIALIZED ZONEMAP;
Les requêtes qui qualifient les deux colonnes cust_id et prod_id, ou le préfixe cust_id, subissent une réduction des E/S. Les requêtes qui qualifient prod_id uniquement ne subissent pas de réduction significative des E/S car prod_id est le suffixe de la clause BY LINEAR ORDER. Les exemples suivants montrent comment la base de données peut réduire les E/S lors des balayages de table.
Exemple 4-9 Spécification de cust_id uniquement
Une application émet l'interrogation suivante :
SELECT * FROM sales WHERE cust_id = 100;Etant donné que la table sales est un cluster BY LINEAR ORDER, la base de données doit uniquement lire les zones qui incluent la valeur cust_id de 100.
Exemple 4-10 Spécification de prod_id et cust_id
Une application émet l'interrogation suivante :
SELECT * FROM sales WHERE cust_id = 100 AND prod_id = 2300;Etant donné que la table sales est un cluster BY LINEAR ORDER, la base de données doit uniquement lire les zones qui incluent la valeur cust_id de 100 et la valeur prod_id de 2300.
Voir aussi :
-
Guide d'entreposage de données Oracle AI Database pour apprendre à mettre en cluster des tables à l'aide de l'ordre linéaire
-
Référence de langage SQL Oracle AI Database pour la syntaxe et la sémantique de la clause
BY LINEAR ORDER
Tables groupées d'attributs avec tri entrelacé
Le tri entrelacé utilise une technique similaire à un ordre Z.
L'ordre entrelacé permet à la base de données de nettoyer les E/S en fonction de n'importe quel sous-ensemble de prédicats dans les colonnes de clustering. Le tri entrelacé est utile pour les hiérarchies dimensionnelles dans un data warehouse.
Comme pour les tables clusterisées d'attributs avec tri linéaire, Oracle AI Database prend en charge le tri entrelacé sur une ou plusieurs tables connectées via une relation clé primaire-clé étrangère. Les colonnes des tables autres que la table de cluster d'attributs doivent être liées par une clé étrangère et jointes à la table de cluster d'attributs.
Les data warehouses volumineux organisent fréquemment les données dans un schéma en étoile. Une table de dimensions utilise une hiérarchie parent-enfant et est connectée à une table de faits par une clé étrangère. La mise en cluster d'une table de faits par ordre imbriqué permet à la base de données d'utiliser une fonction spéciale pour ignorer les valeurs des colonnes de dimension lors des balayages de table.
Exemple 4-11 Exemple de tri entrelacé
Supposons que votre entrepôt de données contient une table de faits sales et ses deux tables de dimension : customers et products. La plupart des interrogations ont des prédicats sur la hiérarchie de table customers (cust_state_province, cust_city) et sur la hiérarchie de produits (prod_category, prod_subcategory). Vous pouvez utiliser l'ordre entrelacé pour la table sales comme indiqué dans l'instruction partielle de l'exemple suivant :
CREATE TABLE sales
(
   prod_id NUMBER NOT NULL
,  cust_id NUMBER NOT NULL
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING sales
   JOIN products ON (sales.prod_id = products.prod_id)
   JOIN customers ON (sales.cust_id = customers.cust_id)
   BY INTERLEAVED ORDER
   (
     (  products.prod_category
     ,  products.prod_subcategory
     ),
     (  customers.cust_state_province
     ,  customers.cust_city
     )
   )
WITH MATERIALIZED ZONEMAP;
Remarque : les colonnes indiquées dans la clause BY INTERLEAVED ORDER ne doivent pas nécessairement figurer dans les tables de dimension réelles, mais elles doivent être connectées via une relation clé primaire-clé étrangère.
Supposons qu'une application interroge les tables sales, products et customers dans une jointure. La requête indique les colonnes customers.prod_category et customers_cust_state_province dans le prédicat comme suit :
SELECT cust_city, prod_sub_category, SUM(amount_sold)
FROM   sales, products, customers
WHERE  sales.prod_id = products.prod_id
AND    sales.cust_id = customers.cust_id
AND    customers.prod_category = 'Boys'
AND    customers.cust_state_province = 'England - Norfolk'
GROUP BY cust_city, prod_sub_category;
Dans la requête précédente, les colonnes prod_category et cust_state_province font partie de la définition de clustering présentée dans l'exemple CREATE TABLE. Au cours de l'analyse de la table sales, la base de données peut consulter la carte de zones et accéder uniquement aux rowids de cette zone.
Voir aussi :
-
Guide de l'entreposage de données Oracle AI Database pour apprendre à clusteriser des tables à l'aide de la commande entrelacée
-
Référence de langage SQL Oracle AI Database pour la syntaxe et la sémantique de la clause
BY INTERLEAVED ORDER
Présentation des tables temporaires
Une table temporaire contient des données qui n'existent que pendant la durée d'une transaction ou d'une session.
Les données d'une table temporaire sont privées de la session. Chaque session ne peut voir et modifier que ses propres données.
Vous pouvez créer une table temporaire globale ou une table temporaire privée. Le tableau suivant présente les différences essentielles entre elles.
Tableau 6 Caractéristiques de la table temporaire
| Caractéristique | Global | Privé |
|---|---|---|
| Règles de dénomination | Identique aux tables permanentes | Doit être précédé de ORA$PTT_ |
| Visibilité de la définition de table | Toutes les sessions | Seule la session qui a créé la table |
| Stockage de la définition de table | Disque | Mémoire uniquement |
| Types | Spécifique à la transaction (ON COMMIT DELETE ROWS) ou spécifique à la session (ON COMMIT PRESERVE ROWS) |
Spécifique à la transaction (ON COMMIT DROP DEFINITION) ou spécifique à la session (ON COMMIT PRESERVE DEFINITION) |
Un troisième type de table temporaire, appelé table temporaire de durée de curseur, est créé automatiquement par la base de données pour certains types de requête.
-
Objectif des tables temporaires Les tables temporaires sont utiles dans les applications où un ensemble de résultats doit être mis en mémoire tampon.
-
Allocation de segments dans les tables temporaires Comme les tables permanentes, les tables temporaires globales sont des objets persistants définis de manière statique dans le dictionnaire de données. Pour les tables temporaires privées, les métadonnées existent uniquement en mémoire, mais elles peuvent résider dans le tablespace temporaire sur disque.
-
Création d'une table temporaire L'instruction
CREATE ... TEMPORARY TABLEcrée une table temporaire. Voir aussi : Guide de réglage SQL Oracle AI Database pour en savoir plus sur les tables temporaires de durée de curseur
Objet des tables temporaires
Les tables temporaires sont utiles dans les applications où un ensemble de résultats doit être mis en mémoire tampon.
Par exemple, une application de planification permet aux étudiants de créer des calendriers de cours facultatifs pour le semestre. Une ligne d'une table temporaire globale représente chaque planning. Pendant la session, les données de planification sont privées. Lorsque l'étudiant choisit un calendrier, l'application déplace la ligne du calendrier choisi vers une table permanente. A la fin de la session, la base de données supprime automatiquement les données de planification qui se trouvaient dans la table temporaire globale.
Les tables temporaires privées sont utiles pour les applications de reporting dynamique. Par exemple, une application de gestion des ressources client (CRM) peut se connecter en tant que même utilisateur indéfiniment, avec plusieurs sessions actives en même temps. Chaque session crée une table temporaire privée nommée ORA$PTT_crm pour chaque nouvelle transaction. L'application peut utiliser le même nom de table pour chaque session, mais modifier la définition. Les données et la définition sont visibles uniquement par la session. La définition de la table persiste jusqu'à la fin de la transaction ou jusqu'à ce que la table soit supprimée manuellement.
Affectation de segment dans les tables temporaires
Comme les tables permanentes, les tables temporaires globales sont des objets persistants définis de manière statique dans le dictionnaire de données. Pour les tables temporaires privées, les métadonnées existent uniquement en mémoire, mais elles peuvent résider dans le tablespace temporaire sur disque.
Pour les tables temporaires globales et privées, la base de données alloue des segments temporaires lorsqu'une session insère les données pour la première fois. Tant que les données ne sont pas chargées dans une session, la table apparaît vide. Pour les tables temporaires spécifiques d'une transaction, la base de données libère les segments temporaires à la fin de la transaction. Pour les tables temporaires spécifiques d'une session, la base de données libère les segments temporaires à la fin de la session.
Voir aussi : "Segments temporaires"
Création de tables temporaires
L'instruction CREATE ... TEMPORARY TABLE crée une table temporaire.
Indiquez GLOBAL TEMPORARY TABLE ou PRIVATE TEMPORARY TABLE. Dans les deux cas, la clause ON COMMIT indique si les données de la table sont propres à la transaction (par défaut) ou à la session. Vous créez une table temporaire pour la base de données elle-même, et non pour chaque procédure stockée PL/SQL.
Vous pouvez créer des index pour les tables temporaires globales (non privées) à l'aide de l'instruction CREATE INDEX. Ces index sont également temporaires. Les données de l'index ont la même portée de session ou de transaction que les données de la table temporaire. Vous pouvez également créer une vue ou un déclencheur sur une table temporaire globale.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment créer et gérer des tables temporaires
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
CREATE ... TEMPORARY TABLE
Présentation des tables externes
Une table externe accède aux données des sources externes comme si ces données se trouvaient dans une table de la base de données.
Les données peuvent être dans n'importe quel format pour lequel un pilote d'accès est fourni. Vous pouvez utiliser le langage SQL (série ou parallèle), le langage PL/SQL et le langage Java pour interroger des tables externes.
-
Objectif des tables externes Les tables externes sont utiles lorsqu'une application de base de données Oracle doit accéder aux données non relationnelles.
-
Les tables externes Données dans les banques d'objets peuvent être utilisées pour accéder aux données des banques d'objets.
-
Pilotes d'accès aux tables externes Un pilote d'accès est une API qui interprète les données externes de la base de données. Le pilote d'accès s'exécute dans la base de données, qui l'utilise pour lire les données de la table externe. Le pilote d'accès et la couche de table externe sont chargés d'effectuer les transformations requises sur les données du fichier de données afin qu'elles correspondent à la définition de la table externe.
-
Création de table externe En interne, la création d'une table externe signifie la création de métadonnées dans le dictionnaire de données. Contrairement à une table ordinaire, une table externe ne décrit pas les données stockées dans la base, ni la façon dont les données sont stockées en externe. Les métadonnées de table externe décrivent plutôt comment la couche de table externe doit présenter les données dans la base de données.
-
Mise en cache automatique des données de table externe Les données des tables externes sont mises en cache de manière transparente pour améliorer les performances des requêtes.
Finalité des tables externes
Les tables externes sont utiles lorsqu'une application de base de données Oracle doit accéder à des données non relationnelles.
Par exemple, une application SQL peut avoir besoin d'accéder à un fichier texte dont les enregistrements sont au format suivant :
100,Steven,King,SKING,515.123.4567,17-JUN-03,AD_PRES,31944,150,90
101,Neena,Kochhar,NKOCHHAR,515.123.4568,21-SEP-05,AD_VP,17000,100,90
102,Lex,De Haan,LDEHAAN,515.123.4569,13-JAN-01,AD_VP,17000,100,90
Vous pouvez créer une table externe, copier le fichier texte à l'emplacement indiqué dans la définition de la table externe, puis utiliser SQL pour interroger les enregistrements du fichier texte. De même, vous pouvez utiliser des tables externes pour accorder un accès en lecture seule aux documents JSON ou aux objets LOB.
Dans les environnements de data warehouse, les tables externes sont utiles pour effectuer des tâches d'extraction, de transformation et de chargement (ETL). Par exemple, les tables externes vous permettent de canaliser la phase de chargement des données avec la phase de transformation. Cette technique élimine la nécessité de transférer des données dans la base de données en vue d'un traitement ultérieur dans celle-ci.
Vous pouvez partitionner des tables externes sur des colonnes virtuelles ou non. Vous pouvez également créer une table partitionnée hybride, où certaines partitions sont internes et d'autres externes. Tout comme les partitions internes, les partitions externes bénéficient d'améliorations de performances telles que l'élagage des partitions et les jointures par partition. Par exemple, vous pouvez utiliser des tables externes partitionnées pour analyser d'importants volumes de données non relationnelles stockées dans HDFS (Hadoop Distributed File System) ou dans une base de données NoSQL.
Voir aussi : "Tables partitionnées"
Données dans les magasins d'objets
Les tables externes peuvent être utilisées pour accéder aux données des banques d'objets.
Outre la prise en charge de l'accès aux données externes résidant dans des fichiers de système d'exploitation et des sources Big Data, Oracle prend en charge l'accès aux données externes dans les banques d'objets. Le stockage d'objets est commun dans le cloud et fournit une architecture plate pour gérer des objets individuels, tout type de données non structurées avec des métadonnées, en les regroupant dans des conteneurs simples. Bien que le stockage d'objets soit principalement une architecture de stockage de données dans le cloud, il est également disponible en tant que matériel de stockage sur site.
Vous pouvez accéder aux données des banques d'objets à l'aide du package DBMS_CLOUD ou en définissant manuellement des tables externes. Oracle recommande vivement d'utiliser le package DBMS_CLOUD car il fournit des fonctionnalités supplémentaires et est entièrement compatible avec Oracle Autonomous Database.
Pilotes d'accès aux tables externes
Un pilote d'accès est une API qui interprète les données externes de la base de données. Le pilote d'accès s'exécute dans la base de données, qui l'utilise pour lire les données de la table externe. Le pilote d'accès et la couche de table externe sont chargés d'effectuer les transformations requises sur les données du fichier de données afin qu'elles correspondent à la définition de la table externe.
La figure suivante représente l'accès SQL aux données externes.
Figure 11 : Tables externes
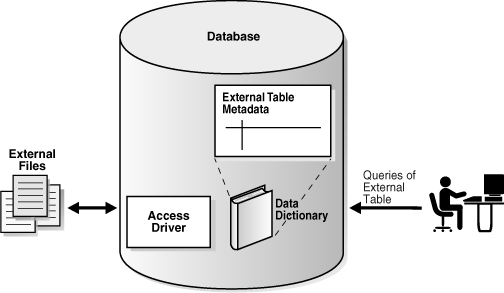
Description de l'image cncpt231.gif
Oracle fournit les pilotes d'accès suivants pour les tables externes :
-
ORACLE_LOADER(par défaut)Permet d'accéder à des fichiers externes en utilisant la plupart des formats pris en charge par SQL*Loader. Vous ne pouvez pas créer, mettre à jour ou ajouter un fichier externe à l'aide du pilote
ORACLE_LOADER. -
ORACLE_DATAPUMPPermet de décharger ou de charger des données externes. Une opération de déchargement lit les données de la base et les insère dans une table externe, représentée par un ou plusieurs fichiers externes. Une fois les fichiers externes créés, la base de données ne peut pas mettre à jour ni y ajouter de données. Une opération de chargement lit une table externe et charge ses données dans une base de données.
-
ORACLE_HDFSPermet d'extraire les données stockées dans un système de fichiers distribué (HDFS) Hadoop.
-
ORACLE_HIVEPermet d'accéder aux données stockées dans une base de données Apache Hive. Les données source peuvent être stockées dans HDFS, HBase, Cassandra ou d'autres systèmes. Contrairement aux autres pilotes d'accès, vous ne pouvez pas spécifier d'emplacement car
ORACLE_HIVEobtient des informations d'emplacement à partir d'une banque de métadonnées externe. -
ORACLE_BIGDATAPermet un accès en lecture seule aux données stockées dans des formats structurés et non structurés, notamment Apache Parquet, Apache Avro, Apache ORC, Apache Iceberg, le protocole Linux Open Project Delta Sharing et les formats de texte. Vous pouvez également utiliser ce pilote pour interroger les données locales, ce qui est utile pour tester et réduire les ensembles de données.
Création de tables externes
En interne, créer une table externe signifie créer des métadonnées dans le dictionnaire de données. Contrairement à une table ordinaire, une table externe ne décrit pas les données stockées dans la base, ni la façon dont les données sont stockées en externe. Les métadonnées de table externe décrivent plutôt la façon dont la couche de table externe doit présenter les données dans la base de données.
Une instruction CREATE TABLE ... ORGANIZATION EXTERNAL comporte deux parties. La définition de table externe décrit les types de colonne. Cette définition est semblable à une vue qui permet à SQL d'interroger des données externes sans les charger dans la base de données. La deuxième partie de l'instruction met en correspondance les données externes avec les colonnes.
Les tables externes sont en lecture seule, sauf si elles sont créées avec CREATE TABLE AS SELECT avec le pilote d'accès ORACLE_DATAPUMP. Les restrictions pour les tables externes ne prennent pas en charge les colonnes indexées et les objets de colonne.
Voir aussi :
-
Utilitaires d'Oracle AI Database pour en savoir plus sur les tables externes
-
Guide de l'administrateur Oracle AI Database, pour en savoir plus sur la gestion des tables externes, des connexions externes et des objets d'annuaire
-
Référence du langage SQL Oracle AI Database pour plus d'informations sur la création et l'interrogation de tables externes
Mise en cache automatique des données de table externe
Les données des tables externes sont mises en cache de manière transparente pour améliorer les performances des requêtes.
Les données fréquemment consultées à partir de tables externes, qui résident entièrement ou partiellement dans le stockage d'objets, sont automatiquement mises en cache pour améliorer les performances. La mise en cache des données de table externe ne nécessite aucune modification de l'application car elle est gérée automatiquement par la base de données Oracle.
Présentation des tables Blockchain
Une table de chaîne de blocs est une table d'ajout uniquement conçue pour les applications de chaîne de blocs centralisées.
Dans la table Oracle Blockchain, les pairs sont des utilisateurs de base de données qui font confiance à la base de données pour maintenir un registre inviolable. Le registre est implémenté en tant que table de chaîne de blocs, qui est définie et gérée par l'application. Les applications existantes peuvent se protéger contre la fraude sans nécessiter de nouvelle infrastructure ou de nouveau modèle de programmation. Bien que le débit des transactions soit inférieur à celui d'une table standard, les performances d'une table de chaîne de blocs sont meilleures que pour une chaîne de blocs décentralisée.
Une table de chaîne de blocs n'est ajoutée qu'à la fin car les seules instructions LMD autorisées sont les commandes INSERT. La table interdit les chargements UPDATE, DELETE, MERGE, TRUNCATE et par chemin direct. Les transactions de base de données peuvent s'étendre sur des tables de chaîne de blocs et des tables standard. Par exemple, une seule transaction peut insérer des lignes dans une table standard et deux tables de chaîne de blocs différentes.
Les tables de chaîne de blocs peuvent être utilisées pour sécuriser le contenu de Flashback Data Archive. Cela vous permet de déterminer si quelqu'un a altéré le contenu d'une table. Une table d'historique de journal de chaîne de blocs peut être considérée comme conservant un fichier de journalisation logique sécurisé sur le plan cryptographique pour les modifications apportées à une table utilisateur suivie.
Vous pouvez ajouter ou supprimer des colonnes utilisateur à partir de tables de chaîne de blocs à partir de tables de chaîne de blocs de version 2. L'ajout ou la suppression de colonnes utilisateur à partir de tables de chaîne de blocs de version 1 n'est pas autorisé. Les colonnes physiques et les données ne sont pas réellement supprimées mais marquées comme invisibles.
-
Chaînes de lignes Dans une table de chaîne de blocs, une chaîne de lignes est une série de lignes liées à un schéma de hachage.
-
Contenu de ligne Le contenu de ligne est une séquence d'octets contiguë contenant les données de colonne de la ligne et la valeur de hachage de la ligne précédente dans la chaîne.
-
Interface utilisateur pour les tables de chaîne de blocs Comme une table standard, une table de chaîne de blocs est créée par SQL et prend en charge les types de données scalaires, les objets LOB, JSON et les partitions. Vous pouvez également créer des index et des déclencheurs pour les tables de chaîne de blocs.
Chaînes de lignes
Dans une table de chaîne de blocs, une chaîne de lignes est une série de lignes liées à un schéma de hachage.
Une chaîne de lignes système est identifiée par une combinaison unique d'ID d'instance de base de données et d'ID de chaîne dans une table de chaîne de blocs version 1. A partir des tables de blockchain de la version 2, l'identificateur unique global de la base de données qui a inséré la ligne est nécessaire en plus de ces deux identificateurs. Une chaîne de lignes système est identifiée par une combinaison unique d'ID unique global de base de données pluggable, d'ID d'instance de base de données et d'ID de chaîne dans une table de chaîne de blocs de version 2. Une ligne d'une table de chaîne de blocs appartient à exactement une chaîne de lignes système. Une table unique prend en charge plusieurs chaînes de lignes système. Remarque : une ligne chaînée d'une table standard est orthogonale à une chaîne de lignes d'une table de chaîne de blocs. Seul le mot "chaîne" est le même.
Chaque ligne d'une chaîne a un numéro de séquence unique. La base de données séquence les lignes à l'aide d'un calcul de hachage SHA2-512 sur les lignes de chaque chaîne. Le hachage de chaque ligne insérée est dérivé du contenu de la ligne insérée, qui inclut la valeur de hachage de la ligne précédemment insérée dans la chaîne.
Bien que chaque ligne d'une table de chaîne de blocs appartienne à une seule chaîne système, elle peut également appartenir à une chaîne d'utilisateurs en fonction des valeurs d'un ensemble de colonnes utilisateur spécifié lors de la création de la table de chaîne de blocs.
Contenu de ligne
Le contenu de ligne est une séquence d'octets contiguës contenant les données de colonne de la ligne et la valeur de hachage de la ligne précédente dans la chaîne.
Lorsque vous créez une table de blockchain, la base de données crée plusieurs colonnes masquées. Par exemple, vous pouvez créer la table de chaîne de blocs bank_ledger avec les colonnes bank et deposit :
CREATE BLOCKCHAIN TABLE bank_ledger (bank VARCHAR2 (128), deposit NUMBER)
  NO DROP UNTIL 31 DAYS IDLE
  NO DELETE UNTIL 31 DAYS AFTER INSERT
  HASHING USING "SHA2_512" VERSION "v1";
La base de données crée automatiquement des colonnes masquées avec le préfixe ORABCTAB : ORABCTAB_INST_ID$, ORABCTAB_CHAIN_ID$, ORABCTAB_SEQ_NUM$, etc. Ces colonnes masquées, que vous ne pouvez pas modifier ou gérer pour la plupart, implémentent l'algorithme anti-altération. Cet algorithme évite les interblocages en acquérant des verrous de chaîne uniques de niveau table dans un ordre spécifique au moment de la validation.
Remarque : le contenu des lignes pour les tables de chaîne de blocs est stocké dans des blocs de données standard. Dans cette version d'Oracle AI Database, les tables de chaîne de blocs ne prennent pas en charge les clusters de tables.
L'ID d'instance, l'ID de chaîne et le numéro de séquence identifient une ligne de manière unique. A partir des tables de blockchain de la version 2, l'identificateur unique global de la base de données qui a inséré la ligne est nécessaire en plus de ces trois valeurs. Chaque ligne dispose d'un hachage SHA2-512 indépendant de la plate-forme stocké dans la colonne masquée ORABCTAB_HASH$. Le hachage est basé sur le contenu de la ligne insérée et le hachage de la ligne précédente dans la chaîne.
Le format de données de la valeur de colonne d'une ligne se compose d'octets provenant des métadonnées et du contenu de la colonne. Les métadonnées de colonne sont une structure de 20 octets qui décrit des caractéristiques telles que la position dans la table, le type de données, le statut NULL et la longueur des octets. Le contenu de la colonne est l'ensemble d'octets représentant la valeur d'une ligne. Par exemple, la représentation ASCII de la valeur Chase est 43 68 61 73 65. Vous pouvez utiliser la fonction DUMP dans SQL pour obtenir le contenu et les métadonnées de colonne.
Le contenu d'une ligne pour un calcul de hachage inclut les formats de données de colonne de plusieurs colonnes : la valeur de hachage de la ligne précédente de la chaîne, les colonnes définies par l'utilisateur et un nombre fixe de colonnes masquées.
L'ordre dans lequel les lignes associées sont insérées, appelées versions de ligne, peut être suivi par le système et enregistré en spécifiant un ensemble de colonnes sur lesquelles les versions de ligne sont définies. En outre, si des versions de ligne sont spécifiées, une vue est automatiquement créée et gérée qui affiche la dernière ligne insérée pour chaque combinaison de valeurs dans le jeu de colonnes spécifié par l'utilisateur. Le nom de la vue utilise la convention de dénomination Blockchain_Table_Name_LAST$.
Dans de nombreux cas, les lignes doivent être signées en plus ou par un délégué de l'utilisateur final. Par exemple, un responsable bancaire signe une ligne insérée par un utilisateur final. Un signataire délégué est un autre utilisateur de base de données qui peut ajouter sa signature sur une ligne calculée sur le hachage cryptographique du système de la ligne. Une ligne peut être signée par un utilisateur final, un délégué ou les deux. La signature d'un délégué n'est acceptée que si la signature peut être vérifiée à l'aide du certificat du délégué et que le certificat du délégué est enregistré dans une table de dictionnaire de base de données.
Lorsqu'une ligne est signée par un utilisateur final ou un délégué, l'utilisateur peut vouloir obtenir une contre-signature pour la ligne. Une contre-signature peut être considérée comme un condensé de table de blockchain spécifiquement pour la ligne qui a déjà été signée par un utilisateur final ou un délégué. Lorsqu'une ligne est contre-signée, la contre-signature est renvoyée au signataire de ligne et également enregistrée dans cette ligne. L'utilisateur qui demande la contre-signature sur la ligne peut enregistrer ces informations à des fins de non-répudiation dans un magasin de données distinct.
Interface utilisateur pour les tables de chaîne de blocs
Comme une table standard, une table de chaîne de blocs est créée par SQL et prend en charge les types de données scalaires, les objets LOB, JSON et les partitions. Vous pouvez également créer des index et des déclencheurs pour les tables de chaîne de blocs.
Pour créer une table de chaîne de blocs, utilisez une instruction CREATE BLOCKCHAIN TABLE. Une table de chaîne de blocs présente une période de conservation indiquée par la clause NO DROP UNTIL n DAYS IDLE. Vous pouvez enlever la table à l'aide de DROP TABLE.
La table Oracle Blockchain prend en charge les interfaces suivantes :
-
Le package
DBMS_BLOCKCHAIN_TABLEvous permet d'effectuer diverses opérations sur les lignes de table. Par exemple, pour appliquer une signature au contenu d'une ligne précédemment insérée, utilisez la procédureSIGN_ROW. Pour vérifier que les lignes n'ont pas été altérées, utilisezVERIFY_ROWS. Pour enlever des lignes après la période de conservation (spécifiée par la clauseNO DELETE), utilisezDELETE_EXPIRED_ROWS. -
La vue
DBA_BLOCKCHAIN_TABLESaffiche les métadonnées de table, telles que la période de conservation des lignes, la période d'inactivité avant la suppression d'une table et l'algorithme de hachage.
Remarque :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer les tables de chaîne de blocs
-
Référence Oracle AI Database PL/SQL Packages and Types pour en savoir plus sur le package
DBMS_BLOCKCHAIN_TABLE -
Référence Oracle AI Database pour en savoir plus sur la vue
DBA_BLOCKCHAIN_TABLES
Présentation des tables non mutables
Les tables non mutables sont des tables en lecture seule qui empêchent la modification de données non autorisées en internes et les modifications des données accidentelles résultant d'erreurs humaines.
Des modifications non autorisées peuvent être tentées par des employés compromis ou malhonnêtes qui ont accès à des informations d'identification internes.
De nouvelles lignes peuvent être ajoutées à une table non mutable, mais les lignes existantes ne peuvent pas être modifiées. Vous devez indiquer une période de conservation à la fois pour la table non mutable et pour les lignes de la table non mutable. Les lignes deviennent obsolètes après la période de conservation de ligne indiquée. Seules les lignes obsolètes peuvent être supprimées de la table non mutable.
Les tables non mutables contiennent des colonnes masquées générées par le système. Les colonnes sont identiques à celles des tables de blockchain. Lorsqu'une ligne est insérée, une valeur non NULL est définie pour les colonnes ORABCTAB_CREATION_TIME$ et ORABCTAB_USER_NUMBER$. A l'exception des tables non mutables V1, une valeur non NULL est définie pour la colonne ORABCTAB_PDB_GUID$. Si la table non mutable a été créée avec des versions de ligne, une valeur non NULL est définie pour les colonnes ORABCTAB_ROW_VERSION$ et ORABCTAB_LAST_ROW_VERSION_NUMBER$. La valeur des colonnes masquées générées par le système restantes est définie sur NULL.
L'utilisation de tables non mutables ne nécessite aucune modification des applications existantes.
Présentation des tables d'objets
Une table d'objets est un type spécial de table dans lequel chaque ligne représente un objet.
Un type d'objet Oracle est un type défini par l'utilisateur avec un nom, des attributs et des méthodes. Les types d'objet permettent de modéliser des entités réelles telles que des clients et des commandes d'achat en tant qu'objets dans la base de données.
Un type d'objet définit une structure logique, mais ne crée pas de stockage. L'exemple suivant crée un type d'objet nommé department_typ :
CREATE TYPE department_typ AS OBJECT
   ( d_name     VARCHAR2(100),
     d_address  VARCHAR2(200) );
/
L'exemple suivant crée une table d'objets nommée departments_obj_t de type d'objet department_typ, puis insère une ligne dans la table. Les attributs (colonnes) de la table departments_obj_t sont dérivés de la définition du type d'objet.
CREATE TABLE departments_obj_t OF department_typ;
INSERT INTO departments_obj_t VALUES ('hr', '10 Main St, Sometown, CA');
A l'instar d'une colonne relationnelle, une table d'objets peut contenir des lignes d'un seul type, à savoir des instances d'objet du même type de déclaration que la table. Par défaut, chaque objet de ligne d'une table d'objets est associé à un identificateur d'objet logique (OID) qui l'identifie de manière unique dans une table d'objets. La colonne OID d'une table d'objets est masquée.
Voir aussi :
-
Guide du développeur Oracle AI Database Object-Relational pour en savoir plus sur les fonctionnalités relationnelles objet dans Oracle AI Database
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
CREATE TYPE