Index et tables organisées en index
Les index sont des objets de schéma qui peuvent accélérer l'accès aux lignes de table. Les tables organisées en index sont des tables stockées dans une structure d'index.
-
Introduction aux index Un index est une structure facultative, associée à une table ou un cluster de tables, qui peut parfois accélérer l'accès aux données.
-
Les arborescences B Présentation des index B-Tree, c'est-à-dire les arborescences équilibrées, constituent le type d'index de base de données le plus courant. Un index B-tree est une liste ordonnée de valeurs divisée en plages. En associant une clé à une ligne ou une plage de lignes, les arbres B offrent d'excellentes performances d'extraction pour un large éventail de requêtes, y compris les recherches de correspondance et de plage exactes.
-
Présentation des index bitmap Dans un index bitmap, la base de données stocke un bitmap pour chaque clé d'index. Dans un index B-tree classique, une entrée d'index pointe vers une seule ligne. Dans un index bitmap, chaque clé d'index stocke des pointeurs vers plusieurs lignes.
-
Présentation des index basés sur une fonction Un index basé sur une fonction calcule la valeur d'une fonction ou d'une expression impliquant une ou plusieurs colonnes et la stocke dans un index. Un index basé sur une fonction peut être un index B-tree ou un index bitmap.
-
Présentation des index de domaine d'application Un index de domaine d'application est un index personnalisé propre à une application.
-
Présentation des index HNSW quantifiés scalaires Les index HNSW (Hierarchical Navigable Small World) quantifiés scalaires peuvent être utilisés pour réduire les besoins en mémoire et accélérer la recherche de similarité.
-
Présentation des tables organisées en index Une table organisée en index est une table stockée dans une variation d'une structure d'index B-tree. En revanche, une table organisée en portions de mémoire insère les lignes à leur place.
Introduction aux index
Un index est une structure facultative, associée à une table ou à un cluster de tables, qui peut parfois accélérer l'accès aux données.
Les index sont des objets de schéma qui sont logiquement et physiquement indépendants des données des objets auxquels ils sont associés. Par conséquent, vous pouvez supprimer ou créer un index sans affecter physiquement la table indexée.
Remarque : si vous supprimez un index, les applications continuent de fonctionner. Toutefois, l'accès aux données précédemment indexées peut être plus lent.
Pour une analogie, supposons qu'un responsable RH dispose d'une étagère de boîtes en carton. Les dossiers contenant les informations sur les employés sont insérés de manière aléatoire dans les cases. Le dossier de l'employé Whalen (ID 200) est de 10 dossiers en haut du bas de la case 1, tandis que le dossier de King (ID 100) est en bas de la case 3. Pour localiser un dossier, le gestionnaire examine chaque dossier de la zone 1 de bas en haut, puis se déplace de la zone à la zone jusqu'à ce que le dossier soit trouvé. Pour accélérer l'accès, le responsable peut créer un index qui répertorie séquentiellement chaque matricule salarié avec son emplacement de dossier :
ID 100: Box 3, position 1 (bottom)
ID 101: Box 7, position 8
ID 200: Box 1, position 10
.
.
.
De même, le responsable peut créer des index distincts pour les noms des salariés, les codes service, etc.
Cette section comprend les rubriques suivantes :
-
Avantages et inconvénients des index L'absence ou la présence d'un index ne nécessite pas de modification du libellé d'une instruction SQL.
-
Les index Usabilité et visibilité des index sont utilisables (par défaut) ou inutilisables, visibles (par défaut) ou invisibles.
-
Clés et colonnes Une clé est un ensemble de colonnes ou d'expressions sur lequel vous pouvez créer un index.
-
Index composites Un index composite, également appelé index concaténé, est un index sur plusieurs colonnes d'une table.
-
Les index Uniques et non uniques peuvent être uniques ou non uniques. Les index uniques garantissent qu'aucune des deux lignes d'une table n'a de valeurs en double dans la ou les colonnes de clé.
-
Types d'index Oracle AI Database fournit plusieurs schémas d'indexation, qui fournissent des fonctionnalités de performances complémentaires.
-
Comment la base de données gère les index La base de données gère et utilise automatiquement les index après leur création.
-
Stockage d'index Oracle AI Database stocke les données d'index dans un segment d'index.
Avantages et inconvénients des index
L'absence ou la présence d'un index ne nécessite pas de modification du libellé d'une instruction SQL.
Un index est un chemin d'accès rapide à une seule ligne de données. Elle n'affecte que la vitesse d'exécution. Etant donné une valeur de données qui a été indexée, l'index pointe directement vers l'emplacement des lignes contenant cette valeur.
Lorsqu'un index existe sur une ou plusieurs colonnes d'une table, la base de données peut dans certains cas extraire un petit ensemble de lignes distribuées de manière aléatoire de la table. Les index sont l'un des nombreux moyens de réduire les E/S disque. Si une table organisée en portions de mémoire n'a pas d'index, la base de données doit effectuer un balayage complet de la table pour trouver une valeur. Par exemple, une interrogation de l'emplacement 2700 dans la table hr.departments non indexée nécessite que la base de données recherche chaque ligne de chaque bloc. Cette approche ne s'adapte pas bien et les volumes de données augmentent.
Les inconvénients des index sont les suivants :
-
La création manuelle d'index requiert souvent une connaissance approfondie du modèle, de l'application et de la distribution des données.
-
Au fur et à mesure que les données changent, vous devez revoir les décisions précédentes concernant les index. Un index peut cesser d'être utile ou de nouveaux index peuvent être nécessaires.
-
Les index occupent de l'espace disque.
-
La base de données doit mettre à jour l'index lorsque des instructions LMD se produisent sur les données indexées, ce qui entraîne une surcharge des performances. Remarque : à partir d'Oracle Database 19c, la base de données Oracle peut surveiller en permanence la charge globale de l'application, en créant et en gérant automatiquement des index. L'indexation automatisée est implémentée en tant que tâche de base de données qui s'exécute à un intervalle fixe.
Envisagez de créer un index dans les situations suivantes :
-
Les colonnes indexées sont fréquemment interrogées et renvoient un faible pourcentage du nombre total de lignes de la table.
-
Une contrainte d'intégrité référentielle existe sur la ou les colonnes indexées. L'index est un moyen d'éviter un verrou de table complète qui serait autrement nécessaire si vous mettez à jour la clé primaire de la table parent, si vous la fusionnez dans la table parent ou si vous la supprimez de la table parent.
-
Une contrainte de clé unique sera placée sur la table et vous souhaitez indiquer manuellement l'index et toutes les options d'index.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur l'indexation automatisée
-
Manuel de l'utilisateur Oracle AI Database Licensing Information pour plus de détails sur les fonctionnalités prises en charge pour différentes éditions et différents services
Utilisabilité et visibilité de l'index
Les index sont utilisables (par défaut) ou inutilisables, visibles (par défaut) ou invisibles.
Ces propriétés sont définies comme suit :
-
Facilité d'utilisation
Un index inutilisable, qui est ignoré par l'optimiseur, n'est pas géré par les opérations LMD. Un index inutilisable peut améliorer les performances des chargements en masse. Au lieu de supprimer un index et de le recréer ultérieurement, vous pouvez le rendre inutilisable, puis le reconstruire. Les index et partitions d'index inutilisables ne consomment pas d'espace. Lorsque vous rendez un index utilisable inutilisable, la base de données supprime son segment d'index.
-
Visibilité
Un index invisible est géré par des opérations LMD, mais n'est pas utilisé par défaut par l'optimiseur. Rendre un index invisible est une alternative à le rendre inutilisable ou à le supprimer. Les index invisibles sont particulièrement utiles pour tester la suppression d'un index avant de le supprimer ou d'utiliser temporairement des index sans affecter l'application globale.
Voir aussi : "Présentation de l'optimiseur" pour savoir comment l'optimiseur sélectionne les plans d'exécution.
Clés et colonnes
Une clé est un ensemble de colonnes ou d'expressions sur lequel vous pouvez créer un index.
Bien que les termes soient souvent utilisés de manière interchangeable, les index et les clés sont différents. Les index sont des structures stockées dans la base de données que les utilisateurs gèrent à l'aide d'instructions SQL. Les clés sont strictement un concept logique.
L'instruction suivante crée un index sur la colonne customer_id de l'exemple de table oe.orders :
CREATE INDEX ord_customer_ix ON orders (customer_id);Dans l'instruction précédente, la colonne customer_id est la clé d'index. L'index lui-même est nommé ord_customer_ix.
Remarque : les clés primaires et uniques ont automatiquement des index, mais vous pouvez vouloir créer un index sur une clé étrangère.
Voir aussi :
-
Référence du langage SQL d'Oracle AI Database Syntaxe et sémantique
CREATE INDEX
Index composites
Un index composite, également appelé index concaténé, est un index sur plusieurs colonnes d'une table.
Placez les colonnes dans un index composite dans l'ordre qui convient le mieux aux requêtes qui extraient les données. Les colonnes ne doivent pas nécessairement être adjacentes à la table.
Les index composites peuvent accélérer l'extraction des données pour les instructions SELECT dans lesquelles la clause WHERE référence la totalité ou la partie supérieure des colonnes de l'index composite. Par conséquent, l'ordre des colonnes utilisées dans la définition est important. En général, les colonnes les plus fréquemment consultées passent en premier.
Par exemple, supposons qu'une application interroge fréquemment les colonnes last_name, job_id et salary dans la table employees. Supposons également que last_name présente une cardinalité élevée, ce qui signifie que le nombre de valeurs distinctes est important par rapport au nombre de lignes de la table. Vous créez un index avec l'ordre des colonnes suivant :
CREATE INDEX employees_ix
   ON employees (last_name, job_id, salary);
Les requêtes qui accèdent aux trois colonnes, à la seule colonne last_name ou aux seules colonnes last_name et job_id utilisent cet index. Dans cet exemple, les requêtes qui n'accèdent pas à la colonne last_name n'utilisent pas l'index.
Remarque : dans certains cas, par exemple lorsque la cardinalité de la colonne de début est très faible, la base de données peut utiliser un balayage par saut de cet index (reportez-vous à "Analyse par saut d'index").
Plusieurs index peuvent exister sur la même table avec le même ordre de colonnes lorsqu'ils remplissent l'une des conditions suivantes :
-
Les index sont de différents types.
Par exemple, vous pouvez créer des index bitmap et B-tree sur les mêmes colonnes.
-
Les index utilisent des schémas de partitionnement différents.
Par exemple, vous pouvez créer des index partitionnés localement et des index partitionnés globalement.
-
Les propriétés d'unicité des index sont différentes.
Par exemple, vous pouvez créer un index unique et un index non unique sur le même ensemble de colonnes.
Par exemple, un index non partitionné, un index partitionné global et un index partitionné localement peuvent exister pour les mêmes colonnes de table dans le même ordre. Un seul index avec le même nombre de colonnes dans le même ordre peut être visible à la fois.
Cette fonctionnalité vous permet de migrer des applications sans avoir à supprimer un index existant et de le recréer avec des attributs différents. En outre, cette fonctionnalité est utile dans une base de données OLTP lorsqu'une clé d'index ne cesse d'augmenter, ce qui entraîne l'insertion de nouvelles entrées dans le même ensemble de blocs d'index. Pour réduire ces "points chauds", vous pouvez faire évoluer l'index d'un index non partitionné vers un index partitionné global.
Si le type ou le schéma de partitionnement des index d'un même ensemble de colonnes ne diffère pas, ces index doivent utiliser des permutations de colonnes différentes. Par exemple, les instructions SQL suivantes spécifient des permutations de colonne valides :
CREATE INDEX employee_idx1 ON employees (last_name, job_id);
CREATE INDEX employee_idx2 ON employees (job_id, last_name);
Voir aussi : Guide de réglage SQL Oracle AI Database pour en savoir plus sur la création de plusieurs index sur le même ensemble de colonnes
Index uniques et non uniques
Les index peuvent être uniques ou non uniques. Les index uniques garantissent qu'aucune des deux lignes d'une table n'a de valeurs en double dans la ou les colonnes de clé.
Par exemple, votre application peut exiger que deux employés n'aient pas le même matricule. Dans un index unique, un rowid existe pour chaque valeur de données. Les données des blocs feuille sont triées uniquement par clé.
Les index non uniques permettent de dupliquer des valeurs dans la ou les colonnes indexées. Par exemple, la colonne first_name de la table employees peut contenir plusieurs valeurs Mike. Pour un index non unique, le rowid est inclus dans la clé par ordre trié, de sorte que les index non uniques sont triés par clé d'index et rowid (croissant).
Oracle AI Database n'indexe pas les lignes de table dans lesquelles toutes les colonnes de clé sont null, à l'exception des index bitmap ou lorsque la valeur de la colonne de clé de cluster est NULL.
Types d'index
Oracle AI Database fournit plusieurs schémas d'indexation, qui fournissent des fonctionnalités de performances complémentaires.
Les index B-tree sont le type d'index standard. Ils sont excellents pour les index hautement sélectifs (peu de lignes correspondent à chaque entrée d'index) et les index de clé primaire. Utilisé comme index concaténé, un index B-tree peut extraire des données triées en fonction des colonnes indexées. Les index B-tree ont les sous-types indiqués dans le tableau suivant.
Tableau 1 - Sous-types d'index B-Tree
| Sous-type d'index B-Tree | Description | Pour en savoir plus |
|---|---|---|
| Tables organisées en Index | Une table organisée en index diffère d'une table organisée en portions de mémoire car les données sont elles-mêmes l'index. | "Présentation des tables triées en index" |
| Index de clé inversée | Dans ce type d'index, les octets de la clé d'index sont inversés, par exemple, 103 est stocké en tant que 301. L'inversion des octets répartit les insertions dans l'index sur de nombreux blocs. | "Index de clé inversée" |
| Index décroissants | Ce type d'index stocke les données d'une ou de plusieurs colonnes en ordre décroissant. | "Index croissants et décroissants" |
| Index de cluster B-tree | Ce type d'index stocke les données d'une ou de plusieurs colonnes en ordre décroissant. | "Index croissants et décroissants" |
Le tableau suivant présente les types d'index qui n'utilisent pas de structure B-tree.
Tableau 2 Index n'utilisant pas de structure B-Tree
| Type | Description | Pour en savoir plus |
|---|---|---|
| Index de jointure bitmap et bitmap | Dans un index bitmap, une entrée d'index utilise un bitmap pour pointer vers plusieurs lignes. En revanche, une entrée d'index B-tree pointe vers une seule ligne. Un index de jointure bitmap est un index bitmap pour la jointure de plusieurs tables. | "Présentation des index bitmap" |
| Index basés sur la fonction | Ce type d'index inclut les colonnes qui sont transformées par une fonction, telle que la fonction UPPER, ou incluses dans une expression. Les index B-tree ou bitmap peuvent être basés sur une fonction. |
"Présentation des index basés sur une fonction" |
| Index de domaine d'application | Un utilisateur crée ce type d'index pour les données d'un domaine propre à l'application. L'index physique n'a pas besoin d'utiliser une structure d'index traditionnelle et peut être stocké dans la base de données Oracle en tant que tables ou en externe en tant que fichier. | "Présentation des index de domaine d'application" |
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment gérer les index
-
Guide de réglage SQL Oracle AI Database pour en savoir plus sur les différents chemins d'accès aux index
Comment la base de données gère les index
La base de données gère et utilise automatiquement les index après leur création.
Les index reflètent automatiquement les modifications apportées aux données dans leurs tables sous-jacentes. Par exemple, vous pouvez ajouter, mettre à jour et supprimer des lignes. Aucune action utilisateur n'est requise.
Les performances d'extraction des données indexées restent presque constantes, même lorsque des lignes sont insérées. Toutefois, la présence de nombreux index sur une table entraîne une dégradation des performances DML car la base de données doit également mettre à jour les index.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur l'indexation automatisée
-
Manuel de l'utilisateur Oracle AI Database Licensing Information pour plus de détails sur les fonctionnalités prises en charge pour différentes éditions et différents services
Stockage d'index
Oracle AI Database stocke les données d'index dans un segment d'index.
L'espace disponible pour les données d'index d'un bloc de données est la taille du bloc de données moins la surcharge du bloc, la surcharge de l'entrée, le rowid et un octet de longueur pour chaque valeur indexée.
Le tablespace d'un segment d'index est soit le tablespace par défaut du propriétaire, soit un tablespace spécifiquement nommé dans l'instruction CREATE INDEX. Pour faciliter l'administration, vous pouvez stocker un index dans un tablespace distinct de sa table. Par exemple, vous pouvez choisir de ne pas sauvegarder les tablespaces contenant uniquement des index, qui peuvent être reconstruits, et donc de réduire le temps et le stockage requis pour les sauvegardes.
Voir aussi : "Présentation des blocs d'index" pour en savoir plus sur les types de bloc d'index (racine, branche et feuille) et sur la façon dont les entrées d'index sont stockées dans un bloc
Présentation des index B-Tree
Les arbres B, abrégés pour les arborescences équilibrées, sont le type d'index de base de données le plus courant. Un index B-tree est une liste ordonnée de valeurs divisée en plages. En associant une clé à une ligne ou une plage de lignes, les arbres B offrent d'excellentes performances d'extraction pour un large éventail de requêtes, y compris les recherches de correspondance et de plage exactes.
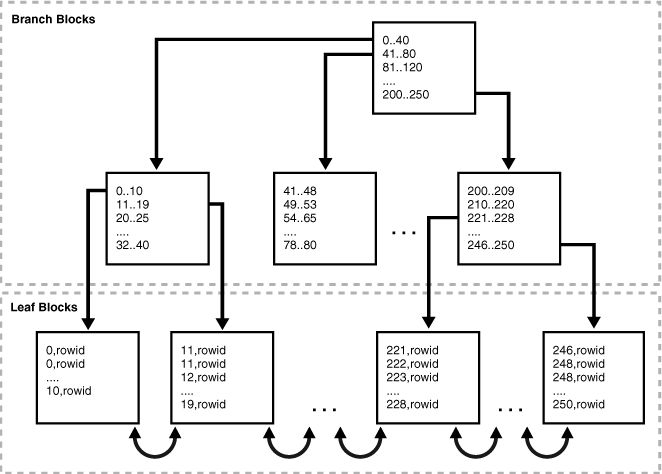
La figure suivante illustre la structure d'un index B-tree. L'exemple présente un index sur la colonne department_id, qui est une colonne de clé étrangère dans la table employees.
Figure 1 : Structure interne d'un index B-tree
Description de l'image cncpt244.gif
Cette section comprend les rubriques suivantes :
-
Blocs de branche et blocs feuille Un index B-tree comporte deux types de bloc : le bloc de branche pour la recherche et le bloc feuille pour le stockage des valeurs de clé. Les blocs de branche de niveau supérieur d'un index B-tree contiennent des données d'index qui pointent vers des blocs d'index de niveau inférieur.
-
Analyses d'index Dans un balayage d'index, la base de données extrait une ligne en parcourant l'index, à l'aide des valeurs de colonne indexées spécifiées par l'instruction. Si la base de données analyse l'index pour une valeur, elle trouve cette valeur dans n E/S où n est la hauteur de l'index B-tree. C'est le principe de base des index Oracle AI Database.
-
Index de clé inverse Un index de clé inverse est un type d'index d'arborescence B qui inverse physiquement les octets de chaque clé d'index tout en conservant l'ordre des colonnes.
-
Index ascendants et descendants Dans un index ascendant, Oracle AI Database stocke les données dans l'ordre croissant. Par défaut, les données alphanumériques sont triées par les valeurs binaires contenues dans chaque octet de la valeur, les données numériques du plus petit au plus grand nombre et la date de la plus ancienne à la plus récente.
-
Compression d'index Pour réduire l'espace dans les index, Oracle AI Database peut utiliser différents algorithmes de compression.
Blocs de branche et blocs de feuille
Un index B-tree comporte deux types de bloc : le bloc de branche pour la recherche et le bloc feuille pour le stockage des valeurs de clé. Les blocs de branche de niveau supérieur d'un index B-tree contiennent des données d'index qui pointent vers des blocs d'index de niveau inférieur.
Dans la Figure 5-1, le bloc de branche racine comporte une entrée 0-40, qui pointe vers le bloc le plus à gauche au niveau de branche suivant. Ce bloc de branchement contient des entrées telles que 0-10 et 11-19. Chacune de ces entrées pointe vers un bloc feuille contenant des valeurs de clé comprises dans la plage.
Un index B-tree est équilibré car tous les blocs feuille restent automatiquement à la même profondeur. Ainsi, l'extraction d'un enregistrement à partir de n'importe quel emplacement de l'index prend environ le même temps. La hauteur de l'index est le nombre de blocs requis pour passer du bloc racine à un bloc feuille. Le niveau de la branche correspond à la hauteur moins 1. Dans la Figure 5-1, l'index a une hauteur de 3 et un niveau de branche de 2.
Les blocs de branchement stockent le préfixe de clé minimum nécessaire pour prendre une décision de branchement entre deux clés. Cette technique permet à la base de données d'adapter autant de données que possible sur chaque bloc de branchement. Les blocs de branchement contiennent un pointeur vers le bloc enfant contenant la clé. Le nombre de clés et de pointeurs est limité par la taille du bloc.
Les blocs feuille contiennent toutes les valeurs de données indexées et un rowid correspondant utilisé pour localiser la ligne réelle. Chaque entrée est triée par (clé, rowid). Au sein d'un bloc feuille, une clé et un rowid sont liés à ses entrées de semblable gauche et droite. Les blocs de feuilles eux-mêmes sont également doublement liés. Dans la Figure 5-1, le bloc feuille le plus à gauche (0-10) est lié au deuxième bloc feuille (11-19). Remarque : les index des colonnes contenant des données alphanumériques sont basés sur les valeurs binaires des caractères du jeu de caractères de la base de données.
Analyses d'index
Dans un balayage d'index, la base de données extrait une ligne en parcourant l'index, à l'aide des valeurs de colonne indexées spécifiées par l'instruction. Si la base de données analyse l'index pour une valeur, elle trouve cette valeur dans n E/S où n est la hauteur de l'index B-tree. C'est le principe de base des index Oracle AI Database.
Si une instruction SQL accède uniquement aux colonnes indexées, la base de données lit les valeurs directement à partir de l'index plutôt qu'à partir de la table. Si l'instruction accède à des colonnes non indexées en plus des colonnes indexées, la base de données utilise des rowid pour rechercher les lignes dans la table. En général, la base de données extrait des données de table en lisant alternativement un bloc d'index, puis un bloc de table.
-
Analyse complète de l'index Lors d'une analyse complète de l'index, la base de données lit l'ensemble de l'index dans l'ordre. Un balayage complet d'index est disponible si un prédicat (clause
WHERE) dans l'instruction SQL référence une colonne de l'index et, dans certains cas, lorsqu'aucun prédicat n'est spécifié. Un balayage complet peut éliminer le tri car les données sont triées par clé d'index. -
Analyse complète rapide d'index Une analyse complète rapide d'index est une analyse complète d'index dans laquelle la base de données accède aux données de l'index lui-même sans accéder à la table. La base de données lit les blocs d'index dans un ordre particulier.
-
Analyse de plage d'index Une analyse de plage d'index est une analyse ordonnée d'un index dans lequel une ou plusieurs colonnes de début d'un index sont spécifiées dans des conditions et où 0, 1 ou plusieurs valeurs sont possibles pour une clé d'index.
-
Analyse unique d'index Contrairement à une analyse d'intervalle d'index, une analyse unique d'index doit avoir 0 ou 1 rowid associé à une clé d'index.
-
Analyse de saut d'index Une analyse de saut d'index utilise des sous-index logiques d'un index composite. La base de données "ignore" un seul index comme si elle recherchait des index distincts.
-
Facteur de regroupement d'index Le facteur de regroupement d'index mesure l'ordre des lignes par rapport à une valeur indexée telle que le nom de famille de l'employé. Au fur et à mesure que le degré d'ordre augmente, le facteur de regroupement diminue. Voir aussi : Guide de réglage SQL Oracle AI Database pour plus d'informations sur les analyses d'index
Balayage complet d'index
Dans un balayage complet d'index, la base de données lit l'ensemble de l'index dans l'ordre. Un balayage complet d'index est disponible si un prédicat (clause WHERE) dans l'instruction SQL référence une colonne de l'index et, dans certains cas, lorsqu'aucun prédicat n'est spécifié. Un balayage complet peut éliminer le tri car les données sont triées par clé d'index.
Exemple 5-1 Analyse complète d'index
Supposons qu'une application exécute l'interrogation suivante :
SELECT department_id, last_name, salary
FROM   employees
WHERE  salary > 5000
ORDER BY department_id, last_name;
Dans cet exemple, department_id, last_name et salary sont une clé composite dans un index. Oracle AI Database effectue un balayage complet de l'index, en le lisant par ordre trié (par ID de service et nom) et en filtrant l'attribut de salaire. Ainsi, la base de données analyse un ensemble de données plus petit que la table employees, qui contient plus de colonnes que celles incluses dans la requête, et évite de trier les données.
L'analyse complète peut lire les entrées d'index comme suit :
50,Atkinson,2800,rowid
60,Austin,4800,rowid
70,Baer,10000,rowid
80,Abel,11000,rowid
80,Ande,6400,rowid
110,Austin,7200,rowid
.
.
.
Balayage complet rapide d'index
Un balayage complet rapide d'index est un balayage complet d'index dans lequel la base de données accède aux données de l'index lui-même sans accéder à la table. La base de données lit les blocs d'index dans un ordre particulier.
Les balayages complets et rapides d'index sont une alternative à un balayage complet de table lorsque les deux conditions suivantes sont remplies :
-
L'index doit contenir toutes les colonnes nécessaires à la requête.
-
Une ligne contenant toutes les valeurs NULL ne doit pas apparaître dans l'ensemble de résultats de la requête. Pour que ce résultat soit garanti, au moins une colonne de l'index doit avoir l'une des valeurs suivantes :
-
Une contrainte
NOT NULL -
prédicat appliqué à la colonne qui empêche la prise en compte des valeurs NULL dans l'ensemble de résultats de la requête
-
Exemple 5-2 Analyse rapide complète des index
Supposons qu'une application émet la requête suivante, qui n'inclut pas de clause ORDER BY :
SELECT last_name, salary
FROM   employees;
La colonne last_name a une contrainte non NULL. Si le nom et le salaire sont une clé composite dans un index, un balayage complet d'index rapide peut lire les entrées d'index pour obtenir les informations demandées :
Baida,2900,rowid
Atkinson,2800,rowid
Zlotkey,10500,rowid
Austin,7200,rowid
Baer,10000,rowid
Austin,4800,rowid
.
.
.
Balayage de plage d'index
Un scan d'intervalle d'index est un balayage ordonné d'un index dans lequel une ou plusieurs colonnes de début d'un index sont spécifiées dans des conditions et où 0, 1 ou plusieurs valeurs sont possibles pour une clé d'index.
Une condition indique une combinaison d'expressions et d'opérateurs logiques (booléens) logiques. Elle renvoie la valeur TRUE, FALSE ou UNKNOWN.
La base de données utilise généralement un balayage d'intervalle d'index pour accéder à des données sélectives. La sélectivité est le pourcentage de lignes de la table que la requête sélectionne, 0 signifiant aucune ligne et 1 signifiant toutes les lignes. La sélectivité est liée à un prédicat de requête, tel que WHERE last_name LIKE 'A%', ou à une combinaison de prédicats. Un prédicat devient plus sélectif à mesure que la valeur approche de 0 et moins sélectif (ou plus non sélectif) à mesure que la valeur approche de 1.
Par exemple, un utilisateur interroge les employés dont le nom commence par A. Supposons que la colonne last_name soit indexée, avec les entrées suivantes :
Abel,rowid
Ande,rowid
Atkinson,rowid
Austin,rowid
Austin,rowid
Baer,rowid
.
.
.
La base de données peut utiliser un balayage de plage car la colonne last_name est indiquée dans le prédicat et plusieurs rowids sont possibles pour chaque clé d'index. Par exemple, deux employés sont nommés Austin, de sorte que deux rowids sont associés à la clé Austin.
Un balayage d'intervalle d'index peut être limité des deux côtés, comme dans une requête pour les services dont les ID sont compris entre 10 et 40, ou limité d'un seul côté, comme dans une requête pour les ID de plus de 40. Pour analyser l'index, la base de données avance ou recule dans les blocs feuille. Par exemple, une recherche d'ID compris entre 10 et 40 localise le premier bloc feuille d'index qui contient la valeur de clé la plus faible (10 ou plus). Le balayage se poursuit ensuite horizontalement dans la liste des noeuds feuille liés jusqu'à ce qu'il trouve une valeur supérieure à 40.
Balayage unique d'index
Contrairement à un balayage d'intervalle d'index, un balayage d'index unique doit avoir 0 ou 1 rowid associé à une clé d'index.
La base de données effectue un balayage unique lorsqu'un prédicat référence toutes les colonnes de la clé d'un index UNIQUE à l'aide d'un opérateur d'égalité. Un balayage unique d'index arrête le traitement dès qu'il trouve le premier enregistrement car aucun second enregistrement n'est possible.
Par exemple, supposons qu'un utilisateur exécute la requête suivante :
SELECT *
FROM   employees
WHERE  employee_id = 5;
Supposons que la colonne employee_id soit la clé primaire et qu'elle soit indexée avec des entrées comme suit :
1,rowid
2,rowid
4,rowid
5,rowid
6,rowid
.
.
.
Dans ce cas, la base de données peut utiliser un balayage unique d'index (index unique scan) pour localiser l'ID de ligne de l'employé dont l'ID est 5.
Ignorer l'analyse d'index
Une analyse par saut d'index utilise des sous-index logiques d'un index composite. La base de données "ignore" un seul index comme si elle recherchait des index distincts.
L'omission du balayage est bénéfique si la colonne de début d'un index composite comporte peu de valeurs distinctes et si la clé non de début de l'index comporte de nombreuses valeurs distinctes. La base de données peut choisir un balayage par saut d'index lorsque la colonne de début de l'index composite n'est pas indiquée dans un prédicat d'interrogation.
Exemple 5-3 Ignorer l'analyse d'un index composite
Supposons que vous exécutez la requête suivante pour un client dans la table sh.customers :
SELECT * FROM sh.customers WHERE cust_email = 'Abbey@company.example.com';La table customers comporte une colonne cust_gender dont les valeurs sont M ou F. Supposons qu'un index composite existe sur les colonnes (cust_gender, cust_email). L'exemple suivant illustre une partie des entrées d'index :
F,Wolf@company.example.com,rowid
F,Wolsey@company.example.com,rowid
F,Wood@company.example.com,rowid
F,Woodman@company.example.com,rowid
F,Yang@company.example.com,rowid
F,Zimmerman@company.example.com,rowid
M,Abbassi@company.example.com,rowid
M,Abbey@company.example.com,rowid
La base de données peut utiliser un balayage par saut de cet index même si cust_gender n'est pas indiqué dans la clause WHERE.
Lors d'un balayage par saut, le nombre de sous-index logiques est déterminé par le nombre de valeurs distinctes dans la colonne de début. Dans l'exemple précédent, la colonne de début a deux valeurs possibles. La base de données divise logiquement l'index en un sous-index avec la clé F et un deuxième sous-index avec la clé M.
Lorsque vous recherchez l'enregistrement du client dont l'adresse électronique est Abbey@company.example.com, la base de données recherche d'abord le sous-index avec la valeur F, puis le sous-index avec la valeur M. Sur le plan conceptuel, la base de données traite l'interrogation comme suit :
SELECT * FROM sh.customers WHERE cust_gender = 'F'
  AND cust_email = 'Abbey@company.example.com'
UNION ALL
SELECT * FROM sh.customers WHERE cust_gender = 'M'
  AND cust_email = 'Abbey@company.example.com';
Voir aussi : Guide de réglage SQL Oracle AI Database pour en savoir plus sur les sauts d'analyse
Facteur de regroupement d'index
Le facteur de regroupement d'index mesure l'ordre des lignes par rapport à une valeur indexée telle que le nom de famille de l'employé. Au fur et à mesure que le degré d'ordre augmente, le facteur de regroupement diminue.
Le facteur de regroupement est utile comme mesure approximative du nombre d'E/S requises pour lire une table entière à l'aide d'un index :
-
Si le facteur de clustering est élevé, Oracle AI Database effectue un nombre d'E/S relativement élevé lors d'un balayage d'intervalle d'index de grande taille. Les entrées d'index pointent vers des blocs de table aléatoires, de sorte que la base de données peut avoir à lire et relire les mêmes blocs encore et encore pour extraire les données désignées par l'index.
-
Si le facteur de clustering est faible, Oracle AI Database effectue un nombre d'E/S relativement faible lors d'un balayage d'intervalle d'index de grande taille. Les clés d'index d'une plage ont tendance à pointer vers le même bloc de données, de sorte que la base de données n'a pas à lire et relire les mêmes blocs encore et encore.
Le facteur de regroupement est pertinent pour les analyses d'index car il peut afficher les éléments suivants :
-
Indique si la base de données utilisera un index pour les analyses à grande plage
-
Le degré d'organisation de la table par rapport à la clé d'index
-
Indique si vous devez envisager d'utiliser une table, un partitionnement ou un cluster de tables organisés en index si les lignes doivent être triées par clé d'index.
Exemple 5-4 Facteur de regroupement
Supposons que la table employees se trouve dans deux blocs de données. Le Table 5-3 représente les lignes des deux blocs de données (les points de suspension indiquent des données qui ne sont pas affichées).
Table des matières 3 Table des matières de deux blocs de données dans le tableau Employés
| Bloc de données 1 | Bloc de données 2 |
|---|---|
|
|
Les lignes sont stockées dans les blocs par ordre de nom (affiché en gras). Par exemple, la ligne inférieure du bloc de données 1 décrit Abel, la ligne suivante vers le haut décrit Ande, et ainsi de suite par ordre alphabétique jusqu'à la ligne supérieure du bloc 1 pour Steven King. La ligne inférieure du bloc 2 décrit Kochar, la ligne suivante vers le haut décrit Kumar, et ainsi de suite par ordre alphabétique jusqu'à la dernière ligne du bloc pour Zlotkey.
Supposons qu'un index existe dans la colonne last name. Chaque entrée de nom correspond à un rowid. Conceptuellement, les entrées d'index se présentent comme suit :
Abel,block1row1
Ande,block1row2
Atkinson,block1row3
Austin,block1row4
Baer,block1row5
.
.
.
Supposons qu'un index distinct existe dans la colonne Matricule salarié. Conceptuellement, les entrées d'index peuvent se présenter comme suit, les ID d'employé étant répartis dans des emplacements presque aléatoires dans les deux blocs :
100,block1row50
101,block2row1
102,block1row9
103,block2row19
104,block2row39
105,block1row4
.
.
.
L'instruction suivante interroge la vue ALL_INDEXES pour le facteur de clusterisation de ces deux index :
SQL> SELECT INDEX_NAME, CLUSTERING_FACTOR
  2  FROM ALL_INDEXES
  3  WHERE INDEX_NAME IN ('EMP_NAME_IX','EMP_EMP_ID_PK');

INDEX_NAME           CLUSTERING_FACTOR
-------------------- -----------------
EMP_EMP_ID_PK                       19
EMP_NAME_IX                          2
Le facteur de regroupement pour EMP_NAME_IX est faible, ce qui signifie que les entrées d'index adjacentes dans un bloc feuille unique ont tendance à pointer vers des lignes dans les mêmes blocs de données. Le facteur de regroupement pour EMP_EMP_ID_PK est élevé, ce qui signifie que les entrées d'index adjacentes dans le même bloc feuille sont beaucoup moins susceptibles de pointer vers des lignes dans les mêmes blocs de données.
Voir aussi : Référence Oracle AI Database pour en savoir plus sur ALL_INDEXES
Index de clé inversée
Un index de clé inverse est un type d'index d'arborescence B qui inverse physiquement les octets de chaque clé d'index tout en conservant l'ordre des colonnes.
Par exemple, si la clé d'index est 20 et que les deux octets stockés pour cette clé en hexadécimal sont C1,15 dans un index B-tree standard, un index de clé inverse stocke les octets en tant que 15,C1.
L'inversion de la clé résout le problème de contention pour les blocs feuille situés sur le côté droit d'un index B-tree. Ce problème peut être particulièrement aigu dans une base de données Oracle Real Application Clusters (Oracle RAC) dans laquelle plusieurs instances modifient de manière répétée le même bloc. Par exemple, dans une table orders, les clés primaires des commandes sont séquentielles. Une instance du cluster ajoute l'ordre 20, tandis qu'une autre ajoute 21, chaque instance écrivant sa clé dans le même bloc feuille du côté droit de l'index.
Dans un index de clé inversée, l'inversion de l'ordre des octets répartit les insertions entre toutes les clés feuille de l'index. Par exemple, les clés telles que 20 et 21 qui auraient été adjacentes dans un index de clé standard sont maintenant stockées très éloignées dans des blocs distincts. Ainsi, les E/S pour les insertions de clés séquentielles sont plus uniformément réparties.
Etant donné que les données de l'index ne sont pas triées par clé de colonne lorsqu'elles sont stockées, l'agencement de clé inverse élimine la possibilité d'exécuter une requête d'analyse de plage d'index dans certains cas. Par exemple, si un utilisateur émet une requête pour des ID de commande supérieurs à 20, la base de données ne peut pas commencer par le bloc contenant cet ID et continuer horizontalement via les blocs feuille.
Index croissants et décroissants
Dans un index ascendant, Oracle AI Database stocke les données dans l'ordre croissant. Par défaut, les données alphanumériques sont triées par les valeurs binaires contenues dans chaque octet de la valeur, les données numériques du plus petit au plus grand nombre et la date de la plus ancienne à la plus récente.
Pour un exemple d'index ascendant, considérons l'instruction SQL suivante :
CREATE INDEX emp_deptid_ix ON hr.employees(department_id);Oracle AI Database trie la table hr.employees sur la colonne department_id. Il charge l'index croissant avec les valeurs department_id et rowid correspondantes dans l'ordre croissant, en commençant par 0. Lorsqu'il utilise l'index, Oracle AI Database recherche les valeurs department_id triées et utilise les rowids associés pour localiser les lignes ayant la valeur department_id demandée.
En spécifiant le mot-clé DESC dans l'instruction CREATE INDEX, vous pouvez créer un index décroissant. Dans ce cas, l'index stocke les données d'une ou de plusieurs colonnes dans l'ordre décroissant. Si l'index du tableau 5-3 sur la colonne employees.department_id était décroissant, le blocage feuille contenant 250 se trouverait sur le côté gauche de l'arborescence et le bloc avec 0 sur la droite. La recherche par défaut dans un index décroissant va de la valeur la plus élevée à la valeur la plus faible.
Les index descendants sont utiles lorsqu'une requête trie certaines colonnes par ordre croissant et d'autres par ordre décroissant. Par exemple, supposons que vous créez un index composite sur les colonnes last_name et department_id comme suit :
CREATE INDEX emp_name_dpt_ix ON hr.employees(last_name ASC, department_id DESC);Si un utilisateur interroge hr.employees pour les noms de famille dans l'ordre croissant (A à Z) et les ID de département dans l'ordre décroissant (de haut en bas), la base de données peut utiliser cet index pour extraire les données et éviter l'étape supplémentaire de tri.
Voir aussi :
-
Guide de réglage SQL Oracle AI Database pour en savoir plus sur les recherches d'index ascendantes et décroissantes
-
Référence de langage SQL Oracle AI Database pour les descriptions des options
ASCetDESCdeCREATE INDEX
Compression d'index
Pour réduire l'espace dans les index, Oracle AI Database peut utiliser différents algorithmes de compression.
-
Compression de préfixe Oracle AI Database peut utiliser la compression de préfixe, également appelée compression de clé, pour compresser des parties des valeurs de colonne de clé primaire dans un index B-tree ou une table organisée en index. La compression de préfixe peut réduire considérablement l'espace consommé par l'index.
-
Compression d'index avancée A partir d'Oracle Database 12c version 1 (12.1.0.2), la compression d'index avancée améliore la compression de préfixe traditionnelle pour les index pris en charge sur les tables organisées en portions de mémoire.
Compression du préfixe
Oracle AI Database peut utiliser la compression de préfixe, également appelée compression de clé, pour compresser des parties des valeurs de colonne de clé primaire dans un index B-tree ou une table organisée en index. La compression de préfixe peut réduire considérablement l'espace consommé par l'index.
Une entrée d'index non compressée a une seule pièce. Une entrée d'index utilisant la compression de préfixe comporte deux éléments : une entrée de préfixe, qui est l'élément de regroupement, et une entrée de suffixe, qui est l'élément unique ou presque unique. La base de données obtient la compression en partageant les entrées de préfixe entre les entrées de suffixe d'un bloc d'index. Remarque : si aucune clé n'est définie pour avoir un élément unique, la base de données en fournit un en ajoutant un rowid à l'élément de regroupement.
Par défaut, le préfixe d'un index unique se compose de toutes les colonnes de clé, à l'exception de la dernière, tandis que le préfixe d'un index non unique se compose de toutes les colonnes de clé. Supposons que vous créez un index composite unique sur deux colonnes de la table oe.orders comme suit :
CREATE UNIQUE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );Dans l'exemple précédent, une clé d'index peut être online,0. Le rowid est stocké dans la partie de données de clé de l'entrée et ne fait pas partie de la clé elle-même.
Remarque : si vous créez un index unique sur une seule colonne, Oracle AI Database ne peut pas utiliser la compression de clé de préfixe car il n'existe aucun préfixe commun.
Vous pouvez également créer un index non unique sur les mêmes colonnes :
CREATE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );Supposons également que des valeurs répétées se produisent dans les colonnes order_mode et order_status. Un bloc d'index peut contenir des entrées, comme indiqué dans l'exemple suivant :
online,0,AAAPvCAAFAAAAFaAAa
online,0,AAAPvCAAFAAAAFaAAg
online,0,AAAPvCAAFAAAAFaAAl
online,2,AAAPvCAAFAAAAFaAAm
online,3,AAAPvCAAFAAAAFaAAq
online,3,AAAPvCAAFAAAAFaAAt
Dans l'exemple précédent, le préfixe de clé consiste en une concaténation des valeurs order_mode et order_status, comme dans online,0. Le suffixe se compose de l'ID ligne, comme dans AAAPvCAAFAAAAFaAAa. L'ID ligne rend l'ensemble de l'entrée d'index unique car un ID ligne est lui-même unique dans la base de données.
Si l'index de l'exemple précédent a été créé avec la compression de préfixe par défaut (spécifiée par le mot-clé COMPRESS), les préfixes de clé en double tels que online,0 et online,3 sont compressés. Sur le plan conceptuel, la base de données effectue la compression comme suit :
online,0
AAAPvCAAFAAAAFaAAa
AAAPvCAAFAAAAFaAAg
AAAPvCAAFAAAAFaAAl
online,2
AAAPvCAAFAAAAFaAAm
online,3
AAAPvCAAFAAAAFaAAq
AAAPvCAAFAAAAFaAAt
Les entrées de suffixe (les rowids) forment la version compressée des lignes d'index. Chaque entrée de suffixe référence une entrée de préfixe, qui est stockée dans le même bloc d'index que le suffixe.
Vous pouvez également indiquer une longueur de préfixe lors de la création d'un index qui utilise la compression de préfixe. Par exemple, si vous avez indiqué COMPRESS 1, le préfixe est order_mode et le suffixe est order_status,rowid. Pour les valeurs de l'exemple de bloc d'index, l'index prend en compte les occurrences en double du préfixe online, qui peuvent être représentées conceptuellement comme suit :
online
0,AAAPvCAAFAAAAFaAAa
0,AAAPvCAAFAAAAFaAAg
0,AAAPvCAAFAAAAFaAAl
2,AAAPvCAAFAAAAFaAAm
3,AAAPvCAAFAAAAFaAAq
3,AAAPvCAAFAAAAFaAAt
L'index stocke un préfixe spécifique une fois par bloc feuille au maximum. Seules les clés des blocs feuille d'un index B-tree sont compressées. Dans les blocs de branchement, le suffixe de clé peut être tronqué, mais la clé n'est pas compressée.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment utiliser des index compressés
-
Oracle AI Database VLDB and Partitioning Guide pour apprendre à utiliser la compression de préfixe pour les index partitionnés
-
Référence de langage SQL Oracle AI Database pour les descriptions de la clause key_compression de
CREATE INDEX
Compression d'index avancée
A partir d'Oracle Database 12c version 1 (12.1.0.2), la compression avancée des index améliore la compression traditionnelle des préfixes pour les index pris en charge sur les tables organisées en portions de mémoire.
Avantages de la compression d'index avancée
La compression de préfixe présente des limites pour les types d'index pris en charge, le taux de compression et la facilité d'utilisation. Contrairement à la compression de préfixe, qui utilise l'élimination fixe des clés en double pour chaque bloc, la compression avancée des index utilise l'élimination adaptative des clés en double par bloc. Les principaux avantages de la compression d'index avancée sont les suivants :
-
La base de données choisit automatiquement la meilleure compression pour chaque bloc, en utilisant un certain nombre d'algorithmes internes tels que les préfixes de niveau intra-colonne, l'élimination des clés en double et la compression des rowid. Contrairement à la compression de préfixe, la compression d'index avancée ne nécessite pas que l'utilisateur connaisse les caractéristiques des données.
-
La compression avancée fonctionne à la fois sur des index non uniques et uniques. La compression de préfixe fonctionne bien sur certains index non uniques, mais les ratios sont plus faibles sur les index dont les colonnes de début n'ont pas beaucoup de répétitions.
-
L'index compressé est utilisable de la même manière qu'un index non compressé. L'index prend en charge les mêmes chemins d'accès : recherches de clés uniques, balayages de plage et balayages complets rapides.
-
Les index peuvent hériter de la compression avancée d'une table parent ou d'un tablespace contenant le tablespace.
-
Les tables organisées en index et les index basés sur des fonctions prennent en charge la compression d'index avancée. Les tables organisées en index prennent en charge la compression faible. Les index basés sur des fonctions prennent en charge la compression faible et élevée.
Fonctionnement de la compression d'index avancée
La compression d'index avancée fonctionne au niveau bloc pour fournir la meilleure compression pour chaque bloc. La base de données utilise la technique suivante :
-
Lors de la création d'un index, lorsqu'un bloc feuille est plein, la base de données compresse automatiquement le bloc au niveau optimal.
-
Lors de la réorganisation d'un bloc d'index suite à une opération LMD (Langage de manipulation de données), si la base de données peut créer suffisamment d'espace pour l'entrée d'index entrante, aucun fractionnement de bloc n'a lieu. Toutefois, pendant les opérations LMD sans compression d'index avancée, un fractionnement de bloc d'index se produit toujours lorsque le bloc est plein.
Compression d'index avancée HIGH
Dans les versions antérieures à Oracle Database 12c version 2 (12.2), la seule forme de compression d'index avancée était la compression faible (COMPRESS ADVANCED LOW). Maintenant, vous pouvez également spécifier une compression élevée (COMPRESS ADVANCED HIGH), qui est la valeur par défaut. La compression d'index avancée avec l'option HIGH offre les avantages suivants :
-
Donne des taux de compression plus élevés dans la plupart des cas, tout en améliorant les performances des requêtes qui accèdent à l'index
-
Utilise des algorithmes de compression plus complexes que les algorithmes avancés
-
Stocke les données dans une unité de compression, qui est un format spécial sur disque. Remarque : lorsque vous appliquez la compression
HIGH, tous les blocs ont une compression. Lorsque vous appliquez la compressionLOW, la base de données peut laisser certains blocs non compressés. Vous pouvez utiliser les statistiques pour déterminer le nombre de blocs qui n'ont pas été compressés.
Exemple 5-5 Création d'un index avec compression élevée avancée
Cet exemple active la compression d'index avancée pour un index sur la table hr.employees :
CREATE INDEX hr.emp_mndp_ix
  ON hr.employees(manager_id, department_id)
  COMPRESS ADVANCED;
La requête suivante indique le type de compression :
SELECT COMPRESSION FROM DBA_INDEXES WHERE INDEX_NAME ='EMP_MNDP_IX';

COMPRESSION
-------------
ADVANCED HIGH
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment activer la compression d'index avancée
-
Référence de langage SQL Oracle AI Database pour les descriptions de la clause key_compression de
CREATE INDEX -
Référence Oracle AI Database pour en savoir plus sur
ALL_INDEXES
Présentation des index bitmap
Dans un index bitmap, la base de données stocke un bitmap pour chaque clé d'index. Dans un index B-tree classique, une entrée d'index pointe vers une seule ligne. Dans un index bitmap, chaque clé d'index stocke des pointeurs vers plusieurs lignes.
Les index bitmap sont principalement conçus pour l'entreposage de données ou les environnements dans lesquels les requêtes référencent de nombreuses colonnes de manière ad hoc. Les situations pouvant nécessiter un index bitmap sont les suivantes :
-
La cardinalité des colonnes indexées est faible, c'est-à-dire que le nombre de valeurs distinctes est faible par rapport au nombre de lignes de table.
-
La table indexée est en lecture seule ou n'est pas soumise à des modifications importantes par les instructions LMD.
Pour un exemple de data warehouse, la table sh.customers comporte une colonne cust_gender avec seulement deux valeurs possibles : M et F. Supposons que les requêtes pour le nombre de clients d'un genre particulier soient courantes. Dans ce cas, la colonne customers.cust_gender peut être utilisée pour un index bitmap.
Chaque bit du bitmap correspond à un rowid possible. Si le bit est défini, la ligne avec le rowid correspondant contient la valeur de clé. Une fonction de mapping convertit la position du bit en un rowid réel, de sorte que l'index bitmap fournit la même fonctionnalité qu'un index B-tree bien qu'il utilise une représentation interne différente.
Si la colonne indexée d'une seule ligne est mise à jour, la base de données verrouille l'entrée de clé d'index (par exemple, M ou F) et non le bit individuel mis en correspondance avec la ligne mise à jour. Etant donné qu'une clé pointe vers de nombreuses lignes, les instructions LMD sur les données indexées verrouillent généralement toutes ces lignes. Pour cette raison, les index bitmap ne sont pas appropriés pour de nombreuses applications OLTP.
-
Exemple : index bitmap sur une table unique Dans cet exemple, certaines colonnes de la table
sh.customerssont candidates pour un index bitmap. -
Index de jointure bitmap Un index de jointure bitmap est un index bitmap pour la jointure de plusieurs tables.
-
Structure de stockage bitmap Oracle AI Database utilise une structure d'index B-tree pour stocker des bitmaps pour chaque clé indexée.
Voir aussi :
-
Guide de réglage SQL Oracle AI Database pour en savoir plus sur les index bitmap
-
Guide de l'entreposage de données Oracle AI Database pour apprendre à utiliser des index bitmap dans un data warehouse
Exemple : index bitmap sur une seule table
Dans cet exemple, certaines colonnes de la table sh.customers sont candidates pour un index bitmap.
Prenons la requête suivante :
SQL> SELECT cust_id, cust_last_name, cust_marital_status, cust_gender
  2  FROM   sh.customers
  3  WHERE  ROWNUM < 8 ORDER BY cust_id;

   CUST_ID CUST_LAST_ CUST_MAR C
---------- ---------- -------- -
         1 Kessel              M
         2 Koch                F
         3 Emmerson            M
         4 Hardy               M
         5 Gowen               M
         6 Charles    single   F
         7 Ingram     single   F

7 rows selected.
Les colonnes cust_marital_status et cust_gender présentent une cardinalité faible, contrairement à cust_id et cust_last_name. Par conséquent, les index bitmap peuvent être appropriés sur cust_marital_status et cust_gender. Un index bitmap n'est probablement pas utile pour les autres colonnes. Au lieu de cela, un index B-tree unique sur ces colonnes fournirait probablement la représentation et l'extraction les plus efficaces. Le Table 5-4 illustre l'index bitmap de la sortie de colonne cust_gender illustrée dans l'exemple précédent. Il se compose de deux bitmaps distincts, un pour chaque sexe.
Exemple de bitmap du tableau 4 pour une colonne
| Valeur | Ligne 1 | Ligne 2 | Ligne 3 | Ligne 4 | Ligne 5 | Ligne 6 | Ligne 7 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
Une fonction de mapping convertit chaque bit du bitmap en rowid de la table customers. Chaque valeur de bit dépend des valeurs de la ligne correspondante dans la table. Par exemple, le bitmap de la valeur M contient le premier bit 1 car le sexe est M dans la première ligne de la table customers. Le bitmap cust_gender='M' a une valeur 0 pour les bits des lignes 2, 6 et 7 car ces lignes ne contiennent pas M comme valeur.
Remarque : les index bitmap peuvent inclure des clés entièrement composées de valeurs NULL, contrairement aux index B-tree. L'indexation des valeurs NULL peut être utile pour certaines instructions SQL, telles que les requêtes avec la fonction d'agrégation COUNT.
Un analyste enquêtant sur les tendances démographiques des clients peut demander : "Combien de nos clientes sont célibataires ou divorcées ?" Cette question correspond à la requête SQL suivante :
SELECT COUNT(*)
FROM   customers
WHERE  cust_gender = 'F'
AND    cust_marital_status IN ('single', 'divorced');
Les index bitmap peuvent traiter efficacement cette requête en comptant le nombre de valeurs 1 dans le bitmap obtenu, comme illustré dans le Table 5-5. Pour identifier les clients qui répondent aux critères, Oracle AI Database peut utiliser le bitmap obtenu pour accéder à la table.
Exemple de bitmap du tableau 5 pour deux colonnes
| Valeur | Ligne 1 | Ligne 2 | Ligne 3 | Ligne 4 | Ligne 5 | Ligne 6 | Ligne 7 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
single |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
divorced |
0 | 0 | 0 | 0 | 0 | 0 | 0 |
single ou divorced, et F |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
L'indexation bitmap fusionne efficacement les index qui correspondent à plusieurs conditions dans une clause WHERE. Les lignes qui remplissent certaines conditions, mais pas toutes, sont filtrées avant l'accès à la table elle-même. Cette technique améliore le temps de réponse, souvent de manière spectaculaire.
Index de jointure bitmap
Un index de jointure bitmap est un index bitmap pour la jointure de plusieurs tables.
Pour chaque valeur d'une colonne de table, l'index stocke l'ID de ligne de la ligne correspondante dans la table indexée. En revanche, un index bitmap standard est créé sur une seule table.
Un index de jointure bitmap est un moyen efficace de réduire le volume de données qui doivent être jointes en appliquant des restrictions à l'avance. Par exemple, si un index de jointure bitmap est utile, supposons que les utilisateurs interrogent souvent le nombre d'employés avec un type de travail particulier. Une requête standard peut se présenter comme suit :
SELECT COUNT(*)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
AND    jobs.job_title = 'Accountant';
La requête précédente utilise généralement un index sur jobs.job_title pour extraire les lignes pour Accountant, puis l'ID de travail, et un index sur employees.job_id pour trouver les lignes correspondantes. Pour extraire les données de l'index lui-même plutôt que d'un balayage des tables, vous pouvez créer un index de jointure bitmap comme suit :
CREATE BITMAP INDEX employees_bm_idx
ON     employees (jobs.job_title)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id;
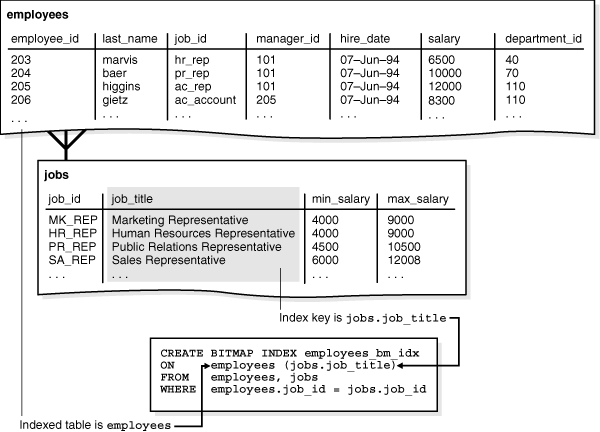
Comme illustré dans la figure suivante, la clé d'index est jobs.job_title et la table indexée est employees.
Figure 2 : Index de jointure bitmap
Description de l'image cncpt239.gif
Sur le plan conceptuel, employees_bm_idx est un index de la colonne jobs.title dans la requête SQL présentée dans la requête suivante (exemple de sortie inclus). La clé job_title de l'index pointe vers les lignes de la table employees. Une requête sur le nombre de comptables peut utiliser l'index pour éviter d'accéder aux tables employees et jobs car l'index lui-même contient les informations demandées.
SELECT jobs.job_title AS "jobs.job_title", employees.rowid AS "employees.rowid"
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
ORDER BY job_title;

jobs.job_title                      employees.rowid
----------------------------------- ------------------
Accountant                          AAAQNKAAFAAAABSAAL
Accountant                          AAAQNKAAFAAAABSAAN
Accountant                          AAAQNKAAFAAAABSAAM
Accountant                          AAAQNKAAFAAAABSAAJ
Accountant                          AAAQNKAAFAAAABSAAK
Accounting Manager                  AAAQNKAAFAAAABTAAH
Administration Assistant            AAAQNKAAFAAAABTAAC
Administration Vice President       AAAQNKAAFAAAABSAAC
Administration Vice President       AAAQNKAAFAAAABSAAB
.
.
.
Dans un data warehouse, la condition de jointure est une équijointure (elle utilise l'opérateur d'égalité) entre les colonnes de clé primaire des tables de dimension et les colonnes de clé étrangère de la table de faits. Les index de jointure bitmap sont parfois beaucoup plus efficaces dans le stockage que les vues de jointure matérialisées, une alternative à la matérialisation des jointures à l'avance.
Voir aussi : Guide de l'entreposage de données Oracle AI Database pour plus d'informations sur les index de jointure bitmap
Structure de stockage bitmap
Oracle AI Database utilise une structure d'index B-tree pour stocker les bitmaps pour chaque clé indexée.
Par exemple, si jobs.job_title est la colonne de clé d'un index bitmap, une arborescence B stocke les données d'index. Les blocs feuille stockent les bitmaps individuels.
Exemple 5-6 Exemple de stockage bitmap
Supposons que la colonne jobs.job_title ait des valeurs uniques Shipping Clerk, Stock Clerk et plusieurs autres. Une entrée d'index bitmap pour cet index comporte les composants suivants :
-
Intitulé du poste en tant que clé d'index
-
Un rowid bas et un rowid haut pour une plage de rowid
-
Un bitmap pour des rowids spécifiques dans la plage
Conceptuellement, un bloc feuille d'index de cet index peut contenir les entrées suivantes :
Shipping Clerk,AAAPzRAAFAAAABSABQ,AAAPzRAAFAAAABSABZ,0010000100
Shipping Clerk,AAAPzRAAFAAAABSABa,AAAPzRAAFAAAABSABh,010010
Stock Clerk,AAAPzRAAFAAAABSAAa,AAAPzRAAFAAAABSAAc,1001001100
Stock Clerk,AAAPzRAAFAAAABSAAd,AAAPzRAAFAAAABSAAt,0101001001
Stock Clerk,AAAPzRAAFAAAABSAAu,AAAPzRAAFAAAABSABz,100001
.
.
.
Le même intitulé de poste apparaît dans plusieurs entrées car la plage d'ID ligne est différente.
Une session met à jour l'ID de poste d'un employé de Shipping Clerk vers Stock Clerk. Dans ce cas, la session requiert un accès exclusif à l'entrée de clé d'index pour l'ancienne valeur (Shipping Clerk) et la nouvelle valeur (Stock Clerk). Oracle AI Database verrouille les lignes pointées par ces deux entrées, mais pas les lignes pointées par Accountant ou toute autre clé jusqu'à ce que UPDATE soit validé.
Les données d'un index bitmap sont stockées dans un segment. Oracle AI Database stocke chaque bitmap en un ou plusieurs éléments. Chaque élément occupe une partie d'un seul bloc de données.
Voir aussi : "Segments utilisateur" explique les différents types de segment et la façon dont les segments sont créés.
Présentation des index basés sur des fonctions
Un index basé sur les fonctions calcule la valeur d'une fonction ou d'une expression impliquant une ou plusieurs colonnes et l'enregistre dans un index. Un index basé sur une fonction peut être un index B-tree ou un index bitmap.
La fonction indexée peut être une expression arithmétique ou une expression qui contient une fonction SQL, une fonction PL/SQL définie par l'utilisateur, une fonction de package ou un appel C. Par exemple, une fonction peut ajouter les valeurs dans deux colonnes.
-
Utilisations des index basés sur des fonctions Les index basés sur des fonctions sont efficaces pour évaluer les instructions qui contiennent des fonctions dans leurs clauses
WHERE. La base de données utilise uniquement l'index basé sur une fonction lorsque celle-ci est incluse dans une requête. Toutefois, lorsque la base de données traite les instructionsINSERTetUPDATE, elle doit tout de même évaluer la fonction pour traiter l'instruction. -
Optimisation avec index basés sur une fonction Pour les requêtes avec des expressions dans une clause
WHERE, l'optimiseur peut utiliser un balayage d'intervalle d'index sur un index basé sur une fonction.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment créer des index basés sur des fonctions
-
Guide de développement Oracle AI Database, pour plus d'informations sur l'utilisation des index basés sur des fonctions
-
Référence du langage SQL d'Oracle AI Database pour connaître les restrictions et les notes d'utilisation des index basés sur des fonctions
Utilisations des index basés sur des fonctions
Les index basés sur des fonctions sont efficaces pour évaluer les instructions qui contiennent des fonctions dans leurs clauses WHERE. La base de données utilise uniquement l'index basé sur une fonction lorsque celle-ci est incluse dans une requête. Toutefois, lorsque la base de données traite les instructions INSERT et UPDATE, elle doit tout de même évaluer la fonction pour traiter l'instruction.
Exemple 5-7 Index basé sur une expression arithmétique
Par exemple, supposons que vous créiez l'index basé sur les fonctions suivant :
CREATE INDEX emp_total_sal_idx
  ON employees (12 * salary * commission_pct, salary, commission_pct);
La base de données peut utiliser l'index précédent lors du traitement de requêtes telles que les suivantes (exemple partiel de sortie inclus) :
SELECT   employee_id, last_name, first_name,
         12*salary*commission_pct AS "ANNUAL SAL"
FROM     employees
WHERE    (12 * salary * commission_pct) < 30000
ORDER BY "ANNUAL SAL" DESC;

EMPLOYEE_ID LAST_NAME                 FIRST_NAME           ANNUAL SAL
----------- ------------------------- -------------------- ----------
        159 Smith                     Lindsey                   28800
        151 Bernstein                 David                     28500
        152 Hall                      Peter                     27000
        160 Doran                     Louise                    27000
        175 Hutton                    Alyssa                    26400
        149 Zlotkey                   Eleni                     25200
        169 Bloom                     Harrison                  24000
Exemple 5-8 Index basé sur une fonction UPPER
Les index basés sur des fonctions définis sur les fonctions SQL UPPER(column_name) ou LOWER(column_name) facilitent les recherches sans distinction entre les majuscules et les minuscules. Par exemple, supposons que la colonne first_name dans employees contienne des caractères majuscules/minuscules. Vous créez l'index basé sur les fonctions suivant sur la table hr.employees :
CREATE INDEX emp_fname_uppercase_idx
ON employees ( UPPER(first_name) );
L'index emp_fname_uppercase_idx peut faciliter les requêtes telles que les suivantes :
SELECT *
FROM   employees
WHERE  UPPER(first_name) = 'AUDREY';
Exemple 5-9 Indexation de lignes spécifiques dans une table
Un index basé sur une fonction est également utile pour indexer uniquement des lignes spécifiques d'une table. Par exemple, la colonne cust_valid de la table sh.customers contient la valeur I ou A. Pour indexer uniquement les lignes A, vous pouvez écrire une fonction qui renvoie une valeur NULL pour toutes les lignes autres que les lignes A. Vous pouvez créer l'index comme suit :
CREATE INDEX cust_valid_idx
ON customers ( CASE cust_valid WHEN 'A' THEN 'A' END );
Voir aussi :
-
Guide de prise en charge de la globalisation d'Oracle AI Database pour plus d'informations sur les index linguistiques
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur les fonctions SQL
Optimisation avec index basés sur des fonctions
Pour les requêtes avec des expressions dans une clause WHERE, l'optimiseur peut utiliser un balayage d'intervalle d'index sur un index basé sur une fonction.
Le chemin d'accès d'analyse de plage est particulièrement utile lorsque le prédicat est très sélectif, c'est-à-dire lorsqu'il choisit relativement peu de lignes. Dans l'exemple 5-7, si un index est créé sur l'expression 12*salary*commission_pct, l'optimiseur peut utiliser un balayage d'intervalle d'index.
Une colonne virtuelle est également utile pour accélérer l'accès aux données dérivées des expressions. Par exemple, vous pouvez définir la colonne virtuelle annual_sal comme 12*salary*commission_pct et créer un index basé sur une fonction sur annual_sal.
L'optimiseur effectue la mise en correspondance des expressions en analysant l'expression dans une instruction SQL, puis en comparant les arborescences d'expressions de l'instruction et l'index basé sur une fonction. Cette comparaison ne tient pas compte de la casse et ignore les espaces.
Différentes interrogations peuvent utiliser différents types d'analyse d'index.
Voir aussi :
-
Guide de réglage SQL Oracle AI Database pour en savoir plus sur la collecte de statistiques
-
Guide de l'administrateur Oracle AI Database pour savoir comment ajouter des colonnes virtuelles à une table
Présentation des index de domaine d'application
Un index de domaine d'application est un index personnalisé propre à une application.
L'indexation étendue peut :
-
Adaptez les index aux types de données complexes et personnalisés tels que les documents, les données spatiales, les images et les clips vidéo (voir )
-
Utiliser des techniques d'indexation spécialisées
Vous pouvez encapsuler des routines de gestion d'index propres à une application en tant qu'objet de schéma de type indéterminé, puis définir un index de domaine sur des colonnes de table ou des attributs d'un type d'objet. L'indexation extensible permet de traiter efficacement les opérateurs propres aux applications.
Le logiciel d'application, appelé cartouche, contrôle la structure et le contenu d'un index de domaine. La base de données interagit avec l'application pour créer, gérer et rechercher l'index du domaine. La structure d'index elle-même peut être stockée dans la base de données en tant que table organisée en index ou en externe en tant que fichier.
Voir aussi :
-
Guide de développement Oracle AI Database pour en savoir plus sur les types de données complexes
-
Guide du développeur des cartouches de données Oracle AI Database pour plus d'informations sur l'utilisation des cartouches de données dans l'architecture d'extensibilité d'Oracle AI Database
Présentation des index HNSW quantifiés scalaires
Les index HNSW (Hierarchical Navigable Small World) quantifiés scalaires peuvent être utilisés pour réduire les besoins en mémoire et accélérer la recherche de similarité.
Dans le contexte des bases de données vectorielles, la quantification scalaire est une méthode de compression ou d'approximation de vecteurs de données haute dimension par quantification indépendante de chaque dimension (ou composant scalaire) du vecteur. Cette approche est utilisée pour réduire les besoins de stockage d'une base de données vectorielle tout en préservant la structure essentielle des données pour des tâches telles que la recherche de similarité. La quantification scalaire peut être particulièrement bénéfique lorsque la simplicité et les faibles besoins de stockage sont des priorités élevées.
Les vecteurs à haute dimension stockés en tant que nombres à virgule flottante nécessitent un espace de stockage important. La quantification scalaire permet d'économiser de la mémoire en compressant les vecteurs. Par exemple, un vecteur 128 dimensions stocké en 8 bits (INT8) par dimension ne nécessite que 128 octets de mémoire, tandis que le stockage en virgule flottante 32 bits (Float32) nécessiterait 512 octets et le stockage en double 64 bits (Float64) nécessiterait 1024 octets. En raison de cette exigence de stockage réduite, la quantification scalaire peut permettre aux bases de données vectorielles de gérer de très grands ensembles de données, composés même de milliards de vecteurs, ce qui serait autrement impraticable en raison de contraintes de stockage.
Un autre avantage de la quantification scalaire est la vitesse de recherche améliorée. Les méthodes de recherche du voisin le plus proche (ANN) peuvent exploiter les données quantifiées pour des comparaisons plus rapides, car les opérations sur les entiers ou les codes binaires sont plus rapides que les calculs en virgule flottante.
Avec Oracle AI Database, la quantification scalaire uniforme est la méthode de compression implémentée, ce qui signifie que la plage d'entrée est divisée en intervalles de taille égale. Chaque intervalle est représenté par un seul niveau de quantification, généralement son point médian. La plage de chaque dimension est divisée en intervalles égaux 2b, où b est le nombre de bits (par exemple, 8 bits pour int8). Chaque valeur flottante est mise en correspondance avec le niveau de quantification le plus proche.
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database AI Vector Search pour la syntaxe et les paramètres d'index HNSW
-
Référence de langage SQL Oracle AI Database pour l'instruction
CREATE VECTOR INDEX
Présentation des tables triées en index
Une table organisée en index est une table stockée dans une variation d'une structure d'index B-tree. En revanche, une table organisée en portions de mémoire insère les lignes à leur place.
Dans une table organisée en index, les lignes sont stockées dans un index défini sur la clé primaire de la table. Chaque entrée d'index dans l'arborescence B stocke également les valeurs de colonne non clé. L'index est donc les données et les données l'index. Les applications manipulent les tables organisées en index comme les tables organisées en portions de mémoire à l'aide d'instructions SQL.
Pour une analogie avec une table organisée en index, supposons qu'un responsable des ressources humaines dispose d'un cas de livre de boîtes en carton. Chaque boîte est étiquetée avec un numéro-1, 2, 3, 4, et ainsi de suite, mais les boîtes ne s'assoient pas sur les étagères dans l'ordre séquentiel. Au lieu de cela, chaque champ contient un pointeur vers l'emplacement d'étagère du champ suivant dans la séquence.
Les dossiers contenant les enregistrements d'employé sont stockés dans chaque case. Les dossiers sont triés par matricule salarié. Employee King a l'ID 100, qui est l'ID le plus bas, de sorte que son dossier se trouve en bas de la case 1. Le dossier de l'employé 101 est au-dessus de 100, 102 est au-dessus de 101, et ainsi de suite jusqu'à ce que la case 1 soit pleine. Le dossier suivant de la séquence se trouve en bas de la case 2.
Dans cette analogie, le classement des dossiers par matricule salarié permet de rechercher efficacement les dossiers sans avoir à tenir à jour un index distinct. Supposons qu'un utilisateur demande les enregistrements pour les employés 107, 120 et 122. Au lieu de rechercher un index en une seule étape et d'extraire les dossiers en une étape distincte, le gestionnaire peut rechercher les dossiers dans l'ordre séquentiel et extraire chaque dossier comme trouvé.
Les tables organisées en index fournissent un accès plus rapide aux lignes de table par clé principale ou par préfixe valide de la clé. La présence de colonnes sans clé d'une ligne dans le bloc feuille évite une E/S de bloc de données supplémentaire. Par exemple, le salaire de l'employé 100 est stocké dans la ligne d'index elle-même. En outre, étant donné que les lignes sont stockées dans l'ordre des clés primaires, l'accès par plage par clé primaire ou préfixe implique un minimum d'E/S de bloc. Un autre avantage est d'éviter la surcharge d'espace d'un index de clé primaire distinct.
Les tables organisées en index sont utiles lorsque des éléments de données connexes doivent être stockés ensemble ou que les données doivent être stockées physiquement dans un ordre spécifique. Ce type de table est généralement utilisé pour l'extraction d'informations, les données spatiales et les applications OLAP.
-
Caractéristiques des tables organisées en index Le système de base de données effectue toutes les opérations sur les tables organisées en index en manipulant la structure d'index de l'arborescence B.
-
Tables organisées en index avec zone de débordement de ligne Lors de la création d'une table organisée en index, vous pouvez indiquer un segment distinct en tant que zone de débordement de ligne.
-
Index secondaires sur des tables organisées en indices Un index secondaire est un index sur une table organisée en indices.
Voir aussi :
-
Guide du développeur Oracle Spatial, pour une présentation d'Oracle Spatial and Graph
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer les tables organisées en index
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
CREATE TABLE ... ORGANIZATION INDEX
Caractéristiques de la table organisée en index
Le système de base de données effectue toutes les opérations sur les tables organisées en index en manipulant la structure d'index de l'arborescence B.
Le tableau suivant récapitule les différences entre les tables organisées en index et les tables organisées en tas.
Tableau 6 Comparaison des tables organisées en portions de mémoire et des tables organisées en index
| Table organisée en portions de mémoire | Table organisée en index |
|---|---|
| L'ID ligne identifie de manière unique une ligne. Une contrainte de clé primaire peut éventuellement être définie. | La clé primaire identifie de manière unique une ligne. La contrainte de clé primaire doit être définie. |
L'ID de ligne physique dans la pseudocolonne ROWID permet de créer des index secondaires. |
L'ID de ligne logique dans la pseudo-colonne ROWID permet de créer des index secondaires. |
| Les lignes individuelles sont accessibles directement par rowid. | L'accès à des lignes individuelles peut être réalisé indirectement par la clé primaire. |
| Le balayage complet de table séquentiel renvoie toutes les lignes dans un ordre donné. | Un balayage complet d'index (full index scan) ou un balayage complet d'index (full index scan) rapide renvoie toutes les lignes dans un certain ordre. |
| Peut être stocké dans un cluster de tables avec d'autres tables. | Ne peut pas être stocké dans un cluster de tables. |
Peut contenir une colonne de type de données LONG et des colonnes de type de données LOB. |
Peut contenir des colonnes LOB mais pas des colonnes LONG. |
| Peut contenir des colonnes virtuelles (seules les tables de portion de mémoire relationnelles sont prises en charge). | Ne peut pas contenir de colonnes virtuelles. |
Les tables organisées en index peuvent être compressées à l'aide de la compression avancée faible en ajoutant la clause COMPRESS ADVANCED LOW à l'instruction CREATE TABLE. Advanced Low compression est une forme adaptative de compression de préfixe qui calcule de manière autonome le nombre optimal de colonnes de préfixe pour chaque bloc feuille, conduisant à une compression optimale au niveau du bloc sans aucune intervention de l'utilisateur. Cela inclut la possibilité de ne pas comprimer du tout, le cas échéant. Cela garantit que la compression négative n'est pas possible. Des taux de compression plus élevés sont observés avec une surcharge globale négligeable.
Les analyses sur les tables organisées en index peuvent être déchargées vers Exadata Smart Scan, où l'optimiseur a estimé que la requête peut être exécutée en tant qu'analyse complète rapide. Cela ne nécessite aucune intervention de l'utilisateur. Le traitement complet côté cellule sera pris en charge sur les blocs feuille de table organisés en index où toutes les colonnes d'intérêt résident dans le bloc feuille. Dans les cas où certaines colonnes résident dans le segment de débordement, l'analyse intelligente ne traite pas ces colonnes et la base de données termine l'analyse. La figure 5-3 illustre la structure d'une table departments organisée en index. Les blocs feuille contiennent les lignes de la table, triées séquentiellement par clé primaire. Par exemple, la première valeur du premier bloc feuille affiche l'ID de département 20, le nom de département Marketing, l'ID de manager 201 et l'ID d'emplacement 1800.
Figure 3 : Table organisée en index
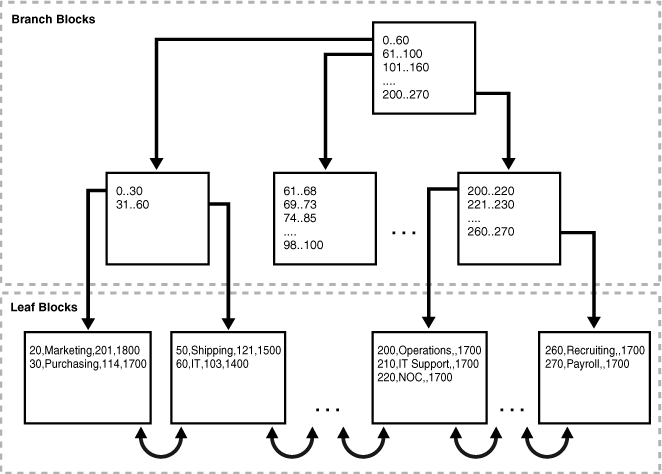
Description de l'image cncpt272.gif
Exemple 5-10 Analyse d'une table organisée en index
Une table organisée en index stocke toutes les données dans la même structure et n'a pas besoin de stocker le rowid. Comme illustré dans la Figure 5-3, le bloc feuille 1 d'une table organisée en index peut contenir les entrées suivantes, classées par clé primaire :
20,Marketing,201,1800
30,Purchasing,114,1700
Le bloc feuille 2 d'une table organisée en index peut contenir les entrées suivantes :
50,Shipping,121,1500
60,IT,103,1400
Un balayage des lignes de table organisées en index dans l'ordre des clés primaires lit les blocs dans l'ordre suivant :
-
Bloc 1
-
Bloc 2
Exemple 5-11 Analyse d'une table organisée en portions de mémoire
Pour comparer l'accès aux données d'une table organisée en portions de mémoire à une table organisée en index, supposons que le bloc 1 d'un segment de table departments organisé en portions de mémoire contient les lignes suivantes :
50,Shipping,121,1500
20,Marketing,201,1800
Le bloc 2 contient des lignes pour la même table, comme suit :
30,Purchasing,114,1700
60,IT,103,1400
Un bloc feuille d'index B-tree pour cette table organisée en portions de mémoire contient les entrées suivantes, où la première valeur est la clé primaire et la seconde est l'ID de ligne :
20,AAAPeXAAFAAAAAyAAD
30,AAAPeXAAFAAAAAyAAA
50,AAAPeXAAFAAAAAyAAC
60,AAAPeXAAFAAAAAyAAB
Un balayage des lignes de table dans l'ordre des clés primaires lit les blocs de segment de table dans l'ordre suivant :
-
Bloc 1
-
Bloc 2
-
Bloc 1
-
Bloc 2
Ainsi, le nombre d'E/S de bloc dans cet exemple est le double du nombre dans l'exemple organisé en index.
Voir aussi :
pour en savoir plus sur les tables organisées en portions de mémoire
pour en savoir plus sur la relation entre les segments et les blocs de données
Tables organisées en index avec zone de débordement de ligne
Lorsque vous créez une table organisée en index, vous pouvez indiquer un segment distinct en tant que zone de débordement de ligne.
Dans les tables organisées en index, les entrées d'index B-tree peuvent être volumineuses car elles contiennent une ligne entière. Par conséquent, un segment distinct contenant les entrées est utile. En revanche, les entrées B-tree sont généralement petites car elles se composent de la clé et du rowid.
Si une zone de débordement de ligne est indiquée, la base de données peut diviser une ligne d'une table organisée en index en plusieurs parties :
-
L'entrée d'index
Cette partie contient des valeurs de colonne pour toutes les colonnes de clé primaire, un rowid physique qui pointe vers la partie de débordement de la ligne et éventuellement quelques colonnes non-clé. Cette partie est stockée dans le segment d'index.
-
La partie de débordement
Cette partie contient des valeurs de colonne pour les colonnes non clés restantes. Cette partie est stockée dans le segment de zone de stockage de débordement.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à utiliser la clause
OVERFLOWdeCREATE TABLEpour définir une zone de débordement de ligne -
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
CREATE TABLE ... OVERFLOW
Index secondaires sur des tables organisées en index
Un index secondaire est un index sur une table organisée en indices.
En un sens, un index secondaire est un index sur un index. Il s'agit d'un objet de schéma indépendant qui est stocké séparément de la table organisée en index.
Oracle AI Database utilise des identificateurs de ligne appelés rowids logiques pour les tables organisées en index. Un rowid logique est une représentation codée en base64 de la clé primaire de la table. La longueur du rowid logique dépend de la longueur de la clé primaire.
Les lignes des blocs feuille d'index peuvent se déplacer à l'intérieur ou entre les blocs en raison d'insertions. Les lignes des tables organisées en index ne migrent pas comme les lignes organisées en portions de mémoire. Etant donné que les lignes des tables organisées en index n'ont pas d'adresses physiques permanentes, la base de données utilise des rowids logiques basés sur la clé primaire.
Par exemple, supposons que la table departments soit organisée en index. La colonne location_id stocke l'ID de chaque département. La table stocke les lignes comme suit, avec la dernière valeur comme ID d'emplacement :
10,Administration,200,1700
20,Marketing,201,1800
30,Purchasing,114,1700
40,Human Resources,203,2400
Un index secondaire de la colonne location_id peut comporter les entrées d'index suivantes, où la valeur suivant la virgule est l'ID de ligne logique :
1700,*BAFAJqoCwR/+
1700,*BAFAJqoCwQv+
1800,*BAFAJqoCwRX+
2400,*BAFAJqoCwSn+
Les index secondaires offrent un accès rapide et efficace aux tables organisées en index à l'aide de colonnes qui ne sont ni la clé primaire ni un préfixe de la clé primaire. Par exemple, une requête portant sur les noms des services dont l'ID est supérieur à 1700 peut utiliser l'index secondaire pour accélérer l'accès aux données.
-
Les index secondaires Logical Rowids and Physical Guesses utilisent des rowids logiques pour localiser des lignes de table.
-
Index bitmap sur des tables organisées en index Un index secondaire sur une table organisée en index peut être un index bitmap. Un index bitmap stocke un bitmap pour chaque clé d'index.
Voir aussi :
-
"Types de données Rowid" pour en savoir plus sur l'utilisation des rowids et de la pseudo-colonne
ROWID -
"Lignes chaînées et migrées" pour comprendre pourquoi les lignes migrent et pourquoi la migration augmente le nombre d'E/S
-
Guide de l'administrateur Oracle AI Database pour découvrir comment créer des index secondaires sur une table organisée en index
-
Oracle AI Database VLDB and Partitioning Guide, pour en savoir plus sur la création d'index secondaires sur des partitions de table organisées en index
Rowids logiques et devoirs physiques
Les index secondaires utilisent des rowids logiques pour localiser des lignes de table.
Un rowid logique inclut un physical devinettes, qui est le rowid physique de l'entrée d'index lors de sa création. Oracle AI Database peut utiliser des hypothèses physiques pour sonder directement le bloc feuille de la table organisée en index, en ignorant la recherche de clé primaire. Lorsque l'emplacement physique d'une ligne change, le rowid logique reste valide même s'il contient une estimation physique périmée.
Pour une table organisée en portions de mémoire, l'accès par un index secondaire implique un balayage de l'index secondaire et une E/S supplémentaire pour extraire le bloc de données contenant la ligne. Pour les tables organisées en index, l'accès par un index secondaire varie en fonction de l'utilisation et de la précision des hypothèses physiques :
-
Sans suppositions physiques, l'accès implique deux balayages d'index : un balayage de l'index secondaire suivi d'un balayage de l'index de clé primaire.
-
Avec des suppositions physiques, l'accès dépend de leur précision :
-
Avec des suppositions physiques précises, l'accès implique un balayage d'index secondaire et une E/S supplémentaire pour extraire le bloc de données contenant la ligne.
-
Avec des suppositions physiques inexactes, l'accès implique un balayage d'index secondaire et une E/S pour extraire le mauvais bloc de données (comme indiqué par la supposition), suivi d'un balayage unique d'index de la table organisée en index par la valeur de clé primaire.
-
Index bitmap sur des tables organisées en index
Un index secondaire sur une table organisée en index peut être un index bitmap. Un index bitmap stocke un bitmap pour chaque clé d'index.
Lorsque des index bitmap existent sur une table organisée en index, tous les index bitmap utilisent une table de mapping organisée en "heaps". La table de mapping stocke les rowids logiques de la table organisée en index. Chaque ligne de table de mapping stocke un rowid logique pour la ligne de table organisée en index correspondante.
La base accède à un index bitmap à l'aide d'une clé de recherche. Si la base de données trouve la clé, l'entrée bitmap est convertie en rowid physique. Avec les tables organisées en "heaps", la base de données utilise l'ID de ligne physique pour accéder à la table de base. Avec les tables organisées en index, la base de données utilise l'ID de ligne physique pour accéder à la table de mapping, ce qui produit un ID de ligne logique que la base de données utilise pour accéder à la table organisée en index. La figure suivante illustre l'accès à l'index pour une requête de la table departments_iot.
Figure 4 : Index bitmap sur une table organisée en index
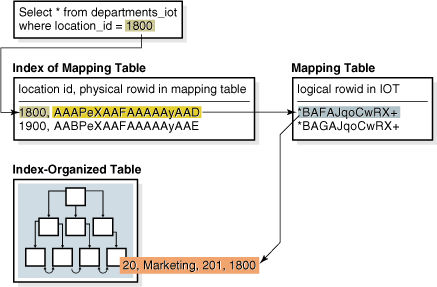
Description de l'image cncpt330.gif
Remarque : le déplacement de lignes dans une table organisée en index ne laisse pas inutilisables les index bitmap créés sur cette table organisée en index.
Voir aussi : "Rowids of Row Pieces" pour en savoir plus sur les différences entre les rowids physiques et logiques