Structures de stockage logique
Ce chapitre décrit la nature des structures de stockage logiques et leurs relations. Ces structures sont créées et reconnues par Oracle AI Database et ne sont pas connues du système d'exploitation.
-
Introduction aux structures de stockage logiques Oracle AI Database alloue de l'espace logique pour toutes les données de la base de données.
-
Présentation des blocs de données Oracle AI Database gère l'espace de stockage logique dans les fichiers de données d'une base de données dans une unité appelée bloc de données, également appelé bloc Oracle ou page. Un bloc de données est l'unité minimale d'E/S de base de données.
-
Présentation des extents Un extent est une unité de stockage de base de données constituée de blocs de données logiquement contigus. Les blocs de données peuvent être répartis physiquement sur le disque en raison du striping RAID et des implémentations de systèmes de fichiers.
-
Présentation des segments Un segment est un ensemble d'extents contenant toutes les données d'une structure de stockage logique dans un tablespace.
-
Présentation des tablespaces Un tablespace est un conteneur de stockage logique pour les segments.
Présentation des structures de stockage logique
Oracle AI Database alloue de l'espace logique à toutes les données de la base.
Les unités logiques d'allocation d'espace de base de données sont les blocs de données, les extents, les segments et les tablespaces. Au niveau physique, les données sont stockées dans des fichiers de données sur disque. Les données des fichiers de données sont stockées dans des blocs du système d'exploitation.
La figure suivante est un diagramme entité-relation pour le stockage physique et logique. La notation en patte d'oie représente une relation de un à plusieurs.
Figure 1 : Stockage logique et physique
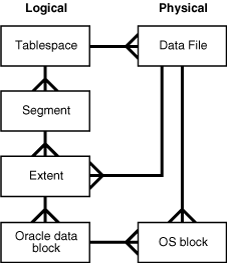
Description de l'image cncpt227.gif
-
Hiérarchie de stockage logique Un segment contient un ou plusieurs extents, chacun contenant plusieurs blocs de données.
-
Gestion logique de l'espace Oracle AI Database doit utiliser la gestion logique de l'espace pour suivre et allouer les extents dans un tablespace. Voir aussi : "Structures de stockage physique"
Hiérarchie de stockage logique
Un segment contient un ou plusieurs extents, chacun contenant plusieurs blocs de données.
La figure suivante illustre les relations entre les blocs de données, les extents et les segments d'un tablespace. Dans cet exemple, deux extents sont stockés dans des fichiers de données différents.
Figure 2 : Segments, extents et blocs de données dans un tablespace
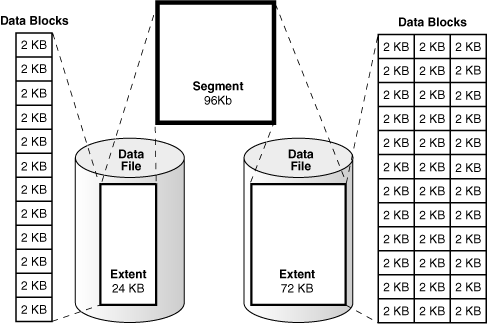
Description de l'image cncpt027.gif
Du niveau de granularité le plus bas au plus élevé, Oracle AI Database stocke les données comme suit :
-
Un bloc de données est la plus petite unité logique de stockage de données dans Oracle AI Database.
Un bloc de données logique correspond à un nombre spécifique d'octets de stockage persistant, par exemple 2 ko. Les blocs de données sont les plus petites unités de stockage qu'Oracle AI Database peut utiliser ou allouer.
Traditionnellement, les fichiers de données ont été stockés sur un disque magnétique ou SSD (Solid State Disk). Oracle AI Database prend également en charge la mémoire persistante (PMEM) pour le stockage des fichiers de base de données. Quelle que soit la façon dont les données sous-jacentes sont stockées physiquement, les processus Oracle lisent et écrivent toujours les blocs de données logiques.
-
Un extent est un ensemble de blocs de données logiquement contigus alloués pour le stockage d'un type spécifique d'informations.
Dans le graphique précédent, l'extent de 24 ko comporte 12 blocs de données, tandis que l'extent de 72 ko en comporte 36.
-
Un segment est un ensemble d'extents alloués pour un objet de base de données spécifique, tel qu'une table.
Par exemple, les données de la table
employeessont stockées dans son propre segment de données, tandis que chaque index deemployeesest stocké dans son propre segment d'index. Chaque objet de base de données qui consomme du stockage se compose d'un seul segment. -
Un tablespace est une unité de stockage de base de données qui contient un ou plusieurs segments.
Chaque segment appartient à un seul tablespace. Par conséquent, tous les extents d'un segment sont stockés dans le même tablespace. Dans un tablespace, un segment peut inclure des extents provenant de plusieurs fichiers de données, comme indiqué dans le graphique précédent. Par exemple, un extent pour un segment peut être stocké dans
users01.dbf, tandis qu'un autre est stocké dansusers02.dbf. Un extent unique ne peut jamais couvrir plusieurs fichiers de données.
Voir aussi : "Introduction aux structures de stockage physique"
Gestion de l'espace logique
Oracle AI Database doit utiliser la gestion de l'espace logique pour suivre et allouer les extents dans un tablespace.
Lorsqu'un objet de base de données nécessite un extent, la base de données doit disposer d'une méthode de recherche et de fourniture. De même, lorsqu'un objet ne nécessite plus d'extent, la base de données doit disposer d'une méthode permettant de rendre l'extent libre disponible.
Oracle AI Database gère l'espace au sein d'un tablespace en fonction du type que vous créez. Vous pouvez créer l'un des types de tablespace suivants :
-
Tablespaces gérés en local (par défaut)
La base de données utilise des bitmaps dans les tablespaces eux-mêmes pour gérer les extents. Par conséquent, une partie du tablespace géré localement est réservée à des bitmaps. Dans un tablespace, la base de données peut gérer les segments à l'aide de la gestion automatique de l'espace dans les segments (ASSM) ou de la gestion manuelle de l'espace dans les segments (MSSM).
-
Tablespaces gérés par un dictionnaire
La base de données utilise le dictionnaire de données pour gérer les extents.
La figure 15-3 présente les alternatives à la gestion de l'espace logique dans un tablespace.
Figure 3 : Gestion de l'espace logique
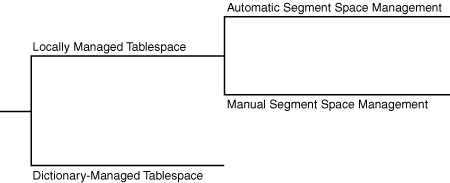
Description de l'image cncpt268.gif
-
Tablespaces gérés localement Un tablespace géré localement gère un bitmap dans l'en-tête du fichier de données pour suivre l'espace libre et utilisé dans le corps du fichier de données.
-
Tablespaces gérés par dictionnaire Un tablespace géré par dictionnaire utilise le dictionnaire de données pour gérer ses extents. Voir aussi : "Présentation du dictionnaire de données"
Tablespaces gérés localement
Un tablespace géré localement gère un bitmap dans l'en-tête du fichier de données pour suivre l'espace libre et utilisé dans le corps du fichier de données.
Chaque bit correspond à un groupe de blocs. Lorsque de l'espace est alloué ou libéré, Oracle AI Database modifie les valeurs de bitmap pour refléter le nouveau statut des blocs.
Le graphique suivant est une représentation conceptuelle du stockage géré par bitmap. Une valeur 1 dans l'en-tête fait référence à l'espace utilisé, tandis qu'une valeur 0 fait référence à l'espace libre.
Figure 4 : Stockage géré par bitmap
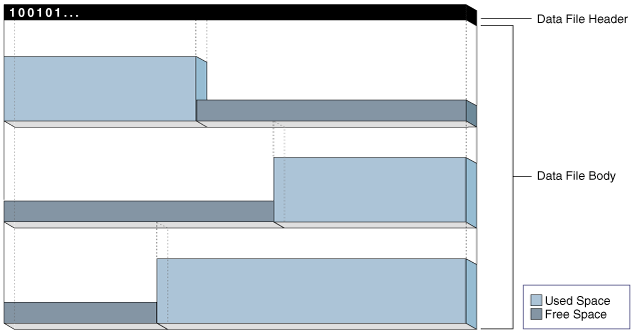
Description de l'image cncpt332.gif
Un tablespace géré localement présente les avantages suivants :
-
Evite d'utiliser le dictionnaire de données pour gérer les extents
Les opérations récursives peuvent se produire dans le cadre d'une gestion par dictionnaire si l'utilisation ou la libération d'espace dans un extent entraînent une autre opération qui consomme ou libère de l'Espace dans une table ou dans une table d'annulation du dictionnaire.
-
Suivi automatique de l'espace libre adjacent
Ainsi, la base de données n'a plus besoin de fusionner les extents libres.
-
Détermine automatiquement la taille des extents gérés localement
L'autre possibilité, dans un tablespace géré localement, toutes les extents peuvent avoir la même taille et remplacer les options de stockage d'objet. Remarque : Oracle recommande vivement d'utiliser des tablespaces gérés localement avec la gestion automatique de l'espace dans les segments.
La gestion de l'espace dans les segments est un attribut hérité du tablespace qui contient le segment. Dans un tablespace géré localement, la base de données peut gérer les segments automatiquement ou manuellement. Par exemple, les segments du tablespace users peuvent être gérés automatiquement tandis que les segments du tablespace tools sont gérés manuellement.
-
Gestion automatique de l'espace dans les segments La méthode de gestion automatique de l'espace dans les segments (ASSM) utilise des bitmaps pour gérer l'espace dans un tablespace.
-
Gestion manuelle de l'espace dans les segments La méthode héritée de gestion manuelle de l'espace dans les segments (MSSM) utilise une liste liée appelée liste libre pour gérer l'espace libre dans le segment.
Gestion automatique de l'espace de segment
La méthode de gestion automatique de l'espace dans les segments (ASSM) utilise des bitmaps pour gérer l'espace dans un tablespace.
Les bitmaps offrent les avantages suivants :
-
L'administration simplifiée
ASSM évite d'avoir à déterminer manuellement les paramètres corrects pour de nombreux paramètres de stockage. Un seul paramètre SQL crucial contrôle l'allocation d'espace :
PCTFREE. Ce paramètre spécifie le pourcentage d'espace à réserver dans un bloc pour les mises à jour futures (reportez-vous à la section "Pourcentage d'espace libre dans les blocs de données"). -
Augmentation de la simultanéité
Plusieurs transactions peuvent rechercher des listes distinctes de blocs de données libres, ce qui réduit les conflits et les attentes. Pour de nombreux workloads standard, les performances des applications avec ASSM sont meilleures que celles d'une application bien réglée qui utilise MSSM.
-
Affinité dynamique de l'espace avec les instances dans un environnement Oracle Real Application Clusters (Oracle RAC)
ASSM est plus efficace et est la valeur par défaut pour les tablespaces permanents gérés localement.
Remarque : ce chapitre suppose l'utilisation d'ASSM dans toutes ses discussions sur l'espace de stockage logique.
Gestion manuelle de l'espace dans les segment
La méthode héritée de gestion manuelle de l'espace dans les segments (MSSM) utilise une liste liée appelée liste libre pour gérer l'espace libre dans le segment.
Pour un objet de base de données disposant d'espace libre, une liste de blocs libres assure le suivi des blocs situés sous la limite supérieure du contrôle du débit (HWM) (HWM), qui est la ligne de division entre l'espace de segment utilisé et non encore utilisé. Lorsque des blocs sont utilisés, la base de données les place ou les supprime de la liste de blocs libres selon les besoins.
En plus de PCTFREE, MSSM vous demande de contrôler l'allocation d'espace avec des paramètres SQL tels que PCTUSED, FREELISTS et FREELIST GROUPS. PCTUSED définit le pourcentage d'espace libre qui doit exister dans un bloc actuellement utilisé pour que la base de données le place sur la liste de blocs libres. Par exemple, si vous définissez PCTUSED sur 40 dans une instruction CREATE TABLE, vous ne pouvez pas insérer de lignes dans un bloc du segment tant que moins de 40 % de l'espace de bloc n'est pas utilisé.
Par exemple, supposons que vous insériez une ligne dans une table. La base de données vérifie la liste des blocs disponibles dans la table. Si la ligne ne tient pas dans le bloc et si l'espace utilisé dans le bloc est supérieur ou égal à PCTUSED, la base de données enlève le bloc de la liste et recherche un autre bloc. Si vous supprimez des lignes du bloc, la base de données vérifie si l'espace utilisé dans le bloc est désormais inférieur à PCTUSED. Si tel est le cas, la base de données place le bloc au début de la liste de blocs libres.
Un objet peut avoir plusieurs listes de blocs libres. Ainsi, plusieurs sessions exécutant des opérations LMD sur une table peuvent utiliser différentes listes, ce qui peut réduire les contentions. Chaque session de base de données utilise une seule liste libre pour la durée de sa session.
Comme le montre la figure 15-5, vous pouvez également créer un objet avec des groupes de listes libres, qui sont des ensembles de listes libres. Chaque groupe dispose d'une liste libre principale qui gère la liste libre de processus individuelle du groupe. La surcharge d'espace pour les listes libres, en particulier pour les groupes de listes libres, peut être importante.
Figure 5 : Groupes de listes de blocs libres
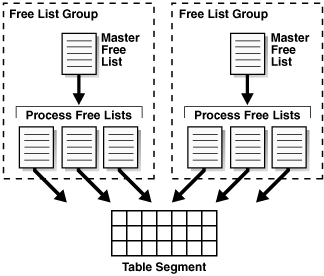
Description de l'image cncpt320.gif
La gestion manuelle de l'espace dans les segments peut s'avérer complexe. Vous devez ajuster PCTFREE et PCTUSED pour réduire la migration de lignes et éviter de gaspiller de l'espace. Par exemple, si chaque bloc utilisé d'un segment est à moitié plein et si PCTUSED est 40, la base de données n'autorise pas les insertions dans ces blocs. En raison de la difficulté d'affiner les paramètres d'allocation d'espace, Oracle recommande fortement ASSM. Dans ASSM, PCTFREE détermine si une nouvelle ligne peut être insérée dans un bloc, mais n'utilise pas de listes de blocs libres et ignore PCTUSED.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur les tablespaces gérés localement
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur la gestion automatique de l'espace dans les segments
-
Référence du langage SQL Oracle AI Database pour en savoir plus sur les paramètres de stockage tels que
PCTFREEetPCTUSED
Tablespaces gérés par le dictionnaire
Un tablespace géré par un dictionnaire de données utilise le dictionnaire de données pour gérer ses extents.
Oracle AI Database met à jour les tables dans le dictionnaire de données chaque fois qu'un extent est affecté ou libéré pour pouvoir être réutilisé. Par exemple, lorsqu'une table a besoin d'un extent, la base de données interroge les tables du dictionnaire de données et recherche les extents libres. Si la base de données trouve de l'espace, elle modifie une table du dictionnaire de données et insère une ligne dans une autre. Ainsi, la base de données gère l'espace en modifiant et en déplaçant les données.
Le code SQL que la base de données exécute en arrière-plan pour obtenir de l'espace pour les objets de base de données est SQL récursif. L'utilisation fréquente d'instructions SQL récursives peut avoir un impact négatif sur les performances car les mises à jour du dictionnaire de données doivent être sérialisées. Les tablespaces gérés localement, qui sont les tablespaces par défaut, évitent ce problème de performances.
Reportez-vous également à : Guide de l'administrateur Oracle AI Database pour apprendre à migrer des tablespaces d'une base de données gérée par le dictionnaire vers une base de données gérée localement
Présentation des blocs de données
Oracle AI Database gère l'espace de stockage logique dans les fichiers de données d'une base de données dans une unité appelée bloc de données, également appelée bloc Oracle ou page. Un bloc de données est l'unité minimale d'E/S de base de données.
-
Blocs de données et blocs de système d'exploitation Au niveau physique, les données de base de données sont stockées dans des fichiers disque composés de blocs de système d'exploitation.
-
Format de bloc de données Chaque bloc de données a un format ou une structure interne qui permet à la base de données de suivre les données et l'espace libre dans le bloc. Ce format est similaire, que le bloc de données contienne des données de table, d'index ou de cluster de tables.
-
Compression des blocs de données La base de données peut utiliser la compression de table pour éliminer les valeurs en double dans un bloc de données. Cette section décrit le format des blocs de données qui utilisent la compression.
-
Gestion de l'espace dans les blocs de données Lorsque la base de données remplit un bloc de données de bas en haut, la quantité d'espace libre entre les données de ligne et l'en-tête de bloc diminue.
-
Présentation des blocs d'index Un bloc d'index est un type spécial de bloc de données qui gère l'espace différemment des blocs de table. Oracle AI Database utilise des blocs d'index pour gérer l'espace de stockage logique dans un index.
Blocs de données et blocs de système d'exploitation
Au niveau physique, les données de base de données sont stockées dans des fichiers disque constitués de blocs du système d'exploitation.
Un bloc de système d'exploitation est l'unité minimale de données que le système d'exploitation peut lire ou écrire. En revanche, un bloc Oracle est une structure de stockage logique dont la taille et la structure ne sont pas connues du système d'exploitation.
La figure suivante montre que la taille des blocs du système d'exploitation peut différer de celle des blocs de données. La base de données demande des données en multiples de blocs de données, et non en blocs du système d'exploitation.
Figure 6 : Blocs de données et blocs du système d'exploitation
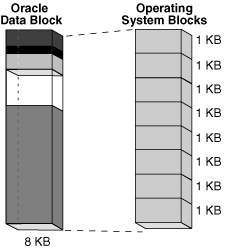
Description de l'image cncpt293.gif
Lorsque la base de données demande un bloc de données, le système d'exploitation convertit cette opération en demandes de données dans un stockage permanent. La séparation logique des blocs de données et des blocs du système d'exploitation a les implications suivantes :
-
Les applications n'ont pas besoin de déterminer les adresses physiques des données sur disque.
-
Les données de base de données peuvent être entrelacées ou mises en miroir sur plusieurs disques physiques.
-
Taille de bloc de base de Données Chaque base de Données a une taille de bloc de base de Données.
-
Taille de bloc du tablespace Vous pouvez créer des tablespaces individuels dont la taille de bloc diffère du paramètre
DB_BLOCK_SIZE.
Taille du bloc de base de données
Chaque base de données a une taille de bloc.
Le paramètre d'initialisation DB_BLOCK_SIZE définit la taille des blocs de données d'une base de données lors de sa création. La taille est définie pour les tablespaces SYSTEM et SYSAUX et est la valeur par défaut pour tous les autres tablespaces. La taille des blocs de base de données ne peut pas être modifiée, sauf en recréant la base de données.
Si DB_BLOCK_SIZE n'est pas défini, la taille de bloc de données par défaut est propre au système d'exploitation. La taille standard des blocs de données d'une base de données est de 4 ko ou 8 ko. Si la taille des blocs de données et des blocs du système d'exploitation diffère, la taille des blocs de données doit être un multiple de la taille des blocs du système d'exploitation.
Voir aussi :
-
Référence Oracle AI Database pour en savoir plus sur le paramètre d'initialisation
DB_BLOCK_SIZE -
Guide de l'administrateur Oracle AI Database et Guide de réglage des performances Oracle AI Database pour savoir comment choisir la taille des blocs
Taille de bloc de tablespace
Vous pouvez créer des tablespaces individuels dont la taille de bloc diffère du paramètre DB_BLOCK_SIZE.
Une taille de bloc non standard peut être utile lors du déplacement d'un tablespace transportable vers une autre plate-forme.
Voir aussi : Guide de l'administrateur Oracle AI Database pour savoir comment indiquer une taille de bloc non standard pour un tablespace
Format de bloc de données
Chaque bloc de données a un format ou une structure interne qui permet à la base de données de suivre les données et l'espace libre dans le bloc. Ce format est similaire, que le bloc de données contienne des données de table, d'index ou de cluster de tables.
La figure suivante illustre le format d'un bloc de données non compressé.
Figure 7 : Format des blocs de données
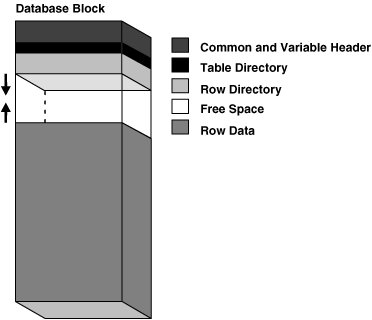
Description de l'image cncpt028.gif
-
Frais généraux de bloc de données Oracle AI Database utilise les frais généraux de bloc pour gérer le bloc lui-même. La surcharge de bloc n'est pas disponible pour le stockage des données utilisateur.
-
Format de ligne La partie de données de ligne du bloc contient les données réelles, telles que les lignes de table ou les entrées de clé d'index. Tout comme chaque bloc de données a un format interne, chaque ligne a un format de ligne qui permet à la base de données de suivre les données de la ligne. Voir aussi : "Compression des blocs de données" pour en savoir plus sur les blocs compressés
Frais généraux du bloc de données
Oracle AI Database utilise les frais généraux de bloc pour gérer le bloc lui-même. La surcharge de bloc n'est pas disponible pour le stockage des données utilisateur.
Comme indiqué dans Format de bloc de données, la surcharge de bloc inclut les parties suivantes :
-
En-tête de bloc
Cette partie contient des informations générales sur le bloc, notamment l'adresse du disque et le type de segment. Pour les blocs gérés par transaction, l'en-tête de bloc contient des informations sur les transactions actives et historiques.
Une entrée de transaction est requise pour chaque transaction qui met à jour le bloc. Oracle AI Database réserve initialement de l'espace dans l'en-tête de bloc pour les entrées de transaction. Dans les blocs de données alloués aux segments qui prennent en charge les modifications transactionnelles, l'espace libre peut également contenir les entrées de transaction lorsque l'espace d'en-tête est épuisé. L'espace requis pour les entrées de transaction dépend du système d'exploitation. Cependant, les entrées de transaction dans la plupart des systèmes d'exploitation nécessitent environ 23 octets.
-
Répertoire de table
Pour une table organisée en portions de mémoire, ce répertoire contient des métadonnées sur les tables dont les lignes sont stockées dans ce bloc. Dans un cluster de tables, plusieurs tables peuvent stocker des lignes dans le même bloc.
-
Répertoire de lignes
Pour une table organisée en portions de mémoire, ce répertoire décrit l'emplacement des lignes dans la partie de données du bloc. La base de données peut placer une ligne n'importe où en bas du bloc. L'adresse de ligne est enregistrée dans l'un des emplacements du vecteur répertoire de ligne.
Un rowid pointe vers un fichier, un bloc et un numéro de ligne spécifiques. Par exemple, dans l'ID de ligne
AAAPecAAFAAAABSAAA, la valeur finaleAAAreprésente le numéro de ligne. Le numéro de ligne est un index dans une entrée du répertoire de lignes. L'entrée de répertoire de ligne contient un pointeur vers l'emplacement de la ligne sur le bloc de données. Si la base de données déplace une ligne dans un bloc, elle met à jour l'entrée du répertoire de lignes pour modifier le pointeur. Le rowid reste constant.Une fois que la base de données a alloué de l'espace dans le répertoire de lignes, elle ne récupère pas cet espace après la suppression de lignes. Ainsi, un bloc qui est actuellement vide mais qui avait auparavant jusqu'à 50 lignes continue d'avoir 100 octets alloués pour le répertoire de lignes. La base de données réutilise cet espace uniquement lorsqu'une session insère de nouvelles lignes dans le bloc.
La taille de certaines parties de la surcharge de bloc est fixe, mais la taille totale est variable. En moyenne, la surcharge totale des blocs est de 84 à 107 octets.
Format de ligne
La partie de données de ligne du bloc contient les données réelles, telles que les lignes de table ou les entrées de clé d'index. Tout comme chaque bloc de données a un format interne, chaque ligne a un format de ligne qui permet à la base de données de suivre les données de la ligne.
Oracle AI Database stocke les lignes sous forme d'enregistrements de longueur variable. Une ligne est contenue dans une ou plusieurs sections. Chaque section est appelée pièce de ligne. Chaque élément de ligne comporte un en-tête de ligne et des données de colonne.
La figure suivante illustre le format d'une ligne.
Figure 8 : Le format d'un morceau de ligne
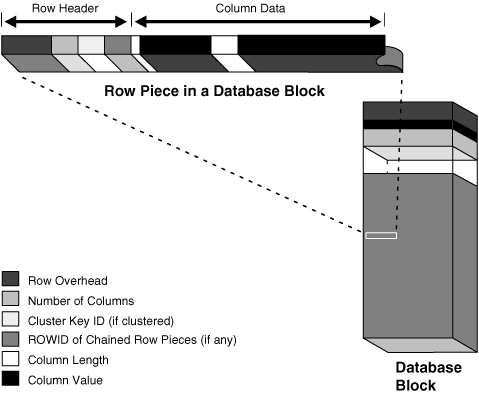
Description de l'image cncpt043.gif
-
En-tête de ligne Oracle AI Database utilise l'en-tête de ligne pour gérer l'élément de ligne stocké dans le bloc.
-
Données de colonne Après l'en-tête de ligne, la section de données de colonne stocke les données réelles dans la ligne. Le morceau de ligne stocke généralement les colonnes dans l'ordre indiqué dans l'instruction
CREATE TABLE, mais cet ordre n'est pas garanti. Par exemple, les colonnes de typeLONGsont créées en dernier. -
Format Rowid Oracle AI Database utilise un rowid pour identifier de manière unique une ligne. En interne, le rowid est une structure qui contient les informations dont la base de données a besoin pour accéder à une ligne. Un rowid n'est pas stocké physiquement dans la base de données, mais est inféré à partir du fichier et du bloc sur lesquels les données sont stockées.
En-tête de ligne
Oracle AI Database utilise l'en-tête de ligne pour gérer le morceau de ligne stocké dans le bloc.
L'en-tête de ligne contient des informations telles que les suivantes :
-
Colonnes du morceau de ligne
-
Eléments de la ligne situés dans d'autres blocs de données
Si une ligne entière peut être insérée dans un seul bloc de données, Oracle AI Database stocke la ligne en tant qu'élément de ligne unique. Toutefois, si toutes les données de ligne ne peuvent pas être insérées dans un seul bloc ou si une mise à jour entraîne la croissance d'une ligne existante, la base de données stocke la ligne dans plusieurs éléments de ligne. Un bloc de données contient généralement un seul élément de ligne par ligne.
-
Clés de cluster pour les clusters de tables
Une ligne entièrement contenue dans un bloc comporte au moins 3 octets d'en-tête de ligne.
Voir aussi :
Données de colonne
Après l'en-tête de ligne, la section de données de colonne stocke les données réelles dans la ligne. Le morceau de ligne stocke généralement les colonnes dans l'ordre indiqué dans l'instruction CREATE TABLE, mais cet ordre n'est pas garanti. Par exemple, les colonnes de type LONG sont créées en dernier.
Comme indiqué dans la figure "Format de ligne", pour chaque colonne d'un élément de ligne, Oracle AI Database stocke la longueur de colonne et les données séparément. L'espace requis dépend du type de données. Si le type de données d'une colonne est de longueur variable, l'espace nécessaire pour contenir une valeur peut augmenter et diminuer avec les mises à jour des données.
Chaque ligne comporte un emplacement dans le répertoire de lignes de l'en-tête du bloc de données. Le créneau pointe vers le début de la ligne.
Voir aussi : "Stockage de table" et "Stockage d'index"
Format Rowid
Oracle AI Database utilise un rowid pour identifier de manière unique une ligne. En interne, le rowid est une structure qui contient les informations dont la base de données a besoin pour accéder à une ligne. Un rowid n'est pas stocké physiquement dans la base de données, mais est inféré à partir du fichier et du bloc sur lesquels les données sont stockées.
Un rowid étendu inclut un numéro d'objet de données. Ce type de rowid utilise un codage de base 64 de l'adresse physique pour chaque ligne. Les caractères de codage sont les suivants : A-Z, a-z, 0-9, + et /.
Exemple 15-1 : pseudo-colonne ROWID
L'exemple suivant interroge la pseudocolonne ROWID pour afficher l'ID de ligne étendu de la ligne dans la table employees pour l'employé 100 :
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
La figure suivante illustre le format d'un rowid étendu.
Figure 9 : Format ROWID
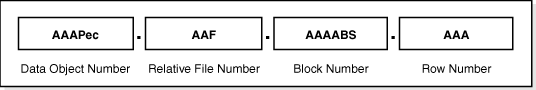
Description de l'image cncpt249.gif
Un rowid étendu est affiché dans un format en quatre parties, OOOOOOFFFBBBBBBRRR, avec le format divisé en composants suivants :
-
OOOOOOLe numéro d'objet de données identifie le segment (objet de données
AAAPecdans l'exemple de requête). Un numéro d'objet de données est affecté à chaque segment de base de données. Les objets de schéma du même segment, tels qu'un cluster de tables, ont le même numéro d'objet de données. -
FFFLe numéro de fichier de données relatif au tablespace identifie le fichier de données qui contient la ligne (fichier
AAFdans l'exemple d'interrogation). -
BBBBBBLe numéro de bloc de données identifie le bloc qui contient la ligne (bloc
AAAABSdans l'exemple de requête). Les numéros de bloc sont relatifs à leur fichier de données et non à leur tablespace. Par conséquent, deux lignes avec des numéros de bloc identiques peuvent résider dans des fichiers de données différents du même tablespace. -
RRRLe numéro de ligne identifie la ligne du bloc (ligne
AAAdans l'exemple de requête).
Une fois qu'un rowid est affecté à un morceau de ligne, il peut changer dans des circonstances particulières. Par exemple, si le déplacement de lignes est activé, l'ID ligne peut changer en raison des mises à jour de clé de partitionnement, des opérations Flashback Table, des opérations de récupération d'espace dans la table, etc. Si le déplacement de lignes est désactivé, un rowid peut changer si la ligne est exportée et importée à l'aide des utilitaires Oracle AI Database. Remarque : en interne, la base de données effectue un déplacement de ligne comme si la ligne avait été physiquement supprimée et réinsérée. Cependant, le déplacement de lignes est considéré comme une mise à jour, ce qui a des implications pour les déclencheurs.
Voir aussi :
-
Référence du langage SQL Oracle AI Database pour en savoir plus sur les rowids
Compression des blocs de données
La base de données peut utiliser la compression de table pour éliminer les valeurs en double dans un bloc de données. Cette section décrit le format des blocs de données qui utilisent la compression.
Le format d'un bloc de données qui utilise la compression de table de base et de ligne avancée est essentiellement le même qu'un bloc non compressé. La différence est qu'une table de symboles au début du bloc stocke des valeurs en double pour les lignes et les colonnes. La base de données remplace les occurrences de ces valeurs par une courte référence à la table de symboles.
Exemple 15-2 Format des blocs de données compressés
Supposons que les lignes suivantes soient stockées dans un bloc de données pour la table sales à sept colonnes :
2190,13770,25-NOV-00,S,9999,23,161
2225,15720,28-NOV-00,S,9999,25,1450
34005,120760,29-NOV-00,P,9999,44,2376
9425,4750,29-NOV-00,I,9999,11,979
1675,46750,29-NOV-00,S,9999,19,1121
Lorsque la compression de base de table ou de ligne avancée est appliquée à cette table, la base de données remplace les valeurs en double par une référence de symbole. La représentation conceptuelle suivante de la compression montre le symbole * remplaçant 29-NOV-00 et % remplaçant 9999 :
2190,13770,25-NOV-00,S,%,23,161
2225,15720,28-NOV-00,S,%,25,1450
34005,120760,*,P,%,44,2376
9425,4750,*,I,%,11,979
1675,46750,*,S,%,19,1121
Le Table 15-1 représente conceptuellement la table de symboles qui mappe les symboles aux valeurs.
Tableau 1 Table des symboles
| Symbole | Valeur | Colonne | Lignes |
|---|---|---|---|
| * | 29-NOV-00 | 3 | 958-960 |
| % | 9 999 | 5 | 956-960 |
Voir aussi : "Compression de table"
Gestion de l'espace dans les blocs de données
Lorsque la base de données remplit un bloc de données de bas en haut, la quantité d'espace libre entre les données de ligne et l'en-tête de bloc diminue.
L'espace libre d'un bloc de données peut également être réduit lors des mises à jour, comme lors de la modification d'une valeur NULL de fin en une valeur non NULL. La base de données gère l'espace libre dans le bloc de données pour optimiser les performances et éviter les pertes d'espace.
Remarque : cette section suppose l'utilisation de la gestion automatique de l'espace dans les segments.
-
Pourcentage d'espace libre dans les blocs de données Le paramètre SQL
PCTFREEdéfinit le pourcentage minimal d'un bloc de données réservé en tant qu'espace libre pour les mises à jour des lignes existantes.PCTFREEest important pour éviter la migration de lignes et l'espace perdu. -
Optimisation de l'espace libre dans les blocs de données Bien que le pourcentage d'espace libre ne puisse pas être inférieur à
PCTFREE, la quantité d'espace libre peut être supérieure. Par exemple, la définition dePCTFREEsur 20 % empêche la quantité totale d'espace libre de tomber à 5 % du bloc, mais permet à 50 % du bloc d'être libre. -
Lignes chaînées et migrées Oracle AI Database utilise le chaînage et la migration pour gérer les lignes trop volumineuses pour tenir dans un seul bloc.
Pourcentage d'espace libre dans les blocs de données
Le paramètre SQL PCTFREE définit le pourcentage minimal d'un bloc de données réservé en tant qu'espace libre pour les mises à jour des lignes existantes. PCTFREE est important pour éviter la migration de lignes et l'espace perdu.
Par exemple, supposons que vous créez une table qui ne nécessitera que des mises à jour occasionnelles, la plupart n'augmentant pas la taille des données existantes. Vous indiquez le paramètre PCTFREE dans une instruction CREATE TABLE comme suit :
CREATE TABLE test_table (n NUMBER) PCTFREE 20;La Figure 15-10 illustre l'impact d'un paramètre PCTFREE de 20 sur la gestion de l'espace. La base de données ajoute des lignes au bloc au fil du temps, ce qui entraîne la croissance des données de ligne vers le haut vers l'en-tête du bloc, qui s'étend lui-même vers le bas vers les données de ligne. Le paramètre PCTFREE garantit que au moins 20 % du bloc de données est libre. Par exemple, la base de données empêche une instruction INSERT de remplir le bloc de sorte que les données de ligne et l'en-tête occupent 90 % de l'espace total du bloc, ne laissant que 10 % libre.
Figure 10 : SANS PCT
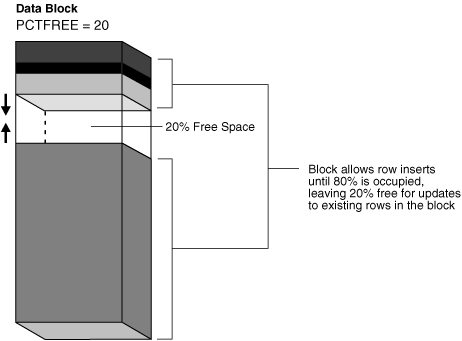
Description de l'image cncpt029.gif
Remarque : cette discussion ne s'applique pas aux types de données LOB, qui n'utilisent ni le paramètre de stockage PCTFREE ni les listes de blocs libres.
Voir aussi :
-
Guide du développeur d'Oracle AI Database SecureFiles et de LOB
-
Référence de langage SQL Oracle AI Database pour la syntaxe et la sémantique du paramètre
PCTFREE
Optimisation de l'espace libre dans les blocs de données
Bien que le pourcentage d'espace libre ne puisse pas être inférieur à PCTFREE, la quantité d'espace libre peut être supérieure. Par exemple, la définition de PCTFREE sur 20 % empêche la quantité totale d'espace libre de tomber à 5 % du bloc, mais permet à 50 % du bloc d'être libre.
-
Optimisation en augmentant l'espace libre Certaines instructions LMD peuvent augmenter l'espace libre dans les blocs de données.
-
Optimisation par fusion de l'espace fragmenté L'espace libéré peut ou non être contigu à la zone principale de l'espace libre d'un bloc de données. L'espace libre non contigu est appelé espace fragmenté.
Optimisation en augmentant l'espace libre
Certaines instructions LMD peuvent augmenter l'espace libre dans les blocs de données.
Les instructions suivantes peuvent augmenter l'espace :
-
Instructions
DELETE -
Instructions
UPDATEqui mettent à jour les valeurs existantes vers des valeurs plus petites ou augmentent les valeurs existantes et forcent la migration d'une ligne -
Instructions
INSERTsur une table qui utilise la compression de ligne avancéeSi les instructions
INSERTremplissent un bloc de données, la base de données appelle la compression de bloc, ce qui peut entraîner une augmentation de l'espace libre pour le bloc.
L'espace libéré est disponible pour les instructions INSERT dans les conditions suivantes :
-
Si l'instruction
INSERTse trouve dans la même transaction, et si elle se trouve après l'instruction qui libère de l'espace, elle peut utiliser l'espace. -
Si l'instruction
INSERTse trouve dans une transaction distincte de l'instruction qui libère de l'espace (peut-être exécutée par un autre utilisateur), et si de l'espace est nécessaire, l'instruction peut utiliser l'espace mis à disposition, mais uniquement après la validation de l'autre transaction.
Voir aussi : Guide de l'administrateur Oracle AI Database pour en savoir plus sur la compression de ligne avancée
Optimisation par fusion de l'espace fragmenté
L'espace libéré peut ou non être contigu à la zone principale de l'espace libre dans un bloc de données. L'espace libre non contigu est appelé espace fragmenté.
La figure suivante illustre un bloc de données avec un espace libre non contigu.
Figure 11 : Bloc de données avec espace fragmenté
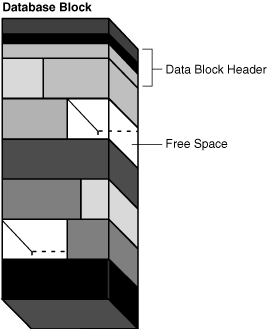
Description de l'image cncpt210.gif
Oracle AI Database fusionne automatiquement et de manière transparente l'espace libre d'un bloc de données uniquement lorsque les conditions suivantes sont remplies :
-
Une instruction
INSERTouUPDATEtente d'utiliser un bloc qui contient suffisamment d'espace libre pour contenir un nouvel élément de ligne. -
L'espace libre est fragmenté de sorte que le morceau de ligne ne peut pas être inséré dans une section contiguë du bloc.
Après la fusion, la quantité d'espace libre est identique à la quantité avant l'opération, mais l'espace est maintenant contigu. La figure 15-12 illustre un bloc de données après la fusion de l'espace.
Figure 12 : Bloc de données après fusion de l'espace libre
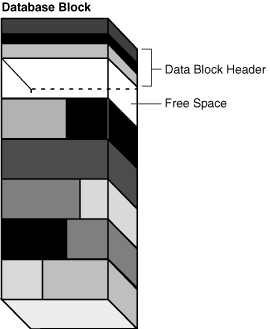
Description de l'image cncpt211.gif
Oracle AI Database effectue la fusion uniquement dans les situations précédentes car sinon, les performances diminueraient en raison de la fusion continue de l'espace libre dans les blocs de données.
Lignes chaînées et migrées
Oracle AI Database utilise le chaînage et la migration pour gérer les lignes trop volumineuses pour tenir dans un seul bloc. Remarque : une ligne chaînée dans une table standard est différente d'une chaîne de lignes dans une table de chaîne de blocs. Oracle AI Database utilise différentes technologies pour gérer les lignes dans une table de chaîne de blocs.
Les situations suivantes sont possibles :
-
La ligne est trop longue pour tenir dans un seul bloc dès sa première insertion.
Dans le chaîne de lignes, Oracle AI Database stocke les données de la ligne dans une chaîne d'un ou plusieurs blocs de données réservés au segment. Le chaînage de lignes se produit le plus souvent avec des lignes volumineuses. Par exemple, les lignes qui contiennent une colonne de type de données
LONGouLONG RAWou une ligne comportant un grand nombre de colonnes. Le chaînage de ces lignes est inévitable. -
Une ligne qui tient initialement dans un bloc de données est mise à jour de sorte que la longueur globale de la ligne augmente, mais il n'y a pas suffisamment d'espace libre pour contenir la ligne mise à jour.
Dans la migration de ligne, Oracle AI Database déplace la ligne entière vers un nouveau bloc de données, en supposant que la ligne puisse tenir dans un nouveau bloc. L'élément de ligne d'origine d'une ligne migrée contient un pointeur ou une "adresse de transfert" vers le nouveau bloc contenant la ligne migrée. L'ID de ligne d'une ligne migrée ne change pas.
-
Une ligne comporte plus de 255 colonnes.
Oracle AI Database ne peut stocker que 255 colonnes dans un élément de ligne. Par conséquent, si vous insérez une ligne dans une table comportant 1000 colonnes, la base de données crée 4 éléments de ligne, généralement chaînés sur plusieurs blocs.
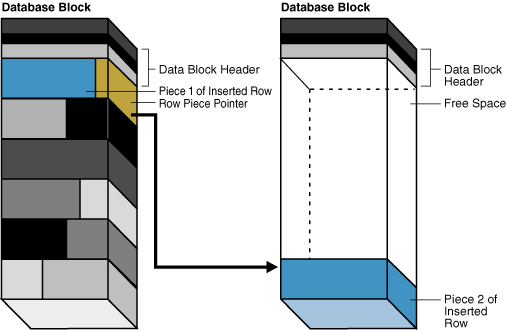
La Figure 15-13 illustre l'insertion d'une ligne de grande taille dans un bloc de données. La ligne est trop grande pour le bloc de gauche, de sorte que la base de données enchaîne la ligne en plaçant le premier élément de ligne dans le bloc de gauche et le deuxième élément de ligne dans le bloc de droite.
Figure 13 : Chaînage de lignes
Description de l'image cncpt316.gif
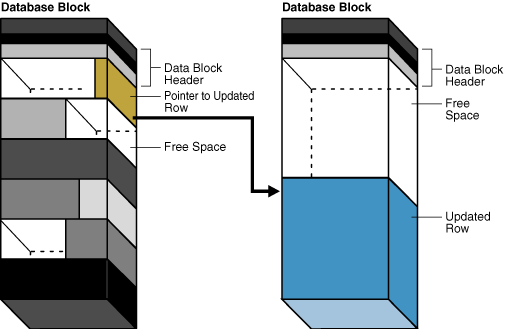
Figure 15-14 : Le bloc de gauche contient une ligne qui est mise à jour de sorte que la ligne est désormais trop volumineuse pour le bloc. La base de données déplace la ligne entière vers le bloc de droite et laisse un pointeur vers la ligne migrée dans le bloc de gauche.
Figure 14 : Migration de lignes
Description de l'image cncpt306.gif
Lorsqu'une ligne est chaînée ou migrée, les E/S nécessaires à l'extraction des données augmentent. Cette situation se produit car Oracle AI Database doit analyser plusieurs blocs pour extraire les informations de la ligne. Par exemple, si la base de données effectue une E/S pour lire un index et une E/S pour lire une ligne de table non migrée, une E/S supplémentaire est requise pour obtenir les données d'une ligne migrée.
Segment Advisor, qui peut être exécuté manuellement et automatiquement, est un composant Oracle AI Database qui identifie les segments disposant d'espace disponible pour la récupération. La fonction de conseil peut fournir des conseils sur les objets qui disposent d'un espace libre important ou d'un trop grand nombre de lignes chaînées.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment récupérer de l'espace perdu
-
Guide de réglage des performances Oracle AI Database pour en savoir plus sur la réduction des lignes chaînées et migrées
Présentation des blocs d'index
Un bloc d'index est un type spécial de bloc de données qui gère l'espace différemment des blocs de table. Oracle AI Database utilise des blocs d'index pour gérer l'espace de stockage logique dans un index.
-
Types de bloc d'index Un index contient un bloc racine, des blocs de branchement et des blocs feuille.
-
Stockage des entrées d'index Les entrées d'index sont stockées dans des blocs d'index de la même manière que les lignes de table d'un bloc de données. Les entrées d'index de la partie de bloc ne sont pas stockées dans l'ordre binaire, mais dans une portion de mémoire.
-
Réutilisation des emplacements dans un bloc d'index La base de données peut réutiliser de l'espace dans un bloc d'index.
-
L'index Coalescence d'un bloc d'index coalescence compacte les données d'index existantes en place et, si la réorganisation libère des blocs, laisse les blocs libres dans la structure d'index. Par conséquent, la fusion ne libère pas les blocs d'index pour d'autres utilisations et n'entraîne pas la réallocation des blocs.
Types de bloc d'index
Un index contient un bloc racine, des blocs de branchement et des blocs feuille.
Les types de bloc sont définis comme suit :
-
Bloc racine
Ce bloc identifie le point d'entrée dans l'index.
-
Blocs de branchement
Les bases de données naviguent dans les blocs de branchement lors de la recherche d'une clé d'index.
-
Blocs de feuilles
Ces blocs contiennent les rowid de valeurs de clé indexées qui pointent vers les lignes associées. Les blocs feuille stockent les valeurs de clé dans un ordre trié afin que la base de données puisse rechercher efficacement toutes les lignes d'une plage de valeurs de clé.
Stockage des entrées d'index
Les entrées d'index sont stockées dans des blocs d'index de la même manière que les lignes de table dans un bloc de données. Les entrées d'index dans la partie de bloc ne sont pas stockées dans l'ordre binaire, mais dans une portion de mémoire.
La base de données gère le répertoire de lignes d'un bloc d'index différemment du répertoire d'un bloc de données. Les entrées du répertoire de lignes (et non les entrées du corps du bloc d'index) sont triées par valeur de clé. Par exemple, dans le répertoire de lignes, l'entrée de répertoire de la clé d'index 000000 précède l'entrée de répertoire de la clé d'index 111111, etc.
L'ordre des entrées dans le répertoire de lignes améliore l'efficacité des balayages d'index. Dans un balayage d'intervalle, la base de données doit lire toutes les clés d'index indiquées dans l'intervalle. La base de données parcourt les blocs de branchement pour identifier le bloc feuille qui contient la première clé. Etant donné que les entrées du répertoire de lignes sont triées, la base de données peut utiliser une recherche binaire pour rechercher la première clé d'index dans la plage, puis progresser séquentiellement dans les entrées du répertoire de lignes jusqu'à ce qu'elle trouve la dernière clé. Ainsi, la base de données évite de lire toutes les clés du corps du bloc feuille.
Voir aussi : "Frais généraux de bloc de données"
Réutilisation des emplacements dans un bloc d'index
La base de données peut réutiliser de l'espace dans un bloc d'index.
Par exemple, une application peut insérer une valeur dans une colonne, puis supprimer la valeur. Lorsqu'une ligne nécessite de l'espace, la base de données peut réutiliser l'emplacement d'index précédemment occupé par la valeur supprimée.
Un bloc d'index comporte généralement beaucoup plus de lignes qu'un bloc de table organisé en portions de mémoire. La possibilité de stocker de nombreuses lignes dans un seul bloc d'index permet à la base de données de gérer plus facilement un index, car elle évite les fractionnements fréquents du bloc pour stocker de nouvelles données.
Un index ne peut pas se fusionner lui-même, bien que vous puissiez le fusionner manuellement avec une instruction ALTER INDEX avec les options REBUILD ou COALESCE. Par exemple, si vous renseignez une colonne avec les valeurs 1 sur 500000, et si vous supprimez ensuite les lignes qui contiennent des nombres pairs, l'index contiendra 250 000 emplacements vides. La base de données réutilise un emplacement uniquement si elle peut insérer des données qui correspondent à un bloc d'index contenant un emplacement vide.
Fusion d'un bloc d'index
La fusion d'index compacte les données d'index existantes et, si la réorganisation libère des blocs, laisse les blocs libres dans la structure d'index. Par conséquent, la fusion ne libère pas les blocs d'index pour d'autres utilisations et n'entraîne pas la réallocation des blocs.
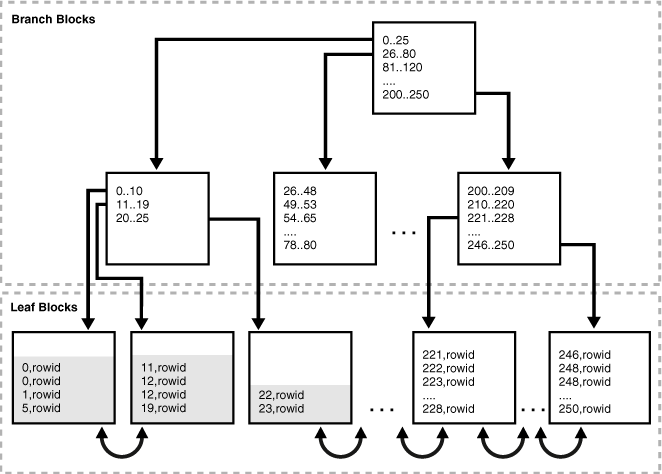
Oracle AI Database ne compacte pas automatiquement l'index : vous devez exécuter une instruction ALTER INDEX avec les options REBUILD ou COALESCE. La figure 15-15 présente un index de la colonne employees.department_id avant la fusion de l'index. Les trois premiers blocs feuille ne sont que partiellement pleins, comme indiqué par les lignes de remplissage gris.
Figure 15 : Index avant fusion
Description de l'image cncpt294.gif
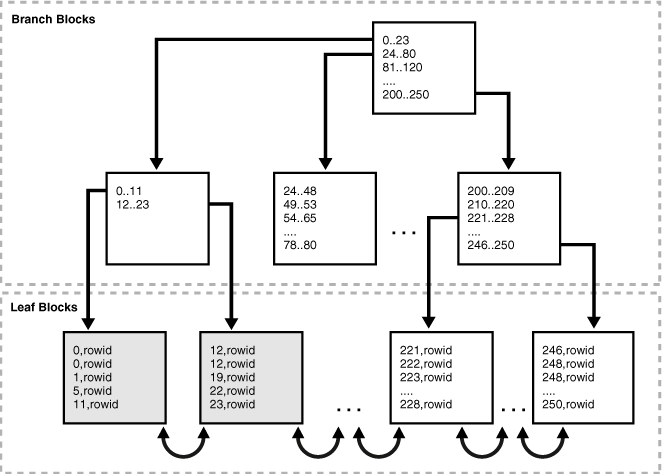
La Figure 15-16 illustre l'index de la Figure 15-15 après la fusion de l'index. Les deux premiers blocs feuille sont maintenant pleins, comme indiqué par les lignes de remplissage gris, et le troisième bloc feuille a été libéré.
Figure 16 : Index après fusion
Description de l'image cncpt295.gif
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment fusionner et reconstruire des index
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur l'instruction
COALESCE
Présentation des extents
Un extent est une unité de stockage de base de données constituée de blocs de données logiquement contigus. Les blocs de données peuvent être répartis physiquement sur disque en raison du striping RAID et des implémentations de systèmes de fichiers.
-
Allocation d'extents Par défaut, la base de données alloue un extent initial à un segment de données lors de sa création. Un extent est toujours contenu dans un fichier de données.
-
Libération des extents En général, les extents d'un segment utilisateur ne reviennent pas au tablespace, sauf si vous supprimez l'objet à l'aide d'une instruction
DROP. -
Paramètres de stockage pour les extents Chaque segment est défini par des paramètres de stockage exprimés en termes d'extents. Ces paramètres contrôlent la façon dont Oracle AI Database alloue de l'espace libre à un segment.
Allocation d'extents
Par défaut, la base de données alloue un extent initial à un segment de données lors de sa création. Un extent est toujours contenu dans un fichier de données.
Bien qu'aucune donnée n'ait été ajoutée au segment, les blocs de données de l'extent initial sont réservés exclusivement à ce segment. Le premier bloc de données de chaque segment contient un répertoire des extents du segment. La figure 15-17 présente l'extent initial d'un segment d'un fichier de données qui ne contenait auparavant aucune donnée.
Figure 17 : Étendue initiale d'un segment
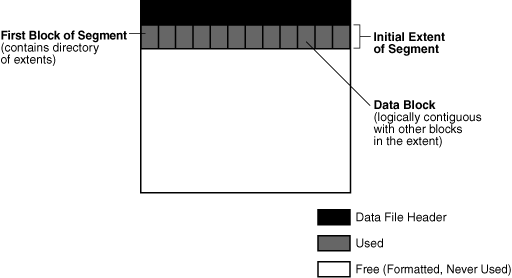
Description de l'image cncpt274.gif
Si l'extent initial devient plein et que davantage d'espace est nécessaire, la base de données alloue automatiquement un extent incrémentiel à ce segment. Un extent incrémentiel est un extent créé ultérieurement pour le segment.
L'algorithme d'allocation varie selon que le tablespace est géré localement ou par dictionnaire. Dans le cas géré localement, la base de données recherche les blocs libres adjacents dans le bitmap d'un fichier de données. Si l'espace du fichier de données est insuffisant, la base recherche dans un autre fichier de données. Les extents d'un segment se trouvent toujours dans le même tablespace, mais peuvent se trouver dans des fichiers de données différents. La figure 15-18 montre que la base de données peut allouer des extents pour un segment dans n'importe quel fichier de données du tablespace. Par exemple, le segment peut allouer l'extent initial dans users01.dbf, allouer le premier extent incrémentiel dans users02.dbf, puis allouer l'extent suivant dans users01.dbf.
Figure 18 : Extension incrémentielle d'un segment
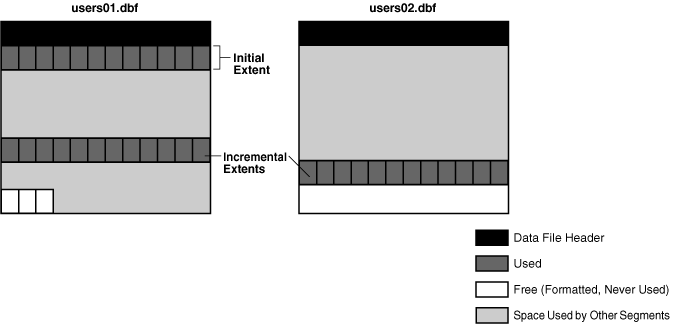
Description de l'image cncpt278.gif
Les blocs d'un extent nouvellement alloué, bien qu'ils soient libres, peuvent ne pas être vides de données anciennes. Dans ASSM, Oracle AI Database formate les blocs d'un extent nouvellement alloué lorsqu'il commence à utiliser l'extent, mais uniquement en fonction des besoins. Remarque : cette section s'applique aux opérations série, dans lesquelles un processus serveur analyse et exécute une instruction. La base de données alloue les extents différemment dans des instructions SQL parallèles, ce qui implique plusieurs processus serveur.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à allouer manuellement des extents
Libération d'extents
En général, les extents d'un segment utilisateur ne reviennent pas dans le tablespace, sauf si vous supprimez l'objet à l'aide d'une instruction DROP.
Par exemple, si vous supprimez toutes les lignes d'une table, la base de données ne récupère pas les blocs de données pour qu'ils soient utilisés par d'autres objets du tablespace. Vous pouvez également supprimer le segment à l'aide du package DBMS_SPACE_ADMIN.
Remarque : dans un segment d'annulation, Oracle AI Database libère régulièrement des extents si la taille OPTIMAL est indiquée ou si la base de données est en mode de gestion automatique des annulations.
Dans certains cas, vous pouvez libérer manuellement de l'espace. Oracle Segment Advisor permet de déterminer si un objet dispose d'espace disponible pour la récupération en fonction du niveau de fragmentation de l'objet. Les techniques suivantes peuvent libérer des extents :
-
Utilisez une récupération d'espace en ligne pour récupérer de l'espace fragmenté dans un segment. La récupération d'espace dans les segments est une opération en ligne. En général, le compactage des données permet une meilleure utilisation du cache et nécessite moins de blocs à lire lors d'un balayage complet des tables.
-
Déplacez les données d'une table non partitionnée ou d'une partition de table dans un nouveau segment, et éventuellement dans un tablespace différent pour lequel vous disposez d'un quota.
-
Recréez ou fusionnez l'index.
-
Vider une table ou un cluster de tables, ce qui supprime toutes les lignes. Par défaut, Oracle AI Database libère tout l'espace utilisé par les lignes enlevées, à l'exception de celui indiqué par le paramètre de stockage
MINEXTENTS. A partir d'Oracle Database 11g Release 2 (11.2.0.2), vous pouvez également utiliserTRUNCATEavec l'optionDROP ALL STORAGEpour supprimer des segments entiers. -
Libérez l'espace inutilisé, ce qui libère l'espace inutilisé à l'extrémité supérieure de la limite supérieure du segment de base de données et rend l'espace disponible pour les autres segments du tablespace.
Lorsque des extents sont libérés, Oracle AI Database modifie le bitmap du fichier de données pour les tablespaces gérés localement afin de refléter les extents récupérés en tant qu'espace disponible. Toutes les données des blocs d'extents libérés deviennent inaccessibles.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment récupérer de l'espace dans les segments
Paramètres de stockage pour les extents
Chaque segment est défini par des paramètres de stockage exprimés en termes d'extents. Ces paramètres contrôlent la façon dont Oracle AI Database alloue de l'espace libre à un segment.
Les paramètres de stockage sont déterminés dans l'ordre de priorité suivant, les paramètres supérieurs dans la liste remplaçant les paramètres inférieurs dans la liste :
-
Clause de stockage de segment
-
Clause de stockage de tablespace
-
Valeur par défaut d'Oracle AI Database
Un tablespace géré localement peut avoir des tailles d'extent uniformes ou des tailles d'extent variables déterminées automatiquement par le système :
-
Pour les extents uniformes, vous pouvez indiquer une taille d'extent ou utiliser la taille par défaut de 1 Mo. Tous les extents du tablespace ont cette taille. Les tablespaces temporaires gérés localement peuvent uniquement utiliser ce type d'allocation.
-
Pour les extents alloués automatiquement, Oracle AI Database détermine la taille optimale des extents supplémentaires.
Pour les tablespaces gérés localement, certains paramètres de stockage ne peuvent pas être indiqués au niveau tablespace. Toutefois, vous pouvez définir ces paramètres au niveau du segment. Dans ce cas, la base de données utilise tous les paramètres ensemble pour calculer la taille initiale du segment. Les algorithmes internes déterminent la taille suivante de chaque extent.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur les considérations relatives à la gestion des extents lors de la création d'un tablespace géré localement
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur les options de la clause de stockage
Présentation des segments
Un segment est un ensemble d'extents qui contient toutes les données d'une structure de stockage logique dans un tablespace.
Par exemple, Oracle AI Database alloue un ou plusieurs extents pour former le segment de données d'une table. La base de données alloue également un ou plusieurs extents pour former le segment d'index d'un index sur une table.
Oracle AI Database gère l'espace des segments automatiquement ou manuellement. Cette section suppose l'utilisation d'ASSM.
-
Segments utilisateur Un seul segment de données d'une base de données stocke les données d'un objet utilisateur.
-
Segments temporaires Lors du traitement d'une requête, Oracle AI Database a souvent besoin d'un espace de travail temporaire pour les étapes intermédiaires de l'exécution des instructions SQL.
-
Segments d'annulation Oracle AI Database tient à jour les enregistrements des actions des transactions, collectivement appelés données d'annulation.
-
Espace de segment et repère high water Pour gérer l'espace, Oracle AI Database suit l'état des blocs dans le segment. La limite supérieure du contrôle du débit (HWM) est le point d'un segment au-delà duquel les blocs de données ne sont pas formatés et n'ont jamais été utilisés. Voir aussi : "Gestion logique de l'espace" pour en savoir plus sur ASSM
Segments utilisateur
Un seul segment de données d'une base de données stocke les données d'un objet utilisateur.
Il existe différents types de segment. Exemples de segments utilisateur :
-
Table, partition de table ou cluster de tables
-
Partition de type LOB ou LOB
-
Partition d'index ou d'index
Chaque objet et partition d'objet non partitionnés est stocké dans son propre segment. Par exemple, si un index comporte cinq partitions, cinq segments contiennent les données d'index.
- Création de segments utilisateur Par défaut, la base de données utilise la création différée de segments pour mettre à jour uniquement les métadonnées de base de données lors de la création de tables, d'index et de partitions.
Création de segment utilisateur
Par défaut, la base de données utilise la création différée de segments pour mettre à jour uniquement les métadonnées de base de données lors de la création de tables, d'index et de partitions.
Lorsqu'un utilisateur insère la première ligne dans une table ou une partition, la base de données crée des segments pour la table ou la partition, ses colonnes LOB et ses index. La création différée de segments évite d'utiliser inutilement des ressources de base de données. Par exemple, l'installation d'une application peut créer des milliers d'objets, consommant beaucoup d'espace disque. Beaucoup de ces objets ne peuvent jamais être utilisés.
Le package DBMS_SPACE_ADMIN gère les segments pour les objets vides. Vous pouvez utiliser ce package PL/SQL pour effectuer les opérations suivantes :
-
matérialiser manuellement des segments pour des tables ou des partitions vides qui n'ont pas de segments créés
-
Supprimer les segments des tables ou partitions vides qui ont actuellement un segment vide alloué
Pour mieux illustrer la relation entre la création d'objet et la création de segment, supposons que la création différée de segment soit désactivée. Pour créer une table, procédez comme suit :
CREATE TABLE test_table (my_column NUMBER);Comme illustré dans la figure 15-19, la base de données crée un segment pour la table.
Figure 19 : Création d'un segment utilisateur
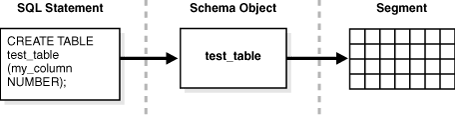
Description de l'image cncpt246.gif
Lorsque vous créez une table avec une clé primaire ou une clé unique, Oracle AI Database crée automatiquement un index pour cette clé. Supposons à nouveau que la création différée de segments soit désactivée. Pour créer une table, procédez comme suit :
CREATE TABLE lob_table (my_column NUMBER PRIMARY KEY, clob_column CLOB);La figure 15-20 montre que les données de lob_table sont stockées dans un segment, tandis que l'index créé implicitement se trouve dans un autre segment. En outre, les données CLOB sont stockées dans leur propre segment, tout comme l'index CLOB associé. Par conséquent, l'instruction CREATE TABLE entraîne la création de quatre segments différents.
Figure 20 : Segments multiples
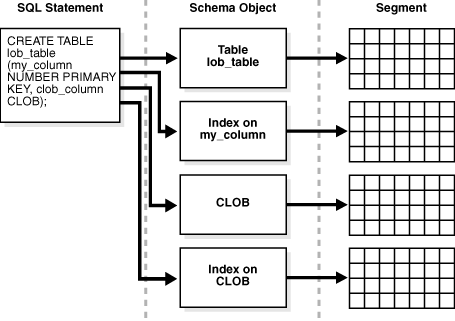
Description de l'image cncpt245.gif
Remarque : les segments d'une table et l'index de cette table n'ont pas à occuper le même tablespace.
La base de données alloue un ou plusieurs extents lorsqu'un segment est créé. Les paramètres de stockage de l'objet déterminent la façon dont les extents de chaque segment sont alloués. Ces paramètres affectent l'efficacité de l'extraction et du stockage des données pour le segment de données associé à l'objet.
Voir aussi :
-
Guide du développeur Oracle AI Database SecureFiles et LOB pour en savoir plus sur les objets LOB internes
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer la création différée de segments
-
Référence du langage SQL d'Oracle AI Database pour la syntaxe
CREATE TABLE
Segments temporaires
Lors du traitement d'une requête, Oracle AI Database nécessite souvent un espace de travail temporaire pour les étapes intermédiaires de l'exécution des instructions SQL.
Les opérations standard qui peuvent nécessiter un segment temporaire incluent le tri, le hachage et la fusion de bitmaps. Lors de la création d'un index, Oracle AI Database place également les segments d'index en segments temporaires, puis les convertit en segments permanents lorsque l'index est terminé.
Oracle AI Database ne crée pas de segment temporaire si une opération peut être effectuée en mémoire. Toutefois, si l'utilisation de la mémoire n'est pas possible, la base de données alloue automatiquement un segment temporaire sur le disque.
-
Allocation de segments temporaires pour les requêtes Oracle AI Database alloue des segments temporaires pour les requêtes selon les besoins au cours d'une session utilisateur et les supprime lorsque la requête est terminée. Les modifications apportées aux segments temporaires ne sont pas enregistrées dans le fichier de journalisation en ligne, à l'exception des opérations de gestion de l'espace sur le segment temporaire.
-
Allocation de segments pour les tables et les index temporaires Oracle AI Database peut allouer des segments temporaires aux tables temporaires et à leurs index.
Allocation de segments temporaires pour les requêtes
Oracle AI Database alloue des segments temporaires pour les requêtes si nécessaire au cours d'une session utilisateur et les supprime lorsque la requête est terminée. Les modifications apportées aux segments temporaires ne sont pas enregistrées dans le fichier de journalisation en ligne, à l'exception des opérations de gestion de l'espace sur le segment temporaire.
La base crée des segments temporaires dans le tablespace temporaire affecté à l'utilisateur. Les caractéristiques de stockage par défaut du tablespace déterminent les caractéristiques des extents du segment temporaire. Etant donné que l'allocation et la libération de segments temporaires sont fréquentes, il est recommandé de créer au moins un tablespace spécial pour les segments temporaires. La base de données répartit les E/S entre les disques et évite de fragmenter SYSTEM et d'autres tablespaces avec des segments temporaires.
Remarque : lorsque SYSTEM est géré localement, vous devez définir un tablespace temporaire par défaut lors de la création de la base de données. Un tablespace SYSTEM géré localement ne peut pas être utilisé pour le stockage temporaire par défaut.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment créer des tablespaces temporaires
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
CREATE TEMPORARY TABLESPACE
Allocation de segments pour les tables et index temporaires
Oracle AI Database peut allouer des segments temporaires aux tables temporaires et à leurs index.
Les tables temporaires stockent des données qui n'existent que pour la durée d'une transaction ou d'une session. Chaque session accède uniquement aux extents qui lui sont alloués et ne peut pas accéder aux extents alloués aux autres sessions.
Oracle AI Database alloue des segments pour une table temporaire globale lorsque le premier élément INSERT se produit dans la table, et pour une table temporaire privée uniquement si nécessaire. L'insertion peut se produire explicitement ou à cause de CREATE TABLE AS SELECT. La base de données alloue les segments de la table et de ses index, crée la page racine des index et alloue tous les segments LOB.
Un tablespace temporaire de l'utilisateur en cours alloue des segments à une table temporaire. Par exemple, le tablespace temporaire affecté à user1 est temp1 et le tablespace temporaire affecté à user2 est temp2. Dans ce cas, user1 stocke les données temporaires dans les segments temp1, tandis que user2 stocke les données temporaires dans les segments temp2.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à créer des tables temporaires
Segments d'annulation
Oracle AI Database conserve des enregistrements des actions des transactions, collectivement appelées données d'annulation.
Oracle AI Database utilise les données d'annulation pour effectuer les opérations suivantes :
-
Annulation d'une transaction active
-
Récupérer une transaction terminée
-
Assurer la cohérence de lecture
-
Effectuer des opérations Flashback logiques
Oracle AI Database stocke les données d'annulation dans la base de données plutôt que dans des journaux externes. Les données d'annulation sont stockées dans des blocs qui sont mis à jour comme des blocs de données, les modifications apportées à ces blocs générant des enregistrements de journalisation. De cette façon, Oracle AI Database peut accéder efficacement aux données d'annulation sans avoir à lire les journaux externes.
Les données d'annulation des objets permanents sont stockées dans un tablespace d'annulation. Oracle AI Database fournit un mécanisme entièrement automatisé, appelé mode de gestion automatique des annulations, pour la gestion des segments et de l'espace d'annulation dans un tablespace d'annulation.
La base de données sépare les données d'annulation en deux flux. Un flux d'annulation temporaire encapsule uniquement les enregistrements d'annulation générés par les modifications apportées aux objets temporaires, tandis qu'un flux d'annulation permanent encapsule uniquement les enregistrements d'annulation pour les objets permanents. La base de données gère les informations d'annulation temporaires et permanentes de manière indépendante. La séparation des informations d'annulation réduit le stockage et améliore les performances en procédant comme suit :
-
Vous permet de configurer les tailles des tablespaces permanents et d'annulation qui conviennent le mieux aux charges globales pour les tables permanentes et temporaires.
-
Réduire la taille des informations de journalisation écrites dans le fichier de journalisation en ligne
-
Eviter la nécessité de sauvegarder les données d'annulation temporaires
Sur une instance Active Data Guard, les opérations LMD sur les tables temporaires globales nécessitent que les informations d'annulation soient générées dans des segments d'annulation temporaires.
-
Segments et transactions d'annulation Lorsqu'une transaction démarre, la base de données lie (affecte) la transaction à un segment d'annulation, et donc à une table de transactions, dans le tablespace d'annulation en cours. Dans de rares cas, si l'instance de base de données ne dispose pas d'un tablespace d'annulation désigné, la transaction est liée au segment d'annulation système.
-
Annulation de transaction Lorsqu'une instruction
ROLLBACKest émise, la base de données utilise des enregistrements d'annulation pour annuler les modifications apportées à la base de données par la transaction non validée. -
Segments d'annulation temporaires Un segment d'annulation temporaire est un conteneur de gestion de l'espace facultatif pour les données d'annulation temporaires uniquement.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur les segments d'annulation temporaires
-
Référence Oracle AI Database pour en savoir plus sur le paramètre d'initialisation
TEMP_UNDO_ENABLED
Segments et transactions d'annulation
Lorsqu'une transaction démarre, la base de données lie (affecte) la transaction à un segment d'annulation, et donc à une table de transactions, dans le tablespace d'annulation en cours. Dans de rares cas, si l'instance de base de données ne dispose pas d'un tablespace d'annulation désigné, la transaction est liée au segment d'annulation système.
Plusieurs transactions actives peuvent écrire simultanément dans le même segment d'annulation ou dans différents segments. Par exemple, les transactions T1 et T2 peuvent écrire dans le segment d'annulation U1, ou T1 dans U1, tandis que T2 écrit dans le segment d'annulation U2.
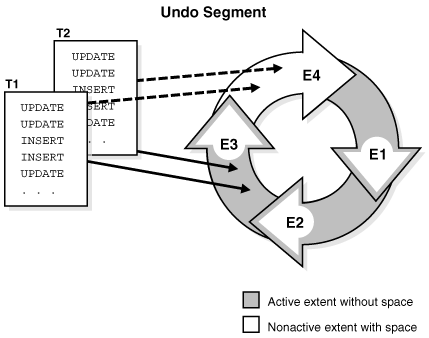
Conceptuellement, les extents d'un segment d'annulation forment un anneau. Les transactions écrivent dans une mesure d'annulation, puis dans la mesure suivante dans l'anneau, etc. de manière cyclique. La figure 15-21 présente deux transactions, T1 et T2, qui commencent à écrire dans le troisième extent (E3) d'un segment d'annulation et continuent à écrire dans le quatrième extent (E4).
Figure 21 : Anneau des extents alloués dans un segment d'annulation
Description de l'image cncpt328.gif
A un moment donné, une transaction écrit de manière séquentielle dans un seul extent d'un segment d'annulation, appelé extent actuel de la transaction. Plusieurs transactions actives peuvent écrire simultanément dans le même extent en cours ou dans des extents différents. La figure 15-21 présente les transactions T1 et T2 en écrivant simultanément dans la mesure E3. Dans un extent d'annulation, un bloc de données contient des données pour une seule transaction.
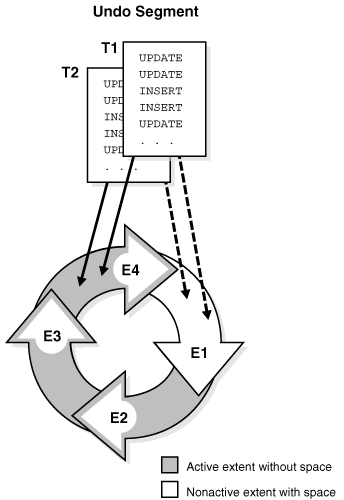
Lorsque l'extent d'annulation actuel est rempli, la première transaction nécessitant de l'espace vérifie la disponibilité de l'extent affecté suivant dans l'anneau. Si l'extent suivant ne contient pas de données provenant d'une transaction active, il devient l'extent actuel. Maintenant, toutes les transactions qui ont besoin d'espace peuvent écrire dans le nouvel extent actuel. Dans la Figure 15-22, lorsque E4 est plein, T1 et T2 continuent d'écrire dans E1, écrasant les données d'annulation non actives dans E1.
Figure 22 : Utilisation cyclique des extents alloués dans un segment d'annulation
Description de l'image cncpt327.gif
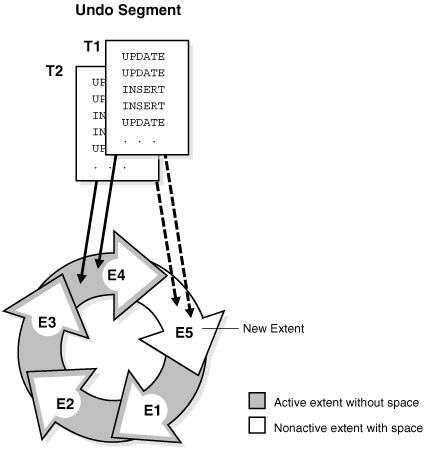
Si l'extent suivant contient les données d'une transaction active, la base de données doit allouer un nouvel extent. La figure 15-23 présente un scénario dans lequel T1 et T2 écrivent vers E4. Lorsque E4 est rempli, les transactions ne peuvent pas continuer à écrire dans E1 car E1 contient des entrées d'annulation actives. Par conséquent, la base de données alloue un nouvel extent (E5) pour ce segment d'annulation. Les transactions continuent à écrire à E5.
Figure 23 : Allocation d'une nouvelle étendue pour un segment d'annulation
Description de l'image cncpt326.gif
Voir aussi : Guide de l'administrateur Oracle AI Database pour apprendre à gérer les segments d'annulation
Annulation de transaction
Lorsqu'une instruction ROLLBACK est émise, la base de données utilise des enregistrements d'annulation pour annuler les modifications apportées à la base de données par la transaction non validée.
Au cours de la récupération, la base de données annule toutes les modifications non validées appliquées du fichier de journalisation en ligne aux fichiers de données. Les enregistrements d'annulation fournissent une cohérence de lecture en conservant l'image "avant" des données pour les utilisateurs qui accèdent aux données en même temps qu'un autre utilisateur les modifie.
Segments d'annulation temporaires
Un segment d'annulation temporaire est un conteneur facultatif de gestion de l'espace pour les données d'annulation temporaires uniquement.
Les enregistrements d'annulation pour les modifications apportées aux tables temporaires sont à la fois propres à la session et utiles uniquement pour la cohérence en lecture et l'annulation des transactions. Avant Oracle Database 12c, la base de données stockait toujours ces enregistrements dans le fichier de journalisation en ligne. Etant donné que les modifications apportées aux objets temporaires ne sont pas consignées dans le fichier de journalisation en ligne, l'écriture d'informations d'annulation pour les objets temporaires dans des segments d'annulation temporaires permet d'économiser de l'espace dans le fichier de journalisation en ligne et les fichiers de journalisation archivés. La base de données ne consigne pas les modifications apportées à l'annulation ou à la table temporaire, ce qui améliore les performances.
Vous pouvez définir le paramètre d'initialisation TEMP_UNDO_ENABLED afin que les tables temporaires stockent les données d'annulation dans un segment d'annulation temporaire. Lorsque ce paramètre est TRUE, la base de données alloue des segments d'annulation temporaires à partir de tablespaces temporaires.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur les segments d'annulation temporaires
-
Référence Oracle AI Database pour en savoir plus sur le paramètre d'initialisation
TEMP_UNDO_ENABLED
Segment Space et High Water Mark
Pour gérer l'espace, Oracle AI Database suit l'état des blocs dans le segment. La limite supérieure du contrôle du débit (HWM) est le point d'un segment au-delà duquel les blocs de données ne sont pas formatés et n'ont jamais été utilisés.
MSSM utilise des listes de blocs libres pour gérer l'espace dans les segments. Lors de la création de la table, aucun bloc du segment n'est formaté. Lorsqu'une session insère des lignes dans la table pour la première fois, la base de données recherche les blocs utilisables dans la liste de blocs libres. Si la base de données ne trouve aucun bloc utilisable, elle prépare un groupe de blocs, les place dans la liste de blocs libres et commence à insérer des données dans les blocs. Dans MSSM, un balayage complet de table lit tous les blocs situés sous le repère high-water mark.
ASSM n'utilise pas de listes de blocs libres et doit donc gérer l'espace différemment. Lorsqu'une session insère des données pour la première fois dans une table, la base de données formate un bloc bitmap unique au lieu de préformer un groupe de blocs comme dans MSSM. Le bitmap suit l'état des blocs dans le segment, en prenant la place de la liste libre. La base de données utilise le bitmap pour rechercher les blocs libres, puis formate chaque bloc avant de le remplir de données. ASSM répartit les insertions entre les blocs pour éviter les problèmes de simultanéité.
Chaque bloc de données d'un segment ASSM présente l'un des états suivants :
-
Au-dessus du HWM
Ces blocs ne sont pas formatés et n'ont jamais été utilisés.
-
Sous le HWM
L'un des états suivants peut être attribué aux blocs :
-
Alloué, mais actuellement non formaté et inutilisé
-
Formaté et contenant des données
-
Formaté et vide car les données ont été supprimées
-
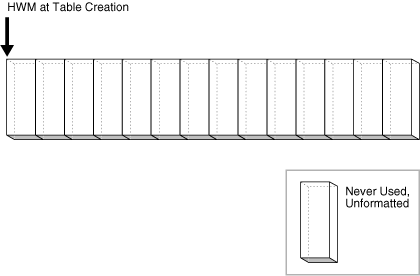
La Figure 15-24 représente un segment ASSM sous la forme d'une série horizontale de blocs. Lors de la création de la table, le repère high-water mark se trouve au début du segment sur la gauche. Comme aucune donnée n'a encore été insérée, tous les blocs du segment ne sont pas formatés et ne sont jamais utilisés.
Figure 24 : HWM lors de la création de la table
Description de l'image cncpt275.gif
Supposons qu'une transaction insère des lignes dans le segment. La base de données doit allouer un groupe de blocs pour contenir les lignes. Les blocs alloués sont inférieurs au repère high-water mark. La base de données formate un bloc bitmap dans ce groupe pour contenir les métadonnées, mais ne préformate pas les blocs restants dans le groupe.
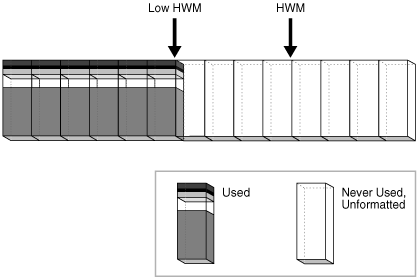
Dans la Figure 15-25, les blocs situés sous le repère high-water mark sont alloués, tandis que les blocs situés au-dessus du repère high-water mark ne sont ni alloués ni formatés. Au fur et à mesure des insertions, la base de données peut écrire dans n'importe quel bloc disposant d'espace disponible. Le repère high water mark (low HWM) marque le point en dessous duquel tous les blocs sont connus pour être formatés car ils contiennent des données ou des données précédemment contenues.
Figure 25 : HWM et HWM bas
Description de l'image cncpt276.gif
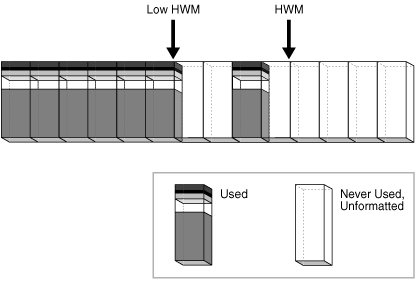
Dans la figure 15-26, la base de données choisit un bloc entre le repère high-water mark et le repère high-water mark bas et y écrit. La base de données aurait pu tout aussi facilement choisir n'importe quel autre bloc entre le repère high-water mark et le repère high-water mark, ou n'importe quel bloc inférieur au repère high-water mark qui disposait d'espace disponible. Dans la Figure 15-26, les blocs de chaque côté du bloc nouvellement rempli ne sont pas formatés.
Figure 26 : HWM et HWM bas
Description de l'image cncpt333.gif
Le repère high-water mark faible est important dans un balayage complet de table. Comme les blocs situés sous le repère high-water mark ne sont formatés qu'en cas d'utilisation, certains blocs peuvent être non formatés, comme dans la Figure 15-26. Pour cette raison, la base de données lit le bloc bitmap pour obtenir l'emplacement du repère high-water mark bas. La base de données lit tous les blocs jusqu'au bas HWM car ils sont connus pour être formatés, puis lit soigneusement uniquement les blocs formatés entre le bas HWM et le HWM.
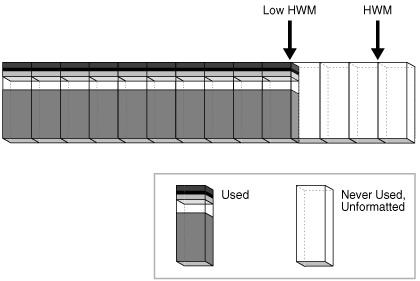
Supposons qu'une nouvelle transaction insère des lignes dans la table, mais que le bitmap indique qu'il n'y a pas suffisamment d'espace libre sous le repère high-water mark. Dans la Figure 15-27, la base de données fait avancer le repère high-water mark vers la droite, en allouant un nouveau groupe de blocs non formatés.
Figure 27 : Avancement des PMH et des PMH faibles
Description de l'image cncpt277.gif
Lorsque les blocs entre le repère high-water mark et le repère high-water mark sont pleins, le repère high-water mark avance vers la droite et le repère high-water mark bas avance vers l'emplacement de l'ancien repère high-water mark. Lorsque la base de données insère des données dans le temps, le repère high-water mark continue d'avancer vers la droite, le repère high-water mark bas étant toujours en arrière. Sauf si vous recréez, tronquez ou réduisez manuellement l'objet, le repère high-water mark ne recule jamais.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment réduire des segments en ligne
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
TRUNCATE TABLE
Présentation des espaces de stockage
Un tablespace est un conteneur de stockage logique pour les segments.
Les segments sont des objets de base de données, tels que des tables et des index, qui consomment de l'espace de stockage. Au niveau physique, un tablespace stocke les données dans un ou plusieurs fichiers de données ou fichiers temporaires.
-
Tablespaces dans un environnement colocatif Dans une base de données Conteneur, chaque base de données pluggable et racine d'application possède son propre ensemble de tablespaces.
-
Tablespaces permanents Un tablespace permanent regroupe les objets de schéma persistants. Les segments des objets du tablespace sont stockés physiquement dans des fichiers de données.
-
Tablespaces temporaires Un tablespace temporaire contient des données transitoires qui persistent uniquement pendant la durée d'une session. Aucun objet de schéma permanent ne peut résider dans un tablespace temporaire. Un fichier temporaire stocke les données de tablespace temporaire.
-
Modes de tablespace Le mode de tablespace détermine l'accessibilité du tablespace.
-
Taille du fichier de tablespace Un tablespace est soit un tablespace bigfile, soit un tablespace smallfile. Ces tablespaces ne peuvent pas être distingués en termes d'exécution d'instructions SQL qui ne font pas explicitement référence aux fichiers de données ou aux fichiers temporaires.
Tablespaces dans un environnement colocatif
Dans une base de données Conteneur, chaque base de données pluggable et racine d'application possède son propre ensemble de tablespaces.
Chaque racine de base de données Conteneur, base de données pluggable et racine d'application doit comporter les tablespaces SYSTEM et SYSAUX. La figure suivante illustre les tablespaces d'un conteneur standard.
Figure 28 : Tablespaces
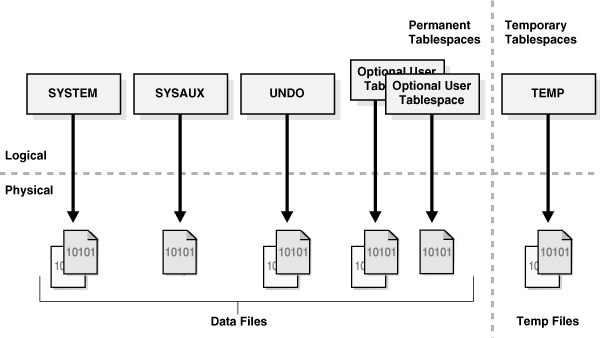
Description de l'image cncpt319.gif
Une base de données Conteneur contient les éléments suivants :
-
Un fichier de contrôle
-
Un fichier de journalisation en ligne
-
Un ou plusieurs tablespaces d'annulation
Seul un utilisateur commun disposant des privilèges appropriés et dont le conteneur en cours est la racine de base de données Conteneur peut créer un tablespace d'annulation. A un moment donné, une base de données Conteneur se trouve dans l'un des modes d'annulation suivants :
-
Mode d'annulation local
Dans ce cas, chaque base de données pluggable dispose de son propre tablespace d'annulation. Si une base Conteneur utilise le mode d'annulation local, la base de données crée automatiquement un tablespace d'annulation dans chaque base pluggable. L'annulation locale offre des avantages tels que la possibilité d'effectuer un clone à chaud d'une base de données pluggable et de transférer rapidement des bases de données pluggables. En outre, l'annulation locale fournit un niveau d'isolement et permet des opérations de déconnexion et de récupération jusqu'à un point dans le temps plus rapides.
Un tablespace d'annulation local est requis pour chaque noeud d'un cluster Oracle Real Application Clusters (RAC) dans lequel la base de données pluggable est ouverte. Par exemple, si vous déplacez une base de données pluggable d'un cluster à deux noeuds vers un cluster à quatre noeuds et que la base de données pluggable est ouverte sur tous les noeuds, la base de données crée automatiquement les tablespaces d'annulation supplémentaires requis. Si vous déplacez à nouveau la base de données pluggable, vous pouvez supprimer les tablespaces d'annulation redondants.
Remarque : par défaut, l'assistant DBCA (Database Configuration Assistant) crée de nouvelles bases de données Conteneur avec l'annulation locale activée.
-
Mode d'annulation partagé
Dans une base de données Conteneur à instance unique, un seul tablespace d'annulation actif existe. Pour une base de données Conteneur Oracle RAC, un tablespace d'annulation actif existe pour chaque instance. Tous les tablespaces d'annulation sont visibles dans les dictionnaires de données et les vues associées de tous les conteneurs.
Le mode d'annulation s'applique à l'ensemble de la base de données Conteneur, ce qui signifie que chaque conteneur utilise une annulation partagée ou que chaque conteneur utilise une annulation locale. Vous pouvez basculer entre les modes d'annulation d'une base de données Conteneur, ce qui nécessite le redémarrage de la base de données.
-
-
Tablespaces
SYSTEMetSYSAUXpour chaque conteneurLa racine de base de données Conteneur, chaque racine d'application et chaque base de données pluggable a ses propres tablespaces
SYSTEMetSYSAUX. Chaque conteneur possède également son propre ensemble de tables de dictionnaire de données décrivant les objets qui y résident. -
Aucun tablespace créé par l'utilisateur ou plus
Dans un cas d'emploi type, chaque base de données pluggable dispose de son propre ensemble de tablespaces non système. Ces tablespaces contiennent les données des schémas et objets définis par l'utilisateur dans la base de données pluggable. Vous pouvez limiter la quantité de stockage utilisée par les fichiers de données pour une base de données pluggable à l'aide de la clause
STORAGEdans une instructionCREATE PLUGGABLE DATABASEouALTER PLUGGABLE DATABASE.Le stockage du dictionnaire de données dans la base de données pluggable lui permet d'être portable. Vous pouvez déconnecter une base pluggable d'une base Conteneur et la connecter à une autre base Conteneur.
-
Un ensemble de fichiers temporaires pour chaque conteneur
Il existe un tablespace temporaire par défaut pour la racine de base de données Conteneur, et un pour chaque racine d'application, base de données pluggable d'application et base de données pluggable.
Exemple 15-3 Base de données Conteneur en mode d'annulation local
Cet exemple présente certains aspects de l'architecture de stockage physique d'une base de données Conteneur avec deux bases de données pluggables : hrpdb et salespdb. Dans cet exemple, la base de données utilise le mode d'annulation local, de même que les fichiers de données d'annulation dans la racine de base de données Conteneur, hrpdb et salespdb.
Figure 29 : Architecture physique d'une base de données Conteneur en mode d'annulation local
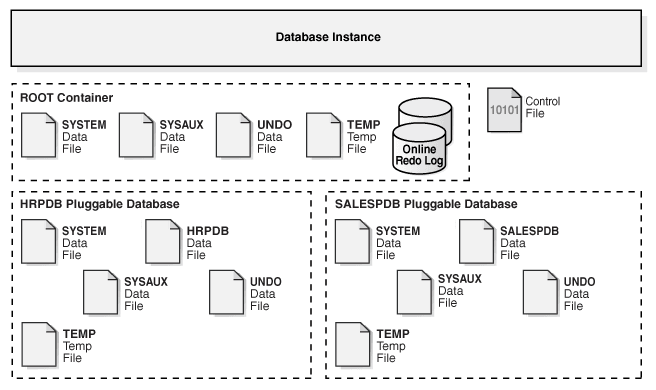
Description de l'image cncpt386.png
Voir aussi : "Dictionnaire de données séparé dans une base de données Conteneur"
Tablespaces permanents
Un tablespace permanent regroupe les objets de schéma persistants. Les segments des objets du tablespace sont stockés physiquement dans des fichiers de données.
Un tablespace permanent par défaut est affecté à chacun des utilisateurs de base de données. Une base de données très petite peut avoir uniquement besoin des tablespaces SYSTEM et SYSAUX par défaut. Toutefois, Oracle recommande de créer au moins un tablespace pour le stockage des données utilisateur et d'application. Vous pouvez utiliser des tablespaces pour atteindre les objectifs suivants :
-
Contrôler l'allocation d'espace disque pour les données de base de données
-
Affecter un quota (allocation d'espace ou limite) à un utilisateur de base de données
-
Mettre des tablespaces individuels en ligne ou hors ligne sans affecter la disponibilité de l'ensemble de la base de données
-
Sauvegarder et récupérer des tablespaces individuels
-
Importer ou exporter des données d'application à l'aide de l'utilitaire Oracle Data Pump
-
Créez un tablespace transportable que vous pouvez copier ou déplacer d'une base de données vers une autre, même sur plusieurs plates-formes.
Le déplacement de données via le transport de tablespaces peut être plus rapide que l'export/import ou le déchargement/chargement des mêmes données, car le transport d'un tablespace implique uniquement la copie des fichiers de données et l'intégration des métadonnées du tablespace. Lorsque vous transportez des tablespaces, vous pouvez également déplacer des données d'index.
-
Tablespace SYSTEM Le tablespace
SYSTEMest un tablespace d'administration nécessaire inclus dans la base de données lors de sa création. Oracle AI Database utiliseSYSTEMpour gérer la base de données. -
Tablespace SYSAUX Le tablespace
SYSAUXest un tablespace auxiliaire du tablespaceSYSTEM. -
Annuler les tablespaces Un tablespace d'annulation est un tablespace géré localement réservé aux données d'annulation gérées par le système.
-
Tablespaces shadow Un tablespace shadow est un tablespace bigfile destiné à la protection contre les pertes d'écriture shadow.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment transporter des tablespaces
-
Utilitaires Oracle AI Database pour en savoir plus sur Oracle Data Pump
Tablespace SYSTEM
Le tablespace SYSTEM est un tablespace d'administration nécessaire inclus dans la base de données lors de sa création. Oracle AI Database utilise SYSTEM pour gérer la base de données.
Le tablespace SYSTEM inclut les informations suivantes, qui appartiennent toutes à l'utilisateur SYS :
-
Dictionnaire de données
-
Tables et vues contenant les informations administratives sur la base de données
-
Objets stockés compilés tels que des déclencheurs, des procédures et des packages
Le tablespace SYSTEM est géré comme n'importe quel autre tablespace, mais nécessite un niveau de privilège plus élevé et est limité d'une certaine manière. Par exemple, vous ne pouvez pas renommer ou supprimer le tablespace SYSTEM.
Par défaut, Oracle AI Database définit tous les tablespaces utilisateur nouvellement créés pour qu'ils soient gérés localement. Dans une base de données avec un tablespace SYSTEM géré localement, vous ne pouvez pas créer de tablespaces gérés par le dictionnaire (en phase d'abandon). Toutefois, si vous exécutez l'instruction CREATE DATABASE manuellement et acceptez les valeurs par défaut, le tablespace SYSTEM est géré par le dictionnaire. Vous pouvez migrer un tablespace SYSTEM géré par un dictionnaire existant vers un format géré localement. Remarque : Oracle vous recommande vivement d'utiliser DBCA (Database Configuration Assistant) pour créer de nouvelles bases de données afin que tous les tablespaces, y compris SYSTEM, soient gérés localement par défaut.
Voir aussi :
-
"Tablespaces en ligne et hors ligne" pour plus d'informations sur la condition en ligne permanente du tablespace
SYSTEM -
Guide de l'administrateur Oracle AI Database pour découvrir comment créer ou migrer vers un tablespace
SYSTEMgéré localement -
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
CREATE DATABASE
Tablespace SYSAUX
Le tablespace SYSAUX est un tablespace auxiliaire du tablespace SYSTEM.
Etant donné que SYSAUX est le tablespace par défaut de nombreux produits et fonctionnalités d'Oracle AI Database qui exigeaient auparavant leurs propres tablespaces, il réduit le nombre de tablespaces requis par la base de données. Elle réduit également la charge sur le tablespace SYSTEM.
La création ou la mise à niveau de la base de données crée automatiquement le tablespace SYSAUX. Pendant le fonctionnement normal de la base de données, la base de données n'autorise pas la suppression ou le changement de nom du tablespace SYSAUX. Si le tablespace SYSAUX devient indisponible, la fonctionnalité de base de données reste opérationnelle. Les fonctionnalités de base de données qui utilisent le tablespace SYSAUX peuvent échouer ou fonctionner avec des capacités limitées.
Voir aussi : Guide de l'administrateur Oracle AI Database pour en savoir plus sur le tablespace SYSAUX
Tablespaces d'annulation
Un tablespace d'annulation est un tablespace géré localement réservé aux données d'annulation gérées par le système.
Comme les autres tablespaces permanents, les tablespaces d'annulation contiennent des fichiers de données. Les blocs d'annulation de ces fichiers sont regroupés dans des extents.
-
Les tablespaces d'annulation en mode de gestion automatique des annulations requièrent que la base de données soit en mode d'annulation automatique par défaut.
-
Conservation automatique des informations d'annulation La période de conservation des informations d'annulation est la durée minimale pendant laquelle Oracle AI Database tente de conserver les anciennes données d'annulation avant de les écraser. Voir aussi : "Annuler des segments"
Mode de gestion d'annulation automatique
Pour les tablespaces d'annulation, la base de données doit être en mode d'annulation automatique par défaut.
Le mode automatique élimine la complexité de l'administration manuelle des segments d'annulation. La base de données se règle automatiquement pour assurer la meilleure conservation possible des données d'annulation afin de répondre aux interrogations à longue durée d'exécution qui peuvent nécessiter ces données.
Une nouvelle installation d'Oracle AI Database crée automatiquement un tablespace d'annulation. Les versions antérieures d'Oracle AI Database peuvent ne pas inclure de tablespace d'annulation et utiliser des segments d'annulation hérités, connus sous le nom de mode de gestion manuelle des annulations. Oracle AI Database contient une fonction de conseil Undo Advisor qui fournit des conseils et aide à automatiser votre environnement d'annulation.
Une base de données peut contenir plusieurs tablespaces d'annulation, mais un seul peut être utilisé à la fois. Lorsqu'une instance tente d'ouvrir une base de données, Oracle AI Database sélectionne automatiquement le premier tablespace d'annulation disponible. Si aucun tablespace d'annulation n'est disponible, l'instance commence sans tablespace d'annulation et stocke les données d'annulation dans le tablespace SYSTEM. Il n'est pas recommandé de stocker les données d'annulation dans SYSTEM.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour en savoir plus sur la gestion automatique des annulations
-
Guide de mise à niveau d'Oracle AI Database pour découvrir comment migrer vers le mode de gestion automatique des annulations
Conservation pour annulation automatique
La période de conservation des annulations est la durée minimale pendant laquelle Oracle AI Database tente de conserver les anciennes données d'annulation avant de les écraser.
La conservation des informations d'annulation est importante car les requêtes à longue durée d'exécution peuvent nécessiter des images de bloc plus anciennes pour fournir une cohérence de lecture. En outre, certaines fonctionnalités d'Oracle Flashback peuvent dépendre de la disponibilité des informations d'annulation.
En général, il est souhaitable de conserver les anciennes données d'annulation aussi longtemps que possible. Une fois la transaction validée, les données d'annulation ne sont plus nécessaires pour l'annulation ou la récupération de la transaction. La base de données peut conserver les anciennes données d'annulation si le tablespace d'annulation dispose d'espace pour les nouvelles transactions. Lorsque l'espace disponible est faible, la base de données commence à remplacer les anciennes données d'annulation pour les transactions validées.
Oracle AI Database fournit automatiquement la meilleure conservation des informations d'annulation possible pour le tablespace d'annulation en cours. La base de données collecte les statistiques d'utilisation et règle la période de conservation en fonction de ces statistiques et de la taille du tablespace d'annulation. Si le tablespace d'annulation est configuré avec l'option AUTOEXTEND et que la taille maximale n'est pas indiquée, le réglage de la conservation des informations d'annulation est différent. Dans ce cas, la base de données règle la période de conservation des informations d'annulation pour qu'elle soit légèrement plus longue que l'interrogation la plus longue, si l'espace le permet.
Voir aussi : Guide de l'administrateur Oracle AI Database pour plus de détails sur le réglage automatique de la conservation des informations d'annulation
Tablespaces fantôme
Un tablespace shadow est un tablespace bigfile destiné à la protection contre les pertes d'écriture shadow.
Remarque : la protection contre les pertes d'écriture shadow n'est pas liée à la protection contre les pertes d'écriture configurée avec le paramètre d'initialisation DB_LOST_WRITE_PROTECT et une base de données de secours.
-
Objectif des tablespaces shadow : la protection contre les pertes d'écriture shadow permet une détection rapide et une réponse immédiate à une écriture perdue.
-
Fonctionnement des tablespaces shadow La protection en écriture perdue nécessite deux tablespaces : un tablespace shadow et un tablespace non shadow dont les blocs sont suivis par le tablespace shadow.
-
Interface utilisateur pour les tablespaces shadow Vous activez et désactivez la protection en écriture shadow lost à l'aide de la commande
ALTER PLUGGABLE DATABASE. -
Exemple : configuration de la protection contre les pertes d'écriture Cet exemple active le suivi des pertes d'écriture shadow pour un ensemble de tablespaces.
Finalité des tablespaces shadow
La protection contre les pertes d'écriture fantôme permet une détection rapide et une réponse immédiate à une écriture perdue.
Une écriture perdue de bloc de données se produit lorsqu'un sous-système d'E/S reconnaît la fin de l'écriture de bloc même si l'écriture n'a pas eu lieu ou lorsqu'une ancienne image du bloc écrase l'image actuelle.
Une écriture perdue non détectée peut entraîner une corruption des données car les données incorrectes peuvent être utilisées pour d'autres transactions LMD. Par exemple, une transaction peut lire des données anciennes et incorrectes à partir d'une table, puis mettre à jour des centaines d'autres tables en fonction de ces données. Ainsi, l'altération des données peut se propager dans l'ensemble de la base.
La protection contre les pertes d'écriture fantôme offre les avantages suivants :
-
Elle détecte une écriture perdue avant d'être utilisée pour les opérations LMD standard, le chargement de chemin conventionnel SQL*Loader, le chargement de chemin direct et les sauvegardes RMAN.
-
Vous pouvez activer la protection en écriture shadow lost pour des tablespaces et des fichiers de données spécifiques. Vous n'avez pas besoin de suivre toutes les données.
-
Vous pouvez remplacer un tablespace shadow par un autre pour modifier sa configuration ou son emplacement.
-
Vous pouvez suspendre et reprendre la protection en écriture shadow perdue pour un tablespace ou un fichier de données.
-
Vous pouvez l'activer ou la désactiver pour une base de données pluggable avec une instruction
ALTER DATABASE ... LOST WRITE PROTECTIONunique. La tablePROP$indique si le suivi est activé pour une base de données pluggable.
Voir aussi : Référence du langage SQL d'Oracle AI Database pour en savoir plus sur la clause LOST WRITE PROTECTION
Fonctionnement des tablespaces shadow
La protection en écriture perdue nécessite deux tablespaces : un tablespace shadow et un tablespace non shadow dont les blocs sont suivis par le tablespace shadow.
La figure suivante illustre un exemple de scénario. Les fichiers de données des tablespaces TBS1 et TBS2 font l'objet d'un suivi par un tablespace shadow. Seul le fichier de données DBF6 du tablespace TBS3 est suivi par le tablespace shadow.
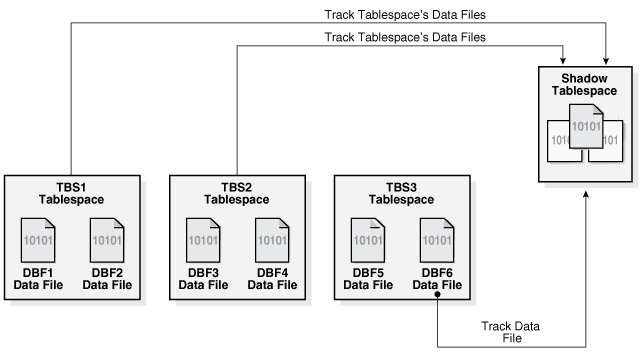
Description de l'image cncpt390.png
Un fichier de données suivi est mis en correspondance avec un extent shadow dans un tablespace shadow. Chaque bloc de données d'un fichier de données suivi a une entrée correspondante dans un bloc shadow. Cette entrée contient le numéro SCN du bloc de données suivi. Lorsqu'un bloc de données suivi est lu à partir du disque, la protection en écriture shadow lost compare le numéro SCN du bloc dans le tablespace shadow au numéro SCN de l'écriture la plus récente dans le bloc de données suivi. Si l'entrée shadow a un SCN supérieur au bloc de données en cours de lecture, une écriture perdue s'est produite, provoquant une erreur.
L'extent shadow est dimensionné avec un espace supplémentaire important pour éviter que le redimensionnement automatique des fichiers de données ne provoque une trop grande taille de l'extent shadow. Si un fichier de données faisant l'objet d'un suivi est redimensionné manuellement ou automatiquement, et si l'étendue shadow doit augmenter, la base de données tente de redimensionner les données de suivi. Si l'espace disponible dans les tablespaces shadow n'est pas suffisant, la base de données écrit un avertissement dans le fichier d'alertes et effectue le suivi du plus grand nombre possible de blocs de données.
Voir aussi : Guide de l'administrateur Oracle AI Database pour apprendre à gérer la protection contre les écritures shadow lost
Interface utilisateur pour les tablespaces shadow
Vous activez et désactivez la protection en écriture shadow lost à l'aide de la commande ALTER PLUGGABLE DATABASE.
Pour protéger un tablespace ou un fichier de données spécifique en cas de perte d'écriture shadow, les conditions suivantes doivent être remplies :
-
Vous devez activer la protection en écriture shadow lost pour l'ensemble de la base de données pluggable à l'aide de l'instruction
ALTER PLUGGABLE DATABASE ENABLE LOST WRITE PROTECTION.Remarque : dans une base de données Conteneur, si vous activez la protection en écriture shadow lost dans la racine, les bases de données pluggables n'en héritent pas. Vous devez activer la protection en écriture shadow lost pour chaque base de données pluggable à protéger.
-
Vous devez avoir activé la protection en écriture shadow lost pour que le tablespace ou le fichier de données soit protégé à l'aide de la clause
ENABLE LOST WRITE PROTECTION.Lorsque vous activez la protection en écriture shadow lost pour un tablespace, tous les fichiers de données du tablespace sont protégés et tous les fichiers de données ajoutés au tablespace sont également protégés. Vous ne pouvez pas activer la protection en écriture perdue sur les tablespaces temporaires ou sur un autre tablespace en écriture perdu.
-
Vous devez avoir créé des tablespaces shadow à l'aide de l'instruction
CREATE BIGFILE TABLESPACEavec la clauseLOST WRITE PROTECTION.
Oracle AI Database affecte automatiquement un fichier de données suivi à un tablespace shadow spécifique. Vous ne pouvez pas indiquer quel tablespace shadow est utilisé pour un fichier de données particulier.
Les vues suivantes du dictionnaire de données surveillent les tablespaces shadow :
-
DBA_TABLESPACESAffiche les tablespaces qui sont des tablespaces shadow via une interrogation.
-
DBA_DATA_FILES.LOST_WRITE_PROTECTIndique si les protections d'écriture perdue sont activées pour un fichier de données
-
USER_TABLESPACES.LOST_WRITE_PROTECTIndique si la protection en écriture perdue est activée pour un tablespace spécifique.
DBA_DATA_FILESn'indique pas si l'écriture perdue est activée pour un tablespace. Vous devez plutôt consulterUSER_TABLESPACES.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer la protection contre les pertes d'écriture avec les tablespaces shadow
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur l'instruction
CREATE TABLESPACE -
Référence Oracle AI Database pour en savoir plus sur
DBA_TABLESPACES
Exemple : configuration de la protection contre les pertes d'écriture
Cet exemple active le suivi des opérations shadow lost write pour un ensemble de tablespaces.
Dans cet exemple, votre objectif est de protéger les tablespaces salestbs et hrtbs au sein d'une base de données pluggable. Vous souhaitez également protéger le fichier de données oetbs01.dbf et uniquement ce fichier de données dans le tablespace oetbs. Pour cela, procédez comme suit :
-
Connectez-vous à la base de données pluggable en tant qu'administrateur.
-
Créez un tablespace shadow unique comme suit :
CREATE BIGFILE TABLESPACE shadow_lwp1 DATAFILE 'shadow_lwp1_df' SIZE 10M LOST WRITE PROTECTION; -
Activez la protection en écriture perdue pour la base de données pluggable comme suit :
ALTER DATABASE ENABLE LOST WRITE PROTECTION; -
Activez la protection en écriture shadow lost pour les tablespaces
salestbsethrtbscomme suit :ALTER TABLESPACE salestbs ENABLE LOST WRITE PROTECTION; ALTER TABLESPACE hrtbs ENABLE LOST WRITE PROTECTION; -
Activez la protection en écriture shadow lost pour le fichier de données
oetbs01.dbfcomme suit :ALTER DATABASE DATAFILE 'oetbs01.dbf' ENABLE LOST WRITE PROTECTION;
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer les tablespaces shadow
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur l'instruction
CREATE TABLESPACE
Tablespaces temporaires
Un tablespace temporaire contient des données transitoires qui persistent uniquement pendant la durée d'une session. Aucun objet de schéma permanent ne peut résider dans un tablespace temporaire. Un fichier temporaire stocke les données de tablespace temporaire.
Les tablespaces temporaires peuvent améliorer la simultanéité de plusieurs opérations de tri qui ne tiennent pas dans la mémoire. Ces tablespaces améliorent également l'efficacité des opérations de gestion de l'espace lors des tris.
-
Tablespaces temporaires partagés et locaux Les tablespaces temporaires sont partagés ou locaux.
-
Tablespaces temporaires par défaut Un tablespace temporaire partagé par défaut est affecté à chaque compte utilisateur de base de données. Si la base de données contient des tablespaces temporaires locaux, un stockage temporaire local par défaut est également affecté à chaque compte utilisateur.
Tablespaces temporaires locaux et partagés
Les tablespaces temporaires sont partagés ou locaux.
Un tablespace temporaire partagé stocke les fichiers temporaires sur un disque partagé afin que l'espace temporaire soit accessible à toutes les instances de base de données. En revanche, un tablespace temporaire local stocke des fichiers temporaires distincts et non partagés pour chaque instance de base de données. Les tablespaces temporaires locaux sont utiles pour Oracle Real Application Clusters ou Oracle Flex Clusters.
Vous pouvez créer des tablespaces temporaires locaux pour les instances de base de données en lecture seule et en lecture/écriture. Lorsque de nombreuses instances en lecture seule accèdent à une seule base de données, les tablespaces temporaires locaux peuvent améliorer les performances des interrogations impliquant des tris, des agrégations de hachage et des jointures. Les avantages sont les suivants :
-
Améliorer les performances d'E/S en utilisant le stockage sur disque local plutôt que partagé
-
Eviter la gestion coûteuse de l'espace temporaire inter-instance
-
Amélioration des performances de démarrage d'instance en éliminant la gestion des métadonnées d'espace sur disque
Le tableau suivant compare les caractéristiques des tablespaces temporaires partagés et locaux.
Tableau 2 Tablespaces temporaires partagés et locaux
| Tablespace temporaire partagé | Tablespace temporaire local |
|---|---|
Créé avec l'instruction CREATE TEMPORARY TABLESPACE. |
Créé avec l'instruction Remarque : un tablespace temporaire local est toujours un tablespace bigfile, mais le mot-clé |
| Crée un tablespace temporaire unique pour la base de données. | Crée des tablespaces temporaires distincts pour chaque instance de base de données. L'option FOR LEAF crée des tablespaces uniquement pour les instances en lecture seule. L'option FOR ALL crée des tablespaces pour toutes les instances, en lecture seule et en lecture/écriture. |
| Prend en charge les groupes de tablespaces. | Ne prend pas en charge les groupes de tablespaces. |
| Stocke les métadonnées du fichier temporaire dans le fichier de contrôle. | Stocke les métadonnées de fichier temporaire communes à toutes les instances du fichier de contrôle et les métadonnées propres à l'instance (par exemple, les bitmaps pour l'allocation, les tailles de fichier temporaire en cours et le statut du fichier) dans la mémoire SGA. |
Voir aussi : "Introduction à l'instance Oracle AI Database"
Tablespaces temporaires par défaut
Un tablespace temporaire partagé par défaut est affecté à chaque compte utilisateur de base de données. Si la base de données contient des tablespaces temporaires locaux, un stockage temporaire local par défaut est également affecté à chaque compte utilisateur.
Vous pouvez indiquer un tablespace temporaire différent pour un compte utilisateur à l'aide des instructions CREATE USER ou ALTER USER. Oracle AI Database utilise le tablespace temporaire par défaut au niveau du système pour les utilisateurs pour lesquels vous n'indiquez pas de tablespace temporaire différent.
-
Création de tablespaces temporaires par défaut Lors de la création d'une base de données, le stockage temporaire par défaut dépend de la gestion locale ou non du tablespace
SYSTEM. -
Accès au stockage temporaire Si un tablespace temporaire est affecté à un utilisateur, la base de données y accède en premier ; sinon, la base de données accède au tablespace temporaire par défaut. Une fois que la base de données a accédé à un tablespace temporaire pour une interrogation, elle ne passe pas à un tablespace différent. Voir aussi : Référence du langage SQL d'Oracle AI Database pour en savoir plus sur l'instruction
CREATE USER
Création de tablespaces temporaires par défaut
Lors de la création d'une base de données, le stockage temporaire par défaut dépend de la gestion locale du tablespace SYSTEM.
Le tableau suivant montre comment Oracle AI Database choisit les tablespaces temporaires par défaut lors de la création de la base de données.
Tableau 3 Création de tablespaces temporaires par défaut
| Le tablespace SYSTEM est-il géré localement ? | L'instruction CREATE DATABASE indique-t-elle un tablespace temporaire par défaut ? | La base de données... |
|---|---|---|
| Oui | Oui | Utilise le tablespace indiqué comme tablespace par défaut. |
| Oui | Non | Crée un tablespace temporaire. |
| Non | Oui | Utilise le tablespace indiqué comme tablespace par défaut. |
| Non | Non | Utilise SYSTEM pour le stockage temporaire par défaut. La base de données écrit un avertissement dans le journal d'alertes indiquant qu'un tablespace temporaire par défaut est recommandé. |
Une fois la base de données créée, vous pouvez modifier le tablespace temporaire par défaut de la base de données à l'aide de l'instruction ALTER DATABASE DEFAULT TEMPORARY TABLESPACE. Remarque : vous ne pouvez pas rendre permanent un tablespace temporaire par défaut.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour découvrir comment créer un tablespace temporaire par défaut
-
Référence de langage SQL Oracle AI Database pour la syntaxe de la clause
DEFAULT TEMPORARY TABLESPACEdeCREATE DATABASEetALTER DATABASE
Accès au stockage temporaire
Si un tablespace temporaire est affecté à un utilisateur, la base de données y accède en premier. Sinon, elle accède au tablespace temporaire par défaut. Une fois que la base de données a accédé à un tablespace temporaire pour une interrogation, elle ne passe pas à un tablespace différent.
Une requête utilisateur peut accéder au stockage temporaire local ou partagé. En outre, un tablespace temporaire local par défaut peut être affecté à un utilisateur pour les instances en lecture seule et un autre tablespace temporaire local par défaut pour les instances en lecture/écriture.
Pour les instances en lecture/écriture, la base de données accorde une priorité plus élevée aux tablespaces temporaires partagés. Pour les instances en lecture seule, la base de données accorde une priorité plus élevée aux tablespaces temporaires locaux. Si l'instance de base de données est en lecture/écriture, la base de données recherche l'espace dans l'ordre suivant :
-
Un tablespace temporaire partagé est-il affecté à l'utilisateur ?
-
Un tablespace temporaire local est-il affecté à l'utilisateur ?
-
Le tablespace temporaire par défaut de la base de données dispose-t-il d'espace ?
Si la réponse à une question précédente est Oui, la base de données arrête la recherche et alloue de l'espace à partir du tablespace indiqué. Sinon, l'espace est alloué à partir du tablespace temporaire local par défaut de la base de données.
Si l'instance de base de données est en lecture seule, la base recherche l'espace dans l'ordre suivant :
-
Un tablespace temporaire local est-il affecté à l'utilisateur ?
-
Le tablespace temporaire local affecté par défaut à la base de données dispose-t-il d'espace ?
-
Un tablespace temporaire partagé est-il affecté à l'utilisateur ?
Si la réponse à l'une des questions précédentes est Oui, la base de données arrête la recherche et alloue de l'espace à partir du tablespace indiqué. Sinon, l'espace est alloué à partir du tablespace temporaire partagé par défaut de la base de données.
Modes de tablespace
Le mode tablespace détermine l'accessibilité du tablespace.
-
Tablespaces en lecture/écriture et en lecture seule Chaque tablespace est en mode écriture qui indique s'il peut être écrit dans.
-
Tablespaces en ligne et hors ligne Un tablespace peut être en ligne (accessible) ou hors ligne (non accessible) chaque fois que la base de données est ouverte.
Tablespaces en lecture/écriture et en lecture seule
Chaque tablespace est en mode écriture qui indique s'il peut être écrit dans.
Les modes mutuellement exclusifs sont les suivants :
-
Mode lecture/écriture
Les utilisateurs disposent d'un droit d'accès en lecture et écriture sur le tablespace. Tous les tablespaces sont initialement créés en lecture/écriture. Les tablespaces
SYSTEMetSYSAUXet les tablespaces temporaires sont en lecture/écriture permanente, ce qui signifie qu'ils ne peuvent pas être définis en lecture seule. -
Mode lecture seule
Les opérations d'écriture dans les fichiers de données du tablespace sont empêchées. Un tablespace en lecture seule peut résider sur un média en lecture seule, tel que des DVD ou des lecteurs WORM.
Les tablespaces en lecture seule éliminent la nécessité de sauvegarder et de récupérer des parties statiques volumineuses d'une base de données. Les tablespaces en lecture seule ne changent pas et ne nécessitent donc pas de sauvegarde répétée. Si vous récupérez une base de données après une défaillance physique, vous n'avez pas besoin de récupérer les tablespaces en lecture seule.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment passer d'un tablespace en mode lecture seule ou lecture/écriture
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
ALTER TABLESPACE -
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour plus d'informations sur la récupération
Tablespaces en ligne et hors connexion
Un tablespace peut être en ligne (accessible) ou hors ligne (non accessible) chaque fois que la base de données est ouverte.
Un tablespace est généralement en ligne (online) de sorte que ses données soient accessibles aux utilisateurs. Le tablespace SYSTEM et les tablespaces temporaires ne peuvent pas être mis hors ligne.
Un tablespace peut être mis hors ligne automatiquement ou manuellement. Par exemple, vous pouvez mettre un tablespace hors ligne à des fins de maintenance ou de sauvegarde et de récupération. La base de données met automatiquement un tablespace hors ligne lorsque certaines erreurs sont détectées, comme lorsque le processus database Writer (DBW) échoue lors de plusieurs tentatives d'écriture dans un fichier de données. Les utilisateurs qui tentent d'accéder aux tables d'un tablespace hors ligne reçoivent une erreur.
Lorsqu'un tablespace est mis hors ligne, la base de données effectue les opérations suivantes :
-
La base de données n'autorise pas les instructions LMD suivantes à référencer des objets dans le tablespace hors ligne. Un tablespace hors ligne ne peut pas être lu ou modifié par un utilitaire autre qu'Oracle AI Database.
-
Les transactions actives avec des instructions terminées qui font référence aux données de ce tablespace ne sont pas affectées au niveau transaction.
-
La base de données enregistre les données d'annulation correspondant aux instructions terminées dans un segment d'annulation différé du tablespace
SYSTEM. Lorsque le tablespace est mis en ligne, la base de données applique les données d'annulation au tablespace, si nécessaire.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour savoir comment modifier la disponibilité des tablespaces
Taille de fichier de tablespace
Un tablespace est soit un tablespace bigfile, soit un tablespace smallfile. Ces tablespaces ne peuvent pas être distingués en termes d'exécution d'instructions SQL qui ne font pas explicitement référence aux fichiers de données ou aux fichiers temporaires.
La différence est la suivante :
-
Un tablespace smallfile peut contenir plusieurs fichiers de données ou fichiers temporaires, mais ces fichiers ne peuvent pas être aussi volumineux que dans un tablespace bigfile. Il s'agit du type de tablespace par défaut.
-
Un tablespace bigfile contient un fichier de données ou un fichier temporaire très volumineux. Ce type de tablespace peut effectuer les opérations suivantes :
-
Augmenter la capacité de stockage d'une base de données
Le nombre maximal de fichiers de données dans une base est limité. Par conséquent, l'augmentation de la taille de chaque fichier augmente le stockage global.
-
Réduire la charge de gestion de nombreux fichiers de données et fichiers temporaires
Les tablespaces bigfile simplifient la gestion des fichiers avec Oracle Managed Files and Automatic Storage Management (Oracle ASM) en éliminant la nécessité d'ajouter de nouveaux fichiers et de traiter plusieurs fichiers.
-
Effectuer des opérations sur des tablespaces plutôt que sur des fichiers individuels
Les tablespaces bigfile font du tablespace l'unité principale de l'administration, de la sauvegarde et de la récupération de l'espace disque, etc.
Les tablespaces bigfile ne sont pris en charge que pour les tablespaces gérés localement avec ASSM. Toutefois, les tablespaces d'annulation gérés localement et les tablespaces temporaires peuvent être des tablespaces bigfile même lorsque les segments sont gérés manuellement.
A partir d'Oracle AI Database 26ai, les tablespaces SYSTEM, SYSAUX et USER sont créés en tant que tablespaces bigfile par défaut. Une base de données mise à niveau à partir d'une version précédente conserve son type de tablespace.
-
Voir aussi :
-
Guide de l'utilisateur Oracle AI Database Backup and Recovery pour en savoir plus sur la sauvegarde et la récupération
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer les tablespaces bigfile