Partitions, vues et autres objets de schéma
Bien que les tables et les index soient les objets de schéma les plus importants et les plus couramment utilisés, la base de données prend en charge de nombreux autres types d'objet de schéma, dont les plus courants sont traités dans ce chapitre.
-
Présentation des partitions Dans une base de données Oracle, le partitionnement vous permet de décomposer des tables et des index très volumineux en éléments plus petits et plus gérables appelés partitions. Chaque partition est un objet indépendant avec son propre nom et éventuellement ses propres caractéristiques de stockage.
-
Présentation des tables distribuées Dans une base de données Oracle, la fonctionnalité Base de données distribuée globale vous permet de diviser n'importe quelle table en éléments appelés shards qui peuvent être stockés dans plusieurs bases de données.
-
Présentation des vues Une vue est une représentation logique d'une ou de plusieurs tables. En substance, une vue est une requête stockée.
-
Présentation des vues matérialisées Une vue matérialisée est un résultat de requête qui a été stocké ou "matérialisé" à l'avance en tant qu'objet de schéma. La clause
FROMde la requête peut nommer des tables, des vues ou des vues matérialisées. -
Présentation des séquences Une séquence est un objet de schéma à partir duquel plusieurs utilisateurs peuvent générer des entiers uniques. Un générateur de séquences fournit une méthode hautement évolutive et performante pour générer des clés de substitution pour un type de données numérique.
-
Présentation des dimensions Un data warehouse classique comporte deux composants importants : les dimensions et les faits.
-
Présentation des synonymes Un synonyme est un alias pour un objet de schéma. Par exemple, vous pouvez créer un synonyme pour une table ou une vue, une séquence, une unité de programme PL/SQL, un type d'objet défini par l'utilisateur ou un autre synonyme. Etant donné qu'un synonyme est un simple alias, il suffit de stocker sa définition dans le dictionnaire de données.
Présentation des partitions
Dans une base de données Oracle, le partitionnement vous permet de décomposer des tables et des index très volumineux en éléments plus petits et plus gérables appelés partitions. Chaque partition est un objet indépendant avec son propre nom et éventuellement ses propres caractéristiques de stockage.
Pour une analogie illustrant le partitionnement, supposons qu'un responsable RH dispose d'une grande boîte contenant les dossiers des salariés. Chaque dossier répertorie la date d'embauche du salarié. Des requêtes sont souvent faites pour les employés embauchés au cours d'un mois donné. Une approche pour satisfaire ces demandes consiste à créer un index à la date d'embauche de l'employé qui spécifie les emplacements des dossiers dispersés dans toute la zone. En revanche, une stratégie de partitionnement utilise de nombreuses boîtes plus petites, chaque boîte contenant des dossiers pour les employés embauchés au cours d'un mois donné.
L'utilisation de petites boîtes présente plusieurs avantages. Lorsqu'il est invité à extraire les dossiers des employés embauchés en juin, le responsable RH peut extraire la case Juin. En outre, si une petite boîte est temporairement endommagée, les autres petites boîtes restent disponibles. Le déménagement des bureaux devient également plus facile car au lieu de déplacer une seule boîte lourde, le gestionnaire peut déplacer plusieurs petites boîtes.
Du point de vue d'une application, un seul objet de schéma existe. Les instructions SQL ne nécessitent aucune modification pour accéder aux tables partitionnées. Le partitionnement est utile pour de nombreux types d'application de base de données, en particulier ceux qui gèrent d'importants volumes de données. Les avantages sont les suivants :
-
Disponibilité accrue
L'indisponibilité de la partition n'implique pas l'indisponibilité de l'objet. L'optimiseur de requête enlève automatiquement les partitions non référencées du plan de requête afin que les requêtes ne soient pas affectées lorsque les partitions ne sont pas disponibles.
-
Administration plus facile des objets de schéma
Un objet partitionné comporte des éléments qui peuvent être gérés collectivement ou individuellement. Les instructions DDL peuvent manipuler des partitions plutôt que des tables ou des index entiers. Par conséquent, vous pouvez répartir des tâches gourmandes en ressources telles que la reconstruction d'un index ou d'une table. Par exemple, vous pouvez déplacer une partition de table à la fois. Si un problème se produit, seul le déplacement de la partition doit être refait, et non le déplacement de la table. En outre, la suppression d'une partition évite d'exécuter de nombreuses instructions
DELETE. -
contention réduite pour les ressources partagées dans les systèmes OLTP
Dans certains systèmes OLTP, les partitions peuvent réduire les contentions pour une ressource partagée. Par exemple, les instructions LMD sont réparties sur plusieurs segments plutôt que sur un seul.
-
Amélioration des performances des requêtes dans les data warehouses
Dans un data warehouse, le partitionnement peut accélérer le traitement des requêtes ad hoc. Par exemple, une table de ventes contenant un million de lignes peut être partitionnée par trimestre.
-
Caractéristiques de partition Chaque partition d'une table ou d'un index doit avoir les mêmes attributs logiques, tels que les noms de colonne, les types de données et les contraintes.
-
Tables partitionnées Une table partitionnée se compose d'une ou plusieurs partitions, qui sont gérées individuellement et peuvent fonctionner indépendamment des autres partitions.
-
Index partitionnés Un index partitionné est un index qui, comme une table partitionnée, a été divisé en éléments plus petits et plus gérables.
-
Index partiels pour les tables partitionnées Un index partiel est un index qui est corrélé aux propriétés d'indexation d'une table partitionnée associée.
-
Utilisation de la banque d'objets pour les partitions plus anciennes Pour les partitions en lecture seule, vous pouvez utiliser le stockage à faible coût, tel que le stockage d'objets dans le cloud. Voir aussi : Oracle AI Database VLDB and Partitioning Guide pour une introduction au partitionnement
Caractéristiques de partition
Chaque partition d'une table ou d'un index doit avoir les mêmes attributs logiques, tels que les noms de colonne, les types de données et les contraintes.
Par exemple, toutes les partitions d'une table partagent les mêmes définitions de colonne et de contrainte. Toutefois, chaque partition peut avoir des attributs physiques distincts, tels que le tablespace auquel elle appartient.
-
Clé de partitionnement La clé de partitionnement est un ensemble de colonnes déterminant la partition dans laquelle chaque ligne d'une table partitionnée doit aller. Chaque ligne est affectée sans ambiguïté à une seule partition.
-
Stratégies de partitionnement Oracle Partitioning propose plusieurs stratégies de partitionnement qui contrôlent la façon dont la base de données place les données dans des partitions. Les stratégies de base sont le partitionnement par plage, par liste et par hachage.
Clé de partitionnement
La clé de partitionnement est un ensemble de colonnes déterminant la partition dans laquelle chaque ligne d'une table partitionnée doit aller. Chaque ligne est affectée sans ambiguïté à une seule partition.
Dans la table sales, vous pouvez indiquer la colonne time_id comme clé d'une partition de plage. La base de données affecte des lignes aux partitions selon que la date de cette colonne se situe dans une plage spécifiée. Oracle AI Database dirige automatiquement les opérations d'insertion, de mise à jour et de suppression vers la partition appropriée à l'aide de la clé de partition.
Stratégies de partitionnement
Oracle Partitioning propose plusieurs stratégies de partitionnement qui contrôlent la façon dont la base de données place les données dans des partitions. Les stratégies de base sont le partitionnement par plage, par liste et par hachage.
Un partitionnement à niveau unique n'utilise qu'une seule méthode de répartition des données, par exemple, le partitionnement par liste ou le partitionnement par plage uniquement. Dans le partitionnement composite, une table est partitionnée par une méthode de distribution de données, puis chaque partition est divisée en sous-partitions à l'aide d'une deuxième méthode de distribution de données. Par exemple, vous pouvez utiliser une partition de liste pour channel_id et une sous-partition de plage pour time_id.
Exemple 6-1 Exemple de jeu de lignes pour une table partitionnée
Cet exemple de partitionnement suppose que vous souhaitez remplir une table partitionnée sales avec les lignes suivantes :
  PROD_ID    CUST_ID TIME_ID   CHANNEL_ID   PROMO_ID QUANTITY_SOLD AMOUNT_SOLD
---------- ---------- --------- ---------- ---------- ------------- -----------
      116      11393 05-JUN-99          2        999             1
12.18
       40     100530 30-NOV-98          9         33             1       44.99
      118        133 06-JUN-01          2        999             1       17.12
      133       9450 01-DEC-00          2        999             1       31.28
       36       4523 27-JAN-99          3        999             1       53.89
      125       9417 04-FEB-98          3        999             1       16.86
       30        170 23-FEB-01          2        999             1         8.8
       24      11899 26-JUN-99          4        999             1       43.04
       35       2606 17-FEB-00          3        999             1       54.94
45 9491 28-AUG-98 4 350 1 47.45-
Partitionnement de plage Dans Partitionnement de plage, la base de données met en correspondance des lignes avec des partitions en fonction de plages de valeurs de la clé de partitionnement. Le partitionnement par plage est le type de partitionnement le plus courant et est souvent utilisé avec des dates.
-
Partitionnement par intervalle
Le partitionnement d'intervalle est une extension du partitionnement par plage.
-
Partitionnement de liste Dans Partitionnement de liste, la base de données utilise une liste de valeurs discrètes comme clé de partition pour chaque partition. La clé de partitionnement se compose d'une ou plusieurs colonnes.
-
Partitionnement de hachage Dans le partitionnement de hachage, la base de données met en correspondance des lignes avec des partitions en fonction d'un algorithme de hachage que la base de données applique à la clé de partitionnement spécifiée par l'utilisateur.
-
Partitionnement de référence Dans le partitionnement de référence, la stratégie de partitionnement d'une table enfant est uniquement définie par la relation de clé étrangère avec une table parent. Pour chaque partition de la table parent, il existe une seule partition correspondante dans la table enfant. La table parent stocke les enregistrements parent dans une partition spécifique et la table enfant stocke les enregistrements enfant dans la partition correspondante.
-
Partitionnement composite Dans le partitionnement composite, une table est partitionnée par une méthode de distribution de données, puis chaque partition est subdivisée en sous-partitions à l'aide d'une deuxième méthode de distribution de données. Par conséquent, le partitionnement composite combine les méthodes de distribution de données de base. Toutes les sous-partitions d'une partition donnée représentent un sous-ensemble logique des données.
Partitionnement par plage
Dans partitionnement de plages, la base de données met en correspondance des lignes avec des partitions en fonction des plages de valeurs de la clé de partitionnement. Le partitionnement par plage est le type de partitionnement le plus courant et est souvent utilisé avec des dates.
Supposons que vous créez time_range_sales en tant que table partitionnée à l'aide de l'instruction SQL suivante, avec la colonne time_id comme clé de partitionnement :
CREATE TABLE time_range_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY RANGE (time_id)
 (PARTITION SALES_1998 VALUES LESS THAN (TO_DATE('01-JAN-1999','DD-MON-YYYY')),
  PARTITION SALES_1999 VALUES LESS THAN (TO_DATE('01-JAN-2000','DD-MON-YYYY')),
  PARTITION SALES_2000 VALUES LESS THAN (TO_DATE('01-JAN-2001','DD-MON-YYYY')),
  PARTITION SALES_2001 VALUES LESS THAN (MAXVALUE)
 );
Ensuite, chargez time_range_sales avec les lignes de l'Example 6-1. Le code affiche les distributions de ligne dans les quatre partitions. La base de données choisit la partition pour chaque ligne en fonction de la valeur time_id en fonction des règles indiquées dans la clause PARTITION BY RANGE. La valeur de clé de partitionnement de plage détermine la limite supérieure non inclusive pour une partition spécifiée.
Partitionnement par intervalle
Le partitionnement d'intervalle est une extension du partitionnement par plage.
Si vous insérez des données qui dépassent les partitions de plage existantes, Oracle AI Database crée automatiquement des partitions de l'intervalle indiqué. Par exemple, vous pouvez créer une table d'historique des ventes qui stocke les données de chaque mois dans une partition distincte.
Les partitions d'intervalle vous permettent d'éviter de créer des partitions de plage de manière explicite. Vous pouvez utiliser le partitionnement par intervalle pour presque toutes les tables partitionnées par plage et utiliser des intervalles fixes pour les nouvelles partitions. Sauf si vous créez des partitions de plage avec des intervalles différents ou si vous définissez toujours des attributs de partition spécifiques, envisagez d'utiliser des partitions d'intervalle.
Lors du partitionnement par intervalle, vous devez spécifier au moins une partition de plage. La valeur de la clé de partitionnement de plage détermine la valeur haute des partitions de plage, appelée point de transition. La base de données crée automatiquement des partitions d'intervalle pour les données dont les valeurs sont au-delà du point de transition. La limite inférieure de chaque partition d'intervalle est la limite supérieure inclusive de la partition d'intervalle ou de la plage précédente. Par conséquent, dans l'Example 6-2, la valeur 01-JAN-2011 se trouve dans la partition p2.
La base de données crée des partitions d'intervalle pour les données au-delà du point de transition. Une partition d'intervalle étend le partitionnement par plage en demandant à la base de données de créer des partitions de la plage ou de l'intervalle spécifié. La base de données crée automatiquement les partitions lorsque les données insérées dans la table dépassent toutes les partitions de plage existantes. Dans l'Exemple 6-2, la partition p3 contient des lignes avec des valeurs de clé de partitionnement time_id supérieures ou égales à 01-JAN-2013.
Exemple 6-2 Partitionnement par intervalle
Supposons que vous créez une table de ventes avec quatre partitions de largeurs variables. Vous indiquez qu'au-dessus du point de transition du 1er janvier 2013, la base de données doit créer des partitions par intervalles d'un mois. La limite supérieure de la partition p3 représente le point de transition. La partition p3 et toutes les partitions en dessous se trouvent dans la section de plage, tandis que toutes les partitions au-dessus se trouvent dans la section d'intervalle.
CREATE TABLE interval_sales
    ( prod_id        NUMBER(6)
    , cust_id        NUMBER
    , time_id        DATE
    , channel_id     CHAR(1)
    , promo_id       NUMBER(6)
    , quantity_sold  NUMBER(3)
    , amount_sold    NUMBER(10,2)
    )
  PARTITION BY RANGE (time_id)
  INTERVAL(NUMTOYMINTERVAL(1, 'MONTH'))
    ( PARTITION p0 VALUES LESS THAN (TO_DATE('1-1-2010', 'DD-MM-YYYY'))
    , PARTITION p1 VALUES LESS THAN (TO_DATE('1-1-2011', 'DD-MM-YYYY'))
    , PARTITION p2 VALUES LESS THAN (TO_DATE('1-7-2012', 'DD-MM-YYYY'))
    , PARTITION p3 VALUES LESS THAN (TO_DATE('1-1-2013', 'DD-MM-YYYY')) );
Vous insérez une vente faite le 10 octobre 2014 :
SQL> INSERT INTO interval_sales VALUES (39,7602,'10-OCT-14',9,null,1,11.79);

1 row created.
Une requête de USER_TAB_PARTITIONS indique que la base de données a créé une nouvelle partition pour la vente du 10 octobre car la date de vente était postérieure au point de transition :
SQL> COL PNAME FORMAT a9
SQL> COL HIGH_VALUE FORMAT a40
SQL> SELECT PARTITION_NAME AS PNAME, HIGH_VALUE
  2  FROM USER_TAB_PARTITIONS WHERE TABLE_NAME = 'INTERVAL_SALES';

PNAME     HIGH_VALUE
--------- ----------------------------------------
P0        TO_DATE(' 2007-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P1        TO_DATE(' 2008-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P2        TO_DATE(' 2009-07-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P3        TO_DATE(' 2010-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
SYS_P1598 TO_DATE(' 2014-11-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
Voir aussi : Oracle AI Database VLDB and Partitioning Guide pour en savoir plus sur les partitions d'intervalle
Partitionnement par liste
Dans le partitionnement de liste, la base de données utilise une liste de valeurs discrètes comme clé de partition pour chaque partition. La clé de partitionnement se compose d'une ou plusieurs colonnes.
Vous pouvez utiliser le partitionnement par liste pour contrôler la façon dont les lignes individuelles sont mappées avec des partitions spécifiques. En utilisant des listes, vous pouvez regrouper et organiser des ensembles de données connexes lorsque la clé utilisée pour les identifier n'est pas ordonnée de manière pratique.
Exemple 6-3 Partitionnement par liste
Supposons que vous créez list_sales en tant que table partitionnée par liste à l'aide de l'instruction suivante, où la colonne channel_id est la clé de partitionnement :
CREATE TABLE list_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY LIST (channel_id)
 ( PARTITION even_channels VALUES ('2','4'),
   PARTITION odd_channels VALUES ('3','9')
 );
Ensuite, chargez la table avec les lignes de l'Example 6-1. Le code indique la répartition des lignes dans les deux partitions. La base de données choisit la partition pour chaque ligne en fonction de la valeur channel_id en fonction des règles indiquées dans la clause PARTITION BY LIST. Les lignes avec une valeur channel_id de 2 ou 4 sont stockées dans les partitions EVEN_CHANNELS, tandis que les lignes avec une valeur channel_id de 3 ou 9 sont stockées dans la partition ODD_CHANNELS.
Partitionnement par hachage
Dans le partitionnement de hachage, la base de données met en correspondance des lignes avec des partitions en fonction d'un algorithme de hachage que la base de données applique à la clé de partitionnement spécifiée par l'utilisateur.
La destination d'une ligne est déterminée par la fonction de hachage interne appliquée à la ligne par la base de données. Lorsque le nombre de partitions est une puissance de 2, l'algorithme de hachage crée une répartition à peu près uniforme des lignes entre toutes les partitions.
Le partitionnement par hachage est utile pour diviser les tables volumineuses afin d'améliorer la facilité de gestion. Au lieu d'une grande table à gérer, vous avez plusieurs petits morceaux. La perte d'une seule partition de hachage n'affecte pas les partitions restantes et peut être récupérée indépendamment. Le partitionnement par hachage est également utile dans les systèmes OLTP avec des conflits de mise à jour élevés. Par exemple, un segment est divisé en plusieurs parties, chacune étant mise à jour, au lieu d'un seul segment faisant l'objet de conflits.
Supposons que vous créez la table hash_sales partitionnée à l'aide de l'instruction suivante, avec la colonne prod_id comme clé de partitionnement :
CREATE TABLE hash_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY HASH (prod_id)
PARTITIONS 2;
Ensuite, chargez la table avec les lignes de l'Example 6-1. Le code indique une distribution de ligne possible dans les deux partitions. Les noms de ces partitions sont générés par le système.
Lorsque vous insérez des lignes, la base de données tente de les répartir de manière aléatoire et uniforme entre les partitions. Vous ne pouvez pas indiquer la partition dans laquelle une ligne est placée. La base de données applique la fonction de hachage, dont le résultat détermine quelle partition contient la ligne.
Voir aussi :
-
Oracle AI Database VLDB and Partitioning Guide pour savoir comment créer des partitions
-
Référence de langage SQL Oracle AI Database pour des exemples
CREATE TABLE ... PARTITION BY
Partitionnement par référence
Dans le partitionnement de référence, la stratégie de partitionnement d'une table enfant est uniquement définie par la relation de clé étrangère avec une table parent. Pour chaque partition de la table parent, il existe une seule partition correspondante dans la table enfant. La table parent stocke les enregistrements parent dans une partition spécifique et la table enfant stocke les enregistrements enfant dans la partition correspondante.
Par exemple, une table orders est le parent de la table line_items, avec une clé primaire et une clé étrangère définies sur order_id. Les tables sont partitionnées par référence. Par exemple, si la base de données stocke la commande 233 dans la partition Q3_2015 de orders, la base de données stocke toutes les lignes de la commande 233 dans la partition Q3_2015 de line_items. Si la partition Q4_2015 est ajoutée à orders, la base de données ajoute automatiquement Q4_2015 à line_items.
Les avantages du partitionnement par référence sont les suivants :
-
En utilisant la même stratégie de partitionnement pour les tables parent et enfant, vous évitez de dupliquer toutes les colonnes de clé de partitionnement. Cette stratégie réduit la surcharge manuelle de la dénormalisation et permet d'économiser de l'espace.
-
Les opérations de maintenance sur une table parent se produisent automatiquement sur la table enfant. Par exemple, lorsque vous ajoutez une partition à la table principale, la base de données propage automatiquement cet ajout à ses descendants.
-
La base de données utilise automatiquement les jointures par partition des partitions de la table parent et de la table enfant, ce qui améliore les performances.
Vous pouvez utiliser le partitionnement de référence avec toutes les stratégies de partitionnement de base, y compris le partitionnement par intervalle. Vous pouvez également créer des tables partitionnées de référence en tant que tables partitionnées composites.
Exemple 6-4 Création de tables partitionnées par référence
Cet exemple crée un ordre de table parent partitionné par plage sur order_date. La table enfant partitionnée par référence order_items est créée avec quatre partitions, Q1_2015, Q2_2015, Q3_2015 et Q4_2015, où chaque partition contient les lignes order_items correspondant aux commandes de la partition parent respective.
CREATE TABLE orders
    ( order_id           NUMBER(12),
      order_date         DATE,
      order_mode         VARCHAR2(8),
      customer_id        NUMBER(6),
      order_status       NUMBER(2),
      order_total        NUMBER(8,2),
      sales_rep_id       NUMBER(6),
      promotion_id       NUMBER(6),
      CONSTRAINT orders_pk PRIMARY KEY(order_id)
    )
  PARTITION BY RANGE(order_date)
    ( PARTITION Q1_2015 VALUES LESS THAN (TO_DATE('01-APR-2015','DD-MON-YYYY')),
      PARTITION Q2_2015 VALUES LESS THAN (TO_DATE('01-JUL-2015','DD-MON-YYYY')),
      PARTITION Q3_2015 VALUES LESS THAN (TO_DATE('01-OCT-2015','DD-MON-YYYY')),
      PARTITION Q4_2015 VALUES LESS THAN (TO_DATE('01-JAN-2006','DD-MON-YYYY'))
    );

CREATE TABLE order_items
    ( order_id           NUMBER(12) NOT NULL,
      line_item_id       NUMBER(3)  NOT NULL,
      product_id         NUMBER(6)  NOT NULL,
      unit_price         NUMBER(8,2),
      quantity           NUMBER(8),
      CONSTRAINT order_items_fk
      FOREIGN KEY(order_id) REFERENCES orders(order_id)
    )
    PARTITION BY REFERENCE(order_items_fk);
Voir aussi : Oracle AI Database VLDB and Partitioning Guide pour une présentation du partitionnement de référence
Partitionnement composite
Dans le partitionnement composite, une table est partitionnée par une méthode de distribution de données, puis chaque partition est subdivisée en sous-partitions à l'aide d'une deuxième méthode de distribution de données. Par conséquent, le partitionnement composite combine les méthodes de distribution de données de base. Toutes les sous-partitions d'une partition donnée représentent un sous-ensemble logique des données.
Le partitionnement composite présente plusieurs avantages :
-
Selon l'instruction SQL, l'élagage des partitions sur une ou deux dimensions peut améliorer les performances.
-
Les requêtes peuvent utiliser des jointures partitionnées complètes ou partielles sur l'une ou l'autre dimension.
-
Vous pouvez effectuer une sauvegarde et une récupération parallèles d'une même table.
-
Le nombre de partitions est supérieur à celui du partitionnement à niveau unique, ce qui peut être bénéfique pour l'exécution en parallèle.
-
Vous pouvez implémenter une fenêtre non simultanée pour prendre en charge les données historiques et partitionner une autre dimension si de nombreuses instructions peuvent bénéficier de l'élagage des partitions ou de jointures au niveau des partitions.
-
Vous pouvez stocker les données différemment en fonction de leur identification par une clé de partitionnement. Par exemple, vous pouvez décider de stocker des données pour un type de produit spécifique dans un format compressé en lecture seule et de ne pas compresser les autres données de type de produit.
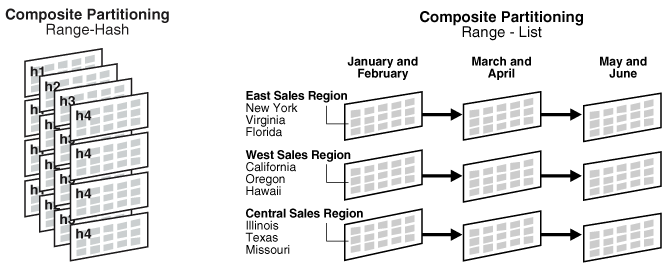
Le partitionnement par plage, liste et hachage est admissible en tant que stratégies de sous-partitionnement pour les tables partitionnées composites. La figure suivante offre une vue graphique du partitionnement composite plage-hachage et plage-liste.
Figure 1 : Partitionnement composite de liste-plage
Description de l'image vldbg009.gif
La base de données stocke chaque sous-partition dans une table partitionnée composite en tant que segment distinct. Par conséquent, les propriétés de sous-partition peuvent différer des propriétés de la table ou de la partition à laquelle appartiennent les sous-partitions.
Voir aussi : Oracle AI Database VLDB and Partitioning Guide pour en savoir plus sur le partitionnement composite
Tables partitionnées
Une table partitionnée se compose d'une ou plusieurs partitions, qui sont gérées individuellement et peuvent fonctionner indépendamment des autres partitions.
Une table est partitionnée ou non. Même si une table partitionnée se compose d'une seule partition, cette table est différente d'une table non partitionnée, qui ne peut pas y ajouter de partitions.
-
Segments pour les tables partitionnées Une table partitionnée est composée d'un ou plusieurs segments de partition de table.
-
Compression pour les tables partitionnées Certaines ou toutes les partitions d'une table organisée en portions de mémoire peuvent être stockées dans un format compressé.
Voir aussi :
"Partition Characteristics" pour des exemples de tables partitionnées
"Présentation des tables organisées en index" pour en savoir plus sur l'objectif et les caractéristiques des tables organisées en index, qui peuvent également bénéficier d'un partitionnement qui offre une facilité de gestion, une disponibilité et des performances améliorées.
Segments pour les tables partitionnées
Une table partitionnée est composée d'un ou plusieurs segments de partition de table.
Si vous créez une table partitionnée nommée hash_products, aucune table segment n'est allouée à cette table. A la place, la base de données stocke les données de chaque partition de table dans son propre segment de partition. Chaque segment de partition de table contient une partie des données de la table.
Lorsqu'une table externe est partitionnée, toutes les partitions résident en dehors de la base de données. Dans une table partitionnée hybride, certaines partitions sont stockées dans des segments, tandis que d'autres sont stockées en externe. Par exemple, certaines partitions de la table sales peuvent être stockées dans des fichiers de données et d'autres dans des feuilles de calcul.
Voir aussi :
pour en savoir plus sur la relation entre les objets et les segments
Compression pour les tables partitionnées
Certaines ou toutes les partitions d'une table organisée en portions de mémoire peuvent être stockées dans un format compressé.
La compression permet d'économiser de l'espace et d'accélérer l'exécution des requêtes. Pour cette raison, la compression peut s'avérer utile dans des environnements tels que les data warehouses, où la quantité d'opérations d'insertion et d'actualisation est faible, et dans des environnements OLTP.
Vous pouvez déclarer les attributs de compression de table pour un tablespace, une table ou une partition de table. Si elles sont déclarées au niveau du tablespace, les tables créées dans le tablespace sont compressées par défaut. Vous pouvez modifier l'attribut de compression d'une table, auquel cas la modification s'applique uniquement aux nouvelles données entrant sur cette table. Par conséquent, une table ou une partition unique peut contenir des blocs compressés et non compressés, ce qui garantit que la taille des données n'augmentera pas en raison de la compression. Si la compression peut augmenter la taille d'un bloc, la base de données ne l'applique pas au bloc.
Voir aussi :
-
"Compression de table" pour en savoir plus sur les types de compression de table, notamment la compression de ligne de base, avancée et hybride en colonnes
-
Guide de l'entreposage de données Oracle AI Database pour en savoir plus sur la compression de table dans un data warehouse
Index partitionnés
Un index partitionné est un index qui, comme une table partitionnée, a été divisé en éléments plus petits et plus gérables.
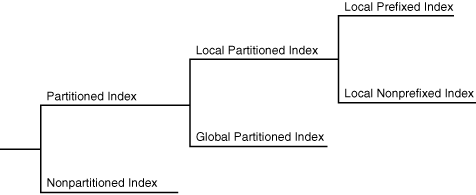
Les index globaux sont partitionnés indépendamment de la table sur laquelle ils sont créés, tandis que les index locaux sont automatiquement liés à la méthode de partitionnement d'une table. Comme les tables partitionnées, les index partitionnés améliorent la gabilité, la disponibilité, les performances et l'évolutivité.
Le graphique suivant présente les options de partitionnement d'index.
Figure 2 : Options de partitionnement d'index
Description de l'image cncpt301.gif
-
Index partitionnés locaux Dans un index partitionné local, l'index est partitionné sur les mêmes colonnes, avec le même nombre de partitions et les mêmes limites de partition que sa table.
-
Index partitionnés globaux Un index partitionné global est un index B-tree qui est partitionné indépendamment de la table sous-jacente sur laquelle il est créé. Une partition d'index unique peut pointer vers n'importe quelle ou toutes les partitions de table, tandis que dans un index partitionné localement, il existe une parité un à un entre les partitions d'index et les partitions de table.
Voir aussi :
-
"Introduction aux index" pour en savoir plus sur la différence entre les index uniques et non uniques et les différents types d'index
-
Oracle AI Database VLDB and Partitioning Guide, pour plus d'informations sur les index partitionnés et sur la manière de décider du type à utiliser
Index partitionnés locaux
Dans un index partitionné local, l'index est partitionné par section dans les mêmes colonnes, qu'il dispose du même nombre de partitions et de mêmes bornes de partition que sa table (partitionnement identique ou équipé).
Chaque partition d'index est associée à une seule partition de la table sous-jacente, de sorte que toutes les clés d'une partition d'index ne font référence qu'aux lignes stockées dans une partition à table unique. Ainsi, la base de données synchronise automatiquement les partitions d'index avec les partitions de table associées, ce qui rend chaque paire table-index indépendante.
Les index partitionnés locaux sont courants dans les environnements de data warehouse. Les index locaux offrent les avantages suivants :
-
La disponibilité est augmentée car les actions qui rendent les données non valides ou indisponibles dans une partition affectent uniquement cette partition.
-
La maintenance des partitions est simplifiée. Lors du déplacement d'une partition de table ou lorsque les données sont retirées d'une partition, seule la partition d'index local associée doit être reconstruite ou gérée. Dans un index global, toutes les partitions d'index doivent être reconstruites ou gérées.
-
Si une récupération jusqu'à un point dans le temps d'une partition se produit, les index peuvent être récupérés jusqu'au moment de la récupération (reportez-vous au Guide de l'utilisateur Oracle AI Database Backup and Recovery). L'index entier n'a pas besoin d'être reconstruit.
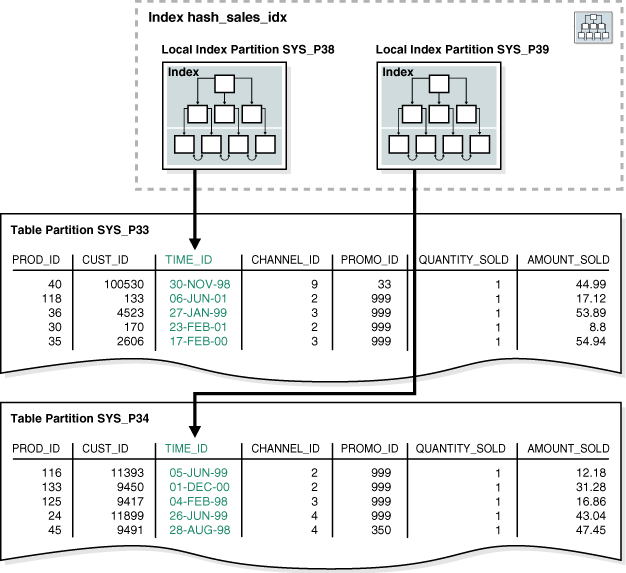
L'exemple de la section Hash Partitioning montre l'instruction de création de la table hash_sales partitionnée, en utilisant la colonne prod_id comme clé de partitionnement. L'exemple suivant crée un index partitionné local sur la colonne time_id de la table hash_sales :
CREATE INDEX hash_sales_idx ON hash_sales(time_id) LOCAL;Dans la Figure 6-3, la table hash_products comporte deux partitions, de sorte que hash_sales_idx en comporte deux. Chaque partition d'index est associée à une partition de table différente. La partition d'index SYS_P38 indexe les lignes de la partition de table SYS_P33, tandis que la partition d'index SYS_P39 indexe les lignes de la partition de table SYS_P34.
Figure 3 : Partitions d'index local
Description de l'image cncpt302.gif
Vous ne pouvez pas ajouter explicitement une partition à un index local. A la place, les nouvelles partitions sont ajoutées aux index locaux uniquement lorsque vous ajoutez une partition à la table sous-jacente. De même, vous ne pouvez pas supprimer explicitement une partition d'un index local. Au lieu de cela, les partitions d'index local sont supprimées uniquement lorsque vous supprimez une partition de la table sous-jacente.
Comme les autres index, vous pouvez créer un index bitmap sur des tables partitionnées. La seule restriction est que les index bitmap doivent être locaux pour la table partitionnée. Ils ne peuvent pas être des index globaux. Les index bitmap globaux sont pris en charge uniquement sur les tables non partitionnées.
-
Index avec préfixe local et index sans préfixe Les index avec partitionnement local sont préfixés ou non.
-
Stockage d'index partitionné local Comme une partition de table, une partition d'index local est stockée dans son propre segment. Chaque segment contient une partie des données d'index totales. Ainsi, un index local composé de quatre partitions n'est pas stocké dans un seul segment d'index, mais dans quatre segments distincts.
Index locaux préfixés et non préfixés
Les index partitionnés locaux sont préfixés ou non préfixés.
Les sous-types d'index sont définis comme suit :
-
Index préfixés locaux
Dans ce cas, les clés de partition se trouvent sur le bord d'attaque de la définition d'index. Dans l'exemple
time_range_salesdans Range Partitioning, la table est partitionnée par plage surtime_id. Un index préfixé local sur cette table auraittime_idcomme première colonne de sa liste. -
Index locaux non préfixés
Dans ce cas, les clés de partition ne se trouvent pas sur le bord d'attaque de la liste de colonnes indexées et ne doivent pas nécessairement figurer dans la liste. Dans l'exemple
hash_sales_idxde la section Local Partitioned Indexes, l'index n'est pas un préfixe local car la clé de partitionnementproduct_idn'est pas sur le bord d'attaque.
Les deux types d'index peuvent tirer parti de l'élimination de la partition (également appelée élagage de la partition), qui se produit lorsque l'optimiseur accélère l'accès aux données en excluant les partitions de la prise en compte. La possibilité pour une requête d'éliminer des partitions dépend du prédicat de la requête. Une requête qui utilise un index local préfixé permet toujours l'élimination des partitions d'index, alors qu'une requête qui utilise un index local non préfixé peut ne pas le faire.
Voir aussi : Oracle AI Database VLDB and Partitioning Guide pour apprendre à utiliser les index préfixés et non préfixés
Stockage d'index partitionné local
Comme une partition de table, une partition d'index local est stockée dans son propre segment. Chaque segment contient une partie des données d'index totales. Ainsi, un index local composé de quatre partitions n'est pas stocké dans un seul segment d'index, mais dans quatre segments distincts.
Voir aussi : Référence de langage SQL Oracle AI Database pour des exemples CREATE INDEX ... LOCAL
Index partitionnés globaux
Un index partitionné global est un index B-tree qui est partitionné indépendamment de la table sous-jacente sur laquelle il est créé. Une partition d'index unique peut pointer vers n'importe quelle ou toutes les partitions de table, tandis que dans un index partitionné localement, il existe une parité un à un entre les partitions d'index et les partitions de table.
En général, les index globaux sont utiles pour les applications OLTP, où l'accès rapide, l'intégrité des données et la disponibilité sont importants. Dans un système OLTP, une table peut être partitionnée par une clé, par exemple la colonne employees.department_id, mais une application peut avoir besoin d'accéder aux données avec de nombreuses clés différentes, par exemple, par employee_id ou job_id. Les index globaux peuvent être utiles dans ce scénario.
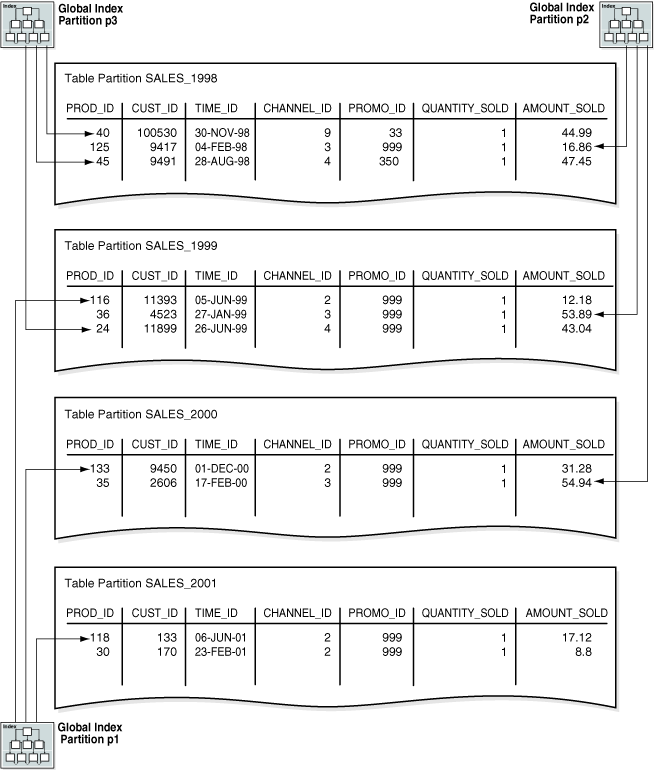
Par exemple, supposons que vous créiez un index partitionné global sur la table time_range_sales à partir de "Range Partitioning". Dans ce tableau, les lignes pour les ventes de 1998 sont stockées dans une partition, les lignes pour les ventes de 1999 dans une autre, etc. L'exemple suivant crée un index global partitionné par plage sur la colonne channel_id :
CREATE INDEX time_channel_sales_idx ON time_range_sales (channel_id)
   GLOBAL PARTITION BY RANGE (channel_id)
      (PARTITION p1 VALUES LESS THAN (3),
       PARTITION p2 VALUES LESS THAN (4),
       PARTITION p3 VALUES LESS THAN (MAXVALUE));
Comme illustré dans la Figure 6-4, une partition d'index global peut contenir des entrées qui pointent vers plusieurs partitions de table. La partition d'index p1 pointe vers les lignes avec une valeur channel_id de 2, la partition d'index p2 pointe vers les lignes avec une valeur channel_id de 3 et la partition d'index p3 pointe vers les lignes avec une valeur channel_id de 4 ou 9.
Figure 4 : Index partitionné global
Description de l'image cncpt300.gif
Voir aussi :
-
Oracle AI Database VLDB and Partitioning Guide pour apprendre à gérer les index partitionnés globaux
-
Référence de langage SQL Oracle AI Database pour en savoir plus sur la clause
GLOBAL PARTITIONdeCREATE INDEX
Index partiels pour les tables partitionnées
Un index partiel est un index qui est corrélé aux propriétés d'indexation d'une table partitionnée associée.
La corrélation vous permet d'indiquer les partitions de table indexées. Les index partiels présentent les avantages suivants :
-
Les partitions de table qui ne sont pas indexées évitent d'utiliser un espace de stockage d'index inutile.
-
Les performances des charges et des requêtes peuvent s'améliorer.
Avant Oracle Database 12c, une opération de partitionnement d'échange nécessitait une mise à jour physique d'un index global associé pour le conserver comme utilisable. A partir d'Oracle Database 12c, si les partitions impliquées dans une opération de maintenance de partition ne font pas partie d'un index global partiel, l'index reste utilisable sans nécessiter de maintenance d'index global.
-
Si vous indexez uniquement certaines partitions de table lors de la création de l'index et si vous indexez ultérieurement d'autres partitions, vous pouvez réduire l'espace de tri requis par la création de l'index.
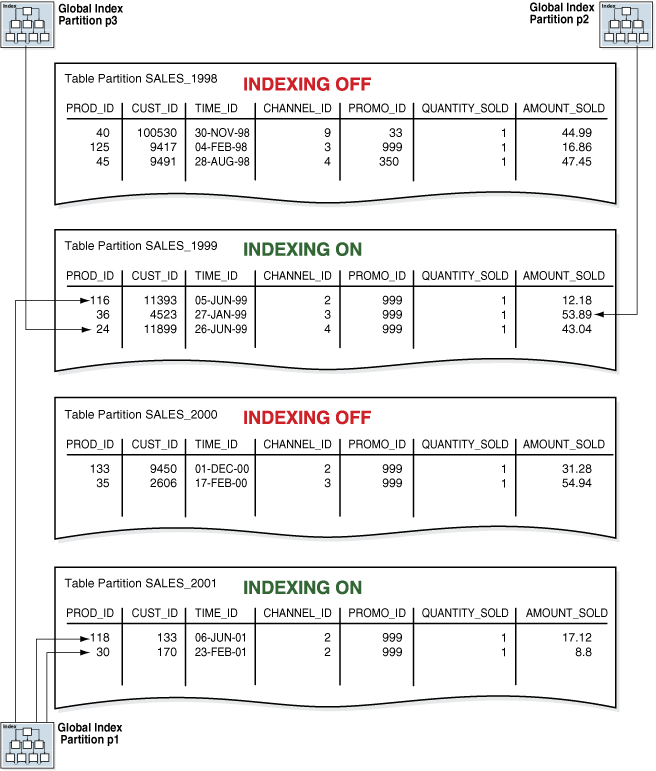
Vous pouvez activer ou désactiver l'indexation pour les partitions individuelles d'une table. Un index local partiel ne dispose pas de partitions d'index utilisables pour toutes les partitions de table dont l'indexation est désactivée. Un index global, qu'il soit partitionné ou non, exclut les données de toutes les partitions pour lesquelles l'indexation est désactivée. La base de données ne prend pas en charge les index partiels pour les index qui appliquent des contraintes uniques. La figure 6-5 présente le même index global que dans la figure 6-4, à ceci près que l'index global est partiel. La propriété d'indexation des partitions de table SALES_1998 et SALES_2000 est définie sur OFF, de sorte que l'index global partiel ne les indexe pas.
Figure 5 : Index partitionné global partiel
Description de l'image cncpt342.png
Utilisation de la banque d'objets pour les partitions plus anciennes
Pour les partitions en lecture seule, vous pouvez utiliser un stockage à faible coût, tel que le stockage d'objets dans le cloud.
Les volumes de données ont énormément augmenté au cours de la dernière décennie. En outre, les réglementations et les politiques gouvernementales ont imposé la conservation des données pendant de très longues périodes dans de nombreux cas. Les clients des bases de données Oracle utilisent diverses stratégies de gestion des données pour les bases de données très volumineuses. Les clients ont les objectifs principaux suivants qu'ils essaient de satisfaire.
Stocker de grandes quantités de données au coût le plus bas possible Pour répondre aux nouvelles exigences réglementaires en matière de conservation et de protection des données Pour améliorer les opportunités commerciales par une meilleure analyse basée sur une quantité accrue de données.
Les clients sur site disposent de différentes solutions pour atteindre les objectifs ci-dessus. Oracle AI Database vous fournit désormais cette fonctionnalité qui vous permet de développer des stratégies de gestion des données similaires pour vos bases de données cloud en tirant parti de niveaux de stockage à faible coût tels que le stockage d'objets dans le cloud.
Les clients de bases de données Oracle ont mis au point diverses stratégies de gestion des données à mesure que leurs ensembles de données évoluaient et se développaient. Toutes ces stratégies relèvent de la gestion du cycle de vie de l'information (ILM). Certaines des fonctionnalités de base de données qui aident à implémenter une solution ILM incluent le partitionnement des données, la compression avancée des lignes, la compression hybride des colonnes, l'optimisation automatique des données, etc.
L'un des aspects d'une solution ILM est la définition d'un niveau de stockage à faible coût. Cela vous permet de conserver de grandes quantités de données pour le coût le plus faible possible. La stratégie ILM d'Oracle permet une compression et un déplacement automatiques des données vers un niveau de stockage moins coûteux. Les clients de base de données Oracle sur site utilisent les solutions de stockage Oracle telles qu'Oracle ZFS Storage Appliance ou Oracle Exadata Extended (XT) Storage Server comme une option de stockage à faible coût pour les données rarement consultées, anciennes ou réglementaires. Vous pouvez également choisir des options de stockage à faible coût similaires auprès de fournisseurs tiers.
L'utilisation de la banque d'objets vous permet de :
-
Stockez les anciennes partitions et les tablespaces en lecture seule dans le stockage d'objets.
-
Interrogez les données des fichiers Object Storage en ligne.
-
Empêcher l'accès non autorisé aux fichiers de stockage d'objets appartenant à une base de données pluggable à partir d'une autre base de données pluggable.
-
Déplacez les données de la banque d'objets vers le stockage standard dans le rare cas où vous souhaitez apporter des modifications aux données en lecture seule.
-
Supprimez les tablespaces contenant des fichiers de données dans la banque d'objets.
-
Déplacement de partitions plus anciennes et de tablespaces en lecture seule vers la banque d'objets Vous pouvez créer une stratégie de partitionnement basée sur le temps et déplacer les fichiers de données d'un tablespace en lecture seule vers un niveau de stockage à moindre coût tel que le stockage d'objets.
-
Accès aux objets dans Object Storage L'accès aux données des tables et des partitions dans le stockage d'objets sera totalement transparent pour les utilisateurs et les clients SQL.
-
Gestion des informations d'identification pour les fichiers de banque d'objets L'accès aux fichiers dans le stockage d'objets nécessite des informations d'identification.
-
Déplacement des fichiers de données d'Object Storage vers le stockage traditionnel Si les données de banque d'objets doivent être mises à jour, elles doivent d'abord être déplacées vers le stockage traditionnel.
-
Suppression de fichiers de données de banque d'objets Vous pouvez supprimer des tablespaces avec des fichiers de données à l'aide de la commande
DROP TABLESPACEstandard.
Déplacement de partitions plus anciennes et de tablespaces en lecture seule vers la banque d'objets
Vous pouvez créer une stratégie de partitionnement basée sur le temps et déplacer les fichiers de données d'un tablespace en lecture seule vers un niveau de stockage moins coûteux, tel que le stockage d'objets.
Supposons que vous ayez une table appelée "orders" qui est partitionnée par plage sur la colonne DATE. Chaque partition contient des lignes pour une année donnée et des partitions existent pour 2022 et 2023. A l'approche d'une nouvelle année, l'administrateur de base de données décide d'ajouter une nouvelle partition pour l'année 2024. En même temps, l'administrateur de base de données décide de déplacer la partition la plus ancienne vers un niveau de stockage à faible coût.
L'exemple de workflow ci-dessous représente un scénario dans lequel l'espace de table comporte une seule partition pour une seule table. Ce n'est pas une restriction. Le tablespace en lecture seule peut comporter des partitions pour une ou plusieurs tables. Vous avez également la possibilité de rendre la partition en lecture seule, en plus de rendre le tablespace en lecture seule. Il est recommandé de définir le tablespace en lecture seule et d'attendre une certaine durée bien définie avant de déplacer les fichiers dans la banque d'objets. Ainsi, toute tentative de mise à jour des données en lecture seule est interceptée et une erreur est renvoyée. Il est beaucoup plus rapide de déplacer les données en mutation vers un autre tablespace alors que les données se trouvent toujours dans Exadata ou dans un autre stockage traditionnel. La copie de ces données à partir du stockage d'objets sera beaucoup plus lente.
create tablespace orders_2022 DATAFILE '+DATA_DG/orders_2022.dbf' size 100g;
create tablespace orders_2023 DATAFILE '+DATA_DG/orders_2023.dbf' size 100g;

create table orders
( prod_id         NUMBER NOT NULL,
  time_id         DATE NOT NULL,
  quantity_sold   NUMBER(10,2) NOT NULL,
  amount_sold     NUMBER(10,2) NOT NULL)
    partition by range (time_id)
    ( partition orders_2022 VALUES LESS THAN (TO_DATE('2023-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2022,
      partition orders_2023 VALUES LESS THAN (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2023)
  ENABLE ROW MOVEMENT;

create tablespace orders_2024 DATAFILE '+DATA_DG/orders_2024.dbf' size 100g;

alter table orders
  ADD partition orders_2024
  values less than (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
  TABLESPACE orders_2024;

alter tablespace orders_2022 read only;

alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database
  move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
Accès aux objets dans Object Storage
L'accès aux données des tables et des partitions dans le stockage d'objets sera totalement transparent pour les utilisateurs et les clients SQL.
Le sous-système d'entrée/sortie de la base de données interroge et traite en interne les blocs à partir des fichiers stockés dans le stockage d'objets. L'instruction SQL suivante interrogera les lignes de la partition en lecture seule orders_2022 qui a été déplacée vers le stockage d'objets dans l'exemple précédent.
select prod_id
from   orders
where  time_id < TO_DATE('2020-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN');
Les index existants, globaux et locaux, fonctionnent de manière transparente. L'interrogation des données de compression en colonnes hybrides et des données cryptées TDE fonctionne de manière transparente et du point de vue du client.
Gestion des informations d'identification pour les fichiers de banque d'objets
L'accès aux fichiers dans le stockage d'objets nécessite des informations d'identification.
Les informations d'identification sont des objets de base de données qui stockent un nom utilisateur et un mot de passe. Les données d'identification sont cryptées et stockées en toute sécurité dans le schéma de base de données pluggable dans lequel elles sont créées.
Lorsque vous envisagez de déplacer des fichiers de données vers le stockage d'objets, vous devez définir des informations d'identification par défaut. Ces informations d'identification par défaut permettent d'accéder aux fichiers de données dans le stockage d'objets.
Choisissez les informations d'identification par défaut avec les privilèges minimum nécessaires. Une fois que les informations d'identification par défaut permettent d'accéder à la banque d'objets, l'authentification et l'autorisation de base de données standard déterminent les utilisateurs de base de données qui peuvent interroger ces fichiers de données ou les utiliser.
alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
Déplacement des fichiers de données d'Object Storage vers le stockage traditionnel
Si les données de la banque d'objets doivent être mises à jour, elles doivent d'abord être déplacées vers le stockage traditionnel.
Dans les rares cas où vous devez modifier les données en lecture seule qui se trouvent déjà dans le stockage d'objets, la seule option consiste à déplacer les données du stockage d'objets vers le stockage traditionnel. Le workflow suivant montre comment déplacer le fichier de données de la banque d'objets vers le système de fichiers ASM. La copie d'un fichier à partir du stockage d'objets aura des conséquences sur les performances.
alter database move datafile
  'https://objectstorage.example.com/oracle/orders_2022.dbf' to
  '+DATA_DG/orders_2022.dbf';

alter tablespace orders_2022 read write;
Suppression des fichiers de données de banque d'objets
Vous pouvez supprimer des tablespaces avec des fichiers de données à l'aide de la commande standard DROP TABLESPACE.
La clause AND DATAFILES permet de supprimer les fichiers de données du stockage back-end. Les fichiers seront supprimés de la banque d'objets. Si le fichier de banque d'objets comporte plusieurs blocs dans la banque d'objets, tous les blocs sont supprimés ainsi que le manifeste.
drop tablespace orders_2022 including contents and datafiles;Présentation des tables distribuées
Dans une base de données Oracle, la fonctionnalité Globally Distributed Database vous permet de diviser n'importe quelle table en éléments appelés shards qui peuvent être stockés dans plusieurs bases de données.
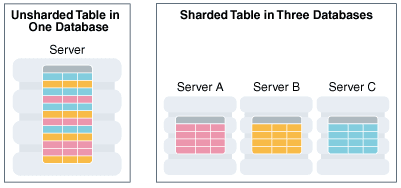
Le partitionnement horizontal implique le fractionnement d'une table de base de données entre les shards afin que chaque shard contienne la table avec les mêmes colonnes mais un sous-ensemble de lignes différent. Une table ainsi fractionnée est également appelée table distribuée.
La figure suivante illustre une table partitionnée horizontalement sur trois shards.
Figure 6 : Partitionnement horizontal d'une table sur plusieurs shards
Description de l'illustration admin_3v_134a.png
- Tables distribuées Une table de base de données est répartie entre les shards, de sorte que chaque shard contient la table avec les mêmes colonnes, mais un sous-ensemble de lignes différent. Une table ainsi fractionnée est appelée table distribuée. Voir aussi : Oracle Globally Distributed AI Database
Tables distribuées
Une table de base de données est divisée entre les shards, de sorte que chaque shard contient la table avec les mêmes colonnes, mais un sous-ensemble de lignes différent. Une table ainsi fractionnée est appelée table distribuée.
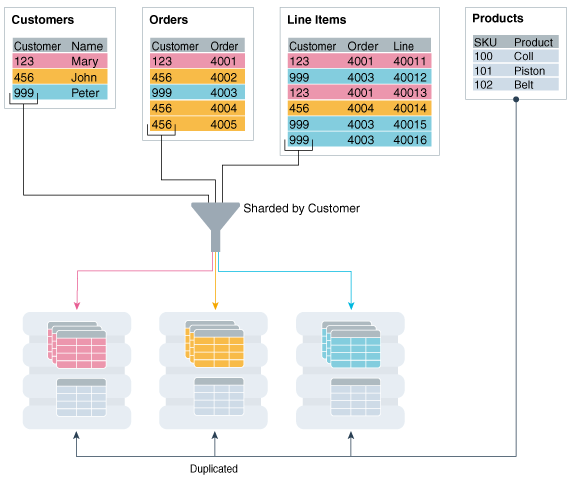
La figure suivante montre comment un ensemble de tables (appelé famille de tables) peut être partitionné horizontalement sur un ensemble de bases de données pluggables de shard, de sorte que chaque shard contient un sous-ensemble de données, indiqué par des lignes rouges, jaunes et bleues.
Figure 7 : Partitionnement horizontal d'une table sur plusieurs shards
Description de l'illustration admin_3v_138e.png
Les partitions sont réparties entre les shards au niveau du tablespace, en fonction d'une clé de sharding. Exemples de clés : code client, numéro de compte et code pays.
Chaque partition d'une table distribuée réside dans un tablespace distinct et chaque tablespace est associé à un shard spécifique. Selon la méthode de sharding, l'association peut être établie automatiquement ou définie par l'administrateur.
Même si les partitions d'une table distribuée résident dans plusieurs shards, pour l'application, la table ressemble et se comporte exactement de la même manière qu'une table partitionnée dans une seule base de données. Les instructions SQL émises par une application ne doivent jamais faire référence à des shards ni dépendre du nombre de shards et de leur configuration.
La syntaxe SQL courante pour le partitionnement de table indique comment les lignes doivent être partitionnées entre les shards. Par exemple, l'instruction SQL suivante crée une table distribuée, en partitionnant horizontalement la table entre les shards en fonction de la clé de sharding cust_id.
CREATE SHARDED TABLE customers
( cust_id     NUMBER NOT NULL,
  name        VARCHAR2(50),
  address     VARCHAR2(250),
  region      VARCHAR2(20),
  class       VARCHAR2(3),
  signup      DATE,
  CONSTRAINT cust_pk PRIMARY KEY(cust_id)
)
PARTITION BY CONSISTENT HASH (cust_id)
PARTITIONS AUTO
TABLESPACE SET ts1;
Dans l'exemple ci-dessus, la table distribuée est partitionnée par hachage cohérent, un type spécial de partitionnement par hachage couramment utilisé dans les systèmes distribués évolutifs. Cette technique répartit automatiquement les tablespaces entre les shards pour assurer une répartition uniforme des données et de la charge globale. Remarque : les index globaux sur les tables distribuées ne sont pas pris en charge, mais les index locaux sont pris en charge.
Généralités sur les vues
Une vue est une représentation logique d'une ou de plusieurs tables. En substance, une vue est une requête stockée.
Une vue tire ses données des tables sur lesquelles elle est basée, appelées tables de base. Les tables de base peuvent être des tables ou d'autres vues. Toutes les opérations effectuées sur une vue ont en fait une incidence dans les tables d'origine. Vous pouvez utiliser des vues dans la plupart des endroits où les tables sont utilisées.
Remarque : Les vues matérialisées utilisent une structure de données différente des vues standard.
Les vues permettent d'adapter la présentation des données aux différents types d'utilisateur. Les vues sont souvent utilisées pour :
-
fournir un niveau de Sécurité supplémentaire pour les tableaux en limitant l'accès à un ensemble prédéfini de lignes ou de colonnes d'une table
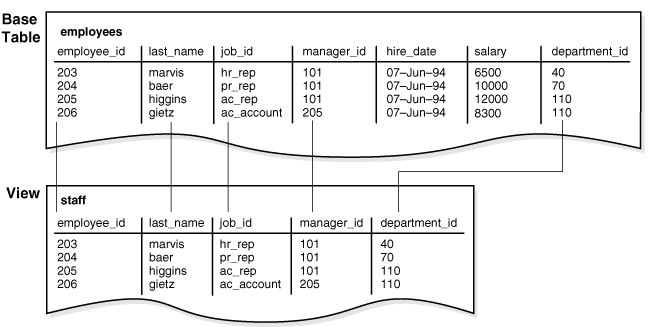
Par exemple, la figure 6-8 montre comment la vue
staffn'affiche pas les colonnessalaryoucommission_pctde la table de baseemployees. -
Masquer la complexité des données
Par exemple, une vue unique peut être définie avec une jointure, qui est un ensemble de colonnes ou de lignes associées dans plusieurs tables. Toutefois, la vue masque le fait que ces informations proviennent de plusieurs tables. Une requête peut également effectuer des calculs approfondis avec des informations de table. Ainsi, les utilisateurs peuvent interroger une vue sans savoir comment effectuer une jointure ou des calculs.
-
présenter les données sous une perspective différente de celle de la table
Par exemple, les colonnes d'une vue peuvent être renommées sans affecter les tables sur lesquelles la vue est basée.
-
Isoler les applications des modifications apportées aux définitions de tables de base
Par exemple, si la requête de définition d'une vue référence trois colonnes d'une table à quatre colonnes et qu'une cinquième colonne est ajoutée à la table, la définition de la vue n'est pas affectée et toutes les applications qui l'utilisent ne le sont pas.
Pour un exemple d'utilisation des vues, considérez la table hr.employees, qui comporte plusieurs colonnes et de nombreuses lignes. Pour permettre aux utilisateurs d'afficher seulement cinq de ces colonnes ou seulement des lignes spécifiques, vous pouvez créer une vue comme suit :
CREATE VIEW staff AS
  SELECT employee_id, last_name, job_id, manager_id, department_id
  FROM   employees;
Comme pour toutes les sous-interrogations, la requête qui définit une vue ne peut pas contenir la clause FOR UPDATE. Le graphique suivant illustre la vue nommée staff. Notez que la vue n'affiche que cinq des colonnes de la table de base.
Figure 8 : Affichage
Description de l'image cncpt045.gif
-
Caractéristiques des vues Contrairement à une table, une vue n'a pas d'espace de stockage alloué et ne contient pas de données. Une vue est plutôt définie par une interrogation qui extrait ou dérive des données des tables de base référencées par la vue. Etant donné qu'une vue est basée sur d'autres objets, elle ne nécessite aucun stockage autre que celui de l'interrogation qui définit la vue dans le dictionnaire de données.
-
Vues de jointure pouvant être mises à jour Une vue de jointure comporte plusieurs tables ou vues dans sa clause
FROM. -
Vues d'objet Tout comme une vue est une table virtuelle, une vue d'objet est une table d'objet virtuel. Chaque ligne de la vue est un objet, qui est une instance d'un type d'objet. Un type d'objet est un type de données défini par l'utilisateur.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer les vues
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
CREATE VIEW
Caractéristiques des vues
Contrairement à une table, une vue n'a pas d'espace de stockage alloué et ne contient pas de données. Une vue est plutôt définie par une interrogation qui extrait ou dérive des données des tables de base référencées par la vue. Etant donné qu'une vue est basée sur d'autres objets, elle ne nécessite aucun stockage autre que celui de l'interrogation qui définit la vue dans le dictionnaire de données.
Une vue a des dépendances sur ses objets référencés, qui sont automatiquement gérés par la base de données. Par exemple, si vous supprimez et recréez une table de base d'une vue, la base de données détermine si la nouvelle table de base est acceptable pour la définition de la vue.
-
Manipulation des données dans les vues Les vues étant dérivées de tables, elles présentent de nombreuses similitudes. Les utilisateurs peuvent interroger des vues et, avec certaines restrictions, effectuer des opérations LMD sur les vues. Les opérations effectuées sur une vue affectent les données de certaines tables de base de la vue et sont soumises aux contraintes d'intégrité et aux déclencheurs des tables de base.
-
Accès aux données dans les vues Oracle AI Database stocke une définition de vue dans le dictionnaire de données en tant que texte de la requête qui définit la vue.
Manipulation de données dans les vues
Les vues étant dérivées de tables, elles présentent de nombreuses similitudes. Les utilisateurs peuvent interroger des vues et, avec certaines restrictions, effectuer des opérations LMD sur les vues. Les opérations effectuées sur une vue affectent les données de certaines tables de base de la vue et sont soumises aux contraintes d'intégrité et aux déclencheurs des tables de base.
L'exemple suivant crée une vue de la table hr.employees :
CREATE VIEW staff_dept_10 AS
SELECT employee_id, last_name, job_id,
       manager_id, department_id
FROM   employees
WHERE  department_id = 10
WITH CHECK OPTION CONSTRAINT staff_dept_10_cnst;
La requête de définition référence uniquement les lignes du service 10. La vue CHECK OPTION est créée avec une contrainte de sorte que les instructions INSERT et UPDATE émises sur la vue ne puissent pas générer de lignes que la vue ne peut pas sélectionner. Ainsi, les lignes des salariés du service 10 peuvent être insérées, mais pas celles du service 30.
Voir aussi : Référence du langage SQL d'Oracle AI Database pour en savoir plus sur les restrictions de sous-interrogation dans les instructions CREATE VIEW
Accès aux données dans les vues
Oracle AI Database stocke une définition de vue dans le dictionnaire de données en tant que texte de la requête qui définit la vue.
Lorsque vous référencez une vue dans une instruction SQL, Oracle AI Database effectue les tâches suivantes :
-
Fusionne une requête (si possible) sur une vue avec les requêtes qui définissent la vue et toutes les vues sous-jacentes.
Oracle AI Database optimise la requête fusionnée comme si vous étiez à l'origine de la requête sans référencer les vues. Par conséquent, Oracle AI Database peut utiliser des index sur n'importe quelle colonne de table de base référencée, que les colonnes soient référencées dans la définition de vue ou dans la requête utilisateur sur la vue.
Parfois, Oracle AI Database ne peut pas fusionner la définition de vue avec la requête utilisateur. Dans ce cas, Oracle AI Database peut ne pas utiliser tous les index sur les colonnes référencées.
-
Analyse l'instruction fusionnée dans une zone SQL partagée
Oracle AI Database analyse une instruction qui référence une vue dans une nouvelle zone SQL partagée uniquement si aucune zone SQL partagée existante ne contient une instruction similaire. Par conséquent, les vues offrent l'avantage d'une utilisation réduite de la mémoire associée aux instructions SQL partagées.
-
Exécute l'instruction SQL
L'exemple suivant illustre l'accès aux données lorsqu'une vue est interrogée. Supposons que vous créez employees_view en fonction des tables employees et departments :
CREATE VIEW employees_view AS
  SELECT employee_id, last_name, salary, location_id
  FROM   employees JOIN departments USING (department_id)
  WHERE  department_id = 10;
Un utilisateur exécute la requête suivante sur employees_view :
SELECT last_name
FROM   employees_view
WHERE  employee_id = 200;
Oracle AI Database fusionne la vue et la requête utilisateur pour créer la requête suivante, qu'il exécute ensuite pour extraire les données :
SELECT last_name
FROM   employees, departments
WHERE  employees.department_id = departments.department_id
AND    departments.department_id = 10
AND    employees.employee_id = 200;
Voir aussi :
-
Guide de réglage SQL d'Oracle AI Database pour en savoir plus sur l'optimisation des requêtes
Vues de jointure modifiables
Une vue de jointure comporte plusieurs tables ou vues dans sa clause FROM.
Dans l'exemple suivant, la vue staff_dept_10_30 joint les tables employees et departments, y compris uniquement les employés des services 10 ou 30 :
CREATE VIEW staff_dept_10_30 AS
SELECT employee_id, last_name, job_id, e.department_id
FROM   employees e, departments d
WHERE  e.department_id IN (10, 30)
AND    e.department_id = d.department_id;
Une vue de jointure modifiable, également appelée vue de jointure modifiable, implique au moins deux tables ou vues de base et autorise les opérations LMD. Une vue pouvant être mise à jour contient plusieurs tables dans la clause FROM de niveau supérieur de l'instruction SELECT et n'est pas limitée par la clause WITH READ ONLY.
Pour pouvoir être mise à jour par nature, une vue doit répondre à plusieurs critères. Par exemple, une règle générale est qu'une opération INSERT, UPDATE ou DELETE sur une vue de jointure ne peut modifier qu'une seule table de base à la fois. La requête suivante de la vue du dictionnaire de données USER_UPDATABLE_COLUMNS indique que la vue staff_dept_10_30 peut être mise à jour :
SQL> SELECT TABLE_NAME, COLUMN_NAME, UPDATABLE
  2  FROM   USER_UPDATABLE_COLUMNS
  3  WHERE  TABLE_NAME = 'STAFF_DEPT_10_30';

TABLE_NAME                     COLUMN_NAME                    UPD
------------------------------ ------------------------------ ---
STAFF_DEPT_10_30               EMPLOYEE_ID                    YES
STAFF_DEPT_10_30               LAST_NAME                      YES
STAFF_DEPT_10_30               JOB_ID                         YES
STAFF_DEPT_10_30               DEPARTMENT_ID                  YES
A partir d'Oracle Database version 21c, il n'est pas obligatoire que toutes les colonnes pouvant être mises à jour dans une vue de jointure soient mises en correspondance avec les colonnes d'une table à clé conservée. La table conservée par clé est une table dans laquelle chaque ligne de la table sous-jacente apparaît au plus une fois dans la sortie de l'interrogation. Dans la vue staff_dept_10_30, department_id est la clé primaire de la table departments. Ainsi, chaque ligne de la table employees apparaît au plus une fois dans l'ensemble de résultats, ce qui permet de conserver la clé de la table employees. La table departments n'est pas conservée par clé car chacune de ses lignes peut apparaître plusieurs fois dans l'ensemble de résultats. Les colonnes d'une table sans conservation de clé peuvent être mises à jour si l'opération UPDATE ne met à jour que les colonnes d'une seule table et que la mise à jour est déterministe, c'est-à-dire qu'elle ne met à jour chaque ligne qu'une seule fois.
Voir aussi : Guide de l'administrateur Oracle AI Database pour savoir comment mettre à jour des vues de jointure
Vues d'objet
Tout comme une vue est une table virtuelle, une vue d'objet est une table d'objet virtuel. Chaque ligne de la vue est un objet, qui est une instance d'un type d'objet. Un type d'objet est un type de données défini par l'utilisateur.
Vous pouvez extraire, mettre à jour, insérer et supprimer des données relationnelles comme si elles étaient stockées en tant que type d'objet. Vous pouvez également définir des vues avec des colonnes correspondant à des types de donnée objet, comme des objets, des REF et des ensembles (tables imbriquées et VARRAY).
Comme les vues relationnelles, les vues d'objet ne peuvent présenter que les données que les administrateurs de base de données souhaitent voir. Par exemple, une vue d'objet peut présenter des données sur les programmeurs informatiques, mais omettre des données sensibles sur les salaires. L'exemple suivant crée un objet employee_type, puis la vue it_prog_view en fonction de cet objet :
CREATE TYPE employee_type AS OBJECT
(
  employee_id  NUMBER (6),
  last_name    VARCHAR2 (25),
  job_id       VARCHAR2 (10)
);
/

CREATE VIEW it_prog_view OF employee_type
  WITH OBJECT IDENTIFIER (employee_id) AS
SELECT  e.employee_id, e.last_name, e.job_id
FROM    employees e
WHERE   job_id = 'IT_PROG';
Les vues d'objet sont utiles pour le prototypage ou la transition vers des applications orientées objet car les données de la vue peuvent être extraites de tables relationnelles et accessibles comme si la table était définie en tant que table d'objet. Vous pouvez exécuter des applications orientées objet sans convertir les tables existantes en une structure physique différente.
Voir aussi :
-
Guide du développeur Oracle AI Database Object-Relational pour en savoir plus sur les types d'objet et les vues d'objet
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur l'instruction
CREATE TYPE
Généralités sur les vues matérialisées
Une vue matérialisée est un résultat de requête qui a été stocké ou "matérialisé" à l'avance en tant qu'objet de schéma. La clause FROM de la requête peut nommer des tables, des vues ou des vues matérialisées.
Une vue matérialisée sert souvent de table principale dans la réplication et de table de faits dans l'entreposage de données. Les vues matérialisées synthétisent, calculent, répliquent et distribuent les données. Ils conviennent à différents environnements informatiques, tels que les suivants :
-
Dans les entrepôts de données, les vues matérialisées peuvent calculer et stocker les données générées à partir de fonctions agrégées telles que les sommes et les moyennes.
Une récapitulatif est une vue agrégée qui réduit le temps de requête en précalculant les jointures et les opérations d'agrégation et en stockant les résultats dans une table. Les vues matérialisées sont équivalentes aux synthèses. Vous pouvez également utiliser des vues matérialisées pour calculer des jointures avec ou sans agrégations.
-
Dans la réplication de vue matérialisée, réalisée à l'aide de XStream et d'Oracle GoldenGate, la vue contient une copie complète ou partielle d'une table à partir d'un point unique dans le temps. Les vues matérialisées répliquent les données sur les sites distribués et synchronisent les mises à jour effectuées sur plusieurs sites. Cette forme de réplication convient aux environnements tels que les ventes sur le terrain lorsque les bases de données ne sont pas toujours connectées au réseau.
-
Dans les environnements informatiques mobiles, les vues matérialisées peuvent télécharger un sous-ensemble de données à partir de serveurs centraux vers des clients mobiles, avec des actualisations périodiques à partir des serveurs centraux et la propagation des mises à jour par les clients vers les serveurs centraux.
Dans un environnement de réplication, une vue matérialisée partage des données avec une table d'une autre base de données, appelée base de données maître. La table associée à la vue matérialisée dans le site maître est la table maître. La figure 6-9 illustre une vue matérialisée dans une base de données basée sur une table maître dans une autre base de données. Les mises à jour de la table maître sont répliquées vers la base de données des vues matérialisées.
Figure 9 : Vue matérialisée
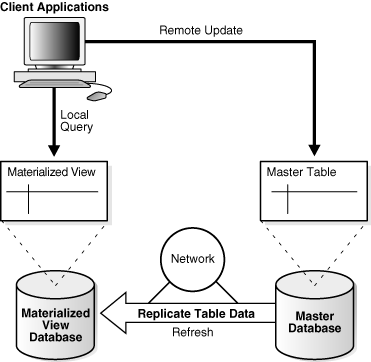
Description de l'image cncpt260.gif
-
Caractéristiques des vues matérialisées Les vues matérialisées partagent certaines caractéristiques des index et des vues non matérialisées.
-
Méthodes d'actualisation des vues matérialisées La base de données tient à jour les données des vues matérialisées en les actualisant après les modifications apportées aux tables de base. La méthode d'actualisation peut être incrémentielle ou complète.
-
Vues matérialisées automatiques A partir de la version 21c d'Oracle Database, les vues matérialisées peuvent être créées et gérées automatiquement.
-
La réécriture de requête transforme une demande utilisateur écrite sous la forme de tables maître en une demande équivalente sémantique comprenant des vues matérialisées.
Voir aussi :
-
Guide de l'entreposage de données Oracle AI Database pour en savoir plus sur les résumés
-
Oracle AI Database XStream Guide pour une introduction à XStream
-
http://www.oracle.com/technetwork/middleware/goldengate/documentation/index.html pour en savoir plus sur Oracle GoldenGate
-
Référence du langage SQL d'Oracle AI Database pour en savoir plus sur l'instruction
CREATE MATERIALIZED VIEW
Caractéristiques des vues matérialisées
Les vues matérialisées partagent certaines caractéristiques des index et des vues non matérialisées.
Les vues matérialisées sont similaires aux index de l'une des manières suivantes :
-
Elles contiennent des données réelles et consomment de l'espace de stockage.
-
Ils peuvent être actualisés lorsque les données de leurs tables maître changent.
-
Ils peuvent améliorer les performances de l'exécution SQL lorsqu'ils sont utilisés pour les opérations de réécriture d'interrogation.
-
Leur existence est transparente pour les applications et les utilisateurs SQL.
Une vue matérialisée est similaire à une vue non matérialisée car elle représente des données dans d'autres tables et vues. Contrairement aux index, les utilisateurs peuvent interroger des vues matérialisées directement à l'aide d'instructions SELECT. En fonction des types d'actualisation requis, les vues peuvent également être mises à jour avec des instructions LMD.
L'exemple suivant crée et alimente une vue d'agrégation matérialisée basée sur trois tables maître dans l'exemple de schéma sh :
CREATE MATERIALIZED VIEW sales_mv AS
  SELECT t.calendar_year, p.prod_id, SUM(s.amount_sold) AS sum_sales
  FROM   times t, products p, sales s
  WHERE  t.time_id = s.time_id
  AND    p.prod_id = s.prod_id
  GROUP BY t.calendar_year, p.prod_id;
L'exemple suivant supprime la table sales, qui est une table maître pour sales_mv, puis interroge sales_mv. La requête sélectionne les données car les lignes sont stockées (matérialisées) séparément des données des tables maître.
SQL> DROP TABLE sales;

Table dropped.

SQL> SELECT * FROM sales_mv WHERE ROWNUM < 4;

CALENDAR_YEAR    PROD_ID  SUM_SALES
------------- ---------- ----------
         1998         13  936197.53
         1998         26  567533.83
         1998         27  107968.24
Une vue matérialisée peut être partitionnée. Vous pouvez définir une vue matérialisée sur une table partitionnée et plusieurs index sur une vue matérialisée.
Voir aussi : Guide de l'entreposage de données Oracle AI Database pour apprendre à utiliser des vues matérialisées dans un data warehouse
Méthodes d'actualisation des vues matérialisées
La base de données tient à jour les données des vues matérialisées en les actualisant après les modifications apportées aux tables de base. La méthode d'actualisation peut être incrémentielle ou complète.
-
Actualisation complète Une actualisation complète exécute la requête qui définit la vue matérialisée. Une actualisation complète est effectuée lors de la création initiale de la vue matérialisée, sauf si la vue matérialisée fait référence à une table prédéfinie ou si vous définissez la table comme
BUILD DEFERRED. -
Actualisation incrémentielle Une actualisation incrémentielle, également appelée actualisation rapide, traite uniquement les modifications apportées aux données existantes. Cette méthode évite d'avoir à recréer des vues matérialisées dès le début. Le traitement des seules modifications peut entraîner une actualisation très rapide.
-
Actualisation sans réutilisation de la mémoire et sans réutilisation de la mémoire Pour les méthodes complètes et incrémentielles, la base de données peut actualiser la vue matérialisée en place, ce qui actualise les instructions directement sur la vue ou sans réutilisation de la mémoire.
Régénération complète
Une actualisation complète exécute la requête qui définit la vue matérialisée. Une actualisation complète est effectuée lors de la création initiale de la vue matérialisée, sauf si la vue matérialisée fait référence à une table prédéfinie ou si vous définissez la table comme BUILD DEFERRED.
Une actualisation complète peut être lente, surtout si la base de données doit lire et traiter d'énormes quantités de données. Vous pouvez effectuer une actualisation complète à tout moment après la création de la vue matérialisée.
Actualisation incrémentielle
Une actualisation incrémentielle, également appelée actualisation rapide, traite uniquement les modifications apportées aux données existantes. Cette méthode évite d'avoir à recréer des vues matérialisées dès le début. Le traitement des seules modifications peut entraîner une actualisation très rapide.
Vous pouvez actualiser les vues matérialisées à la demande ou à intervalles réguliers. Vous pouvez également configurer des vues matérialisées dans la même base de données que leurs tables de base pour qu'elles soient actualisées chaque fois qu'une transaction valide des modifications dans les tables de base.
L'actualisation rapide prend l'une des formes suivantes :
-
Actualisation basée sur les journaux
Dans ce type d'actualisation, un journal de vues matérialisées ou un journal de chargement direct conserve un enregistrement des modifications apportées aux tables de base. Un journal de vues matérialisées est un objet de schéma qui enregistre les modifications apportées à une table de base afin qu'une vue matérialisée définie dans la table de base puisse être actualisée de manière incrémentielle. Chaque journal de vues matérialisées est associé à une seule table de base.
-
Actualisation du suivi des modifications de partition (PCT)
L'actualisation PCT n'est valide que lorsque les tables de base sont partitionnées. L'actualisation PCT supprime toutes les données des partitions de vue matérialisée affectées ou des parties de données affectées, puis les recalcule. La base de données utilise les partitions de table de base modifiées pour identifier les partitions ou portions de données affectées dans la vue. Lorsque des opérations de maintenance de partition ont eu lieu sur les tables de base, l'actualisation PCT est la seule méthode d'actualisation incrémentielle utilisable.
Actualisation sur place et sans réutilisation de la mémoire
Pour les méthodes complètes et incrémentielles, la base de données peut actualiser la vue matérialisée en place, ce qui actualise les instructions directement sur la vue ou à leur place.
Une actualisation "out-of-place" crée une ou plusieurs tables externes, exécute les instructions d'actualisation sur ces tables, puis bascule la vue matérialisée ou les partitions concernées avec les tables externes. Cette technique assure une haute disponibilité lors de l'actualisation, en particulier lorsque la fin des instructions d'actualisation est longue.
L'actualisation synchrone est un type d'actualisation "out-of-place". Une actualisation synchrone ne modifie pas le contenu des tables de base, mais utilise les API du package d'actualisation synchrone, ce qui garantit la cohérence en appliquant ces modifications aux tables de base et aux vues matérialisées en même temps. Cette approche permet de toujours synchroniser un ensemble de tables et les vues matérialisées qui y sont définies. Dans un data warehouse, la méthode d'actualisation synchrone est bien adaptée pour les raisons suivantes :
-
Le chargement des données incrémentielles est étroitement contrôlé et se produit à intervalles réguliers.
-
Les tables et leurs vues matérialisées sont souvent partitionnées de la même manière, ou leurs partitions sont liées par une dépendance fonctionnelle.
Voir aussi : Guide d'entreposage de données Oracle AI Database pour apprendre à actualiser les vues matérialisées
Vues matérialisées automatiques
A partir de la version 21c d'Oracle Database, les vues matérialisées peuvent être créées et gérées automatiquement.
Oracle AI Database peut créer et gérer automatiquement des vues matérialisées afin d'optimiser les performances des requêtes. Avec très peu ou pas d'interaction avec le DBA, les tâches en arrière-plan surveillent et analysent les caractéristiques de la charge globale et identifient où les vues matérialisées amélioreront les performances SQL. Les performances des vues matérialisées candidates sont mesurées en arrière-plan (à l'aide d'interrogations de charge globale) avant qu'elles ne soient visibles pour la charge globale.
Voir aussi :
-
Guide de l'entreposage de données Oracle AI Database pour plus d'informations
-
Référence des types et packages PL/SQL d'Oracle AI Database pour apprendre à utiliser le package
DBMS_AUTO_MVafin d'implémenter des vues matérialisées automatiques
Réécriture de la requête
La réécriture de requête transforme une demande utilisateur écrite sous la forme de tables maître en une demande équivalente sémantique comprenant des vues matérialisées.
Lorsque les tables de base contiennent de grandes quantités de données, le calcul d'une agrégation ou d'une jointure est coûteux et chronophage. Etant donné que les vues matérialisées contiennent des agrégats et des jointures précalculés, la réécriture des requêtes peut rapidement répondre aux requêtes à l'aide de vues matérialisées.
Le transformateur d'interrogation réécrit de manière transparente la demande pour utiliser la vue matérialisée, ce qui ne nécessite aucune intervention de l'utilisateur et aucune référence à la vue matérialisée dans l'instruction SQL. Du fait de la transparence de la réécriture des interrogations, les vues matérialisées peuvent être ajoutées ou supprimées sans que l'instruction SQL dans le code de l'application ne soit invalidée.
En général, la réécriture de requêtes pour utiliser des vues matérialisées plutôt que des tables de détails améliore le temps de réponse. La figure suivante illustre la base de données qui génère un plan d'exécution pour la requête d'origine et réécrite, et choisit le plan le moins coûteux.
Figure 10 : Réécriture de requête
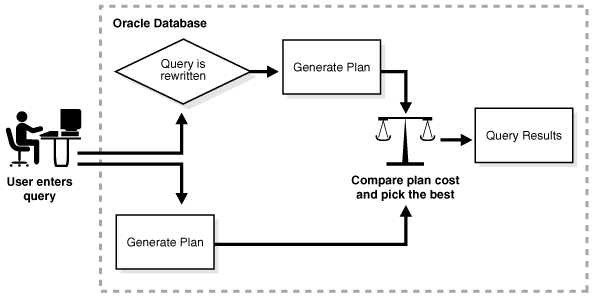
Description de l'image cncpt334.gif
Voir aussi :
-
"Présentation de l'optimiseur" pour en savoir plus sur la transformation des requêtes
-
Guide d'entreposage de données Oracle AI Database pour apprendre à utiliser la réécriture de requête
Présentation des séquencements
Une séquence est un objet de schéma à partir duquel plusieurs utilisateurs peuvent générer des entiers uniques. Un générateur de séquences fournit une méthode hautement évolutive et performante pour générer des clés de substitution pour un type de données numérique.
-
Caractéristiques de séquence Une définition de séquence indique des informations générales sur la séquence, y compris son nom et si la séquence est ascendante ou descendante.
-
Accès simultané aux séquences Le même générateur de séquences peut générer des nombres pour plusieurs tables.
Caractéristiques de séquence
Une définition de séquence indique des informations générales sur la séquence, y compris son nom et si la séquence est ascendante ou descendante.
Une définition de séquence indique également :
-
Intervalle entre les nombres
-
Indique si la base de données doit mettre en cache les ensembles de numéros de séquence générés en mémoire
-
Indique si la séquence doit être cyclée lorsqu'une limite est atteinte
L'exemple suivant crée la séquence customers_seq dans l'exemple de schéma oe. Une application peut utiliser cette séquence pour fournir des numéros d'ID client lorsque des lignes sont ajoutées à la table customers.
CREATE SEQUENCE customers_seq
START WITH      1000
INCREMENT BY    1
NOCACHE
NOCYCLE;
La première référence à customers_seq.nextval renvoie 1000. La seconde renvoie 1001. Chaque référence suivante renvoie une valeur 1 supérieure à la référence précédente.
Voir aussi :
-
Oracle AI Database - Introduction à Oracle AI Database Development pour un tutoriel qui vous explique comment créer une séquence
-
Guide de l'administrateur Oracle AI Database pour apprendre à référencer une séquence dans une instruction SQL
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
CREATE SEQUENCE
Accès simultané aux séquences
Le même générateur de séquences peut générer des numéros pour plusieurs tables.
Le générateur peut créer des clés primaires automatiquement et coordonner des clés sur plusieurs lignes ou tables. Par exemple, une séquence peut générer des clés primaires pour une table orders et une table customers.
Le générateur de séquences est utile dans des environnements multi-utilisateurs pour générer des numéros uniques sans la surcharge des opérations d'E/S disque ou du verrouillage de transaction. Par exemple, deux utilisateurs insèrent simultanément de nouvelles lignes dans la table orders. En utilisant une séquence pour générer des numéros uniques pour la colonne order_id, aucun utilisateur n'a à attendre que l'autre saisisse le prochain numéro de commande disponible. La séquence génère automatiquement les valeurs correctes pour chaque utilisateur.
Chaque utilisateur qui référence une séquence a accès à son numéro de séquence actuel, qui est la dernière séquence générée dans la session. Un utilisateur peut émettre une instruction pour générer un nouveau numéro de séquence ou utiliser le dernier numéro généré par la session. Une fois qu'une instruction d'une session génère un numéro de séquence, elle n'est disponible que pour cette session. Les numéros de séquence individuels peuvent être ignorés s'ils ont été générés et utilisés dans une transaction qui a finalement été annulée.
Avertissement : si votre application requiert un ensemble de nombres sans espace, vous ne pouvez pas utiliser de séquences Oracle. Vous devez sérialiser les activités dans la base de données à l'aide de votre propre code développé.
Voir aussi : "Cohérence et simultanéité des données" pour découvrir comment les sessions accèdent aux données en même temps
Présentation des dimensions
Un data warehouse classique comporte deux composants importants : les dimensions et les faits.
Une dimension est une catégorie utilisée pour spécifier des questions métier, par exemple, l'heure, la géographie, le produit, le service et le canal de distribution. Un fait est un événement ou une entité associé à un ensemble particulier de valeurs de dimension, par exemple les unités vendues ou les bénéfices.
Voici des exemples de demandes multidimensionnelles :
-
Afficher les ventes totales de tous les produits à des niveaux d'agrégation croissants pour une dimension géographique, d'un État à l'autre, pour 2013 et 2014.
-
Créez une analyse transversale de nos opérations montrant les dépenses par territoire en Amérique du Sud pour 2013 et 2014. Incluez tous les sous-totaux possibles.
-
Répertoriez les 10 meilleurs commerciaux d'Asie en fonction du chiffre d'affaires des ventes 2014 pour les produits automobiles et classez leurs commissions.
De nombreuses questions multidimensionnelles nécessitent des données agrégées et des comparaisons d'ensembles de données, souvent sur une période, une zone géographique ou des budgets.
La création d'une dimension permet d'utiliser plus largement la fonctionnalité de réécriture d'interrogation. En réécrivant de manière transparente les requêtes pour utiliser des vues matérialisées, la base de données peut améliorer les performances des requêtes.
-
Structure hiérarchique d'une dimension Une table de dimensions est une structure logique qui définit des relations hiérarchiques (parent/enfant) entre des paires de colonnes ou d'ensembles de colonnes.
-
Création de dimensions Vous créez des dimensions à l'aide de l'instruction SQL
CREATE DIMENSION. Voir aussi : Guide d'entreposage de données Oracle AI Database pour en savoir plus sur les dimensions
Structure hiérarchique d'une dimension
Une table de dimensions est une structure logique qui définit des relations hiérarchiques (parent/enfant) entre des paires de colonnes ou des ensembles de colonnes.
Par exemple, une dimension peut indiquer que dans une ligne, la colonne city implique la valeur de la colonne state et la colonne state implique la valeur de la colonne country.
Au sein d'une dimension client, les clients peuvent être regroupés en ville, état, pays, sous-région et région. L'analyse des données commence généralement à des niveaux plus élevés dans la hiérarchie dimensionnelle et descend progressivement si la situation le justifie.
Chaque valeur au niveau enfant est associée à une valeur unique au niveau parent. Une relation hiérarchique est une dépendance fonctionnelle entre un niveau de la hiérarchie et le niveau suivant.
Aucun stockage de données n'est affecté à une dimension. Les informations de dimension sont stockées dans des tables de dimension, tandis que les informations de fait sont stockées dans une table de faits.
Voir aussi :
- Guide de l'entreposage de données Oracle AI Database pour en savoir plus sur les dimensions
Création de dimensions
Vous créez des dimensions avec l'instruction SQL CREATE DIMENSION.
Cette instruction spécifie :
-
Plusieurs clauses
LEVEL, chacune identifiant une colonne ou une série de colonnes dans la dimension -
Des clauses
HIERARCHYspécifiant les relations parent/enfant entre les niveaux adjacents -
Des clauses
ATTRIBUTEfacultatives, chacune identifiant une colonne ou une série de colonnes supplémentaire associée à un niveau individuel
L'instruction suivante a été utilisée pour créer la dimension customers_dim dans l'exemple de schéma sh :
CREATE DIMENSION customers_dim
   LEVEL customer   IS (customers.cust_id)
   LEVEL city       IS (customers.cust_city)
   LEVEL state      IS (customers.cust_state_province)
   LEVEL country    IS (countries.country_id)
   LEVEL subregion  IS (countries.country_subregion)
   LEVEL region     IS (countries.country_region)
   HIERARCHY geog_rollup (
      customer      CHILD OF
      city          CHILD OF
      state         CHILD OF
      country       CHILD OF
      subregion     CHILD OF
      region
   JOIN KEY (customers.country_id) REFERENCES country )
   ATTRIBUTE customer DETERMINES
   (cust_first_name, cust_last_name, cust_gender,
    cust_marital_status, cust_year_of_birth,
    cust_income_level, cust_credit_limit)
   ATTRIBUTE country DETERMINES (countries.country_name);
Les colonnes d'une dimension peuvent être issues de la même table (dénormalisée) ou de plusieurs tables (totalement ou partiellement normalisées). Par exemple, une dimension Temps normalisé peut comprendre une Table de date, une Table de mois et une Table d'année, avec les conditions de jointure reliant chaque ligne d'une date à une ligne d'un mois et chaque ligne d'un mois à une ligne d'année. Dans une dimension Temps entièrement non normalisée, les colonnes de date, de mois et d'année se trouvent dans la même table. Qu'elles soient normalisées ou dénormalisées, les relations hiérarchiques entre les colonnes doivent être indiquées dans l'instruction CREATE DIMENSION.
Voir aussi : Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique CREATE DIMENSION
Présentation des synonyme
Un synonyme est un alias pour un objet de schéma. Par exemple, vous pouvez créer un synonyme pour une table ou une vue, une séquence, une unité de programme PL/SQL, un type d'objet défini par l'utilisateur ou un autre synonyme. Etant donné qu'un synonyme est un simple alias, il suffit de stocker sa définition dans le dictionnaire de données.
Les synonymes peuvent simplifier les instructions SQL pour les utilisateurs de base de données. Les synonymes sont également utiles pour masquer l'identité et l'emplacement d'un objet de schéma sous-jacent. Si l'objet sous-jacent doit être renommé ou déplacé, seul le synonyme doit être redéfini. Les applications basées sur le synonyme continuent de fonctionner sans modification.
Vous pouvez créer des synonymes privés et publics. Un synonyme privé figure dans le schéma d'un utilisateur spécifique qui contrôle sa disponibilité pour les autres utilisateurs. Un synonyme public appartient au groupe d'utilisateurs nommé PUBLIC et est accessible par chaque utilisateur de base de données.
Exemple 6-5 Synonyme public
Supposons qu'un administrateur de base de données crée un synonyme public nommé people pour la table hr.employees. L'utilisateur se connecte ensuite au schéma oe et compte le nombre de lignes dans la table référencée par le synonyme.
SQL> CREATE PUBLIC SYNONYM people FOR hr.employees;

Synonym created.

SQL> CONNECT oe
Enter password: password
Connected.

SQL> SELECT COUNT(*) FROM people;

  COUNT(*)
----------
       107
Utilisez les synonymes publics avec parcimonie car ils rendent la consolidation de la base de données plus difficile. Comme indiqué dans l'exemple suivant, si un autre administrateur tente de créer le synonyme public people, la création échoue car un seul synonyme public people peut exister dans la base de données. L'utilisation excessive de synonymes publics entraîne des conflits d'espace de noms entre les applications.
SQL> CREATE PUBLIC SYNONYM people FOR oe.customers;
CREATE PUBLIC SYNONYM people FOR oe.customers
                      *
ERROR at line 1:
ORA-00955: name is already used by an existing object

SQL> SELECT OWNER, SYNONYM_NAME, TABLE_OWNER, TABLE_NAME
  2  FROM DBA_SYNONYMS
  3  WHERE SYNONYM_NAME = 'PEOPLE';

OWNER      SYNONYM_NAME TABLE_OWNER TABLE_NAME
---------- ------------ ----------- ----------
PUBLIC     PEOPLE       HR          EMPLOYEES
Les synonymes eux-mêmes ne sont pas sécurisables. Lorsque vous accordez des privilèges objet sur un synonyme, vous accordez réellement des privilèges sur l'objet sous-jacent. Le synonyme agit uniquement comme un alias pour l'objet dans l'instruction GRANT.
Voir aussi :
-
Guide de l'administrateur Oracle AI Database pour apprendre à gérer les synonymes
-
Référence du langage SQL Oracle AI Database pour la syntaxe et la sémantique
CREATE SYNONYM