Prepara impostazioni di connessione, sistema e parametro del database
Informazioni sulla configurazione delle impostazioni di connessione al database, di sistema e di parametri per Oracle GoldenGate for Oracle.
Abilita la modalità di replica e archiviazione GoldenGate
Passo 1: abilitare la replica GoldenGate
I servizi di database necessari per supportare Oracle GoldenGate Extract e Replicat devono essere abilitati in modo esplicito per Oracle AI Database.
Per abilitare la replica di Oracle GoldenGate, impostare il parametro di inizializzazione del database seguente. In tutte le istanze di Oracle RAC questo valore deve essere impostato su TRUE se si utilizza Oracle GoldenGate su uno qualsiasi dei nodi.
ALTER SYSTEM SET enable_goldengate_replication = true SCOPTE=both;Per ulteriori informazioni su questo parametro, vedere Parametri di inizializzazione.
Passaggio 2: abilitare la modalità di archiviazione
I database Oracle devono essere in modalità ARCHIVELOG in modo che Extract possa elaborare i file di log. Per attivare la modalità ARCHIVELOG, attenersi alla procedura descritta in Modifica della modalità di archiviazione del database.
Impostazione della query di flashback
Per informazioni sui dati recuperati da Oracle GoldenGate, vedere Dettagli del supporto per i tipi di dati e gli oggetti Oracle.
Per impostazione predefinita, Oracle GoldenGate utilizza la query di flashback per recuperare i valori dalle tablespace di undo (rollback). In questo modo, Oracle GoldenGate può ricostruire un'immagine di riga coerente in lettura a partire da un'ora specifica o da un SCN corrispondente al redo record.
Per ottenere risultati ottimali, configurare il database di origine come indicato di seguito.
-
Impostare una quantità sufficiente di conservazione dei redo impostando i parametri di inizializzazione Oracle
UNDO_MANAGEMENTeUNDO_RETENTIONcome indicato di seguito (in secondi).UNDO_MANAGEMENT=AUTO UNDO_RETENTION=86400 UNDO_RETENTION can be adjusted upward in high-volume environments. -
Calcolare lo spazio richiesto nella tablespace di undo utilizzando la formula seguente.
*undo_space* = UNDO_RETENTION * *UPS* + *overhead*Dove:
-
undo_space è il numero di blocchi di undo.
-
UNDO_RETENTIONè il valore del parametroUNDO_RETENTION(in secondi). -
UPS è il numero di blocchi di undo per ogni secondo.
-
overhead è il sovraccarico minimo per i metadati (tabelle delle transazioni e così via).
Utilizzare la vista di sistema
V$UNDOSTATper stimare UPS e overhead. -
-
Per le tabelle contenenti
LOBs, effettuare una delle operazioni riportate di seguito.-
Impostare la clausola di memorizzazione
LOBsuRETENTION. Questa è l'impostazione predefinita per le tabelle create quandoUNDO_MANAGEMENTè impostato suAUTO. -
Se si utilizza
PCTVERSIONanzichéRETENTION, impostarePCTVERSIONsu un valore iniziale pari a 25. È possibile regolarlo in base alle statistiche di recupero segnalate con il comandoSTATS EXTRACT. Se il valore del campoSTAT_OPER_ROWFETCHCURRENTBYROWIDoSTAT_OPER_ROWFETCH_CURRENTBYKEYin queste statistiche è elevato, aumentarePCTVERSIONcon incrementi di 10 finché le statistiche non mostrano valori bassi.
-
Oracle GoldenGate fornisce i parametri riportati di seguito per gestire il recupero.
| Parametro o comando | Descrizione |
|---|---|
Comando STATS EXTRACT con opzione REPORTFETCH |
Mostra le statistiche di recupero estrazione su richiesta. |
Parametro STATOPTIONS con opzione REPORTFETCH |
Imposta il comando STATS EXTRACT in modo che mostri sempre le statistiche di recupero. |
Parametro MAXFETCHSTATEMENTS |
Controlla il numero di cursori aperti per le query preparate gestite da Extract nel database di origine e anche per le operazioni SQLEXEC. |
Parametro MAXFETCHSTATEMENTS |
Controlla il funzionamento di recupero predefinito di Extract: se Extract esegue una query di flashback o recupera l'immagine corrente dalla tabella. |
Parametro FETCHOPTIONS con opzione USELATESTVERSION o NOUSELATESTVERSION |
Gestisce l'errore di una query di flashback Extract, ad esempio se la conservazione degli undo è scaduta o la struttura di una tabella è stata modificata. Extract può recuperare l'immagine corrente dalla tabella o ignorare l'errore. |
Parametro REPFETCHEDCOLOPTIONS |
Controlla la risposta in base a Replicat quando elabora record trail che includono dati recuperati o condizioni mancanti a livello di colonna. |
Gestione di altre proprietà del database
Esistono alcune proprietà del database che possono influire su Oracle GoldenGate e sui parametri utilizzati per risolvere o risolvere determinate condizioni.
Nella tabella seguente sono elencate le proprietà del database e la preoccupazione/risoluzione associata.
| Proprietà database | Preoccupazioni / risoluzione |
|---|---|
| Tabella con partizionamento intervallo | Per supportare le tabelle con il partizionamento intervallo, assicurarsi che il parametro WILDCARDRESOLVE rimanga nel valore predefinito DYNAMIC. |
| Tabella con colonne virtuali | Le colonne virtuali non vengono registrate e Oracle non consente DML sulle colonne virtuali. È tuttavia possibile acquisire questi dati e mapparli a una colonna di destinazione che non sia una colonna virtuale effettuando le operazioni riportate di seguito. Includere la tabella nell'istruzione Extract Nell'istruzione Replicat |
| Tabella con vista aggiornabile intrinsecamente | Per replicare in una vista aggiornabile in modo intrinseco, definire una chiave nelle colonne univoche della vista aggiornabile utilizzando una clausola KEYCOLS nella stessa istruzione MAP in cui vengono mappate le tabelle di origine e di destinazione associate. |
| Ripeti i log o gli archivi in posizioni diverse | Il parametro TRANLOGOPTIONS contiene le opzioni per gestire gli ambienti in cui i redo log o gli archivi vengono memorizzati in una posizione diversa da quella predefinita del database o in una piattaforma diversa da quella in cui Extract è in esecuzione. |
operazioni TRUNCATE |
Per replicare le operazioni
|
| Sequenze | Per replicare DDL per le sequenze ( Per replicare solo i valori di sequenza, utilizzare il parametro |
Configurare un container database multi-tenant
Oracle GoldenGate con Oracle AI Database consente l'implementazione di pluggable database (PDB) per l'origine e la destinazione. Extract è registrato per un PDB specifico, denominato Extract per PDB.
Nota: l'accesso al livello radice con l'utente c##ggadmin non è consigliato, tranne nel caso della configurazione Extract a valle. Utilizzare Extract a livello di PDB anziché Extract a livello radice.
Il diagramma riportato di seguito mostra la configurazione per approcci diversi in una configurazione di container database multi-tenant.
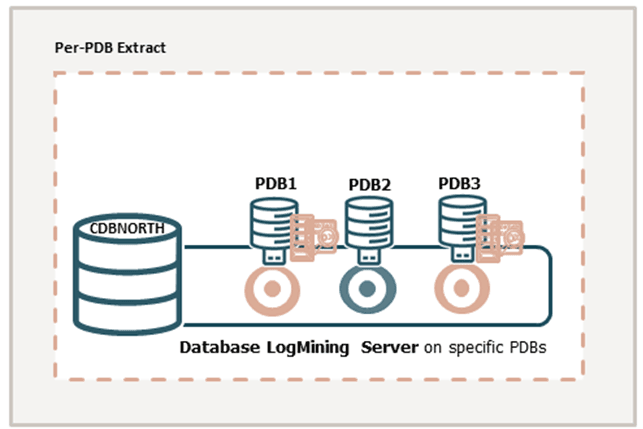
L'aggiunta di Extract direttamente dal PDB acquisisce da PDB isolati, gestendo proprietà e responsabilità a livello di PDB.
Utilizzando un'estrazione per PDB, è possibile connettersi come utente PDB locale (ad esempio, ggadmin) e quindi registrare questa estrazione nel database. Poiché è già stato eseguito il login come utente PDB, non è richiesta una clausola container aggiuntiva. Allo stesso modo, non è necessaria anche la convenzione di denominazione SOURCECATALOG o tre parti.
Per impostare un'estrazione, vedere Aggiungere un'estrazione.
Considerazioni per la configurazione del container database multi-tenant
Tenere presenti le linee guida riportate di seguito durante la configurazione di un container database multi-tenant per la replica dei dati mediante Oracle GoldenGate.
-
I diversi pluggable database nel container database multi-tenant possono avere set di caratteri diversi. Oracle GoldenGate acquisisce i dati da qualsiasi database multi-tenant con set di caratteri diversi in un unico file trail e replica i dati senza danneggiamenti a causa dell'uso di set di caratteri diversi.
-
Per creare e registrare un'estrazione per PDB, sarà necessario connettersi all'utente PDB, ad esempio
ggadmin, creato per l'accesso a livello di PDB. Utilizzare il parametroUSERIDALIASper configurare una stringa di connessione SQLNet, ad esempioggadmin@pdbeast. *Non è necessario la clausola contenitore oSOURCECATALOGper impostare l'estrazione per PDB. -
Se il nome utente PDB, il nome utente CDB o GLOBAL_NAME contiene un trattino, Oracle GoldenGate restituisce il seguente errore:
ERROR OGG-08221 Cannot register or unregister EXTRACT <extract_name> because of the following SQL error: OCI Error ORA (status = 44004-ORA-44004: invalid qualified SQL name -
Per supportare il CDB di origine 12.2, Extract deve specificare il formato trail come release 12.3. A causa delle modifiche apportate ai redo log, per l'acquisizione da un database multi-tenant con versione Oracle 12.2 o successiva, la release del formato trail deve essere 12.3 o successiva.
-
La replica DDL funziona come una replica normale per i database multi-tenant.
Vedere Aggiungi connessioni al database per aggiungere un utente di container database multi-tenant nelle credenziali di Oracle GoldenGate. Vedere Concedi privilegi utente per Oracle Database 21c e versioni precedenti o Concedi privilegi utente per Oracle AI Database 26ai e versioni successive a seconda dell'installazione di Oracle AI Database da configurare.
Sequenza di flush per container database multi-tenant
È possibile utilizzare il comando FLUSH SEQUENCE solo all'interno di Oracle GoldenGate, se lo script sequence.sql applica le procedure del database allo schema di amministrazione GoldenGate del database.
Utilizzare il comando FLUSH SEQUENCE immediatamente dopo aver avviato Extract per la prima volta durante la sincronizzazione iniziale o una nuova sincronizzazione. Questo comando aggiorna una sequenza Oracle in modo che i redo record iniziali siano disponibili quando Extract inizia ad acquisire i dati della transazione. In genere il redo non viene generato finché la cache corrente non viene esaurita. Lo svuotamento fornisce a Replicat un punto di inizio con il quale eseguire la sincronizzazione con il valore di sequenza corretto nel sistema di destinazione. In seguito Extract può utilizzare il redo associato alla consueta prenotazione dei valori di sequenza nella cache. 1. Il comando Oracle utilizza le procedure riportate di seguito da FLUSH SEQUENCE:
 | Database | Procedure | User and Privileges |
 | --- | --- | --- |
 | Source | `updateSequence` | Grants `EXECUTE` to the owner of the Oracle GoldenGate DDL objects, or other selected user if not using DDL support. |
 | Target | `replicateSequence` | Grants `EXECUTE` to the Oracle GoldenGate Replicat user. |

 {: summary="This table lists the Oracle procedures used by FLUSH SEQUENCE. It gives the database, procedure, and user and privileges." }

The `sequence.sql` script installs these procedures. Normally, this script is run as part of the Oracle GoldenGate installation process, but make certain that was done before using `FLUSH SEQUENCE`. If `sequence.sql` was not run, the flush fails and an error message similar to the following is generated:

<pre class="copy"><code>Cannot flush sequence {0}. Refer to the Oracle GoldenGate for Oracle documentation for instructions on how to set up and run the sequence.sql script. Error {1}.</code></pre>
- Prima di utilizzare
FLUSH SEQUENCE, connettersi al database utilizzando il comandoDBLOGIN.
Per creare un utente Oracle GoldenGate in ogni PDB per il quale è richiesta la replica della sequenza, è necessario eseguire il comando FLUSH SEQUENCE a livello di PDB. Usare DBLOGIN per eseguire il login al PDB ed eseguire il comando FLUSH SEQUENCE.
Si consiglia di utilizzare lo stesso schema in ogni PDB, in modo che funzioni con il file di parametri GLOBALS GGSCHEMA.
Nell'esempio riportato di seguito, l'impostazione dell'ambiente è per Oracle 21c to Oracle 21c Replication, con Extract integrato, Replicat parallelo utilizzando Oracle GoldenGate 21c (21.3.0).
Nella tabella seguente sono elencati i nomi del CDB di origine e di destinazione, i PDB e le credenziali utente corrispondenti per la connessione al database.
| CDB di origine | CDB di destinazione |
|---|---|
NORTH |
SOUTH |
Nome PDB: DBEAST |
Nome PDB: DBWEST |
Utente comune: Utente PDB per le sequenze: |
Utente PDB: ggadmin |
sqlplus system/manager
ALTER SESSION SESSION SET CONTAINER=CERTMISSN;
CREATE USER ggate IDENTIFIED BY *password* DEFAULT TABLESPACE USERS TEMPORARY TABLESPACE TEMP QUOTA UNLIMITED ON USERS CONTAINER=CURRENT;
Esegui @sequence.sql
sqlplus system/manager
ALTER SESSION SET CONTAINER=DBEAST;
@sequence.sql
Quando richiesto, immettere quanto segue:
GGADMINEseguire il comando FLUSH SEQUENCE:
DBLOGIN USERIDALIAS ggeast DOMAIN OracleGoldenGate
FLUSH SEQUENCE DBEAST.HR.*
Configurazione di destinazione di Oracle GoldenGate:
sqlplus system/manager
ALTER SESSION SET CONTAINER =PDBWEST;
@sequence.sql
Quando richiesto, immettere il nome utente PDB ggadmin.
Ciò vale anche per lo script @sequence.sql, che è necessario eseguire anche su ogni PDB da cui si desidera acquisire.