Introduzione a Oracle AI Database
In questo capitolo viene fornita una panoramica di Oracle AI Database.
Questo capitolo contiene gli argomenti riportati di seguito.
-
Informazioni sui sistemi informativi Ogni organizzazione dispone di informazioni che deve memorizzare e gestire per soddisfare i propri requisiti. Ad esempio, una società deve raccogliere e gestire i record delle risorse umane per i propri dipendenti. Queste informazioni devono essere a disposizione di coloro che ne hanno bisogno.
-
Oggetti dello schema Una caratteristica di un RDBMS è l'indipendenza dello storage fisico dei dati dalle strutture di dati logiche.
-
Accesso ai dati Un requisito generale per un DBMS è quello di rispettare gli standard di settore accettati per un linguaggio di accesso ai dati.
-
Transaction Management Oracle AI Database è progettato come un database multiutente. Il database deve garantire che più utenti possano lavorare contemporaneamente senza danneggiare i dati l'uno dell'altro.
-
Architettura di Oracle AI Database Un server di database è la chiave per la gestione delle informazioni.
Informazioni sui sistemi informativi
Ogni organizzazione ha informazioni che deve archiviare e gestire per soddisfare i propri requisiti. Ad esempio, una società deve raccogliere e gestire i record delle risorse umane per i propri dipendenti. Queste informazioni devono essere a disposizione di coloro che ne hanno bisogno.
Un sistema di informazioni è un sistema formale per la memorizzazione e l'elaborazione delle informazioni. Un database è una raccolta organizzata di informazioni trattate come un'unità. Lo scopo di un database è quello di raccogliere, memorizzare e recuperare le informazioni correlate per l'uso da parte delle applicazioni di database.
Quando i sistemi di database sono stati inventati per la prima volta, sono stati progettati per un carico di lavoro specifico. Nel corso degli anni è diventato evidente che i database monouso non soddisfano più tutti i requisiti: oltre AI carichi di lavoro relazionali, gli sviluppatori avevano bisogno di memorizzare i dati in altri formati come XML, spaziale, grafico, JSON e, più recentemente, dati vettoriali per l'era dell'intelligenza artificiale.
Oracle AI Database si è sviluppato da un motore di database relazionale a un motore convergente, consentendo agli sviluppatori di memorizzare quasi tutti i tipi di dati nel formato richiesto dalla loro applicazione in modo nativo e completamente integrato nella sua architettura di livello enterprise.
-
Database Management System (DBMS) Un database management system (DBMS) è un software che controlla lo storage, l'organizzazione e il recupero dei dati.
-
Modello relazionale Nel suo articolo seminale del 1970 "Un modello relazionale di dati per grandi banche di dati condivise", E. F. Codd ha definito un modello relazionale basato sulla teoria degli insiemi matematici. Oggi, il modello di database più ampiamente accettato è il modello relazionale.
-
Relational Database Management System (RDBMS) Il modello relazionale è la base per un sistema di gestione dei database relazionali (RDBMS). Un RDBMS sposta i dati in un database, memorizza i dati e li recupera in modo che le applicazioni possano manipolarli.
Sistemi di gestione dei database (DBMS)
Un database management system (DBMS) è un software che controlla lo storage, l'organizzazione e il recupero dei dati.
In genere, un DBMS dispone degli elementi riportati di seguito.
-
Codice kernel
Questo codice gestisce la memoria e lo storage per il DBMS.
-
Repository di metadati
Questo repository è in genere denominato dizionario dati o catalogo di metadati.
-
Linguaggi di query
I linguaggi di query facilitano l'accesso ai dati. I database convergenti come Oracle AI Database supportano più linguaggi di query.
Un'applicazione di database è un programma software che interagisce con un database per accedere e manipolare i dati. Oracle AI Database è stato uno dei primi motori di database a supportare il modello relazionale. Fin dalla sua nascita, si è evoluto in un motore di database convergente, supportando quasi tutti i tipi di dati e molti carichi di lavoro diversi.
Modello relazionale
Nel suo articolo del 1970 "Un modello relazionale di dati per grandi banche di dati condivise", E. F. Codd ha definito un modello relazionale basato sulla teoria degli insiemi matematici. Oggi, il modello di database più accettato è il modello relazionale.
Un database relazionale è un database conforme al modello relazionale. Il modello relazionale presenta i seguenti aspetti principali:
-
Strutture
Gli oggetti ben definiti memorizzano o accedono ai dati di un database.
-
Operazioni
Le azioni chiaramente definite consentono alle applicazioni di manipolare i dati e le strutture di un database.
-
Regole di integrità
Le regole di integrità regolano le operazioni sui dati e sulle strutture di un database.
Un database relazionale memorizza i dati in un insieme di relazioni semplici. Una relazione è un insieme di tuple. Un tuple è un set non ordinato di valori di attributo.
Una tabella è una rappresentazione bidimensionale di una relazione sotto forma di righe (tupli) e colonne (attributi). Ogni riga di una tabella ha lo stesso insieme di colonne. Un database relazionale è un database che memorizza i dati nelle relazioni (tabelle). Ad esempio, un database relazionale potrebbe memorizzare informazioni sui dipendenti della società in una tabella dei dipendenti, in una tabella dei reparti e in una tabella degli stipendi.
Argomenti correlati
RDBMS (Relational Database Management System)
Il modello relazionale è la base per un sistema di gestione del database relazionale (RDBMS). Un RDBMS sposta i dati in un database, memorizza i dati e li recupera in modo che le applicazioni possano manipolarli.
Un RDBMS distingue tra i seguenti tipi di operazioni:
-
Operazioni logiche
In questo caso, un'applicazione specifica quali contenuti sono necessari. Ad esempio, un'applicazione richiede un nome dipendente o aggiunge un record dipendente a una tabella.
-
Operazioni fisiche
In questo caso, l'RDBMS determina come devono essere eseguite le operazioni ed esegue l'operazione. Ad esempio, dopo che un'applicazione esegue una query su una tabella, il database può utilizzare un indice per trovare le righe richieste, leggere i dati in memoria ed eseguire molti altri passi prima di restituire un risultato all'utente. RDBMS memorizza e recupera i dati in modo che le operazioni fisiche siano trasparenti per le applicazioni di database.
Oracle AI Database è un RDBMS alla base. Un RDBMS che implementa funzionalità orientate agli oggetti come tipi definiti dall'utente, ereditarietà e polimorfismo è chiamato un sistema di gestione del database relazionale agli oggetti (ORDBMS). Oracle AI Database estende il modello relazionale a un modello relazionale agli oggetti, consentendo di memorizzare modelli aziendali complessi in un database relazionale. Nel corso del tempo, il motore di dati di base di Oracle si è evoluto in un modello molto più potente ora definito un database convergente.
Architettura del database convergente
Oracle AI Database è un database convergente che supporta più modelli di dati e carichi di lavoro in un unico motore di database. Oltre ai dati relazionali, può gestire documenti JSON, dati grafici, dati spaziali, testo, vettori e altri tipi di dati specializzati.
Queste funzionalità condividono servizi di database comuni, tra cui transazioni, sicurezza, backup e ripristino, alta disponibilità, audit e ottimizzazione delle query. Le applicazioni possono quindi utilizzare modelli di dati diversi senza richiedere un database separato per ciascuno di essi.
Ad esempio, un'applicazione può memorizzare i dati di clienti e transazioni in tabelle relazionali, attributi flessibili nei documenti JSON, informazioni geografiche come dati spaziali e integrazioni vettoriali per la ricerca semantica. SQL può essere utilizzato per eseguire query e combinare queste forme di dati in un'unica operazione. Un'API in stile documento è disponibile per gli sviluppatori che preferiscono questo stile NoSQL.
Un database convergente offre i vantaggi riportati di seguito.
- Riduzione dello spostamento dei dati tra sistemi specializzati
- Sicurezza e governance coerenti
- Transazioni integrate tra i dati correlati
- Applicazione e architettura operativa semplificate
- Analisi unificata di più tipi di dati
- Audit unificato delle operazioni del database
Convergence non richiede che ogni carico di lavoro utilizzi ogni capacità o risieda in un unico database fisico. Le applicazioni possono utilizzare solo le funzioni di cui hanno bisogno. L'architettura flessibile di Oracle consente agli sviluppatori di distribuire applicazioni su più pluggable database.
Oracle Database rimane relazionale alla base. La sua architettura convergente estende tale base in modo che le applicazioni possano funzionare con più modelli di dati utilizzando un set comune di servizi di database per quasi tutti i carichi di lavoro.
Oggetti dello schema
Una caratteristica di un RDBMS è l'indipendenza dello storage fisico dei dati dalle strutture di dati logiche.
In Oracle AI Database, uno schema del database è una raccolta di strutture di dati logiche o oggetti dello schema. Un utente di database è proprietario di uno schema di database con lo stesso nome del nome utente.
Gli oggetti schema sono strutture create dall'utente che fanno riferimento direttamente ai dati nel database. Il database supporta molti tipi di oggetti di schema, i più importanti dei quali sono tabelle e indici. Gli utenti che preferiscono un'API in stile documento per accedere ai propri dati possono creare raccolte (JSON) o viste di dualità relazionali JSON.
Un oggetto schema è un tipo di oggetto database. Alcuni oggetti di database, ad esempio profili e ruoli, non risiedono negli schemi.
-
Tabelle Una tabella descrive un'entità, ad esempio i dipendenti.
-
Indici Un indice è una struttura dati facoltativa che è possibile creare su una o più colonne di una tabella. Gli indici possono aumentare le prestazioni del recupero dei dati.
Argomenti correlati
Tabelle
Una tabella descrive un'entità, ad esempio i dipendenti.
Si definisce una tabella con un nome di tabella, ad esempio employees, e un set di colonne. In generale, è possibile assegnare a ogni colonna un nome, un tipo di dati e una larghezza quando si crea la tabella.
Una tabella è un insieme di righe. Una colonna identifica un attributo dell'entità descritta dalla tabella, mentre una riga identifica un'istanza dell'entità. Ad esempio, gli attributi dell'entità dipendenti corrispondono alle colonne per l'ID dipendente e il cognome. Una riga identifica un dipendente specifico.
Facoltativamente, è possibile specificare una regola, denominata vincolo integrità, per una colonna. Un esempio è un vincolo di integrità NOT NULL. Questo vincolo forza la colonna a contenere un valore in ogni riga. I vincoli che si estendono su più tabelle possono essere definiti come asserzioni SQL. Prima di Oracle AI Database 26ai, era possibile utilizzare i trigger del database per applicare la business logic nell'ambito di una transazione.
Argomenti correlati
Indici
Un indice è una struttura dati facoltativa che è possibile creare su una o più colonne di una tabella. Gli indici possono aumentare le prestazioni del recupero dei dati.
Durante l'elaborazione di una richiesta, il database può utilizzare gli indici disponibili per individuare le righe richieste in modo efficiente. Gli indici sono utili quando le applicazioni spesso eseguono query su una riga o un intervallo di righe specifico.
Gli indici sono logicamente e fisicamente indipendenti dai dati. Pertanto, è possibile eliminare e creare indici senza alcun effetto sulle tabelle o su altri indici. Tutte le applicazioni continuano a funzionare dopo aver eliminato un indice.
Argomenti correlati
Accesso ai dati
Un requisito generale per un DBMS è quello di rispettare gli standard di settore accettati per un linguaggio di accesso ai dati. Nota: JavaScript richiede che Oracle 26ai sia in esecuzione su Linux x86-64 o Linux aarch64.
-
SQL (Structured Query Language) SQL è un linguaggio dichiarativo basato su set che fornisce un'interfaccia a un RDBMS come Oracle AI Database.
-
PL/SQL è un'estensione procedurale di Oracle SQL. Java e JavaScript sono opzioni aggiuntive che è possibile utilizzare per memorizzare la business logic nel database.
SQL (Structured Query Language)
SQL è un linguaggio dichiarativo basato su set che fornisce un'interfaccia a un RDBMS come Oracle AI Database.
I linguaggi procedurali come C descrivono come le cose dovrebbero essere fatte. SQL non procedurale e descrive cosa dovrebbe essere fatto.
SQL è il linguaggio standard ANSI per i database relazionali. Tutte le operazioni sui dati di un database Oracle vengono eseguite utilizzando istruzioni SQL. Ad esempio, si utilizza SQL per creare tabelle ed eseguire query e modificare i dati nelle tabelle.
Un'istruzione SQL può essere considerata come un programma o un'istruzione per computer molto semplice, ma potente. Gli utenti specificano il risultato che desiderano (ad esempio, i nomi dei dipendenti), non come derivarlo. Un'istruzione SQL è una stringa di testo SQL, ad esempio:
SELECT first_name, last_name FROM employees;Le istruzioni SQL consentono di eseguire i task riportati di seguito.
-
Dati query
-
Inserire, aggiornare ed eliminare righe in una tabella
-
Creare, sostituire, modificare ed eliminare oggetti
-
Controllare l'accesso al database e ai relativi oggetti
-
Garantisci coerenza e integrità del database
SQL unifica i task precedenti in una lingua coerente. Oracle SQL è un'implementazione dello standard ANSI. Oracle SQL supporta numerose funzionalità che si estendono oltre il linguaggio SQL standard.
Argomenti correlati
PL/SQL, Java e JavaScript
PL/SQL è un'estensione procedurale di Oracle SQL. Java e JavaScript sono opzioni aggiuntive che è possibile utilizzare per memorizzare la business logic nel database.
PL/SQL è integrato con Oracle AI Database, consentendoti di utilizzare tutte le istruzioni, le funzioni e i tipi di dati SQL di Oracle AI Database. È possibile utilizzare PL/SQL per controllare il flusso di un programma SQL, utilizzare variabili e scrivere procedure di gestione degli errori.
Un vantaggio principale di PL/SQL è la possibilità di memorizzare la logica dell'applicazione nel database stesso. Una procedura PL/SQL o una funzione è un oggetto di schema costituito da un set di istruzioni SQL e altri costrutti PL/SQL raggruppati, raggruppati, memorizzati nel database ed eseguiti come unità per risolvere un problema specifico o per modificarne o eliminarne una esistente. Il vantaggio principale della programmazione lato server è che le funzionalità integrate possono essere distribuite ovunque.
Oracle AI Database può anche memorizzare le program unit scritte in Java e JavaScript. Una stored procedure Java è un metodo Java pubblicato in SQL e memorizzato nel database per uso generale. È possibile chiamare i programmi PL/SQL esistenti da Java e JavaScript, nonché i programmi Java e JavaScript da PL/SQL.
Multilingual Engine (MLE) ti offre la possibilità di scrivere business logic in JavaScript e memorizzare il codice nel database come moduli MLE. Le funzioni esportate dai moduli MLE possono essere esposte a SQL e PL/SQL mediante le specifiche di chiamata. Queste specifiche di chiamata sono unità PL/SQL (funzioni, procedure e pacchetti) e possono essere chiamate ovunque sia chiamato PL/SQL.
Argomenti correlati
API NoSQL per l'accesso ai documenti
Simple Oracle Document Access (SODA) è un set di API in stile NoSQL per la gestione delle raccolte di documenti, in particolare dei documenti JSON, in Oracle AI Database. Le applicazioni possono creare raccolte e inserire, recuperare, aggiornare, eliminare ed eseguire query sui documenti senza richiedere la conoscenza di SQL o dello schema di database sottostante.
SODA fornisce un modello di programmazione incentrato sui documenti basato su raccolte, documenti e filtri query per esempio. Questo è il contrario di SQL, che fornisce un'interfaccia dichiarativa e orientata ai set per l'esecuzione di query e la modifica dei dati relazionali e può esprimere join, aggregazioni e operazioni su più tipi di dati.
SODA è utile quando un'applicazione funziona principalmente con documenti JSON e richiede una semplice API di documento, e può essere un'alternativa per gli sviluppatori che desiderano utilizzare un'API NoSQL.
Gli sviluppatori che effettuano il porting dei carichi di lavoro dei documenti nel database Oracle AI da un data store di terze parti monouso hanno la possibilità di utilizzare l'API Mongo DB per Oracle AI Database, che è simile a SODA ma ha lo scopo di semplificare le migrazioni. Nel caso più semplice, la modifica della stringa di connessione dell'applicazione dal data store monouso a Oracle AI Database è tutto ciò che deve essere fatto.
Gestione transazioni
Oracle AI Database è progettato come database multiutente. Il database deve garantire che più utenti possano lavorare contemporaneamente senza danneggiare i dati l'uno dell'altro.
-
Transazioni Una transazione è un'unità di lavoro logica e atomica che contiene una o più istruzioni SQL.
-
Concorrenza dati Un requisito di un RDBMS multiutente è il controllo della concorrenza dei dati, ovvero l'accesso simultaneo degli stessi dati da parte di più utenti.
-
Coerenza dei dati In Oracle AI Database, ogni utente deve visualizzare una vista coerente dei dati, comprese le modifiche visibili apportate dalle transazioni proprie di un utente e le transazioni sottoposte a commit di altri utenti.
Transazioni
Una transazione è un'unità di lavoro logica e atomica che contiene una o più istruzioni SQL.
Un RDBMS deve essere in grado di raggruppare le istruzioni SQL in modo che siano tutte sottoposte a commit, il che significa che sono state applicate al database o tutte sottoposte a rollback, il che significa che sono state annullate.
Un esempio della necessità di transazioni è un trasferimento di fondi da un conto di risparmio a un conto corrente. Il trasferimento è costituito dalle seguenti operazioni separate:
-
Ridurre il conto di risparmio.
-
Aumentare il conto corrente.
-
Registrare la transazione nella scrittura contabile transazione.
Oracle AI Database garantisce che tutte e tre le operazioni abbiano successo o falliscano come unità. Ad esempio, se un errore hardware impedisce l'esecuzione di un'istruzione nella transazione, è necessario eseguire il rollback delle altre istruzioni.
Le transazioni sono una funzionalità che distingue Oracle AI Database da un file system. Se si esegue un'operazione atomica che aggiorna diversi file e se il sistema non riesce a metà, i file non saranno coerenti. Al contrario, una transazione sposta un database Oracle da uno stato coerente a un altro. Il principio di base di una transazione è "tutto o niente": un'operazione atomica ha successo o fallisce nel suo complesso.
Argomenti correlati
Concorrenza dati
Un requisito di un RDBMS multiutente è il controllo della concorrenza dei dati, ovvero l'accesso simultaneo degli stessi dati da parte di più utenti.
Senza controlli sulla concorrenza, gli utenti potrebbero modificare i dati in modo improprio, compromettendo l'integrità dei dati. Ad esempio, un utente può aggiornare una riga mentre un altro utente la aggiorna contemporaneamente.
Se più utenti accedono agli stessi dati, un modo per gestire la concorrenza consiste nell'attesa degli utenti. Tuttavia, l'obiettivo di un DBMS è quello di ridurre i tempi di attesa in modo che sia inesistente o trascurabile. Tutte le istruzioni SQL che modificano i dati devono procedere con il minor numero possibile di interferenze. Devono essere evitate interazioni distruttive, ovvero interazioni che aggiornano in modo errato i dati o alterano le strutture di dati sottostanti.
Oracle AI Database utilizza i lock per controllare l'accesso concorrente ai dati. Un blocco è un meccanismo che impedisce l'interazione distruttiva tra le transazioni che accedono a una risorsa condivisa. I blocchi garantiscono l'integrità dei dati consentendo al contempo il massimo accesso concorrente ai dati.
Argomenti correlati
Coerenza dati
In Oracle AI Database, ogni utente deve visualizzare una vista coerente dei dati, incluse le modifiche visibili apportate dalle transazioni di un utente e dalle transazioni di altri utenti sottoposte a commit.
Ad esempio, il database deve impedire il problema di lettura non consentita, che si verifica quando una transazione visualizza le modifiche non sottoposte a commit apportate da un'altra transazione concorrente.
Oracle AI Database applica sempre una coerenza della lettura a livello di istruzione, il che garantisce che i dati restituiti da una singola query vengano sottoposti a commit e coerenti per un singolo point-in-time. A seconda del livello di isolamento delle transazioni, questo è il momento in cui l'estratto conto è stato aperto o l'ora di inizio della transazione. La funzione Query di Oracle Flashback consente di specificare questo point-in-time in modo esplicito.
Il database può anche fornire coerenza di lettura a tutte le query in una transazione, nota come coerenza di lettura a livello di transazione. In questo caso, ogni dichiarazione in una transazione vede i dati dallo stesso punto nel tempo, ovvero il momento in cui è iniziata la transazione.
Argomenti correlati
Architettura di Oracle AI Database
Un database server è la chiave per la gestione delle informazioni.
In generale, un server gestisce in modo affidabile una grande quantità di dati in un ambiente multiutente in modo che gli utenti possano accedere contemporaneamente agli stessi dati. Un database server impedisce anche l'accesso non autorizzato e fornisce soluzioni efficienti per il ripristino degli errori.
-
Database e istanza Un database server Oracle è costituito da un database e da almeno un'istanza di database, comunemente indicata come semplicemente un'istanza.
-
Strutture di storage del database Un database può essere considerato sia dal punto di vista fisico che logico.
-
Strutture di istanze di database Un database Oracle utilizza strutture e processi di memoria per gestire e accedere al CDB. Tutte le strutture di memoria esistono nella memoria principale dei computer che costituiscono il RDBMS.
-
Architettura dell'applicazione e della rete Per sfruttare appieno un determinato sistema o rete di computer, Oracle AI Database consente di suddividere l'elaborazione tra il database server e i programmi client. Il computer che esegue l'RDBMS gestisce le responsabilità del database server mentre i computer che eseguono le applicazioni gestiscono l'interpretazione e la visualizzazione dei dati.
Database e istanza
Un database server Oracle è costituito da un database e da almeno un'istanza di database, comunemente indicata come semplicemente un'istanza.
Poiché un'istanza e un database sono così strettamente connessi, il termine database Oracle a volte si riferisce sia all'istanza che al database. Nel senso più stretto, i termini hanno i seguenti significati:
-
Database
Un database è un insieme di file, che si trovano su disco, che memorizzano i dati degli utenti. Questi file di dati possono esistere indipendentemente da un'istanza di database. A partire da Oracle Database 21c, "database" si riferisce in modo specifico ai file di dati di un container database multi-tenant (CDB), di un pluggable database (PDB) o di un container di applicazioni.
-
Istanza database
Un'istanza è un insieme denominato di strutture di memoria che gestiscono i file di database. Un'istanza di database è costituita da un'area di memoria condivisa, denominata SGA (System Global Area), e da un set di processi in background. Un'istanza può esistere indipendentemente dai file di database.
-
Architettura multi-tenant L'architettura multi-tenant consente a un Oracle AI Database di essere un CDB.
-
Architettura di database distribuita a livello globale Oracle Globally Distributed Database (precedentemente denominato Oracle Sharding) è una tecnica di scalabilità del database basata sul partizionamento orizzontale dei dati tra più PDB. Le applicazioni percepiscono il pool di PDB come un singolo database logico. Ogni partizione viene denominata shard.
Architettura multitenant
L'architettura multi-tenant consente a un Oracle AI Database di essere un CDB.
Ogni Oracle AI Database deve contenere o essere in grado di essere contenuto da un altro database. Ad esempio, un CDB contiene PDB e un contenitore di applicazioni contiene PDB di applicazione. Un PDB è contenuto da un CDB o da un contenitore di applicazioni e un contenitore di applicazioni è contenuto da un CDB.
A partire da Oracle Database 21c, un container database multi-tenant è l'unica architettura supportata. Nelle release precedenti, Oracle supportava database non di tipo container (non CDB).
-
Database container Un CDB contiene uno o più PDB e container di applicazioni creati dall'utente.
-
Pluggable database Un PDB è una raccolta portatile di schemi, oggetti schema e oggetti non schema visualizzati in un'applicazione come database separato.
-
Contenitori dell'applicazione Un contenitore dell'applicazione è un contenitore facoltativo creato dall'utente all'interno di un CDB che memorizza dati e metadati per una o più applicazioni.
Container database
Un CDB contiene uno o più PDB e container di applicazioni creati dall'utente.
A livello fisico, un CDB è un insieme di file: control file, redo log file in linea e file di dati. L'istanza di database gestisce i file che compongono il CDB.
La figura seguente mostra un CDB e un'istanza di database associata.
Figura 1: Istanza di database e CDB
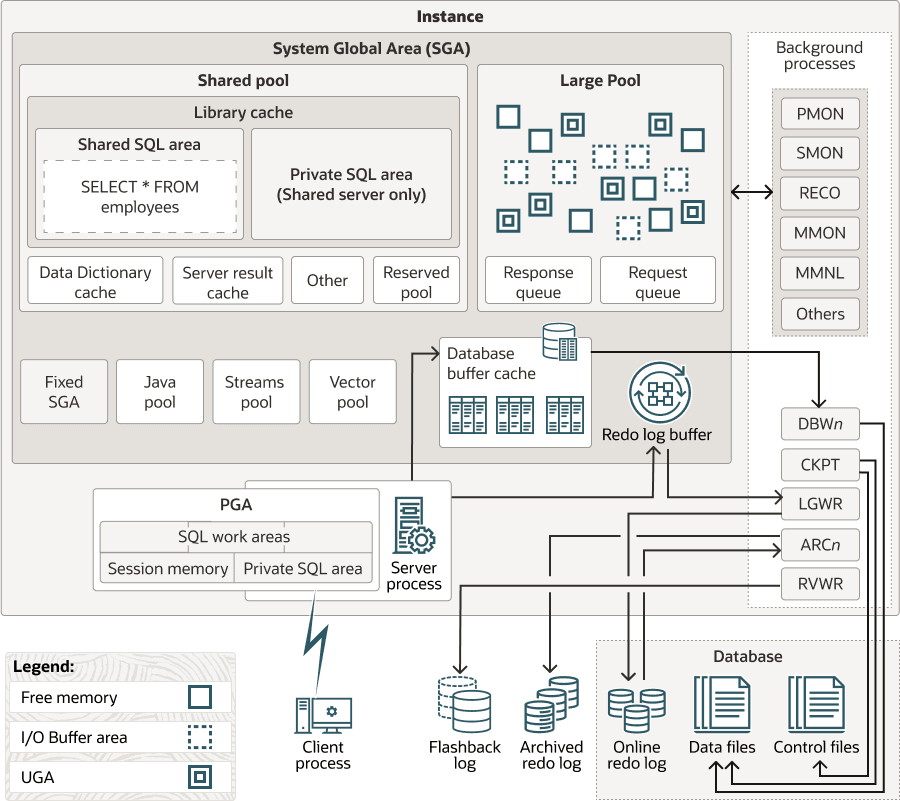
Descrizione dell'illustrazione cncpt233.png
Database collegabili
Un PDB è una raccolta portatile di schemi, oggetti di schema e oggetti non di schema visualizzati in un'applicazione come database separato.
A livello fisico, ogni PDB dispone di un proprio set di file di dati che memorizzano i dati per il PDB. Il CDB include tutti i file di dati per i PDB in esso contenuti e un set di file di dati del sistema che memorizzano i metadati per il CDB stesso.
Per spostare o archiviare un PDB, è possibile scollegarlo. Un PDB scollegato è costituito dai file di dati del PDB e da un file di metadati. Un PDB scollegato non è utilizzabile fino a quando non viene collegato a un CDB.
La figura seguente mostra un CDB denominato MYCDB.
Figura 2: PDB in un CDB
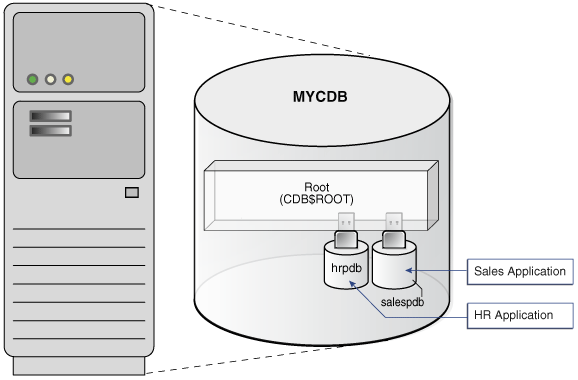
Descrizione dell'illustrazione cncpt352.png
Fisicamente, MYCDB è un Oracle AI Database, nel senso di un set di file di dati associati a un'istanza. MYCDB dispone di un'istanza di database, sebbene siano possibili più istanze in Oracle Real Application Clusters e un set di file di database.
MYCDB contiene due PDB: hrpdb e salespdb. Come illustrato nella Figura 1-2, questi PDB vengono visualizzati nelle rispettive applicazioni come database separati e indipendenti. Un'applicazione non è a conoscenza della connessione a un CDB o a un PDB.
Per amministrare il CDB stesso o qualsiasi PDB al suo interno, è possibile connettersi alla root CDB. La radice è una raccolta di schemi, oggetti schema e oggetti non schema a cui appartengono tutti i PDB e i contenitori applicazione.
Container applicazione
Un contenitore dell'applicazione è un contenitore facoltativo creato dall'utente all'interno di un CDB che memorizza dati e metadati per una o più applicazioni.
In questo contesto, un'applicazione (chiamata anche definizione dell'applicazione principale) è un set con controllo delle versioni denominato di dati e metadati comuni memorizzati nella root dell'applicazione. Ad esempio, l'applicazione potrebbe includere definizioni di tabelle, viste, account utente e package PL/SQL comuni a un set di PDB.
In alcuni modi, un contenitore dell'applicazione funge da CDB specifico dell'applicazione all'interno di un CDB. Un contenitore dell'applicazione, come il CDB stesso, può includere più PDB dell'applicazione e consente a questi PDB di condividere metadati e dati. A livello fisico, un contenitore di applicazioni dispone di un proprio set di file di dati, proprio come un PDB.
Ad esempio, una distribuzione SaaS può utilizzare più PDB applicazione, ciascuno per un cliente separato, che condivida i metadati e i dati dell'applicazione. Ad esempio, nella figura seguente, sales_app è il modello di applicazione nella radice dell'applicazione. Il PDB applicazione denominato cust1_pdb contiene i dati di vendita solo per il cliente 1, mentre il PDB applicazione denominato cust2_pdb contiene i dati di vendita solo per il cliente 2. Il collegamento, lo scollegamento, la duplicazione e altre operazioni a livello di PDB sono disponibili per i singoli PDB dei clienti.
Figura 3: Caso d'uso SaaS
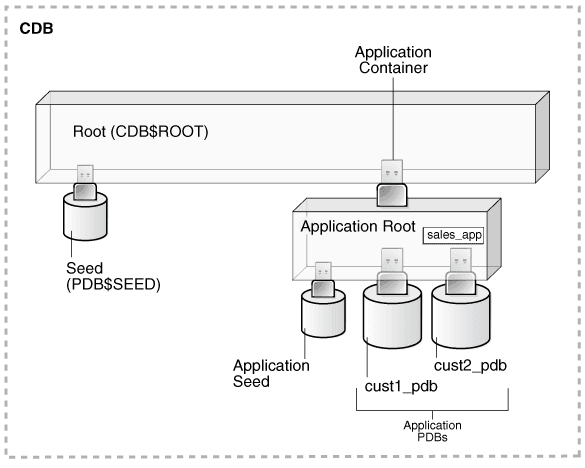
Descrizione dell'illustrazione cncpt389.png
Architettura di database distribuita a livello globale
Oracle Globally Distributed Database (precedentemente denominato partizionamento orizzontale di Oracle) è una tecnica di scalabilità dei database basata sul partizionamento orizzontale dei dati tra più PDB. Le applicazioni percepiscono il pool di PDB come un singolo database logico. Ogni partizione viene denominata shard.
I vantaggi principali del partizionamento orizzontale per le applicazioni includono scalabilità lineare, contenimento degli errori e distribuzione dei dati geografici. Globally Distributed Database è adatto alla distribuzione in Oracle Cloud. A differenza dei data store NoSQL che implementano il partizionamento orizzontale, Globally Distributed Database offre i vantaggi del partizionamento orizzontale senza sacrificare le funzionalità di un RDBMS aziendale.
In un'architettura di partizionamento orizzontale, ogni CDB è ospitato su un server dedicato con le proprie risorse locali: CPU, memoria, flash o disco. È possibile designare un PDB come partita. Le partizioni PDB di CDB diversi costituiscono un singolo database logico, definito database con partizionamento orizzontale. Due partizioni nello stesso CDB non possono essere membri dello stesso database con partizionamento orizzontale. Tuttavia, all'interno dello stesso CDB, un PDB potrebbe trovarsi in un database con partizionamento orizzontale e un altro PDB potrebbe trovarsi in un database con partizionamento orizzontale separato.
Il partizionamento orizzontale implica la suddivisione di una tabella di database tra partizioni in modo che ogni partizione contenga la tabella con le stesse colonne ma un subset di righe diverso. Una tabella suddivisa in questo modo è anche nota come tabella partizionata. La figura seguente mostra una tabella con partizionamento orizzontale partizionata in tre partizioni, ognuna delle quali è un PDB in un CDB separato.
Figura 4: Partizionamento orizzontale di una tabella tra partizioni
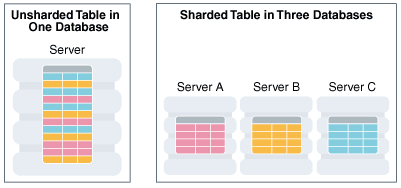
Descrizione dell'immagine admin_3v_134a.png
Un caso d'uso riguarda la distribuzione dei dati del conto cliente su più CDB. Ad esempio, un cliente con ID 28459361 potrebbe cercare i propri record. La figura seguente mostra una possibile architettura. La richiesta del cliente viene instradata tramite un connection pool, in cui i direttori di partizionamento orizzontale (ascoltatori di rete) indirizzano la richiesta alla partizione PDB appropriata, che contiene tutte le righe del cliente.
Figura 5: Architettura di Oracle Globally Distributed Database
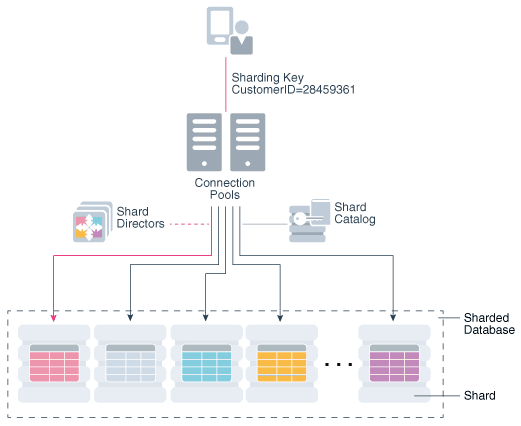
Descrizione dell'immagine admin_3v_143d.png
Argomenti correlati
Strutture di memorizzazione del database
Un database può essere considerato sia da un punto di vista fisico che logico.
I dati fisici sono dati visualizzabili a livello di sistema operativo. Ad esempio, le utility del sistema operativo come Linux ls e ps possono elencare file e processi di database. I dati logici come una tabella sono significativi solo per il database. Un'istruzione SQL può elencare le tabelle in un database Oracle, ma non una utility del sistema operativo.
Il database ha strutture fisiche e logiche. Poiché le strutture fisiche e logiche sono separate, è possibile gestire la memorizzazione fisica dei dati senza influire sull'accesso alle strutture di memorizzazione logica. Ad esempio, la ridenominazione di un file di database fisico non comporta la ridenominazione delle tabelle i cui dati sono memorizzati in questo file.
-
Strutture di memorizzazione fisica Le strutture di database fisiche sono i file che memorizzano i dati.
-
Strutture di storage logiche Le strutture di storage logiche consentono a Oracle AI Database di avere un controllo capillare dell'uso dello spazio su disco.
Strutture di storage fisico
Le strutture fisiche del database sono i file che memorizzano i dati.
Quando si esegue un comando CREATE DATABASE, si crea un CDB. Vengono creati i file seguenti:
-
File di dati
Ogni CDB dispone di uno o più file di dati fisici, che contengono tutti i dati del database. I dati delle strutture di database logiche, ad esempio tabelle e indici, vengono memorizzati fisicamente nei file di dati.
-
Control file
Ogni CDB dispone di un file di controllo. Un control file contiene metadati che specificano la struttura fisica del database, inclusi il nome del database e i nomi e le posizioni dei file di database.
-
Redo log in linea
Ogni CDB dispone di un redo log in linea, che è un set di due o più redo log file online. Un redo log in linea è costituito da redo entry (denominati anche redo log record), che registrano tutte le modifiche apportate ai dati.
Quando si esegue un comando CREATE PLUGGABLE DATABASE all'interno di un CDB, si crea un PDB. Il PDB contiene un set dedicato di file di dati all'interno del CDB. Un PDB non dispone di un control file dedicato separato e di un redo log in linea: questi file sono condivisi dai PDB.
Molti altri file sono importanti per il funzionamento di un CDB. Sono inclusi i file dei parametri e i file di rete. I file di backup e i redo log file archiviati sono file offline importanti per il backup e il recupero.
Argomenti correlati
Vedi anche: "Strutture di storage fisico"
Strutture di storage logico
Le strutture di storage logiche consentono a Oracle AI Database di avere un controllo capillare dell'uso dello spazio su disco.
In questo argomento vengono descritte le strutture di memorizzazione logica.
-
Blocchi di dati
Al massimo livello di granularità, i dati di Oracle AI Database vengono memorizzati in blocchi di dati. Un blocco di dati corrisponde a un numero specifico di byte sul disco.
-
Estensioni
Un extent è un numero specifico di blocchi dati contigui, ottenuto in una singola allocazione, utilizzato per memorizzare un tipo specifico di informazioni.
-
Segmenti
Un segmento è un set di estensioni allocate per un oggetto utente (ad esempio, una tabella o un indice), annulla dati o dati temporanei.
-
Tablespace
Un database è diviso in unità logiche di memorizzazione chiamate tablespace. Uno spazio tabulare è il contenitore logico per i segmenti. Ogni tablespace è costituita da almeno un file di dati.
Argomenti correlati
Strutture istanza database
Un database Oracle utilizza strutture e processi di memoria per gestire e accedere al CDB. Tutte le strutture di memoria esistono nella memoria principale dei computer che costituiscono il RDBMS.
Quando le applicazioni si connettono a un CDB o PDB, si connettono a un'istanza di database. L'istanza fornisce servizi alle applicazioni allocando altre aree di memoria oltre alla SGA e avviando altri processi oltre ai processi in background.
-
Processi di Oracle AI Database Un processo è un meccanismo in un sistema operativo in grado di eseguire una serie di passi. Alcuni sistemi operativi utilizzano i termini job, task o thread.
-
Strutture di memoria dell'istanza Oracle AI Database crea e utilizza strutture di memoria per il codice del programma, i dati condivisi tra gli utenti e le aree dati private per ogni utente connesso.
Processi di Oracle AI Database
Un processo è un meccanismo di un sistema operativo che può eseguire una serie di passi. Alcuni sistemi operativi utilizzano i termini job, task o thread.
Ai fini di questo argomento, un thread equivale a un processo. Un'istanza di database Oracle dispone dei tipi di processi riportati di seguito.
-
Processi client
Questi processi vengono creati e gestiti per eseguire il codice software di un programma applicativo o di uno strumento Oracle. La maggior parte degli ambienti dispone di computer separati per i processi client.
-
Processi in background
Questi processi consolidano le funzioni che altrimenti verrebbero gestite da più programmi Oracle AI Database in esecuzione per ogni processo client. I processi in background eseguono l'I/O in modo asincrono e monitorano altri processi di Oracle AI Database per fornire un maggiore parallelismo per migliorare prestazioni e affidabilità.
-
Processi server
Questi processi comunicano con i processi client e interagiscono con Oracle AI Database per soddisfare le richieste.
I processi Oracle includono processi server e processi in background. Nella maggior parte degli ambienti, i processi e i processi client Oracle vengono eseguiti su computer separati.
Argomenti correlati
Strutture memoria istanza
Oracle AI Database crea e utilizza strutture di memoria per il codice del programma, i dati condivisi tra gli utenti e le aree dati private per ogni utente connesso.
Le seguenti strutture di memoria sono associate a un'istanza di database:
-
SGA (System Global Area)
SGA (System Global Area) è un gruppo di strutture della memoria condivisa contenenti dati e informazioni del controllo per un'istanza di database. Esempi di componenti SGA includono la buffer cache del database e le aree SQL condivise. L'area di memorizzazione colonne SGA può contenere un'area di memorizzazione colonne in memoria facoltativa (In-Memory Column Store), che consente di popolare i dati in memoria in un formato colonna.
-
PGA (Program Global Areas)
Una PGA è un'area di memoria che contiene dati e informazioni di controllo per un server o un processo in background. L'accesso alla PGA è esclusivo del processo. Ogni processo server e processo in background dispone della propria area PGA.
Argomenti correlati
Architettura di applicazioni e reti
Per sfruttare appieno un determinato sistema informatico o rete, Oracle AI Database consente di suddividere l'elaborazione tra il database server e i programmi client. Il computer che esegue l'RDBMS gestisce le responsabilità del database server mentre i computer che eseguono le applicazioni gestiscono l'interpretazione e la visualizzazione dei dati.
-
Architettura delle applicazioni L'architettura delle applicazioni è l'ambiente informatico in cui un'applicazione di database si connette a un database Oracle. Le due architetture di database più comuni sono client/server e multitier.
-
Architettura Oracle Net Services
Oracle Net Services è l'interfaccia tra il database e i protocolli di comunicazione di rete che facilitano l'elaborazione distribuita e i database distribuiti.
Architettura delle applicazioni
L'architettura dell'applicazione è l'ambiente informatico in cui un'applicazione di database si connette a un database Oracle. Le due architetture di database più comuni sono client/server e multitier.
Architettura client-server
In un'architettura client/server, l'applicazione client avvia una richiesta di esecuzione di un'operazione sul database server. Il server esegue il software Oracle AI Database e gestisce le funzioni necessarie per l'accesso concorrente e condiviso ai dati. Il server riceve ed elabora le richieste che provengono dai client.
Architettura multilivello
In un'architettura multilivello, uno o più application server eseguono parti dell'operazione. Un Application Server contiene gran parte della logica dell'applicazione, fornisce l'accesso ai dati per il client ed esegue un'elaborazione delle query. In questo modo, il carico sul database diminuisce. L'Application Server può fungere da interfaccia tra client e più database e fornire un ulteriore livello di sicurezza.
Un'architettura SOA (Service-Oriented Architecture) è un'architettura a più livelli in cui le funzionalità delle applicazioni sono incapsulate nei servizi. I servizi SOA sono in genere implementati come servizi Web. I servizi Web sono accessibili tramite HTTP e si basano su standard basati su XML quali WSDL (Web Services Description Language) e SOAP. Oracle AI Database può fungere da provider di servizi Web in un ambiente tradizionale a più livelli o SOA.
Un'architettura di microservizi divide un'applicazione in servizi di piccole dimensioni, sviluppati e distribuiti in modo indipendente. Ogni servizio possiede la sua logica di business e, idealmente, i suoi dati, riducendo l'accoppiamento e consentendo ai team di ridimensionare, aggiornare e gestire i servizi in modo indipendente.
L'architettura multi-tenant Oracle si associa naturalmente al pattern database-per-service. Ogni microservizio può utilizzare il proprio pluggable database (PDB), fornendo dati, sicurezza e limiti amministrativi separati, mentre più PDB condividono le risorse di un container database (CDB) comune.
Questo approccio combina l'isolamento del servizio con un consolidamento efficiente. È possibile eseguire il provisioning, la copia, la patch, il backup, il riposizionamento e la scalabilità dei PDB in modo indipendente, mentre gli amministratori mantengono il controllo centralizzato dell'infrastruttura di database sottostante.
Argomenti correlati
Architettura Oracle Net Services
Oracle Net Services sono l'interfaccia tra il database e i protocolli di comunicazione di rete che facilitano l'elaborazione distribuita e i database distribuiti.
I protocolli di comunicazione definiscono il modo in cui i dati vengono trasmessi e ricevuti su una rete. Oracle Net Services supporta le comunicazioni su tutti i principali protocolli di rete, inclusi TCP/IP, HTTP, FTP e WebDAV. Oracle Net, un componente di Oracle Net Services, stabilisce e mantiene una sessione di rete da un'applicazione client a un database server. Dopo aver stabilito la connessione, Oracle Net funge da corriere dati sia per l'applicazione client che per il server del database, scambiando i messaggi tra di loro. Oracle Net può eseguire questi job perché è installato su ogni computer della rete.
Un componente importante di Net Services è Oracle Net Listener (chiamato listener), che è un processo eseguito sul database o altrove nella rete. Le applicazioni client inviano richieste di connessione al listener, che gestisce il traffico di tali richieste al database. Quando viene stabilita una connessione, il client e il database comunicano direttamente.
Oracle REST Data Services
Oracle REST Data Services (ORDS) fornisce un gateway HTTPS a Oracle AI Database. Consente alle applicazioni di esporre tabelle, viste, stored procedure scritte in PL/SQL, JavaScript e Java e operazioni di database personalizzate come API REST sicure, spesso senza richiedere un application server separato o un codice middleware esteso.
ORDS supporta anche Oracle Database API for MongoDB, consentendo alle applicazioni di utilizzare driver, strumenti e comandi MongoDB compatibili per accedere alle raccolte di documenti JSON memorizzate in Oracle Database. Il protocollo wire MongoDB viene tradotto in operazioni di database tramite ORDS, consentendo alle applicazioni REST, MongoDB e SQL di utilizzare i dati gestiti dallo stesso database convergente.
Argomenti correlati