Strutture di storage fisico
Le strutture di database fisici di un database Oracle sono visualizzabili a livello di sistema operativo.
-
Introduzione alle strutture di storage fisico Una caratteristica di un RDBMS è l'indipendenza delle strutture di dati logiche come tabelle, viste e indici dalle strutture di storage fisico come i file.
-
Panoramica dei file di dati A livello di sistema operativo, Oracle AI Database memorizza i dati in strutture denominate file di dati. Ogni database Oracle, sia CDB che PDB, deve disporre di almeno un file di dati.
-
Panoramica dei control file Il file di controllo del database è un piccolo file binario associato a un solo CDB.
-
Panoramica del redo log in linea La struttura più importante per il recupero è il redo log in linea, costituito da due o più file preallocati che memorizzano le modifiche al database man mano che si verificano. I redo log record in linea vengono modificati nei file di dati.
Introduzione alle strutture di stoccaggio fisico
Una caratteristica di un RDBMS è l'indipendenza delle strutture di dati logiche come tabelle, viste e indici dalle strutture di archiviazione fisica come i file.
Poiché le strutture fisiche e logiche sono separate, è possibile gestire la memorizzazione fisica dei dati senza influire sull'accesso alle strutture logiche. Ad esempio, la ridenominazione di un file di database non comporta la ridenominazione delle tabelle memorizzate.
Un database Oracle è un set di file che memorizzano i dati Oracle nello storage persistente. A partire da Oracle Database 21c, un container database (CDB) multi-tenant è l'unica architettura supportata. Un CDB contiene uno o più PDB.
In questa sezione vengono descritti i file di database generati quando si emette un'istruzione CREATE DATABASE per creare un CDB.
-
File di dati e file temporanei
Un file di dati è un file fisico nello storage persistente creato da Oracle AI Database e contiene strutture di dati quali tabelle e indici. Un file di modello è un file di dati che appartiene a una tablespace temporanea. Il database scrive i dati in questi file in un formato proprietario di Oracle che non può essere letto da altri programmi.
Quando si crea un PDB all'interno di un PDB, il PDB dispone di un proprio set di file di dati all'interno del set complessivo di file di dati che costituiscono il CDB. Ad esempio, è possibile creare un CDB denominato
mycdb, quindi creare due PDB al suo interno:hrpdbesalespdb. In questo caso,mycdbavrebbe un proprio set di file di dati e file temporanei, così comehrpdbesalespdb. -
Control file
Un file di controllo è un file root che tiene traccia dei componenti fisici del CDB. I PDB non dispongono di control file separati.
-
Redo log in linea
Il redo log in linea è un insieme di file contenenti i record delle modifiche apportate ai dati all'interno del CDB. I PDB non dispongono di redo log file in linea separati.
Un'istanza di database è un set di strutture di memoria che gestiscono i file di database in un CDB. Il grafico seguente mostra la relazione tra l'istanza e i file che gestisce.
Figura 1: Istanza di database e file di database
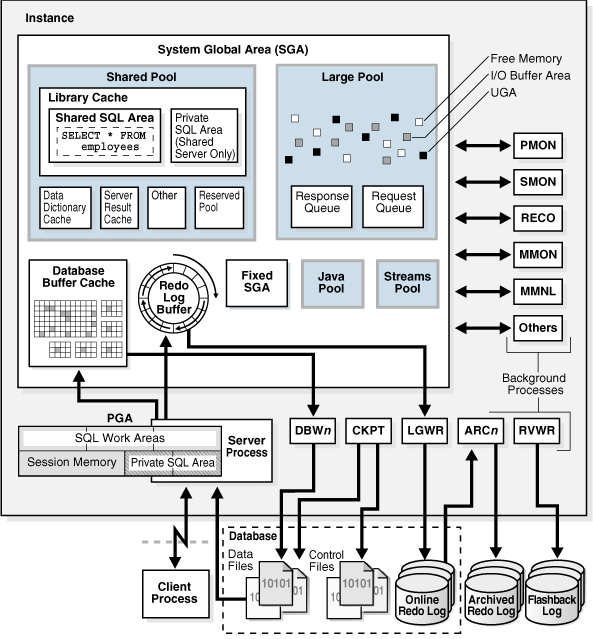
Descrizione dell'illustrazione cncpt223.gif
-
Meccanismi per la memorizzazione dei file di database Sono disponibili diversi meccanismi per l'allocazione e la gestione della memorizzazione di questi file.
-
Oracle Managed Files and User-Managed Files Oracle Managed Files è una strategia di denominazione dei file che consente di specificare le operazioni in termini di oggetti di database anziché di nomi di file. Ad esempio, è possibile creare una tablespace senza specificare i nomi dei relativi file di dati.
-
Oracle Automatic Storage Management (Oracle ASM) Oracle ASM è una soluzione di storage ad alte prestazioni e di facile gestione per i file di Oracle AI Database. Oracle ASM è un volume manager e fornisce un file system progettato esclusivamente per l'uso da parte del database.
-
Oracle Persistent Memory Filestore (PMEM Filestore) PMEM è una memoria persistente indirizzabile in base ai byte. Oracle Persistent Memory Filestore (PMEM Filestore) può memorizzare i file di dati, i redo log file in linea e i control file.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come creare un database
-
Oracle AI Database SQL Language Reference per semantica e sintassi
CREATE DATABASE
Meccanismi per la memorizzazione dei file di database
Sono disponibili diversi meccanismi per l'allocazione e la gestione della memorizzazione di questi file.
I meccanismi includono:
-
File system del sistema operativo
La maggior parte dei database Oracle memorizza i file in un file system, una struttura che consente di memorizzare e recuperare i dati.
Un file system consente di utilizzare lo spazio di storage per i dati delle applicazioni in modo standard e coerente. Ogni file ha un nome e viene visualizzato come spazio di indirizzi contiguo per applicazioni quali Oracle AI Database. Il database può creare, leggere, scrivere, ridimensionare ed eliminare i file.
I file system vengono in genere creati in un volume logico creato da un pacchetto software denominato logical volume manager (LVM). LVM consente a pezzi di più dischi fisici di combinarsi in quello che appare come un singolo spazio di indirizzi contiguo.
-
File System cluster
Un file system cluster è un file system distribuito che è un cluster di server che collaborano per fornire coerenza e prestazioni elevate ai propri client. In un ambiente Oracle RAC, un file system cluster visualizza lo storage condiviso come file system condiviso da molti computer in un ambiente in cluster. Con un file system cluster, l'errore di un computer nel cluster non rende il file system non disponibile. In un file system del sistema operativo, tuttavia, se un computer che condivide i file tramite NFS o altri mezzi non riesce, il file system non è disponibile.
-
Ripristino file memoria persistente Oracle (PMEM Filestore)
PMEM Filestore è progettato per memorizzare i file di database in Persistent Memory (PMEM), che è una memoria persistente indirizzabile in byte. Creare un fileestore utilizzando il comando
CREATE PMEM FILESTORE. A livello di sistema operativo Linux, filestore memorizza i dati in un file system ext4 di grandi dimensioni montato in modalitàfsdax. PMEM Filestore viene visualizzato in Oracle AI Database come file system nativo su Linux.Nota: a differenza di un file system conforme a POSIX, PMEM Filestore non può essere condiviso da più database Oracle.
-
Oracle Automatic Storage Management (Oracle ASM)
Oracle ASM include un file system progettato esclusivamente per l'uso da parte di Oracle AI Database.
Un database può utilizzare una combinazione dei meccanismi di storage precedenti. Ad esempio, un database potrebbe memorizzare il file dei parametri del server in un file system tradizionale, memorizzare i file di database in PMEM Filestore e quindi archiviare i redo log file in un file system cluster.
Vedere anche:
-
Oracle AI Database Administrator's Guide per visualizzare le strutture di storage del database eseguendo query sulle viste del database
Oracle Managed Files e file gestiti dall'utente
Oracle Managed Files è una strategia di denominazione dei file che consente di specificare le operazioni in termini di oggetti di database anziché di nomi di file. Ad esempio, è possibile creare una tablespace senza specificare i nomi dei relativi file di dati.
Oracle Managed Files elimina la necessità per gli amministratori di gestire direttamente i file del sistema operativo in un database. Oracle ASM richiede Oracle Managed Files.
Nota: questa funzione non ha effetto sulla creazione o la denominazione di file amministrativi quali i file di trace, i file di audit e i log degli avvisi.
Con i file gestiti dall'utente, è possibile gestire direttamente i file del sistema operativo nel database. Si prendono le decisioni relative alla struttura e alla denominazione dei file. Ad esempio, quando si crea una tablespace, è possibile impostare il nome e il percorso dei file di dati della tablespace.
Mediante i parametri di inizializzazione, è possibile specificare la directory del file system per un tipo specifico di file. La funzione Oracle Managed Files garantisce che il database crei un file univoco e lo elimini quando non è più necessario. Il database utilizza internamente interfacce di file system standard per creare ed eliminare i file per i file di dati e i file temporanei, i control file e i file correlati al recupero memorizzati nell'area di recupero rapido.
Oracle Managed Files non elimina le funzionalità esistenti. È possibile creare nuovi file durante l'amministrazione manuale dei vecchi file. Pertanto, un database può avere una combinazione di file gestiti da Oracle e file gestiti dall'utente.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni sull'utilizzo di Oracle Managed Files
Oracle Automatic Storage Management (Oracle ASM)
Oracle ASM è una soluzione di storage ad alte prestazioni e di facile gestione per i file di Oracle AI Database. Oracle ASM è un volume manager e fornisce un file system progettato esclusivamente per l'uso da parte del database.
Oracle ASM offre diversi vantaggi rispetto ai file system e ai manager di storage convenzionali, tra cui:
-
Semplifica le attività relative allo storage come la creazione e la creazione di database e la gestione dello spazio su disco
-
Distribuisce i dati tra i dischi fisici per eliminare i punti caldi e fornire prestazioni uniformi su tutti i dischi
-
Ribilancia automaticamente i dati dopo le modifiche alla configurazione di storage
Per utilizzare Oracle ASM, allocare i dischi partizionati per Oracle AI Database con le preferenze per lo striping e il mirroring. Oracle ASM gestisce lo spazio su disco, distribuendo il carico di I/O su tutte le risorse disponibili per ottimizzare le prestazioni e rimuovere la necessità di tuning I/O manuale. Ad esempio, è possibile aumentare le dimensioni del disco per il database o spostare parti del database in nuovi dispositivi senza dover arrestare il database.
-
Componenti di memorizzazione di Oracle ASM Oracle AI Database può memorizzare un file di dati come file Oracle ASM in un gruppo di dischi Oracle ASM. All'interno di un gruppo di dischi, Oracle ASM espone un'interfaccia di file system per i file di database.
-
Istanze Oracle ASM Un'istanza Oracle ASM è un'istanza Oracle speciale che gestisce i dischi Oracle ASM.
Componenti di memorizzazione di Oracle ASM
Oracle AI Database può memorizzare un file di dati come file Oracle ASM in un gruppo di dischi Oracle ASM. All'interno di un gruppo di dischi, Oracle ASM espone un'interfaccia di file system per i file di database.
La figura seguente mostra le relazioni tra i componenti di memorizzazione in un database che utilizza Oracle ASM. Nel diagramma viene illustrata la relazione tra un file Oracle ASM e un file di dati, anche se Oracle ASM può memorizzare altri tipi di file. La notazione del piede di corvo rappresenta una relazione uno-a-molti.
Figura 2: Componenti di Oracle ASM
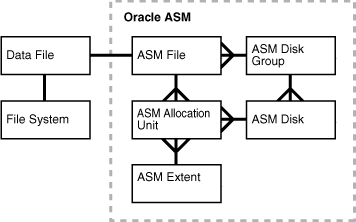
Descrizione dell'illustrazione cncpt267.gif
La Figura 14-2 illustra i seguenti concetti di Oracle ASM:
-
Dischi di Oracle ASM
Un disco Oracle ASM è un dispositivo di memorizzazione di cui è stato eseguito il provisioning a un gruppo di dischi Oracle ASM. Un disco Oracle ASM può essere un disco o una partizione fisica, un numero di unità logica (LUN, Logical Unit Number) da un array di memorizzazione, un volume logico o un file collegato alla rete.
È possibile aggiungere o eliminare dischi Oracle ASM da un gruppo DI dischi mentre il database è in esecuzione. Quando si aggiunge un disco a un gruppo di dischi, si assegna automaticamente un nome di disco oppure al disco viene assegnato automaticamente un nome di disco Oracle ASM.
-
Gruppi di dischi Oracle ASM
Un gruppo di dischi Oracle ASM è una raccolta di dischi Oracle ASM gestiti come unità logica. La struttura dei dati in un gruppo di dischi è autonome e consuma parte dello spazio su disco nel gruppo di dischi.
All'interno di un gruppo di dischi, Oracle ASM espone un'interfaccia file system per i file di database Oracle. Il contenuto dei file memorizzati in un gruppo di dischi viene distribuito in modo uniforme, o strizzato, per eliminare i punti caldi e fornire prestazioni uniformi tra i dischi.
-
File Oracle ASM
Un file Oracle ASM è un file memorizzato in un gruppo di dischi Oracle ASM. Oracle AI Database comunica con Oracle ASM in termini di file. Il database può memorizzare i file di dati, i control file, i redo log file in linea e altri tipi di file come file Oracle ASM. Quando richiesto dal database, Oracle ASM crea un file Oracle ASM e gli assegna un nome che inizia con un segno più (
+) seguito da un nome di gruppo di dischi, come in+DISK1.Nota: i file Oracle ASM possono coesistere con altre opzioni di gestione della memoria, ad esempio i file system di terze parti. Questa funzionalità semplifica l'integrazione di Oracle ASM in ambienti preesistenti.
-
Estensioni di Oracle ASM
Un extent Oracle ASM è una sezione di un file Oracle ASM. Un file Oracle ASM è composto da uno o più extent di file. Ciascuna estensione di Oracle ASM è costituita da una o più unità di allocazione su un disco specifico.
Nota: un'estensione Oracle ASM è diversa dall'estensione utilizzata per memorizzare i dati in un segmento.
-
Unità di allocazione Oracle ASM
Un'unità di allocazione Oracle ASM è l'unità fondamentale dell'allocazione all'interno del gruppo di dischi. Un'unità di allocazione è il più piccolo spazio su disco contiguo allocato da Oracle ASM. Una o più unità di allocazione formano un'estensione Oracle ASM.
Vedere anche: Oracle Automatic Storage Management Administrator's Guide per ulteriori informazioni su Oracle ASM
Istanze di Oracle ASM
Un'istanza di Oracle ASM è un'istanza Oracle speciale che gestisce i dischi Oracle ASM.
Sia Oracle ASM che le istanze di database richiedono l'accesso condiviso ai dischi di un gruppo di dischi Oracle ASM. Le istanze di Oracle ASM gestiscono i metadati del gruppo di dischi e forniscono informazioni sul layout dei file alle istanze di database. Le istanze di database indirizzano l'I/O ai dischi Oracle ASM senza passare attraverso un'istanza di Oracle ASM.
Un'istanza di Oracle ASM si basa sulla stessa tecnologia di un'istanza di database. Ad esempio, un'istanza Oracle ASM dispone di un'area globale di sistema (SGA) e di processi in background simili a quelli di un'istanza di database. Tuttavia, un'istanza di Oracle ASM non può eseguire il MOUNT di un database ed esegue un numero inferiore di task rispetto a un'istanza di database. La Figura 14-3 mostra una configurazione a nodo singolo con un'istanza di Oracle ASM e due istanze di database, ciascuna associata a un database a istanza singola diverso. L'istanza di Oracle ASM gestisce i metadati e fornisce l'allocazione dello spazio per i file Oracle ASM che memorizzano i dati per i due database. Un gruppo di dischi Oracle ASM dispone di quattro dischi Oracle ASM e l'altro di due dischi. Entrambe le istanze di database possono accedere ai gruppi di dischi.
Figura 3: Istanza di Oracle ASM e istanze di database
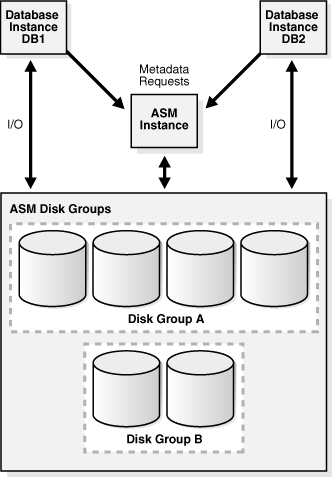
Descrizione dell'illustrazione cncpt266.gif
Vedere anche: Oracle Automatic Storage Management Administrator's Guide per ulteriori informazioni su Oracle ASM
Ripristino file memoria persistente Oracle (PMEM Filestore)
PMEM è una memoria persistente indirizzabile in byte. Oracle Persistent Memory Filestore (PMEM Filestore) può memorizzare i file di dati, i redo log file in linea e i control file.
Le query possono leggere byte direttamente da PMEM senza prima eseguire la migrazione dei blocchi nella buffer cache del database. Questo meccanismo ad alte prestazioni evita la ridondanza dei dati e gli I/O non necessari. Nota: un file PMEM non può memorizzare i file di trace, i file di audit o i file dei parametri del server. I tipi di file supportati per PMEM sono simili ai tipi per Oracle ASM.
-
Buffer cache mappata direttamente Nella piramide di memorizzazione tradizionale, PMEM si trova tra DRAM, che non è persistente, e Flash, che è persistente (non volatile).
-
Interfaccia di file system per PMEM Filestore PMEM Filestore implementa un protocollo denominato File system nello spazio utente (FUSE).
-
Interfaccia utente per PMEM Filestore Per creare un archivio file PMEM, utilizzare il comando
CREATE PMEM FILESTORE.
Buffer cache mappata direttamente
Nella tradizionale piramide di archiviazione, PMEM si trova tra DRAM, che non è persistente, e Flash, che è persistente (non volatile).
Figura 4: Piramide di stoccaggio
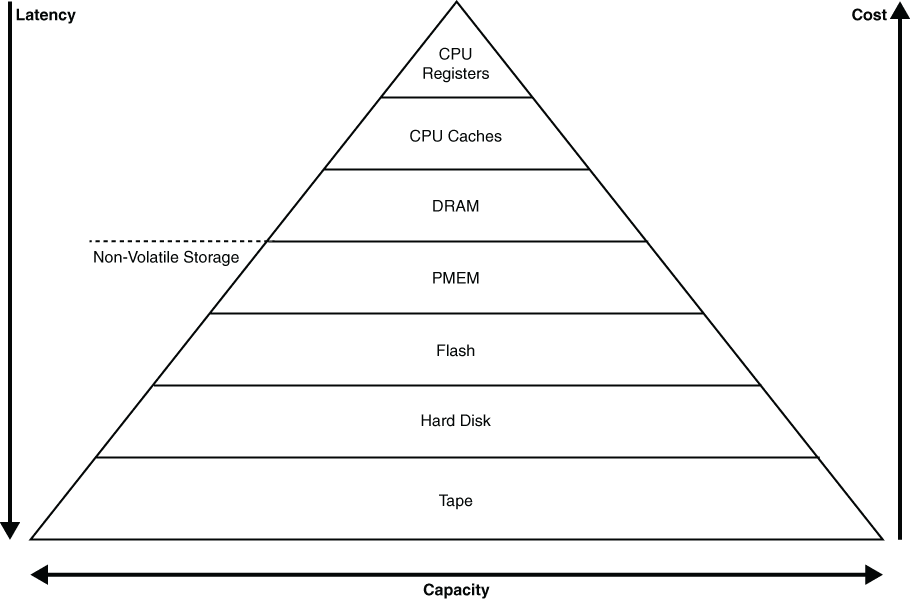
Descrizione dell'illustrazione pmem.png
La buffer cache del database si trova in DRAM. I processi Oracle dispongono dell'accesso diretto indirizzabile in byte ai blocchi in un fileestore PMEM, mappati alla buffer cache del database. Il meccanismo di mappatura viene richiamato automaticamente quando si inserisce un file di dati in un archivio file PMEM.
Oracle AI Database utilizza un algoritmo interno per decidere se eseguire la migrazione dei blocchi di dati dal fileestore PMEM in DRAM. I motivi tipici per la migrazione includono modifiche DML, coerenza delle letture e accesso più rapido per i blocchi di dati a caldo.
Vedere anche: "DRAM e PMEM Buffer"
Interfaccia del file system per PMEM Filestore
PMEM Filestore implementa un protocollo chiamato Filesystem in Userspace (FUSE).
FUSE consente agli utenti del sistema operativo senza privilegi, come il proprietario del software Oracle AI Database, di creare e gestire i file system e le directory e i file al loro interno. Ad esempio, è possibile utilizzare i comandi cp, rm e ls.
Un tipico file system utilizza lo storage raw come backing store, mentre PMEM Filestore ottiene lo storage da un file di sistema operativo nativo in un file system PMEM DAX. Questo file, denominato file di backup, è visibile come file nel sistema operativo. PMEM Filestore suddivide la memoria all'interno del file di supporto e la presenta come un file system locale.
Vedere anche:
- Oracle AI Database Administrator's Guide per ulteriori informazioni su PMEM Filestore
Interfaccia utente per PMEM Filestore
Per creare un fileestore PMEM, utilizzare il comando CREATE PMEM FILESTORE.
Il fileestore PMEM viene attivato automaticamente dopo la sua creazione. Il fileestore PMEM viene visualizzato sotto il punto di attivazione specificato come se fosse un file system nativo.
Il parametro di inizializzazione PMEM_FILESTORE specifica un fileestore PMEM che l'istanza di database attiva automaticamente all'avvio. Il parametro è impostato su una coppia ordinata di stringhe. La prima stringa nell'elenco dei valori dei parametri è la directory in cui è attivato PMEM Filestore. La seconda stringa è il file di supporto.
V$PMEM_FILESTORE mostra i metadati relativi a un fileestore PMEM. Ad esempio, è possibile visualizzare il percorso della directory del punto di attivazione, il percorso del file per il file di supporto e la dimensione del fileestore.
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come creare e gestire un archivio PMEM
Panoramica dei file di dati
A livello di sistema operativo, Oracle AI Database memorizza i dati in strutture denominate file di dati. Ogni database Oracle, sia CDB che PDB, deve disporre di almeno un file di dati.
-
Uso dei file di dati Oracle AI Database memorizza fisicamente i dati delle tablespace nei file di dati.
-
File di dati permanenti e temporanei Una tablespace permanente contiene oggetti di schema persistenti. Gli oggetti nelle tablespace permanenti vengono memorizzati nei file di dati.
-
File di dati in linea e non in linea Ogni file di dati è in linea (disponibile) o non in linea (non disponibile).
-
Struttura file di dati Oracle AI Database crea un file di dati per una tablespace allocando la quantità di spazio su disco specificata più il sovraccarico per l'intestazione del file di dati. Il sistema operativo in cui viene eseguito Oracle AI Database è responsabile della cancellazione delle informazioni e delle autorizzazioni precedenti da un file prima di allocarlo al database.
Uso dei file di dati
Oracle AI Database memorizza fisicamente i dati delle tablespace nei file di dati.
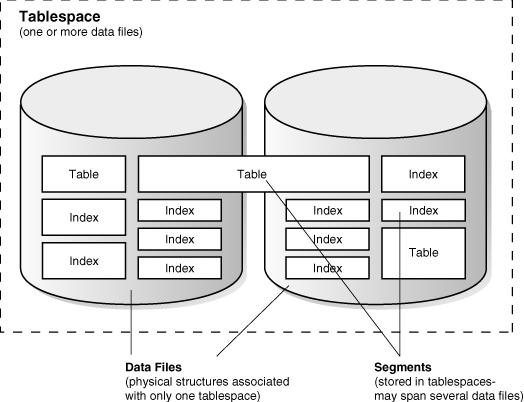
Ogni oggetto schema non partizionato e ogni partizione di un oggetto viene memorizzata nel proprio segmento, che appartiene a una sola tablespace. Ad esempio, i dati di una tabella non partizionata vengono memorizzati in un singolo segmento, che a sua volta viene memorizzato in una tablespace. Le tablespace e i file di dati sono strettamente correlati, ma presentano differenze importanti:
-
Ogni tablespace è costituita da uno o più file di dati, conformi al sistema operativo in cui è in esecuzione Oracle AI Database.
-
I dati di un database vengono memorizzati collettivamente nei file di dati presenti in ciascuna tablespace del database.
-
Un segmento può estendersi su uno o più file di dati, ma non può estendersi su più tablespace.
-
Un CDB deve avere le tablespace
SYSTEMeSYSAUX. Ogni PDB all'interno di un CDB dispone di tablespaceSYSTEMeSYSAUXproprie. Oracle AI Database alloca automaticamente i primi file di dati di qualsiasi database per la tablespaceSYSTEMdurante la creazione del database.La tablespace
SYSTEMcontiene il dizionario dati, un set di tabelle contenente i metadati del database. In genere, un database dispone anche di una tablespace di undo e di una tablespace temporanea (in genere denominataTEMP).
La figura seguente mostra la relazione tra tablespace, file di dati e segmenti.
Figura 5: File di dati e tablespace
Descrizione dell'illustrazione cncpt037.gif
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire i file di dati
File di dati permanenti e temporanei
Una tablespace permanente contiene oggetti schema persistenti. Gli oggetti nelle tablespace permanenti vengono memorizzati nei file di dati.
Una tablespace temporanea contiene oggetti dello schema solo per la durata di una sessione. Le tablespace temporanee gestite localmente dispongono di file temporanei (file temporanei), che sono file speciali progettati per memorizzare i dati in hash, ordinamento e altre operazioni. I file temporanei memorizzano anche i dati del set di risultati quando in memoria è presente spazio insufficiente.
I file temporanei sono simili ai file di dati permanenti, con le seguenti eccezioni:
-
Gli oggetti di database permanenti come le tabelle non vengono mai memorizzati nei file temporanei.
-
I file temporanei sono sempre impostati sulla modalità
NOLOGGING, il che significa che non hanno mai generato redo per loro. Il recupero dei supporti non riconosce i file temporanei. -
Impossibile rendere un file temporaneo di sola lettura.
-
Impossibile creare un file temporaneo con l'istruzione
ALTERDATABASE. -
Quando si creano o si ridimensionano file temporanei, non sempre viene garantita l'allocazione dello spazio su disco per le dimensioni del file specificate. Nei file system, ad esempio Linux e UNIX, i file temporanei vengono creati come file sparse. In questo caso, i blocchi di dischi vengono allocati non durante la creazione o il ridimensionamento dei file, ma poiché per la prima volta si accede ai blocchi.
Nota: i file sparse consentono la creazione e il ridimensionamento rapidi dei file temporanei; tuttavia, lo spazio sul disco potrebbe esaurirsi in un secondo momento quando si accede ai file temporanei.
-
Le informazioni sul file temporaneo vengono visualizzate nella vista dizionario dati
DBA_TEMP_FILESe nella vista prestazioni dinamicheV$TEMPFILE, ma non inDBA_DATA_FILESo nella vistaV$DATAFILE.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire i file temporanei
File di dati online e offline
Ogni file di dati è online (disponibile) o offline (non disponibile).
È possibile modificare la disponibilità di singoli file di dati o file temporanei mettendoli offline o mettendoli in linea. Il database non può accedere ai file di dati non in linea finché non vengono messi in linea.
È possibile mettere i file di dati offline per molti motivi, tra cui l'esecuzione di backup offline o il danneggiamento del blocco. Il database mette automaticamente offline un file di dati se non è in grado di scriverci.
Come un file di dati, una tablespace stessa è offline o in linea. Quando si mette un file di dati fuori linea in una tablespace in linea, la tablespace stessa rimane in linea. È possibile rendere temporaneamente non disponibili tutti i file di dati di una tablespace mettendo fuori linea la tablespace stessa.
A partire da Oracle Database 12c, è possibile utilizzare l'istruzione ALTER DATABASE MOVE DATAFILE per spostare un file di dati in linea da un file fisico a un altro mentre il database è aperto e accede al file. È possibile utilizzare questa tecnica per raggiungere i seguenti obiettivi:
-
Spostare una tablespace da un tipo di storage a un altro
-
Spostare i file di dati a cui non si accede di frequente per ridurre i costi di storage
-
Rendere una tablespace di sola lettura e spostare i relativi file di dati nella memoria di scrittura su una sola volta, ad esempio un'unità WORM (Write Once Read Many)
-
Spostare il database in Oracle ASM
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come modificare la disponibilità dei file di dati
-
Oracle AI Database Administrator's Guide per informazioni su come spostare i file di dati online
-
Oracle AI Database SQL Language Reference per saperne di più su
ALTER DATABASE . . . MOVE DATAFILE
Struttura file di dati
Oracle AI Database crea un file di dati per una tablespace allocando la quantità di spazio su disco specificata più il sovraccarico per l'intestazione del file di dati. Il sistema operativo in cui viene eseguito Oracle AI Database è responsabile della cancellazione delle informazioni e delle autorizzazioni precedenti da un file prima di allocarlo al database.
L'intestazione del file di dati contiene metadati sul file di dati, ad esempio la dimensione e l'SCN checkpoint . Ogni intestazione contiene un numero di file assoluto, che identifica in modo univoco il file di dati nel database, e un numero di file relativo, che identifica in modo univoco un file di dati all'interno di una tablespace.
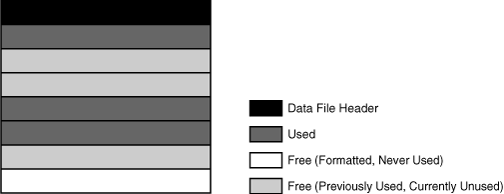
Quando Oracle AI Database crea un file di dati per la prima volta, lo spazio su disco allocato viene formattato ma non contiene dati utente. Tuttavia, il database riserva lo spazio necessario per contenere i dati per i segmenti futuri della tablespace associata. Man mano che i dati crescono in una tablespace, Oracle AI Database utilizza lo spazio libero nei file di dati per allocare le estensioni per il segmento.
La figura seguente illustra i diversi tipi di spazio in un file di dati. Le estensioni vengono utilizzate, il che significa che contengono dati di segmento, o libere, il che significa che sono disponibili per il riutilizzo. Nel tempo, gli aggiornamenti e le eliminazioni di oggetti all'interno della tablespace possono creare sezioni di spazio vuoto che singolarmente non sono sufficientemente grandi da poter essere riutilizzate per nuovi dati. Questo tipo di spazio vuoto è denominato spazio libero frammentato.
Figura 6: Spazio in un file di dati
Descrizione dell'illustrazione cncpt273.gif
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come visualizzare le informazioni sui file di dati
Panoramica dei control file
Il file di controllo del database è un piccolo file binario associato a un solo CDB.
Ogni CDB dispone di un unico control file, anche se sono consentite più copie identiche. I PDB non dispongono di control file separati.
-
Uso dei control file Oracle AI Database utilizza il control file per individuare i file di database e gestire lo stato del database in generale.
-
Multiple Control Files Oracle AI Database consente di aprire più control file identici contemporaneamente e di scriverli nello stesso database. Mediante il multiplexing di un control file su dischi diversi, il database può ottenere ridondanza ed evitare quindi un singolo punto di errore.
-
Struttura del file di controllo Le informazioni sul database vengono memorizzate in sezioni diverse del control file. Ogni sezione è un insieme di record su un aspetto del database.
Uso dei control file
Oracle AI Database utilizza il control file per individuare i file di database e gestire lo stato del database in generale.
Un control file contiene informazioni quali:
-
Nome del database e identificativo univoco del database (DBID)
-
Indicatore orario della creazione del database
-
Informazioni sui file di dati, i redo log file in linea e i redo log file archiviati
-
Informazioni sulla tablespace
-
Backup RMAN
Il control file ha i seguenti scopi:
-
Contiene informazioni sui file di dati, i redo log file in linea e così via necessari per aprire il database.
Il control file tiene traccia delle modifiche strutturali apportate al database. Ad esempio, quando un amministratore aggiunge, rinomina o elimina un file di dati o un redo log file in linea, il database aggiorna il control file per riflettere questa modifica.
-
Contiene metadati che devono essere accessibili quando il database non è aperto.
Ad esempio, il control file contiene le informazioni necessarie per recuperare il database, inclusi i checkpoint. Un checkpoint indica l'SCN nel redo stream in cui sarebbe necessario avviare il recupero dell'istanza. Ogni modifica sottoposta a commit prima di un checkpoint SCN è garantita per essere salvata su disco nei file di dati. Almeno ogni tre secondi il processo di checkpoint registra nel control file le informazioni relative alla posizione del checkpoint nel redo log in linea.
Oracle AI Database legge e scrive continuamente nel control file durante l'uso del database e deve essere disponibile per la scrittura ogni volta che il database è aperto. Ad esempio, il recupero di un database comporta la lettura dal control file dei nomi di tutti i file di dati contenuti nel database. Altre operazioni, come l'aggiunta di un file di dati, aggiornano le informazioni memorizzate nel control file.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire il control file
File di controllo multipli
Oracle AI Database consente di aprire più control file identici contemporaneamente e di scriverli nello stesso database. Mediante il multiplexing di un control file su dischi diversi, il database può ottenere ridondanza ed evitare quindi un singolo punto di errore. Nota: Oracle consiglia di gestire più copie dei control file, ciascuna su un disco diverso.
Se un control file diventa inutilizzabile, l'istanza di database non riesce quando tenta di accedere al control file danneggiato. Se esistono altre copie correnti del control file, è possibile riattivare il database e aprirlo senza il recupero dei supporti. Se tutti i control file di un database vengono persi, tuttavia, l'istanza del database non riesce e il recupero dei supporti è necessario. Il recupero dei supporti non è semplice se è necessario utilizzare un backup precedente di un control file perché non è disponibile una copia corrente.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire più control file
-
Oracle AI Database Backup and Recovery User's Guide per informazioni su come eseguire il backup e il ripristino dei control file
Struttura control file
Le informazioni sul database vengono memorizzate in diverse sezioni del control file. Ogni sezione è un insieme di record su un aspetto del database.
Ad esempio, una sezione del control file tiene traccia dei file di dati e contiene un set di record, uno per ciascun file di dati. Ogni sezione è memorizzata in più blocchi di file di controllo logico. I record possono estendersi su blocchi all'interno di una sezione.
Il control file contiene i tipi di record riportati di seguito.
-
Record di riutilizzo circolare
Un record di riutilizzo circolare contiene informazioni non critiche idonee a essere sovrascritte, se necessario. Quando tutti gli slot di record disponibili sono pieni, il database espande il control file per lasciare spazio a un nuovo record o sovrascrive il record meno recente. Gli esempi includono i record relativi ai redo log file archiviati e ai backup RMAN.
-
Record di riutilizzo non circolari
Un record di riutilizzo non circolare contiene informazioni critiche che non cambiano spesso e non possono essere sovrascritte. Esempi di informazioni includono tablespace, file di dati, redo log file in linea e redo thread. Oracle AI Database non riutilizza mai questi record a meno che l'oggetto corrispondente non venga eliminato dalla tablespace.
È possibile eseguire una query sulle viste prestazioni dinamiche, note anche come viste V$, per visualizzare le informazioni memorizzate nel control file. Ad esempio, è possibile eseguire una query su V$DATABASE per ottenere il nome del database e il DBID. Tuttavia, solo il database può modificare le informazioni nel control file.
La lettura e la scrittura dei blocchi dei file di controllo è diversa dalla lettura e dalla scrittura dei blocchi di dati. Per il control file, Oracle AI Database legge e scrive direttamente dal disco all'area PGA (Program Global Area). Ogni processo alloca una certa quantità di memoria PGA per i blocchi dei file di controllo.
Vedere anche:
-
Oracle AI Database Reference per saperne di più sulla vista
V$CONTROLFILE_RECORD_SECTION -
Oracle AI Database Reference per informazioni sul parametro di inizializzazione
CONTROL_FILE_RECORD_KEEP_TIME
Panoramica del Redo log in linea
La struttura più importante per il recupero è il redo log in linea, costituito da due o più file preallocati che memorizzano le modifiche al database man mano che si verificano. I redo log record in linea vengono modificati nei file di dati.
-
Uso del redo log in linea Il database gestisce i redo log file in linea per proteggerli dalla perdita di dati. In particolare, dopo un errore dell'istanza, i redo log file in linea consentono a Oracle AI Database di recuperare i dati sottoposti a commit non ancora scritti nei file di dati.
-
Come viene scritto Oracle AI Database nel redo log in linea Il redo log in linea per un'istanza di database è denominato redo thread.
-
Struttura del redo log in linea I redo log file in linea contengono redo record.
Uso del redo log in rete
Il database gestisce i redo log file in linea per proteggerli dalla perdita di dati. In particolare, dopo un errore dell'istanza, i redo log file in linea consentono a Oracle AI Database di recuperare i dati sottoposti a commit non ancora scritti nei file di dati.
I processi del server scrivono ogni transazione in modo sincrono nel redo log buffer, che il processo LGWR scrive quindi nel redo log in linea. Il contenuto del redo log in linea include le transazioni non sottoposte a commit e le istruzioni di gestione di schemi e oggetti.
Man mano che il database apporta modifiche ai segmenti di undo, il database scrive anche queste modifiche nei redo log in linea. Di conseguenza, il redo log in linea contiene sempre i dati di annullamento per gli oggetti permanenti. È possibile configurare il database in modo da memorizzare tutti i dati di annullamento per gli oggetti temporanei in un segmento di annullamento temporaneo, che consente di risparmiare spazio e migliorare le prestazioni oppure di consentire al database di memorizzare i dati di annullamento sia permanenti che temporanei nel redo log in linea.
Oracle AI Database utilizza il redo log in linea solo per il recupero. Tuttavia, gli amministratori possono eseguire query sui redo log file in linea tramite un'interfaccia SQL nella utility Oracle LogMiner. I file di redo log sono una fonte utile di informazioni cronologiche sull'attività del database.
Vedere anche:
-
"Architettura dei processi" per informazioni sui processi Oracle
-
Oracle AI Database Administrator's Guide per informazioni sui segmenti di undo temporanei
-
Oracle AI Database Reference per informazioni sul parametro di inizializzazione
TEMP_UNDO_ENABLED
Come Oracle AI Database scrive nel redo log online
Il redo log in linea per un'istanza di database è denominato redo thread.
Nelle configurazioni a istanza singola, solo un'istanza accede a un database, quindi è presente un solo redo thread. In una configurazione di Oracle Real Application Clusters (Oracle RAC), tuttavia, più istanze accedono contemporaneamente a un database, ciascuna delle quali dispone di un proprio redo thread. Un redo thread separato per ciascuna istanza evita conflitti per un singolo set di redo log file in linea.
Un redo log in linea è costituito da due o più redo log file in linea. Oracle AI Database richiede almeno due file per garantire che un file sia sempre disponibile per la scrittura nel caso in cui l'altro file sia in fase di cancellazione o archiviazione.
-
Switch di redo log in linea Oracle AI Database utilizza un solo redo log file in linea alla volta per memorizzare i record scritti dal redo log buffer.
-
Più copie dei redo log file in linea Oracle AI Database può gestire automaticamente due o più copie identiche del redo log in linea in posizioni separate.
-
Redo log file archiviati Un redo log file archiviato è una copia di un membro compilato di un gruppo di redo log in linea.
Vedere anche: Oracle Real Application Clusters Administration and Deployment Guide per informazioni sui gruppi di redo log in linea in Oracle RAC
Switch di redo log in linea
Oracle AI Database utilizza un solo redo log file in linea alla volta per memorizzare i record scritti dal redo log buffer.
Il redo log file in linea in cui il processo di log writer (LGWR) sta scrivendo attivamente è chiamato redo log file in linea corrente.
Lo switch di log si verifica quando il database smette di scrivere in un redo log file in linea e inizia a scrivere in un altro. Normalmente, si verifica uno switch quando il redo log file in linea corrente è pieno e la scrittura deve continuare. Tuttavia, è possibile configurare gli switch di log in modo che si verifichino a intervalli regolari, indipendentemente dal fatto che il redo log file in linea corrente sia compilato e che forzino gli switch manualmente.
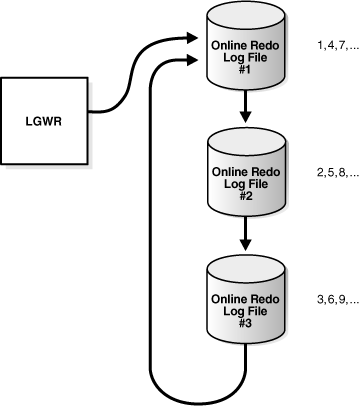
Log Writer scrive i redo log file in linea in modo circolare. Quando il log writer compila l'ultimo redo log file disponibile in linea, il processo scrive nel primo file di log, riavviando il ciclo. La Figura 14-7 illustra la scrittura circolare del redo log.
Figura 7: Riutilizzo dei file di redo log online
Descrizione dell'illustrazione admin054.gif
I numeri riportati nella Figura 14-7 mostrano la sequenza in cui LGWR scrive in ogni redo log file in linea. Il database assegna a ciascun file un nuovo numero di sequenza di log quando un log cambia e inizia a scriverci. Quando il database riutilizza un redo log file in linea, questo file riceve il successivo numero di sequenza di log disponibile.
I redo log file in linea compilati sono disponibili per il riutilizzo a seconda della modalità di archiviazione:
-
Se l'archiviazione è disabilitata, ovvero il database è in modalità
NOARCHIVELOG, un redo log file in linea compilato è disponibile dopo che le modifiche registrate sono state sottoposte a checkpoint (scritte) su disco da database writer (DBW). -
Se l'archiviazione è abilitata, ovvero il database si trova in modalitàARCHIVELOG, un redo log file in linea compilato è disponibile per il processo di scrittura dei log dopo che le modifiche sono state scritte nei file di dati e il file è stato archiviato.
In alcune circostanze, è possibile che al log writer venga impedito di riutilizzare un redo log file in linea esistente. È necessario un redo log file in linea attivo per il recupero delle istanze, in cui come redo log file in linea inattivo non è necessario per il recupero delle istanze. Inoltre, un redo log file in linea potrebbe essere in fase di cancellazione.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire il redo log in linea
Più copie di file di redo log in linea
Oracle AI Database può gestire automaticamente due o più copie identiche del redo log in linea in posizioni separate.
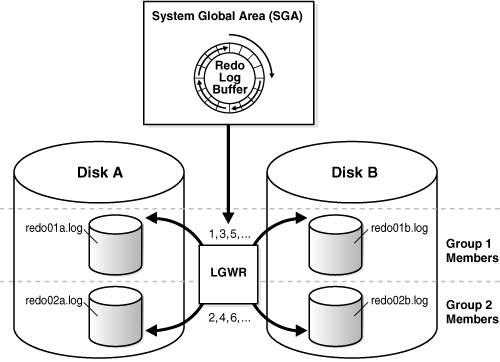
Un gruppo di redo log in linea è costituito da un redo log file in linea e dalle relative copie ridondanti. Ogni copia identica è membro del gruppo di redo log in linea. Ogni gruppo viene definito mediante un numero, ad esempio il gruppo 1, il gruppo 2 e così via.
La gestione di più membri di un gruppo di redo log in linea protegge dalla perdita del redo log. Idealmente, le posizioni dei membri dovrebbero trovarsi su dischi separati in modo che l'errore di un disco non causi la perdita dell'intero redo log in linea.
Nella Figura 14-8, A_LOG1 e B_LOG1 sono membri identici del gruppo 1, mentre A_LOG2 e B_LOG2 sono membri identici del gruppo 2. Ogni membro di un gruppo deve avere le stesse dimensioni. LGWR scrive contemporaneamente al gruppo 1 (membri A_LOG1 e B_LOG1), quindi scrive contemporaneamente al gruppo 2 (membri A_LOG2 e B_LOG2), quindi scrive al gruppo 1 e così via. LGWR non scrive mai contemporaneamente a membri di gruppi diversi.
Figura 8: Copie multiple di file di redo log online
Descrizione dell'illustrazione cncpt270.gif
Nota: Oracle consiglia di sottoporsi a multiplexing il redo log in rete. La perdita di file di log può essere catastrofica se è necessario il recupero. Quando si esegue un multiplexing del redo log in linea, il database deve aumentare il numero di I/O eseguito. A seconda del sistema, questo I/O aggiuntivo può influire sulle prestazioni complessive del database.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire più copie dei redo log file in linea
-
Concetti e amministrazione di Oracle Data Guard per informazioni sul trasferimento automatico dei dati di redo tra i membri di una configurazione Data Guard
Redo log file archiviati
Un redo log file archiviato è una copia di un membro compilato di un gruppo di redo log in linea.
Un redo log file archiviato non viene considerato parte del database. Si tratta piuttosto di una copia offline di un redo log file in linea creato dal database e scritto in una posizione specificata dall'utente.
I redo log file archiviati sono una parte fondamentale di una strategia di backup e ripristino. È possibile utilizzare i redo log file archiviati per:
-
Recupera un backup del database
-
Aggiorna un database in standby
-
Ottenere informazioni sulla cronologia di un database utilizzando la utility Oracle LogMiner
L'operazione di generazione di un redo log file archiviato è denominata archiviazione. Questa operazione è automatica o manuale. È possibile solo se il database è in modalità ARCHIVELOG.
Un redo log file archiviato include le redo entry e il numero di sequenza del log dello stesso membro del gruppo di redo log in linea. In "Più copie dei file di redo log in linea", i file A_LOG1 e B_LOG1 sono membri identici del Gruppo 1. Se il database è in modalità ARCHIVELOG e l'archiviazione automatica è abilitata, il processo dell'archivio (ARCn) archivierà uno di questi file. Se A_LOG1 è danneggiato, il processo può archiviare B_LOG1. Il redo log archiviato contiene una copia di ogni gruppo di redo log esistente a partire dal momento in cui è stata abilitata l'archiviazione.
Vedere anche:
-
Oracle AI Database Utilities per saperne di più su Oracle LogMiner
-
Oracle AI Database Administrator's Guide per informazioni su come gestire il redo log archiviato
-
Concetti e amministrazione di Oracle Data Guard per informazioni su come configurare l'archiviazione dei redo log in standby
Struttura del redo log in linea
I redo log file in linea contengono redo record.
Un redo record è costituito da un gruppo di vettori di modifica, ognuno dei quali descrive una modifica a un blocco dati. Ad esempio, un aggiornamento a uno stipendio nella tabella employees genera un redo record che descrive le modifiche apportate al blocco segmento dati per la tabella, il blocco di dati del segmento di annullamento e la tabella di transazione dei segmenti di annullamento.
I redo record contengono tutti i metadati pertinenti per la modifica, inclusi gli elementi riportati di seguito.
-
SCN e indicatore orario della modifica
-
ID transazione della transazione che ha generato la modifica
-
SCN e indicatore orario durante il commit della transazione (se impegnata)
-
Tipo di operazione che ha apportato la modifica
-
Nome e tipo del segmento dati modificato
Vedere anche: "Panoramica dei blocchi di dati"