Istanza di Oracle AI Database
In questo capitolo viene illustrata la natura di un'istanza di database Oracle, i parametri e i file di diagnostica associati a un'istanza e le informazioni che si verificano durante la creazione e la chiusura di un database.
Nota: ai fini del presente capitolo, il termine "database" si riferisce a un container database (CDB) multi-tenant, a meno che non sia indicato diversamente.
-
Introduzione all'istanza di Oracle AI Database Un'istanza di database è un set di strutture di memoria che gestiscono i file di database.
-
Panoramica sull'avvio e l'arresto dell'istanza di database Un'istanza di database fornisce l'accesso utente a un database. L'istanza e il database possono trovarsi in vari stati.
-
Panoramica dei checkpoint Un checkpoint è un meccanismo fondamentale per la chiusura coerente del database, il recupero delle istanze e l'operazione di Oracle AI Database in generale.
-
Panoramica sul recupero dell'istanza
Il recupero dell'istanza è il processo di applicazione dei record nel redo log in linea ai file di dati per ricostruire le modifiche apportate dopo il checkpoint più recente.
-
Panoramica dei file dei parametri Per avviare un'istanza di database, Oracle AI Database deve leggere un file dei parametri del server, che è consigliato, oppure un file dei parametri di inizializzazione del testo, che è un'implementazione precedente. Questi file contengono una lista di parametri di configurazione.
-
Panoramica dei file di diagnostica Oracle AI Database include un'infrastruttura di diagnostica degli errori per prevenire, rilevare, diagnosticare e risolvere i problemi del database. I problemi includono errori critici come bug di codice, danneggiamento dei metadati e danneggiamento dei dati dei clienti.
Introduzione all'istanza di Oracle AI Database
Un'istanza di database è un set di strutture di memoria che gestiscono i file di database.
A livello fisico, il CDB è un insieme di file presenti sul disco creato dall'istruzione CREATE DATABASE. Un CDB contiene uno o più PDB creati dall'utente. Un PDB contiene il proprio set di file di dati all'interno del set complessivo di file di dati appartenenti al CDB. L'istanza di database gestisce i dati associati al CDB e ai relativi PDB e serve i relativi utenti.
Ogni CDB in esecuzione è associato ad almeno un'istanza di database Oracle. Poiché un'istanza esiste in memoria e un database (nel senso più stretto del termine) è un set di file su disco, un'istanza può esistere senza un database e un database può esistere senza un'istanza.
-
Struttura dell'istanza di database Quando un'istanza viene avviata, Oracle AI Database alloca un'area di memoria denominata area globale di sistema (SGA) e avvia uno o più processi di background.
-
Configurazioni dell'istanza di database Oracle AI Database viene eseguito in una configurazione a istanza singola o in una configurazione Oracle Real Application Clusters (Oracle RAC). Queste configurazioni si escludono a vicenda.
-
Istanze di lettura/scrittura e di sola lettura Ogni istanza di database è in lettura/scrittura o di sola lettura.
-
Durata di un'istanza di database Un'istanza di database inizia quando viene creata con il comando
STARTUPe termina quando viene interrotta. -
Identificazione di un'istanza di database Più istanze di database possono risiedere su un singolo host. Pertanto, è necessario disporre di uno strumento per specificare a quale istanza si desidera accedere.
Struttura istanza di database
Quando un'istanza viene avviata, Oracle AI Database alloca un'area di memoria denominata area globale del sistema (SGA) e avvia uno o più processi di background.
La SGA serve a vari scopi, tra cui:
-
Gestione delle strutture di dati interne a cui molti processi e thread accedono contemporaneamente
-
Memorizzazione nella cache dei blocchi di dati letti dal disco
-
Buffer dei redo data prima di scriverli nei redo log file in linea
-
Memorizzazione dei piani di esecuzione SQL
I processi Oracle in esecuzione su un singolo computer condividono l'area SGA. Il modo in cui i processi Oracle si associano all'SGA varia a seconda del sistema operativo.
Un'istanza di database include anche processi in background e processi server. Ogni processo ha la propria memoria dedicata considerata come parte dell'istanza. L'istanza continua a funzionare quando i processi del server vengono terminati.
Il grafico seguente mostra i componenti principali di un'istanza di database Oracle.
Figura 1: Istanza di database
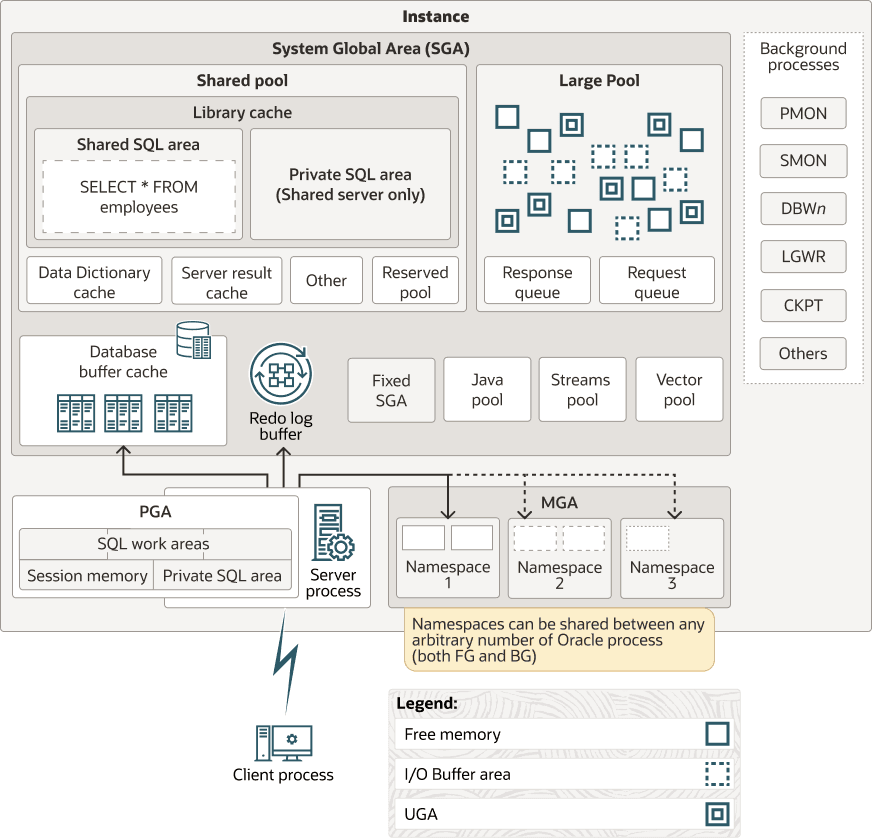
Descrizione dell'illustrazione cncpt325.png
Configurazioni delle istanze del database
Oracle AI Database viene eseguito in una configurazione a istanza singola o in una configurazione Oracle Real Application Clusters (Oracle RAC). Queste configurazioni si escludono a vicenda.
In una configurazione a istanza singola esiste una relazione uno a uno tra il database e un'istanza di database. In Oracle RAC esiste una relazione uno-a-molti tra il database e le istanze di database.
La figura seguente mostra le possibili configurazioni delle istanze di database.
Figura 2: Configurazioni delle istanze di database
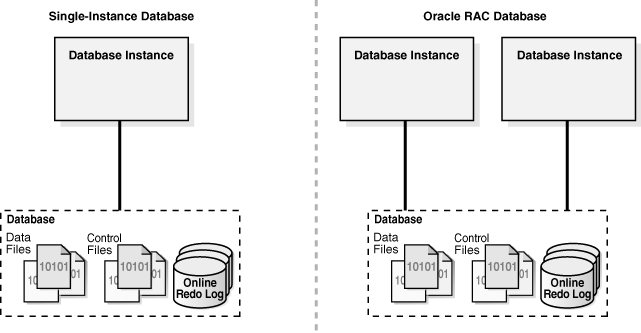
Descrizione dell'illustrazione cncpt296.gif
In una configurazione a istanza singola o Oracle RAC, un'istanza di database viene associata a un solo database alla volta. È possibile avviare un'istanza di database e eseguire il MOUNT (associare l'istanza a) un database, ma non eseguire il MOUNT di due database contemporaneamente alla stessa istanza. Nota: in questo capitolo viene illustrata la configurazione di un database a istanza singola, a meno che non sia indicato diversamente.
Più istanze possono essere eseguite contemporaneamente sullo stesso computer, ognuna delle quali accede al proprio database. Ad esempio, un computer può ospitare due database distinti: prod1 e prod2. Un'istanza di database gestisce prod1, mentre un'istanza separata gestisce prod2.
Vedere anche: Oracle Real Application Clusters Administration and Deployment Guide per informazioni specifiche su Oracle RAC
Istanze di lettura/scrittura e sola lettura
Ogni istanza di database è in lettura/scrittura o di sola lettura.
Un'istanza di database in lettura/scrittura, che è l'impostazione predefinita, può elaborare DML e supporta le connessioni dirette dalle applicazioni client. Al contrario, un'istanza di database di sola lettura può elaborare le query, ma non supporta le connessioni DML di modifica (UPDATE, DELETE, INSERT e MERGE) o client diretto.
Nota: se non diversamente specificato in questo manuale, tutti i riferimenti alle istanze di database devono essere in lettura/scrittura.
Nelle release precedenti, tutte le istanze di database, a meno che non abbiano avuto accesso a un database in standby, erano in lettura/scrittura. A partire da Oracle Database 12c Release 2 (12.2), le istanze di sola lettura e di lettura/scrittura possono coesistere all'interno di un singolo database. Questa configurazione è utile per le istruzioni SQL parallele che eseguono query e modificano i dati, poiché entrambe le istanze di lettura/scrittura e di sola lettura possono eseguire query, mentre le istanze di lettura/scrittura vengono modificate.
A differenza delle istanze di lettura/scrittura, le istanze di sola lettura presentano le caratteristiche riportate di seguito.
-
È possibile aprire solo un database già aperto da un'istanza di lettura/scrittura
-
Disabilitare molti processi in background, inclusi i processi di checkpoint e archiviatore, che non sono necessari
-
Può attivare un redo thread o un thread disabilitato senza alcun re redo log in linea
Per designare un'istanza come di sola lettura, impostare il parametro di inizializzazione INSTANCE_MODE su READ_ONLY. Il valore predefinito del parametro è READ_WRITE.
Vedere anche:
-
"Panoramica dei processi in background" per ulteriori informazioni sui processi in background di checkpoint e archiviatore
-
Oracle AI Database Reference per ulteriori informazioni sul parametro di inizializzazione
INSTANCE_MODE
Durata di un'istanza di database
Un'istanza di database inizia quando viene creata con il comando STARTUP e termina quando viene interrotta.
Durante questo periodo, un'istanza di database può associarsi a un solo database. Inoltre, l'istanza può eseguire il MOUNT di un database una sola volta, chiuderlo una sola volta e aprirlo una sola volta. Dopo la chiusura o la chiusura di un database, è necessario avviare un'istanza diversa per eseguire il MOUNT e aprire questo database.
La tabella seguente illustra un'istanza di database che tenta di riaprire un database precedentemente chiuso.
Tabella 1 Durata di un'istanza
| Istruzione | Spiegazione |
|---|---|
|
Il comando STARTUP crea un'istanza, che attiva e apre il database. |
|
Questa query mostra l'ora di avvio dell'istanza corrente. |
|
L'istanza chiude il database e si arresta, terminando la durata di questa istanza. |
|
Il comando STARTUP crea una nuova istanza, esegue il MOUNT e apre il database. |
|
Questa query mostra l'ora di avvio dell'istanza corrente. L'ora di inizio diversa indica che questa istanza è diversa da quella che ha chiuso il database. |
Identificazione di un'istanza di database
Più istanze di database possono risiedere su un singolo host. Pertanto, è necessario disporre di uno strumento per specificare a quale istanza si desidera accedere. Le regole di Oracle Optimal Flexible Architecture (OFA) sono un set di linee guida di configurazione create per garantire installazioni Oracle ben organizzate. Gli esempi riportati in questa sezione presuppongono un'architettura OFA.
Questa sezione contiene gli argomenti riportati di seguito.
-
Directory Oracle Base La directory Oracle Base memorizza i file binari per i prodotti Oracle.
-
Directory Oracle home La Oracle home è la posizione software per un database Oracle.
-
SID (System Identifier) Oracle L'identificativo di sistema (SID) è un nome univoco per un'istanza di database Oracle su un host specifico. Vedere anche: Oracle AI Database Installation Guide for Linux per una panoramica dell'OFA
Directory Oracle Base
La directory Oracle Base memorizza i file binari per i prodotti Oracle.
La directory Oracle Base è la directory home del database per i proprietari dell'installazione di Oracle AI Database. Ci possono essere molte installazioni di Oracle AI Database su un host e molti proprietari di installazioni software di Oracle AI Database.
L'esempio riportato di seguito mostra la directory Oracle Base dell'account utente del sistema operativo oracle.
/u01/app/oracleNel percorso precedente, /u01/ è il punto di attivazione e /u01/app/ è la struttura secondaria per il software applicativo.
Vedere anche: Oracle AI Database Installation Guide for Linux per una panoramica della base Oracle
Directory Oracle home
La Oracle home è la posizione software per un database Oracle.
È necessario specificare una nuova directory Oracle Home per ogni nuova installazione del software Oracle AI Database. A partire da Oracle Database 21c, la Oracle home è di sola lettura. La Oracle home memorizza file statici, ad esempio file binari.
Per impostazione predefinita, la directory della Oracle home è un discendente all'interno dell'albero delle directory Oracle Base (ORACLE_BASE). È possibile installare questa release, o release precedenti del software del database, più di una volta sullo stesso host, in directory Oracle home diverse all'interno di una singola Oracle Base. Più database, di versioni diverse e di proprietà di account utente diversi, possono coesistere contemporaneamente.
L'esempio riportato di seguito mostra i nomi di percorso completi di tre Oracle home diverse, tutte all'interno della stessa directory Oracle Base di /u01/app/oracle/:
/u01/app/oracle/product/19.3.0/dbhome_1
/u01/app/oracle/product/19.3.0/dbhome_2
/u01/app/oracle/product/20.1.0/dbhome_1
La parte del nome del percorso dopo la Oracle Base (/u01/app/oracle/) include il numero di release del prodotto (ad esempio, 19.3.0) e la directory relativa della Oracle home (ad esempio, dbhome_1). La directory /u01/app/oracle/product/19.3.0/ contiene due Oracle home separate: dbhome_1 e dbhome_2.
La directory Oracle Base home (ORACLE_BASE_HOME), che si trova in ORACLE_BASE/homes/home_name, memorizza i file dinamici specifici di una Oracle home. La directory di configurazione Oracle Base (ORACLE_BASE_CONFIG), condivisa da tutte le Oracle home in una Oracle Base, memorizza i file dinamici specifici dell'istanza.
Nell'esempio riportato di seguito, il primo percorso è una Oracle home e il secondo è la Oracle Base home per questa Oracle home.
/u01/app/oracle/product/20.1.0/dbhome_1
/u01/app/oracle/homes/dbhome_1
Vedere anche: Oracle AI Database Installation Guide for Linux per una panoramica della Oracle home
SID (ID di sistema) Oracle
L'identificativo di sistema (SID) è un nome univoco per un'istanza del database Oracle su un host specifico.
In UNIX e Linux, Oracle AI Database utilizza i valori SID e Oracle home per creare una chiave per la memoria condivisa. Inoltre, Oracle AI Database utilizza il SID per impostazione predefinita per individuare il file dei parametri di inizializzazione, che individua i file pertinenti, ad esempio i file di controllo del database.
Nella maggior parte delle piattaforme, la variabile di ambiente ORACLE_SID imposta il SID e la variabile ORACLE_HOME imposta la Oracle home. Quando si esegue la connessione a un'istanza di database, i client possono specificare il SID in una connessione Oracle Net o utilizzare un nome di servizio di rete. Oracle AI Database converte un nome di servizio di rete in ORACLE_HOME e ORACLE_SID.
I file specifici dell'istanza vengono memorizzati separatamente nella Oracle Base. I file i cui nomi includono il SID risiedono nella sottodirectory dbs della directory di configurazione di Oracle Base (ORACLE_BASE_CONFIG). A causa di questa separazione, puoi creare un database utilizzando il software in una Oracle home esistente, quindi avviare un'istanza per questo database utilizzando il software che risiede in una nuova Oracle home.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come specificare un SID Oracle
Panoramica dell'avvio e della chiusura dell'istanza di database
Un'istanza di database fornisce agli utenti l'accesso a un database. L'istanza e il database possono trovarsi in vari stati.
-
Panoramica sull'avvio di istanze e database In genere, è possibile avviare manualmente un'istanza, quindi eseguire il MOUNT e aprire il database, rendendolo disponibile per gli utenti. Per eseguire queste operazioni, è possibile utilizzare il comando
STARTUPSQL*Plus, Oracle Enterprise Manager (Enterprise Manager) o la utility SRVCTL. -
Panoramica sull'arresto del database e dell'istanza In un caso d'uso tipico, si arresta manualmente il database, rendendolo non disponibile per gli utenti durante l'esecuzione della manutenzione o di altri task amministrativi. È possibile utilizzare il comando
SHUTDOWNdi SQL*Plus o Enterprise Manager per eseguire questi passi.
Panoramica dell'avvio dell'istanza e del database
In genere, si avvia manualmente un'istanza, quindi si esegue il MOUNT e si apre il database, rendendolo disponibile per gli utenti. Per eseguire queste operazioni, è possibile utilizzare il comando STARTUP SQL*Plus, Oracle Enterprise Manager (Enterprise Manager) o la utility SRVCTL.
Per avviare un'istanza di database utilizzando Oracle Net, è necessario che:
-
Il database viene registrato in modo statico con un listener Oracle Net.
-
Il client è connesso al database con il privilegio
SYSDBA.
Il listener crea un server dedicato, che può avviare l'istanza di database.
Il grafico seguente mostra l'avanzamento del database da uno stato di arresto a uno stato aperto.
Figura 3: Sequenza di avvio di istanze e database
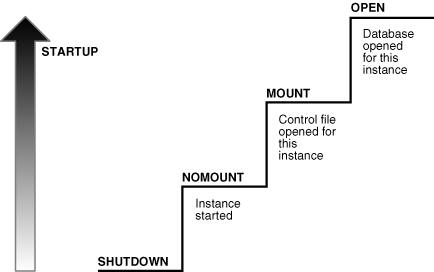
Descrizione dell'illustrazione cncpt212.gif
Un database passa attraverso le fasi seguenti quando passa da uno stato di chiusura a uno stato di database aperto.
Tabella 2 passi nell'avvio dell'istanza
| Fase | Stato MOUNT | Descrizione | Per saperne di più |
|---|---|---|---|
| 1 | Istanza avviata senza il MOUNT del database | L'istanza viene avviata, ma non è ancora associata a un database. | "Come viene avviata un'istanza" |
| 2 | MOUNT del database eseguito | L'istanza viene avviata ed è associata a un database leggendo il relativo file di controllo. Il database è chiuso agli utenti. | "Modalità di installazione di un database" |
| 3 | OPEN del database | L'istanza viene avviata ed è associata a un database aperto. I dati contenuti nei file di dati sono accessibili agli utenti autorizzati. | "Come si apre un database" |
-
L'avvio e la chiusura del database Connessione con privilegi di amministratore sono potenti opzioni amministrative limitate agli utenti che si connettono a Oracle AI Database con privilegi di amministratore.
-
Modalità di avvio di un'istanza Quando Oracle AI Database avvia un'istanza, l'istanza procede attraverso le fasi.
-
Modalità di MOUNT di un database L'istanza installa un database per associare il database a questa istanza.
-
Modalità di apertura di un database L'apertura di un database con MOUNT lo rende disponibile per il normale funzionamento del database.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come avviare un'istanza
-
Oracle AI Database Administrator's Guide per informazioni su come utilizzare SRVCTL
Connessione con privilegi di amministratore
L'avvio e la chiusura del database sono potenti opzioni amministrative limitate agli utenti che si connettono a Oracle AI Database con privilegi di amministratore.
Gli utenti normali non hanno il controllo sullo stato corrente di un database Oracle. A seconda del sistema operativo, una delle condizioni riportate di seguito stabilisce i privilegi di amministratore per un utente.
-
I privilegi del sistema operativo dell'utente consentono all'utente di connettersi utilizzando i privilegi di amministratore.
-
All'utente vengono concessi speciali privilegi di sistema e il database utilizza file di password per autenticare gli amministratori di database sulla rete.
I seguenti privilegi di sistema speciali consentono l'accesso a un'istanza di database anche quando il database non è aperto:
-
SYSDBA -
SYSOPER -
SYSBACKUP -
SYSDG -
SYSKM
Il controllo dei privilegi precedenti è esterno al database stesso. Quando ci si connette a un database con il privilegio di sistema SYSDBA, si è nello schema di proprietà di SYS. Quando ci si connette come SYSOPER, ci si trova nello schema pubblico. I privilegi SYSOPER sono un sottoinsieme di privilegi SYSDBA.
Vedere anche:
-
Oracle AI Database Security Guide per informazioni sugli account amministrativi predefiniti
-
Oracle AI Database Administrator's Guide per informazioni sui privilegi di sistema
-
Oracle AI Database Installation Guide per ulteriori informazioni sui gruppi di privilegi del sistema operativo
Modalità di avvio di un'istanza
Quando Oracle AI Database avvia un'istanza, procede attraverso le fasi.
Le fasi sono le seguenti:
-
Cerca un file dei parametri del server in una posizione predefinita specifica della piattaforma e, se non viene trovato, cerca un file dei parametri di inizializzazione di testo. Se si specifica
STARTUPcon i parametriSPFILEoPFILE, il comportamento predefinito viene sostituito. -
Legge il file dei parametri per determinare i valori dei parametri di inizializzazione
-
Alloca la SGA in base alle impostazioni dei parametri di inizializzazione
-
Avvia i processi in background di Oracle
-
Apre i file di alert log e trace e scrive tutte le impostazioni esplicite dei parametri nell'alert log nella sintassi valida dei parametri.
In questa fase, nessun database è associato all'istanza. Gli scenari che richiedono uno stato NOMOUNT includono la creazione del database e alcune operazioni di backup e ripristino.
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come gestire i parametri di inizializzazione utilizzando un file dei parametri del server.
Modalità di MOUNT di un database
L'istanza installa un database per associare il database a questa istanza.
Per eseguire il MOUNT del database, l'istanza ottiene i nomi dei control file del database specificati nel parametro di inizializzazione CONTROL_FILES e apre i file. Oracle AI Database legge i control file per trovare i nomi dei data file e dei redo log file in linea a cui tenterà di accedere durante l'apertura del database.
In un database attivato, il database viene chiuso e accessibile solo agli amministratori di database. Gli amministratori possono mantenere chiuso il database durante il completamento di operazioni di manutenzione specifiche. Tuttavia, il database non è disponibile per le normali operazioni.
Se Oracle AI Database consente a più istanze di eseguire il MOUNT dello stesso database contemporaneamente, l'impostazione del parametro di inizializzazione CLUSTER_DATABASE può rendere il database disponibile a più istanze. Il funzionamento del database dipende dall'impostazione:
-
Se
CLUSTER_DATABASEèfalse(impostazione predefinita) per la prima istanza che esegue il MOUNT di un database, solo questa istanza può eseguire il MOUNT del database. -
Se
CLUSTER_DATABASEètrueper la prima istanza, altre istanze possono eseguire il MOUNT del database se le relative impostazioni dei parametriCLUSTER_DATABASEsono impostate sutrue. Il numero di istanze che possono eseguire il MOUNT del database è soggetto a un numero massimo predeterminato specificato durante la creazione del database.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come eseguire il MOUNT di un database
-
Oracle Real Application Clusters Administration and Deployment Guide per ulteriori informazioni sull'uso di più istanze con un singolo database
Modalità di apertura di un database
L'apertura di un database con MOUNT lo rende disponibile per il normale funzionamento del database.
Qualsiasi utente valido può connettersi a un database aperto e accedere alle relative informazioni. In genere, un amministratore del database apre il database per renderlo disponibile per uso generale.
Quando si apre il database, Oracle AI Database esegue le azioni riportate di seguito.
-
Apre i file di dati in linea nelle tablespace diverse dall'annullamento delle tablespace
Se una tablespace era offline quando il database era stato precedentemente chiuso, la tablespace e i relativi file di dati corrispondenti saranno offline quando il database verrà riaperto.
-
Acquisisce una tablespace di undo
Se esistono più tablespace di undo, il parametro di inizializzazione
UNDO_TABLESPACEindica la tablespace di undo da utilizzare. Se questo parametro non è impostato, viene scelta la prima tablespace di undo disponibile. -
Apre i redo log file in rete
-
Modalità di sola lettura Per impostazione predefinita, il database viene aperto in modalità di lettura/scrittura. In questa modalità, gli utenti possono apportare modifiche ai dati, generando redo nel redo log in linea. In alternativa, è possibile aprire in modalità di sola lettura per impedire la modifica dei dati da parte delle transazioni utente.
-
Controlli file di database Se uno qualsiasi dei file di dati o dei redo log file non è presente quando l'istanza tenta di aprire il database o se i file sono presenti ma non superano i test di coerenza, il database restituisce un errore. Potrebbe essere necessario il recupero dei supporti.
Vedere anche:
-
Oracle AI Database Backup and Recovery User's Guide per saperne di più sulla riparazione dei dati
Modalità di sola lettura
Per impostazione predefinita, il database viene aperto in modalità di lettura/scrittura. In questa modalità, gli utenti possono apportare modifiche ai dati, generando redo nel redo log in linea. In alternativa, è possibile aprire in modalità di sola lettura per impedire la modifica dei dati da parte delle transazioni utente. Nota: per impostazione predefinita, viene aperto un database in standby fisico in modalità di sola lettura.
La modalità di sola lettura limita l'accesso al database alle transazioni di sola lettura, che non possono scrivere nei file di dati o nei redo log file in linea. Tuttavia, il database può eseguire operazioni di recupero o di modifica dello stato del database senza generare redo. Ad esempio, in modalità di sola lettura:
-
I file di dati possono essere messi offline e online. Tuttavia, non è possibile disconnettere le tablespace permanenti.
-
I file di dati e le tablespace offline possono essere recuperati.
-
Il control file rimane disponibile per gli aggiornamenti sullo stato del database.
-
Le tablespace temporanee create con l'istruzione
CREATE TEMPORARY TABLESPACEsono di lettura/scrittura. -
Le scritture negli audit trail del sistema operativo, nei file di trace e nei log degli avvisi possono continuare.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come aprire un database in modalità di sola lettura
Controlli file database
Se uno qualsiasi dei file di dati o dei redo log file non è presente quando l'istanza tenta di aprire il database o se i file sono presenti ma non superano i test di coerenza, il database restituisce un errore. Potrebbe essere necessario il recupero dei supporti.
Vedere anche: Oracle AI Database Backup and Recovery User's Guide per una panoramica su backup e ripristino
Panoramica dell'arresto del database e dell'istanza
In un caso d'uso tipico, è possibile chiudere manualmente il database, rendendolo non disponibile per gli utenti durante l'esecuzione della manutenzione o di altri task amministrativi. È possibile utilizzare il comando SHUTDOWN di SQL*Plus o Enterprise Manager per eseguire questi passi.
La figura seguente mostra la progressione da uno stato aperto a un arresto coerente.
Figura 4: Sequenza di arresto dell'istanza e del database
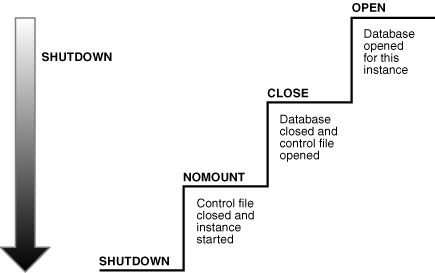
Descrizione dell'illustrazione cncpt281.gif
Oracle AI Database esegue automaticamente i passi riportati di seguito ogni volta che un database aperto viene chiuso in modo coerente.
Tabella 3 Passi nella chiusura coerente
| Fase | Stato MOUNT | Descrizione | Per saperne di più |
|---|---|---|---|
| 1 | Database chiuso | Il database viene attivato, ma i file di dati e i redo log file in linea vengono chiusi. | "Modalità di chiusura di un database" |
| 2 | Database non attivato | L'istanza viene avviata, ma non è più associata al control file del database. | "Modalità di disinstallazione di un database" |
| 3 | Arresto istanza del database | L'istanza di database non è più avviata. | "Modalità di chiusura di un'istanza" |
Oracle AI Database non esegue tutti i passi precedenti in un errore di istanza o in SHUTDOWN ABORT, che termina immediatamente l'istanza.
-
Modalità di chiusura Un amministratore di database con privilegi
SYSDBAoSYSOPERpuò arrestare il database utilizzando il comando SQL*PlusSHUTDOWNo Enterprise Manager. Il comandoSHUTDOWNinclude opzioni che determinano il funzionamento dell'arresto. -
Modalità di chiusura di un database L'operazione di chiusura del database è implicita nella chiusura di un database. La natura dell'operazione dipende dal fatto che la chiusura del database sia normale o anormale.
-
Modalità di annullamento del MOUNT di un database Dopo la chiusura del database, Oracle AI Database disinstalla il database per dissociarlo dall'istanza.
-
Modalità di chiusura di un'istanza Il passo finale della chiusura del database è la chiusura dell'istanza. Quando l'istanza di database si arresta, l'SGA cessa di occupare memoria e i processi in background terminano. Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come chiudere un database
Modalità chiusura
Un amministratore di database con privilegi SYSDBA o SYSOPER può arrestare il database utilizzando il comando SQL*Plus SHUTDOWN o Enterprise Manager. Il comando SHUTDOWN include opzioni che determinano il funzionamento dell'arresto.
La tabella seguente riassume il funzionamento delle diverse modalità di spegnimento.
Tabella 4 Modalità di arresto del database
| Funzionamento del database | INTERROTTO | IMMEDIATE | TRANSAZIONALE | NORMALE |
|---|---|---|---|---|
| Consente nuove connessioni utente | N. | N. | N. | N. |
| Attende la fine delle sessioni correnti | N. | N. | N. | Sì |
| Attende la fine delle transazioni correnti | N. | N. | Sì | Sì |
| Esegue un checkpoint e chiude i file aperti | N. | Sì | Sì | Sì |
Le possibili istruzioni SHUTDOWN sono:
-
SHUTDOWN ABORTQuesta modalità è destinata a situazioni di emergenza, ad esempio quando nessun'altra forma di arresto ha successo. Questa modalità di spegnimento è la più veloce. Tuttavia, un'apertura successiva di questo database potrebbe richiedere molto più tempo perché è necessario eseguire il recupero dell'istanza per rendere i file di dati coerenti.
Poiché
SHUTDOWN ABORTnon esegue il checkpoint dei file di dati aperti, il recupero dell'istanza è necessario prima che il database possa riaprirsi. Le altre modalità di arresto non richiedono il recupero dell'istanza prima della riapertura del database.Nota: in un PDB, l'emissione di
SHUTDOWN ABORTequivale all'emissione diSHUTDOWN IMMEDIATEa livello di CDB. -
SHUTDOWN IMMEDIATEQuesta modalità è in genere la più veloce accanto a
SHUTDOWN ABORT. Oracle AI Database interrompe qualsiasi istruzione SQL in esecuzione e disconnette gli utenti. Le transazioni attive vengono terminate e viene eseguito il rollback delle modifiche non impegnate. -
SHUTDOWN TRANSACTIONALQuesta modalità impedisce agli utenti di avviare nuove transazioni, ma attende il completamento di tutte le transazioni correnti prima della chiusura. Questa modalità può richiedere un tempo significativo a seconda della natura delle transazioni correnti.
-
SHUTDOWN NORMALQuesta è la modalità predefinita di arresto. Il database attende la disconnessione di tutti gli utenti connessi prima della chiusura.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni sulle diverse modalità di arresto
-
SQL*Plus User's Guide and Reference per ulteriori informazioni sul comando
SHUTDOWN
Modalità di chiusura di un database
L'operazione di chiusura del database è implicita in una chiusura del database. La natura dell'operazione dipende dal fatto che la chiusura del database sia normale o anormale.
-
Modalità di chiusura di un database durante la normale chiusura Quando un database viene chiuso come parte di un file
SHUTDOWNcon qualsiasi opzione diversa daABORT, Oracle AI Database scrive i dati nell'area SGA nei file di dati e nei redo log file in linea. -
How a Database Is Closed During Abnormal Shutdown If a
SHUTDOWN ABORTor abnormal termination occurs, then the instance of an open database closes and shuts down the database instantaneously.
Modalità di chiusura di un database durante la normale chiusura
Quando un database viene chiuso come parte di un file SHUTDOWN con qualsiasi opzione diversa da ABORT, Oracle AI Database scrive i dati nell'area SGA nei file di dati e nei redo log file in linea.
Successivamente, il database chiude i file di dati in linea e i redo log file in linea. Tutti i file di dati non in linea delle tablespace non in linea sono già stati chiusi. Quando il database viene riaperto, qualsiasi tablespace non in linea rimane non in linea.
In questa fase, il database è chiuso e inaccessibile per le normali operazioni. I control file rimangono aperti dopo la chiusura di un database.
Modalità di chiusura di un database durante un arresto anomalo
Se si verifica una chiusura anomala o un'interruzione anomala in modalità SHUTDOWN ABORT, l'istanza di un database aperto verrà chiusa e il database verrà arrestato in modo immediato.
In caso di arresto anomalo, Oracle AI Database non scrive dati nei buffer della SGA nei file di dati e nei redo log file. La successiva riapertura del database richiede il recupero dell'istanza, operazione eseguita automaticamente da Oracle AI Database.
Modalità di disinstallazione di un database
Dopo la chiusura del database, Oracle AI Database disinstalla il database per annullarne l'associazione dall'istanza.
Dopo la disinstallazione di un database, Oracle AI Database chiude i control file del database. A questo punto, l'istanza di database rimane in memoria.
Modalità di chiusura di un'istanza
Il passo finale della chiusura del database sta arrestando l'istanza. Quando l'istanza di database si arresta, l'SGA cessa di occupare memoria e i processi in background terminano.
In circostanze insolite, la chiusura di un'istanza di database potrebbe non verificarsi in modo corretto. Le strutture di memoria non possono essere rimosse dalla memoria o uno dei processi in background non può essere terminato. Quando esistono residui di un'istanza precedente, l'avvio successivo dell'istanza potrebbe non riuscire. In tali situazioni, è possibile forzare l'avvio della nuova istanza rimuovendo i residui dell'istanza precedente e quindi avviando una nuova istanza o emettendo un'istruzione SHUTDOWN ABORT.
In alcuni casi, il cleanup del processo stesso può riscontrare errori, che possono comportare l'interruzione del monitoraggio del processo (PMON) o dell'istanza. Il parametro di inizializzazione dinamica INSTANCE_ABORT_DELAY_TIME specifica quanti secondi ritardare un errore di istanza generato internamente. Questo ritardo ti dà la possibilità di rispondere. Il database scrive un messaggio nel log degli avvisi quando viene avviata l'interruzione ritardata. In alcune circostanze, consentendo la messa in quarantena di determinate risorse di database, l'istanza può evitare l'interruzione.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni più dettagliate sulla chiusura del database
-
Oracle AI Database Reference per ulteriori informazioni sul parametro di inizializzazione
INSTANCE_ABORT_DELAY_TIME
Panoramica dei checkpoint
Un checkpoint è un meccanismo cruciale per la chiusura coerente del database, il recupero delle istanze e l'operazione di Oracle AI Database in generale.
Il termine ha i seguenti significati correlati:
-
Struttura dati che indica la posizione del checkpoint, ovvero l'SCN nel redo stream in cui deve iniziare il recupero dell'istanza
La posizione del checkpoint è determinata dal buffer sporco meno recente nella buffer cache del database. La posizione del checkpoint funge da puntatore al flusso di redo e viene memorizzata nel control file e nell'intestazione di ogni file di dati.
-
Scrittura su disco dei buffer di database modificati nella cache del buffer del database
-
Scopo dei checkpoint Oracle AI Database utilizza i checkpoint per raggiungere più obiettivi.
-
Quando Oracle AI Database avvia i checkpoint Il processo di checkpoint (CKPT) è responsabile della scrittura dei checkpoint nelle intestazioni dei file di dati e nel file di controllo. Vedere anche: "System Change Numbers (SCN)"
Scopo dei checkpoint
Oracle AI Database utilizza i checkpoint per raggiungere più obiettivi.
Gli obiettivi includono:
-
Ridurre il tempo necessario per il ripristino in caso di errore dell'istanza o del supporto
-
Assicurarsi che il database scriva regolarmente buffer modificati nella buffer cache su disco
-
Assicurarsi che il database scriva tutti i dati sottoposti a commit su disco durante una chiusura coerente
Quando Oracle AI Database avvia i checkpoint
Il processo di checkpoint (CKPT) è responsabile della scrittura dei checkpoint nelle intestazioni dei file di dati e nel file di controllo.
I checkpoint si verificano in una varietà di situazioni. Ad esempio, Oracle AI Database utilizza i tipi di checkpoint riportati di seguito.
-
Checkpoint thread
Il database scrive su disco tutti i buffer modificati da redo in un thread specifico prima di una determinata destinazione. Il set di checkpoint dei thread in tutte le istanze di un database è un checkpoint del database. I checkpoint dei thread si verificano nelle seguenti situazioni:
-
Chiusura del database coerente
-
istruzione
ALTER SYSTEM CHECKPOINT -
Switch redo log in linea
-
istruzione
ALTER DATABASE BEGIN BACKUP
-
-
Checkpoint tablespace e file di dati
Il database scrive su disco tutti i buffer modificati dal redo prima di una destinazione specifica. Un checkpoint di tablespace è un set di checkpoint di file di dati, uno per ogni file di dati nella tablespace. Questi checkpoint si verificano in diverse situazioni, tra cui la creazione di una tablespace di sola lettura o la messa fuori linea normale, la riduzione di un file di dati o l'esecuzione di
ALTER TABLESPACE BEGIN BACKUP. -
Checkpoint incrementali
Un checkpoint incrementale è un tipo di checkpoint thread in parte destinato a evitare la scrittura di un numero elevato di blocchi nei redo log switch online. DBW controlla almeno ogni tre secondi per determinare se ha lavoro da fare. Quando DBW scrive buffer sporchi, avanza la posizione del checkpoint, facendo sì che CKPT scriva la posizione del checkpoint nel file di controllo, ma non nelle intestazioni del file di dati.
Altri tipi di checkpoint includono checkpoint e checkpoint di recupero di istanze e supporti quando gli oggetti dello schema vengono eliminati o troncati.
Vedere anche:
-
Oracle Real Application Clusters Administration and Deployment Guide per informazioni sui checkpoint globali in Oracle RAC
Panoramica sul recupero dell'istanza
Il recupero dell'istanza è il processo di applicazione dei record nel redo log in linea ai file di dati per ricostruire le modifiche apportate dopo il checkpoint più recente.
Il recupero dell'istanza si verifica automaticamente quando un amministratore tenta di aprire un database precedentemente chiuso in modo incoerente.
-
Scopo del recupero dell'istanza Il recupero dell'istanza garantisce che il database si trovi in uno stato coerente dopo un errore dell'istanza. I file di un database possono essere lasciati in uno stato incoerente a causa di come Oracle AI Database gestisce le modifiche al database.
-
Quando Oracle AI Database esegue il recupero dell'istanza Se il recupero dell'istanza è necessario dipende dallo stato dei redo thread.
-
Importanza dei checkpoint per il recupero dell'istanza Il recupero dell'istanza utilizza i checkpoint per determinare quali modifiche devono essere applicate ai file di dati. La posizione del checkpoint garantisce che ogni modifica di cui è stato eseguito il commit con un SCN inferiore al checkpoint SCN venga salvata nei file di dati.
-
Fasi di recupero dell'istanza La prima fase del recupero dell'istanza è denominata recupero della cache o arrotondamento in avanti e applica di nuovo tutte le modifiche registrate nel redo log in linea ai file di dati.
Scopo del recupero dell'istanza
Il recupero dell'istanza garantisce che il database si trovi in uno stato coerente dopo un errore dell'istanza. I file di un database possono essere lasciati in uno stato incoerente a causa di come Oracle AI Database gestisce le modifiche al database.
Un redo thread è un record di tutte le modifiche generate da un'istanza. Un database a istanza singola ha un thread di redo, mentre un database Oracle RAC ha più redo thread, uno per ogni istanza di database.
Quando viene eseguito il commit di una transazione, il processo Log Writer (LGWR) scrive sia i redo entry rimanenti in memoria che l'SCN della transazione nel re redo log online. Tuttavia, il processo database writer (DBW) scrive nei file di dati blocchi di dati modificati ogni volta che è più efficiente. Per questo motivo, le modifiche non sottoposte a commit potrebbero temporaneamente esistere nei file di dati mentre le modifiche sottoposte a commit non esistono ancora nei file di dati.
Se un'istanza di un database aperto non riesce, a causa di un'istruzione SHUTDOWN ABORT o di un'interruzione anomala, possono verificarsi le seguenti situazioni:
-
I blocchi di dati sottoposti a commit da una transazione non vengono scritti nei file di dati e vengono visualizzati solo nel re redo log in linea. Queste modifiche devono essere applicate nuovamente ai file di dati.
-
I file di dati contengono modifiche di cui non è stato eseguito il commit quando l'istanza non è riuscita. È necessario eseguire il rollback di queste modifiche per garantire la coerenza delle transazioni.
Il recupero delle istanze utilizza solo i redo log file in linea e i file di dati in linea correnti per sincronizzare i file di dati e assicurarsi che siano coerenti.
Vedere anche:
Quando Oracle AI Database esegue il recupero dell'istanza
Il recupero dell'istanza dipende dallo stato dei redo thread.
Un redo thread viene contrassegnato come aperto nel control file quando un'istanza di database viene aperta in modalità di lettura/scrittura e viene contrassegnato come chiuso quando l'istanza viene arrestata in modo coerente. Se i redo thread sono contrassegnati come aperti nel control file, ma nessuna istanza attiva contiene le accodature dei thread corrispondenti a questi thread, il database richiede il recupero dell'istanza.
Oracle AI Database esegue automaticamente il recupero delle istanze nelle situazioni riportate di seguito.
-
Il database viene aperto per la prima volta dopo l'errore di un database a istanza singola o di tutte le istanze di un database Oracle RAC. Questa forma di recupero dell'istanza è anche chiamata crash recovery. Oracle AI Database recupera insieme i redo thread in linea delle istanze terminate.
-
Alcune, ma non tutte, istanze di un database Oracle RAC non riescono. Il recupero dell'istanza viene eseguito automaticamente da un'istanza rimanente nella configurazione.
Il processo in background SMON esegue il recupero delle istanze, applicando automaticamente il redo in linea. Non è richiesto alcun intervento dell'utente.
Vedere anche:
-
Oracle Real Application Clusters Administration and Deployment Guide per informazioni sul recupero delle istanze in un database Oracle RAC
Importanza dei checkpoint per il recupero dell'istanza
Il recupero dell'istanza utilizza i checkpoint per determinare le modifiche da applicare ai file di dati. La posizione del checkpoint garantisce che ogni modifica di cui è stato eseguito il commit con un SCN inferiore al checkpoint SCN venga salvata nei file di dati.
Nella figura seguente viene illustrato il redo thread nel redo log in linea.
Figura 5: Posizione del checkpoint nel redo log in linea
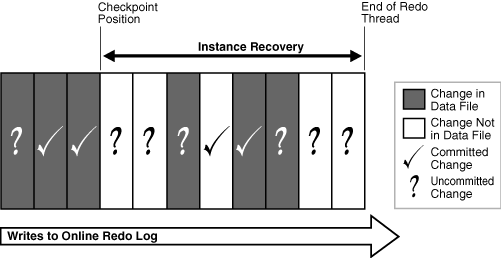
Descrizione dell'illustrazione cncpt282.gif
Durante il recupero dell'istanza, il database deve applicare le modifiche che si verificano tra la posizione del checkpoint e la fine del redo thread. Come illustrato nella Figura 16-5, è possibile che alcune modifiche siano già state scritte nei file di dati. Tuttavia, solo le modifiche con SCN inferiori alla posizione del checkpoint sono garantite sul disco.
Vedere anche: Oracle AI Database Performance Tuning Guide per informazioni su come limitare il tempo di recupero dell'istanza
Fasi recupero istanza
La prima fase del recupero dell'istanza è denominata recupero della cache o arrotondamento in avanti e applica di nuovo tutte le modifiche registrate nel redo log in linea ai file di dati.
Poiché il redo log in linea contiene dati di undo, il rollforward rigenera anche i segmenti di undo corrispondenti. L'avanzamento continua con il numero di redo log file in linea necessario per far avanzare il database nel tempo. Dopo il rollforward, i blocchi di dati contengono tutte le modifiche di cui è stato eseguito il commit registrate nei redo log file in linea. Questi file potrebbero anche contenere modifiche non sottoposte a commit salvate nei file di dati prima dell'errore oppure registrate nel redo log in linea e introdotte durante il recupero della cache.
Dopo il rollforward, le modifiche di cui non è stato eseguito il commit devono essere annullate. Oracle AI Database utilizza la posizione del checkpoint, che garantisce che ogni modifica di cui è stato eseguito il commit con un SCN inferiore all'SCN del checkpoint venga salvata su disco. Oracle AI Database applica blocchi di undo per eseguire il rollback delle modifiche non sottoposte a commit nei blocchi di dati scritti prima dell'errore o introdotti durante il recupero della cache. Questa fase è denominata rollback o recupero delle transazioni.
Nella figura seguente viene illustrato il rollback in avanti e il rollback, ovvero i due passi necessari per il ripristino da un errore dell'istanza di database.
Figura 6: Passi di recupero dell'istanza di base: rollback e rollback
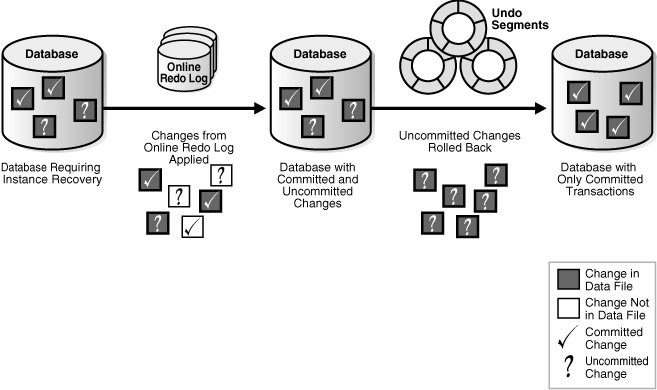
Descrizione dell'illustrazione cncpt196.gif
Oracle AI Database può eseguire il rollback di più transazioni contemporaneamente in base alle esigenze. Tutte le transazioni attive al momento dell'errore sono contrassegnate come cessate. Invece di attendere che il processo SMON esegua il rollback delle transazioni cessate, le nuove transazioni possono eseguire il rollback dei singoli blocchi stessi per ottenere i dati richiesti.
Vedere anche:
-
"Annulla segmenti" per ulteriori informazioni sull'annullamento dei dati
-
Oracle AI Database Performance Tuning Guide per una discussione sulla meccanica e l'ottimizzazione del recupero delle istanze
Panoramica dei file dei parametri
Per avviare un'istanza di database, Oracle AI Database deve leggere un file dei parametri del server, che è consigliato, oppure un file dei parametri di inizializzazione del testo, che è un'implementazione precedente. Questi file contengono una lista di parametri di configurazione.
Per creare un database manualmente, è necessario avviare un'istanza con un file di parametri, quindi emettere un'istruzione CREATE DATABASE. Pertanto, il file dell'istanza e dei parametri può esistere anche quando il database stesso non esiste.
-
I parametri di inizializzazione sono parametri di configurazione che influiscono sul funzionamento di base di un'istanza. L'istanza legge i parametri di inizializzazione da un file durante la procedura di avvio.
-
File dei parametri server Un file dei parametri del server è un repository per i parametri di inizializzazione.
-
File dei parametri di inizializzazione testo Un file dei parametri di inizializzazione testo è un file di testo contenente una lista di parametri di inizializzazione.
-
Modifica dei valori dei parametri di inizializzazione È possibile modificare i parametri di inizializzazione per modificare il funzionamento di un database. La classificazione dei parametri come statici o dinamici determina la modalità di modifica.
Parametri di inizializzazione
I parametri di inizializzazione sono parametri di configurazione che influiscono sul funzionamento di base di un'istanza. L'istanza legge i parametri di inizializzazione da un file durante la procedura di avvio.
Oracle AI Database fornisce molti parametri di inizializzazione per ottimizzare il funzionamento in ambienti diversi. Solo alcuni di questi parametri devono essere impostati esplicitamente perché i valori predefiniti sono generalmente adeguati.
-
I parametri di inizializzazione dei gruppi funzionali dei parametri di inizializzazione rientrano in gruppi funzionali diversi.
-
I parametri di inizializzazione Basic e Advanced Initialization sono suddivisi in due gruppi: basic e advanced.
Gruppi funzionali di parametri di inizializzazione
I parametri di inizializzazione rientrano in gruppi funzionali diversi.
La maggior parte dei parametri di inizializzazione appartiene a uno dei gruppi elencati di seguito.
-
Parametri che denominano entità quali file o directory
-
Parametri che impostano limiti per un processo, una risorsa di database o il database stesso
-
Parametri che influiscono sulla capacità, ad esempio la dimensione dell'SGA (questi parametri sono denominati parametri variabili)
I parametri variabili sono di particolare interesse per gli amministratori del database perché possono utilizzare questi parametri per migliorare le prestazioni del database.
Parametri di inizializzazione di base e avanzati
I parametri di inizializzazione sono suddivisi in due gruppi: base e avanzata.
In genere, è necessario impostare e ottimizzare solo i circa 30 parametri di base per ottenere prestazioni ragionevoli. I parametri di base impostano caratteristiche quali il nome del database, le posizioni dei control file, la dimensione del blocco del database e la tablespace di undo.
In rare situazioni, può essere necessario modificare i parametri avanzati per ottenere prestazioni ottimali. I parametri avanzati consentono ai DBA esperti di adattare il comportamento di Oracle AI Database per soddisfare requisiti unici.
Oracle AI Database fornisce i valori nel file dei parametri di inizializzazione iniziale fornito con il software del database o come creato automaticamente dall'Assistente alla configurazione del database (DBCA). È possibile modificare questi parametri di inizializzazione forniti da Oracle e aggiungerne altri, a seconda della configurazione e della modalità di ottimizzazione del database. Per i parametri di inizializzazione rilevanti non inclusi nel file dei parametri, Oracle AI Database fornisce i valori predefiniti.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come specificare i parametri di inizializzazione
-
Oracle AI Database Reference per una spiegazione dei tipi di parametri di inizializzazione
-
Oracle AI Database Reference per una descrizione di
V$PARAMETERe SQL*Plus User's Guide and Reference per la sintassiSHOW PARAMETER
File dei parametro del server
Un file dei parametri del server è un repository per i parametri di inizializzazione.
Un file dei parametri del server presenta le seguenti caratteristiche chiave:
-
Solo Oracle AI Database legge e scrive nel file dei parametri del server.
-
Per un database esiste un solo file di parametri del server. Questo file deve risiedere nell'host del database.
-
Il file dei parametri del server è binario e non può essere modificato da un editor di testo.
-
I parametri di inizializzazione memorizzati nel file dei parametri del server sono persistenti. Qualsiasi modifica apportata ai parametri durante l'esecuzione di un'istanza di database può persistere durante la chiusura e l'avvio dell'istanza.
Un file di parametri del server elimina la necessità di gestire più file di parametri di inizializzazione del testo per le applicazioni client. Un file dei parametri del server viene creato inizialmente da un file dei parametri di inizializzazione del testo utilizzando l'istruzione CREATE SPFILE. Può anche essere creato direttamente dall'Assistente alla configurazione del database.
Vedere anche:
-
Oracle AI Database Administrator's Guide per ulteriori informazioni sui file dei parametri del server
-
Oracle AI Database SQL Language Reference per saperne di più su
CREATE SPFILE
File dei parametri di inizializzazione del testo
Un file dei parametri di inizializzazione del testo è un file di testo contenente un elenco di parametri di inizializzazione.
Questo tipo di file di parametri, che è un'implementazione precedente del file di parametri, ha le seguenti caratteristiche chiave:
-
Quando si avvia o si chiude un database, il file dei parametri di inizializzazione del testo deve trovarsi sullo stesso host dell'applicazione client che si connette al database.
-
Un file dei parametri di inizializzazione del testo è basato su testo, non binario.
-
Oracle AI Database può leggere ma non scrivere nel file dei parametri di inizializzazione del testo. Per modificare i valori dei parametri, è necessario modificare manualmente il file con un editor di testo.
-
Le modifiche apportate ai valori dei parametri di inizializzazione da
ALTER SYSTEMsono valide solo per l'istanza corrente. È necessario aggiornare manualmente il file dei parametri di inizializzazione del testo e riavviare l'istanza per rendere note le modifiche.
Il file dei parametri di inizializzazione del testo contiene una serie di coppie key=value, una per riga. Ad esempio, una parte di un file dei parametri di inizializzazione potrebbe essere la seguente:
db_name=sample
control_files=/disk1/oradata/sample_cf.dbf
db_block_size=8192
open_cursors=52
undo_management=auto
shared_pool_size=280M
pga_aggregate_target=29M
.
.
.
Per illustrare i problemi di gestibilità che i file dei parametri di testo possono creare, si supponga di utilizzare i computer clienta e clientb e di poter avviare il database con SQL*Plus su entrambi i computer. In questo caso, devono esistere due file di parametri di inizializzazione del testo separati, uno su ciascun computer, come illustrato nella Figura 16-7. Un file dei parametri del server risolve il problema della proliferazione dei file dei parametri.
Figura 7: File dei parametri di inizializzazione multipli
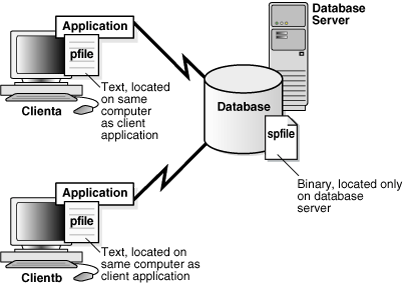
Descrizione dell'illustrazione cncpt247.gif
Vedere anche:
-
Oracle AI Database Administrator's Guide per ulteriori informazioni sui file dei parametri di inizializzazione del testo
-
Oracle AI Database SQL Language Reference per saperne di più su
CREATE PFILE
Modifica dei valori dei parametri di inizializzazione
È possibile modificare i parametri di inizializzazione per modificare il funzionamento di un database. La classificazione dei parametri come statici o dinamici determina la modalità di modifica.
Nella tabella seguente vengono riepilogate le differenze.
Tabella 5 Parametri di inizializzazione statici e dinamici
| Caratteristica | Statico | Dinamico |
|---|---|---|
| Richiede la modifica del file dei parametri (testo o server) | Sì | N. |
| Richiede il riavvio dell'istanza di database prima che l'impostazione abbia effetto | Sì | N. |
| Descritto come "Modifiable" nella voce del parametro di inizializzazione di Oracle AI Database Reference | N. | Sì |
| Modificabile solo per il database o l'istanza | Sì | N. |
I parametri statici includono DB_BLOCK_SIZE, DB_NAME e COMPATIBLE. I parametri dinamici sono raggruppati in parametri a livello di sessione, che interessano solo la sessione utente corrente, e parametri a livello di sistema, che interessano il database e tutte le sessioni. Ad esempio, MEMORY_TARGET è un parametro a livello di sistema, mentre NLS_DATE_FORMAT è un parametro a livello di sessione.
L'ambito della modifica di un parametro dipende dal momento in cui la modifica diventa effettiva. Quando un'istanza è stata avviata con un file dei parametri del server, è possibile utilizzare l'istruzione ALTER SYSTEM SET per modificare i valori per i parametri a livello di sistema come indicato di seguito.
-
SCOPE=MEMORYLe modifiche vengono applicate solo all'istanza di database. La modifica non persisterà se il database viene chiuso e riavviato.
-
SCOPE=SPFILELe modifiche vengono applicate al file dei parametri del server, ma non all'istanza corrente. Pertanto, le modifiche non avranno effetto fino al riavvio dell'istanza.
Nota: quando si modifica il valore di un parametro descritto come non modificabile in Oracle AI Database Reference, è necessario specificare
SPFILE. -
SCOPE=BOTHOracle AI Database scrive le modifiche sia nella memoria che nel file dei parametri del server. Ambito predefinito quando il database utilizza un file dei parametri del server.
Il database stampa il nuovo valore e il vecchio valore di un parametro di inizializzazione nell'alert log. Come misura preventiva, il database convalida le modifiche dei parametri di base per impedire la scrittura di valori non validi nel file dei parametri del server.
Vedere anche:
-
Oracle AI Database Globalization Support Guide per scoprire come scegliere una versione locale con la variabile d'ambiente
NLS_LANG -
Oracle AI Database Administrator's Guide per informazioni su come modificare le impostazioni dei parametri di inizializzazione
-
Oracle AI Database Reference per la descrizione di tutti i parametri di inizializzazione
-
Oracle AI Database SQL Language Reference per sintassi e semantica
ALTER SYSTEM
Panoramica dei file diagnostici
Oracle AI Database include un'infrastruttura di diagnosticabilità degli errori per prevenire, rilevare, diagnosticare e risolvere i problemi del database. I problemi includono errori critici come bug di codice, danneggiamento dei metadati e danneggiamento dei dati dei clienti.
Gli obiettivi dell'infrastruttura di diagnosticabilità degli errori avanzata sono i seguenti:
-
Rilevamento proattivo dei problemi
-
Limitazione di danni e interruzioni dopo il rilevamento di un problema
-
Riduzione dei tempi di diagnostica e risoluzione dei problemi
-
Migliorare la gestibilità consentendo di partizionare i file di trace, consentendo all'utente di definire la dimensione per pezzo e il numero massimo di pezzi da conservare e disabilitando il trace dopo il raggiungimento di un limite di spazio su disco specificato dall'utente
-
Semplificare l'interazione con i clienti con Oracle Support
-
Automatic Diagnostic Repository Automatic Diagnostic Repository (ADR) è un repository basato su file che memorizza i dati di diagnostica del database, ad esempio i file di trace, l'alert log, il log DDL e i report Health Monitor.
-
Log degli avvisi Ogni database dispone di un log degli avvisi, ovvero un file contenente un log cronologico di messaggi ed errori del database.
-
Log attenzione Ogni database dispone di un log attenzione contenente eventi di database critici e ad alta visibilità.
-
Log DDL Il log DDL ha lo stesso formato e lo stesso funzionamento di base dell'alert log, ma contiene solo istruzioni e dettagli DDL. Il database scrive le informazioni DDL nel proprio file per ridurre il disordine nell'alert log.
-
File di traccia Un file di traccia è un file contenente i dati diagnostici utilizzati per analizzare i problemi. Inoltre, i file di trace possono fornire indicazioni per il tuning delle applicazioni o di un'istanza.
-
Dump diagnostici Un file di dump diagnostico è un tipo speciale di file di trace contenente informazioni dettagliate su uno stato o una struttura. Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come gestire i file di diagnostica
Repository di diagnostica automatica
Automatic Diagnostic Repository (ADR) è un repository basato su file che memorizza i dati di diagnostica del database, ad esempio i file di trace, l'alert log, il log DDL e i report Health Monitor.
Le caratteristiche principali dell'ADR includono:
-
Struttura di directory unificata
-
Formati di dati diagnostici coerenti
-
Set di strumenti unificato
Le caratteristiche precedenti consentono ai clienti e al Supporto Oracle di correlare e analizzare i dati di diagnostica su più istanze, componenti e prodotti Oracle.
ADR si trova al di fuori del database, che consente a Oracle AI Database di accedere e gestire l'ADR quando il database fisico non è disponibile. Un'istanza di database può creare un ADR prima della creazione di un database.
-
L'ADR di problemi e incidenti tiene traccia in modo proattivo dei problemi, che sono errori critici nel database.
-
Struttura ADR La base ADR è la directory root ADR.
Problemi e incidenti
ADR tiene traccia in modo proattivo dei problemi, che sono errori critici nel database.
Gli errori critici si manifestano come errori interni, quali ad esempio ORA-600, o altri errori gravi. A ciascun problema è stata associata una chiave del problema, ovvero una stringa di testo che descrive il problema.
Quando si verifica un problema più volte, ADR crea un incidente con indicatore orario per ogni occorrenza. Un incidente è identificato in modo univoco da un ID incidente numerico. Quando si verifica un incidente, ADR invia un avviso di incidente a Enterprise Manager. La diagnosi e la risoluzione di un errore critico iniziano di solito con un alert di incidente.
Poiché un problema potrebbe generare molti incidenti in breve tempo, l'ADR applica il controllo delle inondazioni alla generazione degli incidenti dopo il raggiungimento di determinate soglie. Un incidente controllato dall'inondazione genera una voce dell'alert log, ma non genera dump degli incidenti. In questo modo, ADR informa che è in corso un errore critico senza sovraccaricare il sistema con i dati diagnostici.
Vedere anche: Oracle AI Database Administrator's Guide per informazioni dettagliate sull'infrastruttura di diagnosticabilità degli errori
Struttura ADR
La base ADR è la directory root ADR.
La base ADR può contenere più home ADR, in cui ogni home ADR è la directory radice per tutte le parentesi graffe, i dump, l'alert log e così via per un'istanza di un prodotto o componente Oracle. Ad esempio, in un ambiente Oracle RAC con memorizzazione condivisa e Oracle ASM, ogni istanza di database e ogni istanza Oracle ASM dispone della propria home ADR. La Figura 16-8 illustra la gerarchia di directory ADR per un'istanza di database. Altre home ADR per altri prodotti o componenti Oracle, ad esempio Oracle ASM o Oracle Net Services, possono esistere all'interno di questa gerarchia, nella stessa base ADR.
Figura 8: Struttura della directory ADR per un'istanza di Oracle AI Database
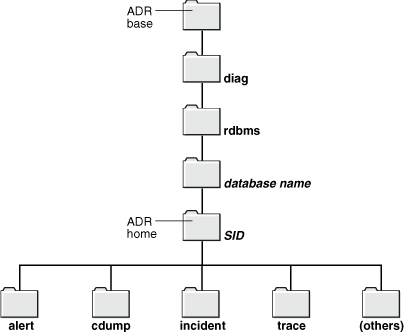
Descrizione dell'illustrazione admin077.gif
Come mostra l'esempio Linux riportato di seguito, quando si avvia un'istanza con un SID e un nome di database univoci prima di creare un database, Oracle AI Database crea ADR per impostazione predefinita come struttura di directory nel file system host. Il SID e il nome del database fanno parte del nome del percorso per i file nella home ADR.
Esempio 16-1 Creazione di ADR
% setenv ORACLE_SID osi
% echo "DB_NAME=dbn" > init.ora
% sqlplus / as sysdba
.
.
.
Connected to an idle instance.

SQL> STARTUP NOMOUNT PFILE="./init.ora"
ORACLE instance started.

Total System Global Area  146472960 bytes
Fixed Size                  1317424 bytes
Variable Size              92276176 bytes
Database Buffers           50331648 bytes
Redo Buffers                2547712 bytes

SQL> COL NAME FORMAT a21
SQL> COL VALUE FORMAT a60
SQL> SELECT NAME, VALUE FROM V$DIAG_INFO;

NAME                  VALUE
--------------------- --------------------------------------------------------
Diag Enabled          TRUE
ADR Base              /d1/3910926111/oracle/log
ADR Home              /d1/3910926111/oracle/log/diag/rdbms/dbn/osi
Diag Trace            /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/trace
Diag Alert            /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/alert
Diag Incident         /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/incident
Diag Cdump            /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/cdump
Health Monitor        /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/hm
Default Trace File    /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/trace/osi_ora_29229.trc
Active Problem Count  0
Active Incident Count 0
ORACLE_HOME           /d1/3910926111/oracle
Attention Log         /d1/3910926111/oracle/log/diag/rdbms/dbn/osi/trace/attention_osi.log
13 rows selected.
Alert log
Ogni database dispone di un log degli avvisi, ovvero un file contenente un log cronologico di messaggi ed errori del database.
Di seguito sono riportati i contenuti dell'alert log.
-
Tutti gli errori interni (
ORA-600), gli errori di danneggiamento dei blocchi (ORA-1578) e gli errori deadlock (ORA-60) -
Operazioni amministrative quali i comandi SQL*Plus
STARTUP,SHUTDOWN,ARCHIVE LOGeRECOVER -
Diversi messaggi ed errori relativi alle funzioni dei processi di server e dispatcher condivisi
-
Errori durante l'aggiornamento automatico di una vista materializzata
Se un'operazione amministrativa riesce, Oracle AI Database scrive un messaggio nell'alert log come "completato" insieme a un indicatore orario.
Oracle AI Database crea un alert log nella sottodirectory alert mostrata nella Figura 16-8 quando si avvia per la prima volta un'istanza di database, anche se non è stato ancora creato alcun database. Questo file è in formato XML. La sottodirectory trace contiene un alert log di solo testo.
Eseguire una query su V$DIAG_INFO per individuare l'alert log.
Log attenzione
Ogni database dispone di un log dell'attenzione contenente eventi di database critici e ad alta visibilità.
Il log attenzione include solo eventi di database critici e altamente visibili, consentendo di identificare un avviso e di eseguire l'azione appropriata. Ogni messaggio di log dell'attenzione ha vari attributi, tra cui audience target, causa e azione da eseguire. Il log attenzione fornisce informazioni nel seguente formato:
-
ID messaggio di attenzione
-
Tipo di messaggio di attenzione: errore, notifica, avvertenza
-
Messaggio di attenzione urgenza: DEFERABLE, IMMEDIATE, INFO, SOON
-
Ambito del messaggio di attenzione: CDB, cluster CDB, istanza CDB, PDB, sessione, istanza PDB, processo, sessione
-
Testo messaggio di attenzione
-
Utente di destinazione messaggio di attenzione: amministratore CDB, amministratore Clusterware, amministratore PDB
-
Causa
-
Azione
Oracle AI Database crea un log dell'attenzione denominato attention_ORACLE_SID.log nella sottodirectory trace illustrata nella Figura 16-8. È inoltre possibile eseguire una query su V$DIAG_INFO per individuare il log attenzione.
Log DDL
Il log DDL ha lo stesso formato e lo stesso funzionamento di base dell'alert log, ma contiene solo istruzioni e dettagli DDL. Il database scrive le informazioni DDL nel proprio file per ridurre il disordine nell'alert log.
I record di log DDL sono testo DDL, facoltativamente aumentato con informazioni supplementari. Esiste un record di log per ogni istruzione DDL. Il log DDL viene memorizzato nella sottodirectory log/ddl della home ADR.
File di trace
Un file di trace è un file contenente i dati diagnostici utilizzati per analizzare i problemi. Inoltre, i file di trace possono fornire indicazioni per il tuning delle applicazioni o di un'istanza.
-
Tipi di file di trace Ogni server e processo in background può scrivere periodicamente in un file di trace associato. I file contengono informazioni sull'ambiente del processo, sullo stato, sulle attività e sugli errori.
-
Posizioni dei file di trace ADR memorizza i file di trace nella sottodirectory
trace. I nomi dei file Trace dipendono dalla piattaforma e utilizzano l'estensione.trc. -
Segmentazione dei file di trace Quando la dimensione del file di trace è limitata, il database può suddividerlo automaticamente in un massimo di cinque segmenti. I segmenti sono file separati con lo stesso nome del file di trace attivo, ma con un numero di segmento aggiunto, come in
ora_1234_2.trc. Vedi anche: Introduzione a Oracle AI Database con il tuning delle prestazioni
Tipi di file di trace
Ogni server e processo in background può scrivere periodicamente in un file di trace associato. I file contengono informazioni sull'ambiente del processo, sullo stato, sulle attività e sugli errori.
La funzione di trace SQL crea anche file di trace che forniscono informazioni sulle prestazioni nelle singole istruzioni SQL. È possibile abilitare il trace per un identificativo client, un servizio, un modulo, un'azione, una sessione, un'istanza o un database in vari modi. Ad esempio, è possibile eseguire le procedure appropriate nel pacchetto DBMS_MONITOR o impostare eventi.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su file di trace, dump e file core
-
Oracle AI Database SQL Tuning Guide per informazioni sul trace dell'applicazione
Posizioni dei file di trace
ADR memorizza i file di trace nella sottodirectory trace. I nomi dei file Trace dipendono dalla piattaforma e utilizzano l'estensione .trc.
In genere, i nomi dei file di trace del processo in background del database contengono il SID Oracle, il nome del processo in background e il numero del processo del sistema operativo. Un esempio di file di trace per il processo RECO è mytest_reco_10355.trc.
I nomi dei file di trace del processo server contengono il SID Oracle, la stringa ora e il numero del processo del sistema operativo. Un esempio di file di trace del processo server è mytest_ora_10304.trc.
A volte i file di trace hanno i corrispondenti file di metadati di trace, che terminano con l'estensione .trm. Questi file contengono informazioni strutturali denominate mappe di trace utilizzate dal database per la ricerca e la navigazione.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come trovare i file di trace
Segmentazione dei file di trace
Quando la dimensione del file di trace è limitata, il database può dividerlo automaticamente in un massimo di cinque segmenti. I segmenti sono file separati con lo stesso nome del file di trace attivo, ma con un numero di segmento aggiunto, come in ora_1234_2.trc.
Ogni segmento è in genere il 20% del limite impostato da MAX_DUMP_FILE_SIZE. Quando la dimensione combinata di tutti i segmenti supera il limite, il database elimina il segmento meno recente (anche se mai il primo segmento, che può contenere informazioni rilevanti sullo stato iniziale del processo), quindi crea un nuovo segmento vuoto.
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come controllare la dimensione dei file di trace
Dump della diagnostica
Un file di dump diagnostico è un tipo speciale di file di trace contenente informazioni dettagliate su uno stato o una struttura.
Un trace tende ad essere un output continuo di dati diagnostici. Al contrario, un dump è in genere un output una tantum di dati diagnostici in risposta a un evento.
- Dump e incidenti di trace La maggior parte dei dump si verifica a causa di incidenti.
Dump e incidenti di trace
La maggior parte dei dump si verificano a causa di incidenti.
Quando si verifica un incidente, il database scrive uno o più dump nella directory degli incidenti creata per l'incidente. I dump degli incidenti contengono anche il numero dell'incidente nel nome del file.
Durante la creazione dell'incidente, un'applicazione può eseguire un dump dello stato dell'heap o del sistema come parte di un'azione. In questi casi, il database aggiunge il nome del dump al nome del file incidente anziché al nome del file di trace predefinito. Ad esempio, a causa di un incidente in un processo, il database crea il file prod_ora_90348.trc. Un dump nell'incidente genera il file prod_ora_90348_incident_id.trc, dove incident_id è l'ID numerico dell'incidente. Un'azione di dump heap creata nell'ambito dell'incidente genera il file di dump heap prod_ora_90348_incident_id_dump_id.trc, dove dump_id è l'ID numerico del dump trace.