Concorrenza e coerenza dei dati
I componenti script in questa pagina sono utilizzati solo per scopi di navigazione e non alterano in alcun modo il contenuto.
Questo capitolo spiega in che modo Oracle AI Database mantiene dati coerenti in un ambiente di database multiutente.
-
Introduzione alla concorrenza e alla coerenza dei dati In un database a utente singolo, un utente può modificare i dati senza preoccuparsi che altri utenti modifichino gli stessi dati contemporaneamente. Tuttavia, in un database multiutente, le istruzioni all'interno di più transazioni simultanee possono aggiornare gli stessi dati. Le transazioni eseguite contemporaneamente devono produrre risultati significativi e coerenti.
-
Panoramica dei livelli di isolamento delle transazioni di Oracle AI Database Lo standard ANSI per i livelli di isolamento delle transazioni è definito in termini di fenomeni consentiti o impediti per ogni livello di isolamento.
-
Panoramica del meccanismo di blocco di Oracle AI Database Un blocco è un meccanismo che impedisce interazioni distruttive.
-
Panoramica dei blocchi automatici Oracle AI Database blocca automaticamente una risorsa per conto di una transazione per impedire ad altre transazioni di eseguire operazioni che richiedono l'accesso esclusivo alla stessa risorsa.
-
Panoramica dei blocchi di dati manuali È possibile sostituire manualmente i meccanismi di blocco predefiniti di Oracle AI Database.
-
Panoramica dei blocchi definiti dall'utente Con i servizi Oracle AI Database Lock Management, è possibile definire blocchi personalizzati per un'applicazione specifica.
Introduzione alla concorrenza e alla coerenza dei dati
In un database a utente singolo, un utente può modificare i dati senza preoccuparsi che altri utenti modifichino gli stessi dati contemporaneamente. Tuttavia, in un database multiutente, le istruzioni all'interno di più transazioni simultanee possono aggiornare gli stessi dati. Le transazioni eseguite contemporaneamente devono produrre risultati significativi e coerenti.
Un database multiutente deve fornire quanto segue:
-
La garanzia che gli utenti possano accedere ai dati contemporaneamente (concorrenza dei dati)
-
La garanzia che ogni utente visualizzi una vista coerente dei dati (coerenza dei dati), comprese le modifiche visibili apportate dalle transazioni dell'utente stesso e dalle transazioni di altri utenti con commit
Per descrivere un funzionamento coerente delle transazioni quando le transazioni vengono eseguite contemporaneamente, i ricercatori del database hanno definito un modello di isolamento delle transazioni denominato serializzabilità. Una transazione serializzabile opera in un ambiente che la fa apparire come se nessun altro utente modificasse i dati nel database.
Sebbene questo grado di isolamento tra le transazioni sia generalmente auspicabile, l'esecuzione di molte applicazioni in modalità serializzabile può compromettere seriamente il throughput delle applicazioni. L'isolamento completo delle transazioni in esecuzione simultanea potrebbe significare che una transazione non può eseguire un inserimento in una tabella interrogata da un'altra transazione. In breve, le considerazioni del mondo reale di solito richiedono un compromesso tra perfetto isolamento delle transazioni e prestazioni.
Oracle AI Database mantiene la coerenza dei dati utilizzando un modello di coerenza multiversione e vari tipi di blocchi e transazioni. In questo modo, il database può presentare una vista dei dati a più utenti simultanei, con ogni vista coerente a un point-in-time. Poiché possono esistere contemporaneamente versioni diverse dei blocchi di dati, le transazioni possono leggere la versione dei dati di cui è stato eseguito il commit nel momento richiesto da una query e restituire risultati coerenti con un singolo point-in-time.
-
Multiversion Read Consistency In Oracle AI Database, il multiversioning è la capacità di materializzare contemporaneamente più versioni di dati. Oracle AI Database garantisce la coerenza delle letture multiversione.
-
Meccanismi di blocco In generale, i database multiutente utilizzano qualche forma di blocco dei dati per risolvere i problemi associati alla concorrenza, alla coerenza e all'integrità dei dati.
-
Livelli di isolamento delle transazioni ANSI/ISO Lo standard SQL, adottato sia da ANSI che ISO/IEC, definisce quattro livelli di isolamento delle transazioni. Questi livelli hanno diversi gradi di impatto sul throughput di elaborazione delle transazioni. Vedi anche: "Integrità dei dati" e "Transazioni"
Coerenza lettura multiversione
In Oracle AI Database, il multiversione è la possibilità di materializzare contemporaneamente più versioni di dati. Oracle AI Database garantisce la coerenza delle letture multiversione.
Le query di un database Oracle presentano le caratteristiche riportate di seguito.
-
Query coerenti in lettura
I dati restituiti da una query vengono sottoposti a commit e coerenti per un singolo point-in-time.
Nota: mai Oracle AI Database consente una lettura sporca, che si verifica quando una transazione legge dati non sottoposti a commit in un'altra transazione.
Per illustrare il problema delle letture non corrette, si supponga che una transazione aggiorni il valore di una colonna senza eseguire il commit. Una seconda transazione legge il valore aggiornato e sporco (non impegnato). La prima sessione esegue il rollback della transazione in modo che la colonna abbia il suo vecchio valore, ma la seconda transazione procede utilizzando il valore aggiornato, danneggiando il database. Letture non corrette compromettono l'integrità dei dati, violano le chiavi esterne e ignorano i vincoli univoci.
-
Query senza blocco
I lettori e gli scrittori di dati non si bloccano a vicenda.
-
Coerenza della lettura a livello di dichiarazione Oracle AI Database applica sempre la coerenza della lettura a livello di dichiarazione, il che garantisce che i dati restituiti da una singola query vengano sottoposti a commit e coerenti per un singolo point-in-time.
-
Coerenza di lettura a livello di transazione Oracle AI Database può anche fornire coerenza di lettura a tutte le query in una transazione, nota come coerenza di lettura a livello di transazione.
-
Leggi coerenza e segmenti di annullamento Per gestire il modello di coerenza di lettura multiversione, il database deve creare un set di dati coerente in lettura quando una tabella viene interrogata e aggiornata contemporaneamente.
-
Leggi coerenza e inserimenti differiti Un tipo speciale di inserimento noto come inserimento differito non utilizza il meccanismo di coerenza della lettura standard. Vedere anche: "Riepilogo del funzionamento del blocco"
Coerenza lettura a livello di rendiconto
Oracle AI Database applica sempre la coerenza della lettura a livello di istruzione, il che garantisce che i dati restituiti da una singola query vengano sottoposti a commit e coerenti per un singolo point-in-time.
Il point-in-time a cui una singola istruzione SQL è coerente dipende dal livello di isolamento delle transazioni e dalla natura della query:
-
Nel livello di isolamento sottoposto a commit di lettura, questo punto è il momento in cui è stata aperta l'istruzione. Ad esempio, se un'istruzione
SELECTviene aperta in SCN 1000, questa istruzione è coerente con SCN 1000. -
In una transazione serializzabile o di sola lettura, questo punto corrisponde all'ora di inizio della transazione. Ad esempio, se una transazione inizia da SCN 1000 e si verificano più istruzioni
SELECTin questa transazione, ogni istruzione è coerente con SCN 1000. -
In un'operazione Flashback Query (
SELECT ... AS OF), l'istruzioneSELECTspecifica in modo esplicito il point-in-time. Ad esempio, è possibile eseguire una query su una tabella come è apparso giovedì scorso alle 2 del pomeriggio.
Vedere anche: Oracle AI Database Development Guide per informazioni su Flashback Query
Coerenza lettura a livello di transazione
Oracle AI Database può anche fornire coerenza di lettura a tutte le query in una transazione, nota come coerenza di lettura a livello di transazione.
In questo caso, ogni istruzione in una transazione visualizza i dati dello stesso point-in-time. Ora di inizio della transazione.
Le query eseguite da una transazione serializzabile visualizzano le modifiche apportate dalla transazione stessa. Ad esempio, una transazione che aggiorna employees e quindi esegue una query su employees visualizzerà gli aggiornamenti. La coerenza di lettura a livello di transazione produce letture ripetibili e non espone una query a letture fantasma.
Leggi coerenza e annulla segmenti
Per gestire il modello di coerenza di lettura multiversione, il database deve creare un set di dati coerente in lettura quando una tabella viene interrogata e aggiornata contemporaneamente.
Oracle AI Database ottiene la coerenza delle letture attraverso dati di annullamento.
Ogni volta che un utente modifica i dati, Oracle AI Database crea voci di annullamento che scrive in segmenti di annullamento. I segmenti di annullamento contengono i vecchi valori dei dati modificati da transazioni di cui non è stato eseguito il commit o di cui è stato eseguito il commit di recente. Così, più versioni degli stessi dati, tutti in punti diversi nel tempo, possono esistere nel database. Il database può utilizzare snapshot di dati in momenti diversi per fornire viste coerenti in lettura dei dati e abilitare query non bloccanti.
La coerenza della lettura è garantita negli ambienti a istanza singola e Oracle Real Application Clusters (Oracle RAC). Oracle RAC utilizza un meccanismo di trasferimento dei blocchi da cache a cache noto come fusione della cache per trasferire immagini coerenti in lettura di blocchi di dati da un'istanza di database a un'altra.
-
Consistenza lettura: esempio questo esempio mostra una query che utilizza i dati di undo per fornire la coerenza della lettura a livello di istruzione nel livello di isolamento di cui è stato eseguito il commit della lettura.
-
Leggi elenchi coerenza e transazioni interessate L'intestazione del blocco di ogni blocco di segmento contiene un elenco di transazioni interessate (ITL).
Vedere anche:
-
"Annulla segmenti" per informazioni sull'annullamento dello storage
-
Oracle AI Database SecureFiles and Large Objects Developer's Guide per scoprire i meccanismi di coerenza delle letture per i LOB
Leggi coerenza: esempio
Questo esempio mostra una query che utilizza dati di undo per fornire la coerenza della lettura a livello di istruzione nel livello di isolamento di cui è stato eseguito il commit della lettura.
Figura 1: Leggere la coerenza nel livello di isolamento impegnato in lettura
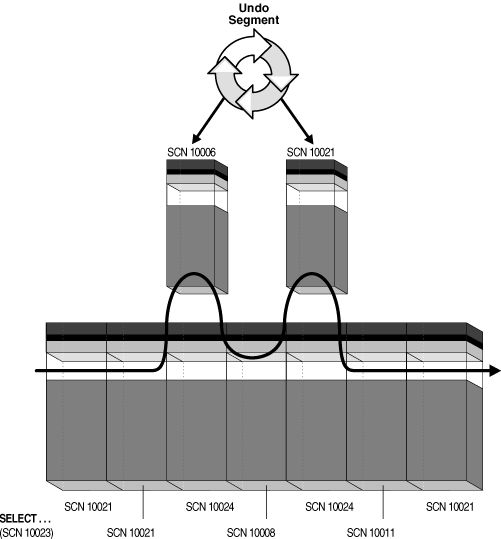
Descrizione dell'illustrazione cncpt069.gif
Quando il database recupera i blocchi di dati per conto di una query, il database garantisce che i dati in ciascun blocco riflettano il contenuto del blocco all'inizio della query. Il database esegue il rollback delle modifiche al blocco in base alle esigenze per ricostruire il blocco fino al momento in cui la query ha avviato l'elaborazione.
Il database utilizza un meccanismo di ordinazione interno denominato SCN per garantire l'ordine delle transazioni. Quando l'istruzione SELECT entra nella fase di esecuzione, il database determina l'SCN registrato al momento dell'esecuzione della query. Nella Figura 12-1, questo SCN è 10023. La query visualizza solo i dati impegnati rispetto a SCN 10023.
Nella Figura 12-1, i blocchi con SCN dopo 10023 indicano dati modificati, come mostrato dai due blocchi con SCN 10024. L'istruzione SELECT richiede una versione del blocco coerente con le modifiche di cui è stato eseguito il commit. Il database copia i blocchi di dati correnti in un nuovo buffer e applica i dati di undo per ricostruire le versioni precedenti dei blocchi. Questi blocchi di dati ricostruiti sono denominati cloni di lettura coerente (CR).
Nella Figura 12-1, il database crea due copie CR: un blocco coerente con SCN 10006 e l'altro blocco coerente con SCN 10021. Il database restituisce i dati ricostruiti per la query. In questo modo, Oracle AI Database impedisce letture non corrette.
Vedere anche: "Database Buffer Cache" e "System Change Numbers (SCN)"
Leggi elenchi coerenza e transazioni interessate
L'intestazione del blocco di ogni blocco di segmento contiene un elenco di transazioni interessate (ITL).
Il database utilizza l'ITL per determinare se è stato annullato il commit di una transazione quando il database ha iniziato a modificare il blocco.
Le voci nell'ITL descrivono quali transazioni hanno righe bloccate e quali righe nel blocco contengono modifiche sottoposte a commit e non sottoposte a commit. L'ITL punta alla tabella delle transazioni nel segmento di annullamento, che fornisce informazioni sulla tempistica delle modifiche apportate al database.
In un certo senso, l'intestazione del blocco contiene una cronologia recente delle transazioni che hanno interessato ogni riga del blocco. Il parametro INITRANS delle istruzioni CREATE TABLE e ALTER TABLE controlla la quantità di cronologia delle transazioni conservata.
Vedere anche: Oracle AI Database SQL Language Reference per informazioni sul parametro INITRANS
Coerenza lettura e inserimenti differiti
Un tipo speciale di inserimento noto come inserimento differito non utilizza il meccanismo di coerenza della lettura standard.
Un inserimento differito utilizza il suggerimento MEMOPTIMIZE_WRITE per l'inserimento in una tabella specificata come MEMOPTIMIZE FOR WRITE. Il database esegue il buffer di questi inserimenti nel pool di grandi dimensioni anziché nella buffer cache. Il database non tiene traccia delle modifiche utilizzando redo e undo. Al contrario, il database esegue automaticamente il commit delle modifiche quando lo Space Management Coordinator (SMCO) scrive il buffer su disco. Impossibile eseguire il rollback delle modifiche.
Gli inserti differiti differiscono dagli inserti convenzionali in modi importanti:
-
I dati che risiedono nel pool di grandi dimensioni, di cui l'applicazione assume il commit, possono andare persi. Ad esempio, l'istanza di database potrebbe non riuscire prima di salvare le modifiche su disco, anche se l'applicazione segnala che le modifiche sono state salvate.
-
La lettura dei dati direttamente dalla memoria non è consentita. Un autore non può leggere le proprie modifiche finché i processi in background non le scrivono su disco. Nessun lettore può vedere le modifiche di cui è stato eseguito il commit finché non vengono scritte su disco.
Le applicazioni client che devono evitare la perdita di dati devono conservare una copia locale dei dati dopo la scrittura nel pool di grandi dimensioni. Il client può utilizzare il pacchetto DBMS_MEMOPTIMIZE per tenere traccia della durabilità delle scritture in memoria e il pacchetto DBMS_MEMOPTIMIZE_ADMIN per forzare la scrittura del database su disco.
Vedere anche:
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sul suggerimento
MEMOPTIMIZE FOR WRITE
Meccanismi di blocco
In generale, i database multiutente utilizzano qualche forma di blocco dei dati per risolvere i problemi associati alla concorrenza, alla coerenza e all'integrità dei dati.
Un blocco è un meccanismo che impedisce l'interazione distruttiva tra transazioni che accedono alla stessa risorsa.
Vedi anche: "Panoramica del meccanismo di blocco di Oracle AI Database"
Livelli di isolamento delle transazioni ANSI/ISO
Lo standard SQL, adottato sia da ANSI che ISO/IEC, definisce quattro livelli di isolamento delle transazioni. Questi livelli hanno diversi gradi di impatto sul throughput di elaborazione delle transazioni.
Questi livelli di isolamento sono definiti in termini di fenomeni che devono essere evitati tra l'esecuzione simultanea delle transazioni. I fenomeni prevenibili sono:
-
Letture non corrette
Una transazione legge i dati scritti da un'altra transazione di cui non è stato ancora eseguito il commit.
-
Letture non ripetibili (non ripetibili)
Una transazione rilascia i dati letti in precedenza e rileva che un'altra transazione di cui è stato eseguito il commit ha modificato o eliminato i dati. Ad esempio, un utente esegue una query su una riga e in seguito esegue una query sulla stessa riga, solo per scoprire che i dati sono stati modificati.
-
Letture fantasma
Una transazione esegue di nuovo una query che restituisce un set di righe che soddisfa una condizione di ricerca e rileva che un'altra transazione di cui è stato eseguito il commit ha inserito righe aggiuntive che soddisfano la condizione.
Ad esempio, una transazione esegue una query sul numero di dipendenti. Cinque minuti dopo esegue la stessa query, ma ora il numero è aumentato di uno perché un altro utente ha inserito un record per una nuova assunzione. Un numero maggiore di dati soddisfa i criteri di query rispetto a prima, ma a differenza di una lettura non esatta, i dati letti in precedenza rimangono invariati.
Lo standard SQL definisce quattro livelli di isolamento in termini di fenomeni che una transazione in esecuzione a un particolare livello di isolamento può sperimentare. La Tabella 12-1 mostra i livelli.
Tabella 1 Fenomeni di lettura prevenibili per livello di isolamento
| Livello isolamento | Lettura non valida | Lettura non ripetibile | Lettura fantasma |
|---|---|---|---|
| Lettura non impegnata | Possibile | Possibile | Possibile |
| Lettura impegnata | Non possibile | Possibile | Possibile |
| Lettura ripetibile | Non possibile | Non possibile | Possibile |
| Serializzabile | Non possibile | Non possibile | Non possibile |
Oracle AI Database offre livelli di isolamento read commit (predefinito) e serializzabili. Inoltre, il database offre una modalità di sola lettura.
Vedere anche:
-
"Panoramica sui livelli di isolamento delle transazioni di Oracle AI Database" per conoscere i livelli di isolamento sottoposti a commit, serializzabili e di sola lettura
-
Oracle AI Database SQL Language Reference per una discussione sulla conformità di Oracle AI Database agli standard SQL
Panoramica dei livelli di isolamento delle transazioni di Oracle AI Database
Lo standard ANSI per i livelli di isolamento delle transazioni è definito in termini di fenomeni consentiti o impediti per ciascun livello di isolamento.
Oracle AI Database fornisce i livelli di isolamento delle transazioni:
-
Livello di isolamento con commit di lettura Nel livello di isolamento con commit di lettura, ogni query eseguita da una transazione visualizza solo i dati di cui è stato eseguito il commit prima dell'esecuzione della query, non della transazione.
-
Livello di isolamento serializzabile Nel livello di isolamento serializzabile, una transazione vede solo le modifiche di cui è stato eseguito il commit al momento in cui la transazione, e non la query, inizia e le modifiche apportate dalla transazione stessa.
-
Livello di isolamento di sola lettura Il livello di isolamento di sola lettura è simile al livello di isolamento serializzabile, ma le transazioni di sola lettura non consentono la modifica dei dati nella transazione a meno che l'utente non sia
SYS.
Vedere anche:
-
Oracle AI Database Development Guide per ulteriori informazioni sui livelli di isolamento delle transazioni
-
Oracle AI Database SQL Language Reference e Oracle AI Database PL/SQL Language Reference per saperne di più su
SET TRANSACTION ISOLATION LEVEL
Livello isolamento confermato lettura
Nel livello di isolamento sottoposto a commit di lettura, ogni query eseguita da una transazione visualizza solo i dati sottoposti a commit prima della query, non l'inizio della transazione.
Questo livello di isolamento è il valore predefinito. È appropriato per ambienti di database in cui è probabile che poche transazioni siano in conflitto.
Una query in una transazione di cui è stato eseguito il commit in lettura evita la lettura dei dati di cui è stato eseguito il commit durante l'esecuzione della query. Ad esempio, se una query viene eseguita a metà di una scansione di una tabella di un milione di righe e una transazione diversa esegue il commit di un aggiornamento alla riga 950.000, la query non visualizzerà questa modifica quando legge la riga 950.000. Tuttavia, poiché il database non impedisce ad altre transazioni di modificare i dati letti da una query, altre transazioni possono modificare i dati tra le esecuzioni delle query. Pertanto, una transazione che esegue la stessa query due volte può verificarsi letture e fantasmi sfocati.
-
Consistenza della lettura nel livello di isolamento confermato dalla lettura Il database fornisce un set di risultati coerente per ogni query, garantendo la coerenza dei dati, senza alcuna azione da parte dell'utente.
-
Conflitto di scritture in transazioni con commit in lettura In una transazione con commit in lettura, si verifica una scrittura in conflitto quando la transazione tenta di modificare una riga aggiornata da una transazione concorrente senza commit.
Coerenza nella lettura del livello di isolamento impegnato
Il database fornisce un set di risultati coerente per ogni query, garantendo la coerenza dei dati, senza alcuna azione da parte dell'utente.
A una interrogazione implicita, ad esempio a una query implicita da una clausola WHERE in un'istruzione UPDATE, viene garantito un set coerente di risultati. Tuttavia, ogni istruzione in una query implicita non vede le modifiche apportate dall'istruzione DML stessa, ma vede i dati come esisteva prima delle modifiche apportate.
Se una lista SELECT contiene una funzione PL/SQL, il database applica la coerenza di lettura a livello di istruzione a livello di istruzione per l'esecuzione SQL all'interno del codice della funzione PL/SQL, anziché a livello di SQL padre. Ad esempio, una funzione può accedere a una tabella i cui dati vengono modificati e sottoposti a commit da un altro utente. Per ogni esecuzione di SELECT nella funzione, viene creata una nuova istantanea coerente in lettura.
Vedere anche: "Subquery"
Scritture in conflitto nelle transazioni con commit in lettura
In una transazione con commit in lettura, si verifica una scrittura in conflitto quando la transazione tenta di modificare una riga aggiornata da una transazione concorrente senza commit.
La transazione che impedisce la modifica della riga viene talvolta chiamata transazione di blocco. La transazione con commit di lettura attende la fine della transazione di blocco e rilascia il relativo blocco di riga.
Di seguito sono riportate le opzioni disponibili.
-
Se la transazione bloccante esegue il rollback, la transazione in attesa procede alla modifica della riga bloccata in precedenza come se l'altra transazione non esistesse mai.
-
Se la transazione di blocco esegue il commit e rilascia i relativi blocchi, la transazione in attesa procede con l'aggiornamento previsto alla riga appena modificata.
La tabella riportata di seguito mostra in che modo la transazione 1, che può essere serializzabile o sottoposta a commit di lettura, interagisce con la transazione 2 sottoposta a commit di lettura. Mostra una situazione classica nota come aggiornamento perso. L'aggiornamento eseguito dalla transazione 1 non è nella tabella anche se la transazione 1 l'ha eseguito. Definire una strategia per gestire gli aggiornamenti persi è una parte importante dello sviluppo delle applicazioni.
Tabella 2 Scritture in conflitto e aggiornamenti persi in una transazione READ COMMITTED
| Sessione 1 | Sessione 2 | Spiegazione |
|---|---|---|
SQL> SELECT last_name,
  salary FROM employees
  WHERE last_name IN
  ('Banda', 'Greene',
 'Hintz');

  LAST_NAME SALARY
 ------------- ----------
 Banda 6200
Greene 9500 |
Nessuna azione | La sessione 1 interroga gli stipendi per Banda, Greene e Hintz. Nessun dipendente denominato Hintz trovato. |
SQL> UPDATE employees SET salary = 7000 WHERE last_name = 'Banda'; |
Nessuna azione | La sessione 1 inizia una transazione aggiornando lo stipendio di Banda. Il livello di isolamento predefinito per la transazione 1 è READ COMMITTED. |
| Nessuna azione | SQL> SET TRANSACTION ISOLATION LEVEL READ COMMITTED; |
La sessione 2 inizia la transazione 2 e imposta il livello di isolamento in modo esplicito su READ COMMITTED. |
| Nessuna azione | SQL> SELECT last_name,
salary FROM employees
WHERE last_name IN
('Banda', 'Greene',
'Hintz');
LAST_NAME SALARY
------------- ----------
Banda 6200
Greene 9500 |
La transazione 2 esegue una query sugli stipendi per Banda, Greene e Hintz. Oracle AI Database utilizza la coerenza delle letture per mostrare lo stipendio di Banda prima dell'aggiornamento non sottoposto a commit eseguito dalla transazione 1. |
| Nessuna azione | SQL> UPDATE employees SET salary = 9900 WHERE last_name='Greene'; |
La transazione 2 aggiorna lo stipendio per Greene perché la transazione 1 ha bloccato solo la riga Banda. |
SQL> INSERT INTO employees (employee_id, last_name, email, hire_date, job_id) VALUES (210, 'Hintz', 'JHINTZ', SYSDATE, 'SH_CLERK'); |
Nessuna azione | La transazione 1 inserisce una riga per il suggerimento dipendente, ma non esegue il commit. |
| Nessuna azione | SQL> SELECT last_name,
salary FROM employees
WHERE last_name IN
('Banda', 'Greene',
'Hintz');
LAST_NAME SALARY
------------- ----------
Banda 6200
Greene 9900 |
La transazione 2 interroga gli stipendi per i dipendenti Banda, Greene e Hintz. La transazione 2 vede il proprio aggiornamento allo stipendio di Greene. La transazione 2 non vede l'aggiornamento non impegnato dello stipendio per Banda o l'inserimento per Hintz effettuato dalla transazione 1. |
| Nessuna azione | SQL> UPDATE employees SET salary = 6300 WHERE last_name = 'Banda'; -- prompt does not return |
La transazione 2 tenta di aggiornare la riga per Banda, attualmente bloccata dalla transazione 1, creando una scrittura in conflitto. La transazione 2 attende la fine della transazione 1. |
SQL> COMMIT; |
Nessuna azione | La transazione 1 esegue il commit del proprio lavoro, terminando la transazione. |
| Nessuna azione | 1 row updated. SQL> |
Il blocco sulla riga Banda è ora rilasciato, quindi la transazione 2 procede con il suo aggiornamento allo stipendio per Banda. |
| Nessuna azione | SQL> SELECT last_name,
salary FROM employees
WHERE last_name IN
('Banda', 'Greene',
'Hintz');
LAST_NAME SALARY
------------- ----------
Banda 6300
Greene 9900
Hintz |
La transazione 2 interroga gli stipendi per i dipendenti Banda, Greene e Hintz. L'inserimento dei suggerimenti eseguito dalla transazione 1 è ora visibile alla transazione 2. La transazione 2 vede il proprio aggiornamento allo stipendio di Banda. |
| Nessuna azione | COMMIT; |
La transazione 2 esegue il commit del proprio lavoro, terminando la transazione. |
SQL> SELECT last_name,
  salary FROM employees
  WHERE last_name IN
 ('Banda', 'Greene',
  'Hintz');

  LAST_NAME SALARY
 ------------- ----------
 Banda 6300
 Greene 9900
Hintz |
Nessuna azione | La sessione 1 esegue una query sulle righe per Banda, Greene e Hintz. Lo stipendio per Banda è 6300, che è l'aggiornamento effettuato dalla transazione 2. L'aggiornamento dello stipendio di Banda a 7000 effettuato con la transazione 1 è ora "perso". |
Vedere anche:
-
"Uso dei blocchi" per informazioni sugli aggiornamenti persi
-
"Row Lock (TX)" per scoprire quando e perché il database ottiene i lock di riga
Livello di isolamento serializzabile
Nel livello di isolamento serializzabile, una transazione visualizza solo le modifiche di cui è stato eseguito il commit al momento della transazione, non l'inizio della query e le modifiche apportate dalla transazione stessa.
Una transazione serializzabile opera in un ambiente che la fa apparire come se nessun altro utente modificasse i dati nel database. L'isolamento serializzabile è adatto agli ambienti:
-
Con database di grandi dimensioni e transazioni brevi che aggiornano solo poche righe
-
Se la possibilità che due transazioni concorrenti modifichino le stesse righe è relativamente bassa
-
Dove le transazioni con tempi di esecuzione relativamente lunghi sono principalmente di sola lettura
Nell'isolamento serializzabile, la coerenza di lettura normalmente ottenuta a livello di istruzione si estende all'intera transazione. Qualsiasi riga letta dalla transazione è assicurata di essere la stessa quando viene riletta. È garantito che qualsiasi query restituisca gli stessi risultati per la durata della transazione, pertanto le modifiche apportate da altre transazioni non sono visibili alla query indipendentemente dal tempo in cui è stata eseguita. Le transazioni serializzabili non presentano letture sporche, letture fuzzy o letture fantasma.
Oracle AI Database consente a una transazione serializzabile di modificare una riga solo se le modifiche apportate alla riga da altre transazioni sono state già sottoposte a commit all'inizio della transazione serializzabile. Il database genera un errore quando una transazione serializzabile tenta di aggiornare o eliminare i dati modificati da una transazione diversa che ha eseguito il commit dopo l'inizio della transazione serializzabile:
ORA-08177: Cannot serialize access for this transactionQuando una transazione serializzabile non riesce con l'errore ORA-08177, un'applicazione può eseguire diverse azioni, tra cui le seguenti:
-
Eseguire il commit del lavoro eseguito fino a quel punto
-
Eseguire istruzioni aggiuntive (ma diverse), forse dopo il rollback a un punto di salvataggio stabilito in precedenza nella transazione
-
Esegui rollback dell'intera transazione
La tabella seguente mostra l'interazione di una transazione serializzabile con altre transazioni. Se la transazione serializzabile non tenta di modificare una riga sottoposta a commit da un'altra transazione dopo l'inizio della transazione serializzabile, viene evitato un problema di accesso serializzato.
Tabella 3 - Transazione serializzabile
| Sessione 1 | Sessione 2 | Spiegazione |
|---|---|---|
|
Nessuna azione | La sessione 1 interroga gli stipendi per Banda, Greene e Hintz. Nessun dipendente denominato Hintz trovato. |
|
Nessuna azione | La sessione 1 inizia la transazione 1 aggiornando lo stipendio di Banda. Il livello di isolamento predefinito è READ COMMITTED. |
| Nessuna azione | |
La sessione 2 inizia la transazione 2 e la imposta sul livello di isolamento SERIALIZABLE. |
| Nessuna azione | |
La transazione 2 esegue una query sugli stipendi per Banda, Greene e Hintz. Oracle AI Database utilizza la coerenza delle letture per mostrare lo stipendio di Banda prima dell'aggiornamento non sottoposto a commit eseguito dalla transazione 1. |
| Nessuna azione | |
La transazione 2 aggiorna lo stipendio Greene perché solo la riga Banda è bloccata. |
|
Nessuna azione | La transazione 1 inserisce una riga per il suggerimento dipendente. |
|
Nessuna azione | La transazione 1 esegue il commit del proprio lavoro, terminando la transazione. |
|
|
La sessione 1 interroga gli stipendi per i dipendenti Banda, Greene e Hintz e vede le modifiche impegnate dalla transazione 1. La sessione 1 non vede l'aggiornamento Greene non impegnato effettuato dalla transazione 2. La transazione 2 interroga gli stipendi per i dipendenti Banda, Greene e Hintz. La coerenza della lettura di Oracle AI Database garantisce che l'inserimento dei suggerimenti e l'aggiornamento di Banda sottoposti a commit per transazione 1 non siano visibili alla transazione 2. La transazione 2 vede il proprio aggiornamento allo stipendio di Greene. |
| Nessuna azione | |
La transazione 2 esegue il commit del proprio lavoro, terminando la transazione. |
|
|
Entrambe le sessioni interrogano gli stipendi per Banda, Greene e Hintz. Ogni sessione visualizza tutte le modifiche di cui è stato eseguito il commit effettuate dalla transazione 1 e dalla transazione 2. |
|
Nessuna azione | La sessione 1 inizia la transazione 3 aggiornando lo stipendio Hintz. Il livello di isolamento predefinito per la transazione 3 è READ COMMITTED. |
| Nessuna azione | |
La sessione 2 inizia la transazione 4 e la imposta sul livello di isolamento SERIALIZABLE. |
| Nessuna azione | |
La transazione 4 tenta di aggiornare lo stipendio per Hintz, ma è bloccata perché la transazione 3 ha bloccato la riga Hintz. Coda transazione 4 dietro transazione 3. |
|
Nessuna azione | La transazione 3 esegue il commit dell'aggiornamento dello stipendio Hintz, terminando la transazione. |
| Nessuna azione | |
Il commit che termina la transazione 3 fa sì che l'aggiornamento Hintz nella transazione 4 non riesca con l'errore ORA-08177. Si è verificato un errore perché nella transazione 3 è stato eseguito il commit dell'aggiornamento Hintz dopo l'avvio della transazione 4. |
| Nessuna azione | |
La sessione 2 esegue il rollback della transazione 4, che termina la transazione. |
| Nessuna azione | |
La sessione 2 inizia la transazione 5 e la imposta sul livello di isolamento SERIALIZABLE. |
| Nessuna azione | |
La transazione 5 esegue una query sugli stipendi per Banda, Greene e Hintz. L'aggiornamento dello stipendio Hintz eseguito dalla transazione 3 è visibile. |
| Nessuna azione | |
La transazione 5 aggiorna lo stipendio Hintz a un valore diverso. Poiché l'aggiornamento Hintz eseguito dalla transazione 3 ha eseguito il commit prima dell'inizio della transazione 5, il problema di accesso serializzato viene evitato. Nota: se una transazione diversa è stata aggiornata ed è stato eseguito il commit della riga Suggerimento dopo l'inizio della transazione 5, il problema di accesso serializzato si verificherà di nuovo. |
| Nessuna azione | |
La sessione 2 esegue il commit dell'aggiornamento senza problemi, terminando la transazione. |
Vedere anche:
Livello di isolamento di sola lettura
Il livello di isolamento di sola lettura è simile al livello di isolamento serializzabile, ma le transazioni di sola lettura non consentono la modifica dei dati nella transazione a meno che l'utente non sia SYS.
Le transazioni di sola lettura non sono soggette all'errore ORA-08177. Le transazioni di sola lettura sono utili per generare report in cui i contenuti devono essere coerenti rispetto all'ora di inizio della transazione.
Oracle AI Database ottiene la coerenza delle letture ricostruendo i dati in base alle esigenze dai segmenti di undo. Poiché i segmenti di undo vengono utilizzati in modo circolare, il database può sovrascrivere i dati di undo. I report con tempi di esecuzione lunghi corrono il rischio che i dati di annullamento richiesti per la coerenza della lettura possano essere stati riutilizzati da una transazione diversa, generando un errore snapshot too old. L'impostazione di un periodo di conservazione degli undo, ovvero il periodo di tempo minimo durante il quale il database tenta di conservare i vecchi dati di undo prima di sovrascriverli, evita in modo appropriato questo problema.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come impostare il periodo di conservazione degli undo
Panoramica del meccanismo di blocco di Oracle AI Database
Un blocco è un meccanismo che impedisce interazioni distruttive.
Le interazioni sono distruttive quando aggiornano in modo errato i dati o alterano in modo errato le strutture dei dati sottostanti, tra le transazioni che accedono ai dati condivisi. I blocchi svolgono un ruolo cruciale nel mantenere la concorrenza e la coerenza del database.
-
Riepilogo del funzionamento del blocco Il database gestisce diversi tipi di blocchi, a seconda dell'operazione che ha acquisito il blocco.
-
Uso dei blocchi In un database con utente singolo, i blocchi non sono necessari perché solo un utente sta modificando le informazioni. Tuttavia, quando più utenti accedono e modificano i dati, il database deve fornire un modo per impedire la modifica simultanea degli stessi dati.
-
Blocca modalità Oracle AI Database utilizza automaticamente il livello più basso di restrittività applicabile per fornire il più alto livello di concorrenza dei dati, ma fornisce anche l'integrità dei dati non sicuri.
-
Blocca conversione ed escalation Oracle AI Database esegue la conversione del blocco in base alle esigenze.
-
Blocca durata Oracle AI Database rilascia automaticamente un blocco quando si verifica un evento in modo che la transazione non richieda più la risorsa.
-
Blocchi e deadlock Un deadlock è una situazione in cui due o più utenti sono in attesa di dati bloccati l'uno dall'altro. I deadlock impediscono ad alcune transazioni di continuare a funzionare.
Riepilogo del funzionamento del blocco
Il database mantiene diversi tipi di lock, a seconda dell'operazione che ha acquisito il lock.
In generale, il database utilizza due tipi di lock: lock esclusivi e lock di condivisione. È possibile ottenere un solo lock esclusivo su una risorsa, ad esempio una riga o una tabella, ma è possibile ottenere molti lock di condivisione su una singola risorsa.
Le serrature influenzano l'interazione di lettori e scrittori. Un lettore è una query di una risorsa, mentre uno scrittore è un'istruzione che modifica una risorsa. Le regole riportate di seguito riepilogano il funzionamento di blocco di Oracle AI Database per lettori e scrittori.
-
Una riga viene bloccata solo se modificata da un autore.
Quando un rendiconto aggiorna una riga, la transazione acquisisce un blocco solo per questa riga. Bloccando i dati della tabella a livello di riga, il database riduce al minimo i conflitti per gli stessi dati. In circostanze normaliPiede 1, il database non esegue l'escalation di un blocco di riga a livello di blocco o tabella.
-
Un autore di una riga blocca un autore concorrente della stessa riga.
Se una transazione modifica una riga, un blocco di riga impedisce a una transazione diversa di modificare contemporaneamente la stessa riga.
-
Un lettore non blocca mai uno scrittore.
Poiché un lettore di una riga non la blocca, un autore può modificare questa riga. L'unica eccezione è un'istruzione
SELECT ... FOR UPDATE, che è un tipo speciale di istruzioneSELECTche impedisce di bloccare la riga che sta leggendo. -
Uno scrittore non blocca mai un lettore.
Quando una riga viene modificata da un writer, il database utilizza i dati di undo per fornire ai lettori una vista coerente della riga.
Nota: i lettori di dati potrebbero dover attendere scrittori degli stessi blocchi di dati in casi molto speciali di transazioni distribuite in sospeso.
Vedere anche:
-
Oracle AI Database SQL Language Reference per saperne di più su
SELECT ... FOR UPDATE -
Oracle AI Database Administrator's Guide per informazioni sulle attese associate a transazioni distribuite insicure
Uso dei blocchi
In un database con utente singolo, i blocchi non sono necessari perché solo un utente sta modificando le informazioni. Tuttavia, quando più utenti accedono e modificano i dati, il database deve fornire un modo per impedire la modifica simultanea degli stessi dati.
I lock soddisfano i seguenti importanti requisiti del database:
-
Coerenza
I dati che una sessione sta visualizzando o modificando non devono essere modificati da altre sessioni fino al termine dell'utente.
-
Integrità
I dati e le strutture devono riflettere tutte le modifiche apportate nella sequenza corretta.
Oracle AI Database fornisce concorrenza, coerenza e integrità dei dati tra le transazioni attraverso i suoi meccanismi di blocco. Il blocco si verifica automaticamente e non richiede alcuna azione dell'utente.
La necessità di blocchi può essere illustrata da un aggiornamento concorrente di una singola riga. Nell'esempio seguente, una semplice applicazione basata sul Web presenta all'utente finale un'e-mail e un numero di telefono del dipendente. Per modificare i dati, l'applicazione utilizza un'istruzione UPDATE, ad esempio:
UPDATE employees
SET    email = ?, phone_number = ?
WHERE  employee_id = ?
AND    email = ?
AND    phone_number = ?
Nell'istruzione UPDATE precedente, i valori e-mail e numero di telefono nella clausola WHERE sono i valori originali e non modificati per il dipendente specificato. Questo aggiornamento garantisce che la riga modificata dall'applicazione non sia stata modificata dopo l'ultima lettura dell'applicazione e che sia stata visualizzata all'utente. In questo modo, l'applicazione evita il problema di aggiornamento perduto in cui un utente sovrascrive le modifiche apportate da un altro utente, perdendo effettivamente l'aggiornamento da parte del secondo utente (la Tabella 12-2 mostra un esempio di aggiornamento perso). La Tabella 12-4 mostra la sequenza di eventi quando due sessioni tentano di modificare la stessa riga nella tabella employees all'incirca nello stesso momento.
Esempio di blocco delle righe nella tabella 4
| T | Sessione 1 | Sessione 2 | Descrizione |
|---|---|---|---|
| t0 | |
Nella sessione 1, l'utente hr1 esegue una query su hr.employees per il record Himuro e visualizza gli attributi employee_id (118), e-mail (GHIMURO) e numero di telefono (515.127.4565). |
|
| t1 | |
Nella sessione 2, l'utente hr2 esegue una query su hr.employees per il record Himuro e visualizza gli attributi employee_id (118), e-mail (GHIMURO) e numero di telefono (515.127.4565). |
|
| t2 | |
Nella sessione 1, l'utente hr1 aggiorna il numero di telefono nella riga a 515.555.1234, che acquisisce un blocco sulla riga GHIMURO. |
|
| t3 | |
Nella sessione 2, l'utente Il tentativo di aggiornamento eseguito da |
|
| t4 | |
Nella sessione 1, l'utente L'impegno rende il cambiamento per Himuro permanente e sblocca la sessione 2, che è stata in attesa. |
|
| t5 | |
Nella sessione 2, l'utente Poiché i predicati non corrispondono, la sessione 2 non aggiorna alcun record. |
|
| t6 | |
Nella sessione 1, l'utente hr1 si rende conto che ha aggiornato la riga GHIMURO con il numero di telefono errato. L'utente avvia una nuova transazione e aggiorna il numero di telefono nella riga in 515.555.1235, che blocca la riga GHIMURO. |
|
| t7 | |
Nella sessione 2, l'utente hr2 interroga hr.employees per il record Himuro. Il record mostra l'aggiornamento del numero di telefono eseguito dalla sessione 1 all'indirizzo t4. La coerenza di lettura di Oracle AI Database garantisce che la sessione 2 non veda la modifica di cui non è stato eseguito il commit effettuata all'indirizzo t6. |
|
| t8 | |
Nella sessione 2, l'utente hr2 tenta di aggiornare la stessa riga, ma è bloccato perché hr1 sta elaborando la riga. |
|
| t9 | |
Nella sessione 1, l'utente hr1 esegue il rollback della transazione, che la termina. |
|
| t10 | |
Nella sessione 2, l'aggiornamento del numero di telefono riesce perché è stato eseguito il rollback dell'aggiornamento della sessione 1. La riga GHIMURO corrisponde al predicato, quindi l'aggiornamento riesce. |
|
| t11 | |
La sessione 2 esegue il commit dell'aggiornamento, terminando la transazione. |
Oracle AI Database ottiene automaticamente i lock necessari durante l'esecuzione delle istruzioni SQL. Ad esempio, prima che il database consenta a una sessione di modificare i dati, la sessione deve prima bloccare i dati. Il blocco fornisce alla sessione il controllo esclusivo sui dati in modo che nessun'altra transazione possa modificare i dati bloccati fino al rilascio del blocco.
Poiché i meccanismi di blocco di Oracle AI Database sono strettamente legati al controllo delle transazioni, i progettisti di applicazioni devono solo definire correttamente le transazioni e Oracle AI Database gestisce automaticamente il blocco. Gli utenti non devono mai bloccare in modo esplicito alcuna risorsa, anche se Oracle AI Database consente anche agli utenti di bloccare i dati manualmente.
Le sezioni seguenti spiegano concetti importanti per comprendere in che modo Oracle AI Database raggiunge la concorrenza tra i dati.
Vedere anche: Oracle AI Database PL/SQL Packages and Types Reference per informazioni sul pacchetto OWA_OPT_LOCK, che contiene sottoprogrammi che possono aiutare a prevenire la perdita di aggiornamenti
Modalità lock
Oracle AI Database utilizza automaticamente il livello più basso di restrittività applicabile per fornire il più alto grado di concorrenza tra i dati, ma fornisce anche l'integrità dei dati non sicuri.
Meno restrittivo è il livello, più i dati sono disponibili per l'accesso da parte di altri utenti. Al contrario, più restrittivo è il livello, più limitate sono le altre transazioni nei tipi di blocchi che possono acquisire.
Oracle AI Database utilizza due modalità di blocco in un database multiutente:
-
Modalità di blocco esclusiva
Questa modalità impedisce la condivisione della risorsa associata. Una transazione ottiene un blocco esclusivo quando modifica i dati. La prima transazione che blocca una risorsa esclusivamente è l'unica transazione che può modificare la risorsa fino al rilascio del blocco esclusivo.
-
Modalità blocco condivisione
Questa modalità consente di condividere la risorsa associata, a seconda delle operazioni coinvolte. Più utenti che leggono i dati possono condividere i dati, ognuno dei quali contiene un blocco di condivisione per impedire l'accesso concorrente da parte di un autore che necessita di un blocco esclusivo. Più transazioni possono acquisire blocchi condivisione sulla stessa risorsa.
Si supponga che una transazione utilizzi un'istruzione SELECT ... FOR UPDATE per selezionare una singola riga di tabella. La transazione acquisisce un blocco esclusivo delle righe e un blocco della tabella di condivisione righe. Il blocco delle righe consente ad altre sessioni di modificare le righe diverse dalla riga bloccata, mentre il blocco delle tabelle impedisce alle sessioni di modificare la struttura della tabella. Pertanto, il database consente di eseguire il maggior numero possibile di istruzioni.
Blocca conversione ed escalation
Oracle AI Database esegue la conversione del blocco in base alle esigenze.
Nella conversione del blocco, il database converte automaticamente un blocco di tabella di minore limitatività in uno di maggiore restrittività. Si supponga, ad esempio, che una transazione emetta un SELECT ... FOR UPDATE per un dipendente e che in seguito aggiorni la riga bloccata. In questo caso, il database converte automaticamente il blocco della tabella di condivisione delle righe in un blocco esclusivo della tabella delle righe. Una transazione contiene blocchi riga esclusivi per tutte le righe inserite, aggiornate o eliminate all'interno della transazione. Poiché i blocchi di riga vengono acquisiti al massimo livello di restrittività, non è richiesta o eseguita alcuna conversione di blocco.
La conversione del blocco è diversa dall'escalation del blocco, che si verifica quando numerosi blocchi vengono bloccati a un livello di granularità (ad esempio, righe) e un database porta i blocchi a un livello di granularità superiore (ad esempio, tabella). Se una sessione blocca molte righe in una tabella, alcuni database eseguono automaticamente l'escalation dei blocchi di riga in una singola tabella. Il numero di serrature diminuisce, ma la restrittività di ciò che viene bloccato aumenta.
Oracle AI Database non aumenta mai i blocchi. L'escalation del blocco aumenta notevolmente la probabilità di deadlock. Si supponga che un sistema stia tentando di escalare i blocchi per conto della transazione 1, ma non è possibile a causa dei blocchi detenuti dalla transazione 2. Viene creato un deadlock se la transazione 2 richiede anche l'escalation di lock degli stessi dati prima di poter procedere.
Durata lock
Oracle AI Database rilascia automaticamente un blocco quando si verifica un evento in modo che la transazione non richieda più la risorsa.
Di solito, il database contiene blocchi acquisiti da istruzioni all'interno di una transazione per la durata della transazione. Questi blocchi impediscono interferenze distruttive come letture non corrette, aggiornamenti persi e DDL distruttive da transazioni concorrenti. Nota: un blocco tabella applicato a una tabella figlio a causa di una chiave esterna non indicizzata viene bloccato per tutta la durata del rendiconto, non per la transazione. Inoltre, il pacchetto DBMS_LOCK consente di rilasciare e allocare i blocchi definiti dall'utente a piacimento e persino di superare i limiti delle transazioni.
Oracle AI Database rilascia tutti i blocchi acquisiti dalle istruzioni all'interno di una transazione quando esegue il commit o il rollback. Oracle AI Database rilascia anche blocchi acquisiti dopo un punto di salvataggio durante il rollback al punto di salvataggio. Tuttavia, solo le transazioni che non attendono le risorse bloccate in precedenza possono acquisire blocchi sulle risorse ora disponibili. Le transazioni in attesa continuano ad attendere fino al completamento del commit o del rollback della transazione originale.
Vedere anche:
-
"Tabella 13-3" che mostra il funzionamento dell'attesa delle transazioni
-
"Panoramica dei blocchi definiti dall'utente" per ulteriori informazioni su
DBMS_LOCK
Lock e deadlock
Un sblocco è una situazione in cui due o più utenti sono in attesa di dati bloccati l'uno dall'altro. I deadlock impediscono ad alcune transazioni di continuare a funzionare.
Oracle AI Database rileva automaticamente i deadlock e li risolve eseguendo il rollback di un'istruzione coinvolta nel deadlock, rilasciando un set di lock di riga in conflitto. Il database restituisce un messaggio corrispondente alla transazione che viene sottoposta a roback a livello di istruzione. L'istruzione di cui è stato eseguito il rollback appartiene alla transazione che rileva il deadlock. In genere, il rollback della transazione segnalata deve essere eseguito in modo esplicito, ma può riprovare l'istruzione di rollback dopo l'attesa. La Tabella 12-5 illustra due transazioni in un deadlock.
Tabella 5 Transazioni bloccate
| T | Sessione 1 | Sessione 2 | Spiegazione |
|---|---|---|---|
| t0 | |
|
La sessione 1 avvia la transazione 1 e aggiorna lo stipendio per il dipendente 100. La sessione 2 avvia la transazione 2 e aggiorna lo stipendio per il dipendente 200. Non esiste alcun problema perché ogni transazione blocca solo la riga che tenta di aggiornare. |
| t1 | |
|
La transazione 1 tenta di aggiornare la riga dipendente 200, attualmente bloccata dalla transazione 2. La transazione 2 tenta di aggiornare la riga dipendente 100, attualmente bloccata dalla transazione 1. Un deadlock risulta perché nessuna transazione può ottenere la risorsa di cui ha bisogno per procedere o terminare. Indipendentemente dal tempo di attesa di ogni transazione, i blocchi in conflitto vengono bloccati. |
| t2 | |
La transazione 1 segnala il deadlock e riavvia la dichiarazione Nota: solo una sessione nel deadlock ottiene effettivamente l'errore di deadlock, ma una delle due sessioni potrebbe ottenere l'errore. |
|
| t3 | |
La sessione 1 esegue il commit dell'aggiornamento eseguito su t0, terminando la transazione 1. Non è stato eseguito il commit dell'aggiornamento tentato in t1. | |
| t4 | |
L'aggiornamento a t1 nella transazione 2, che è stata bloccata dalla transazione 1, viene eseguito. Il prompt viene restituito. | |
| t5 | |
La sessione 2 esegue il commit degli aggiornamenti effettuati su t0 e t1, che termina la transazione 2. |
I deadlock si verificano più spesso quando le transazioni sostituiscono esplicitamente il blocco predefinito di Oracle AI Database. Poiché Oracle AI Database non esegue l'escalation dei blocchi e non utilizza i blocchi di lettura per le query, ma utilizza il blocco a livello di riga (anziché a livello di pagina), i deadlock si verificano raramente.
Vedere anche:
-
Oracle AI Database Development Guide per informazioni su come gestire i deadlock quando si bloccano le tabelle in modo esplicito
Panoramica dei blocchi automatici
Oracle AI Database blocca automaticamente una risorsa per conto di una transazione per evitare che altre transazioni eseguano operazioni che richiedono l'accesso esclusivo alla stessa risorsa.
Il database acquisisce automaticamente diversi tipi di lock a diversi livelli di restrittività a seconda della risorsa e dell'operazione eseguita. Nota: il database non blocca mai le righe durante l'esecuzione di letture semplici.
I lock di Oracle AI Database sono suddivisi nelle categorie visualizzate nella tabella seguente.
Tabella 6 - Categorie blocco
| Blocca | Descrizione | Per saperne di più |
|---|---|---|
| Blocchi DML | Proteggere i dati. Ad esempio, la tabella blocca intere tabelle, mentre i blocchi delle righe bloccano le righe selezionate. | "Blocchi DML" |
| Blocchi DDL | Proteggere la struttura degli oggetti dello schema, ad esempio le definizioni del dizionario di tabelle e viste. | "Blocchi DDL" |
| Blocchi di sistema | Proteggere le strutture di database interne, ad esempio i file di dati. Le maniglie, i mutex e le serrature interne sono completamente automatiche. | "Blocchi di sistema" |
-
Blocchi DML Un blocco DML, chiamato anche blocco dei dati, garantisce l'integrità dei dati a cui accedono contemporaneamente più utenti.
-
Lock DDL Un lock del dizionario dati (DDL) protegge la definizione di un oggetto dello schema mentre un'operazione DDL in corso agisce sull'oggetto o fa riferimento a esso.
-
Serrature di sistema Oracle AI Database utilizza vari tipi di blocchi di sistema per proteggere le strutture interne di database e memoria. Questi meccanismi sono inaccessibili agli utenti perché gli utenti non hanno alcun controllo sulla loro occorrenza o durata.
Blocchi DML
Un blocco DML, chiamato anche blocco dati, garantisce l'integrità dei dati a cui accedono contemporaneamente più utenti.
Ad esempio, un blocco DML impedisce a due clienti di acquistare l'ultima copia di un libro disponibile da un libraio online. I lock DML impediscono l'interferenza distruttiva di operazioni DML o DDL simultanee in conflitto.
Le istruzioni DML acquisiscono automaticamente i seguenti tipi di lock:
Nelle sezioni seguenti, l'acronimo tra parentesi dopo ogni tipo di modalità di blocco o blocco è l'abbreviazione utilizzata in Monitor blocchi di Oracle Enterprise Manager (Enterprise Manager). Enterprise Manager potrebbe visualizzare TM per qualsiasi blocco di tabella, anziché indicare la modalità di blocco della tabella (ad esempio RS o SRX).
-
Blocchi di riga (TX) Un blocco di riga, detto anche blocco TX, è un blocco su una singola riga di tabella. Una transazione acquisisce un blocco di riga per ogni riga modificata da un'istruzione
INSERT,UPDATE,DELETE,MERGEoSELECT... FORUPDATE. Il blocco della riga esiste finché la transazione non esegue il commit o il rollback. -
Bloc tabella (TM) Un blocco tabella, chiamato anche blocco TM, viene acquisito da una transazione quando una tabella viene modificata da un'istruzione
INSERT,UPDATE,DELETE,MERGE,SELECTcon la clausolaFOR UPDATEoLOCK TABLE. -
Bloc e chiavi esterne Oracle AI Database massimizza il controllo di accesso concorrente delle chiavi padre in relazione alle chiavi esterne dipendenti.
Blocchi riga (TX)
Un blocco di una riga, anche denominato blocco TX, è un blocco su una singola riga della tabella. Una transazione acquisisce un blocco di riga per ogni riga modificata da un'istruzione INSERT, UPDATE, DELETE, MERGE o SELECT ... FOR UPDATE. Il blocco della riga esiste finché la transazione non esegue il commit o il rollback.
I blocchi di riga fungono principalmente da meccanismo di accodamento per impedire che due transazioni modifichino la stessa riga. Il database blocca sempre una riga modificata in modalità esclusiva in modo che altre transazioni non possano modificare la riga finché la transazione che contiene il blocco non esegue il commit o il rollback. Il bloccaggio a righe fornisce il miglior bloccaggio delle granaglie possibile e quindi fornisce la migliore concorrenza e throughput possibile.
Nota: se una transazione termina a causa di un errore dell'istanza del database, il recupero a livello di blocco rende disponibile una riga prima del recupero dell'intera transazione.
Se una transazione ottiene un blocco per una riga, la transazione acquisisce anche un blocco per la tabella contenente la riga. Il blocco della tabella impedisce operazioni DDL in conflitto che eseguono l'override delle modifiche ai dati in una transazione corrente. La Figura 12-2 illustra un aggiornamento della terza riga di una tabella. Oracle AI Database posiziona automaticamente un blocco esclusivo sulla riga aggiornata e un blocco secondario sulla tabella.
Figura 2: Blocchi riga e tabella
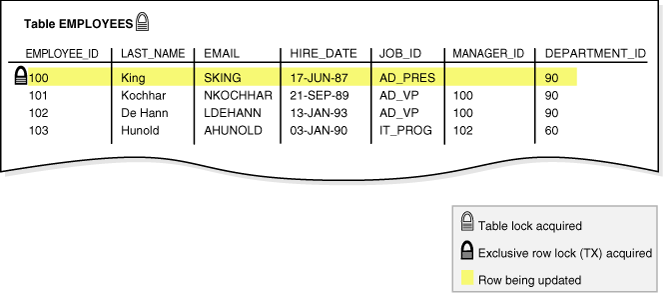
Descrizione dell'illustrazione cncpt265.gif
-
Blocchi di riga e concorrenza Questo scenario illustra il modo in cui Oracle AI Database utilizza i blocchi di riga per la concorrenza.
-
Memorizzazione dei blocchi di riga A differenza di alcuni database, che utilizzano un gestore di blocchi per gestire una lista di blocchi in memoria, Oracle AI Database memorizza le informazioni di blocco nel blocco di dati contenente la riga bloccata.
Blocchi righe e concorrenza
Questo scenario illustra il modo in cui Oracle AI Database utilizza i lock di riga per la concorrenza.
Tre sessioni eseguono query sulle stesse righe contemporaneamente. Le sessioni 1 e 2 procedono a effettuare aggiornamenti non sottoposti a commit a righe diverse, mentre la sessione 3 non aggiorna. Ogni sessione vede i propri aggiornamenti non impegnati, ma non gli aggiornamenti non impegnati di qualsiasi altra sessione.
Tabella 7: esempio concorrenza dati
| T | Sessione 1 | Sessione 2 | Sessione 3 | Spiegazione |
|---|---|---|---|---|
| t0 | |
|
|
Tre sessioni diverse eseguono contemporaneamente query sull'ID e sullo stipendio dei dipendenti 100 e 101. I risultati restituiti da ogni query sono identici. |
| t1 | |
La sessione 1 aggiorna lo stipendio del dipendente 100 ma non esegue il commit. Nell'aggiornamento, il writer acquisisce un blocco a livello di riga solo per la riga aggiornata, impedendo così ad altri scrittori di modificare questa riga. | ||
| t2 | |
|
|
Ogni sessione esegue contemporaneamente la query originale. La sessione 1 mostra lo stipendio di 612 risultante dall'aggiornamento t1. I lettori nella sessione 2 e 3 restituiscono immediatamente le righe e non attendono che la sessione 1 termini la transazione. Il database utilizza la coerenza di lettura multiversione per mostrare lo stipendio esistente prima dell'aggiornamento nella sessione 1. |
| t3 | |
La sessione 2 aggiorna lo stipendio del dipendente 101, ma non esegue il commit della transazione. Nell'aggiornamento, l'autore acquisisce un blocco a livello di riga solo per la riga aggiornata, impedendo ad altri autori di modificare questa riga. | ||
| t4 | |
|
|
Ogni sessione esegue contemporaneamente la query originale. La sessione 1 mostra lo stipendio di 612 risultante dall'aggiornamento t1, ma non l'aggiornamento dello stipendio per il dipendente 101 effettuato nella sessione 2. Il lettore nella sessione 2 mostra l'aggiornamento dello stipendio effettuato nella sessione 2, ma non l'aggiornamento dello stipendio effettuato nella sessione 1. Il lettore nella sessione 3 utilizza la coerenza di lettura per mostrare gli stipendi prima della modifica per sessione 1 e 2. |
Vedere anche:
-
Oracle AI Database Reference per saperne di più su
V$LOCK
Memorizzazione dei blocchi di riga
A differenza di alcuni database, che utilizzano un gestore di blocchi per gestire una lista di blocchi in memoria, Oracle AI Database memorizza le informazioni di blocco nel blocco di dati contenente la riga bloccata.
Il database utilizza un meccanismo di accodamento per l'acquisizione dei lock di riga. Se una transazione richiede un blocco per una riga sbloccata, la transazione inserisce un blocco nel blocco dati. Ogni riga modificata da questa transazione punta a una copia dell'ID transazione memorizzata nell'intestazione del blocco.
Al termine di una transazione, l'ID transazione rimane nell'intestazione del blocco. Se una transazione diversa desidera modificare una riga, utilizza l'ID transazione per determinare se il blocco è attivo. Se il blocco è attivo, la sessione chiede di ricevere una notifica al rilascio del blocco. In caso contrario, la transazione acquisisce il blocco.
Vedere anche:
-
"Panoramica dei blocchi di dati" per ulteriori informazioni sull'intestazione del blocco di dati
-
Oracle AI Database Reference per saperne di più su
V$TRANSACTION
Blocchi tabella (TM)
Un lock tabella, chiamato anche lock TM, viene acquisito da una transazione quando una tabella viene modificata da un'istruzione INSERT, UPDATE, DELETE, MERGE, SELECT con la clausola FOR UPDATE o LOCK TABLE.
Le operazioni DML richiedono che i lock di tabella riservino l'accesso DML alla tabella per conto di una transazione e impediscano le operazioni DDL in conflitto con la transazione.
Un blocco tabella può essere mantenuto in una delle seguenti modalità:
-
Condivisione righe (RS)
Questo blocco, chiamato anche blocco della tabella di condivisione secondaria (SS), indica che la transazione che contiene il blocco nella tabella contiene righe bloccate nella tabella e intende aggiornarle. Un blocco condivisione righe è la modalità meno restrittiva del blocco tabella, che offre il livello più alto di concorrenza per una tabella.
-
Blocco tabella esclusiva riga (RX)
Questo blocco, noto anche come blocco della tabella secondaria esclusiva (SX), indica in genere che la transazione che contiene il blocco ha aggiornato le righe della tabella o ha emesso
SELECT ... FOR UPDATE. Un blocco SX consente ad altre transazioni di eseguire query, inserire, aggiornare, eliminare o bloccare le righe contemporaneamente nella stessa tabella. Pertanto, i blocchi SX consentono a più transazioni di ottenere blocchi di tabelle SX e di condivisione secondaria simultanei per la stessa tabella. -
Condividi blocco tabella (S)
Un blocco della tabella di condivisione detenuto da una transazione consente ad altre transazioni di eseguire query sulla tabella (senza utilizzare
SELECT ... FOR UPDATE), ma gli aggiornamenti sono consentiti solo se una singola transazione contiene il blocco della tabella di condivisione. Poiché più transazioni possono contenere contemporaneamente un blocco della tabella di condivisione, il blocco non è sufficiente per garantire che una transazione possa modificare la tabella. -
Blocco tabella esclusiva riga condivisione (SRX)
Questo blocco, anche denominato blocco della tabella con esclusione della condivisione (SSX,share-subexclusive table lock), è più restrittivo rispetto al blocco della tabella di condivisione. Solo una transazione alla volta può acquisire un blocco SSX su una determinata tabella. Un blocco SSX bloccato da una transazione consente ad altre transazioni di eseguire query sulla tabella (ad eccezione di
SELECT ... FOR UPDATE) ma non di aggiornare la tabella. -
Serratura esclusiva del tavolo (X)
Questo blocco è il più restrittivo e vieta ad altre transazioni di eseguire qualsiasi tipo di istruzione DML o di posizionare qualsiasi tipo di blocco sulla tabella.
Vedere anche:
-
Oracle AI Database Development Guide per ulteriori informazioni sui blocchi delle tabelle
Blocchi e chiavi esterne
Oracle AI Database massimizza il controllo della concorrenza delle chiavi padre in relazione alle chiavi esterne dipendenti.
Il funzionamento del blocco dipende dal fatto che le colonne di chiavi esterne siano indicizzate. Se le chiavi esterne non vengono indicizzate, è probabile che la tabella figlio venga bloccata più frequentemente, si verificheranno deadlock e la concorrenza verrà ridotta. Per questo motivo le chiavi esterne dovrebbero quasi sempre essere indicizzate. L'unica eccezione si verifica quando la chiave univoca o primaria corrispondente non viene mai aggiornata o eliminata.
-
Blocchi e chiavi esterne non indicizzate Il database acquisisce un blocco tabella completo nella tabella figlio quando non esiste alcun indice nella colonna di chiave esterna della tabella figlio e una sessione modifica una chiave primaria nella tabella padre (ad esempio, elimina una riga o modifica gli attributi di chiave primaria) oppure unisce le righe nella tabella padre.
-
Blocchi e chiavi esterne indicizzate Il database non acquisisce un blocco completo della tabella nella tabella figlio quando una colonna di chiave esterna nella tabella figlio è indicizzata e una sessione modifica una chiave primaria nella tabella padre (ad esempio, elimina una riga o modifica gli attributi di chiave primaria) o unisce le righe nella tabella padre.
Blocchi e chiavi esterne non indicizzate
Il database acquisisce un blocco completo della tabella nella tabella figlio quando non esiste alcun indice nella colonna chiave esterna della tabella figlio e una sessione modifica una chiave primaria nella tabella padre (ad esempio, elimina una riga o modifica gli attributi della chiave primaria) oppure unisce le righe nella tabella padre.
Quando entrambe le condizioni riportate di seguito sono vere, il database acquisisce un blocco tabella completo nella tabella figlio.
-
Nessun indice esistente nella colonna chiave esterna della tabella figlio.
-
Una sessione modifica una chiave primaria nella tabella padre (ad esempio, elimina una riga o modifica gli attributi della chiave primaria) oppure unisce le righe nella tabella padre. Nota: gli inserimenti nella tabella padre non acquisiscono blocchi di tabelle di blocco che impediscono DML nella tabella figlio. In caso di inserimenti, il database acquisisce un blocco sulla tabella figlio che impedisce le modifiche strutturali, ma non le modifiche delle righe esistenti o aggiunte di recente.
Si supponga che la tabella hr.departments sia un padre di hr.employees, che contiene la chiave esterna non indicizzata employees.department_id. La figura seguente mostra una sessione che modifica gli attributi di chiave primaria del reparto 60 nella tabella departments.
Figura 3: Meccanismi di bloccaggio con chiave esterna non indicizzata
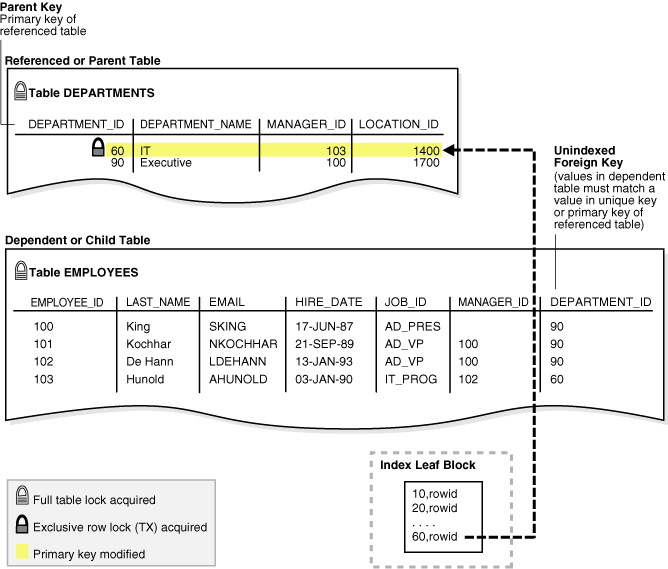
Descrizione dell'illustrazione cncpt308.gif
Nella Figura 12-3, il database acquisisce un blocco completo della tabella su employees durante la modifica della chiave primaria del reparto 60. Questo lock consente ad altre sessioni di eseguire query ma non di aggiornare la tabella employees. Ad esempio, le sessioni non possono aggiornare i numeri di telefono dei dipendenti. La tabella viene bloccata nelle release employees immediatamente dopo il completamento della modifica della chiave primaria nella tabella departments. Se più righe in departments subiscono modifiche alla chiave primaria, viene ottenuto e rilasciato un blocco di tabella in employees una volta per ogni riga modificata in departments. Nota: DML in una tabella figlio non acquisisce un blocco di tabella nella tabella padre.
Blocchi e chiavi esterne indicizzate
Il database non acquisisce un blocco completo della tabella nella tabella figlio quando una colonna di chiave esterna nella tabella figlio è indicizzata e una sessione modifica una chiave primaria nella tabella padre (ad esempio, elimina una riga o modifica gli attributi di chiave primaria) o unisce le righe nella tabella padre.
Un blocco nella tabella padre impedisce alle transazioni di acquisire blocchi di tabella esclusivi, ma non impedisce il DML nella tabella padre o nella tabella figlio durante la modifica della chiave primaria. Questa situazione è preferibile se si verificano modifiche alla chiave primaria nella tabella padre mentre si verificano aggiornamenti nella tabella figlio. La Figura 12-4 mostra la tabella figlio employees con una colonna department_id indicizzata. Una transazione elimina il reparto 280 da departments. Questa eliminazione non comporta l'acquisizione di un blocco completo della tabella nella tabella employees come nello scenario descritto in "Blocchi e chiavi esterne non indicizzate".
Figura 4: Meccanismi di bloccaggio con chiave esterna indicizzata
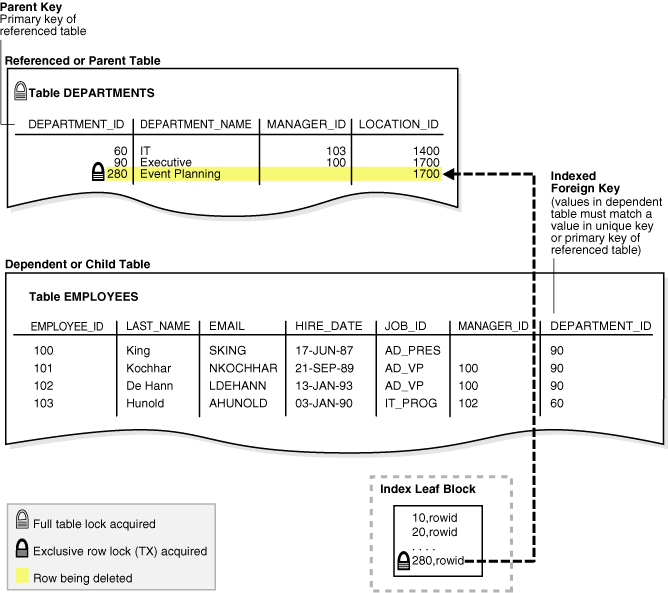
Descrizione dell'illustrazione cncpt309.gif
Se la tabella figlio specifica ON DELETE CASCADE, le eliminazioni dalla tabella padre possono generare eliminazioni dalla tabella figlio. Ad esempio, l'eliminazione del reparto 280 può causare l'eliminazione dei record da employees per i dipendenti del reparto eliminato. In questo caso, le regole di attesa e blocco sono le stesse di quelle eliminate dalla tabella figlio dopo l'eliminazione delle righe dalla tabella padre.
Vedere anche:
Blocchi DDL
Un lock del dizionario dati (DDL) protegge la definizione di un oggetto dello schema mentre un'operazione DDL in corso agisce sull'oggetto o fa riferimento a esso.
Durante le operazioni DDL vengono bloccati solo i singoli oggetti dello schema modificati o a cui viene fatto riferimento. Il database non blocca mai l'intero dizionario dati.
Oracle AI Database acquisisce automaticamente un blocco DDL per conto di qualsiasi transazione DDL che lo richiede. Gli utenti non possono richiedere in modo esplicito i lock DDL. Ad esempio, se un utente crea una procedura memorizzata, Oracle AI Database acquisisce automaticamente i lock DDL per tutti gli oggetti dello schema a cui viene fatto riferimento nella definizione della procedura. I lock DDL impediscono che questi oggetti vengano modificati o eliminati prima del completamento della compilazione della procedura.
-
Blocchi DDL esclusivi Un blocco DDL esclusivo impedisce ad altre sessioni di ottenere un blocco DDL o DML.
-
Condividi blocchi DDL Un blocco DDL condivisione per una risorsa impedisce interferenze distruttive con operazioni DDL in conflitto, ma consente la concorrenza dei dati per operazioni DDL simili.
-
Blocchi di analisi interrogabili Un blocco di analisi è detenuto da un'istruzione SQL o da una program unit PL/SQL per ogni oggetto schema a cui fa riferimento.
Blocchi DDL esclusivi
Un blocco DDL esclusivo impedisce ad altre sessioni di ottenere un blocco DDL o DML.
La maggior parte delle operazioni DDL richiede lock DDL esclusivi per una risorsa per evitare interferenze distruttive con altre operazioni DDL che potrebbero modificare o fare riferimento allo stesso oggetto dello schema. Ad esempio, DROP TABLE non è autorizzato a rilasciare una tabella mentre ALTER TABLE vi sta aggiungendo una colonna e viceversa.
I lock DDL esclusivi durano per la durata dell'esecuzione dell'istruzione DDL e del commit automatico. Durante l'acquisizione di un blocco DDL esclusivo, se un altro blocco DDL viene bloccato sull'oggetto dello schema da un'altra operazione, l'acquisizione attende il rilascio del blocco DDL precedente e quindi procede.
Vedere anche: "Condividi blocchi DDL" descrive le situazioni in cui non sono richiesti blocchi esclusivi per evitare interferenze distruttive.
Condividi blocchi DDL
Un lock DDL di condivisione per una risorsa impedisce interferenze distruttive con operazioni DDL in conflitto, ma consente la concorrenza dei dati per operazioni DDL simili.
Ad esempio, quando viene eseguita un'istruzione CREATE PROCEDURE, la transazione contenente acquisisce i lock DDL di condivisione per tutte le tabelle di riferimento. Altre transazioni possono contemporaneamente creare procedure che fanno riferimento alle stesse tabelle e acquisire blocchi DDL di condivisione concorrenti sulle stesse tabelle, ma nessuna transazione può acquisire un blocco DDL esclusivo su qualsiasi tabella di riferimento.
Un blocco DDL di condivisione dura per la durata dell'esecuzione dell'istruzione DDL e del commit automatico. Pertanto, una transazione che contiene un blocco DDL di condivisione è garantita che la definizione dell'oggetto schema di riferimento rimane costante durante la transazione.
Blocchi analisi interrogabili
Un blocco di analisi è gestito da un'istruzione SQL o da una program unit PL/SQL per ogni oggetto schema a cui fa riferimento.
I lock di analisi vengono acquisiti in modo che l'area SQL condivisa associata possa essere invalidata se un oggetto di riferimento viene modificato o eliminato. Un blocco di analisi è definito blocco di analisi interrogabile perché non consente alcuna operazione DDL e può essere interrotto per consentire operazioni DDL in conflitto.
Un blocco di analisi viene acquisito nel pool condiviso durante la fase di analisi dell'esecuzione dell'istruzione SQL. Il blocco viene mantenuto finché l'area SQL condivisa per tale istruzione rimane nello shared pool.
Vedere anche: "Shared Pool"
Blocchi di sistema
Oracle AI Database utilizza vari tipi di lock di sistema per proteggere le strutture interne di database e memoria. Questi meccanismi sono inaccessibili agli utenti perché gli utenti non hanno alcun controllo sulla loro occorrenza o durata.
-
Latch Un latch è un meccanismo di serializzazione semplice e di basso livello che coordina l'accesso multiutente a strutture di dati, oggetti e file condivisi.
-
Mutex Un oggetto di esclusione reciproca (mutex) è un meccanismo di basso livello che impedisce l'esaurimento o la danneggiamento di un oggetto in memoria quando si accede da processi concorrenti. Un mutex è simile a un latch, ma mentre un latch in genere protegge un gruppo di oggetti, un mutex protegge un singolo oggetto.
-
I blocchi interni sono meccanismi di livello superiore e più complessi rispetto a blocchi e mutex e servono a vari scopi.
Blocchi interni
Un latch è un meccanismo di serializzazione semplice e di basso livello che coordina l'accesso multiutente a strutture di dati, oggetti e file condivisi.
I blocchi proteggono le risorse di memoria condivisa dal danneggiamento quando vi si accede da più processi. In particolare, i latch proteggono le strutture di dati dalle seguenti situazioni:
-
Modifica concorrente da più sessioni
-
Lettura di una sessione durante la modifica di un'altra sessione
-
Disallocazione (aging out) della memoria durante l'accesso
In genere, una singola maniglia protegge più oggetti nella SGA. Ad esempio, processi in background quali DBW e LGWR allocano memoria dal pool condiviso per creare strutture dati. Per allocare questa memoria, questi processi utilizzano un latch dello shared pool che serializza l'accesso per evitare che due processi tentino di ispezionare o modificare lo shared pool contemporaneamente. Dopo l'allocazione della memoria, potrebbe essere necessario che altri processi accedano ad aree dello shared pool come la cache della libreria, necessaria per l'analisi. In questo caso, i processi bloccano solo la cache della libreria, non l'intero shared pool.
A differenza dei latch di accodamento, ad esempio i lock di riga, i latch non consentono alle sessioni di accodarsi. Quando un latch diventa disponibile, la prima sessione a richiedere il latch ottiene l'accesso esclusivo ad esso. Il fenomeno dell'attivazione del latch si verifica quando un processo richiede ripetutamente un latch in un loop, mentre l'attivazione del latch si verifica quando un processo rilascia la CPU prima di rinnovare la richiesta di latch.
In genere, un processo Oracle acquisisce un latch per un tempo estremamente breve durante la manipolazione o l'analisi di una struttura di dati. Ad esempio, durante l'elaborazione di un aggiornamento dello stipendio di un singolo dipendente, il database può ottenere e rilasciare migliaia di latch. L'implementazione dei fermi dipende dal sistema operativo, soprattutto per quanto riguarda se e per quanto tempo un processo attende un fermo.
Un aumento del latching significa una diminuzione della concorrenza. Ad esempio, un'eccessiva operazione di hard parse crea conflitti per il latch della cache della libreria. La vista V$LATCH contiene statistiche dettagliate sull'uso dei latch per ogni latch, incluso il numero di volte in cui ogni latch è stato richiesto e atteso.
Vedere anche:
-
Oracle AI Database Reference per saperne di più su
V$LATCH -
Oracle AI Database Performance Tuning Guide per informazioni sulle statistiche degli eventi di attesa
Mutex
Un oggetto di esclusione reciproca (mutex) è un meccanismo di basso livello che impedisce che un oggetto in memoria venga scaduto o danneggiato quando vi si accede da processi concorrenti. Un mutex è simile a un latch, ma mentre un latch in genere protegge un gruppo di oggetti, un mutex protegge un singolo oggetto.
I mutex offrono diversi vantaggi:
-
Un mutex può ridurre la possibilità di contesa.
Poiché un latch protegge più oggetti, può diventare un collo di bottiglia quando i processi tentano di accedere contemporaneamente a uno di questi oggetti. Se si serializza l'accesso a un singolo oggetto anziché a un gruppo, un mutex aumenta la disponibilità.
-
Un mutex consuma meno memoria di un latch.
-
Quando è in modalità condivisa, un mutex consente un riferimento simultaneo da più sessioni.
Blocchi interni
I blocchi interni sono meccanismi di livello superiore e più complessi rispetto ai fermi e ai mutex e servono a vari scopi.
Il database utilizza i tipi di lock interni riportati di seguito.
-
Blocchi cache dizionario
Questi blocchi sono di durata molto breve e sono contenuti nelle voci nelle cache del dizionario mentre le voci vengono modificate o utilizzate. Garantiscono che le istruzioni analizzate non vedano definizioni di oggetti incoerenti. I lock della cache del dizionario possono essere condivisi o esclusivi. I blocchi condivisi vengono rilasciati al termine dell'analisi, mentre i blocchi esclusivi vengono rilasciati al completamento dell'operazione DDL.
-
Blocchi di gestione di file e log
Questi blocchi proteggono vari file. Ad esempio, un blocco interno protegge il file di controllo in modo che possa essere modificato da un solo processo alla volta. Un altro lock coordina l'uso e l'archiviazione dei redo log file in linea. I file di dati vengono bloccati per garantire che più istanze eseguano il MOUNT di un database in modalità condivisa o che un'istanza lo esegua in modalità esclusiva. Poiché i blocchi di file e log indicano lo stato dei file, questi blocchi vengono necessariamente mantenuti per lungo tempo.
-
Lock di tablespace e segmenti di undo
Questi blocchi proteggono le tablespace e i segmenti di undo. Ad esempio, tutte le istanze che accedono a un database devono stabilire se una tablespace è in linea o non in linea. I segmenti di annullamento sono bloccati in modo che una sola istanza di database possa scrivere in un segmento.
Vedere anche: "Data Dictionary Cache"
Panoramica dei blocchi di dati manuali
È possibile sostituire manualmente i meccanismi di blocco predefiniti di Oracle AI Database.
Oracle AI Database esegue il blocco automatico per garantire la concorrenza, l'integrità dei dati e la coerenza della lettura a livello di istruzione. Tuttavia, l'override del blocco predefinito è utile in situazioni quali:
-
Le applicazioni richiedono coerenza di lettura a livello di transazione o letture ripetibili.
In questo caso, le query devono produrre dati coerenti per la durata della transazione, non riflettendo le modifiche apportate da altre transazioni. È possibile ottenere la coerenza della lettura a livello di transazione utilizzando il blocco esplicito, le transazioni di sola lettura, le transazioni serializzabili o sostituendo il blocco predefinito.
-
Le applicazioni richiedono che una transazione disponga dell'accesso esclusivo a una risorsa in modo che la transazione non debba attendere il completamento di altre transazioni.
È possibile eseguire l'override del blocco automatico di Oracle AI Database a livello di sessione o transazione. A livello di sessione, una sessione può impostare il livello di isolamento delle transazioni richiesto con l'istruzione ALTER SESSION. A livello di transazione, le transazioni che includono le seguenti istruzioni SQL sostituiscono il blocco predefinito di Oracle AI Database:
-
L'istruzione
SET TRANSACTION ISOLATION LEVEL -
L'istruzione
LOCK TABLE(che blocca una tabella o, se utilizzata con le viste, le tabelle di base) -
L'istruzione
SELECT ... FOR UPDATE
I blocchi acquisiti dalle istruzioni precedenti vengono rilasciati al termine della transazione o dopo il rilascio di un rollback per il savepoint.
Se viene eseguito l'override del blocco predefinito di Oracle AI Database a qualsiasi livello, l'amministratore del database o lo sviluppatore dell'applicazione deve assicurarsi che le procedure di blocco di override funzionino correttamente. Le procedure di blocco devono soddisfare i seguenti criteri: l'integrità dei dati è garantita, la concorrenza dei dati è accettabile e i deadlock non sono possibili o sono gestiti in modo appropriato.
Vedere anche:
-
Oracle AI Database SQL Language Reference per le descrizioni di
LOCK TABLEeSELECT -
Oracle AI Database Development Guide per informazioni su come bloccare manualmente le tabelle
Panoramica dei blocchi definiti dall'utente
Con i servizi Oracle AI Database Lock Management, puoi definire i tuoi blocchi per un'applicazione specifica.
Ad esempio, è possibile creare un blocco per serializzare l'accesso a un log dei messaggi nel file system. Poiché un blocco utente riservato è uguale a un blocco di Oracle AI Database, dispone di tutte le funzionalità di blocco di Oracle AI Database, incluso il rilevamento del deadlock. I lock degli utenti non sono mai in conflitto con i lock di Oracle AI Database, poiché sono identificati con il prefisso UL.
I servizi Oracle AI Database Lock Management sono disponibili mediante le procedure nel package DBMS_LOCK. È possibile includere istruzioni nei blocchi PL/SQL che:
-
Richiedere un blocco di un tipo specifico
-
Assegnare al blocco un nome univoco riconoscibile in un'altra procedura nella stessa istanza o in un'altra istanza
-
Modificare il tipo di blocco
-
Rilascia il lock
Vedere anche:
-
Oracle AI Database Development Guide per ulteriori informazioni sui servizi Oracle AI Database Lock Management
-
Oracle AI Database PL/SQL Packages and Types Reference per informazioni su
DBMS_LOCK
Legenda nota a piè di pagina
Nota a piè di pagina 1:
Durante l'elaborazione di un commit a due fasi distribuito, il database può impedire brevemente l'accesso in lettura in circostanze speciali. In particolare, se una query inizia tra le fasi di preparazione e commit e tenta di leggere i dati prima del commit, il database potrebbe escalare un blocco da livello di riga a livello di blocco per garantire la coerenza della lettura.