SQL
In questo capitolo viene fornita una panoramica di Structured Query Language (SQL) e di come Oracle AI Database elabora le istruzioni SQL.
-
Introduzione a SQL SQL (pronunciato sequel) è il linguaggio del computer dichiarativo di alto livello basato su set con cui tutti i programmi e gli utenti accedono ai dati in un database Oracle.
-
Panoramica delle istruzioni SQL Tutte le operazioni eseguite sulle informazioni in un database Oracle vengono eseguite utilizzando le istruzioni SQL. Un'istruzione SQL è un programma o un'istruzione per computer costituita da identificatori, parametri, variabili, nomi, tipi di dati e parole riservate SQL.
-
Panoramica dell'ottimizzatore Per capire come Oracle AI Database elabora le istruzioni SQL, è necessario comprendere la parte del database chiamata ottimizzatore (noto anche come ottimizzatore delle query o ottimizzatore basato sui costi). Tutte le istruzioni SQL utilizzano l'ottimizzatore per determinare le modalità di accesso più efficienti ai dati specificati.
-
Panoramica dell'elaborazione SQL Questa sezione spiega in che modo Oracle AI Database elabora le istruzioni SQL. In particolare, la sezione descrive il modo in cui il database elabora le istruzioni DDL per creare oggetti, DML per modificare i dati e le query per recuperare i dati.
introduzione a SQL
SQL (pronunciato sequel) è il linguaggio informatico di alto livello basato su set con cui tutti i programmi e gli utenti accedono ai dati in un database Oracle.
Sebbene alcuni strumenti e applicazioni Oracle mascherino l'uso di SQL, tutti i task del database vengono eseguiti utilizzando SQL. Qualsiasi altro metodo di accesso ai dati aggira la sicurezza integrata in Oracle AI Database e potenzialmente compromette la sicurezza e l'integrità dei dati.
SQL fornisce un'interfaccia a un database relazionale come Oracle AI Database. SQL unifica task come i seguenti in un'unica lingua coerente:
-
Creazione, sostituzione, modifica ed eliminazione di oggetti
-
Inserimento, aggiornamento ed eliminazione di righe di tabella
-
Esecuzione di query sui dati
-
Controllo dell'accesso al database e ai relativi oggetti
-
Garantire coerenza e integrità del database
SQL può essere utilizzato in modo interattivo, il che significa che le istruzioni vengono immesse manualmente in un programma. Le istruzioni SQL possono anche essere incorporate in un programma scritto in un linguaggio diverso, ad esempio C o Java.
-
SQL Data Access Ci sono due famiglie di linguaggi informatici: linguaggi dichiarativi che non sono di tipo procedurale e descrivono cosa dovrebbe essere fatto e linguaggi procedurali come C++ e Java che descrivono come le cose dovrebbero essere fatte.
-
Standard SQL Oracle si impegna a seguire gli standard accettati dal settore e partecipa attivamente ai comitati degli standard SQL.
Vedere anche:
-
Oracle AI Database Development Guide per scoprire come scegliere un ambiente di programmazione
-
Oracle AI Database SQL Language Reference per un'introduzione a SQL
Accesso dati SQL
Esistono due grandi famiglie di linguaggi informatici: i linguaggi dichiarativi non procedurali che descrivono cosa dovrebbe essere fatto e i linguaggi procedurali come C++ e Java che descrivono come le cose dovrebbero essere fatte.
SQL è dichiarativo nel senso che gli utenti specificano il risultato che desiderano, non come derivarlo. Ad esempio, l'istruzione seguente esegue query sui record per i dipendenti il cui cognome inizia con K:
Il database esegue il lavoro di generazione di una procedura per navigare tra i dati e recuperare i risultati richiesti. La natura dichiarativa di SQL consente di utilizzare i dati a livello logico. È necessario preoccuparsi dei dettagli di implementazione solo quando si manipolano i dati.
SELECT   last_name, first_name
FROM     hr.employees
WHERE    last_name LIKE 'K%'
ORDER BY last_name, first_name;
Il database recupera tutte le righe che soddisfano la condizione WHERE, detta anche predicato, in un unico passo. Il database può passare queste righe come unità all'utente, a un'altra istruzione SQL o a un'applicazione. L'applicazione non ha bisogno di elaborare le righe una per una, né lo sviluppatore deve sapere come le righe vengono fisicamente memorizzate o recuperate.
Tutte le istruzioni SQL utilizzano l'ottimizzatore, un componente del database che determina le modalità di accesso più efficienti ai dati richiesti. Oracle Database supporta anche tecniche che puoi utilizzare per migliorare le prestazioni dell'ottimizzatore.
Vedere anche: Oracle AI Database SQL Language Reference per informazioni dettagliate sulle istruzioni SQL e altre parti del linguaggio SQL (ad esempio operatori, funzioni e modelli di formato)
Standard SQL
Oracle si impegna a seguire gli standard accettati dal settore e partecipa attivamente ai comitati per gli standard SQL.
I comitati accettati dall'industria sono l'American National Standards Institute (ANSI) e l'International Organization for Standardization (ISO). Sia ANSI che ISO/IEC hanno accettato SQL come linguaggio standard per i database relazionali.
Lo standard SQL è composto da dieci parti. Una parte (SQL/RPR:2012) è nuova nel 2012. Altre cinque parti sono state riviste nel 2011. Per le altre quattro parti, la versione 2008 rimane in vigore. Oracle SQL include molte estensioni al linguaggio SQL standard ANSI/ISO e gli strumenti e le applicazioni di Oracle AI Database forniscono istruzioni aggiuntive. Gli strumenti SQL*Plus, SQL Developer e Oracle Enterprise Manager consentono di eseguire qualsiasi istruzione SQL standard ANSI/ISO su un database Oracle e qualsiasi istruzione o funzione aggiuntiva disponibile per tali strumenti.
Vedere anche:
-
Introduzione a Oracle AI Database con lo sviluppo di Oracle AI Database
-
Oracle AI Database SQL Language Reference per una spiegazione delle differenze tra Oracle SQL e SQL standard
-
SQL*Plus User's Guide and Reference per i comandi SQL*Plus, inclusa la distinzione tra le istruzioni SQL
Panoramica delle istruzioni SQL
Tutte le operazioni eseguite sulle informazioni di un database Oracle vengono eseguite utilizzando le istruzioni SQL. Un'istruzione SQL è un programma o un'istruzione per computer costituita da identificatori, parametri, variabili, nomi, tipi di dati e parole riservate SQL. Nota: le parole SQL riservate hanno un significato speciale in SQL e non devono essere utilizzate per altri scopi. Ad esempio, SELECT e UPDATE sono parole riservate e non devono essere usate come nomi di tabella.
Un'istruzione SQL deve essere equivalente a una frase SQL completa, ad esempio:
SELECT last_name, department_id FROM employeesOracle AI Database esegue solo istruzioni SQL complete. Un frammento come il seguente genera un errore che indica che è necessario più testo:
SELECT last_name;Le istruzioni Oracle SQL sono suddivise nelle seguenti categorie:
-
Le istruzioni Data Definition Language (DDL) del linguaggio di definizione dei dati (DLL) definiscono, modificano e rilasciano oggetti dello schema.
-
Le istruzioni Data Manipulation Language (DML) del linguaggio di manipolazione dati (DML) eseguono query o manipolano i dati in oggetti di schema esistenti.
-
Le istruzioni di controllo delle transazioni Transaction Control Statements gestiscono le modifiche apportate dai rendiconti DML e raggruppano i rendiconti DML nelle transazioni.
-
Istruzioni di controllo sessione Le istruzioni di controllo sessione gestiscono in modo dinamico le proprietà di una sessione utente.
-
Istruzione di controllo del sistema Un'istruzione di controllo del sistema modifica le proprietà dell'istanza del database.
-
Istruzioni SQL incorporate Le istruzioni SQL incorporate incorporano istruzioni DDL, DML e di controllo delle transazioni all'interno di un programma di linguaggio procedurale.
Istruzioni DDL (Data Definition Language)
Le istruzioni del linguaggio di definizione dei dati (DLL) definiscono, modificano strutturalmente e eliminano gli oggetti dello schema.
DDL consente di modificare gli attributi di un oggetto senza modificare le applicazioni che accedono all'oggetto. Ad esempio, è possibile aggiungere una colonna a una tabella a cui accede un'applicazione Human Resources senza riscrivere l'applicazione. È inoltre possibile utilizzare DDL per modificare la struttura degli oggetti mentre gli utenti del database eseguono il lavoro nel database.
Più nello specifico, le istruzioni DDL le consentono di:
-
Consente di creare, modificare ed eliminare gli oggetti dello schema e altre strutture di database, inclusi gli utenti del database e il database stesso. La maggior parte delle istruzioni DDL inizia con le parole chiave
CREATE,ALTERoDROP. -
Eliminare tutti i dati negli oggetti dello schema senza rimuovere la struttura di questi oggetti (
TRUNCATE).Nota: a differenza di
DELETE,TRUNCATEnon genera dati di annullamento, il che lo rende più veloce diDELETE. Inoltre,TRUNCATEnon richiama trigger di eliminazione -
Concedere e revocare privilegi e ruoli (
GRANT,REVOKE). -
Attivare e disattivare le opzioni di controllo (
AUDIT,NOAUDIT). -
Aggiungere un commento al dizionario dati (
COMMENT).
Esempio di istruzioni DDL 10-1
Nell'esempio seguente vengono utilizzate le istruzioni DDL per creare la tabella plants e quindi DML per inserire due righe nella tabella. L'esempio utilizza quindi DDL per modificare la struttura della tabella, concedere e revocare i privilegi di lettura su questa tabella a un utente, quindi eliminare la tabella.
CREATE TABLE plants
    ( plant_id    NUMBER PRIMARY KEY,
      common_name VARCHAR2(15) );

INSERT INTO plants VALUES (1, 'African Violet'); # DML statement

INSERT INTO plants VALUES (2, 'Amaryllis'); # DML statement

ALTER TABLE plants ADD
    ( latin_name VARCHAR2(40) );

GRANT READ ON plants TO scott;

REVOKE READ ON plants FROM scott;

DROP TABLE plants;
COMMIT implicito si verifica immediatamente prima che il database esegua un'istruzione DDL e subito dopo si verifica un'istruzione COMMIT o ROLLBACK. Nell'esempio precedente, due istruzioni INSERT sono seguite da un'istruzione ALTER TABLE, quindi il database esegue il commit delle due istruzioni INSERT. Se l'istruzione ALTER TABLE riesce, il database esegue il commit di questa istruzione; in caso contrario, il database esegue il rollback di questa istruzione. In entrambi i casi è già stato eseguito il commit delle due istruzioni INSERT.
Vedere anche:
-
Guida sulla sicurezza di Oracle AI Database per informazioni su privilegi e ruoli
-
Guida introduttiva a Oracle AI Database Development e Oracle AI Database Administrator's Guide per scoprire come creare oggetti dello schema
-
Oracle AI Database Development Guide per scoprire la differenza tra DDL bloccante e non bloccante
-
Oracle AI Database SQL Language Reference per una lista di istruzioni DDL
Istruzioni DML (Data Manipulation Language)
Le istruzioni del linguaggio di manipolazione dati (DML) eseguono query o manipolano i dati negli oggetti dello schema esistenti.
Mentre le istruzioni DDL modificano la struttura del database, le istruzioni DML eseguono query o modificano il contenuto. Ad esempio, ALTER TABLE modifica la struttura di una tabella, mentre INSERT aggiunge una o più righe alla tabella.
Le istruzioni DML sono le istruzioni SQL utilizzate più di frequente e consentono di:
-
Recupera o recupera i dati da una o più tabelle o viste (
SELECT). -
Aggiungere nuove righe di dati in una tabella o vista (
INSERT) specificando un elenco di valori di colonna o utilizzando una subquery per selezionare e modificare i dati esistenti. -
Modificare i valori delle colonne nelle righe esistenti di una tabella o di una vista (
UPDATE). -
Aggiornare o inserire le righe in modo condizionale in una tabella o in una vista (
MERGE). -
Rimuovere le righe dalle tabelle o dalle viste (
DELETE). -
Visualizzare il piano di esecuzione per un'istruzione SQL (
EXPLAINPLAN). -
Bloccare una tabella o una vista, limitando temporaneamente l'accesso da parte di altri utenti (
LOCKTABLE).
Nell'esempio seguente viene utilizzato DML per eseguire una query sulla tabella employees. L'esempio utilizza DML per inserire una riga in employees, aggiornare questa riga, quindi eliminarla:
SELECT * FROM employees;

INSERT INTO employees (employee_id, last_name, email, job_id, hire_date, salary)
  VALUES (1234, 'Mascis', 'JMASCIS', 'IT_PROG', '14-FEB-2008', 9000);

UPDATE employees SET salary=9100 WHERE employee_id=1234;

DELETE FROM employees WHERE employee_id=1234;
Una raccolta di istruzioni DML che costituisce un'unità logica di lavoro è denominata transazione. Ad esempio, una transazione per trasferire denaro potrebbe comportare tre operazioni distinte: la riduzione del saldo del conto di risparmio, l'aumento del saldo del conto corrente e la registrazione del trasferimento in una tabella della cronologia del conto. A differenza delle istruzioni DDL, le istruzioni DML non eseguono implicitamente il commit della transazione corrente.
-
Istruzioni SELECT Una query è un'operazione che recupera dati da una tabella o da una vista.
-
Join Un join è una query che combina righe di due o più tabelle, viste o viste materializzate.
-
Subquery Una subquery è un'istruzione
SELECTnidificata all'interno di un'altra istruzione SQL. Le subquery sono utili quando è necessario eseguire più query per risolvere un singolo problema.
Vedere anche:
-
Introduzione a Oracle AI Database Development per scoprire come eseguire query e manipolare i dati
-
Oracle AI Database SQL Language Reference per una lista di istruzioni DML
Istruzioni SELECT
Una query è un'operazione che recupera dati da una tabella o da una vista.
SELECT è l'unica istruzione SQL che è possibile utilizzare per eseguire query sui dati. Il set di dati recuperati dall'esecuzione di un'istruzione SELECT è noto come set di risultati.
La tabella seguente mostra una parola chiave richiesta e tre parole chiave che si trovano comunemente in un'istruzione SELECT. La tabella associa inoltre le funzionalità di un'istruzione SELECT alle parole chiave.
Parole chiave della Tabella 1 in un'istruzione SQL
| Parola chiave | Obbligatorio? | Descrizione | Capacità |
|---|---|---|---|
SELECT |
Sì | Specifica quali colonne devono essere visualizzate nel risultato. La proiezione produce un sottoinsieme delle colonne nella tabella. Un'espressione è una combinazione di uno o più valori, operatori e funzioni SQL che vengono risolti in un valore. La lista di espressioni visualizzata dopo la parola chiave |
Proiezione |
FROM |
N. | Specifica le tabelle o le viste da cui devono essere recuperati i dati. | Partecipazione |
WHERE |
N. | Specifica una condizione per filtrare le righe, producendo un subset delle righe nella tabella. Una condizione specifica una combinazione di una o più espressioni e operatori logici (booleani) e restituisce un valore TRUE, FALSE o UNKNOWN. |
Selezione |
ORDER BY |
N. | Specifica l'ordine di visualizzazione delle righe. |
Vedi anche: Oracle AI Database SQL Language Reference per sintassi e semantica SELECT
Join
Un join è una query che combina righe di due o più tabelle, viste o viste materializzate.
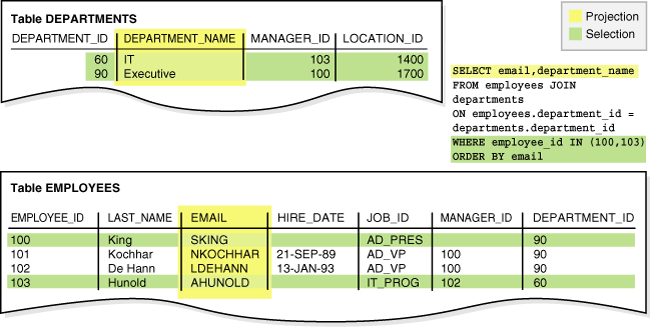
L'esempio seguente unisce le tabelle employees e departments (clausola FROM), seleziona solo le righe che soddisfano i criteri specificati (clausola WHERE) e utilizza la proiezione per recuperare i dati da due colonne (SELECT). L'output di esempio segue l'istruzione SQL.
SELECT email, department_name
FROM   employees
JOIN   departments
ON     employees.department_id = departments.department_id
WHERE  employee_id IN (100,103)
ORDER BY email;

EMAIL                     DEPARTMENT_NAME
------------------------- ------------------------------
AHUNOLD                   IT
SKING                     Executive
Il grafico seguente rappresenta le operazioni di proiezione e selezione nel join mostrato nella query precedente.
Figura 1: Proiezione e selezione
Descrizione dell'illustrazione cncpt290.gif
La maggior parte dei join dispone di almeno una condizione di join, nella clausola FROM o nella clausola WHERE, che confronta due colonne, ciascuna di una tabella diversa. Il database combina coppie di righe, ciascuna contenente una riga da ogni tabella, per le quali la condizione di join restituisce TRUE. L'ottimizzatore determina l'ordine in cui il database unisce le tabelle in base alle condizioni di join, agli indici e alle eventuali statistiche disponibili per le tabelle.
I tipi di join includono i seguenti:
-
Join interni
Un Join interno è un join di due o più tabelle che restituisce solo le righe che soddisfano la condizione di join. Ad esempio, se la condizione di join è
employees.department_id=departments.department_id, le righe che non soddisfano questa condizione non vengono restituite. -
Join esterni
Un outer join restituisce tutte le righe che soddisfano la condizione del join nonché tutte le righe di una tabella per cui nessun'altra riga dell'altra tabella soddisfa la condizione.
Il risultato di un holly sinistro per le tabelle A e B contiene sempre tutti i record della tabella sinistra A, anche se la condizione di join non corrisponde a un record nella tabella destra B. Se non esiste alcuna riga corrispondente da B, le colonne B contengono valori nulli per le righe che non hanno alcuna corrispondenza in B. Ad esempio, se non tutti i dipendenti si trovano nei reparti, un outer join a sinistra di
employees(tabella a sinistra) edepartments(tabella a destra) recupera tutte le righe inemployeesanche se nessuna riga indepartmentssoddisfa la condizione di join (employees.department_idè nullo).Il risultato di un outer join destro per le tabelle A e B contiene tutti i record della tabella destra B, anche se la condizione di join non corrisponde a una riga nella tabella sinistra A. Se non esiste alcuna riga corrispondente da A, le colonne A contengono valori nulli per le righe che non hanno alcuna corrispondenza in A. Ad esempio, se non tutti i reparti dispongono di dipendenti, un outer join destro di
employees(tabella sinistra) edepartments(tabella destra) recupera tutte le righe indepartmentsanche se nessuna riga inemployeessoddisfa la condizione di join.Un full outer join è la combinazione di un outer join sinistro e di un outer join destro.
-
Prodotti cartesiani
Se due tabelle in una query di join non hanno una condizione di join, il database esegue un join cartesiano. Ogni riga di una tabella viene combinata con ogni riga dell'altra. Ad esempio, se
employeescontiene 107 righe edepartmentsne contiene 27, il prodotto cartesiano contiene 107*27 righe. Un prodotto cartesiano è raramente utile.
Vedere anche:
-
Oracle AI Database SQL Tuning Guide per ulteriori informazioni sui join
-
Oracle AI Database SQL Language Reference per descrizioni dettagliate ed esempi di join
Subquery
Una subquery è un'istruzione SELECT nidificata all'interno di un'altra istruzione SQL. Le subquery sono utili quando è necessario eseguire più query per risolvere un singolo problema.
Ogni porzione di query di un'istruzione è denominata blocco di query. Nella query seguente, la subquery tra parentesi è il blocco di query interno:
SELECT first_name, last_name
FROM   employees
WHERE  department_id
IN     ( SELECT department_id
         FROM departments
         WHERE location_id = 1800 );
L'istruzione SELECT interna recupera gli ID dei reparti con ID ubicazione 1800. Questi ID reparto sono necessari per il blocco di query esterno, che recupera i nomi dei dipendenti nei reparti i cui ID sono stati forniti dalla subquery.
La struttura dell'istruzione SQL non impone al database di eseguire prima la query interna. Ad esempio, il database potrebbe riscrivere l'intera query come join di employees e departments, in modo che la subquery non venga mai eseguita da sola. Come altro esempio, la funzione Virtual Private Database (VPD) potrebbe limitare la query dei dipendenti utilizzando una clausola WHERE, in modo che il database esegua prima query sui dipendenti e quindi ottenga gli ID reparto. L'ottimizzatore determina la sequenza di passi migliore per recuperare le righe richieste.
Vedere anche: Oracle AI Database Security Guide per ulteriori informazioni su VPD
Istruzioni controllo transazioni
Le istruzioni di controllo delle transazioni gestiscono le modifiche apportate dalle istruzioni DML e raggruppano le istruzioni DML nelle transazioni.
Queste istruzioni consentono di:
-
Apportare modifiche permanenti a una transazione (
COMMIT). -
Annullare le modifiche in una transazione dall'avvio della transazione (
ROLLBACK) o da un savepoint (ROLLBACK TO SAVEPOINT). Un punto di salvataggio è un indicatore intermedio dichiarato dall'utente nel contesto di una transazione.Nota: l'istruzione
ROLLBACKtermina una transazione, maROLLBACK TO SAVEPOINTnon lo fa. -
Impostare un punto su cui eseguire il rollback (
SAVEPOINT). -
Stabilire le proprietà per una transazione (
SETTRANSACTION). -
Specificare se un vincolo di integrità differibile viene selezionato dopo ogni istruzione DML o quando viene eseguito il commit della transazione (
SET CONSTRAINT).
Nell'esempio seguente viene avviata una transazione denominata Update salaries. L'esempio crea un savepoint, aggiorna lo stipendio di un dipendente e quindi esegue il rollback della transazione al savepoint. L'esempio aggiorna lo stipendio a un valore diverso e esegue il commit.
SET TRANSACTION NAME 'Update salaries';

SAVEPOINT before_salary_update;

UPDATE employees SET salary=9100 WHERE employee_id=1234 # DML

ROLLBACK TO SAVEPOINT before_salary_update;

UPDATE employees SET salary=9200 WHERE employee_id=1234 # DML

COMMIT COMMENT 'Updated salaries';
Vedere anche:
-
Quando il database verifica la validità dei vincoli e delle asserzioni
-
Oracle AI Database SQL Language Reference per informazioni sulle istruzioni di controllo delle transazioni
Istruzioni controllo sessione
Le istruzioni di controllo sessione gestiscono in modo dinamico le proprietà di una sessione utente.
Una sessione è un'entità logica nella memoria dell'istanza di database che rappresenta lo stato di un login utente corrente a un database. Una sessione dura dal momento in cui l'utente viene autenticato dal database e termina con la disconnessione o l'uscita dall'applicazione del database.
Le istruzioni di controllo della sessione consentono di:
-
Modificare la sessione corrente eseguendo una funzione specializzata, ad esempio l'impostazione del formato di data predefinito (
ALTER SESSION). -
Abilitare e disabilitare i ruoli, ovvero gruppi di privilegi, per la sessione corrente (
SET ROLE).
L'istruzione seguente modifica dinamicamente il formato data predefinito per la sessione in 'YYYY MM DD-HH24:MI:SS':
ALTER SESSION
   SET NLS_DATE_FORMAT = 'YYYY MM DD HH24:MI:SS';
Le istruzioni di controllo della sessione non eseguono implicitamente il commit della transazione corrente.
Vedere anche:
-
Oracle AI Database SQL Language Reference per sintassi e semantica
ALTER SESSION
Istruzione di controllo del sistema
Un'istruzione di controllo del sistema modifica le proprietà dell'istanza del database.
L'unica istruzione di controllo del sistema è ALTER SYSTEM. Consente di modificare impostazioni quali il numero minimo di server condivisi, terminare una sessione ed eseguire altre attività a livello di sistema.
Di seguito sono riportati alcuni esempi di istruzione di controllo del sistema.
ALTER SYSTEM SWITCH LOGFILE;

ALTER SYSTEM KILL SESSION '39, 23';
L'istruzione ALTER SYSTEM non esegue il commit implicito della transazione corrente.
Vedi anche: Oracle AI Database SQL Language Reference per sintassi e semantica ALTER SYSTEM
Istruzioni SQL incorporate
Le istruzioni SQL incorporate incorporano istruzioni DDL, DML e di controllo delle transazioni all'interno di un programma di linguaggio procedurale.
Le istruzioni incorporate vengono utilizzate con i precompilatori Oracle. L'istruzione SQL incorporata è un approccio all'integrazione dell'istruzione SQL nelle applicazioni del linguaggio procedurale. Un altro approccio consiste nell'utilizzare un'API procedurale come Open Database Connectivity (ODBC) o Java Database Connectivity (JDBC).
Le istruzioni SQL incorporate consentono di:
-
Definire, allocare e rilasciare un cursore (
DECLARE CURSOR,OPEN,CLOSE). -
Specificare un database e connettersi ad esso (
DECLARE DATABASE,CONNECT). -
Assegnare i nomi delle variabili (
DECLARE STATEMENT). -
Inizializzare i descrittori (
DESCRIBE). -
Specificare la modalità di gestione delle condizioni di errore e avvertenza (
WHENEVER). -
Analizzare ed eseguire le istruzioni SQL (
PREPARE,EXECUTE,EXECUTE IMMEDIATE). -
Recuperare i dati dal database (
FETCH).
Vedere anche:
Panoramica dell'ottimizzatore
Per capire come Oracle AI Database elabora le istruzioni SQL, è necessario comprendere la parte del database chiamata optimizer (noto anche come ottimizzatore query o ottimizzatore basato sui costi). Tutte le istruzioni SQL utilizzano l'ottimizzatore per determinare le modalità di accesso più efficienti ai dati specificati.
-
Uso dell'ottimizzatore L'ottimizzatore genera piani di esecuzione che descrivono i possibili metodi di esecuzione.
-
Componenti ottimizzatore L'ottimizzatore contiene tre componenti principali: il trasformatore, il valutatore e il generatore di piani.
-
Percorsi di accesso Un percorso di accesso è la tecnica utilizzata da una query per recuperare le righe.
-
Statistiche dell'ottimizzatore Le statistiche dell'ottimizzatore sono una raccolta di dati che descrivono i dettagli sul database e sugli oggetti in esso inclusi. Le statistiche forniscono un quadro statisticamente corretto dell'archiviazione e della distribuzione dei dati utilizzabili dall'ottimizzatore durante la valutazione dei percorsi di accesso.
-
Suggerimenti per l'ottimizzatore Un suggerimento è un commento in un'istruzione SQL che funge da istruzione per l'ottimizzatore.
Uso dell'ottimizzatore
L'ottimizzatore genera piani di esecuzione che descrivono i possibili metodi di esecuzione.
L'ottimizzatore determina quale piano di esecuzione è più efficiente considerando diverse fonti di informazioni. Ad esempio, l'ottimizzatore considera le condizioni di query, i percorsi di accesso disponibili, le statistiche raccolte per il sistema e i suggerimenti.
Per eseguire un'istruzione DML, Oracle AI Database potrebbe dover eseguire molti passi. ognuno di essi recupera fisicamente righe di dati dal database o li prepara in modo tale che l'utente possa inviare l'istruzione. I passi utilizzati dal database per eseguire un'istruzione influiscono notevolmente sulla velocità di esecuzione dell'istruzione. Molti modi diversi di elaborare un'istruzione DML sono spesso possibili. Ad esempio, l'ordine di accesso alle tabelle o agli indici può variare.
Quando si determina il piano di esecuzione migliore per un'istruzione SQL, l'ottimizzatore esegue le operazioni riportate di seguito.
-
Valutazione di espressioni e condizioni
-
Ispezione dei vincoli di integrità per ulteriori informazioni sui dati e ottimizzazione in base a questi metadati
-
Trasformazione delle istruzioni
-
Scelta degli obiettivi dell'ottimizzatore
-
Scelta dei percorsi di accesso
-
Scelta degli ordini di adesione
L'ottimizzatore genera la maggior parte dei modi possibili di elaborare una query e assegna un costo a ogni passo del piano di esecuzione generato. Il piano con il costo più basso viene scelto come piano di query da eseguire.
Nota: è possibile ottenere un piano di esecuzione per un'istruzione SQL senza eseguire il piano. Solo un piano di esecuzione che il database utilizza effettivamente per eseguire una query viene definito correttamente un piano di query.
È possibile influenzare le scelte dell'ottimizzatore impostando l'obiettivo dell'ottimizzatore e raccogliendo statistiche rappresentative per l'ottimizzatore. Ad esempio, è possibile impostare l'obiettivo dell'ottimizzatore su uno dei seguenti valori:
-
Throughput totale
Il suggerimento
ALL_ROWSindica all'ottimizzatore di ottenere l'ultima riga del risultato all'applicazione client il più velocemente possibile. -
Tempo di reazione iniziale
Il suggerimento
FIRST_ROWSindica all'ottimizzatore di ottenere la prima riga al client il più velocemente possibile.
Un'applicazione interattiva tipica dell'utente finale trarrebbe vantaggio dall'ottimizzazione iniziale dei tempi di risposta, mentre un'applicazione in modalità batch e non interattiva trarrebbe vantaggio dall'ottimizzazione totale del throughput.
Vedere anche:
-
Oracle AI Database PL/SQL Packages and Types Reference per informazioni sull'uso di
DBMS_STATS -
Oracle AI Database SQL Tuning Guide per ulteriori informazioni sull'ottimizzatore e sull'uso di suggerimenti
Componenti ottimizzatore
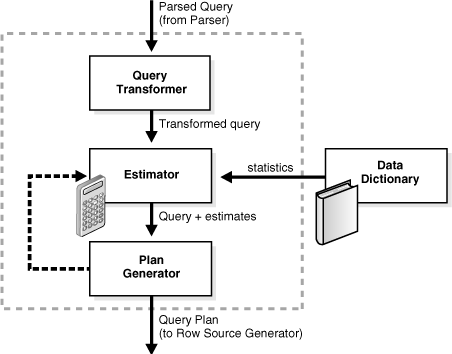
L'ottimizzatore contiene tre componenti principali: il trasformatore, il valutatore e il generatore di piani.
Il diagramma riportato di seguito mostra i componenti.
Figura 2: Componenti ottimizzatore
Descrizione dell'illustrazione cncpt287.gif
L'input per l'ottimizzatore è una query analizzata. L'ottimizzatore esegue le operazioni riportate di seguito.
-
L'ottimizzatore riceve la query analizzata e genera un set di piani potenziali per l'istruzione SQL in base ai percorsi di accesso e ai suggerimenti disponibili.
-
L'ottimizzatore stima il costo di ogni piano in base alle statistiche nel dizionario dati. Il costo corrisponde ad un valore previsto proporzionale all'uso previsto delle risorse necessario ad eseguire l'istruzione mediante un piano specifico.
-
L'ottimizzatore confronta i costi dei piani e sceglie il piano a costo più basso, noto come piano di query, da passare al generatore di origine delle righe.
-
Trasformatore query Il trasformatore query determina se è utile modificare la forma della query in modo che l'ottimizzatore possa generare un piano di esecuzione migliore. L'input per il trasformatore di query è una query analizzata, che l'optimizer rappresenta come un set di blocchi di query.
-
Stimatore Il stimatore determina il costo complessivo di un determinato piano di esecuzione.
-
Generatore di piani Il generatore di piani esegue la prova di piani diversi per una query sottomessa. L'ottimizzatore sceglie il piano con il costo più basso.
Vedere anche:
Trasformatore query
Il trasformatore query determina se è utile modificare la forma della query in modo che l'ottimizzatore possa generare un piano di esecuzione migliore. L'input per il trasformatore di query è una query analizzata, che l'optimizer rappresenta come un set di blocchi di query.
Vedere anche: Riscrittura query
Stimatore
Il stimatore determina il costo complessivo di un determinato piano di esecuzione.
Lo stimatore genera tre diversi tipi di misure per raggiungere questo obiettivo:
-
Selettività
Questa misura rappresenta una frazione di righe di una serie di righe. La selettività è legata a un predicato query, ad esempio
last_name='Smith', o a una combinazione di predicati. -
Cardinalità
Questa misura rappresenta il numero di righe in una serie di righe.
-
Costo
Questa misura rappresenta le unità di lavoro o la risorsa utilizzata. L'ottimizzatore di query utilizza l'I/O su disco, l'uso della CPU e l'uso della memoria come unità di lavoro.
Se sono disponibili statistiche, il valutatore le utilizza per calcolare le misure. Le statistiche migliorano il grado di accuratezza delle misure.
Generatore piano
Il generatore di piani esegue la prova di piani diversi per una query sottomessa. L'ottimizzatore sceglie il piano con il costo più basso.
Per ogni subquery nidificata e vista non unita, l'ottimizzatore genera un piano secondario. L'optimizer rappresenta ogni piano secondario come blocco di query separato. Il generatore di piani esplora vari piani per un blocco di query provando diversi percorsi di accesso, metodi di join e ordini di join.
La funzionalità di ottimizzazione adattiva delle query modifica i piani in base alle statistiche raccolte durante l'esecuzione delle istruzioni. Tutti i meccanismi adattivi possono eseguire un piano finale per un rendiconto diverso dal piano predefinito. L'ottimizzazione adattiva utilizza piani dinamici, che scelgono tra piani secondari durante l'esecuzione delle istruzioni, o riottimizzazione, che modifica un piano sulle esecuzioni dopo l'esecuzione corrente.
Vedere anche:
-
Introduzione a Oracle AI Database con il tuning delle prestazioni per un'introduzione al tuning SQL
-
Oracle AI Database SQL Tuning Guide per ulteriori informazioni sui componenti dell'optimizer e sull'ottimizzazione adattiva
Percorsi di accesso
Un percorso di accesso è la tecnica utilizzata da una query per recuperare le righe.
Ad esempio, una query che utilizza un indice ha un percorso di accesso diverso da una query che non lo fa. In generale, i percorsi di accesso agli indici sono i migliori per le istruzioni che recuperano un piccolo subset di righe di tabella. Le scansioni complete sono più efficienti per accedere a una grande porzione di un tavolo.
Il database può utilizzare diversi percorsi di accesso per recuperare i dati da una tabella. Di seguito è riportato un elenco rappresentativo.
-
Scansioni tabella intera
Questo tipo di scansione legge tutte le righe da una tabella e filtra quelle che non soddisfano i criteri di selezione. Il database esegue la scansione sequenziale di tutti i blocchi di dati nel segmento, inclusi quelli sotto il punto HWM (High Water Mark) che separa lo spazio utilizzato da quello non utilizzato (vedere "Segment Space and the High Water Mark").
-
Scansioni ID riga
Il rowid di una riga specifica il file di dati e il blocco di dati contenente la riga e la posizione della riga in tale blocco. Il database ottiene prima gli ID riga delle righe selezionate, dalla clausola
WHEREdell'istruzione o tramite una scansione dell'indice, quindi individua ogni riga selezionata in base al relativo ID riga. -
Scansioni indice
Questa scansione cerca in un indice i valori delle colonne indicizzate a cui accede l'istruzione SQL (vedere "Scansioni di indici"). Se questa accede solo a colonne dell'indice, Oracle AI Database legge i valori delle colonna indicizzate direttamente dall'indice.
-
Scansioni cluster
Una scansione cluster recupera i dati da una tabella memorizzata in un cluster tabella indicizzato, in cui tutte le righe con lo stesso valore di chiave cluster vengono memorizzate nello stesso blocco di dati (vedere "Panoramica dei cluster indicizzati"). Il database ottiene prima l'ID riga di una riga selezionata analizzando l'indice del cluster. Oracle AI Database individua le righe in base a questo ID riga.
-
Scansioni hash
Una scansione hash individua le righe in un cluster hash, in cui tutte le righe con lo stesso valore hash sono memorizzate nello stesso blocco di dati (vedere "Panoramica dei cluster hash"). Il database ottiene innanzitutto il valore hash applicando una funzione hash a un valore di chiave cluster specificato dall'istruzione. Oracle AI Database esegue quindi la scansione dei blocchi di dati contenenti righe con questo valore hash.
L'ottimizzatore sceglie un percorso di accesso in base ai percorsi di accesso disponibili per l'istruzione e al costo stimato dell'utilizzo di ogni percorso di accesso o combinazione di percorsi.
Vedere anche: Oracle AI Database Introduzione all'ottimizzazione delle prestazioni e Oracle AI Database SQL Tuning Guide per ulteriori informazioni sui percorsi di accesso
Statistiche optimizer
Le statistiche dell'ottimizzatore sono una raccolta di dati che forniscono dettagli sul database e sugli oggetti in esso inclusi. Le statistiche forniscono un quadro statisticamente corretto dell'archiviazione e della distribuzione dei dati utilizzabili dall'ottimizzatore durante la valutazione dei percorsi di accesso.
Le statistiche dell'optimizer includono i tipi di statistiche riportati di seguito.
-
Statistiche tabelle
Questi includono il numero di righe, il numero di blocchi e la lunghezza media delle righe.
-
Statistiche colonne
Questi includono il numero di valori distinti e nulli in una colonna e la distribuzione dei dati.
-
Statistiche indice
Questi includono il numero di blocchi foglia e i livelli di indice.
-
Statistiche di sistema
Queste informazioni includono le prestazioni e l'utilizzo di CPU e I/O.
Oracle AI Database raccoglie automaticamente le statistiche dell'ottimizzatore su tutti gli oggetti di database e gestisce tali statistiche come attività di manutenzione automatizzata. È inoltre possibile raccogliere manualmente le statistiche utilizzando il pacchetto DBMS_STATS. Questo package PL/SQL può modificare, visualizzare, esportare, importare ed eliminare le statistiche. Nota: le statistiche dell'ottimizzatore vengono create ai fini dell'ottimizzazione delle query e vengono memorizzate nel dizionario dati. Non confondere queste statistiche con le statistiche delle prestazioni visibili tramite viste delle prestazioni dinamiche.
Optimizer Statistics Advisor è un software di diagnostica integrato che analizza la modalità di raccolta delle statistiche, l'efficacia dei processi di raccolta delle statistiche esistenti e la qualità delle statistiche raccolte. Optimizer Statistics Advisor gestisce le regole, che incorporano le procedure ottimali di Oracle in base al set di funzioni corrente. In questo modo, il consulente fornisce sempre le raccomandazioni più aggiornate per la raccolta di statistiche.
Vedere anche:
-
Guida introduttiva a Oracle AI Database per il tuning delle prestazioni e Oracle AI Database SQL Tuning Guide per scoprire come raccogliere e gestire le statistiche
-
Oracle AI Database PL/SQL Packages and Types Reference per ulteriori informazioni su
DBMS_STATS
Suggerimenti ottimizzatore
Un suggerimento è un commento in un'istruzione SQL che funge da istruzione per l'ottimizzatore.
A volte il progettista dell'applicazione, che dispone di più informazioni sui dati di una particolare applicazione di quanto sia disponibile per l'ottimizzatore, può scegliere un modo più efficace per eseguire un'istruzione SQL. Il designer dell'applicazione può utilizzare suggerimenti nelle istruzioni SQL per specificare la modalità di esecuzione dell'istruzione. Gli esempi seguenti illustrano l'uso di suggerimenti.
Esempio di piano di esecuzione 10-2 per SELECT con suggerimento FIRST_ROWS
Si supponga che l'applicazione interattiva esegua una query che restituisce 50 righe. Questa applicazione recupera inizialmente solo le prime 25 righe della query da presentare all'utente finale. Si desidera che l'ottimizzatore generi un piano che ottenga i primi 25 record il più rapidamente possibile in modo che l'utente non sia costretto ad attendere. È possibile utilizzare un suggerimento per passare questa istruzione all'ottimizzatore come mostrato nell'istruzione SELECT e nell'output AUTOTRACE nell'esempio seguente:
SELECT /*+ FIRST_ROWS(25) */ employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation                    | Name              | Rows | Bytes
------------------------------------------------------------------------
|  0 | SELECT STATEMENT             |                   | 26   | 182
|  1 |  TABLE ACCESS BY INDEX ROWID | EMPLOYEES         | 26   | 182
|* 2 |   INDEX RANGE SCAN           | EMP_DEPARTMENT_IX |      |
------------------------------------------------------------------------
In questo esempio, il piano di esecuzione mostra che l'ottimizzatore sceglie un indice nella colonna employees.department_id per trovare le prime 25 righe di employees con ID reparto superiore a 50. L'optimizer utilizza l'ID riga recuperato dall'indice per recuperare il record dalla tabella employees e restituirlo al client. Il recupero del primo disco è in genere quasi istantaneo.
Esempio 10-3 Piano di esecuzione per SELECT senza suggerimento
Si supponga di eseguire la stessa istruzione, ma senza il suggerimento dell'ottimizzatore:
SELECT employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation              | Name              | Rows | Bytes | Cos
------------------------------------------------------------------------
|  0 | SELECT STATEMENT       |                   | 50   | 350   |
|* 1 |  VIEW                  | index$_join$_001  | 50   | 350   |
|* 2 |   HASH JOIN            |                   |      |       |
|* 3 |    INDEX RANGE SCAN    | EMP_DEPARTMENT_IX | 50   | 350   |
|  4 |    INDEX FAST FULL SCAN| EMP_EMP_ID_PK     | 50   | 350   |
In questo caso, il piano di esecuzione unisce due indici per restituire i record richiesti il più velocemente possibile. Anziché passare ripetutamente dall'indice alla tabella come nell'Esempio 10-2, l'ottimizzatore sceglie una scansione dell'intervallo di EMP_DEPARTMENT_IX per trovare tutte le righe con ID reparto superiore a 50 e posizionare queste righe in una tabella hash. L'ottimizzatore sceglie quindi di leggere l'indice EMP_EMP_ID_PK. Per ogni riga di questo indice, viene analizzata la tabella hash per trovare l'ID reparto.
In questo caso, il database non può restituire la prima riga al client fino al completamento della scansione dell'intervallo di indici EMP_DEPARTMENT_IX. Pertanto, questo piano generato richiederebbe più tempo per restituire il primo record. A differenza del piano nell'Esempio 10-2, che accede alla tabella in base all'ID riga dell'indice, il piano utilizza l'I/O a più blocchi, generando letture di grandi dimensioni. Le letture consentono di restituire più rapidamente l'ultima riga dell'intero set di risultati.
Vedere anche: Oracle AI Database SQL Tuning Guide per informazioni su come utilizzare i suggerimenti dell'optimizer
Panoramica dell'elaborazione SQL
Questa sezione spiega in che modo Oracle AI Database elabora le istruzioni SQL. In particolare, la sezione spiega il modo in cui il database elabora le istruzioni DDL per creare oggetti, DML per modificare i dati e le query per recuperare i dati.
-
Fasi dell'elaborazione SQL Le fasi generali dell'elaborazione SQL sono l'analisi, l'ottimizzazione, la generazione dell'origine delle righe e l'esecuzione. A seconda dell'istruzione, il database potrebbe omettere alcuni di questi passi.
-
Differenze tra l'elaborazione DML e DDL Oracle AI Database elabora DDL in modo diverso rispetto a DML.
Fasi dell'elaborazione SQL
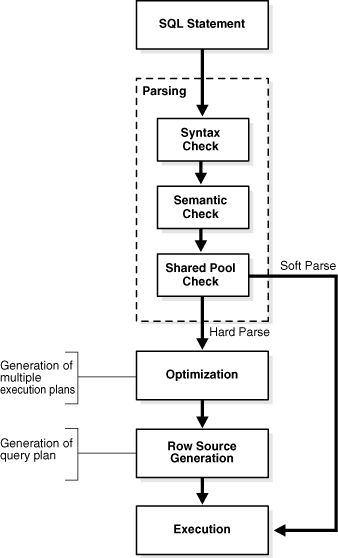
Le fasi generali dell'elaborazione SQL sono l'analisi, l'ottimizzazione, la generazione dell'origine riga e l'esecuzione. A seconda dell'istruzione, il database potrebbe omettere alcuni di questi passi.
La figura seguente illustra le fasi generali:
Figura 3: Fasi dell'elaborazione SQL
Descrizione dell'illustrazione cncpt250.gif
-
SQL Parsing La prima fase dell'elaborazione SQL è l'analisi SQL. Questa fase prevede la separazione delle parti di un'istruzione SQL in una struttura di dati che può essere elaborata da altre routine.
-
L'ottimizzazione delle query è il processo di scelta del mezzo più efficiente per eseguire un'istruzione SQL.
-
Generazione origine riga SQL Il generatore origine riga è un software che riceve il piano di esecuzione ottimale dall'optimizer e produce un piano iterativo, denominato piano query, utilizzabile dal resto del database.
-
Esecuzione SQL Durante l'esecuzione, il modulo di gestione SQL esegue ogni origine riga nell'albero prodotto dal generatore di origine riga. Questo è l'unico passo obbligatorio nell'elaborazione DML.
Analisi SQL
La prima fase dell'elaborazione SQL è l'analisi SQL. Questa fase prevede la separazione delle parti di un'istruzione SQL in una struttura di dati che può essere elaborata da altre routine.
Quando un'applicazione emette un'istruzione SQL, effettua una chiamata di analisi al database per preparare l'istruzione per l'esecuzione. La chiamata di analisi apre o crea un cursore, che è un handle per l'area SQL privata specifica della sessione che contiene un'istruzione SQL analizzata e altre informazioni di elaborazione. Il cursore e l'area SQL privata si trovano nella PGA.
Durante la chiamata di analisi, il database esegue i seguenti controlli:
-
Controllo sintassi
-
Controllo semantico
-
Controllo del pool condiviso
I controlli precedenti identificano gli errori che è possibile trovare prima dell'esecuzione delle istruzioni. Impossibile rilevare alcuni errori mediante l'analisi. Ad esempio, il database può riscontrare un sblocco o errori nella conversione dei dati solo durante l'esecuzione dell'istruzione.
Il database tenta la mitigazione automatica degli errori per le istruzioni SQL che non riescono con un errore ORA-00600 durante la fase di analisi. Un ORA-00600 è un errore grave. Indica che un processo ha rilevato una condizione imprevista di basso livello. Quando un'istruzione SQL non riesce con questo errore durante la fase di analisi, la mitigazione automatica degli errori la intrappola e tenta di risolvere la condizione. Se viene trovata una risoluzione, il database genera una patch SQL per adeguare il piano di esecuzione SQL. Se questa patch consente il completamento dell'analisi, l'errore ORA-00600 non viene generato. Nessuna eccezione viene visualizzata dall'applicazione.
Ottimizzazione SQL
L'ottimizzazione delle query è il processo di scelta del mezzo più efficiente per eseguire un'istruzione SQL.
Il database ottimizza le query in base alle statistiche raccolte sui dati effettivi a cui si accede. L'ottimizzatore utilizza il numero di righe, la dimensione del data set e altri fattori per generare possibili piani di esecuzione, assegnando un costo numerico a ciascun piano. Il database utilizza il piano con il costo più basso.
Il database deve eseguire un hard parse almeno una volta per ogni istruzione DML univoca ed eseguire l'ottimizzazione durante questa analisi. DDL non viene mai ottimizzato a meno che non includa un componente DML come una subquery che richiede l'ottimizzazione.
Vedere anche:
-
Oracle AI Database SQL Tuning Guide per informazioni dettagliate sull'ottimizzatore di query
Generazione origine riga SQL
Il generatore di origini riga è un software che riceve il piano di esecuzione ottimale dall'ottimizzatore e produce un piano iterativo, chiamato piano di query, utilizzabile dal resto del database.
Il piano di query assume la forma di una combinazione di passi. Ogni passo restituisce un set di righe. Le righe in questo set vengono utilizzate dal passo successivo o, nell'ultimo passo, vengono restituite all'applicazione che emette l'istruzione SQL.
Un'origine riga è un set di righe restituito da un passo del piano di esecuzione insieme a una struttura di controllo in grado di elaborare le righe in modo iterativo. L'origine riga può essere una tabella, una vista o il risultato di un'operazione di join o raggruppamento.
Esecuzione SQL
Durante l'esecuzione, il modulo di gestione SQL esegue ogni origine riga nell'albero prodotto dal generatore di origine riga. Questo è l'unico passo obbligatorio nell'elaborazione DML.
Durante l'esecuzione, se i dati non sono in memoria, il database legge i dati dal disco in memoria. Il database esegue inoltre tutti i lock e i latch necessari per garantire l'integrità dei dati e registra le modifiche apportate durante l'esecuzione SQL. La fase finale di elaborazione di un'istruzione SQL sta chiudendo il cursore.
Se il database è configurato per l'utilizzo di Area di memorizzazione colonne in memoria (area di memorizzazione colonne IM), il database instrada in modo trasparente le query all'area di memorizzazione colonne IM, se possibile, e al disco e alla buffer cache del database. Una singola query può anche utilizzare l'area di memorizzazione delle colonne IM, il disco e la buffer cache. Ad esempio, una query potrebbe unire due tabelle, una delle quali è memorizzata nella cache nell'area di memorizzazione delle colonne IM.
Vedere anche:
-
Oracle AI Database SQL Tuning Guide per informazioni dettagliate sui piani di esecuzione e sull'istruzione
EXPLAIN PLAN
Differenze tra elaborazione DML e DDL
Oracle AI Database elabora DDL in modo diverso da DML.
Ad esempio, quando si crea una tabella, il database non ottimizza l'istruzione CREATE TABLE. Oracle AI Database analizza invece l'istruzione DDL ed esegue il comando.
A differenza di DDL, la maggior parte delle istruzioni DML dispone di un componente di query. In una query, l'esecuzione di un cursore posiziona la riga generata dalla query nel set di risultati.
Il database può recuperare le righe del set di risultati in una riga alla volta o in gruppi. Nel recupero, il database seleziona le righe e, se richiesto dalla query, ordina le righe. Ogni recupero successivo recupera un'altra riga del risultato fino al recupero dell'ultima riga.
Vedere anche: Oracle AI Database Development Guide per informazioni sull'elaborazione di DDL, il controllo delle transazioni e altri tipi di istruzioni