Indici e tabelle indicizzate
Gli indici sono oggetti dello schema che possono velocizzare l'accesso alle righe della tabella. Le tabelle organizzate a indice sono tabelle memorizzate in una struttura di indice.
-
Introduzione agli indici Un indice è una struttura facoltativa, associata a una tabella o a un cluster tabella, che a volte può velocizzare l'accesso ai dati.
-
Le strutture B Panoramica degli indici B-Tree, abbreviate in alberi bilanciati, sono il tipo di indice di database più comune. Un indice B-tree è una lista ordinata di valori suddivisi in intervalli. Associando una chiave a una riga o a un intervallo di righe, le strutture B offrono eccellenti prestazioni di recupero per un'ampia gamma di query, incluse le ricerche di corrispondenza e intervallo esatte.
-
Panoramica degli indici bitmap In un indice bitmap, il database memorizza una bitmap per ogni chiave indice. In un indice B-tree convenzionale, una voce indice punta a una singola riga. In un indice bitmap, ogni chiave indice memorizza i puntatori su più righe.
-
Panoramica degli indici basati su funzioni Un indice basato su funzioni calcola il valore di una funzione o di un'espressione che coinvolge una o più colonne e lo memorizza in un indice. Un indice basato su funzioni può essere un B-tree o un indice bitmap.
-
Panoramica degli indici del dominio applicazione Un indice del dominio applicazione è un indice personalizzato specifico di un'applicazione.
-
Panoramica sugli indici HNSW quantizzati scalari Gli indici HNSW (hierarchical Navigable Small World) quantizzati scalari possono essere utilizzati per ridurre i requisiti di memoria e accelerare la ricerca della somiglianza.
-
Panoramica delle tabelle organizzate in base all'indice Una tabella organizzata in base all'indice è una tabella memorizzata in una variazione di una struttura di indice B-tree. Al contrario, una tabella organizzata per heap inserisce le righe in cui rientrano.
Introduzione agli indici
Un indice è una struttura facoltativa, associata a una tabella o a un cluster tabella, che a volte può velocizzare l'accesso ai dati.
Gli indici sono oggetti dello schema che sono indipendenti logicamente e fisicamente dai dati negli oggetti a cui sono associati. Pertanto, è possibile eliminare o creare un indice senza influire fisicamente sulla tabella indicizzata.
Nota: se si elimina un indice, le applicazioni continueranno a funzionare. Tuttavia, l'accesso ai dati indicizzati in precedenza può essere più lento.
Per un'analogia, supponiamo che un responsabile HR abbia uno scaffale di scatole di cartone. Le cartelle contenenti informazioni sui dipendenti vengono inserite in modo casuale nelle caselle. La cartella per il dipendente Whalen (ID 200) è 10 cartelle in alto dalla parte inferiore della casella 1, mentre la cartella per King (ID 100) si trova nella parte inferiore della casella 3. Per individuare una cartella, il manager guarda ogni cartella nella casella 1 dal basso verso l'alto, quindi si sposta da una casella all'altra fino a quando la cartella non viene trovata. Per velocizzare l'accesso, il manager potrebbe creare un indice che elenca in sequenza ogni ID dipendente con la relativa posizione della cartella:
ID 100: Box 3, position 1 (bottom)
ID 101: Box 7, position 8
ID 200: Box 1, position 10
.
.
.
Analogamente, il manager può creare indici separati per i cognomi dei dipendenti, gli ID dei reparti e così via.
Questa sezione contiene gli argomenti riportati di seguito.
-
Vantaggi e svantaggi degli indici L'assenza o la presenza di un indice non richiede una modifica della formulazione di alcuna istruzione SQL.
-
Gli indici di usabilità e visibilità dell'indice sono utilizzabili (impostazione predefinita) o inutilizzabili, visibili (impostazione predefinita) o invisibili.
-
Chiavi e colonne Una chiave è un set di colonne o espressioni su cui è possibile creare un indice.
-
Indici composti Un indice composto, chiamato anche indice concatenato, è un indice su più colonne di una tabella.
-
Gli indici Indici unici e non univoci possono essere univoci o non univoci. Gli indici univoci garantiscono che non vi siano due righe di una tabella con valori duplicati nella colonna o nelle colonne chiave.
-
Tipi di indici Oracle AI Database fornisce diversi schemi di indicizzazione, che forniscono funzionalità di performance complementari.
-
Modalità di gestione degli indici da parte del database Il database gestisce e utilizza automaticamente gli indici dopo la loro creazione.
-
Storage indici Oracle AI Database memorizza i dati degli indici in un segmento di indice.
Vantaggi e svantaggi degli indici
L'assenza o la presenza di un indice non richiede una modifica della formulazione di alcuna istruzione SQL.
Un indice è un percorso di accesso rapido a una singola riga di dati. Colpisce solo la velocità di esecuzione. Dato un valore di dati indicizzato, l'indice punta direttamente alla posizione delle righe che contengono tale valore.
Quando esiste un indice su una o più colonne di una tabella, il database può in alcuni casi recuperare un piccolo set di righe distribuite in modo casuale dalla tabella. Gli indici sono uno dei tanti mezzi per ridurre l'I/O del disco. Se una tabella organizzata dall'heap non dispone di indici, il database deve eseguire una scansione tabella completa per trovare un valore. Ad esempio, una query della posizione 2700 nella tabella hr.departments non indicizzata richiede che il database esegua la ricerca in ogni riga di ogni blocco. Questo approccio non è scalabile e i volumi di dati aumentano.
Gli svantaggi degli indici includono:
-
La creazione manuale degli indici richiede spesso una conoscenza approfondita del modello di dati, dell'applicazione e della distribuzione dei dati.
-
Quando i dati cambiano, è necessario rivedere le decisioni precedenti sugli indici. Un indice potrebbe non essere più utile o potrebbero essere necessari nuovi indici.
-
Gli indici occupano spazio su disco.
-
Il database deve aggiornare l'indice quando DML si verifica sui dati indicizzati, il che crea un sovraccarico delle prestazioni. Nota: a partire da Oracle Database 19c, il database Oracle può monitorare costantemente il carico di lavoro dell'applicazione, creando e gestendo automaticamente gli indici. L'indicizzazione automatizzata viene implementata come attività di database che viene eseguita a intervalli fissi.
Si consiglia di creare un indice nelle situazioni riportate di seguito.
-
Le colonne indicizzate vengono sottoposte a query frequenti e restituiscono una piccola percentuale del numero totale di righe nella tabella.
-
Nella colonna o nelle colonne indicizzate esiste un vincolo di integrità referenziale. L'indice consente di evitare un blocco completo della tabella che sarebbe altrimenti necessario se si aggiorna la chiave primaria della tabella padre, se si esegue l'unione nella tabella padre o se si esegue l'eliminazione dalla tabella padre.
-
Un vincolo di chiave univoco verrà posizionato sulla tabella e si desidera specificare manualmente l'indice e tutte le opzioni di indice.
Vedere anche:
-
Oracle AI Database Administrator's Guide per ulteriori informazioni sull'indicizzazione automatica
-
Manuale dell'utente sulle informazioni sulle licenze di Oracle AI Database per i dettagli sulle funzioni supportate per edizioni e servizi diversi
Usabilità e visibilità dell'indice
Gli indici sono utilizzabili (impostazione predefinita) o inutilizzabili, visibili (impostazione predefinita) o invisibili.
Queste proprietà sono definite come segue:
-
Usabilità
Un indice non utilizzabile, ignorato da optimizer, non viene gestito dalle operazioni DML. Un indice inutilizzabile può migliorare le prestazioni dei caricamenti di massa. Invece di eliminare un indice e ricrearlo in seguito, è possibile rendere l'indice inutilizzabile e quindi ricrearlo. Gli indici e le partizioni di indice non utilizzabili non consumano spazio. Quando si rende inutilizzabile un indice utilizzabile, il database elimina il relativo segmento di indice.
-
Visibilità
Un indice invisibile viene gestito dalle operazioni DML, ma non viene utilizzato per impostazione predefinita dall'ottimizzatore. Rendere un indice invisibile è un'alternativa per renderlo inutilizzabile o rilasciarlo. Gli indici invisibili sono particolarmente utili per testare la rimozione di un indice prima di rilasciarlo o utilizzare temporaneamente gli indici senza influire sull'applicazione complessiva.
Vedere anche: "Panoramica dell'ottimizzatore" per informazioni su come l'ottimizzatore seleziona i piani di esecuzione
Chiavi e colonne
Una chiave è un insieme di colonne o espressioni su cui è possibile creare un indice.
Sebbene i termini siano spesso usati in modo intercambiabile, indici e chiavi sono diversi. Gli indici sono strutture memorizzate nel database che gli utenti gestiscono utilizzando istruzioni SQL. Le chiavi sono un concetto strettamente logico.
L'istruzione seguente crea un indice nella colonna customer_id della tabella di esempio oe.orders:
CREATE INDEX ord_customer_ix ON orders (customer_id);Nell'istruzione precedente, la colonna customer_id è la chiave indice. L'indice stesso è denominato ord_customer_ix.
Nota: le chiavi primarie e univoche dispongono automaticamente di indici, ma potrebbe essere necessario creare un indice su una chiave esterna.
Vedere anche:
-
Oracle AI Database SQL Language Reference
CREATE INDEXsintassi e semantica
Indici composti
Un indice composto, anche denominato indice concatenato, è un indice su più colonne di una tabella.
Posizionare le colonne in un indice composto nell'ordine più appropriato per le query che recupereranno i dati. Le colonne non devono essere adiacenti nella tabella.
Gli indici composti consentono di velocizzare il recupero dei dati per le istruzioni SELECT in cui la clausola WHERE fa riferimento a tutte le colonne o alla parte iniziale dell'indice composto. Pertanto, l'ordine delle colonne utilizzate nella definizione è importante. In generale, le colonne a cui si accede più comunemente vanno prima.
Ad esempio, si supponga che un'applicazione esegua frequentemente query sulle colonne last_name, job_id e salary nella tabella employees. Si supponga inoltre che last_name abbia una cardinalità elevata, ovvero che il numero di valori distinti sia elevato rispetto al numero di righe della tabella. È possibile creare un indice con il seguente ordine di colonne:
CREATE INDEX employees_ix
   ON employees (last_name, job_id, salary);
Le query che accedono a tutte e tre le colonne, solo la colonna last_name o solo le colonne last_name e job_id utilizzano questo indice. In questo esempio, le query che non accedono alla colonna last_name non utilizzano l'indice.
Nota: in alcuni casi, ad esempio quando la colonna iniziale ha una cardinalità molto bassa, il database può utilizzare una scansione skip di questo indice (vedere "Index Skip Scan").
Nella stessa tabella possono esistere più indici con lo stesso ordine di colonna quando soddisfano una delle condizioni seguenti:
-
Gli indici sono di tipi diversi.
Ad esempio, è possibile creare indici bitmap e B-tree sulle stesse colonne.
-
Gli indici utilizzano schemi di partizionamento diversi.
Ad esempio, è possibile creare indici partizionati localmente e indici partizionati globalmente.
-
Gli indici hanno proprietà di univocità diverse.
Ad esempio, è possibile creare un indice univoco e un indice non univoco sullo stesso set di colonne.
Ad esempio, un indice non partizionato, un indice partizionato globale e un indice partizionato localmente possono esistere per le stesse colonne di tabella nello stesso ordine. È possibile visualizzare un solo indice con lo stesso numero di colonne nello stesso ordine alla volta.
Questa funzionalità consente di eseguire la migrazione delle applicazioni senza dover eliminare un indice esistente e ricrearlo con attributi diversi. Inoltre, questa funzionalità è utile in un database OLTP quando una chiave indice continua ad aumentare, causando l'inserimento di nuove voci nello stesso set di blocchi di indice. Per alleviare tali "punti caldi", si potrebbe evolvere l'indice da un indice non partizionato in un indice partizionato globale.
Se gli indici sullo stesso set di colonne non differiscono per tipo o schema di partizionamento, questi indici devono utilizzare autorizzazioni di colonna diverse. Ad esempio, le seguenti istruzioni SQL specificano autorizzazioni di colonna valide:
CREATE INDEX employee_idx1 ON employees (last_name, job_id);
CREATE INDEX employee_idx2 ON employees (job_id, last_name);
Vedere anche: Oracle AI Database SQL Tuning Guide per ulteriori informazioni sulla creazione di più indici nello stesso set di colonne
Indici unici e non univoci
Gli indici possono essere univoci o non univoci. Gli indici univoci garantiscono che non vi siano due righe di una tabella con valori duplicati nella colonna o nelle colonne chiave.
Ad esempio, l'applicazione potrebbe richiedere che nessun dipendente abbia lo stesso ID dipendente. In un indice univoco esiste un rowid per ogni valore di dati. I dati nei blocchi foglia vengono ordinati solo in base alla chiave.
Gli indici non univoci consentono valori duplicati nella colonna o nelle colonne indicizzate. Ad esempio, la colonna first_name della tabella employees può contenere più valori Mike. Per un indice non univoco, l'ID riga viene incluso nella chiave in ordine ordinato, quindi gli indici non univoci vengono ordinati in base alla chiave indice e all'ID riga (crescente).
Oracle AI Database non indicizza le righe di tabella in cui tutte le colonne chiave sono nulle, ad eccezione degli indici bitmap o quando il valore della colonna chiave cluster è nullo.
Tipi di indici
Oracle AI Database offre diversi schemi di indicizzazione che offrono funzionalità di performance complementari.
Gli indici B-tree sono il tipo di indice standard. Sono eccellenti per indici altamente selettivi (poche righe corrispondono a ciascuna voce di indice) e indici di chiave primaria. Utilizzato come indici concatenati, un indice B-tree può recuperare i dati ordinati in base alle colonne indicizzate. Gli indici B-tree hanno i sottotipi mostrati nella tabella seguente.
Tabella 1 Sottotipi di indice B-Tree
| Sottotipo indice albero B | Descrizione | Per saperne di più |
|---|---|---|
| Tabelle organizzate a indici | Una tabella organizzata a indice differisce da una heap organizzata perché i dati sono l'indice stesso. | "Panoramica delle tabelle organizzate a indice" |
| Inverti indici chiave | In questo tipo di indice, i byte della chiave di indice vengono invertiti, ad esempio, 103 viene memorizzato come 301. L'inversione dei byte distribuisce gli inserti nell'indice su molti blocchi. | "Inverti indici di chiavi" |
| Indici decrescenti | Questo tipo di indice memorizza i dati in una o più colonne specifiche in ordine decrescente. | "Indici Crescente e Decrescente" |
| Indici cluster B-tree | Questo tipo di indice memorizza i dati in una o più colonne specifiche in ordine decrescente. | "Indici Crescente e Decrescente" |
La tabella seguente mostra i tipi di indici che non utilizzano una struttura di tipo B.
Tabella 2 Indici che non utilizzano una struttura ad albero B
| Tipo | Descrizione | Per saperne di più |
|---|---|---|
| Indici bitmap e bitmap | In un indice bitmap, una voce indice utilizza una bitmap per puntare a più righe. Al contrario, una voce dell'indice B-tree punta a una singola riga. Un indice di join bitmap è un indice bitmap per il join di due o più tabelle. | "Panoramica degli indici bitmap" |
| Indici basati su funzioni | Questo tipo di indice include colonne che vengono trasformate da una funzione, ad esempio la funzione UPPER, o incluse in un'espressione. Gli indici B-tree o bitmap possono essere basati su funzioni. |
"Panoramica degli indici basati sulle funzioni" |
| Indici dominio applicazione | Un utente crea questo tipo di indice per i dati in un dominio specifico dell'applicazione. L'indice fisico non deve utilizzare una struttura di indice tradizionale e può essere memorizzato nel database Oracle come tabelle o esternamente come file. | "Panoramica degli indici dei domini di applicazione" |
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire gli indici
-
Oracle AI Database SQL Tuning Guide per informazioni sui diversi percorsi di accesso agli indici
Modalità di gestione degli indici da parte del database
Il database gestisce e utilizza automaticamente gli indici dopo la loro creazione.
Gli indici riflettono automaticamente le modifiche dei dati alle tabelle sottostanti. Esempi di modifiche includono l'aggiunta, l'aggiornamento e l'eliminazione di righe. Non sono necessarie azioni utente.
Le prestazioni di recupero dei dati indicizzati rimangono quasi costanti, anche quando vengono inserite righe. Tuttavia, la presenza di molti indici in una tabella riduce le prestazioni DML perché anche il database deve aggiornare gli indici.
Vedere anche:
-
Oracle AI Database Administrator's Guide per ulteriori informazioni sull'indicizzazione automatica
-
Manuale dell'utente sulle informazioni sulle licenze di Oracle AI Database per i dettagli sulle funzioni supportate per edizioni e servizi diversi
Memorizzazione indice
Oracle AI Database memorizza i dati di indice in un segmento di indice.
Lo spazio disponibile per i dati di indice in un blocco di dati è la dimensione del blocco di dati meno il sovraccarico del blocco, il sovraccarico della voce, l'id riga e un byte di lunghezza per ogni valore indicizzato.
La tablespace di un segmento di indice è la tablespace predefinita del proprietario o una tablespace denominata in modo specifico nell'istruzione CREATE INDEX. Per semplificare l'amministrazione, è possibile memorizzare un indice in una tablespace separata dalla relativa tabella. Ad esempio, è possibile scegliere di non eseguire il backup delle tablespace contenenti solo indici, che possono essere ricreati e quindi ridurre il tempo e lo storage necessari per i backup.
Vedere anche: "Panoramica dei blocchi di indice" per informazioni sui tipi di blocco di indice (root, ramo e foglia) e sulla modalità di memorizzazione delle voci di indice all'interno di un blocco
Panoramica degli indici B-Tree
Le strutture B, abbreviate in alberi bilanciati, sono il tipo più comune di indice del database. Un indice B-tree è una lista ordinata di valori suddivisi in intervalli. Associando una chiave a una riga o a un intervallo di righe, le strutture B offrono eccellenti prestazioni di recupero per un'ampia gamma di query, incluse le ricerche di corrispondenza e intervallo esatte.
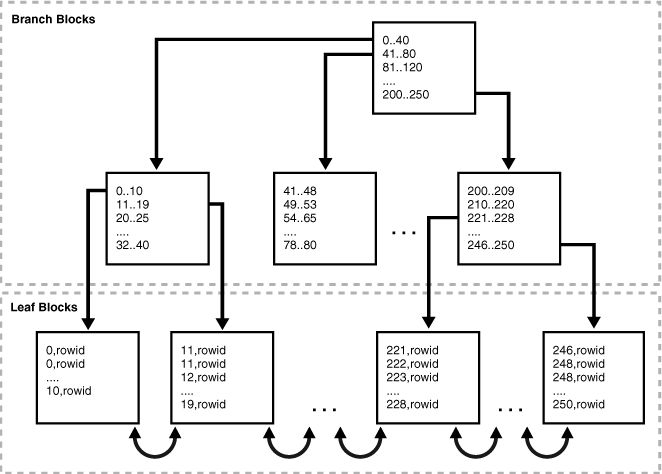
La figura seguente illustra la struttura di un indice B-tree. L'esempio mostra un indice nella colonna department_id, che è una colonna di chiave esterna nella tabella employees.
Figura 1: Struttura interna di un indice di B-tree
Descrizione dell'illustrazione cncpt244.gif
Questa sezione contiene gli argomenti riportati di seguito.
-
Blocchi di ramo e blocchi di foglia Un indice B-tree ha due tipi di blocchi: il blocco di ramo per la ricerca e il blocco di foglia per la memorizzazione dei valori chiave. I blocchi di ramo di livello superiore di un indice B-tree contengono dati di indice che puntano a blocchi di indice di livello inferiore.
-
Scansioni di indici In una scansione di indici, il database recupera una riga attraversando l'indice utilizzando i valori di colonna indicizzati specificati dall'istruzione. Se il database analizza l'indice alla ricerca di un valore, questo valore verrà trovato in n I/O, dove n è l'altezza dell'indice B-tree. Questo è il principio di base degli indici di Oracle AI Database.
-
Inverti indici di chiavi Un indice di chiavi inverse è un tipo di indice B-tree che inverte fisicamente i byte di ciascuna chiave di indice mantenendo l'ordine delle colonne.
-
Indici ascendenti e discendenti In un indice ascendente, Oracle AI Database memorizza i dati in ordine crescente. Per impostazione predefinita, i dati dei caratteri vengono ordinati in base ai valori binari contenuti in ciascun byte del valore, ai dati numerici dal numero più piccolo al numero più grande e alla data dal primo al più recente valore.
-
Compressione dell'indice Per ridurre lo spazio negli indici, Oracle AI Database può utilizzare diversi algoritmi di compressione.
Blocchi filiale e blocchi foglia
Un indice B-tree ha due tipi di blocchi: il blocco ramo per la ricerca e il blocco foglia per la memorizzazione dei valori chiave. I blocchi di ramo di livello superiore di un indice B-tree contengono dati di indice che puntano a blocchi di indice di livello inferiore.
Nella Figura 5-1, il blocco del ramo radice contiene la voce 0-40, che punta al blocco più a sinistra nel livello del ramo successivo. Questo blocco diramazione contiene voci quali 0-10 e 11-19. Ognuna di queste voci punta a un blocco foglia contenente valori chiave che rientrano nell'intervallo.
Un indice B-tree è bilanciato perché tutti i blocchi di foglia rimangono automaticamente alla stessa profondità. Pertanto, il recupero di qualsiasi record da qualsiasi punto dell'indice richiede circa la stessa quantità di tempo. L'altezza dell'indice è il numero di blocchi necessari per passare dal blocco radice a un blocco foglia. Il livello del ramo è l'altezza meno 1. Nella Figura 5-1, l'indice ha un'altezza di 3 e un livello di ramo di 2.
I blocchi diramazione memorizzano il prefisso di chiave minimo necessario per prendere una decisione di diramazione tra due chiavi. Questa tecnica consente al database di adattare il maggior numero possibile di dati su ciascun blocco diramazione. I blocchi di diramazione contengono un puntatore al blocco figlio contenente la chiave. Il numero di tasti e puntatori è limitato dalla dimensione del blocco.
I blocchi foglia contengono ogni valore di dati indicizzato e un ID riga corrispondente utilizzato per individuare la riga effettiva. Ogni voce è ordinata per (chiave, rowid). All'interno di un blocco foglia, una chiave e un ID riga sono collegati alle voci di pari livello sinistro e destro. Anche i blocchi di foglie sono doppiamente collegati. Nella Figura 5-1 il blocco foglia più a sinistra (0-10) è collegato al secondo blocco foglia (11-19). Nota: gli indici nelle colonne con dati carattere si basano sui valori binari dei caratteri nel set di caratteri del database.
Scansioni indice
In una scansione indice, il database recupera una riga attraversando l'indice utilizzando i valori di colonna indicizzati specificati dall'istruzione. Se il database analizza l'indice alla ricerca di un valore, questo valore verrà trovato in n I/O, dove n è l'altezza dell'indice B-tree. Questo è il principio di base degli indici di Oracle AI Database.
Se un'istruzione SQL accede solo a colonne indicizzate, il database legge i valori direttamente dall'indice anziché dalla tabella. Se l'istruzione accede a colonne non indicizzate oltre alle colonne indicizzate, il database utilizza gli ID riga per trovare le righe nella tabella. In genere, il database recupera i dati di tabella leggendo alternativamente un blocco di indice e quindi un blocco di tabella.
-
Scansione indice completa In una scansione indice completa, il database legge l'intero indice in ordine. Una scansione completa dell'indice è disponibile se una clausola predicate (
WHERE) nell'istruzione SQL fa riferimento a una colonna nell'indice e in alcune circostanze quando non viene specificato alcun predicato. Una scansione completa può eliminare l'ordinamento perché i dati vengono ordinati in base alla chiave di indice. -
Scansione rapida dell'indice completo Una scansione rapida dell'indice completo è una scansione completa dell'indice in cui il database accede ai dati nell'indice stesso senza accedere alla tabella e il database legge i blocchi dell'indice in nessun ordine specifico.
-
Scansione intervallo indice Una scansione intervallo indice è una scansione ordinata di un indice in cui una o più colonne iniziali di un indice vengono specificate in condizioni e sono possibili 0, 1 o più valori per una chiave indice.
-
Indice scansione univoca A differenza di una scansione intervallo indice, a una scansione univoca indice deve essere associato un rowid pari a 0 o 1 a una chiave indice.
-
Ignora scansione indice Una scansione di salto indice utilizza indici secondari logici di un indice composto. Il database "salta" attraverso un singolo indice come se stesse cercando indici separati.
-
Fattore cluster indice Il fattore cluster indice misura l'ordine delle righe in relazione a un valore indicizzato, ad esempio il cognome del dipendente. Man mano che il grado di ordine aumenta, il fattore di clustering diminuisce. Vedere anche: Oracle AI Database SQL Tuning Guide per informazioni dettagliate sulle scansioni degli indici
Scansione indice completo
In una scansione dell'indice completo, il database legge l'intero indice in ordine. Una scansione completa dell'indice è disponibile se una clausola predicate (WHERE) nell'istruzione SQL fa riferimento a una colonna nell'indice e in alcune circostanze quando non viene specificato alcun predicato. Una scansione completa può eliminare l'ordinamento perché i dati vengono ordinati in base alla chiave di indice.
Esempio 5-1 Scansione indice completo
Si supponga che un'applicazione esegua la seguente query:
SELECT department_id, last_name, salary
FROM   employees
WHERE  salary > 5000
ORDER BY department_id, last_name;
In questo esempio, department_id, last_name e salary sono una chiave composta in un indice. Oracle AI Database esegue una scansione completa dell'indice, leggerlo in ordine (ordinato per ID reparto e cognome) e filtrare l'attributo stipendio. In questo modo, il database esegue la scansione di un set di dati più piccolo della tabella employees, che contiene più colonne di quelle incluse nella query ed evita l'ordinamento dei dati.
La scansione completa potrebbe leggere le voci dell'indice come segue:
50,Atkinson,2800,rowid
60,Austin,4800,rowid
70,Baer,10000,rowid
80,Abel,11000,rowid
80,Ande,6400,rowid
110,Austin,7200,rowid
.
.
.
Scansioni Fast Full Index
Una scansione dell'indice completo veloce è una scansione completa dell'indice in cui il database accede ai dati nell'indice stesso senza accedere alla tabella e il database legge i blocchi dell'indice in nessun ordine particolare.
Le scansioni complete dell'indice rapide sono un'alternativa a una scansione completa della tabella quando vengono soddisfatte entrambe le condizioni riportate di seguito.
-
L'indice deve contenere tutte le colonne necessarie per la query.
-
Una riga contenente tutti i valori nulli non deve essere visualizzata nel set di risultati della query. Per garantire questo risultato, almeno una colonna dell'indice deve avere una delle seguenti caratteristiche:
-
Un vincolo
NOT NULL -
Predicato applicato alla colonna che impedisce che i valori nulli vengano considerati nel set di risultati della query
-
Esempio 5-2 Fast Full Index Scan
Si supponga che un'applicazione generi la query seguente, che non include una clausola ORDER BY:
SELECT last_name, salary
FROM   employees;
La colonna last_name ha un vincolo non nullo. Se il cognome e lo stipendio sono una chiave composta in un indice, una rapida scansione completa dell'indice può leggere le voci dell'indice per ottenere le informazioni richieste:
Baida,2900,rowid
Atkinson,2800,rowid
Zlotkey,10500,rowid
Austin,7200,rowid
Baer,10000,rowid
Austin,4800,rowid
.
.
.
Scansione intervallo indice
Una scansione intervallo indice è una scansione ordinata di un indice in cui una o più colonne iniziali di un indice vengono specificate in condizioni e sono possibili 0, 1 o più valori per una chiave indice.
La condizione specifica una combinazione di una o più espressioni e operatori logici (booleani). Restituisce il valore TRUE, FALSE o UNKNOWN.
Il database in genere utilizza una scansione dell'intervallo di indici per accedere ai dati selettivi. La selettività è la percentuale di righe nella tabella selezionata dalla query, con 0 che significa nessuna riga e 1 che significa tutte le righe. La selettività è associata a una query predicato, ad esempio WHERE last_name LIKE 'A%', o a una combinazione di predicati. Un predicato diventa più selettivo quando il valore si avvicina a 0 e meno selettivo (o più poco selettivo) quando il valore si avvicina a 1.
Ad esempio, un utente esegue una query sui dipendenti il cui cognome inizia con A. Si supponga che la colonna last_name sia indicizzata, con le voci riportate di seguito.
Abel,rowid
Ande,rowid
Atkinson,rowid
Austin,rowid
Austin,rowid
Baer,rowid
.
.
.
Il database potrebbe utilizzare una scansione intervallo perché la colonna last_name è specificata nel predicato e gli ID riga multipli sono possibili per ogni chiave indice. Ad esempio, due dipendenti si chiamano Austin, quindi due rowid sono associati alla chiave Austin.
Una scansione dell'intervallo di indici può essere limitata su entrambi i lati, come in una query per i reparti con ID compresi tra 10 e 40, o limitata su un solo lato, come in una query per ID superiori a 40. Per eseguire la scansione dell'indice, il database si sposta in avanti o indietro attraverso i blocchi foglia. Ad esempio, una scansione degli ID compresi tra 10 e 40 individua il primo blocco foglia indice contenente il valore di chiave inferiore uguale o superiore a 10. La scansione procede quindi orizzontalmente attraverso la lista collegata di nodi foglia finché non individua un valore maggiore di 40.
Scansione univoca indice
A differenza di una scansione intervallo indice, a una scansione univoca indice deve essere associato 0 o 1 ID riga con una chiave indice.
Il database esegue una scansione univoca quando un predicato fa riferimento a tutte le colonne nella chiave di un indice UNIQUE utilizzando un operatore di uguaglianza. Una scansione univoca dell'indice interrompe l'elaborazione non appena trova il primo record perché non è possibile un secondo record.
Si supponga, a titolo illustrativo, che un utente esegua la seguente query:
SELECT *
FROM   employees
WHERE  employee_id = 5;
Si supponga che la colonna employee_id sia la chiave primaria e che venga indicizzata con le voci come indicato di seguito.
1,rowid
2,rowid
4,rowid
5,rowid
6,rowid
.
.
.
In questo caso, il database può utilizzare una scansione univoca dell'indice per individuare l'ID riga per il dipendente con ID 5.
Ignora scansione indice
Una scansione di salto dell'indice utilizza gli indici secondari logici di un indice composto. Il database "salta" attraverso un singolo indice come se stesse cercando indici separati.
Salta scansione è utile se ci sono pochi valori distinti nella colonna iniziale di un indice composito e molti valori distinti nella chiave non leader dell'indice. Il database può scegliere una scansione di salto dell'indice quando la colonna iniziale dell'indice composto non è specificata in un predicato di query.
Esempio 5-3 Ignora scansione di un indice composto
Si supponga di eseguire la seguente query per un cliente nella tabella sh.customers:
SELECT * FROM sh.customers WHERE cust_email = 'Abbey@company.example.com';La tabella customers contiene una colonna cust_gender i cui valori sono M o F. Si supponga che nelle colonne esista un indice composto (cust_gender, cust_email). L'esempio seguente mostra una parte delle voci dell'indice.
F,Wolf@company.example.com,rowid
F,Wolsey@company.example.com,rowid
F,Wood@company.example.com,rowid
F,Woodman@company.example.com,rowid
F,Yang@company.example.com,rowid
F,Zimmerman@company.example.com,rowid
M,Abbassi@company.example.com,rowid
M,Abbey@company.example.com,rowid
Il database può utilizzare una scansione skip di questo indice anche se cust_gender non è specificato nella clausola WHERE.
In una scansione skip, il numero di sottoindici logici è determinato dal numero di valori distinti nella colonna iniziale. Nell'esempio precedente, la colonna iniziale contiene due valori possibili. Il database suddivide logicamente l'indice in un sottoindice con la chiave F e un secondo sottoindice con la chiave M.
Quando si cerca il record del cliente con e-mail Abbey@company.example.com, il database cerca prima l'indice secondario con il valore F, quindi cerca l'indice secondario con il valore M. Concettualmente, il database elabora la query come segue:
SELECT * FROM sh.customers WHERE cust_gender = 'F'
  AND cust_email = 'Abbey@company.example.com'
UNION ALL
SELECT * FROM sh.customers WHERE cust_gender = 'M'
  AND cust_email = 'Abbey@company.example.com';
Vedere anche: Oracle AI Database SQL Tuning Guide per ulteriori informazioni sulle scansioni skip
Fattore cluster indice
Il fattore di clustering indice misura l'ordine delle righe in relazione a un valore indicizzato, ad esempio il cognome del dipendente. Man mano che il grado di ordine aumenta, il fattore di clustering diminuisce.
Il fattore di clustering è utile come misura approssimativa del numero di I/O necessari per leggere un'intera tabella utilizzando un indice:
-
Se il fattore di clustering è elevato, Oracle AI Database esegue un numero relativamente elevato di I/O durante una scansione di un intervallo di indici di grandi dimensioni. Le voci di indice puntano a blocchi di tabella casuali, quindi il database potrebbe dover leggere e rileggere gli stessi blocchi più e più volte per recuperare i dati puntati dall'indice.
-
Se il fattore di clustering è basso, Oracle AI Database esegue un numero relativamente basso di I/O durante una scansione dell'intervallo di indici di grandi dimensioni. Le chiavi di indice in un intervallo tendono a puntare allo stesso blocco di dati, quindi il database non deve leggere e rileggere gli stessi blocchi più e più volte.
Il fattore di clustering è rilevante per le scansioni degli indici perché può mostrare:
-
Indica se il database utilizzerà un indice per le scansioni di grandi dimensioni
-
Il grado di organizzazione della tabella in relazione alla chiave indice
-
Indica se è necessario utilizzare una tabella organizzata a indice, un partizionamento o un cluster di tabelle se le righe devono essere ordinate in base alla chiave di indice
Esempio di fattore di raggruppamento 5-4
Si supponga che la tabella employees si adatti a due blocchi di dati. La Tabella 5-3 illustra le righe nei due blocchi di dati (i puntini di sospensione indicano dati non visualizzati).
Tabella 3 Contenuto di due blocchi di dati nella tabella Dipendenti
| Blocco di dati 1 | Blocco di dati 2 |
|---|---|
|
|
Le righe vengono memorizzate nei blocchi in ordine di cognome (mostrato in grassetto). Ad esempio, la riga inferiore nel blocco di dati 1 descrive Abel, la riga successiva in alto descrive Ande e così via in ordine alfabetico fino alla riga superiore nel blocco 1 per Steven King. La riga in basso nel blocco 2 descrive Kochar, la riga successiva in alto descrive Kumar e così via in ordine alfabetico fino all'ultima riga nel blocco per Zlotkey.
Si supponga che esista un indice nella colonna del cognome. Ogni voce di nome corrisponde a un rowid. Concettualmente, le voci dell'indice sarebbero le seguenti:
Abel,block1row1
Ande,block1row2
Atkinson,block1row3
Austin,block1row4
Baer,block1row5
.
.
.
Si supponga che nella colonna ID dipendente esista un indice separato. Concettualmente, le voci dell'indice potrebbero apparire come segue, con gli ID dei dipendenti distribuiti in posizioni quasi casuali nei due blocchi:
100,block1row50
101,block2row1
102,block1row9
103,block2row19
104,block2row39
105,block1row4
.
.
.
L'istruzione seguente esegue una query sulla vista ALL_INDEXES per il fattore di clustering per questi due indici:
SQL> SELECT INDEX_NAME, CLUSTERING_FACTOR
  2  FROM ALL_INDEXES
  3  WHERE INDEX_NAME IN ('EMP_NAME_IX','EMP_EMP_ID_PK');

INDEX_NAME           CLUSTERING_FACTOR
-------------------- -----------------
EMP_EMP_ID_PK                       19
EMP_NAME_IX                          2
Il fattore di clustering per EMP_NAME_IX è basso, il che significa che le voci di indice adiacenti in un singolo blocco foglia tendono a puntare a righe negli stessi blocchi di dati. Il fattore di clustering per EMP_EMP_ID_PK è elevato, il che significa che le voci di indice adiacenti nello stesso blocco foglia hanno molte meno probabilità di puntare a righe negli stessi blocchi di dati.
Vedi anche: Oracle AI Database Reference per saperne di più su ALL_INDEXES
Inverti indici chiave
Un indice delle chiavi inverse è un tipo di indice B-tree che inverte fisicamente i byte di ciascuna chiave di indice mantenendo l'ordine delle colonne.
Ad esempio, se la chiave indice è 20 e i due byte memorizzati per questa chiave in esadecimale sono C1,15 in un indice B-tree standard, un indice a chiave inversa memorizza i byte come 15,C1.
L'inversione della chiave risolve il problema della contesa per i blocchi di foglia nel lato destro di un indice di B-tree. Questo problema può essere particolarmente grave in un database Oracle Real Application Clusters (Oracle RAC) in cui più istanze modificano ripetutamente lo stesso blocco. Ad esempio, in una tabella orders le chiavi primarie per gli ordini sono sequenziali. Un'istanza nel cluster aggiunge l'ordine 20, mentre un'altra ne aggiunge 21, con ogni istanza che scrive la sua chiave sullo stesso blocco foglia sul lato destro dell'indice.
In un indice di chiave inversa, l'inversione dell'ordine dei byte distribuisce gli inserti in tutte le chiavi foglia nell'indice. Ad esempio, le chiavi come 20 e 21 che sarebbero state adiacenti in un indice chiave standard sono ora archiviate in blocchi separati. Pertanto, l'I/O per l'inserimento di chiavi sequenziali è distribuito in modo più uniforme.
Poiché i dati nell'indice non vengono ordinati in base alla chiave di colonna quando vengono memorizzati, la disposizione della chiave inversa elimina la possibilità di eseguire una query di scansione dell'intervallo di indici in alcuni casi. Ad esempio, se un utente invia una query per gli ID ordine maggiori di 20, il database non può iniziare con il blocco contenente questo ID e procedere orizzontalmente attraverso i blocchi foglia.
Indici crescente e decrescente
In un indice ascendente, Oracle AI Database memorizza i dati in ordine crescente. Per impostazione predefinita, i dati dei caratteri vengono ordinati in base ai valori binari contenuti in ciascun byte del valore, ai dati numerici dal numero più piccolo al numero più grande e alla data dal primo al più recente valore.
Per un esempio di indice ascendente, considerare la seguente istruzione SQL:
CREATE INDEX emp_deptid_ix ON hr.employees(department_id);Oracle AI Database ordina la tabella hr.employees nella colonna department_id. Carica l'indice crescente con department_id e i corrispondenti valori rowid in ordine crescente, a partire da 0. Quando utilizza l'indice, Oracle AI Database cerca i valori department_id ordinati e utilizza gli ID riga associati per individuare le righe con il valore department_id richiesto.
Se si specifica la parola chiave DESC nell'istruzione CREATE INDEX, è possibile creare un indice decrescente. In questo caso, l'indice memorizza i dati in una o più colonne specificate in ordine decrescente. Se l'indice nella Tabella 5-3 nella colonna employees.department_id è decrescente, il blocco foglia contenente 250 si trova sul lato sinistro dell'albero e sul lato destro del blocco con 0. La ricerca predefinita tramite un indice decrescente è dal valore più alto al valore più basso.
Gli indici decrescenti sono utili quando una query ordina alcune colonne in ordine crescente e altre in ordine decrescente. Ad esempio, si supponga di creare un indice composto nelle colonne last_name e department_id come indicato di seguito.
CREATE INDEX emp_name_dpt_ix ON hr.employees(last_name ASC, department_id DESC);Se un utente esegue una query su hr.employees per i cognomi in ordine crescente (da A a Z) e gli ID reparto in ordine decrescente (da alto a basso), il database può utilizzare questo indice per recuperare i dati ed evitare il passo aggiuntivo di ordinamento.
Vedere anche:
-
Oracle AI Database SQL Tuning Guide per ulteriori informazioni sulle ricerche degli indici crescente e decrescente
-
Oracle AI Database SQL Language Reference per le descrizioni delle opzioni
ASCeDESCdiCREATE INDEX
Compressione indice
Per ridurre lo spazio negli indici, Oracle AI Database può utilizzare diversi algoritmi di compressione.
-
Compressione del prefisso Oracle AI Database può utilizzare la compressione del prefisso, nota anche come compressione della chiave, per comprimere parti dei valori della colonna della chiave primaria in un indice B-tree o in una tabella organizzata a indice. La compressione del prefisso può ridurre notevolmente lo spazio consumato dall'indice.
-
Advanced Index Compression A partire da Oracle Database 12c Release 1 (12.1.0.2), la compressione degli indici avanzata migliora la compressione dei prefissi tradizionali per gli indici supportati nelle tabelle organizzate dall'heap.
Compressione prefisso
Oracle AI Database può utilizzare la compressione dei prefissi, nota anche come compressione delle chiavi, per comprimere parti dei valori delle colonne delle chiavi primarie in un indice B-tree o in una tabella organizzata a indice. La compressione del prefisso può ridurre notevolmente lo spazio consumato dall'indice.
Una voce di indice non compressa ha un pezzo. Una voce di indice che utilizza la compressione del prefisso ha due parti: una voce di prefisso, che è la parte di raggruppamento, e una voce di suffisso, che è la parte univoca o quasi unica. Il database ottiene la compressione condividendo le voci del prefisso tra le voci del suffisso in un blocco di indice. Nota: se una chiave non è definita per avere una parte univoca, il database ne fornisce una aggiungendo un ID riga alla parte di raggruppamento.
Per impostazione predefinita, il prefisso di un indice univoco è costituito da tutte le colonne chiave esclusa l'ultima, mentre il prefisso di un indice non univoco è costituito da tutte le colonne chiave. Si supponga di creare un indice univoco composto su due colonne della tabella oe.orders come indicato di seguito.
CREATE UNIQUE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );Nell'esempio precedente, una chiave di indice può essere online,0. L'ID riga viene memorizzato nella parte dati chiave della voce e non fa parte della chiave stessa.
Nota: se si crea un indice univoco su una singola colonna, Oracle AI Database non può utilizzare la compressione delle chiavi di prefisso perché non esistono prefissi comuni.
In alternativa, si supponga di creare un indice non univoco sulle stesse colonne:
CREATE INDEX orders_mod_stat_ix ON orders ( order_mode, order_status );Si supponga inoltre che valori ripetuti si verifichino nelle colonne order_mode e order_status. Un blocco indice potrebbe avere voci come mostrato nel seguente esempio:
online,0,AAAPvCAAFAAAAFaAAa
online,0,AAAPvCAAFAAAAFaAAg
online,0,AAAPvCAAFAAAAFaAAl
online,2,AAAPvCAAFAAAAFaAAm
online,3,AAAPvCAAFAAAAFaAAq
online,3,AAAPvCAAFAAAAFaAAt
Nell'esempio precedente, il prefisso della chiave sarebbe costituito da una concatenazione dei valori order_mode e order_status, come in online,0. Il suffisso è costituito dall'ID riga, come in AAAPvCAAFAAAAFaAAa. L'ID riga rende univoca l'intera voce di indice perché un ID riga è esso stesso univoco nel database.
Se l'indice nell'esempio precedente è stato creato con la compressione predefinita del prefisso (specificata dalla parola chiave COMPRESS), i prefissi di chiave duplicati come online,0 e online,3 verranno compressi. Concettualmente, il database raggiunge la compressione come segue:
online,0
AAAPvCAAFAAAAFaAAa
AAAPvCAAFAAAAFaAAg
AAAPvCAAFAAAAFaAAl
online,2
AAAPvCAAFAAAAFaAAm
online,3
AAAPvCAAFAAAAFaAAq
AAAPvCAAFAAAAFaAAt
Le voci di suffisso (gli ID riga) formano la versione compressa delle righe di indice. Ogni voce di suffisso fa riferimento a una voce di prefisso, memorizzata nello stesso blocco di indice del suffisso.
In alternativa, è possibile specificare una lunghezza del prefisso quando si crea un indice che utilizza la compressione del prefisso. Ad esempio, se è stato specificato COMPRESS 1, il prefisso sarà order_mode e il suffisso sarà order_status,rowid. Per i valori nell'esempio del blocco di indice, l'indice tiene conto delle occorrenze duplicate del prefisso online, che possono essere rappresentate concettualmente come segue:
online
0,AAAPvCAAFAAAAFaAAa
0,AAAPvCAAFAAAAFaAAg
0,AAAPvCAAFAAAAFaAAl
2,AAAPvCAAFAAAAFaAAm
3,AAAPvCAAFAAAAFaAAq
3,AAAPvCAAFAAAAFaAAt
L'indice memorizza al massimo un prefisso specifico una volta per blocco foglia. Vengono compressi solo i tasti nei blocchi foglia di un indice B-tree. Nei blocchi del ramo il suffisso della chiave può essere troncato, ma la chiave non è compressa.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come utilizzare gli indici compressi
-
Oracle AI Database VLDB and Partitioning Guide per informazioni su come utilizzare la compressione dei prefissi per gli indici partizionati
-
Oracle AI Database SQL Language Reference per le descrizioni della clausola key_compression di
CREATE INDEX
Compressione avanzata indice
A partire da Oracle Database 12c Release 1 (12.1.0.2), la compressione degli indici avanzata migliora la compressione dei prefissi tradizionali per gli indici supportati nelle tabelle organizzate dall'heap.
Vantaggi di Advanced Index Compression
La compressione dei prefissi ha limitazioni per i tipi di indici supportati, il rapporto di compressione e la facilità d'uso. A differenza della compressione del prefisso, che utilizza l'eliminazione della chiave duplicata fissa per ogni blocco, la compressione avanzata dell'indice utilizza l'eliminazione della chiave duplicata adattiva per blocco. I principali vantaggi della compressione avanzata dell'indice sono:
-
Il database sceglie automaticamente la compressione migliore per ogni blocco, utilizzando una serie di algoritmi interni come prefissi a livello intra-colonna, eliminazione della chiave duplicata e compressione rowid. A differenza della compressione del prefisso, la compressione avanzata dell'indice non richiede all'utente di conoscere le caratteristiche dei dati.
-
La compressione avanzata funziona sia su indici e univoci non univoci. La compressione dei prefissi funziona bene su alcuni indici non univoci, ma i rapporti sono più bassi sugli indici le cui colonne iniziali non hanno molte ripetizioni.
-
L'indice compresso è utilizzabile allo stesso modo di un indice non compresso. L'indice supporta gli stessi percorsi di accesso: ricerche di chiavi univoche, scansioni di intervalli e scansioni complete veloci.
-
Gli indici possono ereditare la compressione avanzata da una tabella padre o contenere tablespace.
-
Le tabelle organizzate a indice e gli indici basati sulle funzioni supportano la compressione avanzata degli indici. Le tabelle organizzate a indice supportano una compressione ridotta. Gli indici basati sulle funzioni supportano sia la compressione bassa che quella alta.
Funzionamento della compressione avanzata dell'indice
La compressione avanzata dell'indice funziona a livello di blocco per fornire la migliore compressione per ogni blocco. Il database utilizza la tecnica seguente:
-
Durante la creazione dell'indice, quando un blocco foglia diventa pieno, il database comprime automaticamente il blocco al livello ottimale.
-
Quando si riorganizza un blocco di indice come risultato di DML, se il database può creare spazio sufficiente per la voce di indice in entrata, non si verifica uno split di blocchi. Durante il DML senza compressione avanzata dell'indice, tuttavia, una divisione del blocco di indice si verifica sempre quando il blocco diventa pieno.
Compressione avanzata indice ALTA
Nelle release precedenti a Oracle Database 12c Release 2 (12.2), l'unica forma di compressione avanzata dell'indice era la compressione ridotta (COMPRESS ADVANCED LOW). Ora è anche possibile specificare la compressione elevata (COMPRESS ADVANCED HIGH), che è l'impostazione predefinita. La compressione avanzata dell'indice con l'opzione HIGH offre i seguenti vantaggi:
-
Fornisce rapporti di compressione più elevati nella maggior parte dei casi, migliorando al contempo le prestazioni per le query che accedono all'indice
-
Utilizza algoritmi di compressione più complessi rispetto ai bassi avanzati
-
Memorizza i dati in un'unità di compressione, che è uno speciale formato su disco Nota: quando si applica la compressione
HIGH, tutti i blocchi hanno compressione. Quando si applica la compressioneLOW, il database potrebbe lasciare alcuni blocchi non compressi. È possibile utilizzare le statistiche per determinare il numero di blocchi rimasti non compressi.
Esempio 5-5 Creazione di un indice con compressione elevata avanzata
In questo esempio viene abilitata la compressione avanzata dell'indice per un indice nella tabella hr.employees.
CREATE INDEX hr.emp_mndp_ix
  ON hr.employees(manager_id, department_id)
  COMPRESS ADVANCED;
La seguente query mostra il tipo di compressione:
SELECT COMPRESSION FROM DBA_INDEXES WHERE INDEX_NAME ='EMP_MNDP_IX';

COMPRESSION
-------------
ADVANCED HIGH
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come abilitare la compressione avanzata degli indici
-
Oracle AI Database SQL Language Reference per le descrizioni della clausola key_compression di
CREATE INDEX -
Oracle AI Database Reference per saperne di più su
ALL_INDEXES
Panoramica degli indici bitmap
In un indice bitmap, il database memorizza una bitmap per ogni chiave indice. In un indice B-tree convenzionale, una voce indice punta a una singola riga. In un indice bitmap, ogni chiave indice memorizza i puntatori su più righe.
Gli indici bitmap sono progettati principalmente per il data warehousing o ambienti in cui le query fanno riferimento a molte colonne in modo ad hoc. Le situazioni che possono richiedere un indice bitmap includono:
-
Le colonne indicizzate hanno una cardinalità bassa, ovvero il numero di valori distinti è ridotto rispetto al numero di righe della tabella.
-
La tabella indicizzata è di sola lettura o non è soggetta a modifiche significative da parte delle istruzioni DML.
Per un esempio di data warehouse, la tabella sh.customers contiene una colonna cust_gender con solo due valori possibili: M e F. Supponiamo che le query per il numero di clienti di un particolare genere siano comuni. In questo caso, la colonna customers.cust_gender sarebbe un candidato per un indice bitmap.
Ogni bit nella bitmap corrisponde a un possibile rowid. Se il bit è impostato, la riga con l'ID riga corrispondente contiene il valore della chiave. Una funzione di mapping converte la posizione bit in un rowid effettivo, quindi l'indice bitmap fornisce le stesse funzionalità di un indice B-tree sebbene utilizzi una rappresentazione interna diversa.
Se la colonna indicizzata in una singola riga viene aggiornata, il database blocca la voce della chiave di indice (ad esempio, M o F) e non il singolo bit mappato alla riga aggiornata. Poiché una chiave punta a molte righe, DML sui dati indicizzati in genere blocca tutte queste righe. Per questo motivo, gli indici bitmap non sono appropriati per molte applicazioni OLTP.
-
Esempio: indici bitmap su una tabella singola In questo esempio, alcune colonne della tabella
sh.customerssono candidate per un indice bitmap. -
Indici di join bitmap Un indice di join bitmap è un indice bitmap per il join di due o più tabelle.
-
Struttura di storage bitmap Oracle AI Database utilizza una struttura di indice B-tree per memorizzare le bitmap per ogni chiave indicizzata.
Vedere anche:
-
Oracle AI Database SQL Tuning Guide per ulteriori informazioni sugli indici bitmap
-
Oracle AI Database Data Warehousing Guide per scoprire come utilizzare gli indici bitmap in un data warehouse.
Esempio: indici bitmap su una singola tabella
In questo esempio, alcune colonne della tabella sh.customers sono candidate per un indice bitmap.
Tenere presente quanto riportato di seguito.
SQL> SELECT cust_id, cust_last_name, cust_marital_status, cust_gender
  2  FROM   sh.customers
  3  WHERE  ROWNUM < 8 ORDER BY cust_id;

   CUST_ID CUST_LAST_ CUST_MAR C
---------- ---------- -------- -
         1 Kessel              M
         2 Koch                F
         3 Emmerson            M
         4 Hardy               M
         5 Gowen               M
         6 Charles    single   F
         7 Ingram     single   F

7 rows selected.
Le colonne cust_marital_status e cust_gender hanno una cardinalità bassa, mentre cust_id e cust_last_name non lo sono. Pertanto, gli indici bitmap possono essere appropriati in cust_marital_status e cust_gender. Un indice bitmap probabilmente non è utile per le altre colonne. Invece, un indice B-tree univoco su queste colonne probabilmente fornirebbe la rappresentazione e il recupero più efficienti. La Tabella 5-4 illustra l'indice bitmap per l'output della colonna cust_gender mostrato nell'esempio precedente. Si compone di due bitmap separate, una per ogni genere.
Tabella 4 Bitmap di esempio per una colonna
| Valore | Riga 1 | Riga 2 | Riga 3 | Riga 4 | Riga 5 | Riga 6 | Riga 7 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
Una funzione di mapping converte ogni bit della bitmap in un rowid della tabella customers. Ogni valore di bit dipende dai valori della riga corrispondente nella tabella. Ad esempio, il bitmap per il valore M contiene un valore 1 come primo bit perché il genere è M nella prima riga della tabella customers. Il bitmap cust_gender='M' ha un valore 0 per i bit nelle righe 2, 6 e 7 perché queste righe non contengono il valore M.
Nota: gli indici bitmap possono includere chiavi costituite interamente da valori nulli, a differenza degli indici B-tree. L'indicizzazione dei valori nulli può essere utile per alcune istruzioni SQL, ad esempio query con la funzione di aggregazione COUNT.
Un analista che studia le tendenze demografiche dei clienti può chiedere: "Quanti dei nostri clienti femminili sono single o divorziati?" Questa domanda corrisponde alla seguente query SQL:
SELECT COUNT(*)
FROM   customers
WHERE  cust_gender = 'F'
AND    cust_marital_status IN ('single', 'divorced');
Gli indici bitmap possono elaborare questa query in modo efficiente contando il numero di valori 1 nella bitmap risultante, come illustrato nella Tabella 5-5. Per identificare i clienti che soddisfano i criteri, Oracle AI Database può utilizzare il bitmap risultante per accedere alla tabella.
Tabella 5 Bitmap di esempio per due colonne
| Valore | Riga 1 | Riga 2 | Riga 3 | Riga 4 | Riga 5 | Riga 6 | Riga 7 |
|---|---|---|---|---|---|---|---|
M |
1 | 0 | 1 | 1 | 1 | 0 | 0 |
F |
0 | 1 | 0 | 0 | 0 | 1 | 1 |
single |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
divorced |
0 | 0 | 0 | 0 | 0 | 0 | 0 |
single o divorced e F |
0 | 0 | 0 | 0 | 0 | 1 | 1 |
L'indicizzazione bitmap unisce in modo efficiente gli indici che corrispondono a diverse condizioni in una clausola WHERE. Le righe che soddisfano alcune condizioni, ma non tutte, vengono filtrate prima dell'accesso alla tabella stessa. Questa tecnica migliora i tempi di risposta, spesso drammaticamente.
Indici bitmap join
Un indice di join bitmap è un indice bitmap per il join di due o più tabelle.
Per ogni valore di una colonna di tabella, l'indice memorizza l'ID riga della riga corrispondente nella tabella indicizzata. Al contrario, un indice bitmap standard viene creato su una singola tabella.
Un indice di join bitmap è un mezzo efficiente per ridurre il volume di dati che devono essere uniti eseguendo restrizioni in anticipo. Per un esempio di quando un indice di join bitmap sarebbe utile, si supponga che gli utenti spesso eseguano query sul numero di dipendenti con un determinato tipo di lavoro. Una query tipica potrebbe essere la seguente:
SELECT COUNT(*)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
AND    jobs.job_title = 'Accountant';
La query precedente in genere utilizza un indice in jobs.job_title per recuperare le righe per Accountant, quindi l'ID job e un indice in employees.job_id per trovare le righe corrispondenti. Per recuperare i dati dall'indice stesso anziché da una scansione delle tabelle, è possibile creare un indice di join bitmap come indicato di seguito.
CREATE BITMAP INDEX employees_bm_idx
ON     employees (jobs.job_title)
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id;
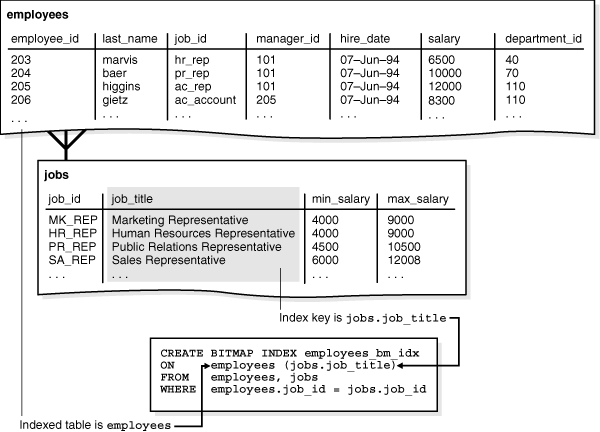
Come illustrato nella figura seguente, la chiave indice è jobs.job_title e la tabella indicizzata è employees.
Figura 2: Indice di join bitmap
Descrizione dell'illustrazione cncpt239.gif
Concettualmente, employees_bm_idx è un indice della colonna jobs.title nella query SQL mostrata nella query seguente (output di esempio incluso). La chiave job_title nell'indice punta alle righe nella tabella employees. Una query del numero di contabili può utilizzare l'indice per evitare di accedere alle tabelle employees e jobs perché l'indice contiene le informazioni richieste.
SELECT jobs.job_title AS "jobs.job_title", employees.rowid AS "employees.rowid"
FROM   employees, jobs
WHERE  employees.job_id = jobs.job_id
ORDER BY job_title;

jobs.job_title                      employees.rowid
----------------------------------- ------------------
Accountant                          AAAQNKAAFAAAABSAAL
Accountant                          AAAQNKAAFAAAABSAAN
Accountant                          AAAQNKAAFAAAABSAAM
Accountant                          AAAQNKAAFAAAABSAAJ
Accountant                          AAAQNKAAFAAAABSAAK
Accounting Manager                  AAAQNKAAFAAAABTAAH
Administration Assistant            AAAQNKAAFAAAABTAAC
Administration Vice President       AAAQNKAAFAAAABSAAC
Administration Vice President       AAAQNKAAFAAAABSAAB
.
.
.
In un data warehouse, la condizione di join è un equijoin (utilizza l'operatore di uguaglianza) tra le colonne chiave primaria delle tabelle dimensione e le colonne chiave esterna della fact table. Gli indici di join bitmap sono a volte molto più efficienti nello storage rispetto alle viste di join materializzate, un'alternativa per materializzare i join in anticipo.
Per ulteriori informazioni sugli indici di join bitmap, vedere anche: Oracle AI Database Data Warehousing Guide
Struttura di memorizzazione bitmap
Oracle AI Database utilizza una struttura di indice B-tree per memorizzare le bitmap per ogni chiave indicizzata.
Ad esempio, se jobs.job_title è la colonna chiave di un indice bitmap, una struttura B memorizza i dati dell'indice. I blocchi foglia memorizzano le singole bitmap.
Esempio di storage bitmap 5-6
Si supponga che la colonna jobs.job_title contenga valori univoci Shipping Clerk, Stock Clerk e molti altri. Una voce di indice bitmap per questo indice ha i seguenti componenti:
-
Titolo mansione come chiave indice
-
ID riga basso e ID riga alto per un intervallo di ID riga
-
Bitmap per ID riga specifici nell'intervallo
Concettualmente, un blocco foglia indice in questo indice potrebbe contenere voci come indicato di seguito.
Shipping Clerk,AAAPzRAAFAAAABSABQ,AAAPzRAAFAAAABSABZ,0010000100
Shipping Clerk,AAAPzRAAFAAAABSABa,AAAPzRAAFAAAABSABh,010010
Stock Clerk,AAAPzRAAFAAAABSAAa,AAAPzRAAFAAAABSAAc,1001001100
Stock Clerk,AAAPzRAAFAAAABSAAd,AAAPzRAAFAAAABSAAt,0101001001
Stock Clerk,AAAPzRAAFAAAABSAAu,AAAPzRAAFAAAABSABz,100001
.
.
.
Lo stesso titolo mansione viene visualizzato in più voci perché l'intervallo di ID riga è diverso.
Una sessione aggiorna l'ID mansione di un dipendente da Shipping Clerk a Stock Clerk. In questo caso, la sessione richiede l'accesso esclusivo alla voce della chiave indice per il vecchio valore (Shipping Clerk) e il nuovo valore (Stock Clerk). Oracle AI Database blocca le righe a cui puntano queste due voci, ma non le righe a cui punta Accountant o qualsiasi altra chiave fino ai commit UPDATE.
I dati per un indice bitmap vengono memorizzati in un segmento. Oracle AI Database memorizza ogni bitmap in uno o più pezzi. Ogni pezzo occupa parte di un singolo blocco di dati.
Vedere anche: "Segmenti utente" spiega i diversi tipi di segmenti e la modalità di creazione dei segmenti.
Panoramica degli indici basati sulle funzioni
Un indice basato su funzioni calcola il valore di una funzione o di un'espressione che coinvolge una o più colonne e lo memorizza in un indice. Un indice basato su funzioni può essere un B-tree o un indice bitmap.
La funzione indicizzata può essere un'espressione aritmetica o un'espressione che contiene una funzione SQL, una funzione PL/SQL definita dall'utente, una funzione package o un callout C. Ad esempio, una funzione potrebbe aggiungere i valori in due colonne.
-
Gli indici basati sulle funzioni Usi di indici basati sulle funzioni sono efficaci per valutare le istruzioni che contengono funzioni nelle rispettive clausole
WHERE. Il database utilizza l'indice basato su funzioni solo quando la funzione è inclusa in una query. Quando il database elabora le istruzioniINSERTeUPDATE, tuttavia, deve comunque valutare la funzione per elaborare l'istruzione. -
Ottimizzazione con indici basati su funzioni Per le query con espressioni in una clausola
WHERE, l'ottimizzatore potrebbe utilizzare una scansione dell'intervallo di indici su un indice basato su funzioni.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come creare indici basati sulle funzioni
-
Oracle AI Database Development Guide per ulteriori informazioni sull'uso degli indici basati sulle funzioni
-
Oracle AI Database SQL Language Reference per le limitazioni e le note d'uso degli indici basati su funzioni
Usi di indici basati sulle funzioni
Gli indici basati sulle funzioni consentono di valutare le istruzioni che contengono funzioni nelle clausole WHERE. Il database utilizza l'indice basato su funzioni solo quando la funzione è inclusa in una query. Quando il database elabora le istruzioni INSERT e UPDATE, tuttavia, deve comunque valutare la funzione per elaborare l'istruzione.
Indice di esempio 5-7 basato sull'espressione aritmetica
Si supponga, ad esempio, di creare il seguente indice basato sulle funzioni:
CREATE INDEX emp_total_sal_idx
  ON employees (12 * salary * commission_pct, salary, commission_pct);
Il database può utilizzare l'indice precedente durante l'elaborazione di query come le seguenti (output di esempio parziale incluso):
SELECT   employee_id, last_name, first_name,
         12*salary*commission_pct AS "ANNUAL SAL"
FROM     employees
WHERE    (12 * salary * commission_pct) < 30000
ORDER BY "ANNUAL SAL" DESC;

EMPLOYEE_ID LAST_NAME                 FIRST_NAME           ANNUAL SAL
----------- ------------------------- -------------------- ----------
        159 Smith                     Lindsey                   28800
        151 Bernstein                 David                     28500
        152 Hall                      Peter                     27000
        160 Doran                     Louise                    27000
        175 Hutton                    Alyssa                    26400
        149 Zlotkey                   Eleni                     25200
        169 Bloom                     Harrison                  24000
Esempio di indice 5-8 basato su una funzione UPPER
Gli indici basati sulle funzioni definiti nelle funzioni SQL UPPER(column_name) o LOWER(column_name) facilitano le ricerche senza distinzione tra maiuscole e minuscole. Ad esempio, si supponga che la colonna first_name in employees contenga caratteri misti. Creare il seguente indice basato sulle funzioni nella tabella hr.employees:
CREATE INDEX emp_fname_uppercase_idx
ON employees ( UPPER(first_name) );
L'indice emp_fname_uppercase_idx può facilitare query come le seguenti:
SELECT *
FROM   employees
WHERE  UPPER(first_name) = 'AUDREY';
Esempio 5-9 Indicizzazione di righe specifiche in una tabella
Un indice basato su funzioni è utile anche per indicizzare solo righe specifiche in una tabella. Ad esempio, la colonna cust_valid della tabella sh.customers contiene un valore I o A. Per indicizzare solo le righe A, è possibile scrivere una funzione che restituisca un valore nullo per qualsiasi riga diversa dalle righe A. È possibile creare l'indice come indicato di seguito.
CREATE INDEX cust_valid_idx
ON customers ( CASE cust_valid WHEN 'A' THEN 'A' END );
Vedere anche:
-
Oracle AI Database Globalization Support Guide per informazioni sugli indici linguistici
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sulle funzioni SQL
Ottimizzazione con indici basati sulle funzioni
Per le query con espressioni in una clausola WHERE, l'ottimizzatore potrebbe utilizzare una scansione dell'intervallo di indici su un indice basato su funzioni.
Il percorso di accesso di scansione dell'intervallo è particolarmente utile quando il predicato è altamente selettivo, ovvero quando sceglie relativamente poche righe. In Esempio 5-7, se un indice viene generato nell'espressione 12*salary*commission_pct, l'ottimizzatore può utilizzare una scansione dell'intervallo di indici.
Una colonna virtuale è utile anche per velocizzare l'accesso ai dati derivati dalle espressioni. Ad esempio, è possibile definire la colonna virtuale annual_sal come 12*salary*commission_pct e creare un indice basato su funzioni in annual_sal.
L'ottimizzatore esegue la corrispondenza delle espressioni analizzando l'espressione in un'istruzione SQL, quindi confrontando gli alberi delle espressioni dell'istruzione e l'indice basato sulle funzioni. Questo confronto non fa distinzione tra maiuscole e minuscole e ignora gli spazi vuoti.
Query diverse possono utilizzare tipi diversi di scansioni degli indici.
Vedere anche:
-
Oracle AI Database SQL Tuning Guide per ulteriori informazioni sulla raccolta delle statistiche
-
Oracle AI Database Administrator's Guide per informazioni su come aggiungere colonne virtuali a una tabella
Panoramica degli indici dei domini applicazione
Un indice del dominio di applicazione è un indice personalizzato specifico di un'applicazione.
L'indicizzazione estesa può:
-
Consente di adattare gli indici a tipi di dati complessi e personalizzati, ad esempio documenti, dati spaziali, immagini e clip video (vedere )
-
Utilizzare tecniche di indicizzazione specializzate
È possibile incapsulare le routine di gestione degli indici specifiche dell'applicazione come oggetto schema di tipo indice e quindi definire un indice di dominio nelle colonne di tabella o negli attributi di un tipo di oggetto. L'indicizzazione estensibile può elaborare in modo efficiente operatori specifici dell'applicazione.
Il software applicativo, denominato cartuccia, controlla la struttura e il contenuto di un indice del dominio. Il database interagisce con l'applicazione per creare, gestire e cercare l'indice del dominio. La struttura dell'indice può essere memorizzata nel database come tabella organizzata dall'indice o esternamente come file.
Vedere anche:
-
Oracle AI Database Development Guide per ulteriori informazioni su tipi di dati complessi
-
Oracle AI Database Data Cartridge Developer's Guide per informazioni sull'uso delle cartucce dati all'interno dell'architettura di estensibilità di Oracle AI Database
Panoramica degli indici HNSW quantizzati scalari
Gli indici HNSW (hierarchical Navigable Small World) possono essere utilizzati per ridurre i requisiti di memoria e accelerare la ricerca della somiglianza.
Nel contesto dei database vettoriali, la quantizzazione scalare è un metodo di compressione o approssimazione dei vettori di dati ad alta dimensione quantificando in modo indipendente ogni dimensione (o componente scalare) del vettore. Questo approccio viene utilizzato per ridurre i requisiti di storage di un database vettoriale, preservando al contempo la struttura essenziale dei dati per attività come la ricerca di somiglianza. La quantizzazione scalare può essere particolarmente utile quando la semplicità e i bassi requisiti di storage sono priorità elevate.
I vettori ad alta dimensione memorizzati come numeri a virgola mobile richiedono uno spazio di archiviazione significativo. La quantizzazione scalare consente di risparmiare memoria comprimendo i vettori. Ad esempio, un vettore a 128 dimensioni memorizzato in 8 bit (INT8) per dimensione richiede solo 128 byte di memoria, mentre lo storage a virgola mobile a 32 bit (Float32) richiederebbe 512 byte e lo storage doppio a 64 bit (Float64) richiederebbe 1024 byte. A causa di questo requisito di storage ridotto, la quantizzazione scalare può consentire ai database vettoriali di gestire set di dati molto grandi, composti anche da miliardi di vettori, che altrimenti sarebbero impraticabili a causa dei vincoli di storage.
Un altro vantaggio della quantizzazione scalare è una maggiore velocità di ricerca. I metodi di ricerca vicino più vicino (ANN) possono sfruttare i dati quantizzati per confronti più rapidi, poiché le operazioni su numeri interi o codici binari sono più veloci dei calcoli a virgola mobile.
Con Oracle AI Database, la quantizzazione scalare uniforme è il metodo di compressione implementato, il che significa che l'intervallo di input è diviso in intervalli di dimensioni uguali. Ogni intervallo è rappresentato da un singolo livello di quantizzazione, di solito il suo punto medio. L'intervallo di ogni dimensione è diviso in intervalli uguali 2b, dove b è il numero di bit (ad esempio, 8 bit per int8). Ogni valore a virgola mobile viene mappato al livello di quantizzazione più vicino.
Vedere anche:
-
Oracle AI Database AI Vector Search User's Guide per la sintassi e i parametri dell'indice HNSW
-
Oracle AI Database SQL Language Reference per l'istruzione
CREATE VECTOR INDEX
Panoramica delle tabelle organizzate a indice
Una tabella organizzata con indice è una tabella memorizzata in una variazione di una struttura di indice B-tree. Al contrario, una tabella organizzata per heap inserisce le righe in cui rientrano.
In una tabella organizzata a indice, le righe vengono memorizzate in un indice definito sulla chiave primaria per la tabella. Ogni voce di indice nell'albero B memorizza anche i valori di colonna non chiave. Pertanto, l'indice è i dati e i dati sono l'indice. Le applicazioni manipolano le tabelle organizzate a indice proprio come le tabelle organizzate a heap, utilizzando istruzioni SQL.
Per un'analogia di un tavolo organizzato da un indice, supponiamo che un responsabile delle risorse umane abbia un caso di libro di scatole di cartone. Ogni scatola è etichettata con un numero-1, 2, 3, 4 e così via, ma le scatole non siedono sugli scaffali in ordine sequenziale. Ogni casella contiene invece un puntatore alla posizione dello scaffale della casella successiva nella sequenza.
Le cartelle contenenti i record dipendente vengono memorizzate in ogni casella. Le cartelle sono ordinate in base all'ID dipendente. Employee King ha l'ID 100, che è l'ID più basso, quindi la sua cartella si trova in fondo alla casella 1. La cartella per il dipendente 101 è sopra 100, 102 è sopra 101 e così via fino a quando la casella 1 è piena. La cartella successiva della sequenza si trova nella parte inferiore della casella 2.
In questa analogia, ordinare le cartelle per ID dipendente consente di cercare in modo efficiente le cartelle senza dover mantenere un indice separato. Si supponga che un utente richieda i record per i dipendenti 107, 120 e 122. Invece di cercare un indice in un passo e recuperare le cartelle in un passo separato, il manager può cercare le cartelle in ordine sequenziale e recuperare ogni cartella come trovato.
Le tabelle organizzate a indice consentono un accesso più rapido alle righe di tabella in base alla chiave principale o a un prefisso valido della chiave. La presenza di colonne non chiave di una riga nel blocco foglia evita un I/O di blocco dati aggiuntivo. Ad esempio, lo stipendio del dipendente 100 viene memorizzato nella riga indice stessa. Inoltre, poiché le righe sono memorizzate nell'ordine della chiave primaria, l'accesso all'intervallo da parte della chiave primaria o del prefisso comporta un numero minimo di I/O a blocchi. Un altro vantaggio è l'evitare il sovraccarico di spazio di un indice di chiave primaria separato.
Le tabelle organizzate a indice sono utili quando le parti di dati correlate devono essere archiviate insieme o i dati devono essere memorizzati fisicamente in un ordine specifico. Un uso tipico di questo tipo di tabella è per il recupero delle informazioni, i dati spaziali e le applicazioni OLAP.
-
Caratteristiche tabella organizzata a indice Il sistema di database esegue tutte le operazioni su tabelle organizzate a indice manipolando la struttura di indice B-tree.
-
Tabelle organizzate a indice con area di overflow delle righe Quando si crea una tabella organizzata a indice, è possibile specificare un segmento separato come area di overflow delle righe.
-
Indici secondari per tabelle organizzate a indice Un indice secondario è un indice di una tabella organizzata a indice.
Vedere anche:
-
Oracle Spatial Developer's Guide per una panoramica su Oracle Spatial and Graph
-
Oracle AI Database Administrator's Guide per informazioni su come gestire le tabelle organizzate a indice
-
Oracle AI Database SQL Language Reference per sintassi e semantica
CREATE TABLE ... ORGANIZATION INDEX
Caratteristiche tabella organizzata a indice
Il sistema di database esegue tutte le operazioni su tabelle organizzate a indice manipolando la struttura di indice B-tree.
Nella tabella seguente sono riepilogate le differenze tra le tabelle organizzate a indice e le tabelle organizzate a heap.
Tabella 6 Confronto delle tabelle organizzate per heap con tabelle organizzate per indice
| Tabella organizzata heap | Tabella organizzata a indice |
|---|---|
| L'ID riga identifica in modo univoco una riga. È possibile definire facoltativamente il vincolo di chiave primaria. | La chiave primaria identifica in modo univoco una riga. È necessario definire il vincolo della chiave primaria. |
L'ID riga fisico nella pseudocolonna ROWID consente di creare indici secondari. |
L'ID riga logico nella pseudocolonna ROWID consente di creare indici secondari. |
| È possibile accedere direttamente alle singole righe in base all'ID riga. | L'accesso alle singole righe può essere ottenuto indirettamente mediante chiave primaria. |
| La scansione tabella completa sequenziale restituisce tutte le righe in un determinato ordine. | Una scansione completa dell'indice o una scansione rapida dell'indice completo restituisce tutte le righe in un determinato ordine. |
| Può essere memorizzato in un cluster tabella con altre tabelle. | Impossibile memorizzarlo in un cluster di tabelle. |
Può contenere una colonna del tipo di dati LONG e colonne dei tipi di dati LOB. |
Può contenere colonne LOB, ma non colonne LONG. |
| Può contenere colonne virtuali (sono supportate solo tabelle heap relazionali). | Impossibile contenere colonne virtuali. |
Le tabelle organizzate a indice possono essere compresse utilizzando la compressione Advanced Low aggiungendo la clausola COMPRESS ADVANCED LOW all'istruzione CREATE TABLE. Advanced Low compressione è una forma adattiva di compressione del prefisso che calcola autonomamente il numero ottimale di colonne di prefisso per ogni blocco foglia, portando a una compressione ottimale a livello di blocco senza alcun intervento dell'utente. Ciò include la possibilità di non comprimere affatto, se del caso. Ciò garantisce che la compressione negativa non è possibile. I rapporti di compressione maggiori sono osservati con un sovraccarico complessivo trascurabile.
Le scansioni su tabelle organizzate a indice possono essere scaricate in Exadata Smart Scan in cui l'optimizer ha ritenuto che la query possa essere eseguita come scansione completa veloce. Questo non richiede alcun intervento dell'utente. L'elaborazione completa lato cella sarà supportata nei blocchi foglia di tabella organizzati a indice in cui risiedono tutte le colonne di interesse nel blocco foglia. Per i casi in cui alcune colonne risiedono nel segmento di overflow, Smart Scan non elaborerà tali colonne e il database completerà la scansione. La Figura 5-3 illustra la struttura di una tabella departments organizzata a indice. I blocchi foglia contengono le righe della tabella, ordinate in sequenza in base alla chiave primaria. Ad esempio, il primo valore nel primo blocco foglia mostra l'ID reparto 20, il nome reparto Marketing, l'ID manager 201 e l'ID ubicazione 1800.
Figura 3: Tabella indicizzata
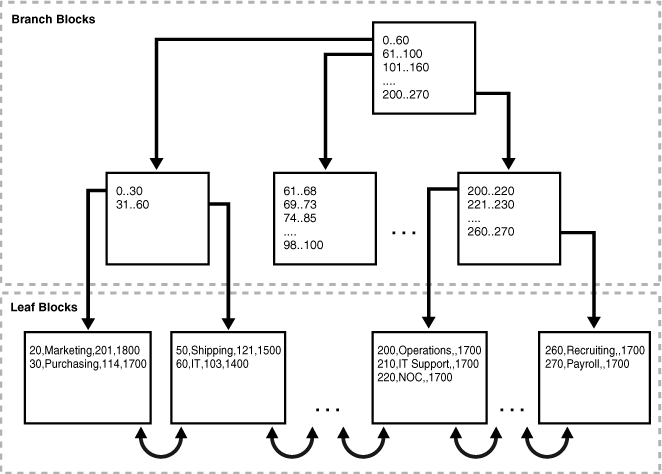
Descrizione dell'illustrazione cncpt272.gif
Esempio di scansione 5-10 della tabella organizzata a indice
Una tabella organizzata a indice memorizza tutti i dati nella stessa struttura e non deve memorizzare l'ID riga. Come illustrato nella Figura 5-3, il blocco foglia 1 di una tabella organizzata in un indice può contenere le voci riportate di seguito, ordinate in base alla chiave primaria.
20,Marketing,201,1800
30,Purchasing,114,1700
Il blocco foglia 2 in una tabella organizzata a indice può contenere voci come indicato di seguito.
50,Shipping,121,1500
60,IT,103,1400
Una scansione delle righe di tabella organizzate a indice nell'ordine delle chiavi primarie legge i blocchi nella seguente sequenza:
-
Blocco 1
-
Blocco 2
Esempio di scansione 5-11 della tabella organizzata heap
Per confrontare l'accesso ai dati in una tabella organizzata dall'heap con una tabella organizzata dall'indice, si supponga che il blocco 1 di un segmento di tabella departments organizzato dall'heap contenga le righe riportate di seguito.
50,Shipping,121,1500
20,Marketing,201,1800
Il blocco 2 contiene righe per la stessa tabella come segue:
30,Purchasing,114,1700
60,IT,103,1400
Un blocco foglia di indice B-tree per questa tabella organizzata da heap contiene le voci seguenti, in cui il primo valore è la chiave primaria e il secondo è l'ID riga:
20,AAAPeXAAFAAAAAyAAD
30,AAAPeXAAFAAAAAyAAA
50,AAAPeXAAFAAAAAyAAC
60,AAAPeXAAFAAAAAyAAB
Una scansione delle righe della tabella nell'ordine delle chiavi primarie legge i blocchi dei segmenti della tabella nella sequenza seguente:
-
Blocco 1
-
Blocco 2
-
Blocco 1
-
Blocco 2
Pertanto, il numero di I/O di blocco in questo esempio è il doppio del numero nell'esempio organizzato dall'indice.
Vedere anche:
per saperne di più sulle tabelle organizzate in heap
per saperne di più sulla relazione tra segmenti e blocchi di dati
Tabelle organizzate a indice con area di overflow delle righe
Quando si crea una tabella organizzata a indice, è possibile specificare un segmento separato come area di overflow delle righe.
Nelle tabelle organizzate a indice, le voci dell'indice B-tree possono essere grandi perché contengono un'intera riga, pertanto è utile un segmento separato per contenere le voci. Al contrario, le voci dell'albero B sono solitamente piccole perché sono costituite dalla chiave e dal rowid.
Se viene specificata un'area di overflow delle righe, il database può suddividere una riga in una tabella organizzata a indice nelle seguenti parti:
-
La voce dell'indice
Questa parte contiene i valori di colonna per tutte le colonne chiave primaria, un ID riga fisico che punta alla parte di overflow della riga e, facoltativamente, alcune colonne non chiave. Questa parte è memorizzata nel segmento indice.
-
La parte di overflow
Questa parte contiene valori di colonna per le colonne non chiave rimanenti. Questa parte viene memorizzata nel segmento dell'area di memorizzazione di overflow.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come utilizzare la clausola
OVERFLOWdiCREATE TABLEper impostare un'area di overflow delle righe -
Oracle AI Database SQL Language Reference per sintassi e semantica
CREATE TABLE ... OVERFLOW
Indici secondari nelle tabelle indicizzate
Un indice secondario è un indice di una tabella organizzata a indice.
In un certo senso, un indice secondario è un indice su un indice. Si tratta di un oggetto schema indipendente e viene memorizzato separatamente dalla tabella organizzata a indice.
Oracle AI Database utilizza identificativi di riga denominati ID di riga logici per le tabelle organizzate a indice. Un ID riga logico è una rappresentazione con codifica base64 della chiave primaria della tabella. La lunghezza dell'ID riga logico dipende dalla lunghezza della chiave primaria.
Le righe nei blocchi foglia indice possono spostarsi all'interno o tra i blocchi a causa degli inserimenti. Le righe nelle tabelle organizzate in indice non vengono migrate come fanno le righe organizzate in heap. Poiché le righe nelle tabelle organizzate in indice non dispongono di indirizzi fisici permanenti, il database utilizza ID riga logici in base alla chiave primaria.
Ad esempio, si supponga che la tabella departments sia organizzata in base all'indice. Nella colonna location_id viene memorizzato l'ID di ogni reparto. La tabella memorizza le righe come indicato di seguito, con l'ultimo valore come ID ubicazione:
10,Administration,200,1700
20,Marketing,201,1800
30,Purchasing,114,1700
40,Human Resources,203,2400
Un indice secondario nella colonna location_id potrebbe avere voci di indice come indicato di seguito, in cui il valore che segue la virgola è l'ID riga logico:
1700,*BAFAJqoCwR/+
1700,*BAFAJqoCwQv+
1800,*BAFAJqoCwRX+
2400,*BAFAJqoCwSn+
Gli indici secondari forniscono un accesso rapido ed efficiente alle tabelle organizzate in base all'indice utilizzando colonne che non sono né la chiave primaria né un prefisso della chiave primaria. Ad esempio, una query dei nomi dei reparti con ID maggiore di 1700 potrebbe utilizzare l'indice secondario per velocizzare l'accesso ai dati.
-
Rayid logici e indovinelli fisici Gli indici secondari utilizzano gli ID riga logici per individuare le righe della tabella.
-
Indici bitmap nelle tabelle organizzate mediante indice Un indice secondario in una tabella organizzata mediante indice può essere un indice bitmap. Un indice bitmap memorizza una bitmap per ogni chiave indice.
Vedere anche:
-
"Tipi di dati riga" per ulteriori informazioni sull'uso degli ID riga e sulla pseudocolonna
ROWID -
"Righe acquisite e migrate" per scoprire perché le righe vengono migrate e perché la migrazione aumenta il numero di I/O
-
Oracle AI Database Administrator's Guide per informazioni su come creare indici secondari in una tabella organizzata a indice
-
Oracle AI Database VLDB and Partitioning Guide per informazioni sulla creazione di indici secondari su partizioni di tabelle indicizzate-organizzate
Rowidi logici e indovinelli fisici
Gli indici secondari utilizzano gli ID riga logici per individuare le righe della tabella.
Un rowid logico include un'ipotesi fisica, ovvero l'ID fisico della voce di indice al momento della prima creazione. Oracle AI Database può utilizzare ipotesi fisiche per esaminare direttamente il blocco foglia della tabella organizzata a indice, ignorando la ricerca della chiave primaria. Quando la posizione fisica di una riga cambia, l'ID riga logico rimane valido anche se contiene un'ipotesi fisica non più valida.
Per una tabella organizzata dall'heap, l'accesso mediante un indice secondario comporta una scansione dell'indice secondario e un I/O aggiuntivo per recuperare il blocco di dati contenente la riga. Per le tabelle organizzate a indice, l'accesso da parte di un indice secondario varia, a seconda dell'uso e della precisione delle congetture fisiche:
-
Senza ipotesi fisiche, l'accesso comporta due scansioni dell'indice: una scansione dell'indice secondario seguita da una scansione dell'indice della chiave primaria.
-
Con ipotesi fisiche, l'accesso dipende dalla loro precisione:
-
Con ipotesi fisiche accurate, l'accesso implica una scansione di indice secondaria e un I/O aggiuntivo per recuperare il blocco di dati contenente la riga.
-
Con ipotesi fisiche imprecise, l'accesso implica una scansione dell'indice secondario e un I/O per recuperare il blocco di dati errato (come indicato dall'ipotesi), seguito da una scansione univoca dell'indice della tabella organizzata dall'indice in base al valore della chiave primaria.
-
Indici bitmap su tabelle indicizzate
Un indice secondario in una tabella organizzata a indice può essere un indice bitmap. Un indice bitmap memorizza una bitmap per ogni chiave indice.
Quando esistono indici bitmap in una tabella organizzata da indice, tutti gli indici bitmap utilizzano una tabella di mapping organizzata da heap. Nella tabella di mapping sono memorizzati gli ID riga logici della tabella organizzata a indice. Ogni riga della tabella di mapping memorizza un rowid logico per la riga corrispondente della tabella organizzata mediante indice.
Il database accede a un indice bitmap utilizzando una chiave di ricerca. Se il database trova la chiave, la voce bitmap viene convertita in un rowid fisico. Con tabelle organizzate in heap, il database utilizza l'ID riga fisico per accedere alla tabella di base. Con le tabelle organizzate a indice, il database utilizza l'ID riga fisico per accedere alla tabella di mapping, che a sua volta produce un ID riga logico utilizzato dal database per accedere alla tabella organizzata a indice. La figura seguente illustra l'accesso all'indice per una query della tabella departments_iot.
Figura 4: Indice bitmap nella tabella organizzata a indice
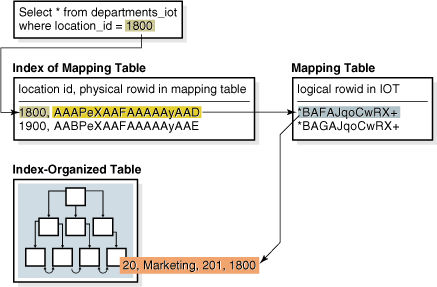
Descrizione dell'illustrazione cncpt330.gif
Nota: lo spostamento delle righe in una tabella organizzata a indice non rende inutilizzabili gli indici bitmap creati su tale tabella organizzata a indice.
Vedere anche: "Righe dei pezzi di riga" per informazioni sulle differenze tra i rowid fisici e logici