Tabelle e cluster di tabelle
Questo capitolo fornisce un'introduzione agli oggetti dello schema e illustra le tabelle, che sono i tipi più comuni di oggetti dello schema.
-
Introduzione agli oggetti dello schema Uno schema del database è un contenitore logico per le strutture di dati, denominate oggetti dello schema. Esempi di oggetti di schema sono tabelle e indici. È possibile creare e manipolare gli oggetti dello schema con SQL.
-
Panoramica delle tabelle Una tabella è l'unità di base dell'organizzazione dati in un database Oracle.
-
Panoramica dei cluster di tabelle Un cluster di tabelle è un gruppo di tabelle che condividono colonne comuni e memorizzano dati correlati negli stessi blocchi.
-
Panoramica delle tabelle in cluster di attributi Una tabella in cluster di attributi è una tabella organizzata in heap che memorizza i dati in prossimità del disco in base alle direttive di clustering specificate dall'utente. Le direttive specificano le colonne in una o più tabelle.
-
Panoramica sulle tabelle temporanee Una tabella temporanea contiene dati esistenti solo per la durata di una transazione o di una sessione.
-
Panoramica delle tabelle esterne Una tabella esterna accede ai dati nelle origini esterne come se questi dati fossero contenuti in una tabella del database.
-
Panoramica delle tabelle blockchain Una tabella blockchain è una tabella di sola aggiunta progettata per le applicazioni blockchain centralizzate.
-
Panoramica delle tabelle immutabili Le tabelle immutabili sono tabelle di sola aggiunta che impediscono modifiche non autorizzate ai dati da parte di addetti interni e modifiche accidentali ai dati derivanti da errori umani.
-
Panoramica delle tabelle degli oggetti Una tabella degli oggetti è un tipo speciale di tabella in cui ogni riga rappresenta un oggetto.
Introduzione agli oggetti schema
Uno schema del database è un contenitore logico per le strutture di dati, denominate oggetti dello schema. Esempi di oggetti di schema sono tabelle e indici. È possibile creare e manipolare gli oggetti dello schema con SQL.
Questa sezione contiene gli argomenti riportati di seguito.
-
Informazioni sugli account utente comuni e locali Un account utente del database dispone di una password e di privilegi di database specifici.
-
Oggetti comuni e locali Un oggetto comune è definito nella radice CDB o nella radice di un'applicazione e può essere utilizzato come riferimento mediante collegamenti metadati o collegamenti oggetto. Un oggetto locale è ogni oggetto che non è un oggetto comune.
-
Tipi di oggetto schema Oracle SQL consente di creare e manipolare molti altri tipi di oggetti schema.
-
Storage degli oggetti dello schema Alcuni oggetti dello schema memorizzano i dati in un tipo di struttura di storage logica denominata segmento. Ad esempio, una tabella organizzata heap non partizionata o un indice crea un segmento.
-
Dipendenze degli oggetti schema Alcuni oggetti schema fanno riferimento ad altri oggetti, creando una dipendenza degli oggetti schema.
-
Schemi di esempio Un database Oracle può includere schemi di esempio, che sono un set di schemi interconnessi che consentono alla documentazione Oracle e ai materiali informativi Oracle di illustrare task comuni del database. Vedere anche: Oracle AI Database Security Guide per ulteriori informazioni su utenti e privilegi
Informazioni sugli account utente comuni e locali
Un account utente del database dispone di una password e di privilegi di database specifici.
Account e schemi utente
Ogni account utente possiede un singolo schema, che ha lo stesso nome dell'utente. Lo schema contiene i dati per l'utente proprietario dello schema. Ad esempio, l'account utente hr è proprietario dello schema hr, che contiene oggetti di schema come la tabella employees. In un database di produzione, il proprietario dello schema di solito rappresenta un'applicazione di database piuttosto che una persona.
All'interno di uno schema, ogni oggetto schema di un tipo particolare ha un nome univoco. Ad esempio, hr.employees fa riferimento alla tabella employees dello schema hr. La figura seguente mostra un proprietario dello schema denominato hr e oggetti dello schema all'interno dello schema hr.
Figura 1: Schema HR
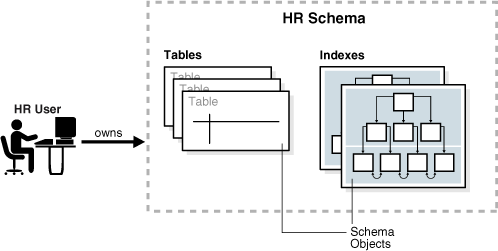
Descrizione dell'illustrazione cncpt230.gif
Account utente comuni e locali
Se un account utente è proprietario di oggetti che definiscono il database, questo account utente è comune. Gli account utente non forniti da Oracle sono locali o comuni. Un utente comune di CDB è un utente comune creato nella directory root del CDB. Un utente comune dell'applicazione è un utente creato in una radice dell'applicazione ed è comune solo all'interno di questo contenitore dell'applicazione.
L'immagine seguente mostra i possibili tipi di account utente in un CDB.
Figura 2: Account utente in un CDB
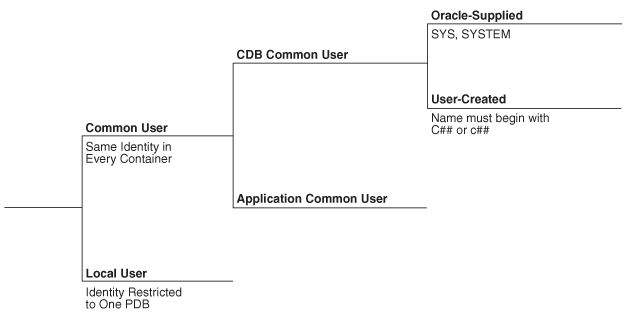
Descrizione dell'illustrazione cncpt370.png
Un utente comune di un CDB può connettersi a qualsiasi contenitore nel CDB a cui disponga di privilegi sufficienti. Al contrario, un utente comune dell'applicazione può connettersi solo alla radice dell'applicazione in cui è stata creata oppure a un PDB collegato a questa radice dell'applicazione, a seconda dei relativi privilegi.
-
Account utente comuni Nel contesto del contenitore di sistema (CDB) o di un contenitore di applicazioni, un utente comune è un utente di database che ha la stessa identità nella radice e in ogni PDB esistente e futuro all'interno di questo contenitore.
-
Account utente locali Un utente locale è un utente di database che non è comune e può funzionare solo all'interno di un singolo PDB.
Account utente comuni
Nel contesto del contenitore di sistema (CDB) o di un contenitore di applicazioni, un utente comune è un utente di database che ha la stessa identità nella radice e in ogni PDB esistente e futuro all'interno di questo contenitore.
Ogni utente comune può connettersi ed eseguire operazioni all'interno della radice del contenitore e all'interno di qualsiasi PDB in cui dispone di privilegi sufficienti. Alcune attività amministrative devono essere eseguite da un utente comune. Ad esempio, la creazione di un PDB e lo scollegamento di un PDB.
Ad esempio, SYSTEM è un utente comune CDB con privilegi DBA. Pertanto, SYSTEM può connettersi alla radice CDB e a qualsiasi PDB nel database. È possibile creare un utente comune saas_sales_admin nel contenitore dell'applicazione saas_sales. In questo caso, l'utente saas_sales_admin può connettersi solo alla radice dell'applicazione saas_sales o a un PDB dell'applicazione nel contenitore dell'applicazione saas_sales.
Ogni utente comune è fornito da Oracle o creato dall'utente. Esempi di utenti comuni forniti da Oracle sono SYS e SYSTEM. Ogni utente comune creato dall'utente è un utente comune CDB o un utente comune dell'applicazione.
La figura seguente mostra gli utenti e gli schemi di esempio in due PDB: hrpdb e salespdb. SYS e c##dba sono utenti comuni CDB che dispongono di schemi in CDB$ROOT, hrpdb e salespdb. Gli utenti locali hr e rep esistono in hrpdb. Gli utenti locali hr e rep esistono anche in salespdb.
Figura 3: Utenti e schemi in un CDB
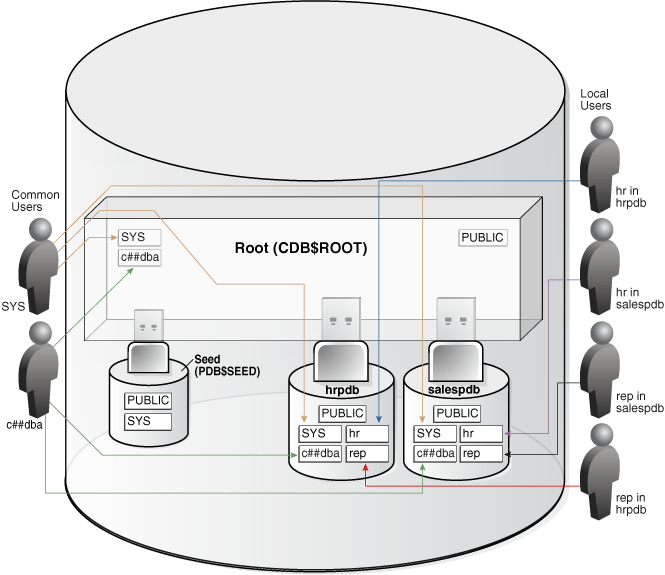
Descrizione dell'illustrazione cncpt340.png
Gli utenti comuni presentano le caratteristiche riportate di seguito.
-
Un utente comune può eseguire il login a qualsiasi contenitore (incluso
CDB$ROOT) in cui dispone del privilegioCREATE SESSION.Un utente comune non deve disporre degli stessi privilegi in ogni contenitore. Ad esempio, l'utente
c##dbapuò disporre del privilegio per creare una sessione inhrpdbe nella radice, ma non per creare una sessione insalespdb. Poiché un utente comune con i privilegi appropriati può passare da un contenitore all'altro, un utente comune nella root può amministrare i PDB. -
Un utente comune dell'applicazione non dispone del privilegio
CREATE SESSIONin alcun contenitore esterno al proprio contenitore dell'applicazione.Pertanto, un utente comune dell'applicazione è limitato al proprio contenitore dell'applicazione. Ad esempio, l'utente comune dell'applicazione creato nell'applicazione
saas_salespuò connettersi solo alla radice dell'applicazione e ai PDB nel contenitore dell'applicazionesaas_sales. -
I nomi degli utenti CDB creati dall'utente devono seguire le regole di denominazione per gli altri utenti del database. Inoltre, i nomi devono iniziare con i caratteri specificati dal parametro di inizializzazione
COMMON_USER_PREFIX, ovveroc##oC##per impostazione predefinita. Questa restrizione non riguarda i nomi utente comuni forniti da Oracle e i nomi utente comuni dell'applicazione creati dall'utente.Nessun nome utente locale può iniziare con i caratteri
c##oC##. -
Ogni utente comune ha un nome univoco in tutti i PDB all'interno del contenitore (il contenitore di sistema o un contenitore di applicazioni specifico) in cui è stato creato.
Un utente comune CDB viene definito nella radice CDB, ma deve essere in grado di connettersi a ogni PDB con la stessa identità. Un utente comune dell'applicazione risiede nella radice dell'applicazione e può connettersi a ogni PDB dell'applicazione nel relativo contenitore con la stessa identità.
-
Caratteristiche degli utenti comuni Ogni utente comune è fornito da Oracle o creato dall'utente.
-
Account SYS e SYSTEM Tutti i database Oracle includono account utente comuni predefiniti con privilegi amministrativi.
Caratteristiche degli utenti comuni
Ogni utente comune è fornito da Oracle o creato dall'utente.
Gli account utente comuni presentano le caratteristiche riportate di seguito.
-
Un utente comune può eseguire il login a qualsiasi contenitore (incluso
CDB$ROOT) in cui dispone del privilegioCREATE SESSION.Un utente comune non deve disporre degli stessi privilegi in ogni contenitore. Ad esempio, l'utente
c##dbapuò disporre del privilegio per creare una sessione inhrpdbe nella root, ma non per creare una sessione insalespdb. Poiché un utente comune con i privilegi appropriati può passare da un contenitore all'altro, un utente comune nella root può amministrare i PDB. -
Un utente comune dell'applicazione non dispone del privilegio
CREATE SESSIONin alcun contenitore esterno al proprio contenitore dell'applicazione.Pertanto, un utente comune dell'applicazione è limitato al proprio contenitore dell'applicazione. Ad esempio, l'utente comune dell'applicazione creato nell'applicazione
saas_salespuò connettersi solo alla radice dell'applicazione e ai PDB nel contenitore dell'applicazionesaas_sales. -
I nomi degli utenti CDB creati dall'utente devono seguire le regole di denominazione per gli altri utenti del database. Inoltre, i nomi devono iniziare con i caratteri specificati dal parametro di inizializzazione
COMMON_USER_PREFIX, ovveroc##oC##per impostazione predefinita. Questa restrizione non riguarda i nomi utente comuni forniti da Oracle e i nomi utente comuni dell'applicazione creati dall'utente.Nessun nome utente locale può iniziare con i caratteri
c##oC##. -
Ogni utente comune ha un nome univoco in tutti i PDB all'interno del contenitore (il contenitore di sistema o un contenitore di applicazioni specifico) in cui è stato creato.
Un utente comune CDB viene definito nella radice CDB, ma deve essere in grado di connettersi a ogni PDB con la stessa identità. Un utente comune dell'applicazione risiede nella radice dell'applicazione e può connettersi a ogni PDB dell'applicazione nel relativo contenitore con la stessa identità.
La figura seguente mostra gli utenti e gli schemi di esempio in due PDB: hrpdb e salespdb. SYS e c##dba sono utenti comuni CDB che dispongono di schemi in CDB$ROOT, hrpdb e salespdb. Gli utenti locali hr e rep esistono in hrpdb. Gli utenti locali hr e rep esistono anche in salespdb.
Figura 4: Utenti e schemi in un CDB
Descrizione dell'illustrazione cncpt340.png
Vedere anche:
-
Oracle AI Database Security Guide per ulteriori informazioni sugli account utente comuni
-
Oracle AI Database Reference per saperne di più su
COMMON_USER_PREFIX
Account SYS e SYSTEM
Tutti i database Oracle includono account utente comuni predefiniti con privilegi di amministrazione.
Gli account amministrativi sono dotati di privilegi importanti e sono destinati solo a DBA autorizzati a eseguire task come l'avvio e l'arresto del database, la gestione della memoria e della memoria, la creazione e la gestione di utenti di database e così via.
L'account utente comune SYS viene creato automaticamente quando viene creato un database. Questo account è possibile eseguire tutte le funzioni amministrative del database. Lo schema SYS memorizza le tabelle e le viste di base per il dizionario dati. Le tabelle e le viste di base rivestono un'influenza fondamentale per il funzionamento di Oracle AI Database. Le tabelle nello schema SYS vengono manipolate solo dal database e non devono mai essere modificate da alcun utente.
Anche l'account amministrativo SYSTEM viene creato automaticamente quando viene creato un database. Lo schema SYSTEM memorizza tabelle e viste aggiuntive che visualizzano informazioni amministrative, nonché tabelle e viste interne utilizzate da diverse opzioni e strumenti Oracle AI Database. Non utilizzare mai lo schema SYSTEM per memorizzare le tabelle di interesse per gli utenti non amministrativi.
Vedere anche:
-
Oracle AI Database Security Guide per informazioni sugli account utente
-
Oracle AI Database Administrator's Guide per ulteriori informazioni su
SYS,SYSTEMe altri account amministrativi
Account utente locali
Un utente locale è un utente del database che non è comune e può funzionare solo all'interno di un singolo PDB.
Gli utenti locali hanno le seguenti caratteristiche:
-
Un utente locale è specifico di un PDB e può essere proprietario di uno schema in questo PDB.
Nell'esempio illustrato in "Caratteristiche degli utenti comuni", l'utente locale
hrinhrpdbè proprietario dello schemahr. Insalespdb, l'utente localerepè proprietario dello schemarepe l'utente localehrè proprietario dello schemahr. -
Un utente locale può amministrare un PDB, inclusa l'apertura e la chiusura.
Un utente comune con privilegi
SYSDBApuò concedere privilegiSYSDBAa un utente locale. In questo caso, l'utente con privilegi rimane locale. -
Un utente locale in un PDB non può eseguire il login a un altro PDB o alla radice del CDB.
Ad esempio, quando l'utente locale
hrsi connette ahrpdb,hrnon può accedere agli oggetti nello schemashche risiedono nel databasesalespdbsenza utilizzare un database link. Allo stesso modo, quando l'utente localeshsi connette al PDBsalespdb,shnon può accedere agli oggetti nello schemahrche risiede inhrpdbsenza utilizzare un database link. -
Il nome di un utente locale non deve iniziare con i caratteri
c##oC##. -
Il nome di un utente locale deve essere univoco solo all'interno del PDB.
Il nome utente e il PDB in cui è contenuto lo schema utente determinano un utente locale univoco. "Caratteristiche degli utenti comuni" indica che un utente locale e uno schema denominato
repesistono inhrpdb. Un utente locale completamente indipendente e uno schema denominatorepesistono nel PDBsalespdb.
Nella tabella seguente viene descritto uno scenario che coinvolge il CDB in "Caratteristiche degli utenti comuni". Ogni riga descrive un'azione che si verifica dopo l'azione nella riga precedente. L'utente comune SYSTEM crea utenti locali in due PDB.
Tabella 1 Utenti locali in un CDB
| Operazione | Descrizione |
|---|---|
|
SYSTEM si connette al contenitore hrpdb utilizzando il nome del servizio hrpdb. |
|
SYSTEM ora crea un utente locale rep e concede il privilegio CREATE SESSION in questo PDB a questo utente. L'utente è locale perché gli utenti comuni possono essere creati solo da un utente comune connesso all'utente root. |
|
L'utente rep, che è locale a hrpdb, tenta di connettersi a salespdb. Il tentativo non riesce perché rep non esiste nel PDB salespdb. |
|
SYSTEM si connette al contenitore salespdb utilizzando il nome del servizio salespdb. |
|
SYSTEM crea un utente locale rep in salespdb e concede il privilegio CREATE SESSION in questo PDB a questo utente. Poiché il nome di un utente locale deve essere univoco solo all'interno del PDB, un utente denominato rep può esistere sia in salespdb che in hrpdb. |
|
L'utente rep esegue il login a salespdb. |
Vedere anche: Oracle AI Database Security Guide per informazioni sugli account utente locali
Oggetti comuni e locali
Un oggetto comune è definito nella radice CDB o nella radice di un'applicazione e può essere utilizzato come riferimento mediante collegamenti metadati o collegamenti oggetto. Un oggetto locale è ogni oggetto che non è un oggetto comune.
Gli oggetti comuni forniti dal database sono definiti in CDB$ROOT e non possono essere modificati. Oracle Database non supporta la creazione di oggetti comuni in CDB$ROOT.
È possibile creare la maggior parte degli oggetti dello schema, ad esempio tabelle, viste, program unit PL/SQL e Java, sequenze e così via come oggetti comuni in una radice dell'applicazione. Se l'oggetto esiste in una radice applicazione, viene definito oggetto comune applicazione.
Un utente locale può possedere un oggetto comune. Inoltre, un utente comune può possedere un oggetto locale, ma solo quando l'oggetto non è collegato ai dati o ai metadati e non è né un collegamento ai metadati né un collegamento ai dati.
Vedere anche: Oracle AI Database Security Guide per ulteriori informazioni sulla gestione dei privilegi per oggetti comuni
Tipi di oggetto schema
Oracle SQL consente di creare e manipolare molti altri tipi di oggetti dello schema.
Nella tabella seguente vengono visualizzati i tipi principali di oggetti dello schema.
Oggetti schema tabella 2
| Oggetto | Descrizione | Per saperne di più |
|---|---|---|
| Tabella | Una tabella memorizza i dati nelle righe. Le tabelle sono gli oggetti di schema più importanti in un database relazionale. | "Panoramica delle tabelle" |
| Indici | Gli indici sono oggetti di schema che contengono una voce per ogni riga indicizzata della tabella o cluster di tabelle e forniscono un accesso diretto e rapido alle righe. Oracle AI Database supporta diversi tipi di indice. Una tabella organizzata con indice è una tabella in cui i dati vengono memorizzati in una struttura di indice. | "Indici e tabelle indicizzate" |
| Partizioni | Le partizioni sono parti di tabelle e indici di grandi dimensioni. Ogni partizione ha il proprio nome e può facoltativamente avere le proprie caratteristiche di storage. | "Panoramica delle partizioni" |
| Viste | Le viste sono presentazioni personalizzate dei dati di una o più tabelle o delle altre viste. Possono essere considerate come query memorizzate. Le viste non contengono effettivamente dati. | "Panoramica delle viste" |
| Sequenze | Una sequenza è un oggetto creato dall'utente che può essere condiviso da più utenti per generare numeri interi. In genere, si utilizzano sequenze per generare valori di chiave primaria. | "Panoramica delle sequenze" |
| Dimensioni | Una dimensione definisce una relazione padre-figlio tra coppie di set di colonne, in cui tutte le colonne di un set di colonne devono provenire dalla stessa tabella. Le dimensioni vengono in genere utilizzate per classificare dati quali clienti, prodotti e ore. | "Panoramica delle dimensioni" |
| Sinonimi | Un sinonimo è un alias per l'altro oggetto dello schema. Poiché si tratta semplicemente di un alias, un sinonimo richiede solo l'archiviazione della propria definizione nel dizionario dati. | "Panoramica dei sinonimi" |
| Sottoprogrammi e package PL/SQL | PL/SQL è l'estensione procedurale Oracle di SQL. Un sottoprogramma PL/SQL è un blocco PL/SQL denominato che può essere richiamato con un set di parametri. Un pacchetto PL/SQL raggruppa tipi, variabili e sottoprogrammi PL/SQL correlati in modo logico. | "Sottoprogrammi PL/SQL" |
Anche altri tipi di oggetti vengono memorizzati nel database e possono essere creati e manipolati con istruzioni SQL, ma non sono contenuti in uno schema. Questi oggetti includono account utente del database, ruoli, contesti e oggetti dizionario.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire gli oggetti dello schema
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sugli oggetti dello schema e degli oggetti del database
Storage degli oggetti schema
Alcuni oggetti dello schema memorizzano i dati in un tipo di struttura di memorizzazione logica denominata segmento. Ad esempio, una tabella o un indice organizzati in heap non partizionati crea un segmento.
Altri oggetti dello schema, ad esempio viste e sequenze, sono costituiti solo da metadati. In questo argomento vengono descritti solo gli oggetti schema con segmenti.
Oracle AI Database memorizza un oggetto schema in modo logico all'interno di uno spazio di tabella. Non esiste alcuna relazione tra schemi e tablespace: una tablespace può contenere oggetti di schemi diversi e gli oggetti di uno schema possono essere contenuti in tablespace diverse. I dati di ciascun oggetto sono contenuti fisicamente in uno o più file di dati.
La figura seguente mostra una possibile configurazione di segmenti di tabella e indice, tablespace e file di dati. Il segmento di dati per una tabella si estende su due file di dati, che fanno entrambi parte della stessa tablespace. Un segmento non può estendersi su più tablespace.
Figura 5: Segmenti, tablespace e file di dati
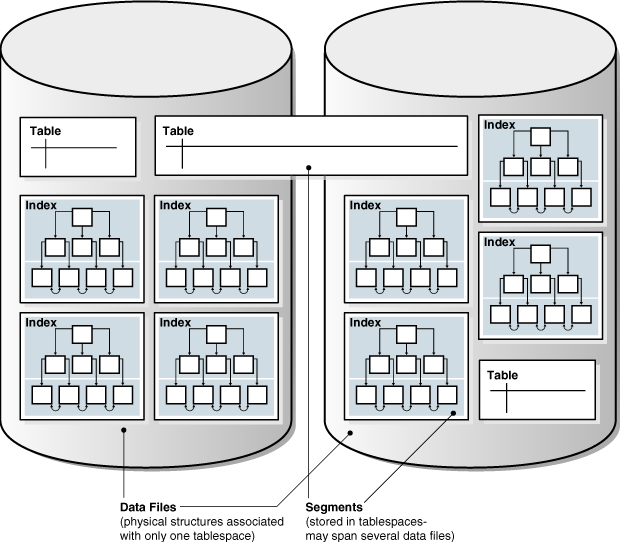
Descrizione dell'illustrazione cncpt284.gif
Vedere anche:
-
"Strutture di storage logiche" per informazioni sulle tablespace e i segmenti
-
Oracle AI Database Administrator's Guide per informazioni su come gestire lo storage per gli oggetti dello schema
Dipendenze oggetto schema
Alcuni oggetti schema fanno riferimento ad altri oggetti, creando una dipendenza degli oggetti schema.
Ad esempio, una vista contiene una query che fa riferimento a tabelle o viste, mentre un sottoprogramma PL/SQL richiama altri sottoprogrammi. Se la definizione dell'oggetto A fa riferimento all'oggetto B, A è un oggetto dipendente su B e B è un oggetto di riferimento per A.
Oracle AI Database fornisce un meccanismo automatico per garantire che un oggetto dipendente sia sempre aggiornato rispetto ai relativi oggetti di riferimento. Quando si crea un oggetto dipendente, il database tiene traccia delle dipendenze tra l'oggetto dipendente e i relativi oggetti di riferimento. Quando un oggetto di riferimento cambia in modo che possa influire su un oggetto dipendente, il database contrassegna l'oggetto dipendente come non valido. Ad esempio, se un utente elimina una tabella, non è possibile utilizzare alcuna vista basata sulla tabella eliminata.
Un oggetto dipendente non valido deve essere ricompilato con la nuova definizione di un oggetto di riferimento prima che l'oggetto dipendente sia utilizzabile. La ricompilazione viene eseguita automaticamente quando si fa riferimento all'oggetto dipendente non valido.
Come esempio di come gli oggetti dello schema possono creare dipendenze, lo script di esempio riportato di seguito crea una tabella test_table e quindi una procedura per eseguire query su questa tabella.
CREATE TABLE test_table ( col1 INTEGER, col2 INTEGER );

CREATE OR REPLACE PROCEDURE test_proc
AS
BEGIN
 FOR x IN ( SELECT col1, col2 FROM test_table )
 LOOP
   -- process data
   NULL;
 END LOOP;
END;
/
La seguente query dello stato della procedura test_proc indica che è valida:
SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Dopo aver aggiunto la colonna col3 a test_table, la procedura è ancora valida perché la procedura non dispone di dipendenze su questa colonna:
SQL> ALTER TABLE test_table ADD col3 NUMBER;

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Tuttavia, la modifica del tipo di dati della colonna col1, da cui dipende la procedura test_proc, invalida la procedura:
SQL> ALTER TABLE test_table MODIFY col1 VARCHAR2(20);

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   INVALID
L'esecuzione o la ricompilazione della procedura la rende nuovamente valida, come mostrato nell'esempio riportato di seguito.
SQL> EXECUTE test_proc

PL/SQL procedure successfully completed.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   VALID
Vedere anche: Oracle AI Database Administrator's Guide e Oracle AI Database Development Guide per informazioni su come gestire le dipendenze degli oggetti dello schema.
Schemi di esempio
Un database Oracle può includere schemi di esempio, che sono un set di schemi interconnessi che consentono alla documentazione Oracle e ai materiali didattici Oracle di illustrare task comuni del database.
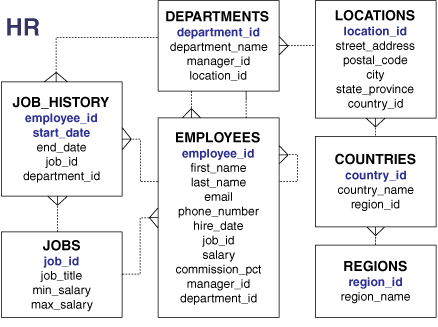
Lo schema di esempio hr contiene informazioni su dipendenti, reparti e ubicazioni, cronologie di lavoro e così via. L'illustrazione seguente illustra un diagramma relativo alle relazioni tra entità delle tabelle in hr. La maggior parte degli esempi in questo manuale utilizza gli oggetti di questo schema.
Figura 6: Schema HR
Descrizione dell'illustrazione cncpt292.gif
Vedere anche: Schemi di esempio di Oracle AI Database per informazioni su come installare gli schemi di esempio
Panoramica delle tabelle
Una tabella è l'unità di base dell'organizzazione dati in un database Oracle.
In una tabella viene descritta una entità, che è un elemento di significato relativo alle informazioni da registrare. Ad esempio, un dipendente potrebbe essere un'entità.
Le tabelle di Oracle AI Database rientrano nelle seguenti categorie di base:
-
Tabelle relazionali
Le tabelle relazionali hanno colonne semplici e sono il tipo di tabella più comune. Nell'Esempio 4-1 viene visualizzata un'istruzione
CREATE TABLEper una tabella relazionale. -
Tabelle oggetti
Le colonne corrispondono agli attributi di livello superiore di un tipo di oggetto. Vedere "Panoramica delle tabelle oggetti".
È possibile creare una tabella relazionale con le caratteristiche organizzative riportate di seguito.
-
Una tabella organizzata dall'heap non memorizza le righe in alcun ordine specifico. L'istruzione
CREATE TABLEcrea una tabella organizzata dall'heap per impostazione predefinita. -
Una tabella organizzata a indice ordina le righe in base ai valori della chiave primaria. Per alcune applicazioni, le tabelle organizzate a indice migliorano le prestazioni e utilizzano lo spazio su disco in modo più efficiente. Per una panoramica delle tabelle organizzate a indice, vedere "Overview of Index Organized Tables".
-
Una tabella esterna è una tabella di sola lettura i cui metadati sono memorizzati nel database, ma i cui dati sono memorizzati al di fuori del database. Vedere "Panoramica delle tabelle esterne".
Una tabella è permanente o temporanea. Una definizione di tabella permanente e i dati persistono tra le sessioni. Una definizione di tabella temporanea persiste come una definizione di tabella permanente, ma i dati esistono solo per la durata di una transazione o di una sessione. Le tabelle temporanee sono utili nelle applicazioni in cui un set di risultati deve essere tenuto temporaneamente, forse perché il risultato viene creato eseguendo più operazioni.
-
Colonne Una definizione di tabella include un nome di tabella e un set di colonne.
-
Righe Una riga è una raccolta di informazioni sulle colonne corrispondenti a un record di una tabella.
-
Esempio: istruzioni CREATE TABLE e ALTER TABLE L'istruzione Oracle SQL per creare una tabella è
CREATE TABLE. -
Tipi di dati Oracle Ogni colonna dispone di un tipo di dati, che è associato a un formato di memorizzazione, vincoli e un intervallo di valori valido specifici. Il tipo di dati di un valore associa un set fisso di proprietà al valore.
-
Vincoli di integrità Un vincolo di integrità è una regola denominata che limita i valori di una o più colonne in una tabella.
-
Memorizzazione tabella Oracle AI Database utilizza un segmento dati in una tablespace per contenere i dati della tabella.
-
Compressione tabella: il database può utilizzare la compressione tabella per ridurre la quantità di storage necessaria per la tabella. Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come gestire le tabelle
Colonne
Una definizione di tabella include un nome di tabella e un set di colonne.
Una colonna identifica un attributo dell'entità descritta dalla tabella. Ad esempio, la colonna employee_id nella tabella employees fa riferimento all'attributo ID dipendente di un'entità dipendente.
In generale, è possibile assegnare a ciascuna colonna un nome di colonna, un tipo di dati e una larghezza quando si crea una tabella. Ad esempio, il tipo di dati per employee_id è NUMBER(6), che indica che questa colonna può contenere solo dati numerici con una larghezza massima di 6 cifre. La larghezza può essere predeterminata dal tipo di dati, come nel caso di DATE.
-
Colonne virtuali Una tabella può contenere una colonna virtuale, detta anche colonna espressione. Le colonne espressione possono essere virtuali, ovvero non memorizzate sul disco o materializzate, ovvero memorizzate sul disco.
-
Colonne invisibili Una colonna invisibile è una colonna specificata dall'utente i cui valori sono visibili solo quando la colonna è specificata in modo esplicito per nome. È possibile aggiungere una colonna invisibile a una tabella senza influire sulle applicazioni esistenti e rendere la colonna visibile, se necessario.
-
Prenotazione senza blocco Una prenotazione senza blocco consente a più aggiornamenti concorrenti su un valore di colonna numerico di continuare senza essere bloccati da aggiornamenti non sottoposti a commit durante l'aggiunta o la sottrazione dal valore della colonna.
Colonne virtuali
Una tabella può contenere una colonna virtuale, detta anche colonna espressione. Le colonne espressione possono essere virtuali, ovvero non memorizzate sul disco o materializzate, ovvero memorizzate sul disco.
Le colonne virtuali, note anche come colonne espressione, derivano i valori calcolando un set di espressioni o funzioni specificate dall'utente. Una tabella può contenere una o più colonne di questo tipo, ma deve sempre avere una colonna normale. Ad esempio, la definizione della tabella EMP riportata di seguito contiene la tariffa oraria calcolata in base allo stipendio del dipendente diviso per 2080 ore all'anno.
CREATE TABLE emp
(
   emp_id           NUMBER(9)     CONSTRAINT emp_pk PRIMARY KEY,
   emp_last_name    VARCHAR2(30)  CONSTRAINT emp_last_name_nn NOT NULL,
   emp_first_name   VARCHAR2(30)  CONSTRAINT emp_first_name_nn NOT NULL,
   emp_salary       NUMBER(9,2),
   emp_hourly_rate  NUMBER(7,2)   GENERATED ALWAYS AS (emp_salary/2080) VIRTUAL,
   emp_phone_no     VARCHAR2(10)
);
Inserire quindi i valori nelle colonne non virtuali.
INSERT INTO emp (emp_id, emp_last_name, emp_first_name, emp_salary, emp_phone_no)
VALUES (8291, 'Patel', 'Siddharth', 60000, '6505551234');
Quando si esegue una query sulla tabella, ora viene visualizzato il valore calcolato restituito come colonna espressione.
SELECT * FROM emp;

 EMP_ID EMP_LAST_NAME  EMP_FIRST_NAME     EMP_SALARY  EMP_HOURLY_RATE EMP_PHONE_NO
_______ ______________ _______________ _____________ ________________ _____________
   8291 Patel          Siddharth               60000            28.85 6505551234
Tali colonne di espressione possono essere virtuali o materializzate su disco. Nel caso di colonne virtuali (espressione) pure, i valori delle colonne non consumano spazio su disco e vengono calcolati su richiesta al momento dell'accesso. Nel caso di colonne di espressioni materializzate, i valori verranno calcolati in tempo DML e memorizzati sul disco.
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come gestire le colonne virtuali
Colonne invisibili
Una colonna invisibile è una colonna specificata dall'utente i cui valori sono visibili solo quando la colonna è specificata in modo esplicito per nome. È possibile aggiungere una colonna invisibile a una tabella senza influire sulle applicazioni esistenti e rendere la colonna visibile, se necessario.
In generale, le colonne invisibili aiutano a migrare ed evolvere le applicazioni online. Uno use case può essere un'applicazione che esegue query su una tabella a tre colonne con un'istruzione SELECT *. L'aggiunta di una quarta colonna alla tabella interromperebbe l'applicazione, che prevede tre colonne di dati. L'aggiunta di una quarta colonna invisibile rende l'applicazione funzionante normalmente. Uno sviluppatore può quindi modificare l'applicazione per gestire una quarta colonna e rendere visibile la colonna quando l'applicazione diventa attiva.
L'esempio seguente crea una tabella products con una colonna invisibile count e quindi rende visibile la colonna invisibile:
CREATE TABLE products ( prod_id INT, count INT INVISIBLE );
ALTER TABLE products MODIFY ( count VISIBLE );
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire le colonne invisibili
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sulle colonne invisibili
Prenotazione senza blocco
Una prenotazione senza blocco consente a più aggiornamenti concorrenti su un valore di colonna numerico di continuare senza essere bloccati da aggiornamenti senza commit durante l'aggiunta o la sottrazione dal valore della colonna.
Evitando il tradizionale meccanismo di bloccaggio durante gli aggiornamenti, questa funzionalità consente di migliorare notevolmente l'esperienza utente con un blocco ridotto in presenza di frequenti aggiornamenti simultanei alle colonne prenotabili. Nelle release precedenti, quando un valore di colonna di una riga viene aggiornato mediante l'aggiunta o la sottrazione, tutti gli altri aggiornamenti della riga vengono bloccati fino al commit della transazione. Con l'introduzione della funzione Prenotazione senza blocco in Oracle AI Database 26ai, è possibile consentire alle transazioni di aggiungere o sottrarre contemporaneamente dalla colonna riservabile della stessa riga senza bloccarsi a vicenda specificando le condizioni per le quali gli aggiornamenti possono continuare. A tale scopo, specificare che la colonna numerica è una colonna RESERVABLE e creare un vincolo CHECK per la colonna. È inoltre possibile ottenere un ulteriore miglioramento del throughput poiché gli aggiornamenti delle colonne impegnabili non bloccano le righe e pertanto non impediscono a un'altra transazione di aggiornare contemporaneamente colonne non impegnabili della stessa riga.
Ad esempio, è possibile consentire che le operazioni di aggiunta e sottrazione in una quantità di magazzino abbiano esito positivo se la quantità in giacenza è sufficiente per la richiesta e non supera lo spazio disponibile per 100 articoli. Qualsiasi aggiornamento di questo tipo al valore della quantità può continuare senza essere bloccato da aggiornamenti non impegnati, purché il valore della quantità sia maggiore di zero e minore o uguale a 100. L'importo aggiunto o sottratto viene impegnato e garantito tramite un meccanismo di impegno interno in modo che la transazione possa procedere senza attendere il commit di altre transazioni che hanno effettuato prenotazioni precedenti nella colonna impegnabile della stessa riga.
I vincoli CHECK a livello di tabella possono includere sia colonne impegnabili che colonne non impegnabili. Una prenotazione senza blocco in sospeso approvata al momento dell'emissione di un aggiornamento potrebbe in seguito violare tale vincolo al momento del commit della transazione. Ciò può verificarsi se le colonne non impegnabili del vincolo sono state aggiornate nel periodo successivo alla prenotazione, in modo che i loro valori correnti possano violare il vincolo CHECK. La transazione dovrà essere terminata se il vincolo viene violato. Tuttavia, le colonne non prenotabili in un vincolo a livello di tabella sono in genere soglie che vengono modificate molto raramente. Lo spazio sugli scaffali, il saldo richiesto in un conto e i limiti di spesa sono esempi di tali soglie.
Nell'esempio seguente viene creata una tabella inventory con una colonna riservabile qty_on_hand. Il vincolo CHECK su qty_on_hand specifica che devono essere presenti zero o più articoli in magazzino e non più della capacità scaffale per questo articolo affinché un aggiornamento su qty_on_hand possa continuare senza bloccare altri aggiornamenti. Nell'esempio seguente, la tabella inventory viene creata con i vincoli appropriati, vengono inserite diverse righe di dati e viene eseguita una query sul dizionario dati per la tabella inventory.
CREATE TABLE inventory
( item_id            NUMBER          CONSTRAINT inv_pk PRIMARY KEY,
  item_display_name  VARCHAR2(100)   NOT NULL,
  item_desc          VARCHAR2(2000),
  qty_on_hand        NUMBER          RESERVABLE CONSTRAINT qty_ck CHECK
                                        (qty_on_hand >= 0) NOT NULL,
  shelf_capacity     NUMBER          NOT NULL,
    CONSTRAINT shelf_ck CHECK (qty_on_hand <= shelf_capacity)
);

-- Insert a few rows in the inventory table
INSERT INTO inventory VALUES (123, 'Milk', 'Lowfat 2%', 100, 120);
INSERT INTO inventory VALUES (456, 'Bread', 'Multigrain', 50, 100);
INSERT INTO inventory VALUES (789, 'Eggs', 'Organic', 50, 75);

COMMIT;

SELECT * FROM inventory;

-- Check views user_tab_cols and user_tables to check
-- if the table is a reservable table and the names of the reservable columns

SELECT table_name, has_reservable_column
FROM   user_tables
WHERE  table_name = 'INVENTORY';

SELECT column_name, reservable_column
FROM   user_tab_cols
WHERE  table_name = 'INVENTORY'
  AND  reservable_column = 'YES';
Esempio di più aggiornamenti concorrenti alla colonna prenotabile:
-
Transazione 1:
UPDATE inventory SET qty_on_hand = qty_on_hand - 10 WHERE item_id = 123; -
Transazione 2:
UPDATE inventory SET qty_on_hand = qty_on_hand + 20 WHERE item_id = 123; -
Transazione 3:
UPDATE inventory SET qty_on_hand = qty_on_hand - 30 WHERE item_id = 123; -
Transazione 2:
commit; -
Transazione 3:
commit; -
Transazione 1:
commit;
Una colonna prenotabile può essere aggiunta a una tabella utilizzando il comando ALTER TABLE che specifica un vincolo CHECK facoltativo. Ad esempio:
ALTER TABLE inventory ADD
(qty_on_hold NUMBER RESERVABLE DEFAULT 0
 CONSTRAINT qty_hold CHECK (qty_on_hold >= 0 and qty_on_hold <= 25));
Una colonna prenotabile può essere convertita in una colonna non prenotabile utilizzando il comando ALTER TABLE seguente. Le applicazioni possono scegliere di applicare i vincoli anche se le prenotazioni prenotabili sono disabilitate, pertanto il vincolo non viene eliminato automaticamente quando una colonna viene convertita in una colonna non impegnabile. L'eliminazione del vincolo è facoltativa, a seconda delle esigenze. Ad esempio:
ALTER TABLE inventory MODIFY (qty_on_hand NOT RESERVABLE);
ALTER TABLE inventory DROP CONSTRAINT qty_ck;
Una colonna non prenotabile può essere convertita in una colonna prenotabile utilizzando il comando ALTER TABLE. Ad esempio:
ALTER TABLE inventory MODIFY
(qty_on_hand RESERVABLE
 CONSTRAINT qty_ck CHECK (qty_on_hand >= 0 and qty_on_hand <= 100));
Righe
Una riga è una raccolta di informazioni sulle colonne corrispondenti a un record di una tabella.
Ad esempio, una riga nella tabella employees descrive gli attributi di un dipendente specifico: ID dipendente, cognome, nome e così via. Dopo aver creato una tabella, è possibile inserire, eseguire query, eliminare e aggiornare le righe utilizzando SQL.
Esempio: istruzioni CREATE TABLE e ALTER TABLE
L'istruzione Oracle SQL per creare una tabella è CREATE TABLE.
Esempio 4-1 CREATE TABLE dipendenti
L'esempio seguente mostra l'istruzione CREATE TABLE per la tabella employees nello schema di esempio hr. L'istruzione specifica colonne quali employee_id, first_name e così via, specificando un tipo di dati, ad esempio NUMBER o DATE, per ogni colonna.
CREATE TABLE employees
    ( employee_id    NUMBER(6),
      first_name     VARCHAR2(20),
      last_name      VARCHAR2(25)   CONSTRAINT emp_last_name_nn  NOT NULL,
      email          VARCHAR2(25)   CONSTRAINT emp_email_nn      NOT NULL,
      phone_number   VARCHAR2(20),
      hire_date      DATE           CONSTRAINT emp_hire_date_nn  NOT NULL,
      job_id         VARCHAR2(10)   CONSTRAINT emp_job_nn        NOT NULL,
      salary         NUMBER(8,2),
      commission_pct NUMBER(2,2),
      manager_id     NUMBER(6),
      department_id  NUMBER(4),
      CONSTRAINT     emp_salary_min CHECK (salary > 0),
      CONSTRAINT     emp_email_uk   UNIQUE (email)
    ) ;
Esempio 4-2 dipendenti ALTER TABLE
L'esempio seguente mostra un'istruzione ALTER TABLE che aggiunge vincoli di integrità alla tabella employees. I vincoli di integrità applicano le regole business e impediscono l'inserimento di informazioni non valide nelle tabelle.
ALTER TABLE employees
ADD ( CONSTRAINT emp_emp_id_pk   PRIMARY KEY (employee_id),
      CONSTRAINT emp_dept_fk     FOREIGN KEY (department_id)
                                   REFERENCES departments,
      CONSTRAINT emp_job_fk      FOREIGN KEY (job_id)
                                   REFERENCES jobs (job_id),
      CONSTRAINT emp_manager_fk  FOREIGN KEY (manager_id)
                                   REFERENCES employees
    ) ;
Esempio 4-3 Righe nella tabella dipendenti
L'output di esempio riportato di seguito mostra 8 righe e 6 colonne della tabella hr.employees.
EMPLOYEE_ID FIRST_NAME  LAST_NAME      SALARY COMMISSION_PCT DEPARTMENT_ID
----------- ----------- ------------- ------- -------------- -------------
        100 Steven      King            24000                           90
        101 Neena       Kochhar         17000                           90
        102 Lex         De Haan         17000                           90
        103 Alexander   Hunold           9000                           60
        107 Diana       Lorentz          4200                           60
        149 Eleni       Zlotkey         10500             .2            80
        174 Ellen       Abel            11000             .3            80
        178 Kimberely   Grant            7000            .15
L'output precedente illustra alcune delle caratteristiche importanti riportate di seguito relative a tabelle, colonne e righe.
-
Una riga della tabella descrive gli attributi di un dipendente: nome, stipendio, reparto e così via. Ad esempio, la prima riga dell'output mostra il record del dipendente Steven King.
-
Una colonna descrive un attributo del dipendente. Nell'esempio, la colonna
employee_idè la chiave principale, il che significa che ogni dipendente è identificato in modo univoco dall'ID dipendente. È garantito che due dipendenti non abbiano lo stesso ID dipendente. -
Una colonna non chiave può contenere righe con valori identici. Nell'esempio, il valore dello stipendio per i dipendenti 101 e 102 è lo stesso:
17000. -
Una colonna chiave esterna fa riferimento a una chiave primaria o univoca nella stessa tabella o in una tabella diversa. In questo esempio, il valore di
90indepartment_idcorrisponde alla colonnadepartment_iddella tabelladepartments. -
Un campo è l'intersezione di una riga e di una colonna. Può contenere un solo valore. Ad esempio, il campo per l'ID reparto del dipendente 103 contiene il valore
60. -
Un campo può mancare di valore. In questo caso, il campo dovrebbe contenere un valore nullo. Il valore della colonna
commission_pctper il dipendente 100 è nullo, mentre il valore del campo per il dipendente 149 è.2. A column allows nulls unless aNOTNULLor primary key integrity constraint has been defined on this column, in which case no row can be inserted without a value for this column.
Vedi anche: Oracle AI Database SQL Language Reference per sintassi e semantica CREATE TABLE
Tipi di dati Oracle
Ogni colonna dispone di un tipo di dati, che è associato a un formato di memorizzazione, vincoli e un intervallo di valori valido specifici. Il tipo di dati di un valore associa un insieme fisso di proprietà al valore.
Queste proprietà fanno sì che Oracle AI Database tratti i valori di un tipo di dati in modo diverso dai valori di un altro. Ad esempio, è possibile moltiplicare i valori del tipo di dati NUMBER, ma non quelli del tipo di dati RAW.
Quando si crea una tabella è necessario specificare un tipo di dati per ognuna delle colonne. Ogni valore inserito successivamente in una colonna assume il tipo di dati della colonna di destinazione.
Oracle AI Database fornisce diversi tipi di dati integrati. I tipi di dati più utilizzati rientrano nelle categorie descritte in questa sezione.
Altre importanti categorie di tipi built-in includono oggetti raw e di grandi dimensioni (LOB) e raccolte. PL/SQL dispone di tipi di dati per costanti e variabili, che includono BOOLEAN, tipi di riferimento, tipi composti (record) e tipi definiti dall'utente.
-
I tipi di dati carattere Tipi di dati carattere memorizzano i dati alfanumerici nelle stringhe. Il tipo di dati carattere più comune è
VARCHAR2, che è l'opzione più efficiente per la memorizzazione dei dati carattere. -
Tipi di dati numerici I tipi di dati numerici di Oracle AI Database memorizzano numeri fissi e a virgola mobile, zero e infinito. Alcuni tipi numerici memorizzano anche i valori che sono il risultato non definito di un'operazione, nota come "non un numero" o
NaN. -
Tipi di dati di data e ora I tipi di dati datetime sono
DATEeTIMESTAMP. Oracle AI Database fornisce un supporto completo del fuso orario per gli indicatori orari. -
Tipi di dati riga Ogni riga memorizzata nel database contiene un indirizzo, ovvero una rappresentazione interna per individuare tale riga all'interno del database. Oracle AI Database utilizza un tipo di dati
ROWIDper memorizzare l'indirizzo (rowid) di ogni riga del database. -
Tipo di dati booleano Il tipo di dati BOOLEAN comprende i valori di verità distinti
TrueeFalse. -
Modelli di formato e tipi di dati Un modello di formato è un valore carattere che descrive il formato dei dati di data/ora o numerici memorizzati in una stringa di caratteri. Un modello di formato non modifica la rappresentazione internazionale del valore nel database.
Vedere anche:
-
Guida per gli sviluppatori di Oracle AI Database SecureFiles e Large Objects
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sui tipi di dati SQL integrati
-
Oracle AI Database PL/SQL Packages and Types Reference per informazioni sui tipi di dati PL/SQL
-
Oracle AI Database Development Guide per scoprire come utilizzare i tipi di dati integrati
Tipi di dati carattere
I tipi di dati carattere memorizzano i dati alfanumerici nelle stringhe. Il tipo di dati carattere più comune è VARCHAR2, che è l'opzione più efficiente per la memorizzazione dei dati carattere.
I valori byte corrispondono allo schema codifica caratteri, generalmente denominato set di caratteri. Il set di caratteri del database viene stabilito durante la creazione del database. Esempi di set di caratteri sono ASCII a 7 bit, EBCDIC e Unicode UTF-8.
La semantica di lunghezza dei tipi di dati carattere è misurabile in byte o caratteri. Il trattamento delle stringhe come sequenza di byte è denominato semantica byte. Questa è l'impostazione predefinita per i tipi di dati carattere. Il trattamento delle stringhe come sequenza di caratteri è denominato semantica dei caratteri. Un carattere è un code point del set di caratteri del database.
-
VARCHAR2 e tipi di dati CHAR Il tipo di dati
VARCHAR2memorizza i valori letterali dei caratteri a lunghezza variabile. Un valore letterale è un valore dati fisso. -
Tipi di dati NCHAR e NVARCHAR2 I tipi di dati
NCHAReNVARCHAR2memorizzano i dati dei caratteri Unicode.
Vedere anche:
-
Oracle AI Database Globalization Support Guide per ulteriori informazioni sui set di caratteri
-
Inizia a utilizzare Oracle AI Database Development per una breve introduzione ai tipi di dati
-
Oracle AI Database Development Guide per informazioni su come scegliere un tipo di dati carattere
Tipi di dati VARCHAR2 e CHAR
Il tipo di dati VARCHAR2 memorizza i valori letterali dei caratteri a lunghezza variabile. Un valore letterale è un valore dati fisso.
Ad esempio, 'LILA', 'St. George Island' e '101' sono tutti letterali di caratteri; 5001 è un letterale numerico. I letterali di carattere sono racchiusi tra virgolette singole in modo che il database possa distinguerli dai nomi degli oggetti dello schema. Nota: in questo manuale vengono utilizzati i termini alfabeto di testo, alfabeto di caratteri e string in modo intercambiabile.
Quando si crea una tabella con una colonna VARCHAR2, si specifica una lunghezza di stringa massima. In Esempio 4-1, la colonna last_name ha un tipo di dati VARCHAR2(25), il che significa che qualsiasi nome memorizzato nella colonna ha un massimo di 25 byte.
Per ogni riga, Oracle AI Database memorizza ogni valore nella colonna come campo di lunghezza variabile a meno che un valore non superi la lunghezza massima, nel qual caso il database restituisce un errore. Ad esempio, in un set di caratteri a byte singolo, se si immettono 10 caratteri per il valore della colonna last_name in una riga, la colonna nella parte della riga memorizza solo 10 caratteri (10 byte), non 25. L'uso di VARCHAR2 riduce il consumo di spazio.
A differenza di VARCHAR2, CHAR memorizza le stringhe di caratteri a lunghezza fissa. Quando si crea una tabella con una colonna CHAR, la colonna richiede una lunghezza stringa. Il valore predefinito è di 1 byte. Il database utilizza spazi vuoti per riempire il valore alla lunghezza specificata.
Oracle AI Database confronta i valori VARCHAR2 utilizzando la semantica di confronto non riempita e confronta i valori CHAR utilizzando la semantica di confronto con riempimento vuoto.
Vedi anche: Oracle AI Database SQL Language Reference per i dettagli sulla semantica di confronto vuota e non riempita
Tipi di dati NCHAR e NVARCHAR2
I tipi di dati NCHAR e NVARCHAR2 memorizzano i dati dei caratteri Unicode.
Unicode è un set di caratteri con codifica universale in grado di memorizzare informazioni in qualsiasi lingua utilizzando un singolo set di caratteri. NCHAR memorizza le stringhe di caratteri a lunghezza fissa corrispondenti al set di caratteri nazionale, mentre NVARCHAR2 memorizza le stringhe di caratteri a lunghezza variabile.
Specificare un set di caratteri nazionale durante la creazione di un database. Il set di caratteri dei tipi di dati NCHAR e NVARCHAR2 deve essere AL16UTF16 o UTF8. Entrambi i set di caratteri utilizzano la codifica Unicode.
Quando si crea una tabella con una colonna NCHAR o NVARCHAR2, la dimensione massima corrisponde sempre alla semantica della lunghezza dei caratteri. La semantica della lunghezza dei caratteri è la semantica predefinita e solo quella della lunghezza per NCHAR o NVARCHAR2.
Vedi anche: Oracle AI Database Globalization Support Guide per informazioni sulla funzione di supporto alla globalizzazione di Oracle
Tipi di dati numerici
I tipi di dati numerici di Oracle AI Database memorizzano numeri fissi e a virgola mobile, zero e infinito. Alcuni tipi numerici memorizzano anche i valori che sono il risultato non definito di un'operazione, nota come "non un numero" o NaN.
Oracle AI Database memorizza i dati numerici in formato a lunghezza variabile. Ogni valore è memorizzato in notazione scientifica, con 1 byte utilizzato per memorizzare l'esponente. Il database utilizza fino a 20 byte per memorizzare la mantissa, che fa parte di un numero a virgola mobile contenente le cifre significative. Oracle AI Database non memorizza gli zeri iniziali e finali.
-
Tipo di dati numero Il tipo di dati
NUMBERmemorizza i numeri fissi e a virgola mobile. Il database può memorizzare numeri di qualsiasi grandezza. È garantito che questi dati siano portabili tra diversi sistemi operativi su cui è in esecuzione Oracle AI Database. Il tipo di datiNUMBERè consigliato per la maggior parte dei casi in cui è necessario memorizzare dati numerici. -
Numeri punto variabile Oracle AI Database fornisce due tipi di dati numerici esclusivamente per i numeri a virgola mobile:
BINARY_FLOATeBINARY_DOUBLE.
Tipo di dati NUMBER
Il tipo di dati NUMBER memorizza i numeri fissi e a virgola mobile. Il database può memorizzare numeri di qualsiasi grandezza. È garantito che questi dati siano portabili tra diversi sistemi operativi su cui è in esecuzione Oracle AI Database. Il tipo di dati NUMBER è consigliato per la maggior parte dei casi in cui è necessario memorizzare dati numerici.
È possibile specificare un numero a punto fisso nel formato NUMBER(p,s), dove p e s fanno riferimento alle seguenti caratteristiche:
-
Precisione
La precisione specifica il numero totale di cifre. Se non viene specificata una precisione, la colonna memorizza i valori esattamente come forniti dall'applicazione senza alcun arrotondamento.
-
Ridimensiona
La scala specifica il numero di cifre dal separatore decimale fino alla cifra meno significativa. La scala positiva conta le cifre a destra del separatore decimale fino alla cifra meno significativa inclusa. La scala negativa conta le cifre a sinistra del separatore decimale fino alla cifra meno significativa, ma non la cifra meno significativa. Se si specifica una precisione senza una scala, come in
NUMBER(6), la scala è 0.
Nell'Esempio 4-1, la colonna salary è di tipo NUMBER(8,2), quindi la precisione è 8 e la scala è 2. Pertanto, il database memorizza uno stipendio di 100.000 come 100000.00.
Numeri a virgola mobile
Oracle AI Database fornisce due tipi di dati numerici esclusivamente per i numeri a virgola mobile: BINARY_FLOAT e BINARY_DOUBLE.
Questi tipi supportano tutte le funzionalità di base fornite dal tipo di dati NUMBER. Tuttavia, mentre NUMBER utilizza la precisione decimale, BINARY_FLOAT e BINARY_DOUBLE utilizzano la precisione binaria, che consente calcoli aritmetici più rapidi e di solito riduce i requisiti di storage.
BINARY_FLOAT e BINARY_DOUBLE sono tipi di dati numerici approssimativi. Memorizzano rappresentazioni approssimative dei valori decimali, anziché rappresentazioni esatte. Ad esempio, il valore 0.1 non può essere rappresentato esattamente da BINARY_DOUBLE o BINARY_FLOAT. Sono spesso utilizzati per calcoli scientifici. Il loro comportamento è simile ai tipi di dati FLOAT e DOUBLE in Java e XMLSchema.
Vedi anche: Oracle AI Database SQL Language Reference per informazioni su precisione, scalabilità e altre caratteristiche dei tipi numerici
Tipi di dati data/ora
I tipi di dati datetime sono DATE e TIMESTAMP. Oracle AI Database fornisce un supporto completo del fuso orario per gli indicatori orari.
-
Tipo di dati AGGIORNA Il tipo di dati
DATEmemorizza la data e l'ora. Sebbene le date/ora possano essere rappresentate in tipi di dati a caratteri o numeri,DATEdispone di proprietà associate speciali. -
Tipo di dati TIMESTAMP Il tipo di dati
TIMESTAMPè un'estensione del tipo di datiDATE.
Tipo di dati DATA
Il tipo di dati DATE memorizza la data e l'ora. Sebbene le date/ora possano essere rappresentate in tipi di dati a caratteri o numeri, DATE dispone di proprietà associate speciali.
Il database memorizza le date internamente come numeri. Le date vengono memorizzate in campi a lunghezza fissa di 7 byte ciascuno, corrispondenti a secolo, anno, mese, giorno, ora, minuto e secondo. Nota: le date supportano completamente le operazioni aritmetiche, in modo da aggiungere e sottrarre le date esattamente come si può con i numeri.
Il database visualizza le date in base al modello di formato specificato. Un modello in formato è un valore carattere che descrive il formato di data/ora in una stringa di caratteri. Il formato della data standard è DD-MON-RR, che visualizza le date nel formato 01-JAN-11.
RR è simile a YY (le ultime due cifre dell'anno), ma il secolo del valore di ritorno varia in base all'anno a due cifre specificato e alle ultime due cifre dell'anno corrente. Si supponga che nel 1999 il database visualizzi 01-JAN-11. Se il formato della data utilizza RR, 11 specifica 2011, mentre se il formato utilizza YY, 11 specifica 1911. È possibile modificare il formato data predefinito sia a livello di istanza di database che a livello di sessione.
Oracle AI Database memorizza l'ora in formato 24 ore-HH:MI:SS. Se non viene immessa alcuna parte temporale, per impostazione predefinita l'ora in un campo data è 00:00:00 A.M. In una voce di sola ora, per impostazione predefinita la parte relativa alla data corrisponde al primo giorno del mese corrente.
Vedere anche:
-
Oracle AI Database Development Guide per ulteriori informazioni sulle maschere in formato secoli e date
-
Oracle AI Database SQL Language Reference per informazioni sui codici formato data/ora
-
Oracle AI Database Development Guide per informazioni su come eseguire operazioni aritmetiche con tipi di dati di data e ora
Tipo di dati TIMESTAMP
Il tipo di dati TIMESTAMP è un'estensione del tipo di dati DATE.
TIMESTAMP memorizza i secondi frazionari oltre alle informazioni memorizzate nel tipo di dati DATE. Il tipo di dati TIMESTAMP è utile per memorizzare valori temporali precisi, ad esempio nelle applicazioni che devono tenere traccia dell'ordine degli eventi.
I tipi di dati DATETIME TIMESTAMP WITH TIME ZONE e TIMESTAMP WITH LOCAL TIME ZONE tengono conto del fuso orario. Quando un utente seleziona i dati, il valore viene modificato in base al fuso orario della sessione utente. Questo tipo di dati è utile per la raccolta e la valutazione delle informazioni sulle date in tutte le aree geografiche.
Vedere anche: Oracle AI Database SQL Language Reference per i dettagli sulla sintassi di creazione e immissione dei dati nelle colonne degli indicatori orari
Tipi di dati ID riga
Ogni riga memorizzata nel database ha un indirizzo - una rappresentazione interna per individuare quella riga all'interno del database. Oracle AI Database utilizza un tipo di dati ROWID per memorizzare l'indirizzo (rowid) di ogni riga del database.
Le Rowid rientrano nelle seguenti categorie:
-
Gli ID riga fisici memorizzano gli indirizzi delle righe nelle tabelle organizzate dall'heap, nei cluster di tabelle e nelle partizioni di tabelle e indici.
-
Gli ID riga logici memorizzano gli indirizzi delle righe nelle tabelle organizzate a indice.
-
Gli ID riga esterni sono identificativi in tabelle esterne, ad esempio le tabelle DB2 a cui si accede tramite un gateway. Non sono ID riga standard di Oracle AI Database.
Un tipo di dati denominato ID riga universale, o Urowid, supporta tutti i tipi di ID riga.
-
Uso dei rowid Oracle AI Database utilizza internamente gli rowid per la creazione degli indici.
-
Pseudocolonna ROVID Ogni tabella di un database Oracle ha una pseudocolonna denominata
ROWID.
Uso degli ID riga
Oracle AI Database utilizza internamente gli ID riga per la creazione di indici.
Un indice B-tree, che è il tipo più comune, contiene una lista ordinata di chiavi suddivise in intervalli. Ogni chiave è associata a un ID riga che punta all'indirizzo della riga associata per un accesso rapido.
Gli utenti finali e gli sviluppatori di applicazioni possono anche utilizzare i rowid per diverse funzioni importanti:
-
Gli ID riga sono un metodo rapido per accedere di nuovo a una riga se il relativo
rowidè stato recuperato in precedenza con un'istruzione SELECT. -
Gli ID riga consentono di visualizzare l'organizzazione di una tabella.
Sebbene sia possibile creare tabelle con colonne definite utilizzando il tipo di dati ROWID, non è consigliabile memorizzare gli ID riga con l'intenzione di utilizzarli per accedere ai dati in una fase successiva. L'utilizzo di rowid in questo modo può produrre risultati imprevedibili o errati. Il rowid per una riga può cambiare per una serie di motivi che possono essere avviati dall'utente o internamente dal motore di database. Non è possibile dipendere dal rowid che punta alla stessa riga o a una riga valida dopo che si è verificata una di queste operazioni.
Pseudocolonna ROWID
Ogni tabella di un database Oracle ha una pseudocolonna denominata ROWID.
Una pseudocolonna funziona come una colonna di tabella, ma non è memorizzata nella tabella. Le pseudocolonne sono disponibili per la selezione di valori, ma le operazioni di inserimento, aggiornamento ed eliminazione dei valori che contengono non sono consentite. Una pseudocolonna è anche simile a una funzione SQL senza argomenti. Le funzioni senza argomenti restituiscono in genere lo stesso valore per ogni riga nel set di risultati, mentre gli pseudocolonne di solito restituiscono un valore diverso per ogni riga.
I valori della pseudocolonna ROWID sono stringhe che rappresentano l'indirizzo di ogni riga. Queste stringhe hanno il tipo di dati ROWID. Questa pseudocolonna non è evidente quando si elenca la struttura di una tabella eseguendo SELECT o DESCRIBE, né la pseudocolonna consuma spazio. Tuttavia, l'ID riga di ogni riga può essere recuperato con una query SQL utilizzando la parola riservata ROWID come nome di colonna.
Nell'esempio seguente viene eseguita una query sulla pseudocolonna ROWID per mostrare l'ID riga della riga nella tabella employees per il dipendente 100:
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
Vedere anche:
-
Oracle AI Database Development Guide per scoprire come identificare le righe in base all'indirizzo
-
Oracle AI Database SQL Language Reference per informazioni sui tipi di ID riga
Tipo dati booleano
Il tipo di dati BOOLEAN comprende i valori di verità distinti True e False.
A meno che non sia vietato da un vincolo NOT NULL, il tipo di dati booleano supporta anche il valore di verità UNKNOWN come valore nullo. È possibile utilizzare il tipo di dati booleano ovunque venga visualizzato il tipo di dati nella sintassi Oracle SQL.
Vedere anche:
- Guida di riferimento rapido su Oracle AI Database SQL Language per informazioni sul tipo di dati booleano.
Formatta modelli e tipi di dati
Un modello di formato è un valore carattere che descrive il formato dei dati di data/ora o numerici memorizzati in una stringa di caratteri. Un modello di formato non modifica la rappresentazione internazionale del valore nel database.
Se si converte una stringa di caratteri in una data o un numero, il modello di formato determina in quale modo il database interpreta la stringa. In SQL, è possibile utilizzare un modello di formato come argomento delle funzioni TO_CHAR e TO_DATE per formattare un valore da restituire dal database o per formattare un valore da memorizzare nel database.
L'istruzione seguente seleziona gli stipendi dei dipendenti nel reparto 80 e utilizza la funzione TO_CHAR per convertire questi stipendi in valori di carattere con il formato specificato dal modello di formato numerico '$99,990.99':
SQL> SELECT last_name employee, TO_CHAR(salary, '$99,990.99') AS "SALARY"
  2  FROM   employees
  3  WHERE  department_id = 80 AND last_name = 'Russell';

EMPLOYEE                  SALARY
------------------------- -----------
Russell                    $14,000.00
L'esempio seguente aggiorna una data di assunzione utilizzando la funzione TO_DATE con la maschera di formato 'YYYY MM DD' per convertire la stringa '1998 05 20' in un valore DATE:
SQL> UPDATE employees
  2  SET hire_date = TO_DATE('1998 05 20','YYYY MM DD')
  3  WHERE last_name = 'Hunold';
Vedi anche: Oracle AI Database SQL Language Reference per ulteriori informazioni sui modelli di formato
Vincoli di integrità
Un vincolo di integrità è una regola denominata che limita i valori di una o più colonne in una tabella.
Le regole di integrità dei dati impediscono l'immissione di dati non validi nelle tabelle. Inoltre, i vincoli possono impedire l'eliminazione di una tabella quando esistono determinate dipendenze.
Se un vincolo è abilitato, il database controlla i dati non appena vengono immessi o aggiornati. Oracle AI Database impedisce l'immissione di dati non conformi al vincolo. Se un vincolo è disabilitato, Oracle AI Database consente ai dati non conformi al vincolo di immettere il database.
In Esempio 4-1, l'istruzione CREATE TABLE specifica i vincoli NOT NULL per le colonne last_name, email, hire_date e job_id. Le clausole vincolo identificano le colonne e le condizioni del vincolo. Questi vincoli garantiscono che le colonne specificate non contengano valori nulli. Ad esempio, un tentativo di inserire un nuovo dipendente senza un ID mansione genera un errore.
È possibile creare un vincolo quando o dopo la creazione di una tabella. Se necessario, è possibile disabilitare temporaneamente i vincoli. Il database memorizza i vincoli nel dizionario dati.
Vedere anche:
-
"Integrità dei dati" per informazioni sui vincoli di integrità
-
"Panoramica del dizionario dati" per informazioni sul dizionario dati
-
Oracle AI Database SQL Language Reference per informazioni sulle clausole dei vincoli SQL
Storage tabella
Oracle AI Database utilizza un segmento dati in una tablespace per contenere i dati della tabella.
Un segmento contiene estensioni costituite da blocchi di dati. Il segmento di dati per una tabella (o un segmento di dati cluster, per un cluster tabella) si trova nella tablespace predefinita del proprietario della tabella o in una tablespace denominata nell'istruzione CREATE TABLE.
-
Organizzazione tabella Per impostazione predefinita, una tabella è organizzata come heap, il che significa che il database inserisce le righe dove si adattano meglio piuttosto che in un ordine specificato dall'utente. Pertanto, una tabella organizzata in heap è una raccolta di righe non ordinata.
-
Storage a righe Il database memorizza le righe in blocchi di dati. Ogni riga di una tabella contenente dati per meno di 256 colonne è contenuta in una o più righe.
-
Righe dei pezzi di riga Un rowid è un indirizzo fisico di 10 byte di una riga.
-
Memorizzazione di valori nulli Un valore nullo indica l'assenza di un valore in una colonna. I valori nulli indicano dati mancanti, sconosciuti o non applicabili. Vedere anche: "Segmenti utente" per informazioni sui tipi di segmenti e sulla modalità di creazione
Organizzazione tabella
Per impostazione predefinita, una tabella è organizzata come heap, il che significa che il database posiziona le righe dove si adattano meglio piuttosto che in un ordine specificato dall'utente. Pertanto, una tabella organizzata in heap è una raccolta di righe non ordinata. Nota: le tabelle organizzate a indice utilizzano un principio di organizzazione diverso.
Quando gli utenti aggiungono righe, il database inserisce le righe nel primo spazio libero disponibile nel segmento dati. Non è garantito che le righe vengano recuperate nell'ordine in cui sono state inserite.
La tabella hr.departments è una tabella organizzata da heap. Dispone di colonne per ID reparto, nome, ID manager e ID ubicazione. Man mano che vengono inserite le righe, il database le memorizza ovunque si trovino. Un blocco di dati nel segmento di tabella potrebbe contenere le righe non ordinate mostrate nel seguente esempio:
50,Shipping,121,1500
120,Treasury,,1700
70,Public Relations,204,2700
30,Purchasing,114,1700
130,Corporate Tax,,1700
10,Administration,200,1700
110,Accounting,205,1700
L'ordine delle colonne è lo stesso per tutte le righe di una tabella. Il database di solito memorizza le colonne nell'ordine in cui sono state elencate nell'istruzione CREATE TABLE, ma questo ordine non è garantito. Ad esempio, se una tabella ha una colonna di tipo LONG, Oracle AI Database memorizza sempre questa colonna per ultima nella riga. Inoltre, se si aggiunge una nuova colonna a una tabella, la nuova colonna diventa l'ultima colonna memorizzata.
Una tabella può contenere una colonna virtuale, che a differenza delle colonne normali non occupa spazio su disco. Il database ricava i valori in una colonna virtuale su richiesta calcolando un set di espressioni o funzioni specificate dall'utente. È possibile indicizzare le colonne virtuali, raccogliere statistiche su di esse e creare vincoli di integrità. Pertanto, le colonne virtuali sono molto simili alle colonne non virtuali.
Vedere anche:
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sulle colonne virtuali
Archiviazione righe
Il database memorizza le righe in blocchi di dati. Ogni riga di una tabella contenente dati per meno di 256 colonne è contenuta in una o più righe.
Se possibile, Oracle AI Database memorizza ogni riga come un pezzo riga. Tuttavia, se tutti i dati delle righe non possono essere inseriti in un singolo blocco di dati o se un aggiornamento di una riga esistente fa sì che la riga superi il relativo blocco di dati, il database memorizza la riga utilizzando più parti di riga.
Le righe in un cluster di tabelle contengono le stesse informazioni delle righe nelle tabelle non in cluster. Inoltre, le righe di un cluster di tabelle contengono informazioni che fanno riferimento alla chiave cluster a cui appartengono.
Vedere anche: "Formato blocco dati" per informazioni sui componenti di un blocco dati
Rowids dei pezzi di fila
Un rowid è in effetti un indirizzo fisico di 10 byte di una riga.
Ogni riga di una tabella organizzata in heap ha un ID riga univoco per questa tabella che corrisponde all'indirizzo fisico di una riga. Per i cluster di tabelle, le righe in tabelle diverse che si trovano nello stesso blocco di dati possono avere lo stesso ID riga.
Oracle AI Database utilizza internamente gli ID riga per la creazione di indici. Ad esempio, ogni chiave in un indice B-tree è associata a un ID riga che punta all'indirizzo della riga associata per un accesso rapido. Gli ID riga fisici forniscono l'accesso più rapido possibile a una riga di tabella, consentendo al database di recuperare una riga in un solo I/O.
Vedere anche:
-
"Formato righe" per informazioni sulla struttura di un ID riga
-
"Panoramica degli indici B-Tree" per conoscere i tipi e la struttura degli indici B-tree
Memorizzazione di valori nulli
Un valore nullo indica l'assenza di un valore in una colonna. I valori nulli indicano dati mancanti, sconosciuti o non applicabili.
I valori nulli vengono memorizzati nel database se rientrano tra colonne con valori dati. In questi casi, richiedono 1 byte per memorizzare la lunghezza della colonna (zero). I valori nulli finali in una riga non richiedono memoria perché una nuova intestazione di riga indica che le colonne rimanenti nella riga precedente sono nulle. Ad esempio, se le ultime tre colonne di una tabella sono nulle, non vengono memorizzati dati per tali colonne.
Vedere anche: Oracle AI Database SQL Language Reference per ulteriori informazioni sui valori nulli
Compressione tabella
Il database può utilizzare la compressione della tabella per ridurre la quantità di storage necessaria per la tabella.
La compressione consente di risparmiare spazio su disco, ridurre l'uso della memoria nella buffer cache del database e, in alcuni casi, velocizzare l'esecuzione delle query. La compressione delle tabelle è trasparente per le applicazioni di database.
-
La compressione della tabella basata sul dizionario Basic Table Compression and Advanced Row Compression fornisce buoni rapporti di compressione per le tabelle organizzate dall'heap.
-
Compressione a colonne ibrida Con Hybrid Columnar Compression, il database memorizza la stessa colonna per un gruppo di righe insieme. Il blocco di dati non memorizza i dati in formato riga maggiore, ma utilizza una combinazione di metodi riga e colonna.
-
Memory Speed Hybrid Columnar Compression Memory Speed Hybrid Columnar Compression introduce formati di unità di compressione su disco che possono essere elaborati alla velocità della memoria.
Compressione tabella di base e compressione riga avanzata
La compressione della tabella basata sul dizionario fornisce buoni rapporti di compressione per le tabelle organizzate in heap.
Oracle AI Database supporta i tipi di compressione delle tabelle basate su dizionario riportati di seguito.
-
Compressione tabella di base
Questo tipo di compressione è destinato alle operazioni di caricamento di massa. Il database non comprime i dati modificati utilizzando DML convenzionale. Per ottenere la compressione delle tabelle di base, è necessario utilizzare le operazioni direct path INSERT,
ALTER TABLE . . . MOVEo la ridefinizione delle tabelle in linea. -
Compressione riga avanzata
Questo tipo di compressione è destinato alle applicazioni OLTP e comprime i dati manipolati da qualsiasi operazione SQL. Il database raggiunge un rapporto di compressione competitivo consentendo all'applicazione di eseguire DML in circa lo stesso periodo di tempo di DML su una tabella non compressa.
Per i tipi di compressione precedenti, il database memorizza le righe compresse nel formato principale della riga. Tutte le colonne di una riga vengono memorizzate insieme, seguite da tutte le colonne della riga successiva e così via. Il database sostituisce i valori duplicati con un breve riferimento a una tabella di simboli memorizzata all'inizio del blocco. Pertanto, le informazioni che il database deve ricreare i dati non compressi vengono memorizzate nel blocco di dati stesso.
I blocchi di dati compressi sono simili ai normali blocchi di dati. La maggior parte delle funzionalità e delle funzioni del database che funzionano su blocchi di dati normali funziona anche su blocchi compressi.
È possibile dichiarare la compressione a livello di tablespace, tabella, partizione o partizione secondaria. Se specificato a livello di tablespace, tutte le tabelle create in tali tablespace vengono compresse per impostazione predefinita.
Esempio 4-4 Compressione a livello di tabella
La seguente istruzione applica la compressione avanzata delle righe alla tabella orders:
ALTER TABLE oe.orders ROW STORE COMPRESS ADVANCED;Esempio di compressione a livello di partizione 4-5
L'esempio seguente di un'istruzione CREATE TABLE parziale specifica la compressione di riga avanzata per una partizione e la compressione di tabella di base per l'altra partizione:
CREATE TABLE sales (
    prod_id     NUMBER     NOT NULL,
    cust_id     NUMBER     NOT NULL, ... )
 PCTFREE 5 NOLOGGING NOCOMPRESS
 PARTITION BY RANGE (time_id)
 ( partition sales_2013 VALUES LESS THAN(TO_DATE(...)) ROW STORE COMPRESS BASIC,
   partition sales_2014 VALUES LESS THAN (MAXVALUE) ROW STORE COMPRESS ADVANCED );
Vedere anche:
-
"Formato riga" per informazioni sulla modalità di memorizzazione dei valori in una riga
-
"Compressione del blocco di dati" per informazioni sul formato dei blocchi di dati compressi
-
Oracle AI Database Utilities per ulteriori informazioni sull'uso di SQL*Loader per il caricamento del percorso diretto
-
Oracle AI Database Administrator's Guide e Oracle AI Database Performance Tuning Guide per ulteriori informazioni sulla compressione delle tabelle
Compressione Hybrid Columnar
Con Hybrid Columnar Compression, il database memorizza la stessa colonna per un gruppo di righe. Il blocco di dati non memorizza i dati in formato riga maggiore, ma utilizza una combinazione di metodi riga e colonna.
La memorizzazione dei dati delle colonne insieme, con lo stesso tipo di dati e caratteristiche simili, aumenta notevolmente il risparmio di storage ottenuto dalla compressione. Il database comprime i dati manipolati da qualsiasi operazione SQL, sebbene i livelli di compressione siano più elevati per i caricamenti dei percorsi diretti. Le operazioni del database funzionano in modo trasparente rispetto agli oggetti compressi, pertanto non sono necessarie modifiche all'applicazione.
Nota: Hybrid Column Compression e In-Memory Column Store (area di memorizzazione delle colonne IM) sono strettamente correlate. La differenza principale è che Hybrid Column Compression ottimizza lo storage su disco, mentre IM column store ottimizza lo storage di memoria.
-
Tipi di compressione a colonne ibride Se lo storage di base supporta la compressione a colonne ibride, è possibile specificare diversi tipi di compressione, a seconda delle esigenze.
-
Unità di compressione Hybrid Columnar Compression utilizza un costrutto logico denominato unità di compressione per memorizzare un set di righe.
-
La compressione a colonne ibrida DML e Hybrid Columnar Compression ha implicazioni per il blocco delle righe in diversi tipi di operazioni DML. Vedere anche: "Area in memoria" per ulteriori informazioni sull'area di memorizzazione colonne IM
Tipi di compressione a colonne ibride
Se lo storage di base supporta Hybrid Columnar Compression, è possibile specificare diversi tipi di compressione, a seconda delle esigenze.
Le opzioni di compressione sono:
-
Compressione warehouse
Questo tipo di compressione è ottimizzato per risparmiare spazio di storage ed è destinato alle applicazioni di data warehouse.
-
Compressione archivio
Questo tipo di compressione è ottimizzato per i massimi livelli di compressione ed è destinato a dati storici e dati che non cambiano.
Hybrid Columnar Compression è ottimizzato per applicazioni di data warehousing e supporto decisionale sullo storage Oracle Exadata. Oracle Exadata massimizza le prestazioni delle query sulle tabelle compresse utilizzando Hybrid Columnar Compression, sfruttando la potenza di elaborazione, la memoria e la larghezza di banda di rete Infiniband che sono parte integrante del server di storage Oracle Exadata.
Altri sistemi di storage Oracle supportano Hybrid Columnar Compression e garantiscono lo stesso risparmio di spazio dello storage Oracle Exadata, ma non garantiscono lo stesso livello di prestazioni delle query. Per questi sistemi di storage, Hybrid Columnar Compression è ideale per l'archiviazione nel database di dati precedenti a cui non si accede di frequente.
Unità di compressione
Hybrid Columnar Compression utilizza un costrutto logico denominato unità di compressione per memorizzare un set di righe.
Quando si caricano i dati in una tabella, il database memorizza gruppi di righe in formato colonnare, con i valori di ogni colonna memorizzati e compressi insieme. Dopo che il database ha compresso i dati delle colonne per un set di righe, il database inserisce i dati nell'unità di compressione.
Ad esempio, si applica Hybrid Columnar Compression a una tabella daily_sales. Alla fine di ogni giorno, si inseriscono nella tabella gli articoli e il numero venduti, con l'ID e la data dell'articolo che formano una chiave primaria composta. La tabella seguente mostra un sottoinsieme delle righe in daily_sales.
Tabella 3 Tabella di esempio daily_sales
| Item_ID | Data | Num_Sold | Shipped_From | Reintegra |
|---|---|---|---|---|
| 1.000 | 01-JUN-18 | 2 | WAREHOUSE1 | S |
| 1.001 | 01-JUN-18 | 0 | WAREHOUSE3 | N |
| 1.002 | 01-JUN-18 | 1 | WAREHOUSE3 | N |
| 1.003 | 01-JUN-14 | 0 | WAREHOUSE2 | N |
| 1.004 | 01-JUN-18 | 2 | WAREHOUSE1 | N |
| 1.005 | 01-JUN-18 | 1 | WAREHOUSE2 | N |
Si supponga che questo sottoinsieme di righe sia memorizzato in un'unità di compressione. Hybrid Columnar Compression memorizza i valori di ogni colonna insieme e quindi utilizza più algoritmi per comprimere ogni colonna. Il database sceglie gli algoritmi in base a una varietà di fattori, tra cui il tipo di dati della colonna, la cardinalità dei valori effettivi nella colonna e il livello di compressione scelto dall'utente.
Come mostrato nel grafico seguente, ogni unità di compressione può estendersi su più blocchi di dati. I valori di una determinata colonna possono o non possono estendersi su più blocchi.
Figura 7: Unità di compressione
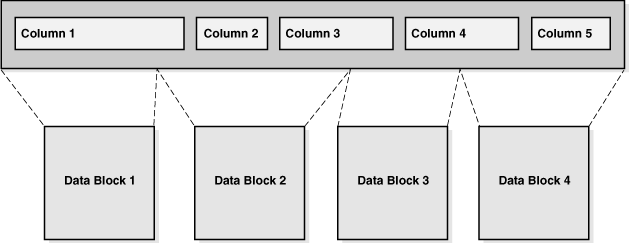
Descrizione dell'illustrazione sagug004.gif
Se Hybrid Columnar Compression non comporta un risparmio di spazio, il database memorizza i dati nel formato DBMS_COMPRESSION.COMP_BLOCK. In questo caso, il database applica la compressione OLTP ai blocchi, che risiedono in un segmento Hybrid Columnar Compression.
Vedere anche:
-
Oracle AI Database Licensing Information User Manual per ulteriori informazioni sui requisiti di licenza per Hybrid Columnar Compression
-
Oracle AI Database Administrator's Guide per informazioni su come utilizzare Hybrid Columnar Compression
-
Oracle AI Database SQL Language Reference per sintassi e semantica
CREATE TABLE -
Oracle AI Database PL/SQL Packages and Types Reference per ulteriori informazioni sul package
DBMS_COMPRESSION
Compressione DML e Hybrid Columnar
Hybrid Columnar Compression ha implicazioni per il blocco delle righe in diversi tipi di operazioni DML.
Carichi di percorsi diretti e inserti convenzionali
Quando si caricano dati in una tabella che utilizza Hybrid Columnar Compression, è possibile utilizzare inserti convenzionali o caricamenti di percorsi diretti. I caricamenti del percorso diretto bloccano l'intera tabella, riducendo così la concorrenza.
A partire da Oracle Database 12c release 2 (12.2), viene aggiunto il supporto per gli inserimenti di array convenzionali nel formato Hybrid Columnar Compression. I vantaggi degli inserti array convenzionali sono:
-
Le righe inserite utilizzano blocchi a livello di riga, che aumentano la concorrenza.
-
L'ottimizzazione automatica dei dati (ADO) e la mappa cromatica supportano la compressione a colonne ibrida per i criteri a livello di riga. Pertanto, il database può utilizzare Hybrid Columnar Compression per i blocchi idonei anche quando l'attività DML si verifica su altre parti del segmento.
Quando l'applicazione utilizza inserimenti di array convenzionali, Oracle AI Database memorizza le righe in unità di compressione quando vengono soddisfatte le seguenti condizioni:
-
La tabella viene memorizzata in una tablespace ASSM.
-
Il livello di compatibilità è 12.2.0.1 o successivo.
-
La definizione della tabella soddisfa i vincoli esistenti della tabella Hybrid Columnar Compression, incluse nessuna colonna di tipo
LONGe nessuna dipendenza di riga.
Gli inserti convenzionali generano redo e undo. Pertanto, le unità di compressione create dall'istruzione DML convenzionale vengono sottoposte a rollback o a commit insieme al DML. Il database esegue automaticamente la manutenzione degli indici, proprio come per le righe memorizzate in blocchi di dati convenzionali.
A partire da Oracle AI Database 26ai, Automatic Storage Compression consente a Oracle AI Database di indirizzare inizialmente il caricamento dei dati in un formato non compresso, quindi spostare gradualmente le righe nel formato Hybrid Columnar Compression in background. Ciò è trasparente per gli utenti, migliorando al contempo le prestazioni ETL e mantenendo prestazioni di query rapide.
Aggiornamenti ed eliminazione
Per impostazione predefinita, il database blocca tutte le righe nell'unità di compressione se viene applicato un aggiornamento o un'eliminazione a qualsiasi riga dell'unità. Per evitare questo problema, è possibile scegliere di abilitare il blocco a livello di riga per una tabella. In questo caso, il database blocca solo le righe interessate dall'operazione di aggiornamento o eliminazione.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come eseguire inserti convenzionali
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sull'istruzione
INSERT -
Oracle AI Database SQL Language Reference per informazioni sull'uso del suggerimento
COMPRESS_IMMEDIATE -
Oracle AI Database VLDB and Partitioning Guide per informazioni sull'uso della compressione automatica dello storage
Velocità di memoria Hybrid Columnar Compression
Memory Speed Hybrid Columnar Compression introduce i formati di unità di compressione su disco che possono essere elaborati alla velocità della memoria.
Simile a Hybrid Columnar Compression, Memory Speed Hybrid Columnar Compression è adatto per ambienti di data warehousing. Trasforma i dati in un formato orientato alle colonne e li comprime durante il caricamento dei dati. La differenza principale è che Memory Speed Hybrid Columnar Compression utilizza lo stesso speciale formato a colonne dell'area di memorizzazione colonne in memoria e CELLMEMORY nella cache flash Exadata, ottenendo così scansioni a colonne ad alta velocità e un efficiente inserimento nella cache a colonne in tutti i livelli di storage. Inoltre, le unità di compressione a colonna ibrida Memory Speed sono significativamente più grandi delle unità di compressione a colonna ibride, il che consente un uso efficace del formato a colonna in memoria sul disco.
Memory Speed Hybrid Columnar Compression è abilitata come estensione di Hybrid Columnar Compression utilizzando il comando CREATE TABLE aggiungendo la parola chiave MEMSPEED.
Esempio 4-6 Velocità di memoria Hybrid Columnar Compression
Nell'esempio seguente viene creata la tabella orders con la compressione ibrida a colonne della velocità di memoria abilitata:
CREATE TABLE orders COLUMN STORE COMPRESS FOR MEMSPEED QUERY;Nota: per ulteriori informazioni, vedere Oracle AI Database SQL Language Reference.
Panoramica dei cluster di tabelle
Un cluster tabella è un gruppo di tabelle che condividono colonne comuni e memorizzano dati correlati negli stessi blocchi.
Quando le tabelle sono in cluster, un singolo blocco di dati può contenere righe da più tabelle. Ad esempio, un blocco può memorizzare le righe delle tabelle employees e departments anziché di una sola tabella.
La chiave cluster è la colonna o le colonne che le tabelle in cluster hanno in comune. Ad esempio, le tabelle employees e departments condividono la colonna department_id. È possibile specificare la chiave cluster durante la creazione del cluster di tabelle e durante la creazione di ogni tabella aggiunta al cluster di tabelle.
Il valore della chiave cluster è il valore delle colonne chiave cluster per un determinato set di righe. Tutti i dati che contengono lo stesso valore di chiave cluster, ad esempio department_id=20, vengono memorizzati fisicamente insieme. Ogni valore chiave del cluster viene memorizzato una sola volta nel cluster e nell'indice del cluster, indipendentemente dal numero di righe di tabelle diverse lo contengono.
Per un'analogia, si supponga che un responsabile HR disponga di due casi di registro: uno con caselle di cartelle di dipendenti e l'altro con caselle di cartelle di reparto. Gli utenti spesso chiedono le cartelle per tutti i dipendenti di un particolare reparto. Per semplificare il recupero, il manager riorganizza tutte le caselle in un'unica custodia. Divide le caselle per ID reparto. Pertanto, tutte le cartelle per i dipendenti del reparto 20 e la cartella per il reparto 20 sono in una casella; le cartelle per i dipendenti del reparto 100 e la cartella per il reparto 100 sono in un'altra casella e così via.
Considerare la possibilità di raggruppare le tabelle quando vengono sottoposte principalmente a query (ma non modificate) e i record delle tabelle vengono spesso sottoposti a query o a join. Poiché i cluster di tabelle memorizzano righe correlate di tabelle diverse negli stessi blocchi di dati, i cluster di tabelle utilizzati correttamente offrono i vantaggi riportati di seguito rispetto alle tabelle non in cluster.
-
Le operazioni di I/O su disco sono ridotte per i join di tabelle in cluster.
-
I tempi di accesso migliorano per i join di tabelle in cluster.
-
Per memorizzare i dati della tabella e dell'indice correlati è necessario meno storage perché il valore della chiave cluster non viene memorizzato ripetutamente per ogni riga.
In genere, le tabelle di clustering non sono appropriate nelle situazioni riportate di seguito.
-
Le tabelle vengono aggiornate di frequente.
-
Le tabelle richiedono spesso una scansione tabella completa.
-
Le tabelle devono essere troncate.
-
Panoramica dei cluster indicizzati Un cluster di indici è un cluster di tabelle che utilizza un indice per individuare i dati. L'indice cluster è un indice B-tree sulla chiave cluster. È necessario creare un indice cluster prima di poter inserire righe nelle tabelle in cluster.
-
Panoramica dei cluster hash Un cluster hash è simile a un cluster indicizzato, ad eccezione della chiave di indice sostituita con una funzione hash. Non esiste alcun indice cluster separato. In un cluster hash, i dati sono l'indice.
Panoramica dei cluster indicizzati
Un cluster indice è un cluster di tabelle che utilizza un indice per individuare i dati. L'indice cluster è un indice B-tree sulla chiave cluster. È necessario creare un indice cluster prima di poter inserire righe nelle tabelle in cluster.
Esempio 4-7 Creazione di un cluster di tabelle e di un indice associato
Si supponga di creare il cluster employees_departments_cluster con la chiave cluster department_id, come mostrato nell'esempio riportato di seguito.
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 512;

CREATE INDEX idx_emp_dept_cluster
   ON CLUSTER employees_departments_cluster;
Poiché la clausola HASHKEYS non è specificata, employees_departments_cluster è un cluster indicizzato. Nell'esempio precedente viene creato un indice denominato idx_emp_dept_cluster sulla chiave cluster department_id.
Esempio 4-8 Creazione di tabelle in un cluster indicizzato
Le tabelle employees e departments vengono create nel cluster, specificando la colonna department_id come chiave del cluster, come indicato di seguito (i puntini di sospensione contrassegnano la posizione in cui va la specifica della colonna).
CREATE TABLE employees ( ... )
   CLUSTER employees_departments_cluster (department_id);

CREATE TABLE departments ( ... )
   CLUSTER employees_departments_cluster (department_id);
Si supponga di aggiungere righe alle tabelle employees e departments. Il database memorizza fisicamente tutte le righe per ogni reparto delle tabelle employees e departments negli stessi blocchi di dati. Il database memorizza le righe in un heap e le individua con l'indice. La Figura 4-8 mostra il cluster della tabella employees_departments_cluster contenente employees e departments. Il database memorizza le righe per i dipendenti del reparto 20, del reparto 110 e così via. Se le tabelle non sono in cluster, il database non garantisce che le righe correlate vengano memorizzate insieme.
Figura 8: Dati della tabella in cluster
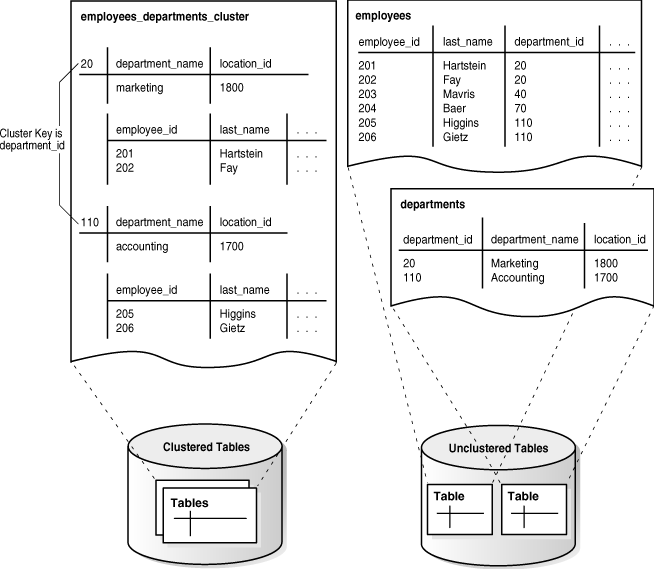
Descrizione dell'illustrazione cncpt023.gif
L'indice del cluster B-tree associa il valore della chiave cluster all'indirizzo DBA (Database Block Address) del blocco contenente i dati. Ad esempio, la voce di indice per la chiave 20 mostra l'indirizzo del blocco contenente i dati per i dipendenti nel reparto 20:
20,AADAAAA9dL'indice cluster viene gestito separatamente, come un indice in una tabella non in cluster, e può esistere in una tablespace separata dal cluster di tabelle.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come creare e gestire i cluster indicizzati
-
Oracle AI Database SQL Language Reference per sintassi e semantica
CREATE CLUSTER
Panoramica dei cluster hash
Un cluster hash è simile a un cluster indicizzato, ad eccezione della chiave indice che viene sostituita con una funzione hash. Non esiste alcun indice cluster separato. In un cluster hash, i dati sono l'indice.
Con una tabella indicizzata o un cluster indicizzato, Oracle AI Database individua le righe di tabella utilizzando i valori chiave memorizzati in un indice separato. Per trovare o memorizzare una riga in una tabella indicizzata o in un cluster di tabelle, il database deve eseguire almeno due operazioni di I/O:
-
Uno o più I/O per trovare o memorizzare il valore della chiave nell'indice
-
Un altro I/O per leggere o scrivere la riga nel cluster di tabelle o tabelle
Per trovare o memorizzare una riga in un cluster hash, Oracle AI Database applica la funzione hash al valore della chiave cluster della riga. Il valore hash risultante corrisponde a un blocco di dati nel cluster, che il database legge o scrive per conto dell'istruzione emessa.
L'hashing è un modo facoltativo di memorizzare i dati delle tabelle per migliorare le prestazioni del recupero dei dati. I cluster hash possono essere utili quando vengono soddisfatte le seguenti condizioni:
-
Una tabella viene interrogata molto più spesso di quanto modificata.
-
La colonna chiave hash viene interrogata frequentemente con condizioni di uguaglianza, ad esempio
WHERE department_id=20. Per tali query, viene eseguito l'hashing del valore della chiave cluster. Il valore della chiave hash punta direttamente all'area del disco in cui sono memorizzate le righe. -
È ragionevolmente possibile indovinare il numero di chiavi hash e la dimensione dei dati memorizzati con ogni valore chiave.
-
Creazione di cluster hash Per creare un cluster hash, utilizzare la stessa istruzione
CREATE CLUSTERdi un cluster indicizzato, con l'aggiunta di una chiave hash. Il numero di valori hash per il cluster dipende dalla chiave hash. -
Query cluster hash Nelle query di un cluster hash, il database determina come eseguire l'hash dei valori chiave immessi dall'utente.
-
Variazioni cluster hash Un cluster hash a tabella singola è una versione ottimizzata di un cluster hash che supporta una sola tabella alla volta. Esiste un mapping uno-a-uno tra chiavi hash e righe.
-
Storage cluster hash Oracle AI Database alloca lo spazio per un cluster hash in modo diverso da un cluster indicizzato.
Creazione cluster hash
Per creare un cluster hash, si utilizza la stessa istruzione CREATE CLUSTER di un cluster indicizzato, con l'aggiunta di una chiave hash. Il numero di valori hash per il cluster dipende dalla chiave hash.
La chiave cluster, come la chiave di un cluster indicizzato, è una singola colonna o chiave composta condivisa dalle tabelle nel cluster. Un valore della chiave hash è un valore effettivo o possibile inserito nella colonna della chiave cluster. Ad esempio, se la chiave del cluster è department_id, i valori della chiave hash potrebbero essere 10, 20, 30 e così via.
Oracle AI Database utilizza una funzione hash che accetta un numero infinito di valori di chiave hash come input e li ordina in un numero finito di bucket. Ogni bucket ha un ID numerico univoco noto come valore hash. Ogni valore hash viene mappato all'indirizzo del blocco del database per il blocco in cui sono memorizzate le righe corrispondenti al valore della chiave hash (reparti 10, 20, 30 e così via).
Nell'esempio seguente, il numero di reparti probabilmente esistenti è 100, quindi HASHKEYS è impostato su 100:
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 8192 HASHKEYS 100;
Dopo aver creato employees_departments_cluster, è possibile creare le tabelle employees e departments nel cluster. È quindi possibile caricare i dati nel cluster hash proprio come nel cluster indicizzato.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come creare e gestire i cluster hash
Query cluster hash
Nelle query di un cluster hash, il database determina come eseguire l'hash sui valori delle chiavi immessi dall'utente.
Ad esempio, gli utenti eseguono frequentemente query come le seguenti, immettendo diversi numeri ID reparto per p_id:
SELECT *
FROM   employees
WHERE  department_id = :p_id;

SELECT *
FROM   departments
WHERE  department_id = :p_id;

SELECT *
FROM   employees e, departments d
WHERE  e.department_id = d.department_id
AND    d.department_id = :p_id;
Se un utente esegue una query sui dipendenti in department_id=20, il database potrebbe eseguire l'hash di questo valore nel bucket 77. Se un utente interroga i dipendenti in department_id=10, il database potrebbe eseguire l'hash di questo valore nel bucket 15. Il database utilizza il valore hash generato internamente per individuare il blocco che contiene le righe dipendente per il reparto richiesto.
L'illustrazione seguente descrive un segmento di cluster hash come una riga orizzontale di blocchi. Come mostrato nel grafico, una query può recuperare i dati in un singolo I/O.
Figura 9: Recupero dei dati da un cluster hash
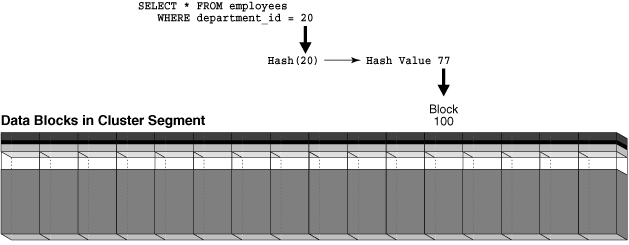
Descrizione dell'illustrazione cncpt329.gif
Una limitazione dei cluster hash è l'indisponibilità delle scansioni di intervallo sulle chiavi cluster non indicizzate. Si supponga che non esista alcun indice separato per il cluster hash creato in Creazione cluster hash. Una query per i reparti con ID compresi tra 20 e 100 non può utilizzare l'algoritmo di hashing perché non può eseguire l'hash di ogni valore possibile compreso tra 20 e 100. Poiché non esiste alcun indice, il database deve eseguire una scansione completa.
Vedere anche: "Scansione intervallo indice"
Variazioni cluster hash
Un cluster hash a tabella singola è una versione ottimizzata di un cluster hash che supporta una sola tabella alla volta. Esiste un mapping uno-a-uno tra chiavi hash e righe.
Un cluster hash a tabella singola può essere utile quando gli utenti richiedono l'accesso rapido a una tabella in base alla chiave primaria. Ad esempio, gli utenti spesso cercano un record dipendente nella tabella employees per employee_id.
Un cluster hash ordinato memorizza le righe corrispondenti a ciascun valore della funzione hash in modo che il database possa restituirle in modo efficiente in ordine di ordinamento. Il database esegue l'ordinamento ottimizzato internamente. Per le applicazioni che utilizzano sempre i dati in ordine, questa tecnica può significare un recupero più rapido dei dati. Ad esempio, un'applicazione potrebbe sempre essere ordinata nella colonna order_date della tabella orders.
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come creare cluster hash a tabella singola e ordinati.
Storage cluster hash
Oracle AI Database alloca lo spazio per un cluster hash in modo diverso da un cluster indicizzato.
Nell'esempio in Creazione cluster hash, HASHKEYS specifica il numero di reparti probabilmente esistenti, mentre SIZE specifica la dimensione dei dati associati a ciascun reparto. Il database calcola un valore dello spazio di storage in base alla formula seguente:
HASHKEYS * SIZE / database_block_sizePertanto, se la dimensione del blocco è di 4096 byte nell'esempio mostrato in Creazione cluster hash, il database alloca almeno 200 blocchi al cluster hash.
Oracle AI Database non limita il numero di valori delle chiavi hash che è possibile inserire nel cluster. Ad esempio, anche se HASHKEYS è 100, nulla impedisce di inserire 200 reparti univoci nella tabella departments. Tuttavia, l'efficienza del recupero del cluster hash diminuisce quando il numero di valori hash supera il numero di chiavi hash.
Per illustrare i problemi di recupero, si supponga che il blocco 100 nella Figura 4-9 sia completamente pieno di righe per il reparto 20. Un utente inserisce un nuovo reparto con department_id 43 nella tabella departments. Il numero di reparti supera il valore HASHKEYS, quindi il database esegue l'hash department_id 43 sul valore hash 77, che è lo stesso valore hash utilizzato per department_id 20. L'inserimento di più valori di input nello stesso valore di output è definito hash collision.
Quando gli utenti inseriscono righe nel cluster per il reparto 43, il database non può memorizzare queste righe nel blocco 100, che è pieno. Il database collega il blocco 100 a un nuovo blocco di overflow, ad esempio il blocco 200, e memorizza le righe inserite nel nuovo blocco. Entrambi i blocchi 100 e 200 sono ora idonei per memorizzare i dati per entrambi i reparti. Come illustrato nella Figura 4-10, una query del reparto 20 o 43 ora richiede due I/O per recuperare i dati: blocco 100 e blocco associato 200. È possibile risolvere il problema ricreando il cluster con un valore HASHKEYS diverso.
Figura 10: Recupero dei dati da un cluster di hash quando si verifica una collisione di hash
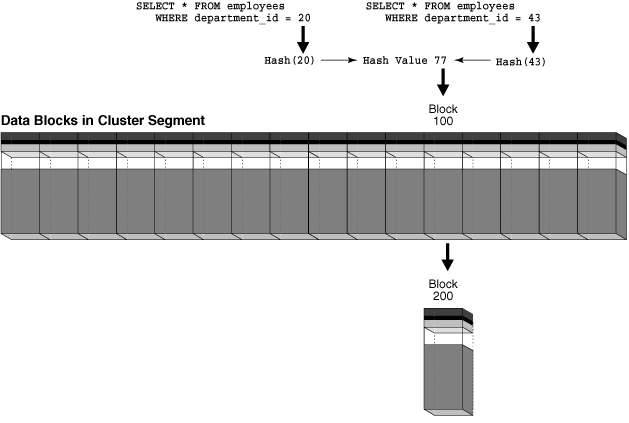
Descrizione dell'illustrazione cncpt331.gif
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come gestire lo spazio nei cluster hash.
Panoramica delle tabelle in cluster di attributi
Una tabella in cluster di attributi è una tabella organizzata in heap che memorizza i dati in prossimità del disco in base alle direttive di clustering specificate dall'utente. Le direttive specificano le colonne in una o più tabelle.
Le direttive sono le seguenti:
-
La direttiva
CLUSTERING ... BY LINEAR ORDERordina i dati in una tabella in base alle colonne specificate.Prendere in considerazione l'utilizzo del clustering
BY LINEAR ORDER, che è l'impostazione predefinita, quando le query qualificano il prefisso delle colonne specificato nella clausola di clustering. Ad esempio, se le query dish.salesspecificano spesso un ID cliente o sia l'ID cliente che l'ID prodotto, è possibile raggruppare i dati nella tabella utilizzando l'ordine di colonna linearecust_id,prod_id. -
La direttiva
CLUSTERING ... BY INTERLEAVED ORDERordina i dati in una o più tabelle utilizzando un algoritmo speciale, simile a una funzione di ordine Z, che consente la riduzione di I/O a più colonne.Prendere in considerazione l'utilizzo del clustering
BY INTERLEAVED ORDERquando le query specificano una varietà di combinazioni di colonne. Ad esempio, se le query dish.salesspecificano dimensioni diverse in ordini diversi, è possibile raggruppare i dati nella tabellasalesin base alle colonne di queste dimensioni.
Il clustering degli attributi è disponibile solo per le operazioni direct path INSERT. Viene ignorato per il DML convenzionale.
Questa sezione contiene gli argomenti riportati di seguito.
-
Vantaggi delle tabelle in cluster di attributi Il vantaggio principale delle tabelle in cluster di attributi è la riduzione di I/O, che può ridurre in modo significativo i costi di I/O e CPU delle scansioni delle tabelle. La riduzione dell'I/O si verifica con le zone o riducendo l'I/O fisico attraverso una maggiore vicinanza fisica sul disco per i valori in cluster.
-
Partecipa a tabelle in cluster di attributi Il clustering di attributi basato su colonne con join è denominato clustering di attributi di join. A differenza dei cluster di tabelle, le tabelle in cluster degli attributi di join non memorizzano i dati di un gruppo di tabelle negli stessi blocchi di database.
-
Riduzione I/O mediante zone Una zona è un insieme di blocchi di dati contigui che memorizza i valori minimo e massimo delle colonne pertinenti.
-
Tabelle in cluster di attributi con ordinamento lineare Uno schema di ordinamento lineare per una tabella divide le righe in intervalli in base agli attributi specificati dall'utente in un ordine specifico. Oracle AI Database supporta l'ordinamento lineare su una o più tabelle connesse tramite una relazione di chiavi primarie straniere.
-
Tabelle in cluster con attributi con ordinamento interleave L'ordinamento interleave utilizza una tecnica simile a un ordine Z.
Vantaggi delle tabelle in cluster di attributi
Il vantaggio principale delle tabelle in cluster di attributi è la riduzione di I/O, che può ridurre in modo significativo il costo di I/O e il costo CPU delle scansioni delle tabelle. La riduzione dell'I/O si verifica con le zone o riducendo l'I/O fisico attraverso una maggiore vicinanza fisica sul disco per i valori in cluster.
Una tabella in cluster di attributi presenta i vantaggi riportati di seguito.
-
È possibile raggruppare le tabelle fact in base alle colonne delle dimensioni negli schemi a stella.
Negli schemi a stella, la maggior parte delle query qualifica le tabelle delle dimensioni e non le tabelle dei fatti, pertanto il clustering in base alle colonne delle tabelle dei fatti non è efficace. Oracle AI Database supporta il clustering sulle colonne nelle tabelle delle dimensioni.
-
La riduzione dell'I/O può verificarsi in diversi scenari:
-
Quando viene utilizzato con gli indici di Oracle Exadata Storage, la potatura min/max di Oracle In-Memory o le mappe di zone
-
Nelle applicazioni OLTP per le query che qualificano un prefisso e utilizzano il clustering degli attributi con ordine lineare
-
Su un subset delle colonne di clustering per il clustering
BY INTERLEAVED ORDER
-
-
Il clustering degli attributi può migliorare la compressione dei dati e in questo modo migliorare indirettamente i costi di scansione delle tabelle.
Quando gli stessi valori sono vicini l'uno all'altro sul disco, il database può comprimerli più facilmente.
-
Oracle AI Database non comporta i costi di storage e manutenzione di un indice.
Vedi anche: Oracle AI Database Data Warehousing Guide per maggiori vantaggi delle tabelle in cluster di attributi
Unisci tabelle in cluster attributi
Il clustering degli attributi basato su colonne unite tramite join è denominato clustering degli attributi di join. A differenza dei cluster di tabelle, le tabelle in cluster degli attributi di join non memorizzano i dati di un gruppo di tabelle negli stessi blocchi di database.
Ad esempio, si consideri una tabella in cluster di attributi, sales, unita tramite join a una tabella dimensioni, products. La tabella sales contiene solo righe della tabella sales, ma l'ordinamento delle righe si basa sui valori delle colonne unite tramite join dalla tabella products. Il join appropriato viene eseguito durante lo spostamento dei dati, l'inserimento diretto del percorso e le operazioni CREATE TABLE AS SELECT. Al contrario, se sales e products si trovano in un cluster di tabelle standard, i blocchi di dati conterranno righe da entrambe le tabelle.
Vedi anche: Oracle AI Database Data Warehousing Guide per ulteriori informazioni sul clustering degli attributi di join
Riduzione I/O mediante zone
Una zona è un set di blocchi di dati contigui che memorizza i valori minimo e massimo delle colonne pertinenti.
Quando un'istruzione SQL contiene predicati sulle colonne memorizzate in una zona, il database confronta i valori del predicato con il minimo e il massimo memorizzati nella zona. In questo modo, il database determina quali zone leggere durante l'esecuzione SQL.
La riduzione di I/O consente di saltare blocchi di tabelle o indici che non contengono dati che il database deve soddisfare una query. Questa riduzione può ridurre in modo significativo i costi di I/O e CPU delle scansioni delle tabelle.
-
Scopo delle zone Per un'analogia libera delle zone, considerare un responsabile delle vendite che utilizza una libreria di piccioni, analoga ai blocchi di dati.
-
Mappe aree Una mappa aree è una struttura di accesso indipendente che divide i blocchi di dati in zone. Oracle AI Database implementa ogni mappa delle aree come tipo di vista materializzata.
-
Le mappe aree di base Creazione mappa aree vengono create manualmente o automaticamente.
-
Funzionamento di una mappa delle zone: esempio In questo esempio viene illustrato come una mappa delle aree può eliminare i dati in una query il cui predicato contiene una costante.
Scopo delle zone
Per un'analogia libera delle zone, considera un responsabile delle vendite che utilizza una libreria di piccioni, che sono analoghi ai blocchi di dati.
Ogni piccione ha ricevute (righe) che descrivono le camicie vendute a un cliente, ordinate per data di spedizione. In questa analogia, una mappa delle zone è come una pila di schede indice. Ogni carta corrisponde a una "zona" (gamma contigua) di piccioni, come le piccioni 1-10. Per ogni zona, la carta elenca le date di spedizione minime e massime per le ricevute memorizzate nella zona.
Quando qualcuno vuole sapere quali magliette spedite in una certa data, il manager capovolge le carte fino a quando non arriva all'intervallo di date che contiene la data richiesta, nota la zona del piccione e quindi cerca solo i piccioni in questa zona per le ricevute richieste. In questo modo, il manager evita di cercare le ricevute in ogni buco nella libreria.
Mappe zone
Una mappa aree è una struttura di accesso indipendente che divide i blocchi di dati in zone. Oracle AI Database implementa ogni mappa delle aree come tipo di vista materializzata.
Come gli indici, le mappe delle aree possono ridurre i costi di I/O e CPU delle scansioni delle tabelle. Quando un'istruzione SQL contiene predicati sulle colonne di una mappa aree, il database confronta i valori di predicato con i valori di colonna di tabella minimo e massimo memorizzati in ciascuna zona per determinare quali zone leggere durante l'esecuzione SQL.
Una mappa aree di base viene definita in una singola tabella e mantiene i valori minimo e massimo di alcune colonne di questa tabella. Una mappa delle aree di join viene definita in una tabella con un outer join a una o più altre tabelle e mantiene i valori minimo e massimo di alcune colonne nelle altre tabelle. Oracle AI Database gestisce automaticamente entrambi i tipi di mappa delle aree.
In una tabella può esistere al massimo una mappa aree. Nel caso di una tabella partizionata, esiste una mappa di zone per tutte le partizioni e le partizioni secondarie. Una mappa aree di una tabella partizionata tiene traccia anche dei valori minimo e massimo per zona, per partizione e per partizione secondaria. Le definizioni della mappa aree possono includere i valori minimo e massimo delle colonne dimensione a condizione che la tabella disponga di un outer join con le tabelle dimensione. Nota: è possibile creare una mappa aree contenente solo la partizione o la zona a livello di partizione secondaria. La creazione di una mappa aree di questo tipo espande le funzionalità di eliminazione della partizione oltre i metadati della partizione.
Per una panoramica delle mappe delle aree, vedere anche: Oracle AI Database Data Warehousing Guide
Creazione mappa zone
Le mappe aree di base vengono create manualmente o automaticamente.
-
Mappe delle zone manuali È possibile creare, eliminare e gestire le mappe delle zone utilizzando le istruzioni DDL.
-
Mappe automatiche delle zone Oracle AI Database può creare automaticamente mappe delle zone di base. Questi sono noti come mappe aree automatiche.
Mappe aree manuali
È possibile creare, eliminare e gestire le mappe aree utilizzando le istruzioni DDL.
Ogni volta che si specifica la clausola CLUSTERING in un'istruzione CREATE TABLE o ALTER TABLE, il database crea automaticamente una mappa aree nelle colonne di clustering specificate. La mappa aree correla i valori minimo e massimo delle colonne con blocchi di dati consecutivi nella tabella in cluster di attributi. Le tabelle in cluster di attributi utilizzano le mappe aree per eseguire la riduzione di I/O.
È inoltre possibile creare mappe di zone in modo esplicito utilizzando l'istruzione CREATE MATERIALIZED ZONEMAP. In questo caso, è possibile creare mappe aree da utilizzare con o senza cluster di attributi. Ad esempio, è possibile creare una mappa delle aree in una tabella le cui righe sono ordinate in modo naturale in un set di colonne, ad esempio una tabella delle negoziazioni azionarie le cui negoziazioni sono ordinate in base al tempo.
Vedere anche:
-
Oracle AI Database Data Warehousing Guide per ulteriori informazioni su come creare mappe aree
Mappe aree automatiche
Oracle AI Database può creare automaticamente mappe di zona di base. Questi sono noti come mappe aree automatiche.
Oracle AI Database può creare automaticamente mappe di zone di base sia per le tabelle partizionate che per quelle non partizionate. Un processo in background gestisce automaticamente le mappe aree create in questo modo.
Utilizzare la procedura DBMS_AUTO_ZONEMAP per abilitare le mappe aree automatiche.
EXEC DBMS_AUTO_ZONEMAP.CONFIGURE('AUTO_ZONEMAP_MODE','ON')Vedere anche:
-
Oracle AI Database Data Warehousing Guide per ulteriori informazioni sulla gestione automatica delle mappe aree mediante il pacchetto
DBMS_AUTO_ZONEMAP -
Oracle AI Database PL/SQL Packages and Types Reference per ulteriori informazioni sul package
DBMS_AUTO_ZONEMAP -
Manuale utente delle informazioni sulle licenze di Oracle AI Database per i dettagli sulle funzioni supportate per edizioni e servizi diversi
Funzionamento di una mappa delle zone: esempio
In questo esempio viene illustrato come una mappa aree può eliminare i dati in una query il cui predicato contiene una costante.
Si supponga di creare la tabella lineitem seguente:
CREATE TABLE lineitem
  ( orderkey      NUMBER        ,
    shipdate      DATE          ,
    receiptdate   DATE          ,
    destination   VARCHAR2(50)  ,
    quantity      NUMBER        );
La tabella lineitem contiene 4 blocchi di dati con 2 righe per blocco. La Tabella 4-4 mostra le 8 righe della tabella.
Tabella 4 - Blocchi dati per tabella voci riga
| Blocco | chiave dell'ordine | data spedizione | data ricezione | destinazione | quantità |
|---|---|---|---|---|---|
| 1 | 1 | 1-1-2014 | 1-10-2014 | San_Fran | 100 |
| 1 | 2 | 1-2-2014 | 1-10-2014 | San_Fran | 200 |
| 2 | 3 | 1-3-2014 | 1-9-2014 | San_Fran | 100 |
| 2 | 4 | 1-5-2014 | 1-10-2014 | San_Diego | 100 |
| 3 | 5 | 1-10-2014 | 1-15-2014 | San_Fran | 100 |
| 3 | 6 | 1-12-2014 | 1-16-2014 | San_Fran | 200 |
| 4 | 7 | 1-13-2014 | 1-20-2014 | San_Fran | 100 |
| 4 | 8 | 1-15-2014 | 1-30-2014 | San_Jose | 100 |
È possibile utilizzare l'istruzione CREATE MATERIALIZED ZONEMAP per creare una mappa aree nella tabella lineitem. Ogni zona contiene 2 blocchi e memorizza il minimo e il massimo delle colonne orderkey, shipdate e receiptdate. Nella Tabella 4-5 viene visualizzata la mappa delle aree.
Tabella 5 Mappa zone per tabella voci riga
| Intervallo blocchi | chiave ordine min | numero massimo chiavi ordine | data spedizione min | data spedizione massima | data ricevuta min | data ricezione massima |
|---|---|---|---|---|---|---|
| 1-2 | 1 | 4 | 1-1-2014 | 1-5-2014 | 1-9-2014 | 1-10-2014 |
| 3-4 | 5 | 8 | 1-10-2014 | 1-15-2014 | 1-15-2014 | 1-30-2014 |
Quando si esegue la query seguente, il database può leggere la mappa delle zone e quindi eseguire la scansione solo dei blocchi 1 e 2, quindi saltare i blocchi 3 e 4, perché la data 1-3-2014 è compresa tra le date minima e massima:
SELECT * FROM lineitem WHERE shipdate = '1-3-2014';Vedere anche:
-
Oracle AI Database Data Warehousing Guide per informazioni su come utilizzare le mappe aree
-
Oracle AI Database SQL Language Reference per la sintassi e la semantica dell'istruzione
CREATE MATERIALIZED ZONEMAP
Tabelle in cluster di attributi con ordinamento lineare
Uno schema di ordinamento lineare per una tabella divide le righe in intervalli basati su attributi specificati dall'utente in un ordine specifico. Oracle AI Database supporta l'ordinamento lineare su una o più tabelle connesse tramite una relazione di chiavi primarie straniere.
Ad esempio, la tabella sales divide le colonne cust_id e prod_id in intervalli e quindi raggruppa questi intervalli su disco. Quando si specifica la direttiva BY LINEAR ORDER per una tabella, una riduzione significativa dell'I/O può verificarsi quando un predicato specifica la colonna del prefisso o tutte le colonne della direttiva.
Si supponga che le query su sales specifichino spesso un ID cliente o una combinazione di un ID cliente e un ID prodotto. È possibile creare una tabella in cluster di attributi in modo che tali query traggano vantaggio dalla riduzione di I/O:
CREATE TABLE sales
(
   prod_id     NOT NULL NUMBER
,  cust_id     NOT NULL NUMBER
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING
  BY LINEAR ORDER (cust_id, prod_id)
  YES ON LOAD YES ON DATA MOVEMENT
  WITH MATERIALIZED ZONEMAP;
Le query che qualificano sia le colonne cust_id che prod_id oppure il prefisso cust_id subiscono una riduzione di I/O. Le query che qualificano prod_id non subiscono una significativa riduzione di I/O perché prod_id è il suffisso della clausola BY LINEAR ORDER. Gli esempi riportati di seguito mostrano come il database può ridurre gli I/O durante le scansioni delle tabelle.
Esempio 4-9 che specifica solo cust_id
Un'applicazione esegue la seguente query:
SELECT * FROM sales WHERE cust_id = 100;Poiché la tabella sales è un cluster BY LINEAR ORDER, il database deve leggere solo le zone che includono il valore cust_id di 100.
Esempio 4-10 con specifica di prod_id e cust_id
Un'applicazione esegue la seguente query:
SELECT * FROM sales WHERE cust_id = 100 AND prod_id = 2300;Poiché la tabella sales è un cluster BY LINEAR ORDER, il database deve leggere solo le zone che includono il valore cust_id di 100 e il valore prod_id di 2300.
Vedere anche:
-
Oracle AI Database Data Warehousing Guide per scoprire come raggruppare le tabelle utilizzando l'ordinamento lineare
-
Oracle AI Database SQL Language Reference per la sintassi e la semantica della clausola
BY LINEAR ORDER
Tabelle in cluster di attributi con ordinamento interleaved
L'ordinamento interleave utilizza una tecnica simile a quella di un ordine Z.
L'ordinamento interleaved consente al database di eseguire l'eliminazione di I/O in base a qualsiasi subset di predicati nelle colonne di clustering. L'ordinamento interleaved è utile per le gerarchie dimensionali in un data warehouse.
Come per le tabelle in cluster di attributi con ordinamento lineare, Oracle AI Database supporta l'ordinamento interleave su una o più tabelle connesse tramite una relazione di chiavi primarie straniere. Le colonne in tabelle diverse dalla tabella in cluster di attributi devono essere collegate tramite chiave esterna e unite tramite join alla tabella in cluster di attributi.
I data warehouse di grandi dimensioni spesso organizzano i dati in uno schema a stella. Una tabella delle dimensioni utilizza una gerarchia padre-figlio ed è connessa a una tabella dei fatti da una chiave esterna. Il clustering di una tabella fact in base all'ordine interleave consente al database di utilizzare una funzione speciale per saltare i valori nelle colonne delle dimensioni durante le scansioni delle tabelle.
Esempio di ordinamento interleave 4-11
Si supponga che il data warehouse contenga una tabella fact sales e le relative due tabelle dimensione: customers e products. La maggior parte delle query dispone di predicati nella gerarchia di tabelle customers (cust_state_province, cust_city) e nella gerarchia di prodotti (prod_category, prod_subcategory). È possibile utilizzare l'ordinamento interleaved per la tabella sales come mostrato nell'istruzione parziale nell'esempio seguente:
CREATE TABLE sales
(
   prod_id NUMBER NOT NULL
,  cust_id NUMBER NOT NULL
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING sales
   JOIN products ON (sales.prod_id = products.prod_id)
   JOIN customers ON (sales.cust_id = customers.cust_id)
   BY INTERLEAVED ORDER
   (
     (  products.prod_category
     ,  products.prod_subcategory
     ),
     (  customers.cust_state_province
     ,  customers.cust_city
     )
   )
WITH MATERIALIZED ZONEMAP;
Nota: le colonne specificate nella clausola BY INTERLEAVED ORDER non devono trovarsi nelle tabelle dimensione effettive, ma devono essere connesse tramite una relazione chiave primaria-straniera.
Si supponga che un'applicazione esegua query sulle tabelle sales, products e customers in un join. La query specifica le colonne customers.prod_category e customers_cust_state_province nel predicato come indicato di seguito.
SELECT cust_city, prod_sub_category, SUM(amount_sold)
FROM   sales, products, customers
WHERE  sales.prod_id = products.prod_id
AND    sales.cust_id = customers.cust_id
AND    customers.prod_category = 'Boys'
AND    customers.cust_state_province = 'England - Norfolk'
GROUP BY cust_city, prod_sub_category;
Nella query precedente, le colonne prod_category e cust_state_province fanno parte della definizione di cluster mostrata nell'esempio CREATE TABLE. Durante la scansione della tabella sales, il database può consultare la mappa delle aree e accedere solo agli ID riga in questa zona.
Vedere anche:
-
Oracle AI Database Data Warehousing Guide per informazioni su come raggruppare le tabelle utilizzando gli ordini interleaved
-
Oracle AI Database SQL Language Reference per la sintassi e la semantica della clausola
BY INTERLEAVED ORDER
Panoramica delle tabelle temporanee
Una tabella temporanea contiene dati esistenti solo per la durata di una transazione o di una sessione.
I dati in una tabella temporanea sono privati della sessione. Ogni sessione può solo visualizzare e modificare i propri dati.
È possibile creare una tabella temporanea globale o una tabella temporanea privata. La tabella seguente mostra le differenze essenziali tra di loro.
Tabella 6 Caratteristiche tabella temporanea
| Caratteristica | Globale | Privato |
|---|---|---|
| Regole di denominazione | Come per le tabelle permanenti | Deve essere preceduto da ORA$PTT_ |
| Visibilità della definizione della tabella | Tutte le sessioni | Solo la sessione che ha creato la tabella |
| Memorizzazione della definizione della tabella | Disco | Solo memoria |
| Tipi | Transazione specifica (ON COMMIT DELETE ROWS) o sessione specifica (ON COMMIT PRESERVE ROWS) |
Transazione specifica (ON COMMIT DROP DEFINITION) o sessione specifica (ON COMMIT PRESERVE DEFINITION) |
Un terzo tipo di tabella temporanea, nota come tabella temporanea di durata del cursore, viene creato automaticamente dal database per determinati tipi di query.
-
Scopo delle tabelle temporanee: le tabelle temporanee sono utili nelle applicazioni in cui un set di risultati deve essere inserito nel buffer.
-
Allocazione segmento in tabelle temporanee Come le tabelle permanenti, le tabelle temporanee globali sono oggetti persistenti definiti in modo statico nel dizionario dati. Per le tabelle temporanee private, i metadati esistono solo in memoria, ma possono risiedere nella tablespace temporanea sul disco.
-
Creazione di tabelle temporanee L'istruzione
CREATE ... TEMPORARY TABLEcrea una tabella temporanea. Vedere anche: Oracle AI Database SQL Tuning Guide per ulteriori informazioni sulle tabelle temporanee di durata del cursore
Scopo delle tabelle temporanee
Le tabelle temporanee sono utili nelle applicazioni in cui un set di risultati deve essere inserito nel buffer.
Ad esempio, un'applicazione di pianificazione consente agli studenti universitari di creare programmi di corsi semestrali facoltativi. Una riga in una tabella temporanea globale rappresenta ogni schedulazione. Durante la sessione, i dati di pianificazione sono privati. Quando lo studente sceglie una schedulazione, l'applicazione sposta la riga per la schedulazione scelta in una tabella permanente. Al termine della sessione, il database elimina automaticamente i dati di pianificazione presenti nella tabella temporanea globale.
Le tabelle temporanee private sono utili per le applicazioni di reporting dinamico. Ad esempio, un'applicazione CRM (Customer Resource Management) potrebbe connettersi come lo stesso utente a tempo indeterminato, con più sessioni attive contemporaneamente. Ogni sessione crea una tabella temporanea privata denominata ORA$PTT_crm per ogni nuova transazione. L'applicazione può utilizzare lo stesso nome di tabella per ogni sessione, ma modificare la definizione. I dati e la definizione sono visibili solo alla sessione. La definizione della tabella persiste fino al termine della transazione o all'eliminazione manuale della tabella.
Allocazione segmenti in tabelle temporanee
Come le tabelle permanenti, le tabelle temporanee globali sono oggetti persistenti definiti in modo statico nel dizionario dati. Per le tabelle temporanee private, i metadati esistono solo in memoria, ma possono risiedere nella tablespace temporanea sul disco.
Per le tabelle temporanee globali e private, il database alloca segmenti temporanei quando una sessione inserisce i dati per la prima volta. Fino a quando i dati non vengono caricati in una sessione, la tabella appare vuota. Per le tabelle temporanee specifiche della transazione, il database disalloca i segmenti temporanei alla fine della transazione. Per le tabelle temporanee specifiche della sessione, il database disalloca i segmenti temporanei alla fine della sessione.
Vedere anche: "Segmenti temporanei"
Creazione tabella temporanea
L'istruzione CREATE ... TEMPORARY TABLE crea una tabella temporanea.
Specificare GLOBAL TEMPORARY TABLE o PRIVATE TEMPORARY TABLE. In entrambi i casi, la clausola ON COMMIT specifica se i dati della tabella sono specifici della transazione (impostazione predefinita) o della sessione. Creare una tabella temporanea per il database stesso, non per ogni stored procedure PL/SQL.
È possibile creare indici per tabelle temporanee globali (non private) con l'istruzione CREATE INDEX. Anche questi indici sono temporanei. I dati nell'indice hanno lo stesso ambito di sessione o transazione dei dati nella tabella temporanea. È inoltre possibile creare una vista o un trigger in una tabella temporanea globale.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come creare e gestire tabelle temporanee.
-
Oracle AI Database SQL Language Reference per sintassi e semantica
CREATE ... TEMPORARY TABLE
Panoramica delle tabelle esterne
Una tabella esterna accede ai dati nelle origini esterne come se questi fossero contenuti in una tabella del database.
I dati possono essere in qualsiasi formato per il quale viene fornito un driver di accesso. È possibile utilizzare SQL (seriale o parallelo), PL/SQL e Java per eseguire query sulle tabelle esterne.
-
Scopo delle tabelle esterne Le tabelle esterne sono utili quando un'applicazione di database Oracle deve accedere a dati non relazionali.
-
Dati nelle aree di memorizzazione degli oggetti È possibile utilizzare tabelle esterne per accedere ai dati nelle aree di memorizzazione degli oggetti.
-
Driver di accesso a tabelle esterne Un driver di accesso è un'API che interpreta i dati esterni per il database. Il driver di accesso viene eseguito all'interno del database, che utilizza il driver per leggere i dati nella tabella esterna. Il driver di accesso e il livello di tabella esterna sono responsabili dell'esecuzione delle trasformazioni richieste sui dati nel file di dati in modo che corrisponda alla definizione della tabella esterna.
-
Creazione di tabelle esterne Internamente, la creazione di una tabella esterna comporta la creazione di metadati nel dizionario dati. A differenza di una tabella ordinaria, una tabella esterna non descrive i dati memorizzati nel database, né descrive come i dati vengono memorizzati esternamente. I metadati delle tabelle esterne descrivono invece il modo in cui il livello delle tabelle esterne deve presentare i dati nel database.
-
Inserimento automatico dei dati delle tabelle esterne nella cache I dati delle tabelle esterne vengono inseriti nella cache in modo trasparente per migliorare le prestazioni delle query.
Scopo delle tabelle esterne
Le tabelle esterne sono utili quando un'applicazione di database Oracle deve accedere a dati non relazionali.
Ad esempio, un'applicazione basata su SQL potrebbe dover accedere a un file di testo i cui record si trovano nel seguente formato:
100,Steven,King,SKING,515.123.4567,17-JUN-03,AD_PRES,31944,150,90
101,Neena,Kochhar,NKOCHHAR,515.123.4568,21-SEP-05,AD_VP,17000,100,90
102,Lex,De Haan,LDEHAAN,515.123.4569,13-JAN-01,AD_VP,17000,100,90
È possibile creare una tabella esterna, copiare il file di testo nella posizione specificata nella definizione della tabella esterna, quindi utilizzare SQL per eseguire query sui record nel file di testo. Analogamente, è possibile utilizzare tabelle esterne per concedere l'accesso in sola lettura ai documenti JSON o ai LOB.
Negli ambienti di data warehouse, le tabelle esterne sono preziose per l'esecuzione di task ETL (estrazione, trasformazione e caricamento). Ad esempio, le tabelle esterne consentono di pipeline della fase di caricamento dei dati con la fase di trasformazione. Questa tecnica elimina la necessità di posizionare i dati all'interno del database in preparazione per un'ulteriore elaborazione all'interno del database.
È possibile partizionare le tabelle esterne su colonne virtuali o non virtuali. Inoltre, è possibile creare una tabella partizionata ibrida, in cui alcune partizioni sono interne ed esterne. Analogamente alle partizioni interne, le partizioni esterne traggono vantaggio da miglioramenti a livello di prestazioni quali l'eliminazione delle partizioni e i join tra partizioni. Ad esempio, è possibile utilizzare tabelle esterne partizionate per analizzare grandi volumi di dati non relazionali memorizzati in HDFS (Hadoop Distributed File System) o in un database NoSQL.
Vedere anche: "Tabelle partizionate"
Dati nei negozi di oggetti
Le tabelle esterne possono essere utilizzate per accedere ai dati nelle aree di memorizzazione degli oggetti.
Oltre a supportare l'accesso ai dati esterni che risiedono nei file del sistema operativo e nelle origini Big Data, Oracle supporta l'accesso ai dati esterni nelle aree di memorizzazione degli oggetti. Lo storage degli oggetti è comune nel cloud e fornisce un'architettura semplice per gestire singoli oggetti, qualsiasi tipo di dati non strutturati con metadati, raggruppandoli in container semplici. Sebbene lo storage degli oggetti sia prevalentemente un'architettura di storage dei dati nel cloud, è disponibile anche come hardware di storage on-premise.
È possibile accedere ai dati nelle aree di memorizzazione degli oggetti utilizzando il package DBMS_CLOUD o definendo manualmente le tabelle esterne. Oracle consiglia di utilizzare il package DBMS_CLOUD perché fornisce funzionalità aggiuntive ed è completamente compatibile con Oracle Autonomous Database.
Driver di accesso alle tabelle esterne
Un driver di accesso è un'API che interpreta i dati esterni per il database. Il driver di accesso viene eseguito all'interno del database, che utilizza il driver per leggere i dati nella tabella esterna. Il driver di accesso e il livello di tabella esterna sono responsabili dell'esecuzione delle trasformazioni richieste sui dati nel file di dati in modo che corrisponda alla definizione della tabella esterna.
La figura seguente rappresenta l'accesso SQL ai dati esterni.
Figura 11: Tabelle esterne
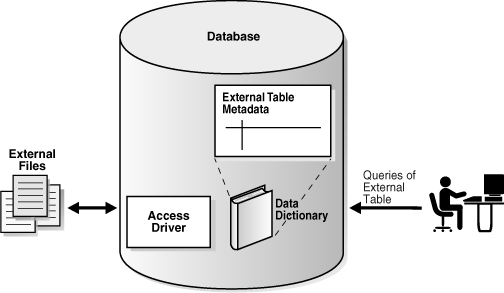
Descrizione dell'illustrazione cncpt231.gif
Oracle fornisce i seguenti driver di accesso per le tabelle esterne:
-
ORACLE_LOADER(predefinito)Consente l'accesso a file esterni utilizzando la maggior parte dei formati supportati da SQL*Loader. Non è possibile creare, aggiornare o aggiungere un file esterno utilizzando il driver
ORACLE_LOADER. -
ORACLE_DATAPUMPConsente di scaricare o caricare dati esterni. Un'operazione di scaricamento legge i dati dal database e li inserisce in una tabella esterna, rappresentata da uno o più file esterni. Dopo la creazione dei file esterni, il database non può aggiornare o aggiungere dati. Un'operazione di caricamento legge una tabella esterna e carica i dati in un database.
-
ORACLE_HDFSConsente l'estrazione dei dati memorizzati in un file system distribuito (HDFS) Hadoop.
-
ORACLE_HIVEConsente l'accesso ai dati memorizzati in un database Apache Hive. I dati di origine possono essere memorizzati in HDFS, HBase, Cassandra o altri sistemi. A differenza degli altri driver di accesso, non è possibile specificare una posizione perché
ORACLE_HIVEottiene informazioni sulla posizione da un'area di memorizzazione dei metadati esterna. -
ORACLE_BIGDATAConsente l'accesso in sola lettura ai dati memorizzati in formati strutturati e non strutturati, tra cui Apache Parquet, Apache Avro, Apache ORC, Apache Iceberg, il protocollo Linux Open Project Delta Sharing e i formati di testo. È inoltre possibile utilizzare questo driver per eseguire query sui dati locali, utile per il test e per data set più piccoli.
Creazione tabella esterna
Internamente, creare una tabella esterna significa creare metadati nel dizionario dati. A differenza di una tabella ordinaria, una tabella esterna non descrive i dati memorizzati nel database, né descrive come i dati vengono memorizzati esternamente. I metadati delle tabelle esterne descrivono invece il modo in cui il livello delle tabelle esterne deve presentare i dati nel database.
Un'istruzione CREATE TABLE ... ORGANIZATION EXTERNAL ha due parti. La definizione della tabella esterna descrive i tipi di colonna. Questa definizione è simile a una vista che consente a SQL di eseguire query sui dati esterni senza caricarli nel database. La seconda parte dell'istruzione mappa i dati esterni alle colonne.
Le tabelle esterne sono di sola lettura a meno che non vengano create con CREATE TABLE AS SELECT con il driver di accesso ORACLE_DATAPUMP. Le restrizioni per le tabelle esterne non includono il supporto per le colonne indicizzate e gli oggetti colonna.
Vedere anche:
-
Oracle AI Database Utilities per informazioni sulle tabelle esterne
-
Oracle AI Database Administrator's Guide per informazioni sulla gestione di tabelle esterne, connessioni esterne e oggetti directory
-
Oracle AI Database SQL Language Reference per informazioni sulla creazione e l'esecuzione di query sulle tabelle esterne
Inserimento automatico nella cache dei dati delle tabelle esterne
I dati delle tabelle esterne vengono inseriti nella cache in modo trasparente per migliorare le prestazioni delle query.
I dati ad accesso frequente provenienti da tabelle esterne, che risiedono completamente o parzialmente nello storage degli oggetti, vengono inseriti automaticamente nella cache per migliorare le prestazioni. L'inserimento nella cache dei dati delle tabelle esterne non richiede modifiche all'applicazione perché viene gestito automaticamente dal database Oracle.
Panoramica delle tabelle Blockchain
Una tabella blockchain è una tabella di sola aggiunta progettata per applicazioni blockchain centralizzate.
In Oracle Blockchain Table, i peer sono utenti del database che si affidano al database per gestire un libro contabile resistente alle manomissioni. Il libro mastro è implementato come una tabella blockchain, che è definita e gestita dall'applicazione. Le applicazioni esistenti possono proteggersi dalle frodi senza richiedere una nuova infrastruttura o un nuovo modello di programmazione. Sebbene il throughput delle transazioni sia inferiore a quello di una tabella standard, le prestazioni di una tabella blockchain sono migliori di quelle di una blockchain decentralizzata.
Una tabella blockchain è di sola aggiunta perché gli unici DML consentiti sono i comandi INSERT. La tabella non consente i caricamenti UPDATE, DELETE, MERGE, TRUNCATE e direct-path. Le transazioni del database possono comprendere tabelle blockchain e tabelle standard. Ad esempio, una singola transazione può inserire righe in una tabella standard e due tabelle blockchain diverse.
Le tabelle blockchain possono essere utilizzate per proteggere il contenuto di Flashback Data Archive. Ciò consente di determinare se qualcuno ha manomesso il contenuto di una tabella. Una tabella di cronologia dei log blockchain può essere considerata come la manutenzione di un redo log logico crittograficamente sicuro per le modifiche a una tabella utente tracciata.
È possibile aggiungere o eliminare le colonne utente dalle tabelle blockchain a partire dalle tabelle blockchain della versione 2. L'aggiunta o l'eliminazione delle colonne utente dalle tabelle blockchain della versione 1 non è consentita. Le colonne fisiche e i dati non vengono effettivamente eliminati, ma contrassegnati come invisibili.
-
Row Chains In una tabella blockchain, una catena di righe è una serie di righe collegate insieme a uno schema di hashing.
-
Contenuto riga Il contenuto riga è una sequenza contigua di byte che contiene i dati della colonna della riga e il valore hash della riga precedente nella catena.
-
Interfaccia utente per tabelle blockchain Come una tabella standard, una tabella blockchain viene creata da SQL e supporta tipi di dati scalari, LOB, JSON e partizioni. Puoi anche creare indici e trigger per le tabelle blockchain.
Catene di righe
In una tabella blockchain, una catena di righe è una serie di righe collegate insieme a uno schema di hashing.
Una catena di righe di sistema è identificata da una combinazione univoca di ID istanza di database e ID catena in una tabella blockchain versione 1. A partire dalle tabelle blockchain della versione 2, è necessario l'identificativo univoco globale del database che ha inserito la riga oltre a questi due identificatori. Una catena di righe di sistema è identificata da una combinazione univoca di ID univoco globale del pluggable database, ID istanza di database e ID catena in una tabella blockchain versione 2. Una riga in una tabella blockchain appartiene esattamente a una catena di righe di sistema. Una singola tabella supporta più catene di righe di sistema. Nota: una riga concatenata in una tabella standard è ortogonale a una catena di righe in una tabella blockchain. Solo la parola "catena" è la stessa.
Ogni riga di una catena ha un numero di sequenza univoco. Il database sequenzia le righe utilizzando un calcolo hash SHA2-512 sulle righe di ogni catena. L'hash per ogni riga inserita deriva dal contenuto della riga inserita, che include il valore hash della riga inserita in precedenza nella catena.
Mentre ogni riga di una tabella blockchain appartiene esattamente a una catena di sistema, può anche appartenere a una catena di utenti in base ai valori di un set di colonne utente specificato quando viene creata la tabella blockchain.
Contenuto della riga
Il contenuto della riga è una sequenza contigua di byte che contiene i dati della colonna della riga e il valore hash della riga precedente nella catena.
Quando crei una tabella blockchain, il database crea diverse colonne nascoste. Ad esempio, è possibile creare la tabella blockchain bank_ledger con le colonne bank e deposit:
CREATE BLOCKCHAIN TABLE bank_ledger (bank VARCHAR2 (128), deposit NUMBER)
  NO DROP UNTIL 31 DAYS IDLE
  NO DELETE UNTIL 31 DAYS AFTER INSERT
  HASHING USING "SHA2_512" VERSION "v1";
Il database crea automaticamente colonne nascoste con il prefisso ORABCTAB: ORABCTAB_INST_ID$, ORABCTAB_CHAIN_ID$, ORABCTAB_SEQ_NUM$ e altre. Queste colonne nascoste, la maggior parte delle quali non è possibile modificare o gestire, implementano l'algoritmo anti-manomissione. Questo algoritmo evita i deadlock acquisendo blocchi di catena univoci a livello di tabella in un ordine specifico al momento del commit.
Nota: il contenuto delle righe per le tabelle blockchain viene memorizzato in blocchi di dati standard. In questa release di Oracle AI Database, le tabelle blockchain non supportano i cluster di tabelle.
L'ID istanza, l'ID catena e il numero di sequenza identificano in modo univoco una riga. A partire dalle tabelle blockchain della versione 2, è necessario l'identificativo univoco globale del database che ha inserito la riga oltre a questi tre valori. Ogni riga ha un hash SHA2-512 indipendente dalla piattaforma che viene memorizzato nella colonna nascosta ORABCTAB_HASH$. L'hash è basato sul contenuto della riga inserita e sull'hash della riga precedente nella catena.
Il formato dei dati per il valore di colonna di una riga è costituito da byte dei metadati e del contenuto della colonna. I metadati della colonna sono una struttura a 20 byte che descrive caratteristiche quali la posizione nella tabella, il tipo di dati, lo stato nullo e la lunghezza in byte. Il contenuto della colonna è l'insieme di byte che rappresenta il valore in una riga. Ad esempio, la rappresentazione ASCII del valore Chase è 43 68 61 73 65. È possibile utilizzare la funzione DUMP in SQL per ottenere metadati di colonna e contenuto.
Il contenuto delle righe per un calcolo hash include i formati dei dati delle colonne da più colonne: il valore hash nella riga precedente della catena, le colonne definite dall'utente e un numero fisso di colonne nascoste.
L'ordine di inserimento delle righe correlate, denominate versioni delle righe, può essere tracciato dal sistema e registrato specificando un set di colonne su cui sono definite le versioni delle righe. Inoltre, se vengono specificate le versioni delle righe, viene creata e gestita automaticamente una vista che mostra l'ultima riga inserita per ogni combinazione di valori nel set di colonne specificato dall'utente. Il nome della vista utilizza la convenzione di denominazione Blockchain_Table_Name_LAST$.
Ci sono molti casi in cui le righe devono essere firmate in aggiunta o in alternativa da un delegato dell'utente finale. Un esempio è un manager bancario che firma una riga inserita da un utente finale. Un firmatario delegato è un altro utente del database che può aggiungere la propria firma su una riga calcolata sull'hash crittografico del sistema della riga. Una riga può essere firmata da un utente finale, da un delegato o da entrambi. La firma di un delegato viene accettata solo se la firma può essere verificata utilizzando il certificato del delegato e il certificato del delegato viene registrato in una tabella del dizionario del database.
Quando una riga viene firmata da un utente finale o da un delegato, l'utente potrebbe voler procurarsi una controfirma per la riga. Una controfirma può essere considerata un digest della tabella blockchain specifico per la riga già firmata da un utente finale o da un delegato. Quando una riga è controfirmata, la controfirma viene restituita al firmatario della riga e salvata anche in tale riga. L'utente che richiede la controfirma sulla riga può salvare queste informazioni a scopo non di disconoscimento in un data store separato.
Interfaccia utente per tabelle blockchain
Come una tabella standard, una tabella blockchain viene creata da SQL e supporta tipi di dati scalari, LOB, JSON e partizioni. Puoi anche creare indici e trigger per le tabelle blockchain.
Per creare una tabella blockchain, utilizzare un'istruzione CREATE BLOCKCHAIN TABLE. Una tabella blockchain ha un periodo di conservazione specificato dalla clausola NO DROP UNTIL n DAYS IDLE. È possibile rimuovere la tabella utilizzando DROP TABLE.
La tabella Oracle Blockchain supporta le interfacce riportate di seguito.
-
Il pacchetto
DBMS_BLOCKCHAIN_TABLEconsente di eseguire varie operazioni sulle righe della tabella. Ad esempio, per applicare una firma al contenuto di una riga inserita in precedenza, utilizzare la proceduraSIGN_ROW. Per verificare che le righe non siano state manomesse, utilizzareVERIFY_ROWS. Per rimuovere le righe dopo il periodo di conservazione (specificato dalla clausolaNO DELETE), utilizzareDELETE_EXPIRED_ROWS. -
La vista
DBA_BLOCKCHAIN_TABLESmostra i metadati della tabella, ad esempio il periodo di conservazione delle righe, il periodo di inattività prima che sia consentito l'eliminazione di una tabella e l'algoritmo hash.
Nota:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire le tabelle blockchain
-
Oracle AI Database PL/SQL Packages and Types Reference per ulteriori informazioni sul package
DBMS_BLOCKCHAIN_TABLE -
Oracle AI Database Reference per saperne di più sulla vista
DBA_BLOCKCHAIN_TABLES
Panoramica delle tabelle immutabili
Le tabelle immutabili sono tabelle di sola aggiunta che impediscono modifiche non autorizzate ai dati da parte di addetti ai lavori e modifiche accidentali ai dati derivanti da errori umani.
Le modifiche non autorizzate possono essere tentate da dipendenti compromessi o non autorizzati che hanno accesso alle credenziali interne.
È possibile aggiungere nuove righe a una tabella non modificabile, ma non è possibile modificare le righe esistenti. È necessario specificare un periodo retention sia per la tabella immutabile che per le righe all'interno della tabella immutabile. Le righe diventano obsolete dopo il periodo retention righe specificato. Solo le righe obsolete possono essere eliminate dalla tabella immutabile.
Le tabelle immutabili contengono colonne nascoste generate dal sistema. Le colonne sono le stesse di quelle per le tabelle blockchain. Quando viene inserita una riga, viene impostato un valore non NULL per le colonne ORABCTAB_CREATION_TIME$ e ORABCTAB_USER_NUMBER$. Ad eccezione delle tabelle immutabili V1, per la colonna ORABCTAB_PDB_GUID$ viene impostato un valore non NULL. Se la tabella immutabile è stata creata con versioni riga, viene impostato un valore non NULL per le colonne ORABCTAB_ROW_VERSION$ e ORABCTAB_LAST_ROW_VERSION_NUMBER$. Il valore delle rimanenti colonne nascoste generate dal sistema è impostato su NULL.
L'utilizzo di tabelle immutabili non richiede modifiche alle applicazioni esistenti.
Panoramica delle tabelle oggetti
Una tabella oggetti è un tipo speciale di tabella in cui ogni riga rappresenta un oggetto.
Un tipo di oggetto Oracle è un tipo definito dall'utente con nome, attributi e metodi. I tipi di oggetto consentono di modellare entità reali come clienti e ordini di acquisto come oggetti nel database.
Un tipo di oggetto definisce una struttura logica, ma non crea storage. Nell'esempio seguente viene creato un tipo di oggetto denominato department_typ.
CREATE TYPE department_typ AS OBJECT
   ( d_name     VARCHAR2(100),
     d_address  VARCHAR2(200) );
/
Nell'esempio seguente viene creata una tabella oggetti denominata departments_obj_t del tipo di oggetto department_typ, quindi viene inserita una riga nella tabella. Gli attributi (colonne) della tabella departments_obj_t derivano dalla definizione del tipo di oggetto.
CREATE TABLE departments_obj_t OF department_typ;
INSERT INTO departments_obj_t VALUES ('hr', '10 Main St, Sometown, CA');
Come una colonna relazionale, una tabella oggetti può contenere righe di un solo tipo di cosa, ovvero istanze di oggetti dello stesso tipo dichiarato della tabella. Per impostazione predefinita, ogni oggetto riga in una tabella oggetti dispone di un identificativo di oggetto logico (OID) associato che lo identifica in modo univoco in una tabella oggetti. La colonna OID di una tabella oggetti è una colonna nascosta.
Vedere anche:
-
Oracle AI Database Object-Relational Developer's Guide per ulteriori informazioni sulle funzioni relazionali agli oggetti in Oracle AI Database
-
Oracle AI Database SQL Language Reference per sintassi e semantica
CREATE TYPE