Strutture di storage logico
Questo capitolo descrive la natura e le relazioni tra le strutture di archiviazione logica. Queste strutture vengono create e riconosciute da Oracle AI Database e non sono note al sistema operativo.
-
Introduzione alle strutture di storage logiche Oracle AI Database alloca spazio logico per tutti i dati nel database.
-
Panoramica dei blocchi di dati Oracle AI Database gestisce lo spazio di storage logico nei file di dati di un database in un'unità chiamata blocco di dati, chiamato anche blocco Oracle o pagina. Un blocco di dati è l'unità minima di I/O del database.
-
Panoramica delle estensioni Un'estensione è un'unità di storage del database costituita da blocchi di dati logicamente contigui. I blocchi di dati possono essere distribuiti fisicamente sul disco a causa dello striping RAID e delle implementazioni del file system.
-
Panoramica dei segmenti Un segmento è un set di estensioni che contiene tutti i dati per una struttura di memorizzazione logica all'interno di una tablespace.
-
Panoramica delle tablespace Una tablespace è un contenitore di storage logico per i segmenti.
Introduzione alle strutture di memorizzazione logica
Oracle AI Database alloca spazio logico per tutti i dati nel database.
Le unità logiche di allocazione dello spazio del database sono blocchi di dati, estensioni, segmenti e tablespace. A livello fisico, i dati vengono memorizzati in file di dati su disco. I dati nei file di dati vengono memorizzati nei blocchi del sistema operativo.
La figura seguente è un diagramma di relazione entità per la memorizzazione fisica e logica. La notazione del piede di corvo rappresenta una relazione uno-a-molti.
Figura 1: Storage logico e fisico
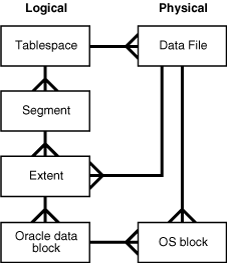
Descrizione dell'illustrazione cncpt227.gif
-
Gerarchia di memorizzazione logica Un segmento contiene uno o più extent, ciascuno dei quali contiene più blocchi di dati.
-
Gestione dello spazio logico Oracle AI Database deve utilizzare la gestione dello spazio logico per tenere traccia e allocare le estensioni in una tablespace. Vedi anche: "Strutture di storage fisico"
Gerarchia memorizzazione logica
Un segmento contiene uno o più extent, ognuno dei quali contiene più blocchi di dati.
La figura seguente mostra le relazioni tra blocchi di dati, estensioni e segmenti all'interno di una tablespace. In questo esempio, un segmento ha due estensioni memorizzate in file di dati diversi.
Figura 2: Segmenti, estensioni e blocchi di dati all'interno di una tablespace
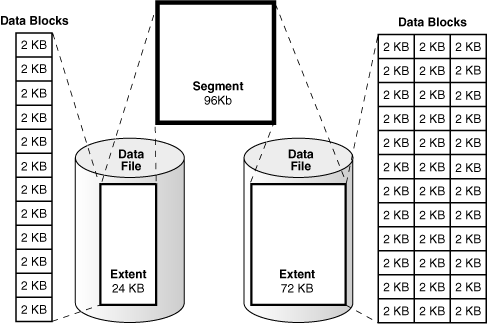
Descrizione dell'illustrazione cncpt027.gif
Dal livello di granularità più basso al più alto, Oracle AI Database memorizza i dati come segue:
-
Un blocco di dati è l'unità logica più piccola di storage dei dati in Oracle AI Database.
Un blocco di dati logici corrisponde a un numero specifico di byte di storage persistente, ad esempio 2 KB. I blocchi di dati sono le unità di storage più piccole che Oracle AI Database può utilizzare o allocare.
Tradizionalmente, i file di dati sono stati memorizzati su disco magnetico o Solid State Disk (SSD). Oracle AI Database supporta anche la memoria persistente (PMEM) per la memorizzazione dei file di database. Indipendentemente dal modo in cui i dati di base vengono memorizzati fisicamente, i processi Oracle leggono e scrivono sempre blocchi di dati logici.
-
Un estensione è un set di blocchi di dati contigui logicamente allocati per la memorizzazione di un tipo specifico di informazioni.
Nel grafico precedente, l'estensione di 24 KB ha 12 blocchi di dati, mentre l'estensione di 72 KB ha 36 blocchi di dati.
-
Un segmento è un set di estensioni allocate per un oggetto di database specifico, ad esempio una tabella.
Ad esempio, i dati per la tabella
employeesvengono memorizzati nel proprio segmento dati, mentre ogni indice peremployeesviene memorizzato nel proprio segmento indice. Ogni oggetto di database che utilizza lo storage è costituito da un singolo segmento. -
Uno spazio tabulare è un'unità di memorizzazione del database che contiene uno o più segmenti.
Ogni segmento appartiene a una sola tablespace. Pertanto, tutte le estensioni per un segmento vengono memorizzate nella stessa tablespace. All'interno di una tablespace, un segmento può includere estensioni da più file di dati, come mostrato nel grafico precedente. Ad esempio, un'estensione per un segmento può essere memorizzata in
users01.dbf, mentre un'altra è memorizzata inusers02.dbf. Una singola estensione non può mai estendersi ai file di dati.
Vedi anche: "Introduzione alle strutture di storage fisico"
Gestione dello spazio logico
Oracle AI Database deve utilizzare la gestione dello spazio logico per tenere traccia e allocare le estensioni in una tablespace.
Quando un oggetto di database richiede un'estensione, il database deve disporre di un metodo per individuarlo e fornirlo. Analogamente, quando un oggetto non richiede più un'estensione, il database deve disporre di un metodo per rendere disponibile l'estensione libera.
Oracle AI Database gestisce lo spazio all'interno di una tablespace in base al tipo creato. È possibile creare i tipi di tablespace descritti di seguito.
-
Tablespace gestite localmente (impostazione predefinita)
Il database utilizza bitmap nelle tablespace stesse per gestire gli extent. Nelle tablespace gestite locamente una parte della tablespace viene riservata per un bitmap. All'interno di una tablespace, il database può gestire segmenti con la gestione automatica dello spazio dei segmenti (ASSM) o la gestione manuale dello spazio dei segmenti (MSSM).
-
Tablespace gestita dal dizionario
Il database utilizza il dizionario dati per gestire gli extent.
La Figura 15-3 mostra le alternative per la gestione dello spazio logico in una tablespace.
Figura 3: Gestione dello spazio logico
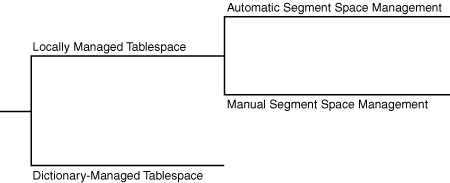
Descrizione dell'illustrazione cncpt268.gif
-
Tablespace gestite localmente Una tablespace gestita localmente mantiene un bitmap nell'intestazione del file di dati per tenere traccia dello spazio libero e utilizzato nel corpo del file di dati.
-
Tablespace gestite dal dizionario Una tablespace gestita dal dizionario utilizza il dizionario dati per gestire le estensioni. Vedere anche: "Panoramica del dizionario dati"
Tablespace gestite localmente
Una tablespace gestita localmente mantiene una bitmap nell'intestazione del file di dati per tenere traccia dello spazio libero e utilizzato nel corpo del file di dati.
Ogni bit corrisponde a un gruppo di blocchi. Quando lo spazio viene allocato o liberato, Oracle AI Database modifica i valori bitmap per riflettere il nuovo stato dei blocchi.
Il grafico seguente è una rappresentazione concettuale dello storage gestito tramite bitmap. Un 1 nell'intestazione si riferisce allo spazio utilizzato, mentre un 0 si riferisce allo spazio libero.
Figura 4: Storage gestito da bitmap
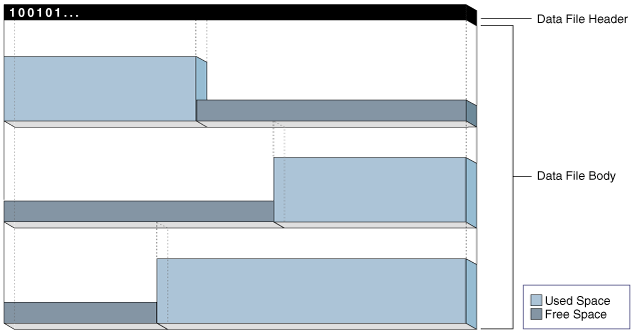
Descrizione dell'illustrazione cncpt332.gif
Una tablespace gestita localmente presenta i vantaggi riportati di seguito.
-
Evita di utilizzare il dizionario dati per gestire gli extent
Le operazioni ricorsive possono verificarsi nelle tablespace gestite da dizionario se l'utilizzo o il rilascio di spazio in un extent comporta un'altra operazione che consuma o rilascia spazio in una tabella o in una tabella di undo del dizionario dati.
-
Tiene traccia automaticamente dello spazio libero adiacente
In questo modo, il database elimina la necessità di creare coalesce di estensioni gratuite.
-
Determina automaticamente le dimensioni degli extent gestiti localmente
In alternativa, tutti gli extent possono avere le stesse dimensioni in una tablespace gestita localmente e sostituire le opzioni di storage degli oggetti. Nota: Oracle consiglia vivamente l'uso di tablespace gestite localmente con Automatic Segment Space Management.
La gestione dello spazio dei segmenti è un attributo ereditato dalla tablespace che contiene il segmento. All'interno di una tablespace gestita localmente, il database può gestire i segmenti in modo automatico o manuale. Ad esempio, i segmenti nella tablespace users possono essere gestiti automaticamente mentre i segmenti nella tablespace tools vengono gestiti manualmente.
-
Gestione automatica dello spazio dei segmenti Il metodo di gestione automatica dello spazio dei segmenti (ASSM, Automatic Segment Space Management) utilizza bitmap per gestire lo spazio in una tablespace.
-
Gestione manuale dello spazio dei segmenti Il metodo precedente di gestione manuale dello spazio dei segmenti (MSSM) utilizza un elenco collegato denominato elenco libero per gestire lo spazio libero nel segmento.
Gestione automatica dello spazio di segmenti
Il metodo automatic segment space management (ASSM) utilizza bitmap per gestire lo spazio in una tablespace.
Le bitmap offrono i seguenti vantaggi:
-
Amministrazione semplificata
ASSM evita la necessità di determinare manualmente le impostazioni corrette per molti parametri di memorizzazione. Solo un parametro SQL cruciale controlla l'allocazione dello spazio:
PCTFREE. Questo parametro specifica la percentuale di spazio da riservare in un blocco per gli aggiornamenti futuri (vedere "Percentuale di spazio libero nei blocchi di dati"). -
Maggiore concorrenza
Più transazioni possono cercare elenchi separati di blocchi di dati liberi, riducendo così i conflitti e le attese. Per molti carichi di lavoro standard, le prestazioni delle applicazioni con ASSM sono migliori rispetto alle prestazioni di un'applicazione ottimizzata che utilizza MSSM.
-
Affinità dinamica dello spazio alle istanze in un ambiente Oracle Real Application Clusters (Oracle RAC)
ASSM è più efficiente ed è l'impostazione predefinita per le tablespace permanenti gestite localmente.
Nota: in questo capitolo si presuppone l'utilizzo di ASSM in tutte le discussioni sullo spazio di memorizzazione logico.
Gestione manuale dello spazio dei segmenti
Il metodo precedente di manual segment space management (MSSM) utilizza un elenco collegato denominato elenco libero per gestire lo spazio libero nel segmento.
Per un oggetto di database che dispone di spazio libero, una lista libera tiene traccia dei blocchi sotto il punto HWM (High Water Mark) (HWM), ovvero la linea di divisione tra lo spazio dei segmenti utilizzato e non ancora utilizzato. Poiché vengono utilizzati i blocchi, il database inserisce i blocchi o rimuove i blocchi dalla lista libera in base alle esigenze.
Oltre a PCTFREE, MSSM richiede di controllare l'allocazione dello spazio con parametri SQL quali PCTUSED, FREELISTS e FREELIST GROUPS. PCTUSED imposta la percentuale di spazio libero che deve esistere in un blocco attualmente utilizzato per il database per inserirlo nella lista libera. Ad esempio, se si imposta PCTUSED su 40 in un'istruzione CREATE TABLE, non sarà possibile inserire righe in un blocco nel segmento fino a quando non verrà utilizzato meno del 40% dello spazio dei blocchi.
Si supponga, ad esempio, di inserire una riga in una tabella. Il database controlla una lista libera della tabella per il primo blocco disponibile. Se la riga non rientra nel blocco e se lo spazio utilizzato nel blocco è maggiore o uguale a PCTUSED, il database rimuove il blocco dall'elenco e cerca un altro blocco. Se si eliminano righe dal blocco, il database controlla se lo spazio utilizzato nel blocco è ora inferiore a PCTUSED. In tal caso, il database posiziona il blocco all'inizio della lista libera.
Un oggetto può avere più elenchi gratuiti. In questo modo, più sessioni che eseguono DML su una tabella possono utilizzare elenchi diversi, che possono ridurre i conflitti. Ogni sessione di database utilizza una sola lista libera per tutta la durata della sessione.
Come illustrato nella Figura 15-5, è inoltre possibile creare un oggetto con uno o più gruppi di liste libere, ovvero raccolte di liste libere. Ogni gruppo dispone di un elenco gratuito master che gestisce il singolo elenco gratuito dei processi nel gruppo. Il sovraccarico di spazio per le liste gratuite, in particolare per i gruppi di liste gratuite, può essere significativo.
Figura 5: Gruppi di elenchi gratuiti
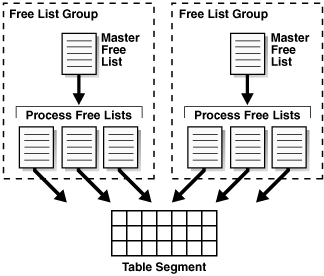
Descrizione dell'illustrazione cncpt320.gif
La gestione manuale dello spazio dei segmenti può essere complessa. È necessario modificare PCTFREE e PCTUSED per ridurre la migrazione delle righe ed evitare sprechi di spazio. Ad esempio, se ogni blocco utilizzato in un segmento è mezzo pieno e PCTUSED è 40, il database non consente l'inserimento in nessuno di questi blocchi. A causa della difficoltà di ottimizzare i parametri di allocazione dello spazio, Oracle consiglia fortemente ASSM. In ASSM, PCTFREE determina se una nuova riga può essere inserita in un blocco, ma non utilizza elenchi liberi e ignora PCTUSED.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni sulle tablespace gestite localmente
-
Oracle AI Database Administrator's Guide per ulteriori informazioni sulla gestione automatica dello spazio dei segmenti
-
Oracle AI Database SQL Language Reference per informazioni sui parametri di storage come
PCTFREEePCTUSED
Tablespace gestite dal dizionario
Una tablespace gestita dal dizionario utilizza il dizionario dati per gestirne gli extent.
Oracle AI Database aggiorna le tabelle nel dizionario dati ogni volta che un extent viene allocato oppure liberato per essere riutilizzato. Ad esempio, quando una tabella richiede un'estensione, il database esegue query sulle tabelle del dizionario dati e cerca estensioni gratuite. Se il database trova spazio, modifica una tabella del dizionario dati e inserisce una riga in un'altra. In questo modo, il database gestisce lo spazio modificando e spostando i dati.
L'istruzione SQL eseguita dal database in background per ottenere spazio per gli oggetti di database è SQL ricorsivo. L'uso frequente di SQL ricorsivo può avere un impatto negativo sulle prestazioni perché gli aggiornamenti al dizionario dati devono essere serializzati. Le tablespace gestite localmente, che sono le predefinite, evitano questo problema di prestazioni.
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come eseguire la migrazione delle tablespace da dizionario gestito a gestito localmente
Panoramica dei blocchi di dati
Oracle AI Database gestisce lo spazio di storage logico nei file di dati di un database in un'unità chiamata blocco di dati, chiamato anche blocco Oracle o pagina. Un blocco di dati è l'unità minima di I/O del database.
-
Blocchi di dati e blocchi del sistema operativo A livello fisico, i dati del database vengono memorizzati in file su disco costituiti da blocchi del sistema operativo.
-
Formato blocco dati Ogni blocco di dati ha un formato o una struttura interna che consente al database di tenere traccia dei dati e dello spazio libero nel blocco. Questo formato è simile se il blocco di dati contiene dati di tabella, indice o cluster di tabelle.
-
Compressione blocco dati Il database può utilizzare la compressione tabella per eliminare i valori duplicati in un blocco di dati. Questa sezione descrive il formato dei blocchi di dati che utilizzano la compressione.
-
Gestione dello spazio nei blocchi di dati Quando il database riempie un blocco di dati dal basso verso l'alto, la quantità di spazio libero tra i dati delle righe e l'intestazione del blocco diminuisce.
-
Panoramica dei blocchi di indice Un blocco di indice è un tipo speciale di blocco di dati che gestisce lo spazio in modo diverso dai blocchi di tabella. Oracle AI Database utilizza blocchi di indice per gestire lo spazio di storage logico in un indice.
Blocchi di dati e blocchi del sistema operativo
A livello fisico, i dati del database vengono memorizzati in file su disco costituiti da blocchi del sistema operativo.
Un blocco del sistema operativo è l'unità minima di dati che il sistema operativo può leggere o scrivere. Al contrario, un blocco Oracle è una struttura di storage logica le cui dimensioni e struttura non sono note al sistema operativo.
La figura seguente mostra che i blocchi del sistema operativo possono differire per dimensioni dai blocchi di dati. Il database richiede dati in multipli di blocchi di dati, non blocchi del sistema operativo.
Figura 6: Blocchi di dati e blocchi del sistema operativo
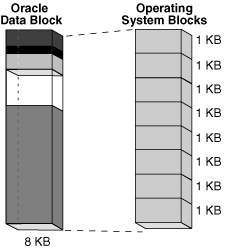
Descrizione dell'illustrazione cncpt293.gif
Quando il database richiede un blocco di dati, il sistema operativo converte questa operazione in richieste di dati nella memorizzazione permanente. La separazione logica dei blocchi di dati dai blocchi del sistema operativo ha le seguenti implicazioni:
-
Non è necessario determinare gli indirizzi fisici dei dati su disco delle applicazioni.
-
È possibile eseguire lo striping o il mirroring dei dati del database su più dischi fisici.
-
Dimensione blocchi database Ogni database ha una dimensione per i blocchi del database.
-
Dimensione blocco tablespace È possibile creare singole tablespace la cui dimensione del blocco è diversa dall'impostazione
DB_BLOCK_SIZE.
Dimensione blocchi database
Ogni database ha una dimensione blocco del database.
Il parametro di inizializzazione DB_BLOCK_SIZE imposta la dimensione del blocco di dati per un database quando viene creato. La dimensione è impostata per le tablespace SYSTEM e SYSAUX ed è quella predefinita per tutte le altre tablespace. La dimensione del blocco del database non può essere modificata se non ricreando il database.
Se DB_BLOCK_SIZE non è impostato, la dimensione predefinita del blocco di dati è specifica del sistema operativo. La dimensione standard del blocco di dati per un database è di 4 KB o 8 KB. Se la dimensione è diversa per i blocchi di dati e i blocchi del sistema operativo, la dimensione del blocco di dati deve essere un multiplo della dimensione del blocco del sistema operativo.
Vedere anche:
-
Oracle AI Database Reference per informazioni sul parametro di inizializzazione
DB_BLOCK_SIZE -
Oracle AI Database Administrator's Guide e Oracle AI Database Performance Tuning Guide per scoprire come scegliere le dimensioni dei blocchi
Dimensione blocco tablespace
È possibile creare singole tablespace la cui dimensione dei blocchi è diversa dall'impostazione DB_BLOCK_SIZE.
Una dimensione di blocco non standard può essere utile quando si sposta una tablespace trasportabile in un'altra piattaforma.
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come specificare una dimensione di blocco non standard per una tablespace
Formato blocco dati
Ogni blocco di dati ha un formato o una struttura interna che consente al database di tenere traccia dei dati e dello spazio libero nel blocco. Questo formato è simile se il blocco di dati contiene dati di tabella, indice o cluster di tabelle.
La figura seguente mostra il formato di un blocco di dati non compresso.
Figura 7: Formato blocco dati
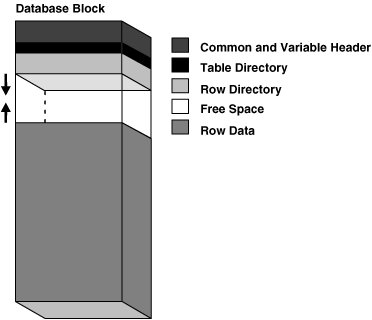
Descrizione dell'illustrazione cncpt028.gif
-
Overhead blocco dati Oracle AI Database utilizza il overhead dei blocchi per gestire il blocco stesso. Il sovraccarico del blocco non è disponibile per memorizzare i dati utente.
-
Formato riga La parte dati riga del blocco contiene i dati effettivi, ad esempio righe di tabella o voci chiave indice. Proprio come ogni blocco di dati ha un formato interno, ogni riga ha un formato di riga che consente al database di tenere traccia dei dati nella riga. Vedere anche: "Compressione dei blocchi di dati" per informazioni sui blocchi compressi
Costo indiretto blocco dati
Oracle AI Database utilizza l'overhead dei blocchi per gestire il blocco stesso. Il sovraccarico del blocco non è disponibile per memorizzare i dati utente.
Come illustrato in "Formato blocco dati", il sovraccarico del blocco include le seguenti parti:
-
Intestazione blocco
Questa parte contiene informazioni generali sul blocco, inclusi l'indirizzo del disco e il tipo di segmento. Per i blocchi gestiti dalle transazioni, l'intestazione del blocco contiene informazioni sulle transazioni attive e cronologiche.
Per ogni transazione che aggiorna il blocco è necessaria una voce di transazione. Oracle AI Database inizialmente riserva spazio nell'intestazione a blocchi per le voci di transazione. Nei blocchi di dati allocati a segmenti che supportano le modifiche transazionali, lo spazio libero può contenere anche voci di transazione quando lo spazio dell'intestazione è esaurito. Lo spazio richiesto per le voci transazione dipende dal sistema operativo. Tuttavia, le voci delle transazioni nella maggior parte dei sistemi operativi richiedono circa 23 byte.
-
Directory tabella
Per una tabella organizzata dall'heap, questa directory contiene metadati sulle tabelle le cui righe sono memorizzate in questo blocco. In un cluster di tabelle più tabelle possono memorizzare righe nello stesso blocco.
-
Directory righe
Per una tabella organizzata in heap, questa directory descrive la posizione delle righe nella parte dati del blocco. Il database può posizionare una riga in qualsiasi punto della parte inferiore del blocco. L'indirizzo della riga viene registrato in uno degli slot del vettore della directory delle righe.
Un ID riga punta a un file, un blocco e un numero di riga specifici. Ad esempio, nell'ID riga
AAAPecAAFAAAABSAAA, l'ID finaleAAArappresenta il numero di riga. Il numero di riga è un indice di una voce nella directory delle righe. La voce della directory delle righe contiene un puntatore alla posizione della riga nel blocco di dati. Se il database sposta una riga all'interno di un blocco, il database aggiorna la voce della directory delle righe per modificare il puntatore. L'ID riga rimane costante.Dopo che il database ha allocato lo spazio nella directory delle righe, il database non recupera questo spazio dopo aver eliminato le righe. Pertanto, un blocco attualmente vuoto ma precedentemente contenente fino a 50 righe continua ad avere 100 byte allocati per la directory delle righe. Il database riutilizza questo spazio solo quando una sessione inserisce nuove righe nel blocco.
Alcune parti del sovraccarico del blocco sono fissate in dimensioni, ma la dimensione totale è variabile. In media, il sovraccarico del blocco ammonta a 84-107 byte.
Formato riga
La parte dati riga del blocco contiene i dati effettivi, ad esempio righe di tabella o voci chiave indice. Proprio come ogni blocco di dati ha un formato interno, ogni riga ha un formato di riga che consente al database di tenere traccia dei dati nella riga.
Oracle AI Database memorizza le righe come record di lunghezza variabile. Una riga è contenuta in una o più sezioni. Ogni sezione è denominata pezzo riga. Ogni parte di riga contiene un'intestazione di riga e dati di colonna.
La figura seguente mostra il formato di una riga.
Figura 8: Il formato di un pezzo di riga
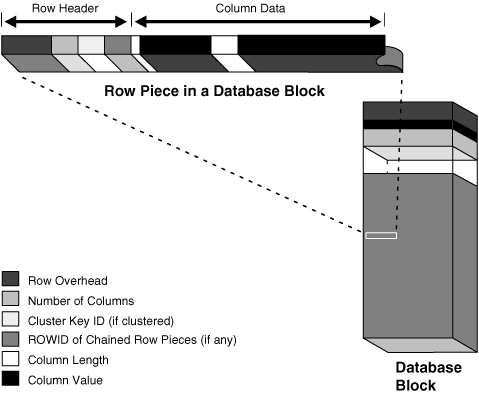
Descrizione dell'illustrazione cncpt043.gif
-
Intestazione riga Oracle AI Database utilizza l'intestazione di riga per gestire la parte di riga memorizzata nel blocco.
-
Dati colonna Dopo l'intestazione della riga, la sezione dei dati della colonna memorizza i dati effettivi nella riga. La parte di riga in genere memorizza le colonne nell'ordine indicato nell'istruzione
CREATE TABLE, ma questo ordine non è garantito. Ad esempio, le colonne di tipoLONGvengono create per ultime. -
Rowid Format Oracle AI Database utilizza un rowid per identificare in modo univoco una riga. Internamente, l'ID riga è una struttura che contiene informazioni alle quali il database deve accedere a una riga. Un ID riga non viene memorizzato fisicamente nel database, ma viene derivato dal file e dal blocco in cui vengono memorizzati i dati.
Intestazione riga
Oracle AI Database utilizza l'intestazione di riga per gestire la parte di riga memorizzata nel blocco.
L'intestazione della riga contiene informazioni quali:
-
Colonne nella parte riga
-
Pezzi della riga posizionati in altri blocchi di dati
Se è possibile inserire un'intera riga in un singolo blocco di dati, Oracle AI Database memorizza la riga come un'unica riga. Tuttavia, se non è possibile inserire tutti i dati della riga in un singolo blocco o se un aggiornamento fa sì che una riga esistente superi il relativo blocco, il database memorizza la riga in più parti della riga. Un blocco di dati in genere contiene una sola riga per riga.
-
Chiavi cluster per i cluster di tabelle
Una riga completamente contenuta in un blocco ha almeno 3 byte di intestazione di riga.
Vedere anche:
Dati colonna
Dopo l'intestazione della riga, la sezione dei dati della colonna memorizza i dati effettivi nella riga. La parte di riga in genere memorizza le colonne nell'ordine indicato nell'istruzione CREATE TABLE, ma questo ordine non è garantito. Ad esempio, le colonne di tipo LONG vengono create per ultime.
Come illustrato nella figura in "Formato riga", per ogni colonna di una riga, Oracle AI Database memorizza la lunghezza della colonna e i dati separatamente. Lo spazio richiesto dipende dal tipo di dati. Se il tipo di dati di una colonna è di lunghezza variabile, lo spazio necessario per contenere un valore può aumentare e diminuire con gli aggiornamenti dei dati.
Ogni riga contiene uno slot nella directory delle righe dell'intestazione del blocco dati. Lo slot punta all'inizio della riga.
Vedi anche: "Storage di tabelle" e "Storage di indici"
Formato ID riga
Oracle AI Database utilizza un rowid per identificare in modo univoco una riga. Internamente, l'ID riga è una struttura che contiene informazioni alle quali il database deve accedere a una riga. Un ID riga non viene memorizzato fisicamente nel database, ma viene derivato dal file e dal blocco in cui vengono memorizzati i dati.
Un rowid esteso include un numero di oggetto dati. Questo tipo di ID riga utilizza una codifica base 64 dell'indirizzo fisico per ogni riga. I caratteri di codifica sono A-Z, a-z, 0-9, + e /.
Esempio 15-1 Pseudocolonna ROWID
Nell'esempio seguente viene eseguita una query sulla pseudocolonna ROWID per mostrare l'ID riga esteso della riga nella tabella employees per il dipendente 100:
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
La figura seguente illustra il formato di un rowid esteso.
Figura 9: formato ROWID
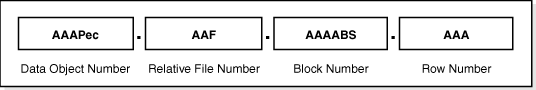
Descrizione dell'illustrazione cncpt249.gif
Un rowid esteso viene visualizzato in un formato in quattro parti, OOOOOOFFFBBBBBBRRR, con il formato diviso nei seguenti componenti:
-
OOOOOOIl numero dell'oggetto dati identifica il segmento (oggetto dati
AAAPecnella query di esempio). Un numero di oggetto dati viene assegnato a ogni segmento di database. Gli oggetti schema nello stesso segmento, ad esempio un cluster tabella, hanno lo stesso numero di oggetto dati. -
FFFIl numero del file di dati relativo alla tablespace identifica il file di dati che contiene la riga (file
AAFnella query di esempio). -
BBBBBBIl numero del blocco di dati identifica il blocco che contiene la riga (blocco
AAAABSnella query di esempio). I numeri di blocco sono relativi al file di dati, non alla tablespace. Pertanto, due righe con numeri di blocco identici potrebbero risiedere in file di dati diversi della stessa tablespace. -
RRRIl numero di riga identifica la riga nel blocco (riga
AAAnella query di esempio).
Dopo l'assegnazione di un ID riga a una parte riga, l'ID riga può cambiare in circostanze speciali. Ad esempio, se lo spostamento delle righe è abilitato, l'ID riga può cambiare a causa degli aggiornamenti delle chiavi di partizione, delle operazioni della tabella di flashback, delle operazioni di riduzione delle tabelle e così via. Se lo spostamento delle righe è disabilitato, un ID riga può cambiare se la riga viene esportata e importata utilizzando le utility di Oracle AI Database. Nota: internamente, il database esegue lo spostamento delle righe come se la riga fosse stata eliminata fisicamente e reinserita. Tuttavia, il movimento delle righe è considerato un aggiornamento, che ha implicazioni per i trigger.
Vedere anche:
-
Oracle AI Database SQL Language Reference per informazioni sugli rowid
Compressione blocco dati
Il database può utilizzare la compressione tabella per eliminare i valori duplicati in un blocco di dati. Questa sezione descrive il formato dei blocchi di dati che utilizzano la compressione.
Il formato di un blocco di dati che utilizza la tabella di base e la compressione avanzata delle righe è essenzialmente lo stesso di un blocco non compresso. La differenza è che una tabella di simboli all'inizio del blocco memorizza valori duplicati per le righe e le colonne. Il database sostituisce le occorrenze di questi valori con un breve riferimento alla tabella dei simboli.
Esempio di formato 15-2 dei blocchi di dati compressi
Si supponga che le righe seguenti siano memorizzate in un blocco di dati per la tabella sales a sette colonne:
2190,13770,25-NOV-00,S,9999,23,161
2225,15720,28-NOV-00,S,9999,25,1450
34005,120760,29-NOV-00,P,9999,44,2376
9425,4750,29-NOV-00,I,9999,11,979
1675,46750,29-NOV-00,S,9999,19,1121
Quando a questa tabella viene applicata la compressione della tabella di base o della riga avanzata, il database sostituisce i valori duplicati con un riferimento al simbolo. La seguente rappresentazione concettuale della compressione mostra il simbolo * che sostituisce 29-NOV-00 e % che sostituisce 9999:
2190,13770,25-NOV-00,S,%,23,161
2225,15720,28-NOV-00,S,%,25,1450
34005,120760,*,P,%,44,2376
9425,4750,*,I,%,11,979
1675,46750,*,S,%,19,1121
La Tabella 15-1 rappresenta concettualmente la tabella di simboli che mappa i simboli ai valori.
Tabella simboli tabella 1
| Simbolo | Valore | Colonna | Righe |
|---|---|---|---|
| * | 29-NOV-00 | 3 | 958-960 |
| % | 9.999 | 5 | 956-960 |
Vedere anche: "Compressione tabella"
Gestione dello spazio nei blocchi di dati
Quando il database riempie un blocco di dati dal basso verso l'alto, la quantità di spazio libero tra i dati della riga e l'intestazione del blocco diminuisce.
Anche lo spazio libero in un blocco di dati può ridursi durante gli aggiornamenti, come quando si modifica un valore nullo finale in un valore non nullo. Il database gestisce lo spazio libero nel blocco di dati per ottimizzare le prestazioni ed evitare sprechi di spazio.
Nota: questa sezione presuppone l'utilizzo della gestione automatica dello spazio dei segmenti.
-
Percentuale di spazio libero nei blocchi di dati Il parametro SQL
PCTFREEimposta la percentuale minima di un blocco di dati riservato come spazio libero per gli aggiornamenti alle righe esistenti.PCTFREEè importante per prevenire la migrazione delle righe ed evitare sprechi di spazio. -
Ottimizzazione dello spazio libero nei blocchi di dati Anche se la percentuale di spazio libero non può essere meno di
PCTFREE, la quantità di spazio libero può essere maggiore. Ad esempio, l'impostazione diPCTFREEsu 20% impedisce che la quantità totale di spazio libero scenda al 5% del blocco, ma consente al 50% del blocco di essere libero. -
Righe acquisite e migrate Oracle AI Database utilizza concatenamento e migrazione per gestire righe troppo grandi per essere inserite in un unico blocco.
Percentuale di spazio libero nei blocchi di dati
Il parametro SQL PCTFREE imposta la percentuale minima di un blocco di dati riservato come spazio libero per gli aggiornamenti alle righe esistenti. PCTFREE è importante per prevenire la migrazione delle righe ed evitare sprechi di spazio.
Ad esempio, si supponga di creare una tabella che richiederà solo aggiornamenti occasionali, la maggior parte dei quali non aumenterà le dimensioni dei dati esistenti. Specificare il parametro PCTFREE all'interno di un'istruzione CREATE TABLE come indicato di seguito.
CREATE TABLE test_table (n NUMBER) PCTFREE 20;La Figura 15-10 mostra in che modo un'impostazione PCTFREE di 20 influisce sulla gestione dello spazio. Il database aggiunge righe al blocco nel tempo, causando la crescita dei dati delle righe verso l'alto verso l'intestazione del blocco, che si sta espandendo verso il basso verso i dati delle righe. L'impostazione PCTFREE garantisce che almeno il 20% del blocco di dati sia libero. Ad esempio, il database impedisce a un'istruzione INSERT di riempire il blocco in modo che i dati delle righe e l'intestazione occupino un 90% combinato dello spazio totale dei blocchi, lasciando solo il 10% libero.
Figura 10: PCTFREE
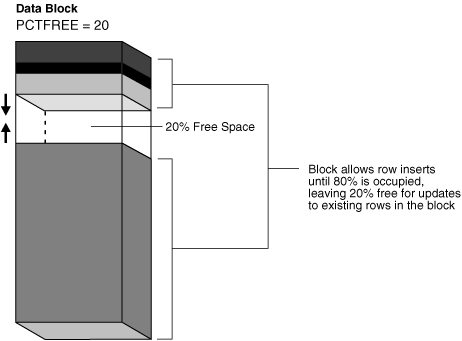
Descrizione dell'illustrazione cncpt029.gif
Nota: questa discussione non si applica ai tipi di dati LOB, che non utilizzano il parametro di memorizzazione PCTFREE o le liste libere.
Vedere anche:
-
Guida per gli sviluppatori di Oracle AI Database SecureFiles e Large Objects
-
Oracle AI Database SQL Language Reference per la sintassi e la semantica del parametro
PCTFREE
Ottimizzazione dello spazio libero nei blocchi di dati
Sebbene la percentuale di spazio libero non possa essere minore di PCTFREE, la quantità di spazio libero può essere maggiore. Ad esempio, l'impostazione di PCTFREE su 20% impedisce che la quantità totale di spazio libero scenda al 5% del blocco, ma consente al 50% del blocco di essere libero.
-
Ottimizzazione mediante aumento dello spazio libero Alcune istruzioni DML possono aumentare lo spazio libero nei blocchi di dati.
-
Ottimizzazione per spazio frammentato a carbone Lo spazio rilasciato può essere o meno contiguo con l'area principale dello spazio libero in un blocco di dati. Lo spazio libero non contiguo è denominato spazio frammentato.
Ottimizzazione grazie all'aumento dello spazio libero
Alcune istruzioni DML possono aumentare lo spazio libero nei blocchi di dati.
Le seguenti istruzioni possono aumentare lo spazio disponibile:
-
Istruzioni
DELETE -
Istruzioni
UPDATEche aggiornano i valori esistenti in valori più piccoli o aumentano i valori esistenti e forzano la migrazione di una riga -
Istruzioni
INSERTin una tabella che utilizza la compressione avanzata delle righeSe le istruzioni
INSERTriempiono un blocco di dati, il database richiama la compressione dei blocchi, con conseguente maggiore spazio libero sul blocco.
Lo spazio rilasciato è disponibile per le istruzioni INSERT nelle seguenti condizioni:
-
Se l'istruzione
INSERTsi trova nella stessa transazione e se è successiva all'istruzione che libera spazio, l'istruzione può utilizzare lo spazio. -
Se l'istruzione
INSERTsi trova in una transazione separata dall'istruzione che libera spazio (forse eseguita da un altro utente) e se è necessario spazio, l'istruzione può utilizzare lo spazio reso disponibile, ma solo dopo il commit dell'altra transazione.
Vedere anche: Oracle AI Database Administrator's Guide per informazioni sulla compressione avanzata delle righe
Ottimizzazione di Coalescing Fragmented Space
Lo spazio rilasciato può o non può essere contiguo con l'area principale dello spazio libero in un blocco di dati. Lo spazio libero non contiguo è denominato spazio frammentato.
La figura seguente mostra un blocco di dati con spazio libero non contiguo.
Figura 11: Blocco di dati con spazio frammentato
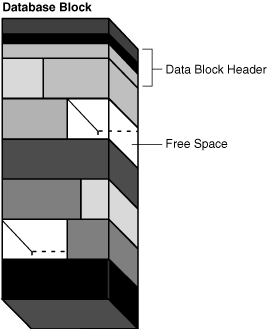
Descrizione dell'illustrazione cncpt210.gif
Oracle AI Database raggruppa automaticamente e in modo trasparente lo spazio libero di un blocco di dati solo quando sono vere le seguenti condizioni:
-
Un'istruzione
INSERToUPDATEtenta di utilizzare un blocco contenente spazio libero sufficiente per contenere una nuova riga. -
Lo spazio libero è frammentato in modo che la parte di riga non possa essere inserita in una sezione contigua del blocco.
Dopo la coalescenza, la quantità di spazio libero è identica alla quantità prima dell'operazione, ma lo spazio è ora contiguo. La Figura 15-12 mostra un blocco di dati dopo la fusione dello spazio.
Figura 12: Blocco di dati dopo lo spazio libero di carbone
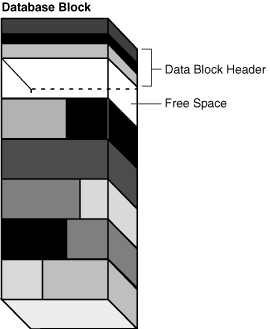
Descrizione dell'illustrazione cncpt211.gif
Oracle AI Database esegue la fusione solo nelle situazioni precedenti perché altrimenti le prestazioni diminuirebbero a causa della continua fusione dello spazio libero nei blocchi di dati.
Righe concatenate e migrate
Oracle AI Database utilizza concatenamento e migrazione per gestire righe troppo grandi per adattarsi a un singolo blocco. Nota: una riga concatenata in una tabella standard è diversa da una catena di righe in una tabella blockchain. Oracle AI Database utilizza tecnologie diverse per gestire le righe in una tabella blockchain.
Sono possibili le seguenti situazioni:
-
La riga è troppo estesa per essere contenuta in un blocco di dati quando viene inserita la prima volta.
Nel catenamento delle righe, Oracle AI Database memorizza i dati per la riga in una catena di uno o più blocchi di dati riservati al segmento. Il concatenamento delle righe si verifica più spesso con righe di grandi dimensioni. Ad esempio, le righe che contengono una colonna di tipo dati
LONGoLONG RAWoppure una riga con un numero enorme di colonne. Il concatenamento delle righe in questi casi è inevitabile. -
Una riga che originariamente si inserisce in un blocco dati viene aggiornata in modo che la lunghezza complessiva della riga aumenti, ma esiste spazio libero insufficiente per contenere la riga aggiornata.
Nella migrazione delle righe, Oracle AI Database sposta l'intera riga in un nuovo blocco di dati, supponendo che la riga possa rientrare in un nuovo blocco. La parte di riga originale di una riga migrata contiene un puntatore o un "indirizzo di inoltro" al nuovo blocco contenente la riga migrata. L'ID riga di una riga migrata non cambia.
-
Una riga contiene più di 255 colonne.
Oracle AI Database può memorizzare solo 255 colonne in una riga. Pertanto, se si inserisce una riga in una tabella con 1000 colonne, il database crea 4 righe, in genere concatenate su più blocchi.
La Figura 15-13 illustra l'inserimento di una riga di grandi dimensioni in un blocco di dati. La riga è troppo grande per il blocco di sinistra, quindi il database incatena la riga posizionando la prima riga nel blocco di sinistra e la seconda riga nel blocco di destra.
Figura 13: Catena di righe
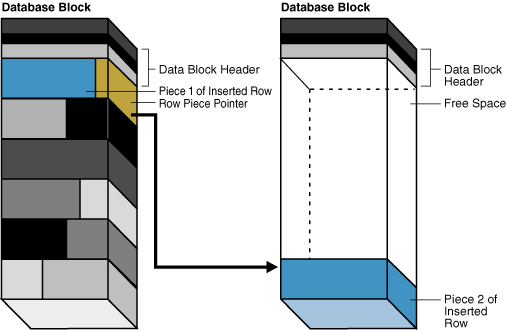
Descrizione dell'illustrazione cncpt316.gif
Nella Figura 15-14, il blocco sinistro contiene una riga aggiornata in modo che la riga sia ora troppo grande per il blocco. Il database sposta l'intera riga nel blocco di destra e lascia un puntatore alla riga migrata nel blocco di sinistra.
Figura 14: Migrazione delle righe
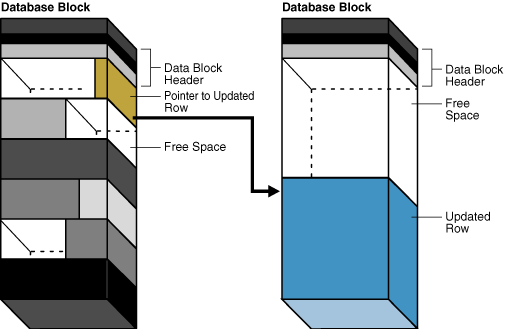
Descrizione dell'illustrazione cncpt306.gif
Quando una riga viene concatenata o migrata, l'I/O necessario per recuperare i dati aumenta. Questa situazione si verifica perché Oracle AI Database deve eseguire la scansione di più blocchi per recuperare le informazioni per la riga. Ad esempio, se il database esegue un I/O per leggere un indice e un I/O per leggere una riga di tabella non migrata, è necessario un I/O aggiuntivo per ottenere i dati per una riga migrata.
Segment Advisor, che può essere eseguito sia manualmente che automaticamente, è un componente di Oracle AI Database che identifica i segmenti con spazio disponibile per il recupero. L'advisor può offrire consigli su oggetti con spazio libero significativo o troppe righe incatenate.
Vedere anche:
-
Oracle AI Database Administrator's Guide per scoprire come recuperare lo spazio sprecato
-
Oracle AI Database Performance Tuning Guide per informazioni sulla riduzione delle righe concatenate e migrate
Panoramica dei blocchi di indice
Un blocco di indice è un tipo speciale di blocco di dati che gestisce lo spazio in modo diverso dai blocchi di tabella. Oracle AI Database utilizza blocchi di indice per gestire lo spazio di storage logico in un indice.
-
Tipi di blocchi di indice Un indice contiene un blocco radice, blocchi di rami e blocchi foglia.
-
Memorizzazione delle voci di indice Le voci di indice vengono memorizzate in blocchi di indice allo stesso modo delle righe di tabella in un blocco di dati. Le voci di indice nella parte di blocco non vengono memorizzate in ordine binario, ma in un heap.
-
Riutilizzo degli slot in un blocco di indice Il database può riutilizzare lo spazio all'interno di un blocco di indice.
-
Coalescing a Index Block Index coalescing compatta i dati dell'indice esistenti in posizione e, se la riorganizzazione libera i blocchi, lascia i blocchi liberi nella struttura dell'indice. Pertanto, il coalescenza non rilascia blocchi di indice per altri usi o causa la riallocazione dei blocchi.
Tipi di blocchi indice
Un indice contiene un blocco radice, blocchi di rami e blocchi foglia.
I tipi di blocco sono definiti come indicato di seguito.
-
Blocco radice
Questo blocco identifica il punto di ingresso nell'indice.
-
Blocchi diramazione
I database navigano attraverso i blocchi di diramazione durante la ricerca di una chiave di indice.
-
Blocchi foglia
Questi blocchi contengono gli ID riga dei valori chiave indicizzati che puntano alle righe associate. I blocchi foglia memorizzano i valori delle chiavi in ordine in modo che il database possa cercare in modo efficiente tutte le righe in un intervallo di valori chiave.
Memorizzazione voci indice
Le voci di indice vengono memorizzate in blocchi di indice allo stesso modo delle righe di tabella in un blocco di dati. Le voci di indice nella parte di blocco non vengono memorizzate in ordine binario, ma in un heap.
Il database gestisce la directory delle righe in un blocco di indice in modo diverso dalla directory in un blocco di dati. Le voci nella directory delle righe (non le voci nel corpo del blocco di indice) sono ordinate in base al valore della chiave. Ad esempio, nella directory delle righe, la voce di directory per la chiave di indice 000000 precede la voce di directory per la chiave di indice 111111 e così via.
L'ordinamento delle voci nella directory delle righe migliora l'efficienza delle scansioni degli indici. In una scansione di intervallo, il database deve leggere tutte le chiavi di indice specificate nell'intervallo. Il database attraversa i blocchi diramazione per identificare il blocco foglia che contiene la prima chiave. Poiché le voci nella directory delle righe sono ordinate, il database può utilizzare una ricerca binaria per trovare la prima chiave di indice nell'intervallo e quindi avanzare in sequenza attraverso le voci nella directory delle righe fino a quando non trova l'ultima chiave. In questo modo, il database evita di leggere tutte le chiavi nel corpo del blocco foglia.
Vedere anche: "Costo comune blocco dati"
Riutilizzo di slot in un blocco indice
Il database può riutilizzare lo spazio all'interno di un blocco di indice.
Ad esempio, un'applicazione può inserire un valore in una colonna e quindi eliminare il valore. Quando una riga richiede spazio, il database può riutilizzare lo slot dell'indice precedentemente occupato dal valore eliminato.
Un blocco di indice in genere contiene molte più righe di un blocco di tabella organizzato dall'heap. La possibilità di memorizzare molte righe in un singolo blocco di indice rende più facile per il database mantenere un indice perché evita frequenti divisioni del blocco per memorizzare nuovi dati.
Un indice non può coalesce se stesso, anche se è possibile coalesce manualmente con un'istruzione ALTER INDEX con le opzioni REBUILD o COALESCE. Ad esempio, se si popola una colonna con i valori da 1 a 500000 e si eliminano le righe contenenti numeri pari, l'indice conterrà 250.000 slot vuoti. Il database riutilizza uno slot solo se può inserire dati che si inseriscono in un blocco di indice contenente uno slot vuoto.
Coalescenza di un blocco indice
L'indice di coalescenza compatta i dati dell'indice esistenti e, se la riorganizzazione libera i blocchi, lascia i blocchi liberi nella struttura dell'indice. Pertanto, il coalescenza non rilascia blocchi di indice per altri usi o causa la riallocazione dei blocchi.
Oracle AI Database non compatta automaticamente l'indice: è necessario eseguire un'istruzione ALTER INDEX con le opzioni REBUILD o COALESCE. La Figura 15-15 mostra un indice della colonna employees.department_id prima che l'indice venga unito. I primi tre blocchi foglia sono solo parzialmente pieni, come indicato dalle linee di riempimento grigie.
Figura 15: Indice prima del carbone
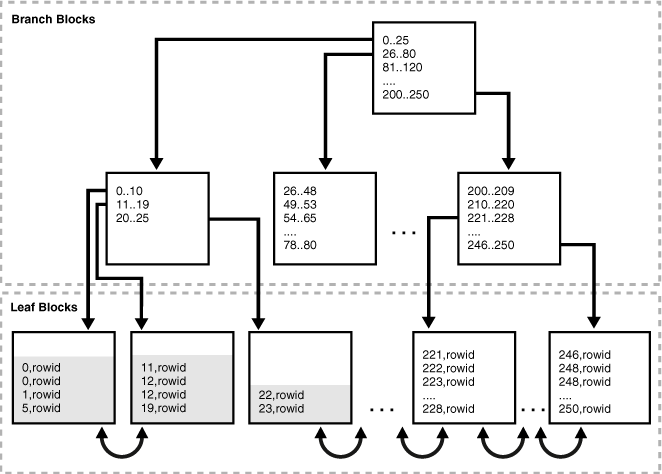
Descrizione dell'illustrazione cncpt294.gif
La Figura 15-16 mostra l'indice nella Figura 15-15 dopo la fusione dell'indice. I primi due blocchi di foglia sono ora pieni, come indicato dalle linee di riempimento grigie, e il terzo blocco di foglia è stato liberato.
Figura 16: Indice dopo il carbone
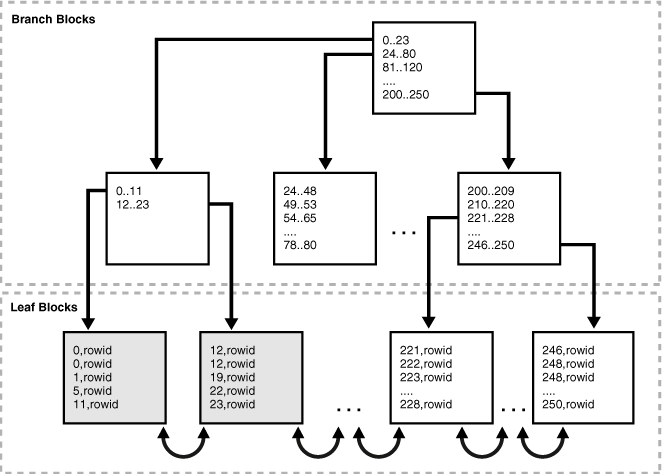
Descrizione dell'illustrazione cncpt295.gif
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come fondere e ricreare gli indici
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sull'istruzione
COALESCE
Panoramica degli extent
Un extent è un'unità di storage del database costituita da blocchi di dati logicamente contigui. I blocchi di dati possono essere distribuiti fisicamente sul disco a causa dello striping RAID e delle implementazioni del file system.
-
Allocazione di estensioni Per impostazione predefinita, il database alloca un'estensione iniziale per un segmento di dati quando viene creato il segmento. Un'estensione è sempre contenuta in un file di dati.
-
Deallocazione degli extent In generale, gli extent di un segmento utente non tornano alla tablespace a meno che l'oggetto non venga eliminato utilizzando un'istruzione
DROP. -
Parametri di memorizzazione per estensioni Ogni segmento è definito dai parametri di memorizzazione espressi in termini di estensioni. Questi parametri controllano il modo in cui Oracle AI Database alloca spazio libero per un segmento.
Allocazione degli extent
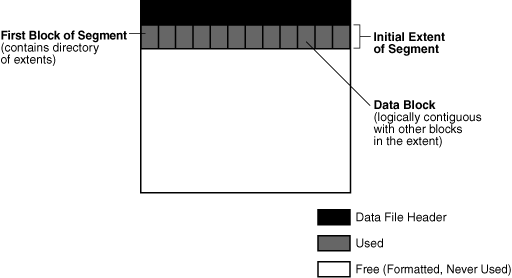
Per impostazione predefinita, il database alloca un'estensione iniziale per un segmento dati quando viene creato il segmento. Un'estensione è sempre contenuta in un file di dati.
Sebbene non siano stati aggiunti dati al segmento, i blocchi di dati nell'estensione iniziale sono riservati esclusivamente a questo segmento. Il primo blocco di dati di ogni segmento contiene una directory degli extent nel segmento. La Figura 15-17 mostra l'estensione iniziale di un segmento in un file di dati che in precedenza non conteneva dati.
Figura 17: Estensione iniziale di un segmento
Descrizione dell'illustrazione cncpt274.gif
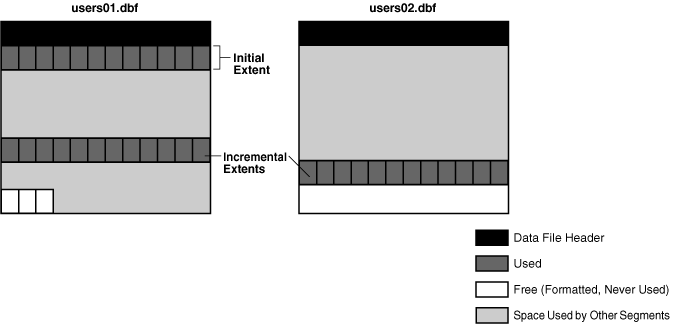
Se l'estensione iniziale diventa completa e se è necessario più spazio, il database alloca automaticamente un'estensione incrementale per questo segmento. Un extent incrementale è un extent successivo creato per il segmento.
L'algoritmo di allocazione dipende dal fatto che la tablespace sia gestita localmente o dal dizionario. Nel caso gestito localmente, il database cerca nella bitmap di un file di dati blocchi liberi adiacenti. Se il file di dati non dispone di spazio sufficiente, il database cerca in un altro file di dati. Gli extent per un segmento si trovano sempre nella stessa tablespace, ma possono trovarsi in file di dati diversi. La Figura 15-18 mostra che il database può allocare estensioni per un segmento in qualsiasi file di dati nella tablespace. Ad esempio, il segmento può allocare l'estensione iniziale in users01.dbf, allocare il primo extent incrementale in users02.dbf e quindi allocare l'estensione successiva in users01.dbf.
Figura 18: Estensione incrementale di un segmento
Descrizione dell'illustrazione cncpt278.gif
I blocchi di un'estensione appena allocata, sebbene liberi, potrebbero non essere vuoti dei vecchi dati. In ASSM, Oracle AI Database formatta i blocchi di un'estensione appena allocata quando inizia a utilizzare l'estensione, ma solo in base alle esigenze. Nota: questa sezione si applica alle operazioni seriali, in cui un processo server analizza ed esegue un'istruzione. Il database alloca gli extent in modo diverso nelle istruzioni SQL parallele, che comportano più processi server.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come allocare manualmente le estensioni
Disallocazione degli extent
In generale, le estensioni di un segmento utente non tornano alla tablespace a meno che non si elimini l'oggetto utilizzando un'istruzione DROP.
Ad esempio, se si eliminano tutte le righe di una tabella, il database non recupera i blocchi di dati utilizzati da altri oggetti nella tablespace. È inoltre possibile eliminare il segmento utilizzando il pacchetto DBMS_SPACE_ADMIN.
Nota: in un segmento di annullamento, Oracle AI Database disalloca periodicamente una o più estensioni se ha la dimensione OPTIMAL specificata o se il database si trova in modalità di gestione automatica degli undo.
In alcune circostanze, è possibile disallocare manualmente lo spazio. Oracle Segment Advisor consente di determinare se un oggetto dispone di spazio disponibile per il recupero in base al livello di frammentazione nell'oggetto. Le seguenti tecniche possono liberare estensioni:
-
Utilizzare un restringimento del segmento online per recuperare spazio frammentato in un segmento. Il restringimento dei segmenti è un'operazione in linea in loco. In generale, la compattazione dei dati porta a un migliore utilizzo della cache e richiede meno blocchi da leggere in una scansione completa della tabella.
-
Spostare i dati di una tabella o di una partizione di tabella non partizionata in un nuovo segmento e, facoltativamente, in una tablespace diversa per la quale si dispone di una quota.
-
Ricostruire o fondere l'indice.
-
Tronca un cluster di tabelle o tabelle, che rimuove tutte le righe. Per impostazione predefinita, Oracle AI Database disalloca tutto lo spazio utilizzato dalle righe rimosse tranne quello specificato dal parametro di storage
MINEXTENTS. A partire da Oracle Database 11g Release 2 (11.2.0.2), è anche possibile utilizzareTRUNCATEcon l'opzioneDROP ALL STORAGEper eliminare interi segmenti. -
Consente di disallocare lo spazio inutilizzato, liberando lo spazio inutilizzato all'estremità High Water Mark del segmento di database e rendendo lo spazio disponibile per altri segmenti nella tablespace.
Quando gli extent vengono liberati, Oracle AI Database modifica il bitmap nel file di dati per le tablespace gestite localmente per riflettere gli extent recuperati come spazio disponibile. Qualsiasi dato nei blocchi di estensioni liberate diventa inaccessibile.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come recuperare lo spazio dei segmenti
Parametri di memorizzazione per estensioni
Ogni segmento è definito da parametri di memorizzazione espressi in termini di extent. Questi parametri controllano il modo in cui Oracle AI Database alloca spazio libero per un segmento.
Le impostazioni di memorizzazione vengono determinate nel seguente ordine di precedenza, con le impostazioni più alte nell'elenco che sostituiscono le impostazioni più basse nell'elenco:
-
Clausola di memorizzazione dei segmenti
-
Clausola di memorizzazione tablespace
-
Impostazione predefinita di Oracle AI Database
Una tablespace gestita localmente può avere dimensioni di extent uniformi o dimensioni di extent variabili determinate automaticamente dal sistema:
-
Per gli extent uniformi, è possibile specificare una dimensione di un extent o utilizzare quelle predefinite di 1 MB. Tutte le estensioni nella tablespace sono di questa dimensione. Le tablespace temporanee gestite localmente possono utilizzare solo questo tipo di allocazione.
-
Per gli extent allocati automaticamente, Oracle AI Database determina la dimensione ottimale degli extent aggiuntivi.
Per le tablespace gestite localmente, alcuni parametri di memorizzazione non possono essere specificati a livello di tablespace. Tuttavia, è possibile specificare questi parametri a livello di segmento. In questo caso, il database utilizza tutti i parametri insieme per calcolare la dimensione iniziale del segmento. Gli algoritmi interni determinano la dimensione successiva di ogni estensione.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni sulle considerazioni sulla gestione delle estensioni quando si crea una tablespace gestita localmente
-
Oracle AI Database SQL Language Reference per informazioni sulle opzioni nella clausola di storage
Panoramica dei segmenti
Un segmento è un set di estensioni che contiene tutti i dati per una struttura di memorizzazione logica all'interno di una tablespace.
Ad esempio, Oracle AI Database alloca una o più estensioni per formare il segmento di dati per una tabella. Il database alloca anche una o più estensioni per formare il segmento di indice per un indice su una tabella.
Oracle AI Database gestisce lo spazio dei segmenti automaticamente o manualmente. In questa sezione si presuppone l'utilizzo di ASSM.
-
Segmenti utente Un singolo segmento di dati in un database memorizza i dati per un oggetto utente.
-
Segmenti temporanei Quando si elabora una query, Oracle AI Database spesso richiede un'area di lavoro temporanea per le fasi intermedie dell'esecuzione delle istruzioni SQL.
-
Annulla segmenti Oracle AI Database gestisce i record delle azioni delle transazioni, noti collettivamente come annulla dati.
-
Spazio segmento e High Water Mark Per gestire lo spazio, Oracle AI Database tiene traccia dello stato dei blocchi nel segmento. Il punto HWM (High Water Mark) è il punto di un segmento oltre il quale i blocchi di dati non sono stati formattati e non sono mai stati utilizzati. Vedere anche: "Gestione dello spazio logico" per ulteriori informazioni su ASSM
Segmenti utente
Un singolo segmento di dati in un database memorizza i dati per un oggetto utente.
Esistono diversi tipi di segmenti. Esempi di segmenti utente includono:
-
Tabella, partizione di tabella o cluster di tabelle
-
Partizione LOB o LOB
-
Partizione indice o indice
Ogni oggetto non partizionato e partizione oggetto viene memorizzato nel proprio segmento. Ad esempio, se un indice contiene cinque partizioni, cinque segmenti contengono i dati dell'indice.
- Creazione del segmento utente Per impostazione predefinita, il database utilizza la creazione differita del segmento per aggiornare solo i metadati del database durante la creazione di tabelle, indici e partizioni.
Creazione segmento utente
Per impostazione predefinita, il database utilizza la creazione differita dei segmenti per aggiornare solo i metadati del database durante la creazione di tabelle, indici e partizioni.
Quando un utente inserisce la prima riga in una tabella o partizione, il database crea segmenti per la tabella o la partizione, le relative colonne LOB e i relativi indici. La creazione di segmenti differiti evita di utilizzare inutilmente le risorse di database. Ad esempio, l'installazione di un'applicazione può creare migliaia di oggetti, occupando una notevole quantità di spazio su disco. Molti di questi oggetti potrebbero non essere mai utilizzati.
Il pacchetto DBMS_SPACE_ADMIN gestisce i segmenti per gli oggetti vuoti. È possibile utilizzare questo package PL/SQL per effettuare le operazioni riportate di seguito.
-
materializzare manualmente i segmenti per tabelle o partizioni vuote che non hanno segmenti creati
-
Rimuovere i segmenti da tabelle vuote o partizioni con un segmento vuoto allocato
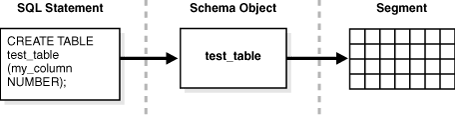
Per illustrare al meglio la relazione tra la creazione di oggetti e la creazione di segmenti, si supponga che la creazione differita di segmenti sia disabilitata. Creare una tabella come indicato di seguito.
CREATE TABLE test_table (my_column NUMBER);Come illustrato nella Figura 15-19, il database crea un segmento per la tabella.
Figura 19: Creazione di un segmento utente
Descrizione dell'illustrazione cncpt246.gif
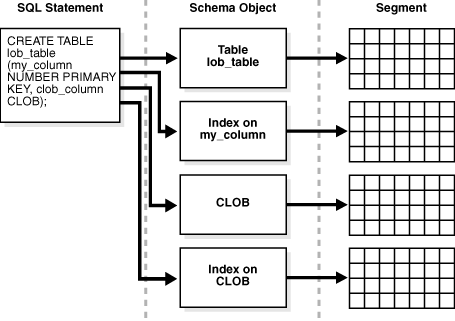
Quando si crea una tabella con una chiave primaria o una chiave univoca, Oracle AI Database crea automaticamente un indice per questa chiave. Si supponga di nuovo che la creazione differita del segmento sia disabilitata. Creare una tabella come indicato di seguito.
CREATE TABLE lob_table (my_column NUMBER PRIMARY KEY, clob_column CLOB);La Figura 15-20 mostra che i dati per lob_table sono memorizzati in un segmento, mentre l'indice creato implicitamente si trova in un segmento diverso. Inoltre, i dati CLOB vengono memorizzati nel proprio segmento, così come l'indice CLOB associato. Pertanto, l'istruzione CREATE TABLE determina la creazione di quattro segmenti diversi.
Figura 20: Segmenti multipli
Descrizione dell'illustrazione cncpt245.gif
Nota: i segmenti di una tabella e l'indice di questa tabella non devono occupare la stessa tablespace.
Il database alloca una o più estensioni quando viene creato un segmento. I parametri di storage per l'oggetto determinano la modalità di allocazione degli extent per ciascun segmento. I parametri influiscono sull'efficienza del recupero e dello storage dei dati per il segmento di dati associato all'oggetto.
Vedere anche:
-
Oracle AI Database SecureFiles and Large Objects Developer's Guide per saperne di più sui LOB interni
-
Oracle AI Database Administrator's Guide per informazioni su come gestire la creazione differita dei segmenti
-
Oracle AI Database SQL Language Reference per la sintassi
CREATE TABLE
Segmenti temporanei
Quando si elabora una query, Oracle AI Database spesso richiede un'area di lavoro temporanea per le fasi intermedie dell'esecuzione dell'istruzione SQL.
Le operazioni tipiche che possono richiedere un segmento temporaneo includono l'ordinamento, l'hashing e l'unione di bitmap. Durante la creazione di un indice, Oracle AI Database colloca anche i segmenti di indice in segmenti temporanei e li converte in segmenti permanenti al termine dell'indice.
Oracle AI Database non crea un segmento temporaneo se un'operazione può essere eseguita in memoria. Tuttavia, se l'uso della memoria non è possibile, il database alloca automaticamente un segmento temporaneo sul disco.
-
Allocazione di segmenti temporanei per le query Oracle AI Database alloca segmenti temporanei per le query in base alle esigenze durante una sessione utente e li elimina al termine della query. Le modifiche apportate ai segmenti temporanei non vengono registrate nel redo log in linea, ad eccezione delle operazioni di gestione dello spazio nel segmento temporaneo.
-
Allocazione di segmenti per tabelle e indici temporanei Oracle AI Database può allocare segmenti temporanei per le tabelle temporanee e i relativi indici.
Allocazione di segmenti temporanei per le query
Oracle AI Database alloca segmenti temporanei per le query in base alle esigenze durante una sessione utente e li elimina al termine della query. Le modifiche apportate ai segmenti temporanei non vengono registrate nel redo log in linea, ad eccezione delle operazioni di gestione dello spazio nel segmento temporaneo.
Il database crea segmenti temporanei nella tablespace temporanea assegnata all'utente. Le caratteristiche di memorizzazione predefinite della tablespace determinano le caratteristiche degli extent nel segmento temporaneo. Poiché l'allocazione e la disallocazione dei segmenti temporanei si verificano di frequente, è consigliabile creare almeno una tablespace speciale per i segmenti temporanei. Il database distribuisce I/O tra i dischi ed evita il frammento di SYSTEM e di altre tablespace con segmenti temporanei.
Nota: quando SYSTEM è gestito localmente, è necessario definire una tablespace temporanea predefinita alla creazione del database. Impossibile utilizzare una tablespace SYSTEM gestita localmente per la memorizzazione temporanea predefinita.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come creare tablespace temporanee.
-
Oracle AI Database SQL Language Reference per sintassi e semantica
CREATE TEMPORARY TABLESPACE
Allocazione di segmenti per tabelle e indici temporanei
Oracle AI Database può allocare segmenti temporanei per le tabelle temporanee e i relativi indici.
Le tabelle temporanee includono dati che esistono solo per la durata di una transazione o sessione. Ogni sessione accede solo agli extent allocati per se stessa e non può accedere agli extent allocati per altre sessioni.
Oracle AI Database alloca segmenti per una tabella temporanea globale quando si verifica il primo INSERT nella tabella e per una tabella temporanea privata solo quando necessario. L'inserimento può avvenire in modo esplicito o a causa di CREATE TABLE AS SELECT. Il database alloca i segmenti per la tabella e i relativi indici, crea la pagina radice per gli indici e alloca i segmenti LOB.
Una tablespace temporanea dell'utente corrente alloca segmenti per una tabella temporanea. Ad esempio, la tablespace temporanea assegnata a user1 è temp1 e la tablespace temporanea assegnata a user2 è temp2. In questo caso, user1 memorizza i dati temporanei nei segmenti temp1, mentre user2 memorizza i dati temporanei nei segmenti temp2.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come creare tabelle temporanee.
Annulla segmenti
Oracle AI Database gestisce i record delle azioni delle transazioni, noti collettivamente come dati di annullamento.
Oracle AI Database utilizza i dati di undo per eseguire le operazioni riportate di seguito.
-
Eseguire il rollback di una transazione attiva
-
Recupera una transazione terminata
-
Fornisci coerenza delle letture
-
Eseguire alcune operazioni di flashback logico
Oracle AI Database memorizza i dati di undo all'interno del database piuttosto che nei log esterni. I dati di undo vengono memorizzati in blocchi che vengono aggiornati proprio come i blocchi di dati, con modifiche a questi blocchi che generano redo record. In questo modo, Oracle AI Database può accedere in modo efficiente ai dati di undo senza dover leggere i log esterni.
I dati di annullamento per gli oggetti permanenti vengono memorizzati in una tablespace di annullamento. Oracle AI Database fornisce un meccanismo completamente automatizzato, noto come modalità di gestione automatica degli undo, per la gestione di segmenti di undo e spazio in una tablespace di undo.
Il database separa i dati di undo in due flussi. Un flusso di undo temporaneo incapsula solo i record di undo generati dalle modifiche apportate agli oggetti temporanei, mentre un flusso di undo permanente incapsula solo i record di undo per gli oggetti permanenti. Il database gestisce l'annullamento temporaneo e permanente in modo indipendente. La separazione degli undo riduce lo storage e migliora le prestazioni effettuando le operazioni riportate di seguito.
-
Abilitazione della configurazione di dimensioni di tablespace permanenti e di undo più adatte ai carichi di lavoro per le tabelle permanenti e temporanee
-
Riduzione delle dimensioni dei redo log scritti nel redo log in linea
-
Evitare la necessità di eseguire il backup dei dati di undo temporanei
In un'istanza di Active Data Guard, il DML nelle tabelle temporanee globali richiede la generazione di undo nei segmenti di undo temporanei.
-
Annulla segmenti e transazioni All'avvio di una transazione, il database associa (assegna) la transazione a un segmento di undo e quindi a una tabella di transazione nella tablespace di undo corrente. In rare circostanze, se l'istanza di database non dispone di una tablespace di undo designata, la transazione si lega al segmento di annullamento del sistema.
-
Rollback transazione Quando viene emessa un'istruzione
ROLLBACK, il database utilizza i record di annullamento per eseguire il rollback delle modifiche apportate al database dalla transazione di cui non è stato eseguito il commit. -
Segmenti di annullamento temporanei Un segmento di annullamento temporaneo è un contenitore di gestione dello spazio facoltativo solo per i dati di annullamento temporanei.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni sui segmenti di undo temporanei
-
Oracle AI Database Reference per informazioni sul parametro di inizializzazione
TEMP_UNDO_ENABLED
Annulla segmenti e transazioni
All'avvio di una transazione, il database associa (assegna) la transazione a un segmento di undo, e quindi a una tabella di transazione, nella tablespace di undo corrente. In rare circostanze, se l'istanza di database non dispone di una tablespace di undo designata, la transazione si lega al segmento di annullamento del sistema.
Più transazioni attive possono scrivere contemporaneamente nello stesso segmento di annullamento o in segmenti diversi. Ad esempio, le transazioni T1 e T2 possono scrivere nel segmento di annullamento U1 oppure T1 può scrivere in U1 mentre T2 scrive nel segmento di annullamento U 2.
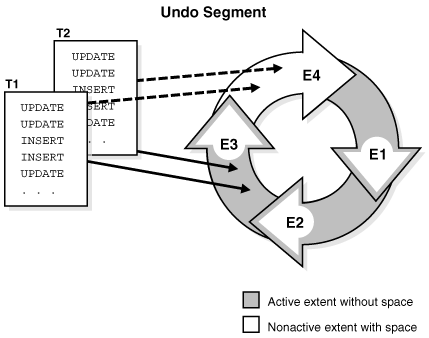
Concettualmente, le estensioni in un segmento di undo formano un anello. Le transazioni scrivono in una misura di undo, e poi nella misura successiva nell'anello, e così via in modo ciclico. La Figura 15-21 mostra due transazioni, T1 e T2, che iniziano a scrivere nella terza misura (E3) di un segmento di undo e continuano a scrivere nella quarta misura (E4).
Figura 21: Anello di estensioni allocate in un segmento di undo
Descrizione dell'illustrazione cncpt328.gif
In qualsiasi momento, una transazione scrive in sequenza in un solo grado in un segmento di undo, noto come estensione corrente per la transazione. Più transazioni attive possono scrivere contemporaneamente nella stessa estensione corrente o in estensioni correnti diverse. La Figura 15-21 mostra le transazioni T1 e T2 che scrivono contemporaneamente fino all'estensione E3. All'interno di undo extent, un blocco di dati contiene dati per una sola transazione.
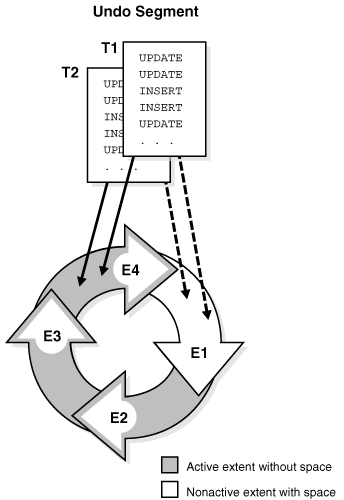
Man mano che l'estensione di undo corrente si riempie, la prima transazione che richiede spazio controlla la disponibilità della successiva estensione allocata nell'anello. Se l'estensione successiva non contiene i dati di una transazione attiva, questa estensione diventa l'estensione corrente. Ora tutte le transazioni che hanno bisogno di spazio possono scrivere nella nuova estensione attuale. Nella Figura 15-22, quando E4 è pieno, T1 e T2 continuano a scrivere a E1, sovrascrivendo i dati di undo non attivi in E1.
Figura 22: Uso ciclico degli extent allocati in un segmento di undo
Descrizione dell'illustrazione cncpt327.gif
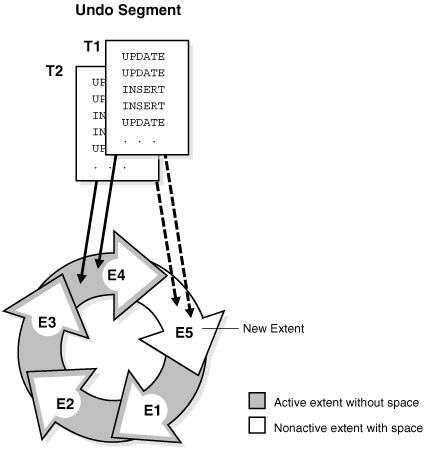
Se l'estensione successiva contiene i dati di una transazione attiva, il database deve allocare una nuova estensione. La Figura 15-23 mostra uno scenario in cui T1 e T2 scrivono a E4. Quando E4 viene compilato, le transazioni non possono continuare a scrivere a E1 perché E1 contiene voci di annullamento attive. Pertanto, il database alloca una nuova estensione (E5) per questo segmento di undo. Le transazioni continuano a scrivere a E5.
Figura 23: Allocazione di un nuovo extent per un segmento di undo
Descrizione dell'illustrazione cncpt326.gif
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come gestire i segmenti di undo
Rollback transazione
Quando viene emessa un'istruzione ROLLBACK, il database utilizza record di undo per eseguire il rollback delle modifiche apportate al database dalla transazione di cui non è stato eseguito il commit.
Durante il recupero, il database esegue il rollback delle modifiche non sottoposte a commit applicate dal redo log in linea ai file di dati. I record di annullamento forniscono una consistenza della lettura mantenendo l'immagine precedente dei dati per gli utenti che accedono ai dati contemporaneamente alla modifica da parte di un altro utente.
Segmenti di annullamento temporanei
Un segmento di undo temporaneo è un contenitore di gestione dello spazio facoltativo solo per i dati di undo temporanei.
I record di undo per le modifiche alle tabelle temporanee sono sia specifici della sessione che utili solo per la coerenza di lettura e il rollback delle transazioni. Prima di Oracle Database 12c, il database memorizzava sempre questi record nel redo log in linea. Poiché le modifiche agli oggetti temporanei non vengono registrate nel redo log in linea, la scrittura di undo per gli oggetti temporanei in segmenti di undo temporanei consente di risparmiare spazio nei redo log in linea e nei redo log file archiviati. Il database non registra le modifiche apportate all'annullamento o alle modifiche apportate alla tabella temporanea, migliorando così le prestazioni.
È possibile impostare il parametro di inizializzazione TEMP_UNDO_ENABLED in modo che le tabelle temporanee memorizzino i dati di undo in un segmento di undo temporaneo. Quando questo parametro è TRUE, il database alloca segmenti di undo temporanei dalle tablespace temporanee.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni sui segmenti di undo temporanei
-
Oracle AI Database Reference per informazioni sul parametro di inizializzazione
TEMP_UNDO_ENABLED
Lo spazio dei segmenti e l'alto segno dell'acqua
Per gestire lo spazio, Oracle AI Database tiene traccia dello stato dei blocchi nel segmento. Il punto HWM (High Water Mark) è il punto di un segmento oltre il quale i blocchi di dati non sono formattati e non sono mai stati utilizzati.
MSSM utilizza elenchi liberi per gestire lo spazio dei segmenti. Alla creazione della tabella, nessun blocco nel segmento viene formattato. Quando una sessione inserisce le righe nella tabella per la prima volta, il database cerca nella lista libera blocchi utilizzabili. Se il database non trova blocchi utilizzabili, preformatta un gruppo di blocchi, li inserisce nella lista libera e inizia a inserire dati nei blocchi. In MSSM, una scansione completa della tabella legge tutti i blocchi sotto l'HWM.
ASSM non utilizza elenchi liberi e quindi deve gestire lo spazio in modo diverso. Quando una sessione inserisce i dati in una tabella, il database formatta un singolo blocco bitmap invece di preformattare un gruppo di blocchi come in MSSM. La bitmap tiene traccia dello stato dei blocchi nel segmento, sostituendo la free list. Il database utilizza il bitmap per trovare i blocchi liberi e quindi formattare ogni blocco prima di riempirlo con i dati. ASSM distribuisce gli inserti tra i blocchi per evitare problemi di concorrenza.
Ogni blocco di dati in un segmento ASSM si trova in uno degli stati seguenti:
-
Sopra l'HWM
Questi blocchi non sono formattati e non sono mai stati utilizzati.
-
Sotto l'HWM
I blocchi sono in uno degli stati elencati di seguito.
-
Allocato, ma attualmente non formattato e non utilizzato
-
Formattato e contiene dati
-
Formattato e vuoto perché i dati sono stati eliminati
-
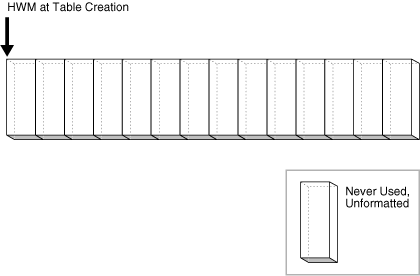
La Figura 15-24 illustra un segmento ASSM come una serie orizzontale di blocchi. Alla creazione del tavolo, l'HWM si trova all'inizio del segmento a sinistra. Poiché non sono stati ancora inseriti dati, tutti i blocchi del segmento non sono formattati e non vengono mai utilizzati.
Figura 24: HWM alla creazione della tabella
Descrizione dell'illustrazione cncpt275.gif
Si supponga che una transazione inserisca righe nel segmento. Il database deve allocare un gruppo di blocchi per contenere le righe. I blocchi allocati sono inferiori all'HWM. Il database formatta un blocco bitmap in questo gruppo per contenere i metadati, ma non preformatta i blocchi rimanenti nel gruppo.
Nella Figura 15-25, i blocchi al di sotto dell'HWM vengono allocati, mentre i blocchi al di sopra dell'HWM non vengono allocati né formattati. Quando si verificano inserimenti, il database può scrivere in qualsiasi blocco con spazio disponibile. La marcatura bassa dell'acqua alta (basso HWM) segna il punto sotto il quale tutti i blocchi sono noti per essere formattati perché contengono dati o contengono dati in precedenza.
Figura 25: HWM e bassa HWM
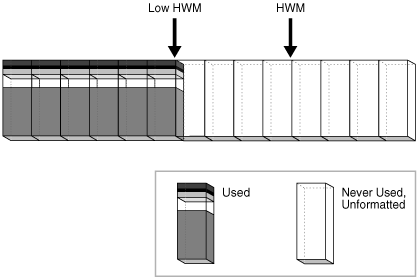
Descrizione dell'illustrazione cncpt276.gif
Nella Figura 15-26, il database sceglie un blocco tra HWM e HWM inferiore e vi scrive. Il database avrebbe potuto scegliere altrettanto facilmente qualsiasi altro blocco tra l'HWM e l'HWM basso, o qualsiasi blocco al di sotto dell'HWM basso che avesse spazio disponibile. Nella Figura 15-26, i blocchi su entrambi i lati del blocco appena compilato non sono formattati.
Figura 26: HWM e bassa HWM
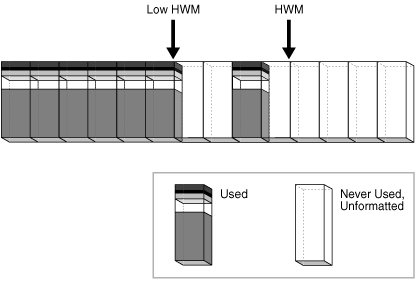
Descrizione dell'illustrazione cncpt333.gif
Il valore HWM basso è importante in una scansione tabella completa. Poiché i blocchi al di sotto dell'HWM vengono formattati solo se utilizzati, è possibile che alcuni blocchi non siano formattati, come illustrato nella Figura 15-26. Per questo motivo, il database legge il blocco bitmap per ottenere la posizione del basso HWM. Il database legge tutti i blocchi fino al basso HWM perché sono noti per essere formattati, e quindi legge attentamente solo i blocchi formattati tra il basso HWM e il HWM.
Si supponga che una nuova transazione inserisca righe nella tabella, ma la bitmap indica che lo spazio libero non è sufficiente sotto l'HWM. Nella Figura 15-27, il database avanza l'HWM a destra, allocando un nuovo gruppo di blocchi non formattati.
Figura 27: Avanzare HWM e bassa HWM
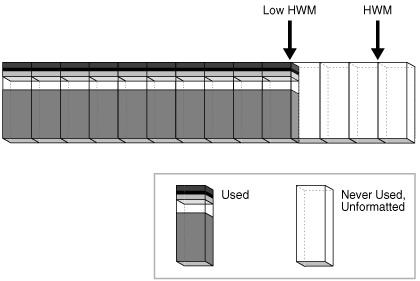
Descrizione dell'illustrazione cncpt277.gif
Quando i blocchi tra l'HWM e il basso HWM sono pieni, l'HWM avanza a destra e il basso HWM avanza verso la posizione del vecchio HWM. Mentre il database inserisce i dati nel tempo, l'HWM continua ad avanzare a destra, con l'HWM basso sempre dietro di esso. A meno che non si ricostruisca, tronchi o riduca manualmente l'oggetto, l'HWM non si ritira mai.
Vedere anche:
-
Oracle AI Database Administrator's Guide per scoprire come ridurre i segmenti online
-
Oracle AI Database SQL Language Reference per sintassi e semantica
TRUNCATE TABLE
Panoramica delle Tablespace
Un tablespace è un contenitore di storage logico per i segmenti.
I segmenti sono oggetti di database, ad esempio tabelle e indici, che consumano spazio di storage. A livello fisico, una tablespace memorizza i dati in uno o più file di dati o file temporanei.
-
Tablespace in un ambiente multi-tenant In un CDB, ogni PDB e root dell'applicazione dispone del proprio set di tablespace.
-
Tablespace permanenti: una tablespace permanente raggruppa gli oggetti dello schema persistente. I segmenti per gli oggetti nella tablespace vengono memorizzati fisicamente nei file di dati.
-
Tablespace temporanee: una tablespace temporanea contiene dati transitori che persistono solo per la durata di una sessione. Nessun oggetto schema permanente può risiedere in una tablespace temporanea. Un file di modello memorizza i dati della tablespace temporanea.
-
Modalità tablespace La modalità tablespace determina l'accessibilità della tablespace.
-
Dimensione file tablespace Una tablespace è una tablespace a file unico o una tablespace a file ridotto. Queste tablespace sono indistinguibili in termini di esecuzione di istruzioni SQL che non fanno riferimento in modo esplicito a file di dati o file temporanei.
Tablespace in un ambiente multi-tenant
In un CDB, ogni PDB e radice applicazione dispone del proprio set di tablespace.
Ogni root, PDB e applicazione CDB deve avere le tablespace SYSTEM e SYSAUX. La figura seguente mostra le tablespace in un contenitore standard.
Figura 28: Tablespace
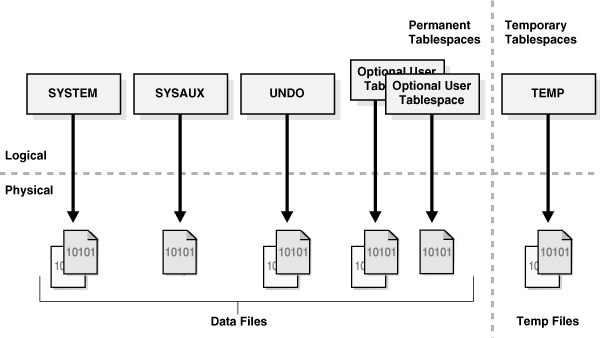
Descrizione dell'illustrazione cncpt319.gif
Un CDB contiene i seguenti elementi:
-
Un unico file di controllo
-
Un redo log in linea
-
Una o più tablespace di undo
Solo un utente comune che dispone dei privilegi appropriati e il cui contenitore corrente è la radice CDB può creare una tablespace di undo. In qualsiasi momento, un CDB si trova in una delle seguenti modalità di annullamento:
-
Modalità undo locale
In questo caso, ogni PDB dispone della propria tablespace di undo. Se un CDB utilizza la modalità di undo locale, il database crea automaticamente una tablespace di undo in ogni PDB. L'annullamento locale offre vantaggi come la possibilità di eseguire una copia diretta di un PDB e di riposizionare rapidamente i PDB. Inoltre, l'annullamento locale fornisce un livello di isolamento e consente operazioni di scollegamento e ripristino point-in-time più rapide.
È richiesta una tablespace di undo locale per ogni nodo in un cluster RAC (Oracle Real Application Clusters) in cui è aperto il PDB. Ad esempio, se si sposta un PDB da un cluster a due nodi a un cluster a quattro nodi e il PDB è aperto in tutti i nodi, il database crea automaticamente le tablespace di undo aggiuntive necessarie. Se si sposta di nuovo il PDB, è possibile eliminare le tablespace di undo ridondanti.
Nota: per impostazione predefinita, DBCA (Database Configuration Assistant) crea nuovi CDB con l'annullamento locale abilitato.
-
Modalità di annullamento condiviso
In un CDB a istanza singola esiste solo una tablespace di undo attiva. Per un CDB Oracle RAC esiste una tablespace di undo attiva per ogni istanza. Tutte le tablespace di undo sono visibili nei dizionari dati e nelle viste correlate di tutti i contenitori.
La modalità di annullamento si applica all'intero CDB, il che significa che ogni contenitore utilizza undo condiviso oppure ogni contenitore utilizza undo locale. È possibile passare da una modalità di annullamento all'altra in un CDB, che richiede il riavvio del database.
-
-
Tablespace
SYSTEMeSYSAUXper ogni contenitoreLa radice CDB, ogni root dell'applicazione e ogni PDB dispone di tablespace
SYSTEMeSYSAUXproprie. Ogni contenitore ha anche un proprio set di tabelle del dizionario dati che descrivono gli oggetti che risiedono nel contenitore. -
Zero o più tablespace create dall'utente
In un caso d'uso tipico, ogni PDB dispone di un proprio set di tablespace non di sistema. Queste tablespace contengono i dati per gli schemi e gli oggetti definiti dall'utente nel PDB. È possibile limitare la quantità di storage utilizzata dai file di dati per un PDB utilizzando la clausola
STORAGEin un'istruzioneCREATE PLUGGABLE DATABASEoALTER PLUGGABLE DATABASE.La memorizzazione del dizionario dati all'interno del PDB ne consente la portabilità. È possibile scollegare un PDB da un CDB e collegarlo a un CDB diverso.
-
Un set di file temporanei per ogni contenitore
Esiste una tablespace temporanea predefinita per la radice CDB e una per ogni root dell'applicazione, PDB dell'applicazione e PDB.
Esempio di CDB 15-3 in modalità di undo locale
Questo esempio mostra gli aspetti dell'architettura di storage fisico di un CDB con due PDB: hrpdb e salespdb. In questo esempio, il database utilizza la modalità di undo locale, così come i file di dati di undo nella radice CDB, hrpdb e salespdb.
Figura 29: Architettura fisica di un CDB in modalità di undo locale
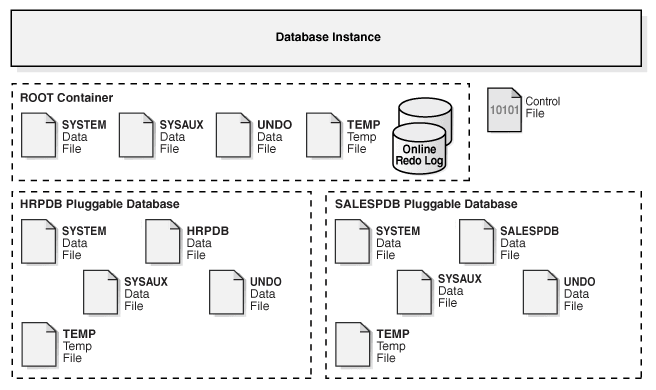
Descrizione dell'illustrazione cncpt386.png
Vedere anche: "Separazione del dizionario dati in un CDB"
Tablespace permanenti
Una tablespace permanente raggruppa gli oggetti dello schema persistente. I segmenti per gli oggetti nella tablespace vengono memorizzati fisicamente nei file di dati.
A ogni utente del database viene assegnata una tablespace permanente predefinita. Un database molto piccolo può richiedere solo le tablespace predefinite SYSTEM e SYSAUX. Tuttavia, Oracle consiglia di creare almeno una tablespace per memorizzare i dati di utenti e applicazioni. È possibile utilizzare le tablespace per raggiungere gli obiettivi riportati di seguito.
-
Controllare l'allocazione dello spazio su disco per i dati del database
-
Assegnare una quota (autorizzazione o limite di spazio) a un utente del database
-
Porta singole tablespace online o offline senza influire sulla disponibilità dell'intero database
-
Eseguire il backup e il recupero delle singole tablespace
-
Importare o esportare i dati dell'applicazione utilizzando la utility Oracle Data Pump
-
Creare una tablespace trasportabile che sia possibile copiare o spostare da un database all'altro, anche su più piattaforme
Lo spostamento dei dati mediante il trasporto delle tablespace può avere un'entità superiore rispetto all'esportazione/importazione o allo scaricamento/caricamento degli stessi dati, poiché il trasporto di una tablespace prevede solo la copia dei file di dati e l'integrazione dei metadati della tablespace. Quando si trasportano le tablespace, è anche possibile spostare i dati dell'indice.
-
Tablespace SYSTEM La tablespace
SYSTEMè una tablespace amministrativa necessaria inclusa nel database quando viene creata. Oracle AI Database utilizzaSYSTEMper gestire il database. -
Tablespace SYSAUX La tablespace
SYSAUXè una tablespace ausiliaria per la tablespaceSYSTEM. -
Annulla tablespace Una tablespace di undo è una tablespace gestita localmente riservata ai dati di undo gestiti dal sistema.
-
Tablespace shadow: una tablespace shadow è una tablespace a file unico destinata alla protezione shadow lost write.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come trasportare le tablespace
-
Oracle AI Database Utilities per saperne di più su Oracle Data Pump
La tablespace SYSTEM
La tablespace SYSTEM è una tablespace amministrativa necessaria inclusa nel database quando viene creata. Oracle AI Database utilizza SYSTEM per gestire il database.
La tablespace SYSTEM include le informazioni riportate di seguito, tutte di proprietà dell'utente SYS.
-
Dizionario dati
-
Tabelle e viste con informazioni amministrative per il database
-
Oggetti memorizzati compilati come trigger, procedure e pacchetti
La tablespace SYSTEM viene gestita come qualsiasi altra tablespace, ma richiede un livello di privilegio più elevato ed è limitata in alcuni modi. Ad esempio, non è possibile rinominare o eliminare la tablespace SYSTEM.
Per impostazione predefinita, Oracle AI Database imposta la gestione locale di tutte le tablespace utente appena create. In un database con una tablespace SYSTEM gestita localmente, non è possibile creare tablespace gestite dal dizionario (non più valide). Tuttavia, se si esegue l'istruzione CREATE DATABASE manualmente e si accettano i valori predefiniti, la tablespace SYSTEM viene gestita dal dizionario. È possibile eseguire la migrazione di una tablespace SYSTEM gestita dal dizionario esistente in un formato gestito localmente. Nota: Oracle consiglia di utilizzare DBCA (Database Configuration Assistant) per creare nuovi database in modo che tutte le tablespace, incluso SYSTEM, siano gestite localmente per impostazione predefinita.
Vedere anche:
-
"Tablespace online e offline" per informazioni sulla condizione in linea permanente della tablespace
SYSTEM -
Oracle AI Database Administrator's Guide per informazioni su come creare o eseguire la migrazione a una tablespace
SYSTEMgestita localmente -
Oracle AI Database SQL Language Reference per sintassi e semantica
CREATE DATABASE
Tablespace SYSAUX
La tablespace SYSAUX è una tablespace ausiliaria per la tablespace SYSTEM.
Poiché è la tablespace predefinita per molte funzioni e prodotti di Oracle AI Database che in precedenza richiedevano le proprie tablespace, SYSAUX riduce il numero di tablespace richieste dal database. Inoltre, riduce il carico sulla tablespace SYSTEM.
La creazione o l'aggiornamento del database crea automaticamente la tablespace SYSAUX. Durante il normale funzionamento del database, il database non consente di eliminare o rinominare la tablespace SYSAUX. Se la tablespace SYSAUX non è più disponibile, la funzionalità del database di base rimane operativa. Le funzioni del database che utilizzano la tablespace SYSAUX potrebbero non riuscire o funzionare con capacità limitate.
Vedere anche: Oracle AI Database Administrator's Guide per informazioni sulla tablespace SYSAUX
Tablespace di undo
Una tablespace di undo è una tablespace gestita localmente riservata ai dati di undo gestiti dal sistema.
Come altre tablespace permanenti, le tablespace di undo contengono file di dati. I blocchi di undo in questi file sono raggruppati in estensioni.
-
Modalità di gestione automatica degli undo Le tablespace di undo richiedono che il database sia nella modalità di annullamento automatico predefinita.
-
Conservazione automatica degli undo Il periodo di conservazione degli undo è il periodo di tempo minimo durante il quale Oracle AI Database tenta di conservare i vecchi dati degli undo prima di sovrascriverli. Vedere anche: "Annulla segmenti"
Modalità di gestione automatica degli undo
Le tablespace di undo richiedono che il database sia in modalità di annullamento automatico predefinita.
La modalità automatica elimina le complessità legate all'amministrazione manuale dei segmenti di undo. Il database si ottimizza automaticamente per fornire la migliore conservazione possibile dei dati di undo per soddisfare le query con tempi di esecuzione lunghi che potrebbero richiedere questi dati.
Una nuova installazione di Oracle AI Database crea automaticamente una tablespace di undo. Le versioni precedenti di Oracle AI Database potrebbero non includere una tablespace di undo e utilizzare invece segmenti di rollback precedenti, noti come modalità di gestione degli undo manuali. Oracle AI Database contiene un Undo Advisor che fornisce suggerimenti e aiuta ad automatizzare l'ambiente di annullamento.
Un database può contenere più tablespace di undo, ma solo una può essere in uso alla volta. Quando un'istanza tenta di aprire un database, Oracle AI Database seleziona automaticamente la prima tablespace di undo disponibile. Se non è disponibile alcuna tablespace di undo, l'istanza viene avviata senza una tablespace di undo e memorizza i dati di undo nella tablespace SYSTEM. La memorizzazione dei dati di undo in SYSTEM non è consigliata.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni sulla gestione automatica degli undo
-
Oracle AI Database Upgrade Guide per informazioni su come eseguire la migrazione alla modalità di gestione automatica degli undo
Conservazione automatica degli undo
Il periodo di conservazione degli undo è il periodo di tempo minimo durante il quale Oracle AI Database tenta di conservare i vecchi dati degli undo prima di sovrascriverli.
La conservazione degli undo è importante perché le query con tempi di esecuzione lunghi potrebbero richiedere immagini a blocchi precedenti per fornire coerenza della lettura. Inoltre, alcune funzioni di Oracle Flashback possono dipendere dalla disponibilità degli undo.
In generale, è auspicabile conservare i vecchi dati di undo il più a lungo possibile. Dopo il commit di una transazione, i dati di annullamento non sono più necessari per il rollback o il recupero della transazione. Il database può conservare i vecchi dati di undo se la tablespace di undo dispone di spazio per le nuove transazioni. Quando lo spazio disponibile è basso, il database inizia a sovrascrivere i vecchi dati di undo per le transazioni sottoposte a commit.
Oracle AI Database fornisce automaticamente la migliore conservazione possibile degli undo per la tablespace di undo corrente. Il database raccoglie le statistiche d'uso e ottimizza il periodo di conservazione in base a queste statistiche e alla dimensione della tablespace di undo. Se la tablespace di undo è configurata con l'opzione AUTOEXTEND e la dimensione massima non è specificata, l'ottimizzazione della conservazione degli undo è diversa. In questo caso, il database ottimizza il periodo di conservazione degli undo in modo che sia leggermente più lungo della query con tempi di esecuzione più lunghi, se lo spazio lo consente.
Vedi anche: Oracle AI Database Administrator's Guide per ulteriori dettagli sull'ottimizzazione automatica della conservazione degli undo
Tablespace shadow
Una tablespace shadow è una tablespace a file unico destinata alla protezione shadow lost write.
Nota: la protezione Shadow lost write non è correlata alla perdita della protezione di scrittura configurata con il parametro di inizializzazione DB_LOST_WRITE_PROTECT e un database in standby.
-
Scopo delle tablespace shadow La protezione dalla perdita di scrittura shadow consente un rilevamento rapido e una risposta immediata a una scrittura persa.
-
Funzionamento delle tablespace shadow La protezione di scrittura persa richiede due tablespace: una tablespace shadow e una tablespace non shadow i cui blocchi vengono tracciati dalla tablespace shadow.
-
Interfaccia utente per tablespace shadow È possibile abilitare e disabilitare la protezione di scrittura shadow persa mediante il comando
ALTER PLUGGABLE DATABASE. -
Esempio: configurazione della protezione di scrittura persa In questo esempio viene abilitata la registrazione di scrittura persa shadow per un set di tablespace.
Scopo delle tablespace shadow
La protezione Shadow lost write fornisce un rilevamento rapido e una risposta immediata a un'scrittura persa.
Un blocco di dati perso si verifica quando un sottosistema I/O riconosce il completamento della scrittura del blocco anche se la scrittura non si è verificata o quando un'immagine precedente del blocco sovrascrive l'immagine corrente.
Una scrittura persa non rilevata può causare il danneggiamento dei dati perché i dati errati possono essere utilizzati per altre transazioni DML. Ad esempio, una transazione può leggere dati vecchi e non corretti da una tabella e quindi aggiornare centinaia di altre tabelle in base a questi dati. In questo modo, il danneggiamento dei dati può diffondersi in tutto il database.
La protezione Shadow lost write offre i vantaggi riportati di seguito.
-
Rileva una scrittura persa prima che venga utilizzata per il DML standard, il caricamento del percorso convenzionale SQL*Loader, il caricamento del percorso diretto e i backup RMAN.
-
È possibile abilitare la protezione shadow lost write per tablespace e file di dati specifici. Non è necessario tenere traccia di tutti i dati.
-
È possibile sostituire una tablespace shadow con un'altra per modificarne la configurazione o la posizione.
-
È possibile sospendere e riprendere la protezione di scrittura mancante shadow per una tablespace o un file di dati.
-
È possibile abilitarla o disabilitarla per un PDB con una singola istruzione
ALTER DATABASE ... LOST WRITE PROTECTION. La tabellaPROP$indica se la registrazione è abilitata per un PDB.
Vedere anche: Oracle AI Database SQL Language Reference per ulteriori informazioni sulla clausola LOST WRITE PROTECTION
Funzionamento delle tablespace shadow
La protezione di scrittura persa richiede due tablespace: una tablespace shadow e una tablespace non shadow i cui blocchi vengono tracciati dalla tablespace shadow.
Nella figura seguente viene fornito uno scenario di esempio. I file di dati nelle tablespace TBS1 e TBS2 vengono tracciati da una tablespace shadow. Solo il file di dati DBF6 nella tablespace TBS3 viene tracciato dalla tablespace shadow.
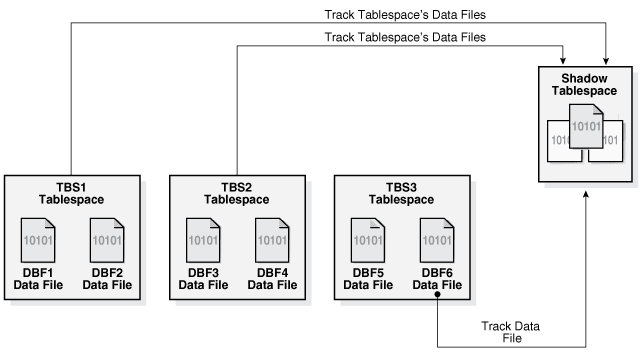
Descrizione dell'illustrazione cncpt390.png
Un file di dati registrato viene mappato a un'estensione shadow in una tablespace shadow. Ogni blocco di dati in un file di dati tracciato ha una voce corrispondente in un blocco shadow. Questa voce contiene l'SCN del blocco di dati tracciato. Quando un blocco di dati tracciato viene letto dal disco, shadow lost write protection confronta l'SCN per il blocco nella tablespace shadow con l'SCN della scrittura più recente nel blocco di dati tracciato. Se la voce shadow dispone di un SCN maggiore del blocco di dati in fase di lettura, si è verificata una scrittura persa, con conseguente richiesta di errore.
L'estensione dell'ombra è dimensionata con uno spazio aggiuntivo significativo per evitare che il ridimensionamento automatico dei file di dati causi un'estensione dell'ombra troppo grande. Se un file di dati tracciato viene ridimensionato manualmente o automaticamente e l'estensione shadow deve aumentare, il database tenta di ridimensionare i dati di tracciamento. Se non esiste spazio sufficiente nelle tablespace shadow, il database scrive un'avvertenza nell'alert log e tiene traccia del maggior numero possibile di blocchi di dati.
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come gestire la protezione shadow lost write
Interfaccia utente per le tablespace shadow
È possibile abilitare e disabilitare la protezione di scrittura shadow lost utilizzando il comando ALTER PLUGGABLE DATABASE.
Per proteggere una tablespace o un file di dati specifici, è necessario che vengano soddisfatte le seguenti condizioni:
-
È necessario che l'opzione shadow abilitata abbia perso la protezione di scrittura per l'intero PDB utilizzando l'istruzione
ALTER PLUGGABLE DATABASE ENABLE LOST WRITE PROTECTION.Nota: in un CDB, se si abilita la protezione di scrittura shadow persa nella radice, i PDB non la ereditano. È necessario abilitare la protezione di scrittura shadow lost per ogni PDB che si desidera proteggere.
-
Per proteggere la tablespace o il file di dati mediante la clausola
ENABLE LOST WRITE PROTECTION, è necessario che l'opzione shadow sia abilitata.Quando si abilita la protezione di scrittura shadow andata persa per una tablespace, vengono protetti tutti i file di dati della tablespace e vengono protetti anche tutti i file di dati aggiunti alla tablespace. Tenere presente che non è possibile abilitare la protezione di scrittura persa nelle tablespace temporanee o in un'altra tablespace di scrittura persa.
-
È necessario aver creato una o più tablespace shadow utilizzando l'istruzione
CREATE BIGFILE TABLESPACEcon la clausolaLOST WRITE PROTECTION.
Oracle AI Database assegna automaticamente un file di dati tracciato a una tablespace shadow specifica. Non è possibile specificare la tablespace shadow utilizzata per un determinato file di dati.
Le viste del dizionario dati riportate di seguito monitorano le tablespace shadow.
-
DBA_TABLESPACESMostra quali tablespace sono tablespace shadow mediante l'esecuzione di query.
-
DBA_DATA_FILES.LOST_WRITE_PROTECTMostra se le protezioni di scrittura perse sono abilitate per un file di dati
-
USER_TABLESPACES.LOST_WRITE_PROTECTIndica se la protezione di scrittura persa è attivata per una tablespace specifica.
DBA_DATA_FILESnon indica se la scrittura persa è attivata per una tablespace: è invece necessario guardareUSER_TABLESPACES.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire la protezione di scrittura persa con le tablespace shadow
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sull'istruzione
CREATE TABLESPACE -
Oracle AI Database Reference per saperne di più su
DBA_TABLESPACES
Esempio: configurazione della protezione da scrittura persa
In questo esempio viene abilitato il tracciamento di scrittura shadow lost per un set di tablespace.
In questo esempio, l'obiettivo è proteggere le tablespace salestbs e hrtbs all'interno di un PDB. Si desidera proteggere anche il file di dati oetbs01.dbf e solo questo file di dati, all'interno della tablespace oetbs. È possibile effettuare le operazioni indicate di seguito.
-
Eseguire il login al PDB come amministratore.
-
Creare una tablespace shadow singola come indicato di seguito.
CREATE BIGFILE TABLESPACE shadow_lwp1 DATAFILE 'shadow_lwp1_df' SIZE 10M LOST WRITE PROTECTION; -
Abilita la protezione di scrittura persa per il PDB nel modo seguente:
ALTER DATABASE ENABLE LOST WRITE PROTECTION; -
Abilitare la protezione di scrittura shadow persa per le tablespace
salestbsehrtbscome indicato di seguito.ALTER TABLESPACE salestbs ENABLE LOST WRITE PROTECTION; ALTER TABLESPACE hrtbs ENABLE LOST WRITE PROTECTION; -
Abilitare la protezione di scrittura shadow persa per il file di dati
oetbs01.dbfcome indicato di seguito.ALTER DATABASE DATAFILE 'oetbs01.dbf' ENABLE LOST WRITE PROTECTION;
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire le tablespace shadow
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sull'istruzione
CREATE TABLESPACE
Tablespace temporanee
Una tablespace temporanea contiene dati transitori che persistono solo per la durata di una sessione. Nessun oggetto schema permanente può risiedere in una tablespace temporanea. Un file di modello memorizza i dati della tablespace temporanea.
Le tablespace temporanee possono migliorare la concorrenza di più operazioni di ordinamento che non rientrano nella memoria. Queste tablespace migliorano inoltre l'efficienza delle operazioni di gestione dello spazio durante gli ordinamenti.
-
Tablespace temporanee condivise e locali Le tablespace temporanee sono condivise o locali.
-
Tablespace temporanee predefinite: a ogni account utente del database viene assegnata una tablespace temporanea condivisa predefinita. Se il database contiene tablespace temporanee locali, a ogni account utente viene assegnato anche lo storage temporaneo locale predefinito.
Tablespace temporanee condivise e locali
Le tablespace temporanee sono condivise o locali.
Una tablespace temporanea condivisa memorizza i file temporanei su un disco condiviso, in modo che lo spazio temporaneo sia accessibile a tutte le istanze di database. Al contrario, una tablespace temporanea locale memorizza file temporanei separati e non condivisi per ogni istanza di database. Le tablespace temporanee locali sono utili per Oracle Real Application Clusters o Oracle Flex Clusters.
È possibile creare tablespace temporanee locali sia per le istanze di database di sola lettura che di lettura/scrittura. Quando molte istanze di sola lettura accedono a un singolo database, le tablespace temporanee locali possono migliorare le prestazioni per le query che coinvolgono ordinamenti, aggregazioni hash e join. I vantaggi sono:
-
Migliorare le prestazioni di I/O utilizzando lo storage su disco locale anziché condiviso
-
Evitare una costosa gestione temporanea dello spazio a più istanze
-
Migliorare le prestazioni di avvio delle istanze eliminando la gestione dei metadati dello spazio su disco
Nella tabella seguente vengono confrontate le caratteristiche delle tablespace temporanee condivise e locali.
Tabella 2 - Tablespace temporanee condivise e locale
| Tablespace temporanea condivisa | Tablespace temporanea locale |
|---|---|
Creato con l'istruzione CREATE TEMPORARY TABLESPACE. |
Creato con l'istruzione Nota: una tablespace temporanea locale è sempre una tablespace a file unico, ma la parola chiave |
| Crea una singola tablespace temporanea per il database. | Crea tablespace temporanee separate per ogni istanza di database. L'opzione FOR LEAF crea tablespace solo per le istanze di sola lettura. L'opzione FOR ALL crea tablespace per tutte le istanze, sia di sola lettura che di lettura/scrittura. |
| Supporta i gruppi di tablespace. | Non supporta i gruppi di tablespace. |
| Memorizza i metadati del file temporaneo nel control file. | Memorizza i metadati dei file temporanei comuni a tutte le istanze nel control file e i metadati specifici dell'istanza (ad esempio, le bitmap per l'allocazione, le dimensioni dei file temporanei correnti e lo stato dei file) nell'area SGA. |
Vedi anche: "Introduzione all'istanza di Oracle AI Database"
Tablespace temporanee predefinite
A ogni account utente del database viene assegnata una tablespace temporanea condivisa predefinita. Se il database contiene tablespace temporanee locali, a ogni account utente viene assegnato anche lo storage temporaneo locale predefinito.
È possibile specificare una tablespace temporanea diversa per un account utente con le istruzioni CREATE USER o ALTER USER. Oracle AI Database utilizza la tablespace temporanea predefinita a livello di sistema per gli utenti per i quali non si specifica una tablespace temporanea diversa.
-
Creazione di tablespace temporanee predefinite Quando si crea un database, la memorizzazione temporanea predefinita dipende dal fatto che la tablespace
SYSTEMsia gestita localmente. -
Accesso allo storage temporaneo Se a un utente è assegnata una tablespace temporanea, il database vi accede per primo; in caso contrario, il database accede alla tablespace temporanea predefinita. Una volta che il database accede a una tablespace temporanea per una query, non passa a una tablespace diversa. Vedere anche: Oracle AI Database SQL Language Reference per ulteriori informazioni sull'istruzione
CREATE USER
Creazione di tablespace temporanee predefinite
Quando si crea un database, lo storage temporaneo predefinito dipende dal fatto che la tablespace SYSTEM sia gestita localmente.
La tabella riportata di seguito mostra come Oracle AI Database sceglie le tablespace temporanee predefinite durante la creazione del database.
Tabella 3 Creazione di tablespace temporanee predefinite
| La tablespace SYSTEM è gestita localmente? | L'istruzione CREATE DATABASE specifica una tablespace temporanea predefinita? | Poi il database... |
|---|---|---|
| Sì | Sì | Utilizza la tablespace specificata come tablespace predefinita. |
| Sì | N. | Crea una tablespace temporanea. |
| N. | Sì | Utilizza la tablespace specificata come tablespace predefinita. |
| N. | N. | Utilizza SYSTEM per la memorizzazione temporanea predefinita. Il database scrive un'avvertenza nel log degli avvisi che indica che è consigliata una tablespace temporanea predefinita. |
Dopo la creazione del database, è possibile modificare la tablespace temporanea predefinita per il database con l'istruzione ALTER DATABASE DEFAULT TEMPORARY TABLESPACE. Nota: non è possibile rendere permanente una tablespace temporanea predefinita.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come creare una tablespace temporanea predefinita
-
Oracle AI Database SQL Language Reference per la sintassi della clausola
DEFAULT TEMPORARY TABLESPACEdiCREATE DATABASEeALTER DATABASE
Accesso allo storage temporaneo
Se a un utente è assegnata una tablespace temporanea, il database vi accede prima; in caso contrario, il database accede alla tablespace temporanea predefinita. Una volta che il database accede a una tablespace temporanea per una query, non passa a una tablespace diversa.
Una query utente può accedere allo storage temporaneo condiviso o locale. Inoltre, a un utente potrebbe essere assegnata una tablespace temporanea locale predefinita per le istanze di sola lettura e una tablespace temporanea locale predefinita diversa per le istanze di lettura/scrittura.
Per le istanze di lettura/scrittura, il database assegna una priorità maggiore alle tablespace temporanee condivise. Per le istanze di sola lettura, il database assegna una priorità maggiore alle tablespace temporanee locali. Se l'istanza di database è in lettura/scrittura, il database cerca lo spazio nel seguente ordine:
-
All'utente è assegnata una tablespace temporanea condivisa?
-
All'utente è assegnata una tablespace temporanea locale?
-
La tablespace temporanea predefinita del database dispone di spazio?
Se la risposta a una domanda precedente è affermativa, il database interrompe la ricerca e alloca lo spazio dalla tablespace specificata; altrimenti, lo spazio viene allocato dalla tablespace temporanea locale predefinita del database.
Se l'istanza di database è di sola lettura, il database cerca lo spazio nel seguente ordine:
-
All'utente è assegnata una tablespace temporanea locale?
-
La tablespace temporanea locale predefinita del database assegnata dispone di spazio?
-
All'utente è assegnata una tablespace temporanea condivisa?
Se la risposta alle domande precedenti è affermativa, il database interrompe la ricerca e alloca spazio dalla tablespace specificata; in caso contrario, lo spazio viene allocato dalla tablespace temporanea condivisa predefinita del database.
Modalità tablespace
La modalità tablespace determina l'accessibilità della tablespace.
-
Tablespace di lettura/scrittura e di sola lettura Ogni tablespace si trova in una modalità di scrittura che specifica se è possibile scriverla.
-
Tablespace in linea e non in linea Una tablespace può essere in linea (accessibile) o non in linea (non accessibile) ogni volta che il database è aperto.
Tablespace di lettura/scrittura e di sola lettura
Ogni tablespace è in modalità di scrittura che specifica se è possibile scriverla.
Di seguito sono riportate le modalità ad esclusione reciproca.
-
Modalità lettura/scrittura
Gli utenti possono effettuare operazioni di lettura e scrittura nella tablespace. Tutte le tablespace vengono inizialmente create in lettura/scrittura. Le tablespace
SYSTEMeSYSAUXe le tablespace temporanee sono di lettura/scrittura permanente, pertanto non possono essere rese di sola lettura. -
Modalità sola lettura
Le operazioni di scrittura nei file di dati nella tablespace non sono consentite. Una tablespace di sola lettura può risiedere su supporti di sola lettura quali DVD o unità WORM.
Le tablespace di sola lettura eliminano la necessità di eseguire il backup e il ripristino di parti statiche di grandi dimensioni di un database. Le tablespace di sola lettura non cambiano e non richiedono pertanto un backup ripetuto. Se si recupera un database dopo un errore del supporto, non è necessario recuperare le tablespace di sola lettura.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come modificare una tablespace in modalità di sola lettura o di lettura/scrittura
-
Oracle AI Database SQL Language Reference per sintassi e semantica
ALTER TABLESPACE -
Oracle AI Database Backup and Recovery User's Guide per ulteriori informazioni sul ripristino
Tablespace online e non in linea
Una tablespace può essere in linea (accessibile) o non in linea (non accessibile) ogni volta che il database è aperto.
In genere, una tablespace è online in modo che i relativi dati siano disponibili per gli utenti. La tablespace SYSTEM e le tablespace temporanee non possono essere messe fuori linea.
Una tablespace può essere messa offline automaticamente o manualmente. Ad esempio, è possibile mettere fuori linea una tablespace per la manutenzione o il backup e il recupero. Il database mette automaticamente offline una tablespace quando si verificano determinati errori, come quando il processo database writer (DBW) non riesce in diversi tentativi di scrittura in un file di dati. Gli utenti che tentano di accedere alle tabelle in una tablespace non in linea ricevono un errore.
Quando una tablespace viene disconnessa, il database esegue le operazioni riportate di seguito.
-
Il database non consente alle istruzioni DML successive di fare riferimento agli oggetti nella tablespace non in linea. Una tablespace non in linea non può essere letta o modificata da utility diverse da Oracle AI Database.
-
Le transazioni attive con istruzioni completate che fanno riferimento ai dati in tale tablespace non sono interessate a livello di transazione.
-
Il database salva i dati di undo corrispondenti alle istruzioni completate in un segmento di undo differito nella tablespace
SYSTEM. Quando la tablespace viene connessa, il database applica i dati di undo alla tablespace, se necessario.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come modificare la disponibilità delle tablespace
Dimensione file tablespace
Una tablespace è una tablespace a file unico o una tablespace a file unico. Queste tablespace sono indistinguibili in termini di esecuzione di istruzioni SQL che non fanno riferimento in modo esplicito a file di dati o file temporanei.
La differenza è la seguente:
-
Una tablespace a file ridotto può contenere più file di dati o file temporanei, ma i file non possono essere grandi come in una tablespace a file unico. Questo è il tipo di tablespace predefinito.
-
Una tablespace a file unico contiene un file di dati o un file temporaneo di grandi dimensioni. Questo tipo di tablespace può eseguire le seguenti operazioni:
-
Aumentare la capacità di storage di un database
Il numero massimo di file di dati in un database è limitato, pertanto l'aumento della dimensione di ciascun file di dati aumenta la memoria complessiva.
-
Ridurre il carico di gestione di molti file di dati e file temporanei
Le tablespace a file unico semplificano la gestione dei file con Oracle Managed Files e Automatic Storage Management (Oracle ASM) eliminando la necessità di aggiungere nuovi file e gestire più file.
-
Eseguire operazioni sulle tablespace anziché su singoli file
Le tablespace a file unico rendono la tablespace l'unità principale dell'amministrazione, del backup e del recupero dello spazio su disco e così via.
Le tablespace a file unico sono supportate solo per le tablespace gestite localmente con ASSM. Tuttavia, gli undo gestiti localmente e le tablespace temporanee possono essere tablespace a file unico anche quando i segmenti vengono gestiti manualmente.
A partire da Oracle AI Database 26ai, le tablespace SYSTEM, SYSAUX e USER vengono create come tablespace bigfile per impostazione predefinita. Un database aggiornato da una release precedente conserva il relativo tipo di tablespace.
-
Vedere anche:
-
Oracle AI Database Backup and Recovery User's Guide per ulteriori informazioni su backup e ripristino
-
Oracle AI Database Administrator's Guide per informazioni su come gestire le tablespace a file unico