Architettura del processo
In questo capitolo vengono descritti i processi di un database Oracle.
-
Introduzione ai processi Un processo è un meccanismo di un sistema operativo che può eseguire una serie di passi.
-
Panoramica dei processi client Quando un utente esegue un'applicazione come un programma Pro*C o SQL*Plus, il sistema operativo crea un processo client (a volte chiamato processo utente) per eseguire l'applicazione utente. Nell'applicazione client sono collegate librerie di Oracle AI Database che forniscono le API necessarie per comunicare con il database.
-
Panoramica dei processi server Oracle AI Database crea processi server per gestire le richieste dei processi client connessi all'istanza. Un processo client comunica sempre con un database tramite un processo server separato.
-
Panoramica dei processi in background I processi in background sono processi aggiuntivi utilizzati da un database Oracle multiprocesso. I processi in background eseguono i task di manutenzione necessari per il funzionamento del database e per ottimizzare le prestazioni per più utenti.
Introduzione ai processi
Un processo è un meccanismo di un sistema operativo che può eseguire una serie di passi.
L'architettura di esecuzione dei processi dipende dal sistema operativo. Ad esempio, in Windows un processo in background Oracle è un thread di esecuzione all'interno di un processo. In Linux e UNIX, un processo Oracle è un processo del sistema operativo o un thread all'interno di un processo del sistema operativo.
Elabora i moduli di codice di esecuzione. Tutti gli utenti di Oracle AI Database connessi devono eseguire i seguenti moduli per accedere a un'istanza di database:
-
Applicazione o utility di Oracle AI Database
Un utente di database esegue un'applicazione di database, ad esempio un programma precompilatore o uno strumento di database, ad esempio SQL*Plus, che invia istruzioni SQL a un database.
-
Codice database Oracle
Ogni utente dispone di un codice di database Oracle in esecuzione per conto proprio che interpreta ed elabora le istruzioni SQL dell'applicazione.
Un processo viene normalmente eseguito nella propria area di memoria privata. La maggior parte dei processi può scrivere periodicamente in un file di trace associato.
-
Tipi di processi Un'istanza di database contiene o interagisce con più processi.
-
Sistemi Oracle AI Database multiprocesso e multithread Oracle AI Database multiprocesso (chiamato anche Oracle AI Database multiutente) utilizza diversi processi per eseguire diverse parti del codice di Oracle AI Database e processi Oracle aggiuntivi per gli utenti, ovvero un processo per ogni utente connesso o uno o più processi condivisi da più utenti.
Vedere anche:
Tipi di processi
Un'istanza di database contiene o interagisce con più processi.
I processi sono suddivisi nei seguenti tipi:
-
Un processo client esegue il codice dell'applicazione o dello strumento Oracle.
-
Un processo Oracle è un'unità di esecuzione che esegue il codice del database Oracle. Nell'architettura multithreaded, un processo Oracle può essere un processo del sistema operativo o un thread all'interno di un processo del sistema operativo. I processi Oracle includono i seguenti sottotipi:
-
Un processo di background inizia con l'istanza di database ed esegue task di manutenzione come l'esecuzione del recupero dell'istanza, il cleanup dei processi, la scrittura di redo buffer su disco e così via.
-
Un processo server esegue il lavoro in base a una richiesta client.
Ad esempio, questi processi analizzano le query SQL, le posizionano nel pool condiviso, creano ed eseguono un piano query per ogni query e i buffer di lettura dalla buffer cache del database o dal disco.
Nota: i processi server e la memoria di processo allocata in questi processi vengono eseguiti nell'istanza di database. L'istanza continua a funzionare quando i processi del server vengono terminati.
-
Un processo figlio esegue task aggiuntivi per un processo in background o server.
-
La struttura del processo varia a seconda del sistema operativo e della scelta delle opzioni di Oracle AI Database. Ad esempio, è possibile configurare il codice per gli utenti connessi alle connessioni al server dedicato o al server condiviso. In un'architettura server condivisa, ogni processo server che esegue il codice del database può servire più processi client. La Figura 18-1 mostra un'area globale di sistema (SGA) e processi in background che utilizzano connessioni server dedicate. Per ogni connessione utente, un processo client esegue l'applicazione. Questo processo client è diverso dal processo server dedicato che esegue il codice del database. Ogni processo client è associato al proprio processo server, che ha la propria area PGA (Program Global Area).
Figura 1: Processi Oracle e SGA
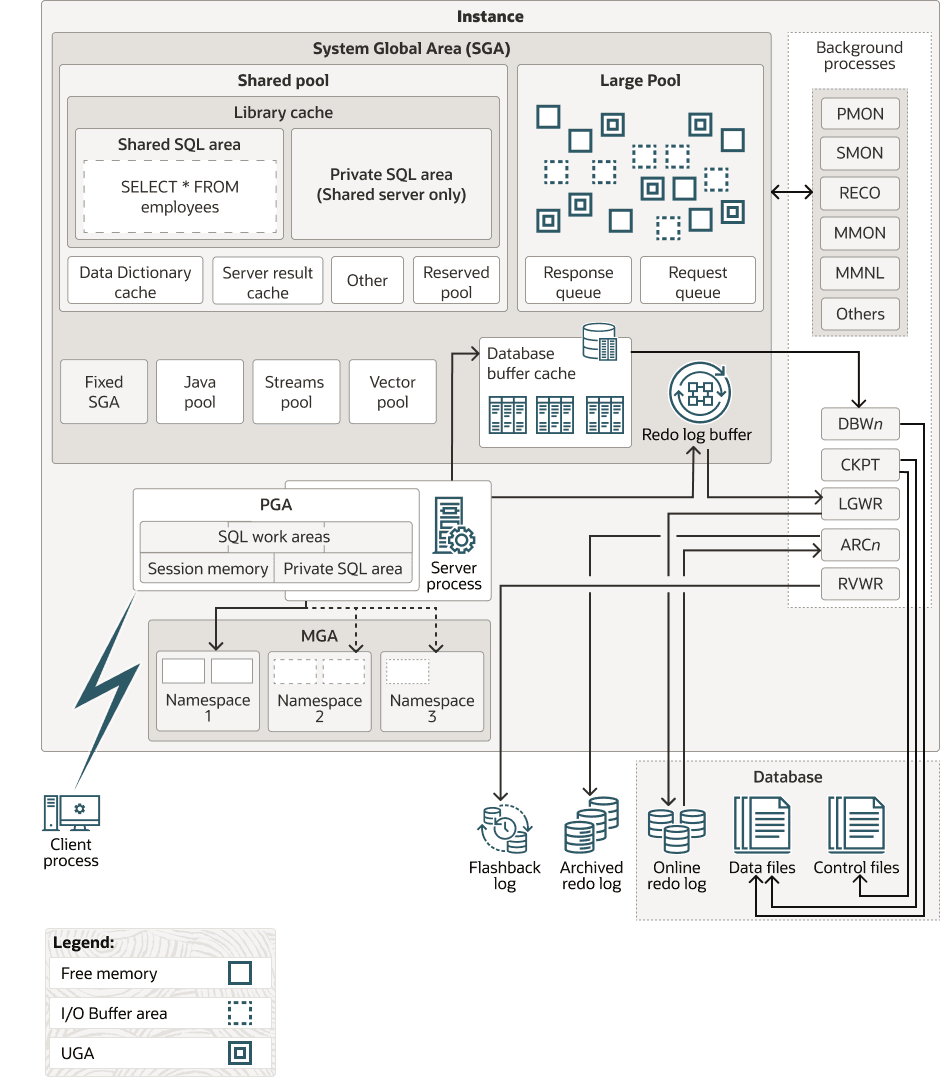
Descrizione dell'illustrazione cncpt283.png
Vedere anche:
-
"Architettura del server dedicato" e "Architettura del server condiviso"
-
La documentazione specifica del sistema operativo Oracle AI Database per ulteriori dettagli sulle scelte di configurazione
-
Oracle AI Database Reference per saperne di più sulla vista
V$PROCESS
Sistemi multiprocesso e multithreading di Oracle AI Database
Oracle AI Database multiprocesso (chiamato anche Oracle AI Database multiutente) utilizza diversi processi per eseguire parti diverse del codice di Oracle AI Database e processi Oracle aggiuntivi per gli utenti: un processo per ogni utente connesso o uno o più processi condivisi da più utenti.
La maggior parte dei database è multiutente perché un vantaggio primario di un database è la gestione dei dati necessari da più utenti contemporaneamente. Ogni processo in un'istanza di database esegue un job specifico. Dividendo il lavoro del database e delle applicazioni in diversi processi, più utenti e applicazioni possono connettersi a un'istanza contemporaneamente mentre il sistema offre buone prestazioni.
Nelle release precedenti a Oracle Database 12c, i processi Oracle non venivano eseguiti come thread nei sistemi UNIX e Linux. A partire da Oracle Database 12c, il modello Oracle AI Database multithread consente ai processi Oracle di essere eseguiti come thread del sistema operativo in spazi di indirizzi separati. Quando Oracle AI Database è installato, il database viene eseguito in modalità processo. Per eseguire il database in modalità thread, è necessario impostare il parametro di inizializzazione THREADED_EXECUTION su TRUE. In modalità thread, alcuni processi in background su UNIX e Linux vengono eseguiti come processi (con ogni processo contenente un thread), mentre i restanti processi Oracle vengono eseguiti come thread all'interno dei processi.
In un database in esecuzione in modalità thread, PMON e DBW potrebbero essere eseguiti come processi del sistema operativo, mentre LGWR e CMON potrebbero essere eseguiti come thread all'interno di un singolo processo. Due processi in primo piano e un processo server di esecuzione parallela (PX) potrebbero essere eseguiti come thread in un secondo processo del sistema operativo. Un terzo processo del sistema operativo potrebbe contenere più thread in primo piano. Pertanto, "processo Oracle" non sempre significa "processo del sistema operativo". Nota: quando il parametro di inizializzazione THREADED_EXECUTION è impostato su TRUE, l'autenticazione del sistema operativo non è supportata.
Esempio 18-1 Visualizzazione dei metadati di Oracle Process
La vista V$PROCESS contiene una riga per ogni processo Oracle connesso a un'istanza di database. Ad esempio, è possibile eseguire la query seguente in SQL*Plus per ottenere l'ID del processo del sistema operativo e l'ID del thread del sistema operativo per ogni processo:
COL SPID FORMAT a8
COL STID FORMAT a8
SELECT SPID, STID, PROGRAM FROM V$PROCESS ORDER BY SPID;
La query produce il seguente output di esempio parziale:
SPID   STID   PROGRAM
-----  -----  ---------------------------
7190   7190   oracle@samplehost (PMON)
7192   7192   oracle@samplehost (PSP0)
7194   7194   oracle@samplehost (VKTM)
7198   7198   oracle@samplehost (SCMN)
7198   7200   oracle@samplehost (GEN0)
7202   7202   oracle@samplehost (SCMN)
7202   7204   oracle@samplehost (DIAG)
7198   7205   oracle@samplehost (DBRM)
7202   7206   oracle@samplehost (DIA0)
.
.
.
Vedere anche:
-
Oracle AI Database Performance Tuning Guide per informazioni su come utilizzare la vista
V$PROCESS -
Oracle AI Database Reference per informazioni sul parametro di inizializzazione
THREADED_EXECUTION
Panoramica dei processi client
Quando un utente esegue un'applicazione, ad esempio un programma Pro*C o SQL*Plus, il sistema operativo crea un processo client (a volte chiamato processo utente) per eseguire l'applicazione utente. Nell'applicazione client sono collegate librerie di Oracle AI Database che forniscono le API necessarie per comunicare con il database.
-
Processi client e server I processi client differiscono in modo importante dai processi Oracle che interagiscono direttamente con l'istanza.
-
Connessioni e sessioni Una connessione al database è un percorso di comunicazione fisica tra un processo client e un'istanza di database.
-
Contenitore corrente Una sessione di database è un'entità logica nella memoria dell'istanza di database che rappresenta lo stato di un login utente corrente a un database.
-
Operazioni del database Nel contesto del monitoraggio del database, un'operazione del database è un'attività di sessione tra due punti nel tempo, secondo quanto definito dagli utenti finali o dal codice dell'applicazione.
Processi client e server
I processi client differiscono in modo importante dai processi Oracle che interagiscono direttamente con l'istanza.
I processi Oracle che gestiscono il processo client possono leggere e scrivere nell'area SGA, mentre il processo client non può farlo. Un processo client può essere eseguito su un host diverso dall'host del database, mentre i processi Oracle non possono.
Ad esempio, si supponga che un utente su un host client avvii SQL*Plus, quindi si connetta in rete al database sample su un host diverso quando l'istanza di database non viene avviata:
SQL> CONNECT SYS@inst1 AS SYSDBA
Enter password: *********
Connected to an idle instance.
Nell'host client, la ricerca dei processi per sqlplus o sample mostra solo il processo client sqlplus:
% ps -ef | grep -e sample -e sqlplus | grep -v grep
clientuser 29437 29436  0 15:40 pts/1    00:00:00 sqlplus           as sysdba
Nell'host del database, una ricerca dei processi per sqlplus o sample mostra un processo server con una connessione non locale, ma nessun processo client:
% ps -ef | grep -e sample -e sqlplus | grep -v grep
serveruser 29441     1  0 15:40 ?        00:00:00 oraclesample (LOCAL=NO)
Vedere anche: "Come viene avviata un'istanza" per informazioni su come un client può connettersi a un database quando l'istanza non viene avviata
Connessioni e sessioni
Una connessione al database è un percorso di comunicazione fisico tra un processo client e un'istanza di database.
Durante una connessione, viene stabilito un percorso di comunicazione utilizzando meccanismi di comunicazione interprocesso disponibili o software di rete. In genere, si verifica una connessione tra un processo client e un processo server o un dispatcher, ma può verificarsi anche tra un processo client e Oracle Connection Manager (CMAN).
Contenitore corrente
Una sessione di database è un'entità logica nella memoria dell'istanza di database che rappresenta lo stato di un login utente corrente a un database.
Ad esempio, quando un utente viene autenticato dal database con una password, viene stabilita una sessione per questo utente. Una sessione dura dal momento in cui l'utente effettua l'autenticazione dal database e termina con la disconnessione o l'uscita dall'applicazione del database.
Sessioni e container
Per una determinata sessione, il contenitore corrente nel CDB è quello in cui è in esecuzione una sessione. Il contenitore corrente può essere la radice CDB, una radice applicazione o un PDB.
Ogni sessione ha esattamente un contenitore corrente in qualsiasi momento. Poiché il dizionario dati in ogni contenitore è separato, Oracle AI Database utilizza il dizionario dati nel contenitore corrente per la risoluzione dei nomi e l'autorizzazione dei privilegi.
Relazione tra connessioni e sessioni
Una singola connessione può avere 0, 1 o più sessioni stabilite su di essa. Le sessioni sono indipendenti: un commit in una sessione non influisce sulle transazioni in altre sessioni.
Nota: se il connection pooling di Oracle Net è configurato, è possibile eliminare una connessione ma lasciare intatte le sessioni.
Possono esistere più sessioni contemporaneamente per un singolo utente del database. Come illustrato nella figura riportata di seguito, l'utente hr può avere più connessioni a un database. Nelle connessioni server dedicate, il database crea un processo server per conto di ciascuna connessione. Solo il processo client che causa la creazione del server dedicato lo utilizza. In una connessione server condivisa, molti processi client accedono a un singolo processo server condiviso.
Figura 2: Una sessione per ogni connessione
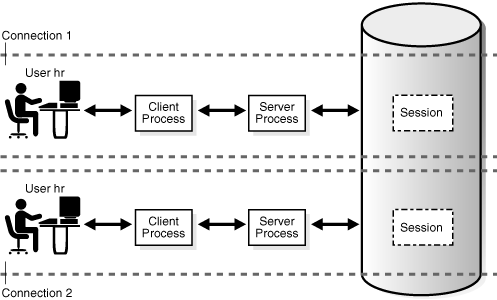
Descrizione dell'illustrazione cncpt237.gif
La Figura 18-3 illustra un caso in cui l'utente hr dispone di una singola connessione a un database, ma questa connessione dispone di due sessioni.
Figura 3: Due sessioni in una sola connessione
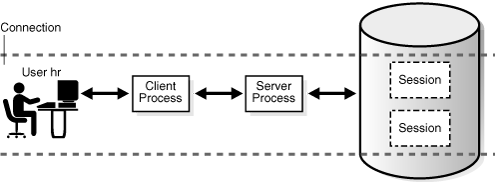
Descrizione dell'illustrazione cncpt238.gif
La generazione di un report di trace automatico delle statistiche di esecuzione delle istruzioni SQL comporta la ricreazione dello scenario nella Figura 18-3.
Il comando DISCONNECT nell'Esempio 18-2 termina effettivamente le sessioni, non la connessione.
Esempio 18-2 Connessioni e sessioni
L'esempio seguente connette SQL*Plus al database come utente SYSTEM e abilita il trace, creando così una nuova sessione (output di esempio incluso):
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 90      91 3BE2E41C

SQL> SET AUTOTRACE ON STATISTICS;
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 88      93 3BE2E41C
 90      91 3BE2E41C
...
SQL> DISCONNECT
Il comando DISCONNECT termina effettivamente le sessioni, non la connessione. Apertura di un nuovo terminale e connessione all'istanza come utente diverso, la seguente query mostra che la connessione con l'indirizzo 3BE2E41C è ancora attiva.
SQL> CONNECT dba1@inst1
Password: ********
Connected.
SQL> SELECT PROGRAM FROM V$PROCESS WHERE ADDR = HEXTORAW('3BE2E41C');

PROGRAM
------------------------------------------------
oracle@stbcs09-1 (TNS V1-V3)
Vedere anche: "Architettura del server condiviso"
Operazioni sul database
Nel contesto del monitoraggio del database, un'operazione del database è un'attività di sessione tra due punti nel tempo, come definito dagli utenti finali o dal codice dell'applicazione.
Un'operazione di database semplice è una singola istruzione SQL o una singola procedura o funzione PL/SQL. Un'operazione di database composito è un set di operazioni singole o composte.
Per monitorare, confrontare e ottimizzare le attività, puoi suddividere un ampio set di attività in operazioni del database e suddividere le operazioni in fasi. Un caso d'uso è un job batch PL/SQL che viene eseguito più lentamente del normale. Configurando il job come operazione di database, è possibile identificare e ottimizzare i passi costosi del job.
Ogni esecuzione di un'operazione di database è identificata in modo univoco da una coppia di attributi: nome operazione e ID esecuzione. Una sessione può avviare o arrestare un'operazione del database in una sessione diversa specificandone l'ID sessione e il numero di serie.
Due occorrenze della stessa operazione di database possono essere eseguite contemporaneamente utilizzando lo stesso nome, ma ID di esecuzione diversi. Ogni esecuzione di un'operazione di database con lo stesso nome può contenere istruzioni diverse.
È possibile creare e gestire le operazioni di database con il package PL/SQL DBMS_SQL_MONITOR. È possibile monitorare le operazioni utilizzando V$SQL_MONITOR, V$SQL_PLAN_MONITOR e V$SQL_MONITOR_SESSTAT.
Vedere anche:
-
Oracle AI Database SQL Tuning Guide per scoprire come monitorare le operazioni del database
-
Oracle AI Database Data Warehousing Guide per scoprire come monitorare i carichi con tempi di esecuzione lunghi
-
Oracle AI Database PL/SQL Packages and Types Reference per ulteriori informazioni su
DBMS_SQL_MONITOR -
Oracle AI Database Reference per saperne di più su
V$SQL_MONITOR
Panoramica dei processi server
Oracle AI Database crea processi server per gestire le richieste dei processi client connessi all'istanza. Un processo client comunica sempre con un database tramite un processo server separato.
I processi server creati per conto di un'applicazione di database possono eseguire uno o più dei task riportati di seguito.
-
Analisi ed esecuzione delle istruzioni SQL eseguite tramite l'applicazione, inclusa la creazione e l'esecuzione del piano query
-
Esegue il codice PL/SQL
-
Leggere i blocchi di dati dai file di dati nella buffer cache del database (il processo in background DBW ha il compito di scrivere i blocchi modificati su disco)
-
Restituire i risultati in modo tale che l'applicazione possa elaborare le informazioni
-
Processi server dedicati Nelle connessioni server dedicate, la connessione client è associata a un solo processo server.
-
Processi del server condiviso Nelle connessioni del server condiviso, le applicazioni client si connettono su una rete a un processo del dispatcher, non a un processo del server. Ad esempio, 20 processi client possono connettersi a un singolo processo di dispatcher.
-
Modalità di creazione dei processi server da parte di Oracle AI Database Il database crea i processi server in vari modi, a seconda dei metodi di connessione. Vedere anche: "Fasi dell'elaborazione SQL"
Processi server dedicati
Nelle connessioni server dedicate, la connessione client è associata a un solo processo server.
Su Linux, 20 processi client connessi a un'istanza di database sono serviti da 20 processi server. Ogni processo client comunica direttamente con il processo server. Questo processo server è dedicato al suo processo client per la durata della sessione. Il processo server memorizza le informazioni specifiche del processo e l'UGA nella relativa PGA.
Processi del server condiviso
Nelle connessioni al server condiviso, le applicazioni client si connettono tramite una rete a un processo di dispatcher, non a un processo server. Ad esempio, 20 processi client possono connettersi a un singolo processo di dispatcher.
Il processo di dispatcher riceve le richieste dai client connessi e le inserisce in una coda di richieste nel pool di grandi dimensioni. Il primo processo del server condiviso disponibile prende la richiesta dalla coda e la elabora. Successivamente, il server condiviso inserisce il risultato nella coda di risposta del dispatcher. Il processo di dispatcher controlla questa coda e trasmette il risultato al client.
Come un processo server dedicato, anche un processo server condiviso ha la propria PGA. Tuttavia, l'area UGA per una sessione è nella MGA in modo che qualsiasi server condiviso possa accedere ai dati della sessione.
Vedere anche:
In che modo Oracle AI Database crea i processi server
Il database crea i processi server in vari modi, a seconda dei metodi di connessione.
Di seguito sono riportati i metodi di connessione.
-
Trasmissione
SQL*Plus, un client OCI o un'altra applicazione client genera direttamente il processo server.
-
Listener Oracle Net
L'applicazione client si connette al database tramite un listener.
-
Broker dedicato
Questo è un processo di database che crea processi in primo piano. A differenza del listener, il broker risiede all'interno dell'istanza di database. Quando si utilizza un broker dedicato, il client si connette all'ascoltatore, che poi distribuisce la connessione al broker dedicato.
Quando una connessione non utilizza il bequeath, il database crea il processo server come indicato di seguito.
-
L'applicazione client richiede una nuova connessione dal listener o dal broker.
-
Il listener o il broker avvia la creazione di un nuovo processo o thread.
-
Il sistema operativo crea il nuovo processo o thread.
-
Oracle AI Database inizializza vari componenti e notifiche.
-
Il database trasferisce il codice specifico della connessione e della connessione.
Facoltativamente, se si utilizza il metodo di connessione broker dedicato, è possibile creare in precedenza un pool di processi server con il pacchetto DBMS_PROCESS. In questo caso, il processo in background di Process Manager (PMAN) monitora il pool di processi creati in precedenza, che attendono di essere associati a una richiesta client. Quando una connessione richiede un processo server, il database salta i passi da 2 a 4 della creazione del processo ed esegue solo il passo 5. Questa ottimizzazione migliora le prestazioni.
Nota:
-
Oracle AI Database PL/SQL Packages and Types Reference per informazioni sul package
DBMS_PROCESSPL/SQL -
Oracle AI Database Reference per saperne di più sul processo in background PMAN
Panoramica dei processi in background
I processi in background sono processi aggiuntivi utilizzati da un database Oracle multiprocesso. I processi in background eseguono i task di manutenzione necessari per il funzionamento del database e per ottimizzare le prestazioni per più utenti.
Ogni processo in background ha un compito separato, ma funziona con gli altri processi. Ad esempio, il processo LGWR scrive i dati dal redo log buffer al redo log in linea. Quando un redo log file compilato è pronto per essere archiviato, LGWR segnala un altro processo per archiviare il redo log file.
Oracle AI Database crea automaticamente processi in background all'avvio di un'istanza di database. Un'istanza può avere molti processi in background, non tutti i quali esistono sempre in ogni configurazione del database. La query seguente elenca i processi in background in esecuzione nel database:
SELECT PNAME
FROM   V$PROCESS
WHERE  PNAME IS NOT NULL
ORDER BY PNAME;
Questa sezione comprende gli argomenti riportati di seguito.
-
Processi in background obbligatori I processi in background obbligatori sono presenti in tutte le configurazioni di database standard.
-
Processi in background facoltativi Un processo in background facoltativo è qualsiasi processo in background non definito come obbligatorio.
-
Processi secondari I processi secondari sono processi in background che eseguono il lavoro per conto di altri processi. Vedi anche: Oracle AI Database Reference per le descrizioni di tutti i processi in background
Processi in background obbligatori
I processi in background obbligatori sono presenti in tutte le configurazioni tipiche del database.
Questi processi vengono eseguiti per impostazione predefinita in un'istanza di database di lettura/scrittura avviata con un file dei parametri di inizializzazione configurato in modo minimo. Un'istanza di database di sola lettura disabilita alcuni di questi processi.
In questa sezione vengono descritti i processi in background obbligatori riportati di seguito.
-
Gruppo Process Monitor Process (PMON) Il gruppo PMON include PMON, Cleanup Main Process (CLMN) e Cleanup Helper Processes (CLnn). Questi processi sono responsabili del monitoraggio e della pulizia di altri processi.
-
Process Manager (PMAN) Process Manager (PMAN) supervisiona diversi processi in background, tra cui server condivisi, server in pool e processi di coda dei job.
-
Processo di registrazione del listener (LREG) Il processo di registrazione del listener (LREG) registra le informazioni sull'istanza di database e sui processi del dispatcher con Oracle Net Listener.
-
System Monitor Process (SMON) Il processo SMON (System Monitor Process) si occupa di diverse attività di pulizia a livello di sistema.
-
Database Writer Process (DBW) Il database writer process (DBW) scrive il contenuto dei buffer del database nei file di dati. I processi DBW scrivono buffer modificati nella buffer cache del database su disco.
-
Processo Log Writer (LGWR) Il processo Log Writer (LGWR) gestisce il redo log buffer in linea.
-
Processo checkpoint (CKPT) Il processo checkpoint (CKPT) aggiorna le intestazioni del control file e del file di dati con informazioni sul checkpoint e segnala al DBW di scrivere i blocchi su disco. Le informazioni sul checkpoint includono la posizione del checkpoint, l'SCN e la posizione nel redo log in linea per iniziare il recupero.
-
Processi MMMON e MMNL Il processo MMMON (Manageability Monitor) esegue molte attività correlate al Automatic Workload Repository (AWR).
-
Processo di recupero (RECO) In un database distribuito, il processo di recupero (RECO) risolve automaticamente gli errori nelle transazioni distribuite.
-
Processo in background (BGnn) I processi in background (BGnn) sono un processo in background standard negli ambienti Oracle RAC che esegue vari task di manutenzione e monitoraggio.
-
Processo VOSD (Virtual Operating System Daemon Process) Il processo VOSD (Virtual Operating System Daemon Process) esegue le azioni del servizio di database Oracle in base al tempo.
-
Network Monitor Process (NMON) Il processo Network Monitor (NMON) è un servizio di monitoraggio della rete leggero.
Vedere anche:
-
Oracle AI Database Reference per le descrizioni di altri processi obbligatori, tra cui MMAN, DIAG, VKTM, DBRM e PSP0
-
Oracle Real Application Clusters Administration and Deployment Guide e Oracle Clusterware Administration and Deployment Guide per ulteriori informazioni sui processi in background specifici di Oracle RAC e Oracle Clusterware
Gruppo Process Monitor (PMON)
Il gruppo PMON include i processi PMON, CLMN (Cleanup Main Process) e CLnn (Cleanup Helper Processes). Questi processi sono responsabili del monitoraggio e della pulizia di altri processi.
Il gruppo PMON supervisiona il cleanup della buffer cache e il rilascio delle risorse utilizzate da un processo client. Ad esempio, il gruppo PMON è responsabile della reimpostazione dello stato della tabella delle transazioni attiva, del rilascio dei blocchi non più necessari e della rimozione dell'ID processo dei processi cessati dall'elenco dei processi attivi.
Il database deve garantire che le risorse detenute dai processi terminati vengano rilasciate in modo che siano utilizzabili da altri processi. Altrimenti, il processo potrebbe finire bloccato o bloccato in conflitto.
-
Process Monitor (PMON) Il process monitor (PMON) rileva l'interruzione di altri processi in background. Se un processo server o dispatcher termina in modo anomalo, il gruppo PMON è responsabile dell'esecuzione del recupero dei processi. L'interruzione del processo può avere più cause, inclusi i comandi kill del sistema operativo o le istruzioni
ALTER SYSTEM KILL SESSION. -
Cleanup Main Process (CLMN) PMON delega il lavoro di cleanup al processo principale di cleanup (CLMN). Il compito di rilevare la cessazione anomala rimane con PMON.
-
Pulizia dei processi di supporto (CLnn) CLMN delega il lavoro di cleanup ai processi di supporto CLnn.
-
Quarantena delle risorse di database Se un processo o una sessione termina, il gruppo PMON rilascia le risorse bloccate nel database. In alcuni casi, il gruppo PMON può mettere automaticamente in quarantena le risorse danneggiate e irrecuperabili in modo che l'istanza di database non venga immediatamente interrotta.
Processo di Process Monitor (PMON)
Il monitor del processo (PMON, Process Monitor) rileva l'interruzione di altri processi in background. Se un processo server o dispatcher termina in modo anomalo, il gruppo PMON è responsabile dell'esecuzione del recupero dei processi. L'interruzione del processo può avere più cause, inclusi i comandi kill del sistema operativo o le istruzioni ALTER SYSTEM KILL SESSION.
Cleanup processo principale (CLMN)
PMON delega il lavoro di cleanup al processo principale di cleanup (CLMN). Il compito di rilevare la cessazione anomala rimane con PMON.
CLMN esegue periodicamente il cleanup dei processi terminati, delle sessioni terminate, delle transazioni, delle connessioni di rete, delle sessioni inattive, delle transazioni scollegate e delle connessioni di rete scollegate che hanno superato il timeout di inattività.
Cleanup dei processi di supporto (CLnn)
CLMN delega il lavoro di cleanup ai processi di supporto CLnn.
I processi CLnn consentono di eseguire il cleanup dei processi e delle sessioni terminati. Il numero di processi di assistenza è proporzionale alla quantità di lavoro di pulizia da fare e all'efficienza attuale della pulizia.
Un processo di cleanup può bloccarsi, impedendogli di procedere al cleanup di altri processi. Inoltre, se più processi richiedono il cleanup, il tempo di cleanup può essere significativo. Per questi motivi, Oracle AI Database può utilizzare più processi di supporto in parallelo per eseguire il cleanup, riducendo così le prestazioni lente.
Le viste V$CLEANUP_PROCESS e V$DEAD_CLEANUP contengono metadati sul cleanup CLMN. La vista V$CLEANUP_PROCESS contiene una riga per ogni processo di cleanup. Ad esempio, se V$CLEANUP_PROCESS.STATE è BUSY, il processo è attualmente impegnato nel cleanup.
Vedi anche: Oracle AI Database Reference per saperne di più su V$CLEANUP_PROCESS
Quarantena risorsa database
Se un processo o una sessione termina, il gruppo PMON rilascia le risorse bloccate nel database. In alcuni casi, il gruppo PMON può mettere automaticamente in quarantena le risorse danneggiate e irrecuperabili in modo che l'istanza di database non venga immediatamente interrotta.
Il gruppo PMON continua a eseguire il maggior numero possibile di operazioni di cleanup sul processo o sulla sessione in cui si trovava la risorsa in quarantena. La vista V$QUARANTINE contiene metadati quali il tipo di risorsa, la quantità di memoria consumata, l'errore Oracle che causa la quarantena e così via.
Vedi anche: Oracle AI Database Reference per saperne di più su V$QUARANTINE
Process Manager (PMAN)
Process Manager (PMAN) supervisiona diversi processi in background, tra cui server condivisi, server in pool e processi di coda dei job.
PMAN monitora, genera e arresta i seguenti tipi di processi:
-
Processi di dispatcher e server condivisi
-
Connection broker e processi server in pool per connection pool residenti nel database
-
Processi di coda job
-
Processi in background riavviabili
Processo di registrazione listener (LREG)
Il processo di registrazione del listener (LREG) registra le informazioni sull'istanza di database e sui processi del dispatcher con Oracle Net Listener.
All'avvio di un'istanza, LREG esegue il polling del listener per determinare se è in esecuzione. Se il listener è in esecuzione, LREG passa i parametri pertinenti. Se non è in esecuzione, LREG tenta periodicamente di contattarlo.
Nota: nelle release precedenti a Oracle Database 12c, PMON ha eseguito la registrazione del listener.
Vedere anche: "Oracle Net Listener"
Processo di monitoraggio del sistema (SMON)
Il processo di monitoraggio del sistema (SMON) è responsabile di una vasta gamma di attività di pulizia a livello di sistema.
Le mansioni assegnate a SMON includono:
-
Esecuzione del recupero dell'istanza, se necessario, all'avvio dell'istanza. In un database Oracle RAC, il processo SMON di un'istanza di database può eseguire il recupero dell'istanza per un'istanza non riuscita.
-
Recupero delle transazioni terminate saltate durante il recupero dell'istanza a causa di errori di lettura file o tablespace non in linea. SMON recupera le transazioni quando la tablespace o il file viene riportato in linea.
-
Cleanup dei segmenti temporanei inutilizzati nelle tablespace permanenti. Ad esempio, Oracle AI Database alloca le estensioni durante la creazione di un indice. Se l'operazione non riesce, SMON pulisce lo spazio temporaneo.
-
Estensioni libere contigue in coalescenza all'interno delle tablespace gestite dal dizionario.
SMON controlla regolarmente per vedere se è necessario. Altri processi possono chiamare SMON se ne rilevano la necessità.
Processo Database Writer (DBW)
Il processo DBW (database writer process) scrive il contenuto dei buffer del database nei file di dati. I processi DBW scrivono buffer modificati nella buffer cache del database su disco.
Sebbene un processo di scrittura di database (DBW0) sia adeguato per la maggior parte dei sistemi, è possibile configurare ulteriori processi: da DBW1 a DBW9, da DBWa a DBWz e da BW36 a BW99 per migliorare le prestazioni di scrittura se il sistema modifica pesantemente i dati. Questi processi DBW aggiuntivi non sono utili sui sistemi uniprocessor.
Il processo DBW scrive i buffer modificati su disco nelle seguenti condizioni:
-
Quando un processo server non riesce a trovare un buffer riutilizzabile pulito dopo la scansione di un numero di buffer di soglia, segnala a DBW di scrivere. DBW scrive i buffer modificati su disco in modo asincrono, se possibile, durante l'esecuzione di altre elaborazioni.
-
DBW scrive periodicamente i buffer per far avanzare il checkpoint, che è la posizione nel redo thread da cui inizia il recupero dell'istanza. La posizione di log del checkpoint è determinata dal buffer sporco meno recente nella buffer cache.
In molti casi i blocchi scritti da DBW sono sparsi su tutto il disco. Pertanto, le scritture tendono ad essere più lente delle scritture sequenziali eseguite da LGWR. DBW esegue scritture multiblocco quando possibile per migliorare l'efficienza. Il numero di blocchi scritti in una scrittura multiblocco varia a seconda del sistema operativo.
Vedere anche:
-
Oracle AI Database Performance Tuning Guide per consigli sulla configurazione, il monitoraggio e l'ottimizzazione di DBW.
Processo di scrittura log (LGWR)
Il processo Log Writer (LGWR) gestisce il redo log buffer in linea.
LGWR scrive una parte del buffer nel redo log in linea. Separando i task di modifica dei buffer del database, eseguendo scritture sparse di buffer sporchi su disco ed eseguendo scritture sequenziali rapide di redo su disco, il database migliora le prestazioni.
Nelle seguenti circostanze, LGWR scrive tutti i redo entry che sono stati copiati nel buffer dall'ultima volta che ha scritto:
-
Un utente esegue il commit di una transazione.
-
Viene eseguito un log switch di redo in linea.
-
Sono passati tre secondi da quando LGWR ha scritto l'ultima volta.
-
Il redo log buffer è pieno di un terzo o contiene 1 MB di dati memorizzati nel buffer.
-
DBW deve scrivere buffer modificati su disco.
Prima che DBW possa scrivere un buffer sporco, il database deve scrivere su disco i redo record associati alle modifiche apportate al buffer (il protocollo write-ahead). Se DBW scopre che alcuni redo record non sono stati scritti, segnala a LGWR di scrivere i record su disco e attende il completamento di LGWR prima di scrivere i buffer di dati su disco.
-
LGWR e commit Oracle AI Database utilizza un meccanismo di commit rapido per migliorare le prestazioni per le transazioni impegnate.
-
LGWR e file non accessibili LGWR scrive in modo sincrono nel gruppo di redo log file in linea con mirroring attivo. Vedere anche: "Commit di transazioni"
LGWR e impegni
Oracle AI Database utilizza un meccanismo di commit rapido per migliorare le prestazioni per le transazioni impegnate.
Quando un utente emette un'istruzione COMMIT, alla transazione viene assegnato un numero di modifica del sistema (SCN). LGWR inserisce un record di commit nel redo log buffer e lo scrive sul disco immediatamente, insieme al commit SCN e alle redo entry della transazione.
Il redo log buffer è circolare. Quando LGWR scrive redo entry dal redo log buffer in un redo log file in linea, i processi del server possono copiare nuove voci sulle voci nel redo log buffer che sono state scritte su disco. LGWR scrive normalmente abbastanza velocemente per garantire che lo spazio sia sempre disponibile nel buffer per le nuove voci, anche quando l'accesso al redo log in linea è pesante.
La scrittura atomica della redo entry contenente il record di commit della transazione è l'evento singolo che determina che la transazione ha eseguito il commit. Oracle AI Database restituisce un codice di operazione riuscita per la transazione di commit, anche se i buffer di dati non sono stati ancora scritti su disco. Le modifiche corrispondenti ai blocchi di dati vengono differite fino a quando DBW non riesce a scriverle nei file di dati.
Nota: LGWR può scrivere le voci dei redo log su disco prima del commit di una transazione. Le modifiche protette dalle redo entry diventano permanenti solo se la transazione viene avviata successivamente.
Quando l'attività è alta, LGWR può utilizzare i commit di gruppo. Ad esempio, un utente esegue il commit, facendo sì che LGWR scriva i redo entry della transazione su disco. Durante questo commit di scrittura altri utenti. LGWR non può scrivere su disco per eseguire il commit di queste transazioni fino al completamento della scrittura precedente. Al termine, LGWR può scrivere l'elenco dei redo entry delle transazioni in attesa (non ancora sottoposte a commit) in un'unica operazione. In questo modo, il database riduce al minimo l'I/O del disco e massimizza le prestazioni. Se le richieste di commit continuano a un ritmo elevato, ogni scrittura di LGWR può contenere più record di commit.
LGWR e file non accessibili
LGWR scrive in modo sincrono nel gruppo di redo log file in linea con mirroring attivo.
Se un file di log è inaccessibile, LGWR continua a scrivere in altri file del gruppo e scrive un errore nel file di trace LGWR e nel log degli avvisi. Se tutti i file di un gruppo sono danneggiati o se il gruppo non è disponibile perché non è stato archiviato, LGWR non può continuare a funzionare.
Vedere anche:
-
"Come Oracle AI Database scrive nel Redo Log online" e "Redo Log Buffer"
-
Oracle AI Database Performance Tuning Guide per informazioni su come monitorare e ottimizzare le prestazioni di LGWR
Processo checkpoint (CKPT)
Il processo di checkpoint (CKPT) aggiorna le intestazioni del control file e del file di dati con informazioni sul checkpoint e segnala al DBW di scrivere blocchi su disco. Le informazioni sul checkpoint includono la posizione del checkpoint, l'SCN e la posizione nel redo log in linea per iniziare il recupero.
Come illustrato nella Figura 18-4, CKPT non scrive blocchi di dati in file di dati o redo block in redo log file in linea.
Figura 4: Processo di checkpoint
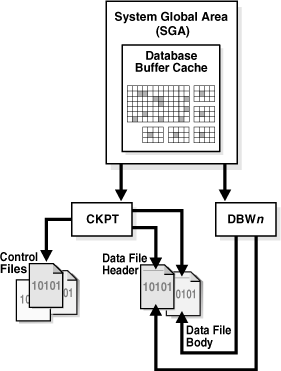
Descrizione dell'illustrazione cncpt228.gif
Vedere anche: "Panoramica dei checkpoint"
Processi di monitoraggio della gestibilità (MMON e MMNL)
Il processo di monitoraggio della gestibilità (MMON) esegue molte attività correlate al repository del carico di lavoro automatico (AWR).
Ad esempio, MMON scrive quando una metrica viola il relativo valore di soglia, acquisisce snapshot e acquisisce il valore delle statistiche per gli oggetti SQL modificati di recente.
Il processo lite di monitoraggio della gestibilità (MMNL) scrive le statistiche dal buffer ASH (Active Session History) nell'SGA su disco. MMNL scrive su disco quando il buffer ASH è pieno.
Vedere anche: "Oracle AI Database - Introduzione al tuning delle prestazioni" e "Panoramica della cronologia delle sessioni attive"
Processo recupero (RECO)
In un database distribuito, il processo RECO risolve automaticamente gli errori nelle transazioni distribuite.
Il processo di RECO di un nodo si connette automaticamente ad altri database coinvolti in una transazione distribuita insicura. Quando RECO ristabilisce una connessione tra i database, risolve automaticamente tutte le transazioni insicure, rimuovendo dalla tabella delle transazioni in sospeso di ogni database tutte le righe corrispondenti alle transazioni risolte.
Vedere anche: Oracle AI Database Administrator's Guide per ulteriori informazioni sul recupero delle transazioni nei sistemi distribuiti
Processo in background (BG nn)
I processi di background (BGnn) sono un processo in background standard negli ambienti Oracle RAC che esegue diversi task di manutenzione e monitoraggio.
Il processo in background è responsabile della gestione della buffer cache, del supporto del processo Log Writer (LGWR), del coordinamento dei checkpoint, del monitoraggio dei processi in background e della raccolta di statistiche.
Processo daemon del sistema operativo virtuale (VOSD)
Il processo daemon del sistema operativo virtuale (VOSD) esegue le azioni del servizio di database Oracle limitate nel tempo.
Questo processo viene generato dinamicamente all'avvio dell'istanza ed è responsabile dell'esecuzione di azioni del servizio di sistema critiche per il database. Questo processo viene utilizzato dalle istanze di database, dalle istanze Oracle ASM e da Oracle RAC.
Processo NMON (Network Monitor)
Il processo Network Monitor (NMON) è un servizio leggero di monitoraggio della rete.
Network Monitor (NMON) è un servizio di monitoraggio della rete a basso carico di lavoro che sfrutta le funzionalità avanzate del kernel per offrire un monitoraggio sempre attivo e completo. Acquisisce continuamente statistiche ed eventi di rete a più livelli, tra cui a livello di sistema, per interfaccia, per IP e per flusso, fornendo metriche dettagliate per i servizi di livello superiore. Basato su NMON, il servizio Health Score semplifica la valutazione dello stato della rete con un punteggio da 0 a 100 standardizzato e risolve in modo proattivo i problemi raccogliendo la diagnostica in base alle esigenze. NMON fornisce statistiche di rete efficienti e fruibili, consentendo il rilevamento tempestivo delle anomalie e una correlazione efficace con le attività del database.
Processi in background facoltativi
Un processo in background facoltativo è qualsiasi processo in background non definito come obbligatorio.
La maggior parte dei processi in background opzionali sono specifici di attività o funzioni. Ad esempio, i processi in background che supportano Oracle ASM sono disponibili solo quando questa funzione è abilitata.
Questa sezione descrive alcuni processi facoltativi comuni:
-
Processi dell'archivio (ARCn) Un processo dell'archivio (ARCn) copia i redo log file in linea nello storage non in linea dopo che si è verificato uno switch di redo log.
-
Processi coda job (CJQ0 e Jnnn) Un processo coda esegue i processi utente, spesso in modalità batch. Un job è un task definito dall'utente pianificato per essere eseguito una o più volte.
-
Flashback Data Archive Process (FBDA) Il processo FBDA (flashback data archive) archivia le righe cronologiche delle tabelle tracciate negli archivi di dati Flashback.
-
Processo SMCO (Space Management Coordinator Process) Il processo SMCO (Space Management Coordinator Process) viene avviato da SMON e coordina l'esecuzione di varie attività correlate alla gestione dello spazio.
Vedere anche:
-
Oracle AI Database Transactional Event Queues and Advanced Queuing User's Guide per un'introduzione a Advanced Queuing (AQ)
-
Oracle AI Database Reference per le descrizioni dei processi in background specifici di AQ e Oracle ASM
Processi Archiver (ARC n)
Un processo dell'archivio (ARCn) copia i redo log file in linea nella memoria non in linea dopo che si è verificato uno switch di redo log.
Questi processi possono anche raccogliere i dati di redo delle transazioni e trasmetterli alle destinazioni del database in standby. I processi ARCn esistono solo quando il database è in modalitàARCHIVELOG e l'archiviazione automatica è abilitata.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come regolare il numero di processi dell'archiviatore
-
Oracle AI Database Performance Tuning Guide per scoprire come ottimizzare le prestazioni degli archiviatori
Processi Job Queue (CJQ0 e Jnnn)
Un processo di coda esegue i processi utente, spesso in modalità batch. Un job è un task definito dall'utente pianificato per essere eseguito una o più volte.
Ad esempio, è possibile utilizzare una coda di job per pianificare un aggiornamento con tempi di esecuzione lunghi in background. Data una data di inizio e un intervallo di tempo, i processi della coda di job tentano di eseguire il job alla ricorrenza successiva dell'intervallo.
Oracle AI Database gestisce i processi di coda dei job in modo dinamico, consentendo ai client di coda dei job di utilizzare più processi di coda dei job quando necessario. Il database rilascia le risorse utilizzate dai nuovi processi quando sono inattivi.
I processi di coda dei job dinamici possono eseguire molti job contemporaneamente in un determinato intervallo. La sequenza di eventi è la seguente:
-
Il processo di coordinatore job (CJQ0) viene avviato e arrestato automaticamente in base alle esigenze di Oracle Scheduler. Il processo di coordinamento seleziona periodicamente i job che devono essere eseguiti dalla tabella
JOB$del sistema. I nuovi job selezionati vengono ordinati in base al tempo. -
Il processo coordinatore genera dinamicamente processi figlio coda job (Jnnn) per eseguire i job.
-
Il processo coda job esegue uno dei job selezionati dal processo CJQ0 per l'esecuzione. Ogni processo della coda di job esegue un job alla volta per il completamento.
-
Al termine dell'esecuzione di un singolo job, il processo esegue il polling per ulteriori job. Se non è previsto alcun job per l'esecuzione, entra in uno stato di sospensione, da cui si sveglia a intervalli periodici e esegue il polling per ulteriori job. Se il processo non trova nuovi job, termina dopo un intervallo preimpostato.
Il parametro di inizializzazione JOB_QUEUE_PROCESSES rappresenta il numero massimo di processi della coda di job che possono essere eseguiti contemporaneamente su un'istanza. Tuttavia, i client non devono presumere che tutti i processi della coda dei job siano disponibili per l'esecuzione dei job. Nota: il processo del coordinatore non viene avviato se il parametro di inizializzazione JOB_QUEUE_PROCESSES è impostato su 0.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su Oracle Scheduler
-
Oracle AI Database Transactional Event Queues and Advanced Queuing User's Guide per informazioni sui processi in background di AQ
Processo Flashback Data Archive (FBDA)
Il processo FBDA (flashback data archive) archivia le righe cronologiche delle tabelle tracciate negli archivi di dati Flashback.
Quando si esegue il commit di una transazione contenente DML in una tabella tracciata, questo processo memorizza l'immagine preliminare delle righe modificate nell'archivio dati di flashback. Inoltre, mantiene i metadati nelle righe correnti.
FBDA gestisce automaticamente Flashback Data Archive per spazio, organizzazione e retention. Inoltre, il processo tiene traccia di quanto tempo si è verificato l'archiviazione delle transazioni tracciate.
Processo SMCO (Space Management Coordinator)
Il processo di coordinamento della gestione dello spazio (SMCO) è avviato da SMON e coordina l'esecuzione di varie attività relative alla gestione dello spazio.
Il processo SMCO coordina l'esecuzione di varie attività relative alla gestione dello spazio.
I task tipici includono l'allocazione e il recupero proattivi dello spazio e la manutenzione temporanea delle tablespace. SMCO genera dinamicamente processi figlio (Wnnn) per implementare il task.
Vedere anche: Oracle AI Database Development Guide per informazioni sulla funzione Flashback Data Archive e Temporal History
Processi secondari
I processi secondari sono processi in background che eseguono il lavoro per conto di altri processi.
In questa sezione vengono descritti alcuni processi secondari utilizzati da Oracle AI Database.
-
I processi secondari I/O (Innn) simulano l'I/O asincrono per sistemi e dispositivi che non lo supportano.
-
Processi del server PX (Parallel Execution) In esecuzione parallela, più processi lavorano contemporaneamente per eseguire una singola istruzione SQL. Vedi anche: Oracle AI Database Reference per le descrizioni dei processi secondari di Oracle AI Database.
Processi secondari I/O
I processi secondari di I/O (Innn) simulano l'I/O asincrono per sistemi e dispositivi che non lo supportano.
In I/O asincrono, non vi è alcun requisito di temporizzazione per la trasmissione, consentendo l'avvio di altri processi prima che la trasmissione sia terminata.
Ad esempio, si supponga che un'applicazione scriva 1000 blocchi su un disco in un sistema operativo che non supporta I/O asincrono. Ogni scrittura si verifica in sequenza e attende una conferma che la scrittura è riuscita. Con il disco asincrono, l'applicazione può scrivere i blocchi in blocco ed eseguire altri lavori in attesa di una risposta dal sistema operativo che tutti i blocchi sono stati scritti.
Per simulare l'I/O asincrono, un processo supervisiona diversi processi secondari. Il processo di richiamo assegna il lavoro a ciascuno dei processi secondari, che attendono il completamento di ogni scrittura e riportano al chiamante al termine. In vero I/O asincrono il sistema operativo attende il completamento dell'I/O e riporta al processo, mentre in simulato I/O asincrono i processi secondari attendono e riportano all'invocatore.
Il database supporta diversi tipi di processi secondari di I/O, tra cui:
-
Processi secondari I/O per Recovery Manager (RMAN)
Quando si utilizza RMAN per eseguire il backup o il ripristino dei dati, è possibile utilizzare processi secondari di I/O sia per i dispositivi disco che per i dispositivi nastro.
-
Processi secondari di Database Writer
Se non è pratico utilizzare più processi di Database Writer, ad esempio quando il computer ha una CPU, il database può distribuire I/O su più processi secondari. DBW è l'unico processo che esegue la scansione della lista LRU della buffer cache per individuare i blocchi da scrivere su disco. Tuttavia, i processi secondari di I/O eseguono l'I/O per questi blocchi.
Vedere anche:
-
Oracle AI Database Backup and Recovery User's Guide per ulteriori informazioni sui processi secondari di I/O per le operazioni di backup e ripristino
-
Oracle AI Database Performance Tuning Guide per ulteriori informazioni sui processi secondari di Database Writer
Processi del server PX (Parallel Execution)
In esecuzione parallela, più processi lavorano insieme contemporaneamente per eseguire una singola istruzione SQL.
Dividendo il lavoro tra più processi, Oracle AI Database può eseguire l'istruzione più rapidamente. Ad esempio, quattro processi gestiscono quattro diversi trimestri di un anno anziché un processo singolo che li gestisce tutti e quattro i trimestri.
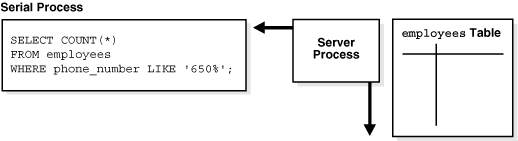
L'esecuzione parallela è in contrasto con l'esecuzione seriale, in cui un singolo processo server esegue tutte le elaborazioni necessarie per l'esecuzione sequenziale di un'istruzione SQL. Ad esempio, per eseguire una scansione della tabella completa come SELECT * FROM employees, un processo server esegue tutto il lavoro, come mostrato nella Figura 18-5.
Figura 5: Scansione della tabella completa seriale
Descrizione dell'illustrazione cncpt016.gif
L'esecuzione parallela riduce i tempi di risposta per le operazioni a uso intensivo di dati su database di grandi dimensioni come i data warehouse. Il multiprocessing simmetrico (SMP) e il sistema in cluster ottengono i maggiori vantaggi in termini di prestazioni dall'esecuzione parallela perché l'elaborazione delle istruzioni può essere suddivisa tra più CPU. L'esecuzione parallela può anche offrire vantaggi a determinati tipi di sistemi OLTP e ibridi.
Nei sistemi Oracle RAC, il posizionamento del servizio di un servizio specifico controlla l'esecuzione parallela. In particolare, i processi paralleli vengono eseguiti sui nodi in cui è configurato il servizio. Per impostazione predefinita, Oracle AI Database esegue processi paralleli solo su un'istanza che offre il servizio utilizzato per connettersi al database. Ciò non influisce su altre operazioni parallele come il recupero parallelo o l'elaborazione di query GV$.
-
Query Coordinator Nell'esecuzione parallela, il processo server funge da coordinatore query (chiamato anche coordinatore esecuzione parallela).
-
Produttori e consumatori I server di esecuzione parallela sono suddivisi in producer e consumer. I produttori sono responsabili del trattamento dei loro dati e quindi della loro distribuzione ai consumatori che ne hanno bisogno.
-
Granuli Nell'esecuzione parallela, una tabella viene divisa dinamicamente in unità di caricamento. Ogni unità, denominata granulo, è l'unità di lavoro più piccola quando si accede ai dati.
Vedere anche:
-
Oracle AI Database VLDB and Partitioning Guide per ulteriori informazioni sull'esecuzione parallela
-
Oracle Real Application Clusters Administration and Deployment Guide per considerazioni sull'esecuzione parallela in ambienti Oracle RAC
Coordinatore delle query
Nell'esecuzione parallela, il processo server funge da coordinatore query (chiamato anche coordinatore esecuzione parallela).
Il coordinatore query è responsabile dei seguenti elementi:
-
Analisi della query
-
Allocazione e controllo dei processi del server di esecuzione parallela
-
Invio dell'output all'utente
Dato un piano di query per una query, il coordinatore suddivide ciascun operatore in una query SQL in parti parallele, le esegue nell'ordine specificato nella query e integra i risultati parziali prodotti dai server delle esecuzioni parallele, che eseguono gli operatori.
Il numero di server delle esecuzioni parallele assegnati a una singola operazione indica il grado di parallelismo per un'operazione. Più operazioni all'interno della stessa istruzione SQL hanno lo stesso grado di parallelismo.
Produttori e consumatori
I server di esecuzione parallela sono suddivisi in produttori e consumer. I produttori sono responsabili del trattamento dei loro dati e quindi della loro distribuzione ai consumatori che ne hanno bisogno.
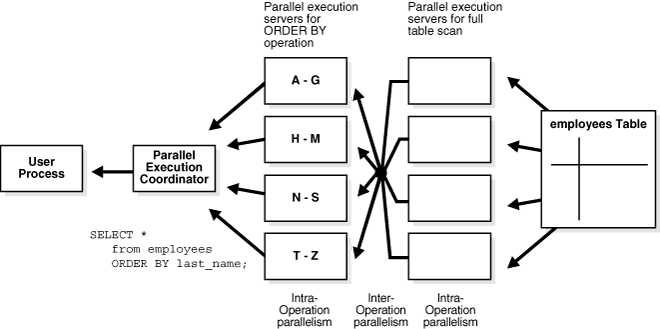
Il database può eseguire la distribuzione utilizzando una varietà di tecniche. Due tecniche comuni sono una trasmissione e un hash. In una trasmissione, ogni produttore invia le righe a tutti i consumatori. In un hash, il database calcola una funzione hash su un set di chiavi e rende ogni consumer responsabile di un sottoinsieme di valori hash. La Figura 18-6 rappresenta l'interazione tra produttori e consumatori nell'esecuzione parallela della seguente dichiarazione:
SELECT * FROM employees ORDER BY last_name;Il piano di esecuzione implementa una scansione completa della tabella employees. La scansione è seguita da un tipo di righe recuperate. Tutti i processi producer coinvolti nell'operazione di scansione inviano righe al processo consumer appropriato eseguendo l'ordinamento.
Figura 6: Produttori e consumatori
Descrizione dell'illustrazione vldbg013.gif
Granuli
In esecuzione parallela, una tabella è divisa dinamicamente in unità di carico. Ogni unità, denominata granulo, è l'unità di lavoro più piccola quando si accede ai dati.
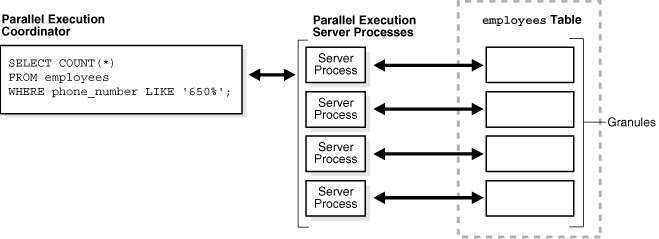
Un granulo basato su blocchi è un intervallo di blocchi di dati della tabella letti da un singolo server di esecuzione parallela (chiamato anche server PX), che utilizza Pnnn come formato di nome. Per ottenere una distribuzione uniforme del lavoro tra processi server paralleli, il numero di granuli è sempre molto superiore al DOP richiesto. La Figura 18-7 mostra una scansione parallela della tabella employees.
Figura 7: Scansione parallela della tabella completa
Descrizione dell'illustrazione cncpt017.gif
Il database esegue il mapping dei granuli ai server di esecuzione paralleli in fase di esecuzione. Quando un server di esecuzione parallela termina la lettura delle righe corrispondenti a un granulo e quando i granuli rimangono, ottiene un altro granulo dal coordinatore query. Questa operazione continua finché la tabella non viene letta. I server di esecuzione inviano i risultati al coordinatore, che assembla i pezzi nella scansione della tabella completa desiderata.
Vedere anche:
-
Oracle AI Database VLDB and Partitioning Guide per informazioni su come utilizzare l'esecuzione parallela
-
Oracle AI Database Data Warehousing Guide per informazioni sui parametri di inizializzazione consigliati per il parallelismo