Architettura della memoria
In questo capitolo viene illustrata l'architettura di memoria di un'istanza di database.
-
Introduzione alle strutture di memoria di Oracle AI Database Quando un'istanza viene avviata, Oracle AI Database alloca un'area di memoria e avvia i processi in background.
-
Panoramica di System Global Area (SGA) SGA è un'area di memoria di lettura/scrittura che, insieme ai processi in background di Oracle, formano un'istanza di database.
-
Panoramica dell'area PGA (Program Global Area) La memoria PGA è specifica di un processo operativo o di un thread non condiviso da altri processi o thread del sistema. Poiché la PGA è specifica del processo, non viene mai allocata nella SGA.
-
Panoramica dell'area globale utente L'area UGA è la memoria di sessione, che è la memoria allocata per le variabili di sessione, ad esempio le informazioni di accesso e altre informazioni richieste da una sessione di database. In sostanza, UGA memorizza lo stato della sessione.
-
Panoramica della Managed Global Area (MGA) La Managed Global Area (MGA) è un framework di memoria unico che consente di condividere e coordinare la memoria in un set di processi Oracle affidabili.
-
Panoramica delle aree del codice software Un'area del codice software è una parte della memoria in cui è memorizzato il codice che viene eseguito o che può essere eseguito. Il codice di Oracle AI Database viene memorizzato in un'area software in genere più esclusiva e protetta rispetto alla posizione dei programmi utente. Vedere anche: Oracle AI Database Administrator's Guide per istruzioni sulla configurazione e la gestione della memoria.
Introduzione alle strutture di memoria di Oracle AI Database
Quando un'istanza viene avviata, Oracle AI Database alloca un'area di memoria e avvia i processi in background.
Nell'area di memoria sono memorizzate informazioni quali:
-
Codice programma
-
Informazioni su ciascuna sessione connessa, anche se attualmente non è attiva
-
Informazioni necessarie durante l'esecuzione del programma, ad esempio lo stato corrente di una query da cui vengono recuperate le righe
-
Informazioni come il blocco di dati che vengono condivisi e comunicati tra processi
-
Dati memorizzati nella cache, ad esempio blocchi di dati e redo record, che esistono anche sul disco
-
Strutture di memoria di base Oracle AI Database include diverse aree di memoria, ognuna delle quali contiene più sottocomponenti.
-
Gestione della memoria di Oracle AI Database La gestione della memoria implica la conservazione di dimensioni ottimali per le strutture della memoria dell'istanza Oracle al variare delle richieste nel database. Oracle AI Database gestisce la memoria in base alle impostazioni dei parametri di inizializzazione correlati alla memoria. Vedi anche: "Architettura dei processi"
Strutture memoria di base
Oracle AI Database include diverse aree di memoria, ognuna delle quali contiene più sottocomponenti.
Le strutture di memoria di base associate a Oracle AI Database includono:
-
Area SGA (System Global)
SGA è un gruppo di strutture di memoria condivisa, note come componenti SGA, che contengono dati e informazioni di controllo per un'istanza di Oracle AI Database. Tutti i processi server e in background condividono l'area SGA. Esempi di dati memorizzati nella SGA includono blocchi di dati inseriti nella cache e aree SQL condivise.
-
PGA (Program Global Region)
Una PGA è un'area di memoria non condivisa che contiene dati e informazioni di controllo esclusivamente per l'uso da parte di un processo Oracle. Oracle AI Database crea la PGA all'avvio di un processo Oracle.
Esiste una PGA per ogni processo server e processo in background. La raccolta dei singoli PGA è la PGA dell'istanza totale o la PGA dell'istanza. I parametri di inizializzazione del database impostano la dimensione della PGA dell'istanza, non delle singole PGA.
-
Area globale utente (UGA)
UGA è la memoria associata a una sessione utente.
-
Area globale gestita (MGA)
MGA è un componente di memoria semi-condivisa utilizzato da un'istanza di Oracle AI Database. Ha la capacità di condividere e coordinare la memoria in un piccolo set di processi Oracle affidabili. Ha la capacità di essere configurabile, elastico, modulare, on-demand e riutilizzato. A differenza di SGA, i moduli di Oracle AI Database possono scegliere quali processi collegare a quest'area e questo comportamento è dinamico.
-
Aree di codice software
Le aree del codice software sono parti di memoria utilizzate per memorizzare il codice in esecuzione o che può essere eseguito. Il codice di Oracle AI Database viene memorizzato in un'area software che in genere si trova in una posizione diversa dai programmi utente, una posizione più esclusiva o protetta.
La figura seguente illustra le relazioni tra queste strutture di memoria.
Figura 1: Strutture di memoria di Oracle AI Database
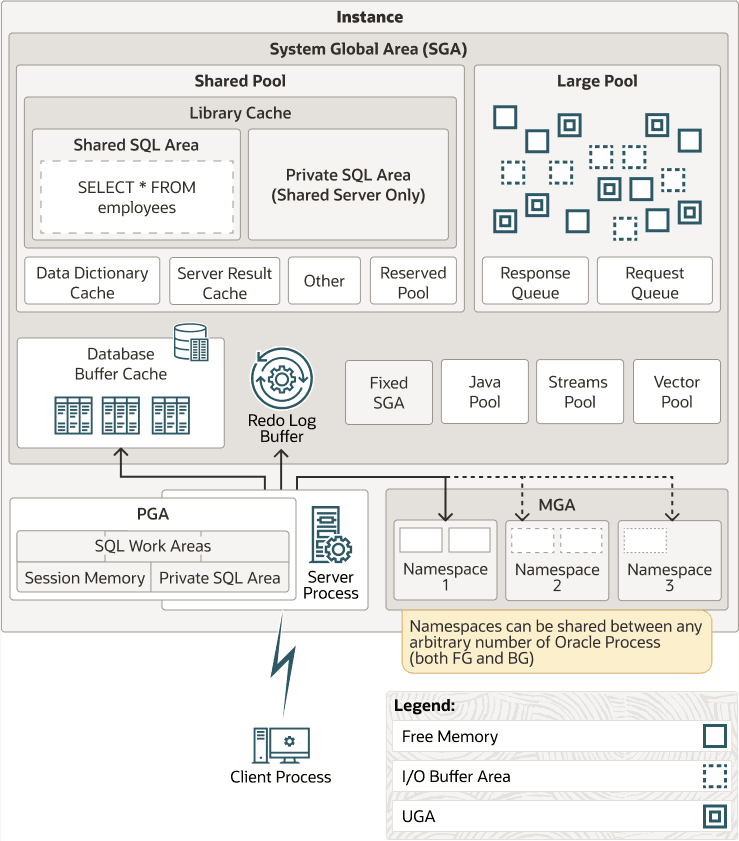
Descrizione dell'illustrazione cncpt217.png
Gestione della memoria di Oracle AI Database
La gestione della memoria prevede la conservazione delle dimensioni ottimali per la struttura di memoria dell'istanza Oracle al variare delle richieste nel database. Oracle AI Database gestisce la memoria in base alle impostazioni dei parametri di inizializzazione correlati alla memoria.
Le opzioni di base per la gestione della memoria sono le seguenti:
-
Gestione unificata della memoria
Unified Memory configura la memoria dell'istanza di database con un singolo parametro,
MEMORY_SIZE. Il database può utilizzare dinamicamente questa memoria per qualsiasi rapporto tra segmenti SGA, PGA, MGA, UGA e altri segmenti di memoria in base al carico di lavoro corrente. La divisione tra segmenti di memoria diversi si basa sul dimensionamento della memoria dei PDB attualmente aperti nel CDB. Se sono configurate pagine di grandi dimensioni, possono essere utilizzate sia per SGA che per PGA. Unified Memory offre una configurazione di memoria estremamente flessibile. -
Gestione automatica della memoria
Specificare la dimensione di destinazione per la memoria dell'istanza di database. L'istanza viene ottimizzata automaticamente in base alla dimensione della memoria di destinazione, ridistribuendo la memoria in base alle esigenze tra SGA e PGA dell'istanza.
-
Gestione automatica della memoria comune
Questa modalità di gestione è parzialmente automatizzata. È possibile impostare una dimensione di destinazione per l'area SGA e quindi impostare una dimensione di destinazione aggregata per l'area PGA o gestire singolarmente le aree di lavoro PGA.
-
Gestione manuale memoria
Anziché impostare la dimensione totale della memoria, è possibile impostare molti parametri di inizializzazione per gestire singolarmente i componenti della SGA e della PGA dell'istanza.
Se si crea un database con Database Configuration Assistant (DBCA) e si sceglie l'opzione di installazione di base, la gestione automatica della memoria è l'impostazione predefinita.
Vedere anche:
-
Oracle AI Database Performance Tuning Guide per ulteriori informazioni sulle opzioni di gestione della memoria per i DBA.
-
Oracle AI Database Administrator's Guide per informazioni sulle opzioni di gestione della memoria.
-
Oracle AI Database Reference per informazioni sui parametri di inizializzazione.
Panoramica dell'area SGA (System Global Area)
SGA è un'area di memoria di lettura/scrittura che, insieme ai processi in background di Oracle, formano un'istanza di database. Nota: i processi server e in background non risiedono all'interno dell'area SGA, ma esistono in uno spazio di memoria separato.
Tutti i processi server eseguiti per conto degli utenti possono leggere le informazioni nell'area SGA dell'istanza. Diversi processi scrivono in SGA durante il funzionamento del database.
Ogni istanza di database ha la propria SGA. Oracle AI Database alloca automaticamente la memoria per una SGA all'avvio dell'istanza e recupera la memoria alla chiusura dell'istanza. Quando si avvia un'istanza con SQL*Plus o Oracle Enterprise Manager, la dimensione di SGA viene visualizzata come nell'esempio riportato di seguito.
SQL> STARTUP
ORACLE instance started.

Total System Global Area  368283648 bytes
Fixed Size                  1300440 bytes
Variable Size             343935016 bytes
Database Buffers           16777216 bytes
Redo Buffers                6270976 bytes
Database mounted.
Database opened.
Come illustrato nella Figura 17-1, la SGA è costituita da diversi componenti di memoria, ovvero pool di memoria utilizzati per soddisfare una determinata classe di richieste di allocazione della memoria. Tutti i componenti SGA, ad eccezione del redo log buffer, allocano e disallocano lo spazio in unità di memoria contigua denominate granule. La dimensione del granulo è specifica della piattaforma ed è determinata dalla dimensione SGA totale.
È possibile eseguire una query sulla vista V$SGASTAT per informazioni sui componenti SGA.
I componenti SGA più importanti sono i seguenti:
-
Database Buffer Cache La database buffer cache, detta anche buffer cache, è l'area di memoria in cui sono memorizzate le copie dei blocchi di dati letti dai file di dati.
-
Buffer redo log Il redo log buffer è un buffer circolare nella SGA che contiene le redo entry che descrivono le modifiche apportate al database.
-
Shared pool Il pool condiviso memorizza nella cache i vari tipi di dati del programma.
-
Large pool: il large pool è un'area di memoria opzionale destinata alle allocazioni di memoria più grandi di quelle appropriate per lo shared pool.
-
Pool Java Il pool Java è un'area di memoria usata per tutto il codice Java specifico della sessione e per i dati contenuti nella JVM (Java Virtual Machine). Questa memoria include gli oggetti Java di cui viene eseguita la migrazione nello spazio della sessione Java al termine della chiamata.
-
SGA fissa La SGA fissa è un'area di housekeeping interna.
-
Aree secondarie SGA correlate alle prestazioni facoltative Alcune aree secondarie SGA sono abilitate solo per funzioni prestazioni specifiche.
Vedere anche:
-
Oracle AI Database Performance Tuning Guide per ulteriori informazioni sul dimensionamento dei granuli
Buffer cache database
La cache buffer del database, detta anche cache buffer, è l'area di memoria in cui sono memorizzate le copie dei blocchi di dati letti dai file di dati.
Un buffer è un indirizzo di memoria principale in cui il buffer manager inserisce temporaneamente nella cache un blocco di dati utilizzato attualmente o di recente. Tutti gli utenti connessi contemporaneamente a un'istanza di database condividono l'accesso alla buffer cache.
-
Scopo della buffer cache del database Oracle AI Database utilizza la buffer cache per raggiungere più obiettivi.
-
Stati del buffer Il database utilizza algoritmi interni per gestire i buffer nella cache.
-
Modalità buffer Quando un client richiede dati, Oracle AI Database recupera i buffer dalla buffer cache del database in modalità corrente o coerente.
-
Buffer I/O A logical I/O, also known as a buffer I/O, refers to reads and writes of buffers in the buffer cache.
-
Pool di buffer Un pool di buffer è una raccolta di buffer.
-
Buffer e scansioni di tabelle complete Il database utilizza un algoritmo complicato per gestire le scansioni di tabelle. Per impostazione predefinita, quando è necessario leggere i buffer dal disco, il database inserisce i buffer al centro dell'elenco LRU. In questo modo, i blocchi caldi possono rimanere nella cache in modo che non sia necessario leggerli di nuovo dal disco.
-
I buffer del database DRAM e PMEM Standard (DRAM) sono diversi dai buffer PMEM, ma condividono le caratteristiche.
Scopo della buffer cache del database
Oracle AI Database utilizza la buffer cache per raggiungere più obiettivi.
Gli obiettivi includono:
-
Ottimizzare le I/O fisiche
Il database aggiorna i blocchi di dati nella cache e memorizza i metadati relativi alle modifiche nel redo log buffer. Dopo un
COMMIT, il database scrive i redo buffer nel redo log in linea, ma non scrive immediatamente i blocchi di dati nei file di dati. Al contrario, database writer (DBW) esegue scritture pigre in background. -
Mantieni i blocchi ad accesso frequente nella buffer cache e scrivi su disco i blocchi ad accesso non frequente
Quando Database Smart Flash Cache (flash cache) è abilitato, parte della buffer cache può risiedere nella flash cache. Questa estensione della buffer cache è memorizzata su uno o più dispositivi flash. Il database può migliorare le prestazioni memorizzando nella cache i buffer nella memoria flash invece di leggere dal disco magnetico.
Utilizzare i parametri di inizializzazione
DB_FLASH_CACHE_FILEeDB_FLASH_CACHE_SIZEper configurare più dispositivi flash. La buffer cache tiene traccia di ogni dispositivo e distribuisce i buffer ai dispositivi in modo uniforme.Nota: Database Smart Flash Cache è disponibile solo in Solaris e Oracle Linux.
-
Gestire le intestazioni del buffer che puntano ai file di dati in Oracle Persistent Memory Filestore (PMEM Filestore)
Se si abilita PMEM Filestore, i file di database vengono mappati per l'accesso diretto in sola lettura. Le query possono ignorare il meccanismo tradizionale della buffer cache, evitando I/O non necessari. In questo caso, le intestazioni del buffer devono memorizzare i metadati corrispondenti ai blocchi PMEM. Il database può comunque utilizzare la cache buffer tradizionale (DRAM) per modifiche, coerenza della lettura e accesso più rapido per i blocchi di dati "hot".
Vedere anche:
-
Oracle AI Database Reference per informazioni sul parametro di inizializzazione
DB_FLASH_CACHE_FILE
Stati buffer
Il database utilizza algoritmi interni per gestire i buffer nella cache.
Un buffer può trovarsi in uno degli stati che si escludono a vicenda:
-
Non utilizzato
Il buffer è disponibile per l'uso perché non è mai stato utilizzato o non è attualmente utilizzato. Questo tipo di buffer è il più semplice da utilizzare per il database.
-
Cancella
Questo buffer è stato utilizzato in precedenza e ora contiene una versione di un blocco coerente in lettura da un point-in-time. Il blocco contiene dati, ma è "pulito", quindi non è necessario eseguirne il checkpoint. Il database può bloccare il blocco e riutilizzarlo.
-
Sporco
Il buffer contiene dati modificati che non sono stati ancora scritti su disco. Il database deve eseguire il checkpoint del blocco prima di riutilizzarlo.
Ogni buffer ha una modalità di accesso: bloccata o libera (non fissata). Un buffer viene "bloccato" nella cache in modo che non invecchi la memoria mentre una sessione utente vi accede. Più sessioni non possono modificare contemporaneamente un buffer bloccato.
Modalità buffer
Quando un client richiede dati, Oracle AI Database recupera buffer dalla buffer cache del database in modalità corrente o coerente.
Le modalità sono le seguenti:
-
Modalità corrente
Un comando current mode get, chiamato anche db block get, è un recupero di un blocco visualizzato nella buffer cache. Ad esempio, se una transazione di cui non è stato eseguito il commit ha aggiornato due righe in un blocco, una modalità corrente recupera il blocco con queste righe di cui non è stato eseguito il commit. Il database utilizza il blocco DB più frequentemente durante le istruzioni di modifica, che devono aggiornare solo la versione corrente del blocco.
-
Modalità coerente
Un read get coerente è il recupero di una versione di un blocco coerente in lettura. Questo recupero può utilizzare undo data. Ad esempio, se una transazione di cui non è stato eseguito il commit ha aggiornato due righe in un blocco e una query in una sessione separata richiede il blocco, il database utilizza i dati di undo per creare una versione coerente in lettura di questo blocco (chiamata copia di lettura coerente) che non include gli aggiornamenti di cui non è stato eseguito il commit. In genere, una query recupera i blocchi in modalità coerente.
Vedere anche:
-
Oracle AI Database Reference per le descrizioni delle statistiche del database come l'acquisizione dei blocchi di database e la lettura coerente
I/O buffer
L'opzione I/O logico, nota anche come I/O buffer, fa riferimento alle letture e alle scritture di tampone effettuate nella buffer cache.
Quando un buffer richiesto non viene trovato in memoria, il database esegue un I/O fisico per copiare il buffer dalla cache flash o dal disco in memoria. Il database esegue quindi un I/O logico per leggere il buffer inserito nella cache.
-
Algoritmi di sostituzione del buffer Per rendere efficiente l'accesso al buffer, il database deve decidere quali buffer inserire nella cache in memoria e quali accedere dal disco.
-
Buffer Writes Il processo database writer (DBW) scrive periodicamente su disco buffer freddi e sporchi.
-
Lettura buffer Quando il numero di buffer non utilizzati è basso, il database deve rimuovere i buffer dalla buffer cache.
-
Conteggi contatti buffer Il database misura la frequenza di accesso dei buffer nell'elenco LRU mediante un conteggio dei contatti. Questo meccanismo consente al database di incrementare un contatore quando viene bloccato un buffer invece di mescolare costantemente i buffer nell'elenco LRU.
Algoritmi di sostituzione del buffer
Per rendere efficiente l'accesso al buffer, il database deve decidere quali buffer memorizzare nella cache e quali accedere dal disco.
Il database utilizza i seguenti algoritmi:
-
Algoritmo di sostituzione a livello di blocco basato su LRU
Questo sofisticato algoritmo, che è l'impostazione predefinita, utilizza un elenco LRU di uso meno recente che contiene puntatori a buffer sporchi e non sporchi. L'elenco LRU ha una estremità calda e fredda. Un cold buffer è un buffer che non è stato utilizzato di recente. Un hot buffer è stato utilizzato di recente e viene utilizzato di frequente. Concettualmente, esiste solo un LRU, ma per la concorrenza dei dati il database utilizza effettivamente diverse LRU.
-
Algoritmo di sostituzione a livello di oggetto basato sulla temperatura
A partire da Oracle Database 12c Release 1 (12.1.0.2), la funzione di inserimento automatico nella cache delle tabelle di grandi dimensioni consente alle scansioni delle tabelle di utilizzare un algoritmo diverso negli scenari riportati di seguito.
-
Query parallele
Nei database a istanza singola e Oracle Real Applications Cluster (Oracle RAC), le query parallele possono utilizzare la cache delle tabelle grandi quando il parametro di inizializzazione
DB_BIG_TABLE_CACHE_PERCENT_TARGETè impostato su un valore diverso da zero ePARALLEL_DEGREE_POLICYè impostato suautooadaptive. -
Query su numeri di serie
Solo in una configurazione a istanza singola, le query seriali possono utilizzare la cache delle tabelle grandi quando il parametro di inizializzazione
DB_BIG_TABLE_CACHE_PERCENT_TARGETè impostato su un valore diverso da zero.
Quando una tabella non si adatta alla memoria, il database decide quali buffer inserire nella cache in base ai pattern di accesso. Ad esempio, se solo il 95% di una tabella popolare si adatta in memoria, il database può scegliere di lasciare il 5% dei blocchi su disco anziché leggere ciclicamente i blocchi in memoria e scrivere i blocchi su disco, un fenomeno noto come thrashing. Quando si inseriscono più oggetti di grandi dimensioni nella cache, il database considera le tabelle più popolari più calde e meno popolari più fredde, il che influenza quali blocchi vengono inseriti nella cache. Il parametro di inizializzazione
DB_BIG_TABLE_CACHE_PERCENT_TARGETimposta la percentuale della buffer cache che utilizza questo algoritmo.Nota: in questo documento viene descritto l'algoritmo di sostituzione a livello di blocco basato su LRU.
-
Vedere anche: Oracle AI Database VLDB and Partitioning Guide per ulteriori informazioni sull'algoritmo basato sulla temperatura
Scritture buffer
Il processo database writer (DBW) scrive periodicamente buffer freddi e sporchi su disco.
DBW scrive i buffer nelle seguenti circostanze:
-
Un processo server non è in grado di trovare buffer di pulizia per la lettura di nuovi blocchi nella buffer cache del database.
Poiché i buffer sono sporchi, il numero di buffer liberi diminuisce. Se il numero scende al di sotto di una soglia interna e se sono necessari buffer puliti, i processi del server segnalano a DBW di scrivere.
Il database utilizza l'LRU per determinare quali buffer sporchi scrivere. Quando i buffer sporchi raggiungono l'estremità fredda dell'LRU, il database li sposta dall'LRU a una coda di scrittura. DBW scrive i buffer nella coda su disco, utilizzando scritture multiblocco, se possibile. Questo meccanismo impedisce alla fine dell'LRU di intasarsi con buffer sporchi e consente di trovare buffer puliti per il riutilizzo.
-
Il database deve far avanzare il checkpoint, ovvero la posizione nel redo thread da cui deve iniziare il recupero dell'istanza.
-
Le tablespace vengono modificate in stato di sola lettura o messe fuori linea.
Vedere anche:
-
Oracle AI Database Performance Tuning Guide per informazioni su come diagnosticare e ottimizzare i problemi di scrittura del buffer
Letture buffer
Quando il numero di buffer non utilizzati è basso, il database deve rimuovere i buffer dalla buffer cache.
L'algoritmo dipende dall'abilitazione della cache flash.
-
Cache flash disabilitata
Il database riutilizza ogni buffer pulito in base alle esigenze, sovrascrivendolo. Se il buffer sovrascritto è necessario in un secondo momento, il database deve leggerlo dal disco magnetico.
-
Cache flash abilitata
DBW può scrivere il corpo di un buffer pulito nella cache flash, consentendo il riutilizzo del buffer in-memory. Il database mantiene l'intestazione del buffer in una lista LRU nella memoria principale per tenere traccia dello stato e della posizione del corpo del buffer nella cache flash. Se questo buffer è necessario in un secondo momento, il database può leggerlo dalla cache flash invece che dal disco magnetico.
Quando un processo client richiede un buffer, il processo del server cerca il buffer nella buffer cache. Un accesso alla cache si verifica se il database trova il buffer in memoria. L'ordine di ricerca è il seguente:
-
Il processo del server cerca l'intero buffer nella buffer cache.
Se il processo trova l'intero buffer, il database esegue una lettura logica di questo buffer.
-
Il processo server cerca l'intestazione del buffer nell'elenco LRU della cache flash.
Se il processo trova l'intestazione del buffer, il database esegue una lettura fisica ottimizzata del corpo del buffer dalla cache flash nella cache in memoria.
-
Se il processo non trova il buffer in memoria (un errore di cache), il processo del server esegue le operazioni riportate di seguito.
-
Copia il blocco da un file di dati su disco in memoria (una lettura fisica)
-
Esegue una lettura logica del buffer letto in memoria
-
La Figura 17-2 illustra l'ordine di ricerca del buffer. La buffer cache estesa include sia la buffer cache in-memory, che contiene buffer interi, sia la flash cache, che contiene buffer body. Nella figura, il database cerca un buffer nella buffer cache e, non trovando il buffer, lo legge in memoria dal disco magnetico.
Figura 2: Ricerca del buffer
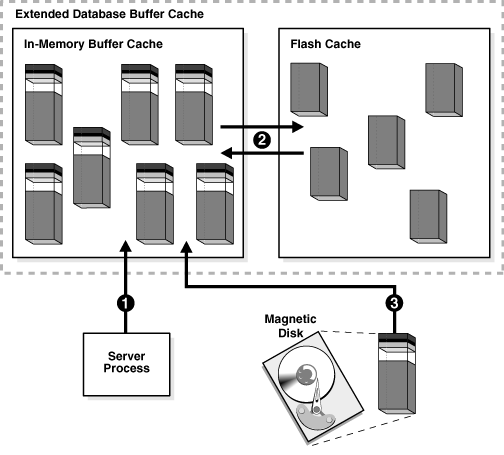
Descrizione dell'illustrazione cncpt304.gif
In generale, l'accesso ai dati mediante una corrispondenza è più veloce dell'accesso alla cache in caso che non venga eseguita la cache. Il rapporto di accessi alla buffer cache misura la frequenza con cui il database ha trovato un blocco richiesto nella buffer cache senza doverlo leggere dal disco.
Il database può eseguire letture fisiche da un file di dati o da un file di modello. Le letture da un file di dati sono seguite da I/O logici. Le letture da un file temporaneo si verificano quando una memoria insufficiente forza la scrittura dei dati del database in una tabella temporanea e la lettura successiva. Queste letture fisiche ignorano la buffer cache e non comportano un I/O logico.
Vedere anche: Oracle AI Database Performance Tuning Guide per informazioni su come calcolare il coefficiente di accessi alla buffer cache
Conteggi contatti buffer
Il database misura la frequenza di accesso dei buffer nell'elenco LRU utilizzando un conteggio dei contatti. Questo meccanismo consente al database di incrementare un contatore quando viene bloccato un buffer invece di mescolare costantemente i buffer nell'elenco LRU.
Nota: il database non sposta fisicamente i blocchi in memoria. Il movimento è il cambiamento di posizione di un puntatore in un elenco.
Quando un buffer viene bloccato, il database determina l'ultimo incremento del conteggio dei contatti. Se il conteggio è stato incrementato oltre tre secondi fa, il conteggio viene incrementato; in caso contrario, il conteggio rimane invariato. La regola di tre secondi impedisce un'esplosione di pin su un buffer contando tutti i tocchi. Ad esempio, una sessione può inserire più righe in un blocco di dati, ma il database considera questi inserimenti come un unico tocco.
Se un buffer si trova all'estremità fredda dell'LRU, ma il suo conteggio dei tocchi è elevato, il buffer si sposta all'estremità calda. Se il conteggio dei contatti è basso, il buffer scade dalla cache.
Buffer pool
Un pool di buffer è una raccolta di buffer.
La buffer cache del database è suddivisa in uno o più pool di buffer, che gestiscono i blocchi nello stesso modo. I pool non dispongono di algoritmi radicalmente diversi per l'invecchiamento o l'inserimento nella cache dei blocchi.
È possibile configurare manualmente pool di buffer separati che mantengano i dati nella buffer cache o rendano i buffer disponibili per i nuovi dati subito dopo l'utilizzo dei blocchi di dati. È quindi possibile assegnare oggetti schema specifici al pool di buffer appropriato per controllare la durata dei blocchi fuori dalla cache. Ad esempio, è possibile separare i segmenti in pool buffer caldi, caldi e freddi.
Di seguito sono riportati i pool di buffer possibili.
-
Pool predefinito
Questo pool è la posizione in cui i blocchi vengono normalmente inseriti nella cache. A meno che non vengano configurati manualmente pool separati, il pool predefinito è l'unico pool di buffer. La configurazione facoltativa degli altri pool non ha effetto sul pool predefinito.
La cache delle grandi tabelle è una sezione facoltativa del pool predefinito che utilizza un algoritmo di sostituzione a livello di oggetto basato sulla temperatura. Nei database a istanza singola e Oracle RAC, le query parallele possono utilizzare la cache delle tabelle grandi quando il parametro di inizializzazione
DB_BIG_TABLE_CACHE_PERCENT_TARGETè impostato su un valore diverso da zero ePARALLEL_DEGREE_POLICYè impostato suautooadaptive. Solo nelle configurazioni a istanza singola, le query seriali possono utilizzare la cache Big Table quando è impostatoDB_BIG_TABLE_CACHE_PERCENT_TARGET. -
Mantieni pool
Questo pool è destinato ai blocchi a cui si è avuto accesso di frequente, ma che sono usciti dal pool predefinito a causa della mancanza di spazio. Lo scopo del buffer pool di mantenimento è quello di mantenere gli oggetti in memoria, evitando così le operazioni di I/O.
Nota: il pool di controllo gestisce i buffer allo stesso modo degli altri pool: non utilizza un algoritmo speciale per fissare i buffer. La parola "mantieni" è una convenzione di denominazione. È possibile posizionare le tabelle che si desidera mantenere nel pool di mantenimento più grande e posizionare le tabelle che non si desidera conservare nel pool di riciclaggio più piccolo.
-
Pool di riciclo
Questo pool è destinato ai blocchi utilizzati raramente. Un pool di riciclo impedisce agli oggetti di consumare spazio non necessario nella cache.
Un database ha una dimensione di blocco standard. È possibile creare una tablespace con una dimensione di blocco diversa dalla dimensione standard. Ogni dimensione del blocco non predefinita ha il proprio pool. Oracle AI Database gestisce i blocchi in questi pool allo stesso modo del pool predefinito.
La figura seguente mostra la struttura della buffer cache quando vengono utilizzati più pool. La cache contiene pool predefiniti, di mantenimento e di riciclo. La dimensione predefinita del blocco è 8 KB. La cache contiene pool separati per le tablespace che utilizzano dimensioni di blocco non standard di 2 KB, 4 KB e 16 KB.
Figura 3: Buffer cache del database
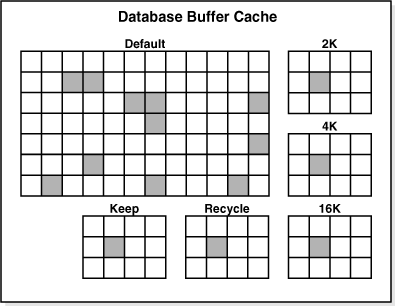
Descrizione dell'illustrazione cncpt220.gif
Vedere anche:
-
Oracle AI Database Administrator's Guide per ulteriori informazioni sui pool di buffer
-
Oracle AI Database Performance Tuning Guide per informazioni su come utilizzare più pool di buffer
-
Oracle AI Database Reference per informazioni sul parametro di inizializzazione
DB_BIG_TABLE_CACHE_PERCENT_TARGET
Buffer e scansioni tabella completa
Il database utilizza un algoritmo complicato per gestire le scansioni delle tabelle. Per impostazione predefinita, quando è necessario leggere i buffer dal disco, il database inserisce i buffer al centro dell'elenco LRU. In questo modo, i blocchi caldi possono rimanere nella cache in modo che non sia necessario leggerli di nuovo dal disco.
Un problema è causato da una scansione della tabella completa, che legge in sequenza tutte le righe sotto la tabella High water mark (HWM). Si supponga che la dimensione totale dei blocchi in un segmento di tabella sia maggiore della dimensione della buffer cache. Una scansione completa di questa tabella potrebbe eliminare la buffer cache, impedendo al database di mantenere una cache di blocchi ad accesso frequente.
-
Modalità predefinita per le scansioni di tabelle complete Per impostazione predefinita, il database adotta un approccio conservativo alle scansioni di tabelle complete, caricando una tabella di piccole dimensioni in memoria solo quando la dimensione della tabella è una piccola percentuale della buffer cache.
-
Esecuzione di query parallele Quando si esegue una scansione completa della tabella, il database può talvolta migliorare i tempi di risposta utilizzando più server di esecuzione parallela.
-
Attributo CACHE Nei rari casi in cui il funzionamento predefinito della CACHE non è desiderato, è possibile utilizzare
ALTER TABLE ... CACHEper modificare la modalità di lettura dei blocchi di tabelle di grandi dimensioni nella buffer CACHE del database. -
AttributoKEEP Per le tabelle di grandi dimensioni, è possibile utilizzare
ALTER TABLE ... STORAGE BUFFER_POOL KEEPper fare in modo che le scansioni carichino i blocchi per queste tabelle nel pool di controllo. -
Forza modalità cache database completo Per migliorare le prestazioni in alcune situazioni, è possibile eseguire in modo esplicito l'istruzione
ALTER DATABASE ... FORCE FULL DATABASE CACHINGper abilitare la modalità di inserimento nella cache del database completo. Vedi anche: "Segment Space and the High Water Mark"
Modalità predefinita per scansioni tabella completa
Per impostazione predefinita, il database adotta un approccio conservativo alle scansioni di tabelle complete, caricando una piccola tabella in memoria solo quando la dimensione della tabella è una piccola percentuale della buffer cache.
Per determinare se le tabelle di medie dimensioni devono essere inserite nella cache, il database utilizza un algoritmo che incorpora l'intervallo tra l'ultima scansione della tabella, l'indicatore orario di durata della buffer cache e lo spazio rimanente nella buffer cache.
Per le tabelle molto grandi, il database in genere utilizza una lettura del percorso diretto, che carica i blocchi direttamente nella PGA e ignora completamente la SGA, per evitare di popolare la buffer cache. Per le tabelle di medie dimensioni, il database può utilizzare una lettura diretta o una lettura cache. Se decide di utilizzare una lettura della cache, il database posiziona i blocchi alla fine dell'elenco LRU per evitare che la scansione elimini efficacemente la buffer cache.
A partire da Oracle Database 12c Release 1 (12.1.0.2), la buffer cache di un'istanza di database esegue automaticamente un calcolo interno per determinare se la memoria è sufficiente perché il database venga inserito completamente nella cache nell'area SGA dell'istanza e se l'inserimento delle tabelle nella cache dell'accesso risulta vantaggioso per le prestazioni. Se l'intero database può integrarsi completamente nella memoria e se vengono soddisfatti vari altri criteri interni, Oracle AI Database considera tutte le tabelle del database come piccole tabelle e le considera idonee per l'inserimento nella cache. Tuttavia, il database non inserisce nella cache i LOB contrassegnati con l'attributo NOCACHE.
Esecuzione query parallela
Quando si esegue una scansione completa delle tabelle, il database a volte può migliorare i tempi di risposta utilizzando più server di esecuzione parallela.
In alcuni casi, come quando il database ha una grande quantità di memoria, il database può memorizzare nella cache i dati di query parallele nell'area SGA (System Global Area) invece di utilizzare letture di percorso diretto nell'area PGA (Program Global Area). In genere, le query parallele si verificano nei data warehouse a bassa valuta a causa del potenziale uso delle risorse.
Vedere anche:
-
Oracle AI Database Data Warehousing Guide per un'introduzione ai data warehouse
-
Oracle AI Database VLDB and Partitioning Guide per ulteriori informazioni sull'esecuzione parallela
Attributo CACHE
Nei rari casi in cui il funzionamento predefinito della cache non è desiderato, è possibile utilizzare ALTER TABLE ... CACHE per modificare la modalità di lettura dei blocchi di tabelle di grandi dimensioni nella buffer cache del database.
Per le tabelle con l'attributo CACHE impostato, il database non forza o blocca i blocchi nella buffer cache. Invece, il database elimina i blocchi dalla cache allo stesso modo di qualsiasi altro blocco di tabella. Prestare attenzione quando si esercita questa opzione perché una scansione completa di una tabella di grandi dimensioni può cancellare la maggior parte degli altri blocchi dalla cache. Nota: l'esecuzione di ALTER TABLE ... CACHE non causa una tabella da inserire nella cache.
Attributo KEEP
Per le tabelle di grandi dimensioni, è possibile utilizzare ALTER TABLE ... STORAGE BUFFER_POOL KEEP per fare in modo che le scansioni carichino i blocchi per queste tabelle nel pool di controllo.
L'inserimento di una tabella nel pool di controllo modifica la parte della buffer cache in cui sono memorizzati i blocchi. Invece di inserire i blocchi nella cache nel pool di buffer predefinito, il database li inserisce nella cache del pool di buffer di conservazione. Nessun algoritmo separato controlla l'inserimento nella cache del pool.
Vedere anche:
-
Oracle AI Database SQL Language Reference per informazioni sulla clausola
CACHEe sull'attributoKEEP -
Oracle AI Database Performance Tuning Guide per informazioni su come interpretare le statistiche di avviso della buffer cache
Forza modalità inserimento nella cache database completo
Per migliorare le prestazioni in alcune situazioni, è possibile eseguire in modo esplicito l'istruzione ALTER DATABASE ... FORCE FULL DATABASE CACHING per abilitare la modalità Applica inserimento nella cache del database completo.
A differenza della modalità predefinita, che è automatica, la modalità di inserimento forzato completo nella cache del database considera l'intero database, inclusi i LOB NOCACHE, come idoneo per l'inserimento nella cache nella buffer cache del database. Questa modalità è disponibile a partire da Oracle Database 12c Release 1 (12.1.0.2). Nota: l'abilitazione della modalità Forza inserimento completo nella cache del database non forza la memoria del database. Piuttosto, l'intero database è idoneo a essere inserito nella cache del buffer. Oracle AI Database inserisce le tabelle nella cache solo quando vi si accede.
Oracle consiglia di abilitare la modalità Forza inserimento completo nella cache del database solo quando la dimensione della buffer cache di ogni singola istanza è maggiore della dimensione del database. Questa linea guida si applica sia ai database a istanza singola che ai database Oracle RAC. Tuttavia, quando le applicazioni Oracle RAC sono ben partizionate, è possibile abilitare la modalità Forza inserimento completo nella cache del database quando la buffer cache combinata di tutte le istanze, con spazio aggiuntivo per gestire blocchi duplicati inseriti nella cache tra le istanze, è maggiore della dimensione del database.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come abilitare la modalità Forza inserimento completo nella cache del database
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sull'istruzione
ALTER DATABASE ... FORCE FULL DATABASE CACHING
Buffer DRAM e PMEM
I buffer di database standard (DRAM) differiscono dai buffer PMEM, ma condividono le caratteristiche.
Quando Oracle Persistent Memory Filestore (PMEM Filestore) è configurato, ogni blocco di dati viene mappato direttamente alla buffer cache in DRAM. A differenza dei buffer DRAM, i buffer PMEM non copiano il contenuto dei blocchi di dati. Piuttosto, le intestazioni del buffer PMEM puntano ai blocchi di dati memorizzati in PMEM Filestore. Per la maggior parte delle letture, il database memorizza nella cache solo i metadati del blocco, non i contenuti. I buffer PMEM utilizzano un tipo speciale di granulo la cui struttura è diversa dai granuli della buffer cache standard.
Nota: il parametro di inizializzazione DB_CACHE_SIZE specifica la dimensione minima della cache DRAM. Sovraccarico dei metadati PMEM non incluso in questa allocazione.
I buffer PMEM possono trovarsi in ciascuno degli stati seguenti:
-
Corrente
Versione corrente di un buffer PMEM. È possibile accedervi direttamente dal fileestore.
Oracle AI Database mantiene la versione corrente di PMEM separata dalla versione corrente del buffer DRAM standard. Questa separazione aiuta a ridurre la complessità del codice durante il pinning a blocchi PMEM, il cleanup e la migrazione a DRAM.
-
Coerente
Questa è la versione di lettura coerente di un buffer PMEM. Viene creata dopo la creazione di una copia in DRAM da parte del database. Il buffer PMEM è accessibile direttamente dal fileestore.
-
Gratuita
Questo è un buffer PMEM gratuito. Può essere riutilizzato da un blocco PMEM. Dopo l'avvio dell'istanza, tutti i buffer PMEM sono in stato libero.
PMEM ha una latenza maggiore rispetto a DRAM. Oracle AI Database utilizza un algoritmo interno basato sul carico di lavoro per decidere quali blocchi migrare da PMEM a DRAM.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come impostare PMEM Filestore
Buffer di redo log
Il redo log buffer è un buffer circolare nella SGA che contiene le redo entry che descrivono le modifiche apportate al database.
Un redo record è una struttura di dati che contiene le informazioni necessarie per ricostruire o ripetere le modifiche apportate al database dalle operazioni DML o DDL. Il recupero del database applica i redo entry ai file di dati per ricostruire le modifiche perse.
I processi del database copiano i redo entry dallo spazio di memoria dell'utente al redo log buffer nell'area SGA. Le redo entry occupano spazio sequenziale continuo nel buffer. Il processo Log Writer (LGWR) del processo in background scrive il redo log buffer nel gruppo di redo log in linea attivo sul disco. La Figura 17-4 mostra questa attività del redo buffer.
Figura 4: Buffer di redo log
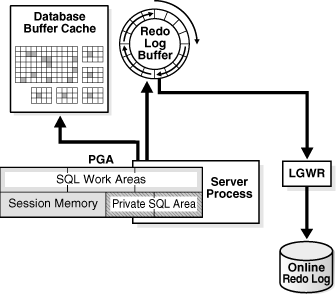
Descrizione dell'illustrazione cncpt226.gif
LGWR scrive redo in sequenza su disco mentre DBW esegue scritture sparse di blocchi di dati su disco. Le scritture sparse tendono ad essere molto più lente delle scritture sequenziali. Poiché LGWR consente agli utenti di evitare di attendere che DBW completi le sue scritture lente, il database offre prestazioni migliori.
Il parametro di inizializzazione LOG_BUFFER specifica la quantità di memoria utilizzata da Oracle AI Database durante il buffering delle redo entry. A differenza di altri componenti SGA, il redo log buffer e il buffer SGA fisso non dividono la memoria in granuli.
Vedere anche:
-
"Processo Log Writer (LGWR)" e "Importanza dei checkpoint per il recupero delle istanze"
-
Oracle AI Database Administrator's Guide per informazioni sul redo log in linea
Shared pool
Il pool condiviso memorizza nella cache i vari tipi di dati del programma.
Ad esempio, lo shared pool memorizza le informazioni SQL analizzate, il codice PL/SQL, i parametri di sistema e il dizionario dati. Lo shared pool è coinvolto in quasi tutte le operazioni che si verificano nel database. Ad esempio, se un utente esegue un'istruzione SQL, Oracle AI Database accede allo shared pool.
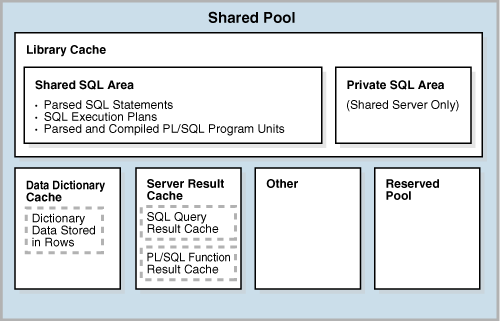
Lo shared pool è suddiviso in diversi sottocomponenti, i più importanti dei quali sono illustrati nella Figura 17-5.
Figura 5: Shared pool
Descrizione dell'illustrazione cncpt225.gif
Questa sezione comprende gli argomenti riportati di seguito.
-
Cache della libreria La cache della libreria è una struttura di memoria dello shared pool che memorizza codice SQL eseguibile e codice PL/SQL.
-
Cache dizionario dati Il dizionario dati è una raccolta di tabelle e viste di database che contengono informazioni di riferimento sul database, sulle sue strutture e sui suoi utenti.
-
Cache dei risultati server La cache dei risultati del server è un pool di memoria all'interno dello shared pool. A differenza dei pool di buffer, la cache dei risultati del server contiene i set di risultati e non i blocchi di dati.
-
Pool riservato Il pool riservato è un'area di memoria nello shared pool che Oracle AI Database può utilizzare per allocare grandi chunk contigui di memoria.
Cache della libreria
La cache della libreria è una struttura di memoria dello shared pool che memorizza il codice SQL e PL/SQL eseguibile.
Questa cache contiene le aree SQL e PL/SQL condivise e le strutture di controllo quali i blocchi e gli handle della cache della libreria. In un'architettura server condivisa, la cache della libreria contiene anche aree SQL private.
Quando viene eseguita un'istruzione SQL, il database tenta di riutilizzare il codice eseguito in precedenza. Se una rappresentazione analizzata di un'istruzione SQL esiste nella cache della libreria e può essere condivisa, il database riutilizza il codice, noto come soft parse o accesso alla cache della libreria. In caso contrario, il database deve creare una nuova versione eseguibile del codice dell'applicazione, nota come hard parse o mi piace alla cache della libreria.
-
Aree SQL condivise Il database rappresenta ogni istruzione SQL eseguita nell'area SQL condivisa e nell'area SQL privata.
-
Unità di programma e cache della libreria La cache della libreria contiene forme eseguibili di programmi PL/SQL e classi Java. Questi elementi vengono definiti collettivamente unità di programma.
-
Allocazione e riutilizzo della memoria nello shared pool Il database alloca la memoria dello shared pool quando viene analizzata una nuova istruzione SQL, a meno che l'istruzione non sia DDL, che non è considerata condivisibile. La dimensione della memoria allocata dipende dalla complessità dell'istruzione.
Aree SQL condivise
Il database rappresenta ogni istruzione SQL eseguita nell'area SQL condivisa e nell'area SQL privata.
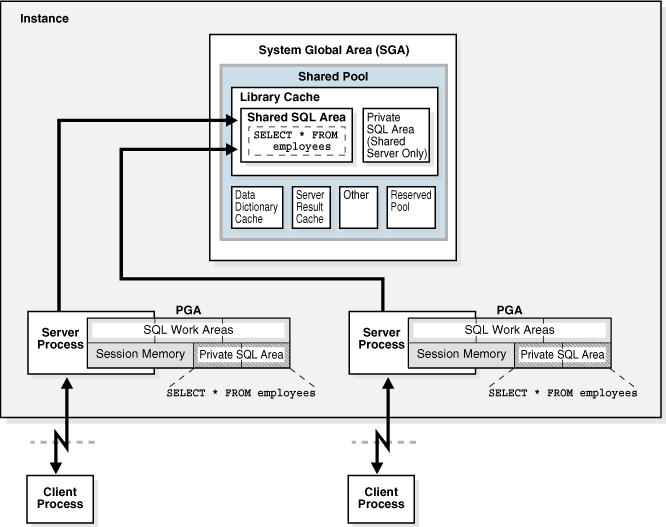
Il database utilizza l'area SQL condivisa per elaborare la prima occorrenza di un'istruzione SQL. Quest'area è accessibile a tutti gli utenti e contiene la struttura di analisi delle istruzioni e il piano di esecuzione. Esiste una sola area SQL condivisa per un'istruzione univoca. Ogni sessione che emette un'istruzione SQL ha un'area SQL privata nella PGA. Ogni utente che invia la stessa istruzione dispone di un'area SQL privata che punta alla stessa area SQL condivisa. Pertanto, molte aree SQL private in aree PGA separate possono essere associate alla stessa area SQL condivisa.
Il database determina automaticamente quando le applicazioni inviano istruzioni SQL simili. Il database considera sia le istruzioni SQL emesse direttamente da utenti e applicazioni che le istruzioni SQL ricorsive emesse internamente da altre istruzioni.
Il database esegue i passi riportati di seguito.
-
Controlla lo shared pool per verificare l'esistenza di un'area SQL condivisa per un'istruzione sintatticamente e semanticamente identica:
-
Se esiste un'istruzione identica, il database utilizza l'area SQL condivisa per l'esecuzione delle nuove istanze successive dell'istruzione, riducendo così il consumo di memoria.
-
Se non esiste un'istruzione identica, il database alloca una nuova area SQL condivisa nello shared pool. Un'istruzione con la stessa sintassi ma semantica diversa utilizza un cursore secondario.
In entrambi i casi, l'area SQL privata per l'utente punta all'area SQL condivisa che contiene l'istruzione e il piano di esecuzione.
-
-
Alloca un'area SQL privata per conto della sessione
La posizione dell'area SQL privata dipende dalla connessione stabilita per la sessione. Se una sessione è connessa tramite un server condiviso, parte dell'area SQL privata viene conservata nell'area SGA.
La Figura 17-6 mostra un'architettura server dedicata in cui due sessioni conservano una copia della stessa istruzione SQL nei propri PGA. In un server condiviso, questa copia viene utilizzata nella fase UGA, che si trova nella fase MGA.
Figura 6: Aree SQL private e area SQL condivisa
Descrizione dell'illustrazione cncpt252.gif
Vedere anche:
-
Oracle AI Database Performance Tuning Guide per ulteriori informazioni sulla gestione della cache della libreria
-
Oracle AI Database Development Guide per ulteriori informazioni su SQL condiviso
Unità di programma e library cache
La cache della libreria contiene forme eseguibili di programmi PL/SQL e classi Java. Questi elementi vengono definiti collettivamente unità di programma.
Il database elabora le program unit in modo simile alle istruzioni SQL. Ad esempio, il database alloca un'area condivisa per contenere la forma analizzata e compilata di un programma PL/SQL. Il database alloca un'area privata per contenere valori specifici della sessione che esegue il programma, incluse le variabili locali, globali e dei pacchetti e i buffer per l'esecuzione di SQL. Se più utenti eseguono lo stesso programma, ogni utente gestisce una copia separata della propria area SQL privata, che contiene valori specifici della sessione e accede a una singola area SQL condivisa.
Il database elabora le singole istruzioni SQL all'interno di una program unit PL/SQL come descritto in precedenza. Nonostante le origini all'interno di una program unit PL/SQL, queste istruzioni SQL utilizzano un'area condivisa per contenere le rappresentazioni analizzate e un'area privata per ogni sessione che esegue l'istruzione.
Allocazione e riutilizzo della memoria nello shared pool
Il database alloca la memoria dello shared pool quando viene analizzata una nuova istruzione SQL, a meno che l'istruzione non sia DDL, che non viene considerata condivisibile. La dimensione della memoria allocata dipende dalla complessità dell'istruzione.
In generale, un elemento nello shared pool rimane fino a quando il database non lo rimuove in base a un algoritmo LRU (Minimum Recent Used). Il database consente agli elementi dello shared pool utilizzati da molte sessioni di rimanere in memoria finché sono utili, anche se il processo di database che ha creato l'elemento termina. Questo meccanismo riduce al minimo il sovraccarico e l'elaborazione delle istruzioni SQL. Se è necessario spazio per i nuovi elementi, il database libera la memoria utilizzata dagli elementi non utilizzati di frequente.
L'istruzione ALTER SYSTEM FLUSH SHARED_POOL rimuove tutte le informazioni nello shared pool, così come la modifica del nome del database globale.
Vedere anche:
-
Oracle AI Database SQL Tuning Guide per una panoramica del ciclo di vita di un'area SQL condivisa
-
Oracle AI Database SQL Language Reference per informazioni sull'uso di
ALTER SYSTEM FLUSH SHARED_POOL -
Oracle AI Database Reference per informazioni sulle viste dinamiche
V$SQLeV$SQLAREA
Cache dizionario dati
Il dizionario dati è una raccolta di tabelle e viste di database che contengono informazioni di riferimento sul database, sulle sue strutture e sui suoi utenti.
Oracle AI Database accede frequentemente al dizionario dati durante l'analisi delle istruzioni SQL. Oracle AI Database accede al dizionario dati così spesso che le seguenti posizioni di memoria speciali sono designate per contenere i dati del dizionario:
-
Cache del dizionario dati
Questa cache contiene informazioni sugli oggetti di database. La cache è nota anche come cache delle righe perché contiene i dati come righe anziché come buffer.
-
Cache della libreria
Tutti i processi server condividono queste cache per l'accesso alle informazioni del dizionario dati.
Vedere anche:
-
Oracle AI Database Performance Tuning Guide per informazioni su come allocare memoria aggiuntiva alla cache del dizionario dati
Cache risultati server
La cache dei risultati del server è un pool di memoria all'interno dello shared pool. A differenza dei pool di buffer, la cache dei risultati del server contiene i set di risultati e non i blocchi di dati. Nota: una cache dei risultati del client è diversa dalla cache dei risultati del server. Una cache client è configurata a livello di applicazione e si trova nella memoria client, non nella memoria del database.
-
Cache dei risultati delle query SQL La cache dei risultati delle query SQL è un sottoinsieme della cache dei risultati del server che memorizza i risultati delle query e dei frammenti delle query. È possibile abilitare o disabilitare l'inserimento dei risultati nella cache a livello di database o istruzione.
-
Cache dei risultati delle funzioni PL/SQL La Cache dei risultati delle funzioni PL/SQL è un sottoinsieme della cache dei risultati del server che memorizza i set di risultati delle funzioni.
-
Infrastruttura cache risultati server La cache dei risultati della query e la cache dei risultati della funzione PL/SQL condividono la stessa infrastruttura.
-
Interfaccia utente cache risultati server Il parametro di inizializzazione
RESULT_CACHE_MODEdetermina se la cache dei risultati della query SQL viene utilizzata per tutte le query possibili o solo per le query suggerite.
Cache risultati query SQL
La cache dei risultati delle query SQL è un sottoinsieme della cache dei risultati del server che memorizza i risultati delle query e dei frammenti di query. È possibile abilitare o disabilitare l'inserimento dei risultati nella cache a livello di database o istruzione.
Quando viene eseguita una query, il database determina se il risultato esiste nella cache dei risultati della query. Se il risultato non viene inserito nella cache e l'inserimento nella cache è abilitato per la query, il database esegue la query, restituisce il risultato e quindi la inserisce nella cache. Se il risultato esiste, tuttavia, il database lo recupera dalla cache invece di eseguire la query.
Il database invalida automaticamente un risultato inserito nella cache ogni volta che una transazione modifica i dati o i metadati degli oggetti di database utilizzati per creare il risultato. La query successiva non può utilizzare il risultato inserito nella cache, quindi il database calcola automaticamente un nuovo risultato e quindi lo inserisce nella cache per essere utilizzato dalle query successive. Il processo di aggiornamento della cache è trasparente per l'applicazione.
In effetti, la cache dei risultati della query funziona come una vista materializzata "just-in-time" che il database crea e gestisce in base alle esigenze. La cache consente al database di evitare il costoso funzionamento di rileggere i blocchi di dati e di ricalcolare i risultati. La maggior parte delle applicazioni trae vantaggio da questo miglioramento delle prestazioni.
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come ottimizzare i tempi di risposta utilizzando la cache dei risultati delle query
Cache risultati funzione PL/SQL
La cache dei risultati delle funzioni PL/SQL è un sottoinsieme della cache dei risultati del server che memorizza i set di risultati delle funzioni.
Senza l'inserimento nella cache, 1000 chiamate di una funzione PL/SQL a 1 secondo per chiamata richiederebbero 1000 secondi. Con l'inserimento nella cache, 1000 chiamate di funzione con gli stessi input potrebbero richiedere totale di 1 secondo. I candidati validi per l'inserimento dei risultati nella cache sono funzioni spesso richiamate che dipendono da dati relativamente statici.
Il codice funzione PL/SQL può includere una richiesta di inserimento nella cache dei risultati. Al richiamo di questa funzione, il sistema controlla la cache. Se la cache contiene il risultato di una chiamata di funzione precedente con gli stessi valori dei parametri, il sistema restituisce il risultato al chiamante e non riesegue il corpo della funzione. Se la cache non contiene il risultato, il sistema esegue il corpo della funzione e aggiunge il risultato (per questi valori di parametro) alla cache prima di restituire il controllo al chiamante.
Nota: è possibile specificare gli oggetti di database utilizzati per calcolare un risultato inserito nella cache, in modo che, se uno qualsiasi di essi viene aggiornato, il risultato inserito nella cache diventi non valido e debba essere ricalcolato.
Una funzione che viene richiamata frequentemente con argomenti diversi può generare risultati che vengono raramente riutilizzati, con conseguente peggioramento delle prestazioni. Oracle AI Database tiene traccia delle funzioni PL/SQL utilizzate di recente che dispongono del suggerimento RESULT_CACHE. Utilizzando questa cronologia, il database memorizza nella cache solo una coppia di funzioni e argomenti PL/SQL se l'ha vista x volte nella cronologia recente, dove x è impostato da una soglia interna. Se il database richiede più memoria perché troppi risultati vengono inseriti nella cache, uno o più risultati inseriti nella cache scadono.
RESULT_CACHE_EXECUTION_THRESHOLD specifica il numero di volte in cui una funzione e un determinato set di argomenti devono essere visualizzati fino a quando non viene inserita nella cache. Si noti che le funzioni sono considerate univoche se hanno argomenti diversi, ad esempio MYFUNC(1,2) e MYFUNC(1,3). È possibile impostare questo parametro solo a livello di sistema, non a livello di sessione.
Vedere anche:
-
Oracle AI Database Development Guide per ulteriori informazioni sulla cache dei risultati delle funzioni PL/SQL
-
Oracle AI Database PL/SQL Language Reference per ulteriori informazioni sulla cache dei risultati delle funzioni PL/SQL
Infrastruttura cache risultati server
La cache dei risultati della query e la cache dei risultati della funzione PL/SQL condividono la stessa infrastruttura.
Tipi di oggetto: Risultato, Dipendenza e Temp
Nella cache dei risultati del server, un oggetto risultato è una struttura dati che memorizza le righe restituite da una query o da una funzione PL/SQL. Un oggetto dipendenza memorizza i metadati per gli oggetti a cui fanno riferimento le query memorizzate come oggetti risultato.
Un tipico risultato delle query è piccolo, costoso da calcolare, riutilizzato spesso e basato su tabelle non volatili. Tuttavia, i risultati a volte possono essere grandi. Se un risultato della query supera il limite di dimensione, il database memorizza parte del risultato come oggetto modello e parte come oggetto risultato standard. Un oggetto temporaneo è una raccolta di metadati della cache dei risultati che punta a un segmento di tablespace temporanea contenente il risultato effettivo della query.
Cache secondarie risultati
A seconda del carico di lavoro, il database può creare cache dei risultati per supportare una concorrenza più elevata durante l'accesso in lettura/scrittura. Oracle AI Database utilizza un algoritmo interno per decidere se creare le cache secondarie e, in caso affermativo, quante creare.
Interfaccia utente cache risultati server
Il parametro di inizializzazione RESULT_CACHE_MODE determina se la cache dei risultati delle query SQL viene utilizzata per tutte le query possibili o solo per le query suggerite.
Il parametro di inizializzazione RESULT_CACHE_MAX_TEMP_SIZE controlla la quantità massima di memoria tablespace temporanea che la cache dei risultati può utilizzare nel PDB. RESULT_CACHE_MAX_TEMP_RESULT controlla la quantità massima di memoria tablespace temporanea che una query memorizzata nella cache può utilizzare.
Per eseguire l'override dell'impostazione del parametro RESULT_CACHE_MODE, è possibile annotare una query o un frammento di query con un suggerimento RESULT_CACHE. A partire da Oracle Database 21c, il suggerimento accetta l'opzione TEMP={TRUE|FALSE}, che controlla se i risultati possono essere memorizzati in una tablespace temporanea.
Il pacchetto DBMS_RESULT_CACHE consente di amministrare la parte dello shared pool utilizzata dalla cache dei risultati SQL e dalla cache dei risultati della funzione PL/SQL. È possibile invalidare oggetti, query e oggetti dell'elenco di blocchi ed eseguire operazioni correlate.
La colonna V$RESULT_CACHE_OBJECTS.TYPE indica il tipo di oggetti nella cache. Se i risultati della query vengono memorizzati nella tablespace temporanea, TYPE mostra due oggetti: Result e Temp. I metadati della cache secondaria sono accessibili mediante V$RESULT_SUBCACHE_STATISTICS e le viste correlate.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni sul dimensionamento e sul controllo del funzionamento della cache dei risultati
-
Oracle AI Database PL/SQL Packages and Types Reference per informazioni sul package
DBMS_RESULT_CACHE -
Oracle AI Database Performance Tuning Guide per ulteriori informazioni sulla cache dei risultati del client
-
Oracle AI Database Reference per ulteriori informazioni sul parametro di inizializzazione
RESULT_CACHE_MODE -
Oracle AI Database SQL Language Reference per ulteriori informazioni sul suggerimento
RESULT_CACHE
Pool riservato
Il pool riservato è un'area di memoria nello shared pool che Oracle AI Database può utilizzare per allocare grandi chunk contigui di memoria.
Il database alloca la memoria dallo shared pool in chunk. Il chunking consente di caricare nella cache oggetti di grandi dimensioni (oltre 5 KB) senza richiedere una singola area contigua. In questo modo, il database riduce la possibilità di esaurire la memoria contigua a causa della frammentazione.
Non di rado, i cursori Java, PL/SQL o SQL possono eseguire allocazioni dallo shared pool di dimensioni superiori a 5 KB. Per consentire l'esecuzione più efficiente di queste allocazioni, il database separa una piccola quantità di shared pool per il pool riservato.
Vedere anche: Oracle AI Database Performance Tuning Guide per informazioni su come configurare il pool riservato
Large pool
Il large pool è un'area di memoria opzionale destinata alle allocazioni di memoria più grandi di quelle appropriate per lo shared pool.
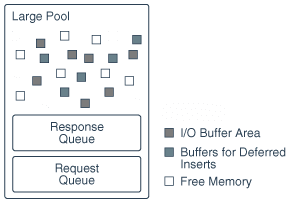
Il pool di grandi dimensioni può fornire allocazioni di memoria di grandi dimensioni per i seguenti elementi:
-
Buffer di messaggi utilizzati nell'esecuzione parallela
-
Buffer per processi figlio I/O Recovery Manager (RMAN)
-
Buffer per inserti differiti (inserisce con il suggerimento
MEMOPTIMIZE_WRITE)
La figura seguente mostra la grande piscina.
Figura 7: Piscina grande
Descrizione dell'illustrazione cncpt221.png
-
Gestione della memoria di pool di grandi dimensioni Il pool di grandi dimensioni gestisce la memoria in modo diverso dallo shared pool, che utilizza un elenco LRU in modo che le parti di memoria possano scadere.
-
Buffer pool di grandi dimensioni per inserimenti differiti Per un tipo speciale di inserimento noto come inserimento differito, il database alloca i buffer dal pool di grandi dimensioni.
Vedere anche:
-
"Query Coordinator" per informazioni sull'allocazione della memoria per l'esecuzione parallela
-
"Code di richieste e risposte dispatcher" per informazioni sull'allocazione della memoria di sessione per il server condiviso
-
Guida allo sviluppo di Oracle AI Database per ulteriori informazioni su Oracle XA
-
Oracle AI Database Performance Tuning Guide per ulteriori informazioni sul pool di grandi dimensioni
Gestione memoria pool di grandi dimensioni
Il pool di grandi dimensioni gestisce la memoria in modo diverso dallo shared pool, che utilizza un elenco LRU in modo che parti di memoria possano scadere.
Il pool di grandi dimensioni non ha un elenco LRU. Quando il database alloca memoria pool di grandi dimensioni a una sessione del database, questa memoria non è idonea per essere rilasciata a meno che la sessione non la rilasci. Non appena una parte della memoria viene liberata, altri processi possono usarla. Allocando la memoria di sessione dal pool di grandi dimensioni, il database evita la frammentazione che può verificarsi nello shared pool.
Buffer pool di grandi dimensioni per inserimento differito
Per un tipo speciale di inserimento noto come inserimento differito, il database alloca i buffer dal pool di grandi dimensioni.
Per gli inserimenti rapidi "fire and forget" dalle applicazioni Internet of Things (IoT), l'infrastruttura di database crea un sovraccarico delle prestazioni. Ad esempio, il percorso del codice include la navigazione nella buffer cache, i pin del buffer e le protezioni della concorrenza. Gli inserti di array riducono al minimo questi costi, ma l'array deve essere costruito sul lato client, che non è tipico per le applicazioni Internet of Things. Per risolvere questo problema, un'applicazione Oracle può utilizzare un suggerimento per inserire righe in una tabella specificata come MEMOPTIMIZE FOR WRITE.
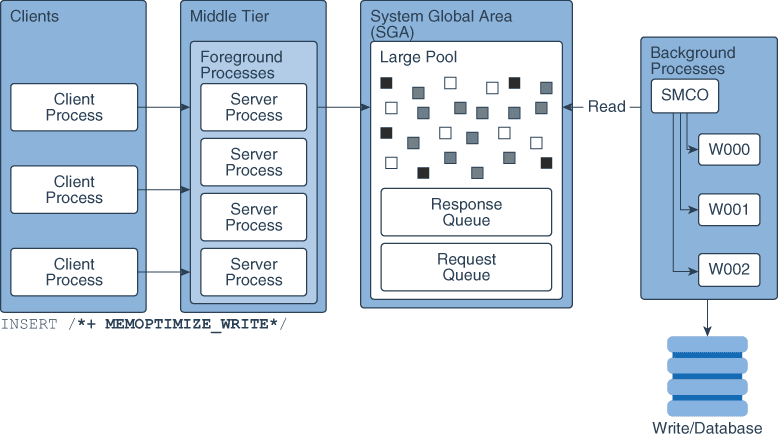
Gli inserimenti vengono differiti in quanto vengono memorizzati nel buffer nel pool di grandi dimensioni e quindi scritti su disco in modo asincrono dai processi in background. Il database elabora gli inserimenti differiti come indicato di seguito.
-
L'applicazione invia inserimenti
MEMOPTIMIZE_WRITEa un livello intermedio, che può aggregare i dati. Mentre un'applicazione IoT invierà quasi sempre inserti al livello intermedio, è anche possibile inviare inserti direttamente al database. Ad esempio, l'utilizzo di SQL*Plus invia gli inserti direttamente al database. -
Il livello intermedio scrive l'aggregazione degli inserti nel database server.
-
Facoltativamente, il client di livello intermedio conserva una copia locale dei dati scritti nel passo precedente.
-
Un processo server scrive i dati in un buffer o buffer nel pool di grandi dimensioni.
Per evitare conflitti, ogni buffer ha il proprio meccanismo di blocco interno. Questo meccanismo di blocco è separato dal meccanismo di blocco utilizzato dalla buffer cache del database per i relativi buffer. Il processo di scrittura di base è il seguente:
-
Dopo l'avvio dell'istanza, il primo inserimento
MEMOPTIMIZE_WRITEalloca i buffer dal pool di grandi dimensioni. -
Il writer sceglie un buffer dall'elenco dei buffer disponibili.
-
Se il buffer scelto non è bloccato e se questo buffer ha spazio libero, il client scrive nel buffer, timbrando ogni scrittura del buffer con un numero di sequenza specifico della sessione. In caso contrario, lo scrittore torna al passo precedente e continua in questo modo fino a quando non viene trovato un buffer o viene liberato spazio sufficiente nel pool di grandi dimensioni.
-
-
Il database crea un array lato server dai dati memorizzati nel buffer.
-
Lo Space Management Coordinator (SMCO) e i relativi processi helper (Wnnn) scrivono l'array su disco in modo asincrono utilizzando il formato di blocco di dati standard.
A differenza degli inserimenti standard, gli inserimenti differiti vengono sottoposti automaticamente a commit e non possono essere sottoposti a rollback. Il database esegue il commit degli inserimenti in un determinato oggetto nell'ordine in cui vengono visualizzati all'interno di una sessione. Non è garantito l'ordine di tra oggetti o sessioni.
Il database supporta i vincoli e la manutenzione degli indici proprio come per gli inserimenti regolari. Tuttavia, il database esegue valutazioni durante la scrittura su disco, non la scrittura nel pool di grandi dimensioni.
Nota: per ottenere prestazioni ottimali, Oracle consiglia di disabilitare i vincoli.
Nella figura seguente viene illustrato il flusso di lavoro per gli inserimenti differiti.
Figura 8: differito InsertMechanism
Descrizione dell'immagine cncpt_pb_002a.png
Vedere anche:
-
Oracle AI Database Performance Tuning Guide per informazioni su come specificare le tabelle come
MEMOPTIMIZE FOR WRITE -
Oracle AI Database SQL Language Reference per sintassi e semantica
INSERT -
Oracle AI Database Reference per saperne di più su
MEMOPTIMIZE_POOL_SIZE
Java pool
Il pool Java è un'area di memoria che memorizza tutti i dati e il codice Java specifici della sessione all'interno della JVM (Java Virtual Machine). Questa memoria include gli oggetti Java di cui viene eseguita la migrazione nello spazio della sessione Java al termine della chiamata.
Per le connessioni server dedicate, il pool Java include la parte condivisa di ogni classe Java, inclusi i metodi e la memoria di sola lettura come i vettori di codice, ma non lo stato Java per sessione di ogni sessione. Per il server condiviso, il pool include la parte condivisa di ogni classe e alcune UGA utilizzate per lo stato di ogni sessione. Ogni UGA cresce e si riduce in base alle esigenze, ma la dimensione UGA totale deve rientrare nello spazio del pool Java.
Le statistiche di Java Pool Advisor forniscono informazioni sulla memoria cache della libreria utilizzata per Java e prevedono in che modo le modifiche delle dimensioni del pool Java possono influire sulla frequenza di analisi. Java Pool Advisor viene attivato internamente quando statistics_level è impostato su TYPICAL o versione successiva. Queste statistiche vengono reimpostate quando l'advisor è disattivato.
Vedere anche:
-
Oracle AI Database Performance Tuning Guide per informazioni sulle viste contenenti le statistiche di advisory del pool Java
SGA fissa
La SGA fissa è un'area interna di housekeeping.
Ad esempio, la SGA fissa contiene:
-
Informazioni generali sullo stato del database e dell'istanza a cui i processi in background devono accedere
-
Informazioni comunicate tra processi, ad esempio informazioni sui blocchi
La dimensione della SGA fissa è impostata da Oracle AI Database e non può essere modificata manualmente. La dimensione SGA fissa può cambiare da release a release.
Vedere anche: "Panoramica dei blocchi automatici"
Aree secondarie SGA correlate alle prestazioni facoltative
Alcune aree secondarie SGA sono abilitate solo per funzioni prestazioni specifiche.
Questa sezione contiene gli argomenti riportati di seguito.
-
Area in memoria L'area in memoria è un componente SGA facoltativo che contiene l'area di memorizzazione colonne in memoria (area di memorizzazione colonne IM).
-
Pool di ottimizzazione Il pool di ottimizzazione memorizza i buffer e le strutture correlate per le tabelle organizzate dall'heap specificate come
MEMOPTIMIZE FOR READ.
Area in memoria
L'area in memoria è un componente SGA facoltativo che contiene l'area di memorizzazione colonne in memoria (area di memorizzazione colonne IM).
L'area di memorizzazione colonne IM contiene copie di tabelle, partizioni e viste materializzate in un formato colonna ottimizzato per le scansioni rapide. L'area di memorizzazione delle colonne IM integra la buffer cache del database, che memorizza i dati in formato riga tradizionale.
Nota: per abilitare un'area di memorizzazione colonne IM, è necessario disporre dell'opzione In-Memory di Oracle AI Database.
Vedere anche: Oracle AI Database In-Memory Guide per ulteriori informazioni sull'area di memorizzazione delle colonne In-Memory e IM
Memoptimizza pool
Il pool di memorizzazione memorizza i buffer e le strutture correlate per le tabelle organizzate dall'heap specificate come MEMOPTIMIZE FOR READ.
Questa struttura offre prestazioni e scalabilità elevate per query basate su chiavi come SELECT * FROM cust WHERE cid = 10. Per ridurre i tempi di risposta end-to-end, i client estraggono i buffer richiesti direttamente dalla SGA sulla rete, evitando il sovraccarico di CPU e sistema operativo. Le applicazioni possono trarre vantaggio dal pool di memoptimize senza richiedere modifiche al codice.
Il pool memoptimize contiene due parti:
-
Memoptimizza area buffer
Per evitare l'I/O del disco, il database blocca in modo permanente i buffer per le tabelle
MEMOPTIMIZE FOR READnel pool memoptimize, finché la tabella non viene contrassegnata comeNO MEMOPTIMIZE FOR READ. I buffer memoptimize utilizzano la stessa struttura dei buffer nella buffer cache del database. Tuttavia, i buffer nel pool memoptimize sono completamente separati dalla buffer cache del database e non contano per le relative dimensioni. L'area buffer di ottimizzazione occupa il 75% del pool di ottimizzazione memoria. -
Indice hash
Un indice hash è una struttura di dati segmento non persistente. Il database alloca l'indice hash come unità di memoria multiple e non contigue. Ogni unità contiene un numero di bucket hash. Una struttura mappa separata correla un'unità di memoria con una chiave primaria. L'indice hash occupa il 25% del pool di memoptimize. Figura 9: Memoptimize Pool
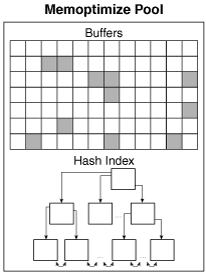
Descrizione dell'immagine cncpt_pb_001a.png
Per abilitare il pool memoptimize, impostare il parametro di inizializzazione MEMOPTIMIZE_POOL_SIZE su un valore intero (il pool è disabilitato per impostazione predefinita). Il valore specifica la quantità di SGA da allocare al pool. Il valore MEMOPTIMIZE_POOL_SIZE non viene conteggiato per SGA_TARGET, ma il database non aumenta e riduce automaticamente il pool memoptimize. Ad esempio, se SGA_TARGET è di 10 GB e MEMOPTIMIZE_POOL_SIZE è di 1 GB, per la memoria SGA è disponibile un totale di 9 GB diverso dal pool memoptimize.
Per modificare le dimensioni del pool di memoptimize, è necessario impostare MEMOPTIMIZE_POOL_SIZE manualmente e riavviare l'istanza di database. Non è possibile modificare la dimensione del pool in modo dinamico utilizzando ALTER SYSTEM.
Il pacchetto DBMS_MEMOPTIMIZE consente di popolare in modo esplicito una tabella nel pool memoptimize.
Vedere anche:
-
Oracle AI Database Performance Tuning Guide per scoprire come migliorare le prestazioni delle query abilitando il pool memoptimize
-
Oracle AI Database PL/SQL Packages and Types Reference per ulteriori informazioni sul package
DBMS_MEMOPTIMIZE -
Oracle AI Database SQL Language Reference per saperne di più su
CREATE TABLE ... MEMOPTIMIZE FOR READ -
Oracle AI Database Reference per saperne di più su
MEMOPTIMIZE_POOL_SIZE
Panoramica dell'area PGA (Program Global Area)
La memoria PGA è specifica per un processo operativo o un thread non condiviso da altri processi o thread del sistema. Poiché la PGA è specifica del processo, non viene mai allocata nella SGA.
Il PGA è un heap di memoria che contiene variabili dipendenti dalla sessione richieste da un processo server dedicato o condiviso. Il processo server alloca le strutture di memoria richieste nella PGA.
Un'analogia per un PGA è uno spazio di lavoro del controsoffitto temporaneo utilizzato da un addetto ai file. In questa analogia, l'impiegato di file è il processo del server che esegue il lavoro per conto del cliente (processo client). L'impiegato cancella una sezione del piano di lavoro, utilizza l'area di lavoro per memorizzare i dettagli sulla richiesta del cliente e per ordinare le cartelle richieste dal cliente, quindi cede lo spazio al termine del lavoro.
La figura seguente mostra un'istanza PGA (raccolta di tutte le PGA) per un'istanza non configurata per i server condivisi. È possibile utilizzare un parametro di inizializzazione per impostare una dimensione massima di destinazione della PGA dell'istanza. I singoli PGA possono crescere in base alle esigenze fino a questa dimensione target.
Figura 10: PGA istanza
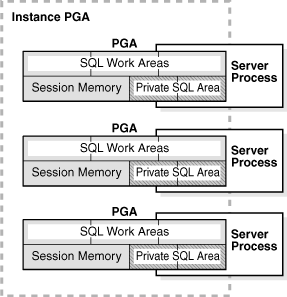
Descrizione dell'illustrazione cncpt218.gif
Nota: i processi in background allocano anche i propri PGA. Questa discussione si concentra solo sui PGA del processo server.
-
Contenuti della PGA La PGA viene suddivisa in diverse aree, ciascuna con uno scopo diverso.
-
L'allocazione della memoria PGA Uso PGA in modalità server dedicato e condiviso dipende dal fatto che il database utilizzi connessioni server dedicate o condivise. Vedi anche: Oracle AI Database Performance Tuning Guide per una panoramica della gestione della memoria PGA
Contenuto della PGA
Il PGA è suddiviso in diverse aree, ognuna con uno scopo diverso.
La figura seguente mostra i possibili contenuti della PGA per una sessione server dedicata. Non tutte le aree PGA esisteranno in ogni caso.
Figura 11: Contenuto PGA
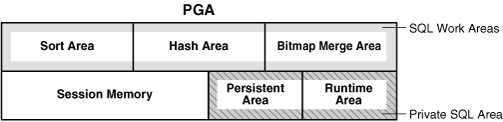
Descrizione dell'illustrazione cncpt219.gif
-
Area SQL privata Un'area SQL privata contiene informazioni su un'istruzione SQL analizzata e altre informazioni specifiche della sessione per l'elaborazione.
-
Aree di lavoro SQL Un'area di lavoro è un'allocazione privata di memoria PGA utilizzata per le operazioni a uso intensivo di memoria.
Area SQL privata
Un'area SQL privata contiene informazioni su un'istruzione SQL analizzata e altre informazioni specifiche della sessione per l'elaborazione.
Quando un processo server esegue codice SQL o PL/SQL, il processo utilizza l'area SQL privata per memorizzare i valori della variabile di associazione, le informazioni sullo stato di esecuzione delle query e le aree di lavoro di esecuzione delle query.
Non confondere un'area SQL privata, che si trova nella PGA, con l'area SQL condivisa, che memorizza i piani di esecuzione nella SGA. Più aree SQL private nella stessa sessione o in sessioni diverse possono puntare a un singolo piano di esecuzione nella SGA. Ad esempio, 20 esecuzioni di SELECT * FROM sales in una sessione e 10 esecuzioni della stessa query in una sessione diversa possono condividere lo stesso piano. Le aree SQL private per ogni esecuzione non sono condivise e possono contenere valori e dati diversi.
Un cursore è un nome o un handle per un'area SQL privata specifica. Come mostrato nel grafico seguente, si può pensare a un cursore come un puntatore sul lato client e come uno stato sul lato server. Poiché i cursori sono strettamente associati alle aree SQL private, i termini vengono talvolta utilizzati in modo intercambiabile.
Figura 12: Cursore
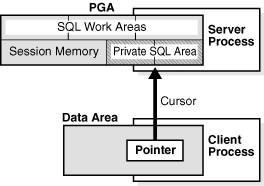
Descrizione dell'illustrazione cncpt324.gif
Un'area SQL privata è suddivisa nelle seguenti aree:
-
Area di runtime
Quest'area contiene informazioni sullo stato di esecuzione delle query. Ad esempio, l'area di runtime tiene traccia del numero di righe recuperate finora in una scansione tabella completa.
Oracle AI Database crea l'area di runtime come primo passo di una richiesta di esecuzione. Per le istruzioni DML, l'area di runtime viene liberata quando l'istruzione SQL viene chiusa.
-
L'area persistente
Quest'area contiene i valori delle variabili di binding. Un valore di bind variable viene fornito a un'istruzione SQL in fase di esecuzione quando l'istruzione viene eseguita. L'area persistente viene liberata solo quando il cursore è chiuso.
Il processo client è responsabile della gestione delle aree SQL private. L'allocazione e la disallocazione delle aree SQL private dipende in gran parte dall'applicazione, sebbene il numero di aree SQL private che un processo client può allocare sia limitato dal parametro di inizializzazione OPEN_CURSORS.
Sebbene la maggior parte degli utenti si affidi alla gestione automatica dei cursori delle utility di database, le interfacce programmatiche di Oracle AI Database offrono agli sviluppatori un maggiore controllo sui cursori. In generale, le applicazioni dovrebbero chiudere tutti i cursori aperti che non verranno utilizzati di nuovo per liberare l'area persistente e ridurre al minimo la memoria necessaria per gli utenti dell'applicazione.
Vedere anche:
-
Oracle AI Database Development Guide e Oracle AI Database PL/SQL Language Reference per scoprire come utilizzare i cursori
Aree di lavoro SQL
Un'area di lavoro è un'allocazione privata di memoria PGA utilizzata per le operazioni che richiedono molta memoria.
Ad esempio, un operatore di ordinamento utilizza l'area di ordinamento per ordinare un set di righe. Analogamente, un operatore hash join utilizza un'area hash per creare una tabella hash dal relativo input a sinistra, mentre un'unione bitmap utilizza l'area di unione bitmap per unire i dati recuperati dalle scansioni di più indici bitmap.
L'esempio seguente mostra un join di employees e departments con il relativo piano query:
SQL> SELECT *
  2  FROM   employees e JOIN departments d
  3  ON     e.department_id=d.department_id
  4  ORDER BY last_name;
.
.
.
--------------------------------------------------------------------------------
| Id| Operation           | Name        | Rows  | Bytes | Cost (%CPU)| Time    |
--------------------------------------------------------------------------------
| 0 | SELECT STATEMENT    |             |   106 |  9328 |    7  (29)| 00:00:01 |
| 1 |  SORT ORDER BY      |             |   106 |  9328 |    7  (29)| 00:00:01 |
|*2 |   HASH JOIN         |             |   106 |  9328 |    6  (17)| 00:00:01 |
| 3 |    TABLE ACCESS FULL| DEPARTMENTS |    27 |   540 |    2   (0)| 00:00:01 |
| 4 |    TABLE ACCESS FULL| EMPLOYEES   |   107 |  7276 |    3   (0)| 00:00:01 |
--------------------------------------------------------------------------------
Nell'esempio precedente, l'area di runtime tiene traccia dello stato di avanzamento delle scansioni di tabelle complete. La sessione esegue un hash join nell'area hash per trovare una corrispondenza tra le righe delle due tabelle. L'ordinamento ORDER BY si verifica nell'area di ordinamento.
Se la quantità di dati che gli operatori devono elaborare non rientra in un'area di lavoro, Oracle AI Database divide i dati di input in parti più piccole. In questo modo, il database elabora alcune parti di dati in memoria durante la scrittura del resto nello storage su disco temporaneo per l'elaborazione successiva.
Il database ottimizza automaticamente le dimensioni dell'area di lavoro quando è abilitata la gestione automatica della memoria PGA. È inoltre possibile controllare e regolare manualmente le dimensioni di un'area di lavoro.
Generalmente, aree di lavoro più grandi possono migliorare significativamente le prestazioni di un operatore al costo di un consumo di memoria più elevato. In modo ottimale, la dimensione di un'area di lavoro è sufficiente per contenere i dati di input e le strutture di memoria ausiliaria allocate dall'operatore SQL associato. In caso contrario, il tempo di risposta aumenta perché parte dei dati di input deve essere memorizzata nella cache sul disco. In casi estremi, se la dimensione di un'area di lavoro è troppo piccola rispetto alla dimensione dei dati di input, il database deve eseguire più passaggi sui dati, aumentando notevolmente il tempo di risposta.
Vedere anche:
-
Oracle AI Database Administrator's Guide per scoprire come utilizzare la gestione PGA automatica
-
Oracle AI Database Performance Tuning Guide per scoprire come ottimizzare la memoria PGA
Utilizzo PGA in modalità server dedicato e condiviso
L'allocazione della memoria PGA dipende dal fatto che il database utilizzi connessioni server dedicate o condivise.
La tabella seguente mostra le differenze.
Tabella 1 Differenze nell'allocazione della memoria tra server dedicati e condivisi
| Area memoria | Server dedicato | Server condiviso |
|---|---|---|
| Natura della memoria della sessione | Privato | Condiviso |
| Posizione dell'area persistente | PGA | SGA |
| Posizione dell'area di runtime per le istruzioni DML e DDL | PGA | PGA |
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come configurare un database per un server condiviso
Panoramica dell'area globale utente
UGA è la memoria di sessione, che è la memoria allocata per le variabili di sessione, come le informazioni di accesso e altre informazioni richieste da una sessione di database. In sostanza, UGA memorizza lo stato della sessione.
La figura seguente mostra la UGA.
Figura 13: Area globale utente (UGA)
Descrizione dell'illustrazione cncpt222.gif
Se una sessione carica in memoria un pacchetto PL/SQL, UGA contiene lo stato del pacchetto, ovvero il set di valori memorizzati in tutte le variabili del pacchetto in un momento specifico. Lo stato del pacchetto cambia quando un sottoprogramma del pacchetto modifica le variabili. Per impostazione predefinita, le variabili del pacchetto sono univoche e persistenti per la durata della sessione.
Anche il pool di pagine OLAP è memorizzato nell'area UGA. Questo pool gestisce le pagine di dati OLAP, equivalenti ai blocchi di dati. Il pool di pagine viene allocato all'inizio di una sessione OLAP e rilasciato alla fine della sessione. Una sessione OLAP viene aperta automaticamente ogni volta che un utente esegue una query su un oggetto dimensionale, ad esempio un cubo.
L'UCA deve essere disponibile per una sessione di database per tutta la durata della sessione. Per questo motivo, la UGA non può essere memorizzata nella PGA quando si utilizza una connessione server condiviso perché la PGA è specifica per un singolo processo. Pertanto, l'area UGA viene memorizzata nell'area MGA quando si utilizzano connessioni al server condiviso, consentendo l'accesso a qualsiasi processo del server condiviso. Quando si utilizza una connessione a un server dedicato, l'UGA viene memorizzata nella PGA.
Vedere anche:
-
Oracle AI Database Net Services Administrator's Guide per informazioni sulle connessioni al server condiviso
Panoramica dell'area globale gestita (MGA)
L'area MGA (Managed Global Area) è un framework di memoria unico che consente di condividere e coordinare la memoria in un set di processi Oracle affidabili.
Ha la capacità di essere un'area di memoria condivisa configurabile, elastica, modulare, on-demand e recuperabile. MGA consente di utilizzare diversi tipi di aree di memoria condivisa nel database. Viene esposto come spazi di nomi per i layer di database interni, ciascuno appartenente a uno solo di essi. Uno spazio di nomi consiste principalmente in un set di segmenti di memoria condivisa e meta-dati che lo accompagnano.
I livelli nel database possono definire le caratteristiche, l'ambito, la durata e la dimensione del segmento interno dello spazio di nomi. Tutte le MGA sono contabilizzate sotto il limite aggregato PGA.
In Linux, MGA richiede l'attivazione di tempfs su /dev/shm ed è configurato per almeno la dimensione del limite di aggregazione PGA. Quando più istanze sono in esecuzione sullo stesso computer, la dimensione di /dev/shm deve essere almeno sum(PGA_AGGREGATE_LIMIT) in tutte le istanze.
Vedere anche:
-
Oracle AI Database Performance Tuning Guide per ulteriori informazioni sul dimensionamento dei granuli
Panoramica delle aree del codice software
Un'area del codice software è una parte della memoria in cui è memorizzato il codice in esecuzione o che può essere eseguito. Il codice di Oracle AI Database viene memorizzato in un'area software in genere più esclusiva e protetta rispetto alla posizione dei programmi utente.
Le aree software sono in genere statiche e cambiano solo quando il software viene aggiornato o reinstallato. Le dimensioni richieste di queste aree variano a seconda del sistema operativo.
Le aree software sono di sola lettura e possono essere installate condivise o non condivise. Alcuni strumenti e utility di database, ad esempio Oracle Forms e SQL*Plus, possono essere installati come condivisi, ma alcuni non possono. Quando possibile, il codice del database viene condiviso in modo che tutti gli utenti possano accedervi senza avere più copie in memoria, con conseguente riduzione della memoria principale e miglioramento generale delle prestazioni. Più istanze di un database possono utilizzare la stessa area di codice del database con database diversi se eseguiti sullo stesso computer. Nota: l'opzione di installazione del software condiviso non è disponibile per tutti i sistemi operativi, ad esempio sui PC che utilizzano Microsoft Windows. Per ulteriori informazioni, consultare la documentazione specifica del sistema operativo.