Programmazione lato server: PL/SQL, Java e JavaScript
SQL spiega il linguaggio SQL (Structured Query Language) e il modo in cui il database elabora le istruzioni SQL. Questo capitolo spiega in che modo i programmi Procedural Language/SQL (PL/SQL) o Java memorizzati nel database possono utilizzare SQL.
-
Introduzione alla programmazione lato server In un linguaggio non procedurale come SQL, viene specificato il set di dati su cui eseguire l'operazione, ma non le operazioni da eseguire o il modo in cui devono essere eseguite.
-
Panoramica di PL/SQL PL/SQL offre un linguaggio procedurale memorizzato sul server facile da usare, senza soluzione di continuità con SQL, affidabile, portatile e sicuro. È possibile accedere e manipolare i dati del database utilizzando oggetti procedurali denominati unità PL/SQL.
-
Panoramica di Java in Oracle AI Database Java è emerso come il linguaggio di programmazione orientato agli oggetti preferito.
-
Panoramica di JavaScript in Oracle AI Database JavaScript è uno dei linguaggi di programmazione più popolari al giorno d'oggi. Oracle AI Database distribuito su Linux x86-64 o Linux aarch64 aggiunge JavaScript alla lista dei linguaggi supportati per lo sviluppo lato server.
-
Panoramica dei trigger Un trigger del database è una program unit memorizzata compilata, scritta in PL/SQL, Java o JavaScript, che Oracle Database richiama ("fuochi") automaticamente in determinate situazioni. Vedere anche: SQL per una panoramica del linguaggio SQL.
Introduzione alla programmazione lato server
In un linguaggio non procedurale come SQL, viene specificato il set di dati su cui operare, ma non le operazioni da eseguire o il modo in cui devono essere eseguite.
In un programma di linguaggio procedurale, la maggior parte dell'esecuzione delle istruzioni dipende dalle istruzioni precedenti o successive e dalle strutture di controllo, come loop o diramazioni condizionali, non disponibili in SQL. Per illustrare la differenza tra le lingue procedurali e non procedurali, si supponga che la seguente istruzione SQL esegua query sulla tabella employees:
SELECT employee_id, department_id, last_name, salary FROM employees;L'istruzione precedente richiede dati, ma non applica la logica ai dati. Si supponga, tuttavia, che si desideri che un'applicazione determini se ciascun dipendente nel set di dati merita un aumento in base allo stipendio e alle prestazioni del reparto. Una condizione necessaria di un aumento è che il dipendente non ha ricevuto più di tre aumenti negli ultimi cinque anni. Se viene richiesto un aumento, l'applicazione deve adeguare lo stipendio e inviare un'e-mail al manager; in caso contrario, l'applicazione deve aggiornare un report.
Il problema è il modo in cui le applicazioni di database procedurali che richiedono la logica condizionale e il controllo del flusso di programma possono utilizzare SQL. Gli approcci di sviluppo di base sono i seguenti:
-
Utilizza la programmazione lato client per incorporare istruzioni SQL in applicazioni scritte in linguaggi procedurali come C, C++ o Java
È possibile inserire le istruzioni SQL nel codice sorgente e sottometterle a un traduttore precompiler o Java prima della compilazione. In alternativa, puoi eliminare il passo di precompilazione e utilizzare un'API come Java Database Connectivity (JDBC) o Oracle Call Interface (OCI) per consentire all'applicazione di interagire con il database.
-
Utilizzare la programmazione lato server per sviluppare la logica dei dati che risiede nel database
Un'applicazione può richiamare in modo esplicito i sottoprogrammi memorizzati (procedure e funzioni), scritti in PL/SQL (pronunciato P L sequel) Java o JavaScript. È inoltre possibile creare un trigger, denominato program unit memorizzata nel database e richiamata in risposta a un evento specificato.
Questo capitolo spiega il secondo approccio. Il vantaggio principale della programmazione lato server è che le funzionalità integrate nel database possono essere distribuite ovunque. Il database e non l'applicazione determina il modo migliore per eseguire le attività su un determinato sistema operativo. Inoltre, i sottoprogrammi aumentano la scalabilità centralizzando l'elaborazione delle applicazioni sul server, consentendo ai client di riutilizzare il codice. Poiché le chiamate ai sottoprogrammi sono rapide ed efficienti, una singola chiamata può avviare un sottoprogramma memorizzato ad alta intensità di calcolo, riducendo il traffico di rete.
È possibile utilizzare i seguenti linguaggi per memorizzare la logica dei dati in Oracle AI Database:
-
PL/SQL
PL/SQL è l'estensione procedurale di Oracle AI Database a SQL. PL/SQL è integrato con il database e supporta tutte le istruzioni, le funzioni e i tipi di dati Oracle SQL. Le applicazioni scritte nelle API di database possono richiamare i sottoprogrammi memorizzati PL/SQL e inviare i blocchi di codice PL/SQL al database per l'esecuzione.
-
Java
Oracle AI Database fornisce anche supporto per lo sviluppo, la memorizzazione e la distribuzione di applicazioni Java. I sottoprogrammi Java memorizzati vengono eseguiti nel database e sono indipendenti dai programmi eseguiti nel livello intermedio. Interfaccia dei sottoprogrammi Java memorizzati con SQL utilizzando un modello di esecuzione simile a PL/SQL.
-
JavaScript
Quando viene distribuito su Linux x86-64 o Linux aarch64, Oracle AI Database consente agli sviluppatori di esprimere la logica aziendale in JavaScript. L'esecuzione ad hoc di JavaScript è resa possibile dal pacchetto PL/SQL DBMS_MLE e dalle relative sottoprogrammi. La memorizzazione della business logic come oggetti dello schema JavaScript consente di scrivere applicazioni più complesse. Le specifiche di chiamata espongono il codice JavaScript memorizzato nel database in SQL e PL/SQL in modo simile alle stored procedure Java.
Vedere anche:
-
Guida allo sviluppo di Oracle AI Database per scoprire come incorporare SQL con precompilatori e API
-
Introduzione a Oracle AI Database Development per un'introduzione allo sviluppo di applicazioni Oracle AI Database
-
Oracle AI Database Development Guide per scoprire come scegliere un ambiente di programmazione
-
Oracle AI Database JavaScript Developer's Guide per saperne di più sul supporto JavaScript in Oracle AI Database.
Panoramica di PL/SQL
PL/SQL offre un linguaggio procedurale memorizzato sul lato server, facile da usare, senza soluzione di continuità con SQL, affidabile, portatile e sicuro. È possibile accedere e manipolare i dati del database utilizzando oggetti procedurali denominati unità PL/SQL.
Le unità PL/SQL in genere sono classificate come segue:
-
Un sottoprogramma PL/SQL è un blocco PL/SQL memorizzato nel database e può essere richiamato per nome da un'applicazione. Quando si crea un sottoprogramma, il database analizza il sottoprogramma e memorizza la rappresentazione analizzata nel database. È possibile dichiarare un sottoprogramma come procedura o funzione.
-
Un blocco anonimo PL/SQL è un blocco PL/SQL visualizzato nell'applicazione e non denominato o memorizzato nel database. In molte applicazioni, i blocchi PL/SQL possono essere visualizzati ovunque possano apparire le istruzioni SQL.
Il compilatore e l'interprete PL/SQL sono incorporati in Oracle SQL Developer, offrendo agli sviluppatori un modello di sviluppo coerente e sfruttato sia sul client che sul server. Inoltre, le stored procedure PL/SQL possono essere richiamate da diversi client di database, come Pro*C, JDBC, ODBC o OCI, e da Oracle Reports e Oracle Forms.
-
Sottoprogrammi PL/SQL Un sottoprogramma PL/SQL è un blocco PL/SQL denominato che consente al chiamante di fornire parametri che possono essere solo valori di input, solo output o input e output.
-
Pacchetti PL/SQL Un pacchetto PL/SQL è un gruppo di sottoprogrammi correlati, insieme ai cursori e alle variabili che utilizzano, memorizzati nel database come unità per l'uso continuato. I sottoprogrammi pacchettizzati possono essere richiamati in modo esplicito da applicazioni o utenti.
-
Blocchi anonimi PL/SQL Un blocco anonimo PL/SQL è un'unità PL/SQL senza nome e senza persistenza.
-
I blocchi PL/SQL PL/SQL Language Constructs possono includere una vasta gamma di costrutti di linguaggio PL/SQL diversi.
-
Raccolte e record PL/SQL Molte tecniche di programmazione utilizzano tipi di raccolta quali array, borse, elenchi, tabelle nidificate, set e alberi.
-
Modalità di esecuzione di PL/SQL PL/SQL supporta sia l'esecuzione interpretata che l'esecuzione nativa.
Vedere anche:
-
Introduzione a Oracle AI Database con lo sviluppo di Oracle AI Database
-
Oracle AI Database PL/SQL Language Reference per informazioni complete su PL/SQL, inclusi i package
Sottoprogrammi PL/SQL
Un sottoprogramma PL/SQL è un blocco PL/SQL denominato che consente al chiamante di fornire parametri che possono essere solo valori di input, solo output o di input e output.
Un sottoprogramma risolve un problema specifico o esegue attività correlate e funge da elemento costitutivo per applicazioni di database modulari e gestibili. Un sottoprogramma è una procedura PL/SQL o una funzione PL/SQL. Le procedure e le funzioni sono identiche tranne che per il fatto che queste restituiscono sempre un valore singolo al chiamante, al contrario di quanto avviene per le procedure. Il termine procedura PL/SQL in questo capitolo fa riferimento a una procedura o a una funzione.
-
I vantaggi della programmazione lato server PL/SQL Subprogram offrono molti vantaggi rispetto alla programmazione lato client.
-
Creazione di sottoprogrammi PL/SQL Un sottoprogramma memorizzato standalone è un sottoprogramma creato a livello di schema con l'istruzione
CREATE PROCEDUREoCREATE FUNCTION. I sottoprogrammi definiti in un pacchetto sono detti sottoprogrammi pacchetto e sono considerati parte del pacchetto. -
Esecuzione dei sottoprogrammi PL/SQL Gli utenti possono eseguire un sottoprogramma in modo interattivo in più modi.
Vedere anche:
-
Pro*C/C++ Developer's Guide e Pro*COBOL Developer's Guide per ulteriori informazioni sulle stored procedure in queste lingue
Vantaggi dei sottoprogrammi PL/SQL
La programmazione lato server ha molti vantaggi rispetto alla programmazione lato client.
I vantaggi includono:
-
Prestazioni migliorate
-
La quantità di informazioni che un'applicazione deve inviare su una rete è ridotta rispetto all'emissione di singole istruzioni SQL o all'invio del testo di un intero blocco PL/SQL a Oracle AI Database, poiché le informazioni vengono inviate solo una volta e successivamente richiamate quando vengono utilizzate.
-
La forma compilata di una procedura è facilmente disponibile nel database, quindi non è necessaria alcuna compilazione al momento dell'esecuzione.
-
Se la procedura è presente nel pool condiviso della SGA, il database non deve richiamarlo dal disco e può iniziare immediatamente l'esecuzione.
-
-
Allocazione memoria
Poiché le stored procedure sfruttano le funzionalità di memoria condivisa di Oracle AI Database, devono caricare in memoria solo una singola copia della procedura per l'esecuzione da parte di più utenti. La condivisione del codice tra gli utenti comporta una sostanziale riduzione dei requisiti di memoria del database per le applicazioni.
-
Maggiore produttività
Le procedure memorizzate aumentano la produttività dello sviluppo. Progettando le applicazioni intorno a un insieme comune di procedure, è possibile evitare la codifica ridondante. Ad esempio, è possibile scrivere procedure per manipolare le righe nella tabella
employees. Qualsiasi applicazione può chiamare queste procedure senza richiedere la riscrittura delle istruzioni SQL. Se i metodi di gestione dei dati cambiano, solo le procedure devono essere modificate, non le applicazioni che utilizzano le procedure.Le procedure memorizzate sono forse il modo migliore per ottenere il riutilizzo del codice. Poiché qualsiasi applicazione client scritta in qualsiasi lingua che si connette al database può richiamare le stored procedure, forniscono il massimo riutilizzo del codice in tutti gli ambienti.
-
Integrità
Le procedure memorizzate migliorano l'integrità e la coerenza delle applicazioni. Sviluppando applicazioni intorno a un gruppo comune di procedure, si riduce la probabilità di errori di codifica.
Ad esempio, è possibile testare un sottoprogramma per garantire che restituisca un risultato accurato e, una volta verificato, riutilizzarlo in un numero qualsiasi di applicazioni senza ripetere il test. Se le strutture di dati a cui fa riferimento la procedura vengono modificate, è necessario ricompilare solo la procedura. Le applicazioni che richiamano la procedura non richiedono necessariamente modifiche.
-
Sicurezza con le procedure di definizione dei diritti
Le stored procedure consentono di applicare la sicurezza dei dati. Una procedura PL/SQL con diritti di definizione viene eseguita con il privilegio del proprietario, non con l'utente corrente. Pertanto, è possibile limitare i task del database eseguiti dagli utenti consentendo loro di accedere ai dati solo tramite procedure e funzioni eseguite con i privilegi del definitore.
Ad esempio, è possibile concedere agli utenti l'accesso a una procedura che aggiorna una tabella ma non concede l'accesso alla tabella stessa. Quando un utente richiama la procedura, viene eseguito con i privilegi del proprietario. Gli utenti che dispongono solo del privilegio per eseguire la procedura (ma non dei privilegi per eseguire query, aggiornare o eliminare dalle tabelle sottostanti) possono richiamare la procedura ma non manipolare i dati delle tabelle in altro modo.
-
Privilegi ereditati e contesto dello schema con le procedure dei diritti del richiedente
Una procedura PL/SQL dei diritti del destinatario viene eseguita nello schema dell'utente corrente con i privilegi dell'utente corrente. In altre parole, la procedura dei diritti di un invocatore non è legata a un particolare utente o schema. Le procedure dei diritti di Invoker semplificano la centralizzazione della logica dell'applicazione da parte degli sviluppatori di applicazioni, anche quando i dati di base sono divisi tra gli schemi utente.
Ad esempio, un utente
hr_managerche esegue una procedura di aggiornamento nella tabellahr.employeespuò aggiornare gli stipendi, mentre un utentehr_clerkche esegue la stessa procedura è limitato all'aggiornamento dei dati dell'indirizzo.
Vedere anche:
-
Oracle AI Database PL/SQL Language Reference per una panoramica dei sottoprogrammi PL/SQL
-
Oracle AI Database Security Guide per ulteriori informazioni sui diritti di definer e invoker
Creazione di sottoprogrammi PL/SQL
Un sottoprogramma memorizzato standalone è un sottoprogramma creato a livello di schema con l'istruzione CREATE PROCEDURE o CREATE FUNCTION. I sottoprogrammi definiti in un pacchetto sono detti sottoprogrammi pacchetto e sono considerati parte del pacchetto.
Il database memorizza i sottoprogrammi nel dizionario dati come oggetti dello schema. Un sottoprogramma ha una specifica, che include descrizioni di qualsiasi parametro e un corpo.
Esempio di procedura PL/SQL 11-1
Questo esempio mostra parte di un'istruzione di creazione per la procedura PL/SQL standalone hire_employees. La procedura inserisce una riga nella tabella employees.
CREATE PROCEDURE hire_employees
  (p_last_name VARCHAR2, p_job_id VARCHAR2, p_manager_id NUMBER,
   p_hire_date DATE, p_salary NUMBER, p_commission_pct NUMBER,
   p_department_id NUMBER)
IS
BEGIN
.
.
.
  INSERT INTO employees (employee_id, last_name, job_id, manager_id, hire_date,
    salary, commission_pct, department_id)
  VALUES (emp_sequence.NEXTVAL, p_last_name, p_job_id, p_manager_id,
          p_hire_date, p_salary, p_commission_pct, p_department_id);
.
.
.
END;
Vedere anche:
-
Guida introduttiva a Oracle AI Database Development di Oracle AI Database per scoprire come creare sottoprogrammi
-
Oracle AI Database PL/SQL Language Reference per informazioni sull'istruzione
CREATE PROCEDURE
Esecuzione di sottoprogrammi PL/SQL
Gli utenti possono eseguire un sottoprogramma in modo interattivo in più modi.
Le opzioni disponibili sono:
-
Uso di uno strumento Oracle, ad esempio SQL*Plus o SQL Developer
-
Chiamata esplicita nel codice di un'applicazione di database, ad esempio un'applicazione Oracle Forms o precompilatore
-
Chiamarlo esplicitamente nel codice di un'altra procedura o trigger
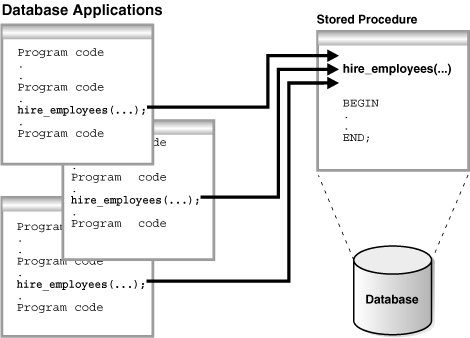
L'immagine seguente mostra diverse applicazioni di database che chiamano hire_employees.
Figura 1: esecuzioni multiple di una procedura memorizzata
Descrizione dell'illustrazione cncpt073.gif
In alternativa, un utente con privilegi può utilizzare Oracle Enterprise Manager o SQL*Plus per eseguire la procedura hire_employees utilizzando un'istruzione come quella riportata di seguito.
EXECUTE hire_employees ('TSMITH', 'CLERK', 1037, SYSDATE, 500, NULL, 20);L'istruzione precedente inserisce un nuovo record per TSMITH nella tabella employees.
Una stored procedure dipende dagli oggetti a cui viene fatto riferimento nel relativo corpo. Il database tiene traccia e gestisce automaticamente queste dipendenze. Ad esempio, se si modifica la definizione della tabella employees a cui fa riferimento la procedura hire_employees in un modo che potrebbe influire su questa procedura, la procedura deve essere ricompilata per verificare che funzioni ancora come progettato. In genere, il database amministra automaticamente tale gestione delle dipendenze.
Vedere anche:
-
Introduzione a Oracle AI Database Development per ulteriori informazioni su SQL*Plus e SQL Developer
-
Guida allo sviluppo di Oracle AI Database per saperne di più sui precompilatori
-
Oracle AI Database PL/SQL Language Reference per scoprire come utilizzare i sottoprogrammi PL/SQL
-
SQL*Plus User's Guide and Reference per ulteriori informazioni sul comando
EXECUTE
Package PL/SQL
Un package PL/SQL è un gruppo di sottoprogrammi correlati, con i cursori esplicitati e le variabili che utilizzano, memorizzati nel database per l'uso continuato come unità. I sottoprogrammi pacchettizzati possono essere richiamati in modo esplicito da applicazioni o utenti.
Oracle AI Database include molti pacchetti forniti che estendono le funzionalità del database e forniscono l'accesso PL/SQL alle funzioni SQL. Ad esempio, il pacchetto UTL_HTTP consente ai callout HTTP di PL/SQL e SQL di accedere ai dati su Internet o di chiamare Oracle Web Server Cartridges. È possibile utilizzare i pacchetti forniti quando si creano applicazioni o come fonte di idee quando si creano le proprie stored procedure.
-
I vantaggi dei package PL/SQL PL/SQL offrono una serie di vantaggi allo sviluppatore dell'applicazione.
-
Creazione di package PL/SQL È possibile creare un package in due parti: la specifica e il corpo. La specifica del pacchetto dichiara tutti i costrutti pubblici del pacchetto, mentre il corpo del pacchetto definisce tutti i costrutti (pubblici e privati) del pacchetto.
-
Esecuzione di sottoprogrammi di package PL/SQL I trigger, i sottoprogrammi memorizzati, i programmi applicativi 3GL e gli strumenti Oracle possono fare riferimento ai contenuti dei package.
Vantaggi dei pacchetti PL/SQL
I pacchetti PL/SQL offrono una serie di vantaggi allo sviluppatore dell'applicazione.
I vantaggi includono:
-
Incapsulamento
I pacchetti consentono di incapsulare o raggruppare procedure, variabili, tipi di dati memorizzati e così via in un'unità memorizzata denominata. L'incapsulamento fornisce una migliore organizzazione durante lo sviluppo e anche una maggiore flessibilità. È possibile creare specifiche e procedure pubbliche di riferimento senza creare effettivamente il package body. L'incapsulamento semplifica la gestione dei privilegi. La concessione del privilegio per un pacchetto rende i costrutti di pacchetti accessibili all'assegnatario.
-
Sicurezza dei dati
I metodi di definizione dei pacchetti consentono di specificare le variabili, i cursori e le procedure pubbliche e private. Pubblico significa che è direttamente accessibile all'utente di un pacchetto. Privato significa che è nascosto all'utente di un pacchetto.
Ad esempio, un pacchetto può contenere 10 procedure. È possibile definire il pacchetto in modo che solo tre procedure siano pubbliche e quindi disponibili per l'esecuzione da parte di un utente del pacchetto. Le restanti procedure sono private e sono accessibili solo dalle procedure all'interno del pacchetto. Non confondere le variabili dei pacchetti pubbliche e private con le autorizzazioni a
PUBLIC. -
Prestazioni migliori
Un intero pacchetto viene caricato in memoria in piccoli pezzi quando una procedura nel pacchetto viene chiamata per la prima volta. Questo carico viene completato in un'unica operazione, al contrario dei carichi separati richiesti per le procedure standalone. Quando si verificano chiamate a procedure pacchettizzate correlate, non è necessario alcun I/O su disco per eseguire il codice compilato in memoria.
Un corpo del pacchetto può essere sostituito e ricompilato senza influenzare la specifica. Di conseguenza, gli oggetti dello schema che fanno riferimento ai costrutti di un pacchetto (sempre attraverso la specifica) non devono essere ricompilati a meno che non venga sostituita anche la specifica del pacchetto. Utilizzando i pacchetti, è possibile ridurre al minimo le ricompilazioni non necessarie, con conseguente minore impatto sulle prestazioni complessive del database.
Creazione di pacchetti PL/SQL
Si crea un pacchetto in due parti: la specifica e il corpo. La specifica del pacchetto dichiara tutti i costrutti pubblici del pacchetto, mentre il corpo del pacchetto definisce tutti i costrutti (pubblici e privati) del pacchetto.
L'esempio seguente mostra parte di un'istruzione che crea la specifica di pacchetto per employees_management, che incapsula diversi sottoprogrammi utilizzati per gestire un database di dipendenti. Ogni parte del pacchetto viene creata con un'istruzione diversa.
CREATE PACKAGE employees_management AS
  FUNCTION hire_employees (last_name VARCHAR2, job_id VARCHAR2, manager_id NUMBER,
    salary NUMBER, commission_pct NUMBER, department_id NUMBER) RETURN NUMBER;
  PROCEDURE fire_employees(employee_id NUMBER);
  PROCEDURE salary_raise(employee_id NUMBER, salary_incr NUMBER);
.
.
.
  no_sal EXCEPTION;
END employees_management;
La specifica dichiara la funzione hire_employees, le procedure fire_employees e salary_raise e l'eccezione no_sal. Tutti questi oggetti di programma pubblici sono disponibili per gli utenti che hanno accesso al pacchetto.
L'istruzione CREATE PACKAGE BODY definisce gli oggetti dichiarati nella specifica. Il corpo del package deve essere creato nello stesso schema del package. Dopo aver creato il pacchetto, è possibile sviluppare applicazioni che chiamano una qualsiasi di queste procedure o funzioni pubbliche o sollevare una qualsiasi delle eccezioni pubbliche del pacchetto.
Vedere anche: Oracle AI Database PL/SQL Language Reference per informazioni sull'istruzione CREATE PACKAGE
Esecuzione di sottoprogrammi package PL/SQL
I trigger del database, i programmi secondari memorizzati, i programmi applicativi 3GL e gli strumenti Oracle possono fare riferimento ai contenuti dei pacchetti.
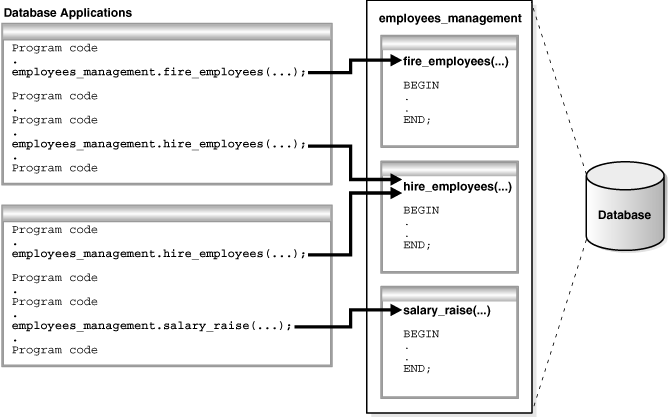
L'immagine seguente mostra le applicazioni di database che richiamano procedure e funzioni nel pacchetto employees_management.
Figura 2: Chiamata di sottoprogrammi in un pacchetto PL/SQL
Descrizione dell'illustrazione cncpt075.gif
Le applicazioni di database chiamano esplicitamente le procedure pacchettizzate in base alle esigenze. Dopo aver ottenuto i privilegi per il pacchetto employees_management, un utente può eseguire in modo esplicito una delle procedure in esso contenute. Ad esempio, SQL*Plus può eseguire l'istruzione seguente per eseguire la procedura del package hire_employees:
EXECUTE employees_management.hire_employees ('TSMITH', 'CLERK', 1037, SYSDATE, 500, NULL, 20);Vedere anche:
-
Oracle AI Database PL/SQL Language Reference per un'introduzione ai pacchetti PL/SQL
-
Oracle AI Database Development Guide per scoprire come codificare i pacchetti PL/SQL
Blocchi anonimi PL/SQL
Un blocco anonimo PL/SQL è un'unità PL/SQL senza nome e non persistente.
Gli usi tipici per i blocchi anonimi includono:
-
Avvio delle chiamate a sottoprogrammi e costrutti di pacchetti
-
Isolamento gestione eccezioni
-
Gestione del controllo mediante la nidificazione del codice in altri blocchi PL/SQL
I blocchi anonimi non hanno i vantaggi del riutilizzo del codice dei sottoprogrammi memorizzati. La Tabella 11-1 riepiloga le differenze tra i due tipi di unità PL/SQL.
Tabella 1 Differenze tra blocchi anonimi e sottoprogrammi
| È l'unità PL/SQL … | Blocchi anonimi | Sottoprogrammi |
|---|---|---|
| Specificare un nome? | N. | Sì |
| Compilato con ogni riutilizzo? | N. | N. |
| Memorizzato nel database? | N. | Sì |
| Richiamabile da altre applicazioni? | N. | Sì |
| È possibile restituire i valori delle bind variable? | Sì | Sì |
| È possibile restituire i valori della funzione? | N. | Sì |
| In grado di accettare parametri? | N. | Sì |
Un blocco anonimo è costituito da una parte dichiarativa facoltativa, una parte eseguibile e uno o più handler di eccezioni facoltativi. Il seguente blocco anonimo di esempio seleziona il cognome di un dipendente in una variabile e stampa il nome:
DECLARE
  v_lname VARCHAR2(25);
BEGIN
  SELECT last_name
    INTO v_lname
  FROM employees
  WHERE employee_id = 101;
  DBMS_OUTPUT.PUT_LINE('Employee last name is '||v_lname);
END;
Oracle AI Database compila il blocco PL/SQL e lo inserisce nello shared pool dell'SGA, ma non memorizza il codice di origine o la versione compilata nel database per il riutilizzo oltre l'istanza corrente. A differenza dei trigger, un blocco anonimo viene compilato ogni volta che viene caricato in memoria. L'istruzione SQL condivisa consente di riutilizzare e condividere blocchi PL/SQL anonimi nello shared pool fino a quando non vengono svuotati dallo shared pool.
Vedere anche: Oracle AI Database Development Guide per ulteriori informazioni sui blocchi PL/SQL anonimi
Costruzioni del linguaggio PL/SQL
I blocchi PL/SQL possono includere una vasta gamma di costrutti di linguaggio PL/SQL diversi.
Questi costrutti includono:
-
Dichiarazione di variabili e costanti
È possibile dichiarare questi costrutti all'interno di una procedura, una funzione o un pacchetto. È possibile utilizzare una variabile o una costante in un'istruzione SQL o PL/SQL per acquisire o fornire un valore quando necessario.
-
Cursori
È possibile dichiarare un cursore in modo esplicito all'interno di una procedura, una funzione o un package per facilitare l'elaborazione dei dati di Oracle AI Database orientata ai record. Il motore PL/SQL può anche dichiarare i cursori implicitamente.
-
Eccezioni
PL/SQL consente di gestire in modo esplicito le condizioni di errore interne e definite dall'utente, denominate eccezioni, che si verificano durante l'elaborazione del codice PL/SQL.
PL/SQL può eseguire istruzioni dynamic SQL il cui testo completo non è noto fino al runtime. Le istruzioni SQL dinamiche vengono memorizzate in stringhe di caratteri inserite o create dal programma in fase di esecuzione. Questa tecnica consente di creare procedure generiche. Ad esempio, è possibile creare una procedura che opera su una tabella il cui nome non è noto fino al runtime.
Vedere anche:
-
Oracle AI Database PL/SQL Packages and Types Reference per dettagli su SQL dinamico
-
Oracle AI Database PL/SQL Packages and Types Reference per informazioni su come utilizzare l'istruzione SQL dinamica nel package
DBMS_SQL
Raccolte e record PL/SQL
Molte tecniche di programmazione utilizzano tipi di raccolta quali array, borse, elenchi, tabelle nidificate, set e alberi.
Per supportare le tecniche di raccolta nelle applicazioni di database, PL/SQL fornisce i tipi di dati TABLE e VARRAY. Questi tipi consentono di dichiarare array associativi, tabelle nidificate e array di dimensioni variabili.
-
Raccolte Una raccolta PL/SQL è un gruppo ordinato di elementi, tutti dello stesso tipo.
-
Record Un record PL/SQL è una variabile composita che può memorizzare valori di dati di diversi tipi, in modo analogo al tipo struttt C, C++ o Java. I record sono utili per contenere i dati delle righe della tabella o di determinate colonne delle righe della tabella.
Raccolte
Una raccolta PL/SQL è un gruppo ordinato di elementi, tutti dello stesso tipo.
Ogni elemento ha un subscript che ne ne determina la posizione nella collection. Per creare una raccolta, definire prima un tipo di raccolta, quindi dichiarare una variabile di quel tipo.
Le raccolte funzionano come gli array trovati nella maggior parte dei linguaggi di programmazione di terza generazione. Inoltre, le raccolte possono essere passate come parametri. Pertanto, è possibile utilizzarli per spostare colonne di dati all'interno e all'esterno delle tabelle di database o tra applicazioni lato client e sottoprogrammi memorizzati.
Record
Un record PL/SQL è una variabile composta che può memorizzare valori di dati di diversi tipi, in modo analogo al tipo struct in C, C++ o Java. I record sono utili per contenere i dati delle righe della tabella o di determinate colonne delle righe della tabella.
Si supponga di disporre di dati relativi a un dipendente, ad esempio nome, stipendio e data di assunzione. Questi elementi sono di tipo diverso, ma logicamente correlati. Un record contenente un campo per ogni elemento consente di trattare i dati come un'unità logica.
È possibile utilizzare l'attributo %ROWTYPE per dichiarare un record che rappresenta una riga o una riga di tabella recuperata da un cursore. Con i record definiti dall'utente è possibile dichiarare i propri campi.
Vedere anche: Oracle AI Database PL/SQL Language Reference per informazioni sull'uso dei record PL/SQL
Modalità di esecuzione di PL/SQL
PL/SQL supporta l'esecuzione interpretata e l'esecuzione nativa.
Nell'esecuzione interpretata, il codice sorgente PL/SQL viene compilato in una cosiddetta rappresentazione bytecode. Un computer virtuale portatile implementato come parte di Oracle AI Database esegue questo bytecode.
L'esecuzione nativa offre le migliori prestazioni su unità a uso intensivo di calcolo. In questo caso, il codice sorgente delle unità PL/SQL viene compilato direttamente al codice oggetto per la piattaforma specificata. Questo codice oggetto è collegato a Oracle AI Database.
Il motore PL/SQL definisce, compila ed esegue le unità PL/SQL. Questo motore è un componente speciale di molti prodotti Oracle, tra cui Oracle AI Database. Sebbene molti prodotti Oracle dispongano di componenti PL/SQL, questo argomento descrive in modo specifico le unità PL/SQL che possono essere memorizzate in Oracle AI Database ed elaborate utilizzando il motore PL/SQL di Oracle AI Database. La documentazione di ogni strumento Oracle descrive le funzionalità PL/SQL.
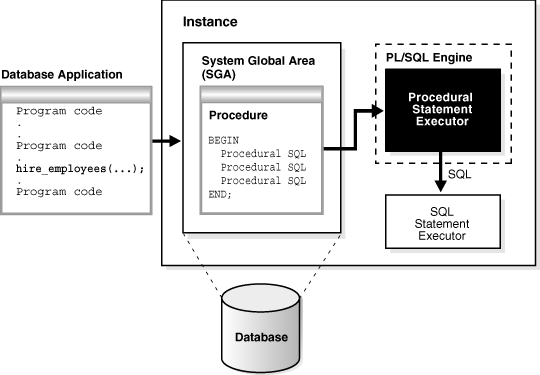
Il grafico seguente illustra il motore PL/SQL contenuto in Oracle AI Database.
Figura 3: Il motore PL/SQL e Oracle AI Database
Descrizione dell'illustrazione cncpt070.gif
L'unità PL/SQL viene memorizzata in un database. Quando un'applicazione chiama una stored procedure, il database carica l'unità PL/SQL compilata nel pool condiviso nell'area globale di sistema (SGA). Gli esecutori delle istruzioni PL/SQL e SQL lavorano insieme per elaborare le istruzioni nella procedura.
È possibile richiamare una stored procedure da un altro blocco PL/SQL, che può essere un blocco anonimo o un'altra stored procedure. Ad esempio, è possibile chiamare una stored procedure da Oracle Forms.
Una procedura PL/SQL in esecuzione su Oracle AI Database può richiamare una funzione o un'operazione esterna scritta nel linguaggio della programmazione C e memorizzata in una libreria condivisa. La routine C viene eseguita in uno spazio di indirizzi separato da quello di Oracle AI Database.
Vedere anche:
-
"Shared Pool " per ulteriori informazioni sullo scopo e sul contenuto dello shared pool
-
Oracle AI Database PL/SQL Language Reference per informazioni sull'architettura PL/SQL
-
Oracle AI Database Development Guide per ulteriori informazioni sulle procedure esterne
Panoramica di Java in Oracle AI Database
Java è emerso come il linguaggio di programmazione orientato agli oggetti di scelta.
Java include le seguenti funzioni:
-
Una Java Virtual Machine (JVM), che fornisce le basi per l'indipendenza della piattaforma
-
Tecniche di gestione automatizzata dello storage, come il garbage collection
-
Sintassi della lingua che prende in prestito da C e applica la digitazione complessa Nota: in questo capitolo si presume che si abbia una certa familiarità con il linguaggio Java.
Il database fornisce ai programmi Java un motore di elaborazione dati dinamico che supporta query complesse e viste multiple di dati. Le richieste client vengono assemblate come query di dati per l'elaborazione immediata. I risultati delle query vengono generati in modo dinamico.
La combinazione di Java e Oracle AI Database ti aiuta a creare applicazioni basate su componenti e incentrate sulla rete che possono essere facilmente aggiornate man mano che le esigenze aziendali cambiano. Inoltre, è possibile spostare applicazioni e data store dal desktop e su reti intelligenti e server incentrati sulla rete. Ancora più importante, è possibile accedere a queste applicazioni e data store da qualsiasi dispositivo client.
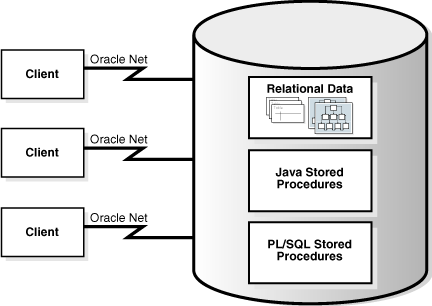
La figura seguente mostra una configurazione client/server a due livelli tradizionale in cui i client chiamano le stored procedure Java nello stesso modo in cui chiamano i sottoprogrammi PL/SQL.
Figura 4: Configurazione client/server a due livelli
Descrizione dell'illustrazione cncpt236.gif
-
Panoramica di Java Virtual Machine (JVM) Un JVM è un processore virtuale su cui viene eseguito il codice Java compilato.
-
Ambiente di programmazione Java Oracle fornisce agli sviluppatori di applicazioni aziendali una soluzione Java end-to-end per la creazione, la distribuzione e la gestione di applicazioni Java. Vedi anche: Inizia a utilizzare Oracle AI Database con lo sviluppo Java per un'introduzione all'uso di Java con Oracle AI Database
Panoramica della Java Virtual Machine (JVM)
JVM è un processore virtuale su cui viene eseguito il codice Java compilato.
Il codice sorgente Java viene compilato in istruzioni per computer di basso livello, note come bytecodes, indipendenti dalla piattaforma. I bytecode Java vengono interpretati tramite JVM in azioni dipendenti dalla piattaforma.
-
Panoramica di Oracle JVM Oracle JVM è un ambiente standard e compatibile con Java che esegue qualsiasi applicazione Java pura. È compatibile con le specifiche JLS e JVM.
-
Componenti principali di Oracle JVM Oracle JVM viene eseguito nello stesso spazio di processo e nello stesso spazio di indirizzo del kernel del database condividendo i relativi heap di memoria e accedendo direttamente ai dati relazionali. Questo design ottimizza l'uso della memoria e aumenta il throughput.
Panoramica di Oracle JVM
Oracle JVM è un ambiente standard compatibile con Java che esegue qualsiasi applicazione Java pura. È compatibile con le specifiche JLS e JVM.
Oracle JVM supporta il formato binario e le API Java standard. Inoltre, Oracle AI Database aderisce alla semantica del linguaggio Java standard, incluso il caricamento dinamico delle classi in fase di runtime.
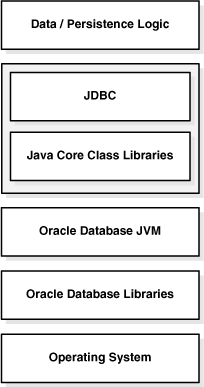
La figura seguente illustra il modo in cui le applicazioni Oracle Java si trovano al di sopra delle librerie di classe core Java, che si trovano al di sopra di JVM Oracle. Poiché il sistema di supporto Oracle Java si trova all'interno del database, JVM interagisce con le librerie di database anziché interagire direttamente con il sistema operativo.
Figura 5: Struttura dei componenti Java
Descrizione dell'illustrazione cncpt206.gif
A differenza di altri ambienti Java, Oracle JVM è incorporato in Oracle AI Database. Esistono alcune importanti differenze tra JVM Oracle e JVM client standard. Ad esempio, in un ambiente Java standard, è possibile eseguire un'applicazione Java tramite l'interpreter eseguendo il comando seguente nella riga di comando, dove classname è il nome della classe che JVM interpreta per prima:
java classnameIl comando precedente fa sì che l'applicazione venga eseguita all'interno di un processo nel sistema operativo. Tuttavia, se non si utilizza l'interfaccia della riga di comando, è necessario caricare l'applicazione nel database, pubblicare l'interfaccia e quindi eseguire l'applicazione all'interno di un dizionario dati del database.
Vedere anche: Vedere Oracle AI Database Java Developer's Guide per una descrizione delle altre differenze tra JVM Oracle e JVM client standard.
Componenti principali di Oracle JVM
Oracle JVM viene eseguito nello stesso spazio di processo e nello stesso spazio di indirizzamento del kernel del database condividendo i propri heap di memoria e accedendo direttamente ai propri dati relazionali. Questo design ottimizza l'uso della memoria e aumenta il throughput.
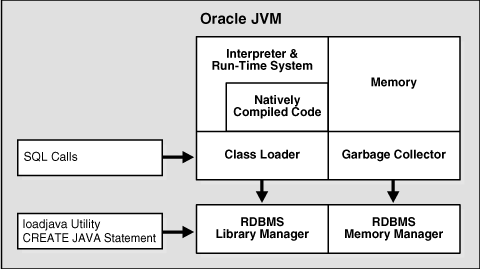
Oracle JVM fornisce un ambiente di runtime per gli oggetti Java. Supporta completamente le strutture di dati Java, l'invio dei metodi, la gestione delle eccezioni e i thread a livello di linguaggio. Supporta anche tutte le librerie di classe Java di base, tra cui java.lang, java.io, java.net, java.math e java.util.
La figura seguente mostra i componenti principali di Oracle JVM.
Figura 6: Componenti principali di Oracle JVM
Descrizione dell'illustrazione cncpt254.gif
Oracle JVM incorpora lo spazio di nomi Java standard negli schemi di database. Questa funzione consente ai programmi Java di accedere agli oggetti Java memorizzati in Oracle AI Database e agli application server in tutta l'azienda.
Inoltre, Oracle JVM è strettamente integrato con l'architettura di memoria condivisa scalabile del database. I programmi Java utilizzano le chiamate, le sessioni e le vite degli oggetti in modo efficiente senza l'intervento dell'utente. Di conseguenza, è possibile ridimensionare la JVM Oracle e i business object Java di livello intermedio, anche quando hanno uno stato lungo la sessione.
Vedere anche: Oracle AI Database Java Developer's Guide per una descrizione dei componenti principali di Oracle JVM
Ambiente di programmazione Java
Oracle offre agli sviluppatori di applicazioni aziendali una soluzione Java end-to-end per la creazione, la distribuzione e la gestione di applicazioni Java.
La soluzione è composta da interfacce programmatiche lato client e lato server, strumenti per supportare lo sviluppo Java e una Java Virtual Machine integrata con Oracle AI Database. Tutti questi prodotti sono compatibili con gli standard Java.
L'ambiente di programmazione Java è costituito dalle seguenti funzioni aggiuntive:
-
Procedure memorizzate Java come equivalente e compagno Java per PL/SQL. Le stored procedure Java sono strettamente integrate con PL/SQL. È possibile chiamare le stored procedure Java dai package e dalle procedure PL/SQL dalle stored procedure Java.
-
Interfacce di programmazione JDBC e SQLJ per l'accesso ai dati SQL.
-
Strumenti e script che aiutano a sviluppare, caricare e gestire le classi.
-
Procedure memorizzate Java Una procedura memorizzata Java è un metodo Java pubblicato in SQL e memorizzato nel database.
-
Integrazione Java e PL/SQL È possibile chiamare i programmi PL/SQL esistenti da programmi Java e Java da PL/SQL. Questa soluzione protegge e sfrutta il tuo codice PL/SQL e Java.
Procedure memorizzate Java
Una procedura memorizzata Java è un metodo Java pubblicato in SQL e memorizzato nel database.
Come un sottoprogramma PL/SQL, una procedura Java può essere richiamata direttamente con prodotti come SQL*Plus o indirettamente con un trigger. È possibile accedervi da qualsiasi client-OCI, precompilatore o JDBC di Oracle Net.
Per pubblicare i metodi Java, si scrivono le specifiche delle chiamate, che mappano i nomi dei metodi Java, i tipi di parametri e restituiscono i tipi alle rispettive controparti SQL. Quando viene chiamata dalle applicazioni client, una stored procedure Java può accettare argomenti, fare riferimento a classi Java e restituire i valori dei risultati Java.
Applicazioni che richiamano il metodo Java facendo riferimento al nome della specifica di chiamata. Il sistema runtime cerca la definizione della specifica di chiamata nel dizionario dati Oracle ed esegue il metodo Java corrispondente.
Inoltre, puoi utilizzare Java per sviluppare programmi potenti indipendentemente da PL/SQL. Oracle AI Database fornisce un'implementazione completamente conforme del linguaggio di programmazione Java e della JVM.
Vedi anche: Oracle AI Database Java Developer's Guide spiega come scrivere stored procedure in Java, come accedervi da PL/SQL e come accedere alla funzionalità PL/SQL da Java
Integrazione di Java e PL/SQL
È possibile chiamare i programmi PL/SQL esistenti da programmi Java e Java da PL/SQL. Questa soluzione protegge e sfrutta il tuo codice PL/SQL e Java.
Oracle AI Database offre JDBC per l'accesso ai dati SQL da Java sia sul client che sul server.
- JDBC Driver JDBC è un protocollo di accesso al database che consente di connettersi a un database ed eseguire istruzioni e query SQL al database.
Driver JDBC
JDBC è un protocollo di accesso al database che consente di connettersi a un database ed eseguire istruzioni e query SQL al database.
Le librerie di classe Java di base forniscono una sola API JDBC, java.sql. Tuttavia, JDBC è progettato per consentire ai fornitori di fornire driver che offrono la specializzazione necessaria per un determinato database. Oracle fornisce i driver JDBC distinti mostrati nella tabella seguente.
Driver JDBC tabella 2
| Driver | Descrizione |
|---|---|
| Driver Thin JDBC | È possibile utilizzare il driver Thin JDBC per scrivere applicazioni e applet Java puri che accedono ai dati Oracle SQL. Il driver JDBC Thin è particolarmente adatto per le applicazioni e le applet basate sul Web, poiché è possibile scaricarlo dinamicamente da una pagina Web, simile a qualsiasi altra applet Java. |
| Driver OCI JDBC | Il driver JDBC OCI accede al codice nativo specifico di Oracle, ovvero al codice non Java e alle librerie sul client o sul livello intermedio, fornendo un incremento delle prestazioni rispetto al driver JDBC Thin, a costo di un'installazione lato client e di dimensioni notevolmente maggiori. |
| Driver interno lato server JDBC | Oracle AI Database utilizza il driver interno lato server quando il codice Java viene eseguito sul server. Consente alle applicazioni Java in esecuzione in JVM Oracle sul server di accedere ai dati definiti localmente, ovvero ai dati sullo stesso sistema e nello stesso processo, con JDBC. Offre un miglioramento delle prestazioni, grazie alla sua capacità di utilizzare direttamente le librerie Oracle RDBMS di base, senza il sovraccarico di una connessione di rete che interviene tra il codice Java e i dati SQL. Supportando la stessa interfaccia Java-SQL sul server, Oracle AI Database non richiede di rielaborare il codice durante la distribuzione. |
Vedere anche:
Panoramica di JavaScript in Oracle AI Database
JavaScript è uno dei linguaggi di programmazione più popolari oggi. Oracle AI Database distribuito su Linux x86-64 o Linux aarch64 aggiunge JavaScript alla lista dei linguaggi supportati per lo sviluppo lato server.
È possibile memorizzare moduli di JavaScript nel database, elaborando i dati in cui vivono offrendo miglioramenti potenzialmente significativi rispetto agli approcci di sviluppo lato client. JavaScript viene eseguito da Multilingual Engine (MLE).
Gli sviluppatori possono scegliere tra l'esecuzione di codice JavaScript standalone e la memorizzazione del codice JavaScript in modo nativo nel database come moduli.
-
Memorizzazione della logica aziendale come moduli nel database Proprio come con JavaScript relativo allo sviluppo lato client, il codice può essere memorizzato insieme sotto forma di modulo.
-
Esecuzione dinamica del codice JavaScript Gli sviluppatori del framework e chiunque desideri eseguire il codice JavaScript standalone senza la necessità di memorizzare il codice nel database può utilizzare il pacchetto
DBMS_MLEe le relative sottoprogrammi. -
Procedure memorizzate JavaScript in linea Le specifiche di chiamata MLE in linea incorporano il codice JavaScript direttamente nelle DDL
CREATE FUNCTIONeCREATE PROCEDURE. Vedi anche: Oracle AI Database JavaScript Developer's Guide per ulteriori informazioni sul supporto JavaScript in Oracle AI Database.
Memorizzazione della logica aziendale come moduli nel database
Proprio come con lo sviluppo lato client JavaScript, il codice può essere memorizzato insieme sotto forma di un modulo.
Gli sviluppatori con background PL/SQL possono pensare a un modulo JavaScript come l'equivalente di un package body PL/SQL, ma scritto in JavaScript. Le funzioni dichiarate in un modulo possono essere contrassegnate per essere esportate o mantenute private.
JavaScript in Oracle AI Database aderisce allo standard ECMAScript 2023 e offre agli sviluppatori una vasta gamma di possibilità per memorizzare la business logic all'interno del database.
Nota:
Fare riferimento anche a quanto riportato di seguito.
-
Oracle AI Database JavaScript Developer's Guide capitolo 2 per un'introduzione approfondita dei moduli MLE.
-
Oracle AI Database JavaScript Developer's Guide capitolo 5 per dettagli sulle Specifiche delle chiamate.
Di seguito è riportato un esempio di creazione di un modulo JavaScript con MLE:
create mle module if not exists example_module
language javascript as

export function string2obj(inputString) {
   if ( inputString === undefined ) {
      throw `must provide a string in the form of key1=value1;...;keyN=valueN`;
   }

   let myObject = {};
   if ( inputString.length === 0 ) {
      return myObject;
   }

   const kvPairs = inputString.split(";");
   kvPairs.forEach( pair => {
      const tuple = pair.split("=");
      if ( tuple.length === 1 ) {
          tuple[1] = false;
      } else if ( tuple.length != 2 ) {
          throw "parse error: you need to use exactly one '=' between key and value and not use '=' in either key or value";
      }
      myObject[tuple[0]] = tuple[1];
  });

  return myObject;
}
/
Il modulo JavaScript, noto anche come modulo MLE, è ora memorizzato nello schema dell'utente. La sua unica funzione, string2obj(), può essere esposta a SQL e PL/SQL creando una specifica di chiamata. Le specifiche di chiamata sono program unit PL/SQL che consentono di chiamare il codice JavaScript ovunque sia possibile chiamare SQL e PL/SQL. La specifica di chiamata per string2obj() può essere scritta come segue:
create function if not exists p_string_to_JSON(p_str varchar2) return JSON
as mle module example_module
   signature 'string2obj(string)';
/
Con la funzione creata può essere chiamata da SQL:
declare
   l_json   JSON;
   l_string VARCHAR2(100);
begin
   l_string := 'a=1;b=2;c=3;d';
   l_json := p_string_to_JSON(l_string);
   dbms_output.put_line(json_serialize(l_json PRETTY));
end;
/

{
  "a" : "1",
  "b" : "2",
  "c" : "3",
  "d" : false
}

PL/SQL procedure successfully completed.
Esecuzione dinamica del codice JavaScript
Gli sviluppatori di framework e chiunque desideri eseguire codice JavaScript standalone senza la necessità di memorizzare il codice nel database possono utilizzare il pacchetto DBMS_MLE e le relative sottoprogrammi.
Oracle Application Express e Database Actions, ad esempio, integrano DBMS_MLE, nascondendo il fatto che un package PL/SQL viene richiamato sotto le coperte.
Rispetto ai moduli MLE, l'uso di DBMS_MLE rende più difficile scrivere intere applicazioni. Ad esempio, è più difficile dividere logicamente un'applicazione in entità separate. La funzione di debug post-esecuzione richiede moduli che rendono più difficile la risoluzione dei problemi negli snippet di codice. Le pipeline di integrazione continua (CI, Continuous Integration) possono anche avere difficoltà nel fornire codice PL/SQL e JavaScript nello stesso file. Allo stesso modo, c'è un potenziale problema con il tuo ambiente di sviluppo integrato (IDE) poiché la maggior parte avrà difficoltà a lavorare sia con PL/SQL che con JavaScript nella stessa finestra.
Nota:
Fare riferimento anche a quanto riportato di seguito.
-
Oracle AI Database PL/SQL Packages and Types Reference per ulteriori dettagli su
DBMS_MLEe sulle relative sottoprogrammi. -
Oracle AI Database JavaScript Developer's Guide, capitolo 3, per ulteriori dettagli sul richiamo dinamico JavaScript.
Stored procedure JavaScript in linea
Le specifiche di chiamata MLE in linea incorporano il codice JavaScript direttamente nelle DDL CREATE FUNCTION e CREATE PROCEDURE.
Se si desidera implementare rapidamente funzionalità semplici utilizzando JavaScript, le specifiche di chiamata MLE in linea possono essere una buona scelta. Con questa opzione, non è necessario distribuire un modulo separato contenente il codice JavaScript. Piuttosto, la funzione JavaScript è integrata nella definizione della specifica di chiamata stessa.
La clausola MLE LANGUAGE viene utilizzata per specificare che la funzione viene implementata utilizzando JavaScript. La stringa che segue il nome della lingua viene considerata come il corpo di una funzione JavaScript che implementa la funzionalità della specifica di chiamata. Quando il codice viene eseguito, i parametri PL/SQL vengono convertiti automaticamente nel tipo JavaScript predefinito e passati alla funzione JavaScript come parametri con lo stesso nome. Si noti che i nomi dei parametri senza virgolette vengono mappati ai nomi JavaScript con lettere maiuscole. Il valore restituito da una funzione JavaScript viene convertito nel tipo restituito della specifica di chiamata PL/SQL, così come con le specifiche di chiamata per i moduli MLE.
Nota:
Fare riferimento anche a quanto riportato di seguito.
- Oracle AI Database JavaScript Developer's Guide, capitolo 5, per maggiori dettagli sulle stored procedure inline JavaScript.
Panoramica dei trigger
Un trigger di database è una program unit memorizzata compilata, scritta in PL/SQL, Java o JavaScript, che Oracle Database richiama ("fuochi") in modo automatico in determinate situazioni.
Un trigger si attiva ogni volta che si verifica una delle seguenti operazioni:
-
Istruzioni DML presenti in una determinata tabella o vista, rilasciate da qualsiasi utente
Le istruzioni DML modificano i dati negli oggetti dello schema. Ad esempio, l'inserimento e l'eliminazione di righe sono operazioni DML.
-
Istruzioni DDL eseguite da un determinato utente o da un qualsiasi utente
Le istruzioni DDL definiscono gli oggetti dello schema. Ad esempio, la creazione di una tabella e l'aggiunta di una colonna sono operazioni DDL.
-
Eventi del database
Login utente o disconnessione, errori e avvio o arresto del database sono eventi che possono richiamare i trigger.
I trigger sono oggetti di schema simili ai sottoprogrammi, ma diversi per la modalità di richiamo. Un sottoprogramma viene eseguito in modo esplicito da un utente, un'applicazione o un trigger. I trigger vengono richiamati in modo implicito dal database quando si verifica un evento di attivazione.
-
Vantaggi dei trigger L'uso corretto dei trigger consente di creare e distribuire applicazioni più solide e che utilizzano il database in modo più efficace.
-
I trigger Tipi di trigger possono essere classificati in base ai relativi mezzi di richiamo e al tipo di azioni che eseguono.
-
Tempistica per i trigger È possibile definire la tempistica del trigger, indipendentemente dal fatto che l'azione del trigger debba essere eseguita prima o dopo l'istruzione di attivazione.
-
Creazione di trigger L'istruzione
CREATE TRIGGERcrea o sostituisce un trigger di database. -
Esecuzione dei trigger Oracle Database esegue un trigger internamente utilizzando gli stessi passi dell'esecuzione del sottoprogramma.
-
Memorizzazione dei trigger Oracle Database memorizza i trigger PL/SQL in formato compilato in uno schema di database, proprio come le stored procedure PL/SQL.
Vedere anche:
-
"Panoramica delle istruzioni SQL" per ulteriori informazioni su DML e DDL
-
"Panoramica dell'avvio e della chiusura dell'istanza di database"
Vantaggi dei trigger
L'uso corretto dei trigger consente di creare e distribuire applicazioni più solide e che utilizzano il database in modo più efficace.
È possibile utilizzare i trigger per:
-
Genera automaticamente valori di colonna derivati
-
Impedisci transazioni non valide
-
Fornire audit e registrazione degli eventi
-
Informazioni sui record relativi all'accesso alle tabelle
È possibile utilizzare i trigger per applicare regole business di basso livello comuni a tutte le applicazioni client. Ad esempio, diverse applicazioni possono accedere alla tabella employees. Se un trigger in questa tabella garantisce il formato dei dati inseriti, la business logic non deve essere riprodotta in ogni client. Poiché il trigger non può essere aggirato dall'applicazione, la logica aziendale nel trigger viene utilizzata automaticamente.
È possibile utilizzare sia i trigger che i vincoli di integrità per definire e applicare qualsiasi tipo di regola di integrità. Tuttavia, Oracle consiglia di utilizzare solo i trigger per applicare regole aziendali complesse non definibili utilizzando un vincolo di integrità.
L'uso eccessivo di trigger può comportare interdipendenze complesse che possono essere difficili da mantenere in un'applicazione di grandi dimensioni. Ad esempio, quando viene richiamato un trigger, un'istruzione SQL all'interno della relativa azione trigger può potenzialmente attivare altri trigger, con conseguenti trigger a catena in grado di produrre effetti non previsti.
Vedere anche:
-
Introduzione a Oracle AI Database con lo sviluppo di Oracle AI Database
-
Oracle AI Database PL/SQL Language Reference per linee guida e limitazioni durante la pianificazione dei trigger per la tua applicazione
automaticamente in certe situazioni.")
Tipi di trigger
I trigger possono essere classificati in base ai loro mezzi di invocazione e al tipo di azioni che eseguono.
Oracle Database supporta i tipi di trigger riportati di seguito.
-
Trigger righe
Un trigger di riga viene attivato ogni volta che la tabella è interessata dall'istruzione di attivazione. Ad esempio, se un'istruzione aggiorna più righe, un trigger di riga viene attivato una volta per ogni riga interessata da
UPDATE. Se un'istruzione di attivazione non interessa alcuna riga, il trigger di riga non viene eseguito. I trigger di riga sono utili se il codice nell'azione di trigger dipende dai dati forniti dall'istruzione o dalle righe di attivazione interessate. -
Trigger delle istruzioni
Un trigger di dichiarazione viene attivato una volta per conto dell'istruzione di attivazione, indipendentemente dal numero di righe interessate dall'istruzione di attivazione. Ad esempio, se un'istruzione elimina 100 righe da una tabella, un trigger
DELETEa livello di istruzione viene attivato una sola volta. I trigger di istruzione sono utili se il codice nell'azione di trigger non dipende dai dati forniti dall'istruzione di attivazione o dalle righe interessate. -
Trigger
INSTEAD OFUn trigger INSTEAD OF viene attivato da Oracle Database invece di eseguire l'istruzione di attivazione. Questi trigger sono utili per modificare in modo trasparente le viste che non possono essere modificate direttamente tramite istruzioni DML.
-
Trigger di eventi
È possibile utilizzare i trigger per pubblicare informazioni sugli eventi del database ai sottoscrittori. I trigger di evento sono suddivisi nelle categorie riportate di seguito.
-
Un trigger evento di sistema può essere causato da eventi quali l'avvio e la chiusura delle istanze di database o messaggi di errore.
-
Un trigger evento utente viene attivato a causa di eventi correlati all'accesso e alla disconnessione degli utenti, alle istruzioni DDL e alle istruzioni DML.
-
Vedere anche:
automaticamente in certe situazioni.")
Tempistica per i trigger
È possibile definire la tempistica del trigger, ovvero se l'azione del trigger deve essere eseguita prima o dopo l'istruzione di attivazione.
Un trigger semplice è un singolo trigger in una tabella che consente di specificare azioni per esattamente uno dei seguenti punti temporali:
-
Prima della dichiarazione di licenziamento
-
Prima di ogni riga interessata dall'istruzione di attivazione
-
Dopo ogni riga interessata dall'istruzione di licenziamento
-
Dopo la dichiarazione di licenziamento
Per i trigger di istruzione e riga, un trigger BEFORE può migliorare la sicurezza e abilitare le regole business prima di apportare modifiche al database. Il trigger AFTER è ideale per le azioni di log.
Un trigger composto può essere avviato in più punti temporali. I trigger composti aiutano a programmare un approccio in cui le azioni implementate per vari punti temporali condividono dati comuni.
Vedere anche: Oracle AI Database PL/SQL Language Reference per informazioni sui trigger composti
automaticamente in certe situazioni.")
Creazione delle spettanze
L'istruzione CREATE TRIGGER crea o sostituisce un trigger di database.
Un trigger PL/SQL ha il seguente formato sintattico generale:
CREATE TRIGGER trigger_name
  triggering_statement
  [trigger_restriction]
BEGIN
 triggered_action;
END;
Un trigger PL/SQL dispone dei seguenti componenti di base:
-
Nome trigger
Il nome deve essere univoco tra gli altri nomi di trigger nello stesso schema. Ad esempio, il nome può essere
part_reorder_trigger. -
Evento o istruzione trigger
Un evento o un'istruzione di attivazione è l'istruzione SQL, l'evento di database o l'evento utente che causa il richiamo di un trigger. Ad esempio, un utente aggiorna una tabella.
-
Limitazione trigger
Una restrizione trigger specifica un'espressione booleana che deve essere
trueaffinché venga attivato il trigger. Ad esempio, il trigger non viene richiamato a meno che il numero di parti disponibili non sia inferiore a un importo di riordino presente. -
Azione attivata
Un'azione attivata è la procedura che contiene le istruzioni SQL e il codice da eseguire quando viene emessa un'istruzione di attivazione e la limitazione del trigger restituisce true. Ad esempio, un utente inserisce una riga in una tabella degli ordini in sospeso.
-
Esempio: istruzione CREATE TRIGGER In questo esempio viene creato un TRIGGER che viene attivato quando un'istruzione
INSERT,UPDATEoDELETEviene eseguita in una tabella di elementi riga. -
Esempio: richiamo di un trigger a livello di riga In questo scenario, un cliente avvia due ordini e aggiunge e rimuove le voci riga dagli ordini.
Vedere anche:
-
Guida introduttiva a Oracle AI Database Development e Oracle AI Database PL/SQL Language Reference per scoprire come creare i trigger
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sull'istruzione
CREATE TRIGGER
automaticamente in certe situazioni.")
Esempio: istruzione CREATE TRIGGER
In questo esempio viene creato un trigger che viene attivato quando un'istruzione INSERT, UPDATE o DELETE viene eseguita in una tabella degli elementi riga.
Si supponga di creare le tabelle orders e lineitems con le istruzioni seguenti. La tabella orders contiene una riga per ogni ordine univoco, mentre la tabella lineitems contiene una riga per ogni elemento di un ordine.
CREATE TABLE orders
( order_id NUMBER PRIMARY KEY,
  /* other attributes */
  line_items_count NUMBER DEFAULT 0 );

CREATE TABLE lineitems
( order_id REFERENCES orders,
  seq_no   NUMBER,
  /* other attributes */
  CONSTRAINT lineitems PRIMARY KEY(order_id,seq_no) );
L'istruzione seguente crea un trigger di esempio che aggiorna automaticamente la tabella orders con il numero di elementi in un ordine:
CREATE OR REPLACE TRIGGER lineitems_trigger
  AFTER INSERT OR UPDATE OR DELETE ON lineitems
  FOR EACH ROW
BEGIN
  IF (INSERTING OR UPDATING)
  THEN
    UPDATE orders SET line_items_count = NVL(line_items_count,0)+1
    WHERE order_id = :new.order_id;
  END IF;
  IF (DELETING OR UPDATING)
  THEN
    UPDATE orders SET line_items_count = NVL(line_items_count,0)-1
    WHERE order_id = :old.order_id;
  END IF;
END;
/
In lineitems_trigger, l'istruzione di attivazione è un INSERT, UPDATE o DELETE nella tabella lineitems. Nessuna limitazione di attivazione esistente. Il trigger viene richiamato per ogni riga modificata. Il trigger ha accesso ai valori di colonna vecchi e nuovi della riga corrente interessata dall'istruzione di attivazione. Esistono due nomi di correlazione per ogni colonna della tabella in fase di modifica: il vecchio valore (:old) e il nuovo valore (:new). Se una sessione aggiorna o inserisce righe in lineitems per un ordine, dopo l'azione il trigger calcola il numero di elementi in questo ordine e aggiorna la tabella orders con il conteggio.
Esempio: richiamo di un trigger a livello di riga
In questo scenario, un cliente avvia due ordini e aggiunge e rimuove le voci riga dagli ordini.
Lo scenario si basa sul TRIGGER creato in Esempio: istruzione CREATE TRIGGER.
Scenario trigger a livello di riga tabella 3
| Istruzione SQL | Istruzione SQL attivata | Descrizione |
|---|---|---|
SQL> INSERT INTO orders (order_id) VALUES (78); 1 row created. |
Il cliente crea un ordine con ID 78. A questo punto il cliente non ha articoli nell'ordine. Poiché non viene eseguita alcuna azione sulla tabella |
|
SQL> INSERT INTO orders (order_id) VALUES (92); 1 row created. |
Il cliente crea un ordine separato con ID 92. A questo punto il cliente non ha articoli nell'ordine. Poiché non viene eseguita alcuna azione sulla tabella |
|
SQL> INSERT INTO lineitems (order_id, seq_no) VALUES (78,1); 1 row created. |
UPDATE orders SET line_items_count = NVL(NULL,0)+1 WHERE order_id = 78; |
Il cliente aggiunge un articolo all'ordine 78. Il comando |
SQL> INSERT INTO lineitems (order_id, seq_no) VALUES (78,2); 1 row created. |
UPDATE orders SET line_items_count = NVL(1,0)+1 WHERE order_id = 78; |
Il cliente aggiunge un articolo aggiuntivo all'ordine 78. Il comando |
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 2 92 0 |
Il cliente esegue una query sullo stato dei due ordini. L'ordine 78 contiene due elementi. L'ordine 92 non contiene articoli. | |
SQL> SELECT * FROM lineitems; ORDER_ID SEQ_NO ---------- ---------- 78 1 78 2 |
Il cliente esegue una query sullo stato delle voci riga. Ogni articolo è identificato in modo univoco dall'ID ordine e dal numero di sequenza. | |
SQL> UPDATE lineitems SET order_id = 92; 2 rows updated. |
UPDATE orders
  SET line_items_count =
  NVL(NULL,0)+1
 WHERE order_id = 92;

  UPDATE orders
  SET line_items_count =
  NVL(2,0)-1
 WHERE order_id = 78;
UPDATE orders SET line_items_count = NVL(1,0)+1 WHERE order_id = 92; UPDATE orders SET line_items_count = NVL(1,0)-1 WHERE order_id = 78; |
Il cliente sposta le voci riga dell'ordine 78 nell'ordine 92. L'istruzione Ogni volta che il trigger viene richiamato, vengono soddisfatte entrambe le condizioni |
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 0 92 2 |
Il cliente esegue una query sullo stato dei due ordini. L'effetto netto è che il conteggio delle voci per l'ordine 92 è aumentato da 0 a 2, mentre il conteggio per l'ordine 78 è diminuito da 2 a 0. | |
SQL> SELECT * FROM lineitems; ORDER_ID SEQ_NO ---------- ---------- 92 1 92 2 |
Il cliente esegue una query sullo stato delle voci riga. Ogni articolo è identificato in modo univoco dall'ID ordine e dal numero di sequenza. | |
SQL> DELETE FROM lineitems; 2 rows deleted. |
UPDATE orders SET line_items_count = NVL(2,0)-1 WHERE order_id = 92; UPDATE orders SET line_items_count = NVL(1,0)-1 WHERE order_id = 92; |
Il cliente ora rimuove tutte le voci riga da tutti gli ordini. L'istruzione |
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 0 92 0 SQL> SELECT * FROM lineitems; no rows selected |
Il cliente esegue una query sullo stato dei due ordini. Nessun ordine contiene voci riga. Il cliente esegue inoltre una query sullo stato delle voci riga. Non esistono articoli. |
Esecuzione dei trigger
Oracle Database esegue un trigger internamente utilizzando gli stessi passi dell'esecuzione del sottoprogramma.
L'unica differenza sottile è che un account utente ha il diritto di attivare un trigger se ha il privilegio di eseguire l'istruzione di attivazione. Con questa eccezione, il database convalida ed esegue i trigger allo stesso modo dei sottoprogrammi memorizzati.
Vedere anche: Oracle AI Database PL/SQL Language Reference per ulteriori informazioni sull'esecuzione dei trigger
automaticamente in certe situazioni.")
Memorizzazione dei trigger
Oracle Database memorizza i trigger PL/SQL in formato compilato in uno schema di database, proprio come le stored procedure PL/SQL.
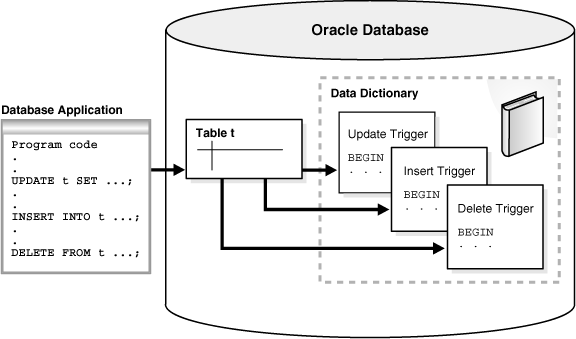
Quando si esegue il commit di un'istruzione CREATE TRIGGER, il codice PL/SQL compilato viene memorizzato nel database. Lo shared pool rimuove il codice sorgente del trigger PL/SQL.
L'immagine riportata di seguito mostra un'applicazione di database con istruzioni SQL che richiamano implicitamente i trigger PL/SQL. I trigger vengono memorizzati separatamente dalle tabelle associate.
Figura 7: Trigger
Descrizione dell'illustrazione cncpt076.gif
I trigger Java vengono memorizzati nello stesso modo dei trigger PL/SQL. Tuttavia, un trigger Java fa riferimento a un codice Java compilato separatamente con un'istruzione CALL. Pertanto, la creazione di un trigger Java implica la creazione di codice Java e la creazione del trigger che fa riferimento a questo codice Java.
Vedere anche: Oracle AI Database PL/SQL Language Reference per informazioni sulla compilazione e la memorizzazione dei trigger
automaticamente in certe situazioni.")