Applicazione e architettura di Oracle Net Services
Questo capitolo definisce l'architettura dell'applicazione e descrive il funzionamento di un database Oracle e delle applicazioni di database in un ambiente di elaborazione distribuita. Questo materiale si applica a quasi tutti i tipi di ambiente Oracle AI Database.
-
Panoramica di Oracle Application Architecture Nel contesto di questo capitolo, architettura dell'applicazione si riferisce all'ambiente informatico in cui un'applicazione di database si connette a un database Oracle.
-
Panoramica dell'architettura di Oracle Net Services
Oracle Net Services è una suite di componenti di rete che fornisce soluzioni di connettività a livello aziendale in ambienti di elaborazione distribuiti ed eterogenei.
-
Panoramica dell'interfaccia del programma L'interfaccia del programma è il livello software tra un'applicazione di database e Oracle AI Database.
-
Panoramica di Oracle True Cache True Cache è una cache in-memory di sola lettura davanti a Oracle AI Database.
Panoramica dell'architettura delle applicazioni Oracle
Nel contesto di questo capitolo, architettura dell'applicazione si riferisce all'ambiente informatico in cui un'applicazione di database si connette a un database Oracle.
-
Panoramica dell'architettura client/server Nell'ambiente Oracle AI Database, l'applicazione di database e il database sono separati in un'architettura client/server.
-
Panoramica dell'architettura multilivello In un'architettura multilivello tradizionale, un server applicazioni fornisce dati per i client e funge da interfaccia tra client e database server.
-
Panoramica di Grid Architecture In un ambiente Oracle AI Database, il grid computing è un'architettura di elaborazione che raggruppa in modo efficace un gran numero di server e storage in una risorsa di elaborazione flessibile e on-demand.
Panoramica dell'architettura client/server
Nell'ambiente Oracle AI Database, l'applicazione di database e il database sono separati in un'architettura client/server.
I componenti sono i seguenti:
-
Il client esegue l'applicazione di database, ad esempio SQL*Plus o un programma di immissione dati Visual Basic, che accede alle informazioni del database e interagisce con un utente.
-
Il server esegue il software Oracle AI Database e gestisce le funzioni necessarie per l'accesso concorrente e condiviso dei dati a un database Oracle.
Sebbene l'applicazione client e il database possano essere eseguiti sullo stesso computer, una maggiore efficienza viene spesso raggiunta quando le porzioni client e la parte server vengono eseguite da diversi computer collegati tramite una rete. Le sezioni seguenti descrivono le variazioni nell'architettura client/server di Oracle AI Database.
-
Elaborazione distribuita L'utilizzo di più host per elaborare un singolo task è noto come elaborazione distribuita.
-
I vantaggi di un'architettura client/server Oracle AI Database client/server in un ambiente di elaborazione distribuita offrono una serie di vantaggi.
Elaborazione distribuita
L'utilizzo di più host per elaborare un singolo task è noto come elaborazione distribuita.
L'elaborazione front-end e back-end avviene su computer diversi. Nella Figura 19-1, il client e il server si trovano su host diversi connessi tramite Oracle Net Services.
Figura 1: Architettura client/server ed elaborazione distribuita
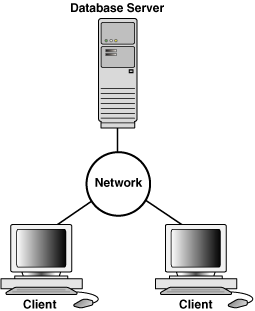
Descrizione dell'illustrazione cncpt083.gif
La Figura 19-2 è una variazione che illustra un database distribuito. In questo esempio, un database su un host accede ai dati su un database separato situato su un host diverso.
Figura 2: Architettura client/server e database distribuito
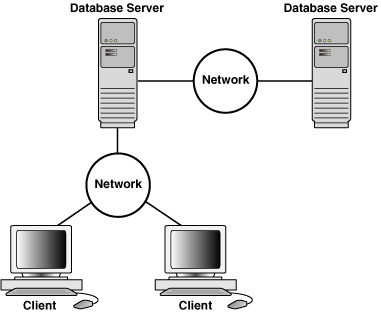
Descrizione dell'illustrazione cncpt240.gif
Nota: il resto di questo capitolo si applica agli ambienti con un database su un unico server.
Vantaggi di un'architettura client/server
L'architettura client/server di Oracle AI Database in un ambiente di elaborazione distribuita offre una serie di vantaggi.
I vantaggi includono:
-
Le applicazioni client non sono responsabili dell'esecuzione dell'elaborazione dei dati. Piuttosto, richiedono input dagli utenti, richiedono dati dal server e quindi analizzano e presentano questi dati utilizzando le funzionalità di visualizzazione della workstation client o del terminale (ad esempio, utilizzando grafici o fogli di calcolo).
-
Le applicazioni client non dipendono dalla posizione fisica dei dati. Anche se i dati vengono spostati o distribuiti in altri database server, l'applicazione continua a funzionare con poca o nessuna modifica.
-
Oracle AI Database sfrutta le funzionalità multitasking e di memoria condivisa del proprio sistema operativo sottostante. Di conseguenza, offre il più alto grado possibile di concorrenza, integrità dei dati e prestazioni alle sue applicazioni client.
-
Le postazioni di lavoro o i terminali client possono essere ottimizzati per la presentazione dei dati (ad esempio, fornendo supporto per grafica e mouse), mentre il server può essere ottimizzato per l'elaborazione e la memorizzazione dei dati (ad esempio, avendo grandi quantità di memoria e spazio su disco).
-
Negli ambienti collegati in rete, è possibile utilizzare workstation client economiche per accedere ai dati remoti del server in modo efficace.
-
Il database può ridimensionarsi man mano che il sistema cresce. È possibile aggiungere più server per distribuire il carico di elaborazione del database in tutta la rete (ridimensionato orizzontalmente) oppure spostare il database in un minicomputer o mainframe per sfruttare le prestazioni di un sistema più grande (ridimensionato verticalmente). In entrambi i casi, i dati e le applicazioni vengono gestiti con poca o nessuna modifica perché Oracle AI Database è portatile tra i sistemi.
-
Negli ambienti in rete, i dati condivisi vengono memorizzati sui server piuttosto che su tutti i computer, rendendo più facile ed efficiente la gestione dell'accesso concorrente.
-
Negli ambienti in rete, le applicazioni client inviano richieste di database al server utilizzando istruzioni SQL. Una volta ricevuta, ogni istruzione SQL viene elaborata dal server, che restituisce i risultati al client. Il traffico di rete viene ridotto al minimo perché solo le richieste e i risultati vengono spediti sulla rete.
Vedere anche: Oracle AI Database Administrator's Guide per ulteriori informazioni sui database distribuiti
Panoramica dell'architettura multilivello
In un'architettura a più livelli tradizionale, un application server fornisce dati per i client e funge da interfaccia tra client e database server.
Questa architettura consente l'utilizzo di un Application Server per:
-
Convalida le credenziali di un client, ad esempio un browser Web
-
Connessione a un database server
-
Eseguire l'operazione richiesta
Nella Figura 19-3 viene visualizzato un esempio di architettura a più livelli.
Figura 3: Un ambiente di architettura multilivello
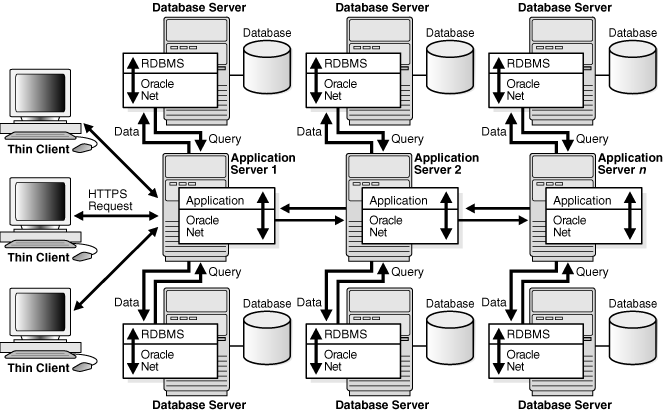
Descrizione dell'illustrazione cncpt121.gif
-
Clienti Un client avvia una richiesta di un'operazione da eseguire sul database server.
-
Application Server Un application server fornisce l'accesso ai dati per il client. Serve come interfaccia tra il client e uno o più database server e ospita le applicazioni.
-
Database server Un database server fornisce i dati richiesti da un application server per conto di un client. Il database esegue l'elaborazione delle query.
-
Service-Oriented Architecture (SOA) Il database può fungere da provider di servizi Web negli ambienti tradizionali a più livelli o architettura SOA (Service-Oriented Architecture).
Client
Un client avvia una richiesta di un'operazione da eseguire sul database server.
Il client può essere un browser Web o un altro programma utente finale. In un'architettura multilivello, il client si connette al database server tramite uno o più application server.
Application Server
Un server applicazioni fornisce l'accesso ai dati per il client. Serve come interfaccia tra il client e uno o più database server e ospita le applicazioni.
Un application server consente ai thin client, che sono client dotati di configurazioni software minime, di accedere alle applicazioni senza richiedere la manutenzione continua dei computer client. L'Application Server può anche eseguire la riformattazione dei dati per il client, riducendo il carico sulla workstation client.
L'Application Server assume l'identità del client quando esegue le operazioni sul database server per questo client. La procedura ottimale prevede la limitazione dei privilegi dell'Application Server per impedire che esegua operazioni non necessarie e indesiderate durante un'operazione client.
Database server
Un database server fornisce i dati richiesti da un application server per conto di un client. Il database esegue l'elaborazione delle query.
Il database server può eseguire l'audit delle operazioni eseguite dall'Application Server per conto dei client e per proprio conto. Ad esempio, un'operazione client può richiedere informazioni da visualizzare sul client, mentre un'operazione server applicazioni può richiedere una connessione al database server.
Nell'auditing unificato, il database può aggiungere contesti di applicazione, che sono coppie nome-valore specifiche dell'applicazione, ai record nell'audit trail unificato. È possibile configurare quali contesti di applicazione il database scrive nei record di audit del database.
Vedi anche: Oracle AI Database Security Guide per un'introduzione all'auditing
Architettura SOA (Service-Oriented Architecture)
Il database può fungere da provider di servizi Web in ambienti tradizionali a più livelli o architettura SOA (Service-Oriented Architecture).
SOA è un'architettura multilivello che si basa su servizi che supportano l'interazione tra computer e computer su una rete. Nel contesto di SOA, un servizio è un endpoint funzionale autosufficiente che dispone di una funzionalità ben definita e di un accordo a livello di servizio, può essere monitorato e gestito e può aiutare ad applicare la conformità dei criteri.
I servizi SOA sono in genere implementati come servizi Web accessibili tramite il protocollo HTTP. Si basano su standard XML quali WSDL e SOAP.
La funzionalità del servizio Web Oracle AI Database, implementata come parte di Oracle XML DB, deve essere abilitata in modo specifico dal DBA. Le applicazioni possono quindi effettuare le operazioni riportate di seguito tramite i servizi Web di database.
-
Invia query SQL o XQuery e ricevi i risultati come XML
-
Richiama funzioni PL/SQL standalone e ricevi risultati
-
Richiama le funzioni del package PL/SQL e riceve i risultati
I servizi Web di database forniscono un modo semplice per aggiungere servizi Web a un ambiente applicativo senza la necessità di un server applicazioni. Tuttavia, il richiamo dei Web Service tramite application server come Oracle Fusion Middleware offre sicurezza, scalabilità, registrazione UDDI e messaggistica affidabile in un ambiente SOA. Tuttavia, poiché i servizi Web di database si integrano facilmente con Oracle Fusion Middleware, potrebbero essere appropriati per l'ottimizzazione delle soluzioni SOA.
Vedere anche:
-
Oracle XML Developer's Kit Programmer's Guide per informazioni sull'abilitazione e l'utilizzo dei servizi Web del database
-
Documentazione di Oracle Fusion Middleware per ulteriori informazioni su SOA e servizi Web
Panoramica di Grid Architecture
In un ambiente Oracle AI Database, il grid computing è un'architettura di elaborazione che raggruppa in modo efficace un gran numero di server e storage in una risorsa di elaborazione flessibile e on-demand.
I componenti hardware e software modulari possono essere connessi e ricongiunti su richiesta per soddisfare le mutevoli esigenze delle aziende.
Vedere anche: Oracle Clusterware Administration and Deployment Guide per informazioni più dettagliate sulle griglie di server e storage
Panoramica dell'architettura di Oracle Net Services
Oracle Net Services è una suite di componenti di rete che fornisce soluzioni di connettività a livello aziendale in ambienti di elaborazione distribuiti ed eterogenei.
Oracle Net Services abilita una sessione di rete da un'applicazione a un'istanza di database e un'istanza di database a un'altra istanza di database.
Oracle Net Services garantisce trasparenza sulla posizione, configurazione e gestione centralizzate, installazione e configurazione rapide. Consente inoltre di massimizzare le risorse di sistema e migliorare le prestazioni. L'architettura del server condiviso aumenta la scalabilità delle applicazioni e il numero di client connessi contemporaneamente al database. Il protocollo Virtual Interface (VI) pone la maggior parte del carico di messaggistica sull'hardware di rete ad alta velocità, liberando la CPU.
Oracle Net Services utilizza i protocolli di comunicazione o le API (Application Programatic Interface) supportate da una vasta gamma di reti per fornire un database distribuito ed un'elaborazione distribuita. Dopo aver stabilito una sessione di rete, Oracle Net Services funge da corriere per l'applicazione client e il database server, stabilendo e gestendo una connessione e scambiando messaggi. Oracle Net Services può eseguire questi task perché esistono su ciascun computer della rete.
-
Come funziona Oracle Net Services I protocolli di Oracle AI Database accettano le istruzioni SQL dall'interfaccia delle applicazioni Oracle e poi le inseriscono nel package per la trasmissione a Oracle AI Database.
-
Oracle Net Listener Oracle Net Listener (il listener) è un processo lato server che ascolta le richieste di connessione client in entrata e gestisce il traffico verso il database. Quando un'istanza di database viene avviata e in vari momenti della sua vita, l'istanza contatta un listener e stabilisce un percorso di comunicazione per questa istanza.
-
Architettura del server dedicato In un'architettura di server dedicato, il processo del server creato per conto di ciascun processo client è denominato processo del server dedicato (o processo shadow).
-
Architettura del server condiviso In un'architettura del server condiviso, un dispatcher indirizza più richieste di sessione di rete in entrata a un pool di processi del server condiviso
-
Database Resident Connection Pooling Il servizio DRCP (Database Resident Connection Pooling) fornisce un connection pool di server dedicati per gli scenari tipici delle applicazioni Web. Vedere anche: Oracle AI Database Net Services Administrator's Guide per una panoramica sull'architettura di Oracle Net
Come funziona Oracle Net Services
I protocolli di Oracle AI Database accettano le istruzioni SQL dall'interfaccia delle applicazioni Oracle, quindi le inseriscono nel package per la trasmissione a Oracle AI Database.
La trasmissione avviene tramite un protocollo o un'API di livello superiore standard del settore supportati. Le risposte di Oracle AI Database vengono inserite all'interno dello stesso meccanismo di comunicazione di livello superiore. Questo lavoro si verifica indipendentemente dal sistema operativo di rete.
A seconda del sistema operativo che esegue Oracle AI Database, il software Oracle Net Services del database server potrebbe includere il software del driver e avviare un ulteriore processo in background.
Vedere anche: Oracle AI Database Net Services Administrator's Guide per ulteriori informazioni sul funzionamento di Oracle Net Services
Oracle Net Listener
Oracle Net Listener (il listener) è un processo lato server che ascolta le richieste di connessione client in entrata e gestisce il traffico verso il database. Quando un'istanza di database viene avviata e in vari momenti della sua vita, l'istanza contatta un listener e stabilisce un percorso di comunicazione per questa istanza.
La registrazione del servizio consente al listener di determinare se un servizio di database e i relativi handler di servizi sono disponibili. Un handler di servizi è un processo server dedicato o un dispatcher che funge da punto di connessione a un database. Durante la registrazione, il processo LREG fornisce al listener il nome dell'istanza, i nomi dei servizi di database e il tipo e gli indirizzi degli handler di servizi. Queste informazioni consentono al listener di avviare un handler di servizi quando arriva una richiesta client.
Il grafico seguente mostra due database, ciascuno su un host separato. L'ambiente di database è servito da due listener, ciascuno su un host separato. Il processo LREG in esecuzione in ogni istanza di database comunica con entrambi i listener per registrare il database.
Figura 4: Due ascoltatori
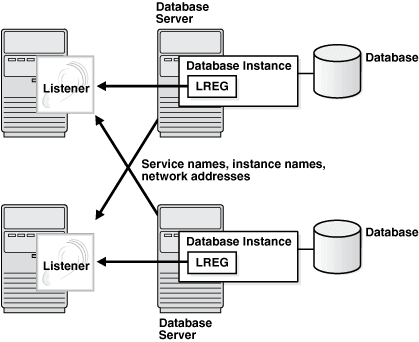
Descrizione dell'illustrazione cncpt315.png
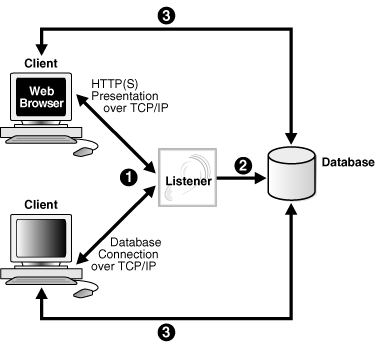
La Figura 19-5 mostra un browser che effettua una connessione HTTP e un client che effettua una connessione al database tramite un listener. Il listener non deve risiedere nell'host del database.
Figura 5: Architettura del listener
Descrizione dell'illustrazione cncpt311.gif
I passaggi di base con cui un client stabilisce una connessione tramite un listener sono:
-
Un processo client o un altro database richiede una connessione.
-
Il listener seleziona un handler di servizi appropriato per servire la richiesta client e inoltra la richiesta all'handler.
-
Il processo client si connette direttamente all'handler di servizi. L'ascoltatore non è più coinvolto nella comunicazione.
-
Nomi servizio Un nome servizio è una rappresentazione logica di un servizio utilizzato per le connessioni client.
-
I servizi in un ambiente multi-tenant I client devono connettersi ai PDB o alle radici delle applicazioni utilizzando i servizi.
-
Registrazione del servizio In Oracle Net, la registrazione del servizio è una funzione mediante la quale il processo LREG registra dinamicamente le informazioni sull'istanza con un listener. Vedere anche: "Panoramica dei processi client" e "Panoramica dei processi server"
Nomi servizio
Un nome di servizio è una rappresentazione logica di un servizio utilizzato per le connessioni client.
Quando un client si connette a un listener, richiede una connessione a un servizio. Quando un'istanza di database viene avviata, si registra con un listener fornendo uno o più servizi in base al nome. Pertanto, il listener funge da mediatore tra il client e le istanze e instrada la richiesta di connessione al posto giusto.
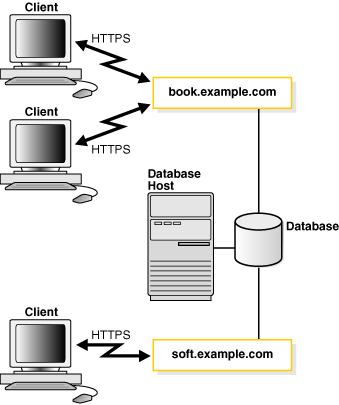
Un singolo servizio, noto da un listener, può identificare una o più istanze di database. Inoltre, una singola istanza di database può registrare uno o più servizi con un listener. I client che si connettono a un servizio non devono specificare l'istanza richiesta. La Figura 19-6 mostra un database a istanza singola associato a due servizi, book.example.com e soft.example.com. I servizi consentono di identificare lo stesso database in modo diverso da client diversi. Un amministratore di database può limitare o riservare le risorse di sistema, consentendo una migliore allocazione delle risorse ai client che richiedono uno di questi servizi.
Figura 6: Più servizi associati a un database
Descrizione dell'illustrazione cncpt314.gif
Vedere anche: Oracle AI Database Net Services Administrator's Guide per ulteriori informazioni sui metodi di denominazione
Servizi in un ambiente multi-tenant
I client devono connettersi ai PDB o alle radici delle applicazioni utilizzando i servizi.
Una connessione che utilizza un nome di servizio avvia una nuova sessione in un PDB o in una radice applicazione. Un processo in primo piano, e quindi una sessione, in ogni momento della sua vita, ha un contenitore di corrente definito in modo univoco.
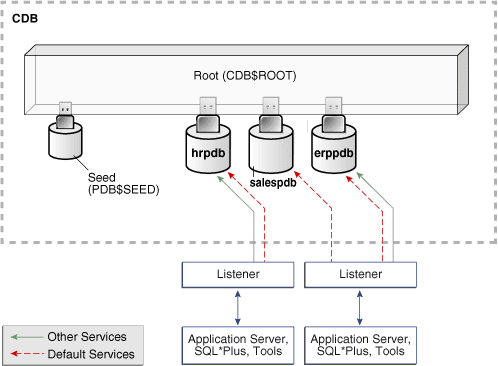
L'immagine riportata di seguito mostra due client che si connettono ai PDB utilizzando due listener diversi.
Figura 7: Servizi in un CDB
Descrizione dell'illustrazione cncpt368.png
-
Creazione del servizio Quando si esegue l'istruzione
CREATE PLUGGABLE DATABASEper creare un PDB, il database crea e avvia automaticamente un servizio all'interno del CDB. -
Connessioni ai contenitori in un CDB In genere, un amministratore CDB deve disporre dei privilegi appropriati per eseguire il provisioning dei PDB e connettersi a vari contenitori. Gli amministratori di CDB sono utenti comuni.
Creazione servizio
Quando si esegue l'istruzione CREATE PLUGGABLE DATABASE per creare un PDB, il database crea e avvia automaticamente un servizio all'interno del CDB.
Il servizio predefinito dispone di una proprietà che identifica il PDB come contenitore corrente iniziale per il servizio. La proprietà viene visualizzata nella colonna DBA_SERVICES.PDB.
-
Servizi predefiniti Il servizio predefinito ha lo stesso nome del PDB. Il nome PDB deve essere un nome di servizio valido, che deve essere univoco nel CDB.
-
Servizi Nondefault: è possibile creare servizi aggiuntivi per ciascun PDB, fino a un massimo di 10.000 CDB per singolo CDB. Ogni servizio aggiuntivo indica il PDB come contenitore corrente iniziale.
Servizi predefiniti
Il servizio predefinito ha lo stesso nome del PDB. Il nome PDB deve essere un nome di servizio valido, che deve essere univoco nel CDB.
Quando si crea un contenitore applicazioni, che richiede la specifica della clausola AS APPLICATION CONTAINER, Oracle AI Database crea automaticamente un nuovo servizio predefinito per la radice dell'applicazione. Il servizio ha lo stesso nome del contenitore dell'applicazione. Per accedere a questo servizio, è necessario che Oracle Net Services sia configurato correttamente per i client. Analogamente, ogni PDB dell'applicazione ha il proprio nome di servizio predefinito e un PDB iniziale dell'applicazione ha il proprio nome di servizio predefinito.
Esempio 19-1 Passaggio a un PDB con un servizio predefinito
Questo esempio passa ai nomi PDB salespdb utilizzando il servizio predefinito, che ha lo stesso nome del PDB:
ALTER SESSION SET CONTAINER = salespdb;Servizi di Nondefault
È possibile creare servizi aggiuntivi per ogni PDB, fino a un massimo di 10.000 servizi per CDB. Ogni servizio aggiuntivo indica il PDB come contenitore corrente iniziale.
Nella Figura 19-7 esistono servizi non predefiniti per erppdb e hrpdb. Ad esempio, nella Figura 19-7 il PDB denominato hrpdb dispone di un servizio predefinito denominato hrpdb. Impossibile eliminare il servizio predefinito.
Quando si passa a un contenitore utilizzando ALTER SESSION SET CONTAINER, la sessione utilizza il servizio predefinito per il contenitore. Facoltativamente, è possibile utilizzare un servizio diverso per il contenitore specificando SERVICE = service_name, dove service_name è il nome del servizio. È possibile utilizzare un determinato servizio in modo che la sessione possa sfruttare gli attributi e le funzioni del servizio, ad esempio le metriche del servizio, il bilanciamento del carico, le impostazioni di Resource Manager e così via.
Esempio 19-2 Passaggio a un PDB mediante un servizio Nondefault
In questo esempio, il servizio predefinito per hrpdb non supporta tutti gli attributi e le funzioni del servizio, ad esempio metriche di servizio, FAN, bilanciamento del carico, Oracle AI Database Resource Manager, Transaction Guard, Application Continuity e così via. Si passa a un servizio non predefinito come indicato di seguito.
ALTER SESSION SET CONTAINER = hrpdb SERVICE = hrpdb_full;Connessioni ai contenitori in un CDB
In genere, un amministratore CDB deve disporre dei privilegi appropriati per eseguire il provisioning dei PDB e connettersi a vari contenitori. Gli amministratori di CDB sono utenti comuni.
L'amministratore del CDB può utilizzare una delle tecniche indicate di seguito.
-
Connettersi direttamente a un PDB o a una radice applicazione.
L'utente richiede il privilegio
CREATE SESSIONnel contenitore. -
Utilizzare l'istruzione
ALTER SESSION SET CONTAINER, utile sia per il connection pooling che per l'amministrazione CDB avanzata, per passare da un contenitore all'altro. La sintassi èALTER SESSION SET CONTAINER = container_name [SERVICE = service_name].Ad esempio, un amministratore CDB può connettersi alla radice in una sessione e quindi nella stessa sessione passare a un PDB. In questo caso, l'utente richiede il privilegio di sistema
SET CONTAINERnel contenitore.
La tabella seguente descrive uno scenario che coinvolge il CDB nella Figura 19-7. Ogni riga descrive un'azione che si verifica dopo l'azione nella riga precedente. L'utente comune SYSTEM esegue una query sul nome del contenitore corrente e sui nomi dei PDB nel CDB.
Tabella 1 Servizi in un CDB
| Operazione | Descrizione |
|---|---|
|
L'utente SYSTEM, comune a tutti i contenitori del CDB, si connette alla root utilizzando il servizio denominato prod. |
|
SYSTEM utilizza il comando SQL*Plus SHOW CON_NAME per elencare il nome del contenitore a cui l'utente è attualmente connesso. CDB$ROOT è il nome del contenitore radice. |
|
Una query di V$SERVICES indica che esistono tre PDB con nomi di servizio corrispondenti al nome del PDB. Sia hrpdb che erppdb dispongono di un servizio aggiuntivo. |
|
SYSTEM utilizza ALTER SESSION per connettersi a hrpdb. |
|
Una query conferma che il contenitore corrente è ora hrpdb. |
Vedi anche: Oracle AI Database SQL Language Reference per la sintassi e la semantica di ALTER SESSION SET CONTAINER
Registrazione del servizio
In Oracle Net, la registrazione del servizio è una funzione mediante la quale il processo LREG registra dinamicamente le informazioni sull'istanza con un listener.
Queste informazioni consentono al listener di inoltrare le richieste di connessione client all'handler di servizi appropriato. LREG fornisce al listener informazioni sui seguenti elementi:
-
Nomi dei servizi di database forniti dal database
-
Nome dell'istanza di database associata ai servizi e relativo carico corrente e massimo
-
Handler di servizi (dispatcher e server dedicati) disponibili per l'istanza, inclusi il tipo, gli indirizzi di protocollo e il carico corrente e massimo
La registrazione del servizio è dinamica e non richiede la configurazione nel file listener.ora. La registrazione dinamica riduce il sovraccarico amministrativo per più database o istanze.
Il parametro di inizializzazione SERVICE_NAMES elenca i servizi a cui appartiene un'istanza. All'avvio, ogni istanza si registra con i listener di altre istanze appartenenti agli stessi servizi. Durante le operazioni del database, le istanze di ciascun servizio trasmettono informazioni sull'uso della CPU e il conteggio corrente delle connessioni a tutti i listener negli stessi servizi. Questa comunicazione consente il bilanciamento dinamico del carico e il failover della connessione.
Vedere anche:
-
Oracle AI Database Net Services Administrator's Guide per ulteriori informazioni sulla registrazione del servizio
-
Oracle Real Application Clusters Administration and Deployment Guide per informazioni sulla registrazione delle istanze e sulle connessioni client/servizio in Oracle RAC
Architettura server dedicata
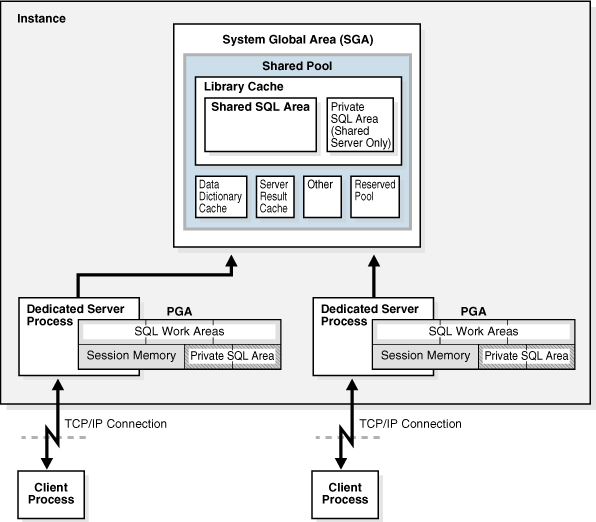
In un'architettura di server dedicato, il processo server creato per conto di ciascun processo client è denominato processo server dedicato (o processo shadow).
Un processo server dedicato è separato dal processo client e agisce solo per suo conto, come mostrato nella Figura 19-8.
Figura 8: Oracle AI Database con processi server dedicati
Descrizione dell'illustrazione cncpt303.gif
Esiste un rapporto uno-a-uno tra i processi client e i processi server. Anche quando l'utente non effettua attivamente una richiesta di database, il processo server dedicato rimane inattivo e può essere eseguito il paging su alcuni sistemi operativi. La Figura 19-8 mostra i processi utente e server in esecuzione su computer collegati in rete. Tuttavia, l'architettura server dedicata viene utilizzata anche se lo stesso computer esegue sia l'applicazione client che il codice del database, ma il sistema operativo host non è in grado di mantenere la separazione dei due programmi se sono stati eseguiti in un unico processo. Linux è un esempio di tale sistema operativo.
Nell'architettura server dedicata, i processi utente e server comunicano utilizzando diversi meccanismi:
-
Se il processo client e il processo server dedicato vengono eseguiti sullo stesso computer, l'interfaccia del programma utilizza il meccanismo di comunicazione tra processi del sistema operativo host per eseguire il proprio lavoro.
-
Se il processo client e il processo server dedicato vengono eseguiti su computer diversi, l'interfaccia del programma fornisce i meccanismi di comunicazione (come il software di rete e Oracle Net Services) tra i programmi.
I server dedicati sottoutilizzati a volte comportano un uso inefficiente delle risorse del sistema operativo. Si consideri un sistema di inserimento ordini con processi server dedicati. Un cliente inserisce un ordine mentre un impiegato inserisce l'ordine nel database. Per la maggior parte della transazione, l'impiegato sta parlando con il cliente mentre il processo server dedicato al processo client dell'impiegato è inattivo. Il processo server non è necessario durante la maggior parte della transazione e il sistema potrebbe essere più lento per altri addetti all'inserimento degli ordini se il sistema gestisce troppi processi. Per le applicazioni di questo tipo, l'architettura del server condiviso può essere preferibile.
Vedere anche: Oracle AI Database Net Services Administrator's Guide per ulteriori informazioni sui processi server dedicati
Architettura del server condiviso
In un'architettura del server condiviso, un dispatcher indirizza più richieste di sessione di rete in entrata a un pool di processi del server condiviso
Lo shared pool elimina la necessità di un processo server dedicato per ogni connessione. Un processo server condiviso inattivo proveniente dal pool recupera una richiesta da una coda comune.
Di seguito sono riportati i potenziali vantaggi del server condiviso.
-
Riduce il numero di processi nel sistema operativo
Un piccolo numero di server condivisi può eseguire la stessa quantità di elaborazione di molti server dedicati.
-
Riduce la memoria PGA dell'istanza
Ogni server dedicato o condiviso ha una PGA. Meno processi server significa meno PGA e meno gestione dei processi.
-
Aumenta la scalabilità dell'applicazione e il numero di client che possono connettersi contemporaneamente al database
-
Può essere più veloce del server dedicato quando il tasso di connessioni client e disconnessioni è elevato
Il server condiviso presenta diversi svantaggi, tra cui tempi di risposta più lenti in alcuni casi, supporto incompleto delle funzioni e maggiore complessità per l'impostazione e l'ottimizzazione. Come linea guida generale, utilizzare il server condiviso solo quando si dispone di più connessioni concorrenti al database di quante il sistema operativo sia in grado di gestire.
In un'architettura server condivisa sono necessari i processi riportati di seguito.
-
Listener di rete che connette i processi client a dispatcher o server dedicati (il listener fa parte di Oracle Net Services, non di Oracle AI Database)
Nota: per utilizzare i server condivisi, un processo client deve connettersi tramite Oracle Net Services, anche se il processo viene eseguito sullo stesso computer dell'istanza di Oracle AI Database.
-
Uno o più processi dispatcher (Dnnn)
-
Uno o più processi server condivisi
Un database può supportare sia le connessioni server condivise che quelle dedicate contemporaneamente. Ad esempio, un client può connettersi utilizzando un server dedicato mentre un altro client si connette allo stesso database utilizzando un server condiviso.
-
Richiesta dispatcher e code di risposta Una richiesta di un utente è una singola chiamata API che fa parte dell'istruzione SQL dell'utente.
-
Operazioni limitate del server condiviso Non è possibile eseguire attività amministrative specifiche durante la connessione a un processo del dispatcher, tra cui la chiusura o l'avvio di un'istanza e il recupero dei supporti.
Vedere anche:
-
Oracle AI Database Net Services Administrator's Guide per ulteriori informazioni sull'architettura del server condiviso
-
Oracle AI Database Administrator's Guide per informazioni su come configurare un database per un server condiviso
Richiesta dispatcher e code di risposta
Una richiesta di un utente è una singola chiamata API che fa parte dell'istruzione SQL dell'utente.
Quando un utente effettua una chiamata, si verificano le azioni riportate di seguito.
-
Il dispatcher inserisce la richiesta nella coda delle richieste, dove viene ripresa dal successivo processo del server condiviso disponibile.
La coda di richieste si trova nell'area SGA ed è comune a tutti i processi del dispatcher di un'istanza.
-
I processi del server condiviso controllano la coda di richieste comune per le nuove richieste, raccogliendo nuove richieste in modalità first-in-first-out.
-
Un processo server condiviso raccoglie una richiesta nella coda ed effettua tutte le chiamate necessarie al database per completare questa richiesta.
Un processo server diverso può gestire ogni chiamata al database. Pertanto, le richieste di analisi di una query, recupero della prima riga, recupero della riga successiva e chiusura del set di risultati possono essere elaborate da un server condiviso diverso.
-
Quando il processo del server completa la richiesta, inserisce la risposta nella coda di risposta del dispatcher chiamante. Ogni dispatcher ha la propria coda di risposte.
-
Il dispatcher restituisce la richiesta completata al processo client appropriato.
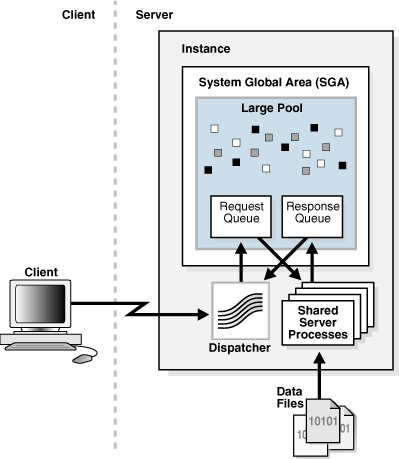
Ad esempio, in un sistema di inserimento ordini, il processo client di ogni impiegato si connette a un dispatcher. Ogni richiesta fatta dall'impiegato viene inviata a questo dispatcher, che inserisce la richiesta in coda. Il successivo server condiviso disponibile seleziona la richiesta, la assiste e inserisce la risposta nella coda di risposta. Quando una richiesta viene completata, l'impiegato rimane connesso al dispatcher, ma il server condiviso che ha elaborato la richiesta viene rilasciato e disponibile per altre richieste. Mentre un impiegato parla con un cliente, un altro impiegato può utilizzare lo stesso processo di server condiviso. La Figura 19-9 mostra il modo in cui i processi client comunicano con il dispatcher attraverso l'API e il modo in cui il dispatcher comunica le richieste utente ai processi del server condiviso.
Figura 9: Configurazione e processi del server condiviso
Descrizione dell'illustrazione cncpt067.gif
-
Processi dispatcher (Dnnn) I processi dispatcher consentono ai processi client di condividere un numero limitato di processi server.
-
Processi server condivisi (Snn) Ogni processo del server condiviso gestisce più richieste client nella configurazione del server condiviso. Vedi anche: "Large Pool"
Processi dispatcher (D nnn)
I processi dispatcher consentono ai processi client di condividere un numero limitato di processi server.
È possibile creare più processi dispatcher per una singola istanza di database. Il numero ottimale di processi di dispatcher a seconda della limitazione del sistema operativo e del numero di connessioni per ciascun processo.
Nota: ogni processo client che si connette a un dispatcher deve utilizzare Oracle Net Services, anche se entrambi i processi vengono eseguiti sullo stesso host.
I processi di dispatcher stabiliscono la comunicazione come segue:
-
All'avvio di un'istanza, il processo del listener di rete si apre e stabilisce un percorso di comunicazione attraverso il quale gli utenti si connettono a Oracle AI Database.
-
Ogni processo del dispatcher fornisce al processo del listener un indirizzo al quale il dispatcher ascolta le richieste di connessione.
È necessario configurare e avviare almeno un processo dispatcher per ogni protocollo di rete utilizzato dai client di database.
-
Quando un processo client effettua una richiesta di connessione, il listener determina se il processo client deve utilizzare un processo server condiviso:
-
Se il listener determina che è necessario un processo del server condiviso, il listener restituisce l'indirizzo del processo del dispatcher con il carico più leggero e il processo client si connette direttamente al dispatcher.
-
Se il processo non riesce a comunicare con il dispatcher o se il processo client richiede un server dedicato, il listener crea un processo server dedicato e stabilisce una connessione appropriata.
-
Vedere anche: Oracle AI Database Net Services Administrator's Guide per informazioni su come configurare i dispatcher
Processi del server condiviso (S nnn)
Ogni processo del server condiviso serve più richieste client nella configurazione del server condiviso.
I processi server condivisi e dedicati forniscono le stesse funzionalità, ad eccezione dei processi server condivisi non associati a un processo client specifico. Invece, un processo server condiviso serve qualsiasi richiesta client nella configurazione del server condiviso.
La PGA di un processo server condiviso non contiene dati UGA, che devono essere accessibili a tutti i processi server condivisi. La PGA del server condiviso contiene solo dati specifici del processo.
Tutte le informazioni relative alla sessione sono contenute nella SGA. Ogni processo del server condiviso deve essere in grado di accedere agli spazi di dati di tutte le sessioni in modo che qualsiasi server possa gestire le richieste da qualsiasi sessione. Lo spazio viene allocato nella SGA per lo spazio di dati di ogni sessione.
Vedi anche: "Panoramica sull'area globale del programma (PGA)"
Operazioni limitate del server condiviso
Non è possibile eseguire attività amministrative specifiche durante la connessione a un processo di dispatcher, tra cui la chiusura o l'avvio di un'istanza e il recupero dei supporti.
In genere, queste attività vengono eseguite quando si è connessi ai privilegi di amministratore. Per connettersi con i privilegi di amministratore in un sistema configurato con server condivisi, è necessario specificare che si sta utilizzando un processo server dedicato.
Vedere anche: Oracle AI Database Net Services Administrator's Guide per informazioni sulla sintassi corretta della stringa di connessione.
Connection pooling residente del database
DRCP (Database Resident Connection Pooling) fornisce un connection pool di server dedicati per gli scenari tipici delle applicazioni Web.
Un'applicazione Web in genere effettua una connessione al database, utilizza brevemente la connessione e quindi la rilascia. Attraverso DRCP, il database può scalare fino a decine di migliaia di connessioni simultanee.
DRCP offre i vantaggi riportati di seguito.
-
Integrazione di connection pool di livello intermedio che condividono le connessioni tra i thread in un processo di livello intermedio.
-
Consente la condivisione delle connessioni al database tra più processi di livello intermedio. Questi processi di livello intermedio possono appartenere allo stesso host di livello intermedio o a un altro host.
-
Consente una riduzione significativa delle risorse di database chiave necessarie per supportare molte connessioni client. Ad esempio, DRCP riduce la memoria necessaria per il database e aumenta la scalabilità del database e del livello intermedio. Il pool di server disponibili riduce anche il costo della ricreazione delle connessioni client.
-
Fornisce pooling per architetture con server applicativi multiprocesso a thread singolo, come PHP e Apache, che non possono eseguire connection pooling di livello intermedio.
DRCP utilizza un server in pool, che equivale a un processo server dedicato (non un processo server condiviso) e a una sessione del database combinati. Il modello di server in pool evita il sovraccarico di dedicare un server per ogni connessione che richiede il server per un breve periodo.
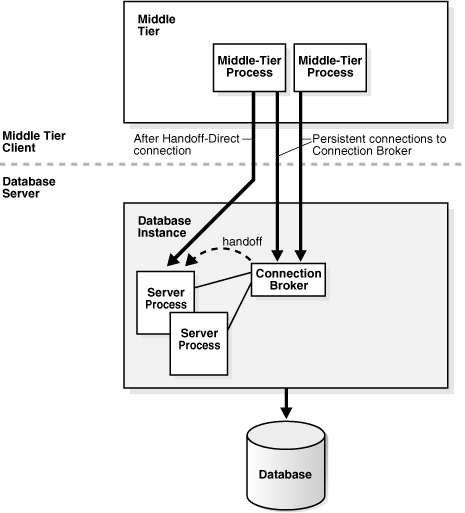
I client che ottengono le connessioni dal connection pool residente del database si connettono a un processo in background Oracle noto come connection broker. Il broker di connessione implementa la funzionalità del pool e i server in pool multiplex tra le connessioni in entrata dai processi client.
Come illustrato nella Figura 19-10, quando un client richiede l'accesso al database, il broker di connessione preleva un processo server dal pool e lo consegna al client. Il client è collegato direttamente al processo del server fino a quando la richiesta non viene soddisfatta. Al termine, il processo del server viene rilasciato nel pool. La connessione dal client viene ripristinata al broker.
Figura 10: DRCP
Descrizione dell'illustrazione cncpt312.gif
In DRCP, il rilascio delle risorse lascia la sessione intatta, ma non più associata a una connessione (processo del server). A differenza del server condiviso, questa sessione memorizza la relativa UGA nella PGA e non nella SGA. Un client può ristabilire una connessione in modo trasparente al momento di rilevare l'attività.
Vedere anche:
-
Oracle AI Database Administrator's Guide e Oracle Call Interface Developer's Guide per ulteriori informazioni su DRCP
Panoramica dell'interfaccia del programma
L'interfaccia del programma è il livello software tra un'applicazione di database e Oracle AI Database.
L'interfaccia del programma esegue le seguenti funzioni:
-
Fornisce una barriera di sicurezza, impedendo l'accesso distruttivo alla SGA da parte dei processi client
-
Agisce come meccanismo di comunicazione, formattazione delle richieste di informazioni, passaggio di dati, trapping e restituzione di errori
-
Converte e traduce i dati, in particolare tra diversi tipi di computer o in tipi di dati del programma utente esterno
Il codice Oracle funge da server, eseguendo task di database per conto di un'applicazione (un client), ad esempio recuperando le righe dai blocchi di dati. L'interfaccia del programma è composta da diverse parti, fornite sia dal software Oracle AI Database che dal software specifico del sistema operativo.
-
Struttura interfaccia programma L'interfaccia del programma è costituita da diversi componenti diversi.
-
Driver dell'interfaccia di programma Un driver è un componente software che trasporta i dati, in genere attraverso una rete.
-
Software di comunicazione per il sistema operativo Il software di livello più basso che connette l'utente al lato Oracle AI Database dell'interfaccia del programma è il software di comunicazione fornito dal sistema operativo host.
Struttura interfaccia programma
L'interfaccia del programma è composta da diversi componenti.
Tra questi componenti sono inclusi gli elementi riportati di seguito.
-
Interfaccia di chiamata Oracle (OCI) o libreria run-time Oracle (SQLLIB)
-
Il lato client o utente dell'interfaccia del programma
-
Vari driver Oracle Net Services (software di comunicazione specifico per protocollo)
-
Software di comunicazione del sistema operativo
-
Il lato server o Oracle AI Database dell'interfaccia del programma (chiamato anche OPI)
I lati utente e Oracle AI Database dell'interfaccia del programma eseguono il software Oracle, così come i driver.
Driver interfaccia programma
Un driver è un software che trasporta i dati, di solito attraverso una rete.
I driver eseguono operazioni quali connessione, disconnessione, errori di segnale e verifica della presenza di errori. I driver sono specifici di un protocollo di comunicazione.
Un driver predefinito esiste sempre. È possibile installare più driver, ad esempio i driver asincroni o DECnet, e selezionarne uno come driver predefinito, ma consentire a un utente di utilizzare altri driver specificando un driver durante la connessione.
Processi diversi possono utilizzare driver diversi. Un processo può avere connessioni simultanee a un singolo database o a più database utilizzando driver Oracle Net Services diversi.
Vedere anche:
-
Guida all'installazione e alla configurazione del sistema per informazioni dettagliate sulla scelta, l'installazione e l'aggiunta di driver
-
Oracle AI Database Net Services Administrator's Guide per informazioni sui driver JDBC
Software di comunicazione per il sistema operativo
Il software di livello più basso che connette il lato utente al lato Oracle AI Database dell'interfaccia del programma è il software di comunicazione fornito dal sistema operativo host.
DECnet, TCP/IP, LU6.2 e ASYNC sono esempi. Il software di comunicazione può essere fornito da Oracle, ma in genere viene acquistato separatamente dal fornitore hardware o da un fornitore software di terze parti.
Panoramica di Oracle True Cache
True Cache è una cache in-memory di sola lettura davanti a Oracle AI Database.
Come Oracle Active Data Guard, True Cache è una replica completamente funzionale e di sola lettura del database primario, tranne per il fatto che è per lo più diskless.
Le applicazioni moderne spesso richiedono un numero elevato di connessioni e un accesso rapido e a bassa latenza ai dati. Un approccio popolare è quello di posizionare le cache davanti al database perché le applicazioni in genere eseguono molte più letture rispetto agli aggiornamenti e possono leggere dalla cache senza influire sulle prestazioni del database. Ad esempio, un sistema di prenotazione di una compagnia aerea legge i dati frequentemente mentre le persone acquistano voli, e va bene se i dati non sono i più aggiornati rispetto a quelli presenti nel database. L'applicazione deve accedere ai dati più recenti solo quando qualcuno prenota un volo.
A differenza delle cache convenzionali, True Cache conserva automaticamente i dati ad accesso più frequente nella cache e mantiene la cache coerente con il database primario, altri oggetti nella stessa cache e altre cache. Memorizza nella cache tutti gli oggetti e i tipi di dati di Oracle AI Database, incluso JSON.
Poiché True Cache implementa i criteri di sicurezza di Oracle AI Database, puoi controllare l'accesso alla cache. Ciò consente di memorizzare nella cache i dati sensibili, come le informazioni personali private, che normalmente non si possono memorizzare nella cache.
Argomenti correlati