Partizioni, viste e altri oggetti dello schema
Sebbene le tabelle e gli indici siano gli oggetti di schema più importanti e comunemente utilizzati, il database supporta molti altri tipi di oggetti di schema, i più comuni dei quali sono discussi in questo capitolo.
-
Panoramica delle partizioni In un database Oracle, il partizionamento consente di scomporre tabelle e indici di grandi dimensioni in parti più piccole e gestibili chiamate partizioni. Ogni partizione è un oggetto indipendente con il proprio nome e, facoltativamente, le proprie caratteristiche di storage.
-
Panoramica delle tabelle suddivise In un database Oracle, la funzione Globally Distributed Database consente di suddividere qualsiasi tabella in parti denominate partizioni che possono essere memorizzate in più database.
-
Panoramica delle viste Una vista è una rappresentazione logica di una o più tabelle. In sostanza, una vista è una query memorizzata.
-
Panoramica delle viste materializzate Una vista materializzata è un risultato di query memorizzato o "materializzato" in anticipo come oggetto di schema. La clausola
FROMdella query può indicare tabelle, viste o viste materializzate. -
Panoramica delle sequenze Una sequenza è un oggetto schema da cui più utenti possono generare numeri interi univoci. Un generatore di sequenze fornisce un metodo altamente scalabile e con buone prestazioni per generare chiavi alternative per un tipo di dati numerico.
-
Panoramica delle dimensioni Un data warehouse tipico dispone di due componenti importanti: dimensioni e fact.
-
Panoramica dei sinonimi Un sinonimo è un alias per un oggetto schema. Ad esempio, è possibile creare un sinonimo per una tabella o vista, una sequenza, una program unit PL/SQL, un tipo di oggetto definito dall'utente o un altro sinonimo. Poiché si tratta semplicemente di un alias, un sinonimo richiede solo l'archiviazione della propria definizione nel dizionario dati.
Panoramica delle partizioni
In un database Oracle, il partizionamento consente di scomporre tabelle e indici di grandi dimensioni in parti più piccole e gestibili chiamate partizioni. Ogni partizione è un oggetto indipendente con il proprio nome e, facoltativamente, le proprie caratteristiche di storage.
Per un'analogia che illustra il partizionamento, si supponga che un responsabile HR disponga di una grande casella contenente le cartelle dei dipendenti. Ogni cartella elenca la data di assunzione del dipendente. Le query vengono spesso eseguite per i dipendenti assunti in un determinato mese. Un approccio per soddisfare tali richieste è quello di creare un indice alla data di assunzione del dipendente che specifica le posizioni delle cartelle sparse in tutta la casella. Al contrario, una strategia di partizionamento utilizza molte caselle più piccole, con ogni casella contenente cartelle per i dipendenti assunti in un determinato mese.
L'utilizzo di scatole più piccole ha diversi vantaggi. Quando viene richiesto di recuperare le cartelle per i dipendenti assunti a giugno, il responsabile HR può recuperare la casella di giugno. Inoltre, se una piccola scatola è temporaneamente danneggiata, le altre piccole scatole rimangono disponibili. Anche spostare gli uffici diventa più facile perché, invece di spostare una singola scatola pesante, il manager può spostare diverse piccole scatole.
Dal punto di vista di un'applicazione, esiste un solo oggetto schema. Le istruzioni SQL non richiedono alcuna modifica per accedere alle tabelle partizionate. Il partizionamento è utile per molti tipi diversi di applicazioni di database, in particolare quelle che gestiscono grandi volumi di dati. I vantaggi includono:
-
Maggiore disponibilità
L'indisponibilità di una partizione non comporta l'indisponibilità dell'oggetto. La query optimizer rimuove automaticamente le partizioni non referenziate dal piano query in modo che le query non siano interessate quando le partizioni non sono disponibili.
-
Amministrazione più semplice degli oggetti dello schema
Un oggetto partizionato dispone di parti che possono essere gestite collettivamente o singolarmente. Le istruzioni DDL possono manipolare le partizioni anziché intere tabelle o indici. Pertanto, è possibile suddividere le attività a uso intensivo di risorse, ad esempio la ricostruzione di un indice o di una tabella. Ad esempio, è possibile spostare una partizione di tabella alla volta. Se si verifica un problema, è necessario eseguire di nuovo solo lo spostamento della partizione, non lo spostamento della tabella. Inoltre, l'eliminazione di una partizione evita l'esecuzione di numerose istruzioni
DELETE. -
Conflitto ridotto di risorse condivise nei sistemi OLTP
In alcuni sistemi OLTP le partizioni possono ridurre i conflitti per una risorsa condivisa. Ad esempio, il DML viene distribuito su più segmenti anziché su un segmento.
-
Prestazioni delle query migliorate nei data warehouse
In un data warehouse, il partizionamento può accelerare l'elaborazione di query ad hoc. Ad esempio, una tabella vendite contenente un milione di righe può essere partizionata per trimestre.
-
Caratteristiche della partizione Ogni partizione di una tabella o di un indice deve avere gli stessi attributi logici, ad esempio i nomi delle colonne, i tipi di dati e i vincoli.
-
Tabelle partizionate Una tabella partizionata è costituita da una o più partizioni, che vengono gestite singolarmente e possono funzionare indipendentemente dalle altre partizioni.
-
Indici partizionati Un indice partizionato è un indice che, come una tabella partizionata, è stato diviso in parti più piccole e più gestibili.
-
Indici parziali per tabelle partizionate Un indice parziale è un indice correlato alle proprietà di indicizzazione di una tabella partizionata associata.
-
Utilizzo dell'area di memorizzazione degli oggetti per le partizioni precedenti Per le partizioni di sola lettura, è possibile utilizzare lo storage a basso costo, ad esempio lo storage degli oggetti nel cloud. Vedere anche: Oracle AI Database VLDB and Partitioning Guide per un'introduzione al partizionamento
Caratteristiche della partizione
Ogni partizione di una tabella o indice deve avere gli stessi attributi logici, ad esempio nomi di colonna, tipi di dati e vincoli.
Ad esempio, tutte le partizioni di una tabella condividono le stesse definizioni di colonna e vincolo. Tuttavia, ogni partizione può avere attributi fisici separati, ad esempio la tablespace a cui appartiene.
-
Chiave di partizione chiave di partizione è un set di una o più colonne che determina la partizione in cui devono essere inserite le righe in una tabella partizionata. Ogni riga viene assegnata in modo univoco a una singola partizione.
-
Strategie di partizionamento Oracle Partitioning offre diverse strategie di partizionamento che controllano il modo in cui il database inserisce i dati nelle partizioni. Le strategie di base sono range, list e hash partitioning.
Chiave di partizionamento
La chiave di partizione è un set di una o più colonne che determina la partizione in cui devono essere inserite tutte le righe in una tabella partizionata. Ogni riga viene assegnata in modo univoco a una singola partizione.
Nella tabella sales è possibile specificare la colonna time_id come chiave di una partizione di intervallo. Il database assegna righe alle partizioni in base al fatto che la data in questa colonna rientri in un intervallo specificato. Oracle AI Database indirizza automaticamente le operazioni di inserimento, aggiornamento ed eliminazione alla partizione appropriata utilizzando la chiave di partizione.
Strategie di partizionamento
Oracle Partitioning offre diverse strategie di partizionamento che controllano il modo in cui il database inserisce i dati nelle partizioni. Le strategie di base sono range, list e hash partitioning.
Un partizionamento a livello singolo utilizza un solo metodo di distribuzione dei dati, ad esempio solo il partizionamento elenco o solo il partizionamento intervallo. In partizionamento composto, una tabella viene partizionata da un metodo di distribuzione dei dati, quindi ogni partizione viene ulteriormente suddivisa in partizioni secondarie utilizzando un secondo metodo di distribuzione dei dati. Ad esempio, è possibile utilizzare una partizione elenco per channel_id e una partizione secondaria intervallo per time_id.
Esempio 6-1 serie di righe di esempio per tabella partizionata
In questo esempio di partizionamento si presuppone che si desideri popolare una tabella partizionata sales con le righe seguenti:
  PROD_ID    CUST_ID TIME_ID   CHANNEL_ID   PROMO_ID QUANTITY_SOLD AMOUNT_SOLD
---------- ---------- --------- ---------- ---------- ------------- -----------
      116      11393 05-JUN-99          2        999             1
12.18
       40     100530 30-NOV-98          9         33             1       44.99
      118        133 06-JUN-01          2        999             1       17.12
      133       9450 01-DEC-00          2        999             1       31.28
       36       4523 27-JAN-99          3        999             1       53.89
      125       9417 04-FEB-98          3        999             1       16.86
       30        170 23-FEB-01          2        999             1         8.8
       24      11899 26-JUN-99          4        999             1       43.04
       35       2606 17-FEB-00          3        999             1       54.94
45 9491 28-AUG-98 4 350 1 47.45-
Range Partitioning In range partitioning, il database mappa le righe alle partizioni in base agli intervalli di valori della chiave di partizionamento. Il partizionamento dell'intervallo è il tipo più comune di partizionamento ed è spesso utilizzato con le date.
-
Partizionamento intervallo di curva
Il partizionamento intervallo è un'estensione del partizionamento intervallo.
-
List Partitioning In list partitioning, il database utilizza un elenco di valori discreti come chiave di partizione per ciascuna partizione. La chiave di partizionamento è costituita da una o più colonne.
-
Hash Partitioning In hash partitioning, il database mappa le righe alle partizioni in base a un algoritmo di hashing che il database applica alla chiave di partizionamento specificata dall'utente.
-
Partizionamento di riferimento In partizionamento di riferimento, la strategia di partizionamento di una tabella figlio viene definita esclusivamente tramite la relazione tra chiave esterna e una tabella padre. Per ogni partizione nella tabella padre esiste esattamente una partizione corrispondente nella tabella figlio. La tabella padre memorizza i record padre in una partizione specifica e la tabella figlio memorizza i record figlio nella partizione corrispondente.
-
Partizionamento composto In partizionamento composto, una tabella viene partizionata da un metodo di distribuzione dei dati e ogni partizione viene ulteriormente suddivisa in sottopartizioni utilizzando un secondo metodo di distribuzione dei dati. Pertanto, il partizionamento composito combina i metodi di distribuzione dei dati di base. Tutte le partizioni secondarie per una determinata partizione rappresentano un sottoinsieme logico dei dati.
Range partitioning
In range partitioning, il database mappa le righe alle partizioni in base agli intervalli di valori della chiave di partizionamento. Il partizionamento dell'intervallo è il tipo più comune di partizionamento ed è spesso utilizzato con le date.
Si supponga di creare time_range_sales come tabella partizionata utilizzando la seguente istruzione SQL, con la colonna time_id come chiave di partizione:
CREATE TABLE time_range_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY RANGE (time_id)
 (PARTITION SALES_1998 VALUES LESS THAN (TO_DATE('01-JAN-1999','DD-MON-YYYY')),
  PARTITION SALES_1999 VALUES LESS THAN (TO_DATE('01-JAN-2000','DD-MON-YYYY')),
  PARTITION SALES_2000 VALUES LESS THAN (TO_DATE('01-JAN-2001','DD-MON-YYYY')),
  PARTITION SALES_2001 VALUES LESS THAN (MAXVALUE)
 );
Successivamente, si carica time_range_sales con le righe dall'Esempio 6-1. Il codice mostra le distribuzioni delle righe nelle quattro partizioni. Il database sceglie la partizione per ogni riga in base al valore time_id in base alle regole specificate nella clausola PARTITION BY RANGE. Il valore della chiave di partizione dell'intervallo determina il limite massimo non inclusivo per una partizione specificata.
Partizionamento intervallo di curva
Il partizionamento intervallo è un'estensione del partizionamento intervallo.
Se si inseriscono dati che superano le partizioni di intervallo esistenti, Oracle AI Database crea automaticamente le partizioni di un intervallo specificato. Ad esempio, è possibile creare una tabella della cronologia delle vendite che memorizzi i dati per ogni mese in una partizione separata.
Le partizioni di intervallo consentono di evitare di creare partizioni di intervallo in modo esplicito. È possibile utilizzare il partizionamento a intervalli per quasi tutte le tabelle partizionate a intervalli fissi per le nuove partizioni. A meno che non si creino partizioni di intervallo con intervalli diversi o a meno che non si impostino sempre attributi di partizione specifici, considerare l'utilizzo di partizioni di intervallo.
Quando si esegue il partizionamento per intervallo, è necessario specificare almeno una partizione di intervallo. Il valore della chiave di partizionamento intervallo determina l'alto valore delle partizioni dell'intervallo, denominato punto di transizione. Il database crea automaticamente partizioni di intervallo per i dati con valori che si trovano oltre il punto di transizione. Il limite inferiore di ogni partizione di intervallo è il limite superiore inclusivo dell'intervallo precedente o della partizione di intervallo. Pertanto, nell'Esempio 6-2, il valore 01-JAN-2011 si trova nella partizione p2.
Il database crea partizioni di intervallo per i dati oltre il punto di transizione. Una partizione di intervallo estende il partizionamento dell'intervallo indicando al database di creare partizioni dell'intervallo o dell'intervallo specificato. Il database crea automaticamente le partizioni quando i dati inseriti nella tabella superano tutte le partizioni di intervallo esistenti. In Esempio 6-2, la partizione p3 contiene righe con valori time_id della chiave di partizionamento maggiori o uguali a 01-JAN-2013.
Esempio di partizionamento intervallo 6-2
Si supponga di creare una tabella vendite con quattro partizioni di larghezza variabile. Si specifica che sopra il punto di transizione del 1° gennaio 2013, il database deve creare partizioni in intervalli di un mese. Il limite massimo della partizione p3 rappresenta il punto di transizione. La partizione p3 e tutte le partizioni sottostanti si trovano nella sezione dell'intervallo, mentre tutte le partizioni precedenti rientrano nella sezione dell'intervallo.
CREATE TABLE interval_sales
    ( prod_id        NUMBER(6)
    , cust_id        NUMBER
    , time_id        DATE
    , channel_id     CHAR(1)
    , promo_id       NUMBER(6)
    , quantity_sold  NUMBER(3)
    , amount_sold    NUMBER(10,2)
    )
  PARTITION BY RANGE (time_id)
  INTERVAL(NUMTOYMINTERVAL(1, 'MONTH'))
    ( PARTITION p0 VALUES LESS THAN (TO_DATE('1-1-2010', 'DD-MM-YYYY'))
    , PARTITION p1 VALUES LESS THAN (TO_DATE('1-1-2011', 'DD-MM-YYYY'))
    , PARTITION p2 VALUES LESS THAN (TO_DATE('1-7-2012', 'DD-MM-YYYY'))
    , PARTITION p3 VALUES LESS THAN (TO_DATE('1-1-2013', 'DD-MM-YYYY')) );
Inserisci una vendita effettuata il 10 ottobre 2014:
SQL> INSERT INTO interval_sales VALUES (39,7602,'10-OCT-14',9,null,1,11.79);

1 row created.
Una query di USER_TAB_PARTITIONS mostra che il database ha creato una nuova partizione per la vendita del 10 ottobre perché la data di vendita era successiva al punto di transizione:
SQL> COL PNAME FORMAT a9
SQL> COL HIGH_VALUE FORMAT a40
SQL> SELECT PARTITION_NAME AS PNAME, HIGH_VALUE
  2  FROM USER_TAB_PARTITIONS WHERE TABLE_NAME = 'INTERVAL_SALES';

PNAME     HIGH_VALUE
--------- ----------------------------------------
P0        TO_DATE(' 2007-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P1        TO_DATE(' 2008-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P2        TO_DATE(' 2009-07-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P3        TO_DATE(' 2010-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
SYS_P1598 TO_DATE(' 2014-11-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
Vedere anche: Oracle AI Database VLDB and Partitioning Guide per ulteriori informazioni sulle partizioni degli intervalli
Partitioning con metodo List
In partizionamento elenco, il database utilizza un elenco di valori discreti come chiave di partizione per ciascuna partizione. La chiave di partizionamento è costituita da una o più colonne.
È possibile utilizzare il partizionamento degli elenchi per controllare il modo in cui le singole righe vengono mappate a partizioni specifiche. Utilizzando gli elenchi, è possibile raggruppare e organizzare i set di dati correlati quando la chiave utilizzata per identificarli non è ordinata in modo conveniente.
Esempio di partizionamento elenco 6-3
Si supponga di creare list_sales come tabella partizionata da una lista utilizzando l'istruzione seguente, in cui la colonna channel_id è la chiave di partizione:
CREATE TABLE list_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY LIST (channel_id)
 ( PARTITION even_channels VALUES ('2','4'),
   PARTITION odd_channels VALUES ('3','9')
 );
Successivamente, caricare la tabella con le righe dall'Esempio 6-1. Il codice mostra la distribuzione delle righe nelle due partizioni. Il database sceglie la partizione per ogni riga in base al valore channel_id in base alle regole specificate nella clausola PARTITION BY LIST. Le righe con valore channel_id pari a 2 o 4 vengono memorizzate nelle partizioni EVEN_CHANNELS, mentre le righe con valore channel_id pari a 3 o 9 vengono memorizzate nella partizione ODD_CHANNELS.
Hash partitioning
In hash partitioning, il database mappa le righe alle partizioni in base a un algoritmo di hashing che il database applica alla chiave di partizionamento specificata dall'utente.
La destinazione di una riga è determinata dalla funzione hash interna applicata alla riga dal database. Quando il numero di partizioni è una potenza di 2, l'algoritmo di hashing crea una distribuzione approssimativamente uniforme di righe su tutte le partizioni.
Il partizionamento hash è utile per dividere tabelle di grandi dimensioni per aumentare la gestibilità. Invece di un grande tavolo da gestire, hai diversi pezzi più piccoli. La perdita di una singola partizione hash non influisce sulle partizioni rimanenti e può essere recuperata in modo indipendente. Il partizionamento hash è utile anche nei sistemi OLTP con elevati conflitti di aggiornamento. Ad esempio, un segmento è diviso in diversi pezzi, ognuno dei quali viene aggiornato, invece di un singolo segmento che sperimenta la contesa.
Si supponga di creare la tabella hash_sales partizionata utilizzando l'istruzione seguente, con la colonna prod_id come chiave di partizione:
CREATE TABLE hash_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY HASH (prod_id)
PARTITIONS 2;
Successivamente, caricare la tabella con le righe dall'Esempio 6-1. Il codice mostra una possibile distribuzione delle righe nelle due partizioni. I nomi di queste partizioni vengono generati dal sistema.
Quando si inseriscono le righe, il database tenta di distribuirle in modo casuale e uniforme tra le partizioni. Non è possibile specificare la partizione in cui viene inserita una riga. Il database applica la funzione hash, il cui risultato determina quale partizione contiene la riga.
Vedere anche:
-
Oracle AI Database VLDB and Partitioning Guide per informazioni su come creare partizioni.
-
Oracle AI Database SQL Language Reference per esempi
CREATE TABLE ... PARTITION BY
Partizionamento di riferimento
In partizionamento di riferimento, la strategia di partizionamento di una tabella figlio viene definita esclusivamente tramite la relazione tra chiave esterna e tabella padre. Per ogni partizione nella tabella padre esiste esattamente una partizione corrispondente nella tabella figlio. La tabella padre memorizza i record padre in una partizione specifica e la tabella figlio memorizza i record figlio nella partizione corrispondente.
Ad esempio, una tabella orders è l'elemento padre della tabella line_items, con una chiave primaria e una chiave esterna definite in order_id. Le tabelle sono partizionate per riferimento. Ad esempio, se nel database viene memorizzato l'ordine 233 nella partizione Q3_2015 di orders, nel database vengono memorizzate tutte le voci per l'ordine 233 nella partizione Q3_2015 di line_items. Se la partizione Q4_2015 viene aggiunta a orders, il database aggiunge automaticamente Q4_2015 a line_items.
I vantaggi del partizionamento di riferimento sono:
-
Utilizzando la stessa strategia di partizionamento sia per le tabelle padre che per quelle figlio, si evita di duplicare tutte le colonne chiave di partizionamento. Questa strategia riduce il carico di lavoro manuale della denormalizzazione e consente di risparmiare spazio.
-
Le operazioni di manutenzione su una tabella padre vengono eseguite automaticamente sulla tabella figlio. Ad esempio, quando si aggiunge una partizione alla tabella primaria, il database propaga automaticamente questa aggiunta ai relativi discendenti.
-
Il database utilizza automaticamente i join partizionati delle partizioni nella tabella padre e figlio, migliorando le prestazioni.
È possibile utilizzare il partizionamento di riferimento con tutte le strategie di partizionamento di base, incluso il partizionamento a intervalli. È inoltre possibile creare tabelle partizionate di riferimento come tabelle partizionate composte.
Esempio 6-4 Creazione di tabelle partizionate con riferimento
In questo esempio vengono creati ordini di tabelle padre con partizionamento intervallo in order_date. La tabella figlio partizionata di riferimento order_items viene creata con quattro partizioni, Q1_2015, Q2_2015, Q3_2015 e Q4_2015, in cui ogni partizione contiene le righe order_items corrispondenti agli ordini nella rispettiva partizione padre.
CREATE TABLE orders
    ( order_id           NUMBER(12),
      order_date         DATE,
      order_mode         VARCHAR2(8),
      customer_id        NUMBER(6),
      order_status       NUMBER(2),
      order_total        NUMBER(8,2),
      sales_rep_id       NUMBER(6),
      promotion_id       NUMBER(6),
      CONSTRAINT orders_pk PRIMARY KEY(order_id)
    )
  PARTITION BY RANGE(order_date)
    ( PARTITION Q1_2015 VALUES LESS THAN (TO_DATE('01-APR-2015','DD-MON-YYYY')),
      PARTITION Q2_2015 VALUES LESS THAN (TO_DATE('01-JUL-2015','DD-MON-YYYY')),
      PARTITION Q3_2015 VALUES LESS THAN (TO_DATE('01-OCT-2015','DD-MON-YYYY')),
      PARTITION Q4_2015 VALUES LESS THAN (TO_DATE('01-JAN-2006','DD-MON-YYYY'))
    );

CREATE TABLE order_items
    ( order_id           NUMBER(12) NOT NULL,
      line_item_id       NUMBER(3)  NOT NULL,
      product_id         NUMBER(6)  NOT NULL,
      unit_price         NUMBER(8,2),
      quantity           NUMBER(8),
      CONSTRAINT order_items_fk
      FOREIGN KEY(order_id) REFERENCES orders(order_id)
    )
    PARTITION BY REFERENCE(order_items_fk);
Vedere anche: Oracle AI Database VLDB and Partitioning Guide per una panoramica sul partizionamento di riferimento
Partizionamento composto
In partizionamento composto, una tabella viene partizionata mediante un metodo di distribuzione dei dati, quindi ogni partizione viene ulteriormente suddivisa in sottopartizioni utilizzando un secondo metodo di distribuzione dei dati. Pertanto, il partizionamento composito combina i metodi di distribuzione dei dati di base. Tutte le partizioni secondarie per una determinata partizione rappresentano un sottoinsieme logico dei dati.
Il partizionamento composto offre diversi vantaggi.
-
A seconda dell'istruzione SQL, l'eliminazione delle partizioni su una o due dimensioni può migliorare le prestazioni.
-
Le query possono utilizzare join completi o parziali a livello di partizione in entrambe le dimensioni.
-
È possibile eseguire backup e ripristino paralleli di una singola tabella.
-
Il numero di partizioni è maggiore rispetto al partizionamento a livello singolo, che può essere utile per l'esecuzione parallela.
-
È possibile implementare una finestra in sequenza per supportare i dati cronologici e la partizione su un'altra dimensione se molte istruzioni possono trarre vantaggio dall'eliminazione della partizione o dai join tra partizioni.
-
È possibile memorizzare i dati in modo diverso in base all'identificazione mediante una chiave di partizionamento. Ad esempio, è possibile decidere di memorizzare i dati per un tipo di prodotto specifico in un formato di sola lettura, compresso e di mantenere i dati di altri tipi di prodotto non compressi.
L'intervallo, la lista e il partizionamento hash sono idonei come strategie di partizionamento secondario per le tabelle partizionate composte. La figura seguente offre una vista grafica del partizionamento composito range-hash e range-list.
Figura 1: Partizionamento di Range-List composito
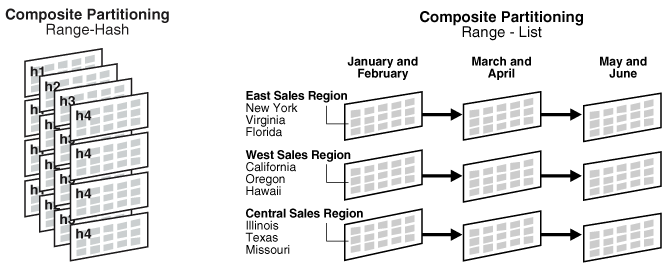
Descrizione dell'illustrazione vldbg009.gif
Il database memorizza ogni partizione secondaria in una tabella partizionata composta come segmento separato. Pertanto, le proprietà della partizione secondaria possono differire dalle proprietà della tabella o dalla partizione a cui appartengono le partizioni secondarie.
Vedere anche: Oracle AI Database VLDB and Partitioning Guide per ulteriori informazioni sul partizionamento dei composti
Tabelle partizionate
Una tabella partizionata è costituita da una o più partizioni, che vengono gestite singolarmente e possono funzionare indipendentemente dalle altre partizioni.
Una tabella è partizionata o non partizionata. Anche se una tabella partizionata è costituita da una sola partizione, questa tabella è diversa da una tabella non partizionata, alla quale non possono essere aggiunte partizioni.
-
Segmenti per le tabelle partizionate Una tabella partizionata è costituita da uno o più segmenti di partizione di tabella.
-
Compressione per le tabelle partizionate Alcune o tutte le partizioni di una tabella organizzata in heap possono essere memorizzate in un formato compresso.
Vedere anche:
"Caratteristiche di partizione" per esempi di tabelle partizionate
"Panoramica sulle tabelle organizzate nell'indice" per conoscere lo scopo e le caratteristiche delle tabelle organizzate nell'indice, che possono anche trarre vantaggio dal partizionamento che offre una migliore gestibilità, disponibilità e prestazioni.
Segmenti per tabelle partizionate
Una tabella partizionata è costituita da uno o più segmenti di partizione di tabella.
Se si crea una tabella partizionata denominata hash_products, non viene allocata alcuna tabella segmento per questa tabella. Il database memorizza invece i dati per ogni partizione di tabella nel proprio segmento di partizione. Ogni segmento di partizione della tabella contiene una parte dei dati della tabella.
Quando viene partizionata una tabella esterna, tutte le partizioni risiedono al di fuori del database. In una tabella partizionata ibrida, alcune partizioni vengono memorizzate in segmenti, mentre altre vengono memorizzate esternamente. Ad esempio, alcune partizioni della tabella sales potrebbero essere memorizzate in file di dati e altre in fogli di calcolo.
Vedere anche:
per conoscere la relazione tra oggetti e segmenti
Compressione per le tabelle partizionate
Alcune o tutte le partizioni di una tabella organizzata dall'heap possono essere memorizzate in un formato compresso.
La compressione consente di risparmiare spazio e velocizzare l'esecuzione delle query. Per questo motivo, la compressione può risultare utile in ambienti quali data warehouse, dove la quantità di operazioni di inserimento e aggiornamento è ridotta rispetto agli ambienti OLTP.
È possibile dichiarare gli attributi per la compressione tabella per una tablespace, una tabella o una partizione di tabella. Se dichiarate a livello di tablespace, le tabelle create in tali tablespace vengono compresse per impostazione predefinita. È possibile modificare l'attributo di compressione per una tabella, nel qual caso la modifica è valida solo per i nuovi dati che entrano in tale tabella. Di conseguenza, una singola tabella o partizione può contenere blocchi compressi e non compressi, il che garantisce che la dimensione dei dati non aumenterà a causa della compressione. Se la compressione può aumentare le dimensioni di un blocco, il database non lo applica al blocco.
Vedere anche:
-
"Compressione tabella" per informazioni sui tipi di compressione della tabella, incluse le righe di base, avanzate e Hybrid Columnar Compression
-
Oracle AI Database Data Warehousing Guide per informazioni sulla compressione delle tabelle in un data warehouse
Indici partizionati
Un indice partizionato è un indice che, come una tabella partizionata, è stato diviso in parti più piccole e gestibili.
Gli indici globali vengono partizionati indipendentemente dalla tabella in cui vengono creati, mentre gli indici locali vengono collegati automaticamente al metodo di partizionamento per una tabella. Come le tabelle partizionate, gli indici partizionate migliorano l' gestibilità, la disponibilità, le prestazioni e il livello di scalabilità.
L'immagine riportata di seguito mostra le opzioni di partizionamento dell'indice.
Figura 2: Opzioni di partizionamento dell'indice
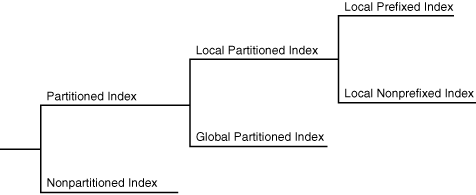
Descrizione dell'illustrazione cncpt301.gif
-
Indici partizionati locali In un indice partizionato locale, l'indice viene partizionato sulle stesse colonne, con lo stesso numero di partizioni e gli stessi limiti di partizione della relativa tabella.
-
Indici partizionati globali Un indice partizionato globale è un indice B-tree partizionato indipendentemente dalla tabella di base in cui viene creato. Una singola partizione di indice può puntare a una o a tutte le partizioni di tabella, mentre in un indice partizionato localmente esiste una parità uno a uno tra le partizioni di indice e le partizioni di tabella.
Vedere anche:
-
"Introduzione agli indici" per conoscere la differenza tra indici univoci e non univoci e i diversi tipi di indice
-
Oracle AI Database VLDB and Partitioning Guide per ulteriori informazioni sugli indici partizionati e su come decidere quale tipo utilizzare
Indici partizionati locali
In un indice partizionato locale, l'indice viene partizionato sulle stesse colonne, con lo stesso numero di partizioni e gli stessi limiti di partizione della tabella.
Ogni partizione di indice è associata esattamente a una partizione della tabella sottostante, in modo che tutte le chiavi in una partizione di indice si riferiscano solo alle righe memorizzate in una singola partizione di tabella. In questo modo, il database sincronizza automaticamente le partizioni di indice con le partizioni di tabella associate, rendendo ogni coppia tabella-indice indipendente.
Gli indici partizionati locali sono comuni negli ambienti di data warehousing. Gli indici locali offrono i seguenti vantaggi:
-
La disponibilità viene aumentata perché le azioni che rendono i dati non validi o non disponibili in una partizione influiscono solo su questa partizione.
-
La manutenzione delle partizioni è semplificata. Quando si sposta una partizione di tabella o quando i dati escono da una partizione, è necessario ricreare o gestire solo la partizione di indice locale associata. In un indice globale, è necessario ricreare o gestire tutte le partizioni di indice.
-
Se si verifica il recupero point-in-time di una partizione, gli indici possono essere recuperati nel tempo di recupero (vedere Oracle AI Database Backup and Recovery User's Guide). Non è necessario ricostruire l'intero indice.
L'esempio in Hash Partitioning mostra l'istruzione di creazione per la tabella hash_sales partizionata, utilizzando la colonna prod_id come chiave di partizione. Nell'esempio seguente viene creato un indice partizionato locale nella colonna time_id della tabella hash_sales.
CREATE INDEX hash_sales_idx ON hash_sales(time_id) LOCAL;Nella Figura 6-3, la tabella hash_products contiene due partizioni, pertanto hash_sales_idx dispone di due partizioni. Ogni partizione di indice è associata a una partizione di tabella diversa. La partizione indice SYS_P38 indicizza le righe nella partizione tabella SYS_P33, mentre la partizione indice SYS_P39 indicizza le righe nella partizione tabella SYS_P34.
Figura 3: Partizioni di indici locali
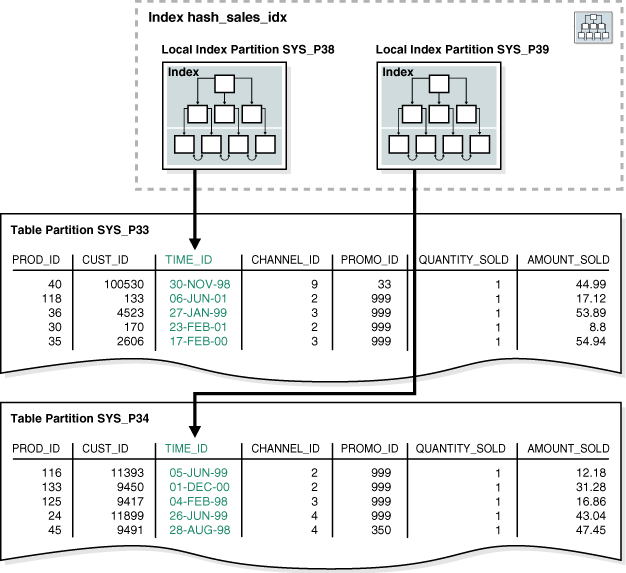
Descrizione dell'illustrazione cncpt302.gif
Non è possibile aggiungere esplicitamente una partizione a un indice locale. Le nuove partizioni vengono invece aggiunte agli indici locali solo quando si aggiunge una partizione alla tabella sottostante. Allo stesso modo, non è possibile eliminare esplicitamente una partizione da un indice locale. Al contrario, le partizioni di indice locali vengono eliminate solo quando si elimina una partizione dalla tabella sottostante.
Come altri indici, è possibile creare un indice bitmap su tabelle partizionate. L'unica restrizione è che gli indici bitmap devono essere locali alla tabella partizionata: non possono essere indici globali. Gli indici bitmap globali sono supportati solo su tabelle non partizionate.
-
Gli indici partizionati locali Indici con prefisso locale e non con prefisso hanno il prefisso o non il prefisso.
-
Memorizzazione indice partizionato locale Come una partizione di tabella, una partizione di indice locale viene memorizzata nel proprio segmento. Ogni segmento contiene una parte dei dati totali dell'indice. Pertanto, un indice locale composto da quattro partizioni non viene memorizzato in un singolo segmento di indice, ma in quattro segmenti separati.
Indici prefissi e non prefissi locali
Gli indici partizionati locali hanno il prefisso o non il prefisso.
I sottotipi di indice sono definiti come segue:
-
Indici prefissi locali
In questo caso, le chiavi di partizione si trovano sul bordo anteriore della definizione dell'indice. Nell'esempio
time_range_salesdi Range Partitioning, la tabella viene partizionata per intervallo intime_id. Un indice locale con prefisso in questa tabella avrebbetime_idcome prima colonna nella relativa lista. -
Indici non prefissi locali
In questo caso, le chiavi di partizione non si trovano sul bordo iniziale dell'elenco di colonne indicizzate e non devono necessariamente trovarsi nell'elenco. Nell'esempio
hash_sales_idxdi Indici partizionati locali, l'indice è locale senza prefisso perché la chiave di partizioneproduct_idnon si trova sul bordo iniziale.
Entrambi i tipi di indici possono trarre vantaggio dall'eliminazione della partizione (chiamata anche eliminazione della partizione), che si verifica quando l'ottimizzatore accelera l'accesso ai dati escludendo le partizioni da considerare. L'eventuale eliminazione di partizioni da parte di una query dipende dalla query predicate. Una query che utilizza un indice locale con prefisso consente sempre l'eliminazione della partizione di indice, mentre una query che utilizza un indice locale senza prefisso potrebbe non esserlo.
Vedere anche: Oracle AI Database VLDB and Partitioning Guide per informazioni sull'uso degli indici con prefisso e non prefisso
Memoria indice partizionato locale
Come una partizione di tabella, una partizione di indice locale viene memorizzata nel proprio segmento. Ogni segmento contiene una parte dei dati totali dell'indice. Pertanto, un indice locale composto da quattro partizioni non viene memorizzato in un singolo segmento di indice, ma in quattro segmenti separati.
Vedi anche: Oracle AI Database SQL Language Reference per esempi CREATE INDEX ... LOCAL
Indici partizionati globali
Un indice partizionato globale è un indice B-tree partizionato indipendentemente dalla tabella sottostante in cui viene creato. Una singola partizione di indice può puntare a una o a tutte le partizioni di tabella, mentre in un indice partizionato localmente esiste una parità uno a uno tra le partizioni di indice e le partizioni di tabella.
In generale, gli indici globali sono utili per le applicazioni OLTP, in cui l'accesso rapido, l'integrità dei dati e la disponibilità sono importanti. In un sistema OLTP, una tabella può essere partizionata da una chiave, ad esempio la colonna employees.department_id, ma un'applicazione potrebbe dover accedere ai dati con molte chiavi diverse, ad esempio employee_id o job_id. Gli indici globali possono essere utili in questo scenario.
Si supponga di creare un indice partizionato globale nella tabella time_range_sales da "Range Partitioning". In questa tabella, le righe relative alle vendite dal 1998 sono memorizzate in una partizione, le righe relative alle vendite dal 1999 sono in un'altra e così via. L'esempio seguente crea un indice globale partizionato in base all'intervallo nella colonna channel_id:
CREATE INDEX time_channel_sales_idx ON time_range_sales (channel_id)
   GLOBAL PARTITION BY RANGE (channel_id)
      (PARTITION p1 VALUES LESS THAN (3),
       PARTITION p2 VALUES LESS THAN (4),
       PARTITION p3 VALUES LESS THAN (MAXVALUE));
Come illustrato nella Figura 6-4, una partizione di indice globale può contenere voci che puntano a più partizioni di tabella. La partizione indice p1 punta alle righe con un channel_id di 2, la partizione indice p2 punta alle righe con un channel_id di 3 e la partizione indice p3 punta alle righe con un channel_id di 4 o 9.
Figura 4: Indice partizionato globale
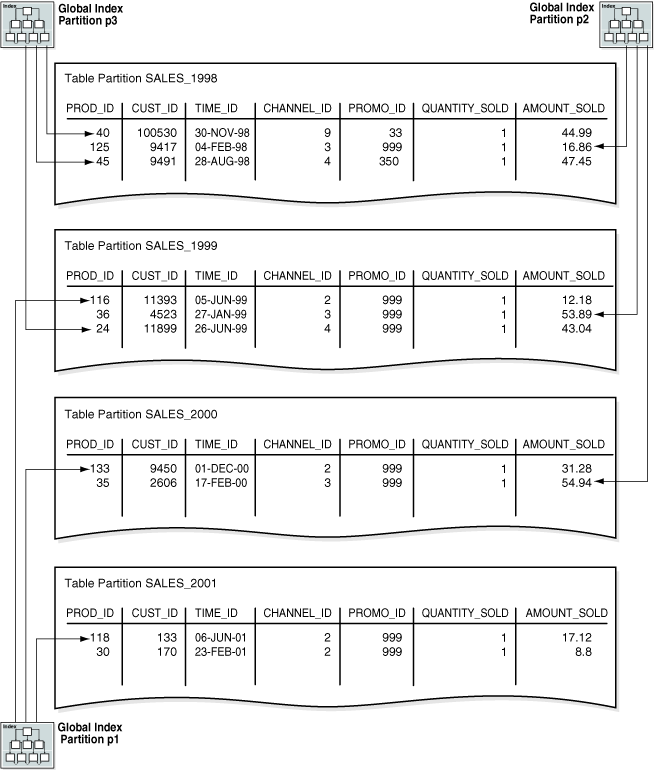
Descrizione dell'illustrazione cncpt300.gif
Vedere anche:
-
Oracle AI Database VLDB and Partitioning Guide per informazioni su come gestire gli indici partizionati globali
-
Oracle AI Database SQL Language Reference per informazioni sulla clausola
GLOBAL PARTITIONdiCREATE INDEX
Indici parziali per tabelle partizionate
Un indice parziale è un indice correlato alle proprietà di indicizzazione di una tabella partizionata associata.
La correlazione consente di specificare le partizioni della tabella indicizzate. Gli indici parziali offrono i vantaggi riportati di seguito.
-
Le partizioni di tabella non indicizzate evitano di consumare spazio di storage degli indici non necessario.
-
Le prestazioni di carichi e query possono migliorare.
Prima di Oracle Database 12c, un'operazione di partizione di scambio richiedeva un aggiornamento fisico di un indice globale associato per mantenerlo utilizzabile. A partire da Oracle Database 12c, se le partizioni coinvolte in un'operazione di manutenzione della partizione non fanno parte di un indice globale parziale, l'indice rimane utilizzabile senza richiedere alcuna manutenzione dell'indice globale.
-
Se si indicizzano solo alcune partizioni di tabella durante la creazione dell'indice e in seguito si indicizzano altre partizioni, è possibile ridurre lo spazio di ordinamento richiesto dalla creazione dell'indice.
È possibile attivare o disattivare l'indicizzazione per le singole partizioni di una tabella. Un indice locale parziale non dispone di partizioni di indice utilizzabili per tutte le partizioni di tabella con indicizzazione disattivata. Un indice globale, partizionato o meno, esclude i dati da tutte le partizioni con indicizzazione disattivata. Il database non supporta indici parziali per gli indici che applicano vincoli univoci. La Figura 6-5 mostra lo stesso indice globale della Figura 6-4, ad eccezione del fatto che l'indice globale è parziale. Le partizioni di tabella SALES_1998 e SALES_2000 hanno la proprietà di indicizzazione impostata su OFF, pertanto l'indice globale parziale non le indicizza.
Figura 5: Indice partizionato globale parziale
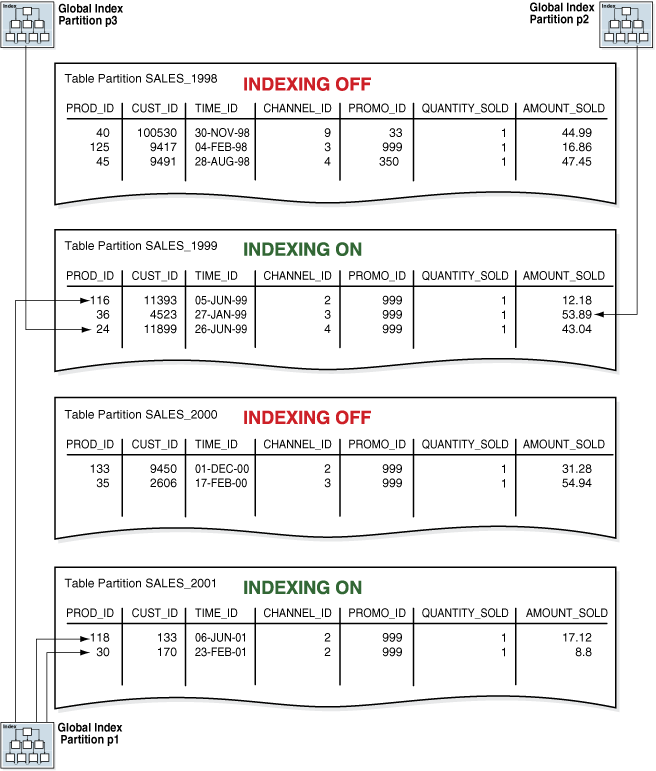
Descrizione dell'illustrazione cncpt342.png
Utilizzo dell'area di memorizzazione degli oggetti per le partizioni precedenti
Per le partizioni di sola lettura, puoi utilizzare lo storage a basso costo, ad esempio lo storage degli oggetti nel cloud.
I volumi di dati sono cresciuti enormemente nell'ultimo decennio. Inoltre, le normative e le politiche governative hanno imposto la conservazione dei dati per periodi di tempo molto lunghi in molti casi. I clienti del database Oracle utilizzano varie strategie di gestione dei dati per database molto grandi. I clienti hanno i seguenti obiettivi principali che stanno cercando di soddisfare.
Per memorizzare grandi quantità di dati al minor costo possibile Per soddisfare i nuovi requisiti normativi per la conservazione e la protezione dei dati Per migliorare le opportunità di business attraverso una migliore analisi basata su una maggiore quantità di dati.
I clienti on-premise hanno diverse soluzioni per raggiungere gli obiettivi di cui sopra. Oracle AI Database ora ti offre questa funzione che ti consente di sviluppare strategie di gestione dei dati simili per i tuoi database cloud sfruttando livelli di storage a basso costo come lo storage degli oggetti nel cloud.
I clienti del database Oracle hanno messo a punto varie strategie di gestione dei dati man mano che i loro set di dati si sono evoluti e cresciuti. Tutte queste strategie rientrano in Information Lifecycle Management (ILM). Alcune delle funzioni del database utili per l'implementazione di una soluzione ILM includono Partitioning dati, Advanced Row Compression, Hybrid Columnar Compression, Automatic Data Optimization e altre.
Uno degli aspetti di una soluzione ILM è la definizione di un livello di storage a basso costo. Ciò consente di conservare grandi quantità di dati per il costo più basso possibile. La strategia di Oracle ILM consente la compressione automatica dei dati e lo spostamento dei dati a un livello di storage a costi inferiori. I clienti di database Oracle on-premise utilizzano le soluzioni di storage Oracle come Oracle ZFS Storage Appliance o Oracle Exadata Extended (XT) Storage Server come opzione di storage a basso costo per dati ad accesso poco frequente, meno recenti o normativi. È inoltre possibile scegliere opzioni di archiviazione a basso costo simili da fornitori di terze parti.
L'utilizzo dell'area di memorizzazione degli oggetti consente di:
-
Memorizza le partizioni meno recenti e le tablespace di sola lettura nello storage degli oggetti.
-
Eseguire query sui dati dai file di storage degli oggetti in modalità online.
-
Impedisci l'accesso non autorizzato ai file di storage degli oggetti di proprietà di un PDB da un altro PDB.
-
Sposta i dati dall'area di memorizzazione degli oggetti nello storage normale nel raro caso in cui si desideri apportare modifiche ai dati di sola lettura.
-
Elimina le tablespace con i file di dati nell'area di memorizzazione degli oggetti.
-
Spostamento di partizioni precedenti e tablespace di sola lettura nell'area di memorizzazione degli oggetti È possibile creare una strategia di partizionamento basata sul tempo e spostare i file di dati per una tablespace di sola lettura in un livello di storage a costi inferiori come lo storage degli oggetti.
-
Accesso agli oggetti nello storage degli oggetti L'accesso ai dati dalle tabelle e dalle partizioni nello storage degli oggetti sarà completamente trasparente per gli utenti e i client SQL.
-
Gestione delle credenziali per i file dell'area di memorizzazione degli oggetti L'accesso ai file nello storage degli oggetti richiede una credenziale.
-
Spostamento dei file di dati dallo storage degli oggetti nello storage tradizionale Se è necessario aggiornare i dati dell'area di memorizzazione degli oggetti, è necessario prima spostare i dati nello storage tradizionale.
-
Eliminazione dei file di dati dell'area di memorizzazione degli oggetti È possibile eliminare le tablespace con i file di dati utilizzando il comando
DROP TABLESPACEstandard.
Spostamento delle partizioni precedenti e delle tablespace di sola lettura nell'area di memorizzazione degli oggetti
È possibile creare una strategia di partizionamento basata sul tempo e spostare i file di dati per una tablespace di sola lettura in un livello di storage a costi inferiori, ad esempio lo storage degli oggetti.
Si supponga di disporre di una tabella denominata 'ordini' con intervallo partizionato nella colonna DATA. Ogni partizione contiene righe per un determinato anno e ci sono partizioni esistenti per il 2022 e il 2023. Con l'avvicinarsi di un nuovo anno, l'amministratore del database decide di aggiungere una nuova partizione per il 2024. Allo stesso tempo, l'amministratore del database decide di spostare la partizione meno recente in un livello di storage a basso costo.
L'esempio di workflow riportato di seguito rappresenta uno scenario in cui lo spazio tabella ha una singola partizione per una singola tabella. Questa non è una restrizione. La tablespace di sola lettura può avere partizioni per una o più tabelle. È inoltre possibile rendere la partizione di sola lettura oltre a rendere la tablespace di sola lettura. Come procedura ottimale, è possibile rendere la tablespace di sola lettura e attendere un periodo di tempo ben definito prima di spostare i file nell'area di memorizzazione degli oggetti. Ciò garantirà che eventuali tentativi di aggiornamento dei dati di sola lettura vengano rilevati e che venga restituito un errore. Lo spostamento dei dati mutati in un'altra tablespace è molto più rapido, mentre i dati si trovano ancora in Exadata o in un altro storage tradizionale. Sarà molto più lento se questi dati devono essere copiati dallo storage degli oggetti.
create tablespace orders_2022 DATAFILE '+DATA_DG/orders_2022.dbf' size 100g;
create tablespace orders_2023 DATAFILE '+DATA_DG/orders_2023.dbf' size 100g;

create table orders
( prod_id         NUMBER NOT NULL,
  time_id         DATE NOT NULL,
  quantity_sold   NUMBER(10,2) NOT NULL,
  amount_sold     NUMBER(10,2) NOT NULL)
    partition by range (time_id)
    ( partition orders_2022 VALUES LESS THAN (TO_DATE('2023-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2022,
      partition orders_2023 VALUES LESS THAN (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2023)
  ENABLE ROW MOVEMENT;

create tablespace orders_2024 DATAFILE '+DATA_DG/orders_2024.dbf' size 100g;

alter table orders
  ADD partition orders_2024
  values less than (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
  TABLESPACE orders_2024;

alter tablespace orders_2022 read only;

alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database
  move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
Accesso agli oggetti nello storage degli oggetti
L'accesso ai dati dalle tabelle e dalle partizioni nello storage degli oggetti sarà completamente trasparente per gli utenti e i client SQL.
Il sottosistema di input/output del database eseguirà internamente query e servirà blocchi dai file memorizzati nello storage degli oggetti. L'istruzione SQL seguente eseguirà una query sulle righe della partizione di sola lettura orders_2022 spostata nello storage degli oggetti nell'esempio precedente.
select prod_id
from   orders
where  time_id < TO_DATE('2020-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN');
Gli indici esistenti, sia globali che locali, funzionano in modo trasparente. L'esecuzione di query sui dati di compressione ibridi a colonne e sui dati cifrati TDE funziona in modo trasparente anche dal punto di vista del client.
Gestione credenziali per file area di memorizzazione oggetti
L'accesso ai file nello storage degli oggetti richiede una credenziale.
Una credenziale è un oggetto di database che memorizza un nome utente e una password. I dati delle credenziali vengono cifrati e memorizzati in modo sicuro nello schema PDB in cui vengono creati.
Quando si prevede di spostare i file di dati nello storage degli oggetti, è necessario definire una credenziale predefinita. Questa credenziale predefinita viene utilizzata per accedere ai file di dati nello storage degli oggetti.
Scegliere la credenziale predefinita con i privilegi minimi necessari. Dopo che la credenziale predefinita abilita l'accesso all'area di memorizzazione degli oggetti, l'autenticazione e l'autorizzazione del database standard determinano quali utenti del database possono eseguire query o utilizzare su tali file di dati.
alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
Spostamento dei file di dati dallo storage degli oggetti nello storage tradizionale
Se è necessario aggiornare i dati dell'area di memorizzazione degli oggetti, è necessario prima spostare i dati nello storage tradizionale.
Nel raro caso in cui sia necessario modificare i dati di sola lettura che si trovano già nello storage degli oggetti, l'unica opzione è quella di spostare i dati dallo storage degli oggetti allo storage tradizionale. Il workflow riportato di seguito mostra come spostare di nuovo il file di dati dall'area di memorizzazione degli oggetti nel file system ASM. La copia di un file dallo storage degli oggetti avrà implicazioni in termini di prestazioni.
alter database move datafile
  'https://objectstorage.example.com/oracle/orders_2022.dbf' to
  '+DATA_DG/orders_2022.dbf';

alter tablespace orders_2022 read write;
Eliminazione dei file di dati dell'area di memorizzazione degli oggetti
È possibile eliminare tablespace con file di dati utilizzando il comando DROP TABLESPACE standard.
La clausola AND DATAFILES viene utilizzata per eliminare i file di dati dallo storage backend. I file verranno eliminati dall'area di memorizzazione degli oggetti. Se il file dell'area di memorizzazione degli oggetti contiene più chunk nell'area di memorizzazione degli oggetti, tutti i chunk verranno eliminati e il file manifesto.
drop tablespace orders_2022 including contents and datafiles;Panoramica delle tabelle con partizionamento orizzontale
In un database Oracle, la funzione Globally Distributed Database consente di suddividere qualsiasi tabella in parti denominate partizioni che possono essere memorizzate in più database.
Il partizionamento orizzontale implica la suddivisione di una tabella di database tra partizioni in modo che ogni partizione contenga la tabella con le stesse colonne ma un subset di righe diverso. Una tabella suddivisa in questo modo è anche nota come tabella partizionata.
La figura seguente mostra una tabella partizionata orizzontalmente su tre partizioni.
Figura 6: Partizionamento orizzontale di una tabella tra partizioni
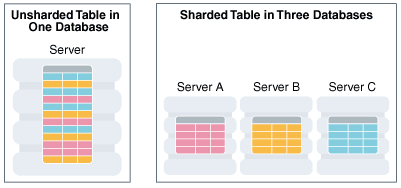
Descrizione dell'immagine admin_3v_134a.png
- Tabelle con partizionamento orizzontale Una tabella di database viene suddivisa tra le partizioni in modo che ogni partizione contenga la tabella con le stesse colonne, ma un diverso subset di righe. Una tabella suddivisa in questo modo è denominata tabella partizionata. Vedi anche: Oracle Globally Distributed AI Database
Tabelle con partizionamento orizzontale
Una tabella di database viene suddivisa tra le partizioni, in modo che ogni partizione contenga la tabella con le stesse colonne, ma un sottoinsieme di righe diverso. Una tabella suddivisa in questo modo è denominata tabella partizionata.
La figura seguente mostra come un set di tabelle (denominato famiglia di tabelle) può essere partizionato orizzontalmente in un set di PDB della partizione, in modo che ogni partizione contenga un subset di dati, indicati con righe rosse, gialle e blu.
Figura 7: Partizionamento orizzontale di una tabella tra partizioni
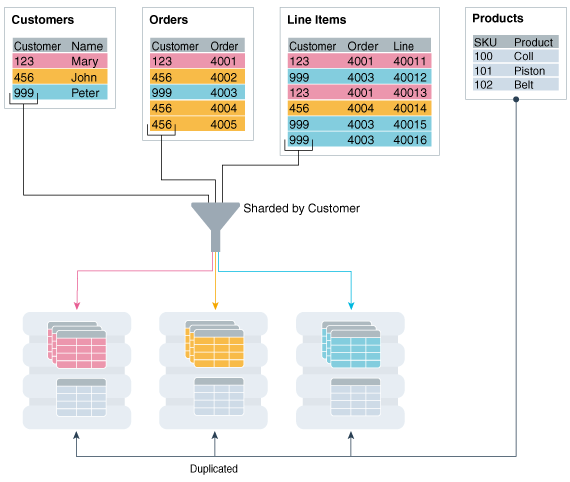
Descrizione dell'immagine admin_3v_138e.png
Le partizioni vengono distribuite tra partizioni a livello di tablespace, in base a una chiave di partizionamento orizzontale. Esempi di chiavi includono l'ID cliente, il numero di conto e l'ID paese.
Ogni partizione di una tabella con partizionamento orizzontale risiede in una tablespace separata e ogni tablespace è associata a una partizione specifica. A seconda del metodo di partizionamento orizzontale, l'associazione può essere stabilita automaticamente o definita dall'amministratore.
Anche se le partizioni di una tabella con partizionamento orizzontale risiedono in più partizioni, per l'applicazione, la tabella appare e si comporta esattamente come una tabella partizionata in un singolo database. Le istruzioni SQL emesse da un'applicazione non devono mai fare riferimento a partizioni o dipendere dal numero di partizioni e dalla relativa configurazione.
La sintassi SQL nota per il partizionamento delle tabelle specifica la modalità di partizionamento delle righe tra partizioni. Ad esempio, l'istruzione SQL seguente crea una tabella con partizionamento orizzontale, suddividendo la tabella in partizioni in base alla chiave di partizionamento orizzontale cust_id.
CREATE SHARDED TABLE customers
( cust_id     NUMBER NOT NULL,
  name        VARCHAR2(50),
  address     VARCHAR2(250),
  region      VARCHAR2(20),
  class       VARCHAR2(3),
  signup      DATE,
  CONSTRAINT cust_pk PRIMARY KEY(cust_id)
)
PARTITION BY CONSISTENT HASH (cust_id)
PARTITIONS AUTO
TABLESPACE SET ts1;
La tabella con partizionamento orizzontale nell'esempio precedente è partizionata da hash coerente, un tipo speciale di partizionamento hash comunemente usato nei sistemi distribuiti scalabili. Questa tecnica distribuisce automaticamente le tablespace tra le partizioni per fornire una distribuzione uniforme di dati e carichi di lavoro. Nota: gli indici globali nelle tabelle con partizionamento orizzontale non sono supportati, ma gli indici locali sono supportati.
Panoramica delle viste
Una vista è una rappresentazione logica di una o più tabelle. In sostanza, una vista è una query memorizzata.
Una vista deriva i propri dati dalle tabelle su cui si basa, denominate tabelle di base. Le tabelle di base possono essere tabelle o altre viste. Tutte le operazioni eseguite su una vista influiscono effettivamente sulle tabelle base. È possibile utilizzare le viste nella maggior parte delle posizioni in cui vengono utilizzate le tabelle.
Nota: le viste materializzate utilizzano una struttura dati diversa dalle viste standard.
Le viste consentono di adeguare la presentazione di dati a tipi di utenti diversi. Le viste sono spesso utilizzate per:
-
Fornire un ulteriore livello di sicurezza della tabella limitando l'accesso a un set predeterminato di righe o colonne di una tabella
Ad esempio, la Figura 6-8 mostra in che modo la vista
staffnon mostra le colonnesalaryocommission_pctdella tabella di baseemployees. -
Nascondere la complessità dei dati
Ad esempio, è possibile definire una singola vista con un join, ovvero una raccolta di colonne o righe correlate in più tabelle. Tuttavia, la vista nasconde il fatto che queste informazioni provengono effettivamente da diverse tabelle. Una query può anche eseguire calcoli estesi con informazioni sulla tabella. Pertanto, gli utenti possono eseguire query su una vista senza sapere come eseguire un join o calcoli.
-
Presentare i dati in una prospettiva diversa da quella della tabella base.
Ad esempio, è possibile rinominare le colonne di una vista senza influire sulle tabelle su cui si basa la vista.
-
Isola le applicazioni dalle modifiche nelle definizioni delle tabelle di base
Ad esempio, se la query di definizione di una vista fa riferimento a tre colonne di una tabella a quattro colonne e viene aggiunta una quinta colonna alla tabella, la definizione della vista non viene interessata e tutte le applicazioni che utilizzano la vista non vengono interessate.
Per un esempio di utilizzo delle viste, considerare la tabella hr.employees, che contiene più colonne e numerose righe. Per consentire agli utenti di visualizzare solo cinque di queste colonne o solo righe specifiche, è possibile creare una vista come indicato di seguito.
CREATE VIEW staff AS
  SELECT employee_id, last_name, job_id, manager_id, department_id
  FROM   employees;
Come per tutte le subquery, la query che definisce una vista non può contenere la clausola FOR UPDATE. Il grafico seguente illustra la vista denominata staff. Si noti che la vista mostra solo cinque colonne della tabella di base.
Figura 8: Visualizzazione
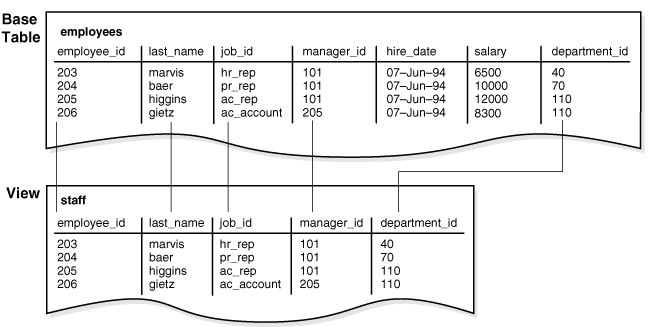
Descrizione dell'illustrazione cncpt045.gif
-
Caratteristiche delle viste A differenza di una tabella, a una vista non è allocato spazio di memorizzazione, né una vista contiene dati. Una vista è invece definita da una query che estrae o ricava dati dalle tabelle di base a cui fa riferimento la vista. Poiché una vista si basa su altri oggetti, non richiede altro storage se non storage per la query che definisce la vista nel dizionario dati.
-
Viste join aggiornabili Una vista di join dispone di più tabelle o viste nella clausola
FROM. -
Viste oggetto Proprio come una vista è una tabella virtuale, una vista oggetto è una tabella di oggetti virtuali. Ogni riga della vista è un oggetto, ovvero un'istanza di un tipo di oggetto. Un tipo di oggetto è un tipo di dati definito dall'utente.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire le viste
-
Oracle AI Database SQL Language Reference per sintassi e semantica
CREATE VIEW
Caratteristiche delle viste
A differenza di una tabella, a una vista non è allocato spazio di memorizzazione, né una vista contiene dati. Una vista è invece definita da una query che estrae o ricava dati dalle tabelle di base a cui fa riferimento la vista. Poiché una vista si basa su altri oggetti, non richiede altro storage se non storage per la query che definisce la vista nel dizionario dati.
Una vista ha dipendenze sui relativi oggetti di riferimento, che vengono gestiti automaticamente dal database. Ad esempio, se si elimina e si crea di nuovo una tabella di base di una vista, il database determina se la nuova tabella di base è accettabile per la definizione della vista.
-
Manipolazione dei dati nelle viste Poiché le viste derivano dalle tabelle, presentano molte somiglianze. Gli utenti possono eseguire query sulle viste e, con alcune limitazioni, possono eseguire DML sulle viste. Le operazioni eseguite su una vista influiscono sui dati di alcune tabelle di base della vista e sono soggette ai vincoli di integrità e ai trigger delle tabelle di base.
-
Modalità di accesso ai dati nelle viste Oracle AI Database memorizza una definizione di vista nel dizionario dati come testo della query che definisce la vista.
Manipolazione dei dati nelle viste
Poiché le viste sono derivate dalle tabelle, hanno molte somiglianze. Gli utenti possono eseguire query sulle viste e, con alcune limitazioni, possono eseguire DML sulle viste. Le operazioni eseguite su una vista influiscono sui dati di alcune tabelle di base della vista e sono soggette ai vincoli di integrità e ai trigger delle tabelle di base.
Nell'esempio seguente viene creata una vista della tabella hr.employees.
CREATE VIEW staff_dept_10 AS
SELECT employee_id, last_name, job_id,
       manager_id, department_id
FROM   employees
WHERE  department_id = 10
WITH CHECK OPTION CONSTRAINT staff_dept_10_cnst;
La query di definizione fa riferimento solo alle righe per il reparto 10. CHECK OPTION crea la vista con un vincolo in modo che le istruzioni INSERT e UPDATE emesse a fronte della vista non possano generare righe che la vista non può selezionare. È pertanto possibile inserire righe per i dipendenti nel reparto 10, ma non righe per il reparto 30.
Vedere anche: Oracle AI Database SQL Language Reference per informazioni sulle limitazioni delle subquery nelle istruzioni CREATE VIEW
Modalità di accesso ai dati nelle viste
Oracle AI Database memorizza una definizione di vista nel dizionario dati come testo della query che definisce la vista.
Quando si fa riferimento a una vista in un'istruzione SQL, Oracle AI Database esegue i task riportati di seguito.
-
Unisce una query (se possibile) a una vista con le query che definiscono la vista e le viste sottostanti
Oracle AI Database ottimizza la query unita come se la query fosse stata eseguita senza fare riferimento alle viste. Pertanto, Oracle AI Database può utilizzare gli indici su qualsiasi colonna della tabella di base a cui viene fatto riferimento, indipendentemente dal fatto che alla colonna venga fatto riferimento nella definizione della vista o nella query dell'utente sulla vista.
A volte Oracle AI Database non è in grado di unire la definizione della vista alla query dell'utente. In questi casi, Oracle AI Database non può utilizzare tutti gli indici nelle colonne di riferimento.
-
Analizza l'istruzione unita in un'area SQL condivisa
Oracle AI Database analizza un'istruzione che fa riferimento a una vista in una nuova area SQL condivisa solo se nessuna area SQL condivisa esistente contiene un'istruzione simile. Pertanto, le viste offrono il vantaggio di un uso ridotto della memoria associato a SQL condiviso.
-
Esegue l'istruzione SQL
Nell'esempio seguente viene illustrato l'accesso ai dati quando viene eseguita una query su una vista. Si supponga di creare employees_view in base alle tabelle employees e departments:
CREATE VIEW employees_view AS
  SELECT employee_id, last_name, salary, location_id
  FROM   employees JOIN departments USING (department_id)
  WHERE  department_id = 10;
Un utente esegue la seguente query di employees_view:
SELECT last_name
FROM   employees_view
WHERE  employee_id = 200;
Oracle AI Database unisce la vista e la query dell'utente per creare la query seguente, che viene quindi eseguita per recuperare i dati:
SELECT last_name
FROM   employees, departments
WHERE  employees.department_id = departments.department_id
AND    departments.department_id = 10
AND    employees.employee_id = 200;
Vedere anche:
-
Oracle AI Database SQL Tuning Guide per ulteriori informazioni sull'ottimizzazione delle query
Viste join aggiornabili
Una vista di join dispone di più tabelle o viste nella clausola FROM.
Nell'esempio riportato di seguito, la vista staff_dept_10_30 unisce le tabelle employees e departments, inclusi solo i dipendenti dei reparti 10 o 30.
CREATE VIEW staff_dept_10_30 AS
SELECT employee_id, last_name, job_id, e.department_id
FROM   employees e, departments d
WHERE  e.department_id IN (10, 30)
AND    e.department_id = d.department_id;
Una vista join aggiornabile, detta anche vista join modificabile, coinvolge due o più tabelle o viste di base e consente operazioni DML. Una vista aggiornabile contiene più tabelle nella clausola FROM di livello superiore dell'istruzione SELECT e non è limitata dalla clausola WITH READ ONLY.
Per essere intrinsecamente aggiornabile, una vista deve soddisfare diversi criteri. Ad esempio, una regola generale prevede che un'operazione INSERT, UPDATE o DELETE in una vista join possa modificare una sola tabella di base alla volta. La seguente query della vista dizionario dati USER_UPDATABLE_COLUMNS mostra che la vista staff_dept_10_30 è aggiornabile:
SQL> SELECT TABLE_NAME, COLUMN_NAME, UPDATABLE
  2  FROM   USER_UPDATABLE_COLUMNS
  3  WHERE  TABLE_NAME = 'STAFF_DEPT_10_30';

TABLE_NAME                     COLUMN_NAME                    UPD
------------------------------ ------------------------------ ---
STAFF_DEPT_10_30               EMPLOYEE_ID                    YES
STAFF_DEPT_10_30               LAST_NAME                      YES
STAFF_DEPT_10_30               JOB_ID                         YES
STAFF_DEPT_10_30               DEPARTMENT_ID                  YES
A partire da Oracle Database Release 21c, non è obbligatorio che tutte le colonne aggiornabili in una vista join vengano mappate alle colonne di una tabella con conservazione della chiave. La tabella con conservazione della chiave è una tabella in cui ogni riga della tabella sottostante viene visualizzata al massimo una volta nell'output della query. Nella vista staff_dept_10_30, department_id è la chiave primaria della tabella departments, quindi ogni riga della tabella employees viene visualizzata al massimo una volta nel set di risultati, rendendo la tabella employees conservata come chiave. La tabella departments non è conservata in base alla chiave perché ciascuna delle relative righe può essere visualizzata più volte nel set di risultati. Le colonne di una tabella non conservata mediante chiave possono essere aggiornate se l'operazione UPDATE aggiorna solo le colonne da una singola tabella e l'aggiornamento è deterministico, ovvero aggiorna ogni riga una sola volta.
Vedere anche: Oracle AI Database Administrator's Guide per informazioni su come aggiornare le viste di join
viste di oggetti;
Proprio come una vista è una tabella virtuale, una vista oggetto è una tabella di oggetti virtuali. Ogni riga della vista è un oggetto, ovvero un'istanza di un tipo di oggetto. Un tipo di oggetto è un tipo di dati definito dall'utente.
È possibile recuperare, aggiornare, inserire ed eliminare i dati relazionali come se fossero memorizzati come un tipo di oggetto. È inoltre possibile definire viste con colonne che sono tipi di data oggetto, ad esempio oggetti, REF e raccolte (tabelle nidificate e VARRAY).
Analogamente alle viste relazionali, le viste oggetto possono presentare solo i dati che gli amministratori del database desiderano visualizzare agli utenti. Ad esempio, una vista oggetto potrebbe presentare dati sui programmatori IT, ma omettere dati riservati sugli stipendi. L'esempio seguente crea un oggetto employee_type e quindi la vista it_prog_view basata su questo oggetto:
CREATE TYPE employee_type AS OBJECT
(
  employee_id  NUMBER (6),
  last_name    VARCHAR2 (25),
  job_id       VARCHAR2 (10)
);
/

CREATE VIEW it_prog_view OF employee_type
  WITH OBJECT IDENTIFIER (employee_id) AS
SELECT  e.employee_id, e.last_name, e.job_id
FROM    employees e
WHERE   job_id = 'IT_PROG';
Le viste degli oggetti sono utili nella creazione di prototipi o nella transizione ad applicazioni orientate agli oggetti perché i dati nella vista possono essere presi da tabelle relazionali e accessibili come se la tabella fosse definita come una tabella degli oggetti. È possibile eseguire applicazioni orientate agli oggetti senza convertire le tabelle esistenti in una struttura fisica diversa.
Vedere anche:
-
Oracle AI Database Object-Relational Developer's Guide per informazioni sui tipi di oggetto e sulle viste degli oggetti
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sull'istruzione
CREATE TYPE
Panoramica delle viste materializzate
Una vista materializzata è un risultato di query memorizzato o "materializzato" in anticipo come oggetto dello schema. La clausola FROM della query può indicare tabelle, viste o viste materializzate.
Una vista materializzata spesso funge da tabella master nella replica e da tabella fact nel data warehousing. Le viste materializzate riepilogano, calcolano, replicano e distribuiscono i dati. Sono adatti in vari ambienti di elaborazione, come ad esempio:
-
Nei data warehouse, le viste materializzate possono calcolare e memorizzare i dati generati da funzioni di aggregazione quali somme e medie.
Un riepilogo è una vista aggregata che riduce il tempo di esecuzione delle query precalcolando i join e le operazioni di aggregazione e memorizzando i risultati in una tabella. Le viste materializzate sono equivalenti ai riepiloghi. È inoltre possibile utilizzare le viste materializzate per calcolare i join con o senza aggregazioni.
-
Nella replica delle viste materializzate, che viene eseguita utilizzando XStream e Oracle GoldenGate, la vista contiene una copia completa o parziale di una tabella da un singolo point in time. Le viste materializzate replicano i dati nei siti distribuiti e sincronizzano gli aggiornamenti eseguiti in diversi siti. Questa forma di replica è adatta per ambienti quali le vendite sul campo quando i database non sono sempre connessi alla rete.
-
Negli ambienti di mobile computing, le viste materializzate possono scaricare un sottoinsieme di dati dai server centrali ai client mobili, con aggiornamenti periodici dai server centrali e propagazione degli aggiornamenti da parte dei client ai server centrali.
In un ambiente di replica, una vista materializzata condivide dati con una tabella in un database diverso definito database principale. La tabella associata alla vista materializzata nel sito principale è la tabella principale. La Figura 6-9 illustra una vista materializzata in un database basata su una tabella master in un altro database. Gli aggiornamenti della tabella master vengono replicati nel database delle viste materializzate.
Figura 9: Vista materializzata
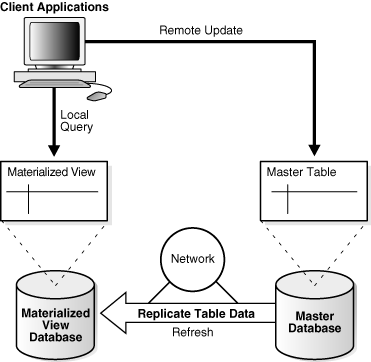
Descrizione dell'illustrazione cncpt260.gif
-
Caratteristiche delle viste materializzate Le viste materializzate condividono alcune caratteristiche degli indici e delle viste non materializzate.
-
Metodi di aggiornamento per le viste materializzate Il database gestisce i dati nelle viste materializzate aggiornandoli dopo le modifiche apportate alle tabelle di base. Il metodo di aggiornamento può essere incrementale o un aggiornamento completo.
-
Viste materializzate automatiche A partire da Oracle Database Release 21c, le viste materializzate possono essere create e gestite automaticamente.
-
La riscrittura della interrogazione trasforma una richiesta dell'utente scritta in termini di tabelle master in una richiesta equivalente dal punto di vita che comprende viste materializzate.
Vedere anche:
-
Oracle AI Database Data Warehousing Guide per saperne di più sui riepiloghi
-
Oracle AI Database XStream Guide per un'introduzione a XStream
-
http://www.oracle.com/technetwork/middleware/goldengate/documentation/index.html per ulteriori informazioni su Oracle GoldenGate
-
Oracle AI Database SQL Language Reference per ulteriori informazioni sull'istruzione
CREATE MATERIALIZED VIEW
Caratteristiche delle viste materializzate
Le viste materializzate condividono alcune caratteristiche degli indici e delle viste non materializzate.
Le viste materializzate sono simili agli indici nei modi seguenti:
-
Contengono dati effettivi e consumano spazio di storage.
-
Possono essere aggiornati quando i dati nelle tabelle principali vengono modificati.
-
Possono migliorare le prestazioni dell'esecuzione SQL quando vengono utilizzate per le operazioni di riscrittura delle query.
-
La loro esistenza è trasparente per le applicazioni e gli utenti SQL.
Una vista materializzata è simile a una vista non materializzata perché rappresenta i dati di altre tabelle e viste. A differenza degli indici, gli utenti possono eseguire query sulle viste materializzate direttamente utilizzando le istruzioni SELECT. A seconda dei tipi di aggiornamento necessari, è possibile aggiornare le viste anche con le istruzioni DML.
Nell'esempio seguente viene creata e popolata una vista di aggregazione materializzata basata su tre tabelle principali nello schema di esempio sh.
CREATE MATERIALIZED VIEW sales_mv AS
  SELECT t.calendar_year, p.prod_id, SUM(s.amount_sold) AS sum_sales
  FROM   times t, products p, sales s
  WHERE  t.time_id = s.time_id
  AND    p.prod_id = s.prod_id
  GROUP BY t.calendar_year, p.prod_id;
Nell'esempio seguente viene eliminata la tabella sales, che è una tabella master per sales_mv, quindi viene eseguita una query su sales_mv. La query seleziona i dati perché le righe vengono memorizzate (materializzate) separatamente dai dati nelle tabelle principali.
SQL> DROP TABLE sales;

Table dropped.

SQL> SELECT * FROM sales_mv WHERE ROWNUM < 4;

CALENDAR_YEAR    PROD_ID  SUM_SALES
------------- ---------- ----------
         1998         13  936197.53
         1998         26  567533.83
         1998         27  107968.24
Una vista materializzata può essere partizionata. È possibile definire una vista materializzata in una tabella partizionata e uno o più indici nella vista materializzata.
Vedere anche: Oracle AI Database Data Warehousing Guide per scoprire come utilizzare le viste materializzate in un data warehouse.
Metodi di aggiornamento per viste materializzate
Il database gestisce i dati nelle viste materializzate aggiornandoli dopo le modifiche apportate alle tabelle di base. Il metodo di aggiornamento può essere incrementale o un aggiornamento completo.
-
Aggiornamento completo Un aggiornamento completo esegue la query che definisce la vista materializzata. L'aggiornamento completo viene eseguito quando si crea inizialmente la vista materializzata, a meno che la vista materializzata non faccia riferimento a una tabella precostruita oppure si definisca la tabella come
BUILD DEFERRED. -
Aggiornamento incrementale Un aggiornamento incrementale, denominato anche aggiornamento rapido, elabora solo le modifiche apportate ai dati esistenti. Questo metodo elimina la necessità di ricreare le viste materializzate dall'inizio. L'elaborazione solo delle modifiche può comportare un tempo di aggiornamento molto rapido.
-
Aggiornamento in loco e non in loco Per i metodi completi e incrementali, il database può aggiornare la vista materializzata in posizione, che aggiorna le istruzioni direttamente sulla vista o in posizione errata.
Aggiornamento completo
Un aggiornamento completo esegue la query che definisce la vista materializzata. L'aggiornamento completo viene eseguito quando si crea inizialmente la vista materializzata, a meno che la vista materializzata non faccia riferimento a una tabella precostruita oppure si definisca la tabella come BUILD DEFERRED.
Un aggiornamento completo può essere lento, soprattutto se il database deve leggere ed elaborare enormi quantità di dati. È possibile eseguire un aggiornamento completo in qualsiasi momento dopo la creazione della vista materializzata.
Aggiornamento incrementale
Un aggiornamento incrementale, denominato anche aggiornamento rapido, elabora solo le modifiche apportate ai dati esistenti. Questo metodo elimina la necessità di ricreare le viste materializzate dall'inizio. L'elaborazione solo delle modifiche può comportare un tempo di aggiornamento molto rapido.
È possibile aggiornare le viste materializzate su richiesta o a intervalli di tempo regolari. In alternativa, è possibile configurare le viste materializzate nello stesso database delle tabelle di base per l'aggiornamento ogni volta che una transazione esegue il commit delle modifiche alle tabelle di base.
L'aggiornamento rapido viene fornito in uno dei seguenti moduli:
-
Aggiornamento basato su log
In questo tipo di aggiornamento, un log delle viste materializzate o un log del programma di caricamento diretto conserva un record delle modifiche apportate alle tabelle di base. Un log delle viste materializzate è un oggetto schema che registra le modifiche apportate a una tabella di base in modo che una vista materializzata definita nella tabella di base possa essere aggiornata in modo incrementale. Ogni log delle viste materializzate è associato a una singola tabella di base.
-
Aggiornamento di Partition Change Tracking (PCT)
L'aggiornamento PCT è valido solo se le tabelle di base sono partizionate. L'aggiornamento PCT rimuove tutti i dati nelle partizioni delle viste materializzate interessate o nelle porzioni di dati interessate, quindi li ricalcola. Il database utilizza le partizioni di tabella di base modificate per identificare le partizioni o le parti di dati interessate nella vista. Quando si sono verificate operazioni di manutenzione delle partizioni sulle tabelle di base, l'aggiornamento PCT è l'unico metodo di aggiornamento incrementale utilizzabile.
Aggiornamento in loco e in posizione errata
Per i metodi completi e incrementali, il database può aggiornare la vista materializzata in posizione, che aggiorna le istruzioni direttamente nella vista o in posizione errata.
Un aggiornamento non in loco crea una o più tabelle esterne, esegue le istruzioni di aggiornamento su di esse, quindi cambia la vista materializzata o le partizioni interessate con le tabelle esterne. Questa tecnica consente di ottenere l'alta disponibilità durante l'aggiornamento, soprattutto quando il completamento delle istruzioni di aggiornamento richiede molto tempo.
L'aggiornamento sincrono è un tipo di aggiornamento non in loco. Un aggiornamento sincrono non modifica il contenuto delle tabelle di base, ma utilizza invece le API nel package di aggiornamento sincrono, che garantisce la coerenza applicando queste modifiche alle tabelle di base e alle viste materializzate contemporaneamente. Questo approccio consente di sincronizzare sempre un set di tabelle e le viste materializzate definite. In un data warehouse, il metodo di aggiornamento sincrono è adatto per i seguenti motivi:
-
Il caricamento dei dati incrementali è strettamente controllato e si verifica a intervalli periodici.
-
Le tabelle e le relative viste materializzate vengono spesso partizionate allo stesso modo oppure le relative partizioni sono correlate da una dipendenza funzionale.
Vedere anche: Oracle AI Database Data Warehousing Guide per informazioni su come aggiornare le viste materializzate
Viste materializzate automatiche
A partire da Oracle Database Release 21c, le viste materializzate possono essere create e gestite automaticamente.
Oracle AI Database può creare e gestire automaticamente le viste materializzate per ottimizzare le prestazioni delle query. Grazie a un'interazione minima o nulla con il DBA, i task in background monitorano e analizzano le caratteristiche del carico di lavoro e identificano le posizioni in cui le viste materializzate miglioreranno le prestazioni SQL. Il vantaggio in termini di prestazioni delle viste materializzate dei candidati viene misurato in background (utilizzando query del carico di lavoro) prima che vengano rese visibili al carico di lavoro.
Vedere anche:
-
Per ulteriori informazioni, consulta Oracle AI Database Data Warehousing Guide
-
Oracle AI Database PL/SQL Packages and Types Reference per informazioni su come utilizzare il package
DBMS_AUTO_MVper implementare le viste materializzate automatiche
Riscrittura query
La riscrittura della interrogazione trasforma una richiesta dell'utente scritta in termini di tabelle master in una richiesta equivalente dal punto di vita che comprende viste materializzate.
Quando le tabelle di base contengono grandi quantità di dati, il calcolo di un aggregato o di un join è costoso e richiede molto tempo. Poiché le viste materializzate contengono aggregati e join precalcolati, la riscrittura delle query può rispondere rapidamente alle query utilizzando le viste materializzate.
Il trasformatore query riscrive in modo trasparente la richiesta di utilizzo della vista materializzata, senza richiedere alcun intervento dell'utente e nessun riferimento alla vista materializzata nell'istruzione SQL. Poiché la riscrittura della query è trasparente, è possibile aggiungere o eliminare le viste materializzate senza invalidare l'istruzione SQL nel codice dell'applicazione.
In generale, la riscrittura delle query per utilizzare le viste materializzate anziché le tabelle di dettaglio migliora il tempo di risposta. Nella figura riportata di seguito viene illustrato il database che genera un piano di esecuzione per la query originale e riscritta e sceglie il piano a costi inferiori.
Figura 10: Riscrittura query
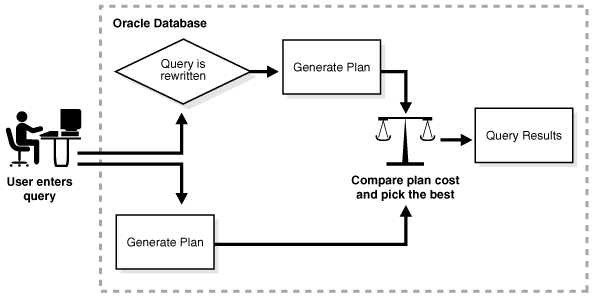
Descrizione dell'illustrazione cncpt334.gif
Vedere anche:
-
"Panoramica dell'ottimizzatore" per ulteriori informazioni sulla trasformazione delle query
-
Oracle AI Database Data Warehousing Guide per scoprire come utilizzare la riscrittura delle query
Panoramica delle sequenze
Una sequenza è un oggetto schema da cui più utenti possono generare numeri interi univoci. Un generatore di sequenze fornisce un metodo altamente scalabile e con buone prestazioni per generare chiavi alternative per un tipo di dati numerico.
-
Caratteristiche sequenza Una definizione di sequenza indica informazioni generali sulla sequenza, incluso il nome e se la sequenza aumenta o diminuisce.
-
Accesso concorrente alle sequenze Lo stesso generatore di sequenze può generare numeri per più tabelle.
Caratteristiche sequenza
Una definizione di sequenza indica informazioni generali sulla sequenza, incluso il nome e se la sequenza ascende o discende.
Una definizione di sequenza indica inoltre:
-
L'intervallo tra i numeri
-
Indica se il database deve inserire nella cache i set di numeri di sequenza generati in memoria
-
Indica se la sequenza deve essere ciclica quando viene raggiunto un limite
Nell'esempio seguente viene creata la sequenza customers_seq nello schema di esempio oe. Un'applicazione potrebbe utilizzare questa sequenza per fornire i numeri ID cliente quando le righe vengono aggiunte alla tabella customers.
CREATE SEQUENCE customers_seq
START WITH      1000
INCREMENT BY    1
NOCACHE
NOCYCLE;
Il primo riferimento a customers_seq.nextval restituisce 1000. Il secondo restituisce 1001. Ogni riferimento successivo restituisce un valore 1 maggiore del riferimento precedente.
Vedere anche:
-
Introduzione a Oracle AI Database Development per un'esercitazione che mostra come creare una sequenza
-
Oracle AI Database Administrator's Guide per informazioni su come fare riferimento a una sequenza in un'istruzione SQL
-
Oracle AI Database SQL Language Reference per sintassi e semantica
CREATE SEQUENCE
Accesso concorrente alle sequenze
Lo stesso generatore di sequenze può generare numeri per più tabelle.
Il generatore può creare automaticamente chiavi primarie e coordinare le chiavi su più righe o tabelle. Ad esempio, una sequenza può generare chiavi primarie per una tabella orders e una tabella customers.
Il generatore di sequenze risulta particolarmente utile in ambienti multiutente per generare numeri univoci senza il sovraccarico dell'I/O su disco o del blocco delle transazioni. Ad esempio, due utenti inseriscono contemporaneamente nuove righe nella tabella orders. Utilizzando una sequenza per generare numeri univoci per la colonna order_id, nessuno degli utenti deve attendere che l'altro inserisca il successivo numero d'ordine disponibile. La sequenza genera automaticamente i valori corretti per ogni utente.
Ogni utente che fa riferimento a una sequenza ha accesso al proprio numero di sequenza corrente, ovvero l'ultima sequenza generata nella sessione. Un utente può emettere un'istruzione per generare un nuovo numero di sequenza o utilizzare l'ultimo numero generato dalla sessione. Dopo che un'istruzione in una sessione genera un numero di sequenza, è disponibile solo per questa sessione. È possibile ignorare singoli numeri di sequenza se sono stati generati e utilizzati in una transazione di cui è stato eseguito il rollback finale.
Avvertenza: se l'applicazione richiede un set di numeri senza interruzioni, non è possibile utilizzare le sequenze Oracle. È necessario serializzare le attività nel database utilizzando il proprio codice sviluppato.
Vedi anche: "Concorrenza e coerenza dei dati" per scoprire come le sessioni accedono ai dati contemporaneamente
Panoramica delle dimensioni
Un data warehouse tipico ha due componenti importanti: dimensioni e fatti.
Una dimensione è qualsiasi categoria utilizzata per specificare le domande aziendali, ad esempio tempo, geografia, prodotto, reparto e canale di distribuzione. Un fatto è un evento o un'entità associata a un determinato set di valori dimensione, ad esempio unità vendute o profitti.
Esempi di richieste multidimensionali includono:
-
Mostra le vendite totali di tutti i prodotti a livelli di aggregazione crescenti per una dimensione geografica, da stato a paese a regione, per il 2013 e il 2014.
-
Crea un'analisi intertabulare delle nostre operazioni che mostri le spese per territorio in Sud America per il 2013 e il 2014. Includi tutti i totali parziali possibili.
-
Elenca i primi 10 rappresentanti commerciali in Asia in base ai ricavi di vendita per i prodotti automobilistici del 2014 e classifica le loro commissioni.
Molte domande multidimensionali richiedono dati aggregati e confronti di set di dati, spesso nel tempo, nell'area geografica o nei budget.
La creazione di una dimensione consente un uso più ampio della funzione di riscrittura delle query. Riscrivendo in modo trasparente le query per utilizzare le viste materializzate, il database può migliorare le prestazioni delle query.
-
Struttura gerarchica di una dimensione Una tabella delle dimensioni è una struttura logica che definisce le relazioni gerarchiche (padre/figlio) tra coppie di colonne o set di colonne.
-
Creazione di dimensioni Le dimensioni vengono create con l'istruzione SQL
CREATE DIMENSION. Vedi anche: Oracle AI Database Data Warehousing Guide per ulteriori informazioni sulle dimensioni
Struttura gerarchica di una dimensione
Una tabella dimensioni è una struttura logica che definisce relazioni gerarchiche (padre/figlio) tra coppie di colonna o set di colonna.
Ad esempio, una dimensione può indicare che all'interno di una riga la colonna city implica il valore della colonna state e la colonna state implica il valore della colonna country.
All'interno di una dimensione cliente, i clienti possono eseguire il rollup su città, stato, paese, sottoregione e area. L'analisi dei dati in genere inizia a livelli più alti nella gerarchia dimensionale e si espande gradualmente se la situazione richiede tale analisi.
Ogni valore al livello figlio è associato a un solo valore al livello padre. Una relazione gerarchica è una dipendenza funzionale da un livello di una gerarchia al livello successivo.
A una dimensione non è assegnata alcuna memorizzazione dati. Le informazioni dimensionali vengono memorizzate nelle tabelle dimensioni, mentre le informazioni fact vengono memorizzate in una tabella fact.
Vedere anche:
- Oracle AI Database Data Warehousing Guide per informazioni sulle dimensioni
Creazione di dimensioni
È possibile creare dimensioni con l'istruzione SQL CREATE DIMENSION.
Questa istruzione specifica:
-
più clausole
LEVEL, ognuna delle quali identifica una colonna o una serie di colonne nella dimensione; -
una o più clausole
HIERARCHYche specificano la relazione padre/figlio tra livelli adiacenti; -
clausole facoltative
ATTRIBUTE, ognuna delle quali identifica una colonna o un set di colonne aggiuntivo associato a un singolo livello
Per creare la dimensione customers_dim nello schema di esempio sh è stata utilizzata l'istruzione seguente:
CREATE DIMENSION customers_dim
   LEVEL customer   IS (customers.cust_id)
   LEVEL city       IS (customers.cust_city)
   LEVEL state      IS (customers.cust_state_province)
   LEVEL country    IS (countries.country_id)
   LEVEL subregion  IS (countries.country_subregion)
   LEVEL region     IS (countries.country_region)
   HIERARCHY geog_rollup (
      customer      CHILD OF
      city          CHILD OF
      state         CHILD OF
      country       CHILD OF
      subregion     CHILD OF
      region
   JOIN KEY (customers.country_id) REFERENCES country )
   ATTRIBUTE customer DETERMINES
   (cust_first_name, cust_last_name, cust_gender,
    cust_marital_status, cust_year_of_birth,
    cust_income_level, cust_credit_limit)
   ATTRIBUTE country DETERMINES (countries.country_name);
Le colonne in una dimensione possono provenire dalla stessa tabella (assenza di normalizzazione) o da più tabelle (normalizzazione completa o parziale). Ad esempio, una dimensione temporale normalizzata può includere una tabella data, una tabella mese e una tabella anno, con condizioni di join che collegano ogni riga data a una riga mese e ogni riga mese a una riga anno. In una dimensione tempo completamente denormalizzata, le colonne di data, mese e anno si trovano nella stessa tabella. Normalizzate o denormalizzate, le relazioni gerarchiche tra le colonne devono essere specificate nell'istruzione CREATE DIMENSION.
Vedi anche: Oracle AI Database SQL Language Reference per sintassi e semantica CREATE DIMENSION
Panoramica dei sinonimi
Un sinonimo è un alias per un oggetto dello schema. Ad esempio, è possibile creare un sinonimo per una tabella o vista, una sequenza, una program unit PL/SQL, un tipo di oggetto definito dall'utente o un altro sinonimo. Poiché si tratta semplicemente di un alias, un sinonimo richiede solo l'archiviazione della propria definizione nel dizionario dati.
I sinonimi possono semplificare le istruzioni SQL per gli utenti del database. I sinonimi sono utili anche per nascondere l'identità e la posizione di un oggetto schema di base. Se l'oggetto sottostante deve essere rinominato o spostato, è necessario ridefinire solo il sinonimo. Le applicazioni basate sul sinonimo continuano a funzionare senza modifiche.
È possibile creare sinonimi sia privati che pubblici. Un sinonimo privato è nello schema di un utente specifico che ha il controllo sulla sua disponibilità ad altri. Un sinonimo pubblico è di proprietà del gruppo di utenti denominato PUBLIC ed è accessibile da ogni utente del database.
Esempio 6-5 Sinonimo pubblico
Si supponga che un amministratore di database crei un sinonimo pubblico denominato people per la tabella hr.employees. L'utente si connette quindi allo schema oe e conta il numero di righe nella tabella a cui fa riferimento il sinonimo.
SQL> CREATE PUBLIC SYNONYM people FOR hr.employees;

Synonym created.

SQL> CONNECT oe
Enter password: password
Connected.

SQL> SELECT COUNT(*) FROM people;

  COUNT(*)
----------
       107
Usa i sinonimi pubblici con parsimonia perché rendono più difficile il consolidamento del database. Come mostrato nell'esempio riportato di seguito, se un altro amministratore tenta di creare il sinonimo pubblico people, la creazione non riesce perché nel database può esistere un solo sinonimo pubblico people. L'uso eccessivo di sinonimi pubblici causa conflitti di spazio dei nomi tra le applicazioni.
SQL> CREATE PUBLIC SYNONYM people FOR oe.customers;
CREATE PUBLIC SYNONYM people FOR oe.customers
                      *
ERROR at line 1:
ORA-00955: name is already used by an existing object

SQL> SELECT OWNER, SYNONYM_NAME, TABLE_OWNER, TABLE_NAME
  2  FROM DBA_SYNONYMS
  3  WHERE SYNONYM_NAME = 'PEOPLE';

OWNER      SYNONYM_NAME TABLE_OWNER TABLE_NAME
---------- ------------ ----------- ----------
PUBLIC     PEOPLE       HR          EMPLOYEES
I sinonimi non sono sicuri. Quando si concedono privilegi di oggetto su un sinonimo, si concedono privilegi sull'oggetto di base. Il sinonimo agisce solo come alias per l'oggetto nell'istruzione GRANT.
Vedere anche:
-
Oracle AI Database Administrator's Guide per informazioni su come gestire i sinonimi
-
Oracle AI Database SQL Language Reference per sintassi e semantica
CREATE SYNONYM