データ・サブセット化の概要
データ・サブセット化(単に「サブセット化」とも呼ばれる)では、参照整合性とアプリケーションが正しく機能するために必要な関係を維持しながら、本番データからより小さく代表的なデータセットが作成されます。開発、テスト、分析、またはモデル・トレーニングに必要なデータのみを抽出し、環境のプロビジョニングを加速し、コストを削減し、機密データへの露出を最小限に抑えることができます。非本番環境では、サブセット化をデータ・マスキングと組み合せて保護を強化できます。
課題と解決策
データ量と複雑さが増すにつれ、開発とテスト用にデータベース・コピー全体を作成することは、時間がかかり、コストがかかり、効率が悪くなります。Oracle Data Safeのデータ・サブセット化機能を使用すると、開発者は参照整合性を保持する、より小規模な集中コピーを使用してデータベースを迅速にプロビジョニングできます。チームは、各開発者に専用のテスト環境を提供できるため、競合が減り、開発者の変更が他の開発者の作業に影響を及ぼさないようにできます。これらのコピーは軽量で迅速に作成できるため、チームは頻繁にリフレッシュできます。セルフサービス・プロビジョニングが有効な場合、開発者はオンデマンドでデータベース・コピーを作成することもできます。
アプリケーション・テストの場合、サブセット化は、本番データで見つかった実際のバリエーションを保持するため、合成データまたはマスキングされたデータのみよりも、より現実的で信頼性の高いテスト・データを提供できます。これらのバリエーションを再現するマスキングされたデータセットまたは合成データセットの作成は困難であり、フルサイズのデータベースのクローニングおよびマスキングには時間がかかる可能性があります。サブセットにより、各テスト・シナリオに必要なデータを保持しながら、テスト・データのサイズが小さくなります。
ユース・ケース
サブセッティングの主なユース・ケースは次のとおりです。
- より高速でセキュアなアプリケーション・テスト
- ビジネス分析のためのターゲット・データ抽出
- モデルのトレーニングと検証
- データ主権
より高速でセキュアなアプリケーション・テスト
より高速でセキュアなアプリケーション・テスト、開発およびQAを実現するために、テスト・チームは完全な本番データベースではなく、小規模で参照可能な無傷のデータセットを使用できます。多くの場合、テスト環境では大きすぎ、コストがかかり、リスクが高くなります。サブセッティングにより、正確なテスト、テストサイクルの短縮、インフラストラクチャ、ストレージ、処理コストの削減、機密データを公開するリスクの低減を実現しながら、これらのデータセットの管理が容易になります。
たとえば、元のデータセットに1,000万人の顧客、1億件の注文、および50TBを占める1億件のトランザクション・レコードが含まれているとします。サブセッティング・ポリシーでは、行の1%を選択し、マスキング・ポリシーを適用して、100,000人の顧客、100万件の注文および100万件のトランザクション・レコードを含む、より小さくマスクされたデータセットを生成できます。結果のデータセットは、次に示すように50 GBを占有します。
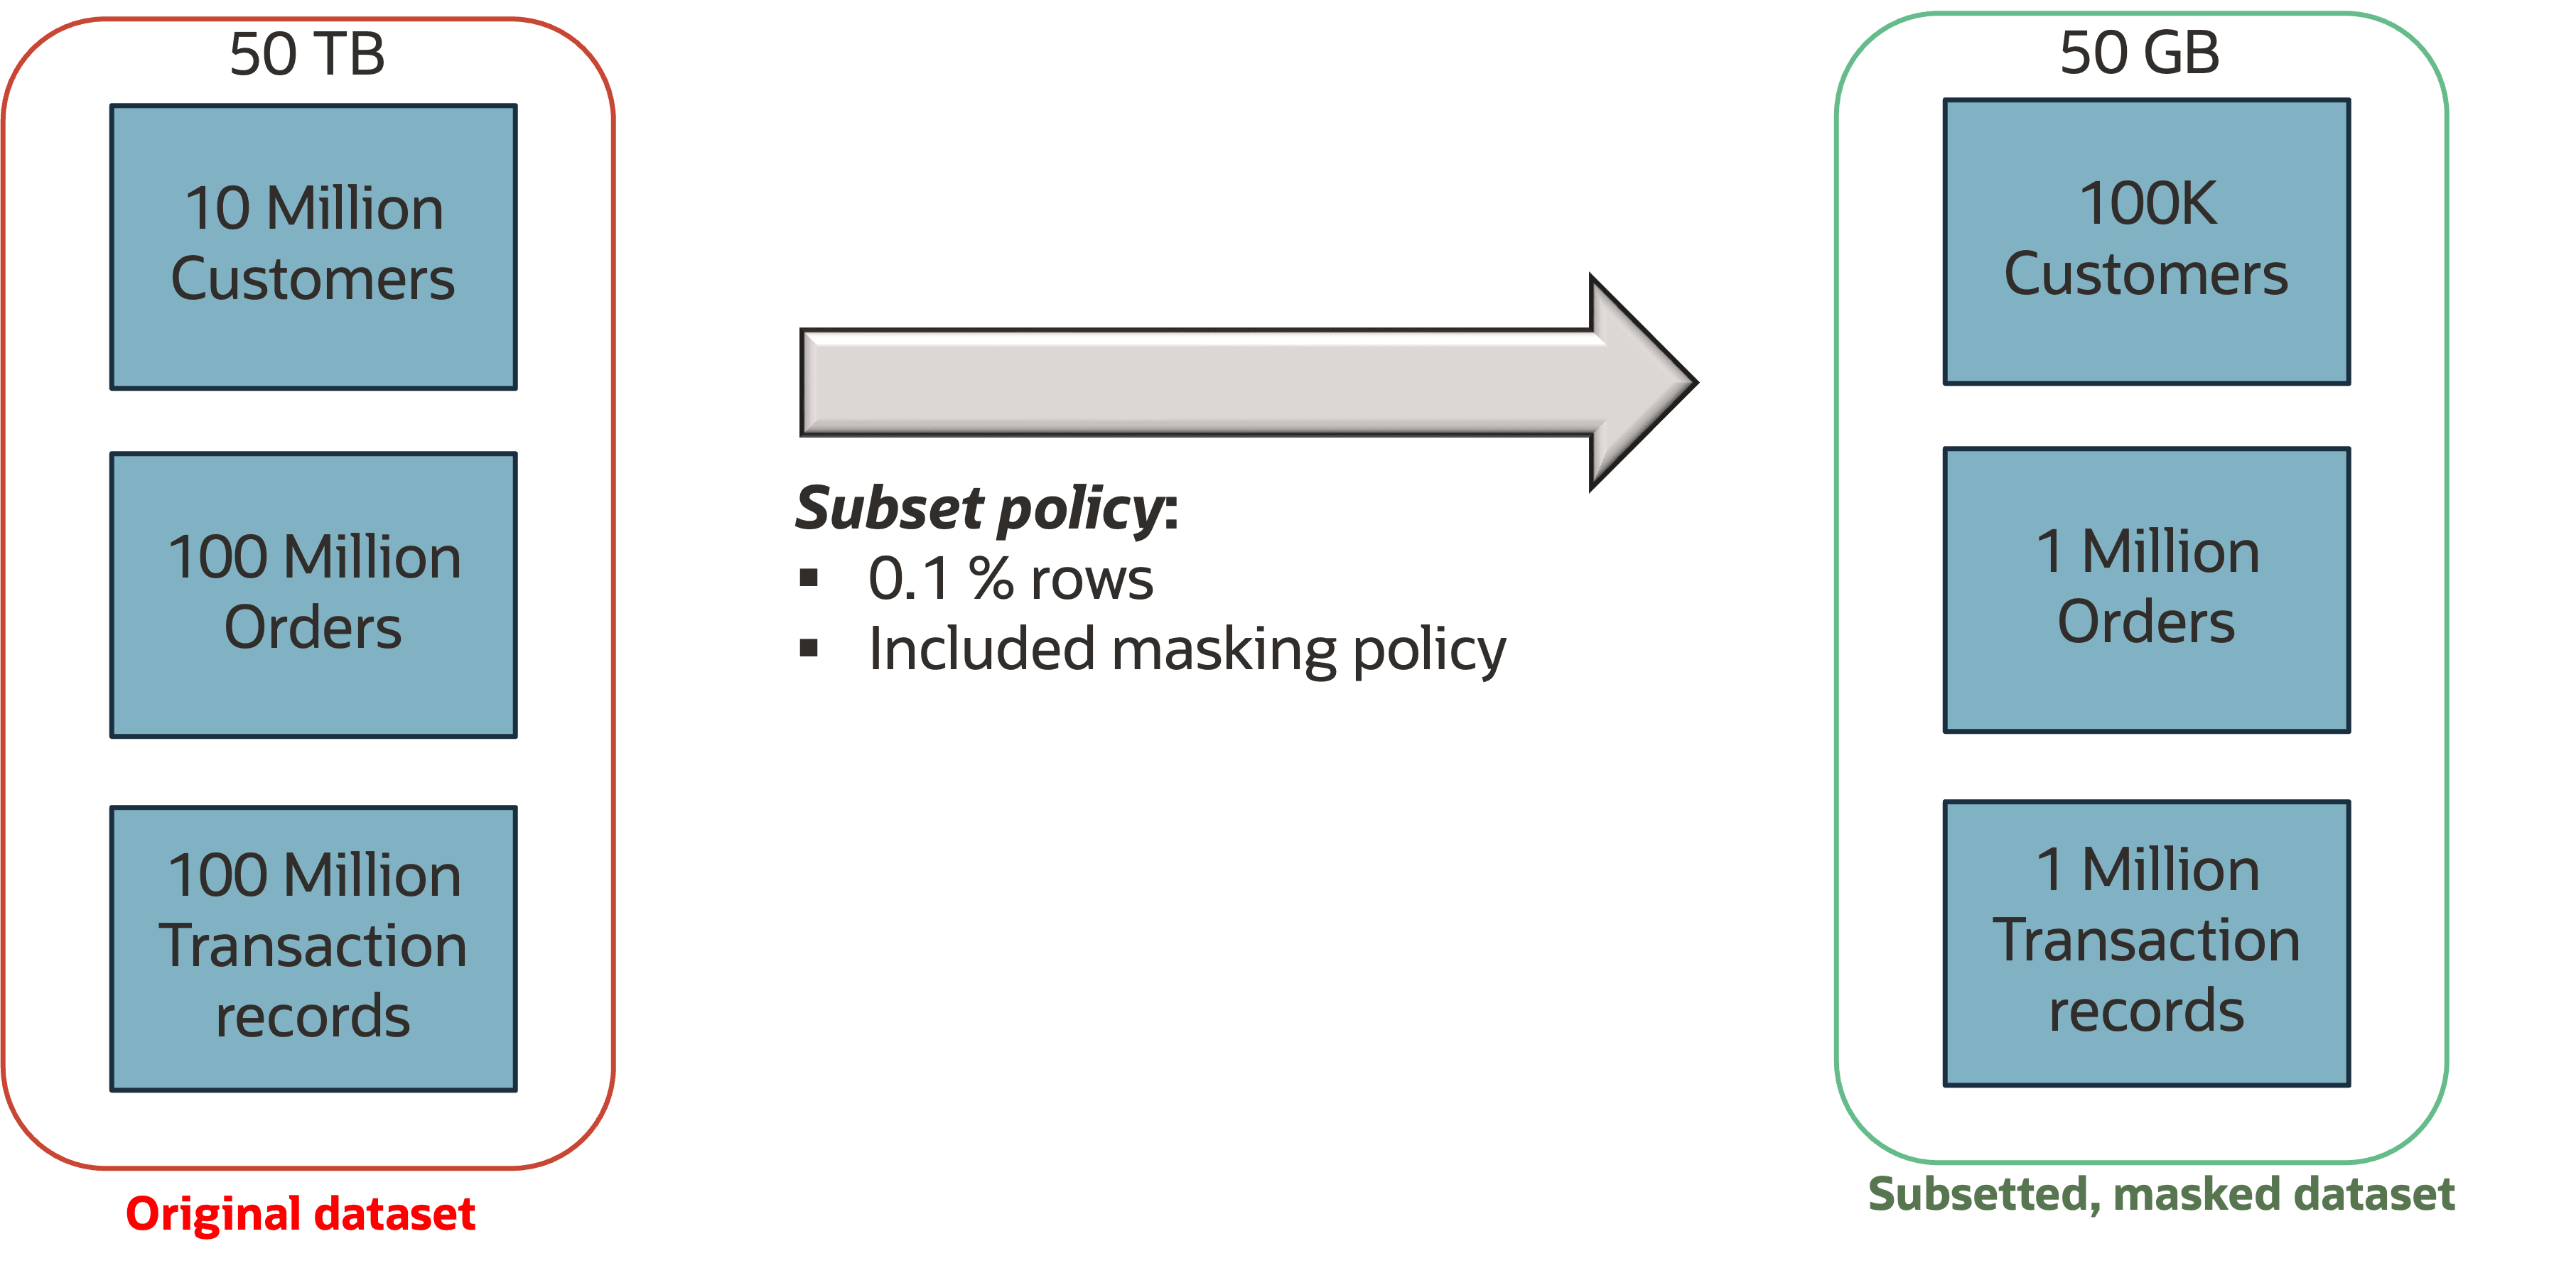
図faster-secure-application-testing.pngの説明
ビジネス分析のターゲット・データ抽出
ターゲットを絞ったビジネス分析のために、組織は期間や地域などの条件付き抽出を使用して、データ整合性を維持しながら、集中的なデータセットをアナリストに提供できます。このアプローチにより、完全なデータセットを分析するというパフォーマンス上の課題を回避し、地域の売上や四半期ごとの傾向などの領域に対する的を絞ったインサイトを可能にするとともに、最も関連性の高いデータのみを処理することで分析を迅速化します。
たとえば、財務アナリストは、sale_year = 2024やquarter = 'Q4'などの特定の年および四半期でフィルタリングすることで、四半期ごとの売上データからターゲット・データセットを作成できます。同様に、医療アナリストはPATIENTSおよびTREATMENT表を患者の年齢および診断でフィルタし、特定のグループの治療結果を分析しながら、患者とその治療記録との関係を維持できます。この例を次に示します。
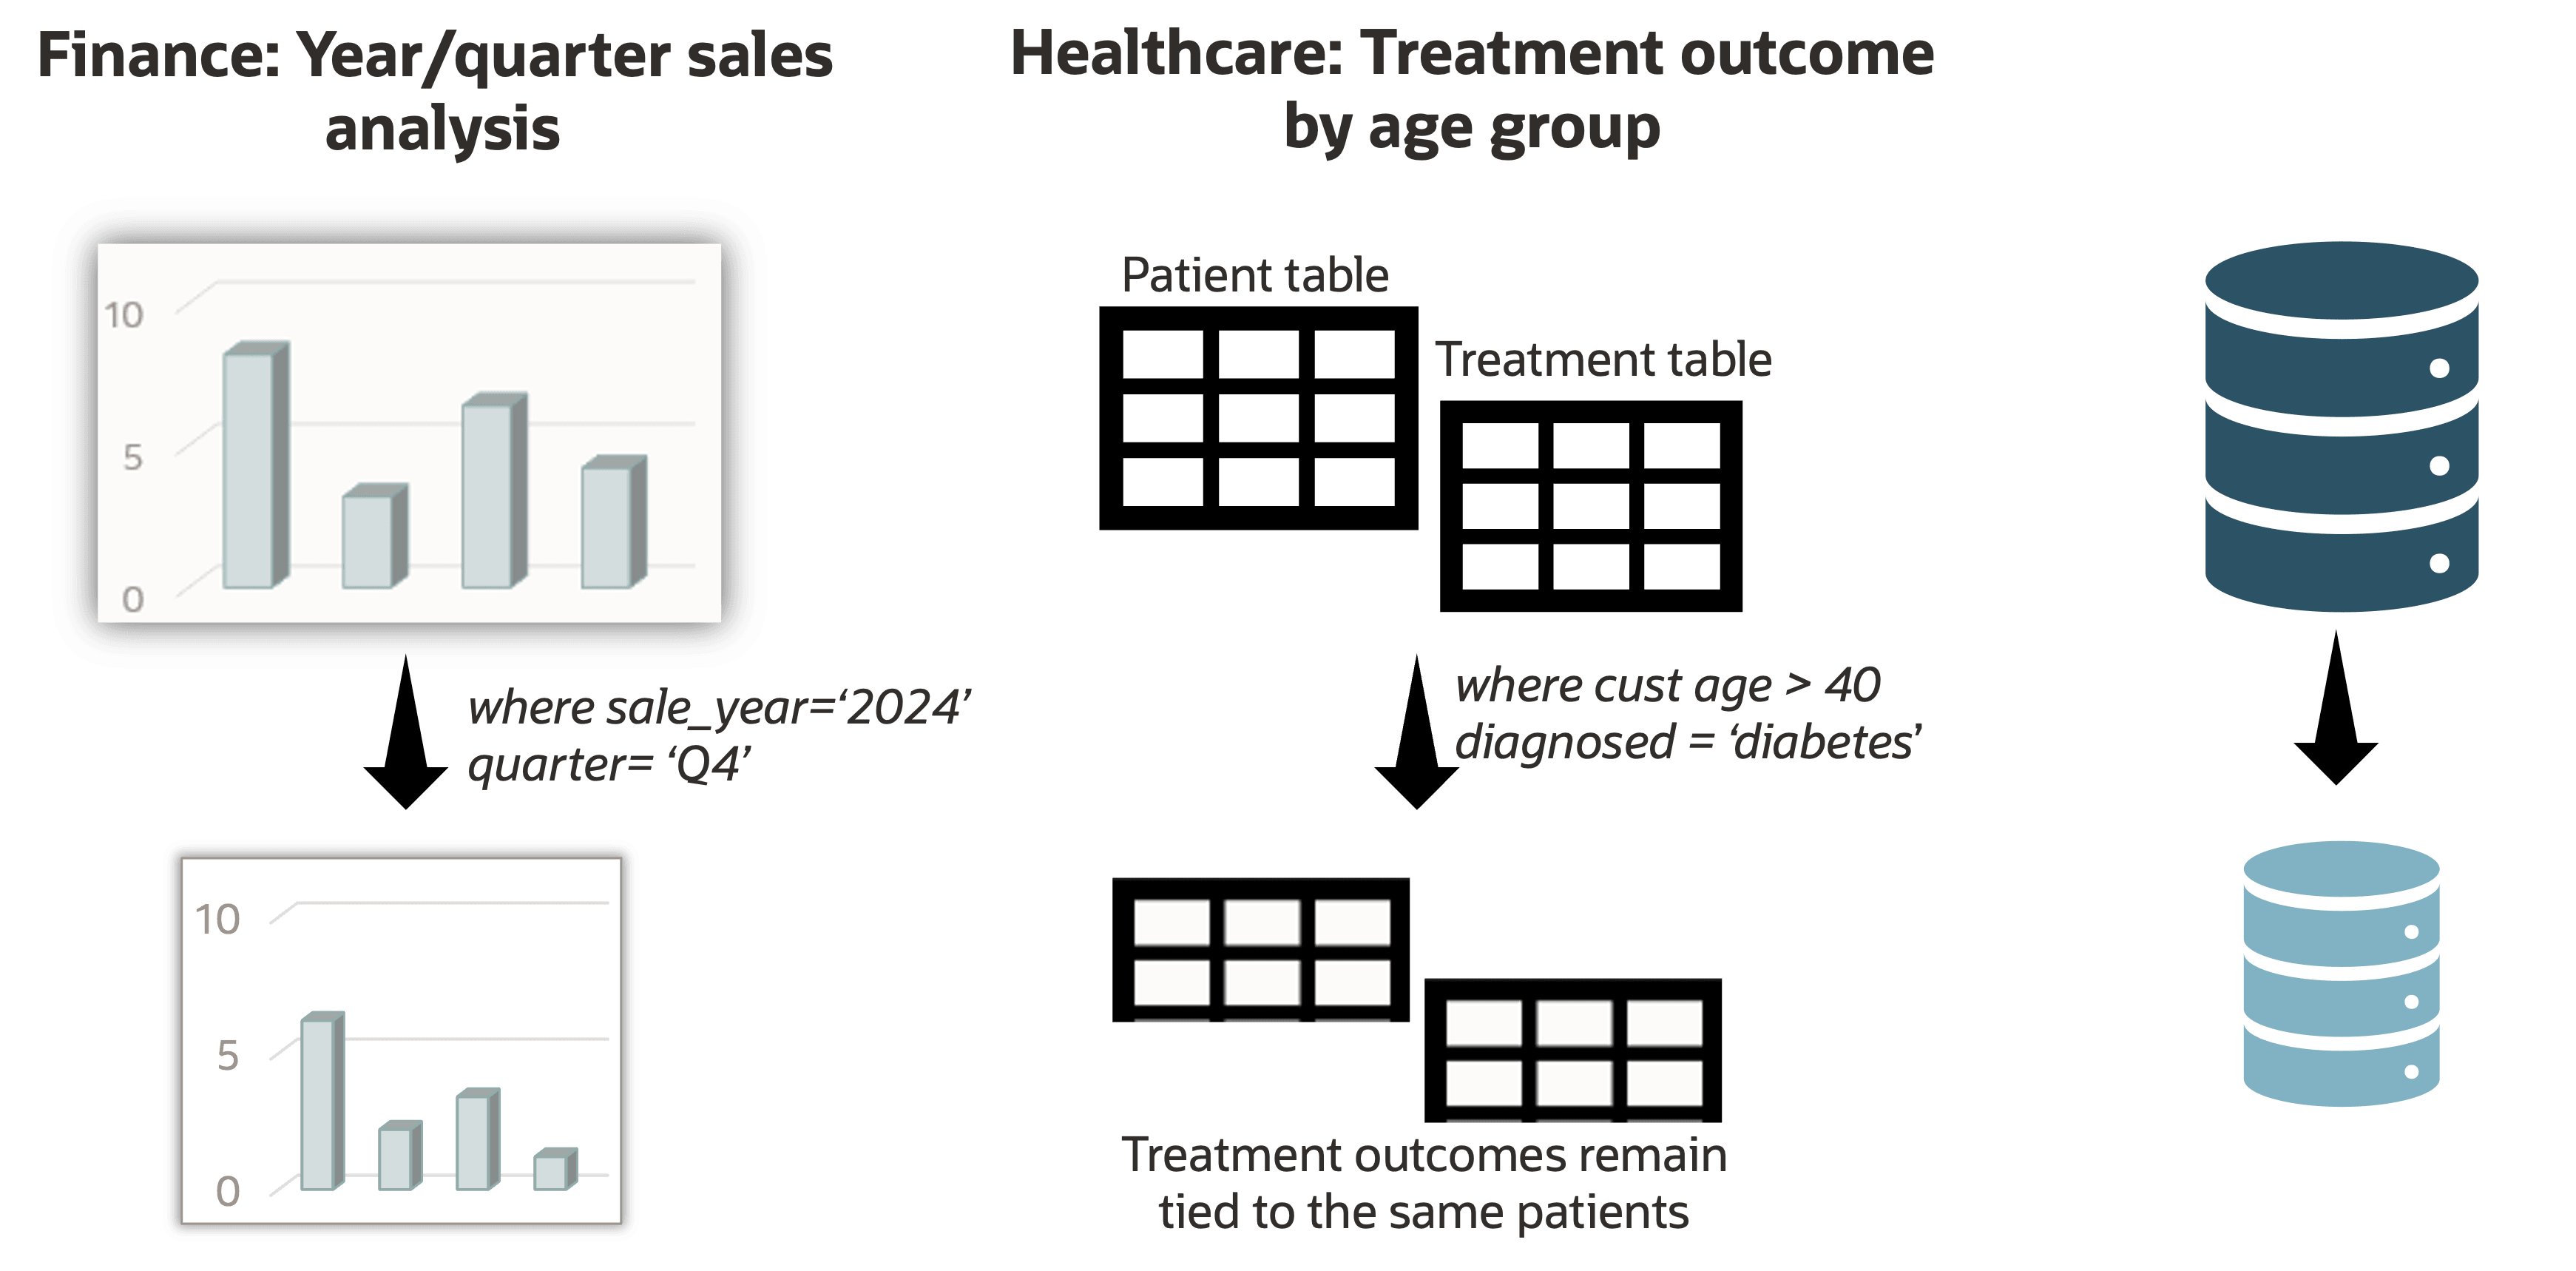
図targeted-data-extraction-for-business-analysis.pngの説明
データの主権
データ主権のために、組織はパートナー、顧客、オフショアチームに、必要な特定のデータのみを提供し、法的にアクセスを許可することができます。このアプローチは、コンプライアンスを簡素化し、データ・エクスポージャを最小限に抑え、慎重にスコープ指定されたサブセットを介したより安全なデータ共有をサポートします。
サブセット・ポリシー
サブセッティング・ポリシーは、ターゲット・データセットの作成に使用されるソース・スキーマ、データ選択ルール、表の関係および処理オプションを定義します。リレーションシップ・グラフおよび処理チェーンは、ジョブを実行する前にデータのサブセット化方法を理解し、検証するのに役立ちます。
サブセット・ポリシー・スコープ
サブセッティング・ポリシーは、機密データ・モデル(SDM)またはターゲット・データベース・スキーマのいずれかを使用して作成できます。
- SDM: SDMで定義されたスキーマおよび関係は、ポリシーに自動的に追加されます。
- ターゲット・データベース:ポリシーに含める特定のスキーマを選択するか、すべてのスキーマを選択できます。
サブセット化ルール
サブセッティング・ルールでは、含めるデータとその処理方法を指定します。ルールを作成するためのワークフローは、駆動表を選択し、ルールを定義してから、関連表の処理オプションを定義することから始まります。駆動表は、データの選択および伝播の開始点として機能するサブセット化表であり、サブセット化ポリシーに含める特定のスキーマを選択した場合に必要です。サブセッティング・ジョブを実行する前に、予想される影響をビジュアル化し、必要に応じてルールを変更し、処理順序を確認できます。
次の表では、パーセンテージ、条件またはその両方でルールを定義する方法について説明します。
| ルール・タイプ | 説明 | 例 |
|---|---|---|
| パーセント | 表から指定された行の割合を選択します。 | EMPLOYEES表の10%を選択します。 |
| 条件 | 指定されたWHERE条件を満たす行を選択します。 |
WHERE SALES_REGION = 'EMEA' |
| 条件と割合 | 指定されたWHERE条件を満たす行を選択し、表から指定された割合の行を選択します。 |
WHERE REGION_ID = 'EMEA': フィルタされたEMEA行の10%を選択します。 |
ルールを次の種類の関連表に伝播するかどうかを指定するオプションがあります。これらの関連表に指定されたオプションは、選択したオプションの組合せに対して整合性が損なわれないようにします。
- 祖先:ルールを親表に伝播します(駆動表が依存する表)。参照された行のみを保持するか、すべての行を保持できます(デフォルト)。
- 子孫:子表(駆動表に依存する表)にルールを伝播します。参照行のみを保持するか(デフォルト)、すべての行を削除できます。
- その他の関連表:駆動表に関連する表にルールを伝播します(祖先パスと子孫パスを除く)。可能な最大行数を保持するか、サブセット・ルールを伝播するか(駆動表の保持された行(デフォルト)に関連する他の関連表の関連行のみを保持するか)、最小行数を保持できます。
関連グラフ
関係グラフは、次の図に示すように、選択したスキーマ内の表間の関係を表示します。これは、ポリシーの作成時に生成されます。リレーションシップ・グラフを使用して、データ・リレーションシップがサブセット化およびルールの伝播にどのように影響するかを理解できます。
- 「ボックス」は表を表します。ドライビングテーブルは緑色。古代のテーブルは青い。下位表はオレンジです。他の関連表は灰色です。一時表、外部表、ネストした表、AQキュー表、マテリアライズド・ビュー、IOTオーバーフロー表、属性クラスタ化されたヒープ表、ブロックチェーン表および不変表はサポートされません。
- 「行」は、表間の関係を表します。実線は、データベース・レベルの関係です。点線はアプリケーション・レベルの関係で、関係がターゲット・データベースに定義されていない2つの列間の関係です。サブセッティング・ポリシーの作成時およびデータ検出で、アプリケーション・レベルの関係およびコンポジット関係を定義できます。
リレーションシップ・グラフを表示するときに、サブセット化中に関連表がどのように処理されるかを構成できます。参照整合性の保持に必要な最小行数を保持したり、サブセッティング・ルールを他の関連表に伝播したり(デフォルト)、参照整合性を損なうことなく可能な最大行数を保持できます。
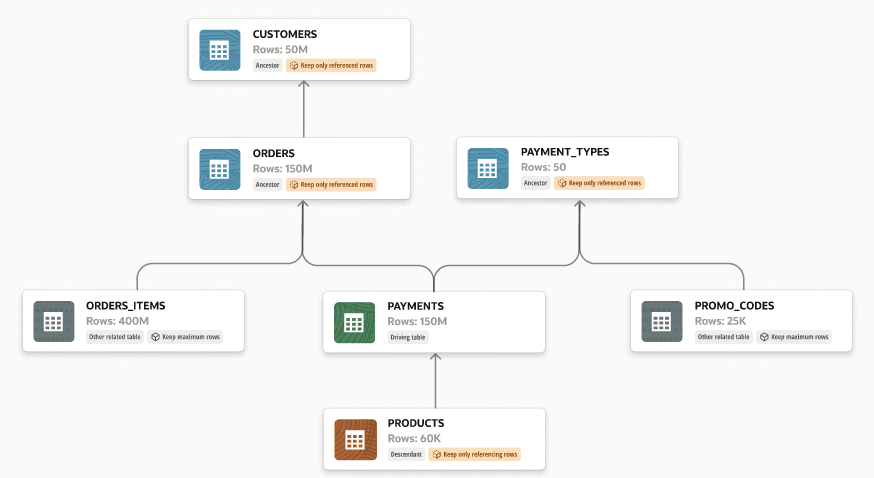
図relationship-graph-data-subsetting.pngの説明
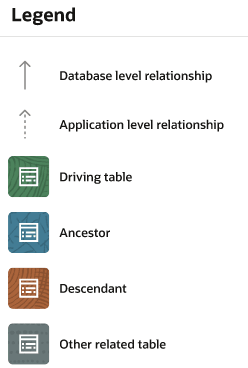
図relationship-graph-legend.pngの説明
処理シーケンス
「処理順序」には、サブセッティング・ルールに対して表の関係が処理される順序が表示されます。これは、ルールの作成時に生成され、ポリシーが予期した結果を生成することを確認するのに役立ちます。
高度なサブセット化機能
サブセッティングには、次の高度な機能が含まれます。
-
サブセット化される表に関連しない表に対するルールの構成:関連のない表の場合、すべてのデータを保持するか、データベース内の関連のない表からすべての行を完全に削除するかを選択できます。デフォルトでは、すべてのデータが保持されます。
-
並列度の構成:この機能を使用すると、データのサブセット化中にパラレル実行を制御できます。指定できる値は「なし」(並列度なし)、「デフォルト」(Oracle Databaseが最適な並列度を選択)です。これはデフォルトで選択されています。または、1つの操作のパラレル実行サーバーの数を指定する整数です。
-
サブセット化中のREDOログ生成の無効化:デフォルトでは、サブセット化によってREDOおよびフラッシュバック・ロギングが無効になり、元のデータがログからパージされます。ロールバック/再試行が必要なテスト・シナリオでは、ロギングを有効にし、フラッシュバック・データベースを使用して、サブセット化後に元のデータをリカバリできます。このオプションは、デフォルトでは選択されません。
-
無効なオブジェクトの再コンパイル:サブセット後に無効なオブジェクトを再コンパイルする方法を選択できます。オプションには、コンパイルしない、順次再コンパイルする、並行して再コンパイルするなどがあります。デフォルトでは、「なし」が選択されています。
-
サブセット化後に統計をリフレッシュ:データ削減後に、サブセット化された表のデータベース・オプティマイザ統計をリフレッシュするように選択できます。これにより、正確な問合せ計画が保証されますが、処理時間が長くなる可能性があります。このオプションは、デフォルトでは選択されません。
-
ユーザーのデフォルト表領域の自動使用:サブセッティング・ジョブ中にカスタム表領域が指定されていない場合、サブセット化に使用されるデータベース・ユーザーのデフォルト表領域がジョブに自動的に使用されます。
-
複雑なフィルタリング:データ・サブセッティングでは、ソース・データの取得時に
WHERE句に変換できる複雑なフィルタリング基準がサポートされます。正確なフィルタの作成を支援するために、インタフェースは表の列および関係を表示し、構文を検証し、エラーを識別できます。フィルタでは、静的値または個別に定義されたパラメータを使用できるため、従業員IDなどの値を簡単に指定および更新できます。 -
サブセッティング前およびサブセッティング後スクリプト:サブセッティング・プロセスの前または後に実行するようにスクリプトを構成できます。これらのオプションはデフォルトでは構成されていません。
-
サブセッティングを使用したデータ・マスキング:サブセッティング操作の後でデータ・マスキングを実行するようにサブセッティング・ジョブを構成できます。このオプションは、マスキング・ポリシーがサブセッティング・ポリシーに関連付けられている場合にデフォルトで有効になります。
サブセット・ジョブ
サブセッティング・ジョブを開始または中止し、経過時間、推定完了時間、完了ステップ、現在のステップ、残りのステップなど、その進行状況をモニターできます。ジョブが終了したら、そのログをダウンロードできます。
サブセッティング・ジョブを開始すると、サブセッティング事前チェックが自動的に実行され、潜在的な問題が識別されます。サブセット化準備レポートを生成して、事前に実行することもできます。事前チェックを実行するには、サブセット化ポリシーが必要です。
サブセッティング・ジョブが完了すると、サブセット化レポートを表示できます。このレポートは、PDFまたはXLS形式で生成およびダウンロードできます。
サブセット・ワークフロー
サブセッティングは、ターゲット・データ・サブセットを作成および管理するためのエンドツーエンドのワークフローを提供します。
Oracleでは、次のアプローチおよびワークフローを使用してOracle Data Safeでデータをサブセット化することをお薦めします。
-
重要:本番データベースのバックアップを作成します。たとえば、Recovery Manager (RMAN)およびOracle Cloud Storageサービス(または他のバックアップの場所)を使用して、本番バックアップを作成および格納できます。実際の本番データベースをサブセット化することは避けてください。
-
本番データベースのバックアップをクローニングし、ステージ・データベースを作成します。ステージ・データベースをユーザーに公開しないでください。サポートされているサービスを使用して、ステージ・データベースをOracle Cloudで作成します。
-
ステージ・データベースをOracle Data Safeに登録します。
-
SDMを使用してサブセット化ポリシーを作成する場合は、ステージ・データベースで機密データを検出し、機密データ・モデルを生成します。データ検出の使用を参照してください。
-
データのサブセット化時にデータ・マスキングを実行する場合は、マスキング・フォーマット(必要な場合)とマスキング・ポリシーを作成します。マスキング前チェックを実行し、修正の推奨事項をすべて完了します。「データ・マスキングを使用した新しいマスキング・フォーマットの作成」、「データ・マスキングを使用したマスキング・ポリシーの作成」および「マスキング前チェック」を参照してください。
-
サブセッティング・ジョブを構成および実行するには、次の2つのオプションがあります。
-
オプション1:ウィザードを使用してデータベースをサブセット化します。ウィザードでは、すべてのサブセッティング・オプションを構成し、サブセッティング・ジョブを実行できます。サブセッティング・ジョブが実行される前に、準備状況チェックが自動的にトリガーされます。データベースのサブセット化を参照してください。
-
オプション2:最初にサブセッティング・ポリシーを作成し、手動でサブセッティング準備状況チェックを実行して、データベースまたはサブセッティング・ポリシーの問題を修正してから、サブセッティング・ジョブを実行します。「サブセット化ポリシーの作成および管理」、「サブセット化準備レポートの実行および管理」、「データベースのサブセット化」を参照してください。
-
Oracle Data Safeでデータ・サブセットを使用するための前提条件
Oracle Data Safeのデータ・サブセット化機能を使用するための前提条件は次のとおりです:
-
データ・サブセッティングで使用するターゲット・データベースを登録します。
-
データ・サブセット化にはターゲット・データベース資格証明が必要です。
-
ターゲット・データベースでデータ・サブセッティング・ロール(
DS$DATA_SUBSETTING_ROLE)を付与します。データベース管理者は、このロールをターゲット・データベースのOracle Data Safeサービス・アカウントに付与できます。サブセットする表にLONGデータ型列が含まれている場合は、データベース・ユーザーにDELETE ANY TABLE権限を付与する必要もあります。 -
Oracle Data Safeのデータ・サブセッティング機能を使用するためのOracle Cloud Infrastructure Identity and Access Management (IAM)の権限を取得します。OCI管理者は、これらの権限を付与できます。これらのリソースには権限が必要です:
-
data-safe-subsetting-policies -
data-safe-subsetting-reportsデータ・サブセット化を実行するには、ターゲット・データベースのコンパートメント内の
data-safe-subsetting-reportsに対するmanage権限が必要です。 -
data-safe-subsetting-policy-health-report -
data-safe-work-requests
-
-
(オプション) Oracle Data Safeのデータ・マスキング機能を使用するためのIAMの権限を取得します。データ・マスキングは、データ・サブセット化とともに使用できます。
-
data-safe-masking-policies -
data-safe-masking-reportsデータ・マスキングを実行するには、ターゲット・データベースのコンパートメント内の
data-safe-masking-reportsに対するmanage権限が必要です。 -
data-safe-masking-policy-health-report -
data-safe-library-masking-formats
権限を選択的に付与するかわりに、関連するコンパートメントの
data-safe-subsetting-familyおよびdata-safe-masking-familyに対する権限を付与できます。これには、前述のすべてのリソースに対する権限が含まれます。data-safe-subsetting-family Resourceおよびdata-safe-masking-family Resourceを参照してください。 -