Oracle AI Databaseの概要
この章では、Oracle AI Databaseの概要について説明します。
この章には次のトピックが含まれます:
-
情報システムについてどの組織にも、その要件を満たすために格納し管理する必要がある情報があります。たとえば、会社では従業員の人事管理レコードを収集し、管理する必要があります。この情報は、必要とする人が使用できるようにする必要があります。
-
スキーマ・オブジェクト RDBMSの特性の1つは、物理データ記憶域は論理データ構造から独立しています。
-
データ・アクセスDBMSの一般的な要件は、データ・アクセス言語に関して、業界が認められている標準に準拠していることです。
-
トランザクションの管理Oracle AI Databaseはマルチユーザー・データベースとして設計されています。データベースは、複数のユーザーが互いのデータを破損することなく同時に作業できることを保証する必要があります。
-
Oracle AI Databaseアーキテクチャデータベース・サーバーは、情報管理のキーです。
情報システムについて
すべての組織には、その要件を満たすために格納および管理する必要のある情報があります。たとえば、会社では従業員の人事管理レコードを収集し、管理する必要があります。この情報は、必要とする人が使用できるようにする必要があります。
情報システムとは、情報を格納および処理する形式が定まったシステムです。データベースとは、1つの単位として取り扱われる編成されたデータの集合です。データベースの目的は、データベース・アプリケーションで使用するための関連情報の収集、格納、および取得です。
データベース・システムが最初に発明されたときは、特定のワークロード用に設計されています。長年にわたり、単一目的データベースはすべての要件を満たさなくなったことが明らかになりました。リレーショナル・ワークロードに加えて、開発者はXML、空間、グラフ、JSONなどの他の形式でデータを格納する必要があり、最近ではAI時代のベクトル・データを格納する必要がありました。
Oracle AI Databaseは、リレーショナル・データベース・エンジンからコンバージド・エンジンまで開発されており、開発者はほぼすべてのタイプのデータをアプリケーションに必要な形式でネイティブに格納し、エンタープライズ・グレードのアーキテクチャに完全に統合できます。
-
データベース管理サービス(DBMS)データベース管理システム(DBMS)とは、データの格納、編成および取得を制御するソフトウェアです。
-
リレーショナル・モデル1970年準の論文「A Relational Model of Data for Large Shared Data Banks」において、E. F. Codd、同数的な集合理論に基づいてリレーショナル・モデルを定義した。今日、最も普及しているデータベース・モデルはリレーショナル・モデルです。
-
リレーショナル・データベース管理システム(RDBMS)リレーショナル・モデルは、リレーショナル・データベース管理システム(RDBMS)の基礎です。RDBMSではデータをデータベース内に移動して格納し、それを取り出してアプリケーションで操作できるようにします。
データベース管理システム(DBMS)
データベース管理システム(DBMS)とは、データの格納、編成および取得を制御するソフトウェアです。
通常、DBMSの要素は次のとおりです。
-
カーネル・コード
このコードでは、DBMS用のメモリーと記憶域を管理します。
-
メタデータのリポジトリ
このリポジトリは、通常、データ・ディクショナリまたはメタデータ・カタログと呼ばれます。
-
言語の問合せ
問合せ言語を使用すると、データへのアクセスが容易になります。Oracle AI Databaseなどのコンバージド・データベースは、複数のクエリ言語をサポートしています。
データベース・アプリケーションとは、データにアクセスして操作するためにデータベースと対話するソフトウェア・プログラムである。Oracle AI Databaseは、リレーショナル・モデルをサポートする最初のデータベース・エンジンの1つでした。創業以来、コンバージド・データベース・エンジンへと進化し、ほぼすべてのデータ型と多くの多様なワークロードをサポートします。
リレーショナル・モデル
独創性に富む1970年度の論文「A Relational Model of Data for Large Shared Data Banks」において、E. F. Codd、数学的な集合理論に基づいてリレーショナル・モデルを定義した。今日、最も普及しているデータベース・モデルはリレーショナル・モデルです。
リレーショナル・データベースとは、リレーショナル・モデルに準拠したデータベースである。リレーショナル・モデルには次の特徴があります。
-
構造体
詳細に定義されたオブジェクトによって、データベースのデータの格納またはアクセスが行われます。
-
操作
明確に定義されたアクションによって、アプリケーションはデータベースのデータおよび構造を操作できます。
-
整合性規則
整合性規則は、データベースのデータおよび構造に対する操作を制御します。
リレーショナル・データベースでは、データは一連の単純なリレーションに格納されます。リレーションは、タプルのセットです。タプルは、順不同の一連の属性値です。
表は、行(タプル)と列(属性)の形式でのリレーション(2次元表現)です。表の各行は同じ一連の列を持ちます。リレーショナル・データベースは、データをリレーション(表)に格納するデータベースです。たとえば、リレーショナル・データベースで会社の従業員に関する情報を従業員表、部門表、および給与表に格納できます。
関連項目
リレーショナル・データベース管理システム(RDBMS)
リレーショナル・モデルは、リレーショナル・データベース管理システム(RDBMS)の基礎です。RDBMSではデータをデータベース内に移動して格納し、それを取り出してアプリケーションで操作できるようにします。
RDBMSでは、次のように操作のタイプが区別されます。
-
論理操作
この場合、アプリケーションは、必要な内容を指定します。たとえば、従業員の名前を要求したり、従業員レコードを表に追加します。
-
物理操作
この場合、RDBMSは、どのように実行すべきかを判断して演算を実行します。たとえば、アプリケーションが表に問合せを実行すると、データベースの索引を使用して要求した行が検索され、データがメモリーに読み込まれ、その他多くのステップが実行されてからユーザーに結果が戻されます。RDBMSがデータの格納と取得を行うため、物理演算はデータベース・アプリケーションに対して透過的です。
Oracle AI Databaseは、その中核となるRDBMSです。ユーザー定義型、継承、ポリモフィズムなどのオブジェクト指向機能を実装したRDBMSは、オブジェクト・リレーショナル・データベース管理システム(ORDBMS)と呼ばれます。Oracle AI Databaseはリレーショナル・モデルをオブジェクト・リレーショナル・モデルに拡張し、複雑なビジネス・モデルをリレーショナル・データベースに格納できるようにします。時間の経過とともに、Oracleのコア・データ・エンジンは、今ではコンバージド・データベースと呼ばれる、より強力なモデルへと進化してきました。
コンバージド・データベースのアーキテクチャ
Oracle AI Databaseは、単一のデータベース・エンジンで複数のデータ・モデルとワークロードをサポートするコンバージド・データベースです。リレーショナル・データに加えて、JSONドキュメント、グラフ・データ、空間データ、テキスト、ベクトル、その他の特殊なデータ型を管理できます。
これらの機能は、トランザクション、セキュリティ、バックアップとリカバリ、高可用性、監査、問合せの最適化など、一般的なデータベース・サービスを共有します。したがって、アプリケーションはそれぞれに個別のデータベースを必要とせずに、異なるデータ・モデルを使用できます。
たとえば、アプリケーションは、顧客およびトランザクション・データをリレーショナル表に格納し、JSONドキュメントの柔軟な属性、空間データとしての地理情報、セマンティック検索のためのベクトル埋込みを格納できます。SQLを使用して、これらの形式のデータを1回の操作で問合せおよび結合できます。このNoSQLスタイルを好む開発者は、ドキュメント・スタイルのAPIを使用できます。
コンバージド・データベースには次の利点があります。
- 専用システム間のデータ移動の削減
- 一貫したセキュリティとガバナンス
- 関連データ間の統合トランザクション
- アプリケーションと運用アーキテクチャの簡素化
- 複数のデータ型の統合分析
- データベース操作の統合監査
Convergenceでは、すべてのワークロードがすべての機能を使用したり、1つの物理データベースに存在したりする必要はありません。アプリケーションは、必要な機能のみを使用できます。Oracleの柔軟なアーキテクチャにより、開発者はアプリケーションを複数のプラガブル・データベースに分散できます。
Oracle Databaseは依然としてリレーショナル中心です。コンバージド・アーキテクチャは、ほぼすべてのワークロードに対応した共通のデータベース・サービス・セットを使用しながら、アプリケーションが複数のデータ・モデルと連携できるように、その基盤を拡張します。
スキーマ・オブジェクト
RDBMSの特性の1つは、物理データ記憶域が論理データ構造から独立していることです。
Oracle AI Databaseにおいて、データベース・スキーマとは、論理データ構造またはスキーマ・オブジェクトのコレクションです。データベース・ユーザーは、データベース・スキーマを所有します。データベース・スキーマの名前は、ユーザー名と同じです。
スキーマ・オブジェクトは、ユーザーが作成する構造であり、データベース内のデータを直接参照します。データベースは多くのタイプのスキーマ・オブジェクトをサポートしますが、最も重要なのは表と索引です。データにアクセスするためにドキュメント・スタイルのAPIを希望するユーザーは、(JSON)コレクションまたはJSONリレーショナル二面性ビューを作成できます。
スキーマ・オブジェクトは、データベース・オブジェクトの一種です。プロファイルやロールなど、一部のデータベース・オブジェクトは、スキーマに常駐しません。
関連項目
テーブル
表は従業員などのエンティティを表します。
表は、employeesなどの表名と列セットを使用して定義します。通常、表を作成するとき、各列に名前、データ型、および幅を指定します。
表は行の集合です。列は、表によって記述されるエンティティの属性を識別する一方、行は、エンティティのインスタンスを識別します。たとえば、従業員というエンティティの属性は、従業員IDや姓の列に対応します。行は特定の従業員を識別します。
オプションで、列に対して整合性制約と呼ばれる規則を指定できます。NOT NULLは、整合性制約のNOT NULLです。これは、各行の列に値を指定することを強制する制約です。複数の表にまたがる制約は、SQLアサーションとして定義できます。Oracle AI Database 26aiより前は、データベース・トリガーを使用して、トランザクションの一部としてビジネス・ロジックを適用できました。
関連項目
索引
索引は、表の1つ以上の列に対して作成可能なオプションのデータ構造です。索引によってデータ検索のパフォーマンスが向上する場合があります。
要求を処理するとき、データベースでは使用可能な索引を使用して、要求された行を効率よく見つけることができます。索引は、アプリケーションが特定の行または行範囲を頻繁に問い合せる場合に便利です。
索引は、データから論理的にも物理的にも独立しています。したがって、索引を削除または作成しても、表または他の索引に影響はありません。索引を削除しても、すべてのアプリケーションは機能し続けます。
関連項目
データ・アクセス
DBMSの一般的な要件は、業界で受け入れられているデータ・アクセス言語の標準に準拠することです。ノート: JavaScriptでは、Linux x86-64またはLinux aarch64で実行されているOracle 26aiが必要です。
-
Structured Query Language (SQL) SQLは、Oracle AI DatabaseなどのRDBMSへのインタフェースを提供する、集合ベースの宣言型言語である。
-
PL/SQLは、Oracle SQLに対する手続き型拡張機能です。JavaおよびJavaScriptは、ビジネス・ロジックをデータベースに格納するために使用できる追加オプションです。
Structured Query Language (SQL)
SQLは、Oracle AI DatabaseなどのRDBMSへのインタフェースを提供する、集合ベースの宣言型言語である。
Cなどの手続き型言語は、処理の実行方法を記述します。SQLは非手続き型であり、処理の実行内容を記述します。
SQLはリレーショナル・データベース用のANSI標準言語です。Oracle Database内のデータの操作はすべて、SQL文を使用して実行されます。たとえば、SQLを使用して表を作成し、表内のデータを問い合せ、変更します。
SQL文は、非常に単純なものと考えられることがあり、強力なコンピュータ・プログラムまたは命令と考えることができます。ユーザーは、求める結果(たとえば、従業員の名前)を指定し、その結果をどのようにして導出するかは指定します。SQL文は、次のようなSQLテキストの文字列です。
SELECT first_name, last_name FROM employees;SQL文を使用して次のタスクを実行できます。
-
問合せデータ
-
表内の行の挿入、更新および削除
-
オブジェクトの作成、置換、変更および削除
-
データベースおよびそのオブジェクトへのアクセスの制御
-
データベースの整合性と一貫性の保証
SQLでは、前述のタスクを1つの一貫した言語に統合します。Oracle SQLは、ANSI標準の実装の1つです。Oracle SQLでは、標準SQLを拡張した数多くの機能がサポートされています。
関連項目
PL/SQL、JavaおよびJavaScript
PL/SQLは、Oracle SQLに対する手続き型拡張機能です。JavaおよびJavaScriptは、ビジネス・ロジックをデータベースに格納するために使用できる追加オプションです。
PL/SQLはOracle AI Databaseに統合されており、Oracle AI DatabaseのすべてのSQL文、関数、およびデータ型を使用できます。PL/SQLを使用すると、SQLプログラムのフローの制御、変数の使用、およびエラー処理プロシージャの記述を行うことができます。
PL/SQLの主な利点は、アプリケーション・ロジックをデータベースそのものに格納できることです。PL/SQLプロシージャまたはファンクションは、一連のSQL文と他のPL/SQL構文で構成され、グループとしてまとめてデータベースに格納され、特定の問題を解決したり、一連の関連タスクを実行するために1つとして実行されるスキーマ・オブジェクトです。サーバー側プログラミングの主な利点は、組込み機能を任意の場所にデプロイできることです。
Oracle AI Databaseは、JavaおよびJavaScriptで作成されたプログラム単位も格納できます。Javaストアド・プロシージャは、SQLにパブリッシュされ、一般的な用途向けにデータベースに格納されるJavaメソッドです。既存のPL/SQLプログラムをJavaおよびJavaScriptからコールしたり、JavaおよびJavaScriptプログラムをPL/SQLからコールできます。
マルチリンガル・エンジン(MLE)では、ビジネス・ロジックをJavaScriptに記述し、そのコードをMLEモジュールとしてデータベースに格納できます。MLEモジュールによってエクスポートされるファンクションは、コール仕様を使用してSQLおよびPL/SQLに公開できます。これらのコール仕様はPL/SQLユニット(ファンクション、プロシージャおよびパッケージ)であり、PL/SQLがコールされる任意の場所でコールできます。
関連項目
ドキュメント・アクセス用のNoSQL API
Simple Oracle Document Access (SODA)は、Oracle AI Databaseでドキュメント・コレクション(特にJSONドキュメント)を管理するためのNoSQL形式のAPIのセットです。アプリケーションは、SQLまたは基礎となるデータベース・スキーマの知識を必要とせずに、コレクションを作成し、ドキュメントの挿入、取得、更新、削除および問合せを実行できます。
SODAは、コレクション、ドキュメントおよび例による問合せフィルタに基づくドキュメント中心のプログラミング・モデルを提供します。これは、リレーショナル・データの問合せおよび変更のための宣言的でセット指向のインタフェースを提供し、複数のデータ型にわたる結合、集計および操作を表現できるSQLとは反対です。
SODAは、アプリケーションが主にJSONドキュメントを処理し、単純なドキュメントAPIを必要とし、NoSQL APIを使用する開発者にとって代替となる場合に役立ちます。
サードパーティの単一目的のデータ・ストアからOracle AIデータベースにドキュメント・ワークロードを移植する開発者は、SODAに似ていますが、移行を容易にすることを目的としたMongo DB API for Oracle AI Databaseを使用できます。最も単純なケースでは、アプリケーションの接続文字列を単一目的のデータ・ストアからOracle AI Databaseに変更するだけで済みます。
トランザクション管理
Oracle AI Databaseはマルチユーザー・データベースとして設計されています。データベースは、複数のユーザーが互いのデータを破損することなく同時に作業できることを保証する必要があります。
-
トランザクション トランザクションとは、1つ以上のSQL文を含むアトミックな論理作業単位のことです。
-
データ同時実行性マルチユーザーRDBMSの要件の1つは、データ同時実行性(同じデータに複数のユーザーが同時にアクセスすること)の制御です。
-
データ整合性 Oracle AI Databaseでは、各ユーザーに対し、ユーザー自身のトランザクションによって行われた変更および他のユーザーのトランザクションのコミットによる変更を含む、整合性のあるデータのビューが表示される必要があります。
トランザクション
トランザクションとは、1つ以上のSQL文を含むアトミックな論理作業単位のことです。
RDBMSは、すべてのSQL文がコミットされた状態(つまりデータベースに適用された状態)にするか、すべてのSQL文がロールバックされた状態(つまり取り消された状態)にならないように、SQL文をグループ分けする必要があります。
トランザクションの必要性を示す図として、普通預金勘定から当座預金勘定への資金振替があります。転送は、次の独立した操作で構成されます。
-
普通預金口座の減額
-
当座預金口座の増額
-
トランザクション・ジャーナルへのトランザクションの記録
Oracle AI Databaseでは、3つの操作すべてが1つの単位として成功するか、失敗するかが保証されます。たとえば、ハードウェア障害によってトランザクション内の文の1つを実行できなかった場合は、その他の文をロールバックする必要があります。
トランザクションは、Oracle AI Databaseとファイル・システムとの明確な違いを示す1つの機能です。複数のファイルを更新する不可分な操作を実行する場合、その途中でシステム障害が発生すると、ファイル間の整合性が失われます。対照的に、トランザクションは、Oracle Databaseを矛盾のない1つの状態から矛盾のない別の状態に移行します。トランザクションの基本的な原則は、100かゼロかであり、不可分の操作はその部分が成功するかその全体が失敗します。
関連項目
データ同時実行性
マルチユーザーRDBMSの要件の1つとして、データ同時実行性(同じデータに複数のユーザーが同時にアクセスすること)の制御があります。
同時実行性が制御されていない場合、ユーザーがデータを不適切に変更し、データ整合性が損われることがあります。たとえば、あるユーザーが行を更新する一方で、別のユーザーがその行を同時に更新することがあります。
複数のユーザーが同じデータにアクセスした場合、同時実行性を管理する1つの方法は、ユーザーを待機させることです。ただし、DBMSの目標は待機時間をゼロまたはごくわずかまで減らすことです。データを変更するすべてのSQL文は、できるだけ干渉されない状態で処理する必要があります。破壊的な相互作用とは、不正確なデータの更新または基礎となるデータ構造の不正な変更を引き起こす相互作用であり、これを回避する必要があります。
Oracle AI Databaseでは、ロックを使用して、データへの同時アクセスを制御します。ロックは、共有リソースにアクセスするトランザクション間で、破壊的な相互作用が起きないようにするメカニズムです。ロックは、データ整合性を保証する場合に役立つ一方、データへの最大の同時アクセスを可能にします。
関連項目
データの整合性
Oracle AI Databaseでは、各ユーザーに対し、ユーザー自身のトランザクションによって行われた変更および他のユーザーのトランザクションのコミットによる変更を含む、整合性のあるデータのビューが表示される必要があります。
たとえば、データベースは、あるトランザクションが別の同時トランザクションによるコミットされていない変更に遭った場合に発生する内容を保証する問題を防ぐ必要があります。
Oracle AI Databaseでは、文レベルの読取り一貫性を常に適用することにより、ある特定の時点で1つの問合せによって戻されたデータがコミット済であり、一貫していることを保証しています。トランザクション分離レベルに応じて、この時点は文またはトランザクションが開始されたときになります。この時点は、Oracle Flashback Query機能で明示的に指定できます。
データベースは、トランザクションのすべての問合せに対して、トランザクション・レベルの読取り一貫性と呼ばれる読取り一貫性を実現することもできます。この場合、トランザクション内の各文には同じ時点(トランザクション開始時)のデータが表示されます。
関連項目
Oracle AI Databaseのアーキテクチャ
データベース・サーバーは、情報管理のキーです。
一般的にサーバーは、多数のユーザーが同時に同じデータにアクセスできるように、マルチユーザー環境において大量のデータが確実に管理されます。権限のないアクセスに対して保護機能を備えながら、障害のリカバリについても効率のよい解決方法を提供します。
-
データベースおよびインスタンス Oracleデータベース・サーバーは、データベースと、1つ以上のデータベース・インスタンス(通常は単にインスタンスと呼ばれます)で構成されます。
-
データベース記憶域構造データベースは、物理と論理の両方の観点から考察できます。
-
データベース・インスタンス構造 Oracleデータベースでは、メモリー構造とプロセスを使用してCDBの管理やアクセスが実行されます。すべてのメモリー構造は、RDBMSを構成するコンピュータのメイン・メモリー内に存在します。
-
アプリケーションおよびネットワークのアーキテクチャ特定のコンピュータ・システムまたはネットワークを最大限に活用できるように、Oracle AI Databaseでは、処理をデータベース・サーバーとクライアント・プログラムとで分割できます。RDBMSを実行しているコンピュータはデータベース・サーバーの処理を実行し、アプリケーションを実行しているコンピュータはデータの解釈と表示を行います。
データベースとインスタンス
Oracleデータベース・サーバーは、データベースと、1つ以上のデータベース・インスタンス(通常は単にインスタンスと呼ばれます)で構成されます。
インスタンスとデータベースは非常に密接に関連しているため、Oracleデータベースという用語は、インスタンスとデータベースの両方を指す場合があります。これらの用語の厳密な意味は次のとおりです。
-
データベース
データベースは、ディスク上に配置された、ユーザー・データを格納する一連のファイルです。これらのデータ・ファイルは、データベース・インスタンスとは別に存在できます。Oracle Database 21c以降では、データベースとは、具体的にはマルチテナント・コンテナ・データベース(CDB)、プラガブル・データベース(PDB)またはアプリケーション・コンテナのデータ・ファイルを指すようになります。
-
データベース・インスタンス
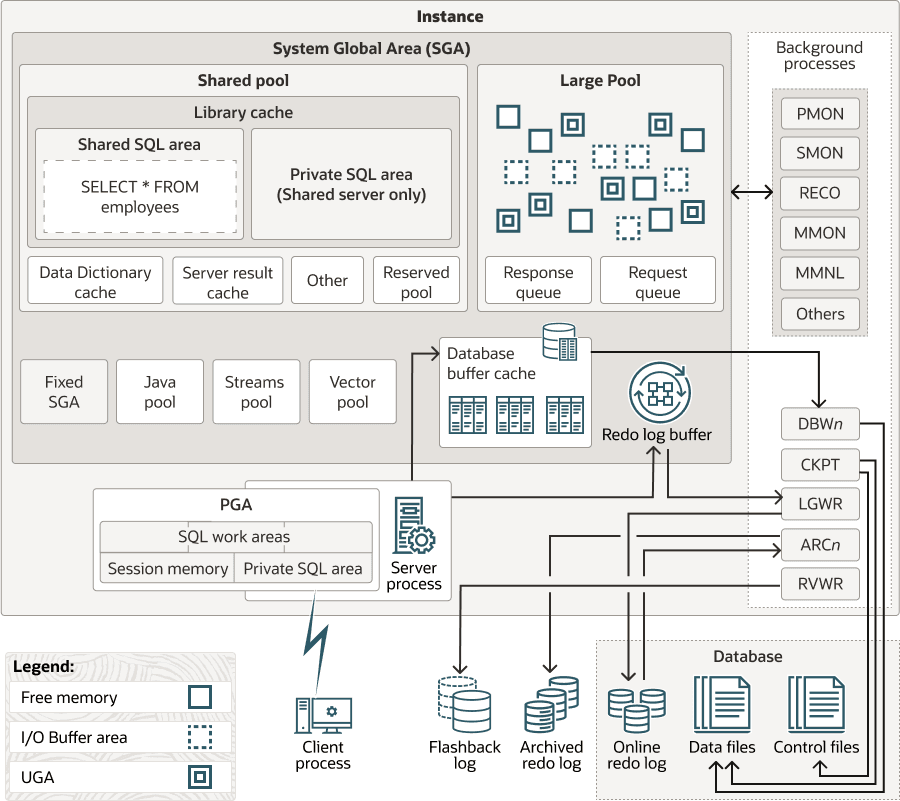
インスタンスは、データベース・ファイルを管理する一連の名前付きのメモリー構造である。データベース・インスタンスは、システム・グローバル領域(SGA)と呼ばれる共有メモリー領域のほか、一連のバックグラウンド・プロセスで構成されます。インスタンスはデータベース・ファイルとは別に存在できます。
-
マルチテナント・アーキテクチャマルチテナント・アーキテクチャによって、Oracle AI DatabaseをCDBにすることができます。
-
Globally Distributed Database Architecture Oracle Globally Distributed Database (以前Oracle Shardingと呼ばれていた)は、複数のPDB間におけるデータの水平パーティション化に基づくデータベース・スケーリング技術です。アプリケーションは、PDBのプールを単一の論理データベースとして認識します。各パーティションはシャードと呼ばれます。
マルチテナント・アーキテクチャ
マルチテナント・アーキテクチャによって、Oracle AI DatabaseをCDBにすることができます。
すべてのOracle AI Databaseは、他のデータベースによって格納されているか、または格納できる必要があります。たとえば、CDBにはPDBが含まれており、アプリケーション・コンテナにはアプリケーションPDBが含まれています。PDBはCDBまたはアプリケーション・コンテナに含まれており、アプリケーション・コンテナはCDBに含まれています。
Oracle Database 21c以降では、マルチテナント・コンテナ・データベースがサポート対象の唯一のアーキテクチャになっています。以前のリリースでは、Oracleは非コンテナ・データベース(非CDB)をサポートしています。
-
コンテナ・データベース CDBには、ユーザーが作成した1つ以上のPDBおよびアプリケーション・コンテナが含まれています。
-
プラガブル・データベース PDBは、アプリケーションに対して個別のデータベースとして表示されるスキーマ、スキーマ・オブジェクトおよび非スキーマ・オブジェクトをポータブル・コレクションしたものです。
-
アプリケーション・コンテナアプリケーション・コンテナは、オプションのCDB内にユーザーが作成したコンテナであり、1つ以上のアプリケーションのデータおよびメタデータが格納されます。
コンテナ・データベース
CDBには、ユーザーが作成した1つ以上のPDBおよびアプリケーション・コンテナが含まれています。
物理レベルでは、CDBは制御ファイルとオンラインREDOログ・ファイル、データ・ファイルの一連のファイルになります。データベース・インスタンスは、CDBを構成するファイルを管理します。
次の図に、CDBおよび関連するデータベース・インスタンスを示します。
図1: データベース・インスタンスとCDB
プラガブル・データベース
PDBは、アプリケーションに対して個別のデータベースとして表示されるスキーマ、スキーマ・オブジェクトおよび非スキーマ・オブジェクトをポータブル・コレクションしたものです。
物理レベルでは、各PDBに、そのPDBのデータを格納する独自のデータ・ファイルのセットがあります。CDBには、そこに含まれるPDBのすべてのデータ・ファイル、およびCDB自体のメタデータを格納する一連のシステム・データ・ファイルも含まれます。
PDBを移動またはアーカイブするには、PDBを切断できます。切断されたPDBは、PDBのデータファイルおよびメタデータ・ファイルで構成されます。切断されたPDBは、CDBに接続されるまで使用できません。
次の図に、MYCDBという名前のCDBを示します。
図2: CDB内のPDB
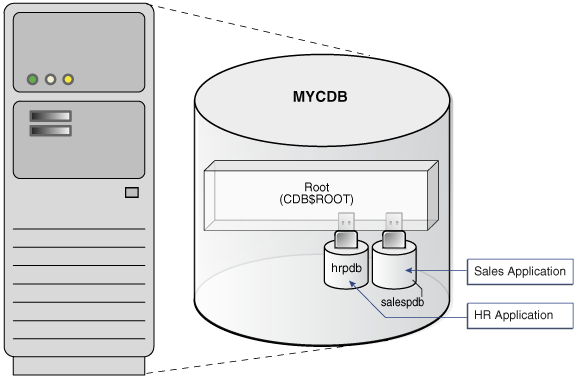
物理的に、MYCDBは、インスタンスに関連付けられた一連のデータ・ファイルという意味では、Oracle AI Databaseです。MYCDBには、1つのデータベース・インスタンス(ただし、Oracle Real Application Clustersでは複数のインスタンスが可能)と、1つのデータベース・ファイル・セットがあります。
MYCDBには2つのPDB、hrpdbとsalespdbが含まれています。図1-2に示すように、これらのPDBが、それぞれのアプリケーションで別個の独立したデータベースとして認識されます。アプリケーションは、CDBとPDBのどちらに接続しているのかを認識しません。
CDB自体またはその中のPDBを管理するために、CDBルートに接続できます。ルートは、スキーマ、スキーマ・オブジェクトおよび非スキーマ・オブジェクトの集合であり、すべてのPDBおよびアプリケーション・コンテナが属します。
アプリケーション・コンテナ
アプリケーション・コンテナは、オプションのCDB内にユーザーが作成したコンテナであり、1つ以上のアプリケーションのデータおよびメタデータが格納されます。
このコンテキストでは、アプリケーション(マスター・アプリケーション定義とも呼ばれる)は、アプリケーション・ルートに格納される共通データおよびメタデータの名前付けおよびバージジェットされたセットです。たとえば、アプリケーションには一連のPDBに共通の表、ビュー、ユーザー・アカウント、PL/SQLパッケージの定義を含めることができます。
ある意味で、アプリケーション・コンテナがCDB内のアプリケーション固有CDBとして機能します。アプリケーション・コンテナにはCDB自身のように複数のアプリケーションPDBが含まれ、これらのPDBはメタデータおよびデータを共有できます。物理レベルでは、アプリケーション・コンテナには、PDBと同様に独自の一連のデータ・ファイルが存在します。
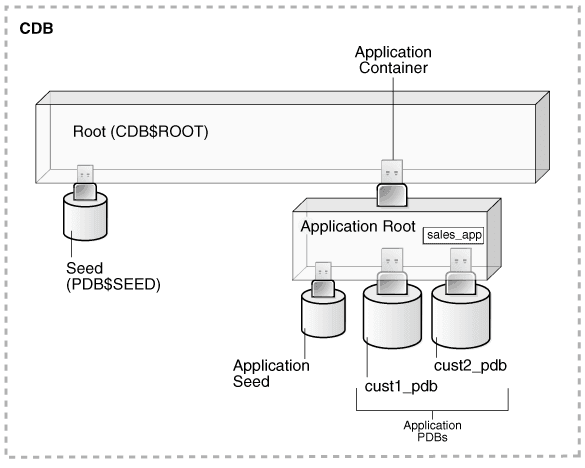
たとえば、SaaSデプロイメントは、それぞれがアプリケーション・メタデータとデータを共有する個別の顧客に対して、複数のアプリケーションPDBを使用できます。たとえば次の図では、sales_appはアプリケーション・ルート内のアプリケーション・モデルです。cust1_pdbというアプリケーションPDBには顧客1用の販売データのみが含まれる一方、cust2_pdbというアプリケーションPDBに顧客2用の販売データのみが含まれます。接続、切断、クローニングおよびその他のPDBレベルの操作を、個々の顧客PDBで使用できます。
図3: SaaSのユースケース
Globally Distributed Databaseアーキテクチャ
Oracle Globally Distributed Database (以前はOracle Shardingと呼ばれていました)は、複数のPDB間におけるデータの水平パーティション化に基づくデータベース・スケーリング技術です。アプリケーションは、PDBのプールを単一の論理データベースとして認識します。各パーティションはシャードと呼ばれます。
アプリケーションのシャーディングの主な利点には、線形スケーラビリティ、障害の封じ込め、および地理的データ分散などが挙げられます。Globally Distributed Databaseは、Oracle Cloudでのデプロイメントに適しています。シャーディングを実装するNoSQLデータ・ストアとは異なり、Globally Distributed DatabaseはエンタープライズRDBMSの機能を犠牲にすることなく、シャーディングの利点を提供します。
シャーディング・アーキテクチャでは、各CDBは、独自のローカル・リソース(CPU、メモリー、フラッシュまたはディスク)を持つ専用サーバーでホストされます。シャードとしてPDBを指定できます。異なるCDBからのPDBシャードが単一の論理データベースを構成し、これはシャード・データベースと呼ばれます。同じCDBの2つのシャードは、同じシャード・データベースのメンバーにはできません。ただし、同じCDB内で、あるPDBが1つのシャード・データベース内にあり、別のPDBが別々のシャード・データベースに存在する可能性があります。
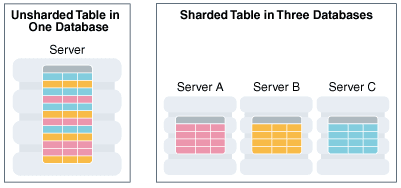
水平パーティション化にはシャード間のデータベース表の分割が伴うため、各シャードには同じ列の異なる行のサブセットを持つ表が含まれます。この方法で分割された表はシャード表とも呼ばれています。次の図は、3つのシャード間で水平パーティション化されたシャード表を示っており、各シャードは別個のCDB内のPDBです。
図4: シャード間での表の水平パーティション化
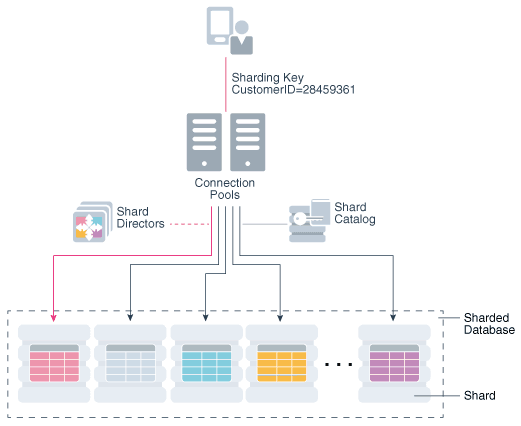
ユースケースの1つは、複数のCDBへの顧客アカウント・データの分散です。たとえば、IDが28459361の顧客が自身のレコードを検索するとします。次の図に、考えられるアーキテクチャを示します。顧客のリクエストは、接続プールを介してルーティングされます。接続プールでは、シャード・ディレクタ(ネットワーク・リスナー)がリクエストをすべての顧客の行が含まれている適切なPDBシャードに送信します。
図5: Oracle Globally Distributed Databaseのアーキテクチャ
関連項目
データベース記憶域構造
データベースは、物理と論理の両方の観点から考察できます。
物理データとは、オペレーティング・システム・レベルで表示可能なデータのことです。たとえば、Linuxのlsやpsなどのオペレーティング・システム・ユーティリティは、データベース・ファイルおよびプロセスをリスト表示できます。表などの論理データは、データベースに対してのみ意味を持ちます。SQL文でOracleデータベース内の表をリストできますが、オペレーティング・システムのユーティリティはできません。
データベースには、物理構造と論理構造が含まれます。物理構造の構造と論理構造は分離されているため、論理記憶域構造へのアクセスに影響を与えることなく、データの物理記憶域を管理することができます。たとえば、物理データベース・ファイルの名前を変更しても、このファイルにデータが格納されている表の名前は変更されません。
-
物理記憶域構造物理データベース構造とは、データを格納するファイルである。
-
論理記憶域構造 Oracle AI Databaseでは、論理記憶域構造により、ディスク領域の使用をきめ細かに制御することができます。
物理ストレージ構造
物理データベース構造とは、データを格納するファイルです。
CREATE DATABASEコマンドを実行してCDBを作成します。次のファイルが作成されます。
-
データファイル
すべてのCDBには、すべてのデータベース・データを含む1つ以上の物理データ・ファイルがあります。表や索引などの論理データベース構造のデータは、データファイルに物理的に格納されます。
-
制御ファイル
すべてのCDBには、制御ファイルがあります。制御ファイルには、データベース名やデータベース・ファイルの名前と位置など、データベースの物理構造を指定したメタデータが含まれています。
-
オンラインREDOログ・ ファイル
すべてのCDBには、2つ以上のオンラインREDOログ・ファイルのセットからなるオンラインREDOログがあります。オンラインREDOログは、データに加えられたすべての変更を記録するREDOエントリ(REDOログ・レコードとも呼ばれる)で構成されています。
CDB内でCREATE PLUGGABLE DATABASEコマンドを実行してPDBを作成します。PDBには、CDB内の専用のデータ・ファイル・セットが含まれています。PDBには、それぞれ専用の制御ファイルとオンラインREDOログはありません。これらのファイルはPDBで共有されます。
CDBが機能するために重要なその他多くのファイルがあります。これらには、パラメータ・ファイルやネットワーキング・ファイルが含まれています。バックアップ・ファイルとアーカイブREDOログ・ファイルは、バックアップおよびリカバリに重要なオフライン・ファイルです。
関連項目
関連項目: 「物理記憶域構造」
論理ストレージ構造
論理記憶域構造により、Oracle AI Databaseでディスク領域の使用をきめ細かに制御することができます。
このトピックでは、論理記憶域構造について説明します。
-
データ・ブロック
Oracle AI Databaseのデータは、最も粒度の高いレベルでデータ・ブロックに格納されます。1つのデータ・ブロックは、ディスク上の特定のバイト数に対応します。
-
エクステント
エクステントとは、1回の割当てで取得された一定数の連続するデータ・ブロックで、特定タイプの情報の格納に使用されます。
-
セグメント
セグメントとは、ユーザー・オブジェクト(表または索引など)、UNDOデータまたは一時データに割り当てられるエクステントの集合のことです。
-
表領域
データベースは、表領域と呼ばれる論理記憶域の単位に分割されます。表領域とは、セグメントの論理コンテナのことです。各表領域は1つ以上のデータ・ファイルで構成されます。
関連項目
データベース・インスタンス構造
Oracleデータベースでは、メモリー構造とプロセスを使用してCDBの管理やアクセスが実行されます。すべてのメモリー構造は、RDBMSを構成するコンピュータのメイン・メモリー内に存在します。
アプリケーションがCDBまたはPDBに接続すると、データベース・インスタンスに接続します。インスタンスは、SGA以外にその他のメモリー領域を割り当て、バックグラウンド・プロセスに加えて他のプロセスを起動して、アプリケーションに対応します。
-
Oracle AI Databaseプロセスプロセスとは、一連のステップを実行できる、オペレーティング・システムにおけるメカニズムの1つです。オペレーティング・システムによっては、「ジョブ」、「タスク」または「スレッド」という用語を使用します。
-
インスタンス・メモリー構造 Oracle AI Databaseでは、プログラム・コード、ユーザー間で共有するデータ、および接続されている各ユーザーのプライベート・データ領域のために、メモリー構造が作成され、使用されます。
Oracle AI Databaseのプロセス
プロセスとは、一連のステップを実行できるオペレーティング・システムのメカニズムのことです。オペレーティング・システムによっては、「ジョブ」、「タスク」または「スレッド」という用語を使用します。
このトピックの目的では、スレッドはプロセスと同等です。Oracleデータベース・インスタンスには次のタイプのプロセスがあります。
-
クライアント・プロセス
これらのプロセスは、アプリケーション・プログラムまたはOracleツールのソフトウェア・コードを実行するために作成およびメンテナンスされます。ほとんどの環境ではクライアント・プロセス用に独立したコンピュータが使用されます。
-
バックグラウンドプロセス
これらのプロセスでは、各クライアント・プロセスごとに実行されている複数のOracle AI Databaseプログラムによって処理される機能を統合します。バックグラウンド・プロセスは、非同期的にI/Oを実行し、他のOracle AI Databaseプロセスを監視することで、並列性を高め、パフォーマンスと信頼性を向上させています。
-
サーバープロセス
これらのプロセスは、クライアント・プロセスと通信し、Oracle AI Databaseと対話してリクエストに対応します。
Oracleプロセスには、サーバー・プロセスとバックグラウンド・プロセスがあります。ほとんどの環境では、Oracleプロセスとクライアント・プロセスは別々のコンピュータ上で実行されます。
関連項目
インスタンスのメモリー構造
Oracle AI Databaseでは、プログラム・コード、ユーザー間で共有されているデータ、および接続されている各ユーザーのプライベート・データ領域のために、メモリー構造が作成および使用される。
次のメモリー構造がデータベース・インスタンスに関連付けられています。
-
システム・グローバル領域(SGA)
SGAは、1つのデータベース・インスタンスのデータおよび制御情報を格納する共有メモリー構造のグループです。SGAコンポーネントの例として、データベース・バッファ・キャッシュや共有SQL領域があります。The SGA can contain an optional In-Memory Column Store (IM column store), which enables data to be populated in memory in a columnar format.
-
プログラム・グローバル・エリア(PGA)
PGAは、サーバー・プロセスまたはバックグラウンド・プロセス用のデータや制御情報を含むメモリー領域です。PGAにアクセスできるのはプロセスのみです。それぞれのサーバー・プロセスおよびバックグラウンド・プロセスには固有のPGAが含まれます。
関連項目
アプリケーションおよびネットワークのアーキテクチャ
Oracle AI Databaseでは、特定のコンピュータ・システムまたはネットワークを最大限に活用できるように、データベース・サーバーとクライアント・プログラムの間で処理を分割できます。RDBMSを実行しているコンピュータはデータベース・サーバーの処理を実行し、アプリケーションを実行しているコンピュータはデータの解釈と表示を行います。
-
アプリケーション・アーキテクチャアプリケーション・アーキテクチャとは、データベース・アプリケーションがOracleデータベースに接続されているコンピューティング環境である。データベースの最も一般的なアーキテクチャは、クライアント/サーバーと複数層の2種類です。
-
Oracle Net Servicesは、データベースとネットワークの通信プロトコルとの間のインタフェースであり、分散処理と分散データベースの提供を支援します。
アプリケーション・アーキテクチャ
アプリケーション・アーキテクチャは、データベース・アプリケーションがOracleデータベースに接続されているコンピューティング環境です。データベースの最も一般的なアーキテクチャは、クライアント/サーバーと複数層の2種類です。
クライアント・サーバー・アーキテクチャ
クライアント/サーバー・アーキテクチャでは、クライアント・アプリケーションは、データベース・サーバー上で実行される操作に関するリクエストを開始します。サーバーは、Oracle AI Databaseソフトウェアを実行し、同時実行される共有データ・アクセスに必要な機能を処理します。サーバーは、クライアントから発行されたリクエストを受け取って処理します。
複数層アーキテクチャ
複数層アーキテクチャでは、1つ以上のアプリケーション・サーバーが操作の各部分を実行します。アプリケーション・サーバーには、アプリケーション・ロジックスの大部分が含まれ、クライアントのデータ・アクセスを可能にし、いくつかの問合せ処理を実行します。この方法で、データベースの負荷が軽減します。アプリケーション・サーバーは、クライアントと複数のデータベース間のインタフェースとして機能し、セキュリティ・レベルを高める役割を果します。
サービス指向アーキテクチャ(SOA)は、アプリケーション機能がサービスにカプセル化されている複数層アーキテクチャです。通常、SOAサービスはWebサービスとして実装されます。WebサービスはHTTP経由でアクセス可能なものであり、Webサービス記述言語(WSDL)やSOAPなどのXMLベースの規格に基づいています。Oracle AI Databaseは、従来の複数層またはSOA環境においてWebサービス・プロバイダとして機能できます。
マイクロサービス・アーキテクチャは、アプリケーションを独立して開発およびデプロイされた小規模なサービスに分割します。各サービスはビジネス・ロジックを所有し、理想的にはそのデータを所有するため、結合が削減され、チームはサービスを個別に拡張、更新および運用できます。
Oracleマルチテナント・アーキテクチャは、サービスごとのデータベース・パターンに自然にマッピングされます。各マイクロサービスは独自のプラガブル・データベース(PDB)を使用できるため、個別のデータ、セキュリティおよび管理境界を提供でき、複数のPDBは共通コンテナ・データベース(CDB)のリソースを共有します。
このアプローチでは、サービスの分離と効率的な統合が結合されます。PDBは個別にプロビジョニング、クローニング、パッチ適用、バックアップ、再配置およびスケーリングできますが、管理者は基礎となるデータベース・インフラストラクチャを一元的に制御できます。
関連項目
Oracle Net Servicesのアーキテクチャ
Oracle Net Servicesは、データベースとネットワークの通信プロトコルとの間のインタフェースで、分散処理と分散データベースの提供を支援します。
通信プロトコルにより、ネットワーク上でのデータの送受信方法が定義されます。Oracle Net Servicesは、TCP/IP、HTTP、FTPおよびWebDAVなど、主要なネットワーク・プロトコルによる通信をすべてサポートしています。Oracle NetはOracle Net Servicesのコンポーネントであり、クライアント・アプリケーションからデータベース・サーバーへのネットワーク・セッションを確立し、維持します。ネットワーク・セッションの確立後は、Oracle Netはクライアント・アプリケーションとデータベース・サーバーのためのデータ伝達手段として機能し、これらの間でメッセージを交換します。このようなジョブは、Oracle Netがネットワーク内の各コンピュータに配置されることにより可能になる。
Net Servicesの重要なコンポーネントにOracle Net Listener (リスナーと呼ばれます)があり、これは、データベースまたはネットワークの他の場所で実行されるプロセスです。クライアント・アプリケーションは、リスナーに接続要求を送信し、リスナーはデータベースに対するこれらの要求のトラフィックを管理します。接続が確立されると、クライアントとデータベースは直接通信します。
Oracle REST Data Services
Oracle REST Data Services (ORDS)は、Oracle AI DatabaseへのHTTPSゲートウェイを提供します。これにより、アプリケーションは、表、ビュー、PL/SQL、JavaScriptおよびJavaで記述されたストアド・プロシージャ、およびカスタム・データベース操作をセキュアなREST APIとして公開できます。多くの場合、個別のアプリケーション・サーバーや広範なミドルウェア・コードを必要としません。
ORDSは、Oracle Database API for MongoDBもサポートしているため、アプリケーションは互換性のあるMongoDBドライバ、ツールおよびコマンドを使用して、Oracle Databaseに格納されているJSONドキュメント・コレクションにアクセスできます。MongoDBワイヤ・プロトコルはORDSを介してデータベース操作に変換されるため、REST、MongoDBおよびSQLアプリケーションは、同じコンバージド・データベースによって管理されるデータを操作できます。
関連項目