物理ストレージ構造
Oracle Databaseの物理データベース構造は、オペレーティング・システム・レベルで表示可能です。
-
物理記憶域構造の概要 RDBMSの特徴の1つは、表、ビュー、索引などが物理記憶域構造(ファイルなど)から独立しているということです。
-
データファイルの概要 Oracle AI Databaseでは、オペレーティング・システム・レベルで、データファイルと呼ばれる構造にデータが格納されます。CDBまたはPDBのどちらでも、すべてのOracleデータベースには、少なくとも1つのデータ・ファイルが必要です。
-
制御ファイルの概要データベースの制御ファイルは、1つのCDBのみに関連付けられている小さいバイナリ・ファイルです。
-
オンラインREDOログの概要リカバリに最も重要な構造がオンラインREDOログであり、これは、データベースに対して変更を格納したときにその変更内容が格納される、事前に割り当てられた複数のファイルで構成されます。オンラインREDOログには、データファイルに対する変更が記録されます。
物理記憶域構造の概要
RDBMSの特徴の1つは、表、ビュー、索引など、論理データ構造がファイルなどの物理記憶域構造から独立していることです。
物理構造の構造と論理構造は分離されているため、論理構造へのアクセスに影響を与えずに、データの物理記憶域を管理できます。たとえば、データベース・ファイルの名前を変更しても、ファイルに格納されている表の名前は変更されません。
Oracleデータベースは、Oracleデータを永続記憶域に格納する一連のファイルです。Oracle Database 21cから、マルチテナント・コンテナ・データベース(CDB)がサポート対象の唯一のアーキテクチャになりました。CDBには、1つ以上のPDBが含まれています。
この項では、CREATE DATABASE文を発行してCDBを作成するときに生成されるデータベース・ファイルについて説明します。
-
データファイルおよび一時ファイル
データファイルは永続ストレージにOracle AI Databaseが作成した物理ファイルで、表や索引などのデータ構造が含まれています。一時ファイルは、一時表領域に属するデータファイルです。データベースでは、他のプログラムでは読み取れないOracle独自の形式で、データをこれらのファイルに書き込みます。
PDB内でPDBを作成する場合、PDBにはCDBを構成するデータ・ファイルの全体のセット内に独自のデータ・ファイルがあります。たとえば、
mycdbという名前のCDBを作成し、その中にhrpdbおよびsalespdbという2つのPDBを作成できます。この場合、mycdbには、hrpdbおよびsalespdbなどの一連の独自データ・ファイルと一時ファイルがあります。 -
制御ファイル
制御ファイルは、CDBの物理コンポーネントを追跡するためのルート・ファイルです。PDBには、独自の制御ファイルはありません。
-
オンラインREDOログ・ ファイル
オンラインREDOログは、CDB内のデータに対する変更が記録された一連のファイルですPDBには、独自のオンラインREDOログ・ファイルはありません。
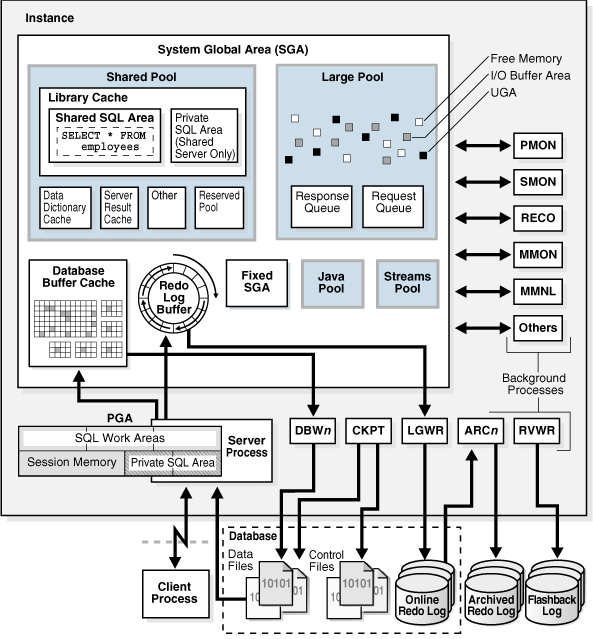
データベース・インスタンスは、CDB内のデータベース・ファイルを管理する一連のメモリー構造です。次の図に、インスタンスとインスタンスによって管理されるファイルの間の関係を示します。
図1: データベース・インスタンスとデータベース・ファイル
-
データベース・ファイルの記憶域の割当ておよび管理これらのファイルの記憶域の割当ておよび管理には、複数のメカニズムを使用できます。
-
Oracle Managed Filesおよびユーザー管理ファイルOracle Managed Filesとは、ファイル名ではなく、データベース・オブジェクトの観点で操作を指定できるようにするためのファイル命名方法のことです。たとえば、表領域のデータファイルの名前を指定しなくても、表領域を作成できます。
-
Oracle Automatic Storage Management (Oracle ASM)Oracle ASMは、Oracle AI Databaseファイルの高パフォーマンスと管理しやすいストレージ・ソリューションです。Oracle ASMはボリューム・マネージャで、データベース専用に設計されたファイル・システムを提供します。
-
Oracle永続メモリー・ファイルストア(PMEMファイルストア)PMEMは、バイトアドレス設定可能な永続メモリーです。Oracle永続メモリー・ファイルストア(PMEMファイルストア)には、データ・ファイル、オンラインREDOログ・ファイルおよび制御ファイルを格納できます。
関連情報:
-
データベースの作成方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
CREATE DATABASEのセマンティクスおよび構文については『Oracle AI Database SQL言語リファレンス』を参照
データベース・ファイル格納のメカニズム
データベース・ファイルの記憶域の割当ておよび管理には、複数のメカニズムを使用できます。
次のメカニズムがあります。
-
オペレーティング・システムのファイル・システム
ほとんどのOracleデータベースは、データを格納および取得するための構造であるファイル・システムにファイルを格納します。
ファイル・システムでは、標準の一貫した方法で記憶領域をアプリケーション・データに使用できます。各ファイルには名前があり、Oracle AI Databaseなどのアプリケーションに対して連続するアドレス空間として表示されます。データベースでは、ファイルの作成、読取り、書込み、サイズ変更および削除が可能です。
通常、ファイル・システムは、論理ボリューム・マネージャ(LVM)と呼ばれるソフトウェア・パッケージによって作成される論理ボリュームの上に構築されています。LVMを使用すると、複数の物理ディスクの断片を結合して、単一の連続したアドレス空間として使用することができます。
-
クラスタ・ファイル・ システム
クラスタ・ファイル・システムとは、共同して、一貫性と高いパフォーマンスがクライアントに提供するサーバーのクラスタである分散ファイルシステムです。Oracle RAC環境でクラスタ・ファイル・システムを使用すると、共有記憶域がクラスタ化環境内の多数のコンピュータによって共有されるファイル・システムとして表示されるようになります。クラスタ・ファイル・システムを使用すると、クラスタ内のいずれかのコンピュータで障害が発生しても、ファイル・システムが使用できなくなることはありません。ただし、オペレーティング・システムのファイル・システムにおいて、NFSまたはその他の方法を使用してファイルを共有しているコンピュータに障害が発生した場合、ファイル・システムは使用できません。
-
Oracle永続メモリー・ファイルストア(PMEMファイルストア)
PMEM Filestoreは、データベース・ファイルをバイトアドレスを指定可能な永続メモリーである永続メモリー(PMEM)に格納するように設計されています。
CREATE PMEM FILESTOREコマンドを使用してファイルストアを作成します。Linuxオペレーティング・システム・レベルでは、ファイルストアはfsdaxモードでマウントされた大規模なext4ファイル・システムにデータを格納します。PMEMファイルストアは、Linuxのネイティブ・ファイル・システムとしてOracle AI Databaseに表示されます。ノート: POSIX準拠のファイル・システムとは異なり、PMEMのファイルストアは複数のOracleデータベースで共有できません。
-
Oracle Automatic Storage Management(Oracle ASM)
Oracle ASMには、Oracle AI Databaseでのみ使用できるよう設計されたファイル・システムが含まれています。
データベースでは、前述の記憶域メカニズムを組み合せて使用できます。たとえば、データベースではサーバー・パラメータ・ファイルが従来のファイル・システムに格納され、データベース・ファイルがPMEMのファイルストアに格納されてから、REDOログ・ファイルをクラスタ・ファイル・システムにアーカイブできます。
関連情報:
-
データベース・ビューを問い合せてデータベース記憶域構造を表示する方法の詳細は『Oracle AI Database管理者ガイド』を参照
Oracle Managed Filesおよびユーザー管理ファイル
Oracle Managed Filesとは、ファイル名ではなく、データベース・オブジェクトの観点で操作を指定できるようにするためのファイル命名方法のことです。たとえば、表領域のデータファイルの名前を指定しなくても、表領域を作成できます。
Oracle Managed Filesでは、データベース内のオペレーティング・システム・ファイルを管理者が直接管理する必要がなくなります。Oracle ASMではOracle Managed Filesが必要です。
ノート:この機能は、トレース・ファイル、監査ファイル、アラート・ログなどの管理ファイルの作成または命名にも影響を与えません。
ユーザー管理ファイルを使用すると、データベース内のオペレーティング・システム・ファイルをユーザーが直接管理できます。ユーザーは、ファイルの構造および名前を決定できます。たとえば、表領域を作成する場合は、表領域データファイルの名前とパスを設定します。
初期化パラメータを使用して、特定タイプのファイルに使用するファイル・システム・ディレクトリを指定します。Oracle Managed Filesの主な役割は、データベースによって一意のファイルが作成され、そのファイルが不要になったら削除されるようにすることです。データベースでは、標準のファイル・システム・インタフェースを内部で使用して、データファイルと一時ファイルのファイル、制御ファイル、および高速リカバリ領域に格納されているリカバリ関連ファイルなどのファイルが作成および削除されます。
Oracle Managed Filesを使用しても、既存の機能は削除されません。以前のファイルを手動で管理しながら、新しいファイルを作成できます。このため、データベースにはOracle Managed Filesとユーザー管理ファイルが混在する場合があります。
関連情報:
-
Oracle Managed Filesの使用を学習するには、『Oracle AI Database管理者ガイド』を参照
Oracle Automatic Storage Management(Oracle ASM)
Oracle ASMは、Oracle AI Databaseファイル用の高パフォーマンス、管理しやすいストレージ・ソリューションである。Oracle ASMはボリューム・マネージャで、データベース専用に設計されたファイル・システムを提供します。
Oracle ASMには、従来のファイル・システムおよびストレージ・マネージャと比較して、次のような利点があります。
-
データベースの作成およびレイアウトやディスク領域の管理など、ストレージ関連のタスクが簡略化されます。
-
複数の物理ディスクにわたってデータが配分されるため、ホットスポットがなくなり、ディスク間のパフォーマンスが均一になります。
-
ストレージ構成が変わると、データのバランスが自動的にリバランスされます。
Oracle ASMを使用するには、ストライプ化およびミラー化のプリファレンスを設定して、Oracle AI Databaseのパーティション化されたディスクを割り当てます。Oracle ASMは、I/Oロードを使用可能なすべてのリソースにI/O負荷が分散されるため、I/Oの手動チューニングが不要になり、パフォーマンスを最適化します。たとえば、データベースをシャットダウンすることなくデータベース用のディスクのサイズを増やしたり、データベースの一部を新しいデバイスに移動したりできます。
-
Oracle ASMのストレージ・コンポーネント Oracle AI Databaseでは、データファイルをOracle ASMファイルとしてOracle ASMディスク・グループ内に格納できます。ディスク・グループ内では、各データベース・ファイルに使用するファイル・システム・インタフェースがOracle ASMによって公開されます。
-
Oracle ASMインスタンスOracle ASMインスタンスとは、Oracle ASMディスクを管理する特別なOracleインスタンスで、
Oracle ASMのストレージ・コンポーネント
Oracle AI Databaseでは、データファイルをOracle ASMファイルとしてOracle ASMディスク・グループ内に格納できます。ディスク・グループ内では、各データベース・ファイルに使用するファイル・システム・インタフェースがOracle ASMによって公開されます。
次の図に、Oracle ASMを使用するデータベース内のストレージ・コンポーネント間の関係を示します。このダイアグラムは、Oracle ASMファイルとデータファイルの間の関係を表していますが、Oracle ASMには他のタイプのファイル も格納できます。クロウの足の表記は、1対多の関係を表しています。
図2: Oracle ASMのコンポーネント
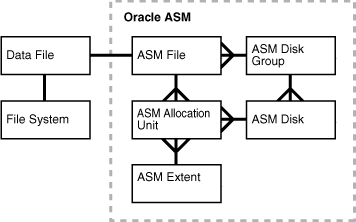
図14-2は、次のOracle ASMの概念を示しています。
-
Oracle ASMディスク
Oracle ASMディスクとは、Oracle ASMディスク・グループにプロビジョニングされるストレージ・デバイスのことです。Oracle ASMディスクは、物理ディスクまたはパーティション、ストレージ・アレイからの論理ユニット番号(LUN)、論理ボリュームまたはネットワーク接続ファイルのいずれでもかまいません。
Oracle ASMディスク・グループ内のOracle ASMディスクは、データベースの稼働中に追加または削除できます。ディスクをディスク・グループに追加するときは、ディスク名を割り当てます(割り当てない場合は、Oracle ASMディスク名が自動的に指定されます)。
-
Oracle ASMディスク・グループ
Oracle ASMディスク・グループは、論理単位として管理されるOracle ASMディスクのコレクションです。ディスク・グループのデータ構造は自己完結型で、ディスク・グループの一部のディスク領域を使用します。
ディスク・グループ内では、Oracle ASMは、Oracleデータベース・ファイルのファイル・システム・インタフェースを公開します。ディスク・グループ内に保存されたファイルの内容は均等に配分されるか、またはストライプ化されます。これにより、ホット・スポットが排除され、ディスク間のパフォーマンスが均一となります。
-
Oracle ASMファイル
Oracle ASMファイルは、Oracle ASMディスク・グループに格納されるファイルです。Oracle AI Databaseは、ファイルに関してOracle ASMと通信します。データベースには、データファイル、制御ファイル、オンラインREDOログ・ファイルなどの様々なファイルをOracle ASMファイルとして格納できます。データベースから要求されると、Oracle ASMによってOracle ASMファイルが作成され、プラス記号(
+)の後にディスク・グループ名が続く名前(+DISK1など)が、このファイルに割り当てられます。ノート: Oracle ASMファイルは、他のストレージ管理オプション(サード・パーティ・ファイル・システムなど)、と共存できます。この機能により、Oracle ASMの既存の環境への統合が簡素化されています。
-
Oracle ASMエクステント
Oracle ASMエクステントは、Oracle ASMファイル内のセクションです。Oracle ASMファイルは、1つ以上のファイル・エクステントで構成されます。それぞれのOracle ASMエクステントは、特定のディスク上にある1つ以上の割当て単位で構成されます。
-
Oracle ASM割当て単位
Oracle ASM割当て単位とは、ディスク・グループ内での割当ての基本単位のことです。割当て単位は、Oracle ASMによって割り当てられる最小の連続するディスク領域になります。1つ以上の割当て単位によって、1つのOracle ASMエクステントが構成されます。
関連項目: Oracle ASMについてさらに学習するには、Oracle Automatic Storage Management管理者ガイドを参照してください。
Oracle ASMインスタンス
Oracle ASMインスタンスは、Oracle ASMディスクを管理する特殊なOracleインスタンスである。
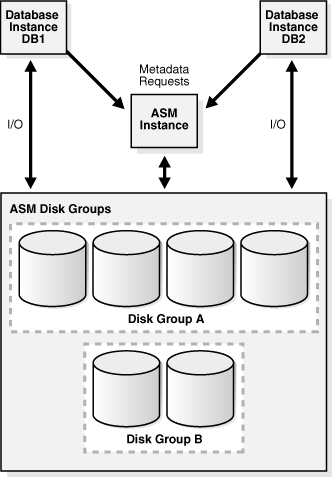
Oracle ASMインスタンスとデータベース・インスタンスのどちらにも、Oracle ASMディスク・グループのディスクへの共有アクセスが必要です。Oracle ASMインスタンスはディスク・グループのメタデータを管理して、ファイルのレイアウト情報をデータベース・インスタンスに提供します。データベース・インスタンスによって、Oracle ASMインスタンスを経由せずに、I/OがOracle ASMディスクに転送されます。
Oracle ASMインスタンスは、データベース・インスタンスと同じテクノロジに基づいています。たとえば、Oracle ASMインスタンスには、データベース・インスタンスおよび同様のシステム・グローバル領域の(SGA)およびバックグラウンド・プロセスがあります。ただし、Oracle ASMインスタンスではデータベースをマウントできず、実行されるタスクもデータベース・インスタンスより少なくなります。図14-3に、Oracle ASMインスタンスは1つとデータベース·インスタンスが2つある、それぞれが異なる単一インスタンス・データベースに関連付けられている単一ノード構成を示します。このOracle ASMインスタンスによってメタデータが管理され、2つのデータベースのデータが格納されているOracle ASMファイルの領域が割り当てられます。一方のOracle ASMディスク・グループには4つのOracle ASMディスクがあり、もう一方には2つのディスクがあります。いずれのデータベース・インスタンスも、これらのディスク・グループにアクセスできます。
図3: Oracle ASMインスタンスとデータベース・インスタンス
関連項目: Oracle ASMについてさらに学習するには、Oracle Automatic Storage Management管理者ガイドを参照してください。
Oracle永続メモリー・ファイルストア(PMEMファイルストア)
PMEMは、バイトアドレス指定可能な永続メモリーです。Oracle永続メモリー・ファイルストア(PMEMファイルストア)には、データ・ファイル、オンラインREDOログ・ファイルおよび制御ファイルを格納できます。
問合せは、最初にブロックをデータベース・バッファ・キャッシュに移行せずに、PMEMからバイトを直接読み取ることができます。この高パフォーマンスのメカニズムにより、データの重複と不要なI/Oを回避できます。ノート: PMEMファイルストアには、トレース・ファイル、監査ファイルまたはサーバー・パラメータ・ファイルを格納できません。PMEMでサポートされているファイル・タイプは、Oracle ASMのタイプに似ています。
-
直接マップされたバッファ・キャッシュ従来のストレージのピラミッドでは、非永続的DRAMと永続的(非揮発性)なフラッシュとの間にPMEMが存在しています。
-
PMEMファイルストア用ファイル・システム・インタフェースPMEMファイルストアは、Filesystem in Userspace (FUSE)というプロトコルを実装します。
-
PMEMファイルストアのユーザー・インタフェースPMEMファイルストアを作成するには、
CREATE PMEM FILESTOREコマンドを使用します。
直接マップされたバッファ・キャッシュ
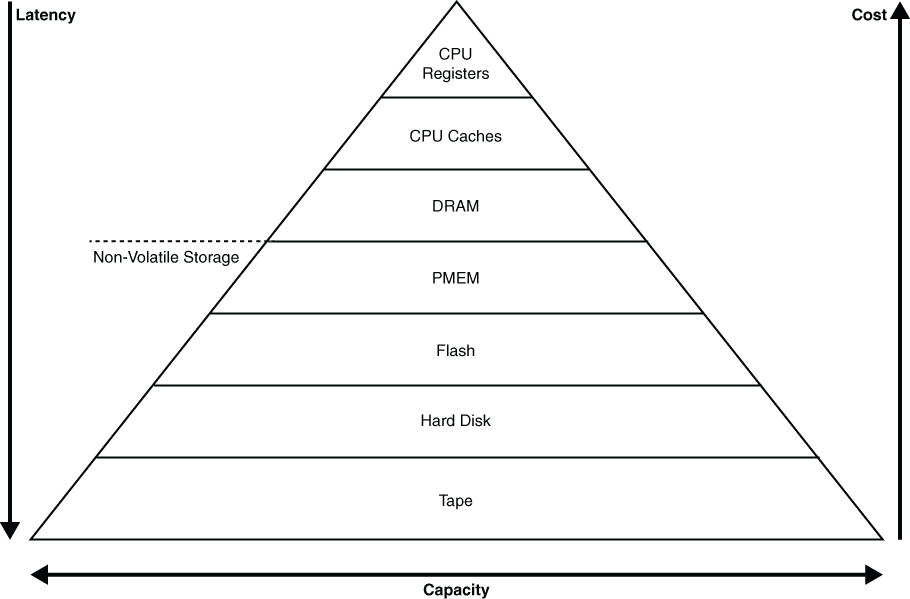
従来のストレージのピラミッドでは、非永続的DRAMと永続的(非揮発性)なフラッシュとの間にPMEMが存在しています。
図4: ストレージのピラミッド
データベース・バッファ・キャッシュはDRAM内にあります。Oracleプロセスには、データベース・バッファ・キャッシュにマップされた、PMEMファイルストア内のブロックにバイトアドレスを指定可能なアクセス権があります。マッピング・メカニズムは、データ・ファイルをPMEMファイルストアに置くと自動的に起動されます。
Oracle AI Databaseでは、内部アルゴリズムを使用して、データ・ブロックのPMEMファイルストアからDRAMに移行するかどうかを決定します。移行する一般的な理由には、DMLの変更、読取りの一貫性、ホット・データ・ブロックに対するアクセスの高速化が含まれます。
関連項目: 「DRAMおよびPMEMバッファ」
PMEMファイルストアのファイル・システム・インタフェース
PMEMファイルストアでは、Filesystem in Userspace (FUSE)というプロトコルを実装します。
FUSEでは、Oracle AI Databaseソフトウェア所有者などの権限のないオペレーティング・システム・ユーザーが、ファイル・システム、ディレクトリ、およびそれに含まれるファイルを作成および管理できます。たとえば、cp、rm、およびlsコマンドを使用できます。
一般的なファイル・システムでは、RAWストレージをそのバッキング・ストアとして使用し、PMEMファイルストアがPMEM DAXファイル・システムのネイティブ・オペレーティング・システム・ファイルからストレージを取得します。このファイルはバッキング・ファイルと呼ばれ、オペレーティング・システム内のファイルとして表示されます。PMEMファイルストアはバッキング・ファイル内でストレージを分割し、それをローカル・ファイル・システムとして提示します。
関連情報:
- PMEMファイルストアについてさらに学習するには、『Oracle AI Database管理者ガイド』を参照してください
PMEMファイルストアのユーザー・インタフェース
PMEMファイル・ストアを作成するには、CREATE PMEM FILESTOREコマンドを使用します。
PMEMファイルストアは、作成後に自動的にマウントされます。PMEMファイルストアは、指定したマウント・ポイントの下にネイティブ・ファイル・システムであるかのように表示されます。
PMEM_FILESTORE初期化パラメータは、データベース・インスタンスが起動時に自動的にマウントするPMEMファイルストアを指定します。パラメータは、順序付けられた文字列のペアに設定されます。パラメータ値リストの最初の文字列は、PMEMファイルストアがマウントされるディレクトリです。2番目の文字列は、バッキング・ファイルです。
V$PMEM_FILESTOREは、PMEMファイルストアに関するメタデータを表示します。たとえば、マウント・ポイントのディレクトリ・パス、バッキング・ファイルのファイル・パス、およびファイルストア・サイズを表示できます。
関連項目: PMEMファイルストアの作成および管理の方法を学習するには、『Oracle AI Database管理者ガイド』を参照してください
データファイルの概要
オペレーティング・システム・レベルで、Oracle AI Databaseでは、データファイルと呼ばれる構造にデータが格納されます。CDBまたはPDBのどちらでも、すべてのOracleデータベースには、少なくとも1つのデータ・ファイルが必要です。
-
データファイルの使用 Oracle AI Databaseでは、表領域データがデータファイルに物理的に格納されます。
-
永続データファイルと一時データファイル永続表領域には、永続スキーマ・オブジェクトが含まれています。永続表領域内のオブジェクトは、データファイルに格納されます。
-
オンライン・データファイルとオフライン・データファイル各データファイルは、オンライン(使用可能)かオフライン(不使用)のどちらかになります。
-
データファイルの構造 Oracle AI Databaseでは、表領域のデータファイルの作成時に、指定されたディスク領域量に加えて、データファイル・ヘッダーのオーバーヘッドを割り当てます。Oracle AI Databaseを実行するオペレーティング・システムによって、ファイルから古い情報や認可がクリアされた後に、そのファイルがデータベースに割り当てられています。
データファイルの使用
Oracle AI Databaseでは、表領域データがデータファイルに物理的に格納されます。
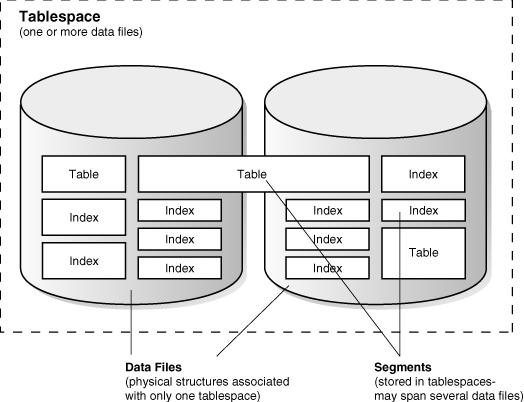
パーティション化されていないそれぞれのスキーマ・オブジェクトとオブジェクトの各パーティションは、独自のセグメント(1つの表領域のみに属している)に格納されます。たとえば、パーティション化されていない表のデータは1つのセグメントに格納され、このセグメントは1つの表領域に格納されます。表領域とデータファイルは密接に関連していますが、次のような重要な違いがあります。
-
各表領域は1つ以上のデータファイルで構成され、これらのファイルは、Oracle AI Databaseを実行しているオペレーティング・システムに準拠しています。
-
データベースのデータは、データベースの各表領域にあるデータファイルにまとめて格納されます。
-
1つのセグメントは1つ以上のデータファイルにまたがることができるが、複数の表領域にまたがれることはできません。
-
CDBには、
SYSTEM表領域とSYSAUX表領域が必要です。CDB内の各PDBには、固有のSYSTEM表領域とSYSAUX表領域があります。Oracle AI Databaseでは、データベースの作成時に、データベースの最初のデータファイルがSYSTEM表領域に自動的に割り当てられます。SYSTEM表領域には、データベースのメタデータを含む一連の表を含むデータ・ディクショナリが含まれています。通常、データベースにはUNDO表領域と一時表領域(通常の名前はTEMP)もあります。
次の図に、表領域、データファイルおよびセグメントの関係を示します。
図5: データファイルと表領域
関連情報:
-
データファイルの管理方法を学習するには、『Oracle AI Database管理者ガイド』を参照
永続データファイルと一時データファイル
永続表領域には、永続スキーマ・オブジェクトが含まれています。永続表領域内のオブジェクトは、データファイルに格納されます。
一時表領域には、セッションの存続時間のみのスキーマ・オブジェクトが含まれます。ローカルで管理される一時表領域には、ハッシュやソートなどの操作でデータを格納するための特殊なファイルである一時的なファイル(一時ファイル)が含まれています。一時ファイルには、メモリー内の領域が不足したときの結果セットのデータも格納されます。
一時ファイルは永続データファイルと似ていますが、次のような例外があります。
-
表などの永続データベース・オブジェクトは、一時ファイルには格納されません。
-
一時ファイルは常に
NOLOGGINGモードに設定され、これは、一時ファイルにはREDOが生成されないということを意味します。メディア・リカバリは一時ファイルを認識しません。 -
一時ファイルを読取り専用にすることはできません。
-
ALTERDATABASE文では一時ファイルを作成できません。 -
一時ファイルを作成またはサイズ変更する場合、指定したファイル・サイズのディスク領域が常に保証されるとはかぎりません。LinuxやUNIXなどのファイル・システムでは、一時ファイルはスパース・ファイルとして作成されます。この場合、ディスク・ブロックはファイルの作成時やサイズ変更時ではなく、最初にブロックがアクセスされるときに割り当てられます。
ノート:スパース・ファイルを使用すると、一時ファイルの作成とサイズ変更が素早く行われますが、一時ファイルへのアクセス時に、ディスク領域が不足する可能性があります。
-
一時ファイルの情報は、データ・ディクショナリ・ビュー
DBA_TEMP_FILESと動的パフォーマンス・ビューV$TEMPFILEには表示されますが、DBA_DATA_FILESビューやV$DATAFILEビューには表示されません。
関連情報:
-
一時ファイルの管理方法を学習するには、Oracle AI Database管理者ガイドを参照
オンライン・データファイルとオフライン・データファイル
すべてのデータファイルは、オンライン(使用可能)またはオフライン(使用不可能)のいずれかです。
個々のデータファイルまたはテンポラリファイルの可用性は、ファイルをオフラインにするか、オンラインにすることにより変更できます。データベースでは、オフライン・データファイルには、それらがオンラインになるまでアクセスできません。
データファイルをオフラインにする理由は、オフライン・バックアップの実行やブロックの破損など数多くあります。データベースでは、データファイルに書き込めない場合に、ファイルが自動的にオフラインになります。
データファイルと同様に、表領域自体もオフラインまたはオンラインになります。オンラインの表領域にあるデータファイルをオフラインにしても、表領域自体はオンラインのままです。表領域の自体をオフラインにすると、表領域のすべてのデータファイルを一時的に使用不可能にできます。
Oracle Database 12c以降、ALTER DATABASE MOVE DATAFILE文を使用して、データベースをオープンした状態でファイルにアクセスしている間に、複数の物理ファイルに対してオンライン・データ・ファイルを移動できます。この手法を使用すれば、次の目的を達成できます。
-
異なる種類のストレージ間での表領域の移動
-
頻繁にアクセスしないデータファイルを、より低コストの記憶域に移動します
-
表領域を読取り専用にし、そのデータ・ファイルをライト・オン・ストレージ(WORM (write once read many)ドライブなど)に移動
-
データベースをOracle ASMに移動
関連情報:
-
データ・ファイルの可用性を変更する方法を学習するには、Oracle AI Database管理者ガイドを参照
-
オンライン・データ・ファイルの移動方法を学習するには、Oracle AI Database管理者ガイドを参照
-
ALTER DATABASE . . . MOVE DATAFILEについて学習するには、Oracle AI Database SQL言語リファレンスを参照
データファイルの構造
Oracle AI Databaseでは、表領域のデータファイルを作成するには、指定されたディスク領域に加えて、データファイル・ヘッダーのオーバーヘッドを割り当てます。Oracle AI Databaseを実行するオペレーティング・システムによって、ファイルから古い情報や認可がクリアされた後に、そのファイルがデータベースに割り当てられています。
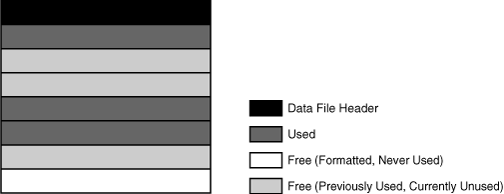
データファイル・ヘッダーには、サイズやチェックポイントSCNなど、データファイルに関するメタデータが含まれています。それぞれのヘッダーには、データベース内でデータファイルを一意に識別する絶対ファイル番号と、表領域内でデータファイルを一意に識別する相対ファイル番号が含まれます。
Oracle AI Databaseでデータファイルが初めて作成されると、割り当てられたディスク領域がフォーマットされますが、ユーザー・データは含まれません。ただし、データベースでは、関連付けられた表領域の将来のセグメントのデータを保持する領域が確保されます。Oracle AI Databaseでは、表領域内のデータが増加すると、データファイル内の空き領域を使用してセグメントにエクステントを割り当てます。
次の図に、データファイル内の各種の領域を示します。エクステントは、使用中(セグメント・データが含まれている場合)または空き(再使用が可能な場合)のいずれかです。表領域内のオブジェクトの更新または削除が繰り返されると、単独では新しいデータに再使用できるほど大きくはないものの、孤立した空き領域ができる場合があります。このような空き領域は、断片化空き領域と呼ばれます。
図6: データファイル内の領域
関連項目:データファイル情報の表示方法を学習するには、『Oracle AI Database管理者ガイド』を参照してください
制御ファイルの概要
データベースの制御ファイルは、1つのCDBのみに関連付けられた小さなバイナリ・ファイルです。
各CDBには一意の制御ファイルが1つあります(ただし、複数の同一コピーも使用できます)。PDBには、別個の制御ファイルがありません。
-
制御ファイルの使用 Oracle AI Databaseでは、制御ファイルを使用して、データベース・ファイルを検出し、データベースの状態を大まかな管理するために、制御ファイルが使用されます。
-
多重制御ファイル Oracle AI Databaseでは、同一の複数の制御ファイルを同時に開くことや同じデータベースに書き込むことが可能です。1つの制御ファイルを複数のディスク上で多重化することにより、データベースの冗長性が実現されるため、シングル・ポイント障害を回避できます。
-
制御ファイルの構造データベースに関する情報は、制御ファイルの様々なセクションに格納されます。各セクションは、データベースの特定の側面に関するレコードの集合です。
制御ファイルの使用
Oracle AI Databaseでは、データベース・ファイルを見つけるために、データベースの状態を大まか管理するために、制御ファイルが使用されます。
制御ファイルには、次のような情報が含まれています。
-
データベース名およびデータベースの一意の識別子(DBID)
-
データベースを作成したときのタイムスタンプ
-
データファイル、オンラインREDOログ・ファイルおよびアーカイブREDOログ・ファイルに関する情報
-
表領域情報
-
RMANのバックアップ
制御ファイルは、次のような目的で使用されます。
-
データベースをオープンするために必要となるデータファイル、オンラインREDOログ・ファイルなどに関する情報を格納します。
制御ファイルは、データベースに対する構造上の変更を追跡します。たとえば、管理者がデータファイルやオンラインREDOログ・ファイルの追加、名前変更または削除を実行すると、データベースで制御ファイルが更新され、変更が反映されます。
-
データベースがオープンしていないときにアクセスする必要があるメタデータを格納します。
制御ファイルには、チェックポイントなどデータベースのリカバリに必要な情報などが含まれています。チェックポイントは、インスタンス・リカバリの開始が必要なときである、REDOストリームにおけるSCNを示します。チェックポイントSCNの前にコミットされたすべての変更は、データファイルのディスクに保存されることが保証されます。チェックポイント・プロセスは、オンラインREDOログ内のチェックポイント位置に関する情報を、少なくとも3秒ごとに制御ファイルに記録します。
Oracle AI Databaseは、データベースの使用中に制御ファイルの読取りと書込みを絶えず実行するため、データベースがオープンしているときは、常に書込み可能であることが必要です。たとえば、データベースのリカバリには、データベースに含まれているすべてのデータファイルの名前を制御ファイルから読み取る必要があります。データファイルの追加など他の操作を実行すると、制御ファイルに格納された情報が更新されます。
関連情報:
-
インスタンス・リカバリの概要に関する項
-
制御ファイルの管理方法を学習するには、Oracle AI Database管理者ガイドを参照
多重制御ファイル
Oracle AI Databaseでは、同一の制御ファイルを同時に複数オープンし、同じデータベースに書き込むことができます。1つの制御ファイルを複数のディスク上で多重化することにより、データベースの冗長性が実現されるため、シングル・ポイント障害を回避できます。ノート: Oracleでは、それぞれ異なるディスク上に複数の制御ファイルのコピーを保持することをお薦めします。
制御ファイルが使用不可能になると、データベース・インスタンスから破損した制御ファイルへのアクセスが試行されたときに、インスタンスが失敗します。現在の制御ファイルのコピーが他にある場合は、メディア・リカバリを実行してなくても、データベースを再マウントしてオープンできます。ただし、データベースのすべての制御ファイルが失われた場合は、データベース・インスタンスが失敗し、メディア・リカバリが必要になります。現行の制御ファイルを使用できず、制御ファイルの古いバックアップを使用する場合、メディア・リカバリは容易ではありません。
関連情報:
-
複数の制御ファイルを維持する方法を学習するには、Oracle AI Database管理者ガイドを参照
-
制御ファイルのバックアップとリストア方法を学習するには、Oracle AI Databaseバックアップおよびリカバリ・ユーザーズ・ガイドを参照
制御ファイルの構造
データベースに関する情報は、制御ファイルの異なるセクションに格納されます。各セクションは、データベースの特定の側面に関するレコードの集合です。
たとえば、制御ファイルの1つのセクションではデータファイルが追跡され、レコードの集合がデータファイルごとに1つ含まれています。各セクションは、複数の論理的な制御ファイル・ブロックに格納されます。レコードは、1つのセクション内のブロックにまたがることができる場合があります。
制御ファイルには、次のようなレコードが含まれています。
-
循環再利用レコード
循環再使用レコードには、必要に応じて上書き可能な、重要度の低い情報が含まれています。使用可能なすべてのレコード・スロットがいっぱいになると、データベースでは制御ファイルを拡張して新規レコード用の領域を作成するか、または最も古いレコードを上書きします。たとえば、アーカイブREDOログ・ファイルやRMANバックアップのレコードなどです。
-
非循環再利用レコード
非循環再利用レコードには、頻繁に変更されず、上書きできない重要な情報が含まれています。たとえば、表領域、データファイル、オンラインREDOログ・ファイル、REDOスレッドなどの情報です。Oracle AI Databaseでは、対応するオブジェクトが表領域から削除されないかぎり、これらのレコードを再使用することはありません。
動的パフォーマンス・ビュー(V$ビューとも呼ばれる)を問い合せて、制御ファイルに格納されている情報を表示できます。たとえば、V$DATABASEを問い合せると、データベース名およびDBIDを取得できます。ただし、制御ファイルの情報を変更できるのは、そのデータベースのみです。
制御ファイル・ブロックの読取りおよび書込みは、データ・ブロックの場合とは異なります。制御ファイルの場合は、Oracle AI Databaseによって、ディスクからプログラム・グローバル領域(PGA)への読取りおよび書込みが行われます。各プロセスでは、そのPGAメモリーの一定量が制御ファイル・ブロックに割り当てられます。
関連情報:
-
V$CONTROLFILE_RECORD_SECTIONビューについて学習するには、Oracle AI Databaseリファレンスを参照 -
CONTROL_FILE_RECORD_KEEP_TIME初期化パラメータについて学習するには、Oracle AI Databaseリファレンスを参照してください。
オンラインREDOログの概要
リカバリにとって最も重要な構造がオンラインREDOログであり、このアーカイブは、データベースへの変更が発生したときにその変更が格納される、事前に割り当てられた複数のファイルで構成されます。オンラインREDOログには、データファイルに対する変更が記録されます。
-
オンラインREDOログの使用データベースでは、オンラインREDOログ・ファイルを維持してデータ損失から保護します。特に、インスタンス障害の後、Oracle AI Databaseではまだデータファイルに書き込まれていないコミット済のデータをリカバリできるオンラインREDOログ・ファイルです。
-
Oracle AI DatabaseによるオンラインREDOログへの書込み方法データベース・インスタンスのオンラインREDOログは、REDOスレッドと呼ばれます。
-
オンラインREDOログの構造オンラインREDOログ・ファイルには、REDOレコードが含まれています。
オンラインREDOログの使用
データベースでは、オンラインREDOログ・ファイルを維持してデータ損失から保護します。特に、インスタンス障害の後は、オンラインREDOログ・ファイルを使用すると、Oracle AI Databaseではまだデータファイルに書き込まれていないコミット済のデータをリカバリできるようになります。
サーバー・プロセスは、すべてのトランザクションをREDOログ・バッファに同期的に書き込みます。REDOログ・バッファは、LGWRプロセスがオンラインREDOログに書き込みます。オンラインREDOログの内容には、コミットされていないトランザクションや、スキーマおよびオブジェクトの管理文などが含まれます。
データベースでUNDOセグメントに変更を加えると、変更内容はオンラインREDOログにも書き込まれます。その結果、オンラインREDOログには常に永続オブジェクトのUNDOデータが含まれます。一時UNDOセグメントにある一時オブジェクトのすべてのUNDOデータを格納するようにデータベースを構成でき、これによって領域が節約されパフォーマンスが向上するか、またはデータベースで永続および一時の両方のUNDOデータをオンラインREDOログに格納できるようになります。
Oracle AI Databaseは、リカバリのためにのみオンラインREDOログを使用します。ただし、管理者はOracle LogMinerユーティリティでSQLインタフェースを使用して、オンラインREDOログ・ファイルを問い合せることができます。REDOログ・ファイルは、データベース・アクティビティに関する履歴情報の入手に役立ちます。
関連情報:
-
インスタンス・リカバリの概要に関する項
-
Oracleのプロセスについて学習するには、「プロセス・アーキテクチャ」
-
一時UNDOセグメントについて学習するには、Oracle AI Database管理者ガイドを参照してください。
-
TEMP_UNDO_ENABLED初期化パラメータについて学習するには、『Oracle AI Databaseリファレンス』を参照
Oracle AI DatabaseでのオンラインREDOログの書込み方法
データベース・インスタンスのオンラインREDOログは、REDOスレッドと呼ばれます。
単一インスタンス構成では、1つのインスタンスしかデータベースにアクセスできないため、REDOスレッドは1つのみです。ただし、Oracle Real Application Clusters (Oracle RAC)構成では、複数のインスタンスが同時にデータベースにアクセスし、各インスタンスには独自のREDOスレッドがあります。インスタンスごとにREDOスレッドを分けると、オンラインREDOログ・ファイルの1つの集合に対する競合を回避できます。
オンラインREDOログは、複数のオンラインREDOログ・ファイルで構成されています。Oracle AI Databaseでは、ファイルの1つがクリア中またはアーカイブ中の場合に、もう1つのファイルが常に書込み可能であることを保証するため、少なくとも2つのファイルが必要です。
-
オンラインREDOログ・スイッチ Oracle AI Databaseでは、REDOログ・バッファから書き込まれたレコードを格納するために、一度に1つのオンラインREDOログ・ファイルが使用されます。
-
オンラインREDOログ・ファイルの複数コピー Oracle AI Databaseでは、自動的に、オンラインREDOログの複数の同一コピーを別々の場所で保持できます。
-
アーカイブREDOログ・ファイルアーカイブREDOログ・ファイルとは、オンラインREDOログ・グループ内でいっぱいになったメンバーのコピーのことです。
関連項目: Oracle RACのオンラインREDOログ・グループについて学習するには、『Oracle Real Application Clusters管理およびデプロイメント・ガイド』
オンラインREDOログ・スイッチ
Oracle AI Databaseでは、REDOログ・バッファから書き込まれたレコードを格納するために、一度に1つのオンラインREDOログ・ファイルのみが使用されます。
ログ・ライター・プロセス(LGWR)による書込みがアクティブであるオンラインREDOログのファイルは、現行のオンラインREDOログのファイルと呼ばれます。
ログ・スイッチは、データベースで、1つのオンラインREDOログ・ファイルに書込みが停止し、別のファイルへの書込みが開始するときに発生します。スイッチは通常、現行のオンラインREDOログ・ファイルがいっぱいになり、さらに書込みを継続する必要があるときに発生します。ただし、ログ・スイッチは、現行のオンラインREDOログ・ファイルがいっぱいになったかどうかに関係なく、定期的にログ・スイッチが発生するように構成し、手動で強制的に実行できます。
ログ・ライターでは、オンラインREDOログ・ファイルが循環的に書き込まれます。ログ・ライター・プロセスは、使用可能な最後のオンラインREDOログ・ファイルがいっぱいになると、最初のログ・ファイルへ書き込み、循環が再び始まります。図14-7に、REDOログの循環書込みを示します。
図7: オンラインREDOログ・ファイルの再使用
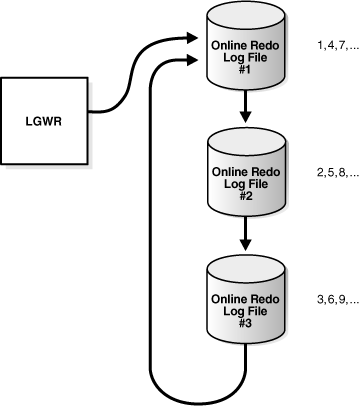
図14-7の数字は、それぞれのオンラインREDOログ・ファイルへのLGWRによる書込みの順序を示しています。データベースでは、ログ・スイッチおよびログ・ライターが書込みを開始したときに、各ファイルに新しいログ順序番号を割り当てます。データベースでオンラインREDOログ・ファイルが再利用されると、このファイルには次に使用可能なログ順序番号が与えられる。
いっぱいになったオンラインREDOログ・ファイルは、アーカイブ・モードに応じて再利用できます。
-
アーカイブが無効、つまりデータベースを
NOARCHIVELOGモードの場合、ファイルに記録された変更のデータベース・ライター(DBW)によってディスクにチェックポイント(書込み)が行われたまで、いっぱいになったオンラインREDOログ・ファイルを利用できません。 -
アーカイブが有効(データベースがARCHIVELOGモード)の場合は、変更がデータファイルに書き込まれ、さらにそのファイルがアーカイブされた後、いっぱいになったオンラインREDOログ・ファイルをロギング・ライターで使用できるようになります。
状況によっては、既存のオンラインREDOログ・ファイルをログ・ライターで再利用できない場合もあります。インスタンス・リカバリにはアクティブなオンラインREDOログ・ファイルが必要です。この場合、アクティブではないオンラインREDOログ・ファイルはインスタンスのリカバリには必要ありません。また、オンラインREDOログ・ファイルがクリア・プロセスの途中である場合もあります。
関連情報:
-
オンラインREDOログの管理方法を学習するには、Oracle AI Database管理者ガイドを参照
オンラインREDOログ・ファイルの複数コピー
Oracle AI Databaseでは、オンラインREDOログの複数の同一コピーを別々の場所で自動的に維持できます。
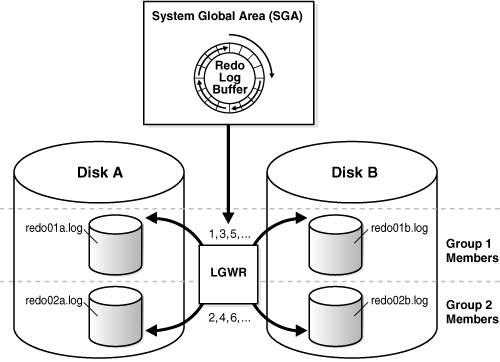
オンラインREDOログ・グループは、オンラインREDOログ・ファイルとその冗長コピーで構成されています。それぞれの同一コピーは、オンラインREDOログ・グループのメンバーです。各グループはグループ1、グループ2のように番号で定義されます。
オンラインREDOログ・グループの複数のメンバーを維持すると、REDOログの損失を防ぐことができます。メンバーの場所を別個のディスクに配置し、1つのディスクで障害が発生してもオンラインREDOログ全体が失われないようにすることが理想的です。
図14-8では、A_LOG1とB_LOG1はグループ1の同一のメンバーであり、A_LOG2とB_LOG2はグループ2の同一のメンバーです。同じグループの各メンバーは同じサイズである必要があります。LGWRは、グループ1(メンバーA_LOG1とB_LOG1)への書込みを同時に実行した後、グループ2(メンバーA_LOG2とB_LOG2)への書込みを同時に実行し、次にグループ1への書込みを実行します。LGWRでは、異なるグループのメンバーに同時に書き込まれることはありません。
図8: オンラインREDOログ・ファイルの複数コピー
注意: Oracleでは、オンラインREDOログを多重化することをお薦めします。ログ・ファイルの損失は、リカバリが必要な場合に壊滅的な被害を招く可能性があります。オンラインREDOログを多重化し、データベースで実行するI/Oの量を増やす必要があります。システムによっては、I/Oをこのように追加すると、データベース全体のパフォーマンスに影響を与える場合があります。
関連情報:
-
オンラインREDOログ・ファイルの複数コピーを維持する方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
Data Guard構成のメンバー間のREDOデータの自動転送について学習するには、『Oracle Data Guard概要および管理』を参照
アーカイブREDOログ・ファイル
アーカイブREDOログ・ファイルとは、オンラインREDOログ・グループ内で一杯になったメンバーのコピーのことです。
アーカイブREDOログ・ファイルはデータベースの一部とはみなされません。そうではなく、データベースによって作成されたオンラインREDOログ・ファイルのオフライン・コピーであり、ユーザーが指定した場所に書き込まれます。
アーカイブREDOログ・ファイルは、バックアップおよびリカバリ計画にとって重要です。アーカイブREDOログ・ファイルは、次の目的に使用できます。
-
データベース・バックアップのリカバリ
-
スタンバイ・データベースの更新
-
Oracle LogMinerユーティリティを使用したデータベースの履歴情報の取得
アーカイブREDOログ・ファイルを生成する操作をアーカイブといいます。この操作は、自動または手動のいずれかです。これは、データベースがARCHIVELOGモードの場合にのみ実行できます。
アーカイブREDOログ・ファイルには、オンラインREDOログ・グループの同一メンバーのREDOエントリ、およびログ順序番号が含まれています。「オンラインREDOログ・ファイルの複数コピー」では、ファイルA_LOG1とB_LOG1がグループ1の同一メンバーです。データベースがARCHIVELOGモードで、自動アーカイブが有効になっている場合は、アーカイバ・プロセス(ARCn)によってこれらのファイルの1つがアーカイブされます。A_LOG1が破損している場合は、B_LOG1をアーカイブできます。アーカイブREDOログには、アーカイブを有効にしたときから存在したすべてのREDOログ・グループのコピーが含まれます。
関連情報:
-
Oracle LogMinerについて学習するには、Oracle AI Databaseユーティリティを参照
-
アーカイブREDOログの管理方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
スタンバイREDOログ・アーカイブの構成方法を学習するには、『Oracle Data Guard概要および管理』を参照
オンラインREDOログの構造
オンラインREDOログ・ファイルには、REDOレコードが含まれています。
REDOレコードは、変更ベクトルのグループで構成され、それぞれがデータ・ブロックに対する変更を記述します。たとえば、employees表の給与を更新すると、この表のデータ・セグメント・ブロック、UNDOセグメント・データ・ブロックおよびUNDOセグメントのトランザクション表に対する変更を記述するREDOレコードが生成されます。
REDOレコードには、変更に関係するすべてのメタデータが設定されます。たとえば、次のものがあります。
-
変更のSCNおよびタイムスタンプ
-
変更が生成されたトランザクションのトランザクションID
-
トランザクションがコミットされたときのSCNおよびタイムスタンプ(トランザクションがコミットされた場合)
-
変更を実行した操作のタイプ
-
変更されたデータ・セグメントの名前およびタイプ
関連項目: 「データ・ブロックの概要」