メモリー・アーキテクチャ
この章では、データベース・インスタンスのメモリー・アーキテクチャについて説明します。
-
Oracle AI Databaseのメモリー構造の概要Oracle AI Databaseが起動されると、Oracle AI Databaseによってメモリー領域が割り当てられる、バックグラウンド・プロセスが起動されます。
-
システム・グローバル領域(SGA)の概要 SGAは、Oracleバックグラウンド・プロセスとともにデータベース・インスタンスを構成する、読取り/書込み可能なメモリー領域です。
-
プログラム・グローバル領域(PGA)の概要 PGAは、システム上の他のプロセスやスレッドによって共有されていない、動作中プロセスやスレッドに固有のメモリーです。PGAはプロセス固有であるため、SGA内で割り当てられることはありません。
-
ユーザー・グローバル領域の概要UGAはセッション・メモリーです。セッション・メモリーは、ログイン情報や、データベース・セッションに必要なその他の情報など、セッション変数に割り当てられたメモリーです。基本的に、UGAにはセッション状態が格納されています。
-
管理対象グローバル領域(MGA)の概要管理対象グローバル領域(MGA)は、一連の信頼できるOracleプロセス間でメモリーを共有および調整できる一意のメモリ・フレームワークである。
-
ソフトウェア・コード領域の概要 ソフトウェア・コード領域は、実行中または実行可能なコードを格納するメモリーの部分です。Oracle AI Databaseのコードはソフトウェア領域に格納され、通常、この場所はユーザー・プログラムの保存場所よりも排他的で、保護されています。関連項目:メモリーの構成および管理方法は、Oracle AI Database管理者ガイドを参照してください。
Oracle AI Databaseのメモリー構造の概要
インスタンスが開始されると、Oracle AI Databaseによってメモリー領域が割り当てられます。バックグラウンド・プロセスが起動されます。
メモリー領域には、次のような情報が格納されます。
-
プログラム・コード
-
接続されているセッションについての情報(現在はアクティブかどうかは不問)
-
プログラムの実行時に必要な情報(行をフェッチしている問合せの現在の状態など)
-
プロセス間で共有および通信されるロック・データなどの情報
-
データ・ブロックやREDOレコードなどの、ディスク上にも存在するキャッシュ・データ
-
基本的なメモリー構造 Oracle AI Databaseには複数のメモリー領域が含まれており、各メモリーには複数のサブコンポーネントが格納されています。
-
Oracle AI Databaseのメモリー管理のメモリー管理では、データベースでの需要の変化に応じて、Oracleインスタンスのメモリー構造の最適なサイズを維持します。Oracle AI Databaseでは、メモリー関連の初期化パラメータの設定に基づいて、メモリーが管理されます。関連項目: 「プロセス・アーキテクチャ」
基本的なメモリー構造
Oracle AI Databaseには複数のメモリー領域が含まれており、各メモリー・領域に複数のサブ・コンポーネントが含まれています。
Oracle AI Databaseに関連する基本的なメモリー構造は、次のような領域で構成されています。
-
システム・グローバル・エリア(SGA)
SGAは、SGAコンポーネントという共有メモリー構造のグループで、1つのOracle AI Databaseインスタンスのデータと制御情報が含まれます。すべてのサーバー・プロセスとバックグラウンド・プロセスでSGAを共有します。SGAに格納されるデータの例としては、キャッシュされたデータ・ブロックや共有SQL領域があります。
-
プログラム・グローバル・エリア(PGA)
PGAは、Oracleプロセス専用のデータおよび制御情報を含む、非共有メモリー領域である。Oracle AI Databaseでは、Oracleプロセスの起動時にPGAが作成されます。
PGAは、サーバー・プロセスごと、およびバックグラウンド・プロセスごとに存在します。個々のPGAの集合は、合計インスタンスPGAまたはインスタンスPGAです。個々のPGAではなく、データベース初期化パラメータを使用してインスタンスPGAのサイズを設定します。
-
ユーザー・グローバル領域(UGA)
UGAは、ユーザー・セッションに関連付けられたメモリーです。
-
管理対象グローバル領域(MGA)
MGAは、Oracle AI Databaseインスタンスで使用される半共有メモリー・コンポーネントです。信頼できる少数のOracleプロセス間でメモリーを共有および調整する機能を備えています。構成可能で柔軟性に富み、モジュール式のオンデマンドかつリカバリ可能な機能を備えています。SGAとは異なり、Oracle AI Databaseモジュールでは、この領域にアタッチするプロセスを選択できます。この動作は動的です。
-
ソフトウェア・コード領域
ソフトウェア・コード領域とは、実行中または実行される可能性のあるコードを格納するためのメモリー部分です。Oracle AI Databaseのコードはソフトウェア領域に格納され、通常、ユーザー・プログラムとは異なる場所(より排他的または保護される場所)にあります。
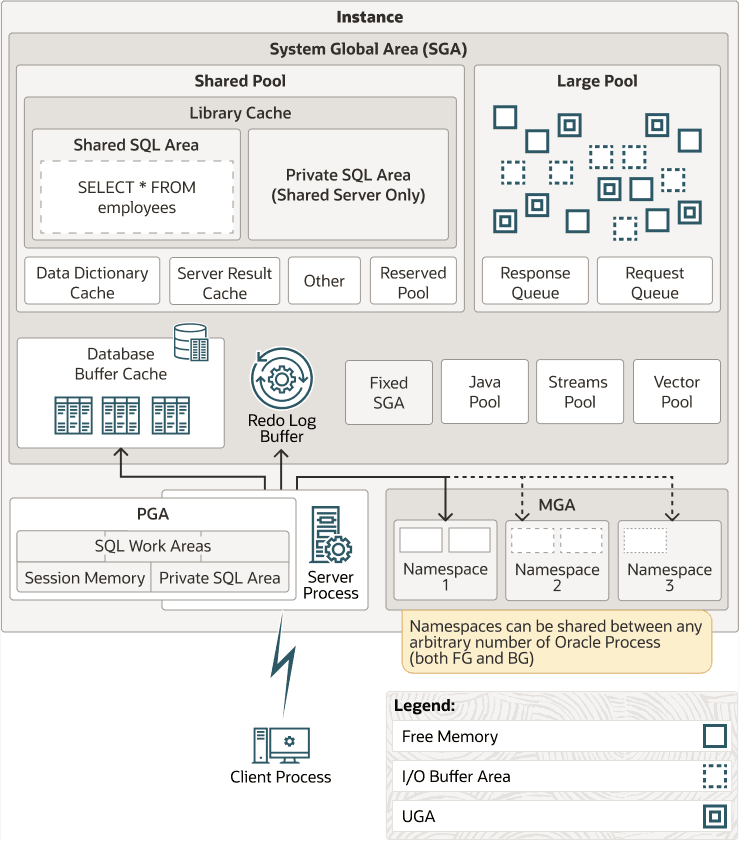
次の図に、これらのメモリー構造の関係を示します。
図1: Oracle AI Databaseのメモリー構造
Oracle AI Databaseのメモリー管理
メモリー管理では、データベースでの需要の変化に応じて、Oracleインスタンスのメモリー構造の最適なサイズを維持する必要があります。Oracle AI Databaseでは、メモリー関連の初期化パラメータの設定に基づいて、メモリーが管理されます。
メモリー管理の基本的なオプションは、次のとおりです。
-
統合メモリー管理
統合メモリーでは、単一パラメータ
MEMORY_SIZEによりデータベース・インスタンス・メモリーを構成します。データベースでは、現在のワークロードに基づいて、SGA、PGA、MGA、UGAおよびその他のメモリー・セグメントの任意の比率でこのメモリーを動的に使用できます。異なるメモリー・セグメント間での分割は、CDBに現在オープンされているPDBのメモリー・サイズに基づきます。ヒュージ・ページが構成されている場合は、SGAとPGAの両方に使用できます。統合メモリーは、非常に柔軟なメモリー構成を提供します。 -
自動メモリー管理
データベース・インスタンス・メモリーのターゲット・サイズを指定します。インスタンスは自動的にターゲット・メモリー・サイズにチューニングし、必要に応じてSGAとインスタンスPGAとの間でメモリーの再配分が行われます。
-
自動共有メモリー管理
この管理モードでは、一部の処理が自動化されます。SGAは、ターゲット・サイズを設定し、PGAは、ターゲット・サイズの合計を設定するか、作業領域を個別に管理できます。
-
手動メモリー管理
合計メモリー・サイズを設定するかわりに、SGAのコンポーネントおよびインスタンスPGAを個別に管理するための数多くの初期化パラメータを設定します。
Database Configuration Assistant(DBCA)を使用してデータベースを作成し、基本インストール・オプションを選択した場合のデフォルトは、自動メモリー管理です。
関連情報:
-
DBAのメモリー管理オプションの詳細は、Oracle AI Databaseパフォーマンス・チューニング・ガイドを参照してください。
-
メモリー管理オプションについて学習するには、『Oracle AI Database管理者ガイド』を参照してください。
-
初期化パラメータについて学習するには、『Oracle AI Databaseリファレンス』を参照してください。
システム・グローバル領域(SGA)の概要
SGAは、Oracleバックグラウンド・プロセスとともにデータベース・インスタンスを構成する、読取り/書込み可能なメモリー領域です。ノート:サーバー・プロセスおよびバックグラウンド・プロセスはSGA内ではなく、別のメモリー領域内に存在しています。
ユーザー用に実行されるすべてのサーバー・プロセスで、インスタンスSGA内の情報の読取りが可能です。データベース操作中にSGAに書き込むプロセスもあります。
各データベース・インスタンスには、独自のSGAが含まれます。Oracle AI Databaseでは、インスタンスの起動時にSGAのメモリーが自動的に割り当てられて、インスタンスが停止するとメモリーが再利用します。SQL*PlusまたはOracle Enterprise Managerを使用してインスタンスを開始した場合、SGAは次の例に示すサイズになります。
SQL> STARTUP
ORACLE instance started.

Total System Global Area  368283648 bytes
Fixed Size                  1300440 bytes
Variable Size             343935016 bytes
Database Buffers           16777216 bytes
Redo Buffers                6270976 bytes
Database mounted.
Database opened.図17-1に示すように、SGAはいくつかのメモリー・コンポーネントで構成されています。これらのコンポーネントは、特定の種類のメモリー割当て要求を満たすために使用されるメモリーのプールです。REDOログ・バッファを除くすべてのSGAコンポーネントは、グラニュルと呼ばれる連続したメモリーの単位で割当ておよび割当て解除します。グラニュルのサイズはプラットフォーム固有であり、SGAサイズの合計から決定されます。
SGAコンポーネントの情報は、V$SGASTATビューに問い合せることができます。
次に、最も重要なSGAコンポーネントを示します。
-
データベース・バッファ・キャッシュ データベース・バッファ・キャッシュ(バッファ・キャッシュとも呼ばれる)とは、データファイルから読み取ったデータ・ブロックのコピーを格納するメモリー領域のことで、
-
REDOログ・バッファREDOログ・バッファとは、SGA内の循環バッファで、データベースに加えられた変更についてのREDOエントリが格納されます。
-
共有プール共有プールは、様々なタイプのプログラム・データをキャッシュします。
-
ラージ・プールラージ・プールは、共有プールでの割当てには適さないサイズのメモリー割当て用のオプションのメモリ領域です。
-
Javaプール Javaプールは、セッション固有のすべてのJavaコードとデータをJava Virtual Machine (JVM)内に格納するメモリー領域です。このメモリーには、コール終了時にJavaセッション領域に移行されるJavaオブジェクトが含まれています。
-
固定SGA: 固定SGAは、内部のハウスキーピング領域です。
-
オプションのパフォーマンス関連SGAサブ領域一部のSGAサブ領域は、特定のパフォーマンス機能のみが使用できます。
関連情報:
-
グラニュルのサイズ設定についてさらに学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照してください。
データベース・バッファ・キャッシュ
データベース・バッファ・キャッシュ(バッファ・キャッシュとも呼ばれる)とは、データファイルから読み取られたデータ・ブロックのコピーを格納するメモリー領域のことです。
バッファとは、現在使用されているデータ・ロックまたは最近使用されたデータ・ロックがバッファ・マネージャで一時的にキャッシュされるメイン・メモリーのアドレスのです。データベース・インスタンスに同時接続されたユーザーはすべて、バッファ・キャッシュへのアクセスを共有します。
-
データベース・バッファ・キャッシュの目的 Oracle AI Databaseでは、複数の目的を達成するためにバッファ・キャッシュが使用されます。
-
バッファ状態データベースでは、内部アルゴリズムを使用してキャッシュ内のバッファを管理します。
-
バッファ・モードクライアントがデータを要求すると、Oracle AI Databaseでは、現在のモードまたは一貫したモードいずれかでデータベース・バッファ・キャッシュからバッファを取得されます。
-
バッファI/O論理I/Oは、バッファI/Oとも呼ばれている、バッファ・キャッシュ内でのバッファの読取りおよび書込みのことを指します。
-
バッファ・プールバッファ・プールは、バッファの集合です。
-
バッファと全表スキャンデータベースでは、複雑なアルゴリズムを使用して表スキャンが管理されています。デフォルトでは、バッファをディスクから読み取る必要がある場合、そのバッファはLRUリストの中央に挿入されます。これにより、ホット・ブロックがキャッシュ内に維持されて、再度ディスクから読み取る必要がなくなります。
-
DRAMおよびPMEMバッファ標準(DRAM)データベース・バッファはPMEMバッファとは異なっていますが、それらには特徴があります。
データベース・バッファ・キャッシュの目的
Oracle AI Databaseでは、複数の目的でバッファ・キャッシュが使用されます。
目的には次のものがあります。
-
物理I/Oを最適化します。
データベースでは、キャッシュ内のデータ・ブロックが更新されて、REDOログ・バッファに変更についてのメタデータが格納されます。
COMMITの後、データベースによってREDOバッファがオンラインREDOログに書き込まれますが、データ・ブロックが即座にデータ・ファイルに書き込まれるわけではありません。かわりに、データベース・ライター(DBW)によって、バックグラウンドで遅延書込みが実行されます。 -
頻繁にアクセスされるブロックをバッファ・キャッシュに保持して、頻繁にアクセスされないブロックはディスクに書き込みます。
データベース・スマート・フラッシュ・キャッシュ(フラッシュ・キャッシュ)を有効にすると、バッファ・キャッシュの一部をフラッシュ・キャッシュ内に格納できます。このバッファ・キャッシュ拡張は、1つ以上のフラッシュ・デバイスに格納されます。フラッシュ・メモリー内にバッファがキャッシュされ、磁気ディスクからの読取りが必要なくなるため、データベースのパフォーマンスが向上します。
DB_FLASH_CACHE_FILEおよびDB_FLASH_CACHE_SIZE初期化パラメータを使用して、複数のフラッシュ・デバイスを構成します。バッファ・キャッシュでは、各デバイスを追跡し、デバイスに均等にバッファを分配します。ノート:データベース・スマート・フラッシュ・キャッシュは、SolarisおよびOracle Linuxでのみ使用できます。
-
Oracle永続メモリー・ファイルストアのデータ・ファイルを指すバッファ・ヘッダー(PMEMフィレストア)を管理します
PMEM Filestoreを有効にすると、データベース・ファイルは直接読取り専用アクセス用にマップされます。問合せでは、従来のバッファ・キャッシュ・メカニズムをバイパスでき、不要なI/Oを回避できます。この場合、バッファ・ヘッダーにはPMEMブロックに対応するメタデータを格納する必要があります。データベースは、変更、読取りの一貫性、およびホット・データ・ブロックへの高速アクセスのために、従来の(DRAM)バッファ・キャッシュを引き続き使用できます。
関連情報:
-
DRAMおよびPMEMバッファに関する項
-
DB_FLASH_CACHE_FILE初期化パラメータについて学習するには、『Oracle AI Databaseリファレンス』を参照
バッファ状態
データベースでは、内部アルゴリズムを使用してキャッシュ内のバッファが管理されます。
バッファには、次のような相互に排他的な状態があります。
-
未使用
このバッファはまだ使用されていないか、現在使用されていないため、使用可能です。このタイプのバッファは、最も使用しやすいバッファです。
-
消去
このバッファは過去に使用され、現在はある時点において読取り一貫性があるバージョンのブロックが含まれています。このブロックにはデータが含まれていますが、クリーンであるため、チェックポイントを作成する必要はありません。データベースでは、このブロックを確保して再利用できます。
-
ダーティ
このバッファには、まだディスクに書き込まれていない変更されたデータが含まれています。データベースでこのバッファを再利用する前に、このブロックのチェックポイントを作成する必要があります。
すべてのバッファには、使用中または使用可能(確保解除)というアクセス・モードがあります。バッファは、ユーザー・セッションによってアクセスされている間にメモリーからエージング・アウトされないように、キャッシュ内で確保されています。確保されたバッファを複数のセッションから同時に変更することはできません。
バッファのモード
クライアントがデータを要求すると、Oracle AI Databaseでは、現在のモードまたは一貫したモードいずれかでデータベース・バッファ・キャッシュからバッファを取得されます。
モードの違いは次のとおりです。
-
現行モード
現在のモード取得は、dbブロック取得とも呼ばれ、バッファ・キャッシュ内のブロックをそのまま検索します。たとえば、コミットされていないトランザクションによってブロック内の2つの行が更新された場合、現行モード取得により、これらのコミットされていない行を含むブロックが取得されます。データベースは、変更文中にdb block getsを最も頻繁に使用するため、ブロックの現在のバージョンのみを更新する必要があります。
-
一貫したモード
読取り一貫性取得は、ブロックの読取り一貫性バージョンを取得するものです。この取得では、UNDOデータが使用される場合があります。たとえば、コミットされていないトランザクションによってブロック内の2つの行が更新され、別のセッション内の問合せによってブロックがリクエストされた場合、データベースはUNDOデータを使用して、コミットされていない更新を含まないこのブロックの読取り一貫性バージョン(一貫性読取りクローンと呼ばれます)を作成します。一般に、問合せは一貫性モードでブロックを取得します。
関連情報:
-
DBブロック取得および読取り一貫性取得などのデータベース統計については、Oracle AI Databaseリファレンスを参照してください。
バッファI/O
論理I/Oは、バッファI/Oとも呼ばれている、バッファ・キャッシュ内でのバッファの読取りおよび書込みを意味します。
要求されたバッファがメモリーにない場合、Oracle Databaseは物理I/Oを実行してフラッシュ・キャッシュまたはディスクからメモリーにバッファをコピーします。その後、論理I/Oを実行して、キャッシュされたバッファを読み取ります。
-
バッファ置換アルゴリズム効率的にバッファにアクセスできるようにするため、データベースはメモリーにキャッシュするバッファーと、ディスクからアクセスするバッファーを決定する必要があります。
-
バッファ書込み データベース・ライター(DBW)プロセスでは、コールド・かつ使用済のバッファが定期的にディスクに書き込まれる。
-
バッファ読取り未使用バッファの数が減少したら、データベースによってバッファ・キャッシュからバッファが削除される必要があります。
-
バッファのタッチ・カウントデータベースでは、タッチ・カウントを使用して、LRUリスト上のバッファへのアクセス頻度が測定されます、このメカニズムによって、バッファが確保されたときに常にLRUリスト上でバッファをシャッフルするかわりに、カウンタを増加できます。
バッファ置換アルゴリズム
効率的にバッファにアクセスできるようにするため、データベースはメモリーにキャッシュするバッファと、ディスクからアクセスするバッファを決定する必要があります。
データベースでは次のアルゴリズムを使用します。
-
LRUベースでブロック・レベルの置換アルゴリズム
この高度なアルゴリズムはデフォルトの アルゴリズムで、使用済みバッファと使用済みでないバッファへのポインタを含む、最近の使用頻度が最も高い(LRU)リストを使用します。LRUリストにはホット・エンドとコールド・エンドがあります。コールド・バッファとは、最近使用されていないバッファのことです。ホット・バッファは、頻繁にアクセスされ、最近使用されたものです。概念的にはLRUは1つのみですが、データベースでは実際にはデータ同時実行性のために複数のLRUが使用されます。
-
温度ベースでオブジェクト・レベルの置換アルゴリズム
Oracle Database 12cリリース1(12.1.0.2)以降、自動ビッグ・テーブル・キャッシング機能により、表スキャンで次のシナリオに異なるアルゴリズムを使用できるようになります。
-
パラレル問合せ
単一インスタンスおよびOracle Real Applications Cluster (Oracle RAC)データベースでは、
DB_BIG_TABLE_CACHE_PERCENT_TARGET初期化パラメータがゼロ以外の値に設定され、PARALLEL_DEGREE_POLICYがautoまたはadaptiveに設定されている場合、パラレル問合せでビッグ・テーブル・キャッシュを使用できます。 -
シリアル問合せ
単一インスタンス構成の場合のみ、
DB_BIG_TABLE_CACHE_PERCENT_TARGET初期化パラメータがゼロ以外の値に設定されている場合、シリアル問合せでビッグ・テーブル・キャッシュを使用できます。
表がメモリー内におさまらない場合、データベースはアクセス・パターンに基づいてキャッシュするバッファを決定します。たとえば、よく使用される表の95%しかメモリー内に収まっていない場合、データベースは、周期的に ブロックをメモリーに読み取って最低使用頻値のブロックを排除する(スラッシングと呼ばれる)、ブロックの5%をディスク上に残す選択を行うことがあります。複数のラージ・オブジェクトをキャッシュする際、データベースはよりポピュラーの表が高く、ポピュラーでない表は高くないと見なし、これはキャッシュするブロックに影響を与えます。
DB_BIG_TABLE_CACHE_PERCENT_TARGET初期化パラメータは、このアルゴリズムを使用するバッファ・キャッシュの比率を設定します。ノート:このドキュメントでは、LRUベースのブロック・レベルの置換アルゴリズムについて説明します。
-
関連項目:温度ベースのアルゴリズムについてさらに学習するには、『Oracle AI Database VLDBおよびパーティショニング・ガイド』を参照してください。
バッファ書込み
データベース・ライター(DBW)プロセスでは、コールドで使用済のバッファが定期的にディスクに書き込まれる。
DBWでは、次の状況でバッファが書き込まれます。
-
サーバー・プロセスで、新しいブロックをデータベース・バッファ・キャッシュに読み取るときにクリーンなバッファが見つからなかった場合。
バッファが使用されるにつれて、使用可能バッファの数が減少します。使用可能バッファの数が内部のしきい値未満になり、クリーンなバッファが必要な場合には、サーバー・プロセスからDBWに対して、書込みを行うように通知されます。
Oracle Databaseでは、LRUを使用して、どの使用済バッファに書き込むかが決定されます。使用済バッファがLRUのコールド・エンドに達すると、そのブロックはLRUを書込みキューに移動します。DBWによって、可能な場合にはマルチブロック書込みを使用して、キュー内のバッファがディスクに書き込まれます。このメカニズムによって、LRUの終端に使用済バッファが滞留しなくなり、クリーンなバッファを検出して再利用できるようになります。
-
データベースで、REDOスレッド内のインスタンス・リカバリを開始する位置であるチェックポイントを進める必要がある場合。
-
表領域が読取り専用ステータスに変更されたか、オフラインにされた場合。
関連情報:
-
バッファ書込み問題を診断およびチューニングする方法を学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照
バッファ読取り
未使用バッファの数が減少したら、データベースにより、バッファ・キャッシュからバッファが削除されます。
アルゴリズムはフラッシュ・キャッシュが有効かどうかに応じて変わります。
-
フラッシュ・キャッシュが無効な場合
各クリーン・バッファは、必要に応じて上書きされ、再使用されます。上書きされたバッファが後から必要になった場合は、そのバッファが磁気ディスクから読み取られます。
-
フラッシュ・キャッシュが有効な場合
DBWがフラッシュ・キャッシュにクリーン・バッファ本体を書き込めるため、インメモリーのバッファの再利用が可能になります。データベースは、フラッシュ・キャッシュ内のバッファ本体の状態と場所を追跡できるように、メイン・メモリー内のLRUリストにバッファのヘッダーを保持します。バッファが後で必要になったときに、データベースは磁気ディスクからではなく、フラッシュ・キャッシュからバッファを読み取ります。
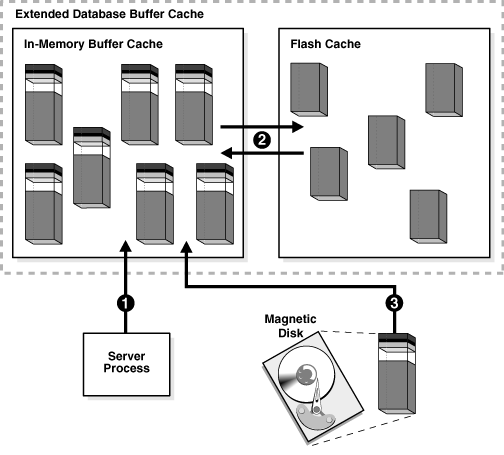
クライアント・プロセスからバッファが要求されると、サーバー・プロセスは最初にバッファ・キャッシュ内でそのバッファを検索します。データベースによるメモリー内のバッファの検索時には、キャッシュ・ヒットの処理が実行されます。検索順序は、次のとおりです。
-
サーバー・プロセスによってバッファ・キャッシュ内にバッファ全体があるかどうかが検索されます。
バッファ全体が見つかった場合は、データベースによってそのバッファの論理読取りが実行されます。
-
サーバー・プロセスによってフラッシュ・キャッシュのLRUリスト内にバッファのヘッダーがあるかどうかが検索されます。
バッファのヘッダーが見つかった場合、データベースによってフラッシュ・キャッシュからインメモリーのキャッシュにバッファ本体の最適化物理読取りが実行されます。
-
キャッシュ・メモリー内にバッファが見つからない場合は(キャッシュ・ミス)、サーバー・プロセスによって次のステップが実行されます。
-
データファイルからメモリーへのブロックのコピー(物理読取り)
-
メモリーに読み取られたバッファの論理読取りの実行
-
図17-2に、バッファの検索順序を示します。拡張バッファ・キャッシュは、バッファ全体を格納するインメモリーのバッファ・キャッシュと、バッファ本体を格納するフラッシュ・キャッシュから構成されます。図では、データベースによってバッファ・キャッシュ内にバッファがあるかどうか検索され、バッファが見つからなければ、磁気ディスクからメモリーにバッファが読み込まれます。
図2: バッファの検索
通常、キャッシュにヒットした場合のデータへのアクセスは、キャッシュ・ミスの場合よりも高速です。バッファ・キャッシュ・ヒット率は、要求されたブロックはバッファ・キャッシュ内に存在し、ディスクからの読取りが不要である確率が測定されます。
データベースは、データファイルまたは一時ファイルから物理読取りを実行できます。データファイルからの読取りの後には、論理I/Oが実行されます。一時ファイルからの読取りは、メモリー不足によってデータベースがデータを一時表に書き込み、後 からそのファイルを読み取る必要がある場合に行われます。このような物理読取りでは、バッファ・キャッシュにはアクセスされないため、論理I/Oは発生しません。
関連項目:バッファ・キャッシュ・ヒット率の計算方法を学習するには、Oracle AI Databaseパフォーマンス・チューニング・ガイドを参照してください
バッファのタッチ・カウント
データベースでは、タッチ・カウントを使用して、LRUリスト上のバッファへのアクセス頻度が測定されます。このメカニズムによって、バッファが確保されたときに常にLRUリスト上でバッファをシャッフルするかわりに、カウンタを増加できます。
ノート:データベースでは、メモリー内のブロックは物理的には移動されません。移動は、リスト上のポインタの位置を変更することによって行われます。
バッファが確保されると、最後にタッチ・カウントが増加された時間が特定されます。カウントが3秒前より以前に増加されている場合は、カウントが増加され、そうでない場合は、カウントはそのままです。この3秒ルールによって、バッファが非常に多くの回数確保されたときに、同じ数だけタッチ・カウントが増加されることを防止できます。たとえば、セッションでデータ・ブロックに複数の行を挿入する場合に、データベースではこれらの挿入が1回のタッチであるとみなされます。
バッファがLRUのコールド・エンドにあり、タッチ・カウントが大きい場合、バッファはホット・エンドに移動されます。タッチ・カウントが小さい場合、バッファはキャッシュからエージ・アウトされます。
バッファ・プール
バッファ・プールは、バッファの集合です。
データベース・バッファ・キャッシュは、1つ以上のバッファ・プールに分割されており、そのほとんどで同じ方法でブロックが管理されます。プールのアルゴリズムは、経過期間ブロックとキャッシュ・ブロックで根本的には異なりません。
バッファ・キャッシュ内のデータを保持するバッファ・プール、または新しいデータがデータ・ブロックを使用した直後に使用可能なバッファを提供するバッファ・プールを手動で個別に構成できます。その後、適切なバッファ・プールに特定のスキーマ・オブジェクトを割り当て、ブロックがキャッシュからエージ・アウトされる方法を制御できます。たとえば、セグメントをホット、ウォームおよびコールド・バッファ・プールに分割することができます。
次のバッファ・プールがあります。
-
デフォルト・プール
このプールは、ブロックが通常キャッシュされる場所です。手動で個別にプールを構成しない場合は、DEFAULTプールが唯一のバッファ・プールとなります。他のプールのオプション構成によって、デフォルト・プールは影響を受けません。
ビッグ・テーブル・キャッシュは、温度ベースかつオブジェクト・レベルの置換アルゴリズムを使用するデフォルト・プールのオプションのセクションとなっています。単一インスタンスおよびOracle RACデータベースでは、
DB_BIG_TABLE_CACHE_PERCENT_TARGET初期化パラメータがゼロ以外の値に設定され、PARALLEL_DEGREE_POLICYがautoまたはadaptiveに設定されている場合、パラレル問合せでビッグ・テーブル・キャッシュを使用できます。単一インスタンス構成の場合のみ、DB_BIG_TABLE_CACHE_PERCENT_TARGETが設定されている場合、シリアル問合せでビッグ・テーブル・キャッシュを使用できます。 -
プールの保持
このプールは、頻繁にアクセスされたが、領域が不足したためにDEFAULTプールからエージ・アウトされたブロック用のプールです。KEEPバッファ・プールの目的は、メモリー内にオブジェクトを保存して、I/O操作を避けることにあります。
ノート:キープ・プールは、他のプールと同じようにバッファを管理します。バッファをピン留めにするために特別なアルゴリズムを使用しません。「keep」という単語は命名規則です。保存する表はより大規模な保存プールに配置し、保存しない表はより小規模なリサイクル・プールに配置できます。
-
RECYCLEプール
このプールは、頻繁に使用されないブロック用のプールです。RECYCLEプールによって、キャッシュ内の領域が不要なオブジェクトによって消費されることを防止できます。
データベースには、標準ブロック・サイズがあります。標準のサイズとは異なるブロック・サイズを持つ表領域を作成できます。非デフォルトのブロック・サイズには、それぞれ独自のプールがあります。Oracle AI Databaseでは、これらのプールのブロックもデフォルト・プールと同様に管理されます。
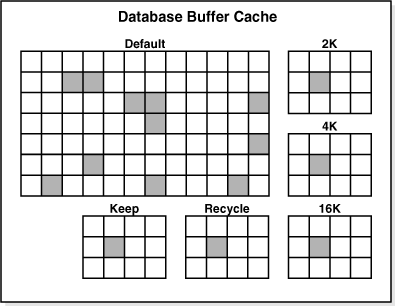
次の図に、複数のプールが使用された場合のバッファ・キャッシュの構造を示します。このキャッシュには、DEFAULTプール、KEEPプールおよびRECYCLEプールが含まれています。ブロックの大きさは省略時で8KBになっています。このキャッシュには、2KB、4KBおよび16KBという非標準のブロック・サイズを使用する表領域用の個別のプールが含まれています。
図3: データベース・バッファ・キャッシュ
関連情報:
-
バッファ・プールについてさらに学習するには、Oracle AI Database管理者ガイドを参照してください。
-
複数のバッファ・プールを使用する方法を学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照
-
DB_BIG_TABLE_CACHE_PERCENT_TARGET初期化パラメータについて学習するには、『Oracle AI Databaseリファレンス』を参照
バッファと全表スキャン
データベースは複雑なアルゴリズムを使用して表スキャンを管理します。デフォルトでは、バッファをディスクから読み取る必要がある場合、そのバッファはLRUリストの中央に挿入されます。これにより、ホット・ブロックがキャッシュ内に維持されて、再度ディスクから読み取る必要がなくなります。
表の2最高水位標(HWM)より下のすべての行を順次読み取る全表スキャンでは、問題が発生します表セグメント内のブロックの合計サイズが、バッファ・キャッシュのサイズよりも大きいとします。この表の全体スキャンでは、バッファ・キャッシュが一つの掃除され、頻繁にアクセスされるブロックのキャッシュが維持されない可能性があります。
-
完全表スキャンのデフォルト・モードデフォルトでは、データベースは全表スキャンに対して保守的なアプローチを取り、テーブル・サイズの割合はバッファ・キャッシュに小さい場合のみ、小規模な表をメモリーにロードします。
-
パラレル問合せの実行全表スキャンの実行時、複数のパラレル実行サーバーを使用すると、レスポンス時間が改善されることがあります。
-
CACHE属性まれに、デフォルトのキャッシュ動作が望ましくないことが、その場合は、
ALTER TABLE ... CACHEを使用して、大規模な表からデータベース・バッファ・キャッシュにブロックが読み取られる方法を変更できます。 -
KEEP属性大規模な表に対しては、
ALTER TABLE ... STORAGE BUFFER_POOL KEEPを使用して、これらの表のブロックをキープ・プールにロードするようにスキャンできます。 -
強制全データベース・キャッシュ・モード状況によっては、パフォーマンスを向上するために、
ALTER DATABASE ... FORCE FULL DATABASE CACHING文を明示的に実行して強制全データベース・キャッシュ・モードを有効にできます。関連項目: 「セグメント領域と最高水位標」
完全表スキャンのデフォルト・モード
デフォルトでは、データベースは全表スキャンに対して厳密的なアプローチを取り、テーブル・サイズの割合がバッファ・キャッシュに対して小さい場合のみ、小規模な表をメモリーにロードします。
データベースは、中規模の表をキャッシュするかどうか決定するため、最後の表スキャンの間隔、バッファ・キャッシュの経過期間タイムスタンプおよびバッファ・キャッシュに残っている容量を考慮するアルゴリズムを使用します。
非常に大規模な表の場合、データベースでは、通常、ダイレクト・パス読取りを使用します。この方法は、バッファ・キャッシュに移入されないように、ブロックがPGAに直接ロードされ、SGAが完全にバイパスされます。データベースは、中規模の表に対しては、ダイレクト読取りまたはキャッシュ読取りを使用する場合があります。データベースは、キャッシュ読取りを使用することを決定した場合、スキャンによって実質的にバッファ・キャッシュが一掃されることを防止するために、これらのブロックをLRUの最後に配置します。
Oracle Database 12c Release 1 (12.1.0.2)以降、データベース・インスタンスのバッファ・キャッシュでは自動的に内部計算を実行して、データベースをインスタンスSGAに完全にキャッシュするのに十分なメモリーがあるかどうか、アクセス時に表をキャッシュすることがパフォーマンス上有益かどうかを判断します。データベース全体をメモリー内に完全に収めることができ、他の様々な内部基準が満たされる場合、Oracle AI Databaseはデータベース内のすべての表を小規模な表として処理し、キャッシュの対象であると見なします。ただし、データベースではNOCACHE属性が付けられたLOBはキャッシュしません。
パラレル問合せの実行
全表スキャンの実行時、複数のパラレル実行サーバーを使用すると、レスポンス時間が改善されることがあります。
一部の例では、データベースに大量のメモリーがある場合、データベースでは、プログラム・グローバル領域(PGA)へのダイレクト・パス読取りを使用するかわりに、システム・グローバル領域(SGA)にパラレル問合せのデータをキャッシュできます。パラレル問合せは、リソースを使用する可能性があるため、通常では同時実行性の低いデータ・ウェアハウスで実行されます。
関連情報:
-
データウェアハウスの概要は、Oracle AI Databaseデータ・ウェアハウス・ガイドを参照
-
パラレル実行についてさらに学習するには、Oracle AI Database VLDBおよびパーティショニング・ガイドを参照してください。
CACHE属性
まれに、デフォルトのキャッシュ動作が望ましくないことがありますが、その場合は、ALTER TABLE ... CACHEを使用して、大規模な表からデータベース・バッファ・キャッシュにブロックが読み取られる方法を変更できます。
CACHE属性が設定された表では、データベースはバッファ・キャッシュでブロックを強制または確保しません。かわりに、他の表ブロックと同じようにブロックをキャッシュからエージ・アウトします。このオプションを使用すると、大規模な表の全体スキャンを行ったときに、キャッシュ内の他のほとんどのブロックが一掃される可能性があるため、注意が必要です。ノート: ALTER TABLE ... CACHEを実行しても、表はキャッシュされません。
KEEP属性
大規模な表に対しては、ALTER TABLE ... STORAGE BUFFER_POOL KEEPを使用して、これらの表のブロックをKEEPプールにロードできます。
表をKEEPプールに配置すると、ブロックが保管されているバッファ・キャッシュの部分が変更されます。ブロックは、デフォルト・バッファ・プールにキャッシュされるのではなく、KEEPバッファ・プールにキャッシュされます。プールのキャッシュを制御する別個のアルゴリズムはありません。
関連情報:
-
CACHE句およびKEEP属性の詳細は、『Oracle AI Database SQL言語リファレンス』を参照 -
バッファ・キャッシュ・アドバイザ統計を解釈する方法を学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照
全データベース・キャッシュ・モードの強制
状況によっては、パフォーマンスを向上するために、ALTER DATABASE ... FORCE FULL DATABASE CACHING文を明示的に実行して全データベース・キャッシュ強制モードを有効にできます。
自動的なデフォルト・モードとは逆に、強制全データベース・キャッシュ・モードは、データベース・バッファ・キャッシュに適しているNOCACHE LOBを含むデータベース全体を考慮します。このモードは、Oracle Database 12cリリース1(12.1.0.2)以降で使用可能です。ノート:全データベース・キャッシュ強制モードを有効にしても、データベースはメモリーに強制的に入れません。正確に言えば、データベース全体がバッファ・キャッシュにキャッシュされる対象になります。Oracle AI Databaseは、アクセスされたときにのみ表をキャッシュします。
個々のインスタンスのバッファ・キャッシュ・サイズがデータベース・サイズよりも大きい場合にのみ、完全データベース・キャッシュ強制モードを有効化することをお薦めします。このガイドラインは、単一インスタンスとOracle RACデータベースの両方に適用されます。ただし、Oracle RACアプリケーションが適切にパーティション化されている場合、すべてのインスタンスのバッファ・キャッシュの合計にインスタンス間の重複キャッシュ・ブロックを処理する追加領域を加えたものがデータベース・サイズよりも大きい場合は、完全データベース・キャッシュ強制モードを有効化できます。
関連情報:
-
完全データベース・キャッシュ強制モードを有効にする方法を学習するには、Oracle AI Database管理者ガイドを参照
-
ALTER DATABASE ... FORCE FULL DATABASE CACHING文の詳細は、Oracle AI Database SQL言語リファレンスを参照してください。
DRAMおよびPMEMバッファ
標準の(DRAM)データベース・バッファは、PMEMバッファとは異なりますが、特性を共有しています。
Oracle永続メモリー・ファイルストア(PMEMファイルストア)を構成すると、すべてのデータ・ブロックがDRAMでバッファ・キャッシュに直接マップされます。DRAMバッファとは異なり、PMEMバッファはデータ・ブロックの内容をコピーしません。かわりに、PMEMバッファ・ヘッダーは、PMEMファイルストアに格納されているデータ・ブロックを指しています。ほとんどの読取りでは、データベースはコンテンツではなくブロック・メタデータのみをキャッシュします。PMEMバッファでは、構造が標準バッファのキャッシュ・グラニュルとは異なる特殊なグラニュルの型が使用されます。
ノート:初期化パラメータDB_CACHE_SIZEでは、DRAMキャッシュの最小サイズを指定します。PMEMメタデータ・オーバーヘッドは、この割当てには含まれません。
PMEMバッファは、次のいずれかの状態になります。
-
現在
これはPMEMバッファの現在のバージョンです。ファイルストアから直接アクセスできます。
Oracle AI Databaseでは、PMEMの現行バージョンが標準のDRAMバッファの現行バージョンから切り離されて維持されます。この分離によって、PMEMブロックのピンニング、クリーン・アップ、およびDRAMへの移行時のコードの複雑さを軽減できます。
-
一貫性
これは、PMEMバッファの読取り一貫性バージョンです。これは、データベースがDRAMにクローンを作成した後に作成されます。PMEMバッファには、ファイルストアから直接アクセスできます。
-
空き
これは、空きPMEMバッファです。PMEMブロックで再利用できます。インスタンスの起動後、すべてのPMEMバッファは空き状態になります。
PMEMのレイテンシはDRAMより長くなっています。Oracle AI Databaseでは、内部のワークロード・ベースのアルゴリズムを使用して、PMEMからDRAMに移行するブロックを決定します。
関連情報:
-
PMEMファイルストアの設定方法を学習するには、『Oracle AI Database管理者ガイド』を参照してください
REDOログ・バッファ
REDOログ・バッファとは、SGA内の循環バッファで、データベースに加えられた変更についてのREDOエントリが格納されます。
REDOレコードは、DML操作またはDDL操作によってデータベースに加えられた変更を再構成または再作成するために必要な情報が含まれているデータ構造。データベースのリカバリでは、データファイルにREDOエントリを適用して、失われた変更が再構築されます。
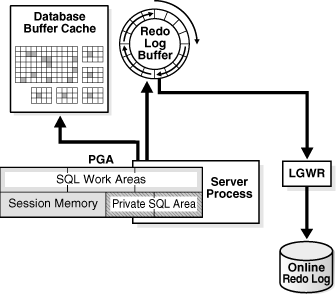
REDOエントリは、データベース・プロセスによってユーザーのメモリー領域からSGA内のREDOログ・バッファにコピーされます。REDOエントリは、バッファ内の連続した領域を占めます。バックグラウンド・プロセスのログ・ライター・プロセス(LGWR)は、REDOログ・バッファをディスク上のアクティブなオンラインREDOログ・グループに書き込みます。図17-4に、このREDOバッファのアクティビティを示します。
図4: REDOログ・バッファ
DBWではデータ・ブロックは分散してディスクに書き込まれますが、LGWRではREDOログ・バッファはディスクに対して順次書き込まれます。通常、分散書込みの速度は順次書込みよりも大幅に遅くなります。LGWRでは、ユーザーはDBWによる遅い書込みが完了するまで待機する必要がないため、パフォーマンスが向上します。
LOG_BUFFER初期化パラメータでは、Oracle AI DatabaseでREDOエントリをバッファリングする場合に使用するメモリー量を指定します。他のSGAコンポーネントとは異なり、REDOログ・バッファおよび固定SGAバッファのメモリーは、グラニュルに分割されません。
関連情報:
-
オンラインREDOログについては、Oracle AI Database管理者ガイドを参照してください。
共有プール
共有プールは、様々なタイプのプログラム・データをキャッシュします。
たとえば、共有プールには、解析済のSQL、PL/SQLのコード、システム・パラメータ、データ・ディクショナリ情報が格納されます。共有プールは、データベースで行われるほぼすべての操作に関連します。たとえば、ユーザーがSQL文を実行すると、Oracle AI Databaseは共有プールにアクセスします。
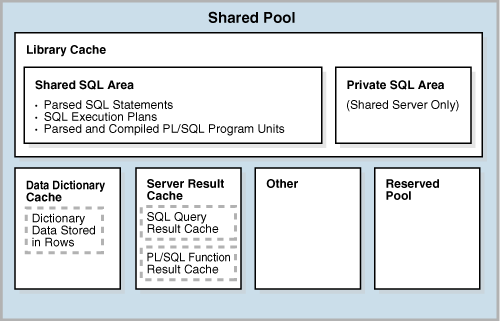
共有プールは、複数のサブコンポーネントから構成されています。図17-5に、最も重要なサブコンポーネントを示します。
図5: 共有プール
この項には次のトピックが含まれます。
-
ライブラリ・キャッシュライブラリ・キャッシュとは、実行可能なSQLおよびPL/SQLコードが格納されている共有プール・メモリー構造である。
-
データ・ディクショナリ・キャッシュ データ・ディクショナリとは、データベース、その構造およびそのユーザーについての参照情報を含むデータベース表およびビューの集まりです。
-
サーバーの結果キャッシュ サーバーの結果キャッシュは共有プール内のメモリー・プールです。バッファ・プールとは異なり、サーバー結果キャッシュにはデータ・ブロックではなく結果セットが保持されています。
-
予約プール予約プールは、共有プール内のメモリー領域であり、Oracle AI Databaseで大量の連続したメモリーのチャンクを割り当てる場合に使用できます。
ライブラリ・キャッシュ
ライブラリ・キャッシュとは、実行可能なSQLやPL/SQLコードが格納されている共有プール・メモリー構造である。
このキャッシュには、SQLとPL/SQLの共有領域や、ロックやライブラリ・キャッシュ・ハンドルなどの制御構造が含まれています。共有サーバー・アーキテクチャでは、ライブラリ・キャッシュにはプライベートSQL領域も含まれています。
SQL文が実行されると、データベースでは、以前に実行されたコードの再利用が試みられます。解析されたSQL文の表現がライブラリ・キャッシュに存在し、共有可能である場合には、そのコードが再利用されます。これはソフト解析またはライブラリ・キャッシュ・ヒットと呼ばれます。それ以外の場合、データベースは、ハード解析またはライブラリ・キャッシュ・ミスと呼ばれる、新しいアプリケーション・コードの実行可能バージョンを構築する必要があります。
-
共有SQL領域データベースは、共有SQL領域およびプライベートSQL領域で実行される各SQL文を表します。
-
プログラム・ユニットとライブラリ・キャッシュライブラリ・キャッシュは、PL/SQLプログラムおよびJavaクラスの実行可能形式を保持します。これらの項目は、プログラム・ユニットと総称されます。
-
共有プール内のメモリーの割当てと再利用データベースでは、新しいSQL文 が解析されたときに共有プール・メモリーを割り当てますが、共有可能なと想定されないDDLの文である場合を除きます。割り当てられるメモリーのサイズは、文の複雑度に応じて決められます。
共有SQL領域
データベースでは、実行される各SQL文の表現が、共有SQL領域とプライベートSQL領域に格納されます。
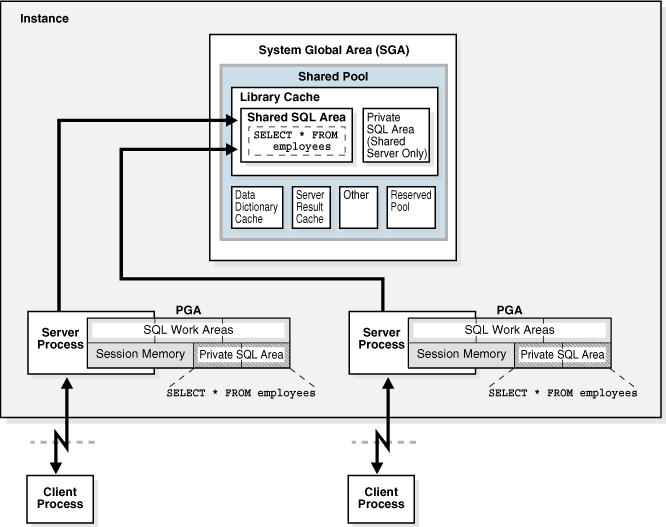
SQL文が最初に実行されたときは、共有SQL領域を使用してSQL文が処理されます。この領域は、すべてのユーザーがアクセス可能であり、文の解析ツリーと実行計画が含まれています。一意の文に対して、共有SQL領域は1つのみ存在します。SQL文を発行するセッションは、それぞれのPGAにプライベートSQL領域を持っています。同じ文を発行する各ユーザーのプライベートSQL領域は、同じ共有SQL領域を指しています。これにより、異なるPGA内の数多くのプライベートSQL領域を同一の共有SQL領域に関連付けることができます。
データベースでは、アプリケーションによって同じSQL文が発行されたことが自動的に判断されます。ユーザーやアプリケーションが直接発行したSQL文も、他の文によって内部的に発行された再帰的SQL文も対象となります。
データベースでは、次のステップが実行されます。
-
構文およびセマンティクスが同一の文について共有SQL領域が存在しているかどうかを確認するため、共有プールがチェックされます。
-
同一の文が存在する場合、これ以降この文の新たなインスタンスが実行されるときには共有SQL領域が使用されるため、メモリー消費が削減されます。
-
同一の文が存在しない場合は、共有プールに新しい共有SQL領域がデータベースによって割り当てられます。構文が同じであるもののセマンティクスが異なる文では、子カーソルが使用されます。
どちらの場合も、ユーザーのプライベートSQL領域が、その文と実行計画を含む共有SQL領域に対応付けられます。
-
-
セッションのためにプライベートSQL領域が割り当てられます。
プライベートSQL領域の位置は、セッションのために確立される接続に応じて異なります。セッションが共有サーバーを介して接続されている場合、プライベートSQL領域の一部はSGAに保持されます。
図17-6に、専用サーバー・アーキテクチャにおいて、2つのセッションが同じSQL文のコピーをそれぞれのPGA内に保持する様子を示します。共有サーバーでは、このコピーはMGA内のUGAにあります。
図6: プライベートSQL領域と共有SQL領域
関連情報:
-
ライブラリ・キャッシュの管理についてさらに学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照してください。
-
共有SQLの詳細は『Oracle AI Database開発ガイド』を参照してください。
プログラム・ユニットとライブラリ・キャッシュ
ライブラリ・キャッシュには、PL/SQLプログラムおよびJavaクラスの実行可能形式が保持されます。これらの項目は、プログラム・ユニットと総称されます。
データベースでは、プログラム・ユニットはSQL文と同様に処理されます。たとえば、データベースでは、解析済のコンパイル済形式のPL/SQLプログラムを保持する共有領域が割り当てられます。データベースでは、ローカル変数、グローバル変数、パッケージ変数、SQL実行用バッファなど、プログラムを実行するセッションに固有の値を保持するためのプライベート領域が割り当てられます。複数のユーザーが同じプログラムを実行する場合は、各ユーザーが独自のプライベートSQL領域を持ち、セッション固有の値はそこに保持され、単一の共有SQL領域にアクセスします。
データベースでは、PL/SQLプログラム・ユニット内の個別のSQL文はすでに説明したように処理されます。PL/SQLプログラム・ユニット内の起点には関係なく、これらのSQL文は解析された表現を保持するために共有領域を使用し、その文を実行するセッションごとにプライベートSQL領域を使用します。
共有プール内のメモリーの割当てと再利用
データベースでは、新しいSQL文が解析されたときに共有プール・メモリーが割り当てられますが、共有可能と想定されないDDLの文である場合は例外です。割り当てられるメモリーのサイズは、文の複雑度に応じて決められます。
一般的に、共有プール内のアイテムは、最低使用頻度の(LRU)アルゴリズムに従ってデータベースが削除されるまで残されたままです。多数のセッションが使用している共有プール項目は、その項目を作成したデータベース・プロセスが終了しても、その項目が使用されているかぎりメモリーに残ります。このメカニズムによって、SQL文のオーバーヘッドと処理を最小限に抑えることができます。新しい項目の領域が必要になった場合は、頻繁に使用されていない項目で使用されるメモリーが解放されます。
ALTER SYSTEM FLUSH SHARED_POOL文では共有プール内のすべての情報が削除され、同様にグローバル・データベース名も変更されます。
関連情報:
-
共有SQL領域のライフサイクルの概要は、『Oracle AI Database SQLチューニング・ガイド』を参照してください。
-
ALTER SYSTEM FLUSH SHARED_POOLの使用方法の詳細は、『Oracle AI Database SQL言語リファレンス』を参照 -
V$SQLおよびV$SQLAREA動的ビューの詳細は、『Oracle AI Databaseリファレンス』を参照してください
データ・ディクショナリ・キャッシュ
データ・ディクショナリとは、データベース、データベース構造およびそのユーザーについての参照情報を含むデータベース表およびビューの集まりです。
Oracle AI Databaseは、SQL文の解析中に頻繁にデータ・ディクショナリにアクセスします。データ・ディクショナリはOracle AI Databaseによって頻繁にアクセスされるので、ディクショナリ・データを保持するために、次のような特別な場所がメモリーまでに指定されています。
-
データ・ディクショナリ・ キャッシュ
このキャッシュには、データベース・オブジェクトについての情報が保持されています。このキャッシュにはデータがバッファではなく行として保持されるため、行キャッシュとも呼ばれます。
-
ライブラリ・キャッシュ
これらのキャッシュは、データ・ディクショナリ情報にアクセスするすべてのサーバー・プロセスによって共有されます。
関連情報:
-
追加メモリーをデータ・ディクショナリ・キャッシュに割り当てる方法を学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照
サーバー結果キャッシュ
サーバーの結果キャッシュは、共有プール内のメモリー・プールです。バッファ・プールとは異なり、サーバー結果キャッシュにはデータ・ブロックではなく結果セットが保持されています。ノート:クライアント結果キャッシュは、サーバー結果キャッシュとは異なります。クライアント・キャッシュはアプリケーション・レベルで構成されており、データベース・メモリーではなくクライアント・メモリー内に配置されます。
-
SQL問合せ結果キャッシュSQL問合せ結果キャッシュは、問合せおよび問合せの断片の結果を格納するサーバー結果キャッシュのサブセットである。結果キャッシュは、データベース・レベルまたは文レベルで有効化または無効化できます。
-
PL/SQLファンクション結果キャッシュ PL/SQLファンクション結果キャッシュとは、ファンクションの結果セットを格納する、サーバー結果キャッシュのサブセットです。
-
サーバー結果キャッシュ・インフラストラクチャ問合せ結果キャッシュとPL/SQLファンクション結果キャッシュでは、同じインフラストラクチャが共有されています。
-
サーバー結果キャッシュのユーザー・インタフェース
RESULT_CACHE_MODE初期化パラメータにより、SQL問合せ結果キャッシュを、実行可能なすべての問合せで使用されるか、ヒントが設定された問合せにのみ使用するかを決めます。
SQL問合せ結果キャッシュ
SQL問合せ結果キャッシュは、問合せおよび問合せの断片の結果を格納するサーバー結果キャッシュのサブセットである。結果キャッシュは、データベース・レベルまたは文レベルで有効化または無効化できます。
問合せを実行すると、データベースはその結果が問合せ結果キャッシュに存在するかどうかを判断します。結果がキャッシュされておらず、キャッシュが問合せで有効になっている場合、データベースは問合せを実行して結果を返し、キャッシュします。ただし、結果が存在する場合、問合せを実行せずにキャッシュから取得します。
結果を構成するために使用されているデータベース・オブジェクトのデータまたはメタデータがトランザクションで変更されると、キャッシュされた結果はデータベースにより自動的に無効化されます。次の問合せでは、キャッシュされた結果を使用できないため、データベースは新しい結果を自動的に計算し、以降の問合せで使用するためにキャッシュします。このキャッシュ・リフレッシュ・プロセスは、アプリケーションに対して透過的です。
実際には、問合せ結果キャッシュは、データベースで必要に応じて作成および保持されるジャスタインタイムのマテリアライズ・ビューとして機能しています。キャッシュを使用すると、データ・ブロックの再読取りおよび結果の再計算というコストのかかる操作を回避できます。ほとんどのアプリケーションにとって、このパフォーマンスの向上は有益です。
関連項目:問合せ結果キャッシュを使用して応答時間を最適化する方法を学習するには、Oracle AI Database管理者ガイドを参照してください
PL/SQLファンクションの結果キャッシュ
PL/SQLファンクション結果キャッシュは、ファンクションの結果セットを格納するサーバー結果キャッシュのサブセットです。
キャッシュがない場合には、1コール当たり1秒かかるPL/SQLファンクションを1000回コールすると、1000秒かかります。キャッシュでは、同じ入力を持つ1000個の関数呼び出しの合計に1秒かかることがあります。 結果キャッシュは、比較的静的なデータに依存し、頻繁に起動されるファンクションに適しています。
PL/SQLファンクション・コードには、その結果をキャッシュするように要求するコードを含めることができます。このようなファンクションが起動されると、システムによってキャッシュがチェックされます。同じパラメータ値が指定された以前のファンクション・コールの結果がキャッシュに含まれている場合は、実行者に結果が戻され、ファンクション本体は再実行されません。キャッシュに結果が含まれていない場合は、ファンクション本体が実行され、実行元に制御が戻される前に、指定されたパラメータ値での結果がキャッシュに追加されます。
ノート:キャッシュされた結果を計算するために使用されるデータベース・オブジェクトを指定して、これらのオブジェクトのいずれかが更新され、キャッシュされた結果が無効になり、再計算されるように設定できます。
異なる引数で頻繁に呼び出される関数は、ほとんど再使用されない結果を生成することがあり、パフォーマンス低下につながります。Oracle AI Databaseでは、RESULT_CACHEヒントがある最近使用したPL/SQLファンクションが追跡されます。この履歴を使用することで、データベースはPL/SQLファンクションと引数ペアを最近の履歴でx回認識した場合にのみキャッシュし、xは内部しきい値によって設定されます。キャッシュされている結果が多すぎるためにデータベースがさらにメモリーを必要とする場合は、キャッシュされた結果が1つ以上エージ・アウトされます。
RESULT_CACHE_EXECUTION_THRESHOLDは、ファンクションと特定の引数セットがキャッシュされるまでに表示する必要がある回数を指定します。持っている引数が異なるファンクション(たとえば、MYFUNC(1,2)とMYFUNC(1,3))は一意とみなされることに注意してください。このパラメータは、セッション・レベルではなくシステム・レベルでのみ設定できます。
関連情報:
-
PL/SQLファンクション結果キャッシュについてさらに学習するには、『Oracle AI Database開発ガイド』を参照
-
PL/SQLファンクション結果キャッシュについてさらに学習するには、『Oracle AI Database PL/SQL言語リファレンス』を参照
サーバー結果キャッシュのインフラストラクチャ
問合せ結果キャッシュとPL/SQLファンクション結果キャッシュは、同じインフラストラクチャを共有します。
オブジェクト・タイプ: 結果、依存性、一時
サーバー結果キャッシュ内で、結果オブジェクトは、問合せまたはPL/SQLファンクションによって戻される行を格納するデータ構造です。依存性オブジェクトは、結果オブジェクトとして格納された問合せによって参照されるオブジェクトのメタデータを格納します。
典型的な問合せ結果は、小規模で、計算にコストがかかり、再使用頻度が高く、不揮発性の表に基づいています。ただし、結果が大きくなる場合があります。問合せ結果がサイズ制限を超えた場合、データベースは結果の一部を一時オブジェクトとして保存し、一部を標準の結果オブジェクトとして保存します。一時オブジェクトは、実際の問合せ結果を保持する一時表領域セグメントを指す結果キャッシュ・メタデータのコレクションです。
結果サブキャッシュ
ワークロードによっては、読取り/書込みアクセス時により高い同時実行性をサポートするために、データベースが結果サブキャッシュを作成する場合があります。Oracle AI Databaseでは内部アルゴリズムを使用して、サブキャッシュを作成するかどうか、作成しない場合はその数を決定します。
サーバー結果キャッシュのユーザー・インタフェース
RESULT_CACHE_MODE初期化パラメータは、SQL問合せ結果キャッシュがすべての可能な問合せで使用されるか、ヒントが設定された問合せにのみ使用されるかを決定します。
RESULT_CACHE_MAX_TEMP_SIZE初期化パラメータは、PDBで結果キャッシュが使用できる一時表領域メモリーの最大量を制御します。RESULT_CACHE_MAX_TEMP_RESULTは、キャッシュした1つの問合せで使用できる、一時表領域メモリーの最大量を制御します。
RESULT_CACHE_MODEパラメータの設定をオーバーライドするには、問合せまたは問合せのフラグメントにRESULT_CACHEのヒントで注釈を付けることができます。Oracle Database 21cから、ヒントでTEMP={TRUE|FALSE}オプションが受け入れられ、結果を一時表領域に格納できるかどうかが制御されます。
DBMS_RESULT_CACHEパッケージを使用すると、SQL結果キャッシュとPL/SQLファンクション結果キャッシュで使用される共有プールの部分を管理できます。オブジェクトを無効化し、問合せおよびオブジェクトをブロックリストに登録し、関連操作を実行できます。
V$RESULT_CACHE_OBJECTS.TYPE列は、キャッシュ内のオブジェクトのタイプを示します。問合せ結果が一時表領域に格納されている場合、TYPEによってResultとTempの2つのオブジェクトが表示されます。サブキャッシュ・メタデータには、V$RESULT_SUBCACHE_STATISTICSおよび関連ビューを使用してアクセスできます。
関連情報:
-
結果キャッシュの動作のサイズ設定および制御について学習するには、Oracle AI Database管理者ガイドを参照してください。
-
DBMS_RESULT_CACHEパッケージの詳細は、『Oracle AI Database PL/SQLパッケージおよびタイプ・リファレンス』を参照してください。 -
クライアント結果キャッシュの詳細については、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照してください。
-
RESULT_CACHE_MODE初期化パラメータについてさらに学習するには、『Oracle AI Databaseリファレンス』を参照 -
RESULT_CACHEヒントについて学習するには、『Oracle AI Database SQL言語リファレンス』を参照
予約済プール
予約プールは、共有プール内のメモリー領域であり、Oracle AI Databaseで大量の連続したメモリーのチャンクを割り当てる場合に使用できます。
データベースによって、共有プールからメモリーがチャンクで割り当てられます。チャンクを使用することによって、単一の連続した領域がない場合でもキャッシュに大きなオブジェクト(5KBよりも大きいオブジェクト)をロードできます。これにより、データベースでは、断片化によって連続したメモリーが使用できなくなる可能性が低減されます。
まれに、Java、PL/SQLまたはSQLカーソルによって、5KBを超える共有プールからの割当てが行われる場合があります。このような割当てが最も効率的に行われるように、データベースでは共有プールの一部分が予約プールとして分離されています。
予約プールの構成方法を学習するには、関連項目: 『Oracle AI Databaseパフォーマンス・チューニング・ガイド』
ラージ・プール
ラージ・プールは、共有プールでの割当てには適さないサイズのメモリー割当て用のオプション・メモリー領域です。
ラージ・プールでは、次のような領域に対して大量のメモリー割当てを行うことができます。
-
パラレル実行で使用されるメッセージ・バッファ
-
Recovery Manager(RMAN)I/O子プロセス用のバッファ
-
遅延挿入のためのバッファ(
MEMOPTIMIZE_WRITEヒントによる挿入)
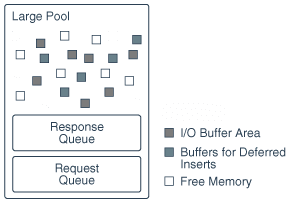
次の図は、ラージ・プールを示します。
図7: ラージ・プール
-
ラージ・プール・メモリー管理ラージ・プールでは、共有 プールとは異なる方法でメモリーが管理されます。共有プールでは、LRUリストを使用して、メモリーの一部がエージ・アウトできるようになります。
-
遅延挿入のためのラージ・プール・バッファ 遅延挿入と呼ばれる特殊なタイプの挿入の場合、データベースはバッファをラージ・プールから割り当てます。
関連情報:
-
パラレル実行時にメモリーを割り当てる方法の詳細は、問合せコーディネータを参照してください。
-
共有サーバーのセッション・メモリーの割当てについて学習するには、「ディスパッチャ・リクエスト・キューとレスポンス・キュー」を参照してください
-
Oracle XAについて学習するには、『Oracle AI Database開発ガイド』を参照
-
ラージ・プールについては、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照してください。
ラージ・プール・メモリー管理
ラージ・プールでは共有プールとは異なる方法でメモリーが管理されます。共有プールでは、メモリーの一部がエージ・アウトできるようにLRUリストが使用されます。
ラージ・プールには、LRUリストはありません。データベースにラージ・プール・メモリーがデータベース・セッションに割り当てられると、このメモリーは、セッションで解放されないかぎり解放できません。メモリーの一部が解放されると、その領域は他のプロセスがすぐに使用できます。セッション・メモリーをラージ・プールから割り当てることにより、共有プールで発生する可能性のある断片化を防ぎます。
遅延挿入のラージ・プール・バッファ
遅延挿入と呼ばれる特殊なタイプの挿入の場合、データベースはバッファをラージ・プールから割り当てます。
Internet of Things (IoT)アプリケーションからのファイア・アンド・フォーゲット方式の高速な挿入においては、データベース・インフラストラクチャにおいてパフォーマンス・オーバーヘッドが発生します。たとえば、コード・パスには、バッファ・キャッシュ・ナビゲーション、バッファ・ピンおよび同時実行性保護が含まれます。配列の挿入によってこれらのコストは最小限に抑えられるものの、配列はクライアント側で構築される必要があり、これは、Internet of Thingsアプリケーションにおいては一般的ではありません。この問題に対処するために、Oracleアプリケーションではヒントを使用して、MEMOPTIMIZE FOR WRITEとして指定された表に行を挿入できます。
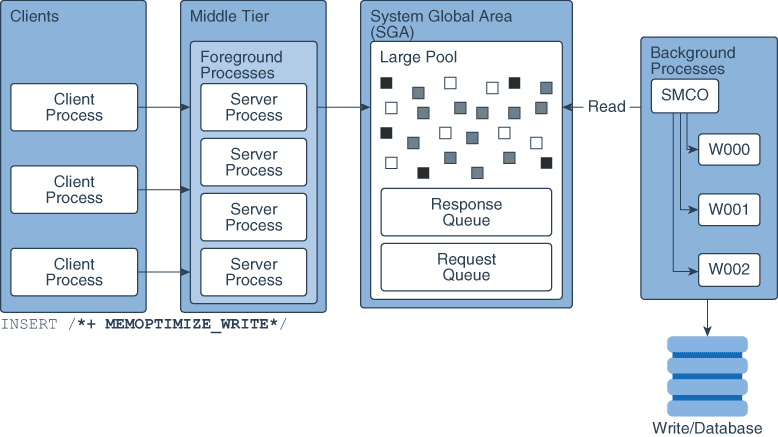
この挿入はラージ・プールにバッファされ、バックグラウンド・プロセスによって後から非同期にディスクに書き込まれるため、遅延されます。データベースでは、遅延挿入は次のように処理されます。
-
アプリケーションは
MEMOPTIMIZE_WRITE挿入を、データを集計できる中間層に送ります。ほとんどの場合、IoTアプリケーションは挿入を中間層に送信しますが、データベースに挿入を直接送信することもできます。たとえば、SQL*Plusを使用すると挿入がデータベースに直接送信されます。 -
中間層は、挿入の集計をデータベース・サーバーに書き込みます。
-
オプションで、中間層クライアントは、前のステップで書き込んだデータのローカル・コピーを保持します。
-
サーバー・プロセスは、ラージ・プールのバッファにデータを書き込みます。
競合を防ぐために、各バッファには独自の内部ロック・メカニズムがあります。このロック・メカニズムは、データベース・バッファ・キャッシュがバッファに対して使用するロック・メカニズムとは異なります。基本的な書込みプロセスは次のとおりです。
-
インスタンスの起動後、最初の
MEMOPTIMIZE_WRITE挿入によって、ラージ・プールからバッファが割り当てられます。 -
ライターは、使用可能なバッファのリストからバッファを選択します。
-
選択したバッファがロックされておらず、かつそのバッファに空き領域がある場合、クライアントはそのバッファへの書込みを行い、セッション固有の順序番号が各バッファ書込みにスタンプされます。そうでない場合、ライターは前のステップに戻り、バッファが見つかるか、ラージ・プールで十分な領域が解放されるまでこの方法を続行します。
-
-
データベースで、バッファされたデータからサーバー側配列が作成されます。
-
Space Management Coordinator (SMCO)とそのヘルパー・プロセス(Wnnn)は、標準のデータ・ブロック形式を使用して配列をディスクに非同期に書き込みます。
標準挿入とは異なり、遅延挿入は自動的にコミットされ、ロールバックできません。データベースは、指定されたオブジェクトへの挿入をセッションに出現する順序でコミットします。オブジェクトまたはセッションどうしの順序付けは保証されません。
データベースでは、通常の挿入と同様に制約および索引のメンテナンスがサポートされます。ただし、データベースは、ラージ・プールへの書込み時ではなくディスクへの書込み時に評価を実行します。
ノート:最適なパフォーマンスを得るため、Oracleでは制約を使用禁止にすることをお薦めします。
次の図に、遅延挿入のワークフローを示します。
図8: 遅延InsertMechanism
関連情報:
-
MEMOPTIMIZE FOR WRITEとして表を指定する方法を学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照 -
INSERTの構文およびセマンティクスについては、Oracle AI Database SQL言語リファレンスを参照 -
MEMOPTIMIZE_POOL_SIZEについてさらに学習するには、Oracle AI Databaseリファレンスを参照してください。
Javaプール
Javaプールは、セッション固有のすべてのJavaコードとデータをJava Virtual Machine (JVM)内に格納するメモリー領域です。このメモリーには、コール終了時にJavaセッション領域に移行されるJavaオブジェクトが含まれています。
専用サーバー接続では、Javaプールには各Javaクラスの共有部分(メソッドおよびコード配列などの読取り専用メモリー)が含まれていますが、各セッションのセッションごとのJava状態は含まれていません。共有サーバーでは、プールには、各クラスの共有部分および各セッションの状態に使用される一部のUGAが含まれています。各UGAは必要に応じて拡大および縮小されますが、UGAの合計サイズはJavaプール領域に収まる必要があります。
Javaプール・アドバイザの統計は、Javaに使用されるライブラリ・キャッシュ・メモリーに関する情報を提供し、Javaプールのサイズの変化が解析率に与える影響を予測します。Javaプール・アドバイザは、statistics_levelをTYPICAL以上に設定すると内部的にオンに設定されます。これらの統計は、アドバイザをオフにするとリセットされます。
関連情報:
-
Javaプール・アドバイザ統計を含むビューについて学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照
固定SGA
固定SGAは、内部のハウスキーピング用の領域です。
固定SGAには、たとえば次のような情報が含まれています。
-
バックグラウンド・プロセスがアクセスする必要のある、データベースとインスタンスの状態に関する一般的な情報
-
ロックに関する情報など、プロセス間で通信される情報
固定SGAのサイズはOracle AI Databaseによって設定され、手動では変更できません。固定SGAのサイズは、リリースによって異なります。
関連項目: 「自動ロックの概要」
オプションのパフォーマンス関連SGAサブ領域
一部のSGA領域は、特定のパフォーマンス機能のみが使用できます。
この項では、次のトピックについて説明します:
-
インメモリ領域インメモリー領域とは、インメモリ列ストア(IM列ストア)が含まれている、オプションのSGAコンポーネントです
-
memoptimizeプール memoptimizeプールには、
MEMOPTIMIZE FOR READと指定されたヒープ構成表のバッファおよび関連構造を格納します。
インメモリー領域
インメモリー領域は、インメモリ列ストア(IM列ストア)が含まれるオプションのSGAコンポーネントである。
IM列ストアには、高速スキャン用に最適化された列形式で表、パーティションおよびマテリアライズド・ビューのコピーが格納されています。IM列ストアは、従来の行形式でデータを格納するデータベースバッファ・キャッシュを補完するものです。
ノート: IM列ストアを有効にするには、Oracle AI Database In-Memoryオプションが必要です。
関連項目:インメモリ領域およびIM列ストアについてさらに学習するには、Oracle AI Databaseインメモリー・ガイドを参照してください。
Memoptimizeプール
memoptimizeプールには、バッファおよびMEMOPTIMIZE FOR READと指定されたヒープ構成表の関連構造を格納します。
この構造は、SELECT * FROM cust WHERE cid = 10などのキー・ベースの問合せに対して、優れたパフォーマンスとスケーラビリティを提供します。エンドツーエンドのレスポンス時間を短縮するために、クライアントはリクエストしたバッファをネットワーク経由でSGAから直接プルし、CPUとオペレーティング・システムのオーバーヘッドを回避します。アプリケーションは、コードを変更することなくmemoptimizeプールを利用できます。
memoptimizeプールは次の2つのパートで構成されています。
-
Memoptimizeバッファ領域
ディスクI/Oを回避するために、データベースはmemoptimizeプールで
MEMOPTIMIZE FOR READ表のバッファを、表にNO MEMOPTIMIZE FOR READのマークが付いたまで永続的にロックします。memoptimizeバッファには、データベース・バッファ・キャッシュ内のバッファと同じ構造が使用されます。ただし、memoptimizeプールのバッファはデータベース・バッファ・キャッシュから完全に分離され、そのサイズにカウントされません。memoptimizeバッファ領域の占有率は、memoptimizeプールの75%です。 -
ハッシュ索引
ハッシュ索引は、非永続なセグメント・データ構造です。データベースは、複数の非連続メモリー単位としてハッシュ索引を割り当てます。各単位には、複数のハッシュ・バケットが含まれます。個別のマップ構造により、メモリー単位と主キーが関連付けられます。ハッシュ索引はmemoptimizeプールの25%を占めています。図9: Memoptimizeプール
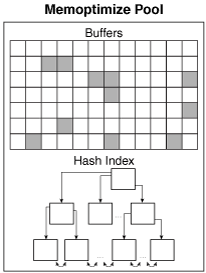
memoptimizeプールを有効にするには、MEMOPTIMIZE_POOL_SIZE初期化パラメータを整数値に設定します(プールはデフォルトで無効になっています)。この値は、プールに割り当てるSGAの量を指定します。MEMOPTIMIZE_POOL_SIZE値はSGA_TARGETの対象ですが、データベースはmemoptimizeプールを自動で拡大および縮小しません。たとえば、SGA_TARGETが10 GB、MEMOPTIMIZE_POOL_SIZEが1 GBの場合、使用可能なSGAメモリーはmemoptimizeプール以外の合計9 GBです。
memoptimizeプールのサイズを変更するには、MEMOPTIMIZE_POOL_SIZEを手動で設定し、データベース・インスタンスを再起動する必要があります。ALTER SYSTEMを使用して動的にプール・サイズを変更することはできません。
DBMS_MEMOPTIMIZEパッケージを使用すると、memoptimizeプールに表を明示的に移入できます。
関連情報:
-
memoptimizeプールを有効にして問合せのパフォーマンスを向上させる方法を学習するには、Oracle AI Databaseパフォーマンス・チューニング・ガイドを参照してください
-
DBMS_MEMOPTIMIZEパッケージについてさらに学習するには、Oracle AI Database PL/SQLパッケージおよびタイプ・リファレンスを参照してください。 -
CREATE TABLE ... MEMOPTIMIZE FOR READについてさらに学習するには、Oracle AI Database SQL言語リファレンスを参照してください。 -
MEMOPTIMIZE_POOL_SIZEについてさらに学習するには、Oracle AI Databaseリファレンスを参照してください。
プログラム・グローバル領域(PGA)の概要
PGAは、システム上の他のプロセスやスレッドによって共有されていない、動作中プロセスやスレッドに固有のメモリーです。PGAはプロセス固有であるため、SGA内で割り当てられることはありません。
PGAは、専用サーバー・プロセスまたは共有サーバー・プロセスが必要とするセッション依存の変数を含むメモリー・ヒープです。サーバー・プロセスでは、必要なメモリー構造がPGA内に割り当てられます。
PGAは、文書係が使用するカウンタ上の一時的な作業領域に似ています。このたとえの場合、文書係はサーバー・プロセスを表しており、顧客(クライアント・プロセス)のために作業を行います。文書係は、作業のための場所をカウンタ上に準備し、その場所に顧客のリクエストの詳細をまとめ、顧客が要求するフォルダをソートし、作業が終わるとその場所を解放します。
次の図に、共有サーバー用に構成されていないインスタンスのインスタンスPGA (すべてのPGAの集合)を示します。初期化パラメータを使用して、インスタンスPGAの最大ターゲット・サイズを設定できます。個々のPGAでは、必要に応じて最大このターゲット・サイズまでサイズを増加できます。
図10: インスタンスPGA
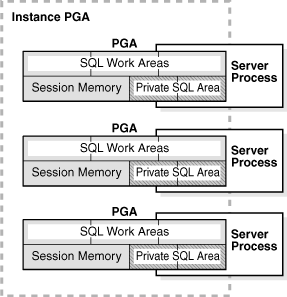
ノート:バックグラウンド・プロセスでは、独自のPGAも割り当てられます。ここでは、サーバー・プロセスPGAのみを説明します。
-
PGAの内容 PGAは、それぞれ異なる目的を持つ複数の領域によって構成されます。
-
専用サーバー・モードで共有サーバー・モードにおけるPGAの使用 PGAメモリーの割当ては、データベースで専用サーバーに接続されるか、共有サーバー接続が使用されるかに応じます。関連項目: PGAメモリー管理の概要は、Oracle AI Databaseパフォーマンス・チューニング・ガイドを参照してください。
PGAの内容
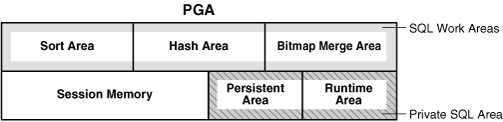
PGAは、それぞれ異なる目的を持つ複数の領域によって構成されています。
次の図に、専用サーバー・セッションのPGAの内容を示します。どの場合にもすべてのPGA領域が揃っているとはかぎりません。
図11: PGAの内容
-
プライベートSQL領域 プライベートSQL領域には、解析済のSQL文に関する情報、および処理に使用するその他のセッション固有情報が格納されます。
-
SQL作業領域作業領域とは、メモリー集中型の操作に使用されるPGAメモリーを個別に割り当てるために領域です。
プライベートSQL領域
プライベートSQL領域には、解析済のSQL文に関する情報と、処理に使用するその他のセッション固有の情報が保持されます。
サーバー・プロセスでSQLまたはPL/SQLのコードが実行される場合、プロセスではプライベートSQL領域を使用してバインド変数値、問合せ実行状態情報、問合せ実行作業領域が格納されます。
PGA内のプライベートSQL領域は、SGAにおいて実行計画が格納される共有SQL領域とは別です。同じセッション内または異なるセッション内の複数のプライベートSQL領域から、SGA内の単一の実行計画を指すことができます。たとえば、あるセッションにおけるSELECT * FROM salesの20回の実行および別のセッションにおける同じ問合せの10回の実行において、同じ計画を共有できます。各実行におけるプライベートSQL領域は共有されず、異なる値やデータが含まれている可能性があります。
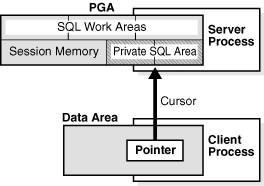
カーソルは、特定のプライベートSQL領域の名前またはハンドルです。次の図に示すように、カーソルはクライアントから見るとポインタ、サーバーから見ると状態のようなものです。カーソルはプライベートSQL領域と密接に関連しているため、これらの用語は同じ意味で使用されることがあります。
図12: カーソル
プライベートSQL領域は、次の領域によって構成されています。
-
ランタイム領域
この領域には、問合せ実行状態情報が含まれています。たとえば、ランタイム領域では、全表スキャンで現在までに取得された行数を追跡します。
Oracle AI Databaseは、ランタイム領域を、実行要求の最初のステップとして作成します。DML文では、SQL文が終了するとランタイム領域が解放されます。
-
持続領域
この領域には、バインド変数値が含まれています。バインド変数値は、SQL文が実行される実行時に、SQL文に指定されます。持続領域は、カーソルのクローズ時にのみ解放されます。
クライアント・プロセスは、プライベートSQL領域の管理を担当します。クライアント・プロセスが割り当てることのできるプライベートSQL領域の数は、初期化パラメータOPEN_CURSORSによって制限されますが、プライベートSQL領域の割当ておよび割当て解除は、アプリケーションに大きく依存します。
ほとんどのユーザーはデータベース・ユーティリティの自動カーソル処理を利用しますが、Oracle AI Databaseのプログラム・インタフェースを利用すると開発者はカーソルをより制御できるようになります。一般的に、持続領域を解放し、アプリケーション・ユーザーが必要とするメモリーを最小限に抑えるには、オープンされているカーソルのうち再利用しないすべてのカーソルをアプリケーション側でクローズする必要があります。
関連情報:
-
カーソルの使用方法について学習するには、『Oracle AI Database開発ガイド』および『Oracle AI Database PL/SQL言語リファレンス』を参照してください
SQL作業領域
作業領域は、メモリー集中型の操作に使用されるPGAメモリーのプライベート割当てです。
たとえば、ソート演算子では、ソート領域を使用して行のセットがソートされます。同様に、ハッシュ結合演算子ではハッシュ領域を使用して左側の入力からハッシュ表が構築され、ビットマップ・マージではビットマップ・マージ領域を使用して複数のビットマップ索引のスキャンを使用して複数のビットマップ索引のスキャンによって取得されたデータがマージされる。
次の例では、employeesおよびdepartmentsの結合をその問合せ計画とともに示しています。
SQL> SELECT *
  2  FROM   employees e JOIN departments d
  3  ON     e.department_id=d.department_id
  4  ORDER BY last_name;
.
.
.
--------------------------------------------------------------------------------
| Id| Operation           | Name        | Rows  | Bytes | Cost (%CPU)| Time    |
--------------------------------------------------------------------------------
| 0 | SELECT STATEMENT    |             |   106 |  9328 |    7  (29)| 00:00:01 |
| 1 |  SORT ORDER BY      |             |   106 |  9328 |    7  (29)| 00:00:01 |
|*2 |   HASH JOIN         |             |   106 |  9328 |    6  (17)| 00:00:01 |
| 3 |    TABLE ACCESS FULL| DEPARTMENTS |    27 |   540 |    2   (0)| 00:00:01 |
| 4 |    TABLE ACCESS FULL| EMPLOYEES   |   107 |  7276 |    3   (0)| 00:00:01 |
--------------------------------------------------------------------------------前述の例では、ランタイム領域で全表スキャンの進行状況が追跡されます。セッションでは、ハッシュ領域を使用してハッシュ結合が実行されて、2つの表の行が照合されます。ORDER BYによるソートは、ソート領域で行われます。
演算子で処理するデータの量が作業領域に収まらない場合は、Oracle AI Databaseによって入力データがより小さく分割されます。データベースでは、このようにして一部のデータがメモリー内で処理され、残りのデータは後で処理するために一時ディスク記憶域に格納されます。
自動PGAメモリー管理が有効になっている場合、作業領域サイズはデータベースにより自動的にチューニングされます。作業領域のサイズを手動で制御してチューニングすることもできます。
一般に、作業領域が大きいほど、演算子のパフォーマンスは大幅に向上しますが、メモリーも多く使用されます。作業領域は、入力データや関連するSQL演算子によって割り当てられる補助メモリー構造を格納するために十分なサイズにすることをお薦めします。十分なサイズが確保されていない場合は、一部の入力データがディスクにキャッシュされるため、レスポンス時間が長くなります。作業領域のサイズが入力データ・サイズに比べて非常に小さい場合は、データを分割して何度も渡すことが必要となるため、レスポンス時間が大幅に長くなります。
関連情報:
-
自動PGA管理の使用方法を学習するには、Oracle AI Database管理者ガイドを参照
-
PGAメモリーの調整方法を学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照
専用サーバー・モードおよび共有サーバー・モードにおけるPGAの使用
PGAにメモリーが割り当てられるかどうかは、データベースで専用サーバー接続が使用されるか、共有サーバー接続が使用されるかに応じて異なります。
次の表にこの相違を示します。
表1専用サーバーと共有サーバーのメモリー割当て方法の相違点
| メモリー領域 | 専用サーバー | 共有サーバー |
|---|---|---|
| セッション・メモリーの性質 | プライベート | 共有 |
| 持続領域の位置 | PGA | SGA |
| DMLおよびDDL文のランタイム領域の位置 | PGA | PGA |
関連項目:共有サーバー用のデータベースの構成方法を学習するには、『Oracle AI Database管理者ガイド』を参照してください。
ユーザー・グローバル領域の概要
UGAはセッション・メモリーであり、ログオン情報のほか、データベース・セッションに必要なその他の情報などのセッション変数に割り当てられるメモリーです。基本的に、UGAにはセッション状態が格納されています。
次の図に、UGAを示します。
図13: ユーザー・グローバル領域(UGA)
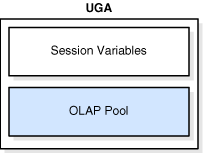
セッションによってPL/SQLパッケージがメモリーにロードされると、特定の時点においてすべてのパッケージ変数に格納されている値のセットであるパッケージ状態がUGA保管されます。パッケージのサブプログラムによって変数が変更されると、パッケージ状態も変更されます。デフォルトで、パッケージ変数はセッションの存続期間に対して固有の変数であり、セッションの存続期間中保持されます。
UGAには、OLAPページ・プールも格納されています。このプールでは、OLAPデータ・ページを管理し、データ・ブロックと同じものです。ページ・プールは、OLAPセッションの開始時に割り当てられて、セッションの終了時に解放されます。OLAPセッションは、ユーザーがキューブなどのディメンション・オブジェクトを問い合せると、自動的に開かれます。
データベース・セッションの存続期間中は、セッションでUGAが使用可能である必要があります。このことは、PGAは単一のプロセス固有のものであるため、共有サーバー接続を使用する場合にはPGAをPGAに格納できないことになります。したがって、共有サーバー接続を使用する場合は、すべての共有サーバー・プロセスからMGAにアクセスできるよう、UGAはMGAに格納されます。専用サーバー接続を使用する場合は、UGAはPGAに格納されます。
関連情報:
-
接続とセッションに関する項
-
共有サーバー接続について学習するには、『Oracle AI Database Net Services管理者ガイド』を参照してください。
管理対象グローバル領域(MGA)の概要
管理対象グローバル領域(MGA)は、一連の信頼できるOracleプロセス間でメモリーを共有および調整できる一意のメモリー・フレームワークです。
これは、構成可能で柔軟性に富み、モジュール式のオンデマンドかつリカバリ可能な共有メモリー領域としての機能を持ちます。MGAは、データベース内の様々なタイプの共有メモリー領域を利用する手段を提供します。これは、内部データベース・レイヤー用のネームスペースとして公開され、各レイヤーが1つのレイヤーのみに属します。ネームスペースは主に、共有メモリー・セグメントのセットとそれに関連するメタデータで構成されます。
データベース内のレイヤーは、ネームスペースの特性、スコープ、存続期間および内部セグメント・サイズを定義できます。MGAはすべて、PGA集計制限の対象となります。
Linuxでは、MGAでは、/dev/shmにマウントされたtempfsを必要とし、少なくともPGA集計制限のサイズに構成されます。複数のインスタンスが同じマシンで実行されている場合、/dev/shmのサイズはすべてのインスタンスでsum(PGA_AGGREGATE_LIMIT)以上である必要があります。
関連情報:
-
グラニュルのサイズ設定についてさらに学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照してください。
ソフトウェア・コード領域の概要
ソフトウェア・コード領域は、実行中または実行できるコードが保管されるメモリーの部分です。Oracle AI Databaseのコードはソフトウェア領域に格納され、通常、この場所はユーザー・プログラムの保存場所よりも排他的で、保護されています。
ソフトウェア領域のサイズは通常固定されており、ソフトウェアの更新時か再インストール時にかぎり変化します。これらの領域に必要なサイズは、オペレーティング・システムによって異なります。
ソフトウェア領域は読取り専用で、共有または非共有でインストールされます。Oracle FormsやSQL*Plusなど一部のデータベース・ツールおよびユーティリティは共有で インストールできますが、共有でインストールできないものもあります。データベースのコードは、メモリー内に複数のコピーを保持することなくすべてのユーザーがアクセスできるよう、可能なかぎり共有され、その結果、メイン・メモリーの使用量は削減されて、全体的にパフォーマンスが向上します。データベースの複数のインスタンスが同じコンピュータ上で実行されている場合、それらのインスタンスは異なるデータベースにおいても同じデータベース・コード領域を使用できます。ノート:ソフトウェアを共有でインストールするオプションは、すべてのオペレーティング・システムで使用できるわけではありません(たとえば、Microsoft Windowsが稼動しているPCでは使用できません。詳細は、オペレーティング・システム別のドキュメントを参照してください。