アプリケーションとOracle Net Servicesのアーキテクチャ
この章では、アプリケーション・アーキテクチャについて定義し、分散処理環境でOracleデータベースとデータベースのアプリケーションがどのように機能するかを説明します。この資料は、ほとんどすべてのタイプのOracle AI Database環境に適用されます。
-
Oracleアプリケーション・アーキテクチャの概要この章においては、アプリケーション・アーキテクチャとは、システム・アプリケーションがOracleデータベースに接続しているコンピューティング環境のことを指しています。
-
Oracle Net Servicesのアーキテクチャの概要
Oracle Net Servicesは分散された、異機種間コンピューティング環境において、企業全体の接続性を保つ一連のネットワーク・コンポーネントである。
-
プログラム・インタフェースの概要プログラム・インタフェースとは、データベース・アプリケーションとOracle AI Databaseの間のソフトウェア・レイヤーである。
-
Oracle True Cacheの概要True Cacheは、Oracle AI Databaseの前にある、読取り専用のインメモリー・キャッシュです。
Oracleアプリケーション・アーキテクチャの概要
この章では、アプリケーション・アーキテクチャは、データベース・アプリケーションがOracleデータベースに接続するコンピューティング環境を示します。
-
クライアント/サーバー・アーキテクチャの概要 Oracle AI Database環境は、データベース・アプリケーションとデータベースをクライアント/サーバー・アーキテクチャに分割します。
-
複数層アーキテクチャの概要従来の複数層アーキテクチャでは、アプリケーション・サーバーは、クライアントにデータを提供し、クライアントとデータベース・サーバーの間のインタフェースとして機能します。
-
グリッド・アーキテクチャの概要 Oracle AI Database環境において、グリッド・コンピテンスは、柔軟性のあるオンデマンド・コンピテンス・リソースに多数のサーバーおよび記憶域を効率的にプールするコンピテンス・アーキテクチャである。
クライアント/サーバー・アーキテクチャの概要
Oracle AI Database環境においては、データベース・アプリケーションとデータベースがクライアント/サーバー・アーキテクチャに分割されます。
コンポーネントは次のとおりです。
-
クライアントでは、データベース情報にアクセスしたり、ユーザーと対話するデータベース・アプリケーション(SQL*Plus、Visual Basicデータ入力プログラムなど)が実行されます。
-
サーバーでは、Oracle AI Databaseソフトウェアが実行され、Oracleデータベースへの同時送信の共有データ・アクセスに必要な機能が処理されます。
クライアント・アプリケーションとデータベースを同じコンピュータで実行することもできますが、クライアント部分とサーバー部分を別々のコンピュータで実行し、それらのコンピュータをネットワークで接続する方がさらに効率的です。次の各項では、Oracle AI Databaseクライアント/サーバー・アーキテクチャの様々な形態を説明します。
-
分散処理複数ホストを使用した個別タスクの処理は、分散処理と呼ばれます。
-
クライアント/サーバー・アーキテクチャの利点分散処理環境でのOracle AI Databaseクライアント/サーバー・アーキテクチャには、多くの利点があります。
分散処理
複数ホストを使用した個別タスクの処理は、分散処理と呼ばれます。
フロントエンド処理とバックエンド処理は異なるコンピュータ上で実行されます。図19-1では、クライアントとサーバーが異なるホストに配置され、Oracle Net Servicesを介して接続されています。
図1: クライアント/サーバー・アーキテクチャと分散処理
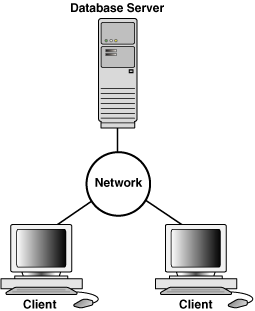
図19-2に、様々な分散データベースを示します。この例では、あるホスト上のデータベースが、異なるホスト上の別のデータベースにアクセスしています。
図2: クライアント/サーバー・アーキテクチャと分散データベース
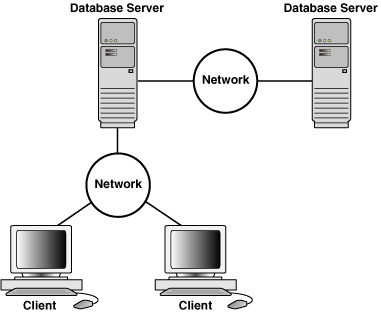
ノート:この章の以降の内容は、1つのサーバー上に1つのデータベースがある環境に適用されます。
クライアント/サーバー・アーキテクチャの利点
分散処理環境でのOracle AI Databaseクライアント/サーバー・アーキテクチャには、多くの利点があります。
次のような利点があります:
-
クライアント・アプリケーションではデータ処理は実行されません。そのかわり、クライアント・アプリケーションは、ユーザーに入力をリクエストし、必要なデータをサーバーにリクエストし、そのデータを分析してクライアント・ワークステーションまたは端末の表示機能(グラフィックスやスプレッドシート)を使用して表示します。
-
クライアント・アプリケーションはデータの物理的な位置に依存しません。データを他のデータベース・サーバーに移動したり分散しても、アプリケーションはほとんど、またはまったく変更することなく、機能を続行できます。
-
Oracle AI Databaseは、基礎となるオペレーティング・システムのマルチタスキングおよび共有メモリー機能を利用します。その結果、クライアント・アプリケーションに最高度の同時実行性、データ整合性およびパフォーマンスが提供されます。
-
クライアント・ワークステーションや端末はデータの表示用に最適化でき(グラフィックスやマウスのサポート提供など)、サーバーはデータの処理と格納用に最適化できます(大容量のメモリーとディスク領域の搭載など)。
-
ネットワーク化された環境では、安価なクライアント・ワークステーションを使用して、サーバーのリモート・データに効率的にアクセスできます。
-
データベースは、システムの拡張とともにスケーリングできます。複数のサーバーを追加して、データベース処理の負荷をネットワーク全体に分散することまたは(水平スケール)、データベースをミニコンピュータやメインフレームに移動して、より大規模なシステムのパフォーマンス上の利点を活用(垂直スケール)することができます。どちらの場合も、Oracle AI Databaseはシステム間で移植できるため、データとアプリケーションはほとんど変更することなく維持されます。
-
ネットワーク化された環境の場合、共有データは、すべてのコンピュータに格納されるのではなく、サーバーに格納されます。これにより、同時アクセスの管理が簡略化され、効率的になります。
-
ネットワーク化された環境では、クライアント・アプリケーションからサーバーにデータベース・リクエストを送るときにSQL文を使用できます。サーバーが受け取ったSQL文はそのサーバーで処理され、その結果がクライアントに戻されます。ネットワークを介してやりとりされるのはリクエストと結果のみであるため、ネットワーク通信量は最小限ですみます。
関連項目: Oracle AI Database管理者ガイドを参照してください。
複数層アーキテクチャの概要
従来の複数層アーキテクチャにおいては、アプリケーション・サーバーはクライアントにデータを提供し、クライアントとデータベース・サーバー間のインタフェースとして機能します。
このアーキテクチャでは、アプリケーション・サーバーを使用して次のことを実行できます。
-
Webブラウザなど、クライアントの資格証明の検証
-
データベース・サーバーへの接続
-
リクエストされた操作の実行
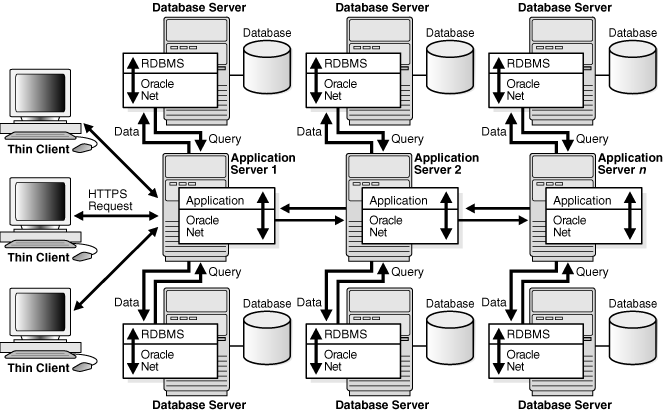
図19-3は、複数層アーキテクチャの例を示しています。
図3: 複数層アーキテクチャ環境
-
クライアントクライアントは、操作がデータベース・サーバー上で実行されるようにリクエストを出します。
-
アプリケーション・サーバーアプリケーション・サーバーは、クライアントにデータへのアクセスを提供します。また、クライアントと、1つ以上のデータベース・サーバーとの間のインタフェースとして機能し、アプリケーションをホスティングします。
-
データベース・サーバーデータベース・サーバーは、クライアントにかわってアプリケーション・サーバーからリクエストされたデータを提供します。問合せ処理は、データベースによって実行されます。
-
サービス指向アーキテクチャ(SOA)データベースは、従来の複数層またはサービス指向アーキテクチャ(SOA)環境でWebサービス・プロバイダとして機能できます。
クライアント
クライアントは、データベース・サーバー上で実行される操作についてリクエストを出します。
このクライアントは、Webブラウザでも他のエンド・ユーザー・プログラムでもかまいません。複数層アーキテクチャでは、クライアントは1つ以上のアプリケーション・サーバーを介してデータベース・サーバーに接続します。
アプリケーション・サーバー
アプリケーション・サーバーは、クライアントにデータ・アクセスを提供します。また、クライアントと、1つ以上のデータベース・サーバーとの間のインタフェースとして機能し、アプリケーションをホスティングします。
アプリケーション・サーバーでは、最小限のソフトウェア構成を備えたクライアントであるシン・クライアントから、クライアント・コンピュータの継続的なメンテナンスを必要とせずにアプリケーションにアクセスできます。また、アプリケーション・サーバーは、クライアント用にデータを再フォーマットし、クライアント・ワークステーションの負荷を軽減することもできます。
アプリケーション・サーバーは、クライアントのためにデータベース・サーバー上で操作を実行するとき、そのクライアントの識別を想定します。クライアント操作中に不要な操作や望ましくない操作を実行できないように、アプリケーション・サーバーの権限を制限することが、最良の方法です。
データベース・サーバー
データベース・サーバーは、クライアントにかわってアプリケーション・サーバーからリクエストされたデータを提供します。問合せ処理は、データベースによって実行されます。
データベース・サーバーは、クライアントおよび自身のためにアプリケーション・サーバーで実行された操作を監査できます。たとえば、クライアント操作はクライアントに表示する情報をリクエストでき、アプリケーション・サーバー操作はデータベース・サーバーに接続をリクエストできます。
統合監査では、データベースでは、アプリケーション・コンテキスト(アプリケーション固有の名前/値のペア)を統合監査証跡のレコードに追加できます。データベースによってデータベース監査レコードに書き込まれるアプリケーション・コンテキストを構成できます。
関連項目:監査の概要は、Oracle AI Databaseセキュリティ・ガイドを参照してください
サービス指向のアーキテクチャ(SOA)
データベースは、従来の複数層またはサービス指向アーキテクチャ(SOA)環境でWebサービス・プロバイダとして機能できるようになりました。
SOAは、ネットワーク上でのコンピュータ間における相互作用をサポートするサービスに依存している、複数層アーキテクチャです。SOAとの関連で、サービスは自給自足の機能的エンドポイントで、機能とサービス・レベルの明確な合意があり、監視および管理が可能で、ポリシー・コンプライアンスの実施に役立ちます。
通常、SOAサービスはHTTPプロトコルを介してアクセスできるWebサービスとして実装されます。これらのサービスは、WSDLやSOAPなどのXML標準に基づいています。
Oracle XML DBの一部として実装されるOracle AI DatabaseのWebサービス機能は、DBAが明示的に有効化する必要があります。アプリケーションは、データベースWebサービスを介して次のことを実行できます。
-
SQLまたはXQuery問合せの発行およびXMLでの結果の受信
-
スタンドアロンPL/SQLファンクションの起動および結果の受信
-
PL/SQLパッケージ・ファンクションの起動および結果の受信
データベースWebサービスを使用すると、アプリケーション・サーバーがなくても、アプリケーション環境に簡単にWebサービスを追加できます。ただし、Oracle Fusion Middlewareなどのアプリケーション・サーバーを介してWebサービスを起動すると、SOA環境で、セキュリティ、スケーラビリティ、UDDI登録および信頼できるメッセージ機能の面でさらに利点があります。ただし、データベースWebサービスはOracle Fusion Middlewareと簡単に統合できるため、SOAソリューションの最適化に適しています。
関連情報:
-
データベースWebサービスを有効化する方法および使用方法の詳細は『Oracle XML Developer's Kitプログラマーズ・ガイド』を参照してください。
-
SOAおよびWebサービスの詳細は、Oracle Fusion Middlewareのマニュアルを参照してください。
グリッド・アーキテクチャの概要
Oracle AI Database環境では、グリッド・コンピューティングは、柔軟なオンデマンド・コンピューティング・リソースに多くのサーバーおよび記憶域を効率的にプールするコンピューティング・アーキテクチャである。
ビジネスのニーズの変化に対応して、必要であればモジュール化したハードウェアおよびソフトウェア・コンポーネントのグループを接続および再結合できます。
関連項目:サーバー・グリッドおよびストレージ・グリッドの詳細は、Oracle Clusterware管理およびデプロイメント・ガイドを参照してください。
Oracle Net Servicesのアーキテクチャの概要
Oracle Net Servicesは分散された、異機種間コンピューティング環境において、企業全体の接続性を保つ一連のネットワーク・コンポーネントである。
Oracle Net Servicesを使用すると、アプリケーションからデータベース・インスタンスへのネットワーク・セッションと、別のデータベース・インスタンスへのデータベース・インスタンスのネットワーク・セッションを確立することができます。
Oracle Net Servicesにより、位置の透過性、構成と管理の一元化および迅速なインストールと構成が実現されます。また、システム・リソースの最大化とパフォーマンスの改善が可能です。共有サーバー・アーキテクチャによって、アプリケーションのスケーラビリティが向上し、データベースへのクライアントの同時接続数が増大します。Virtual Interface (VI)プロトコルは、メッセージ機能の負荷のほとんどを高速ネットワーク・ハードウェアに負わせることによって、CPUを解放します。
Oracle Net Servicesは、広範囲のネットワークでサポートされている通信プロトコルやApplication Program Interface(API)を使用して、分散データベースと分散処理の機能を提供します。ネットワーク・セッションの確立後、Oracle Net Servicesは、接続を確立してメッセージを交換することで、クライアント・アプリケーションとデータベース・サーバーのためのデータ伝達方法として機能します。Oracle Net Servicesはネットワーク内の各コンピュータに配置されているため、これらのタスクを実行できます。
-
Oracle Net Servicesの仕組み Oracle AI Databaseプロトコルは、Oracle applicationsのインタフェースからSQL文を受け入れ、Oracle AI Databaseへの転送用にパッケージ化します。
-
Oracle Net ListenerOracle Net Listener(リスナー)は、着信するクライアント接続リクエストをリスニングし、データベースへのトラフィックを管理する、サーバー側のプロセスである。データベース・インスタンスの起動時、および起動中の様々なタイミングで、インスタンスはリスナーに接続してそのインスタンスへの接続経路を確立します。
-
専用サーバー・アーキテクチャ 専用サーバー・アーキテクチャにおいては、各クライアント・プロセスのかわりに作成されたサーバー処理を専用サーバー・プロセス(またはシャドウ・プロセス)と呼びます。
-
共有サーバー・アーキテクチャ 共有サーバー・アーキテクチャの場合、ディスパッチャは、複数の受信ネットワーク・セッション・リクエストを共有サーバー・プロセスのプールに送信します。
-
データベース常駐接続プーリング: データベース常駐接続プーリング(DRCP)は、一般的なWebアプリケーション使用シナリオにおける、専用サーバーの接続プールを提供します。関連項目: Oracle Netアーキテクチャの概要は、『Oracle AI Database Net Services管理者ガイド』を参照してください
Oracle Net Servicesの動作
Oracle AI Databaseプロトコルは、Oracle applicationsのインタフェースからSQL文を受け入れ、Oracle AI Databaseへの転送用にパッケージ化します。
送信は、サポートされている業界標準の高レベルのプロトコルまたはAPIを介して行われます。Oracle AI Databaseからの返信は、同じ高レベルの通信メカニズムを介してパッケージ化されます。これらの処理はネットワーク・オペレーティング・システムからは独立して実行されます。
Oracle AI Databaseを実行するオペレーティング・システムによっては、データベース・サーバーのOracle Net Servicesソフトウェアにドライバー・ソフトウェアが含まれており、追加のバックグラウンド・プロセスが起動されることがあります。
関連項目: Oracle Net Servicesの動作の詳細は、『Oracle AI Database Net Services管理者ガイド』を参照してください。
Oracle Net Listener
Oracle Net Listener(リスナー)は、受信するクライアント接続リクエストをリスニングし、データベースへのトラフィックを管理する、サーバー側のプロセスである。データベース・インスタンスの起動時、および起動中の様々なタイミングで、インスタンスはリスナーに接続してそのインスタンスへの接続経路を確立します。
サービス登録により、リスナーは、データベース・サービスおよびそのサービス・ハンドラが使用可能かどうかを判断できます。サービス・ハンドラは、データベースへの接続ポイントとなる、ディスパッチャまたは専用サーバー・プロセスです。登録時に、LREGプロセスは、インスタンス名、データベース・サービス名、およびサービス・ハンドラのタイプとアドレスをリスナーに提供します。リスナーは、この情報を使用することにより、クライアント・リクエストの受信時にサービス・ハンドラを起動できます。
次の図に、異なるホスト上にある2つのデータベースを示します。このデータ環境は、異なるホスト上にある2つのリスナーが対応しています。各データベース・インスタンスで実行されているLREGプロセスは、両方のリスナーと通信してデータベースを登録します。
図4: 2つのリスナー
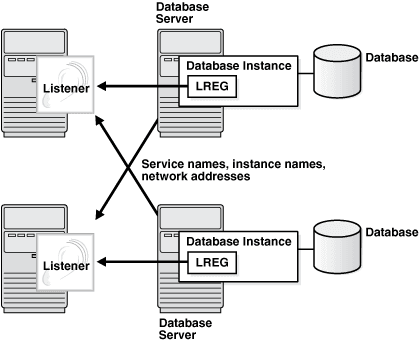
図19-5は、ブラウザによるHTTP接続の実行と、クライアントによるリスナーを介したデータベース接続の実行を示します。このリスナーは、データベース・ホストに常駐する必要はありません。
図5: リスナー・アーキテクチャ
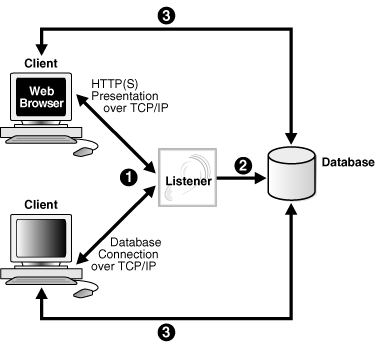
クライアントがリスナーを経由して接続を確立する基本ステップを次に示します。
-
クライアント・プロセスまたは別のデータベースが接続をリクエストします。
-
リスナーは、クライアント・リクエストの処理に適したサービス・ハンドラを選択し、そのリクエストをハンドラに送ります。
-
クライアント・プロセスは、サービス・ハンドラに直接接続します。リスナーは通信に関わりません。
-
サービス名サービス名とは、クライアント接続に使用するサービスの論理表現です。
-
マルチテナント環境サービスクライアントは、サービスを使用してPDBまたはアプリケーション・ルートに接続する必要があります。
-
サービス登録Oracle Netにおいては、サービス登録という機能により、LREGプロセスがリスナーに動的にインスタンス情報を登録する機能です。関連項目: 「クライアント・プロセスの概要」および「サーバー・プロセスの概要」
サービス名
サービス名とは、クライアント接続に使用するサービスの論理表現です。
クライアントは、リスナーに接続するときにサービスへの接続をリクエストします。データベース・インスタンスは、起動時にリスナーに登録し、1つ以上のサービスとして名前で指定できるようになります。このようにして、リスナーはクライアントおよびインスタンスとの間の仲介を果たし、接続リクエストを適切な場所に渡します。
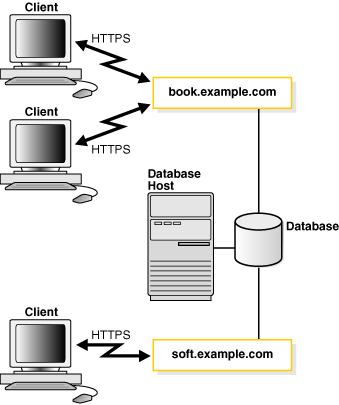
各サービスは、リスナーを介して、1つ以上のデータベース・インスタンスを識別できます。また、各データベース・インスタンスは、1つ以上のサービスをリスナーに登録できます。サービスに接続するクライアントは、必要なインスタンスを指定する必要がありません。図19-6は、book.example.comとsoft.example.comの2つのサービスに関連付けられた1つの単一インスタンス・データベースを示します。これらのサービスにより、同じデータベースを異なるクライアントが個別に識別できるようになります。データベース管理者はシステム・リソースを制限または確保できるため、これらのサービスの1つをリクエストするクライアントに対してリソースをより効率的に割り当てることができます。
図6: 1つのデータベースに対する複数サービスの対応付け
関連項目:ネーミング方法についてさらに学習するには、『Oracle AI Database Net Services管理者ガイド』を参照してください。
マルチテナント環境のサービス
クライアントは、サービスを使用してPDBまたはアプリケーション・ルートに接続する必要があります。
サービス名を使用した接続により、PDBまたはアプリケーション・ルートでは新規のセッションが開始されます。フォアグラウンド・プロセス、およびその結果のセッションは、ライフタイムの各時点で、一意に定義された現在のコンテナがあります。
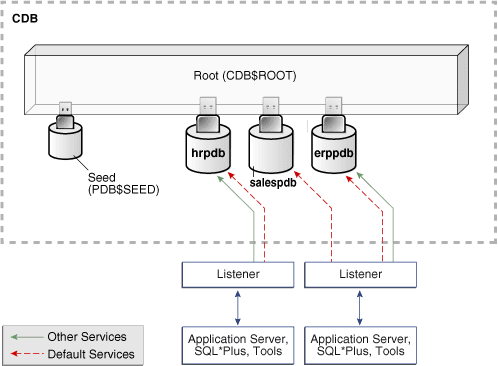
次の図に、2つの異なるリスナーを使用してPDBに接続する2つのクライアントを示します。
図7: CDBのサービス
-
サービスの作成
CREATE PLUGGABLE DATABASE文を実行してPDBを作成すると、データベースではCDB内のサービスが自動的に作成され、起動されます。 -
CDBのコンテナへの接続一般に、CDB管理者はPDBをプロビジョニングして様々なコンテナに接続するための適切な特権を持つ必要があります。CDB管理者は共通ユーザーです。
サービスの作成
CREATE PLUGGABLE DATABASE文を実行してPDBを作成すると、データベースではCDB内のサービスが自動的に作成されて起動されます。
このデフォルト・サービスには、PDBをサービスの最初の現行コンテナとして識別するプロパティがあります。このプロパティは、DBA_SERVICES.PDB列に表示されます。
-
デフォルト・サービスデフォルト・サービスは、PDBと同じ名前になります。PDB名は、CDB内で一意となる有効なサービス名である必要があります。
-
非デフォルトのサービスPDBごとにサービスを追加作成でき、CDB当たり10,000までの追加サービスを作成できます。各追加サービスでは、そのPDBが最初の現行コンテナとして表示されます。
デフォルト・サービス
デフォルト・サービスの名前はPDBと同じになります。PDB名は、CDB内で一意となる有効なサービス名である必要があります。
アプリケーション・コンテナを作成する際、AS APPLICATION CONTAINER句の指定が必要となり、Oracle AI Databaseではアプリケーション・ルートの新しいデフォルト・サービスが自動的に作成されます。サービスはアプリケーション・コンテナと同じ名前を持ちます。このサービスにアクセスするクライアントには、Oracle Net Serviceが正しく構成されている必要があります。同様に、すべてのアプリケーションPDBには固有のデフォルト・サービス名があり、アプリケーション・シードPDBには固有のデフォルト・サービス名があります。
例19-1 デフォルト・サービスを使用したPDBへの切替え
この例では、PDBと同じ名前を持つデフォルト・サービスを使用して、PDB名salespdbに切り替えます。
ALTER SESSION SET CONTAINER = salespdb;非デフォルトのサービス
各PDBについて、CDBごとに上限10,000までの追加サービスを作成できます。各追加サービスでは、そのPDBが最初の現行コンテナとして表示されます。
図19-7では、erppdbとhrpdbにデフォルト以外のサービスが存在します。たとえば、図19-7では、hrpdbというPDBに、hrpdbというデフォルトのサービスがあります。デフォルト・サービスは削除できません。
ALTER SESSION SET CONTAINERを使用してコンテナに切り替えると、セッションはコンテナのデフォルト・サービスを使用します。オプションで、SERVICE = service_nameを指定することでコンテナに別のサービスを使用できます。service_nameはサービスの名前を表します。特定のサービスを使用して、セッションがそのサービス属性および機能(サービス・メトリック、ロード・バランシング、リソース・マネージャ設定など)を利用できるようにする場合があります。
例19-2 非デフォルト・サービスを使用したPDBへの切替え
この例では、hrpdbのデフォルト・サービスで、サービス・メトリック、FAN、ロード・バランシング、Oracle AI Database Resource Manager、トランザクション・ガード、アプリケーション・コンティニュイティなど、すべてのサービスの属性および機能がサポートされるわけではありません。非デフォルト・サービスには次のように切り替えます。
ALTER SESSION SET CONTAINER = hrpdb SERVICE = hrpdb_full;CDBのコンテナへの接続
一般に、CDB管理者はPDBをプロビジョニングして様々なコンテナに接続するための適切な特権を持つ必要があります。CDB管理者は共通ユーザーです。
CDB管理者は、次のいずれかの方法を使用できます。
-
PDBまたはアプリケーション・ルートに直接接続します。
ユーザーにはそのコンテナでの
CREATE SESSION権限が必要です。 -
接続プーリングおよび高度なCDB管理の両方に役立つ
ALTER SESSION SET CONTAINER文を使用して、コンテナの切替えを実行します。構文はALTER SESSION SET CONTAINER = container_name [SERVICE = service_name]です。たとえば、CDB管理者は1つのセッションでルートに接続した後、同じセッションでPDBに切り替えることができます。この場合、ユーザーにはそのコンテナでの
SET CONTAINERシステム権限が必要です。
次の表で、図19-7のCDBに関連したシナリオを説明します。各行は、前の行のアクションの後に発生する操作について説明します。共通ユーザーSYSTEMは、現行コンテナの名前と、CDB内のPDBの名前を問い合せます。
表1 CDBのサービス
| オペレーション | 摘要 |
|---|---|
|
SYSTEMユーザーは、CDBのすべてのコンテナに対して共通で、prodというサービスを使用してルートに接続します。 |
|
SYSTEMは、ユーザーが現在接続されているコンテナの名前をリストするために、SQL*PlusコマンドSHOW CON_NAMEを使用します。CDB$ROOTは、ルート・コンテナの名前です。 |
|
V$SERVICESの問合せは、PDB名と一致するサービス名を持つ3つのPDBが存在することを意味します。hrpdbとerppdbの両方に追加サービスが1つあります。 |
|
SYSTEMは、ALTER SESSIONを使用してhrpdbに接続します。 |
|
問合せにより、現行コンテナがhrpdbであることを確認します。 |
関連項目: ALTER SESSION SET CONTAINERの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照
サービス登録
Oracle Netでサービス登録は、LREGプロセスがリスナーに動的にインスタンス情報を登録する機能です。
この情報により、リスナーはクライアント接続リクエストを適切なサービス・ハンドラに転送することができます。LREGによって、次の情報がリスナーに提供されます。
-
データベースが提供するデータベース・サービスの名前
-
サービスと関連付けられたデータベース・インスタンスの名前と、その現在および最大のロード情報
-
インスタンスから使用可能なサービス・ハンドラ(ディスパッチャおよび専用サーバー)とそのタイプ、プロトコル・アドレスおよび現在のロードと最大ロード量
サービス登録は動的であり、listener.oraファイルでの構成は必要ありません。動的登録により、複数のデータベースやインスタンスの管理に伴うオーバーヘッドが低減します。
初期化パラメータSERVICE_NAMESでは、インスタンスが属するサービスを示します。起動時に、各インスタンスは、同じサービスに属している他のインスタンスのリスナーに登録します。データベース操作中、各サービスのインスタンスはCPUの使用と現行の接続カウントに関する情報を、同じサービスのすべてのリスナーに渡します。この通信により、動的なロード・バランシング機能と接続フェイルオーバー機能が使用可能になります。
関連情報:
-
サービス登録についてさらに学習するには、Oracle AI Database Net Services管理者ガイドを参照してください。
-
Oracle RACでのインスタンス登録およびクライアント/サービス接続について学習するには、『Oracle Real Application Clusters管理およびデプロイメント・ガイド』を参照
専用サーバー・アーキテクチャ
専用サーバー・アーキテクチャでは、各クライアント・プロセスのかわわりとして作成されるサーバー・プロセスは専用サーバー・プロセス(またはシャドウ・プロセス)と呼ばれます。
図19-8に示すように、専用サーバー・プロセスはクライアント・プロセスとは別のものであり、クライアント・プロセスのかわりとしてのみ動作します。
図8: Oracle AI Databaseでの専用サーバー・プロセスの使用
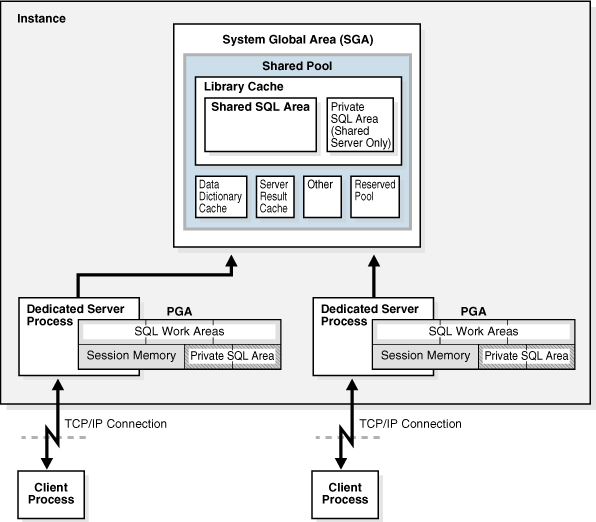
クライアント・プロセスとサーバー・プロセスの比率は1対1です。ユーザーが活発にデータベース・リクエストをしていない場合でも、専用サーバー・プロセスはそのまま残ります(ただし、アクティブでない状況の場合、オペレーティング・システムによっては、ページアウトされることもあります)。図19-8には、ユーザー・プロセスとサーバー・プロセスが、ネットワーク接続された複数のコンピュータで実行されている状態を示しています。専用サーバー・アーキテクチャは、同じコンピュータ上でクライアント・アプリケーションとデータベース・コードの両方が実行される場合にも使用されますが、この2つのプログラムが1つのプロセスで実行されている場合は、ホスト・オペレーティング・システムはその2つの分離を維持できません。Linuxはそのようなオペレーティング・システムの一例です。
専用サーバー・アーキテクチャでは、ユーザー・プロセスとサーバー・プロセスは異なるメカニズムを使用して通信します。
-
クライアント・プロセスと専用サーバー・プロセスが同じコンピュータで実行される場合、プログラム・インタフェースは、ホスト・オペレーティング・システムのプロセス間通信メカニズムを使用してジョブを実行します。
-
クライアント・プロセスと専用サーバー・プロセスを別々のコンピュータで実行する場合は、プログラム・インタフェースがプログラム間の通信メカニズム(ネットワーク・ソフトウェアやOracle Net Servicesなど)を提供します。
専用サーバーを十分に活用しない場合は、オペレーティング・システムを効率的に使用できなくなることがあります。専用サーバー・プロセスを使用した注文入力システムを考えてみます。顧客が注文をデータベースに入力し、事務員が注文を出します。トランザクションの大半では、事務員が顧客と話し合い、事務員のクライアント・プロセス専用のサーバー・プロセスはアイドル状態になっています。サーバー・プロセスは、トランザクションの大半で不要であり、管理されているプロセスが多数存在する場合、他の事務担当が注文を入力するときに、システムの処理スピードは遅くなることがあります。このようなタイプのアプリケーションでは、共有サーバー・アーキテクチャを選択してください。
関連項目:専用サーバー・プロセスについてさらに学習するには、『Oracle AI Database Net Services管理者ガイド』を参照してください
共有サーバー・アーキテクチャ
共有サーバー・アーキテクチャでは、ディスパッチャは、複数の受信ネットワーク・セッション・リクエストを共有サーバー・プロセスのプールに送信します。
共有プールを使用すると、各接続の専用サーバー・プロセスの必要性が排除されます。プールにあるアイドル状態の共有サーバー・プロセスは、共通キューからリクエストをピックアップします。
共有サーバーには、次のような潜在的な利点があります。
-
オペレーティング・システム上のプロセス数の削減
少数の共有サーバーで、多数の専用サーバーと同じ量の処理を実行できます。
-
インスタンスPGAメモリーの削減
すべての専用サーバーおよび共有サーバーにはPGAがあります。サーバー・プロセスの数が減少すると、PGAおよびプロセス管理も減少します。
-
アプリケーションのスケーラビリティ向上、およびデータベースに同時に接続できるクライアントの数の増加
-
クライアントの接続と切断の比率が高いときに専用サーバーより高速である可能性
共有サーバーには、一部のケースにおけるレスポンス時間の遅延、機能の不完全なサポート、および設定とチューニングの複雑化など、いくつかのデメリットがあります。一般的な目安としては、データベースへの同時接続数がオペレーティング・システムで処理可能な数を超える場合にのみ、共有サーバーを使用してください。
共有サーバー・アーキテクチャでは、次のプロセスが必要となります。
-
クライアント・プロセスをディスパッチャまたは専用サーバーに接続するネットワーク・リスナー(リスナーは、Oracle AI DatabaseではなくOracle Net Servicesの一部)
ノート:共有サーバーを使用するには、プロセスがOracle AI Databaseインスタンスと同じコンピュータ上で実行されている場合でも、クライアント・プロセスはOracle Net Servicesを介して接続する必要があります。
-
1つ以上のディスパッチャ・プロセス(Dnnn)
-
1つ以上の共有サーバー・プロセス
データベースは、共有サーバー接続と専用サーバー接続の両方を同時にサポートできます。たとえば、1つのクライアントが専用サーバーを使用して接続すると同時に、別のクライアントが共有サーバーを使用して同じデータベースに接続できます。
-
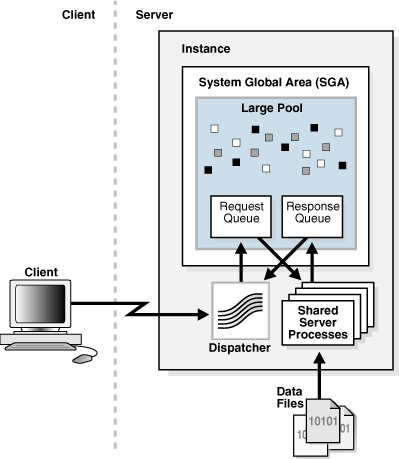
ディスパッチャ・リクエスト・キューとレスポンス・キューユーザーからのリクエストは、ユーザーのSQL文の一部である単一のAPIコールです。
-
共有サーバーの限定的運用ディスパッチャ・プロセスへの接続中に、インスタンスおよびメディア・リカバリの停止や起動などの特定の管理アクティビティを実行できません。
関連情報:
-
共有サーバー・アーキテクチャの詳細は、Oracle AI Database Net Services管理者ガイドを参照してください。
-
共有サーバー用のデータベースの構成方法を学習するには、『Oracle AI Database管理者ガイド』を参照
ディスパッチャのリクエスト・キューとレスポンス・キュー
ユーザーからのリクエストは、ユーザーのSQL文の一部である単一のAPIコールです。
ユーザーがコールを実行すると、次のアクションが発生します。
-
ディスパッチャがリクエストをリクエスト・キューに入れると、次に使用可能な共有サーバー・プロセスがそこから要求を取り出します。
リクエスト・キューはSGA内に存在し、インスタンスのディスパッチャ・プロセスすべてに共通です。
-
共有サーバー・プロセスは、共通のリクエスト・キューをチェックして新しいリクエストがないかどうかを調べ、先入れ先出し方式に基づいて新しいリクエストをピックアップします。
-
1つの共有サーバー・プロセスがキュー内のリクエストを1つピックアップし、そのリクエストを完了するのに必要なデータベースに対するコールをすべて出します。
各データベース・コールは異なるサーバー・プロセスが処理できます。このため、問合せの解析、最初の行のフェッチ、次の行のフェッチ、および結果セットのクローズそれぞれのリクエストは、別の共有サーバーが処理できます。
-
サーバー・プロセスはリクエストを完了すると、コール・ディスパッチャのレスポンス・キューにレスポンスが入ります。各ディスパッチャには、固有のレスポンス・キューがあります。
-
ディスパッチャは、完了したリクエストを適切なクライアント・プロセスに戻します。
たとえば、注文入力システムで、各事務員のクライアント・プロセスがディスパッチャに接続します。事務担当によって作成されたそれぞれのリクエストはこのディスパッチャに送られ、ディスパッチャがリクエストをキューに入れます。次に使用可能な共有サーバーは、リクエストをピックアップして処理し、レスポンス・キューにレスポンスを入れます。リクエストが完了しても、事務担当はディスパッチャに接続されたままですが、そのリクエストを処理した共有サーバーは解放されるため、別のリクエストで使用できます。1人の事務担当が顧客と話し合っている間に、別の事務担当は同じ共有サーバー・プロセスを使用できます。図19-9に、クライアント・プロセスがAPIを介してディスパッチャと通信する方法と、ディスパッチャがユーザー・リクエストを共有サーバー・プロセスに伝達する方法を示します。
図9: 共有サーバー構成とプロセス
-
ディスパッチャ・プロセス(Dnnn) ディスパッチャ・プロセスにより、クライアント・プロセスが限定された数のサーバー・プロセスを共有できるようになります。
-
共有サーバーのプロセス(Snnn)各共有サーバー・プロセスでは、共有サーバー構成で複数のクライアント・リクエストが実行されます。関連項目: 「ラージ・プール」
ディスパッチャ・プロセス(D nnn)
ディスパッチャ・プロセスによって、クライアント・プロセスが限定された数のサーバー・プロセスを共有できるようになります。
1つのデータベース・インスタンスに対し、複数のディスパッチャ・プロセスを作成できます。ディスパッチャの最適な数は、オペレーティング・システムの制限事項と各プロセスの接続数に応じて異なります。
ノート:ディスパッチャに接続するそれぞれのクライアント・プロセスは、両方のプロセスが同じホスト上で実行される場合でも、Oracle Net Servicesを使用する必要があります。
ディスパッチャ・プロセスは次のように通信を確立します。
-
インスタンスが起動されると、ネットワーク・リスナー・プロセスは、ユーザーがOracle AI Databaseへの接続に使用する通信経路をオープンして確立します。
-
各ディスパッチャ・プロセスは、接続リクエストをリスニングするアドレスをリスナー・プロセスに割り当てます。
データベース・クライアントで使用するネットワーク・プロトコルごとに、最低1つ以上のディスパッチャ・プロセスを構成し起動する必要があります。
-
クライアント・プロセスで接続リクエストが行われると、リスナーは、クライアント・プロセスで共有サーバー・プロセスを使用する必要があるかどうかを判断します。
-
共有サーバーが必要であるとリスナーが判断した場合、リスナーは負荷が最も軽いディスパッチャ・プロセスのアドレスを戻し、クライアント・プロセスはディスパッチャに直接接続します。
-
プロセスがディスパッチャと通信できない場合、またはクライアント・プロセスが専用サーバーをリクエストする場合には、リスナーは専用サーバー・プロセスを作成して適切な接続を確立します。
-
関連項目:ディスパッチャの構成方法を学習するには、『Oracle AI Database Net Services管理者ガイド』を参照してください。
共有サーバー・プロセス(S nnn)
共有サーバー構成では、各共有サーバー・プロセスは複数のクライアント・リクエストを処理します。
共有サーバー・プロセスには専用サーバー・プロセスと同じ機能がありますが、特定のクライアント・プロセスと関連付けられていません。共有サーバー・プロセスは、共有サーバー構成におけるクライアント・リクエストに対してサービスを提供します。
共有サーバーのプロセスのPGAには、すべての共有サーバー・プロセスでアクセス可能であることが必要なUGAデータは含まれません。共有サーバーのPGAには、プロセス固有のデータのみが含まれています。
セッション関連の情報はすべてSGA内に入れられます。各共有サーバー・プロセスは、サーバーがどのセッションからのリクエストでも処理できるように、すべてのセッションのデータ・スペースにアクセスできる必要があります。各セッションのデータ領域に対してSGA内の領域が割り当てられます。
関連項目: 「プログラム・グローバル領域(PGA)の概要」
共有サーバーの限定的運用
ディスパッチャ・プロセスへの接続中に、インスタンスおよびメディア・リカバリの停止または起動を含む特定の管理アクティビティを実行できません。
これらのアクティビティは、一般的には管理者権限を使用して接続しているときに実行されます。共有サーバーにより構成されたシステムで管理者権限を使用して接続する場合は、専用サーバー・プロセスを使用することを指定する必要があります。
関連項目:適切な接続文字列構文については、『Oracle AI Database Net Services管理者ガイド』を参照してください。
データベース常駐接続プーリング
データベース常駐接続プーリング(DRCP)は、一般的なWebアプリケーション使用のシナリオにおいて、専用サーバーの接続プールを提供します。
通常、Webアプリケーションは、データベースへの接続を取得し、その接続を短時間使用した後、接続を解放します。DRCPを使用すると、データベースは同時接続数を数万にまで増やすことができます。
DRCPには、次の利点があります。
-
中間層プロセス内のスレッド間で接続を共有する、中間層接続プールを補完します。
-
複数の中間層プロセスにわたってデータベース接続を共有できるようにします。これらの中間層プロセスは、中間層ホストが同一の場合と異なる場合があります。
-
多数のクライアント接続のサポートに必要な、主要データベース・リソースを大幅に削減できます。たとえば、DRCPは、データベースに必要なメモリーの量を削減し、データベースと中間層の両方のスケーラビリティを向上させます。利用可能なサーバーのプールにより、クライアント接続を再作成するコストも削減されます。
-
中間層接続プーリングを実行できないPHPやApacheサーバーなど、マルチ・プロセスのシングルスレッド・アプリケーション・サーバーを含むアーキテクチャでプーリングが実行できるようになります。
DRCPでは、専用のサーバー・プロセス(共有サーバー・プロセスではない)とデータベース・セッションを組み合せたものと同じ機能をプールされたサーバーを使用します。プールされたサーバー・モデルは、短時間だけサーバーを必要とする接続のすべてに専用サーバーを割り当てることによるオーバーヘッドを排除します。
データベース常駐接続プールから接続を取得したクライアントは、接続ブローカと呼ばれるOracleバックグラウンド・プロセスに接続します。接続ブローカはプール機能を実装しており、プールされたサーバーをクライアント・プロセスからのインバウンド接続間で多重化します。
図19-10に示すように、クライアントがデータベース・アクセスをリクエストすると、接続ブローカがプールから、サーバー・プロセスを選択してクライアントに渡します。クライアントは、リクエストが処理されるまで、サーバー・プロセスに直接接続します。サーバーでの処理が終了すると、サーバー・プロセスはプールに戻されます。クライアントからの接続はブローカにリストアされます。
図10: DRCP
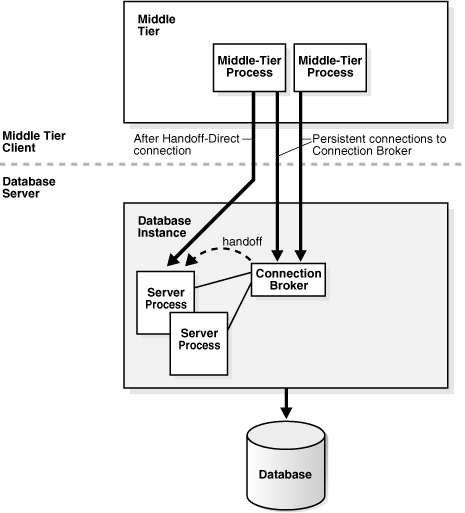
DRCPでは、リソースを解放しても、セッションはそのまま残りますが、接続(サーバー・プロセス)との関連付けがなくなります。共有サーバーとは異なり、このセッションではそのUGAをSGAではなくPGAに格納します。クライアントは、検出アクティビティを実行するとき、接続を透過的に再確立できます。
関連情報:
-
接続とセッションに関する項
-
DRCPについてさらに学習するには、Oracle AI Database管理者ガイドおよび『Oracle Call Interface開発者ガイド』を参照してください。
プログラム・インタフェースの概要
プログラム・インタフェースは、データベース・アプリケーションとOracle AI Databaseの間のソフトウェア・レイヤーになります。
プログラム・インタフェースでは、次の機能を実行します。
-
クライアント・プロセスによるSGAへの破壊的アクセスを防ぐ、セキュリティのための障壁になります。
-
通信メカニズムとして働きます。つまり、情報リクエストの形式を設定し、データを渡し、エラーをトラップして返します。
-
特に、異なるタイプのコンピュータ間、または外部ユーザー・プログラム・データ型のデータを変換し解釈します。
Oracleコードはサーバーとして動作し、アプリケーション(クライアント)のために、データ・ブロックからの行のフェッチなどデータベース・タスクを実行します。プログラム・インタフェースは、Oracle AI Databaseソフトウェアおよびオペレーティング・システム固有のソフトウェアの両方によって提供される複数の部分で構成されます。
-
プログラム・インタフェースの構造プログラム・インタフェースは、様々なコンポーネントから構成されます。
-
プログラム・インタフェース・ドライバドライバとは、通常はネットワークを介してデータを転送するソフトウェアの一部です。
-
オペレーティング・システムの通信ソフトウェアユーザー側とプログラム・インタフェースのOracle AI Database側を接続する最下位レベルのソフトウェアは、ホスト・オペレーティング・システムが提供する通信ソフトウェアです。
プログラム・インタフェースの構造
プログラム・インタフェースは、様々なコンポーネントから構成されます。
これらのコンポーネントには次が含まれます。
-
Oracleコール・インタフェース(OCI)またはOracleランタイム・ライブラリ(SQLLIB)
-
クライアント側またはユーザー側のプログラム・インタフェース
-
様々なOracle Net Servicesドライバ(プロトコル固有の通信ソフトウェア)
-
オペレーティング・システムの通信ソフトウェア
-
サーバーまたはOracle AI Database側のプログラム・インタフェース(OPIとも呼ばれます)
ユーザー側とOracle AI Database側のプログラム・インタフェースは、いずれドライバのような仕組でOracleソフトウェアを実行します。
プログラム・インタフェース・ドライバ
ドライバとは、通常はネットワークを介してデータを転送するソフトウェアの一部です。
ドライバは、接続、切断、エラーの通知、エラーのテストなどの操作を実行します。ドライバは通信プロトコルに固有のものです。
デフォルトのドライバが常に存在します。複数のドライバ(非同期またはDECnetドライバなど)をインストールし、その1つをデフォルト・ドライバとして選択しますが、各ユーザーは、接続の時点で必要なドライバを指定することで、他のドライバを使用できます。
プロセスが異なる場合は、異なるドライバを使用できます。1つのプロセスは、異なるOracle Net Servicesドライバを使用して、単一または複数のデータベースに同時接続できます。
関連情報:
-
ドライバの選択、インストールおよび追加方法の詳細は、システムのインストレーションおよび構成ガイドを参照してください。
-
JDBCドライバについて学習するには、『Oracle AI Database Net Services管理者ガイド』を参照してください
オペレーティング・システムの通信ソフトウェア
ユーザー側とプログラム・インタフェースのOracle AI Database側のプログラム・インタフェースを接続する最下位レベルのソフトウェアは、ホスト・オペレーティング・システムが提供する通信ソフトウェアです。
たとえば、DECnet、TCP/IP、LU6.2、ASYNCなどです。通信ソフトウェアはOracleから提供されることもありますが、通常、ハードウェア・ベンダーまたはサード・パーティのソフトウェア・サプライヤから別途購入します。
Oracle True Cacheの概要
True Cacheは、Oracle AI Databaseの前にある、読取り専用のインメモリ・キャッシュである。
Oracle Active Data Guardと同様に、True Cacheはプライマリ・データベースの完全に機能している読取り専用レプリカですが、大部分がディスクレスである点が異なります。
最新のアプリケーションには、多くの場合、多数の接続と、データへの高速で低レイテンシなアクセスが必要です。通常、アプリケーションは更新よりも多くの読取りを実行し、データベースのパフォーマンスに影響を与えずにキャッシュから読み取ることができるため、一般的な方法は、データベースの前にキャッシュを配置することです。たとえば、航空会社の予約システムは、人々がフライトを購入するときに頻繁にデータを読み取り、データがデータベース内のものと比較して最新ではない場合は問題ありません。アプリケーションが最新のデータにアクセスする必要があるのは、ユーザーがフライトを予約するときのみです。
従来のキャッシュとは異なり、True Cacheは、最も頻繁にアクセスされるデータをキャッシュ内に自動的に保持し、キャッシュとプライマリ・データベース、同じキャッシュ内の他のオブジェクト、およびその他のキャッシュとの整合性を保ちます。JSONを含むすべてのOracle AI Databaseオブジェクトおよびデータ型をキャッシュします。
True CacheではOracle AI Databaseセキュリティ・ポリシーを実装しているため、キャッシュへのアクセスを制御できます。これにより、通常はキャッシュされない場合がある個人情報などの機密データをキャッシュできます。
関連項目