プロセス・アーキテクチャ
この章では、Oracle Databaseのプロセスについて説明します。
-
プロセスの概要プロセスとは、一連のステップを実行できる、オペレーティング・システムにおけるメカニズムの1つです。
-
クライアント・プロセスの概要ユーザーがPro*CプログラムやSQL*Plusなどのアプリケーションを実行すると、オペレーティング・システムにより、そのシステム・アプリケーションを実行するクライアント・プロセス(ユーザー・プロセスとも呼ばれる)が作成されます。クライアント・アプリケーションにはOracle AI Databaseライブラリがリンクされており、このアプリケーションによってデータベースとの通信に必要なAPIが提供されます。
-
サーバー・プロセスの概要 Oracle AI Databaseでは、インスタンスに接続されたクライアント・プロセスの要求を処理するために、サーバー・プロセスが作成されます。クライアント・プロセスは常に別のサーバー・プロセスを介してデータベースと通信します。
-
バックグラウンド・プロセスの概要バックグラウンド・プロセスとは、マルチプロセスのOracleデータベースによって使用される追加のプロセスです。バックグラウンド・プロセスでは、データベースの操作、および複数ユーザーのパフォーマンスの最大化に必要なメンテナンス・タスクを実行します。
プロセスの概要
プロセスとは、一連のステップを実行できるオペレーティング・システムのメカニズムのことです。
プロセス実行のアーキテクチャは、オペレーティング・システムによって決まります。たとえば、Windowsでは、Oracleバックグラウンド・プロセスはプロセス内の実行スレッドです。LinuxおよびUNIXにおけるOracleプロセスは、オペレーティング・システム・プロセスか、またはオペレーティング・システム・プロセス内部のスレッドです。
プロセスは、コード・モジュールで実行されます。データベース・インスタンスにアクセスするために、接続されているすべてのOracle AI Databaseユーザーが次のモジュールを実行する必要があります。
-
アプリケーションまたはOracle AI Databaseユーティリティ
データベース・ユーザーは、データベースにSQL文を発行するプリコンパイラ・プログラムや、データベース・ツール(SQL*Plusなど)を実行します。
-
Oracleデータベース・コード
各ユーザーには、アプリケーションのSQL文を解釈および処理するOracleデータベース・コードが、ユーザーのかわりに実行されています。
プロセスは通常、そのプロセスのプライベート・メモリー領域で実行されます。ほとんどのプロセスは、関連付けられたトレース・ファイルに定期的に書き込むことができます。
-
プロセスのタイプデータベース・インスタンスは、複数のプロセスを含んでおり、それらと相互作用します。
-
マルチプロセスおよびマルチスレッドOracle AI DatabaseシステムマルチプロセスOracle AI Database(マルチユーザーOracle AI Databaseとも呼ばれる)では、複数のプロセスを使用して、Oracle AI Databaseコードの様々な部分と、ユーザー用の追加のOracleプロセス(接続ユーザーごとに1つのプロセス、または複数のユーザーが共有する1つ以上のプロセス)を実行します。
プロセスのタイプ
複数のプロセスが、データベース・インスタンスに含まれているか、データベース・インスタンスと対話します。
プロセスは、次のタイプに分類されます。
-
クライアント・プロセスがアプリケーションまたはOracleツール・コードを実行します。
-
Oracleプロセスは、Oracleデータベース・コードを実行する実行ユニットです。マルチスレッド・アーキテクチャでは、Oracleプロセスは、 オペレーティング・システム・プロセスまたはオペレーティング・システム・プロセス内のスレッドにもなります。Oracleプロセスには、次のサブタイプがあります。
-
バックグラウンド・プロセスは、データベース・インスタンスとともに開始し、インスタンス・リカバリの実行、プロセスのクリーン・アップ、ディスクへのREDOバッファーの書込みなどのメンテナンス・タスクを実行します。
-
サーバー・プロセスは、クライアントの要求に基づいて作業を実行します。
たとえば、これらのプロセスは、SQL問合せを解析して共有プールに入れて実行し、問合せごとに問合せ計画を作成して実行し、データベース・バッファ・キャッシュまたはディスクからバッファを読み取ります。
ノート:サーバー・プロセスおよびこれらのプロセス内で割り当てられたプロセス・メモリーは、データベース・インスタンス内で実行されます。サーバー・プロセスが終了しても、インスタンスは機能し続けます。
-
子プロセスは、バックグラウンドまたはサーバー・プロセスに対して追加タスクを実行します。
-
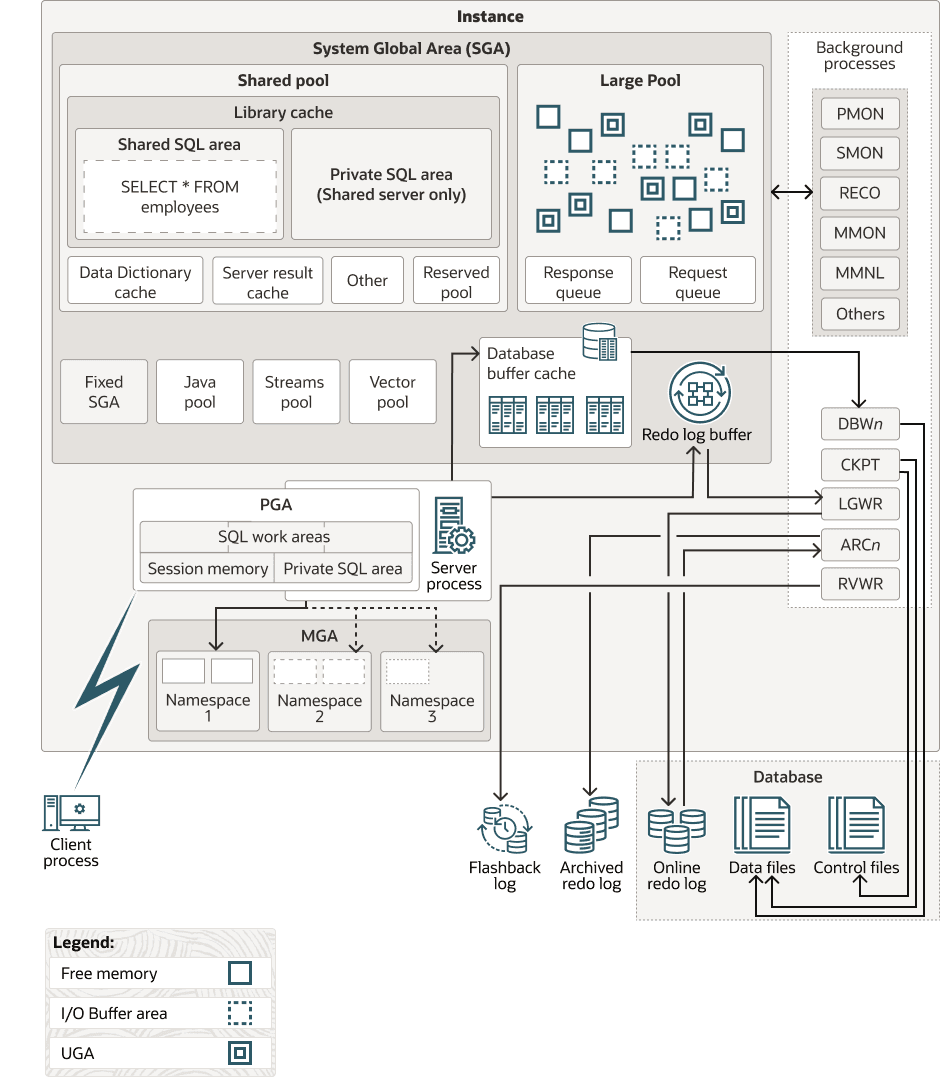
プロセスの構造は、オペレーティング・システムおよびOracle AI Databaseオプションの選択に応じて異なります。たとえば、接続されたユーザーのコードを、専用サーバー接続または共有サーバー接続に対して構成できます。共有サーバー・アーキテクチャでは、データベース・コードを実行する各サーバー・プロセスが複数のクライアント・プロセスに対応できます。図18-1に、専用のサーバー接続を使用する、システム・グローバル領域(SGA)およびバックグラウンド・プロセスを示します。ユーザー接続ごとに、クライアント・プロセスによってアプリケーションが実行されます。このクライアント・プロセスは、データベース・コードを実行する専用サーバー・プロセスとは異なります。各クライアント・プロセスは、その自体のプログラム・グローバル領域(PGA)を持つ独自のサーバー・プロセスに関連付けられています。
図1: OracleプロセスおよびSGA
関連情報:
-
専用サーバー・アーキテクチャおよび共有サーバー・アーキテクチャに関する項
-
構成の選択の詳細は、Oracle AI Databaseオペレーティング・システム固有のドキュメントを参照してください。
-
V$PROCESSビューについて学習するには、Oracle AI Databaseリファレンスを参照してください。
マルチプロセスおよびマルチスレッドのOracle AI Databaseシステム
マルチプロセスOracle AI Database(マルチユーザーOracle AI Databaseとも呼ばれる)では、複数のプロセスを使用して、Oracle AI Databaseコードの様々な部分と、ユーザー用の追加のOracleプロセスを実行します。接続ユーザーごとに1つのプロセス、または複数のユーザーが共有する1つ以上のプロセスです。
データベースの主なメリットが、複数のユーザーが同時に必要とするデータを管理することにあるため、多くのデータベースはマルチユーザー対応です。データベース・インスタンスの各プロセスは、特定のジョブを実行します。データベースとアプリケーションの作業をいくつかのプロセスに分割することにより、複数のユーザーおよびアプリケーションが1つのインスタンスに同時に接続でき、優れたパフォーマンスを確保することができます。
Oracle Database 12cより前のリリースでは、Oracleプロセスは、UNIXおよびLinuxシステムではスレッドとして実行されませんでした。Oracle Database 12cからは、マルチスレッドOracle AI Databaseモデルにより、Oracleプロセスが、別のアドレス空間でオペレーティング・システム・スレッドとして実行可能になっています。Oracle AI Databaseがインストールされると、そのデータベースはプロセス・モードで実行されます。データベースをスレッド・モードで実行するには、THREADED_EXECUTION初期化パラメータをTRUEに設定する必要があります。スレッド・モードでは、UNIXおよびLinux上の一部のバックグラウンド・プロセスは、プロセス(各プロセスが1つのスレッドを含む)として実行されるのに対し、残りのOracleプロセスは、プロセス内のスレッドとして実行されます。
スレッド・モードで実行されているデータベースでは、PMONおよびDBWがオペレーティング・システム・プロセスとして実行される可能性があるのに対して、LGWRおよびCMONは単一プロセス内のスレッドとして実行される可能性があります。2つのフォアグラウンド・プロセスおよびパラレル実行(PX)サーバー・プロセスは、2つ目のオペレーティング・システム・プロセス内のスレッドとして実行される可能性があります。3番目のオペレーティング・システム・プロセスには、複数のフォアグラウンド・スレッドが含まれている可能性があります。したがって、Oracleプロセスは、必ずしも「オペレーティング・システム・プロセス」とは限りません。ノート: THREADED_EXECUTION初期化パラメータがTRUEに設定された場合、オペレーティング・システム認証はサポートされません。
例18-1 Oracle Processメタデータの表示
V$PROCESSビューには、データベース・インスタンスに接続されているOracleプロセスごとに1行が含まれます。たとえば、次のSQL*Plusでの問合せを実行して、オペレーティング・システム・プロセスIDおよびオペレーティング・システム・スレッドIDをプロセスごとに取得できます。
COL SPID FORMAT a8
COL STID FORMAT a8
SELECT SPID, STID, PROGRAM FROM V$PROCESS ORDER BY SPID;
問合せにより、次の部分的サンプル出力が得られます。
SPID   STID   PROGRAM
-----  -----  ---------------------------
7190   7190   oracle@samplehost (PMON)
7192   7192   oracle@samplehost (PSP0)
7194   7194   oracle@samplehost (VKTM)
7198   7198   oracle@samplehost (SCMN)
7198   7200   oracle@samplehost (GEN0)
7202   7202   oracle@samplehost (SCMN)
7202   7204   oracle@samplehost (DIAG)
7198   7205   oracle@samplehost (DBRM)
7202   7206   oracle@samplehost (DIA0)
.
.
.
関連情報:
-
V$PROCESSビューの使用方法を学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照 -
THREADED_EXECUTION初期化パラメータについて学習するには、『Oracle AI Databaseリファレンス』を参照
クライアント・プロセスの概要
ユーザーがPro*CプログラムやSQL*Plusなどのアプリケーションを実行する場合、オペレーティング・システムでは、ユーザー・アプリケーションを実行するために、クライアント・プロセス(ユーザー・プロセスとも呼ばれる)を作成します。クライアント・アプリケーションにはOracle AI Databaseライブラリがリンクされており、このアプリケーションによってデータベースとの通信に必要なAPIが提供されます。
-
クライアント・プロセスおよびサーバー・プロセスクライアント・プロセスは、「インスタンス」と直接対話するOracleプロセスとは大きく異なります。
-
接続とセッションデータベース接続は、クライアント・プロセスとデータベース・インスタンスとの間の物理的な通信経路です。
-
現在のコンテナデータベース・セッションとは、データベースへの現在のユーザー・ログインの状況を示す、データベース・インスタンス・メモリー内の論理エンティティです。
-
データベース操作データベース監視のコンテキストにおけるデータベースの操作とは、エンド・ユーザーまたはアプリケーション・コードによって定義されたとおりに、2つの時点の間のセッション・アクティビティである。
クライアントおよびサーバー・プロセス
クライアント・プロセスは、インスタンスと直接対話するOracleプロセスとは大きく異なります。
クライアント・プロセスを提供するOracleプロセスでは、SGAからの読取りおよびSGAへの書込みが可能ですが、クライアント・プロセスではできません。クライアント・プロセスは、データベース・ホストとは別のホストで実行できますが、Oracleプロセスは実行できません。
たとえば、クライアント・ホストのユーザーがSQL*Plusを起動し、データベース・インスタンスが開始されていないときに、ネットワークを介して別のホストのデータベース、sampleに接続するとします。
SQL> CONNECT SYS@inst1 AS SYSDBA
Enter password: *********
Connected to an idle instance.クライアント・ホストで、sqlplusまたはsampleのプロセスを検索するとsqlplusクライアント・プロセスのみが表示されます。
% ps -ef | grep -e sample -e sqlplus | grep -v grep
clientuser 29437 29436 0 15:40 pts/1 00:00:00 sqlplus as sysdbaデータベース・ホスト上でsqlplusまたはsampleのプロセスを検索すると、ローカル以外の接続を伴うサーバー・プロセスが表示されますが、クライアント・プロセスは表示されません。
% ps -ef | grep -e sample -e sqlplus | grep -v grep
serveruser 29441 1 0 15:40 ? 00:00:00 oraclesample (LOCAL=NO)関連項目:インスタンスが開始されていないときにクライアントがデータベースに接続する方法を学習するには、「インスタンスの開始方法」を参照してください
接続とセッション
データベース接続は、クライアント・プロセスとデータベース・インスタンスとの間の物理的な通信経路です。
接続中、通信経路は、使用可能なプロセス間通信メカニズムまたはネットワーク・ソフトウェアを使用して確立されます。一般的に、接続はクライアント・プロセスとサーバー・プロセスまたはディスパッチャとの間で確立されますが、クライアント・プロセスとOracle Connection Manager(CMAN)との間でも確立されます。
現在のコンテナ
データベース・セッションは、データベースに現在ログインしているユーザーの状態を示すデータベース・インスタンス・メモリー内の論理エンティティです。
たとえば、ユーザーがパスワードによってデータベースから認証されると、このユーザーに対してセッションが確立されます。セッションは、ユーザーがデータベースから認証された時点から、ユーザーが接続を切断するか、データベース・アプリケーションを終了する時点まで続きます。
セッションとコンテナ
指定されたセッションでは、CDBの現在のコンテナは、セッションが実行されているコンテナーです。現在のコンテナはCDBルート、アプリケーション・ルートまたはPDBになります。
各セッションには、任意の時点で現在のコンテナがそれぞれ1つのみ含まれます。各コンテナのデータ・ディクショナリは個別のため、Oracle AI Databaseでは、名前の解決と権限の認証に、現在のコンテナのデータ・ディクショナリを使用します。
接続とセッションの関係
1つの接続では、セッションが確立されないか、1つ以上のセッションが確立されます。セッションは独立しており、あるセッションでのコミットは別のセッションでのトランザクションに影響しません。
ノート: Oracle Netの接続プーリングが構成されている場合、接続は削除できますが、セッションはそのままにしておくことができます。
単独のデータベース・ユーザーに対して、複数のセッションが同時に存在できます。次の図に示すように、ユーザーhrが1つのデータベースに複数の接続を確立できます。専用サーバー接続の場合、それぞれの接続のかわりに1つのサーバー・プロセスがデータベースによって作成されます。これは、専用サーバーを作成するクライアント・プロセスのみが使用します。共有サーバー接続では、多数のクライアント・プロセスが1つの共有サーバー・プロセスにアクセスします。
図2: 各接続に1セッション
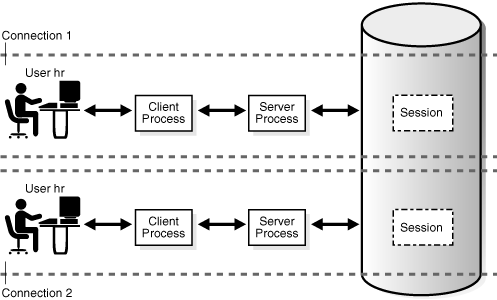
図18-3は、ユーザーhrが1つのデータベースに1つの接続を確立していることを示していますが、この接続には2つのセッションがあります。
図3: 1つの接続に存在する2つのセッション
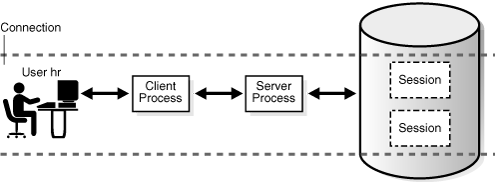
SQL文実行統計の自動トレース・レポートを作成すると、図18-3のシナリオが再作成されます。
例18-2のDISCONNECTコマンドは、実際には、接続ではなくセッションを終了しています。
例18-2 接続とセッション
次の例では、ユーザーSYSTEMとしてデータベースにSQL*Plusを接続してトレースを実行し可能にし、新規セッションを作成しています(サンプル出力を含みます)。
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 90      91 3BE2E41C

SQL> SET AUTOTRACE ON STATISTICS;
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 88      93 3BE2E41C
 90      91 3BE2E41C
...
SQL> DISCONNECTDISCONNECTコマンドは、実際には、接続ではなくセッションを終了しています。新規端末を開いて別のユーザーとしてインスタンスに接続し、次の問合せを実行すると、アドレス3BE2E41Cの接続がアクティブなままであることが示されます。
SQL> CONNECT dba1@inst1
Password: ********
Connected.
SQL> SELECT PROGRAM FROM V$PROCESS WHERE ADDR = HEXTORAW('3BE2E41C');

PROGRAM
------------------------------------------------
oracle@stbcs09-1 (TNS V1-V3)
関連項目: 「共有サーバー・アーキテクチャ」
データベースの操作
データベース監視のコンテキストにおけるデータベース操作は、エンド・ユーザーまたはアプリケーション・コードによって定義されたとおりに2つの時点間のセッション・アクティビティです。
単一データベースの操作は、1つのSQL文または1つのPL/SQLプロシージャまたはファンクションのいずれかです。コンポジット・データベースの操作は、一連の単一またはコンポジット操作です。
タスクを監視、比較およびチューニングするため、大きなタスクのセットは複数のデータベース操作に分割し、複数の操作は複数のフェーズにさらに分割できます。ユースケースとしては、実行速度が通常より遅いPL/SQLバッチ・ジョブがあります。ジョブをデータベース操作として構成することで、ジョブ内のコストがかかるステップを特定してチューニングできます。
データベース操作の各実行は、操作名と実行IDという属性のペアにより一意に特定されます。あるセッションから、セッションIDとシリアル番号を指定することで、別のセッションのデータベース操作を開始または終了できます。
同じデータベース操作が2つ出現した場合は、同じ名前で異なる実行IDを使用することで、同時に実行できます。同じ名前のデータベース操作の各実行には、異なる文を含めることができます。
データベース操作は、DBMS_SQL_MONITOR PL/SQLパッケージにより作成し管理します。V$SQL_MONITOR、V$SQL_PLAN_MONITORおよびV$SQL_MONITOR_SESSTATを使用して操作を監視できます。
関連情報:
-
データベース操作の監視方法を学習するには、Oracle AI Database SQLチューニング・ガイドを参照
-
長時間のロードの監視方法を学習するには、『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照します
-
DBMS_SQL_MONITORについてさらに学習するには、Oracle AI Database PL/SQLパッケージおよびタイプ・リファレンスを参照してください。 -
V$SQL_MONITORについてさらに学習するには、Oracle AI Databaseリファレンスを参照してください。
サーバー・プロセスの概要
Oracle AI Databaseでは、インスタンスに接続されたクライアント・プロセスの要求を処理するために、サーバー・プロセスが作成されます。クライアント・プロセスは常に別のサーバー・プロセスを介してデータベースと通信します。
データベース・アプリケーション用に作成されたサーバー・プロセスでは、次のタスクを1つ以上実行できます。
-
アプリケーションを介して発行されたSQL文を解読し、実行します。これには問合せ計画の作成および実行も含まれします。
-
PL/SQLコードの実行
-
データファイルからデータベース・バッファ・キャッシュにデータ・ブロックを読み取ります(DBWバックグラウンド・プロセスには、修正されたブロックをディスクに戻して書き込むというタスクがあります)。
-
アプリケーションが情報を処理できるような方法で結果を戻します。
-
専用サーバー・プロセス専用サーバー接続では、クライアント接続は、1つのサーバー・プロセスにのみ関連付けられています。
-
共有サーバー・プロセス共有サーバー接続では、クライアント・アプリケーションはネットワーク経由でサーバー・プロセスではなく、ディスパッチャ・プロセスに接続します。たとえば、20のクライアント・プロセスが1つのディスパッチャ・プロセスに接続できます。
-
Oracle AI Databaseによるサーバー・プロセスの作成方法データベースでは、接続メソッドに応じて様々な方法でサーバー・プロセスが作成されます。関連項目: 「SQL処理の段階」
専用サーバー・プロセス
専用サーバー接続の場合は、クライアント接続は、1つのサーバー・プロセスにのみ関連付けられています。
Linuxでは、1つのデータベース・インスタンスに接続された20のクライアント・プロセスに、20のサーバー・プロセスが対応します。各クライアント・プロセスは、そのサーバー・プロセスと直接通信します。セッションの継続中、このサーバー・プロセスはそのクライアント・プロセス専用になります。サーバー・プロセスでは、プロセス固有の情報およびUGAをPGAに格納します。
関連情報:
-
「専用サーバー・モードのPGAの使用」を参照してください。
共有サーバー・プロセス
共有サーバー接続では、クライアント・アプリケーションは、ネットワークを介して、サーバー・プロセスではなくディスパッチャ・プロセスに接続します。たとえば、20のクライアント・プロセスが1つのディスパッチャ・プロセスに接続できます。
ディスパッチャ・プロセスでは、接続されたクライアントからのリクエストを受け取り、ラージ・プールのリクエスト・キューに入れます。最初に使用可能な共有サーバー・プロセスが、キューからリクエストを受け取って処理します。その後、共有サーバーは、その結果をディスパッチャ・レスポンス・キューに入れます。ディスパッチャ・プロセスはこのキューを監視し、結果をクライアントに送信します。
専用サーバー・プロセスと同様、共用サーバー・プロセスにはそれ自体のPGAがあります。ただし、セッションに対するUGAは、共有サーバーがセッション・データにアクセスできるようにMGAにあります。
関連情報:
Oracle AI Databaseによるサーバー・プロセスの作成方法
データベースでは接続メソッドに応じて、様々な方法でサーバー・プロセスが作成されます。
接続方法は次のとおりです。
-
Bequeath
SQL*Plus、OCIクライアントまたは別のクライアント・アプリケーションがサーバー・プロセスを直接生成します。
-
Oracle Netリスナー
クライアント・アプリケーションがリスナー経由でデータベースに接続します。
-
専用ブローカ
これは、フォアグラウンド・プロセスを作成するデータベース・プロセスです。リスナーと異なり、ブローカはデータベース・インスタンスの内部に常駐します。専用ブローカを使用するときは、クライアントがリスナーに接続した後、リスナーがその接続を専用ブローカに渡します。
接続でbequeathを使用しない場合、データベースは次のようにサーバー・プロセスを作成します。
-
クライアント・アプリケーションがリスナーまたはブローカから新規の接続をリクエストします。
-
リスナーまたはブローカが新規のプロセスまたはスレッドの作成を開始します。
-
オペレーティング・システムが新規のプロセスまたはスレッドを作成します。
-
Oracle AI Databaseが様々なコンポーネントおよび通知を初期化します。
-
データベースが接続および接続固有コードを引き渡します。
オプションで、専用ブローカ接続メソッドを使用する場合は、DBMS_PROCESSパッケージを使用してサーバー・プロセスのプールを事前に作成できます。この場合、Process Manager (PMAN)バックグラウンド・プロセスは、クライアント・リクエストとの関連付けを待機する、事前作成されたプロセスのプールを監視します。接続でサーバー・プロセスが求められる場合、データベースではプロセス作成のステップ2-4がスキップされ、ステップ5のみが実行されます。この最適化により、パフォーマンスが向上します。
注意:
-
DBMS_PROCESSPL/SQLパッケージについて学習するには、『Oracle AI Database PL/SQLパッケージおよびタイプ・リファレンス』を参照します -
PMANバックグラウンド・プロセスについて学習するには、『Oracle AI Databaseリファレンス』を参照
バックグラウンド・プロセスの概要
バックグラウンド・プロセスはマルチプロセスのOracleデータベースによって使用される追加のプロセスです。バックグラウンド・プロセスでは、データベースの操作、および複数ユーザーのパフォーマンスの最大化に必要なメンテナンス・タスクを実行します。
各バックグラウンド・プロセスには個別のタスクがありますが、他のプロセスと連携して動作します。たとえば、LGWRプロセスでは、REDOログ・バッファのデータをオンラインREDOログに書き込みます。いっぱいになったREDOログ・ファイルをアーカイブする準備ができたら、LGWRから別のプロセスにそのREDOログ・ファイルをアーカイブするように信号が送られます。
Oracle AI Databaseは、データベース・インスタンスが起動すると、自動的にバックグラウンド・プロセスを作成します。インスタンスは多数のバックグラウンド・プロセスを持つことができますが、そのすべてが常にそれぞれのデータベース構成に存在するとはかぎりません。次の問合せを実行すると、データベースで実行中のバックグラウンド・プロセスが表示されます。
SELECT PNAME
FROM   V$PROCESS
WHERE  PNAME IS NOT NULL
ORDER BY PNAME;
この項には次のトピックが含まれます。
-
必須のバックグラウンド・プロセス必須のバックグラウンド・プロセスが、すべての一般的なデータベース構成に存在します。
-
オプション・バックグラウンド・プロセスオプションのバックグラウンド・プロセスは、必須として定義されていないバックグラウンド・プロセスです。
-
セカンダリ・プロセスセカンダリ・プロセスとは、他のプロセスにかわって作業を実行するバックグラウンド・プロセスである。関連項目:すべてのバックグラウンド・プロセスの説明は、『Oracle AI Databaseリファレンス』を参照してください。
必須のバックグラウンド・プロセス
必須のバックグラウンド・プロセスは、すべての一般的なデータベース構成に存在します。
これらのプロセスは、デフォルトでは、最小限に構成された初期化パラメータ・ファイルを使用して起動される読取り/書込みデータベース・インスタンス内で実行されます。読取り専用データベース・インスタンスはこれらの一部のプロセスを無効化します。
この項では、次の必須のバックグラウンド・プロセスについて説明します。
-
プロセス・モニター・プロセス(PMON)グループPMONグループには、PMON、クリーン・アップ・メイン・プロセス(CLMN)またはクリーン・アップ・ヘルパー・プロセス(CLnn)が含まれています。これらのプロセスは、他のプロセスの監視とクリーンアップを担当します。
-
プロセス・マネージャ(PMAN)プロセス・マネージャ(PMAN)は、共有サーバー、プーリングされたサーバーおよびジョブ・キュー・プロセスを含む、いくつかのバックグラウンド・プロセスをモニターします。
-
リスナー登録プロセス(LREG) リスナー登録プロセス(LREG)は、データベース・インスタンスおよびディスパッチャ・プロセスに関する情報をOracle Net Listenerに登録します。
-
システム・モニター・プロセス(SMON)システム・モニター・プロセス(SMON)は、システム・レベルで異なるクリーン・アップ作業を行います。
-
データベース・ライター・プロセス(DBW) データベース・ライター・プロセス(DBW)は、データベース・バッファのコンテンツをデータファイルに書き込みします。DBWプロセスは、データベース・バッファ・キャッシュ内の変更されたバッファをディスクに書き込みます。
-
ログ・ライター・サービス(LGWR)ログ・ライター・プロセス(LGWR)は、オンラインREDOログ・バッファを管理しています。
-
チェックポイント・システム(CKPT) チェックポイント・プロセス(CKPT)は、チェックポイント情報で制御ファイルおよびデータファイル・ヘッダーを更新して、DBWに対してブロックがディスクに書き込むよう信号を送る。チェックポイント情報には、チェックポイント位置、SCNおよびオンラインREDOログの中でリカバリを開始する位置が含まれます。
-
管理性モニター・プロジェクト(MMONおよびMMNG) 管理性モニター・プロセス(MMON)は、自動ワークロード・リポジトリ(AWR)に関連する多数のタスクを実行します。
-
リカバリ・プロセス(RECO)分散データベースでは、リカバリ・プロセス(RECO)によって、分散トランザクションにおける障害が自動的に解決されます。
-
バックグラウンド・プロセス(BGnn) バックグラウンド・プロセス(BGnn)は、様々なメンテナンス・プロセスおよびモニタリング・タスクを実行するOracle RAC環境の標準バックグラウンド・プロセスである。
-
仮想オペレーティング・システム・デーモン・サービス(VOSD)仮想オペレーティング・システム・デーモン・プロセス(VOSD)は、期限付きのOracleデータベース・サービス・アクションを実行します。
-
ネットワークモニタープロセス(NMON) ネットワークモニタープロセス(NMON)は、軽量のネットワークモニタリングサービスです。
関連情報:
-
MMAN、DIAG、VKTM、DBRM、PSP0などの他の必須プロセスについては、『Oracle AI Databaseリファレンス』を参照してください。
-
Oracle RACおよびOracle RACに固有のバックグラウンド・プロセスの詳細は、『Oracle Real Application Cluster管理およびデプロイ・ガイド』および『Oracle RAC管理およびデプロイ・ガイド』を参照してください。
プロセス・モニター・プロセス(PMON)グループ
PMONグループには、PMON、クリーン・アップ・メイン・プロセス(CLMN)およびクリーン・アップ・ヘルパー・プロセス(CLnn)が含まれています。これらのプロセスは、他のプロセスの監視とクリーンアップを担当します。
PMONグループは、バッファ・キャッシュのクリーンアップとクライアント・プロセスが使用していたリソースの解放を監視します。たとえば、PMONグループはアクティブ・トランザクション表の状態をリセットし、不要になったロックを解除し、アクティブ・プロセスのリストから終了したプロセスのプロセスIDを削除します。
データベースでは、終了したプロセスによって保持されているリソースが解放され、他のプロセスで使用できるようになっていることを確認する必要があります。そうしないと、競合のためにプロセスがブロックされたり、動作不能になる可能性があります。
-
プロセス・モニタ・プロセス(PMON)プロセス・モニター(PMON)は、他のバックグラウンド・プロセスの終了を検出します。サーバー・プロセスまたはディスパッチャ・プロセスが異常終了すると、PMONグループがプロセスのリカバリを実行します。プロセス終了には、オペレーティング・システムのkillコマンドまたは
ALTER SYSTEM KILL SESSION文などの複数の原因が考えられます。 -
クリーンアップ・メイン・プロセス(CLMN)PMONは、クリーンアップ作業をクリーンアップ・メイン・プロセス(CLMN)に委任します。異常終了を検知するタスクはPMONに残されます。
-
クリーン・アップ・ヘルパー・プロセス(CLnn)CLMNは、クリーン・アップ作業をCLnnヘルパー・プロセスと委譲します。
-
データベース・リソースの隔離プロセスまたはセッションが終了すると、PMONグループは保持リソースをデータベースに解放します。場合によっては、破損してリカバリ不可能なリソースがPMONグループによって自動的に隔離されるため、データベース・インスタンスがただちに強制終了されることはありません。
プロセス・モニター・プロセス(PMON)
プロセス・モニター(PMON)は、他のバックグラウンド・プロセスの終了を検出します。サーバー・プロセスまたはディスパッチャ・プロセスが異常終了すると、PMONグループがプロセスのリカバリを実行します。プロセス終了には、オペレーティング・システムのkillコマンドまたはALTER SYSTEM KILL SESSION文などの複数の原因が考えられます。
クリーンアップ・メイン・プロセス(CLMN)
PMONは、クリーンアップ作業をクリーンアップ・メイン・プロセス(CLMN)に委譲します。異常終了を検知するタスクはPMONに残されます。
CLMNでは終了したプロセス、終了したセッション、トランザクション、ネットワーク接続、アイドル・セッション、デタッチされたトランザクション、およびアイドル・タイムアウトを超過したデタッチされたネットワーク接続のクリーンアップが、定期的に実行されます。
クリーンアップ・ヘルパー・プロセス(CLnn)
CLMNは、クリーン・アップ作業をCLnnヘルパー・プロセスへ委譲します。
CLnnプロセスは終了したプロセスおよびセッションのクリーンアップを補助します。ヘルパー・プロセスの数は、実行されるクリーンアップ作業の量と、現在のクリーンアップ効率に比例します。
クリーンアップ・プロセスはブロックされる場合があり、これによって他のプロセスのクリーンアップを続行できなくなります。また、複数のプロセスでクリーンアップが要求されると、クリーンアップ時間が膨大になる可能性があります。これらの理由により、Oracle AI Databaseでは複数のヘルパー・プロセスをパラレルに使用し、クリーンアップを実行できるため、パフォーマンスの低下が緩和されます。
V$CLEANUP_PROCESSビューおよびV$DEAD_CLEANUPビューにCLMNクリーンアップに関するメタデータが含まれます。V$CLEANUP_PROCESSビューには、クリーンアップ・プロセスごとに1行が含まれます。たとえば、V$CLEANUP_PROCESS.STATEがBUSYの場合は、このプロセスが現在クリーンアップを行っています。
関連項目: V$CLEANUP_PROCESSについてさらに学習するには、『Oracle AI Databaseリファレンス』を参照してください
データベース・リソースの隔離
プロセスまたはセッションが終了した場合、PMONグループは保持リソースをデータベースに解放します。場合によっては、破損してリカバリ不可能なリソースがPMONグループによって自動的に隔離されるため、データベース・インスタンスがただちに強制終了されることはありません。
PMONグループは、隔離されたリソースを保持していたプロセスまたはセッションに対して、できるかぎり多くのクリーンアップを実行し続けます。V$QUARANTINEビューには、リソースのタイプ、消費されたメモリー量、隔離の原因であるOracleエラーなどのメタデータが含まれます。
関連項目: V$QUARANTINEについてさらに学習するには、『Oracle AI Databaseリファレンス』を参照してください
プロセス・マネージャ(PMAN)
プロセス・マネージャ(PMAN)は、共有サーバー、プーリングされたサーバー、およびジョブ・キュー・プロセスなど、いくつかのバックグラウンド・プロセスをモニターします。
PMANは、次のタイプのプロセスを監視、起動および停止します。
-
ディスパッチャ・プロセスおよび共有サーバー・プロセス
-
接続ブローカおよびデータベース常駐接続プールのプール・サーバー・プロセス
-
ジョブ・キューのプロセス
-
再起動可能なバックグラウンド・プロセス
リスナー登録プロセス(LREG)
リスナー登録プロセス(LREG)は、データベース・インスタンスおよびディスパッチャ・プロセスに関する情報をOracle Net Listenerに登録します。
インスタンスの起動時に、LREGはリスナーに対してポーリングを実行し、リスナーが実行されているかどうかを確認します。リスナーが実行されている場合、LREGはリスナーに該当パラメータを渡します。実行されていない場合には、LREGは定期的にリスナーとの接続を試行します。
ノート: Oracle Database 12cまでのリリースでは、PMONがリスナー登録を実行していました。
関連項目: 「Oracle Net Listener」
システム・モニター・プロセス(SMON)
システム・モニター・プロセス(SMON)は、システム・レベルの様々なクリーン・アップ作業を実行します。
SMONには次のような役割があります。
-
必要に応じて、インスタンスの起動時に、インスタンス・リカバリを実行します。Oracle RACデータベースでは、障害の発生したインスタンスのインスタンス・リカバリを、データベース・インスタンスのSMONプロセスが実行できます。
-
ファイル読取りまたは表領域オフライン・エラーが原因で、インスタンス・リカバリ時にスキップされた終了済トランザクションがリカバリされます。表領域またはファイルがオンラインに戻ると、SMONによってトランザクションがリカバリされます。
-
永続表領域の未使用一時セグメントをクリーン・アップします。たとえば、Oracle AI Databaseでは、索引を作成するときにエクステントを割り当てます。この操作が失敗すると、SMONによって一時領域がクリーン・アップされます。
-
ディクショナリ管理表領域内の、連続した空きエクステントを結合します。
SMONでは、処理が必要かどうかを定期的にチェックします。他のプロセスでは、SMONが必要であると判断された場合、SMONをコールできます。
データベース・ライター・プロセス(DBW)
データベース・ライター・プロセス(DBW)は、データベース・バッファの内容をデータファイルに書き込みます。DBWプロセスは、データベース・バッファ・キャッシュ内の変更されたバッファをディスクに書き込みます。
ほとんどのシステムでは1つのデータベース・ライター・プロセス(DBW0)があれば十分ですが、追加プロセス(DBW1からDBW9、DBWaからDBWzおよびBW36からBW99)を構成して、データを頻繁に変更する場合は、他のプロセス(DBW1からDBW9、DBWaからDBWz)を構成して書込みパフォーマンスを向上させることができます。これらの追加DBWプロセスは、ユニプロセッサ・システムでは効果がありません。
DBWプロセスは、次のような場合に使用済バッファをディスクに書き込みます。
-
サーバー・プロセスは、しきい値バッファの数をスキャンした後に、クリーンで再利用可能なバッファが見つからない場合は、DBWに書込み信号が送付されます。DBWは、可能であれば、他の処理中に使用済バッファをディスクに非同期に書き込みます。
-
DBWは、定期的にバッファを書き込んで、REDOスレッド内のインスタンス・リカバリを開始する位置(チェックポイント)を進めます。チェックポイントのログ位置は、バッファ・キャッシュ内で最も古い使用済のバッファによって決まります。
多くの場合、DBWによって書き込まれるブロックは、ディスク内に分散されます。このため、この書込みはLGWRによって実行される順次書き込みよりも遅くなる傾向にあります。効率を向上させるために、可能であればDBWは、マルチブロック書込みを実行します。マルチブロック書込みで書き込まれるブロックの数は、オペレーティング・システムに応じて異なります。
関連情報:
-
チェックポイントの概要に関する項
-
DBWの構成、監視およびチューニングに関するアドバイスは、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照。
ログ・ライター・プロセス(LGWR)
ログ・ライター・プロセス(LGWR)では、オンラインREDOログ・バッファを管理します。
LGWRは、バッファの一部分をオンラインREDOログに書き込みます。データベース・バッファを変更するタスクを切り離すことによって、分散した使用済バッファのディスクへの書込み、およびREDOのディスクへの高速順次書込みの処理で、データベースのパフォーマンスが向上します。
次の状況では、LGWRは、最後の書込み以降にバッファにコピーされたREDOエントリすべてを、REDOログ・ファイルに書き込みます。
-
ユーザーがトランザクションをコミットしたとき。
-
オンラインREDOログ・スイッチが発生したとき。
-
LGWRによる最後の書込みから3秒経過したとき
-
REDOログ・バッファが3分の1になったとき、またはバッファ・データが1MBになったとき
-
DBWは、修正済のバッファをディスクに書き込む必要がある。
DBWによってダーティ・バッファを書き込むには、バッファの変更に関連するREDOレコードがディスクに書き込む必要があります(事前書込みプロトコル)。DBWは、書き込まれていないREDOレコードがあることを検出すると、そのレコードをディスクに書き込むようにLGWRに信号を送り、LGWRの処理が完了するまで待機して、データ・バッファをディスクに書き込みます。
-
LGWRおよびコミット Oracle AI Databaseでは、コミットされたトランザクションのパフォーマンスを向上させるために、高速コミット・メカニズムを使用します。
-
LGWRおよびアクセス不能ファイルLGWRは、ミラー化されたアクティブなオンラインREDOログ・ファイルのグループにも同期的に書き込みます。参照: "Commits of Transactions"
LGWRおよびコミット
Oracle AI Databaseでは、コミットされたトランザクションのパフォーマンスを向上させるために、高速コミット・メカニズムを使用します。
ユーザーがCOMMIT文を発行すると、トランザクションにシステム変更番号(SCN)が割り当てられます。LGWRは、コミット・レコードをREDOログ・バッファに入れ、コミットSCNおよびトランザクションのREDOエントリとともにそれを即時にディスクに書き込みます。
REDOログ・バッファは循環バッファです。LGWRがREDOログ・バッファからオンラインREDOログ・ファイルにREDOエントリを書き込んだ後、サーバー・プロセスはディスクに書き込まれたREDOログ・バッファのエントリ上に新しいエントリをコピーできます。オンラインREDOログへのアクセスが頻繁なときにも、新しいエントリを書き込めるよう常にバッファ内の領域を空けておくため、LGWRが行う書込みは通常は非常に高速になります。
トランザクションのコミットのレコードを含むREDOエントリのアトミックな書込みでは、トランザクションでコミットされたことが確認される1つのイベントです。Oracle AI Databaseでは、データ・バッファがまだディスクに書き込まれている場合でも、コミットしたトランザクションに対する成功コードが返されます。対応するデータ・ブロックに対する変更は、DBWがそれらのデータを効率的にデータファイルに書き込めるようになるまで延期されます。
ノート: LGWRは、トランザクションのコミット前にREDOログ・エントリをディスクに記述できます。後でトランザクションがコミットされた場合にのみ、REDOエントリにより保護された変更が確定します。
アクティビティが高いとき、LGWRはグループ・コミットを使用できます。たとえば、ユーザーがコミットすると、LGWRによってトランザクションのREDOエントリがディスクに書き込まれます。この書込み中、他のユーザーがコミットします。LGWRでは、前の書込みが完了するまで、これらのトランザクションをディスクに書き込んでコミットすることはできません。完了すると、LGWRは、(まだコミットされていない)待機しているトランザクションに関するREDOエントリのリストを1回の操作で書き込むことができます。これにより、データベースでは、ディスクI/Oが最小化され、パフォーマンスが最大化されます。コミットの要求が高い頻度で続くと、LGWRによる毎回の書込みに複数のコミット・レコードが含まれることがあります。
LGWRおよびアクセス不能ファイル
LGWRは、ミラー化されたアクティブなオンラインREDOログ・ファイルのグループにも同時に書き込みます。
ログ・ファイルにアクセスできない場合、LGWRはグループ内の他のファイルに書込みを続け、LGWRトレース・ファイルおよびアラート・ログにエラーを書込みます。グループ内のすべてのファイルが破損している場合や、アーカイブされていないためにグループ全体が使用できない場合、LGWRは機能を続行できません。
関連情報:
-
LGWRのパフォーマンスの監視およびチューニング方法の詳細は、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』に関する項を参照してください。
チェックポイント・プロセス(CKPT)
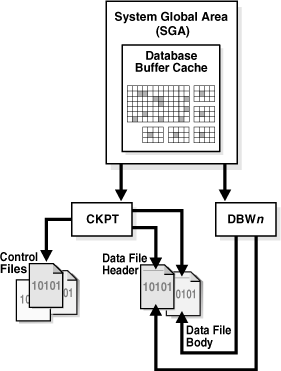
チェックポイント・プロセス(CKPT)は、チェックポイント情報により制御ファイルおよびデータファイル・ヘッダーを更新するとともに、DBWに対してブロックがディスクに書き込むように信号を送る。チェックポイント情報には、チェックポイント位置、SCNおよびオンラインREDOログの中でリカバリを開始する位置が含まれます。
図18-4に示すように、CKPTではデータファイルへのデータ・ブロックの書込み、およびオンラインREDOログ・ファイルへのREDOブロックの書込みは行いません。
図4: チェックポイント・プロセス
参照: 「チェックポイントの概要」
管理性モニター・プロセス(MMONおよびMMNL)
管理性モニター・プロセス(MMON)は、自動ワークロード・リポジトリ(AWR)に関連する多数のタスクを実行します。
たとえば、MMONは、メトリックがしきい値に違反し、スナップショットを取得して、最近変更されたSQLオブジェクトの統計値を取得したときに書込みを行います。
管理性モニター・ライト・プロセス(MMNL)は、SGAのアクティブ・セッション履歴(ASH)バッファ内の統計をディスクに書き込みます。MMNLは、ASHバッファがいっぱいになるとディスクに書き込みます。
関連項目: 「Oracle AI Databaseパフォーマンス・チューニング・スタート・ガイド」および「アクティブ・セッション履歴の概要」
リカバラ・プロセス(RECO)
分散データベースでは、リカバー・プロセス(RECO)によって、分散トランザクションに関連する障害が自動的に解決されます。
ノードのRECOプロセスは、インダウト分散トランザクションにかかわる他のデータベースに自動的に接続されます。RECOは、データベース間の接続を再確立するとき、すべてのインダウト・トランザクションを自動的に解決し、解決されたトランザクションに対応する行を各データベースの保留中のトランザクション表から除去します。
関連項目:分散システムでのトランザクション・リカバリの詳細は、『Oracle AI Database管理者ガイド』を参照してください。
バックグラウンド・プロセス(BG nn)
バックグラウンド・プロセス(BGnn)は、様々なメンテナンス・タスクのおよびモニタリング・タスクを実行するOracle RAC環境の標準バックグラウンド・プロセスである。
バックグラウンド・プロセスは、バッファ・キャッシュ管理、ログ・ライター(LGWR)プロセスのサポート、チェックポイント調整、バックグラウンド・プロセスの監視および統計収集を行います。
仮想オペレーティング・システム・デーモン・プロセス(VOSD)
仮想オペレーティング・システム・デーモン・プロセス(VOSD)は、期限付きのOracleデータベース・サービス・アクションを実行します。
このプロセスはインスタンスの起動時に生成され、データベースにとって重要なシステム・サービス・アクションの実行を担当します。このプロセスは、データベース・インスタンス、Oracle ASMインスタンスおよびOracle RACで使用されます。
ネットワーク監視プロセス(NMON)
ネットワークモニタープロセス(NMON)は、軽量のネットワークモニタリングサービスです。
ネットワーク・モニター(NMON)は、オーバーヘッドの少ないネットワーク監視サービスであり、高度なカーネル機能を利用して、常時オンの包括的な監視を実現します。システム全体、インタフェースごと、IPごと、およびフローごとのネットワーク統計およびイベントを複数レベルで継続的に取得し、より高いレベルのサービスの詳細なメトリックを提供します。NMON上に構築されたHealth Scoreサービスは、標準化された0-100スコアでネットワークの健全性評価を簡素化し、必要に応じて診断を収集して問題にプロアクティブに対処します。NMONは、効率的で実用的なネットワーク統計を提供し、異常のタイムリーな検出とデータベース・アクティビティとの効果的な相関を可能にします。
オプションのバックグラウンド・プロセス
オプションのバックグラウンド・プロセスは、必須として定義されていないバックグラウンド・プロセスです。
ほとんどのオプションのバックグラウンド・プロセスは、タスクまたは機能に固有です。たとえば、Oracle ASMをサポートするバックグラウンド・プロセスは、この機能が有効になっている場合のみ使用できます。
この項では、いくつかの一般的なオプションのプロセスについて説明します。
-
アーカイバ・プロセス(ARCn)アーカイバ・プロセス(ARCn)は、REDOログ・スイッチが実行されるとオンラインREDOログ・ファイルをオフライン・ストレージにコピーします。
-
ジョブ・キュー・プロセス(CJQ0およびJnnn)キュー・プロセスは、ユーザー・ジョブを実行します。多くの場合、バッチ・モードで実行されます。ジョブとは、1回以上実行するようにスケジューリングされたユーザー定義のタスクです。
-
フラッシュバック・データ・アーカイブ・プロセス(FBDA)フラッシュバック・データ・アーカイブ・プロセス(FBDA)は、追跡している表にある、古い行をフラッシュバック・データ・アーカイブ内に保管します。
-
スペース管理コーディネータ・プロセス(SMCO)領域管理コーディネータ・プロセスの(SMCO)は、SMONによって起動され、各種領域管理関連タスクの実行を調整ます。
関連情報:
-
アドバンスト・キューイング(AQ)の概要は、『Oracle AI Database Transactional Event QueuesおよびAdvanced Queuingユーザーズ・ガイド』を参照してください。
-
AQおよびOracle ASMに固有のバックグラウンド・プロセスについては、『Oracle AI Databaseリファレンス』を参照
アーカイバプロセス(ARC n)
アーカイバ・プロセス(ARCn)は、REDOログ・スイッチが発生すると、オンラインREDOログ・ファイルをオフライン・ストレージにコピーします。
また、トランザクションのREDOデータを収集し、そのデータをスタンバイ・データベースの宛先に転送できます。ARCnプロセスが、データベースがARCHIVELOGモードで、自動アーカイブが使用可能になっている場合にのみ存在します。
関連情報:
-
アーカイバ・プロセス数の調整方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
アーカイバ・パフォーマンスの調整方法を学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照
ジョブ・キュー・プロセス(CJQ0およびJnnn)
キュー・プロセスでは、多くの場合、バッチ・モードでユーザー・ジョブを実行します。ジョブとは、1回以上実行するようにスケジューリングされたユーザー定義のタスクです。
たとえば、ジョブ・キューを使用して、バックグラウンドで長時間実行される更新をスケジュールできます。開始日と時間間隔を指定すると、ジョブ・キュー・プロセスは、次の間隔でジョブの実行を試行します。
Oracle AI Databaseではジョブ・キュー・プロセスが動的に管理されるため、ジョブ・キュー・クライアントは、必要に応じてより多くのジョブ・キュー・プロセスを使用できます。新規プロセスが使用するリソースは、そのプロセスがアイドル状態になると解放されます。
動的ジョブ・キュー・プロセスは、指定された間隔で多数のジョブを同時に実行できます。イベントのシーケンスは次のとおりです。
-
ジョブ・コーディネータ・プロセス(CJQ0)は、Oracle Schedulerの必要に応じて、自動的に起動し、停止します。コーディネータ・プロセスは、システムの
JOB$表から、実行する必要があるジョブを定期的に選択します。選択された新規ジョブは、時間順に並べ替えられます。 -
コーディネータ・プロセスは、ジョブを実行するためにジョブ・キュー子プロセス(Jnnn)を動的に生成します。
-
ジョブ・キュー・プロセスは、実行のためにCJQ0プロセスによって選択されたジョブの1つを実行します。ジョブ・キュー・プロセスは、一度に1つずつジョブを実行して完了します。
-
ジョブ・キュー・プロセスは、1つのジョブの実行が終了すると、次のジョブの問合せを行います。実行予定のジョブが存在しない場合、ジョブ・キュー・プロセスはスリープ状態に入り、定期的な周期で起動すると次のジョブの問合せを行います。新しいジョブがない場合、事前に設定した周期が経過した後に終了します。
初期化パラメータJOB_QUEUE_PROCESSESは、1つのインスタンスで同時に実行できるジョブ・キュー・プロセスの最大数を示します。ただし、クライアントは、すべてのジョブ・キュー・プロセスがジョブの実行に使用可能であると想定することはできません。ノート:初期化パラメータJOB_QUEUE_PROCESSESが0(0)に設定されている場合、コーディネータ・プロセスは起動しません。
関連情報:
-
Oracle Schedulerについて学習するには、『Oracle AI Database管理者ガイド』を参照
-
AQバックグラウンド・プロセスについて学習するには、『Oracle AI Database Transactional Event QueuesおよびAdvanced Queuingユーザーズ・ガイド』を参照してください。
フラッシュバック・データ・アーカイブ・プロセス(FBDA)
フラッシュバック・データ・アーカイブ・プロセス(FBDA)は、追跡した表の履歴行をフラッシュバック・データ・アーカイブにアーカイブする。
追跡した表に対するDMLを含むトランザクションがコミットされると、このプロセスでは、変更された行の事前イメージがフラッシュバック・データ・アーカイブに格納されます。また、現在の行にメタデータを保存します。
FBDAは、フラッシュバック・データ・アーカイブの領域、編成および保存に関する管理を自動的に行います。また、追跡対象トランザクションのアーカイブが行われた期間が記録されます。
領域管理コーディネータ・プロセス(SMCO)
領域管理コーディネータ・プロセス(SMCO)は、SMONによって起動され、様々な領域管理関連タスクの実行を調整します。
SMCOプロセスでは、様々な領域管理関連タスクの実行を調整します。
通常のタスクには、事前の領域割当ておよび再利用、および一時表領域のメンテナンスが含まれます。SMCOは、動的に子プロセス(Wnnn)を起動してそのタスクを実行します。
フラッシュバック・データ・アーカイブおよび一時履歴機能について学習するには、『Oracle AI Database開発ガイド』を参照してください。
セカンダリ・プロセス
セカンダリ・プロセスとは、他のプロセスのかわりに作業を実行するバックグラウンド・プロセスです。
この項では、Oracle AI Databaseで使用されるセカンダリ・プロセスのいくつかを説明します。
-
I/Oセカンダリプロセス I/Oセカンダリプロセス(Innn)は、それをサポートしないシステムおよびデバイスの非同期 I/Oをシミュレートします。
-
パラレル実行(PX)サーバー・プロセス パラレル実行では、複数のプロセスが同時に機能して、単一のSQL文を実行します。関連項目: Oracle AI Databaseのセカンダリ・プロセスの詳細は、『Oracle AI Databaseリファレンス』を参照してください。
I/Oセカンダリ・プロセス
I/Oセカンダリ・プロセス(Innn)は、非同期I/Oをサポートしていないシステムおよびデバイスのかわりに非同期I/Oをシミュレートします。
非同期I/Oの場合、伝送のためのタイミング要件がないため、伝送が終了する前に他のプロセスを起動できます。
たとえば、非同期I/Oがサポートされていないオペレーティング・システムのディスクに、アプリケーションが1000ブロックを書き込むとします。それぞれの書込みは順次実行され、書込みの完了確認まで待機します。非同期ディスクの場合、アプリケーションは一括でブロックを書き込み、すべてのブロックが書き込まれたというオペレーティング・システムからのレスポンスを待機している間、他の作業を実行できます。
非同期I/Oをシミュレートするには、1つのプロセスで複数のセカンダリ・プロセスを監視します。呼び出し側プロセスが、各セカンダリ・プロセスに作業を割り当てます。各セカンダリ・プロセスは、それぞれの書込みが完了するまで待ち、完了すると呼び出し側に折り返し通知します。実際の非同期I/Oの場合は、オペレーティング・システムが、I/Oの完了を待ってからそのプロセスに折り返し通知しますが、シミュレートした非同期I/Oの場合は、セカンダリ・プロセスが、完了を待ってから呼び出し側に折り返し通知します。
データベースでは、次のような様々なタイプのI/Oセカンダリ・プロセスがサポートされています。
-
Recovery Manager (RMAN)のI/Oセカンダリ・プロセス
RMANを使用してデータをバックアップまたはリストアする場合は、I/Oセカンダリ・プロセスをディスク・デバイスとテープ・デバイスの両方のために使用できます。
-
データベース・ライターのセカンダリ・プロセス
複数のデータベース・ライター・プロセスを使用することが現実的でない場合(コンピュータのCPUが1つのみである場合など)は、データベースによって複数のセカンダリ・プロセスにI/Oを分散できます。DBWは、ディスクへのブロックの書込みを可能にするため、バッファ・キャッシュLRUリストをスキャンする唯一のプロセスです。しかしながら、I/Oセカンダリ・プロセスは、これらのブロックに対してI/Oを実行します。
関連情報:
-
バックアップ操作およびリストア操作のI/Oセカンダリ・プロセスについてさらに学習するには、『Oracle AI Databaseバックアップおよびリカバリ・ユーザーズ・ガイド』を参照
-
データベース・ライター・セカンダリ・プロセスについてさらに学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照してください。
パラレル実行(PX)サーバー・プロセス
パラレル実行では、複数のプロセスが同時に機能して、単一のSQL文を実行します。
複数プロセス内で作業を分割すると、Oracle AI Databaseでは、より迅速に文を実行できます。たとえば、1つのプロセスで4つの四半期分をすべて処理するのではなく、4つのプロセスが1年のそれぞれの四半期を分担して処理するなどがこの例です。
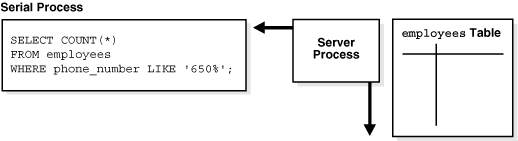
パラレル実行は、シリアル実行と対照的です。このとき、1つのサーバー・プロセスによって、SQL文の順順次実行に必要な処理がすべて実行されます。たとえば、SELECT * FROM employeesなどの全表スキャンを実行するには、図18-5に示すように、1つのサーバー・プロセスですべての作業が実行されます。
図5: シリアルの全表スキャン
パラレル実行では、データ・ウェアハウスなどの大規模データベースでの、データ処理集中型の操作におけるレスポンス時間が短縮されます。対称型マルチプロセッサ(SMP)およびクラスタ化されたシステムでは、文の処理を複数のCPUに分割できるため、パラレル実行によりパフォーマンスが大幅に向上します。パラレル実行は特定のタイプのOLTPおよびハイブリッド・システムにとっても利点があります。
Oracle RACシステムでは、特定のサービスのサービス配置によってパラレル実行が制御されます。つまり、パラレル・プロセスはサービスが構成されているノードで実行されます。デフォルトでは、Oracle AI Databaseは、データベースへの接続に使用されるサービスを提供するインスタンスに対してのみ、パラレル・プロセスを実行します。これは、パラレル・リカバリやGV$問合せの処理などの他のパラレル操作には影響しません。
-
問合せコーディネータパラレル実行では、サーバー・プロセスは問合せコーディネータ(パラレル実行コーディネータとも呼ばれます)として機能します。
-
プロデューサとコンシューマパラレル実行サーバーは、プロデューサとコンシューマに分かれています。プロデューサはデータを処理し、それを必要とするコンシューマに配布します。
-
グラニュルパラレル実行では、表は動的にロード単位に分割されます。各単位はグラニュルと呼ばれ、データにアクセスする際の最小の作業単位です。
関連情報:
-
パラレル実行についてさらに学習するには、Oracle AI Database VLDBおよびパーティショニング・ガイドを参照してください。
-
Oracle RAC環境でのパラレル実行に関する考慮事項については、『Oracle Real Application Clusters管理およびデプロイメント・ガイド』をご覧ください。
問合せコーディネータ
パラレル実行において、サーバー・プロセスは問合せコーディネータとして動作します(パラレル実行コーディネータとも呼ばれます)。
問合せコーディネータの役割は次のとおりです。
-
問合せの解析
-
パラレル実行サーバー・プロセスの割当てと制御
-
ユーザーへの出力の送信
問合せの問合せ計画が指定された場合、コーディネータはSQL問合せ内の各オペレータをパラレル・ピースに分割して、それらを問合せで指定した順序に従って実行します。また、演算子を実行するパラレル実行サーバーによって生成された部分的な結果を統合できます。
1つの操作に割り当てられているパラレル実行サーバーの数は、操作の並列度です。同じSQL文内の複数の操作は同じ並列度を持ちます。
プロデューサとコンシューマ
パラレル実行サーバーは、プロデューサとコンシューマに分かれます。プロデューサはデータを処理し、それを必要とするコンシューマに配布します。
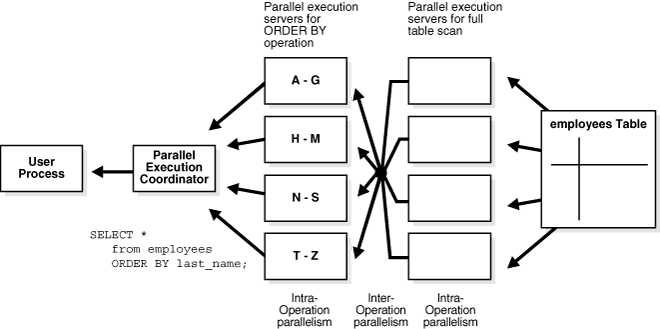
データベースは、様々なテクニックを使用して配布を実行できます。一般的な方法として、ブロードキャストとハッシュの2つがあります。ブロードキャストでは、各プロデューサがすべてのコンシューマに行を送信します。ハッシュでは、データベースが一連のキーに対するハッシュ関数を計算し、各コンシューマにハッシュ値のサブセットを担当させます。図18-6は、次の文のパラレル実行でのプロデューサとコンシューマーの相互作用を表しています。
SELECT * FROM employees ORDER BY last_name;実行計画により、employees表の全体スキャンが実装されます。スキャンの後に、取得された行のソートが続きます。また、スキャン操作に関係するすべてのプロデューサ・プロセスが、ソートを実行する適切なコンシューマ・プロセスに行を送信します。
図6: プロデューサとコンシューマ
グラニュル
パラレル実行では、表は動的にロード単位に分割されます。各単位はグラニュルと呼ばれ、データにアクセスする際の最小の作業単位です。
ブロックに基づくグラニュルは、1つのパラレル実行サーバー(PXサーバー)によって読み取られる表のデータ・ブロックの範囲です(このオブジェクトは名前の形式としてPnnnを使用します)。パラレル・サーバー・プロセス間で作業を均等に分散するには、グラニュル数が常にリクエストDOPよりもかなり多くなります。図18-7に、employees表のパラレル・スキャンを示します。
図7: パラレルの全表スキャン
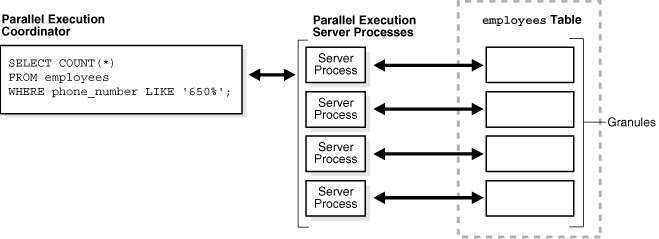
データベースでは、実行時にグラニュルをパラレル実行サーバーにマップします。パラレル実行サーバーがグラニュルに対応する行の読取りを終了したとき、グラニュルがまだ残っている場合、問合せコーディネータから他のグラニュルを取得します。この操作は、表全体が読み取られるまで続行されます。実行サーバーは結果をコーディネータに送り返し、それぞれの状態が組み立てられて、目的の全表スキャンになります。
関連情報:
-
パラレル実行の使用方法を学習するには、『Oracle AI Database VLDBおよびパーティショニング・ガイド』を参照
-
推奨の並列性初期化パラメータについて学習するには、Oracle AI Databaseデータ・ウェアハウス・ガイドを参照