SQL
この章では、Structured Query Language (SQL)の概要およびOracle AI DatabaseによるSQL文の処理方法を示します。
-
SQLの概要(sequelと発音する)は、すべてのプログラムおよびユーザーがOracleデータベースのデータにアクセスする際に使用する、セットベースの高レベルの宣言型コンピュータ言語である。
-
SQL文の概要Oracleデータベース内の情報に関して実行されたすべての操作は、SQL文を使用して実行します。SQL文はコンピュータ・プログラムまたは命令で、識別子、パラメータ、変数、名前、データ型およびSQL予約単語で構成されます。
-
オプティマイザの概要 Oracle AI DatabaseでどのようにSQL文が処理されるかを理解するには、データベースのオプティマイザと呼ばれる部分(問合せオプティマイザまたはコストベース・オプティマイザとも呼ばれる)について理解する必要があります。すべてのSQL文でオプティマイザを使用して、指定されたデータへの最も効率的なアクセス手段を決定します。
-
SQL処理の概要この項では、Oracle AI DatabaseでどのようにSQL文が処理されるかについて説明します。具体的には、データベースがDDL文を処理してオブジェクトを作成する仕組み、DMLでデータを変更する仕組、および問合せでデータを取得する方法を説明します。
SQLの紹介
SQL (sequelと発音)は、すべてのプログラムおよびユーザーがOracleデータベースのデータにアクセスする際に使用する、セットベースの高レベルの宣言型コンピュータ言語である。
いくつかのOracleツールおよびアプリケーションでは、SQLの使用はマスクされていますが、すべてのデータベース・タスクはSQLを使用して実行されます。その他のデータ・アクセス方法を使用すると、Oracle AI Databaseに組み込まれているセキュリティが活用され、データのセキュリティと整合性が損われる可能性があります。
SQLはOracle AI Databaseなどのリレーショナル・データベースに対するインタフェースを提供します。SQLでは、次のようなタスクを1つの一貫した言語に統合します。
-
オブジェクトの作成、置換、変更および削除
-
表の行の挿入、更新および削除
-
データの問合せ
-
データベースおよびそのオブジェクトへのアクセスを制御する
-
データベースの整合性と整合性の保証
SQLは対話的に使用できます(つまり、文を手動でプログラムに入力できます)。SQL文はCまたはJavaなどの異なる言語で記述されたプログラム内に埋め込むこともできます。
-
SQLデータ・アクセスコンピュータ言語の広範なファミリには、宣言型言語(非手続き形であり、何を達成する必要があるかを記述する)と、もう1つは実行経度を表すC++およびJavaなどのプロシージャ型言語の2つがあります。
-
SQL標準 Oracleは、業界で認められている標準に準拠するよう努め、SQL標準委員会に積極的に参加しています。
関連情報:
-
プログラミング環境の選択方法を学習するには、Oracle AI Database開発ガイドを参照してください。
-
SQLの概要は、『Oracle AI Database SQL言語リファレンス』を参照
SQLデータ・アクセス
コンピュータ言語は大きくなり、2つの種類があり、1つは実行対象を表す非手続き型宣言言語、もう1つは実行経経緯を表すC++およびJavaなどの手続き型語です。
SQLは、ユーザーが結果の導出方法ではなく目的とする結果を指定するという意味において、宣言型です。たとえば、次の文を使用すると、姓がKで始まる従業員のレコードを問い合せることができます。
データベースでは、データをナビゲートし、リクエストされた結果を取得するプロシージャを生成する作業を実行します。SQLの宣言型の性質により、論理レベルでデータを操作できます。実装の詳細は、データを操作する場合にのみ、考慮する必要があります。
SELECT   last_name, first_name
FROM     hr.employees
WHERE    last_name LIKE 'K%'
ORDER BY last_name, first_name;データベースはWHERE条件(述語とも呼ばれる)を満たすすべての行を1つのステップで取得します。データベースは、ユーザー、別のSQL文またはアプリケーションに、これらの行をまとめて渡すことができます。アプリケーションで行を1つずつ処理する必要はなく、また、開発者が行の物理的な格納方法または取得方法を認識する必要もありません。
すべてのSQL文で、オプティマイザが使用されます。オプティマイザは、要求されたデータにアクセスする最も効率的な方法を決定するデータベースのコンポーネントです。Oracle Databaseでは、オプティマイザにジョブを適切に実行させるための技術もサポートされています。
関連項目: SQL文とSQLのその他の部分(演算子、ファンクションおよび書式モデルなど)の詳細は、Oracle AI Database SQL言語リファレンスを参照してください。
SQL規格
オラクル社は業界で承認されている標準への準拠に努め、SQLの規格協会に積極的に参加しています。
業界が認可している協会として、米国規格協会(ANSI)および国際標準化機構(ISO)があります。ANSIとISO/IECはともに、SQLがリレーショナル・データベースの標準言語として認められています。
SQL標準は10のパートで構成されます。1つのパート(SQL/RPR:2012)は2012年の新しいものです。2011年には、他の5つ部品が改訂されました。他の4つのパートは2008年バージョンで、元のままです。Oracle SQLにはANSI/ISO標準SQL言語に対応する多くの拡張機能が埋められており、Oracle AI Databaseのツールとアプリケーションを使用することで追加の文が提供されます。SQL*Plus、SQL DeveloperおよびOracle Enterprise Managerツールを使用すると、Oracleデータベースおよびそれらのツールで使用可能な追加の文または関数に対してANSI/ISO標準SQL文を実行できます。
関連情報:
-
Oracle SQLと標準SQLの相違点については、『Oracle AI Database SQL言語リファレンス』を参照
-
SQL文との区別など、SQL*Plusコマンドについては、『SQL*Plusユーザーズ・ガイドおよびリファレンス』を参照してください
SQL文の概要
Oracleデータベース内の情報に対して実行されるすべての操作は、SQL文を使用して実行されます。SQL文はコンピュータ・プログラムまたは命令で、識別子、パラメータ、変数、名前、データ型およびSQL予約文字で構成されます。ノート: SQL予約語は、SQLで特別な意味を持ち、他の目的には使用できません。たとえば、SELECTとUPDATEは予約語のため、表名には使用できません。
SQL文は、完全なSQL文と等価であることが必要です。次に例を示します。
SELECT last_name, department_id FROM employeesOracle AI Databaseでは、完全なSQL文のみが実行されます。次のような不完全文を実行しようとすると、テキストの不足を示すエラーが発生します。
SELECT last_name;Oracle SQL文は、次のカテゴリに分類されます。
-
データ定義言語(DDL)文データ定義言語(DLL)文は、スキーマ・オブジェクトに対し、定義、構造の変更および削除を行います。
-
データ操作言語(DML)文データ操作言語(DML)文によって、既存のスキーマ・オブジェクト内のデータの問合せや操作が実行されます。
-
トランザクション制御文トランザクション制御文は、DML文による変更を管理し、DML文をトランザクションにグループ化します。
-
セッション制御文: セッション制御文は、ユーザー・セッションのプロパティを動的に管理します
-
システム制御文 データベース・インスタンスのプロパティを変更するシステム制御文。
-
埋込みSQL文埋込みSQL文により、手続き型言語プログラム内にDDL、DMLおよびトランザクション制御文を取り込みます。
データ定義言語(DDL)文(Data Definition Language (DDL) Statements)
データ定義言語(DLL)文は、スキーマ・オブジェクトに対し、定義、構造の変更および削除を実行します。
DDLを使用すると、オブジェクトにアクセスするアプリケーションを変更することなく、オブジェクトの属性を変更できます。たとえば、アプリケーションをリライトせずに、人事管理アプリケーションからアクセスできる表に列を追加できます。また、DDLを使用して、データベース・ユーザーがデータベース内で作業を実行している間に、オブジェクトの構造を変更することもできます。
具体的には、DDL文を使用すると次のことができます。
-
スキーマ・オブジェクトと他のデータベース構造(データベースとデータベース・ユーザーを含む)を作成、変更および削除します。ほとんどのDDL文は
CREATE、ALTERまたはDROPのキーワードで始まります。 -
スキーマ・オブジェクトの構造を削除することなく、それらのオブジェクトの中のすべてのデータを削除します(
TRUNCATE)。ノート:
DELETEとは異なり、TRUNCATEはUNDOデータを生成しないため、DELETEよりも処理が速くなります。また、TRUNCATEは削除トリガーを起動しません。 -
権限とロールを付与および取り消します(
GRANT、REVOKE)。 -
監査オプションのオンまたはオフを切り替えます(
AUDIT、NOAUDIT)。 -
データ・ディクショナリにコメントを追加します(
COMMENT)。
例10-1 DDL文
次の例では、DDL文を使用してplants表を作成した後、DMLを使用して表に2つの行を挿入します。次に、DDLを使用して表構造を変更し、この表に対するユーザーの読取り権限を付与および取り消してから、表を削除します。
CREATE TABLE plants
    ( plant_id    NUMBER PRIMARY KEY,
      common_name VARCHAR2(15) );

INSERT INTO plants VALUES (1, 'African Violet'); # DML statement

INSERT INTO plants VALUES (2, 'Amaryllis'); # DML statement

ALTER TABLE plants ADD
    ( latin_name VARCHAR2(40) );

GRANT READ ON plants TO scott;

REVOKE READ ON plants FROM scott;

DROP TABLE plants;データベースがDDL文を実行する直前に暗黙的なCOMMITが行われ、直後にCOMMITまたはROLLBACKが行われます。次の例では、2つのINSERT文の後にALTER TABLE文が続くため、データベースによって2つのINSERT文がコミットされます。ALTER TABLE文が成功した場合は、この文はデータベースによってコミットされ、失敗した場合は、この文はデータベースによってロールバックされます。いずれの場合も、2つのINSERT文はすでにコミットされています。
関連情報:
-
権限およびロールについて学習するには、Oracle AI Databaseセキュリティ・ガイドを参照してください
-
スキーマ・オブジェクトの作成方法について学習するには、Oracle AI Database Oracle AI Database開発スタート・ガイドおよびOracle AI Database管理者ガイドを参照してください
-
ブロック化DDLと非ブロック化DDLの相違について学習するには、『Oracle AI Database開発ガイド』を参照してください。
-
DDL文のリストは、『Oracle AI Database SQL言語リファレンス』を参照
データ操作言語(DML)文(Data Manipulation Language (DML) Statements)
データ操作言語(DML)文は、既存のスキーマ・オブジェクト内のデータの問合せや操作を行います。
DDL文ではデータベースの構造を変更するのに対して、DML文では内容の問合せまたは変更を行います。たとえば、ALTER TABLEは表の構造を変更するのに対して、INSERTは1つ以上の行を表に追加します。
DML文は、最も頻繁に使用するSQL文であり、次の操作を実行できます。
-
1つ以上の表またはビューからデータの取出しまたはフェッチを行います(
SELECT)。 -
列値のリストを指定するか、既存のデータを選択および操作する副問合せを使用して、表またはビューに新しいデータ行を追加します(
INSERT)。 -
表またはビューの既存の行の列値を変更します(
UPDATE)。 -
表またはビュー(
MERGE)に行の更新または条件付きの挿入を行います。 -
表またはビューから行を削除します(
DELETE)。 -
SQL文の実行計画を表示します(
EXPLAINPLAN)。 -
表またはビューをロックして、一時的に他のユーザーのアクセスを制限します(
LOCKTABLE)。
次の例では、DMLを使用してemployees表に問い合せます。例では、DMLを使用してemployeesに行を挿入し、この行を更新した後、行を削除します。
SELECT * FROM employees;

INSERT INTO employees (employee_id, last_name, email, job_id, hire_date, salary)
  VALUES (1234, 'Mascis', 'JMASCIS', 'IT_PROG', '14-FEB-2008', 9000);

UPDATE employees SET salary=9100 WHERE employee_id=1234;

DELETE FROM employees WHERE employee_id=1234;論理作業単位を形成するDML文のコレクションは、トランザクションと呼ばれます。たとえば、預金を振り替えるトランザクションは、普通預金口座の残高の減額、当座預金口座の残高の増額および預金口座履歴表への振替えの記録という3つの別々の操作を伴います。DDL文とは異なり、DML文は現行のトランザクションを暗黙的にコミットしません。
-
SELECT文問合せとは、表またはビューからデータを取得する操作である。
-
結合結合とは、2つ以上の表、ビューまたはマテリアライズド・ビューからの行を組み合せる問合せのことです。
-
副問合せ 副問合せは別のSQL文内にネストされた
SELECT文である。副問合せは、1つの問題を解決するために複数の問合せを実行する必要がある場合に便利です。
関連情報:
-
データの問合せおよび操作方法を学習するには、『Oracle AI Database Oracle AI Database開発スタート・ガイド』を参照してください
-
DML文のリストは、Oracle AI Database SQL言語リファレンスを参照
SELECTステートメント
問合せは、表またはビューからデータを取得する操作である。
SELECTはデータの問合せに使用できる唯一のSQL文です。SELECT文の実行から取得した一連のデータは結果セットと呼ばれます。
次の表に、SELECT文でよく見られる1つの必須キーワードと3つのキーワードを示します。また、表では、キーワードとSELECT文の機能を関連付けています。
表1 SQL文のキーワード
| キーワード | 必須? | 摘要 | 能力 |
|---|---|---|---|
SELECT |
はい | 結果に表示される列を指定します。投影により、表内の列のサブセットが作成されます。 式は、値に解決される1つ以上の値、演算子、およびSQLファンクションの組合せです。 |
予測 |
FROM |
いいえ | データの取得元の表またはビューを指定します。 | 結合 |
WHERE |
いいえ | 条件を指定して行をフィルタ処理し、表内の行のサブセットを作成します。条件は、1つ以上の式および論理(ブール)演算子の組合せを指定し、TRUE、FALSEまたはUNKNOWNの値を戻します。 |
選択 |
ORDER BY |
いいえ | 行の表示順序を指定します。 |
関連項目: SELECTの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照してください
結合
結合とは、2つ以上の表、ビューまたはマテリアライズド・ビューの行を組み合せる問合せのことです。
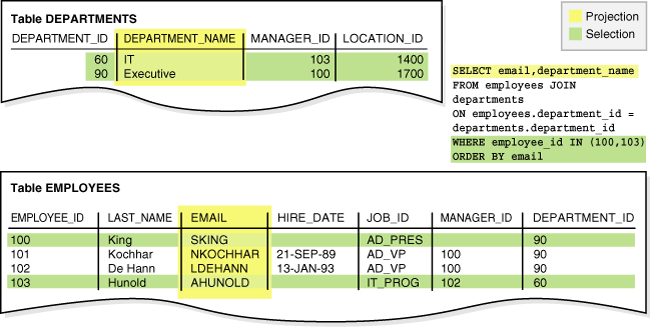
次の例は、employees表およびdepartments表を結合して(FROM句)、指定した条件に一致する行のみを選択し(WHERE句)、投影を使用して2つの列からデータを取得します(SELECT)。SQL文の後にサンプルの出力を示しています。
SELECT email, department_name
FROM   employees
JOIN   departments
ON     employees.department_id = departments.department_id
WHERE  employee_id IN (100,103)
ORDER BY email;

EMAIL                     DEPARTMENT_NAME
------------------------- ------------------------------
AHUNOLD                   IT
SKING                     Executive
次の図に、前述の問合せの結合で示した投影および選択の操作を表します。
図1: 投影と選択
ほとんどの結合には、FROM句またはWHERE句のいずれかに1つ以上の結合条件があり、それぞれ異なる表の2つの列をこの基準によって比較します。データベースでは1対の行を組み合せ、それぞれの対には、結合条件がTRUEになる各表の行を1行ずつ含みます。オプティマイザは結合条件、索引、および表に使用できる任意の統計に基づいて、データベースが表を結合する順序を決定します。
結合タイプは次のとおりです。
-
内部結合
内部結合とは、結合条件を満たす行のみを戻す2つ以上の表の結合のことです。たとえば、結合条件が
employees.department_id=departments.department_idの場合、この条件を満たさない行は戻されません。 -
外部結合
外部結合は結合条件を満たすすべての行を戻すだけでなく、一方の表からも、他方の表の条件を満たさない行に対応する行が戻されます。
結合の条件が右側の表Bのレコードに一致していない場合でも、表AとBの左側外結合の結果には常に、左側の表Aのすべてのレコードが含まれます。Bに一致していない行が存在する場合、Bの列には、Bで一致していない行にはNULLが含まれます。たとえば、一部の従業員が部署に属していない場合、
employees(左側の表)とdepartments(右側の表)の左側外部結合では、departmentsの行が結合条件を満たしていない(employees.department_idがNULLである)ときも、employeesのすべての行が取得されます。結合条件が左側の表Aの行に一致していない場合でも、表AとBの右側外結合のすべてのレコードは、右側の表Aに含まれます。Aに一致していない行が存在する場合、Aの列には、Aで一致していない行にはNULLが含まれます。たとえば、一部の部署に従業員がいない場合、
employees(左側の表)とdepartments(右側の表)の右側外部結合では、employeesの行が結合条件を満たしていないときも、departmentsのすべての行が取得されます。完全外部 結合は、左側外部 結合と右側の外部 結合の組合せです、
-
デカルト積
結合問合せ内の2つの表に結合条件がない場合、データベースはデカルト結合を実行します。一方の表の各行を他方の表の各行と組み合せます。たとえば、
employeesに107行ありdepartmentsには27行ある場合、デカルト積には107*27行が含まれます。デカルト積が便利な場合はほとんどありません。
関連情報:
-
結合について学習するには、Oracle AI Database SQLチューニング・ガイドを参照してください。
-
結合の詳細は、『Oracle AI Database SQL言語リファレンス』を参照してください。
サブクエリー
副問合せとは、別のSQL文内にネストされたSELECT文のことです。副問合せは、1つの問題を解決するために複数の問合せを実行する必要がある場合に便利です。
文の各問合せ部分は、問合せブロックと呼ばれます。次の問合せでは、カッコ内の副問合せが内部問合せブロックです。
SELECT first_name, last_name
FROM   employees
WHERE  department_id
IN     ( SELECT department_id
         FROM departments
WHERE location_id = 1800 );内部SELECT文により、場所IDが1800の部門のIDが取得されます。これらの部門IDは、副問合せによってIDが戻された部門の従業員名を取得する外部問合せブロックに必要です。
このSQL文の構造では、内部問合せを最初に実行することをOracle Databaseに強制しているわけではありません。たとえば、Oracle Databaseにより問合せ全体がemployeesとdepartmentsの結合としてリライトされることもあり、その場合は副問合せ自体が実行されません。また、別の例として、Virtual Private Database (VPD)機能では、WHERE句を使用して従業員の問合せが絞り込まれることがあり、この場合は、Oracle Databaseでは、最初に従業員を問い合せてから部門IDが取得されます。オプティマイザにより、要求された行を取得するためのステップの最適な順序が決定されます。
関連項目: VPDについてさらに学習するには、『Oracle AI Databaseセキュリティ・ガイド』を参照してください
取引制御文
トランザクション制御文は、DML文による変更を管理し、DML文をトランザクションにグループ化します。
これらの文によって、次のことを実行できます。
-
トランザクションの変更を確定します(
COMMIT)。 -
トランザクションの開始以降(
ROLLBACK)またはセーブポイント以降(ROLLBACK TO SAVEPOINT)に実行されたトランザクション内での変更を取り消します。セーブポイントは、トランザクションのコンテキスト内のユーザー宣言の中間マーカーです。ノート:
ROLLBACK文によってトランザクションが終了されますが、ROLLBACK TO SAVEPOINTでは終了します。 -
ロールバックできるポイントを設定します(
SAVEPOINT)。 -
トランザクションのプロパティを設定します(
SETTRANSACTION)。 -
後に続く各DML文の遅延可能整合性制約をチェックするかどうか、またはトランザクションをコミットするタイミングを指定します(
SET CONSTRAINT)。
次の例はUpdate salariesという名前のトランザクションを開始します。例ではセーブポイントを作成し、従業員の給与を変更した後、セーブポイントまでトランザクションをロールバックします。さらに、給与を別の値に更新してコミットします。
SET TRANSACTION NAME 'Update salaries';

SAVEPOINT before_salary_update;

UPDATE employees SET salary=9100 WHERE employee_id=1234 # DML

ROLLBACK TO SAVEPOINT before_salary_update;

UPDATE employees SET salary=9200 WHERE employee_id=1234 # DML

COMMIT COMMENT 'Updated salaries';
関連情報:
-
トランザクション制御文について学習するには、Oracle AI Database SQL言語リファレンスを参照してください。
セッション制御ステートメント
セッション制御文は、ユーザー・セッションのプロパティを動的に管理します。
セッションは、データベースに現在ログインしているユーザーの状態を示すデータベース・インスタンス・メモリーの論理エンティティです。セッションは、ユーザーがデータベースに認証された時点から、ユーザーが接続を切断するか、データベース・アプリケーションを終了する時点まで続きます。
セッション制御文によって、次のことを実行できます。
-
デフォルトの日付形式の設定など、特化された機能を実行して現行のセッションを変更します(
ALTER SESSION)。 -
現行のセッションのロール(権限のグループ)を使用可能または使用禁止にします(
SET ROLE)。
次の文は、セッションのデフォルトの日付形式を動的に'YYYY MM DD-HH24:MI:SS'に変更します。
ALTER SESSION
   SET NLS_DATE_FORMAT = 'YYYY MM DD HH24:MI:SS';
セッション制御文は現行のトランザクションを暗黙的にコミットしません。
関連情報:
-
ALTER SESSIONの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照
システム制御ステートメント
システム制御文によって、データベース・インスタンスのプロパティが変更されます。
システム制御文は、ALTER SYSTEMのみです。この文は、設定値(共有サーバーの最小数など)の変更、セッションの終了およびその他のシステム・レベルでのタスクの実行に使用します。
システム制御文の例を次に示します。
ALTER SYSTEM SWITCH LOGFILE;

ALTER SYSTEM KILL SESSION '39, 23';
ALTER SYSTEM文は現行のトランザクションを暗黙的にコミットしません。
関連項目: ALTER SYSTEMの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』
埋込みSQL文
埋込みSQL文は、手続き型言語プログラム内にDDL、DMLおよびトランザクション制御文を取り込みます。
埋込み文は、Oracleプリコンパイラで使用されます。埋込みSQLは、手続き型言語アプリケーションにSQLを取り込むための1つの方法です。他に、Open Database Connectivity(ODBC)またはJava Database Connectivity(JDBC)などの手続き型APIを使用する方法もあります。
埋込みSQL文によって、次のことを実行できます。
-
カーソルの定義、割当ておよび解放を行います(
DECLARE CURSOR、OPEN、CLOSE). -
データベースを指定して、接続します(
DECLARE DATABASE、CONNECT)。 -
変数名を割り当てます(
DECLARE STATEMENT)。 -
記述子を初期化します(
DESCRIBE)。 -
エラー条件と警告の処理方法を指定します(
WHENEVER)。 -
SQL文を解析および実行します(
PREPARE、EXECUTE、EXECUTE IMMEDIATE)。 -
データベースからデータを取り出します(
FETCH)。
オプティマイザの概要
Oracle AI DatabaseがSQL文を処理する仕組みを理解するには、データベースのオプティマイザと呼ばれる部分(問合せオプティマイザまたはコストベース・オプティマイザとも呼ばれる)を把握する必要があります。すべてのSQL文でオプティマイザを使用して、指定されたデータへの最も効率的なアクセス手段を決定します。
-
オプティマイザの使用オプティマイザでは、実行に使用可能な方法が記述されている、実行計画が生成されます。
-
オプティマイザのコンポーネントオプティマイザには、3つの主要コンポーネント(トランスフォーマ、エスティメータおよびプラン・ジェネレータ)が含まれています。
-
アクセス・パスアクセス・パスとは、問合せで行の取得に使用される手法のことです。
-
オプティマイザ統計 オプティマイザ統計は、データベースの詳細とデータベース内のオブジェクトを記述したデータのコレクションです。統計は、データ・ストレージと分散に関して統計的に正しい実態を示すもので、アクセス・パスを評価する際にオプティマイザによって使用されます。
-
オプティマイザ・ヒント ヒントは、オプティマイザへの指示として機能するSQL文のコメントです。
オプティマイザの使用
オプティマイザは、使用可能な実行方法を表す実行計画を生成します。
オプティマイザにより、いくつかの情報ソースが考慮されて、最も効率的な実行計画が決定されます。たとえば、オプティマイザでは、問合せ条件、使用可能なアクセス・パス、収集された対象システムの統計、ヒントなどが考慮されます。
DML文を実行するために、Oracle AI Databaseで多くの処理を必要とする場合があります。各処理では、データベースからデータ行を物理的に検索するか、文を発行したユーザーのためにデータ行を準備します。データベースがSQL文を実行するときに使用するステップは、文の実行速度に大きな影響を与えます。多くの場合、DML文の処理には多くの様々な方法を使用できます。たとえば、表または索引のアクセス順序を変更できます。
SQL文の最適な実行計画を決定する際に、オプティマイザは次の操作を実行します。
-
式と条件の評価
-
データの詳細を把握し、このメタデータに基づいて最適化するための整合性制約の検査
-
文の変換
-
オプティマイザの目標の選択
-
アクセス・パスの選択
-
結合順序の選択
オプティマイザは、問合せの処理に使用できる方法の大部分を生成し、生成した実行計画の各ステップにコストを割り当てます。コストが最も低い計画が、実行する問合せ計画として選択されます。
ノート: SQL文の実行計画は、その計画を実行しなくても取得できます。データベースが問合せの実行に実際に使用する実行計画は、適切に規定された問合せ計画のみです。
オプティマイザの目標を設定して、オプティマイザの代表的な統計を収集することにより、オプティマイザの選択を変えることができます。たとえば、オプティマイザの目的を次のいずれかに設定できます。
-
合計スループット
結果の最後の行を可能なかぎり迅速にクライアント・アプリケーションに取得するよう、
ALL_ROWSヒントがオプティマイザに指示します。 -
初期レスポンス時間
最初の行を可能なかぎり迅速にクライアントに取得するよう、
FIRST_ROWSヒントがオプティマイザに指示します。
典型的なエンド・ユーザーの対話型アプリケーションの場合、初期レスポンス時間による最適化が有用であるのに対して、バッチモードの非対話型アプリケーションの場合、合計スループットによる最適化が有用です。
関連情報:
-
DBMS_STATSの使用方法の詳細は、Oracle AI Database PL/SQLパッケージおよびタイプ・リファレンスを参照してください。 -
オプティマイザおよびヒントの使用の詳細は、『Oracle AI Database SQLチューニング・ガイド』を参照してください。
オプティマイザ・コンポーネント
オプティマイザには、3つの主要コンポーネント(トランスフォーマ、エスティメータおよびプラン・ジェネレータ)が含まれています。
次の図は、そのコンポーネントを示しています。
図2: オプティマイザのコンポーネント
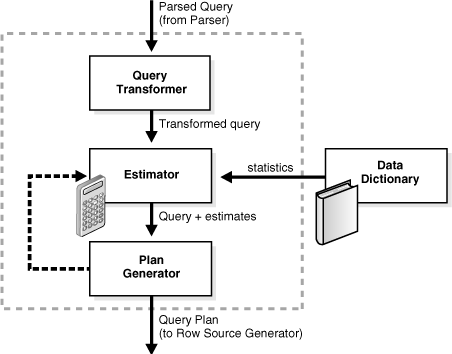
オプティマイザには、解析済の問合せが入力されます。オプティマイザは、次の操作を実行します。
-
オプティマイザは解析済の問合せを受け取り、使用可能なアクセス・パスおよびヒントに基づいてSQL文に対する一連の計画候補を生成します。
-
オプティマイザは、データ・ディクショナリ内の統計に基づき、各計画のコストを見積ります。コストとは、特定の計画を使用して文を実行するために必要な、予想されるリソース使用に比例した見積り値です。
-
オプティマイザは、計画のコストを比較し、コストが最も低い計画(「問合せ計画」と呼ばれる)を選択して、行ソース・ジェネレータに渡します。
-
問合せトランスフォーマ 問合せトランスフォーマは、オプティマイザがより優れた実行計画を生成できるように、問合せの形式を変更することが有用かどうかを判断します。問合せトランスフォーマへの入力は解析済の問合せで、オプティマイザでは問合せブロックのセットとして表されます。
-
エスティメータエスティメータは、指定された実行計画の全体コストを判断します。
-
プラン・ジェネレータプラン・ジェネレータは、発行された問合せに対して異なる計画を試行します。オプティマイザは、コストが最も低い計画を選択します。
問合せトランスフォーマ
問合せトランスフォーマは、オプティマイザがより優れた実行計画を生成できるように、問合せの形式を変更することが有用かどうかを判断します。問合せトランスフォーマへの入力は解析済の問合せで、オプティマイザでは問合せブロックのセットとして表されます。
関連項目: 「クエリー・リライト」
エスティメータ
エスティメータは、指定された実行計画の全体コストを判断します。
エスティメータは、この目標を達成するために3つのタイプの異なる計測を生成します。
-
選択性
このメジャーは、行セット内の行の一部分を表します。選択性は、問合せの述語(
last_name='Smith'など)や述語の組合せに関連します。 -
カーディナリティ
この計測タイプは、行セット内の行数を表します。
-
原価
このメジャーは、作業単位または使用されるリソースを表します。問合せオプティマイザは、ディスクI/O、CPU使用量およびメモリー使用量を作業単位として使用します。
統計が使用可能な場合、エスティメータはこれらの統計を使用してメジャーを計算します。統計によって、メジャーの正確さの度合いは改良されます。
プラン・ジェネレータ
プラン・ジェネレータは、発行された問合せに対して異なる計画を試行します。オプティマイザは、コストが最も低い計画を選択します。
ネストされた副問合せおよびマージされていないビューごとに、オプティマイザはサブプランを生成します。オプティマイザでは、各サブプランが個別の問合せブロックとして表されます。プラン・ジェネレータは、異なるアクセス・パス、結合方法および結合順序を試行することによって、問合せブロックに対して様々な計画を探索します。
適応問合せ最適化機能により、文の実行中に収集された統計に基づいて計画が変更されています。すべての適応メカニズムでは、デフォルトの計画とは異なる、文の最終計画を実行できます。適応最適化では、文の実行中にサブプランの中から選択する動的プラン、または現在の実行後の実行でプランを変更する再最適化のいずれかを使用します。
関連情報:
-
SQLのチューニングの詳細は、『Oracle AI Databaseパフォーマンス・チューニング・スタート・ガイド』を参照してください。
-
オプティマイザのコンポーネントおよび適応最適化について学習するには、Oracle AI Database SQLチューニング・ガイドを参照してください
アクセス・パス
アクセス・パスとは、問合せで行の取得に使用される手法のことです。
たとえば、索引を使用する問合せは、索引を使用しない問合せとは異なるアクセス・パスになります。通常、表内の行の小規模なサブセットを取得する文には、索引アクセス・パスが最適です。表内の大きな一部分にアクセスするには、全体スキャンがより効率的です。
データベースは、表からデータを取得するために、複数の異なるアクセス・パスを使用できます。代表的なものは次のとおりです。
-
全表スキャン
このタイプのスキャンでは、表からすべての行を読み取り、選択基準に合致しない行をフィルタ処理して除外します。データベースは、使用済領域のと未使用領域が分離する最高水位標(HWM)より下のものも含め、(「セグメント領域と高水位標」を参照)セグメント内のすべてのデータ・ブロックの順次スキャンを行います。
-
ROWIDスキャン
行のROWIDは、行が含まれるデータファイルとデータ・ブロック、およびブロック内での行の位置を指定します。データベースは、最初に文中の
WHERE句または索引スキャンのいずれかから選択した行のROWIDを取得し、次にそのROWIDに基づいて選択した各行の位置を特定します。 -
インデックス・スキャン
このスキャンは、SQL文によってアクセスされる索引付けされた列値に対応する索引を検索します(「索引スキャン」を参照)。文によって索引の列のみにアクセスする場合、Oracle AI Databaseは索引付けされた列値を索引から直接読み取ります。
-
クラスタ・スキャン
クラスタ・スキャンでは、索引付きの表クラスタに格納された表からデータを取得します。この表では、同じクラスタ・キー値を持つすべての行が同じデータ・ブロックに格納されています(「索引付きクラスタの概要」を参照)。データベースは最初にクラスタ索引をスキャンして、選択した1つの行のROWIDを取得します。Oracle AI DatabaseはこのROWIDに基づいて行の位置を特定します。
-
ハッシュ・走査
ハッシュ・スキャンはハッシュ・クラスタ内の行の位置を特定し、ハッシュ値を持つすべての行が同じデータ・ブロックに格納されています(「ハッシュ・クラスタの概要」を参照)。データベースは最初に、文によって指定されたクラスタ・キー値にはハッシュ関数を適用することにより、ハッシュ値を取得します。次に、Oracle AI Databaseはこのハッシュ値の行を含むデータ・ブロックにスキャンします。
オプティマイザは、文に対して使用可能なアクセス・パスと、各アクセス・パスまたはパスの組合せの使用時の見積りコストに基づいて、1つのアクセス・パスを選択します。
関連項目:アクセス・パスについて学習するには、Oracle AI Databaseパフォーマンス・チューニング・スタート・ガイドおよびOracle AI Database SQLチューニング・ガイドを参照してください。
オプティマイザ統計
オプティマイザ統計は、データベースの詳細とデータベース内のオブジェクトを記述したデータのコレクションです。統計は、データ・ストレージと分散に関して統計的に正しい実態を示すもので、アクセス・パスを評価する際にオプティマイザによって使用されます。
オプティマイザ統計には、次が含まれます。
-
表統計
行数、ブロック数および行の平均長が含まれます。
-
列の統計
列内の個々の値とNULLの数およびデータ配分が含まれます。
-
索引統計
リーフ・ブロックおよび索引レベルの数が含まれます。
-
システム統計
CPUとI/Oのパフォーマンスおよび使用率が含まれます。
Oracle AI Databaseは、すべてのデータベース・オブジェクトのオプティマイザ統計を自動的に収集し、これらの統計を自動メンテナンス・タスクとして保持します。また、DBMS_STATSパッケージを使用して、手動で統計を収集することもできます。このPL/SQLパッケージでは、統計を変更、表示、エクスポート、インポートおよび削除できます。ノート:オプティマイザ統計は問合せの最適化を目的として作成され、データ・ディクショナリに格納されます。これらの統計と動的パフォーマンス・ビューを介して表示できるパフォーマンス統計を混同しないでください。
オプティマイザ統計アドバイザは、現在の統計収集の状況、既存の統計収集ジョブの有効性、および収集された統計の品質を分析するビルトイン診断ソフトウェアです。オプティマイザ統計アドバイザでは、現在の機能セットに基づくOracleのベスト・プラクティスが組み込まれたルールが管理されます。このように、アドバイザは常に統計収集のための最新の推奨事項を提供します。
関連情報:
-
統計を収集および管理する方法を学習するには、『Oracle AI Databaseパフォーマンス・チューニング・スタート・ガイド』および『Oracle AI Database SQLチューニング・ガイド』を参照してください。
-
DBMS_STATSについて学習するには、『Oracle AI Database PL/SQLパッケージおよびタイプ・リファレンス』を参照
オプティマイザ・ヒント
ヒントとは、オプティマイザへの指示として機能するSQL文内のコメントのことです。
特定のアプリケーションのデータについて、オプティマイザよりも多くの情報を持つアプリケーションデザイナーであれば、より効率的なSQL文を実行する方法を選択できる場合もあります。アプリケーション設計者は、SQL文内にヒントを使用して文の実行方法を指定できます。次の例では、ヒントの使用方法を示します。
例10-2 FIRST_ROWSヒントを指定したSELECTの実行計画
対話型アプリケーションによって、50行を戻す問合せが実行されるとします。このアプリケーションでは、問合せによって戻される最初の25行のみを初めにフェッチしてエンド・ユーザーに表示します。オプティマイザを使用して、最初の25レコードを可能なかぎり迅速に取得する計画を生成し、ユーザーが待たずに済むようにします。この指示をオプティマイザに渡すには、次の例のSELECT文およびAUTOTRACE出力に示すように、ヒントを使用します。
SELECT /*+ FIRST_ROWS(25) */ employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation                    | Name              | Rows | Bytes
------------------------------------------------------------------------
|  0 | SELECT STATEMENT             |                   | 26   | 182
|  1 |  TABLE ACCESS BY INDEX ROWID | EMPLOYEES         | 26   | 182
|* 2 |   INDEX RANGE SCAN           | EMP_DEPARTMENT_IX |      |
------------------------------------------------------------------------この例では、実行計画は、オプティマイザがemployees.department_id列の索引を選択して部門IDが50を超えるemployeesの最初の25行を検索することを示します。オプティマイザは索引から取得したROWIDを使用してemployees表からレコードを取得し、クライアントに戻します。通常、最初のレコードの取得はほとんど即時です。
例10-3 ヒントを指定しないSELECTの実行計画
オプティマイザ・ヒントを指定しない同じ文を実行するとします。
SELECT employee_id, department_id
FROM   hr.employees
WHERE  department_id > 50;

------------------------------------------------------------------------
| Id | Operation              | Name              | Rows | Bytes | Cos
------------------------------------------------------------------------
|  0 | SELECT STATEMENT       |                   | 50   | 350   |
|* 1 |  VIEW                  | index$_join$_001  | 50   | 350   |
|* 2 |   HASH JOIN            |                   |      |       |
|* 3 |    INDEX RANGE SCAN    | EMP_DEPARTMENT_IX | 50   | 350   |
| 4 | INDEX FAST FULL SCAN| EMP_EMP_ID_PK | 50 | 350 |この場合、実行計画では2つの索引を結合して、可能なかぎり迅速に要求されたレコードを戻します。オプティマイザは、例10-2のように索引から表へと繰り返し移動するのではなく、EMP_DEPARTMENT_IXのレンジ・スキャンを選択して、部門IDが50を超えるすべての行を検索し、ハッシュ表にこれらの行を配置します。オプティマイザは次に、EMP_EMP_ID_PK索引を読み取ることを選択します。この索引の各行について、ハッシュ表を調査して部門IDを検索します。
この場合、EMP_DEPARTMENT_IXの索引レンジ・スキャンが完了するまで、データベースはクライアントに最初の行を戻すことができません。このため、生成されたこの計画では最初のレコードを戻すために、より長い時間がかかります。索引のROWIDによって表にアクセスする例10-2の計画とは異なり、計画はマルチブロックI/Oを使用し、読取りの範囲が大きくなります。読取りによって、全結果セットの最後の行をより迅速に戻すことができます。
関連項目:オプティマイザ・ヒントの使用方法を学習するには、Oracle AI Database SQLチューニング・ガイドを参照してください。
SQL処理の概要
この項では、Oracle AI DatabaseによるSQL文の処理方法について説明します。特に、データベースがDDL文を処理してオブジェクトを作成する仕組み、DMLでデータを変更する仕組、問合せを使用してデータを取得する仕組について説明します。
-
SQL処理の段階 SQL処理の一般的な段階では、解析、最適化、行ソース生成、および実行があります。文によっては、データベースがこれらのステップの一部を省略する場合があります。
-
DMLとDDL処理の違い Oracle AI Databaseでは、DMLとは異なる方法でDDLが処理されます。
SQL処理の段階
SQL処理の一般的な段階は、解析、最適化、行ソース生成、および実行です。文によっては、データベースがこれらのステップの一部を省略する場合があります。
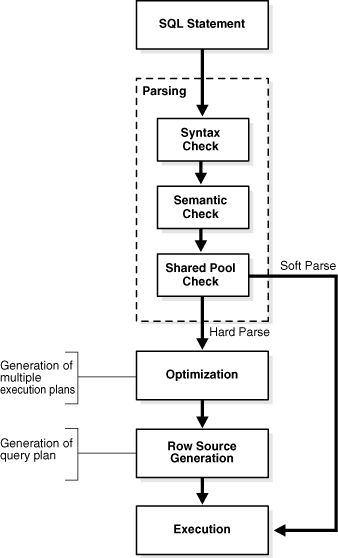
次の図は、一般的な段階を示しています:
図3: SQL処理の段階
-
SQLの解析SQLの解析は、SQL処理の最初の段階です。この段階では、SQL文の各部分を他のルーチンで処理できるデータ構造に分解します。
-
問合せの最適化は、SQL文を実行する最も効率的な方法を選択するプロセスである。
-
SQL行ソース生成行ソース・ジェネレータとは、オプティマイザから最適な実行計画を受け取り、問合せ計画という反復的な計画を生成するソフトウェアです。この計画は、データベースのリストで使用可能です。
-
SQLの実行実行中には、SQLエンジンによって行ソース・ジェネレータによって作成されたツリー内の各行ソースが実行されます。これのみがDML処理の必須ステップです。
SQL解析
SQL処理の最初の段階は、SQLの解析です。この段階では、SQL文の各部分を他のルーチンで処理できるデータ構造に分解します。
アプリケーションがSQL文を発行すると、アプリケーションはOracle Databaseに解析コールを出して、文の実行を準備します。解析コールは、解析済のSQL文と処理に使用するその他の情報が保持されるセッション固有のプライベートSQL領域のハンドルであるカーソルがオープンまたは作成されます。カーソルおよびプライベートSQL領域はPGA内にあります。
解析コール時には、データベースでは次のチェックを実行します。
-
構文チェック
-
セマンティクス・チェック
-
共有プール・チェック
これらのチェックにより、文の実行前に検出できるエラーを特定します。解析では捕捉できないエラーもあります。たとえば、データベースで、文の実行時にのみ、データ変換に関してデッドロックまたはエラーが発生する場合があります。
データベースは、解析フェーズ中にORA-00600エラーで失敗したSQL文に対して自動エラー緩和を試行します。ORA-00600は重大なエラーです。プロセスにおいて、低レベルの予期しない状態が発生したことを示します。解析フェーズ中にこのエラーでSQL文が失敗すると、自動エラー軽減によってSQL文はトラップされ、条件の解決が試行します。解決策が見つかった場合、データベースによってSQL実行計画を調整するためにSQLパッチが生成されます。このパッチにより解析が正常に完了できるようになる場合、ORA-00600エラーは発生しません。アプリケーションでは例外は表示されません。
関連項目: ロックおよびデッドロック SQLエラーの自動軽減について
SQLの最適化
問合せの最適化は、SQL文を実行する最も効率的な方法を選択するプロセスである。
データベースは、アクセスする実際のデータに関して収集した統計に基づいて、問合せを最適化します。オプティマイザでは、行数、データ・セットのサイズおよびその他の要因を使用して、使用可能な実行計画を生成し、各計画に数値コストを割り当てます。コストが最も低い計画が使用されます。
データベースは一意のDML文ごとに必ず1回以上のハード解析を実行して、この解析中に最適化を実行します。最適化を要求する副問合せなどのDMLコンポーネントを含まないかぎり、DDLは最適化されません。
関連情報:
-
問合せオプティマイザの詳細は、『Oracle AI Database SQLチューニング・ガイド』を参照してください。
SQL行ソース生成
行ソース・ジェネレータは、オプティマイザから最適な実行計画を受け取り、データベースのその他の部分で使用できる問合せ計画と呼ばれる反復実行計画を作成するソフトウェアです。
問合せ計画はステップを組み合せた形式になります。各ステップは、行セットを返します。このセット内の行は次のステップまたは最後のステップのいずれかで使用され、SQL文を発行するアプリケーションに返されます。
行ソースは、行を反復的に処理できる制御構造に沿って、実行計画のステップから戻された行セットになります。行ソースは、表、ビュー、または結合またはグループ化操作の結果になる可能性があります。
SQL実行
実行時には、SQLエンジンによって行ソース・ジェネレータによって作成されたツリー内の各行ソースを実行します。これのみがDML処理の必須ステップです。
実行中、データがメモリー内にない場合は、データベースがディスクからメモリーへとデータを読み取ります。また、データベースはデータ整合性を保証するために必要なすべてのロックおよびラッチを取り除き、SQL実行時に行われたすべての変更を記録します。SQL文処理の最後のステージでは、カーソルがクローズされます。
データベースがインメモリ列ストア(IM列ストア)を使用するように構成されている場合、データベースは問合せを、可能な場合はIM列ストアに、さもなければディスクおよびデータベース・バッファ・キャッシュに透過的にルーティングします。1つの問合せでも、IM列ストア、ディスク、バッファ・キャッシュを使用できます。たとえば、ある問合せで2つの表を結合し、そのうち1つのみがIM列ストアにキャッシュされていることがあります。
関連情報:
-
実行計画および
EXPLAIN PLAN文の詳細は、Oracle AI Database SQLチューニング・ガイドを参照してください。
DML処理とDDL処理の違い
Oracle AI DatabaseはDMLとは異なる方法でDDLを処理します。
たとえば、表を作成するとき、データベースはCREATE TABLE文を最適化しません。かわりに、Oracle AI DatabaseはDDL文を解析してコマンドを実行します。
DDLとは対照的に、ほとんどのDML文には問合せコンポーネントがあります。問合せでカーソルを実行すると、問合せで生成された行が結果セットに入力されます。
データベースでは、結果セットの行を一度に1行ずつまたはグループとしてまとめてフェッチできます。フェッチでは、データベースで行が選択され、問合せで要求された場合には行がソートされます。最後の行がフェッチされるまで、毎回のフェッチで結果の行が連続して取得されます。
関連項目: DDLの処理、トランザクション制御およびその他のタイプの文について学習するには、Oracle AI Database開発ガイドを参照してください。