パーティション、ビューおよびその他のスキーマ・オブジェクト
最も重要かつ一般的に使用されるスキーマ・オブジェクトは表と索引ですが、データベースでは他のタイプの多数のスキーマ・オブジェクトもサポートされています。この章では、最も一般的なスキーマ・オブジェクトについて説明します。
-
パーティションの概要 Oracleデータベースではパーティション化により、大規模な表や索引を、パーティションという、より小さく管理されやすい部分に分割することができます。各パーティションは独自の名前を持つ独立したオブジェクトであり、独自の記憶特性を持つ場合があります。
-
シャード表の概要 OracleデータベースではGlobally Distributed Databaseの機能によって、複数のデータベースに格納できるシャードという単位に表を分割できます。
-
ビューの概要ビューは、1つまたは複数の表の論理表現である。本質的には、ビューはストアド・クエリーです。
-
マテリアライズド・ビューの概要マテリアライズド・ビューとは、スキーマ・オブジェクトとして事前に格納またはマテリアライズされた問合せ結果です。問合せの
FROM句では表、ビューまたはマテリアライズド・ビューの名前を指定できます。 -
順序の概要順序はスキーマ・オブジェクトであり、このオブジェクトから、複数のユーザーが一意の整数を生成できます。順序ジェネレータは、数値データ型に対してサロゲート・キーを生成するスケーラブルかつパフォーマンスの高い方法を提供します。
-
ディメンションの概要典型的なデータ・ウェアハウスには、ディメンションとファクトという2つの重要なコンポーネントがあります。
-
シノニムの概要シノニムとは、スキーマ・オブジェクトの別名です。たとえば、表またはビュー、順序、PL/SQLプログラム・ユニット、ユーザー定義オブジェクト型または別のシノニムに対してシノニムを作成できます。シノニムは単に別名であるため、データ・ディクショナリ内に定義以外の記憶域は必要ありません。
パーティションの概要
Oracleデータベースでは、パーティション化により、大規模な表や索引をパーティションという、より小さく管理されやすい部分に分割することができます。各パーティションは独自の名前を持つ独立したオブジェクトであり、独自の記憶特性を持つ場合があります。
パーティション化の例として、あるHRマネージャが複数の従業員フォルダを含む1つの大きな箱を管理しているとします。各フォルダは従業員の雇用日を示しています。特定の月に雇用された従業員に対する問合せが頻繁に行われます。このような要求を満たす1つのアプローチとして、箱内に分散しているフォルダの位置を指定する索引を、従業員の雇用日に対して作成する方法があります。一方、パーティション化計画ではより小さなボックスを多数使用して、指定した月に雇用された従業員のフォルダをそれぞれの箱に保存します。
より小さな箱の使用には、いくつかの利点があります。6月に雇用された従業員のフォルダを取り出すよう依頼された場合、人事管理マネージャは6月の箱を取り出します。さらに、いずれかの小さな箱が破損したとしても、他の小さな箱は引き続き使用できます。また、マネージャは1つの重い箱を移動するのではなく、複数の小さな箱を移動すればよいため、オフィスの移転も容易になります。
アプリケーションから見ると、スキーマ・オブジェクトは1つのみ存在します。パーティション表にアクセスするためにSQL文を修正する必要はありません。パーティション化は、様々なタイプのデータベース・アプリケーション(特に大量のデータを管理するデータベース・アプリケーション)で役立ちます。次のような利点があります:
-
可用性の向上
いずれかのパーティションが使用できない場合も、オブジェクトの使用には関係ありません。問合せオプティマイザは参照されないパーティションを問合せ計画から自動的に削除するため、パーティションが使用できない場合には、問合せが影響を受けません。
-
スキーマ・オブジェクトの管理の簡素化
パーティション・オブジェクトには、集中管理および個別管理のいずれも可能な要素があります。DDL文では、表全体または索引ではなくパーティションを操作できます。このため、索引または表の再作成など、リソース集中型のタスクを細分化できます。たとえば、一度に1つずつ表のパーティションを移動できます。問題が発生した場合は、表の移動ではなく、パーティションの移動のみを再実行します。また、パーティションを削除すると、
DELETE文を多数実行する必要がなくなります。 -
OLTPシステムの共有リソースの競合の軽減
一部のOLTPシステムでは、パーティションによって共有リソースの競合を軽減できます。たとえば、DMLを1つのセグメントではなく、多数のセグメントに分散します。
-
データ・ウェアハウスでの問合せパフォーマンスの向上
データ・ウェアハウスでは、パーティションによって非定型問合せの処理を高速化できます。たとえば、100万行ある売上表を四半期ごとにパーティション化できます。
-
パーティション特性表や索引の各パーティションは、列名、データ型、制約などの論理属性が同じである必要があります。
-
パーティション表パーティション表は1つ以上のパーティションで構成されており、パーティションが個別に管理され、他のパーティションから独立して機能できます。
-
パーティション索引パーティション索引とは、パーティション表のように、より小さく管理しやすい単位に分割された索引のことです。
-
パーティション表の部分索引部分索引とは、関連付けられたパーティション表の索引付けプロパティと相互に関連付けられている索引付けのことです。
-
古いパーティションへのオブジェクト・ストアの使用読取り専用パーティションの場合、クラウド内のオブジェクト・ストレージなど、低コストのストレージを使用できます。関連項目: 『Oracle AI Database VLDBおよびパーティショニング・ガイド』のパーティション化の概要に関する項
パーティションの特性
表や索引の各パーティションは、列名、データ型、制約などの論理属性が同じである必要があります。
たとえば、1つの表内のすべてのパーティションは同じ列定義と制約定義を共有します。ただし、パーティションが属する表スペースなど、各パーティションの物理属性は異なる場合があります。
-
パーティション・キーパーティション・キーとは、パーティション化表の各行が属するパーティションを決定する、1つ以上の列のセットです。各行は、単一パーティションに明示的に割り当てられます。
-
パーティション化戦略 Oracle Partitioningには、データベースによるパーティションへのデータの配置方法を制御する、複数のパーティション化戦略が用意されています。基本的な計画は、レンジ・パーティション化、リスト・パーティション化およびハッシュ・パーティション化です。
パーティション・キー
パーティション・キーは、1つ以上の列のセットで、パーティション化表の各行が属するパーティションを決定します。各行は、単一パーティションに明示的に割り当てられます。
たとえば、sales表で、レンジ・パーティションのキーとしてtime_id列を指定できます。Oracle Databaseにより、この列の日付が指定された範囲内にあるかどうかに基づいてパーティションに行が割り当てられます。Oracle AI Databaseでは、そのパーティション・キーを使用して適切なパーティションに対して挿入、更新および削除操作が自動的に行われます。
パーティショニング戦略
Oracle Partitioningは、データベースによる個々のパーティションへのデータの配置方法を制御する、複数のパーティション化計画を提供します。基本的な計画は、レンジ・パーティション化、リスト・パーティション化およびハッシュ・パーティション化です。
単一レベル・パーティション化では、リスト・パーティション化のみまたはレンジ・パーティション化のみなど、データ配分方法を1つのみ使用します。コンポジット・パーティション化では、1つのデータ配分方法を表をパーティション化し、2番目のデータ配分方法を使用して、各パーティションをさらに複数のサブ パーティションに分割します。たとえば、channel_idにリスト・パーティションを使用し、time_idにレンジ・サブパーティションを使用できます。
例6-1 パーティション表のサンプル行セット
このパーティション化の例では、次の行を含むパーティション表salesを移入するとします。
  PROD_ID    CUST_ID TIME_ID   CHANNEL_ID   PROMO_ID QUANTITY_SOLD AMOUNT_SOLD
---------- ---------- --------- ---------- ---------- ------------- -----------
      116      11393 05-JUN-99          2        999             1
12.18
       40     100530 30-NOV-98          9         33             1       44.99
      118        133 06-JUN-01          2        999             1       17.12
      133       9450 01-DEC-00          2        999             1       31.28
       36       4523 27-JAN-99          3        999             1       53.89
      125       9417 04-FEB-98          3        999             1       16.86
       30        170 23-FEB-01          2        999             1         8.8
       24      11899 26-JUN-99          4        999             1       43.04
       35       2606 17-FEB-00          3        999             1       54.94
45 9491 28-AUG-98 4 350 1 47.45-
レンジ・パーティション化 レンジ・パーティション化では、データベースにより、パーティション化キーの値の範囲に基づいて行がパーティションにマップされます。レンジ・パーティション化は、最も一般的なタイプのパーティション化であり、通常は日付とともに使用されます。
-
時間隔パーティション化は、レンジ・パーティション化の拡張機能です。
-
リスト・パーティション化 リスト・パーティション化では、データベースによりの各パーティションのパーティション・キーとして離散値のリストが使用されます。パーティション化キーは1つ以上の列で構成されます。
-
ハッシュ・パーティション化ハッシュ・パーティション化では、データベースによって、ユーザーが指定したパーティション・キーに適用するハッシング・アルゴリズムに基づいて、行がパーティションにマップします。
-
参照パーティション化 参照パーティション化で、子表のパーティション化戦略は、外部キーの親表との関係から単独で定義されます。親表内の各パーティションごとに、対応する1つのパーティションが子表内に存在します。親表では特定のパーティションに親レコードが格納され、子表では対応するパーティションに子レコードが格納されます。
-
コンポジット・パーティション化 コンポジット・パーティション化では、1つのデータ配分方法を使用して表をパーティション化し、2番目のデータ配分方法を使用して各パーティションをさらに小さいサブ パーティションに分割します。このように、コンポジット・パーティション化は基本的なデータ分配方法を組み合せたものです。1つのパーティションのすべてのサブパーティションは、データの論理的サブセットを表します。
レンジ・パーティション化
レンジ・パーティション化では、データベースは、パーティション化キーの値の範囲に基づいて行をパーティションにマップします。レンジ・パーティション化は、最も一般的なタイプのパーティション化であり、通常は日付とともに使用されます。
time_id列をパーティション・キーとして指定して次のSQL文を使用して、time_range_salesをパーティション表として作成するとします。
CREATE TABLE time_range_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY RANGE (time_id)
 (PARTITION SALES_1998 VALUES LESS THAN (TO_DATE('01-JAN-1999','DD-MON-YYYY')),
  PARTITION SALES_1999 VALUES LESS THAN (TO_DATE('01-JAN-2000','DD-MON-YYYY')),
  PARTITION SALES_2000 VALUES LESS THAN (TO_DATE('01-JAN-2001','DD-MON-YYYY')),
  PARTITION SALES_2001 VALUES LESS THAN (MAXVALUE)
);その後、例6-1の行をtime_range_salesにロードします。このコードは、4つのパーティションへの行の配分を示します。Oracle Databaseでは、PARTITION BY RANGE句に指定されたルールに従って、time_id値に基づいて各行のパーティションが選択されます。レンジ・パーティション・キーの値は、指定されたパーティションの上限(境界を含まない)を決定します。
時間隔パーティション化
時間隔パーティション化は、レンジ・パーティション化の拡張機能です。
既存のレンジ・パーティションを超えるデータを挿入した場合、Oracle AI Databaseでは指定した間隔のパーティションが自動的に作成されます。たとえば、各月のデータを別のパーティションに格納する、販売履歴表を作成する場合があります。
時間隔パーティションでは、レンジ・パーティションを明示的に作成することを回避できます。時間隔パーティション化は、レンジ・パーティション化されており、新しいパーティションで固定間隔を使用するほぼすべての表で使用できます。レンジ・パーティションを様々な間隔で作成しない場合や、特定のパーティション属性を常に設定するわけではない場合は、時間隔パーティションの使用を検討してください。
時間隔でパーティション化する際は、少なくとも1つのレンジ・パーティションを指定してください。レンジ・パーティション化キーの値は、遷移ポイントと呼ばれる、レンジ・パーティション化キーの値の上限の決定。データベースでは遷移ポイントを超える値を持つデータに対して、時間隔パーティションが自動的に作成されます。各時間隔パーティションの下限は、前のレンジまたは時間隔パーティションの上限(境界を含む)です。したがって、例6-2では、値01-JAN-2011はパーティションp2にあります。
データベースでは遷移ポイントを超えるデータに対して、時間隔パーティションを作成します。時間間隔パーティションは、指定された範囲または間隔のパーティションを作成するようデータベースに指示する範囲パーティション化の拡張機能です。表に挿入されたデータが既存のすべてのレンジ・パーティションを超えると、データベースによってパーティションが自動的に作成されます。例6-2では、p3パーティションに、パーティション化キーtime_idの値が01-JAN-2013と等しいか、それより大きい行が含まれています。
例6-2 時間隔パーティション化
様々な幅の4つのパーティションを持つ販売表を作成すると仮定します。2013年1月1日の遷移ポイントを超えると、データベースでは1か月の時間間隔でパーティションが作成されることを指定します。パーティションp3の上位バウンドは遷移ポイントを表します。パーティションp3およびそれより下位のすべてのパーティションはレンジ・セクションにありますが、それより上位のすべてのパーティションは時間隔セクションに分類されます。
CREATE TABLE interval_sales
    ( prod_id        NUMBER(6)
    , cust_id        NUMBER
    , time_id        DATE
    , channel_id     CHAR(1)
    , promo_id       NUMBER(6)
    , quantity_sold  NUMBER(3)
    , amount_sold    NUMBER(10,2)
    )
  PARTITION BY RANGE (time_id)
  INTERVAL(NUMTOYMINTERVAL(1, 'MONTH'))
    ( PARTITION p0 VALUES LESS THAN (TO_DATE('1-1-2010', 'DD-MM-YYYY'))
    , PARTITION p1 VALUES LESS THAN (TO_DATE('1-1-2011', 'DD-MM-YYYY'))
    , PARTITION p2 VALUES LESS THAN (TO_DATE('1-7-2012', 'DD-MM-YYYY'))
    , PARTITION p3 VALUES LESS THAN (TO_DATE('1-1-2013', 'DD-MM-YYYY')) );
2014年10月10日に行われた販売を挿入します。
SQL> INSERT INTO interval_sales VALUES (39,7602,'10-OCT-14',9,null,1,11.79);

1 row created.USER_TAB_PARTITIONSの問合せでは、販売日が遷移ポイントよりも後であるため、10月10日の販売用の新規パーティションがデータベースで作成されたことが示されます。
SQL> COL PNAME FORMAT a9
SQL> COL HIGH_VALUE FORMAT a40
SQL> SELECT PARTITION_NAME AS PNAME, HIGH_VALUE
  2  FROM USER_TAB_PARTITIONS WHERE TABLE_NAME = 'INTERVAL_SALES';

PNAME     HIGH_VALUE
--------- ----------------------------------------
P0        TO_DATE(' 2007-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P1        TO_DATE(' 2008-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P2        TO_DATE(' 2009-07-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
P3        TO_DATE(' 2010-01-01 00:00:00', 'SYYYY-M
          M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA
SYS_P1598 TO_DATE(' 2014-11-01 00:00:00', 'SYYYY-M
M-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIA関連項目:時間間隔パーティションについてさらに学習するには、『Oracle AI Database VLDBおよびパーティショニング・ガイド』を参照してください。
リスト・パーティション化
リスト・パーティション化では、データベースは、各パーティションのパーティション・キーとして離散値のリストを使用します。パーティション化キーは1つ以上の列で構成されます。
リスト・パーティション化を使用して、特定のパーティションに対する個々の行のマップ方法を制御できます。リストを使用すると、データの識別に使用されるキーの並び順が目的にそぐわない場合に、関連するデータのセットをグループ化して整理できます。
例6-3 リスト・パーティション化
channel_id列がパーティション・キーである次の文を使用して、リスト・パーティション表としてlist_salesを作成するとします。
CREATE TABLE list_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY LIST (channel_id)
 ( PARTITION even_channels VALUES ('2','4'),
   PARTITION odd_channels VALUES ('3','9')
);その後、例6-1の行を表にロードします。このコードは、2つのパーティションへの行の配分を示します。データベースでは、PARTITION BY LIST句に指定されたルールに従って、channel_id値に基づいて各行のパーティションが選択されます。channel_idの値が2または4である行はEVEN_CHANNELSパーティションに格納され、channel_idの値が3または9である行はODD_CHANNELSパーティションに格納されます。
ハッシュ・パーティション化
ハッシュ・パーティション化では、データベースは、ユーザーが指定したパーティション・キーに適用するハッシング・アルゴリズムに基づいて、行をパーティションにマップします。
行の宛先は、データベースが行に適用する内部ハッシュ関数によって決定されます。パーティションの数が2のべき乗である場合は、ハッシング・アルゴリズムによって行がすべてのパーティションにほぼ均等に分配されます。
ハッシュ・パーティション化は、大きな表を分割して管理しやすくする場合に役立ちます。1つの大きな表ではなく、複数のより小さい単位を管理します。1つのハッシュ・パーティションが失われても、残りのパーティションに影響はなく、個別にリカバリできます。また、ハッシュ・パーティション化は、更新時の競合が発生しやすくOLTPシステムにも役立ちます。たとえば、競合が発生する1つのセグメントを複数の単位に分割し、各単位がそれぞれ更新されるようにすることができます。
prod_id列をパーティション・キーとして指定して次の文を使用して、パーティション化されたhash_sales表を作成するとします。
CREATE TABLE hash_sales
   ( prod_id        NUMBER(6)
   , cust_id        NUMBER
   , time_id        DATE
   , channel_id     CHAR(1)
   , promo_id       NUMBER(6)
   , quantity_sold  NUMBER(3)
   , amount_sold    NUMBER(10,2)
   )
PARTITION BY HASH (prod_id)
PARTITIONS 2;その後、例6-1の行を表にロードします。このコードは、2つのパーティションへの行の配分の例を示します。これらのパーティションの名前は、システムによって生成されます。
ユーザーが行を挿入すると、データベースではすべてのパーティションへのランダムかつ均等な行の配分が試行されます。行をどのパーティションに配置するかは指定できません。データベースはハッシュ関数を適用し、関数の出力結果に基づいて、どのパーティションに行を格納するかを決定します。
関連情報:
-
パーティションの作成方法を学習するには、Oracle AI Database VLDBおよびパーティショニング・ガイドを参照
-
CREATE TABLE ... PARTITION BYの例については、Oracle AI Database SQL言語リファレンスを参照
参照パーティション化
参照パーティション化で、子表のパーティション化戦略は、外部キーの親表との関係から単独で定義されます。親表内の各パーティションごとに、対応する1つのパーティションが子表内に存在します。親表では特定のパーティションに親レコードが格納され、子表では対応するパーティションに子レコードが格納されます。
たとえば、orders表はline_items表の親で、主キーおよび外部キーがorder_idで定義されています。表は参照別にパーティション化されます。たとえば、データベースがオーダー233をordersのパーティションQ3_2015に格納する場合、データベースはオーダー233のすべての明細項目をline_itemsのパーティションQ3_2015に格納します。パーティションQ4_2015がordersに追加される場合、データベースは自動的にQ4_2015をline_itemsに追加します。
参照パーティション化の利点は次のとおりです。
-
親テーブルと子表の両方で同じパーティション計画を使用することにより、すべてのパーティション化キー列の重複を回避します。この計画によって非正規化の手動によるオーバーヘッドが軽減され、領域も節約できます。
-
親表に対するメンテナンス操作は、子表に対して自動的に行われます。たとえば、プライマリ表にパーティションを追加すると、データベースによって自動的にこの追加が子表に伝播されます。
-
データベースでは自動的に親表および子表でパーティションのパーティション・ワイズ結合が使用されるので、パフォーマンスが向上する。
時間隔パーティション化などのすべての基本パーティション化計画とともに、参照パーティション化を使用できます。参照パーティション表をコンポジット・パーティション表として作成することもできます。
例6-4参照パーティション表の作成
この例は、order_dateでレンジ・パーティション化された親表ordersを作成します。参照パーティションの子表order_itemsは、Q1_2015、Q2_2015、Q3_2015およびQ4_2015の4つの パーティションとともに作成されています。各パーティションには、それぞれの親パーティションの注文に対応するorder_items行が含まれています。
CREATE TABLE orders
    ( order_id           NUMBER(12),
      order_date         DATE,
      order_mode         VARCHAR2(8),
      customer_id        NUMBER(6),
      order_status       NUMBER(2),
      order_total        NUMBER(8,2),
      sales_rep_id       NUMBER(6),
      promotion_id       NUMBER(6),
      CONSTRAINT orders_pk PRIMARY KEY(order_id)
    )
  PARTITION BY RANGE(order_date)
    ( PARTITION Q1_2015 VALUES LESS THAN (TO_DATE('01-APR-2015','DD-MON-YYYY')),
      PARTITION Q2_2015 VALUES LESS THAN (TO_DATE('01-JUL-2015','DD-MON-YYYY')),
      PARTITION Q3_2015 VALUES LESS THAN (TO_DATE('01-OCT-2015','DD-MON-YYYY')),
      PARTITION Q4_2015 VALUES LESS THAN (TO_DATE('01-JAN-2006','DD-MON-YYYY'))
    );

CREATE TABLE order_items
    ( order_id           NUMBER(12) NOT NULL,
      line_item_id       NUMBER(3)  NOT NULL,
      product_id         NUMBER(6)  NOT NULL,
      unit_price         NUMBER(8,2),
      quantity           NUMBER(8),
      CONSTRAINT order_items_fk
      FOREIGN KEY(order_id) REFERENCES orders(order_id)
    )
PARTITION BY REFERENCE(order_items_fk);参照:参照パーティション化の概要は『Oracle AI Database VLDBおよびパーティショニング・ガイド』を参照してください。
コンポジット・パーティション化
コンポジット・パーティション化では、1つのデータ配分方法を使用して表をパーティション化し、2番目のデータ配分方法を使用して、各パーティションをさらにサブパーティション化します。このように、コンポジット・パーティション化は基本的なデータ分配方法を組み合せたものです。1つのパーティションのすべてのサブパーティションは、データの論理的サブセットを表します。
コンポジット・パーティション化にはいくつかの利点があります。
-
SQL文によっては、1つまたは2つのディメンションに対するパーティション・プルーニングによってパフォーマンスが向上する場合があります。
-
問合せで、いずれかのディメンションに対してパーシャルまたはフル・パーティション・ワイズ結合を使用できる場合があります。
-
1つの表のパラレル・バックアップおよびリカバリを実行できます。
-
パーティション数が単一レベル・パーティション化より多いため、効果的なパラレル実行が可能になります。
-
履歴データをサポートするためのローリング・ウィンドウを実装でき、多くの文がパーティション・プルーニングまたはパーティション・ワイズ結合の恩恵を受ける場合には、別のディメンションでのパーティション化も可能です。
-
パーティション化キーによる識別に基づいて、異なる方法でデータを格納できます。たとえば、特定の製品タイプのデータは読取り専用として圧縮形式で格納し、その他の製品タイプのデータは圧縮せずに保存することができます。
コンポジット・パーティション表のサブパーティション化計画としては、レンジ、リストおよびハッシュ・パーティション化が適しています。次の図に、レンジ - ハッシュおよびレンジ - リスト・コンポジット・パーティション化の図を示します。
図1: コンポジット・レンジ- リスト・パーティション化
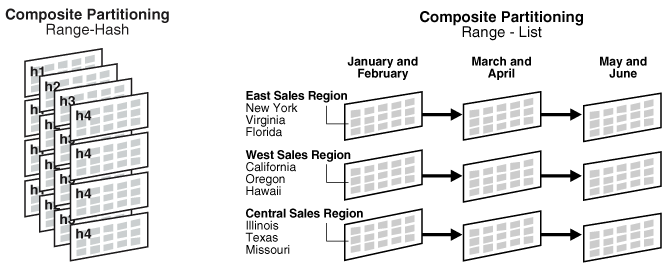
データベースでは、コンポジット・パーティション化された表の各サブパーティションが個別のセグメントとして格納されます。このため、サブパーティションのプロパティは、表のプロパティや、そのサブパーティションが属するパーティションとは異なる場合があります。
関連項目:コンポジット・パーティション化についてさらに学習するには、Oracle AI Database VLDBおよびパーティショニング・ガイドを参照してください
パーティション化された表
パーティション表は1つ以上のパーティションで構成されており、そのパーティションが個別に管理され、他のパーティションから独立して機能できます。
表はパーティション化または非パーティション化のいずれかです。パーティション表が1つのパーティションのみで構成されている場合も、この表は、パーティションを追加できない非パーティション表のとは異なります。
-
パーティション表セグメントパーティション表は、1つ以上の表パーティション・セグメントから構成されます。
-
パーティション表の圧縮ヒープ構成表の一部またはすべてのパーティションが、圧縮形式で格納できます。
関連情報:
パーティション表の例は、「パーティションの特性」を参照
索引構成の表の目的および特性について学習するには、「索引構成の表の概要」を参照してください。索引構成の表により、パーティション化による管理性、可用性およびパフォーマンス向上の恩恵もを受けられます。
パーティション表のセグメント
パーティション表は、1つ以上の表パーティション・セグメントで構成されています。
hash_productsという名前のパーティション表を作成した場合、この表に表セグメントは割り当てられません。かわりに、データベースでは独自のパーティション・セグメントに各表パーティションのデータを格納します。各表パーティション・セグメントには表データの断片が含まれます。
外部表がパーティション化されている場合、すべてのパーティションはデータベース外に存在します。ハイブリッド・パーティション表では、一部のパーティションはセグメントに格納され、それ以外は外部に格納されます。たとえば、sales表の一部のパーティションをデータ・ファイルに、それ以外をスプレッドシート内に格納できます。
パーティション表の圧縮
ヒープ構成表の一部またはすべてのパーティションは圧縮形式で格納できます。
圧縮すると領域を節約でき、問合せの実行を高速化できます。このため、圧縮は挿入および更新操作の量が少ないデータ・ウェアハウスなどの環境およびOLTP環境で役立つ場合があります。
表圧縮の属性は、表領域、表または表パーティションに対して宣言できます。表領域レベルで宣言した場合、その表領域に作成される表はデフォルトで圧縮されます。表の圧縮属性を変更すると、変更はその表に格納される新規データにのみ適用されます。このため、1つの表またはパーティションには圧縮ブロックと非圧縮ブロックの両方を含むことができ、これにより、圧縮によってデータ・サイズが大きくならないことが保証されます。圧縮によりブロックのサイズが大きくなる場合、そのブロックに圧縮が適用されません。
関連情報:
-
基本表圧縮と拡張行、ハイブリッド列圧縮を含む表圧縮のタイプについて学習するには、「表の圧縮」を参照
-
データ・ウェアハウスの表の圧縮について学習するには、『Oracle AI Databaseデータ・ウェアハウス・ガイド』
パーティション化されたインデックス
パーティション索引とは、パーティション表のように、より小さく管理しやすい単位に分割された索引のことです。
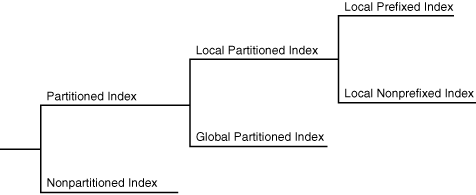
グローバル索引は索引の作成対象の表から独立してパーティション化されますが、ローカル索引は表のパーティション化方法に自動的にリンクされます。パーティション表と同様、パーティション索引も管理性、可用性、パフォーマンスおよびスケーラビリティを改善します。
次の図に、索引パーティション化のオプションを示します。
図2: 索引パーティション化のオプション
-
ローカル・パーティション索引 ローカル・パーティション索引では、索引が、その表と同じ列で、同じパーティション数および同じパーティション・バウンドでこの索引がパーティション化されています。
-
グローバル・パーティション索引グローバル・パーティション索引とは、この索引の作成の対象である基礎となる表とは関係なくパーティション化されたBツリー索引です。単一の索引パーティションは、任意またはすべての表パーティションを指す場合があり、その一方で、ローカル・パーティション索引では、索引パーティションと表パーティションの間に1対1のパリティが存在します。
関連情報:
-
一意および非一意索引と様々な索引タイプの違いについて学習するには、「索引の概要」を参照してください
-
パーティション索引と使用する索引タイプの決定方法の詳細は、『Oracle AI Database VLDBおよびパーティショニング・ガイド』を参照してください。
ローカル・パーティション索引
ローカル・パーティション索引では、その表と同じパーティション数および同じパーティション・バウンドで、同じ列に対してパーティションがパーティション化されています。
索引パーティションにあるすべてのキーが単一の表パーティションに格納された行のみを参照するように、各索引パーティションは、基礎となる表のパーティションと1対1で関連付けられます。この方法で、データベースは索引パーティションと関連する表パーティションを自動的に同期化し、表と索引の各ペアを独立させます。
ローカル・パーティション索引はデータ・ウェアハウス環境で共通のものです。ローカル索引には、次の利点があります。
-
パーティションのデータを無効または使用不可能にするアクションは、該当のパーティションにのみ反映されるため、可用性が向上します。
-
パーティションのメンテナンスが簡単になります。表パーティションを移動した場合、またはデータがパーティションをエージ・アウトした場合、再作成またはメンテナンスが必要となるのは、関連するローカル索引パーティションのみです。グローバル索引では、すべての索引パーティションを再作成またはメンテナンスする必要があります。
-
パーティションのポイント・イン・タイム・リカバリが発生した場合は、索引をリカバリ時間までリカバリできます(『Oracle AI Databaseバックアップおよびリカバリ・ユーザーズ・ガイド』を参照)。索引全体を再作成する必要はありません。
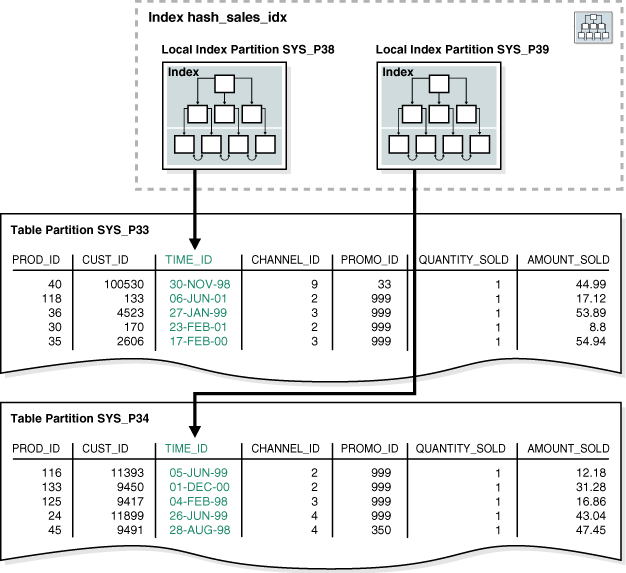
ハッシュ・パーティション化の例は、prod_id列をパーティション・キーとして使用して、パーティション化したhash_sales表の作成文を示しています。次の例では、hash_sales表のtime_id列にローカル・パーティション索引を作成します。
CREATE INDEX hash_sales_idx ON hash_sales(time_id) LOCAL;図6-3では、hash_products表に2つのパーティションがあり、そのため、hash_sales_idxにも2つのパーティションがあります。各索引パーティションは異なる表パーティションに関連付けられています。索引パーティションSYS_P38は表パーティションSYS_P33の行を索引付けするのに対し、索引パーティションSYS_P39は表パーティションSYS_P34の行を索引付けします。
図3: ローカル索引のパーティション
ローカル索引にパーティションを明示的に追加することはできません。かわりに、基礎となる表にパーティション化を追加した場合にのみ、新しいパーティションがローカル・インデックスに追加されます。同様に、ローカル索引から明示的にパーティションを削除することもできません。かわりに、基礎となる表からパーティションを削除した場合にのみ、ローカル索引パーティションが削除されます。
他の索引と同じように、ビットマップ索引もパーティション表に対して作成できます。唯一の制限は、ビットマップ索引がパーティション表に対してローカルであることが必要で、グローバル索引にはできません。グローバル・ビットマップ索引は、非パーティション表でのみサポートされます。
-
ローカルの同一鍵および非同一鍵索引ローカル・パーティション索引は、同一鍵か非同一鍵のいずれかです。
-
ローカル・パーティション索引の記憶域表パーティションと同様に、ローカル索引パーティションは、それ固有のセグメントに格納されます。各セグメントには、索引の総データの断片が含まれます。したがって、4つのパーティションから構成されるローカル索引は単一の索引セグメントではなく、4つの別々のセグメントに格納されます。
ローカルの同一キーおよび非同一キー索引
ローカル・パーティション索引は、同一キーまたは非同一キーのいずれかです。
索引のサブタイプは次のように定義されます。
-
ローカル同一キー索引
この索引の場合、パーティション・キーは索引定義の最初に配置されます。「レンジ・パーティション化」の
time_range_salesの例では、表がtime_idの範囲によってパーティション化されています。この表のローカル同一キー索引では、time_idがリストの最初の列になります。 -
ローカル非同一キー索引
この索引の場合、パーティション・キーは索引付けされた列のリストの最初にはなく、またリスト内に存在する必要もありません。「ローカル・パーティション索引」の
hash_sales_idxの例では、パーティション・キーproduct_idが先頭エッジに置かれていないため、索引がローカル非同一です。
これらの両方のタイプの索引で、パーティション絞込み(パーティションのプルーニングとも呼ばれる)を活用でき、この機能、オプティマイザはパーティションを対象とすることによって、データ・アクセスに高速化する場合に使用されます。問合せでパーティションを排除できるかどうかが、問合せの述語によって決まります。ローカル同一キー索引を使用する問合せでは、常に索引のパーティション絞込みが可能ですが、ローカル非同一キー索引を使用している問合せでは、絞込みはできない場合があります。
関連項目: 『Oracle AI Database VLDBおよびパーティショニング・ガイド』を参照して、同一キー索引および非同一キー索引の使用方法について学習します。
ローカル・パーティション索引の記憶域
表パーティションと同様に、ローカル索引パーティションは独自のセグメントに格納されます。各セグメントには、索引の総データの断片が含まれます。したがって、4つのパーティションから構成されるローカル索引は単一の索引セグメントではなく、4つの別々のセグメントに格納されます。
関連項目: CREATE INDEX ... LOCALの例については、『Oracle AI Database SQL言語リファレンス』を参照してください
グローバル・パーティション索引
グローバル・パーティション索引は、この索引の作成先である基礎となる表とは別々にパーティション化されたBツリー索引です。単一の索引パーティションは、任意またはすべての表パーティションを指す場合があり、その一方で、ローカル・パーティション索引では、索引パーティションと表パーティションの間に1対1のパリティが存在します。
一般的に、グローバル索引は高速アクセス、データ整合性および可用性が重要となるOLTPアプリケーションに役立ちます。OLTPシステムでは、employees.department_id列など1つのキーによって表がパーティション化される場合がありますが、アプリケーションではemployee_idまたはjob_idなどの多数の異なるキーによるデータへのアクセスが必要になる可能性があります。このような使用例では、グローバル索引が便利な場合があります。
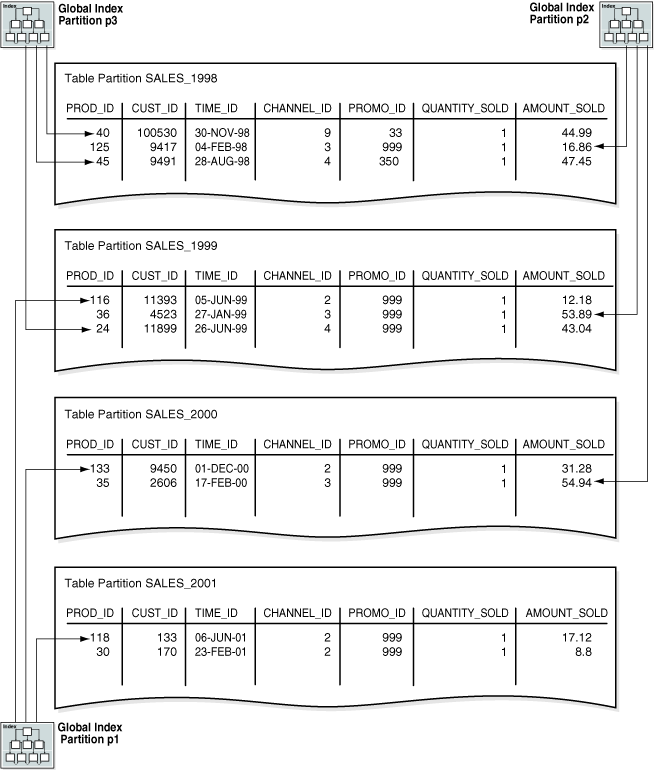
たとえば、「レンジ・パーティション化」のtime_range_sales表にグローバル・パーティション索引を作成すると仮定します。この表では、1998年の売上を含む行が1つのパーティションに格納され、1999年の売上を含む行は別のパーティションに格納されるというように、行が格納されます。次の例では、channel_id列の範囲別にパーティション化されたグローバル索引を作成します。
CREATE INDEX time_channel_sales_idx ON time_range_sales (channel_id)
   GLOBAL PARTITION BY RANGE (channel_id)
      (PARTITION p1 VALUES LESS THAN (3),
       PARTITION p2 VALUES LESS THAN (4),
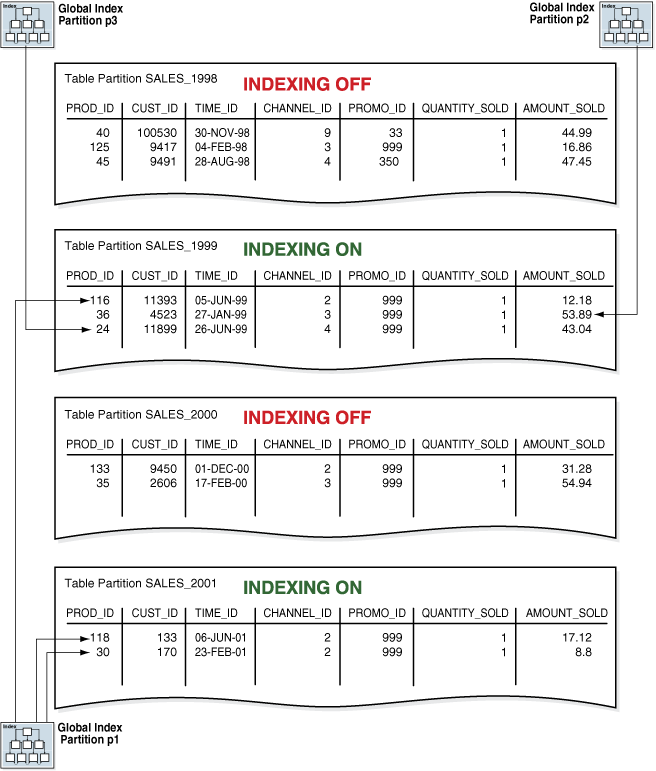
PARTITION p3 VALUES LESS THAN (MAXVALUE));図6-4に示すように、グローバル索引パーティションには、複数の表パーティションをそれぞれ指すエントリを含めることができます。索引パーティションp1はchannel_idが2の行を指し、索引パーティションp2はchannel_idが3の行を指し、索引パーティションp3はchannel_idが4または9の行を指しています。
図4: グローバル・パーティション索引
関連情報:
-
グローバル・パーティション索引の管理方法を学習するには、『Oracle AI Database VLDBおよびパーティショニング・ガイド』を参照
-
CREATE INDEXのGLOBAL PARTITION句について学習するには、『Oracle AI Database SQL言語リファレンス』を参照
パーティション表の部分索引
部分索引とは、関連付けられたパーティション表の索引付けプロパティと相互に関連付けられている索引付けのことです。
相関関係により、どの表パーティションに索引を付けるかを指定できます。部分索引には、次の利点があります。
-
索引付けされていない表パーティションでは、不要な索引記憶域が消費されません。
-
ロードおよび問合せのパフォーマンスを改善できます。
Oracle Database 12c以前は、パーティションの交換操作には、関連付けられたグローバル索引を物理的に更新して、使用可能にしておく必要がありました。Oracle Database 12cからは、パーティションのメンテナンス操作に関係のあるパーティションを部分グローバル索引の一部でない場合、その索引はグローバル索引メンテナンスを必要とせずに、そのまま使用可能です。
-
索引作成時には一部の表パーティションにのみ索引を付け、後でその他のパーティションに索引を付けることで、索引の作成に必要なソート領域を削減できます。
表のパーティションごとに、索引付けを有効または無効にできます。部分ローカル索引では、索引付けが無効になっているすべての表パーティションに対して、使用可能な索引パーティションはありません。グローバル索引は、パーティション化されているかどうかにかかわらず、索引付けがオフになっているすべてのパーティションからデータを除外します。データベースでは、一意制約が強制される索引の部分索引はサポートされません。図6-5に、グローバル索引が部分的である点を除いて、図6-4と同じグローバル索引を示します。表パーティションSALES_1998およびSALES_2000では、索引付けプロパティがOFFに設定されているため、部分グローバル索引によって索引は付けられません。
図5: 部分グローバル・パーティション索引
古いパーティションでのオブジェクト・ストアの使用
読取り専用パーティションの場合、クラウド内のオブジェクト・ストレージなど、低コストのストレージを使用できます。
データ量は過去10年間で大きく増加しています。また、政府の規制やポリシーにより、多くのケースで非常に長い期間、データ保持が義務付けられています。Oracleデータベースの顧客は、非常に大規模なデータベースに対して様々なデータ管理戦略を使用します。顧客は、次の主要目標を達成しようとしています。
最低限のコストで大量のデータを格納すること、データの保存と保護について新しい規制要件を満たすこと、さらにデータの増加分に基づく効果的な分析によってビジネス・チャンスを拡大することです。
オンプレミスの顧客には、前述の目標を達成するための様々なソリューションがあります。Oracle AI Databaseでこの機能が提供されることで、Cloud内のオブジェクト・記憶域などの低コストのストレージ層を利用して、Cloudデータベースに対して同様のデータ管理戦略を開発できるようになりました。
Oracleデータベースの顧客は、データセットの発展と成長に合せて、様々なデータ管理戦略を考え出してきました。これらの戦略はすべて、情報ライフサイクル管理(ILM)に分類されます。ILMソリューションの実装に役立つデータベース機能には、データのパーティション化、高度な行圧縮、ハイブリッド列圧縮、自動データ最適化などがあります。
ILMソリューションの特徴の1つは、低コストのストレージ階層を定義することです。これにより、最小限のコストで大量のデータを保持できます。Oracle ILM戦略により、データ圧縮と低コストのストレージ階層へのデータ移動を自動的に行うことができます。オンプレミスのOracleデータベースの顧客は、Oracle ZFS Storage ApplianceやOracle Exadata Extended (XT) Storage ServerなどのOracleストレージ・ソリューションを、アクセス頻度の低いデータ、古いデータまたは規制データのための低コストのストレージ・オプションとして使用します。サード・パーティ・ベンダーから同様の低コストのストレージ・オプションを選択することもできます。
オブジェクト・ストアを使用すると、次のことができます。
-
古いパーティションおよび読取り専用表領域をオブジェクト・ストレージに格納します。
-
オンラインでオブジェクト・ストレージ・ファイルからデータを問い合せます。
-
PDBが所有するオブジェクト・ストレージ・ファイルへの別のPDBからの不正アクセスを防止します。
-
まれに読取り専用データに変更を加える場合に、オブジェクト・ストアから通常のストレージにデータを戻します。
-
オブジェクト・ストアのデータ・ファイルを含む表領域を削除します。
-
古いパーティションおよび読取り専用表領域とオブジェクト・ストアへの移動時間ベースのパーティション化計画を作成し、読取り専用表領域のデータ・ファイルをオブジェクト・ストレージのような低コストのストレージ階層に移動できます。
-
オブジェクト・ストレージ内のオブジェクトへのアクセスオブジェクト・ストレージ内の表および パーティションのデータへのアクセスでは、ユーザーおよびSQLクライアントに完全に透過的になります。
-
オブジェクト・ストア・ファイルの資格管理オブジェクト・ストレージのファイルにアクセスするには、資格証明が必要です。
-
オブジェクト・記憶域から従来のストレージにデータファイルを戻すオブジェクト・ストア・データを更新する必要がある場合は、まずデータを従来のストレージに戻す必要があります。
-
オブジェクト・ストア・データ・ファイルの削除標準の
DROP TABLESPACEコマンドを使用して、データ・ファイルを含む表領域を削除できます。
古いパーティションおよび読取り専用表領域のオブジェクト・ストアへの移動
時間ベースのパーティション化計画を作成し、読取り専用表領域のデータ・ファイルをオブジェクト・ストレージのような低コストのストレージ階層に移動できます。
DATE列でレンジ・パーティション化されたorderという表があるとします。各パーティションには特定の年の行が含まれ、2022年および2023年の既存のパーティションがあります。新年が近づき、データベース管理者は2024年用の新しいパーティションを追加することにしました。同時に、データベース管理者は、最も古いパーティションを低コストのストレージ階層に移動することを決定しました。
次のワークフローの例は、表領域において単一の表に1つのパーティションがあるシナリオを示しています。これは制限ではありません。読取り専用表領域には、1つ以上の表のパーティションを含めることができます。また、表領域を読取り専用にすることに加えて、パーティションを読取り専用にすることもできます。ベスト・プラクティスとしては、表領域を読取り専用にし、適切に定義された期間を待機してから、それらのファイルをオブジェクト・ストアに移動できます。これにより、読取り専用データの更新の試行が捕捉され、エラーが返されます。変異データがまだExadataまたは他の従来のストレージにある間に、このデータを別の表領域に移動する方がはるかに高速です。このデータをオブジェクト・ストレージからコピーする必要がある場合、はるかに遅くなります。
create tablespace orders_2022 DATAFILE '+DATA_DG/orders_2022.dbf' size 100g;
create tablespace orders_2023 DATAFILE '+DATA_DG/orders_2023.dbf' size 100g;

create table orders
( prod_id         NUMBER NOT NULL,
  time_id         DATE NOT NULL,
  quantity_sold   NUMBER(10,2) NOT NULL,
  amount_sold     NUMBER(10,2) NOT NULL)
    partition by range (time_id)
    ( partition orders_2022 VALUES LESS THAN (TO_DATE('2023-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2022,
      partition orders_2023 VALUES LESS THAN (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
        TABLESPACE orders_2023)
  ENABLE ROW MOVEMENT;

create tablespace orders_2024 DATAFILE '+DATA_DG/orders_2024.dbf' size 100g;

alter table orders
  ADD partition orders_2024
  values less than (TO_DATE('2024-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN'))
  TABLESPACE orders_2024;

alter tablespace orders_2022 read only;

alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database
  move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
オブジェクト・ストレージ内のオブジェクトへのアクセス
オブジェクト・ストレージ内の表およびパーティションのデータに対するアクセスは、ユーザーおよびSQLクライアントに対して完全に透過的になります。
データベース入出力サブシステムは、オブジェクト・ストレージに格納されているファイルのブロックを内部的に問い合せて処理します。次のSQLは、前の例でオブジェクト・ストレージに移動された読取り専用パーティションorders_2022の行を問い合せます。
select prod_id
from   orders
where  time_id < TO_DATE('2020-01-01 00:00:00', 'SYYYY-MM-DD HH24:MI:SS', 'NLS_CALENDAR=GREGORIAN');
既存の索引(グローバルおよびローカルの両方)が透過的に動作します。ハイブリッド列圧縮データおよびTDE暗号化データの問合せは、クライアントの視点からも透過的に動作します。
オブジェクト・ストア・ファイルの資格証明管理
オブジェクト・ストレージ内のファイルにアクセスするには、資格証明が必要です。
資格証明は、ユーザー名とパスワードを格納するデータベース・オブジェクトです。資格証明データは暗号化され、作成先のPDBスキーマに安全に格納されます。
データ・ファイルをオブジェクト・ストレージに移動する場合は、デフォルトの資格証明を定義する必要があります。このデフォルトの資格証明は、オブジェクト・ストレージ内のデータ・ファイルにアクセスするために使用されます。
最小限必要な権限を持つデフォルトの資格証明を選択します。デフォルトの資格証明によってオブジェクト・ストアへのアクセスが可能になった後、標準データベース認証および認可によって、どのデータベース・ユーザーがこれらのデータファイルを問い合せたり操作できるかが決まります。
alter database property set default_credential = 'ADM.DEF_CRED_NAME';

alter database move datafile '+DATA_DG/orders_2022.dbf' to
  'https://objectstorage.example.com/oracle/orders_2022.dbf';
オブジェクト・ストレージから従来のストレージにデータファイルを戻す
オブジェクト・ストア・データを更新する必要がある場合は、まずデータを従来のストレージに戻す必要があります。
まれに、オブジェクト・ストレージにすでに存在する読取り専用データを変更する必要がある場合、唯一のオプションは、データをオブジェクト・ストレージから従来のストレージに戻すことです。次のワークフローは、データファイルをオブジェクト・ストアからASMファイル・システムに戻す方法を示しています。オブジェクト・ストレージからファイルをコピーして戻すと、パフォーマンスに影響します。
alter database move datafile
  'https://objectstorage.example.com/oracle/orders_2022.dbf' to
  '+DATA_DG/orders_2022.dbf';

alter tablespace orders_2022 read write;
オブジェクト・ストア・データ・ファイルの削除
標準のDROP TABLESPACEコマンドを使用して、データ・ファイルを含む表領域を削除できます。
AND DATAFILES句は、バックエンド・ストレージからデータファイルを削除するために使用されます。これにより、ファイルがオブジェクト・ストアから削除されます。オブジェクト・ストア・ファイルでオブジェクト・ストアに複数のチャンクがある場合、すべてのチャンクとマニフェストが削除されます。
drop tablespace orders_2022 including contents and datafiles;シャード表の概要
OracleデータベースではGlobally Distributed Databaseの機能によって、複数のデータベースに格納できるシャードという単位に表を分割できます。
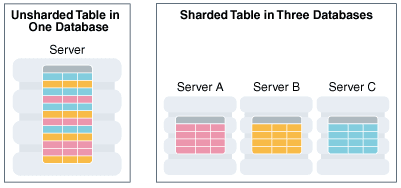
水平パーティション化にはシャード間のデータベース表の分割が伴うため、各シャードには同じ列の異なる行のサブセットを持つ表が含まれます。この方法で分割された表はシャード表とも呼ばれています。
次の図は、3つのシャード間に水平にパーティション化された表を示しています。
図6: シャード間での表の水平パーティション化
- シャード表データベース表はシャード間で分割されるため、各シャードには同じ列を持つ表が行のサブセットが異なる表が含まれます。この方法で分割された表はシャード表と呼ばれます。関連項目: Oracle Globally Distributed AI Database
シャードされた表
データベース表はシャード間で分割されるため、各シャードには同じ列を持つ表が行の異なるサブセットに含まれるように水平に分割された表。この方法で分割された表はシャード表と呼ばれます。
次の図は、表のセット(表ファミリと呼ばれる)をシャードPDBのセット間で水平にパーティション化して、各シャードに赤、黄および青の行で示されるデータのサブセットを含める方法を示しています。
図7: シャード間の表の水平パーティション化
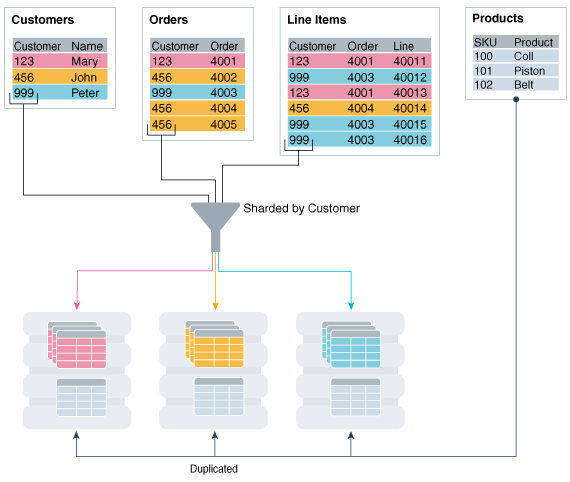
パーティションはシャーディング・キーに基づいて表領域レベルでシャード間に分散されます。キーの例として顧客ID、アカウント番号、国IDなどがあります。
シャード表の各パーティションは別々の表領域に存在し、各表領域は特定のシャードに関連付けられます。関連付けは、シャーディング方法に応じて自動的に確立されるか、または管理者によって定義されます。
シャード表のパーティションが複数のシャード内に存在する場合でも、アプリケーションにはその表が単一データベース内のパーティション表とまったく同じように表示されて、動作します。アプリケーションから発行されるSQL文がシャードを参照する必要はなく、シャード数やその構成に依存することもありません。
表をパーティション化するための一般的なSQL構文は、シャード間における表の行のパーティション化方法を指定します。たとえば、次のSQL文はシャーディング・キーcust_idに基づいて、シャード間で表を水平にパーティション化したシャード表を作成します。
CREATE SHARDED TABLE customers
( cust_id     NUMBER NOT NULL,
  name        VARCHAR2(50),
  address     VARCHAR2(250),
  region      VARCHAR2(20),
  class       VARCHAR2(3),
  signup      DATE,
  CONSTRAINT cust_pk PRIMARY KEY(cust_id)
)
PARTITION BY CONSISTENT HASH (cust_id)
PARTITIONS AUTO
TABLESPACE SET ts1;前述の例のシャード表はコンシステント・ハッシュ(スケーラブルな分散システムで一般的に使用される特殊なタイプのハッシュ・パーティション化)によりパーティション化されます。この手法は、シャード間で表領域を自動的に分散し、データおよびワークロードが均等に分散します。ノート:シャード表でのグローバル索引はサポートされていませんが、ローカル索引はサポートされています。
ビューの概要
ビューとは、1つまたは複数の表の論理表現のことです。本質的には、ビューはストアド・クエリーです。
ビューは、実表と呼ばれる、その基礎となる表からデータを導出します実表には、表または他のビューを指定できます。ビュー上で実行されるすべての操作は、実際にその実表に影響します。多くの場合、ビューは表と同じように使用できます。
ノート:マテリアライズド・ビューは、標準のビューとは異なるデータ構造を使用します。
ビューを使用すると、様々なタイプのユーザーに合せてデータの表現形式を変化させることができます。多くの場合、ビューは次の目的で使用されます。
-
事前設定した表の行または列(あるいはその両方)へのアクセスを制限することにより、表のセキュリティのレベルを強化します。
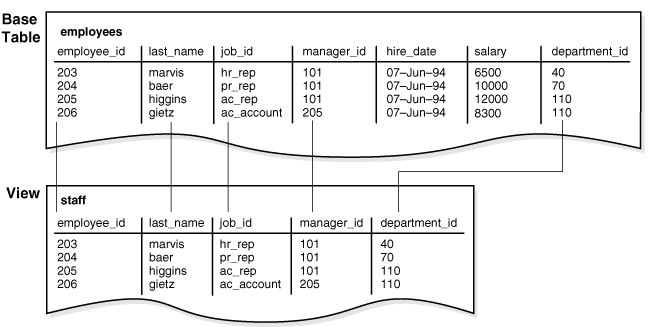
たとえば、図6-8は、
staffビューに実表employeesの列salaryまたはcommission_pctが含まれない仕組みを示しています。 -
データの複雑さを隠す
たとえば、複数の表の関連した列または行を1つまとめる結合によって、単一のビューを定義できます。ただし、ビューからは、この情報が複数の表から抽出されたものであるということはわかりません。1つの問合せで、表情報に対して複雑な計算を実行する場合もあります。これにより、ユーザーはビューに対して問い合せることができ、結合または計算の実行方法を知る必要がなくなります。
-
実表の視点とは異なる視点でデータを表示します。
たとえば、ビューが基礎にしている表に影響を与えずに、ビューの列名を変更できます。
-
実表の定義の変更からのアプリケーションの分離
たとえば、ビューを定義している問合せが表の4つの列の中の3つの列を参照している場合、たとえ5番目の列が追加されてもビューの定義は影響を受けないため、ビューを使用しているすべてのアプリケーションも影響を受けません。
ビューの使用例として、複数の列と膨大な行を持つhr.employees表について検討します。ユーザーがこれらの列のうち5つの列のみ、または特定の行のみをユーザーに表示可能にするには、次のビューを作成します。
CREATE VIEW staff AS
  SELECT employee_id, last_name, job_id, manager_id, department_id
FROM employees;すべてのサブ問合せと同様に、ビューを定義する問合せにFOR UPDATE句を含めることはできません。次の図に、staffという名前のビューを示します。ビューが、実表の5つの列のみを表示していることに注目してください。
図8: ビュー
-
ビューの特性表とは異なり、ビューには記憶域は割り当てられず、データが格納されることもありません。ビューは、参照する実表からデータを抽出または導出する問合せによって定義されます。ビューは他のオブジェクトを基盤としているため、データ・ディクショナリ.内でビューを定義する問合せ用の記憶域以外には記憶域が必要ありません。
-
更新可能な結合ビュー結合ビューでは、その
FROM句に複数の表またはビューがあります。 -
オブジェクト・ビュービューが仮想表であるのと同様に、オブジェクト・ビューは仮想オブジェクト表です。ビュー内の各行はオブジェクト・タイプのインスタンスであり、オブジェクトです。オブジェクト型はユーザー定義データ型です。
関連情報:
-
ビューの管理方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
CREATE VIEWの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照
ビューの特性
表とは異なり、ビューには記憶域は割り当てられず、データが格納されることもありません。ビューは、参照する実表からデータを抽出または導出する問合せによって定義されます。ビューは他のオブジェクトを基盤としているため、データ・ディクショナリ.内でビューを定義する問合せ用の記憶域以外には記憶域が必要ありません。
ビューは、データベースによって自動的に操作される参照先のオブジェクトに依存します。たとえば、ビューの実表を削除してから再作成した場合、データベースは新しい実表がビュー定義と一致するかどうかを確認します。
-
ビューでのデータ操作ビューは表から導出されるため、ビューおよび表には多数の類似点が存在します。ユーザーはビューを問い合せることができ、いくつかの制限付きでビューに対してDMLを実行できます。ビューに対して実行される操作は、そのビューの実表のデータに影響し、実表の整合性制約とトリガーの対象になります。
-
ビュー内のデータへのアクセス方法 Oracle AI Databaseでは、ビューの定義は、ビューを定義する問合せのテキストとしてデータ・ディクショナリに格納されます。
ビューのデータ操作
ビューは表から導出されるため、ビューと表には多数の類似点があります。ユーザーはビューを問い合せることができ、いくつかの制限付きでビューに対してDMLを実行できます。ビューに対して実行される操作は、そのビューの実表のデータに影響し、実表の整合性制約とトリガーの対象になります。
次の例では、hr.employees表のビューを作成します。
CREATE VIEW staff_dept_10 AS
SELECT employee_id, last_name, job_id,
       manager_id, department_id
FROM   employees
WHERE  department_id = 10
WITH CHECK OPTION CONSTRAINT staff_dept_10_cnst;定義された問合せでは部門10の行のみを参照します。CHECK OPTIONは、ビューに対して発行されたINSERTおよびUPDATE文の結果が必ずビューで選択できる行になるよう、制約を持つビューを作成します。これにより、部門10の従業員の行は挿入できますが、部門30の行は挿入できません。
CREATE VIEW文の副問合せ制限について学習するには、『Oracle AI Database SQL言語リファレンス』も参照してください。
ビュー内のデータへのアクセス方法
Oracle AI Databaseでは、ビューの定義は、ビューを定義する問合せのテキストとしてデータ・ディクショナリに格納されます。
SQL文でビューを参照すると、Oracle AI Databaseでは次のタスクが実行されます。
-
可能な場合は常に、ビューに対する問合せとそのビューおよび基礎となるビューを定義する問合せをマージします。
Oracle AI Databaseにより、マージされた問合せは、ビューを参照せずに問合せを発行したかのように最適化されます。そのため、Oracle AI Databaseでは、列がビュー定義で参照されても、またはビューに対するユーザーの問合せで参照されても、検索される実表の列に対する索引を使用できます。
Oracle AI Databaseでは、ユーザーの問合せとビュー定義をマージできないこともあります。その場合、Oracle AI Databaseは参照された列の索引すべてを使用できるとはかぎりません。
-
共有SQL領域内のマージ済の文を解析します
Oracle AI Databaseでは、新しい共有SQL領域内のビューを参照する文は、既存の共有SQL領域にも同様の文が含まれていない場合にのみ解析されます。したがって、ビューを使用すると、共有SQLに関連付けられているメモリーの使用量を減らせるという利点があります。
-
SQLステートメントを実行します。
次の例に、ビューが問合せを受ける際のデータ・アクセスを示します。employeesおよびdepartments表を基にemployees_viewを作成するとします。
CREATE VIEW employees_view AS
  SELECT employee_id, last_name, salary, location_id
  FROM   employees JOIN departments USING (department_id)
WHERE department_id = 10;ユーザーはemployees_viewの次の問合せを実行します。
SELECT last_name
FROM   employees_view
WHERE  employee_id = 200;
Oracle AI Databaseはビューとユーザーの問合せをマージして、データ取得のために実行する次の問合せを作成します。
SELECT last_name
FROM   employees, departments
WHERE  employees.department_id = departments.department_id
AND    departments.department_id = 10
AND    employees.employee_id = 200;
関連情報:
-
問合せの最適化について学習するには、『Oracle AI Database SQLチューニング・ガイド』を参照してください。
更新可能な結合ビュー
結合ビューは、FROM句に複数の表またはビューがあります。
次の例では、staff_dept_10_30ビューがemployees表とdepartments表を結合し、部門10または30の従業員のみを含めるように指定しています。
CREATE VIEW staff_dept_10_30 AS
SELECT employee_id, last_name, job_id, e.department_id
FROM   employees e, departments d
WHERE  e.department_id IN (10, 30)
AND e.department_id = d.department_id;変更可能な結合ビューは更新可能な結合ビューとも呼ばれ、2つ以上の実表またはビューを含み、DML操作が可能です。更新可能なビューはSELECT文のトップレベルのFROM句に複数の表を含み、WITH READ ONLY句で制限されません。
本質的に更新可能であるためには、ビューは複数の条件を満たす必要があります。たとえば、結合ビューに対するINSERT、UPDATEまたはDELETE操作では、1回に変更可能な実表は1つのみであることが一般的なルールです。次のUSER_UPDATABLE_COLUMNSデータ・ディクショナリ・ビューの問合せは、staff_dept_10_30ビューが更新可能であることを示しています。
SQL> SELECT TABLE_NAME, COLUMN_NAME, UPDATABLE
  2  FROM   USER_UPDATABLE_COLUMNS
  3  WHERE  TABLE_NAME = 'STAFF_DEPT_10_30';

TABLE_NAME                     COLUMN_NAME                    UPD
------------------------------ ------------------------------ ---
STAFF_DEPT_10_30               EMPLOYEE_ID                    YES
STAFF_DEPT_10_30               LAST_NAME                      YES
STAFF_DEPT_10_30               JOB_ID                         YES
STAFF_DEPT_10_30               DEPARTMENT_ID                  YES
Oracle Databaseリリース21c以降では、結合ビューのすべての更新可能な列をキー保存表のカラムにマップする必要はありません。キー保存表は、基礎となる表の各行が問合せ出力に最高で1回表示される表です。staff_dept_10_30ビューでは、department_idがdepartments表の主キーであるため、employees表をキー保存表にして、employees表からの各行が結果セットに最高で1回のみ表示されます。departments表は、表内の各行が結果セットに複数回表示される可能性があるため、キー保存表ではありません。UPDATE操作で単一表の列のみが更新され、更新が確定的である場合、つまり各行が1回のみ更新される場合に、キー保存されていない表の列を更新できます。
関連項目:結合ビューの更新方法を学習するには、Oracle AI Database管理者ガイドを参照してください。
オブジェクト・ビュー
ビューが仮想表であるのと同様に、オブジェクト・ビューは仮想オブジェクト表です。ビュー内の各行はオブジェクトであり、オブジェクト・タイプのインスタンスになります。オブジェクト型はユーザー定義データ型です。
リレーショナル・データは、オブジェクト型として格納されているかのように取得、更新、挿入および削除できます。また、オブジェクト、REFおよびコレクション(ネストした表とVARRAY)などのオブジェクト・データ型である列を持つビューを定義できます。
リレーショナル・ビューと同様、オブジェクト・ビューには、データベース管理者がユーザーに対して表示するデータのみを表示できます。たとえば、オブジェクト・ビューにITプログラマについてのデータは表示し、給与に関する機密データは除外することが可能です。次の例では、employee_typeオブジェクトを作成してから、このオブジェクトを基にしたビューit_prog_viewを作成しています。
CREATE TYPE employee_type AS OBJECT
(
  employee_id  NUMBER (6),
  last_name    VARCHAR2 (25),
  job_id       VARCHAR2 (10)
);
/

CREATE VIEW it_prog_view OF employee_type
  WITH OBJECT IDENTIFIER (employee_id) AS
SELECT  e.employee_id, e.last_name, e.job_id
FROM    employees e
WHERE   job_id = 'IT_PROG';
オブジェクト・ビューは、ビュー内のデータをリレーショナル表から取得し、この表がオブジェクト表として定義されているものとしてデータにアクセスできるため、プロトタイプ化、およびオブジェクト指向アプリケーションへの移行に便利です。オブジェクト指向アプリケーションは、既存の表を別の物理構造に変換せずに実行できます。
関連情報:
-
オブジェクト・タイプおよびオブジェクト・ビューについて学習するには、『Oracle AI Databaseオブジェクト・リレーショナル開発者ガイド』を参照してください。
-
CREATE TYPE文について学習するには、Oracle AI Database SQL言語リファレンスを参照してください。
マテリアライズド・ビューの概要
マテリアライズド・ビューは、スキーマ・オブジェクトとして事前に格納またはマテリアライズされた問合せ結果です。問合せのFROM句では表、ビューまたはマテリアライズド・ビューの名前を指定できます。
マテリアライズド・ビューは、レプリケーションのマスター表およびデータ・ウェアハウスのファクト表として使用されることがよくあります。マテリアライズド・ビューは、データを集計、計算、レプリケートおよび分配します。これらは、次のような様々なコンピューティング環境に適しています。
-
データ・ウェアハウスでは、マテリアライズド・ビューによって、合計や平均など、集計関数から生成されたデータを計算し、格納することができます。
サマリーは集計ビューです。集計ビューでは、結合および集計操作が事前に計算されて結果を表に格納することで、問合せ時間が短縮されます。マテリアライズド・ビューは、サマリーと同じものです。また、マテリアライズド・ビューを使用して、集計操作の有無に関係なく、結合を計算できます。
-
XStreamおよびOracle GoldenGateの使用により実現されるマテリアライズド・ビュー・レプリケーションでは、ある特定の時点における表の完全または部分的なコピーがビューに格納されます。マテリアライズド・ビューは分散サイトにデータをレプリケートし、複数のサイトで実行される更新を同期化します。このレプリケーション形式は、フィールドが常時ネットワークに接続されていない場合のフィールド・セールスなどの環境に適しています。
-
モバイル・コンピューティング環境では、マテリアライズド・ビューで、中央のサーバーからモバイル・クライアントにデータのサブセットをダウンロードし、中央のサーバーから定期的にリフレッシュし、クライアントで実行された更新を中央のサーバーに伝播できます。
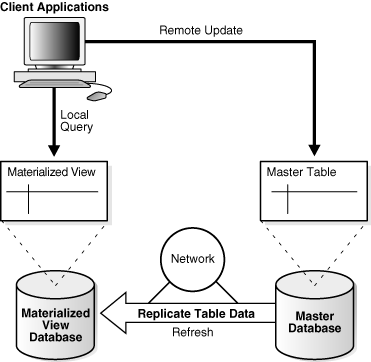
レプリケーション環境では、マテリアライズド・ビューはマスター・データベースと呼ばれる別のデータベース内の表とデータを共有します、マテリアライズド・ビューに関連付けられたマスター・サイトの表がマスター表です。図6-9に、別のデータベース内のマスター表に基づく、1つのデータベース内のマテリアライズド・ビューを示します。マスター表を更新すると、マテリアライズド・ビューのデータベースにレプリケートされます。
図9: マテリアライズド・ビュー
-
マテリアライズド・ビューの特性マテリアライズド・ビューは、索引および非マテリアライズ・ビューの特性の一部を共有します。
-
マテリアライズド・ビューのリフレッシュ方法データベースでは、実表の変更後にマテリアライズド・ビューをリフレッシュして、マテリアライズド・View内のデータを管理します。リフレッシュ方法は、増分または完全リフレッシュです。
-
自動マテリアライズド・ビュー Oracle Databaseリリース21c以降は、マテリアライズド・ビューを自動的に作成およびメンテナンスできます。
-
クエリー・リライトでは、マスター表について記述されたユーザー要求が、マテリアライズド・ビューを含む同等のリクエストに変換されます。
関連情報:
-
サマリーについてさらに学習するには、Oracle AI Databaseデータ・ウェアハウス・ガイドを参照してください
-
XStreamの概要は、『Oracle AI Database XStreamガイド』を参照
-
Oracle GoldenGateについてさらに学習するには、http://www.oracle.com/technetwork/middleware/goldengate/documentation/index.htmlを参照
-
CREATE MATERIALIZED VIEW文について学習するには、Oracle AI Database SQL言語リファレンスを参照
マテリアライズド・ビューの特性
マテリアライズド・ビューには、索引および非マテリアライズド・ビューと同じ特性がいくつかあります。
マテリアライズド・ビューは、次の点が索引に類似しています。
-
実際のデータを含み、記憶域を使用します。
-
マスター表のデータに変更があった場合は、リフレッシュできます。
-
クエリー・リライト操作に使用すると、SQLの実行効率が改善されます。
-
さらに、その存在は、SQLアプリケーションとユーザーに対して透過的です。
マテリアライズド・ビューは他の表およびビューのデータを表す点において、非マテリアライズド・ビューに類似しています。索引とは異なり、ユーザーはSELECT文を使用してマテリアライズド・ビューを直接問合せできます。必要なリフレッシュのタイプによっては、DML文を使用してビューを更新することも可能です。
次の例では、shサンプル・スキーマの3つのマスター表に基づくマテリアライズド集計ビューを作成して、データを投入しています。
CREATE MATERIALIZED VIEW sales_mv AS
  SELECT t.calendar_year, p.prod_id, SUM(s.amount_sold) AS sum_sales
  FROM   times t, products p, sales s
  WHERE  t.time_id = s.time_id
  AND    p.prod_id = s.prod_id
GROUP BY t.calendar_year, p.prod_id;次の例では、sales_mvのマスター表であるsales表を削除してから、sales_mvを問い合せます。行はマスター表のデータとは別に格納(マテリアライズ)されているため、問合せによってデータが選択されます。
SQL> DROP TABLE sales;

Table dropped.

SQL> SELECT * FROM sales_mv WHERE ROWNUM < 4;

CALENDAR_YEAR    PROD_ID  SUM_SALES
------------- ---------- ----------
         1998         13  936197.53
         1998         26  567533.83
         1998         27  107968.24
マテリアライズド・ビューはパーティション化できます。マテリアライズド・ビューはパーティション表に定義して、1つ以上の索引を定義できます。
関連項目:データ・ウェアハウスでマテリアライズド・ビューを使用する方法を学習するには、Oracle AI Databaseデータ・ウェアハウス・ガイドを参照してください。
マテリアライズド・ビューのリフレッシュ方法
データベースでは、実表の変更後にマテリアライズド・ビューをリフレッシュして、マテリアライズド・ビューのデータを管理します。リフレッシュ方法は、増分または完全リフレッシュです。
-
完全リフレッシュ 完全リフレッシュでは、マテリアライズド・ビューを定義する問合せが実行されます。マテリアライズド・ビューで事前作成表を参照するか、ユーザーが表を
BUILD DEFERREDとして定義しないかぎり、完全リフレッシュは、マテリアライズド・ビューを最初に作成したときに実行されます。 -
増分リフレッシュ増分リフレッシュは、高速リフレッシュとも呼ばれて、既存データの変更のみを処理します。この方法では、マテリアライズド・ビューを最初から再作成する必要がなくなります。変更のみを処理するため、リフレッシュ時間が非常に速くなります。
-
インプレース・のリフレッシュおよびアウトオブプレース・リフレッシュ完全および増分方法の場合、データベースでは、インプレース(ビュー上で文を直接リフレッシュする)またはアウトオブプレースでマテリアライズド・ビューをのリフレッシュできます。
完全更新
完全リフレッシュでは、マテリアライズド・ビューを定義するクエリーが実行されます。マテリアライズド・ビューで事前作成表を参照するか、ユーザーが表をBUILD DEFERREDとして定義しないかぎり、完全リフレッシュは、マテリアライズド・ビューを最初に作成したときに実行されます。
完全リフレッシュは、特にデータベースで大量のデータを読み込んで処理する必要がある場合には、遅くなる可能性があります。マテリアライズド・ビューの作成後、いつでも完全リフレッシュを実行できます。
増分更新
増分リフレッシュは、高速リフレッシュとも呼ばれて、既存データの変更のみを処理します。この方法では、マテリアライズド・ビューを最初から再作成する必要がなくなります。変更のみを処理するため、リフレッシュ時間が非常に速くなります。
マテリアライズド・ビューは、必要に応じて、または定期的な間隔で、リフレッシュできます。また、実表と同じデータベース内のマテリアライズド・ビューは、トランザクションによって実表の変更がコミットされるたびにリフレッシュするように構成できます。
高速リフレッシュは、次のいずれかの形式です。
-
ログベースのリフレッシュ
このタイプのリフレッシュでは、マテリアライズド・ビュー・ログまたはダイレクト・ローダー・ログに実表の変更が記録されます。マテリアライズド・ビュー・ログは、実表への変更を記録し、実表で定義されたマテリアライズド・ビューを増分的にリフレッシュできるように、実表への変更を記録します。各マテリアライズド・ビュー・ログは、1つの実表と関連付けられています。
-
パーティション・チェンジ・トラッキング(PCT)リフレッシュ
PCTリフレッシュは、実表がパーティション化されている場合のみ有効です。PCTリフレッシュでは、影響を受けるマテリアライズド・ビューのパーティションのすべてのデータ、または影響を受ける部分のデータを削除し、それらを再計算します。データベースでは、変更された実表パーティションを使用して、ビュー内で影響を受けるパーティションまたはデータの一部を識別します。パーティションの管理操作が実表で行われている場合、使用できる増分リフレッシュの方法はPCTリフレッシュのみです。
インプレース・リフレッシュおよびホーム外リフレッシュ
完全および増分方法の場合、データベースでは、インプレース(ビューに対して文を直接リフレッシュする)またはホーム外でマテリアライズド・ビューをリフレッシュできます。
ホーム外リフレッシュでは、1つ以上の外部表が作成され、そこでリフレッシュ文が実行されて、マテリアライズド・ビューまたは影響を受けるパーティションが外部表に切り替えられます。この方法により、リフレッシュ時、特にリフレッシュ文の終了まで長くかかる場合に、高可用性が実現します。
同期リフレッシュは、ホーム外リフレッシュの一種です。同期リフレッシュでは、実表の内容は変更されませんが、かわりに同期リフレッシュ・パッケージのAPIを使用することで、これらの変更を実表とマテリアライズ・ビューに同時に適用して、一貫性を確保します。この方法により、一連の表とそれらで定義されているマテリアライズド・ビューを常に同期できます。データ・ウェアハウスでは、同期リフレッシュの方法が次の理由で適しています。
-
増分データのロードは、しっかり制御され、定期的に実行されます。
-
表およびそれらのマテリアライズド・ビューでは、多くの場合、同じようにパーティション化されるか、またはパーティションが機能依存性で関連付けられます。
関連項目:マテリアライズド・ビューのリフレッシュ方法を学習するには、『Oracle AI Databaseデータ・ウェアハウス・ガイド』
自動マテリアライズド・ビュー
Oracle Databaseリリース21c以降は、マテリアライズド・ビューを自動的に作成およびメンテナンスできます。
Oracle AI Databaseでは、問合せパフォーマンスを最適化するために、マテリアライズド・ビューを自動的に作成および管理できます。DBAとのやりとりがほとんどあるいはまったくない場合、バックグラウンド・タスクでワークロード特性を監視および分析し、マテリアライズド・ビューによりSQLパフォーマンスが向上する場所を識別します。候補マテリアライズド・ビューのパフォーマンス上の利点は、バックグラウンドで確認する前に(ワークロード問合せを使用して)測定されます。
関連情報:
-
詳細は『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照してください。
-
DBMS_AUTO_MVパッケージを使用して自動マテリアライズド・ビューを実装する方法を学習するには、『Oracle AI Database PL/SQLパッケージおよびタイプ・リファレンス』を参照
問合せリライト
クエリー・リライトでは、マスター表について記述されたユーザー要求が、マテリアライズド・ビューを含む同等のリクエストに変換されます。
実表に大量のデータが含まれている場合には、集計または結合の計算は負荷が高く、時間がかかります。マテリアライズド・ビューには事前に計算された集計と結合が含まれているため、クエリー・リライトはマテリアライズド・ビューを使用してすぐに問合せに応答できます。
問合せトランスフォーマは、マテリアライズド・ビューを使用するために透過的にリクエストをリライトします。ユーザー操作は不要で、SQL文でのマテリアライズド・ビューへの参照も必要ありません。クエリー・リライトは透過的であるため、アプリケーション・コードのSQLを無効にしなくても、マテリアライズド・ビューを追加または削除できます。
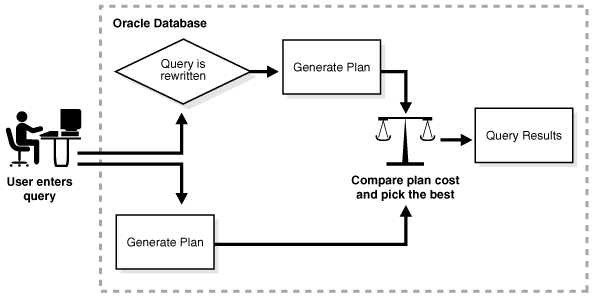
一般的に、ディテール表ではなくマテリアライズド・ビューを使用するクエリー・リライトでは、レスポンス時間が短縮されます。次の図は、オリジナル・クエリーおよびリライトされた問合せに対してデータベースが実行計画を生成し、最もコストの低い計画を選択する仕組を示しています。
図10: クエリー・リライト
関連情報:
-
問合せ変換についてさらに学習するには、「オプティマイザの概要」を参照してください
-
クエリー・リライトの使用方法を学習するには、『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照
順序の概要
順序とは、複数のユーザーが一意の整数を生成できるスキーマ・オブジェクトのことです。順序ジェネレータは、数値データ型に対してサロゲート・キーを生成するスケーラブルかつパフォーマンスの高い方法を提供します。
-
順序の特性順序定義により、順序の名前、順序が昇順か降順にかなど、順序に関する一般的な情報を示します。
-
順序への同時アクセス同じ順序ジェネレータで、複数の表に対して数値を生成できます。
順序の特性
順序の定義には、順序の名前、順序が昇順か降順かなど、順序に関する一般的な情報を指定します。
順序の定義では、次についても指定します。
-
数値の増分値
-
データベースが、メモリー内に生成された一連の順序番号をキャッシュするかどうか
-
制限に到達したときに、順序を循環させるかどうか
次の例では、サンプル・スキーマoeに順序customers_seqを作成します。customers表に行が追加されると、アプリケーションはこの順序を使用して、顧客ID番号を付与します。
CREATE SEQUENCE customers_seq
START WITH      1000
INCREMENT BY    1
NOCACHE
NOCYCLE;最初のcustomers_seq.nextvalの参照では、1000が戻されます。2回目には1001が戻されます。以降の各参照では、前回の参照よりも1大きい値が戻されます。
関連情報:
-
順序の作成方法を示すチュートリアルは『Oracle AI Database Oracle AI Database開発スタート・ガイド』を参照
-
SQL文で順序を参照する方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
CREATE SEQUENCEの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照してください。
順序への同時アクセス
同じ順序ジェネレータから、複数の表に対して数値を生成できます。
ジェネレータから自動的に主キーを作成して、複数の行または表にまたがるキーを統合できます。たとえば、順序はorders表およびcustomers表の主キーを生成できます。
順序ジェネレータは、ディスクI/Oのオーバーヘッドまたはトランザクション・ロックを発生させずに、一意の番号を生成するため、マルチ・ユーザー環境で便利です。たとえば、2人のユーザーがorders表に新しい行を同時に挿入するとします。順序を使用してorder_id列に一意の番号を生成すると、一方のユーザーは、他方のユーザーが注文番号を入力するのを待機する必要はありません。どちらのユーザーにも、順序により、正しい値が自動的に生成されるためです。
順序を参照する各ユーザーは、現在の順序番号(セッションで生成された最後の順序)にアクセスできます。ユーザーは、文を発行して新しい順序番号を生成することも、セッションで最後に生成された現行の番号を使用することもできます。セッション内の文が順序番号を生成すると、その番号はこのセッションでのみ使用可能となります。最終的にロールバックされたトランザクションで生成されて使用された個々の順序番号はスキップされます。
警告:アプリケーションが連続する番号を使用する場合、Oracle順序は使用できません。独自に開発したコードを使用して、データベースのアクティビティをシリアライズする必要があります。
参照: セッションが同時にデータにアクセスする方法を学習するには、「データの同時実行性と整合性」を参照
ディメンションの概要
データ・ウェアハウスには通常、ディメンションとファクトという2つの重要な要素があります。
ディメンションは、時刻、地理、製品、部門および販売チャネルなどのビジネスでの質問を指定する場合に使用される任意のカテゴリ。ファクトとは、売上単位または利益などの特定のディメンション値のセットに関連付けられたイベントまたはエンティティのことです。
多次元要求の例には、次の処理が含まれます。
-
2013年と2014年について、州、国、地域というように地理ディメンションの集計レベルの昇順で全製品の総売上を表示します。
-
2013年と2014年における南アメリカの地域別経費を示す事業のクロス集計分析を作成します。可能な小計をすべて組み込みます。
-
自動車製品に関する2014年の販売収入に従って、アジアでの販売代理店の上位10社をリストし、そのコミッションのランキングを作成します。
多次元による多数の質問では、通常は時間、地理または予算にまた がって集計されたデータと、データ・セットの比較が必要になります。
ディメンションを作成すると、より広範囲でのクエリー・リライト機能の使用が許可されます。データベースでは、マテリアライズド・ビューを使用した透過的なクエリー・リライトによって、問合せのパフォーマンスを改善できます。
-
ディメンションの階層構造 ディメンション表は、列または列セットのペア間の階層(親/子)関係を定義する論理構造である。
-
ディメンション作成ディメンションを作成するには、
CREATE DIMENSIONSQL文を使用します。関連項目:ディメンションについてさらに学習するには、Oracle AI Databaseデータ・ウェアハウス・ガイドを参照してください
ディメンションの階層構造
ディメンション表は、列または列セットのペア間の階層(親/子)関係を定義する論理構造である。
たとえば、1行内でcity列がstate列の値を示し、state列がcountry列の値を示すなど、ディメンションで指定できます。
顧客ディメンション内では、顧客は都市、州、国、準地域、地域までロールアップできます。通常、データ分析は、ディメンション階層の上位レベルから開始され、状況がこのような分析を正当化すると徐々にドリルダウンします。
子レベルの値は、それぞれが親レベルの1つの値にのみ対応付けられます。階層関係とは、階層内のあるレベルのデータが次のレベルのどのデータに結びつくかと呼ばれる依存関係を指します。
ディメンションには、この論理構造に割り当てるデータ記憶域がありません。ディメンション情報がディメンション表に格納されるのに対して、ファクト情報はファクト表に格納されます。
関連情報:
- ディメンションについて学習するには、『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照してください。
ディメンションの作成
ディメンションの作成では、CREATE DIMENSION SQL文を使用します。
この文では、次について指定します。
-
複数の
LEVEL句。それぞれがディメンション内の1列または列の集合を識別します。 -
1つ以上の
HIERARCHY句。隣接するレベル間の親子関係を指定します。 -
オプションの
ATTRIBUTE句。それぞれが個々のレベルに対応付けられている他の列または列セットを識別します。
次の文は、サンプル・スキーマshにcustomers_dimディメンションを作成するために使用されました。
CREATE DIMENSION customers_dim
   LEVEL customer   IS (customers.cust_id)
   LEVEL city       IS (customers.cust_city)
   LEVEL state      IS (customers.cust_state_province)
   LEVEL country    IS (countries.country_id)
   LEVEL subregion  IS (countries.country_subregion)
   LEVEL region     IS (countries.country_region)
   HIERARCHY geog_rollup (
      customer      CHILD OF
      city          CHILD OF
      state         CHILD OF
      country       CHILD OF
      subregion     CHILD OF
      region
   JOIN KEY (customers.country_id) REFERENCES country )
   ATTRIBUTE customer DETERMINES
   (cust_first_name, cust_last_name, cust_gender,
    cust_marital_status, cust_year_of_birth,
    cust_income_level, cust_credit_limit)
ATTRIBUTE country DETERMINES (countries.country_name);ディメンション内の列は、同じ表のもの(非正規化)でも複数の表のもの(完全正規化または一部正規化)でもかまいません。たとえば、正規化されているtimeディメンションには、date表、month表およびyear表と、各date行をmonth行に、各month行をyear行に接続する結合条件を含めることができます。完全な非正規化のtimeディメンションでは、date、monthおよびyear列は同じ表に格納されます。正規化されているかどうかに関係なく、列相互の階層関係をCREATE DIMENSION文で指定する必要があります。
関連項目: CREATE DIMENSIONの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』
シノニムの概要
シノニムは、スキーマ・オブジェクトの別名です。たとえば、表またはビュー、順序、PL/SQLプログラム・ユニット、ユーザー定義オブジェクト型または別のシノニムに対してシノニムを作成できます。シノニムは単に別名であるため、データ・ディクショナリ内に定義以外の記憶域は必要ありません。
シノニムを使用すると、データベース・ユーザー側のSQL文を単純化できます。シノニムは、基礎となるスキーマ・オブジェクトのIDと場所を非表示にも役立ちます。基礎となるオブジェクトを改名または移動する必要がある場合、シノニムのみを再定義するとよいことになります。シノニムに基づくアプリケーションは、今後も変更なしに機能し続けることができます。
プライベート・シノニムとパブリック・シノニムの両方を作成できます。プライベート・シノニムは特定ユーザーのスキーマ内にあります。このユーザーは他のユーザーによるシノニムの使用を制御できます。パブリック・シノニムはPUBLICという名前の特別なユーザー・グループが所有し、すべてのデータベース・ユーザーがアクセスできます。
例6-5 パブリック・シノニム
データベース管理者がhr.employees表のpeopleという名前のパブリック・シノニムを作成するとします。その後、ユーザーがoeスキーマに接続して、シノニムが参照する表内の行数をカウントしています。
SQL> CREATE PUBLIC SYNONYM people FOR hr.employees;

Synonym created.

SQL> CONNECT oe
Enter password: password
Connected.

SQL> SELECT COUNT(*) FROM people;

  COUNT(*)
----------
107パブリック・シノニムではデータベースの統合が困難になるため、パブリック・シノニムは慎重に使用してください。次の例に示すように、データベース内に存在するパブリック・シノニムpeopleは1つのみであるため、別の管理者がパブリック・シノニムpeopleの作成を試行すると失敗します。パブリック・シノニムを多用すると、アプリケーション間でネームスペースに競合が発生します。
SQL> CREATE PUBLIC SYNONYM people FOR oe.customers;
CREATE PUBLIC SYNONYM people FOR oe.customers
                      *
ERROR at line 1:
ORA-00955: name is already used by an existing object

SQL> SELECT OWNER, SYNONYM_NAME, TABLE_OWNER, TABLE_NAME
  2  FROM DBA_SYNONYMS
  3  WHERE SYNONYM_NAME = 'PEOPLE';

OWNER      SYNONYM_NAME TABLE_OWNER TABLE_NAME
---------- ------------ ----------- ----------
PUBLIC PEOPLE HR EMPLOYEESシノニム自体は保護されていません。シノニムに対してオブジェクト権限を付与すると、実際には基礎となるオブジェクトに権限を付与することになります。シノニムは、GRANT文のオブジェクトの別名としてのみ機能しています。
関連情報:
-
シノニムの管理方法を学習するには、『Oracle AI Database管理者ガイド』を参照してください。
-
『Oracle AI Database SQL言語リファレンス』(
CREATE SYNONYMの構文およびセマンティクス)