表と表クラスタ
この章では、スキーマ・オブジェクトの概要、および最も一般的なスキーマ・オブジェクトである表について説明します。
-
スキーマ・オブジェクトの概要データベース・スキーマとは、スキーマ・オブジェクトと呼ばれる、データ構造の論理コンテナのことです。スキーマ・オブジェクトの例には、表や索引があります。SQLを使用して、スキーマ・オブジェクトを作成および操作できます。
-
表の概要表は、Oracleデータベースにおけるデータ編成の基本単位です。
-
表クラスタの概要表クラスタは、共通の列を共有し、関連するデータを同じブロックに格納する表のグループです。
-
属性クラスタ表の概要属性クラスタ表とは、ユーザーが指定したクラスタリング・ディレクティブに基づいてディスク上に近接でデータを格納するヒープ構成表であり、ディレクティブでは、単一または複数の表で列を指定します。
-
一時表の概要一時表には、トランザクションまたはセッションの期間中のみ存在するデータが保持します。
-
外部表の概要外部表は、外部ソースのデータに、データベース内の表にあるかのようにアクセスします。
-
ブロックチェーン表の概要 ブロックチェーン表は、集中管理ブロックチェーン・アプリケーション向けに設計された追加専用の表である。
-
不変表の概要不変表とは、内部関係によって不正にデータが変更されることや、人間のミスが原因で想定外でデータが変更されることがある、追加専用の表です。
-
オブジェクト表の概要オブジェクト表とは、各行で1つのオブジェクトが表される、特殊な表の一種です。
スキーマ・オブジェクトの概要
データベース・スキーマは、スキーマ・オブジェクトと呼ばれるデータ構造の論理コンテナです。スキーマ・オブジェクトの例には、表や索引があります。SQLを使用して、スキーマ・オブジェクトを作成および操作できます。
この項では、次のトピックについて説明します:
-
共通およびローカル・ユーザー・アカウントについてデータベース・ユーザー・アカウントには、パスワードおよび特定のデータベース権限が含まれます。
-
共通およびローカル・オブジェクト 共通オブジェクトは、CDBルートまたはアプリケーション・ルートのいずれかで定義されており、メタデータ・リンクまたはオブジェクト・リンクを使用して参照できます。 ローカル・オブジェクトは、共通オブジェクトではないすべてのオブジェクトです。
-
スキーマ・オブジェクトのタイプ Oracle SQLでは、他でも多くのタイプのスキーマ・オブジェクトを作成および操作することができます。
-
スキーマ・オブジェクトの格納一部のスキーマ・オブジェクトでは、セグメントと呼ばれる、一種の論理記憶域構造でデータが格納されます。たとえば、パーティション化されていないヒープ構成表や索引では、セグメントを作成します。
-
スキーマ・オブジェクトの依存性一部のスキーマ・オブジェクトは、他のオブジェクトを参照し、スキーマ・オブジェクトの依存性を作成します。
-
サンプル・スキーマ Oracleデータベースには、サンプル・スキーマが含まれる場合があります。サンプル・スキーマは、OracleドキュメントおよびOracleの指示資料で一般的なデータベース・タスクを説明できるようにする、相互リンクされたスキーマのセットです。関連項目:ユーザーおよび権限についてさらに学習するには、Oracle AI Databaseセキュリティ・ガイドを参照してください
共通およびローカル・ユーザー・アカウントについて
データベース・ユーザー・アカウントには、パスワードおよび特定のデータベース権限があります。
ユーザー・アカウントとスキーマ
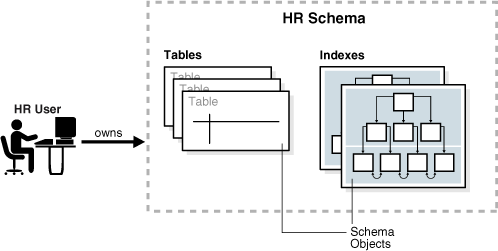
各ユーザー・アカウントは、ユーザーと同じ名前が付いた単一のスキーマを所有します。スキーマには、スキーマを所有するユーザーのデータが含まれています。たとえば、hrユーザー・アカウントはhrスキーマを所有し、このスキーマにemployees表などのスキーマ・オブジェクトが含まれます。通常、本番データベースでは、スキーマ所有者は人ではなく、データベース・アプリケーションを表します。
スキーマ内の特定のタイプの各スキーマ・オブジェクトには、一意の名前が付きます。たとえば、hr.employeesはhrスキーマ内のemployees表を指します。次の図に、hrという名前のスキーマ所有者とhrスキーマ内のスキーマ・オブジェクトを示します。
図1: HRスキーマ
共通およびローカルユーザーアカウント
ユーザー・アカウントがデータベースを定義するオブジェクトを所有する場合、このユーザー・アカウントは共通です。Oracle提供ではないユーザー・アカウントがローカルまたは共通のいずれかです。CDB共通ユーザーは、CDBルートで作成される共通ユーザーです。アプリケーション共通ユーザーはアプリケーション・ルートで作成されるユーザーで、このアプリケーション・コンテナ内のみで共通です。
次の図は、CDBで使用可能なユーザー・アカウント・タイプを示しています。
図2: CDBのユーザー・アカウント
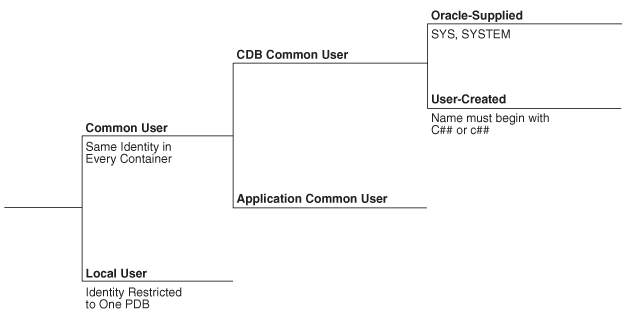
CDB共通ユーザーは、十分な権限を持つCDB内のどのコンテナにも接続できます。対照的に、アプリケーション共通ユーザーは(権限に応じて)そのユーザーが作成されたアプリケーション・ルートまたはこのアプリケーション・ルートに接続しているPDBのみに接続できます。
-
共通ユーザー・アカウントシステム・コンテナ(CDB)またはアプリケーション・コンテナのいずれかのコンテキスト内の、共通ユーザーは、ルートとこのコンテナ内の既存と将来のすべてのPDBにおいて同じIDを持つデータベース・ユーザーです。
-
ローカル・ユーザー・アカウントローカル・ユーザーとは、共通ではなく、1つのPDBでのみ操作が可能なデータベース・ユーザーです。
共通ユーザー・アカウント
システム・コンテナ(CDB)またはアプリケーション・コンテナのいずれかのコンテキスト内の、共通ユーザーは、ルートとこのコンテナ内の既存と将来のすべてのPDBにおいて同じIDを持つデータベース・ユーザーです。
どの共通ユーザーも、そのコンテナのルートに接続し、ルート内および十分な権限を持つすべてのPDB内で操作を実行できます。一部の管理タスクは、共通ユーザーによって実行される必要があります。例として、PDBの作成やPDBの切断などがあります。
たとえば、SYSTEMはDBA権限を持つCDB共通ユーザーです。したがって、SYSTEMはCDBルートおよびデータベース内の任意のPDBに接続できます。saas_salesアプリケーション・コンテナでsaas_sales_admin共通ユーザーを作成する場合があります。この場合、saas_sales_adminユーザーが接続できるのはsaas_salesアプリケーション・ルートか、saas_salesアプリケーション・コンテナ内のアプリケーションPDBのみです。
すべての共通ユーザーは、Oracle提供のもの、またはユーザーが作成したもののいずれかになります。Oracle提供の共通ユーザーの例は、SYSやSYSTEMです。すべてのユーザー作成共通ユーザーは、CDB共通ユーザーまたはアプリケーション共通ユーザーのいずれかです。
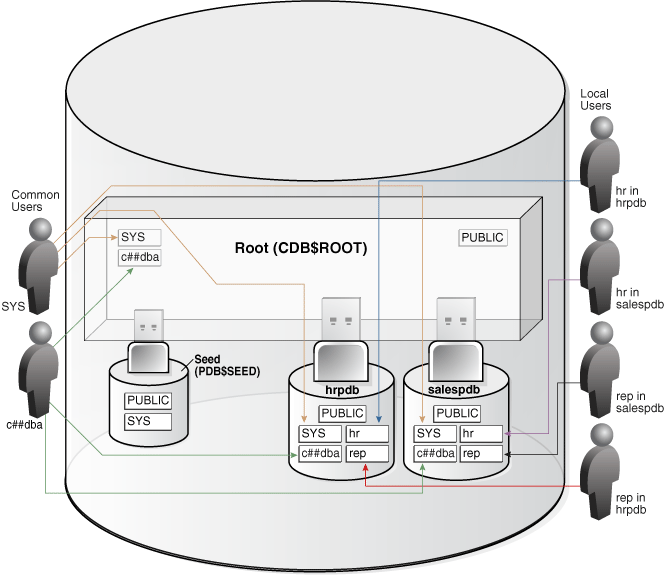
次の図に、2つのPDB (hrpdbとsalespdb)のユーザーとスキーマの例を示します。SYSとc##dbaは、CDB$ROOT、hrpdbおよびsalespdbにスキーマを持つCDB共通ユーザーです。ローカル・ユーザーhrとrepは、hrpdbに存在します。ローカル・ユーザーhrとrepは、salespdbにも存在します。
図3: CDBのユーザーとスキーマ
共通ユーザーには、次の特徴があります。
-
共通ユーザーは、
CREATE SESSION権限を持つどのコンテナ(CDB$ROOTも含む)にもログインできます。共通ユーザーは、すべてのコンテナで同じ権限を持つ必要はありません。たとえば、
c##dbaユーザーには、hrpdbおよびルートでセッション作成権限を持っていて、salespdbではセッション作成権限を持っていないという場合があります。適切な権限を持つ共通ユーザーはコンテナ間の切替えが可能であるため、ルートの共通ユーザーはPDBを管理できます。 -
アプリケーション共通ユーザーには、その固有アプリケーション・コンテナ外のコンテナでの
CREATE SESSION権限がありません。したがって、アプリケーション共通ユーザーはその固有のアプリケーション・コンテナに制限されます。たとえば、
saas_salesアプリケーションで作成されたアプリケーション共通ユーザーは、saas_salesアプリケーション・コンテナ内のアプリケーション・ルートおよびPDBにのみ接続できます。 -
ユーザーが作成するCDB共通ユーザーの名前は、他のデータベース・ユーザーに対する命名規則に従う必要があります。また、名前は、
COMMON_USER_PREFIX初期化パラメータによって指定された文字(デフォルトではc##またはC##)で始まる必要があります。Oracle提供の共通ユーザー名とユーザー作成のアプリケーション共通ユーザー名にはこの制限がありません。ローカル・ユーザー名で
c##またはC##の文字で始まる名前はありません。 -
すべての共通ユーザーには、そのユーザーが作成されたコンテナ(システム・コンテナまたは特定のアプリケーション・コンテナのいずれか)内のすべてのPDBにおいて、一意の名前が付けられます。
CDB共通ユーザーはCDBルートで定義されますが、同じIDを持つどのPDBにも接続できる必要があります。アプリケーション共通ユーザーはアプリケーション・ルートに常駐しますが、同じIDを持つそのコンテナのどのアプリケーションPDBにも接続できます。
-
共通ユーザーの特性すべての共通ユーザーは、Oracle提供またはユーザー作成のいずれかです。
-
SYSおよびSYSTEMアカウントすべてのOracleデータベースには、管理権限を持つデフォルトの共通ユーザー・アカウントが含まれます。
共通ユーザーの特性
すべての共通ユーザーは、Oracle提供のもの、またはユーザーが作成したもののいずれかになります。
共通ユーザー・アカウントには、次の特性があります:
-
共通ユーザーは、
CREATE SESSION権限を持つどのコンテナ(CDB$ROOTも含む)にもログインできます。共通ユーザーは、すべてのコンテナで同じ権限を持つ必要はありません。たとえば、
c##dbaユーザーには、hrpdbおよびルートでセッション作成権限を持っていても、salespdbではセッション作成権限を持っていないという場合があります。適切な権限を持つ共通ユーザーはコンテナ間で切替えできるため、ルートの共通ユーザーはPDBを管理できます。 -
アプリケーション共通ユーザーには、その固有アプリケーション・コンテナ外のコンテナでの
CREATE SESSION権限がありません。したがって、アプリケーション共通ユーザーはその固有のアプリケーション・コンテナに制限されます。たとえば、
saas_salesアプリケーションで作成されたアプリケーション共通ユーザーは、saas_salesアプリケーション・コンテナ内のアプリケーション・ルートおよびPDBにのみ接続できます。 -
ユーザーが作成するCDB共通ユーザーの名前は、他のデータベース・ユーザーに対する命名規則に従う必要があります。また、名前は、
COMMON_USER_PREFIX初期化パラメータによって指定された文字(デフォルトではc##またはC##)で始まる必要があります。Oracle提供の共通ユーザー名とユーザー作成のアプリケーション共通ユーザー名にはこの制限がありません。ローカル・ユーザー名で
c##またはC##の文字で始まる名前はありません。 -
すべての共通ユーザーには、そのユーザーが作成されたコンテナ(システム・コンテナまたは特定のアプリケーション・コンテナのいずれか)内のすべてのPDBにおいて、一意の名前が付けられます。
CDB共通ユーザーはCDBルートで定義されますが、同じIDを持つどのPDBにも接続できる必要があります。アプリケーション共通ユーザーはアプリケーション・ルートに常駐し、同じIDを持つそのコンテナのすべてのアプリケーションPDBに接続できます。
次の図に、2つのPDB (hrpdbとsalespdb)のユーザーとスキーマの例を示します。SYSとc##dbaは、CDB$ROOT、hrpdbおよびsalespdbにスキーマを持つCDB共通ユーザーです。ローカル・ユーザーhrとrepは、hrpdbに存在します。ローカル・ユーザーhrとrepは、salespdbにも存在します。
図4: CDBのユーザーとスキーマ
関連情報:
-
共通ユーザー・アカウントについて学習するには、Oracle AI Databaseセキュリティ・ガイドを参照してください
-
COMMON_USER_PREFIXについて学習するには、Oracle AI Databaseリファレンスを参照
SYSおよびSYSTEMアカウント
すべてのOracleデータベースには、管理権限を持つデフォルトの共通ユーザー・アカウントが含まれます。
管理アカウントは高度な権限を持つアカウントであり、データベースを起動および停止したり、メモリーと記憶域を管理したり、データベース・ユーザーを作成および管理したりするなどのタスクの実行を認可されているDBA専用です。
SYS共通ユーザー・アカウントは、データベースが作成されたときに自動的に作成されます。このアカウントでは、すべてのデータベース管理機能を実行できます。SYSスキーマには、データ・ディクショナリの実表とビューが格納されています。これらの実表およびベース・ビューはOracle AI Databaseを操作する場合に重要となります。SYSスキーマ内の表はデータベースによってのみ操作され、ユーザーからは決して変更されません。
SYSTEM管理アカウントも、データベースが作成されたときに自動的に作成されます。SYSTEMスキーマは、管理情報を表示する追加の表とビュー、およびOracle AI Databaseの様々なオプションとツールで使用される内部の表とビューを格納します。SYSTEMスキーマは、管理ユーザー以外のユーザーが必要とする表の格納には決して使用しないでください。
関連情報:
-
ユーザー・アカウントについて学習するには、Oracle AI Databaseセキュリティ・ガイドを参照してください
-
SYS、SYSTEMおよびその他の管理アカウントについて学習するには、『Oracle AI Database管理者ガイド』をクリックします。
ローカル・ユーザー・アカウント
ローカル・ユーザーとは、共通ではなく、1つのPDBでのみ操作が可能なデータベース・ユーザーです。
ローカル・ユーザーには、次の特徴があります。
-
ローカル・ユーザーは、PDBに固有のもので、このPDB内でスキーマが所有できます。
共通ユーザーの特性に示す例では、
hrpdbのローカル・ユーザーhrがhrスキーマを所有しています。salespdbでは、ローカル・ユーザーrepがrepスキーマを、ローカル・ユーザーhrがhrスキーマを所有しています。 -
ローカル・ユーザーは、オープンやクローズなどを含め、PDBを管理できます。
SYSDBA権限を持つ共通ユーザーは、ローカル・ユーザーにSYSDBA権限を付与できます。この場合、権限を付与されたユーザーはローカルのままとなります。 -
あるPDBのローカル・ユーザーは、別のPDBまたはCDBルートにはログインできません。
たとえば、ローカル・ユーザー
hrがhrpdbに接続する場合、hrは、データベース・リンクを使用せずに、salespdbデータベースに常駐するshスキーマのオブジェクトにアクセスすることはできません。同様に、ローカル・ユーザーshがsalespdbPDBに接続する場合、shは、データベース・リンクを使用せずに、hrpdbに存在するhrスキーマのオブジェクトにアクセスすることはできません。 -
ローカル・ユーザーには、
c##またはC##の文字で始まる名前を付けることはできません。 -
ローカル・ユーザーの名前は、PDB内でのみ一意である必要があります。
ユーザー名とそのユーザーのスキーマが含まれているPDBにより、一意のローカル・ユーザーが決まります。「共通ユーザーの特性」では、
repというローカル・ユーザーおよびスキーマはhrpdbに存在することが示されています。repという完全に独立したローカル・ユーザーとスキーマが、salespdbPDBに存在します。
次の表に、CDBに関連するシナリオを共通ユーザーの特性に示します。各行は、前の行のアクションの後に発生する操作について説明します。共通ユーザーSYSTEMが、2つのPDBでローカル・ユーザーを作成します。
表1 CDBの ローカル・ユーザー
| オペレーション | 摘要 |
|---|---|
|
SYSTEMが、サービス名hrpdbを使用してhrpdbコンテナに接続します。 |
|
SYSTEMは、ここでローカル・ユーザーrepを作成し、このユーザーにこのPDBでのCREATE SESSION権限を付与します。共通ユーザーを作成できるのはルートに接続された共通ユーザーのみであるため、このユーザーはローカルです。 |
|
repユーザーは、hrpdbに対するローカル・ユーザーで、salespdbへの接続を試みます。repはPDB salespdbに存在しないため、この試みは失敗します。 |
|
SYSTEMは、サービス名salespdbを使用してsalespdbコンテナに接続します。 |
|
SYSTEMは、salespdbでローカル・ユーザーrepを作成し、このPDBでのCREATE SESSION権限をこのユーザーに付与します。ローカル・ユーザー名はそのPDBでのみ一意である必要があるため、repというユーザーはsalespdbとhrpdbの両方に存在できます。 |
|
repユーザーは、正常にsalespdbにログインします。 |
ローカル・ユーザー・アカウントについて学習するには、『Oracle AI Databaseセキュリティ・ガイド』を参照してください。
共通オブジェクトとローカル・オブジェクト
共通オブジェクトは、CDBルートまたはアプリケーション・ルートのいずれかで定義されており、メタデータ・リンクまたはオブジェクト・リンクを使用して参照できます。ローカル・オブジェクトは、共通オブジェクトではないすべてのオブジェクトです。
データベースによって提供される共通オブジェクトは、CDB$ROOTで定義されており、変更できません。Oracle Databaseでは、CDB$ROOTでの共通オブジェクトの作成はサポートされていません。
アプリケーション・ルートで、表、ビュー、PL/SQLおよびJavaプログラム・ユニット、順序などのほとんどのスキーマ・オブジェクトを共通オブジェクトとして作成できます。オブジェクトがアプリケーション・ルートに存在する場合、それはアプリケーション共通オブジェクトと呼ばれます。
ローカル・ユーザーは共通オブジェクトを所有できます。また、共通ユーザーはローカル・オブジェクトを所有できますが、これはオブジェクトがデータリンクまたはメタデータリンクされてなく、なおかつメタデータ・リンクでもデータ・リンクでもない場合のみです。
共通オブジェクトの権限管理についてさらに学習するには、『Oracle AI Databaseセキュリティ・ガイド』を参照してください。
スキーマ・オブジェクト・タイプ
Oracle SQLでは、他にも多数のタイプのスキーマ・オブジェクトを作成および操作できます。
次の表に、スキーマ・オブジェクトの主要なタイプを示します。
表2スキーマ・オブジェクト
| オブジェクト | 摘要 | 詳細を表示するには |
|---|---|---|
| 表 | テーブルは、データを行に格納します。表は、リレーショナル・データベースで最も重要なスキーマ・オブジェクトです。 | 「表の概要」 |
| 索引 | 索引とは、表または表クラスタの索引付けされた各行のエントリを含み、行に直接かつ高速にアクセスするスキーマ・オブジェクトのことです。Oracle AI Databaseは、いくつかのタイプの索引をサポートしています。索引構成表とは、データが索引の構造で格納される表のことです。 | 「索引と索引構成表」 |
| パーティション | パーティションとは、大規模な表や索引の断片のことです。各パーティションには独自の名前があり、独自の記憶特性を持つ場合があります。 | パーティションの概要に関する項 |
| ビュー | ビューは、1つ以上の表または他のビュー内のデータのカスタマイズ・プレゼンテーションです。ストアド・クエリーと考えることができます。実際にはビューにデータは含まれていません。 | ビューの概要に関する項 |
| シーケンス | 順序とは、ユーザーが作成し、複数のユーザーが整数生成目的で共有できるユーザー作成オブジェクトのことです。通常、順序を使用して主キーの値を生成します。 | 順序の概要 |
| ディメンション | ディメンションは、列セット間の親子関係を定義します。列セットのすべての列は、同じ表から得られたものである必要があります。ディメンションは、主に顧客、製品および時刻などのデータを分類するために使用されます。 | 「ディメンションの概要」 |
| シノニム | シノニムは、別のスキーマ・オブジェクトの別名です。シノニムは単に別名であるため、その定義をデータ・ディクショナリに保存する以外に、保存の必要がありません。 | シノニムの概要に関する項 |
| PL/SQLサブプログラムとPL/SQLパッケージ | PL/SQLは、SQLに対するOracleの手続き型の拡張機能です。PL/SQLサブプログラムは、一連のパラメータで起動できる、名前付きのPL/SQLブロックです。PL/SQLパッケージでは、論理的に関連するPL/SQLタイプ、変数およびサブプログラムがグループ化されます。 | PL/SQLサブプログラム |
データベースには他のタイプのオブジェクトも保存されており、SQL文で作成および操作できますが、スキーマには含まれていません。これらのオブジェクトには、データベース・ユーザー・アカウント、ロール、コンテキストおよびディクショナリ・オブジェクトが含まれています。
関連情報:
-
スキーマ・オブジェクトの管理方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
スキーマ・オブジェクトをデータベース・オブジェクトの詳細は、『Oracle AI Database SQL言語リファレンス』を参照してください。
スキーマ・オブジェクトの格納
一部のスキーマ・オブジェクトでは、セグメントと呼ばれる論理記憶域構造のタイプでデータを格納しています。たとえば、パーティション化されていないヒープ構成表や索引では、セグメントを作成します。
ビューや順序などの他のスキーマ・オブジェクトは、メタデータのみで構成されます。このトピックでは、セグメントを持つスキーマ・オブジェクトについてのみ説明します。
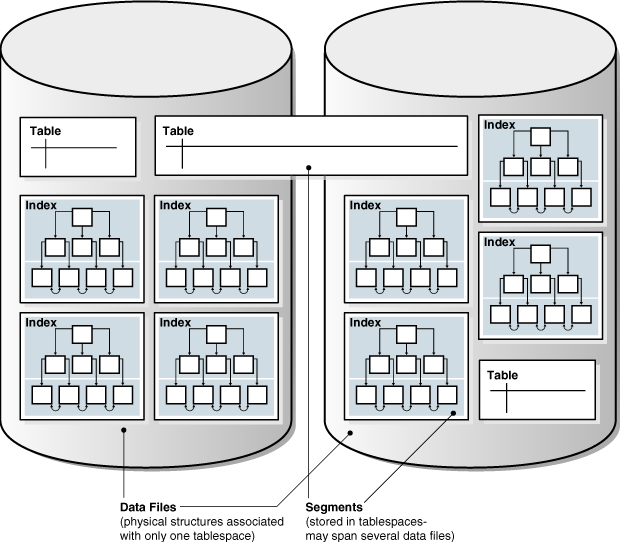
Oracle AI Databaseでは、スキーマ・オブジェクトは表領域内に論理的に格納されます。スキーマと表領域には関連はなく、表領域は異なるスキーマのオブジェクトを含むことができ、スキーマの各オブジェクトは異なる表領域に含めることができます。各オブジェクトのデータは、物理的には、1つ以上のデータファイルに格納されます。
次の図に、表と索引のセグメント、表領域およびデータファイルの可能な構成を示します。1つの表のデータ・セグメントが2つのデータファイル(両方とも同じ表領域の一部)にまたがっています。セグメントが複数の表領域にまたがることはできません。
図5: セグメント、表領域およびデータファイル
関連情報:
-
表スペースとセグメントについて学習するには、「論理記憶域構造」を参照してください
-
スキーマ・オブジェクトの記憶域を管理する方法を学習するには、『Oracle AI Database管理者ガイド』を参照してください。
スキーマ・オブジェクトの依存性
一部のスキーマ・オブジェクトは、他のオブジェクトを参照し、スキーマ・オブジェクトの依存性を作成します。
たとえば、ビューに表またはビューを参照する問合せが含まれている場合には、PL/SQLサブプログラムが他のサブプログラムを起動する場合。オブジェクトAの定義がオブジェクトBを参照している場合、Aは、Bの依存オブジェクト、BはAの参照オブジェクトです。
Oracle AI Databaseには、依存オブジェクトがその参照オブジェクトに関して常に最新であることを保証する自動メカニズムが用意されています。依存オブジェクトを作成すると、データベースによって、依存オブジェクトとその参照オブジェクトとの間の依存性が追跡します。参照オブジェクトに変更があり、依存オブジェクトがその影響を受ける可能性がある場合は、データベースにより依存オブジェクトに無効のマークが付けられます。たとえば、ユーザーが表を削除した場合、その表に基づくビューは使用できなくなります。
無効な依存オブジェクトを使用できるようにするには、その依存オブジェクトが参照オブジェクトの新しい定義で再コンパイルされる必要があります。再コンパイルが行われるのは、無効な依存オブジェクトが参照された場合です。
スキーマ・オブジェクトでどのように依存性を作成できるかを示す例として、次のサンプル・スクリプトでは、表test_tableを作成し、この表を問い合せるプロシージャを作成します。
CREATE TABLE test_table ( col1 INTEGER, col2 INTEGER );

CREATE OR REPLACE PROCEDURE test_proc
AS
BEGIN
 FOR x IN ( SELECT col1, col2 FROM test_table )
 LOOP
   -- process data
   NULL;
 END LOOP;
END;
/次のようにプロシージャtest_procのステータスを問い合せると、プロシージャは有効であることが示されます。
SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC VALIDtest_tableにcol3列を追加しても、プロシージャにはこの列に対する依存性がないため、その後もプロシージャは有効です。
SQL> ALTER TABLE test_table ADD col3 NUMBER;

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC VALIDただし、test_procプロシージャが依存しているcol1列のデータ型を変更すると、プロシージャは無効化されます。
SQL> ALTER TABLE test_table MODIFY col1 VARCHAR2(20);

Table altered.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC   INVALID
次の例に示すように、プロシージャを実行または再コンパイルすると、プロシージャは再び有効になります。
SQL> EXECUTE test_proc

PL/SQL procedure successfully completed.

SQL> SELECT OBJECT_NAME, STATUS FROM USER_OBJECTS WHERE OBJECT_NAME = 'TEST_PROC';

OBJECT_NAME STATUS
----------- -------
TEST_PROC VALID関連項目:スキーマ・オブジェクトの依存性の管理方法を学習するには、『Oracle AI Database管理者ガイド』および『Oracle AI Database開発ガイド』を参照してください。
サンプル・スキーマ
Oracleデータベースには、サンプル・スキーマが含まれる場合があります。サンプル・スキーマは、OracleドキュメントおよびOracleのインストラクション資料で一般的なデータベース・タスクを説明できるようにする、相互リンクされたスキーマのセットです。
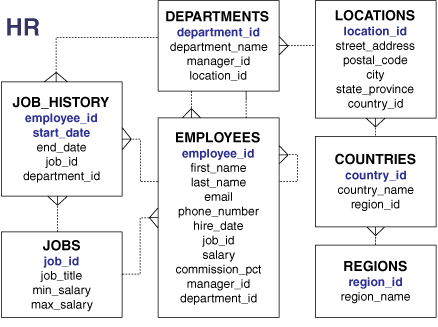
hrサンプル・スキーマには、従業員、部門、勤務地、職歴などの情報が含まれています。次の図に、hr内の表のエンティティ関連ダイアグラムを示します。このマニュアルのほとんどの例では、このスキーマのオブジェクトを使用します。
図6: HRスキーマ
関連項目:サンプル・スキーマのインストール方法を学習するには、『Oracle AI Databaseサンプル・スキーマ』を参照
表の概要
表は、Oracleデータベースのデータ編成の基本単位です。
表には、記録が必要な情報に関してなんらかの意味を持ったエンティティが記述されます。たとえば、従業員がエンティティになることがあります。
Oracle AI Databaseの表は、次の基本カテゴリに分類されます。
-
リレーショナル・テーブル
リレーショナル表は、単純な列で構成された最も一般的な表タイプです。例4-1に、リレーショナル表の
CREATE TABLE文を示します。 -
オブジェクトテーブル
列は、オブジェクト型のトップレベルの属性に対応しています。「オブジェクト表の概要」を参照してください。
次の構成特性を持つリレーショナル表を作成できます。
-
ヒープ構成表では、行は特定の順序で格納されません。デフォルトでは、
CREATE TABLE文でヒープ構成表が作成されます。 -
索引構成表では、主キー値に従って行が整列に並びます。アプリケーションによっては、索引構成表によりパフォーマンスが強化され、ディスク領域をより効率的に使用できるものがあります。「索引構成表の概要」を参照してください。
-
外部表は読取り専用の表であり、メタデータはデータベースに格納されますが、データはデータベースの外部に格納されます。「外部表の概要」を参照してください。
表は永続または一時のいずれかです。永続表の定義とデータは、セッションをまたいで存続します。一時表の定義は永続表の定義と同様に存続しますが、データはトランザクションまたはセッションの期間中にのみ存在します. 一時表は、複数の操作の実行によって結果を作成する場合があるために、結果セットを一時的に保持する必要があるアプリケーションで役立ちます。
-
列表の定義には、表名と列の集合が含まれています。
-
行は、表内のレコードに対応する列情報の集合です。
-
例: CREATE TABLE文とALTER TABLE文表を作成するためのOracle SQL文は、
CREATE TABLEです。 -
Oracleデータ型各列にはデータ型があり、これは、特定の記憶域形式、制約および値の有効範囲に関連付けられています。値のデータ型は、固定されたプロパティの集合を値に関連付けます。
-
整合性制約整合性制約は、表の1つ以上の列の値を制限する名前付き規則です。
-
表記憶域 Oracle AI Databaseは、表領域内のデータ・セグメントを使用して表データを保持します。
-
表圧縮データベースでは、表圧縮を使用して、表に必要な記憶域の量を削減できます。関連項目:表の管理方法を学習するには、『Oracle AI Database管理者ガイド』を参照してください。
カラム
表の定義には、表名と列の集合が含まれています。
列は、表で示されるエンティティの属性を識別します。たとえば、employees表の列employee_idは、従業員エンティティの従業員ID属性を参照します。
通常、表を作成するとき、各列に列名、データ型、および幅を指定します。たとえば、employee_idのデータ型がNUMBER(6)である場合、この列に6桁以内の幅の数値データのみが格納されることを示します。幅は、DATEデータ型の場合のようにデータ型によって事前に決定されている場合があります。
-
仮想列表には、式列とも呼ばれる仮想列を含めることができます。式列は、仮想(ディスクに格納されない)または実体化(ディスクに格納される)のいずれかです。
-
非表示列 非表示列とは、列が明示的に名前で指定される場合のみ値が表示されるユーザー指定の列です。既存のアプリケーションに影響を与えることなく不可視の列を表に追加でき、必要ならばその列を表示可能にできます。
-
ロックフリー予約 ロックフリー予約では、数値列の値に対して加減算を実行するときに、コミットされていない更新によって阻ストされることがなく、その列値に対して複数の更新を同時に進めるできます。
仮想列
表には、仮想列(式列とも呼ばれる)を含めることができます。式列は、仮想(ディスクに格納されない)または実体化(ディスクに格納される)のいずれかです。
仮想列は式列とも呼ばれ、ユーザー指定の式または関数のセットを計算して値を導出します。表には、このような複数の列の1つを含めることができますが、常に1つの通常の列が必要です。たとえば、次のEMP表定義には、従業員の給与を年間2080時間で割った値に基づいて計算された時給が含まれています。
CREATE TABLE emp
(
   emp_id           NUMBER(9)     CONSTRAINT emp_pk PRIMARY KEY,
   emp_last_name    VARCHAR2(30)  CONSTRAINT emp_last_name_nn NOT NULL,
   emp_first_name   VARCHAR2(30)  CONSTRAINT emp_first_name_nn NOT NULL,
   emp_salary       NUMBER(9,2),
   emp_hourly_rate  NUMBER(7,2)   GENERATED ALWAYS AS (emp_salary/2080) VIRTUAL,
   emp_phone_no     VARCHAR2(10)
);
次に、非仮想列に値を挿入します。
INSERT INTO emp (emp_id, emp_last_name, emp_first_name, emp_salary, emp_phone_no)
VALUES (8291, 'Patel', 'Siddharth', 60000, '6505551234');
表を問い合せると、計算された値が式列として返されます。
SELECT * FROM emp;

 EMP_ID EMP_LAST_NAME  EMP_FIRST_NAME     EMP_SALARY  EMP_HOURLY_RATE EMP_PHONE_NO
_______ ______________ _______________ _____________ ________________ _____________
   8291 Patel          Siddharth               60000            28.85 6505551234
このような式の列は、ディスク上で仮想または実体化できます。純粋な仮想(式)列の場合、列値はディスク領域を消費せず、アクセス時にオンデマンドで計算されます。マテリアライズド式列の場合、値はDML時に計算され、ディスクに格納されます。
関連項目:仮想列の管理方法を学習するには、Oracle AI Database管理者ガイドを参照してください。
非表示列
非表示列とは、列が明示的に名前で指定される場合のみ値が表示されるユーザー指定の列です。既存のアプリケーションに影響を与えることなく不可視の列を表に追加でき、必要ならばその列を表示可能にできます。
一般に、非表示列により、オンライン・アプリケーションの移行や開発がしやすくなります。ユースケースが、3列の表をSELECT *文で問い合せるアプリケーションだとします。この表に4番目の列を追加すると、3列のデータを必要とするアプリケーションは破損します。4番目の非表示列を追加すると、アプリケーションは正常に機能します。そこで開発者は、4番目の列を処理できるようにアプリケーションを変更して、アプリケーションが起動すると、その列が表示されるようにすることができます。
次の例では、表productsを非表示列countを付けて作成し、その非表示列を表示します。
CREATE TABLE products ( prod_id INT, count INT INVISIBLE );
ALTER TABLE products MODIFY ( count VISIBLE );
関連情報:
-
非表示列の管理方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
非表示列の詳細は、『Oracle AI Database SQL言語リファレンス』を参照してください。
ロックフリー予約
ロックフリー予約では、数値列の値に対して加減算を実行するときに、コミットされていない更新によって阻まれることがなく、その列値に対して複数の更新を同時に進めるできます。
この機能では、予約可能列に対して頻繁に複数の更新が同時発生する場合でも、更新中に従来のロック・メカニズムが回避されるため、阻止されることが減り、ユーザー・エクスペリエンスが大幅に向上します。以前のリリースでは、行の列値を加算または減算によって更新すると、そのトランザクションがコミットされるまで、その行に対する他のすべての更新が阻止されます。Oracle AI Database 26aiでのロックフリー予約機能の導入により、更新を進めるための条件を指定することで、多くのトランザクションで、同じ行の予約可能列に対して加算または減分を同時に実行できるようになります。これは、その数値列が予約可能列であることを指定し、その列のCHECK制約を作成することで実現されます。予約可能列の更新では行がロックされることがなく、したがって、同じ行の予約不可列が同時に別のトランザクションによって更新されてもそれが阻止されることはないため、さらにスループットが向上する可能性もあります。
たとえば、在庫数量に対する加算操作と減算操作を、手持ちの数量がそのリクエストに対して十分であり100品目分の棚スペースを超えなければ成功するように条件指定できます。数量値に対するこのような更新は、その数量値がゼロより大きく100以下であるかぎり、コミットされていない更新によって阻止されることなく続行できます。加算または減算される量は内部の予約メカニズムによって予約され保証されるため、そのトランザクションは、同じ行の予約可能列に関して先に予約を行った他のトランザクションがコミットされるまで待つことなく、続行されます。
表レベルのCHECK制約には、予約可能列と予約不可列の両方を含めることができます。保留状態のロックフリー予約が、更新が発行された時点で承認された場合、後で、トランザクションのコミット時にそのような制約に違反する可能性があります。これは、その制約の予約不可列が予約後に更新されており更新後の値がそのCHECK制約に違反している場合に発生する可能性があります。そのトランザクションは、その制約に違反している場合は終了される必要があります。ただし、表レベルの制約における予約不可列は、通常は、変更されることがめったにないしきい値です。このようなしきい値の例としては、棚スペース、口座の必要残高、および支出限度があります。
次の例では、予約可能列qty_on_handがある表inventoryを作成します。qty_on_handに対するCHECK制約では、qty_on_handに対する更新を他の更新を阻止することなく続行するには、商品の在庫がゼロ個以上であり、棚に収容可能な商品数を超えない必要があると指定されています。下の例では、inventory表を適切な制約付きで作成し、複数のデータ行を挿入し、inventory表のデータ・ディクショナリに問い合せます。
CREATE TABLE inventory
( item_id            NUMBER          CONSTRAINT inv_pk PRIMARY KEY,
  item_display_name  VARCHAR2(100)   NOT NULL,
  item_desc          VARCHAR2(2000),
  qty_on_hand        NUMBER          RESERVABLE CONSTRAINT qty_ck CHECK
                                        (qty_on_hand >= 0) NOT NULL,
  shelf_capacity     NUMBER          NOT NULL,
    CONSTRAINT shelf_ck CHECK (qty_on_hand <= shelf_capacity)
);

-- Insert a few rows in the inventory table
INSERT INTO inventory VALUES (123, 'Milk', 'Lowfat 2%', 100, 120);
INSERT INTO inventory VALUES (456, 'Bread', 'Multigrain', 50, 100);
INSERT INTO inventory VALUES (789, 'Eggs', 'Organic', 50, 75);

COMMIT;

SELECT * FROM inventory;

-- Check views user_tab_cols and user_tables to check
-- if the table is a reservable table and the names of the reservable columns

SELECT table_name, has_reservable_column
FROM   user_tables
WHERE  table_name = 'INVENTORY';

SELECT column_name, reservable_column
FROM   user_tab_cols
WHERE  table_name = 'INVENTORY'
  AND  reservable_column = 'YES';
予約可能列に対する複数の更新の同時実行の例:
-
トランザクション 1:
UPDATE inventory SET qty_on_hand = qty_on_hand - 10 WHERE item_id = 123; -
トランザクション 2:
UPDATE inventory SET qty_on_hand = qty_on_hand + 20 WHERE item_id = 123; -
トランザクション 3:
UPDATE inventory SET qty_on_hand = qty_on_hand - 30 WHERE item_id = 123; -
トランザクション 2:
commit; -
トランザクション 3:
commit; -
トランザクション 1:
commit;
予約可能列は、オプションのCHECK制約を指定してALTER TABLEコマンドを使用することで、表に追加できます。例:
ALTER TABLE inventory ADD
(qty_on_hold NUMBER RESERVABLE DEFAULT 0
CONSTRAINT qty_hold CHECK (qty_on_hold >= 0 and qty_on_hold <= 25));予約可能列は、次のALTER TABLEコマンドを使用して予約不可列に変換できます。予約可能予約が無効になってもアプリケーションによって制約が強制適用される場合があります。そのため、列が予約不可列に変換されてからも制約が自動的に削除されないことはありません。制約の削除はオプションであるため、必要に応じて実行してください。たとえば:
ALTER TABLE inventory MODIFY (qty_on_hand NOT RESERVABLE);
ALTER TABLE inventory DROP CONSTRAINT qty_ck;予約不可列は、ALTER TABLEコマンドを使用して予約可能列に変換できます。例:
ALTER TABLE inventory MODIFY
(qty_on_hand RESERVABLE
 CONSTRAINT qty_ck CHECK (qty_on_hand >= 0 and qty_on_hand <= 100));
行
行は、表内のレコードに対応する列情報の集合です。
たとえば、employees表の行では、特定の従業員の属性(従業員ID、姓、名など)が記述されます。表の作成後に、SQL文を使用して行の挿入、問合せ、削除および更新ができます。
例: CREATE TABLEステートメントとALTER TABLEステートメント
表を作成するためのOracle SQL文は、CREATE TABLEです。
例4-1 CREATE TABLE employees
次の例に、hrサンプル・スキーマに含まれるemployees表のCREATE TABLE文を示します。この文では、employee_idおよびfirst_nameなどの列を指定し、各列にNUMBERまたはDATEなどのデータ型を指定します。
CREATE TABLE employees
    ( employee_id    NUMBER(6),
      first_name     VARCHAR2(20),
      last_name      VARCHAR2(25)   CONSTRAINT emp_last_name_nn  NOT NULL,
      email          VARCHAR2(25)   CONSTRAINT emp_email_nn      NOT NULL,
      phone_number   VARCHAR2(20),
      hire_date      DATE           CONSTRAINT emp_hire_date_nn  NOT NULL,
      job_id         VARCHAR2(10)   CONSTRAINT emp_job_nn        NOT NULL,
      salary         NUMBER(8,2),
      commission_pct NUMBER(2,2),
      manager_id     NUMBER(6),
      department_id  NUMBER(4),
      CONSTRAINT     emp_salary_min CHECK (salary > 0),
      CONSTRAINT     emp_email_uk   UNIQUE (email)
    ) ;
例4-2 ALTER TABLE employees
次の例に、employees表に整合性制約を追加するALTER TABLE文を示します。整合性制約はビジネス・ルールを適用し、無効な情報が表に入力されるのを防止します。
ALTER TABLE employees
ADD ( CONSTRAINT emp_emp_id_pk   PRIMARY KEY (employee_id),
      CONSTRAINT emp_dept_fk     FOREIGN KEY (department_id)
                                   REFERENCES departments,
      CONSTRAINT emp_job_fk      FOREIGN KEY (job_id)
                                   REFERENCES jobs (job_id),
      CONSTRAINT emp_manager_fk  FOREIGN KEY (manager_id)
                                   REFERENCES employees
    ) ;
例4-3 employees表の行
次のサンプル出力は、8行および6列のhr.employees表を示しています。
EMPLOYEE_ID FIRST_NAME  LAST_NAME      SALARY COMMISSION_PCT DEPARTMENT_ID
----------- ----------- ------------- ------- -------------- -------------
        100 Steven      King            24000                           90
        101 Neena       Kochhar         17000                           90
        102 Lex         De Haan         17000                           90
        103 Alexander   Hunold           9000                           60
        107 Diana       Lorentz          4200                           60
        149 Eleni       Zlotkey         10500             .2            80
        174 Ellen       Abel            11000             .3            80
        178 Kimberely   Grant            7000            .15
前述の出力は、表、列および行に関する、次の重要な特徴のいくつかを示しています。
-
表の行には、1人の従業員の、名前、給与、部門などの属性が記述されます。たとえば、出力の最初の行には、Steven Kingという名前の従業員のレコードが表示されています。
-
列には、従業員の属性が記述されます。この例では、
employee_id列が主キーであり、すべての従業員が従業員IDで一意に識別されることを意味します。2人の従業員が同じ従業員IDを持たないことが保証されます。 -
非キー列には、同じ値の行が含まれることがあります。この例では、従業員101と従業員102の給与の値が同じ
17000です。 -
外部キー列は、同じ表または別の表の主キーや一意キーを参照します。この例では、
department_idの90の値は、departments表のdepartment_id列に対応しています。 -
フィールドは、行と列の交差部分です。 フィールドには1つの値のみが含まれます。たとえば、従業員103の部門IDのフィールドには、値
60が含まれています。 -
フィールドには、値がないこともあります。この場合、フィールドにはNULL値が含まれることになります。従業員100の
commission_pct列の値はNULLですが、従業員149のこのフィールドの値は.2です。列にNULL値を入力できるのは、その列にNOTNULLまたは主キー整合性制約が定義されていない場合のみです。この場合、その列に値を持たない行は挿入できません。
関連項目: CREATE TABLEの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照してください。
Oracleのデータ型
各列には、特定の記憶域形式、制約および値の有効範囲に関連付けられたデータ型があります。値のデータ型により、固定されたプロパティの集合がその値に関連付けられます。
これらのプロパティによって、Oracle AI Databaseは、あるデータ・タイプの値を別のデータ・タイプの値とは別の方法で扱います。たとえば、NUMBERデータ型の値を乗算できますが、RAWデータ型の値は乗乗算できません。
表を作成する場合、各列のデータ型を指定する必要があります。その後、列に挿入した各値はその列をデータ型と想定します。
Oracle AI Databaseには、いくつかの組込みデータ型が用意されています。最も一般的に使用されるデータ型は、この項で説明するカテゴリに分類されます。
組込みデータ型のその他の重要なカテゴリには、RAW、ラージ・オブジェクト(LOB)およびコレクションがあります。PL/SQLには、定数と変数のデータ型として、BOOLEAN、参照型、コンポジット型(レコード)およびユーザー定義型があります。
-
文字データ型文字データ型は 英数字データを文字列で格納します。最も一般的な文字データ型は
VARCHAR2で、文字データを最も効率よく格納できます。 -
数値データ型Oracle AI Databaseの数値データ型には、固定小数点数数、浮動小数点数、ゼロおよび無限大が格納されます。いくつかの数値データ型には操作結果の未定義を示す値も格納され、これは、非数値つまり
NaNと呼ばれます。 -
日時データ型 日時データ型は、
DATEとTIMESTAMPです。Oracle AI Databaseでは、タイム・スタンプに対する包括的なタイムゾーン・サポートが提供されます。 -
ROWIDデータ型データベースに格納されているどの行にも、アドレス(データベース内のその行を特定するための内部表現)があります。Oracle AI Databaseでは、
ROWIDデータ型にデータベース内の各ロウのアドレス(ROWID)が格納されます。 -
ブール・データ型BOOLEANデータ型は、明確な真理値
TrueおよびFalseで構成されます。 -
書式モデルとデータ型書式モデルとは、格納された日時または数値データの書式を文字列で記述する文字リテラルです。フォーマット・モデルはデータベース内の値の内部表現を変更しません。
関連情報:
-
組込みのSQLデータ型について学習するには、『Oracle AI Database SQL言語リファレンス』
-
PL/ SQLデータ型について学習するには、『Oracle AI DatabasePL/SQL0パッケージおよびタイプ・リファレンス』を参照
-
組込みデータ型の使用方法を学習するには、『Oracle AI Database開発ガイド』を参照
文字データ型
文字データ型は、英数字データを文字列で格納します。最も一般的な文字データ型はVARCHAR2で、文字データを最も効率よく格納できます。
バイト値は、文字エンコーディング体系(通常、文字セットと呼ばれます)に対応します。データベースの文字セットは、データベースの作成時に設定されます。文字セットの例には、7ビットASCII、EBCDICおよびUnicode UTF-8があります。
文字データ型の長さセマンティクスは、バイト数または文字数で測定できます。文字列を一連のバイトとして取り扱っていることは、バイトセマンティクスと呼ばれます。これは、文字データ型のデフォルトです。文字列を一連の文字として取り扱っていることは、キャラクタ・セマンティクスと呼ばれます。文字は、データベース文字セットのコード・ポイントです。
-
VARCHAR2およびCHARデータ型
VARCHAR2データ型は、可変長文字リテラルを格納します。リテラルとは、固定データ値です。 -
NCHARおよびNVARCHAR2データ型
NCHARおよびNVARCHAR2データ型はUnicode文字データを格納します。
関連情報:
-
文字セットについてさらに学習するには、Oracle AI Databaseグローバリゼーション・サポート・ガイドを参照してください。
-
データ型の概要は、Oracle AI Database Oracle AI Database開発スタート・ガイドを参照してください
-
文字データ型の選択方法を学習するには、『Oracle AI Database開発ガイド』を参照
VARCHAR2およびCHARデータ型
VARCHAR2データ型には、可変長の文字リテラルが格納されます。リテラルとは、固定データ値です。
たとえば、'LILA'、'St. George Island'および'101'はすべて文字リテラルで、5001は数値リテラルです。文字リテラルは、一重引用符で囲み、これにより、データベースでスキーマ・オブジェクト名と区別できます。ノート: このマニュアルでは、テキスト・リテラル、文字リテラルおよび文字という用語を区別して使用しています。
VARCHAR2の列を含む表の作成時には、文字列の最大長を指定します。例4-1では、last_name列にVARCHAR2(25)というデータ型が定義されており、これは、この列に最大25バイトの名前を格納できることを意味します。
それぞれの行で、列の値はOracle AI Databaseにより可変長のフィールドとして格納され、値が最大長を超えている場合は、データベースからエラーが戻されます。たとえば、シングルバイト文字セットで、ある行のlast_name列に10文字を入力すると、その行の列には25文字ではなく10文字(10バイト)のみが格納されます。VARCHAR2を使用することにより、領域の消費量を削減できます。
VARCHAR2とは異なり、CHARは、固定長の文字列を格納します。CHAR列を含む表の作成時には、列の文字列の長さを指定する必要があります。デフォルトは1バイトです。データベースは、空白を使用して指定された長さまで値を埋め込みます。
Oracle AI Databaseは、非スペース埋め比較セマンティクスを使用してVARCHAR2値を比較し、空白埋め比較セマンティクスを使用してCHAR値を比較します。
関連項目:空白埋め比較および非空白埋め比較セマンティクスの詳細は、『Oracle AI Database SQL言語リファレンス』を参照してください。
NCHARおよびNVARCHAR2データ型
NCHARとNVARCHAR2 データ型は、Unicode文字データを格納します。
Unicodeは、ユニバーサル・エンコードされた文字セットであり、1つの文字セットを使用して任意の言語で情報を格納できます。NCHARは、各国語文字セットに対応する固定長の文字列を格納します。一方、NVARCHAR2は可変長の文字列を格納します。
データベースの作成時に各国語文字セットを指定します。NCHARデータ型とNVARCHAR2データ型の文字セットは、AL16UTF16またはUTF8のいずれかにする必要があります。どちらの文字セットでも、Unicodeエンコーディングが使用されます。
NCHARまたはNVARCHAR2の列で表を作成すると、最大サイズは、必ず文字長セマンティクスになります。文字長セマンティクスはNCHARまたはNVARCHAR2のデフォルトであり、その唯一の長さセマンティクスです。
関連項目: Oracleのグローバリゼーション・サポート機能の詳細は、『Oracle AI Databaseグローバリゼーション・サポート・ガイド』を参照してください
数値のデータ型
Oracle AI Databaseの数値データ型には、固定小数点数数、浮動小数点数、ゼロおよび無限大が格納されます。いくつかの数値データ型には操作結果の未定義を示す値も格納され、これは、非数値つまりNaNと呼ばれます。
Oracle AI Databaseでは、数値データが可変長形式で格納されます。それぞれの値は科学表記法で格納され、指数を格納するために1バイトが使用されます。データベースでは、仮数(浮動小数点数の一部の部分で、有効桁数を含む部分)を格納するために最大20バイトが使用されます。Oracle AI Databaseでは、先行および後続のゼロは格納されません。
-
NUMBERデータ型
NUMBERデータ型には、固定浮動小数点数および浮動小数点数数が格納されます。実質的には、どのような大きさの数値でも、データベースに格納可能です。Oracle AI Databaseが稼働するオペレーティング・システムであれば、これらのデータを移植することが可能です。数値データの格納が必要となるほとんどの場合で、NUMBERデータ型をお薦めします。 -
浮動小数点数値 Oracle AI Databaseでは、浮動小数点数値専用に、
BINARY_FLOATおよびBINARY_DOUBLEという2つの数値データ型が用意されています。
NUMBERデータ型
NUMBERデータ型には、固定小数点数および浮動小数点数が格納されます。実質的には、どのような大きさの数値でも、データベースに格納可能です。Oracle AI Databaseが稼働するオペレーティング・システムであれば、これらのデータを相互に移植することが可能です。数値データの格納が必要となるほとんどの場合で、NUMBERデータ型をお薦めします。
固定小数点数は、NUMBER(p,s)という形式で指定します。このpおよびsは、次の特性を示しています。
-
精度
precisionは、桁数の合計を指定します。精度を指定しない場合、値は丸められることなく、アプリケーションから提供されたとおりに列に格納されます。
-
スケール
スケールは、小数点から最下位の有効桁までの桁数を指定します。正スケールは、小数点の右側から最下位の有効桁まで(最上位有効桁も含む)の桁数をカウントします。負の値のスケールは、小数点左側から最下位の有効桁まで(ただし、最上位有効桁を含まない)の桁数をカウントします。
NUMBER(6)のように、精度を指定してスケールを指定しない場合、スケールは0になります。
例4-1では、salary列はNUMBER(8,2)型であるため、精度は8でスケールは2です。したがって、100,000という給料は、データベースに100000.00という値で格納されます。
浮動小数点数
Oracle AI Databaseでは、浮動小数点数値専用にBINARY_FLOATおよびBINARY_DOUBLEという2つの数値データ型が用意されています。
これらのデータ型は、NUMBERデータ型の基本機能をすべてサポートしています。ただし、NUMBERは10進精度を使用しますが、BINARY_FLOATおよびBINARY_DOUBLEは2進精度を使用します(2進精度により、算術計算が高速になり、通常は記憶域必要量が減少します)。
BINARY_FLOATとBINARY_DOUBLEは、近似値データ型です。どちらにも、10進値の正確な表現ではなく近似値表現が格納されます。たとえば、BINARY_DOUBLEまたはBINARY_FLOATでは、値0.1を正確に表現できません。この2つは、通常科学関係の計算に使用されます。両者の動作は、JavaとXMLSchemaのデータ型FLOATおよびDOUBLEに似ています。
精度、スケールおよびその他の数値データ型の特性について学習するには、『Oracle AI Database SQL言語リファレンス』を参照してください。
日時データ型
日時データ型は、DATEとTIMESTAMPです。Oracle AI Databaseでは、タイム・スタンプに対する包括的なタイムゾーン・サポートが提供されます。
-
DATEデータ型
DATEデータ型には、日付と時刻が格納されます。日時は、文字または数値のデータ型で表現できますが、DATEには、関連付けられた特別なプロパティがあります。 -
TIMESTAMPデータ型
TIMESTAMPデータ型は、DATEデータ型の拡張です。
DATEデータ型
DATEデータ型には、日付と時刻が格納されます。日時は、文字または数値のデータ型で表現できますが、DATEには、関連付けられた特別なプロパティがあります。
データベースには、日付が数字として内部的に格納されます。日付は、それぞれ世紀、年、月、日、時、分および秒に対応する7バイトの固定長フィールドに格納されます。ノート:日付では算術演算が完全にサポートされているため、数値の場合とまったく同様に日付を加算および減算できます。
データベースでは、指定された書式モデルに従って日付が表示されます。書式モデルは、日時の書式を文字列で記述する文字リテラルです。標準の日付書式はDD-MON-RRであり、日付は01-JAN-11の形式で表示されます。
RRは、YY(年の最後の2桁)と似ていますが、戻り値の世紀は、指定された2桁の年と現在の年の最後の2桁に応じて異なります。1999年の日付がデータベースに01-JAN-11と表示されるとします。日付書式にRRを使用する場合、11は2011を指しますが、日付書式にYYを使用する場合、11は1911を指します。デフォルトの日付書式は、データベース・インスタンスとセッション・レベルの両方で変更できます。
Oracle AI Databaseでは、時刻はHH:MI:SSの24時間形式で格納されます。時刻部分に何も指定しない場合、デフォルトでは、日付フィールドの時刻部分は00:00:00 A.M.になります。時刻のみの入力では、日付部分は現在の月の1日にデフォルト設定されます。
関連情報:
-
世紀および日付書式マスクの詳細は、『Oracle AI Database開発ガイド』を参照してください。
-
日時書式コードの詳細は、『Oracle AI Database SQL言語リファレンス』を参照してください。
-
日時データ型を使用した算術演算の実行方法を学習するには、『Oracle AI Database開発ガイド』を参照
TIMESTAMPデータ型
TIMESTAMPデータ型は、DATEデータ型を拡張したものです。
TIMESTAMPには、DATEデータ型に格納される情報に加え、小数秒が格納されます。TIMESTAMPデータ型は、イベントの順序を追跡する必要があるアプリケーションなどで、正確な時間を格納するために役立ちます。
DATETIMEデータ型のTIMESTAMP WITH TIME ZONEおよびTIMESTAMP WITH LOCAL TIME ZONEでは、タイム・ゾーンも認識されます。ユーザーがデータを選択すると、値はユーザー・セッションのタイム・ゾーンに調整られます。このデータ型は、複数の地理的地域にまたがって日付情報を収集および評価する場合に役立ちます。
関連項目:タイムスタンプ列のデータの作成と入力を行う構文の詳細は、『Oracle AI Database SQL言語リファレンス』を参照してください。
ROWIDデータ型
データベースに格納されているどの行にも、アドレス(データベース内のその行を特定するための内部表現)があります。Oracle AI Databaseでは、ROWIDデータ型にデータベース内の各行に対応するアドレス(ROWID)が格納されます。
ROWIDは、次のカテゴリに分類されます。
-
物理ROWIDは、ヒープ構成表の行アドレス、表クラスタ、表パーティションおよび索引パーティションに格納します。
-
論理ROWIDは、索引構成表に行のアドレスを格納します。
-
外部ROWIDは、ゲートウェイを介してアクセスされるDB2表などの外部表の識別子です。これらは、標準のOracle AI DatabaseROWIDではありません。
ユニバーサルROWidまたはUROWidと呼ばれるデータ型は、すべてのタイプのROWIDをサポートしています。
-
ROWIDの使用 Oracle AI Databaseでは、ROWIDが内部的に使用して索引が構築されます。
-
ROWID疑似列 Oracleデータベース内の各表には、
ROWIDという疑似列があります。
ROWIDの使用
Oracle AI Databaseでは、ROWIDが内部的に使用して索引が構築されます。
最も一般的なタイプはBツリー索引で、このキーは、範囲に分割され、順序付けられたキーのリストから構成されています。それぞれのキーは、高速アクセスのために、対応する行のアドレスを指すrowidに関連付けられています。
エンド・ユーザーとアプリケーション開発者は、次のような重要な用途にROWIDを使用することもできます。
-
ROWIDは、行に素早く再アクセスするための手段であり、ある行に再びアクセスするときに、その
ROWIDが以前にSELECT文で取得されていれば、高速にアクセスできます。 -
ROWIDは表の編成を把握する機能を提供します。
ROWIDデータ型で定義した列を含めて表を作成することはできますが、後で、データへのアクセスに使用する目的でROWIDを格納しないでください。このような方法でROWIDを使用すると、予測不可能な結果や誤った結果になる可能性があります。行のrowidは、ユーザーが起動するか、データベース・エンジンによって内部的に原因となる様々な理由で変更される可能性があります。このような操作が発生した後は、ROWIDが同じ行や有効な行を指していない可能性があります。
ROWID疑似列
Oracleデータベースのそれぞれの表は、ROWIDという名前の疑似列を持っています。
疑似列は表の列のように動作しますが、実際は表に格納されません。擬似列からの選択は可能ですが、擬似列に対する値の挿入、更新または削除はできません。擬似列は、引数のないSQL関数にも似ています。引数のない関数は通常、結果セットの各行に同じ値を戻しますが、疑似列は通常、行ごとに異なる値を戻します。
ROWID疑似列の値は、各行のアドレスを表す文字列です。これらの文字列は、ROWIDデータ型です。SELECTまたはDESCRIBEを実行して表の構造をリストしても疑似列は表示されず、疑似列は領域も使用しません。ただし、それぞれの行のROWIDは、予約語ROWIDを列名として使用すると、SQL問合せで取得できます。
次の例では、ROWID疑似列を問い合せて、employees表にある従業員100の行のROWidを表示します。
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
関連情報:
-
アドレスによる行の識別方法を学習するには、『Oracle AI Database開発ガイド』を参照
-
ROWIDデータ型について学習するには、『Oracle AI Database SQL言語リファレンス』を参照してください。
ブール・データの種類
BOOLEANデータ型は、明確な真理値TrueおよびFalseで構成されます。
NOT NULL制約によって禁止されていないかぎり、ブール・データ型でも真理値UNKNOWNがNULL値としてサポートされます。ブール・データ型はOracle SQL構文でデータ型が出現するたびにいつでも使用できます。
関連情報:
- ブール・データ型の詳細は、『Oracle AI Database SQL言語クイック・リファレンス』を参照してください。
書式モデルとデータ型
フォーマット・モデルは、文字列に格納された日時または数値データのフォーマットを表す文字リテラルです。フォーマット・モデルはデータベース内の値の内部表現を変更しません。
文字列を日付または数値に変換する場合、データベースが文字列を解釈する方法は、書式モデルによって決まります。SQLでは、TO_CHAR関数とTO_DATE関数の引数としてフォーマット・モデルを使用し、データベースから戻される値のフォーマットまたはデータベースに格納される値のフォーマットを設定できます。
次の文は、部門80の従業員の給与を選択し、TO_CHAR関数を使用してそれらの給与を数値書式モデル'$99,990.99'で指定された書式の文字値に変換します。
SQL> SELECT last_name employee, TO_CHAR(salary, '$99,990.99') AS "SALARY"
  2  FROM   employees
  3  WHERE  department_id = 80 AND last_name = 'Russell';

EMPLOYEE                  SALARY
------------------------- -----------
Russell $14,000.00次の例では、TO_DATE関数で書式マスク'YYYY MM DD'を使用して採用日を更新し、文字列'1998 05 20'をDATE値に変換します。
SQL> UPDATE employees
  2  SET hire_date = TO_DATE('1998 05 20','YYYY MM DD')
3 WHERE last_name = 'Hunold';関連項目:書式モデルについてさらに学習するには、『Oracle AI Database SQL言語リファレンス』を参照してください。
整合性制約
整合性制約は、表の1つ以上の列の値を制限する名前付き規則です。
データ整合性の規則により、表に無効なデータが入力されないようにします。また、特定の依存性が存在する場合、制約によって表の削除を回避できます。
制約が使用可能である場合、データベースは、入力または更新の時点でのデータをチェックします。Oracle AI Databaseでは制約に準拠していないデータは入力されません。制約が使用禁止になっている場合は、Oracle AI Databaseでは制約に準拠していないデータでデータベースに入力される可能性があります。
例4-1のCREATE TABLE文には、last_name、email、hire_dateおよびjob_idの各列にNOT NULL制約が指定されています。これらの制約句により、列と制約の条件が識別されます。これらの制約は、指定された列にNULL値が含まれないことを保証します。たとえば、ジョブIDのない新しい従業員を挿入しようとすると、エラーが発生します。
制約は、表の作成時または作成後に作成できます。必要に応じて、制約を一時的に無効にできます。データベースでは、制約はデータ・ディクショナリに格納されます。
関連情報:
-
整合性制約について学習するには、「データ整合性」
-
データ・辞書について学習するには、「データ・ディクショナリの概要」を参照
-
SQL制約句について学習するには、Oracle AI Database SQL言語リファレンスを参照してください。
表の記憶域
Oracle AI Databaseは、表領域のデータ・セグメントを使用して表データを保持します。
セグメントには、データ・ブロックから構成されるエクステントが含まれます。表のデータ・セグメント(表クラスタの場合はクラスタ用のデータ・セグメント)は、表所有者のデフォルト表領域、またはCREATE TABLE文で指定された表領域に配置されます。
-
表編成デフォルトでは、表はヒープとして編成されます。つまり、データベースでは、ユーザーが指定する順序ではなく、最も収まりすいように行が配置されます。このため、ヒープ構成表は、順不同の行のコレクションとなります。
-
行の格納データベースでは、行がデータ・ブロックに格納されます。列数が256未満のデータを含む表の各行断片は、1つ以上の行断片に格納されます。
-
行分割のROWIDROWIDは、実質的に行の10バイトの物理アドレスです。
-
NULL値の保存NULLとは、列に値がないことを示します。NULLは、欠落データ、不明データまたは適用不可データを示します。セグメントのタイプと、セグメントの作成方法について学習するには、「ユーザー・セグメント」を参照
表編成
デフォルトでは、表はヒープとして編成されます。つまり、データベースでは、ユーザーが指定する順序ではなく、最も収まりすいように行が配置されます。このため、ヒープ構成表は、順不同の行のコレクションとなります。ノート:索引構成表では、異なる編成の原理が使用されます。
ユーザーが行を追加すると、データベースではデータ・セグメントの最初の使用可能な空き領域に行が格納されます。挿入された順序どおりに行が取得されることは保証されていません。
hr.departments表は、ヒープ構成表です。この表には、部門ID、部門名、管理者ID、所在地IDの列があります。行が挿入されると、データベースでは、それらの行が収まる位置に格納されます。表セグメント内のデータ・ブロックには、次の例に示すように、順不同の行が含まれることがあります。
50,Shipping,121,1500
120,Treasury,,1700
70,Public Relations,204,2700
30,Purchasing,114,1700
130,Corporate Tax,,1700
10,Administration,200,1700
110,Accounting,205,17001つの表内のすべての行は、列の順序が同一です。データベースでは、通常、CREATE TABLE文でリストされた順序で列が格納されますが、この順序は保証されません。たとえば、表にLONG型の列がある場合、Oracle AI Databaseでは、この列は必ず最後に行に格納されます。また、表に新しい列を追加すると、その新しい列は最後に格納されます。
表には仮想列を含めることができ、仮想列が通常の列とは異なり、ディスク上の領域を使用しません。データベースによりユーザーの指定する一連の式または関数が計算され、必要に応じて仮想列から値が導出されます。仮想列には、索引付け、統計の収集および整合性制約の作成が可能です。このため、仮想列は通常の列とほとんど同じです。
関連情報:
-
仮想列について学習するには、Oracle AI Database SQL言語リファレンスを参照してください。
行の格納
データベースでは、行がデータ・ブロックに格納されます。列数が256未満のデータを含む表の各行が、1つ以上の行断片に格納されます。
Oracle AI Databaseは、可能なかぎり各行を1つの行断片として格納しますただし、行データのすべてを1つのデータ・ブロックに挿入できない場合、または既存の行が更新されてそのデータ・ブロックの容量を超えた場合、データベースは複数の行断片を使用して行を格納します。
表クラスタ内の行には、クラスタ化されていない表の行と同じ情報が格納されます。また、表クラスタ内の行には、それらの列が属するクラスタ・キーを参照する情報も表示されます。
参照:データ・ブロックのコンポーネントについて学習するには、「データ・ブロックの形式」を参照
行断片のROWID
ROWIDは、実質的に行の10バイトの物理アドレスです。
ヒープ構成表のすべての行にはその表で一意のROWIDがあり、これは行断片の物理アドレスに相当します。表クラスタの場合、同じデータ・ブロックにある異なる表の行のROWIDが同一の場合もあります。
Oracle AI Databaseでは、ROWIDが内部的に使用して索引が構築されます。たとえば、Bツリー索引のそれぞれのキーは、高速アクセスのために、対応する行のアドレスを指すROWidに関連付けられています。物理ROWIDを使用すると、表の行に最速でアクセスでき、データベースではわずか1回のI/Oで行を取得できます。
関連情報:
-
ROWID構造について学習するには、「ROWID形式」を参照
-
Bツリー索引のタイプおよび構造について学習するには、「Bツリー索引の概要」を参照してください
NULL値の格納
NULLは、列に値がないことを示します。NULLは、欠落データ、不明データまたは適用不可データを示します。
データ値を持つ2つの列の間にはさまれたNULLはデータベースに格納されます。このような場合、列の長さ(ゼロ)を格納する1バイトが必要となります。新しい行のヘッダーが前行の残りの列がNULLであることを示すため、行の末尾にあるNULLには記憶域は不要です。たとえば、表の最後の3列がNULLであれば、その3列にはデータは格納されません。
NULL値についてさらに学習するには、『Oracle AI Database SQL言語リファレンス』を参照してください。
表圧縮
データベースでは、表の圧縮を使用して、表に必要な記憶域を削減します。
圧縮によりディスク領域を節約し、データベース・バッファ・キャッシュでのメモリー使用量を減らすことができ、場合によっては問合せ実行時間も短縮できます。表圧縮は、データベース・アプリケーションに対して透過的です。
-
基本表圧縮と高度な行圧縮ディクショナリベースの表圧縮では、ヒープ構成の表に対する低い圧縮率が実現されます。
-
ハイブリッド列圧縮ハイブリッド列圧縮を使用すると、データベースで、行のグループの、同じ列がまとめて格納されます。データ・ブロックのデータは行優先形式では格納されませんが、行および列の両方を組み合せた方法が使用されます。
-
メモリー速度ハイブリッド・コラム圧縮メモリー速度ハイブリッド・コラム圧縮では、メモリー速度で処理できるディスク上の圧縮ユニット形式が導入されています。
基本的な表圧縮と高度な行圧縮
ディクショナリ・ベースの表圧縮は、ヒープ構成表に対する高い圧縮率を実現します。
Oracle AI Databaseでは、次のタイプのディクショナリ・ベースの表圧縮をサポートしています。
-
基本表圧縮
このタイプの圧縮は、バルク・ロード操作向けのものです。データベースでは、従来型DMLを使用して変更されたデータは圧縮しません。基本表の圧縮を実行するには、ダイレクト・パスINSERT操作、
ALTER TABLE . . . MOVE操作、または表のオンライン再定義を使用する必要があります。 -
高度な行圧縮
このタイプの圧縮はOLTPアプリケーション向けで、すべてのSQL操作によって操作されたデータを圧縮します。データベースでは、アプリケーションを有効化する際に競合する圧縮率を取得し、圧縮されていない表でのDMLとほとんど同じ時間でDMLを実行します。
前述の圧縮タイプの場合、圧縮された行は行メジャー形式で格納されます。この形式では、ある行のすべての列がまとめて格納され、それ以降の行も同様に行単位ですべての列がまとめて格納されます。重複する値は、ブロックの先頭に格納されているシンボル表の短い参照で置き換えられます。このため、非圧縮データを再作成するためにデータベースに必要な情報は、データ・ブロック自体に格納されます。
圧縮されたデータ・ブロックは、通常のデータ・ブロックとほぼ同じです。通常のデータ・ブロックに対して動作するデータベース機能のほとんどは、圧縮ブロックに対しても機能します。
表領域、表、パーティションまたはサブパーティション・レベルで圧縮を宣言できます。表領域レベルで指定した場合、その表領域に作成されたすべての表はデフォルトで圧縮されます。
例4-4 表レベルの圧縮
次の文は、高度な行圧縮をorders表に適用します。
ALTER TABLE oe.orders ROW STORE COMPRESS ADVANCED;例4-5 パーティション・レベルの圧縮
次の部分的なCREATE TABLE文の例では、1つのパーティションの高度な行圧縮を指定し、もう1つのパーティションの基本的な表圧縮を指定しています:
CREATE TABLE sales (
    prod_id     NUMBER     NOT NULL,
    cust_id     NUMBER     NOT NULL, ... )
 PCTFREE 5 NOLOGGING NOCOMPRESS
 PARTITION BY RANGE (time_id)
 ( partition sales_2013 VALUES LESS THAN(TO_DATE(...)) ROW STORE COMPRESS BASIC,
   partition sales_2014 VALUES LESS THAN (MAXVALUE) ROW STORE COMPRESS ADVANCED );
関連情報:
-
値が行に格納される方法を学習するには、「行形式」を参照
-
圧縮データ・ブロックの形式について学習するには、「データ・ブロックの圧縮」を参照してください
-
ダイレクト・パス・ロードでのSQL*ローダーの使用について学習するには、『Oracle AI Databaseユーティリティ』を参照してください。
-
表圧縮について学習するには、Oracle AI Database管理者ガイドおよびOracle AI Databaseパフォーマンス・チューニング・ガイドを参照してください。
Hybrid Columnar圧縮
ハイブリッド列圧縮では、行グループの同じ列がまとめてデータベースに格納されます。データ・ブロックのデータは行優先形式では格納されませんが、行および列の両方を組み合せた方法が使用されます。
同じデータ型や同様の特性の列データをまとめて格納することによって、圧縮によるストレージの容量が大幅に節約されます。データベースでは、任意のSQL操作によって処理されるデータを圧縮しますが、ダイレクト・パス・ロードでは圧縮レベルがより高くなります。データベース操作は圧縮オブジェクトに対して透過的に実行されるため、アプリケーションを変更する必要はありません。
ノート:ハイブリッド列圧縮とインメモリー列ストア(IM列ストア)は密接に関係しています。主な違いは、ハイブリッド列圧縮ではディスク記憶域を最適化するのに対し、IM列ストアではメモリー記憶域を最適化する点です。
-
ハイブリッド列圧縮のタイプ基礎となるストレージにハイブリッド列圧縮がサポートされている場合は、必要に応じて、様々なタイプの圧縮を指定できます。
-
圧縮ユニット・ハイブリッド・コラム圧縮では、行の集合を格納するために、圧縮ユニットと呼ばれる論理的な構造が使用されます。
-
DMLとハイブリッド列圧縮ハイブリッド列圧縮では、様々なタイプのDML操作における行のロックに影響があります。関連項目: IM列ストアについてさらに学習するには、「インメモリー領域」を参照
ハイブリッド列圧縮のタイプ
基礎となるストレージがハイブリッド列圧縮をサポートしている場合は、必要に応じて異なるタイプの圧縮を指定できます。
圧縮オプションは次のとおりです。
-
ウェアハウスの圧縮
このタイプの圧縮は、記憶域の節減用に最適化されており、データ・ウェアハウス・アプリケーション向けです。
-
アーカイブの圧縮
このタイプの圧縮は、最大の圧縮レベル用に最適化されており、履歴データおよび変更されないデータ向けです。
ハイブリッド列圧縮は、データ・ウェアハウジング用およびOracle Exadataストレージ上の意思決定支援アプリケーション用に最適化されています。Oracle Exadataでは、ハイブリッド列圧縮を使用して圧縮された表の問合せパフォーマンスが最大化され、Oracle Exadataストレージ・サーバーに統合されている処理能力、メモリーおよびインフィニバンド・ネットワーク帯域幅の利点を活用できます。
その他のOracleストレージ・システムでは、ハイブリッド列圧縮がサポートされ、Oracle Exadataストレージと同様の領域の節減は可能ですが、Oracle Exadataストレージと同じレベルの問合せパフォーマンスは得られません。これらのストレージ・システムでは、ハイブリッド列圧縮は、アクセス頻度が低い古いデータのデータベース内アーカイブに最適です。
圧縮ユニット
ハイブリッド列圧縮では、行の集合を格納するために、圧縮ユニットと呼ばれる論理的な構造が使用されます。
表にデータをロードする場合、データベースでは、行のグループは列形式で、それぞれの列の値としてまとめて圧縮されて格納されます。データベースでは、一連の行の列データが圧縮された後、そのデータが圧縮ユニットに収められます。
たとえば、ハイブリッド列圧縮をdaily_sales表に適用するとします。1日の終わりに、品目と販売数が表に移入し、品目IDと日付がコンポジット主キーになるようになります。次の表にdaily_sales内の行のサブセットを示します。
表3サンプル表daily_sales
| Item_ID | 日付 | Num_Sold | Shipped_From | 仕入 |
|---|---|---|---|---|
| 1000 | 01-JUN-18 | 2 | WAREHOUSE1 | あり |
| 1001 | 01-JUN-18 | 0 | WAREHOUSE3 | なし |
| 1002 | 01-JUN-18 | 1 | WAREHOUSE3 | なし |
| 1003 | 01-JUN-14 | 0 | WAREHOUSE2 | なし |
| 1004 | 01-JUN-18 | 2 | WAREHOUSE1 | なし |
| 1005 | 01-JUN-18 | 1 | WAREHOUSE2 | なし |
この行サブセットが1つの圧縮ユニットに格納されるとします。ハイブリッド列圧縮では、各列の値がまとめて格納され、その後で複数のアルゴリズムを使用してそれぞれの列が圧縮されます。データベースでは、列のデータ型、列内の実際の値のカーディナリティ、ユーザーの選択した圧縮レベルなどの様々な要因に基づいてアルゴリズムが選択されます。
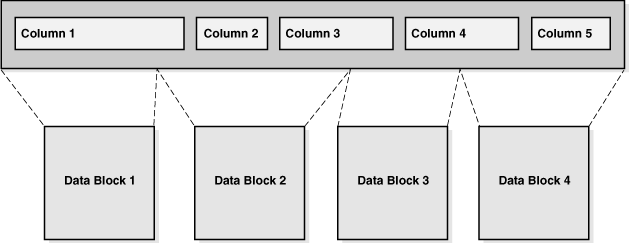
次の図に示すように、各圧縮ユニットは、複数のデータ・ブロックにまたがることができます。特定の列の値は、複数のブロックにわたる場合と、またがらない場合があります。
図7: 圧縮ユニット
ハイブリッド列圧縮が領域節約につながらない場合、データベースではデータがDBMS_COMPRESSION.COMP_BLOCK形式で格納されます。この場合、データベースではハイブリッド列圧縮セグメントにあるブロックにOLTP圧縮が適用されます。
関連情報:
-
ハイブリッド列圧縮に対するライセンス要件について学習するには、『Oracle AI Databaseライセンス情報ユーザー・マニュアル』を参照してください。
-
ハイブリッド列圧縮の使用方法について学習するには、『Oracle AI Database管理者ガイド』を参照してください。
-
CREATE TABLEの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照してください。 -
DBMS_COMPRESSIONパッケージについて学習するには、『Oracle AI Database PL/SQLパッケージおよびタイプ・リファレンス』を参照
DMLとハイブリッド列圧縮
ハイブリッド列圧縮は、様々なタイプのDML操作の行のロックと密接に関連しています。
ダイレクト・パス・ロードと従来型挿入
ハイブリッド列圧縮を使用する表にデータをロードするときは、従来型挿入またはダイレクト・パス・ロードのいずれかを使用できます。ダイレクト・パス・ロードでは、表全体がロックされ、同時実行性が低下します。
Oracle Database 12cリリース2 (12.2)以降、ハイブリッド列圧縮形式に対する従来の配列挿入のサポートが追加されました。従来型の配列挿入の利点は次のとおりです。
-
挿入された行で行レベル・ロックが使用され、同時実行性が向上します。
-
自動データ最適化(ADO)およびヒート・マップが行レベル・ポリシーに対するハイブリッド列圧縮をサポートしています。したがって、DMLアクティビティがセグメントの他の部分で発生している場合でも、データベースでは対象のブロックについてハイブリッド列圧縮が使用されます。
アプリケーションで従来型の配列挿入が使用されると、Oracle AI Databaseでは次の条件に一致したときに行が圧縮ユニットに格納されます。
-
表がASSM表領域に格納されています。
-
互換性レベルは12.2.0.1以上です。
-
LONG型の列がないことを含めて、表定義が既存のハイブリッド列圧縮の表制約を満たしており、行依存性もありません。
従来型挿入では、REDOとUNDOが生成されます。したがって、従来型のDML文によって作成された圧縮ユニットは、そのDMLとともにロールバックまたはコミットされます。データベースでは、従来型データ・ブロックに格納された行に対する場合と同様に、自動的に索引メンテナンスが実行されます。
Oracle AI Database 26ai以降は、自動記憶域圧縮により、Oracle AI Databaseで、まずデータを圧縮なし形式に直接ロードしてから、バックグラウンドで行を段階的にハイブリッド列圧縮形式に移動することができます。これは、ETLパフォーマンスを向上させ、高速な問合せパフォーマンスを維持しながら、ユーザーに対して透過的です。
更新および削除
デフォルトでは、圧縮ユニットのいずれかの行で更新または削除が発生した場合に、データベースによってそのユニットのすべての行がロックされます。この問題を回避するために、表で行レベルのロックを有効にすることができます。この場合は、更新または削除操作の影響を受ける行のみがデータベースによってロックされます。
関連情報:
-
従来型挿入の実行方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
INSERT文について学習するには、『Oracle AI Database SQL言語リファレンス』を参照 -
COMPRESS_IMMEDIATEヒントの使用方法の詳細は、『Oracle AI Database SQL言語リファレンス』を参照 -
自動ストレージ圧縮の使用方法の詳細は、『Oracle AI Database VLDBおよびパーティショニング・ガイド』を参照してください。
メモリー速度ハイブリッド・コラム圧縮
メモリー速度ハイブリッド・コラム圧縮では、ディスク上の圧縮ユニット形式が導入され、メモリー速度で処理できます。
ハイブリッド・コラム圧縮と同様に、メモリー速度のハイブリッド・コラム圧縮はデータ・ウェアハウス環境に適しています。データは列指向の形式に変換され、データ・ロード中に圧縮されます。主な違いは、メモリー速度のハイブリッド列圧縮では、インメモリー列ストアおよびExadataフラッシュ・キャッシュのCELLMEMORYと同じ特殊な列形式が使用されるため、すべてのストレージ層で高速列スキャンと効率的な列キャッシングが実現されることです。また、メモリー速度のハイブリッド・コラム圧縮ユニットは、ディスク上でインメモリー列形式を効果的に使用できるようにするハイブリッド列圧縮ユニットよりも大幅に大きくなります。
メモリー速度ハイブリッド・コラム圧縮は、キーワードMEMSPEEDを追加してCREATE TABLEコマンドを使用してハイブリッド・コラム圧縮の拡張として有効化されます。
例4-6メモリー速度ハイブリッド・コラム圧縮
次の例では、メモリー速度のハイブリッド列圧縮を有効にしたorders表を作成します。
CREATE TABLE orders COLUMN STORE COMPRESS FOR MEMSPEED QUERY;ノート:詳細は、『Oracle AI Database SQL言語リファレンス』を参照してください。
表クラスタの概要
表クラスタは、共通の列を共有し、関連するデータを同じブロックに格納する表のグループです。
表がクラスタ化されると、1つのデータ・ブロックに複数の表の行を含めることができます。たとえば、ブロックにemployees表とdepartments表のいずれか1つのみでなく、両方の表の行を格納できます。
クラスタ・キーとは、クラスタ化された表で共通になる1つ以上の列のことです。たとえば、employeesおよびdepartments表はdepartment_id列を共有しています。表クラスタの作成時と表クラスタに追加されるすべての表の作成時にクラスタ・キーを指定します。
クラスタ・キー値とは、特定の行のセットに対するクラスタ・キー列の値のことです。department_id=20などの同じクラスタ・キー値を含むすべてのデータは、物理的にまとめて格納されます。各クラスタ・キー値は、その値を持つ行がいくつかの表に含まれているとしても、クラスタとクラスタ索引にそれぞれ一度のみ格納されます。
たとえば、HRマネージャに2つの書棚があり、1つは従業員フォルダの箱、もう1つは部門フォルダの箱があるとします。ユーザーは、特定の部門に属する全従業員のフォルダを頻繁に問い合せます。管理者は、取り出しやすいようにすべての箱を1つの書棚に配置しなおします。管理者は、部門IDごとに箱を分割します。その結果、部門20に属する従業員のすべてのフォルダと部門20自体のフォルダが1つの箱に入り、部門100の従業員のフォルダと部門100のフォルダも別の箱に入り、他の部門のフォルダもそれぞれの箱に入ります。
複数の表が主に問合せの対象になり(ただし、変更はできない)、表のレコードが、頻繁に問い合せたり結合したりする場合に、表のクラスタ化を検討します。表クラスタは、異なる表の関連した行を、同じデータ・ブロック内に格納するため、表クラスタを適切に使用すると、クラスタ化されていない表と比較して次のような利点があります。
-
クラスタ化表を結合する場合のディスクI/Oが減少します。
-
クラスタ化表を結合する場合のアクセス時間が改善されます。
-
クラスタ・キー値が行ごとに繰り返し格納されないため、関連する表データと索引データの格納に必要な記憶域が少なくなる。
通常、表のクラスタ化は、次のような場合には適していません。
-
表が頻繁に更新される場合。
-
表の全表スキャンが頻繁に必要な場合。
-
表で切捨てが必要な場合。
-
索引付きクラスタの概要索引クラスタとは、索引を使用してデータを検索する表クラスタのすることです。クラスタ索引とは、クラスタ・キーのBツリー索引のことで、クラスタ索引は、クラスタ化表に行を挿入する前に作成しておく必要があります。
-
ハッシュ・クラスタの概要ハッシュ・クラスタは、索引キーがハッシュ関数に置き換わることを除いて、索引付きクラスタに類似しています。別個のクラスタ索引は存在しません。ハッシュ・クラスタでは、データが索引になります。
索引付きクラスタの概要
索引クラスタは、索引を使用してデータを検索する表クラスタです。クラスタ索引は、クラスタ・キーのBツリー索引です。クラスタ索引は、クラスタ化表に行を挿入する前に作成しておく必要があります。
例4-7表クラスタと関連する索引の作成
次の例に示すように、クラスタ・キーdepartment_idを指定して、クラスタemployees_departments_clusterを作成するとします:
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 512;

CREATE INDEX idx_emp_dept_cluster
ON CLUSTER employees_departments_cluster;HASHKEYS句は指定されないため、employees_departments_clusterは索引付きクラスタになります。前述の例では、クラスタ・キーdepartment_idにidx_emp_dept_clusterという名前の索引を作成します。
例4-8索引付きクラスタでの表の作成
その後、次のように、クラスタにemployees表とdepartments表を作成し、クラスタ・キーとしてdepartment_id列を指定します(省略記号は、列指定される場所のマーク)。
CREATE TABLE employees ( ... )
   CLUSTER employees_departments_cluster (department_id);

CREATE TABLE departments ( ... )
CLUSTER employees_departments_cluster (department_id);employees表とdepartments表に行を追加するとします。データベースでは、employees表とdepartments表の各部門の行がすべて同じデータ・ブロックに物理的に格納されます。データベースでは、行がヒープに格納され、索引を使用してこれらの行が検索されます。図4-8に、employeesとdepartmentsを含むemployees_departments_cluster表クラスタを示します。データベースでは、従業員20に属する従業員や部門110などの行がまとめて格納されます。表がクラスタ化されていない場合、データベースでは関連する行がまとめて格納されることは保証されません。
図8: クラスタ化表データ
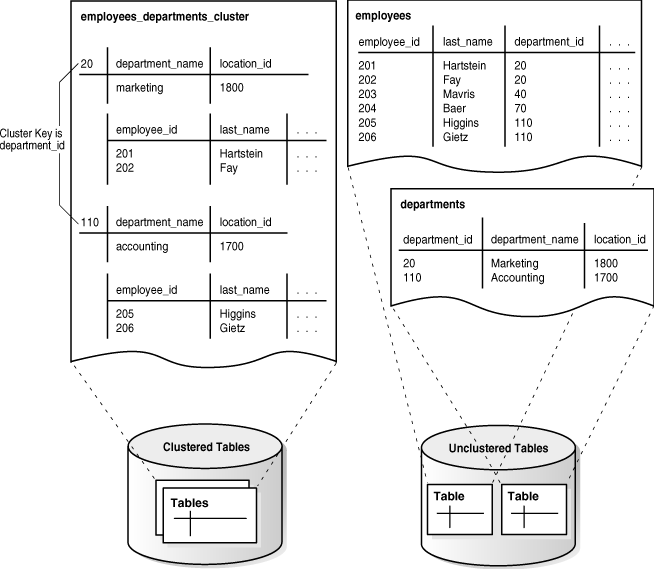
Bツリー・クラスタ索引は、データを含む ブロックのデータベース・ブロック・アドレス(DBA)にクラスタ・キー値を関連付けます。たとえば、キー20の索引エントリには、部門20の従業員のデータを含むブロックのアドレスが表示されます。
20,AADAAAA9dクラスタ索引は、クラスタ化されていない表の索引と同様に個別に管理され、表クラスタとは別の表領域に存在することがあります。
関連情報:
-
索引付きクラスタの作成方法と管理方法を学習するには、『Oracle AI Database管理者ガイド』をクリックします。
-
CREATE CLUSTERの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照してください
ハッシュ・クラスタの概要
ハッシュ・クラスタは、索引キーがハッシュ関数に置き換わることを除いて、索引付きクラスタに類似しています。別個のクラスタ索引は存在しません。ハッシュ・クラスタでは、データが索引になります。
索引付き表または索引付きクラスタでは、Oracle AI Databaseは、別個の索引に格納されたキー値を使用して、表の行を見つけます。索引付きの表または表クラスタを検索または格納するには、次のようにデータベースは、最低2回のI/Oを実行する必要があります。
-
索引内のキー値を検索または格納する1つ以上のI/O
-
表または表クラスタ内の行を読取り/書込みするためにさらに1回のI/O
Oracle AI Databaseでは、ハッシュ・クラスタ内で行を検索または格納するため、ハッシュ関数はその行のクラスタ・キー値に適用されます。結果として得られるハッシュ値はクラスタ内の1つデータ・ブロックに対応しており、データベースでは、発行された文のかわりにその読取りまたは書込みを行います。
ハッシングは、データ検索のパフォーマンスを改善するために表データを格納するオプションの方法です。ハッシュ・クラスタは、次の条件が満たされている場合に便利です。
-
表の問合せが、表の変更よりもはるかに頻繁に行われる場合。
-
ハッシュ・キー列に対する問合せの条件が、多くの場合、
WHERE department_id=20のような等価条件である場合。このような問合せでは、クラスタ・キー値がハッシュ化されます。ハッシュ・キー値は、行が格納されているディスク領域を直接指します。 -
当然、ハッシュ・キーの数が多くなれば、キー値も一緒に格納されるためデータのサイズが大きくなります。
-
ハッシュ・クラスタの作成ハッシュ・クラスタを作成するときは、索引付きクラスタの場合と同じ
CREATE CLUSTER文を使用します が、ハッシュ・キーを別途指定してください。クラスタのハッシュ値の数はハッシュ・キーに応じて増減します。 -
ハッシュ・クラスタの問合せハッシュ・クラスタの問合せでは、ユーザーが入力するキー値のハッシュ方法が、データベースによって決定されます。
-
ハッシュ・クラスタ・バリエーション単一表ハッシュ・クラスタとは、一度に1つの表のみをサポートするために最適化されたハッシュ・クラスタのバージョンのことです。ハッシュ・キーと行との間には、1対1のマッピングがあります。
-
ハッシュ・クラスタの記憶域 Oracle AI Databaseは、ハッシュ・クラスタのための領域を索引付きクラスタとは異なる方法で割り当てます。
ハッシュ・クラスタの作成
ハッシュ・クラスタを作成するときは、索引付きクラスタの場合と同じCREATE CLUSTER文を使用しますが、ハッシュ・キーを別途指定してください。クラスタのハッシュ値の数はハッシュ・キーに応じて増減します。
クラスタ・キーは、索引付きクラスタのキーと同様に、単一の列、またはクラスタ内の表が共有するコンポジット・キーです。ハッシュ・キー値は、クラスタ・キー列に挿入された実際の値または推定値です。たとえば、クラスタ・キーがdepartment_idの場合は、ハッシュ・キー値が10、20、30のような値になります。
Oracle AI Databaseでは、無数にあるハッシュ・キー値を入力として受け付け、限定的な数のバケットに選別されるハッシュ関数が使用されます。各バケットには、ハッシュ値と呼ばれる一意の数値IDがあります。各ハッシュ値は、ハッシュ・キー値(部門10、20、30など)に対応する行の格納ブロックのデータベース・ブロック・アドレスにマップされます。
次の例では、存在すると推測される部門数が100であるため、HASHKEYSが100に設定されています。
CREATE CLUSTER employees_departments_cluster
   (department_id NUMBER(4))
SIZE 8192 HASHKEYS 100;employees_departments_clusterの作成後に、そのクラスタ内にemployees表とdepartments表を作成できます。次に、索引付きクラスタの場合と同様に、ハッシュ・クラスタにデータをロードできます。
関連情報:
-
ハッシュ・クラスタの作成方法と管理方法を学習するには、『Oracle AI Database管理者ガイド』を参照
ハッシュ・クラスタの問合せ
ハッシュ・クラスタの問合せで、ユーザーが入力するキー値をハッシュする方法は、データベースが決定します。
たとえば、ユーザーが次のような問合せを頻繁に実行し、p_idに様々な部門ID番号を入力するとします。
SELECT *
FROM   employees
WHERE  department_id = :p_id;

SELECT *
FROM   departments
WHERE  department_id = :p_id;

SELECT *
FROM   employees e, departments d
WHERE  e.department_id = d.department_id
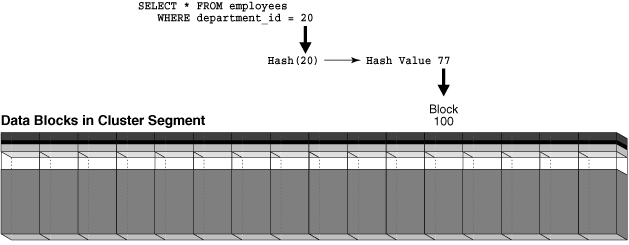
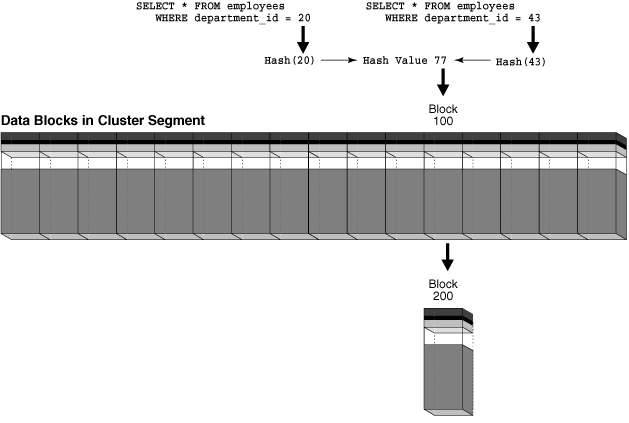
AND d.department_id = :p_id;ユーザーがdepartment_id=20の従業員に問い合せた場合は、この値がバケット77にハッシュされる場合があります。ユーザーがdepartment_id=10の従業員に問い合せた場合は、この値がバケット15にハッシュされる場合があります。データベースは、内部的に生成されるハッシュ値を使用して、問合せ対象の部署に対応する従業員行を格納したブロックを検索します。
次の図に、ハッシュ・クラスタ・セグメントを水平方向に並べたブロック行として示します。この図に示すように、1件の問合せにつき、1回のI/Oでデータを取得できます。
図9: ハッシュ・クラスタからのデータの取得
ハッシュ・クラスタの制限は、索引のないクラスタ・キーのレンジ・スキャンを使用できないことです。「ハッシュ・クラスタの作成」で作成したハッシュ・クラスタに、独立した索引が存在しないものとします。IDが20から100の部門の問合せでは、20から100の間のすべての取得る値をハッシュしていないため、ハッシュ・アルゴリズムを使用できません。索引が存在しないため、データベースでは全体スキャンを実行する必要があります。
関連項目: 「索引レンジ・スキャン」
様々なハッシュ・クラスタ
単一表ハッシュ・クラスタとは、同時に1つの表のみをサポートするために最適化されたハッシュ・クラスタのバージョンのことです。ハッシュ・キーと行との間には、1対1のマッピングがあります。
単一表ハッシュ・クラスタは、ユーザーが主キーで表に迅速にアクセスする必要がある場合に便利です。たとえば、ユーザーがemployee_idを使用してemployees表の従業員レコードを頻繁に検索する場合などです。
ソート済のハッシュ・クラスタに、ハッシュ関数の各値に対応する行が、ソートされた順序で効率良くデータベースから返すことができるような方法で格納されます。データベースは最適化されたソートを内部的に実行します。ソートされた状態のデータを常に使用するアプリケーションの場合は、この方式によりデータの取得が速くなる可能性があります。たとえば、アプリケーションがorders表のorder_date列で常にソートする場合が考えられます。
関連項目:単一表およびソート済のハッシュ・クラスタの作成方法を学習するには、『Oracle AI Database管理者ガイド』を参照してください。
ハッシュ・クラスタの記憶域
Oracle AI Databaseは、ハッシュ・クラスタのための領域を索引付きクラスタとは異なる方法で割り当てます。
「ハッシュ・クラスタの作成」の例では、HASHKEYSに存在する可能性のある部門数を指定し、SIZEに各部門に関連付けられたデータのサイズを指定しています。次の式に従って記憶域領域の値が計算されます。
HASHKEYS * SIZE / database_block_sizeしたがって、「ハッシュ・クラスタの作成」に示す例,のようにブロック・サイズが4096バイトの場合は、ハッシュ・クラスタに200以上のブロックが割り当てられます。
Oracle AI Databaseでは、クラスタに挿入可能なハッシュ・キー値の数に制限されません。たとえば、HASHKEYSが100になっている場合でも、departments表に一意の部門を200個挿入することが可能です。ただし、ハッシュ値の数がハッシュ・キーの数よりも多くなると、ハッシュ・クラスタ取得の効率が悪くなります。
取得の問題について、図4-9でブロック100が部門20の行で全く空きがない場合の例で説明します。ユーザーがdepartment_idが43の新しい部署をdepartments表に挿入します。部門の数がHASHKEYS値よりも大きいため、department_id 43はハッシュ値77にハッシュされますが、これは、department_id 20に使用されているハッシュ値と同じです。複数の入力値を同じ出力値にハッシュすることをハッシュ衝突と呼びます.
ユーザーが部門43のクラスタに行を挿入しようとしても、ブロック100はいっぱいであるため、行は格納されません。ブロック100は新しいオーバーフロー・ブロック(ここではブロック200とします)にリンクされ、その新しいブロックに挿入行が格納されます。つまり、ブロック100とブロック200の両方に、どちらの部門のデータも格納されている可能性があることになります。図4-10に示すように、部門20または43の問合せでは、データを取得するために2個のI/O(ブロック100とそれに関連付けられたブロック200)が必要になりました。この問題を解決するには、別々のHASHKEYS値を持つクラスタを作成しなおす必要があります。
図10: ハッシュ衝突が発生している場合のハッシュ・クラスタからのデータの取得
関連項目:ハッシュ・クラスタの領域を管理する方法を学習するには、『Oracle AI Database管理者ガイド』を参照してください。
属性クラスタ表の概要
属性クラスタ表は、ディスク上の近接するデータを、ユーザーが指定したクラスタリング・ディレクティブに基づいて格納する、ヒープ構成テーブルです。ディレクティブでは、単一または複数の表で列を指定します。
ディレクティブは次のようになります。
-
CLUSTERING ... BY LINEAR ORDERディレクティブは、指定された列に応じて表のデータを並べます。問合せにおいてクラスタリング句で指定された列の接頭辞を付与するときに、デフォルトの
BY LINEAR ORDERクラスタリングを使用することを検討します。たとえば、sh.salesの問合せで、顧客IDまたは顧客IDと製品IDの両方を指定する場合、線形の列順序cust_id、prod_idを使用して、表のデータをクラスタ化できます。 -
CLUSTERING ... BY INTERLEAVED ORDERディレクティブは、複数列のI/O削減を可能にするZオーダー関数に似ている特別なアルゴリズムを使用して、1つ以上の表のデータを並べます。問合せで様々な列の組合せを指定する際に、
BY INTERLEAVED ORDERクラスタリングを使用することを検討します。たとえば、sh.salesの問合せで、様々な次元を様々な順序で指定する場合、これらのディメンションの列に応じて、sales表のデータをクラスタ化できます。
属性クラスタリングは、ダイレクト・パス挿入操作でのみ使用可能です。従来のDMLでは無視されます。
この項では、次のトピックについて説明します:
-
属性クラスタ化表の利点属性クラスタ表の主な利点はI/Oの削減であり、表スキャンのI/OコストとCPUコストを大幅に軽減できます。I/Oの削減は、ゾーンを使用して行うか、ディスク上のクラスタ値の物理的近接により物理I/Oを削減することで行われます。
-
結合属性クラスタ表結合された列に基づく属性クラスタリングは、結合属性クラスタリングと呼ばれます。表クラスタと異なり、結合属性クラスタ表は、表グループのデータを同じデータベース・ブロックには格納しません。
-
ゾーンを使用するI/Oの削減ゾーンとは、関連する列の最小値と最大値を格納する、一連の隣接するデータ・ブロックのことです。
-
線形順序付けを使用する属性クラスタ表表の線形順序付けスキームでは、ユーザーが指定した属性に基づいて、行を特定の順序で範囲に分割します。Oracle AI Databaseでは、主キーおよび外部キーの関係を介して接続された単一の表または複数の表で、線形順序付けをサポートしています。
-
インターリーブされた順序付けを使用する属性クラスタ表インターリーブされた順序付けでは、Zオーダーとよく似た技法が使用されます。
属性クラスタリングの表の利点
属性クラスタ表の主な利点はI/Oの削減で、表スキャンのI/OコストとCPUコストを大幅に軽減できます。I/Oの削減は、ゾーンを使用して行うか、ディスク上のクラスタ値の物理的近接により物理I/Oを削減することで行われます。
属性クラスタ表には次の利点があります。
-
スター・スキーマのディメンション列に基づいて、ファクト表をクラスタリングできます。
スター・スキーマでは、ほとんどの問合せで、ファクト表ではなくディメンション表が修飾されるため、ファクト表の列でクラスタリングすることは効果的ではありません。Oracle AI Databaseでは、ディメンション表の列でクラスタリングをサポートしています。
-
I/Oの削減は、次の複数のシナリオで生じます。
-
Oracle Exadata Storage Indexes、Oracle In-Memory最小/最大プルーニングまたはゾーン・マップで使用した場合
-
OLTPアプリケーションの接頭辞を付与する問合せで、線形順序で属性クラスタリングを使用する場合
-
BY INTERLEAVED ORDERクラスタリングのクラスタリング列のサブセットにおいて
-
-
属性クラスタリングではデータ圧縮が改善されるため、これにより、表スキャン・コストが間接的に削減されます。
ディスク上で同じ値が互いに接近している場合、データベースでは、これらの値を容易に圧縮できます。
-
Oracle AI Databaseでは、索引の記憶域コストおよび保守コストは発生しません。
関連項目:属性クラスタ表の利点の詳細は、『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照してください。
結合属性クラスタ表
結合された列に基づく属性クラスタリングは、結合属性クラスタリングと呼ばれます。表クラスタと異なり、結合属性クラスタ表は、表グループのデータを同じデータベース・ブロックには格納しません。
たとえば、ディメンション表productsと結合された属性クラスタ表salesを考えてみます。sales表にはsales表の行のみが含まれますが、行の順序はproducts表から結合された列の値に基づいています。データ移動操作、ダイレクト・パス挿入操作およびCREATE TABLE AS SELECT操作中に、適切な結合が実行されます。これに対し、salesおよびproductsが標準の表クラスタ内にある場合、データ・ブロックには両方の表の行が含まれます。
結合属性クラスタリングについてさらに学習するには、『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照してください。
ゾーンを使用するI/Oの削減
ゾーンとは、関連する列の最小値と最大値を格納する、一連の隣接するデータ・ブロックのことです。
SQL文に、ゾーンに格納されている列の述部が含まれる場合、データベースは述部の値をゾーンに格納されている最小値および最大値と比較します。このようにして、データベースはSQL実行時に読み取るゾーンを判別します。
I/Oの削減とは、データベースの問合せを満たすデータを含まない、表ブロックまたは索引ブロックをスキップする機能です。この削減により、表スキャンのI/OコストとCPUコストが著しく削減されます。
-
ゾーンの目的ゾーンの小仕切り(これはデータ・ブロック似ている)を使用しているところを思い浮かべるセールス・マネージャを考えてみてください。
-
ゾーン・マップゾーン・マップとは、データ・ブロックをゾーンに分割する、独立したアクセス構造である。Oracle AI Databaseでは、各ゾーン・マップがマテリアライズド・ビューのタイプとして実装されます。
-
ゾーン・マップの作成基本ゾーン・マップは、手動または自動で作成されます。
-
ゾーン・マップの仕組み: 例この例では、述語に定数が含まれている問合せにおいてゾーン・マップがデータをプルーニングする方法を示します。
ゾーンの目的
ゾーンのゆるいアナロジーとして、書棚の小仕切り(これはデータ・ブロックと似ています)を使用するセールス・マネージャを考えてみます。
各小仕切りには、出荷日別に並べられた、顧客に販売したシャツを表す受領物(行)があります。このアナロジーで、ゾーン・マップは、索引カードのスタックに似ています。各カードは、小仕切1-10など、小仕切いのゾーン(隣接範囲)に相当します。ゾーンごとに、カードにはゾーンに格納されている受領物の最小および最大出荷日がリストされます。
特定日付にどのシャツが出荷されたかを知りたい場合、マネージャはリクエストされた日付を含む日付範囲が来るまでカードをめくり、小仕切りゾーンをノートにとってから、リクエストされた受領物についてこのゾーン内の小仕切りのみを検索します。この方法で、マネージャは受領物のために書棚のすべての小仕切りを探す必要がなくなります。
ゾーン・マップ
ゾーン・マップは、データ・ブロックをゾーンに分割する、独立したアクセス構造です。Oracle AI Databaseでは、各ゾーン・マップがマテリアライズド・ビューのタイプとして実装されます。
索引と同様に、ゾーン・マップは表スキャンのI/OおよびCPUコストを削減できます。SQL文にゾーン・マップの列の述語が含まれる場合、データベースは述語の値と各ゾーンに格納されている最小および最大の表の列値を比較して、SQL実行中に読み込まれるゾーンを判断します。
基本ゾーン・マップは単一の表で定義され、この表の一部の列の最小値と最大値を保持します。結合ゾーン・マップは、1つ以上の他の表への外部結合を持っており、その表内の一部の列の最小値と最大値を保持している表の上で定義される。Oracle AI Databaseでは両方のタイプのゾーン・マップが自動的に保持されます。
1つの表に存在できるゾーン・マップは最大1つです。パーティション表の場合は、すべてのパーティションおよびサブパーティションに対して1つのゾーン・マップが存在します。パーティション表のゾーン・マップは、ゾーンごと、パーティションごと、サブパーティションごとの最小値と最大値を追跡します。表に、ディメンション表との外部結合がある場合、ゾーン・マップ定義には、ディメンション列の最小値と最大値を含めることができます。ノート:パーティションまたはサブパーティション・レベルのゾーンのみを含むゾーン・マップを作成できます。このようなゾーン・マップを作成すると、パーティション・メタデータ以外のパーティション・プルーニング機能が拡張されます。
関連項目:ゾーン・マップの概要は、Oracle AI Databaseデータ・ウェアハウス・ガイドを参照してください
ゾーン・マップの作成
基本ゾーン・マップは、手動または自動で作成されます。
-
手動ゾーン・マップDDL文を使用して、ゾーン・マップを作成、削除および管理できます。
-
自動ゾーン・マップOracle AI Databaseでは、基本ゾーン・マップは自動的に作成されます。これらは自動ゾーン・マップと呼ばれます。
手動ゾーン・マップ
DDL文を使用して、ゾーン・マップを作成、削除および管理できます。
CREATE TABLE文またはALTER TABLE文でCLUSTERING句を指定すると、データベースは指定されたクラスタリング列でゾーン・マップを自動的に作成します。ゾーン・マップは、列の最小値と最大値を、属性クラスタの表内の連続するデータ・ブロックと互いに関係付けます。属性クラスタ表では、ゾーン・マップを使用してI/Oの削減を実行します。
CREATE MATERIALIZED ZONEMAP文を使用して、ゾーン・マップを明示的に作成することもできます。この場合、属性クラスタリングの使用に関係なくゾーン・マップを作成できます。たとえば、取引が時系列で並べられる株式取引表など、行が列セット上に自然に並べられる表にゾーン・マップを作成できます。
関連情報:
-
ゾーン・マップの作成方法を学習するには、Oracle AI Databaseデータ・ウェアハウス・ガイドを参照してください
自動ゾーン・マップ
Oracle AI Databaseでは、基本ゾーン・マップが自動的に作成されます。これらは自動ゾーン・マップと呼ばれます。
Oracle AI Databaseでは、パーティション・テーブルと非パーティション表の両方に対して、基本ゾーン・マップを自動的に作成できます。バックグラウンド・プロセスでは、この方法で作成されたゾーン・マップが自動的に保持されます。
DBMS_AUTO_ZONEMAPプロシージャを使用して、自動ゾーン・マップを有効にします。
EXEC DBMS_AUTO_ZONEMAP.CONFIGURE('AUTO_ZONEMAP_MODE','ON')関連情報:
-
DBMS_AUTO_ZONEMAPパッケージを使用した自動ゾーン・マップの管理についてさらに学習するには、『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照してください -
DBMS_AUTO_ZONEMAPパッケージについてさらに学習するには、Oracle AI Database PL/SQLパッケージおよびタイプ・リファレンスを参照してください。 -
様々なエディションとサービスでサポートされる機能の詳細は、『Oracle AI Databaseライセンス情報ユーザー・マニュアル』を参照してください
ゾーン・マップの仕組み: 例
この例は、述語が定数を含む問合せにおいてゾーン・マップがデータをプルーニングする方法を示しています。
次のlineitem表を作成するとします。
CREATE TABLE lineitem
  ( orderkey      NUMBER        ,
    shipdate      DATE          ,
    receiptdate   DATE          ,
    destination   VARCHAR2(50)  ,
quantity NUMBER );表lineitemには、各ブロックに2つの行がある4つのデータ・ブロックが含まれます。表4-4に、表の8つの行を示します。
表4 lineitem表のデータ・ブロック
| ブロック | 驢馬 | 出荷日 | 受入日 | 宛先 | 数量 |
|---|---|---|---|---|---|
| 1 | 1 | 1-1-2014 | 1-10-2014 | San_Fran | 100 |
| 1 | 2 | 1-2-2014 | 1-10-2014 | San_Fran | 200 |
| 2 | 3 | 1-3-2014 | 1-9-2014 | San_Fran | 100 |
| 2 | 4 | 1-5-2014 | 1-10-2014 | San_Diego | 100 |
| 3 | 5 | 1-10-2014 | 1-15-2014 | San_Fran | 100 |
| 3 | 6 | 1-12-2014 | 1-16-2014 | San_Fran | 200 |
| 4 | 7 | 1-13-2014 | 1-20-2014 | San_Fran | 100 |
| 4 | 8 | 1-15-2014 | 1-30-2014 | San_Jose | 100 |
CREATE MATERIALIZED ZONEMAP文を使用して、lineitem表にゾーン・マップを作成できます。各ゾーンには2個のブロックが含まれ、orderkey、shipdateおよびreceiptdate列の最小値および最大値を格納しています。表4-5は、ゾーン・マップを示しています。
表5 lineitem表のゾーン・マップ
| ブロックの範囲 | 最小オーダー・キー | 最大オーダー・キー | 最小出荷日 | 最大出荷日 | 最小入荷日 | 最大受入日 |
|---|---|---|---|---|---|---|
| 1-2 | 1 | 4 | 1-1-2014 | 1-5-2014 | 1-9-2014 | 1-10-2014 |
| 3-4 | 5 | 8 | 1-10-2014 | 1-15-2014 | 1-15-2014 | 1-30-2014 |
次の問合せを実行すると、データベースはゾーン・マップを読み取り、日付1-3-2014が最小日付と最大日付の間にあるため、ブロック1とブロック2のみをスキャンして、ブロック3とブロック4をスキップできます。
SELECT * FROM lineitem WHERE shipdate = '1-3-2014';関連情報:
-
ゾーン・マップの使用方法を学習するには、Oracle AI Databaseデータ・ウェアハウス・ガイドを参照してください。
-
CREATE MATERIALIZED ZONEMAP文の構文とセマンティクスの詳細は、『Oracle AI Database SQL言語リファレンス』を参照してください。
線形順序付けを使用する属性クラスタ表
表の線形順序付けスキームでは、ユーザーが指定した属性に基づいて、行を特定順序で範囲に分割します。Oracle AI Databaseでは、主キーおよび外部キーの関係を介して接続された単一の表または複数の表で、線形順序付けをサポートしています。
たとえば、sales表ではcust_id列とprod_id列を範囲に分割してから、これらの範囲をディスク上で一緒にクラスタ化します。表にBY LINEAR ORDERディレクティブを指定すると、述部で接頭辞列または指令のすべての列を指定する際に、I/Oが著しく削減されることがあります。
salesの問合せでは通常、顧客IDまたは顧客IDと製品IDの組合せを指定するとします。属性クラスタ表を作成して、こうした問合せでI/O削減の利点を享受することができます。
CREATE TABLE sales
(
   prod_id     NOT NULL NUMBER
,  cust_id     NOT NULL NUMBER
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING
  BY LINEAR ORDER (cust_id, prod_id)
  YES ON LOAD YES ON DATA MOVEMENT
WITH MATERIALIZED ZONEMAP;列cust_idおよびprod_idの両方、または接頭辞cust_idを付与する問合せでは、I/O削減が生じます。prod_idはBY LINEAR ORDER句の接頭辞であるため、prod_idのみを付与する問合せでは、著しいI/O削減は生じません。次の例では、表スキャン時にデータベースでI/Oを削減する方法を示します。
例4-9 cust_idのみを指定
アプリケーションで、次の問合せが発行されます。
SELECT * FROM sales WHERE cust_id = 100;sales表はBY LINEAR ORDERクラスタであるため、データベースではcust_id値100を含むゾーンのみを読み取る必要があります。
例4-10 prod_idとcust_idを指定
アプリケーションで、次の問合せが発行されます。
SELECT * FROM sales WHERE cust_id = 100 AND prod_id = 2300;sales表はBY LINEAR ORDERクラスタであるため、データベースではcust_id値100とprod_id値2300を含むゾーンのみを読み取る必要があります。
関連情報:
-
線形順序付けを使用する表をクラスタリングする方法を学習するには、『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照
-
BY LINEAR ORDER句の構文とセマンティクスの詳細は『Oracle AI Database SQL言語リファレンス』を参照
インターリーブされた順序付けを使用する属性クラスタ表
インターリーブされた順序付けでは、Zオーダーとよく似た技術を使用します。
インターリーブされた順序付けにより、データベースではクラスタリング列の述部の任意のサブセットに基づいて、I/Oをプルーニングできます。インターリーブされた順序付けは、データ・ウェアハウスのディメンション階層では便利です。
線形順序付けを使用する属性クラスタ表と同様に、Oracle AI Databaseでは、主キーおよび外部キーの関係を介して接続された単一表または複数表で、インターリーブされた順序付けをサポートしています。属性クラスタ表以外の表内の列は、外部キーでリンクして、属性クラスタの表に結合する必要があります。
大規模なデータ・ウェアハウスでは多くの場合に、データをスター・スキーマで編成しますディメンション表では親子階層が使用されており、外部キーでファクト表に接続されています。インターリーブされた順序でファクト表をクラスタリングすることで、データベースでは表スキャン時に、特別な関数を使用してディメンション列の値をスキップできます。
例4-11インターリーブされた順序付けの例
データ・ウェアハウスにsalesファクト表とその2つのディメンション表customersとproductsが含まれているとします。ほとんどの問合せでは、customers表階層(cust_state_province, cust_city)と製品階層(prod_category, prod_subcategory)に述部があります。次の例の文の一部に示すように、sales表にインターリーブされた順序付けを使用できます。
CREATE TABLE sales
(
   prod_id NUMBER NOT NULL
,  cust_id NUMBER NOT NULL
,  amount_sold NUMBER(10,2) ...
)
CLUSTERING sales
   JOIN products ON (sales.prod_id = products.prod_id)
   JOIN customers ON (sales.cust_id = customers.cust_id)
   BY INTERLEAVED ORDER
   (
     (  products.prod_category
     ,  products.prod_subcategory
     ),
     (  customers.cust_state_province
     ,  customers.cust_city
     )
   )
WITH MATERIALIZED ZONEMAP;
ノート: BY INTERLEAVED ORDER句で指定した列が実際のディメンション表に存在する必要はありませんが、主キーと外部キーの関係を介して接続されている必要があります。
アプリケーションで結合内のsales、productsおよびcustomers表を問い合せるとします。問合せでは、述部でcustomers.prod_categoryおよびcustomers_cust_state_province列を次のように指定します。
SELECT cust_city, prod_sub_category, SUM(amount_sold)
FROM   sales, products, customers
WHERE  sales.prod_id = products.prod_id
AND    sales.cust_id = customers.cust_id
AND    customers.prod_category = 'Boys'
AND    customers.cust_state_province = 'England - Norfolk'
GROUP BY cust_city, prod_sub_category;前述の問合せでは、prod_categoryおよびcust_state_province列は、CREATE TABLEの例に示すクラスタリング定義の一部です。sales表のスキャン時に、データベースはゾーン・マップを参照して、このゾーン内のROWIDにのみアクセスすることができます。
関連情報:
-
インターリーブされた順序付けを使用する表をクラスタリングする方法を学習するには、『Oracle AI Databaseデータ・ウェアハウス・ガイド』を参照
-
BY INTERLEAVED ORDER句の構文とセマンティクスの詳細は、『Oracle AI Database SQL言語リファレンス』を参照してください。
一時表の概要
一時表には、トランザクションまたはセッションの期間中のみ存在するデータが格納されます。
一時表内のデータはセッション専用です。各セッションで参照および変更できるのは、そのセッション自体のデータのみです。
グローバル一時表またはプライベート一時表のどちらかを作成できます。次の表に、これらの本質的な相違点を示します。
表6一時表の特徴
| 特性 | グローバル | プライベート |
|---|---|---|
| ネーミング・ルール | 永続表の場合と同じです | ORA$PTT_を接頭辞として付ける必要がある |
| 表定義の可視性 | すべてのセッション | 表を作成したセッションのみ |
| 表定義の記憶域 | ディスク | メモリーのみ |
| タイプ | トランザクション固有(ON COMMIT DELETE ROWS)、またはセッション固有(ON COMMIT PRESERVE ROWS) |
トランザクション固有(ON COMMIT DROP DEFINITION)またはセッション固有(ON COMMIT PRESERVE DEFINITION) |
3番目のタイプの一時表は、cursor-duration一時表と呼ばれるもので、特定のタイプの問合せに対してデータベースによって自動的に作成されます。
-
一時表の目的一時表は、結果セットをバッファに格納する必要があるアプリケーションで役立ちます。
-
一時表におけるセグメントの割当て永続表と同様に、グローバル一時表は、データ・ディクショナリにおいて静的に定義されている永続オブジェクトです。プライベート一時表の場合、メタデータはメモリー内にのみ存在しますが、ディスク上の一時表領域に格納できます。
-
一時表の作成一時表は、
CREATE ... TEMPORARY TABLE文で作成します。関連項目: cursor-duration一時表についてさらに学習するには、『Oracle AI Database SQLチューニング・ガイド』を参照してください。
一時表の目的
一時表は、結果セットがバッファリングされる必要があるアプリケーションで役立ちます。
たとえば、スケジューリング・アプリケーションでは、大学生が学期のオプション・コースのスケジュールを作成できます。グローバル一時表内の1行は、各スケジュールを表します。セッション中、スケジュール・データはプライベートです。学生がスケジュールを選択すると、アプリケーションは選択したスケジュールの行を永続表に移します。セッションの終了時、データベースではグローバル一時表内にあったスケジュール・データが自動的に削除されます。
プライベート一時表は、動的レポート作成アプリケーションに役立ちます。たとえば、顧客リソース管理(CRM)アプリケーションが同じユーザーで無制限に接続し、複数のセッションが同時にアクティブになる可能性があります。各セッションは、新規トランザクションごとにORA$PTT_crmという名前のプライベート一時表を作成します。アプリケーションは、定義が異なればすべてのセッションで同じ表名を使用できます。データと定義は、そのセッションのみで表示できます。表の定義は、トランザクションが終了するか表を手動で削除するまで保持されます。
一時表でのセグメントの割当て
永続表と同様に、グローバル一時表は、データ・ディクショナリで静的に定義されている永続オブジェクトです。プライベート一時表の場合、メタデータはメモリー内にのみ存在しますが、ディスク上の一時表領域に格納できます。
グローバル一時表とプライベート一時表では、セッションで初めてデータが挿入される際にデータベースによって一時セグメントが割り当てられます。データがセッションにロードされるまでは、表は空のように見えます。トランザクション固有の一時表の場合、データベースではトランザクションの終了時に一時セグメントの割当てが解除されます。セッション固有の一時表の場合、データベースではセッションの終了時に一時セグメントの割当てが解除されます。
関連項目: 「一時セグメント」
一時表の作成
一時表は、CREATE ... TEMPORARY TABLE文で作成されます。
GLOBAL TEMPORARY TABLEまたはPRIVATE TEMPORARY TABLEのいずれかを指定します。どちらの場合も、ON COMMIT句では、表データをトランザクション固有(デフォルト)とセッション固有のどちらにするかを指定します。それぞれのPL/SQLストアド・プロシージャではなく、データベース自体に一時表を作成します。
プライベートではないグローバル一時表の索引は、CREATE INDEX文で作成できます。これらの索引も一時的です。索引内のデータは、一時表のデータと同じセッションまたはトランザクション・スコープを持ちます。また、グローバル一時表のビューまたはトリガーを作成することもできます。
関連情報:
-
ビューの概要に関する項
-
一時表の作成および管理方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
CREATE ... TEMPORARY TABLEの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照してください
外部表の概要
外部表では、外部ソースのデータに対しては、データベース内の表にあるデータのようにアクセスできます。
アクセス・ドライバが提供されている任意の形式のデータを使用できます。SQL (シリアルまたはパラレル)、PL/SQLおよびJavaを使用して外部データを問い合せることができます。
-
外部表の目的外部表は、Oracleデータベース・アプリケーションが非リレーショナル・データにアクセスする必要がある場合に役立ちます。
-
オブジェクト・ストア内のデータ外部表を使用すると、オブジェクト・ストア内のデータにアクセスできます。
-
外部表のアクセス・ドライバアクセス・ドライバとは、データベースの外部データを解釈するAPIのすることです。アクセス・ドライバはデータベースの内部で動作し、そのドライバを使用して外部表のデータを読み取ります。外部表の定義に合うようにデータファイルのデータに必要な変換を行うのは、アクセス・ドライバおよび外部表レイヤーの役割です。
-
外部表の作成内部的には、外部表の作成は、データ・ディクショナリでのメタデータの作成を意味します。通常の表とは異なり、外部表にはデータベースに格納されているデータは示されず、外部でのデータの格納方法も示されません。かわりに、外部表のメタデータに外部表レイヤーに対するデータベースに対するデータの表示方法が記述されます。
-
外部表データの自動キャッシュ外部表からのデータは透過的にキャッシュされ、問合せのパフォーマンスが向上します。
外部表の目的
外部表は、Oracle Databaseアプリケーションで非リレーショナル・データにアクセスする必要がある場合に役立ちます。
たとえば、SQLベースのアプリケーションで次の形式のレコードを含むテキスト・ファイルにアクセスする必要があるとします。
100,Steven,King,SKING,515.123.4567,17-JUN-03,AD_PRES,31944,150,90
101,Neena,Kochhar,NKOCHHAR,515.123.4568,21-SEP-05,AD_VP,17000,100,90
102,Lex,De Haan,LDEHAAN,515.123.4569,13-JAN-01,AD_VP,17000,100,90
外部表を作成し、外部表の定義で指定した場所にテキスト・ファイルをコピーすると、SQLを使用してテキスト・ファイル内のレコードを問い合せることができます。同様に、外部表を使用してJSONドキュメントまたはLOBへの読取り専用アクセスを提供できます。
データ・ウェアハウス環境では、抽出、変換およびロード(ETL)タスクを実行するために外部表が役立ちます。たとえば、外部表を使用して、データ・ロード・フェーズと変換フェーズをパイプライン処理できます。この手法により、データベース内で後続の処理に備えてデータをステージングする必要がなくなります。
外部表を仮想列または通常の列でパーティション化できます。また、ハイブリッド・パーティション表を作成することもできます。この場合、一部のパーティションは内部であり、一部は外部です。内部パーティションと同様に、外部パーティションもパーティション・プルーニングやパーティション・ワイズ結合などのパフォーマンス拡張の利点を享受します。たとえば、パーティション化された外部表を使用して、Hadoop Distributed File System (HDFS)または非SQLデータベースに格納されている大量の非リレーショナル・データを分析できます。
関連項目: 「パーティション表」
オブジェクト・ストアのデータ
外部表を使用して、オブジェクト・ストア内のデータにアクセスできます。
Oracleでは、オペレーティング・システム・ファイルやビッグ・データ・ソースに存在する外部データへのアクセスと、オブジェクト・ストア内の外部データへのアクセスをサポートしています。オブジェクト・ストレージはクラウドでは一般的であり、個々のオブジェクト(メタデータを含むあらゆるタイプの非構造化データ)を単純なコンテナにグループ化することで、管理するためのフラット・アーキテクチャを提供します。オブジェクト・ストレージは主にクラウドのデータ・ストレージ・アーキテクチャですが、オンプレミスのストレージ・ハードウェアとしても使用できます。
オブジェクト・ストアのデータにアクセスするには、DBMS_CLOUDパッケージを使用するか、外部表を手動で定義します。DBMS_CLOUDパッケージは追加機能を提供し、Oracle Autonomous Databaseと完全に互換性があるため、このパッケージの使用をお薦めします。
外部表のアクセス・ドライバ
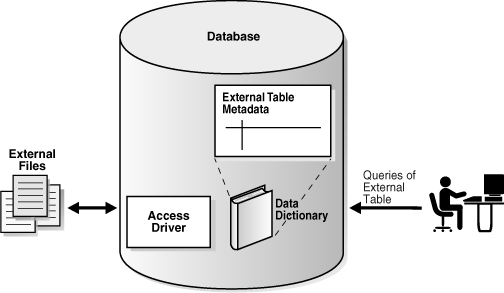
アクセス・ドライバとは、データベースの外部データを解釈するAPIのすることです。アクセス・ドライバはデータベースの内部で動作し、そのドライバを使用して外部表のデータを読み取ります。外部表の定義に合うようにデータファイルのデータに必要な変換を行うのは、アクセス・ドライバおよび外部表レイヤーの役割です。
次の図に、外部データへのSQLアクセスを示します。
図11: 外部表
Oracleでは、外部表のために次のアクセス・ドライバを提供しています。
-
ORACLE_LOADER(デフォルト)SQL*Loaderでサポートされているほとんどの形式を使用して、外部ファイルにアクセスできます。
ORACLE_LOADERドライバを使用して外部ファイルを作成または更新することや、外部ファイルへの追加を行うことはできません。 -
ORACLE_DATAPUMP外部データをアンロードまたはロードできます。アンロード操作では、データベースからデータが読み取られ、1つ以上の外部ファイルで表される外部表にデータが挿入されます。外部ファイルが作成されると、データベースはデータの更新や外部ファイルへのデータの追加を実行できなくなります。ロード操作では、外部表が読み取られ、そのデータがデータベースにロードされます。
-
ORACLE_HDFSHadoop Distributed File System (HDFS)に格納されたデータの抽出を有効にします。
-
ORACLE_HIVEApache Hiveデータベースに格納されたデータにアクセスできます。ソース・データは、HDFS、HBase、Cassandraまたはその他のシステムに格納できます。他のアクセス・ドライバとは異なり、
ORACLE_HIVEでは外部のメタデータ・ストアから場所の情報が取得されるため、場所は指定できません。 -
ORACLE_BIGDATAApache Parquet、Apache Avro、Apache ORC、Apache Iceberg、Linux Open Project Delta Sharingプロトコル、テキスト形式など、構造化および非構造化された形式の両方で保存されたデータへの読取り専用アクセスを有効にします。また、このドライバを使用して、ローカル・データを問い合せることもできます。これは、テストおよび小規模なデータ・セットに便利です。
外部表の作成
内部的には、外部表の作成はデータ・ディクショナリでのメタデータの作成を意味します。通常の表とは異なり、外部表にはデータベースに格納されているデータは示されず、外部でのデータの格納方法も示されません。かわりに、外部表のメタデータに外部表レイヤーに対するデータベースに対するデータの表示方法が記述されます。
CREATE TABLE ... ORGANIZATION EXTERNAL文は、2つの部分に分かれています。外部表の定義には、列型を記述します。この定義は、外部データをデータベースにロードすることなくSQL問合せを実行できるビューに似ています。文の2番目の部分は、外部データを列にマップします。
外部表は、CREATE TABLE AS SELECTでORACLE_DATAPUMPアクセス・ドライバを指定して作成される場合を除き、読取り専用です。外部表の制限は、索引付けされた列および列オブジェクトがサポートされないことです。
関連情報:
-
外部表について学習するには、『Oracle AI Databaseユーティリティ』を参照してください
-
外部表、外部接続およびディレクトリ・オブジェクトの管理について学習するには、『Oracle AI Database管理者ガイド』を参照してください
-
外部表の作成と問合せの詳細は、Oracle AI Database SQL言語リファレンスを参照してください。
外部表データの自動キャッシュ
外部表からのデータは透過的にキャッシュされるため、問合せのパフォーマンスが向上します。
オブジェクト・ストレージに完全または部分的に存在する外部表から頻繁にアクセスされるデータは、パフォーマンスを向上させるために自動的にキャッシュされます。外部表データのキャッシュは、Oracleデータベースによって自動的に処理されるため、アプリケーションを変更する必要はありません。
ブロックチェーン表の概要
ブロックチェーン表は、集中管理ブロックチェーン・アプリケーション向けに設計された追加専用の表である。
Oracle Blockchain Tableでは、ピアとはデータベースを信頼して改ざん不可能です元帳を維持するデータベース・ユーザーです。元帳は、アプリケーションによって定義および管理されるブロックチェーン表として実装されます。既存のアプリケーションで、新しいインフラストラクチャやプログラミング・モデルを必要とせずに、不正から保護できます。トランザクションのスループットは標準の表よりも低くなりますが、ブロックチェーン表のパフォーマンスは、分散ブロックチェーンの場合よりも優れています。
ブロックチェーン表は、許可されたDMLがINSERTコマンドのみであるため、追加専用です。この表はUPDATE、DELETE、MERGE、TRUNCATEおよびダイレクト・パス・ロードを許可しません。データベース・トランザクションは、ブロックチェーン表と標準の表にまたがることができます。たとえば、1つのトランザクションで、標準の表と2つの異なるブロックチェーン表に行を挿入できます。
ブロックチェーン表を使用すると、フラッシュバック・データ・アーカイブのコンテンツを保護できます。これにより、表のコンテンツが改ざんされたかどうかを判別できるようになります。ブロックチェーン・ログ履歴表は、追跡しているユーザー表に対する変更について、暗号化で保護された論理REDOログを保持していることと考えることができます。
バージョン2のブロックチェーン表から始まるブロックチェーン表からユーザー列を追加および削除できます。バージョン1のブロックチェーン表からのユーザー列の追加または削除は許可されていません。物理列およびデータは実際には削除されませんが、不可視としてマークされる。
-
行チェーンの場合ブロックチェーン表では、行連チェーンとは、ハッシング・スキームで連結された一連の行です。
-
行コンテンツ 行コンテンツは、行の列データとチェーン内の以前の行のハッシュ値を含む、連続するバイトのシーケンス。
-
ブロックチェーン表のユーザー・インタフェース標準の表と同じように、ブロックチェーン表は、SQLで作成され、スカラー・データ型、LOB、JSONおよびパーティションをサポートしています。ブロックチェーン表に対して索引およびトリガーを作成することもできます。
行のチェーン
ブロックチェーン表では、行チェーンとは、ハッシング・スキームとともにリンクされた一連の行です。
バージョン1のブロックチェーン表では、システム行チェーンは、データベース・インスタンスIDとチェーンIDの一意の組合せによって識別されます。バージョン2のブロックチェーン表から、この2つの識別子に加えて、行を挿入したデータベースのグローバル一意識別子が必要です。バージョン2のブロックチェーン表では、システム行チェーンは、プラガブル・データベースのグローバル一意ID、データベース・インスタンスIDおよびチェーンIDの一意の組合せによって識別されます。ブロックチェーン表内の1つの行は、1つのシステム行チェーンに属しています。単一表では、複数のシステム行チェーンがサポートされています。ノート:標準表の連鎖行は、ブロックチェーン表の行チェーンの直交です。「チェーン」という単語のみが同じです。
チェーンのすべての行にはそれぞれ順序番号が付いています。データベースは、各チェーンの行でSHA2-512ハッシュ計算を使用して行の順序を決定します。挿入されたすべての行に対するハッシュは、チェーンに以前に挿入された行のハッシュ値を含む、挿入された行の行コンテンツから導出されます。
ブロックチェーン表内の各行は、1つのシステム・チェーンに属していますが、ブロックチェーン表の作成時に指定された一連のユーザー列の値に基づいてユーザー・チェーンに属することもできます。
行コンテンツ
行コンテンツは、列のデータとチェーン内の前回のロウのハッシュ値を含む、連続するバイトのシーケンスである。
ブロックチェーン表を作成すると、データベースでは非表示の複数の列が作成されます。たとえば、bank列とdeposit列を使用して、ブロックチェーン表bank_ledgerを作成できます。
CREATE BLOCKCHAIN TABLE bank_ledger (bank VARCHAR2 (128), deposit NUMBER)
  NO DROP UNTIL 31 DAYS IDLE
  NO DELETE UNTIL 31 DAYS AFTER INSERT
HASHING USING "SHA2_512" VERSION "v1";データベースでは、接頭辞ORABCTABのある非表示の列、ORABCTAB_INST_ID$、ORABCTAB_CHAIN_ID$、ORABCTAB_SEQ_NUM$などが自動的に作成されます。これらの非表示列(それらの多くは変更も管理もできない)により、改ざん防止アルゴリズムを実装します。このアルゴリズムは、コミット時に一意の表レベル・チェーン・ロックを特定の順序で取得することでデッドロックを回避します。
ノート:ブロックチェーン表の行内容は、標準データ・ブロックに格納されます。このリリースのOracle AI Databaseでは、ブロックチェーン表で表クラスタはサポートされていません。
インスタンスID、チェーンIDおよびシーケンス番号によって、行が一意に識別されます。バージョン2のブロックチェーン表から、この3つの値に加えて、行を挿入したデータベースのグローバル一意識別子が必要です。各行には、非表示の列ORABCTAB_HASH$に格納されるプラットフォームに依存しないSHA2-512ハッシュがあります。ハッシュは、挿入された行の内容、およびチェーン内の前の行のハッシュに基づいています。
行の列値のデータ形式は、列のメタデータと内容のバイトで構成されます。列のメタデータは、表内の位置、データ型、NULLステータス、バイト長などの特性を記述する20バイト構造です。列の内容は、1行の値を表すバイト・セットです。たとえば、値ChaseのASCII表現は43 68 61 73 65です。SQLでDUMP関数を使用すると、列のメタデータと内容の両方を取得できます。
ハッシュ計算の行内容には、複数の列からの列データ形式(連鎖内の前の行のハッシュ値、ユーザー定義列および非表示の固定列数)が含まれています。
関連する行が挿入される順序(行バージョンと呼ばれる)は、システムで追跡でき、行バージョンが定義されている一連の列を指定することで記録できます。また、行バージョンが指定されている場合は、ユーザーが指定した一連の列にある値の組合せごとに最後の挿入行が示されるビューが、自動的に作成されメンテナンスされます。このビューの名前には、Blockchain_Table_Name_LAST$というネーミング規則が使用されます。
行には、エンド・ユーザーの代理人が追加で、またはかわりに署名する必要がある多くのケースがあります。たとえば、エンド・ユーザーが挿入した行に署名する銀行マネージャです。代理署名者とは、その行のシステム暗号ハッシュを使用して計算される行に自分の署名を追加できる別のデータベース・ユーザーです。行には、エンド・ユーザー、代理人、またはその両者が署名できます。代理人の署名が受け入れられるのは、代理人の証明書を使用してその署名を検証でき、代理人の証明書がデータベース・ディクショナリ表に記録されている場合のみです。
エンド・ユーザーまたは代理人によって行に署名する場合、その行の副署名を取得することもできます。副署名は、エンド・ユーザーまたは代理人がすでに署名してある行のブロックチェーン表ダイジェストとみなすことができます。行に連署した場合、その連署は、その行の署名者に返され、その行にも保存されます。行に対する連署を求めたユーザーは、この情報を、否認防止の目的で別のデータ・ストアに保存できます。
ブロックチェーン表のユーザー・インタフェース
標準の表と同じように、ブロックチェーン表は、SQLで作成され、スカラー・データ型、LOB、JSONおよびパーティションをサポートしています。ブロックチェーン表に対して索引およびトリガーを作成することもできます。
ブロックチェーン表を作成するには、CREATE BLOCKCHAIN TABLE文を使用します。ブロックチェーン表には、NO DROP UNTIL n DAYS IDLE句で指定された保存期間が含まれます。この表はDROP TABLEを使用して削除できます。
Oracle Blockchain Tableでは、次のインタフェースをサポートしています。
-
DBMS_BLOCKCHAIN_TABLEパッケージでは、表の行に対して様々な操作を実行できます。たとえば、以前に挿入した行の内容に署名を適用するには、SIGN_ROWプロシージャを使用します。行が改ざんされていないことを確認するには、VERIFY_ROWSを使用します。保存期間(NO DELETE句で指定した期間)が経過した後に行を削除するには、DELETE_EXPIRED_ROWSを使用します。 -
DBA_BLOCKCHAIN_TABLESビューには、行の保存期間、表の削除が許可されるまでの非アクティブ期間、ハッシュ・アルゴリズムなどの表メタデータが表示されます。
注意:
-
ブロックチェーン表の管理方法を学習するには、Oracle AI Database管理者ガイドを参照
-
DBMS_BLOCKCHAIN_TABLEパッケージについて学習するには、Oracle AI Database PL/SQLパッケージおよびタイプ・リファレンスを参照 -
DBA_BLOCKCHAIN_TABLESビューについて学習するには、Oracle AI Databaseリファレンスを参照
不変表の概要
不変表とは、内部関係者によって不正にデータが変更されることや、人間のミスが原因で想定外にデータが変更されることがない、追加専用の表です。
不正な変更は、インサイダー資格証明へのアクセス権を持つ安全性のない従業員や悪意のある従業員によって試行される可能性があります。
不変表には新しい行を追加できますが、既存の行は変更できません。保存期間は、不変テーブルと不変表内の行の両方に指定する必要があります。指定した行の保存期間が経過すると、行は不要になります。不変表から削除できるのは、使用されなくなりました行だけです。
不変表には、システム生成の非表示列が含まれています。この列は、ブロックチェーン表のものと同じです。行が挿入されると、ORABCTAB_CREATION_TIME$列とORABCTAB_USER_NUMBER$列にNULL以外の値が設定されます。V1不変表を除き、ORABCTAB_PDB_GUID$列にはNULL以外の値が設定されます。不変表を行バージョン付きで作成した場合、ORABCTAB_ROW_VERSION$列とORABCTAB_LAST_ROW_VERSION_NUMBER$列には、NULL以外の値が設定されます。残りのシステム生成の非表示列の値は、NULLに設定されます。
不変表を使用する場合、既存のアプリケーションを変更する必要はありません。
オブジェクト表の概要
オブジェクト表は、各行がオブジェクトを表す特殊な表の一種です。
Oracleのオブジェクト型は、名前、属性およびメソッドを含むユーザー定義型です。オブジェクト型を使用すると、顧客や発注など実社会のエンティティをデータベース内のオブジェクトとしてモデル化できるようになります。
オブジェクト型では論理構造が定義されますが、記憶域は作成されません。次の例では、department_typという名前のオブジェクト型を作成します。
CREATE TYPE department_typ AS OBJECT
   ( d_name     VARCHAR2(100),
     d_address  VARCHAR2(200) );
/次の例では、オブジェクト型department_typのdepartments_obj_tという名前のオブジェクト表を作成し、その表に行を挿入します。departments_obj_t表の属性(列)は、オブジェクト型の定義から導出されます。
CREATE TABLE departments_obj_t OF department_typ;
INSERT INTO departments_obj_t VALUES ('hr', '10 Main St, Sometown, CA');
リレーショナル列と同様に、オブジェクト表に含めることができるのは、表と同一の宣言された型のオブジェクト・インスタンスなど、1種類の行のみです。デフォルトで、オブジェクト表のすべての行オブジェクトに関連する論理オブジェクト識別子(OID)があり、この識別子によりオブジェクト表の行オブジェクトが一意に識別されます。オブジェクト表のOID列は、非表示の列です。
関連情報:
-
Oracle AI Databaseのオブジェクト・リレーショナル機能について学習するには、Oracle AI Databaseオブジェクト・リレーショナル開発者ガイドを参照してください。
-
CREATE TYPEの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照