論理ストレージ構造
この章では、論理記憶域構造の性質と論理記憶域構造間の関係について説明します。これらの構造は、Oracle AI Databaseによって作成され、認識されるものであり、オペレーティング・システムでは認識されません。
-
論理記憶域構造の概要 Oracle AI Databaseでは、データベース内のすべてのデータに対して論理領域が割り当てられています。
-
データ・ブロックの概要 Oracle AI Databaseでは、データベースのデータファイル内の論理記憶域は、データ・ブロックと呼ばれる単位で管理されます(データ・ブロックが、Oracleブロックまたはページとも呼ばれます)。データ・ブロックは、データベースI/Oの最小単位です。
-
エクステントの概要エクステントは、論理的に連続したデータ・ブロックからなる、データベース記憶域の単位です。データ・ブロックは、RAIDのストライプ化やファイル・システムの実装によって、物理的にはディスク上に断続的に存在する可能性があります。
-
セグメントの概要セグメントは、表領域内の論理記憶域構造のデータがすべて含まれている、エクステントの集合です。
-
表領域の概要表領域とは、セグメントの論理記憶域コンテナです。
論理記憶域構造の概要
Oracle AI Databaseでは、データベース内のすべてのデータに対して論理領域を割り当てます。
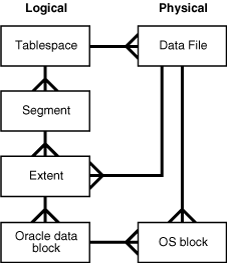
データベース領域の論理単位は、データ・ブロック、エクステント、セグメントおよび表領域です。物理レベルでは、データはディスク上のデータ・ファイル内に格納されます。データファイル内のデータは、オペレーティング・システムのブロックに格納されます。
次の図に、物理記憶域と論理記憶域のエンティティ関係ダイアグラムを示します。クロウの足の表記は、1対多の関係を表しています。
図1: 論理格納と物理記憶域
-
論理記憶域階層セグメントには1つ以上のエクステントが含まれており、各エクステントには複数のデータ・ブロックが含まれています。
-
論理領域管理 Oracle AI Databaseでは、表領域内でエクステントの追跡および割当てを行うために論理領域管理を使用する必要があります。関連項目: 「物理記憶域構造」
論理記憶域階層
セグメントには、それぞれが複数のデータ・ブロックを含む1つ以上のエクステントが含まれます。
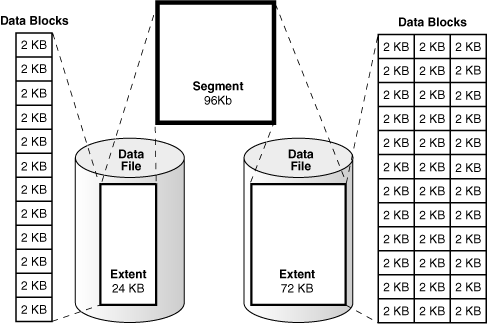
次の図に、表領域内のデータ・ブロック、エクステントおよびセグメント間の関係を示します。この例では、1つのセグメントに対して、異なるデータファイルに格納された2つのエクステントがあります。
図2: 表領域内セグメント、エクステントおよびデータ・ブロック
最低レベルの粒度から最高レベルまで、Oracle AI Databaseは次のようにデータを格納します。
-
データ・ブロックは、Oracle AI Databaseのデータ記憶域の最小論理単位です。
1つの論理データ・ブロックは、永続ストレージの特定のバイト数(2 KBなど)に対応します。データ・ブロックは、Oracle AI Databaseで使用または割当て可能な記憶域の最小単位です。
従来、データ・ファイルは磁気ディスクまたは半導体ディスク(SSD)に格納されていました。Oracle AI Databaseは、データベース・ファイルの記憶域のための永続メモリー(PMEM)もサポートします。基礎となるデータが物理的に格納される方法にかかわらず、Oracleプロセスでは常に論理データ・ブロックの読取りと書込みが行われます。
-
エクステントとは、論理的に連続した一連のデータ・ブロックで、特定のタイプの情報を格納するために割り当てられます
前の図では、24KBのエクステントには12のデータ・ブロックが存在し、72KBのエクステントには36のデータ・ブロックが存在しています。
-
セグメントとは、表などの特定のデータベース・オブジェクトのために割り当てられる一連のエクステントです。
たとえば、
employees表のデータは、それぞれ専用のデータ・セグメントに格納されており、employeesの各索引は、それぞれ専用の索引セグメントに格納されます。記憶域を消費するそれぞれのデータベース・オブジェクトは、1つのセグメントで構成されます。 -
表領域は、1つ以上のセグメントが含まれるデータベース記憶域単位です。
各セグメントは、1つの表領域にのみ属しています。このため、セグメントのすべてのエクステントは、同じ表領域に格納されます。前の図に示すように、表領域内のセグメントには、複数のデータファイルのエクステントが含まれている場合があります。たとえば、セグメントのあるエクステントは
users01.dbfに格納され、他のエクステントはusers02.dbfに格納されます。1つのエクステントが複数のデータファイルにまたがることはありません。
参照: 「物理記憶域構造の概要」
論理領域管理
Oracle AI Databaseでは、表領域内でエクステントの追跡および割当てを行うために論理領域管理を使用する必要があります。
データベース・オブジェクトでエクステントが必要な場合、データベースには、エクステントを検索および提供する手段が必要です。同様に、オブジェクトでエクステントが不要になった場合、データベースに空きエクステントを使用可能にする手段が必要です。
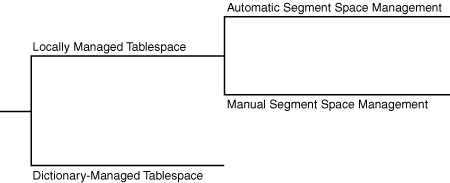
Oracle AI Databaseでは、作成する表領域のタイプに基づいて表領域内の領域が管理されます。次のいずれかのタイプの表領域を作成できます。
-
ローカル管理表領域(デフォルト)
エクステントの管理に、表領域自体にあるビットマップが使用されます。したがって、ローカル管理表領域の一部には、ビットマップ用の表領域があります。表領域内のセグメントは、自動セグメント領域管理(ASSM)または手動セグメント領域管理(MSSM)を使用して管理できます。
-
ディクショナリ管理表領域
データベースは、エクステントの管理にデータ・ディクショナリを使用します。
図15-3に、表領域の論理領域管理の方法を示します。
図3: 論理領域管理
-
ローカル管理表領域ローカル管理表領域では、データファイル・ヘッダー内に、データファイル本体の空き領域および使用済領域を追跡するためのビットマップが保持されている。
-
ディクショナリ管理表領域ディクショナリ管理表領域では、データ・ディクショナリを使用してそのエクステントを管理します。関連項目: 「データ・ディクショナリの概要」
ローカル管理表領域
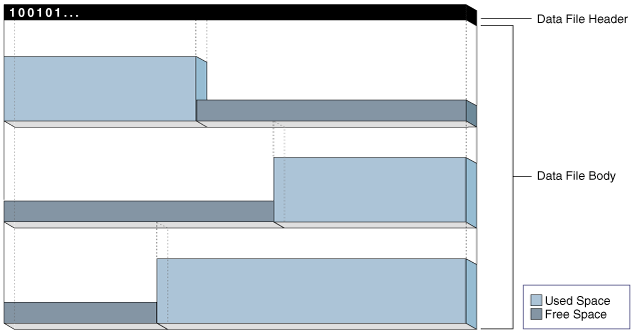
ローカル管理表領域では、データファイル・ヘッダー内に、データファイル本体の空き領域および使用済領域を追跡するためのビットマップが保持されています。
各ビットは、1ブロック・グループに対応します。領域が割り当てられるか、解放されると、Oracle AI Databaseでは、ビットマップの値がブロックの新しい状態を反映する値に変更されます。
ビットマップ管理記憶域を概念的に表現すると、次の図のようになります。ヘッダー内の1は使用済領域を表し、0は空き領域を表します。
図4: ビットマップ管理記憶域
ローカル管理表領域には、次のような利点があります。
-
エクステントの管理にデータ・ディクショナリを使用する必要がありません。
ディクショナリ管理表領域では、エクステント内の領域を使用または解放することにより、データ・ディクショナリ表やUNDOセグメントの領域を使用または解放する他の操作が行われた場合、再帰的な操作が発生することがあります。
-
隣接する空き領域が自動的に追跡されます。
これにより、データベースで空きエクステントを結合する必要がなくなります。
-
ローカル管理エクステントのサイズが自動的に決定されます。
また、ローカル管理表領域内では、すべてのエクステントを同じサイズにすることもでき、さらにオブジェクト記憶域オプションがオーバーライドされます。ノート: Oracleでは、自動セグメント領域管理でローカル管理表領域を使用することを強くお薦めします。
セグメント領域管理は、セグメントを含む表領域から継承される属性です。ローカル管理表領域内では、セグメントは自動または手動で管理できます。たとえば、表領域users内のセグメントは自動で管理でき、表領域tools内のセグメントは手動で管理できます。
-
自動セグメント領域管理 自動セグメント領域管理(ASSM)方式では、ビット・マップを使用して表領域の領域が管理されています。
-
手動セグメント領域管理従来の手動セグメント領域管理(MSSM)方式では、空きリストと呼ばれるリンク・リストを使用して、セグメントの空き領域を管理します。
自動セグメント領域管理
自動セグメント領域管理(ASSM)方式では、ビット・マップを使用して表領域の領域が管理されています。
ビットマップには、次の利点があります。
-
管理の簡素化
ASSMでは、多数の記憶域パラメータの設定を手動で厳密に決定する必要がありません。唯一の重要なSQLパラメータ
PCTFREEによって、領域割当てが制御されます。このパラメータは、将来の更新用にブロック内に予約する領域の割合を指定します(「データ・ブロック内の空き領域の割合」を参照)。 -
同時実行性の向上
複数のトランザクションで別々の空きデータ・ブロックのリストを検索できるため、競合や待機時間が減少します。多数の標準的なワークロードでは、適切にチューニングされた、MSSMを使用するアプリケーションよりも、ASSMを使用するアプリケーションの方が高いパフォーマンスを示します。
-
Oracle Real Application Clusters(Oracle RAC)環境における、インスタンスへの領域の動的アフィニティ
ASSMは永続的なローカル管理表領域に対するデフォルトであり、より効率的です。
ノート:この章では、論理記憶域のすべての説明において、ASSMを使用することを前提としています。
手動セグメント領域の管理
従来の手動セグメント領域管理(MSSM)方式では、空きリストと呼ばれるリンク・リストを使用して、セグメントの空き領域を管理できます。
空きスペースが存在するデータベース・オブジェクトでは、空きリストにより、使用済のセグメント領域の分割ラインである最高水位標(HWM)(HWM)よりも下のブロックが追跡されます。ブロックが使用済になると、データベースは必要に応じて、空きリストにブロックを登録したり、空きリストからブロックを削除したりします。
MSSMでは、PCTFREE以外にもPCTUSED、FREELISTS、FREELIST GROUPSなどのSQLパラメータを使用して、領域割当てを制御する必要がある。PCTUSEDでは、現在使用されているブロックが空きリストに登録されるためには、どの程度の空き領域が必要なのかの割合を設定します。たとえば、CREATE TABLE文でPCTUSEDを40に設定すると、ブロックの使用済領域の割合が40%未満になるまでは、セグメント内のブロックに行を挿入できません。
たとえば、表に行を挿入するとします。データベースは表の空きリストを参照し、最初の空き領域がどこなのかをチェックします。行がブロックに格納し切れず、ブロック内の使用済領域がPCTUSED以上になっている場合、そのブロックはリストから削除され、別のブロックが検索されます。ブロックから行を削除した場合は、ブロック内の使用済領域がPCTUSED未満になったかどうかがチェックされます。その場合は、そのブロックが空きリストの先頭に登録されます。
オブジェクトに対して、空きリストを複数にすることもできます。こうしておくと、表に対してDMLを実行している複数のセッションが別々のリストを使用できるため、競合を回避できます。各データベース・セッションがセッション中に使用する空きリストは1つです。
図15-5に示すように、1つ以上の空きリストの集合が存在するオブジェクト1つ作成することもできます。各グループにはマスター空き一覧があり、グループ内の各プロセス空き一覧を管理します。空きリストに必要な領域は、特に空きリスト・グループの場合、大きくなることがあります。
図5: 空きリスト・グループ
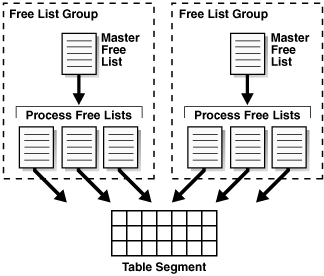
セグメント領域を手動で管理する手順は複雑です。行の移行を少なくし、領域を無駄にしないようにするには、PCTFREEおよびPCTUSEDを調整する必要があります。たとえば、たとえ、セグメント内のど使用済ブロックが半分の空き領域が一杯になっており、PCTUSEDが40になっている場合は、これらのブロックのいずれにも挿入できません。領域割当てパラメータの詳細なチューニングは難しいため、ASSMの使用をお薦めします。ASSMでは、ブロックに新しい行を挿入可能かどうかを判断するためにPCTFREEが使用されますが、空きリストは使用されず、PCTUSEDは無視されます。
関連情報:
-
ローカル管理表領域について学習するには、Oracle AI Database管理者ガイドを参照してください。
-
自動セグメント領域管理についてさらに学習するには、Oracle AI Database管理者ガイドを参照してください。
-
PCTFREEやPCTUSEDなどの記憶域パラメータについて学習するには、『Oracle AI Database SQL言語リファレンス』を参照
ディクショナリ管理領域
ディクショナリ管理表領域では、データ・ディクショナリを使用してそのエクステントが管理されます。
Oracle AI Databaseでは、エクステントが割り当てられたり再利用のために解放されるたびに、データ・ディクショナリ内の表が更新されます。たとえば、表でエクステントが必要な場合は、データ・ディクショナリ表が問い合せられ、空きエクステントを検索します。領域が見つかると、あるデータ・ディクショナリ表が変更され、別のデータ・ディクショナリ表に行が挿入されます。このようにデータを変更および移動することによって、領域が管理されます。
データベース・オブジェクト用の領域を取得するため、データベースでバックグラウンドで実行されるSQLは再帰的SQLです。データ・ディクショナリへの更新はシリアライズされる必要があるため、再帰的SQLを頻繁に使用するとパフォーマンスに大きな影響を与える可能性があります。デフォルトのローカル管理表領域では、このようなパフォーマンス上の問題は回避されます。
関連項目: ディクショナリ管理表領域からローカル管理表領域への移行方法を学習するには、『Oracle AI Database管理者ガイド』を参照してください
データ・ブロックの概要
Oracle AI Databaseでは、データベースのデータファイル内の論理記憶域は、Oracleブロックまたはページとも呼ばれるデータ・ブロックと呼ばれる単位で管理されます。データ・ブロックは、データベースI/Oの最小単位です。
-
データ・ブロックとオペレーティング・システム・ブロック物理レベルは、データベースのデータは、オペレーティング・システム・ブロックによって構成されたディスク・ファイルに格納されます。
-
データ・ブロック・フォーマットすべてのデータ・ブロックには、形式、つまりデータベースによるブロック内のデータや空き領域の追跡を可能にする内部構造が含まれます。この形式は、データ・ブロックに表、索引、表クラスタのいずれのデータが含まれている場合でも同じです。
-
データ・ブロックの圧縮データベースでは、表の圧縮を使用して、データ・ブロック内の重複値を排除できます。この項では、圧縮を使用するデータ・ブロックの形式について説明します。
-
データ・ブロック内のスペース管理データベースではデータ・ブロックは下から順に使用されますため、行データとブロック・ヘッダーの間の空き領域量が減少します。
-
索引 ブロックの概要索引 ブロックは、領域を表ブロックとは異なる方法で管理する特殊なタイプのデータ・ブロックである。Oracle AI Databaseでは、索引ブロックを使用して、索引の論理記憶域を管理します。
データ・ブロックとオペレーティング・システム・ブロック
物理レベルにおいて、データベース・データは、オペレーティング・システム・ブロックで構成されたディスク・ファイルに格納されます。
オペレーティング・システム・ブロックは、オペレーティング・システムが読取りまたは書込みを行うことができるデータの最小単位である。一方、Oracleブロックは、論理記憶域構造であり、そのサイズや構造はオペレーティング・システムには認識されません。
次の図に、オペレーティング・システム・ブロックのサイズがデータ・ブロックのサイズと異なる場合があることを示します。データベースでは、オペレーティング・システム・ブロックではなく、データ・ブロックの倍数を単位としてデータを要求します。
図6: データ・ブロックとオペレーティング・システム・ブロック
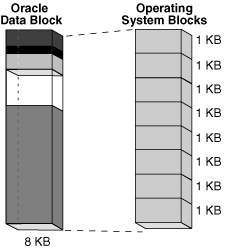
データベースがデータ・ブロックを要求すると、オペレーティング・システムは、この操作を永続ストレージ内のデータに対する要求に変換します。データ・ブロックをオペレーティング・システム・ブロックから論理的に分離することは、次のことを意味します。
-
アプリケーションでは、データのディスク上の物理アドレスを特定する必要がありません。
-
データベースのデータは、複数の物理ディスクにストライプ化またはミラー化できます。
-
データベース・ブロック・サイズすべてのデータベースには、データベース・ブロック・サイズが含まれます。
-
表領域ブロック・サイズ
DB_BLOCK_SIZEの設定とは異なるブロック・サイズの表領域が個別に作成できます。
データベース・ブロック・サイズ
すべてのデータベースには、データベース・ブロック・サイズが含まれます。
DB_BLOCK_SIZE初期化パラメータでは、データベース作成時のデータ・ブロック・サイズが設定されます。このサイズは、SYSTEM表領域およびSYSAUX表領域に対して設定され、他のすべての表領域のデフォルトとなります。データベース・ブロック・サイズは、データベースを再作成する場合以外は変更できません。
DB_BLOCK_SIZEが設定されていない場合、デフォルトのデータ・ブロック・サイズは、オペレーティング・システム固有のサイズになります。データベースの標準的なデータ・ブロック・サイズは、4KBまたは8KBです。データ・ブロックのサイズとオペレーティング・システム・ブロックのサイズが異なる場合、データ・ブロックのサイズは、オペレーティング・システム・ブロックのサイズの倍数である必要があります。
関連情報:
-
DB_BLOCK_SIZE初期化パラメータについて学習するには、『Oracle AI Databaseリファレンス』を参照 -
ブロック・サイズの選択方法を学習するには、Oracle AI Database管理者ガイドおよびOracle AI Databaseパフォーマンス・チューニング・ガイドを参照してください。
表領域ブロック・サイズ
DB_BLOCK_SIZEの設定とは異なるブロック・サイズの表領域を個別に作成できます。
非標準のブロック・サイズは、トランスポータブル表領域を別のプラットフォームに移動する場合に役立ちます。
関連項目:表領域の非標準のブロック・サイズを指定する方法を学習するには、『Oracle AI Database管理者ガイド』を参照してください。
データ・ブロックの形式
すべてのデータ・ブロックには、形式、つまりデータベースでのブロック内のデータや空き領域の追跡を可能にする内部構造があります。この形式は、データ・ブロックに表、索引、表クラスタのいずれのデータが含まれている場合でも同じです。
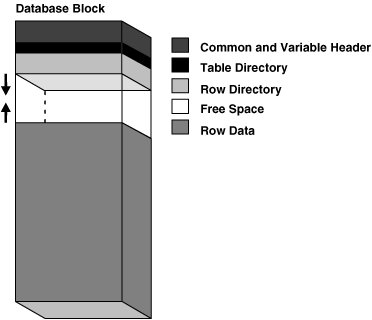
次の図に、非圧縮データ・ブロックの形式を示します。
図7: データ・ブロックの形式
-
データ・ブロック・オーバーヘッドOracle AI Databaseでは、ブロック・オーバーヘッドを使用してブロック自体が管理されます。ブロック・オーバーヘッドには、ユーザー・データは格納できません。
-
行形式ブロックの行データ部分には、表の行や索引キー・エントリなどの実際のデータは格納されます。すべてのデータ・ブロックに内部形式があるように、すべての行に行形式があり、これにより、データベースにおける行のデータ追跡が可能になります。関連項目:圧縮済ブロックについて学習するには、「データ・ブロック圧縮」を参照してください
データ・ブロック・オーバーヘッド
Oracle AI Databaseでは、ブロック・オーバーヘッドを使用してブロック自体を管理します。ブロック・オーバーヘッドには、ユーザー・データは格納できません。
「データ・ブロックの形式」に示すように、ブロック・オーバーヘッドには次の構成要素が含まれています。
-
ブロック・ヘッダー
ブロック・ヘッダーには、ディスク・アドレスやセグメント・タイプなどブロックについての一般的な情報が含まれています。トランザクション管理ブロックの場合、ブロック・ヘッダーにはアクティブなトランザクションとトランザクション履歴情報が含まれています。
ブロックを更新するすべてのトランザクションには、トランザクション・エントリが必要です。Oracle AI Databaseでは、トランザクション・エントリ用の領域が最初にブロック・ヘッダーに予約されています。トランザクションの変更をサポートするセグメントに割り当てられたデータ・ブロックでは、ヘッダー領域の空きがなくなったと、トランザクション・エントリが空き領域にも保持されます。トランザクション・エントリに必要な領域のサイズは、オペレーティング・システムによって異なります。ただし、ほとんどのオペレーティング・システムで、トランザクション・エントリのサイズは約23バイトです。
-
表ディレクトリ
ヒープ構成表では、このディレクトリには、このブロックに行を格納する表についてのメタデータが含まれています。表クラスタ内では、複数の表が同じブロック内に行を格納できます。
-
行ディレクトリ
ヒープ構成表では、このディレクトリはブロックのデータ部分内の行の位置を示しています。データベースでは、ブロックの下部の任意の場所に行を配置できます。行アドレスは、行ディレクトリ・ベクターのいずれかのスロットに記録されます。
ROWIDは、特定のファイル、ブロックおよび行番号を指します。たとえば、ROWID
AAAPecAAFAAAABSAAAでは、最後のAAAは行番号を表します。行番号は、行ディレクトリのエントリへの索引です。行ディレクトリ・エントリには、データ・ブロックの行の位置へのポインタが含まれます。データベースがブロック内で行を移動する場合、データベースは行ディレクトリ・エントリを更新してポインタを修正します。ROWIDは変わりません。データベースが行が行ディレクトリに領域を割り当てると、行が削除された後もデータベースはこの領域を再利用しません。したがって、現在は空き状態でも、以前に最大50行が格納されていた場合は、行ディレクトリには100バイトが割り当てられたままになります。データベースがこの領域を再利用するのは、セッションが新しい行をブロックに挿入する場合のみです。
一部のブロック・オーバーヘッドはサイズが固定ですが、全体のサイズは可変です。ブロック・オーバーヘッド全体のサイズは、平均で84から107バイトです。
行形式
ブロックの行データ部分には、表の行や索引キー・エントリなどの実際のデータが格納されます。すべてのデータ・ブロックに内部形式があるように、すべての行に行形式があり、これにより、データベースにおける行のデータ追跡が可能になります。
Oracle AI Databaseでは、行は可変長レコードとして格納されます。1つの行は1つ以上のセクションに格納されます。各セクションは、行断片と呼ばれます。各行断片は、行ヘッダーおよび列データで構成されます。
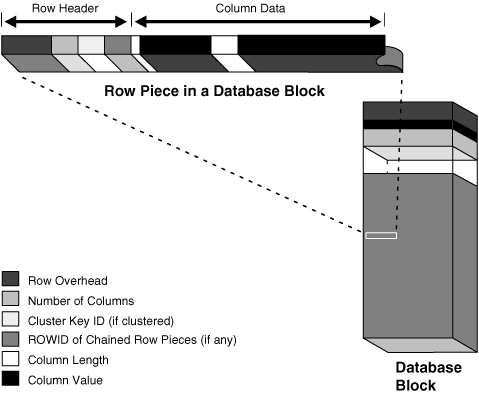
次の図に、行の形式を示します。
図8: 行断片の形式
-
行ヘッダー Oracle AI Databaseでは、行ヘッダーを使用して、ブロック内に格納された行断片が管理されています。
-
列データ行ヘッダーの後で、列データ・セクションに、行の実際のデータが格納されます。行断片には通常、
CREATE TABLE文で指定された順序で列が格納されますが、必ずこの順序であるとはかぎりません。たとえば、LONG型の列は最後に作成されます。 -
ROWID形式 Oracle AI Databaseでは、ROWIDを使用して行が一意に識別されます。内部的には、ROWIDは、データベースが行にアクセスするために必要な情報を保持する構造です。ROWIDは、物理的にはデータベースに格納されませんが、データが格納されているファイルやブロックから推論されます。
行ヘッダ
Oracle AI Databaseでは、行ヘッダーを使用して、ブロック内に格納された行断片を管理します。
行ヘッダーには、次のような情報が含まれています。
-
行断片内の列
-
他のデータ・ブロック内にある行の断片
Oracle AI Databaseでは、行全体を単一のデータ・ブロックに挿入できる場合、その行が1つの行断片として格納されます。ただし、行データのすべてを単一のブロックに挿入できない場合、または行の更新によって既存の行が単一のブロックに収まらなくなった場合には、その行は複数の行断片として格納されます。データ・ブロックには、通常1つの行につき1つの行断片のみが含まれています。
-
表クラスタのクラスタ・キー
1つのブロックに完全に収まる行は、最低3バイトの行ヘッダーを持っています。
関連情報:
列データ
行ヘッダーの後ろにある列データ・セクションに、行の実際のデータが格納されます。行断片には通常、CREATE TABLE文で指定された順序で列が格納されますが、必ずこの順序であるとはかぎりません。たとえば、LONG型の列は最後に作成されます。
Oracle AI Databaseでは、「行の形式」の図に示すように、行断片内の各列の長さとデータが別々に格納されます。必要な領域は、データ型によって異なります。列のデータ型が可変長である場合、値を保持するために必要な領域は、データの更新によって変動します。
各行には、データ・ブロック・ヘッダーの行ディレクトリにスロットがあります。このスロットは行の先頭を指しています。
ROWID形式
Oracle AI Databaseでは、ROWIDを使用して行が一意に識別されます。内部的には、ROWIDは、データベースが行にアクセスするために必要な情報を保持する構造です。ROWIDは、物理的にはデータベースに格納されませんが、データが格納されているファイルやブロックから推論されます。
拡張ROWIDには、データ・オブジェクト番号が含まれています。このROWIDタイプは、各行の物理アドレスをBASE64エンコーディングで表現したものです。エンコーディング文字は、AからZ、aからz、0から9、+および/です。
例15-1 ROWID擬似列
次の例では、ROWID擬似列を問い合せて、employees表にある従業員100の行の拡張ROWidを表示します。
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
次の図に、拡張ROWIDの形式を示します。
図9: ROWID形式
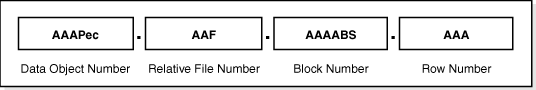
拡張ROWIDは、OOOOOOFFFBBBBBBRRRという4つの部分から構成される形式で表示されます。各部分の内容は、次のとおりです。
-
OOOOOOセグメントを識別するデータ・オブジェクト番号(問合せの例では、データ・オブジェクト
AAAPecです)。データ・オブジェクト番号は、各データベース・セグメントに割り当てられます。同じセグメント内のスキーマ・オブジェクト(表クラスタなど)は、同じデータ・オブジェクト番号を持っています。 -
FFF行を含むデータファイルを識別する表領域関連のデータファイル番号(問合せの例では、ファイル
AAFです)。 -
BBBBBB行を含むブロックを識別するデータ・ブロック番号(問合せの例では、ブロック
AAAABSです)。ブロック番号は、表領域ではなくデータファイルに対する相対値です。このため、同じブロック番号の行が、同じ表領域の異なるデータファイルに存在することもあります。 -
RRRブロック内の行を識別する行番号(問合せの例では、行
AAAです)。
特殊な状況では、ROWIDが行断片に割り当てられた後、ROWIDが変更される場合があります。たとえば、行の移動が可能な場合、ROWIDはパーティション・キーの更新、フラッシュバック表の操作、表の縮小操作などのために変更されることがあります。行の移動が無効な場合は、Oracle AI Databaseユーティリティを使用して行をエクスポートおよびインポートした場合にROWidが変更される可能性があります。ノート:内部的には、行の移動は行が物理的に削除されて再挿入されたものとして実行されます。ただし、行の移動は更新であるとみなされ、これはトリガーに影響します。
関連情報:
-
ROWIDについて学習するには、Oracle AI Database SQL言語リファレンスを参照してください。
データ・ブロックの圧縮
データベースでは、表の圧縮を使用して、データ・ブロック内の重複値を排除できます。この項では、圧縮を使用するデータ・ブロックの形式について説明します。
基本表および高度な行圧縮を使用するデータ・ブロックのフォーマットは、基本的には非圧縮ブロックのフォーマットと同じです。相違点は、ブロックの先頭にあるシンボル表に、行および列の重複値が格納されるということです。Oracle Databaseでは、発生した重複値はシンボル表の短い参照で置き換えられます。
例15-2 圧縮されたデータ・ブロックの形式
次の行が、7列で構成されたsales表のデータ・ブロックに格納されるとします。
2190,13770,25-NOV-00,S,9999,23,161
2225,15720,28-NOV-00,S,9999,25,1450
34005,120760,29-NOV-00,P,9999,44,2376
9425,4750,29-NOV-00,I,9999,11,979
1675,46750,29-NOV-00,S,9999,19,1121この表に基本表または高度な行圧縮が適用されると、重複値がシンボル参照に置き換えられます。次の圧縮の概念的な表現では、29-NOV-00がシンボル*、9999が%に置き換えられています。
2190,13770,25-NOV-00,S,%,23,161
2225,15720,28-NOV-00,S,%,25,1450
34005,120760,*,P,%,44,2376
9425,4750,*,I,%,11,979
1675,46750,*,S,%,19,1121表15-1は、シンボルを値にマップするシンボル表の概念を示します。
表1シンボル表
| 記号 | 値 | カラム | 行 |
|---|---|---|---|
| * | 29-NOV-00 | 3 | 958-960 |
| % | 9999 | 5 | 956-960 |
関連項目: 「表の圧縮」
データ・ブロック内の領域管理
Oracle Databaseでは、データ・ブロックは下から順に使用されるため、行データとブロック・ヘッダー間の空き領域は減少します。
データ・ブロック内の空き領域は、行の末尾のNULL値がNULL以外の値に変更されるときなどの更新の際にも減少します。Oracle Databaseでは、パフォーマンスを最適化し、領域を無駄にしないようにするために、データ・ブロック内の空き領域が管理されます。
ノート:この項では、自動セグメント領域管理の使用を前提としています。
-
データ・ブロック内の空き領域の割合
PCTFREESQLパラメータでは、既存の行の更新用に空き領域として予約されるデータ・ブロックの最小の割合を設定します。行の移行を防止し、領域を無駄にしないようにするためにPCTFREEが必要です。 -
Optimization of Free Space in Data Blocks While the percentage of free space cannot be less than
PCTFREE, the amount of free space can be greater. たとえば、PCTFREEを20%に設定すると、空き領域の合計がブロックの5%になることはありませんが、50%になることはあります。 -
行の連鎖と移行Oracle AI Databaseでは、大きすぎる行を単一のブロックに収まるように管理するために、連鎖と移行が使用されます。
データ・ブロック内の空き領域の割合
PCTFREE SQLパラメータでは、既存の行の更新用に空き領域として予約されるデータ・ブロックの最小の割合を設定します。行の移行を防止し、領域を無駄にしないようにするためにPCTFREEが必要です。
たとえば、時折更新のみが必要な表を作成し、そのほとんどが既存のデータのサイズを増加させないとします。CREATE TABLE文内のPCTFREEパラメータを次のように指定します。
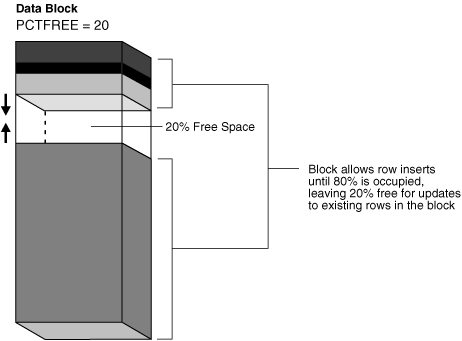
CREATE TABLE test_table (n NUMBER) PCTFREE 20;図15-10に、PCTFREEを20に設定した場合の領域管理への影響について示します。時間の経過とともにブロックに行が追加され、行データがブロック・ヘッダの方向へ上向きに増加し、ブロック・ヘッダー自体も、行データの方向への下向きに増加します。PCTFREEの設定によって、データ・ブロックの20%以上が空き領域となることが保証されます。たとえば、行を挿入すると行データとヘッダーの合計がブロック領域全体の90%を占め、空き領域が10%になる場合には、INSERT文は実行できません。
図10: PCTFREE
ノート:この説明は、PCTFREE記憶域パラメータや空きリストを使用しないLOBデータ型には該当しません。
関連情報:
-
PCTFREEパラメータの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照
データ・ブロック内の空き領域の最適化
空き領域の割合は、PCTFREEよりも小さく なることはありませんが、大きくなることがあります。たとえば、PCTFREEを20%に設定すると、空き領域の合計がブロックの5%になることはありませんが、50%になることはあります。
-
空き領域の拡大による最適化一部のDML文を使用すると、データ・ブロック内の空き領域のサイズを大きくすることができます。
-
断片化領域の結合による最適化: 解放された領域は、データ・ブロックの主な空き領域と連続するとはかぎりません。連続しない空き領域は、断片化領域と呼ばれます。
空き領域の拡大による最適化
一部のDML文を使用すると、データ・ブロックの空き領域のサイズが増えます。
次の文を使用すると、空き領域のサイズが増えます。
-
DELETE文 -
既存の値をより小さいサイズの値に更新するか、既存の値をより大きいサイズの値に更新して行の移行を強制する
UPDATE文 -
高度な行圧縮を使用する表に対する
INSERT文INSERT文によってブロックがデータでいっぱいになると、データベースによってブロック圧縮が開始され、ブロックにより多くの空き領域が生じる可能性があります。
解放された領域は、次の条件下でINSERT文に使用できます。
-
INSERT文が同じトランザクション内にあり、領域を解放した文の後にある場合、その文で使用できるようになった領域を使用できます。 -
INSERT文が、領域を解放する文とは別のトランザクションに含まれている(別々のユーザーが実行している)場合、その文では、もう一方のトランザクションがコミットされた後で、しかもその領域が必要とされる場合にかぎり、使用可能になった領域を使用できます。
関連項目:拡張行圧縮について学習するには、『Oracle AI Database管理者ガイド』を参照してください
断片化領域の結合による最適化
解放される領域は、データ・ブロック内で主な空き領域と連続する領域とはかぎりません。連続しない空き領域は、断片化領域と呼ばれます。
次の図に、連続しない空き領域を含むデータ・ブロックを示します。
図11: 断片化領域があるデータ・ブロック
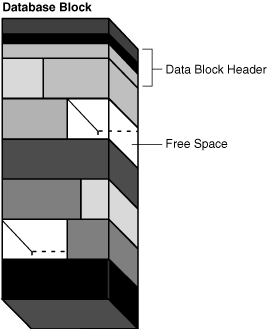
Oracle AI Databaseでは、次の条件に該当する場合にのみ、データ・ブロックの空き領域が自動的かつ透過的に結合されます。
-
INSERT文またはUPDATE文において、新しい行断片を格納するために十分な空き領域のあるブロックの使用が試行された場合。 -
空き領域が断片化されており、行断片をブロック内の連続したセクションに挿入できない場合。
結合後、空き領域の量は処理の前の量と同一ですが、領域は連続的に存在するようになります。図15-12に、領域結合後のデータ・ブロックを示します。
図12: 空き領域結合後のデータ・ブロック
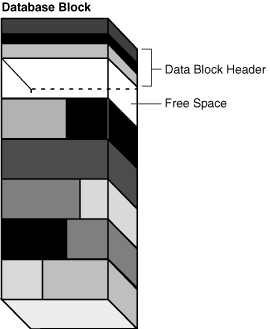
Oracle AI Databaseでは、前述の状態でのみ結合が実行されます。それ以外の状況で結合すると、データ・ブロック内の空き領域が連続的に結合されることによって、パフォーマンスは低下する可能性があります。
行の連鎖と移行
Oracle AI Databaseでは、大きすぎる行が1つのブロック内に収まるように管理するために、連鎖と移行が使用されます。ノート:標準表の連鎖行は、ブロックチェーン表の行連鎖とは異なります。Oracle AI Databaseでは、様々なテクノロジを使用してブロックチェーン表内の行を管理します。
次の状況が考えられます。
-
最初に行を挿入するとき、大きすぎて1つのデータ・ブロック内に収まらない場合。
行連鎖では、Oracle AI Databaseにより、その行のデータは、セグメント用に確保された1つ以上のデータ・ブロックのチェーンに格納されます。多くの場合、行連鎖は、行が大きい場合に発生します。大きい行の例には、
LONGまたはLONG RAWデータ型の列を含む行、または行に含まれる列の数が多すぎる場合があります。このような場合の行連鎖は、避けられられません。 -
1つのデータ・ブロックに収まっていた行が更新されて、行全体の長さが増加したが、更新後に行を保持する十分な空き領域がない場合。
行の移行では、Oracle AI Databaseにより、行自体が新しいブロックに収まるように、行全体は新しいデータ・ブロックに移動されます。移行した行の元の行の断片には、移行した行を含む新しいブロックへのポインタまたは「転送先のアドレス」が含まれます。そのため、移動された行のROWIDは変わりません。
-
行に255を超える列が含まれる。
Oracle AI Databaseでは、1つの行断片に格納できる列数は、255列のみです。したがって、1000列の行を表に挿入すると、データベースでは通常、複数のブロックに連鎖された4つの行断片が作成されます。
図15-13に、データ・ブロックへの大きなサイズの行の挿入を示します。この行は左側のブロックには大きすぎて格納し切れないため、Oracle Databaseでは行を連鎖し、最初の行断片を左側のブロックに配置し、2つ目の行断片を右側のブロックに配置します。
図13: 行の連鎖
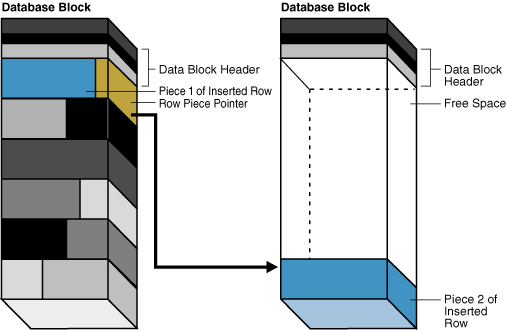
図15-14では、左側のブロックには、更新によってサイズが増大してこのブロックに収まらなくなった行が格納されています。データベースは行全体を右側のブロックに移動し、左側のブロック内の移行行へのポインタを残します。
図14: 行の移行
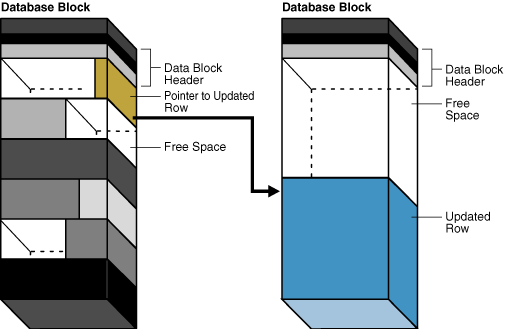
行が連鎖または移行されると、データの取出しに必要なI/Oが増加します。この状況は、その行の情報を取り出す際にOracle AI Databaseが複数のブロックをスキャンする必要があるためです。たとえば、索引の読取りに対して1回のI/Oを行い、移行されていない表の行を読み取るために1回のI/Oを行う場合、移行された行のデータを取得するために追加のI/Oが必要になります。
セグメント・アドバイザは、手動と自動の両方で実行でき、再利用可能な領域があるセグメントを識別するOracle AI Databaseコンポーネントです。セグメント・アドバイザを使用すると、多くの空き領域のあるオブジェクト、または多くの連鎖行があるオブジェクトについてのアドバイスを入手できます。
関連情報:
-
「行の格納」および「行ピースのROWID」
-
無駄な領域の再利用方法を学習するには、Oracle AI Database管理者ガイドを参照
-
行の連鎖と移行を削減する方法を学習するには、『Oracle AI Databaseパフォーマンス・チューニング・ガイド』を参照
索引ブロックの概要
索引ブロックとは、領域を表ブロックとは異なる方法で管理する特殊なタイプのデータ・ブロックのことです。Oracle AI Databaseでは、索引ブロックを使用して、索引の論理記憶域を管理します。
-
索引ブロックのタイプ索引には、ルート・ブロック、ブランチ・ブロックおよびリーフ・ブロックが含まれています。
-
索引エントリの記憶域索引エントリはデータ・ブロック内の表の行と同じように、索引ブロックに格納されます。ブロック部分にある索引エントリはバイナリの順序ではなく、ヒープで保管されます。
-
索引ブロック内のスロットのを再利用データベースでは、索引ブロック内の領域を再利用できます。
-
索引ブロックの結合索引は、既存の索引データが所定の位置で圧縮されます。また、その再編成によってブロックは解放された場合、それらの空きブロックはその索引構造に残されます。したがって、結合により索引ブロックは他のユーザーには解放されず、その索引ではブロックが再割当てされます。
索引ブロックのタイプ
索引には、ルート・ブロック、ブランチ・ブロックおよびリーフ・ブロックが含まれています。
ブロック・タイプは次のように定義されています。
-
ルート・ブロック
このブロックは、索引へのエントリ・ポイントを識別します。
-
ブランチ・ブロック
データベースでは、索引キーを検索する際、ブランチ・ブロックを検索します。
-
リーフ・ブロック
これらのブロックには、関連行を指す索引付きキー値の行IDが含まれています。リーフ・ブロックにはキー値がソート順に格納され、データベースではキー値の範囲内のすべての行を効率的に検索できます。
索引エントリの記憶域
索引エントリは、表の行がデータ・ブロックに格納されるのと同じように、索引ブロックに格納されます。ブロック部分の索引エントリはバイナリの順序ではなく、ヒープで格納されます。
データベースは、データ・ブロックのディレクトリとは異なる索引ブロックの行ディレクトリを管理します。行ディレクトリのエントリ(索引ブロックの本体のエントリではない)は、キー値で順序付けられます。たとえば、行ディレクトリでは、索引キー000000のディレクトリ・エントリは、索引キー111111のディレクトリ・エントリよりも優先されます。
行ディレクトリのエントリの順序は、索引スキャンの効率を改善します。レンジ・スキャンでは、データベースはレンジに指定されたすべての索引キーを読み取る必要があります。データベースは、ブランチ・ブロックを横断して、最初のキーを含むリーフ・ブロックを特定します。行ディレクトリのエントリがソートされるため、データベースは、バイナリ検索を使用してレンジ内の最初のキーを検索し、最後のキーが見つかるまで行ディレクトリのエントリを順に検索します。このようにして、データベースはリーフ・ブロック本体のすべてのキーを読み取らないようにできます。
関連項目:「データ・ブロック・オーバーヘッド」
索引ブロック内のスロットの再利用
データベースでは、索引ブロック内の領域を再利用できます。
たとえば、アプリケーションはある値を列に挿入してから、その値を削除する場合があります。行に領域が必要な場合、データベースでは、削除された値によって以前専有されていた索引スロットを再利用できます。
索引ブロックには通常、ヒープ構成表ブロックより多くの行があります。単一の索引ブロックに多数の行を格納する機能により、新規データ格納のための頻繁なブロック分割が避けられることから、データベースでの索引の管理が容易になります。
索引は、それ自体は結合できませんが、REBUILDまたはCOALESCEオプションを指定したALTER INDEX文により、手動で結合できます。たとえば、列に1から500000の値を移入し、その後偶数を含む行を削除した場合、索引には250000の空のスロットが含まれます。データベースでは、空のスロットを含む索引ブロックに適合するデータを挿入できる場合のみ、スロットを再利用します。
索引ブロックの結合
索引の結合は、既存の索引データを所定の位置で圧縮し、再編成によりブロックが解放された場合、空きブロックをその索引構造に残します。したがって、結合により索引ブロックは他のユーザーには解放されず、その索引ではブロックが再割当てされます。
Oracle AI Databaseでは索引は自動的に圧縮されません。REBUILDまたはCOALESCEオプションを指定したALTER INDEX文を実行する必要があります。図15-15に、索引結合前のemployees.department_id列の索引を示します。最初の3つのリーフ・ブロックは、グレーの格納ラインで示されているように、まだ満杯ではありません。
図15: 結合前の索引
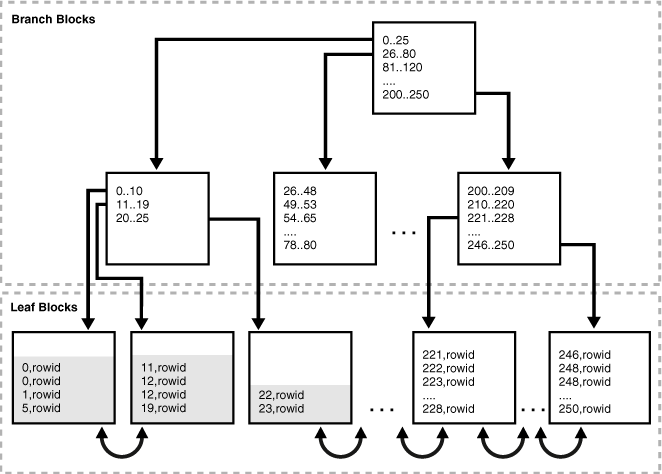
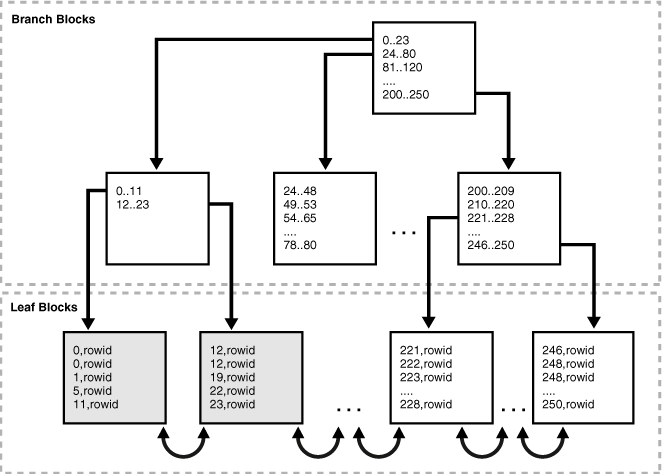
図15-16に、図15-15の索引の結合後を示します。最初の2つのリーフ・ブロックは、グレーの格納ラインで示されているように満杯になり、3つ目のリーフ・ブロックは解放されています。
図16: 結合後の索引
関連情報:
-
索引の結合および再構築方法を学習するには、Oracle AI Database管理者ガイドを参照
-
COALESCE文について学習するには、『Oracle AI Database SQL言語リファレンス』を参照
エクステントの概要
エクステントは、連続したデータ・ブロックで論理的に構成される、データベース記憶域のユニットです。データ・ブロックは、RAIDのストライプ化やファイル・システムの実装によって、物理的にはディスク上に断続的に存在する可能性があります。
-
エクステントの割当てデフォルトでは、データベースでは、セグメントが作成されたときにデータ・セグメント用の初期エクステントを割り当てます。エクステントは、常に1つのデータファイルに含まれています。
-
エクステントの割当て解除一般的に、ユーザー・セグメントのエクステントは、
DROP文を使用してオブジェクトを削除しないかぎり、表領域に戻されません。 -
エクステントの記憶域パラメータ各セグメントは、エクステントに関して示す記憶域パラメータによって定義します。これらのパラメータにより、Oracle AI Databaseでセグメントに空き領域がどのように割り当てられるかが制御されます。
エクステントの割当て
デフォルトでは、データベースでは、セグメントが作成されたときにデータ・セグメント用の初期エクステントを割り当てます。エクステントは、常に1つのデータファイルに含まれています。
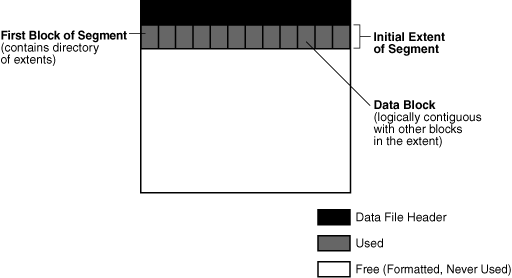
セグメントにデータが追加されていない場合でも、初期エクステント内にこのセグメント専用のデータ・ブロックが予約されます。すべてのセグメントの最初のデータ・ブロックには、そのセグメント内のエクステントのディレクトリが含まれています。図15-17に、データが含まれていなかったデータファイル内の、セグメントの初期エクステントを示します。
図17: セグメントの初期エクステント
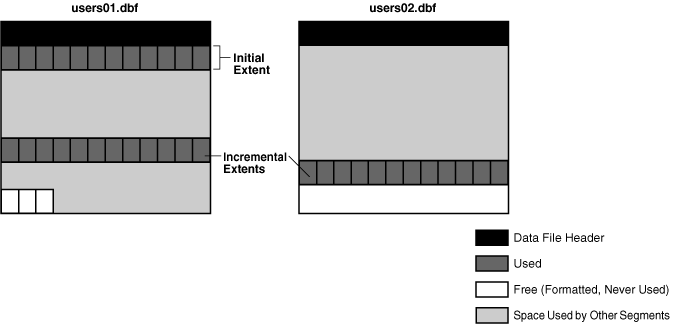
初期エクステントがいっぱいになり、さらに追加の領域が必要になると、データベースによって自動的にこのセグメントの増分エクステントが割り当てられます。増分エクステントは、セグメントに対して後から作成されるエクステントです。
割当てアルゴリズムは、ローカル管理表領域であるか、ディクショナリ管理表領域であるかに応じて異なります。ローカル管理表領域の場合は、データファイルのビットマップで、隣接する空きブロックが検索されます。データファイルに十分な領域がない場合は、他のデータファイルが検索されます。セグメントのエクステントは常に同じ表領域内に存在しますが、異なるデータファイル内に存在する場合もあります。図15-18に、セグメントのエクステントは表領域内の任意のデータファイル内に割当て可能であることを示します。たとえば、セグメントの初期エクステントをusers01.dbfに、最初の増分エクステントをusers02.dbfに、次のエクステントをusers01.dbfに割り当てることができます。
図18: セグメントの増分エクステント
新しく割り当てられたエクステントのブロックは、空き領域であったブロックですが、古いデータが残っていることがあります。ASSMでは、新たに割り当てられたエクステントの使用開始時に、Oracle AI Databaseによってそのエクステントのブロックはフォーマットされます(ただし、必要な場合にのみ)。ノート:この項は、1つのサーバー・プロセスによって文を解析して実行する、シリアル操作に適用されます。複数のサーバー・プロセスを必要とするパラレルSQL文では、エクステントは異なる方法で割り当てられます。
関連情報:
-
エクステントの手動割当て方法を学習するには、Oracle AI Database管理者ガイドを参照
エクステントの割当て解除
一般的に、ユーザー・セグメントのエクステントは、DROP文を使用してオブジェクトを削除するまでは表領域に戻されません。
たとえば、表の行をすべて削除しても、データベースによりデータ・ブロックが再利用されて表領域内の他のオブジェクトがそれらのブロックを使用できるようになることはありません。セグメントは、DBMS_SPACE_ADMINパッケージを使用して削除することもできます。
ノート: UNDOセグメントでは、サイズとしてOPTIMALが指定されている場合、またはデータベースが自動UNDO管理モードである場合には、Oracle AI Databaseにより定期的に1つ以上のエクステントの割当て解除が行われます。
領域の割当てを手動で解除できる場合もあります。Oracle Segment Advisorは、オブジェクト内の断片化のレベルに応じて、オブジェクトに再利用可能な領域があるかどうかを判断する際に役立ちます。次の方法でエクステントを解放できます。
-
オンラインでのセグメントの縮小を使用すると、セグメント内の断片化領域を再利用します。セグメントの縮小は、オンラインのインプレース操作です。一般的に、データ圧縮によって、より効率的にキャッシュを使用できるようになり、全表スキャン時に読み取る必要があるブロック数が少なくなります。
-
パーティション化されていない表や表パーティションのデータを新しいセグメントに移動し、必要であれば割当て制限を持つ別の表領域に移動します。
-
索引を再構築または結合します。
-
表または表クラスタを切り捨てて、すべての行を削除します。デフォルトで、Oracle AI Databaseでは、
MINEXTENTS記憶域パラメータで指定された値を除き、削除された行で使用していたすべての領域の割当てが解除されています。Oracle Database 11gリリース2 (11.2.0.2)以降、DROP ALL STORAGEオプションを指定してTRUNCATEを使用することで、セグメント全体を削除することもできます。 -
未使用領域の割当てを解除すると、データベース・セグメントの最高水位標の最後で未使用領域を解放して、表領域の他のセグメントで領域を使用できるようにします。
エクステントを解放すると、Oracle AI Databaseでは、ローカル管理表領域のデータファイル内のビットマップが変更され、再度取得されたエクステントを使用可能領域として反映されます。解放されたエクステントのブロックにあるデータにはアクセスできなくなります。
関連情報:
-
セグメント領域の再利用方法を学習するには、『Oracle AI Database管理者ガイド』を参照
エクステントの記憶域パラメータ
各セグメントは、エクステントについての設定である記憶域パラメータによって定義されます。これらのパラメータにより、Oracle AI Databaseでセグメントに空き領域がどのように割り当てられるかが制御されます。
記憶域設定は、次に示す優先順位で決定されます。つまり、リストの上位の設定は下位の設定よりも優先されます。
-
セグメントのSTORAGE句
-
表領域のSTORAGE句
-
Oracle AI Databaseのデフォルト
ローカル管理表領域の場合は、システムによって自動的に決定される可変エクステント・サイズでもかまいません。
-
均一エクステントの場合は、エクステント・サイズを指定するか、デフォルト・サイズである1MBを使用できます。表領域内のすべてのエクステントが指定したサイズになります。ローカル管理一時表領域の場合は、均一サイズの割当てのみ使用できます。
-
自動割当てエクステントの場合は、追加エクステントの最適なサイズがOracle AI Databaseにより決定されます。
ローカル管理表領域では、一部の記憶域パラメータは表領域レベルでは指定できません。ただし、これらのパラメータをセグメント・レベルで指定することはできます。この場合、データベースでは、すべてのパラメータをまとめて使用して、セグメントの初期サイズが計算されます。内部のアルゴリズムによって、その後に割り当てられる各エクステントのサイズが決定されます。
関連情報:
-
ローカル管理の表領域を作成する場合、エクステント管理についての考慮事項について学習するには、『Oracle AI Database管理者ガイド』を参照
-
STORAGE句のオプションについて学習するには、『Oracle AI Database SQL言語リファレンス』
セグメントの概要
セグメントは、表領域内の論理記憶域構造のデータがすべて入っている、エクステントの集合です。
たとえば、Oracle AI Databaseでは、1つ以上のエクステントを割り当てることによって、表のデータ・セグメントを形成します。また、データベースでは、1つ以上のエクステントを割り当てて、表に対する索引の索引セグメントを形成します。
Oracle AI Databaseは、セグメント領域を自動または手動で管理します。この項では、ASSMを使用することを前提としています。
-
ユーザー・セグメントデータベース内の1つのデータ・セグメントでは、1つのユーザー・オブジェクトのデータが格納されます。
-
一時セグメント Oracle AI Databaseでは、問合せの処理時に、SQL文実行の中間段階で、一時作業領域が必要になることがよくあります。
-
UNDOセグメント Oracle AI Databaseでは、UNDOデータと総称される、トランザクションのアクションのレコードが保持されています
-
セグメント領域と高水位標Oracle AI Databaseでは、領域を管理するためにセグメント内のブロックの状態を追跡します。最高水位標(HWM)は、セグメント内の地点を指し示し示し、その地点を超えると、データ・ブロックは未フォーマットであり使用されていません。関連項目: ASSMについてさらに学習するには、「論理領域管理」を参照
ユーザー・セグメント
データベース内の1つのデータ・セグメントには、1つのユーザー・オブジェクトのデータが格納されます。
セグメントには様々なタイプがあります。次に、ユーザー・セグメントの例を示します。
-
表、表パーティションまたは表クラスタ
-
LOBまたはLOBパーティション
-
索引または索引パーティション
パーティション化されていない各オブジェクトおよび各オブジェクト・パーティションは、それぞれ独自のセグメントに格納されます。たとえば、索引に5つのパーティションがある場合は、5つのセグメントに索引データが格納されます。
- ユーザー・セグメントの作成デフォルトでは、データベースでは遅延セグメント作成により、表、索引およびパーティションを作成する際、データベース・メタデータのみが更新されます。
ユーザー・セグメントの作成
デフォルトで、データベースでは遅延セグメント作成により、表、索引およびパーティションを作成する際、データベース・メタデータのみが更新されます。
ユーザーが最初の行を表またはパーティションに挿入するときに、その表またはパーティション、LOB列およびその索引のセグメントが作成されます。遅延セグメント作成が発生すると、データベース・リソースが必要以上に使用されなくなります。たとえば、アプリケーションをインストールすると、数千ものオブジェクトが作成されて、ディスク領域を大量に消費する場合があります。これらのオブジェクトの多くは、決して使用されない可能性があります。
DBMS_SPACE_ADMINパッケージは、空のオブジェクト用のセグメントを管理します。このPL/SQLパッケージを使用すれば、次のことができます。
-
セグメントが作成されていない空の表またはパーティション用のセグメントの手動マテリアライズ
-
空のセグメントが割り当てられている空の表またはパーティションからのセグメントの削除
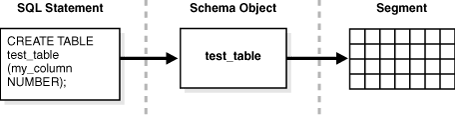
オブジェクトの作成とセグメントの作成との関係がわかりやすくなるように、遅延セグメント作成は発生しないものとします。次のような表を作成するとします。
CREATE TABLE test_table (my_column NUMBER);図15-19に示すように、表のセグメントが1つ作成されます。
図19: ユーザー・セグメントの作成
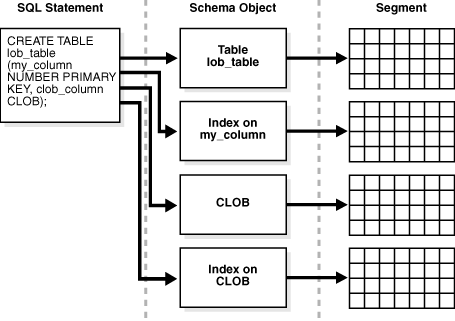
主キーまたは一意キーを持つ表を作成する場合は、Oracle AI Databaseによって、このキーの索引が自動的に作成されます。ここでも、遅延セグメント作成は発生しないものとします。次のような表を作成するとします。
CREATE TABLE lob_table (my_column NUMBER PRIMARY KEY, clob_column CLOB);図15-20は、lob_tableのデータがあるセグメントに格納され、暗黙的に作成された索引が別のセグメントに格納されることを示しています。また、CLOBデータは、関連付けられたCLOB索引と同様に、専用のセグメントに格納されます。したがって、CREATE TABLE文を実行すると、4つの異なるセグメントが作成されます。
図20: 複数のセグメント
ノート: 表のセグメントとその表の索引は、同一の表領域に存在する必要はありません。
セグメントが作成されると、1つ以上のエクステントが割り当てられます。オブジェクトの記憶域パラメータにより、各セグメントのエクステントが割り当てられる方法が決定します。これらのパラメータは、オブジェクトに関連するデータ・セグメントのデータ検索と格納の効率に影響を与えます。
関連情報:
-
内部LOBについて学習するには、『Oracle AI Database SecureFilesおよびラージ・オブジェクト開発者ガイド』を参照してください。
-
遅延セグメント作成の管理方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
CREATE TABLE構文については、『Oracle AI Database SQL言語リファレンス』を参照してください
一時セグメント
Oracle AI Databaseでは、問合せの処理中、SQL文実行の中間段階で、一時作業領域が必要になることがよくあります。
一時セグメントが必要になる一般的な操作には、ソート、ハッシング、ビットマップのマージなどがあります。索引の作成時に、Oracle AI Databaseは索引セグメントを一時セグメントに配置し、索引の完了時にそれらを永続セグメントに変換します。
Oracle AI Databaseでは、メモリー内で操作を実行できる場合、一時セグメントは作成されません。ただし、メモリーを使用できない場合には、ディスク上に一時セグメントが自動的に割り当てられます。
-
問合せ用の一時セグメントの割当て Oracle AI Databaseでは、ユーザー・セッション中に必要に応じて問合せ用の一時セグメントが割り当てられると、問合せが完了するとその問合せが削除されます。一時セグメントに対する領域管理操作以外の、一時セグメントに対する変更は、オンラインREDOログに記録されません。
-
一時表および索引用のセグメントの割当て Oracle AI Databaseでは、一時表およびその索引用の一時のセグメントを割り当てることができます。
問合せ用の一時セグメントの割当て
Oracle AI Databaseでは、ユーザー・セッション中に必要に応じて問合せ用の一時セグメントを割り当て、問合せが完了するとそれらのセグメントが削除されます。一時セグメントに対する領域管理操作以外の、一時セグメントに対する変更は、オンラインREDOログに記録されません。
データベースでは、ユーザーに割り当てられた一時表領域に一時セグメントが作成されます。表領域のデフォルトの記憶域特性によって、一時セグメント内のエクステントの特性が決定されます。一時セグメントの割当てと割当て解除は頻繁に発生するため、一時セグメント専用に1つ以上の表領域を作成してください。これにより、I/Oがディスク間で分散され、SYSTEM表領域やその他の一時セグメントがある表領域の断片化が回避されます。
ノート: SYSTEMがローカル管理の場合は、データベースの作成時にデフォルトの一時表領域を定義する必要があります。ローカル管理のSYSTEM表領域は、デフォルトの一時記憶域として使用できません。
関連情報:
-
オンラインREDOログの概要に関する項
-
一時表領域の作成方法を学習するには、『Oracle AI Database管理者ガイド』を参照してください。
-
CREATE TEMPORARY TABLESPACEの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照してください
一時表および索引用のセグメントの割当て
Oracle AI Databaseでは、一時表およびその索引用の一時セグメントを割り当てることができます。
一時表には、トランザクションまたはセッションの期間中にのみ存在するデータが保持されます。各セッションは、それ自体に割り当てられたエクステントにのみアクセスし、他のセッションに割り当てられたエクステントにはアクセスできません。
Oracle AI Databaseがグローバル一時表に対してセグメントを割り当てるのは、表への最初のINSERTが発生したときに、プライベート一時表の場合のみ、セグメントを割り当てます。この挿入は、明示的に行われたものでも、CREATE TABLE AS SELECTによって行われたものでもかまいません。データベースは、表とその索引にセグメントを割り当て、索引のルート・ページを作成し、LOBセグメントを割り当てます。
現行ユーザーの一時表領域は、一時表のセグメントを割り当てます。たとえば、user1に割り当てられた一時表領域がtemp1であり、user2に割り当てられた一時表領域がtemp2であるとします。この場合、user1の一時データはtemp1のセグメントに格納され、user2の一時データはtemp2のセグメントに格納されます。
関連情報:
-
一時表の作成方法を学習するには、『Oracle AI Database管理者ガイド』を参照
UNDOセグメント
Oracle AI Databaseでは、UNDOデータと総称される、トランザクションのアクションのレコードが保持されます。
Oracle AI Databaseでは、次の場合にUNDOデータが使用されます。
-
アクティブ・トランザクションのロールバック
-
終了したトランザクションのリカバリ
-
一部の論理フラッシュバック操作の実行
Oracle AI Databaseでは、UNDOデータは、外部ログではなくデータベース内部に格納されます。UNDOデータが格納されるブロックは、データ・ブロックと同様に更新され、これらのブロックに対する変更によってREDOレコードが生成されます。このように、Oracle AI Databaseでは、外部ログを読み取ることなくUNDOデータに効率的にアクセスできます。
永続オブジェクトのUNDOデータは、UNDO表領域に格納されます。Oracle AI Databaseには、UNDO表領域のUNDOセグメントおよび領域を管理するための自動UNDO管理モードと呼ばれる完全に自動化したメカニズムが提供されています。
データベースでは、UNDOデータを2つのストリームに分けます。一時UNDOストリームでは、一時オブジェクトへの変更によって生成されたUNDOレコードのみをカプセル化するのに対して、永続UNDOストリームでは、永続オブジェクトのUNDOレコードのみをカプセル化します。データベースでは、一時および永続UNDOを別々に管理します。UNDOの分離により記憶域が減り、次のことを行うことでパフォーマンスが向上します。
-
永続および一時表に最適の永続およびUNDO表領域のサイズを構成できるようにします。
-
オンラインREDOログに書き込まれたREDOのサイズを縮小します。
-
一時UNDOデータのバックアップの必要を回避します。
Active Data Guardインスタンスでは、グローバル一時表のDMLで、UNDOが一時UNDOセグメントに生成される必要があります。
-
UNDOセグメントとトランザクショントランザクションが開始されるときに、データベースによってそのトランザクションをUNDOセグメントに(したがって現在のUNdo表領域内のトランザクション表にバインド(割当て)します。データベース・インスタンスに対し専用のUNDO表領域が割り当てられていない場合は、トランザクションがシステムUNDOセグメントにバインドされます。
-
トランザクションのロールバック
ROLLBACK文が発行されると、UNDOレコードは、コミットされていないトランザクションによってデータベースに加えられた変更をロールバックするために使用されます。 -
一時UNDOセグメント 一時UNDOセグメントは、一時UNDOデータ専用のオプションの領域管理コンテナです。
関連情報:
-
オンラインREDOログの使用に関する項
-
一時UNDOセグメントについて学習するには、Oracle AI Database管理者ガイドを参照してください。
-
TEMP_UNDO_ENABLED初期化パラメータについて学習するには、Oracle AI Databaseリファレンスを参照してください。
UNDOセグメントとトランザクション
トランザクションが開始するときに、そのトランザクションをバインド(割当て)すると、現在のUNdo表領域内のUNDOセグメント(トランザクション表)にバインド(割当て)されます。データベース・インスタンスに対し専用のUNDO表領域が割り当てられていない場合は、トランザクションがシステムUNDOセグメントにバインドされます。
複数のアクティブなトランザクションが、同じUNDOセグメントに同時に書き込むこともあれば、別々のセグメントに書き込むこともあります。たとえば、トランザクションT1とT2が両方ともUNDOセグメントU1に書き込むこともあれば、T2がUNDOセグメントU 2に書き込むこともありますが、T1がU1に書き込むこともできます。
概念的には、UNDOセグメント内のエクステントは輪のようなものです。トランザクションは、輪に沿って回るように、UNDOエクステントに順に書き込んでいきます。図15-21では、T1とT2という2つのトランザクションを示し、この2つのトランザクションはそれぞれ、UNDOセグメントの3番目のエクステント(E3)から書込みを開始し、4番目のエクステント(E4)まで書込みを進めます。
図21: UNDOセグメントに環環状に割り当てられたエクステント
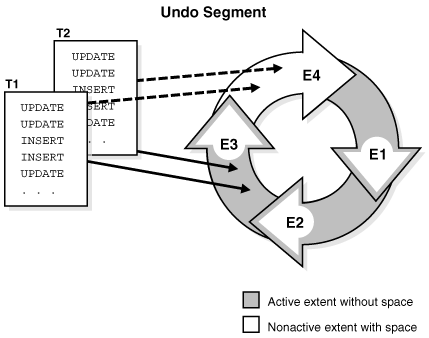
トランザクションは必ずUNDOセグメント内の現行エクステントと呼ばれる、UNDOセグメント内の1つのエクステントに順番に記述します。複数のアクティブなトランザクションが同時に、同じ現行エクステントに書き込むことも、別々の現行エクステントに書き込むことも可能です。図15-21では、T1とT2のトランザクションがエクステントE3に同時に書き込んでいます。UNDOエクステント内では、各データ・ブロックに格納されるデータは、1つのトランザクションのデータのみです。
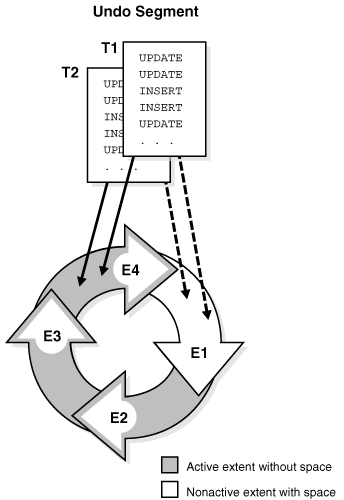
現在のUNDOエクステントがいっぱいになると、領域を必要とする最初のトランザクションによって、輪の中にある次の割当てエクステントの空き状況がチェックされます。次のエクステントにアクティブなトランザクションのデータが格納されていない場合は、このエクステントが現行エクステントになります。この時点で、領域を必要としているすべてのトランザクションが、新しい現行エクステントに書込み可能な状態になります。図15-22では、E4がいっぱいになると、T1とT2がE1に書込みを継続して、E1内のアクティブでないUNDOデータを上書きしています。
図22: UNDOセグメントに円環状に割り当てられたエクステントを再利用
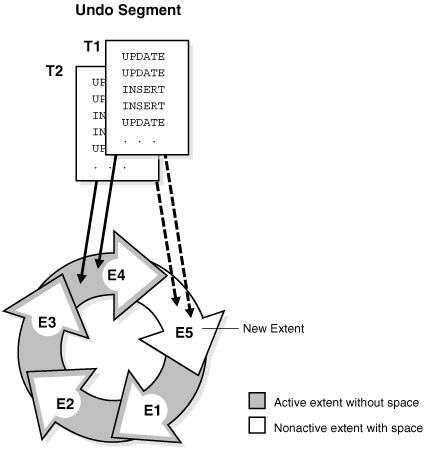
次のエクステントにアクティブなトランザクションのデータが格納されいる場合は、新しいエクステントが割り当てられます。図15-23では、T1とT2はE4に書き込んでいます。E4がいっぱいになっても、E1にはアクティブなUNDOデータが格納されているため、トランザクションはE1に書込みを継続することができません。そこで、このUNDOセグメントに新しいエクステント(E5)が割り当てられます。トランザクションはE5に書込みを継続します。
図23: UNDOセグメントに対する新しいエクステントの割当て
関連項目: UNDOセグメントの管理方法を学習するには、Oracle AI Database管理者ガイドを参照してください
トランザクション・ロールバック
ROLLBACK文が発行されると、UNDOレコードは、コミットされていないトランザクションによってデータベースに加えられた変更を元に戻すために使用されます。
リカバリ中には、オンラインREDOログからデータファイルに適用されたコミットされていないすべての変更が元に戻されます。UNDOレコードでは、あるユーザーがデータを変更しているときと同じデータに同時にアクセスする別のユーザーのために、そのデータの変更前のイメージを維持することによって、読取り一貫性が実現されます。
一時UNDOセグメント
一時UNDOセグメントは、一時UNDOデータ専用のオプションの領域管理コンテナです。
一時表への変更のUNDOレコードは、セッション固有であるとともに、読取りの一貫性とトランザクション・ロールバックに対してのみ役立ちます。Oracle Database 12c以前は、データベースではこれらのレコードをいつでもオンラインREDOログに格納していました。一時オブジェクトに対する変更はオンラインREDOログに記録されないため、一時オブジェクトのUNDOを一時UNDOセグメントに書き込むと、オンラインREDOログおよびアーカイブ済のREDOログ・ファイルで領域が節約されます。データベースでは、UNDOへの変更、または一時表への変更は記録されないため、パフォーマンスが向上します。
TEMP_UNDO_ENABLED初期化パラメータを設定すれば、一時表でUNDOデータを一時UNDAセグメントに格納できます。このパラメータがTRUEの場合、データベースでは一時表領域から一時UNDOセグメントを割り当てます。
関連情報:
-
一時UNDOセグメントについて学習するには、Oracle AI Database管理者ガイドを参照してください。
-
TEMP_UNDO_ENABLED初期化パラメータについて学習するには、『Oracle AI Databaseリファレンス』を参照
セグメント領域と最高水位標
領域を管理するため、Oracle AI Databaseでは、セグメント内のブロックの状態を追跡します。最高水位標(HWM)は、セグメント内の場所を指し示し示し、その場所を超えると、データ・ブロックは未フォーマットで、使用されていません。
MSSMでは、空きリストを使用してセグメント領域が管理されます。表の作成時には、セグメント内のブロックはフォーマットされていません。セッションが最初に行を表に挿入すると、空きリストが検索され、使用可能なブロックが検出されます。使用可能なブロックが見つからなかった場合には、ブロックのグループが事前にフォーマットされ、それらが空きリストに追加され、ブロックへのデータの挿入が開始されます。MSSMでは、全表スキャンがHWMより下のすべてのブロックを読み取ります。
ASSMでは空きリストは使用されないため、異なる方法で領域を管理する必要があります。セッションで最初にデータを表に挿入すると、MSSMの場合のようにブロックのグループが事前にフォーマットされるかわりに、1つのビットマップ・ブロックがフォーマットされます。このビットマップでは、セグメント内のブロックの状態が追跡されます(空きリストのかわりとなります)。データベースでは、ビットマップを使用して空きブロックが検索されて、データが格納される前に各ブロックがフォーマットされます。ASSMを使用すると、挿入処理が各ブロックに分散されるため、同時実行性の問題を回避できます。
ASSMセグメント内の各データ・ブロックは、次のいずれかの状態になっています。
-
HWMより上
これらのブロックは未フォーマットであり、使用されていません。
-
HWMより下
これらのデータ・ブロックは、次のいずれかの状態になっています。
-
割当て済ですが、現時点では未フォーマットで使用されていません。
-
フォーマット済でデータが格納されています。
-
フォーマット済ですが、データが削除されたため空です。
-
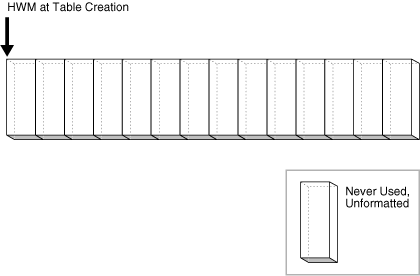
図15-24に、ブロックを水平方向に並べて表現したASSMのセグメントを示します。表の作成時には、HWMはセグメントの先頭(左端)にあります。まだデータが挿入されていないため、セグメント内のすべてのブロックは未フォーマットで使用されたことはありません。
図24: 表作成時のHWM
トランザクションでセグメントに行が挿入されるとします。Oracle Databaseにより、これらの行を保持するためのブロックのグループが割り当てられます。割り当てられたブロックは、HWMを下回っています。データベースでは、このグループ内のビットマップ・ブロックはフォーマットされてメタデータが保持されますが、グループ内の他のブロックは事前にフォーマットされません。
図15-25では、HWMより下のブロックは割り当てられていますが、HWMより上のブロックは割当てもフォーマットも行われません。挿入が行われるときに、データベースは空き領域がある任意のブロックに書き込みます。低い最高水位標(低いHWM)は、この位置より下のすべてのブロックは、データが格納されているか、以前にデータが格納されていたため、フォーマット済であることを示しています。
図25: HWMと低いHWM
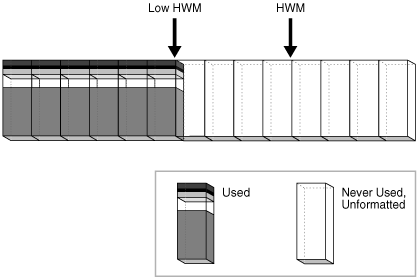
図15-26に示すように、データベースはHWMと低いHWMの間のブロックを選択し、そのブロックに書き込みます。データベースが書込み対象として選択するブロックは、HWMと低いHWMの間のブロックになることもあれば、低いHWMよりも低い、空き領域のあるブロックになることもあります。図15-26に示すように、新しくいっぱいになったブロックの両側のブロックは、未フォーマットになっています。
図26: HWMと低いHWM
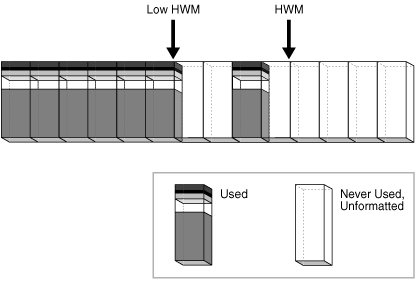
全表スキャン時には、低いHWMが重要になります。HWMより下のブロックは使用時にのみフォーマットされるため、図15-26に示すように、いくつかのブロックは未フォーマッタのままになる可能性があります。このため、Oracle Databaseでは、低いHWMの位置を取得するためにビットマップ・ブロックが読み取られます。低いHWMまでのブロックはフォーマット済であることが既知であるためすべて読み取られ、次に、低いHWMとHWMの間にあるフォーマット済ブロックのみが選択されて読み取られます。
新しいトランザクションによって表に行が挿入されるときに、HWMより下に十分な空き領域が存在しないことがビットマップから判明したとします。図15-27では、HWMが右側に移動して、未フォーマット・ブロックのグループが新しく割り当てられます。
図27: HWMと低いHWMの拡張
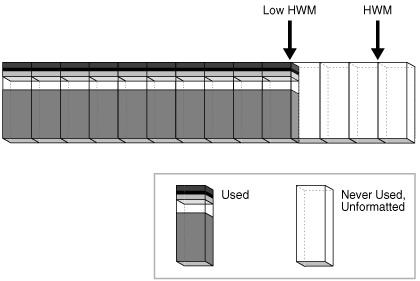
HWMと低いHWMとの間のブロックに空きがなくなると、HWMが右側に拡張されて、低いHWMも以前のHWMの場所まで拡張されます。データベースにデータが徐々に挿入されるにつれて、HWMは次第を右側へと拡張され、それに伴い、低いHWMも常にHWMに従って拡張します。オブジェクトを手動で再構築、切捨てまたは縮小しないかぎり、HWMが縮小することはありません。
関連情報:
-
セグメントをオンラインで縮小する方法を学習するには、Oracle AI Database管理者ガイドを参照
-
TRUNCATE TABLEの構文およびセマンティクスについては、Oracle AI Database SQL言語リファレンスを参照
表領域の概要
表領域は、セグメントを格納するための論理記憶域コンテナです。
セグメントは表や索引などのデータベース・オブジェクトであり、記憶域領域を使用します。物理レベルでは、表領域のデータは、1つ以上のデータファイルまたは一時ファイルに格納されます。
-
マルチテナント環境の表領域CDBでは、各PDBとアプリケーション・ルートに、それ固有の一連の表領域があります。
-
永続表領域 永続表領域では、永続スキーマ・オブジェクトがまとめられます。永続表領域内のオブジェクトのセグメントは、物理的にはデータファイルに格納されます。
-
一時表領域一時表領域には、セッションの存続期間中のみ保持される一時的なデータが含まれています。永続スキーマ・オブジェクトを一時表領域に格納することはできません。一時ファイルには一時的な表領域データが格納されます。
-
表領域モード表領域モードによって、表領域のアクセス可能性が決まります。
-
表領域ファイル・サイズ表領域は、bigfile表領域かsmallfile表領域のどちらかになります。これらの表領域は、データファイルまたは一時ファイルを明示的に参照しないSQL文の実行時には区別できません。
マルチテナント環境の表領域
CDBでは、各PDBとアプリケーション・ルートに独自の表領域のセットがあります。
すべてのCDBルート、PDBおよびアプリケーション・ルートに、SYSTEMおよびSYSAUX表領域が必要です。次の図に、標準的なコンテナの表領域を示します。
図28: 表領域
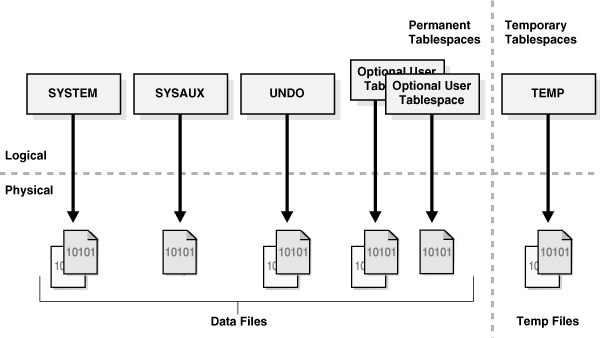
CDBには次のものが含まれています。
-
1つの制御ファイル
-
1つのオンラインREDOログ
-
1つ以上のUNDO表領域
適切な権限を持ち、現在のコンテナがCDBルートである共通ユーザーのみが、UNDO表領域を作成できます。どの時点でも、CDBは次のいずれかのUNDOモードにあります。
-
ローカルUNDOモード
この場合は、各PDBに固有のUNDO表領域があります。CDBがローカルUNDOモードを使用している場合は、データベースにより、すべてのPDBにUNDO表領域が自動的に作成されます。ローカルUNDOはPDBのホット・クローンを実行する機能などの利点を備えており、PDBが素早く再配置されます。また、ローカルUNDOでは分離レベルが提供され、迅速な切断およびポイント・イン・タイム・リカバリ操作が可能です。
ローカルUNDO表領域は、Oracle Real Application Clusters (RAC)クラスタ内のPDBが開いているノードごとに必要です。たとえば、PDBを2ノードのクラスタから4ノードのクラスタに移動した場合や、すべてのノードでPDBが開いている場合は、必要な追加のUNDO表領域がデータベースによって自動的に作成されます。PDBを元に戻した場合は、冗長なUNDO表領域を削除できます。
ノート:デフォルトでは、Database Configuration Assistant (DBCA)によってローカルUNDOが有効になった状態で新しいCDBが作成されます。
-
共有UNDOモード
単一インスタンスCDBでは、アクティブなUNDO表領域が1つのみ存在します。Oracle RAC CDBの場合、それぞれのインスタンスについてアクティブなUNDO表領域が1つ存在します。すべてのUNDO表領域は、すべてのコンテナのデータ・ディクショナリおよび関連ビューで表示されます。
UNDOモードはCDB全体に適用されます。つまり、すべてのコンテナが共有UNDOを使用するか、すべてのコンテナがローカルUNDOを使用するかのどちらかです。CDBでUNDOモードを切り替えることは可能で、これにはデータベースの再起動が伴います。
-
-
コンテナごとの
SYSTEM表領域およびSYSAUX表領域CDBルート、各アプリケーション・ルートおよび各PDBには、それぞれ固有の
SYSTEMおよびSYSAUXの各表領域があります。各コンテナには、そのコンテナに存在するオブジェクトを説明する独自のデータ・ディクショナリ表のセットもあります。 -
0以上のユーザー作成表領域
一般的なユースケースでは、各PDBに独自の非システム表領域のセットがあります。これらの表領域には、PDB内のユーザー定義のスキーマおよびオブジェクトのデータが含まれています。
CREATE PLUGGABLE DATABASEまたはALTER PLUGGABLE DATABASE文でSTORAGE句を使用して、PDBのデータファイルで使用される記憶域の量を制限できます。PDB内のデータ・ディクショナリの記憶域は、移植可能です。PDBはCDBから切断し、異なるCDBに接続できます。
-
コンテナごとの一連の一時ファイル
デフォルトの一時表領域は、CDBルートに1つ、および各アプリケーション・ルート、アプリケーションCDBおよびPDBごとに1つあります。
例15-3 ローカルUNDOモードのCDB
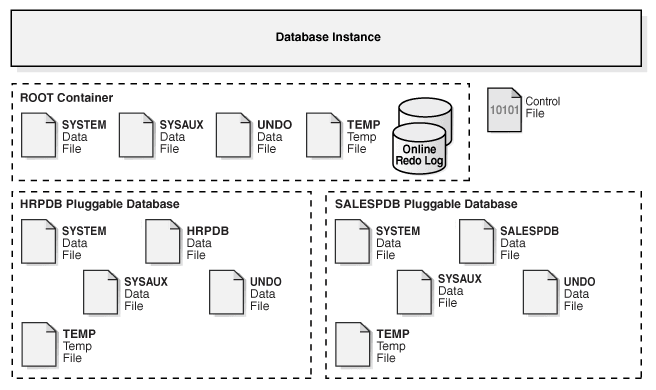
この例は、2つのPDB(hrpdbとsalespdb)を持つCDBの物理記憶域アーキテクチャの様子を示します。この例では、データベースはローカルUNDOモードを使用するため、CDBルート、hrpdbおよびsalespdb内にUNDOデータ・ファイルがあります。
図29: ローカルUNdoモードのCDBの物理アーキテクチャ
永続テーブルスペース
永続表領域では、永続スキーマ・オブジェクトがまとめられます。永続表領域内のオブジェクトのセグメントは、物理的にはデータファイルに格納されます。
各データベース・ユーザーには、デフォルトの永続表領域が割り当てられます。非常に小規模なデータベースでは、デフォルトのSYSTEM表領域およびSYSAUX表領域のみで十分な場合があります。ただし、ユーザー・データおよびアプリケーション・データを格納するための表領域を1つ以上作成することをお薦めします。表領域を使用して次の目的を達成できます。
-
データベース・データに対するディスク領域の割当ての制御
-
データベース・ユーザーに割当て制限(領域の許容量または制限)を割り当てます。
-
データベース全体の可用性に影響を与えることなく、個別の表領域をオンライン化またはオフライン化します。
-
個別の表領域のバックアップとリカバリを実行します。
-
Oracle Data Pumpユーティリティを使用したアプリケーション・データのインポートまたはエクスポート
-
プラットフォーム間でも、データベース間でコピーまたは移動できるトランスポータブル表領域を作成します。
表領域を移動する場合は、データファイルをコピーして表領域のメタデータを統合するのみでよいため、この方法によるデータ移動は同じデータをエクスポート/インポートまたはアンロード/ロードするよりも何倍も高速です。表領域を移動する場合は、索引データも移動できます。
-
SYSTEM表領域
SYSTEM表領域は、データベースの作成時にデータベースに含まれる、必須の管理表領域です。Oracle AI Databaseでは、データベースの管理にSYSTEMが使用されます。 -
SYSAUX表領域
SYSAUX表領域は、SYSTEM表領域の補助表領域である。 -
UNDO表領域 UNDO表領域は、システムが管理するUNDOデータ用に予約されている、ローカル管理表領域である。
-
シャドウ表領域シャドウ表領域は、シャドウ書込み消失保護を対象とするビッグファイル表領域です
関連情報:
-
表領域を転送する方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
Oracle Data Pumpについて学習するには、『Oracle AI Databaseユーティリティ』を参照
SYSTEM表領域
SYSTEM表領域は、データベースの作成時に生成される、必須の管理表領域です。Oracle AI Databaseでは、データベースの管理にSYSTEMが使用されます。
SYSTEM表領域には、次の情報が含まれています。これらの情報は、すべてSYSユーザーが所有しています。
-
データ・ディクショナリ
-
データベースの管理情報を含む表およびビュー
-
トリガー、プロシージャ、パッケージなどのコンパイル済ストアド・オブジェクト
SYSTEM表領域は、他のすべての表領域と同じ管理されますが、より高いレベルの権限が必要であり、また一部制限事項があります。たとえば、SYSTEM表領域の名前変更や削除はできません。
デフォルトで、Oracle AI Databaseでは、新しく作成されたすべてのユーザー表領域がローカル管理に設定されます。ローカル管理のSYSTEM表領域を持つデータベースには、ディクショナリ管理表領域を作成できません(非推奨)。ただし、手動でCREATE DATABASE文を実行してデフォルトを受け入れると、SYSTEM表領域はディクショナリ管理になります。既存のディクショナリ管理SYSTEM表領域をローカル管理形式に移行できます。ノート: Oracleでは、SYSTEMを含むすべての表領域がデフォルトでローカル管理されるように、Database Configuration Assistant (DBCA)を使用して新しいデータベースを作成することを強くお薦めします。
関連情報:
-
SYSTEM表領域を永続的にオンラインにする条件の詳細は、「オンラインおよびオフライン表領域」を参照 -
ローカル管理
SYSTEM表領域を作成する方法またはローカル管理に移行する方法を学習するには、『Oracle AI Database管理者ガイド』 -
CREATE DATABASEの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』に関する項を参照してください。
SYSAUX表領域
SYSAUX表領域は、SYSTEM表領域の補助表領域です。
SYSAUXは、以前に固有の表領域を必要としていましたOracle AI Databaseの多くの機能と製品に対するデフォルトの表領域であるため、データベースに必要な表領域の数が削減されます。また、SYSTEM表領域の負荷も軽減されます。
データベースの作成または更新により、自動的にSYSAUX表領域が作成されます。通常のデータベース操作中には、SYSAUX表領域の削除や変更変更は許可されません。SYSAUX表領域が使用できなくなった場合でも、中核となるデータベース機能は利用できます。SYSAUX表領域を使用するデータベース機能は、エラーが発生したり、機能が制限されることがあります。
SYSAUX表領域について学習するには、『Oracle AI Database管理者ガイド』も参照してください。
UNDO表領域
UNDO表領域は、システムが管理されているUNDOデータ用に予約されている、ローカル管理表領域である。
他の永続表領域と同様、UNDO表領域にもデータファイルが含まれています。これらのファイル内のUNDOブロックは、エクステントにグループ化されています。
-
自動UNDO管理のモードUNDO表領域の場合は、データベースがデフォルト自動UNDOモードにあることが必要です。
-
自動UNDO保存UNDO保存期間とは、Oracle AI Databaseで古いUNDOデータが上書きされるまでの、最小限のUNDOデータ保存期間のことです。関連項目: UNDOセグメント
自動UNDO管理モードでは、
UNDO表領域を使用する場合、データベースがデフォルト自動UNDOモードにあることが必要です。
自動モードでは、手動でUNDOセグメントを管理する複雑な作業が不要です。UNDOデータを可能なかぎり最適に保存して、UNDOデータを必要とする長時間実行される問合せに対応できるように、データベース自体が自動的にチューニングされます。
Oracle AI Databaseを新しくインストールすると、UNDO表領域が自動的に作成されます。Oracle AI Databaseの以前のバージョンで、UNDO表領域が含まれておらず、かわりに手動UNDO管理モードと呼ばれる従来のロールバック・セグメントが使用される場合があります。Oracle AI Databaseには、UNDO環境についてのアドバイスを提供し、UNDO環境の自動化に役立つUNDOアドバイザが含まれています。
データベースに複数のUNDO表領域を含めることができますが、使用中となるのは常に1つのUNDO表領域のみです。インスタンスによってデータベースのオープンが試行されると、Oracle AI Databaseでは、使用可能な最初のUNDO表領域が自動的に選択されます。使用可能なUNDO表領域がない場合、インスタンスはUNDO表領域なしで起動され、UNDOデータはSYSTEM表領域に格納されます。ただし、SYSTEM表領域にUNDOデータを格納しないことをお薦めします。
関連情報:
-
自動UNDO管理について学習するには、『Oracle AI Database管理者ガイド』を参照してください。
-
自動UNDO管理モードへの移行方法を学習するには、『Oracle AI Databaseアップグレード・ガイド』を参照
自動UNDO保存
UNDO保存期間とは、Oracle AI Databaseで古いUNDOデータを上書きせずに保存する最低限の期間です。
長時間実行される問合せは、読取り一貫性を提供するために古いブロック・イメージを必要とする場合があるため、UNDO保存が重要です。また、一部のOracle Flashback機能は、UNDOデータの可用性に依存しています。
一般的に、古いUNDOデータは可能なかぎり長期間保存することをお薦めします。トランザクションのコミット後、ロールバックやトランザクション・リカバリの目的にはUNDOデータは不要になります。UNDO表領域に新しいトランザクション用の領域がある場合には、古いUNDOデータを保持できます。領域が少なくなると、コミットされたトランザクションのデータによる古いUNDOデータの上書きが開始されます。
Oracle AI Databaseでは、現在のUNDO表領域で、可能なかぎり最適にUNDAデータが自動的に保存されています。データベースは、使用統計を収集し、これらの統計およびUNDO表領域サイズに基づいて保存期間をチューニングします。UNDO表領域がAUTOEXTENDオプションを使用して構成されており、最大サイズが指定されていない場合は、UNDO保存期間は異なる方法でチューニングされます。この場合には、データベースにより、実行時間が最も長い問合せより少し長くなるように、UNDO保存期間がチューニングされます(領域が許す場合)。
関連項目: UNDO保存の自動チューニングの詳細は、『Oracle AI Database管理者ガイド』を参照
シャドウ表領域
シャドウ表領域は、シャドウ書込み消失保護を対象とするビッグファイル表領域である。
ノート:シャドウ消失書込み保護は、DB_LOST_WRITE_PROTECT初期化パラメータおよびスタンバイ・データベースで構成されている消失書込み保護とは関連しません。
-
シャドウ表領域の目的シャドウ書込み消失保護により、書込み消失の迅速な検出と即時の対応が提供されます。
-
シャドウ表領域の機能書込み損失保護では、シャド表領域と、そのシャドウ表領域によって追跡されるブロックがある非シャドウ表領域という、2つの表領域が必要になります。
-
シャドウ表領域のユーザー・インタフェースシャドウ書込み消失保護を有効または無効にするには、
ALTER PLUGGABLE DATABASEコマンドを使用します。 -
例: 欠落書込み保護の構成この例では、一連の表領域に対してシャドウ書込み欠落トラッキングを有効化します。
シャドウ表領域の目的
シャドウ書込み欠落保護では、書込み欠落の迅速な検出と即時の対応が提供されます。
データ・ブロックの書込み欠落は、書込みが実際には行われていないのにブロック書込みの完了がI/Oサブシステムで認識される場合や、ブロックの前回イメージが現在のイメージを上書きする場合に発生します。
書込み欠落を検知しないと、不適切なデータが他のDMLトランザクションに使用されるためにデータ破損が生じる可能性があります。たとえば、ある表から古い不適切なデータがトランザクションで読み取られて、このデータに基づいて他の何百という表が更新される場合があります。このようにして、データ破損がデータベース全体に広がる可能性があります。
シャドウ書込み欠落保護には次のような利点があります。
-
標準のDML、SQL*Loaderの従来型パス・ロード、ダイレクト・パス・ロードおよびRMANバックアップで使用される前に、書込み欠落が検知されます。
-
特定の表領域およびデータ・ファイルについてシャドウ書込み欠落保護を有効化できます。すべてのデータを追跡する必要はありません。
-
あるシャドウ表領域を別のシャドウ表領域に置き換えて、その構成や場所を変更できます。
-
表領域またはデータ・ファイルに対してシャドウ書込み欠落保護を中断および再開できます。
-
ALTER DATABASE ... LOST WRITE PROTECTION文単体でPDBを全体的に有効または無効にできます。PROP$表は、PDBに対してトラッキングが有効かどうかを示します。
関連項目: LOST WRITE PROTECTION句についてさらに学習するには、Oracle AI Database SQL言語リファレンスを参照してください
シャドウ表領域の機能
書込み欠落保護ではシャドウ表領域と、シャドウ表領域によって追跡されるブロックを持つ非シャドウ表領域の2つの表領域が必要です。
次の図に、サンプル・シナリオを示します。表領域TBS1およびTBS2内のデータ・ファイルがシャドウ表領域によって追跡されます。表領域TBS3内のデータ・ファイルDBF6のみがシャドウ表領域によって追跡されます。
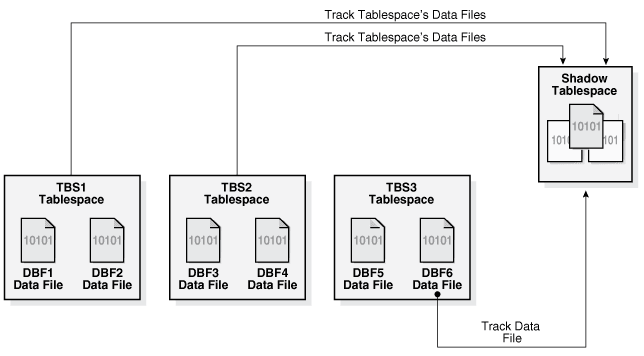
1つの追跡データ・ファイルは、シャドウ表領域の1つのシャドウ・エクステントにマップされます。追跡データ・ファイル内のすべてのデータ・ブロックは、シャドウ・ブロック内に対応するエントリを持ちます。このエントリには、追跡データ・ブロックのSCNが含まれます。追跡データ・ブロックがディスクから読み取られる際、シャドウ書込み欠落保護ではシャドウ表領域内のブロックのSCNと、追跡データ・ブロック内の最近の書込みのSCNが比較されます。シャドウ・エントリのSCNが読取り中のデータ・ブロックを上回る場合、書込み欠落が起こってエラーが発生します。
データファイルの自動サイズ変更によってシャドウ・エクステントが大きくなりすぎるのを防ぐために、シャドウ・エクステントはかなりの追加領域を持つサイズに設定されます。追跡データ・ファイルが手動または自動でサイズ変更された場合、およびシャドウ・エクステントを大きくする必要がある場合、データベースはトラッキング・データのサイズを変更しようとします。シャドウ表領域に十分な領域が存在しない場合、データベースではアラート・ログに警告を書き込み、可能なかぎり多くのデータ・ブロックを追跡します。
関連項目:シャドウ書込み損失保護の管理方法を学習するには、Oracle AI Database管理者ガイドを参照してください。
シャドウ表領域のユーザー・インタフェース
シャドウ書込み欠落保護は、ALTER PLUGGABLE DATABASEコマンドを使用して有効化および無効化します。
シャドウ書込み欠落保護で特定の表領域またはデータ・ファイルを保護するためには、次の条件が満たされる必要があります。
-
ALTER PLUGGABLE DATABASE ENABLE LOST WRITE PROTECTION文を使用して、PDB全体に対してシャドウ書込み欠落保護を有効化しておく必要があります。ノート: CDBでは、シャドウ書込み消失保護をルートで有効化した場合は、PDBはその保護を継承しません。保護対象のPDBすべてでシャドウ書込み欠落保護を有効にする必要があります。
-
ENABLE LOST WRITE PROTECTION句を使用して、保護対象の表領域またはデータ・ファイルに対してシャドウ書込み欠落保護を有効化しておく必要があります。表領域に対してシャドウ書込み欠落保護を有効化すると、表領域のすべてのデータ・ファイルが保護され、表領域に追加されたデータ・ファイルもすべて保護されます。一時表領域または別の書込み消失表領域では書込み欠落保護を有効にすることはできません。
-
LOST WRITE PROTECTION句を含むCREATE BIGFILE TABLESPACE文を使用して、シャドウ表領域を1つ以上作成しておく必要があります。
Oracle AI Databaseでは、追跡されたデータ・ファイルが特定のシャドウ表領域に自動的に割り当てられます。特定のデータ・ファイルに使用されるシャドウ表領域を指定することはできません。
次のデータ・ディクショナリ・ビューでは、シャドウ表領域を監視します。
-
DBA_TABLESPACES問合せによりどの表領域がシャドウ表領域かを示します。
-
DBA_DATA_FILES.LOST_WRITE_PROTECT書込み欠落保護がデータファイルに対して有効になっているかどうかを示します
-
USER_TABLESPACES.LOST_WRITE_PROTECT特定の表領域に対して書込み欠落保護が有効になっているかどうかを示します。
DBA_DATA_FILESは、表領域で書込み欠落保護がオンになっているかどうかを示しません。かわりに、USER_TABLESPACESを参照する必要があります。
関連情報:
-
シャドウ表領域での書込み損失保護の管理方法を学習するには、Oracle AI Database管理者ガイドを参照してください。
-
CREATE TABLESPACE文について学習するには、『Oracle AI Database SQL言語リファレンス』を参照 -
DBA_TABLESPACESについて学習するには、『Oracle AI Databaseリファレンス』を参照
例: 書込み欠落保護の構成
この例では、一連の表領域に対してシャドウ書込み欠落保護を有効化する方法を示します。
この例での目的は、PDB内のsalestbsおよびhrtbs表領域を保護することです。また、oetbs表領域内のoetbs01.dbfデータファイルのみ、およびこのデータファイルのみを保護します。あなたは次のことを行います:
-
PDBに管理者としてログインします。
-
1つのシャドウ表領域を次のように作成します。
CREATE BIGFILE TABLESPACE shadow_lwp1 DATAFILE 'shadow_lwp1_df' SIZE 10M LOST WRITE PROTECTION; -
PDBに対する書込み欠落保護を次のように有効化します。
ALTER DATABASE ENABLE LOST WRITE PROTECTION; -
salestbsおよびhrtbs表領域に対するシャドウ書込み欠落保護を次のように有効化します。ALTER TABLESPACE salestbs ENABLE LOST WRITE PROTECTION; ALTER TABLESPACE hrtbs ENABLE LOST WRITE PROTECTION; -
次のように、
oetbs01.dbfデータファイルのシャドウ書込み欠落保護を有効にします。ALTER DATABASE DATAFILE 'oetbs01.dbf' ENABLE LOST WRITE PROTECTION;
関連情報:
-
シャドウ表領域の管理方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
CREATE TABLESPACE文について学習するには、『Oracle AI Database SQL言語リファレンス』を参照
一時表領域
一時表領域には、セッションの存続期間中にのみ存続する一時的なデータが含まれています。永続スキーマ・オブジェクトを一時表領域に格納することはできません。一時ファイルには一時的な表領域データが格納されます。
一時表領域によって、メモリー内に収まらない複数のソート操作の同時実行性が向上します。また、一時表領域によって、ソート中の領域管理操作の効率も向上します。
-
共有およびローカル一時表領域一時表領域は、共有かローカルのどちらかになります。
-
デフォルト一時表領域各データベース・ユーザー・アカウントには、デフォルトの共有一時表領域が割り当てられます。データベースにローカル一時表領域が含まれる場合、すべてのユーザー・アカウントにデフォルトのローカル一時記憶域も割り当てられます。
共有およびローカル一時表領域
一時表領域は、共有かローカルのいずれかになります。
共有一時表領域は、共有ディスク上に一時ファイルを格納するため、一時領域はすべてのデータベース・インスタンスに対してアクセス可能です。対照的に、ローカル一時表領域はデータベース・インスタンスごとに個別の非共有一時ファイルを格納します。ローカル一時表領域は、Oracle Real Application ClustersまたはOracle Flex Clustersに対して有効です。
読取り専用および読取り/書込みの両方のデータベース・インスタンスについて、ローカル一時表領域を作成できます。多数の読取り専用インスタンスが1つのデータベースにアクセスする際、ソート、ハッシュ集計および結合が含まれる問合せのパフォーマンスがローカル一時表領域によって向上します。次のようなメリットがあります。
-
共有ではなくローカルのディスク記憶域を使用することによる、I/Oパフォーマンスの向上
-
コストの高いインスタンス間の一時領域管理の回避
-
ディスク上の領域メタデータ管理の排除による、インスタンスの起動パフォーマンスの向上
次の表では、共有およびローカル一時表領域の各特性を比較します。
表2共有およびローカル一時表領域
| 共有一時表領域 | ローカル一時表領域 |
|---|---|
CREATE TEMPORARY TABLESPACE文によって作成されます。 |
ノート:ローカル一時表領域は常にbigfile表領域ですが、作成文に |
| データベースの単一の一時表領域を作成します。 | データベース・インスタンスごとに個別の一時表領域を作成します。FOR LEAFオプションは、読取り専用インスタンスのみの表領域を作成します。FOR ALLオプションは、読取り専用および読取り/書込みの両方のすべてのインスタンスの表領域を作成します。 |
| 表領域グループをサポートしています。 | 表領域グループをサポートしていません。 |
| 一時ファイル・メタデータを制御ファイルに格納します。 | 制御ファイルのすべてのインスタンスに共通の一時ファイル・メタデータ、およびインスタンス固有のメタデータ(たとえば、割当て用ビットマップ、現在の一時ファイル・サイズ、ファイル・ステータスなど)をSGAに格納します。 |
参照: 「Oracle AI Databaseインスタンスの概要」
デフォルトの一時表領域
各データベース・ユーザー・アカウントには、デフォルトの共有一時表領域が割り当てられます。データベースにローカル一時表領域が含まれる場合、すべてのユーザー・アカウントにデフォルトのローカル一時記憶域も割り当てられます。
CREATE USER文またはALTER USER文によってユーザー・アカウントに異なる一時表領域を指定できます。Oracle AI Databaseでは、システムレベルのデフォルト一時表領域を別の一時表領域を指定していないユーザーに対して使用します。
-
デフォルト一時表領域を作成データベースを作成する際の、デフォルトの一時記憶域は、
SYSTEM表領域がローカルで管理されるかどうかによって異なります。 -
一時記憶域へのアクセスユーザーに一時表領域が割り当てられている場合、データベースは最初にそれにアクセスします。それ以外の場合、データベースはデフォルト一時表領域にアクセスします。データベースは問合せのために一時表領域にアクセスした後、別の表領域には切り替えません。
CREATE USER文についてさらに学習するには、『Oracle AI Database SQL言語リファレンス』を参照
デフォルト一時表領域の作成
データベースを作成する際、デフォルトの一時記憶域はSYSTEM表領域がローカルに管理されるかどうかによって異なります。
次の表に、データベース作成時のデフォルトの一時表領域をOracle AI Databaseでどのように選択するかを示します。
表3デフォルト一時表領域の作成
| SYSTEM表領域がローカルに管理されていますか。 | CREATE DATABASE文がデフォルトの一時表領域を指定しますか。 | 次に、データベース… |
|---|---|---|
| はい | はい | 指定された表領域をデフォルトとして使用します。 |
| はい | いいえ | 一時表領域を作成します。 |
| いいえ | はい | 指定された表領域をデフォルトとして使用します。 |
| いいえ | いいえ | デフォルトの一時記憶域にSYSTEMを使用します。データベースによってアラート・ログに、デフォルトの一時表領域を推奨する警告が書き込まれる。 |
データベースの作成後、ALTER DATABASE DEFAULT TEMPORARY TABLESPACE文によってデータベースのデフォルト一時表領域を変更できます。ノート:デフォルトの一時表領域を永続化することはできません。
関連情報:
-
デフォルトの一時表領域の作成方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
CREATE DATABASEおよびALTER DATABASEのDEFAULT TEMPORARY TABLESPACE句の構文については、『Oracle AI Database SQL言語リファレンス』を参照
一時記憶域へのアクセス
ユーザーに一時表領域が割り当てられている場合、データベースは最初にそれにアクセスします。それ以外の場合、データベースはデフォルト一時表領域にアクセスします。データベースは問合せのために一時表領域にアクセスした後、別の表領域には切り替えません。
ユーザー問合せは共有またはローカルのいずれかの一時記憶域にアクセスできます。さらに、ユーザーは読取り専用インスタンスに対して1つのデフォルトのローカル一時表領域を割り当てて、読取り/書込みインスタンスに対して別のデフォルトのローカル一時表領域を割り当てることができます。
読取り/書込みインスタンスの場合、データベースは共有一時表領域の優先度を高くします。読取り専用インスタンスの場合、データベースはローカル一時表領域の優先度を高くします。データベース・インスタンスが読取り/書込みの場合、データベースは次の順序で領域を検索します。
-
ユーザーに共有一時表領域が割り当てられていますか。
-
ユーザーにローカル一時表領域が割り当てられていますか。
-
データベースのデフォルト一時表領域に領域がありますか。
前述の質問のいずれかに対する回答が「はい」の場合、データベースは検索を停止し、指定された表領域から領域を割り当てます。それ以外の場合は、データベースのデフォルトのローカル一時表領域から領域が割り当てられます。
データベース・インスタンスが読取り専用の場合、データベースは次の順序で領域を検索します。
-
ユーザーにローカル一時表領域が割り当てられていますか。
-
割り当てられたデータベースのデフォルトのローカル一時表領域に領域がありますか。
-
ユーザーに共有一時表領域が割り当てられていますか。
前述の質問のいずれかに対する回答が「はい」の場合、データベースは検索を停止し、指定された表領域から領域を割り当てます。それ以外の場合は、データベースのデフォルトの共有一時表領域から領域が割り当てられます。
表領域モード
表領域モードによって、表領域のアクセス可能性が決まります。
-
読取り/書込みおよび読取り専用表領域各表領域は書込みモードになっていて、それに書き込むかどうかを指定します。
-
オンラインおよびオフラインの表領域表領域は、データベースがオープンしているときはいつでも、オンライン(アクセス可能)またはオフライン(アクセスできます)にできます。
読取り/書込み表領域と読取り専用表領域
すべての表領域は、書込み可能であるかどうかを指定する書込みモードのうちいずれかのモードになっています。
次の相互に排他的なモードがあります。
-
読み取り/書き込みモード
ユーザーは、表領域の読取りおよび書込みが可能です。すべての表領域は、最初は読取り/書込み用として作成されます。
SYSTEMおよびSYSAUXの表領域および一時表領域は、永続的に読取り/書込み可能であるため、読取り専用にはできません。 -
読み取り専用モード
表領域内のデータファイルへの書込み操作を行うことができません。読取り専用表領域は、DVDドライブやWORMドライブなどの読取り専用メディア上にのみ存在します。
読取り専用表領域では、データベースの静的な部分を大量にバックアップしたり、リカバリする必要がなくなります。読取り専用表領域は変更されないため、繰り返しバックアップする必要はありません。メディア障害後にデータベースをリカバリする場合、読取り専用表領域はリカバリする必要がありません。
関連情報:
-
表領域が読取り専用または読取り/書込みモードに変更される方法を学習するには、『Oracle AI Database管理者ガイド』を参照
-
ALTER TABLESPACEの構文およびセマンティクスについては、『Oracle AI Database SQL言語リファレンス』を参照 -
リカバリの詳細は、『Oracle AI Databaseバックアップおよびリカバリ・ユーザーズ・ガイド』を参照してください。
オンライン表領域とオフライン表領域
表領域は、データベースがオープンされているときはいつでも、オンライン(アクセス可能)またはオフライン(アクセス不能)にできます。
表領域は通常はオンラインになっており、ユーザーはその表領域内のデータを使用できます。SYSTEM表領域と一時表領域は、オフラインにはできません。
表領域は、自動または手動でオフラインにできます。たとえば、メンテナンスまたはバックアップとリカバリのために表領域をオフラインにできます。データベース・ライター(DBW)プロセスによるデータファイルへの書込みが数回失敗した場合など、特定のエラーが発生すると、データベースは自動的に表領域をオフラインにします。オフライン表領域にある表にアクセスしようとしたユーザーは、エラーを受け取ります。
表領域がオフラインになると、データベースで次のような処理が実行されます。
-
データベースでは、表領域がオフラインになると、その表領域内のオブジェクトをDML文で参照できなくなります。Oracle AI Database以外のユーティリティでは、オフライン表領域を読取りまたは編集できません。
-
その表領域内のデータを参照する文が完了しているアクティブなトランザクションは、トランザクション・レベルでは影響を受けません。
-
これらの完了した文に対応するUNDOデータは、
SYSTEM表領域内の遅延UNDOセグメントに保存されます。表領域が再びオンライン化されたとき、必要に応じてUNDOデータが表領域に適用されます。
関連情報:
-
表領域の可用性を変更する方法を学習するには、『Oracle AI Database管理者ガイド』を参照
表領域ファイル・サイズ
表領域の1つに、bigfile表領域またはsmallfile表領域を指定します。これらの表領域は、データファイルまたは一時ファイルを明示的に参照しないSQL文の実行時には区別できません。
これらの表領域の違いは、次のとおりです。
-
smallfile表領域には、複数のデータファイルや一時ファイルを含むことができますが、bigfile表領域ほど大きなファイルは含むことができません。これがデフォルトの表領域タイプです。
-
bigfile表領域には、1つの非常に大きなデータファイルまたは一時ファイルを含むことができます。このタイプの表領域には、次のような利点があります。
-
データベースの記憶域容量の増加
データベース内のデータファイルの最大数には制限があるため、各データファイルのサイズを増加することによって、全体的な記憶域容量を増加できます。
-
数多くのデータファイルおよび一時ファイルを管理する負担の軽減
bigfile表領域により、新規ファイルを追加したり複数ファイルを取り扱うために必要がなくなり、Oracle Managed Filesと自動ストレージ管理(Oracle ASM)によるファイル管理の簡素化が行われます。
-
個々のファイルではなく表領域に対する操作の実行
ビッグファイル表領域を作成すると、ディスク領域の管理、バックアップおよびリカバリの主要な単位として表領域を使用できます。
bigfile表領域がサポートされるのは、ASSMを使用するローカル管理表領域の場合のみです。ただし、ローカル管理のUNDO表領域と一時表領域は、セグメントが手動管理される場合にもbigfile表領域として使用できます。
Oracle AI Database 26ai以降、SYSTEM、SYSAUXおよびUSER表領域は、デフォルトでbigFile表領域として作成されます。以前のリリースからアップグレードされたデータベースでは、その表領域タイプを保持します。
-
関連情報:
-
バックアップとリカバリについてさらに学習するには、『Oracle AI Databaseバックアップおよびリカバリ・ユーザーズ・ガイド』を参照してください。
-
bigfile表領域の管理方法を学習するには、『Oracle AI Database管理者ガイド』を参照