표
테이블을 사용하여 데이터의 구조를 정의합니다.
새 데이터를 테이블로 로드하거나 기존 위치의 데이터를 참조할 수 있습니다. 테이블 권한을 생성하여 테이블에 대해 상세한 액세스 제어 권한을 정의할 수 있습니다. 자세한 내용은 테이블 사용 권한을 참조하십시오.
테이블을 공유하려면 Share Data를 참조하십시오.
테이블은 관리되거나 외부에 있을 수 있습니다.
관리 테이블
관리 테이블은 AI 데이터 플랫폼 내에 저장되고 AI 데이터 플랫폼 사용자만 액세스할 수 있는 데이터의 구조를 정의합니다.
관리 테이블을 삭제하면 테이블 정의 및 테이블 데이터가 삭제됩니다.
외부 테이블
외부 테이블은 Oracle AI Data Platform에서 관리하지 않는 위치에 저장된 데이터의 구조를 정의합니다. AI 데이터 플랫폼에서 외부 테이블을 생성하는 경우 메타데이터 수명 주기는 AI 데이터 플랫폼에서 관리됩니다. External Table을 삭제하면 테이블 정의만 삭제됩니다. 외부 테이블에서 참조하는 데이터가 삭제되지 않습니다.
External Table을 생성하는 데 필요한 다음 IAM 정책이 유저에게 있는지 확인합니다.
allow group <GroupName> to read buckets in compartment id <external-data-CompartmentId>
allow group <GroupName> to inspect objects in compartment id <external-data-CompartmentId>
외부 테이블에 대한 추가 IAM 정책이 필요합니다. 자세한 내용은 Oracle AI Data Platform에 대한 IAM 정책을 참조하십시오.
지원되는 테이블 형식
테이블은 CSV, JSON, Avro, Parquet 및 ORC와 같은 파일 기반 형식이나 Delta 및 Apache Iceberg와 같은 트랜잭션 테이블 형식을 사용할 수 있습니다. Iceberg 테이블은 Hadoop 카탈로그 구현을 사용하여 Oracle Cloud Infrastructure Object Storage에서 테이블 메타데이터를 관리합니다.
| 형식 | 설명 | 사용 |
|---|---|---|
| CSV(콤마로 구분된 값) | 데이터는 지정된 행 기반 파일 형식을 사용하여 데이터를 구조화하는 텍스트 파일로 저장됩니다. 일반적으로 파일의 첫번째 행은 데이터의 열 이름을 포함하는 머리글 행입니다. | 시스템 간에 표 형식 데이터를 교환하는 데 사용됩니다. 파일의 각 행은 테이블의 행입니다. |
| JSON(JavaScript 객체 표기법) | 데이터는 JavaScript 객체 구문을 기반으로 구조화된 데이터를 나타내는 표준 텍스트 기반 형식으로 저장됩니다. JSON은 객체 또는 계층 구조 목록을 지원합니다. | 스트림 애플리케이션에서 사용됩니다. JSON은 단일 문서에서 복잡한 관계로 관련 데이터의 저장을 단순화하고 관계형 데이터 모델로의 혼란스러운 목록 변환을 방지합니다. JSON은 분할할 수 없습니다. |
| Avro | 데이터는 행 기반 바이너리 형식으로 저장되고 스키마는 파일 크기를 최소화하고 효율성을 극대화하기 위해 JSON 형식으로 저장됩니다. Avro는 추가, 누락 및 변경된 필드를 관리하여 스키마 진화에 대한 안정적인 지원을 제공합니다. 이것은 오래된 소프트웨어가 새로운 데이터를 읽고 새로운 소프트웨어가 오래된 데이터를 읽을 수있게합니다. 데이터 직렬화 시스템이라고도 합니다. | Avro 파일이 분할 가능하고 압축 가능하므로 데이터 스토리지에 사용됩니다. 직렬화된 행 기반 스토리지는 AI 데이터 플랫폼에 데이터를 삽입하는 등 많은 쓰기 트랜잭션에 적합합니다. 또한 Avro는 고속 쓰기 작업 중에 스키마 변경이 중요한 경우에도 적합합니다. |
| Parquet | 데이터는 열 형식 데이터 형식으로 저장되며 압축 및 분할이 매우 가능합니다. Parquet는 WORM(Write Once Read Many) 패러다임에 최적화되어 있습니다. 쓰기 속도는 느리지만 읽기 속도가 매우 빠릅니다. 특히 열의 부분 집합에만 액세스할 경우 더욱 그렇습니다. | 압축 알고리즘이 열 형식 데이터 형식에서 더 잘 작동하므로 Big Data 문제를 해결하는 데 사용됩니다. 이미지, 비디오, 문서 및 구조화된 데이터 테이블과 같은 다양한 형식으로 빅 데이터를 저장할 수 있습니다. Parquet는 데이터 부분을 읽을 때 많은 워크로드에 적합합니다. 예를 들어, 데이터 집합에 열이 많지만 열의 하위 집합에만 액세스하려는 경우 Spark에 의존하거나 여러 서비스가 오브젝트 스토리지에 저장된 동일한 데이터에 액세스하기를 원할 때 이상적입니다. |
| 최적화된 행 열 형식(ORC) | 데이터는 열 형식으로 단일 파일의 행 모음에 저장됩니다. | 클러스터 전체에서 행 모음의 병렬 처리에 사용됩니다. 읽기 트랜잭션이 쓰기 트랜잭션보다 많거나 압축 우선 순위가 높은 경우에 이상적입니다. |
| 델타호 | 데이터는 ACID 트랜잭션 및 확장 가능한 메타데이터 처리를 위한 JSON 파일 기반 트랜잭션 로그를 통해 Parquet 데이터 파일을 확장하는 열 형식으로 저장됩니다. | 트랜잭션 지원에 사용됩니다. |
| 아이스버그 | 버전 지정된 메타데이터, 매니페스트 및 스냅샷을 통해 Parquet 데이터 파일을 관리하는 열린 테이블 형식입니다. AI Data Platform은 Iceberg Hadoop 카탈로그 구현을 사용합니다. | ACID 트랜잭션, 동시 읽기/쓰기, 스키마/파티션의 변화, 시간 여행 쿼리, 행 레벨 업데이트, 업서트 및 스냅샷 관리에 사용됩니다. |
지원되는 데이터 유형
| 데이터 유형 | 설명 |
|---|---|
| 바이트 유형 | 1바이트 부호 있는 정수를 나타냅니다. 숫자 범위는 -128에서 127 사이입니다. |
| 짧은 유형 | 2바이트 부호 있는 정수를 나타냅니다. 숫자 범위는 -32768에서 32767 사이입니다. |
| 정수 유형 | 4바이트 부호 있는 정수를 나타냅니다. 숫자 범위는 -2147483648에서 2147483647 사이입니다. |
| 긴 유형 | 8바이트 부호 있는 정수를 나타냅니다. 숫자 범위는 -9223372036854775808에서 9223372036854775807 사이입니다. |
| 유동 유형 | 4바이트 단일 정밀도 부동 소수점 수를 나타냅니다. |
| 이중 유형 | 8바이트 이중 정밀도 부동 소수점 수를 나타냅니다. |
| 십진수 유형 | 임의의 전체 자릿수 부호 있는 소수 자릿수를 나타냅니다. java.math.BigDecimal에 의해 내부적으로 지원됩니다. BigDecimal은 임의의 소수점 이하 자릿수 배율이 조정되지 않은 값과 32비트 정수 배율로 구성됩니다. |
| 문자열 유형 | 문자열 값을 나타냅니다. |
| VarcharType (길이) | 길이 제한이 있는 StringType의 변형입니다. 입력 문자열이 길이 제한을 초과하면 데이터 쓰기가 실패합니다. |
| CharType(길이) | 고정 길이인 VarcharType(길이)의 변형입니다. CharType(n) 유형의 읽기 열은 항상 n 길이의 문자열 값을 반환합니다. 특성 유형 열 비교는 짧은 값을 더 긴 길이로 채웁니다. |
| 바이너리 유형 | 바이트 시퀀스 값을 나타냅니다. |
| 부울 유형 | 부울 값을 나타냅니다. |
| 일자 유형 | 시간대 없이 연도, 월 및 일 필드 값으로 구성된 값을 나타냅니다. |
| 시간 기록 유형 | 로컬 시간대(TIMESTAMP_LTZ)가 포함된 시간기록입니다. 세션 로컬 시간대와 함께 연도, 월, 일, 시, 분 및 초 필드의 값으로 구성된 값을 나타냅니다. 시간 기록 값은 절대 시점을 나타냅니다. |
| 시간기록NTZ 유형 | 시간대가 없는 시간기록(TIMESTAMP_NTZ)입니다. 연도, 월, 일, 시, 분 및 초 필드의 값으로 구성된 값을 나타냅니다. 모든 작업은 시간대를 고려하지 않고 수행됩니다. |
| YearMonthIntervalType(startField, endField) | [0..178956970] 범위의 연속된 MONTH 하위 세트, 연도[0..11] 및 연도[0..178956970] 내의 월로 구성된 연도-월 간격을 나타냅니다. |
| DayTimeIntervalType(startField, endField) | [0..59.99999], MINUTE, minutes within hours [0..59], HOUR, hours within days [0..23] 및 DAY, days in the range [0..106751991]의 연속 부분 집합으로 구성된 일 시간 간격을 나타냅니다. |
| ArrayType(elementType, containsNull) | 유형이 elementType인 요소 시퀀스로 구성된 값을 나타냅니다. containsNull은 ArrayType 값의 요소에 널 값이 있을 수 있는지 여부를 나타내는 데 사용됩니다. |
| MapType(keyType, valueType, valueContainsNull) | 키-값 쌍 세트로 구성된 값을 나타냅니다. 키의 데이터 유형은 keyType로 설명되고 값의 데이터 유형은 valueType로 설명됩니다. MapType 값의 경우 널 값을 가질 수 없습니다. valueContainsNull는 MapType 값의 값이 널 값을 가질 수 있는지 여부를 나타내는 데 사용됩니다. |
| 구조 유형(필드) | StructFields(필드) 시퀀스로 설명된 구조의 값을 나타냅니다. |
| StructField(이름, dataType, 널 가능) | StructType의 필드를 나타냅니다. 필드의 이름은 이름으로 표시됩니다. 필드의 데이터 유형은 dataType으로 표시됩니다. 널 가능은 해당 필드의 값이 널 값을 가질 수 있는지 여부를 나타내는 데 사용됩니다. |
제한사항
AI 데이터 플랫폼의 테이블에는 다음과 같은 제한 사항이 적용됩니다.
- 볼륨 내 또는 볼륨의 데이터 파일이나 디렉토리에서 외부 테이블을 정의할 수 없습니다.
- 다른 외부 테이블 또는 외부 볼륨에 이미 사용된 버킷 또는 해당 디렉토리에 외부 테이블을 정의할 수 없습니다.
- 뷰를 보거나 마스터 카탈로그에 나열할 수 없습니다.
스키마 전개
Oracle AI Data Platform의 스키마 변화를 통해 필요한 권한을 가진 사용자는 노트북에서 SQL을 사용하여 관리 테이블을 업데이트할 수 있습니다.
이 기능은 새 열, 제거된 열, 이름이 바뀐 열, 분할 영역 변경 또는 데이터 세트를 처음부터 다시 만들지 않고 테이블 이름을 바꾸도록 시간이 지남에 따라 테이블 정의가 변경되는 경우에 유용합니다. 지원되는 형식은 Parquet, Avro, Delta 및 Iceberg입니다.
지원되는 운영
관리 테이블에 대한 다음 스키마 전개 작업이 분석되었습니다.
| 연산 | 델타 | Parquet | Avro | 아이스버그 |
|---|---|---|---|---|
| 테이블 이름 바꾸기 | 지원되는 | 지원되는 | 지원되는 | 지원되는 |
| 열 추가 | 지원되는 | 지원되는 | 지원되는 | 지원되는 |
| 열 삭제 | 지원되는 | 지원되지 않음 | 지원되지 않음 | 지원되는 |
| 열 변경 또는 이름 바꾸기 | 지원되는 | 지원되지 않음 | 지원되지 않음 | 지원되는 |
| 열 바꾸기 | 지원되는 | 지원되지 않음 | 지원되지 않음 | 지원되는 |
| 파티션 추가 | 분할 영역은 데이터가 기록될 때 자동으로 생성됩니다. DDL을 통해 개별 파티션을 추가할 수 없습니다. | DDL을 통해 지원됨 | DDL을 통해 지원됨 | 분할 영역은 데이터가 기록될 때 자동으로 생성됩니다. DDL을 통해 개별 파티션을 추가할 수 없습니다. ALTER TABLE ... ADD PARTITION FIELD를 사용하여 분할 영역 지정에 필드를 추가할 수 있습니다.
|
| 분할 영역 놓기 | 관련 데이터를 제거하고 VACUUM를 실행합니다.
|
지원되는 | 지원되는 | DDL을 통해 개별 파티션을 삭제할 수 없습니다. 대신 관련 행을 삭제합니다. ALTER TABLE ... DROP PARTITION FIELD를 사용하여 분할 영역 지정에서 필드를 제거할 수 있습니다.
|
| 데이터 유형 변경 | CTAS 또는 겹쳐쓰기 스키마 임시해결책이 필요할 수 있습니다. | 지원되지 않음 | 지원되지 않음 | INT에서 BIGINT, FLOAT to DOUBLE로, ALTER TABLE까지 소수점 이하 자릿수 증가와 같이 호환되는 유형 프로모션에만 지원됩니다. 축소 및 호환되지 않는 변환은 지원되지 않습니다.
|
관리 테이블 생성
관리하는 스키마에 대해 구조화된 데이터를 보유할 관리 테이블을 생성할 수 있습니다.
- 테이블 생성 대화상자를 엽니다.
- 왼쪽 탐색 창에서 다음을 수행합니다.
 생성을 누르고 테이블을 선택합니다.
- 테이블 위치 선택 대화상자에서 테이블을 생성할 카탈로그 및 스키마를 선택하고 선택을 누릅니다.
 마스터 카탈로그에서 다음을 수행합니다.
- 마스터 카탈로그 트리 또는 카탈로그 탭에서 테이블을 만들려는 카탈로그를 눌러 엽니다.
- 스키마 탭에서 테이블을 생성하여 열려는 스키마를 누릅니다.
- 스키마에 추가를 누르고 테이블을 선택합니다.
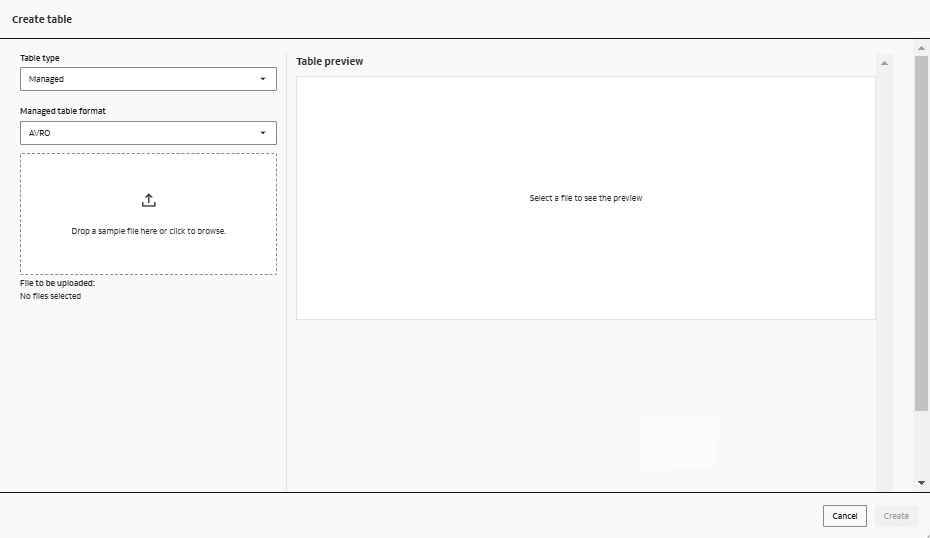
- 왼쪽 탐색 창에서 다음을 수행합니다.
외부 테이블 생성
Oracle AI Data Platform에서 데이터를 이동하거나 복제하지 않고도 OCI Object Storage에서 직접 데이터를 쿼리할 외부 테이블을 생성할 수 있습니다.
- 테이블 생성 대화상자를 엽니다.
- 왼쪽 탐색 창에서 다음을 수행합니다.
- 생성을 누르고 테이블을 선택합니다.
- 테이블 위치 선택 대화상자에서 테이블을 생성할 카탈로그 및 스키마를 선택하고 선택을 누릅니다.
- 마스터 카탈로그에서 다음을 수행합니다.
- 마스터 카탈로그 트리 또는 카탈로그 탭에서 테이블을 만들려는 카탈로그를 눌러 엽니다.
- 스키마 탭에서 테이블을 생성하여 열려는 스키마를 누릅니다.
- 스키마에 추가를 누르고 테이블을 선택합니다.
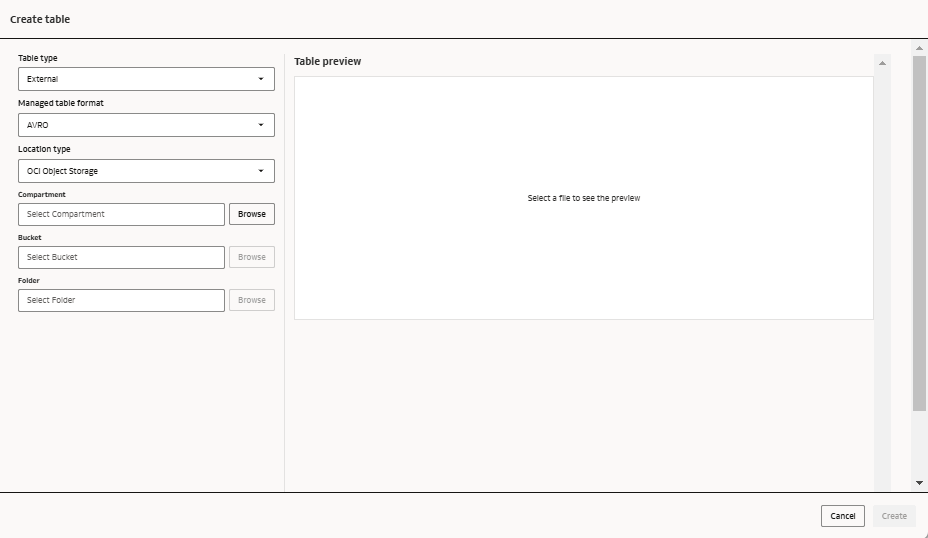
- 왼쪽 탐색 창에서 다음을 수행합니다.
테이블 세부정보 보기
테이블의 세부 정보를 보고 해당 구성 및 메타 데이터를 검토할 수 있습니다.
테이블의 세부정보 탭에는 테이블 키, 유형 및 형식과 함께 테이블 생성 및 최종 업데이트 시기 및 기준이 표시됩니다. 또한 테이블 속성을 표시합니다.
- 왼쪽 탐색 창에서 마스터 카탈로그를 누릅니다.
- 마스터 카탈로그 트리에서 보려는 테이블이 포함된 카탈로그 및 스키마를 확장한 다음 테이블을 누릅니다.
- 테이블 탭에서 테이블을 찾아
 작업을 누른 다음 보기를 누릅니다.
- 세부정보를 누릅니다.
테이블 이름 변경
내용이나 목적이 변경된 경우 관리하는 테이블의 이름을 바꿀 수 있습니다.
주:
Oracle AI Data Platform의 외부 테이블에 대한 편집은 OCI Object Storage의 원격 카탈로그로 푸시되지 않습니다.- 왼쪽 탐색 창에서 마스터 카탈로그를 누릅니다.
- 마스터 카탈로그 트리에서 편집할 테이블이 포함된 카탈로그 및 스키마를 확장한 다음 테이블을 누릅니다.
- 테이블 탭에서 테이블을 찾아 작업을 누른 다음 이름 바꾸기를 누릅니다.
- 테이블 이름을 편집하고 Enter를 누릅니다.