Introdução ao Oracle AI Database
Este capítulo fornece uma visão geral do Oracle AI Database.
Este capítulo contém os seguintes tópicos:
-
Sobre Sistemas de Informação Toda organização tem informações que deve armazenar e gerenciar para atender às suas necessidades. Por exemplo, uma corporação deve coletar e manter registros de recursos humanos para seus funcionários. Esta informação deve estar disponível para aqueles que precisam dela.
-
Objetos do Esquema Uma característica de um RDBMS é a independência do armazenamento físico de dados das estruturas de dados lógicas.
-
Acesso a Dados Um requisito geral para um DBMS é aderir aos padrões aceitos do setor para uma linguagem de acesso a dados.
-
Gerenciamento de Transações O Oracle AI Database foi projetado como um banco de dados multiusuário. O banco de dados deve garantir que vários usuários possam trabalhar simultaneamente sem corromper os dados uns dos outros.
-
Arquitetura do Oracle AI Database Um servidor de banco de dados é a chave para o gerenciamento de informações.
Sobre Sistemas de Informação
Toda organização tem informações que deve armazenar e gerenciar para atender às suas necessidades. Por exemplo, uma corporação deve coletar e manter registros de recursos humanos para seus funcionários. Esta informação deve estar disponível para aqueles que precisam dela.
Sistema de informações é um sistema formal para armazenar e processar informações. Um banco de dados é uma coleção organizada de informações tratadas como uma unidade. A finalidade de um banco é coletar, armazenar e recuperar informações relacionadas para serem usadas pelos aplicativos.
Quando os sistemas de banco de dados foram inventados, eles foram projetados para uma carga de trabalho específica. Ao longo dos anos, tornou-se evidente que os bancos de dados de uso único não atendem mais a todos os requisitos: além das cargas de trabalho relacionais, os desenvolvedores precisavam armazenar dados em outros formatos, como XML, espacial, gráfico, JSON e, mais recentemente, dados vetoriais para a era da IA.
O Oracle AI Database evoluiu de um mecanismo de banco de dados relacional para um mecanismo convergente, permitindo que os desenvolvedores armazenem quase qualquer tipo de dados no formato que sua aplicação exige de forma nativa e totalmente integrada à sua arquitetura de nível empresarial.
-
Sistema de Gerenciamento de Banco de Dados (DBMS) Um sistema de gerenciamento de banco de dados (DBMS) é um software que controla o armazenamento, a organização e a recuperação de dados.
-
Modelo Relacional Em seu artigo seminal de 1970, "Um Modelo Relacional de Dados para Grandes Bancos de Dados Compartilhados", E. F. Codd definiu um modelo relacional baseado na teoria dos conjuntos matemáticos. Hoje, o modelo de banco de dados mais aceito é o relacional.
-
Sistema de Gerenciamento de Banco de Dados Relacional (RDBMS) O modelo relacional é a base para um Sistema de Gerenciamento de Banco de Dados Relacional (RDBMS). Um RDBMS move os dados para um banco de dados, os armazena e os recupera para que os aplicativos possam manipulá-los.
Sistema de Administração de Banco de Dados (DBMS)
Sistema de Gerenciamento de Banco de Dados (DBMS) é um software que controla o armazenamento, a organização e a recuperação de dados.
Normalmente, um DBMS tem os seguintes elementos:
-
Código Kernel
Este código gerencia memória e armazenamento para o DBMS.
-
Repositório de metadados
Esse repositório geralmente é chamado de dicionário de dados ou catálogo de metadados.
-
Linguagens de consulta
As linguagens de consulta facilitam o acesso aos dados. Bancos de dados convergentes, como o Oracle AI Database, suportam várias linguagens de consulta.
Aplicativo de banco de dados é um programa de software que interage com um banco de dados para acessar e manipular dados. O Oracle AI Database foi um dos primeiros mecanismos de banco de dados a oferecer suporte ao modelo relacional. Desde a sua criação, evoluiu para um mecanismo de banco de dados convergente, suportando quase qualquer tipo de dados e muitas cargas de trabalho diversas.
Modelo Relacional
Em seu seminal artigo de 1970 "Um Modelo Relacional de Dados para Grandes Bancos de Dados Compartilhados", E. F. Codd definiu um modelo relacional baseado na teoria dos conjuntos matemáticos. Hoje, o modelo de banco de dados mais aceito é o relacional.
Um banco de dados relacional é um banco de dados que está em conformidade com o modelo relacional. O modelo relacional tem os seguintes aspectos principais:
-
Estruturas
Objetos bem definidos armazenam ou acessam os dados de um banco de dados.
-
Operações
Ações claramente definidas permitem que os aplicativos manipulem os dados e as estruturas de um banco de dados.
-
Regras de integridade
As regras de integridade controlam as operações nos dados e nas estruturas de um banco de dados.
Um banco de dados relacional armazena dados em um conjunto de relações simples. Uma relação é um conjunto de tuplas. Tuple é um conjunto não ordenado de valores de atributo.
Uma tabela é uma representação bidimensional de uma relação na forma de linhas (dois) e colunas (atributos). cada linha de uma tabela tem o mesmo conjunto de colunas. Banco de dados relacional é um banco de dados que armazena dados em relações (tabelas). Por exemplo, um banco de dados relacional poderia armazenar informações sobre funcionários da empresa em uma tabela de funcionários, uma tabela de departamentos e uma tabela de salários.
Tópicos Relacionados
Sistema Relacional de Administração de Banco de Dados (RDBMS)
O modelo relacional é a base de um sistema de gerenciamento de banco de dados relacional (RDBMS). Um RDBMS move os dados para um banco de dados, os armazena e os recupera de forma que os aplicativos possam manipulá-los.
Um RDBMS faz distinção entre os seguintes tipos de operações:
-
Operações lógicas
Nesse caso, um aplicativo especifica qual conteúdo é necessário. Por exemplo, um aplicativo solicita um nome de funcionário ou adiciona um registro de funcionário a uma tabela.
-
Operações físicas
Nesse caso, o RDBMS determina como as coisas devem ser feitas e realiza a operação. Por exemplo, depois que um aplicativo consulta uma tabela, o banco de dados pode usar um índice para localizar as linhas solicitadas, ler os dados na memória e executar muitas outras etapas antes de retornar um resultado ao usuário. O RDBMS armazena e recupera dados para que as operações físicas sejam transparentes para os aplicativos de banco de dados.
O Oracle AI Database é um RDBMS em sua essência. Um RDBMS que implementa recursos orientados a objetos, como tipos definidos pelo usuário, herança e polimorfismo, é chamado de ORDBMS (Object-Relational Database Management System). O Oracle AI Database estende o modelo relacional a um modelo objeto-relacional, possibilitando armazenar modelos de negócios complexos em um banco de dados relacional. Com o tempo, o principal mecanismo de dados da Oracle evoluiu para um modelo muito mais avançado, agora conhecido como banco de dados convergente.
Arquitetura do Banco de Dados Convergente
O Oracle AI Database é um banco de dados convergente que suporta vários modelos de dados e cargas de trabalho em um único mecanismo de banco de dados. Além dos dados relacionais, ele pode gerenciar documentos JSON, dados gráficos, dados espaciais, texto, vetores e outros tipos de dados especializados.
Esses recursos compartilham serviços comuns de banco de dados, incluindo transações, segurança, backup e recuperação, alta disponibilidade, auditoria e otimização de consultas. Os aplicativos podem, portanto, usar diferentes modelos de dados sem exigir um banco de dados separado para cada um.
Por exemplo, uma aplicação pode armazenar dados de clientes e transações em tabelas relacionais, atributos flexíveis em documentos JSON, informações geográficas como dados espaciais e incorporações de vetores para pesquisa semântica. O SQL pode ser usado para consultar e combinar essas formas de dados em uma única operação. Uma API de estilo de documento está disponível para desenvolvedores que preferem esse estilo NoSQL.
Um banco de dados convergente oferece os seguintes benefícios:
- Redução da movimentação de dados entre sistemas especializados
- Segurança e governança consistentes
- Transações integradas entre dados relacionados
- Arquitetura operacional e de aplicação simplificada
- Análise unificada de vários tipos de dados
- Auditoria unificada das operações do banco de dados
A convergência não requer que todas as cargas de trabalho usem todos os recursos ou residam em um banco de dados físico. Os aplicativos podem usar apenas os recursos de que precisam. A arquitetura flexível da Oracle permite que os desenvolvedores espalhem aplicativos por vários bancos de dados plugáveis.
O Oracle Database permanece relacional em sua essência. Sua arquitetura convergente estende essa base para que os aplicativos possam trabalhar com vários modelos de dados enquanto usam um conjunto comum de serviços de banco de dados que atendem a quase todas as cargas de trabalho.
Objetos do Esquema
Uma característica de um RDBMS é a independência do armazenamento físico de dados de estruturas de dados lógicas.
No Oracle AI Database, um esquema de banco de dados é um conjunto de estruturas de dados lógicas ou objetos de esquema. Um usuário do banco de dados possui um esquema de banco de dados, que tem o mesmo nome que o nome de usuário.
Objetos de esquema são estruturas criadas pelo usuário que se referem diretamente aos dados no banco de dados. O banco de dados suporta muitos tipos de objetos de esquema, sendo os mais importantes tabelas e índices. Os usuários que preferem uma API no estilo de documento para acessar seus dados podem criar coleções (JSON) ou views de dualidade relacional JSON.
Um objeto de esquema é um tipo de objeto de banco de dados. Alguns objetos de banco de dados, como perfis e funções, não residem em esquemas.
-
Tabelas Uma tabela descreve uma entidade, como funcionários.
-
Índices Um índice é uma estrutura de dados opcional que você pode criar em uma ou mais colunas de uma tabela. Os índices podem aumentar o desempenho da recuperação de dados.
Tópicos Relacionados
Tabelas
Uma tabela descreve uma entidade como funcionários.
Você define uma tabela com um nome, como employees, e um conjunto de colunas. Em geral, você dá a cada coluna um nome, um tipo de dados e uma largura ao criar a tabela.
Uma tabela é um conjunto de linhas. Uma coluna identifica um atributo da entidade descrita pela tabela, enquanto uma linha identifica uma instância da entidade. Por exemplo, os atributos da entidade funcionários correspondem a colunas para ID e sobrenome do funcionário. Uma linha identifica um funcionário específico.
Opcionalmente, você pode especificar uma regra, chamada constraint de integridade, para uma coluna. Um exemplo é uma restrição de integridade NOT NULL. Essa constraint força a coluna a conter um valor em todas as linhas. Restrições que abrangem várias tabelas podem ser definidas como asserções SQL. Antes do Oracle AI Database 26ai, era possível usar acionadores de banco de dados para impor a lógica de negócios como parte de uma transação.
Tópicos Relacionados
Índices
Um índice é uma estrutura de dados opcional que você pode criar em uma ou mais colunas de uma tabela. Os índices podem aumentar o desempenho da recuperação de dados.
Ao processar uma solicitação, o banco de dados pode usar índices disponíveis para localizar as linhas solicitadas com eficiência. Os índices são úteis quando os aplicativos costumam consultar uma linha ou um intervalo de linhas específico.
Os índices são lógica e fisicamente independentes dos dados. Assim, você pode eliminar e criar índices sem afetar as tabelas ou outros índices. Todos os aplicativos continuam funcionando depois que você elimina um índice.
Tópicos Relacionados
Acesso a Dados
Um requisito geral para um DBMS é aderir aos padrões aceitos do setor para uma linguagem de acesso a dados. Observação: JavaScript requer que o Oracle 26ai seja executado no Linux x86-64 ou Linux aarch64.
-
O SQL Structured Query Language (SQL) é uma linguagem declarativa baseada em conjunto que fornece uma interface para um RDBMS, como o Oracle AI Database.
-
O PL/SQL é uma extensão procedural do Oracle SQL. Java e JavaScript são opções adicionais que você pode usar para armazenar a lógica de negócios no banco de dados.
SQL (Structured Query Language)
SQL é uma linguagem declarativa baseada em conjunto que fornece uma interface para um RDBMS, como o Oracle AI Database.
Linguagens procedurais como C descrevem como as coisas devem ser feitas. O SQL não é processual e descreve o que deve ser feito.
SQL é a linguagem padrão ANSI para bancos de dados relacionais. Todas as operações nos dados em um banco de dados Oracle são executadas com instruções SQL. Por exemplo, você usa SQL para criar tabelas e consultar e modificar dados em tabelas.
Uma instrução SQL pode ser considerada um programa ou instrução de computador muito simples, mas poderoso. Os usuários especificam o resultado desejado (por exemplo, os nomes dos funcionários), não como derivá-lo. Uma instrução SQL é uma string de texto SQL como a seguinte:
SELECT first_name, last_name FROM employees;As instruções SQL permitem que você execute as seguintes tarefas:
-
Consultar dados
-
Inserir, atualizar e excluir linhas em uma tabela
-
Criar, substituir, alterar e eliminar objetos
-
Controlar acesso ao banco de dados e seus objetos
-
Garantir a consistência e a integridade do banco de dados
O SQL unifica as tarefas anteriores em uma linguagem consistente. Oracle SQL é uma implementação do padrão ANSI. O Oracle SQL suporta vários recursos que vão além do SQL padrão.
Tópicos Relacionados
PL/SQL, Java e JavaScript
O PL/SQL é uma extensão procedural do Oracle SQL. Java e JavaScript são opções adicionais que você pode usar para armazenar a lógica de negócios no banco de dados.
O PL/SQL é integrado ao Oracle AI Database, permitindo que você use todas as instruções, funções e tipos de dados do Oracle AI Database SQL. você pode usar PL/SQL para controlar o fluxo de um programa SQL, usar variáveis e criar procedimentos de tratamento de erros.
Um benefício principal da linguagem PL/SQL é a capacidade de armazenar a lógica do aplicativo no próprio banco de dados. Um procedimento PL/SQL ou uma função é um objeto de esquema que consiste em um conjunto de instruções SQL e outras construções PL/SQL, agrupadas, armazenadas no banco de dados e executadas como uma unidade para resolver um problema específico ou para executar um conjunto de tarefas relacionadas. O principal benefício da programação do lado do servidor é que a funcionalidade integrada pode ser implantada em qualquer lugar.
O Oracle AI Database também pode armazenar unidades de programa gravadas em Java e JavaScript. Procedimento armazenado em Java é um método Java publicado em SQL e armazenado no banco de dados para uso geral. Você pode chamar programas PL/SQL existentes de Java e JavaScript, e programas Java e JavaScript de PL/SQL.
O Multilingual Engine (MLE) oferece a capacidade de escrever lógica de negócios em JavaScript e armazenar o código no banco de dados como Módulos MLE. As funções exportadas por Módulos MLE podem ser expostas a SQL e PL/SQL por meio de Especificações de Chamada. Essas especificações de chamada são unidades PL/SQL (funções, procedimentos e pacotes) e podem ser chamadas em qualquer lugar em que o PL/SQL seja chamado.
Tópicos Relacionados
NoSQL APIs para Acesso a Documentos
O SODA (Simple Oracle Document Access) é um conjunto de APIs no estilo NoSQL para gerenciar coleções de documentos, particularmente documentos JSON, no Oracle AI Database. Os aplicativos podem criar coleções e inserir, recuperar, atualizar, excluir e consultar documentos sem exigir conhecimento de SQL ou do esquema de banco de dados subjacente.
O SODA fornece um modelo de programação centrado em documentos com base em coleções, documentos e filtros de consulta por exemplo. Isso é o oposto do SQL, que fornece uma interface declarativa e orientada a conjuntos para consultar e modificar dados relacionais e pode expressar junções, agregações e operações em vários tipos de dados.
O SODA é útil quando um aplicativo funciona principalmente com documentos JSON e requer uma API de documento simples, e pode ser uma alternativa para desenvolvedores que desejam usar uma API NoSQL.
Os desenvolvedores que portam cargas de trabalho de documentos para o banco de dados Oracle AI de um armazenamento de dados de terceiros de finalidade única têm a opção de usar a API de BD Mongo para o Oracle AI Database, que é semelhante à SODA, mas visa facilitar as migrações. No caso mais simples, a alteração da string de conexão da aplicação do armazenamento de dados de finalidade única para o Oracle AI Database é tudo o que precisa ser feito.
Gerenciador de Transação
O Oracle AI Database foi projetado como um banco de dados multiusuário. O banco de dados deve garantir que vários usuários possam trabalhar simultaneamente sem corromper os dados uns dos outros.
-
Transações Uma transação é uma unidade de trabalho lógica e atômica que contém uma ou mais instruções SQL.
-
Simultaneidade de Dados Um requisito de um RDBMS multiusuário é o controle da simultaneidade de dados, que é o acesso simultâneo dos mesmos dados por vários usuários.
-
Consistência de Dados No Oracle AI Database, cada usuário deve ver uma exibição consistente dos dados, incluindo alterações visíveis feitas pelas próprias transações de um usuário e transações confirmadas de outros usuários.
Transações
transaction é uma unidade de trabalho lógica e atômica que contém uma ou mais instruções SQL.
Um RDBMS deve ser capaz de agrupar instruções SQL de modo que todas sejam submetidas a commit, o que significa que são aplicadas ao banco de dados ou a rollback de todas elas, o que significa que são desfeitas.
Uma ilustração da necessidade de transações é uma transferência de fundos de uma conta poupança para uma conta corrente. A transferência consiste nas seguintes operações separadas:
-
Diminua a conta poupança.
-
Aumente a conta corrente.
-
Registre a transação no lançamento da transação.
O Oracle AI Database garante que todas as três operações sejam bem-sucedidas ou falhem como unidade. Por exemplo, se uma falha de hardware impedir a execução de uma instrução na transação, será necessário fazer rollback das outras instruções.
As transações são um recurso que diferencia o Oracle AI Database de um sistema de arquivos. Se você executar uma operação atômica que atualiza vários arquivos e se o sistema falhar no meio do caminho, os arquivos não serão consistentes. Por outro lado, uma transação move um banco de dados Oracle de um estado consistente para outro. O princípio básico de uma transação é "tudo ou nada": uma operação atômica consegue ou falha como um todo.
Tópicos Relacionados
Concorrência de Dados
Um requisito de um RDBMS multiusuário é o controle de simultaneidade de dados, que é o acesso simultâneo dos mesmos dados por vários usuários.
Sem controles de simultaneidade, os usuários poderiam alterar os dados de forma inadequada, comprometendo a integridade dos dados. Por exemplo, um usuário pode atualizar uma linha enquanto outro usuário a atualiza simultaneamente.
Se vários usuários acessam os mesmos dados, uma maneira de gerenciar a simultaneidade é fazer com que os usuários esperem. No entanto, o objetivo de um SGBD é reduzir o tempo de espera para que seja inexistente ou insignificante. Todas as instruções SQL que modificam dados devem continuar com o mínimo de interferência possível. Interações destrutivas, que são interações que atualizam dados incorretamente ou alteram estruturas de dados subjacentes, devem ser evitadas.
O Oracle AI Database usa bloqueios para controlar o acesso simultâneo aos dados. Um bloqueio é um mecanismo que impede a interação destrutiva entre transações que acessam um recurso compartilhado. Os bloqueios ajudam a garantir a integridade dos dados, permitindo o acesso simultâneo máximo aos dados.
Tópicos Relacionados
Consistência de Dados
No Oracle AI Database, cada usuário deve ver uma visão consistente dos dados, incluindo alterações visíveis feitas pelas próprias transações de um usuário e transações confirmadas de outros usuários.
Por exemplo, o banco de dados deve evitar o problema de leitura suja, que ocorre quando uma transação vê alterações não confirmadas feitas por outra transação concorrente.
O Oracle AI Database sempre impõe a consistência de leitura no nível de instrução, o que garante que os dados retornados por uma única consulta sejam confirmados e consistentes para um único ponto no tempo. Dependendo do nível de isolamento da transação, esse ponto é o horário em que o demonstrativo foi aberto ou o horário em que a transação começou. O recurso Oracle Flashback Query permite que você especifique esse ponto no tempo explicitamente.
O banco de dados também pode fornecer consistência de leitura para todas as consultas em uma transação, conhecida como consistência de leitura no nível da transação. Neste caso, cada instrução em uma transação vê dados do mesmo ponto no tempo, que é o momento em que a transação começou.
Tópicos Relacionados
Arquitetura do Oracle AI Database
Um servidor de banco de dados é a chave para o gerenciamento de informações.
Em geral, um servidor gerencia com segurança uma grande quantidade de dados em um ambiente multiusuário para que os usuários possam acessar simultaneamente os mesmos dados. Um servidor de banco de dados também impede o acesso não autorizado e fornece soluções eficientes para a recuperação de falhas.
-
Banco de Dados e Instância Um servidor de banco de dados Oracle consiste em um banco de dados e pelo menos uma instância de banco de dados, comumente chamada de simplesmente instância.
-
Estruturas de Armazenamento de Banco de Dados Um banco De dados pode ser considerado de uma perspectiva física e lógica.
-
Estruturas de Instância de Banco de Dados Um banco de dados Oracle usa estruturas e processos de memória para gerenciar e acessar o CDB. Todas as estruturas de memória existem na memória principal dos computadores que constituem o RDBMS.
-
Arquitetura de Aplicação e Rede Para aproveitar ao máximo um determinado sistema de computador ou rede, o Oracle AI Database permite que o processamento seja dividido entre o servidor de banco de dados e os programas clientes. O computador que executa o RDBMS lida com as responsabilidades do servidor de banco de dados enquanto os computadores que executam os aplicativos lidam com a interpretação e exibição de dados.
Banco de Dados e Instância
Um servidor de banco de dados Oracle consiste em um banco de dados e pelo menos uma instância de banco de dados, comumente chamada de simplesmente instância.
Como uma instância e um banco de dados estão tão intimamente conectados, o termo banco de dados Oracle às vezes se refere à instância e ao banco de dados. No sentido mais estrito, os termos têm os seguintes significados:
-
Banco de Dados
Um banco de dados é um conjunto de arquivos, localizado no disco, que armazenam dados do usuário. Esses arquivos de dados podem existir independentemente de uma instância de banco de dados. A partir do Oracle Database 21c, "banco de dados" refere-se especificamente aos arquivos de dados de um banco de dados contêiner (CDB) multitenant, banco de dados plugável (PDB) ou contêiner de aplicativos.
-
Instância de banco de dados
Instância é um conjunto nomeado de estruturas de memória que gerenciam arquivos de banco de Dados. Uma instância de banco de dados consiste em uma área de memória compartilhada, chamada de área global do sistema (SGA), e um conjunto de processos em segundo plano. Uma instância pode existir independentemente dos arquivos de banco de dados.
-
Arquitetura Multitenant A arquitetura multitenant permite que um Oracle AI Database seja um CDB.
-
Arquitetura de Banco de Dados Globalmente Distribuído O Oracle Globally Distributed Database (anteriormente chamado de Oracle Sharding) é uma técnica de dimensionamento de banco de dados baseada no particionamento horizontal de dados em vários PDBs. Os aplicativos percebem o pool de PDBs como um único banco de dados lógico. Cada partição é chamada de shard.
Arquitetura Multitenant
A arquitetura multitenant permite que um Oracle AI Database seja um CDB.
Cada Oracle AI Database deve conter ou ser capaz de ser contido por outro banco de dados. Por exemplo, um CDB contém PDBs e um contêiner de aplicativos contém PDBs de aplicativos. Um PDB é contido por um CDB ou contêiner de aplicativos, e um contêiner de aplicativos é contido por um CDB.
A partir do Oracle Database 21c, um banco de dados contêiner multitenant é a única arquitetura suportada. Em versões anteriores, os bancos de dados não contêineres (não CDBs) suportados pela Oracle.
-
Bancos de Dados Contêineres Um CDB contém um ou mais PDBs criados pelo usuário e contêineres de aplicativos.
-
Bancos de Dados Plugáveis Um PDB é uma coleção portátil de esquemas, objetos de esquema e objetos sem esquema que aparece em um aplicativo como um banco de dados separado.
-
Contêineres de Aplicativos Um contêiner de aplicativos é um contêiner opcional criado pelo usuário em um CDB que armazena dados e metadados para um ou mais aplicativos.
Bancos de Dados de Container
Um CDB contém um ou mais PDBs criados pelo usuário e contêineres de aplicativos.
No nível físico, um CDB é um conjunto de arquivos: arquivo de controle, arquivos de redo log on-line e arquivos de dados. A instância do banco de dados gerencia os arquivos que compõem o CDB.
A figura a seguir mostra um CDB e uma instância de banco de dados associada.
Figura 1: Instância do Banco de Dados e CDB
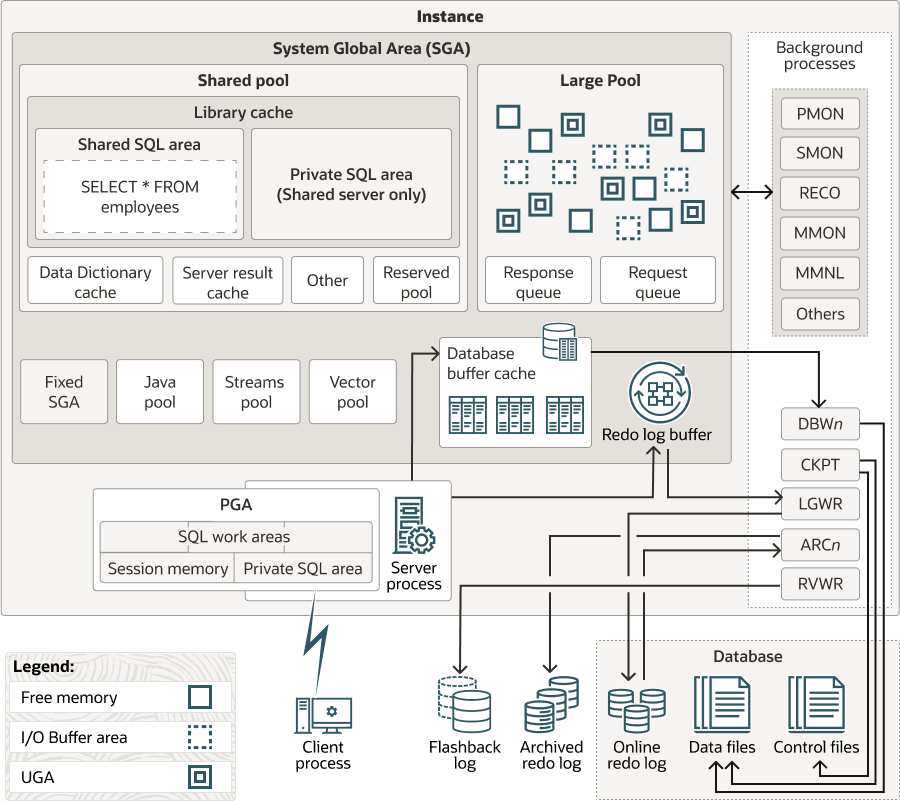
Descrição da ilustração cncpt233.png
Bancos de Dados Plugáveis
Um PDB é uma coleção portátil de esquemas, objetos de esquema e objetos sem esquema que aparece em um aplicativo como um banco de dados separado.
No nível físico, cada PDB tem seu próprio conjunto de arquivos de dados que armazenam os dados do PDB. O CDB inclui todos os arquivos de dados dos PDBs contidos nele e um conjunto de arquivos de dados do sistema que armazenam metadados do próprio CDB.
Para mover ou arquivar um PDB, você pode desconectá-lo. Um PDB desconectado consiste em arquivos de dados do PDB e um arquivo de metadados. Um PDB desconectado não poderá ser usado até que seja conectado a um CDB.
A figura a seguir mostra um CDB chamado MYCDB.
Figura 2: PDBs em um CDB
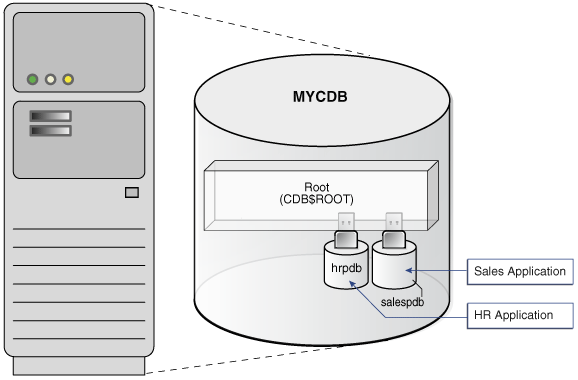
Descrição da ilustração cncpt352.png
Fisicamente, MYCDB é um Oracle AI Database, no sentido de um conjunto de arquivos de dados associados a uma instância. MYCDB tem uma instância de banco de dados, embora várias instâncias sejam possíveis no Oracle Real Application Clusters, e um conjunto de arquivos de banco de dados.
MYCDB contém duas PDBs: hrpdb e salespdb. Conforme mostrado na Figura 1-2, esses PDBs aparecem para seus respectivos aplicativos como bancos de dados separados e independentes. Um aplicativo não tem conhecimento de se está se conectando a um CDB ou PDB.
Para administrar o próprio CDB ou qualquer PDB dentro dele, você pode estabelecer conexão com a raiz do CDB. A raiz é um conjunto de esquemas, objetos de esquema e objetos sem esquema aos quais todos os PDBs e contêineres de aplicativos pertencem.
Contêineres de Aplicativos
Um contêiner de aplicativos é um contêiner opcional criado pelo usuário em um CDB que armazena dados e metadados para um ou mais aplicativos.
Nesse contexto, um aplicativo (também chamado de definição do aplicativo mestre) é um conjunto nomeado e controlado por versão de dados e metadados comuns armazenados na raiz do aplicativo. Por exemplo, o aplicativo pode incluir definições de tabelas, views, contas de usuário e pacotes PL/SQL que são comuns a um conjunto de PDBs.
De certa forma, um contêiner de aplicativos funciona como um CDB específico do aplicativo dentro de um CDB. Um contêiner de aplicativos, como o próprio CDB, pode incluir vários PDBs de aplicativos e permite que esses PDBs compartilhem metadados e dados. No nível físico, um contêiner de aplicativos tem seu próprio conjunto de arquivos de dados, assim como um PDB.
Por exemplo, uma implantação SaaS pode usar vários PDBs de aplicativo, cada um para um cliente separado, que compartilha metadados e dados de aplicativo. Por exemplo, na figura a seguir, sales_app é o modelo de aplicativo na raiz do aplicativo. O PDB de aplicativo chamado cust1_pdb contém dados de vendas apenas para o cliente 1, enquanto o PDB de aplicativo chamado cust2_pdb contém dados de vendas apenas para o cliente 2. Plugging, desplugging, clonagem e outras operações no nível do PDB estão disponíveis para PDBs de clientes individuais.
Figura 3: SaaS Caso de Uso
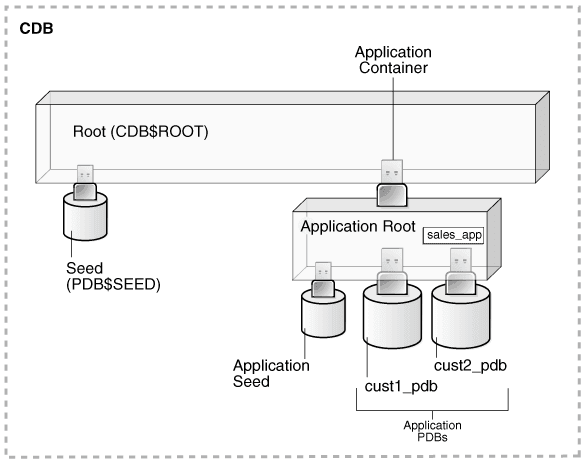
Descrição da ilustração cncpt389.png
Arquitetura de Banco de Dados Distribuído Globalmente
O Oracle Globally Distributed Database (anteriormente chamado de Oracle Sharding) é uma técnica de dimensionamento de banco de dados baseada no particionamento horizontal de dados em vários PDBs. Os aplicativos percebem o pool de PDBs como um único banco de dados lógico. Cada partição é chamada de shard.
Os principais benefícios do sharding para aplicações incluem escalabilidade linear, contenção de falhas e distribuição geográfica de dados. O Globally Distributed Database é adequado para implementação no Oracle Cloud. Ao contrário dos armazenamentos de dados NoSQL que implementam o sharding, o Globally Distributed Database oferece os benefícios do sharding sem sacrificar os recursos de um RDBMS corporativo.
Em uma arquitetura de sharding, cada CDB é hospedado em um servidor dedicado com seus próprios recursos locais: CPU, memória, flash ou disco. Você pode designar um PDB como um shard. Os shards do PDB de diferentes CDBs formam um único banco de dados lógico, que é chamado de banco de dados com sharding. Dois shards no mesmo CDB não podem ser membros do mesmo banco de dados com sharding. No entanto, dentro do mesmo CDB, um PDB pode estar em um banco de dados com sharding e outro PDB pode estar em um banco de dados com sharding separado.
O particionamento horizontal envolve a divisão de uma tabela de banco de dados entre shards para que cada shard contenha a tabela com as mesmas colunas, mas com um subconjunto diferente de linhas. Uma divisão de tabela dessa maneira também é conhecida como tabela fragmentada. A figura a seguir mostra uma tabela com shards particionada horizontalmente em três shards, cada um dos quais é um PDB em um CDB separado.
Figura 4: Particionamento horizontal de uma tabela entre fragmentos
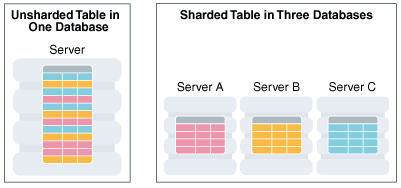
Descrição da ilustração admin_3v_134a.png
Um caso de uso é distribuir dados da conta do cliente entre vários CDBs. Por exemplo, um cliente com o ID 28459361 pode pesquisar seus registros. A figura a seguir mostra uma possível arquitetura. A solicitação do cliente é roteada por meio de um pool de conexões, em que os diretores de sharding ( listeners de rede) direcionam a solicitação para o shard do PDB apropriado, que contém todas as linhas do cliente.
Figura 5: Arquitetura do Oracle Globally Distributed Database
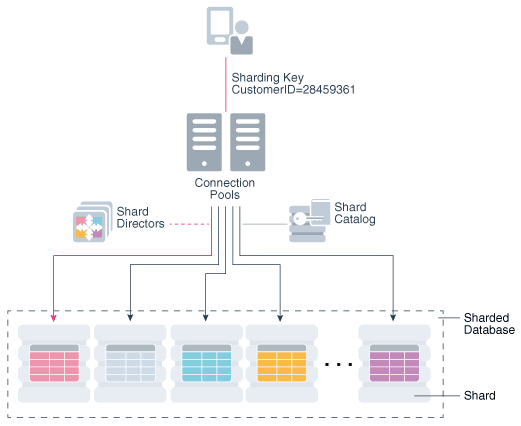
Descrição da ilustração admin_3v_143d.png
Tópicos Relacionados
Estruturas de Armazenamento de Banco de Dados
Um banco de dados pode ser considerado de uma perspectiva lógica e física.
Dados físicos são dados que podem ser visualizados no nível do sistema operacional. Por exemplo, utilitários do sistema operacional, como ls e ps do Linux, podem listar arquivos e processos do banco de dados. Os dados lógicos, como uma tabela, são significativos apenas para o banco de dados. Uma instrução SQL pode listar as tabelas em um banco de dados Oracle, mas um utilitário de sistema operacional não.
O banco de dados tem estruturas físicas e lógicas. Como as estruturas físicas e lógicas são separadas, você pode gerenciar o armazenamento físico de dados sem afetar o acesso a estruturas lógicas de armazenamento. Por exemplo, a renomeação de um arquivo de banco de dados físico não renomeia as tabelas cujos dados são armazenados nesse arquivo.
-
Estruturas de Armazenamento Físico As estruturas físicas do banco de dados são os arquivos que armazenam os dados.
-
Estruturas de Armazenamento Lógico As estruturas de armazenamento lógico permitem que o Oracle AI Database tenha um controle detalhado do uso do espaço em disco.
Estruturas de Armazenamento Físico
As estruturas físicas do banco de dados são os arquivos que armazenam os dados.
Ao executar um comando CREATE DATABASE, você cria um CDB. Os arquivos seguintes são criados:
-
Arquivos de dados
Cada CDB tem um ou mais arquivos de dados físicos, que contêm todos os dados do banco de dados. Os dados das estruturas lógicas de banco de dados, como tabelas e índices, são armazenados fisicamente nos arquivos de dados.
-
Arquivos de controle
Todo CDB tem um arquivo de controle. Um arquivo de controle contém metadados que especificam a estrutura física do banco de dados, incluindo o nome do banco de dados e os nomes e locais dos arquivos do banco de dados.
-
Arquivos de redo log on-line
Cada CDB tem um redo log on-line, que é um conjunto de dois ou mais arquivos de redo log on-line. Um redo log on-line é composto de entradas de redo (também chamadas de registros de redo log), que registram todas as alterações feitas nos dados.
Quando você executa um comando CREATE PLUGGABLE DATABASE em um CDB, cria um PDB. O PDB contém um conjunto dedicado de arquivos de dados no CDB. Um PDB não tem um arquivo de controle dedicado separado e um redo log on-line: esses arquivos são compartilhados pelos PDBs.
Muitos outros arquivos são importantes para o funcionamento de um CDB. Estes incluem arquivos de parâmetros e arquivos de rede. Os arquivos de backup e os arquivos de redo log arquivados são arquivos off-line importantes para backup e recuperação.
Tópicos Relacionados
Consulte Também: "Estruturas de Armazenamento Físico"
Estruturas Lógicas de Armazenamento
As estruturas de armazenamento lógico permitem que o Oracle AI Database tenha um controle detalhado do uso do espaço em disco.
Este tópico discute estruturas de armazenamento lógico:
-
Blocos de dados
No melhor nível de granularidade, os dados do Oracle AI Database são armazenados em blocos de dados. Um bloco de dados corresponde a um número específico de bytes em disco.
-
Extensões
Uma extensão é um número específico de bloqueios de dados logicamente contíguos, obtidos em uma única alocação, usados para armazenar um tipo específico de informação.
-
Segmentos
Um segmento é um conjunto de extensões alocadas para um objeto de usuário (por exemplo, uma tabela ou um índice), desfazer dados ou dados temporários.
-
Tablespaces
Um banco de dados é dividido em unidades de armazenamento lógico denominadas tablespaces. Um tablespace é o contêiner lógico para segmentos. Cada tablespace consiste em pelo menos um arquivo de dados.
Tópicos Relacionados
Estruturas de Instância do Banco de Dados
Um banco de dados Oracle usa estruturas e processos de memória para gerenciar e acessar o CDB. Todas as estruturas de memória existem na memória principal dos computadores que constituem o RDBMS.
Quando os aplicativos se conectam a um CDB ou PDB, eles se conectam a uma instância do banco de dados. A instância atende aos aplicativos alocando outras áreas de memória, além da SGA, e iniciando outros processos, além de processos em segundo plano.
-
Processos do Oracle AI Database Processo é um mecanismo em um sistema operacional que pode executar uma série de etapas. Alguns sistemas operacionais usam os termos job, task ou thread.
-
Estruturas de Memória da Instância O Oracle AI Database cria e usa estruturas de memória para código de programa, dados compartilhados entre usuários e áreas de dados privadas para cada usuário conectado.
Processos do Oracle AI Database
Processo é um mecanismo em um sistema operacional que pode executar uma série de etapas. Alguns sistemas operacionais usam os termos job, task ou thread.
Para os fins deste tópico, um thread é equivalente a um processo. Uma instância de banco de dados Oracle tem os seguintes tipos de processos:
-
Processos do cliente
Esses processos são criados e mantidos para executar o código de software de um programa aplicativo ou uma ferramenta Oracle. A maioria dos ambientes tem computadores separados para processos do cliente.
-
Processos em segundo plano
Esses processos consolidam funções que, de outra forma, seriam tratadas por vários programas Oracle AI Database em execução para cada processo de cliente. Os processos em segundo plano executam E/S de forma assíncrona e monitoram outros processos do Oracle AI Database para fornecer maior paralelismo e maior desempenho e confiabilidade.
-
Processos de servidor
Esses processos se comunicam com os processos do cliente e interagem com o Oracle AI Database para atender às solicitações.
Os processos da Oracle incluem processos de servidor e processos em segundo plano. Na maioria dos ambientes, os processos da Oracle e os processos do cliente são executados em computadores separados.
Tópicos Relacionados
Estruturas de Memória da Instância
O Oracle AI Database cria e usa estruturas de memória para código de programa, dados compartilhados entre usuários e áreas de dados privadas para cada usuário conectado.
As seguintes estruturas de memória estão associadas a uma instância do banco de dados:
-
SGA (System Global Area)
A SGA é um grupo de estruturas da memória compartilhada que contêm dados e informações de controle para uma instância do banco de dados. Exemplos de componentes SGA incluem o cache de buffer do banco de dados e áreas SQL compartilhadas. A SGA pode conter um Armazenamento de Colunas na Memória opcional (armazenamento de colunas do IM), que permite que os dados sejam preenchidos na memória em um formato de coluna.
-
PGA (Program Global Areas, Áreas Globais do Programa)
Uma PGA é uma região de memória que contém dados e informações de controle para um servidor ou processo em segundo plano. O acesso ao PGA é exclusivo do processo. Cada processo de servidor e processo em segundo plano tem seu próprio PGA.
Tópicos Relacionados
Arquitetura de Aplicativos e Redes
Para aproveitar ao máximo um determinado sistema de computador ou rede, o Oracle AI Database permite que o processamento seja dividido entre o servidor de banco de dados e os programas clientes. O computador que executa o RDBMS lida com as responsabilidades do servidor de banco de dados enquanto os computadores que executam os aplicativos lidam com a interpretação e exibição de dados.
-
Arquitetura de Aplicativo A arquitetura de aplicativo é o ambiente de computação no qual um aplicativo de banco de dados se conecta a um banco de dados Oracle. As duas arquiteturas de banco de dados mais comuns são cliente/servidor e multicamada.
-
Arquitetura do Oracle Net Services
Oracle Net Services é a interface entre o banco de dados e os protocolos de comunicação de rede que facilitam o processamento distribuído e os bancos de dados distribuídos.
Arquitetura da Aplicação
A arquitetura do aplicativo é o ambiente de computação no qual um aplicativo de banco de dados se conecta a um banco de dados Oracle. As duas arquiteturas de banco de dados mais comuns são cliente/servidor e multicamada.
Arquitetura Cliente-Servidor
Em uma arquitetura cliente/servidor, o aplicativo cliente inicia uma solicitação para que uma operação seja executada no servidor de banco de dados. O servidor executa o software Oracle AI Database e trata as funções necessárias para acesso simultâneo a dados compartilhados. O servidor recebe e processa solicitações que se originam de clientes.
Arquitetura Multicamadas
Em uma arquitetura multicamadas, um ou mais servidores de aplicativos executam partes da operação. Um servidor de aplicativos contém uma grande parte da lógica do aplicativo, fornece acesso aos dados do cliente e executa algum processamento de consulta. Dessa forma, a carga no banco de dados diminui. O servidor de aplicações pode servir como uma interface entre clientes e vários bancos de dados e fornecer um nível adicional de segurança.
Uma arquitetura orientada a serviços (SOA) é uma arquitetura multicamadas na qual a funcionalidade do aplicativo é encapsulada em serviços. Os serviços SOA geralmente são implementados como Web services. Os serviços Web são acessíveis através de HTTP e são baseados em padrões baseados em XML, como Web Services Description Language (WSDL) e SOAP. O Oracle AI Database pode atuar como um provedor de serviços Web em um ambiente tradicional de várias camadas ou SOA.
Uma arquitetura de microsserviços divide um aplicativo em serviços pequenos, desenvolvidos e implantados de forma independente. Cada serviço possui sua lógica de negócios e, idealmente, seus dados, reduzindo o acoplamento e permitindo que as equipes dimensionem, atualizem e operem serviços de forma independente.
A arquitetura multitenant da Oracle é mapeada naturalmente para o padrão de banco de dados por serviço. Cada microsserviço pode usar seu próprio banco de dados plugável (PDB), fornecendo dados, segurança e limite administrativo separados, enquanto vários PDBs compartilham os recursos de um CDB (banco de dados contêiner) comum.
Essa abordagem combina isolamento de serviço com consolidação eficiente. Os PDBs podem ser provisionados, clonados, corrigidos, submetidos a backup, realocados e dimensionados de forma independente, enquanto os administradores mantêm o controle centralizado da infraestrutura de banco de dados subjacente.
Tópicos Relacionados
Arquitetura do Oracle Net Services
Oracle Net Services são a interface entre o banco de dados e os protocolos de comunicação de rede que facilitam o processamento distribuído e os bancos de dados distribuídos.
Os protocolos de comunicação definem a forma como os dados são transmitidos e recebidos em uma rede. O Oracle Net Services suporta comunicações em todos os principais protocolos de rede, incluindo TCP/IP, HTTP, FTP e WebDAV. Oracle Net, um componente do Oracle Net Services, estabelece e mantém uma sessão de rede de um aplicativo cliente para um servidor de banco de dados. Depois que uma sessão de rede é estabelecida, o Oracle Net atua como o courier de dados para o aplicativo cliente e o servidor de banco de dados, o que faz a troca de mensagens entre os usuários. O Oracle Net não pode executar esses jobs porque ele está localizado em cada computador da rede.
Um componente importante dos Serviços de Rede é o Oracle Net Listener (chamado de listener), que é um processo executado no banco de dados ou em outro lugar da rede. Os aplicativos cliente enviam solicitações de conexão ao listener, que gerencia o tráfego dessas solicitações para o banco de dados. Quando uma conexão é estabelecida, o cliente e o banco de dados se comunicam diretamente.
Oracle REST Data Services
O ORDS (Oracle REST Data Services) fornece um gateway HTTPS para o Oracle AI Database. Ele permite que os aplicativos exponham tabelas, views, procedimentos armazenados gravados em PL/SQL, JavaScript e Java, além de operações de banco de dados personalizadas como APIs REST seguras, geralmente sem exigir um servidor de aplicativos separado ou um código de middleware extenso.
O ORDS também suporta a Oracle Database API for MongoDB, permitindo que os aplicativos usem drivers, ferramentas e comandos MongoDB compatíveis para acessar coleções de documentos JSON armazenadas no Oracle Database. O protocolo de conexão MongoDB é convertido em operações de banco de dados por meio do ORDS, permitindo que aplicativos REST, MongoDB e SQL trabalhem com dados gerenciados pelo mesmo banco de dados convergente.
Tópicos Relacionados