Estruturas de Armazenamento Físico
As estruturas físicas do banco de dados Oracle são visíveis no nível do sistema operacional.
-
Introdução a Estruturas de Armazenamento Físico Uma característica de um RDBMS é a independência de estruturas de dados lógicas, como tabelas, views e índices de estruturas de armazenamento físico, como arquivos.
-
Visão Geral dos Arquivos de Dados No nível do sistema operacional, o Oracle AI Database armazena dados em estruturas chamadas arquivos de dados. Cada banco de dados Oracle, seja um CDB ou PDB, deve ter pelo menos um arquivo de dados.
-
Visão Geral dos Arquivos de Controle O arquivo de controle do banco de Dados é um pequeno arquivo binário associado a apenas um CDB.
-
Visão Geral do Redo Log On-line A estrutura mais crucial para a recuperação é o redo log on-line, que consiste em dois ou mais arquivos pré-alocados que armazenam alterações no banco de dados à medida que elas ocorrem. Os registros de redo log on-line são alterados nos arquivos de dados.
Introdução a Estruturas de Armazenamento Físico
Uma característica de um RDBMS é a independência de estruturas de dados lógicas, como tabelas, views e índices, de estruturas de armazenamento físico, como arquivos.
Como as estruturas físicas e lógicas são separadas, você pode gerenciar o armazenamento físico de dados sem afetar o acesso a elas. Por exemplo, a renomeação de um arquivo de banco de dados não renomeia as tabelas armazenadas nele.
Um banco de dados do sistema Oracle é um conjunto de arquivos que armazenam dados do sistema Oracle em armazenamento persistente. A partir do Oracle Database 21c, um banco de dados contêiner (CDB) multitenant é a única arquitetura suportada. Um CDB contém um ou mais PDBs.
Esta seção descreve os arquivos de banco de dados gerados quando você executa uma instrução CREATE DATABASE para criar um CDB:
-
Arquivos de dados e temporários
Arquivo de dados é um arquivo físico em armazenamento persistente que foi criado pelo Oracle AI Database e contém estruturas de dados, como tabelas e índices. Um arquivo de temperatura é um arquivo de dados que pertence a um tablespace temporário. O banco de dados grava dados nesses arquivos em um formato proprietário do sistema Oracle que não pode ser lido por outros programas.
Quando você cria um PDB em um PDB, esse PDB tem seu próprio conjunto de arquivos de dados dentro do conjunto geral de arquivos de dados que compõem o CDB. Por exemplo, você pode criar um CDB chamado
mycdbe, em seguida, criar dois PDBs nele:hrpdbesalespdb. Nesse caso, omycdbteria seu próprio conjunto de arquivos de dados e arquivos temporários, comohrpdbesalespdb. -
Arquivos de controle
arquivo de controle é um arquivo raiz que rastreia os componentes físicos do CDB. Os PDBs não têm seus próprios arquivos de controle separados.
-
Arquivos de redo log on-line
O log de redo on-line é um conjunto de arquivos que contêm registros de alterações feitas nos dados do CDB. Os PDBs não têm seus próprios arquivos de redo log on-line separados.
Instância do banco de dados é um conjunto de estruturas de memória que gerenciam arquivos de banco de dados em um CDB. O gráfico a seguir mostra a relação entre a instância e os arquivos que ela gerencia.
Figura 1: Instância do Banco de Dados e Arquivos do Banco de Dados
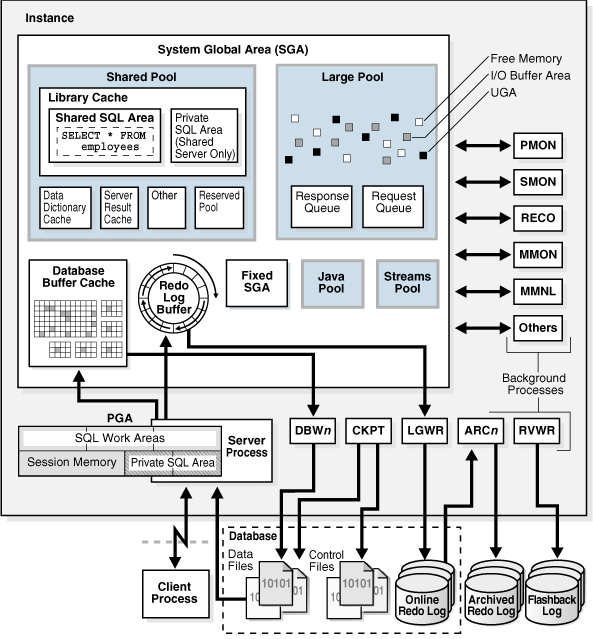
Descrição da ilustração cncpt223.gif
-
Mecanismos para Armazenar Arquivos de Banco de Dados Vários mecanismos estão disponíveis para alocar e gerenciar o armazenamento desses arquivos.
-
Arquivos Gerenciados pela Oracle e Arquivos Gerenciados pelo Usuário Arquivos Gerenciados pela Oracle é uma estratégia de nomeação de arquivos que permite especificar operações em termos de objetos de banco de dados em vez de nomes de arquivos. Por exemplo, você pode criar um tablespace sem especificar os nomes de seus arquivos de dados.
-
Oracle Automatic Storage Management (Oracle ASM) O Oracle ASM é uma solução de armazenamento de alto desempenho e fácil gerenciamento para arquivos do Oracle AI Database. O Oracle ASM é um gerenciador de volumes e fornece um sistema de arquivos projetado exclusivamente para uso pelo banco de dados.
-
O PMEM do Armazenamento de Arquivos de Memória Persistente da Oracle (PMEM Filestore) é memória persistente endereçável por bytes. O Oracle Persistent Memory Filestore (PMEM Filestore) pode armazenar arquivos de dados, arquivos de redo log on-line e arquivos de controle.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a criar um banco de dados
-
Referência de Linguagem SQL do Oracle AI Database para semântica e sintaxe
CREATE DATABASE
Mecanismos para Armazenar Arquivos de Banco de Dados
Diversos mecanismos estão disponíveis para alocar e gerenciar o armazenamento desses arquivos.
Os mecanismos incluem:
-
Sistema de arquivos do sistema operacional
A maioria dos bancos de dados Oracle armazena arquivos em um sistema de arquivos, que é uma estrutura para armazenar e recuperar dados.
Um sistema de arquivos permite que o espaço de armazenamento seja usado para dados de aplicativos de maneira padrão e consistente. Cada arquivo tem um nome e aparece como um espaço de endereço contíguo para aplicativos como o Oracle AI Database. O banco de dados pode criar, ler, gravar, redimensionar e excluir arquivos.
Um sistema de arquivos é comumente construído sobre um volume lógico construído por um pacote de software chamado LVM (logical volume manager). O LVM permite que partes de vários discos físicos se combinem no que aparece como um único espaço de endereço contíguo.
-
Sistema de arquivos de clusters
Um sistema de arquivos cluster é um sistema de arquivos distribuído que é um cluster de servidores que colaboram para fornecer consistência e alto desempenho aos seus clientes. Em um ambiente Oracle RAC, um sistema de arquivos de cluster faz com que o armazenamento compartilhado apareça como um sistema de arquivos compartilhado por muitos computadores em um ambiente em cluster. Com um sistema de arquivos de cluster, a falha de um computador no cluster não torna o sistema de arquivos indisponível. Em um sistema de arquivos do sistema operacional, no entanto, se um computador que compartilha arquivos por meio de NFS ou outros meios falhar, o sistema de arquivos ficará indisponível.
-
Armazenamento de Arquivos de Memória Persistente da Oracle (Armazenamento de Arquivos PMEM)
O PMEM Filestore foi projetado para armazenar arquivos de banco de dados em Memória Persistente (PMEM), que é memória persistente endereçável por bytes. Você cria um armazenamento de arquivos usando o comando
CREATE PMEM FILESTORE. No nível do sistema operacional Linux, o armazenamento de arquivos armazena dados em um sistema de arquivos ext4 grande montado no modofsdax. O PMEM Filestore aparece no Oracle AI Database como um sistema de arquivos nativo no Linux.Observação: Ao contrário de um sistema de arquivos compatível com POSIX, o Armazenamento de Arquivos PMEM não pode ser compartilhado por vários bancos de dados Oracle.
-
Oracle Automatic Storage Management (Oracle ASM)
O Oracle ASM inclui um sistema de arquivos projetado exclusivamente para uso pelo Oracle AI Database.
Um banco de dados pode usar uma combinação dos mecanismos de armazenamento anteriores. Por exemplo, um banco de dados pode armazenar o arquivo de parâmetros do servidor em um sistema de arquivos tradicional, armazenar arquivos de banco de dados no PMEM Filestore e, em seguida, arquivar os arquivos de redo log em um sistema de arquivos de cluster.
Consulte Também:
-
Oracle AI Database Administrator's Guide para exibir estruturas de armazenamento de banco de dados consultando views de banco de dados
Arquivos Gerenciados pela Oracle e Arquivos Gerenciados pelo Usuário
Oracle Managed Files é uma estratégia de nomeação de arquivo que permite especificar operações em termos de objetos de banco de dados em vez de nomes de arquivo. Por exemplo, você pode criar um tablespace sem especificar os nomes de seus arquivos de dados.
O Oracle Managed Files elimina a necessidade de os administradores gerenciarem diretamente os arquivos do sistema operacional em um banco de dados. O Oracle ASM requer Arquivos Gerenciados da Oracle.
Observação: esse recurso não afeta a criação ou a nomeação de arquivos administrativos, como arquivos de rastreamento, arquivos de auditoria e logs de alerta.
Com arquivos gerenciados pelo usuário, você gerencia diretamente os arquivos do sistema operacional no banco de dados. Você toma as decisões relacionadas à estrutura e ao nome do arquivo. Por exemplo, ao criar um tablespace, você define o nome e o caminho dos arquivos de dados do tablespace.
Por meio de parâmetros de inicialização, você especifica o diretório do sistema de arquivos para um tipo específico de arquivo. O recurso Arquivos Gerenciados da Oracle garante que o banco de dados crie um arquivo exclusivo e o exclua quando não for mais necessário. O banco de dados usa internamente interfaces de sistema de arquivos padrão para criar e excluir arquivos de dados e arquivos temporários, arquivos de controle e arquivos relacionados à recuperação armazenados na área de recuperação rápida.
O Oracle Managed Files não elimina a funcionalidade existente. Você pode criar novos arquivos ao administrar manualmente os arquivos antigos. Assim, um banco de dados pode ter uma mistura de Arquivos Gerenciados Oracle e arquivos gerenciados pelo usuário.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber como usar os Oracle Managed Files
Oracle Automatic Storage Management (Oracle ASM)
O Oracle ASM é uma solução de armazenamento de alto desempenho e facilidade de gerenciamento para arquivos do Oracle AI Database. O Oracle ASM é um gerenciador de volumes e fornece um sistema de arquivos projetado exclusivamente para uso pelo banco de dados.
O Oracle ASM oferece várias vantagens sobre os sistemas de arquivos convencionais e os gerenciadores de armazenamento, incluindo:
-
Simplifica tarefas relacionadas ao armazenamento, como criar e estabelecer bancos de dados e gerenciar espaço em disco
-
Distribui dados entre discos físicos para eliminar hot spots e fornecer desempenho uniforme entre os discos
-
Rebalanceia os dados automaticamente após alterações na configuração de armazenamento
Para usar o Oracle ASM, você aloca discos particionados para o Oracle AI Database com preferências para striping e espelhamento. O Oracle ASM gerencia o espaço em disco, distribuindo a carga de E/S entre todos os recursos disponíveis para otimizar o desempenho e, ao mesmo tempo, eliminar a necessidade de ajuste manual de E/S. Por exemplo, você pode aumentar o tamanho do disco para o banco de dados ou mover partes do banco de dados para novos dispositivos sem precisar fazer shutdown do banco de dados.
-
Componentes de Armazenamento do Oracle ASM O Oracle AI Database pode armazenar um arquivo de dados como um arquivo Oracle ASM em um grupo de discos do Oracle ASM. Dentro de um grupo de discos, o Oracle ASM expõe uma interface de sistema de arquivos para arquivos de banco de dados.
-
Instâncias do Oracle ASM Uma instância do Oracle ASM é uma instância especial do Oracle que gerencia discos do Oracle ASM.
Componentes de Armazenamento do Oracle ASM
O Oracle AI Database pode armazenar um arquivo de dados como um arquivo Oracle ASM em um grupo de discos do Oracle ASM. Dentro de um grupo de discos, o Oracle ASM expõe uma interface de sistema de arquivos para arquivos de banco de dados.
A figura a seguir mostra os relacionamentos entre os componentes de armazenamento em um banco de dados que usa o Oracle ASM. O diagrama ilustra o relacionamento entre um arquivo do Oracle ASM e um arquivo de dados, embora o Oracle ASM possa armazenar outros tipos de arquivos. a notação pés-de-galinha representa um relacionamento de um para muitos.
Figura 2: Componentes do Oracle ASM
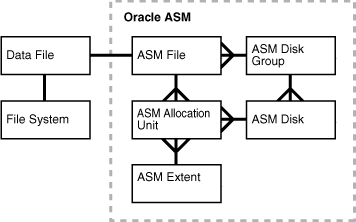
Descrição da ilustração cncpt267.gif
A Figura 14-2 ilustra os seguintes conceitos do Oracle ASM:
-
Discos do Oracle ASM
Um disco Oracle ASM é um dispositivo de armazenamento que é provisionado para um grupo de discos Oracle ASM. Um disco do Oracle ASM pode ser um disco físico ou uma partição, um LUN (Número de Unidade Lógica) de uma matriz de armazenamento, um volume lógico ou um arquivo anexado à rede.
É possível adicionar ou eliminar discos do Oracle ASM de um grupo enquanto o banco de dados está em execução. Ao adicionar um disco a um grupo de discos, você designa um nome de disco ou o disco recebe um nome de disco do Oracle ASM automaticamente.
-
Grupos de Discos do Oracle ASM
Um grupo de discos do Oracle ASM é um conjunto de discos do Oracle ASM gerenciados como uma unidade lógica. As estruturas dos dados em um grupo são autossuficientes e consomem algum espaço em disco em um grupo.
Em um grupo de discos, o Oracle ASM expõe uma interface de sistema de arquivos para arquivos de banco de dados Oracle. O conteúdo dos arquivos armazenados em um grupo de discos é distribuído uniformemente, ou distribuído, para eliminar hot spots e fornecer desempenho uniforme em todos os discos.
-
Arquivos do Oracle ASM
Arquivo Oracle ASM é um arquivo armazenado em um grupo de discos do Oracle ASM. O Oracle AI Database se comunica com o Oracle ASM em termos de arquivos. O banco de dados pode armazenar arquivos de dados, arquivos de controle, arquivos de redo log on-line e outros tipos de arquivos como arquivos do Oracle ASM. Quando solicitado pelo banco de dados, o Oracle ASM cria um arquivo do Oracle ASM e designa a ele um nome que começa com um sinal de mais (
+) seguido por um nome de grupo de discos, como em+DISK1.Observação: os arquivos do Oracle ASM podem coexistir com outras opções de gerenciamento de armazenamento, como sistemas de arquivos de terceiros. Esse recurso simplifica a integração do Oracle ASM em ambientes pré-existentes.
-
Extensões do Oracle ASM
Uma extensão do Oracle ASM é uma seção de um arquivo do Oracle ASM. Um arquivo ASM consiste de uma ou mais extensões. Cada extensão do Oracle ASM consiste em uma ou mais unidades de alocação em um disco específico.
Observação: Uma extensão do Oracle ASM é diferente da extensão usada para armazenar dados em um segmento.
-
Unidades de Alocação do Oracle ASM
Uma unidade de alocação do Oracle ASM é a unidade fundamental de alocação em um grupo de discos. Uma unidade de alocação é o menor espaço em disco contíguo que o Oracle ASM aloca. Uma ou mais unidades de alocação formam uma extensão do Oracle ASM.
Consulte Também: Oracle Automatic Storage Management Administrator's Guide para saber mais sobre o Oracle ASM
Instâncias do Oracle ASM
Uma instância do Oracle ASM é uma instância especial do Oracle que gerencia discos do Oracle ASM.
As instâncias do Oracle ASM e do banco de dados exigem acesso compartilhado aos discos em um grupo de discos do Oracle ASM. As instâncias do Oracle ASM gerenciam os metadados do grupo de discos e fornecem informações de layout de arquivo para as instâncias do banco de dados. As instâncias de banco de dados direcionam E/S para discos do Oracle ASM sem passar por uma instância do Oracle ASM.
Uma instância do Oracle ASM é criada com a mesma tecnologia de uma instância de banco de dados. Por exemplo, uma instância do Oracle ASM tem uma área global do sistema (SGA) e processos em segundo plano semelhantes aos de uma instância do banco de dados. No entanto, uma instância do Oracle ASM não pode montar um banco de dados e executar menos tarefas do que uma instância do banco de dados. A Figura 14-3 mostra uma configuração de nó único com uma instância do Oracle ASM e duas instâncias de banco de dados, cada uma associada a um banco de dados de instância única diferente. A instância do Oracle ASM gerencia os metadados e fornece alocação de espaço para os arquivos do Oracle ASM que armazenam os dados dos dois bancos de dados. Um grupo de discos do Oracle ASM tem quatro discos do Oracle ASM e o outro tem dois discos. Ambas as instâncias de banco de dados podem acessar os grupos de discos.
Figura 3: Instância do Oracle ASM e Instâncias do Banco de Dados
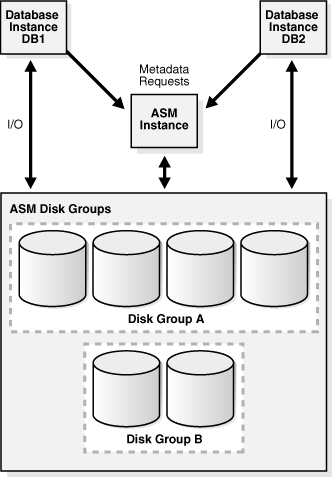
Descrição da ilustração cncpt266.gif
Consulte Também: Oracle Automatic Storage Management Administrator's Guide para saber mais sobre o Oracle ASM
Armazenamento de Arquivos de Memória Persistente da Oracle (Armazenamento de Arquivos PMEM)
PMEM é memória persistente endereçável por bytes. O Oracle Persistent Memory Filestore (PMEM Filestore) pode armazenar arquivos de dados, arquivos de redo log on-line e arquivos de controle.
As consultas podem ler bytes diretamente do PMEM sem primeiro migrar blocos para o cache do buffer do banco de dados. Este mecanismo de alto desempenho evita redundância de dados e E/S desnecessária. Observação: Um armazenamento de arquivos PMEM não pode armazenar arquivos de rastreamento, arquivos de auditoria ou arquivos de parâmetros do servidor. Os tipos de arquivo suportados para PMEM são semelhantes aos tipos do Oracle ASM.
-
Cache de Buffer Mapeado Diretamente Na pirâmide de armazenamento tradicional, o PMEM fica entre o DRAM, que é não persistente, e o Flash, que é persistente (não volátil).
-
A Interface do Sistema de Arquivos para PMEM Filestore PMEM Filestore implementa um protocolo chamado Filesystem in Userspace (FUSE).
-
Interface do Usuário para o Armazenamento de Arquivos PMEM Para criar um armazenamento de arquivos PMEM, use o comando
CREATE PMEM FILESTORE.
Cache de Buffer Mapeado Diretamente
Na pirâmide de armazenamento tradicional, PMEM fica entre DRAM, que é não persistente, e Flash, que é persistente (não volátil).
Figura 4: Pirâmide de armazenamento
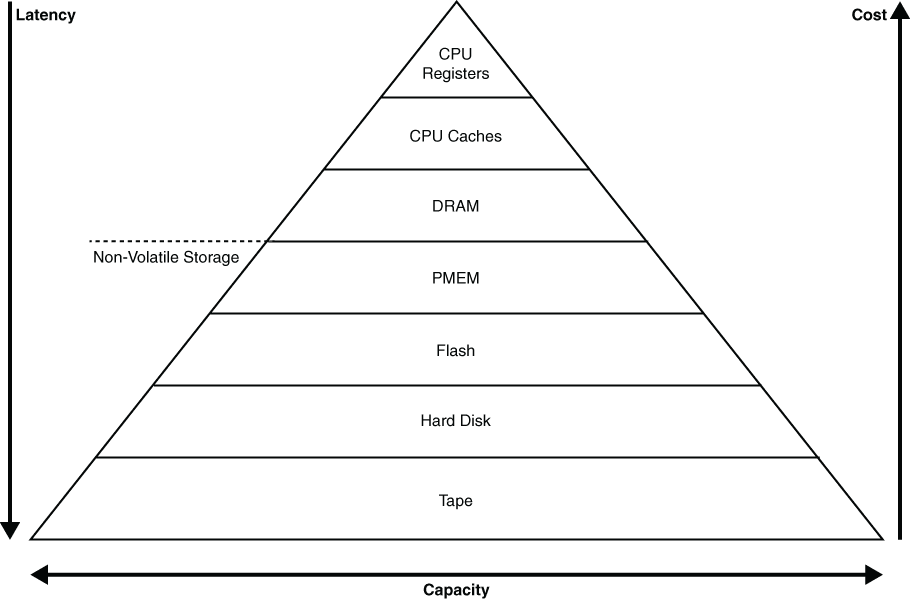
Descrição da ilustração pmem.png,
O cache do buffer do banco de dados reside no DRAM. Os processos Oracle têm acesso direto endereçável a bytes a blocos em um armazenamento de arquivos PMEM, que são mapeados para o cache de buffer do banco de dados. O mecanismo de mapeamento é chamado automaticamente quando você coloca um arquivo de dados em um armazenamento de arquivos PMEM.
O Oracle AI Database usa um algoritmo interno para decidir se deseja migrar blocos de dados do armazenamento de arquivos PMEM para DRAM. Os motivos comuns para migração incluem modificações de DML, consistência de leitura e acesso mais rápido para blocos de dados em funcionamento.
Consulte Também: "Buffers DRAM e PMEM"
Interface do Sistema de Arquivos para Armazenamento de Arquivos PMEM
O PMEM Filestore implementa um protocolo chamado Filesystem in Userspace (FUSE).
O FUSE permite que usuários não privilegiados do sistema operacional, como o proprietário do software Oracle AI Database, criem e gerenciem sistemas de arquivos e os diretórios e arquivos dentro deles. Por exemplo, você pode usar os comandos cp, rm e ls.
Um sistema de arquivos típico usa armazenamento bruto como seu armazenamento de apoio, enquanto o PMEM Filestore obtém armazenamento de um arquivo de sistema operacional nativo em um sistema de arquivos DAX PMEM. Esse arquivo é chamado de arquivo de backup e é visível como um arquivo no sistema operacional. O PMEM Filestore subdivide o armazenamento dentro do arquivo de apoio e o apresenta como um sistema de arquivos local.
Consulte Também:
- Oracle AI Database Administrator's Guide para saber mais sobre PMEM Filestore
Interface do Usuário para Armazenamento de Arquivos PMEM
Para criar um armazenamento de arquivos PMEM, use o comando CREATE PMEM FILESTORE.
O armazenamento de arquivos PMEM é montado automaticamente após sua criação. O armazenamento de arquivos PMEM aparece sob o ponto de montagem especificado como se fosse um sistema de arquivos nativo.
O parâmetro de inicialização PMEM_FILESTORE especifica um armazenamento de arquivos PMEM que a instância do banco de dados monta automaticamente quando é iniciada. O parâmetro é definido como um par de strings ordenadas. A primeira string na lista de valores de parâmetro é o diretório em que o PMEM Filestore está montado. A segunda string é o arquivo de apoio.
V$PMEM_FILESTORE mostra metadados sobre um armazenamento de arquivos PMEM. Por exemplo, você pode visualizar o caminho do diretório do ponto de montagem, o caminho do arquivo de apoio e o tamanho do armazenamento de arquivos.
Consulte Também: Oracle AI Database Administrator's Guide para saber como criar e gerenciar um armazenamento de arquivos PMEM
Visão Geral de Arquivos de Dados
No nível do sistema operacional, o Oracle AI Database armazena dados em estruturas chamadas arquivos de dados. Cada banco de dados Oracle, seja um CDB ou PDB, deve ter pelo menos um arquivo de dados.
-
Uso de Arquivos de Dados O Oracle AI Database armazena fisicamente dados de tablespace em arquivos de dados.
-
Arquivos de Dados Permanentes e Temporários Um tablespace permanente contém objetos de esquema persistentes. Os objetos em tablespaces permanentes são armazenados em arquivos de dados.
-
Arquivos de Dados On-line e Off-line Cada arquivo de dados está on-line (disponível) ou off-line (indisponível).
-
Estrutura do Arquivo de Dados O Oracle AI Database cria um arquivo de dados para um tablespace alocando o volume especificado de espaço em disco mais a sobrecarga do cabeçalho do arquivo de dados. O sistema operacional no qual o Oracle AI Database é executado é responsável por limpar informações e autorizações antigas de um arquivo antes de alocá-lo no banco de dados.
Uso de Arquivos de Dados
O Oracle AI Database armazena fisicamente dados de tablespace em arquivos de dados.
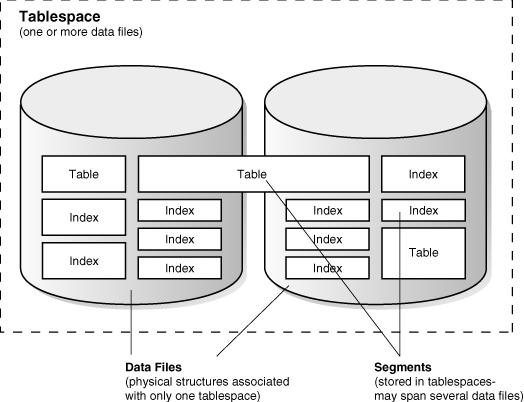
Cada objeto de esquema não particionado e cada partição de um objeto são armazenados em seu próprio segmento, que pertence a apenas um tablespace. Por exemplo, os dados de uma tabela não particionada são armazenados em um único segmento, que, por sua vez, é armazenado em um tablespace. Os tablespaces e arquivos do dados estão intimamente relacionados, mas têm diferenças importantes:
-
Cada tablespace consiste em um ou mais arquivos de dados, que se conformam ao sistema operacional no qual o Oracle AI Database está sendo executado.
-
Os dados de uma base de dados estão coletivamente armazenados nos arquivos localizados em cada tablespace da base de dados.
-
Um segmento pode abranger um ou mais arquivos de dados, mas não pode abranger vários tablespaces.
-
Um CDB deve ter as tabelas
SYSTEMeSYSAUX. Cada PDB em um CDB tem seus próprios tablespacesSYSTEMeSYSAUX. O Oracle AI Database aloca automaticamente os primeiros arquivos de dados de qualquer banco de dados para o tablespaceSYSTEMdurante as criações do banco de dados.O tablespace
SYSTEMcontém o dicionário de dados, um conjunto de tabelas que contém metadados de banco de dados. Normalmente, um banco de dados também tem um desfazer tablespace e um tablespace temporário (geralmente denominadoTEMP).
A figura a seguir mostra o relacionamento entre tablespaces, arquivos de dados e segmentos.
Figura 5: Arquivos de Dados e Tablespaces
Descrição da ilustração cncpt037.gif
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a gerenciar arquivos de dados
Arquivos de Dados Permanentes e Temporários
Um tablespace permanente contém objetos de esquema persistentes. Os objetos em tablespaces permanentes são armazenados em arquivos de dados.
Um tablespace temporário contém objetos de esquema somente pela duração de uma sessão. Os tablespaces temporários gerenciados localmente têm arquivos temporários (arquivos de temperatura), que são arquivos especiais projetados para armazenar dados em hash, classificação e outras operações. Os arquivos temporários também armazenam dados do conjunto de resultados quando há espaço insuficiente na memória.
Os arquivos temporários são semelhantes aos arquivos de dados permanentes, com as seguintes exceções:
-
Objetos de banco de dados permanente, como tabelas, nunca são armazenados em arquivos temporários.
-
Os arquivos temporários são sempre definidos para o modo
NOLOGGING, o que significa que eles nunca têm um redo gerado para eles. A recuperação de mídia não reconhece arquivos temporários. -
Não é possível tornar um arquivo temporário somente leitura.
-
Não é possível criar um arquivo temporário com a instrução
ALTERDATABASE. -
Quando você cria ou redimensiona arquivos temporários, nem sempre é garantida a alocação de espaço em disco para o tamanho do arquivo especificado. Em sistemas de arquivos, como Linux e UNIX, arquivos temporários são criados como arquivos esparsos. Nesse caso, os blocos de disco são alocados não na criação ou redimensionamento de arquivos, mas à medida que os blocos são acessados pela primeira vez.
Observação: Os arquivos esparsos permitem a criação e o redimensionamento rápidos de arquivos temporários; no entanto, o disco pode ficar sem espaço posteriormente quando os arquivos temporários são acessados.
-
As informações do arquivo temporário são mostradas na view do dicionário de dados
DBA_TEMP_FILESe na view de desempenho dinâmicoV$TEMPFILE, mas não na viewDBA_DATA_FILESouV$DATAFILE.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a gerenciar arquivos temporários
Arquivos de Dados On-line e Off-line
Cada arquivo de dados está on-line (disponível) ou off-line (não disponível).
Você pode alterar a disponibilidade de arquivos de dados individuais ou arquivos temporários colocando-os off-line ou colocando-os on-line. O banco de dados não pode acessar arquivos de dados off-line até que sejam colocados on-line.
Você pode colocar os arquivos de dados off-line por muitos motivos, incluindo a execução de backups off-line ou a corrupção de blocos. O banco de dados coloca um arquivo de dados off-line automaticamente se o banco de dados não puder gravá-lo.
Como um arquivo de dados, o próprio tablespace está off-line ou on-line. Quando você coloca um arquivo de dados off-line em um tablespace on-line, o próprio tablespace permanece on-line. Você pode tornar todos os arquivos de dados de um tablespace temporariamente indisponíveis, colocando o próprio tablespace off-line.
A partir do Oracle Database 12c, você pode usar a instrução ALTER DATABASE MOVE DATAFILE para mover um arquivo de dados on-line de um arquivo físico para outro enquanto o banco de dados está aberto e acessando o arquivo. Você pode usar essa técnica para atingir os seguintes objetivos:
-
Mover um tablespace de um tipo de armazenamento para outro
-
Mova arquivos de dados acessados com pouca frequência para um armazenamento de menor custo
-
Tornar um tablespace somente para leitura e mover seus arquivos de dados para armazenamento write-once, como uma unidade WORM (write once read many)
-
Mover um banco de dados para o Oracle ASM
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber como alterar a disponibilidade do arquivo de dados
-
Oracle AI Database Administrator's Guide para saber como mover arquivos de dados on-line
-
Oracle AI Database SQL Language Reference para saber mais sobre
ALTER DATABASE . . . MOVE DATAFILE
Estrutura do Arquivo de Dados
O Oracle AI Database cria um arquivo de dados para um tablespace alocando a quantidade especificada de espaço em disco mais a sobrecarga do cabeçalho do arquivo de dados. O sistema operacional no qual o Oracle AI Database é executado é responsável por limpar informações e autorizações antigas de um arquivo antes de alocá-lo no banco de dados.
O cabeçalho do arquivo de dados contém metadados sobre o arquivo de dados, como seu tamanho e ponto de verificação SCN. Cada cabeçalho contém um número de arquivo absoluto, que identifica exclusivamente o arquivo de dados dentro do banco de dados, e um número de arquivo relativo, que identifica exclusivamente um arquivo de dados dentro de um tablespace.
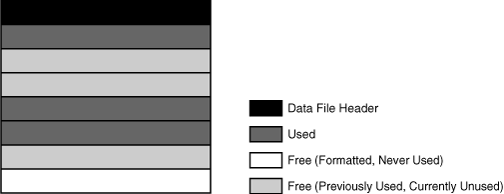
Quando o Oracle AI Database cria um arquivo de dados pela primeira vez, o espaço em disco alocado é formatado, mas não contém dados do usuário. No entanto, o banco de dados reserva o espaço para armazenar os dados para segmentos futuros do tablespace associado. À medida que os dados aumentam em um tablespace, o Oracle AI Database usa o espaço livre nos arquivos de dados para alocar extensões para o segmento.
A figura a seguir ilustra os diferentes tipos de espaço em um arquivo de dados. As extensões são usadas, o que significa que contêm dados de segmento, ou gratuitas, o que significa que estão disponíveis para reutilização. Com o tempo, as atualizações e exclusões de objetos dentro de um tablespace podem criar bolsões de espaço vazio que individualmente não são grandes o suficiente para serem reutilizados para novos dados. Esse tipo de espaço vazio é chamado de espaço livre fragmentado.
Figura 6: Espaço em um arquivo de dados
Descrição da ilustração cncpt273.gif
Consulte Também: Oracle AI Database Administrator's Guide para saber como exibir informações do arquivo de dados
Visão Geral de Arquivos de Controle
O arquivo de controle do banco de Dados é um pequeno arquivo binário associado a apenas uma CDB.
Cada CDB tem um único arquivo de controle, embora várias cópias idênticas sejam permitidas. Os PDBs não têm arquivos de controle separados.
-
Uso de Arquivos de Controle O Oracle AI Database usa o arquivo de controle para localizar arquivos de banco de dados e gerenciar o estado geral do banco de dados.
-
Vários Arquivos de Controle O Oracle AI Database permite que vários arquivos de controle idênticos sejam abertos simultaneamente e gravados no mesmo banco de dados. Ao multiplexar um arquivo de controle em discos diferentes, o banco de dados pode obter redundância e, assim, evitar um único ponto de falha.
-
Estrutura do Arquivo de Controle As informações sobre o banco de dados são armazenadas em diferentes seções do arquivo de controle. Cada seção é um conjunto de registros sobre um aspecto do banco de dados.
Uso de Arquivos de Controle
O Oracle AI Database usa o arquivo de controle para localizar arquivos de banco de dados e gerenciar o estado geral do banco de dados.
Um arquivo de controle contém informações como as seguintes:
-
O nome e o identificador exclusivo (DBID) do banco de dados
-
O carimbo de data/hora da criação do banco de dados
-
Informações sobre os arquivos de dados, arquivos de redo log on-line e arquivos de redo log arquivados
-
Informações sobre o tablespace
-
Backups de RMAN
O arquivo de controle tem as seguintes finalidades:
-
Ele contém informações sobre arquivos de dados, arquivos de redo log on-line e assim por diante que são necessários para abrir o banco de dados.
O arquivo de controle rastreia as alterações estruturais no banco de dados. Por exemplo, quando um administrador adiciona, renomeia ou elimina um arquivo de dados ou um arquivo de redo log on-line, o banco de dados atualiza o arquivo de controle para refletir essa alteração.
-
Ela contém metadados que devem ser acessíveis quando o banco de dados não estiver aberto.
Por exemplo, o arquivo de controle contém informações necessárias para recuperar o banco de dados, incluindo pontos de verificação. Um ponto de verificação indica o SCN no fluxo de redo no qual seria necessário iniciar a recuperação da instância. Todas as alterações confirmadas antes de um SCN de checkpoint são salvas em disco nos arquivos de dados. Pelo menos a cada três segundos, o processo de checkpoint registra informações no arquivo de controle sobre a posição do checkpoint no redo log on-line.
O Oracle AI Database lê e grava continuamente no arquivo de controle durante o uso do banco de dados e deve estar disponível para gravação sempre que o banco de dados estiver aberto. Por exemplo, recuperar um banco de dados envolve a leitura do arquivo de controle dos nomes de todos os arquivos de dados contidos no banco de dados. Outras operações, como adicionar um arquivo de dados, atualizam as informações armazenadas no arquivo de controle.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a gerenciar o arquivo de controle
Vários Arquivos de Controle
O Oracle AI Database permite que vários arquivos de controle idênticos sejam abertos simultaneamente e gravados no mesmo banco de dados. Multiplexando um arquivo de controle em discos diferentes, o banco de dados pode obter redundância e, assim, evitar um único ponto de falha. Observação: A Oracle recomenda que você mantenha várias cópias de arquivos de controle, cada uma em um disco diferente.
Se um arquivo de controle se tornar inutilizável, a instância do banco de dados falhará quando tentar acessar o arquivo de controle danificado. Quando existirem outras cópias do arquivo de controle atual, você poderá remontar o banco de dados e abri-lo sem recuperação de mídia. Se todos os arquivos de controle de um banco de dados forem perdidos, no entanto, a instância do banco de dados falhará e a recuperação de mídia será necessária. A recuperação de mídia não é simples se um backup mais antigo de um arquivo de controle deve ser usado porque uma cópia atual não está disponível.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a manter vários arquivos de controle
-
Oracle AI Database Backup and Recovery User's Guide para saber como fazer backup e restaurar arquivos de controle
Estrutura do Arquivo de Controle
As informações sobre o banco de dados são armazenadas em diferentes seções do arquivo de controle. Cada seção é um conjunto de registros sobre um aspecto do banco de dados.
Por exemplo, uma seção no arquivo de controle rastreia arquivos de dados e contém um conjunto de registros, um para cada arquivo de dados. Cada seção é armazenada em vários blocos de arquivos de controle lógico. Os registros podem abranger blocos em uma seção.
O arquivo de controle contém os seguintes tipos de registros:
-
Registros de reutilização circular
Um registro de reutilização circular contém informações não críticas que podem ser substituídas, se necessário. Quando todos os slots de registro disponíveis estiverem cheios, o banco de dados expandirá o arquivo de controle para abrir espaço para um novo registro ou substituirá o registro mais antigo. Exemplos incluem registros sobre arquivos de redo log arquivados e backups do RMAN.
-
Registros de reutilização não circular
Um registro de reutilização não circular contém informações críticas que não são alteradas com frequência e que não podem ser substituídas. Exemplos de informações incluem tablespaces, arquivos de dados, arquivos de redo log on-line e threads de redo. O Oracle AI Database nunca reutiliza esses registros, a menos que o objeto correspondente seja eliminado do tablespace.
Você pode consultar as exibições de desempenho dinâmico, também conhecidas como exibições V$, para exibir as informações armazenadas no arquivo de controle. Por exemplo, você pode consultar V$DATABASE para obter o nome do banco de dados e o DBID. No entanto, somente o banco de dados pode modificar as informações no arquivo de controle.
Ler e gravar os blocos de arquivos de controle é diferente de ler e gravar blocos de dados. Para o arquivo de controle, o Oracle AI Database lê e grava diretamente do disco para a PGA (program global area). Cada processo aloca uma certa quantidade de sua memória PGA para blocos de arquivos de controle.
Consulte Também:
-
Oracle AI Database Reference para saber mais sobre a view
V$CONTROLFILE_RECORD_SECTION -
Oracle AI Database Reference para saber mais sobre o parâmetro de inicialização
CONTROL_FILE_RECORD_KEEP_TIME
Visão Geral do Redo Log On-line
A estrutura mais crucial para a recuperação é o redo log on-line, que consiste em dois ou mais arquivos pré-alocados que armazenam alterações no banco de dados à medida que ocorrem. Os registros de redo log on-line são alterados nos arquivos de dados.
-
Uso do Redo Log On-line O banco de dados mantém arquivos de redo log on-line para proteção contra perda de dados. Especificamente, após uma falha de instância, os arquivos de redo log on-line permitem que o Oracle AI Database recupere dados confirmados que ainda não foram gravados nos arquivos de dados.
-
Como o Oracle AI Database Grava no Redo Log On-line O redo log on-line de uma instância de banco de dados é chamado de thread de refazer.
-
Os arquivos de redo log On-line da Estrutura do Redo Log On-line contêm registros de redo.
Uso do Redo Log On-line
O banco de dados mantém arquivos de redo log on-line para proteção contra perda de dados. Especificamente, após uma falha de instância, os arquivos de redo log on-line permitem que o Oracle AI Database recupere dados confirmados que ainda não foram gravados nos arquivos de dados.
Os processos do servidor gravam cada transação de forma síncrona no buffer de redo log, que o processo LGWR grava no redo log on-line. O conteúdo do redo log on-line inclui transações não confirmadas e instruções de gerenciamento de objetos e esquemas.
À medida que o banco de dados faz alterações nos segmentos de undo, ele também grava essas alterações nos redo logs on-line. Consequentemente, o redo log on-line sempre contém os dados de undo para objetos permanentes. Você pode configurar o banco de dados para armazenar todos os dados de undo de objetos temporários em um segmento de undo temporário, o que economiza espaço e melhora o desempenho, ou permitir que o banco de dados armazene dados de undo permanentes e temporários no redo log on-line.
O Oracle AI Database usa o redo log on-line somente para recuperação. No entanto, os administradores podem consultar arquivos de redo log on-line por meio de uma interface SQL no utilitário Oracle LogMiner. Os arquivos de redo log são uma fonte útil de informações históricas sobre a atividade do banco de dados.
Consulte Também:
-
"Arquitetura de Processo" para saber mais sobre os processos da Oracle
-
Oracle AI Database Administrator's Guide para aprender sobre segmentos de undo temporários
-
Oracle AI Database Reference para saber mais sobre o parâmetro de inicialização
TEMP_UNDO_ENABLED
Como o Oracle AI Database Grava no Redo Log On-line
O redo log on-line de uma instância de banco de dados é chamado de thread de refazer.
Em configurações de instância única, somente uma instância acessa um banco de dados; portanto, apenas um thread de redo está presente. Em uma configuração do Oracle Real Application Clusters (Oracle RAC), no entanto, várias instâncias acessam simultaneamente um banco de dados, com cada instância tendo seu próprio thread de redo. Um thread de redo separado para cada instância evita a disputa por um único conjunto de arquivos de redo log on-line.
Um redo log on-line consiste em dois ou mais arquivos de redo log on-line. O Oracle AI Database requer no mínimo dois arquivos para garantir que um arquivo esteja sempre disponível para gravação caso o outro esteja em processo de limpeza ou arquivamento.
-
Switches de Redo Log On-line O Oracle AI Database usa apenas um arquivo de redo log on-line por vez para armazenar registros gravados no buffer de redo log.
-
Várias Cópias de Arquivos de Redo Log On-line O Oracle AI Database pode manter automaticamente duas ou mais cópias idênticas do redo log on-line em locais separados.
-
Arquivos de Redo Log Arquivados Um arquivo de redo log arquivado é uma cópia de um membro preenchido de um grupo de redo log on-line.
Consulte Também: Oracle Real Application Clusters Administration and Deployment Guide para saber mais sobre grupos de redo log on-line no Oracle RAC
Alternâncias de Redo Log On-line
O Oracle AI Database usa apenas um arquivo de redo log on-line por vez para armazenar registros gravados no buffer de redo log.
O arquivo de redo log on-line no qual o processo de gravação de log (LGWR) está gravando ativamente é chamado de arquivo de redo log on-line atual.
Uma chave de log ocorre quando o banco de dados para de gravar em um arquivo de redo log on-line e começa a gravar em outro. Normalmente, ocorre uma alternância quando o arquivo de redo log on-line atual está cheio e a gravação deve continuar. No entanto, você pode configurar switches de log para ocorrer em intervalos regulares, independentemente de o arquivo de redo log on-line atual estar preenchido e forçar switches de log manualmente.
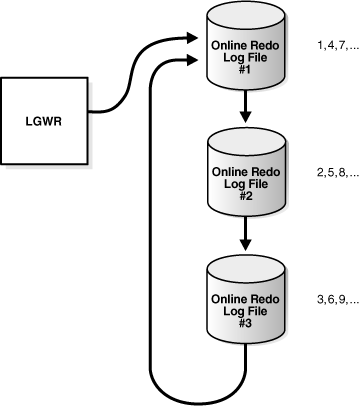
O gravador de log grava em arquivos de redo log on-line circularmente. Quando o gravador de log preenche o último arquivo de redo log on-line disponível, o processo grava no primeiro arquivo de log, reiniciando o ciclo. A Figura 14-7 ilustra a gravação circular do redo log.
Figura 7: Reutilização de Arquivos de Redo Log On-line
Descrição da ilustração admin054.gif
Os números na Figura 14-7 mostram a sequência na qual o LGWR grava em cada arquivo de redo log on-line. O banco de dados atribui a cada arquivo um novo número de sequência de log quando um log alterna e os gravadores de log começam a gravar nele. Quando o banco de dados reutiliza um arquivo de redo log on-line, esse arquivo recebe o próximo número de sequência de log disponível.
Arquivos de redo log on-line preenchidos estão disponíveis para reutilização, dependendo do modo de arquivamento:
-
Se o arquivamento estiver desativado, o que significa que o banco de dados está no modo
NOARCHIVELOG, um arquivo de redo log on-line preenchido estará disponível após as alterações registradas nele terem sido submetidas a checkpoint (gravadas) para o disco pelo database writer (DBW). -
Se o arquivamento estiver ativado, o que significa que o banco de dados está no modo ARQUIVELOG, um arquivo de redo log on-line preenchido estará disponível para o gravador de logs após as alterações terem sido gravadas nos arquivos de dados e o arquivo tiver sido arquivado.
Em algumas circunstâncias, o gravador de logs pode ser impedido de reutilizar um arquivo de redo log on-line existente. Um arquivo de redo log on-line ativo é necessário para a recuperação da instância, em que, como um arquivo de redo log on-line inativo não é necessário para a recuperação da instância. Além disso, um arquivo de redo log on-line pode estar em processo de limpeza.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a gerenciar o redo log on-line
Várias Cópias de Arquivos de Redo Log On-line
O Oracle AI Database pode manter automaticamente duas ou mais cópias idênticas do redo log on-line em locais separados.
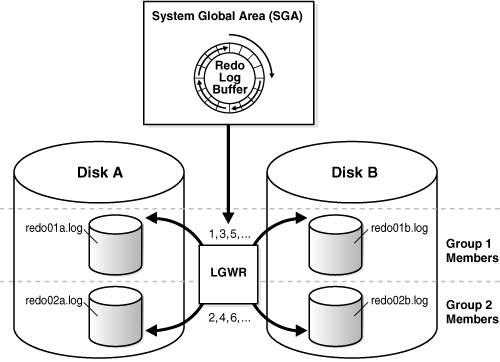
Um grupo de redo log on-line consiste em um arquivo de redo log on-line e suas cópias redundantes. Cada cópia idêntica é membro do grupo de redo logs on-line. Cada grupo é definido por um número, como grupo 1, grupo 2, e assim por diante.
A manutenção de vários membros de um grupo de redo logs on-line protege contra a perda do redo log. O ideal é que os locais dos membros estejam em discos separados para que a falha de um disco não cause a perda de todo o redo log on-line.
Na Figura 14-8, A_LOG1 e B_LOG1 são membros idênticos do grupo 1, enquanto A_LOG2 e B_LOG2 são membros idênticos do grupo 2. Cada membro de um grupo deve ter o mesmo tamanho. LGWR grava simultaneamente no grupo 1 (membros A_LOG1 e B_LOG1), depois grava simultaneamente no grupo 2 (membros A_LOG2 e B_LOG2), depois grava no grupo 1 e assim por diante. O LGWR nunca escreve simultaneamente para membros de diferentes grupos.
Figura 8: Várias Cópias de Arquivos de Redo Log On-line
Descrição da ilustração cncpt270.gif
Observação: A Oracle recomenda que você multiplexe o redo log on-line. A perda de arquivos de log pode ser catastrófica se a recuperação for necessária. Quando o redo log on-line é multiplexado, o banco de dados deve aumentar a quantidade de Entrada/Saída executada. Dependendo do seu sistema, essa E/S adicional pode afetar o desempenho geral do banco de dados.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a manter várias cópias dos arquivos de redo log on-line
-
Conceitos e Administração do Oracle Data Guard para saber mais sobre a transferência automatizada de dados de redo entre membros de uma configuração do Data Guard
Arquivos de Redo Log Arquivados
Um arquivo de redo log arquivado é uma cópia de um membro preenchido de um grupo de redo log on-line.
Um arquivo de redo log arquivado não é considerado parte do banco de dados. Em vez disso, é uma cópia off-line de um arquivo de redo log on-line criado pelo banco de dados e gravado em um local especificado pelo usuário.
Os arquivos de redo log arquivados são uma parte crucial de uma estratégia de backup e recuperação. Você pode usar arquivos de redo log arquivados em:
-
Recuperar um backup do banco de dados
-
Atualizar um banco de dados stand-by
-
Obter informações sobre o histórico de um banco de dados usando o utilitário Oracle LogMiner
A operação de geração de um arquivo de redo log arquivado é conhecida como arquivo. Esta operação é automática ou manual. Só é possível quando o banco de dados está no modo ARCHIVELOG.
Um arquivo de redo log arquivado inclui as entradas de redo e o número de sequência do log do membro idêntico do grupo de redo log on-line. Em "Várias Cópias de Arquivos de Redo Log On-line", os arquivos A_LOG1 e B_LOG1 são membros idênticos do Grupo 1. Se o banco de dados estiver no modo ARCHIVELOG e se o arquivamento automático estiver ativado, o processo de arquivamento (ARCn) arquivará um desses arquivos. Se A_LOG1 estiver corrompido, o processo poderá arquivar B_LOG1. O redo log arquivado contém uma cópia de cada grupo de redo log existente a partir do momento em que você ativou o arquivamento.
Consulte Também:
-
Oracle AI Database Utilities para saber mais sobre o Oracle LogMiner
-
Oracle AI Database Administrator's Guide para saber como gerenciar o redo log arquivado
-
Oracle Data Guard Concepts and Administration para saber como configurar o arquivamento de redo log stand-by
Estrutura do Redo Log On-line
Os arquivos de redo log on-line contêm registros de redo.
Um registro de redo é composto por um grupo de vetores de alteração, cada um dos quais descreve uma alteração em um bloco de dados. Por exemplo, uma atualização de um salário na tabela employees gera um redo registro que descreve alterações no bloco segmento de dados da tabela, no bloco de dados do segmento de undo e na tabela de transações dos segmentos de undo.
Os registros de redo têm todos os metadados relevantes para a alteração, incluindo o seguinte:
-
SCN e carimbo de data/hora da alteração
-
ID da transação que gerou a alteração
-
SCN e carimbo de data/hora quando a transação foi confirmada (se tiver sido confirmada)
-
Tipo de operação que fez a alteração
-
Nome e tipo do segmento de dados modificado
Consulte Também: "Visão Geral de Blocos de Dados"