Arquitetura do Processo
Este capítulo descreve os processos em um banco de dados Oracle.
-
Introdução a Processos Um processo é um mecanismo em um sistema operacional que pode executar uma série de etapas.
-
Visão Geral dos Processos do Cliente Quando um usuário executa um aplicativo, como um programa Pro*C ou SQL*Plus, o sistema operacional cria um processo do cliente (às vezes chamado de processo do usuário) para executar o aplicativo do usuário. O aplicativo cliente tem bibliotecas do Oracle AI Database vinculadas a ele que fornecem as APIs necessárias para se comunicar com o banco de dados.
-
Visão Geral dos Processos do Servidor O Oracle AI Database cria processos do servidor para tratar as solicitações de processos do cliente conectados à instância. Um processo cliente sempre se comunica com um banco de dados por meio de um processo de servidor separado.
-
Visão Geral de Processos em Segundo Plano Os processos em segundo plano são processos adicionais usados por um banco de dados Oracle de multiprocessamento. Os processos em segundo plano executam tarefas de manutenção necessárias para operar o banco de dados e maximizar o desempenho de vários usuários.
Introdução aos Processos
Processo é um mecanismo em um sistema operacional que pode executar uma série de etapas.
A arquitetura de execução do processo depende do sistema operacional. Por exemplo, no Windows, um processo em segundo plano da Oracle é um thread de execução em um processo. Em Linux e UNIX, um processo Oracle é um processo de sistema operacional ou um thread dentro de um processo de sistema operacional.
Os processos executam módulos de código. Todos os usuários conectados do Oracle AI Database devem executar os seguintes módulos para acessar uma instância de banco de dados:
-
Aplicativo ou utilitário do Oracle AI Database
Um usuário de banco de dados executa um aplicativo de banco de dados, como um programa pré-compilador ou uma ferramenta de banco de dados, como o SQL*Plus, que emite instruções SQL para um banco de dados.
-
Código do banco de dados Oracle
Cada usuário tem o código de banco de dados Oracle em execução em seu nome que interpreta e processa as instruções SQL do aplicativo.
Um processo normalmente é executado em sua própria área de memória privada. A maioria dos processos pode gravar periodicamente em um arquivo de rastreamento associado.
-
Tipos de Processos Uma instância de banco de dados contém ou interage com vários processos.
-
Sistemas Multiprocessados e Multithread do Oracle AI Database O Oracle AI Database Multiprocessado (também chamado de Oracle AI Database multiusuário) usa vários processos para executar diferentes partes do código do Oracle AI Database e processos adicionais da Oracle para os usuários - um processo para cada usuário conectado ou um ou mais processos compartilhados por vários usuários.
Consulte Também:
Tipos de Processos
Uma instância de banco de dados contém ou interage com vários processos.
Os processos são divididos nos seguintes tipos:
-
Um processo do cliente executa o código do aplicativo ou da ferramenta Oracle.
-
Processo Oracle é uma unidade de execução que executa o código do banco de dados Oracle. Na arquitetura multithread, um processo Oracle pode ser um processo de sistema operacional ou um thread dentro de um processo de sistema operacional. Os processos Oracle incluem os seguintes subtipos:
-
Um processo em segundo plano começa com a instância do banco de dados e executa tarefas de manutenção, como executar recuperação de instância, limpar processos, gravar buffers de redo em disco e assim por diante.
-
Um processo do servidor executa o trabalho com base em uma solicitação do cliente.
Por exemplo, esses processos analisam consultas SQL, as colocam no pool compartilhado, criam e executam um plano de consulta para cada consulta e leem buffers do cache de buffer do banco de dados ou do disco.
Observação: os processos do servidor e a memória do processo alocada nesses processos são executados na instância do banco de dados. A instância continua a funcionar quando os processos do servidor são encerrados.
-
Um processo filho executa tarefas adicionais para um processo em segundo plano ou servidor.
-
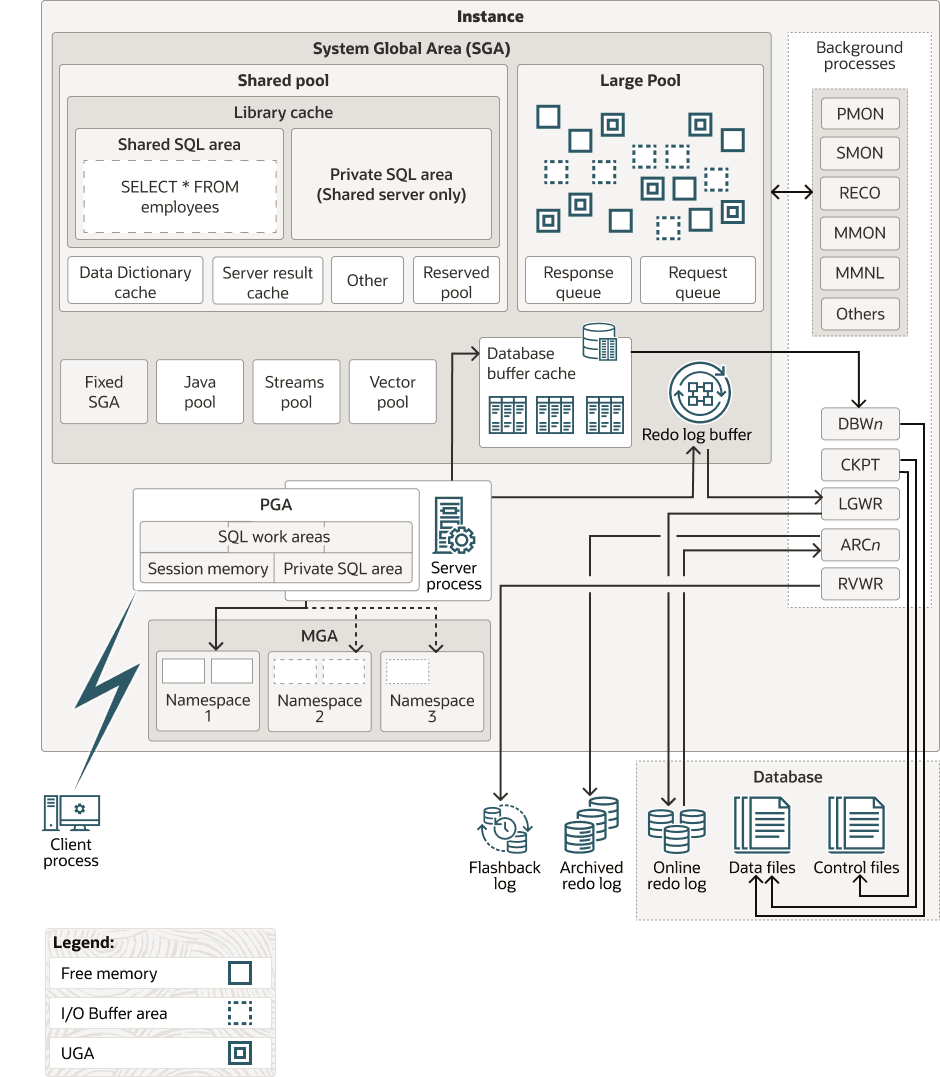
A estrutura do processo varia dependendo do sistema operacional e da escolha das opções do Oracle AI Database. Por exemplo, você pode configurar o código para usuários conectados para conexões de servidor dedicado ou servidor compartilhado. Em uma arquitetura de servidor compartilhado, cada processo de servidor que executa o código do banco de dados pode atender a vários processos de cliente. A Figura 18-1 mostra uma área global do sistema (SGA) e processos em segundo plano usando conexões de servidor dedicadas. Para cada conexão de usuário, um processo do cliente executa o aplicativo. Esse processo do cliente é diferente do processo do servidor dedicado que executa o código do banco de dados. Cada processo cliente é associado ao seu próprio processo de servidor, que tem sua própria área global do programa (PGA).
Figura 1: Processos da Oracle e a SGA
Descrição da ilustração cncpt283.png
Consulte Também:
-
"Arquitetura de Servidor Dedicado" e "Arquitetura de Servidor Compartilhado"
-
Sua documentação específica do sistema operacional Oracle AI Database para obter mais detalhes sobre as opções de configuração
-
Oracle AI Database Reference para saber mais sobre a view
V$PROCESS
Sistemas Oracle AI Database Multiprocessados e Multithread
O Oracle AI Database multiprocessado (também chamado de Oracle AI Database multiusuário) usa vários processos para executar diferentes partes do código do Oracle AI Database e processos adicionais da Oracle para os usuários - um processo para cada usuário conectado ou um ou mais processos compartilhados por vários usuários.
A maioria dos bancos de dados é multiusuário porque uma das principais vantagens de um banco de dados é gerenciar dados necessários para vários usuários simultaneamente. Cada processo em uma instância de banco de dados executa um job específico. Ao dividir o trabalho do banco de dados e dos aplicativos em vários processos, vários usuários e aplicativos podem se conectar a uma instância simultaneamente, enquanto o sistema oferece um bom desempenho.
Em versões anteriores ao Oracle Database 12c, os processos da Oracle não eram executados como threads nos sistemas UNIX e Linux. A partir do Oracle Database 12c, o modelo Oracle AI Database multithread permite que os processos da Oracle sejam executados como threads do sistema operacional em espaços de endereço separados. Quando o Oracle AI Database é instalado, o banco de dados é executado no modo de processo. Defina o parâmetro de inicialização THREADED_EXECUTION como TRUE para executar o banco de dados no modo encadeado. No modo encadeado, alguns processos em segundo plano no UNIX e no Linux são executados como processos (com cada processo contendo um encadeamento), enquanto os processos Oracle restantes são executados como threads dentro dos processos.
Em um banco de dados em execução no modo encadeado, o PMON e o DBW podem ser executados como processos do sistema operacional, enquanto o LGWR e o CMON podem ser executados como encadeamentos em um único processo. Dois processos em primeiro plano e um processo de servidor de execução paralela (PX) podem ser executados como threads em um segundo processo do sistema operacional. Um terceiro processo do sistema operacional pode conter vários threads de primeiro plano. Assim, "processo Oracle" nem sempre significa "processo do sistema operacional". Observação: Quando o parâmetro de inicialização THREADED_EXECUTION é definido como TRUE, a autenticação do sistema operacional não é suportada.
Exemplo 18-1 Exibindo Metadados do Oracle Process
A view V$PROCESS contém uma linha para cada processo Oracle conectado a uma instância do banco de dados. Por exemplo, você pode executar a seguinte consulta no SQL*Plus para obter o ID do processo do sistema operacional e o ID do thread do sistema operacional para cada processo:
COL SPID FORMAT a8
COL STID FORMAT a8
SELECT SPID, STID, PROGRAM FROM V$PROCESS ORDER BY SPID;
A consulta gera a seguinte saída de amostra parcial:
SPID   STID   PROGRAM
-----  -----  ---------------------------
7190   7190   oracle@samplehost (PMON)
7192   7192   oracle@samplehost (PSP0)
7194   7194   oracle@samplehost (VKTM)
7198   7198   oracle@samplehost (SCMN)
7198   7200   oracle@samplehost (GEN0)
7202   7202   oracle@samplehost (SCMN)
7202   7204   oracle@samplehost (DIAG)
7198   7205   oracle@samplehost (DBRM)
7202   7206   oracle@samplehost (DIA0)
.
.
.
Consulte Também:
-
Guia de Ajuste de Desempenho do Oracle AI Database para saber como usar a exibição
V$PROCESS -
Oracle AI Database Reference para saber mais sobre o parâmetro de inicialização
THREADED_EXECUTION
Visão geral dos processos do cliente
Quando um usuário executa um aplicativo como um programa Pro*C ou SQL*Plus, o sistema operacional cria um processo cliente (às vezes chamado de processo do usuário) para executar o aplicativo do usuário. O aplicativo cliente tem bibliotecas do Oracle AI Database vinculadas a ele que fornecem as APIs necessárias para se comunicar com o banco de dados.
-
Processos do Cliente e do Servidor Os processos do cliente diferem de maneiras importantes dos processos da Oracle que interagem diretamente com a instância.
-
Conexões e Sessões Uma conexão de banco de dados é um caminho de comunicação física entre um processo do cliente e uma instância do banco de dados.
-
Contêiner Atual Uma sessão de banco de dados é uma entidade lógica na memória da instância de banco de dados que representa o estado de um log-in de usuário atual em um banco de dados.
-
Operações do Banco de Dados No contexto do monitoramento do banco de dados, uma operação do banco de dados é a atividade da sessão entre dois pontos no tempo, conforme definido pelos usuários finais ou pelo código do aplicativo.
Processos de Cliente e Servidor
Os processos do cliente diferem de maneiras importantes dos processos da Oracle que interagem diretamente com a instância.
Os processos Oracle que atendem ao processo do cliente podem ler e gravar na SGA, enquanto o processo do cliente não pode. Um processo cliente pode ser executado em um host diferente do host do banco de dados, enquanto os processos Oracle não podem.
Por exemplo, suponha que um usuário em um host cliente inicie o SQL*Plus e, em seguida, estabeleça conexão pela rede com o banco de dados sample em outro host quando a instância do banco de dados não for iniciada:
SQL> CONNECT SYS@inst1 AS SYSDBA
Enter password: *********
Connected to an idle instance.
No host do cliente, uma pesquisa dos processos para sqlplus ou sample mostra apenas o processo do cliente sqlplus:
% ps -ef | grep -e sample -e sqlplus | grep -v grep
clientuser 29437 29436  0 15:40 pts/1    00:00:00 sqlplus           as sysdba
No host do banco de dados, uma pesquisa dos processos para sqlplus ou sample mostra um processo do servidor com uma conexão não local, mas nenhum processo do cliente:
% ps -ef | grep -e sample -e sqlplus | grep -v grep
serveruser 29441     1  0 15:40 ?        00:00:00 oraclesample (LOCAL=NO)
Consulte Também: "Como uma Instância é Iniciada" para saber como um cliente pode estabelecer conexão com um banco de dados quando a instância não é iniciada
Conexões e Sessões
Uma conexão de banco de dados é um caminho de comunicação física entre um processo cliente e uma instância de banco de dados.
Durante uma conexão, um caminho de comunicação é estabelecido usando mecanismos de comunicação entre processos disponíveis ou software de rede. Normalmente, ocorre uma conexão entre um processo cliente e um processo servidor ou despachador, mas também pode ocorrer entre um processo cliente e o Oracle Connection Manager (CMAN).
Contêiner Atual
Uma sessão de banco de dados é uma entidade lógica na memória da instância de banco de dados que representa o estado de um log-in de usuário atual em um banco de dados.
Por exemplo, quando um usuário é autenticado pelo banco de dados com uma senha, uma sessão é estabelecida para esse usuário. A sessão dura a partir do momento em que o usuário é autenticado pelo banco de dados até o momento em que o usuário desconecta ou sai do aplicativo de banco de dados.
Sessões e Contêineres
Para uma determinada sessão, o contêiner atual no CDB é aquele em que uma sessão está em execução. O contêiner atual pode ser a raiz do CDB, uma raiz do aplicativo ou um PDB.
Cada sessão tem exatamente um contêiner atual a qualquer momento. Como o dicionário de dados em cada contêiner é separado, o Oracle AI Database usa o dicionário de dados no contêiner atual para resolução de nome e autorização de privilégio.
Relacionamento entre Conexões e Sessões
Uma única conexão pode ter 0, 1 ou mais sessões estabelecidas nela. As sessões são independentes: um commit em uma sessão não afeta as transações em outras sessões.
Observação: Se o pooling de conexões do Oracle Net for configurado, será possível eliminar uma conexão, mas deixar as sessões intactas.
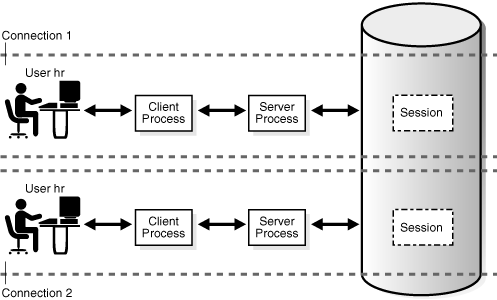
Várias sessões podem existir simultaneamente para um único usuário do banco de dados. Conforme mostrado na figura a seguir, o usuário hr pode ter várias conexões com um banco de dados. Em conexões de servidor dedicadas, o banco de dados cria um processo de servidor em nome de cada conexão. Apenas o processo do cliente que faz com que o servidor dedicado seja criado o utiliza. Em uma conexão de servidor compartilhado, muitos processos de cliente acessam um único processo de servidor compartilhado.
Figura 2: Uma sessão para cada conexão
Descrição da ilustração cncpt237.gif
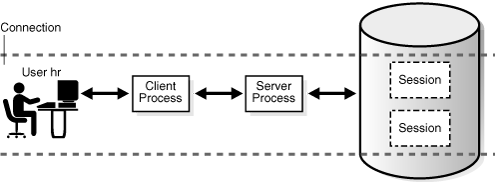
A Figura 18-3 ilustra um caso em que o usuário hr tem uma única conexão com um banco de dados, mas essa conexão tem duas sessões.
Figura 3: Duas sessões em uma conexão
Descrição da ilustração cncpt238.gif
A geração de um relatório de rastreamento automático de estatísticas de execução de instrução SQL recria o cenário na Figura 18-3.
O comando DISCONNECT no Exemplo 18-2 na verdade encerra as sessões, não a conexão.
Exemplo 18-2 Conexões e Sessões
O exemplo a seguir conecta o SQL*Plus ao banco de dados como usuário SYSTEM e ativa o rastreamento, criando assim uma nova sessão (saída de amostra incluída):
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 90      91 3BE2E41C

SQL> SET AUTOTRACE ON STATISTICS;
SQL> SELECT SID, SERIAL#, PADDR FROM V$SESSION WHERE USERNAME = USER;

SID SERIAL# PADDR
--- ------- --------
 88      93 3BE2E41C
 90      91 3BE2E41C
...
SQL> DISCONNECT
O comando DISCONNECT realmente encerra as sessões, não a conexão. Abrindo um novo terminal e estabelecendo conexão com a instância como outro usuário, a consulta a seguir mostra que a conexão com o endereço 3BE2E41C ainda está ativa.
SQL> CONNECT dba1@inst1
Password: ********
Connected.
SQL> SELECT PROGRAM FROM V$PROCESS WHERE ADDR = HEXTORAW('3BE2E41C');

PROGRAM
------------------------------------------------
oracle@stbcs09-1 (TNS V1-V3)
Consulte Também: "Arquitetura de Servidor Compartilhado"
Operações de Banco de Dados
No contexto do monitoramento do banco de dados, uma operação do banco de dados é a atividade da sessão entre dois pontos no tempo, conforme definido pelos usuários finais ou pelo código do aplicativo.
Uma operação simples de banco de dados é uma única instrução SQL ou um único procedimento ou função PL/SQL. Operação de banco de dados composto é um conjunto de operações únicas ou compostas.
Para monitorar, comparar e ajustar tarefas, você pode dividir um grande conjunto de tarefas em operações de banco de dados e subdividir operações em fases. Um caso de uso é uma tarefa em batch PL/SQL que está sendo executada mais lentamente do que o normal. Ao configurar o job como uma operação de banco de dados, você pode identificar e ajustar as etapas caras no job.
Cada execução de uma operação de banco de dados é identificada exclusivamente por um par de atributos: nome da operação e ID da execução. Uma sessão pode iniciar ou interromper uma operação de banco de dados em outra sessão especificando seu ID de sessão e número de série.
Duas ocorrências da mesma operação de banco de dados podem ser executadas ao mesmo tempo usando o mesmo nome, mas IDs de execução diferentes. Cada execução de uma operação de banco de dados com o mesmo nome pode conter instruções diferentes.
Você cria e gerencia operações de banco de dados com o pacote PL/SQL DBMS_SQL_MONITOR. Você pode monitorar operações usando V$SQL_MONITOR, V$SQL_PLAN_MONITOR e V$SQL_MONITOR_SESSTAT.
Consulte Também:
-
Oracle AI Database SQL Tuning Guide para aprender a monitorar operações de banco de dados
-
Guia do Oracle AI Database Data Warehousing para aprender a monitorar cargas de longa execução
-
Oracle AI Database PL/SQL Packages and Types Reference para saber mais sobre
DBMS_SQL_MONITOR -
Oracle AI Database Reference para saber mais sobre a
V$SQL_MONITOR
Visão Geral dos Processos do Servidor
O Oracle AI Database cria processos do servidor para tratar as solicitações de processos do cliente conectados à instância. Um processo cliente sempre se comunica com um banco de dados por meio de um processo de servidor separado.
Os processos de servidor criados em nome de um aplicativo de banco de dados podem executar uma ou mais das seguintes tarefas:
-
Faça parse e execute instruções SQL emitidas por meio do aplicativo, incluindo a criação e a execução do plano de consulta
-
Executar código PL/SQL
-
Ler blocos de dados de arquivos de dados no cache de buffer do banco de dados (o processo em segundo plano do DBW tem a tarefa de gravar blocos modificados de volta ao disco)
-
Retornar resultados de forma que o aplicativo possa processar as informações
-
Processos de Servidor Dedicado Em conexões de servidor dedicado, a conexão do cliente é associada a um e somente um processo de servidor.
-
Processos de Servidor Compartilhados Em conexões de servidor compartilhado, os aplicativos cliente se conectam através de uma rede a um processo de despachador, não a um processo de servidor. Por exemplo, 20 processos de cliente podem se conectar a um único processo de despachador.
-
Como o Oracle AI Database Cria Processos de Servidor O banco de dados cria processos de servidor de várias maneiras, dependendo dos métodos de conexão. Consulte Também: "Estágios do Processamento de SQL"
Processos de Servidor Dedicados
Em conexões de servidor dedicado, a conexão do cliente está associada a um e somente um processo de servidor.
No Linux, 20 processos clientes conectados a uma instância de banco de dados são atendidos por 20 processos de servidor. Cada processo do cliente se comunica diretamente com seu processo do servidor. Este processo de servidor é dedicado ao seu processo de cliente durante a sessão. O processo do servidor armazena informações específicas do processo e a UGA em sua PGA.
Consulte Também:
Processos de Servidor Compartilhado
Em conexões de servidor compartilhado, os aplicativos cliente se conectam através de uma rede a um processo de despatcher, não a um processo de servidor. Por exemplo, 20 processos de cliente podem se conectar a um único processo de despachador.
O processo de despachador recebe solicitações de clientes conectados e as coloca em uma fila de solicitações no pool grande. O primeiro processo de servidor compartilhado disponível pega a solicitação da fila e a processa. Posteriormente, o servidor compartilhado coloca o resultado na fila de resposta do dispatcher. O processo do dispatcher monitora essa fila e transmite o resultado ao cliente.
Como um processo de servidor dedicado, um processo de servidor compartilhado tem sua própria PGA. No entanto, a UGA de uma sessão está na MGA para que qualquer servidor compartilhado possa acessar os dados da sessão.
Consulte Também:
Como o Oracle AI Database Cria Processos de Servidor
O banco de dados cria processos de servidor de várias maneiras, dependendo dos métodos de conexão.
Os métodos de conexão são os seguintes:
-
Bequeath
O SQL*Plus, um cliente do OCI ou outro aplicativo cliente gera diretamente o processo do servidor.
-
Listener do Oracle Net
O aplicativo cliente se conecta ao banco de dados por meio de um listener.
-
Broker dedicado
Este é um processo de banco de dados que cria processos em primeiro plano. Ao contrário do listener, o broker reside dentro da instância do banco de dados. Ao usar um broker dedicado, o cliente se conecta ao listener, que então distribui a conexão ao broker dedicado.
Quando uma conexão não usa legenda, o banco de dados cria o processo do servidor da seguinte forma:
-
O aplicativo cliente solicita uma nova conexão do listener ou do broker.
-
O listener ou broker inicia a criação de um novo processo ou thread.
-
O sistema operacional cria o novo processo ou thread.
-
O Oracle AI Database inicializa vários componentes e notificações.
-
O banco de dados passa pelo código específico da conexão.
Se preferir, se você usar o método de conexão do broker dedicado, poderá pré-criar um pool de processos do servidor com o pacote DBMS_PROCESS. Nesse caso, o processo em segundo plano do Gerenciador de Processos (PMAN) monitora o pool de processos pré-criados, que aguardam para serem associados a uma solicitação do cliente. Quando uma conexão requer um processo de servidor, o banco de dados ignora as Etapas 2-4 da criação do processo e executa apenas a Etapa 5. Essa otimização melhora o desempenho.
Observação:
-
Referência de Tipos e Pacotes PL/SQL do Oracle AI Database para saber mais sobre o pacote PL/SQL
DBMS_PROCESS -
Oracle AI Database Reference para saber mais sobre o processo em segundo plano de PMAN
Visão Geral de Processos de Segundo Plano
Processos em segundo plano são processos adicionais usados por um banco de dados Oracle de multiprocessamento. Os processos em segundo plano executam tarefas de manutenção necessárias para operar o banco de dados e maximizar o desempenho de vários usuários.
Cada processo em segundo plano tem uma tarefa separada, mas trabalha com os outros processos. Por exemplo, o processo LGWR grava dados do buffer de redo log no blog redo on-line. Quando um arquivo de redo log preenchido está pronto para ser arquivado, o LGWR sinaliza outro processo para arquivar o arquivo de redo log.
O Oracle AI Database cria processos em segundo plano automaticamente quando uma instância de banco de dados é iniciada. Uma instância pode ter muitos processos em segundo plano, nem todos os quais sempre existem em todas as configurações de banco de dados. A consulta a seguir lista os processos em segundo plano em execução no banco de dados:
SELECT PNAME
FROM   V$PROCESS
WHERE  PNAME IS NOT NULL
ORDER BY PNAME;
Esta seção inclui os tópicos a seguir:
-
Processos em Segundo Plano Obrigatórios Os processos em segundo plano obrigatórios estão presentes em todas as configurações típicas do banco de dados.
-
Processos em Segundo Plano Opcionais Um processo em segundo plano opcional é qualquer processo em segundo plano não definido como obrigatório.
-
Processos Secundários Os processos secundários são processos em segundo plano que executam o trabalho em nome de outros processos. Consulte Também: Oracle AI Database Reference para obter descrições de todos os processos em segundo plano
Processos em Segundo Plano Obrigatórios
Processos em segundo plano obrigatórios estão presentes em todas as configurações típicas do banco de dados.
Esses processos são executados por padrão em uma instância de banco de dados de leitura/gravação iniciada com um arquivo de parâmetros de inicialização minimamente configurado. Uma instância de banco de dados somente para leitura desativa alguns desses processos.
Esta seção descreve os seguintes processos obrigatórios em segundo plano:
-
Grupo do Processo do Monitor do Processo (PMON) O grupo PMON inclui PMON, Processo Principal de Limpeza (CLMN) e Processos Auxiliares de Limpeza (CLnn). Esses processos são responsáveis pelo monitoramento e limpeza de outros processos.
-
O Gerenciador de Processos (PMAN) Gerenciador de Processos (PMAN) supervisiona vários processos em segundo plano, incluindo servidores compartilhados, servidores agrupados e processos da fila de jobs.
-
Processo de Registro do Listener (LREG) O processo de registro do listener (LREG) registra informações sobre a instância do banco de dados e os processos do dispatcher com o Oracle Net Listener.
-
Processo do Monitor do Sistema (SMON) O processo do monitor do sistema (SMON) é responsável por uma variedade de tarefas de limpeza no nível do sistema.
-
Processo de Gravação de Banco de Dados (DBW) O processo de gravação de banco de dados (DBW) grava o conteúdo dos buffers de banco de dados em arquivos de dados. O DBW processa os buffers modificados de gravação no cache de buffer do banco de dados para disco.
-
Processo de Gravação de Log (LGWR) O processo de gravação de log (LGWR) gerencia o buffer de redo log on-line.
-
Processo de Checkpoint (CKPT) O processo de checkpoint (CKPT) atualiza os cabeçalhos do arquivo de controle e do arquivo de dados com informações de checkpoint e sinaliza o DBW para gravar blocos no disco. As informações do checkpoint incluem a posição do checkpoint, o SCN e a localização no redo log on-line para iniciar a recuperação.
-
Processos do Monitor de Gerenciabilidade (MMON e MMNL) O processo do monitor de gerenciabilidade (MMON) executa muitas tarefas relacionadas ao Automatic Workload Repository (AWR).
-
Processo de Recuperador (RECO) Em um banco de dados distribuído, o processo de recuperador (RECO) resolve automaticamente falhas em transações distribuídas.
-
Processo em Segundo Plano (BGnn) Os processos em segundo plano (BGnn) são um processo em segundo plano padrão em ambientes Oracle RAC que executa várias tarefas de manutenção e monitoramento.
-
Processo daemon do sistema operacional virtual (VOSD) O processo daemon do sistema operacional virtual (VOSD) executa ações de serviço de banco de dados Oracle com limite de tempo.
-
Processo do Monitor de Rede (NMON) O processo do monitor de rede (NMON) é um serviço de monitoramento de rede leve.
Consulte Também:
-
Oracle AI Database Reference para obter descrições de outros processos obrigatórios, incluindo MMAN, DIAG, VKTM, DBRM e PSP0
-
Oracle Real Application Clusters Administration and Deployment Guide e Oracle Clusterware Administration and Deployment Guide para obter mais informações sobre processos em segundo plano específicos para Oracle RAC e Oracle Clusterware
Grupo de Processos do Process Monitor (PMON)
O grupo PMON inclui PMON, Processo Principal de Limpeza (CLMN) e Processos Auxiliares de Limpeza (CLnn). Esses processos são responsáveis pelo monitoramento e limpeza de outros processos.
O grupo PMON supervisiona a limpeza do cache de buffer e a liberação de recursos usados por um processo do cliente. Por exemplo, o grupo PMON é responsável por redefinir o status da tabela de transações ativa, liberar bloqueios que não são mais necessários e remover o ID processo de processos encerrados da lista de processos ativos.
O banco de dados deve garantir que os recursos mantidos por processos encerrados sejam liberados para que possam ser usados por outros processos. Caso contrário, o processo pode acabar bloqueado ou preso em contenção.
-
Processo do Monitor de Processo (PMON) O monitor de processo (PMON) detecta o encerramento de outros processos em segundo plano. Se um processo de servidor ou despachador for encerrado de forma anormal, o grupo PMON será responsável por executar a recuperação do processo. O encerramento do processo pode ter várias causas, incluindo comandos de eliminação do sistema operacional ou instruções
ALTER SYSTEM KILL SESSION. -
O Processo Principal de Limpeza (CLMN) PMON delega o trabalho de limpeza ao processo principal de limpeza (CLMN). A tarefa de detectar terminação anormal permanece com PMON.
-
O CLMN Processos Auxiliares de Limpeza (CLnn) delega o trabalho de limpeza aos processos auxiliares do CLnn.
-
Quarentena de Recursos do Banco de Dados Se um processo ou sessão for encerrado, o grupo PMON liberará os recursos retidos para o banco de dados. Em alguns casos, o grupo PMON pode colocar automaticamente em quarentena recursos irrecuperáveis e corrompidos para que a instância do banco de dados não seja imediatamente forçada a ser encerrada.
Processo do Process Monitor (PMON)
O monitor de processo (PMON) detecta o encerramento de outros processos em segundo plano. Se um processo de servidor ou despachador for encerrado de forma anormal, o grupo PMON será responsável por executar a recuperação do processo. O encerramento do processo pode ter várias causas, incluindo comandos de eliminação do sistema operacional ou instruções ALTER SYSTEM KILL SESSION.
Limpar Processo Principal (CLMN)
O PMON delega o trabalho de limpeza ao processo principal de limpeza (CLMN). A tarefa de detectar terminação anormal permanece com PMON.
O CLMN executa periodicamente a limpeza de processos encerrados, sessões encerradas, transações, conexões de rede, sessões ociosas, transações desanexadas e conexões de rede desanexadas que excederam seu tempo limite de inatividade.
Processos Auxiliares de Limpeza (CLnn)
O CLMN delega trabalho de limpeza aos processos auxiliares do CLnn.
Os processos CLnn auxiliam na limpeza de processos e sessões encerrados. O número de processos auxiliares é proporcional à quantidade de trabalho de limpeza a ser feito e à eficiência atual da limpeza.
Um processo de limpeza pode ser bloqueado, o que o impede de continuar a limpar outros processos. Além disso, se vários processos exigirem limpeza, o tempo de limpeza poderá ser significativo. Por esses motivos, o Oracle AI Database pode usar vários processos auxiliares em paralelo para executar a limpeza, aliviando assim o desempenho lento.
As views V$CLEANUP_PROCESS e V$DEAD_CLEANUP contêm metadados sobre a limpeza de CLMN. A exibição V$CLEANUP_PROCESS contém uma linha para cada processo de limpeza. Por exemplo, se V$CLEANUP_PROCESS.STATE for BUSY, o processo será ativado no momento na limpeza.
Consulte Também: Oracle AI Database Reference para saber mais sobre o V$CLEANUP_PROCESS
Quarentena de recursos do banco de dados
Se um processo ou sessão for encerrado, o grupo PMON liberará os recursos mantidos no banco de dados. Em alguns casos, o grupo PMON pode colocar automaticamente em quarentena recursos irrecuperáveis e corrompidos para que a instância do banco de dados não seja imediatamente forçada a ser encerrada.
O grupo PMON continua a executar o máximo de limpeza possível no processo ou sessão que estava mantendo o recurso em quarentena. A view V$QUARANTINE contém metadados como o tipo de recurso, a quantidade de memória consumida, o erro da Oracle que causa a quarentena e assim por diante.
Consulte Também: Oracle AI Database Reference para saber mais sobre o V$QUARANTINE
Gerenciador de Processos (PMAN)
O Gerenciador de Processos (PMAN) supervisiona vários processos em segundo plano, incluindo servidores compartilhados, servidores agrupados e processos de fila de jobs.
O PMAN monitora, gera e interrompe os seguintes tipos de processos:
-
Processos do Dispatcher e do servidor compartilhado
-
Processos do broker de conexão e do servidor em pool para pools de conexões residentes do banco de dados
-
Processos da fila de jobs
-
Processos em segundo plano reiniciáveis
Processo de Registro do Listener (LREG)
O processo de registro do listener (LREG) registra informações sobre a instância do banco de dados e os processos do dispatcher com o Oracle Net Listener.
Quando uma instância é iniciada, o LREG sonda o listener para determinar se ele está em execução. Se o listener estiver em execução, o LREG passará os parâmetros relevantes. Se não estiver em execução, o LREG tentará contatá-lo periodicamente.
Observação: Nas releases anteriores ao Oracle Database 12c, o PMON executou o registro do listener.
Consulte Também: "O Oracle Net Listener"
Processo do Monitor do Sistema (SMON)
O processo de monitoramento do sistema (SMON) é responsável por uma variedade de tarefas de limpeza no nível do sistema.
Os deveres atribuídos ao SMON incluem:
-
Executando a recuperação da instância, se necessário, na inicialização da instância. Em um banco de dados Oracle RAC, o processo SMON de uma instância de banco de dados pode executar a recuperação de instância para uma instância com falha.
-
Recuperando transações encerradas que foram ignoradas durante a recuperação da instância por causa de erros off-line de leitura de arquivo ou tablespace. O SMON recupera as transações quando o tablespace ou arquivo é colocado on-line novamente.
-
Limpeza de segmentos temporários não utilizados em tablespaces permanentes. Por exemplo, o Oracle AI Database aloca extensões ao criar um índice. Se a operação falhar, o SMON limpará o espaço temporário.
-
Agrupando extensões livres contíguas em tablespaces gerenciados por dicionário.
O SMON verifica regularmente para verificar se é necessário. Outros processos podem chamar SMON se detectarem uma necessidade dele.
Processo do Gravador de Banco de Dados (DBW)
O processo de gravação de banco de dados (DBW) grava o conteúdo dos buffers de banco de dados em arquivos de dados. O DBW processa os buffers modificados de gravação no cache de buffer do banco de dados para disco.
Embora um processo de gravação de banco de dados (DBW0) seja adequado para a maioria dos sistemas, você pode configurar processos adicionais - DBW1 a DBW9, DBWa a DBWz e BW36 a BW99 - para melhorar o desempenho de gravação se o sistema modificar os dados fortemente. Esses processos DBW adicionais não são úteis em sistemas uniprocessadores.
O processo DBW grava buffers sujos no disco nas seguintes condições:
-
Quando um processo do servidor não consegue localizar um buffer reutilizável limpo após a verificação de um número limite de buffers, ele sinaliza o DBW para gravar. O DBW grava buffers sujos no disco de forma assíncrona, se possível, ao executar outro processamento.
-
O DBW grava buffers periodicamente para avançar o ponto de verificação, que é a posição no thread de refazer do qual a recuperação da instância começa. A posição do log do checkpoint é determinada pelo buffer sujo mais antigo no cache do buffer.
Em muitos casos, os blocos que o DBW escreve estão espalhados por todo o disco. Assim, as gravações tendem a ser mais lentas do que as gravações sequenciais realizadas pela LGWR. O DBW executa gravações em vários blocos quando possível para melhorar a eficiência. O número de blocos gravados em uma gravação de vários blocos varia de acordo com o sistema operacional.
Consulte Também:
-
Guia de Ajuste de Desempenho do Oracle AI Database para obter conselhos sobre como configurar, monitorar e ajustar DBW.
Processo de Gravação de Log (LGWR)
O processo de gravação de log (LGWR) gerencia o buffer de redo log on-line.
O LGWR grava uma parte do buffer no redo log on-line. Ao separar as tarefas de modificação de buffers de banco de dados, executar gravações dispersas de buffers sujos em disco e executar gravações sequenciais rápidas de redo em disco, o banco de dados melhora o desempenho.
Nas seguintes circunstâncias, o LGWR grava todas as entradas de redo que foram copiadas para o buffer desde a última vez que ele gravou:
-
Um usuário faz commit de uma transação.
-
Uma chave de log de redo on-line ocorre.
-
Três segundos se passaram desde que a LGWR escreveu pela última vez.
-
O buffer de redo log está um terço cheio ou contém 1 MB de dados armazenados em buffer.
-
O DBW deve gravar buffers modificados no disco.
Para que o DBW possa gravar um buffer sujo, o banco de dados deve gravar em disco os registros de redo associados a alterações no buffer (o protocolo de gravação antecipada). Se o DBW descobrir que alguns registros de redo não foram gravados, ele sinalizará o LGWR para gravar os registros no disco e aguardará a conclusão do LGWR antes de gravar os buffers de dados no disco.
-
LGWR e Commits O Oracle AI Database usa um mecanismo de commit rápido para melhorar o desempenho de transações submetidas a commit.
-
O LGWR LGWR e Arquivos Inacessíveis grava de forma síncrona no grupo espelhado ativo de arquivos de redo log on-line. Consulte Também: "Commits of Transactions"
LGWR e Confirmações
O Oracle AI Database usa um mecanismo de commit rápido para melhorar o desempenho de transações confirmadas.
Quando um usuário emite uma instrução COMMIT, uma número de alteração do sistema (SCN) é atribuída à transação. O LGWR coloca um registro de commit no buffer de redo log e o grava no disco imediatamente, junto com o SCN de commit e as entradas de redo da transação.
O buffer de redo log é circular. Quando LGWR grava entradas de redo do buffer do redo log em um arquivo redo log on-line, os processos do servidor podem copiar novas entradas sobre as entradas no buffer do redo log que foram gravadas no disco. O LGWR normalmente grava com rapidez suficiente para garantir que o espaço esteja sempre disponível no buffer para novas entradas, mesmo quando o acesso ao redo log on-line é pesado.
A gravação atômica da entrada de redo que contém o registro de commit da transação é o único evento que determina que a transação foi confirmada. O Oracle AI Database retorna um código de sucesso para a transação de commit, embora os buffers de dados ainda não tenham sido gravados no disco. As alterações correspondentes nos blocos de dados são adiadas até que seja eficiente para o DBW gravá-las nos arquivos de dados.
Observação: O LGWR pode gravar entradas de redo log no disco antes de uma transação ser confirmada. As alterações que são protegidas pelas entradas de redo se tornam permanentes somente se a transação for confirmada posteriormente.
Quando a atividade é alta, o LGWR pode usar commits de grupo. Por exemplo, um usuário faz commit, fazendo com que o LGWR grave as entradas de redo da transação no disco. Durante esta gravação, outros usuários fazem commit. O LGWR não pode gravar no disco para confirmar essas transações até que a gravação anterior seja concluída. Após a conclusão, o LGWR pode gravar a lista de entradas de redo de transações em espera (ainda não confirmadas) em uma operação. Dessa forma, o banco de dados minimiza a E/S do disco e maximiza o desempenho. Se as solicitações de commits continuarem em uma taxa alta, cada gravação por LGWR poderá conter vários registros de commit.
LGWR e Arquivos Inacessíveis
O LGWR grava de forma síncrona no grupo espelhado ativo de arquivos de redo log on-line.
Se um arquivo de log estiver inacessível, o LGWR continuará gravando em outros arquivos do grupo e gravará um erro no arquivo de rastreamento do LGWR e no log de alerta. Se todos os arquivos de um grupo estiverem danificados ou se o grupo estiver indisponível porque não foi arquivado, o LGWR não poderá continuar a funcionar.
Consulte Também:
-
"Como o Oracle AI Database Grava no Redo Log On-line" e "Buffer de Redo Log"
-
Oracle AI Database Performance Tuning Guide para obter informações sobre como monitorar e ajustar o desempenho do LGWR
Processo de Checkpoint (CKPT)
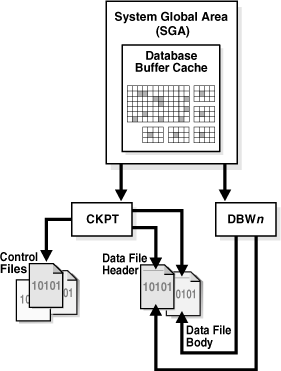
O processo de checkpoint (CKPT) atualiza os cabeçalhos de arquivo de controle e de arquivo de dados com informações de checkpoint e sinaliza o DBW para gravar blocos no disco. As informações do checkpoint incluem a posição do checkpoint, o SCN e a localização no redo log on-line para iniciar a recuperação.
Conforme mostrado na Figura 18-4, o CKPT não grava blocos de dados em arquivos de dados ou blocos de redo em arquivos de redo log on-line.
Figura 4: Processo de Checkpoint
Descrição da ilustração cncpt228.gif
Consulte Também: "Visão Geral dos Pontos de Verificação"
Processos do Monitor de Gerenciabilidade (MMON e MMNL)
O processo de monitor de capacidade de gerenciamento (MMON) executa muitas tarefas relacionadas ao Automatic Workload Repository (AWR).
Por exemplo, o MMON grava quando uma métrica viola seu valor limite, tirando snapshots e capturando valor de estatísticas para objetos SQL modificados recentemente.
O processo lite do monitor de gerenciabilidade (MMNL) grava estatísticas do buffer ASH (Active Session History) no SGA para o disco. O MMNL grava no disco quando o buffer ASH está cheio.
Consulte Também: "Oracle AI Database Get Started with Performance Tuning" e "Overview of Active Session History"
Processo do Recuperador (RECO)
Em um banco de dados distribuído, o processo de recuperação (RECO) resolve automaticamente falhas em transações distribuídas.
O processo RECO de um nó se conecta automaticamente a outros bancos de dados envolvidos em uma transação distribuída duvidosa. Quando RECO restabelece uma conexão entre os bancos de dados, ele resolve automaticamente todas as transações duvidosas, removendo da tabela de transações pendentes de cada banco de dados quaisquer linhas que correspondam às transações resolvidas.
Consulte Também: Oracle AI Database Administrator's Guide para obter mais informações sobre a recuperação de transações em sistemas distribuídos
Processo em Segundo Plano (BG nn )
Os processos em segundo plano (BGnn) são um processo em segundo plano padrão em ambientes Oracle RAC que executa várias tarefas de manutenção e monitoramento.
O processo em segundo plano é responsável pelo gerenciamento do cache de buffer, pelo suporte ao processo de gravação de log (LGWR), pela coordenação do ponto de verificação, pelo monitoramento do processo em segundo plano e pela coleta de estatísticas.
Processo do Virtual Operating System Daemon (VOSD)
O processo daemon de sistema operacional virtual (VOSD) executa ações de serviço de banco de dados Oracle com limite de tempo.
Esse processo é gerado na inicialização da instância e é responsável por executar ações de serviço do sistema críticas para o banco de dados. Esse processo é usado por instâncias de banco de dados, instâncias do Oracle ASM e Oracle RAC.
Processo do Monitor de Rede (NMON)
O processo de monitoramento de rede (NMON) é um serviço de monitoramento de rede leve.
O Network Monitor (NMON) é um serviço de monitoramento de rede de baixa sobrecarga que utiliza recursos avançados do kernel para fornecer monitoramento abrangente e sempre ativo. Ele captura continuamente estatísticas e eventos de rede em vários níveis, incluindo em todo o sistema, por interface, por IP e por fluxo, fornecendo métricas detalhadas para serviços de nível superior. Construído no NMON, o serviço Health Score simplifica a avaliação de integridade da rede com uma pontuação padronizada de 0 a 100 e aborda proativamente os problemas coletando diagnósticos conforme necessário. O NMON fornece estatísticas de rede eficientes e acionáveis, permitindo a detecção oportuna de anomalias e a correlação eficaz com as atividades do banco de dados.
Processos de Segundo Plano Opcionais
Um processo em segundo plano opcional é qualquer processo em segundo plano não definido como obrigatório.
A maioria dos processos opcionais em segundo plano é específica para tarefas ou recursos. Por exemplo, os processos em segundo plano que suportam o Oracle ASM só estão disponíveis quando esse recurso está ativado.
Esta seção descreve alguns processos opcionais comuns:
-
Processos de Arquivamento (ARCn) Um processo de arquivamento (ARCn) copia arquivos de redo log on-line para armazenamento off-line após a ocorrência de uma alternância de redo log.
-
Processos de Fila de Jobs (CJQ0 e Jnn) Um processo de fila executa jobs do usuário, geralmente no modo batch. Um job é uma tarefa definida pelo usuário programada para ser executada uma ou mais vezes.
-
Processo de Arquivamento de Dados de Flashback (FBDA) O processo de arquivamento de dados de flashback (FBDA) arquiva linhas históricas de tabelas rastreadas em Arquivos de Dados de Flashback.
-
Processo de Coordenador de Gerenciamento de Espaço (SMCO) O processo de coordenador de gerenciamento de espaço (SMCO) é iniciado pelo SMON e coordena a execução de várias tarefas relacionadas ao gerenciamento de espaço.
Consulte Também:
-
Oracle AI Database Transactional Event Queues and Advanced Queuing User's Guide para uma introdução ao Advanced Queuing (AQ)
-
Oracle AI Database Reference para obter descrições de processos em segundo plano específicos do AQ e do Oracle ASM
Processos do arquivador (ARC n )
Um processo de arquivamento (ARCn) copia arquivos de redo log on-line para armazenamento off-line após a ocorrência de uma alternância de redo log.
Esses processos também podem coletar dados de redo de transação e transmiti-los para destinos de banco de dados stand-by. Os processos ARCn existem somente quando o banco de dados está no modo ARQUIVELOG e o arquivamento automático está ativado.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber como ajustar o número de processos do arquivador
-
Guia de Ajuste de Desempenho do Oracle AI Database para saber como ajustar o desempenho do arquivador
Processos de Filas de Jobs (CJQ0 e Jnnn)
Um processo de fila executa jobs do usuário, geralmente no modo batch. Um job é uma tarefa definida pelo usuário programada para ser executada uma ou mais vezes.
Por exemplo, você pode usar uma fila de jobs para programar uma atualização de longa execução em segundo plano. Dada uma data de início e um intervalo de tempo, os processos da fila de trabalhos tentam executar o trabalho na próxima ocorrência do intervalo.
O Oracle AI Database gerencia processos de fila de jobs dinamicamente, permitindo assim que os clientes de fila de jobs usem mais processos de fila de jobs quando necessário. O banco de dados libera recursos usados pelos novos processos quando eles estão ociosos.
Os processos dinâmicos da fila de trabalhos podem executar muitos trabalhos simultaneamente em um determinado intervalo. A sequência de eventos é a seguinte:
-
O processo do coordenador de job (CJQ0) é iniciado e interrompido automaticamente conforme necessário pelo Oracle Scheduler. O processo do coordenador seleciona periodicamente jobs que precisam ser executados na tabela
JOB$do sistema. Os novos trabalhos selecionados são ordenados por tempo. -
O processo do coordenador gera dinamicamente processos filho da fila de jobs (Jnn) para executar os jobs.
-
O processo de fila de jobs executa um dos jobs selecionados pelo processo CJQ0 para execução. Cada processo de fila de jobs executa um job por vez até a conclusão.
-
Depois que o processo termina a execução de um único job, ele procura mais jobs. Se nenhum job for programado para execução, ele entrará em um estado de suspensão, do qual acordará em intervalos periódicos e pesquisará mais jobs. Se o processo não localizar novos trabalhos, ele será encerrado após um intervalo predefinido.
O parâmetro de inicialização JOB_QUEUE_PROCESSES representa o número máximo de processos de fila de jobs que podem ser executados simultaneamente em uma instância. No entanto, os clientes não devem assumir que todos os processos da fila de jobs estejam disponíveis para execução do job. Observação: O processo do coordenador não será iniciado se o parâmetro de inicialização JOB_QUEUE_PROCESSES estiver definido como 0.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber mais sobre o Oracle Scheduler
-
Oracle AI Database Transactional Event Queues and Advanced Queuing User's Guide para aprender sobre processos em segundo plano de AQ
Processo Flashback Data Archive (FBDA)
O processo de arquivamento de dados de flashback (FBDA) arquiva linhas históricas de tabelas rastreadas em Flashback Data Archives.
Quando uma transação que contém DML em uma tabela rastreada é submetida a commit, esse processo armazena a pré-imagem das linhas alteradas no Arquivo de Dados de Flashback. Ele também mantém metadados nas linhas atuais.
O FBDA gerencia automaticamente o Flashback Data Archive para espaço, organização e retenção. Além disso, o processo mantém o controle de quanto tempo o arquivamento de transações rastreadas ocorreu.
Processo de Coordenador de Gerenciamento de Espaço (SMCO)
O processo de coordenador de gerenciamento de espaço (SMCO) é iniciado pelo SMON e coordena a execução de várias tarefas relacionadas ao gerenciamento de espaço.
O processo SMCO coordena a execução de várias tarefas relacionadas ao gerenciamento de espaço.
As tarefas comuns incluem alocação e recuperação proativas de espaço e manutenção temporária de tablespace. O SMCO gera dinamicamente processos filhos (Wnnn) para implementar a tarefa.
Consulte Também: Guia de Desenvolvimento do Oracle AI Database para saber mais sobre o Flashback Data Archive e o recurso Histórico Temporal
Processos Secundários
Processos secundários são processos em segundo plano que executam o trabalho em nome de outros processos.
Esta seção descreve alguns processos secundários usados pelo Oracle AI Database.
-
Os processos secundários de E/S (Processos Secundários de E/S) simulam E/S assíncrona para sistemas e dispositivos que não oferecem suporte a ela.
-
Processos do Servidor de Execução Paralela (PX) Em execução paralela, vários processos trabalham juntos simultaneamente para executar uma única instrução SQL. Consulte Também: Oracle AI Database Reference para obter descrições dos processos secundários do Oracle AI Database.
Processos Secundários de Entrada/Saída
Processos secundários de E/S (Innn) simulam E/S assíncrona para sistemas e dispositivos que não o suportam.
Na E/S assíncrona, não há necessidade de tempo para a transmissão, permitindo que outros processos comecem antes que a transmissão tenha terminado.
Por exemplo, suponha que uma aplicação grave 1000 blocos em um disco em um sistema operacional que não suporte E/S assíncrona. Cada gravação ocorre sequencialmente e aguarda uma confirmação de que a gravação foi bem-sucedida. Com o disco assíncrono, a aplicação pode gravar os blocos em massa e executar outro trabalho enquanto aguarda uma resposta do sistema operacional que todos os blocos foram gravados.
Para simular E/S assíncrona, um processo supervisiona vários processos secundários. O processo do chamador atribui trabalho a cada um dos processos secundários, que aguardam a conclusão de cada gravação e o reportam ao chamador quando concluído. Na E/S assíncrona verdadeira, o sistema operacional aguarda a conclusão da E/S e reporta de volta ao processo, enquanto na E/S assíncrona simulada os processos secundários aguardam e reportam de volta ao chamador.
O banco de dados suporta diferentes tipos de processos secundários de E/S, incluindo:
-
Processos secundários de E/S para o Recovery Manager (RMAN)
Ao usar o RMAN para fazer backup ou restaurar dados, você pode usar processos secundários de E/S para dispositivos de disco e fita.
-
Processos secundários do gravador de banco de dados
Se não for prático usar vários processos de gravação de banco de dados, como quando o computador tem uma CPU, o banco de dados pode distribuir E/S por vários processos secundários. O DBW é o único processo que verifica a lista LRU de cache de buffer em busca de blocos a serem gravados no disco. No entanto, os processos secundários de E/S executam a E/S desses blocos.
Consulte Também:
-
Oracle AI Database Backup and Recovery User's Guide para saber mais sobre processos secundários de E/S para operações de backup e restauração
-
Guia de Ajuste de Desempenho do Oracle AI Database para saber mais sobre os processos secundários do gravador de banco de dados
Processos do Servidor de Execução Paralela (PX)
Em execução paralela, vários processos trabalham juntos simultaneamente para executar uma única instrução SQL.
Ao dividir o trabalho entre vários processos, o Oracle AI Database pode executar a instrução mais rapidamente. Por exemplo, quatro processos tratam quatro trimestres diferentes em um ano, em vez de um processo tratar todos os quatro trimestres sozinho.
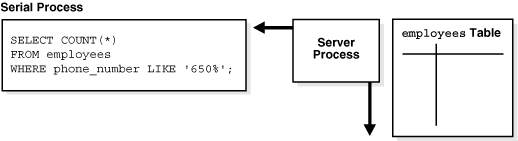
A execução paralela contrasta com a execução em série, na qual um único processo de servidor executa todo o processamento necessário para a execução sequencial de uma instrução SQL. Por exemplo, para executar uma verificação de tabela completa como SELECT * FROM employees, um processo do servidor executa todo o trabalho, conforme mostrado na Figura 18-5.
Figura 5: Varredura de Tabela Completa Serial
Descrição da ilustração cncpt016.gif
A execução paralela reduz o tempo de resposta para operações com uso intensivo de dados em bancos de dados grandes, como data warehouses. O multiprocessamento simétrico (SMP) e o sistema clusterizado obtêm os maiores benefícios de desempenho da execução paralela porque o processamento de instruções pode ser dividido entre várias CPUs. A execução paralela também pode beneficiar determinados tipos de sistemas OLTP e híbridos.
Nos sistemas Oracle RAC, o posicionamento de serviço de um serviço específico controla a execução paralela. Especificamente, os processos paralelos são executados nos nós nos quais o serviço está configurado. Por padrão, o Oracle AI Database só executa processos paralelos em uma instância que oferece o serviço usado para estabelecer conexão com o banco de dados. Isso não afeta outras operações paralelas, como recuperação paralela ou o processamento de consultas GV$.
-
Coordenador de Consultas Em execução paralela, o processo do servidor atua como o coordenador de consultas (também chamado de coordenador de execução paralela).
-
Os servidores de execução paralela Produtores e Consumidores são divididos em produtores e consumidores. Os produtores são responsáveis por processar seus dados e depois distribuí-los aos consumidores que precisam deles.
-
Grânulos Em execução paralela, uma tabela é dividida dinamicamente em unidades de carga. Cada unidade, chamada de grânulo, é a menor unidade de trabalho ao acessar dados.
Consulte Também:
-
Oracle AI Database VLDB and Partitioning Guide para saber mais sobre execução paralela
-
Oracle Real Application Clusters Administration and Deployment Guide para considerações relacionadas à execução paralela em ambientes Oracle RAC
Coordenador de Consulta
Em execução paralela, o processo do servidor atua como o coordenador de consulta (também chamado de coordenador de execução paralela).
O coordenador da consulta é responsável pelo seguinte:
-
Analisando a consulta
-
Alocando e controlando os processos do servidor de execução paralela
-
Enviando saída para o usuário
Dado um plano de consulta para uma consulta, o coordenador divide cada operador em uma consulta SQL em partes paralelas, executa-as na ordem especificada na consulta e integra os resultados parciais produzidos por servidores em execução paralela executando os operadores.
O número de servidores da execução paralela designados a uma única operação é o grau de paralelismo de uma operação. Várias operações dentro da mesma instrução SQL têm o mesmo grau de paralelismo.
Produtores e Consumidores
Os servidores de execução paralela são divididos em produtores e consumidores. Os produtores são responsáveis por processar seus dados e depois distribuí-los aos consumidores que precisam deles.
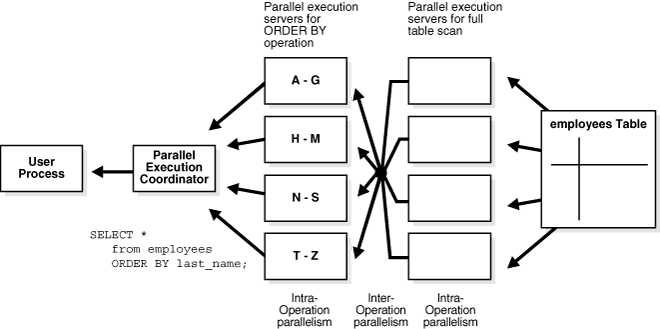
O banco de dados pode executar a distribuição usando uma variedade de técnicas. Duas técnicas comuns são uma transmissão e um hash. Em uma transmissão, cada produtor envia as linhas para todos os consumidores. Em um hash, o banco de dados calcula uma função de hash em um conjunto de chaves e torna cada consumidor responsável por um subconjunto de valores de hash. A Figura 18-6 representa a interação entre produtores e consumidores na execução paralela da seguinte instrução:
SELECT * FROM employees ORDER BY last_name;O plano de execução implementa uma verificação completa da tabela employees. A verificação é seguida por uma espécie de linhas recuperadas. Todos os processos do produtor envolvidos na operação de varredura enviam linhas para o processo do consumidor apropriado que executa a classificação.
Figura 6: Produtores e Consumidores
Descrição da ilustração vldbg013.gif
Grânulos
Em execução paralela, uma tabela é dividida dinamicamente em unidades de carga. Cada unidade, chamada de grânulo, é a menor unidade de trabalho ao acessar dados.
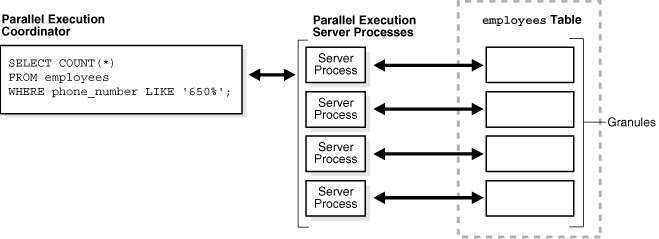
Um grânulo baseado em bloco é uma faixa de blocos de dados da tabela lida por um único servidor de execução paralela (também chamado de servidor PX), que usa Pnnn como um formato de nome. Para obter uma distribuição uniforme do trabalho entre processos de servidores paralelos, o número de grânulos é sempre muito maior do que o DOP solicitado. A Figura 18-7 mostra uma verificação paralela da tabela employees.
Figura 7: Verificação de tabela completa paralela
Descrição da ilustração cncpt017.gif
O banco de dados mapeia os grânulos para servidores de execução paralela no momento da execução. Quando um servidor de execução paralela termina de ler as linhas correspondentes a um grânulo, e quando os grânulos permanecem, ele obtém outro grânulo do coordenador de consulta. Esta operação continua até que a tabela seja lida. Os servidores de execução enviam os resultados de volta ao coordenador, que monta as partes na verificação completa da tabela desejada.
Consulte Também:
-
Oracle AI Database VLDB and Partitioning Guide para saber como usar a execução paralela
-
Guia do Oracle AI Database Data Warehousing para saber mais sobre os parâmetros de inicialização recomendados para paralelismo