Aplicativo e Arquitetura do Oracle Net Services
Este capítulo define a arquitetura do aplicativo e descreve como um banco de dados Oracle e aplicativos de banco de dados funcionam em um ambiente de processamento distribuído. Esse material se aplica a quase todos os tipos de ambiente do Oracle AI Database.
-
Visão Geral da Arquitetura de Aplicativo Oracle No contexto deste capítulo, arquitetura de aplicativo refere-se ao ambiente de computação no qual um aplicativo de banco de dados se conecta a um banco de dados Oracle.
-
Visão Geral da Arquitetura do Oracle Net Services
Oracle Net Services é um conjunto de componentes de rede que fornece soluções de conectividade em toda a empresa em ambientes de computação heterogêneos e distribuídos.
-
Visão Geral da Interface do Programa A interface do programa é a camada de software entre um aplicativo de banco de dados e o Oracle AI Database.
-
Visão Geral do Oracle True Cache O True Cache é um cache na memória e somente leitura na frente de um Oracle AI Database.
Visão Geral do Oracle Application Architecture
No contexto deste capítulo, arquitetura de aplicativo refere-se ao ambiente de computação no qual um aplicativo de banco de dados se conecta a um banco de dados Oracle.
-
Visão Geral da Arquitetura Cliente/Servidor No ambiente do Oracle AI Database, o aplicativo de banco de dados e o banco de dados são separados em uma arquitetura cliente/servidor.
-
Visão Geral da Arquitetura Multicamadas Em uma arquitetura multicamadas tradicional, um servidor de aplicativos fornece dados para clientes e serve como uma interface entre clientes e servidores de banco de dados.
-
Visão Geral da Arquitetura de Grade Em um ambiente do Oracle AI Database, a computação de grade é uma arquitetura de computação que efetivamente reúne grandes números de servidores e armazenamento em um recurso de computação flexível e sob demanda.
Visão Geral da Arquitetura Cliente/Servidor
No ambiente do Oracle AI Database, o aplicativo de banco de dados e o banco de dados são separados em uma arquitetura cliente/servidor.
Os componentes são os seguintes:
-
O cliente executa o aplicativo de banco de dados, por exemplo, o SQL*Plus ou um programa de entrada de dados do Visual Basic, que acessa informações do banco de dados e interage com um usuário.
-
O servidor executa o software Oracle AI Database e trata as funções necessárias para acesso simultâneo de dados compartilhados a um banco de dados Oracle.
Embora o aplicativo cliente e o banco de dados possam ser executados no mesmo computador, uma maior eficiência é frequentemente alcançada quando as partes do cliente e a parte do servidor são executadas por diferentes computadores conectados por meio de uma rede. As seções a seguir discutem as variações na arquitetura cliente/servidor do Oracle AI Database.
-
Processamento Distribuído O uso de vários hosts para processar uma tarefa individual é conhecido como processamento distribuído.
-
Vantagens de uma Arquitetura Cliente/Servidor A arquitetura cliente/servidor do Oracle AI Database em um ambiente de processamento distribuído oferece vários benefícios.
Processamento Distribuído
O uso de vários hosts para processar uma tarefa individual é conhecido como processamento distribuído.
O processamento front-end e back-end ocorre em diferentes computadores. Na Figura 19-1, o cliente e o servidor estão localizados em diferentes hosts conectados por meio do Oracle Net Services.
Figura 1: Arquitetura de Cliente/Servidor e Processamento Distribuído
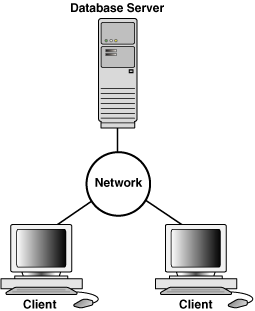
Descrição da ilustração cncpt083.gif
A Figura 19-2 é uma variação que descreve um banco de dados distribuído. Neste exemplo, um banco de dados em um host acessa dados em um banco de dados separado localizado em um host diferente.
Figura 2: Arquitetura de Cliente/Servidor e Banco de Dados Distribuído
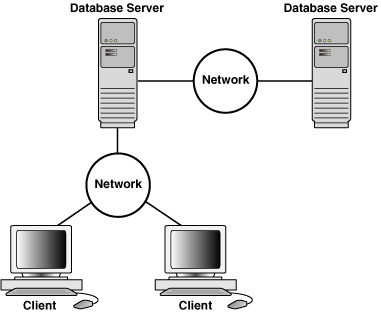
Descrição da ilustração cncpt240.gif
Observação: Este restante deste capítulo se aplica a ambientes com um banco de dados em um servidor.
Vantagens de uma Arquitetura Cliente/Servidor
A arquitetura cliente/servidor do Oracle AI Database em um ambiente de processamento distribuído oferece vários benefícios.
Os benefícios incluem:
-
Os aplicativos clientes não são responsáveis pela execução do processamento de dados. Em vez disso, eles solicitam a entrada dos usuários, solicitam dados do servidor e, em seguida, analisam e apresentam esses dados usando os recursos de exibição da estação de trabalho do cliente ou do terminal (por exemplo, usando gráficos ou planilhas).
-
Os aplicativos clientes não dependem da localização física dos dados. Mesmo que os dados sejam movidos ou distribuídos para outros servidores de banco de dados, o aplicativo continua funcionando com pouca ou nenhuma modificação.
-
O Oracle AI Database explora as instalações de multitarefa e memória compartilhada de seu sistema operacional subjacente. Consequentemente, ela oferece o mais alto grau possível de simultaneidade, integridade de dados e desempenho para seus aplicativos clientes.
-
As estações de trabalho ou os terminais do cliente podem ser otimizados para a apresentação de dados (por exemplo, fornecendo gráficos e suporte ao mouse), enquanto o servidor pode ser otimizado para o processamento e armazenamento de dados (por exemplo, por ter grandes quantidades de memória e espaço em disco).
-
Em ambientes de rede, você pode usar estações de trabalho de cliente de baixo custo para acessar os dados remotos do servidor de forma eficaz.
-
O banco de dados pode ser dimensionado à medida que o sistema cresce. Você pode adicionar vários servidores para distribuir a carga de processamento do banco de dados por toda a rede (dimensionada horizontalmente) ou pode mover o banco de dados para um minicomputador ou mainframe para aproveitar o desempenho de um sistema maior (dimensionado verticalmente). Em ambos os casos, os dados e as aplicações são mantidos com pouca ou nenhuma modificação porque o Oracle AI Database é portátil entre sistemas.
-
Em ambientes de rede, os dados compartilhados são armazenados nos servidores em vez de em todos os computadores, tornando mais fácil e eficiente gerenciar o acesso simultâneo.
-
Em ambientes em rede, os aplicativos clientes enviam solicitações de banco de dados para o servidor usando instruções SQL. Depois de recebida, cada instrução SQL é processada pelo servidor, que retorna os resultados para o cliente. O tráfego de rede é minimizado porque somente as solicitações e os resultados são enviados pela rede.
Consulte Também: Oracle AI Database Administrator's Guide para saber mais sobre bancos de dados distribuídos
Visão Geral da Arquitetura Multicamadas
Em uma arquitetura multicamada tradicional, um servidor de aplicativos fornece dados para clientes e serve como uma interface entre clientes e servidores de banco de dados.
Essa arquitetura permite o uso de um servidor de aplicativos para:
-
Validar as credenciais de um cliente, como um navegador da Web
-
Conecte-se a um servidor da base de dados
-
Executar a operação solicitada
Um exemplo de arquitetura multicamadas aparece na Figura 19-3.
Figura 3: Um ambiente de arquitetura multicamadas
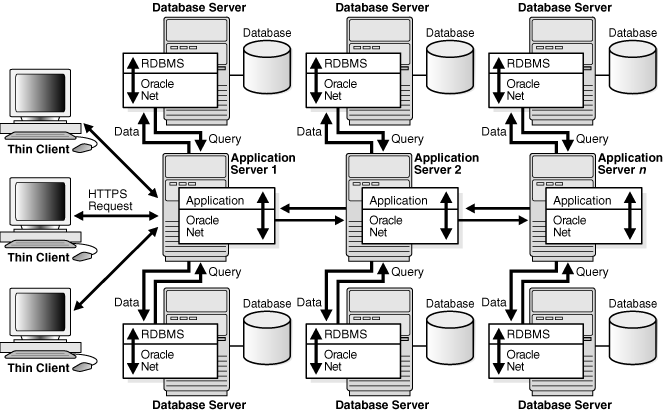
Descrição da ilustração cncpt121.gif
-
Clientes Um cliente inicia uma solicitação para que uma operação seja executada no servidor de banco de dados.
-
Servidores de Aplicativos Um servidor de aplicativos fornece acesso aos dados do cliente. Ele serve como uma interface entre o cliente e um ou mais servidores de banco de dados e hospeda os aplicativos.
-
Servidores de Banco de Dados Um servidor de banco de dados fornece os dados solicitados por um servidor de aplicativos em nome de um cliente. O banco de dados executa o processamento da consulta.
-
Arquitetura Orientada a Serviços (SOA) O banco de dados pode servir como um provedor de serviços Web em ambientes tradicionais de várias camadas ou arquitetura orientada a serviços (SOA).
Clientes
Um cliente inicia uma solicitação para que uma operação seja executada no servidor de banco de dados.
O cliente pode ser um navegador da Web ou outro programa de usuário final. Em uma arquitetura multicamadas, o cliente se conecta ao servidor de banco de dados por meio de um ou mais servidores de aplicativos.
Servidores de Aplicativos
Um servidor de aplicativos fornece acesso aos dados do cliente. Ele serve como uma interface entre o cliente e um ou mais servidores de banco de dados e hospeda os aplicativos.
Um servidor de aplicativos permite que clientes thin, que são clientes equipados com configurações mínimas de software, acessem aplicativos sem exigir manutenção contínua dos computadores clientes. O servidor de aplicativos também pode executar a reformatação de dados para o cliente, reduzindo a carga na estação de trabalho do cliente.
O servidor de aplicativos assume a identidade do cliente quando ele está executando operações no servidor de banco de dados para este cliente. A melhor prática é restringir os privilégios do servidor de aplicativos para impedir que ele execute operações desnecessárias e indesejadas durante uma operação do cliente.
Servidores de Banco de Dados
Um servidor de banco de dados fornece os dados solicitados por um servidor de aplicativos em nome de um cliente. O banco de dados executa o processamento da consulta.
O servidor de banco de dados pode auditar as operações executadas pelo servidor de aplicativos em nome dos clientes e em seu próprio nome. Por exemplo, uma operação cliente pode solicitar informações para serem exibidas no cliente, enquanto uma operação do servidor de aplicativos pode solicitar uma conexão com o servidor de banco de dados.
Na auditoria unificada, o banco de dados pode anexar contextos de aplicativos, que são pares nome-valor específicos de aplicativos, a registros na trilha de auditoria unificada. Você pode configurar quais contextos de aplicativo o banco de dados grava nos registros de auditoria do banco de dados.
Consulte Também: Oracle AI Database Security Guide para obter uma introdução à auditoria
Arquitetura Orientada a Serviços (SOA)
O banco de dados pode servir como um provedor de Web service em ambientes tradicionais de várias camadas ou arquitetura orientada a serviços (SOA).
SOA é uma arquitetura de várias camadas que conta com serviços que suportam a interação computador-computador através de uma rede. No contexto do SOA, um serviço é um ponto final funcional autossuficiente que tem uma funcionalidade bem definida e um acordo de nível de serviço, pode ser monitorado e gerenciado e pode ajudar a impor a conformidade com a política.
Serviços SOA são geralmente implementados como Web services acessíveis através do protocolo HTTP. Eles são baseados em padrões XML, como WSDL e SOAP.
O recurso de Web service do Oracle AI Database, que é implementado como parte do Oracle XML DB, deve ser ativado especificamente pelo DBA. Os aplicativos podem, então, fazer o seguinte por meio de serviços Web de banco de dados:
-
Enviar consultas SQL ou XQuery e receber resultados como XML
-
Chamar funções PL/SQL autônomas e receber resultados
-
Chamar funções de pacote PL/SQL e receber resultados
Os Web services de banco de dados fornecem uma maneira simples de adicionar Web services a um ambiente de aplicativo sem a necessidade de um servidor de aplicativos. No entanto, chamar Web services por meio de servidores de aplicações, como o Oracle Fusion Middleware, oferece segurança, escalabilidade, registro UDDI e mensagens confiáveis em um ambiente SOA. No entanto, como os Web services de banco de dados se integram facilmente ao Oracle Fusion Middleware, eles podem ser apropriados para otimizar soluções SOA.
Consulte Também:
-
Oracle XML Developer's Kit Programmer's Guide para obter informações sobre como ativar e usar Web services de banco de dados
-
Documentação do Oracle Fusion Middleware para obter mais informações sobre SOA e Web services
Visão Geral da Arquitetura de Grade
Em um ambiente Oracle AI Database, a computação em grade é uma arquitetura de computação que efetivamente reúne grandes números de servidores e armazenamento em um recurso de computação flexível e sob demanda.
Componentes modulares de hardware e software podem ser conectados e reintegrados sob demanda para atender às necessidades em constante mudança das empresas.
Consulte Também: Oracle Clusterware Administration and Deployment Guide para obter informações mais detalhadas sobre grades de servidor e armazenamento
Visão Geral da Arquitetura do Oracle Net Services
Oracle Net Services é um conjunto de componentes de rede que fornece soluções de conectividade em toda a empresa em ambientes de computação heterogêneos e distribuídos.
O Oracle Net Services permite uma sessão de rede de um aplicativo para uma instância de banco de dados e uma instância de banco de dados para outra instância de banco de dados.
O Oracle Net Services fornece transparência de localização, configuração e gerenciamento centralizados, além de instalação e configuração rápidas. Ele também permite maximizar os recursos do sistema e melhorar o desempenho. A arquitetura do servidor compartilhado aumenta a escalabilidade dos aplicativos e o número de clientes conectados simultaneamente ao banco de dados. O protocolo de Interface Virtual (VI) coloca a maior parte da carga de mensagens no hardware de rede de alta velocidade, liberando a CPU.
O Oracle Net Services usa os protocolos de comunicação ou as interfaces programáticas de aplicativos (APIs) suportadas por uma ampla variedade de redes para fornecer banco de dados distribuído e processamento distribuído. Após uma sessão de rede ser estabelecida, o Oracle Net Services atua como um courier de dados para o aplicativo cliente e o servidor de banco de dados, estabelecendo e mantendo uma conexão e trocando mensagens. O Oracle Net Services pode executar essas tarefas porque elas existem em cada computador da rede.
-
Como o Oracle Net Services Funciona Os protocolos do Oracle AI Database aceitam instruções SQL da interface dos aplicativos Oracle e depois as empacotam para transmissão ao Oracle AI Database.
-
O Oracle Net Listener O Oracle Net Listener (o listener) é um processo do lado do servidor que faz listening das solicitações de conexão do cliente de entrada e gerencia o tráfego para o banco de dados. Quando uma instância do banco de dados é iniciada e, em vários momentos durante sua vida útil, a instância entra em contato com um listener e estabelece um caminho de comunicação para essa instância.
-
Arquitetura de Servidor Dedicado Em uma arquitetura de servidor dedicado, o processo do servidor criado em nome de cada processo cliente é chamado de processo de servidor dedicado (ou processo paralelo).
-
Arquitetura de Servidor Compartilhado Em uma arquitetura de servidor compartilhado, um despachador direciona várias solicitações de sessão de rede recebidas para um pool de processos de servidor compartilhado
-
O DRCP (Database Resident Connection Pooling) do Database Resident Connection Pooling fornece um pool de conexões de servidores dedicados para cenários típicos de aplicativos Web. Consulte Também: Oracle AI Database Net Services Administrator's Guide para obter uma visão geral da arquitetura do Oracle Net
Como o Oracle Net Services Funciona
Os protocolos do Oracle AI Database aceitam instruções SQL da interface dos aplicativos Oracle e depois as empacotam para transmissão ao Oracle AI Database.
A transmissão ocorre por meio de um protocolo ou API de nível superior padrão do setor suportado. As respostas do Oracle AI Database são empacotadas por meio do mesmo mecanismo de comunicação de nível superior. Este trabalho ocorre independentemente do sistema operacional da rede.
Dependendo do sistema operacional que executa o Oracle AI Database, o software Oracle Net Services do servidor de banco de dados pode incluir o software do driver e iniciar um processo em segundo plano adicional.
Consulte Também: Oracle AI Database Net Services Administrator's Guide para obter mais informações sobre como o Oracle Net Services funciona
O Oracle Net Listener
O Oracle Net Listener (o listener) é um processo do servidor que faz listening das solicitações de conexão de entrada do cliente e gerencia o tráfego para o banco de dados. Quando uma instância do banco de dados é iniciada e, em vários momentos durante sua vida útil, a instância entra em contato com um listener e estabelece um caminho de comunicação para essa instância.
O registro de serviço permite que o listener determine se um serviço de banco de dados e seus handlers de serviço estão disponíveis. Um handler de serviço é um processo do servidor ou despachador dedicado que atua como um ponto de conexão com um banco de dados. Durante o registro, o processo LREG fornece ao listener o nome da instância, os nomes de serviço do banco de dados e o tipo e os endereços dos handlers de serviço. Essas informações permitem que o listener inicie um handler de serviço quando uma solicitação de cliente chegar.
O gráfico a seguir mostra dois bancos de dados, cada um em um host separado. O ambiente de banco de dados é atendido por dois listeners, cada um em um host separado. O processo LREG em execução em cada instância do banco de dados se comunica com os dois listeners para registrar o banco de dados.
Figura 4: Dois ouvintes
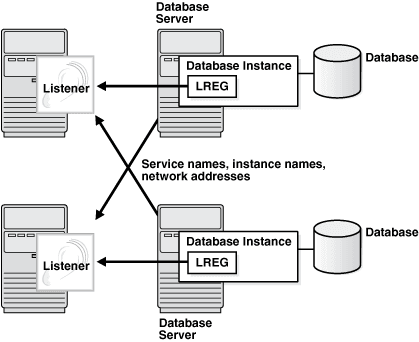
Descrição da ilustração cncpt315.png
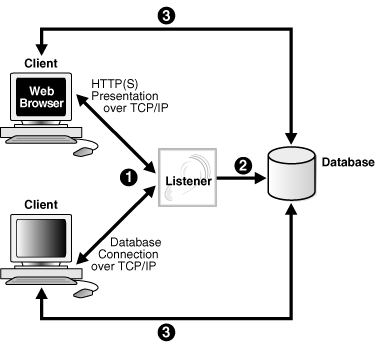
A Figura 19-5 mostra um browser que faz uma conexão HTTP e um cliente que faz uma conexão de banco de dados por meio de um listener. O listener não precisa residir no host do banco de dados.
Figura 5: Arquitetura do Listener
Descrição da ilustração cncpt311.gif
As etapas básicas pelas quais um cliente estabelece uma conexão por meio de um listener são:
-
Um processo do cliente ou outro banco de dados solicita uma conexão.
-
O listener seleciona um handler de serviço apropriado para atender à solicitação do cliente e encaminha a solicitação ao handler.
-
O processo do cliente se conecta diretamente ao processador de serviço. O ouvinte não está mais envolvido na comunicação.
-
Nomes de Serviço Um nome de serviço é uma representação lógica de um serviço usado para conexões de cliente.
-
Serviços em um Ambiente Multitenant Os clientes devem estabelecer conexão com PDBs ou raízes de aplicativos usando serviços.
-
Registro de Serviço No Oracle Net, o registro de serviço é um recurso pelo qual o processo LREG registra dinamicamente as informações da instância com um listener. Consulte Também: "Visão Geral dos Processos do Cliente" e "Visão Geral dos Processos do Servidor"
Nomes de Serviços
Nome do serviço é uma representação lógica de um serviço usado para conexões de cliente.
Quando um cliente se conecta a um listener, ele solicita uma conexão com um serviço. Quando uma instância de banco de dados é iniciada, ela se registra em um listener como fornecendo um ou mais serviços por nome. Assim, o listener atua como um mediador entre o cliente e as instâncias e roteia a solicitação de conexão para o lugar certo.
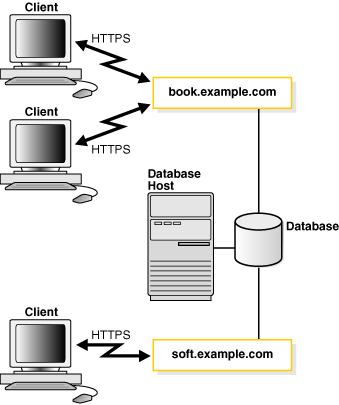
Um único serviço, como conhecido por um listener, pode identificar uma ou mais instâncias de banco de dados. Além disso, uma única instância de banco de dados pode registrar um ou mais serviços com um listener. Os clientes que se conectam a um serviço não precisam especificar qual instância eles exigem. A Figura 19-6 mostra um banco de dados de instância única associado a dois serviços, book.example.com e soft.example.com. Os serviços permitem que o mesmo banco de dados seja identificado de maneira diferente por clientes diferentes. Um administrador de banco de dados pode limitar ou reservar recursos do sistema, permitindo uma melhor alocação de recursos para os clientes que solicitam um desses serviços.
Figura 6: Vários Serviços Associados a um Banco de Dados
Descrição da ilustração cncpt314.gif
Consulte Também: Oracle AI Database Net Services Administrator's Guide para saber mais sobre métodos de nomeação
Serviços em um Ambiente Multitenant
Os clientes devem estabelecer conexão com PDBs ou raízes de aplicativos usando serviços.
Uma conexão usando um nome de serviço inicia uma nova sessão em um PDB ou em uma raiz de aplicativo. Um processo de primeiro plano e, portanto, uma sessão, a cada momento de sua vida útil, tem um contêiner atual definido exclusivamente.
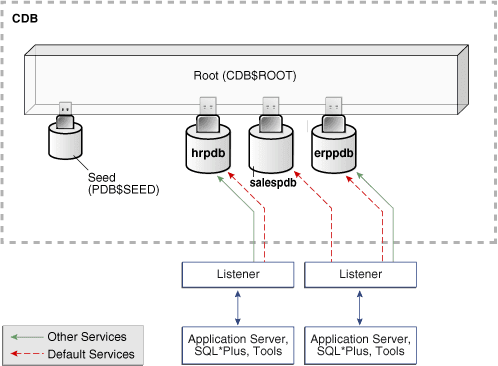
O gráfico a seguir mostra dois clientes que se conectam a PDBs usando dois listeners diferentes.
Figura 7: Serviços em um CDB
Descrição da ilustração cncpt368.png
-
Criação de Serviço Quando você executa a instrução
CREATE PLUGGABLE DATABASEpara criar um PDB, o banco de dados cria e inicia automaticamente um serviço no CDB. -
Conexões com Contêineres em um CDB Normalmente, um administrador do CDB deve ter privilégios apropriados para provisionar PDBs e estabelecer conexão com vários contêineres. Os administradores do CDB são usuários comuns.
Criação do Serviço
Quando você executa a instrução CREATE PLUGGABLE DATABASE para criar um PDB, o banco de dados cria e inicia automaticamente um serviço no CDB.
O serviço padrão tem uma propriedade que identifica o PDB como o contêiner atual inicial do serviço. A propriedade é mostrada na coluna DBA_SERVICES.PDB.
-
Serviços Padrão O serviço padrão tem o mesmo nome do PDB. O nome do PDB deve ser um nome de serviço válido, que deve ser exclusivo no CDB.
-
Serviços Não com Falha Você pode criar serviços adicionais para cada PDB, até um máximo de 10.000 por CDB. Cada serviço adicional denota seu PDB como o contêiner atual inicial.
Serviços Padrão
O serviço padrão tem o mesmo nome que o PDB. O nome do PDB deve ser um nome de serviço válido, que deve ser exclusivo no CDB.
Quando você cria um contêiner de aplicativos, que requer a especificação da cláusula AS APPLICATION CONTAINER, o Oracle AI Database cria automaticamente um novo serviço padrão para a raiz do aplicativo. O serviço tem o mesmo nome do contêiner de aplicativos. O Oracle Net Services deve ser configurado corretamente para que os clientes acessem esse serviço. Da mesma forma, cada PDB de aplicativo tem seu próprio nome de serviço padrão e um PDB pré-implantado de aplicativo tem seu próprio nome de serviço padrão.
Exemplo 19-1 Alternando para um PDB Usando um Serviço Padrão
Este exemplo alterna para os nomes do PDB salespdb usando o serviço padrão, que tem o mesmo nome que o PDB:
ALTER SESSION SET CONTAINER = salespdb;Serviços Não Padrão
Você pode criar serviços adicionais para cada PDB, até um máximo por CDB de 10.000. Cada serviço adicional denota seu PDB como o contêiner atual inicial.
Na Figura 19-7, existem serviços não padrão para erppdb e hrpdb. Por exemplo, na Figura 19-7, o PDB chamado hrpdb tem um serviço padrão chamado hrpdb. O serviço padrão não pode ser eliminado.
Quando você alterna para um contêiner usando ALTER SESSION SET CONTAINER, a sessão usa o serviço padrão para o contêiner. Opcionalmente, você pode usar outro serviço para o contêiner especificando SERVICE = service_name, em que service_name é o nome do serviço. Talvez você queira usar um serviço específico para que a sessão possa aproveitar seus atributos e recursos de serviço, como métricas de serviço, balanceamento de carga, configurações do Resource Manager etc.
Exemplo 19-2 Alternando para um PDB Usando um Serviço Não Padrão
Neste exemplo, o serviço padrão para hrpdb não suporta todos os atributos e recursos de serviço, como métricas de serviço, FAN, balanceamento de carga, Oracle AI Database Resource Manager, Transaction Guard, Continuidade de Aplicativos etc. Você alterna para um serviço não padrão da seguinte forma:
ALTER SESSION SET CONTAINER = hrpdb SERVICE = hrpdb_full;Conexões com Contêineres em um CDB
Normalmente, um administrador do CDB deve ter privilégios apropriados para provisionar PDBs e estabelecer conexão com vários contêineres. Os administradores do CDB são usuários comuns.
O administrador do CDB pode usar uma das seguintes técnicas:
-
Conecte-se diretamente a um PDB ou raiz de aplicativo.
O usuário requer o privilégio
CREATE SESSIONno contêiner. -
Use a instrução
ALTER SESSION SET CONTAINER, que é útil para pool de conexões e administração avançada de CDB, para alternar entre contêineres. A sintaxe éALTER SESSION SET CONTAINER = container_name [SERVICE = service_name].Por exemplo, um administrador do CDB pode estabelecer conexão com a raiz em uma sessão e, em seguida, na mesma sessão, alternar para um PDB. Nesse caso, o usuário requer o privilégio de sistema
SET CONTAINERno contêiner.
A tabela a seguir descreve um cenário que envolve o CDB na Figura 19-7. Cada linha descreve uma ação que ocorre após a ação na linha anterior. O usuário comum SYSTEM consulta o nome do contêiner atual e os nomes dos PDBs no CDB.
Serviços da Tabela 1 em um CDB
| Operação | Descrição |
|---|---|
|
O usuário SYSTEM, que é comum a todos os contêineres no CDB, se conecta à raiz usando o serviço chamado prod. |
|
SYSTEM usa o comando SHOW CON_NAME do SQL*Plus para listar o nome do contêiner ao qual o usuário está conectado no momento. CDB$ROOT é o nome do contêiner raiz. |
|
Uma consulta de V$SERVICES mostra que existem três PDBs com nomes de serviço que correspondem ao nome do PDB. hrpdb e erppdb têm um serviço adicional. |
|
O SYSTEM usa ALTER SESSION para estabelecer conexão com hrpdb. |
|
Uma consulta confirma que o contêiner atual agora é hrpdb. |
Consulte Também: Referência da Linguagem SQL do Oracle AI Database para obter a sintaxe e a semântica do ALTER SESSION SET CONTAINER
Registro de Serviço
No Oracle Net, o registro de serviço é um recurso pelo qual o processo LREG registra dinamicamente as informações da instância com um listener.
Essas informações permitem que o listener encaminhe solicitações de conexão do cliente para o handler de serviço apropriado. O LREG fornece ao listener informações sobre o seguinte:
-
Nomes dos serviços de banco de dados fornecidos pelo banco de dados
-
Nome da instância do banco de dados associada aos serviços e sua carga atual e máxima
-
Handlers de serviço (despachadores e servidores dedicados) disponíveis para a instância, incluindo seu tipo, endereços de protocolo e carga atual e máxima
O registro de serviço é dinâmico e não requer configuração no arquivo listener.ora. O registro dinâmico reduz a sobrecarga administrativa para vários bancos de dados ou instâncias.
O parâmetro de inicialização SERVICE_NAMES lista os serviços aos quais uma instância pertence. Na inicialização, cada instância se registra com os listeners de outras instâncias pertencentes aos mesmos serviços. Durante as operações de banco de dados, as instâncias de cada serviço passam informações sobre o uso da CPU e as contagens de conexões atuais para todos os listeners nos mesmos serviços. Esta comunicação permite balanceamento de carga dinâmico e failover de conexão.
Consulte Também:
-
Oracle AI Database Net Services Administrator's Guide para saber mais sobre o registro de serviços
-
Oracle Real Application Clusters Administration and Deployment Guide para saber mais sobre registro de instância e conexões cliente/serviço no Oracle RAC
Arquitetura de Servidor Dedicado
Em uma arquitetura de servidor dedicado, o processo do servidor criado em nome de cada processo cliente é chamado de processo de servidor dedicado (ou processo paralelo).
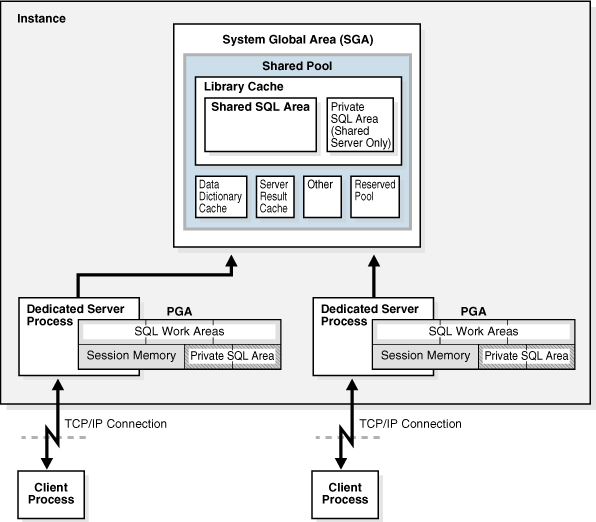
Um processo de servidor dedicado é separado do processo do cliente e age somente em seu nome, conforme mostrado na Figura 19-8.
Figura 8: Oracle AI Database Usando Processos de Servidor Dedicado
Descrição da ilustração cncpt303.gif
Existe uma relação um-para-um entre os processos do cliente e do servidor. Mesmo quando o usuário não está fazendo ativamente uma solicitação de banco de dados, o processo do servidor dedicado permanece - embora esteja inativo e possa ser despaginado em alguns sistemas operacionais. A Figura 19-8 mostra processos de usuário e servidor em execução em computadores em rede. No entanto, a arquitetura do servidor dedicado também é usada se o mesmo computador executar o aplicativo cliente e o código do banco de dados, mas o sistema operacional do host não pôde manter a separação dos dois programas se eles fossem executados em um único processo. O Linux é um exemplo de tal sistema operacional.
Na arquitetura do servidor dedicado, os processos do usuário e do servidor se comunicam usando diferentes mecanismos:
-
Se o processo do cliente e o processo do servidor dedicado forem executados no mesmo computador, a interface do programa usará o mecanismo de comunicação entre processos do sistema operacional do host para executar seu trabalho.
-
Se o processo do cliente e o processo do servidor dedicado forem executados em computadores diferentes, a interface do programa fornecerá os mecanismos de comunicação (como o software de rede e o Oracle Net Services) entre os programas.
Servidores dedicados subutilizados às vezes resultam em uso ineficiente dos recursos do sistema operacional. Considere um sistema de inserção de prescrições com processos de servidor dedicados. Um cliente faz um pedido quando um funcionário insere o pedido no banco de dados. Para a maior parte da transação, o funcionário está falando com o cliente enquanto o processo do servidor dedicado ao processo do cliente do funcionário está ocioso. O processo do servidor não é necessário durante a maior parte da transação, e o sistema pode ser mais lento para outros funcionários que inserem prescrições se o sistema estiver gerenciando muitos processos. Para aplicações deste tipo, a arquitetura de servidor compartilhado pode ser preferível.
Consulte Também: Oracle AI Database Net Services Administrator's Guide para saber mais sobre processos de servidor dedicados
Arquitetura do Servidor Compartilhado
Em uma arquitetura de servidor compartilhado, um despachador direciona várias solicitações de sessão de rede recebidas para um pool de processos de servidor compartilhado
O pool compartilhado elimina a necessidade de um processo de servidor dedicado para cada conexão. Um processo de servidor compartilhado ocioso do pool seleciona uma solicitação de uma fila comum.
Os benefícios potenciais do servidor compartilhado são os seguintes:
-
Reduz o número de processos no sistema operacional
Um pequeno número de servidores compartilhados pode executar a mesma quantidade de processamento que muitos servidores dedicados.
-
Reduz a memória PGA da instância
Cada servidor dedicado ou compartilhado tem um PGA. Menos processos de servidor significa menos PGAs e menos gerenciamento de processos.
-
Aumenta a escalabilidade do aplicativo e o número de clientes que podem se conectar simultaneamente ao banco de dados
-
Pode ser mais rápido do que o servidor dedicado quando a taxa de conexões e desconexões do cliente é alta
O servidor compartilhado tem várias desvantagens, incluindo tempo de resposta mais lento em alguns casos, suporte incompleto a recursos e maior complexidade para configuração e ajuste. Como diretriz geral, use somente o servidor compartilhado quando tiver mais conexões simultâneas com o banco de dados do que o sistema operacional pode manipular.
Os seguintes processos são necessários em uma arquitetura de servidor compartilhado:
-
Um listener de rede que conecta os processos do cliente a alocadores ou servidores dedicados (o listener faz parte do Oracle Net Services, não do Oracle AI Database)
Observação: para usar servidores compartilhados, um processo cliente deve se conectar por meio do Oracle Net Services, mesmo que o processo seja executado no mesmo computador da instância do Oracle AI Database.
-
Um ou mais processo de despachador (Dnnn)
-
Um ou mais processos de servidor compartilhados
Um banco de dados pode suportar conexões de servidor compartilhado e servidor dedicado simultaneamente. Por exemplo, um cliente pode se conectar usando um servidor dedicado enquanto outro cliente se conecta ao mesmo banco de dados usando um servidor compartilhado.
-
Filas de Solicitação e Resposta do Despachador Uma solicitação de um usuário é uma única chamada de API que faz parte da instrução SQL do usuário.
-
Operações Restritas do Servidor Compartilhado Atividades administrativas específicas não podem ser executadas enquanto estiverem conectadas a um processo de despachador, incluindo o shutdown ou o início de uma instância e a recuperação de mídia.
Consulte Também:
-
Oracle AI Database Net Services Administrator's Guide para obter mais informações sobre a arquitetura de servidor compartilhado
-
Oracle AI Database Administrator's Guide para saber como configurar um banco de dados para servidor compartilhado
Filas de Solicitação e Resposta do Despachador
Uma solicitação de um usuário é uma chamada de API única que faz parte da instrução SQL do usuário.
Quando um usuário faz uma chamada, ocorrem as seguintes ações:
-
O despachador coloca a solicitação na fila de solicitações, onde ela é selecionada pelo próximo processo de servidor compartilhado disponível.
A fila de solicitações está na SGA e é comum a todos os processos de despachador de uma instância.
-
Os processos do servidor compartilhado verificam a fila de solicitações comuns para novas solicitações, retirando novas solicitações em uma base first-in-first-out.
-
Um processo de servidor compartilhado seleciona uma solicitação na fila e faz todas as chamadas necessárias ao banco de dados para concluir essa solicitação.
Um processo de servidor diferente pode lidar com cada chamada de banco de dados. Portanto, as solicitações para analisar uma consulta, extrair a primeira linha, extrair a próxima linha e fechar o conjunto de resultados podem ser processadas por um servidor compartilhado diferente.
-
Quando o processo do servidor conclui a solicitação, ele coloca a resposta na fila de resposta do despachador de chamadas. Cada dispatcher tem sua própria fila de respostas.
-
O despachador retorna a solicitação concluída para o processo de cliente apropriado.
Por exemplo, em um sistema de inserção de prescrições, cada processo de cliente do funcionário se conecta a um despachador. Cada solicitação feita pelo funcionário é enviada para este despachador, que coloca a solicitação na fila. O próximo servidor compartilhado disponível seleciona a solicitação, a atende e coloca a resposta na fila de resposta. Quando uma solicitação é concluída, o funcionário permanece conectado ao dispatcher, mas o servidor compartilhado que processou a solicitação é liberado e disponível para outras solicitações. Enquanto um funcionário fala com um cliente, outro funcionário pode usar o mesmo processo de servidor compartilhado. A Figura 19-9 mostra como os processos do cliente se comunicam com o despachador na API e como o despachador comunica as solicitações do usuário aos processos do servidor compartilhado.
Figura 9: Configuração e Processos do Servidor Compartilhado
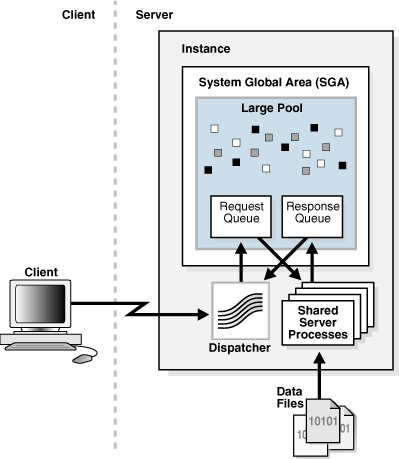
Descrição da ilustração cncpt067.gif
-
Processos do despachador (Dnn) Os processos do despachador permitem que os processos do cliente compartilhem um número limitado de processos do servidor.
-
Processos de Servidor Compartilhado (Snn) Cada processo de servidor compartilhado atende a várias solicitações de cliente na configuração do servidor compartilhado. Consulte Também: "Grande Pool"
Processos do Dispatcher (D nnn )
Os processos despachadores permitem que os processos clientes compartilhem um número limitado de processos do servidor.
Você pode criar vários processos do dispatcher para uma única instância do banco de dados. O número ideal de processos do dispatcher, dependendo da limitação do sistema operacional e do número de conexões para cada processo.
Observação: cada processo cliente que se conecta a um dispatcher deve usar o Oracle Net Services, mesmo que ambos os processos sejam executados no mesmo host.
Os processos do despachador estabelecem a comunicação da seguinte forma:
-
Quando uma instância é iniciada, o processo do listener de rede é aberto e estabelece um caminho de comunicação pelo qual os usuários se conectam ao Oracle AI Database.
-
Cada processo do dispatcher fornece ao processo do listener um endereço no qual o dispatcher escuta as solicitações de conexão.
Pelo menos um processo do dispatcher deve ser configurado e iniciado para cada protocolo de rede que os clientes do banco de dados usarão.
-
Quando um processo do cliente faz uma solicitação de conexão, o listener determina se o processo do cliente deve usar um processo de servidor compartilhado:
-
Se o listener determinar que um processo de servidor compartilhado é necessário, o listener retornará o endereço do processo do dispatcher que tem a carga mais leve e o processo do cliente se conectará diretamente ao dispatcher.
-
Se o processo não puder se comunicar com o dispatcher ou se o processo do cliente solicitar um servidor dedicado, o listener criará um processo de servidor dedicado e estabelecerá uma conexão apropriada.
-
Consulte Também: Oracle AI Database Net Services Administrator's Guide para saber como configurar despachadores
Processos do Servidor Compartilhado (S nnn )
Cada processo de servidor compartilhado atende a várias solicitações de cliente na configuração do servidor compartilhado.
Os processos de servidor compartilhado e dedicado fornecem a mesma funcionalidade, exceto que os processos de servidor compartilhado não estão associados a um processo de cliente específico. Em vez disso, um processo de servidor compartilhado atende a qualquer solicitação de cliente na configuração do servidor compartilhado.
O PGA de um processo de servidor compartilhado não contém dados UGA, que devem estar acessíveis a todos os processos de servidor compartilhado. O servidor compartilhado PGA contém apenas dados específicos do processo.
Todas as informações relacionadas à sessão estão contidas na SGA. Cada processo de servidor compartilhado deve ser capaz de acessar todos os espaços de dados das sessões para que qualquer servidor possa lidar com solicitações de qualquer sessão. O espaço é alocado na SGA para cada espaço de dados da sessão.
Consulte Também: "Visão Geral da PGA (Program Global Area)"
Operações restritas do servidor compartilhado
Atividades administrativas específicas não podem ser executadas enquanto estiverem conectadas a um processo de despachador, incluindo desligamento ou inicialização de uma instância e recuperação de mídia.
Essas atividades geralmente são executadas quando conectadas a privilégios de administrador. Para estabelecer conexão com privilégios de administrador em um sistema configurado com servidores compartilhados, você deve especificar que está usando um processo de servidor dedicado.
Consulte Também: Oracle AI Database Net Services Administrator's Guide para obter a sintaxe de string de conexão adequada
Pool de Conexões Residente do Banco de Dados
O DRCP (Database Resident Connection Pooling) fornece um pool de conexões de servidores dedicados para cenários típicos de aplicativos Web.
Um aplicativo Web normalmente faz uma conexão de banco de dados, usa a conexão brevemente e depois a libera. Por meio do DRCP, o banco de dados pode ser dimensionado para dezenas de milhares de conexões simultâneas.
O DRCP oferece as seguintes vantagens:
-
Complementa pools de conexões de camada intermediária que compartilham conexões entre threads em um processo de camada intermediária.
-
Permite que conexões de banco de dados sejam compartilhadas entre vários processos de camada intermediária. Esses processos de middle-tier podem pertencer ao mesmo host de middle-tier ou diferente.
-
Permite uma redução significativa nos principais recursos do banco de dados necessários para suportar muitas conexões de cliente. Por exemplo, o DRCP reduz a memória necessária para o banco de dados e aumenta a escalabilidade do banco de dados e da camada intermediária. O pool de servidores disponíveis também reduz o custo de recriação de conexões de clientes.
-
Fornece pooling para arquiteturas com servidores de aplicativos multi-processo e de thread único, como PHP e Apache, que não podem fazer pool de conexão de camada intermediária.
O DRCP usa um servidor em pool, que é o equivalente a um processo de servidor dedicado (não a um processo de servidor compartilhado) e a uma sessão de banco de dados combinada. O modelo de servidor em pool evita a sobrecarga de dedicar um servidor para cada conexão que requer o servidor por um curto período.
Os clientes que obtêm conexões do pool de conexões residente do banco de dados se conectam a um processo em segundo plano da Oracle conhecido como broker de conexão. O agente de conexão implementa a funcionalidade de pool e multiplexa servidores agrupados entre conexões de entrada de processos do cliente.
Conforme mostrado na Figura 19-10, quando um cliente requer acesso ao banco de dados, o broker de conexão pega um processo do servidor no pool e o entrega ao cliente. O cliente é conectado diretamente ao processo do servidor até que a solicitação seja atendida. Após o término do servidor, o processo do servidor é liberado no pool. A conexão do cliente é restaurada para o broker.
Figura 10: DRCP
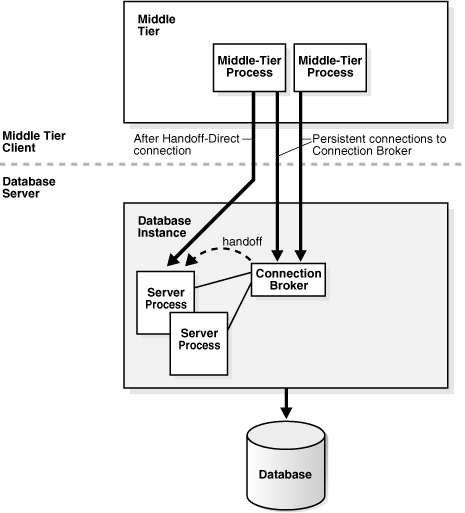
Descrição da ilustração cncpt312.gif
No DRCP, a liberação de recursos deixa a sessão intacta, mas não mais associada a uma conexão (processo do servidor). Ao contrário do servidor compartilhado, esta sessão armazena sua UGA na PGA, não na SGA. Um cliente pode restabelecer uma conexão de forma transparente ao detectar a atividade.
Consulte Também:
-
Oracle AI Database Administrator's Guide e Oracle Call Interface Developer's Guide para saber mais sobre DRCP
Visão geral da interface do programa
A interface de programa é a camada de software entre um aplicativo de banco de dados e o Oracle AI Database.
A interface do programa executa as seguintes funções:
-
Fornece uma barreira de segurança, impedindo o acesso destrutivo à SGA pelos processos do cliente
-
Atua como um mecanismo de comunicação, formatando solicitações de informações, transmitindo dados e interceptando e retornando erros
-
Converte e traduz dados, particularmente entre diferentes tipos de computadores ou para tipos de dados de programas de usuários externos
O código da Oracle atua como um servidor, executando tarefas de banco de dados em nome de um aplicativo (um cliente), como extrair linhas de blocos de dados. A interface do programa consiste em várias partes, fornecidas pelo software Oracle AI Database e pelo software específico do sistema operacional.
-
Estrutura da Interface do Programa A interface do programa consiste em vários componentes diferentes.
-
Drivers de Interface de Programa Um driver é um software que transporta dados, geralmente através de uma rede.
-
Software de Comunicação para o Sistema Operacional O software de nível mais baixo que conecta o lado do usuário ao lado do Oracle AI Database da interface do programa é o software de comunicação, que o sistema operacional do host fornece.
Estrutura da Interface do Programa
A interface do programa consiste em vários componentes diferentes.
Esses componentes incluem:
-
Interface de chamada da Oracle (OCI) ou a biblioteca de run-time da Oracle (SQLLIB)
-
O cliente ou o lado do usuário da interface do programa
-
Vários drivers do Oracle Net Services (software de comunicação específico do protocolo)
-
Software de comunicação do sistema operacional
-
O servidor ou o lado do Oracle AI Database da interface do programa (também chamado de OPI)
Os lados do usuário e do Oracle AI Database da interface do programa executam o software Oracle, assim como os drivers.
Drivers de Interface do Programa
Um driver é um software que transporta dados, geralmente através de uma rede.
Os drivers executam operações como conectar, desconectar, sinalizar erros e testar erros. Os drivers são específicos de um protocolo de comunicação.
Um driver padrão sempre existe. É possível instalar vários drivers, como os drivers assíncronos ou DECnet, e selecionar um como o driver padrão, mas permitir que um usuário use outros drivers especificando um driver ao se conectar.
Diferentes processos podem usar drivers diferentes. Um processo pode ter conexões simultâneas com um único banco de dados ou com vários bancos de dados usando diferentes drivers do Oracle Net Services.
Consulte Também:
-
Seu guia de instalação e configuração do sistema para obter detalhes sobre como escolher, instalar e adicionar drivers
-
Oracle AI Database Net Services Administrator's Guide para saber mais sobre drivers JDBC
Software de Comunicação para o Sistema Operacional
O software de nível mais baixo que conecta o lado do usuário ao lado do Oracle AI Database da interface do programa é o software de comunicação, que o sistema operacional do host fornece.
DECnet, TCP/IP, LU6.2 e ASYNC são exemplos. O software de comunicação pode ser fornecido pela Oracle, mas geralmente é comprado separadamente do fornecedor de hardware ou de um fornecedor de software de terceiros.
Visão Geral do Oracle True Cache
O True Cache é um cache na memória e somente leitura na frente de um Oracle AI Database.
Assim como o Oracle Active Data Guard, o True Cache é uma réplica totalmente funcional e somente leitura do banco de dados principal, exceto pelo fato de ser praticamente sem disco.
As aplicações modernas geralmente exigem um alto número de conexões e acesso rápido e de baixa latência aos dados. Uma abordagem popular é colocar caches na frente do banco de dados porque os aplicativos geralmente executam muito mais leituras do que atualizações e podem ler a partir do cache sem afetar o desempenho do banco de dados. Por exemplo, um sistema de reservas de companhias aéreas lê os dados com frequência à medida que as pessoas compram voos, e não há problema se os dados não forem os mais atuais em comparação com o que está no banco de dados. O aplicativo só precisa acessar os dados mais atuais quando alguém reserva um voo.
Ao contrário dos caches convencionais, o True Cache mantém automaticamente os dados acessados com mais frequência no cache, e mantém o cache consistente com o banco de dados principal, outros objetos no mesmo cache e outros caches. Ele armazena em cache todos os objetos e tipos de dados do Oracle AI Database, incluindo JSON.
Como o True Cache implementa as políticas de segurança do Oracle AI Database, você pode controlar o acesso ao cache. Isso permite que você armazene dados confidenciais em cache, como informações pessoais privadas, que você pode não armazenar em cache normalmente.
Tópicos Relacionados