Programação no Lado do Servidor: PL/SQL, Java e JavaScript
O SQL explica a linguagem SQL (Structured Query Language) e como o banco de dados processa as instruções SQL. Este capítulo explica como os programas PL/SQL (Procedural Language/SQL) ou Java armazenados no banco de dados podem usar SQL.
-
Introdução à Programação no Lado do Servidor Em uma linguagem não processual, como SQL, o conjunto de dados a ser operado é especificado, mas não as operações a serem executadas ou a maneira pela qual elas devem ser executadas.
-
Visão Geral do PL/SQL O PL/SQL fornece uma linguagem procedural armazenada no lado do servidor que é fácil de usar, integrada ao SQL, robusta, portátil e segura. Você pode acessar e manipular dados do banco de dados usando objetos de procedimento chamados unidades PL/SQL.
-
Visão geral do Java no Oracle AI Database O Java surgiu como a linguagem de programação orientada a objetos de sua escolha.
-
Visão geral do JavaScript no Oracle AI Database JavaScript é uma das linguagens de programação mais populares atualmente. O Oracle AI Database implantado no Linux x86-64 ou no Linux aarch64 adiciona JavaScript à lista de idiomas suportados para desenvolvimento no lado do servidor.
-
Visão Geral de Triggers Um trigger de banco de dados é uma unidade de programa armazenada compilada, gravada em PL/SQL, Java ou JavaScript, que o Oracle Database chama ("dispara") automaticamente em determinadas situações. Consulte Também: SQL para obter uma visão geral da linguagem SQL.
Introdução à Programação no Lado do Servidor
Em uma linguagem não processual, como o SQL, o conjunto de dados a ser operado é especificado, mas não as operações a serem executadas ou a maneira pela qual devem ser realizadas.
Em um programa de linguagem procedural, a execução da maioria das instruções depende de instruções anteriores ou subsequentes e de estruturas de controle, como loops ou ramificações condicionais, que não estão disponíveis em SQL. Para uma ilustração da diferença entre linguagens procedurais e não processuais, suponha que a seguinte instrução SQL consulte a tabela employees:
SELECT employee_id, department_id, last_name, salary FROM employees;A instrução anterior solicita dados, mas não aplica lógica aos dados. No entanto, suponhamos que você queira que um aplicativo determine se cada funcionário no conjunto de dados merece um aumento com base no salário e no desempenho do departamento. Uma condição necessária para um aumento é que o funcionário não tenha recebido mais de três aumentos nos últimos cinco anos. Se for necessário um aumento, o aplicativo deverá ajustar o salário e enviar um e-mail ao gerente; caso contrário, o aplicativo deverá atualizar um relatório.
O problema é como os aplicativos de banco de dados procedural que exigem lógica condicional e controle de fluxo de programa podem usar SQL. As abordagens básicas de desenvolvimento são as seguintes:
-
Usar programação do lado do cliente para incorporar instruções SQL em aplicativos escritos em linguagens procedurais, como C, C++ ou Java
Você pode colocar instruções SQL no código-fonte e enviá-las para um pré-compilador ou um tradutor Java antes da compilação. Como alternativa, você pode eliminar a etapa de pré-compilação e usar uma API, como Java Database Connectivity (JDBC) ou Oracle Call Interface (OCI), para permitir que o aplicativo interaja com o banco de dados.
-
Usar a programação do servidor para desenvolver a lógica de dados que reside no banco de dados
Um aplicativo pode chamar explicitamente subprogramas armazenados (procedimentos e funções), gravados em PL/SQL (pronuncia-se P L sequel) Java ou JavaScript. Você também pode criar um trigger, que é nomeado como unidade de programa que é armazenada no banco de dados e chamada em resposta a um evento especificado.
Este capítulo explica a segunda abordagem. O principal benefício da programação do lado do servidor é que a funcionalidade incorporada ao banco de dados pode ser implantada em qualquer lugar. O banco de dados, e não o aplicativo, determina a melhor maneira de executar tarefas em um determinado sistema operacional. Além disso, os subprogramas aumentam a escalabilidade ao centralizar o processamento de aplicativos no servidor, permitindo que os clientes reutilizem o código. Como as chamadas de subprograma são rápidas e eficientes, uma única chamada pode iniciar um subprograma armazenado com uso intensivo de computação, reduzindo o tráfego de rede.
Você pode usar os seguintes idiomas para armazenar a lógica de dados no Oracle AI Database:
-
PL/SQL
PL/SQL é a extensão procedural do Oracle AI Database para SQL. O PL/SQL é integrado ao banco de dados, oferecendo suporte a todas as funções, instruções e tipos de dados do Oracle SQL. Os aplicativos criados em APIs de banco de dados podem chamar subprogramas PL/SQL armazenados e enviar blocos de código PL/SQL para o banco de dados para execução.
-
Java
O Oracle AI Database também fornece suporte para desenvolver, armazenar e implantar aplicativos Java. Os subprogramas armazenados em Java são executados no banco de dados e independentes dos programas executados na camada intermediária. Os subprogramas Java armazenados fazem interface com o SQL usando um modelo de execução semelhante para PL/SQL.
-
JavaScript
Quando implantado no Linux x86-64 ou Linux aarch64, o Oracle AI Database permite que os desenvolvedores expressem lógica de negócios no JavaScript. A execução ad hoc do JavaScript é possível graças ao pacote PL/SQL DBMS_MLE e suas sub-rotinas. O armazenamento da lógica de negócios como objetos de esquema JavaScript permite gravar aplicativos mais complexos. As especificações de chamada expõem o código JavaScript armazenado no banco de dados em SQL e PL/SQL de uma forma semelhante aos procedimentos armazenados em Java.
Consulte Também:
-
Guia de Desenvolvimento do Oracle AI Database para aprender a incorporar SQL com pré-compiladores e APIs
-
Oracle AI Database Conceitos Básicos do Desenvolvimento do Oracle AI Database para uma introdução ao desenvolvimento de aplicações do Oracle AI Database
-
Guia de Desenvolvimento do Oracle AI Database para aprender a escolher um ambiente de programação
-
Oracle AI Database JavaScript Developer's Guide para saber mais sobre o suporte ao JavaScript no Oracle AI Database.
Visão Geral de PL/SQL
O PL/SQL fornece uma linguagem procedural armazenada e do lado do servidor que é fácil de usar, integrada ao SQL, robusta, portátil e segura. Você pode acessar e manipular dados do banco de dados usando objetos de procedimento chamados unidades PL/SQL.
Geralmente, as unidades PL/SQL são categorizadas da seguinte forma:
-
Um subprograma PL/SQL é um bloco PL/SQL armazenado no banco de dados e que pode ser chamado por nome de um aplicativo. Quando você cria um subprograma, o banco de dados analisa o subprograma e armazena sua representação analisada no banco de dados. Você pode declarar um subprograma como um procedimento ou uma função.
-
Um bloco anônimo PL/SQL é um bloco PL/SQL que aparece no seu aplicativo e não é nomeado nem armazenado no banco de dados. Em muitas aplicações, os blocos PL/SQL podem aparecer sempre que instruções SQL puderem ser exibidas.
O compilador e o interpretador PL/SQL são incorporados ao Oracle SQL Developer, oferecendo aos desenvolvedores um modelo de desenvolvimento consistente e aproveitado no cliente e no servidor. Além disso, os procedimentos armazenados PL/SQL podem ser chamados de vários clientes de banco de dados, como Pro*C, JDBC, ODBC ou OCI, e do Oracle Reports e Oracle Forms.
-
Subprogramas PL/SQL Um subprograma PL/SQL é um bloco PL/SQL nomeado que permite ao chamador fornecer parâmetros que podem ser somente entrada, somente saída ou valores de entrada e saída.
-
Pacotes PL/SQL Um pacote PL/SQL é um grupo de subprogramas relacionados, juntamente com os cursores e variáveis que eles usam, armazenados juntos no banco de dados para uso contínuo como uma unidade. Os subprogramas empacotados podem ser chamados explicitamente por aplicativos ou usuários.
-
Blocos Anônimos PL/SQL Um bloco anônimo PL/SQL é uma unidade PL/SQL não persistente e sem nome.
-
Construções de Linguagem PL/SQL Os blocos PL/SQL podem incluir várias construções de linguagem PL/SQL diferentes.
-
Coleções e Registros PL/SQL Muitas técnicas de programação usam tipos de coleta, como matrizes, bags, listas, tabelas aninhadas, conjuntos e árvores.
-
Como o PL/SQL Executa O PL/SQL suporta execução interpretada e execução nativa.
Consulte Também:
-
Oracle AI Database PL/SQL Language Reference para oferecer informações completas sobre PL/SQL, inclusive pacotes
Subprogramas PL/SQL
Um subprograma PL/SQL é um bloco PL/SQL nomeado que permite ao chamador fornecer parâmetros que podem ser somente entrada, somente saída ou valores de entrada e saída.
Um subprograma resolve um problema específico ou executa tarefas relacionadas e serve como um bloco de construção para aplicativos de banco de dados modulares e de manutenção. Um subprograma é um procedimento PL/SQL ou uma função PL/SQL. Procedimentos e funções são idênticos, exceto que funções sempre retornam um único valor para o chamador, enquanto procedimentos não. O termo procedimento PL/SQL neste capítulo refere-se a um procedimento ou a uma função.
-
Vantagens de Subprogramas PL/SQL A programação no lado do servidor tem muitas vantagens em relação à programação no lado do cliente.
-
Criação de Subprogramas PL/SQL Um subprograma armazenado stand-alone é um subprograma criado no nível do esquema com a instrução
CREATE PROCEDUREouCREATE FUNCTION. Os subprogramas definidos em um pacote são denominados subprogramas de pacote e são considerados parte do pacote. -
Execução de Subprogramas PL/SQL Os usuários podem executar um subprograma interativamente de várias maneiras.
Consulte Também:
-
Pro*C/C++ Developer's Guide e Pro*COBOL Developer's Guide para aprender sobre procedimentos armazenados nessas linguagens
Vantagens de Subprogramas PL/SQL
A programação do lado do servidor tem muitas vantagens sobre a programação do lado do cliente.
As vantagens incluem:
-
Desempenho aprimorado
-
A quantidade de informações que um aplicativo deve enviar por uma rede é pequena em comparação com a emissão de instruções SQL individuais ou o envio do texto de um bloco PL/SQL inteiro para o Oracle AI Database, porque as informações são enviadas apenas uma vez e depois chamadas quando são usadas.
-
A forma compilada de um procedimento está prontamente disponível no banco de dados, portanto, nenhuma compilação é necessária no momento da execução.
-
Se o procedimento estiver presente no pool compartilhado da SGA, o banco de dados não precisará recuperá-lo do disco e poderá iniciar a execução imediatamente.
-
-
Alocação de Memória
Como os procedimentos armazenados aproveitam os recursos de memória compartilhada do Oracle AI Database, ele deve carregar apenas uma única cópia do procedimento na memória para execução por vários usuários. O compartilhamento de código entre os usuários resulta em uma redução substancial nos requisitos de memória do banco de dados para aplicativos.
-
Melhoria na produtividade
Os procedimentos armazenados aumentam a produtividade do desenvolvimento. Ao projetar aplicativos em torno de um conjunto comum de procedimentos, você pode evitar a codificação redundante. Por exemplo, você pode gravar procedimentos para manipular linhas na tabela
employees. Qualquer aplicativo pode chamar esses procedimentos sem exigir que as instruções SQL sejam regravadas. Se os métodos de gerenciamento de dados mudarem, apenas os procedimentos deverão ser modificados, não os aplicativos que usam os procedimentos.Os procedimentos armazenados são talvez a melhor maneira de obter a reutilização do código. Como qualquer aplicativo cliente gravado em qualquer idioma que se conecte ao banco de dados pode chamar procedimentos armazenados, eles fornecem o máximo de reutilização de código em todos os ambientes.
-
Integridade
Os procedimentos armazenados melhoram a integridade e a consistência dos aplicativos. Ao desenvolver aplicativos em torno de um grupo comum de procedimentos, você reduz a probabilidade de erros de codificação.
Por exemplo, você pode testar um subprograma para garantir que ele retorne um resultado preciso e, depois de verificado, reutilizá-lo em qualquer número de aplicativos sem repetir o teste. Se as estruturas de dados referenciadas pelo procedimento forem alteradas, você só deverá recompilar o procedimento. As aplicações que chamam o procedimento não exigem necessariamente modificações.
-
Segurança com os procedimentos de direitos do definidor
Os procedimentos armazenados podem ajudar a impor a segurança dos dados. Um procedimento PL/SQL de direitos do definidor é executado com o privilégio de seu proprietário, e não com seu usuário atual. Dessa forma, você pode restringir as tarefas de banco de dados que os usuários executam, permitindo que eles acessem dados somente por meio de procedimentos e funções executados com os privilégios do definidor.
Por exemplo, você pode conceder aos usuários acesso a um procedimento que atualiza uma tabela, mas não concede acesso à própria tabela. Quando um usuário chama o procedimento, ele é executado com os privilégios de seu proprietário. Os usuários que tiverem somente o privilégio para executar o procedimento (mas não para consultar, atualizar ou excluir das tabelas subjacentes) poderão chamar o procedimento, mas não manipular dados da tabela de qualquer outra maneira.
-
Privilégios herdados e contexto de esquema com procedimentos de direitos do chamador
Um procedimento PL/SQL de direitos do chamador é executado no esquema do usuário atual com os privilégios do usuário atual. Em outras palavras, o procedimento de direitos de um chamador não está vinculado a um usuário ou esquema específico. Os procedimentos de direitos do chamador facilitam para os desenvolvedores de aplicativos centralizar a lógica do aplicativo, mesmo quando os dados subjacentes são divididos entre os esquemas do usuário.
Por exemplo, um usuário
hr_managerque executa um procedimento de atualização na tabelahr.employeespode atualizar salários, enquanto umhr_clerkque executa o mesmo procedimento se restringe à atualização dos dados de endereço.
Consulte Também:
-
Oracle AI Database PL/SQL Language Reference para obter uma visão geral dos subprogramas PL/SQL
-
Oracle AI Database Security Guide para saber mais sobre os direitos do definidor e do invocador
Criação de Subprogramas PL/SQL
Subprograma armazenado stand-alone é um subprograma criado no nível do esquema com a instrução CREATE PROCEDURE ou CREATE FUNCTION. Os subprogramas definidos em um pacote são denominados subprogramas de pacote e são considerados parte do pacote.
O banco de dados armazena subprogramas no dicionário de dados como objetos de esquema. Um subprograma tem uma especificação, que inclui descrições de quaisquer parâmetros e um corpo.
Exemplo 11-1 Procedimento PL/SQL
Este exemplo mostra parte de uma instrução de criação para o procedimento PL/SQL standalone hire_employees. O procedimento insere uma linha na tabela employees.
CREATE PROCEDURE hire_employees
  (p_last_name VARCHAR2, p_job_id VARCHAR2, p_manager_id NUMBER,
   p_hire_date DATE, p_salary NUMBER, p_commission_pct NUMBER,
   p_department_id NUMBER)
IS
BEGIN
.
.
.
  INSERT INTO employees (employee_id, last_name, job_id, manager_id, hire_date,
    salary, commission_pct, department_id)
  VALUES (emp_sequence.NEXTVAL, p_last_name, p_job_id, p_manager_id,
          p_hire_date, p_salary, p_commission_pct, p_department_id);
.
.
.
END;
Consulte Também:
-
Oracle AI Database Conceitos Básicos do Oracle AI Database Development para aprender a criar subprogramas
-
Referência de Linguagem PL/SQL do Oracle AI Database para saber mais sobre a instrução
CREATE PROCEDURE
Execução de Subprogramas PL/SQL
Os usuários podem executar um subprograma interativamente de várias maneiras.
As opções são:
-
Usando uma ferramenta Oracle, como o SQL*Plus ou o SQL Developer
-
Chamando-o explicitamente no código de um aplicativo de banco de dados, como um aplicativo Oracle Forms ou pré-compilador
-
Chamá-lo explicitamente no código de outro procedimento ou trigger
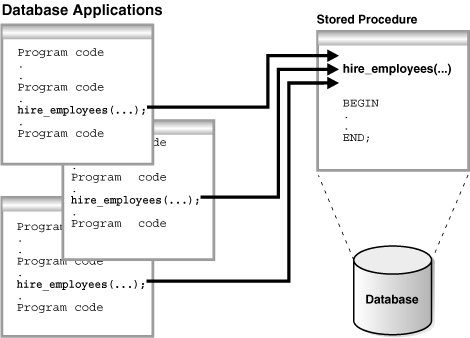
O gráfico a seguir mostra diferentes aplicativos de banco de dados que chamam hire_employees.
Figura 1: Várias Execuções de um Procedimento Armazenado
Descrição da ilustração cncpt073.gif
Como alternativa, um usuário privilegiado pode usar o Oracle Enterprise Manager ou o SQL*Plus para executar o procedimento hire_employees usando uma instrução como a seguinte:
EXECUTE hire_employees ('TSMITH', 'CLERK', 1037, SYSDATE, 500, NULL, 20);A instrução anterior insere um novo registro para TSMITH na tabela employees.
Um procedimento armazenado depende dos objetos referenciados em seu corpo. O banco de dados rastreia e gerencia automaticamente essas dependências. Por exemplo, se você alterar a definição da tabela employees referenciada pelo procedimento hire_employees de uma maneira que afete esse procedimento, o procedimento deverá ser recompilado para validar se ele ainda funciona conforme projetado. Normalmente, o banco de dados administra automaticamente esse gerenciamento de dependência.
Consulte Também:
-
Oracle AI Database Conceitos Básicos do Oracle AI Database Development para saber mais sobre o SQL*Plus e o SQL Developer
-
Guia de Desenvolvimento do Oracle AI Database para saber mais sobre os pré-compiladores
-
Oracle AI Database PL/SQL Language Reference para aprender a usar subprogramas PL/SQL
-
SQL*Plus User's Guide and Reference para saber mais sobre o comando
EXECUTE
Pacotes PL/SQL
Um pacote PL/SQL é um grupo de subprogramas relacionados, juntamente com os cursores e variáveis que eles usam, armazenados juntos no banco de dados para uso contínuo como uma unidade. Os subprogramas empacotados podem ser chamados explicitamente por aplicativos ou usuários.
O Oracle AI Database inclui muitos pacotes fornecidos que estendem a funcionalidade do banco de dados e fornecem acesso PL/SQL a recursos SQL. Por exemplo, o pacote UTL_HTTP permite que chamadas HTTP do PL/SQL e SQL acessem dados na Internet ou chamem Cartuchos do Oracle Web Server. Você pode usar os pacotes fornecidos ao criar aplicativos ou como uma fonte de ideias ao criar seus próprios procedimentos armazenados.
-
Os pacotes PL/SQL Vantagens de Pacotes PL/SQL oferecem várias vantagens para o desenvolvedor de aplicativos.
-
Criação de Pacotes PL/SQL Você cria um pacote em duas partes: a especificação e o corpo. A especificação do pacote declara todas as construções públicas do pacote, enquanto o corpo do pacote define todas as construções (públicas e privadas) do pacote.
-
Execução de Subprogramas de Pacote PL/SQL. Acionadores de banco de dados, subprogramas armazenados, programas de aplicativos 3GL e ferramentas Oracle podem fazer referência ao conteúdo do pacote.
Vantagens dos Pacotes PL/SQL
Os pacotes PL/SQL oferecem várias vantagens para o desenvolvedor de aplicativos.
As vantagens incluem:
-
Encapsulamento
Os pacotes permitem encapsular ou agrupar procedimentos armazenados, variáveis, tipos de dados etc. em uma unidade armazenada nomeada. O encapsulamento proporciona melhor organização durante o desenvolvimento e também mais flexibilidade. Você pode criar especificações e fazer referência a procedimentos públicos sem realmente criar o corpo do pacote. O encapsulamento simplifica o gerenciamento de privilégios. A concessão do privilégio para um pacote torna as construções de pacote acessíveis ao favorecido.
-
Segurança de dados
Os métodos de definição de pacote permitem especificar quais variáveis, cursores e procedimentos são públicos e privados. Público significa que é diretamente acessível ao usuário de um pacote. Privado significa que ele está oculto do usuário de um pacote.
Por exemplo, um pacote pode conter 10 procedimentos. Você pode definir o pacote de modo que apenas três procedimentos sejam públicos e, portanto, estejam disponíveis para execução por um usuário do pacote. Os procedimentos restantes são privados e só podem ser acessados pelos procedimentos do pacote. Não confunda variáveis de pacote público e privado com concessões a
PUBLIC. -
Melhor desempenho
Um pacote inteiro é carregado na memória em pequenos blocos quando um procedimento no pacote é chamado pela primeira vez. Esta carga é concluída em uma operação, ao contrário das cargas separadas necessárias para procedimentos independentes. Quando ocorrem chamadas para procedimentos empacotados relacionados, nenhuma E/S de disco é necessária para executar o código compilado na memória.
Um corpo de pacote pode ser substituído e recompilado sem afetar a especificação. Consequentemente, os objetos de esquema que fazem referência às construções de um pacote (sempre através da especificação) não precisam ser recompilados, a menos que a especificação do pacote também seja substituída. Com o uso de pacotes, recompilações desnecessárias podem ser minimizadas, resultando em menos impacto no desempenho geral do banco de dados.
Criação de Pacotes PL/SQL
Você cria um pacote em duas partes: a especificação e o corpo. A especificação do pacote declara todas as construções públicas do pacote, enquanto o corpo do pacote define todas as construções (públicas e privadas) do pacote.
O exemplo a seguir mostra parte de uma instrução que cria a especificação de pacote para employees_management, que encapsula vários subprogramas usados para gerenciar um banco de dados de funcionário. Cada parte do pacote é criada com uma instrução diferente.
CREATE PACKAGE employees_management AS
  FUNCTION hire_employees (last_name VARCHAR2, job_id VARCHAR2, manager_id NUMBER,
    salary NUMBER, commission_pct NUMBER, department_id NUMBER) RETURN NUMBER;
  PROCEDURE fire_employees(employee_id NUMBER);
  PROCEDURE salary_raise(employee_id NUMBER, salary_incr NUMBER);
.
.
.
  no_sal EXCEPTION;
END employees_management;
A especificação declara a função hire_employees, os procedimentos fire_employees e salary_raise, e a exceção no_sal. Todos esses objetos de programa público estão disponíveis para os usuários que têm acesso ao pacote.
A instrução CREATE PACKAGE BODY define objetos declarados na especificação. O corpo do pacote deve ser criado no mesmo esquema que o pacote. Depois de criar o pacote, você poderá desenvolver aplicativos que chamem qualquer um desses procedimentos ou funções públicos ou que gerem qualquer uma das exceções públicas do pacote.
Consulte Também: Referência de Linguagem PL/SQL do Oracle AI Database para saber mais sobre a instrução CREATE PACKAGE
Execução de Subprogramas de Pacote PL/SQL
Acionadores de banco de dados, subprogramas armazenados, programas de aplicativos 3GL e ferramentas Oracle podem fazer referência ao conteúdo do pacote.
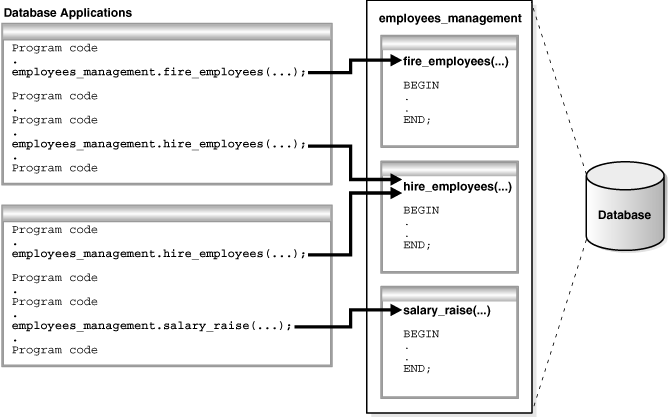
O gráfico a seguir mostra os aplicativos de banco de dados chamando procedimentos e funções no pacote employees_management.
Figura 2: Chamando Subprogramas em um Pacote PL/SQL
Descrição da ilustração cncpt075.gif
Os aplicativos de banco de dados chamam explicitamente os procedimentos empacotados conforme necessário. Depois de receber os privilégios do pacote employees_management, um usuário poderá executar explicitamente qualquer um dos procedimentos contidos nele. Por exemplo, o SQL*Plus pode emitir a seguinte instrução para executar o procedimento do pacote hire_employees:
EXECUTE employees_management.hire_employees ('TSMITH', 'CLERK', 1037, SYSDATE, 500, NULL, 20);Consulte Também:
-
Oracle AI Database PL/SQL Language Reference para obter uma introdução aos pacotes de PL/SQL
-
Guia de Desenvolvimento do Oracle AI Database para aprender a codificar pacotes PL/SQL
Blocos Anônimos PL/SQL
Bloco anônimo PL/SQL é uma unidade não nomeada e não persistente do código PL/SQL.
Os usos típicos para blocos anônimos incluem:
-
Iniciando chamadas para subprogramas e construções de pacote
-
Isolando o tratamento de exceções
-
Gerenciar o controle aninhando código em outros blocos PL/SQL
Blocos anônimos não têm vantagens de reutilização de código de subprogramas armazenados. A Tabela 11-1 resume as diferenças entre os dois tipos de unidades PL/SQL.
Tabela 1 - Diferenças entre Blocos Anônimos e Subprogramas
| É a Unidade PL/SQL… | Blocos Anônimos | Subprogramas |
|---|---|---|
| Especificado com um nome? | Não | Sim |
| Compilado com cada reutilização? | Não | Não |
| Armazenado no Banco de Dados? | Não | Sim |
| Invocável por outros aplicativos? | Não | Sim |
| Capaz de retornar valores de variáveis de vínculo? | Sim | Sim |
| Capaz de retornar valores de função? | Não | Sim |
| Capaz de aceitar parâmetros? | Não | Sim |
Um bloco anônimo consiste em uma parte declarativa opcional, uma parte executável e um ou mais handlers de exceção opcionais. O bloco anônimo de amostra a seguir seleciona o sobrenome de um funcionário em uma variável e imprime o nome:
DECLARE
  v_lname VARCHAR2(25);
BEGIN
  SELECT last_name
    INTO v_lname
  FROM employees
  WHERE employee_id = 101;
  DBMS_OUTPUT.PUT_LINE('Employee last name is '||v_lname);
END;
O Oracle AI Database compila o bloco PL/SQL e o coloca no shared pool da SGA, mas não armazena o código-fonte ou a versão compilada no banco de dados para reutilização além da instância atual. Ao contrário dos gatilhos, um bloco anônimo é compilado toda vez que é carregado na memória. O Shared SQL permite que blocos PL/SQL anônimos no shared pool sejam reutilizados e compartilhados até que sejam liberados do shared pool.
Consulte Também: Oracle AI Database Development Guide para saber mais sobre blocos PL/SQL anônimos
Construções de Linguagem PL/SQL
Os blocos PL/SQL podem incluir várias construções de linguagem PL/SQL diferentes.
Essas construções incluem o seguinte:
-
Variáveis e constantes
Você pode declarar essas construções dentro de um procedimento, uma função ou um pacote. Você pode usar uma variável ou constante em uma instrução SQL ou PL/SQL para capturar ou fornecer um valor quando for necessário.
-
Cursores
Você pode declarar um cursor explicitamente em um procedimento, função ou pacote para facilitar o processamento orientado a registros de dados do Oracle AI Database. O mecanismo PL/SQL também pode declarar cursores implicitamente.
-
Exceções
O PL/SQL permite tratar explicitamente condições de erro internas e definidas pelo usuário, chamadas exceções, que surgem durante o processamento do código PL/SQL.
O PL/SQL pode executar instruções SQL dinâmicas cujo texto completo não é conhecido até o tempo de execução. As instruções SQL dinâmicas são armazenadas em strings de caracteres que são inseridas ou criadas pelo programa no run-time. Essa técnica permite criar procedimentos de finalidades gerais. Por exemplo, você pode criar um procedimento que opere em uma tabela cujo nome não seja conhecido até o run-time.
Consulte Também:
-
Oracle AI Database PL/SQL Packages and Types Reference para obter detalhes sobre SQL dinâmico
-
Referência de Tipos e Pacotes PL/SQL do Oracle AI Database para aprender a usar SQL dinâmico no pacote
DBMS_SQL
Coleções e registros PL/SQL
Muitas técnicas de programação usam tipos de coleta, como matrizes, sacos, listas, tabelas aninhadas, conjuntos e árvores.
Para suportar técnicas de coleta em aplicações de banco de dados, o PL/SQL fornece os tipos de dados TABLE e VARRAY. Esses tipos permitem declarar matrizes associativas, tabelas aninhadas e matrizes de tamanho variável.
-
Coleções Uma coleção PL/SQL é um grupo ordenado de elementos, todos do mesmo tipo.
-
Registros Um registro PL/SQL é uma variável composta que pode armazenar valores de dados de diferentes tipos, semelhantes a um tipo de estrutura em C, C++ ou Java. Os registros são úteis para armazenar dados de linhas ou determinadas colunas de linhas das tabelas.
Coleções
Uma coleção PL/SQL é um grupo ordenado de elementos, todos do mesmo tipo.
Cada elemento tem um subscrito exclusivo que determina sua posição na coleta. Para criar uma coleção, primeiro você define um tipo de coleção e, em seguida, declara uma variável desse tipo.
As coleções funcionam como os arrays encontrados na maioria das linguagens de programação de terceira geração. Além disso, as coletas podem ser passadas como parâmetros. Assim, você pode usá-los para mover colunas de dados para dentro e para fora de tabelas de banco de dados ou entre aplicativos do lado do cliente e subprogramas armazenados.
Registros
Um registro PL/SQL é uma variável composta que pode armazenar valores de dados com diferentes tipos, semelhantes a um tipo de estrutura em C, C++ ou Java. Os registros são úteis para armazenar dados das linhas das tabelas ou determinadas colunas de linhas das tabelas.
Suponha que você tenha dados sobre um funcionário, como nome, salário e data de contratação. Estes itens são diferentes em tipo, mas logicamente relacionados. Um registro que contém um campo para cada item permite tratar os dados como uma unidade lógica.
Você pode usar o atributo %ROWTYPE para declarar um registro que represente uma linha ou linha de tabela extraída de um cursor. Com registros definidos pelo usuário, você pode declarar seus próprios campos.
Consulte Também: Referência de Linguagem PL/SQL do Oracle AI Database para saber como usar registros PL/SQL
Como o Código PL/SQL É Executado
O PL/SQL suporta execução interpretada e execução nativa.
Na execução interpretada, o código-fonte PL/SQL é compilado em uma representação chamada bytecode. Um computador virtual portátil implementado como parte do Oracle AI Database executa esse código de bytes.
A execução nativa oferece o melhor desempenho em unidades computacionalmente intensivas. Nesse caso, o código-fonte das unidades PL/SQL é compilado diretamente no código-objeto da plataforma fornecida. Este código de objeto está vinculado ao Oracle AI Database.
O mecanismo PL/SQL define, compila e executa unidades PL/SQL. Esse mecanismo é um componente especial de muitos produtos Oracle, incluindo o Oracle AI Database. Embora muitos produtos Oracle tenham componentes PL/SQL, este tópico abrange especificamente as unidades PL/SQL que podem ser armazenadas no Oracle AI Database e processadas usando o mecanismo PL/SQL do Oracle AI Database. A documentação de cada ferramenta Oracle descreve seus recursos de PL/SQL.
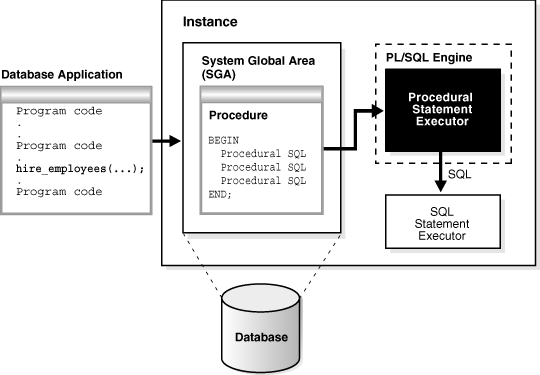
O gráfico a seguir ilustra o mecanismo PL/SQL contido no Oracle AI Database.
Figura 3: O Mecanismo PL/SQL e o Oracle AI Database
Descrição da ilustração cncpt070.gif
A unidade PL/SQL é armazenada em um banco de dados. Quando um aplicativo chama um procedimento armazenado, o banco de dados carrega a unidade PL/SQL compilada no pool compartilhado na Área Global do Sistema (SGA). Os executores de instruções PL/SQL e SQL trabalham juntos para processar as instruções no procedimento.
Você pode chamar um procedimento armazenado de outro bloco PL/SQL, que pode ser um bloco anônimo ou outro procedimento armazenado. Por exemplo, você pode chamar um procedimento armazenado do Oracle Forms.
Um procedimento PL/SQL executado no Oracle AI Database pode chamar um procedimento externo ou uma função gravada na linguagem de programação C e armazenada em uma biblioteca compartilhada. A rotina C é executada em um espaço de endereço separado do Oracle AI Database.
Consulte Também:
-
"Shared Pool " para saber mais sobre a finalidade e o conteúdo do shared pool
-
Oracle AI Database PL/SQL Language Reference para saber mais sobre a arquitetura de PL/SQL
-
Guia de Desenvolvimento do Oracle AI Database para saber mais sobre procedimentos externos
Visão Geral do Java no Oracle AI Database
O Java surgiu como a linguagem de programação orientada a objetos de sua escolha.
O Java inclui os seguintes recursos:
-
Java Virtual Machine (JVM), que fornece a base para a independência da plataforma
-
Técnicas automatizadas de gerenciamento de armazenamento, como coleta de lixo
-
A sintaxe da linguagem que toma emprestado de C e impõe a digitação forte Observação: Este capítulo pressupõe que você tenha alguma familiaridade com a linguagem Java.
O banco de dados fornece aos programas Java um mecanismo de processamento de dados dinâmico que suporta consultas complexas e várias exibições de dados. As solicitações do cliente são montadas como consultas de dados para processamento imediato. Os resultados da consulta são gerados dinamicamente.
A combinação de Java e Oracle AI Database ajuda a criar aplicações baseadas em componentes e centradas na rede que podem ser facilmente atualizadas à medida que as necessidades de negócios mudam. Além disso, você pode mover aplicativos e armazenamentos de dados para fora da área de trabalho e para redes inteligentes e servidores centrados na rede. Mais importante ainda, você pode acessar esses aplicativos e armazenamentos de dados de qualquer dispositivo cliente.
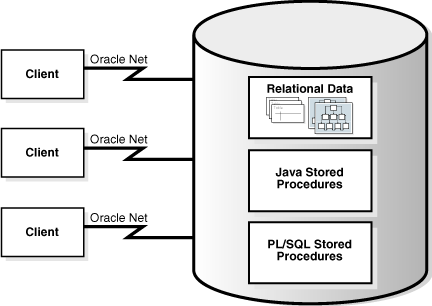
A figura a seguir mostra uma configuração tradicional de cliente/servidor de duas camadas na qual os clientes chamam procedimentos armazenados Java da mesma forma que chamam subprogramas PL/SQL.
Figura 4: Configuração de Cliente/Servidor de Duas Camadas
Descrição da ilustração cncpt236.gif
-
Visão Geral da Java Virtual Machine (JVM) Uma JVM é um processador virtual que executa o código Java compilado.
-
Ambiente de Programação Java A Oracle fornece aos desenvolvedores de aplicativos empresariais uma solução Java completa para criação, implantação e gerenciamento de aplicativos Java. Consulte Também: Oracle AI Database Conceitos Básicos do Desenvolvimento Java para uma introdução ao uso do Java com o Oracle AI Database
Visão Geral do Java Virtual Machine (JVM)
Uma JVM é um processador virtual que executa o código Java compilado.
O código-fonte Java é compilado para instruções de máquina de baixo nível, conhecidas como bytecodes, que são independentes de plataforma. Os bytecodes Java são interpretados por meio da JVM em direção a ações dependentes de plataforma.
-
Visão Geral da Oracle JVM A Oracle JVM é um ambiente padrão compatível com Java que executa qualquer aplicativo Java puro. É compatível com as especificações JLS e JVM.
-
Componentes Principais do Oracle JVM O Oracle JVM é executado no mesmo espaço de processo e no mesmo espaço de endereço do kernel do banco de dados, compartilhando seus heaps de memória e acessando diretamente seus dados relacionais. Esse design otimiza o uso da memória e aumenta o throughput.
Visão Geral do Oracle JVM
A Oracle JVM é um ambiente padrão compatível com Java que executa qualquer aplicativo Java puro. É compatível com as especificações JLS e JVM.
A JVM da Oracle suporta o formato binário Java padrão e as APIs. Além disso, o Oracle AI Database adere à semântica de linguagem Java padrão, incluindo o carregamento dinâmico de classes em tempo de execução.
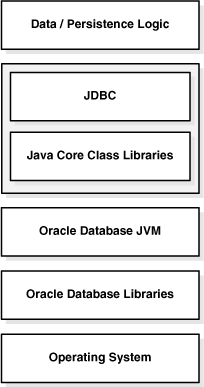
A figura a seguir ilustra como os aplicativos Oracle Java residem na parte superior das bibliotecas de classes principais Java, que residem na parte superior da JVM Oracle. Como o sistema de suporte Oracle Java está localizado dentro do banco de dados, a JVM interage com as bibliotecas de banco de dados, em vez de interagir diretamente com o sistema operacional.
Figura 5: Estrutura do Componente Java
Descrição da ilustração cncpt206.gif
Ao contrário de outros ambientes Java, a Oracle JVM está incorporada ao Oracle AI Database. Existem algumas diferenças importantes entre a JVM do Oracle e as JVMs típicas do cliente. Por exemplo, em um ambiente Java padrão, você executa um aplicativo Java por meio do interpretador emitindo o seguinte comando na linha de comando, em que classname é o nome da classe que a JVM interpreta primeiro:
java classnameO comando anterior faz com que o aplicativo seja executado dentro de um processo no sistema operacional. No entanto, se você não estiver usando a interface de linha de comando, deverá carregar o aplicativo no banco de dados, publicar a interface e, em seguida, executar o aplicativo em um dicionário de dados do banco de dados.
Consulte Também: Consulte o Oracle AI Database Java Developer's Guide para obter uma descrição de outras diferenças entre a JVM do Oracle e as JVMs típicas do cliente
Principais Componentes do Oracle JVM
A JVM da Oracle é executada no mesmo espaço de processo e de endereço que o kernel do banco de dados, compartilhando seus heaps de memória e acessando diretamente seus dados relacionais. Esse design otimiza o uso da memória e aumenta o throughput.
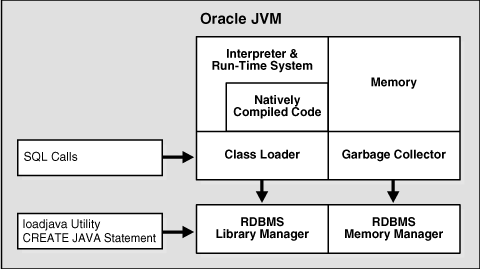
A JVM da Oracle fornece um ambiente de runtime para objetos Java. Ele suporta totalmente estruturas de dados Java, despacho de método, tratamento de exceções e threads no nível de linguagem. Ele também suporta todas as bibliotecas de classes Java básicas, incluindo java.lang, java.io, java.net, java.math e java.util.
A ilustração a seguir mostra os principais componentes da JVM Oracle.
Figura 6: Principais Componentes da JVM Oracle
Descrição da ilustração cncpt254.gif
A JVM da Oracle incorpora o namespace Java padrão nos esquemas de banco de dados. Esse recurso permite que os programas Java acessem objetos Java armazenados no Oracle AI Database e em servidores de aplicativos em toda a empresa.
Além disso, a JVM da Oracle está totalmente integrada à arquitetura de memória compartilhada e escalável do banco de dados. Os programas Java usam chamadas, sessões e vidas de objetos com eficiência, sem a intervenção do usuário. Consequentemente, os objetos de negócios Java de camada intermediária e JVM da Oracle podem ser dimensionados, mesmo quando têm um estado de sessão longa.
Consulte Também: Oracle AI Database Java Developer's Guide para obter uma descrição dos principais componentes da Oracle JVM
Ambiente de Programação Java
A Oracle fornece aos desenvolvedores de aplicativos empresariais uma solução Java de ponta a ponta para criar, implementar e gerenciar aplicativos Java.
A solução consiste em interfaces programáticas do lado do cliente e do lado do servidor, ferramentas para suportar o desenvolvimento do Java e uma Java Virtual Machine integrada ao Oracle AI Database. Todos esses produtos são compatíveis com os padrões Java.
O ambiente de programação Java consiste nos seguintes recursos adicionais:
-
Procedimentos armazenados em Java como o equivalente em Java e companheiro de PL/SQL. Os procedimentos armazenados em Java são totalmente integrados ao PL/SQL. Você pode chamar procedimentos armazenados em Java de pacotes PL/SQL e procedimentos de procedimentos armazenados em Java.
-
As interfaces de programação JDBC e SQLJ para acessar dados SQL.
-
Ferramentas e scripts que auxiliam no desenvolvimento, carregamento e gerenciamento de classes.
-
Procedimentos Armazenados Java Um procedimento armazenado Java é um método Java publicado no SQL e armazenado no banco de dados.
-
Integração de Java e PL/SQL Você pode chamar programas PL/SQL existentes em programas Java e Java em PL/SQL. Essa solução protege e utiliza seus códigos PL/SQL e Java.
Procedimentos Armazenados Java
Procedimento armazenado em Java é um método Java publicado em SQL e armazenado no banco de dados.
Como um subprograma PL/SQL, um procedimento Java pode ser chamado diretamente com produtos como o SQL*Plus ou indiretamente com um trigger. Você pode acessá-lo em qualquer OCI cliente, pré-compilador ou JDBC do Oracle Net.
Para publicar métodos Java, você grava especificações de chamada, que mapeiam nomes de métodos Java, tipos de parâmetros e tipos de retorno para suas contrapartes SQL. Quando chamado por aplicativos cliente, um procedimento armazenado em Java pode aceitar argumentos, fazer referência a classes Java e retornar valores de resultado Java.
Os aplicativos que chamam o método Java fazem referência ao nome da especificação de chamada. O sistema de run-time procura a definição de especificação de chamada no dicionário de dados Oracle e executa o método Java correspondente.
Além disso, você pode usar o Java para desenvolver programas avançados, independentemente da linguagem PL/SQL. O Oracle AI Database fornece uma implementação totalmente compatível da linguagem de programação Java e da JVM.
Consulte Também: O Oracle AI Database Java Developer's Guide explica como escrever procedimentos armazenados em Java, como acessá-los em PL/SQL e como acessar a funcionalidade PL/SQL do Java
Integração Java e PL/SQL
Você pode chamar programas PL/SQL existentes em programas Java e Java em programas PL/SQL. Essa solução protege e utiliza seus códigos PL/SQL e Java.
O Oracle AI Database oferece JDBC para acessar dados SQL do Java no cliente e no servidor.
- Drivers JDBC JDBC é um protocolo de acesso ao banco de dados que permite estabelecer conexão com um banco de dados e executar instruções e consultas SQL no banco de dados.
Drivers JDBC
JDBC é um protocolo de acesso ao banco de dados que permite estabelecer conexão com um banco de dados e executar instruções e consultas SQL no banco de dados.
As bibliotecas de classe Java básicas fornecem apenas uma API JDBC, java.sql. No entanto, o JDBC foi projetado para permitir que os fornecedores forneçam drivers que ofereçam a especialização necessária para um determinado banco de dados. O Oracle fornece os drivers JDBC distintos mostrados na tabela a seguir.
Drivers JDBC da Tabela 2
| Driver | Descrição |
|---|---|
| Driver JDBC Thin | Você pode usar o driver JDBC Thin para gravar aplicativos e applets Java puros que acessam dados do Oracle SQL. O driver JDBC Thin é especialmente adequado para aplicativos e applets baseados na Web, porque você pode baixá-lo dinamicamente de uma página da Web, semelhante a qualquer outro applet Java. |
| Driver JDBC OCI | O driver JDBC OCI acessa o código nativo específico da Oracle, ou seja, código não Java e bibliotecas na camada cliente ou intermediária, proporcionando um aumento de desempenho em comparação com o driver JDBC Thin, ao custo de tamanho significativamente maior e instalação no lado do cliente. |
| Driver interno do servidor JDBC | O Oracle AI Database usa o driver interno do servidor quando o código Java é executado no servidor. Ele permite que os aplicativos Java em execução na JVM da Oracle no servidor acessem dados definidos localmente, ou seja, dados no mesmo sistema e no mesmo processo, com JDBC. Ele proporciona um aumento de desempenho, devido à sua capacidade de usar as bibliotecas subjacentes do Oracle RDBMS diretamente, sem a sobrecarga de uma conexão de rede intermediária entre o código Java e os dados SQL. Ao suportar a mesma interface Java-SQL no servidor, o Oracle AI Database não exige que você retrabalhe o código ao implantá-lo. |
Consulte Também:
-
Guia de Desenvolvimento do Oracle AI Database para obter uma visão geral do JDBC
-
Oracle AI Database Get Started with Java Development e Oracle AI Database JDBC Developer's Guide
Visão geral do JavaScript no Oracle AI Database
O JavaScript é uma das linguagens de programação mais populares atualmente. O Oracle AI Database implantado no Linux x86-64 ou no Linux aarch64 adiciona JavaScript à lista de idiomas suportados para desenvolvimento no lado do servidor.
Você pode armazenar módulos do JavaScript no banco de dados, processando dados onde eles residem, oferecendo melhorias potencialmente significativas em relação às abordagens de desenvolvimento do lado do cliente. JavaScript é executado pelo Multilingual Engine (MLE).
Os desenvolvedores têm a opção de executar o código JavaScript standalone e armazenar o código JavaScript nativamente no banco de dados como módulos.
-
Armazenando Lógica de Negócios como Módulos no Banco de Dados Assim como no desenvolvimento do cliente relacionado a JavaScript, o código pode ser armazenado juntos na forma de um módulo.
-
Execução Dinâmica de desenvolvedores de Framework JavaScript Code e qualquer pessoa que deseje executar código JavaScript standalone sem a necessidade de armazenar código no banco de dados pode fazer uso do pacote
DBMS_MLEe suas sub-rotinas. -
Procedimentos Armazenados JavaScript em Linha As especificações de chamada MLE incorporadas incorporam o código JavaScript diretamente nas DDLs
CREATE FUNCTIONeCREATE PROCEDURE. Consulte Também: Oracle AI Database JavaScript Developer's Guide para saber mais sobre o suporte a JavaScript no Oracle AI Database.
Armazenando Lógica de Negócios como Módulos no Banco de Dados
Assim como no desenvolvimento do lado do cliente relacionado ao JavaScript, o código pode ser armazenado em conjunto na forma de um módulo.
Os desenvolvedores com um plano de fundo PL/SQL podem pensar em um módulo JavaScript como o equivalente a um corpo de pacote PL/SQL, mas escrito em JavaScript. Funções declaradas em um módulo podem ser marcadas para serem exportadas ou mantidas privadas.
O JavaScript no Oracle AI Database adere ao padrão ECMAScript 2023 e oferece aos desenvolvedores uma ampla gama de possibilidades para armazenar lógica de negócios no banco de dados.
Observação:
Consulte também:
-
Oracle AI Database JavaScript Developer's Guide capítulo 2 para uma introdução completa dos Módulos MLE.
-
Oracle AI Database JavaScript Developer's Guide capítulo 5 para obter detalhes sobre as Especificações de Chamada.
Veja abaixo um exemplo de criação de um módulo JavaScript com MLE:
create mle module if not exists example_module
language javascript as

export function string2obj(inputString) {
   if ( inputString === undefined ) {
      throw `must provide a string in the form of key1=value1;...;keyN=valueN`;
   }

   let myObject = {};
   if ( inputString.length === 0 ) {
      return myObject;
   }

   const kvPairs = inputString.split(";");
   kvPairs.forEach( pair => {
      const tuple = pair.split("=");
      if ( tuple.length === 1 ) {
          tuple[1] = false;
      } else if ( tuple.length != 2 ) {
          throw "parse error: you need to use exactly one '=' between key and value and not use '=' in either key or value";
      }
      myObject[tuple[0]] = tuple[1];
  });

  return myObject;
}
/
O módulo JavaScript, também conhecido como Módulo MLE, agora é armazenado no esquema do usuário. Sua única função, string2obj(), pode ser exposta a SQL e PL/SQL criando uma Especificação de Chamada. As Especificações de Chamada são unidades de programa PL/SQL que permitem chamar o código JavaScript em todos os lugares em que SQL e PL/SQL podem ser chamados. A Especificação de Chamada para string2obj() pode ser escrita da seguinte forma:
create function if not exists p_string_to_JSON(p_str varchar2) return JSON
as mle module example_module
   signature 'string2obj(string)';
/
Com a função criada, ela pode ser chamada de SQL:
declare
   l_json   JSON;
   l_string VARCHAR2(100);
begin
   l_string := 'a=1;b=2;c=3;d';
   l_json := p_string_to_JSON(l_string);
   dbms_output.put_line(json_serialize(l_json PRETTY));
end;
/

{
  "a" : "1",
  "b" : "2",
  "c" : "3",
  "d" : false
}

PL/SQL procedure successfully completed.
Execução Dinâmica do Código JavaScript
Os desenvolvedores de framework e qualquer pessoa que deseje executar código JavaScript autônomo sem a necessidade de armazenar código no banco de dados pode fazer uso do pacote DBMS_MLE e de suas sub-rotinas.
O Oracle Application Express e o Database Actions, por exemplo, integram o DBMS_MLE, ocultando o fato de que um pacote PL/SQL é chamado nas capas.
Em comparação com os módulos MLE, o uso de DBMS_MLE dificulta a gravação de aplicativos inteiros. Por exemplo, é mais difícil dividir logicamente um aplicativo em entidades separadas. O recurso Depuração Pós-Execução requer módulos, dificultando a solução de problemas em trechos de código. Os pipelines de Integração Contínua (CI) também podem ter dificuldades com o linting de código PL/SQL e JavaScript no mesmo arquivo. Da mesma forma, há um possível problema com seu Ambiente de Desenvolvimento Integrado (IDE), pois a maioria terá dificuldade em trabalhar com PL/SQL e JavaScript na mesma janela.
Observação:
Consulte também:
-
Referência de Tipos e Pacotes PL/SQL do Oracle AI Database para obter mais detalhes sobre o
DBMS_MLEe suas sub-rotinas. -
Oracle AI Database JavaScript Developer's Guide capítulo 3 para obter mais detalhes sobre a chamada dinâmica do JavaScript.
Procedimentos Armazenados JavaScript em Linha
As especificações de chamada MLE embutidas incorporam o código JavaScript diretamente nas DDLs CREATE FUNCTION e CREATE PROCEDURE.
Se você quiser implementar rapidamente uma funcionalidade simples usando JavaScript, as especificações de chamada MLE inline podem ser uma boa escolha. Com essa opção, você não precisa implantar um módulo separado que contenha o código JavaScript. Em vez disso, a função JavaScript é incorporada à definição da própria especificação de chamada.
A cláusula MLE LANGUAGE é usada para especificar que a função é implementada usando JavaScript. A string que segue o nome do idioma é tratada como o corpo de uma função JavaScript que implementa a funcionalidade da especificação de chamada. Quando o código é executado, os parâmetros PL/SQL são automaticamente convertidos no tipo JavaScript padrão e passados para a função JavaScript como parâmetros com o mesmo nome. Observe que os nomes de parâmetros sem aspas são mapeados para nomes JavaScript em letras maiúsculas. O valor retornado por uma função JavaScript é convertido no tipo de retorno da especificação de chamada PL/SQL, assim como acontece com as especificações de chamada para módulos MLE.
Observação:
Consulte também:
- Oracle AI Database JavaScript Developer's Guide capítulo 5 para obter mais detalhes sobre procedimentos armazenados JavaScript em linha.
Visão Geral de Acionadores
Um trigger de banco de dados é uma unidade de programa armazenada compilada, gravada em PL/SQL, Java ou JavaScript, que o Oracle Database chama ("dispara") automaticamente em determinadas situações.
Um trigger é acionado sempre que ocorre uma das seguintes operações:
-
instruções DML em uma tabela ou view específica, emitidas por qualquer usuário
As instruções DML modificam dados nos objetos de esquema. Por exemplo, a inserção e a exclusão de linhas são operações DML.
-
Instruções DDL emitidas por um usuário específico ou por qualquer usuário
As instruções DDL definem objetos de esquema. Por exemplo, a criação de uma tabela e a adição de uma coluna são operações DDL.
-
Eventos do banco de dados
Logon ou logoff do usuário, erros e inicialização ou shutdown do banco de dados são eventos que podem chamar acionadores.
Triggers são objetos de esquema que são semelhantes a subprogramas, mas diferem na forma como são chamados. Um subprograma é executado explicitamente por um usuário, aplicativo ou acionador. Os triggers são implicitamente chamados pelo banco de dados quando um evento de trigger ocorre.
-
Vantagens de Triggers O uso correto de triggers permite criar e implantar aplicativos mais robustos e que usam o banco de dados com mais eficiência.
-
Tipos de Triggers Os Triggers podem ser categorizados de acordo com seus meios de chamada e com o tipo de ações que eles executam.
-
Tempo para Triggers Você pode definir o tempo de trigger—se a ação de trigger deve ser executada antes ou depois da instrução de trigger.
-
Criação de Triggers A instrução
CREATE TRIGGERcria ou substitui um trigger de banco de dados. -
Execução de Triggers O Oracle Database executa um trigger internamente usando as mesmas etapas da execução do subprograma.
-
Armazenamento de Triggers O Oracle Database armazena triggers PL/SQL em forma compilada em um esquema de banco de dados, assim como procedimentos armazenados em PL/SQL.
Consulte Também:
-
"Visão Geral de Instruções SQL" para saber mais sobre DML e DDL
-
"Visão Geral da Inicialização e do Shutdown da Instância do Banco de Dados
Vantagens dos Triggers
O uso correto de triggers permite que você crie e implante aplicativos mais robustos e que usem o banco de dados com mais eficiência.
Você pode usar acionadores para:
-
Gerar automaticamente valores de coluna derivados
-
Impedir transações inválidas
-
Fornecer auditoria e registro de eventos
-
Informações de registro sobre acesso a tabelas
Você pode usar triggers para impor regras de negócios de nível inferior comuns a todos os aplicativos cliente. Por exemplo, vários aplicativos podem acessar a tabela employees. Se um acionador nesta tabela garantir o formato dos dados inseridos, essa lógica de negócios não precisará ser reproduzida em todos os clientes. Como o acionador não pode ser contornado pelo aplicativo, a lógica de negócios no acionador é usada automaticamente.
Você pode usar triggers e constraints de integridade para definir e impor qualquer tipo de regra de integridade. No entanto, a Oracle recomenda que você só use triggers para impor regras de negócios complexas não definíveis usando uma constrição de integridade.
O uso excessivo de gatilhos pode resultar em interdependências complexas que podem ser difíceis de manter em um aplicativo grande. Por exemplo, quando um trigger é chamado, uma instrução SQL dentro de sua ação de trigger pode potencialmente acionar outros triggers, resultando em triggers em cascata que podem produzir efeitos indesejados.
Consulte Também:
-
Oracle AI Database PL/SQL Language Reference para obter diretrizes e restrições ao planejar acionadores para seu aplicativo
automaticamente em determinadas situações.")
Tipos de Triggers
Os gatilhos podem ser categorizados de acordo com seus meios de invocação e o tipo de ações que eles executam.
O Oracle Database suporta os seguintes tipos de triggers:
-
Acionadores de linha
Um gatilho de linha é acionado toda vez que a tabela é afetada pela instrução de acionamento. Por exemplo, se uma instrução atualizar várias linhas, um acionador de linha será acionado uma vez para cada linha afetada pelo
UPDATE. Se uma instrução acionadora não afetar linhas, um acionador de linha não será executado. Os acionadores de linha serão úteis se o código na ação do acionador depender dos dados fornecidos pela instrução ou linhas acionadoras afetadas. -
Acionadores de instrução
Um trigger de instrução é acionado uma vez em nome da instrução de acionamento, independentemente do número de linhas afetadas pela instrução de acionamento. Por exemplo, se uma instrução excluir 100 linhas de uma tabela, um acionador
DELETEno nível da instrução será acionado apenas uma vez. Os acionadores de instrução serão úteis se o código na ação do acionador não depender dos dados fornecidos pela instrução do acionador ou das linhas afetadas. -
Acionadores
INSTEAD OFUm gatilho INSTEAD OF é acionado pelo Oracle Database em vez de executar a instrução de acionamento. Esses triggers são úteis para modificar de forma transparente views que não podem ser modificadas diretamente por meio de instruções DML.
-
Triggers de eventos
Você pode usar triggers para publicar informações sobre eventos de banco de dados para assinantes. Os acionadores de evento são divididos nas seguintes categorias:
-
Um gatilho de evento do sistema pode ser causado por eventos como inicialização e shutdown da instância do banco de dados ou mensagens de erro.
-
Um gatilho de evento do usuário é acionado por causa de eventos relacionados a log-on e log-off do usuário, instruções DDL e instruções DML.
-
Consulte Também:
automaticamente em determinadas situações.")
Tempo para Triggers
É possível definir o tempo de acionamento - se a ação de acionamento deve ser executada antes ou depois da instrução de acionamento.
Um gatilho simples é um único trigger em uma tabela que permite especificar ações para exatamente um dos seguintes pontos de tempo:
-
Antes da declaração de disparo
-
Antes de cada linha afetada pela instrução de disparo
-
Depois de cada linha afetada pela instrução de disparo
-
Após a declaração de disparo
Para acionadores de instrução e linha, um acionador BEFORE pode aprimorar a segurança e ativar regras de negócios antes de fazer alterações no banco de dados. O trigger AFTER é ideal para ações de log.
Um gatilho composto pode ser acionado em vários pontos de tempo. Os gatilhos compostos ajudam a programar uma abordagem na qual as ações que você implementa para vários pontos de tempo compartilham dados comuns.
Consulte Também: Referência de Linguagem PL/SQL do Oracle AI Database para saber mais sobre triggers compostos
automaticamente em determinadas situações.")
Criação de Triggers
A instrução CREATE TRIGGER cria ou substitui um trigger de banco de dados.
Um trigger PL/SQL tem a seguinte forma sintática geral:
CREATE TRIGGER trigger_name
  triggering_statement
  [trigger_restriction]
BEGIN
 triggered_action;
END;
Um trigger de PL/SQL tem os seguintes componentes básicos:
-
Nome de trigger
O nome deve ser exclusivo entre outros nomes de trigger no mesmo esquema. Por exemplo, o nome pode ser
part_reorder_trigger. -
O evento ou a instrução do acionador
Um evento ou instrução de acionamento é a instrução SQL, o evento do banco de dados ou o evento do usuário que faz com que um acionador seja chamado. Por exemplo, um usuário atualiza uma tabela.
-
Restrição de gatilho
Uma restrição de trigger especifica uma expressão Booliana que deve ser
truepara que o trigger seja acionado. Por exemplo, o acionador não é chamado a menos que o número de peças disponíveis seja menor que um valor de reposição presente. -
Ação acionada
Uma ação acionada é o procedimento que contém as instruções SQL e o código a serem executados quando uma instrução acionadora é emitida e a restrição do acionador é avaliada como verdadeira. Por exemplo, um usuário insere uma linha em uma tabela de prescrições pendentes.
-
Exemplo: Instrução CREATE TRIGGER Este exemplo cria um TRIGGER que é acionado quando uma instrução
INSERT,UPDATEouDELETEé executada em uma tabela de itens de linha. -
Exemplo: Chamando um Acionador de Nível de Linha Nesse cenário, um cliente inicia dois pedidos e adiciona e remove itens de linha dos pedidos.
Consulte Também:
-
Oracle AI Database Conheça o Oracle AI Database Development e a Oracle AI Database PL/SQL Language Reference para saber como criar triggers
-
Oracle AI Database SQL Language Reference para saber mais sobre a instrução
CREATE TRIGGER
automaticamente em determinadas situações.")
Exemplo: Instrução CREATE TRIGGER
Este exemplo cria um trigger que é acionado quando uma instrução INSERT, UPDATE ou DELETE é executada em uma tabela de itens de linha.
Suponha que você crie as tabelas orders e lineitems com as instruções a seguir. A tabela orders contém uma linha para cada ordem exclusiva, enquanto a tabela lineitems contém uma linha para cada item em uma ordem.
CREATE TABLE orders
( order_id NUMBER PRIMARY KEY,
  /* other attributes */
  line_items_count NUMBER DEFAULT 0 );

CREATE TABLE lineitems
( order_id REFERENCES orders,
  seq_no   NUMBER,
  /* other attributes */
  CONSTRAINT lineitems PRIMARY KEY(order_id,seq_no) );
A instrução a seguir cria um trigger de amostra que atualiza automaticamente a tabela orders com o número de itens em uma ordem:
CREATE OR REPLACE TRIGGER lineitems_trigger
  AFTER INSERT OR UPDATE OR DELETE ON lineitems
  FOR EACH ROW
BEGIN
  IF (INSERTING OR UPDATING)
  THEN
    UPDATE orders SET line_items_count = NVL(line_items_count,0)+1
    WHERE order_id = :new.order_id;
  END IF;
  IF (DELETING OR UPDATING)
  THEN
    UPDATE orders SET line_items_count = NVL(line_items_count,0)-1
    WHERE order_id = :old.order_id;
  END IF;
END;
/
Em lineitems_trigger, a instrução de acionamento é INSERT, UPDATE ou DELETE na tabela lineitems. Não existe restrição de acionamento. O trigger é chamado para cada linha alterada. O acionador tem acesso aos valores de coluna antigos e novos da linha atual afetada pela instrução de acionamento. Existem dois nomes de correlação para cada coluna da tabela que está sendo modificada: o valor antigo (:old) e o novo (:new). Se uma sessão atualizar ou inserir linhas em lineitems para um pedido, após a ação, o acionador calculará o número de itens neste pedido e atualizará a tabela orders com a contagem.
Exemplo: Chamando um Acionador no Nível da Linha
Nesse cenário, um cliente inicia dois pedidos e adiciona e remove itens de linha dos pedidos.
O cenário é baseado no TRIGGER criado em Exemplo: Instrução CREATE TRIGGER.
Cenário de Acionador no Nível de Linha da Tabela 3
| Instrução SQL | Instrução SQL Acionada | Descrição |
|---|---|---|
SQL> INSERT INTO orders (order_id) VALUES (78); 1 row created. |
O cliente cria um pedido com o ID 78. nesse ponto, o cliente não tem itens no pedido. Como nenhuma ação é executada na tabela |
|
SQL> INSERT INTO orders (order_id) VALUES (92); 1 row created. |
O cliente cria um pedido separado com o ID 92. nesse ponto, o cliente não tem itens no pedido. Como nenhuma ação é executada na tabela |
|
SQL> INSERT INTO lineitems (order_id, seq_no) VALUES (78,1); 1 row created. |
UPDATE orders SET line_items_count = NVL(NULL,0)+1 WHERE order_id = 78; |
O cliente adiciona um item ao pedido 78. O |
SQL> INSERT INTO lineitems (order_id, seq_no) VALUES (78,2); 1 row created. |
UPDATE orders SET line_items_count = NVL(1,0)+1 WHERE order_id = 78; |
O cliente adiciona um item adicional ao pedido 78. O |
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 2 92 0 |
O cliente consulta o status dos dois pedidos. A ordem 78 contém dois itens. A ordem 92 não contém itens. | |
SQL> SELECT * FROM lineitems; ORDER_ID SEQ_NO ---------- ---------- 78 1 78 2 |
O cliente consulta o status dos itens de linha. Cada item é identificado exclusivamente pelo ID da ordem e pelo número de sequência. | |
SQL> UPDATE lineitems SET order_id = 92; 2 rows updated. |
UPDATE orders
  SET line_items_count =
  NVL(NULL,0)+1
 WHERE order_id = 92;

  UPDATE orders
  SET line_items_count =
  NVL(2,0)-1
 WHERE order_id = 78;
UPDATE orders SET line_items_count = NVL(1,0)+1 WHERE order_id = 92; UPDATE orders SET line_items_count = NVL(1,0)-1 WHERE order_id = 78; |
o cliente move os itens de linha que estavam no pedido 78 para o pedido 92. A instrução Cada vez que o trigger é chamado, as duas condições |
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 0 92 2 |
O cliente consulta o status dos dois pedidos. O efeito líquido é que a contagem de itens de linha para a ordem 92 aumentou de 0 para 2, enquanto a contagem para a ordem 78 diminuiu de 2 para 0. | |
SQL> SELECT * FROM lineitems; ORDER_ID SEQ_NO ---------- ---------- 92 1 92 2 |
O cliente consulta o status dos itens de linha. Cada item é identificado exclusivamente pelo ID da ordem e pelo número de sequência. | |
SQL> DELETE FROM lineitems; 2 rows deleted. |
UPDATE orders SET line_items_count = NVL(2,0)-1 WHERE order_id = 92; UPDATE orders SET line_items_count = NVL(1,0)-1 WHERE order_id = 92; |
Agora o cliente remove todos os itens de linha de todos os pedidos. A instrução |
SQL> SELECT * FROM orders; ORDER_ID LINE_ITEMS_COUNT --------- ---------------- 78 0 92 0 SQL> SELECT * FROM lineitems; no rows selected |
O cliente consulta o status dos dois pedidos. Nenhuma ordem contém itens de linha. O cliente também consulta o status dos itens de linha. Não existem itens. |
Execução de Triggers
O Oracle Database executa um trigger internamente usando as mesmas etapas da execução do subprograma.
A única diferença sutil é que uma conta de usuário tem o direito de acionar um trigger se tiver o privilégio de executar a instrução de acionamento. Com essa exceção, o banco de dados valida e executa acionadores da mesma forma que os subprogramas armazenados.
Consulte Também: Referência de Linguagem PL/SQL do Oracle AI Database para saber mais sobre a execução do trigger
automaticamente em determinadas situações.")
Armazenamento de Triggers
O Oracle Database armazena triggers PL/SQL em forma compilada em um esquema de banco de dados, assim como os procedimentos armazenados PL/SQL.
Quando uma instrução CREATE TRIGGER é submetida a commit, o código PL/SQL compilado é armazenado no banco de dados. O shared pool remove o código-fonte do trigger PL/SQL.
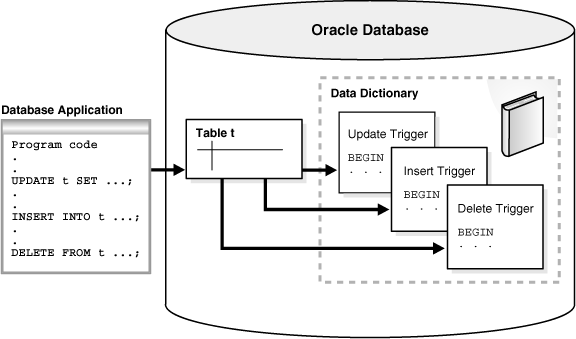
O gráfico a seguir mostra um aplicativo de banco de dados com instruções SQL que chamam acionadores PL/SQL implicitamente. Os acionadores são armazenados separadamente de suas tabelas associadas.
Figura 7: Triggers
Descrição da ilustração cncpt076.gif
Os triggers Java são armazenados da mesma maneira que os triggers PL/SQL. No entanto, um trigger Java faz referência ao código Java que foi compilado separadamente com uma instrução CALL. Assim, criar um trigger Java envolve a criação de código Java e a criação do trigger que faz referência a esse código Java.
Consulte Também: Referência de Linguagem PL/SQL do Oracle AI Database para saber mais sobre como compilar e armazenar triggers
automaticamente em determinadas situações.")