Arquitetura de Memória
Este capítulo descreve a arquitetura da memória de uma ocorrência de banco de dados.
-
Introdução às Estruturas de Memória do Oracle AI Database Quando uma instância é iniciada, o Oracle AI Database aloca uma área de memória e inicia processos em segundo plano.
-
Visão Geral da SGA (System Global Area) A SGA é uma área de memória de leitura/gravação que, juntamente com os processos em segundo plano da Oracle, formam uma instância do banco de dados.
-
Visão Geral da PGA (Program Global Area) A PGA é uma memória específica de um processo operacional ou thread que não é compartilhado por outros processos ou threads no sistema. Como o PGA é específico do processo, ele nunca é alocado no SGA.
-
Visão Geral da Área Global do Usuário A UGA é a memória de sessão, que é a memória alocada para variáveis de sessão, como informações de log-on e outras informações exigidas por uma sessão de banco de dados. Essencialmente, o UGA armazena o estado da sessão.
-
Visão Geral da MGA (Managed Global Area) A MGA (Managed Global Area) é uma estrutura de memória exclusiva que tem a capacidade de compartilhar e coordenar memória em um conjunto de processos Oracle confiáveis.
-
Visão Geral de Áreas de Código de Software Uma área de código de software é uma parte da memória que armazena o código que está sendo executado ou pode ser executado. O código do Oracle AI Database é armazenado em uma área de software que geralmente é mais exclusiva e protegida do que a localização dos programas do usuário. Consulte Também: Oracle AI Database Administrator's Guide para obter instruções sobre como configurar e gerenciar a memória.
Introdução às Estruturas de Memória do Oracle AI Database
Quando uma instância é iniciada, o Oracle AI Database aloca uma área de memória e inicia processos em segundo plano.
A área de memória armazena informações como as seguintes:
-
Código do programa
-
Informações sobre cada sessão conectada, mesmo que ela não esteja ativa no momento
-
Informações necessárias durante a execução do programa, por exemplo, o estado atual de uma consulta da qual as linhas estão sendo extraídas
-
Informações como bloquear dados que são compartilhados e comunicados entre processos
-
Dados armazenados em cache, como blocos de dados e registros de redo, que também existem no disco
-
Estruturas Básicas de Memória O Oracle AI Database inclui várias áreas de memória, cada uma contendo vários subcomponentes.
-
Gerenciamento de Memória do Oracle AI Database O gerenciamento de memória envolve a manutenção de tamanhos ideais para as estruturas da memória de instância do Oracle, conforme as demandas sobre a alteração do banco de dados. O Oracle AI Database gerencia a memória com base nas definições dos parâmetros de inicialização relacionados à memória. Consulte Também: "Arquitetura do Processo"
Estruturas Básicas de Memória
O Oracle AI Database inclui várias áreas de memória, cada uma contendo vários subcomponentes.
As estruturas básicas de memória associadas ao Oracle AI Database incluem:
-
SGA (System Global area)
A SGA é um grupo de estruturas de memória compartilhada, conhecidas como componentes da SGA, que contêm dados e informações de controle para uma instância do Oracle AI Database. Todos os processos de servidor e em segundo plano compartilham a SGA. Exemplos de dados armazenados na SGA incluem blocos de dados em cache e áreas SQL compartilhadas.
-
PGA (Program global area, Área global do programa)
PGA é uma região de memória não compartilhada que contém dados e informações de controle exclusivamente para uso por um processo Oracle. O Oracle AI Database cria o PGA quando um processo Oracle é iniciado.
Existe um PGA para cada processo do servidor e processo em segundo plano. O conjunto de PGAs individuais é o PGA da instância total ou o PGA da instância. Os parâmetros de inicialização do banco de dados definem o tamanho do PGA da instância, não dos PGAs individuais.
-
Área global do usuário (UGA)
A UGA é a memória associada a uma sessão do usuário.
-
Área Global Gerenciada (MGA)
A MGA é um componente de memória semi-compartilhada que é usado por uma instância do Oracle AI Database. Ele tem a capacidade de compartilhar e coordenar a memória em um pequeno conjunto de processos Oracle confiáveis. Ele tem a capacidade de ser configurável, elástico, modular, sob demanda e reutilizado. Diferentemente da SGA, os módulos do Oracle AI Database podem escolher quais processos são anexados a essa área e esse comportamento é dinâmico.
-
Áreas de código de software
Áreas de código de software são partes da memória usadas para armazenar código que está sendo executado ou pode ser executado. O código do Oracle AI Database é armazenado em uma área de software que geralmente está em um local diferente dos programas do usuário, um local mais exclusivo ou protegido.
A figura a seguir ilustra as relações entre essas estruturas de memória.
Figura 1: Estruturas de memória do Oracle AI Database
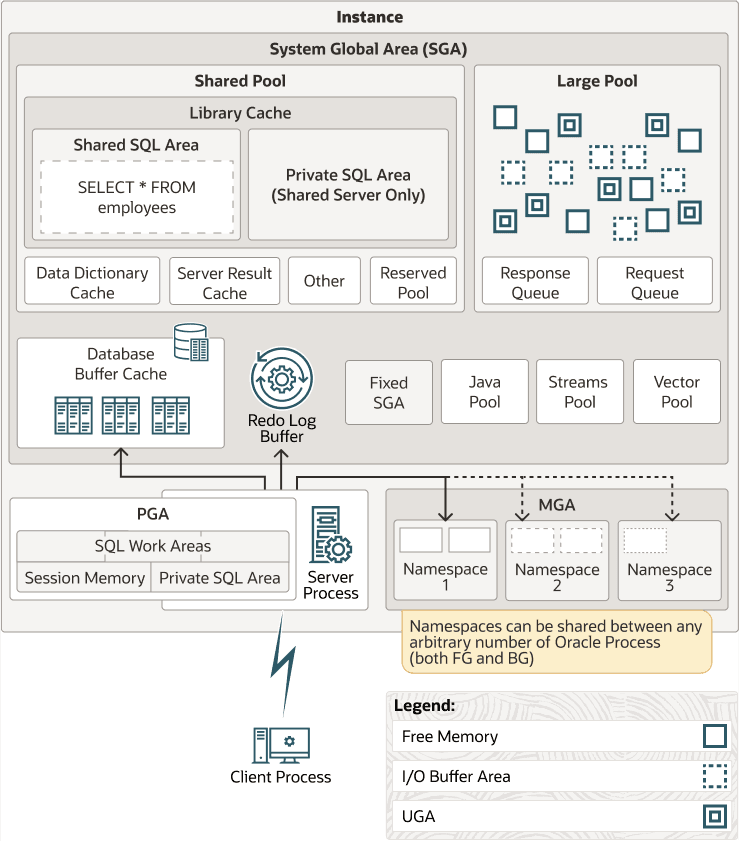
Descrição da ilustração cncpt217.png
Gerenciamento de memória do Oracle AI Database
O gerenciamento de memória envolve manter tamanhos ideais para as estruturas da memória da instância Oracle como demandas sobre a alteração do banco de dados. O Oracle AI Database gerencia a memória com base nas definições dos parâmetros de inicialização relacionados à memória.
As opções básicas para o gerenciamento de memória são as seguintes:
-
Gerenciamento unificado de memória
A Memória Unificada configura a memória da instância do banco de dados com um único parâmetro,
MEMORY_SIZE. O banco de dados pode usar dinamicamente essa memória para qualquer proporção de SGA, PGA, MGA, UGA e outros segmentos de memória com base na carga de trabalho atual. A divisão entre diferentes segmentos de memória é baseada no dimensionamento de memória dos PDBs atualmente abertos no CDB. Se grandes páginas forem configuradas, elas poderão ser usadas para SGA e PGA. A Memória Unificada fornece uma configuração de memória extremamente flexível. -
Gerenciamento automático de memória
Especifique o tamanho de destino para a memória da instância do banco de dados. A instância é ajustada automaticamente ao tamanho da memória de destino, redistribuindo a memória conforme necessário entre a SGA e a PGA da instância.
-
Gerenciamento automático de memória compartilhada
Este modo de gerenciamento é parcialmente automatizado. Defina um tamanho de destino para a SGA e, em seguida, tenha a opção de definir um tamanho de destino agregado para a PGA ou gerenciar as áreas de trabalho da PGA individualmente.
-
Gerenciamento manual de memória
Em vez de definir o tamanho total da memória, você define muitos parâmetros de inicialização para gerenciar componentes da SGA e da instância PGA individualmente.
Se você criar um banco de dados com o Assistente de Configuração de Banco de Dados (DBCA) e escolher a opção de instalação básica, o gerenciamento automático de memória será o padrão.
Consulte Também:
-
Guia de Ajuste de Desempenho do Oracle AI Database para obter mais informações sobre opções de gerenciamento de memória para DBAs.
-
Oracle AI Database Administrator's Guide para conhecer as opções de gerenciamento de memória.
-
Oracle AI Database Reference para saber mais sobre parâmetros de inicialização.
Visão Geral da SGA (System Global Area)
A SGA é uma área de memória de leitura/gravação que, junto com os processos em segundo plano da Oracle, formam uma instância de banco de dados. Observação: os processos de servidor e de segundo plano não residem dentro da SGA, mas existem em um espaço de memória separado.
Todos os processos do servidor que são executados em nome dos usuários podem ler informações na SGA da instância. Vários processos gravam na SGA durante a operação do banco de dados.
Cada instância de banco de dados tem sua própria SGA. O Oracle AI Database aloca automaticamente a memória de uma SGA na inicialização da instância e recupera a memória no shutdown da instância. Quando você inicia uma instância com o SQL*Plus ou o Oracle Enterprise Manager, o tamanho da SGA é mostrado como no seguinte exemplo:
SQL> STARTUP
ORACLE instance started.

Total System Global Area  368283648 bytes
Fixed Size                  1300440 bytes
Variable Size             343935016 bytes
Database Buffers           16777216 bytes
Redo Buffers                6270976 bytes
Database mounted.
Database opened.
Conforme mostrado na Figura 17-1, a SGA consiste em vários componentes de memória, que são pools de memória usados para satisfazer uma determinada classe de solicitações de alocação de memória. Todos os componentes da SGA, exceto o buffer de redo log, alocam e desalocam espaço em unidades de memória contígua chamadas granules. O tamanho do grânulo é específico da plataforma e é determinado pelo tamanho total da SGA.
Você pode consultar a exibição V$SGASTAT para obter informações sobre componentes SGA.
Os componentes SGA mais importantes são os seguintes:
-
Cache de Buffer do Banco de Dados O cache de buffer do banco de dados, também chamado de cache de buffer, é a área de memória que armazena cópias de blocos de dados lidos de arquivos de dados.
-
Buffer de Refazer Log O buffer de refazer log é um buffer circular na SGA que armazena entradas de redo descrevendo as alterações feitas no banco de dados.
-
Pool Compartilhado O pool compartilhado armazena em cache vários tipos de dados do programa.
-
Pool Grande O pool grande é uma área de memória opcional destinada a alocações de memória maiores que a apropriada para o pool compartilhado.
-
Pool Java O pool Java é uma área de memória que armazena todos os dados e códigos Java específicos da sessão na JVM (Java Virtual Machine). Essa memória inclui objetos Java que são migrados para o espaço de sessão Java no fim da chamada.
-
SGA Fixa A SGA Fixa é uma área interna de governança.
-
Subáreas SGA Relacionadas ao Desempenho Opcionais Algumas subáreas SGA só são ativadas para recursos de desempenho específicos.
Consulte Também:
-
Guia de Ajuste de Desempenho do Oracle AI Database para saber mais sobre dimensionamento de grânulos
Cache de Buffer do Banco de Dados
O cache de buffer do banco de dados, também chamado de cache de buffer, é a área de memória que armazena cópias de blocos de dados lidos de arquivos de dados.
Um buffer é um endereço de memória principal no qual o gerenciador de buffer armazena temporariamente em cache um bloco de dados usado no momento ou recentemente. Todos os usuários conectados simultaneamente a uma instância do banco de dados compartilham acesso ao cache do buffer.
-
Finalidade do Cache de Buffer do Banco de Dados O Oracle AI Database usa o cache de buffer para atingir várias metas.
-
Estados do Buffer O banco de dados usa algoritmos internos para gerenciar buffers no cache.
-
Modos de Buffer Quando um cliente solicita dados, o Oracle AI Database recupera buffers do cache de buffer do banco de dados no modo atual ou consistente.
-
Entrada/Saída do Buffer Uma Entrada/Saída lógica, também conhecida como Entrada/Saída do Buffer, refere-se a leituras e gravações de buffers no cache de buffer.
-
Pools de Buffers Um pool de buffers é uma coleção de buffers.
-
Buffers e Varreduras Completas de Tabela O banco de dados usa um algoritmo complicado para gerenciar varreduras de tabela. Por padrão, quando os buffers precisam ser lidos do disco, o banco de dados insere os buffers no meio da lista LRU. Dessa forma, os blocos quentes podem permanecer no cache para que não precisem ser lidos do disco novamente.
-
Os buffers de banco de dados padrão (DRAM) Buffers DRAM e PMEM diferem dos buffers PMEM, mas compartilham características.
Finalidade do Buffer Cache do Banco de dados
O Oracle AI Database usa o cache de buffer para atingir várias metas.
As metas incluem:
-
Otimizar a Entrada/Saída física
O banco de dados atualiza blocos de dados no cache e armazena metadados sobre as alterações no buffer de redo log. Após uma
COMMIT, o banco de dados grava os buffers de redo no redo log on-line, mas não grava imediatamente blocos de dados nos arquivos de dados. Em vez disso, o gravador de banco de dados (DBW) executa gravações preguiçosas em segundo plano. -
Manter blocos acessados com frequência no cache de buffer e gravar blocos acessados com pouca frequência no disco
Quando o Database Smart Flash Cache (cache flash) está ativado, parte do cache de buffer pode residir no cache flash. Esta extensão de cache de buffer é armazenada em um ou mais dispositivos flash. O banco de dados pode melhorar o desempenho armazenando buffers em cache na memória flash em vez de ler a partir do disco magnético.
Use os parâmetros de inicialização
DB_FLASH_CACHE_FILEeDB_FLASH_CACHE_SIZEpara configurar vários dispositivos flash. O cache de buffer rastreia cada dispositivo e distribui buffers para os dispositivos uniformemente.Observação: o Database Smart Flash Cache só está disponível no Solaris e no Oracle Linux.
-
Gerenciar cabeçalhos de buffer que apontam para arquivos de dados no Armazenamento de Arquivos de Memória Persistente da Oracle (Armazenamento de Arquivos PMEM)
Se você ativar o Armazenamento de Arquivos PMEM, os arquivos de banco de dados serão mapeados para acesso direto somente leitura. As consultas podem ignorar o mecanismo de cache de buffer tradicional, evitando E/S desnecessária. Nesse caso, os cabeçalhos de buffer devem armazenar metadados correspondentes aos blocos PMEM. O banco de dados ainda pode usar o cache de buffer tradicional (DRAM) para modificações, consistência de leitura e acesso mais rápido para blocos de dados "quentes".
Consulte Também:
-
Oracle AI Database Reference para saber mais sobre o parâmetro de inicialização
DB_FLASH_CACHE_FILE
Estados do buffer
O banco de dados usa algoritmos internos para gerenciar buffers no cache.
Um buffer pode estar em um dos seguintes estados mutuamente exclusivos:
-
Não utilizado
O buffer está disponível para uso porque ele nunca foi usado ou não está sendo usado no momento. Esse tipo de buffer é o mais fácil de utilizar pelo banco de dados.
-
Limpar
Este buffer foi usado anteriormente e agora contém uma versão com consistência de leitura de um bloco a partir de um ponto no tempo. O bloco contém dados, mas é "limpo", portanto, não precisa ser submetido a checkpoint. O banco de dados pode fixar o bloco e reutilizá-lo.
-
Sujo
O buffer contém dados modificados que ainda não foram gravados no disco. O banco de dados deve fazer checkpoint do bloco antes de reutilizá-lo.
Cada buffer tem um modo de acesso: pinado ou livre (sem pinagem). Um buffer é "fixado" no cache para que não fique sem memória enquanto uma sessão do usuário o acessa. Várias sessões não podem modificar um buffer fixado ao mesmo tempo.
Modos de buffer
Quando um cliente solicita dados, o Oracle AI Database recupera buffers do cache de buffer do banco de dados no modo atual ou no modo consistente.
Os modos diferem da seguinte forma:
-
Modo atual
Uma obtenção do modo atual, também chamada de obtenção do bloco de bd, é uma recuperação de um bloco como ele aparece atualmente no cache do buffer. Por exemplo, se uma transação não confirmada tiver atualizado duas linhas em um bloco, o modo atual recuperará o bloco com essas linhas não confirmadas. O banco de dados usa o bloco db com mais frequência durante as instruções de modificação, que devem atualizar apenas a versão atual do bloco.
-
Modo consistente
Uma read get consistente é uma recuperação de uma versão com consistência de leitura de um bloco. Essa recuperação pode usar desfazer dados. Por exemplo, se uma transação não confirmada tiver atualizado duas linhas em um bloco e uma consulta em uma sessão separada solicitar o bloco, o banco de dados usará dados de undo para criar uma versão consistente de leitura desse bloco (chamada de clone de leitura consistente) que não inclua as atualizações não confirmadas. Normalmente, uma consulta recupera blocos no modo consistente.
Consulte Também:
-
Oracle AI Database Reference para obter descrições de estatísticas de banco de dados, como obtenção de bloco de banco de dados e obtenção de leitura consistente
E/S do buffer
Uma Entrada/Saída lógica, também conhecida como Entrada/Saída do buffer, refere-se a leituras e gravações de buffers no buffer cache.
Quando um buffer solicitado não é encontrado na memória, o banco de dados executa uma E/S física para copiar o buffer do cache flash ou do disco para a memória. Em seguida, o banco de dados executa uma E/S lógica para ler o buffer armazenado no cache.
-
Algoritmos de Substituição de Buffer Para tornar o acesso ao buffer eficiente, o banco de dados deve decidir quais buffers serão armazenados em cache na memória e quais serão acessados do disco.
-
Gravações de Buffer O processo gravador de banco de dados (DBW) grava periodicamente buffers frios e sujos no disco.
-
Leituras de Buffer Quando o número de buffers não utilizados é baixo, o banco de dados deve remover buffers do cache de buffer.
-
Contagens de Toque no Buffer O banco de dados mede a frequência de acesso de buffers na lista LRU usando uma contagem de toques. Esse mecanismo permite que o banco de dados incremente um contador quando um buffer é fixado, em vez de embaralhar constantemente os buffers na lista LRU.
Algoritmos de Substituição de Buffer
Para tornar o acesso ao buffer eficiente, o banco de dados deve decidir quais buffers armazenar em cache na memória e quais acessar do disco.
O banco de dados usa os seguintes algoritmos:
-
Algoritmo de substituição em nível de bloco baseado em LRU
Esse algoritmo sofisticado, que é o padrão, usa uma lista de LRU menos usada recentemente que contém ponteiros para buffers sujos e não sujos. A lista LRU tem uma extremidade quente e uma extremidade fria. Um buffer frio é um buffer que não foi usado recentemente. Um buffer de captura é acessado com frequência e foi usado recentemente. Conceitualmente, há apenas um LRU, mas para simultaneidade de dados o banco de dados realmente usa várias LRUs.
-
Algoritmo de substituição em nível de objeto baseado em temperatura
A partir do Oracle Database 12c Release 1 ( 12.1.0.2), o recurso de armazenamento em cache automático de tabela grande permite que as verificações de tabela usem um algoritmo diferente nos seguintes cenários:
-
Consultas paralelas
Em bancos de dados de instância única e do Oracle Real Applications Cluster (Oracle RAC), as consultas paralelas podem usar o cache de tabela grande quando o parâmetro de inicialização
DB_BIG_TABLE_CACHE_PERCENT_TARGETé definido com um valor diferente de zero ePARALLEL_DEGREE_POLICYé definido comoautoouadaptive. -
Consultas em série
Somente em uma configuração de instância única, as consultas seriais podem usar o cache de tabela grande quando o parâmetro de inicialização
DB_BIG_TABLE_CACHE_PERCENT_TARGETé definido com um valor diferente de zero.
Quando uma tabela não cabe na memória, o banco de dados decide quais buffers armazenar em cache com base nos padrões de acesso. Por exemplo, se apenas 95% de uma tabela popular se encaixar na memória, o banco de dados poderá optar por deixar 5% dos blocos no disco em vez de ler blocos ciclicamente na memória e gravar blocos no disco — um fenômeno conhecido como thrashing. Ao armazenar vários objetos grandes em cache, o banco de dados considera tabelas mais populares mais quentes e tabelas menos populares mais frias, o que influencia quais blocos são armazenados em cache. O parâmetro de inicialização
DB_BIG_TABLE_CACHE_PERCENT_TARGETdefine a porcentagem do cache de buffer que usa esse algoritmo.Observação: Este documento explica o algoritmo de substituição em nível de bloco baseado em LRU.
-
Consulte Também: Oracle AI Database VLDB and Partitioning Guide para saber mais sobre o algoritmo baseado em temperatura
Gravações de Buffer
O processo de gravador de banco de dados (DBW) grava periodicamente buffers frios e sujos no disco.
O DBW grava buffers nas seguintes circunstâncias:
-
Um processo do servidor não pode localizar buffers limpos para ler novos blocos no cache de buffer do banco de dados.
À medida que os buffers estão sujos, o número de buffers gratuitos diminui. Se o número ficar abaixo de um limite interno e se forem necessários buffers limpos, o servidor processará o sinal DBW para gravar.
O banco de dados usa o LRU para determinar quais buffers sujos gravar. Quando os buffers sujos atingem a extremidade fria do LRU, o banco de dados os move para fora do LRU para uma fila de gravação. O DBW grava buffers na fila para disco, usando gravações em vários blocos, se possível. Este mecanismo evita que o final do LRU fique entupido com buffers sujos e permite que buffers limpos sejam encontrados para reutilização.
-
O banco de dados deve avançar o ponto de verificação, que é a posição no thread de redo do qual a recuperação da instância deve começar.
-
Os tablespaces são alterados para o status somente leitura ou ficam off-line.
Consulte Também:
-
Guia de Ajuste de Desempenho do Oracle AI Database para aprender a diagnosticar e ajustar problemas de gravação de buffer
Leituras de Buffer
Quando o número de buffers não utilizados é baixo, o banco de dados deve remover buffers do cache de buffer.
O algoritmo depende se o cache flash está ativado:
-
Cache flash desativado
O banco de dados reutiliza cada buffer limpo conforme necessário, substituindo-o. Se o buffer substituído for necessário posteriormente, o banco de dados deverá lê-lo do disco magnético.
-
Flash cache ativado
O DBW pode gravar o corpo de um buffer limpo no cache flash, permitindo a reutilização de seu buffer na memória. O banco de dados mantém o cabeçalho do buffer em uma lista LRU na memória principal para rastrear o estado e a localização do corpo do buffer no cache flash. Se esse buffer for necessário posteriormente, o banco de dados poderá lê-lo no cache flash em vez de no disco magnético.
Quando um processo do cliente solicita um buffer, o processo do servidor pesquisa o buffer cache. Um hit no cache ocorre se o banco de dados encontra o buffer na memória. A ordem de pesquisa é a seguinte:
-
O processo do servidor procura todo o buffer no cache do buffer.
Se o processo localizar o buffer inteiro, o banco de dados executará uma leitura lógica desse buffer.
-
O processo do servidor procura o cabeçalho do buffer na lista LRU do cache flash.
Se o processo encontrar o cabeçalho do buffer, o banco de dados executará uma leitura física otimizada do corpo do buffer do flash cache para o cache na memória.
-
Se o processo não localizar o buffer na memória (uma falta no cache), o processo do servidor executará as seguintes etapas:
-
Copia o bloco de um arquivo de dados no disco para a memória (leitura física)
-
Executa uma leitura lógica do buffer que foi lido na memória
-
A Figura 17-2 ilustra a ordem de pesquisa do buffer. O cache de buffer estendido inclui o cache de buffer na memória, que contém buffers inteiros, e o cache flash, que contém corpos de buffer. Na figura, o banco de dados procura um buffer no cache do buffer e, sem encontrar o buffer, o lê na memória do disco magnético.
Figura 2: Pesquisa de buffer
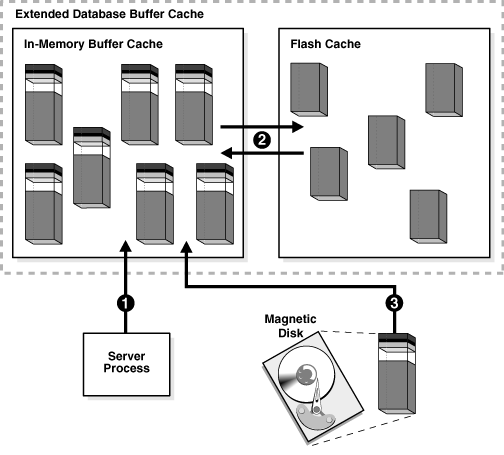
Descrição da ilustração cncpt304.gif
Em geral, o acesso aos dados por meio de uma ocorrência no cache é mais rápido do que por meio de uma falha no cache. A taxa de acertos do buffer cache mede a frequência com que o banco de dados encontrou um bloco solicitado no buffer cache sem precisar lê-lo do disco.
O banco de dados pode executar leituras físicas de um arquivo de dados ou de um arquivo temperatura. As leituras de um arquivo de dados são seguidas por E/S lógica. As leituras de um arquivo temporário ocorrem quando a memória insuficiente força o banco de dados a gravar dados em uma tabela temporária e a lê novamente mais tarde. Essas leituras físicas ignoram o cache de buffer e não incorrem em uma E/S lógica.
Consulte Também: Guia de Ajuste de Desempenho do Oracle AI Database para saber como calcular a taxa de acertos do buffer cache
Contagens de Toque no Buffer
O banco de dados mede a frequência de acesso de buffers na lista LRU usando uma contagem de toque. Esse mecanismo permite que o banco de dados incremente um contador quando um buffer é fixado, em vez de embaralhar constantemente os buffers na lista LRU.
Observação: O banco de dados não move fisicamente os blocos na memória. O movimento é a alteração no local de um ponteiro em uma lista.
Quando um buffer é fixado, o banco de dados determina quando sua contagem de toque foi incrementada pela última vez. Se a contagem tiver sido incrementada há mais de três segundos, a contagem será incrementada; caso contrário, a contagem permanecerá a mesma. A regra de três segundos impede uma explosão de pinos em um buffer contando quantos toques. Por exemplo, uma sessão pode inserir várias linhas em um bloco de dados, mas o banco de dados considera essas inserções como um toque.
Se um buffer estiver na extremidade fria do LRU, mas sua contagem de toque for alta, o buffer se moverá para a extremidade quente. Se a contagem de toque for baixa, o buffer ficará fora do cache.
Pools de Buffers
Um pool de buffers é uma coleção de buffers.
O cache de buffer do banco de dados é dividido em um ou mais pools de buffer, que gerenciam os blocos da mesma forma. Os pools não têm algoritmos radicalmente diferentes para blocos de aging ou cache.
Você pode configurar manualmente pools de buffer separados que mantenham dados no cache de buffer ou disponibilizem os buffers para novos dados imediatamente após usar os blocos de dados. Em seguida, você pode atribuir objetos de esquema específicos ao pool de buffers apropriado para controlar como os blocos ficam fora do cache. Por exemplo, você pode segregar segmentos em pools de buffer quentes, quentes e frios.
Os possíveis pools de buffer são os seguintes:
-
Pool padrão
Este pool é o local onde os blocos são normalmente armazenados em cache. A menos que você configure manualmente pools separados, o pool padrão é o único pool de buffers. A configuração opcional dos outros pools não tem efeito sobre o pool padrão.
O cache de tabela grande é uma seção opcional do pool padrão que usa um algoritmo de substituição de nível de objeto baseado em temperatura. Nos bancos de dados de instância única e Oracle RAC, as consultas paralelas podem usar o cache de tabela grande quando o parâmetro de inicialização
DB_BIG_TABLE_CACHE_PERCENT_TARGETé definido com um valor diferente de zero, ePARALLEL_DEGREE_POLICYé definido comoautoouadaptive. Somente em configurações de instância única, as consultas seriais podem usar o cache de tabela grande quandoDB_BIG_TABLE_CACHE_PERCENT_TARGETestiver definido. -
Manter pool
Este pool destina-se a blocos que foram acessados com frequência, mas que ficaram fora do pool padrão por falta de espaço. A finalidade do pool de buffers de manutenção é reter objetos na memória, evitando assim operações de Entrada/Saída.
Observação: O pool de manutenção gerencia buffers da mesma forma que os outros pools: ele não usa um algoritmo especial para fixar buffers. A palavra "manter" é uma convenção de nomenclatura. Você pode colocar tabelas que deseja manter no pool keep maior e colocar tabelas que não deseja manter no pool de reciclagem menor.
-
Reciclar pool
Este pool destina-se a blocos que são utilizados com pouca frequência. Um pool de reciclagem impede que objetos consumam espaço desnecessário no cache.
Um banco de dados tem um tamanho de bloco padrão. Você pode criar um tablespace com um tamanho de bloco diferente do tamanho padrão. Cada tamanho de bloco não padrão tem seu próprio pool. O Oracle AI Database gerencia os blocos nesses pools da mesma forma que no pool padrão.
A figura a seguir mostra a estrutura do cache de buffer quando vários pools são usados. O cache contém pools padrão, de manutenção e de reciclagem. O tamanho do bloco padrão é 8 KB. O cache contém pools separados para tablespaces que usam os tamanhos de bloco não padrão de 2 KB, 4 KB e 16 KB.
Figura 3: Cache de Buffer do Banco de dados
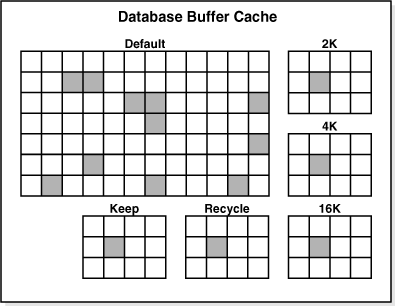
Descrição da ilustração cncpt220.gif
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber mais sobre pools de buffers
-
Guia de Ajuste de Desempenho do Oracle AI Database para aprender a usar vários pools de buffer
-
Oracle AI Database Reference para saber mais sobre o parâmetro de inicialização
DB_BIG_TABLE_CACHE_PERCENT_TARGET
Buffers e Varreduras Completas de Mesa
O banco de dados usa um algoritmo complicado para gerenciar varreduras de tabelas. Por padrão, quando os buffers precisam ser lidos do disco, o banco de dados insere os buffers no meio da lista LRU. Dessa forma, os blocos quentes podem permanecer no cache para que não precisem ser lidos do disco novamente.
Um problema é apresentado por uma verificação completa da tabela, que lê sequencialmente todas as linhas sob a tabela marca d'água alta (HWM). Suponha que o tamanho total dos blocos em um segmento de tabela seja maior que o tamanho do cache de buffer. Uma verificação completa desta tabela pode limpar o cache do buffer, impedindo que o banco de dados mantenha um cache de blocos acessados com frequência.
-
Modo Padrão para Verificações Completas de Tabelas Por padrão, o banco de dados adota uma abordagem conservadora para verificações completas de tabelas, carregando uma pequena tabela na memória somente quando o tamanho da tabela é uma pequena porcentagem do cache de buffer.
-
Execução de Consulta Paralela Ao executar uma verificação completa da tabela, o banco de dados às vezes pode melhorar o tempo de resposta usando vários servidores de execução paralela.
-
Atributo CACHE No raro caso o comportamento de armazenamento em CACHE padrão não seja desejado, você pode usar
ALTER TABLE ... CACHEpara alterar como os blocos de tabelas grandes são lidos no CACHE de buffer do banco de dados. -
Atributo KEEP Para tabelas grandes, você pode usar
ALTER TABLE ... STORAGE BUFFER_POOL KEEPpara fazer com que as verificações carreguem blocos para essas tabelas no pool KEEP. -
Forçar o Modo de Armazenamento no Cache Completo do Banco de Dados Para melhorar o desempenho em algumas situações, você pode executar explicitamente a instrução
ALTER DATABASE ... FORCE FULL DATABASE CACHINGpara ativar o modo de armazenamento no cache completo do banco de dados. Consulte Também: "Espaço de Segmento e a Marca d'água Alta"
Modo Padrão para Verificações Completas da Tabela
Por padrão, o banco de dados adota uma abordagem conservadora para verificações completas de tabelas, carregando uma pequena tabela na memória somente quando o tamanho da tabela é uma pequena porcentagem do cache de buffer.
Para determinar se as tabelas de tamanho médio devem ser armazenadas em cache, o banco de dados usa um algoritmo que incorpora o intervalo entre a última verificação de tabela, o timestamp de vencimento do cache de buffer e o espaço restante no cache de buffer.
Para tabelas muito grandes, o banco de dados geralmente usa uma leitura de caminho direto, que carrega blocos diretamente no PGA e ignora a SGA por completo, para evitar o preenchimento do cache de buffer. Para tabelas de tamanho médio, o banco de dados pode usar uma leitura direta ou uma leitura de cache. Se ele decidir usar uma leitura de cache, o banco de dados colocará os blocos no final da lista LRU para evitar que a verificação limpe efetivamente o cache de buffer.
A partir do Oracle Database 12c Release 1 (12.1.0.2), o cache de buffer de uma instância de banco de dados executa automaticamente um cálculo interno para determinar se a memória é suficiente para o banco de dados ser totalmente armazenado em cache na SGA da instância e se o armazenamento em cache das tabelas no acesso seria benéfico para o desempenho. Se todo o banco de dados puder se encaixar totalmente na memória e se vários outros critérios internos forem atendidos, o Oracle AI Database tratará todas as tabelas do banco de dados como pequenas e as considerará elegíveis para armazenamento em cache. No entanto, o banco de dados não armazena em cache LOBs marcados com o atributo NOCACHE.
Execução de Consulta Paralela
Ao executar uma verificação completa da tabela, o banco de dados às vezes pode melhorar o tempo de resposta usando vários servidores de execução paralela.
Em alguns casos, como quando o banco de dados tem uma grande quantidade de memória, o banco de dados pode armazenar em cache dados de consulta paralela na área global do sistema (SGA) em vez de usar leituras de caminho direto na área global do programa (PGA). Normalmente, as consultas paralelas ocorrem em data warehouses de baixa simultaneidade devido ao uso potencial de recursos.
Consulte Também:
-
Guia do Oracle AI Database Data Warehousing para uma introdução aos data warehouses
-
Oracle AI Database VLDB and Partitioning Guide para saber mais sobre execução paralela
Atributo CACHE
No raro caso em que o comportamento de armazenamento em cache padrão não é desejado, você pode usar ALTER TABLE ... CACHE para alterar como os blocos de tabelas grandes são lidos no cache de buffer do banco de dados.
Para tabelas com o atributo CACHE definido, o banco de dados não força nem fixa os blocos no cache de buffer. Em vez disso, o banco de dados envelhece os blocos fora do cache da mesma forma que qualquer outro bloco de tabela. Tenha cuidado ao exercitar essa opção porque uma varredura completa de uma tabela grande pode limpar a maioria dos outros blocos do cache. Observação: A execução de ALTER TABLE ... CACHE não faz com que uma tabela seja armazenada em cache.
Atributo KEEP
Para tabelas grandes, você pode usar ALTER TABLE ... STORAGE BUFFER_POOL KEEP para fazer com que as verificações carreguem blocos para essas tabelas no pool keep.
Colocar uma tabela no pool keep altera a parte do cache de buffer onde os blocos são armazenados. Em vez de armazenar blocos em cache no pool de buffers padrão, o banco de dados os armazena em cache no pool de buffers keep. Nenhum controle de algoritmo separado mantém o cache do pool.
Consulte Também:
-
para obter informações sobre a cláusula
CACHEe o atributoKEEP, consulte Oracle AI Database SQL Language Reference -
Guia de Ajuste de Desempenho do Oracle AI Database para aprender a interpretar estatísticas de consultoria de cache de buffer
Forçar Modo de Armazenamento no Cache Completo do Banco de Dados
Para melhorar o desempenho em algumas situações, você pode executar explicitamente a instrução ALTER DATABASE ... FORCE FULL DATABASE CACHING para ativar o modo de armazenamento no cache completo do banco de dados.
Em contraste com o modo padrão, que é automático, o modo de armazenamento em cache forçar banco de dados completo considera todo o banco de dados, incluindo LOBs NOCACHE, como elegível para armazenamento em cache no buffer cache do banco de dados. Esse modo está disponível a partir do Oracle Database 12c Release 1 ( 12.1.0.2). Observação: A ativação do modo de armazenamento no cache completo do banco de dados não força o banco de dados na memória. Em vez disso, todo o banco de dados é elegível para ser armazenado em cache no buffer cache. O Oracle AI Database armazena no cache as tabelas somente quando elas são acessadas.
A Oracle recomenda que você ative o modo de armazenamento no cache completo do banco de dados somente quando o tamanho do cache do buffer de cada instância individual for maior que o tamanho do banco de dados. Esta diretriz se aplica a bancos de dados de instância única e Oracle RAC. No entanto, quando os aplicativos Oracle RAC estiverem bem particionados, você poderá ativar o modo de armazenamento em cache completo do banco de dados quando o cache de buffer combinado de todas as instâncias, com espaço extra para tratar blocos em cache duplicados entre instâncias, for maior que o tamanho do banco de dados.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a ativar o modo de armazenamento no cache completo do banco de dados
-
Oracle AI Database SQL Language Reference para obter mais informações sobre a instrução
ALTER DATABASE ... FORCE FULL DATABASE CACHING
Buffers DRAM e PMEM
Os buffers de banco de dados padrão (DRAM) diferem dos buffers PMEM, mas compartilham características.
Quando o Oracle Persistent Memory Filestore (PMEM Filestore) é configurado, cada bloco de dados é diretamente mapeado para o cache de buffer no DRAM. Ao contrário dos buffers DRAM, os buffers PMEM não copiam o conteúdo dos blocos de dados. Em vez disso, os cabeçalhos de buffer PMEM apontam para blocos de dados armazenados no PMEM Filestore. Para a maioria das leituras, o banco de dados só armazena em cache os metadados do bloco, não o conteúdo. Os buffers PMEM usam um tipo especial de grânulo cuja estrutura é diferente dos grânulos de cache de buffer padrão.
Observação: O parâmetro de inicialização DB_CACHE_SIZE especifica o tamanho mínimo do cache DRAM. A sobrecarga de metadados PMEM não está incluída nesta alocação.
Os buffers de PMEM podem estar em qualquer um dos seguintes estados:
-
Atual
Esta é a versão atual de um buffer PMEM. Pode ser acessado diretamente do arquivo.
O Oracle AI Database mantém a versão atual do PMEM separada da versão atual do buffer DRAM padrão. Essa separação ajuda a reduzir a complexidade do código durante a fixação, limpeza e migração do bloco PMEM para DRAM.
-
Consistente
Esta é a versão de leitura consistente de um buffer PMEM. Ele é criado após o banco de dados criar um clone no DRAM. O buffer PMEM pode ser acessado diretamente do armazenamento de arquivos.
-
Livre
Este é um buffer PMEM livre. Pode ser reutilizado por um bloco PMEM. Após a inicialização da instância, todos os buffers PMEM estão em um estado livre.
O PMEM tem latência maior que o DRAM. O Oracle AI Database usa um algoritmo interno baseado em carga de trabalho para decidir quais blocos migrar de PMEM para DRAM.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber como configurar o PMEM Filestore
Buffer de Redo Log
O buffer de log de redo é um buffer circular na SGA que armazena entradas de redo descrevendo as alterações feitas no banco de dados.
Um registro de redo é uma estrutura de dados que contém as informações necessárias para reconstruir ou refazer as alterações feitas no banco de dados por operações DML ou DDL. A recuperação do banco de dados aplica entradas de redo aos arquivos de dados para reconstruir as alterações perdidas.
Os processos do banco de dados copiam entradas de redo do espaço de memória do usuário para o buffer de redo log na SGA. As entradas de redo ocupam espaço sequencial contínuo no buffer. O processo de gravação de log (LGWR) do processo em segundo plano grava o buffer de redo log no grupo de redo log on-line ativo no disco. A Figura 17-4 mostra esta atividade de buffer de redo.
Figura 4: Buffer de Redo Log
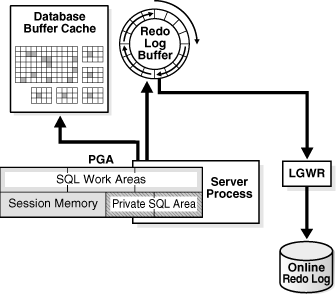
Descrição da ilustração cncpt226.gif
O LGWR grava redo sequencialmente no disco enquanto o DBW executa gravações dispersas de blocos de dados no disco. Escrever disperso tende a ser muito mais lento do que escrever sequencialmente. Como o LGWR permite que os usuários evitem esperar que o DBW conclua suas gravações lentas, o banco de dados oferece melhor desempenho.
O parâmetro de inicialização LOG_BUFFER especifica a quantidade de memória que o Oracle AI Database usa ao armazenar em buffer entradas de redo. Ao contrário de outros componentes da SGA, o buffer de redo log e o buffer de SGA fixo não dividem a memória em grânulos.
Consulte Também:
-
"Processo de Gravação de Log (LGWR)" e "Importância de Checkpoints para Recuperação de Instância"
-
Oracle AI Database Administrator's Guide para obter informações sobre o redo log on-line
Pool Compartilhado
O pool compartilhado armazena em cache vários tipos de dados do programa.
Por exemplo, o shared pool armazena informações sobre SQL analisado, código PL/SQL, parâmetros do sistema e dicionário de dados. O shared pool está envolvido em quase todas as operações que ocorrem no banco de dados. Por exemplo, se um usuário executar uma instrução SQL, o Oracle AI Database acessará o shared pool.
O shared pool é dividido em vários subcomponentes, sendo que o mais importante é mostrado na Figura 17-5.
Figura 5: Pool compartilhado
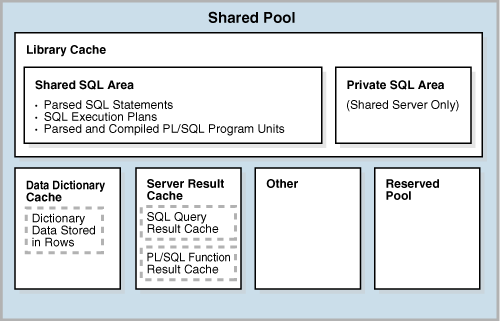
Descrição da ilustração cncpt225.gif
Esta seção inclui os tópicos a seguir:
-
Cache de Biblioteca O cache de biblioteca é uma estrutura de memória de pool compartilhado que armazena códigos SQL e PL/SQL executáveis.
-
Cache de Dicionário de Dados O dicionário de dados é um conjunto de tabelas e views de banco de dados que contêm informações de referência sobre o banco de dados, suas estruturas e seus usuários.
-
Cache de Resultados do Servidor O cache de resultados do servidor é um pool de memória dentro do pool compartilhado. Ao contrário dos pools de buffer, o cache de resultados do servidor contém conjuntos de resultados e não blocos de dados.
-
Pool Reservado O pool reservado é uma área de memória no pool compartilhado que o Oracle AI Database pode usar para alocar grandes blocos contíguos de memória.
Cache de Biblioteca
O cache de biblioteca é uma estrutura de memória de pool compartilhado que armazena o código SQL e PL/SQL executável.
Esse cache contém as áreas SQL e PL/SQL compartilhadas e estruturas de controle, como bloqueios e identificadores de cache de biblioteca. Em uma arquitetura de servidor compartilhado, o cache da biblioteca também contém áreas SQL privadas.
Quando uma instrução SQL é executada, o banco de dados tenta reutilizar o código executado anteriormente. Se uma representação analisada de uma instrução SQL existir no cache da biblioteca e puder ser compartilhada, o banco de dados reutilizará o código, conhecido como parsing suave ou ataque no cache da biblioteca. Caso contrário, o banco de dados deverá criar uma nova versão executável do código do aplicativo, conhecida como hard parse ou library cache miss.
-
Áreas SQL Compartilhadas O banco de dados representa cada instrução SQL executada na área SQL compartilhada e na área SQL privada.
-
Unidades de Programa e o Cache de Biblioteca O cache de biblioteca contém formas executáveis de programas PL/SQL e classes Java. Esses itens são chamados coletivamente de unidades de programa.
-
Alocação e Reutilização de Memória no Shared Pool O banco de dados aloca memória do shared pool quando uma nova instrução SQL é analisada, a menos que a instrução seja DDL, que não é considerada compartilhável. O tamanho da memória alocada depende da complexidade da instrução.
Áreas SQL Compartilhadas
O banco de dados representa cada instrução SQL executada na área SQL compartilhada e na área SQL privada.
O banco de dados usa a área SQL compartilhada para processar a primeira ocorrência de uma instrução SQL. Essa área pode ser acessada por todos os usuários e contém a árvore de parsing da instrução e o plano de execução. Existe apenas uma área SQL compartilhada para uma instrução exclusiva. Cada sessão que emite uma instrução SQL tem uma área SQL privada em sua PGA. Cada usuário que envia a mesma instrução tem uma área SQL privada que aponta para a mesma área SQL compartilhada. Assim, muitas áreas SQL privadas em PGAs separados podem ser associadas à mesma área SQL compartilhada.
O banco de dados determina automaticamente quando as inscrições enviam instruções SQL semelhantes. O banco de dados considera as instruções SQL emitidas diretamente pelos usuários e aplicativos e as instruções SQL recursivas emitidas internamente por outras instruções.
O banco de dados executa as seguintes etapas:
-
Verifica o shared pool para ver se existe uma área SQL compartilhada para uma instrução sintática e semanticamente idêntica:
-
Se existir uma instrução idêntica, o banco de dados usará a área SQL compartilhada para a execução das novas instâncias subsequentes da instrução, reduzindo assim o consumo de memória.
-
Se não existir uma instrução idêntica, o banco de dados alocará uma nova área SQL compartilhada no shared pool. Uma instrução com a mesma sintaxe, mas semântica diferente, usa um cursor filho.
Em ambos os casos, a área SQL privada do usuário aponta para a área SQL compartilhada que contém o plano de instrução e execução.
-
-
Aloca uma área SQL privada em nome da sessão
A localização da área SQL privada depende da conexão estabelecida para a sessão. Se uma sessão for conectada por meio de um servidor compartilhado, parte da área SQL privada será mantida na SGA.
A Figura 17-6 mostra uma arquitetura de servidor dedicado na qual duas sessões mantêm uma cópia da mesma instrução SQL em seus próprios PGAs. Em um servidor compartilhado, esta cópia está na UGA, que está na MGA.
Figura 6: Áreas SQL Privadas e Área SQL Compartilhada
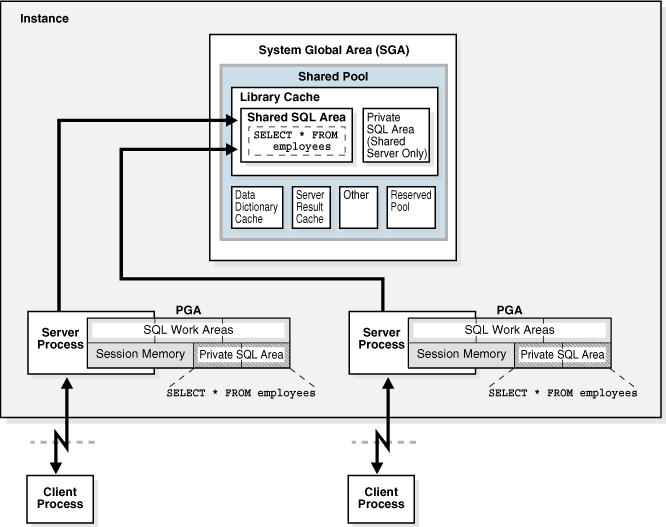
Descrição da ilustração cncpt252.gif
Consulte Também:
-
Guia de Ajuste de Desempenho do Oracle AI Database para saber mais sobre como gerenciar o cache da biblioteca
-
Guia de Desenvolvimento do Oracle AI Database para obter mais informações sobre SQL compartilhado
Unidades do Programa e Cache da Biblioteca
O cache de biblioteca contém forms executáveis de programas PL/SQL e classes Java. Esses itens são chamados coletivamente de unidades de programa.
O banco de dados processa unidades de programa da mesma forma que as instruções SQL. Por exemplo, o banco de dados aloca uma área compartilhada para armazenar a forma analisada e compilada de um programa PL/SQL. O banco de dados aloca uma área privada para conter valores específicos da sessão que executa o programa, incluindo variáveis locais, globais e de pacote, além de buffers para executar SQL. Se vários usuários executarem o mesmo programa, cada usuário manterá uma cópia separada de sua área SQL privada, que contém valores específicos da sessão, e acessará uma única área SQL compartilhada.
O banco de dados processa instruções SQL individuais em uma unidade de programa PL/SQL conforme descrito anteriormente. Apesar de suas origens em uma unidade de programa PL/SQL, essas instruções SQL utilizam uma área compartilhada para armazenar suas representações analisadas e uma área privada para cada sessão que executa a instrução.
Alocação e Reutilização de Memória no Shared Pool
O banco de dados aloca memória de pool compartilhado quando uma nova instrução SQL é submetida a parse, a menos que a instrução seja DDL, que não é considerada compartilhável. O tamanho da memória alocada depende da complexidade da instrução.
Em geral, um item no shared pool permanece até que o banco de dados o remova de acordo com um algoritmo de LRU (menor uso recente). O banco de dados permite que os itens do pool compartilhado usados por muitas sessões permaneçam na memória enquanto forem úteis, mesmo que o processo do banco de dados que criou o item seja encerrado. Esse mecanismo minimiza a sobrecarga e o processamento de instruções SQL. Se for necessário espaço para novos itens, o banco de dados liberará a memória consumida por itens usados com pouca frequência.
A instrução ALTER SYSTEM FLUSH SHARED_POOL remove todas as informações no pool compartilhado, assim como altera o nome global do banco de dados.
Consulte Também:
-
Guia de Ajuste do Oracle AI Database SQL para obter uma visão geral do ciclo de vida de uma área SQL compartilhada
-
Referência de Linguagem SQL do Oracle AI Database para obter informações sobre como usar
ALTER SYSTEM FLUSH SHARED_POOL -
Oracle AI Database Reference para obter informações sobre as views dinâmicas
V$SQLeV$SQLAREA
Cache do Dicionário de Dados
O dicionário de dados é um conjunto de tabelas e views de banco de dados que contêm informações de referência sobre o banco de dados, suas estruturas e seus usuários.
O Oracle AI Database acessa o dicionário de dados com frequência durante a análise de instruções SQL. O dicionário de dados é acessado com tanta frequência pelo Oracle AI Database que os seguintes locais de memória especiais são designados para conter dados do dicionário:
-
Cache do dicionário de dados
Este cache contém informações sobre objetos de banco de dados. O cache também é conhecido como cache de linha porque contém dados como linhas em vez de buffers.
-
Cache de biblioteca
Todos os processos do servidor compartilham esses caches para acesso às informações do dicionário de dados.
Consulte Também:
-
Guia de Ajuste de Desempenho do Oracle AI Database para saber como alocar memória adicional ao cache do dicionário de dados
Cache de Resultados do Servidor
O cache de resultados do servidor é um pool de memória dentro do pool compartilhado. Ao contrário dos pools de buffer, o cache de resultados do servidor contém conjuntos de resultados e não blocos de dados. Observação: Um cache de resultados do cliente difere do cache de resultados do servidor. Um cache de cliente é configurado no nível do aplicativo e está localizado na memória do cliente, não na memória do banco de dados.
-
Cache de Resultados de Consulta SQL O Cache de resultados de consulta SQL é um subconjunto do cache de resultados do servidor que armazena os resultados de consultas e fragmentos de consulta. Você pode ativar ou desativar o cache de resultados no nível do banco de dados ou da instrução.
-
Cache de Resultados de Funções PL/SQL O Cache de resultados de funções PL/SQL é um subconjunto do cache de resultados do servidor que armazena conjuntos de resultados de funções.
-
Infraestrutura do Cache de Resultados do Servidor O cache de resultados da consulta e o cache de resultados da função PL/SQL compartilham a mesma infraestrutura.
-
Interface do Usuário do Cache de Resultados do Servidor O parâmetro de inicialização
RESULT_CACHE_MODEdetermina se o cache de resultados da consulta SQL é usado para todas as consultas possíveis ou apenas para consultas com dicas.
Cache de Resultados de Consulta SQL
O cache de resultados de consulta SQL é um subconjunto do cache de resultados do servidor que armazena os resultados de consultas e fragmentos de consulta. Você pode ativar ou desativar o cache de resultados no nível do banco de dados ou da instrução.
Quando uma consulta é executada, o banco de dados determina se o resultado existe no cache de resultados da consulta. Se o resultado não for armazenado em cache e se o armazenamento em cache estiver ativado para a consulta, o banco de dados executará a consulta, retornará o resultado e o armazenará em cache. No entanto, se o resultado existir, o banco de dados o recuperará do cache em vez de executar a consulta.
O banco de dados invalida automaticamente um resultado armazenado em cache sempre que uma transação modifica os dados ou metadados dos objetos de banco de dados usados para construir o resultado. A próxima consulta não pode usar o resultado armazenado em cache, portanto, o banco de dados calcula automaticamente um novo resultado e depois o armazena em cache para uso por consultas subsequentes. O processo de atualização do cache é transparente para o aplicativo.
Com efeito, o cache de resultados de consulta funciona como uma view materializada "just-in-time" que o banco de dados cria e mantém conforme necessário. O cache permite que o banco de dados evite a operação dispendiosa de reler blocos de dados e recalcular resultados. A maioria dos aplicativos se beneficia dessa melhoria de desempenho.
Consulte Também: Oracle AI Database Administrator's Guide para saber como otimizar o tempo de resposta usando o cache de resultados da consulta
Cache de Resultados de Função PL/SQL
O cache de resultados de função PL/SQL é um subconjunto do cache de resultados do servidor que armazena conjuntos de resultados de função.
Sem armazenamento em cache, 1000 chamadas de uma função PL/SQL a 1 segundo por chamada levariam 1000 segundos. Com o armazenamento em cache, 1000 chamadas de função com as mesmas entradas podem levar 1 segundo de total. Bons candidatos para armazenamento em cache de resultados são funções frequentemente chamadas que dependem de dados relativamente estáticos.
O código de função PL/SQL pode incluir uma solicitação para armazenar seus resultados em cache. Quando esta função é chamada, o sistema verifica o cache. Se o cache contiver o resultado de uma chamada de função anterior com os mesmos valores de parâmetro, o sistema retornará o resultado para o chamador e não executará novamente o corpo da função. Se o cache não contiver o resultado, o sistema executará o corpo da função e adicionará o resultado (para esses valores de parâmetro) ao cache antes de retornar o controle ao chamador.
Observação: Você pode especificar os objetos de banco de dados usados para calcular um resultado armazenado no cache, de modo que, se algum deles for atualizado, o resultado armazenado no cache se tornará inválido e deverá ser recalculado.
Uma função que é chamada com frequência com argumentos diferentes pode gerar resultados que raramente são reutilizados, levando à degradação do desempenho. O Oracle AI Database rastreia funções PL/SQL usadas recentemente que têm a dica RESULT_CACHE. Usando esse histórico, o banco de dados só armazena em cache uma função PL/SQL e um par de argumentos se tiver visto x vezes no histórico recente, em que x é definido por um limite interno. Se o banco de dados precisar de mais memória porque muitos resultados são armazenados em cache, um ou mais resultados armazenados em cache são expirados.
RESULT_CACHE_EXECUTION_THRESHOLD especifica o número de vezes que uma função e um determinado conjunto de argumentos devem ser vistos até que sejam armazenados em cache. Observe que as funções serão consideradas exclusivas se tiverem argumentos diferentes, por exemplo, MYFUNC(1,2) e MYFUNC(1,3). Só é possível definir esse parâmetro no nível do sistema, não no nível da sessão.
Consulte Também:
-
Oracle AI Database Development Guide para saber mais sobre o cache de resultados de funções PL/SQL
-
Oracle AI Database PL/SQL Language Reference para saber mais sobre o cache de resultados de funções PL/SQL
Infraestrutura de Cache de Resultados do Servidor
O cache de resultados de consulta e o cache de resultados de função PL/SQL compartilham a mesma infraestrutura.
Tipos de Objeto: Resultado, Dependência e Temp.
No cache de resultados do servidor, um objeto de resultado é uma estrutura de dados que armazena as linhas retornadas por uma consulta ou função PL/SQL. Um objeto de dependência armazena os metadados dos objetos referenciados por consultas armazenadas como objetos de resultado.
Um resultado de consulta típico é pequeno, caro de calcular, reutilizado com frequência e baseado em tabelas não voláteis. No entanto, os resultados às vezes podem ser grandes. Se um resultado de consulta ultrapassar o limite de tamanho, o banco de dados armazenará parte do resultado como um objeto de temperatura e parte como um objeto de resultado padrão. Objeto temporário é um conjunto de metadados do cache de resultados que aponta para um segmento de tablespace temporário que contém o resultado da consulta real.
Subcaches do Resultado
Dependendo da carga de trabalho, o banco de dados pode criar subcaches de resultados para suportar maior simultaneidade durante o acesso de leitura/gravação. O Oracle AI Database usa um algoritmo interno para decidir se deseja criar subcaches e, em caso afirmativo, quantos criar.
Interface do Usuário do Cache de Resultados do Servidor
O parâmetro de inicialização RESULT_CACHE_MODE determina se o cache de resultados da consulta SQL é usado para todas as consultas possíveis ou apenas para consultas com dicas.
O parâmetro de inicialização RESULT_CACHE_MAX_TEMP_SIZE controla a quantidade máxima de memória temporária do tablespace que o cache de resultados pode consumir no PDB. RESULT_CACHE_MAX_TEMP_RESULT controla a quantidade máxima de memória de tablespace temporária que uma consulta armazenada no cache pode consumir.
Para substituir a definição do parâmetro RESULT_CACHE_MODE, você pode anotar uma consulta ou fragmento de consulta com uma dica RESULT_CACHE. A partir do Oracle Database 21c, a dica aceita a opção TEMP={TRUE|FALSE}, que controla se os resultados podem ser armazenados em um tablespace temporário.
O pacote DBMS_RESULT_CACHE permite que você administre a parte do shared pool usada pelo cache de resultados SQL e pelo cache de resultados da função PL/SQL. Você pode invalidar objetos, consultas e objetos da lista de bloqueios e executar operações relacionadas.
A coluna V$RESULT_CACHE_OBJECTS.TYPE indica o tipo de objetos no cache. Se os resultados da consulta forem armazenados no tablespace temporário, o TYPE mostrará dois objetos: Result e Temp. Os metadados do subcache podem ser acessados usando V$RESULT_SUBCACHE_STATISTICS e views relacionadas.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender sobre dimensionamento e controle do comportamento do cache de resultados
-
Referência de Tipos e Pacotes PL/SQL do Oracle AI Database para obter informações sobre o pacote
DBMS_RESULT_CACHE -
Guia de Ajuste de Desempenho do Oracle AI Database para obter mais informações sobre o cache de resultados do cliente
-
Oracle AI Database Reference para saber mais sobre o parâmetro de inicialização
RESULT_CACHE_MODE -
Referência de Linguagem SQL do Oracle AI Database para saber mais sobre a dica
RESULT_CACHE
Pool Reservado
O pool reservado é uma área de memória no pool compartilhado que o Oracle AI Database pode usar para alocar grandes blocos contíguos de memória.
O banco de dados aloca memória do shared pool em chunks. A divisão em blocos permite que objetos grandes (mais de 5 KB) sejam carregados no cache sem exigir uma única área contígua. Dessa forma, o banco de dados reduz a possibilidade de ficar sem memória contígua devido à fragmentação.
Com pouca frequência, cursores Java, PL/SQL ou SQL podem fazer alocações fora do shared pool maiores que 5 KB. Para permitir que essas alocações ocorram com mais eficiência, o banco de dados segrega uma pequena quantidade do shared pool para o pool reservado.
Consulte Também: Guia de Ajuste de Desempenho do Oracle AI Database para saber como configurar o pool reservado
Grande pool
O large pool é uma área de memória opcional destinada a alocações de memória maiores que a apropriada para o shared pool.
O pool grande pode fornecer grandes alocações de memória para o seguinte:
-
Buffers de mensagens usados em execução paralela
-
Buffers para processos filho de E/S do Recovery Manager (RMAN)
-
Buffers para inserções diferidas (inserções com a dica
MEMOPTIMIZE_WRITE)
A figura a seguir mostra o grande pool.
Figura 7: Grande pool
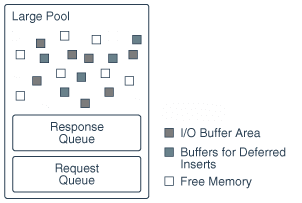
Descrição da ilustração cncpt221.png
-
Gerenciamento de Memória de Pool Grande O pool grande gerencia a memória de maneira diferente do pool compartilhado, que usa uma lista de LRU para que partes da memória possam expirar.
-
Buffers de Pool Grande para Inserções Diferidas Para um tipo especial de inserção conhecido como inserção diferida, o banco de dados aloca buffers do pool grande.
Consulte Também:
-
"Coordenador de Consultas" para obter informações sobre a alocação de memória para execução paralela
-
"Filas de Solicitação e Resposta do Dispatcher" para saber mais sobre a alocação de memória de sessão para servidor compartilhado
-
Guia de Desenvolvimento do Oracle AI Database para saber mais sobre o Oracle XA
-
Guia de Ajuste de Desempenho do Oracle AI Database para obter mais informações sobre o pool grande
Gerenciamento de Memória de Pool Grande
O grande pool gerencia a memória de maneira diferente do pool compartilhado, que usa uma lista de LRU para que partes da memória possam expirar.
O pool grande não tem uma lista de LRU. Quando o banco de dados aloca memória de pool grande para uma sessão de banco de dados, essa memória não é elegível para ser liberada, a menos que a sessão a liberte. Assim que uma parte da memória é liberada, outros processos podem usá-la. Ao alocar memória de sessão do pool grande, o banco de dados evita a fragmentação que pode ocorrer no pool compartilhado.
Buffers de piscina grande para inserções adiadas s
Para um tipo especial de inserção conhecido como inserção diferida, o banco de dados aloca buffers do pool grande.
Para inserções rápidas de "disparar e esquecer" de aplicativos da Internet of Things (IoT), a infraestrutura de banco de dados cria sobrecarga de desempenho. Por exemplo, o caminho do código inclui navegação no cache de buffer, pinos de buffer e proteções de simultaneidade. As inserções de array minimizam esses custos, mas a matriz deve ser criada no lado do cliente, o que não é típico de aplicativos da Internet of Things. Para resolver esse problema, um aplicativo Oracle pode usar uma dica para inserir linhas em uma tabela especificada como MEMOPTIMIZE FOR WRITE.
As inserções são diferidas porque são armazenadas no buffer no pool grande e, posteriormente, gravadas no disco de forma assíncrona por processos em segundo plano. O banco de dados processa as inserções diferidas da seguinte forma:
-
O aplicativo envia inserções
MEMOPTIMIZE_WRITEpara uma camada intermediária, que pode agregar os dados. Embora um aplicativo IoT quase sempre envie inserções para a camada intermediária, também é possível enviar inserções diretamente para o banco de dados. Por exemplo, o uso do SQL*Plus envia as inserções diretamente ao banco de dados. -
A camada intermediária grava a agregação de inserções no servidor de banco de dados.
-
Opcionalmente, o cliente da camada intermediária retém uma cópia local dos dados gravados na etapa anterior.
-
Um processo de servidor grava dados em um buffer ou buffers no pool grande.
Para evitar contenção, cada buffer tem seu próprio mecanismo de bloqueio interno. Esse mecanismo de bloqueio é separado do mecanismo de bloqueio que o cache de buffer do banco de dados usa para seus buffers. O processo básico de gravação é o seguinte:
-
Após a inicialização da instância, a primeira inserção
MEMOPTIMIZE_WRITEaloca os buffers do pool grande. -
O gravador escolhe um buffer na lista de buffers disponíveis.
-
Se o buffer escolhido não estiver bloqueado e esse buffer tiver espaço livre, o cliente gravará no buffer, marcando cada gravação de buffer com um número de sequência específico da sessão. Caso contrário, o gravador retornará à etapa anterior e continuará dessa forma até que um buffer seja encontrado ou haja espaço suficiente no pool grande.
-
-
O banco de dados cria uma matriz do servidor a partir dos dados armazenados em buffer.
-
O SMCO (Space Management Coordinator) e seus processos auxiliares (Wnn) gravam o array de forma assíncrona usando o formato de bloco de dados padrão.
Diferentemente das inserções padrão, as inserções diferidas são automaticamente submetidas a commit e não podem ser submetidas a rollback. O banco de dados confirma as inserções em um determinado objeto na ordem em que elas aparecem em uma sessão. Não há garantia de ordenar entre objetos ou sessões.
O banco de dados suporta restrições e manutenção de índice, assim como para inserções regulares. No entanto, o banco de dados realiza avaliações durante a gravação no disco, não na gravação no pool grande.
Observação: Para obter melhor desempenho, a Oracle recomenda desativar as restrições.
A figura a seguir ilustra o workflow para inserções diferidas.
Figura 8: Diferido InsertMechanism
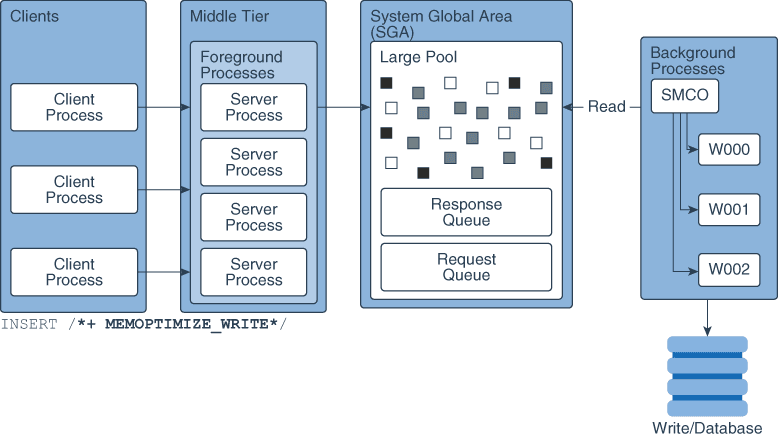
Descrição da ilustração cncpt_pb_002a.png
Consulte Também:
-
Guia de Ajuste de Desempenho do Oracle AI Database para saber como especificar tabelas como
MEMOPTIMIZE FOR WRITE -
Oracle AI Database SQL Language Reference para sintaxe e semântica do
INSERT -
Oracle AI Database Reference para saber mais sobre a
MEMOPTIMIZE_POOL_SIZE
Pool Java
O pool Java é uma área de memória que armazena todos os dados e códigos Java específicos da sessão dentro da Java Virtual Machine (JVM). Essa memória inclui objetos Java que são migrados para o espaço de sessão Java no fim da chamada.
Para conexões de servidor dedicadas, o pool Java inclui a parte compartilhada de cada classe Java, incluindo métodos e memória somente leitura, como vetores de código, mas não o estado Java por sessão de cada sessão. Para o servidor compartilhado, o pool inclui a parte compartilhada de cada classe e alguns UGA usados para o estado de cada sessão. Cada UGA cresce e diminui conforme necessário, mas o tamanho total da UGA deve caber no espaço do pool Java.
As estatísticas do Supervisor de Pool Java fornecem informações sobre a memória de cache da biblioteca usada para Java e preveem como as alterações no tamanho do pool Java podem afetar a taxa de parsing. O Supervisor de Pool Java é ativado internamente quando statistics_level é definido como TYPICAL ou superior. Essas estatísticas são redefinidas quando o consultor está desativado.
Consulte Também:
-
Guia de Ajuste de Desempenho do Oracle AI Database para saber mais sobre views que contêm estatísticas de consultoria de pool Java
SGA Fixo
A SGA fixa é uma área interna de governança.
Por exemplo, a SGA fixa contém:
-
Informações gerais sobre o estado do banco de dados e a instância, que os processos em segundo plano precisam acessar
-
Informações comunicadas entre processos, como informações sobre bloqueios
O tamanho da SGA fixa é definido pelo Oracle AI Database e não pode ser alterado manualmente. O tamanho fixo da SGA pode mudar de liberação para liberação.
Consulte Também: "Visão Geral de Bloqueios Automáticos"
Subáreas SGA Opcionais Relacionadas ao Desempenho
Algumas subáreas da SGA só são ativadas para recursos de desempenho específicos.
Essa seção contém os seguintes tópicos:
-
Área na Memória A Área na Memória é um componente SGA opcional que contém o Armazenamento de Colunas na Memória (armazenamento de colunas do IM).
-
Memoptimize Pool O pool memoptimize armazena buffers e estruturas relacionadas para tabelas organizadas por heap especificadas como
MEMOPTIMIZE FOR READ.
Área na Memória
A Área na Memória é um componente SGA opcional que contém o Armazenamento de Colunas na Memória (armazenamento de colunas do IM).
O armazenamento de colunas do IM contém cópias de tabelas, partições e views materializadas em um formato coluna otimizado para varreduras rápidas. O armazenamento de colunas IM complementa o cache de buffer do banco de dados, que armazena dados no formato de linha tradicional.
Observação: Para ativar um armazenamento de colunas de IM, você deve ter a opção Oracle AI Database In-Memory.
Consulte Também: Guia do Oracle AI Database In-Memory para saber mais sobre a Área In-Memory e o armazenamento de colunas do IM
Pool de Memoptimização
O pool memoptimize armazena buffers e estruturas relacionadas para tabelas organizadas por heap especificadas como MEMOPTIMIZE FOR READ.
Essa estrutura fornece alto desempenho e escalabilidade para consultas baseadas em chaves, como SELECT * FROM cust WHERE cid = 10. Para reduzir o tempo de resposta de ponta a ponta, os clientes extraem buffers solicitados diretamente da SGA pela rede, evitando a sobrecarga da CPU e do sistema operacional. Os aplicativos podem se beneficiar do pool de memoptimização sem exigir alterações de código.
O pool de memoptimização contém duas partes:
-
Memoptimizar área de buffer
Para evitar a E/S do disco, o banco de dados bloqueia permanentemente os buffers das tabelas
MEMOPTIMIZE FOR READno pool de memoptimização, até que a tabela seja marcada comoNO MEMOPTIMIZE FOR READ. Os buffers de memoptimização usam a mesma estrutura que os buffers no cache de buffer do banco de dados. No entanto, os buffers no pool de memoptimização são completamente separados do cache de buffer do banco de dados e não contam para seu tamanho. A área de buffer memoptimize ocupa 75% do pool memoptimize. -
Índice de hash
Um índice de hash é uma estrutura de dados de segmento não persistente. O banco de dados aloca o índice de hash como várias unidades de memória não contíguas. Cada unidade contém vários buckets de hash. Uma estrutura de mapa separada correlaciona uma unidade de memória com uma chave primária. O índice de hash ocupa 25% do pool de memoptimização. Figura 9: Memoptimize Pool
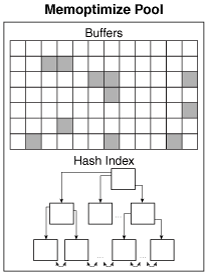
Descrição da ilustração cncpt_pb_001a.png
Para ativar o pool de memoptimização, defina o parâmetro de inicialização MEMOPTIMIZE_POOL_SIZE como um valor inteiro (o pool é desativado por padrão). O valor especifica a quantidade de SGA a ser alocada para o pool. O valor MEMOPTIMIZE_POOL_SIZE conta em direção a SGA_TARGET, mas o banco de dados não aumenta e diminui automaticamente o pool de memoptimização. Por exemplo, se SGA_TARGET for 10 GB e MEMOPTIMIZE_POOL_SIZE for 1 GB, um total de 9 GB estará disponível para memória SGA diferente do pool de memoptimização.
Para alterar o tamanho do pool de memoptimização, você deve definir MEMOPTIMIZE_POOL_SIZE manualmente e reiniciar a instância do banco de dados. Não é possível alterar o tamanho do pool dinamicamente usando ALTER SYSTEM.
O pacote DBMS_MEMOPTIMIZE permite que você preencha explicitamente uma tabela no pool de memoptimização.
Consulte Também:
-
Guia de Ajuste de Desempenho do Oracle AI Database para aprender a melhorar o desempenho da consulta ativando o pool de memoptimização
-
Referência de Tipos e Pacotes PL/SQL do Oracle AI Database para saber mais sobre o pacote
DBMS_MEMOPTIMIZE -
Oracle AI Database SQL Language Reference para saber mais sobre
CREATE TABLE ... MEMOPTIMIZE FOR READ -
Oracle AI Database Reference para saber mais sobre a
MEMOPTIMIZE_POOL_SIZE
Visão Geral da PGA (Program Global Area)
A PGA é uma memória específica de um processo operacional ou thread que não é compartilhado por outros processos ou threads no sistema. Como o PGA é específico do processo, ele nunca é alocado no SGA.
O PGA é um heap de memória que contém variáveis dependentes de sessão exigidas por um processo de servidor dedicado ou compartilhado. O processo do servidor aloca estruturas de memória que ele requer no PGA.
Uma analogia para um PGA é um espaço de trabalho temporário de bancada usado por um funcionário de arquivo. Nessa analogia, o servidor de arquivos é o processo do servidor que trabalha em nome do cliente (processo do cliente). O funcionário limpa uma seção da bancada, usa o espaço de trabalho para armazenar detalhes sobre a solicitação do cliente e para classificar as pastas solicitadas pelo cliente e, em seguida, desiste do espaço quando o trabalho é feito.
A figura a seguir mostra uma PGA de instância (coleção de todos os PGAs) para uma instância que não está configurada para servidores compartilhados. Você pode usar um parâmetro de inicialização para definir um tamanho máximo de destino da PGA da instância. Os PGAs individuais podem crescer conforme necessário até esse tamanho alvo.
Figura 10: PGA da Instância
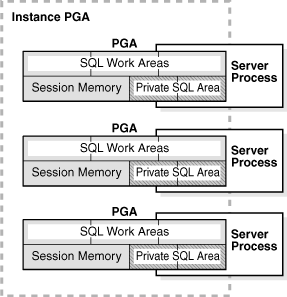
Descrição da ilustração cncpt218.gif
Observação: Os processos em segundo plano também alocam seus próprios PGAs. Esta discussão se concentra apenas nos PGAs do processo do servidor.
-
Conteúdo do PGA O PGA é subdividido em diferentes áreas, cada uma com uma finalidade diferente.
-
Uso da PGA nos Modos de Servidor Dedicado e Compartilhado A alocação de memória da PGA depende se o banco de dados usa conexões de servidor dedicadas ou compartilhadas. Consulte Também: Guia de Ajuste de Desempenho do Oracle AI Database para obter uma visão geral do gerenciamento de memória PGA
Conteúdo do PGA
A PGA é subdividida em diferentes áreas, cada uma com um propósito diferente.
A figura a seguir mostra o possível conteúdo do PGA para uma sessão de servidor dedicada. Nem todas as áreas PGA existirão em todos os casos.
Figura 11: Conteúdo PGA
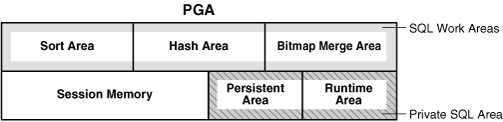
Descrição da ilustração cncpt219.gif
-
Área SQL Privada Uma área SQL privada contém informações sobre uma instrução SQL analisada e outras informações específicas da sessão para processamento.
-
Áreas de Trabalho SQL Uma área de trabalho é uma alocação privada de memória PGA usada para operações com uso intenso de memória.
Área SQL Privada
Uma área de SQL privada contém informações sobre uma instrução SQL analisada e outras informações específicas da sessão para processamento.
Quando um processo do servidor executa um código SQL ou PL/SQL, o processo usa a área SQL privada para armazenar valores de variáveis de bind, informações de estado de execução de consulta e áreas de trabalho de execução de consulta.
Não confunda uma área de SQL privada, que está no PGA, com a área SQL compartilhada, que armazena planos de execução no SGA. Várias áreas SQL privadas na mesma sessão ou em sessões diferentes podem apontar para um único plano de execução na SGA. Por exemplo, 20 execuções do SELECT * FROM sales em uma sessão e 10 execuções da mesma consulta em uma sessão diferente podem compartilhar o mesmo plano. As áreas de SQL privadas para cada execução não são compartilhadas e podem conter diferentes valores e dados.
Um cursor é um nome ou um identificador para uma área SQL privada específica. Como mostrado no gráfico a seguir, você pode pensar em um cursor como um ponteiro no lado do cliente e como um estado no lado do servidor. Como os cursores estão intimamente associados a áreas SQL privadas, os termos às vezes são usados de forma intercambiável.
Figura 12: Cursor
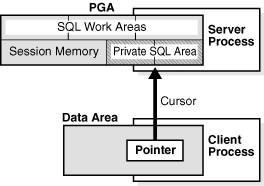
Descrição da ilustração cncpt324.gif
Uma área SQL privada é dividida nas seguintes áreas:
-
A área de run-time
Esta área contém informações de estado de execução da consulta. Por exemplo, a área de tempo de execução rastreia o número de linhas recuperadas até agora em uma verificação de tabela completa.
O Oracle AI Database cria a área de run-time como a primeira etapa de uma solicitação de execução. Para instruções DML, a área de runtime é liberada quando a instrução SQL é fechada.
-
A área persistente
Essa área contém valores de variável de vinculação. Um valor de variável de bind é fornecido a uma instrução SQL no tempo de execução quando a instrução é executada. A área persistente é liberada somente quando o cursor está fechado.
O processo do cliente é responsável pelo gerenciamento de áreas SQL privadas. A alocação e desalocação de áreas SQL privadas depende em grande parte do aplicativo, embora o número de áreas SQL privadas que um processo cliente pode alocar seja limitado pelo parâmetro de inicialização OPEN_CURSORS.
Embora a maioria dos usuários dependa do tratamento automático de cursor de utilitários de banco de dados, as interfaces programáticas do Oracle AI Database oferecem aos desenvolvedores mais controle sobre os cursores. Em geral, os aplicativos devem fechar todos os cursores abertos que não serão usados novamente para liberar a área persistente e minimizar a memória necessária para os usuários do aplicativo.
Consulte Também:
-
Oracle AI Database Development Guide e Oracle AI Database PL/SQL Language Reference para aprender a usar cursores
Áreas de Trabalho SQL
Uma área de trabalho é uma alocação privada de memória PGA usada para operações que consomem muita memória.
Por exemplo, um operador de classificação usa a área de classificação para classificar um conjunto de linhas. Da mesma forma, um operador de junção hash usa uma área de hash para criar uma tabela hash com base em sua entrada esquerda, enquanto uma mesclagem de bitmap usa a área de mesclagem de bitmap para mesclar dados recuperados de varreduras de vários índices de bitmap.
O exemplo a seguir mostra uma junção de employees e departments com seu plano de consulta:
SQL> SELECT *
  2  FROM   employees e JOIN departments d
  3  ON     e.department_id=d.department_id
  4  ORDER BY last_name;
.
.
.
--------------------------------------------------------------------------------
| Id| Operation           | Name        | Rows  | Bytes | Cost (%CPU)| Time    |
--------------------------------------------------------------------------------
| 0 | SELECT STATEMENT    |             |   106 |  9328 |    7  (29)| 00:00:01 |
| 1 |  SORT ORDER BY      |             |   106 |  9328 |    7  (29)| 00:00:01 |
|*2 |   HASH JOIN         |             |   106 |  9328 |    6  (17)| 00:00:01 |
| 3 |    TABLE ACCESS FULL| DEPARTMENTS |    27 |   540 |    2   (0)| 00:00:01 |
| 4 |    TABLE ACCESS FULL| EMPLOYEES   |   107 |  7276 |    3   (0)| 00:00:01 |
--------------------------------------------------------------------------------
No exemplo anterior, a área de tempo de execução rastreia o andamento das verificações completas da tabela. A sessão executa uma junção de hash na área de hash para corresponder às linhas das duas tabelas. A classificação ORDER BY ocorre na área de classificação.
Se o volume de dados a ser processado pelos operadores não se encaixar em uma área de trabalho, o Oracle AI Database dividirá os dados de entrada em partes menores. Dessa forma, o banco de dados processa algumas partes de dados na memória enquanto grava o restante no armazenamento temporário em disco para processamento posterior.
O banco de dados ajusta automaticamente os tamanhos da área de trabalho quando o gerenciamento automático da memória PGA está ativado. Você também pode controlar e ajustar manualmente o tamanho de uma área de trabalho.
Geralmente, áreas de trabalho maiores podem melhorar significativamente o desempenho de um operador ao custo de maior consumo de memória. O tamanho ideal de uma área de trabalho é suficiente para acomodar os dados de entrada e as estruturas de memória auxiliar alocadas por seu operador SQL associado. Caso contrário, o tempo de resposta aumenta porque parte dos dados de entrada deve ser armazenada em cache no disco. No caso extremo, se o tamanho de uma área de trabalho for muito pequeno em comparação com o tamanho dos dados de entrada, o banco de dados deverá executar várias passagens sobre as partes dos dados, aumentando drasticamente o tempo de resposta.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a usar o gerenciamento automático de PGA
-
Guia de Ajuste de Desempenho do Oracle AI Database para saber como ajustar a memória PGA
Uso do PGA nos Modos de Servidor Dedicado e Compartilhado
A alocação de memória PGA depende se o banco de dados usa conexões de servidor dedicadas ou compartilhadas.
A tabela a seguir mostra as diferenças.
Tabela 1 Diferenças na Alocação de Memória entre Servidores Dedicados e Compartilhados
| Área de memória | Servidor Dedicado | Servidor Compartilhado |
|---|---|---|
| Natureza da memória de sessão | Privado | Compartilhado |
| Localização da área persistente | PGA | SGA |
| Localização da área de run-time para instruções DML e DDL | PGA | PGA |
Consulte Também: Oracle AI Database Administrator's Guide para saber como configurar um banco de dados para servidor compartilhado
Visão Geral da Área Global do Usuário
A UGA é a memória de sessão, que é a memória alocada para variáveis de sessão, como informações de logon e outras informações exigidas por uma sessão de banco de dados. Essencialmente, o UGA armazena o estado da sessão.
A figura a seguir ilustra a UGA.
Figura 13: Área Global do Usuário (UGA)
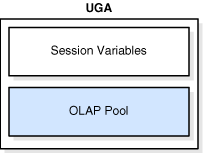
Descrição da ilustração cncpt222.gif
Se uma sessão carregar um pacote PL/SQL na memória, o UGA conterá o estado do pacote, que é o conjunto de valores armazenados em todas as variáveis do pacote em um momento específico. O estado do pacote é alterado quando um subprograma de pacote altera as variáveis. Por padrão, as variáveis do pacote são exclusivas e persistem durante a vida útil da sessão.
O pool de páginas OLAP também é armazenado na UGA. Este pool gerencia páginas de dados de OLAP, que são equivalentes a blocos de dados. O pool de páginas é alocado no início de uma sessão OLAP e liberado no final da sessão. Uma sessão OLAP é aberta automaticamente sempre que um usuário consulta um objeto dimensional, como um cubo.
A UGA deve estar disponível para uma sessão de banco de dados durante a vida útil da sessão. Por esse motivo, o UGA não pode ser armazenado no PGA ao usar uma conexão de servidor compartilhado porque o PGA é específico de um único processo. Portanto, a UGA é armazenada na MGA ao usar conexões de servidor compartilhado, permitindo que qualquer processo de servidor compartilhado acesse a ela. Ao usar uma conexão de servidor dedicado, o UGA é armazenado no PGA.
Consulte Também:
-
Oracle AI Database Net Services Administrator's Guide para saber mais sobre conexões de servidor compartilhadas
Visão Geral da Área Global Gerenciada (MGA)
A MGA (Managed Global Area) é uma estrutura de memória exclusiva que tem a capacidade de compartilhar e coordenar memória em um conjunto de processos Oracle confiáveis.
Ele tem a capacidade de ser uma área de memória compartilhada configurável, elástica, modular, sob demanda e recuperável. O MGA fornece uma maneira de utilizar diferentes tipos de áreas de memória compartilhada no banco de dados. Ele é exposto como namespaces para camadas internas do banco de dados, cada uma pertencendo a apenas uma delas. Um namespace consiste principalmente em um conjunto de segmentos de memória compartilhada e metadados que acompanham ele.
As camadas no banco de dados podem definir as características do namespace, o escopo, a vida útil e o tamanho do segmento interno. Todas as MGA são contabilizadas sob o limite agregado PGA.
No Linux, o MGA requer tempfs montado em /dev/shm e é configurado para pelo menos o tamanho do limite de agregação do PGA. Quando várias instâncias estão em execução na mesma máquina, o tamanho de /dev/shm precisa ser pelo menos sum(PGA_AGGREGATE_LIMIT) em todas as instâncias.
Consulte Também:
-
Guia de Ajuste de Desempenho do Oracle AI Database para saber mais sobre dimensionamento de grânulos
Visão Geral de Áreas de Código de Software
Uma área de código de software é uma parte da memória que armazena o código que está sendo executado ou pode ser executado. O código do Oracle AI Database é armazenado em uma área de software que geralmente é mais exclusiva e protegida do que a localização dos programas do usuário.
As áreas de software são geralmente estáticas em tamanho, mudando apenas quando o software é atualizado ou reinstalado. O tamanho necessário dessas áreas varia de acordo com o sistema operacional.
As áreas de software são somente leitura e podem ser instaladas compartilhadas ou não compartilhadas. Algumas ferramentas e utilitários de banco de dados, como o Oracle Forms e o SQL*Plus, podem ser instalados compartilhados, mas alguns não. Quando possível, o código do banco de dados é compartilhado para que todos os usuários possam acessá-lo sem ter várias cópias na memória, resultando em memória principal reduzida e melhoria geral no desempenho. Várias instâncias de um banco de dados podem usar a mesma área de código do banco de dados com bancos de dados diferentes se estiverem em execução no mesmo computador. Observação: A opção de instalar o software compartilhado não está disponível para todos os sistemas operacionais, por exemplo, em PCs que operam o Microsoft Windows. Consulte a documentação específica do sistema operacional para obter mais informações.