Estruturas Lógicas de Armazenamento
Este capítulo descreve a natureza e os relacionamentos entre estruturas de armazenamento lógico. Essas estruturas são criadas e reconhecidas pelo Oracle AI Database e não são conhecidas pelo sistema operacional.
-
Introdução a Estruturas de Armazenamento Lógico O Oracle AI Database aloca espaço lógico para todos os dados no banco de dados.
-
Visão Geral de Blocos de Dados O Oracle AI Database gerencia o espaço de armazenamento lógico nos arquivos de dados de um banco de dados em uma unidade chamada bloco de dados, também chamada de bloco Oracle ou página. Bloco de dados é a unidade mínima de Entradas/Saídas do banco de dados.
-
Visão Geral de Extensões Uma extensão é uma unidade de armazenamento de banco de dados composta de blocos de dados logicamente contíguos. Os blocos de dados podem ser fisicamente distribuídos no disco devido a distribuição RAID e implementações de sistema de arquivos.
-
Visão Geral de Segmentos Um segmento é um conjunto de extensões que contém todos os dados de uma estrutura de armazenamento lógico em um tablespace.
-
Visão Geral de Tablespaces Um tablespace é um contêiner de armazenamento lógico para segmentos.
Introdução a Estruturas Lógicas de Armazenamento
O Oracle AI Database aloca espaço lógico para todos os dados do banco de dados.
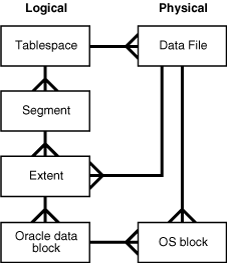
As unidades lógicas de alocação de espaço no banco de dados são blocos de dados, expansões, segmentos e tablespaces. Em um nível físico, os dados são armazenados em arquivos de dados no disco. Os dados nos arquivos de dados são armazenados em blocos do sistema operacional.
A figura a seguir é um diagrama de entidade-relacionamento para armazenamento físico e lógico. a notação pés-de-galinha representa um relacionamento de um para muitos.
Figura 1: Armazenamento Lógico e Físico
Descrição da ilustração cncpt227.gif
-
Hierarquia de Armazenamento Lógico Um segmento contém uma ou mais extensões, cada uma contendo vários blocos de dados.
-
Gerenciamento de Espaço Lógico O Oracle AI Database deve usar o gerenciamento de espaço lógico para rastrear e alocar as extensões em um tablespace. Consulte Também: "Estruturas de Armazenamento Físico"
Hierarquia de Armazenamento Lógico
Um segmento contém uma ou mais extensões, cada uma contendo vários blocos de dados.
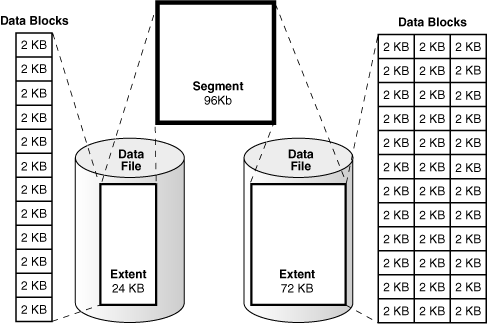
A figura a seguir mostra os relacionamentos entre blocos de dados, expansões e segmentos dentro de um tablespace. Neste exemplo, um segmento tem duas extensões armazenadas em arquivos de dados diferentes.
Figura 2: Segmentos, Extensões e Blocos de Dados em um Tablespace
Descrição da ilustração cncpt027.gif
Do nível mais baixo de granularidade ao mais alto, o Oracle AI Database armazena dados da seguinte forma:
-
Um bloco de dados é a menor unidade lógica de armazenamento de dados no Oracle AI Database.
Um bloco de dados lógico corresponde a um número específico de bytes de armazenamento persistente, por exemplo, 2 KB. Os blocos de dados são as menores unidades de armazenamento que o sistema Oracle AI Database pode usar ou alocar.
Tradicionalmente, os arquivos de dados foram armazenados em disco magnético ou disco de estado sólido (SSD). O Oracle AI Database também suporta Memória Persistente (PMEM) para armazenamento de arquivos de banco de dados. Independentemente de como os dados subjacentes sejam armazenados fisicamente, o Oracle processa sempre blocos de dados lógicos de leitura e gravação.
-
Uma extensão é um conjunto de blocos logicamente contíguos de dados alocados para armazenar um tipo específico de informação
No gráfico anterior, a extensão de 24 KB tem 12 blocos de dados, enquanto a extensão de 72 KB tem 36 blocos de dados.
-
Segmento é um conjunto de extensões alocadas para um objeto de banco de dados específico, como uma tabela.
Por exemplo, os dados da tabela
employeessão armazenados em seu próprio segmento de dados, enquanto cada índice doemployeesé armazenado em seu próprio segmento de índice. Cada objeto de banco de dados que consome armazenamento consiste em um único segmento. -
Um tablespace é uma unidade de armazenamento de banco de dados que contém um ou mais segmentos.
Cada segmento pertence a apenas um tablespace. Dessa forma, todas as expansões para um segmento são armazenadas no mesmo tablespace. Em um tablespace, um segmento pode incluir expansões de vários arquivos de dados, como mostrado no gráfico anterior. Por exemplo, uma extensão para um segmento pode ser armazenada em
users01.dbf, enquanto outra é armazenada emusers02.dbf. Uma única extensão nunca pode abranger arquivos de dados.
Consulte Também: "Introdução a Estruturas de Armazenamento Físico"
Gerenciamento Lógico de Espaço
O Oracle AI Database deve usar o gerenciamento lógico de espaço para rastrear e alocar as extensões em um tablespace.
Quando um objeto de banco de dados requer uma extensão, o banco de dados deve ter um método para encontrá-lo e fornecê-lo. Da mesma forma, quando um objeto não requer mais uma extensão, o banco de dados deve ter um método de disponibilizar a extensão livre.
O Oracle AI Database gerencia o espaço em um tablespace com base no tipo que você cria. Você pode criar um dos seguintes tipos de tablespaces:
-
Tablespaces gerenciados localmente (padrão)
O banco de dados usa bitmaps nos próprios tablespaces para gerenciar extensões. Assim, os tablespaces gerenciados localmente têm uma parte do tablespace reservada para um bitmap. Dentro de um tablespace, o banco de dados pode gerenciar segmentos com gerenciamento automático de espaço de segmento (ASSM) ou gerenciamento manual de espaço de segmento (MSSM).
-
Tablespaces gerenciados por dicionário
O banco de dados usa o dicionário de dados para gerenciar extensões.
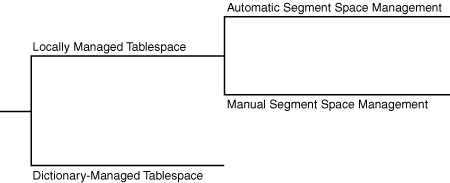
A Figura 15-3 mostra as alternativas para o gerenciamento de espaço lógico em um tablespace.
Figura 3: Gerenciamento lógico de espaço
Descrição da ilustração cncpt268.gif
-
Tabelas Gerenciadas Localmente Um tablespace gerenciado localmente mantém um bitmap no cabeçalho do arquivo de dados para rastrear o espaço livre e usado no corpo do arquivo de dados.
-
Tablespaces Gerenciados por Dicionário Um tablespace gerenciado por dicionário usa o dicionário de dados para gerenciar suas extensões. Consulte Também: "Visão Geral do Dicionário de Dados"
Tablespaces Gerenciados Localmente
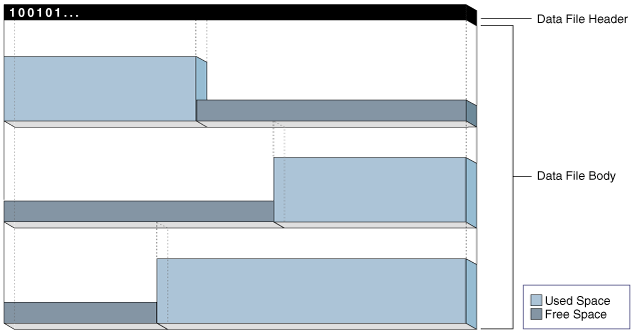
Um tablespace gerenciado localmente mantém um bitmap no cabeçalho do arquivo de dados para rastrear o espaço livre e usado no corpo do arquivo de dados.
Cada bit corresponde a um grupo de blocos. Quando o espaço é alocado ou liberado, o Oracle AI Database altera os valores de bitmap para refletir o novo status dos blocos.
O gráfico a seguir é uma representação conceitual do armazenamento gerenciado por bitmap. Um 1 no cabeçalho refere-se ao espaço usado, enquanto um 0 refere-se ao espaço livre.
Figura 4: Armazenamento Gerenciado por Bitmap
Descrição da ilustração cncpt332.gif
Um tablespace gerenciado localmente tem as seguintes vantagens:
-
Evita usar o dicionário de dados para gerenciar extensões
As operações recursivas podem ocorrer em tablespaces gerenciados pelo dicionário se o consumo ou a liberação de espaço resultar em outra operação que consome ou libera espaço em uma tabela do dicionários de dados ou segmento de undo.
-
Rastreia espaço livre adjacente automaticamente
Dessa forma, o banco de dados elimina a necessidade de aglutinar extensões livres.
-
Determina o tamanho das extensões gerenciadas localmente automaticamente
Como alternativa, todas as extensões podem ter o mesmo tamanho em um tablespace gerenciado localmente e substituir as opções de armazenamento de objetos. Observação: A Oracle recomenda enfaticamente o uso de tablespaces gerenciados localmente com Gerenciamento Automático de Espaço de Segmento.
O gerenciamento de espaço de segmento é um atributo herdado do tablespace que contém o segmento. Em um tablespace gerenciado localmente, o banco de dados pode gerenciar segmentos de forma automática ou manual. Por exemplo, segmentos no tablespace users podem ser gerenciados automaticamente enquanto segmentos no tablespace tools são gerenciados manualmente.
-
Gerenciamento Automático de Espaço de Segmento O método gerenciamento automático de espaço de segmento (ASSM) usa bitmaps para gerenciar espaço em um tablespace.
-
Gerenciamento de Espaço de Segmento Manual O método legado de gerenciamento de espaço de segmento manual (MSSM) usa uma lista vinculada chamada lista livre para gerenciar o espaço livre no segmento.
Gerenciamento Automático do Espaço de Segmento
O método de gerenciamento automático de espaço de segmento (ASSM) usa bitmaps para gerenciar espaço em um tablespace.
Os bitmaps oferecem as seguintes vantagens:
-
Administração simplificada
O ASSM evita a necessidade de determinar manualmente as configurações corretas para muitos parâmetros de armazenamento. Apenas um parâmetro SQL crucial controla a alocação de espaço:
PCTFREE. Este parâmetro especifica a porcentagem de espaço a ser reservada em um bloco para atualizações futuras (consulte "Porcentagem de Espaço Livre em Blocos de Dados"). -
Maior simultaneidade
Várias transações podem pesquisar listas separadas de blocos de dados gratuitos, reduzindo assim a contenção e as esperas. Para muitas cargas de trabalho padrão, o desempenho do aplicativo com ASSM é melhor do que o desempenho de um aplicativo bem ajustado que usa MSSM.
-
Afinidade dinâmica de espaço para instâncias em um ambiente Oracle Real Application Clusters (Oracle RAC)
O ASSM é mais eficiente e é o padrão para tablespaces permanentes gerenciados localmente.
Observação: Este capítulo pressupõe o uso do ASSM em todas as suas discussões sobre espaço de armazenamento lógico.
Gerenciamento Manual do Espaço de Segmento
O método manual segment space management (MSSM) legado usa uma lista vinculada chamada lista gratuita para gerenciar espaço livre no segmento.
Para um objeto de banco de dados que tem espaço livre, uma lista livre mantém um controle dos blocos sob a marca d'água alta (HWM) (HWM), que é a linha divisória entre o espaço do segmento que é usado e ainda não é usado. À medida que os blocos são usados, o banco de dados coloca blocos ou remove blocos da lista livre, conforme necessário.
Além do PCTFREE, o MSSM exige que você controle a alocação de espaço com parâmetros SQL, como PCTUSED, FREELISTS e FREELIST GROUPS. PCTUSED define a porcentagem de espaço livre que deve existir em um bloco usado no momento para que o banco de dados o coloque na lista livre. Por exemplo, se você definir PCTUSED como 40 em uma instrução CREATE TABLE, não poderá inserir linhas em um bloco no segmento até que menos de 40% do espaço em bloco seja usado.
Por exemplo, suponhamos que você insira uma linha em uma tabela. O banco de dados verifica a existência do primeiro bloco disponível em uma lista livre da tabela. Se a linha não caber no bloco e o espaço usado no bloco for maior ou igual a PCTUSED, o banco de dados removerá o bloco da lista e procurará outro bloco. Se você excluir linhas do bloco, o banco de dados verificará se o espaço usado no bloco agora é menor que PCTUSED. Em caso afirmativo, o banco de dados coloca o bloco no início da lista livre.
Um objeto pode ter várias listas livres. Dessa forma, várias sessões que executam DML em uma tabela podem usar listas diferentes, o que pode reduzir a contenção. Cada sessão de banco de dados usa apenas uma lista livre durante a sessão.
Conforme mostrado na Figura 15-5, você também pode criar um objeto com um ou mais grupos de listas livres, que são coleções de listas livres. Cada grupo tem uma lista livre mestre que gerencia a lista livre de processos individual no grupo. A sobrecarga de espaço para listas livres, especialmente para grupos de listas livres, pode ser significativa.
Figura 5: Grupos de listas livres
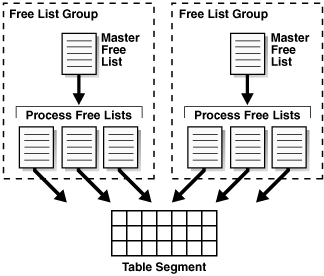
Descrição da ilustração cncpt320.gif
Gerenciar o espaço do segmento manualmente pode ser complexo. Ajuste PCTFREE e PCTUSED para reduzir a migração de linhas e evitar o desperdício de espaço. Por exemplo, se cada bloco usado em um segmento estiver meio cheio e se PCTUSED for 40, o banco de dados não permitirá inserções em nenhum desses blocos. Devido à dificuldade de ajustar os parâmetros de alocação de espaço, a Oracle recomenda enfaticamente o ASSM. No ASSM, PCTFREE determina se uma nova linha pode ser inserida em um bloco, mas não usa listas livres e ignora PCTUSED.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber mais sobre tablespaces gerenciados localmente
-
Oracle AI Database Administrator's Guide para saber mais sobre o gerenciamento automático de espaço de segmento
-
Oracle AI Database SQL Language Reference para saber mais sobre parâmetros de armazenamento, como
PCTFREEePCTUSED
Tablespaces Gerenciados por Dicionário
Um tablespace gerenciado pelo dicionário usa o dicionário de dados para gerenciar suas extensões.
O Oracle AI Database atualiza tabelas no dicionário de dados sempre que uma extensão é alocada ou liberada para reutilização. Por exemplo, quando uma tabela precisa de uma extensão, o banco de dados consulta as tabelas do dicionário de dados e procura extensões livres. Se o banco de dados encontrar espaço, modificará uma tabela do dicionário de dados e inserirá uma linha em outra. Dessa forma, o banco de dados gerencia o espaço modificando e movendo dados.
O SQL que o banco de dados executa em segundo plano para obter espaço para objetos de banco de dados é SQL recursivo. O uso frequente de SQL recursivo pode ter um impacto negativo no desempenho porque as atualizações no dicionário de dados devem ser serializadas. Tablespaces gerenciados localmente, que são o padrão, evitam esse problema de desempenho.
Consulte Também: Oracle AI Database Administrator's Guide para saber como migrar tablespaces de gerenciados por dicionário para gerenciados localmente
Visão Geral de Blocos de Dados
O Oracle AI Database gerencia o espaço de armazenamento lógico nos arquivos de dados de um banco de dados em uma unidade chamada bloco de dados, também chamada de bloco Oracle ou página. Bloco de dados é a unidade mínima de Entradas/Saídas do banco de dados.
-
Blocos de Dados e Blocos do Sistema Operacional No nível físico, os dados de banco de dados são armazenados em arquivos em disco formados por blocos do sistema operacional.
-
Formato do Bloco de Dados Cada bloco de dados tem um formato ou uma estrutura interna que permite ao banco de dados rastrear os dados e liberar espaço no bloco. Esse formato é semelhante se o bloco de dados contém dados de tabela, índice ou cluster de tabela.
-
Compactação do Bloco de Dados O banco de dados pode usar a compactação de tabela para eliminar valores duplicados em um bloco de dados. Esta seção descreve o formato dos blocos de dados que usam compactação.
-
Gerenciamento de Espaço em Blocos de Dados À medida que o banco de dados preenche um bloco de dados de baixo para cima, a quantidade de espaço livre entre os dados da linha e o cabeçalho do bloco diminui.
-
Visão Geral de Blocos de Índice Um bloco de índice é um tipo especial de bloco de dados que gerencia o espaço de maneira diferente dos blocos de tabela. O Oracle AI Database usa blocos de índice para gerenciar o espaço de armazenamento lógico em um índice.
Blocos de Dados e Blocos do Sistema Operacional
No nível físico, os dados do banco de dados são armazenados em arquivos de disco formados por blocos do sistema operacional.
Bloco do sistema operacional é a unidade mínima de dados que o sistema operacional pode ler ou gravar. Por outro lado, bloco do Oracle é uma estrutura de armazenamento lógico cujo tamanho e a estrutura não são conhecidos do sistema operacional.
A figura a seguir mostra que os blocos do sistema operacional podem diferir em tamanho dos blocos de dados. O banco de dados solicita dados em múltiplos de blocos de dados, não blocos do sistema operacional.
Figura 6: Blocos de dados e blocos do sistema operacional
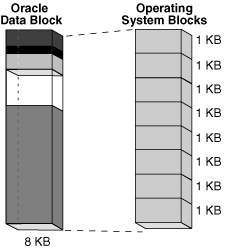
Descrição da ilustração cncpt293.gif
Quando o banco de dados solicita um bloco de dados, o sistema operacional converte essa operação em uma solicitação de dados em armazenamento permanente. A separação lógica dos blocos de dados dos blocos do sistema operacional tem as seguintes implicações:
-
Os aplicativos não precisam determinar os endereços físicos dos dados em disco.
-
Os dados do banco de dados podem ser distribuídos ou espelhados em vários discos físicos.
-
Tamanho do Bloco de Banco de Dados Cada banco de dados tem um tamanho de bloco de banco de dados.
-
Tamanho do Bloco de Tablespace Você pode criar tablespaces individuais cujo tamanho de bloco difere da definição
DB_BLOCK_SIZE.
Tamanho do Bloco do Banco do Dados
Cada banco de dados tem um tamanho de bloco de banco de dados.
O parâmetro de inicialização DB_BLOCK_SIZE define o tamanho do bloco de dados para um banco de dados quando ele é criado. O tamanho é definido para os tablespaces SYSTEM e SYSAUX e é o padrão para todos os outros tablespaces. O tamanho do bloco do banco de dados não pode ser alterado, exceto recriando o banco de dados.
Se DB_BLOCK_SIZE não estiver definido, o tamanho do bloco de dados padrão será específico do sistema operacional. O tamanho padrão do bloco de dados para um banco de dados é de 4 KB ou 8 KB. Se o tamanho for diferente para blocos de dados e blocos do sistema operacional, o tamanho do bloco de dados deverá ser um múltiplo do tamanho do bloco do sistema operacional.
Consulte Também:
-
Oracle AI Database Reference para saber mais sobre o parâmetro de inicialização
DB_BLOCK_SIZE -
Oracle AI Database Administrator's Guide e Oracle AI Database Performance Tuning Guide para saber como escolher tamanhos de bloco
Tamanho do Bloco do Tablespace
Você pode criar tablespaces individuais cujo tamanho de bloco difere da definição DB_BLOCK_SIZE.
Um tamanho de bloco não padrão pode ser útil ao mover um tablet transportável para outra plataforma.
Consulte Também: Oracle AI Database Administrator's Guide para saber como especificar um tamanho de bloco não padrão para um tablespace
Formato do Bloco de Dados
Cada bloco de dados tem um formato ou uma estrutura interna que permite ao banco de dados rastrear os dados e liberar espaço no bloco. Esse formato é semelhante se o bloco de dados contém dados de tabela, índice ou cluster de tabela.
A figura a seguir mostra o formato de um bloco de dados descompactado.
Figura 7: Formato do Bloco de Dados
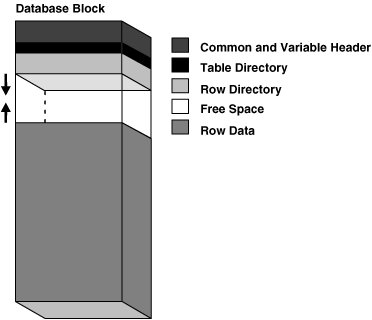
Descrição da ilustração cncpt028.gif
-
Custos Indiretos do Bloco de Dados O Oracle AI Database usa os custos indiretos do bloco para gerenciar o próprio bloco. O overhead do bloco não está disponível para armazenar dados do usuário.
-
Formato da Linha A parte de dados da linha do bloco contém os dados reais, como linhas de tabela ou entradas de chave de índice. Assim como todos os blocos de dados têm um formato interno, todas as linhas têm um formato de linha que permite ao banco de dados rastrear os dados na linha. Consulte Também: "Compactação do Bloco de Dados" para saber mais sobre blocos compactados
Custos Indiretos do Bloco de Dados
O Oracle AI Database usa a sobrecarga de bloco para gerenciar o próprio bloco. O overhead do bloco não está disponível para armazenar dados do usuário.
Conforme mostrado no "Formato do Bloco de Dados", a sobrecarga do bloco inclui as seguintes partes:
-
Cabeçalho do bloco
Esta parte contém informações gerais sobre o bloco, incluindo endereço de disco e tipo de segmento. Para blocos que são gerenciados por transação, o cabeçalho do bloco contém informações de transação ativas e históricas.
Uma entrada de transação é necessária para cada transação que atualiza o bloco. O Oracle AI Database inicialmente reserva espaço no cabeçalho do bloco para entradas de transação. Em blocos de dados alocados para segmentos que suportam alterações transacionais, o espaço livre também pode conter entradas de transação quando o espaço do cabeçalho é esgotado. O espaço necessário para entradas de transação depende do sistema operacional. No entanto, as entradas de transação na maioria dos sistemas operacionais exigem aproximadamente 23 bytes.
-
Diretório da tabela
Para uma tabela organizada por heap, esse diretório contém metadados sobre tabelas cujas linhas são armazenadas nesse bloco. Em um cluster de tabelas, várias tabelas podem armazenar linhas no mesmo bloco.
-
Diretório de linhas
Para uma tabela organizada por heap, este diretório descreve a localização das linhas na parte de dados do bloco. O banco de dados pode colocar uma linha em qualquer lugar na parte inferior do bloco. O endereço da linha é registrado em um dos slots do vetor do diretório da linha.
Um id de linha aponta para um arquivo, bloco e número de linha específicos. Por exemplo, no id de linha
AAAPecAAFAAAABSAAA, oAAAfinal representa o número da linha. O número da linha é um índice em uma entrada no diretório de linhas. A entrada do diretório de linhas contém um ponteiro para o local da linha no bloco de dados. Se o banco de dados mover uma linha dentro de um bloco, o banco de dados atualizará a entrada do diretório de linhas para modificar o ponteiro. O rowid permanece constante.Depois que o banco de dados aloca espaço no diretório de linhas, ele não recupera esse espaço após a exclusão das linhas. Assim, um bloco que está vazio no momento, mas anteriormente tinha até 50 linhas, continua a ter 100 bytes alocados para o diretório de linhas. O banco de dados reutiliza esse espaço somente quando uma sessão insere novas linhas no bloco.
Algumas partes da sobrecarga do bloco são fixadas em tamanho, mas o tamanho total é variável. Em média, o overhead do bloco totaliza 84 a 107 bytes.
Formato de Linha
A parte de dados da linha do bloco contém os dados reais, como linhas de tabela ou entradas de chave de índice. Assim como todos os blocos de dados têm um formato interno, todas as linhas têm um formato de linha que permite ao banco de dados rastrear os dados na linha.
O Oracle AI Database armazena linhas como registros de tamanho variável. Uma linha está contida em uma ou mais seções. Cada seção denomina-se peça da linha. Cada parte da linha tem um cabeçalho de linha e dados de coluna.
A figura a seguir mostra o formato de uma linha.
Figura 8: O formato de uma peça de linha
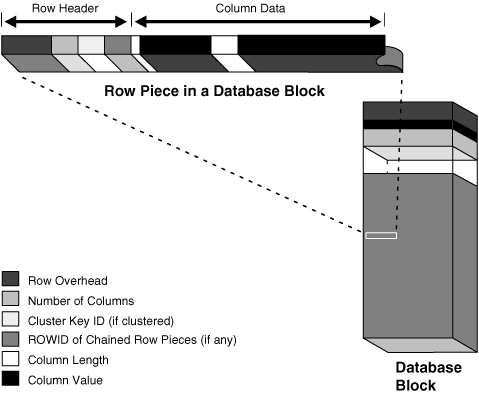
Descrição da ilustração cncpt043.gif
-
Cabeçalho de Linha O Oracle AI Database usa o cabeçalho de linha para gerenciar a parte da linha armazenada no bloco.
-
Dados da Coluna Após o cabeçalho da linha, a seção de dados da coluna armazena os dados reais na linha. A parte da linha geralmente armazena colunas na ordem listada na instrução
CREATE TABLE, mas essa ordem não é garantida. Por exemplo, as colunas do tipoLONGsão criadas por último. -
Formato de Rowid O Oracle AI Database usa um rowid para identificar exclusivamente uma linha. Internamente, rowid é uma estrutura que contém informações de que o banco de dados precisa para acessar uma linha. Um id de linha não é armazenado fisicamente no banco de dados, mas é inferido do arquivo e do bloco nos quais os dados são armazenados.
Cabeçalho de Linha
O Oracle AI Database usa o cabeçalho da linha para gerenciar a parte da linha armazenada no bloco.
O cabeçalho da linha contém informações como as seguintes:
-
Colunas na parte da linha
-
Partes da linha localizadas em outros blocos de dados
Se for possível inserir uma linha inteira em um único bloco de dados, o Oracle AI Database armazenará a linha como uma parte da linha. No entanto, se todos os dados da linha não puderem ser inseridos em um único bloco ou uma atualização fizer com que uma linha existente ultrapasse seu bloco, o banco de dados armazenará a linha em várias partes de linha. Um bloco de dados geralmente contém apenas uma parte de linha por linha.
-
Chaves de cluster para clusters de tabelas
Uma linha totalmente contida em um bloco tem pelo menos 3 bytes de cabeçalho de linha.
Consulte Também:
Dados da Coluna
Após o cabeçalho da linha, a seção de dados da coluna armazena os dados reais na linha. A parte da linha geralmente armazena colunas na ordem listada na instrução CREATE TABLE, mas essa ordem não é garantida. Por exemplo, as colunas do tipo LONG são criadas por último.
Conforme mostrado na figura em "Formato de Linha", para cada coluna em uma linha, o Oracle AI Database armazena o tamanho e os dados da coluna separadamente. O espaço necessário depende do tipo de dados. Se o tipo de dados de uma coluna for de tamanho variável, o espaço necessário para manter um valor poderá aumentar e diminuir com atualizações nos dados.
Cada linha tem um slot no diretório de linhas do cabeçalho do bloco de dados. O slot aponta para o início da linha.
Consulte Também: "Armazenamento em Tabela" e "Armazenamento em Índice"
Formato de id de linha
O Oracle AI Database usa um rowid para identificar exclusivamente uma linha. Internamente, rowid é uma estrutura que contém informações de que o banco de dados precisa para acessar uma linha. Um id de linha não é armazenado fisicamente no banco de dados, mas é inferido do arquivo e do bloco nos quais os dados são armazenados.
Um rowid estendido inclui um número de objeto de dados. Este tipo de id de linha usa uma codificação de base 64 do endereço físico para cada linha. Os caracteres de codificação são A-Z, a-z, 0-9, + e /.
Exemplo 15-1 Pseudocoluna ROWID
O exemplo a seguir consulta a ROWID pseudocolumn para mostrar o rowid estendido da linha na tabela employees para o funcionário 100:
SQL> SELECT ROWID FROM employees WHERE employee_id = 100;

ROWID
------------------
AAAPecAAFAAAABSAAA
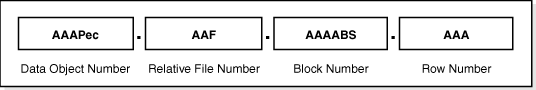
A figura a seguir ilustra o formato de um rowid estendido.
Figura 9: Formato ROWID
Descrição da ilustração cncpt249.gif
Um rowid estendido é exibido em um formato de quatro peças, OOOOOOFFFBBBBBBRRR, com o formato dividido nos seguintes componentes:
-
OOOOOOO número do objeto de dados identifica o segmento (objeto de dados
AAAPecna consulta de amostra). Um número de objeto de dados é atribuído a cada segmento de banco de dados. Os objetos de esquema no mesmo segmento, como um cluster de tabela, têm o mesmo número de objeto de dados. -
FFFO número do arquivo de dados relativo ao tablespace identifica o arquivo de dados que contém a linha (arquivo
AAFna consulta de amostra). -
BBBBBBO número do bloco de dados identifica o bloco que contém a linha (bloco
AAAABSna consulta de amostra). Os números de bloco são relativos ao arquivo de dados, não ao tablespace. Assim, duas linhas com números de bloco idênticos poderiam residir em arquivos de dados diferentes do mesmo tablespace. -
RRRO número da linha identifica a linha no bloco (linha
AAAna consulta de amostra).
Depois que um id de linha é atribuído a uma parte da linha, o id de linha pode mudar em circunstâncias especiais. Por exemplo, se o movimento da linha estiver ativado, o id da linha poderá ser alterado por causa de atualizações de chave de partição, operações de Flashback de Tabela, operações de redução de tabela e assim por diante. Se a movimentação da linha estiver desativada, um rowid poderá ser alterado se a linha for exportada e importada usando os utilitários do Oracle AI Database. Observação: Internamente, o banco de dados executa o movimento da linha como se ela tivesse sido excluída e reinserida fisicamente. No entanto, o movimento da linha é considerado uma atualização, o que tem implicações para acionadores.
Consulte Também:
-
Oracle AI Database SQL Language Reference para saber mais sobre rowids
Compactação do Bloco de Dados
O banco de dados pode usar a compactação de tabela para eliminar valores duplicados em um bloco de dados. Esta seção descreve o formato dos blocos de dados que usam compactação.
O formato de um bloco de dados que usa tabela básica e compactação avançada de linha é essencialmente o mesmo que um bloco descompactado. A diferença é que uma tabela de símbolos no início do bloco armazena valores duplicados para as linhas e colunas. O banco de dados substitui as ocorrências desses valores por uma breve referência à tabela de símbolos.
Exemplo 15-2 Formato de Blocos de Dados Compactados
Suponha que as seguintes linhas sejam armazenadas em um bloco de dados para a tabela sales de sete colunas:
2190,13770,25-NOV-00,S,9999,23,161
2225,15720,28-NOV-00,S,9999,25,1450
34005,120760,29-NOV-00,P,9999,44,2376
9425,4750,29-NOV-00,I,9999,11,979
1675,46750,29-NOV-00,S,9999,19,1121
Quando a tabela básica ou a compactação avançada de linhas é aplicada a essa tabela, o banco de dados substitui os valores duplicados por uma referência de símbolo. A seguinte representação conceitual da compactação mostra o símbolo * substituindo 29-NOV-00 e % substituindo 9999:
2190,13770,25-NOV-00,S,%,23,161
2225,15720,28-NOV-00,S,%,25,1450
34005,120760,*,P,%,44,2376
9425,4750,*,I,%,11,979
1675,46750,*,S,%,19,1121
A Tabela 15-1 representa conceitualmente a tabela de símbolos que mapeia símbolos para valores.
Tabela 1 Tabela de Símbolos
| Símbolo | Valor | Coluna | Linhas |
|---|---|---|---|
| * | 29-NOV-00 | 3 | 958-960 |
| % | 9.999 | 5 | 956-960 |
Consulte Também: "Compressão de Tabela"
Gerenciamento de Espaço em Blocos de Dados
À medida que o banco de dados preenche um bloco de dados de baixo para cima, a quantidade de espaço livre entre os dados da linha e o cabeçalho do bloco diminui.
O espaço livre em um bloco de dados também pode ser reduzido durante as atualizações, como ao alterar um valor nulo à direita para um valor não nulo. O banco de dados gerencia o espaço livre no bloco de dados para otimizar o desempenho e evitar o desperdício de espaço.
Observação: Esta seção pressupõe o uso do gerenciamento automático de espaço de segmento.
-
Porcentagem de Espaço Livre em Blocos de Dados O parâmetro SQL
PCTFREEdefine a porcentagem mínima de um bloco de dados reservado como espaço livre para atualizações em linhas existentes. OPCTFREEé importante para evitar a migração de linhas e o desperdício de espaço. -
Otimização do Espaço Livre em Blocos de Dados Embora a porcentagem de espaço livre não possa ser menor que
PCTFREE, a quantidade de espaço livre pode ser maior. Por exemplo, definirPCTFREEcomo 20% impede que a quantidade total de espaço livre caia para 5% do bloco, mas permite que 50% do bloco seja livre. -
Linhas Encadeadas e Migradas O Oracle AI Database usa encadeamento e migração para gerenciar linhas muito grandes para caber em um único bloco.
Porcentagem de Espaço Livre em Blocos de Dados
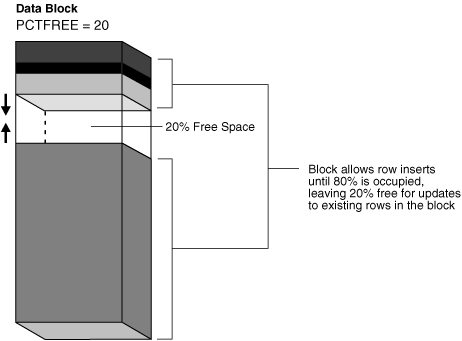
O parâmetro SQL PCTFREE define a porcentagem mínima de um bloco de dados reservado como espaço livre para atualizações em linhas existentes. O PCTFREE é importante para evitar a migração de linhas e o desperdício de espaço.
Por exemplo, suponha que você crie uma tabela que exigirá apenas atualizações ocasionais, a maioria das quais não aumentará o tamanho dos dados existentes. Você especifica o parâmetro PCTFREE dentro de uma instrução CREATE TABLE da seguinte forma:
CREATE TABLE test_table (n NUMBER) PCTFREE 20;A Figura 15-10 mostra como uma definição PCTFREE de 20 afeta o gerenciamento de espaço. O banco de dados adiciona linhas ao bloco ao longo do tempo, fazendo com que os dados da linha cresçam para cima em direção ao cabeçalho do bloco, que está se expandindo para baixo em direção aos dados da linha. A definição PCTFREE garante que pelo menos 20% do bloco de dados esteja livre. Por exemplo, o banco de dados impede que uma instrução INSERT preencha o bloco para que os dados da linha e o cabeçalho ocupem 90% do espaço total do bloco, deixando apenas 10% livres.
Figura 10: PCTFREE
Descrição da ilustração cncpt029.gif
Observação: Esta discussão não se aplica a tipos de dados LOB, que não usam o parâmetro de armazenamento PCTFREE ou listas livres.
Consulte Também:
-
Guia do Desenvolvedor do Oracle AI Database SecureFiles and Large Objects
-
Referência de Linguagem SQL do Oracle AI Database para obter a sintaxe e a semântica do parâmetro
PCTFREE
Otimização de espaço livre em blocos de dados
Embora a porcentagem de espaço livre não possa ser menor que PCTFREE, a quantidade de espaço livre pode ser maior. Por exemplo, definir PCTFREE como 20% impede que a quantidade total de espaço livre caia para 5% do bloco, mas permite que 50% do bloco seja livre.
-
Otimização Aumentando o Espaço Livre Algumas instruções DML podem aumentar o espaço livre em blocos de dados.
-
Otimização por Agrupamento de Espaço Fragmentado O espaço liberado pode ou não ser contíguo com a área principal de espaço livre em um bloco de dados. O espaço livre não contíguo é denominado espaço fragmentado.
Otimização aumentando o espaço livre
Algumas instruções DML podem aumentar o espaço livre em blocos de dados.
As seguintes instruções podem aumentar o espaço:
-
Instruções
DELETE -
Instruções
UPDATEque atualizam valores existentes para valores menores ou aumentam valores existentes e forçam uma linha a migrar -
Instruções
INSERTem uma tabela que usa compactação avançada de linhaSe as instruções
INSERTpreencherem um bloco com dados, o banco de dados chamará a compactação de bloco, o que pode resultar no bloco ter mais espaço livre.
O espaço liberado está disponível para instruções INSERT nas seguintes condições:
-
Se a instrução
INSERTestiver na mesma transação e for depois da instrução que libera espaço, a instrução poderá usar o espaço. -
Se a instrução
INSERTestiver em uma transação separada da instrução que libera espaço (talvez executada por outro usuário) e se o espaço for necessário, a instrução poderá usar o espaço disponibilizado, mas somente após a confirmação da outra transação.
Consulte Também: Oracle AI Database Administrator's Guide para saber mais sobre compactação avançada de linhas
Otimização por Agrupamento de Espaço Fragmentado
O espaço liberado pode ou não ser contíguo com a área principal do espaço livre em um bloco de dados. O espaço livre não contíguo é denominado espaço fragmentado.
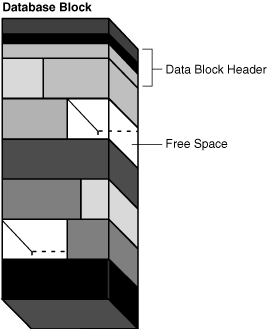
A figura a seguir mostra um bloco de dados com espaço livre não contíguo.
Figura 11: Bloco de Dados com Espaço Fragmentado
Descrição da ilustração cncpt210.gif
O Oracle AI Database coalesce de forma automática e transparente o espaço livre de um bloco de dados somente quando as seguintes condições forem verdadeiras:
-
Uma instrução
INSERTouUPDATEtenta usar um bloco que contém espaço livre suficiente para conter uma nova parte da linha. -
O espaço livre é fragmentado para que a parte da linha não possa ser inserida em uma seção contígua do bloco.
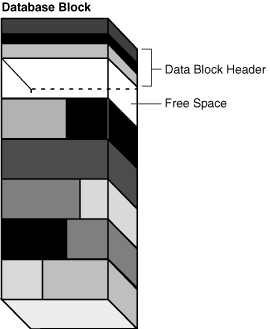
Após a aglutinação, a quantidade de espaço livre é idêntica à quantidade antes da operação, mas o espaço é agora contíguo. A Figura 15-12 mostra um bloco de dados após a aglutinação do espaço.
Figura 12: Bloco de dados após a fusão do espaço livre
Descrição da ilustração cncpt211.gif
O Oracle AI Database executa a aglutinação apenas nas situações anteriores porque, caso contrário, o desempenho diminuiria por causa da aglutinação contínua do espaço livre em blocos de dados.
Linhas Encadeadas e Migradas
O Oracle AI Database usa encadeamento e migração para gerenciar linhas muito grandes para caber em um único bloco. Observação: Uma linha encadeada em uma tabela padrão é diferente de uma cadeia de linhas em uma tabela blockchain. O Oracle AI Database usa diferentes tecnologias para gerenciar linhas em uma tabela blockchain.
As seguintes situações são possíveis:
-
A linha é muito grande para se encaixar em um bloco de dados quando é inserida pela primeira vez.
No cadeamento de linhas, o Oracle AI Database armazena os dados da linha em uma cadeia de um ou mais blocos de dados reservados para o segmento. O encadeamento de linhas ocorre com mais frequência com linhas grandes. Os exemplos incluem linhas que contêm uma coluna do tipo de dados
LONGouLONG RAWou uma linha com um grande número de colunas. Nesses casos, é inevitável o encadeamento de linha. -
Uma linha que originalmente se encaixa em um bloco de dados é atualizada para que o comprimento geral da linha aumente, mas não há espaço livre suficiente para manter a linha atualizada.
Na migração de linha, o Oracle AI Database move toda a linha para um novo bloco de dados, supondo que a linha possa caber em um novo bloco. A parte da linha original de uma linha migrada contém um ponteiro ou "endereço de encaminhamento" para o novo bloco que contém a linha migrada. O id da linha de uma linha migrada não é alterado.
-
Uma linha tem mais de 255 colunas.
O Oracle AI Database só pode armazenar 255 colunas em uma linha. Assim, se você inserir uma linha em uma tabela que tenha 1000 colunas, o banco de dados criará 4 partes de linha, geralmente encadeadas por vários blocos.
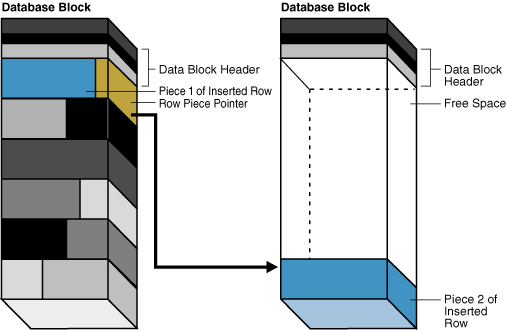
A Figura 15-13 descreve a inserção de uma linha grande em um bloco de dados. A linha é muito grande para o bloco esquerdo; portanto, o banco de dados encadeia a linha colocando a primeira linha no bloco esquerdo e a segunda linha no bloco direito.
Figura 13: Encadeamento de Linhas
Descrição da ilustração cncpt316.gif
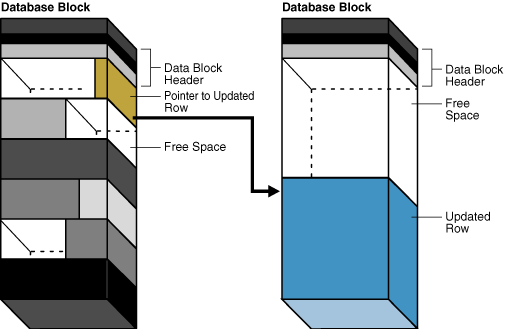
Figura 15-14, o bloco esquerdo contém uma linha que é atualizada para que a linha seja agora muito grande para o bloco. O banco de dados move a linha inteira para o bloco da direita e deixa um ponteiro para a linha migrada no bloco da esquerda.
Figura 14: Migração de Linha
Descrição da ilustração cncpt306.gif
Quando uma linha é encadeada ou migrada, a E/S necessária para recuperar os dados aumenta. Essa situação resulta porque o Oracle AI Database deve verificar vários blocos para recuperar as informações da linha. Por exemplo, se o banco de dados executar uma E/S para ler um índice e uma E/S para ler uma linha de tabela não migrada, uma E/S adicional será necessária para obter os dados de uma linha migrada.
O Supervisor de Segmentos, que pode ser executado manual e automaticamente, é um componente do Oracle AI Database que identifica segmentos com espaço disponível para recuperação. O consultor pode oferecer conselhos sobre objetos que têm espaço livre significativo ou muitas linhas encadeadas.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber como recuperar o espaço desperdiçado
-
Guia de Ajuste de Desempenho do Oracle AI Database para aprender a reduzir linhas encadeadas e migradas
Visão Geral de Blocos de Índice
Um bloco de índice é um tipo especial de bloco de dados que gerencia o espaço de maneira diferente dos blocos de tabela. O Oracle AI Database usa blocos de índice para gerenciar o espaço de armazenamento lógico em um índice.
-
Tipos de Blocos de Índice Um índice contém um bloco raiz, blocos de ramificação e blocos de folha.
-
Armazenamento de Entradas de Índice As entradas de índice são armazenadas em blocos de índice da mesma forma que as linhas da tabela em um bloco de dados As entradas de índice na parte do bloco não são armazenadas em ordem binária, mas em um heap.
-
Reutilização de Slots em um Bloco de Índice O banco de dados pode reutilizar espaço em um bloco de índice.
-
O índice Coalescing an Index Block coalesce compacta os dados de índice existentes no local e, se a reorganização liberar blocos, deixa os blocos livres na estrutura de índice. Assim, a coalescência não libera blocos de índice para outros usos ou faz com que o índice realoque blocos.
Tipos de Blocos de Índice
Um índice contém um bloco raiz, blocos de ramificação e blocos de folha.
Os tipos de bloco são definidos da seguinte forma:
-
Bloco raiz
Este bloco identifica o ponto de entrada no índice.
-
Blocos de ramificação
Os bancos de dados navegam pelos blocos de ramificação ao procurar uma chave de índice.
-
Blocos de folhas
Esses blocos contêm os valores de chave indexados que apontam para as linhas associadas. Os blocos de folha armazenam valores de chave em ordem classificada para que o banco de dados possa pesquisar eficientemente todas as linhas em um intervalo de valores de chave.
Armazenamento de Entradas de Índice
As entradas do índice são armazenadas em blocos de índice da mesma forma que as linhas da tabela em um bloco de dados As entradas do índice na parte do bloco não são armazenadas em ordem binária, mas em um heap.
O banco de dados gerencia o diretório de linhas em um bloco de índices de maneira diferente do diretório em um bloco de dados. As entradas no diretório de linhas (não as entradas no corpo do bloco de índice) são ordenadas por valor de chave. Por exemplo, no diretório de linhas, a entrada do diretório para a chave de índice 000000 precede a entrada do diretório para a chave de índice 111111 e assim por diante.
A ordenação de entradas no diretório de linhas melhora a eficiência das varreduras de índice. Em uma verificação de faixa, o banco de dados deve ler todas as chaves de índice especificadas na faixa. O banco de dados atravessa os blocos de ramificação para identificar o bloco de folha que contém a primeira chave. Como as entradas no diretório de linhas são classificadas, o banco de dados pode usar uma pesquisa binária para localizar a primeira chave de índice no intervalo e, em seguida, avançar sequencialmente pelas entradas no diretório de linhas até encontrar a última chave. Desta forma, o banco de dados evita a leitura de todas as chaves no corpo do bloco de folhas.
Consulte Também: "Custos Indiretos do Bloco de Dados"
Reutilização de Slots em um Bloco de Índice
O banco de dados pode reutilizar espaço dentro de um bloco de índice.
Por exemplo, um aplicativo pode inserir um valor em uma coluna e, em seguida, excluir o valor. Quando uma linha requer espaço, o banco de dados pode reutilizar o slot de índice anteriormente ocupado pelo valor excluído.
Um bloco de índice geralmente tem muito mais linhas do que um bloco de tabela organizado por heap. A capacidade de armazenar muitas linhas em um único bloco de índice facilita a manutenção de um índice pelo banco de dados, pois evita divisões frequentes do bloco para armazenar novos dados.
Um índice não pode se coalescer, embora você possa coalescer manualmente com uma instrução ALTER INDEX com as opções REBUILD ou COALESCE. Por exemplo, se você preencher uma coluna com os valores 1 a 500000 e, em seguida, excluir as linhas que contêm números pares, o índice conterá 250.000 slots vazios. O banco de dados só reutilizará um slot se puder inserir dados que se encaixem em um bloco de índice que contenha um slot vazio.
Agrupando um Bloco de Índice
A coalescência de índices compacta os dados de índices existentes e, se a reorganização liberar blocos, deixa os blocos livres na estrutura do índice. Assim, a coalescência não libera blocos de índice para outros usos ou faz com que o índice realoque blocos.
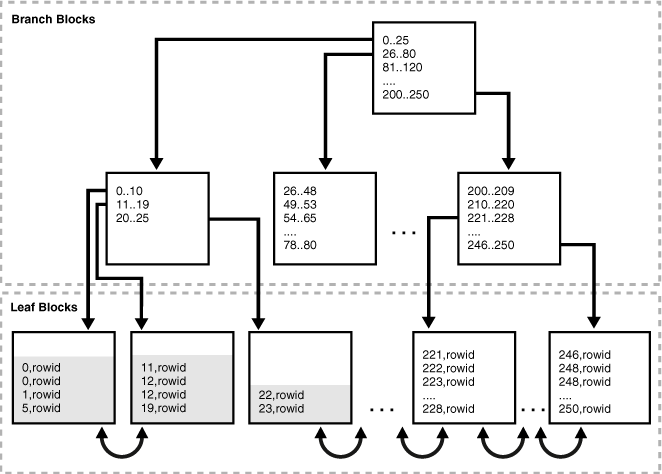
O Oracle AI Database não compacta automaticamente o índice: você deve executar uma instrução ALTER INDEX com as opções REBUILD ou COALESCE. A Figura 15-15 mostra um índice da coluna employees.department_id antes de o índice ser agrupado. Os três primeiros blocos foliares estão apenas parcialmente cheios, conforme indicado pelas linhas de preenchimento cinza.
Figura 15: Índice antes do coalescimento
Descrição da ilustração cncpt294.gif
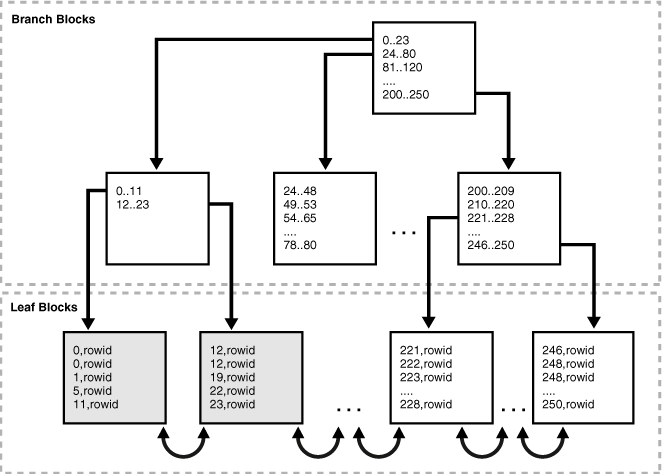
A Figura 15-16 mostra o índice na Figura 15-15 após a aglutinação do índice. Os dois primeiros blocos de folhas estão agora cheios, como indicado pelas linhas de preenchimento cinza, e o terceiro bloco de folhas foi liberado.
Figura 16: Índice após coalescência
Descrição da ilustração cncpt295.gif
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a coalescer e reconstruir índices
-
Oracle AI Database SQL Language Reference para saber mais sobre a instrução
COALESCE
Visão Geral de Extensões
Expansão é uma unidade de armazenamento de banco de dados formada por blocos de dados logicamente contíguos. Os blocos de dados podem ser fisicamente distribuídos no disco devido a distribuição RAID e implementações de sistema de arquivos.
-
Alocação de Extensões Por padrão, o banco de dados aloca uma extensão inicial para um segmento de dados quando o segmento é criado. Uma extensão está sempre contida em um arquivo de dados.
-
Desalocação de Extensões Em geral, as extensões de um segmento de usuário não retornam ao tablespace, a menos que você elimine o objeto usando uma instrução
DROP. -
Parâmetros de Armazenamento para Extensões Cada segmento é definido por parâmetros de armazenamento expressos em termos de extensões. Esses parâmetros controlam como o Oracle AI Database aloca espaço livre para um segmento.
Alocação de Extensões
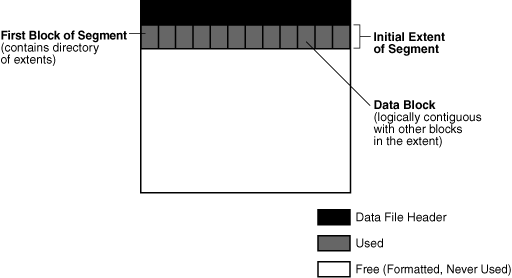
Por padrão, o banco de dados aloca uma expansão inicial para um segmento de dados quando ele é criado. Uma extensão está sempre contida em um arquivo de dados.
Embora nenhum dado tenha sido adicionado ao segmento, os blocos de dados na extensão inicial são reservados exclusivamente para este segmento. O primeiro bloco de dados de cada segmento contém um diretório de expansões no segmento. A Figura 15-17 mostra a extensão inicial em um segmento em um arquivo de dados que anteriormente não continha dados.
Figura 17: Extensão Inicial de um Segmento
Descrição da ilustração cncpt274.gif
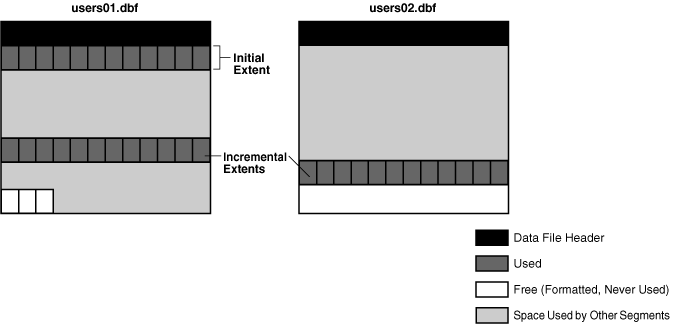
Se a extensão inicial ficar cheia e se for necessário mais espaço, o banco de dados alocará automaticamente uma extensão incremental para este segmento. Uma extensão incremental é uma extensão subsequente criada para o segmento.
O algoritmo de alocação depende se o tablespace é gerenciado localmente ou gerenciado pelo dicionário. No caso gerenciado localmente, o banco de dados pesquisa o bitmap de um arquivo de dados para blocos livres adjacentes. Se o arquivo de dados tiver espaço insuficiente, o banco de dados procurará outro arquivo de dados. As extensões de um segmento estão sempre no mesmo tablespace, mas podem estar em arquivos de dados diferentes. A Figura 15-18 mostra que o banco de dados pode alocar extensões para um segmento em qualquer arquivo de dados do tablespace. Por exemplo, o segmento pode alocar a extensão inicial em users01.dbf, alocar a primeira extensão incremental em users02.dbf e, em seguida, alocar a próxima extensão em users01.dbf.
Figura 18: Extensão Incremental de um Segmento
Descrição da ilustração cncpt278.gif
Os blocos de uma extensão recém-alocado, embora fossem livres, não podem ficar vazios de dados antigos. No ASSM, o Oracle AI Database formata os blocos de uma extensão recém-alocada quando começa a usar a extensão, mas apenas conforme necessário. Observação: Esta seção se aplica a operações seriais, nas quais um processo do servidor analisa e executa uma instrução. O banco de dados aloca extensões de forma diferente em instruções SQL paralelas, que envolvem vários processos de servidor.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber como alocar extensões manualmente
Desalocação de Extensões
Em geral, as expansões de um segmento de usuário não retornam ao tablespace, a menos que você elimine o objeto usando uma instrução DROP.
Por exemplo, se você excluir todas as linhas de uma tabela, o banco de dados não recuperará os blocos de dados para uso por outros objetos no tablespace. Você também pode eliminar o segmento usando o pacote DBMS_SPACE_ADMIN.
Observação: em um segmento de undo, o Oracle AI Database desaloca periodicamente uma ou mais extensões se ele tiver o tamanho OPTIMAL especificado ou se o banco de dados estiver no modo de gerenciamento de undo automático.
Em algumas circunstâncias, você pode desalocar o espaço manualmente. O Supervisor de Segmentos da Oracle ajuda a determinar se um objeto tem espaço disponível para recuperação com base no nível de fragmentação no objeto. As seguintes técnicas podem liberar extensões:
-
Use uma redução de segmento on-line para recuperar espaço fragmentado em um segmento. A redução de segmento é uma operação on-line no local. Em geral, a compactação de dados leva a uma melhor utilização do cache e requer menos blocos para serem lidos em uma verificação completa da tabela.
-
Mova os dados de uma tabela ou partição de tabela não particionada para um novo segmento e, opcionalmente, para um tablespace diferente para o qual você tem cota.
-
Reconstruir ou aglutinar o índice.
-
Trunca uma tabela ou cluster de tabelas, o que remove todas as linhas. Por padrão, o Oracle AI Database desaloca todo o espaço usado pelas linhas removidas, exceto o especificado pelo parâmetro de armazenamento
MINEXTENTS. A partir do Oracle Database 11g Release 2 ( 11.2.0.2), você também pode usarTRUNCATEcom a opçãoDROP ALL STORAGEpara eliminar segmentos inteiros. -
Desaloque o espaço não utilizado, que libera o espaço não utilizado na extremidade da marca d'água alta do segmento do banco de dados e disponibiliza o espaço para outros segmentos no tablespace.
Quando as extensões são liberadas, o Oracle AI Database modifica o bitmap no arquivo de dados para tablespaces gerenciados localmente para refletir as extensões recuperadas como espaço disponível. Qualquer dado nos blocos de extensões liberadas torna-se inacessível.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber como recuperar o espaço do segmento
Parâmetros de Armazenamento para Extensões
Cada segmento é definido por parâmetros de armazenamento expressos em termos de extensões. Esses parâmetros controlam como o Oracle AI Database aloca espaço livre para um segmento.
As configurações de armazenamento são determinadas na seguinte ordem de precedência, com as configurações superiores na lista substituindo as configurações inferiores na lista:
-
Cláusula de armazenamento do segmento
-
Cláusula de armazenamento de tablespace
-
Padrão do Oracle AI Database
Um tablespace gerenciado localmente pode ter tamanhos de extensão uniformes ou tamanhos de extensão variáveis determinados automaticamente pelo sistema:
-
Para extensões uniformes, você pode especificar um tamanho de extensão ou usar o tamanho padrão de 1 MB. Todas as extensões do tablespace são desse tamanho. Tablespaces temporários gerenciados localmente só podem usar esse tipo de alocação.
-
Para extensões alocadas automaticamente, o Oracle AI Database determina o tamanho ideal de extensões adicionais.
Para tablespaces gerenciados localmente, alguns parâmetros de armazenamento não podem ser especificados no nível do tablespace. No entanto, você pode especificar esses parâmetros no nível de segmento. Nesse caso, o banco de dados usa todos os parâmetros juntos para calcular o tamanho inicial do segmento. Algoritmos internos determinam o tamanho subsequente de cada extensão.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber mais sobre considerações de gerenciamento de extensão ao criar um tablespace gerenciado localmente
-
Oracle AI Database SQL Language Reference para saber mais sobre as opções na cláusula de armazenamento
Visão Geral de Segmentos
Um segmento é um conjunto de extensões que contém todos os dados de uma estrutura de armazenamento lógico em um tablespace.
Por exemplo, o Oracle AI Database aloca uma ou mais expansões para formar o segmento de dados de uma tabela. O banco de dados também aloca uma ou mais expansões para formar o segmento de índice de um índice em uma tabela.
O Oracle AI Database gerencia o espaço do segmento de forma automática ou manual. Esta seção pressupõe o uso do ASSM.
-
Segmentos de Usuário Um único segmento de dados em um banco de dados armazena os dados de um objeto de usuário.
-
Segmentos Temporários Ao processar uma consulta, o Oracle AI Database geralmente requer um espaço de trabalho temporário para estágios intermediários da execução da instrução SQL.
-
Desfazer Segmentos O Oracle AI Database mantém registros das ações das transações, conhecidas coletivamente como desfazer dados.
-
Espaço de Segmento e a Marca d'água Alta Para gerenciar o espaço, o Oracle AI Database rastreia o estado dos blocos no segmento. A marca d'água alta (HWM) é o ponto em um segmento além do qual os blocos de dados não são formatados e nunca foram usados. Consulte Também: "Gerenciamento de Espaço Lógico" para saber mais sobre o ASSM
Segmentos de Usuário
Um único segmento de dados em um banco de dados armazena os dados de um objeto de usuário.
Há diferentes tipos de segmentos. Exemplos de segmentos de usuário incluem:
-
Tabela, partição de tabela ou cluster de tabelas
-
Partição de LOB ou LOB
-
Partição de índice ou índice
Cada objeto e partição de objeto não particionados são armazenados em seu próprio segmento. Por exemplo, se um índice tiver cinco partições, cinco segmentos conterão os dados do índice.
- Criação de Segmento do Usuário Por padrão, o banco de dados usa a criação de segmento diferido para atualizar apenas metadados do banco de dados ao criar tabelas, índices e partições.
Criação de Segmento do Usuário
Por padrão, o banco de dados usa a criação de segmentos diferidos para atualizar apenas os metadados do banco de dados ao criar tabelas, índices e partições.
Quando um usuário insere a primeira linha em uma tabela ou partição, o banco de dados cria segmentos para a tabela ou partição, suas colunas LOB e seus índices. A criação de segmento diferido evita o uso desnecessário de recursos do banco de dados. Por exemplo, a instalação de um aplicativo pode criar milhares de objetos, consumindo espaço em disco significativo. Muitos desses objetos nunca podem ser usados.
O pacote DBMS_SPACE_ADMIN gerencia segmentos para objetos vazios. Você pode usar esse pacote PL/SQL para fazer o seguinte:
-
Materializar manualmente segmentos para tabelas vazias ou partições que não tenham segmentos criados
-
Remover segmentos de tabelas ou partições vazias que atualmente têm um segmento vazio alocado
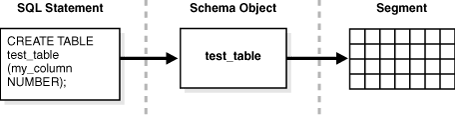
Para melhor ilustrar o relacionamento entre criação de objeto e criação de segmento, suponha que a criação de segmento diferido esteja desativada. Você cria uma tabela da seguinte forma:
CREATE TABLE test_table (my_column NUMBER);Conforme mostrado na Figura 15-19, o banco de dados cria um segmento para a tabela.
Figura 19: Criação de um segmento de usuário
Descrição da ilustração cncpt246.gif
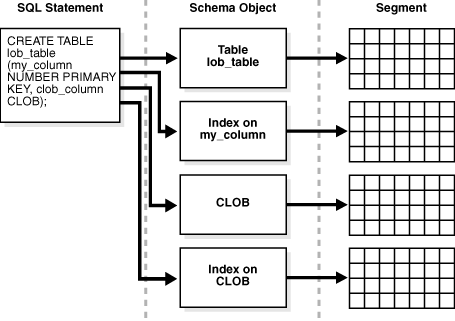
Quando você cria uma tabela com uma chave primária ou chave exclusiva, o Oracle AI Database cria automaticamente um índice para essa chave. Suponha novamente que a criação de segmento diferido esteja desativada. Você cria uma tabela da seguinte forma:
CREATE TABLE lob_table (my_column NUMBER PRIMARY KEY, clob_column CLOB);A Figura 15-20 mostra que os dados de lob_table são armazenados em um segmento, enquanto o índice criado implicitamente está em um segmento diferente. Além disso, os dados CLOB são armazenados em seu próprio segmento, assim como seu índice CLOB associado. Assim, a instrução CREATE TABLE resulta na criação de quatro segmentos diferentes.
Figura 20: Vários segmentos
Descrição da ilustração cncpt245.gif
Observação: Os segmentos de uma tabela e o índice desta tabela não precisam ocupar o mesmo tablespace.
O banco de dados aloca uma ou mais expansões quando um segmento é criado. Os parâmetros de armazenamento do objeto determinam como as extensões de cada segmento são alocadas. Os parâmetros afetam a eficiência da recuperação e do armazenamento de dados para o segmento de dados associado ao objeto.
Consulte Também:
-
Oracle AI Database SecureFiles and Large Objects Developer's Guide para aprender sobre LOBs internos
-
Oracle AI Database Administrator's Guide para aprender a gerenciar a criação de segmentos diferidos
-
Referência de Linguagem SQL do Oracle AI Database para sintaxe
CREATE TABLE
Segmentos Temporários
Ao processar uma consulta, o Oracle AI Database geralmente requer um espaço de trabalho temporário para estágios intermediários da execução de instruções SQL.
As operações típicas que podem exigir um segmento temporário incluem classificação, hashing e mesclagem de bitmaps. Ao criar um índice, o Oracle AI Database também coloca segmentos de índice em segmentos temporários e, em seguida, os converte em segmentos permanentes quando o índice é concluído.
O Oracle AI Database não criará um segmento temporário se uma operação puder ser executada na memória. No entanto, se o uso da memória não for possível, o banco de dados alocará automaticamente um segmento temporário no disco.
-
Alocação de Segmentos Temporários para Consultas O Oracle AI Database aloca segmentos temporários para consultas conforme necessário durante uma sessão do usuário e os elimina quando a consulta é concluída. As alterações em segmentos temporários não são registradas no redo log on-line, exceto para operações de gerenciamento de espaço no segmento temporário.
-
Alocação de Segmentos para Tabelas e Índices Temporários O Oracle AI Database pode alocar segmentos temporários para tabelas temporárias e seus índices.
Alocação de segmentos temporários para consultas
O Oracle AI Database aloca segmentos temporários para consultas conforme necessário durante uma sessão do usuário e os elimina quando a consulta é concluída. As alterações em segmentos temporários não são registradas no redo log on-line, exceto para operações de gerenciamento de espaço no segmento temporário.
O banco de dados cria segmentos temporários no tablespace temporário atribuído ao usuário. As características de armazenamento padrão do tablespace determinam as características das expansões no segmento temporário. Como a alocação e a desalocação de segmentos temporários ocorrem com frequência, a melhor prática é criar pelo menos um tablespace especial para segmentos temporários. O banco de dados distribui E/S entre discos e evita a fragmentação de SYSTEM e outros tablespaces com segmentos temporários.
Observação: Quando o SYSTEM é gerenciado localmente, você deve definir um tablespace temporário padrão na criação do banco de dados. Um tablespace SYSTEM gerenciado localmente não pode ser usado para armazenamento temporário padrão.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a criar tablespaces temporários
-
Oracle AI Database SQL Language Reference para sintaxe e semântica do
CREATE TEMPORARY TABLESPACE
Alocação de Segmentos para Tabelas e Índices Temporários
O Oracle AI Database pode alocar segmentos temporários para tabelas temporárias e seus índices.
As tabelas temporárias contêm dados que existem apenas para a duração de uma transação ou sessão. Cada sessão acessa apenas as extensões alocadas para si mesma e não pode acessar as extensões alocadas para outras sessões.
O Oracle AI Database aloca segmentos para uma tabela temporária global quando ocorre o primeiro INSERT na tabela e para uma tabela temporária privada somente quando necessário. A inserção pode ocorrer explicitamente ou devido a CREATE TABLE AS SELECT. O banco de dados aloca os segmentos da tabela e seus índices, cria a página raiz dos índices e aloca qualquer segmento LOB.
Um tablespace temporário do usuário atual aloca segmentos para uma tabela temporária. Por exemplo, o tablespace temporário designado a user1 é temp1 e o tablespace temporário designado a user2 é temp2. Nesse caso, user1 armazena dados temporários nos segmentos temp1, enquanto user2 armazena dados temporários nos segmentos temp2.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a criar tabelas temporárias
Desfazer Segmentos
O Oracle AI Database mantém registros das ações das transações, conhecidas coletivamente como desfazer dados.
O Oracle AI Database usa dados de undo para fazer o seguinte:
-
Fazer rollback de uma transação ativa
-
Recuperar uma transação encerrada
-
Forneça consistência de leitura
-
Executar algumas operações de flashback lógicas
O Oracle AI Database armazena dados de undo dentro do banco de dados, em vez de em logs externos. Os dados de undo são armazenados em blocos que são atualizados da mesma forma que os blocos de dados, com alterações nesses blocos gerando registros de redo. Dessa forma, o Oracle AI Database pode acessar com eficiência dados de undo sem a necessidade de ler logs externos.
Os dados de undo para objetos permanentes são armazenados em um undo tablespace. O Oracle AI Database fornece um mecanismo totalmente automatizado, conhecido como modo de gerenciamento automático de undo, para gerenciar segmentos e espaço de undo em um tablespace de undo.
O banco de dados separa dados de undo em dois fluxos. Um fluxo de undo temporário encapsula apenas registros de undo gerados pelas alterações em objetos temporários, enquanto um fluxo de undo permanente encapsula apenas registros de undo para objetos permanentes. O banco de dados gerencia undo temporário e permanente de modo independente. A separação Desfazer diminui o armazenamento e melhora o desempenho fazendo o seguinte:
-
Permitindo que você configure tamanhos de tablespace permanentes e de undo que melhor se ajustem às cargas de trabalho para tabelas permanentes e temporárias
-
Reduzindo o tamanho do redo gravado no redo log on-line
-
Evitando a necessidade de fazer backup de dados de undo temporários
Em uma instância do Active Data Guard, o DML em tabelas temporárias globais requer que o undo seja gerado em segmentos de undo temporários.
-
Desfazer Segmentos e Transações Quando uma transação é iniciada, o banco de dados vincula (atribui) a transação a um segmento de undo e, portanto, a uma tabela de transações, no tablespace de undo atual. Em raras circunstâncias, se a instância do banco de dados não tiver um tablespace de undo designado, a transação será vinculada ao segmento de undo do sistema.
-
Rollback de Transação Quando uma instrução
ROLLBACKé executada, o banco de dados usa registros de undo para fazer rollback das alterações feitas no banco de dados pela transação não confirmada. -
Segmentos de Desfazer Temporários Um segmento de desfazer temporário é um contêiner de gerenciamento de espaço opcional apenas para dados de desfazer temporários.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender sobre segmentos de undo temporários
-
Oracle AI Database Reference para saber mais sobre o parâmetro de inicialização
TEMP_UNDO_ENABLED
Desfazer Segmentos e Transações
Quando uma transação é iniciada, o banco de dados vincula (atribui) a transação a um segmento de undo e, portanto, a uma tabela de transações no tablespace de undo atual. Em raras circunstâncias, se a instância do banco de dados não tiver um tablespace de undo designado, a transação será vinculada ao segmento de undo do sistema.
Várias transações ativas podem gravar simultaneamente no mesmo segmento de undo ou em segmentos diferentes. Por exemplo, as transações T1 e T2 podem gravar para desfazer o segmento U1 ou T1 pode gravar em U1 enquanto T2 grava para desfazer o segmento U 2.
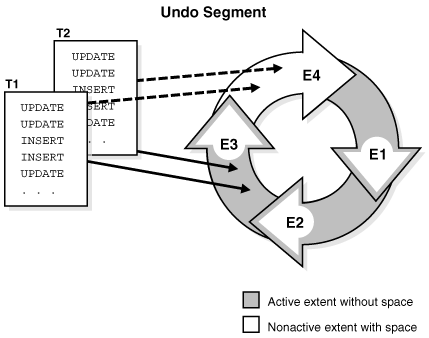
Conceitualmente, as extensões em um segmento de undo formam um anel. As transações gravam em uma extensão de desfazer, e depois na próxima extensão no anel, e assim por diante de forma cíclica. A Figura 15-21 mostra duas transações, T1 e T2, que começam a gravar na terceira extensão (E3) de um segmento de undo e continuam a gravar na quarta extensão (E4).
Figura 21: Anel de Extensões Alocadas em um Segmento Desfazer
Descrição da ilustração cncpt328.gif
A qualquer momento, uma transação grava sequencialmente em apenas uma extensão em um segmento de undo, conhecido como extensão atual para a transação. Várias transações ativas podem ser gravadas simultaneamente na mesma extensão atual ou em diferentes extensões atuais. A Figura 15-21 mostra as transações T1 e T2 gravando simultaneamente na extensão E3. Em uma extensão desfazer, um bloco de dados contém dados de apenas uma transação.
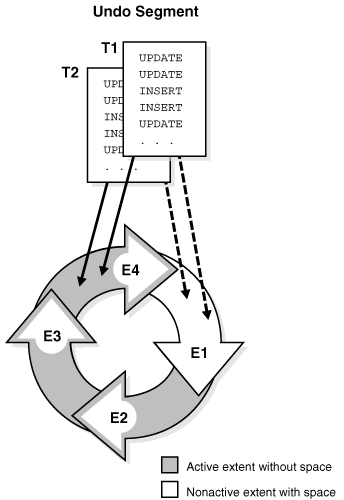
À medida que a extensão de undo atual é preenchida, a primeira transação que precisa de espaço verifica a disponibilidade da próxima extensão alocada no anel. Se a próxima extensão não contiver dados de uma transação ativa, essa extensão se tornará a extensão atual. Agora, todas as transações que precisam de espaço podem gravar na nova extensão atual. Na Figura 15-22, quando E4 está cheio, T1 e T2 continuam gravando em E1, substituindo os dados de undo não ativos em E1.
Figura 22: Uso Cíclico de Extensões Alocadas em um Segmento Desfazer
Descrição da ilustração cncpt327.gif
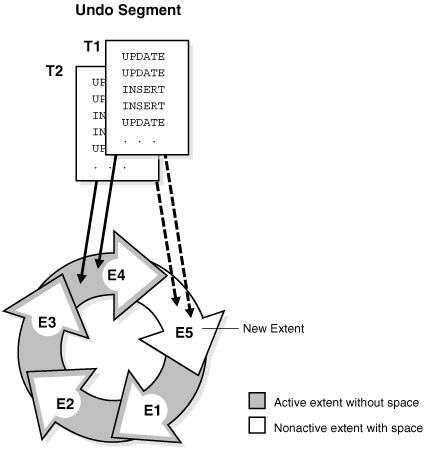
Se a próxima extensão contiver dados de uma transação ativa, o banco de dados deverá alocar uma nova extensão. A Figura 15-23 mostra um cenário no qual T1 e T2 estão gravando no E4. Quando E4 preenche, as transações não podem continuar gravando em E1 porque E1 contém entradas de undo ativas. Portanto, o banco de dados aloca uma nova extensão (E5) para esse segmento de undo. As transações continuam gravando em E5.
Figura 23: Alocação de uma Nova Extensão para um Segmento Desfazer
Descrição da ilustração cncpt326.gif
Consulte Também: Oracle AI Database Administrator's Guide para saber como gerenciar segmentos de undo
Rollback da Transação
Quando uma instrução ROLLBACK é executada, o banco de dados usa registros de undo para fazer rollback das alterações feitas no banco de dados pela transação não confirmada.
Durante a recuperação, o banco de dados faz rollback de quaisquer alterações não confirmadas aplicadas do redo log on-line para os arquivos de dados. Os registros de desfazer fornecem consistência de leitura, mantendo a imagem anterior dos dados para usuários que acessam dados ao mesmo tempo em que outro usuário os está alterando.
Segmentos de Desfazer Temporários
Um segmento de undo temporário é um contêiner de gerenciamento de espaço opcional somente para dados de undo temporários.
Os registros de undo para alterações em tabelas temporárias são específicos da sessão e úteis somente para consistência de leitura e rollback de transações. Antes do Oracle Database 12c, o banco de dados sempre armazenava esses registros no redo log on-line. Como as alterações nos objetos temporários não são registradas no redo log on-line, a gravação de undo para objetos temporários em segmentos de undo temporários economiza espaço nos arquivos de redo log on-line e de redo log arquivado. O banco de dados não registra alterações nos undo ou alterações na tabela temporária, o que melhora o desempenho.
Você pode definir o parâmetro de inicialização TEMP_UNDO_ENABLED para que as tabelas temporárias armazenem dados de undo em um segmento de undo temporário. Quando esse parâmetro é TRUE, o banco de dados aloca segmentos de undo temporários de tablespaces temporários.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender sobre segmentos de undo temporários
-
Oracle AI Database Reference para saber mais sobre o parâmetro de inicialização
TEMP_UNDO_ENABLED
Espaço de segmento e a marca d'água alta
Para gerenciar o espaço, o Oracle AI Database rastreia o estado dos blocos no segmento. A marca d'água alta (HWM) é o ponto em um segmento além do qual os blocos de dados não são formatados e nunca foram usados.
O MSSM usa listas livres para gerenciar o espaço do segmento. Na criação da tabela, nenhum bloco no segmento é formatado. Quando uma sessão insere linhas na tabela pela primeira vez, o banco de dados procura blocos utilizáveis na lista livre. Se o banco de dados não encontrar blocos utilizáveis, ele pré-formatará um grupo de blocos, os colocará na lista livre e começará a inserir dados nos blocos. No MSSM, uma verificação completa da tabela lê todos os blocos abaixo do HWM.
O ASSM não usa listas livres e, portanto, deve gerenciar o espaço de forma diferente. Quando uma sessão insere dados pela primeira vez em uma tabela, o banco de dados formata um único bloco de bitmap em vez de pré-formatar um grupo de blocos como no MSSM. O bitmap rastreia o estado dos blocos no segmento, substituindo a lista livre. O banco de dados usa o bitmap para encontrar blocos livres e, em seguida, formata cada bloco antes de preenchê-lo com dados. ASSM distribui inserções entre blocos para evitar problemas de simultaneidade.
Cada bloco de dados em um segmento ASSM está em um dos seguintes estados:
-
Acima do HWM
Estes blocos não estão formatados e nunca foram utilizados.
-
Abaixo do HWM
Estes blocos estão em um dos seguintes estados:
-
Alocado, mas atualmente não formatado e não usado
-
Formatado e contém dados
-
Formatado e vazio porque os dados foram excluídos
-
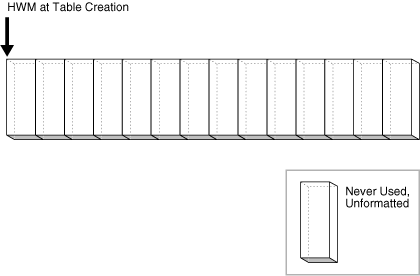
A Figura 15-24 descreve um segmento ASSM como uma série horizontal de blocos. Na criação da tabela, o HWM está no início do segmento à esquerda. Como nenhum dado foi inserido ainda, todos os blocos do segmento não estão formatados e nunca são usados.
Figura 24: HWM na Criação da Tabela
Descrição da ilustração cncpt275.gif
Suponhamos que uma transação insira linhas no segmento. O banco de dados deve alocar um grupo de blocos para conter as linhas. Os blocos alocados ficam abaixo do HWM. O banco de dados formata um bloco de bitmap neste grupo para armazenar os metadados, mas não pré-formata os blocos restantes no grupo.
Na Figura 15-25, os blocos abaixo do HWM são alocados, enquanto os blocos acima do HWM não são alocados nem formatados. Conforme as inserções ocorrem, o banco de dados pode gravar em qualquer bloco com espaço disponível. A marca d'água baixa alta (baixo HWM) marca o ponto abaixo do qual todos os blocos são conhecidos por serem formatados porque contêm dados ou contêm dados anteriormente.
Figura 25: HWM e HWM baixo
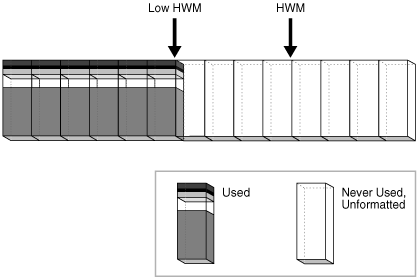
Descrição da ilustração cncpt276.gif
Na Figura 15-26, o banco de dados escolhe um bloco entre o HWM e o HWM baixo e grava nele. O banco de dados poderia ter facilmente escolhido qualquer outro bloco entre o HWM e o HWM baixo, ou qualquer bloco abaixo do HWM baixo que tivesse espaço disponível. Na Figura 15-26, os blocos em ambos os lados do bloco recém-preenchido não estão formatados.
Figura 26: HWM e HWM baixo
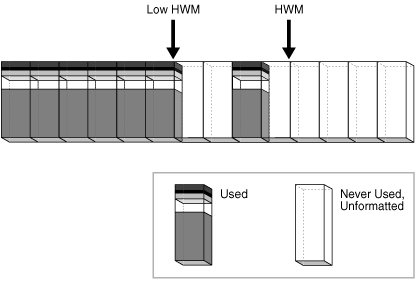
Descrição da ilustração cncpt333.gif
O HWM baixo é importante em uma verificação completa da tabela. Como os blocos abaixo do HWM são formatados somente quando usados, alguns blocos podem ser desformatados, como na Figura 15-26. Por esse motivo, o banco de dados lê o bloco de bitmap para obter a localização do HWM baixo. O banco de dados lê todos os blocos até o HWM baixo porque eles são conhecidos por serem formatados e, em seguida, lê cuidadosamente apenas os blocos formatados entre o HWM baixo e o HWM.
Suponha que uma nova transação insira linhas na tabela, mas o bitmap indica que há espaço livre insuficiente no HWM. Na Figura 15-27, o banco de dados avança o HWM para a direita, alocando um novo grupo de blocos não formatados.
Figura 27: Avançando HWM e HWM baixo
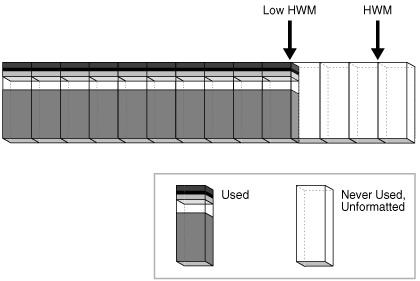
Descrição da ilustração cncpt277.gif
Quando os blocos entre o HWM e o HWM baixo estão cheios, o HWM avança para a direita e o HWM baixo avança para a localização do HWM antigo. À medida que o banco de dados insere dados ao longo do tempo, o HWM continua avançando para a direita, com o HWM baixo sempre atrás dele. A menos que você reconstrua, trunque ou reduza manualmente o objeto, o HWM nunca se retira.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a reduzir segmentos on-line
-
Oracle AI Database SQL Language Reference para sintaxe e semântica do
TRUNCATE TABLE
Visão Geral de Tablespaces
Um tablespace é um contêiner de armazenamento lógico para segmentos.
Os segmentos são objetos de banco de dados, como tabelas e índices, que consomem espaço de armazenamento. No nível físico, um tablespace armazena dados em um ou mais arquivos de dados ou arquivos temporários.
-
Tablespaces em um Ambiente Multitenant Em um CDB, cada PDB e raiz do aplicativo têm seu próprio conjunto de tablespaces.
-
Tablespaces Permanentes Um tablespace permanente agrupa objetos de esquema persistentes. Os segmentos dos objetos no tablespace são armazenados fisicamente em arquivos de dados.
-
Tablespaces Temporários Um tablespace temporário contém dados transitórios que persistem apenas durante a duração de uma sessão. Nenhum objeto de esquema permanente pode residir em um tablespace temporário. Um arquivo de temperatura armazena dados temporários do tablespace.
-
Modos de Tablespace O modo de tablespace determina a acessibilidade do tablespace.
-
Tamanho do Arquivo de Tablespace Um tablespace é um tablespace de bigfile ou um tablespace de smallfile. Esses tablespaces são indistinguíveis em termos de execução de instruções SQL que não se referem explicitamente a arquivos de dados ou arquivos temporários.
Tablespaces em um Ambiente Multitenant
Em um CDB, cada PDB e raiz do aplicativo têm seu próprio conjunto de tablespaces.
Cada raiz do CDB, PDB e raiz do aplicativo deve ter os tablespaces SYSTEM e SYSAUX. A figura a seguir mostra os tablespaces em um contêiner típico.
Figura 28: Tablespaces
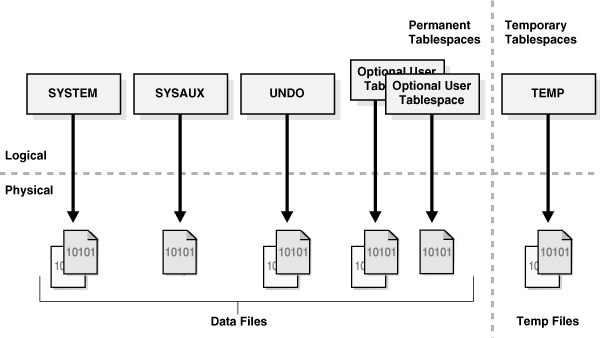
Descrição da ilustração cncpt319.gif
Um CDB contém o seguinte:
-
Um arquivo de controle
-
Um redo log on-line
-
Um ou mais tablespaces de undo
Somente um usuário comum que tenha os privilégios apropriados e cujo contêiner atual seja a raiz do CDB pode criar um tablespace de undo. A qualquer momento, um CDB está em um dos seguintes modos de desfazer:
-
Modo de undo local
Nesse caso, cada PDB tem seu próprio tablespace de undo. Se um CDB estiver usando o modo de undo local, o banco de dados criará automaticamente um tablespace de undo em cada PDB. O undo local oferece vantagens como a capacidade de executar um clone ativo de um PDB e realocar PDBs rapidamente. Além disso, o undo local fornece nível de isolamento e permite operações mais rápidas de desconexão e recuperação pontual.
É necessário um tablespace de undo local para cada nó em um cluster do Oracle Real Application Clusters (RAC) no qual o PDB está aberto. Por exemplo, se você mover um PDB de um cluster de dois nós para um cluster de quatro nós e o PDB estiver aberto em todos os nós, o banco de dados criará automaticamente os tablespaces de undo necessários adicionais. Se você mover o PDB novamente, poderá eliminar os tablespaces de undo redundantes.
Observação: Por padrão, o DBCA (Database Configuration Assistant) cria novos CDBs com undo local ativado.
-
Modo de desfazer compartilhado
Em um CDB de instância única, existe apenas um tablespace de undo ativo. Para um CDB do Oracle RAC, existe um tablespace de undo ativo para cada instância. Todos os tablespaces de undo são visíveis nos dicionários de dados e nas exibições relacionadas de todos os contêineres.
O modo de desfazer se aplica a todo o CDB, o que significa que cada contêiner usa desfazer compartilhado ou cada contêiner usa desfazer local. Você pode alternar entre os modos de desfazer em um CDB, o que exige a reinicialização do banco de dados.
-
-
TableSpaces
SYSTEMeSYSAUXpara cada contêinerA raiz do CDB, cada raiz do aplicativo e cada PDB têm seus próprios tablespaces
SYSTEMeSYSAUX. Cada contêiner também tem seu próprio conjunto de tabelas do dicionário de dados que descrevem os objetos que residem no contêiner. -
Zero ou mais tablespaces criados pelo usuário
Em um caso de uso típico, cada PDB tem seu próprio conjunto de tablespaces que não são do sistema. Esses tablespaces contêm os dados para esquemas e objetos definidos pelo usuário no PDB. Você pode limitar o volume de armazenamento usado pelos arquivos de dados de um PDB usando a cláusula
STORAGEem uma instruçãoCREATE PLUGGABLE DATABASEouALTER PLUGGABLE DATABASE.O armazenamento do dicionário de dados no PDB permite que ele seja portátil. Você pode desconectar um PDB de um CDB e conectá-lo a outro CDB.
-
Um conjunto de arquivos temporários para cada contêiner
Existe um tablespace temporário padrão para a raiz do CDB e um para cada raiz do aplicativo, PDB do aplicativo e PDB.
Exemplo 15-3 CDB no Modo de Undo Local
Este exemplo mostra aspectos da arquitetura de armazenamento físico de um CDB com dois PDBs: hrpdb e salespdb. Neste exemplo, o banco de dados usa o modo de undo local e, portanto, tem arquivos de dados de undo na raiz do CDB, hrpdb e salespdb.
Figura 29: Arquitetura física de um CDB no modo de desfazer local
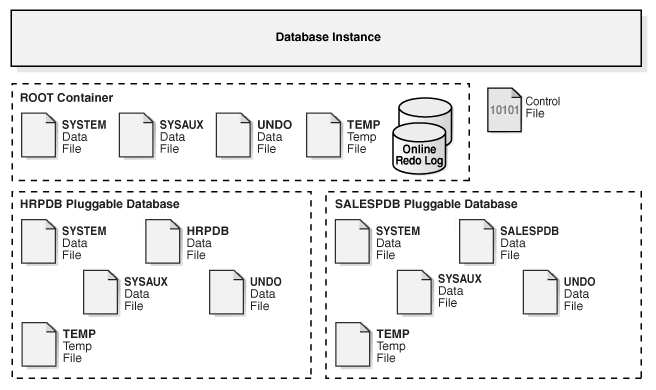
Descrição da ilustração cncpt386.png
Consulte Também: "Separação do Dicionário de Dados em um CDB"
Tablespaces Permanentes
Um tablespace permanente agrupa objetos de esquema persistentes. Os segmentos dos objetos no tablespace são armazenados fisicamente em arquivos de dados.
Para cada usuário de banco de dados é designado um tablespace permanente padrão. Um banco de dados muito pequeno pode precisar apenas dos tablespaces SYSTEM e SYSAUX padrão. No entanto, a Oracle recomenda que você crie pelo menos um tablespace para armazenar dados de usuários e aplicativos. Você pode usar tablespaces para atingir as seguintes metas:
-
Controlar alocação de espaço em disco para dados do banco de dados
-
Atribuir uma cota (de espaço ou limite) a um usuário do banco de dados
-
Colocar tablespaces individuais on-line ou off-line sem afetar a disponibilidade de todo o banco de dados
-
Executar backup e recuperação de tablespaces individuais
-
Importar ou exportar dados do aplicativo usando o utilitário Oracle Data Pump
-
Criar um tablespace transportável que você pode copiar ou mover de um banco de dados para outro, mesmo entre plataformas
A movimentação de dados pelo transporte de tablespaces pode ser ordem de magnitude mais rápida do que exportar/importar ou descarregar/carregar dos mesmos dados, porque o transporte de um tablespace envolve apenas a cópia de arquivos de dados e a integração dos metadados do tablespace. Ao transportar tablespaces, você também pode mover dados de índice.
-
Tablespace SYSTEM O tablespace
SYSTEMé um tablespace administrativo necessário incluído no banco de dados quando ele é criado. O Oracle AI Database usa oSYSTEMpara gerenciar o banco de dados. -
O Tablespace SYSAUX O tablespace
SYSAUXé um tablespace auxiliar para o tablespaceSYSTEM. -
Desfazer Tablespaces Um desfazer tablespace é um tablespace gerenciado localmente reservado para dados de undo gerenciados pelo sistema.
-
Shadow Tablespaces Um shadow tablespace é um tablespace bigfile destinado à proteção contra gravação perdida shadow.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a transportar tablespaces
-
Oracle AI Database Utilities para saber mais sobre o Oracle Data Pump
O Tablespace SYSTEM
O tablespace SYSTEM é um tablespace administrativo necessário incluído no banco de dados quando ele é criado. O Oracle AI Database usa o SYSTEM para gerenciar o banco de dados.
O tablespace SYSTEM inclui as seguintes informações, todas de propriedade do usuário SYS:
-
O dicionário de dados
-
Tabelas e views que contêm informações administrativas sobre o banco de dados
-
Objetos armazenados compilados, como triggers, procedures e pacotes
O tablespace SYSTEM é gerenciado como qualquer outro tablespace, mas requer um nível mais alto de privilégio e é restrito de algumas maneiras. Por exemplo, não é possível renomear ou eliminar o tablespace SYSTEM.
Por padrão, o Oracle AI Database define todos os tablespaces de usuário recém-criados para serem gerenciados localmente. Em um banco de dados com um tablespace SYSTEM gerenciado localmente, você não pode criar tablespaces gerenciados por dicionário (que estão obsoletos). No entanto, se você executar a instrução CREATE DATABASE manualmente e aceitar os padrões, o tablespace SYSTEM será gerenciado pelo dicionário. Você pode migrar um tablespace SYSTEM existente gerenciado pelo dicionário para um formato gerenciado localmente. Observação: A Oracle recomenda enfaticamente que você use o Assistente de Configuração de Banco de Dados (DBCA) para criar novos bancos de dados para que todos os tablespaces, incluindo SYSTEM, sejam gerenciados localmente por padrão.
Consulte Também:
-
"Tabelas On-line e Off-line" para obter informações sobre a condição on-line permanente do tablespace
SYSTEM -
Oracle AI Database Administrator's Guide para aprender a criar ou migrar para um tablespace
SYSTEMgerenciado localmente -
Oracle AI Database SQL Language Reference para sintaxe e semântica do
CREATE DATABASE
O Tablespace SYSAUX
O tablespace SYSAUX é um tablespace auxiliar para o tablespace SYSTEM.
Como SYSAUX é o tablespace padrão de muitos recursos e produtos do Oracle AI Database que exigiam anteriormente seus próprios tablespaces, ele reduz o número de tablespaces exigidos pelo banco de dados. Ele também reduz a carga no tablespace SYSTEM.
A criação ou o upgrade do banco de dados cria automaticamente o tablespace SYSAUX. Durante a operação normal do banco de dados, o banco de dados não permite que o tablespace SYSAUX seja eliminado ou renomeado. Se o tablespace SYSAUX ficar indisponível, a funcionalidade do banco de dados principal permanecerá operacional. Os recursos do banco de dados que usam o tablespace SYSAUX podem falhar ou funcionar com capacidade limitada.
Consulte Também: Oracle AI Database Administrator's Guide para saber mais sobre o tablespace SYSAUX
Desfazer Tablespaces
desfazer tablespace é um tablespace gerenciado localmente reservado para dados de undo gerenciados pelo sistema.
Como outros tablespaces permanentes, os tablespaces de undo contêm arquivos de dados. Os blocos de desfazer nesses arquivos são agrupados em extensões.
-
Modo de Gerenciamento de Undo Automático Os tablespaces de Undo exigem que o banco de dados esteja no modo de undo automático padrão.
-
Retenção Automática de Undo O período de retenção de undo é o tempo mínimo que o Oracle AI Database tenta reter dados de undo antigos antes de substituí-los. Consulte Também: "Desfazer Segmentos"
Modo de Gerenciamento de Undo Automático
Os tablespaces de undo requerem que o banco de dados esteja no modo de undo automático padrão.
O modo automático elimina as complexidades da administração manual de segmentos de undo. O banco de dados se ajusta automaticamente para fornecer a melhor retenção possível de dados de undo para atender a consultas de longa execução que podem exigir esses dados.
Uma nova instalação do Oracle AI Database cria automaticamente um tablespace de undo. Versões anteriores do Oracle AI Database podem não incluir um tablespace de undo e usar segmentos de rollback legados, conhecidos como modo de gerenciamento de undo manual. O Oracle AI Database contém um Supervisor de Undo que fornece consultoria e ajuda a automatizar seu ambiente de undo.
Um banco de dados pode conter vários tablespaces de undo, mas apenas um pode estar em uso por vez. Quando uma instância tenta abrir um banco de dados, o Oracle AI Database seleciona automaticamente o primeiro tablespace de undo disponível. Se nenhum tablespace de undo estiver disponível, a instância será iniciada sem um tablespace de undo e armazenará dados de undo no tablespace SYSTEM. Não é recomendado armazenar dados de undo em SYSTEM.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender sobre o gerenciamento automático de undo
-
Oracle AI Database Upgrade Guide para saber como migrar para o modo de gerenciamento de undo automático
Retenção Automática de Undo
O período de retenção de undo é o tempo mínimo que o Oracle AI Database tenta reter dados de undo antigos antes de substituí-los.
A retenção de undo é importante porque consultas de longa execução podem exigir imagens de bloco mais antigas para fornecer consistência de leitura. Além disso, alguns recursos do Oracle Flashback podem depender da disponibilidade de undo.
Em geral, é desejável manter os dados de undo antigos o maior tempo possível. Depois que uma transação é confirmada, os dados de undo não são mais necessários para rollback ou recuperação de transação. O banco de dados poderá reter dados de undo antigos se o tablespace de undo tiver espaço para novas transações. Quando o espaço disponível é baixo, o banco de dados começa a substituir dados de undo antigos para transações submetidas a commit.
O Oracle AI Database fornece automaticamente a melhor retenção de undo possível para o tablespace de undo atual. O banco de dados coleta estatísticas de uso e ajusta o período de retenção com base nessas estatísticas e no tamanho do tablespace de undo. Se o tablespace de undo for configurado com a opção AUTOEXTEND e o tamanho máximo não for especificado, o ajuste de retenção de undo será diferente. Nesse caso, o banco de dados ajustará o período de retenção de undo para ser um pouco maior do que a consulta de execução mais longa, se o espaço permitir.
Consulte Também: Oracle AI Database Administrator's Guide para obter mais detalhes sobre o ajuste automático da retenção de undo
Tablespaces de Sombra
Um shadow tablespace é um bigfile tablespace destinado a proteção contra gravação perdida de sombra.
Observação: A proteção de gravação perdida de sombra não está relacionada à proteção de gravação perdida configurada com o parâmetro de inicialização DB_LOST_WRITE_PROTECT e um banco de dados stand-by.
-
Finalidade de Tablespaces de Sombra A proteção contra gravação perdida de sombra fornece detecção rápida e resposta imediata a uma gravação perdida.
-
Como os Tablespaces de Sombra Funcionam A proteção de gravação perdida requer dois tablespaces: um tablespace de sombra e um tablespace de não sombra cujos blocos são rastreados pelo tablespace de sombra.
-
Interface do Usuário para Tablespaces de Sombra Você ativa e desativa a proteção de gravação de sombra perdida usando o comando
ALTER PLUGGABLE DATABASE. -
Exemplo: Configurando a Proteção de Gravação Perdida Este exemplo permite o rastreamento de gravação perdida de sombra para um conjunto de tablespaces.
Finalidade dos Tablespaces Sombra
A proteção contra gravação perdida de sombra fornece detecção rápida e resposta imediata a uma gravação perdida.
Uma gravação perdida de bloco de dados ocorre quando um subsistema de E/S reconhece a conclusão da gravação em bloco, mesmo que a gravação não tenha ocorrido ou quando uma imagem anterior do bloco substitui a imagem atual.
Uma gravação perdida não detectada pode resultar em corrupção de dados porque os dados incorretos podem ser usados para outras transações DML. Por exemplo, uma transação pode ler dados antigos e incorretos de uma tabela e, em seguida, atualizar centenas de outras tabelas com base nesses dados. Dessa forma, a corrupção de dados pode se espalhar por todo o banco de dados.
A proteção contra gravação perdida de sombra oferece os seguintes benefícios:
-
Ele detecta uma gravação perdida antes de ser consumida para DML padrão, carga de caminho convencional do SQL*Loader, carga de caminho direto e backups do RMAN.
-
Você pode ativar a proteção de gravação perdida de sombra para tablespaces e arquivos de dados específicos. Você não precisa rastrear todos os dados.
-
Você pode substituir um tablespace de sombra por outro para alterar sua configuração ou localização.
-
Você pode suspender e retomar a proteção de gravação perdida de sombra para um tablespace ou arquivo de dados.
-
Você pode ativá-lo ou desativá-lo para um PDB com uma única instrução
ALTER DATABASE ... LOST WRITE PROTECTION. A tabelaPROP$indica se o rastreamento está ativado para um PDB.
Consulte Também: Referência de Linguagem SQL do Oracle AI Database para saber mais sobre a cláusula LOST WRITE PROTECTION
Como os Tablespaces Shadow Funcionam
A proteção de gravação perdida requer dois tablespaces: um tablespace de sombra e um tablespace de não sombra cujos blocos são rastreados pelo tablespace de sombra.
A figura a seguir fornece um cenário de amostra. Os arquivos de dados nos tablespaces TBS1 e TBS2 são rastreados por um tablespace de sombra. Somente o arquivo de dados DBF6 no tablespace TBS3 é rastreado pelo tablespace de sombra.
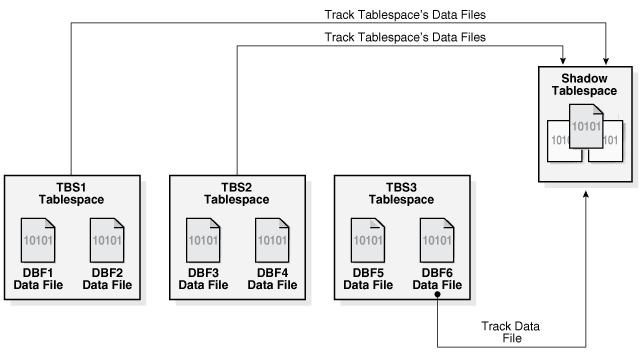
Descrição da ilustração cncpt390.png
Um arquivo de dados rastreado é mapeado para uma extensão shadow em um tablespace shadow. Cada bloco de dados em um arquivo de dados rastreado tem uma entrada correspondente em um bloco de sombra. Esta entrada contém o SCN do bloco de dados rastreados. Quando um bloco de dados rastreado é lido no disco, a proteção de gravação perdida de sombra compara o SCN do bloco no tablespace de sombra com o SCN da gravação mais recente no bloco de dados rastreado. Se a entrada de sombra tiver um SCN maior que o bloco de dados que está sendo lido, ocorreu uma gravação perdida, o que provocou um erro.
A extensão da sombra é dimensionada com espaço extra significativo para evitar que o redimensionamento automático de arquivos de dados faça com que a extensão da sombra cresça muito. Se um arquivo de dados rastreados for redimensionado manual ou automaticamente e se a extensão shadow precisar aumentar, o banco de dados tentará redimensionar os dados de rastreamento. Se não existir espaço suficiente nos tablespaces de sombra, o banco de dados gravará uma advertência no log de alerta e rastreará o maior número possível de blocos de dados.
Consulte Também: Oracle AI Database Administrator's Guide para saber como gerenciar a proteção contra gravação perdida de sombra
Interface do Usuário para Tablespaces Sombra
Você ativa e desativa a proteção de gravação perdida de sombra usando o comando ALTER PLUGGABLE DATABASE.
Para proteger um tablespace ou arquivo de dados específico, as seguintes condições devem ser atendidas:
-
Você deve ter ativado a proteção shadow lost write para o PDB inteiro usando a instrução
ALTER PLUGGABLE DATABASE ENABLE LOST WRITE PROTECTION.Observação: Em um CDB, se você ativar a proteção de gravação perdida de sombra na raiz, os PDBs não a herdarão. Você deve ativar a proteção de gravação perdida de sombra para cada PDB que deseja proteger.
-
Você deve ter ativado a proteção shadow lost write para que o tablespace ou arquivo de dados seja protegido usando a cláusula
ENABLE LOST WRITE PROTECTION.Quando você ativa a proteção de gravação perdida de sombra para um tablespace, todos os arquivos de dados do tablespace são protegidos, e todos os arquivos de dados adicionados ao tablespace também são protegidos. Observe que você não pode ativar a proteção de gravação perdida em tablespaces temporários ou em outro tablespace de gravação perdido.
-
Crie um ou mais tablespaces de sombra usando a instrução
CREATE BIGFILE TABLESPACEcom a cláusulaLOST WRITE PROTECTION.
O Oracle AI Database designa automaticamente um arquivo de dados rastreado a um tablespace de sombra específico. Não é possível especificar qual tablespace de sombra é usado para um arquivo de dados específico.
As seguintes views do dicionário de dados monitoram tablespaces de sombra:
-
DBA_TABLESPACESMostra quais tablespaces são tablespaces de sombra consultando.
-
DBA_DATA_FILES.LOST_WRITE_PROTECTMostra se as proteções de gravação perdidas estão ativadas para um arquivo de dados
-
USER_TABLESPACES.LOST_WRITE_PROTECTMostra se a proteção de gravação perdida está ativada para um tablespace específico.
DBA_DATA_FILESnão indica se a gravação perdida está ativada para um tablespace: você deve observarUSER_TABLESPACES.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a gerenciar a proteção contra gravação perdida com tablespaces de sombra
-
Oracle AI Database SQL Language Reference para saber mais sobre a instrução
CREATE TABLESPACE -
Oracle AI Database Reference para saber mais sobre a
DBA_TABLESPACES
Exemplo: Configurando a Proteção de Gravação Perdida
Este exemplo permite o rastreamento de gravação de sombra perdida para um conjunto de tablespaces.
Neste exemplo, sua meta é proteger os tablespaces salestbs e hrtbs em um PDB. Você também deseja proteger o arquivo de dados oetbs01.dbf e somente esse arquivo de dados, dentro do tablespace oetbs. Você faz o seguinte:
-
Faça log-in no PDB como administrador.
-
Crie um único tablespace de sombra da seguinte forma:
CREATE BIGFILE TABLESPACE shadow_lwp1 DATAFILE 'shadow_lwp1_df' SIZE 10M LOST WRITE PROTECTION; -
Ative a proteção de gravação perdida para o PDB da seguinte forma:
ALTER DATABASE ENABLE LOST WRITE PROTECTION; -
Ative a proteção de gravação perdida de sombra para os tablespaces
salestbsehrtbsda seguinte forma:ALTER TABLESPACE salestbs ENABLE LOST WRITE PROTECTION; ALTER TABLESPACE hrtbs ENABLE LOST WRITE PROTECTION; -
Ative a proteção de gravação perdida de sombra para o arquivo de dados
oetbs01.dbfda seguinte forma:ALTER DATABASE DATAFILE 'oetbs01.dbf' ENABLE LOST WRITE PROTECTION;
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a gerenciar tablespaces de sombra
-
Oracle AI Database SQL Language Reference para saber mais sobre a instrução
CREATE TABLESPACE
Tablespaces Temporários
Um temporário tablespace contém dados transitórios que persistem apenas durante uma sessão. Nenhum objeto de esquema permanente pode residir em um tablespace temporário. Um arquivo de temperatura armazena dados temporários do tablespace.
Tablespaces temporários podem melhorar a simultaneidade de várias operações de classificação que não se encaixam na memória. Esses tablespaces também melhoram a eficiência das operações de gerenciamento de espaço durante as classificações.
-
Tablespaces Temporários Compartilhados e Locais Os tablespaces temporários são compartilhados ou locais.
-
Tablespaces Temporários Padrão Cada conta de usuário do banco de dados recebe um tablespace temporário compartilhado padrão. Se o banco de dados contiver tablespaces temporários locais, cada conta de usuário também receberá o armazenamento temporário local padrão.
Tablespaces Temporários Compartilhados e Locais
Os tablespaces temporários são compartilhados ou locais.
Um t tablespace temporário compartilhado armazena arquivos temporários em disco compartilhado, de modo que o espaço temporário seja acessível a todas as instâncias do banco de dados. Por outro lado, um tablespace temporário local armazena arquivos temporários separados e não compartilhados para cada instância do banco de dados. Os tablespaces temporários locais são úteis para o Oracle Real Application Clusters ou Oracle Flex Clusters.
Você pode criar tablespaces temporários locais para instâncias de banco de dados somente para leitura e de leitura/gravação. Quando muitas instâncias somente leitura acessam um único banco de dados, os tablespaces temporários locais podem melhorar o desempenho de consultas que envolvem classificações, agregações de hash e junções. As vantagens são:
-
Melhorar o desempenho de E/S usando armazenamento em disco local em vez de compartilhado
-
Evitando o dispendioso gerenciamento de espaço temporário entre instâncias
-
Aprimoramento do desempenho de inicialização da instância eliminando o gerenciamento de metadados do espaço em disco
A tabela a seguir compara as características de tablespaces temporários compartilhados e locais.
Tabela 2 Tablespaces Compartilhados e Temporários Locais
| Tablespace Temporário Compartilhado | Tablespace Temporário Local |
|---|---|
Criado com a instrução CREATE TEMPORARY TABLESPACE. |
Criado com a instrução Observação: um tablespaces temporários locais é sempre um tablespace de bigfile, mas a palavra-chave |
| Cria um único tablespace temporário para o banco de dados. | Cria tablespaces temporários separados para cada instância do banco de dados. A opção FOR LEAF cria tablespaces somente para instâncias somente para leitura. A opção FOR ALL cria tablespaces para todas as instâncias, somente para leitura e leitura/gravação. |
| Suporta grupos de tablespaces. | Não suporta grupos de tablespaces. |
| Armazena metadados do arquivo temporário no arquivo de controle. | Armazena metadados de arquivos temporários comuns a todas as instâncias do arquivo de controle e metadados específicos da instância (por exemplo, os bitmaps para alocação, tamanhos de arquivos temporários atuais e status do arquivo) na SGA. |
Consulte Também: "Introdução à Instância do Oracle AI Database"
Tablespaces Temporários Padrão
Cada conta de usuário do banco de dados recebe um tablespace temporário compartilhado padrão. Se o banco de dados contiver tablespaces temporários locais, cada conta de usuário também receberá o armazenamento temporário local padrão.
Você pode especificar outro tablespace temporário para uma conta de usuário com as instruções CREATE USER ou ALTER USER. O Oracle AI Database usa o tablespace temporário padrão no nível do sistema para usuários para os quais você não especifica outro tablespace temporário.
-
Criação de Tablespaces Temporários Padrão Ao criar um banco de dados, o armazenamento temporário padrão depende de o tablespace
SYSTEMser gerenciado localmente. -
Acesso ao Armazenamento Temporário Se um usuário tiver um tablespace temporário designado, o banco de dados o acessará primeiro; caso contrário, o banco de dados acessará o tablespace temporário padrão. Depois que o banco de dados acessa um tablespace temporário para uma consulta, ele não alterna para outro. Consulte Também: Referência da Linguagem SQL do Oracle AI Database para saber mais sobre a instrução
CREATE USER
Criação de Tablespaces Temporários Padrão
Ao criar um banco de dados, o armazenamento temporário padrão depende de o tablespace SYSTEM ser gerenciado localmente.
A tabela a seguir mostra como o Oracle AI Database escolhe tablespaces temporários padrão na criação do banco de dados.
Tabela 3 Criação de Tablespaces Temporários Padrão
| O tablespace SYSTEM é gerenciado localmente? | A instrução CREATE DATABASE especifica um tablespace temporário padrão? | Então, o banco de dados... |
|---|---|---|
| Sim | Sim | Usa o tablespace especificado como padrão. |
| Sim | Não | Cria um tablespace temporário. |
| Não | Sim | Usa o tablespace especificado como padrão. |
| Não | Não | Usa SYSTEM para armazenamento temporário padrão. O banco de dados grava uma advertência no log de alerta informando que um tablespace temporário padrão é recomendado. |
Após a criação do banco de dados, você pode alterar o tablespace temporário padrão do banco de dados com a instrução ALTER DATABASE DEFAULT TEMPORARY TABLESPACE. Observação: Não é possível tornar um tablespace temporário padrão permanente.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a criar um tablespace temporário padrão
-
Referência de Linguagem SQL do Oracle AI Database para obter a sintaxe da cláusula
DEFAULT TEMPORARY TABLESPACEdeCREATE DATABASEeALTER DATABASE
Acesso ao armazenamento temporário
Se um usuário tiver um tablespace temporário designado, o banco de dados o acessará primeiro; caso contrário, o banco de dados acessará o tablespace temporário padrão. Depois que o banco de dados acessa um tablespace temporário para uma consulta, ele não alterna para outro.
Uma consulta de usuário pode acessar o armazenamento temporário compartilhado ou local. Além disso, um usuário pode ter um tablespace temporário local padrão designado para instâncias somente para leitura e outro tablespace temporário local padrão designado para instâncias de leitura/gravação.
Para instâncias de leitura/gravação, o banco de dados dá maior prioridade aos tablespaces temporários compartilhados. Para instâncias somente para leitura, o banco de dados dá maior prioridade aos tablespaces temporários locais. Se a instância do banco de dados for leitura/gravação, o banco de dados procurará espaço na seguinte ordem:
-
Um tablespace temporário compartilhado é designado ao usuário?
-
Um tablespace temporário local está atribuído ao usuário?
-
O tablespace temporário padrão do banco de dados tem espaço?
Se a resposta a qualquer pergunta anterior for sim, o banco de dados interromperá a pesquisa e alocará espaço do tablespace especificado; caso contrário, o espaço será alocado do tablespace temporário local padrão do banco de dados.
Se a instância do banco de dados for somente para leitura, o banco de dados procurará espaço na seguinte ordem:
-
Um tablespace temporário local está atribuído ao usuário?
-
O tablespace temporário local padrão do banco de dados atribuído tem espaço?
-
Um tablespace temporário compartilhado é designado ao usuário?
Se a resposta a qualquer pergunta anterior for sim, o banco de dados interromperá a pesquisa e alocará espaço do tablespace especificado; caso contrário, o espaço será alocado do tablespace temporário compartilhado padrão do banco de dados.
Modos de Tablespace
O modo tablespace determina a acessibilidade do tablespace.
-
Tablespaces de Leitura/Gravação e Somente Leitura Cada tablespace está em um modo de gravação que especifica se pode ser gravado.
-
Tablespaces On-line e Off-line Um tablespace pode estar on-line (acessível) ou off-line (não acessível) sempre que o banco de dados estiver aberto.
Tablespaces de Leitura/Gravação e Leitura Somente
Cada tablespace está em um modo de gravação que especifica se pode ser gravado.
Os modos mutuamente exclusivos são os seguintes:
-
Modo de leitura/gravação
Os usuários podem ler e gravar no tablespace. Todos os tablespaces são criados inicialmente como leitura/gravação. Os tablespaces
SYSTEMeSYSAUXe os tablespaces temporários são de leitura/gravação permanente, o que significa que eles não podem ser transformados em somente leitura. -
Modo somente leitura
São impedidas operações de gravação nos arquivos de dados do tablespace. Um tablespace somente para leitura pode residir em mídia somente para leitura, como DVDs ou unidades WORM.
Tablespaces somente para leitura eliminam a necessidade de executar backup e recuperação de partes grandes e estáticas de um banco de dados. Tablespaces somente para leitura não são alterados e, portanto, não exigem backup repetido. Se você recuperar um banco de dados após uma falha de mídia, não será necessário recuperar tablespaces somente leitura.
Consulte Também:
-
Oracle AI Database Administrator's Guide para aprender a alterar um tablespace para o modo somente leitura ou leitura/gravação
-
Oracle AI Database SQL Language Reference para sintaxe e semântica do
ALTER TABLESPACE -
Oracle AI Database Backup and Recovery User's Guide para obter mais informações sobre recuperação
Tablespaces On-line e Off-line
Um tablespace pode estar on-line (acessível) ou off-line (não acessível) sempre que o banco de dados estiver aberto.
Um tablespace geralmente fica on-line para que seus dados fiquem disponíveis para os usuários. O tablespace SYSTEM e os tablespaces temporários não podem ser colocados off-line.
Um tablespace pode ficar off-line automática ou manualmente. Por exemplo, você pode colocar um tablespace off-line para manutenção ou backup e recuperação. O banco de dados coloca automaticamente um tablespace off-line quando determinados erros são encontrados, como quando o processo database writer (DBW) falha em várias tentativas de gravação em um arquivo de dados. Os usuários que tentam acessar tabelas em um tablespace off-line recebem um erro.
Quando um tablespace fica off-line, o banco de dados faz o seguinte:
-
O banco de dados não permite que instruções DML subsequentes façam referência a objetos no tablespace off-line. Um tablespace off-line não pode ser lido ou editado por qualquer utilitário que não seja o Oracle AI Database.
-
As transações ativas com instruções concluídas que se referem aos dados desse tablespace não são afetadas no nível da transação.
-
O banco de dados salva dados de undo correspondentes às instruções concluídas em um segmento de undo diferido no tablespace
SYSTEM. Quando o tablespace é colocado on-line, o banco de dados aplica os dados de undo ao tablespace, se necessário.
Consulte Também:
-
Oracle AI Database Administrator's Guide para saber como alterar a disponibilidade do tablespace
Tamanho do Arquivo de Tablespace
Um tablespace é um tablespace de bigfile ou um tablespace de smallfile. Esses tablespaces são indistinguíveis em termos de execução de instruções SQL que não se referem explicitamente a arquivos de dados ou arquivos temporários.
A diferença é a seguinte:
-
Um tablespace smallfile pode conter vários arquivos de dados ou arquivos temporários, mas os arquivos não podem ser tão grandes quanto em um tablespace bigfile. Este é o tipo de tablespace padrão.
-
Um tablespace bigfile contém um arquivo de dados ou arquivo temporário muito grande. Esse tipo de tablespace pode fazer o seguinte:
-
Aumentar a capacidade de armazenamento de um banco de dados
O número máximo de arquivos de dados em um banco de dados é limitado, portanto, aumentar o tamanho de cada arquivo de dados aumenta o armazenamento geral.
-
Reduza a carga de gerenciamento de muitos arquivos de dados e arquivos temporários
Os tablespaces Bigfile simplificam o gerenciamento de arquivos com o Oracle Managed Files and Automatic Storage Management (Oracle ASM), eliminando a necessidade de adicionar novos arquivos e lidar com vários arquivos.
-
Executar operações em tablespaces em vez de arquivos individuais
Os tablespaces Bigfile tornam o tablespace a unidade principal da administração, backup e recuperação de espaço em disco, e assim por diante.
Os tablespaces Bigfile são suportados somente para tablespaces gerenciados localmente com ASSM. No entanto, os tablespaces temporários e de undo gerenciados localmente podem ser tablespaces de bigfile mesmo quando os segmentos são gerenciados manualmente.
A partir do Oracle AI Database 26ai, os tablespaces SYSTEM, SYSAUX e USER são criados como tablespaces de bigfile por padrão. Um banco de dados submetido a upgrade de uma release anterior mantém seu tipo de tablespace.
-
Consulte Também:
-
Oracle AI Database Backup and Recovery User's Guide para saber mais sobre backup e recuperação
-
Oracle AI Database Administrator's Guide para aprender a gerenciar tablespaces de bigfile